Erstellt von All in One SEO Pro v5.0.1.1. Dies ist eine llms-full.txt -Datei, die von hoch entwickelten KI-Systemen (LLMs) zur Indizierung der Websites verwendet wird. # The Cattle Crew Blog All about Digital Transformation. Powered by OPITZ CONSULTING ## Beiträge ### [Oracle Forms 14: New Features Every Forms Developer Should Know](https://thecattlecrew.net/2026/07/02/oracle-forms-14-new-features-every-forms-developer-should-know/) **Published:** Juli 2, 2026 **Author:** Gerd Volberg **Content:** Oracle Forms 14, the latest version of the proven enterprise application development environment, brings many new features and improvements. This new version focuses on a modern user experience, improved integration with web technologies and optimized performance. In this article, we take an in-depth look at the new features of Oracle Forms 14 and how they help developers create and manage powerful applications efficiently. ## Improvements to the user interface With Oracle Forms 14, developers can now design more modern and flexible user interfaces. The most important new features are Placeholder texts in text fields: This improves user-friendliness by displaying relevant notes directly in input fields. ![Placeholders in text items ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild01-300x140.jpg)Figure 1: Placeholders in text items**Modern progress bars:** Developers can now implement progress bars for long-running processes. ![Modern progress bars ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild02-300x237.jpg)Figure 2: Modern progress bars**Gauge progress bars:** Gauge and Half Gauge are very similar to progress bars as they support the visual representation of a data value. ![Gauge progress bar ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild03-268x300.jpg)Figure 3: Gauge progress bar**Auto-complete function:** Combo boxes can display text suggestions based on data already entered. ![Auto-complete function ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild04-300x154.jpg)Figure 4: Auto-complete function**Hidden input:** Passwords that are hidden during input can be made visible with a new button. However, only as long as the button is pressed. After the click, the value is hidden again. ![Hidden input of passwords ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild05-300x152.jpg)Figure 5: Hidden input of passwords**Show number of characters:** For larger text fields, a character counter can be displayed so that you always know how many characters can still be entered. ![Show number of characters ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild06-300x178.jpg)Figure 6: Show number of characters**Transparent UI elements:** A new glass fill pattern enables the creation of modern, transparent interfaces. **Dynamic layouts:** Automatic resizing of blocks based on the amount of data for an optimized display. There is a new parameter Records\_Displayed in the procedure SET\_BLOCK\_PROPERTY. BEGIN SET\_BLOCK\_PROPERTY (‚EMP‘, RECORDS\_DISPLAYED, 3); END; *Listing 1: Reducing the number of rows displayed in a block* ![Reducing the number of rows ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild07.jpg)Figure 7: Reducing the number of rows**Rollover button:** With the “Rollover Color Swap” property, the foreground and background colors are swapped when the mouse is moved over the button. ![Rollover button ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild08-300x281.jpg)Figure 8: Rollover button## REST services Oracle Forms 14 extends the possibilities of application integration with modern web technologies. Particularly noteworthy is the native support of RESTful web services: Developers can now use REST APIs to retrieve or send data from external sources. CRUD operations can be called directly from forms: This allows editing, creating, deleting and retrieving data from REST services. Support for JSON data retrieved via REST services is also new. **REST Package Designer:** With the new REST Package Designer, developers can create PL/SQL packages for direct access to REST services. This enables seamless integration with modern web technologies and APIs. ![REST Package Designer ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild09.jpg)Figure 9: REST Package DesignerThe REST Package Designer generates a separate PL/SQL package for each operation at the touch of a button. ![Automatically generated PL/SQL REST packages ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild10.jpg)Figure 10: Automatically generated PL/SQL REST packages## Real-time data update with Continuous Query Notification A new feature in Oracle Forms 14 is the support for Continuous Query Notification (CQN). With this function, data is updated in real time when the underlying data changes. The advantages are obvious: Forms masks always show the current values without the user having to start a query. This reduces unnecessary database queries as changes are automatically displayed in the interface. This is perfect for dashboard and reporting applications that require continuous updating. To do this, you register the query of the forms block that you want to update on the database side. This change notification (QRCN) then starts events that can be queried in Forms. To do this, a WHEN-EVENT-RAISED trigger must be created at form level. The GET\_EVENT\_OBJECT\_PROPERTY function can then be used here to check whether the data block needs to be updated. The following new properties can be read in the function: - TOTAL\_ROWS\_AFFECTED - TOTAL\_ROWS\_UPDATED - TOTAL\_ROWS\_INSERTED - TOTAL\_ROWS\_DELETED - ROWS\_INSERTED - ROWS\_DELETED - ROWS\_UPDATED - TABLE\_ALTERED - TABLE\_DROPPED ## Performance improvements in data processing Many performance improvements have been implemented in the new release. The most important are the following features. Sorting in blocks: In Oracle Forms 14, data can be sorted locally. This reduces the load on the database and significantly improves the reaction speed of the application. A best practice with this new feature is to set the Query All Records property in the data block to TRUE so that all data records are cached in Forms. Otherwise, the sorted data records could lose their sorting when new data records are fetched, as the new data records do not automatically appear in the sorting, but are displayed at the end of the data block. Such sorting could, for example, be built into a WHEN-MOUSE-DOUBLECLICK trigger at block level. ``` BEGIN Sort_Block (:System.Cursor_Item, Nulls_First, Descending) END; ``` *Listing 2: Start sorting by double-clicking with the mouse* In addition to the field name, up to four parameters can be passed: - ASCENDING (default) or DESCENDING - NULLS\_LAST (default) or NULLS\_FIRST - CASE\_SENSITIVE (default) or CASE\_INSENSITIVE - BINARY\_ORDER (default) or LINGUISTIC\_ORDER ## Improvements in the Form Builder The Form Builder has also received important new features. The most important ones follow here. **Revised file open dialog:** Developers can now open multiple files at the same time, which significantly increases productivity. In addition, the file filter has been set to \*.fmb by default, a feature that many developers have requested in previous versions. **Database name display:** Forms Builder now also displays the current database name in the status bar, which is particularly helpful for developers with multiple environments. XML backup: Forms modules can now be automatically backed up to XML files, making integration with version control systems such as Git easier. ![Automatically generated XML backup copy ](http://thecattlecrew.net/wp-content/uploads/2026/06/cattle-crew-2026-06-30_volberg_bild11.jpg)Figure 11: Automatically generated XML backup copy**Improvements to the Forms Standalone Launcher (FSAL):** The Forms Standalone Launcher receives some important enhancements with Forms 14. Automatic updates within the same main version are now possible. The **SSL/TLS certificate management has been improved** and **a cache deletion function has been added** for troubleshooting. ## Conclusion Oracle Forms 14 brings a host of improvements for developers, administrators and end users. With new UI elements, enhanced REST integrations, real-time data updates and improved performance features, Forms continues to position itself as a powerful platform for enterprise applications. The new features make development more efficient and application maintenance easier. For companies working with Oracle Forms 12, the upgrade to version 14 represents significant added value. ## Links [„Framework for Oracle Forms“ in: Best of Talk2Gerd (German)](https://thecattlecrew.net/2026/08/27/wiederverwenden-statt-wiederholen-ein-framework-fuer-oracle-forms/) **Would you be interested in an Oracle Forms training course? [Find out more here](https://opitz-consulting.com/oracle-forms-schulung)** **Kategorien:** Database, Development **Schlagwörter:** Oracle Forms --- ### [Wiederverwenden statt wiederholen: Ein Framework für Oracle Forms](https://thecattlecrew.net/2026/08/27/wiederverwenden-statt-wiederholen-ein-framework-fuer-oracle-forms/) **Published:** August 27, 2026 **Author:** Gerd Volberg **Content:** Wenn du diesen Post liest, weißt du wie lange sich viele von uns schon mit Oracle Forms beschäftigen. Mit meinen Best Practices bin ich 1992 gestartet in Trainings, meinem Blog Talk2Gerd, DOAG-Konferenzen und der Oracle Open World, und egal ob alte Hasen oder Neulinge: Immer noch treffe ich auf dankbare Gesichter, wenn ich meine Fundgrube öffne. Die beliebtesten Tipps habe ich jetzt in einer Serie zusammengefaßt, vor der du gerade stehst oder vermutlich eher sitzt. Aber wir wollen keine Zeit verlieren! Und los geht’s: ![Ein Businessmann mit trifft mit Pfeil und Bogen ins Schwarze](https://thecattlecrew.net/wp-content/uploads/2026/08/cattle-crew-best-of-talk-to-gerd-oracle-forms_serienbild-1.png)Teil 1 der Serie Best of Talk2Gerd | Ein Framework für Oracle FormsEine einzelne Oracle-Forms-Maske hast du schnell gebaut. Ein Datenblock, ein paar Items, einige Trigger – und die Anwendung tut, was sie soll. Die eigentliche Herausforderung beginnt, wenn aus einer Maske fünfzig, hundert oder mehrere hundert werden. Dann entscheidet nicht mehr die Geschwindigkeit beim Erstellen der nächsten FMB über die Qualität der Anwendung, sondern die Frage, wie konsequent wiederkehrende Aufgaben nur einmal gelöst werden. Genau darin liegt die wichtigste Best Practice aus meiner langjährigen Projektarbeit: Eine große Forms-Anwendung braucht ein Framework. Gemeint ist kein möglichst kompliziertes technisches Fundament. Gemeint ist ein verbindliches System aus Konventionen, wiederverwendbaren Bausteinen und klaren Erweiterungspunkten. Es sorgt dafür, dass Entwickler nicht in jeder Maske erneut über Fehlermeldungen, Navigation, Berechtigungen oder Benennungen nachdenken müssen. ## Ohne Framework entsteht Architektur trotzdem, halt nur ungeplant Auch eine Anwendung ohne offiziell definiertes Framework hat gemeinsame Muster. Sie sind dann lediglich verstreut: Ein Kollege unterdrückt Meldungen über :SYSTEM.MESSAGE\_LEVEL, eine Entwicklerin baut ein eigenes Alert-Package, ein dritter kopiert einen Trigger aus einer alten Maske. Mit jeder Kopie entstehen neue Varianten. Fehlerkorrekturen müssen anschließend an vielen Stellen nachgezogen werden – oder bleiben inkonsistent. Das Problem ist nicht, dass es Leute gibt, die den Code wiederverwenden. Das Problem ist, dass du mit Copy-and-paste die Herkunft eines Bausteins verschleierst. Ein Framework macht beides: Wo befindet sich die zentrale Implementierung, und wie wird sie von einer Maske verwendet? ## Die fünf Bausteine eines praxistauglichen Forms-Frameworks Mein ursprünglicher Ansatz beginnt mit drei Schritten: Styleguide definieren, Referenzform und Templates bereitstellen, anschließend Prototypen bauen. Für heutige Teams kannst du daraus ein Modell mit fünf Bausteinen ableiten: ### 1. Ein Styleguide beschreibt Entscheidungen, nicht Geschmack Ein Forms-Styleguide sollte mehr enthalten als Farben, Schriftgrößen und Namenspräfixe. Wertvoll wird er dort, wo er das Laufzeitverhalten vereinheitlicht. Dazu gehören beispielsweise: - Welche Trigger dürfen Logik enthalten, und welche delegieren nur an Packages? - Wie werden Fehler klassifiziert, angezeigt und protokolliert? - Wie werden Form-, Block- und Item-Namen gebildet? - Welche Regeln gelten für Commit, Rollback, Exit und Navigation? - Wie werden Berechtigungen und dynamische Menüs behandelt? - Welche Logik gehört in die Maske, welche in eine PLL und welche in die Datenbank? Ein guter Styleguide macht Code-Reviews kürzer. Du diskutierst dann nicht bei jeder Änderung in deinem Team dieselben Grundsatzfragen, sondern du prüfst, ob die vereinbarten Regeln korrekt angewendet wurden. ### 2. Die Referenzform zeigt den Sollzustand Dokumentation allein reicht bei Forms selten aus. Besser ist eine Referenzform. Denn diese macht sichtbar, wie die Standards zusammenspielen: Welche Libraries sind angebunden? Welche Form-Level-Trigger existieren? Wie werden Alerts aufgerufen? Wie sehen Menüanbindung, Toolbar-Verhalten und Exception Handling aus? Diese Form ist kein möglichst großes Demo-Modul, sondern ein ausführbares Architekturbeispiel. Sie sollte klein genug bleiben, damit neue Teammitglieder die Mechanik an einem Nachmittag nachvollziehen können. Gleichzeitig muss sie produktionsnah genug sein, um dir als Ausgangspunkt für neue Masken zu dienen. ### 3. Templates reduzieren Varianz Ein Template spart dir nicht nur Klickarbeit. Sondern es setzt sichere Defaults. Neue Forms starten mit den richtigen Libraries, Triggern, Visual Attributes und Standardobjekten. Noch entscheidender ist jedoch die Pflege: Denn ein Template ist eine Momentaufnahme. Bereits erzeugte Masken übernehmen spätere Änderungen nicht automatisch. Deshalb braucht jede zentrale Funktion zusätzlich einen wiederverwendbaren Implementierungsort – meistens eine PLL oder ein Datenbank-Package. ### 4. Libraries bündeln Querschnittsfunktionen In meinem [Blog](https://talk2gerd-de.blogspot.com) nenne ich hier unter anderem Exception Handling, dynamisches Meldungswesen, Zugriffsrechte, dynamische Menüs und PL/SQL-Libraries als Framework-Themen. Der gemeinsame Nenner: Es handelt sich um Funktionen, die viele Masken benötigen, deren Regeln aber nur an einer Stelle geändert werden müssen. Wichtig: Eine Library sollte dabei nicht zu einem ungeordneten Sammelbecken werden. Besser sind klar abgegrenzte Packages, etwa für Navigation, Meldungen, Fehlerprotokollierung, Berechtigungsprüfung und technische Hilfsfunktionen. Denn so bleibt erkennbar, welcher Baustein wofür verantwortlich ist. ### 5. Prototypen prüfen nicht nur die Funktion, sondern das Framework Ein Prototyp ist für dich besonders wertvoll, wenn er bewusst schwierige Fälle enthält: einen Multi-Record-Block, eine Master-Detail-Beziehung, Validierung mit Navigation, Datenbankfehler und einen Abbruch durch den Anwender. Erst an solchen Fällen zeigt sich, ob das Framework den Alltag erleichtert oder lediglich den einfachen Happy Path abdeckt. ## Konstanten: Kleine Technik, große Wirkung Eine der einfachsten und zugleich wirksamsten Regeln ist für mich die Trennung von Literalen und Logik. Namen von Alerts, Blöcken, Items, Statuswerten oder Navigationsmodi tauchen in Forms häufig als Strings auf. Werden diese Zeichenketten überall hart codiert, reicht ein Tippfehler für einen schwer auffindbaren Laufzeitfehler. Deshalb schlage ich in meinen [Trainings](https://opitz-consulting.com/oracle-forms-schulung) zwei Ebenen vor: ein globales Konstanten-Package in einer zentralen Library und ein lokales Package in jeder Formsmaske. ``` PACKAGE const IS alr_error CONSTANT VARCHAR2(30) := 'AL_ERROR';  alr_info CONSTANT VARCHAR2(30) := 'AL_INFO'; alr_warning CONSTANT VARCHAR2(30) := 'AL_WARNING'; sta_changed CONSTANT VARCHAR2(10) := 'CHANGED'; mod_open_form CONSTANT VARCHAR2(10) := 'OPEN_FORM'; END const; ``` Das globale Package enthält Konstanten, die in der gesamten Anwendung dieselbe Bedeutung haben. Maskenspezifische Namen bleiben lokal: ``` PACKAGE const_local IS blk_control CONSTANT VARCHAR2(30) := 'CONTROL'; itm_search CONSTANT VARCHAR2(61) := 'CONTROL.SEARCH_TEXT'; END const_local; ``` Der Aufruf wird dadurch lesbarer: ``` IF :SYSTEM.RECORD_STATUS = const.sta_changed THEN -- geänderten Datensatz behandeln END IF; ``` Der Nutzen geht über Lesbarkeit hinaus. Das heißt: Hast du den Namen einer Konstanten falsch geschrieben, meldet der Compiler den Fehler. Hat jemand hingegen den hinterlegten Stringwert falsch gepflegt, bleibt zwar weiterhin ein Laufzeitproblem möglich, aber die Ursache findest du an einem zentralen Ort und nicht in vielen Triggern. Diese Unterscheidung ist wichtig: Konstanten beseitigen also keine dynamische Namensauflösung von Forms, sie machen sie kontrollierbarer. ## Was gehört global, was lokal? Eine einfache Entscheidungsregel hilft: - **Global:** fach- oder anwendungsweit identische Begriffe, gemeinsame Alerts, Statuswerte, Standardmodi und Framework-Ereignisse. - **Lokal:** Block- und Item-Namen einer konkreten Form, form-spezifische Canvas- oder Window-Namen sowie lokale Ereigniscodes. - **Nicht als Konstante:** Werte, die Administratoren konfigurieren sollen, Geheimnisse, Umgebungsparameter oder fachliche Regeln mit eigenem Lebenszyklus. Sie gehören in Konfigurationstabellen oder geeignete Services. ## Ein Framework darf Entwicklung nicht verstecken Ein Framework ist dann gelungen, wenn du die fachliche Absicht eines Triggers schneller erkennst. Ein WHEN-BUTTON-PRESSED, der eine klar benannte Navigationsroutine aufruft, ist verständlicher als zwanzig Zeilen wiederholte Status-, Fehler- und Fokuslogik. Problematisch wird es, wenn ein einziger vermeintlich komfortabler Aufruf unbemerkt Commit, Navigation, Berechtigungsprüfung und Meldungsunterdrückung kombiniert. Deshalb sind bei Framework-Routinen **drei Eigenschaften** wichtig: 1. Eindeutige Verantwortung: Der Name beschreibt die relevante Wirkung. 2. Dokumentierte Vor- und Nachbedingungen: Darf die Routine validieren, navigieren oder Transaktionen beenden? 3. Vorhersehbares Fehlerverhalten: Fehler werden entweder behandelt oder eindeutig an den Aufrufer zurückgegeben. ## So startest du ohne Big Bang Ein bestehendes Forms-System muss du nicht in ein Großprojekt umbauen. Stattdessen könnte ein pragmatischer Einstieg so aussehen: 1. Du sammelst wiederholten Code und häufige Fehler aus mehreren repräsentativen Masken. 2. Daraus leitest du wenige verbindliche Regeln für Deinen Styleguide und deren Namenskonventionen ab. 3. Du erstellst eine kleine Referenzform mit den wichtigsten Objekten, die in jeder Maske benötigt werden. 4. Querschnittsfunktionen verschiebst du zentral in Packages und Libraries. 5. Zwei oder drei unterschiedlich komplexe Forms migrierst du als Pilot. 6. Neue Standards führst du anschließend immer dort ein, wo eine Maske ohnehin geändert wird. So wächst das Framework mit realen Anforderungen. Es bleibt überprüfbar und wird nicht zu einer theoretischen Plattform, die an deinem Alltag als Entwickler vorbeigeht. ## Fazit: Einmal entscheiden, überall profitieren Die zentrale Erkenntnis aus drei Jahrzehnten Forms-Praxis heißt für mich: Große Anwendungen bekommst du wartungsmäßig nicht durch einzelne geniale Trigger in den Griff, sondern durch wiederholbare Entscheidungen. Styleguide, Referenzform, Templates, Libraries und Konstanten bilden hierbei gemeinsam eine Plattform, die alle im Team nutzen können. Das bedeutet im Klartext: Ein gutes Oracle-Forms-Framework nimmt dir nicht die Kontrolle. Es nimmt dir Wiederholungen ab. Dadurch hast du mehr Zeit für das, was in jeder Maske tatsächlich neu ist: die Fachlichkeit. ## Links **Im Cattle Crew Blog:** [Oracle Forms 14: New Features Every Forms Developer Should Know](https://thecattlecrew.net/2026/07/02/oracle-forms-14-new-features-every-forms-developer-should-know/) **In meinem Blog Talk2Gerd:** [Erstellen eines Forms Frameworks](https://talk2gerd-de.blogspot.com/2006/07/erstellen-eines-forms-framework.html) [Globales Konstanten-Package](https://talk2gerd-de.blogspot.com/2005/10/globales-konstanten-package.html) **Auf Github:** [Auf Github Historischer Quellstand des Forms-Framework-Projekts](https://github.com/GerdVolberg/forms-framework) **Du brauchst eine Schulung?** [5-tägige Oracle-Forms-Schulung für Unternehmen mit Gerd Volberg](https://opitz-consulting.com/oracle-forms-schulung) **Kategorien:** Database, Development **Schlagwörter:** Forms, Frameworks, oracle, Oracle DB --- ### [MinIO-Alternative SeaweedFS: S3-Storage auf Kubernetes migrieren](https://thecattlecrew.net/2026/08/13/minio-alternative-seaweedfs-kubernetes-migration/) **Published:** August 13, 2026 **Author:** Philipp Kürsten **Content:** MinIO war jahrelang die Standardantwort auf die Frage nach S3-kompatiblem Object Storage im eigenen Cluster. Seit Ende 2025 gilt das nur noch eingeschränkt: Die Community-Edition ist im Dezember 2025 in den Maintenance-Modus gewechselt, das öffentliche Repository wurde Anfang 2026 archiviert. Neue Funktionen entstehen ausschließlich in der kommerziellen Variante. Für viele Self-Hosting-Setups ist das der Anlass, sich nach einer dauerhaft quelloffenen Alternative umzusehen. [SeaweedFS](https://github.com/seaweedfs/seaweedfs) ist dafür ein ausgereifter Kandidat: Apache-2.0-lizenziert, aktiv weiterentwickelt und S3-kompatibel. Dieser Beitrag zeigt anhand eines praxisnahen Ablaufs, wie SeaweedFS per Helm im HA-Setup auf Kubernetes installiert und bestehende Buckets anschließend per rclone-Job migriert werden – bis hin zum Cutover. ## SeaweedFS in Kürze Wo MinIO ein einziger, symmetrischer Server-Prozess ist, teilt SeaweedFS die Aufgaben auf mehrere Rollen auf: der **Master** koordiniert den Cluster (Leader-Election per Raft), die **Volume Server** halten die eigentlichen Daten, der **Filer** legt den Namespace darüber, und ein zustandsloses **S3-Gateway** stellt die S3-API bereit. Für ein Setup, das man an SeaweedFS anbindet, spricht man am Ende nur mit dem S3-Gateway – der Rest ist Innenleben. Zwei Dinge entscheiden über echtes HA: Der Master ist erst mit **drei** Replicas hochverfügbar (Raft-Quorum), und der Filer braucht einen gemeinsamen Metadaten-Store (PostgreSQL, MySQL oder Redis) – mehrere Filer mit lokalem `leveldb` sind kein HA. ## Installation von SeaweedFS per Helm SeaweedFS bringt ein offizielles Helm-Chart mit, das die einzelnen Rollen als getrennte StatefulSets ausrollt. Das ist genau der Modus, den wir für ein HA-Setup brauchen. Zunächst das Chart-Repository einbinden: ``` helm repo add seaweedfs https://seaweedfs.github.io/seaweedfs/helm helm repo update ``` Die eigentliche Arbeit steckt in den Values. Für ein hochverfügbares Setup bekommt jede Rolle drei Replicas und `replicationPlacement` legt fest, wie SeaweedFS die Daten über die Volume Server verteilt: Der Wert `001` sorgt dafür, dass jeder Chunk zusätzlich auf einem zweiten Server im selben Cluster liegt. ``` # seaweedfs-ha-values.yaml global: replicationPlacement: "001" # eine zusätzliche Kopie auf anderem Volume-Server master: replicas: 3 # 3 = Raft-Quorum, erst dann HA data: { type: persistentVolumeClaim, size: 5Gi, storageClass: standard } volume: replicas: 3 dataDirs: - name: data type: persistentVolumeClaim size: 100Gi # an Datenmenge anpassen storageClass: standard filer: replicas: 3 # Für echtes HA: gemeinsamen Store (Postgres/MySQL/Redis) statt lokalem leveldb. data: { type: persistentVolumeClaim, size: 10Gi, storageClass: standard } s3: enabled: true replicas: 3 enableAuth: true ``` Die Größenangaben sind bewusst klein gehalten: Master und Filer speichern nur Metadaten, der Platzbedarf liegt also fast vollständig bei den Volume-Servern. Mit diesen Values lässt sich das Chart ausrollen: ``` helm upgrade --install seaweedfs seaweedfs/seaweedfs \ --namespace storage --create-namespace \ -f seaweedfs-ha-values.yaml ``` Der erste Start dauert einen Moment, weil die Master erst untereinander ein Quorum bilden müssen, bevor sich Volume Server und Filer anmelden können. Ein Blick auf die Pods zeigt, ob alle Rollen oben sind: ``` kubectl -n storage get pods -l app.kubernetes.io/name=seaweedfs ``` Sobald alles läuft, ist das S3-Gateway clusterintern unter `http://seaweedfs-s3.storage.svc:8333` erreichbar – das ist die Adresse, die später sowohl der Migrations-Job als auch die Anwendung selbst verwendet. ## Migration von MinIO Der Ansatz: Beide Object Stores laufen parallel, die Daten werden in einem Wartungsfenster per `rclone` synchronisiert und verifiziert, dann stellt man die Anwendung um. MinIO bleibt als Fallback stehen. `rclone` passt hier gut, weil es beide Seiten als reines S3 spricht und mit `sync` idempotent arbeitet – ein abgebrochener Lauf lässt sich risikofrei wiederholen. Vorab das Ziel-Bucket in SeaweedFS anlegen und die Anwendung read-only schalten, damit während der Migration nichts mehr nach MinIO geschrieben wird. Das Manifest besteht aus zwei Teilen: Eine ConfigMap hält die `rclone.conf` mit beiden Endpunkten sowie das Migrationsskript, ein Job mountet beides und führt es aus. Beide Stores sind darin schlicht zwei S3-Remotes – der eigentliche Wechsel reduziert sich damit auf einen Kopiervorgang zwischen zwei Adressen: ``` # rclone-migration.yaml apiVersion: v1 kind: ConfigMap metadata: name: rclone-migration-config namespace: storage data: rclone.conf: | [minio] type = s3 provider = Minio access_key_id = MINIO_ACCESS_KEY secret_access_key = MINIO_SECRET_KEY endpoint = http://minio.storage.svc:9000 region = us-east-1 [seaweedfs] type = s3 provider = Other access_key_id = SEAWEEDFS_ACCESS_KEY secret_access_key = SEAWEEDFS_SECRET_KEY endpoint = http://seaweedfs-s3.storage.svc:8333 region = us-east-1 force_path_style = true migrate.sh: | #!/bin/sh set -e BUCKET="my-app-data" FLAGS="--transfers=16 --checkers=8 --checksum --retries=3 --stats=10s --stats-one-line" rclone sync minio:$BUCKET seaweedfs:$BUCKET $FLAGS rclone check minio:$BUCKET seaweedfs:$BUCKET --one-way $FLAGS echo "Migration OK" --- apiVersion: batch/v1 kind: Job metadata: name: rclone-minio-to-seaweedfs namespace: storage spec: backoffLimit: 2 template: spec: restartPolicy: OnFailure containers: - name: rclone image: rclone/rclone:latest command: ["/bin/sh", "/scripts/migrate.sh"] volumeMounts: - { name: config, mountPath: /config/rclone, readOnly: true } - { name: scripts, mountPath: /scripts, readOnly: true } volumes: - name: config configMap: name: rclone-migration-config items: [{ key: rclone.conf, path: rclone.conf }] - name: scripts configMap: name: rclone-migration-config items: [{ key: migrate.sh, path: migrate.sh, mode: 0755 }] ``` Im Produktivbetrieb gehören die Access-Keys in ein Secret, nicht in die ConfigMap. Hier stehen sie zur besseren Lesbarkeit inline 😉 Ausgerollt wird der Job wie jedes andere Manifest; die Logs zeigen den Fortschritt live mit: ``` kubectl apply -f rclone-migration.yaml kubectl -n storage logs -f job/rclone-minio-to-seaweedfs ``` `rclone check` vergleicht Quelle und Ziel und lässt den Job fehlschlagen, falls etwas nicht übertragen wurde – die Verifikation ist also direkt eingebaut. **Cutover**: Anwendungskonfiguration auf den SeaweedFS-Endpoint umstellen (`endpoint: http://seaweedfs-s3.storage.svc:8333`, `forcePathStyle: true` – SeaweedFS erwartet Path-Style), Wartungsmodus deaktivieren, Smoke-Test fahren. MinIO noch ein bis zwei Wochen als Fallback stehen lassen, dann abbauen. ## Worauf ist zu achten? - **Path-Style**: SeaweedFS adressiert per Path-Style. In `rclone` (`force_path_style = true`) und in der App (`forcePathStyle: true`) setzen, sonst laufen Requests ins Leere. - **Filer-HA**: Mehrere Filer-Replicas brauchen einen gemeinsamen Metadaten-Store – sonst driften die Namespaces auseinander. - **S3-Randfälle**: Multipart-Uploads und Presigned URLs verhalten sich zwischen Implementierungen leicht unterschiedlich. Vor dem produktiven Cutover im Staging testen. ## Fazit Die Migration ist kein Big-Bang, sondern ein planbarer Zwei-Schritt: HA-Setup per Helm, dann eine idempotente rclone-Migration mit eingebauter Prüfung. Weil beide Systeme reines S3 sprechen, bleibt der Eingriff auf Infrastrukturebene – die Anwendungslogik bleibt unangetastet. Und mit MinIO im Fallback verliert der Cutover seinen Schrecken. **Kategorien:** Cloud, DevOps, Infrastructure **Schlagwörter:** Helm, Kubernetes --- ### [APEX IntelliSense für VS Code](https://thecattlecrew.net/2021/03/19/apex-intellisense-fuer-vs-code/) **Published:** März 19, 2021 **Author:** janwinkels **Content:** Das großartige, wenn man mit Oracle APEX arbeitet, ist dass es immer noch eine Menge an Pionierarbeit zu erledigen gilt. Oft gibt es Ansätze, die man erweitern kann, aber oft gibt es für bestimmte Probleme noch gar keine Lösung. Genau diese Art von Problemstellungen sind es doch, warum wir ursprünglich mal Softwareentwickler geworden sind. Weil wir es lieben zu tüfteln, zu knobeln, oder nach der Arbeit die Welt von einem bösen Zombiepiraten zu befreien. Aber zurück zum Thema: In allen weit verbreiteten Programmiersprachen ist eine IDE mit Autovervollständigung der Standard. Der Vergleich mit Oracle APEX ist hier aber nicht hundertprozentig fair, weil APEX im eigentlichen Sinne keine Programmiersprache, sondern ein Framework ist. Die Bibliotheken, die wir bei der Entwicklung in APEX verwenden, liegen in der Oracle Datenbank. Diese brauchen wir, um APEX zu betreiben. Ihr merkt also schon, wir haben kein lokales class-File, dass wir parsen können oder keine lokalen Klassen. Unsere Klassen sind Packages die als kompilierter Code in einem Datenbankschema liegen. **Welche Tools stehen uns also als APEX Entwickler zur Verfügung?** Oracles SQL Developer oder Quests Toad sind bisher die beiden Tools, die mir zur Datenbankentwicklung am meisten begegnet sind. Beide haben ihre Vor- und Nachteile, auf die ich hier nicht weiter eingehen will. Aber eine vernünftige Autovervollständigung haben beide nicht! Als nächstes wäre APEX selbst zu nennen. Ab Version 20.2 gibt es eine integrierte Autovervollständigung. Diese kennt aber „nur“ die APEX Packages und die Objekte die wir in unserem Parsing-Schema (die View Schicht einer APEX Anwendung) definieren. Das Problem hat eine weitere Dimension: Es gibt einen quasi Standard, der besagt, dass man Code innerhalb von APEX aus Performance-, und damit letztendlich User Experience-, gründen vermeiden soll. Der Code soll stattdessen in Form von Packages in der Datenbank gehalten werden. Es scheint also als müssten wir uns zwischen zwei Alternativen entscheiden: entweder suboptimale Anwendungen in APEX bauen oder auf eine komfortable Entwicklungsumgebung verzichten. Suboptimale Anwendungen zu entwickeln ist natürlich keine Alternative. Deshalb haben wir uns eine Best Practise Architektur geschaffen, die ich im Folgenden kurz beschrieben möchte, um damit die Problemstellung noch klarer zu machen. [![](https://thecattlecrew.net/wp-content/uploads/2021/03/standardarchitektur.png)](https://thecattlecrew.net/wp-content/uploads/2021/03/standardarchitektur.png) Abbildung1: Unsere Best Practice Architektur für Oracle APEX Anwendungen Wie man in der Abbildung 1 sieht, schneiden wir unsere Anwendungsarchitektur, nach Vorbild des MVC Patterns, in drei Schichten: Die DATA Schicht ist unsere Persistenz und enthält alle Entitäten unserer Anwendung. Die LOGIC Schicht enthält die gesamte Anwendungslogik und übernimmt den Transport und die Aufbereitung von Daten von der DATA zur APP-Schicht. Die APP Schicht ist unser APEX Parsing Schema und übernimmt Aufgaben, die sich auf das Frontend beziehen wie Validierungen, Datenpräsentation etc. Insbesondere auf dieser Ebene wird immer wieder auf Objekte der LOGIC Schicht, auf 3rd Party Libraries oder auf APEX native Objekte zugegriffen. Um uns also die Arbeit in der APP-Schicht zu erleichtern brauchen wir ein Tool, dass: - APEX Packages, APEX Variablen (Page Items), - Objekte der LOGIC Schicht auf welche die APP-Schicht Zugriff hat, - 3rd Party Libraries die auf der APP-Schicht zum Einsatz kommen kennt und uns beim coden als Vorschläge zur Autovervollständigung anbietet. **APEX meet Visual Studio Code**, **Visual Studio Code** **meet APEX** Die Möglichkeit das zu verwirklichen ist eine Visual Studio Code Extension, [ApexIntelliSense](https://marketplace.visualstudio.com/items?itemName=JanWinkels.ais)! Visual Studio Code hat sich, aufgrund der guten Erweiterbarkeit durch Extensions, in den letzten Jahren bei uns zu einem de facto Standard entwickelt. Die [ApexIntelliSense](https://marketplace.visualstudio.com/items?itemName=JanWinkels.ais)-Extension bietet die Möglichkeit sich mit einem APEX Parsing Schema zu verbinden. Dabei werden dann alle oben genannten Objekte ausgelesen und in einem Cache gespeichert, der auf Wunsch aktualisiert werden kann. Der Cache wird in Form von yaml-Dateien vorgehalten, die sich gut in eine Versionierung einbinden lassen. Es werden zwei yaml-Cache-Files aufgebaut: - eine für Parsing-Schema Objekte - eine für APEX Objekte Ein Feature der Extension ist, dass ein bereits erstellter APEX Cache als Quelle angegeben werden kann. Die Datei kann also zentral abgelegt werden und in mehrere Workspaces in Visual Studio Code eingebunden werden. Die Extension steht im Marketplace kostenlos zur Verfügung und kann bequem in Visual Studio Code installiert werden. Es sei hier explizit erwähnt, dass unsere oben vorgestellt „Best Practise Architektur“ keine Voraussetzung für die Nutzung der Extension ist. **Demo** [![](https://thecattlecrew.net/wp-content/uploads/2021/03/demo-1.gif)](https://thecattlecrew.net/wp-content/uploads/2021/03/demo-1.gif) **Kategorien:** Database, Development, Tools & Methoden **Schlagwörter:** APEX, LowCode, oracle --- ### [Vom Monitoring zur Fachanwendung: Prometheus-Alerts für Business-Prozesse nutzbar machen](https://thecattlecrew.net/2026/06/22/fachliche-benachrichtigungen-aus-prometheus-alerts/) **Published:** Juni 22, 2026 **Author:** Mark Hansen **Content:** Monitoring- und Alerting-Lösungen wie Prometheus informieren in erster Linie technische Teams über Probleme in Anwendungen und Infrastrukturen. In vielen Szenarien müssen jedoch auch Fachbereiche zeitnah auf Störungen reagieren können. Dieser Beitrag zeigt anhand eines Praxisbeispiels, wie Prometheus-Alerts über den Alertmanager aggregiert und direkt in eine Fachanwendung integriert werden können. ## Ausgangslage: FTP-Störungen in einer skalierenden Microservice-Architektur Im betrachteten Szenario übernimmt ein Microservice die Übertragung von Dateien an ein externes Drittsystem. Ein Microservice dient als Datei-Mover, um Daten von einem S3-Bucket via FTP an ein Drittsystem zu übertragen. Um Lastspitzen abzufangen, skaliert der Service horizontal auf bis zu zehn Instanzen. In der Praxis erwies sich die FTP-Verbindung jedoch als störungsanfällig. Die Ursachen reichen von kurzzeitigen Netzwerkschwankungen bis hin zu vollständigen Ausfällen des Drittsystems. Um das Operations-Team bzw. die Entwickler über anhaltende Probleme zu informieren, existierte ein Prometheus-Alert: Besteht die Verbindungsstörung länger als zehn Minuten, wird automatisch eine Benachrichtigung in Microsoft Teams abgesetzt. Diese dient primär der technischen Analyse. ## Warum technische Prometheus-Alerts nicht ausreichen Die technische Alarmierung allein reichte nicht aus. Auch der Fachbereich musste zeitnah über Störungen informiert werden, um deren Auswirkungen bewerten und gegebenenfalls Gegenmaßnahmen einleiten zu können. Bei länger anhaltenden Störungen muss der Fachbereich die Verarbeitung selbstständig über ein Feature-Toggle stoppen können. Technische Alerts sollen deshalb direkt in der Fachanwendung sichtbar sein und dort konkrete Handlungen ermöglichen. Außerdem soll nicht bei jeder Netzwerkschwankung eine Benachrichtigung erzeugt werden, sondern nur wenn der Fehler instanzübergreifend über einen längeren Zeitraum auftritt. ## Umsetzung: Prometheus-Alerting für fachliche Benachrichtigungen Die Grundlage bildet ein Prometheus-Alert in dem Microservice, der für den Dateitransfer zum FTP-Server zuständig ist. Ausgelöst wird der Alert unter folgenden Bedingungen: Der Alarm schlägt an, wenn über einen Zeitraum von zehn Minuten hinweg FTP-Befehle fehlschlagen und in diesem Zeitfenster keine einzige erfolgreiche FTP-Aktion registriert wird. So werden kurzzeitige kurzzeitige Netzwerkstörungen ignoriert und nur echte, anhaltende Blockaden gemeldet. Da unsere Container-Umgebung stark skaliert, setzen wir auf den Amazon Managed Service for Prometheus. Der serverlose Dienst ermöglicht die zuverlässige Überwachung unserer dynamisch skalierenden Infrastruktur – auch bei hoher Last und vielen Instanzen. Weitere Informationen zur Definition von Alerting Rules finden sich in der offiziellen [Prometheus-Dokumentation](https://prometheus.io/docs/prometheus/latest/configuration/alerting_rules/). Amazon Managed Service for Prometheus stellt einen vollständig [verwalteten Alertmanager](https://docs.aws.amazon.com/prometheus/latest/userguide/AMP-alert-manager.html) bereit, über den Alerts gruppiert und an verschiedene Zielsysteme weitergeleitet werden können. ### Alert-Aggregation mit dem Prometheus Alertmanager Ein zentraler Bestandteil dieser Architektur ist der Prometheus Alertmanager. Er empfängt die von Prometheus erzeugten Alerts, fasst sie zusammen und leitet sie an die definierten Zielsysteme weiter. ![](http://thecattlecrew.net/wp-content/uploads/2026/06/PrometheusAlertmanagerToNotification-300x102.png) Da unser File Mover bei hoher Last auf bis zu zehn Instanzen hochskaliert, würden ohne den Alertmanager im Fehlerfall zehn separate Alarme ausgelöst werden. Der Alertmanager erkennt diese Redundanz, fasst die Meldungen der einzelnen Instanzen zu einem einzigen logischen Alarm zusammen und leitet diesen gebündelt weiter – bisher primär an Microsoft Teams und nun zusätzlich an unsere Fachanwendung. ### Alert im Microservice[](#Alert-im-Microservice) ``` changes(aws_lambda_successful_ftp_command_exists_sum[5m]) == 0 and max_over_time(aws_lambda_failed_ftp_command_exists_sum[10m]) > 0 ``` ### Integration der Alerts in AWS SNS und SQS Prometheus und der Alertmanager wurden in Terraform definiert, um die Ressourcen auf den verschiedenen Umgebungen identisch zu erstellen. Die Routing-Logik des Alertmanagers wird ebenfalls über Terraform abgebildet. Dafür werden zunächst die möglichen Empfänger sowie die Regeln für die Weiterleitung der Alerts definiert. Da es verschiedene Empfänger des Alerts vom Alertmanager gibt, wurden Variablen definiert: ```terraform variable "alert_routes" { type = list(object({ receiver = string matchers = list(string) active_time_intervals = list(string) })) description = "Describes an AlertManager route. The receiver must match a key in the alert_receivers map. The mute_time_intervals is ignored when empty." } variable "alert_receivers" { type = map(object({ hook_parameter = optional(string) send_resolved = bool })) description = "Describes an AlertManager receiver. The map key is used as receiver name." } ``` Anschließend folgt die **Definition der Alert-Routen.** Dafür werden die Variablen werden wie folgt befüllt: ```terraform alert_receivers = { teams_technical = { hook_parameter = "/amp/alertmanager/ms/teams/support/hook/url" send_resolved = false } sqs_receiver = { send_resolved = false } } alert_routes = [ { receiver : "sqs_receiver" matchers : [ "architecture = application", "error_type = business" ] }, { receiver : "teams_technical" matchers : [ "architecture = application", "error_type = technical" ] } ] ``` Über das Label `error_type` wird zwischen rein technischen Benachrichtigungen und fachlich relevanten Störungen unterschieden. Dadurch können Alerts gezielt an unterschiedliche Empfängergruppen weitergeleitet werden. ### Bereitstellung der SNS-Topics Für jeden definierten Empfänger wird anschließend ein eigenes SNS-Topic erzeugt: ```terraform module "sns_topic" { for_each = var.alert_receivers source = "./modules/sns_topic" name = "${module.label.id}-${each.key}-notification" topic_policy_statements = { amp = { actions = [ "sns:Publish", "sns:GetTopicAttributes" ] } effect = "Allow" principals = [{ type = "Service" identifiers = ["aps.amazonaws.com"] }] } } ``` Das SNS-Topic des SQS-Empfängers wird anschließend über eine Subscription mit der Ziel-Queue verbunden: ``` resource "aws_sns_topic_subscription" "aws_sqs_notification_input_queue_name_sns_subscription" { for_each = { for k, v in var.alert_receivers : k => v if startswith(k, "sqs_receiver") } topic_arn = module.sns_topic[each.key].aws_sns_topic_arn protocol = "sqs" endpoint = module.sqs.aws_sqs_topic_arn } ``` ## Nachrichtentemplates für Fachanwendungen Damit die Fachanwendung die Alertinformationen verarbeiten kann, wird die Nachrichtenstruktur über ein Template standardisiert. ```yml {{ define "sns.sqs.notification.message" }}{ "messageHeader": "{{ .CommonLabels.MessageHeader }}", "type": "ERROR", "title": "{{ .CommonLabels.Title }}", "message": "{{ .CommonLabels.Message }}" }{{ end }} ``` Abschließend wird der **Prometheus Alertmanager definiert**: ```terraform resource "aws_prometheus_alert_manager_definition" "alerts_definition" { workspace_id = aws_prometheus_workspace.this.id definition = templatefile("${path.module}/alertmanager_config.yml", { sns_subject_template = file("${path.module}/templates/sns_subject_template.yml"), sns_teams_template = file("${path.module}/templates/sns_ms_teams_template.yml"), sns_sqs_template = file("${path.module}/templates/sns_sqs_notification_template.yml"), topics = module.sns_topic, alert_routes = var.alert_routes, alert_receivers = var.alert_receivers } ) } ``` Hier die alertmanager\_config.yml: ```yml --- template_files: sns_subject_template: | ${sns_subject_template} sns_teams_template: | ${sns_teams_template} sns_sqs_template: | ${sns_sqs_template}: alertmanager_config: | global: templates: - 'sns_subject_template' - 'sns_teams_template' - 'sns_sqs_template' route: group_by: ['alertname', 'severity', 'cluster', 'one_shelf_cloud_environment', 'namespace', 'exported_namespace', 'app_kubernetes_io_instance'] receiver: default_receiver routes: %{ for alert_route in alert_routes } - receiver: ${alert_route.receiver} matchers: %{ for matcher in alert_route.matchers } - ${matcher} %{ endfor ~} %{ if length(alert_route.active_time_intervals) > 0 } active_time_intervals: %{ for active_time_interval in alert_route.active_time_intervals } - ${active_time_interval} %{ endfor ~} %{ endif } %{ endfor ~} receivers: %{ for alert_receiver_key, alert_receiver in alert_receivers } - name: ${alert_receiver_key} sns_configs: - topic_arn: ${topics[alert_receiver_key].aws_sns_topic_arn} send_resolved: ${alert_receiver.send_resolved} message: | %{ if startswith(alert_receiver_key, "sqs_receiver") ~} {{ template "sns.sqs.notification.message" . }} %{ else ~} {{ template "sns.ms.teams.subject" . }} %{ endif ~} sigv4: region: eu-central-1 attributes: key: severity value: info %{ endfor ~} ``` Für die Microsoft-Teams-Benachrichtigungen müssen noch die Hook-Parameter aus dem SSM-Parameter-Store gesetzt werden und die SNS-Topic-Subscription definiert werden. Als Endpoint dient eine AWS-Lambda-Funktion, die die eingehenden Nachrichten an den entsprechenden Microsoft-Teams-Kanal weiterleitet. Wie diese Ressourcen genau definiert sind, wird in diesen Fall außer acht gelassen. ## Fazit und Ausblick[](#Fazit-und-Ausblick) Die direkte Integration von Prometheus-Alerts in die Fachanwendung schließt die Lücke zwischen technischem Monitoring und operativen Geschäftsprozessen. Fachbereiche erhalten relevante Informationen direkt dort, wo sie arbeiten, und können ohne Umwege auf Störungen reagieren. Stattdessen erhält das Business nun in Echtzeit handlungsrelevante Informationen direkt in seiner gewohnten Arbeitsumgebung. Durch die intelligente Aggregation im Alertmanager verhindern wir ein Überfluten der Anwendung mit redundanten Meldungen, selbst wenn unser Microservice voll skaliert ist. Der Fachbereich wird befähigt, über die integrierten Feature-Toggles autonom und ohne Verzögerung auf anhaltende Drittanbieter-Störungen zu reagieren. Das entlastet nicht nur die Bereitschaftsdienste der Softwareentwickler, sondern minimiert auch Ausfallzeiten und inkonsistente Datenzustände im Gesamtsystem. **Kategorien:** Development --- ### [Eventbasierte Synchronisation zwischen Monolith und Cloud-Modul](https://thecattlecrew.net/2026/06/18/eventbasierte-2-wege-synchronisation/) **Published:** Juni 18, 2026 **Author:** Christoph Ortmann **Content:** Viele Unternehmen modernisieren ihre IT-Landschaften schrittweise, indem einzelne Funktionen aus bestehenden Monolithen herausgelöst und als Cloud-Anwendungen neu entwickelt werden. Während dieser Transformation müssen Alt- und Neusystem häufig über längere Zeit parallel betrieben werden. Die Synchronisation von Daten und Geschäftsprozessen stellt dabei eine besondere Herausforderung dar. In einem Kundenprojekt stehen wir genau vor dieser Aufgabe: Eine Komponente eines monolithischen ERP-Systems soll in der Cloud neu implementiert werden, während das bestehende System weiterhin produktiv und führend bleibt. Änderungen am Monolithen sind prinzipiell möglich, benötigen aufgrund der Release-Prozesse allerdings lange und sind mit Risiko behaftet. Für die Kommunikation mit dem Cloud-Modul implementieren wir im Umfeld des Monolithen eine Service-Fassade mit Zugriff auf die Datenbank und Anwendungsschnittstellen des Monolithen. Die Kommunikation zwischen Alt- und Neusystem erfolgt bevorzugt eventbasiert über Kafka. Um den Parallelbetrieb von Alt- und Neusystem sicherzustellen, soll eine Synchronisation beider Systeme über Events hergestellt werden. ## Vorgehen zur Synchronisation Zur Synchronisation vom Altsystem in das Neusystem wird das Altsystem erweitert, sodass jede fachliche Änderung als Event veröffentlicht werden kann. Die Events geben Auskunft darüber, welche fachliche Operation ausgeführt wurde und welches Domänen-Objekt wie geändert wurde. Wir bezeichnen diese Events daher als Domain-Events. ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild2-e1781727024862.png)Synchronisation Altsystem => Cloud-Modul Das Altsystem schreibt die Domain-Events zunächst in eine Outbox-Tabelle in der Datenbank. In der Service-Fassade läuft ein Prozess, der periodisch die Outbox auf neue Events prüft und diese an Kafka sendet. Das Cloud-Modul verarbeitet diese Events und führt die entsprechenden Operationen in seinen Backend-Services durch. ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild1-e1781727040948.png)Synchronisation Cloud-Modul => Altsystem Zur Synchronisation vom Neusystem in das Altsystem werden ebenfalls die fachlichen Änderungen als Domain-Events veröffentlicht. Auch diese werden zunächst in eine Outbox-Tabelle geschrieben, ehe sie an Kafka gesendet werden. Aufseiten des Altsystems werden die Events zunächst durch einen Prozess der Service-Fassade konsumiert und in eine Inbox-Tabelle geschrieben. Von dort werden sie durch einen Hintergrund-Prozess des Monolithen gelesen. Dieser Prozess führt die Events mithilfe der bestehenden Business-Funktionen des Monolithen aus. ## Konflikte vermeiden: Pessimistic Locking Bei dieser Form der Synchronisation können Konflikte entstehen, wenn dieselben Business-Objekte parallel in beiden Systemen geändert werden. Der erste Ansatz zur Konfliktvermeidung, den wir betrachteten, beruht auf Pessimistic Locking. Im Prinzip bedeutet das, dass das Altsystem als führendes System Business-Objekte zur Änderung sperrt. Das Neusystem fordert vor jeder Änderung eine Sperre beim Altsystem an. Die Sperre wird gewährt, sofern das Altsystem das Business-Objekt nicht selbst gesperrt hat. Die Sperr-Anforderung kann mittels API- oder Command- & Response-Kommunikation über Kafka erfolgen. Einen beispielhaften Ablauf zeigt die Grafik: ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild3-e1781727003818.png)Pessimistic Locking ausgehend vom Monolithen Im Altsystem wird eine Änderung vorgenommen. Das Altsystem sperrt das geänderte Business-Objekt und sendet an das Neusystem die Aufforderung, die Änderung ebenfalls durchzuführen. Parallel wird im Neusystem versucht, eine Sperre für das bereits geänderte Business-Objekt zu erlangen. Die Sperranfrage wird vom Altsystem abgelehnt, der Anwender wird informiert, dass das Business-Objekt gesperrt ist und nicht bearbeitet werden kann. Nachdem das Kommando zum Wiederholen der Änderung im Neusystem verarbeitet wurde, wird eine Bestätigung der Änderung an das Altsystem gesendet, worauf das Business-Objekt durch das Altsystem wieder freigegeben wird. Das Vorgehen bietet den Vorteil, dass Konflikte weitgehend vermieden werden können. Allerdings erfordert die Einführung einer Sperrverwaltung im Altsystem einen aufwändigen Eingriff in das bestehende System. Darüber hinaus bewirkt die Notwendigkeit der Sperranforderung eine noch engere Kopplung des Cloud-Moduls an das Altsystem, die – besonders im Falle einer asynchronen Umsetzung – zu Latenzen führen kann. Aufgrund der Nachteile einer Umsetzung mithilfe von Pessimistic Locking wurde als Alternative ein Ansatz auf Grundlage von Optimistic Locking betrachtet. ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild4-e1781726987847.png)Grundprinzip Optimistic Locking Während beim Pessimistic Locking versucht wird, Konflikte durch das Sperren von Datensätzen gar nicht erst entstehen zu lassen, beruht das Optimistic Locking darauf, Konflikte zu erkennen, wenn sie auftreten und durch den Anwender auflösen zu lassen. Typischerweise wird dazu jedes Business-Objekt mit einer Version oder dem Zeitstempel der letzten Änderung versehen, die beim Speichern hochgezählt bzw. aktualisiert werden. Zeitstempel oder Version werden vor der Bearbeitung des Datensatzes gelesen. Beim Speichern wird geprüft, ob der persistente Wert mit dem gelesenen Wert übereinstimmt. Ist dies nicht der Fall, wurde der Datensatz in der Zwischenzeit geändert. Typischerweise müssen die Daten nun neu geladen und die Änderung erneut durchgeführt werden. ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild5-e1781726967100.png)Optimistic Locking ohne Rückmeldung an den Nutzer Bezogen auf unseren Anwendungsfall bedeutet das, dass alle Business-Objekte versioniert werden und das Altsystem als führendes System für das Hochzählen der Version in Folge von Änderungen verantwortlich ist. Jedes vom Altsystem ausgehende Domain-Event beinhaltet auch die aktuelle Version des jeweiligen Business-Objekts. Diese Version wird im Neusystem gespeichert und im Falle eigener Änderungen in den resultierenden Domain-Events mitgeschickt, jedoch ohne hochgezählt zu werden. In unserem Beispiel ist das Business-Objekt bereits in beiden Systemen in derselben Version vorhanden. Nun wird das Objekt in beiden Systemen geändert. Das Altsystem erhöht die Version und informiert mit einem Domain-Event über die Änderung und die neue Version. Noch bevor das Event im Neusystem verarbeitet wurde, schickt dieses ebenfalls ein Event mit den Daten der Änderung sowie der zu diesem Zeitpunkt vorhandenen Version. Anschließend verarbeitet das Neusystem das Event aus dem Altsystem. Dabei können Änderungen überschrieben werden, die im Neusystem zwischenzeitlich vorgenommen wurden, aber noch nicht mit dem Altsystem synchronisiert waren. Das Altsystem verarbeitet das Domain-Event aus dem Neusystem und stellt eine parallele Änderung fest, da die Version aus dem Event älter ist als die in der Datenbank. Als Reaktion darauf wird die Verarbeitung des Domain-Events abgelehnt und ein Sync-Event mit dem vollständigen Aggregat an das Neusystem geschickt. Mit den Daten dieses Events wird der komplette Datensatz im Neusystem überschrieben, wodurch die Konsistenz wiederhergestellt ist. Dieses Vorgehen lässt Inkonsistenzen zu und behebt sie durch Überschreiben der Daten im Cloud-Modul. Von Nachteil ist, dass Änderungen im Cloud-Modul ohne Vorwarnung überschrieben werden und der Anwender ohne es zu bemerken auf veralteten oder sogar inkonsistenten Daten arbeiten kann. Dieses Problem kann abgemildert werden, indem das Nachführen der Änderung am Cloud-Modul im Altsystem als Kommando umgesetzt wird. Damit böte sich die Möglichkeit, den Anwender direkt über die Ablehnung der Anforderung zu informieren. Darüber hinaus könnte das Business-Objekt für weitere Änderungen gesperrt werden, bis die Konsistenz wiederhergestellt ist. ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild9-e1781726662743.png)Optimistic Locking mit Rückmeldung an den Nutzer In Abwandlung zum vorherigen Beispiel wird nach der Änderung im Neusystem nun ein Command statt eines Events an das Altsystem gesendet. Das System kann dem Anwender kenntlich machen, dass die aktuelle Änderung erst nach der Bestätigung durch das Altsystem gültig ist. Das Altsystem lehnt die Änderungsanforderung ab, da eine parallele Änderung erkannt wurde. Das Neusystem verarbeitet die Ablehnung und sperrt das Business-Objekt für weitere Änderungen. Das Neusystem sendet nun ein weiteres Kommando, um einen vollständigen Stand des inkonsistenten Business-Objekts anzufordern. Das Altsystem antwortet mit einem entsprechenden Data-Event, welches im Neusystem verarbeitet wird, wodurch das Business-Objekt überschrieben und wieder für Änderungen freigegeben wird. Zwar werden bei dieser Variante Änderungen auf veralteten Daten weitestgehend vermieden, jedoch hat dies den Preis, dass Business-Objekte gegebenenfalls für die Bearbeitung gesperrt werden. Darüber hinaus führt das Anfordern von Sperren zu einer engeren Kopplung beider Systeme, die sich auch durch Wartezeiten für den Anwender bemerkbar machen kann. Beides zusammen kann sich negativ auf die Akzeptanz des Neusystems auswirken. ## Zyklische Updates Ein weiteres Problem, das es zu lösen galt, ist das von zyklischen Updates: Wenn jede Änderung an einem Business-Objekt zu einem Domain-Event führt, welches vom jeweils anderen System verarbeitet wird, wodurch dort ein Business-Objekt geändert wird sodass wieder ein Domain-Event entsteht, können wir leicht in einer Endlosschleife landen. Ein einfacher Weg, dies zu vermeiden, ist eine global eindeutige Transaktions-Id, die zum Beginn einer jeden Nutzer-Interaktion mit einem System erzeugt wird und mit jedem ausgehenden Event mitgeschickt wird. ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild6-e1781726947937.png)Zyklische Updates mit GlobalTransactionIds vermeiden Im konkreten Beispiel erzeugt das Cloud-Modul zu Beginn einer Nutzer-Anforderung eine neue Transaktions-Id. Wird aufgrund dieser Interaktion ein Business-Objekt geändert, wird ein Domain-Event zunächst in der Outbox-Tabelle gespeichert und anschließend an Kafka gesendet. Das Event trägt die Transaktions-Id im Header. Das Alt-System verarbeitet nun das Event und kopiert die Transaktions-Id in seinen Ausführungskontext, anstatt selbst eine Transaktions-Id anzulegen. Ist die vom Event getriggerte Aktion durchgeführt, wird wieder ein Domain-Event erzeugt, wieder mit der Transaktions-Id im Header. Wird nun das Event im Neusystem verarbeitet, wird zunächst die Transaktions-Id aus dem Header gegen die eigene Outbox-Tabelle geprüft. Dabei wird festgestellt, dass die Transaktions-Id bereits in diesem System bekannt ist, es sich also um einen Zyklus handeln muss. Das Event wird verworfen. Von Nachteil ist, dass sowohl das Alt- als auch das Neusystem in der Lage sein müssen, Transaktions-Ids zu erzeugen und entsprechend zu behandeln. In unserem Falle hätte es einen massiven Eingriff in das Altsystem bedeutet, das zu ermöglichen, weshalb der Ansatz etwas abgewandelt wurde. Statt einer global gültigen Transaktions-Id wurde auf einen Operations-Key zurückgegriffen, der jede Business-Operation eindeutig identifiziert und im Altsystem bereits zu Audit- und Loggingzwecken eingesetzt wurde: ![](http://thecattlecrew.net/wp-content/uploads/2026/03/cattle-crew-eventbasierte-synchronisation-bild8.png) Die Verantwortung für das Vermeiden von Zyklen liegt hier allein beim Altsystem: Es wird sichergestellt, dass bei Aktionen, die als Reaktion auf ein Domain-Event ausgeführt werden, ein anderer Operations-Key gesetzt ist als bei Operationen, die durch eine Nutzerinteraktion angestoßen werden. Bevor ein Event in die Outbox-Tabelle geschrieben wird, wird nun immer anhand des Operations-Keys geprüft, ob es sich um eine neue Interaktion oder eine Reaktion auf ein Event handelt. Für Reaktionen auf ein Event wird kein neues Event in die Outbox geschrieben. ## Fazit Die Arbeit an dem Projekt hat noch einmal vor Augen geführt, dass die Synchronisation zweier Systeme, die dieselben Daten ändern, herausfordernd sein kann. Zur Vermeidung von Konflikten durch paralleles Arbeiten müssen Kompromisse eingegangen werden. Ansätze mit Pessimistic Locking bieten einen guten Schutz vor Konflikten, können aber die Akzeptanz der Anwender schmälern. Ansätze mit Optimistic Locking verringern die Auswirkung gesperrter Objekte, stellen die Konsistenz allerdings nur verzögert sicher. Diesen Nachteilen wurde im Projekt begegnet, indem das neue System schrittweise für einzelne Standorte ausgerollt wurde. Aufgrund der getrennten Zuständigkeiten der einzelnen Standorte war die Notwendigkeit für gleichzeitige Änderungen an denselben Datenobjekten in beiden Systemen gering. Das Projekt zeigt, dass es bei der Synchronisation von Alt- und Neusystemen selten eine universell richtige Lösung gibt. Vielmehr hängt die Wahl des geeigneten Ansatzes von den fachlichen Anforderungen, den technischen Randbedingungen und dem gewünschten Nutzererlebnis ab. **Kategorien:** Cloud, Development --- ### [Oracle SE2 und moderne Prozessorarchitekturen: Worauf Unternehmen jetzt achten sollten](https://thecattlecrew.net/2026/06/02/oracle-se2-und-moderne-prozessorarchitekturen-worauf-unternehmen-jetzt-achten-sollten/) **Published:** Juni 2, 2026 **Author:** thecattlecrew **Content:** *Interview der Blogredaktion mit Oracle-Lizenzexperte Michael Paege.* ## Michael, es scheint, es gibt Neuigkeiten bei Prozessoren und Hardware-Architekturen im Hause Oracle? Was ist da los? **Michael Paege:** In den vergangenen Jahren haben sich Prozessorarchitekturen erheblich verändert. Sowohl Intel als auch AMD setzen zunehmend auf Designs, die deutlich mehr Rechenleistung auf gleichem Raum ermöglichen. Für die meisten Unternehmen ist das zunächst eine positive Entwicklung. Im Oracle-Umfeld können diese technischen Veränderungen jedoch unerwartete Auswirkungen auf die Lizenzierung haben. Gerade bei Oracle Database Standard Edition 2 (SE2) gelten bestimmte Einschränkungen hinsichtlich der Nutzung von CPU-Sockets. Nämlich, dass die DB SE2 nur auf Server mit maximal 2 CPU-Sockets eingesetzt werden darf. ## Und was hat jetzt der CPU-Sockel, also der Steckplatz, mit der darin steckenden CPU zu tun? **Michael Paege:** Bereits seit 2011 definiert Oracle in seinen Allgemeinen Geschäftsbedingungen (Oracle-Lizenz- und Service-Abkommen (OLSA), (Transaktionales) Oracle Master Agreement ((T)OMA) und Lizenzdefinitionen und Regeln (LDR)) bei Multi-Chip-Modulen, dass jeder Chip auf einem Multi-Chip-Modul einem (belegten) CPU-Socket entspricht. ## Was hat sich bei aktuellen Prozessorgenerationen konkret verändert? **Michael Paege:** Moderne Prozessoren setzen zunehmend auf sogenannte Chiplet- oder Multi-Die-Architekturen. Dabei besteht ein Prozessor nicht mehr zwingend aus einem einzigen Silizium-Chip, sondern aus mehreren miteinander verbundenen Komponenten. Solche Multi-Chip-Module gibt es bei der IBM Power Prozessorserie schon sehr lange. Bei AMD sind die Ryzen- und EPYC-Prozessorfamilien ebenfalls schon seit einigen Jahren meist Multi-Chip-Module, und bei Intel trifft man seit der 4. Generation der Xeon-Prozessoren ebenfalls verstärkt auf Multi-Chip-Module. ## **Warum ist das gerade für Oracle Database Standard Edition 2 relevant?** **Michael Paege:** Oracle SE2 ist bewusst für kleinere und mittlere Datenbankumgebungen positioniert. Deshalb sind die Nutzungsmöglichkeiten der Hardware/CPUs gegenüber der Enterprise Edition eingeschränkt. Diese Einschränkung besteht – neben der in der DB SE2 Software vorhandenen Einschränkung auf die Nutzung von maximal 16 Threads für Datenbankprozesse – hauptsächlich in der oben bereits erwähnten Begrenzung auf Server, die maximal 2 CPU-Sockel haben dürfen. Hat ein Server beispielsweise 2 SPU-Sockel, von denen ein CPU-Sockel mit einer CPU mit zwei Chips gefüllt ist, dann hat dieser Server nach den aktuellen Oracle-Regeln drei CPU-Sockel: 1 gefüllter Sockel mit 2 Chips, also 2 Sockel plus ein leerer Sockel, in Summe also drei Sockel. Und darauf darf eine DB SE2 nicht eingesetzt werden. Wenn neue Hardwaregenerationen eingeführt werden, stellt sich regelmäßig die Frage, wie diese Systeme unter den bestehenden Lizenzregeln einzuordnen sind. Unternehmen müssen sicherstellen, dass die eingesetzte Hardware weiterhin mit den Vorgaben von Oracle kompatibel ist und keine unerwarteten Lizenzrisiken entstehen. ## **Welche Risiken siehst du aktuell für Unternehmen?** **Michael Paege:** Das größte Risiko besteht darin, Hardware ausschließlich aus technischer Perspektive auszuwählen. Viele Unternehmen betrachten Performance, Energieeffizienz oder Anschaffungskosten, ohne die Oracle-Lizenzierung frühzeitig einzubeziehen. Im ungünstigsten Fall wird eine neue Plattform beschafft und erst später festgestellt, dass die geplante Nutzung lizenzrechtlich problematisch oder wirtschaftlich nachteilig ist. Die Kosten für nachträgliche Anpassungen können erheblich sein. ## **Betrifft das nur neue Oracle-Kunden oder auch bestehende Installationen?** **Michael Paege:** Das betrifft neue und bestehende Kunden gleichermaßen. Bestehende Kunden haben aber ggf. ein höheres Risiko, weil solche neuen Regelungen beim einfachen Hardwaretausch schnell mal übersehen werden. Eine Plattform, die vor einigen Jahren problemlos eingesetzt werden konnte, ist nicht automatisch mit heutigen Architekturen vergleichbar. Deshalb empfiehlt es sich, vor einer Beschaffung sowohl die technische als auch die lizenzrechtliche Bewertung vorzunehmen. ## **Welche typischen Fehler beobachtest du in der Praxis?** **Michael Paege:** Ein häufiger Fehler besteht darin, Oracle-Lizenzexperten erst sehr spät in Infrastrukturentscheidungen einzubeziehen. Oft wird zunächst die Hardware ausgewählt, im schlimmsten Fall sogar schon bestellt, und erst danach geprüft, welche Auswirkungen dies auf die Lizenzierung hat. Ein weiterer Fehler ist die Annahme, dass sich neue Prozessorgenerationen automatisch identisch zu ihren Vorgängern verhalten. Gerade bei grundlegenden Architekturänderungen sollte man genau hinschauen. ## **Was empfiehlst du Organisationen, die aktuell neue Datenbankserver planen?** **Michael Paege:** Ich empfehle, die Lizenzperspektive frühzeitig in die Planung einzubeziehen. Idealerweise werden Infrastruktur-, Datenbank- und Lizenzexperten bereits in der Evaluierungsphase eingebunden. So lassen sich spätere Überraschungen vermeiden und Unternehmen können eine Lösung auswählen, die sowohl technisch als auch wirtschaftlich sinnvoll ist. ## **Welche Fragen sollten IT-Verantwortliche vor einer Hardwarebeschaffung stellen?** **Michael Paege:** Wichtige Fragen sind beispielsweise: - Welche Prozessorarchitektur wird eingesetzt? - Gibt es Besonderheiten bei der Anzahl von Dies, Chiplets oder Sockeln? - Welche Auswirkungen ergeben sich für Oracle SE2? - Gibt es bereits Erfahrungen aus vergleichbaren Projekten? - Welche langfristigen Lizenzkosten entstehen durch die gewählte Plattform? Je früher diese Fragen beantwortet werden, desto sicherer fällt die Investitionsentscheidung aus. Und wichtig: Laut Oracle sind alle Intel Xeon-Prozessoren der 6. Generation nicht für die DB SE2 geeignet. ## **Erwartest du weitere Veränderungen in diesem Bereich?** **Michael Paege:** Die Entwicklung moderner Prozessoren schreitet sehr schnell voran. Deshalb ist davon auszugehen, dass Unternehmen auch künftig regelmäßig neue technische Konzepte bewerten müssen. Für Oracle-Kunden bedeutet das, Hardwareentscheidungen nicht isoliert zu betrachten, sondern immer im Zusammenspiel mit Lizenzierung, Compliance und langfristiger Betriebsstrategie. ## **Über Michael Paege** **Michael Paege** verfügt über mehr als 30 Jahre Erfahrung im Umfeld der Oracle-Lizenzierung. Gemeinsam mit unseren Datenbankexperten informiert er jährlich in umfassenden Lizenz-Webinaren über die neuesten Entwicklungen bei Oracle. Er engagiert sich bei der Deutschen Oracle Anwendergruppe, hält Vorträge und betreibt einen eigenen Blog. Bei **OPITZ CONSULTING Systems** arbeitet er als Senior Manager Cloud & Compliance und berät Unternehmen und Behörden jeder Größe zu Lizenzfragen. ![Foto von Michael Paege, Lizenzierungsexperte bei OPITZ CONSULTING](http://thecattlecrew.net/wp-content/uploads/2026/06/michael-paege-2025.png) **Kategorien:** Database, Infrastructure **Schlagwörter:** oracle, Oracle DB --- ### [Die Nachtwache: Rufbereitschaft für IT-Profis](https://thecattlecrew.net/2026/06/09/rufbereitschaft-fuer-profis/) **Published:** Juni 9, 2026 **Author:** Mateusz Mis **Content:** Wenn Produktionssysteme rund um die Uhr laufen, müssen auch die Menschen dahinter jederzeit handlungsfähig sein. Genau dafür gibt es die Rufbereitschaft. Sie ist ein wichtiger Bestandteil des Betriebs und sorgt dafür, dass kritische Systeme auch außerhalb der regulären Arbeitszeiten zuverlässig unterstützt werden können. ## **Die Realität hinter dem Diensttelefon** 4:00 Uhr morgens, Samstagnacht. Ich schlafe nicht – nichts Neues. Seit Dienstag habe ich keine einzige Nacht durchgeschlafen, ohne aus dem Bett aufspringen zu müssen. Über das Diensttelefon spreche ich mit einem Anwender „unserer“ Produktionssysteme und versuche zu verstehen, warum ein Problem, das seit Donnerstagmorgen besteht, erst am Samstag um 4:00 Uhr morgens an unser Team eskaliert wurde – als etwas, das unter keinen Umständen warten kann. **„Darauf kann ich nicht antworten, ich weiß es nicht. Eigentlich ist es keine Priorität, es kann problemlos bis Montag warten“,** behauptet mein Gesprächspartner, übrigens sehr freundlich im Ton und in seiner Ausdrucksweise. ## **Einstellung ist key** Manche von euch würden sich vielleicht ärgern, und vielleicht hätten sie sogar das Recht dazu. **„Warum holen sie mich mitten in der Nacht aus dem Bett?“** Ich sehe das anders. Ich fühle eher Erleichterung und ein Gefühl der Erfüllung einer wichtigen Pflicht. Schließlich ist es meine Aufgabe, das Funktionieren der Systeme sicherzustellen. Außerdem helfe ich gerne in schwierigen Situationen und löse Probleme – und genau damit haben wir es hier zu tun. Manchmal besteht eine gut ausgeführte „**Aktivierung**“ nicht ausschließlich darin, einen Incident zu lösen, sondern darin, mit dem Betrieb die verfügbaren Optionen zu besprechen, das Problem selbst sowie seine Auswirkungen auf die Systeme zu analysieren. Oft gehört dazu auch eine gewisse verbale Unterstützung, die paradoxerweise einen großen Einfluss auf die gesamte Situation hat – aber dazu gleich mehr. Jede Meldung, die die Rufbereitschaft erreicht, ist ein Signal dafür, dass irgendwo etwas nicht so funktioniert, wie es sollte. Manchmal kann die Rechtmäßigkeit solcher Meldungen in der Eskalationskette nicht überprüft werden, bevor nicht jemand mit entsprechender Erfahrung und dem nötigen Wissen erscheint, um die Situation objektiv zu beurteilen – das ist unsere Rolle. ## **Gefährdung der Produktionskontinuität** Wie wichtig die Rufbereitschaft für unser Projekt ist, ist auf den ersten Blick vielleicht nicht offensichtlich. Was kann schon passieren? Bekommt jemand die angeforderten Berechtigungen nicht? Kann sich jemand nicht in ein System einloggen? Ja – und nein. Das Thema ist viel komplexer, deshalb gehen wir kurz ins Detail. Grundsätzlich hat jede Meldung, die außerhalb der Bürozeiten an unser Team eskaliert wird, einen direkten Einfluss auf die Kontinuität von Produktions- und Logistikprozessen des Kunden. Die gemeldeten Vorfälle können (müssen aber nicht) direkt die Stabilität industrieller Systeme gefährden – von der eigentlichen Stahlproduktion bis hin zu Logistik und Planung. Wir sind also in jeden wichtigen Prozess eingebunden, der den reibungslosen Ablauf beeinflusst. Hinter jeder erfolgreichen Rufbereitschaft steht letztlich ein klares Ziel: die Sicherstellung stabiler Produktions- und Logistikprozesse. Für Unternehmen wie thyssenkrupp Steel bedeutet das, Produktionsausfälle zu vermeiden, Lieferketten aufrechtzuerhalten und wirtschaftliche Risiken zu minimieren. In einem so großen Unternehmen wie thyssenkrupp Steel kann jede Verzögerung potenziell katastrophale Folgen haben, was sich natürlich auch negativ auf unser Projekt auswirken würde. ## Erfahrung schlägt Handbuchwissen Die Probleme, die uns erreichen, sind daher sehr unterschiedlich. Deshalb können wir hier im Incident Management nicht von standardisierten SOP-Lösungen sprechen. Der Schein kann trügen. Trotz des Namens MES/FLS passt die Zahl der Systeme, die wir überwachen, nicht einmal auf die Finger beider Hände – und FLS ist nur der zentrale Teil dieser Landschaft. Manchmal erreichen uns auch Meldungen aus Systemen, die wir gar nicht betreuen. Für die meldenden Nutzer ist das meist unwichtig – „**Ich kenne nur diese Telefonnummer und brauche Hilfe**“. Für sie vereinfacht das die Arbeit, für uns erschwert es sie deutlich. Aber irgendetwas lässt sich immer tun: Informationen in Datenbanken suchen, Punkte in JIRA durchsehen und dem Nutzer raten, an wen er sich wenden sollte – schließlich sitzen wir alle im selben Boot. Multiplizieren wir also die Anzahl der Systeme mit einer noch größeren Zahl möglicher Störungen und ihrer Schnittpunkte – von Servern bis hin zu spezialisierten Programmen zur Verarbeitung bestimmter Aktionen innerhalb eines Systems. Dazu kommen menschliche Fehler und Fehlalarme, und langsam offenbart sich uns ein ganzer Ozean von Möglichkeiten, in dem wir jede Nacht waten, um herauszufinden, wo etwas nicht funktioniert, wer Zugriff darauf hat und wer es nachts beheben kann (falls wir es nicht selbst sind). ## **Die Last der Verantwortung** Wie man sieht, ist das alles gar nicht so einfach, wie es auf den ersten Blick erscheinen mag. Deshalb sprechen wir in unserem Team von einer Einarbeitungsphase im Projekt, die mehrere Monate bis hin zu einem Jahr dauern kann. Erst danach kann eine neue Person beginnen, sogenannte „Rufbereitschaften oder RBs“ zu übernehmen und selbstständig Entscheidungen zu treffen, die direkten Einfluss auf die industriellen Prozesse des Kunden haben. Ich muss euch wohl nicht erklären, welche psychische Belastung es bedeutet, wenn man als neuer Mitarbeiter eine ganze Woche lang (Montag 17:00 Uhr bis Montag 8:00 Uhr – außerhalb der Bürozeiten) mit dem Gedanken konfrontiert ist, dass nun der gesamte Service auf den eigenen Schultern liegt und man in jeder Situation und zu jeder Uhrzeit zurechtkommen muss. Ich erinnere mich jedoch gut daran, wie stressig meine ersten Bereitschaften waren. Zur Klarstellung: In den meisten dieser Systeme sind wir Administratoren, sodass jede falsche Entscheidung schwerwiegende Folgen haben und große Verluste verursachen kann. Deshalb müssen wir vor allem vorsichtig und zurückhaltend handeln. Natürlich gibt es Bereiche mit klaren Prozessen und festen Abläufen – dort können wir ohne Zögern handeln. Viele Fälle sind jedoch reine Improvisation, und auch das muss man lernen. Natürlich sind wir nicht völlig auf uns allein gestellt – es gibt weitere Eskalationswege, und der gesamte Prozess ist sehr gut aufgebaut. Doch angesichts der Vielzahl an Themen, mit denen wir konfrontiert werden, stellt sich immer wieder die Frage: „**Muss ich wirklich noch eine weitere Person aus dem Bett holen und zusätzlichen Aufwand verursachen**?“ oder „**Ist das überhaupt die richtige Person, die mir hier helfen kann?**“ Und damit kommen wir zurück zum wichtigsten Punkt – der Erfahrung. Sie ist der Grund, warum man uns so schwer ersetzen kann. Das Wissen, das wir über Jahre hinweg sammeln, ist hier ein unverzichtbares Element. ## **30 Minuten Reaktionszeit – jederzeit** Der Bereitschaftsdienst ist heute eine anstrengende, aber zweifellos wichtige Pflicht in unserem Projekt. Zwar ermöglicht die über Jahre gesammelte Erfahrung meist eine schnelle Identifikation des Problems und möglicher Lösungswege, dennoch bleibt eine gewisse „Bindung“ an das Diensttelefon bestehen. Das hängt sicherlich von der Person ab, aber für mich ist es erwähnenswert, weil es nicht für jeden selbstverständlich ist. Unser SLA beträgt 30 Minuten. Das bedeutet, dass ich nach der Eskalation eines Incidents 30 Minuten Zeit habe, um zum Computer zu gelangen, mich in die Systeme einzuloggen und den Status eines Tickets in JIRA zu ändern. Wie ihr euch sicher vorstellen könnt, schränkt das die Freiheit, seine Freizeit außerhalb der Bürozeiten zu gestalten, erheblich ein. Nicht jeder möchte schließlich überall mit einem mobilen Hotspot und einem Dienstlaptop unterwegs sein. Zum Glück dauert eine Bereitschaftsperiode nur sieben Tage – danach wechseln wir uns ab. ## Wertschätzung macht einen Unterschied Diese Arbeitsweise hat sicherlich ihre Vor- und Nachteile. Auf jeden Fall ist es keine Arbeit für jeden. Persönlich sehe ich darin jedoch eher eine Herausforderung und eine Gelegenheit, mein Wissen und meine Erfahrung einzusetzen, um jemandem zu helfen. Vor Kurzem ist mir etwas sehr Nettes passiert. Für die Nutzer ist es meist selbstverständlich, dass irgendwo jemand sitzt und nachts bereit ist, ihre Zweifel auszuräumen oder ein System zu reparieren – schließlich ist es seine Arbeit. Und natürlich nehme ich das niemandem übel. Bei einer der letzten „Aktivierungen“ sagte mir jedoch ein Nutzer während unseres Gesprächs, dass er die Arbeit der Menschen, die solche Bereitschaftsdienste leisten, sehr respektiert und sich sehr für die Unterstützung bedankt. In einer idealen Welt wäre das vielleicht selbstverständlich, doch in Wirklichkeit hören wir so etwas nur selten. Umso mehr hat es mich gefreut. Es ist schön zu wissen, dass das, was wir tun, nicht nur als Selbstverständlichkeit und Pflicht gesehen wird, sondern auch als etwas, das wir von uns ausgeben. Deshalb habe ich vorher die verbale Unterstützung erwähnt. Es ist gut, dem Nutzer zu vermitteln, dass ich nicht nur hier bin, weil ich muss, sondern weil ich helfen möchte – und das ist ein großer Unterschied. Wenn wir mit dieser Einstellung an die Sache herangehen, wird die Arbeit angenehmer und bringt bessere Ergebnisse. Rufbereitschaft bedeutet mehr als technische Unterstützung außerhalb der Bürozeiten. Sie bedeutet Verantwortung für geschäftskritische Prozesse, schnelle Entscheidungen unter Druck und die Bereitschaft, Menschen in schwierigen Situationen zu helfen. Genau diese Kombination macht den Unterschied – für unsere Kunden und für den Erfolg ihrer Systeme. **Kategorien:** Infrastructure, IT-Security **Schlagwörter:** Administration, AdminServer, Agile Methode, Apps, Architecture, Articles, responsibility, Zusammenarbeit --- ### [Databricks verstehen – Teil 4: Gegenüberstellung der Ansätze und Fazit](https://thecattlecrew.net/2026/03/12/databricks-verstehen-teil-4-fazit/) **Published:** März 12, 2026 **Author:** Maximilian Wilhelmi **Content:** ## Gegenüberstellung der Ansätze und Fazit Moderne Datenplattformen stehen vor der Herausforderung, stetig wachsende Datenmengen aus unterschiedlichsten Quellen zuverlässig, reproduzierbar und skalierbar zu verarbeiten. In diesem Kontext haben sich Cloud Data Warehouses, Lakehouse-Architekturen und ELT-Ansätze als Quasi-Standard etabliert. Zwei Werkzeuge, die dabei häufig genannt werden, sind Delta Live Tables (DLT) von Databricks und dbt (data build tool). Obwohl beide Frameworks im selben technologischen Umfeld eingesetzt werden, verfolgen sie unterschiedliche Ziele und adressieren klar getrennte Problemstellungen. In der Praxis entsteht dennoch oft Verwirrung: DLT und dbt werden miteinander verglichen oder als Alternativen betrachtet. Tatsächlich handelt es sich um grundlegend unterschiedliche Tools, die jeweils für eigene Aufgabenbereiche konzipiert wurden. Dieser Blogartikel stellt beide Frameworks gegenüber, grenzt sie sauber voneinander ab, beleuchtet Vor- und Nachteile und schließt mit einem praxisnahen Fazit. ## Einordnung im modernen Datenstack Um DLT und dbt sinnvoll zu vergleichen, ist zunächst eine Einordnung im typischen Datenverarbeitungsprozess notwendig. Dieser beginnt bei operativen Datenquellen wie Applikationsdatenbanken, SaaS-Tools, APIs oder Event-Streams. Anschließend werden die Daten in eine zentrale Datenplattform geladen, dort transformiert, angereichert und schließlich für Analytics, Reporting oder Machine-Learning-Anwendungen bereitgestellt. Delta Live Tables (DLT) ist vor allem auf Dateningestion und Pipeline-Orchestrierung ausgelegt. Das Framework unterstützt dabei, Daten aus unterschiedlichen Quellsystemen zuverlässig zu erfassen, zu validieren und in ein Zielsystem wie ein Databricks-Data-Lakehouse zu laden. Als vollständig in Databricks integriertes Managed-Framework auf Basis von Spark bietet DLT automatisierte Funktionen für Schema-Evolution, Inkrementalität und Monitoring, die den Aufbau stabiler Pipelines erleichtern. dbt hingegen konzentriert sich stärker auf Transformation, Modellierung und Qualitätssicherung der bereits vorhandenen Daten. In der Praxis können sich die Aufgabenbereiche von DLT und dbt teilweise überschneiden, insbesondere wenn Transformationen oder Validierungen bereits während der Ingestion notwendig sind. Grundsätzlich bleibt jedoch der Unterschied bestehen: DLT legt den Schwerpunkt auf die technische Bereitstellung und Stabilität der Datenpipelines, während dbt stärker auf fachliche Modellierung, Tests und Dokumentation fokussiert ist. ## DLT – Fokus auf robuste Datenpipelines in Databricks Delta Live Tables ist ein proprietäres Managed-Framework von Databricks, das speziell für den Aufbau stabiler, skalierbarer und wartbarer Datenpipelines entwickelt wurde. Es ermöglicht, Pipelines deklarativ zu definieren, und automatisiert viele technische Details – wie die Anpassung an Schemaänderungen, inkrementelle Verarbeitung und Monitoring – direkt im Spark-Umfeld. Ein wesentliches Merkmal von DLT ist das integrierte State- und Schema-Management. Ändert sich beispielsweise die Struktur einer Datenquelle, kann DLT die Änderung erkennen, entsprechende Anpassungen durchführen und die Pipeline ohne manuelle Eingriffe fortsetzen. Dadurch wird der Wartungsaufwand deutlich reduziert, insbesondere bei komplexen oder dynamischen Datenquellen. DLT-Pipelines werden in Databricks typischerweise über Python oder SQL definiert und lassen sich direkt in die Spark- und Lakehouse-Umgebung integrieren. Typische Einsatzszenarien sind das Laden von API-Daten, die Replikation operativer Datenbanken oder die Befüllung von Raw- bzw. Bronze-Schichten in einem Lakehouse. DLT legt den Fokus bewusst auf robuste Datenbereitstellung und Qualitätssicherung. ## dbt – Transformation und fachliche Modellierung Im Gegensatz dazu versteht sich dbt als Werkzeug für die Transformation von Daten innerhalb des Data Warehouses. dbt folgt dem Prinzip „Transform data where it lives“ und verzichtet vollständig auf eigene Extraktions- oder Ladefunktionen. Stattdessen werden Transformationen als SQL-Modelle definiert, die direkt im Zielsystem ausgeführt werden. Die Stärke von dbt liegt in der strukturierten Modellierung von Daten. Rohdaten werden zunächst in Staging-Modellen bereinigt und vereinheitlicht, anschließend in fachliche Kernmodelle überführt und schließlich zu analytischen Marts aggregiert. Dieser schichtweise Ansatz fördert Übersichtlichkeit, Wiederverwendbarkeit und eine klare Trennung zwischen technischer und fachlicher Logik. Ein weiterer zentraler Aspekt von dbt ist die Datenqualität. Über Tests lassen sich Annahmen wie Eindeutigkeit, Nicht-Null-Werte oder referenzielle Integrität direkt im Entwicklungsprozess absichern. Ergänzt wird dies durch automatisch generierte Dokumentation und eine transparente Abhängigkeitsdarstellung, die den gesamten Transformationspfad nachvollziehbar macht. ## Abgrenzung und Vergleich DLT und dbt unterscheiden sich grundlegend in Zielsetzung und Einsatzgebiet. DLT ist ein Werkzeug für den technischen Aufbau von Datenpipelines und adressiert in erster Linie die zuverlässige Erfassung und Bereitstellung von Daten aus operativen Quellsystemen. Der Schwerpunkt liegt dabei auf Stabilität, Wiederholbarkeit und dem Umgang mit technischen Herausforderungen wie Inkrementalität, Fehlertoleranz und Schemaänderungen. dbt verfolgt hingegen einen deutlich anderen Ansatz. Es ist kein Pipeline- oder Ingestion-Framework, sondern ein Modellierungs- und Transformationswerkzeug, das ausschließlich innerhalb des Data Warehouses operiert. dbt setzt voraus, dass Daten bereits in strukturierter Form vorliegen, und konzentriert sich auf deren fachliche Interpretation, Qualitätsabsicherung und Dokumentation. Auch aus technologischer Sicht sind beide Tools klar voneinander zu trennen. DLT ist Python-basiert und im klassischen Data-Engineering-Umfeld verankert, in dem Themen wie Datenzugriff, Orchestrierung und technische Robustheit im Vordergrund stehen. dbt hingegen ist SQL-zentriert und richtet sich an Rollen, die nahe an Fachlichkeit und Analytics arbeiten. Die Wahl zwischen DLT und dbt ist daher weniger eine Frage der Kombination, sondern vielmehr eine Frage danach, welches Problem im jeweiligen Kontext gelöst werden soll. ## Vorteile und Grenzen von DLT DLT überzeugt insbesondere durch seine Robustheit und den hohen Grad an Automatisierung bei der Dateningestion. Änderungen an Datenquellen lassen sich häufig ohne manuelle Eingriffe verarbeiten, was den operativen Aufwand reduziert und die Stabilität der Ladeprozesse erhöht. Der Python-basierte Ansatz ermöglicht zudem eine hohe Flexibilität, insbesondere beim Umgang mit komplexen, heterogenen oder schwer standardisierbaren Datenquellen. Gleichzeitig ist DLT bewusst auf den Bereich der Dateningestion fokussiert und erhebt nicht den Anspruch, ein umfassendes Framework für analytische oder fachliche Transformationen zu sein. Weitergehende Logik, Kennzahlenberechnungen oder semantische Modellierung können daher entweder in nachgelagerten Werkzeugen oder – abhängig von Plattformstrategie und Teamkompetenzen – auch innerhalb eines Spark-basierten oder vergleichbaren Ökosystems umgesetzt werden. In Umgebungen, die bereits stark auf Spark oder Lakehouse-Technologien ausgerichtet sind, kann es sinnvoll sein, Transformationen bewusst dort zu bündeln, statt zusätzliche spezialisierte Tools einzuführen. Die Abgrenzung von DLT ist in diesem Sinne weniger als Einschränkung zu verstehen, sondern als Einladung zu einer bewussten architektonischen Entscheidung. ## Vorteile und Grenzen von dbt Die größte Stärke von dbt liegt in der klaren Strukturierung von Transformationen und Business-Logik. Durch Versionierung, Tests und Dokumentation wird Datenmodellierung zu einem echten Software-Engineering-Prozess. Dies erhöht Transparenz, Qualität und Vertrauen in die Daten. Gleichzeitig ist dbt vollständig auf vorgelagerte Ingestion angewiesen. Ohne saubere, stabile Rohdaten kann dbt seine Stärken nicht ausspielen. Zudem kann sehr komplexe Logik in SQL schnell unübersichtlich werden, insbesondere wenn prozedurale Verarbeitung notwendig wäre. ## Zusammenspiel in der Praxis In modernen Datenplattformen kann der kombinierte Einsatz von DLT und dbt eine mögliche Architekturvariante darstellen. In einer solchen Konstellation wird DLT häufig für den Aufbau und Betrieb der Ladeprozesse genutzt und stellt die extrahierten Daten in einer Raw- oder Bronze-Schicht bereit. dbt kann darauf aufbauend eingesetzt werden, um diese Daten weiterzuverarbeiten und schrittweise in fachlich strukturierte und analytisch nutzbare Datenmodelle zu überführen. Diese Aufteilung orientiert sich an einer Trennung zwischen technischer Dateningestion und fachlicher Transformation, ohne jedoch als allgemeingültige Referenzarchitektur verstanden werden zu müssen. Ob ein solches Vorgehen sinnvoll ist, hängt stark ab - von organisatorischen Rahmenbedingungen, - Teamzuschnitten - und der Komplexität der Datenquellen. In Umgebungen, in denen technische Stabilität und fachliche Weiterentwicklung voneinander entkoppelt werden sollen, kann dieser Ansatz Vorteile bieten. Änderungen an Datenquellen lassen sich dabei tendenziell auf die DLT-Pipelines begrenzen. Fachliche Anpassungen dagegen können unabhängig davon in dbt-Modellen umgesetzt werden. Gleichzeitig sollte berücksichtigt werden, dass der Betrieb einer solchen Kombination von Tools sorgfältige Pflege, Beherrschung und Wartung erfordert. Beide Frameworks müssen von den Teams verstanden und regelmäßig überwacht werden, um eine zuverlässige Datenbereitstellung zu gewährleisten. Dies umfasst nicht nur die technische Umsetzung, sondern auch die kontinuierliche Anpassung an sich ändernde Datenquellen, Versionsupdates, Monitoring, Alerting und Teststrategien. Auch organisatorische Aspekte wie klare Verantwortlichkeiten, Schulung und Dokumentation spielen hier eine wichtige Rolle. Kurz gesagt: Die Kombination aus DLT und dbt kann eine leistungsfähige Datenarchitektur unterstützen, sie setzt aber voraus, dass die jeweiligen Werkzeuge konsequent betrieben und weiterentwickelt werden. Ohne eine solche Pflege kann auch eine technisch solide Architektur schnell an ihre Grenzen stoßen. ## Fazit DLT und dbt adressieren unterschiedliche Aspekte der Datenverarbeitung und sollten daher nicht primär als konkurrierende Werkzeuge verstanden werden. Der Schwerpunkt dieses Vergleichs liegt jedoch klar auf der Rolle von DLT als Fundament moderner Datenplattformen. Durch den Fokus auf robuste, wartbare und weitgehend automatisierte Dateningestion eignet sich DLT insbesondere für den Aufbau stabiler Datenpipelines. Vor allem in Umgebungen, in denen Daten aus vielen, sich verändernden Quellen integriert werden müssen. Gleichzeitig ist DLT nicht die einzige Option für diesen Teil des Datenstacks. Abhängig von Anforderungen an Skalierung, Performance und Komplexität können auch Frameworks wie Apache Spark oder Spark-basierte Lakehouse-Ansätze eine sinnvolle Alternative darstellen. Insbesondere wenn umfangreiche Transformationen, Streaming-Szenarien oder sehr große Datenvolumina bereits früh im Verarbeitungsprozess notwendig sind. Welche Architektur letztlich geeignet ist, hängt dabei nicht nur von technischen Kriterien ab, sondern maßgeblich vom organisatorischen Umfeld. Die vorhandenen Kompetenzen im Team spielen eine zentrale Rolle: In Organisationen mit starker SQL- und Analytics-Ausrichtung können warehouse-zentrierte Ansätze naheliegen. Hingegen profitieren Python- oder Data-Engineering-lastige Teams häufig von ingestion-zentrierten oder Spark-basierten Lösungen. Ebenso macht es einen Unterschied, ob eine Datenplattform auf der „grünen Wiese“ neu aufgebaut wird oder ob bestehende Strukturen, Prozesse und Tools berücksichtigt werden müssen. Eine nachhaltige Datenarchitektur entsteht daher weniger durch die Wahl eines bestimmten Tools als durch eine bewusste Abwägung von Anforderungen, Teamfähigkeiten und Ausgangslage. DLT kann in diesem Kontext eine tragende Rolle einnehmen. Zum einen als eigenständiges Ingestion-Framework zum anderen als Bestandteil eines umfassenderen, individuell zugeschnittenen Datenökosystems. ## Mehr aus dieser Blogserie **Teil 1:** [Medaillon-Architektur, Delta Live Tables und dbt in der Praxis](https://thecattlecrew.net/2026/01/15/databricks-verstehen-teil-1-medaillon-architektur-delta-live-tables-und-dbt-in-der-praxis/) **Teil 2:** [Was ist Databricks? Was bietet mir das Tool?](https://thecattlecrew.net/2026/02/06/databricks-verstehen-teil-2-was-ist-databricks-was-bietet-mir-das-tool/) **Teil 3:** [Was ist DBT und warum ist es für moderne Datenpipelines so wichtig?](https://thecattlecrew.net/?p=40947&preview=true) **Teil 4:** [Gegenüberstellung der Ansätze und Fazit](https://thecattlecrew.net/2026/03/12/databricks-verstehen-teil-4-fazit/) Viel Spaß beim Lesen! **Kategorien:** Analytics & Insights, Architecture & Process Models --- ### [Databricks verstehen – Teil 3: Was ist DBT und warum ist es für moderne Datenpipelines so wichtig?](https://thecattlecrew.net/2026/03/05/databricks-verstehen-teil-3-was-ist-dbt-und-warum-ist-es-fuer-moderne-datenpipelines-so-wichtig/) **Published:** März 5, 2026 **Author:** Maximilian Wilhelmi **Content:** ## Was ist dbt und was bietet mir das Tool? Data Build Tool (dbt), ist ein Open-Source-Framework, das entwickelt wurde, um den Prozess der Datenmodellierung, -transformation und -pflege in modernen Data Warehouses zu vereinfachen und zu optimieren. Es basiert auf SQL und ermöglicht es Datenanalysten und Data Engineers, einfache bis komplexere Datenpipelines zu gestalten. Das Hauptziel von dbt ist es, die Kluft zwischen Datenanalyse und Datenentwicklung zu überbrücken, indem es eine strukturierte Umgebung schafft, in der Transformationen nachvollziehbar dokumentiert, getestet und wiederverwendet werden können. ## Hier einige zentrale Vorteile: **Automatisierte Daten-Transformationen:** Mit dbt kannst du deine Datenmodelle in SQL definieren, die dann automatisiert ausgeführt werden. Das reduziert manuelle Eingaben, minimiert Fehler und sorgt für konsistente Ergebnisse. **Transparenz und Nachvollziehbarkeit:** Alle Transformationen werden dokumentiert, was eine klare Übersicht über den Datenfluss ermöglicht. Dadurch kannst du jederzeit nachvollziehen, wie Daten entstehen und sich entwickeln. **Qualitätssicherung durch Tests:** dbt unterstützt die Implementierung von Tests, um die Integrität und Korrektheit deiner Daten sicherzustellen. Fehler werden frühzeitig erkannt, was die Zuverlässigkeit deiner Analysen erhöht. **Modularität und Wiederverwendbarkeit:** Datenmodelle können in Komponenten aufgebaut werden, die leicht wiederverwendet und angepasst werden können. Das erleichtert die Pflege und Weiterentwicklung deiner Datenpipelines erheblich. **Integration in moderne Data-Stacks:** dbt lässt sich nahtlos in gängige Data-Warehouse-Lösungen wie Snowflake, Databricks, BigQuery, Redshift und andere integrieren, was eine flexible Nutzung in verschiedenen Umgebungen ermöglicht. ## Aktive Community und kontinuierliche Weiterentwicklung Als Open-Source-Projekt profitiert dbt von einer lebendigen Community, die regelmäßig neue Funktionen, Best Practices und Support bereitstellt. Aber auch eine kostenpflichtige Cloud Version ist verfügbar und nicht nur ein Tool zur Datenmodellierung, sondern eine umfassende SaaS-Plattform, die den gesamten Datenentwicklungsprozess in der Cloud vereinfacht, beschleunigt und absichert. Für Unternehmen, die auf Skalierbarkeit, Zusammenarbeit und Automatisierung setzen, kann die kostenpflichtige Version eine wertvolle Investition. **Kurz gesagt:** dbt ist ein Tool für moderne Datenprojekte, das dir helfen kann, saubere, nachvollziehbare und wartbare Datenpipelines zu erstellen. Es fördert eine Kultur der Transparenz und Qualität in der Datenentwicklung und trägt dazu bei, datengetriebene Entscheidungen effizienter zu treffen. ## Einrichtung der Verbindung zwischen dbt und Databricks Für unser Projekt haben wir eine Verbindung zwischen dbt und Databricks eingerichtet. Die Entwicklung und Strukturierung der Datenmodelle erfolgt dabei in dbt, während Databricks als skalierbare Ausführungsumgebung für die Transformationen dient. Technisch wird die Integration über den dbt-databricks-Adapter realisiert. Dieser ermöglicht es dbt, SQL-Modelle in Databricks auszuführen und dort Tabellen oder Views im jeweiligen Lakehouse zu materialisieren. Für die Authentifizierung haben wir in Databricks einen Personal Access Token erstellt. Dieser Token dient ausschließlich zur Authentifizierung und ermöglicht es dbt, sich gegenüber Databricks zu legitimieren und eine Verbindung aufzubauen. Alternativ stehen weitere Authentifizierungsmethoden zur Verfügung, beispielsweise: - Azure Active Directory (Azure AD) Authentifizierung - Service Principal mit OAuth 2.0 - JDBC/ODBC-Verbindungen mit entsprechenden Zugangsdaten Welche Methode geeignet ist, hängt von der jeweiligen Infrastruktur, den Sicherheitsanforderungen und organisatorischen Vorgaben ab. Auf eine detaillierte Gegenüberstellung verzichten wir an dieser Stelle und konzentrieren uns im Folgenden auf die tokenbasierte Authentifizierung in unserem Beispiel. ## Vorbereitungen für dbt Als erstes haben wir den dbt-Adapter für Databricks installiert. Dieser installiert auch gleichzeitig das Grundpaket von dbt mit, sollte dies noch nicht vorhanden sein. Als nächsten Schritt haben wir die Verbindungen aus Databricks in unsere profiles.yml eingetragen: *![Profiles](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/Profiles.png)Abbildung 1: Profiles* Zur Überprüfung der eingerichteten Verbindung kann im Terminal der Befehl `dbt debug` ausgeführt werden. Dieser prüft, ob die Konfiguration korrekt ist und ob sich dbt erfolgreich mit Databricks verbinden kann. Nach erfolgreicher Validierung konnten wir mit der Entwicklung und Ausführung unserer Datenmodelle beginnen. ## Unser Projekt und die Umsetzung #### Allgemeiner Überblick In unserem Projekt setzen wir auf eine automatisierte Datenpipeline, die vom Rohdatenimport im Bronze Layer bis zur finalen Verarbeitung im Gold Layer reicht. Hierbei versuchen wir auf die einzelnen Funktionen und Grenzen von dbt einzugehen. Auch nicht benutze Funktionen innerhalb der Demonstration haben wir uns angeschaut und werden dies im Blog beschreiben. Für unser Projekt lassen wir 5 verschieden CSV-Dateien laden und verarbeiten diese in den bekannten Layer Bronze, Silver und Gold. Anschließend schauen wir uns das Einbinden in Databricks-Workflows an, da diese Funktion in dbt nicht zur Verfügung steht. *![Metallion](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/Metallion.png)Abbildung 2: Metallion – Architektur* Wir starten mit dem Bronze Layer und möchten die Dateien so weit wie möglich automatisiert in den Bronze Layer 1:1 importieren. In dbt lässt sich die effektive Funktion Auto-Loader nicht nutzen, weshalb wir auf die Funktion „COPY INTO“ zurückgreifen mussten. Diese kopiert die Daten aus einem Verzeichnis oder auch von einem Volumen direkt in eine Delta-Tabelle und übergeht bereits geladene Dateien. Hierfür legen wir die zu verarbeitenden CSV-Dateien in unser Volumen, von dem wir die Daten anschließend laden können. Da dbt den Befehl „COPY INTO“ in SQL nicht direkt unterstützt, müssen wir uns stattdessen mit einem Makro behelfen. Dieses sorgt im ersten Schritt für die Erstellung der Tabelle, bevor der Befehl „COPY INTO“ ausgeführt wird. *![Macro](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/Macro.png)Abbildung 3: Macro* Für die Schicht laden wir die Daten dann nicht direkt aus dem Code, der für den Bronze-Layer vorgesehen ist, sondern nutzen den Vorgang als Teil der Beladung im Vorfeld des Silver-Layer, der als PreHook gestartet wird. Der Aufruf dazu sieht folgendermaßen aus: *![BeladungBronzeundSilverLayer](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/BeladungBronzeundSilverLayer.png)Abbildung 4: Beladung Bronze* In der ersten Zeile „materialized“ wird angegeben, dass die Tabelle im Silver-Layer als Tabelle angelegt werden soll. Die zweite Zeile erstellt die Tabelle im Bronze-Layer und importiert mit der dritten Zeile die Daten in die Tabelle. Die Spalten beim Erstellen der Tabelle mussten wir nicht angeben und wurden bei der ersten Beladung automatisch gesetzt. Im Silver-Layer erfolgt die weitere Verarbeitung: Hier werden die Daten formatiert, die Datentypen angepasst und die Tabellenstrukturen festgelegt (s. Bild-Beispiel Bestellungen). *![SilverLayer](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/SilverLayer.png)Abbildung 5: Beispiel Bestellung* Für jede Tabelle im Bronze- und Silver-Layer erstellen wir in dbt eine eigene SQL-Datei, die die Transformationslogik in Form eines SELECT-Statements definiert. Ergänzend dazu pflegen wir eine YAML-Datei, in der Metadaten wie Spaltenbeschreibungen, Tests (z. B. `not_null` oder `unique`) sowie zusätzliche Modellkonfigurationen hinterlegt sind. Während die SQL-Datei die eigentliche Datenverarbeitung steuert, dient die YAML-Datei der Dokumentation, Qualitätssicherung und strukturierten Verwaltung der Modelle. Eine automatische Generierung von SQL-Statements erfolgt dabei nicht – vielmehr ergänzt die YAML-Konfiguration die fachliche Logik aus der SQL-Datei. Während der Erstellung ist uns aufgefallen, dass strukturelle Änderungen an einer bereits materialisierten Tabelle nicht immer automatisch übernommen werden. Insbesondere bei grundlegenden Anpassungen – etwa an bestehenden Spalten – ist häufig ein erneuter vollständiger Aufbau erforderlich. Dies kann über den Befehl `dbt run --full-refresh` erfolgen, der die betroffene Tabelle löscht und vollständig neu erstellt. Für unseren Anwendungsfall ist das unproblematisch, da wir im Rahmen unseres Beispiels ausschließlich eine Vollbeladung durchführen. Kleinere Schemaänderungen – wie das Hinzufügen neuer Spalten – lassen sich je nach Materialisierung und Konfiguration (z. B. bei inkrementellen Modellen über `on_schema_change`) teilweise auch ohne vollständigen Neuaufbau umsetzen. Dennoch sind strukturelle Anpassungen insbesondere bei inkrementellen oder historisierten Tabellen mit zusätzlichem Aufwand verbunden. Bei einer inkrementellen Lösung oder einer historisierten Variante müssten bestehende Daten gegebenenfalls gesichert oder Migrationsstrategien eingeplant werden, um Datenverluste zu vermeiden. Anschließend setzen wir unsere Arbeit im Gold-Layer fort und beginnen als erstes die Tabellen für Kunde und Bestellungen in eine historisierte Dimensionstabelle nach SCD 2 zu erstellen. Hierzu nutzen wir die Funktion Snapshot von dbt, um dies automatisiert erstellen zu lassen. Mit wenig Aufwand ist hier sichergestellt, dass bei einer Änderung der Daten der alte Satz geschlossen wird und ein neuer Satz mit „Gültig von“ und „Gültig bis“ erstellt wird. *![Gold Layer](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/GoldLayer.png)Abbildung 6: Gold Layer* Nachfolgend haben wir die weiteren Dimensionstabellen mithilfe von klassischen Modellen mit SQL- und YAML-Dateien erstellt. Abschließend wurde dann die Faktentabelle generiert, in die wir die jeweiligen IDs der Dimensionen integriert haben. Damit war unser Star-Schema-Modell erfolgreich fertiggestellt. *![Star Modell](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/StarModell.png)Abbildung 7: Star Modell* Für einen vollständigen Datenladeprozess reicht es jedoch nicht aus, nur den Befehl „dbt run“ auszuführen, da dieser lediglich die Modelle verarbeitet, aber keine Snapshots erstellt. Stattdessen empfiehlt sich die Verwendung von „dbt build“, da dieser Befehl automatisch erkennt, welche Komponenten als nächstes verarbeitet werden müssen und sowohl Modelle als auch Snapshots in der richtigen Reihenfolge berücksichtigt. Ein weiterer wichtiger Aspekt betrifft die Verwaltung der Abhängigkeiten bei der Datenbeladung sowie die Möglichkeit, die Data Lineage transparent darzustellen. Hierbei ist es essenziell, dass die Aufrufe der zu ladenden Tabellen nicht direkt über die Tabellen selbst erfolgen, sondern ausschließlich über Referenzierung und Quellen. Das bedeutet, dass die Entwickler vor Beginn der Entwicklung sorgfältig planen sollten, wie die Referenzen und Abhängigkeiten gestaltet werden, um eine klare, nachvollziehbare und wartbare Datenpipeline zu gewährleisten. Während der Entwicklung haben wir festgestellt, dass die Data Lineage in unserem aktuellen Tool nur die Modelle (Tabellen) in der Datenkette visualisiert. Es wird jedoch nicht angezeigt, welche Quellspalte in welche Zielspalte geladen wird. *![Data Lineage](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/DataLineage.png)Abbildung 8: Data Lineage in dbt* Im Gegensatz dazu bietet Databricks eine umfassendere Übersicht der Data Lineage bis auf die Spaltenebene. Zusätzlich werden die Quellen der CSV-Dateien angezeigt, was eine detailliertere und genauere Nachverfolgung der Daten ermöglicht. *![Data Lineage mit Data Bricks](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/DataLineagemitDataBricks.png)Abbildung 9: Data Lineage in Databricks* ## Ausführung und Workflows Die Integration von dbt in einen Databricks-Workflow ist ein bewährter Ansatz, um analytische Transformationen reproduzierbar, versioniert und automatisiert auszuführen. Besonders leistungsfähig wird dieses Setup, wenn der gesamte Workflow direkt aus einem Git-Repository gestartet wird und Ausführungsdetails wie Logs und Status transparent sichtbar sind. Im Kern basiert der Ansatz darauf, dass das dbt-Projekt vollständig in einem Git-Repository (z. B. auf GitHub oder GitLab) liegt. Dieses Repository enthält neben den dbt-Modellen auch Konfigurationsdateien wie profiles.yml (oder entsprechende Umgebungsvariablen), Tests und Dokumentation. Databricks selbst wird mit dem Repository verbunden, sodass der Code direkt im Workspace verfügbar ist oder bei jeder Ausführung frisch ausgecheckt wird. Damit ist sichergestellt, dass jeder Lauf exakt auf einem definierten Commit basiert – ein zentraler Punkt für Nachvollziehbarkeit und Governance. Die eigentliche Ausführung erfolgt über einen Databricks-Job, der als Workflow definiert ist. In diesem Job wird ein Task angelegt, der auf einem Job-Cluster läuft. Das Cluster wird meist schlank konfiguriert und nur für die Dauer der dbt-Ausführung gestartet, was Kosten spart und eine saubere Trennung von Entwicklung und Produktion ermöglicht. Innerhalb des Tasks wird dbt entweder über ein init script installiert oder – noch robuster – über ein vorbereitetes Docker-Image bzw. eine Wheel-/Library-Installation bereitgestellt. Die Verbindung zu Databricks SQL-Warehouses oder Clustern erfolgt dabei über das dbt-databricks-Adapterprofil. *![workflow](https://thecattlecrew.loom.de/wp-content/uploads/2026/04/Workflow-1024x511.png)Abbildung 10: Workflow* Der Startpunkt des Workflows ist bewusst das Git-Repository: Der Job referenziert einen bestimmten Branch oder Tag (z. B. main oder ein Release-Tag). Änderungen an dbt-Modellen werden somit automatisch Teil des nächsten Laufs, ohne dass manuell Code in Databricks kopiert werden muss. Für CI/CD-Szenarien lässt sich dieser Job zusätzlich über externe Trigger (z. B. Merge in den Main-Branch) anstoßen. Ein entscheidender Aspekt für den produktiven Einsatz ist die Sichtbarkeit der Ausführung. Databricks bietet hier mehrere Ebenen von Transparenz. Auf Job-Ebene sind Status, Laufzeit, verwendetes Cluster und Exit-Code sofort ersichtlich. Innerhalb des Tasks werden die Standardausgaben von dbt – also dbt run, dbt test oder dbt build – vollständig in den Driver-Logs angezeigt. Diese Logs enthalten Informationen zu gestarteten Modellen, Ausführungszeiten, Warnungen und Fehlern und sind direkt im Databricks-UI abrufbar. Zusätzlich lassen sich dbt-Logs gezielt strukturieren. Durch die Nutzung von JSON-Logs oder durch das Persistieren der target/run\_results.json und manifest.json in einem Storage (z. B. DBFS oder Cloud Object Storage) können Ausführungsergebnisse weiterverarbeitet oder visualisiert werden. In Kombination mit Databricks-Notebooks oder Dashboards entsteht so ein Reporting über dbt-Runs, Fehlerraten oder Modelllaufzeiten. Für erweiterte Transparenz können einzelne dbt-Kommandos als separate Tasks modelliert werden, etwa ein Task für „dbt deps“, einer für „dbt run“ und ein weiterer für „dbt test“. Dadurch wird im Workflow auf einen Blick sichtbar, in welchem Schritt ein Lauf fehlschlägt. Auch Parameter wie Zielumgebung (dev, prod) oder dbt-Selektoren lassen sich als Job-Parameter definieren und beim Start variabel setzen. Insgesamt entsteht durch die Kombination aus Git-Repository, dbt und Databricks-Workflows eine saubere, nachvollziehbare und skalierbare Architektur. Transformationen sind versioniert, automatisiert ausführbar und durch Logs sowie Job-Metadaten jederzeit transparent. Genau diese Eigenschaften machen den Ansatz besonders attraktiv für moderne Analytics- und Lakehouse-Architekturen auf Basis von Databricks und dbt Labs. ## Weiter dbt-Funktionen Im Rahmen der Entwicklung des Projekts habe wir uns noch weiteren Optionen von dbt angeschaut. Hierzu zählen: ## Tests in dbt Tests in dbt sind automatisierte Prüfungen, die sicherstellen, dass die Daten den erwarteten Qualitätsstandards entsprechen. Sie helfen dabei, Fehler frühzeitig zu erkennen und die Integrität der Daten zu gewährleisten. Hierbei bietet dbt zwei Arten von Tests an: Schema-Tests: Diese prüfen grundlegende Eigenschaften der Daten, z.B. ob eine Spalte nicht null ist (not\_null), ob Werte innerhalb eines bestimmten Bereichs liegen (accepted\_values) oder ob eine Spalte eindeutig ist (unique). Benutzerdefinierte Tests: Für spezielle Anforderungen können eigene SQL-Tests geschrieben werden, um komplexe Validierungen durchzuführen wie zum Beispiel Regressionstest. Tests werden in dbt meist in YAML-Dateien definiert, die den jeweiligen Modellen oder Spalten zugeordnet sind. Bei der Ausführung von „dbt test“ werden alle definierten Tests automatisch ausgeführt. Falls ein Test fehlschlägt, erhält das Team eine Fehlermeldung, sodass Probleme schnell behoben werden können. ## Dokumentation in dbt Die Dokumentation in dbt umfasst die Beschreibung der Modelle, Spalten, Quellen und Transformationen innerhalb des Data-Warehouse. Sie schafft Transparenz und erleichtert das Verständnis der Datenstrukturen für alle Beteiligten. dbt ermöglicht es, Dokumentationen direkt in den Modell- und Spaltendefinitionen zu hinterlegen. Diese werden in YAML-Dateien gepflegt und können mit Beschreibungen, Metadaten und Beispielen versehen werden. Zudem können zusätzliche Markdown-Dokumente eingebunden werden. Mit dem Befehl „dbt docs generate“ wird eine interaktive HTML-Dokumentation erstellt, die alle Modelle, Spalten und deren Beschreibungen übersichtlich darstellt. Diese Dokumentation kann anschließend im Browser eingesehen werden und ist stets aktuell, wenn die Modelle neu gebaut werden. ## Seeds in dbt Seeds sind statische Datensätze, die in Form von CSV-Dateien im Projekt gespeichert werden. Sie dienen dazu, kleine, unveränderliche Datenmengen in das Data-Warehouse zu laden, z.B. Lookup-Tabellen, Konfigurationsdaten oder Referenzinformationen. Seeds ermöglichen es, wichtige Referenzdaten versioniert im Projekt zu verwalten. Sie können mit „dbt seed“ in das Ziel-Data-Warehouse geladen werden. Da Seeds in CSV-Format vorliegen, sind sie leicht zu erstellen, zu bearbeiten und zu pflegen. ## Fazit dbt ermöglicht eine strukturierte, transparente und automatisierte Entwicklung von Datenpipelines. In Kombination mit Databricks lassen sich Transformationen effizient ausführen, Datenqualität sichern und Workflows nachvollziehbar orchestrieren. Unser Beispiel zeigt, wie dbt Teams bei modernen Analytics-Projekten unterstützt, zuverlässige Daten aufzubereiten und datengetriebene Entscheidungen zu erleichtern. ## Mehr aus dieser Blogserie **Teil 1:** [Medaillon-Architektur, Delta Live Tables und dbt in der Praxis](https://thecattlecrew.net/2026/01/15/databricks-verstehen-teil-1-medaillon-architektur-delta-live-tables-und-dbt-in-der-praxis/) **Teil 2:** [Was ist Databricks? Was bietet mir das Tool?](https://thecattlecrew.net/2026/02/06/databricks-verstehen-teil-2-was-ist-databricks-was-bietet-mir-das-tool/) **Teil 3:** [Was ist DBT und warum ist es für moderne Datenpipelines so wichtig?](https://thecattlecrew.net/?p=40947&preview=true) **Teil 4:** [Gegenüberstellung der Ansätze und Fazit](https://thecattlecrew.net/2026/03/12/databricks-verstehen-teil-4-fazit/) Viel Spaß beim Lesen! **Kategorien:** Analytics & Insights, Architecture & Process Models --- ### [Databricks verstehen – Teil 2: Was ist Databricks? Was bietet mir das Tool?](https://thecattlecrew.net/2026/02/06/databricks-verstehen-teil-2-was-ist-databricks-was-bietet-mir-das-tool/) **Published:** Februar 6, 2026 **Author:** Thomas Eichler **Content:** Databricks ist eine cloudbasierte Datenanalyse- und KI-Plattform, die auf Apache Spark basiert und die Zusammenarbeit zwischen Data-Scientists, Data-Engineers und Analysten erleichtert. Die Plattform vereint Big-Data-Verarbeitung, Machine Learning, Data Warehousing und Business Intelligence in einer zentralen Umgebung. Sie wird als sogenannte Lakehouse-Plattform bezeichnet, da sie die Vorteile von Data Lakes (Flexibilität, niedrige Speicherkosten) und Data Warehouses (hohe Performance, strukturierte Abfragen) kombiniert. ## Was bietet dir Databricks konkret? Die Plattform dient als zentraler Ort für unterschiedliche Data-Workloads, darunter Datenimport, -verarbeitung und -analyse. Sie integriert sich mit den gängigen Cloud-Anbietern AWS, Azure und Google Cloud und unterstützt verschiedene Programmiersprachen wie Python, SQL, Scala und R. Collaborative Notebooks ermöglichen eine cloudbasierte Zusammenarbeit ähnlich wie Jupyter Notebooks, inklusive Versionierung und Kommentaren. Im Bereich Machine Learning bietet Databricks einen vollständigen End-to-End-Prozess für Datenaufbereitung, Modellierung und Deployment und integriert dabei das Open-Source-Framework MLflow. Ein weiteres zentrales Element ist Delta Lake, das ACID-Transaktionen im Data Lake ermöglicht und Funktionen wie inkrementelle Verarbeitung, Time-Travel und konsistente Abfragen unterstützt. Databricks stellt außerdem Funktionen zur Orchestrierung von Data-Engineering-Pipelines bereit, inklusive Jobs und Workflows, die sowohl Batch- als auch Streaming-Szenarien abdecken. Für Analysten gibt es ein benutzerfreundliches SQL-Interface, das sich auch mit BI-Tools wie Pyramid-Analytics, Power BI und Tableau verbinden lässt. Dank Spark bietet Databricks eine hohe Skalierbarkeit bis hin zu Petabyte-Datenmengen sowie automatische Skalierungsfunktionen. ## Für wen ist Databricks besonders geeignet? Databricks eignet sich für Data-Scientists, die Modelle entwickeln, für Data-Engineers, die komplexe Pipelines aufbauen, sowie für Analysts, die Daten abfragen und visualisieren. Unternehmen profitieren dabei von einer modernen, skalierbaren Datenplattform, die unterschiedlichste analytische Anforderungen in einer Umgebung vereint. ## Was ist Delta Live Tables (DLT)? Delta Live Tables ist eine deklarative Schicht über Apache Spark und Delta Lake, mit der Datenpipelines deutlich einfacher erstellt und verwaltet werden können. Datenregeln, Fehlerbehandlung, Optimierung und Abhängigkeiten werden dabei automatisch verarbeitet. Ziel ist eine robuste, wartbare und gleichzeitig leicht implementierbare Pipeline-Entwicklung. DLT bietet deklarative Pipeline-Definitionen in SQL oder Python, automatisches Abhängigkeitsmanagement, integrierte Datenqualitätsregeln sowie inkrementelle Verarbeitung. Durch Monitoring- und Auto-Healing-Mechanismen werden Pipelines zuverlässig überwacht und visualisiert. Batch- und Streaming-Verarbeitung werden innerhalb eines einheitlichen Modells unterstützt. Typische Anwendungsfälle sind der Aufbau von Data-Warehouse-Strukturen, Datenbereinigung, Bronze-/Silver-/Gold-Layer-Transformationen sowie zeitgesteuerte oder kontinuierliche Verarbeitung. ## Einrichtung Databricks Die Einrichtung hängt davon ab, ob Databricks über die Community Edition, Azure oder andere Cloud-Anbieter genutzt wird. 1. Databricks Community Edition Die Community Edition eignet sich gut zum Lernen. Nach der Registrierung auf der Databricks-Website kann man direkt ein Notebook erstellen und mit Spark arbeiten. 2. Databricks auf Azure Hierzu sind ein Azure-Konto sowie entsprechende Berechtigungen notwendig. Im Azure-Portal wird eine Databricks-Ressource erstellt und anschließend ein Workspace gestartet. Danach können Cluster erstellt und Notebooks verbunden werden. Anschließend lassen sich Daten laden, transformieren, Machine-Learning-Modelle trainieren oder Dashboards erstellen. ## Unser Projekt und die Umsetzung ## Allgemeiner Überblick Im Projekt wurde eine automatisierte Datenpipeline aufgebaut, die Rohdaten im Bronze-Layer importiert, im Silver-Layer weiterverarbeitet und im Gold-Layer final modelliert. Insgesamt wurden fünf CSV-Dateien geladen und in den bekannten Layern Bronze, Silver und Gold verarbeitet. Anschließend wurde zusätzlich die Einbindung in Databricks Workflows untersucht. Der gesamte DLT-Code basiert auf PySpark (Raw-Layer) sowie SQL (Silver- und Gold-Layer). Ziel war ein möglichst generischer 1:1-Import der Dateien im Bronze-Layer. ## Bronze-Layer Für das Laden der Daten kommt der Auto-Loader zum Einsatz, der kontinuierlich im Storage nach neuen Dateien sucht und Streaming-Tabellen befüllt. Die Dateien werden in einem Volume abgelegt, aus dem der Auto-Loader die Daten liest. ![Autoloader](https://thecattlecrew.net/wp-content/uploads/2026/02/Bildschirmfoto-2026-02-05-um-08.47.45-1024x361.png)*Abbildung 1: Auto-Loader-Konfig* Mithilfe von DLT werden anschließend generische RAW-Streaming-Tabellen erzeugt, wobei Tabellen- und Spaltennamen direkt aus den CSV-Dateien übernommen werden. ![DLT Input Tabelle](https://thecattlecrew.net/wp-content/uploads/2026/02/DLT.png)*Abbildung 2: DLT* ## Silver-Layer Im Silver-Layer erfolgt die weitere Verarbeitung, Formatierung und Strukturierung der Daten sowie die Anpassung der Datentypen. Für jede Tabelle wird ein eigener Codeblock definiert, der Spalten, Datentypen, Kommentare und Bedingungen enthält. Zusätzlich wird ein Constraint auf die Spalte BestellungID definiert, um Zeilen mit NULL-Werten zu entfernen. Auch in diesem Layer entstehen Streaming-Tabellen. ## ![Create or Refresh](https://thecattlecrew.net/wp-content/uploads/2026/02/silver_layer.png) ## Beispiele für möglichen Constraints: ## ![Create Live Tables](https://thecattlecrew.net/wp-content/uploads/2026/02/violation_rules.png)Gold-Layer Im Gold-Layer werden Dimensionstabellen nach SCD2-Logik erstellt. DLT stellt hierfür integrierte Funktionen bereit, die automatisch Versionierung, Zeiträume sowie das Schließen alter Datensätze übernehmen. ![Gold Dim](https://thecattlecrew.net/wp-content/uploads/2026/02/gold_dim.png)*Abbildung 3: Dimension* ![Gold Dim Bestellung](https://thecattlecrew.net/wp-content/uploads/2026/02/SCD2.png)*Abbildung 4: SCD2* Anschließend wird die Faktentabelle generiert, in die die jeweiligen IDs der Dimensionen integriert werden. Damit ist das Star-Schema vollständig aufgebaut. ![Gold Fkt](https://thecattlecrew.net/wp-content/uploads/2026/02/gold_fkt.png)*Abbildung 5: Fakten* ![Star Model](https://thecattlecrew.net/wp-content/uploads/2026/02/star_model_blog-1012x1024.png)*Abbildung 6: Star-Modell* ## Ausführung und Workflows Um DLT nutzen zu können, wird eine Pipeline erstellt. In ihr werden MatViews definiert, einschließlich Cluster und zugehöriger Notebooks. DLT erkennt dabei automatisch die korrekte Ausführungsreihenfolge. Im Beispiel sind Raw-Layer vom Silver- und Gold-Layer getrennt. Eine Aufsplittung von Silver- und Gold-Layer wäre selbstverständlich ebenfalls möglich. ![Pipeline](https://thecattlecrew.net/wp-content/uploads/2026/02/Pipeline-1024x779.png)*Abbildung 7: Pipeline* ![Modell](https://thecattlecrew.net/wp-content/uploads/2026/02/Modell-1024x797.png) *Abbildung 8: Modell* Databricks Workflows basieren auf Jobs und ermöglichen komplexe Abhängigkeiten. Ein Workflow besteht aus mehreren Tasks. Unser Prozess wird über einen Job ausgelöst, der die Pipeline ausführt. ![Job](https://thecattlecrew.net/wp-content/uploads/2026/02/Job.png)*Abbildung 9: Job* Jede Ausführung beinhaltet Logs, Metriken, Status sowie Artefakte wie erzeugte Tabellen oder Dateien. Ein weiterer wichtiger Aspekt ist die Darstellung der Data Lineage, die in Databricks bis auf Spaltenebene erfolgt. ![Lineage](https://thecattlecrew.net/wp-content/uploads/2026/02/Lineage-1024x684.png)*Abbildung 10: Lineage overview* Diese geht bis auf Spaltenebene runter. ![Lineage Detail](https://thecattlecrew.net/wp-content/uploads/2026/02/Lineage_Spalten.png)Abbildung 11: Lineage detail ## Feeling Databricks DLT Die Arbeit im Projekt zeigt, dass SQL allein für komplexere File-Verarbeitung nicht ausreicht und Python in Kombination mit SQL die beste Herangehensweise darstellt. Der RAW-Layer lässt sich mithilfe von KI-Tools sehr schnell entwickeln, während ab dem Conformed-Layer solide Python-Kenntnisse erforderlich sind. SQL-Abfragen dauern meist nur wenige Sekunden, allerdings benötigen auch Cluster-Initialisierungen eine gewisse Zeit. Die Notebook-Umgebung ist angenehm, jedoch wird komplexere Logik schnell unübersichtlich, weshalb eine sehr strukturierte Arbeitsweise notwendig ist. Gleiches gilt insbesondere für den Gold-Layer.“ ## Mehr aus dieser Blogserie **Teil 1:** [Medaillon-Architektur, Delta Live Tables und dbt in der Praxis](https://thecattlecrew.net/2026/01/15/databricks-verstehen-teil-1-medaillon-architektur-delta-live-tables-und-dbt-in-der-praxis/) **Teil 2:** [Was ist Databricks? Was bietet mir das Tool?](https://thecattlecrew.net/2026/02/06/databricks-verstehen-teil-2-was-ist-databricks-was-bietet-mir-das-tool/) **Teil 3:** [Was ist DBT und warum ist es für moderne Datenpipelines so wichtig?](https://thecattlecrew.net/?p=40947&preview=true) **Teil 4:** [Gegenüberstellung der Ansätze und Fazit](https://thecattlecrew.net/2026/03/12/databricks-verstehen-teil-4-fazit/) Viel Spaß beim Lesen! **Kategorien:** Analytics & Insights, Architecture & Process Models --- ### [Databricks verstehen – Teil 1: Medaillon-Architektur, Delta Live Tables und dbt in der Praxis](https://thecattlecrew.net/2026/01/15/databricks-verstehen-teil-1-medaillon-architektur-delta-live-tables-und-dbt-in-der-praxis/) **Published:** Januar 15, 2026 **Author:** Thomas Eichler **Content:** Datenmengen wachsen in rasantem Tempo – Studien zufolge verdoppeln sie sich alle zwei Jahre. Klassische Architekturen geraten dabei schnell an ihre Grenzen. Immer mehr Informationen aus Transaktionssystemen, IoT-Geräten oder sozialen Medien müssen integriert, verarbeitet und für Analysen verfügbar gemacht werden. Für IT-Architekten stellt sich deshalb die zentrale Frage, wie sie eine Infrastruktur aufbauen können, die nicht nur heute funktioniert, sondern auch in Zukunft flexibel und skalierbar bleibt. Genau hier setzt Databricks an. Die Plattform vereint eine cloudbasierte Umgebung mit der Fähigkeit, große Datenmengen performant zu speichern, zu transformieren und für Analysen oder Machine-Learning-Szenarien bereitzustellen. Unternehmen erhalten damit die Möglichkeit, ihre Datenlandschaft kontinuierlich zu erweitern, ohne dass die Leistungsfähigkeit leidet. ## Stärken von Databricks Was Databricks besonders interessant macht, ist die Kombination aus Offenheit und Integration. Die Plattform baut auf offenen Standards auf und lässt sich durch eine Vielzahl von Open-Source-Tools erweitern. Das gibt Architekten die Freiheit, bestehende Technologien weiterzuverwenden und neue Lösungen nahtlos einzubinden. Gleichzeitig sorgt die modulare Architektur dafür, dass sich einzelne Komponenten flexibel austauschen oder ergänzen lassen. Die Vorteile lassen sich im Kern so zusammenfassen: - Databricks wächst flexibel mit den Anforderungen und bleibt dabei performant. - Daten unterschiedlichster Herkunft und Formate können integriert und verarbeitet werden. - Sowohl einfache Analysen als auch komplexe Machine-Learning-Szenarien finden in der Plattform einen geeigneten Rahmen. Für die Praxis bedeutet das, dass IT-Architekten nicht nur ein leistungsfähiges Werkzeug, sondern auch eine strategische Grundlage erhalten, um ihre Datenarchitektur langfristig zukunftsfähig zu gestalten. ## Delta Live Tables und dbt: Zwei Wege zur modernen Datenpipeline Ein zentrales Thema in jeder Datenplattform ist das Management von Pipelines – also die Frage, wie Rohdaten zuverlässig in eine für Analysen nutzbare Form gebracht werden. In Databricks existieren dafür unterschiedliche Ansätze. - **Delta Live Tables** ist ein nativer Service, der die Erstellung, Überwachung und Wartung von Pipelines weitgehend automatisiert. Fehlerhandling, Monitoring und Skalierung sind direkt integriert, was den Betrieb spürbar vereinfacht. Wie in diesem Blogbeitrag beschrieben, wird DLT durch die Weiterentwicklung zu Spark Declarative Pipelines (SDP) abgelöst. Auf SDP als Nachfolger von DLT gehen wir in einem eigenen Kapitel dieser Blogserie im Detail ein. - Mit **dbt (Data Build Tool)** steht ein ganz anderer Ansatz zur Verfügung. Hier werden Transformationen deklarativ beschrieben, meist mit starkem Fokus auf SQL. dbt hat sich vor allem im Umfeld von Analysten etabliert, wo mit vertrauten Werkzeugen gearbeitet werden soll und man gleichzeitig von einer großen Community profitieren möchte. Während Delta Live Tables die Plattformintegration in den Vordergrund stellt, bietet dbt eine Arbeitsweise, die sich gut in bestehende Teams und Prozesse einfügt. ## Die Medaillon-Architektur als Demo-Szenario Um die Unterschiede und Gemeinsamkeiten der beiden Frameworks greifbar zu machen, haben wir ein Beispiel-Szenario auf Basis der Medaillon-Architektur entwickelt. Diese Architektur unterteilt Daten in drei Schichten. 1. Im Bronze-Layer werden die Rohdaten möglichst unverändert importiert – etwa aus CSV-Dateien, die automatisiert erkannt und eingelesen werden. 2. Der Silver-Layer dient anschließend dazu, die Daten zu bereinigen, anzureichern und historisch konsistent zu speichern. So entsteht eine solide Grundlage für Analysen. 3. Im Gold-Layer schließlich werden Fakt- und Dimensionstabellen erstellt, die sich unmittelbar für Dashboards, Reports oder weiterführende Data-Warehouse-Konzepte nutzen lassen. Die Abbildung zeigt den Weg der Daten durch diese Schichten. Besonders interessant ist dabei, wie Delta Live Tables und dbt jeweils – oder auch in Kombination – eingesetzt werden können, um diese Prozesse effizient und zuverlässig zu gestalten. ![Die Abbildung zeigt eine Medaillon-Architektur in Databricks](https://thecattlecrew.net/wp-content/uploads/2025/12/cattle-crew-data-bricks-1_bild1.png)Modellzeichnung unserer Projektarchitektur ## Mehr als nur Technik: Organisatorische Faktoren Die Wahl zwischen Delta Live Tables und dbt ist jedoch keine rein technische Frage. Sie hängt stark von organisatorischen Rahmenbedingungen ab. Verfügt das Team bereits über Erfahrung mit einem der Tools, oder sind zusätzliche Schulungen notwendig? Wie leicht lassen sich Fachkräfte mit den entsprechenden Kenntnissen am Markt finden? Und welche strategische Ausrichtung verfolgt das Unternehmen – setzt es lieber auf ein stark integriertes Plattform-Feature oder auf ein weit verbreitetes Open-Source-Werkzeug mit aktiver Community? Auch die Zukunftssicherheit spielt eine Rolle. Datenarchitekturen müssen so ausgelegt sein, dass sie sich mit den Anforderungen des Geschäfts entwickeln können. Die Entscheidung für ein bestimmtes Tool sollte deshalb immer im Kontext des gesamten Unternehmens betrachtet werden. Letztlich geht es darum, die richtige Balance zwischen technologischen Möglichkeiten, organisatorischen Ressourcen und strategischen Zielen zu finden. ## Mehr aus dieser Blogserie **Teil 1:** [Medaillon-Architektur, Delta Live Tables und dbt in der Praxis](https://thecattlecrew.net/2026/01/15/databricks-verstehen-teil-1-medaillon-architektur-delta-live-tables-und-dbt-in-der-praxis/) **Teil 2:** [Projektumsetzung mit Delta Live Tables](https://thecattlecrew.net/2026/02/06/databricks-verstehen-teil-2-was-ist-databricks-was-bietet-mir-das-tool/) **Teil 3:** [Projektumsetzung mit dbt](https://thecattlecrew.net/?p=40947&preview=true) **Teil 4:** [Gegenüberstellung der Ansätze und Fazit](https://thecattlecrew.net/2026/03/12/databricks-verstehen-teil-4-fazit/) Viel Spaß beim Lesen! **Kategorien:** Analytics & Insights, Architecture & Process Models --- ### [n8n: AI Workflow Automation in der Praxis](https://thecattlecrew.net/2026/05/21/n8n-ai-workflow-automation-in-der-praxis/) **Published:** Mai 21, 2026 **Author:** Simon Weißmüller **Content:** ## Vom Video-Call zur automatischen Zusammenfassungen für alle Teilnehmer Im Zuge der rasanten Entwicklungen von Künstlicher Intelligenz im Allgemeinen und Large Language Models im speziellen, vergeht kaum eine Woche in der kein neues KI-Tool erscheint, welches nicht verspricht die Arbeitswelt zu revolutionieren. Einer der neusten Trends ist dabei AI-Workflow Automation. Zwar ist Workflow- Automatisierung nicht neu, doch durch die Integration von LLMs und visuell bedienbaren No-Code-Oberflächen versprechen diese Tools, Geschäftsprozesse schneller, flexibler und vor allem intelligenter automatisieren zu können. Ein Tool, das in diesem Bereich hervorsticht, ist das von einem Berliner Start-up entwickelte **n8n**. Das Versprechen ist groß: Auch Einzelpersonen oder kleine Teams sollen in der Lage sein, komplexe Arbeitsprozesse zu automatisieren und durch das Einbinden von KI-Modellen anzureichen. Eine tiefe technische Expertise dabei nicht zwingend erforderlich, jedoch gibt es die Möglichkeit auch selbstgeschrieben Javascript Code einzubinden um Prozesse noch detailgenauer abzubilden. Ich musste bei diesem Versprechen, direkt an ein Problem denken, welches mir im beruflichen Kontext immer wieder begegnet: **Meetings die zu lange dauern, ohne klare Struktur verlaufen und deren Ergebnisse nach wenigen Tagen nicht mehr greifbar sind.** Deshalb habe ich mich direkt daran gemacht, die Möglichkeiten von n8n, an diesem Praxisbeispiel zu untersuchen. Ich habe also einen Workflow gebaut, der den Inhalt eines Meetings automatisch transkribiert, diesen mittels KI auswertet, die relevanten Themen und ToDos identifiziert und eine Zusammenfassung als E-Mail an alle Teilnehmer aufsetzt. ## Was ist n8n? Ein kurzer Überblick n8n bietet ein visuelles User-Interface mit dem Nutzer durch das Verbinden von **Nodes** Arbeitsabläufe erstellen können. Jeder dieser Nodes empfängt Daten, führt eine Aufgabe auf und reicht die verarbeiteten Daten an die nächsten mit ihm verbunden Nodes weiter. Die Daten liegen dabei fast immer als JSON vor, ein für Entwickler vertrautes Format. Nodes lassen sich in vier Typen unterteilen: **Trigger-Nodes:** Starten einen Workflow, etwa bei neuen Dateien im Drive oder eingehenden E-Mails. **Action-Nodes:** Führen Aufgaben aus und können mit verschiedensten externe Services interagiere, zum Beispiel durch Senden von Emails über ein Gmail Konto, Ausführen von Linux Commands auf einem Remote Server, Prompting von LLMs, oder Zugriff auf Postgres-Datenbanken. **Transformation:** Erlauben das Filtern, Mappen oder Umformen von Daten – inklusive JavaScript Expressions. **Logik & Verzweigung:** Ermöglichen mit If/Else, Switch, Merge, Split und Loops komplexe Entscheidungslogik zu implementieren. ## Praxis Beispiel – Vom Meeting zur automatischenZusammenfassung Ich habe mich für mein Projekt für die Cloud-Version entschieden, die nach einem Testzeitraum kostenpflichtig ist. Die Community Edition ist dagegen kostenlos, open-source und kann vollständig selbst gehostet werden. Mein Ziel war ein Workflow, der Folgendes leistet: 1. Ein Meeting findet statt. 2. Google Meet erzeugt automatisch ein Transkript und speichert dieses als Google Doc. 3. n8n erkennt das neu erzeugte Dokument. 4. Das Transkript wird von einem LLM ausgewertet. 5. Die Zusammenfassung wird als E-Mail Entwurf in meinem Gmail-Account erstellt. ![Bild 1: Visueller Workflow in n8n Cloud](http://thecattlecrew.net/wp-content/uploads/2026/05/Bild1-Visueller-Workflow-1024x358.png)Bild 1: Visueller Workflow in n8n Cloud Der Workflow startet mit einem **Google Drive Trigger**, der auf neue Dateien in meinem Ordner *“Meet Transcription”* hört. Wenn ein Meeting endet, legt Google Meet ein Google Doc mit allen Sprecherbeiträgen in diesem Ordner ab. Der Output des **Trigger-Nodes** ein JSON-Objekt mit Metadaten der Datei: Dateipfad, ID, Timestamp usw. Der nächste Node nutzt die Dokument-ID, um den Textinhalt aus Google Docs abzurufen. Das komplette Transkript liegt damit als reiner Text vor und kann weiterverarbeitet werden Der Inhalt wird nun von 2 Nodes weiterverarbeitet. Zum einen nutzt der **OpenAI Node**, den Text um einen Prompt mit folgenden Aufgabe zu definieren: - Meeting verständlich zusammenfassen - Action Items identifizieren - Verantwortlichkeiten zuweisen - Entscheidungen und offene Fragen extrahieren ![Abbildung 2: Der Input eines Knotens lässt sich mittels Javascript Expression Syntax leicht einbinden. Hier nutze ich das Transkript des Meetings um daraus einen Prompt zu erstellen.](http://thecattlecrew.net/wp-content/uploads/2026/05/Bild2-KnotenInput-1024x600.png)Abbildung 2: Der Input eines Knotens lässt sich mittels Javascript Expression Syntax leicht einbinden. Hier nutze ich das Transkript des Meetings um daraus einen Prompt zu erstellen. Ein **Transformation-Node** extrahiert aus dem Transkript den Meeting-Titel um diesen später als Betreff der E-Mail zu nutzen. n8n unterstützt JavaScript-Expressions, sodass Mapping und Parsing sehr flexibel möglich sind. ![Abbildung 3: Die Verwendung von Javascript Expression eröffnet die Möglichkeit zu komplexeren Datenmanipulation](http://thecattlecrew.net/wp-content/uploads/2026/05/Bild3-Datentransformation-1024x592.png)Abbildung 3: Die Verwendung von Javascript Expression eröffnet die Möglichkeit zu komplexeren Datenmanipulation Die Outputs der jeweiligen **Nodes** müssen daraufhin zu einem einzelnen JSON zusammengeführt werden, bevor wir die Daten für meinen E-Mail Entwurf nutzen können. Im finalen Schritt nutzt ein **G-Mail Node**, welchen ich vorher mit meinem E-Mail Account verbunden habe, den Output der vorherigen Nodes als Betreff und Inhalt für den Entwurf. Das Ergebnis: Eine fertiger E-Mail mit allen relevanten Infos – bereit zum Versenden an die Teilnehmer. Optional ließen sich noch die E-Mail-Adressen der Teilnehmer automatisch aus dem Google Calendar Event extrahieren. ![Abbildung 4: Automatisch erstellter E-Mail Entwurf](http://thecattlecrew.net/wp-content/uploads/2026/05/Bild4-Email-1024x709.png)Abbildung 4: Automatisch erstellter E-Mail Entwurf ## Fazit Für das Aufsetzten den gesamten Workflow habe ich rund **zwei Stunden** benötigt, wobei der größte Teil davon in das Einrichten der API-Credentials für Drive, Docs und Gmail geflossen ist. Sobald die Authentifizierung stand, ließ sich der Workflow sehr intuitiv umsetzen. Besonders hilfreich: Der integrierte **n8n AI Helper**, der in der Cloud-Version direkt bei Fehlern Vorschläge liefert oder Transformationslogik generieren kann. Mein Fazit: - **Für kleine Teams und wiederkehrende Aufgaben ist n8n eine extrem leistungsfähige Lösung.** - **Die JSON-basierte Architektur und Javascript Expression Syntax macht es für Entwickler angenehm flexibel.** - Wie bei vielen Low-Code-Tools nimmt der Nutzen ab, wenn Prozesse sehr komplex, stark verzweigt oder hochskalierbar sein müssen. Aber für den beschriebenen Use Case – und viele ähnliche – ist n8n ein beeindruckend effektives Werkzeug **Kategorien:** AI & Data Science, Automation --- ### [Ein halbes Jahr STACKIT: Cloud-Erfahrungen aus der Praxis](https://thecattlecrew.net/2026/05/05/ein-halbes-jahr-stackit-cloud-erfahrungen-aus-der-praxis/) **Published:** Mai 5, 2026 **Author:** Anton Rösemann **Content:** In den letzten Monaten haben wir intensiv in einem Showcase Projekt im Rahmen des OC Public Digital Innovation Lab mit [STACKIT](https://stackit.com/de), dem Cloudanbieter der [Schwarz Gruppe](https://schwarz-digits.de), gearbeitet. Zeit für ein erstes Fazit aus Entwicklersicht: Was kann STACKIT heute schon gut, wo unterscheidet es sich von Hyperscalern wie AWS oder Azure – und für wen lohnt sich der Blick auf diese Cloudlösung aus der DACH-Region? ## **Was ist STACKIT – und warum überhaupt eine Alternative?** STACKIT ist die Cloud-Plattform der Schwarz Gruppe (u.a. Lidl, Kaufland) und positioniert sich ganz klar als europäische Alternative zu den großen US-Hyperscalern. Funktional bewegt sich STACKIT in einer ähnlichen Liga: Compute, Storage, Netzwerke, Kubernetes, APIs, IaC-Anbindung (z.?B. Terraform) – alles da, was man für moderne Cloud-Projekte braucht. Der entscheidende Unterschied ist weniger technisch als strategisch und rechtlich motiviert: [Datenschutz](https://thecattlecrew.net/tag/it-secutity/). Wer sensible oder besonders schützenswerte Daten verarbeitet – etwa im Behördenumfeld oder in regulierten Branchen – muss sich sehr bewusst mit dem Thema Datenzugriff durch Drittstaaten auseinandersetzen. Bei US-Anbietern bleibt, unabhängig von Verschlüsselung, immer ein Restrisiko durch amerikanisches Recht. STACKIT hingegen hostet in europäischen Rechenzentren (Deutschland und Österreich) und unterliegt europäischer Gesetzgebung. Für viele Projekte ist das ein echtes Argument. ## **Technisch: weniger Spezial-Showcases, aber ausreichend Substanz** Wenn man AWS oder Azure gewohnt ist, fällt eines sofort auf: STACKIT hat (noch) nicht diese riesige Breite an hochspezialisierten Managed Services – etwa für KI, Machine Learning oder fertige Analysepipelines. Wo Azure mit „One-Click“-Lösungen für Regression, Logs oder Data Science glänzt, ist STACKIT deutlich nüchterner unterwegs. In der Praxis ist das aber oft weniger relevant, als man denkt. Viele dieser Showcase-Services sind nett für Demos oder Experimente, spielen im langlebigen Projektalltag aber eine untergeordnete Rolle. Für stabile, langlaufende Anwendungen ist der vorhandene Werkzeugkasten von STACKIT absolut ausreichend – und genau darauf scheint der Fokus auch zu liegen. ## **Kosten: kein Schnäppchen, aber realistisch** Preislich unterscheidet sich STACKIT weniger von den Hyperscalern, als man zunächst vermutet. Der Einstieg wirkt etwas teurer, dafür sind die Kosten sehr transparent. Man sieht klar, was Compute, Cluster, Netzwerk oder Zusatzdienste pro Tag kosten. Das Prinzip ist überall gleich: Einzelne Bausteine sind günstig, aber sobald ein realistisches Setup läuft, summieren sich die Kosten. AWS und Azure funktionieren nicht anders – nur heißen die Pakete dort anders. Für produktive Umgebungen bewegen sich die Kosten am Ende auf vergleichbarem Niveau. ## **Stabilität, Performance und Support** In unserem bisherigen Einsatz gab es keine echten Showstopper. Die Plattform lief stabil, die Performance der (bewusst klein dimensionierten) Maschinen war völlig ausreichend, Netzwerke und Zugriffe funktionierten erwartungsgemäß. Die wenigen Probleme, die auftraten, waren eher klassische „Kinderkrankheiten“: wenig aussagekräftige Fehlermeldungen oder Situationen, in denen man erst lernen muss, wie ein bestimmter Mechanismus gedacht ist. Positiv: Der Support war erreichbar, hilfsbereit und kompetent – und das ist gerade bei jüngeren Plattformen ein großer Pluspunkt. ## **Usability und Entwicklungstempo** Die größte Herausforderung ist aktuell weniger die Technik als die Übersichtlichkeit. Wie bei AWS oder Azure wächst das Produktportfolio schnell, und alle Services landen in einer langen, unübersichtlichen Menüstruktur. Man muss sich aktiv merken, welche Services man wirklich nutzt. Gleichzeitig ist beeindruckend, wie schnell sich STACKIT weiterentwickelt. Neue Features sind klar gekennzeichnet, ganze Produktbereiche (z.B. Workflows, Notebooks, Firewall, KI-Themen) kommen hinzu. Das Produkt wirkt klar auf Wachstum ausgelegt und hat im letzten halben Jahr massiv an Features hinzugewonnen. ## **Lernen und Einstieg: noch wenig Community, aber solide Basis** Der Einstieg ist etwas holpriger als bei AWS – schlicht, weil es weniger Blogposts, StackOverflow-Antworten und YouTube-Videos gibt. Dafür bietet STACKIT eine eigene Academy mit Kursen und Zertifizierungen sowie eine ordentliche Dokumentation. Interessant: Selbst KI-Tools kommen mit der STACKIT-API schon erstaunlich gut zurecht. Für einen Anbieter dieser Größe ist das ein gutes Zeichen. ## **Fazit: Würden wir STACKIT empfehlen?** Ja – definitiv. STACKIT ist keine preisgünstigere Kopie von AWS und auch kein Feature-Monster. Aber es ist eine professionelle, stabile Cloud-Plattform, die besonders dort überzeugt, wo Datenschutz, europäische Hosting-Standards und Langfristigkeit wichtig sind. Für hochkritische Produktivsysteme, Behörden, regulierte Branchen oder Unternehmen mit klarer EU-Strategie ist STACKIT heute schon eine sehr ernstzunehmende Option. Und der aktuelle Entwicklungsspeed lässt vermuten: Das ist erst der Anfang und die nächsten neuen Features sind bereits in der Pipeline. **Kategorien:** Cloud, Development, Infrastructure --- ### [Dynamische, Multiparameter REST-Queries mit RSQL](https://thecattlecrew.net/2026/01/19/dynamische-multiparameter-rest-queries-mit-rsql/) **Published:** Januar 19, 2026 **Author:** Andreas Meyer **Content:** In meinem Beitrag soll es um RSQL gehen, eine kleine Ausdruckssprache, die sich eignet, um dynamische Multiparameter Queries zu generieren. RSQL ist eine Erweiterung der „Feed Item Query Language“ (kurz: FIQL). FIQL ist ein [IETF-Draft](https://datatracker.ietf.org/doc/html/draft-nottingham-atompub-fiql-00), der bisher nicht in den IETF-Standard übernommen wurde. RSQL/FIQL umfasst eine kontextfreie Grammatik, mit der sich Ausdrücke bilden lassen, die den Rechenregeln boolescher Algebra folgen. Warum halte ich das Thema für relevant? Ein alltägliches Problem in der Anwendungsentwicklung ist, Suchfunktionen umzusetzen, die einerseits den Endanwendenden ein hohes Maß an Flexibilität lassen, welches nur durch fachliche Bedingungen eingeschränkt werden sollte, während die technische Komplexität für die Entwickelnden gering bleibt. Da wir Suchanfragen üblicherweise als Filter modellieren, die durch boolesche Ausdrücke repräsentiert werden, lohnt es sich, RSQL zu kennen. Solche Filter zu implementieren ist nicht trivial, besonders, wenn sie zur Laufzeit variabel sein sollen. Und selbst wenn es trivial wäre, wäre die Umsetzung immer noch nicht umsonst: Ein Design muss her, Tests, Dokumentation etc, man kennt es; nur um am Ende ein bereits gelöstes Problem nochmal gelöst zu haben, während die üblichen Kinderkrankheiten frischer Prototypen als Bonus oben drauf kommen. Denjenigen, die in so einer Situation auch lieber pragmatisch auf Selbstverwirklichung auf Kundenkosten verzichten und stattdessen auf bewährte Technologien setzen, möchte ich im weiteren RSQL etwas detaillierter vorstellen. Bibliotheken, die FIQL-Ausdrücke generieren und parsen, gibt es z.b. für [Python](https://fiql-parser.readthedocs.io/en/stable/usage.html), [Typescript](https://npm.io/package/rsql-criteria-typescript) und [Java](https://github.com/jirutka/rsql-parser). Für das Beispiel verwende ich eine Java-Bibliothek. Meiner Erfahrung nach ist RSQL noch nicht so bekannt, wie es sein sollte, daher habe ich mich entschlossen, diesen Artikel zu schreiben. (Bei dieser Gelegenheit meine freundlichsten Grüße an Thomas Behrendt, der mich auf RSQL aufmerksam gemacht hat) ### Was meine ich mit dynamischen Multiparameter Queries? Dynamische Multiparameter Queries sind Suchanfragen, die auf verschiedenen Spalten mit unterschiedlichen Operatoren filtern, während die Filter zur Laufzeit frei kombinierbar sind. Nehmen wir einen Betrieb an, der sich für seinen Onlineshop Pflegemasken für Bestellungen, Rechnungen etc wünscht. Die Übersicht für Bestellungen könnte z.b. folgende Felder umfassen: - Kundennummer - Name - Produktnummer - Bestellstatus - Händlerpreis - Verkaufspreis - Bestelldatum - Lieferdatum - Rechnungsdatum - Verkäufer Idealerweise möchten wir den Sachbearbeitenden erlauben, für jedes Feld Filter zu setzen. Z.b. nach Kundenummern, nach Bestellstatus, nach Bestelldatum. Aber auch nach Kombinationen all dieser: - Kundennummer == 1234567 - Kundennummer startswith 123 - Bestellstatus in (Geliefert, Bestellt) - Bestellstatus == Geliefert und Rechnungsdatum < now() - Lieferdatum < 31.12.2018 und Lieferdatum > 01.01.2017 oder Lieferdatum = now() - … Viele Anfragen sind sicher Unsinn, aber auch an sinnvollen Anfragen gibt es unzählige Möglichkeiten. Einerseits möchten wir den Nutzenden ermöglichen, beliebige Anfragen zu stellen, ob sie nun Sinn machen oder nicht. Andererseits muss die technische Abbildung aller Filterkombinationen die Regeln der booleschen Algebra befolgen, was in der Umsetzung gar nicht so unkompliziert ist. ((„true && ((true || false) && false)“ ist bekanntlich was anderes als „true && (true || false && false)“), zumindest für mich. Bevor man sich selber was überlegt, bietet es sich an, einfach eine Bibliothek wie RSQL zu benutzen. Es löst das Problem und ist mit geringem Aufwand einbindbar. ### Beispiel Verwendung von RSQL mit Java und Spring Web Verwendete Bibliothek: Ein Filter im RSQL- Format kann als String als z.b. REST-Parameter übergeben werden: „Produktnummer==1234,Name=IN=(‚Max‘, ‚Kim‘, ‚Alex‘)“ entspricht z.b. der sql-Clause: „WHERE Produktnummer = 1234 OR Name in (‚Max‘, ‚Kim‘, ‚Alex‘)“. Das Mapping der FIQL-Darstellung nach einer in sql sähe z.b. so aus: In einem REST-Controller deklarieren wir ein GET, dass als Request-Parameter einen String erwartet, mit dem eine RSQL-konforme Filteranweisung übergeben wird. Aus der Bibliothek erhalten wir einen RSQL-Parser, der den String in einen booleschen Ausdrucksbaum umwandelt: ``` import cz.jirutka.rsql.parser.RSQLParser; @RestController @RequestMapping("/api/v1/order") public class PurchaseOrderController { private final PurchaseOrderService purchaseOrderService; public PurchaseOrderController(PurchaseOrderService purchaseOrderService) { this.purchaseOrderService = purchaseOrderService; } @GetMapping public ResponseEntity rsqlFeatured(@RequestParam String rsqlFilter, Pageable pageable) { var expressionTree = new RSQLParser().parse(rsqlFilter); var result = purchaseOrderService.findAll(expressionTree, pageable); return ResponseEntity.ok(new PagedModel(result)); } } ``` Der RSQL-Filterbaum ist visitable, d.h. im Service muss ein Visitor instanziiert werden, der den Baum auf einen Ausdruck abbildet, der von der verwendeten Datenbank, z.b. Postgresql, verstanden werden kann: ``` import cz.jirutka.rsql.parser.ast.*; @Service public class PurchaseOrderService { private final PurchaseOrderRepository purchaseOrderRepository; public PurchaseOrderService(PurchaseOrderRepository purchaseOrderRepository) { this.purchaseOrderRepository = purchaseOrderRepository; } @Transactional(readOnly = true) public Page findAll(Node expressionTree, Pageable pageable) { var query = expressionTree.accept(new NodeToMyDatalayerQueryLanguageVisitor()); return purchaseOrderRepository.findAll(query, pageable).map(PoOverview::of); } } ``` Den Visitor (siehe Beispiel) kann man selbst implementieren und dort den RSQL-Filterbaum in die von der verwendeten Datenbank gewünschte Form bringen ``` import cz.jirutka.rsql.parser.ast.*; final class NodeToMyDatalayerQueryLanguageVisitor extends NoArgRSQLVisitorAdapter { @Override public Specification visit(AndNode andNode) { return andNode.getChildren() .stream() .map(node -> node.accept(this)) .reduce(Specification.unrestricted(), Specification::and); } @Override public Specification visit(OrNode orNode) { return orNode.getChildren() .stream() .map(node -> node.accept(this)) .reduce(Specification.not(Specification.unrestricted()), Specification::or); } @Override public Specification visit(ComparisonNode comparisonNode) { ComparisonOperator operator = comparisonNode.getOperator(); String symbol = operator.getSymbol(); String selector = comparisonNode.getSelector(); List arguments = comparisonNode.getArguments(); return switch (symbol) { case "==" -> (root, _, cb) -> cb.equal(root.get(selector), arguments.getFirst()); case "=IN=" -> (root, _, cb) -> cb.in(root.get(selector)).value(arguments); default -> throw new UnknownRsqlComparionOp(symbol); }; } } ``` Allerdings gibt es auch Bibliotheken, die diese Aufgabe erledigen, z.b. für [Jpa-Specifications](https://mvnrepository.com/artifact/io.github.perplexhub/rsql-jpa/6.0.33). Allerdings muss man an der Stelle ein bisschen auf Vulnerabilites, transitive Dependencies etc achten und überlegen, ob dieses Teilproblem nicht vielleicht doch eines ist, welches man lieber selbst löst. ### Fazit Mit RSQL lassen sich mit geringem Aufwand schlanke, robuste APIs schreiben, die Endanwendenden und UX-Designern flexiblen und niederschwelligen Zugriff auf den Datenbestand erlauben ohne die Komplexität im Backend in die Höhe zu treiben. Da die Lösung konsistent in gängige Autorisierung- und Datenzugriffsprozesse einbinden lässt (Der RSQL Filter lässt sich als Requestparameter in einem normalen REST-Request übermitteln und der RSQL-AST ist nicht von Datenbanktreibern out-of-the-box intepretierbar), entsteht kein zusätzliches Risiko. Als Herausforderung bleibt, Konventionen zu erarbeiten, wie Selektoren und Argumente zu formen sind. Aber das betrachte ich mehr als Chance. Solche Diskussionen müssen ohnehin geführt werden und helfen, eine gemeinsame Sprache zu entwickeln, die jedes Produkt braucht. ### Ein letzter Punkt: Beschränkt sich RSQL auf REST? Nein, natürlich nicht. Solange die Zeichenkette mit der Filteranweisung nach den Regeln der RSQL-Grammatik erzeugt wird, spielen der technische oder der fachliche Kontext der Anwendung keine Rolle. **Kategorien:** Development, Tools & Methoden **Schlagwörter:** API, design, Filtering, Java, methoden, Quality, rest, Softwarenentwicklung --- ### [First experience with AWS IoT - Amazon IoT Hackathon](https://thecattlecrew.net/2016/06/15/first-experience-with-aws-iot-amazon-iot-hackathon/) **Published:** Juni 15, 2016 **Author:** Attila Nemeth **Content:** I recently had the opportunity to visit the Amazon IoT Hackathon in Munich. I did expect a lot from the event and I was not disappointed. But more on the event later, lets start with a brief introduction to the AWS IoT cloud. Amazon released its IoT Cloud at the very end of last year. Its main purpose is to handle device management and communication from and to the devices (aka „Things“). Its architecture is shown in the next Figure. [![aws-iot-overview](https://thecattlecrew.net/wp-content/uploads/2016/06/aws-iot-overview.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/06/aws-iot-overview.png) The communication between the devices and the cloud is primarly based on the *MQTT* protocol. The devices publish state changes and custom events to MQTT topics and can subscribe to another topic so that they can be notified by the cloud in case of desired state changes (more on this later). Before the device first communicates with the cloud, a *certificate* needs to be created for the device. Furthermore, a policy needs to be attached to the certificate, defining the rights of the device (enabling it to post messages to topics or to subscribe to topics). A policy for testing IoT applications could be like: ``` { "Version": "2012-10-17", "Statement": [ { "Effect": "Allow", "Action": [ "iot:*" ], "Resource": [ "*" ] } ] } ``` Here we see the first integration within the Amazon Cloud: policies are standard IAM policies as known from AWS Identity and Access Management. Speaking of integration with other Amazon products: *rules* can be defined within the AWS IoT cloud, which can then forward the message to various other Amazon Cloud products, including S3 for storing the message, Kinesis for stream processing, Lambda for executing custom code on receipt of the message, etc. Rules have an SQL syntax like this: `SELECT JSonAttributes FROM MQTT topics WHERE FilterConditions based on the JSonAttributes` so if you have a device submitting temperature values every second to the topic *tempSensorData* and you want to be notified via email if the temperature is above 40 degrees, you can create a rule `SELECT temp FROM tempSensorData WHERE temp > 40` and configure an action to send a message to SNS (simple notification service) which will send out the mail. As you might have noted, however, rules only act on single messages, if aggregation of messages is required, the messages need to be forwarded to Kinesis and the resulting stream needs to be processed. Devices can also have state information – for example an LED can send its current color to the cloud. This information can be stored in *device shadows*. These device shadows are always available, even if the real device is not connected, so other applications can read the last state of the device. Applications can also update the state of the device shadow (asking the LED to turn green, for example). A state is always made up of a *desired* and a *reported* value. You can change the desired value in the cloud and this change will be propagated to the real device – the message containing the delta to the previous state is sent to an MQTT topic the device has subscribed to. Once the device has completed the state change, it will report back the current state in the reported attribute. From this moment on, the cloud will know that the change is processed by the device and the device shadow is in sync again. So if you want to change the color of the LED to green, you can change the attribute of the device shadow to ``` { "desired": {"color":"green"}, "reported": {"color":"red"} } ``` Once the color is set by the device, it will report back: ``` { "desired": null, "reported": {"color":"green"} } ``` There is also a *registry* component for storing metadata about the devices – device location or manufacturer for example. This information can be used to query a set of devices – for example find all the devices in Munich. You can do all these activities from the AWS Console but Amazon has also built an *API* do administrative stuff programmatically (if the appropriate policies enable you to do these). In order to speed up connecting devices to the cloud, Amazon has also released [*client SDKs*](https://aws.amazon.com/iot/sdk/) which you can use on your device to connect it to the cloud – currently C, JavaScript and Arduino Yܺn libraries are available. Now lets back to the event itself: we started with some presentations where the main concepts of AWS IoT were explained. We also had a short introduction from Intel for the hardware part of the Hackathon. Later on, we started the more interesting part: we have formed teams and each team has received an Intel Edison board with some sensors and a small display attached. [![edison](https://thecattlecrew.net/wp-content/uploads/2016/06/edison.jpg?w=576)](https://thecattlecrew.net/wp-content/uploads/2016/06/edison.jpg) Each team had to build something with the Edison and the AWS products. Time limit was ca. 4 hours. A sample code was provided, which read out all sensor values and sent them to the cloud every second. In the end, each team had to present their idea and vote for the best idea/solution presented. Our team members had little to no experience with AWS products so it was quite a challenge for us to create something useful within this short time period. We wanted to build something which not only sends data to the cloud but also receives data from it (in order to test the communication in both directions). After a short discussion, we had the idea: we want to build a barkeeper training application. Our idea was: the Edison is attached to a shaker and with the help of the accelerometer the power of shaking is measured and submitted to the cloud. The values are aggregated there and after a minute a text is sent to display of the trainer (in our case, the display on the Edison) if the shaker was shaked correctly. A button on the bottom of the shaker (in our case, on the Edison) should notice that the shaker is put back on the table and reset the text message. Creating a certificate, installing it and starting the Edison was an easy task. Sensor messages started arriving in the cloud immediately. Creating a rule and forwarding the messages to Kinesis (for aggregating them) was also no problem. For the aggregation itself we did not find a solution in the small time window. Apparently this is not so easy to do with the current Cloud offering of Amazon, custom code is inevitable here. Amazon has, however, already noticed that there is a missing component here and started developing [Kinesis Analytics](https://aws.amazon.com/kinesis/analytics/) which should simplify the aggregation of events in the future. Instead of analysing the stream directly, we have created a Kinesis Firehose rule to buffer events for a minute, then write the aggregated data to S3 in a csv format. Setting up a trigger in S3 which would fire if a new file has been written and start a Lambda script for calculating if the shaking was OK was very straightforward as well. This way, we have evaluated if the shaker was shaked enough for a minute (although we could not use a sliding window for evaluating data of the last minute because of the lack of stream processing). Next up was to send back a text message to the device. For that, we needed to update the device shadow. It took us quite some time to figure out how to use the SDK to do that but in the end we suceeded in creating a Lambda script updating the device shadow, thus sending data back to the device. The last task was also an easy one, reacting on a button push to invoke the previously created Lambda script and send the „reset“ text. For this, we have created another rule, which invoked Lambda. It was interesting to see how easy it is to start with the AWS IoT cloud and configure the first rules. We have noticed that if you can use AWS built-in integrations (from which you do have quite some), you have an easy job configuring your integration. Once you need something more complex, you can use custom code (for example in a Lambda script) but for that some practice and knowledge of the AWS APIs is of advantage. What we really missed was an easy way to aggregate IoT messages and react on the aggregated results – but, as said earlier, Amazon is working on this already. All in all, it was great to see how multiple AWS components work seamlessly together and how easy it is to start working with AWS. At the end of the day, our solution was voted 2nd of ca. 15 teams, we just cannot complain about this result! Summarizing my impressions: - Amazon AWS (and the IoT Cloud) is easy to start with, you can set up sample integration within minutes. - For more complex integrations custom code is needed. Experience is very helpful if you are planning to do that. - There is a huge list of available Amazon Cloud products, with lots of different cost structures. In order to find the best combination of products for your integration needs, some experience is needed, too. - In one sentence: Amazon AWS is easy to start with, challenging to master. **Kategorien:** Cloud, Tech Events & Networking **Schlagwörter:** AWS, cloud, English, IoT --- ### [AWS News KW 48](https://thecattlecrew.net/2017/12/04/aws-news-kw-48/) **Published:** Dezember 4, 2017 **Author:** Marco Buss **Content:** Letzte Woche war die re:Invent in Las Vegas, Amazons große Hauskonferenz. Wie zu erwarten gab es eine große Anzahl an Ankündigungen. Deutlich zu viele um sie hier noch einmal im Detail zusammen zu fassen. Daher verweise ich diese Woche lediglich auf den Blogeintrag meines Kollegen Danilo Schmiedel, der vor Ort war und die wichtigsten Ankündigungen er ersten Keynote von Andy Jessy (CEO Amazon) zusammenfasst. – [OC @ Amazon re:Invent (Part 1)](https://thecattlecrew.net/2017/11/30/oc-amazon-reinvent-part-1/) Am Donnerstag bot sich dann die Gelegenheit die Keynote von Dr. Werner Vogels (CTO Amazon) als Livestream bei Amazon in Berlin zu sehen. Die wichtigsten Aussagen dieser Keynote waren für mich folgende: **Conversational Interfaces:** In Zukunft werden immer mehr Interfaces sprachbasiert sein, da es einfach in vielen Situationen die intuitivste Interaktion ist. Bisher waren Interaktionen mit Maschinen durch die Limitierungen der Maschinen begrenzt. Mit dem Fortschritten bei sprachbasierten Interfaces verschieben sich diese Grenzen wieder ein wenig. Ein Beispiel das Werner Vogels brachte kann ich sehr gut nachvollziehen und zwar das Thema Hausautomatisierung. Aus eigener Erfahrung mit simplen Schaltern und Apps, kann ich sagen das die Anbindung eines Sprachinterfaces an die Haussteuerung den meisten Komfort gebracht hat und auch am meisten genutzt wird. **IOT + Daten:** Ein großer Teil der Keynote handelte von IOT und den Daten die dabei erzeugt werden. Amazon bietet ja bereits einen eigene [IOT Plattform](https://aws.amazon.com/de/iot/). Die in Zukunft auch einige wichtige [Erweiterungen](https://aws.amazon.com/new/reinvent/#iot) bekommen wird. Auch die immer mächtiger werdenden Möglichkeiten des Maschine Learning fallen in diese Kategorie. Auch auf diesem Feld gab es diverse [Ankündigungen](https://aws.amazon.com/new/reinvent/#machine-learning). Am Interessantesten für mich war an dieser Stelle [Sagemaker](https://aws.amazon.com/de/sagemaker/). **Cloud9:** Die für mich interessanteste Ankündigung war allerdings [Cloud9](https://aws.amazon.com/cloud9/). Amazons eigene Browserbasierte IDE. Wie gut sich damit arbeiten lässt muss zwar noch evaluiert werden, die [Installation](https://thecattlecrew.net/2017/12/01/aws-cloud9-first-steps-creating-the-environment/) lief aber schon mal Problemlos. Ich bin noch skeptisch ob sich damit ein komplettes Projekt inklusive Oberflächen entwickeln lässt. Die Möglichkeit Lambda Functions zu Debuggen ist aber schon mal ein Killerfeature, für das alleine sich die Installation lohnt. Alle Ankündigungen der re:Invent gibt es in hübscher Form [hier](https://aws.amazon.com/de/new/reinvent/). **Kategorien:** Cloud **Schlagwörter:** AWS, Cloud9, SageMaker --- ### [AWS News KW 17 und KW 18](https://thecattlecrew.net/2018/06/25/aws-news-kw-17-und-kw-18/) **Published:** Juni 25, 2018 **Author:** Marco Buss **Content:** ## AWS IoT Analytics generally available Seit dem 24.04. ist das neue AWS IoT Analytics für Jeden in den Regionen US East (N. Virginia), US West (Oregon), US East (Ohio), und EU (Ireland) verfügbar. IoT Analytics vereinfacht die Bereitstellung einer Datenpipeline für IoT Geräte. Die Analyse der Daten war auch schon vorher möglich, aber mit IoT Analytics vereinfacht sich der komplette Konfigurationsaufwand für die Schritte Datenaufbereitung und Transformation, Anwendung von ML Techniken wie Anomalieerkennung und schlussendlich die grafische Darstellung der Daten. Weitere Informationen zu IoT Analytics [hier](https://aws.amazon.com/iot-analytics/). ## EC2 Price Reduction „“ H1 Instances Seit dem 4. Mai haben sich die Kosten für H1 on Demand und Reserved EC2 Instanzen um 15% verringert. H1 Instanzen bieten 2-16 TB Speicher der für sequentielle I/O Operationen optimiert ist. Damit eignet sich dieser Instanztyp vor allem für BigData Anwendungen. Weitere Informationen zu H1 Instanz Typen [hier](https://aws.amazon.com/ec2/instance-types/h1/). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [AWS News KW 19 und KW 20](https://thecattlecrew.net/2018/07/05/aws-news-kw-19-und-kw-20/) **Published:** Juli 5, 2018 **Author:** Marco Buss **Content:** ## AWS IoT 1-Click ![81CPVqwm8xL._SL1500_](https://thecattlecrew.net/wp-content/uploads/2018/07/81cpvqwm8xl-_sl1500_.jpg) Nachdem die [IoT Buttons der 2. Generation](https://www.amazon.de/AWS-IoT-Button-2-Generation) vom Amazon ca. 1 Jahr in Deutschland verfügbar sind gibt es jetzt eine [neue Version der IoT Buttons](https://www.amazon.de/AWS-IoT-Enterprise-Button-1-Click-Dienst). Die neuen Buttons unterstützen IoT 1-Click. Dadurch wird das Setup und die Verwendung der IoT Buttons stark vereinfacht. Musste man vorher erst entsprechende Zertifikate erzeugen, auf den IoT Button aufspielen und dann auch noch Security Profile anlegen bevor der Button verwendet werden konnte ist dieser ganze Prozess mittlerweile auf 2-3 einfach Schritte reduziert worden. Der IoT Button ist dabei lediglich das erste Device in Europa das IoT 1-Click unterstützt und benötigt weiterhin ein WLAN. In den USA ist darüber hinaus noch ein Button der LTE-M nutz verfügbar und Amazon sucht weitere Partner die Devices für IoT 1-Click anbieten wollen. Weitere Informationen zu AWS IoT 1-Click [hier](https://aws.amazon.com/iot-1-click/). ## Amazon Aurora Backtrack Nachdem DynamoDB bereits eine Restore Funktion erhalten hat (siehe [hier](https://thecattlecrew.net/2018/06/11/aws-news-kw-13-und-kw-14/)) ist dieses Feature ab sofort für alle neu angelegten Aurora Cluster verfügbar. Damit kann die Datenbank im Falle eines Fehlers auf einen beliebigen Punkt innerhalb des Backtrack Fensters zurückgesetzt werden. Das Fenster kann dabei bis zu 72 Stunden in die Vergangenheit reichen. Ein weiterer Nützlicher Usecase wäre das zurücksetzen der Datenbank nach einem durchgeführten Test. Weitere Informationen zu Amazon Aurora [hier](https://aws.amazon.com/rds/aurora/). ## Amazon Sumerian – Generally Available Nachdem [Amazon Sumerian](https://aws.amazon.com/sumerian/) auf der re:Invent 2017 vorgestellt wurde ist der Dienst jetzt für alle Nutzer verfügbar. Mit Amazon Sumerian können eigene virtuelle Räume für VR, AR und 3D erstellt werden. Mit Hilfe eines Web basierten Editors können die eigenen Räume ohne Expertenwissen und spezielle Tools erstellt werden. Die erstellen Umgebungen können im Anschluss für verschiedene Platformen wie Beispielsweise Oculus Rift, HTC Vive aber auch für Browser Umgebungen die WebGL unterstützen deployt werden. Weitere Informationen zu Amazon Sumerian [hier](https://aws.amazon.com/sumerian/). ## Neue EC2 Instanztypen Ab sofort sind die neuen C5 Instanztypen verfügbar und lösen die C4 Typen ab. Die neuen Typen bieten eine um 25-50% Reduzierung des Preis/Perfomance Verhältnisses. C5 Instanztypen sind für rechenintensive Aufgaben wie Batch Verarbeitung, Echtzeitanlaysen, Video Encoding u.s.w geeignet. Für Usecases die darüber hinaus von schnellem Temporären Speicher profitieren sind die neuen **C5d** Instanzen gedacht. Diese sind identisch mit den C5 Instanzen, bieten darüber hinaus aber per NVMe SSD Storage und sind in folgenden Konfigurationen in den Regionen US East (N. Virginia), US West (Oregon), EU (Ireland), US East (Ohio) und Canada (Central) verfügbar. **Instance Name****vCPUs****RAM****Local Storage****EBS Bandwidth****Network Bandwidth****c5d.large**24 GiB1 x 50 GB NVMe SSDUp to 2.25 GbpsUp to 10 Gbps**c5d.xlarge**48 GiB1 x 100 GB NVMe SSDUp to 2.25 GbpsUp to 10 Gbps**c5d.2xlarge**816 GiB1 x 225 GB NVMe SSDUp to 2.25 GbpsUp to 10 Gbps**c5d.4xlarge**1632 GiB1 x 450 GB NVMe SSD2.25 GbpsUp to 10 Gbps**c5d.9xlarge**3672 GiB1 x 900 GB NVMe SSD4.5 Gbps10 Gbps**c5d.18xlarge**72144 GiB2 x 900 GB NVMe SSD9 Gbps25 Gbps **Kategorien:** Cloud **Schlagwörter:** Amazon Aurora, AWS --- ### [AWS News KW 31 und KW 32](https://thecattlecrew.net/2018/08/22/aws-news-kw-31-und-kw-32/) **Published:** August 22, 2018 **Author:** Marco Buss **Content:** ## Aurora Serverless MySQL verfügbar Aurora Serverless war für mich „die“ Ankündigung auf der letzten [re:Invent](https://www.youtube.com/watch?v=1IxDLeFQKPk&feature=youtu.be&t=2595). Aurora Servleress kann erheblich zur Kostenersparnis beitragen, vor allem in Use-Cases mit schwer vorhersehbaren Lasten oder für wenig genutzte Services und das mit MySQL Kompatibilität. Das dürfte viele Migrationen vereinfachen, da die Datenhaltung nicht auf eine DB wie Dynamo migriert werden muss. Bei der Erstellung eines Aurora Clusters entfallen bei der Wahl von Serverless die Angaben welche Instanztypen der Cluster verwenden soll. Vielmehr ist lediglich die Angabe einer minimalen Kapazität und eine maximalen Kapazität notwendig. Innerhalb dieser Grenzen wird der Aurora Cluster skaliert. Entsprechende Autoscaling Events werden vom Dienst selbständig angelegt. Neben den Kapazitätsgrenzen kann noch definiert werden, nach welcher Zeit ohne Last die Compute Kapazität auf Null skaliert werden soll und somit keine weiteren Kosten verursacht. Weitere Informationen zu Aurora Serverless [hier](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/aurora-serverless.html). ## Provisioned Throughput für Amazon Elastic File System Amazon Elastic File System (EFS) ist ein verteiltes Dateisystem, auf das bei Bedarf gleichzeitig tausende von EC2 Instanzen oder lokale Ressourcen zugreifen können. Der mögliche Durchsatz skaliert dabei mit der Größe des Dateisystems. Für Szenarien mit wenigen Dateien also wenig Volumen aber einem hohen Durchsatz über längere Zeit war EFS bisher keine Option. Mit der Einführung von provisioned throughput ist es jetzt möglich bis zu 1 GiB/Sekunde an Durchsatz zu buchen. Zum Vergleich ein EFS mit 1TiB bietet 50 MiB/Sekunde mit einem Burst von 100MiB/Sekunde für bis zu 12 Stunden am Tag. Mit provisioned throughput ändert sich auch die Kostenstruktur. Es muss dann für die Größe des Dateisystems bezahlt werden plus die Kosten für den provisioned throughput. Weitere Informationen zur Wahl des Throughputs [hier](https://d1.awsstatic.com/whitepapers/Storage/amazon_efs_choosing_between_different_performance_and_throughput.pdf). ## AWS IoT Device Defender verfügbar Immer mehr IoT Geräte wandern in die Haushalte und Unternehmen. Oft wird bei den Geräten aber die Sicherheit nicht ernst genommen. Mit dem AWS IoT Device Defender bietet AWS einen Service mit dem sich die Sicherheit von IoT Geräten erhöhen lässt. Der IoT Defender prüft kontinuierlich die Konfigurationen der einzelnen Geräte. Das umfasst zum einen die Prüfung der Zertifikate, also das jedes Gerät ein eigenes Zertifikat verwendet oder keine ungültigen Zertifikate verwendet werden. Sollten Geräte nicht den Anforderungen entsprechen wird eine Entsprechende Warnmeldung erzeugt. Neben der Prüfung der Konfiguration können auch andere Metriken überwacht werden, wie beispielsweise der Datenverkehr der Geräte. Bewegt sich dieser nicht im erwarteten Rahmen kann ebenfalls eine entsprechende Meldung erzeugt werden. Weitere Informationen zu AWS IoT Device Defender [hier](https://aws.amazon.com/iot-device-defender/). **Kategorien:** Cloud **Schlagwörter:** Amazon Aurora, Amazon EFS, AWS, Device Defender, Serverless --- ### [Sensordaten live erleben: Big Data im Kontext der Industrie 4.0](https://thecattlecrew.net/2019/03/25/sensordaten-live-erleben-big-data-im-kontext-der-industrie-4-0/) **Published:** März 25, 2019 **Author:** mrogolowski **Content:** #### Kapitel 1: Projektkontext und verwendete Technologien Bei der HannoverMesse 2019 präsentieren wir gemeinsam mit einem maschinenverarbeitenden Unternehmen einen spannenden Showcase zur Analyse von Maschinen-Sensordaten und deren Darstellung in einem Dashboard, um den Zustand der Maschine zu überwachen und im Bedarfsfall eingreifen zu können. Es war uns wichtig, den Showcase so nah wie möglich an den realen Bedingungen zu entwickeln. Dafür haben wir keinen Aufwand gescheut: · Die Umsetzung findet in einer cloudbasierten Umgebung statt. · Für den Showcase wurde eine Visualisierung mit echtem Mehrwert entwickelt. · Besucher können eine zusätzliche Visualisierung in der HoloLens erleben. Die Architektur des Showcases haben wir in der AWS Cloud aufgesetzt. AWS stellt sämtliche Komponenten als Self-Managed Services zur Verfügung, was dem Anwenderunternehmen den Aufwand für die Wartung der Maschinenvisualisierung erspart. Die folgende Abbildung zeigt den groben Aufbau der Architektur, ihre grundlegenden Bestandteile und deren Verbindungen. Die Architektur setzt sich zusammen aus einer Testmaschine, die unser Partnerunternehmen im Rahmen des Showcases für die Entwicklung zur Verfügung stellte. Diese Maschine sendet die erforderlichen Daten per MQTT im JSON Format an den AWS IoT Core. Dort werden die Daten mithilfe einer Lambda Function weiterverarbeitet, mittels Elasticsearch Service visualisiert und in Amazon S3 persistiert. Soweit, so kurz. Doch was genau leisten die einzelnen Komponenten, und welche Rolle spielen sie im Showcase? Dies möchten wir nun im Einzelnen betrachten, also: „Vorhang auf!“ ![](https://thecattlecrew.net/wp-content/uploads/2026/04/Architektur_HannoverMesse_Deu-1.jpg)**AWS IoT Core** Im ersten Schritt wird der AWS IoT Core verwendet, um die ankommenden Maschinendaten abzugreifen und an die Folgekomponenten weiterzuleiten. In unserem Showcase werden die Daten im JSON Format per MQTT an unseren IoT Core übertragen. **Amazon Elasticsearch Service** Im nächsten Schritt werden bestimmte Rohdaten, die keiner weiteren Verarbeitung bedürfen, an den Amazon Elasticsearch Service weitergeleitet. Der Elasticsearch Service kann einerseits zum Zwischenspeichern der Daten verwendet werden und andererseits zur Kommunikation mit dem Visualisierungstool Kibana. Des Weiteren werden transformierte Daten zum Elasticsearch Service geschrieben, die nicht im Rohformat übertragen werden können. Hierbei handelte es sich beispielsweise um Daten, die innerhalb eines Arrays zur Verfügung gestellt wurden. Da Kibana keine Möglichkeit bietet, die Daten eines Arrays darzustellen, teilen wir die einzelnen Daten in dem Array auf. **Kibana** Im Showcase entschieden wir uns für Kibana als Visualisierungstool, da Kibana zum einen als Plugin an den Elasticsearch Service angebunden und zum anderen unabhängig von AWS auch on-premises verwendet werden kann. Nachdem die Daten an den Elasticsearch Service weitergeleitet wurden, greift Kibana die Daten über einen Index ab. **Lambda Function** Wir standen im Showcase vor der Herausforderung, neben den einfachen Laufzeiten der Messer zusätzlich verschiedene Durchschnittswerte zu berechnen. Aus diesem Grund haben wir die Daten vom IoT Core zu einer Lambda Function weitergeleitet, die für jeden Datensatz ausgeführt wird. Diese Lambda Function erfüllt vor allem zwei Zwecke: - ***Aufteilung der Arrays***: Die Maschinendaten innerhalb des Arrays werden in einzelne Werte aufgeteilt, die von Kibana verarbeitet werden können. - ***Berechnung von Durchschnittswerten***: Für den Showcase werden bestimmte Durchschnittswerte visualisiert, die dynamisch berechnet werden müssen. Von der Lambda Function werden die Daten an den Elasticsearch Service für eine weitere Verarbeitung weitergeleitet. Darüber hinaus werden die Daten an einen Amazon S3 Bucket geschickt, um eine Speicherung der Maschinendaten von bis zu zwei Jahren sicherzustellen. **Amazon S3** Zur kostengünstigen und persistenten Speicherung der Maschinen-Sensordaten haben wir einen Amazon S3 Bucket angelegt. Zum einen werden die Rohdaten vom IoT Core in den S3 Bucket übertragen. Zum anderen werden die transformierten Daten ebenfalls im S3 Bucket abgelegt. In Kapitel 2 folgt eine detaillierte Beschreibung der verwendeten Technologien. **Hannover Messe** Eine erste vollständige Live-Demonstration des Showcases mit Testmaschine und Cloud-Anbindung zeigen wir gemeinsam mit unseren Kooperationspartnern vom **01. bis 05. April 2019 bei der HannoverMesse**. Sie planen einen Besuch bei der HannoverMesse? Dann treffen Sie uns! Sie finden unseren Stand in der Digital Factory, Halle 6, D53. Eine kurze Vorschau können Sie im folgenden Video sehen: [](https://www.youtube.com/watch?v=h9yvg-pbFHk) **Kategorien:** Analytics & Insights **Schlagwörter:** AWS, Big Data, industrie4.0, Kibana --- ### [Überblick im Technologie-Dschungel: Technologie-Management bei OPITZ CONSULTING](https://thecattlecrew.net/2023/03/22/ueberblick-im-technologie-dschungel-technologie-management-bei-opitz-consulting/) **Published:** März 22, 2023 **Author:** Torsten Winterberg **Excerpt:** War vor 10 Jahren die Welt für ein mittelständisches IT-Beratungshaus oder eine IT-Abteilung noch relativ überschaubar, so ist die Anzahl der Technologien, mit denen man in IT-Projekten heute in Berührung kommt, sehr stark angewachsen. Wir wollen euch in diesem Blog-Post einen Einblick geben, wie wir bei OC unser Technologieportfolio managen. **Content:** War vor 10 Jahren die Welt für ein mittelständisches IT-Beratungshaus oder eine IT-Abteilung noch relativ überschaubar, so ist die Anzahl der Technologien, mit denen man in IT-Projekten heute in Berührung kommt, sehr stark angewachsen. Wir wollen euch in diesem Blog-Post einmal einen Einblick geben, wie wir bei OC unser Technologieportfolio managen. **Autoren dieses Beitrags:** Richard Attermeyer (Chief Architect) Sven Bernhardt (Chief Architect) Jens Bleiholder (Chief Architect) Torsten Winterberg (Director Technology) Wichtig für uns ist, dass die Tätigkeiten von Projektmitarbeitenden, Accountteams, Zentralbereichen und Management optimal ineinandergreifen, damit wir die gewohnt hohe OC-Qualität beim Kunden dauerhaft und über die ganze Mannschaft leisten können. Dazu haben wir einen schlanken Technologie-Management-Prozess festgelegt, der durch verschiedene Systeme unterstützt wird: - TLMT: The Lifecycle Management Tool. Unser Tech-Radar. - Blueboard: Verwaltung von Tickets zur Durchführung einer Technologieevaluierung. - OCEH: OC Engineering Handbook. Dokumentation der Technologiebewertungen, Standardarchitekturen und Beratungshandreichungen. - Oscar: Skillbewertung durch die Mitarbeiter. - Susy: Vorschlagswesen für Oscar und TLMT zur Erfassung neuer Tech-Items (Funktion in TLMT). Das Blueboard ist als Jira-Projekt realisiert, die anderen Systeme sind kleine Anwendungen. Über diesen Systeme liegt ein schlanker Prozess, welcher vom Corporate Development Team und dem OC-Architekturboard bespielt wird. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/prozess4.jpg) *Abb. 1: Technologie-Management: Zusammenspiel der Werkzeuge* ## TLMT Das „The Lifecycle Management Tool“ (kurz TLMT) nutzen wir bei OPITZ CONSULTING, um uns die Vielfalt der Werkzeuge, Technologien und Methoden am IT-Markt zu erschließen und auf die für uns strategischen Technologien zu fokussieren. Gemäß unserer Strategie #zukunftswirksam, hilft uns das TLMT dabei, proaktiv zu bewerten, welche Technologien unseren Leitthemen (Modern, Automatisiert, Integriert, Sicher) entsprechen, worauf wir unsere Kompetenzen perspektivisch ausrichten sollten und welche Technologien wir unseren Kunden empfehlen (wenn wir die freie Wahl haben). Zusätzlich erhalten wir durch die Verknüpfung zu unserem Skill Management Tool OSCAR eine einfache Übersicht über die Anzahl unserer Mitarbeiter und deren Tiefe der Qualifizierung pro Technologie. So können wir Rückschlüsse für unsere Wissensdomänen zur Personalentwicklung ziehen, sowie einschätzen, wie gut Kundenanfragen zu unserem Knowhow passen. Kurzum, das TLMT schafft Transparenz darüber: 1. Was wir für Technologien, Methoden und Standards einsetzen 2. Wie gut wir die Technologien, Methoden und Standards beherrschen 3. Worauf wir uns in der Weiterbildung fokussieren 4. Wie gut Technologien, Methoden und Standards in unser Portfolio passen ## Blueboard Blueboard steht für eine Innovationsmethode, die Transparenz und Nachhaltigkeit im Ideen-Management fördern soll. Wir haben uns daran angelehnt und unser eigenes, elektronisches Blueboard gebaut. Hierfür haben wir die Möglichkeiten von Jira genutzt, um Ideen und deren Status visualisieren zu können. Ziel ist es, Transparenz über Aktivitäten bei OC zu erzeugen, um nicht Dinge doppelt zu machen und auch um zu wissen, wer sich gerade mit welchem Thema beschäftigt. Des Weiteren ist das Blueboard ein Hilfsmittel bei der Fokussierung und Bündelung unserer Schlagkraft. Klar ist, dass wir nicht alle Themen gleichzeitig bearbeiten können. Doch welche Themen sind gerade wichtig für die Entwicklung von OC und was wollen und wünschen die Kunden? In verschiedenen Gremien werden die einzelnen Ideen diskutiert und die Auswirkungen auf den Markt und OC betrachtet. Darauf basierend wird dann entschieden, was mit der Idee passieren soll, also geht sie in die Umsetzung, wird sie erstmal zurückgestellt oder liegt sie nicht im Fokus von OC. ![Abb. 2: Status-Modell für Items im OC-Blueboard](https://thecattlecrew.net/wp-content/uploads/2023/03/prozess2.jpg)*Abb. 2: Status-Modell für Items im OC-Blueboard* Alle Mitarbeiter sind aktiv aufgerufen Ideen, die unsere Kunden, OC oder sich selbst weiterbringen, ins Blueboard einzutragen. Je mehr Informationen initial gefüllt sind, umso einfacher ist es für das passende Gremium, die Entscheidung zu treffen. Sofern Kollegen gerade nicht voll durch Projekte ausgelastet sind, finden sie hier Ideen, bei denen sie unterstützen können. Die einzelnen Bereiche des Blueboard sind über Swimlanes abgebildet. Hinter jeder Swimlane steht ein eigenes Gremium, das sich um die Tickets kümmert: - F&E: Technologie-Themen und Technologie-Evaluierungen - (Technologie-) Partnerschaften - Business Development (neue Themen mit Markteintrittsziel) - (Technologie-) Communities - Interne Systeme - Delivery Process & Knowledge (Optimierung und Weiterbildung) - Allgemeine Verbesserungsvorschläge ## OCEH Das OC Engineering Handbuch (OCEH) entwickelt sich zu DER Wissensquelle für alle OC’ler. Damit OC die in der Strategie definierten Ziele erreicht, werden im OCEH die verschiedenen Bereiche adressiert, die für die Erstellung und den Betrieb von Lösungen notwendig sind. Die Art der Leistungserbringung beim Kunden definiert den notwendigen „OC-Way“, also die OC-bewährte Herangehensweise. Und dies verstehen wir unter dem „OC-Way“: - Wie wir das Problem des Kunden analysieren (Auftragsklärung, Business Problem Understanding, Early Solution Design) - Wie wir eine Lösung entwerfen (Lösungsarchitektur + Design) - Wie wir Teile einer Lösung umsetzen (Service Design und Development) - Wie wir eine Lösung produzieren (Local Development, Continuous Integration and Deployment, Staging, Test und Verifikation) - Wie wir eine Lösung übergeben (Service Transition) - Wie wir eine Lösung betreiben (Operations und Support) - Wie wir eine Lösung weiterentwickeln (Application Maintenance) Damit ist das OCEH in folgenden Situationen hilfreich: - Eine Begründung für einen bestimmten Technologiestatus finden (über die zugehörige Technologieevaluierung) - Beantwortung der Frage, welche Technologien bei der Erstellung einer Lösungsarchitektur verwendet werden sollten - Welche Erfahrungen haben wir bei OC mit einer bestimmten Technologie? - Was soll ich beim Einsatz einer bestimmten Technologie / Methode beachten? Das OCEH gliedert sich in diese inhaltlichen Bestandteile, die in den folgenden Abschnitten genauer beschrieben werden: - Beratungshandreichungen - Engineering Guidelines - Lösungs-Architekturen (konkret) - Architekturschablonen und Standardarchitekturen - Technologie-Evaluierungen Generell gilt: Das OCEH ist ein lebendes Dokument, das redaktionell vom OC-Architekturboard betreut wird. Es lebt aber davon, dass jeder seine Erfahrungen beisteuern kann. Dazu nutzen wir das aus Open Source Projekten bekannte „Fork and Pull Request“-Prinzip. Dies gilt auch für schon bestehende Teile, die OC‘ler genutzt und vielleicht um eigene Aspekte ergänzt haben. Wenn ihr im Rahmen von Projekten eine Evaluierung oder eine Architekturentscheidung getroffen habt, dann kann diese auch anderen OC-Kollegen über das OCEH zur Verfügung gestellt werden. Unsere Kunden erwarten zu Recht, dass wir sie aufgrund der Erfahrung bei anderen Kunden beraten können. Eine solche Austauschplattform zu haben, ist ebenfalls ein Mittel, um Kopfmonopole aufzubrechen. Das OCEH wird in AsciiDoc geschrieben, arbeitet mit einfachen Git Fork und Merge Workflows und wird mittels Antora als Webseite veröffentlicht. ### Beratungshandreichungen In diesem Sub-Kapitel im OCEH sammeln wir Dinge, die sich beim Kunden bewährt haben und im Beratungskontext helfen können. Es stellt dar, wie sich OC auf Basis von Projekterfahrungen zu einem bestimmten Themenbereich positioniert, etwa zum Einsatz von Kubernetes in unterschiedlichen Einsatzszenarien. ### Engineering Guidelines Sich auf Spielregeln und Best Practices im Einsatz von Technologien festzulegen, ist in jedem Projekt hilfreich. In diesem Sub-Kapitel sammeln wir bewährte Guidelines aus der OC-Praxis, etwa: - Angular Guidelines - REST Guidelines - Apache Camel Guidelines - Database Development Guidelines - Git Guidelines - usf. Diese Guidelines werden in unseren Projekten verwendet, um eine Einheitlichkeit bei der Projektumsetzung, bezogen auf die entsprechenden Aspekte, gewährleisten zu können. Zudem wird die Delivery hierdurch effizienter, da man sich keine eigenen Gedanken zu immer wiederkehrenden Fragestellungen machen muss. Neue Erkenntnisse aus den Projekten fließen hier immer wieder zurück, wenn sich Vorgaben als nicht praktikabel erweisen. ### Lösungs-Architekturen (konkret) In diesem Sub-Kapitel findet ihr beispielhafte, anonymisierte Lösungsarchitekturen, die wir im Rahmen von Angeboten für Kunden ausgearbeitet haben. Sie sind ggf. nachträglich aufbereitet und ihr findet entsprechende Hinweise, falls wir bei einem Review festgestellt haben, dass wir in der Zwischenzeit etwas anders machen würden. Beispielhafte Inhalte: - Moderne Integrationsarchitektur für Ablösung eines alten Enterprise Service Bus (ESB) - API-Management Konzept für Open Data, Partner-Data, Internal-Data - Integration vorhandener Daten über API Gateway und Integrationsmuster, um neue Use-Cases zu unterstützen. - Ansteuerung von verschiedenen Backend-Diensten über eine cloud-native Integration mittels Camel und Priorisierung der Anfragen über priorty based messaging. - Aufbau einer hybriden, Multi-Cloud API Plattform auf der Basis von Kong ### Architekturschablonen und Standardarchitekturen Wenn wir uns über Architekturschablonen und Standardarchitekturen unterhalten, dann müssen wir erst einmal ein paar Begriffe definieren. **Architekturstil**: Ein Architekturstil bezeichnet eine abstrakte Sammlung, die von konkreten Elementen und Aspekten einer Architektur abstrahiert. Sie besteht daher aus einer Menge an gemeinsamen Annahmen und Randbedingung, die über alle konkreten Architekturen gleich ist. Es werden damit eine Menge an konkreten Designentscheidungen schon vorweggenommen und bestimmte Aspekte werden isoliert betrachtet. Beispiele für einen Architekturstil sind - Microservices Architektur - Monolithische Architektur - Schichtenarchitektur - Datenbank-zentrische Architektur - Event getriebene Architektur - REST - SOA **Architekturschablone**: Eine Architekturschablone kombiniert unter Umständen mehrere Architekturstile zu einer abstrakten Architektur. Wir gehen davon aus, dass diese Art der Architekturschablonen für eine gewisse Klasse an Anwendungstypen passt, ohne dass dort konkrete Technologien genannt sind. Beispiele - Cloud Native Systems - Integrationsarchitekturen - Analytische Architekturen Wir beschreiben Schablonen durch die zu realisierenden Technischen Capabilities. Dabei kann eine solche Capability auch Aspekte eines Architekturstils enthalten, etwa „event-based communication“. **Standardarchitekturen**: Standardarchitekturen konkretisieren die Schablonen durch eine Auswahl von konkreten Technologiebausteinen. Diesen Standardarchitekturen liegen weitere Glaubenssätze und Randbedingungen zugrunde. Glaubenssätze und Randbedingungen schränken den möglichen Lösungsraum ein. Wir sprechen auch von „Flavors“. Beispiele können sein: - Mixed Flavor (bspw. für Hybride Architekturen) - AWS Flavor - Azure Flavor - Oracle Flavor **Lösungsarchitektur**: Eine konkrete Lösungsarchitektur entwickeln wir für ein konkretes Kundenproblem. Da Probleme so unterschiedlich sind, wie unsere Kunden, können wir in der Regel nicht einfach mit der Präsentation einer Standardarchitektur antworten. Wir müssen die Architekturtreiber erheben und eine passende Antwort entwickeln. Dabei können Standardarchitekturen und Architekturschablonen eine gute Hilfestellung sein. Die definierten Standardarchitekturen sind in diesem Zusammenhang als eine Art Baukasten zu verstehen, aus dem wir uns bedienen können, um eine passgenaue Lösungsarchitektur für ein Kundenproblem zu definieren. So können wir bspw. mit Hilfe der Standardarchitekturen für „Cloud Native Systems“ und für „Integration“ eine Lösungsarchitektur für eine Cloud-native Integrationsplattform entwerfen, die On-premises, in der Cloud oder auch hybrid und Multi-Cloud deployed und betrieben werden kann. Die Schablonen helfen durch die Auflistung von häufig notwendigen technischen Capabilities, dass wir an alles denken, was im konkreten Kontext wichtig ist; also dienen die Schablonen als eine Art Checkliste. Dabei ist nicht immer die Adressierung aller Capabilities notwendig. Wir treffen die Entscheidung aber bewusst (und dokumentieren diese), damit wir z.B. im Projektverlauf nicht unliebsame Überraschungen erleben, weil wir vergessen haben einen wichtigen Teil zu schätzen. Gleichzeitig helfen uns Standardarchitekturen in Pre-Sales Situationen in eine Diskussion mit Kunden einzusteigen: Wenn wir die Wahl haben, dann würden wir ihr Problem wie in unserer Standardarchitektur beschrieben lösen. Sehen Sie auch alle Elemente für notwendig? Worauf wollen Sie verzichten? Das hat aber folgende Auswirkungen. Wir können auch eine andere Technologie verwenden, aber das ist mit größerem Risiko oder Aufwand verbunden. ### Technologie-Evaluierungen und ADRs Wird eine für OC neue Technologie zur Aufnahme ins OC-Technologie-Portfolio vorgeschlagen, geschieht dies über einen Vorschlagseintrag im TLMT. Das OC-Architekturboard (OCAB) bewertet den konkreten Vorschlag. Soll eine Verprobung stattfinden, wird ein Evaluierungsticket im Blueboard erzeugt und die Ergebnisse werden in Form einer Technologieevaluierung im entsprechenden Sub-Kapitel im OCEH dokumentiert. Beispiele: - Pyramid Analytics - Confluent Cloud - Ionos Cloud - Service Meshes - Go - … Allgemeinere Architekturentscheidungen werden in Form von bewährten ADRs (Architecture Decision Records) dokumentiert. Des Weiteren werden ADRs geschrieben, wenn es für die Umsetzung von Capabilities mehrere Technologiebausteine gibt. Der ADR definiert dann den zu präferierenden Baustein und begründet, warum das so ist. Beispiele für ADRs: - Rancher Desktop als Docker Desktop Umgebung - Nutzung eines Key-Value-Stores zur Speicherung einer Service Konfiguration im mixed Flavour - Nutzung von Prometheus für cloud-natives Service Monitoring - Nutzung von Kong als API Gateway im mixed Flavour - Nutzung von Caching Reverse Proxies im Mostly-AWS Flavour ## Wissensdomänen Das Management von Technologien auf Ebene der einzelnen Tech-Items ist wichtig, aufgrund der hohen Anzahl von Tech-Items jedoch sehr schnell unübersichtlich und schwer handhabbar. Aus diesem Grund verwenden wir zur Komplexitätsreduktion eine Bündelung vieler Tech-Items. Wir sprechen von den sogenannten Wissensdomänen: ![](https://thecattlecrew.net/wp-content/uploads/2023/03/WD3.jpg) *Abb. 3: Die OC-Wissensdomänen* Auf Basis dieser Wissensdomänen planen wir Aus- und Weiterbildungen im Kontext des Technologie-Managements. Das Trend-Scouting, also das Auffinden neuer technischer Strömungen, neuer Technologien, Frameworks oder Lösungsansätze wird so ebenfalls handhabbarer. ## Das OC-Architekturboard (OCAB) Das OCAB erweitert das Corporate Development Tech-Team und ist zentrales Instrument für #zukunftswirksame OC-Lösungen. Es stellt die technologische sowie methodische Kompetenz von OC für unsere #zukunftswirksamen IT-Lösungen sicher. Dort Wirkung erzeugen, wo Bedarf ist: In Kundenszenarien, in den Communities, vor Ort. Immer enablend für andere. Hauptaufgaben des OCAB: - Tech-Portfoliomanagement und Bereitstellung eines klar kommunizierten Tech-Stacks: Wir helfen unseren Projekten durch eine Standardisierung der technologischen Basis - Wissensdrehscheibe für Projekterfahrungen: Aus laufenden Projekten lernen und laufende Projekte besser machen. Wiederverwendbarkeit von bereits gelösten Themen. Deliveryfähigkeit verbessern (Qualität). - Support beim Gewinnen von „modernen“ Projekten (Akquise & Ausschreibungen; im Enablement-Modus für Andere; „mehr Lösungsarchitekten haben“; mehr moderne Technologien, mehr Projekte, Attraktivität als Arbeitgeber) - Kommunikation über Technologien sicherstellen nach innen und außen (u.a. OC Engineering Handbook, OC TechTalks, Tech-Blog, Fachartikel, Konferenzen) Das OCAB-Leistungsangebot gliedert sich in drei Bereiche: 1. Technologie-Management / Wissensmanagement (Basis für Akquise und Umsetzung) 2. Unterstützung bei Akquise 3. Unterstützung bei Projekt / Produkt / Service ## Das OC-Forum Unser Forum ist ein Ort zum technischen Austausch und Quell für wichtige Wissensfundstücke im Projektalltag. Es ist wichtig, wenn man nicht nur Kollegen eines Teams ansprechen will, sondern das gesamte Wissen aller Kollegen anzapfen möchte. Wir hatten schon vor Jahren ein Forum und haben es bei der Einführung von Microsoft Teams zunächst abgeschafft. Aus heutiger Sicht lässt sich sagen: das war eine grenzwertig gute Idee. Teams hat viele Vorteile, die Funktionalität der Abbildung eines Forums gehört leider nicht dazu. Wir haben gelernt und daher ein neues Forum aufgesetzt. Bei der Struktur haben wir uns bewusst an unseren Wissensdomänen orientiert, um dieses Denkmodell in der täglichen Praxis zu verankern. ## Die OC Communities Neben den Werkzeugen gibt es auch die Möglichkeit des Netzwerkens in Communities. Jede Community richtet sich an den strategischen Zielen von OC aus. In den Communities tauschen wir uns mit anderen am Thema interessierten Mitarbeiter:innen aus und vergrößern so unser OC-Netzwerk. Die Communities treiben aus ihrer Sicht relevante Aufgaben und gestalten so aktiv die Zukunft von OC mit. In den Communities wird gelernt, neue Technologien werden ausprobiert, evaluiert und angewendet. Hieraus ergeben sich viele Synergien zum Technologie-Management in den Kategorien der Wissensdomänen. Beispiele für OC-Communities: - Next Level Analytics (C42) - Data Engineering - DevOps Infrastructure- & Container-Experts (DICE) - Software-Development-Architektur - Low Code - PostgreSQL - Agile Softwareentwicklung - Projekt Management - Team Management ## Schlussbemerkung Wir hoffen, euch hiermit einen guten Überblick über das Technologie Management gegeben zu haben, das aus unserer Sicht auf diesem Niveau für einen professional arbeitenden IT-Lösungsexperten wie OC absolut unabdingbar ist. Hat es euch gefallen? Sind Fragen aufgetaucht? Wir freuen uns über euer Feedback! Richard, Sven, Jens und Torsten **Kategorien:** Tools & Methoden **Schlagwörter:** Corporate Development, Strategie, Technologiemanagement, Technologieradar --- ### [ETL mit LLM: Warum KI meine Zeichenkünste ernster nimmt als meine Kunstlehrerin](https://thecattlecrew.net/2025/12/19/etl-mit-llm-warum-ki-meine-zeichenkuenste-ernster-nimmt-als-meine-kunstlehrerin/) **Published:** Dezember 19, 2025 **Author:** Sebastian Pospiech **Content:** Vor Kurzem schrieb ich davon, wie Human-Computer Interaction (HCI) unsere Art und Weise, wie wir mit Computern interagieren, ändert – und sprang dann in eine Nische meines Herzensthemas Business Intelligence: dem ETL (Extract, Transform, Load). Auf dieser Reise habe ich euch berichtet, dass das ETL in so einer Art kleiner Krise steckt. Wo bis vor fünf Jahren grafisch basierte Low-Code-Ansätze dominierten, kehrt man aus vielfältigen Gründen nun zurück in echtes Coding. Absoluter Change-Horror für unseren inneren Elefanten. Probieren wir doch mal aus, ob uns das LLM (Large Language Model) retten kann … ## Die Demo Ich bekomme CSV-Dateien mit Informationen von einer Photovoltaik-Anlage. Darin enthalten ist eine Dimension: Zeit. Die Daten sind Aggregate im Abstand von ca. 5 Minuten. Erste kleine Gemeinheit: technologiebedingt können es auch mal 5:01 Minuten sein oder 5:03 Minuten. Dazu gibt es eine Reihe von Fakten wie den Ertrag, die Netzeinspeisung usw., jeweils in Kilowatt angegeben als Aggregat für dieses „ca. 5-Minuten“-Intervall. ![CSV-Datei mit den Werten der PV-Anlage](https://thecattlecrew.net/wp-content/uploads/2025/12/catlle-crew-etl-und-llm_3_bild1.png)CSV-Datei mit den Werten der PV-Anlage ![Säulendiagramm zu den Tagesaggregaten der PV-Anlage](https://thecattlecrew.net/wp-content/uploads/2025/12/catlle-crew-etl-und-llm_3_bild2.png)Säulendiagramm zu den Tagesaggregaten der PV-Anlage (KI-generiert) ## Versuch 1: Eine textuelle Beschreibung für ein einfaches Importieren Das LLM bekommt eine CSV-Datei mit den oben genannten Inhalten und folgende Beschreibung: Ich möchte, dass du ein Python-Skript schreibst: – Lese eine oder mehrere CSV-Dateien mit diesem Format und Inhalt – Schreibe die Inhalte 1:1 in eine MariaDB-Tabelle namens `stage_pv` – Bitte erzeuge auch ein DDL mit den Create-Befehlen – Nach Abarbeitung einer Datei, schiebe sie in den Unterordner `Archiv` – Vermeide Leerzeichen in Spaltennamen und füge eine Spalte mit dem Dateinamen hinzu, aus dem die jeweilige Zeile kommt – Die Datenbank erreichst du über `localhost:3306`, Benutzername: `demouser`, Passwort: `123`; Schema: `demo` ### Was hat funktioniert? - Ich bekomme ein lauffähiges Python-Skript. - Ich kann den Pfad als Parameter mit angeben. - Das LLM importiert eine CSV oder iterativ mehrere. - Es hat meine Anweisungen bezüglich der Daten, des Logins zur Datenbank und der Archivierung der Datei umgesetzt. ### Was hat nicht so gut funktioniert? - Ich habe nicht erfahren, welche Python-Bibliotheken ich noch herunterladen muss. - Das DDL, um die Tabelle zu erstellen, ist eingebettet. Das brauche ich bei einem regelmäßig laufenden Job nicht. Ein einmaliger DDL-Befehl wäre mir lieber gewesen. Ganz ehrlich: Zwei Minuten Arbeit und ich habe ein Skript, das ich so laufen lassen kann und das seinen Job macht. Keinen komplexen. Aber es läuft, ist leserlich formatiert und in Funktionen untergliedert. ![Ein Blick in die Python Bibliothek](https://thecattlecrew.net/wp-content/uploads/2025/12/catlle-crew-etl-und-llm_3_bild3.png)Die vom LLM generierte Staging-Tabelle Die Abstriche sind Nebensache und lassen sich mit einem „Kannst du mir bitte das Create-Skript als .sql einzeln geben?“ lösen. Ich habe hier auch nicht präzise gepromptet. Allerdings: Während ich dies schreibe, nutze ich das taufrische OpenAI-5.2-Modell. Mit dem 5.0 hat der gleiche Prompt auch die beiden Negativpunkte besser gelöst. Sei’s drum. Weiter geht’s. ## Schaffen wir Fakten Ja, so einen einfachen Staging-Job zum Import von Hand zu schreiben ist nervig, aber das kann man heute auch super generisch erledigen. Als Data-Lakehouse-Betreiber hat man sein Ingestion-Framework, welches das ziemlich schnell erledigen sollte, parat. Da braucht’s die KI im Grunde nicht. Gehen wir einen Schritt weiter und erzeugen echte Kennzahlen. Mein Prompt: Ich möchte außerdem, dass du eine View v\_fkt\_pv anlegst, die auf der stage\_pv basiert und neben den gegebenen Spalten zusätzlich eine Umrechnung in Kilowattstunden anbietest sowie die Autarkie pro Zeile. Ich möchte, dass du eine fkt\_pv anlegst, die den Output der View persistiert und mit jedem Ladelauf aktuell gehalten wird. Ich möchte, dass du eine fkt\_pv\_agg anlegst, die eine Aggregation der Einzelwerte auf Tagesbasis vornimmt. Ich beschreibe also relativ präzise, wie er die Faktenschicht bauen soll, nämlich mit einer View als Definition für Transformationen und einer Persistenzschicht. Allerdings verrate ich dem LLM ein paar Dinge NICHT. So erfährt es - nichts davon, wie es auf Kilowattstunden kommt, - nichts davon, dass die Zeilen Aggregate unterschiedlicher Länge beinhalten – was entscheidend ist für eine korrekte Umrechnung in kWh, - und ich erzähle auch nicht, was ich mit „Autarkie“ meine. Und siehe da. Es riecht den Braten: (s.stromerzeugung\_kw \* (IFNULL(TIMESTAMPDIFF(SECOND, LAG(s.uhrzeit) OVER (PARTITION BY s.source\_filename ORDER BY s.uhrzeit), s.uhrzeit), 300) / 3600.0)) AS stromerzeugung\_kwh,Statt auf fixe 5-Minuten-Intervalle zu gehen, baut es eine LAG-Funktion in die Abfrage ein und macht es sauber, fragt mich aber gleichzeitig: *„Wenn du mir kurz sagst, ob deine Daten immer 5-Minuten sind (oder variabel), kann ich dir die kWh-Berechnung noch so anpassen, dass sie:* *– entweder fix per Parameter läuft (z. B. –interval-seconds 300)* *– oder robust per LEAD/LAG + Plausibilitätskappung (z. B. max. 15 min, min. 1 min) gerechnet wird.“*Das heißt, die KI merkt, dass man hier vereinfachen könnte, wenn die Datenqualität etwas besser wäre. Auch die Autarkie, also den Anteil am Eigenverbrauch, der über die PV-Anlage abgedeckt wird, berechnet sie korrekt als **1 – (Netzbezug / Stromverbrauch)** inkl. 0-Teiler-Absicherung. ## Und jetzt die Sternchenaufgabe Ich gebe der KI den Endgegner: meine Zeichenkunst. Ich fertige ganz im klassischen ETL-Style einen graphischen Datenfluss an und gebe ein paar Stichwörter mit, wie z. B., dass die Quelle eine CSV ist, welche Tabellen ich erwarte und welche KPI. Der Prompt sieht so aus: Ich habe dir eine CSV-Datei mitgegeben. Das ist ein Beispiel für eine tägliche Quellsystemlieferung. Bitte implementiere eine ETL-Strecke, wie im PNG skizziert, für diese CSV.![Skizze der ETL-Strecke](https://thecattlecrew.net/wp-content/uploads/2025/12/cattle-crew-etl-und-llm_bild6-e1766130677358.png)Skizze der ETL-Strecke ### Die KI ist nicht intelligent An dieser Stelle sei erwähnt: Eine KI besitzt natürlich keine echte Intelligenz, auch wenn das „I“ dies suggeriert. Hinter ihr steht ein Algorithmus – ein kompliziertes Matheprogramm, das ausrechnet, wofür man es geschaffen hat. Es sind clevere und komplexe Aufgaben, aber am Ende sind es Matheaufgaben. Das LLM ist in der Lage, einen Text aus einer Datenbank entgegenzunehmen und für jedes Textstück Vektoren abzurufen – dargestellt als Zahlen, die das Wort beschreiben – und dann ähnliche Wörter als Antwort zu finden. Das sind Wörter mit nahegelegenen Vektoren, vereinfacht ausgedrückt. Und diese nahen Wörter nach und nach immer wieder durchgerechnet ergeben dann die Antwort. ### Was brauche ich für ein gutes Ergebnis? Damit ich ein gutes Ergebnis erhalte, kommt es also darauf an, dass 1. eine gute OCR-Erkennung vorgeschaltet ist, die meine Handschrift erkennt 2. und meine Skizze genug beschreibende Elemente enthält. Als erstes fällt auf, dass deutlich länger „nachgedacht“ wird als zuvor. Allerdings habe ich nun auch die komplette Anforderung eingekippt, nicht wie zuvor in zwei Teilen. Das LLM suggeriert mir erst mal, es habe verstanden, was ich will: *„Hier ist eine komplette ETL-Strecke für deine tägliche PV-CSV – exakt nach der Skizze:* *CSV ? stge\_pv (1:1) ? fkt\_pv (+ kWh-Spalten + Autarkie) ? fkt\_pv\_agg (Tages-SUM je Typ)“*Das heißt, die OCR-Erkennung scheint funktioniert zu haben. Mehr lässt sich daraus zunächst nicht ableiten. Offensichtlich ist die 1:1-Wiedergabe dessen, was ich möchte, in einem Vektorraum mit nahe beieinanderliegenden Repräsentationen noch kein Ausdruck von tatsächlichem Verständnis. Übrigens ein Grund, warum die KI immer so „selbstsicher“ und korrekt wirkt und doch, wenn sie etwas nicht kann, ganz zwangsweise halluziniert (lügt). Dieses Mal wird mir eine ZIP-Datei angeboten. Das LLM liefert neben dem eigentlichen Code ein docker-compose-File, das eine lokale Datenbank startet, sowie eine README und eine requirements.txt. Im Vergleich zum vorherigen Prompt wählt es damit an einer Stelle, an der ich in beiden Fällen Freiheitsgrade gelassen habe, einen anderen Lösungsweg. Der Prompt war allerdings etwas präziser: „Die Datenbank erreichst du über …“ suggeriert, dass diese bereits existiert. Daher wurde im ersten Versuch kein docker File bereitgestellt, welches eine Datenbank hochfährt. Hier schon, da es keine Aussage gab, ob ich eine Datenbank erstellt haben oder nur ansprechen möchte. Ich übernehme lediglich den Python-Code und lasse die restlichen Artefakte weg. Wie zuvor führe ich ihn blind aus – ganz im Sinne eines fail-fast-Ansatzes. Und er failt fast: keine Datenbankverbindung. Bei der Analyse stelle ich fest, dass meine handschriftliche Vorlage nicht korrekt erkannt wurde; ich passe den Datenbanknutzer an. Zusätzlich scheint das diesmal verwendete SQLAlchemy Probleme mit der DNS-Namensauflösung zu haben. Statt localhost nutze ich daher 127.0.0.1 – und siehe da: es läuft. Ich erhalte die Staging-Tabelle (mit dem Namen „stge“) sowie beide gewünschten Faktentabellen. Auch in dieser Version werden alle KPIs korrekt berechnet. Beim Durchlesen des Codes fällt jedoch schnell die veränderte Herangehensweise auf: Während zuvor stark SQL-lastig gearbeitet wurde – was ich durch die View explizit intendiert hatte –, wird die Business-Logik diesmal deutlich näher am Python-Code umgesetzt. Nachfolgend ein Ausschnitt aus der Berechnung der kWh-Stunden: ![Ein Auszug des Skripts](https://thecattlecrew.net/wp-content/uploads/2025/12/cattle-crew-etl-und-llm_bild7.png)Ein Auszug des Skripts Die Faktentabelle mit dem Tagesaggregat sieht diesmal völlig anders aus: ![Tabelle mit dem Tagesaggregat der PV-Anlage](https://thecattlecrew.net/wp-content/uploads/2025/12/cattle-crew-etl-und-llm_bild8.png)Tabelle mit dem Tagesaggregat der PV-Anlage Fachlich ist sie korrekt, aber sie wurde transponiert. Statt einem Attribut je Kennzahl, gibt es eine Spalte für die Metrik und eine beschreibende Spalte. Die Skizze ließ hier einfach mehr Spielraum zur Interpretation des Ergebnisses zu als ein gut formulierter Prompt. Dennoch: Für eine so lieblos dahingeschmierte Skizze wie meine war das Ergebnis durchaus brauchbar. ## Fazit Ich habe in diesem Beitrag praktisch gezeigt, wie die Theorie des HCI im Sinne von *Die Arbeit mit einem Computer ist ähnlicher zur Kommunikation mit einem Gegenüber als dem Nutzen eines Werkzeugs (und mit LLMs erst recht)* für eine Nische der Softwareentwicklung aussehen kann. Der Test mit dem OpenAI-Modell 5.2 war durchaus gut, und in dieser Qualität kann man verwendbaren Code produzieren. Eine fachliche Beschreibung und eine Zeichnung, die das Wesentliche sichtbar macht, müssen als Anforderungsdokumentation ohnehin angefertigt werden. Es ist also denkbar, eine verständlich geschriebene und strukturierte Story als Aufsatzpunkt zum Coden zu nehmen. Für die angesprochene Nische ETL, die sich aktuell in einem großen Change befindet, könnten LLMs eventuell diese Lücke füllen und eine Hilfestellung für Menschen sein, die sich nun umstellen müssen. Der zuletzt erzeugte Code ist übrigens inklusive Kommentaren 337 Zeilen lang. Das grafische ETL-Tool Talend, in dem dieselbe Semantik abgebildet wurde, hat hingegen 9.319 Zeilen Java-Code produziert – was einer der Gründe dafür ist, warum diese Tools kritisch betrachtet werden. ### Müssen wir nun Sorge um unsere Jobs haben? Nein. Ohne Verständnis für Datenmodellierung, ETL und Co. würden wir 1. nicht verstehen, was da passiert, könnten außerdem nicht debuggen und müssten dem LLM vollends vertrauen. 2. könnten wir die Prompts nicht präzise genug schreiben. 3. ist das LLM nur so gut wie das Wissen, mit dem es gefüttert wurde. Es braucht also die Entwickler:innen da draußen, die Lösungen finden, Kennzahlen definieren und Berechnungen implementieren, damit das LLM diese finden und wiedergeben kann. Denn mehr tut es nicht: Es gibt Wissen wieder, das ein Mensch gefunden hat. Die Suche nach dem passenden Wissen wird nur leichter. --- ## Mehr aus dieser Serie lesen? Diese Reihe lohnt sich für alle Analytics-Expert:innen, die verstehen wollen, wie KI und LLMs unsere tägliche Praxis im BI- und ETL-Umfeld verändern. 1. **Was haben ein Hammer und ein LLM (nicht) gemeinsam?** In diesem Einstiegsteil geht es um die Grundidee hinter LLMs und Human-Computer Interaction: Warum ein LLM kein Werkzeug im klassischen Sinne ist, wie natürliche Sprache zur neuen Schnittstelle wird und welche Rolle das für die Interaktion mit Systemen spielt. Hier weiterlesen: [Was haben ein Hammer und ein LLM (nicht) gemeinsam?](https://thecattlecrew.net/2025/10/02/was-haben-ein-hammer-und-ein-llm-nicht-gemeinsam/) 2. **Vibe Coding im BI-Bereich – Wie KI uns ETL-Entwickler retten kann** Der nächste Beitrag der Serie widmet sich dem Trend Vibe Coding, bei dem KI-gestützte Interaktion die Art verändert, wie Code entsteht und Workflows definiert werden. Er beleuchtet, wie dieser Ansatz für BI-Teams aussehen kann und welche Chancen er für ETL-Entwickler bietet. Hier weiterlesen: [Vibe Coding im BI-Bereich: Wie KI uns ETL-Entwickler retten kann](https://thecattlecrew.net/2025/11/24/vibe-coding-im-bi-bereich-wie-ki-uns-etl-entwickler-retten-kann/) **Kategorien:** AI & Data Science, Analytics & Insights --- ### [Was machen Business Analysten? – Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) **Published:** April 30, 2025 **Author:** Charlotte Grade **Content:** Business Analysten lieben das Unbekannte. Sie entdecken, analysieren und bringen Struktur ins Chaos – und dabei spielt Sprache eine zentrale Rolle. Gemeinsam mit Fachleuten entwickeln sie Lösungsansätze, übersetzen Ideen in Konzepte und helfen, Ergebnisse in produktive Bahnen zu lenken. Vor allem in der Zusammenarbeit mit Informatiker:innen, Mathematiker:innen und Physiker:innen sind Business Analysten unentbehrlich. Sie sind geduldig, analytisch und gewissenhaft – denn Sicherheit und Klarheit stehen an erster Stelle. Und natürlich: Dokumentation ist ihr zweiter Vorname. Besonders im Anforderungsmanagement, dem Lieblingsbegriff vieler Analyst:innen, zeigt sich ihre Stärke. --- Neugierig? Hier geht’s zu den ersten beiden Teilen der Serie: [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) Aber nun zurück zu diesem 3. Teil der Serie – Let’s go! --- ## Was sind eigentlich Anforderungen? In Projekten fällt das Wort „Anforderungen“ oft – und nicht immer ist klar, was gemeint ist. Es wird fast inflationär verwendet, doch selten sauber definiert. Tatsächlich sind Anforderungen oft vage Ideen, noch nicht dokumentiert, noch nicht greifbar. Sie entstehen, wenn Expertinnen über lange Zeiträume hinweg Wissen anhäufen – oft in mehreren parallelen Projekten. Dabei nimmt jede Person nur ein Puzzlestück mit. Das führt zu wertvollem, aber verstreutem Wissen. Irgendwann muss jemand das kreative Chaos ordnen – und das ist selten die Lieblingsaufgabe der Fachexpertinnen. Hier kommen Business Analysten ins Spiel: Sie sammeln, bündeln, strukturieren und übersetzen Wissen in umsetzbare Aufgaben. Dieser Prozess – auch sprachliches Mapping genannt – ist essenziell, um aus Ideen tatsächlich funktionierende Produkte oder Prozesse zu machen. ### Kurz gesagt: Anforderungen sind oft lose Wissensfragmente – schön gedacht, aber noch nicht nutzbar. ## Die Anforderungsanalyse: Zuhören, fragen, ordnen Business Analysten arbeiten mit Texten und Zahlen, oft mit beidem gleichzeitig. Sie analysieren Berichte, führen Gespräche, nehmen an Meetings teil und extrahieren systematisch relevante Informationen. Doch: Niemand legt ihnen freiwillig alle Daten auf den Tisch. Analyst\*innen müssen aktiv auf Stakeholder zugehen, mutig nachfragen und feinfühlig Informationen einholen – oft über Wochen hinweg. Sobald Informationen vorhanden sind, beginnt die eigentliche Analyse: 1. Inhalte werden bewertet, geordnet, kategorisiert. 2. Sensible Daten werden mit Bedacht behandelt. 3. Ergebnisse werden in der Sprache der jeweiligen Organisation formuliert – ob Bank, Versicherung oder IT-Unternehmen. ### Tipp: Konzentriere dich auf fachlich relevante Inhalte. Zu viele irrelevante Details können Entscheidungen behindern. Prägnanz spart Zeit. ## Vom Analyse-Chaos zum Anforderungsmanagement Sind Anforderungen analysiert, gilt es, sie nachhaltig verfügbar zu machen – und zwar für alle Beteiligten. Das bedeutet: Inhalte müssen strukturiert dokumentiert werden, am besten in den Systemen, die der Kunde nutzt. Dabei gilt es, sich an interne Vorgaben zu halten – jede Organisation hat ihre eigenen Standards. Business Analysten bauen in dieser Phase ein Wissensportfolio auf, das: 1. fortlaufend wächst, 2. regelmäßig geprüft wird, 3. und langfristig lebendig bleibt. Das Ziel: Wissen kontrollieren, Entscheidungen ermöglichen, Projekte antreiben. ### Ein Beispiel: Stell dir einen verspielten Welpen vor, der durch dein Wohnzimmer rennt – wild, chaotisch, aber voller Energie. Damit er nicht die teure Vase umwirft, braucht es Erziehung, klare Strukturen und Geduld. Genauso ist es mit Wissen im Projekt: Ohne Kontrolle ist es schnell verloren. Anforderungsmanagement ist quasi der Hundekurs fürs Projektwissen. ### Notizen und Dokumentationen Eine Notiz ist keine Dokumentation. Allerdings kann eine Notiz ein Bestandteil einer umfassenden Dokumentation sein. Beim Anforderungsmanagement entstehen viele Ideen. Die meisten Ideen werden nie gebraucht. Business Analysten schreiben aber auch solche Ideen auf. Dadurch entstehen Grafiken, die einem Mini-Prozessmodell ähneln, weil sie für eine ‚richtige Grafik‘ viel zu schematisch erarbeitet sind. Diese Grafiken sind Randnotizen und werden für die Erarbeitung einer Business-Analyse-Dokumentation gebraucht. Diese Notizschnipsel sind also auch nicht als Workshop-Vorbereitung geeignet, weil dafür zu viel Inhalt fehlt. Sie werden aber beispielsweise während eines Workshops erarbeitet und fließen dann in die Anforderungsanalyse mit ein. Das ganze sieht dann so aus. ![](https://thecattlecrew.net/wp-content/uploads/2025/04/Scan-11-Apr.-25-18·17·36-17443883079131-3-scaled.jpeg) Mehr zur Methodik findest du übrigens auch im zweiten Teil dieser Serie: [Die unsichtbare Kraft hinter erfolgreichen Projekten.](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) ## Wie Wissen nutzbar wird Gut gemanagte Anforderungen helfen nicht nur Business Analysten – sie bringen das ganze Projektteam voran. Möglich wird das durch: 1. Dashboards 2. Workshops 3. Schulungen 4. Folgeprojekte So wird Expertenwissen geteilt, Entscheidungen werden fundierter und Entwickler erhalten konkrete, umsetzbare Aufgaben. ### Merke: Anforderungsmanagement heißt, analysierte Informationen kontrolliert zugänglich zu machen – dauerhaft, nachvollziehbar, nutzbar. ## Fazit Business Analysten bewegen sich zwischen Analyse, Kommunikation und Dokumentation. Sie sammeln Wissen, strukturieren es und schaffen die Basis für umsetzbare Ergebnisse. In Teil 3 unserer Serie ging es um Anforderungen – vom ersten Gespräch bis zur langfristigen Dokumentation. Bleib dran! Im nächsten Teil geht’s darum, wie **Dashboards zum Fliegen gebracht werden.** --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Business Intelligence, Data Warehouse, Moderation --- ### [Was machen Business Analysten? – Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) **Published:** April 4, 2025 **Author:** Charlotte Grade **Content:** Business Analysten – sie sind überall! In Banken, Versicherungen, Start-ups und der Industrie. Aber was macht sie so unersetzlich? Sie jonglieren mit Zahlen, Technik und Fakten, bleiben selbst in den unruhigsten Projekten gelassen und wissen: Die richtigen Fragen bringen die besten Antworten. Ein Tag im Leben von Business Analysten beginnt selten ruhig. Ein Beispiel: Du startest deinen Laptop im Homeoffice oder kommst ins Büro, und schon prasseln die ersten Anfragen auf dich ein. Der Product Owner braucht Klarheit zu einer Anforderung, das Entwicklungsteam hat technische Rückfragen, und eine Stakeholder-Person möchte wissen, warum ein bestimmter Prozess so lange dauert. Na, neugierig geworden? In diesem Blogpost erfährst du, welche methodischen Werkzeuge Business Analysten nutzen, um Projekte voranzubringen. --- Für alle, die neu dabei sind: Hier geht es zu Teil 1 dieser Serie: [Was machen Business Analysten? – Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) --- ## Methodik: Struktur statt Chaos Business Analyse ist ein Zusammenspiel aus Kommunikation und Dokumentation. Ohne klare Strukturen verliert sich ein Projekt schnell im Nebel der Anforderungen. ![Ein Kreisdiagramm zeigt Kommunikation und Dokumentation im Wechselspiel](https://thecattlecrew.net/wp-content/uploads/2025/02/Bild1.jpg) Business Analysten setzen dabei auf verschiedene Tools und Techniken: 1. **Excel-Tabellen** zur schnellen Analyse von Daten 2. **Hands-on Notizen** für spontane Ideen 3. **Listen und Organizing-Tools**, um den Überblick zu behalten 4. **Textdokumente** zur detaillierten Anforderungsbeschreibung Doch Tools allein reichen nicht. Die wahre Herausforderung liegt in der schnellen Anpassung an kundenspezifische Systeme. Nicht alle Unternehmen arbeiten mit Jira oder Confluence, manche setzen auf Tableau, andere auf MS Power BI. Wer das nicht versteht, verbringt viel Zeit mit doppelter Dokumentation. Hier gilt: Keine Angst vor Aufgaben: 1. Aufgaben sollten in agilen Kontexten am Sprintplan ausgerichtet sein. 2. Tages- und Stundenplanung hilft, Zeit für Meetings und kreative Ideen zu schaffen. 3. In Meetings: aufmerksam zuhören, mitschreiben, nachbereiten. So bleibt man auf dem neuesten Stand. ### Umsetzung der Methodik: Flexibilität ist der Schlüssel Vielleicht denkst du jetzt: Das ist leichter gesagt als getan. Wie lassen sich all diese Aufgaben mit Leichtigkeit bearbeiten? So, dass am Ende alle Beteiligten mit dem Ergebnis zufrieden sein können? Die Lösung heißt **Dynamisches Aufgabenmanagement:** 1. Offene Tasks nach Priorität neu ordnen. 2. Flexible Zeiträume einplanen. 3. Wichtige Aufgaben nicht zu lange mitziehen. Zusätzlich helfen regelmäßige Schulungen, um flexibel auf Kundenwünsche eingehen zu können. Die Themen reichen von Requirements Engineering über Prozessmanagement bis zu Soft Skills und technologische Vertiefungen. Gerade in unvorhersehbaren Situationen müssen Business Analysten bereit sein, spontane Workshops oder Schulungen vor großen Gruppen zu halten – auch zu Themen, die sie selbst erst vor Kurzem kennengelernt haben. #### **Business Analyse in Action:** Ein Praxisbeispiel Ein Unternehmen aus der Versicherungsbranche hat ein klares Ziel: eine neue Software soll Schadensfälle schneller bearbeiten. Doch das Projekt steckt fest. Die Fachabteilung wünscht sich eine intuitive Oberfläche, die IT hat eine hochkomplexe technische Lösung entwickelt. Keiner versteht die andere Seite. Hier kommt die Business Analyse ins Spiel. Innerhalb weniger Stunden: 1. Werden bestehende Dokumente analysiert, 2. Gespräche mit Stakeholder-Personen geführt, 3. Der Knackpunkt identifiziert: fehlende Kommunikation zwischen IT und Fachabteilung. Der Vorschlag? Ein gemeinsamer Workshop, in dem beide Seiten ihre Anforderungen und Möglichkeiten offenlegen. Das Ergebnis: Eine klare, umsetzbare Lösung – und ein Projekt, das endlich vorankommt. ### **Warum jedes Team einen Business Analysten braucht** Die Zusammenarbeit mit Business Analysten zahlt sich aus. Sie bringen Struktur ins Chaos, entdecken Optimierungspotenziale und sorgen dafür, dass alle Beteiligten an einem Strang ziehen. Ob in der Versicherung, Industrie, einem Start-up oder der öffentlichen Verwaltung – eine gute Business Analyse ist immer eine Bereicherung. ## **Fazit** Ohne Business Analysten bleiben viele Projekte bloße Ideen. Sie sind die Übersetzer zwischen Fachbereich und IT, die Architekten der Anforderungen und die Strippenzieher für den Projekterfolg. Bald folgt Teil 3 dieser Blogreihe über Business Analysten. In [Teil 3](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) teile ich als Business Analyst meine Erfahrungen zu Anforderungsanalysen und dem Anforderungsmanagement. --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Agil, BI, Data Visualization, Workshop --- ### [Was machen Business Analysten? – Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) **Published:** März 27, 2025 **Author:** Charlotte Grade **Content:** Sie sind up to date und kennen den Markt: Business Analysten unterstützen Product Owner, Developer, Projektmanager, Führungspersonen, Stakeholder und natürlich ihre Vorgesetzten. Mit Business Analysten zusammenzuarbeiten – so höre ich es oft – bringt nicht immer Freude, erleichtert aber das Projektcontrolling! Denn sie können besondere Dinge: Zum Beispiel finden sie die Lösungen, die ein Kunde erwartet. Außerdem ist ihr Namensgedächtnis phänomenal, denn ihr soziales Umfeld skaliert immer wieder während eines Projekts. Aber was machen Business Analysten eigentlich den lieben langen Tag? Als Analystin sollte ich es wissen und die Antwort ist alles andere als langweilig! In diesem Blogpost erfährst du, welche **vier Aufgaben** für Business Analysten entscheidend sind, um die Lage zu überblicken. ## 1. Informationen sammeln Zu Beginn kommt es für die Business-Analyse darauf an, einen Überblick zu bekommen. Danach ist es wichtig, während der gesamten Projektlaufzeit den Überblick zu behalten. Und das ist gar nicht so einfach, wie es klingt. Denn zu Beginn eines Projekts ist oft Chaos angesagt: Das Projektteam des Kunden stellt sich vor. Organisatorische Aufgaben werden abgearbeitet. Es gibt viel fachlichen Input. Dieses Wissen muss aufgeschrieben werden, erste „Kennenlernpräsentationen“ werden erarbeitet und dann geht es auch schon ans Eingemachte: 1. Präsentationen 2. Moderationen 3. und das Daily Business. Stell dir vor, du kommst in ein völlig fremdes Haus und sollst herausfinden, wo die Tür, die Fenster und das Badezimmer sind – und zwar möglichst schnell. Genau dafür ist eine Business Analyse da: Die Business-Analyse-Fachleute sammeln Informationen, sortieren sie und erstellen daraus eine Karte, die für alle verständlich ist. ## 2. Zeit managen Nachdem alles abgestimmt wurde, müssen die Aufgaben des Kunden abgearbeitet werden. Um diese Arbeit zu bewältigen, braucht es ein gutes Aufgabenmanagement. Denn jeden Tag verlängert sich die Aufgabenliste. **Dann heißt es:** Aufgaben thematisch strukturieren, Aufgabenpakete mit wenigen oder vielen Aufgaben bestücken und sofort einplanen. Parallel können die ersten einfachen Aufgaben bereits abgearbeitet werden. **Wichtig:** Bereits zu Beginn eines Projekts heißt es, Termine mit den Beteiligten vereinbaren! Also mit denjenigen, die das Projektziel im Auge behalten müssen: 1. Stakeholder 2. Kunden 3. Dienstleister 4. weitere Ansprechpersonen ## 3. Kommunizieren & dokumentieren Kommunikation mit Ansprechpartnern, und die Dokumentation der Fachinhalte in den Systemlandschaften des Kunden sind wichtige Aufgaben für die Analyseverantwortlichen. Allerdings kann es auch vorkommen, dass Business Analysten und Analystinnen nicht direkt zu Projektbeginn eingesetzt werden, sondern erst im Projektverlauf dazukommen. Dann heißt es für sie, sich schnell zurechtfinden und wie immer: Erst mal einen Überblick bekommen! ## 4. Wissen weitergeben Erst wenn Business Analysten die Lage überschauen, können sie Wissen stückchenweise aufbauen. Wissen, das im späteren Projektverlauf gebraucht wird. ### Analysten als gefragte Wissensträger Die Personen, die Business-Analysen anfertigen, entwickeln sich zu Wissensträgern. Oft sind sie die einzigen mit einem detaillierten Blick auf alle Projektinhalte. Und das hat Folgen: Irgendwann sind nicht mehr sie es, die Termine einstellen und Ansprechpersonen und Stakeholder einladen, sondern sie selbst werden zu Terminen und regelmäßigen Meetings eingeladen. Anders als in den selbstorganisierten Terminen haben Business Analysten in Terminen, zu denen sie eingeladen wurden, die Aufgabe, über Fachinhalte aus dem Projekt zu sprechen. Meist werden gezielte Fragen gestellt und präzise Antworten erwartet; Antworten die nachweislich korrekt ausfallen. Da kann es schnell passieren, dass eine Antwort, die gegeben wurde, nicht direkt das Thema trifft, das gerade besprochen wird. Dann hakt ein Kunde gerne zwei oder drei Mal nach und wartet auch nach Terminende geduldig auf die korrekte Antwort. Denn das Wissen aus der Analyse wird gebraucht: Mit diesem Projektwissen werden Entscheidungen getroffen, das Projektbudget „controllt“ und Projektpläne erarbeitet. ## Ausblick Im zweiten Teil dieser Serie geht es um die Frage [Was machen Business Analysten? – Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/). Es lohnt sich dran zu bleiben! **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Data Warehouse, Datenstrategie --- ### [Was machen Business Analysten? – Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) **Published:** Mai 28, 2025 **Author:** Charlotte Grade **Content:** Business Analysten arbeiten zwischen IT und Fachbereichen. Sie suchen in Daten und Datenbanken spezifische Zahlen, an denen es sich lohnt, dranzubleiben – oder anders ausgedrückt: Sie suchen Potenziale für Report-Statistiken in Organisationen. Deshalb erstellen sie für Fachbereiche diverse **Auswertungen, Analysen, Reportings- und Report-Landschaften**. Das passiert aktuell nicht mehr nur mit Microsoft Excel und MS Access sondern auch mit Dashboard-Tools, wie **Tableau, Power BI oder SAP BO/BI Business Objects**. Dashboard-Tools sind Teil von Business-Intelligence-Lösungen (**BI-Tools**) oder Analytics-Software und kommen in allen Branchen zum Einsatz: von Automobilbranche, Logistik- oder Finanzsektor, bis hin zur öffentlichen Verwaltung; sogar im Startup-Umfeld sind sie anzutreffen. Inhaltlich sind diese Tools allerdings – auch kostentechnisch – eher für große und langfristige Vorhaben geeignet. Daher werden sie am häufigsten im Finance-Umfeld oder im Strategie- und Marketing-Bereich verwendet. Was ein Dashboard in der Business Analyse leistet – Funktionen, Beispiele und Tipps zur Umsetzung, zeige ich in diesem Teil der Serie **‚Was machen Business Analysten?‘**. --- Neu hier? Hier kannst du dir die ersten drei Teile der Serie ansehen: [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) Aber nun zurück zu diesem 4. Teil der Serie – Let’s go! --- ## Was sind Dashboards? **Dashboards** bieten Übersichten, mit wenigen oder vielen Auswertungen, die interaktiv genutzt werden können. Fachlich ausgedrückt: **Daten werden in Übersichtsblättern visualisiert**, also grafisch dargestellt. So entstehen nicht nur Analyseergebnisse sondern lebendige Auswertungen, die direkt für Entscheidungen herangezogen werden können. Business Analysten lieben es, auf diese Art und Weise, Entscheidungsvorlagen, für Kund:innen zu erstellen. Dashboards sind also moderne Werkzeuge für **Reporting** und **Business Intelligence**. Sie ermöglichen datenbasierte Entscheidungen auf einen Blick – sie sind also aus dem standardisierten BWL-Berichtswesen. Das klingt ziemlich langweilig, oder? Das Berichtswesen hat einen Bezug zum **Strategischen Management** – egal, ob in Geschäftsleitungsbereichen, auf Vorstandsniveau, oder beispielsweise in IT-Abteilungen. Dashboards sind ein Management-Instrument, die Kennzahlen – sogenannte **KPIs** (Key Perfomance Indicator) abbilden. Darüber können Umsatzentwicklungen, Geschäftsfeldentwicklungen und Trendanalysen mit Prognosetendenz erstellt werden. **Denn: Dashboards leben von Daten.** ## Beispiel: Dashboard in Rohfassung Diese Skizze zeigt, wie unglaublich kompliziert ein Dashboard im Ergebnis auf den ersten Blick aussehen kann. Dabei wird hier nur genau ein Dashboard beispielhaft gezeigt. Es gibt auch Fachbereiche und Organisationseinheiten, die mit mehreren Dashboards arbeiten. ## ![](https://thecattlecrew.net/wp-content/uploads/2025/05/Blog-4.quer_.jpeg) Wie komplex ist es, ein Dashboard zu erstellen? Kommt‘ drauf an! Dashboards enthalten strategische Kennzahlen (KPIs: Key Perfomance Indicator). Die Erstellung eines einzelnen Dashboards kann wenige Minuten oder Stunden dauern; manchmal nimmt es auch Wochen oder Monate in Anspruch. Das hängt davon ab, welche Fragestellungen ein Dashboard beantworten soll. ### **Beispiel aus einem Einstellungsgepräch für Business Analysten** Ein Unternehmen in der Logistikbranche möchte seine Umsatzentwicklung über die letzte fünf Jahre in einem Dashboard abbilden, um Potenzialanalysen auf Quartalsebene vorzunehmen. Das Ziel ist klar definiert und heißt: Wachstum. Es haben sich bereits erste Tendenzen gezeigt, dass es in den Wintermonaten zu Auslastungsdefizieten kommt, die durch den Zukauf von Geschäftsfeldern kompensiert werden könnten. Die Daten der Umsätze liegen allen vor. Die Erstellung – inklusive der Visualisierung der Dashboards – dauert daher in diesem Fall nur wenige Tage. Die Komplexität eines Dashboards hängt davon ab, welche Fragen es beantworten soll – und ob die nötigen Daten bereits vorliegen. Einfache KPIs wie Umsatzzahlen liegen einer Organisation zum Beispiel direkt vor. Aufwändiger wird es bei: 1. Spezifischeren Informationen 2. Daten, die länger in die Vergangenheit hinein reichen. Hier kann es also dauern und Business Analysten müssen dann besonders geduldig sein. ### Datenbeschaffung In der Praxis müssen Business Analysten diese Informationen zunächst in Form von Rohdaten über einzelne Fachbereiche anfragen und sich mit Expert:innen über den Detailgrad der relevanten Daten austauschen. Dafür sind manchmal wenige, manchmal auch viele Meetings nötig. Meist entwickeln sich Dashboards im Laufe der Zeit jedoch von alleine. Es fängt an mit einer ersten Variante, die im Zeitverlauf mit weiteren Inhalten, also Zahlen und Daten, angereichert und grafisch visualsiert werden. Erfahrene Analysten beginnen mit wenigen Inhalten, d. h. sie verzichten zugunsten der Richtigkeit der Auswertung zunächst auf Details. Denn: Gerade bei Auswertungen mit Zeitverlaufsbezug, wo eine Vergleichsgrafik von **Neudaten** zu **Altdaten** erstellen werden sollen, muss die **Vergleichsbasis** immer stimmen. ## Wann ist ein Dashboard fertig? (Spoiler: nie ganz) **Zunächst einmal:** Jedes Dashboard ist ein individueller, visuell-aufbereiteter Report. Er ist also ein Blitzlicht und damit nie „fertig“. Im Berichtswesen müssen Fragen beantwortet werden. Das braucht Zeit. Diese Fragen werden Business Anlaysten vorgegeben. Manchmal erarbeiten Business Analysten diese Fragestellungen auch zusammen mit Fachabteilungen aus dem Kundenkreis – zum Beispiel mit Projektleitung, Abteilungsleitung oder Geschäftsführung. (Wie so eine Anforderungsanalyse abläuft, erfährst du hier: ‚[Was machen Business Analysten? – Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/)‚) Dashboards werden häufig in Echtzeit aktualisiert. So sind die Daten immer präsent. Also wie gesagt: Mit einem Dashboard wird aktiv gearbeitet. Fertig ist es daher nie, sondern es wird stetig um weitere Inhalte ergänzt, mit neuen Daten und Altdaten für Vergleichsansichten angereichert, und in Nutzerkreisen zugunsten von Entscheidungen diskutiert. ### Ein Gerüst steht bereit Die Grundstruktur eines Dashboards kann jedoch einmal initial aufgebaut werden. Sind alle relevanten Daten im Dashboard da, ist der visualisierte Bericht fertig. Und natürlich kann dieser im Zeitverlauf weiter ‚***verschönert***‚ werden. ## Warum liefert der Bericht nicht das Ergebnis, das ich jetzt brauche? Dashboards bilden die Zahlen ab, die ausgewertet wurden. Liefert eine Auswertung also ein Ergebnis, ist das für uns gut und wir haben unser Ziel erreicht. Stellt darüber hinaus jemand aus dem **Dashboard-Team** fest, dass das Ergebnis im Dashboard nicht korekt ist, ist das noch besser. Dann kann das Dashboard optimimiert werden! ### Fehler finden und Reports verbessern Hier ein paar Beispielfragen, die im Falle eines falschen Wertes im Bericht an das Dashboard gestellt werden sollten: - Hat sich das Ziel hinter dem Dashboard verändert? - Stimmt die Datengrundlage eigentlich noch? - Wurde der Report in der Zwischenzeit um weitere Werte angereicht? Wurde die Anreicherung dokumentiert? Ist diese Datenanreicherung für jeden, der am Bericht arbeitet, nachvollziehbar? - Kann eine Ist-Soll-Analyse helfen, die aktuelle Abweichung zum erwarteten Ergebnis zu veranschaulichen? ## Welche Rolle spielen Business Analysten im Dashboard-Prozess? Business Analysten bewegen sich zwischen Development-Teams und dem Fachbereich. Sie verstehen also nicht nur die technische Seite, sondern begreifen vor allem, was das Fachpersonal inhaltlich braucht. Diese Anforderungen übersetzen sie so gut, dass exakt die Daten von der IT-Abteilung bereitgestellt werden, die erforderlich sind, um ein **qualitativ-hochwertiges Dashboard** zu erstellen. ### Schlüsselqualifikation: Fokus und Kommunikation Business Analysten handeln getreu nach dem Motto: ‚Wozu Daten auswerten, die gar nicht wichtig sind?!‘. Sie schaffen einen Fokus, haben immer das **Projektziel** im Blick und helfen konkrete Lösungen zu finden. Dabei stellen sie viele, viele Fragen und führen Gespräche mit allen Beteiligten, die für die Erstellung des Dashboards gebraucht werden. Alle Projektinvolvierte einzubinden und mitzunehmen gehört zu ihrem täglichen Geschäft. --- ## Fazit: Dashboards leben – dank Business Analyse Business Analysten lieben das Hinterfragen von Zusammenhängen. Daher fällt es ihnen auch so leicht, Dashboards zu bearbeiten. Du möchtest wissen, wie Business Analysten im Projektalltag ihre Aufgaben detailgetreu umsetzen können? Du bist vielleicht selbst Business Analyst und suchst nach einer gelungenen Organisationsstruktur für deinen Kalender? Dann bleib unbedingt dabei – wenn es in Teil 5 dieser Serie heißt: [Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/). --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Business Intelligence, Data Visualization, Data Warehouse, Datenmodellierung, Reports --- ### [Was machen Business Analysten? – Teil 9: Arbeiten in Gruppen und Projektteams](https://thecattlecrew.net/2025/11/19/was-machen-business-analysten-teil-9-arbeiten-in-gruppen-und-projektteams/) **Published:** November 19, 2025 **Author:** Charlotte Grade **Content:** Für Business Analysten ist die Arbeit in Gruppen und Teams alltägliche Normalität. In Fachbereichen gibt es immer mehrere Ansprechpersonen, oft eingebettet in Gruppen, Teams, Abteilungen oder Referaten – und natürlich in die übergeordneten Organisationseinheiten. Business Analysten laufen inhaltlich zwischen Fachbereichen und Entwicklern permanent hin und her, sammeln Informationen zu Projektinhalten und bereiten diese wiederum sowohl für Fachansprechpersonen als auch für Developer passgenau auf. Dafür müssen Personen und Rollen in Organisationen möglichst ‚*sauber*‚ auseinandergehalten werden. Oft werden Fachinhalte in großen Unternehmen sogar von genau einer Person pro Abteilung bearbeitet – bei einer Unternehmensgröße von mehreren hunderttausend Mitarbeitenden. Genauso wie einige Entwickler sich lieber in Python- und andere sich eher in Java-Umgebungen wohlfühlen, müssen Business Analysten mitdenken. --- Wie es Business Analysten trotz dieser Herausforderung schaffen regelmäßig zu überzeugen darum geht es in diesem Blogpost aus der Kategorie „Was machen Business Analysten?“. Du willst diese Serie besser von Anfang an beginnen? Das kann ich verstehen: [Hier geht’s zum Serienstart](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/). --- ## Was ist eine Gruppe? Ich habe einmal gehört, dass es einen Unterschied macht, ob man über Teams oder Gruppen redet. Während ein Team bereits bei einer Größe von zwei Personen starten kann und dann natürlich auch auf eine Teamgröße von acht oder zehn Personen anwachsen kann, definiert sich eine Gruppe erst ab einer Größe von mindestens drei Personen. Ich fand diese Unterscheidung interessant – vor allem, weil ich ursprünglich dachte, dass Teams so ungefähr das gleiche wie Gruppen sind. Wahrscheinlich hatte ich „Team“ immer als englischen Begriff verstanden und als Synonym für „Gruppe“ genutzt; ähnlich wie das Wort „Mannschaft“, das ja unter Umständen sprachlich auch eine Gruppe sein könnte. Das ist aber offensichtlich nicht so. Ich habe mir diese Unterscheidung zu Teams und Gruppen seitdem gemerkt. Eine Gruppe beschreibt sich also über die Größe von mindestens drei Personen, ein Team kann bereits aus zwei Personen bestehen. Projektmitglieder können in Gruppen arbeiten – und Business Analysten auch. Die folgende Skizze macht die Arbeit von Business Analysten in Gruppen ein wenig verständlicher: ![](https://thecattlecrew.net/wp-content/uploads/2025/10/blogpost9.jpeg) Im Kern sind Business Analysten Kommunikationsassistent:innen. Sie sind Unterstützer:innen. ### Business Analysten in Gruppen Business Analysten gehen in Gruppenkontexten in Projekten zumeist: - aktiv, - offensiv und - ruhig vor. #### 1 Das Reh nicht aufscheuchen Ein guter Vergleich ist ein 15-Kilometer-Lauf in der Natur. Wenn man unterwegs auf zwei Rehe trifft, ist man grundsätzlich geneigt, einen Bogen um sie zu machen – doch meistens laufen sie bereits weg, bevor man überhaupt reagieren kann. Rehe sind extrem scheue Tiere. Ähnlich ist es manchmal in Organisationen: Wenn Business Analysten in neuen Projektumfeldern auftreten, reagieren Projektmitglieder zunächst zurückhaltend. Wenn Analysten dann zusätzlich hektisch, gestresst oder mit unangebrachtem Verhalten auftreten, kann es passieren, dass man einige Personen nie wieder zu Gesicht bekommt – und dann werden auch keine Auswertungen oder Analysen entstehen. Business Analysten agieren daher, bewusst und bedacht. #### 2 Gelassen bleiben Business Analysten brauchen außerdem, wie ihr euch vorstellen könnt, viel Geduld. Es kann vorkommen, dass Analysten mehrfach im Quartal auf dieselben Projektbeteiligten zugehen und Fragen zum grundsätzlich gleichen Inhalt haben. So ist das. Und natürlich kann es auch nerven, wenn immer wieder dieselbe Frage gestellt wird – obwohl sie bereits mehrfach beantwortet wurde. #### 3 Details haben Vorrang Wie so oft gilt auch hier: **Auf den Detailgrad kommt es an!** Manche Inhalte müssen halt diskutiert werden – egal, ob zwei, zwölf oder dreißig Mal. So ist Business Analyse. Denn, genau diese detaillierten Informationen sind entscheidend, weil Developer darauf angewiesen sind. Nur so können Softwareprodukte korrekt ausgesteuert werden. Bleib gerne dran! Im nächsten und damit auch letzten Teil von „Was machen Business Analysten?“ werden endlich [**Workshops** ](https://thecattlecrew.net/2025/12/02/was-machen-business-analysten-teil-10-spontane-workshops-meistern/)vorgestellt. Das wird auch wieder spannend. --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) - [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) - [Teil 5: Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/) - [Teil 6: Tools gezielt nutzen](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/) - [Teil 7: Fachlich klar bleiben](https://thecattlecrew.net/2025/08/28/was-machen-business-analysten-teil-7-fachlich-klar-bleiben/) - [Teil 8: Modernes Projektmanagement](https://thecattlecrew.net/2025/09/23/was-machen-business-analysten-teil-8-modernes-projektmanagement/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Management, Market Research, Marketing --- ### [Was machen Business Analysten? – Teil 5: Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/) **Published:** Juli 4, 2025 **Author:** Charlotte Grade **Content:** Business Analysten leben vom Austausch. Ob persönlich, per E-Mail, im Video-Call oder im Workshop – sie sind präsent, motiviert und mittendrin. Im Gespräch mit Kolleginnen und Kollegen, bei Schulungen oder Meetings erleben wir sie als lösungsorientiert, neugierig und engagiert. Man könnte fast sagen: Je komplexer das Problem, desto größer die Motivation. Vorbehalte? Rückschritte? Für Business Analysten kein Grund zum Aufgeben – sondern ein Impuls zum Dranbleiben. Der Grund für diese Beharrlichkeit? Ganz klar: **das Ziel**. ## Warum Ziele wichtig sind Ziele sind mehr als Wunschdenken. Sie geben Orientierung und machen aus Ideen konkrete Vorhaben. Denn ohne Ziel gibt es keinen Weg – und ohne Weg kein Ergebnis. Ein Ziel motiviert, gibt Struktur und ermöglicht Fortschritt. Deshalb ist das Zielbewusstsein für Business Analysten ein entscheidender Erfolgsfaktor. --- Neugierig auf den Kontext? Lies gerne auch Teil 3 der Serie: **[Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/)** --- Du interessierst dich für die **Business Analyse**? Dann empfehle ich dir die Serie vorne zu starten: [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) Aber nun zurück zu diesem 5. Teil der Serie – los geht es. --- ## Ziele setzen: Vom Großen ins Kleine Business Analysten entwickeln Ziele meist nicht selbst – sie bekommen sie vorgegeben. Doch sie spielen eine zentrale Rolle dabei, Ziele zu verstehen, zu übersetzen und in machbare Aufgaben zu überführen. Sie helfen dabei, Ziele zu strukturieren – zum Beispiel in: 1. große Aufgabenpakete 2. kleine Teilaufgaben 3. konkrete Einzelschritte. So wird ein großes Ziel greifbar und das Projektteam kann gemeinsam daran arbeiten. ### Ziele geben die Richtung vor – Ergebnisse machen sie sichtbar Ziele sind nicht bloß Wünsche, sondern klare Vorgaben, die ein gewünschtes Ergebnis vorwegnehmen. Damit aus Theorie auch Praxis wird, müssen diese Ziele im Projektverlauf konsequent verfolgt werden. Daran arbeitet das gesamte Team – und Business Analysten spielen dabei eine zentrale Rolle. Ihre Aufgabe: Das Ziel verstehen, es inhaltlich durchdringen und so aufbereiten, dass es für jedes Teammitglied nachvollziehbar und greifbar bleibt. Dafür übersetzen sie die Zielvorgabe in strukturierte Aufgaben – von großen Arbeitspaketen bis hin zu konkreten Einzelschritten. Währenddessen sorgt die Projektleitung für den organisatorischen Rahmen; damit Zeit, Ressourcen und Zielerreichung in Einklang bleiben. In gut aufgestellten Teams funktioniert das meist reibungslos – vor allem dann, wenn alle Beteiligten das gemeinsame Ziel wirklich verstanden haben. #### Beispiel: Der Marathon Stell dir vor, du nimmst am Marathon-Event deiner Stadt teil, weil es schon immer dein größter Traum war, einen Marathon zu laufen. Das Ziel ist klar: Die 42 km vom Start bis zum Ziellinie laufend zu meistern. Dafür bereitest du dich natürlich gut vor: - Du kaufst ein neues, ziemlich teures Paar Laufschuhe deiner Lieblingsmarke, - du trainierst viele Monate auf das Event hin, - du schaust etliche Video-Clips über Marathon-Events, - du informierst dich über die Geschichte des Marathons und - du achtest über einige Wochen diszipliniert auf deine Ernährung. Am Tag des Events bist du aufgeregt, freust dich aber auf deinen Lauf. Die Sonne scheint sogar ein wenig. Und zack, ist das Lauf-Event vorbei und du hast den Marathon sogar unter fünf Stunden geschafft. Und wenn du ins Ziel kommst, stellt sich Zufriedenheit ein. Und danach? Du setzt ein neues Ziel. Genau so funktioniert Zielarbeit auch in der Business Analyse. ## Ziele erreichen – mit Motivation statt Druck Auch ein Ziel hat ein Ziel. Oder besser gesagt, einen Zweck. Der Zweck ist es, dabei zu helfen, Ergebnisse zu schaffen. Auf dem Weg dorthin müssen Aufgaben abgearbeitet werden. ### Ohne Fleiß kein Preis? Aufgaben abarbeiten … – Das klingt nicht nur nach viel Anstrengung, das ist auch viel Anstrengung – vor allem, wenn man dem Glauben verfällt, dass nur Anstrengung zum Ziel führen kann. Wie wäre es hingegen, wenn wir leicht und fröhlich unsere Ziele erreichen könnten? Gelassen, entspannt, voller Erwartung, mit Energie und Geduld. Das Konzept dahinter nennt man **Motivation**. ### Motivation ist der Schlüssel Es ist erwiesen: Motiviert an Zielen zu arbeiten, führt häufiger dazu, dass Ziele erreicht werden als ein eher unmotiviertes Vorgehen. Und: Ziele zu verfolgen muss nicht kräftezehrend sein. Wer motiviert ist, erlebt Aufgaben nicht als Last, sondern als sinnvolle Etappen auf dem Weg zum Ergebnis. Man könnte sagen: Motivation … 1. … macht aus „Müssen“ ein „Wollen“. 2. … erzeugt Energie statt Widerstand. 3. … stärkt die Verbindung zwischen Ziel und Sinn. Unsere Ziele motivieren uns, in dem sie unserem Tun einen Sinn geben. Eine Sinn, für den es sich lohnt, zu *ackern*. Wer weiß, warum er oder sie etwas tut, arbeitet mit innerem Antrieb – nicht gegen die Uhr. ### Ein Hoch auf die Ziele! Es lohnt sich also an Zielen zu arbeiten – egal, ob alleine, zu zweit oder mit mehreren. Ergebnisse, die nach und nach sichtbar werden, sind etwas Wunderbares. Sie helfen uns, den Griffel wie von selbst zu schwingen und unsere Aufgaben abzuarbeiten. Ohne übermäßige Anspannung und Widerstand. Gedanken wie: „Wann kann ich endlich Pause machen?“, „Noch eine Stunde dann ist endlich Feierabend.“ oder „Mir tut jetzt schon der Nacken weh.“, gehören der Vergangenheit an. Stattdessen fühlen wir in unserem Element. ## Sinn stiften mit Ergebnissen Business Analysten arbeiten ergebnisorientiert. Das bedeutet: Ihre Arbeit soll einen Beitrag leisten – für mehr Sicherheit, mehr Transparenz, bessere Entscheidungen. Ihre Ziele sind messbar, nachvollziehbar und langfristig wirksam. ### **Typische Zielwirkungen in der Business Analyse:** 1. Struktur statt Chaos 2. Mehrwert durch faktenbasierte Entscheidungen 3. Fundiertes Wissen, das für Folgeprojekte nutzbar ist Auf Ergebnissen kann aufgebaut werden; neue, zusätzliche Ergebnisse können entstehen und es entsteht natürlich **Wissen**. Und Business Analysten brauchen Wissen, um am Projekterfolg mitwirken zu können. Das Ziel schafft also nicht nur Ergebnisse – es stiftet Sinn. Und dieser Sinn ist es, der Business Analysten täglich antreibt. --- ## Ausblick: Tools für den Alltag Im nächsten Teil der Serie dreht sich alles um Tools, Methoden und Techniken, die Business Analysten in ihrem Arbeitsalltag nutzen. Bleib also dran, wenn es bald weitergeht mit: [**Was machen Business Analysten? – Teil 6: Tools gezielt nutzen**](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/) --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) - [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Agile Methode --- ### [Was machen Business Analysten? – Teil 10: Spontane Workshops meistern](https://thecattlecrew.net/2025/12/02/was-machen-business-analysten-teil-10-spontane-workshops-meistern/) **Published:** Dezember 2, 2025 **Author:** Charlotte Grade **Content:** Business Analysten reden gerne, sie hören aber auch gerne zu und dokumentieren fachlichen Kontext. Vor allem aber blühen Business Analysten bei Moderationen und Workshops auf. Meistens sind Workshops so organisiert, dass es genug Zeit gibt, sich gezielt darauf vorzubereiten. Eine strukturierte Arbeitsweise ist Business Analyst:innen schließlich sehr wichtig – vor allem, weil Begriffe wie Chaos, Durcheinander, Stress, Hektik und Unordnung im Alltag von Business Analysten permanent präsent sind. --- Falls du neu hier bist, kannst du direkt weiterlesen – oder du startest die gesamte Serie über den Alltag von Business Analysten ganz von vorne. Hier geht’s los: [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) --- ## Bühne frei für Business Analysten Das Ziel von Rollen aus der Kategorie „Business Analyse“ ist eindeutig definiert: Business Analysten bauen Wissen auf – Schritt für Schritt. Ein systematischer Umgang mit Tools und Software (siehe [Teil 6: Tools gezielt nutzen](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/)) gibt ihnen dabei das Vertrauen und die Sicherheit, die sie im Arbeitsalltag brauchen. Und dann kommt die große Kunst, die Business Analysten besonders anzieht: **WORKSHOPS**. Bei Workshops geht es um: 1. Sprache, Ausdruck und Wort 2. Fachkontexte 3. Interaktion in und mit Teams und Menschen 4. Routinen und Regelmäßigkeiten ### Die Workshop-Realität Ein guter Moderator kennt sich aus. Der Speaker weiß, worüber er oder sie spricht. Business Analysten müssen Workshop-Teilnehmende überzeugen – rednerisch und inhaltlich. Ansonsten steigen 30 – 70 % der Teilnehmenden erfahrungsgemäß aus, verabschieden sich remote als Kurznachricht oder verschwinden leise aus dem Raum. Das ist eine richtige ‚Klatsche‘ für die präsentierende Person. Für Business Analysten ist das oft kein Problem. Analysten können sich auf ihre Umgebung verlassen – zumindest theoretisch. Auch Analysten müssen erst lernen, ihrem Umfeld Vertrauen zu schenken: Kolleginnen und Kollegen, Stakeholdern und ihrer Arbeitsumgebung. Meist bleibt es ohnehin nie bei einem Workshop. Mein Alltag zeigt: Menschen lieben Workshops. Workshops sind nicht nur „Memory spielen“ (siehe [Teil 7: Fachlich klar bleiben](https://thecattlecrew.net/2025/08/28/was-machen-business-analysten-teil-7-fachlich-klar-bleiben/)) – Workshops sind wesentlich mehr. Menschen haben gleichzeitig Freude und Spaß. Haben Business Analysten ihre Teilnehmenden erst einmal überzeugt, folgt fast immer ein Folge-Workshop. Workshops sind lebendig. Einer folgt auf den nächsten, und so weiter … ### Die Geschichte von der Torte Workshops täglich vorzubereiten ist nicht möglich. Workshops sind das sogenannte i-Tüpfelchen – etwas Besonderes, bildlich gesprochen: die Kirsche auf der Sahnehaube. Wer liebt sie nicht, die Schwarzwälder Kirschtorte. Auf ihr glänzt die Kirsche wunderschön, aber seien wir ehrlich: Zumeist schmeckt die Torte besser als die Kirsche selbst. Workshops sind wie Torten: aufwendig, teuer, besonders. Ein Stück Kuchen kaufen ist einfach – aber eine ganze Torte transportieren? Vielleicht sogar mit dem Fahrrad? Nicht so leicht, oder? ## Mindmaps, Menschen und viel Gestaltungsraum Workshops sind chaotisch. Mindmaps helfen. Nicht zuletzt müssen Gedanken sofort aufgeschrieben werden, sonst verfliegen sie. Aus Analyse-Sicht ist es wichtig, sich auf wesentliche Fakten zu konzentrieren – zu viele Details nerven Teilnehmende in der Regel. Der Aufbau eines Workshops ist kleinteilig definiert und durchstrukturiert. Das sehen die Teilnehmenden jedoch nicht, weil es vor dem Workshop passiert. Dass es nach Workshops oft hitzige Debatten über die Vortragenden gibt, wissen alle Workshop-Durchführenden – Business Analysten eingeschlossen. Oft melden sich einige Teilnehmende nach einem Workshop direkt bei den Business Analysten, um etwas Persönliches mitzuteilen. ### Test: Mindmap-Idee oder Architektur? Während des Workshops entsteht häufig Kreativität: Mindmaps, Ideen, kleine Architektur-Skizzen. Für mich als Business Analyst sind das „Mindmap-Ideen“, fachlich aber eigentlich Architektur-Ansätze für technische Systemumgebungen. Pass auf, ich zeige dir, was ich meine. Guck dir diese Abbildung aus einem Beispielprojekt an. Ist das eine Mindmap oder eine Architektur? ![](https://thecattlecrew.net/wp-content/uploads/2025/11/blogpost-10-scaled.jpeg) Bis Business Analysten sich an Workshops wirklich einmal heranwagen, vergehen manchmal mehrere Jahre bis Jahrzehnte. Zunächst lernen Business Analysten kleine bis mittlere Meetings zu moderieren. --- ## Serienende Abschließend zu der Blogserie ‚**Was machen Business Analysten?**‚ stelle ich hier aktuelle Empfehlungen und Trends im Buchmarkt bereit. Beim Schreiben dieser Serie habe ich manchmal versucht den Schreibstil von äußerst erfolgreichen Büchern einzubeziehen, wie z. B. von: - **„Komm, ich erzähl dir eine Geschichte“** von **Jorge Bucay** - „**Elefant**“ von **Martin Suter**, oder - „**Rich Dad Poor Dad**“ von Robert Kiyosaki und Sharin L. Lechter. Und hier ist meine Top 14-Bücherliste: **Nr.** **Titel****Autor****1**Der AlchimistPaulo Coelho**2**Vom Glück des WandernsAlbert Kitzler**3**Wege zum glücklichen HandelnEpiktet**4**Der tägliche StoikerRyan Holiday**5**No Logo!Naomi Klein**6**FleischmarktLaurie Penny**7**Bitch DoktrinLaurie Penny**8**Harry Potter und der Stein der Weisen (Carlsen Verlag als gebundene Ausgabe)J. K. Rowling**9**Axolotl RoadkillHelene Hegemann**10**Das Spiel ist ausJean Paul Sartre**11**The Big Five for Life John Strelecky **12**Minimalismus Joshua Fields Millburn und Ryan Nicodemus **13**Selbstporträt Helene Beltracchi und Wolfgang Beltracchi **14**Haben oder Sein Erich Fromm --- ## In dieser Blogserie sind erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) - [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) - [Teil 5: Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/) - [Teil 6: Tools gezielt nutzen](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/) - [Teil 7: Fachlich klar bleiben](https://thecattlecrew.net/2025/08/28/was-machen-business-analysten-teil-7-fachlich-klar-bleiben/) - [Teil 8: Modernes Projektmanagement](https://thecattlecrew.net/2025/09/23/was-machen-business-analysten-teil-8-modernes-projektmanagement/) - [Teil 9: In Gruppen überzeugen](https://thecattlecrew.net/?p=40491&preview=true) - Teil 10: [Spontane Workshops meistern](https://thecattlecrew.net/2025/12/02/was-machen-business-analysten-teil-10-spontane-workshops-meistern/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Data Warehouse, Datenarchitekturen, Datenbankmigration, Datenmodellierung --- ### [Was machen Business Analysten? – Teil 8: Modernes Projektmanagement](https://thecattlecrew.net/2025/09/23/was-machen-business-analysten-teil-8-modernes-projektmanagement/) **Published:** September 23, 2025 **Author:** Charlotte Grade **Content:** Business Analysten arbeiten in Projekten eng mit dem Projektmanagement zusammen. Beide Rollen haben völlig unterschiedliche Aufgaben – und doch werden sie in der Praxis oft verwechselt. Business Analysten sind aber keine Projektmanager. Während Projektmanager Budgets, Zeitpläne und Ressourcen im Blick behalten, kümmern sich Business Analysten darum, Inhalte zu sammeln, zu strukturieren und für die Entwicklung aufzubereiten. Sie unterstützen – flexibel und pragmatisch – immer im Rahmen der Projektvorgaben. **Kurz gesagt:** Business Analysten ersetzen keine Projektmanager, sondern ergänzen sie. Und oft sind sie auf die Arbeit des Projektmanagements angewiesen, um ihre eigenen Aufgaben effektiv erledigen zu können. --- In diesem Teil der Serie ‚Was machen Business Analysten?‘ wird es besonders interessant. Denn hier stelle ich ‚Modernes Projektmanagement‘ in der Business Analyse praktisch vor. --- ## Modernes Projektmanagement Modernes Projektmanagement bedeutet heute vor allem agiles Arbeiten – auch in großen Projekten. Stell dir ein Team vor: unterschiedliche Entwickler:innen, ein Projektmanager und eine oder mehrere Business Analysten. Dazu kommen interne Kolleg:innen des Kunden und externe Dienstleister. Für Business Analysten ist das ein Alltag– endlich gibt es wieder viele Inhalte, die sortiert, gebündelt und dokumentiert werden wollen. Der Projektmanager bündelt alle relevanten Informationen, Business Analysten nehmen diese auf, diskutieren sie mit Fachbereichen oder Entwickler:innen und bereiten sie so auf, dass sie im Projektteam weiterbearbeitet werden können. ### **Business Analysten im Projektmanagement** Im modernen Projektumfeld übernehmen Business Analysten zentrale Aufgaben: 1. Inhalte für Projektmanager strukturieren und kategorisieren 2. Ergebnisse in den Zielsystemen dokumentieren 3. Termine und Abstimmungen mit Stakeholdern organisieren 4. Aufgaben für Entwickler in umsetzbare Pakete übersetzen Parallel arbeiten die Entwickler:innen an der Umsetzung, während der Projektmanager den Überblick behält. Business Analysten sorgen dafür, dass Entwickler möglichst klare, direkte Aufgabenstellungen bekommen – damit Code und Ergebnisse eindeutig und zielführend sind. Bildlich ausgedrückt könnte das zum Beispiel dann so aussehen: ![](https://thecattlecrew.net/wp-content/uploads/2025/09/Blogpost8.jpeg) ### Warum ist Zeit dabei so wichtig? Am Anfang eines Projekts sammelt der Projektmanager die wichtigsten Informationen vom Auftraggeber. Daraus ergeben sich für die Business Analysten erste Aufgabenpakete für die Entwickler. Doch diese Aufgaben sind meist noch grob. Rückfragen seitens der Entwickler sind die Regel – und manchmal führt das zu Diskussionen zwischen Analysten, Entwicklern und Projektmanager:innen. Im Ergebnis gehen Business Analysten dann zurück in die Fachbereiche, um Klarheit zu schaffen. Diese Termine müssen erst organisiert werden – und das kostet Zeit. In der Zwischenzeit analysieren Business Analysten deshalb andere Inhalte und übersetzen sie in Aufgaben. ## Fazit Business Analysten und Projektmanager haben unterschiedliche Rollen – doch gerade im modernen Projektmanagement greifen sie direkt ineinander. Während die Projektmanager den Rahmen setzen, sorgen Business Analysten dafür, Inhalte zu strukturieren, verständlich aufzubereiten und zu bearbeiten. Gemeinsam halten sie Projekte am Laufen und bringen sie zum Erfolg. Bleib gerne dabei, wenn es im nächsten Teil wieder heißt: *Was machen Business Analysten?* – mit neuen Einblicken aus dem Tagesgeschäft von Analysten. --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) - [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) - [Teil 5: Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/) - [Teil 6: Tools gezielt nutzen](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/) - [Teil 7: Fachlich klar bleiben](https://thecattlecrew.net/2025/08/28/was-machen-business-analysten-teil-7-fachlich-klar-bleiben/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Data Warehouse --- ### [Was machen Business Analysten? – Teil 6: Tools gezielt nutzen](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/) **Published:** Juli 18, 2025 **Author:** Charlotte Grade **Content:** Business Analysten arbeiten mit vielen Tools – und oft mit vielen verschiedenen auf einmal. Die Tool-Auswahl bestimmen sie jedoch nicht immer selbst: Häufig steigen sie in bereits bestehende Projekt-Umgebungen ein, in denen bestimmte Software-Lösungen vorgegeben sind. Dabei bleiben sie flexibel und offen – denn im Mittelpunkt steht das Projektziel, nicht das Tool. Ob es um Software-Entwicklung, Daten-Analysen oder Dokumentation geht – Business Analysten wollen zuerst den Bedarf verstehen. Welche Tools dabei genutzt werden, ist oft zweitrangig. Und doch: Der richtige Umgang mit Tools ist ein Erfolgsfaktor. In diesem Beitrag zeige ich, wie Business Analysten Tools sinnvoll einsetzen können. --- Dies ist übrigens eine ganze Serie zur Business Analyse und startet hier: [**Serienstart: Die Lage überblicken**.](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) --- ## Tool-Auswahl In der Praxis begegnen Business Analysten einer Vielzahl von Tools – von geliebten Klassikern bis zu sperrigen Systemen. Was zählt, ist in der Regel nicht, ob ein Tool „cool“ ist, sondern ob es die Projektarbeit effizient unterstützt. ### Gezielter Einsatz von Tools Fangen wir von vorne an: Wofür werden Tools gebraucht? Dies kann in Form einer Dokumentation, einer Unterlage für eine Workshop-Vorbereitung oder in Gestalt eines Dashboards sein. Business Analysten nutzen Tools, um Fachinhalte greifbar zu machen. Das geschieht etwa in Form von: 1. Dokumentationen 2. Workshop-Unterlagen 3. Dashboards & Reports 4. Datenbankabfragen 5. Modellen und Diagrammen Zum Einsatz kommen u. a.: 1. BI-Tools wie Tableau, Power BI, SAP BO, etc. 2. ausgewählter Statistik- und Analyse-Software 3. Kalkulationstools (Excel, Google Sheets) 4. Datenbank-Umgebungen 5. Projekt- & Doku-Tools wie Jira, Confluence, Miro, usw. Business Analysten unterstützen gerne. Deshalb stellen sie auch viele Fragen. Expert:innen und Spezialist:innen kennen sich schließlich viel besser aus. Hier lohnt sich das Fragenstellen also besonders. Auf diese Weise entsteht eine erste Zusammenarbeit mit Developern, Product-Ownern, Stakeholdern, und vielen, vielen weiteren Ansprechpersonen – egal, ob intern oder extern. Die Anforderungen werden in Aufgaben und Fachinhalten übersetzt; jeweils direkt in der jeweiligen Toolumgebung im Projektkontext. ### Beispiel: Eine Medien-Analyse Ein Medien-Unternehmen nutzt eine BI-/Analytics-Software um Echtzeit-Analysen über performance-freundliche Werbeeinheiten in Form von Werbe-Issues zu tracken. Das Ziel ist eindeutig: Kund:innen, die Werbe-Minuten buchen, sollen die optimalen Werbe-Zeiten erhalten. Das sichert langfristig die Zusammenarbeit – beidseitig. Business Analysten sind dabei und arbeiten an den Analytics-Tools, um die wichtigen Berichte und Dashboards zu erstellen und entwickeln diese stückchenweise mit den Analysten des Medien-Unternehmens weiter. ## Einsatz neuer Tool-Lösungen Sich neuen Tools zu öffnen, ist nicht immer leicht – aber oft notwendig. Wer zu sehr an gewohnten Tools festhält, macht sich den Arbeitsalltag schwer. Statt Energie in den Wunsch nach Toolwechseln zu investieren, konzentrieren sich erfahrene Analysten auf Inhalte, Ziele und Zusammenarbeit. In den meisten Projekten wird ohnehin mit verschiedenen Tools gleichzeitig gearbeitet. Umso wichtiger ist ein strukturierter Umgang und ein gesunder Pragmatismus. Neue Tools kennenzulernen, kann Spaß und Freude mit sich bringen. Dafür braucht es allerdings wie gesagt ein gewisses Maß an Offenheit. Wer sich auf die gewohnten Tools fixiert, erschwert sich den Arbeitsalltag. Das ist verschwendete Energie. Besser ist es, man wartet erst einmal ab, und lässt sich situativ auf Tools ein. Schließlich arbeiten Business Analysten während des Projektzyklus genauso wie Developer und Projektmanger gleichzeitig mit vielen verschiedenen Tools. Hektik und Stress lenken gerne vom Fachinhalt ab. Da ist es langfristig effektiver und effizienter, sich auf Inhalte zu konzentrieren, als beispielsweise über die Abschaffung einer im Unternehmen integrierten Software zu debattieren. Die Entscheidung trifft der Business Analyst meist nicht selbst. Viel entscheidender kann es daher für ihn sein, den Überblick zu behalten und eine gewisse Ordnung im Umgang mit Tools zu lernen. ### 5 Tipps für den erfolgreichen Umgang mit Tools Sind Tools neu oder noch unbekannt, muss der Umgang damit gelernt werden. Nicht, dass noch ein Tool-Chaos entsteht; das wäre fatal … Hier 5 Tipps, die helfen können: 1. **Zeit nehmen:** Sich Zeit für die neuen Tools nehmen, um diese kennen zu lernen, um den Umgang damit zu begreifen. 2. **Hilfe holen:** Ansprechpersonen bei Unternehmen sofort um Hilfe bitten, wenn etwas nicht direkt funktioniert. Es wäre schade, wenn wichtige Inhalte verloren gehen – vor allem, wenn dies vermeidbar ist. 3. **Direkt im Tool arbeiten:** Gemeinsam mit Expert:innen und Spezialist:innen an Fachinhalten direkt in der Toolumgebung arbeiten. Es kostet einfach so unglaublich viel Zeit erst einmal alles auf Papier aufzuschreiben und dann in die Tools zu übersetzen. Viel entspannter ist es, alles direkt am neuen Tool zu machen. Auch Aufgaben direkt innerhalb der Tool-Lösung abarbeiten – nicht mit alternativen Tool-Umgebungen als Zwischenlösung ‚*rumexperimentieren*‚. Das kostet richtig viel Zeit. 4. **Geduld bewahren:** Mutig und gelassen bleiben – auch, wenn einmal etwas nicht sofort funktioniert. Es gibt schließlich immer freundliche und hilfsbereite Expert:innen, die immer gerne weiterhelfen. Wirklich wahr! 5. **Dokumentieren:** Schrittfolgen zur Nutzung von neuen Tools für die eigene, persönliche Dokumentation aufschreiben. Man wird sicher nicht jede ‚*Doku*‚ brauchen, aber manchmal kann die eine oder andere Mitschrift von ‚*früher*‚ schon helfen, um in neuen Projektsituationen fachlich dabei zu bleiben und sich eben nicht nur mit den Tools zu ‚*beschäftigen*‚. In der Beratung kann das ein Schlüssel-Moment sein. ## Fazit: Tool-Kompetenz als Schlüssel Wenn du für dich erst eine eigene Herangehensweise im Umgang mit Tools gefunden hast, kannst du dieses Wissen weitergeben. Das wird auch anderen Business Analysten helfen. Vielleicht hilft deine Erfahrung sogar bei der Softewarentwicklung. Wer mit vielen Tools arbeitet, braucht Struktur – nicht Perfektion. Business Analysten bringen genau das mit: Sie adaptieren sich an neue Umgebungen, behalten den Überblick und nutzen Tools zielgerichtet. So unterstützen sie Projekte nicht nur technisch, sondern auch methodisch und menschlich. --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) - [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) - [Teil 5: Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/) **Kategorien:** Analytics & Insights **Schlagwörter:** Softwarenentwicklung, Technologiemanagement, Transformation --- ### [Was machen Business Analysten? – Teil 7: Fachlich klar bleiben](https://thecattlecrew.net/2025/08/28/was-machen-business-analysten-teil-7-fachlich-klar-bleiben/) **Published:** August 28, 2025 **Author:** Charlotte Grade **Content:** Business Analysten müssen Entscheidungen treffen – und zwar häufig. Das ist wichtig, um den Überblick über Fachinhalte zu behalten. Genau dieser Überblick ist in der Business Analyse unverzichtbar. Schließlich soll am Ende ein Produkt entstehen – sei es eine Software, eine Auswertung oder ein Prozess. Eine zentrale Aufgabe von Business Analysten ist es daher, Themen fachlich klar voneinander zu trennen und inhaltlich zu unterscheiden. Ansonsten droht das große Durcheinander im Projekt – und das kann niemand gebrauchen. Business Analysten verleihen Projekten gezielt Struktur und schaffen damit auch eine angenehme Arbeitsumgebung für Entwicklerinnen und Entwickler. In diesem Teil der Serie erfährst du, welche Möglichkeiten es gibt, Fakten auseinanderzuhalten – auch wenn sie inhaltlich manchmal eng beieinander liegen. --- Dies ist Teil einer kompletten Serie zur Business Analyse, die hier startet: [**Serienstart: Die Lage überblicken**](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) --- ## 5 Tipps, um Fakten auseinanderzuhalten 1. **Themen trennen** Fachinhalte sollen meist unabhängig voneinander bearbeitet werden – oft ist das auch ein ausdrücklicher Kundenwunsch. Business Analysten orientieren sich daran. Jeder Fachinhalt wird wie ein eigenes Thema behandelt. Manchmal hängen Themen zusammen, manchmal aber auch gar nicht. Und selbst wenn Begriffe ähnlich klingen, steckt inhaltlich oft etwas ganz anderes dahinter. Ein Beispiel: Eine „Cashcow“ ist selbstverständlich keine echte Kuh – das ist Standardwissen im Unternehmen. 2. **Themen splitten und verfeinern** Business Analysten müssen sich schnell in alle relevanten Inhalte einarbeiten, um diese für Entwickler-Teams so präzise wie möglich aufzubereiten. Oft geht es um eine Detailtiefe bis „fünf Stellen nach dem Komma“. Erst mit dieser Klarheit kann sichergestellt werden, dass das Ergebnis wirklich den Projektbedarf deckt. Kommunikation muss dafür direkt, klar und unkompliziert sein. 3. **Komplex oder kompliziert?** Fachinhalte können verschachtelt, komplex oder schlicht kompliziert sein. Manchmal ist nicht einmal klar, was ein Begriff bedeutet – da hilft ein Wörterbuch, Selbstvertrauen und die Fähigkeit, sich schnell in neue Themen einzuarbeiten. Je nach Projektkontext sind Inhalte unterschiedlich priorisiert – und Business Analysten müssen sich darin zurechtfinden. 4. **Aufgaben definieren** Projekte dauern manchmal nur wenige Wochen, manchmal Monate oder Jahre. Über die Zeit sammelt sich viel Fachwissen an – deshalb ist eine ordentliche Dokumentation unverzichtbar. Analysieren ist das eine, Inhalte in konkrete Aufgaben und Ergebnisse zu übersetzen das andere. Beides gehört zur Business Analyse. 5. **Ergebnisse abliefern** Alte Projekterfahrungen können hilfreich wirken – müssen es aber nicht. Häufig sind Inhalte aus vergangenen Projekten nicht auf aktuelle Kontexte übertragbar. Darum ist es so wichtig, alle Ergebnisse in den Systemumgebungen der Kunden zu dokumentieren – am besten mehrfach. Denn in Projekten sammelt sich oft mehr Wissen an als man es vermuten mag. ### Methodik-Idee: Netzwerkanalyse Eine hilfreiche Methode in der Business Analyse ist die Netzwerkanalyse. Dabei werden aktuelle Themen gesammelt und visuell miteinander vernetzt. So wird sichtbar, welche Inhalte zusammengehören und welche eigenständig sind. Es ist ein bisschen so wie das Kinderspiel „Memory“: Pärchen suchen – konzentriert und schnell. **So geht’s:** 1. Alle aktuellen Themen schriftlich sammeln. 2. Inhalte in Gruppen und Gebiete aufteilen. 3. Themen an übergeordneten Kategorien anheften. 4. Zusammenhänge markieren und sichtbar machen. 5. Aufgaben aus den Themen ableiten und direkt abarbeiten. So entsteht eine Struktur, die Orientierung gibt und Klarheit schafft – selbst bei hoher Themenvielfalt. Das könnte z. B. so aussehen: ![Eine Skizze, die eine Netzwerkanalyse visualisiert](https://thecattlecrew.net/wp-content/uploads/2025/08/Abbildung-netzwerkanalyse-1.jpeg) --- Bald erscheint Teil 8 dieser Serie zum Thema **„Modernes Projektmanagement“**. Dort geht es um Projektmanagement in der Business Analyse. Auch wenn Business Analysten selbst nicht fürs Projektmanagement verantwortlich sind, müssen sie doch immer den Überblick behalten: über Ressourcen, Zeit, Bedarfe und Planungsdaten. --- ## Bisher erschienen: - [Teil 1: Die Lage überblicken](https://thecattlecrew.net/2025/03/27/was-machen-business-analysten-teil-1-die-lage-ueberblicken/) - [Teil 2: Die unsichtbare Kraft hinter erfolgreichen Projekten](https://thecattlecrew.net/2025/04/04/was-machen-business-analysten-teil-2-die-unsichtbare-kraft-hinter-erfolgreichen-projekten/) - [Teil 3: Aus Anforderungen produktive Ergebnisse machen](https://thecattlecrew.net/2025/04/30/was-machen-business-analysten-teil-3-aus-anforderungen-produktive-ergebnisse-machen/) - [Teil 4: Dashboards zum Fliegen bringen](https://thecattlecrew.net/2025/05/28/was-machen-business-analysten-teil-4-dashboards-zum-fliegen-bringen/) - [Teil 5: Motiviert Ziele erreichen](https://thecattlecrew.net/2025/07/04/was-machen-business-analysten-teil-5-motiviert-ziele-erreichen/) - [Teil 6: Tools gezielt nutzen](https://thecattlecrew.net/2025/07/18/was-machen-business-analysten-teil-6-tools-gezielt-nutzen/) **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** DWH, Entscheidungsfindung, Moderation, Reports --- ### [Vibe Coding im BI-Bereich: Wie KI uns ETL-Entwickler retten kann](https://thecattlecrew.net/2025/11/24/vibe-coding-im-bi-bereich-wie-ki-uns-etl-entwickler-retten-kann/) **Published:** November 24, 2025 **Author:** Sebastian Pospiech **Content:** Vor ein paar Wochen habe ich etwas theoretischer auf die Entwicklungen der letzten zwei Jahre rund um KI und LLMs geschaut ([„Was haben ein Hammer und ein LLM (nicht) gemeinsam?“](https://thecattlecrew.net/2025/10/02/was-haben-ein-hammer-und-ein-llm-nicht-gemeinsam/)). Mir ging es darum zu erklären, dass ein LLM nicht die „böse KI“ ist, die uns unsere Jobs wegnimmt. Vielmehr stellt es aus der Perspektive des Human-Computer-Interaction-(HCI)-Designs die konsequente Weiterentwicklung von User Interfaces dar: von Lochkarten über Command Lines, GUIs und NUIs bis hin zu LLMs. Letztlich ist es ein intuitiver Weg, mit einem Computer zu kommunizieren und dieses „Werkzeug“ effizient zu bedienen. ## ETL – eine Geschichte Für diesen Beitrag möchte ich in eine spezielle Nische eintauchen: ETL – Extract, Transform, Load. Eine zentrale Disziplin beim Aufbau und Betrieb von Data Warehouses und Lakehouses. Hier wird Software entwickelt, die Daten transportiert, transformiert, integriert und in ihrer Qualität sichert. Bis vor etwa fünf Jahren folgte diese Disziplin stark der allgemeinen Entwicklung der HCI. Als Softwareentwicklungsdisziplin nutzte man dafür geeignete Sprachen auf passenden Plattformen: COBOL oder PL/SQL, Bash-Skripte, die Dateien kopieren oder orchestrieren, und natürlich SQL, das bis heute hervorragende Aggregationen liefert. Mit der Zeit erkannte man das Potenzial und entwickelte dedizierte ETL-Software. Es entstanden Entwicklungsumgebungen und Frameworks, die alles unter einem Dach konsolidierten. Statt vieler einzelner Komponenten gab es nun komplette Suites – oft mit grafischen Oberflächen. Man programmierte und skriptete weniger und definierte stattdessen Graphen, die Prozessschritte und Datenflüsse visualisierten. 20 Jahre lang arbeiteten BI-Entwickler:innen genau so: spezialisiert auf Datenmodellierung und Tools der Anbieter. Dank des Low-Code-Ansatzes mussten sie jedoch keine voll ausgebildeten Softwareentwickler:innen sein. Entscheidend waren das Verständnis von Datenflüssen, der Fachlichkeit und das Lösen vielfältiger Optimierungsprobleme. ![Datenflüsse in ETL-Systemen - Grafik zeigt die zeitliche Entwicklung](https://thecattlecrew.net/wp-content/uploads/2025/11/cattle-crew-vibe-coding-for-bi_pospiech_bild01.jpg.png) ## Was passierte nun vor fünf Jahren? LLMs waren noch nicht praxisreif, aber die ETL-Welt wurde durcheinandergerüttelt. Cloudanbieter boten die ideale Basis für Data Lakes: günstiger, skalierbar, flexibel. Aber sie boten keine monolithischen Suites. Stattdessen viele kleine Tools, die miteinander integriert werden wollten. Keine Low-Code-Oberflächen, sondern Python, Spark, Scala. Gefühlt ein Rückschritt. Während die Softwarewelt immer weiter Richtung „weniger Code, mehr Framework“ wanderte, schien die ETL-Nische einen anderen Weg einzuschlagen. Viele BI-Spezialist:innen fragten sich: „Muss ich jetzt Softwareentwickler werden?“ „Lohnt sich das alles, wenn wir statt Standardlösungen wieder selbst bauen müssen?“ ## Was hat es mit dem Trend auf sich? … Um das zu verstehen, lohnt ein Blick darauf, warum ETL so wurde, wie es war. Grafische Tools waren ein offensichtlicher Trend – aber nicht der einzige Grund. Wer sich mit Prozessdesign, Prozessoptimierung und Modellierungssprachen wie BPMN, EPK, UML, DFD oder PAP beschäftigt hat, erkennt schnell: grafische ETL-Tools sind im Kern nichts anderes als Datenflussdiagramme (DFDs). Betrachtet man zudem die Zeit, in der große Unternehmen begonnen haben, stark in Prozesse und deren Modellierung zu investieren, fällt auf, dass die Erfolgsphase graphbasierter ETL-Tools eng mit diesem Trend zusammenhängt. ![Grafisches ETL im Zeitstrahl der ETL-Entwicklung](https://thecattlecrew.net/wp-content/uploads/2025/11/cattle-crew-vibe-coding-for-bi_pospiech_bild02.jpg.png) Vielleicht war ETL also lange Zeit nicht deshalb grafisch, weil es intuitiv ist, sondern weil es den dominierenden Zeitgeist traf. Das ist meine persönliche These – wissenschaftlich nicht belegt, aber faktisch lässt sich festhalten: - Man ist in proprietären Toolwelten gefangen. - Compiler übersetzen die Grafen ohnehin wieder in Code – oft nicht optimal. - Versionierung, Kollaboration und Annotationen funktionieren nur eingeschränkt. - Selbst nach 20 Jahren haben die Oberflächen teilweise gravierende Bugs. - Performanceoptimierungen verlangen kreative Workarounds innerhalb der Suite-Beschränkungen. Kurzum: Es gibt gute Gründe für den aktuellen „Rückschritt“ hin zu mehr Code. Und so befinden wir uns seit einigen Jahren in einer Phase des „more code“ statt „low code“ – verbunden mit der Herausforderung, Mitarbeitende für diese Reise zu befähigen. ## Gäbe es da nicht … … eine ganz neue Form der Mensch-Computer-Interaktion: eine, bei der ich fachliche Anforderungen in natürlicher Sprache formuliere und am Ende ein funktionierendes Stück Software erhalte. Eine Form, die ohne grafisches Design und ohne „Wenn-Dann“-Compiler auskommt, die riesige Bausteine erzeugen. Ihr wisst, worauf es hinausläuft. Die aktuelle Lücke – sinkender ETL-Entwicklungskomfort – kann durch ein nutzerfreundliches Interface gefüllt werden, das barrierefrei zugänglich ist und Code erzeugt, der: - toolunabhängig ist, - moderne Versionierung unterstützt, - kollaborativ weiterentwickelt werden kann, - und sich performanceoptimieren lässt (oder es bereits ist). LLMs könnten unsere grafische Oberfläche ersetzen. Ich modelliere nicht mehr visuell – ich schreibe oder beschreibe den Code. In beiden Fällen entsteht ETL-Code. Aber vielleicht ist der neue Weg einfacher – und das Ergebnis besser. ## Quo Vadis Soweit die Vision. Funktioniert das heute schon – oder sind wir noch Jahre entfernt? Nach dem Clickbait meines letzten Blogbeitrags (der Hammer) nutze ich heute das Instrument des Cliffhangers. Im nächsten Beitrag werde ich versuchen, aus einer fachlich-textuellen Beschreibung mittels KI einen vollwertigen ETL-Prozess zu erzeugen – und dasselbe mit einer einfachen Handzeichnung. Bis dahin: Schaut gern in die anderen Cattle-Crew-Blogbeiträge. Es gibt bereits einiges zu LLMs und Vibe Coding. ### Hier nur ein paar Beispiele: [Zeitreihenanalysen im Controlling](https://thecattlecrew.net/2025/11/12/zeitreihenanalysen-im-controlling-von-belastbaren-forecasts-zu-besseren-entscheidungen/) [Vibe Coding – Teil 1: Mit KI zum eigenen Homeserver](https://thecattlecrew.net/2025/10/20/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen/) [Vibe Coding – Teil 2: Linux-Server mit KI konfigurieren](https://thecattlecrew.net/2025/11/08/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen-teil-2/) [KI im Kundeneinsatz: Ein Reality Check der Pyramid-Funktionalität](https://thecattlecrew.net/2025/10/14/ki-im-kundeneinsatz-ein-reality-check-der-pyramid-funktionalitaet/) [Was haben ein Hammer und ein LLM (nicht) gemeinsam?](https://thecattlecrew.net/2025/10/02/was-haben-ein-hammer-und-ein-llm-nicht-gemeinsam/) [Open Data in Aktion: Mit KI Abwasserdaten analysieren](https://thecattlecrew.net/2025/08/21/open-data-in-aktion-mit-ki-abwasserdaten-analysieren/) [RAG or not to RAG, Teil 1: Wann braucht es einen RAG-Ansatz](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/) [RAG or not to RAG, Teil 2: Prozesse und Aufwand in der Praxis](https://thecattlecrew.net/2025/05/15/to-rag-or-not-to-rag-2-2/) [Was steckt hinter RAG und Semantischer Suche?](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) [RAG und Semantische Suche in der Praxis](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/) **Kategorien:** AI & Data Science, Development --- ### [Auf nach Red Hat/Oracle Linux 9 – der Sonne entgegen](https://thecattlecrew.net/2025/11/07/auf-nach-red-hat-oracle-linux-9-der-sonne-entgegen/) **Published:** November 7, 2025 **Author:** Mario Nolte **Content:** Red Hat Enterprise Linux 7 (RHEL7) oder Oracle Linux 7 (OL7) bietet gegenüber RHEL9/OL9 vor allem Vorteile in Bezug auf Stabilität, Kompatibilität mit älterer Software und langjährige Produktionsumgebungen. Allerdings ist RHEL7/OL7 seit Juni 2024 im regulären Wartungszyklus ausgelaufen und nur noch mit Extended Life Cycle Support (ELS) verfügbar. ## **Vorteile von RHEL9/OL9 gegenüber RHEL7/OL7** ### 1. Bewährte Stabilität RHEL7/OL7 ist seit 2014 im Einsatz und hat sich in vielen produktiven Umgebungen als äußerst stabil erwiesen. Viele Unternehmen setzen auf RHEL7/OL7, weil es über Jahre hinweg getestet und optimiert wurde. RHEL9/OL9 ist eine stabile Weiterentwicklung und bringt viele Vorteile mit sich. So in Themen Virtualisierung und Containerisierung. Damit verbunden sind verbesserte und flexible Möglichkeiten der Datensicherheit unter Beachtung der Sicherheitsstandards wie NIS2, Dora oder dem CRA. ### 2. Kompatibilität mit älterer Software Legacy-Anwendungen, die auf älteren Bibliotheken oder Kernel-Versionen basieren, laufen oft nur unter RHEL7/OL7 ohne Anpassungen. RHEL9/OL9 verwendet neuere Compiler und Bibliotheken, was zu Inkompatibilitäten führen kann. Jedoch sind die Hersteller schon seit längeren auf den Umstieg vorbereitet. ### 3. Vertraute Systemverwaltung RHEL7/OL7 nutzt noch klassische Tools wie iptables, network-scripts und init.d, die in RHEL9/OL9 durch nftables, NetworkManager und systemd ersetzt wurden. Für Administratoren, die mit älteren Tools vertraut sind, ist RHEL7/OL7 oft einfacher zu handhaben (da bekannt). symtemd, nftables, NetworkManager sind allgemeingültige Tools und Mechanismen, die in der Linux Welt seit geraumer Zeit einen Standard darstellen. Dies führt speziell in heterogenen Umgebungen zu Vereinfachungen in der Administration. ### 4. Langfristige Infrastrukturabhängigkeiten Viele Unternehmen haben ihre Infrastruktur (z.B. Monitoring, Backup, Automatisierung) speziell auf RHEL7/OL7 abgestimmt. Ein Umstieg auf RHEL 9 erfordert oft umfassende Tests und Anpassungen. Die Einsatz von Virtualisierung und Containerisierung wird sehr vereinfacht. Hersteller von Lösungen haben Ihre Hausaufgaben erledigt und Releases für RHEL9/OL9 für bereitgestellt. ### 5. ELS (Extended Life Cycle Support) bis 2029 Red Hat bietet für RHEL7 optionalen ELS-Support bis Mai 2029 an. Damit einhergehend wird auch OL9 über Oracle im Extended Support betrieben. Damit können Unternehmen weiterhin Sicherheitsupdates für kritische Komponenten erhalten, ohne sofort migrieren zu müssen. Jedoch ist dies an Bedingungen geknüpft. Auch ist hier der Kostenfaktor zu nennen. Da es mit der Einleitung der EOL Phase, um none-Standard-Produkt handelt. ### 6. NIS2 fordert aktuellen Stand der Technik Die NIS2-Richtlinie soll die Cybersicherheit in der EU verbessern und Unternehmen wie Behörden widerstandsfähiger gegen digitale Angriffe machen. Die aktuelle Version von Redhat und Oracle Linux in Organisationen einzusetzen wäre also für Compliance und Sicherheit relevant. NIS2 fordert „den aktuellen Stand der Technik“. **Stand der NIS2 Gesetzgebung**: - **Aktueller Stand:** Seit 13. November 2025 ist das Gesetzgebungsverfahren abgeschlossen. - **Erwartetes Inkrafttreten:** Anfang 2026. ## **Einschränkungen von RHEL7/OL7 (Stand 2025)** Kein regulärer Wartungssupport mehr seit Juni 2024. Keine neuen Hardware-Treiber oder Features. Sicherheitsrisiken steigen, wenn kein ELS gebucht wird. ## **Fazit** RHEL7/OL7 war lange die richtige Wahl. Aber wer heute noch auf Altbewährtes setzt, läuft Gefahr, morgen den Anschluss zu verlieren. RHEL9/OL9 ist nicht nur ein Upgrade – es ist ein strategischer Schritt in Richtung Zukunft. Du willst wissen, wie der Umstieg gelingt, ohne dass die Produktion ins Stolpern gerät? Ob Oracle Database, Fusion Middleware 14c, PostgreSQL, MongoDB, Virtualisierung, OnPrem oder in der Cloud … – wir unterstützen dich! Praxisnah, effizient, sicher und mit Weitblick – [DOAG 2025](https://anwenderkonferenz.doag.org/de/home/) komm doch vorbei! **Kategorien:** Database, Infrastructure, IT-Security --- ### [Zeitreihenanalysen im Controlling: Von belastbaren Forecasts zu besseren Entscheidungen](https://thecattlecrew.net/2025/11/12/zeitreihenanalysen-im-controlling-von-belastbaren-forecasts-zu-besseren-entscheidungen/) **Published:** November 12, 2025 **Author:** Fabian Heidenstecker **Content:** Zeitreihen begegnen uns im Controlling täglich: Absatzkurven, Umsatzentwicklung, Kapazitätsauslastung, Retourenquoten oder externe Treiber wie Inflations- und Wechselkurse. Sie alle verändern sich über die Zeit und enthalten damit mehr als Historie. Sie tragen Information über mögliche zukünftige Entwicklungen in sich. Wer diese Signale sauber extrahiert, gewinnt Handlungsspielräume. Konkret lassen sich so z. B. Budgets proaktiver steuern, Bestände gezielter planen, Kampagnenzeitpunkte präziser wählen. ## Von der vagen Vorhersage zum belastbaren Forecast Der Forecast ist die betriebswirtschaftlich relevante Form der Vorhersage: datenbasiert, modellgestützt, wiederholbar. Entscheidend ist nicht nur die Präzision, sondern die Verwendbarkeit im jeweiligen Entscheidungskontext. Ein guter Forecast macht Annahmen transparent, liefert eine nachvollziehbare Logik und zahlt auf eine konkrete Managementfrage ein – etwa *„Wie staffeln wir Werbedruck und Personal in den nächsten acht Wochen filial- bzw. kanalgenau?“*. ## Woran erkennt man einen brauchbaren Forecast? - **Präzision:** geringe Abweichung zu Vergleichsdaten und der späteren Realität - **Validität:** realistische Größenordnung und realistische Annahmen. - **Nützlichkeit:** klare Übergabe an Planung/Steuerung (z. B. Budget, Personal, Bestände). - **Transparenz:** Annahmen, Treiber und Grenzen sind erklärbar. ## Bausteine einer Zeitreihe – und warum sie praktisch zählen Eine Zeitreihe lässt sich idealtypisch in drei Komponenten zerlegen. Der **Trend** zeigt die Richtung (z. B. Wachstum eines Segments). **Saisonalität** repräsentiert wiederkehrende Muster – wöchentlich, monatlich, jährlich. **Zufallskomponenten** stehen für Zufälle und Einmaleffekte. Diese Trennung ist keine Theorie-Spielerei: Sie bestimmt die geeignete Modellfamilie und die sinnvolle Granularität: z. B. Tag vs. Woche. ### Praxisbeispiel In Retail-Daten führen Ladenschlusszeiten, Feiertage und saisonale Peaks zu regelmäßigen „Zacken“; auf Tagesebene kann die Streuung hoch sein. Eine Aggregation auf Wochenebene glättet Zufälligkeit und erhöht häufig die Prognosequalität – bei gleichzeitig höherer Steuerbarkeit im Controlling. ## Baselines zuerst: Warum einfache Methoden sinnvoll sind Viele Teams starten mit Excel – und das ist gut so. Ein **Baseline-Forecast** (z. B. *„Vorjahr fortschreiben“*, *„gleitender Mittelwert“*, *„naive Saisonkurve“*) ist schnell erstellt und liefert einen wichtigen Referenzpunkt. Zwei Effekte sind dabei zentral: 1. **Benchmarking**: Komplexere Modelle müssen zeigen, dass sie die Baseline zuverlässig schlagen. 2. **Kommunikation**: Einfache Regeln sind für Stakeholder unmittelbar nachvollziehbar und schaffen Akzeptanz. In einfachen und wenig schwankenden Zeitreihen erreichen naive saisonale Verfahren oft bereits einstellige prozentuale Abweichungen. Das genügt nicht immer – aber es ist eine solide Unterkante. ## Mehr Präzision mit Statistik – direkt im BI-Kontext Wo Muster stabil sind und Saisonalität dominiert, leisten statistische Verfahren (z. B. exponentielle Glättung) hervorragende Dienste. In BI Tools wie Power BI lassen sich automatische Forecasts unmittelbar auf Visualisierungen anwenden: Parameter wie Horizont, Saisonalität (z. B. 52 Wochen, 364 Tage), Konfidenzintervalle und Backtest-Fenster machen Effekte sichtbar. Die Stärke liegt in der Interaktivität – Filialen, Segmente, Kanäle lassen sich „on the fly“ vergleichen. ### Wo liegt die Grenze? Viele BI-Forecasts existieren primär im Diagramm. Für Summenbildung, KPI-Vergleiche oder MAPE\*-Berechnung braucht es einen Export oder einen modellierten Datenpfad, der die Vorhersagewerte als Datensätze verfügbar macht. ## Wenn’s komplex wird: Machine Learning, Python und Fabric Sobald mehrere Treiber interagieren (Preis, Rabattierungen, Wetter, Kampagnen, Kanäle), spielt **Machine Learning** seine Stärke aus. Mit **Python-Notebooks** lassen sich Explorationsschritte, Feature-Engineering und Modellierung transparent dokumentieren und versionieren. **AutoML-Ansätze** (z. B. in Microsoft Fabric) testen mehrere Modellfamilien, wählen hyperparametrisiert die beste Variante und erzeugen reproduzierbare Pipelines – inklusive Backtests und Qualitätsmetrik. Das verschiebt den Fokus: weniger manuelle Modellpflege, mehr Augenmerk auf Datenqualität, Feature-Design und die Übersetzung der Ergebnisse in Steuerungslogik (z. B. „Wie viele FTE-Stunden verschieben wir pro Woche je Filiale?“). ## Qualität messen – ohne Matheballast Zur Einordnung der Vorhersagequalität hat sich im Controlling der **MAPE** (Mean Absolute Percentage Error)\* bewährt. Er drückt die mittlere prozentuale Abweichung aus. Der macht es für Stakeholder leicht verständlich und über Perioden vergleichbar. Daumenregel für die Einordnung: - **< 10 %:** sehr gute Qualität - **10 – 20 %:** gut/zweckmäßig - **20 – 50 %:** begrenzt nutzbar, modellieren oder granularitätsseitig neu denken Wichtig: Den MAPE immer konsequent **out-of-sample** (auf Testfenstern) bestimmen und im Betrieb laufend überwachen. ## Praxisnahe Erkenntnis: Granularität schlägt Feintuning In Retail-Zeitreihen mit Sonn- und Feiertagseffekten führt die Tagesebene häufig zu schwankenden Abweichungen. Eine Aggregation auf Wochenebene glättet Ausreißer und erhöht die Prognosequalität sichtbar (z. B. von ~8 % auf ~6 % MAPE). Gleichzeitig ist die Wochenebene näher an vielen Steuerungsrhythmen (Personalplanung, Kampagnentaktung, Warenverfügbarkeit). Statt ein Tagesmodell immer weiter zu „feintunen“, ist die sauber begründete Granularitätswahl oft der größere Hebel. ## Grenzen anerkennen – und bewusst umgehen Nicht jede Zeitreihe ist vorhersagbar. Märkte, die einem Random-Walk ähneln (z. B. kurzfristige Kursbewegungen), lassen sich mit Standardverfahren kaum treffsicher prognostizieren. Tests auf Stationarität (z. B. Augmented Dickey-Fuller) helfen bei der Einordnung. Der Punkt ist operativ: Ressourcen dorthin lenken, wo Vorhersagefähigkeit und Entscheidungnutzen hoch sind. Bei chaotischen Reihen stattdessen mit Szenarien, Schwankungsbreiten und Risikobudgets arbeiten. ## Vom Modell zum Management-Instrument Ein Forecast entfaltet seinen Wert erst im Prozess. Das erfordert drei Dinge: 1. einen klaren Zweck, 2. robuste Datenpfade 3. und sichtbare Verantwortung. ### Minimal-Checkliste für Business-Analysten - **Purpose klar?** Welche Entscheidung wird mit dem Forecast getroffen – und auf welcher Ebene (Tag/Woche/Monat)? - **Datenbereitstellung robust?** Fehlende/ausreißende Werte, Kalenderlogik, Feiertage, Promotions, Preisänderungen – alles im Griff? - **Qualität im Betrieb sichtbar?** MAPE/MAE je Segment, Drift-Erkennung, Alarmierung bei Qualitätsabfall. - **Persistenz & Reproduzierbarkeit?** Versionierte Modelle, Trainingsdaten-Stände, Parameter-Historie, wiederholbare Pipelines. - **Hand-off definiert?** Schnittstellen zu Budget, Einsatzplanung, Einkauf, Kampagnenmanagement. ## Werkzeugwahl pragmatisch treffen Es gibt nicht das eine „richtige“ Tool – es gibt den passenden Stack für euren Reifegrad und Anwendungsfall. - **Excel:** ideal für Baselines, schnelle Vergleichsrechnungen, Kommunikation mit Fachbereichen. - **Power BI:** interaktive Visual Analytics, schnelle statistische Forecasts, Storytelling mit Daten – mit Exportpfad für Weiterverarbeitung. - **Python/Fabric:** wiederholbare ML-Pipelines, AutoML, Skalierung über Workspaces, Integration mit Lakehouse/Data Warehouse. Die sinnvolle Kombination sieht in vielen Organisationen so aus: Baselines und Visualisierung im BI, operative Forecasts und Qualitätsmonitoring in reproduzierbaren Pipelines – mit klaren Übergaben in die Planungs- und Steuerungsprozesse. ## Fazit Zeitreihenanalysen sind dann wertvoll, wenn sie Entscheidungen verändern. Eine solide Baseline schafft Transparenz. Statistik bringt Stabilität. Machine Learning erweitert das Vorhersagefenster – vorausgesetzt, Datenqualität, Granularität und Prozessintegration stimmen. Wer den Forecast als iterativen Management-Prozess versteht, gewinnt nicht nur Genauigkeit, sondern vor allem Geschwindigkeit in der Steuerung. Oder kürzer: Jede Vorhersage ist eine Einladung, die Zukunft besser zu gestalten. ***\* MAPE** steht für Mean Absolute Percentage Error, also den durchschnittlichen prozentualen Fehler einer Prognose. Er zeigt, wie weit Prognosen im Mittel von den tatsächlichen Werten abweichen, bezogen auf die Größe der Werte selbst. (Vgl. [Wikipedia](https://en.wikipedia.org/wiki/Mean_absolute_percentage_error))* **Kategorien:** AI & Data Science, Analytics & Insights --- ### [10 (scheinbare) Selbstverständlichkeiten im operativen Projektmanagement](https://thecattlecrew.net/2025/11/11/10-scheinbare-selbstverstaendlichkeiten-im-operativen-projektmanagement/) **Published:** November 11, 2025 **Author:** Stefan Sonner **Content:** In meinem letzten Blogpost *„Deine Stakeholder sollen sich gefälligst entscheiden!“* ging es um einen Aspekt des Stakeholder-Managements – und ich hatte bereits angekündigt, demnächst mehr über meine Arbeit in Projekten und meine Übernahme zu berichten. Heute ist es soweit: Ich nehme euch wieder mit in eine fiktive Situation, die ich im Projektalltag immer wieder erlebe – mit überraschenden Erkenntnissen, viel Kommunikationsbedarf und der Frage: Was darf man als Projektleitung eigentlich voraussetzen? Es geht um unausgesprochene Standards, Routinen, die dann aber nicht wirklich existieren, und vermeintliche Selbstverständlichkeiten, die sich als alles andere als selbstverständlich entpuppen. ## Ausgangssituation: Unzufriedenheit beim Kunden Es war Herbst, als sich unser fiktiver Kunde bei meinem Arbeitgeber meldete, weil er unzufrieden über den Verlauf eines Projektes war. Das Team bestand zu dieser Zeit aus einer Projektleitung und drei Entwicklern. Der Kunde sah eine Lösung im Wechsel der Projektleitung und ich wurde gebeten, diese Rolle zu übernehmen. Eine Situation, die ich nicht zum ersten Mal erlebe. Aber in diesem Fall zeigte sich – auch das erlebe ich immer wieder – schon bei der Übergabe: Es gab einiges, das ich als selbstverständlich angesehen hatte, was in der Realität schlicht nicht gegeben war. ## Erste Erkenntnis: Der Scope – oder eher: der große Nebel Meine erste Frage an den bisherigen Projektleiter war simpel: *„Was genau muss bis zum Projektende noch umgesetzt werden?“* ### Meine Erwartung: Als PL habe ich einen Überblick über das, was noch zu tun ist – insbesondere, wenn das Projekt nur noch rund drei Monate läuft. ### Die Realität: Kein klarer Scope. Ein völlig überladener, unstrukturierter Backlog. Unpriorisierte Tickets, veraltete Einträge, Duplikate – eine wahre JIRA-Geisterbahn. Meine (zugegeben direkte) Frage: „Warum hast du das denn nicht längst bereinigt?“ Die Antwort: „Ja, wollte ich ja, aber mit mir redet ja keiner.“ Das ließ mich erstmal sprachlos zurück. ## Kein Kollegen-Bashing – sondern ein Appell Ich möchte hier nicht den moralischen Zeigefinger heben oder jemanden bloßstellen. Vielmehr ist dies ein Aufruf an alle, die Projekte leiten: ### Ihr seid das Kommunikationsdrehkreuz. Ihr haltet die Fäden zusammen, vernetzt Stakeholder und treibt Entscheidungen voran. *Communication is King.* Oder wie ich manchmal sage: *„Projektleitung ohne Kommunikation? Das ist wie Schach spielen, ohne dem Gegner zu sagen, dass er dran ist.“* ## Was ich daraus gelernt habe Im Zuge der Projektübernahme und beim Blick in Dailys, Backlog und Teamrunden habe ich mir einige grundlegende Leitlinien zusammengestellt. Dinge, die für mich in der Projektleitung selbstverständlich sind – und die ich heute gern mit euch teile: ### 10 (scheinbare) Selbstverständlichkeiten in der Projektleitung 1. **Entscheidungen und relevante Infos werden schriftlich dokumentiert** Egal ob in Confluence, per Mail oder im JIRA-Ticket. 2. **Tickets, die begonnen wurden, werden zügig abgeschlossen** a) Idealerweise fertiggestellt und ausgeliefert b) Alternativ sinnvoll gesplittet – Teil 1 fertig, Teil 2 ins Backlog c) Hauptsache: eindeutiger Status 3. **Tickets werden kommentiert** Mindestens dann, wenn sie im Board von Spalte zu Spalte wandern. 4. **Jedes Ticket wird geschätzt** Story Points ? Stunden ? Personentage. 5. **Das JIRA-Board ist zentrales Arbeitsmittel** Im Daily, im Jour fixe, in Reviews. So wissen alle, was läuft – oder eben nicht. 6. **Wir kommunizieren aktiv – mit allen Beteiligten** a) Entwicklerteam b) Fachbereich c) Kunden-IT d) Projektleitungskolleg:innen Ein *„Mit mir redet ja keiner“* zählt nicht. 7. **Restlicher Scope wird regelmäßig gegen Zeit und Kapazität geprüft** a) Wenn’s klemmt: kommunizieren, priorisieren, nachjustieren b) Wenn’s am Anfang schon nicht passt: frühzeitig ansprechen! 8. **Ausgelieferte Releases werden dokumentiert** z.B. mit Confluence-Seite, JIRA-Release oder einfachen Release-Notes. 9. **Dokumentation wird nicht vergessen** Ab und zu prüfen, aktualisieren, aufräumen. 10. **JIRA wird strukturiert genutzt** Mit Sprints, Epics, Komponenten, Releases. Struktur ist kein Selbstzweck, sondern Grundlage für Klarheit. ## Diskussionsanstoß an die Community Ich bin mir sicher: Viele von euch nicken jetzt – andere vielleicht auch nicht. Und genau das interessiert mich. - Welche dieser Punkte sind für euch selbstverständlich? - Wo habt ihr ähnliche Erfahrungen gemacht? - Oder ganz andere? Ich freue mich auf eure Gedanken, Kommentare und Beispiele. **Let’s talk PL!** **Kategorien:** Development, Tools & Methoden --- ### [Vibe Coding – Teil 2: Linux-Server mit KI konfigurieren](https://thecattlecrew.net/2025/11/08/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen-teil-2/) **Published:** November 8, 2025 **Author:** Andreas Lorenz **Content:** Ein eigener Linux-Server, der Dienste wie Nextcloud, Collabora, Immich, einen DLNA Server und weitere Services bereitstellt – bei mir zu Hause, ohne Cloud-Abhängigkeiten, ohne monatliche Abos, ohne die Frage, wer meine Fotos scannt und Dokumente indiziert. Souveräne IT eben. So mein Ziel. Im [ersten Teil](https://thecattlecrew.net/2025/10/20/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen/) haben wir Hardware ausgewählt und den Mini-PC aufgebaut – leistungsfähig, leise und sparsam genug für den 24/7-Betrieb. Jetzt geht es an die Konfiguration: Welches Betriebssystem? Wie binde ich Storage an und wie richte ich Virtuelle Maschinen (VMs) ein? ChatGPT begleitet mich dabei als „Co-Pilot“ – und wie sich zeigen wird, ist das ein zweischneidiges Schwert. --- ## Die Wahl des Betriebssystems Zuerst die Auswahl des passenden Betriebssystems: Mit meinen Vorgaben schlägt mir die KI tatsächlich meine Favoriten vor – Proxmox, TrueNAS, Unraid und einen vollständigen Selbstbau. Letzteren sortiere ich sofort aus. Ich will in meiner Freizeit nicht zum Vollzeit-System-Administrator mutieren, zumal die Profis vieles deutlich besser beherrschen als der Freizeit-Admin. Wichtig ist für mich vor allem die **Effizienz**: Was 24/7 läuft, darf im Idle-Modus nicht viel Strom verbrauchen. Dazu kommt die **einfache Konfiguration** und sehr wichtig die Möglichkeit fertige Apps als Docker Images nutzen zu können. Final auch **Security**: Wer sich schon einmal aktiv Gedanken gemacht hat, wie viele wichtige Daten heute nur noch digital vorhanden sind, kennt die Gedanken vermutlich. Von den digitalen Fotoalben über wichtige Dokumente bis hin zu Unterlagen für Versicherungen und Steuererklärung – bei so vielen privaten und auch sensiblen Daten sind Sicherheit und Backup zentrale Parameter. Final entscheide ich mich für **Proxmox VE**, vor allem weil mich die Option, LXC-Container zu nutzen, sehr reizt. Auch so benötigt Proxmox als Hypervisor selbst nur wenig Ressourcen, die Software ist ausgesprochen professionell, mit dem Web-Frontend lassen sich die meisten Admin-Aufgaben auch ohne Konsole erledigen und wenn nicht, dann erlaubt mir der Debian Unterbau, auch mal tief ins System einzugreifen. Für mich die perfekte Wahl. ![](https://thecattlecrew.net/wp-content/uploads/2025/09/Proxmox-VE-9-0-Metrics-1024x575.png) Zum Thema Proxmox könnt Ihr gerne auch den Artikel von meinem Kollegen [Jeremy Smeets ](https://thecattlecrew.net/author/jeremy-smeets/) lesen: [Proxmox VE: Mit #OpenSource in die Digitale Souveränität](https://thecattlecrew.net/2025/09/18/proxmox-ve-open-source-virtualisierung-fuer-digitale-souveraenitaet/) --- ## Storage einrichten: Viele Optionen, eine Falle Zwei SATA-SSDs sollen für alle Apps als Storage genutzt werden – und hier gibt es nicht nur viele unterschiedliche Optionen, sondern auch sehr viele Wünsche, die erfüllt werden müssen. ChatGPT liefert wieder gute Vorarbeit und stellt CIFS, NFS, VirtioFS, Mount bind und sogar einen eigenen Storage Service zur Diskussion. **Ich mag diesen Dialog.** Es ist fast wie ein Gespräch mit einem erfahrenen Kollegen, bei dem man verschiedene Ansätze abwägen kann. Die KI erklärt Vor- und Nachteile strukturiert, ich kann Rückfragen stellen, Szenarien durchspielen. Doch dann kommt der Moment, wo das gute Gefühl, sagen wir rückblickend einmal, dem Entsetzen weicht … ### Die BTRFS-Falle Bei der Auswahl des Dateisystems entscheide ich mich nach „intensiver Beratung“ für **BTRFS**, ChatGPT liefert viele Vorteile und eigentlich keine wirklichen Nachteile. Doch weit gefehlt, das war keine gute Entscheidung, wie die Praxis glücklicherweise sehr früh zeigen wird. Früh genug, dass nur wenige Daten vom Backup wiederhergestellt werden müssen. **Was war passiert?** Mehrere Container müssen gleichzeitig auf die Daten zugreifen – und genau das verträgt BTRFS nicht. Das Dateisystem war schon kurz nach dem Start korrumpiert und die Daten waren verloren. Da ich BTRFS bis dahin nicht kannte, hätte ich diese Information schon gerne für die Entscheidung gehabt. Natürlich hatte ich ChatGPT nicht explizit nach den Risiken paralleler Schreibzugriffe gefragt – und mit einem vollständigeren Prompt hätte mich die KI vermutlich besser beraten. Für mich ist das ein klassisches „Hinterher ist man immer klüger“-Phänomen. **Aber:** Der Mehrwert von Erfahrung ist ja gerade, dass man vorher abwägt und es gar nicht erst zum „Hinterher“ kommt. Aus meinem Use-Case-Szenario war eigentlich klar ersichtlich, dass es zu parallelen Schreibzugriffen kommen würde. Ein erfahrener Kollege hätte mich hier gewarnt und ein anderes Dateisystem empfohlen. --- ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Zwei Seiten der KI-Medaille **Hier zeigen sich für mich zwei wichtige Facetten beim Einsatz der KI als Projektpartner:** ### Die positive Seite Ich stelle Fragen zu Optionen, bekomme verständliche Erklärungen strukturiert aufbereitet und kann dann bewusst entscheiden. Das ist Vibe Coding / Engineering im besten Sinne – die KI als Erklärbär und Sparringspartner. ### Die Schattenseite Schwierig wird es, wenn man sich in einer Technologie gar nicht auskennt und meint, sich zusammen mit der KI das Thema erschließen zu können. **Ein LLM „denkt“ NICHT wie ein erfahrener Administrator / Entwickler.** Zugegeben, ein Sprachmodell denkt natürlich nicht im klassischen Sinne, sondern sagt nur die wahrscheinlichste Antwort voraus; Aber OK, lassen wir das mal außen vor. Die KI präsentiert Optionen, erklärt Features – aber sie antizipiert nicht die kritischen Fragen, die ein Experte stellen würde. Ein menschlicher Senior-Administrator hätte vermutlich gefragt: „*Mehrere Container? Parallele Zugriffe?*“ und wäre dann zum Schluß gekommen „*Dann nimm besser kein BTRFS*„. --- ## Die erste VM: Parameter verstehen lernen Auch beim Aufsetzen der VMs gibt es Positives zu berichten, allerdings auch wieder ungewünschte Nebeneffekte. Ich verwende Debian Linux als minimales System – kein Desktop, nur das Nötigste. Beim Erstellen der VM in Proxmox begegnen mir eine ganze Reihe von Einstellungen: Cores vs. Sockets? Welche Disk-Technologie? Welches Disk-Format? Cache-Settings? Hier komme ich zusammen mit der KI schnell voran und die erste VM läuft, Debian ist installiert. ChatGPT war hier zunächst ein guter Lernbegleiter. Ich verstehe die Parameter, kann informierte Entscheidungen treffen. Das ist genau die Stärke der KI: Optionen erklären, Kontext liefern, Verständnis ermöglichen. Aber auch hier hat die Medaille ihre Kehrseite: --- ## Der Boot-Crash: Eine kritische Lektion Das Fiasko beginnt harmlos: Immich braucht mehr Speicherplatz, also füge ich der VM eine zweite Disk nur für die Daten hinzu. Partitionieren, formatieren, in die System-Konfiguration eintragen. Alles schnell erledigt. Ich will einen kleinen Test machen und starte die VM neu. Autsch, das war nicht gut. Der Server bzw. die Virtuelle Maschine kommt gar nicht mehr hoch. **Was war passiert?** Es gab ein Problem, die neue Festplatte einzubinden und in der Konfiguration fehlte leider das Flag `nofail`. Ohne dieses Flag blockiert der Boot-Prozess komplett, wenn eine Disk nicht verfügbar ist. Und weil ich bei der Installation keinen Root-Zugang vorbereitet hatte, kam ich auch nicht an eine Recovery-Shell. Als Ergebnis durfte ich die Maschine neu installieren. Dramatisch war das nicht, aber ärgerlich allemal. **Die wichtigste Erkenntnis:** `nofail` ist kein Nice-to-have, sondern bisweilen sehr wichtig und bei einer Virtuellen Maschine sollte man nicht auf einen expliziten root Account verzichten. **Und genau hier liegt für mich wieder ein Schwachpunkt der KI-Beratung:** ChatGPT hatte sauber erklärt, welche Parameter ich verwenden kann, um eine Disk einzubinden. Genau die feinen Details zur Syntax sind es , die ich nicht im Kopf behalten will: *Wo kommt ein Leerzeichen, ein Komma, ein Doppelpunkt hin; wie binde ich ein NFS Laufwerk ein?* Bei solchen Details hilft die KI enorm! Allerdings wurden Hinweise, die für ein robustes System wichtig sind, wieder erst auf Nachfrage gegeben. Welcher VIBE Coder weiß denn die kritischen Fragen, bevor etwas zu Bruch gegangen ist? ## Die pragmatische Lösung: Physical Disk Passthrough Nach diesen Erfahrungen überdenke ich die Storage-Strategie und reiche eine der beiden SSD einfach komplett in den Container für Immich durch. ChatGPT hatte verschiedene Ansätze vorgeschlagen – *VirtioFS, CIFS/NFS, eigener Storage Service*. Für mich fehlten hier oftmals Hinweise, die für das Einsatzszenario wichtig waren und damit scheiterten einige Versuche in der Praxis. Manchmal waren es sofort offensichtliche Probleme, dass man z.B. die Zugriffsrechte kaum in den Griff bekam. In anderen Fällen hatte ich schlicht Sicherheitsbedenken, zu riskieren „Löcher vom Container zur Virtualisierung-Schicht zu bohren“. Hier bin ich im Chat mit der KI auch an meine Grenzen gestoßen, den richtigen Prompt zu formulieren, damit alle Kriterien berücksichtigt sind. Immerhin hat die KI hier viel geholfen und geduldig Fragen beantwortet und Szenarien durchgespielt und immer wieder die Sicherheit unterschiedlicher Optionen bewertet – ich hoffe mal, dass ich nie erfahren werde, ob sie dabei richtig lag 😉 ## Fazit: Erkenntnisse zum Vibe Engineering Nach dieser Phase des Projekts zeichnet sich für mich folgendes Bild ab: ### Wo mich der Einsatz von KI überzeugt **Parameter, Syntax und Optionen verstehen** Die Erklärungen zu Details & Einstellungen sowie technische Trade-offs waren ausgesprochen hilfreich und sehr oft auch präzise. Generative KI ist ein ausgezeichneter Erklärbär für etablierte Technologien. Dazu hat es mir auch sehr geholfen, die richtige Optionen inklusive korrekter Syntax von der KI zu erhalten. Dies hat mir einiges an Zeit erspart. **Strukturierte Dialoge** Das Durchspielen verschiedener Ansätze im Dialog – z.B. CIFS vs. NFS vs. VirtioFS – war wertvoll. Man kann Rückfragen stellen, Szenarien durchdenken und kann informierte Entscheidungen treffen. **Schnelle Iteration** Bei Problemen kann man Fehlermeldungen direkt an die KI geben und bekommt meist sinnvolle Lösungsansätze. ### Wo ich die Arbeit des Co-Piloten kritisch bewerte #### **Fehlende Risikobewertung** BTRFS wurde als „modernes Dateisystem mit tollen Features“ präsentiert, ohne auf die Einschränkungen bei parallelen Zugriffen hinzuweisen. Kritische Hinweise wurden nicht proaktiv gegeben. #### Die Grenzen des Promptings: Wenn zu viele Anforderungen zusammenkommen Eine Schwäche in der Arbeit mit einem LLM zeigte sich, wenn mehrere Anforderungen gleichzeitig erfüllt werden mussten: Beim Einbinden der Festplatten hatte ich zum Beispiel mehrere Ziele: Performance, Sicherheit/Isolation, Robustheit, Effizienz und noch mehr. ChatGPT berücksichtigte bei seinen Vorschlägen oft nur einen Teil der Wünsche. **Das größere Problem:** Nachfragen half nicht. Bei jedem „Ja, aber was ist mit…?“ beginnt ChatGPT von vorne, berücksichtigte den neuen Aspekt, vergaß aber dafür andere. **Die bessere Strategie:** Die KI für Teilaspekte nutzen (z.B. „Erkläre mir BTRFS-Einschränkungen“), aber die Gesamtlösung selbst zusammendenken. Nur werden dann die Chats sehr schlecht leserlich und man findet später kaum noch den roten Faden, warum man sich so entschieden hat. #### **Bevorzugung „moderner“ bzw \*populärer\* Lösungen** VirtioFS oder gar ein dedizierte Storage-Service – alles wurde als elegant präsentiert, ohne die praktische Komplexität ausreichend zu betonen. Die KI tendierte für mein Dafürhalten zu neueren Technologien. Ich vermute es sind eben die Themen, die auf reddit und Stackoverflow viel diskutiert werden. Und das macht die KI leider auch dann, wenn einfachere Ansätze besser passen. #### **Fehlende Antizipation von Problemen** Die KI erklärt gut den Standardablauf bzw. die Wege, die besonders oft im Netz zu finden sind. Sie liefert aber im Regelfall keine Antworten, wie sie ein erfahrener Administrator geben würde, der potenzielle Fallstricke proaktiv anspricht. **Unabhängig von den sachlichen Themen** Den Dialog zu den unterschiedlichen Themen führt ChatGPT angenehm und geschickt. Eine bisweilen geradezu euphorische Wortwahl und immer wieder plakatives Lob der KI: „*Sehr gute Überlegung – und du sprichst einen der wichtigsten Punkte an …*“ empfinde ich zunächst als sehr angenehm und sogar motivierend. Irgendwann fällt es dann doch auf 🙂 und mittlerweile schätze ich mehr die Sprachassistenten, die diese unterschwellige Beeinflussung zumindest weniger deutlich zeigen. ## Wie geht es weiter? Im nächsten Teil geht es vermutlich um echtes Vibe Coding. In der Tat habe ich auch eine Flask Web-App mit ChatGPT programmiert, mit der ich vom Handy aus die Container einfach mit einem Klick starten und stoppen kann… --- **Weitere Ressourcen:** - [Teil 1: Hardware-Auswahl und Aufbau](https://thecattlecrew.net/2025/10/20/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen/) - Teil 3: Docker, Immich und Backup-Strategien (coming soon) **Kategorien:** AI & Data Science, Infrastructure --- ### [Vibe Coding – Teil 1: Mit KI zum eigenen Homeserver](https://thecattlecrew.net/2025/10/20/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen/) **Published:** Oktober 20, 2025 **Author:** Andreas Lorenz **Content:** Wir leben in einer Zeit, in der die Nutzung von KI-Tools alltäglich geworden ist – beruflich wie privat. Doch während viele der KI blind vertrauen und andere ihr grundsätzlich misstrauen, stelle ich mir die Frage nach der Mitte: **Wie nutze ich KI als Sparringspartner, ohne die Kontrolle über mein Handeln zu verlieren?** ## Was ist Vibe Coding? Vibe Coding beschreibt eine neue Form der Zusammenarbeit zwischen Mensch und Künstlicher Intelligenz – ursprünglich beim Programmieren, zunehmend aber auch in anderen Entwicklungs-Bereichen, hier Hardware- und Infrastruktur. KI agiert dabei als Projektpartner, der Entwürfe analysiert, Lösungen vorschlägt und Entwicklungsprozesse beschleunigt. ## Die Motivation für diesen Artikel? In diesem Artikel möchte ich meine Erfahrungen teilen, wie ich **privat** technische Projekte zusammen mit der KI umsetze. Am Beispiel meines Homeserver-Projekts zeige ich, wo die KI mich in der Praxis sinnvoll unterstützt hat und welche Herausforderungen es gab. Die Erfahrungen waren auch ganz unterschiedlich, je nachdem welche Aufgabe anstand: - Der Hardwareaufbau - Die Installation und Konfiguration des Betriebssystems - Das Aufsetzen der Apps auf dem Homeserver - Entwicklung eines Admin UIs als pures Vibe Coding - Konfiguration des OpenWRT Routers ## Das Projekt – Homeservers aufsetzen mit KI Seit Jahren beschäftige ich mich mit dem Thema souveräne IT (siehe auch die [Blogserie Datensouveränität](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/)) – Wenn ich meine Daten kontrollieren will, muss ich verstehen, wo sie liegen und wie sie verarbeitet werden. Diverse Synology-, QNAP- und Terramaster-NAS-Systeme haben mir über die Jahre gute Dienste geleistet. Da ich einen langjährigen Background im Bereich Linux-Server habe und mich auch im Bereich Docker wohl fühle, will ich jetzt einen Schritt weitergehen und starte das Projekt zusammen mit meinem Sohn (E-Technik Student) und mit ChatGPT als „Co-Pilot“. ![Der Selbstbau Server zu Hause](https://thecattlecrew.net/wp-content/uploads/2025/10/Homeserver-Hardware-KI-300x245.jpg)leiser, sparsamer Server @Home **Das Ziel:** Ein eigener Linux-Server, der u.a. Dienste wie Nextcloud, Collabora, Immich und OpenProject als Container für mich und die Familie bereitstellt. Der Betrieb ist dann bei mir zu Hause und somit entfallen Cloud-Abhängigkeiten, monatlichen Abos und die Frage, wer meine Fotos scannt und Dokumente indiziert. Zu Hause bedeutet aber auch, dass er sehr leise, sparsam und optisch unauffällig sein muss! Und Leistung darf trotzdem nicht zu kurz kommen, damit Webseiten auch bei Lastspitzen schnell geladen werden. Seine Vorgänger waren entweder zu schwach oder zu laut, sozusagen „teuer erkaufte Erfahrung“. Diesmal soll es direkt passen, ohne Fehleinkäufe 🙂 ## Hardware-Auswahl – KI als Recherche-Turbo Bei der Auswahl der richtigen Hardware hilft ChatGPT sehr und vergleicht u.a. CPU-Leistungen, Stromverbräuche und wichtige technische Parameter – zunächst von fertigen Lösungen, darunter sowohl PCs als auch NAS Systeme und später auch für Bausätze. Das Ganze ist weit ab von einfach, alleine aus Asien kommen mittlerweile so viele hübsche, kleine Kraftprotze in die Webstores von Amazon und Co, da muss man schon auf die Details achten, damit der Frust nicht direkt nach dem Kauf beginnt. Dazu recherchiert die KI für mich auch Erfahrungsberichte zu technischen Problemen und zur Kompatibilität mit Linux. Nach demselben Muster werden ein Switch mit VLAN-Support & 2,5-GBit/s-Ports sowie die SSD ausgesucht. ![ChatGPT SSD Vergleich im Tabellenformat](https://thecattlecrew.net/wp-content/uploads/2025/10/CGPT_DiskVergleich.png)ChatGPT SSD Vergleich Ich hatte das Gefühl, dass mir die Zuarbeit der KI hier sehr viel Zeit erspart hat. Allerdings hilft es hier auch enorm, der KI **genau** zu sagen, was einem wichtig ist. Und selbst dann, wenn ich mal nicht alles im Blick hatte, kamen wertvolle Tipps: Es hilft gelegentlich offene Fragen zu stellen: „*Vergleiche mir einmal SSD A mit SSD B, was sind die Vorteile und Nachteile*„. Erst so kam ich z.B. auf das Detail DRAM Cache, dass für die Langlebigkeit von SSDs nicht unwichtig ist. > Die Rolle der KI ? > Es war ausgesprochen hilfreich, eine enorme Anzahl an Infos innerhalb kürzester Zeit sortiert und aufbereitet auf dem Monitor zu haben und die Suche nach Hardware basierend auf unseren Wünschen einzugrenzen. > > Besonders gut gefiel uns, dass es auch sehr viele praxisnahe Tipps gibt. Zum Beispiel das Thema DRAM-Cache bei SSDs hatte ich so gar nicht auf dem Schirm. Die Entscheidung: Bauvorschlag als Basis Wir entschieden uns final für eine vollständige Selbstbau-Lösung, gehen aber auf Nummer sicher: Die Wahl fiel auf einen Bauvorschlag aus der c’t (*Sonderheft Dez 2024*) – solide durchdacht und von der Redaktion erprobt. Beim Hardwareaufbau ist der c’t-Fachartikel und ein Video aus dem Verlag eine große Hilfe. Wenn noch Infos fehlen, dann fragen wir die KI und bekommen ebenfalls Tipps, die sich aber auch genauso gut googlen lassen. ## Realitätscheck: Grenzen der KI beim Einkauf Beim Einkauf bzw. Bestellen der Einzelteile sind es dann doch Google und Preissuchmaschinen, die helfen, alle Bauteile auch zu bekommen. Die Ergebnisse und Preise, die uns ChatGPT zu dieser Zeit anzeigt, können wir oft nicht nachvollziehen zumal wir auch nicht alle Teile einzeln sondern bei möglichst wenig unterschiedlichen Anbietern bestellen wollten. Ich denke, heute, etwa ein halbes Jahr später, kann das schon wieder ganz anders aussehen. > Die Rolle der KI ? > Bei zeitkritischen Daten wie Preisen und Verfügbarkeit muss(te) wir noch gegenchecken. Die KI war für uns noch kein Ersatz für eine aktuelle Marktrecherche. ## Mission accomplished Final hat alles sehr gut geklappt: Mein Sohn und ich haben gemeinsam geschraubt, verkabelt und das System zum ersten Mal gebootet, dazu dann aber mehr im nächsten Artikel 😉 Der Server erfüllt bis heute zu 100% seinen Zweck: ist absolut leise, klein mit cleanem Design und wenn mal ein Service richtig Leistung braucht, dann ist auch das kein Thema. Bis dahin war es dann aber doch noch ein netter Weg an Herausforderungen, bei der die KI dann noch deutlich mehr unterstützen durfte. --- **Lest gerne im nächsten Artikel**, wie es bei der [Auswahl und Installation des Betriebssystems und dem Aufsetzen des Servers](https://thecattlecrew.net/2025/11/08/vibe-coding-in-aktion-einen-homeserver-mit-ki-aufsetzen-teil-2/) weitergeht… **Kategorien:** AI & Data Science, Infrastructure --- ### [Deine Stakeholder sollen sich gefälligst entscheiden!](https://thecattlecrew.net/2025/11/04/deine-stakeholder-sollen-sich-gefaelligst-entscheiden/) **Published:** November 4, 2025 **Author:** Stefan Sonner **Content:** Alle, die IT-Projekte leiten, kommen im Laufe ihrer Ausbildung und Berufspraxis irgendwann an die Stelle, wo sie lernen, dass klare Verantwortlichkeiten und definierte Entscheidungskompetenzen dem Projekterfolg zuträglich, ja fast unabdingbar, sind. Was aber, wenn genau das fehlt? Wenn du dich in einem Projekt befindest, in dem eine Handvoll Stakeholder mitreden und jede der Parteien so ein bisschen was entscheiden darf? Wenn dich das interessiert, dann lies gerne weiter. Ich möchte euch gerne von meinen Erfahrungen zu genau diesem Aspekt berichten. Dafür betrachten wir ein rein fiktives Beispiel. Es mag übertrieben wirken. Ist es tatsächlich aber nicht. Ich spreche dabei definitiv nicht über die Mehrzahl der Projekte, das möchte ich an dieser Stelle betonen. Doch das, was ich gleich schildere, habe ich persönlich erlebt. ## Die wichtigsten Stakeholder Zunächst muss ich euch die wichtigsten Stakeholder vorstellen: - Der Fachbereich: Inhaltlicher Owner, darf Featurewünsche äußern und hat Mitspracherecht bei der Priorisierung. - Die IT, Abteilung Softwareentwicklung: Hat die finanzielle Verantwortung und Mitspracherecht, was inhaltlich gemacht wird. Hat außerdem technische Anforderungen, die mit den fachlichen Features hinsichtlich Entwicklerkapazität konkurrieren. - Das IT-Controlling: Kontrollorgan für die IT und den Fachbereich hinsichtlich Verwendung finanzieller Mittel sowie umzusetzender Inhalte. Hat außerdem ausgeprägtes Mitspracherecht in allen Bereichen, also auch fachlich und technisch. Hat organisatorische Anforderungen, z. B. bezüglich der Revisionssicherheit, und bestimmt, wann das Projekt zu enden hat. - Die Fachbereichsleitung: Eskalationsinstanz des Fachbereichs, ihre Priorisierung ist teilweise abweichend von den Priorisierungsvorstellungen der Sachbearbeiter. - Die Leitungsposition der IT/Softwareentwicklung: Zu Beginn der Geschichte unbesetzt. Wird später noch spannend. ## Erste Maßnahmen: Diskussion über Entscheidungswege Vier Monate nachdem ich das Projekt übernahm, lud ich die genannten Stakeholder zur Besprechung von zwei Kernthemen ein: Eines davon war „Entscheidungen im Projekt“. In zwei, drei Folien habe ich den Teilnehmern erklärt, warum klare Entscheidungswege so wichtig sind und dass ich wahrnehme, dass hier im Projekt genau das Gegenteil der Fall ist: Keine Klarheit, niemand, der „den Hut aufhat“, jeder zwar ein bisschen, aber keine finale Instanz, die bei konkurrierenden Haltungen ein Machtwort sprechen kann. Meine nächste Folie beschrieb ein paar Lösungsvorschläge, um die Diskussion anzukurbeln und die Teilnehmer ins Reden und ins „Miteinander“ zu bringen: z. B. den Fachbereich mit einem Storypoint-Budget und mehr Entscheidungsbefugnis auszustatten, den Entscheidungsweg prozessual abzubilden oder den Kreis der Entscheider in einen Refinement-/Replenishment-Zyklus einzubinden. Das Feedback war allerdings ernüchternd. Genau genommen gab es gar kein Feedback dazu. Es wurde geschwiegen. ## Ein überladener Backlog und neue Herausforderungen Ganz ehrlich, das hatte ich mir anders vorgestellt. Aber machen wir erstmal weiter. Unser größtes Problem im Projekt war, dass der Backlog eine gigantische Größe hatte, aber das Projektende bereits optimistisch festgesetzt war. Wir mussten also einen Weg finden, zu entscheiden, was noch umgesetzt werden soll und was nicht. Irgendwie haben wir dann in einer ersten Runde den Backlog etwas verkleinern und das Projekt restrukturieren können. Es blieb aber die Frage offen, was das Entwicklerteam als Nächstes umsetzen soll. Und, ob das Feature „X“ überhaupt noch seine Berechtigung hat und umgesetzt werden soll. Zudem wurden seit meiner Projektübernahme weitere notwendige Features identifiziert, die bis dato noch nicht als Feature/Story erfasst waren. ## Mein Vorschlag: Sprints als Ausweg Die Meinungen gingen nun stark auseinander. Was hat Prio? Fachliches Feature A vs. Features zugunsten der Revisionssicherheit vs. Fachliches Feature B vs. notwendige technische Features vs. X … 5 Stakeholder mit je 2–3 Meinungen. Ihr bekommt sicher gerade ein Gefühl für die Situation. Was tun? Mein Vorschlag war der folgende: - Wir führen Sprints ein. - Der Fachbereich erarbeitet zusammen mit mir jeweils einen Sprintvorschlag. - Alle Stakeholder segnen den nächsten Sprint im Rahmen des wöchentlichen Jour-Fixe ab. - Damit alle Themen adressiert sind, erfolgt ein Mapping der scheinbar möglichen Stories auf die Sprints von jetzt bis Projektende (durch Fachbereich und mich). Ich war positiv überrascht, aber der Vorschlag wurde einstimmig angenommen. ## Rückschlag: Priorisierung im Dauerwechsel Die Enttäuschung erfolgte eine Woche später! Im nächsten Jour-Fixe entfachte wieder die Diskussion über die Prioritäten. Die IT-Steuerung spielte den Präsidenten-Joker und der Priorisierungsslalom begann … in den nächsten 6 Wochen wechselte unsere Prio von links nach rechts und wieder zurück – je nachdem, welcher Teilnehmerkreis gerade im Jour-Fixe anwesend war. Weitere Prio-Veränderungen erreichten das Projektteam per E-Mail. Mal aus der einen, mal aus der anderen Stakeholder-Ecke. ## Notlösungen aus dem PM-Werkzeugköfferchen Ich kramte in meinem Projektmanagement-Werkzeugköfferchen: Was war da noch so drin? - Entscheidungen im **Jour-Fixe-Protokoll** schriftlich fixieren? Ja, das geschah sowieso und regelmäßig. Half aber nicht! Entscheidungen wurden revidiert und überschrieben. - Ich führte **Einzelgespräche** mit den Stakeholdern, um jeden Einzelnen zur Situation abzuholen und deutlich zu machen, dass weitere Prio-Wechsel das Projekt stark verzögern. - **Arbeitshypothesen**? In anderen Projekten bei diesem Kunden hatte es sich bewährt, bei offenen Fragen mit Arbeitshypothesen zu arbeiten. Also mit der am wahrscheinlichsten eintretenden Option weiterzumachen. Doch in diesem Projekt waren von mir formulierte Hypothesen nach nur wenigen Tagen nichts mehr wert. ## Der Wendepunkt: Neue Leitung übernimmt So langsam war ich mit meinem Latein am Ende. Aber inzwischen war die Leitungsposition von IT/Softwareentwicklung wieder besetzt, und nach kurzer Einarbeitungszeit war mein Projekt stark im Fokus der neuen Leitung – glücklicherweise. Ich konnte meine Sicht der Dinge nun mit der frischen Führungskraft besprechen, fehlende Entscheidungskompetenzen aufzeigen und notwendige Dringlichkeit herstellen. Die neue Leitung holte alle Beteiligten an den (virtuellen) runden Tisch und traf zwei Entscheidungen: - Klare inhaltliche Fokussierung bis Projektende. - Klare Absichtserklärung, das derzeitige Projektteam über das Projektende hinaus an den weiteren Themen arbeiten zu lassen. Insbesondere die zweite Entscheidung führte nach meiner Wahrnehmung dazu, dass die Stakeholder entspannter waren und in das Projekt eine gewisse Ruhe einkehrte. Die Zuversicht, dass man „seine“ Themen irgendwann in die Umsetzung bekommt, stieg. Die „Torschlusspanik“ nahm ab und dadurch entstandene Handlungsmuster reduzierten sich. ## Fazit und offene Fragen an euch Rückblickend würde ich mir an die eigene Nase fassen und sagen: Nachdem ich gemerkt habe, dass ich im bestehenden Projektteam niemanden finde, der ein finaler Entscheider sein kann, hätte ich außerhalb weitersuchen müssen. Ich habe möglicherweise zu viel Energie in das Ziel gesteckt, die Stakeholder zu entschlüsseln. Welches Fazit würdet ihr ziehen? Was hättet ihr anders gemacht? Oder wie wärt ihr mit der Situation umgegangen? Schreibt das gerne in die Kommentare. ## Ausblick In meinem nächsten Artikel geht es um *10 (scheinbare) Selbstverständlichkeiten im Projektmanagement*. Es bleibt also interessant und die Diskussion darf weitergehen. Seid gerne wieder dabei. **Kategorien:** Development, Tools & Methoden --- ### [Schuld und SYNE – Alte Sünden in der IT-Sicherheit und wie wir sie überwinden](https://thecattlecrew.net/2025/10/28/schuld-und-syne-alte-suenden-in-der-it-sicherheit-und-wie-wir-sie-ueberwinden/) **Published:** Oktober 28, 2025 **Author:** Torsten Jaeschke **Content:** Am 17. September 2025 habe ich auf der Digital Xchange 2025 in Gummersbach meinen Vortrag „Schuld und SYNE“ gehalten. Darin habe ich gezeigt, wie sich alte Sünden in der IT-Sicherheit – technische Schulden in der System- und Netzwerksicherheit – über Jahre aufbauen und welche psychologischen Mechanismen dafür sorgen, dass sie bestehen bleiben. Der Titel „Schuld und SYNE“ hat übrigens einen doppelten Hintergrund: In unserer Firma wird die Richtlinie zur System- und Netzwerksicherheit mit SYNE abgekürzt – diese Abkürzung inspirierte mich zu dem Titel, der bewusst an Dostojewskis Schuld und Sühne erinnert. Das Echo des Publikums hat mir gezeigt: Wir alle kennen diese Probleme aus der Praxis. Schauen wir gemeinsam noch einmal genauer hin. ![Zeichnung in schwarz-weiß: Ein Mensch trägt eine schwere Last](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-schuld-und-syne_jaeschke_bild01.jpg) ## Alte Sünden in der IT-Sicherheit *Alles Vergangene war nicht vergangen, es lastete.* Wir stoßen in Audits und Architekturreviews regelmäßig auf dieselben Muster: zu weitgehende Benutzerrechte, fehlende Trennung zwischen Domänen und administrativen Konten, gewachsene Strukturen ohne klare Sicherheitsarchitektur. Meist waren diese Entscheidungen nicht böswillig, sondern das Ergebnis von Zeitdruck und pragmatischen Lösungen. Doch was einst schnelle Ergebnisse versprach, wird heute zum Risiko. Genau diese Ambivalenz beschreibt Dostojewski in Schuld und Sühne: Raskolnikow begeht eine Tat, die er sich als „erlaubt“ rationalisiert. Organisationen tun Ähnliches, wenn sie Ausnahmen und Quickfixes rechtfertigen. ![Ein Gerichtshammer als Zeichnung in schwarz-weiß](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-schuld-und-syne_jaeschke_bild02.jpg) ## Technische Schulden sind auch psychologische Schulden *Wenn ich es für Recht halte, dann war es Recht.* Technische Schulden sind mehr als alte Software. Sie sind ein Geflecht aus gewachsenen Strukturen, veralteten Verfahren und fehlender Dokumentation. Niemand fühlt sich mehr verantwortlich. In der Trauerarbeit spricht Chris Paul von „vagabundierender Schuld“ – Schuld, die keinen klaren Ort oder Adressaten hat. Genau das passiert auch in IT-Organisationen: Konten, Policies, Systeme hängen in der Luft, ohne klaren Owner. Das Ergebnis: Innovation wird blockiert, Kosten steigen und die Angriffsfläche wächst. Die Psychologie liefert dafür Erklärungen. Leon Festinger beschrieb schon 1957 die „kognitive Dissonanz“: Wir wissen, dass etwas nicht stimmt, verdrängen es aber, weil Handeln unangenehm wäre. Neurowissenschaftliche Studien von McClure et al. zeigen, dass unser Gehirn kurzfristige Belohnungen – etwa ein erfolgreiches Release – stärker honoriert als langfristige Sicherheit. Kahneman erinnert uns daran, wie oft wir im „schnellen Denken“ bleiben und uns mit Ausreden beruhigen. Chris Paul ergänzt: Schuld kann normativ sein (Verstoß gegen Regeln), instrumentell (Schuldzuweisung als Druckmittel) oder vagabundierend (niemand fühlt sich verantwortlich). Diese Mechanismen wirken auch in Unternehmen – und sie erklären, warum technische Schulden bleiben. ![Eine Maus guckt aus einer Mülltonne hervor - Zeichnung in schwarz-weiß](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-schuld-und-syne_jaeschke_bild03.jpg) ## Das Katz-und-Maus-Spiel vor Audits *Verbergen, immer verbergen das war sein Schicksal.* Wir kennen alle die Symptome: kurzfristig Ports schließen, Policies temporär ändern, Dokumentation kosmetisch aufbereiten. Statt Probleme zu lösen, werden sie geschminkt. Wie Raskolnikow, der lügt und verschweigt, geraten Organisationen in ein Katz-und-Maus-Spiel: Verbergen statt Eingestehen. Doch Audit-Kosmetik beseitigt nicht das Problem, sie stabilisiert es. ![Eine Bombe mit Zündschnur, die bald explodiert, Zeichnung schwarz-weiß](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-schuld-und-syne_jaeschke_bild04.jpg) ## Die tickende Zeitbombe *Nicht die Schuld ist tödlich, sondern das Schweigen darüber.* Das Verdrängen funktioniert nicht ewig. Mit jeder weiteren Lücke wächst die Gefahr. Kumulative Risiken – von DSGVO-Verstößen über erhöhte Angriffsflächen bis zu Reputationsschäden – und dauerhafte Alarmbereitschaft führen zu Stress und Burnout im Team. Chris Paul formuliert es treffend: „Unbearbeitete Schuld kann zerstörerisch wirken – nicht, weil sie existiert, sondern weil sie nicht ausgesprochen wird.“ ![Ein Pfeil der sich aus einem unübersichtlichen Knäuel den Weg nach oben bahnt als einfache Zeichnung in schwarz-weiß](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-schuld-und-syne_jaeschke_bild05-1.jpg) ## Wege aus der Schuldenfalle *Im Bekenntnis liegt die Erlösung.* Der erste Schritt ist das Eingeständnis: Ja, wir haben Schulden. Genau wie Raskolnikows Geständnis ist es ein Wendepunkt. Dann gilt es, systematisch zu handeln: - **Technisch:** Rechte- und Rollenkonzepte (RBAC/ABAC) implementieren, administrative Ebenen trennen, Legacy-Komponenten priorisiert migrieren. - **Organisational:** Schuldenregister führen wie einen Bugtracker, Verantwortlichkeiten klar zuordnen, eine Kultur schaffen, in der man Schwächen offen ansprechen darf. Ergänzend gilt: Schuld verliert ihre zerstörerische Macht, wenn sie Sprache bekommt. Wir brauchen Räume ohne Strafe, in denen technische Schulden offen benannt werden können. Transparenz und Struktur sind der Weg zur Sühne. ![Eine Frau hebt eine Hantel in die Höhe und zeigt ihre Muskeln - einfache Zeichnung in schwarz-weiß](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-schuld-und-syne_jaeschke_bild06b.jpg) ## Von Schuld zur SYNE *Das Eingeständnis von Schuld ist nicht Schwäche, sondern der Anfang von Stärke.* Schuld ist nicht Stillstand, sondern Ausgangspunkt. Wer sie anerkennt, kann Veränderung gestalten. Unternehmen, die hinschauen, gestalten eine sichere Zukunft – für sich und ihre Kunden. ## Fazit Technische Schulden sind kein rein technisches Problem, sondern Spiegel menschlicher Muster: Wir verdrängen, rechtfertigen und verschieben. Doch wer Schuld anerkennt, schafft die Grundlage für Veränderung. Mit Transparenz, klaren Verantwortlichkeiten und dem Mut, Schwächen offen anzusprechen, werden alte Sünden zum Ausgangspunkt für mehr Sicherheit und Stärke. Von Schuld zur SYNE bedeutet: hinsehen, Verantwortung übernehmen und IT-Sicherheit als lebendigen Prozess begreifen – zum Schutz von Unternehmen, Mitarbeitenden und Kunden. ## Quellen - Dostojewski, F. (1866). Schuld und Sühne - Festinger, L. (1957). A Theory of Cognitive Dissonance - McClure, S. M. et al. (2004). Science, 306(5695) - Kahneman, D. (2011). Thinking, Fast and Slow - Sapolsky, R. M. (2004). Why Zebras Don’t Get Ulcers - Paul, C. (2014). Schuld – Macht – Sinn **Kategorien:** IT-Security, Sustainability & Awareness --- ### [KI im Kundeneinsatz: Ein Reality Check der Pyramid-Funktionalität](https://thecattlecrew.net/2025/10/14/ki-im-kundeneinsatz-ein-reality-check-der-pyramid-funktionalitaet/) **Published:** Oktober 14, 2025 **Author:** Janine Ellner **Content:** Generative KI gilt aktuell als das neue Must-have – kaum eine moderne Analytics-Plattform verzichtet noch auf die Integration von Large Language Models (LLMs). Auch Pyramid bewirbt sich als Gamechanger: Wer Daten in natürlicher Sprache abfragt, soll ohne Umwege zu Tabellen, Visualisierungen oder Prognosen gelangen. Doch wie so oft im echten Leben ist der Weg von der Vision zur Praxis steinig. Für einen Kunden haben wir die GenAI-Integration in Pyramid getestet. Das Ergebnis ist gemischt: KI kann tatsächlich unterstützen. Allerdings nur dann, wenn man einige Voraussetzungen schafft – sowohl auf technischer als auch auf organisatorischer Ebene – und typische Stolperfallen kennt. ## Erwartungen an GenAI in Pyramid Die Vorstellung ist verlockend: Statt SQL-Abfragen zu schreiben, reicht eine einfache Frage wie *„Zeig mir die Umsätze der letzten sechs Monate“*. Pyramid übersetzt das Anliegen automatisch in eine Abfrage und liefert die passenden Ergebnisse. Gerade für Fachbereiche eröffnet das einen niedrigschwelligen Zugang zu Daten. Sie können selbst explorieren, ohne auf die Unterstützung der IT angewiesen zu sein. Für BI- und Analytics-Experten wiederum bedeutet das mehr Freiraum für komplexere Aufgaben. Die Realität zeigt jedoch: Dieses Versprechen erfüllt sich nur, wenn Modell, Organisation und Anwender vorbereitet sind. ## Modellstruktur – das Fundament der Ergebnisse Im Test wurde schnell klar, dass die Qualität des Datenmodells über die Qualität der Antworten entscheidet. Ein zu großes, unübersichtliches Modell produziert nicht nur schwer nachvollziehbare Ergebnisse, sondern treibt auch die Kosten in die Höhe. Denn jede natürlichsprachliche Anfrage wird vom LLM in eine technische Abfrage übersetzt. Informationen zum *„Verhalten“* des LLMs, Modelldefinition und Anfrage des Anwenders werden an das LLM gesendet. Dieses liefert eine technische Definition des Outputs zurück. Dabei werden sogenannte Tokens verbraucht, die je nach Modellgröße stark variieren. Ein Token umfasst hierbei bis zu 4-5 Buchstaben, also kurze Wörter oder Wortteile. In einem Fall erzeugte ein Modell mit über 1.000 Objekten bis zu 150.000 Tokens pro Anfrage – in längeren Dialogen summiert sich das schnell. Wer Pyramid mit GenAI einsetzt, sollte deshalb Modelle möglichst schlank halten, klare und sprechende Feldnamen verwenden und kurze, präzise Beschreibungen ergänzen. So versteht nicht nur das LLM besser, worum es geht – auch die Anwender finden sich leichter zurecht. ## Prompting – ohne Übung kein Gewinn Die zweite große Stellschraube ist das Prompting. Pyramid erlaubt sowohl einfache als auch komplexe Fragestellungen. Aber: Je genauer die Formulierung, desto hilfreicher das Ergebnis. Während eine Standardfrage wie *„Zeig mir die Umsätze“* meist problemlos funktioniert, erfordert eine komplexe Anweisung (*„Erstelle eine Prognose der nächsten drei Monate und visualisiere sie als Liniendiagramm“*) ein gewisses Verständnis dafür, wie man mit dem System kommuniziert. Das bedeutet: Unternehmen sollten ihre Anwender schulen. Nur wer weiß, wie man gute Prompts formuliert, schöpft das volle Potenzial aus. ## Sicherheit und Datenschutz Ein weiteres wichtiges Thema ist die sichere Anbindung der LLMs. Pyramid erlaubt die Integration externer Anbieter wie OpenAI. Wer hier unvorsichtig agiert, läuft jedoch Gefahr, dass API-Keys in falsche Hände geraten. Ein geleakter Key ermöglicht Zugriff auf das gesamte Konto – inklusive Abrechnungsdaten. Sicherer ist der Betrieb über Azure AI. Damit lassen sich Modelle in europäischen Datenzonen hosten, Endpunkte absichern und Zugriffe kontrollieren. Einschränkungen gibt es aber auch hier: Einige Funktionen wie Bildgenerierung oder Entra-ID-Authentifizierung sind noch nicht verfügbar. ## Technische Grenzen der aktuellen Implementierung So tief die Integration in die Oberfläche wirkt – sie bleibt aktuell auf die Modellebene beschränkt. Dashboards oder gespeicherte Objekte lassen sich nicht per KI öffnen oder steuern. Auch ein plattformweiter Chatbot, der Anwender durch alle Module führt, ist noch Zukunftsmusik. In der Praxis bedeutet das: LLMs agieren derzeit vor allem als intelligente Assistenten, nicht als umfassende Copiloten. Sie erleichtern die Arbeit innerhalb eines klar definierten Rahmens, ersetzen aber keine End-to-End-Steuerung. ## Fazit: Viel Potenzial, aber kein Selbstläufer Die Integration von GenAI in Pyramid kann echte Mehrwerte schaffen – aber ohne schlanke Modelle, ohne durchdachtes Sicherheitskonzept und ohne geschulte Anwender bleiben die Ergebnisse oft hinter den Erwartungen zurück. Wer die Einführung strategisch plant, Pilotprojekte aufsetzt und die organisatorischen Rahmenbedingungen berücksichtigt, kann jedoch profitieren: Datenanalysen werden zugänglicher, schneller und für mehr Nutzergruppen verständlich. ### **Sie möchten herausfinden, wie GenAI Ihre BI- und Analytics-Prozesse unterstützen kann?** Sprechen Sie mich an – Wir begleiten Sie von der ersten Pilotierung bis zum sicheren, produktiven Einsatz. Vereinbaren Sie jetzt einen Beratungstermin oder fordern Sie eine individuelle Demo an. **Kategorien:** AI & Data Science, Analytics & Insights --- ### [Anforderungsmanagement in IT-Projekten – Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Published:** Oktober 7, 2025 **Author:** Tim Teulings **Content:** Nach sechs Gesprächen zwischen **Architekt Adam (AM)** und **Anforderungsmanager Manfred (AM)** ist es Zeit, Bilanz zu ziehen. Auch wenn diese Dialoge fiktiv sind, spiegeln sie doch reale Herausforderungen aus Projekten im öffentlichen Sektor wider – und liefern konkrete Denkanstöße für ein effizienteres Anforderungsmanagement. ## Die Quadratur des Kreises … soviel zu Adam und Manfred. Diese Gespräche haben nie so stattgefunden. Aber die Probleme, die Architekt Adam hat, sind aus unserer Sicht typisch. Nicht nur typisch für die Rolle von Architekt:innen sondern wir sind überzeugt, dass es ein entsprechendes Gespräch unter den Verantwortlichen auch auf der Kundenseite geben könnte. By the way: Auch dieser Blickwinkel wäre eine eigene Blogserie wert … aber das wäre ein anderes Thema. Die Situation des Architekten Adam in einem Projekt bei einer öffentlichen Institution ist charakteristisch, auch für andere Branchen. Dafür gibt es eine ganze Reihe von Gründen. Doch es gibt Wege aus dem Labyrinth, aus der Quadratur des Kreises: Oder sagen wir lieber: Es gibt Alternativen. Und nein, wir werden im Folgenden nicht die nächste Revolution ausrufen oder intensiv über KI reden. Stattdessen wollen wir auf relativ einfache Anpassungen hinweisen, die zu einem erheblich besseren Ergebnis für alle Beteiligten führen könnten. Wie das gehen kann, darum geht es in dieser Zusammenfassung im letzten Teil der Serie. Dafür sehen wir uns die Erkenntnisse der simulierten Diskussion unserer Protagonisten der letzten Wochen genauer an. Wer hier auf operative Fragen hofft, wie: „Was ist in einem Kick-off-Termin zu beachten?“, den müssen wir leider enttäuschen. Uns interessiert heute das Große und Ganze. ## Das Glaubenssystem hinter dem klassischen Ansatz Das initiale Ziel der Anforderungsanalyse im diskutierten Projekt-Setup war eine möglichst detaillierte Spezifikation zu schreiben. Diese wiederum bildete den Kern einer Ausschreibung bzgl. der Umsetzung der Anforderungen als Gewerk zum Festpreis. Dahinter steht oft die Annahme: „Je detaillierter die Spezifikation, desto geringer das Umsetzungsrisiko.“ Und das bedeutet häufig, wenn man mit Fachexperten spricht, eine zu starke Betonung der Fachanforderungen. Fachanforderungen sind aber aus Sicht der Architektur nur einer von vielen Bereichen, die betrachtet werden müssen. Im Rahmen der Risikoübertragung ins Gewerk wird angenommen, dass im Ergebnis damit das magische Dreieck aus Umfang, Kosten, Zeit fixiert ist. Doch die Praxis zeigt: Risiken treten fast immer ein – und dann bleibt oft nur die Qualität als Stellschraube. Damit riskieren Auftraggeber und Auftragnehmer gleichermaßen wirtschaftliche oder qualitative Einbußen. ## Typische Probleme in der Praxis - Spezifikation unvollständig oder unpräzise - Änderungen der Anforderungen zwischen Analyse und Umsetzung - Implizite Annahmen nicht explizit gemacht - Neue Erkenntnisse beim Kunden während der Umsetzung - Kalkulation zu ungenau, realer Aufwand deutlich höher Diese Mängel sind seit Langem bekannt. Agile Methoden versuchen, sie durch kleinere, interaktive Iterationen abzufedern. Doch im öffentlichen Sektor sind agile Projekte oft nur eingeschränkt möglich – sei es aus rechtlichen, organisatorischen oder budgetären Gründen. ## Ein alternativer Weg: Zielorientierte Analyse Ein Ausweg kann sein, die Anforderungsanalyse zu verkürzen und sich auf das zu konzentrieren, was für eine belastbare Kalkulation wirklich entscheidend ist. Statt maximaler Detailtiefe geht es um das klare Umreißen von Anforderungen und eine wertorientierte Budgetierung. Das bedeutet: - Fokus auf architekturrelevante Aufwandstreiber. Architekturtreiber sind auch unter dem Namen -ilities bekannt (Functionality, Maintainability, Usability, Interoperability, …). - Grundsätzliche Aussagen zu Schnittstellen, Prozessen, UI - Berücksichtigung typischer Querschnittsfunktionalitäten - Klärung wesentlicher Aspekte zum Betrieb Detailliert wird nur dort, wo es Kosten und Risiken maßgeblich beeinflusst. ## Was braucht es? Wir glauben: Die „Quadratur des Kreises“ ist möglich. Mit mehr Zielorientierung und angepassten Analyse- und Moderationstechniken kann die Zeit für die Anforderungsanalyse deutlich verkürzt werden – ohne zusätzliche Risiken in der Umsetzung. Das erfordert: - Den Willen des Kunden, Perfektion gegen klare, risikoarme Anforderungen zu tauschen - Die Bereitschaft, früh konzeptionelle Entscheidungen zu treffen - Ein Beraterteam, das konsequent auf dieses Ziel hinarbeitet und die passenden Methoden einsetzt ## Fazit: Mehr Fokus, weniger Ballast Mit einem schlankeren, aber zielgerichteten Analyseansatz gewinnen Auftraggeber und Auftragnehmer. **Die drei wichtigsten Vorteile:** - Weniger Overhead in der Analyse - Bessere Planbarkeit - Mehr Freiraum für agile, kreative Umsetzung So wird Anforderungsmanagement im Festpreisprojekt nicht zur Fleißarbeit, sondern zu einem echten Erfolgsfaktor – und die Quadratur des Kreises ein Stück greifbarer. --- ## Dein Feedback ist gefragt! Wie hat dir unsere Serie zum Anforderungsmanagement im Public-Sektor gefallen? Hast du eigene Erfahrungen, Ideen oder Beispiele, die du teilen möchtest? Dann freuen wir uns sehr über deine **Gedanken und Kommentare** – lass uns wissen, welche Aspekte dich besonders beschäftigt haben und wo du vielleicht noch tiefer einsteigen möchtest. --- ## Alle Teile der Serie ansehen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Anforderungsmanagement in IT-Projekten – Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) **Published:** September 25, 2025 **Author:** Tim Teulings **Content:** Wie stellt man sicher, dass Analyse, Ausschreibung und Umsetzung eines Projekts wirklich aufeinander abgestimmt sind? In Teil 6 unserer Gesprächsreihe mit **Architekt Adam (ARCH)** und **Anforderungsmanager Manfred (AM)** geht es um die wohl wichtigste strategische Frage im Anforderungsmanagement: Welche Inhalte gehören in die initiale Analyse – und was sollte besser erst im Umsetzungsprojekt geklärt werden? ## Sechstes Treffen: Zwischen Fußball und Fazit **Ort des Geschehens:** Das Pokalfinale der Kinder – und ein letztes Gespräch vor der Abgabe. **ARCH:** Hi Manfred, dein Kleiner scheint ja richtig fit fürs Pokalfinale zu sein. Hast du ihm Kaffee gegeben oder warum ist der so energiegeladen? **AM:** Schön dich zu sehen Adam! Du weißt doch, es ist wie bei jedem Projekt. Gute Vorbereitung ist das A und O! Und beim Sport gehört dazu halt eine ordentliche Portion Spaghetti Bolo 90 min bevor es ernst wird. Apropos Projekt: Wie läuft dein Lastenheft. Habt ihr nicht morgen Abgabe? Da hast du Zeit für deine Kids? **ARCH:** Ja, es fällt echt schwer, mich auf Fußball zu konzentrieren. Ich sage mir: Ein bisschen Ablenkung muss sein, ich schaffe auch nicht mehr, wenn ich noch 2 Stunden länger darüber nachdenke. Außerdem ist doch Finale! **AM:** Also bist du nicht mit dem Ergebnis zufrieden? **ARCH:** Ach, was soll’s. Nein, zufrieden bin ich nicht. Am Anfang war ich euphorisch, weil ich dachte, dass ich es besser kann. Ich schätze, da habe ich zu viel von mir erwartet. Du hast mir gezeigt, was alles zu berücksichtigen ist. Danach habe ich erst gezweifelt, ob das wirklich alles nötig ist. Als ich es dann verstanden hatte, war ich pessimistisch. Insofern freue ich mich, dass wir doch noch so ein gutes Ergebnis erreichen konnten. **AM:** Na also. Das klingt schon eher nach dem Adam, den ich kenne. Erzähl mal! **ARCH:** Meine Erkenntnis des Projekts ist, dass wir früh mit den Kunden nicht nur Fachlichkeit und Technik klären müssen, sondern auch das grundsätzliche Projektvorgehen. Zur Klärung gehört auch, zu klären, was Teil der initialen Anforderungsanalyse ist, um eine Ausschreibung zu erstellen, und was Teil des Umsetzungsprojekts ist. Viele versuchen, im initialen Anforderungsprojekt alles zu klären. Das braucht dann ewig, erzeugt Papierwüsten und wenn es dann nach langer Zeit zur Ausschreibung und zur Umsetzung kommt, ist eigentlich allen Beteiligten klar, dass es so, wie es beschrieben wurde, doch keiner will. Das war schließlich die Erkenntnis, die zu verschiedenen agilen Vorgehensmodellen geführt hat. Oft sind erste Anpassungen für den ein oder anderen Fachexperten schon offensichtlich, bevor die erste Zeile Code geschrieben wurde. Andererseits gibt es trotz der erheblichen Aufwände keine wirklich gute Grundlage für die Aufwandskalkulation, weil die Aspekte, die für eine Kalkulation notwendig sind, nicht ausreichend beschrieben wurden. Oder ggf. verstecken sich Aufwandstreiber irgendwo in Nebensätzen und werden schnell übersehen. Mein Gefühl ist, dass so auch nicht immer der Beste die Ausschreibung gewinnt. Und das Risiko für alle Beteiligten so immer noch sehr hoch ist. Es scheitern ja immer noch eine erhebliche Menge an Projekten. Besonders wenn der Kunde zu einem gewissen Maße an Agilität in der Umsetzung bereit ist, würde ich Dinge zwischen dem Anforderungs- und dem Umsetzungsprojekt anders aufteilen. Ich denke, da sind wir im Ergebnis besser als andere, hätten aber noch effizienter und noch fokussierter sein können. Ich freue mich daher auf das nächste Projekt, um hier nochmal an der Effizienz zu feilen. Ich habe auch schon ein paar konkretere Ideen. Kann ich dir später mal mehr erläutern. **AM:** Ja, das war der Teil unserer sommerlichen Gespräche, der für mich auch erkenntnisreich war und mich zum Nachdenken gebracht hat. Das ein oder andere in meinem Standardvorgehen werde ich auch noch mal überdenken. Da sollten wir auf jeden Fall im Kontakt bleiben. Unsere Töchter sind ja jetzt auch im gleichen Verein, habe ich gehört, da werden wir uns nun noch häufiger sehen. ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Erkenntnis des Tages: Das Timing entscheidet Adams Fazit macht deutlich: Eine gute Anforderungsanalyse muss nicht alles vorab klären – aber sie muss die richtigen Dinge klären. Nur wenn Analyse, Ausschreibung und Umsetzung logisch aufeinander abgestimmt sind, lassen sich Risiken minimieren und unnötige Schleifen vermeiden. --- ## Wie geht es weiter? Eine Ausschreibung ist kein Selbstzweck. Sie muss die Basis für eine erfolgreiche Umsetzung sein – ohne Papierwüsten, die später niemand mehr will. Im abschließenden Teil 7 der Serie ziehen Adam und Manfred Bilanz und zeigen, wie die „Quadratur des Kreises“ im Anforderungsmanagement gelingen kann. --- ## Bereits erschienen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Anforderungsmanagement in IT-Projekten – Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) **Published:** September 11, 2025 **Author:** Tim Teulings **Content:** Tests im Projekt? Oft erst Thema, wenn es fast zu spät ist. In Teil 5 unserer Gesprächsreihe mit **Architekt Adam (ARCH)** und **Anforderungsmanager Manfred (AM)** geht es um einen der größten Klassiker in IT-Projekten: Das Testen wird übersehen – und plötzlich muss alles unter Zeitdruck passieren. ## Fünftes Treffen: Wenn Tests erst am Ende miteinbezogen werden Ort des Geschehens: Wieder ein Gespräch am Spielfeldrand – diesmal mit einer Mischung aus Erleichterung und Kopfschütteln. **ARCH:** Manfred, du glaubst nicht, was diese Woche passiert ist, ich bin fast vom Stuhl gefallen. **AM:** Deine Frau hat dir dein Lieblingsessen gekocht? Dein Sohn hat eine 1 in Mathe? **ARCH:** Nein! Also doch, meine Frau hat mein Lieblingsessen gekocht. War auch bitter nötig. Was ich meine: Wir sind eine Woche vor Abgabe und da fällt dem Projektmanager ein, dass sich noch niemand um den Test gekümmert hat. Wäre das nicht seine Aufgabe gewesen? Wenigsten einen Qualitätsmanager einzubinden? Ich habe ihn ja schließlich jede Woche darauf aufmerksam gemacht, dass das noch fehlt … **AM:** Oh, der Klassiker. Niemand denkt ans Testen und der Tester darf dann in 30 % der Zeit alles machen und wird zur Rechenschaft gezogen, wenn es ein großes Problem gibt. Jetzt sag mir bitte nicht, dass du noch eben ein grobes Testvorgehen aus dem Ärmel schütteln darfst? **ARCH:** Oh doch! **AM:** Hast du schon Ideen? **ARCH:** Ideen ja, aber ob das den Anforderungen genügt, weiß ich nicht. Wir konzipieren eine Anwendung mit Frontend, Backend und Datenbank. Im Backend gibt es Schnittstellen zu anderen Systemen und es gibt eine Datenbank-Synchronisation zur Golden Source von gewissen Informationen. Ich habe an ein klassisches Setup mit viel Automatisierung gedacht. JUnit-Tests, Testautomatisierung für fachliche Use Cases inklusive UI-Test und ein manueller Integrationstest überall dort, wo wir mit automatisierten Tests an Grenzen stoßen. Dazu Performance-Tests und ein Pen-Test. **AM:** Das klingt schon mal nicht so verkehrt. Wie testet ihr den DB-Sync? Gibt es eine initiale Datenbeladung, die gesondert getestet werden muss? **ARCH:** Oh, guter Punkt. Den DB-Sync hätten wir durch Integration in der Testumgebung implizit über die fachlichen Tests getestet. Aber das stößt bei der Initialbefüllung auf Probleme. Ich glaube, hier braucht es noch einen gesonderten Test. **AM:** Ja, das wird häufig übersehen. Ebenfalls wird häufig das Test-Setup unterschätzt. Wie genau ist die Testumgebung bestückt? Welche Einschränkungen gibt es? Welche Qualität haben die Testdaten? Welche Performance ist zu erwarten? Wer kümmert sich? **ARCH:** Ähhhh … Also … **AM:** Ich sehe schon, ich treffe da einen wunden Punkt. Dann hast du dir bestimmt schon Gedanken gemacht, wann welche Tests laufen? Also im Wasserfall erst alles entwickeln, dann testen, oder doch eher agil nach jedem Feature? Was sagt denn eigentlich der Kunde dazu, wie getestet werden soll? Will er selber testen? Was will er testen? Oder will er nur einen Testreport? Kunden sind da sehr unterschiedlich. Wann werden Dinge abgenommen? Handelt es sich um ein agil umzusetzendes Projekt? **ARCH:** Ja klar, das Projekt ist agil, also wird in jeder Iteration das jeweilige Inkrement getestet. Durch die hohe Automatisierung können die Testfälle danach regressiv durchgeführt werden. **AM:** Sehr gut! Die UI-Tests enthalten auch Barrierefreiheit? **ARCH:** Ja klar, Barrierefreiheit ist inzwischen absoluter Standard und wird natürlich mitgetestet. Wir haben da ein Tool, das uns auf etwaige Lücken hinweist. **AM:** Das klingt jetzt halbwegs vollständig. Ich kenne deine spezifischen Projektherausforderungen nicht. Da könnte auch noch Testbedarf schlummern, den ich nicht kenne. Beispielsweise wenn eure Anwendung KI-Anteile enthält. Es wird auch Unterschiede geben, je nachdem ob eure Anwendung öffentlich zugänglich ist oder bspw. für die Mitarbeiter eures Kunden gedacht ist. Die Fachlichkeit selbst oder die Branche als Ganze kann auch noch Unterschiede bringen. Eine Anwendung im Public-Sektor hat differenzierte Anforderungen an die Qualität. Andere spezifische Anforderungen existieren im Finance-Sektor, insbesondere bei (Voll-)Banken und Versicherungen. Die Liste könnte ich immer weiterführen, aber ich denke, dass du meinen Punkt verstehst. **ARCH:** Ja absolut, hier muss ich mich nochmal hinsetzen und alles durchgehen. Glücklicherweise hatten wir ja über regulatorische Rahmenbedingungen mal recht am Anfang gesprochen, so dass ich hier nicht von vorne anfange. ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Erkenntnis des Tages: Testen ist kein „Nice-to-have“ Diese Unterhaltung zeigt deutlich: Testkonzepte gehören von Anfang an in jedes Projekt – nicht erst in die Endphase. Gerade in komplexen IT-Projekten im öffentlichen Sektor sind Teststrategie, Testumgebung und Abnahmekriterien entscheidend, um Risiken zu minimieren und die Qualität zu sichern. --- ## Wie geht’s weiter? Tests sind kein „Nice-to-have“, sondern ein zentrales Qualitätsmerkmal. Doch was passiert, wenn die Analyse, die Ausschreibung und die Umsetzung nicht aufeinander abgestimmt sind? Im nächsten Teil der Serie sprechen Adam und Manfred genau darüber – und ziehen Lehren, wie die richtige Balance zwischen Analyse, Projektplanung und Umsetzung aussehen muss. --- ## Bereits erschienen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Anforderungsmanagement in IT-Projekten – Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) **Published:** August 29, 2025 **Author:** Tim Teulings **Content:** Manchmal sind es nicht die fehlenden Prozessbilder, sondern die fehlenden Schätzgrundlagen, die Projekte ins Stocken bringen. In Teil 4 unserer Gesprächsreihe mit **Architekt Adam (ARCH)** und **Anforderungsmanager Manfred** (AM) geht es um eine zentrale Frage: Welche Informationen sind wirklich nötig, um Aufwand und Architektur sicher kalkulieren zu können? ## Viertes Treffen: Prozessbilder sind nicht genug Ort des Geschehens: Wieder am Spielfeldrand. Diesmal wirkt Adam spürbar frustriert. **AM:** Und…? Wie geht es dir heute? **ARCH:** Oh man, es wird nicht besser. Unser Anforderungsmanager geht mir gerade ziemlich auf den Keks. Wir hatten ja intern besprochen, dass die Kollegen erst einmal mit dem Kunden abstimmen, wie die Applikation funktionieren soll, damit der Kunde meine technisch-orientierten Fragen anschließend besser beantworten kann. Das ist auch alles ganz nett, was sie da machen und hilft auch dem Kunden, aber es beantwortet keine meiner Fragen. Ich komme gerade nicht weiter. Schön, dass wir detaillierte Prozessbilder haben. Aber meine Frage ist eher, wie schnell ändern sich die Prozesse, wie soll die UI dazu aussehen? Das interessiert aber die Kollegen nicht. Was machen die da? Am Ende des Tages muss man auf Basis der Analyseergebnisse ja ein Angebot schreiben – und im konkreten Fall wollen wir ja auch teilnehmen und haben daher ein direktes Interesse, dass wir ein gutes Angebot machen. Aber trotz der vielen erfassten Informationen, habe ich nicht die Informationen, um eine angemessene Lösungsarchitektur zu erarbeiten und die Umsetzung dieser dann auch zu schätzen. Und so langsam wird die Zeit knapp… **AM:** Naja, das ist grundsätzlich nicht falsch. Klar beschriebene Prozesse sind schon grundsätzlich ein wichtiger Aspekt für eine Umsetzung. Ich verstehe aber, dass sie nicht ausreichend sind, eine spezielle Umsetzung dieser zu identifizieren. Mir scheint, ihr habt kein gemeinsames Bild, was ihr für den Kunden und auch für euch erreichen wollt und in welcher Reihenfolge ihr diese Dinge wann erreichen wollt? Was ist für den Kunden und euch heute das wichtigste? Was sind die zu erreichenden Ziele und was muss dafür getan werden – und was ggf. (noch) nicht? Welches Ziel versucht ihr denn deiner Meinung nach gerade zu erreichen? **ARCH:** Äh …!? Hmm … **AM:** Was ist dein Ziel? **ARCH:** Wie gesagt…Ich stelle mir vor, dass ich irgendwann diese Ausschreibung selbst auf den Tisch habe und sie dann schätzen muss. Das ist mein grundsätzlicher Anspruch gegenüber dem Kunden und deckt sich aus meiner Sicht mit seinem Wunsch, ein wirtschaftliches Angebot für eine für ihn möglichst optimale Lösung von einem „guten“ Dienstleister zu bekommen. Dann hab ich meine Arbeit gemacht, dann ist der Kunde zufrieden und empfiehlt mich ggf. auch weiter oder spricht mich für andere Projekte wieder an. Dies funktioniert aber aktuell so noch nicht. **AM:** OK. Das klingt spannend, da könnte ich auch noch was lernen. Lass uns das mal aufmalen (nimmt seinem Sohn eines der leeren Blätter, auf denen dieser zwischen den Spielen gerade malt, weg). Und schreibt „Schätzen“ auf das Blatt. Was brauchst du, um zu schätzen? **Arch:** Ich muss eine konkrete architektonische Lösung im Kopf haben. **AM:** Irgendeine? **ARCH:** Nein. Eine angemessene, wirtschaftliche Lösung. Eine, die die Rahmenbedingungen und die Qualitätsanforderungen einhält und die Features des Kunden erfüllt. **AM:** OK, das reicht doch aber nicht. Du kannst ja nicht einfach hingehen und sagen „5 Features => 5 Tage“. Du brauchst doch eine detaillierte Beschreibung der Features, um den Aufwand benennen zu können. Deswegen machen die Kollegen ja so einen Aufwand, oder?**ARCH:** \[Grübelt\] Nein! Das brauche ich nicht! Wir sind ja eine professionelle Firma und haben schon viele Projekte umgesetzt. Die Projekte sind sehr verschieden, aber viele, fast alle Projekte bestehen aus wiederkehrenden Bausteinen. In der Regel gibt es eine Handvoll Lösungen, die sich in ihren spezifischen Eigenschaften unterscheiden. Meist reicht es mir zu wissen, welche Lösung ich umsetzen muss, wie oft ich sie umsetzen muss und wie komplex sie aus Sicht der fachlichen Anforderungen jeweils ist. Nimm so ein Webformular: Für die Schätzung ist es egal, wie die Felder heißen. Wichtig ist eher die Anzahl der Felder, die Komplexität der Validierung und ob es ggf. besondere Merkmale wie z. B. Tabellen gibt. Da verstehe ich auch nicht, warum die Kollegen stundenlang um Namen ringen. Oder nimm die Erstellung eines T-Shirts. Für die Bestimmung des Preises ist völlig egal, was für ein Motiv auf dem T-Shirt gedruckt wird. Entscheidend ist die Qualität des Materials, die Größe des T-Shirts, sowie ob es ein einfarbiger oder mehrfarbiger Druck ist. Ggf. ist es auch interessant, wie viele T-Shirts der Kunde will. Wenn der Kunde 50 Shirts haben will, kann ich einen anderen Preis machen, ggf. kann ich sogar in der Herstellung durch die Menge etwas effizienter werden, weil meine Mitarbeiter anders arbeiten können. Aber das konkrete Motiv brauch ich ggf. erst kurz vor dem Druck (also bei der Entwicklung), speziell wenn der Kunde sicherstellt, dass das Motiv bestimmte Eigenschaften z.B. bzgl. Größe und Auflösung einhält. **AM:** Hmm, das ist interessant. Grundsätzlich ist das für mich ja nicht neu. Aber die Vehemenz deiner Aussage überrascht mich dann doch. Da muss ich mal drüber nachdenken. ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Erkenntnis des Tages: Schätzen heißt Muster erkennen Was Architekt Adam hier deutlich macht: Nicht jede Schätzung braucht jedes Detail. Oft reicht es, die Bausteine zu kennen, aus denen eine Lösung zusammengesetzt wird – und diese richtig zu klassifizieren. Für das Anforderungsmanagement bedeutet das: Weg vom reinen Festhalten einzelner Fakten hin zu einer strukturierten Erfassung von Aufwandstreibern und Wiederholungsmustern. Das spart Zeit und schafft eine realistischere Basis für Angebote. --- ## Wie geht es weiter? Im nächsten Teil unserer Serie wird es noch praktischer: Adam erlebt hautnah, was passiert, wenn das Testen im Projekt zu spät auf die Agenda kommt. Ein Thema, das im öffentlichen Sektor besonders häufig übersehen wird – und dessen Konsequenzen weitreichend sein können. --- ## Bereits erschienen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Anforderungsmanagement in IT-Projekten – Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) **Published:** August 12, 2025 **Author:** Richard Attermeyer **Content:** Was passiert, wenn sich die Organisation, die dich beauftragt, nicht einig ist? Im dritten Teil unserer Gesprächsreihe mit **Architekt Adam (ARCH)** und **Anforderungsmanager Manfred (AM)** zeigt sich: Selbst die beste Vorbereitung hilft nur bedingt, wenn bei den Verantwortlichen verschiedene Interessen aufeinandertreffen – und keine klare fachliche Linie vorhanden ist. ## Drittes Treffen: Wenn sich die Organisation selbst widerspricht **Ort des Geschehens:** Wieder am Spielfeldrand. Zwischen Kaffee, Checklisten und Kopfschütteln. **ARCH:** Danke nochmal für deinen Hinweis, ich habe eine Checkliste erstellt und bin diese beim Kunden durchgegangen. Aber auch die hat nicht geholfen. Wir kamen zwar in die Diskussion, aber ich merkte, dass in der Organisation noch nicht viel dazu nachgedacht worden ist bzw. sich nicht alle Ansprechpersonen des Kunden einig waren. Dann habe ich mal nach konkreten Rahmenbedingungen und Qualitätsmerkmalen gefragt. Glücklicherweise hatte ich da auch etwas vorbereitet, das hat dann geholfen. **AM:** Ja, jede Kundensituation ist anders. Die einen sind gut darin, Anforderungen zu formulieren. Andere können Anforderungen zumindest diskutieren. Wenn sie beides nicht können, wird es spannend. Aber mit irgendeiner Frage kriegt man sie alle dazu, ihre Anforderungen zumindest so weit benennen zu können, dass sich dadurch der Anforderungsraum konkretisiert und der potenzielle Lösungsraum Stück für Stück kleiner wird. Es ist ein wenig auch eine Kunst, immer die nächste konkreteste und wichtigste Frage zu identifizieren, die das Gegenüber beantworten kann. Und mit jeder Diskussion konkretisiert sich auch das Bild im Kopf, so dass neue Erkenntnisse gewonnen werden und Fragen besser beantworten können. Interessant, dass bei dir die Frage nach den Rahmenbedingungen geholfen hat, einen Einstieg zu finden. Das habe ich so auch noch nicht gesehen. **ARCH:** Ja, ja, allerdings habe ich dann gemerkt, dass es auch da noch schwer fiel, weiter zu kommen. Letztlich habe ich im weiteren Gespräch dann festgestellt, dass es einfach noch gar keine Idee gab, wie die zukünftige Software aussehen und funktionieren soll. Und das meine ich nicht technisch, nein fachlich! Alles, was ich hörte, klang schwammig und an einigen Stellen haben sich die Leute, mit denen ich zu tun hatte, komplett widersprochen. In einer Situation hätten sie sich fast in die Haare bekommen. **AM:** Oh, oh: Ich dachte, ihr macht parallel auch die fachliche Anforderungsanalyse? Davon wäre ich jetzt ausgegangen. Es macht ja keinen Sinn, technische Themen zu beleuchten, wenn die Fachlichkeit nicht klar ist. **ARCH:** Wiebke, die dafür zuständig ist, war erst krank und dann im Urlaub. Sie legt aber jetzt los. Und du hast ja Recht: Deshalb haben wir auch entschieden, dass ich jetzt erst einmal auf die Ergebnisse von ihr warte, bevor noch irgendwelche Türen ausgehebelt werden. **AM:** So schlimm? Hast du eine Ahnung, woran das liegt? Also nicht, dass sich die Leute widersprechen, sondern weshalb sie sich widersprechen? **ARCH:** Gute Frage, da habe ich noch gar nicht darüber nachgedacht. Ich denke, sie mögen sich einfach nicht. Keine Ahnung, was da los ist. **AM:** Vielleicht haben sie schlicht unterschiedliche Vorstellungen? Ggf. sehen sie eine andere Lösung, weil ihre Rahmenbedingungen anders sind. Es macht z. B. einen großen Unterschied, ob ein Team aus 2–3 oder aus 20 Personen besteht. Man hat ganz andere Herausforderungen und optimiert entsprechend auch ganz anders. Was wurde denn intern bereits kommuniziert und diskutiert? Ggf. dringen die einen mit ihren Wünschen schon in ihrem Team nicht durch. Eine andere Idee wäre, dass alle ihre eigene Agenda im Kopf haben. Du wirst schlecht die Zielvereinbarungen der Mitarbeitenden einsehen können, aber eventuell kannst du ja etwas aus ihrem Verhalten ablesen? Herrscht in der Organisation grundsätzlich Ellenbogenmentalität, dann kann das ein Indiz dafür sein. Es kann aber auch sein, dass aus irgendeiner persönlichen Wertvorstellung heraus, die unabhängig von den Zielvereinbarungen ist, einzelne oder sogar alle Beteiligte ihre Macht im Unternehmen demonstrieren wollen. Es gibt weitere Erklärungen, aber in den allermeisten Fällen sind es entweder unterschiedliche Kontexte, mangelnde Kommunikation oder Kompetenzspielchen – oder die Kombination aus allen dreien. Wenn Wiebke es nicht bereits getan hat, würde ich dir raten, das mit deiner Auftraggeberin in einem offenen Gespräch zu klären. **ARCH:** Hmm, verstehe. Deswegen war auch am Anfang so wichtig, dass ich die handelnden Personen, also Ansprechpersonen, Verantwortliche und Entscheidungsebene kennenlerne. **AM:** Korrekt. Und nicht nur das Organigramm würde ich studieren, sondern auch die Dynamik hinter diesem Organigramm. ### Wenn interne Konflikte die Analyse blockieren Anforderungsmanagement scheitert nicht nur an fehlenden Informationen – sondern oft an internen Zielkonflikten beim Kunden. Gerade im öffentlichen Sektor mit seinen vielfältigen Stakeholdern kann es passieren, dass es nicht „den einen Kunden“ gibt, sondern mehrere widersprüchliche Sichtweisen innerhalb der Organisation. Für Berater:innen bedeutet das: Beobachten, analysieren, moderieren. Und vor allem: Geduld haben. ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Erkenntnis des Tages: Wer entscheidet, wer spricht – und warum? Was Architekt Adam in diesem Treffen lernt, ist zentral: Fachlichkeit entsteht nicht im Vakuum, sondern im sozialen Gefüge einer Organisation. Bevor technische Entscheidungen vorbereitet werden können, braucht es ein gemeinsames Verständnis – nicht nur über die Anforderungen, sondern auch über die Rollen, Machtverhältnisse und Kommunikationswege im Kundenunternehmen. --- ## Wie geht es weiter? Im nächsten Teil wird es noch technischer: Wie lassen sich Anforderungen so strukturieren, dass sie architekturrelevant und kalkulierbar werden? Und welche Informationen braucht man wirklich, um zu schätzen? --- ## Bereits erschienen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Anforderungsmanagement in IT-Projekten – Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) **Published:** August 5, 2025 **Author:** Tim Teulings **Content:** Nach dem ersten positiven Auftaktgespräch beim Kunden kommt die Ernüchterung: Die technischen Fragen bleiben unbeantwortet, die Unsicherheit wächst. In Teil 2 unserer Blogserie „Anforderungsmanagement im Public-Sektor“ treffen sich **Architekt Adam (ARCH)** und **Anforderungsmanager Manfred (AM)** erneut – und sprechen über den Kern jeder guten Anforderungsanalyse: ## Zweites Treffen: Zwischen Erwartung und Wirklichkeit **Ort des Geschehens:** Wieder ein Treffen beim Sport – Gelegenheit für einen ehrlichen Rückblick auf das erste Kundengespräch. **AM:** Und, wie ist es gelaufen? ARCH:** Ach ja, der Kick-Off war eigentlich ganz gut. Deine Tipps haben mir echt geholfen, vielen Dank noch mal dafür! … Allerdings hat es danach Probleme gegeben. Nachdem wir die von dir genannten Punkte geklärt hatten, bin ich dann eingestiegen und habe die Anwesenden gefragt, welche Datenbank sie brauchen. Das konnten sie nicht beantworten. Da war ich schon überrascht. Dann habe ich sie gefragt, wie die Software betrieben wird und wie ihre Mengengerüste sein werden. Konnten sie auch nicht beantworten. Sie haben auch gar nicht verstanden, warum ich die Fragen stelle, schließlich entscheiden das doch die Bieter. Wie kann man nur so engstirnig sein, dachte ich bei mir! Wenn sie entsprechende Informationen nicht ins Angebot packen, werden sie ggf. sehr unterschiedliche Angebote bekommen. Ggf. fliegt ein eigentlich guter Anbieter so raus, weil er falsche Annahmen getroffen hat. **AM:** Ja, das erlebe ich immer wieder. Man muss halt verstehen, dass die Leute, mit denen wir reden, meist keine technische Expertise haben. Ihnen ist nicht klar, dass eine Zehnerpotenz im Mengengerüst oder ein paar Prozentpunkte in der Verfügbarkeit im Zweifel auch zu um Faktoren höheren Kosten führen können. Zwischen Sätzen wie „ich kann auf alle historischen Börsenkursänderungen zugreifen und bekomme den aktuellen Stand verlässlich innerhalb von Millisekunden“ und „ich zeige immer den letzten bekannten Stand des DAX auf dem Desktop an“ liegen ggf. Millionen von Euro. Wie habt ihr das gelöst? Was habt ihr gemacht, als ihr das erkannt habt? **ARCH:** Wir haben das Meeting erstmal beendet, weil wir schon über die Zeit waren. Gestern haben wir uns dann noch einmal intern beratschlagt. Meine Projektleiterin meint, wir müssen wohl weiter vorne anfangen. Da waren wir uns alle nach kurzer Diskussion einig. Wie würdest du vorgehen? Du sagst ja, du kennst das Problem? **AM:** Ja klar. Zuerst ist es eine völlig normale Situation. Ich ertappe mich z. B. auch immer wieder dabei, dass ich denke, beim Kunden erwarten sie die eierlegende Wollmilchsau und alles in „schick“ und „aufwändig“. Andererseits hat man ja auch schon viel gemacht und gesehen und hat auch eine bekannte Standardlösung parat – die ist aber ggf. nicht das ist, was gewollt ist. Und so denken Ansprechpersonen in den Behörden in der Regel meist auch nicht. Die kommen meist erst einmal mit ihrem spezifischen Problem und haben eine optimale Lösung im Kopf, die dann auch noch bezahlbar sein soll. ### Die Frage hinter der Frage: Perspektivwechsel im Anforderungsmanagement **AM:** Mir hilft dann immer, dass ich mich frage: Wie denkt der Kunde? Was ist die Frage hinter der Frage? Was genau macht den Unterschied? Was sorgt dafür, dass deine Ansprechpersonen mit dem Ergebnis zufrieden sind oder nicht? Beispiel: Der Wunsch wäre ein Webshop , in dem Produkte verkauft werden können. Nun gibt es in der betreffenden Organisation eine unzählige Anzahl Produkte, die in vielen verschiedenen Datenbanken gepflegt sind – falls sie überhaupt in einer Datenbank sind. Das kann zum Beispiel daran liegen, dass die Produkte von verschiedenen Fachabteilungen entwickelt und betreut werden und jede Fachabteilung hat ihre eigene Anwendung. **ARCH:** OK, was willst du damit sagen, komm mal zum Punkt. Ich brauche eine konkrete Idee für mein Problem. **AM:** Ich komme gleich zum Punkt. Die Frage hinter der Frage in meinem Beispiel könnte also sein: Warum möchte der Kunde einen Webshop? Möchte er ein neues Marktsegment erobern? Möchte er in seiner bestehenden Zielgruppe die Durchdringung erhöhen? Geht es dabei eventuell um eine eingeschränkte Produktauswahl? All diese Fragen können einen Hinweis auf die benötigte Technik liefern. Du darfst ihn also nicht nach der Technik fragen, sondern du musst dir überlegen, welche Kriterien du für eine Auswahl benötigst. Die musst du dann beim Kunden abfragen. **ARCH:** Ich glaube, es ergibt so langsam Sinn. Wenn in deinem Beispiel der Kunde nur 2–3 Produkte in neuen Kundensegmenten verkaufen möchte, könnte eine Präsenz bei Amazon die Antwort sein. Wenn er aber für seine bestehende Kundengruppe einen neuen Verkaufskanal haben möchte ohne Provision zahlen zu müssen, dann ist wahrscheinlich ein eigener Webshop besser. Und vielleicht will er sogar das eine heute und das andere später? **AM:** So ist es. Hast du schon eine Idee, wie du das bei deinem Kunden anwenden kannst? **ARCH:** Ja und nein. Ein paar Fragen hinter den Fragen finde ich bestimmt. Aber was mache ich damit? Wie gehe ich damit auf den Kunden zu? ### Struktur statt Frust: Die Checkliste als Brücke **AM:** Du hattest ja nun schon einen ersten Termin mit dem Kunden, der nicht so gut gelaufen ist. Eine Option, die sich jetzt aus meiner Sicht anbieten würde, wäre z. B. eine Checkliste. So zeigst du, dass du zum einen natürlich weiter an einer Lösung interessiert und hoch engagiert bist, aber zum anderen beweist du auch, dass du die Analyse strukturiert und professionell vorantreiben kannst. Denk also über die Fragen hinter den Fragen nach und erstelle daraus eine Checkliste. Meistens fallen dir auch noch ganz andere Fragen ein, die sich deine Ansprechpersonen sich selbst noch gar nicht gestellt haben. Die kannst du direkt mit einfließen lassen. Mit ein bisschen Glück und moderativem Geschick erfährst du so, speziell durch die dadurch entstehende Diskussion, viel mehr darüber, wie das Bild im Kopf deines Gegenübers aussieht. **ARCH:** Das mache ich, danke dir! ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Erkenntnis des Tages: Vom Verstehen zum Vermitteln Ein zentrales Learning dieses Treffens: Fragen nicht wörtlich nehmen – sondern hinterfragen. Häufig fehlt gerade im öffentlichen Umfeld die technische Perspektive, um den Lösungsraum korrekt abzubilden. Hier hilft kein Bohren in technischen Details, sondern das Denken in Zielbildern und Entscheidungskriterien. Eine gut vorbereitete Checkliste kann zum Dialog auf Augenhöhe führen – und zur Erkenntnis: Es gibt nicht den einen richtigen Weg, sondern viele mögliche. Wichtig ist nur, dass alle Beteiligten wissen, welchen Weg sie gehen wollen. --- ## Wie geht es weiter? Im nächsten Teil zeigt sich, wie diese neue Herangehensweise bei Adams Kunden ankommt – und warum es manchmal nicht nur an der Technik, sondern an der Kommunikation im Projekt scheitert. Bleiben Sie dran! --- ## Bereits erschienen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Anforderungsmanagement in IT-Projekten – Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) **Published:** Juli 29, 2025 **Author:** Tim Teulings **Content:** Wie beginnt eigentlich ein gutes Anforderungsmanagementprojekt? Oft mit Unklarheiten. Und mit Gesprächen – auf dem Sportplatz, in der Turnhalle oder zwischen zwei Terminen. Im Rahmen unserer Blogserie begleiten wir zwei erfahrene Köpfe – **Architekt Adam (ARCH)** und **Anforderungsmanager Manfred (AM)** – bei ihren Treffen im Alltag. Gemeinsam beleuchten sie typische Herausforderungen aus dem Anforderungsmanagement in IT-Projekten. ## Wie alles begann: Architektur trifft auf Anforderung Im ersten Teil geht es um den Startpunkt: Wie gelingt der Einstieg in ein komplexes IT-Projekt, bei dem eine öffentliche Ausschreibung vorbereitet werden soll? ## Erstes Treffen: Anforderungsmanagement für eine Ausschreibung **Ort des Geschehens:** Die Turnhalle beim Sport der Kinder – ein alltäglicher, entspannter Rahmen für ein Fachgespräch mit Tiefgang. **Hinweis:** Der folgende Dialog ist Teil einer fiktiven Gesprächsreihe, die typische Rollen und Herausforderungen im Anforderungsmanagement realitätsnah beleuchtet. **ARCH:** Na, Manfred, wie geht’s? Was macht die Kunst? **AM:** Muss, und selbst? Was macht die Arbeit? Bist du endlich aus diesem ollem Wartungsprojekt raus? **ARCH:** Ja, das war wirklich sehr langweilig, puh. Aber jetzt habe ich etwas Neues, allerdings wieder nicht das schöne „Grüne Wiese Projekt“, von dem wir alle träumen – zumindest noch nicht … **AM:** Noch nicht? Wieso? **ARCH:** Die Auftraggeberin, eine Behörde, möchte, dass wir die fachlichen und technischen Dokumente für eine darauffolgende Ausschreibung erstellen. Die Bestandslösung ist in die Jahre gekommen, nicht mehr wirklich wartbar und fachlich tragfähig. Die kommt aus einer Zeit, wo Digitalisierung ein Synonym für „irgendwie in Software und wie Akte und Karteikarte – nur am Computer“ war. Wenn wir etwas Glück haben und gute Arbeit machen, gewinnen wir ggf. später auch die Ausschreibung … **AM:** Cool. Also sollte ihr faktisch ein Lastenheft mit dem Kunden erarbeiten? **ARCH:** Ja, so nennt man das wohl. Spannende Sache, normalerweise kenne ich ja nur fertige Versionen solcher Dokumente – die in der Regel aber nie gut waren. Aus der Sicht der Behörde war dann die Standardantwort „Diskutieren sie nicht, schauen sie in die Spezifikation“, aber da fand ich nicht, was wir wissen mussten. Das führte zu Diskussionen und Mehraufwand, den wir dann an anderer Stelle sparen mussten oder wo die Auftraggeberin dann nochmals versuchen musste, weiteres Geld zu besorgen. Jetzt habe ich mal die Chance, das besser zu machen. Aber im Team können wir uns nicht einigen, was wir denn jetzt genau wie machen, und was in das Dokument am Ende reingehört. Zu allem Überfluss haben wir nicht so viel Zeit, wie wir dachten. Wir können also nicht einfach mal anfangen, das muss schon von Anfang an sitzen. **AM:** Aber nun ja. Eure Auftraggeberin muss doch gesagt haben, was sie für die Ausschreibung braucht und haben will – und was nicht. Ebenso sollte sie ja einschätzen können, was sie bereits weiß und nur noch aufgeschrieben haben will oder wo sie noch Hilfe braucht, z. B. in Form von Workshops oder technischer Beratung und Konzeption braucht. **ARCH:** Nein, die macht das leider auch zum ersten Mal und hat daher auch noch keine wirklich konkreten Vorstellungen. Ich bin mir noch nicht sicher, ob ich unseren Vertrieb loben oder verteufeln soll, aber irgendwie hat er es geschafft, dass auch wir mit wenig Konkretem die Behörde als Kunden gewinnen konnten. **AM:** Oh … und nu? **ARCH:** Hmm, nächste Woche ist ein erstes Kennenlernen und wir brauchen langsam eine Agenda für diesen Termin aber auch einen Masterplan für die folgenden Termine … Was würdest du machen? Du bist da doch ein alter Hase? **AM:** Na ja, erst einmal Kennenlernen klingt schon mal gut. Dann soll die Auftraggeberin sagen, warum sie das Projekt angeht. Was wird bezweckt? Welche Geschäftsziele verfolgt die Organisation und was sind Erfolgskriterien? Auch die Rahmenbedingungen sind wichtig. Wie groß soll das Projekt werden? Meist gibt es ja einen angestrebten finanziellen Rahmen für die Umsetzung. Aber auch für den späteren Betrieb? Gibt es bereits bekannte grundsätzliche Rahmenbedingungen? **ARCH:** OK, das ergibt Sinn. Auf Basis der allgemeinen Projektbeschreibung hätte ich sogar schon erste Ideen. Ich würde daher ja gerne sofort mit den Umsetzungsdetails loslegen. Wieso brauche ich da „Geschäftsziele“? Das klingt ein wenig weit von der Technik entfernt. Ist das keine Zeitverschwendung? Ich dachte eher an konkrete Fragen zu Technologien, Qualitätsanforderungen, Sicherheitskriterien und natürlich auch zu den Use Cases. **AM:** Immer langsam und eins nach dem anderen. Wenn du nicht weißt, warum dein Kunde Dinge macht, dann wirst du ihm irgendein, aber nicht ein auch wirklich passendes Lastenheft schreiben können. Und passend bedeutet erst einmal, dass am Ende deien Auftraggeberin mit den Ergebnissen zufrieden ist, weil ihre Behörde mit der neuen Lösung die erhofften Ziele auch erreicht. Du musst immer wissen, was deinen Kunden glücklich macht und vor allem was er braucht. Nur so kannst du ein Lastenheft schreiben, das ihn zufrieden stellt und gegen das du auch gerne entwickelst. Wenn du die Geschäftsziele verstanden hast, sind organisatorische Fragen zu klären. Wer sind deine Ansprechpartner, Verantwortliche und Entscheidungsträger? Wo soll das Projekt umgesetzt werden? Remote? Vor Ort? Welche Abstimmungsrunden und andere Regelmeetings gibt es? Wer entscheidet, wer muss mit einbezogen werden? Was ist die Verfügbarkeit der einzelnen Personen? Ich habe es schon mal gehabt, dass ein Keyplayer nur noch zwei Wochen da war, um dann den Rest der Projektphase z.?B. in Elternzeit zu sein. **ARCH:** So habe ich das ja noch nie betrachtet, aber klingt eigentlich logisch. Ich versuche das mal zusammenzuschreiben und die ersten Gespräche mit dem Kunden so anzugehen! ## ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-blau.png)Erkenntnis des Tages: Ohne Ziel kein Plan Dieses erste Gespräch zeigt, wie wichtig es ist, nicht sofort mit der Lösung loszulegen, sondern das „Warum“ eines Projekts zu verstehen – gerade wenn die Ausschreibung noch vorbereitet werden muss. Die richtigen Fragen zu Beginn helfen, Risiken und Missverständnisse zu vermeiden und eine tragfähige Basis für das Lastenheft zu schaffen. --- ## Wie geht es weiter? In der nächsten Episode erfahren wir, wie das erste Treffen mit der Auftraggeberin gelaufen ist – und warum die Frage nach der richtigen Datenbank manchmal das falsche Gespräch eröffnet. Bleiben Sie dran! --- ## Bereits erschienen [Teil 1: Ein neues Projekt und viele offene Fragen](https://thecattlecrew.net/2025/07/29/anforderungsmanagement-im-public-sektor-teil-1-ein-neues-projekt-und-viele-offene-fragen/) [Teil 2: Viele Wege führen nach Rom, aber welchen wollen wir gehen?](https://thecattlecrew.net/2025/08/05/anforderungsmanagement-im-public-sektor-teil-2-viele-wege-fuehren-nach-rom-aber-welchen-wollen-wir-gehen/) [Teil 3: Ein Auftrag? Nein, viele! Und alle wollen etwas anderes](https://thecattlecrew.net/2025/08/12/anforderungsmanagement-im-public-sektor-teil-3-ein-auftrag-nein-viele-und-alle-wollen-etwas-anderes/) [Teil 4: Was braucht man wirklich, um zu schätzen?](https://thecattlecrew.net/2025/08/29/anforderungsmanagement-im-public-sektor-teil-4-was-braucht-man-wirklich-um-zu-schaetzen/) [Teil 5: Testen vergessen?](https://thecattlecrew.net/2025/09/11/anforderungsmanagement-im-public-sektor-teil-5-testen-vergessen/) [Teil 6: Analyse, Ausschreibung und Umsetzung – es muss zusammenpassen!](https://thecattlecrew.net/2025/09/25/anforderungsmanagement-im-public-sektor-teil-6-analyse-ausschreibung-und-umsetzung-es-muss-zusammenpassen/) [Teil 7: Fazit und Ausblick](https://thecattlecrew.net/2025/10/07/anforderungsmanagement-im-public-sektor-teil-7-fazit-und-ausblick/) **Kategorien:** Development, Tools & Methoden --- ### [Was haben ein Hammer und ein LLM (nicht) gemeinsam?](https://thecattlecrew.net/2025/10/02/was-haben-ein-hammer-und-ein-llm-nicht-gemeinsam/) **Published:** Oktober 2, 2025 **Author:** Sebastian Pospiech **Content:** Sicher habt ihr alle schon mal einen Hammer benutzt, oder? Ein einfaches, altes Werkzeug. Seine Zwecke sind begrenzt: Nägel in die Wand bekommen, im Notfall eine Scheibe einschlagen oder meinen Daumen zerstören. In allen drei Fällen nutzt man ihn auf dieselbe Art – und das Feedback ist in der Regel unmittelbar visuell erfassbar (oder spürbar). Mit der Verbreitung von Computersystemen in den 80ern zog auch das Bewusstsein ein, dass man nun ein neues Werkzeug hatte, das den bisherigen ungleich war. Eine Maschine für dutzende Zwecke anstatt nur für einen – und mit deutlich komplexerem Feedback. Dies brachte eine neue wissenschaftliche Disziplin hervor: **Human-Computer Interaction, kurz HCI.** ## Die Kernbotschaft von HCI HCI ist ein interdisziplinäres Forschungsfeld. Es verbindet unter anderem Verhaltenswissenschaften mit der Informatik und versucht, die Besonderheiten der Arbeit an und mit Computersystemen herauszuarbeiten. Schon in den ersten Werken, die dieses Feld begründeten, wurde die Arbeit mit einem Computer eher wie die Kommunikation mit einem Menschen verglichen als wie die Nutzung eines Werkzeugs. Man muss bewusst eine Aktion wählen, Daten eingeben und erhält hoffentlich ein Feedback – eine Reaktion, die bei mir als Nutzer wiederum eine neue Handlung auslöst. Entsprechend muss ein Nutzer die Möglichkeit haben, klar zu formulieren, was der Computer tun soll – zum Beispiel eine Datei löschen. Und so hat sich das Markieren einer Datei und das Betätigen des Papierkorbsymbols für diese Aktion durchgesetzt. Eine semantisch äquivalente, aber rudimentärere Kommunikationsform ist die textbasierte Variante mittels Konsole: ``` rm langweiliger-blogbeitrag.doc ``` Überraschung: Im Mainstream hat sich Ersteres durchgesetzt. Wir holen ja unser Geld am Geldautomaten auch nicht ab, indem wir ``` ./give-me-all-money.sh –iban DE… ``` in eine Konsole tippen, sondern werden durch ein intuitives Menü geführt. In Entwicklerkreisen sieht das nicht immer so aus, doch auch hier haben sich spezialisierte Werkzeuge etabliert – etwa IDEs. Jede Disziplin hat ihre eigene Software, vom ETL-Datenschubser bis zum Game Designer. So entstanden über die Jahre viele Paradigmen, Best Practices und Tools, um gute User Interfaces zu bauen. Schließlich entstand daraus sogar das Berufsbild des **UX-Designers**. ## Gängige Anforderungen an ein gutes Interface - **Usability First** – Interfaces sollen leicht erlernbar, effizient und fehlerarm sein (Nielsen’s Usability Heuristics, 1990er). - **Affordances & Signifiers** – Nutzer erkennen an der Gestaltung, wie man ein Interface bedienen kann (Norman, The Design of Everyday Things). - **Consistency & Standards** – vertraute Muster (z. B. „Save“-Icon) erleichtern Interaktion. - **Feedback & Visibility** – Systeme sollen jederzeit zeigen, was gerade passiert (z. B. Ladebalken, Statusmeldungen). - **Minimierung der kognitiven Last** – Systeme sollen Informationen so präsentieren, dass sie leicht verarbeitet werden können. - **User-Centered Design** – Entwicklung orientiert sich an den Bedürfnissen, Fähigkeiten und Kontexten der Nutzer:innen. Und doch … alles, was wir hier tun, sind Krücken. Grafiken visualisieren Datenflüsse oder Prozesse, Buttons visualisieren Aktionen. Mit Baukästen versuchen wir, Low-Code- oder No-Code-Ansätze zu erreichen. Animationen, Warnungen oder auch Geräusche sollen uns Feedback geben. ## ![Die Zeichnugn zeigt eine Person, die mit einem Computer interagiert](https://thecattlecrew.net/wp-content/uploads/2025/09/cattle-crew-hammer-und-llm-pospiech_abbildung.png)Barrierefreiheit Ein kurzer Abschweif ins Thema Barrierefreiheit, weil er mir wichtig ist. Einfach ist das Thema nicht – im Gegenteil, es ist komplex und schwer. Wo Standards Wiedererkennungswerte schaffen und viele Funktionen auf einem Screen untergebracht werden müssen, müssen auch Anforderungen an Barrierefreiheit berücksichtigt werden. Menschen sollen Zugänge haben, ob sie sehschwach, motorisch eingeschränkt oder anderweitig beeinträchtigt sind. Ein User Interface funktioniert in der Regel am besten, wenn es nicht versucht, alle Bedarfe abzudecken, sondern auf eine Persona zugeschnitten ist. Bei Barrierefreiheit müssen jedoch viele individuelle Charakteristika gleichzeitig bedient werden. Ein Widerspruch, der sich nicht leicht auflösen lässt. Zum Glück gibt es mittlerweile gute Gesetze, die Lösungen trotz dieser Herausforderung einfordern. ## Und dann kam das LLM Und nun, nach 45 Jahren Forschung und Fortschritt in HCI (lassen wir die Zeit, in der Computer noch keine Bildschirme hatten, mal außen vor) kommen die **Large Language Models**. Ein simples Chatfenster oder ein Mikrofon reicht. - „Lösche bitte meinen langweiligen Blogbeitrag!“ – zack, weg. - „Schreib einen neuen!“ – zack, Influencer. - „Durchsuche meine Mails!“, „Schicke eine Nachricht!“, „Recherchiere Folgendes!“, „Programmiere mir ein Skript!“ – alles über dasselbe Interface. Wo man früher zehn verschiedene Interfaces brauchte, gibt es jetzt nur noch eins. Die „Zeichensprache“, die jahrelang unsere Kommunikation mit dem Computer geprägt hat, wird nun zur echten, natürlichen Sprache – zu **Natural User Interfaces (NUI)**. ## LLMs als neue Gesprächspartner Ja, persönliche Assistenten wie Siri oder Alexa können das schon ein paar Jahre. Aber deren Feedback war immer stark eingeschränkt. Ein LLM dagegen agiert mit mir, als wäre ich – oder besser gesagt: als wäre es – ein Mensch. Damit kommen wir der alten Analogie aus den 80ern („HCI ist näher an Mensch-zu-Mensch-Kommunikation als an einer Werkzeugbenutzung“) nun sehr nahe. Ein LLM als Frontend für ein IT-System kann vieles einfacher machen: - **Usability:** Die Einstiegshürde sinkt radikal, weil natürliche Sprache jeder versteht. - **Effizienz:** Statt zehn Klicks reicht eine Anweisung. - **Barrierefreiheit:** Auch Menschen mit Einschränkungen oder geringen IT-Kenntnissen können komplexe Systeme bedienen. - **Flexibilität:** Dasselbe Interface kann für unzählige Aufgaben genutzt werden – vom ETL-Skript bis zum Marketingtext. ## Chancen und Risiken Das bringt viele Vorteile mit sich, die wir alle seit ein bis zwei Jahren spüren. Aber: Kommunikation „wie mit einem Menschen“ bedeutet auch Missverständnisse „wie mit einem Menschen“. *„Lösche bitte meinen langweiligen Blogbeitrag“* ist sehr viel undeutlicher als ``` rm langweiliger-blogbeitrag.doc ``` – und definitiv Interpretationssache. Das Verhalten der Maschine kann plötzlich nicht-deterministisch sein und bei gleichen Anfragen Unterschiedliches tun. ## Hybride Ansätze im Entwickleralltag Dennoch: Gerade aus Sicht eines Analytics-Entwicklers blicke ich positiv auf diese Entwicklung. Von Lochkarten zu Assembler, zu gängigen Programmiersprachen, zu grafischen Low-Code-Baukästen – und nun zu einem reinen Beschreiben von Anforderungen. Hybride Ansätze halten Einzug in unseren Alltag: - Tools wie **GitHub Copilot** oder **DBT** verbinden Spracheingabe mit Code-Generierung. - Erste Plattformen wandeln Prompts in Flowcharts oder Visualisierungen um. - Hybride Interfaces erlauben es, zwischen Code, Grafik und Sprache zu wechseln – ohne Medienbruch. ## Fazit – und zurück zum Hammer Mitte November wird es weitere, konkretere (versprochen!) Beiträge zu diesem Thema geben. Wie können grafische ETL-Workflows durch KI-basierte Ansätze abgelöst werden? Warum wird der Code dadurch effizienter? Und wo sind (noch) die Limits? Und was hat die KI nun mit dem Hammer gemein? Beide sind Teil der HCI-Forschung – und mit beiden muss man umgehen können. Ansonsten nicht viel. Verzeiht mir also den Clickbait. Ob KI eine ähnliche technologische Explosion auslöst wie das erste menschliche Werkzeug? Wir werden sehen. ## Literatur - Card, S.K. (Ed.). (1983). *The Psychology of Human-Computer Interaction* (1st ed.). CRC Press. - Nielsen, J. (1994a). *Enhancing the explanatory power of usability heuristics*. Proc. ACM CHI’94 Conf. (Boston, MA, April 24-28), 152-158. - Norman, D. A. (2013). *The Design of Everyday Things*. MIT Press. **Kategorien:** AI & Data Science, Development --- ### [Professioneller Stolz – Qualität, auch wenn keiner hinschaut](https://thecattlecrew.net/2025/09/30/professioneller-stolz-qualitaet-auch-wenn-keiner-hinschaut/) **Published:** September 30, 2025 **Author:** Stefan Sonner **Content:** In Projekten – egal ob im Projektmanagement, in der Softwareentwicklung, im Testing oder in der Systemarchitektur – gibt es einen unsichtbaren Maßstab, der darüber entscheidet, ob wir am Ende stolz auf unsere Arbeit sein können: Qualität. Wie oft sprechen wir über Termine, Budgets, Liefergegenstände. Selten dagegen über den inneren Anspruch, den wir an unsere Arbeit stellen sollten – ganz unabhängig davon, ob ein Kunde, ein Vorgesetzter oder ein Kollege gerade zusieht. Was bringt der schönste Projektplan, wenn die Dokumentation niemandem verständlich ist? Was nützt ein pünktliches Meeting, wenn die Architektur dahinter wackelt? ``` „Qualität ist: Es gut zu machen, auch wenn keiner guckt.“ Henry Ford ``` Dieser Satz ist mehr als ein nettes Zitat. Er ist ein Prüfstein für unsere Berufsethik. ## Die 10-Prozent-Regel: Sichtbare Ergebnisse vs. unsichtbare Arbeit In fast jedem Projekt sind nur etwa 10 % unserer Arbeit unmittelbar sichtbar: - Das fertige Feature im Sprint-Review - Die Projektpräsentation beim Steering Committee - Die Testabnahme durch den Kunden Die anderen 90 % sind im Verborgenen: - Die saubere Dokumentation, die später jemandem das Leben leichter macht - Der durchdachte Code, der wartbar bleibt - Die sorgfältig gepflegten Testfälle, die Fehler in Zukunft verhindern - Die gewissenhafte Abstimmung zwischen Teams, die keine sofortigen „Show-Ergebnisse“ bringt, aber Risiken minimiert ## Die unsichtbaren 90 Prozent: Wo sich echter Projekterfolg entscheidet Genau in diesen unsichtbaren 90 % entscheidet sich, ob ein Projekt nachhaltig erfolgreich ist – oder ob es in ein paar Monaten unter der Last technischer Schulden, Missverständnisse oder unklarer Prozesse zusammenbricht. ## ![Ein Kreisdiagramm zeigt das Verhältnis an: 10 Prozent sichtbare Arbeit und 90 Prozent unsichtbare Arbeit](https://thecattlecrew.net/wp-content/uploads/2025/09/10_prozent_regel_infografik-e1758276196428.png)Professioneller Stolz als Kompass für nachhaltige Qualität Professioneller Stolz bedeutet nicht, stur perfektionistisch zu sein. Es bedeutet: - Verantwortung für die eigene Arbeit zu übernehmen - Ehrlich zu sich selbst zu sein, wenn etwas nicht den eigenen Qualitätsmaßstäben entspricht - Langfristig zu denken, auch wenn der kurzfristige Druck groß ist Es heißt, die Latte nicht deshalb niedriger zu hängen, weil „es ja keiner merkt“. Denn irgendjemand wird es merken – oft sind es die Kolleginnen und Kollegen im nächsten Projekt, die mit den Folgen leben müssen … ## Qualität betrifft alle: Vom Projektmanagement bis zur Architektur Qualität ist kein Luxus, den man sich nur leistet, wenn Zeit übrig ist. Sie ist die Basis für Effizienz, Verlässlichkeit und Vertrauen. - Projektmanagement: Qualität in Planung und Kommunikation sorgt dafür, dass Entscheidungen auf einer soliden Grundlage getroffen werden. - Entwicklungsteam: Sauberer Code spart in Zukunft Zeit, Nerven und Kosten. - Testing: Gründliche Tests verhindern spätere Katastrophen und sichern die Reputation. - IT-Architects: Eine durchdachte Architektur ist wie ein stabiles Fundament – man sieht es nicht, aber es trägt alles. ## Fazit: Warum die Qualität der unsichtbaren Arbeit bleibt Der beste Weg, den eigenen professionellen Stolz zu leben, ist simpel: Arbeite so, dass du auch in einem Jahr noch mit Überzeugung sagen kannst: „Das war mein Werk – und ich stehe dazu.“ Denn am Ende sind es nicht die schnell gelieferten Features oder die pünktlich gehaltenen Meetings, die bleiben – es ist die Qualität der unsichtbaren 90%, die den Unterschied macht. Oder, um es mit den Worten des eingangs zitierten Satzes zu sagen: Qualität ist: Es gut zu machen, auch wenn keiner guckt. Wie gehst du in deinem Projekt mit den unsichtbaren 90 % um? Diskutiere mit mir in den Kommentaren. **Kategorien:** Development, IT-Security, Sustainability & Awareness --- ### [Proxmox VE: Open-Source-Virtualisierung für digitale Souveränität](https://thecattlecrew.net/2025/09/18/proxmox-ve-open-source-virtualisierung-fuer-digitale-souveraenitaet/) **Published:** September 18, 2025 **Author:** Jeremy Smeets **Content:** Digitale Souveränität – sie ist der Schlüssel zur Unabhängigkeit von Organisationen gegenüber globalen IT-Giganten. Mit **Proxmox VE** steht eine leistungsfähige **Open-Source-Virtualisierungsplattform** bereit, die Offenheit, Sicherheit und Skalierbarkeit vereint. Unternehmen schaffen damit ein stabiles Fundament für nachhaltige Selbstbestimmung, volle Kontrolle über ihre Daten und flexible Zukunftsfähigkeit. ## Digitale Souveränität beginnt bei der IT-Architektur Souveränität ist ein großes Wort. Eines, das viele für sich beanspruchen und das doch selten greifbar wird, wenn es um konkrete **IT-Architekturen** geht. Zu oft bleibt es in PowerPoint-Folien hängen, während im Backend längst proprietäre Lizenzmodelle, Blackbox-Systeme und globale Abhängigkeiten regieren. Dabei ist der Begriff aktueller denn je. Was lange wie eine idealistische Forderung wirkte, ist heute ein strategischer Imperativ. Nicht nur im öffentlichen Sektor. Denn die Realität zeigt: Juristische Kontrolle über Infrastruktur ist nicht selbstverständlich. Als Microsoft jüngst auf Anweisung der US-Regierung den ICC-Chefankläger von der E-Mail-Kommunikation aussperrte, wurde einer breiten Öffentlichkeit bewusst, was **CLOUD Act** und extraterritoriale Gesetzgebung tatsächlich bedeuten. Solche Eingriffe sind keine Ausnahme, sondern systemisch legitimiert und technisch jederzeit möglich, wenn wir die Kontrolle über unsere IT-Landschaft aus der Hand geben. ## Warum Virtualisierung die Grundlage für Unabhängigkeit ist Ob öffentliche Verwaltung, Forschung, Industrie oder IT-Dienstleister, wer heute **Virtualisierung** einführt, migriert oder weiterentwickelt, steht vor mehr als einer Produktwahl. Es geht um die Frage: Wer kontrolliert, wie meine Systeme laufen, wie sie skaliert werden, wer worauf Zugriff hat und was passiert, wenn ein Anbieter seine Regeln ändert? ### **Virtualisierung bildet den Sockel** Auf dem Sockel der Virtualisierung laufen Datenbanken, Entwicklerumgebungen, Containerplattformen, Testsysteme, Authentifizierungsdienste und vieles mehr. Wenn dieser Sockel fremdgesteuert ist, etwa durch proprietäre Lizenzzwänge, unklare Jurisdiktionen oder nicht dokumentierte API-Verhalten – dann ist alles darüber automatisch gefährdet. ## Proxmox VE: Offene Alternative zu VMware und Co. **Proxmox VE** bringt dafür eine seltene Kombination mit: vollständige Offenheit, starke technologische Basis, aktive Community, optionalen Support und die Fähigkeit, mit klassischen Enterprise-Strukturen zu sprechen, ohne sich von ihnen abhängig zu machen. ### Vorteile von Proxmox VE auf einen Blick: - **Open Source und transparent**: Keine versteckten Lizenzbedingungen oder Blackbox-Komponenten. - **Alternative zu VMware**: Starke Virtualisierungsfunktionen ohne Abhängigkeit von proprietären Herstellern. - **Flexible Virtualisierung**: Unterstützung von KVM für VMs und LXC für Container. - **Integriertes Storage & Backup**: Mit Ceph und ZFS lassen sich hochverfügbare und sichere Umgebungen aufbauen. - **Keine Telemetrie-Zwänge**: Datenschutz und Unabhängigkeit von externen Cloud-Diensten. - **Aktive Community & optionaler Enterprise-Support**: Stabile Weiterentwicklung und professioneller Betrieb. - **Nahtlose Integration**: API-first, Infrastructure-as-Code und volle Dokumentierbarkeit für souveräne IT-Strukturen. Das System basiert auf bewährten Technologien wie **KVM, LXC, Ceph und ZFS**. Es verzichtet konsequent auf Telemetrie, Cloud-Zwänge oder Lizenzverklausulierungen. Und es erlaubt Organisationen, ihre gesamte Virtualisierungsarchitektur – vom Clusteraufbau über Backup bis zu Monitoring und IAM – dokumentierbar, überprüfbar und reproduzierbar selbst zu gestalten. [![Ein Screenshot der Proxmox VE Web Gui - VM Übersicht & Monitoring](https://thecattlecrew.net/wp-content/uploads/2025/09/Proxmox-VE-9-0-Metrics-1024x575.png)](https://thecattlecrew.net/wp-content/uploads/2025/09/Proxmox-VE-9-0-Metrics.png)Proxmox VE Web Gui – VM Übersicht & Monitoring ## Mehr als nur Container: Proxmox im Spannungsfeld von Legacy und Cloud Ein häufiger Irrtum in Architekturgesprächen ist die Gleichsetzung von „moderner IT“ mit Kubernetes. Natürlich haben Containerplattformen ihre Berechtigung. Insbesondere dort, wo dynamische Skalierung, Self-Healing und Microservice-Paradigmen sinnvoll sind. Doch sie lösen nur einen Teil der Herausforderungen. In den meisten Umgebungen existieren weiterhin klassische Workloads: Windows-basierte Fachverfahren, monolithische Datenbanken, sicherheitskritische Legacy-Systeme. Auch moderne Systeme wie GitLab, Keycloak oder Prometheus laufen nicht zwingend containerisiert. **Proxmox VE ist hier keine Konkurrenz zu Kubernetes – sondern die Basis, auf der Kubernetes sinnvoll betrieben werden kann.** Wer Proxmox als Infrastruktur verwendet, kann Containerplattformen dort ausrollen, wo sie gebraucht werden, ohne dafür seine gesamte Architektur umzustellen oder in Herstellerabhängigkeiten zu geraten. ## Praxisnähe mit echten Erfolgsgeschichten **Proxmox VE** wird weltweit in unterschiedlichsten Einsatzszenarien genutzt, von Forschungseinrichtungen über Unternehmen bis hin zu Behörden. So konnte etwa ein global agierender Musiksoftware-Hersteller durch den Einsatz von Proxmox-Clustern die Auslastung seiner Systeme optimieren und zugleich hohe Verfügbarkeit sicherstellen. Ein IT-Dienstleister in Hamburg berichtet wiederum von erfolgreichen Migrationen weg von VMware hin zu Proxmox – verbunden mit größerer Unabhängigkeit und reduzierten Betriebskosten. Weitere Beispiele aus Bereichen wie Bildung, öffentlicher Verwaltung oder dem NGO-Sektor sind auf der Proxmox-Unternehmensseite unter [Success Stories](https://www.proxmox.com/de/ueber-uns/ueber-uns/stories?utm_source=chatgpt.com) dokumentiert. Sie verdeutlichen, wie die Plattform in der Praxis Mehrwerte schafft und Organisationen befähigt, ihre IT-Strukturen nachhaltig souverän auszurichten. ## Souveränität in der Praxis: Transparenz, Exit-Strategien und offene APIs Eine souveräne Virtualisierungsarchitektur erlaubt es, neue Systeme aufzusetzen, alte zu migrieren, Monitoring zu integrieren, Disaster-Recovery-Strategien umzusetzen und IAM sauber einzubinden, ohne dafür auf proprietäre Portale zugreifen zu müssen. - Vollständige Audits sind möglich, weil der Quellcode offenliegt. - Dokumentierte Exit-Szenarien sichern Unabhängigkeit, da keine Lizenzbindungen den Wechsel blockieren. - APIs, Infrastructure-as-Code und modulare Betriebskonzepte sorgen für Integrationsfähigkeit. In der Praxis bedeutet das zum Beispiel **spürbare Einsparungen bei Lizenzkosten, eine gesteigerte Audit- und Compliance-Fähigkeit, eine deutliche Reduzierung der Total Cost of Ownership (TCO) sowie die Befähigung interner Teams, die Plattform eigenständig weiterzuentwickeln,** frei von Herstellerabhängigkeiten und ohne Risiko eines Know-how-Verlustes. ## Architektur als kontinuierlicher Prozess Bei **OPITZ CONSULTING** haben wir ein Vorgehen etabliert, das genau diesen Anspruch aufgreift. Es basiert auf einem zyklischen Modell, das den Aufbau souveräner IT-Strukturen als Prozess versteht, nicht als einmalige Umstellung. **Define – Design – Deploy – Distribute – Debug – Maintain – Define** In der Definitionsphase werden bestehende Abhängigkeiten analysiert: Welche proprietären Systeme existieren? Wo ist juristische Kontrolle unklar? Welche Risiken entstehen durch Lock-in oder fehlende Exit-Strategien? Daraus ergeben sich Design-Prinzipien, z. B. Redundanz, Transparenz, Automatisierbarkeit, die in ein konkretes Architekturmodell übersetzt werden. Die Deployment-Phase bringt diese Architektur in die Realität: Clusteraufbau, Storage, Backup, IAM, Netzwerk, Monitoring. In der Distributionsphase geht es um Wissen: SOPs, Schulungen, Dokumentation. Debugging sorgt für kontinuierliche Verbesserung. Und Maintenance etabliert den laufenden Betrieb auf Basis nachvollziehbarer Regeln, nicht durch Ticket-Magie. Am Ende beginnt der Zyklus von vorn: **Architektur ist nie fertig, aber sie kann gesund wachsen.** ## Fazit: Mit Proxmox IT-Souveränität und Zukunftssicherheit erreichen **Proxmox VE** ist nicht die Antwort auf alle Architekturfragen. Aber es ist ein Baustein, der fundamental zur Unabhängigkeit beitragen kann, technisch, rechtlich, organisatorisch. Wer Proxmox einführt, entscheidet sich nicht nur für ein Virtualisierungsprodukt. Sondern für einen Ansatz, der **digitale Souveränität systemisch ermöglicht**. Gerade in Zeiten geopolitischer Spannungen, unvorhersehbarer Lizenzveränderungen und zunehmender Regulierungsanforderungen wird deutlich: Selbstbestimmung ist kein Luxus. Sie ist das Betriebssystem einer zukunftsfähigen Organisation. --- ## Mehr zum Thema digitale Souveränität - [Was bedeutet Digitale Souveränität konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) - [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) - [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) - [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) - [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Kategorien:** Cloud, Infrastructure, IT-Security --- ### [IT-Support in der Industrie: Ohne uns läuft kein Stahl](https://thecattlecrew.net/2025/09/16/it-support-in-der-industrie-ohne-uns-laeuft-kein-stahl/) **Published:** September 16, 2025 **Author:** Mateusz Mis **Content:** Stahlproduktion klingt nach Hochöfen, Funkenflug und tonnenschweren Maschinen. Doch hinter den Kulissen sorgt ein komplexes Netz aus Systemen, Daten und Prozessen dafür, dass alles reibungslos funktioniert – von der ersten Schmelze bis zum fertigen Transport. Ohne diese IT-Infrastruktur würde kein einziger Rohling das Werk verlassen. Genau hier kommen wir ins Spiel: unser CDS-Team (Customer Domain Support). Wir sind die Feuerwehr, die Detektive und manchmal auch die Kaffeemaschine in einem – immer dann zur Stelle, wenn ein digitales Rädchen klemmt, ein Incident eskaliert oder ein System mitten in der Nacht beschließt, seine eigene Meinung zu haben. “*Oha… aus Versehen aus 2 Tonnen Stahl plötzlich 10 gemacht?*” Klingt unmöglich? Nicht bei uns! Manche nennen’s Magie – wir nennen’s **Freitag …** ## Fertigungsleitsysteme: kein Auto, sondern ein Nervensystem Bei uns heißt das Projekt oft einfach „FLS“ (Fertigungsleitsystem) oder „MES“ (Manufacturing Execution System). Klingt wie ein neues Automodell, ist aber in Wahrheit ein komplexes Geflecht aus Produktions- und Logistiksystemen. Klingt kompliziert? Ist es auch. Genau deshalb gibt es uns. Ob Incident-Management, Systemadministration, Support für lokale Teams oder schlicht „irgendwas geht nicht, macht mal bitte“ – wir sind mittendrin. Vom Hochofen bis zur LKW-Rampe oder zum Bahnsteig: Wenn irgendwo ein digitales Rädchen klemmt, legen wir los. Mit einem wachen Auge (manchmal auch mitten in der Nacht), analytischem Verstand und oft einer Kaffeetasse in der einen und einer JIRA- und MES-Instanz in der anderen Hand. ## So erklären wir unseren Job Wie unser Alltag aussieht? Gar nicht so leicht zu beantworten. Im Privatleben bekommen wir oft Fragen, was wir eigentlich machen – und meistens klingt jede Erklärung ein bisschen nach Science-Fiction. Deshalb habe ich das mal an meine Kollegen Adrian und Dominik weitergegeben. **Was antwortet ihr, wenn euch Freunde oder Familie fragen, was ihr bei eurer Arbeit macht?** ``` Adrian: Kinder unter 10? – „Ich arbeite am Computer.“ Teenies bis 16? – „Ich mach irgendwas mit IT … und Deutsch.“ Alle zwischen 17 und 50? – „Büro-Ninja im Großkonzern.“ Und Ü50? – „IT für ein Industrieunternehmen, klingt solide und vertrauenswürdig.“ ``` ``` Dominik: „Das hängt vom Tag ab. Manchmal muss ich die Fabrik retten, manchmal einen Benutzer im System anlegen.“ ``` Lustig? Ja. Aber auch ziemlich treffend. Denn unser Job ist schwer auf einen Satz zu bringen – vor allem, weil er so vielseitig ist. Zwischen Tickets, Logfiles und Systemen gleicht kaum ein Tag dem anderen. ## Standard-Incidents? Fehlanzeige. Ob es so etwas wie einen typischen Incident gibt? Ich frage Matthias, unser wandelndes Wikipedia. **Gibt’s bei uns sowas wie ein „Standard-Incident“?** ``` Matthias: „Oft gibt es Probleme bei Transporten aller Art. Viele Systeme kümmern sich um Lagerung, Verladung und Abstimmung mit der Infrastruktur. Unser MES vermittelt zwischen diesen Welten. Wenn das nicht klappt, sind wir gefragt.“ ``` Wir sind also zentrale Ansprechpartner für viele Teams, die verschiedene Systeme betreiben. Kein einfacher Job, denn die Vielfalt an Fachlichkeiten sorgt dafür, dass Probleme oft schwer einzugrenzen sind. ## Superkräfte im IT-Support Sieht ganz so aus, als wäre das kein Job für alle. Deshalb frage ich weiter: **Welche Superkraft braucht man für diesen Job?** ``` Matthias: „Im MES-Support musst du Hinweise erkennen und Spuren folgen – das erfordert den Verstand von Batman. Die Wahl des richtigen Werkzeugs allerdings das Gespür von MacGyver.“ ``` Manchmal fühlt sich unser Job tatsächlich an wie eine Mischung aus Supernatural und CSI. Und ja – es passiert, dass sich ein Problem wie von Geisterhand löst. Meistens sind die Enduser glücklich, wir eher misstrauisch. Deshalb frage ich noch Adrian: **Hast du schon mal ein Problem gelöst, ohne zu wissen, wie du’s gemacht hast?** ``` Adrian: „Klar, das gibt’s! Oft denke ich: ‚Keine Ahnung, ob das funktioniert – aber ich probier’s mal.‘ Oder: ‚Darf ich das überhaupt?‘“ ``` ## Zwischen Minesweeper und MacGyver Natürlich nutzen wir dafür eine Menge Tools. Manche lieben wir, manche verfluchen wir – brauchen tun wir sie alle. Nach dem letzten gelösten Incident tausche ich mich kurz mit Michal aus – und denke mir: Gut, dass wir so viele Systeme zur Verfügung haben, um ein Problem aus verschiedenen Blickwinkeln zu analysieren. Ich frage ihn: **Gibt es ein Tool oder System, das du jeden Tag brauchst – aber ehrlich gesagt am liebsten niemals wiedersehen würdest?** ``` Michal: „Ganz klar: QCS. Ein System mit hundert Tabs und einem Interface aus dem letzten Jahrzehnt. Mächtig, ja – intuitiv, eher nicht.“ ``` Da kann ich nur zustimmen. Und mein persönlicher Klassiker? Ein Bahn-System, das manchmal aussieht wie eine Runde Minesweeper auf Windows XP … nur in echt. ## Führung im Dauerbetrieb Aber Technik allein reicht nicht. Hinter den Kulissen braucht es jemanden, der den Überblick behält – und auch bei der fünften Eskalation am Tag Ruhe bewahrt. Also frage ich unseren Teamleiter Thomas: **Was sind für dich die größten Herausforderungen bei der Führung eines so vielseitigen und verteilten Teams wie CDS?** ``` Thomas: „Die größte Herausforderung ist, trotz räumlicher Verteilung und 24/7-Betrieb den Teamzusammenhalt zu sichern. Informationen müssen schnell fließen, Prioritäten klar sein, und niemand soll das Gefühl haben, allein zu arbeiten.“ ``` **Wie hält man dabei Struktur und Motivation hoch?** ``` Thomas: „Das Wichtigste ist für mich, Ruhe und Struktur vorzuleben. Wir haben klare Abläufe, damit jeder weiß, was im Ernstfall zu tun ist. Aber genauso wichtig ist der menschliche Umgang: gegenseitiges Vertrauen, Humor und die Sicherheit, dass man sich aufeinander verlassen kann. Auch wenn mal fünf ungeplante Themen gleichzeitig auf den Tisch kommen – wir packen das gemeinsam an. Diese positive Stimmung und das gute Miteinander im Team sind der Grund, warum wir trotz Dauerstress motiviert bleiben.“ ``` ## Fazit: Digitaler Feuerwehrdienst mit Humor Was Thomas sagt, bringt es auf den Punkt. Unser Alltag lebt nicht nur von Technik, sondern von Teamgeist, Flexibilität und einer guten Portion Humor. Zwischen nächtlichen Incidents, verschwundenen Datenpaketen und Tickets, die sich selbst erledigen, wird es bei uns nie langweilig. Wir sind IT-Support, Systemanalysten und digitale Feuerwehr zugleich – und dabei immer auf der Suche nach der richtigen Spur im System. Am Ende machen nicht nur Tools und Prozesse den Unterschied, sondern vor allem die Menschen, die sich aufeinander verlassen können. Und das ist auch gut so. Denn ohne uns würde der Stahl tatsächlich nicht laufen. **Kategorien:** Development, Infrastructure **Schlagwörter:** agilität, Agility, Analytics, Bewusste IT, communication, German, Softwarenentwicklung, Teams, Zusammenarbeit --- ### [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Published:** September 2, 2025 **Author:** Aaron Kreis **Content:** ### **Warum Datenhoheit über den Erfolg von KI entscheidet** Künstliche Intelligenz (KI) wird nicht aus dem Nichts erschaffen, sie lebt von Daten. Ohne umfangreiche und qualitativ hochwertige Beispiele kann ein neuronales Netz keine Sprache verstehen, keine Objekte erkennen und keine Handlungsempfehlungen geben. Für Unternehmen bedeutet das: Wer über die eigenen Daten nicht souverän verfügt, schenkt fremden Plattformen das Rohöl der digitalen Wirtschaft. Der Begriff Datensouveränität beschreibt die rechtliche und faktische Kontrolle über Datenbestände. Er geht über klassischen Datenschutz hinaus. Datenschutz will sicherstellen, dass personenbezogene Informationen nicht missbraucht werden und dass die Grundrechte Betroffener gewahrt bleiben. Datensouveränität hingegen fragt, wem die Daten gehören, wer sie wie nutzen darf. Während Datenschutz die Privatsphäre schützt, ist Datensouveränität eine wirtschaftliche und strategische Frage. Sie bestimmt, ob Daten zu einem Wettbewerbsvorteil werden oder unbemerkt in die Wertschöpfung anderer fließen. ### **Warum Daten für KI systemrelevant sind** Die Frage der Datensouveränität zeigt sich besonders deutlich beim Einsatz von KI, denn deren Leistungsfähigkeit hängt unmittelbar von den verfügbaren Daten ab. KI-Modelle lernen aus vielen Beispielen, welche Zusammenhänge sich in der Realität verbergen, und übertragen diese Muster auf neue Situationen. Die Menge und vor allem die Qualität der Trainingsdaten sind dabei entscheidend. Große generative Modelle wie zum Beispiel Sprachmodelle benötigen Milliarden von Parametern, um natürliche Sprache fließend zu erzeugen. Bei solchen Modellen hängt die erforderliche Datenmenge von der Modellgröße, der konkreten Aufgabe und der Vielfalt der Inhalte ab. Fehlende oder minderwertige Daten lassen sich nicht einfach durch größere Mengen ausgleichen. Im Gegenteil sie verstärken Fehler. Für Unternehmen bedeutet das, dass nicht allein der Zugang zu großen Datenmengen ausschlaggebend ist, sondern die Fähigkeit, relevante, saubere und konsistente Datenbestände gezielt für den Aufbau von KI zu nutzen. Wer hier die Kontrolle verliert, riskiert fehlerhafte Ergebnisse, steigende Kosten und Abhängigkeiten von fremden Plattformen. ### **Herausforderungen auf dem Weg zur Datensouveränität in der KI** Der Aufbau von Datensouveränität für KI erfordert weit mehr als den bloßen Zugriff auf große Datenmengen. Der Weg zu souveränen KI-Systemen ist voller Stolpersteine. Die folgenden Probleme treten häufig auf und sollten frühzeitig adressiert werden: ![](https://thecattlecrew.net/wp-content/uploads/2025/08/Herausforderungen_KI_02-1024x518.png) - **Verzerrungen**: Verzerrungen können in jeder Phase der Entwicklung einer Künstlichen Intelligenz entstehen. Bereits vorhandene gesellschaftliche Ungleichheiten in den Daten werden oft als normal übernommen und im Modell fortgeführt. Beim Sammeln und Beschriften der Daten können persönliche oder kulturelle Vorurteile einfließen, und wenn bestimmte Gruppen in den Trainingsdaten zu selten vorkommen, lernt das Modell vor allem die Muster der Mehrheit. Auch die mathematische Optimierung kann dazu führen, dass Minderheiten weniger berücksichtigt werden, was zu schlechteren Prognosen oder Empfehlungen für diese Gruppen führt. - **Undurchsichtige Modelle**: Viele KI-Modelle wirken wie Black Boxes. Zwar lassen sich ihre Berechnungen theoretisch offenlegen, doch die Vielzahl an Parametern und komplexen Wechselwirkungen macht es für Menschen praktisch unmöglich, den genauen Entscheidungsweg vollständig zu verstehen. Ohne zusätzliche Methoden zur Erklärbarkeit ist schwer zu erkennen, welche Faktoren eine Entscheidung beeinflusst haben und ob diese fair ist. Mehr Transparenz schafft Vertrauen und ermöglicht Kontrolle durch Anwender und Aufsichtsstellen. - **Optimierungsziele ohne gesellschaftliche Rückkopplung**: Wenn eine KI nur darauf ausgerichtet ist, schnell und effizient messbare Erfolge zu erzielen, wie etwa möglichst viele Nutzer zu einem Kauf zu bewegen, kann sie dabei aggressiv personalisierte Werbung an besonders verletzliche Gruppen ausspielen, um die Kaufwahrscheinlichkeit zu erhöhen, auch wenn das ethisch problematisch ist. - **Explosion der Datenquellen**: Unternehmen erzeugen heute Daten auf vielen verschiedenen Plattformen, etwa in Cloud-Diensten, Software-as-a-Service-Anwendungen und sozialen Netzwerken. Diese Daten liegen oft verstreut an unterschiedlichen Orten und werden nicht in einem gemeinsamen System zusammengeführt. Eine sogenannte Datenkarte ist eine Übersicht, die zeigt, an welchen Stellen im Unternehmen Daten entstehen, wer sie verwendet und ob sie unterwegs verändert werden. Wenn Daten weder verstanden noch auffindbar oder kontrollierbar sind, werden sie nicht zum Vorteil, sondern zur potenziellen Gefahr. ### **Die Datenökonomie boomt** Trotz der zuvor beschriebenen Herausforderungen beim Umgang mit Daten wächst der Markt rund um Künstliche Intelligenz rasant. Unternehmen investieren Milliarden in Management, Aufbereitung und Qualitätssicherung, um Daten verfügbar, nutzbar und sicher zu machen. Laut einem Bericht von Fortune Business Insights betrug der weltweite KI Markt 2024 rund 233,46 Milliarden USD und soll bis 2032 auf 1.771 Milliarden USD wachsen. Gleichzeitig vergrößern sich auch die Märkte für Datenmanagement, Datenlabeling und Trainingsdatensätze: Der Markt für KI-Datamanagement hatte 2023 ein Volumen von 25,50 Milliarden USD und wird bis 2030 auf über 104,00 Milliarden USD steigen. Services zum Labeln von Daten, die essenziell für die Überwachung des Lernens sind, erreichten 2024 eine Größe von 18,60 Milliarden USD und dürften bis 2030 auf 57,60 Milliarden USD anwachsen. Die Nachfrage nach synthetischen Daten nimmt ebenfalls zu. Ein Markt von 0,51 Milliarden USD (2025) wächst bis 2030 voraussichtlich auf 2,67 Milliarden USD, da Unternehmen anonymisierte und realistische Datensätze für datenschutzkonforme Trainingszwecke benötigen. Diese Zahlen zeigen: Daten sind das neue Rohmaterial. Unternehmen investieren Milliarden in Datenaufbereitung, Annotation und Qualitätssicherung. Gleichzeitig ist die Verfügbarkeit hochwertiger Daten entscheidend für die Leistungsfähigkeit von KI-Systemen. ### **Wachstumsmärkte: Datenmanagement, Annotation & synthetische Daten** Die KI-Branche erlebt derzeit eine starke Konsolidierung. Große Plattformen kaufen spezialisierte Datenunternehmen auf, um sich den Zugang zu hochwertigen Datensätzen zu sichern. Ein Beispiel ist Microsofts Übernahme des Sprach- und Spracherkennungsunternehmens Nuance für 19,7 Milliarden USD. Gleichzeitig boomt der Markt für synthetische Daten. Dabei erzeugen generative Modelle künstliche Datensätze, die dieselben statistischen Eigenschaften wie reale Daten besitzen, aber keine persönlichen Informationen enthalten. Solche Daten erlauben es, vertrauliche oder seltene Muster zu lernen, ohne Originaldaten preiszugeben. Diese Daten wahren die Privatsphäre, sind strukturell identisch mit der Vorlage und enthalten keine personenbezogenen Daten. Dies ermöglicht die sichere Entwicklung und das Testen von KI Lösungen. Der Wettbewerb um Fachkräfte im Bereich KI hat sich zu einer intensiven Talentejagd entwickelt. Große Technologiekonzerne sichern sich nicht nur Unternehmen mit wertvollen Datensätzen, sondern konkurrieren auch um die besten Köpfe. Medien berichten, dass Microsoft Fachleute aus dem Umfeld von Apple abgeworben hat und sie mit Millionengehältern sowie umfassenden Aktienpaketen lockt. Die gebotenen Summen erinnern an Ablösesummen im Profisport, denn gesucht sind vor allem Spezialisten für Sprachverarbeitung, maschinelles Lernen und Computer Vision. Solche Abwerbungen werden mit langfristigen Bonusprogrammen und Forschungsbudgets begleitet. ### **Welche Daten sind schützenswert?** Mit dem Wachstum der Datenökonomie rückt auch die Frage in den Vordergrund, welche Daten für Unternehmen besonders kritisch sind und daher besonderen Schutz erfordern. Nicht alle Daten sind gleich kritisch. Schützenswert sind: - **Personenbezogene Daten**: Angaben, die sich einer Person zuordnen lassen, etwa Name, Adresse, biometrische Daten, Gesundheitsdaten oder Finanzinformationen. - **Geschäftsgeheimnisse und Forschungsdaten**: Produktrezepte, Algorithmen, Marktanalysen oder Forschungsergebnisse, deren Verlust den Wettbewerbsvorteil mindern würde. - **Sensor und Produktionsdaten**: Daten aus Maschinen können Rückschlüsse auf Produktionsprozesse geben und sind daher schützenswert. - **Kombinierte Daten**: Durch die Verknüpfung verschiedener Quellen können scheinbar harmlose Daten Hinweise auf Konsumverhalten oder politische Einstellungen liefern. Daher sollten Unternehmen immer prüfen, welche Schlüsse aus ihren Daten gezogen werden können. Für echte Datensouveränität reicht es nicht, große Datenmengen zu besitzen. Entscheidend ist, ob diese Daten für die jeweilige KI-Anwendung relevant, konsistent und nutzbar sind. Ungefilterte Masse kann im schlimmsten Fall die Modellqualität verschlechtern. Wert entsteht erst, wenn Daten gezielt ausgewählt, strukturiert und in einen sinnvollen Kontext gebracht werden. Genau hier setzt das Konzept von Smart Data an. ### **Smart Data statt Big Data: Qualität schlägt Quantität** Smart Data steht für den bewussten Umgang mit Daten. Im Mittelpunkt steht nicht die schiere Menge, sondern die Relevanz und Qualität der Informationen. Für KI bedeutet das, dass Datensätze gezielt auf die zu lösende Aufgabe zugeschnitten, bereinigt und angereichert werden. So entstehen Datenbestände, die aussagekräftig und effizient nutzbar sind. Während Big Data häufig als Sammelbegriff für große und vielfältige Datenmengen dient, konzentriert sich Smart Data auf gezielte Auswahl, saubere Struktur und eindeutige Zuordnung. Beispielsweise kann ein kleiner, aber sorgfältig gelabelter Datensatz ein Sprachmodell besser trainieren als unstrukturierte Terabytes voller irrelevanter Inhalte. Der Mehrwert von Smart Data liegt in der klaren Zielorientierung. Daten werden so gefiltert, dass sie nur die Informationen enthalten, die für eine konkrete KI-Aufgabe wichtig sind. Sie sind konsistent, aktuell und nachvollziehbar, was nicht nur die Modellleistung verbessert, sondern auch die Einhaltung von Compliance- und Datenschutzvorgaben erleichtert. Für Unternehmen bedeutet das: Wer Smart Data beherrscht, erzielt präzisere Ergebnisse, spart Rechenressourcen und wahrt gleichzeitig die Kontrolle über seine wertvollsten Datenbestände. Damit aus Smart Data ein strategischer Vorteil wird, braucht es technische Konzepte, die Unternehmen die volle Kontrolle über ihre Daten sichern, auch wenn diese für den Einsatz von KI verarbeitet oder geteilt werden. ### **Technische Schlüsselkonzepte für Datensouveränität** Technische Konzepte für mehr Datensouveränität sind wichtig, weil sie es ermöglichen, KI-Systeme zu nutzen, ohne die Kontrolle über sensible Daten zu verlieren. KI benötigt große Mengen an Informationen, um zuverlässig zu arbeiten, doch viele davon sind vertraulich oder unterliegen strengen Datenschutzregeln. Mit den folgenden Verfahren können diese Daten sicher genutzt werden, ohne sie ungeschützt weiterzugeben. ![](https://thecattlecrew.net/wp-content/uploads/2025/08/Schluesselkonzepte-1024x832.png) - **Föderiertes Lernen:** Beim Föderierten Lernen werden die Daten nicht zu einem zentralen Server geschickt. Statt die Daten zu übertragen, werden die Berechnungen direkt vor Ort auf den vorhandenen Daten durchgeführt. Anschließend werden nur die daraus resultierenden aktualisierten Modellparameter weitergegeben. So können beispielsweise mehrere Krankenhäuser ihre Diagnosesysteme gemeinsam verbessern, ohne Patientendaten weiterzugeben. - **Self Sovereign Identity:** Self Sovereign Identity bedeutet, dass Nutzer ihre digitale Identität in einer eigenen elektronischen Brieftasche, einer sogenannten Wallet, verwalten. Sie entscheiden selbst, welche Informationen sie preisgeben. In einer Onlineplattform könnte sich ein Nutzer so als volljährig ausweisen, ohne seinen vollständigen Namen oder seine Adresse offenlegen zu müssen. - **Data Trusts:** Ein Data Trust ist eine treuhänderische Struktur, bei der Datenbesitzer die Verwaltung ihrer Daten an eine unabhängige Stelle übertragen, die im Interesse aller Beteiligten handelt. Mehrere Krankenhäuser könnten so Patientendaten in anonymisierter Form bündeln, um gemeinsam medizinische Forschung zu betreiben. Der Treuhänder entscheidet, wer auf welche Daten zugreifen darf, und sorgt für Transparenz und faire Nutzung. - **Differenzielle Privatsphäre:** Bei der Differenziellen Privatsphäre wird den Daten gezielt statistisches Rauschen hinzugefügt. Dadurch können Analysen durchgeführt werden, ohne einzelne Personen identifizieren zu können. Ein Beispiel ist die Auswertung von Bewegungsdaten einer Fitness App, um allgemeine Trends zu erkennen, ohne exakte Routen einzelner Nutzer zu speichern. - **Homomorphe Verschlüsselung:** Homomorphe Verschlüsselung ermöglicht es, Berechnungen auf verschlüsselten Daten durchzuführen, ohne diese zu entschlüsseln. Ein einfaches Beispiel ist eine Bank, die prüfen möchte, ob ein Kunde für einen Kredit infrage kommt. Der Kunde sendet seine Einkommens- und Ausgabedaten in verschlüsselter Form an die Bank. Die Bank führt dann spezielle mathematische Berechnungen direkt auf diesen verschlüsselten Daten aus, um zum Beispiel das Verhältnis von Einnahmen zu Ausgaben zu bestimmen. Das Ergebnis dieser Berechnung bleibt ebenfalls verschlüsselt und wird erst vom Kunden entschlüsselt. So kann die Bank die Entscheidung über den Kredit treffen, ohne jemals die genauen Beträge im Klartext zu sehen. - **Blockchain:** Die Blockchain dient als fälschungssicheres, verteiltes Register, in dem Datenzugriffe und Transaktionen dauerhaft gespeichert werden. Dadurch lässt sich jederzeit nachvollziehen, wer wann auf welche Daten zugegriffen hat. In der Lebensmittelindustrie kann so die gesamte Lieferkette dokumentiert und die Herkunft eines Produkts überprüft werden. Diese Techniken zeigen, dass Datenschutz und der Einsatz von KI sich nicht ausschließen. Richtig kombiniert ermöglichen sie eine verantwortungsvolle Nutzung von Daten, ohne deren Souveränität zu gefährden. Doch technische Lösungen allein reichen nicht aus. Damit der verantwortungsvolle Umgang mit Daten und KI verbindlich gewährleistet ist, braucht es klare gesetzliche Rahmenbedingungen. ### **Warum klare Regeln für Künstliche Intelligenz unverzichtbar sind** Regulierungen im Bereich Künstliche Intelligenz sind entscheidend, um den technologischen Fortschritt in sichere und verantwortungsvolle Bahnen zu lenken. Ohne klare Vorgaben könnten KI-Systeme eingesetzt werden, die Menschen gezielt manipulieren, diskriminieren oder ihre Privatsphäre massiv verletzen. Ein Negativbeispiel ist die Kritik an Elon Musks KI „Grok“, die Berichten zufolge so angepasst wurde, dass sie Musks persönliche Sichtweisen stärker wiedergibt und bei kontroversen Themen seine Position bevorzugt darstellt. Positivbeispiele für den Schutz der Bürgerrechte gibt es ebenfalls: Dänemark arbeitet an einem Gesetz, das seinen Bürgern das Urheberrecht an ihrem eigenen Gesicht, ihrer Stimme und anderen persönlichen Merkmalen zusichert. Damit soll verhindert werden, dass Bilder oder Audioaufnahmen ohne Zustimmung für KI-Trainings und Deepfakes genutzt werden. In einer Welt ohne solche Regeln bestünde die Gefahr, dass wirtschaftliche Interessen und kurzfristige Effizienzgewinne über den Schutz von Grundrechten und gesellschaftlichen Werten gestellt werden. Aus genau diesem Grund wurden Regulierungen wie der Europäische AI Act, die Datenschutz Grundverordnung (DSGVO) und die Norm ISO/IEC 42001 ins Leben gerufen. Sie sollen Innovation fördern, Risiken minimieren, Missbrauch verhindern und das Vertrauen der Öffentlichkeit in KI stärken. ### **Fazit: Datensouveränität als strategischer Wettbewerbsvorteil** Datensouveränität entscheidet über den Erfolg von Künstlicher Intelligenz. Ohne qualitativ hochwertige Daten bleibt jedes Modell fehleranfällig, ohne Kontrolle über diese Daten verlieren Unternehmen Gestaltungsmacht und Wertschöpfungspotenzial und ohne rechtliche wie organisatorische Verankerung gehen Chancen verloren. Wer KI verantwortungsvoll einsetzen will, muss daher technische, rechtliche und strategische Fragen gemeinsam betrachten. Es zeigt sich, dass für leistungsfähige KI nicht Masse, sondern gezielte Qualität der Daten ausschlaggebend ist. Gleichzeitig wächst rund um Datenaufbereitung, Annotation und synthetische Datensätze ein milliardenschwerer Markt, der Chancen, aber auch neue Risiken schafft. Unternehmen stehen vor der Aufgabe, nicht nur Datenbestände aufzubauen, sondern diese auch zu schützen, zu strukturieren und im Sinne von Smart Data gezielt nutzbar zu machen. Technische Konzepte wie föderiertes Lernen, homomorphe Verschlüsselung oder differenzielle Privatsphäre ermöglichen es, sensible Informationen in KI-Anwendungen einzubringen, ohne die Kontrolle zu verlieren. Doch Technik allein reicht nicht. Erst klare Regeln wie der AI Act, die DSGVO oder ISO-Normen schaffen den Rahmen, in dem Innovation und Verantwortung zusammengehen. Damit wird Datensouveränität zu einer Führungsaufgabe. Sie verlangt nach rechtlichen Grundlagen, gelebter Verantwortung, technologischer Kompetenz und einer Unternehmenskultur, die Daten nicht als Nebenprodukt, sondern als zentrales Kapital behandelt. Wer frühzeitig in diese Fähigkeiten investiert, stärkt Vertrauen bei Kunden und Partnern, reduziert Risiken, erhöht die eigene Unabhängigkeit und erschließt sich neue Wertschöpfungspotenziale. Datensouveränität ist damit kein Nebenaspekt der Digitalisierung, sondern ein strategischer Kernfaktor im globalen Wettbewerb um KI. --- ## Alle Artikel zum Thema digitale Souveränität - [Was bedeutet Digitale Souveränität konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) - [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) - [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) - [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) - [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Kategorien:** AI & Data Science, IT-Security, Sustainability & Awareness --- ### [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) **Published:** Juli 1, 2025 **Author:** Andreas Lorenz **Content:** Dies ist der zweite Beitrag der Blogserie zur Digitalen- bzw. Datensouveränität. Lies gerne auch: Teil 1: [Was bedeutet Digitale Souveränität](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) ## Vorab: Keine Blaupause, kein Standardweg Bevor es konkret wird, sollten wir uns über eines klar werden: In den meisten Fällen lässt sich Datensouveränität nicht einfach in den Warenkorb legen oder als Komplettpaket einkaufen. Zwar gibt es seit einiger Zeit erste Produkte und Dienste, die echte Alternativen versprechen – etwa durch offene Standards, europäische Hosting-Standorte oder transparente Geschäftsmodelle. Doch in der Breite bleibt der Markt noch schwierig zu durchschauen. Gerade aktuell sprießen neue Angebote rund um „souveräne Cloud“ wie Pilze aus dem Boden – insbesondere von großen Tech-Anbietern, die auf politischen Druck reagieren. Doch oft bleibt der Begriff ein Etikett, während das grundlegende Abhängigkeitsverhältnis zum Dienstanbieter bestehen bleibt. ## Die richtige Strategie Ich halte es für sinnvoll, zunächst noch einmal einen Schritt zurückzutreten und das große Ganze zu betrachten – insbesondere die strategische Dimension der digitalen- bzw. Datensouveränität. Die Debatte wird derzeit leider oft auf eine rein technische Ebene reduziert: als müsste Europa „nur“ eigene Produkte entwickeln oder – auf Unternehmensebene – technische Systeme austauschen und Daten zurück ins eigene Rechenzentrum holen. Ich will gar nicht in Abrede stellen, dass solche Maßnahmen sinnvoll sein können – möglicherweise sind sie langfristig sogar notwendig. Aber: Diese Entscheidungen bringen in der Regel erhebliche Herausforderungen mit sich (mehr dazu später). Daher lohnt ein kurzer Blick zurück zur eigentlichen Frage: Was genau bedeutet Datensouveränität? Sowohl für Unternehmen wie auch für Privatpersonen heißt es vor allem: zu jeder Zeit zu wissen, wo die eigenen Daten liegen, wer darauf zugreifen kann – und im Zweifel wieder selbst die Kontrolle übernehmen zu können. Es geht darum, sich nicht in einseitige Abhängigkeiten zu begeben, die später kaum noch aufzulösen sind. Dabei geht es nicht primär um Technik – sondern um Strategie. Die zentrale Frage lautet: Wie stelle ich sicher, dass ich echte Wahlfreiheit habe – heute und auch in Zukunft? Hier sind zumindest drei Elemente sehr wichtig: - **Offene Standards**, die es ermöglichen, Daten portabel zu halten und Systeme verschiedener Anbieter miteinander zu verbinden. - **Faire Wettbewerbsbedingungen**, in denen Qualität und Nutzen entscheiden – wo man Systeme unterschiedlicher Anbieter frei wählen und kombinieren kann. - **Transparenz**, damit klar ist, wie Systeme funktionieren und wer Zugriff hat – für Entscheidungen auf Basis von Fakten, nicht von Versprechungen. --- ### Ist Open Source das Allheilmittel? Oft lese ich, dass digitale Souveränität nur mit Open Source möglich sei – und ja, offene Software kann ein starker Hebel sein. Sie schafft Transparenz, ermöglicht Kontrolle über den Quellcode und erlaubt flexible Anpassungen an die eigenen Anforderungen. Aber Open Source ist kein Selbstläufer. Wer diesen Weg wählt, übernimmt ggfs. auch Verantwortung – für Wartung, Sicherheit und Weiterentwicklung. Und nicht jede Open-Source-Lösung ist automatisch souverän: Es kann an professioneller Unterstützung, strategischer Reife oder langfristiger Verlässlichkeit fehlen. **Schlussendlich** ist eines klar: Wer den Kurs ändern will, muss zuerst die eigene Position kennen. Digitale Souveränität beginnt nicht mit einem Wechsel des Systems – sondern mit dem Blick auf das eigene Fundament. Legen wir los – mit der Standortbestimmung. --- ## Kapitel 1: Standortbestimmung – Wo bin ich abhängig? Ich halte die Standortbestimmung für einen der wichtigsten Schritte! Der Umfang der Aufgabe variiert aber stark, je nachdem, welches Ziel man verfolgt. Will man z.B. die Hoheit über die eigenen digitalen Bilder aus der Cloud von Apple oder Google zurückgewinnen, dann ist dies viel einfacher umgesetzt, als wenn man im Unternehmen „digitale Workflows“ in ein neues System umziehen will. ### Warum dieser Schritt so wichtig ist Bevor du losläufst, musst du wissen, wo du stehst. Das klingt banal – ist aber in der digitalen Welt komplexer, als es scheint. Denn Abhängigkeiten sind oft unsichtbar, verzweigt oder unterschätzt. ### Die zentrale Aufgabe Fragen zur Selbstanalyse: - Welche Tools nutze ich – privat oder beruflich? E-Mail, Office, Cloudspeicher, Messenger, Buchhaltung, CRM, Zeiterfassung usw. - Wie kritisch wäre ein Ausfall eines Systems , bzw. was passiert, wenn der Dienst morgen nicht mehr verfügbar ist? Viel dreht sich um meine Daten - Welche Daten werden verarbeitet? - und wo werden sie gespeichert? Lokal? In der Cloud? Auf Servern Dritter? In welchem Land? - Welche Daten sind für mich oder für mein Unternehmen besonders wertvoll? - Wie komme ich an meine Daten – exportierbar, dokumentiert, wiederverwendbar? **Tipp** Viele der Informationen können in Unternehmen z.B. als Teil einer Backup- & Recovery-Strategie schon vorhanden sein. ### Beispiel Das Umziehen eines Mail-Accounts – Was auf den ersten Blick einfach wirkt, kann bei genauerem Hinsehen ein komplexer Migrationsprozess sein – gerade, wenn der Account seit Jahren genutzt wird oder geschäftlich relevant ist. **1. Bestandsaufnahme** Fragestellung: Welche Daten liegen im Account? – E-Mails, Kontakte, Kalender, Notizen, Aufgaben, ggf. Chatverläufe – Archivordner, Weiterleitungen, Filterregeln **2. Optionen für den Datenexport** Fragestellung: Wie komme ich an meine Daten? – Kann ich meine Mails als Standardformat (z.B. .eml, .mbox, .pst) exportieren? – über wieviel Daten sprechen wir: Ist es 1 oder 100 GB oder vielleicht noch viel mehr? – Lassen sich Kontakte und Kalender im offenen Format (z.B. vCard, .ics) sichern? **3. Analyse der Abhängigkeiten** Greifen weitere Systeme oder Tools auf den Account zu? – Zwei-Faktor-Authentifizierung (z.B. für Banking, Cloudspeicher, Social Media) – Wo ist der Domainname für meine Mail Adresse registriert? – kann ich meine Mail Adresse einfach mitnehmen? – Wenn nicht: wird die Mail Adresse in anderen Systemen genutzt, z.B. als Recovery Option für einen Systemzugang – mit welchen Mail Clients soll auf den Account zugegriffen werden (Desktop, Mobil …) – Login via E-Mail bei anderen Diensten ### Bei besonders großen Umstellungen Insbesondere in großen Unternehmenskontexten können weitere Informationen sehr wichtig sein: - Welche Schnittstellen bestehen zu anderen Systemen? - Welche Daten fließen ab und welche Daten kommen von anderen Systemen - Welche Protokolle werden verwendet (z.B. REST, SOAP, ftp) und wird Verschlüsselung eingesetzt? - Welche Datenformate werden genutzt: JSON, XML, CSV-Exporte etc. - Gibt es Abhängigkeiten zu Dritten, die man nicht auf dem Schirm hat? Dies könnte z.B. ein eingebundener Service sein, um automatisiert im Hintergrund Dokumente oder gar Rechnungen zu erstellen und via e-Post zu versenden. > Je tiefer man in diese Analyse einsteigt, desto deutlicher wird: > Die Aufgabe ist komplex – aber machbar, wenn man sie systematisch angeht. ### Unterstützung durch Tools Bei besonders großen Umstellungen ist es sinnvoll, Tools für die Inventarisierung der IT Systemlandschaft zu nutzen. Dies können einfache Worksheets (eher bekannt als Excel) sein oder kann eine Enterprise-Architecture Management (EAM) Lösung sein. So hatte ich 2022 für diese Aufgabe bei einem größeren Konzern LeanIX verwendet. Ein sehr mächtiges aber auch kostenintensives Werkzeug. ## Kapitel 2: Ziele setzen – Schritt für Schritt Hast du deine digitale Landschaft durchdrungen, kommt der nächste wichtige Schritt: **Ziele definieren.** ### Was du jetzt tun solltest: - **Wähle einen Einstiegspunkt.** Starte mit einem System, das z.B. überschaubar ist oder bei dem Du den größten Nutzen siehst. Wichtig: Vermeide es, an vielen Baustellen gleichzeitig zu arbeiten. - Benenne Dein Ziel für das System. Willst Du eine Software gegen eine neue Lösung austauschen oder reicht es vielleicht schon, vertraglich mit dem Anbieter eines Systems zu verhandeln und die Zusicherung zu erhalten, wie Du im Fall der Fälle an Deine Daten gelangst. - Erstelle Dir einen Umsetzungsplan und überlege welche Schritte nötig sind? - Wenn Du einen Systemwechsel anstrebst, dann solltest Du unbedingt (wenn es möglich ist) eine Übergangsphase haben, wo sowohl das alte wie auch das neue System verfügbar sind. Beispiel Handywechsel: Das alte Gerät noch ein paar Tage behalten und erst dann löschen und abgeben, wenn sicher ist, dass das neue Gerät alle Zugänge hat. ### Mein Tipp: Arbeite mit einem klaren Fahrplan – am besten schriftlich. Wie ein gutes Rezept in der Küche hilft es, Fehler frühzeitig zu erkennen und nicht planlos vorzugehen. Und wenn du dir unsicher bist: Hol dir Expertise dazu. Gerade bei sensiblen Systemen ist eine zweite Meinung oft Gold wert. ## Lust auf mehr? Die gute Nachricht: Ich konnte mittlerweile auch einige Kollegen gewinnen, die ebenfalls zu dieser Blogserie beitragen werden und technisch sehr visiert sind. Dann geht es z.B. um Architekturvorgaben und technische Lösungen: **Hier geht es weiter zu Teil 3**, den mein Kollege Lienhard Siegmund geschrieben hat: [Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/ "Wie kompatibel sind Hyperscaler mit EU-Vorgaben?") --- ## Alle Artikel zum Thema Datensouveränität - [Was bedeutet Digitale Souveränität konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) - [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) - [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) - [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) - [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Kategorien:** Development --- ### [Digitale Souveränität – Was bedeutet das konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) **Published:** Juni 11, 2025 **Author:** Andreas Lorenz **Content:** Die Smartwatch weckt uns morgens mit einem sanften Vibrieren. Im Halbschlaf greifen wir zum Smartphone – die ersten Push-Nachrichten rauschen über den Bildschirm. Noch vor dem Frühstück ploppen die ersten Termine auf, der digitale Kalender ist bereits ein paar Schritte voraus, und beim Kaffee wird Musik direkt aus der Cloud gestreamt. Im Büro geht es nahtlos weiter: Outlook, Chats und Videokonferenzen via Microsoft Teams, Anwendungen laufen über die Cloud – als Software-as-a-Service, flexibel, ortsunabhängig und ständig aktualisiert. Digitale Workflows und vernetzte Tools strukturieren den Arbeitstag. Wir leben in einer Welt, in der Daten fließen wie Strom – unsichtbar, aber allgegenwärtig. Und doch machen sich nur wenige Gedanken darüber, woher dieser Strom kommt, wer den Schalter in der Hand hält – und was passiert, wenn jemand den Stecker zieht. > Was haben die meisten digitalen Dienste heute gemeinsam? Sie laufen auf Servern von nicht-EU-Anbietern – unabhängig davon, ob diese physikalisch in Europa, den USA oder in China stehen. Damit entziehen sie sich unserer direkten Kontrolle. So unterliegen Server von US-Anbietern dem US-amerikanischen Recht, insbesondere dem CLOUD Act, der US-Behörden weitreichenden Zugriff auf gespeicherte Daten erlaubt – auch außerhalb der USA. > Ist das ein Problem? > Schauen wir erst einmal weiter … ## ![](https://thecattlecrew.net/wp-content/uploads/2025/06/icon-achtung-blau-300x300.png)Die Risiken einer digitalen Abhängigkeit sind vielfältig ### Privatsphäre war gestern Seit unsere Phones „smart“ geworden sind, hat sich auch das Geschäftsmodell vieler digitaler Dienste grundlegend verändert: Bezahlt wird nicht mit Euro oder Dollar – sondern mit persönlichen Daten: was auf den ersten Blick kostenlos erscheint, hat einen versteckten Preis: Suchanfragen, Chats, Kontakte, Aufenthaltsorte, Verhaltensmuster und Interessen – all das wird kontinuierlich erfasst, analysiert und kommerziell verwertet. ### Reichweite erzeugt Sichtbarkeit Neben dem Verkauf persönlicher Daten an die Werbeindustrie scheint sich in den letzten Jahren ein weiterer Trend zu verstärken: Immer mehr Menschen nutzen Social-Media-Plattformen als primäre Nachrichtenquelle – und verdrängen dabei, dass sie nur das sehen, was ihnen der Algorithmus vorsortiert: entweder, weil es vermeintlich zu ihren Interessen passt – oder, auch das kommt immer häufiger vor, um gezielt Meinung zu beeinflussen. Wer die Kontrolle über die Informationskanäle hat, kann auch öffentliche Stimmungen lenken, polarisieren – und Zustimmung für bestimmte politische Narrative erzeugen. Influencer, Plattformbetreiber und Content-Kreateure monetarisieren Aufmerksamkeit – und damit auch Meinungsmache: Was Reichweite erzeugt, bekommt Sichtbarkeit. Was sichtbar ist, beeinflusst öffentliche Wahrnehmung. Ein subtiler, aber mächtiger Einfluss auf demokratische Willensbildung ebenso wie auf unser gemeinsames Werteverständnis. ### Daten sind das Öl der digitalen Gegenwart Disruptive Geschäftsmodelle – von Airbnb über Spotify bis Amazon – zeigen, wie Datenhoheit über ganze Branchen entscheiden kann. Wer die Daten besitzt, kontrolliert die Schnittstellen zum Kunden, erkennt Muster schneller, automatisiert Entscheidungen – und kann Märkte aufrollen, noch bevor traditionelle Anbieter reagieren. Und die Entwicklung endet nicht bei Plattformökonomie: Daten sind auch der Treibstoff für KI-getriebene Geschäftsmodelle, die das Potential haben bestehende Wertschöpfungsketten tiefgreifend zu verändern – vom Vertrieb über die Produktion bis hin zu Entscheidungen im Management. Digitale Infrastrukturen sind längst mehr als nur technische Grundlagen – sie sind wirtschaftliche Hebel, geopolitische Einflussfaktoren und mediale Verstärker. Ob wirtschaftliche Abhängigkeiten, politische Einflussnahme oder der stille Verlust an Privatsphäre: Unsere digitale Realität wirft grundlegende Fragen auf – nach Kontrolle, Verantwortung und Gestaltungsfreiheit. Genau hier setzt für mich der Begriff der digitalen bzw. Datensouveränität an. Doch was genau bedeutet er – und warum betrifft er uns alle? ## Digitale bzw. Datensouveränität Digitale Souveränität ist weit mehr als ein politisches Schlagwort. In einer zunehmend vernetzten, datengetriebenen und globalisierten Welt beschreibt sie die Fähigkeit von Individuen, Organisationen und Staaten, über ihre digitalen Infrastrukturen, Daten und Systeme eigenständig und selbstbestimmt zu entscheiden. ### Für mich heißt Datensouveränität … Ich will selbst entscheiden, ob meine Daten in die Cloud wandern – und wenn ja, in welche. Ich will bestimmen, wer Zugriff darauf hat und was diese Personen oder Unternehmen damit tun dürfen. Es geht um meine Privatsphäre, meine Kontrolle – und letztlich auch um meine Freiheit in der digitalen Welt. Als Unternehmen habe ich viele Anforderungen an digitale Lösungen: hohe Verfügbarkeit, Sicherheit, Flexibilität, Performance und Effizienz. Aber ebenso wichtig sind Kompatibilität, verlässliche Planbarkeit – und echte Wahlfreiheit, auch beim Anbieterwechsel. Und wenn aus meinen Daten digitale Werte entstehen – sei es durch Auswertung, Automatisierung oder KI – will ich mitentscheiden. Wer profitiert? Wer trägt Verantwortung? Der aktuelle Streit zwischen der New York Times und großen Tech-Konzernen zeigt: Wenn Inhalte und Daten die Grundlage für neue Geschäftsmodelle bilden, stellt sich auch die Frage nach fairer Teilhabe. Digitale Souveränität beschreibt die Fähigkeit von Staaten, Organisationen oder Unternehmen, digitale Technologien eigenständig zu nutzen, weiterzuentwickeln und strategisch zu gestalten. Datensouveränität ist dabei ein zentraler Baustein – sie betrifft den verantwortungsvollen, kontrollierten Umgang mit Daten, technisch, rechtlich und organisatorisch. Wer die Kontrolle über seine Daten verliert, macht sich abhängig. ## ![](https://thecattlecrew.net/wp-content/uploads/2025/06/icon-achtung-blau-300x300.png)Digitale Abhängigkeit wird zur strategischen Schwachstelle Mit der Rückkehr von Donald Trump ins Weiße Haus und zunehmenden Spannungen zwischen den USA und Europa wird sichtbar, wie abhängig Europa von fremden digitalen Infrastrukturen ist. US-Gesetze erlauben amerikanischen Behörden den Zugriff auf Daten – selbst wenn sie physisch in Europa liegen. Und wenn ein Tech-Gigant aus dem Silicon Valley entscheidet, Preise zu ändern, Dienste einzuschränken oder gar abzuschalten, dann stehen europäische Nutzer:innen oft ohne Einfluss da. Was wir uns gestern nicht mal im Traum vorstellen konnten, ist heute real – da wird die E-Mail-Adresse des Chefermittlers des Internationalen Strafgerichtshofs (IStGH) einfach gesperrt. Das ist für mich der Versuch der digitalen Erpressung. Es geht längst nicht mehr nur um Technik. Es geht um Macht und um die Frage: Wem gehören die Daten, auf denen unsere Wirtschaft läuft, unsere Kommunikation basiert und unsere Innovation aufbaut? Wer darf bestimmen, was mit diesen Daten geschieht – und nach welchen Regeln? Europa ist in zentralen digitalen Bereichen hochgradig abhängig – von Cloud-Diensten über Kommunikationsplattformen bis hin zur Datenverarbeitung. Die Effizienz dieser Systeme ist unbestritten, doch der Preis dafür ist hoch: ein wachsender Kontrollverlust, wirtschaftliche Risiken und geopolitische Verwundbarkeit. Deshalb rückt digitale Souveränität zunehmend in den Fokus von Politik, Wirtschaft und Zivilgesellschaft. Spätestens seit dem EuGH-Urteil „Schrems II“ und mit neuen Regulierungen wie DSGVO, NIS2 oder DORA zeigt sich: Digitale Souveränität ist kein Ideal – sie wird zur Grundvoraussetzung für rechtssicheren Betrieb, Wettbewerbsfähigkeit und verantwortungsvolle Gestaltung der digitalen Zukunft. ## ![Icon: Zwei Personen und ein Fragezeichen](https://thecattlecrew.net/wp-content/uploads/2025/05/icon-fragezeichen.svg_.png)Wie sollte nun der Weg nach vorne aussehen? Wege zur Daten- bzw. digitalen Souveränität Hier geht es zu Teil 2 der Blog Serie: [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) --- ## Alle Artikel zum Thema Datensouveränität - [Was bedeutet Digitale Souveränität konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) - [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) - [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) - [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) - [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Kategorien:** Sustainability & Awareness **Schlagwörter:** Daten, Digitalisierung, Moderne IT, zukunftswirksam --- ### [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) **Published:** August 19, 2025 **Author:** Lienhard Siegmund **Content:** In meinem letzten Blogpost habe ich beleuchtet, [wie sich Cloud-Anbieter auf die wachsenden Anforderungen an Datensouveränität einstellen](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) – von EU-Regelwerken bis zu technischen Schutzmaßnahmen. Doch Souveränität ist keine Dienstleistung, die man einfach „dazu bucht“ – sie beginnt im eigenen Haus. In diesem Artikel zeige ich, wie Unternehmen ihre Cloud-Architektur aktiv gestalten können, um Kontrolle über sensible Daten zurückzugewinnen. Sechs konkrete Stellschrauben helfen dabei, aus regulatorischem Druck unternehmerische Handlungsfähigkeit zu machen – pragmatisch, wirksam und individuell skalierbar. Denn: Wer souverän handeln will, muss wissen, wo er steht – und welche Entscheidungen ihn wirklich weiterbringen. ## 6 Stellschrauben für mehr Datensouveränität in der Cloud Was können Unternehmen also konkret tun? Sechs Stellschrauben helfen, mehr Kontrolle über die eigenen Daten zu gewinnen: 1. **Regionale Datenhaltung:** Durch Speicherung und Verarbeitung in europäischen Rechenzentren wird die Schwelle für außer-europäische Behördenzugriffe erhöht und Transparenz über die Datenflüsse geschaffen. 2. **Eigene Verschlüsselung & Schlüsselverwaltung:** Stichwort „Bring Your Own Key“ oder „Customer Managed Keys“. Damit behalten Unternehmen die Hoheit über ihre sensiblen Daten – selbst in der Public Cloud. Wichtig ist: Nicht nur verschlüsseln – sondern auch selbst kontrollieren, wer Zugriff auf die Schlüssel hat 3. **Sovereign- oder Trusted-Cloud-Angebote prüfen:** Entweder ich bleibe beim Hyperscaler und nutze dessen Sovereign-Angebot mit europäischem Betrieb und Schlüsselhoheit – oder ich gehe direkt zu einem europäischen Anbieter, der zu 100?% im EU-Rechtsraum agiert. Beides sind Optionen – mit unterschiedlichem Souveränitätsgrad und je nach Risikoabwägung sinnvoll. 4. **Hybride und segmentierte Cloud-Architektur:** Wer nicht alles auf eine Karte setzen will, sollte die Architektur flexibel gestalten: Zum Beispiel bestimmte Daten On-Prem betreiben, andere in der EU-Cloud hosten – oder Dienste so bauen, dass sie portierbar bleiben. 5. **Offene Standards & Open Source:** Technische Souveränität hängt auch davon ab, wie stark ich von proprietären Lösungen abhängig bin. Offenen Standards wie z.?B. bei APIs, Datenformaten, Deployment-Tools mit Technologien wie z.B. Kubernetes, Terraform usw, helfen dabei enorm – damit kann ich leichter wechseln und behalte länger die Kontrolle. 6. **Governance & Compliance aktiv leben:** Ohne Governance bleibt alles Theorie. Policies, Rollen, Audit-Mechanismen – all das muss definiert und gelebt werden. Viele Cloud-Plattformen stellen diese Governance-Tools bereits bereit – entscheidend ist, sie gezielt zu konfigurieren und regelmäßig zu nutzen. ![6 Kennzahlen für mehr Souveränität in der Cloud: Cloud-Stadnorte in EU/DE, Eigene Schlüssel und Verschlüsselung, Sovereign/Trusted Cloud-Angebote, Hybride / Multi-Cloud-Modelle, Offene Standards & Open Source Stacks, Governance & Compliance Framework](https://thecattlecrew.net/wp-content/uploads/2025/07/cattle-crew-datensouveraenitaet-04_grafik1-scaled.png) ## Datensouveränität messbar machen: Reifegrad statt Bauchgefühl Wie können wir aus dem Thema Datensouveränität etwas Handfestes machen? Etwas, das man messen, vergleichen und verbessern kann? Der erste Schritt dahin: Klarheit über den eigenen Reifegrad. Denn oft ist die Cloud-Nutzung längst Realität – mal strategisch geplant, mal eher historisch gewachsen. Manche Systeme laufen produktiv, andere stehen noch auf der Roadmap. Doch egal wo Sie stehen: Um gezielt zu handeln, müssen Sie zuerst wissen, wo Sie anfangen sollten. Und genau dabei helfen Kennzahlen. Keine graue Tabelle, sondern ein pragmatischer Blick auf sechs zentrale Bereiche, die zeigen, wie souverän Ihre Cloud-Infrastruktur wirklich ist. **Ihr Fragenkatalog könnte zum Beispiel so aussehen:** - Wissen Sie, wo Ihre Daten tatsächlich gespeichert sind – und steuern Sie dies aktiv? - Sind Ihre Daten verschlüsselt – und liegt der Schlüssel auch wirklich in Ihrer Hand? - Haben Sie definiert, was schützenswert ist – und wie Sie damit umgehen? - Und ganz konkret: Wenn morgen ein Prüfer kommt – haben Sie die passenden Verträge, Nachweise und Protokolle parat? Hilfreich sind konkrete Kennzahlen – von Verschlüsselung bis Vertragstransparenz. Einige Punkte kennen Sie vielleicht schon aus dem vorherigen Kapitel. Aber jetzt geht es ums Ganze: ## Wie gut sind Sie wirklich aufgestellt – und was fehlt noch, um souverän zu handeln? Die folgende Grafik zeigt die wichtigsten Kennzahlen, die dabei helfen, ein klareres Bild vom eigenen aktuellen Stand zu bekommen – jenseits von Bauchgefühl oder Einzelmaßnahmen. Sie zeigen, wo bereits gute Grundlagen bestehen und wo gezielt nachgebessert werden kann.![Das Diagramm zeigt diese 6 Kennzahlen: 1. Verschlüsselungsquote, 2. Datenlokalisationsklarheit, 3. Exitfähigkeit, 4. Zugriffstransparenz, 5 Datenklassifizierungsquote und 6. Vertragsklarheit](https://thecattlecrew.net/wp-content/uploads/2025/07/cattle-crew-datensouveraenitaet-04_grafik2-2-scaled.png) ## Datensouveränität ist kein One-Size-Fits-All Natürlich gilt dabei: Souveränität ist keine Einheitsgröße. Was für das eine Unternehmen essenziell ist, kann für ein anderes überdimensioniert sein. Die passenden Maßnahmen hängen stark vom Geschäftsmodell, den Datenarten und den regulatorischen Anforderungen ab. Ob Bank, HealthTech-Start-up oder Maschinenbauer – jedes Unternehmen muss seinen eigenen Souveränitätsgrad definieren. Deshalb lohnt sich der Blick auf konkrete Beispiele: Die **Deutsche Bank** etwa nutzt längst Cloud-Dienste – beispielsweise Google Cloud für Datenanalysen. Aber eben nicht für kritische Kernsysteme wie Zahlungsverkehr oder Risikosteuerung. Hier gelten strenge Anforderungen der BaFin: klare Exit-Strategien, Datenlokalisierung in der EU und maximale Transparenz. Im Gesundheitsbereich ist **Ada Health** ein spannendes Beispiel. Das Berliner Start-up entwickelt eine KI zur medizinischen Symptomanalyse – und speichert alle sensiblen Daten verschlüsselt in der Google Cloud, ausschließlich in einem belgischen Rechenzentrum. Die sensiblen Gesundheitsdaten sind logisch dabei getrennt von personenbezogenen Informationen – ein interessantes Beispiel für Privacy by Design in der Anwendung. Und im Maschinenbau? Da geht es seltener um personenbezogene Daten, dafür aber oft um hochsensible Konstruktions- und Produktionsdaten. Unternehmen wie **Trumpf** oder **Bosch** setzen auf Cloud-basierte Predictive-Maintenance-Lösungen – lassen aber ihre CAD-Pläne lieber im eigenen Rechenzentrum. Der Fokus liegt hier auf technischer Kontrolle und Exit-Fähigkeit, nicht auf juristischer Isolierung. Der gemeinsame Nenner? Bewusste Architekturentscheidungen und eine klare Risikoabwägung. Souveränität bedeutet nicht, alles abzusichern – sondern zu wissen, was gesichert werden muss. ## Fazit: Souveränität ist eine bewusste Entscheidung – keine technische Konfiguration Ob globaler Konzern, Mittelständler oder Behörde – wer die Cloud nutzt, steht heute in der Verantwortung, Datensouveränität aktiv zu gestalten. Das gelingt nicht durch Einzellösungen, sondern durch ein ganzheitliches Verständnis von Risiken, Schutzbedarf und Verantwortlichkeiten. Die vorgestellten sechs Stellschrauben bieten dafür einen praktischen Rahmen: Sie helfen dabei, technische, organisatorische und juristische Aspekte sinnvoll miteinander zu verzahnen – und die eigene Cloud-Nutzung auf ein tragfähiges Fundament zu stellen. Denn letztlich ist Datensouveränität kein Zustand, sondern ein kontinuierlicher Prozess – und der beginnt mit einer ehrlichen Bestandsaufnahme. Nutzen Sie die Chance, Ihre Architektur bewusst weiterzuentwickeln – Schritt für Schritt, mit klarer Zielsetzung. --- ## Alle Artikel zum Thema Datensouveränität - [Was bedeutet Digitale Souveränität konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) - [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) - [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) - [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) - [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Kategorien:** Development, IT-Security --- ### [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) **Published:** Juli 31, 2025 **Author:** Lienhard Siegmund **Content:** Cloud ist kein Neuland mehr – sie ist Realität. Für Start-ups wie für Mittelständler, für Konzerne ebenso wie für Behörden. Und doch drängt sich in der Praxis immer öfter eine unbequeme Frage auf: Haben wir die Kontrolle über unsere Daten wirklich behalten? Im letzten Beitrag dieser losen Blogserie zur Digitalen Souveränität haben wir den Begriff Datensouveränität entschlüsselt und ihn von Datensicherheit und digitaler Souveränität abgegrenzt. Jetzt gehen wir einen Schritt weiter: Wie lässt sich Datensouveränität in der Praxis erreichen – speziell in der Cloud? Und was bedeutet das im Spannungsfeld zwischen Innovation und Regulierung, zwischen Hyperscalern und EU-Recht? In diesem 3. Teil dieser Serie geht es um Digitale Souveränität in der Cloud und ich richte ich meinen Blick auf die Lieferantenseite. Wie reagieren Hyperscaler und kleinere Cloudanbieter auf die steigenden Ansprüchen und Risiken im Bereich der Digitalen Souveränität? In welchem technischen, politischen und juristischen Spannungsfeld bewegen sie sich? Wie verändern sich ihre Cloud Services und was bedeutet das für uns als Kunden? Fragen, die Unternehmen heute ganz konkret beantworten müssen. ## Warum Unternehmen ihre Cloud-Strategie überdenken müssen Datensouveränität rückt nicht ohne Grund in den Fokus. Politische Unsicherheiten, neue EU-Verordnungen und datenhungrige Technologien wie KI sorgen dafür, dass Unternehmen ihre Cloud-Strategien neu überdenken müssen. - Politisch sorgen CLOUD Act & Co. für Rechtsrisiken – auch ohne physische Datenverlagerung. - Regulatorisch erhöht die EU mit NIS2, dem Data Act und dem Cyber Resilience Act den Druck auf Transparenz und Kontrolle. - Technologisch treiben Cloud und KI den Datenbedarf – und die Fragen nach Standort, Zugriff und Exit-Fähigkeit. Kurz: Die Cloud treibt Innovation – aber nur, wenn Unternehmen die Kontrolle behalten. ## Hyperscaler und Souveränität – ein Widerspruch? Viele Unternehmen setzen auf Hyperscaler wie AWS, Azure oder Google Cloud – und das aus guten Gründen. Die Plattformen bieten bewährte Performance, Innovationskraft, ein breites Service-Ökosystem und schnelle Skalierbarkeit. Doch die Frage bleibt: Ist Datensouveränität mit diesen Anbietern überhaupt möglich? Die Antwort hängt stark von der Zielsetzung des Unternehmens ab – und davon, wie Datensouveränität priorisiert wird. Denn sie lässt sich in drei Bereiche aufteilen: - Technische Unabhängigkeit - Organisatorische Kontrolle - Juristische Absicherung Je nachdem, welche dieser Bereiche für ein Unternehmen im Vordergrund stehen, fällt auch die Bewertung anders aus. **Technisch:** Ja. Hyperscaler bieten mittlerweile umfangreiche Funktionen zur Steuerung und Absicherung: - Datenlokalisierung durch Auswahl von EU-Regionen - Eigene Schlüsselverwaltung (Customer Managed Keys) - Umfangreiche Monitoring- und Governance-Tools **Organisatorisch:** Auch Exit-Strategien und eine klare Datenklassifikation lassen sich technisch und prozessual umsetzen – durch definierte Migrationsprozesse, Richtlinien für Datenkategorien und klare Verantwortlichkeiten im Datenmanagement. **Juristisch** wird’s knifflig. Der US CLOUD Act erlaubt US-Behörden theoretisch den Zugriff auf Daten – auch wenn diese in Rechenzentren innerhalb der EU liegen, solange der Anbieter seinen Hauptsitz in den USA hat. Das zwingt Unternehmen zur ehrlichen Abwägung: Wie viel Kontrolle brauche ich – und welches Risiko bin ich bereit einzugehen? Die großen Cloud-Anbieter versuchen, dieses Spannungsfeld zu entschärfen. Sie integrieren längst EU-Standardvertragsklauseln in ihre Verträge, veröffentlichen Transparenzberichte und geben Schutzversprechen wie Microsofts „Defending Your Data“ oder das AWS GDPR Addendum, in denen sie sich verpflichten, Behördenanfragen anzufechten und ihre Kunden zu informieren. Zusätzlich entstehen Sovereign-Cloud-Angebote in Kooperation mit europäischen Partnern oder über separate Tochtergesellschaften, die das EU-Geschäft rechtlich und organisatorisch klar vom US-Konzern trennen sollen. Diese Maßnahmen ersetzen zwar keine juristische Unabhängigkeit, sie wirken aber wie ein Puffer: Sie verschaffen technische Kontrolle über Daten und Schlüssel, rechtliche Absicherung durch klar geregelte Verträge – und sie machen Zugriffe von außen deutlich schwerer. Das Restrisiko bleibt, aber es wird kleiner. Für viele Unternehmen ist genau das der Unterschied zwischen unsicher und tragbar. Was das für Unternehmen konkret bedeutet – und welche Stellschrauben sie selbst in der Hand haben – beleuchte ich im nächsten Teil dieser Serie. ## Neue Verantwortung für Cloud-Anbieter durch EU-Regulierungen Lange galten Cloud-Anbieter primär als Technologielieferanten: Sie lieferten Rechenleistung, Speicher und Services – um Datenschutz und Compliance musste sich der Kunde selbst kümmern. Doch diese Zeiten sind vorbei. Mit Regulierungen wie der DSGVO, NIS2, dem Cyber Resilience Act und dem neuen EU Data Act verändert sich das Kräfteverhältnis. Cloud-Anbieter geraten stärker in die Verantwortung. Sie müssen nicht nur performante, sondern auch rechtskonforme und vertrauenswürdige Plattformen bereitstellen. Und die großen Player reagieren: AWS, Microsoft und Google investieren massiv in Sovereign-Cloud-Angebote, europäische Datenräume und Partnerschaften mit EU-Anbietern wie T-Systems oder Thales. Datenlokalisierung, Schlüsselhoheit, Audit-Funktionen und Governance-Tools gehören zunehmend zum Standard – nicht nur für Behörden, sondern auch für den Mittelstand. Gleichzeitig positionieren sich europäische Anbieter wie STACKIT oder OVHcloud offensiv mit dem Versprechen: „Unsere Daten unterliegen ausschließlich EU-Recht.“ Gerade bei kritischen Infrastrukturen und sicherheitsbewussten Unternehmen sorgt das für Vertrauen – und damit für ein neues Wettbewerbsumfeld. **Kurz gesagt:** Die Rolle der Cloud-Anbieter verändert sich grundlegend. Wer heute auf Souveränität – technisch wie juristisch – setzt, positioniert sich nicht nur als Dienstleister, sondern als strategischer Partner. Für Unternehmen eröffnet das neue Spielräume – vorausgesetzt, sie wissen, was sie brauchen und worauf sie setzen. Im nächsten Teil dieser Serie betrachten wir die Anwenderseite: Was können Unternehmen konkret tun, um ihre Datensouveränität in der Cloud zu stärken? Welche Strategien, Tools und Partnerschaften helfen dabei? Bleiben Sie dran! --- ## Alle Artikel zum Thema Datensouveränität - [Was bedeutet Digitale Souveränität konkret?](https://thecattlecrew.net/2025/06/11/digitale-souveraenitaet-was-bedeutet-digitale-souveraenitaet-konkret/) - [Wege zur Datensouveränität](https://thecattlecrew.net/2025/07/01/wege-zur-datensouveraenitaet/) - [Datensouveränität & Cloud: Wie kompatibel sind Hyperscaler mit EU-Vorgaben?](https://thecattlecrew.net/2025/07/31/datensouveraenitaet-cloud-wie-kompatibel-sind-hyperscaler-mit-eu-vorgaben/) - [Datensouveränität & Cloud: Sechs Stellschrauben für mehr Kontrolle](https://thecattlecrew.net/2025/08/19/datensouveraenitaet-cloud-sechs-stellschrauben-fuer-mehr-kontrolle/) - [Datensouveränität in der KI-Ära: Warum Datenhoheit das größte Kapital ist](https://thecattlecrew.net/2025/09/02/datensouveraenitaet-in-der-ki-aera-warum-datenhoheit-das-groesste-kapital-ist/) **Kategorien:** Development --- ### [Open Data in Aktion: Mit KI Abwasserdaten analysieren](https://thecattlecrew.net/2025/08/21/open-data-in-aktion-mit-ki-abwasserdaten-analysieren/) **Published:** August 21, 2025 **Author:** Anton Rösemann **Content:** Der Impuls für diesen Artikel kam während eines KI-Tech-Talks bei OPITZ CONSULTING: Ein Kollege demonstrierte, wie sich ChatGPT zur Visualisierung strukturierter Daten einsetzen lässt – ganz ohne Programmierkenntnisse. Für mich als Berater im Public Sector war sofort klar: Das Potenzial für öffentliche Institutionen ist enorm – gerade, wenn man bedenkt, wie viele spannende Open-Data-Quellen heute schon existieren. In mehreren aktuellen Projekten arbeiten wir mit Abwasserdaten, teilweise auf Basis offener Daten. ([-> Kundenstory Berliner Wasserbetriebe](https://www.opitz-consulting.com/kompetenz/kundenstory-berliner-wasserbetriebe)) Ein perfektes Umfeld also, um die Möglichkeiten der dialogbasierten Datenanalyse mit ChatGPT-5 auszuprobieren – konkret anhand der Daten aus dem AMELAG-Projekt, einer vom RKI betriebenen Abwassersurveillance. ## Warum Abwasser ein Frühindikator ist Abwasserdaten sind viel mehr als technisches Beiwerk. Während der Corona-Pandemie zeigte sich, dass steigende Viruslasten im Abwasser oft Vorboten regionaler Infektionswellen waren – teils mehrere Tage vor den offiziellen Meldezahlen. Auch die neue **EU-Abwasserrichtlinie (KARL, EU 2024/3019)** erkennt dieses Potenzial und fordert den systematischen Aufbau entsprechender Überwachungsnetze. Das bedeutet: Öffentliche Einrichtungen könnten künftig deutlich schneller auf Gesundheitsentwicklungen reagieren – mit gezielter Personalplanung, Medikamentenlogistik oder Hygieneempfehlungen. Das Thema Abwasseranalyse ist im Public Sektor äußerst relevant und viel mehr als eine technische Spielerei: Während der Corona-Pandemie zeigte sich, dass steigende Viruslasten im Abwasser ein Frühindikator für regionale Ausbrüche sein können. Mit entsprechenden Modellen ließen sich künftig gezielt Hygienemaßnahmen, Medikamentenlieferungen oder andere Gesundheitsinterventionen steuern. Das Potenzial ist also groß – und wird durch die neue Abwasserrichtlinie bereits in wichtigen Teilen adressiert. ## ChatGPT-5 im Datenanalyse-Modus Für unseren Test haben wir ChatGPT-5 im Modus Advanced Data Analysis genutzt. Besonders hilfreich waren dabei: - **Uploadfunktion für Dateien (CSV/TSV)** direkt im Chatfenster - **Kontextbezogenes Prompting**, um gezielte Analysen und Visualisierungen zu steuern - **Erklärende Rückfragen und Ergebnisse**, auch für Nicht-IT-Fachleute verständlich Die Grundlage: eine TSV-Datei aus dem AMELAG-Projekt mit Viruslastdaten einzelner Standorte. ## Erste Analysen: Was steckt im Datensatz? Nach dem Upload identifizierte ChatGPT-5 automatisch die vorhandenen Spalten: Standortinformationen, Zeitstempel, Messwerte für SARS-CoV-2, Influenza u. a. Auffällig: In manchen Feldern fehlten bis zu 75 % der Einträge. Statt aufwendiger Vorverarbeitung entschieden wir uns für einen realistischen Blick auf die Rohdaten. Auf eine einfache Frage wie „Welche Bundesländer sind im Datensatz enthalten?“ reagierte das Modell schnell und korrekt mit: „Alle 16 Bundesländer.“ Hier zwei Screenshots: ## ![Screenshot: ChatGPT hat die Datenqualität geprüft und fehlende Werte ermittelt](https://thecattlecrew.net/wp-content/uploads/2025/08/cattle-crew-blog_use-case-abwasser_roesemann_abbildung1-1.png) ## ![Screenshot zeigt Ergebnisse mit einer persönlichen Kommentierung von Chat-GPT](https://thecattlecrew.net/wp-content/uploads/2025/08/cattle-crew-blog_use-case-abwasser_roesemann_abbildung2.png) ## Visualisieren mit Prompts: Iteratives Vorgehen Die eigentliche Stärke von ChatGPT-5 offenbarte sich bei der Visualisierung: 1. Zunächst ließen wir uns eine LOESS-Glättung der Influenza-A-Werte für den Standort Stuttgart anzeigen. 2. ![Grafik zeigt die Kurve der LOESS Glättung an](https://thecattlecrew.net/wp-content/uploads/2025/08/cattle-crew-blog_use-case-abwasser_roesemann_abbildung3.png)Danach ergänzten wir weitere Virusparameter für Influenza, um die Entwicklung im Vergleich darzustellen. ![Grafik zeigt Kurve der LOESS-Vorhersage](https://thecattlecrew.net/wp-content/uploads/2025/08/cattle-crew-blog_use-case-abwasser_roesemann_abbildung4.png) 3. Im nächsten Schritt erweiterten wir den Betrachtungsbereich auf ganz Baden-Württemberg. ![Graik zeigt die Kurve für Baden Württemberg](https://thecattlecrew.net/wp-content/uploads/2025/08/cattle-crew-blog_use-case-abwasser_roesemann_abbildung5.png) 4. Wir wiederholten diesen Ablauf für andere Bundesländer, um Unterschiede und Gemeinsamkeiten zu erkennen. 5. Parallel dazu prüften wir den Datensatz gelegentlich manuell in Excel, um ein Gefühl für die Rohwerte zu bekommen. Die Ergebnisse zeigten saisonale Effekte, auffällige Peaks und Unterschiede zwischen Regionen. Besonders spannend: Aggregationen über mehrere Standorte mit nur einem Prompt. Ein Feature, das ältere Modellversionen so noch nicht beherrschten. **Wichtig:** Bei diesen Versuchen war es wichtig, gezielt festzulegen, welche Werte wir für die Darstellung verwenden – in unserem Fall die LOESS-berechneten Werte, da sie für Vorhersagen besonders aussagekräftig sind. ## Was haben wir daraus gelernt? Die Analyse lieferte eine Reihe von Diagrammen, die interessante Muster aufzeigen: - **Saisonale Effekte:** Im Winter sind die Influenza-Werte erwartungsgemäß höher. - **Auffällige Peaks:** Einzelne Zeitpunkte zeigen ungewöhnlich hohe Messwerte. Solche Peaks könnten bei einer zeitnahen Auswertung als Frühindikatoren dienen, um gezielte Maßnahmen einzuleiten. - **Aggregation nach bestimmten Kriterien:** Ein weiterer Vorteil von ChatGPT-5 ist die Fähigkeit, Daten nach bestimmten Kriterien zu aggregieren – beispielsweise alle Standorte in Baden-Württemberg zusammenzufassen. Solche Aggregationen waren mit demselben Prompt in Modellversion 4.0 in dieser Form noch nicht möglich. ## Wo Behörden profitieren könnten Die Einsatzmöglichkeiten im Public Sector sind vielfältig: Die Fähigkeit zur Mustererkennung im Abwasser bietet nicht nur Potenzial für den Gesundheitsbereich, sondern es sind auch Einsatzmöglichkeiten in ganz anderen Bereichen denkbar, wie zum Beispiel: - **Gesundheitswesen:** Früherkennung und Intervention bei Ausbrüchen - **Bildungseinrichtungen:** Planung von Vertretungsregelungen oder mobilem Unterricht - **Verwaltungen & Infrastruktur:** Flexible Maßnahmenplanung basierend auf Infektionsprognosen Viele dieser Ideen erinnern an die Corona-Zeit– nur, dass wir heute über smartere Tools verfügen, um schneller und präziser zu reagieren. ## Auch für Unternehmen interessant: Monitoring per Abwasseranalyse Was im Public Sector seinen Anfang nimmt, kann auch für privatwirtschaftliche Akteure von Interesse sein – insbesondere dort, wo Betriebssicherheit, Gesundheitsschutz oder Standortsteuerung im Fokus stehen. Denkbar sind zum Beispiel folgende Szenarien: - **Großunternehmen & Produktionsstandorte:** Frühwarnsysteme für saisonale Infektionswellen, um Personalengpässe besser zu planen oder gezielt Schutzmaßnahmen einzuleiten. - **Immobilien- und Facility Management:** Überwachung von Gebäuden oder Liegenschaften mit vielen Nutzer:innen – etwa Wohnanlagen, Pflegeeinrichtungen oder Bürokomplexe. - **Eventbranche & Veranstaltungsorte:** Einsatz temporärer Sensorik zur Risikoabschätzung bei Großveranstaltungen – z.?B. bei Festivals, Messen oder Sportereignissen. - **Kliniken & Laborbetreiber:** Ergänzende Datenquelle für Infektionscontrolling oder zur Validierung eigener Messreihen. - **Logistikzentren & Transportinfrastruktur:** Nutzung zur Entscheidungsvorbereitung bei Personal- oder Routenplanung in Phasen hoher Ausfallgefahr. In vielen dieser Kontexte liegt der Vorteil klar auf der Hand: Die Kombination aus offenen oder lokal erhobenen Daten mit KI-gestützter Analyse ermöglicht flexible, kostenbewusste Entscheidungen – und das ohne den Aufwand komplexer BI-Infrastrukturen. ## Grenzen und klare Empfehlungen Natürlich ersetzt ChatGPT keine professionelle BI-Lösung. Was fehlt: - Interaktive Dashboards - Filtern und Aggregieren per Klick - Kombination mit anderen Datenquellen Und: **Datenschutz bleibt oberstes Gebot.** Der Einsatz sollte auf anonymisierte, offene Datensätze beschränkt bleiben. Für sensible Daten sind On-Premise-Lösungen oder KI-Modelle in geschützten Umgebungen notwendig. ## Fazit: Starkes Tool für erste Einblicke Die Arbeit mit ChatGPT-5 hat gezeigt: Wer Open Data nutzt, kann mit einfachen Prompts fundierte Erkenntnisse gewinnen. Für schnelle, explorative Analysen – insbesondere im Public Sector – ist das Sprachmodell ein hilfreiches Werkzeug. Und vielleicht der perfekte Einstiegspunkt für datengetriebene Entscheidungen in öffentlichen Einrichtungen. Auch außerhalb des Public Sector bieten sich spannende Anwendungsfelder – von Unternehmen mit vielen Mitarbeitenden über das Immobilienmanagement bis hin zu Veranstaltern. KI-gestützte Abwasseranalysen könnten künftig überall dort unterstützen, wo Planungssicherheit gefragt ist. **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** Artificial Intelligence, Business Intelligence, Prompt --- ### [Helm-Charts in Gefahr? Bitnami Images werden kostenpflichtig](https://thecattlecrew.net/2025/08/13/helm-charts-in-gefahr-bitnami-images-werden-kostenpflichtig/) **Published:** August 13, 2025 **Author:** Philipp Kürsten **Content:** Bitnami ist für viele Kubernetes- und Cloud-Teams ein vertrauter Name. Die vorgefertigten Container-Images und Helm-Charts für Anwendungen wie PostgreSQL, Redis oder Keycloak haben es einfach gemacht, Open-Source-Software schnell und zuverlässig in Kubernetes bereitzustellen. Wer eine neue Datenbank oder einen Cache brauchte, konnte bisher darauf vertrauen, dass Bitnami ein getestetes Image und gleich das passende Helm-Chart mitliefert. Doch diese Selbstverständlichkeit steht nun vor einem großen Umbruch: Broadcom, seit der VMware-Übernahme Eigentümer von Bitnami, stellt das bisherige kostenlose Image-Angebot in weiten Teilen ein. ## **Was ändert sich konkret?** Ab dem **28. August 2025** werden ältere und versionierte Bitnami-Images nicht mehr unter der bekannten Registry `docker.io/bitnami` verfügbar sein. Stattdessen wandern sie in ein **„Legacy Repository“**, das keine Sicherheitsupdates mehr erhält. Parallel dazu führt Broadcom die **Bitnami Secure Images** ein: kommerzielle, sicherheitsgehärtete Container-Images, die in einem reproduzierbaren Build-Prozess erstellt werden und mit zusätzlichen Informationen wie SBOMs (Software Bill of Materials) sowie VEX-Daten (Vulnerability Exploitability Exchange) ausgeliefert werden. Diese Images werden langfristig in LTS-Branches gepflegt – allerdings nur im Rahmen eines [kostenpflichtigen Abonnements](https://aws.amazon.com/marketplace/pp/prodview-pwqgz3mnvxvok). Die Helm-Charts selbst bleiben zwar Open Source und unter Apache-2-Lizenz auf GitHub verfügbar, doch sie referenzieren standardmäßig auf Images, die nach dem Stichtag ohne Subscription nicht mehr zugänglich sein könnten. Wer also nach dem 28. August ein `helm upgrade` durchführt, **riskiert fehlschlagende Deployments**. ## **Warum macht Bitnami das?** Broadcom verfolgt seit der Übernahme von VMware eine klar auf Enterprise-Kunden ausgerichtete Strategie. Das Ziel: Kunden in regulierten oder sicherheitskritischen Umgebungen ein vollständig kontrolliertes und überprüftes Container-Ökosystem zu bieten. Bitnami Secure Images (BSI) sollen dabei nicht nur Sicherheit und Compliance garantieren, sondern auch eine stabile Lieferkette mit nachvollziehbaren Builds schaffen. Für Unternehmen, die auf Zertifizierungen und Audits angewiesen sind, ist das attraktiv. Für kleinere Teams oder Open-Source-Projekte hingegen kann die neue Kostenstruktur eine echte Hürde darstellen. ## **Auswirkungen in der Praxis** Die Änderungen treffen nicht nur große Plattform-Teams, sondern auch viele kleinere Projekte: - **Helm-Charts könnten brechen**, wenn die referenzierten Images nicht mehr verfügbar sind. - **CI/CD-Pipelines** riskieren Build-Fehler, wenn `docker pull` nicht mehr funktioniert. - **Sicherheitslücken bleiben offen**, wenn Legacy-Images ohne Updates im Einsatz bleiben. Gerade in produktiven Umgebungen kann das zu Ausfällen oder Compliance-Problemen führen. ## **Handlungsoptionen für Teams** Kurzfristig lässt sich der Betrieb sichern, indem man Helm-Charts so anpasst, dass sie auf das Legacy-Repository zeigen oder benötigte Images in eine eigene Registry spiegelt. Letzteres sorgt für Stabilität, löst aber nicht das Problem fehlender Sicherheitsupdates. Langfristig gibt es drei Ansätze: 1. **Bitnami Secure Images abonnieren** Wer Wert auf Support, Sicherheit und LTS legt, kann die kommerzielle Lösung in Betracht ziehen. Der manuelle Aufwand zur Härtung von Images sollte hierbei nicht unterschätzt werden! 2. **Eigene Images bauen** Dafür können die Open-Source-Helm-Charts geforkt und auf alternative Basis-Images (z. B. Docker Official Images, Chainguard oder Distroless) umgestellt werden. Hierbei ist allerdings zu beachten, dass die Bitnami-Images meisst mehr als nur den reinen Service implementiert hatten. So wurde beispielsweise bei dem PostgreSQL Image auch das entsprechende Seeding von Datenbanken und Nutzern im EntryPoint des Image mit durchgeführt. 3. **Auf Alternativen aus der Community oder vom Hersteller setzen** Viele Anwendungen werden direkt vom Upstream-Projekt als Container-Image gepflegt. Häufig gibt es auch OEM-Helm-Charts oder dedizierte Kubernetes-Operatoren. Wie beispielsweise folgende Projekte beweisen: - Für **PostgreSQL** bietet sich etwa der [cloudnative-pg Operator](https://cloudnative-pg.io/) an, ein CNCF-Projekt, das Installation, Updates, Hochverfügbarkeit und Backups automatisiert. - **Keycloak** lässt sich ebenfalls mit einem [Operatoren von der Community](https://www.keycloak.org/operator/installation) betreiben. - **Redis** lässt sich mit Operatoren wie dem [von Spot.io](https://github.com/spotahome/redis-operator) oder dem Helm-Chart [des Herstellers](https://redis.io/docs/latest/operate/kubernetes/deployment/helm/) betreiben. Der Einsatz von Operatoren hat den Vorteil, dass viele Betriebsaufgaben direkt automatisiert werden und sich die Integration in Kubernetes-Workflows verbessert. Trotzdem ist es auch hier Notwendig eine Auge auf die Härtung der Images zu legen und diese – bei Bedarf – selbstständig nachzubessern. ## **Praktisches Beispiel: PostgreSQL-Deployment anpassen** Damit der Wechsel reibungslos gelingt, lohnt sich ein Blick in die `values.yaml` des Bitnami PostgreSQL Helm-Charts. Hier lassen sich die Image-Quelle und der Tag überschreiben. ### **1. Kurzfristig: Nutzung des Legacy-Repository** ``` image: registry: docker.io repository: bitnamilegacy/postgresql tag: 15.4.0 ``` Das funktioniert nur so lange, wie die benötigte Version im Legacy-Repo liegt – Updates gibt es dort nicht mehr. ### 2. Etwas robuster: Spiegelung in eine eigene Registry ``` # Image aus dem Legacy-Repo ziehen docker pull docker.io/bitnamilegacy/postgresql:15.4.0 # In eigene Registry pushen docker tag docker.io/bitnamilegacy/postgresql:15.4.0 registry.example.com/postgresql:15.4.0 docker push registry.example.com/postgresql:15.4.0 ``` Im Helm-Chart verweist du dann auf deine Registry: ``` image: registry: registry.example.com repository: postgresql tag: 15.4.0 ``` So bist du nicht mehr von Änderungen bei Bitnami abhängig – Updates musst du allerdings selbst einspielen. ### 3. Alternative: Einsatz des cloudnative-pg Operators **Installation des Operators:** `helm repo add cnpg https://cloudnative-pg.github.io/charts` `helm install cnpg cnpg/cloudnative-pg` **Deployment einer PostgreSQL-Instanz via CRD:** ``` apiVersion: postgresql.cnpg.io/v1 kind: Cluster metadata: name: my-postgres spec: instances: 3 imageName: ghcr.io/cloudnative-pg/postgresql:15.4 storage: size: 10Gi ``` Der Operator kümmert sich anschließend um Hochverfügbarkeit, Backups und Updates – ohne dass du manuell ein Helm-Chart anpassen musst. ## **Fazit** Die verbleibende Zeit **bis zum 28. August** sollte genutzt werden, um Klarheit zu schaffen: Welche Bitnami-Images sind im Einsatz? Sind die genutzten Versionen nach dem Stichtag noch zugänglich? Und welche Migrationsstrategie passt zur eigenen Organisation – Secure Images, Eigenbau oder ein Umstieg auf OEM-Charts bzw. Operatoren? **Je eher diese Fragen beantwortet werden, desto reibungsloser kann der Wechsel erfolgen.** Die Umstellung bei Bitnami ist ein deutliches Beispiel dafür, wie schnell sich die Rahmenbedingungen im Open-Source-Ökosystem ändern können – besonders dann, wenn beliebte Projekte in den Besitz großer Konzerne gelangen. Für Betreiber von Kubernetes-Workloads bedeutet das: Nicht allein auf die Bequemlichkeit bestehender Lösungen verlassen, sondern frühzeitig Alternativen evaluieren. Wer jetzt handelt, kann Ausfälle vermeiden und seine Plattform langfristig unabhängiger und resilienter aufstellen. **Kategorien:** Development, DevOps, IT-Security **Schlagwörter:** CI, Deployment, Helm, IT Security, Kubernetes --- ### [Zwischen KI, Governance und Zukunftsvisionen: Das war der Gartner Data & Analytics Summit](https://thecattlecrew.net/2025/06/10/zwischen-ki-governance-und-zukunftsvisionen-das-war-der-gartner-data-analytics-summit/) **Published:** Juni 10, 2025 **Author:** Jens Bleiholder **Excerpt:** Alle paar Jahre lohnt sich der Besuch das Gartner Data & Analytics Summit, um sich in drei 3 Tagen kompakt mit Trends und Themen auseinanderzusetzen. Nicht immer ist alles neu, aber es wird kompakt und sehr gut präsentiert und bietet einen vielfältigen und ganzheitlichen Blick auf die Dinge und wie sie zusammenhängen. Hier nun eine notwendigerweise subjektive Sicht auf spannende und relevante Themen der Konferenz. **Content:** Am 12. bis 14. Mai 2025 war es wieder so weit: Gartner lud Business-Analysten und Datenverantwortliche aus der ganzen Welt zum Gartner Data & Analytics Summit nach London ein. Wir waren zu dritt dabei und freuten uns auf drei Tage geballte Informationen zu den unterschiedlichsten Data-&-Analytics-Themen. Der Gartner Summit findet zu unterschiedlichen Themen jährlich mehrmals an verschiedenen Orten statt. Bei dieser Gelegenheit berichten die Analysten von Gartner über ihre Erkenntnisse und Erfahrungen aus den Gesprächen mit ihren Kundenfirmen weltweit und aus ihrer Forschungsarbeit. Neben den Trends, die sie am Markt wahrnehmen, kann man auf dem Summit aber auch Unternehmen und Produkthersteller näher kennenlernen und sich deren Produkte zeigen lassen. Es war nicht immer leicht, sich aus den über 200 verschiedenen Sessions die spannendste herauszusuchen, da meist fünf oder mehr Sessions parallel stattfanden. Neben den Vorträgen der Gartner Analysten gab es auch viele Projekt- und Produktvorstellungen der fast 100 Aussteller. Hier nun meine notwendigerweise subjektive Sicht auf spannende und relevante Themen der Konferenz. ## Generative KI & Decision Intelligence Wie erwartet war das Thema Künstliche Intelligenz, insbesondere generative KI (GenAI), allgegenwärtig. In den Vorträgen ging es zum einen darum einzuordnen, wie stark diese Technologie zukünftig unsere Arbeit verändern wird (erheblich) und wo sie überall eine Rolle spielen wird (in vielen Bereichen). Zum anderen gab es viele technische Hilfestellungen, wie KI-Projekte angegangen und auch erfolgreich umgesetzt werden können. Zwei von vielen Themenbereichen des Summit möchte ich hier besonders hervorheben: - Wie verbessert KI die Tools, die wir benutzen - Wie treffen wir bessere Entscheidungen, auch mit Hilfe von KI ### Toolunterstützung durch KI Im Bereich Tools geht es um die KI-Unterstützung bei der Erstellung von z. B. Berichten und Datenpipelines. Zwei einfache Beispiele: - Microsoft, das die Copilot-Funktionalitäten in nahezu allen Bereichen integrieren wird, insbesondere zur Verbesserung der Berichtserstellung (z. B. in Power BI) und der Datentransformationen (z. B. in der Data Factory). - Auch Plotly plant die Einführung eines Assistenzsystems, das in der Lage sein soll, natürliche Sprachbefehle zu verstehen und darauf basierend Reporting-Anwendungen zu bauen. GenAI soll uns also dabei helfen, schneller und einfacher zu Ergebnissen zu kommen. Es zeigt sich, dass die Hersteller hier unterschiedlich weit sind, meist aber noch nicht so weit, wie man sich das erhofft. KI-Funktionalität ist bisher häufig nur in Form von Beta-Features umgesetzt, die in den Produkten erst im Laufe des Jahres ausgerollt werden. Generell befindet sich das Thema GenAI im Hype-Zyklus (siehe: ) nach anfänglicher Euphorie nun auf dem Weg ins „Tal der Enttäuschung“, was man an den mittlerweile immer häufiger werdenden Berichte über die Grenzen der Technologie sieht. So musste der Finanzdienstleister Klarna z. B. feststellen, dass seine Idee, seine gesamte Kundenbetreuung auf Chatbots umzustellen, so (noch) nicht funktioniert. Also ruderte er zurück und stellte wieder „echte“ Mitarbeiter:innen für die schwierigen Fälle ein. (siehe: ). Trotz allem war der Grundtenor auf dem Summit aber positiv: Man freut sich auf die neue Welt, in der viele Mitarbeitende enorm von den Möglichkeiten der KI profitieren werden. ### Entscheidungsunterstützung mit KI Der zweite Themenbereich ist die weitergehende Unterstützung und idealerweise auch Automatisierung von Entscheidungen. Schlussendlich wollen wir mit unserer Arbeit im Bereich Data und Analytics ja immer die Fachbereiche bei ihren Entscheidungen unterstützen. Und das in einer Welt, in der einerseits immer mehr und komplexere Entscheidungen getroffen werden müssen und uns auf der anderen Seite immer mehr Daten und Analysetechniken zur Verfügung stehen. Decision Intelligence (siehe: ) versteht sich als Fachgebiet, bei dem es darum geht, den Entscheidungsprozess genauer zu betrachten, zu verstehen und zu verbessern. Die Idee, mit Hilfe von Daten (liefert Data & Analytics) Entscheidungen (trifft der Fachbereich) zu verbessern, ist ja nicht neu, scheint aber schwieriger umzusetzen zu sein als gedacht. Das Thema war gleich in mehreren Vorträgen präsent. Neben Hinweisen wie man es angeht, Entscheidungen zu formalisieren und gezielt zu verbessern, wurde immer wieder das Thema „Wert“ betont: Vielleicht ist es an der Zeit den Begriff „data-driven“ endgültig durch den Begriff „value-driven“ zu ersetzen; denn schließlich wollen wir mit den Daten und Analysemöglichkeiten den Fachbereichen ja zu Entscheidungen verhelfen, die dann einen Mehrwert liefern. Sich etwas methodischer mit der Art und Weise zu beschäftigen, wie Entscheidungen getroffen werden und wie man dies verbessern kann, ist auch deshalb keine schlechte Idee. Hier schließt sich dann auch wieder der Kreis zur (generativen) KI, die als Technologie dabei helfen soll, Entscheidungen besser zu unterstützen und weiter zu automatisieren. ## Data Governance & Data Observability Auch die Themen Data Governance und Data Observability waren beim Gartner Data & Analytics Summit prominent vertreten. Data Observability, unter allen Konferenzthemen vermutlich das neueste – bezeichnet die Fähigkeit, den Zustand von Daten sowie deren Transformationen innerhalb eines Unternehmens kontinuierlich zu überwachen, zu analysieren und nachzuvollziehen. Ziel ist es, frühzeitig Unregelmäßigkeiten zu erkennen, Fehlerquellen zu identifizieren und die Integrität datenbasierter Prozesse sicherzustellen. Im Rahmen des Summit stellten viele Anbieter aus diesem Bereich ihre Tools vor, darunter auch einige, die mir noch nicht bekannt waren. Diese Tools erlauben die Definition von Datenqualitätstests, zeigen Data Lineage an, integrieren dafür Informationen aus anderen Tools, wie ELT-Tools, Reportingools und Datenkatalogen, oder integrieren sich in solche. Die Tools hinterließen einen ersten guten Eindruck und scheinen schon einen guten Reifegrad zu haben. Der Übergang zu Datenkatalogen ist fließend und vermutlich muss man sich die Frage stellen, ob der Einsatz eines eigenen Tools gerechtfertigt ist, oder ob Data Observability nicht einfach Teil der Funktionalität eines Datenkatalogs oder der Datenplattform an sich wird. ### Doppelstrategie Auffällig: Viele Anbieter fahren mittlerweile eine Doppelstrategie und richten ihre Tools sowohl an die Zielgruppe der technischen Nutzer, als auch an Nutzer aus den Fachbereichen. Einerseits sollen damit beide Gruppen in die Lage versetzt werden Datenqualitätschecks o. ä. zu definieren, andererseits soll die Zusammenarbeit gestärkt werden, indem sie z. B. toolgestützt gemeinsam Datenprodukte oder -kontrakte definieren können. Hier kann man dann auch wieder den Bogen zum Thema KI schlagen: GenAI kann hier an der Schnittstelle zwischen Technik und Business übersetzen und die Zusammenarbeit verbessern. In natürlicher Sprache vom Fachbereich beschriebene Tests, Produkte, Kontrakte, etc. übersetzt die KI in Programmcode, genauso wie von der Technik geschriebener Code in SQL, Python, etc. in natürliche Sprache übersetzt werden kann. ## Datenarchitekturen & Organisationen Was Datenarchitekturen angeht, fiel vor allem dies auf: Vor 5-10 Jahren gab es beim Gartner Summit noch viele Vorträge über die Unterschiede zwischen Data Lake und Data Warehouse und unter welchen Umständen was zu verwenden ist. Jetzt ging es dagegen eher um die Frage, wie man die Konzepte Data Fabric und Data Mesh voneinander abgrenzen kann und wie man diese einsetzt. Der Fokus hat sich mit der Zeit also von der Technik in Richtung Organisation verschoben. Generell scheint auch die Zeit der unerbittlichen Debatten vorbei zu sein (wenn es sie denn je gegeben hat…!?): - Lake oder Warehouse? – Egal, beides koexistiert und erfüllt seinen Zweck! - Fabric oder Mesh? – Kann man nicht so richtig vergleichen, beides koexistiert, oder beides wird nicht genutzt. - Zentral oder dezentral organisiert? In der IT oder im Fachbereich angesiedelt? – Man benötigt jeweils beides, je nachdem. Aus dem gefühlten Entweder-oder hat sich ein entspanntes Sowohl-als-auch ergeben, was ich sehr begrüßenswert finde. ### Neue Teamorganisation Mit der Zeit ändern sich nicht nur Architekturen, sondern auch Teamorganisationen und Rollen. Gartner berichtet hier in einigen Vorträgen, wie die durchschnittliche Teamgröße der Data-&-Analytics-Funktionen in Unternehmen in Abhängigkeit von Umsatz oder Gesamtmitarbeiterzahl derzeit aussieht. Aber auch über beobachtete prozentuale Verteilungen von Data-&-Analytics-Rollen: - Die klassischen Rollen wie Data Engineer, Data Analyst, Data Architect und Data Scientist dominieren weiterhin und machen fast 60 % aus. - Neuere Rollen wie Model Validator oder AI Product Manager zeigen die wachsende Bedeutung von KI. - Spannend sind auch neue Rollen an der Grenze zwischen Technik und Fachbereich wie z.B. der Data Translator. Der Data Translator soll als Rolle zwischen Technik und Fachbereich übersetzen, die Transformation vorantreiben, sich um die Themen Data Literacy und Data Culture kümmern und generell das Thema Data & Analytics voranbringen. Solche Zahlen und Trends sind spannend und können als grobe Anhaltspunkte für die Größe und Aufgabenspektren seiner eigenen Data & Analytics Organisation dienen. Allerdings lassen sie auch die jeweiligen Eigenarten der eigenen Organisation außer Acht und haben vermutlich noch nicht die Einflüsse von KI mit eingepreist. ## Fazit Alle paar Jahre lohnt sich der Besuch das Gartner Data & Analytics Summit, um sich in drei Tagen kompakt mit den aktuellen Trends und Themen auseinanderzusetzen. Nicht immer ist alles neu, aber es wird kompakt und sehr gut präsentiert und bietet einen vielfältigen und ganzheitlichen Blick auf die Dinge, und wie sie zusammenhängen. Natürlich darf man nicht vergessen, dass alles durch die Gartner-Brille präsentiert wird. Es darf also immer hinterfragt werden, inwieweit der deutsche Markt und die eigene Organisation nicht doch ein wenig anders tickt als der Rest der Welt. Neben den Vorträgen war auch die Vielzahl der Aussteller beeindruckend und bot einen guten Überblick über die derzeitige Anwendungslandschaft. **Kategorien:** AI & Data Science, Analytics & Insights, Tech Events & Networking **Schlagwörter:** Analytics, Artificial Intelligence, Conference, Data, Data Governance, Data Observability, data science, Datenarchitekturen, Gartner, Konferenz, Summit --- ### [ACP-120 Erfahrungsbericht: Vom YouTube-Kurs zum Zertifikat](https://thecattlecrew.net/2025/06/17/acp-120-erfahrungsbericht-vom-youtube-kurs-zum-zertifikat/) **Published:** Juni 17, 2025 **Author:** Mateusz Mis **Content:** Für alle, die sich gerade fragen, worum es hier überhaupt geht: ACP-120 ist die Zertifizierung für erfahrene Jira-Administratoren – offiziell nennt sich das Ganze **Atlassian Certified Cloud JIRA Administration**. Der Test richtet sich eigentlich an Profis, die mehrere Jahre tief in der Administration von Confluence und JIRA unterwegs sind. Leute, die Space Permissions im Schlaf konfigurieren und User Management mit verbundenen Augen erledigen. Kurz: eine Liga für sich. Und dann – na ja… dann komme ich 😀 Ein Frischling mit großen Plänen. Keine jahrelange Berufserfahrung, keine tägliche Administration komplexer Instanzen. Nur Motivation, eine Portion Wahnsinn – und das unerschütterliche Vorhaben, mit einer metaphorischen Gabel gegen Windmühlen zu kämpfen. Oder eben mit einem veralteten YouTube-Kurs gegen einen Zertifizierungstest auf Expertenniveau. ## **Die Vorbereitung – zwischen Selbstzweifel und Copy-Paste-Taktik** Es begann, wie viele Lernreisen anfangen: chaotisch. Ein halbstaubiger YouTube-Kurs, irgendwo aus der Vor-Migration-Ära, ein paar Mock-Tests auf Udemy (mal hilfreich, mal fragwürdig), und Artikel aus der Atlassian-Dokumentation, die wahrscheinlich zuletzt aktualisiert wurden, als Confluence noch ein Teenager war 😐 Das Fundament war also wackelig, aber ich hatte zwei Ass im Ärmel: Regelmäßigkeit und Sturheit. Kein Tag ohne Lernen. Kein Thema zu trocken. Permissions? Her damit. Schemes? Los geht’s. Ich klickte, las, testete – und machte Fehler. Viele. Aber ich machte sie konsequent, und das zählt. ## **Der Endspurt – aka Tag vor dem Examen** Der letzte Tag glich einem Trainingslager. Vier komplette Mock-Exams, eins nach dem anderen. Kaffee, Schweiß und ein Kopf voller Shortcuts. Danach die härteste Disziplin: Fehleranalyse. Nicht nur „was war falsch?“, sondern „warum war’s falsch?“. Und wie kann ich das in 60 Sekunden erkennen, wenn’s drauf ankommt? Die Synapsen glühten, die Konzentration hielt – und die Hoffnung wuchs. ## **Der Tag X – mit Sicherheitscheck und Nervenflattern** Am Prüfungstag: Wiederholung bis zur letzten Sekunde. Frühstück? Vielleicht. Erinnerungen daran? Keine. Ich war voll im Tunnel. Dann der Prüfungsstart – und das bedeutete: Willkommen im digitalen Hochsicherheitstrakt. Bevor ich auch nur *eine* Frage sehen durfte, wurde ich dazu aufgefordert, den Raum in unserem Büro zu scannen: Wände, Boden, Decke, Handgelenke, Ohren – ja, sogar unter den Schreibtisch musste ich filmen. Ich durfte nicht murmeln, nicht mit den Lippen bewegen – und mein Gesicht wurde so intensiv beobachtet wie beim Lügendetektortest. Ganz großes Kino. Der Test selbst? Anspruchsvoll. Technisch, kontextbezogen, mit Zeitdruck. Die Fragen hatten nicht mal eine Antwort, sondern manchmal zwei bis vier. Nach der ersten Runde hatte ich alle Fragen beantwortet – aber innerlich war ich ein Fragezeichen auf zwei Beinen. Also: alles noch mal durchgehen. Prüfen, vergleichen, neu bewerten. ## **Und dann kam das WLAN (absolute cinema)** Zehn Minuten vor dem Ende, ich hatte gerade die letzte Antwort überprüft – *plötzlich friert alles ein*. Eine Fehlermeldung: “WLAN Qualität ist zu schwach.“ Ich sehe meinen Bildschirm, aber niemand sieht mehr mich. Vorsichtshalber klicke ich auf “OK” und schreibe auf dem Live-Chat, dass ich eine seltsame Fehlermeldung bekommen habe und ob der Test noch läuft. Auf einmal, ohne ein Wort, schließt sich alles von selbst – der Prüfer beendet die Sitzung. Mein Herz setzt aus. Meine Hände schwitzen. Ich starre auf die Anzeige wie auf einen Krimi-Finale. Schnell wieder eingeloggt. Hoffnungslos. Sicherheitsprüfung von vorn: Raum, Handgelenke, Ohren – ich hätte fast noch die Socken gezeigt, wenn es geholfen hätte 😀 Dann endlich: Ich darf wieder rein. Meine Antworten sind noch da. Noch 10 Minuten, um die restlichen Antworten zu prüfen – jede Sekunde mit dem Gedanken, dass gleich wieder alles unterbrochen werden kann – das würden meine Nerven nicht mehr aushalten, die des Prüfers wahrscheinlich auch. Ein letzter Klick. Und das Ergebnis – scrollen, scrollen – WO SIND DIE ERGEBNISSE, ah, ja, hier, am Ende. Bestanden. 😮 ## **Fazit und Ausblick** Ich bin zwar kein Veteran der Jira Cloud-Administration, aber ich habe bewiesen, dass Ausdauer, Selbstdisziplin und Lernbereitschaft selbst die höchsten Hürden überwinden können. ACP-120 war kein Test – es war ein Statement. Und das ist erst der Anfang. Ich bin bereit für mehr. Mehr Wissen. Mehr Zertifikate. Mehr Herausforderungen. Der Mond ist nicht genug – jetzt geht’s zu den Sternen <3 **Kategorien:** Cloud, Tools & Methoden **Schlagwörter:** Administration, cloud, German, HowTo, Projektmanagement, zukunftswirksam --- ### [Bessere KI-Prompts erstellen – mit dem Prompt Engineering Maturity Model](https://thecattlecrew.net/2025/05/22/prompt-engineering-maturity-model-bessere-ki-prompts-erstellen/) **Published:** Mai 22, 2025 **Author:** Falk Schramm **Content:** # Was ist Prompt Engineering und warum ist es interessant? Künstliche Intelligenz ist derzeit in aller Munde. Jeder spricht über LLMs (Large Language Models) und die nahezu unbegrenzten Möglichkeiten, die sich damit eröffnen – von kreativen Texten, Zusammenfassungen langer Dokumente, künstlerischen Bildern bis hin zu vollständigen Reiseplänen. Das Potenzial scheint nur durch unsere Fantasie begrenzt. Sobald es jedoch an die konkrete Nutzung von KI-Tools geht, fällt schnell ein Begriff: **Prompt**. Einfach gesagt sind Prompts die Anweisungen, die einem KI-System gegeben werden, um ein gewünschtes Ergebnis zu erzielen. Wer sich intensiver mit der Materie beschäftigt, stellt fest: **Prompt Engineering** ist mehr als nur ein paar geschriebene Zeilen – es wird teils sogar als Tätigkeit von Datenanalysten und Software-Entwicklern betrachtet. Aber was steckt wirklich dahinter? In Gesprächen mit Freunden und Kolleg:innen haben wir festgestellt, dass neben der Begeisterung über KI auch Frust über unklare oder enttäuschende Ergebnisse mitschwingt. Häufig liegt das am Prompt selbst – der lässt sich in vielen Fällen nämlich verbessern. In diesem Beitrag möchten wir unsere Beobachtungen und Erfahrungen in einem **Prompt Engineering Maturity Model (PEMM)** zusammenfassen. Ziel ist es insbesondere, Perspektiven aufzuzeigen, wie du deine Prompts systematisch optimieren kannst, um auf deine Fragestellungen bessere Antworten zu erhalten. # Überblick: Das Prompt Engineering Maturity Model (PEMM) Unser Reifegradmodell umfasst vier Stufen, die wir im Folgenden vorstellen. In den darauffolgenden Abschnitten beschreiben wir jede Stufe ausführlich und zeigen konkrete Prompt-Beispiele. 1. **Ad-hoc-Prompts**: Einstieg ohne Systematik. Die Prompts sind spontan, kurz und unstrukturiert. 2. **Wiederholbare Prompts**: Erste Systematik. Du beginnst zu verstehen, was effektive Prompts ausmacht. Deine Prompts werden allmählich etwas länger. 3. **Standardisierte Prompts**: Du entwickelst eine persönliche Methodik und nutzt strukturierte Templates zum Schreiben von Prompts. Du erhältst verlässlich gute Ergebnisse bei komplexeren Fragestellungen. 4. **Datengetriebene Prompts**: Du misst und optimierst systematisch die Wirksamkeit deiner Prompts mit Metriken. In dieser Ausprägung ist das Schreiben von Prompts mit Softwareentwicklung vergleichbar. Es geht nicht darum, jeden Prompt auf der höchsten Reifegradstufe zu formulieren. Entscheidend ist allein, dass der Prompt ein zufriedenstellendes Ergebnis für deine konkrete Fragestellung liefert. ## ![Icon: Mauersteine](https://thecattlecrew.net/wp-content/uploads/2025/05/icon-mauersteine.png)Stufe 1: Ad-hoc-Prompts – spontane Fragen, schnelle Antworten ![Illustration im Comic-Style: Junge Frau arbeitet an einem Touchscree, Bots applaudieren](https://thecattlecrew.net/wp-content/uploads/2025/05/cattle-crew-pemm_level1-300x300.jpg)Diese erste Stufe kennzeichnet den typischen Einstieg. Die Prompts sind oft nur ein oder zwei Sätze lang und entstehen spontan – etwa im Online-Meeting oder bei einer schnellen Recherche. **Beispiele:** - *Was ist ein ATS?* - *Wie oft wurde Donald Trump zum US-Präsidenten gewählt?* - *Wer ist reicher: Iron Man oder Batman?* - *Bitte nenne mir fünf Gründe, warum ich einen Blogartikel schreiben sollte.* Die Ergebnisse solcher Prompts sind nicht immer korrekt; kleine Tippfehler können große Auswirkungen haben: Vielleicht sollte im ersten Beispiel nach einem ATM gefragt werden? Im zweiten Beispiel kennen viele Modelle nur die erste Amtszeit von Donald Trump. Das liegt daran, dass die Trainingsdaten für ein LLM nur bis zu einem bestimmten Zeitpunkt reichen. Die Antworten auf Wissensfragen sollten daher immer sorgfältig geprüft werden. Solche kurzen Prompts eignen sich für schnelle und generische Anfragen, Brainstorming oder auch Smalltalk-Fragen – nach der „Fictional 15“-Liste von Forbes ist Tony Stark übrigens etwas reicher als Bruce Wayne. Eine weitere Beschränkung besteht darin, dass die Kontrolle über Länge und Form der Antwort begrenzt ist. Das LLM schöpft ohne Einschränkung aus seinem gesamten Wissen. Für kreative Zwecke mag dies gut funktionieren, für konkretere Fragestellungen ist dagegen mehr Kontrolle sinnvoll. Übrigens: Unabhängig davon, ob du mit ChatGPT, Gemini, Claude oder einem anderen LLMs arbeitest, funktionieren die dargestellten Methoden bei allen Modellen. ## ![Icon: Mauersteine](https://thecattlecrew.net/wp-content/uploads/2025/05/icon-mauersteine.png)Stufe 2: Wiederholbare Prompts – erste Struktur und Kontrolle ![Illustration im Comic-Style: Man arbeitet an Virtuellem Monitor. Bots beobachten ihn.](https://thecattlecrew.net/wp-content/uploads/2025/05/cattle-crew-pemm_level2-300x300.jpg)Wer öfter mit LLMs arbeitet, wünscht sich bald mehr Kontrolle über Inhalt, Form und Länge der Antwort – ein erster Schritt beim Schreiben strukturierter Prompts. **Beispiele:** - *Erstelle eine Liste mit fünf negativen Eigenschaften von Superman und illustriere sie jeweils mit einem Beispiel. Die Liste soll prägnant sein und keine weitere Erklärungen enthalten.* - *Bitte erzeuge eine Liste der zehn reichsten fiktiven Figuren, ihrem geschätzten Vermögen und dem Erfinder der Figur. Die Liste soll im JSON-Format erstellt werden.* Die Formulierung von expliziten Anforderungen an die Ausgabe ist der Einstieg in das strukturierte Schreiben von Prompts. Auch einfache Kontextangaben verbessern die Ergebnisse deutlich: - *Ich moderiere einen Kurs für Hobbymaler. Bitte generiere 10 Bildideen, basierend auf berühmten Kunstwerken.* - *Ich möchte einen Webserver unter Linux aufsetzen. Leider bin ich sehr unerfahren mit Linux. Erstelle mir bitte eine Schritt-für-Schritt Anleitung, wie ich einen Webserver mit Linux aufsetzen kann.* Das Beispiel zum Aufsetzen eines Webservers zeigt deutlich die Grenzen solcher Prompts bei komplexen Fragestellungen: Wir haben das Beispiel auf verschiedenen LLMs ausprobiert. Am Ende kam zwar immer irgendwie ein Webserver heraus, aber für echte Anfänger wären die Erklärungen nicht ausreichend gewesen; teilweise wurden zusätzlich Datenbanken oder Programmiersprachen installiert etc. Als ein echter Booster für bessere Antworten hat sich „Role Play“ herausgestellt. Hier wird dem LLM eine Rolle zugewiesen. Probiere mal diese beiden Prompts aus: - *Du bist ein erfahrener Lehrer für Programmierung mit Java. Bitte zeige und erkläre mir ein „Hello World“ Programm.* - *Du bist ein ironischer Freund und Technikfreak. Bitte zeige und erkläre mir ein „Hello World“ Programm.* Je komplexer und spezifischer eine Fragestellung ist, desto genauer muss der Prompt formuliert sein. Für präzise und konsistente Ergebnisse ist ein systematischer Ansatz notwendig – willkommen auf der nächsten Stufe. ## ![Icon: Mauersteine](https://thecattlecrew.net/wp-content/uploads/2025/05/icon-mauersteine.png)Stufe 3: Standardisierte Prompts – Methode statt Zufall ![Illustration im Comic-Style: Junger Mann arbeitet an Rechnern im industriellen Umfeld, Bots und Maschinen unterstützen ihn.](https://thecattlecrew.net/wp-content/uploads/2025/05/cattle-crew-pemm_level3-300x300.jpg)Mit wachsender Erfahrung entwickelst du eine eigene Methodik für die Erstellung effektiver Prompts. Ziel ist immer die zuverlässige Generierung qualitativ hochwertiger Ergebnisse. ### A. Struktur mit Prompt-Templates Ein bewährter Ansatz ist die Verwendung von Templates. Es gibt sehr viele Prompt-Templates, die für unterschiedliche Fragestellungen entwickelt wurden. Um sich inspirieren zu lassen reicht schon eine einfache Suche nach *Prompt Templates*. Das Ausprobieren (und Lernen!) von neuen Templates macht Spaß und vertieft dein Verständnis von Prompts. Ein vielseitig und allgemein nutzbares Template ist **RTCF** (Role – Task – Context – Format). Das Beispiel zeigt den Aufbau des Prompts. **Aufbau eines RTCF-Prompts:** ``` Role: – Du bist ein erfahrener Marketingspezialist. – Du berätst deine Nutzer zu Unternehmenswebseiten. Task: – Hier steht eine Beschreibung der konkreten Aufgabe. – Jede Teilaufgabe erhält einen eigenen Aufzählungspunkt. Context: – Deine Nutzer arbeiten in kleinen Unternehmen. Format: – Kurz, prägnant, vorzugsweise Listenform. – Du präsentierst Ergebnisse ohne Erklärungen. ``` Ideen für eigene Versuche: Probiere RTCF-Prompts mit verschiedenen Themen aus. Variiere, wie knapp oder wie ausführlich die Angaben in den einzelnen Abschnitten formuliert sind. ### B. Tools zur Prompt-Erstellung Viele Standard-UIs von Chatbots bieten keine gute Unterstützung für längere Prompts. Es lohnt sich daher, einen Editor (oder ein ähnliches Tool) zum Schreiben von Prompts zu nutzen. Den fertigen Prompt kopierst du dann auf einen Schlag in den Chatbot. Ein Editor macht es leichter, umfangreiche eigene Inhalte in den Prompt zu integrieren. Denke etwa an die stichwortartige Mitschrift eines Meetings, dass du mit Hilfe des LLM in ein strukturiertes Protokoll überführen willst. Die meisten Chatbots zudem bieten die Möglichkeit, Vorgaben für Chats zu konfigurieren (z.B. Customize ChatGPT, Gemini: Saved info). Dies ist sehr nützlich, um sich nicht ständig zu wiederholen. Ich habe in meiner Konfiguration z. B. hinterlegt, dass ich Python als Programmiersprache bevorzuge, Listen und knappe Erklärungen bevorzuge und keine langen Erklärungen und Beispiele will. ### C. Prompts testen und optimieren Sobald Prompts regelmäßig verwendet werden, lohnt sich ein systematisches Testing. Du sparst damit Zeit, steigerst die Qualität und gewinnst Vertrauen in die Ergebnisse. ### D. Typische Anwendungsbereiche Die Anwendungsfälle für standardisierte Prompts sind vielfältig. Die folgende Liste zeigt ausgewählte Fragestellungen, die auf dieser Stufe adressiert werden können. - Erstellung von Blog- oder Social-Media-Inhalten - Gliederung komplexer Dokumente - Zusammenfassungen längerer Texte nach spezifischen Kriterien - Analyse von Webseiten, Dokumenten oder Bildern ## ![Icon: Mauersteine](https://thecattlecrew.net/wp-content/uploads/2025/05/icon-mauersteine.png)Stufe 4: Datengetriebene Prompts – messen, analysieren, verbessern ![Illustration im Comic-Style: Junger Mann arbeitet an Virtuellen Screens, Bots arbeiten ihm zu. ](https://thecattlecrew.net/wp-content/uploads/2025/05/cattle-crew-pemm_level4-300x300.jpg)Auf dieser Reifestufe nutzt du **Metriken und Datenanalysen**, um deine Prompts kontinuierlich zu verbessern. Statt Bauchgefühl und Trial-and-Error kommt ein Vorgehen ähnlich wie in der Softwareentwicklung zum Einsatz. Die Leistung von Prompts wird systematisch mit Hilfe von Metriken und definierten Testfällen gemessen. Mittels Datenanalyse werden unterschiedliche Versionen des Prompts verglichen. In einem iterativen Prozess wird der effektivste Prompt entwickelt und optimiert. Eine Automatisierung dieses Verfahrens kann mit Hilfe fortgeschrittener Techniken wie der automatisierten Erstellung von Prompts erreicht werden. Diese Stufe eignet sich besonders für **KI-Anwendungen im Unternehmenskontext**, bei denen Prompts für spezifische Aufgabenstellungen fest in eine Anwendung integriert werden. Die Nutzer müssen die Feinheiten des Prompts und seiner Erstellung nicht mehr verstehen und können sich ganz auf ihre fachlichen Tätigkeiten konzentrieren. # Fazit: Wie du mit dem PEMM-Modell deinen Umgang mit Prompts verbesserst Die Fähigkeit, LLMs effektiv zu nutzen, wird für Wissensarbeiter:innen heute und in Zukunft eine zentrale Kompetenz sein. Mit dem Prompt Engineering Maturity Model geben wir dir ein praxisnahes Werkzeug an die Hand, um deine Kompetenz beim Schreiben von Prompts weiterzuentwickeln. Die Beispiele in diesem Artikel konzentrieren sich auf Prompts für „normale“ Chatbots. Viele Chatbots bieten inzwischen komplexe Tools wie z. B. *Canvas* oder *Deep Research* an, die über einen einfachen Chat hinausgehen. Prompts für solche Tools können ebenfalls mit den vorgestellten Ideen und Methoden erstellt werden. Zusätzlich sind natürlich die spezifischen Eigenschaften des jeweiligen Tools zu berücksichtigen. Wie in vielen Bereichen ist **Learning by Doing** und **Erfahrung** der Schlüssel zum Erfolg. Das Lesen von Artikeln oder Ansehen von Tutorial-Videos alleine reicht nicht aus. Beobachte, reflektiere und verfeinere deine eigene Praxis kontinuierlich. Wenn wir dich mit diesem Artikel ein wenig unterstützen konnten, effektive Prompts zu schreiben, haben wir unser Ziel erreicht. Wenn du möchtest, gib uns gerne Feedback in den Kommentaren. --- *Die Bilder in diesem Artikel wurden mithilfe von Gemini generiert; Chat GPT half dabei, den Text hinsichtlich Lesefluss und SEO zu optimieren (und einige der aggressiveren Kürzungen und Zusammenfassungen wurden manuell wieder rückgängig gemacht)* Diese Artikel könnten dich auch interessieren: [To RAG or not to RAG (1/2)](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/)[Ein Bot mit echtem Security-Know-how](https://thecattlecrew.net/2024/02/09/ein-bot-mit-echtem-security-know-how/) [Was steckt hinter RAG und Semantischer Suche?](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) **Kategorien:** AI & Data Science, Tools & Methoden --- ### [Kurzes Fazit zum DOAG Expertenseminar Forms 12c in Berlin](https://thecattlecrew.net/2017/07/14/kurzes-fazit-zum-doag-expertenseminar-forms-12c-in-berlin/) **Published:** Juli 14, 2017 **Author:** Holger Lehmann **Content:** Am 11. und 12. Juli 2017 fand in den Räumen der DOAG in Berlin das Expertenseminar Forms 12c statt. Als Referenten waren Gerd Volberg und ich angereist, um 12 Teilnehmern unser geballtes Expertenwissen im Bereich Forms zu vermitteln. Wie wir später hörten, war das für eine solche Veranstaltung eine super Teilnehmerzahl, die in anderen Seminaren oft unterschritten wurde. Wir haben für unsere Übungen und Seminarinhalte zwei Virtuelle Maschinen vorbereitet, die sich die Teilnehmer kopiert und später darin gearbeitet haben. Zu Beginn musste Gerd erst einmal wieder mit dem Vorurteil kämpfen, dass Oracle Forms nicht weiterentwickelt und daher das Produkt tot sei. Aufgeteilt haben wir uns in zwei verschiedene Themenbereiche. Während Gerd Vieles aus seinem Framework und seinen Best Practices gezeigt hat, habe ich den Part mit Forms 12c New Features und Installation übernommen. Zitat von Gerd: Der Mix aus Forms 12 + Best Practices passt einfach sehr gut in die heutige Zeit. Die einen hätten gerne noch mehr New Features gehabt, die anderen noch mehr Best Practices „¦ Auch hat sich gezeigt, dass einige Teilnehmer noch vor der Migration auf die 12er-Version stehen und das bald angehen werden. Unser Fazit ist klar: wir hätten das Ganze auch auf 3 Tage verteilen und ausweiten können! Die ganze Veranstaltung war super durchorganisiert und am Dienstag nach harter Arbeit hatten wir ein schönes Abendevent mit Führung durch den Reichstag und anschließendem Essen auf der Dachterrasse. Viele Grüße Holger **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** DOAG, Forms, Oracle Forms --- ### [To RAG or not to RAG (2/2)](https://thecattlecrew.net/2025/05/15/to-rag-or-not-to-rag-2-2/) **Published:** Mai 15, 2025 **Author:** Thomas Kerkmann **Content:** In [Teil 1](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/) dieses Zweiteilers haben wir gesehen, welche Aspekte berücksichtigt werden sollten, bevor man sich für eine RAG-Lösung (RAG = Retrieval-Augmented Generation) entscheidet. Der Aufwand ist nicht unerheblich, und die Vorbereitung der Dokumente erfordert ein hohes Maß an Anpassung. Welche Prozesse wir in der Vorbereitung eines Dokuments genau durchlaufen müssen, darum geht es in diesem 2. Teil der Serie. Dafür sehen wir uns eine RAG-Pipeline genauer an, testen und bewerten unterschiedliche Ansätze. ![](https://thecattlecrew.net/wp-content/uploads/2025/04/Its-ragtime-baby-300x230.png) # Was gehört zur RAG-Pipeline? – Drei zentrale Schritte Für die Aufnahme von Dokumenten in die Vektordatenbank müssen diese vorbereitet werden. Sie werden in ein Textformat konvertiert, in möglichst semantisch zusammenhängende Abschnitte aufgeteilt und dann vektorisiert:[![](https://thecattlecrew.net/wp-content/uploads/2025/05/to-rag-or-not-to-rag.png)](https://thecattlecrew.net/wp-content/uploads/2025/05/to-rag-or-not-to-rag.png) *Abbildung 1: Vorbereitung eines Dokuments für eine Vektordatenbank* ## Schritt 1: Konvertierung Die Konvertierung aus dem zumeist vorliegenden Dokumentformat PDF stellt die erste Hürde dar. Hierzu gibt es zwar einfache Tools (PdfBox, Apache Tika, …), die jedoch einige Schwierigkeiten beim „Druckformat“ PDF ausblenden, wie z. B. Kopf-/Fußzeilen. Diese werden einfach in den laufenden Text mit übernommen, was den Zusammenhang zerreißt. Weiterhin können Textstrukturierungen nicht erkannt und übernommen werden. Bei unseren Tests haben wir festgestellt, dass es sinnvoll ist, Kopf- und Fußzeilen zunächst zu entfernen. Dazu wurde ein Algorithmus erstellt, der die ersten Zeilen jeder Seite miteinander vergleicht (übrigens auf Basis eines Embeddings und dann unter Verwendung des Cosinus-Abstands) und sie bei relativer Gleichheit als Kopf-/Fußzeile klassifiziert und entfernt. Eine weitere Möglichkeit – die wir getestet haben – ist, den Text zunächst in das Markdown-Format umzuwandeln. Es gibt eine gute Python Bibliothek (pymupdf, pymupdf4llm), die dies kann. Die Umwandlung dauert länger, aber das Ergebnis lässt sich einfacher in Abschnitte mit Zusammenhang aufteilen. Es gibt weitere Konzepte zur Umwandlung von Dokumenten in strukturierten Text, die auf OCR basieren, und zunächst versuchen, die Textblöcke eines Dokuments durch optische Analyse zu ermitteln, eine Reihenfolge herzustellen (z. B. bei mehrspaltiger Anordnung) und dann erst die Konvertierung vorzunehmen. Vgl. RagFlow (open source), oder Docupanda (kommerziell) ## Schritt 2: Splitting & Chunking Wenn der Text keine Struktur mehr hat, wird es schwierig sinnvolle Gruppen von Text zu bilden. Wir haben unterschiedliche Ansätze getestet, die im Folgenden erläutert werden sollen. ### SentenceBasedTextSplitter Dieser Splitter zerlegt den Dokument-Text in einzelne Sätze zur Weiterverarbeitung. Dabei wird eine NLP Bibliothek verwendet, z.B. „opennlp-de-ud-gsd-sentence-1.1-2.4.0.bin“. Diese ist für deutsche Texte optimiert. Beispiel: Lorem ipsum dolor sit amet, consectetur adipiscing elit. Sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat. Duis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur. Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum. \#Satz1Lorem ipsum dolor sit amet, consectetur adipiscing elit.2Sed do eiusmod tempor incididunt ut labore et dolore magna aliqua.3Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat.4Duis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur.5Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.Dieser Splitter bildet die Basis der folgenden Splitter und wird nicht selbst direkt verwendet. ### Group Der SimpleGroupTextsplitter bildet Gruppen von Sätzen einstellbarer Anzahl (3,5…?). z. B. groupSize=3 GruppeSätze1Lorem ipsum dolor sit amet, consectetur adipiscing elit. Sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat.2Duis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur. Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.Die Idee ist eine größere, zusammenhängende Informationseinheit zu gewinnen. Der Nachteil ist jedoch, dass dieser Zusammenhang praktisch willkürlich gewählt wurde, allein durch die groupSize. ### Overlapped Group Der OverlapGroupTextSplitter läßt diese Gruppen noch um eine bestimmte Anzahl an Sätzen (1,2…?) überlappen. z.B. groupSize=3, overlap=1 GruppeSätze1Lorem ipsum dolor sit amet, consectetur adipiscing elit. Sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. *Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat.*2*Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat.* Duis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur. Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.Die Intention dabei ist, den Kontextzusammenhang zwischen Gruppen von Sätzen nicht zu verlieren. ### Similarity Der SimilarityTextSplitter versucht Gruppen von Sätzen anhand des Abstands ihrer Vektordarstellung (cosinus-distance) zu ermitteln. Die einstellbare Similarity bestimmt die Größe der Satzgruppen. Die Gruppen haben dann keine einheitliche Anzahl von Sätzen. \#SätzeCosinus DistanzGruppe1Lorem ipsum dolor sit amet, consectetur adipiscing elit.012Sed do eiusmod tempor incididunt ut labore et dolore magna aliqua.0.555123Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat.0.457924Duis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur.0.566935Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.0.63134Wenn man nun einen Schwellwert (similarity) von 0.5 annimmt, würde Satz 2 zu weit weg vom ersten Satz stehen, und damit dort eine neue Satzgruppe beginnen. Der nächste Satz (#3) liegt unterhalb des Schwellwertes, und wird daher der gleichen Gruppe zugeschlagen, usw. Hier erhofft man sich durch die Ähnlichkeitssuche unter den Sätzen, einen realen Bruch im Zusammenhang zu ermitteln. Es wird also nicht mehr willkürlich eine Informationseinheit erstellt, sondern gezielt anhand von Brüchen im Kontext. ### Grouped Similarity Der SentenceGroupSimilarityTextSplitter gruppiert Sätze, und bestimmt den Abstand der jeweiligen Satzgruppe zur nächsten. Darauf folgend wird der Splitting-Abstand (breakpointThreshold) aus der 95ten Percentile ermittelt. Der Ablauf ist also ähnlich wie beim SimilarityTextSplitter außer, dass der Splitting Schwellwert dynamisch ermittelt wird. Von diesem Ansatz erhofft man sich, die Grenzen der Informationseinheiten im Text noch genauer zu erkennen. Vergleiche auch verschiedene Splittling Algorithmen [hier](https://github.com/FullStackRetrieval-com/RetrievalTutorials/blob/main/tutorials/LevelsOfTextSplitting/5_Levels_Of_Text_Splitting.ipynb) (5 Levels of Text Splitting). ### Markdown Der MarkdownTextsplitter benötigt als Eingabedateiformat wie der Name schon sagt Markdown Text. Er verwendet als Trennzeichen die wichtigsten Strukturtags für Markdown. In unseren Test haben wir uns auf „#“, „##“, „###“ und „\*\*“ geeinigt. Man könnte sich in dem Fall auch Gedanken über weitere Merkmale zur Abgrenzung von Texteinheiten machen. Letztendlich geht es immer darum, Kontext zusammenzuhalten. Das doppelte Sternchen wurde übrigens aufgenommen, weil die Umsetzung von Pdf zu Markdown oft fälschlicherweise die Klassifizierung ‚fett‘ für Absätze der vierten Ebene erkennt. Des Weiteren wird eine maximale Chunk-Größe vorgegeben. (Derzeit fest auf 1024 Zeichen eingestellt.) Auch hier gibt es Optimierungs- bzw. Anpassungsbedarf. ## Schritt 3: Embedding Nun erst erfolgt das Embedding, d. h. das Umwandeln der Textabschnitte in Vektoren und die Speicherung in der Vektordatenbank. Es gibt spezielle Modell für das Embedding, die wesentlich kleiner sind als die Modelle für die Generierung. In diesem Schritt ist es entscheidend, wie gut das gewählte Embedding-Modell mit den Dokumenten zurechtkommt. Ausschlaggebend sind oft eine oder mehrere Sprachen, für die ein Modell optimiert wurde. Wir verwenden gerne das Modell „jina/jina-embeddings-v2-base-de“, weil dieses Modell für Deutsch und Englisch trainiert wurde. Beim Speichern in der Vektordatenbank werden noch weitere Metadaten zu den einzelnen Dokument-Abschnitten hinzugefügt, z. B. der originale Dateiname. Diese Metadaten erlauben die Ähnlichkeitssuche einzugrenzen, so dass diese effizienter wird. So können auch große Datenmengen mit gleichem Metadaten Schema sehr schnell durchsucht werden. # Fazit Für die Befüllung eines RAG müssen wor also eine Kette von Verarbeitungsschritten mit einer großen Menge an Stellschrauben durchlaufen. Um in einem bestimmten Anwendungsfall das bestmögliche Ergebnis zu erhalten, ist es nötig, - alle Parameter im Auge zu behalten, die Ergebnisse zu bewerten und ggf. immer wieder nachzujustieren. - Im besten Fall lassen sich Zwischenergebnisse messbar miteinander vergleichen, um für die Gesamtmenge an Dokumenten durch Stichproben einen optimierten Parametersatz zu erstellen. - Hierzu ist es dann notwendig, der Anwendung auch ein Tool zur Ermittlung und Verbesserung der Parameter hinzuzufügen. In unserem Testszenario haben wir diesem den Namen „parameter-tuning-service“ gegeben. In Teil 1 haben wir bei der Betrachtung der Daten und deren Mengen gesehen, welche Aspekte für die Entscheidung für oder gegen RAG wichtig sind. Teil 2 zeigte uns wie hoch der Entwicklungaufwand für die Vorverarbeitung der Dokumente sein kann, denn es gibt nicht „die“ Methode, die für alle Dokumentformate das beste Ergebnis liefert. Weitere Methoden werden sicherlich in Zukunft noch entwickelt werden. Komplexe Dokumente mit Hilfe von OCR Technologien zu analysieren ist sicherlich nur der Anfang. Bereits heute sehen wir, dass KI gestützte Analyse ebenfalls möglich ist, jedoch unter Kostenaspekten noch viel zu teuer für große Mengen. Unter all diesen Bedingungen ist die Frage „To RAG or not to RAG“ nicht so einfach zu beantworten. Schon gar nicht allgemein. Sie hängt von vielen Faktoren ab, und die Entscheidung dafür oder dagegen hat große Auswirkung auf die Gestaltung der Anwendung und deren Erstellungs- und Betriebskosten. # Mehr zum Thema [RAG or not to RAG, Teil 1: Wann braucht es einen RAG-Ansatz](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/) [RAG or not to RAG, Teil 2: Prozesse und Aufwand in der Praxis](https://thecattlecrew.net/2025/05/15/to-rag-or-not-to-rag-2-2/) [Was steckt hinter RAG und Semantischer Suche?](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) [RAG und Semantische Suche in der Praxis](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/) **Kategorien:** AI & Data Science **Schlagwörter:** Artificial Intelligence, RAG, Retrieval Augmented Generation --- ### [To RAG or not to RAG (1/2)](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/) **Published:** Mai 8, 2025 **Author:** Thomas Kerkmann **Content:** In zwei vorangegangenen Artikeln von Falk Schramm wurden bereits einige [Grundlagen zu generativer KI und RAG](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) angesprochen. Mit meiner Artikelserie **„To RAG or not to RAG“** möchte ich den Fokus noch einmal besonders auf diese Fragen bezüglich Retrieval Augmented Generation (RAG) richten: - Welche Aufwände und Prozesse bringt RAG mit sich? - Braucht es immer einen RAG-Ansatz? Wann ist er sinnvoll ist und wann vielleicht eher nicht? Doch auch in dieser Serie fangen wir zunächst vorne an und ich erkläre, was RAG ist und wofür es eingesetzt wird. Wer sich hier bereits auskennt, darf natürlich gerne weiter unten einsteigen. # Was ist RAG? RAG (Retrieval Augmented Generation) erweitert das „Wissen“ eines LLM (Large Language Model) durch Spezialwissen, welches sich nicht im gelernten Wissen eines LLM befindet oder nur unzureichend abgebildet ist, z. B. aufgrund des Veröffentlichungsdatums des LLM. Dieses Spezialwissen kann auch firmeninternes Wissen sein, das in Form von Dokumenten in Formaten wie PDF, DOCX oder MD (Markdown) vorliegt. Wenn es für die Bearbeitung durch ein LLM bereitgestellt werden soll, muss es in eine Form gebracht werden, die das Modell versteht. Dafür eignen sich sogenannte Vektor-Datenbanken. Über eine semantischen Suche können hier große Mengen an Text verfügbar gemacht werden. So können relevante Textteile bereitgestellt werden, die ein LLM braucht, um seine Antworten zu generieren. ![](https://huggingface.co/datasets/huggingface/cookbook-images/resolve/main/RAG_workflow.png) *Abbildung 1: Die Schritte vom Wissen zur Antwort (Bild-Quelle: [https://huggingface.co/learn/cookbook/advanced\_rag):](https://huggingface.co/learn/cookbook/advanced_rag)* 1. Dokumente werden zunächst zerteilt (chunking), 2. in einen Vektor überführt (embedding) 3. und dann in der Vektordatenbank abgespeichert. 4. Bei der Abfrage (query) werden zunächst relevante Chunks in der Vektordatenbank gesucht (similarity search) 5. und die besten Matches (top k) dem Kontext hinzugefügt. 6. Aus diesen Inhalten generiert das LLM nun seine Antwort. # Warum RAG? Wenn es nur darum ginge, ein Dokument in den Kontext des LLM zu stellen und es analysieren zu lassen, wäre es einfach. Doch leider gibt es technische Einschränkungen: Das Modells kann nämlich nur eine limitierte Menge an Informationen verarbeiten. Deshalb kann es nützlich sein, wenn man große Mengen an Informationen auswerten möchte, diese in semantische Blöcke aufzuteilen. Mittels RAG lassen sich diese vorselektieren und passend zur gewünschten Aufgabe auswählen. ## Welche Begrenzung gibt es genau? Ein wichtiger Begriff, wenn wir über die Begrenzung der Informationsmenge sprechen, ist **das Kontextfenster**: Es begrenzt die Anzahl der Token, die von einem Modell verarbeitet werden können. Dabei müssen die Eingabe- und Ausgabe-Token zusammengerechnet werden, um die Grenzwerte einzuhalten. Die Kontextfenster der aktuellen Modelle haben sich erheblich erweitert: **Modell****Kontextfenster in Tokens****entspricht Text**GPT-32.000ca. 2-3 SeitenGPT-3.5-Turbo Instruct4.000ca. 3.000 Worte (englisch), 6 SeitenMistral Tiny (7B)8.000ca. 6.000 Worte, 12 SeitenGPT-48.000ca. 6.000 Worte, 12 SeitenLlama 38.192ca. 6.000 Worte, 12 SeitenGPT-3.5 Turbo16.000ca. 12.000 Worte, 24 SeitenMistral Small16.000ca. 12.000 Worte, 24 SeitenMistral Medium32.000ca. 24.000 Worte, 48 SeitenGemini Pro32.000ca. 24.000 Worte, 48 SeitenGPT-4-32k32.000ca. 24.000 Worte, 48 SeitenClaude 2100.000ca. 75.000 Worte, 150 SeitenGPT-4-Turbo128.000ca. 96.000 Worte, 192 SeitenLlama 3.1128.000ca. 96.000 Worte, 192 SeitenClaude 2.1200.000ca. 150.000 Worte, 300 SeitenGemini 1.5bis zu 1.000.000ca. 750.000 Worte, 1500 SeitenDemgegenüber stehen aber auch unterschiedliche Kosten, die zu berücksichtigten sind. Diese sind von Anbieter zu Anbieter verschieden, daher können wir diese hier nicht im Einzelnen darstellen. Quellen im Internet finden sich leicht. Nun stellt sich die Frage: Setze ich auf größere Kontextfenster? Oder arbeite ich mit kleinen Kontextfenstern, und setze auf semantische Suche? Hier die drei wichtigsten Vor- und Nachteile beider Varianten auf einen Blick sowie passende Anwendungsfälle: ### Größere Kontextfenster – Vorteile 1. **Verbesserte Kohärenz bei langen Inhalten:** Größere Kontextfenster ermöglichen es dem Modell, mehr Informationen zu speichern und zu verarbeiten, was für die Erstellung kohärenter und detaillierter Antworten in langen Dokumenten oder Gesprächen unerlässlich ist. Dies ist vorteilhaft für Anwendungen wie das Zusammenfassen langer Artikel, das Erstellen juristischer Verträge oder die Bearbeitung langer Kundensupport-Chats, bei denen Kontinuität entscheidend ist. 2. **Verbesserte Informationsspeicherung:** Mit einem größeren Fenster können LLMs mehr historische Eingaben referenzieren, wodurch sie den Kontext über lange Interaktionen hinweg beibehalten können. Dies ist nützlich für Konversations-Agenten, für die Beantwortung von Fragen, die mehrere Runden umfassen, oder für die Zusammenfassung umfassender Berichte. 3. **Geringerer Bedarf an Kürzung:** Bei umfangreichen Texten müssen bei kleineren Kontextfenstern oft Teile der Eingabe gekürzt oder ausgelassen werden, was zu unvollständigen oder ungenauen Antworten führen kann. Ein größeres Fenster kann einen größeren Teil des Eingabetextes umfassen, wodurch das Risiko verringert wird, wichtige Details zu übersehen. ### Größere Kontextfenster – Nachteile 1. **Höhere Rechenkosten:** Die Verarbeitung größerer Kontextfenster erfordert mehr Rechenressourcen, was zu längeren Antwortzeiten und höheren Kosten führt. Dies kann sich bei Echtzeitanwendungen oder bei begrenztem Budget negativ auswirken. 2. **Erhöhtes Risiko irrelevanter Informationen:** Ein größeres Fenster kann auch mehr irrelevante Inhalte enthalten, die das Modell ablenken und die Qualität der Antwort beeinträchtigen können. Modelle mit großen Kontextfenstern müssen sorgfältig geführt werden, um sich auf die wichtigsten Teile der Eingabe zu konzentrieren. 3. **Komplexität in der Prompt-Entwicklung:** Größere Kontextfenster können die Gestaltung von Prompts komplexer machen. Denn es ist herausfordernd, umfangreiche Eingaben kohärent zu strukturieren. Prompt-Designer müssen die enthaltenen Informationen sorgfältig abwägen, um das Modell nicht mit überflüssigen Details zu überfrachten. ### Kleinere Kontextfenster – Vorteile 1. **Geringere Latenz und Kosteneffizienz:** Kleinere Kontextfenster erfordern weniger Rechenressourcen, was zu schnelleren Verarbeitungszeiten und niedrigeren Betriebskosten führt. Dies ist vorteilhaft für Anwendungen, die zahlreiche Anfragen schnell bearbeiten müssen. 2. **Gezielte Antworten:** Ein kleineres Fenster kann dazu beitragen, den Fokus des Modells auf den unmittelbarsten und relevantesten Kontext einzugrenzen, wodurch die Gefahr der Einführung von nicht verwandten Inhalten verringert wird. Dies ist oft von Vorteil bei Anwendungen wie dem kurzen Austausch mit dem Kundensupport oder schnellen Antworten in Q&A-Systemen. 3. **Einfachheit in der Implementierung:** Bei kleineren Fenstern ist die Erstellung von Eingabeaufforderungen in der Regel einfacher. Die Gefahr, das Modell mit fremden Informationen zu überfrachten, ist geringer, was die Einrichtung erleichtert und oft zu konsistenteren Antworten führt. ### Kleinere Kontextfenster – Nachteile 1. **Begrenzte Informationskapazität:** Der größte Nachteil kleinerer Kontextfenster ist die geringere Informationskapazität. Dies kann zu unzusammenhängenden oder sich wiederholenden Antworten führen, wenn das Modell nicht in der Lage ist, ausreichend Kontext über eine lange Eingabe zu speichern. 2. **Häufiges Abschneiden in großen Dokumenten:** Bei einem begrenzten Token-Limit müssen kleinere Fenster häufig abgeschnitten werden, was dazu führen kann, dass kritische Details ausgelassen werden, was die Qualität der Antworten in Anwendungen, die eine umfassende Analyse oder Synthese großer Texte erfordern, verringert. ### Anwendungsfälle für größere Kontextfenster Bestimmte Anwendungen eignen sich besser für größere Kontextfenster, insbesondere bei der Verarbeitung umfangreicher Textdaten oder wenn die Beibehaltung von Informationen über lange Eingaben unerlässlich ist: 1. **Dokumentenzusammenfassung:** Bei der Zusammenfassung langer Inhalte, wie z. B. Forschungsarbeiten oder juristische Dokumente, muss das Modell umfangreichen Text ohne Abschneiden berücksichtigen, was von einem größeren Kontextfenster erheblich profitieren kann. 2. **Detaillierte Konversationen:** In Anwendungen für den Kundensupport oder virtuelle Assistenten, bei denen die Benutzer längere Interaktionen mit mehreren Umdrehungen durchführen, hilft ein größeres Kontextfenster dem Modell, die Kontinuität und den Kontext der Konversation über die Zeit zu erhalten. 3. **Datenextraktion und -analyse:** In Fällen, in denen das Modell Informationen aus großen Datensätzen oder Dokumenten extrahiert, z. B. aus medizinischen Berichten oder Jahresabschlüssen, stellt ein größeres Kontextfenster sicher, dass keine wichtigen Informationen ausgelassen werden. ### Anwendungsfälle für kleinere Kontextfenster Kleinere Kontextfenster können dagegen gut in Anwendungen funktionieren, die schnelle Antworten benötigen, bei denen die Ressourcen begrenzt sind oder bei denen knappe Informationen ausreichen: 1. **Echtzeit-Q&A-Systeme:** Anwendungen, die einfache Fragen beantworten, können oft effektiv in kleineren Kontextfenstern funktionieren. Beispiele hierfür sind schnelle Fragen des Kundendienstes oder einfache FAQ-Bots. 2. **Klassifizierung von Kurztexten:** Aufgaben wie Spam-Erkennung, Stimmungsanalyse oder Kurztextklassifizierung erfordern keine umfangreichen Kontextfenster. Das Modell muss nur kurze Nachrichten oder Phrasen verarbeiten, weshalb ein kleineres Kontextfenster ideal ist. 3. **Transaktionsbezogene Interaktionen:** Anwendungen, die kurze, transaktionale Interaktionen verarbeiten (z. B. Restaurantreservierungen oder Wetteraktualisierungen), benötigen im Allgemeinen keinen umfangreichen Kontext. Kleinere Fenster rationalisieren die Antworten und reduzieren die Verarbeitungszeit. Quelle: [Medium Artikel „Understanding Context Windows in LLMs“, Tahier Saeed](https://medium.com/@tahir.saeed_46137/understanding-context-windows-in-large-language-models-llms-4ad3dca6b86f) ## Welche Rolle spielt die Performance? Große Informationsmengen enthalten natürlich nicht immer nur relevante Inhalte zu einer bestimmten Fragestellung. Es ist daher vorteilhaft, zunächst die Inhalte zu ermitteln, die mit der Anfrage in Zusammenhang stehen. Insbesondere für die Performance der Anwendung ist dies enorm wichtig. Hier hilft der RAG-Ansatz: Basierend auf einer Ähnlichkeitssuche (Similarity Search) werden nur jene Inhalte in das Kontextfenster importiert, die in einem relevanten Zusammenhang mit der Anfrage stehen. Diese Suche findet statt, bvor das LLM eine Antwort generiert. Sie ist ein rein mathematischer Vergleich von Vektoren und damit viel performanter, als die Auswertung der gesamten Datenmenge. Daraus resultieren - ein reduzierter Tokenverbrauch, - eine geringere Netzwerklatenz - und damit schnellere Reaktionszeiten bei der Generierung der Antwort. Vektordatenbanken sind auf diese Suche spezialisiert. Es gibt Extensions für bekannte Datenbanksysteme wie Postgres oder Oracle, aber auch speziell für diesen Zweck entwickelte Datenbanken wie [Weaviate](https://weaviate.io/) oder [Chroma](https://trychroma.com/) (beide Open Source) und auch kommerzielle Produkte. # Fazit: Wann setzte ich RAG ein? So kommt man schlussendlich zu der Frage: Benötige ich für meinen Anwendungsfall ein RAG oder nicht? Welche Aspekte müssen dabei berücksichtigt werden? ## Wie groß sind meine Daten/Dokumente? Macht eine Zerlegung Sinn, oder passen sie einfach in ein Kontext-Fenster des LLM meiner (Kosten-)Vorauswahl. ## Wie volatil sind die Daten/Inhalte? Werden sie oft geändert, oder sind sie statisch? Bei sich oft ändernden Daten muss man sich überlegen, ob das erneute Verarbeiten der Ausgangsdaten durch eine andere Speicherung und Filterung verbessert werden kann. Hier ist vielleicht die Vektordatenbank nicht unbedingt das geeignete Mittel. Durch den Einsatz sogenannter Tools im LLM kann auch auf andere Datenbanken mit eigenen Filter Werkzeugen zugegriffen werden (ElasticSearch, OpenSearch, Solr, …). ## Handelt es sich um strukturierte oder unstrukturierte Inhalte? Strukturierte Inhalte lassen sich gut zerlegen und in einer Vektordatenbank abspeichern. Unstrukturierte Inhalte verlangen unter Umständen viel Probieren, um die optimalen Zerlegungsparameter zu bestimmen. Wenn die Dokumentgröße und die Kosten es zulassen, könnte es hier einfacher sein, das Dokument direkt an das LLM zu übergeben. ## Wie langlebig oder kurzlebig sind meine Daten und Dokumente (Gültigkeitsdauer, Ablaufdatum)? Kurzlebig gültige Daten sollten aus Gründen der Performance der Vektordatenbank nach Ablauf der Gültigkeit wieder entfernt werden. Hier ist der jeweilige Aufwand dafür abzuschätzen. Bei kleineren Dokumenten kann auch hier ggf. auf ein RAG verzichtet werden. ## Wie oft greife ich auf diese Daten mit Hilfe der KI zu? Wenn viele Zugriffe auf die gleichen Daten erfolgen, hat das RAG einen Vorteil, da es Rechenleistung beim LLM einspart, und somit die Antwortzeiten und Kosten geringhält. Wenn die Daten nur selten oder sogar nur einmalig ausgewertet werden sollen, kann auch hier eine Vektordatenbank unter Umständen gar nicht erforderlich sein. # Weiterlesen … Wenn ein RAG zum Tragen kommen soll oder muss, kommt der **Pre-Production-Prozess** aus Abbildung 1 (siehe oben) zum Einsatz. **Lesen Sie im zweiten Teil dieser kleinen Artikelserie:** - Wie die Prozessschritte im Einzelnen aussehen - und worauf dabei zu achten ist [RAG or not to RAG, Teil 2](https://thecattlecrew.net/2025/05/15/to-rag-or-not-to-rag-2-2/) **Kategorien:** AI & Data Science **Schlagwörter:** Artificial Intelligence, RAG, Retrieval Augmented Generation --- ### [RAG und Semantische Suche in der Praxis](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/) **Published:** Januar 29, 2024 **Author:** Falk Schramm **Content:** # Chatbots für Spezialwissen – Teil 2 Umsetzung Neben KI-Themen, mit denen ich mich auch privat gerne beschäftige, ist Cybersecurity mein zweites großes Interessengebiet. Aus Erfahrung weiß ich daher, dass vielen IT’lern und IT’lerinnen das Lesen von formellen Security-Anforderungen keinen Spaß macht. Zudem ist der Zugang zu Security-Standards oft nicht einfach. Diese Schwachstelle wollen wir mit einem Chatbot abstellen, der bei der Nutzung der IT-Grundschutz-Bausteine unterstützt. [Teil 1: Was Sie über Retrieval Augmented Generation, Semantische Suche und Prompts wissen sollten: Versuch einer verständlichen Erklärung](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/ "Artikel ansehen") Teil 2: Im zweiten Teil stellen wir unser internes Projekt Chatbot für IT-Grundschutz vor und geben einen Überblick über die Herausforderungen, die sich im Rahmen des (noch andauernden) Projekts ergeben haben. In weiteren Artikeln gehen wir auf tiefergehende Erfahrungen und Lösungsansätze mit unterschiedlichen Implementierungen und Technologien ein. ## Ein Chatbot für den IT-Grundschutz ### IT-Grundschutz – umfangreich und komplex Beim [IT-Grundschutz](https://www.bsi.bund.de/DE/Themen/Unternehmen-und-Organisationen/Standards-und-Zertifizierung/IT-Grundschutz/it-grundschutz_node.html) handelt es sich um einen Security-Standard, der vom [Bundesamt für Sicherheit in der Informationstechnik](https://www.bsi.bund.de/) herausgegeben wird. Ein wichtiger Bestandteil des IT-Grundschutzes sind die sogenannten Bausteine. In einem Baustein werden alle relevanten Sicherheitsaspekte zu einem Thema beleuchtet, z. B. Server, Datenbanken, Firewalls, Administration etc. Da es im IT-Grundschutz mehr als 100 Bausteine gibt, ist es selbst für einen erfahrenen Security-Consultant schwer, alle Maßnahmen korrekt und vollständig im Kopf zu haben. Für „normale“ IT-Mitarbeitende, die den IT-Grundschutz in seinem Bereich umsetzen muss, erscheint dies nahezu unmöglich. ### Was soll der Chatbot für den IT-Grundschutz leisten? Die Aufgabe unseres **Chatbots für den IT-Grundschutz** ist es, Security-Beauftragte bzw. IT-Mitarbeitende beim Umgang mit den IT-Grundschutz-Bausteinen zu unterstützen. Er soll zu allen Fragen, die die Bausteine betreffen, verlässliche, also korrekte und vollständige Antworten liefern. Hier sind ein paar Beispiele für solche Fragen: - Welche Gefährdungen bestehen in einer konkreten Situation? - Welche Maßnahmen sind in einer bestimmten Situation relevant? - Wie ist eine Maßnahme genau formuliert? Eine Besonderheit der Bausteine besteht darin, dass ein Thema zwar vollständig beleuchtet wird, aber in der Regel in einer konkreten Situation mehrere Bausteine zu berücksichtigen sind. Möchte man zum Beispiel einen Kubernetes-Cluster absichern, sind neben dem „eigentlichen“ Kubernetes-Baustein weitere Bausteine zur Administration, Containerisierung, Virtualisierung etc. anzuwenden. Das muss der Chatbot in seinen Antworten natürlich berücksichtigen. Neben dem fachlichen Ziel, einen Chatbot zu bauen, nahmen wir uns vor, Technologien, Frameworks und Lösungsansätze für die Architektur zu evaluieren, die die die Funktionen des Large Language Models ergänzt. Eine der wichtigsten dieser Funktionen ist die *Retrieval Augmentation Generation (RAG)*. ### Ansätze für die Implementierung In diesem Projekt untersuchen wir parallel zwei technologische Ansätze: - Der erste Ansatz basiert auf einer möglichst weitgehenden Nutzung von Azure Cognitive Services und der Vermeidung von individuell erstelltem Code. - Der zweite Ansatz basiert auf einer möglichst weitgehenden Nutzung von Open-Source-Technologien (u. a. [Langchain](https://python.langchain.com/docs/get_started/introduction)) und der Verwendung von Python als Programmiersprache. In beiden Fällen nutzten wir primär Chat GPT als LLM (in verschiedenen [Versionen](https://platform.openai.com/docs/models)). Die Evaluation weiterer LLM (Llama 2, Mistral, Falcon etc.) ist zu einem späteren Zeitpunkt ebenfalls geplant. ## Herausforderungen Unabhängig von den genutzten Technologien gibt es vielfältige fachliche Herausforderungen. Diese ergeben sich insbesondere daraus, dass die vom Chatbot gelieferten Antworten ***in Bezug auf das Spezialwissen IT-Grundschutz korrekt und vollständig*** sein müssen. Antworten, die nicht auf dem IT-Grundschutz sondern auf dem Allgemeinwissens des LLM beruhen, wären also aus Sicht der Aufgabenstellung fehlerhaft. Um dem LLM die IT-Grundschutz-Bausteine zugänglich zu machen, nutzen wir einen auf *Retrieval Augmented Generation (RAG)* basierenden Ansatz für die Implementierung. Dabei gibt es mehrere wesentliche Stellschrauben: - Bereitstellung der Wissensbasis (Chunking) - Auswahl des Embeddings - Abfrage der Wissensbasis - Anweisungen an das LLM Die ersten beiden Stellschrauben sind weitgehend unabhängig von der zur Implementierung genutzten Technologie und sollen im Folgenden beleuchtet werden. Zu den Punkten *Abfrage der Wissensbasis* und *Anweisungen an das LLM* sind eigenständige Blog-Artikel geplant. ### Bereitstellung der Wissensbasis (Chunking) Das durch den Chatbot zu erschließende Spezialwissen kann in unterschiedlichen Formaten vorliegen. Neben Websites, PDF- und Word-Dokumenten können dies Datenbanken, DWHs und viele weitere Formate sein. Neben reinen Texten sind zudem vielfach Bilder und Tabellen in den Dokumenten enthalten. Da eine LLM hauptsächlich Texteingaben versteht, liegt die erste Herausforderung darin, die Ausgangsdokumente konsequent in Textform zu überführen. Damit verknüpft sind Fragen nach der Behandlung von Überschriften, Fußzeilen, Referenzen und Metadaten. Denn diese enthalten in der Regel wichtige inhaltliche Informationen. Für HTML- und andere XML-basierten Dokumente kommt die Frage dazu, wie mit Tags umgegangen wird. Auch Tags können wichtige Aspekte eines Textes darstellen. ### Fragmente bilden Um das Embedding sinnvoll durchführen zu können, müssen die in Textform überführten Dokumente zunächst in kleinere Fragmente zerlegt werden, sogenannte Chunks. In vielen Beispielen und Demos wird hierfür die Strategie gewählt, Chunks mit einer festen Länge (z. B. 1000 Zeichen) und einer definierten Überlappung angrenzender Chunks (z. B. 300 Zeichen) zu verwenden. Wie sich in unserem Projekt schnell gezeigt hat, ist solch ein „blindes Chunking“ keine optimale Strategie, wenn es um korrekte Aussagen geht: Ein Chunk, der das Ende des einen und den Anfang des nächsten Kapitels umfasst, ist nicht sinnvoll. Lesson learned: **Chunks sollten die Struktur der Kapitel, Abschnitte und Absätze in einem Dokument respektieren**. Ein weiteres Thema beim Bilden der Fragmente ist die Behandlung von Überschriften und anderen Strukturierungselementen im Text. Die Identifikation von Kapitel- und Abschnittsüberschriften ist auf der Ebene von Strings ein erstaunlich komplexes Problem: Überschriften sehen aus wie ein sehr kurzer Absatz. Für unseren Chatbot für IT-Grundschutz haben wir deshalb letztlich auf die Nutzung der vom BSI bereitgestellten PDF-Dokumente verzichtet und verwenden stattdessen die XML-Fassung des IT-Grundschutzkompendiums. Aus der XML-Fassung lassen sich Kapitel, Abschnitte und Absätze mit wenig Aufwand präzise extrahieren. ### Auswahl des Embeddings Es gibt eine Vielzahl von Embeddings, die teilweise mit sehr unterschiedlichen Zielen trainiert werden. Neben den Trainingszielen spielen auch die Trainingsdaten eine wichtige Rolle: So kommt ein ausschließlich mit englischen Trainingsdaten erstelltes Embedding mit der deutschen Sprache oft nicht gut zurecht. Lesson learned: **Die Auswahl und Optimierung des Embeddings ist eine der wichtigsten Entscheidungen, die bei der Erstellung einer Wissensbasis getroffen werden muss.** Um ein optimales Ergebnis zu erzielen, müssen verschiedene *Embeddings* in Kombination mit unterschiedlichen Varianten für das Chunking objektiv bewertet werden. Für eine erste grobe Einschätzung des Embeddings ist eine manuelle Bewertung ausreichend. In der Optimierungsphase stößt sie dagegen schnell an ihre Grenzen. Lesson learned: **Für die Optimierung von Embeddings sollte eine automatisierte Bewertung verschiedener Varianten erfolgen.** Die automatisierte Bewertung von Embeddings ist eine eigenständige Aufgabe im Projekt. Sie beinhaltet unter anderem die Erstellung von Trainingsdaten, die (naturgemäß) abhängig vom Spezialwissen sind, das mit dem Chatbot erschlossen werden soll. Damit der Artikel nicht zu lang wird, wollen wir an dieser Stelle die Darstellung der Herausforderungen unterbrechen. Weitere Herausforderungen und unsere Lösungsansätze werden wir Ihnen in Folgeartikeln vorstellen. ## Fazit In diesem zweiteiligen Beitrag haben wir zunächst die Konzepte beleuchtet, die es ermöglichen, das Allgemeinwissen eines LLM um Spezialwissen zu einem bestimmten Thema zu erweitern. Anschließend haben wir unser internes Projekt „Chatbot für den IT-Grundschutz“ vorgestellt und sind auf einige der Herausforderungen eingegangen, die sich während der Implementierung gezeigt haben. Die Darstellung ist bei weitem nicht vollständig und wir planen Folgeartikel, die auf weitere Herausforderungen und die untersuchten Implementierungsvarianten eingehen. Die möglichen Einsatzgebiete eines „Chatbots mit Spezialwissen“ sind ebenso vielfältig wie die Wissensdomänen, die innerhalb eines Unternehmens vorhanden sind. Wir sehen wir zwei grundsätzliche Treiber für den Einsatz solcher Chatbots. Der erste Treiber ist die Erschließung/Aufrechterhaltung von Wissen, für das in der Organisation kein oder nur wenige Wissensträger vorhanden sind. Ein typisches Beispiel sind ältere Legacy-Technologien, deren ursprünglichen Entwickler in den Ruhestand gegangen sind oder inzwischen in anderen Bereichen arbeiten. Die Dokumentation der Legacy-Technologien ist ein interessantes Ziel für Chatbots. Sie können eine wertvolle Unterstützung bei der Erschließung und Nutzung der Dokumentation darstellen. Der zweite Treiber ist die Entlastung/Produktivitätssteigerung von Fachteams, die umfangreiches Wissen benötigen. Beispiele hierfür sind alle Arten von Support-Teams und Teams, die Kunden fachlich beraten und unterstützen. Der Einsatz von Chatbots mit Spezialwissen fördert die Qualität und Effizienz bei der Beantwortung komplexer Fragen. Die unterstützt sowohl erfahrene Mitarbeiter wie auch neue Mitarbeiter. Diese können mit Unterstützung eines Chatbots schneller produktiv werden. Aus technologischer Seite sind Chatbots mit Spezialwissen ebenfalls ein interessantes Thema. Die Technologien, die solche Chatbots ermöglichen, sind größtenteils noch ziemlich neu und werden ständig weiterentwickelt. Es lohnt sich daher am Ball zu bleiben. Wir jedenfalls sind gespannt, was die Zukunft bringen wird! [Teil 1: Was Sie über Retrieval Augmented Generation, Semantische Suche und Prompts wissen sollten: Versuch einer verständlichen Erklärung](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/ "Artikel ansehen") # Mehr zum Thema [RAG or not to RAG, Teil 1: Wann braucht es einen RAG-Ansatz](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/) [RAG or not to RAG, Teil 2: Prozesse und Aufwand in der Praxis](https://thecattlecrew.net/2025/05/15/to-rag-or-not-to-rag-2-2/) [Was steckt hinter RAG und Semantischer Suche?](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) [RAG und Semantische Suche in der Praxis](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/) **Kategorien:** AI & Data Science **Schlagwörter:** Generative AI, IT-Grundschutz, LLM, Prompt, Retrieval Augmented Generation, Semantische Suche --- ### [Was steckt hinter RAG und Semantischer Suche?](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) **Published:** Januar 29, 2024 **Author:** Falk Schramm **Content:** # Chatbots für Spezialwissen – Teil 1: Konzepte Wenn es um Chatbots geht, geistern seit einige Zeit Begriffe wie Retrieval Augmented Generation (RAG), Semantische Suche und Large Language Model (LLM) durch die Medien. Mit Hilfe dieser Techniken sollen Chatbots Fragen beantworten können, auf die herkömmliche Suchmaschinen keine oder nur unzureichende Antworten anbieten. Was steckt dahinter? In diesem Zweiteiler möchte ich zunächst kurz vorstellen, was genau sich hinter RAG, Semantischer Suche und den Prompts des LLM verbirgt. Anschließend werden Implementierungsansätze und Herausforderungen beim produktiven Einsatz beleuchtet. Wir haben die Techniken selbst ausprobiert und teilen unsere Erfahrungen mit Ihnen. Teil 1: Was Sie über Retrieval Augmented Generation, Semantische Suche und Prompts wissen sollten: Versuch einer verständlichen Erklärung [Teil 2: Im zweiten Teil stellen wir unser internes Projekt Chatbot für IT-Grundschutz vor und geben einen Überblick über die Herausforderungen, die sich im Rahmen des (noch andauernden) Projekts ergeben haben.](https://thecattlecrew.net/2024/01/16/spezialwissen-fuer-chatbots/ "Artikel ansehen") In weiteren Artikeln gehen wir auf tiefergehende Erfahrungen und Lösungsansätze mit unterschiedlichen Implementierungen und Technologien ein. ## Retrieval Augmented Generation Öffentlich verfügbare LLM (wie z.B. das vielzitierte ChatGPT) besitzen auf Grund ihres Trainings eine große Menge an Allgemeinwissen. Obwohl dieses Wissen nicht immer korrekt und vollständig ist, reicht es für eine unverbindliche Unterhaltung locker aus. Für den produktiven Einsatz sind Korrektheit und Vollständigkeit der Antworten eines Chatbots jedoch unverzichtbare Kriterien. Man denke beispielsweise an einen Chatbot, der auf Anfragen von Kunden reagiert. Am Beispiel des Chatbots für Kundenanfragen lässt sich auch eine weitere Problematik veranschaulichen: Trotz des umfangreichen Allgemeinwissens besitzt ein LLM kein Spezialwissen über das Angebot eines Unternehmens. Dieses Spezialwissen muss für den Chatbot in Form einer Wissensbasis verfügbar gemacht werden. Das durch einen Chatbot zu erschließende Spezialwissen ist dabei nicht auf Angebote eines Unternehmens beschränkt: Informationen aus dem Intranet, interne Dokumente, externe Standards (DIN, ISO etc.) , Tickets zu Supportanfragen, Foren und vieles mehr kommt als Quelle für Spezialwissen in Frage. Die Nutzung von Spezialwissen zur Beantwortung von Anfragen ist der Use Case für Retrieval Augmented Generation (RAG). Dahinter steckt die Idee, dass das LLM die Eingabe des Nutzers nicht direkt beantwortet. Stattdessen werden vorher aus der Wissensbasis relevante Informationen (Textstellen) als Kontext für die Beantwortung der Nutzereingabe extrahiert. Das LLM wird angewiesen, diesen Kontext für die Beantwortung zu verwenden und sein Allgemeinwissen nicht oder erst in zweiter Linie zu nutzen. Die folgende Grafik illustriert die Schritte, die im Einzelnen durchlaufen werden. ## ![](https://thecattlecrew.net/wp-content/uploads/2024/01/rag-diagramm-300x132.png)Semantische Suche Die Auswertung der Wissensbasis und das Ermitteln der relevanten Kontexts ist Aufgabe der Semantischen Suche. Eine einfache Stichwortsuche à la Google reicht nämlich typischerweise nicht aus: Der Nutzer formuliert seine Anfrage umgangssprachlich und in seinen eigenen Worten. Er kennt und verwendet möglicherweise nicht die „richtigen“ Stichwörter. Eine numerische Bewertung, wie ähnlich sich zwei Texte im Hinblick auf ihren Inhalt sind, ist eine seit langem untersuchte Fragestellung in der Linguistik. Im Kontext der Sprachverarbeitung durch Computer (NLP, Natural Language Processing) erfolgt diese Bewertung anhand von Embeddings. Dafür wird ein Text in einen Zahlenvektor umgewandelt und so, mathematisch gesprochen, der Text in einen Vektorraum „eingebettet“ (engl. Embedding). Diese Vektorräume besitzen im Unterschied zu unser 3-dimensionalen Welt höhere Dimensionen. Typische Werte sind etwa 768, 1024 oder 1536. Der Abstand zwischen zwei Texten lässt sich nun als Abstand der Textvektoren numerisch berechnen. Die „Magie“ des Embeddings besteht darin, dass inhaltlich ähnliche Texte in Textvektoren umgewandelt werden, die kleine Abstände voneinander haben. Beispielsweise werden die Texte „Ich mag meinen Hund“ und „Ich mag meinen vierbeinigen Freund.“ einen kleineren Abstand besitzen als die Texte „Ich mag meinen Hund.“ und „Ich mag indisches Essen.“ Für die semantischen Suche wird die Eingabe des Nutzers mit Hilfe des Embeddings in einen Textvektor umgewandelt und mit den Vektoren aus der Wissensbasis verglichen. Die der Eingabe am nächsten liegenden Vektoren/Texte werden als Ergebnis der semantischen Suche zurück geliefert. Wie Embeddings genau funktionieren, kann hier nicht dargestellt werden. Embeddings sind ein sich schnell entwickelndes Thema der aktuellen Forschung. Für den interessierten Leser empfehlen wir die Webseite [SBERT](https://www.sbert.net/) und das [METB-Leaderboard](https://huggingface.co/spaces/mteb/leaderboard) der Plattform HuggingFace als Einstieg in eine Vertiefung. ## Prompts: Anweisungen an das LLM LLM sind im Kern nur eine komplexe statistische Methode, um aus einer natürlich sprachigen Eingabe, dem Prompt, eine Ausgabe zu erzeugen. Im Falle von Retrieval Augmented Generation besteht der Prompt aus der Nutzereingabe, dem ermittelten Kontext und Anweisungen für die Beantwortung. Warum sind Anweisungen notwendig? Genau wie Menschen brauchen LLMs eine klare Aufgabenbeschreibung: Wie soll geantwortet werden, wenn der Kontext für die Beantwortung einer Frage nicht ausreicht? Wie soll mit Anfragen umgegangen werden, die sich nicht auf die Wissensbasis beziehen? Wie soll geantwortet werden, wenn der Nutzer nach einem Konkurrenzprodukt fragt? Dies und weitere Fragen sind für den produktiven Einsatz eines Chatbots zu klären. Welche Anweisungen dem LLM gegeben werden, hängt vom jeweiligen Use Case und den Nutzern des Chatbots ab: Wenn die Nutzer des Chatbots Kunden eines Unternehmens sind, werden an Korrektheit, Vollständigkeit und Verhalten bei „Out-of-Topic“ Anfragen hohe Anforderungen gestellt. Wenn die Nutzer des Chatbots dagegen ein internes Expertenteam sind (z.B. eine Fachabteilung), könnte beispielsweise die Behandlung von „Out-of-Topic“ Anfragen ausgelassen werden. Auch Anforderungen an Vollständigkeit und Korrektheit stellen sich möglicherweise anders dar. Das Verständnis dieser weniger Konzepte reicht bereits aus, um die grundlegende Funktion von Chatbots mit Spezialwissen zu verstehen. Wie schlagen sich diese Konzepte in der Praxis? Welche Herausforderungen und Lösungsansätze gibt es? [Teil 2: Im zweiten Teil stellen wir unser internes Projekt Chatbot für IT-Grundschutz vor und geben einen Überblick über die Herausforderungen, die sich im Rahmen des (noch andauernden) Projekts ergeben haben.](https://thecattlecrew.net/2024/01/16/spezialwissen-fuer-chatbots/ "Artikel ansehen") In weiteren Artikeln gehen wir auf tiefergehende Erfahrungen und Lösungsansätze mit unterschiedlichen Implementierungen und Technologien ein. # Mehr zum Thema [RAG or not to RAG, Teil 1: Wann braucht es einen RAG-Ansatz](https://thecattlecrew.net/2025/05/08/to-rag-or-not-to-rag-1-2/) [RAG or not to RAG, Teil 2: Prozesse und Aufwand in der Praxis](https://thecattlecrew.net/2025/05/15/to-rag-or-not-to-rag-2-2/) [Was steckt hinter RAG und Semantischer Suche?](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) [RAG und Semantische Suche in der Praxis](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/) **Kategorien:** AI & Data Science **Schlagwörter:** Artificial Intelligence, LLM, Prompts, RAG, Semantische Suche, Spezialwissen --- ### [Visuelle Analysen mit Open Source BI Tools – Teil 2: Plotly Dash](https://thecattlecrew.net/2024/01/18/38426/) **Published:** Januar 18, 2024 **Author:** Nicolas Schaefer **Content:** Im ersten Teil unserer Blogserie haben wir uns mit der Erstellung interaktiver Grafiken unter Verwendung des Open-Source Visualisierungstools Plotly befasst. Diese Grafiken bieten bereits einige Funktionalitäten wie z. B. Mouse-Over oder Zoom, jedoch fehlt die Möglichkeit, die angezeigten Daten durch User-Input anzupassen. In diesem Beitrag gehen wir den nächsten Schritt und zeigen, wie man diese Grafiken mit Plotly Dash in interaktiven Dashboards nutzen kann. Nach einer Einführung in den Aufbau und die Gestaltung einer Dash App werden wir einen kurzen Vergleich zum Arbeiten mit Tableau ziehen und einen Ausblick zum effektiveren Arbeiten mit Dash durch das Nutzen von KI geben. Doch warum überhaupt Plotly Dash? - Dash ist wie die Visualisierungsbibliotheken von Plotly auch ein Open-Source Framework und damit grundsätzlich kostenlos nutzbar. - Es ermöglicht die Entwicklung von interaktiven Dashboards Apps nativ in Python, ohne dass Kenntnisse in anderen Programmiersprachen für Front-End Gestaltung nötig sind. Für tiefergehende Anpassungen können aber CSS oder JavaScript Bestandteile eingebunden werden. - Dash nutzt Plotly Grafiken und erweitert diese um Input Möglichkeiten wie z.B. Dropdown Filter, Schieberegler oder andere reaktive Elemente. - Dash Code kann seit Version 2.11 direkt in Jupyter Notebooks ausgeführt werden und ermöglicht so schnelle und aussagekräftige Visualisierungen mit Dashboards in Data Science Kontexten. # Implementieren einer Dash App Wir stellen im Folgenden den Aufbau einer Dash-App vor. ## App Layout Es folgt ein Beispiel für eine Basis Dash App (siehe Abbildung 1), die eine einzige Plotly Grafik anzeigt, ohne eine Möglichkeit für User-Input. Nach dem Importieren der benötigten Bibliotheken und dem Initialisieren einer leeren App wird ein Sub-Dataframe erstellt. Dieser basiert auf dem Superstore Sample Dataset. Dann wird ein statischer Barplot erstellt und das App Layout definiert. In einem div HTML-Element wird die erstellte Grafik referenziert und für spätere Anpassungen HTML Klassen definiert. ``` ``` from dash import Dash, html, dcc, Input, Output import plotly.express as px ``` #app init app = Dash(__name__) #sub dataframe df_bar_plot = df.groupby(['Category', 'Sub-Category']).agg({'Sales': 'sum', 'Profit': 'sum'}).reset_index() # create a static plot fig = px.bar(df_bar_plot, x='Category', y='Sales', color='Sub-Category', barmode='stack', text='Sub-Category') fig.update_traces(textposition='auto', textfont_size=10, width=0.8) fig.update_xaxes(tickangle=45) #define app layout app.layout = html.Div([ dcc.Graph(id='bar-plot', figure=fig, className='full-width-graph') ], className='main-container') #run app if __name__ == '__main__': app.run_server(debug=True, port=8081) ``` Nach dem Ausführen der Dash App sieht das Resultat wie folgt aus. ![](https://thecattlecrew.net/wp-content/uploads/2024/01/Screenshot-2023-12-20-at-18.27.23.png)Abbildung 1: Basis-App mit einem Barchart Die resultierende App unterscheidet sich auf den ersten Blick nicht von einer einfachen Plotly Grafik. Im unteren Bereich finden sich jedoch 3 Icons, die den Dash Status wiedergeben. Zum einen den Status des Servers, der in diesem Fall der lokale Rechner ist, dann mögliche Fehler und zuletzt vorhandene Callbacks. ## Multi-Page Apps In Dash ist es auch möglich Apps mit mehreren Seiten zu erstellen. Das Navigieren kann über Links und Klickpfade erfolgen. Ein Layout mit einzelnen Tabs pro Seite ist genauso möglich. Der Aufbau einer Multi-Page App kann in drei Layout Elemente unterteilt werden: 1. Das Hauptlayout, das den Aufbau der App und Unterseiten beschreibt. In diesem Beispiel werden für die App drei Seiten jeweils als Tab festgesetzt und mit Label versehen. ``` app.layout = html.Div([ dcc.Tabs(id="tabs", value='tab-1', className='dash-tab-label' ,children=[ dcc.Tab(label='Sales by Category', value='tab-1'), dcc.Tab(label='Sales by State', value='tab-2'), dcc.Tab(label='Product Analysis', value='tab-product-analysis') ]), html.Div(id='tabs-content') ]) ``` 2\. Den Seitenlayouts die aufgerufen werden, wenn ein Tab oder eine Seite aufgerufen wird. ``` elif tab == 'tab-1': return html.Div([ html.Div([ html.Label('Year', className='dropdown-label'), dcc.Dropdown( id='year-dropdown', options=year_options, value=years[0], clearable=False, className='dropdown-quarter-width' ) ], className='dropdown-container'),-content') ]) ``` 3\. Den Callbacks der einzelnen Seiten, die auch miteinander verknüpft sein können. Wie diese funktionieren wird im nächsten Abschnitt erklärt. Abschließend zum Thema Multi-Page Apps noch ein Beispiel, wie eine Tab-basierte App aussehen kann. Im oberen Reiter kann auf die einzelnen Seiten zugegriffen werden ![](https://thecattlecrew.net/wp-content/uploads/2024/01/Screenshot-2023-12-21-at-13.45.24.png)Abbildung 2: Tab-basierte Dash-App mit drei Seiten ## Interaktivität durch Callbacks Callbacks ermöglichen eine Interaktion des Users mit den angezeigten Daten. Über z.B. das Auswählen von Werten in einem Dropdown Filter oder das Bewegen eines Sliders werden bestimmte Elemente eines Dashboards aktualisiert und die Darstellung angepasst. Der Code im folgenden Block generiert drei Callbacks für das zuvor gezeigte Basis Dashboard. ``` @app.callback( Output('bar-plot', 'figure'), [Input('year-dropdown', 'value'), Input('sub-category-dropdown', 'value'), Input('profit-range-slider', 'value')] ) def update_bar_chart(selected_year, selected_sub_categories, selected_profit_range): # Filter based on the selected year filtered_df = df[df['Order Date'].dt.year == selected_year] # Aggregate data agg_df = filtered_df.groupby(['Category', 'Sub-Category']).agg({'Sales': 'sum', 'Profit': 'sum'}).reset_index() # Apply sub-category filter if sub-categories are selected if selected_sub_categories: agg_df = agg_df[agg_df['Sub-Category'].isin(selected_sub_categories)] # Filter sub-categories based on total profit agg_df = agg_df[(agg_df['Profit'] >= selected_profit_range[0]) & (agg_df['Profit'] **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Open Source, Python, Reports --- ### [Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) **Published:** März 18, 2025 **Author:** Torsten Jaeschke **Content:** Die Sicherheit von Kubernetes-Umgebungen ist keine einmalige Aufgabe, sondern ein **dynamischer und kontinuierlicher Prozess**. Wer Kubernetes produktiv einsetzt, weiß: Es reicht nicht aus, die Cluster-Umgebung einmal sicher zu konfigurieren – Bedrohungen entwickeln sich weiter, und mit ihnen die Abwehrstrategien. In dieser Blogserie haben wir die größten Sicherheitsrisiken, bewährte Schutzmaßnahmen und innovative Strategien beleuchtet. Zum Abschluss ziehen wir in diesem siebten und letzten Teil der Serie ein Fazit und werfen einen Blick auf zukünftige Entwicklungen. --- *Sie steigen gerade erst ein? Hier finden Sie Teil 1 bis 6 dieser Serie sowie das Video des Webcasts, auf dem die Serie aufbaut:* [*Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie*](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [*Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen*](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [*Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren*](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [*Video: Kubernetes Security Webcast*](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- ## 1. Risiken erkennen und proaktiv gegensteuern Kubernetes-Cluster sind hochattraktive Ziele für Angreifer. Eine ungesicherte API-Schnittstelle, falsch konfigurierte RBAC-Rollen oder ein kompromittierter Container – oft reicht ein einziges Einfallstor, um Zugriff auf das gesamte Cluster zu erlangen. Neben bekannten Bedrohungen wie Container Escape Attacks oder Kryptomining rücken Supply-Chain-Angriffe und Insider-Bedrohungen zunehmend in den Fokus. **Praxisbeispiel:** Ein IT-Team stellte fest, dass ein Entwickler versehentlich ein Kubernetes-Manifest mit hartkodierten Zugangsdaten in ein öffentliches GitHub-Repository hochgeladen hatte. Innerhalb weniger Stunden tauchten verdächtige Container im Cluster auf, die Krypto-Mining-Software ausführten. Nur durch schnelle Reaktionsmaßnahmen – Rotieren aller Secrets, Isolieren der betroffenen Pods und ein forensisches Log-Review – konnte ein größerer Schaden verhindert werden. ### ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-2.png) **Lösungsansatz** Unternehmen sollten regelmäßig Security Audits durchführen, Least-Privilege-Richtlinien implementieren und den Zugriff auf Cluster-Ressourcen strikt beschränken. ## 2. Automatisierung und Kontrolle im Fokus Um Kubernetes sicher zu betreiben, müssen Best Practices nicht nur definiert, sondern auch automatisiert und regelmäßig überprüft werden. **Hier einige Kernstrategien:** - Minimaler Zugriff (Least Privilege): Berechtigungen granular verwalten und regelmäßig auditieren. - Security-Scans automatisieren: Container-Images und Infrastruktur als Code kontinuierlich scannen. - Netzwerksegmentierung optimieren: Klare Trennung zwischen internen und externen Services. - RBAC-Richtlinien gezielt überwachen: Unerwünschte Privilegien mit Automatisierungstools aufdecken. - Echtzeit-Logging & Alerting ausweiten: Sicherheitsrelevante Ereignisse sichtbar machen und mit Eskalationsstufen kombinieren. ### **![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-2.png)Technik-Tipp** Ein oft übersehener Bereich ist die sichere Container-Registry. Images sollten nur aus vertrauenswürdigen Quellen bezogen und durch Signaturen abgesichert werden, um Manipulationen zu erkennen und kompromittierte Anwendungen zurückzuweisen. ## 3. Sicherheitsvorfälle effizient im Griff mit Incident Response Angriffe lassen sich nie komplett verhindern – entscheidend ist, wie schnell und strukturiert darauf reagiert wird. Unternehmen, die ihre Incident-Response-Prozesse regelmäßig testen und optimieren, sind klar im Vorteil. ### Best Practices für eine effektive Reaktionsstrategie - Zentrales Logging: Alle sicherheitsrelevanten Events mit Loki, Elasticsearch oder Splunk erfassen. - Automatisiertes Alerting: Kritische Ereignisse mit Prometheus, Grafana und SIEM-Systemen eskalieren. - Forensik-Analysen stärken: Langfristige Audit-Logs für retrospektive Untersuchungen archivieren. - Tabletop-Exercises und Angriffssimulationen: Sicherheitsvorfälle regelmäßig durchspielen, um Abläufe zu verbessern. ### **![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-2.png)Praxisbeispiel:** In einem Unternehmen wurde eine Sicherheitslücke im Kubernetes-Cluster übersehen, die es Angreifern ermöglichte, sensible Daten zu exfiltrieren. Da das Team gut vorbereitet war, konnten Logs innerhalb weniger Minuten ausgewertet, der betroffene Pod isoliert und die Schwachstelle innerhalb von Stunden geschlossen werden. Ohne diesen klaren Incident-Response-Plan hätte es mehrere Tage kosten können. ## 4. Zero Trust in Kubernetes: Der nächste Schritt Das klassische Perimeter-Sicherheitsmodell hat ausgedient. Zero Trust geht davon aus, dass kein Benutzer oder System von Natur aus vertrauenswürdig ist. Dieses Konzept gewinnt in Kubernetes-Umgebungen zunehmend an Bedeutung. ### Kernstrategien für Zero Trust in Kubernetes - Pod-Sicherheitsrichtlinien verschärfen: Nur notwendige Berechtigungen und Ressourcen zuweisen. - IAM-Optimierung: Adaptive Rollenverwaltung und regelmäßige Überprüfung von Berechtigungen. - Workloads verschlüsseln: Daten bei der Übertragung und im Ruhezustand absichern. - Service Meshes nutzen: Istio oder Linkerd zur Absicherung von Service-Kommunikation einsetzen. ### ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-2.png)Technik-Tipp eBPF-basierte Sicherheitsmechanismen ermöglichen eine tiefgehende Überwachung der Systemprozesse, ohne die Performance zu beeinträchtigen. ## 5. Zukunftsausblick: Kubernetes-Sicherheit im Wandel Die Kubernetes-Sicherheitslandschaft entwickelt sich stetig weiter. Diese Trends werden in den kommenden Jahren prägend sein: - KI-gestützte Threat Detection: Machine Learning für Anomalie-Erkennung in Echtzeit. - Policy-as-Code: Sicherheitsrichtlinien als Code standardisieren und versionieren. - eBPF-basierte Überwachung: Effiziente Laufzeit-Sicherheitsanalysen mit minimalem Overhead. - Self-Healing-Infrastrukturen: Automatisierte Reaktionen auf Sicherheitsvorfälle. ### ![Icon: Glühbirne](https://thecattlecrew.net/wp-content/uploads/2025/03/icon-gluehbirne-2.png) Praxisbeispiel Einige Unternehmen setzen bereits auf AI-basierte Sicherheitslösungen, die Kubernetes-Logs in Echtzeit analysieren und verdächtiges Verhalten automatisch erkennen. Der Vorteil? Sicherheitsvorfälle können erkannt und automatisiert eingedämmt werden, noch bevor Schaden entsteht. ## Fazit: Kubernetes-Sicherheit ist ein dynamischer Prozess Kubernetes-Sicherheit bedeutet **kontinuierliches Lernen**, **Optimieren** und **Automatisieren**. Wer sich allein auf einmalige Maßnahmen verlässt, läuft Gefahr, überrollt zu werden. Erfolgreiche Unternehmen setzen auf eine Kombination aus **Best Practices**, **Automatisierung** und **proaktiver Überwachung**: ![Der Kubernetes Sicherheitslebenszyklus als Kreisdiagramm: Von Sicherheit planen, Sicherheit umsetzen, und Sicherheit überwachen bis Verbesserung kontinuierlich und auf Vorfälle reagieren](https://thecattlecrew.net/wp-content/uploads/2025/03/kubernetes-sicherheitslebenszyklus.png)**Jetzt heißt es:** - Sicherheitskonzepte aus dieser Blogserie in die Praxis umsetzen. - Bestehende Sicherheitsmechanismen regelmäßig evaluieren und weiterentwickeln. - Den technologischen Wandel aktiv mitgestalten. **Die Devise: Nicht nur auf Angriffe reagieren, sondern immer einen Schritt vorausdenken!** --- ### Noch einmal nachlesen? Hier finden Sie alle Artikel dieser Serie: [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) Einen Blick wert: Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- Mit diesem letzten Teil endet unsere Blogserie zur Kubernetes-Sicherheit – doch der Schutz Ihrer Cluster ist ein fortlaufender Prozess. Nutzen Sie die Erkenntnisse aus dieser Serie, optimieren Sie Ihre Sicherheitsstrategien und bleiben Sie Angreifern immer einen Schritt voraus. **Bleiben Sie wachsam, bleiben Sie sicher – und diskutieren Sie mit uns weiter über die Zukunft der Kubernetes-Sicherheit!** **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Unerlaubte Zugriffe in Kubernetes: Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) **Published:** Februar 7, 2025 **Author:** Torsten Jaeschke **Content:** Unerlaubte Zugriffe zählen zu den häufigsten und gefährlichsten Sicherheitsbedrohungen in Kubernetes-Umgebungen. Ohne eine granulare Zugriffskontrolle können Angreifer schnell Schwachstellen ausnutzen, um Zugang zu sensiblen Ressourcen zu erhalten. Wie im klassischen IT-Betrieb sind klare Zugriffsbeschränkungen unerlässlich, doch Kubernetes bringt zusätzliche Herausforderungen und Chancen mit sich. In diesem zweiten Teil unserer Serie zu Kubernetes Security erfahren Sie: - Warum unautorisierte Zugriffe ein Risiko darstellen. - Welche Tools und Methoden Sie nutzen können, um Zugriffe granular zu kontrollieren. - Wie Sie Ihre Umgebung effektiv absichern können. --- *Sie steigen gerade erst ein? Hier finden Sie Teil 1 mit einer Übersicht zur Serie sowie den Link zu unserem Webcast, auf dem die Serie aufbaut:* [*Kubernetes-Sicherheit im Fokus: Best Practices und Strategie*](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [*Kubernetes Security Webcast*](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- ## Warum granularer Zugriffsschutz entscheidend ist Anders als bei herkömmlichen IT-Systemen müssen Kubernetes-Cluster viele verschiedene Komponenten absichern: Pods, Nodes, Secrets und APIs. Ohne abgegrenzte Autorisierung können selbst interne Nutzer oder Anwendungen versehentlich Sicherheitslücken öffnen. ## Effektive Schutzmaßnahmen im Detail ### 1. Granulare Zugriffskontrolle mit RBAC (Role-Based Access Control) RBAC Autorisierung ist ein Kubernetes Bordmittel. Es ermöglicht, den Zugriff auf Kubernetes-Ressourcen für Benutzer und Anwendungen zu reglementieren. So stellen Sie sicher, dass jeder nur das tun kann, was unbedingt erforderlich ist. **Beispiel:** Der folgende YAML-Ausschnitt erstellt eine Rolle, die nur Lesezugriff auf Pods erlaubt: ``` kind: Role apiVersion: rbac.authorization.k8s.io/v1 metadata: namespace: development name: pod-reader rules: - apiGroups: [""] resources: ["pods"] verbs: ["get", "list", "watch"] ``` Zusätzlich hilft **Kubescape**, um sicherzustellen, dass RBAC-Policies korrekt angewendet werden. Führen Sie dazu einfach den folgenden Befehl aus: ``` kubescape scan framework rbac ``` ### 2. Richtlinien für den Netzwerk-Zugriff Wie die RBAC gehören auch die Network Policies zu den Kubernetes Bordmitteln. Sie regeln den Cluster-internen IP- und Port-Zugriff und verhindern, dass Pods und Services unkontrolliert miteinander kommunizieren. Ein Beispiel: Nur Pods mit der Rolle „backend“ dürfen auf eine Datenbank zugreifen: ``` kind: NetworkPolicy apiVersion: networking.k8s.io/v1 metadata: name: allow-backend-to-database namespace: production spec: podSelector: matchLabels: app: database ingress: - from: - podSelector: matchLabels: role: backend ``` ### 3. Admission Policies zur Absicherung Admission Controller prüfen API-Anfragen und verhindern nicht autorisierte Aktionen. Mit **Kyverno** können Sie beispielsweise sicherstellen, dass nur Images aus einem vertrauenswürdigen Repository genutzt werden: ``` apiVersion: kyverno.io/v1 kind: ClusterPolicy metadata: name: restrict-image-repo spec: rules: - name: validate-image-repo match: resources: kinds: - Pod validate: message: "Images must be from trusted.registry.com." pattern: spec: containers: - image: "trusted.registry.com/*" ``` ## Zusammenfassung Eine Kombination aus RBAC, Admission Policies und Netzwerkisolation bietet eine starke Verteidigung gegen unautorisierte Zugriffe. Tools wie **Kubescape** und **Kyverno** erleichtern die Umsetzung und sorgen für eine kontinuierliche Überwachung. ## Kubernetes-Sicherheit weiterdenken! Kubernetes mit seinen Bordmitteln ist mächtig – aber auch anfällig für Bedrohungen. In unserer Artikelserie beleuchten wir kritische Sicherheitsaspekte und zeigen praxiserprobte Lösungen. Freuen Sie sich auf weitere Analysen, Best Practices und konkrete Codebeispiele zu diesen wichtigen Themen: - Sichere Architektur für Kubernetes-Cluster - Bedrohungserkennung in Echtzeit - Sicherheitsmaßnahmen direkt in den Entwicklungsprozess einbinden --- ## Die Blog-Serie komplett Hier finden Sie alle Teile unserer siebenteiligen Blog-Serie: [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) Einen Blick wert: Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- Haben Sie eigene Erfahrungen oder Fragen? Teilen Sie sie in den Kommentaren oder kontaktieren Sie uns. Gemeinsam stärken wir Ihre Kubernetes-Sicherheit! **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Unsichere Kubernetes-Systeme absichern: Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) **Published:** Februar 14, 2025 **Author:** Torsten Jaeschke **Content:** **Unsichere Systeme** sind eine tickende Zeitbombe in Kubernetes-Umgebungen. Fehlerhafte Konfigurationen, veraltete Images oder unzureichende Ressourcenbegrenzungen bieten eine breite Angriffsfläche. In diesem dritten Teil unserer Serie zu Kubernetes Security zeigen wir Ihnen, wie Sie mit den richtigen Tools und Best Practices Ihre Umgebung absichern und automatisieren können. --- *Sie steigen gerade erst ein? Hier finden Sie Teil 1 und 2 dieser Serie sowie das Video des Webcasts, auf dem die Serie aufbaut:* [*Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie*](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [*Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen*](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [*Video: Kubernetes Security Webcast*](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- ## **Schwachstellen frühzeitig erkennen und beheben** Mit automatisierte Schwachstellenscans und Ressourcenlimits und Quotas können Sie viel für die Sicherheit Ihrer Systeme erreichen. Aber bei der Aufsetzung ist einiges zu beachten. Darum geht es: ### **1. Automatisierte Schwachstellenscans** **Container Scanning und Sicherheitsrichtlinien:** Manuelles Überprüfen ist ineffizient – automatisierte Tools wie **Trivy** oder **Clair** bieten hier entscheidende Vorteile. Sie scannen Container-Images auf bekannte Sicherheitslücken und lassen sich in CI/CD-Pipelines integrieren: Beispiel für **Trivy** in einer Pipeline: ``` scan: stage: security image: aquasec/trivy:latest script: - trivy image my-image:latest ``` Ergänzend dazu hilft **Kubescape**, Sicherheitsrichtlinien auf Clusterebene zu überprüfen, indem es ermöglicht den Cluster gegen verschiedene Sicherheitsframeworks zu testen. Kubescape bietet bisher Unterstützung für folgende Frameworks: - NSA – basiert auf dem Kubernetes Hardening Guide der NSA und CISA - MITRE – basiert auf dem MITRE ATT&CK® Framework - CIS – basiert auf den CIS Benchmarks für Kubernetes und ist in drei Varianten vertreten: für Standard Kubernetes, und für Managed Kubernetes jeweils in Azure oder in AWS Eine Auflistung der unterstützen Frameworks kann über folgenden Aufruf angezeigt werden: ``` kubescape list frameworks ``` Es ist ebenfalls möglich mit einem Aufruf auf unterschiedlichen Frameworks zu testen. Dazu werden die Frameworks kommasepariert im Scan-Befehl aufgeführt: ``` kubescape scan framework nsa,mitre,cis-v1.23-t1.0.1 ``` **HELM Chart Scanning:** Nicht nur Container-Images, sondern auch HELM Charts können Schwachstellen enthalten. Tools wie **Trivy** oder **Checkov** helfen, fehlerhafte oder unsichere Konfigurationen zu erkennen. Trivy für HELM Chart Scans: ``` trivy config /path/to/helm/chart ``` Checkov für Infrastructure-as-Code (IaC) Scans: ``` checkov -d /pfad/zu/helm/chart ``` In diesem Beispiel hat Checkov eine unsichere Konfiguration erkannt. Es fehlt eine SecurityContext-Konfiguration, was ein Sicherheitsrisiko darstellt: ``` apiVersion: apps/v1 kind: Deployment metadata: name: my-app spec: template: spec: containers: - name: app image: my-image:latest ``` ### 2. Ressourcenlimits und Quotas setzen Unbegrenzte Ressourcen können den gesamten Cluster lahmlegen oder einen Denial-of-Service (DoS) durch fehlerhafte Pods verursachen. Kubernetes bietet zwei Mechanismen zur Begrenzung: - **ResourceQuotas** – Begrenzen die maximal nutzbaren Ressourcen von CPU, Memory und Storage innerhalb eines Namespace - **LimitRanges** – Definieren Default-Limits für einzelne Pods **ResourceQuota – Globale Limits für einen Namespace:** Mit ResourceQuotas kann verhindert werden, dass ein einzelner Namespace den Cluster monopolisiert. Beispiel: ResourceQuota für CPU und Speicher ``` apiVersion: v1 kind: ResourceQuota metadata: name: compute-resources namespace: production spec: hard: requests.cpu: "4" requests.memory: "8Gi" limits.cpu: "10" limits.memory: "16Gi" pods: "20" ``` *Erklärung:* requests.cpu/memory – Minimale garantierte Ressourcen limits.cpu/memory – Maximale Nutzung pro Namespace pods – Begrenzung der Gesamtanzahl an Pods *Warum ist das wichtig?* – Es wird verhindert, dass einzelne Teams zu viele Ressourcen beanspruchen. – Es werden Obergrenzen gesetzt, um eine Überlastung des Clusters zu vermeiden. **LimitRange – Standardwerte für Pods setzen:** Während **ResourceQuotas** auf Namespace-Ebene arbeiten, ermöglichen **LimitRanges**, dass jeder Pod oder Container innerhalb eines Namespace Mindest- und Höchstwerte für CPU und RAM bekommt. Beispiel – LimitRange für Container-Limits: ``` apiVersion: v1 kind: LimitRange metadata: name: container-defaults namespace: production spec: limits: - default: cpu: "500m" memory: "512Mi" defaultRequest: cpu: "200m" memory: "256Mi" type: Container ``` *Erklärung:* default – Maximale Ressourcen, die ein Container erhalten kann. defaultRequest – Standardanforderungen für neue Container. *Warum ist das wichtig?* – Erzwingt Limits, selbst wenn Entwickler sie nicht explizit setzen. – Verhindert, dass ein Container den gesamten Namespace überlastet. **Sicherstellen der Limits mit Kyverno:** Tools wie Kyverno helfen, dass alle neuen Pods automatisch Limits enthalten, wenn sie nicht explizit gesetzt sind. Beispiel – Kyverno Policy zur Erzwingung von Ressourcenlimits: ``` apiVersion: kyverno.io/v1 kind: ClusterPolicy metadata: name: enforce-resource-limits spec: validationFailureAction: Enforce rules: - name: check-container-resources match: resources: kinds: - Pod validate: message: "CPU und Memory Limits sind erforderlich!" pattern: spec: containers: - resources: limits: cpu: "?*" memory: "?*" ``` *Vorteile:* – Pods ohne CPU- oder Memory-Limits werden blockiert. – Automatisiert die Durchsetzung von Best Practices. ## Zusammenfassung Automatisierte Scans und Ressourcenmanagement sind essenziell, um Schwachstellen und Sicherheitsrisiken zu minimieren und Cluster-Überlastung zu vermeiden. Setzen Sie auf Tools wie **Trivy**, **Clair**, **Kubescape** und **Checkov**, um proaktiv Sicherheitslücken zu erkennen, zu beheben und die Durchsetzung dieser Regeln zu automatisieren. ## Mehr Sicherheit für Ihre Kubernetes-Umgebung! Kubernetes bietet enorme Flexibilität – aber auch neue Angriffsflächen. In dieser Artikelserie zeigen wir, wie Sie Risiken minimieren und Ihre Cluster effektiv absichern. ### Was erwartet Sie? - Strategien gegen unbefugte Zugriffe - Best Practices für eine widerstandsfähige Kubernetes-Architektur - Methoden zur frühzeitigen Bedrohungserkennung - Sicherheit von Anfang an in Ihre Entwicklung integrieren --- ## Lesen Sie die ganze Serie! Alle Teile diese 7-Teilers finden Sie hier: [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) Einen Blick wert: Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://youtu.be/s5o6TOnt-EM) --- Teilen Sie Ihre Erfahrungen oder stellen Sie Fragen in den Kommentaren. Gemeinsam entwickeln wir bessere Kubernetes-Sicherheitsstrategien! **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Shift-Left-Security: Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) **Published:** März 12, 2025 **Author:** Torsten Jaeschke **Content:** Wenn Sicherheitslücken erst spät im Entwicklungsprozess entdeckt werden – wie es leider oft der Fall ist – erzeugt das hohe potenzielle Risiken und Kosten. Shift-Left-Security setzt genau hier an: Sicherheitsmaßnahmen werden frühzeitig in den Entwicklungsprozess integriert, um Schwachstellen schnell zu identifizieren und zu beheben. Gerade in Kubernetes-Umgebungen ist ein strukturierter Sicherheitsansatz essenziell, da containerisierte Workloads spezifische Herausforderungen mit sich bringen. --- *Sie steigen gerade erst ein? Hier finden Sie Teil 1 bis 5 dieser Serie sowie das Video des Webcasts, auf dem die Serie aufbaut:* [*Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie*](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [*Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen*](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [*Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren*](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [*Video: Kubernetes Security Webcast*](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- ## Warum frühe Sicherheitsmaßnahmen entscheidend sind Früher wurden Sicherheitsprüfungen oft erst am Ende des Entwicklungszyklus durchgeführt – mit teuren Nachbesserungen und Verzögerungen als Folge. Heute setzt sich zunehmend die **frühzeitige Integration von Security in den Entwicklungsprozess** durch. Durch die Einbindung von **Sicherheits-Scans in CI/CD-Pipelines** können Schwachstellen bereits in frühen Phasen erkannt und behoben werden. Automatisierte Security-Tools analysieren **Code, Container-Images und Konfigurationsdateien**, um Sicherheitsrisiken zu minimieren. ## Sicherheitsherausforderungen in Kubernetes Kubernetes bietet **Skalierbarkeit und Automatisierung**, erfordert aber auch eine konsequente Sicherheitsstrategie. Fehlkonfigurationen oder unsichere Container-Images können Angriffsflächen schaffen. Daher ist es entscheidend, **Security-Richtlinien strikt einzuhalten und regelmäßig zu überprüfen**. In unserer Artikelserie haben wir bereits bewährte **Security-Tools für Kubernetes** vorgestellt: - **Trivy**: Scannt Container-Images auf bekannte Schwachstellen - **Kubescape**: Prüft Kubernetes-Konfigurationen und sorgt für Compliance - **Falco**: Überwacht Kubernetes-Cluster in Echtzeit und erkennt verdächtige Aktivitäten - **Checkov**: Statische Analyse für IaC, um sichere Deployments zu gewährleisten - **SonarQube & Snyk**: Scannen Code und Abhängigkeiten auf Sicherheitsrisiken Diese Werkzeuge helfen dabei, **Sicherheitsprobleme frühzeitig zu identifizieren und Kubernetes-Cluster resilienter zu machen**. Ein weiteres wichtiges Thema ist die **Software Bill of Materials (SBOMs)**, die Transparenz über genutzte Softwarekomponenten schafft. Mehr dazu gibt es in unserer separaten **SBOM-Artikelserie auf dem Cattlecrew Blog**. ## Wirtschaftliche Betrachtung: Sicherheit als Investition Die frühzeitige Identifikation von Sicherheitslücken führt zu erheblichen Kosteneinsparungen. Studien zeigen: Die Behebung einer Sicherheitslücke in der Produktionsumgebung kann bis zu 100-mal teurer sein als eine Korrektur in der Entwicklungsphase. Laut der Analyse des Artikels [„Economics of Shift Left Security“](https://stellarcyber.ai/economics-of-shift-left-security/) von Stellar Cyber liegen die wirtschaftlichen Vorteile vor allem in reduzierten Kosten und geringeren Ausfallzeiten. ### Fokus auf Kubernetes und DevSecOps Besonders im DevOps- und DevSecOps-Umfeld mit Kubernetes zeigt sich der Effekt von „Shift Left Security“. Modell 2, das sich auf DevSecOps konzentriert, verdeutlicht dies eindrücklich**:** - Behebung von Sicherheitslücken in der Entwicklungsphase **(Shift-Left)**: Ø 3,61 Stunden - Behebung nach der Produktion **(Shift-Right)**: Ø 10,71 Stunden - Reduktion der mittleren Behebungszeit von Sicherheitslücken bei hoher Scan-Frequenz: von 217 auf 62 Tage (–71 %) Diese proaktive Herangehensweise senkt den finanziellen und personellen Aufwand für Entwickler- und Sicherheitsteams und minimiert das Risiko teurer Datenverletzungen. ### Nachhaltiger Wettbewerbsvorteil Die Analyse zeigt, dass Unternehmen durch „Shift Left Security“ effizienter werden und Risiken verringern. Dies stärkt die Marktposition, da verlässliche Sicherheitspraktiken zu mehr Vertrauen führen. Kunden bevorzugen zunehmend sichere Lösungen – wer früh in Security investiert, sichert sich klare Vorteile. ## Schulung & Awareness: Ein starkes Team als Sicherheitsfaktor **Tools allein reichen nicht aus** – das Security-Bewusstsein im Team ist entscheidend. Entwickler sollten regelmäßig zu den **OWASP Top 10, SANS Top 25 und anderen Sicherheitsstandards** geschult werden. Gerade Kubernetes bringt viele Vorteile, erfordert aber spezialisiertes Wissen. **Ein geschultes Team kann Risiken proaktiv minimieren** und Sicherheitsstrategien gezielt umsetzen. ## Fazit: Security von Anfang an mitdenken! Sicherheit sollte **nicht erst am Ende**, sondern **von Anfang an** in den Entwicklungsprozess integriert werden. Der Einsatz von **automatisierten Security-Scans, bewährten Analysetools und gezielten Schulungen** hilft dabei, Risiken zu minimieren und langfristige Kosten zu senken. Gerade in Kubernetes-Umgebungen ist eine frühzeitige Sicherheitsstrategie entscheidend, um **stabile, sichere und skalierbare Anwendungen** bereitzustellen. ### Was bedeutet das für Ihre Organisation, Ihr Unternehmen? - Wie sicher ist Ihre **aktuelle Kubernetes-Umgebung**? - Nutzen Sie bereits **automatisierte Security-Scans** in Ihren Pipelines? - Ist Ihr Team mit den **wichtigsten Security-Standards** vertraut? Falls nicht, ist jetzt der richtige Zeitpunkt, **Ihre Sicherheitsstrategie zu überdenken**. Setzen Sie auf **bewährte Methoden und moderne Security-Tools**, um Ihre Anwendungen von Anfang an zu schützen. Ein durchdachter Security-Ansatz hilft dabei, Kubernetes-Umgebungen langfristig sicher und stabil zu halten. ## Kubernetes absichern – Praxiswissen & Best Practices! Kubernetes-Sicherheit ist entscheidend, um Ihre Anwendungen zu schützen. In dieser Artikelserie zeigen wir, welche Maßnahmen wirklich funktionieren. Folgende Themen erwarten Sie: - Schutzmechanismen gegen unbefugte Zugriffe - Best Practices für sichere Kubernetes-Architekturen - Bedrohungen frühzeitig erkennen & abwehren - Sicherheit von Anfang an in den Entwicklungsprozess integrieren --- ### Alle Artikel der Serie auf einen Blick [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) **Einen Blick wert:** Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- Tauschen Sie sich mit uns aus! Welche Herausforderungen begegnen Ihnen in der Kubernetes-Sicherheit? Wir freuen uns auf Ihre Kommentare & Fragen. **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) **Published:** Januar 31, 2025 **Author:** Torsten Jaeschke **Content:** Die Sicherheit von Kubernetes-Umgebungen ist ein entscheidender Erfolgsfaktor für moderne Softwarearchitekturen. Kubernetes bietet immense Flexibilität und Skalierbarkeit – doch ohne gezielte Sicherheitsmaßnahmen können Risiken entstehen, die schwerwiegende Folgen haben. In unserem [Webcast „Kubernetes Security – Schmerzpunkte und Lösungen“](https://www.opitz-consulting.com/kompetenz/kubernetes-security) haben wir zentrale Herausforderungen und effektive Lösungsstrategien diskutiert. Unser Ziel war es, Softwarearchitekten und DevOps-Teams praxisnahe Ansätze an die Hand zu geben, um Kubernetes-Cluster wirksam zu schützen. --- In diesem ersten Artikel unserer 7-teiligen Blog-Serie möchten wir Ihnen einen Überblick geben über die wichtigsten Themen aus dem Kubernetes Security Webcast. In weiteren Artikeln der Serie haben wir diese Themen weiter zu vertieft. Freuen Sie sich auf konkrete Tipps und Best Practices! Zu den weiterführenden Artikeln kommen Sie ganz unten in diesem Beitrag. --- ## **Kubernetes-Sicherheit: Die Schlüsselthemen im Überblick** Im oben erwähnte Webcast haben wir uns vier zentrale Aspekte der Kubernetes-Sicherheit angesehen: 1. **Unerlaubte Zugriffe verhindern** 2. **Unsichere Systeme absichern** 3. **Verdächtiges Verhalten erkennen** 4. **Shift-Left-Security umsetzen** Diese vier Aspekte bilden das Fundament für eine sichere Kubernetes-Umgebung. Worum geht es dabei im Einzelnen? Hier eine kurze Erläuterung zu den Webcast-Themen: ### **1. Unerlaubte Zugriffe – ein oft unterschätztes Risiko** Ein großes Risiko in Kubernetes-Umgebungen sind unautorisierte Zugriffe. Granulare Zugriffskontrollen sind entscheidend, um sensible Daten und Services zu schützen. Wir haben im Webcast gezeigt, wie Sie **RBAC (Role-Based Access Control)** und Netzwerkisolation effektiv einsetzen können. Zusätzlich haben wir Tools wie **Kubescape** und **Kyverno** vorgestellt, die Ihnen dabei helfen, Sicherheitsrichtlinien zu definieren und durchzusetzen. Der Fokus lag auf praxisnahen Tipps zur Minimierung von Angriffsflächen. ### **2. Unsichere Systeme – eine tickende Zeitbombe** Von veralteten Images bis hin zu unzureichenden Ressourcenlimits: Schwachstellen in Kubernetes-Systemen sind oft die Ursache für Sicherheitsvorfälle. Automatisierte Schwachstellenscans mit Tools wie **Trivy** oder **Clair** können hier Abhilfe schaffen. Zusätzlich haben wir erklärt, wie Sie Ressourcen effizient begrenzen können, um Überlastungen zu vermeiden. **Kontinuierliche Überwachung** und Automatisierung waren zentrale Empfehlungen, um Systeme langfristig sicher und stabil zu halten. ### **3. Verdächtiges Verhalten – Angriffe frühzeitig erkennen** Ein auffälliges Verhalten in Kubernetes-Umgebungen kann ein Hinweis auf Sicherheitsvorfälle sein. Mithilfe von **Laufzeitüberwachungs-Tools** wie **Falco** lässt sich verdächtiges Verhalten in Echtzeit erkennen. Wir haben konkrete Beispiele aus der Praxis vorgestellt, die zeigen, wie anomales Verhalten identifiziert und darauf reagiert werden kann. Eine Kombination aus Echtzeitüberwachung und Compliance-Checks ist hierbei unverzichtbar, um potenzielle Sicherheitslücken zu minimieren. ### **4. Shift-Left-Security – Sicherheit frühzeitig integrieren** Sicherheitsmaßnahmen sollten nicht erst in der Produktion beginnen. **Shift-Left-Security** bedeutet, dass Sicherheitsmechanismen bereits in frühen Entwicklungsphasen implementiert werden. Automatisierte Tests und statische Codeanalysen helfen, Schwachstellen frühzeitig zu identifizieren. Im Webcast haben wir gezeigt, wie **Sicherheitsrichtlinien** direkt in CI/CD-Pipelines integriert werden können. Tools wie **Kubescape** bieten hier praktische Lösungen. ## **Warum Kubernetes-Sicherheit mehr ist als Technologie** Sicherheit in Kubernetes ist kein rein technisches Thema. Es geht um das Zusammenspiel aus kulturellem Bewusstsein, organisatorischen Richtlinien und den richtigen Technologien. Ziel sollte es daher sein, Teams dabei zu unterstützen, ein ganzheitliches Verständnis für Kubernetes-Sicherheit zu entwickeln. ## **Bleiben Sie in der Kubernetes-Security einen Schritt voraus!** Kubernetes ist leistungsstark – aber auch anfällig für Sicherheitsrisiken. In unserer kommenden Artikelserie tauchen wir tiefer in die einzelnen Themen ein und zeigen praxisnahe Lösungen auf. Lesen Sie den nächsten Teil dieser Serie: [Wie Sie Ihre Cluster vor unbefugten Zugriffen schützen.](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) Und freuen Sie sich auf weitere fundierte Einblicke, Codebeispiele und konkrete Handlungsempfehlungen zu den vier oben genannten Aspekten: - Best Practices für eine robuste Kubernetes-Sicherheitsarchitektur. - Bedrohungen frühzeitig aufspüren und abwehren. - Sicherheit von Anfang an in Ihre Entwicklungsprozesse integrieren. --- ### **Bleiben Sie gespannt– weitere Artikel folgen bald!** Diese Artikel sind schon erschienen: [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) Einen Blick wert: Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://youtu.be/s5o6TOnt-EM) --- ## **Teilen Sie gerne Ihre Erfahrungen** Wir freuen uns auf den Austausch mit Ihnen! Haben Sie Fragen oder Herausforderungen in Ihren Kubernetes-Umgebungen? Teilen Sie Ihre Erfahrungen und Best Practices gerne in den Kommentaren oder kontaktieren Sie uns direkt. Gemeinsam können wir daran arbeiten, Ihre Sicherheitsstrategien auf das nächste Level zu heben. Vielen Dank an alle, die an unserem [Webcast „Kubernetes Security – Schmerzpunkte und Lösungen“](https://www.opitz-consulting.com/kompetenz/kubernetes-security) teilgenommen haben. Bleiben Sie sicher – in der Entwicklung, im Betrieb und darüber hinaus! **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) **Published:** Februar 21, 2025 **Author:** Torsten Jaeschke **Content:** Kubernetes ist das Rückgrat vieler moderner Cloud-Native-Anwendungen – aber auch ein attraktives Ziel für Angreifer. Unautorisierte Zugriffe, Privilege Escalation oder schadhafte Container-Images können ganze Cluster kompromittieren. Eine kontinuierliche Überwachung ist daher essenziell, um Sicherheitsrisiken frühzeitig zu erkennen und zu beheben. In diesem Artikel stellen wir zwei leistungsstarke Open-Source-Tools vor, die Kubernetes-Umgebungen sicherer machen: **Falco** und **Kubescape**. *Sie steigen gerade erst ein? Hier finden Sie Teil 1 bis 3 dieser Serie sowie das Video des Webcasts, auf dem die Serie aufbaut:* [*Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie*](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [*Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen*](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [*Video: Kubernetes Security Webcast*](https://www.opitz-consulting.com/kompetenz/kubernetes-security) ## Laufzeitüberwachung mit Falco Falco ist ein Sicherheitsmonitoring-Tool, das verdächtige Aktivitäten in Echtzeit erkennt. Durch vordefinierte oder benutzerdefinierte Regeln können Angriffe und Fehlkonfigurationen aufgedeckt werden. ### **Beispiel: Erkennen einer Shell in einem Container** Eine der häufigsten Angriffsmethoden ist das Starten einer interaktiven Shell innerhalb eines Containers. Dies kann auf eine Kompromittierung hinweisen. Die folgende Falco-Regel warnt Administratoren, wenn eine Shell in einem laufenden Container gestartet wird: ``` - rule: Detect Shell in Container desc: "Warnung, wenn eine Shell innerhalb eines Containers ausgeführt wird" condition: container and shell output: "Shell innerhalb eines Containers ausgeführt (user=%user.name shell=%proc.name)" priority: WARNING ``` ### **Erweiterte Falco-Regel: Unerwartete Dateiänderungen** Falco kann auch ungewollte Änderungen an wichtigen Systemdateien erkennen. Diese Regel löst eine Warnung aus, wenn Dateien in sensiblen Verzeichnissen wie `/etc/` oder `/var/run/` verändert werden: ``` - rule: Detect File Modification in Sensitive Directory desc: "Warnung bei Änderungen in sensiblen Verzeichnissen" condition: open_write and (fd.name startswith /etc/ or fd.name startswith /var/run/) output: "Verdächtige Dateiänderung erkannt (user=%user.name file=%fd.name)" priority: WARNING ``` ### **Falco in Kubernetes integrieren** Falco kann als **DaemonSet** in Kubernetes bereitgestellt werden, um kontinuierlich alle Pods zu überwachen. Die Installation erfolgt mit: ``` kubectl apply -f https://raw.githubusercontent.com/falcosecurity/charts/master/stable/falco.yaml ``` Nach der Installation gibt Falco Log-Daten aus oder sendet Warnungen an Monitoring-Tools wie **Prometheus** oder **Grafana**. ## Laufzeitüberwachung mit Kubescape Während Falco primär auf System-Calls und Container-Prozesse fokussiert ist, bietet **Kubescape** zusätzlich eine umfassende Analyse der Cluster-Sicherheit – einschließlich Laufzeitüberwachung und Konfigurationsprüfung. ### **Wie funktioniert die Laufzeitüberwachung mit Kubescape?** Kubescape kombiniert Verhaltensanalyse, Netzwerküberwachung und System-Call-Monitoring, um verdächtige Aktivitäten frühzeitig zu erkennen. Das Tool identifiziert unter anderem: - Ungewohnte Netzwerkverbindungen - Nicht autorisierte Prozesse in Containern - Manipulationen an wichtigen Systemdateien ### **Beispiel: Auffällige Container-Aktivitäten erkennen** Um eine Laufzeitüberprüfung durchzuführen, kann folgender Befehl genutzt werden: ``` kubescape runtime scan ``` ### **Kubescape in CI/CD-Pipelines integrieren** Um Sicherheitsprüfungen bereits während der Entwicklung zu automatisieren, kann Kubescape in **CI/CD-Pipelines** eingebunden werden. Hier ein Beispiel für die Integration mit **GitHub Actions**: ``` jobs: security-scan: runs-on: ubuntu-latest steps: - name: Install Kubescape run: curl -s https://raw.githubusercontent.com/kubescape/kubescape/main/install.sh | bash - name: Run runtime security scan run: kubescape runtime scan --format json --output results.json ``` Diese Automatisierung stellt sicher, dass verdächtige Aktivitäten erkannt werden, bevor sie in die Produktionsumgebung gelangen. ## Fazit: Kubernetes-Sicherheit braucht Echtzeitüberwachung Sowohl **Falco** als auch **Kubescape** sind leistungsstarke Open-Source-Tools, die zur Absicherung von Kubernetes-Clustern beitragen. Während **Falco** verdächtige Aktivitäten in Echtzeit überwacht, bietet **Kubescape** eine zusätzliche Laufzeitanalyse und umfassende Sicherheitsprüfungen. Die Kombination beider Tools bietet eine **robuste Sicherheitsstrategie**, um Risiken frühzeitig zu minimieren – sei es durch **Monitoring in der Produktionsumgebung** oder durch **automatisierte Prüfungen in CI/CD-Pipelines**. ### Sind Ihre Kubernetes-Cluster ausreichend geschützt? - Nutzen Sie bereits eine Laufzeitüberwachung für Ihre Container? - Sind Ihre Sicherheitsrichtlinien in Kubernetes konsequent umgesetzt? - Haben Sie automatisierte Tools zur Bedrohungserkennung integriert? Falls nicht, könnte es an der Zeit sein, Ihre **Security-Strategie** zu überdenken. Kubernetes-Sicherheit ist kein einmaliges Projekt, sondern ein fortlaufender Prozess. Wer frühzeitig auf robuste Monitoring-Lösungen setzt, kann sich langfristig vor Angriffen und ungewollten Sicherheitsvorfällen schützen. --- ## Sicher unterwegs mit Kubernetes! Kubernetes erleichtert moderne Softwarearchitekturen, bringt aber auch Sicherheitsherausforderungen mit sich. In dieser Blogserie geben wir Ihnen praxisnahe Lösungen an die Hand. Erfahren Sie mehr über: - Zugriffsschutz & Berechtigungen - Eine sichere Cluster-Architektur - Erkennung & Abwehr von Angriffen - Sicherheitsmaßnahmen direkt in der Entwicklung --- ### Die Blogserie auf einen Blick: [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) Einen Blick wert: Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- Haben Sie Fragen oder eigene Best Practices? Teilen Sie sie gerne in den Kommentaren oder nehmen Sie direkt Kontakt auf. **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) **Published:** Februar 28, 2025 **Author:** Torsten Jaeschke **Content:** Kubernetes begeistert uns mit seiner Flexibilität und Skalierbarkeit und ist inzwischen der Standard für moderne Container-Orchestrierung. Doch mit dieser Leistungsfähigkeit geht auch eine erweiterte Angriffsfläche einher. In diesem Beitrag unserer Artikelserie zeigen wir, welche zentralen Angriffspunkte in einem Kubernetes-Cluster existieren, warum sie so kritisch sind und wie Sie mit konkreten technischen Maßnahmen den Schutz Ihrer Infrastruktur nachhaltig verbessern können. Dabei knüpfen wir auch an Erkenntnisse aus früheren Artikeln zu Themen wie Sicherheitsfokus, unerlaubte Zugriffe und Automatisierung an – Themen, die uns persönlich sehr am Herzen liegen. --- *Sie steigen gerade erst ein? Hier finden Sie Teil 1 bis 4 dieser Serie sowie das Video des Webcasts, auf dem die Serie aufbaut:* [*Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie*](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [*Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen*](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [*Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren*](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [*Video: Kubernetes Security Webcast*](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- ## Die kritischen Angriffspunkte im Überblick ![](https://thecattlecrew.net/wp-content/uploads/2025/02/a45629dd-7f71-4c1f-89a7-d759520af21f.png)Sicherheitsrelevante Komponenten im Schema ### Der Kubernetes API-Server Der sogenannte kubeapiserver ist die zentrale Steuereinheit Ihres Clusters. Er nimmt alle Befehle entgegen, verteilt sie an die entsprechenden Komponenten und hält den gesamten Zustand des Systems aktuell. Genau deshalb ist er ein beliebtes Ziel für Angreifer. - Werden **schwache Authentifizierungsmechanismen** verwendet - oder sind **Schnittstellen ungeschützt** aus dem Internet erreichbar, können Angreifer schnell administrativen Zugriff erlangen. Ein kompromittierter API-Server bedeutet nicht nur, dass einzelne Daten gestohlen werden, sondern potenziell der komplette Cluster in Gefahr ist. ### Das Gehirn von Kubernetes Als primärer Datenspeicher für Kubernetes dient eine verteilte, zuverlässige Key-Value-Datenbank. Hierfür hat sich etcd als Standard etabliert. Kubernetes gleicht kontinuierlich den tatsächlichen Cluster-Zustand mit dem gewünschten ab, und leitet bei Bedarf korrigierende Maßnahmen ein. Etcd fungiert damit als Fundamentalgedächtnis von Kubernetes. Die Datenbank beinhaltet auch sämtliche sensible Daten des Clusters – von Secrets und Zugangsdaten bis hin zu kritischen Konfigurationen. Der ungesicherte Zugriff auf etcd bedeutet potenziell eine vollständige Kompromittierung des gesamten Clusters. Ein Angreifer, der Zugriff auf etcd erlangt, kann vertrauliche Daten einsehen oder sogar Manipulationen am Cluster-Zustand vornehmen, was katastrophale Folgen haben kann. Daher sollten entsprechende Sicherheitsmaßnahmen wie TLS-Verschlüsselung und strenge Zugriffsbeschränkungen absolute Priorität haben. ### Die Rolle der Netzwerkarchitektur Ein weiterer kritischer Punkt liegt in der Netzwerkarchitektur. Ohne eine klare Trennung der Netzwerksegmente können Angreifer lateral im Cluster agieren – sprich, sie bewegen sich von einem kompromittierten Container zu anderen Komponenten. Fehlende Isolation zwischen verschiedenen Umgebungen (wie Produktions-, Entwicklungs- und Management-Netzwerken) erhöht dieses Risiko erheblich. Ein gut segmentiertes Netzwerk ist daher ein zentrales Element, um Angriffe frühzeitig einzudämmen. ### Abgesicherte Container Auch wenn Container grundsätzlich in einer isolierten Umgebung laufen, können sie durch Schwachstellen in der Container-Runtime oder unsichere Basis-Images kompromittiert werden. - Ein erfolgreicher **Container-Escape** ermöglicht es einem Angreifer, die Isolation zu durchbrechen und direkten Zugriff auf das Host-System zu erlangen. - **Sicherheitsprofile** wie seccomp, AppArmor oder SELinux sind hier essenziell, um die erlaubten Systemaufrufe zu begrenzen und den Schaden im Fall eines Exploits zu minimieren. ### Die Bedeutung von Verwaltungsschnittstellen und Supply-Chain Verwaltungsschnittstellen wie das Kubernetes Dashboard sollten niemals öffentlich zugänglich sein. Sind diese unzureichend gesichert, bieten sie Angreifern direkten Zugang zu administrativen Funktionen. Ebenso wichtig ist die Sicherheit der Supply-Chain: Kompromittierte Container-Images, die unbemerkt in den Build-Prozess eingeschleust werden, können Ihre gesamte Umgebung gefährden. - Durch den Einsatz von **Image-Signaturen,** - **regelmäßigen Sicherheits-Scans** in der CI/CD-Pipeline - und proaktiver Prüfung der Inventarisierung durch **SBOM**s können Sie hier einen entscheidenden Schritt in Richtung Absicherung machen. ## Konkrete Maßnahmen für einen robusten Cluster-Schutz ### 1. Absichern des API-Servers Um Ihren API-Server gegen unbefugten Zugriff zu schützen, ist es unerlässlich, ausschließlich gesicherte Verbindungen zuzulassen. Eine typische Konfiguration könnte folgendermaßen aussehen: ``` kube-apiserver \ --tls-cert-file=/etc/kubernetes/pki/apiserver.crt \ --tls-private-key-file=/etc/kubernetes/pki/apiserver.key \ --client-ca-file=/etc/kubernetes/pki/ca.crt ``` Neben dieser TLS-Absicherung sollten Sie auf zertifikatsbasierte Authentifizierung und Multi-Faktor-Authentifizierung (MFA) setzen. Eine feingranulare RBAC-Konfiguration, dass Benutzer und Service Accounts nur die Rechte erhalten, die sie tatsächlich benötigen – ein Ansatz, der den potenziellen Schaden im Fall eines Angriffs erheblich reduziert. Ein Beispiel, wie eine solche RBAC Konfiguration aussehen kann, haben wir in unserem Artikel zu [unerlaubten Zugriffen in Kubernetes](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) aufgeführt. ### 2. Den etcd schützen Da ***etcd*** den gesamten Zustand Ihres Clusters speichert, ist es entscheidend, alle Kommunikationswege zu verschlüsseln. Eine Beispielkonfiguration für ***etcd*** könnte wie folgt aussehen: ``` etcd  --cert-file=/etc/etcd/ssl/etcd.pem \      --key-file=/etc/etcd/ssl/etcd-key.pem \       --trusted-ca-file=/etc/etcd/ssl/ca.pem \       --peer-cert-file=/etc/etcd/ssl/peer.pem \       --peer-key-file=/etc/etcd/ssl/peer-key.pem \      --peer-trusted-ca-file=/etc/etcd/ssl/ca.pem ``` Ergänzend sollten Sie den Zugriff auf ***etcd*** über Firewalls oder cloudbasierte Sicherheitsgruppen strikt auf vertrauenswürdige Quellen beschränken. So stellen Sie sicher, dass nur autorisierte Systeme auf diese kritischen Daten zugreifen können. ### 3. Das Netzwerk segmentieren und isolieren Um eine unkontrollierte seitliche Bewegung im Cluster zu verhindern, setzen Sie auf Network Policys. Mit einer gezielten Policy können Sie beispielsweise den Zugriff auf einen Datenbank-Pod so einschränken, dass nur bestimmte Applikations-Pods darauf zugreifen dürfen: ``` apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata:   name: allow-db-access   namespace: default spec:   podSelector:     matchLabels:       role: database   ingress:   - from:     - podSelector:         matchLabels:           role: app     ports:     - protocol: TCP       port: 5432 ``` Ergänzen Sie diese Maßnahme durch Mikrosegmentierung, indem Sie Management-, Produktions- und Entwicklungsnetzwerke klar voneinander trennen. Diese Trennung reduziert die Angriffsfläche und sorgt dafür, dass ein potenzieller Einbruch in einem Segment nicht gleich den gesamten Cluster gefährdet. Weitere Informationen zu Network Policys und Admission Controllern finden Sie in unserem Beitrag zu [unerlaubten Zugriffen in Kubernetes](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/). ### 4. Für Container-Sicherheit und Laufzeitschutz sorgen Container sollten immer mit Sicherheitsprofilen betrieben werden, um unerlaubte Systemaufrufe zu blockieren. So können Sie beispielsweise ein ***seccomp***-Profil in einem Pod aktivieren: ```  apiVersion: v1  kind: Pod  metadata:  name: secure-pod  spec:  containers:   - name: mycontainer     image: mysecureimage     securityContext:       seccompProfile:          type: RuntimeDefault ``` Darüber hinaus empfehlen wir den Einsatz von Monitoring-Tools wie Falco, die kontinuierlich das Laufzeitverhalten der Container überwachen. So können Sie ungewöhnliche Aktivitäten frühzeitig erkennen und entsprechende Gegenmaßnahmen einleiten, bevor es zu einem Sicherheitsvorfall kommt. Mehr zu Laufzeitmonitoring erfahren Sie in unserem Beitrag zur [Erkennung und Reaktion auf verdächtiges Verhalten in Kubernetes](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/). ### 5. Mit Verwaltungsschnittstellen und Supply-Chains umgehen Verwaltungsschnittstellen wie das Kubernetes Dashboard sollten niemals offen im Internet erreichbar sein. Setzen Sie auf Ingress-Lösungen mit starker Authentifizierung – etwa über OAuth2 oder SAML – und nutzen Sie IP-Whitelisting, um den Zugriff gezielt zu steuern. Zusätzlich sollten Service Accounts nur minimale Berechtigungen besitzen, und alle administrativen Aktivitäten sollten durch umfassende Audit-Logs dokumentiert werden. Auch der Schutz der Software-Lieferkette ist ein wichtiger Aspekt: Kompromittierte Container-Images können Ihre gesamte Umgebung gefährden. Durch den Einsatz von Image-Signaturen mit Tools wie [Cosign](https://github.com/sigstore/cosign) und automatisierten Sicherheits-Scans in Ihrer CI/CD-Pipeline, wie in unserem Artikel zur [Absicherung unsicherer Kubernetes-Systeme](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) vorgestellt, stellen Sie sicher, dass nur vertrauenswürdige Images in den Cluster gelangen. ## Fazit: Es braucht ein ganzheitliches Sicherheitskonzept! Ein sicherer Kubernetes-Betrieb ist kein Zufall, sondern das Ergebnis eines ganzheitlichen Sicherheitskonzepts, das alle Ebenen der Infrastruktur abdeckt. Durch den konsequenten Einsatz von TLS, präzisen RBAC- und Network Policies, Sicherheitsprofilen für Container sowie der Absicherung kritischer Verwaltungs- und Kommunikationswege legen Sie eine solide Basis gegen vielfältige Angriffsvektoren. **So sichern Sie Ihren Kubernetes Cluster ab:** - API-Server mit TLS und RBAC schützen - etcd-Verschlüsselung aktivieren - Network Policys zur Segmentierung nutzen - Sicherheitsprofile für Container einsetzen - CI/CD-Pipelines mit Security-Scans absichern Wir hoffen, dieser Beitrag konnte Ihnen Einblicke und Tipps vermitteln, um Ihre Kubernetes-Umgebung nachhaltig abzusichern. Denken Sie daran: Sicherheitsmaßnahmen müssen kontinuierlich überprüft und an die sich ständig verändernde Bedrohungslage angepasst werden. Bleiben Sie also immer am Ball, und scheuen Sie sich nicht, auch neue Ansätze und Technologien in Ihre Sicherheitsstrategie zu integrieren. Vielen Dank fürs Lesen – viel Erfolg bei der Optimierung Ihrer Infrastruktur und bleiben Sie sicher! --- ## **Teil 1-7 der Blog-Serie** [Teil 1: Kubernetes-Sicherheit im Fokus: Best Practices und Strategie](https://thecattlecrew.net/2025/01/31/kubernetes-sicherheit-im-fokus/) [Teil 2: Unerlaubte Zugriffe in Kubernetes – Ursachen, Risiken und Schutzmaßnahmen](https://thecattlecrew.net/2025/02/07/unerlaubte-zugriffe-in-kubernetes-ursachen-risiken-und-schutzmassnahmen/) [Teil 3: Unsichere Kubernetes-Systeme absichern – Tools, Best Practices und Automation](https://thecattlecrew.net/2025/02/14/unsichere-kubernetes-systeme-absichern-tools-best-practices-und-automation/) [Teil 4: Verdächtiges Verhalten in Kubernetes erkennen und darauf reagieren](https://thecattlecrew.net/2025/02/21/verdaechtiges-verhalten-in-kubernetes-erkennen-und-darauf-reagieren/) [Teil 5: Kubernetes-Sicherheit: Die größten Schwachstellen und wie Sie Ihre Cluster schützen](https://thecattlecrew.net/2025/02/28/kubernetes-sicherheit-die-groessten-schwachstellen-und-wie-du-deine-cluster-schuetzt/) [Teil 6: Shift-Left-Security – Sicherheit von Anfang an in der Softwareentwicklung](https://thecattlecrew.net/2025/03/12/shift-left-security-sicherheit-von-anfang-an-in-der-softwareentwicklung/) [Teil 7: Kubernetes-Sicherheit: Fazit und Ausblick](https://thecattlecrew.net/2025/03/18/kubernetes-sicherheit-fazit-und-ausblick/) Einen Blick wert: Auf diesem Webcast basiert die Blogserie: [Kubernetes Security Webcast](https://www.opitz-consulting.com/kompetenz/kubernetes-security) --- Welche Maßnahmen nutzen Sie, um Ihren Kubernetes-Cluster abzusichern? Teilen Sie Ihre Erfahrungen in den Kommentaren! **Kategorien:** DevOps, IT-Security **Schlagwörter:** Container, IT Security, Kubernetes --- ### [Machine Learning mit MLOps – Teil 4: Den Schatz in den Daten bergen mit Data Engineering](https://thecattlecrew.net/2024/11/25/machine-learning-mit-mlops-teil-4-data-engineering-den-schatz-in-den-daten-bergen/) **Published:** November 25, 2024 **Author:** Jeffrey Remien **Content:** Ahoi, ihr unerschrockenen Datentaucherinnen und -taucher! Wir setzen unsere spannende Reise durch die Gewässer des Machine Learnings fort. Nachdem wir in den letzten Artikeln die Bedeutung der Daten erkannt und unsere Karten sorgfältig gezeichnet haben, schnallen wir uns heute die Tiefseetaucheranzüge an und tauchen noch tiefer ein. Falls ihr die bisherigen Etappen verpasst habt, könnt ihr sie hier nachlesen: [Machine Learning mit MLOps – Teil 1: Woran viele ML-Projekte scheitern](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) [Machine Learning mit MLOps – Teil 2: Scoping. Wie umfahren wir die Untiefen im ML-Gewässer?](https://thecattlecrew.net/2024/05/08/machine-learning-mit-mlops-teil-2-scoping/) [Machine Learning mit MLOps – Teil 3: Abtauchen ins Datenmeer](https://thecattlecrew.net/2024/10/22/machine-learning-mit-mlops-teil-3-abtauchen-ins-datenmeer/) Heute nehmen wir Kurs auf die verborgenen Schätze unter der Oberfläche unserer Datenmeere. Wir werden entdecken, wie wir unsere Daten analysieren, aufbereiten und für die Verarbeitung in ML-Modellen vorbereiten können. Es geht darum, unsere Navigationsinstrumente – Feature Engineering, Dimensionalitätsreduktion, Datenaugmentation und Datenpipelines – zu meistern, um sicher durch die Tiefen zu navigieren. ## **Die Tiefe ausloten: Explorative Datenanalyse** Bevor wir uns in die dunklen Tiefen stürzen, ist es entscheidend, das Gewässer gründlich zu erkunden. Die Explorative Datenanalyse (EDA) ist unser Sonar, mit dem wir den Meeresgrund kartografieren und versteckte Gefahren sowie wertvolle Ressourcen entdecken. Ohne EDA wäre unsere Reise wie eine Fahrt ins Ungewisse, bei der wir jederzeit auf unerwartete Hindernisse stoßen könnten. ### **Warum ist EDA so wichtig?** Stellt euch vor, ihr seid Kapitän eines Forschungsschiffs, das unbekannte Gewässer erkunden soll. Ohne genaue Karten oder Informationen über Untiefen und Strömungen ist das Risiko groß, auf Riffe aufzulaufen oder in einen Sturm zu geraten. Ähnlich verhält es sich mit unseren Daten. Ohne eine gründliche EDA könnten wir wichtige Muster übersehen oder uns von Ausreißern in die Irre führen lassen. ### **Wie führen wir eine effektive EDA durch?** - **Visualisierung:** Durch Diagramme und Grafiken können wir die Verteilung unserer Daten besser verstehen. Histogramme zeigen uns, wie unsere Daten verteilt sind, während Scatterplots Beziehungen zwischen Variablen aufdecken können. Zum Beispiel kann ein Scatterplot zwischen der Motorleistung eines Schiffs und seiner Geschwindigkeit zeigen, ob ein Zusammenhang besteht. - **Statistische Analysen:** Mit Kennzahlen wie Mittelwert, Median und Standardabweichung erhalten wir ein Gefühl für die zentralen Tendenzen und die Variabilität unserer Daten. Korrelationsmatrizen helfen uns, Zusammenhänge zwischen verschiedenen Merkmalen zu erkennen. Wenn wir beispielsweise feststellen, dass die Länge eines Schiffs stark mit seiner Tragfähigkeit korreliert, können wir diese Information für unsere Modellierung nutzen. #### **Beispiel aus der Praxis:** Angenommen, wir arbeiten an einem ML-Projekt zur Vorhersage von Wetterbedingungen auf See. Durch EDA könnten wir feststellen, dass bestimmte Muster in der Windgeschwindigkeit und dem Luftdruck Hinweise auf kommende Stürme geben. Ohne diese Analyse könnten wir unsere Schiffe in gefährliche Gewässer schicken, ohne es zu wissen. ### **Vorteile der EDA** - **Frühes Erkennen von Problemen:** Indem wir unsere Daten genau untersuchen, können wir fehlende Werte, Ausreißer oder ungewöhnliche Muster frühzeitig erkennen und entsprechend handeln. Das ist vergleichbar mit dem Erkennen eines aufziehenden Sturms, bevor wir in See stechen. - **Bessere Modellierung:** Ein tiefes Verständnis der Daten ermöglicht es uns, geeignetere Modelle zu wählen und diese besser anzupassen. So vermeiden wir, mit dem falschen Schiff in die falschen Gewässer zu fahren. ## **Die Ausrüstung vorbereiten: Datenqualität und -bereinigung** Ein guter Taucher überprüft immer seine Ausrüstung, bevor er ins Wasser springt. Genauso müssen wir sicherstellen, dass unsere Daten in einwandfreiem Zustand sind, bevor wir sie in unsere Modelle einspeisen. Unsaubere oder fehlerhafte Daten sind wie Löcher in unserem Taucheranzug – sie können uns gefährden und den Erfolg unserer Mission beeinträchtigen. ### **Herausforderungen bei der Datenqualität** - **Fehlende Werte:** Diese können auftreten, wenn Daten nicht erfasst wurden oder verloren gegangen sind. Sie können zu Verzerrungen führen, wenn sie nicht richtig behandelt werden. Ein fehlender Datenpunkt in unserer Wettervorhersage könnte dazu führen, dass wir einen Sturm übersehen. - **Ausreißer:** Extremwerte können das Modelltraining negativ beeinflussen, insbesondere bei sensitiven Algorithmen wie der linearen Regression. Ein einzelnes Schiff, das ungewöhnlich schnell ist, könnte unsere Geschwindigkeitsprognosen verfälschen. - **Inkonstistente Formate:** Unterschiedliche Datumsformate, Maßeinheiten oder Kodierungen können zu Verwirrung führen und müssen vereinheitlicht werden. Wenn einige unserer Daten in Knoten und andere in Kilometern pro Stunde angegeben sind, müssen wir sie angleichen. ### **Strategien zur Datenbereinigung** - **Imputation fehlender Werte:** Fehlende Daten können durch statistische Methoden wie Mittelwert, Median oder mittels komplexerer Techniken wie k-NN-Imputation ersetzt werden. Wenn uns die Temperaturdaten für einen bestimmten Tag fehlen, können wir den Durchschnitt der umliegenden Tage verwenden. - **Entfernung oder Anpassung von Ausreißern:** Wir können entscheiden, ob Ausreißer entfernt, transformiert oder behalten werden sollen, basierend auf ihrer Ursache und ihrem Einfluss auf das Modell. Wenn ein Sensor einen unrealistisch hohen Wellengang meldet, sollten wir prüfen, ob es sich um einen Messfehler handelt. - **Standardisierung von Formaten:** Durch die Umwandlung aller Daten in ein konsistentes Format vermeiden wir Interpretationsfehler. Alle Geschwindigkeiten könnten in Knoten angegeben werden, um Verwechslungen zu vermeiden. ### **Warum sich die Mühe lohnt** Saubere Daten führen zu zuverlässigeren Modellen. Sie minimieren das Risiko von Fehlinterpretationen und erhöhen die Genauigkeit unserer Vorhersagen. So wie ein Taucher mit gut gewarteter Ausrüstung tiefer und sicherer tauchen kann, können wir mit bereinigten Daten bessere Ergebnisse erzielen. ## **Den Kompass kalibrieren: Feature Engineering** Mit sauberem Schiff und klaren Karten sind wir bereit, den Kurs festzulegen. Das Feature Engineering ist unser Kompass, der uns die richtige Richtung weist. Es geht darum, die wichtigsten Merkmale in unseren Daten zu identifizieren und sie so zu transformieren, dass sie unserem Modell den bestmöglichen Input liefern. ### **Feature Selection** Nicht alle Datenpunkte sind gleich wichtig. Wie ein Seefahrer, der die Sterne zur Navigation nutzt, müssen wir die relevanten „Sterne“ in unseren Daten finden. Durch die Auswahl der wichtigsten Features verbessern wir die Effizienz und Genauigkeit unseres Modells. #### **Methoden der Feature Selection:** - **Filtermethoden:** Diese verwenden statistische Tests, um die Merkmale zu bewerten. Beispielsweise können wir die Korrelation zwischen jedem Feature und der Zielvariable berechnen und diejenigen mit geringer Korrelation ausschließen. - **Wrapper-Methoden:** Hierbei wird das Modell selbst genutzt, um die besten Features zu finden. Ein Beispiel ist die rekursive Feature-Eliminierung, bei der das Modell wiederholt trainiert wird, wobei jedes Mal weniger Features verwendet werden. - **Embedded-Methoden:** Diese integrieren die Feature Selection direkt in den Trainingsprozess des Modells, wie es beispielsweise bei Lasso-Regression der Fall ist. #### **Beispiel:** Angenommen, wir möchten die Wahrscheinlichkeit vorhersagen, mit der Kunden einen Online-Kauf abschließen. Mögliche Features könnten die Verweildauer auf der Seite, die Anzahl der angesehenen Produkte, demografische Daten usw. sein. Durch Feature Selection könnten wir feststellen, dass die Verweildauer und die Anzahl der Produkte stärkere Prädiktoren sind als das Alter des Kunden. ### **Feature Transformation** Neben der Auswahl relevanter Merkmale müssen wir diese oft auch in eine Form bringen, die unser Modell optimal nutzen kann. Das ist vergleichbar mit dem Kalibrieren unserer Instrumente, um präzise Messungen zu erhalten. #### **Techniken der Feature Transformation** - **Skalierung:** Anpassung der Wertebereiche der Features, z.B. durch Min-Max-Skalierung oder Standardisierung. Dies ist besonders wichtig für Algorithmen, die auf Distanzen basieren, wie k-Means oder k-NN. - **Encoding kategorialer Variablen:** Kategoriale Daten müssen in numerische Form gebracht werden. One-Hot-Encoding wandelt Kategorien in binäre Vektoren um, während Label-Encoding ihnen numerische Werte zuweist. - **Transformation schiefer Verteilungen:** Logarithmische oder Box-Cox-Transformationen können angewendet werden, um die Symmetrie der Daten zu verbessern. #### **Beispiel:** In einem Modell zur Kreditrisikobewertung könnten wir das Einkommen der Antragsteller logarithmieren, um eine gleichmäßigere Verteilung zu erzielen. Ebenso könnten wir die Beschäftigungsart (z.B. Angestellter, Selbstständig, Arbeitslos) mittels One-Hot-Encoding in numerische Features umwandeln. ### **Warum ist Feature Engineering so wichtig?** Ein gut durchgeführtes Feature Engineering kann die Leistung eines Modells erheblich steigern. Es ermöglicht dem Modell, die relevanten Muster in den Daten besser zu erkennen und sorgt für stabilere und genauere Vorhersagen. Es ist, als würden wir unserem Schiff die optimalen Segel setzen, um den Wind bestmöglich zu nutzen. ## **Überflüssigen Ballast abwerfen: Dimensionalitätsreduktion** Auf hoher See ist es wichtig, nicht zu viel Ballast mitzuschleppen. Zu viele unnötige Daten können unser Schiff verlangsamen und den Verbrauch erhöhen. In der Datenwelt bedeutet eine hohe Anzahl von Features nicht immer bessere Ergebnisse; tatsächlich kann sie zu Problemen wie dem „Fluch der Dimensionalität“ führen. ### **Was ist der Fluch der Dimensionalität?** Je mehr Dimensionen (Features) unsere Daten haben, desto exponentiell mehr Datenpunkte benötigen wir, um den Raum adäquat zu füllen. Das kann zu Überanpassung führen, bei der unser Modell die Trainingsdaten zu gut lernt und auf neuen Daten schlecht generalisiert. ### **Techniken der Dimensionalitätsreduktion** - **Hauptkomponentenanalyse (PCA):** PCA projiziert die Daten auf weniger Dimensionen, indem sie die Varianz maximiert. Die neuen Komponenten sind lineare Kombinationen der ursprünglichen Features. - **t-SNE (t-Distributed Stochastic Neighbor Embedding):** Eine nichtlineare Methode, die besonders gut für die Visualisierung hoher Dimensionen in 2D oder 3D geeignet ist. - **UMAP (Uniform Manifold Approximation and Projection):** Ähnlich wie t-SNE, aber oft schneller und bewahrt sowohl lokale als auch globale Strukturen. #### **Beispiel:** In der Genomik arbeiten wir oft mit Tausenden von Genexpressionsdaten. Durch PCA können wir diese auf wenige Hauptkomponenten reduzieren, die den Großteil der Varianz erklären. Das erleichtert die Analyse und Visualisierung erheblich. #### **Vorteile der Dimensionalitätsreduktion** - **Effizienzsteigerung:** Weniger Features bedeuten kürzere Trainingszeiten und geringeren Speicherbedarf. - **Verbesserte Generalisierung:** Reduziert das Risiko von Overfitting. - **Bessere Visualisierung:** Erleichtert das Verständnis komplexer Daten durch Darstellung in niedrigeren Dimensionen. **Aber Vorsicht:** Es besteht die Gefahr, dass wichtige Informationen verloren gehen. Daher sollten wir immer prüfen, wie viel Varianz durch die Reduktion erklärt wird und ob die reduzierten Daten noch aussagekräftig sind. ## **Den Wind in die Segel holen: Datenaugmentation** Manchmal reicht der Wind nicht aus, um unser Schiff voranzutreiben. In solchen Fällen setzen wir zusätzliche Segel oder nutzen alternative Antriebsmethoden. Ähnlich verhält es sich, wenn unsere vorhandenen Daten nicht ausreichen, um ein robustes Modell zu trainieren. ### **Was ist Datenaugmentation?** Datenaugmentation ist die künstliche Erweiterung des vorhandenen Datensatzes durch Generierung zusätzlicher Datenpunkte. Dies ist besonders nützlich, wenn wir mit begrenzten oder unausgewogenen Datensätzen arbeiten. ### **Methoden der Datenaugmentation** - **Bilddaten:** - *Geometrische Transformationen:* Rotieren, Spiegeln, Skalieren oder Verschieben von Bildern. Zum Beispiel können wir ein Bild eines Schiffs drehen, um verschiedene Perspektiven zu simulieren. - *Farbvariationen:* Anpassung von Helligkeit, Kontrast oder Sättigung, um unterschiedliche Lichtverhältnisse zu imitieren. - *Hinzufügen von Rauschen:* Einfügen von zufälligem Rauschen, um die Robustheit gegenüber Störungen zu erhöhen. - **Textdaten:** - *Synonymersetzung:* Ersetzen von Wörtern durch ihre Synonyme, um verschiedene Ausdrucksweisen abzudecken. - *Back-Translation:* Übersetzen in eine andere Sprache und zurück, um den Satzbau zu variieren. - *Einfügen von Tippfehlern:* Simuliert menschliche Eingabefehler, was in Rechtschreibkorrektur-Systemen hilfreich sein kann. #### **Beispiel:** Angenommen, wir trainieren ein Modell zur Spracherkennung, haben aber nur wenige Aufnahmen von bestimmten Dialekten. Durch Datenaugmentation können wir vorhandene Aufnahmen leicht verändern, um verschiedene Sprechgeschwindigkeiten oder Tonhöhen zu simulieren. ### **Warum ist Datenaugmentation wichtig** - **Verbesserte Generalisierung:** Das Modell lernt, mit einer größeren Vielfalt an Daten umzugehen und wird robuster gegenüber Variationen. - **Ausgleich von Klassenungleichgewichten:** Erhöht die Anzahl von Beispielen in unterrepräsentierten Klassen, was zu ausgewogeneren Modellen führt. **Aber Vorsicht:** Ungeeignete Augmentation kann zu unrealistischen Daten führen und das Modell verwirren. Es ist wichtig, Methoden zu wählen, die den realen Bedingungen entsprechen. ## **Die Route planen: Aufbau von Datenpipelines** Ein erfolgreicher Törn erfordert eine sorgfältige Planung und klare Abläufe. Die Datenpipelines sind unsere festgelegten Routen und Seewege, die den Fluss der Daten von der Quelle bis zum Ziel steuern. Sie sorgen dafür, dass alles reibungslos läuft und wir effizient vorankommen. ### **Was ist eine Datenpipeline?** Eine Datenpipeline automatisiert die Prozesse der Datenbeschaffung, -verarbeitung, -speicherung und -bereitstellung. Sie stellt sicher, dass die Daten kontinuierlich und konsistent fließen, ähnlich wie ein gut geöltes Uhrwerk. ### **Komponenten einer Datenpipeline** - **Datenextraktion:** Sammeln von Daten aus verschiedenen Quellen wie Datenbanken, APIs oder Dateien. - **Datentransformation:** Bereinigung, Normalisierung und Feature Engineering der Daten. - **Datenladung:** Speichern der verarbeiteten Daten in Data Warehouses oder für das Modelltraining. - **Modelltraining und -bereitstellung:** Automatisiertes Training des Modells mit den neuesten Daten und Deployment in die Produktionsumgebung. #### **Beispiel:** Ein E-Commerce-Unternehmen möchte täglich die neuesten Verkaufsdaten analysieren und Prognosen erstellen. Eine Datenpipeline könnte automatisiert die Verkaufsdaten aus dem System extrahieren, sie bereinigen, relevante Features extrahieren und das Modell täglich neu trainieren und aktualisieren. ### **Vorteile von Datenpipelines** - **Effizienzsteigerung:** Automatisierung reduziert manuelle Eingriffe und Fehler. - **Skalierbarkeit:** Kann leicht an wachsende Datenmengen angepasst werden. - **Reproduzierbarkeit:** Standardisierte Prozesse führen zu konsistenten Ergebnissen. ### **Tools zur Orchestrierung von Datenpipelines** - **Apache Airflow:** Ein Plattform zur Erstellung, Planung und Überwachung von Workflows. - **Kubeflow Pipelines:** Speziell für ML-Workflows auf Kubernetes entwickelt. - **Luigi:** Ein Python-Paket zur Erstellung komplexer Datenpipelines. ## **Das Logbuch führen: Versionierung und Automatisierung** Auf hoher See ist es unerlässlich, ein genaues Logbuch zu führen. So können wir jederzeit nachvollziehen, wo wir waren, welche Entscheidungen wir getroffen haben und wie wir auf Herausforderungen reagiert haben. In der Welt der MLOps entspricht dies der Versionierung von Daten, Modellen und Code. ### **Warum ist Versionierung wichtig** - **Nachvollziehbarkeit:** Wir können jederzeit zurückverfolgen, welche Version von Daten und Modellen zu bestimmten Ergebnissen geführt hat. - **Reproduzierbarkeit:** Andere können unsere Ergebnisse reproduzieren, indem sie die gleichen Versionen verwenden. - **Fehlerbehebung:** Bei Problemen können wir auf frühere stabile Versionen zurückgreifen. ### **Tools für die Versionierung** - **Git:** Weit verbreitet für die Versionierung von Code. - **DVC (Data Version Control):** Ermöglicht die Versionierung von Daten und Modellen in Verbindung mit Git. - **MLflow:** Plattform für das Tracking von Experimenten, die Verwaltung von Modellen und deren Deployment. ### **Automatisierung mit CI/CD** Continuous Integration und Continuous Deployment (CI/CD) sind Prozesse, die die automatische Integration von Codeänderungen und deren Deployment ermöglichen. ### **Vorteile der Automatisierung** - *Schnellere Entwicklungszyklen:* Änderungen können schneller implementiert und getestet werden. - *Qualitätssicherung:* Automatisierte Tests stellen sicher, dass neue Änderungen keine Fehler einführen. #### **Beispiel:** Ein Unternehmen möchte sicherstellen, dass jedes Mal, wenn ein Data Scientist Änderungen am Modell vornimmt, diese automatisch getestet und, wenn sie bestehen, in die Produktionsumgebung übertragen werden. Durch CI/CD-Pipelines wird dieser Prozess automatisiert, was Zeit spart und die Zuverlässigkeit erhöht. ## **Die Sterne lesen: Metadaten und Data Lineage** Ein erfahrener Seefahrer verlässt sich nicht nur auf seine Instrumente, sondern auch auf die Sterne und die Kenntnis der Meeresströmungen. Metadaten und Data Lineage sind unsere Sterne und Meereskarten, die uns zusätzliche Orientierung bieten und uns helfen, den Überblick über unsere Daten zu behalten. ### **Was sind Metadaten?** Metadaten sind Daten über Daten. Sie liefern Kontextinformationen wie Herkunft, Erstellungsdatum, Format, Autor und vieles mehr. ### **Warum sind Metadaten wichtig?** - **Verständnis:** Helfen uns, die Bedeutung und den Zweck der Daten zu verstehen. - **Verwaltung:** Erleichtern das Auffinden und die Organisation von Datenbeständen. - **Compliance:** Unterstützen bei der Einhaltung gesetzlicher Vorschriften durch Dokumentation von Datenquellen und -verarbeitungen. ### **Was ist Data Lineage?** Data Lineage beschreibt den Weg der Daten von der Quelle bis zur Nutzung. Es zeigt, wie Daten transformiert und bewegt wurden. ### **Vorteile von Data Lineage** - **Transparenz:** Ermöglicht das Nachvollziehen von Datenfluss und Transformationen. - **Fehlerbehebung:** Erleichtert das Finden von Fehlerquellen in der Datenpipeline. - **Compliance:** Unterstützt bei Audits und der Einhaltung von Datenschutzrichtlinien. #### **Beispiel:** In einer Bank müssen alle Schritte, die Kundendaten durchlaufen, dokumentiert sein. Von der Datenerfassung über die Verarbeitung bis hin zur Nutzung in Modellen muss klar sein, wer wann was mit den Daten gemacht hat. Metadaten und Data Lineage sind hier unerlässlich. ### **Tools** - **Apache Atlas:** Open-Source-Plattform für Metadatenmanagement und Data Governance. - **ML Metadata (MLMD):** Framework für Metadaten in ML-Pipelines. --- ## **Auf stürmische Gewässer vorbereitet sein: Best Practices** Kein Seefahrer begibt sich ohne Vorbereitung auf eine Reise. Sicherheitsmaßnahmen und bewährte Praktiken sind entscheidend, um in stürmischen Gewässern zu bestehen und sicher ans Ziel zu gelangen. ### **Sicherheitsaspekte** Der Schutz sensibler Daten ist wie das Tragen einer Rettungsweste – unerlässlich für die Sicherheit. Datenschutzverletzungen können nicht nur rechtliche Konsequenzen haben, sondern auch das Vertrauen der Kunden beeinträchtigen. #### **Maßnahmen** - **Datenverschlüsselung:** Schutz der Daten während der Übertragung und Speicherung. - **Zugriffskontrollen:** Implementierung von Rollen und Berechtigungen, um sicherzustellen, dass nur autorisierte Personen auf bestimmte Daten zugreifen können. - **Anonymisierung und Pseudonymisierung:** Entfernung oder Verschleierung personenbezogener Daten, um die Privatsphäre zu schützen. #### **Beispiel** Ein Gesundheitsdienstleister muss Patientendaten schützen. Durch Verschlüsselung und strenge Zugriffskontrollen wird sichergestellt, dass nur befugtes medizinisches Personal Zugriff hat. ### **Qualitätssicherung** Die regelmäßige Überprüfung und Wartung unserer Systeme ist wie die Inspektion des Schiffes vor der Abfahrt. Sie stellt sicher, dass alles reibungslos funktioniert und minimiert das Risiko von Pannen. #### **Methoden:** - **Monitoring:** Kontinuierliche Überwachung der Modellleistung in der Produktion, um Leistungseinbußen oder Datenverschiebungen zu erkennen. - **Automatisierte Tests:** Implementierung von Unit-Tests, Integrationstests und Validierungen, um sicherzustellen, dass Änderungen keine negativen Auswirkungen haben. - **Feedback-Schleifen:** Nutzung von Benutzerfeedback und Performance-Daten zur kontinuierlichen Verbesserung des Modells. #### **Beispiel:** Ein Unternehmen bemerkt, dass die Genauigkeit seines Empfehlungsalgorithmus abnimmt. Durch Monitoring wird festgestellt, dass sich das Nutzerverhalten geändert hat. Das Modell wird entsprechend angepasst und neu trainiert. ### **Zusammenarbeit im Team** Eine gut koordinierte Crew ist das Herzstück jeder erfolgreichen Reise. In ML-Projekten arbeiten oft interdisziplinäre Teams zusammen, und klare Kommunikation sowie effektive Zusammenarbeit sind entscheidend. #### **Strategien:** - **Dokumentation:** Sorgfältige Aufzeichnung von Entscheidungen, Prozessen und Modelländerungen. - **Kommunikationstools:** Nutzung von Plattformen wie Slack, Microsoft Teams oder Jira zur Koordination und zum Informationsaustausch. - **Agile Methoden:** Anwendung von Scrum oder Kanban zur flexiblen und iterativen Projektentwicklung. #### **Beispiel:** Ein Team aus Data Scientists, Entwicklern und Fachspezialisten arbeitet gemeinsam an einem Projekt zur Betrugserkennung. Durch regelmäßige Meetings und klare Aufgabenverteilung werden Missverständnisse vermieden und das Projekt effizient vorangetrieben. ## **Fazit** Unsere Reise durch die Tiefen der Daten hat uns gezeigt, dass ein erfolgreiches ML-Projekt weit mehr erfordert als nur fortschrittliche Algorithmen. Es ist ein Zusammenspiel aus sorgfältiger Planung, präziser Navigation und effektiver Teamarbeit. Wie ein erfahrener Kapitän, der sein Schiff sicher durch unbekannte Gewässer führt, müssen wir die Herausforderungen erkennen und meistern. Die Datenanalyse und -aufbereitung sind unsere Karten und Instrumente, die uns den Weg weisen. Mit Feature Engineering und Dimensionalitätsreduktion optimieren wir unsere Route, während Datenaugmentation uns den nötigen Schub gibt, wenn der Wind nachlässt. Durch den Aufbau von Datenpipelines, die sorgfältige Versionierung und Automatisierung stellen wir sicher, dass unser Schiff in bestem Zustand bleibt. Am Ende hängt der Erfolg von ML-Projekten davon ab, wie gut wir unsere Daten verstehen und nutzen. Mit der richtigen Vorbereitung und den passenden Werkzeugen können wir die Schätze heben, die in unseren Daten verborgen liegen. Es ist eine Reise, die kontinuierliches Lernen erfordert, aber die Belohnungen sind den Aufwand mehr als wert. --- ## **Ausblick** Die Gewässer sind erkundet, das Schiff ist bereit, und die Crew ist motiviert. Doch die Reise ist noch nicht zu Ende. Im nächsten Artikel werden wir die Segel setzen und uns auf den Weg machen, um die Geheimnisse des Modelltrainings zu lüften. Wir werden herausfinden, wie wir das passende Modell auswählen, es auf unseren Daten trainieren und wie Automatisierung und Pipelines uns dabei unterstützen können. Oder, um in unserer Seefahrtsprache zu bleiben: **Wie setzen wir die Segel, um mit voller Kraft voraus in Richtung Erfolg zu steuern?** ### **Bereits erschienene Artikel:** [Machine Learning mit MLOps – Teil 1: Woran viele ML-Projekte scheitern](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) [Machine Learning mit MLOps – Teil 2: Scoping. Wie umfahren wir die Untiefen im ML-Gewässer?](https://thecattlecrew.net/2024/05/08/machine-learning-mit-mlops-teil-2-scoping/) [Machine Learning mit MLOps – Teil 3: Abtauchen ins Datenmeer](https://thecattlecrew.net/2024/10/22/machine-learning-mit-mlops-teil-3-abtauchen-ins-datenmeer/) [Machine Learning mit MLOps – Teil 4: Den Schatz in den Daten bergen mit Data Engineering](https://thecattlecrew.net/2024/11/25/machine-learning-mit-mlops-teil-4-data-engineering-den-schatz-in-den-daten-bergen/) ### Weitere Teile sind geplant: - **Modelltraining:** Was brauche ich, um ein Modell auf den eigenen Daten zu trainieren? Wie wähle ich das geeignete Modell, und wie können Automatisierung und Pipelines die Arbeit erleichtern? - **Deployment:** Wie integriere ich das Modell in ein zukünftiges oder bestehendes System bzw. eine Infrastruktur? Welche Strategien ermöglichen einen reibungslosen Umstieg? - **Monitoring und Maintenance:** Wie überwachen wir ab hier unser bestehendes ML-System? Welche Entwicklungen können Anpassungen erfordern? Wie bereiten wir uns auf diese vor? **Kategorien:** Development --- ### [Machine Learning mit MLOps – Teil 1: Woran viele ML-Projekte scheitern. Ein Überblick über MLOps als Lösung](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) **Published:** Mai 22, 2023 **Author:** Jeffrey Remien **Content:** Im alltäglichen Leben nutzen wir Sprachassistenzsysteme wie Siri oder Alexa, Onlineshops geben uns personalisierte Empfehlungen, Smartphones erkennen unser Gesicht, können es sogar verändern. Und mittlerweile schreibt ChatGPT für uns professionelle Bewerbungen oder erklärt uns die chinesische Kulturrevolution im Rapstil von Eminem. Alles auf der Basis intelligenter Systeme. Was in den 1950er Jahren als Idee auf dem Papier begann und lange Zeit für unmöglich gehalten wurde, hat längst Einzug in unseren Alltag gehalten. Künstliche Intelligenz und der Weg zu dieser: Machine Learning. Beide sind aus heutigen IT-Systemen nicht mehr wegzudenken. # Der Praxis Gap Bei neuen Technologien, die Machine Learning einsetzen, werden zumeist Durchbrüche in Algorithmen und ML-Modellen gepriesen. Der große Erfolg und die schier endlos scheinenden Anwendungsmöglichkeiten machen den Einsatz von KI und Machine Learning für viele Firmen interessant. Beim Versuch für das eigene Problem eine KI-Lösung zum Einsatz zu bringen, kommt es aber oft zu ernüchternden Ergebnissen: Eine Studie von Dimensional Research aus dem Jahr 2021 ergab, dass fast die Hälfte (47 %) der befragten Unternehmen Schwierigkeiten bei der Umsetzung von ML-Projekten hatten. Woran liegt das? Bei den Erfolgsgeschichten von KI wird meist ein gewaltiger Faktor außer Acht gelassen, nämlich die Praktiken, die dazu führen, dass die Daten verfügbar, frei von Bias und repräsentativ sind. Dazu gehört beispielsweise auch, dass das Modell mit möglichst wenig Aufwand und Redundanzen trainiert wurde und die Integration in die Betriebssoftware alle Besonderheiten des Anwendungsgebietes berücksichtigt oder ein Monitoring, das die Qualität der Lösung dauerhaft gewährleistet. Hier könnten wir immer noch Hilfe gebrauchen, oder eine Anleitung. Diese kommt in Form des Frameworks Machine Learning Operations, kurz: MLOps. Dieser Artikel soll eine kleine Blogreihe zum Thema MLOps einleiten. Was führt ML-Projekte zum Erfolg? Wir wollen uns ansehen, wie es andere machen und was erfolgreiche ML-Projekte auszeichnet. In diesem ersten Teil sehen wir uns zwei Beispiele an, die zeigen, wie man es eher nicht machen sollte. Denn tatsächlich gibt es viele Fallen, in die wir tappen können, wenn wir ein ML-Modell trainieren. Diese Negativ-Beispiele zeigen, wo genau MLOps ansetzt und sollen dir helfen, das Konzept hinter MLOps besser zu verstehen. # Was ist eigentlich MLOps? ![](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild1-1-300x246.png)Quelle: [towards data science](https://towardsdatascience.com/ml-ops-machine-learning-as-an-engineering-discipline-b86ca4874a3f) Stark vereinfacht könnten wir sagen: Machine Learning Operations, kurz: MLOps bedient sich des DevOps-Ansatzes, der aus der Softwareentwicklung bekannt ist, und überträgt ihn auf Machine Learning. Mit MLOps sollen sich also Machine-Learning-Modelle effizienter entwickeln, deployen, verwalten und monitoren lassen. Data-Science-Prozesse werden dabei in enger Zusammenarbeit mit Fachleuten aus dem Data Engineering, dem Development und dem IT-Betrieb auf die Strecke gebracht. Mit dem Ziel, Künstliche Intelligenz schneller und geschäftlich erfolgreicher nutzen zu können. Denn Machine Learning ist in der Praxis mehr als die Entwicklung eines Modells mit geringer Fehlerquote. Es hat sich herausgestellt, dass der größte Teil der Arbeit im „Umland“ liegt. Also bei den Daten, der Softwareintegration, der IT-Infrastruktur und beim konstanten Monitoring. ![Machine Learning und sein „Umland“](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild2-1.png)Abbildung 1: Machine Learning und sein „Umland“ Machine-Learning-Modelle sind für sich allein genommen höchst akademisch und längst nicht so praxisbezogen wie die Softwareentwicklung. Um ein gut funktionierendes Modell zu trainieren, mag es reichen, ein paar Machine-Learning-Fachkräfte einzustellen. Wollen wir das Modell aber in einer Produktivumgebung langfristig und zukunftssicher einsetzen, gibt es einiges mehr zu beachten und viele Fallen zu vermeiden. Ähnlich wie sich in der klassischen Softwareentwicklung DevOps als Sammlung produktiver Praktiken entwickelt hat, trägt MLOps dazu bei, - den Umfang und die Anforderungen eines Problems an ein Machine-Lerning-Modell zu erfassen und die Ressourcen frühzeitig angemessen zu skalieren, - die Daten, sowie deren Vorverarbeitung so anzupassen, dass das Modell effizient und zielgerichtet auf das Problem lernen kann, - den Aufwand und Redundanzen bei der Entwicklung, Bereitstellung und Wartung von Machine-Learning-Modellen gering zu halten, - wiederzuverwenden was wiederverwendet werden kann, - zielführende, robuste Designentscheidungen zu treffen - und auf möglichst alle Eventualitäten und Sicherheitsrisiken vorbereitet zu sein. Aber wie sieht das in der Praxis aus? Wo und wie kann MLOps helfen, die erwähnten Fallen zu vermeiden? An zwei Negativbeispielen möchte ich das zeigen. # Beispiel A: Die zu optimistische Diagnose: Daten können trügerisch sein 2017 wurde das Modell CheXNet auf ca. 112.000 Röntgenaufnahmen des Brustkorbs von mehr als 30.000 Patienten trainiert, um verschiedene Krankheiten oder Befunde zu diagnostizieren. Das resultierende Modell arbeitete zuverlässig mit einer Trefferquote von 99 % auf den Testdaten. ![ Diagnose durch CheXNet auf einer Röntgenaufnahme einer Person mit Lungenentzündung](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild4.jpg)*Abbildung 2: Diagnose durch CheXNet auf einer Röntgenaufnahme einer Person mit Lungenentzündung (Quelle: )* Da die Ergebnisse zufriedenstellend waren, wurde das System testweise auf echten Daten angewendet. Hierbei kam heraus, dass es einen bestimmten Befund gab, den das System nur schlecht bis gar nicht erkannte: Im Falle einer Hernie war die Trefferquote deutlich geringer als bei allen anderen Befunden. Wäre es nicht um einen Test gegangen, hätte dies schlimme Folgen haben können. Was war geschehen? ## Der Trugschluss Bei genauerem Hinsehen stellte sich heraus, dass der betroffen Befund sehr selten war und dass es in den Trainings- und Testdaten nur ca. 100 Beispiele für eine Hernie gab. Im Vergleich dazu gab es für die meisten anderen Befunde rund 10.000 Beispiele. Der Befund spielte in den Testdaten also eine derart geringe Rolle, dass die geforderte Trefferquote selbst dann eingehalten werden konnte, wenn das System sie einfach überging. Das Modell hätte eine Hernie also in 100 % der Fälle ignorieren und trotzdem in den Tests zuverlässig erscheinen können. Die Trainings- und Testdaten bildeten somit zwar die Tatsachen realistisch ab, da eine Hernie eine seltene Erkrankung ist, waren aber ungenügend aufbereitet, um ein Modell auf alle Krankheiten gleichermaßen zu trainieren. Die Folgen für betroffene Patienten hätten schwerwiegend sein können. Wir dürfen nie vergessen, dass Modelle nicht wie wir denken. Ihr einziges Ziel ist eine hohe Zuverlässigkeit auf den Trainings- und Testdaten zu erreichen. Denn die Güte dieser Daten entscheidet über die Entscheidungsqualität des Modells. Dies ist nur ein Beispiel für viele andere mögliche Fallstricke, die in unseren Daten lauern können, noch bevor wir überhaupt Optimierungen am Modell vornehmen. So ist zum Beispiel häufig ist einfach unklar, welche Daten für die vorliegende Fragestellung benötigt werden und in welcher Gestalt sie gebraucht werden. Viele Daten enthalten zudem irrelevante Werte , die ein Training sehr verlangsamen können. Oder die Daten sind nicht angemessen vorverarbeitet. Oder sie sagen nicht das aus, was sie aussagen sollen und so weiter. ## Was ist bei CheXNet schiefgelaufen? ### **Falle 1: Wenn das Vorgehen fehlerhaft ist …** Zunächst brauchen wir ein umfassendes Domänenwissen. Wir müssen wissen, auf welcher Grundlage wir arbeiten, um ein Modell effektiv zu trainieren. Wäre beim Training von *CheXNet* nach MLOps-Prinzipien vorgegangen worden, dann hätte das Team die Daten auf die Repräsentation aller gesuchten Klassen überprüft. Dabei wäre den Verantwortlichen aufgefallen, dass eine Krankheit besonders unterrepräsentiert ist. Durch „Supersampling“ oder mithilfe von „künstlichen“ Daten hätten sie hier beispielsweise gegensteuern können. Ein solches Vorgehen wird auch „Data Augmentation“ genannt. MLOps beschäftigt sich aber auch mit Techniken wie „Data Validation“ oder „Feature Selection“. Das heißt, es wird geprüft, ob die vorliegenden Daten für unser Anliegen gültig sind und ob die Auswahl der Datensätzen für die unsere Problemstellung relevant ist. ### **Falle 2: Wenn es subjektiv wird …** Auch psychologische Aspekte können sich in Daten widerspiegeln: Daten, die von Menschen erzeugt werden, können immer Vorbehalte oder persönliche Einstellungen enthalten, die wir später mit bloßem Auge nicht mehr nachvollziehen können. Dies kann dramatische Auswirkungen auf die Entscheidungen haben, die ein KI-Systems für uns trifft. Beispielsweise wenn die Kreditwürdigkeit einer Person an ihrer Herkunft scheitert, weil die Trainingsdaten eine entsprechende Ungleichverteilung enthalten. ### **Falle 3: Wenn Infrastrukturen die Analyse schwer machen …** Ferner können Dateninfrastrukturen die Qualität unserer Daten beeinflussen. Immer wieder erleben wir, dass sich eine Person, die ein ML-Projekt bei uns in Auftrag gibt, sicher ist, alle nötigen Daten zu besitzen. „Es müsse nur noch ein Modell gebaut werden!“ Dann erleben wir, dass die Daten auf diversen Plattformen verteilt, durch unterschiedliche Formate schwer verknüpfbar, voller Redundanzen oder voll von Datensätzen mit wenig Aussagekraft sind. Aus diesem Chaos dann eine verwertbare Quelle zu machen – etwa mittels einer ETL-Strecke, einer Data Pipeline und eines Data Warehouses – kann ein komplett eigenes Team beschäftigen. Ist dies nicht eingeplant, scheitert das Projekt eventuell bereits an diesem Punkt. ### **Falle 4: Wenn Aufwand geschätzt werden muss …** Sehr häufig werden bei ML-Projekten Arbeitspakete nicht eingeplant oder deren Aufwand nicht richtig eingeschätzt, meist unterschätzt. Auch hier setzt MLOps an. MLOps bietet Tools und Vorgehensweisen an, die uns einen Überblick verschaffen über alles, was da ist und alles, was getan werden muss. Erst wenn wir diesen Überblick haben, sind wir in der Lage, Modelle und das Rahmenwerk sinnvoll zu skalieren und den Aufwand richtig einzuschätzen. Außerdem gibt es heute zahlreiche Tools, die dabei helfen Aufwand beim Machine Learning zu sparen: So lassen sich Modelle wiederverwenden oder mit wenig Aufwand auf andere Zwecke „umtrainieren“. Auch Datenvorverarbeitungsstrecken, Trainingskonfigurationen und daraus resultierende Artefakte können versioniert und wiederverwendet werden. Mit all diesen Mitteln hilft MLOps dabei, Modelle effektiv, schnell und mit dem geringstmöglichen Aufwand zu trainieren und auszuliefern. ## **Fazit** An diesem Beispiel erkennen wir, dass der Weg zu einem erfolgreichen ML-Projekt nicht nur über spezielle Fachkräfte und ein gut trainiertes Modell führt, sondern deutlich mehr Überlegungen und Designentscheidungen im Vornherein, sowie eine umfassende Sichtung und ggf. Anpassung der Daten und der Betriebsumgebung erfordert. # Beispiel B: À la mode – Auch KI hat ein Verfallsdatum In diesem Beispiel verwendete eine Online-Modefirma ein Machine-Learning-Modell, um vorherzusagen, welche Kleidungsstücke eine bestimmte Person am wahrscheinlichsten kaufen wird. Dazu wurde das Modell auf Verkaufsdaten der letzten drei Jahre trainiert. Das Unternehmen integrierte das Modell erfolgreich in seine Website, um personalisierte Produktempfehlungen an seine Kundschaft zu liefern. Ein Jahr später änderte das Unternehmen seine Modekollektion und brachte eine neue Linie von Kleidungsstücken auf den Markt. Diese neuen Produkte wurden von einer jüngeren Zielgruppe bevorzugt und wichen stark von den Produkten ab, auf denen das ursprüngliche Modell trainiert wurde. Da das Modell ausschließlich auf historische Verkaufsdaten basierte, in denen die neuen Produkte keine Rolle spielten, entstand eine Abweichung. Ein Data Drift, der verhinderte, dass das Modell die neuen Muster und Trends in den Daten erfassen konnte. In der Folge lieferte es schlechte Vorhersagen. ![ Verschiebungen durch einen Data Drift](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild5-1.png)Abbildung 3: Verschiebungen durch einen Data Drift ## Fallen in den Daten ### **Falle 1: Data Drift** Der Data Drift, den wir in diesem Beispiel erlebt haben, bezieht sich auf Veränderungen in den Daten, die ein Machine-Learning-Modell verarbeiten soll. Veränderungen, die im Laufe der Zeit entstehen können. Diese Veränderungen können dazu führen, dass das Modell auf einmal nicht mehr in der in der Lage ist, genaue Vorhersagen zu treffen. Denn es kann die neuen Muster und Trends nicht in den Daten erfassen, die es kennt. In unserem Beispiel führte die Änderung der Mode zu einer Verschiebung in den Daten. Wenn wir ein Modell also als Funktion mit Eingabe- und Ausgabewert F(X) = Y betrachten, dann hat sich die Distribution unserer X-Werte so grundlegend geändert, dass die Y-Werte, die das Modell ausgibt für unseren Anwendungsbereich unbrauchbar sind. ### **Falle 2: Concept Drift** Ein anderes aber ebenso fatales Alterungsanzeichen unseres Modells wäre der sogenannte *Concept Drift.* Ein Beispiel für einen Concept Drift kennen wir alle aus Spam-Filtern. Während früher E-Mails mit dem gleichen Absender, die häufig aufeinanderfolgten oder über viele Mailkonten mit dem gleichen Betreff verschickt wurden, als unerwünschte Massen-E-Mail galten, haben wir es heutzutage mit diversen automatischen Kaufbestätigungen und automatisierten Benachrichtigungen zu tun. Ein Spamfilter, der auf dem alten Konzept von Spam-E-Mails liefe, würde heutzutage also legitime E-Mails aussortieren. ### **Fazit** Das Beispiel zeigt deutlich, dass das Erstellen und Bereitstellen eines ML-basierten Systems kein abgeschlossener Prozess ist. Es reicht also nicht, wenn wir ein Team einmal dafür bezahlen, ein möglichst akkurates Modell zu liefern und zu deployen. Jedenfalls nicht, wenn wir ein nachhaltig funktionierendes Artefakt in der Hand halten möchten. Vielmehr sollten wir uns bewusst sein, dass sich die Welt um uns herum und damit auch die inneren Faktoren des Machine-Learning-Prozesses ständig verändern. # Summary Möchten wir also ein ML-basiertes System betreiben, sollten wir uns bewusst sein, dass die laufenden Kosten nach der Entwicklung nicht bloß mit der IT-Infrastruktur zusammenhängen. Man kauft kein fertiges Haus, man kauft sich Expertise auf Dauer ein. Nur so sind die Zuverlässigkeit und Weiterentwicklung des Systems gewährleistet. MLOps unterstützt diesen Prozess mit diversen Tools für das Scoping und Deployment sowie die Wartung und das Monitoring von ML-Projekten. In einigen Fällen ist es vonnöten, das Modell erneut zu trainieren. Bedient man sich Techniken wie dem „Transfer-Learning“ muss eventuell nicht von vorne begonnen werden, sondern es reicht die Ausprägungen durch Nachtrainings anzupassen. ![MLOPs Kurs von Chang Yaochen](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild6-1.png)Abbildung 4: Der MLOps-Prozess (Quelle: [MLOps Kurs von Chang Yaochen)](https://changyaochen.github.io/MLOps-course-1/) Zusammenfassend würde ich sagen, dass MLOps sich vor allem mit dem „Davor“, dem „Währenddessen“ und dem „Danach“ im Lebenszyklus eines ML-Modells beschäftigt. Es geht also um - das richtige Einschätzen der Anforderungen und Ausgangssituation eines Projekts und den dazugehörigen Daten, - die richtige Skalierung der Datenstrecken, des Modells, dessen Trainings und den Softwarestrukturen, in die es eingebettet werden soll - ein Vorgehen, mit dem sich die Gültigkeit und Performance eines Modells prüfen und überwachen lassen, - das Einhalten von Compliance-Anforderungen - und die Wahrung von Sicherheit und Integrität des Systems. Das Ziel von MLOps ist dabei, so wenig Ressourcen wie möglich für den größtmöglichen Effekt aufzuwenden. # Ausblick Damit endet der erste Beitrag dieser Serie. Wie geht es weiter? In den nächsten Teilen dieser Blogreihe, stechen wir mit dem sprichwörtlichen ML-Schiff in See und werden die grundlegenden Etappen der ML-Reise durchlaufen: [**–> Scoping:** Die Vorbereitung, Planung und Vorabprüfung des Projekts und seiner Ressourcen. Hier können früh projektentscheidende Hindernisse oder Fehler erkannt und vermieden werden.](https://thecattlecrew.net/?p=38761&preview=true) [**-> Daten:** Wir lernen, die Wichtigkeit der Daten, zu schätzen, sie zu verstehen und einzuschätzen sowie die möglichen Quellen von Daten und was geschehen muss, damit wir mit ihnen Arbeiten können.](https://thecattlecrew.net/2024/10/22/machine-learning-mit-mlops-teil-3-daten-verstehen-woher-wissen-wir-ob-wir-bei-unserer-ml-ueberfahrt-auf-kurs-sind/) **-> Modelltraining:** Was gehört dazu, ein Modell auf den eigenen Daten zu trainieren? Wie wählt man das geeignete Modell und wie können uns Automatisierung und Pipelines bei beiden Schritten die Arbeit erleichtern? **-> Deployment:** Wie integrieren wir das Modell in ein zukünftiges oder bestehendes System bzw. eine Infrastruktur? Und welche Strategien ermöglichen einen reibungslosen Umstieg? **-> Monitoring und Maintanance:** Wie überwachen wir ab hier unser bestehendes ML-System? Welche Entwicklungen können Anpassungen erfordern und wie bereiten wir uns auf diese vor? Ich hoffe, ich konnte mit dieser Einführung dein Interesse für MLOps wecken und wir sehen uns im nächsten Blogbeitrag wieder. **Kategorien:** AI & Data Science, DevOps --- ### [Machine Learning mit MLOps – Teil 2: Scoping. Wie umfahren wir die Untiefen im ML-Gewässer?](https://thecattlecrew.net/2024/05/08/machine-learning-mit-mlops-teil-2-scoping/) **Published:** Mai 8, 2024 **Author:** Jeffrey Remien **Content:** Willkommen zurück an Bord unseres KI-Schiffs! In dieser Episode begeben wir uns auf die nächste Etappe einer spannenden Reise. Im ersten Teil unserer Artikelreihe „[In die Falle getappt! Woran viele ML-Projekte scheitern und wie MLOps dies verhindern kann“](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) ging es um die oft unterschätzten Herausforderungen und Fallen bei der Umsetzung von Machine Learning-Projekten. Wir haben uns einen Überblick über die typischen Fallstricke in ML-Projekten verschafft und eine Einführung erhalten wie MLOps sowohl dabei helfen kann diese Fallstricke zu vermeiden als auch ML-Projekte und die dafür benötigten Ressourcen effektiv zu Planen und mit so wenig Aufwand wie möglich zum Erfolg zu führen. Nun wollen wir tiefer in die Materie einsteigen und die einzelnen Etappen der ML-Reise durchlaufen. Beginnend mit dem **Scoping.** ## Worum geht es in diesem Teil? Im zweiten Teil unserer Reise tauchen wir tiefer in die Welt der MLOps ein. Wir werden uns damit beschäftigen, wie man die Untiefen und Risiken in Projekten durch **Scoping** voraussieht. Wir werden lernen, wie man mit den Augen von Entdecker:innen auf das Projekt und seine Daten blickt, um den in ihnen verborgenen Schatz zu heben. Und nicht zuletzt werden wir lernen die Ressourcen und Problemstellung unter Zuhilfenahme von Domänenwissen richtig einschätzen. Bereite dich auf eine Reise vor, auf der du lernst, wie du ein ML-Projekt mit den richtigen Werkzeugen und Strategien zum Erfolg führst. ## Wie hilft Scoping? ### Durch Voraussicht den richtigen Kurs setzen Rufen wir uns die Grafik bezüglich des Ablaufs von ML-Projekten noch einmal ins Gedächtnis: ![](https://thecattlecrew.net/wp-content/uploads/2024/04/Bild1.png)*Abbildung 1: Ablauf von ML-Projekten (**Quelle:* [*MLOps Kurs von Chang Yaochen)*](https://changyaochen.github.io/MLOps-course-1/) die Abbildung zeigt die typischen Schritte eines MLOp-Teams bis zum fertigen Projekt: 1. Scoping 2. Daten -> Sichten -> Ordnen -> Selektieren -> Vorverarbeiten 3. Modell: -> Trainieren -> Anpassen -> in Arbeitsumgebung integrieren Wie bereits in Teil 1 erwähnt, sind ML-Projekte höchst iterativer Natur. Das bedeutet, sie verlaufen nicht nach Plan und damit geradlinig voran. Stattdessen kann von jedem Abschnitt im Prozess zu jedem vorhergehenden zurückgesprungen werden, um die darauffolgenden dann erneut zu durchlaufen. Das Scoping entspricht in unserem Seefahrtsgleichnis dem Setzen des richtigen Kurses. Stimmt dieser nicht, arbeiten wir in die falsche Richtung und können wertvolle Zeit und Ressourcen verlieren. Anfangs ist es noch einfacher, Korrekturen vorzunehmen. Doch je weiter unsere Reise fortgeschritten ist, desto länger und teurer werden die Umwege. Also wollen wir im späteren Verlauf des Projektes diese möglichst vermeiden. ### Lohnt sich die Reise? Zum Scoping eines ML-Projekts gehört zunächst die Frage, ob wir die Reise überhaupt antreten wollen. Passen Ressourcen und Ziele zusammen? Oft muss man schon „losgefahren“ sein, um diese Frage zu beantworten. Denn häufig ermöglicht erst die [Sichtung der Daten](#_Daten_sichten_(was) die Einschätzung, ob der eingeschlagene Kurs Erfolg haben kann. Deshalb gilt es auch hier früh so viele Erkenntnisse wie möglich zu gewinnen. ### KI oder nicht KI? Ein weiterer Punkt, den wir prüfen sollten ist, ob Machine Learning oder generell KI überhaupt das richtige Gefährt für unsere Reise ist. Es kann gut sein, dass wir damit durch die Gewässer kommen, die wir befahren wollen. Wie ein riesiger moderner Segler erfordert ein ML-Projekt allerdings eine entsprechend große und geschulte Mannschaft und außerdem konstante Pflege und ist bei weitem nicht so leicht zu handhaben wie ein traditionelles Boot, also eine herkömmliche Lösung. Nicht selten erweist es sich als effektiver, einen Algorithmus zu schreiben und mit erprobten Methoden und einem eingespielten Team eine einfache Lösung zu entwickeln. Hier hat man deutlich mehr Planungssicherheit und weniger Überraschungen. KI kann ein tolles Fahrzeug mit ungeahnten Möglichkeiten sein, aber sie erfordert eben auch ein deutlich spezialisierteres Team und die Bereitschaft, größere Risiken einzugehen. Es ist also unbedingt zu prüfen, welche Alternativen du hast. Dabei hilft es eventuell, über den Tellerrand zu blicken: Also erst einmal nachsehen, wie andere das Problem angegangen sind, bevor wir auf eigene Faust anfangen, das große KI-Schiff zu beladen! ### ![](https://thecattlecrew.net/wp-content/uploads/2024/04/DALL·E-2024-04-10-14.40.51-For-the-title-KI-oder-nicht-KI-create-an-image-of-a-person-standing-on-a-dock-having-to-choose-between-two-ships-to-navigate-uncertain-waters.-One.webp)Welcher Weg führt zum Ziel? Bist du die ersten Schritte gegangen und zu dem Schluss gekommen, dass sich dein Problem nicht ohne Machine Learning lösen lässt, dann kann es losgehen: Wir beginnen, die grobe Route abzustecken, auf der wir entlangsegeln wollen. Dies geschieht zunächst in Form von Meilensteinen. Eins ist aber gewiss: Nichts ist gewiss! Das heißt, wir können davon ausgehen, dass ähnlich wie bei einer Expedition zur See, die tatsächliche Route nicht mehr ganz der ursprünglich geplanten entsprechen wird. Wie schon erwähnt: Am Anfang der Reise werden uns gröbere Kursanpassungen noch verziehen, im späteren Verlauf kosten sie uns Zeit und Geld und sollten, nach Möglichkeit, nur noch leichte Korrekturen sein. Allerdings gibt es immer mehrere Wege zum Ziel und nicht „den einen richtigen“. Es kann sich also lohnen, die Umgebung zu erforschen und mehrere Möglichkeiten auszuprobieren. Manche Entscheidungen lohnt es aufzuschieben, bis wir Erkenntnisse aus Experimenten gewonnen haben. Denn erst dann können wir unsere Entscheidungen auf einer fundierten Basis treffen und abwägen. In manchen Fällen kann es sich auch lohnen, Kundschafter vorauszuschicken. Bei MLOps würde dies heißen, dass wir einige oder sogar alle Abschnitte mit reduzierter Komplexität ganz ablaufen, um die Machbarkeit oder Erfolgsaussichten einer geplanten Lösung abschätzen zu können. Hierzu wird es in den folgenden Episoden noch mehr Beispiele geben. ### Kenne deine Gewässer! Oder: Warum Domänenwissen wichtig ist Wenn es um die Entwicklung von ML-Modellen bzw. KI-Projekten insgesamt geht, brauchen wir Domänenwissen. Zwar können heutige Modelle häufig auch schon ohne näheres Verständnis der Daten oder des Anwendungsgebiets vielversprechende Ergebnisse liefern. Trotzdem: Das Material zu kennen, seinen Kontext und seine Bedeutung in der „echten Welt“ zu verstehen, kann jedoch entscheidende Ideen dafür liefern, wie wir die Daten geschäftlich nutzen können oder wie wir effektiver vorgehen können. Außerdem kann das Domänenwissen dazu beitragen, deutlich schneller zum Ziel zu kommen und Ballast in Form von unnötigen Daten und Ressourcen „über Bord zu werfen“. So wie ein IT-Team ohne KI-Kenntnisse nicht ohne Weiteres ein Modell trainieren kann, benötigen KI-Expert:innen in ihrer Mannschaft Personen mit Domänenwissen. So wie die beste Schiffscrew auch ortskundige Mitglieder braucht. ![](https://thecattlecrew.net/wp-content/uploads/2024/04/DALL·E-2024-04-10-14.40.32-For-the-title-Kenne-deine-Gewaesser-create-an-image-depicting-our-captain-standing-in-a-modern-futuristic-chart-room.-The-room-is-filled-with-inter.webp) ## Fazit Das Titelbild für diesen Artikel habe ich bewusst ausgewählt: Wie der Blick durch ein Fernrohr, ermöglicht das Scoping eine klare Sicht nach vorne. So wie ich durch das Fernrohr Untiefen und Klippen entdecke, die es zu umschiffen gilt, entdecke ich auf meiner Suche nach der idealen ML-Lösung für mein Problem Stolpersteine und Risiken, die ich kennen sollte. Was ich versuche, deutlich zu machen: Es ist wichtig, zukünftige Ereignisse vorherzudenken, statt sich sofort in ein ML-Projekt zu stürzen. Denn viele Probleme erwecken zunächst den Anschein durch KI vereinfacht werden zu können, die nötigen Ressourcen und Expertise werden dabei gerne unterschätzt. Kurz: Ein ML-Projekt will gut geplant und das Problem gut verstanden sein, um auf Erfolgskurs gehen zu können! Ich hoffe, dieser Artikel konnte dich darauf vorbereiten und dir ein Gefühl vermitteln, wie ML-Projekte angegangen werden müssen. # Wie geht die Reise weiter? In der nächsten Etappe unserer großen MLOps-Reise werden wir uns ganz den Daten widmen. Also den Gewässern, die wir befahren, wie wir uns in ihnen zurechtfinden, wie wir den verborgenen Schatz in den Daten identifizieren, und wie wir ihn erfolgreich heben. Daten sind der Dreh- und Angelpunkt jedes ML-Projektes und meistens deutlich wichtiger als das ML-Modell selbst, hierbei geht es aber nicht bloß um die Auswahl der richtigen Datenquellen, sondern auch wie diese aufbereitet und weiterverarbeitet werden. Hier gibt es zahllose Möglichkeiten und Techniken. Im nächsten Artikel versuche ich dir das Rüstzeug mitgeben, das erfahrene Seeleute brauchen, um erfolgreich durch die Datengewässer zu navigieren. --- # Überblick Artikelreihe Machine Learning mit MLOPs: [**-> Einführung MLOps:** Woran scheitern die meisten ML-Projekte und wie kann MLOPs helfen?](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) **-> Scoping:** Aktueller Artikel [**-> Daten:** Wir lernen, die Wichtigkeit der Daten, zu schätzen, sie zu verstehen und einzuschätzen sowie die möglichen Quellen von Daten und was geschehen muss, damit wir mit ihnen Arbeiten können.](https://thecattlecrew.net/2024/10/22/machine-learning-mit-mlops-teil-3-daten-verstehen-woher-wissen-wir-ob-wir-bei-unserer-ml-ueberfahrt-auf-kurs-sind/) **-> Modelltraining:** Was gehört dazu, ein Modell auf den eigenen Daten zu trainieren? Wie wählt man das geeignete Modell und wie können uns Automatisierung und Pipelines bei beiden Schritten die Arbeit erleichtern? **-> Deployment:** Wie integrieren wir das Modell in ein zukünftiges oder bestehendes System bzw. eine Infrastruktur? Und welche Strategien ermöglichen einen reibungslosen Umstieg? **-> Monitoring und Maintanance:** Wie überwachen wir ab hier unser bestehendes ML-System? Welche Entwicklungen können Anpassungen erfordern und wie bereiten wir uns auf diese vor? **Kategorien:** AI & Data Science, DevOps **Schlagwörter:** Artificial Intelligence, Datenstrategie, DevOps, LLM, Projektmanagement, Softwarenentwicklung, Strategie, Strategy --- ### [Machine Learning mit MLOps – Teil 3: Abtauchen ins Datenmeer. Warum Daten oft wichtiger sind als Modelle](https://thecattlecrew.net/2024/10/22/machine-learning-mit-mlops-teil-3-abtauchen-ins-datenmeer/) **Published:** Oktober 22, 2024 **Author:** Jeffrey Remien **Content:** Ahoi! Ihr seid ja immer noch da! Alle, die nach den ersten beiden Etappen unserer Reise noch nicht von Bord gegangen sind, können sich die Sauerstoffflasche umschnallen, denn diesmal tauchen wir tief in die Daten ein. Wer die ersten beiden Teile dieser Serie noch nicht kennt, darf sie hier selbstverständlich gerne nachlesen: [Einführung MLOps: Woran scheitern die meisten ML-Projekte, und wie kann MLOps helfen?](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) [Machine Learning mit MLOps – Teil 2: Scoping. Wie umfahren wir die Untiefen im ML-Gewässer?](https://thecattlecrew.net/2024/05/08/machine-learning-mit-mlops-teil-2-scoping/) In den letzten beiden Artikeln dieser Serie haben wir gelernt, wie wir ein Projekt richtig einschätzen lernen. Und es ging darum, wie wir Ressourcen richtig planen und möglichen Problemen früh vorgreifen. In diesem Artikel geht es eher darum, zu verstehen, was wir mit unseren Daten überhaupt vor uns haben. Wie diese uns helfen können, um unseren Kurs, also die Richtung unseres ML-Projekts, zu überprüfen: - Woran erkennen wir, ob unser „Datenschatz“ ausreicht? - Wo bekommen wir unsere (und gegebenenfalls noch weitere) Daten her? - Wie können wir mithilfe unserer Daten früh prüfen, ob wir überhaupt auf Kurs sind? ## Warum sind Daten für MLOps wichtig? Vielleicht fragst du dich, warum es in dieser Artikelreihe zum Thema Machine Learning in zwei Teilen ausschließlich um Daten geht. Die Antwort ist einfach: Daten entscheiden darüber, ob ein Projekt durchführbar ist. Unter uns ML-Engineers gelten die Daten deshalb als „First Class Citizen“. Sie sind für uns noch wichtiger als das Training eines Modells oder das Anpassen von dessen Parametern. Kleinste Unterschiede in Qualität, Menge oder Aufbereitung von Daten können sich auf die Trefferquote eines ML-Modells auswirken. Oder um bei unserem Seefahrtsgleichnis zu bleiben: Ein ML-Modell ohne Daten ist wie ein Schiff ohne Wasser. ## Daten: Welche und wieviel brauche ich? ![](https://thecattlecrew.net/wp-content/uploads/2024/08/DALL·E-2024-10-22-17.11.39-A-scene-on-the-deck-of-a-ship-that-blends-futuristic-and-old-pirate-aesthetics.-An-officer-in-pirate-like-attire-with-futuristic-elements-is-holding-a.webp) Fast jedes Projekt beginnt mit dieser Frage. Und sehr häufig treten Kunden an mich heran und sind überzeugt, die nötigen Daten für das geplante Unterfangen zu haben. Und dann, bereits nach ein paar Fragen meinerseits sehen sie ihr Projekt ins Schwanken gebracht. Ddenn Daten können in unzähligen Formen vorliegen. Und: „Viele Daten“ nicht automatisch „gute Daten“. Wie auch die Seeleute unseres ML-Schiffs ihre Gewässer bestens kennen müssen, um die richtige Route einzuschlagen, müssen wir tief in die Materie unserer Kunden „eintauchen“, um unser Vorgehen zu bestimmen. Das dies nicht immer reibungslos klappt, kannst du dir sicher denken. 3 typische Hindernisse: 1. Daten an verschiedenen Orten: Gut und effektiv können wir in der Regel mit Daten arbeiten, die für uns an **einer Stelle** verfügbar sind. Hier trennt sich leider oft schon die Spreu vom Weizen. Viele Projektverantwortliche schwören mir, alle nötigen Daten zu haben. In der Realität kann das aber bedeuten, dass diese auf zehn verschiedenen Systemen verteilt sind und unterschiedliche Definitionen die gleichen Parameter besitzen. Das Zusammenführen kann zu einem Alptraum werden. Ich habe schon erlebt, dass „Wir haben alle Daten“ bedeutete, dass ich mich durch eine 20 GB große händisch ausgefüllte Excel Tabelle kämpfen musste. Natürlich hatte kein Mensch zuvor festgelegt, wie ihre Felder auszufüllen sind. 2. Unterschiedliche Sprachen: Noch schlimmer wenn die Systeme alle unterschiedliche „Sprachen sprechen“ also die Daten auf unterschiedliche Arten durch diese Systeme verfügbar gemacht werden, das eine vielleicht über eine API, das andere mittels CSV Download. 3. Privacy: Weitere Schwierigkeiten können auftreten, wenn Datenschutzrichtlinien beachtet werden müssen. Enthält der Datensatz Informationen über Privatpersonen? Welche Auflagen des Gesetzgebers und welche Firmenpolicys müssen beachtet werden? Welchen Teil der Daten können wir überhaupt verwenden? Was wenn wir nichts verwenden dürfen? Keine Sorge! Keins dieser Probleme sorgt dafür, dass unser KI-Schiff auf dem Trockenen liegt. Aber es müssen ausreichende Vorkehrungen getroffen werden. Und als projektverantwortliche Person ist es möglich, bereits [beim Scoping](https://thecattlecrew.net/2024/05/08/machine-learning-mit-mlops-teil-2-scoping/) einige Fragen durchzugehen: - Welche Daten werden für mein Vorhaben vermütlich nötig sein? - Habe ich diese? - Falls nein, weiß ich, woher ich sie beschaffen kann? - Falls ja, in welcher Form liegen diese vor? - Habe ich Zugriff auf diese Daten? - Gibt es bezüglich der Daten Sicherheits- oder Datenschutzbedenken? Die 3 genannten Hindernisse lassen sich auf vielerlei Art beseitigen: 1. **Data Warehouse:** Idealerweise wollen wir, dass unsere Daten aus einer Quelle kommen. Z. B. aus einem Data Warehouse. Dieses kann für die Integrität und Verfügbarkeit sowie Konformität unserer Daten Sorge tragen. Haben wir wie im ersten Beispiel viele unterschiedliche Quellen und vielleicht auch Protokolle oder Formate, wirkt sich das vor allem auf die Entwicklungszeit aus. Wir müssen Data Scientists beschäftigen, die sich eingehend mit den Daten beschäftigen und diese zu einem Data Warehouse oder auch einfach erstmal einer gemeinsamen Datenbank zusammenführen. Auch Dynamische Modelle exisiteren. 2. **Mit den Fachleuten sprechen:** Schildere deinen Data Scientists die Problemdomäne ausführlich und verlasse dich auf ihre Empfehlung hinsichtlich einer robusten Lösung zur Datenbereitstellung! Data Scientists sind wie Unterwasserbewohner. Daten sind ihr Meer. Darin kennen sie sich bestens aus und können uns schnell Aufschluss geben, wie wir navigieren müssen. Selbst aus der chaotischsten Excel Tabelle kann eine sinnvolle Struktur gewonnen werden. Aber das hat seinen Preis und gegebenenfalls ist es günstiger zu prüfen ob die Daten in anderer Form verfügbar gemacht werden können. 3. **Datenschutz klären:** Im Falle der ungeklärten Datenschutzbedenken müssen wir abschätzen wie relevant der personenbezogene Teil der Daten für unser Projekt ist. Eventuell können wir diese Einträge komplett ausklammern. Falls nicht sind *Anonymisierung* oder *Pseudonymisierung* die Werkzeuge unserer Wahl. Falls dies nicht ausreichend möglich ist, empfehle ich unbedingt, Datenschutzbeauftragte heranziehen. Auch dies wirkt sich natürlich auf die Kosten aus. Selbst wenn die vorher genannten Schritte möglich sind, ist es oft sinnvoll, sich kurz beraten lassen. So verhindern Sie, versehentlich gegen Auflagen zu verstoßen, die Sie später das ganze Projekt kosten können. ## Den Kurs festlegen: Baseline etablieren ![](https://thecattlecrew.net/wp-content/uploads/2024/08/DALL·E-2024-10-22-17.13.12-In-the-futuristic-pirate-world-aboard-the-ship-a-group-of-officers-dressed-in-a-mix-of-pirate-and-futuristic-attire-are-gathered-around-a-holographic.webp) Wenn Kund: innen mich fragen, ab wann es sich lohnt, mit dem Training von Modellen zu beginnen, antworte ich gerne „sofort“. Damit ist aber nicht gemeint, dass wir uns direkt eine 200 TeraFLOPS Compute-Instanz in der Cloud reservieren oder uns ein Server Rack voller GPUs ins Office stellen und anfangen, am „großen Modell“ zu arbeiten. Nein. Aber wir können kleine „Testtraings“ mit reduzierter Genauigkeit, Ressourcen und Daten machen. Diese sollen kein Modell optimieren. Vielmehr schauen wir uns an ob unsere Änderungen an den Daten(quellen) oder in der Konfiguration einen positiven Einfluss auf die Genauigkeit haben. Oder ob ein einfaches Modell einigermaßen zufriedenstellend Zusammenhänge aus den Daten beziehen kann. Daran erkennen wir früh, ob es sich lohnt so weiterzumachen wie bisher oder ob wir Faktoren ändern müssen. Wir testen sozusagen „die Gewässer“. Aber worauf achten wir eigentlich? Und wie definieren wir „gut“ oder zumindest „zufriedenstellend“? Das hängt von unserer Aufgabe ab: Auf Machine Learning basierte KIs werden für sehr unterschiedliche Aufgaben eingesetzt. In der Regel wollen wir etwas klassifizieren, etwa: Ob Produkte auf einem Fertigungsband Schäden aufweisen. Oder: Welchen Gesichtsausdruck eine Person hat, die in die Kamera schaut. In den anderen Fällen sind es meist Vorhersagen, wie die Fortentwicklung eines Aktienkurses oder der Zeitpunkt an dem ein Bauteil wahrscheinlich wegen seiner Vibrationen versagen wird. Eine gute Nachricht, für alle, die aufgrund meiner vorangegangenen Aussagen etwas pessimistisch auf ML-Projekte blicken: Wir können in Jedem Fall sagen, dass wir prinzipiell jede Aufgabe in den vorher genannten Bereichen auch von einer KI übernehmen lassen können, wenn ein oder mehrere Personen sie bisher ausüben konnte und wir zu allen Informationen Zugang erhalten, zu denen diese auch diese Personen Zugang haben. (Achtung! Wie erwähnt kann es hier selbst bei alten Hasen zu massiven Fehleinschätzungen kommen.) Oder wenn wir wissen, dass es in dem was wir vorhersagen wollen eine Regelmäßigkeit oder Kausalität gibt. Aha! Erleichterung! Leinen Los! Grünes Licht für das Projekt! Alles lässt sich mit KI lösen! Nicht so schnell … „möglich“ heißt noch nicht „machbar“! Selbst wenn wir das Problem, das bisher eine Person gelöst hat, perfekt verstehen und wirklich sämtliche Informationsquellen zur Entscheidungsfindung identifiziert haben, könnte es sein, dass das was der Mensch intuitiv entscheidet, für einen Algorithmus ein derart großes Datenaufkommen darstellt, dass wir so viele Ressourcen aufbringen müssten, dass es günstiger wäre, hier einen Menschen einzusetzen. KI ist nach wie vor eine hochspezialisierte Technologie und je unspezifischer und „breiter“ unsere Aufgabe wird, desto schwieriger oder **teurer** wird es auch, sie mittels KI zu lösen: - Tierarten auf Fotos erkennen? Mittlerweile eine Standardaufgabe. - Besucherzahlen anhand von Wetter, Saison, Nachrichten und Ausfallzeiten abschätzen? Etwas kniffliger, aber wohl noch im Rahmen. - Eine Projektstruktur entwerfen nur basierend auf verbalen Input: Möglich? Mit Sicherheit! Aber auch machbar? Mit einem dreistelligen Millionen schweren Investment und einigen Jahren Forschung könnte es gehen. Haben wir aber ein Problem identifiziert, dessen Domäne wir gut durchblicken und das spezifisch genug ist, um im Rahmen unserer Möglichkeiten von einer KI automatisiert zu werden, dann können wir uns Gedanken über Erfolgskennzahlen machen. In der MLOps ist die Baseline oft ein einfaches Modell oder eine Heuristik, die den aktuellen Stand der Technik oder den bisherigen Ansatz für das zu lösende Problem darstellt. Dies kann ein einfaches statistisches Modell sein, eine regelbasierte Logik oder sogar menschliche Leistung. Die Idee ist nicht, das komplexeste oder leistungsfähigste Modell zu wählen, sondern eins, das robust, verständlich und leicht zu implementieren ist. Diese Baseline dient vor allem drei Zwecken. 1. **Sie bietet einen realistischen Maßstab für Verbesserungen.** Wenn ein neues, komplexes Modell entwickelt wird, gibt die Baseline Aufschluss darüber, wie viel besser das neue Modell im Vergleich zu einfacheren Ansätzen ist. Es ist wie das Wissen um die Geschwindigkeit und Stabilität eines alten Schiffes, bevor ein neues, modernes Schiff gebaut wird. 2. **Sie hilft, die Erwartungen zu kalibrieren.** In der Welt der MLOps ist es leicht, sich von den Versprechungen neuester Technologien mitreißen zu lassen. Doch nicht immer führen komplexere Modelle zu besseren Ergebnissen. Die Baseline erdet uns und stellt sicher, dass wir die Vorteile neuer Ansätze objektiv bewerten. 3. **Sie ermöglicht eine schnelle Iteration.** Anstatt sofort mit komplexen Modellen zu beginnen, können Entwickler: innen mit der Baseline beginnen und schrittweise Verbesserungen vornehmen. Dies ist wie das schrittweise Aufrüsten eines Schiffes, anstatt ein neues von Grund auf zu bauen. Und wo wir zuvor gerade von Aufgaben gesprochen haben, die zuvor von Menschen gelöst wurden: eine weitere bewährte Methode, die Performance einer KI bei einer gegebenen Aufgabe zu messen, ist der Vergleich zum Menschen … ## Mensch versus Navigationssystem: Human Level Performance ![](https://thecattlecrew.net/wp-content/uploads/2024/08/DALL·E-2024-10-22-22.31.48-In-the-futuristic-pirate-world-aboard-the-ship-a-human-navigator-is-competing-with-a-computer-based-navigator-to-plot-a-course-through-the-data-ocean.webp) Wenn wir eine Aufgabe mittels KI automatisieren wollen, die zuvor ein Mensch übernommen hat, kann die Leistung von Menschen eine gute Metrik sein, um herauszufinden, wie gut sich unsere KI macht. Idealerweise lassen wir diese auf exakt die gleichen Daten los, die auch der Mensch zu sehen bekommt. Dann müssen wir versuchen, aussagekräftige und messbare Vergleichsmetriken zu finden. Ein Beispiel: Eine Firma, die gebrauchte Handys recycelt, hat einen Prüfstand auf dem schnell und nach „Augenmaß“ entschieden wird, ob ein Gerät erneuert und wiederverkauft werden kann, ob es sich als Ersatzteillager lohnt oder ob es keinen Wert mehr hat und komplett verschrottet werden muss. Um uns eine zuverlässige Metrik zu schaffen, begleiten wir die Person, die für diese Entscheidungen zuständig ist, an einem typischen Arbeitstag und untersuchen alle Geräte, die sie den Tag über geprüft hat, im Labor auf tatsächliche Verwertbarkeit. Jede Entscheidung bei der das Labor mit ihrem Urteil übereinstimmt ist ein Treffer. Daraus errechnen wir eine Trefferquote zum Beispiel von 87 %. Was erstmal nach nicht viel klingt, kann im laufenden Betrieb und aus Zeitersparnisgründen trotzdem effektiv sein. Diese selben Geräte können wir auch als Maßstab für ein trainiertes Modell nutzen und so prüfen, wie nah es an die Trefferquote des Menschen herankommt. Akzeptable Ergbnisse sind, wenn wir die Ergebnisse des Menschen mindestens zu 95 % reproduzieren können. Unsere Fehlerrate ist hier also reduziert um die Leistung des Menschen, tatsächlich richtig erkannt hätte man mit dieser Quote immerhin noch 82,65 % der Geräte. Es ist aber auch gut möglich, dass unser Modell, das ja auf tatsächlich untersuchten Geräten trainiert wird, den Menschen übertrifft und 92 % aller geräte richtig einsortiert. Dies entspräche 105 % der Trefferquote des Menschen. Aber hier müssen wir vorsichtig sein. Denn KIs können gleichzeitig auf dem Papier eine durchschnittlich deutlich bessere Performance als Menschen abliefern und die „dümmsten Fehler machen“. Das liegt daran, dass Menschen viele Entscheidungen durch weiteren Kontext treffen können, während die KI „passen“ muss, weil ihr Informationen fehlen. Human Level Performance kann also ein erster Indikator sein ob wir auf dem richtigen Weg sind und unsere Lösng **konvergiert**, sie sollte aber niemals der einzige Maßstab sein. Und unser Training sollte immer möglichst breit aufgestellt sein und viele Situationen abdecken. Aber wie stellen wir das sicher und wo holen wir entsprechende Daten her? ## Daten kartografieren: Labeling In manchen Fällen haben wir bereits alles was wir brauchen und können ein Modell auf unsere Daten loslassen. Sehr oft müssen wir aber Kontext hinzufügen, damit das Modell auf den erwarteten Antworten trainiert werden kann. Beispielsweise wenn wir ein Modell darauf trainieren wollen bestimmte Personen zu erkennen, wir brauchen nur zwei Listen Anlegen und unsere Fotos in diese einsortieren, die Bilder mit den zu erkennenden Personen und solche anderer zufälliger Personen. Das sind unsere Labels. Das präzise Labeling von Daten ist wie das sorgfältige Kartografieren unerforschter Meere. Jedes Label ist ein Punkt auf der Karte, und jeder Fehler ist eine potenzielle Klippe, die unsere Reise gefährden könnte. In der Welt der MLOps ist ein akkurates und konsistentes Labeling entscheidend, um sicherzustellen, dass unser Modell die Welt so sieht und versteht, wie sie wirklich ist. Stellen wir uns vor, wir sind Kartografen, mit der Aufgabe, unentdeckte Inseln zu kartieren. Jeder Fehler, jede falsche Markierung könnte dazu führen, dass zukünftige Seeleute in die Irre geführt werden. Ähnlich verhält es sich mit dem Labeling beim MLOps. Unsachgemäß gelabelte Daten können unser Modell in die Irre führen, zu falschen Vorhersagen führen und das Vertrauen in unsere KI-Systeme untergraben. Das Labeling erfordert also Genauigkeit und ein tiefes Verständnis für die Daten und den Kontext, in dem sie verwendet werden. Es handelt sich um einen Prozess, der Sorgfalt und Aufmerksamkeit für Details erfordert. Wie in der Kartografie, bei der eine Person sicherstellt, dass jede Insel korrekt verzeichnet ist, müssen wir sicherstellen, dass jedes Datenlabel so präzise wie möglich ist. Aber das Labeling ist nicht nur eine Frage der Genauigkeit. Es ist auch eine Frage der Perspektive. Wie Kartografie-Fachleute, die entscheiden, welche Merkmale einer Landschaft hervorzuheben sind, müssen wir entscheiden, welche Aspekte unserer Daten gelabelt werden müssen. Mit dem Ziel, das Problem, das wir lösen möchten, bestmöglich darzustellen. Dies erfordert ein tiefes Verständnis für das Problem und eine klare Vision davon, wie die gelabelten Daten verwendet werden sollen. Und da Labels so gut wie immer von Menschen erstellt werden, gibt es auch hier eine Subjektivitätsfalle. Das heißt, Entscheidungen unterliegen immer auch kulturellen und persönlichen Einfärbungen und damit Vorurteilen der jeweiligen Person. Das ist unausweichlich und sollte uns daher bei jedem bereits gelabelten Datenset, das wir einkaufen, bewusst sein. Wollen wir möglichst neutrale und allgemeingültige Labels, kann es notwendig sein, ein vielfältiges Team aus diversen Persönlichkeiten zusammenzustellen. ## Fazit Ich würde sagen: Wir erreichen gerade die 30-Meter-Marke auf unserer Tauchreise durch die Tiefen des Datenmeers. Wir haben gesehen, dass das Erfolgsgeheimnis eines ML-Projekts nicht allein in der Modellarchitektur oder den ausgeklügelten Algorithmen liegt, sondern in der gründlichen Vorbereitung und dem bewussten Umgang mit Daten. Wie ein erfahrener Kapitän, der seine Route sorgfältig plant und seine Ressourcen klug einsetzt, müssen auch wir unsere Datenlandschaft genau kartieren, potenzielle Gefahrenstellen identifizieren und frühzeitig entscheiden, ob wir auf dem richtigen Kurs sind. Das Navigieren im Meer der Daten erfordert Präzision, Umsicht und die Bereitschaft, jederzeit auf neue Herausforderungen zu reagieren. Nur wenn wir die notwendigen Vorbereitungen treffen, können wir sicherstellen, dass unser ML-Schiff auch in stürmischen Gewässern stabil bleibt und sein Ziel erreicht. Am Ende gilt: Die Qualität unserer Ergebnisse hängt nicht nur davon ab, wie gut unser Modell trainiert ist, sondern vor allem davon, wie gut wir unsere Daten verstehen und nutzen. Jedes Projekt ist einzigartig, und es gibt keine allgemeingültige Lösung. Doch mit einem soliden Verständnis für die Daten und einer klaren Strategie können wir den Erfolg unserer ML-Vorhaben erheblich steigern. ## Ausblick Jetzt, wo der Kompass kalibriert ist und die Karten gezeichnet sind, kann die Reise weitergehen. Schließlich gilt es, den Schatz zu heben, der sich in unseren Daten verbirgt. Im nächsten Artikel werden wir daher die Sauerstoffflasche gegen eine Taucherglocke tauschen und noch tiefer abtauchen: Es geht um die Frage, was wir tun können, wenn die Menge oder Qualität unserer Daten nicht ausreicht und wie wir die Daten in eine Form bringen, mit der unser Modell arbeiten kann. Oder, um in der Seefahrtssprache zu bleiben: Wie machen wir unsere Gewässer befahrbar? --- # Überblick Artikelreihe Machine Learning mit MLOPs: [**-> Einführung MLOps:** Woran scheitern die meisten ML-Projekte, und wie kann MLOps helfen?](https://thecattlecrew.net/2023/05/22/machine-learning-mit-mlops-teil-1-in-die-falle-getappt-woran-viele-ml-projekte-scheitern-und-wie-mlops-dies-verhindern-kann-zwei-beispiele/) [**-> Scoping mit MLOps:** Wie schätze ich ein Projekt und die dafür benötigten Ressourcen richtig ein?](https://thecattlecrew.net/2024/05/08/machine-learning-mit-mlops-teil-2-scoping/) **-> Daten verstehen mit MLOps:** Aktueller Artikel **-> Daten verarbeiten mit MLOps:** Wie hole ich das Meiste aus meinen Daten heraus? **-> Modelltraining:** Was brauche ich, um ein Modell auf den eigenen Daten zu trainieren? Wie wähle ich das geeignete Modell und wie können Automatisierung und Pipelines die Arbeit erleichtern? **-> Deployment:** Wie integriere ich das Modell in ein zukünftiges oder bestehendes System bzw. eine Infrastruktur? Welche Strategien ermöglichen einen reibungslosen Umstieg? **-> Monitoring und Maintenance:** Wie überwachen wir ab hier unser bestehendes ML-System? Welche Entwicklungen können Anpassungen erfordern? Wie bereiten wir uns auf diese vor? **Kategorien:** AI & Data Science, Analytics & Insights, DevOps --- ### [Remix – eine Alternative für Geschäftsanwendungen](https://thecattlecrew.net/2024/09/06/remix-eine-alternative-fuer-geschaeftsanwendungen/) **Published:** September 6, 2024 **Author:** Richard Attermeyer **Content:** In dieser Blog-Serie möchte ich euch das Full Stack Framework Remix als eine vielversprechende Alternative vorstellen, insbesondere für die Entwicklung von Geschäftsanwendungen. Darum geht’s in dieser ersten Folge: - Wie hat sich die Entwicklung von Business Applications in den letzten Jahren verändert? - Welche technischen Herausforderungen haben dazu geführt, dass wir heute dort stehen, wo wir stehen? - Welche weiteren Technologien gibt es, und was ist das Besondere an Remix? Viel Spaß beim Lesen! ## Rückblick auf die Vergangenheit Vor 10 bis 15 Jahren war es noch üblich, Geschäftsanwendungen mittels serverseitigem Rendering zu entwickeln. Frameworks wie PHP, Ruby on Rails, ASP.NET oder Java Server Faces dominierten diese Ära. Die Anwendungen wurden auf dem Server gerendert und als HTML an den Browser ausgeliefert. JavaScript war damals nicht sehr populär, da Browser noch nicht so standardisiert und performant waren wie heute. Allerdings hatten diese serverseitig gerenderten Anwendungen einen entscheidenden Nachteil gegenüber klassischen Desktop-Anwendungen, die sie ablösen sollten: Sie waren nicht so responsiv und interaktiv. Deshalb führte der ständige Austausch mit dem Server zu einer langsamen Benutzererfahrung. ## Die Ära der Single Page Applications (SPA) Mit der Einführung von AJAX und später Single Page Applications (SPA) änderte sich dies. Anwendungen wurden interaktiver und responsiver. SPAs kommunizieren über HTTP APIs, die Daten im JSON-Format austauschen, wodurch das Frontend im Browser gerendert und die Daten über APIs geladen werden. Dies führte zur Verbreitung des REST-Paradigmas. ![Klassische single-page Applikationsarchitrektur](https://thecattlecrew.net/wp-content/uploads/2024/08/spa-classic.png) Abbildung 1. Klassische SPA-Architektur ## Herausforderungen und Komplexität von SPAs Die Umstellung auf SPAs brachte jedoch einige Herausforderungen mit sich: - Komplexität der Netzwerkkommunikation: Daten mussten häufig mehrfach gemappt werden, was fehleranfällig und zeitaufwendig war. - Overfetching und Underfetching: REST-APIs lieferten oft entweder zu viele oder zu wenige Daten, was zu ineffizientem Datenmanagement führte. - Fragmentierung der Daten: Durch die Einführung von Microservices wurden Daten auf verschiedene Services verteilt, was die Datenabfrage komplexer machte. ![](https://thecattlecrew.net/wp-content/uploads/2024/08/spa-classic-whitebox.png)Abbildung 2. Whitebox SPA Die Komplexität lag auch darin begründet, dass viel „Boilerplate Code“ geschrieben wurde, um Daten zwischen Datenbank und UI auszutauschen. Die Architektur der Whitebox SPA ermöglichte z. B. diese beiden Funktionen: 1. Definition von JPA Entites und **Mapping** zwischen SQL und Java Objekten 2. **Mapping** zwischen Java Objekten und JSON Wir haben hier ein Objektmodell, ein JSON Modell und Mappings drin, die gepflegt werden müssen. Dies ist nicht nur fehleranfällig, sondern auch zeitaufwändig. Für bestimmte Use Cases konnten Ansätze wie Spring Data REST weiterhelfen. Diese automatisieren zum Teil das Mapping, zumindest Richtung REST. Daraus ergibt sich dann wieder ein Code-First-Ansatz für REST-Schnittstellen. Was in Ordnung sein kann, wenn es sich um private Schnittstellen handelt. Leider ist die Trennung zwischen „privaten“ und „öffentlichen“ Business-API-Schnittstellen nicht immer so klar: Private Schnittstellen sind z. B. von einem Backend for Frontend (BFF) für ein bestimmtes UI optimiert mit speziellen Schnittstellen. Dies kann dazu führen, dass wir, obwohl wir eine „Business API“ ansteuern wollen, bei einer spezifischen BFF-Schnittstelle landen, die eigentlich privat sein sollte. Ferner war hier zu beobachten, dass wir Validierungslogik häufig doppelt implementieren. Hier können generierende Ansätze helfen, die aus Java-Klassen (Annotationen) entsprechende Zod-Schemata generieren. Hierzu empfehle ich den Post: [Validieren mit Zod: zwischen Frontend und Backend](https://thecattlecrew.net/2024/07/08/validieren-mit-zod-zwischen-frontend-und-backend/). ## Lösungsansätze: BFF und GraphQL So langsam wurden auch bei der Benutzung von REST Probleme sichtbar. Ein zentrales Problem war es, Daten bei einem REST-Architekturstil so zu laden, wie das Frontend sie für einen bestimmten Use Case benötigt. Dahinter verbarg sich das Phänomen des Overfetching und Underfetching, von dem oben schon einmal die Rede war. Es werden also zu viele oder zu wenige Daten vom Backend geladen. Mit diesen Folgen: - **Overfetching** hat zur Folge, dass die Latenzzeit und die Datenmenge, die übertragen werden muss – gerade auch im mobilen Bereich – steigen. - **Underfetching** hat zur Folge, dass mehrere Requests gemacht werden müssen, um die Daten zu laden, die für einen Use Case benötigt werden. Dies erhöht die Latenzzeit und die Komplexität der Anwendung. Gleichzeitig muss das Frontend wissen, welche Endpunkte es ansprechen muss, um die Daten zu laden. Mit der Einführung von Microservices, ist dies häufig nicht mehr so einfach, da die Daten auf verschiedene Services verteilt sind. Um das Problem zu lösen, gibt es verschiedene Lösungen: Zum einen wurde je Frontend ein spezielles Backend entwickelt, das die Daten so liefert, wie das Frontend sie benötigt. Diese Lösung ist als [„Backend for Frontend“](https://bff-patterns.com) bekannt. Eine andere Lösung ist die Einführung von GraphQL oder Falcor. Diese Technologien erlauben dem Frontend, die Daten zu laden, die es benötigt. Hier hat sich klar GraphQL durchgesetzt. Der GraphQL Server fungiert dabei häufig als Gateway zu den Microservices. Das Frontend braucht nur noch den GraphQL Server ansprechen und bekommt die Daten, die es benötigt. Wer ein Frontend auf mehrere Backend Microservices aufsetzen muss, ist immer noch mit dieser Technologie oder anderen Technologien, die das gleiche Problem lösen, gut beraten, wie etwa tRPC. Allerdings wird diese Komplexität für viele Geschäftsanwendungen mit einer überschaubaren Nutzerbasis gar nicht benötigt. Man würde gerne die Vorteile von Single Page Applications nutzen, aber nicht die Komplexität, die damit einhergeht. Die Entwicklung solcher Anwendungen scheint damit zu teuer und zu komplex zu werden. ## Lösungsansatz: Low Code Vielleicht verstärkt u. a. diese Situation auch den Trend zu No-Code- und Low-Code- Plattformen. Denn diese versprechen die Entwicklung solcher Anwendungen drastisch zu vereinfachen und zu beschleunigen. Aus meiner Sicht allerdings leider auf Kosten von Flexibilität und Kontrolle über die Anwendungen. Denn hier kommt es zu einem starken Vendor Lock-in. Irgendwie erinnert mich das an die 90er Jahre und das Aufkommen von [4GL Sprachen](https://de.wikipedia.org/wiki/4GL). Der Wechsel zu einer anderen Technologie kann schwierig und kostspielig werden. Low-Code-Plattformen sind sehr „opinionated“ in der Art und Weise, wie Software entwickelt wird. Sie bieten vorgefertigte Bausteine und Prozesse. Die können die Entwicklung beschleunigen, bei spezifischen Anforderungen aber an Grenzen stoßen. Häufig bedeuten sie aus meiner Sicht eher einen Rückschritt in der Softwareentwicklung. - Wenige unterstützen sauberes Unit Testing und die Integration in CI/CD Pipelines. - Ebenfalls stellen wir immer wieder fest, dass die Entwicklungskosten gesenkt werden, aber die Gesamtkosten aufgrund von Lizenzkosten und Abo-Gebühren steigen. Gerade, wenn dann die Nutzeranzahl steigt, kann es schnell teuer werden. - Aufgrund der hohen Abhängigkeit von den Plattformen, kann es auch schwierig werden, die Anwendung zu skalieren oder zu migrieren. - Gleichzeitig benötigt man für die Entwicklung dieser Anwendungen auch noch Entwickler, die sich mit der Plattform auskennen. Die Plattformen sind also nicht so einfach zu bedienen, wie es auf den ersten Blick scheint. Was aber tun, wenn wir Entwicklungsgeschwindigkeit und Entwicklungskosten senken wollen, aber gleichzeitig keine Kompromisse bei Standard-Technologien und einem relativ un-opinionated Ansatz eingehen wollen? Was gibt es für Alternativen? ## Lösungsansatz: Fullstack Frameworks Hier kommt Remix ins Spiel. Remix ist ein sogenanntes Fullstack Framework, das auf React und React Router aufsetzt. [Next.js](https://nextjs.org) ist der Platzhirsch im React-Umfeld, aber auch für andere SPA Frameworks gibt es Fullstack Frameworks, wie [Nuxt.js](https://nuxt.com) für Vue.js oder [SvelteKit](https://kit.svelte.dev) für Svelte. Nur für Angular ist das Angebot dünn. Es gibt mit [Analog](https://analogjs.org) ein Fullstack Framework, das auf Angular aufsetzt, aber es ist noch nicht so ausgereift wie die anderen Frameworks. Viele Fullstack Frameworks motivieren sich über den Aspekt der Search-Engine-Optimierung (SEO). Da HTML-Seiten auf dem Server gerendert werden, sind diese Anwendungen für Suchmaschinen unter Umständen besser geeignet. Dies ist sicherlich wichtig für Anwendungen, die öffentlich zugänglich sind und von Suchmaschinen indexiert werden sollen. Für interne Anwendungen ist der SEO-Aspekt weniger interessant. Der generelle Aufbau sieht wie folgt aus ![](https://thecattlecrew.net/wp-content/uploads/2024/08/remix-whitebox.png) Abbildung 3. Whitebox Remix Im Gegensatz zum ersten Ansatz mit dem Ökosystem-Bruch (JavaScript/Java), haben wir hier einen durchgängigen Ansatz. Wir brauchen keine unnötigen Mappings zu definieren, da wir direkt JSON aus der Datenbank bekommen. Außerdem definieren wir nur einmal die Validierungslogik für die Daten und können diese dann sowohl im Frontend als auch im Backend nutzen. Remix sorgt als Aufsatz auf „React Router“ dafür, dass folgende vier Dinge bereitgestellt werden: 1. ein Compiler 2. ein HTTP Handler (Runtime Server Adapter) 3. ein Server Framework 4. ein Browser Framework Eine detaillerte Beschreibung findet sich in der [Remix-Dokumentation](https://remix.run/docs/en/main/discussion/introduction). Einer der wesentlichen Unterschiede zu der Entwicklung mit einer REST API wie Spring MVC ist, dass Remix UI zentrisch ist. Während man bei der Implementierung einer REST API einen Controller implementiert, der mehrere URLs für ein einzelnes Modell bereitstellt, ist bei Remix immer eine Datei für das Laden, die Manipulation und das Layout zuständig. Dabei kann eine Route auf ein Segment einer URL mappen. Remix aggregiert Daten und Komponenten, um dann die komplette UI auszuliefern. Mit diesem Ansatz erfüllt Remix einige der Anforderungen, die wir an eine Geschäftsanwendung haben: - Serverseitiger Zugriff auf Datenbanken - Authentifizierung und Autorisierung - Testbarkeit - Integration von Frontend und Backend, ohne dass wir uns um die Details kümmern müssen Einiges davon wird schon durch das Node.js-Ökosystem abgedeckt. Aber gerade der letzte Punkt, also die Integration von Fronend und Backend, ist die Domäne der Fullstack Frameworks. Dies wird als Hydration und Dehydration bezeichnet. ## React-Ökosystem für Geschäftsanwendungen Für Geschäftsanwendungen ebenfalls häufig wichtig sind aus meiner Sicht zwei Dinge: - Mächtige Tabellen - Formulare und Validierung Beides wird von Remix nicht bereitgestellt. Für Tabellen setzen wir auf Mantine React Tables bzw. Material React Tables. Diese Komponenten setzen wiederum auf der (Headless) Tanstack Table auf. Neben der kommerziellen [AG-Grid](https://www.ag-grid.com)-Komponente ist das sicherlich eine der mächtigsten Tabellenkomponenten im React-Umfeld. Für Formulare und Validierung setzen wir auf remix-hook-form, eine kleine Erweiterung von react-hook-form. Stellt sich aber immer noch die Frage, warum wir Remix statt Next.js einsetzen. Denn war Next.js nicht der Platzhirsch im React Umfeld? Antworten findet ihr z. B. auf Prisimic.io. Dort gibt es einen [Blogpost](https://prismic.io/blog/compare-remix-vs-nextjs#should-you-use-remix-or-next), der die beiden Frameworks vergleicht. Oer ihr lest einfach hier weiter: ### Remix versus Next.js Vor allem diese vier Argumente sprechen für die Wahl von Remix als Technologie statt Next.js: - Remix setzt auf React Router auf (d. h. wir können Wissen wiederverwenden, etwa auch für klassische React-Projekte) - Remix kann als Web Standard genutzt werden (Flexiblität für unterschiedliche Einsatzszenarien) - Remix hat keine („unnötigen“) Extra-Features - Bei Remix findet automatische State Synchronisation zwischen Server und UI statt, wenn wir Actions für die Manipulation von Daten verwenden Insgesamt bietet Remix also genau das, was wir brauchen, um eine Fullstack-React-Anwendung zu bauen, und das ohne weiteren Overhead. Das hat den Vorteil, dass die Lernkurve relativ flach bleibt und man schnell produktiv werden kann. Wobei der Punkt „unnötigte“ Extra Features natürlich immer eine Frage des Standpunkts ist, schon klar! Aber einiges, was Next.JS anbietet, wie Static Site Generate oder Incremental Static Regeneration, ist für Geschäftsanwendungen tatsächlich weniger wichtig. Denn hier ist es eher fragwürdig, Daten zu cachen, die ein Nutzer ändern kann. HTTP Caching ist eher etwas für öffentliche Daten, die durch Back-Office Prozesse aktualisiert werden. Da bin ich ganz beim [Standpunkt](https://github.com/remix-run/remix/discussions/1228) von Ryan Florence, einem der Köpfe hinter Remix. Von Florence kann ich auch diese Quelle empfehlen: [CDN Caching, SSG, and SSR](https://youtu.be/bfLFHp7Sbkg?si=T6ROk_sOkch_J8We). Was er sagt, ist nicht nur relevant für CDN Caching, sondern für jede Art von Reverse Proxy vor dem eigentlichen Server. Das heißt, auch wenn wir etwa einen Caddy Server oder einen Nginx Server vor unserem Node.js Server haben. Bisher haben wir eine reine React-Fullstack-Anwendung gesehen. Was wir aber häufig antreffen, ist eine Aufteilung: Für alle UI relevanten Aspekte wird Remix verwendet, für die Integration mit Fremdsystemen und komplexe Business-Logik ein Java Backend. Die Integration mit Umsystemen sollte ja möglichst asynchron erfolgen, gegebenenfalls werden diese gecacht. Die Beantwortung einer UI-Integration erfolgt dann möglichst innerhalb des eigenen Systems. Daher wird Remix bei etwas komplexeren Anforderungen nicht alleine genutzt, sondern in Kombination mit einem Java Backend. ![](https://thecattlecrew.net/wp-content/uploads/2024/08/complex-remix-spring.png) Abbildung 4. Komplexere Remix-/Spring-Architektur Das wäre es für diesen Post. Doch es geht weiter: In der nächsten Folge könnt ihr erleben, wie sich das Framework im Alltag anfühlt, wenn wir damit entwickeln und einen einfachen CRUD Use Case umsetzen: [Remix: Data Routes und Data Loading](https://thecattlecrew.net/2024/09/13/remix-routes-und-data-loading/) *Alle Teile dieser Blogserie:* *[Teil 1: Remix – eine Alternative für Geschäftsanwendungen](https://thecattlecrew.net/2024/09/06/remix-eine-alternative-fuer-geschaeftsanwendungen/)* [*Teil 2: Remix – Routes und Data Loading*](https://thecattlecrew.net/2024/09/13/remix-routes-und-data-loading/) [*Teil 3: Remix – Formulare, Validierung und Datenänderungen*](https://thecattlecrew.net/2024/09/27/remix-formulare-validierung-und-datenaenderungen/) **Kategorien:** Architecture & Process Models, Development **Schlagwörter:** Business Application, Full Stack Framework, Geschäftsanwendung, React, Remix, Software-Architektur, Softwarenentwicklung, Webentwicklung --- ### [Remix: Routes und Data Loading](https://thecattlecrew.net/2024/09/13/remix-routes-und-data-loading/) **Published:** September 13, 2024 **Author:** Richard Attermeyer **Content:** Nachdem wir im ersten Teil dieser Serie die [Vorteile von Typescript Fullstack Frameworks wie Remix](https://thecattlecrew.net/2024/09/06/remix-eine-alternative-fuer-geschaeftsanwendungen/) betrachtet haben, wollen wir in diesem zweiten Teil damit anfangen, Remix in Action zu bringen. Dazu bauen wir eine Trackliste für Musikalben. Also: Kopfhörer anlegen und los geht’s. ## Wir deployen Remix Remix lässt sich auf unterschiedliche Arten deployen. Es hat keine feste Bindung etwa an Node.JS. Alles, was es braucht, ist ein kleiner Adapter. Die gibt es als offizielle Varianten vom Remix Team oder auch von der Community. Wer Remix selbst betreibt, wird wahrscheinlich Node.JS, Deno oder Express verwenden. Wer Remix auf einem CDN betreibt, kann auch einen Adapter für Cloudflare oder Netlify verwenden. Wir werden Remix mit einem Node.JS Adapter verwenden. Den Source Code findet ihr auf [github](https://github.com/opitzconsulting/remix-blog). Wir verwenden für unser Beispiel eine einfache Datenbank, die [Chinook-Datenbank](https://github.com/lerocha/chinook-database). Die Chinook-Datenbank repräsentiert eine Musikverkaufsplattform mit Tabellen für Künstler, Alben, Tracks, Kunden, Bestellungen, …? Damit wir uns um die Remix-bezogenen Aspekte kümmern können, gibt es mit dem branch `blog-start` einen Startpunkt. Dort sind alle Tools und Technologien schon so aufgesetzt, dass wir loslegen können. ## **Wir legen unsere Track-Seite an** Wir wollen eine Seite aufbauen, die es erlaubt über eine Select-Box ein Album auszuwählen. Im unteren Bereich werden die Tracks angezeigt. ![](https://thecattlecrew.net/wp-content/uploads/2024/08/screenshot-albums.png) Abbildung 1. Screenshot-Album / Tracks-Seite ## Wir definieren Remix-Routen Die Frage, die wir uns stellen müssen, ist wie wir die Seiten und angezeigte Daten auf Remix-Routen mappen. Generell gibt es dazu mehrere Möglichkeiten: 1. Wir bauen zwei Seiten und zwei Routen `/albums` und `/albums/:albumId/tracks`. Dabei müssen wir aber überlegen, wie wir vermeiden, dass die Select Box nicht doppelt genutzt wird. 2. Wir bauen verschachtelte Routen `/albums` und `/albums/:albumId/tracks`. Die erste Route stellt das generelle Layout bereit und die zweite Route wird an der entsprechenden Stelle eingebettet. Wir werden die zweite Möglichkeit nutzen. ### So baut ihr Layouts und Routen Der Layout-Code für die `/albums`-Route sieht wie folgt aus: Albums-Komponente ``` export default function Albums() { // einige Zeilen ausgelassen // ... return ( Albums { setSelectedAlbum(value) const album = getAlbum(value) album ? navigate(`/albums/${album?.album_id}/tracks`) : navigate(`/albums`) }} label={"Albums"} clearable /> // rendered die verschachtelte Route ); } ``` Der Layout-Code für die `/albums/:albumId/tracks`-Route sieht wie in Listing Track-Komponente aus. Er stellt im Wesentlichen eine Tabelle dar. Listing: Track-Komponente ``` export default function Tracks() { // einige Zeilen ausgelassen return {album?.album_title} {album?.artist_name} {tracks.length} tracks } ``` Die Konvention ist, dass die Dateien im `/routes`-Ordner die Routen repräsentieren. ``` src/ app/ routes/ albums.tsx // Die Album Route albums.$id.tracks.tsx // Tracks Route, mit einem dynamischen Segment $id ``` Es gibt eine sehr gute [Visualisierung](https://interactive-remix-routing-v2.netlify.app/actors/trending) von Dilum Sanjaya, die zeigt, wie Routen auf dem Dateisystem zu URLs gemappt werden. Die hier dargestellte Konvention ist die bevorzugte Methode, um Routen in Remix zu definieren. Es gibt aber auch andere Möglichkeiten, etwa über Ordner oder eine komplett manuelle Konfiguration. ### So funktioniert die Verschachtelung Was man hier sieht ist: ein Punkt `.` im Dateinamen wird zu einem `/` in der URL **und** sorgt für die Verschachtelung (nesting) der Routen. Da man mit den Dateinamen auch die möglichen URLs definiert, gibt es weitere Möglichkeiten, je nach Anwendungsfall, etwa - verschachtelte URLs ohne verschachteltes Layout - verschachtelte Layouts ohne verschachtelte URLs - Optionale URL Segmente - Splat Routes, die beliebig viele Segmente aufnehmen können (den Rest der URL) Die [Dokumentation](https://remix.run/docs/en/main/file-conventions/routes) über Routen sollte man sich auf jeden Fall gründlich durchlesen, gerne auch nochmal, wenn man ein paar Seiten gebaut hat. ## Wir nutzen das Route Modul Nachdem wir die Routen definiert haben, müssen wir uns um das Data Loading kümmern. Unsere Routen enthalten aktuell nur den default export. Die Dateien (Routen), die wir oben erzeugt haben, sind Typescript-(ESM)-Module. Das Route Modul kann verschiedene Exporte haben, die von Remix interpretiert werden. Zu den typischen Exporten gehören: - loader - action - Component (default export) - ErrorBoundary - headers Letztere Funktion wird häufig verwendet, um die Cache-Control Header (für öffentliche Routen) zu setzen. Details zu den verschiedenen Exporten findet sich unter dem Stichwort [Route Module](https://remix.run/docs/en/main/route/action) in der Remix-Dokumentation. ### So funktionert das Data Loading Wir wollen jetzt alle Musikalben laden, um sie in der Select Box anzuzeigen. Dazu verwenden wir den `loader-`Export. ``` export const loader = async ({request}: LoaderFunctionArgs) => { const albums = await db.query.album_viewInChinook.findMany(); return json({albums}); }; ``` Auf das Laden aus der Datenbank gehen wir hier nicht weiter ein. Die Anwendung verwendet drizzle-orm als ORM. Interessant ist die Rückgabe über die [json-Hilfsfunktion](https://remix.run/docs/en/main/utils/json). Sie erzeugt ein JSON Response Object, welches in der Komponente verwendet werden kann: ``` export default function Albums() { const {albums} = useLoaderData(); // ... } ``` Dabei ist unerheblich, ob die Komponenten auf dem Server oder auf dem Client gerendert wird. Remix sorgt dafür, dass die Daten, die im Loader geladen wurden, in der Komponente genutzt werden können. Danach kann man einfach auf das Typescript-Objekt zugreifen. Dies vereinfacht das Zusammenspiel mit dem Backend enorm. ### So klappt die Navigation Für die Navigation verwenden wir eine Mantine Select Box. Mittels `onChange` navigieren wir dort zur nächsten Route. Dazu nutzen wir einen weiteren Remix Hook `useNavigate`. ``` onChange={(value) => { setSelectedAlbum(value) const album = getAlbum(value) album ? navigate(`/albums/${album?.album_id}/tracks`) : navigate(`/albums`) }} ``` Wenn ein Album ausgewählt wurde, navigieren wir die Route an, die auch die Tracks darstellt. Im anderen Fall, wenn etwa die Select-Box geleert wird, navigieren wir zurück zur Album-Route. ### Ähnlichkeiten: Remix und React Router Übrigens stammt Remix von den Machern von [React Router](https://reactrouter.com/en/main). Deshalb heißt es auf der Webseite mittlerweile „Made by Remix“. Und so kommt es auch, dass sich ``, `loader()`, `useNavigate()`, `json()` und viele andere Hooks und Utilities auch in React Router finden. Bei Remix sind die Module hingegen aus `@remix-run/react` zu importieren. Dies bedeutet aber auch, dass das Wissen für beide Frameworks wiederverwendet werden kann. React Router kennt ebenso das Konzept von verschachtelten Routen. Ein Tipp: Manchmal ist es hilfreich, in die Dokumentation von React Router zu schauen, wenn man etwas in der Remix-Dokumentation nicht findet! ## Wir verwenden Track-Route und ErrorBoundaries Hier gibt es nichts Neues bzgl. des Ladens und Anzeigens der Tracks. Auch hier nutzen wir [Mantine React Table,](https://www.mantine-react-table.com) um die Tracks anzuzeigen. Spannender ist es, die Funktion der Error Boundaries zu betrachten: Dazu definieren wir im Track-Modul eine Funktion `ErrorBoundary`: ``` export function ErrorBoundary() { const error = useRouteError() console.log(error) return Nothing to Display } ``` Wenn wir jetzt im Loader einen Fehler werfen: ``` export const loader = async ({request, params}: LoaderFunctionArgs) => { // ausgeblendeter Code... throw new Error('test') return json({tracks, album}); } ``` Dann sehen wir statt der Trackliste die Fehlermeldung „Nothing to Display“. Es ist also nur ein Teil der Seite betroffen und nicht die gesamte Anwendung. Auch in der neuesten React Router Version 6.4 gibt es für die Data Router die Möglichkeit, Error Boundaries zu [definieren](https://reactrouter.com/en/main/hooks/use-route-error). ## Summary Das Laden von Daten, Navigation und Error Boundaries sind die wichtigsten Konzepte von Remix. Dadurch, dass Remix das Thema REST Kommunikation kapselt, vereinfacht es die Kommunikation mit dem Backend enorm. Im nächsten Teil dieser Serie geht es darum, in Remix Daten zu erstellen und zu ändern. Insbesondere, wenn ihr mit Geschäftsanwendungen zu tun habt, solltet ihr den Blogpost nicht verpassen! *Alle Teile dieser Blogserie:* *[Teil 1: Remix – eine Alternative für Geschäftsanwendungen](https://thecattlecrew.net/2024/09/06/remix-eine-alternative-fuer-geschaeftsanwendungen/)* [*Teil 2: Remix – Routes und Data Loading*](https://thecattlecrew.net/2024/09/13/remix-routes-und-data-loading/) [*Teil 3: Remix – Formulare, Validierung und Datenänderungen*](https://thecattlecrew.net/2024/09/27/remix-formulare-validierung-und-datenaenderungen/) **Kategorien:** Development **Schlagwörter:** Business Application, Full Stack Framework, Geschäftsanwendung, React, Remix, Software-Architektur, Softwarenentwicklung, Webentwicklung --- ### [Remix: Formulare, Validierung und Datenänderungen](https://thecattlecrew.net/2024/09/27/remix-formulare-validierung-und-datenaenderungen/) **Published:** September 27, 2024 **Author:** Richard Attermeyer **Content:** Gerade in Geschäftsanwendungen brauchen wir Formulare, um Daten zu erstellen und zu ändern. In einem Customer Relationship Management (CRM)-System bearbeiten Benutzer beispielsweise Kundendaten wie Namen, Adressen und Kontaktinformationen. Remix, als modernes Fullstack-Framework, kann sicherstellen, dass diese Daten in Echtzeit geladen und aktualisiert werden, ohne dass die Seite neu geladen wird. Durch „Actions“ und „Loaders“ werden nur die Daten aktualisiert, die wir brauchen, was die Benutzererfahrung verbessert und Systemressourcen spart. Remix folgt da seiner Philosophie, baut auf Webstandards und nutzt HTML-Formulare als zentrales Element für die Kommunikation von Datenänderungen mit dem Backend, statt alles auf einer separaten REST-Kommunikation aufzubauen. In diesem dritten Teil unserer Blogserie zu Remix wollen wir uns das in der Praxis ansehen. Dabei bleiben wir in der Musikbranche: 1. Beispiele für Kundendaten aus dem Musikvertrieb bekommen wir uns in der Chinook-Datenbank. 2. Dann erstellen wir ein Formular, um die Daten zu ändern. *Du bist neu in dieser Blogserie? Hier kannst du Teil 1 und Teil 2 nachlesen:* *[Teil 1: Remix – eine Alternative für Geschäftsanwendungen](https://thecattlecrew.net/2024/09/06/remix-eine-alternative-fuer-geschaeftsanwendungen/)* *[Teil 2: Remix: Routes und Data Loading](https://thecattlecrew.net/2024/09/13/remix-routes-und-data-loading/)* ## So geht’s: Zunächst erstellen wir diese Routen: ([Mehr über Routen in Remix erfahren)](https://remix.run/docs/en/main/file-conventions/routes) - `customers` als Layout, das aktuell nur den Header bereitstellt - `customers._index` für die Übersicht der Kunden - `customers.edit.$id` für die Bearbeitung eines Kunden - `customers.create` für das Anlegen eines neuen Kunden - `customers.delete` für das Löschen eines Kunden ### Action-Funktion Die Route-Module haben einen weiteren Export: die [`action`-Funktion](https://remix.run/docs/en/main/route/action). Diese Funktion wird bei Non-GET-Anfragen (`DELETE`, `POST`, `PUT`, `PATCH`) aufgerufen, bevor die `loader`-Funktion aufgerufen wird. Die Loader-Funktion wird aufgerufen, um die geänderten Daten zu laden und zu revalidieren. Damit wird ein Statusabgleich zwischen Server und Client hergestellt. Remix weiß in der Regel, welche Loader-Funktionen optimaler Weise aufgerufen werden müssen und wann. Zusätzlich, falls benötigt, kann dies über die Funktion [`shouldRevalidate`](https://remix.run/docs/en/main/route/should-revalidate) gesteuert werden. Wie der `loader` ist `action` Teil der öffentlichen API. Das heißt, Daten, die wir über die Action-Funktion empfangen, müssen – wie alle Daten aus dem Web – validiert werden. Und damit kommen wir zu einem weiteren wesentlichen Aspekt: ### Benutzereingaben validieren Daten, die eine Person zum Beispiel über Formulare eingibt, müssen validiert werden. Bei Webanwendungen sorgen wir für eine Validierung in der Regel sowohl auf der Client- als auch auf der Server-Seite. Vor allem die Validierung auf der Server-Seite ist ein Muss, da die Client-Seite manipuliert werden kann. Wie aber schaffen wir es, dass wir die Validierungslogik nur einmal schreiben müssen und sie danach sowohl auf der Client- wie auch auf der Serverseite verwenden können? Warum? Dies wäre ein großer Vorteil für die Wartbarkeit und die Sicherheit der Anwendung. Eine doppelte Implementierung erzeugt nicht nur mehr Aufwand bei der initialen Erstellung und auch bei der Wartung, sondern birgt auch die Gefahr, dass die Regeln unterschiedlich implementiert werden. Dies hätte zur FOlge, dass das Frontend Eingaben zulässt, die das Backend dann zurückweist. Der Frust bei denjenigen, die die Anwendung benutzen, wäre vorstellbar. Viele Ansätze für die Validierung setzen in dem Fall auf die Verwendung von Schemata. Eine Bibliothek, die dies ermöglicht, ist [`zod`](https://zod.dev). Zod selbst ist für jede Art von TypeScript-Anwendung einsetzbar, weiß aber selbst zunächst noch nichts von HTML-Formularen. Hier kommen weitere Bibliotheken ins Spiel. Eine beliebte Bibliothek für die Formularvalidierung in React ist [`react-hook-form`](https://react-hook-form.com). Diese Bibliothek kann mit `zod` kombiniert werden, um die Validierung auf der Clientseite zu übernehmen. Mit [`remix-hook-form`](https://github.com/forge42dev/remix-hook-form) gibt es eine für Remix abgestimmte Integration von `react-hook-form`. Dieser Adapter ist im Kern keine 300 Zeilen lang. Andere Vertreter sind - [remix-validated-form](https://www.remix-validated-form.io) - [remix-forms](https://github.com/seasonedcc/remix-forms) - [conform](https://github.com/edmundhung/conform) Jede dieser Bibliotheken kann die Kombination mit Zod. Deshalb sind sie für die Validierung auf Client- und Serverseite verwendbar. Wir haben uns übrigens auch deshalb für Remix Hook Form entschieden, weil es auf React Hook Form aufsetzt, das wir bereits für andere Projekte verwenden. ### „Unsere“ Action-Funktion In `customers._create.tsx` haben wir die folgende Action-Funktion: ``` const resolver = zodResolver(customerCreateForm); export const action = async ({ request }: ActionFunctionArgs) => { const { errors, data, receivedValues: defaultValues, } = await getValidatedFormData(request, resolver); if (errors) { return json({ errors, defaultValues }); } const insertedCustomers = await db .insert(customerInChinook) .values(data) .returning(); if (insertedCustomers.length === 0) { return json({ errors: { root: { type: "insert_failed" } } }); } return redirect(`/customers/edit/${insertedCustomers[0].customer_id}`); }; ``` Die Funktion verwendet die `getValidatedFormData`-Funktion von Remix Hook Form, um die Daten gegen das `CustomerCreateForm`-Schema zu validieren. Falls Fehler auftreten, werden diese zurückgegeben. Remix Hook Form kümmert sich um die Interpretion von Fehlern und `defaultValues` für das Formular. Die Magic passiert dabei im Hook `useRemixForm`, das einen angepassten submitHandler bereitstellt. Die Nutzung in der Komponente ist dabei sehr einfach: ``` export default function CustomersCreate() { const { handleSubmit, formState: { errors }, register, } = useRemixForm({ mode: "onSubmit", reValidateMode: "onBlur", resolver, }); return ( Submit ); } ``` Etwas mehr Aufwand ist notwendig, wenn es sich um [Controlled-Komponenten](https://react.dev/learn/sharing-state-between-components#controlled-and-uncontrolled-components) handelt. Dies wird in der Dokumentation von [React Hook Form](https://react-hook-form.com/get-started#IntegratingControlledInputs) beschrieben. Controlled-Komponenten führen schnell dazu, dass es für eine Select-Komponente (hier `customer_.edit.$id.tsx`) umfangreicher werden kann: ``` { // Map salesReps to Select options const options: SelectOption[] = [ { value: "", label: "None", }, ...salesReps.map( (salesRep) => ({ value: salesRep.employee_id?.toString(), label: salesRep.name, }) as SelectOption, ), ]; // Set the Select component's value to match the current field value const selectedValue = options.find( (option) => option.value === (field.value?.toString() || ""), ); return ( { field.onChange( value ? Number.parseInt(value || "") : null, ); }} /> ); }} /> ``` ## Zwei kleine Hinweise zu unserem Beispiel ### 1. Zugriffe und Routen trennen Im Beispielcode mixen wir Routen-Definition und Datenbankzugriff, da der Zugriff auf die Datenbank hier sehr einfach ist und die Konzepte von Remix einfacher erklärt werden können. Im Sinne einer produktionsreifen Implementierung wäre es allerdings es sinnvoll, diese Zugriffe aus den Routen herauszunehmen und in eigene Module zu kapseln, um eine Strukturierung entsprechend der Hauptaufgaben ([Seperation of Concerns](https://en.wikipedia.org/wiki/Separation_of_concerns)) zu erreichen. Das macht die Routen übersichtlicher und erleichtert das Testen und ermöglicht mehr Flexibilität. ### 2. Formularmodell braucht weitere Daten Häufig kommen in `action` und `loader` noch kleine Logiken hinzu, etwa um weitere Daten zu laden und zu speichern. Dies kommt daher, dass häufig das Formularmodell nicht 1:1 mit dem Datenbankmodell übereinstimmt und noch weitere Daten benötigt werden. Für unseren Code überlassen wir das Refactoring den Leser:innen. ## Summary Wir haben gesehen, dass die Erstellung von Formularen in Remix ähnlich komplex ist wie in React. Aber durch die Verwendung von `zod` und `remix-hook-form` können wir die Validierung auf der Client- und Serverseite vereinheitlichen. Wir haben also alle Zutaten, um CRUD-Funktionen in Remix zu implementieren. *Alle Teile dieser Blogserie:* *[Teil 1: Remix – eine Alternative für Geschäftsanwendungen](https://thecattlecrew.net/2024/09/06/remix-eine-alternative-fuer-geschaeftsanwendungen/)* [*Teil 2: Remix – Routes und Data Loading*](https://thecattlecrew.net/2024/09/13/remix-routes-und-data-loading/) [*Teil 3: Remix – Formulare, Validierung und Datenänderungen*](https://thecattlecrew.net/2024/09/27/remix-formulare-validierung-und-datenaenderungen/) **Kategorien:** Development **Schlagwörter:** Business Application, Formulare, Full Stack Framework, React, Remix, Softwarenentwicklung, Webentwicklung --- ### [Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Published:** August 23, 2024 **Author:** Dominik Kloke **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 9: Ein Fazit Was ist nun unser Fazit? „Vielfältig“, wäre hier die kurze, knappe Antwort. Wir versuchen daher unsere Erkenntnisse so zu clustern, dass sie die wahrscheinlich häufigsten Fragen des Lesers beantworten. Sollten noch etwas offen bleiben, schickt uns eure Fragen, schreibt einen Kommentar … wir freuen uns über jedes Feedback! *Du bist neu dabei? Hier kannst du einen Blick in die bisherigen Teile der Blogserie werfen:* - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) - [Teil 3: SBOM-Formate im Vergleich – CycloneDX versus SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) - [Teil 4: Was ist eine gute SBOM – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) - [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) - [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) - [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) - [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) ## Was halten wir von den Konzepten hinter der SBOM? Die grundsätzliche Idee hat uns überzeugt. Als technikaffine Menschen lieben wir strukturierte, formal definierte und automatisch erzeug- und bearbeitbare Dateiformate. Diese lassen sich leicht in CI-Builds integrieren und weiterverarbeiten. Es lassen sich einfach entsprechende Blaupausen definieren, die dann mit wenig Aufwand in viele Projekte integriert werden können. Die Hoffnung ist, hier ein wichtiges Thema, das uns in der Praxis einen hohen Mehrwert bringt, ohne viel Aufwand umzusetzen. Der Mehrwert für die Security in der Softwareentwicklung ist offensichtlich. Gleiches gilt für die Anwendung der Software: Nutzer:innen profitieren von der höheren Transparenz und können eigene Prozesse aufsetzen. Herausfordernd sind das Tooling und die tatsächliche Bewertbarkeit potenzieller CVEs bei der Softwarenutzung. Über einen CVE zeitnah informiert zu sein, bedeutet noch lange nicht, diesen bewerten oder die richtigen Reaktionen initiieren zu können. Leider besitzt die Basis hierfür, also der CVE selbst,oft nicht die nötige Qualität. Die Analyse eines CVEs bleibt daher weiterhin aufwändig und erfordert ein gewisses Expertenwissen. Wir müssen damit rechnen, dass es bei einer flächigen Einführung, wie zum Beispiel über den Cyber Resilience Act, zu „Einschwingeffekten“ und „Übersprungshandlungen“ kommen wird. Auch die Auswirkungen eines Cyber Resilience Acts auf die Open Source Community sind schwer zu bewerten. Es ist zu befürchten, dass sich eine breitere Transparenz sowie eine mögliche Haftbarkeit eher negativ auf die Bewertung des Einsatzes von Open-Source-Produkten auswirken wird. Dies macht zwar die wahren Kosten von sicherer Software sichtbarer, jedoch ohne dabei eine offensichtliche Alternative aufzuzeigen. ## Nehme ich nun CycloneDX oder SPDX? In der Praxis und für das Ziel unserer Analyse sind beide Formate gleichwertig und gleichen sich auch bei Unterschieden immer wieder an. In der CycloneDX Welt scheint es mehr Werkzeuge zu geben, was aber nicht sofort bedeutet, dass diese auch besser sind. Für SPDX spricht wiederum die ISO-Zertifizierung, die Unternehmen mehr Sicherheit geben kann. So setzten Microsoft und IBM scheinbar auf SPDX. Über die Nutzung von entsprechenden Client-Bibliotheken ist es allerdings auch möglich, beide Standards in einem Werkzeug zu nutzen. Am Markt beobachten wir aktuell keine offensichtliche Entscheidung für das eine oder andere Format. Den Schluss, den wir daraus ziehen können ist, dass die Entscheidung am Ende eher über die Werkzeuge und die geplante Prozesskette geführt werden sollte. Darüber hinaus sind Konvertierungen grundsätzlich möglich. Diese sollten aber minimal gehalten und erst im finalen Prozessschritt realisiert werden. ## Gibt es das eine, beste Werkzeug? Keines der Werkzeuge war perfekt. Alle Werkzeuge, die wir untersucht haben, wiesen an der ein oder anderen Stelle Mängel auf. An den meisten Werkzeugen wird weiterhin auch noch fleißig geschrieben, verbessert und optimiert. So zeigen Tickets, dass Werkzeuge auch noch Probleme mit der Einhaltung von Spezifikationen haben. Ein weiterer Punkt, den wir bemängeln, ist die Dokumentation. Hier wird teilweise zu wenig erklärt, wie die Werkzeuge konkret vorgehen. Besonders aufgefallen ist uns dies bei der Auswertung von Java beziehungsweise Maven Projekten. Sind nun die \*.jars im Zielverzeichnis relevant oder die POM? Oder gar beides? Wie genau wird die Maven POM analysiert? Aus dem gleichem Grund kritisieren wir auch die Ausgaben zur Laufzeit. Wenn während des Scans weitere SBOMs gefunden und ausgewertet werden, weil wir bei der Analyse zwischen den einzelnen Tests nicht sauber aufgeräumt haben, ist dies etwas, das aus unserer Sicht zumindest protokolliert werden sollte. Gleiches gilt für die Auflistung der konkreten Dateien, die zu einer Analyse herangezogen werden. Insbesondere bei der Auswertung von pom.xml oder während des Builds erzeugter \*.jar Dateien. Gerne hätten wir auch mehr Schalter oder mehr strukturierte Ausgaben, um das Werkzeug besser in den CI Build zu integrieren. Speziell definierte Return Codes o. ä. wären hier hilfreich. ## Gibt es das eine große Projekt? Viele Projekte erschienen uns klein, selbst die großen Projekte mit vielen Sternen hatten eine überschaubare Anzahl von Contributors und durchaus längere Listen von Issues. Diese müssten für eine noch bessere Bewertung genauer analysiert werden. Unzufrieden sind wir auch mit dem monolithischen Ansatz einiger Applikationen. Aus unserer Sicht ist das Scannen zur Erzeugung der SBOM klar von der Auswertung der SBOM zu trennen. Trivy kann beispielsweise beides. Speziell im Lizenzbereich könnten wir uns vorstellen, die Gesamtfunktionalität auf mehrere, kleine Werkzeuge aufzuteilen, die für sich SBOM erstellen, anreichern, auslesen oder modifizieren. Möglicher Weise stehen dem marktwirtschaftliche Interessen entgegen aber auch das Bedürfnis, ein zentrales Werkzeug für alles zu haben. Mögliche kommerzielle Gesamtlösungen, die man alternativ im Kontext SBOM Management evaluieren könnte, wären z. B.: - [Anchore](https://anchore.com/) (Anchore ist auch der Hersteller von Syft und Grype) - [Snyk.io](https://snyk.io/de/) - [Mend.io](https://www.mend.io/) - [Checkpoint](https://www.checkpoint.com/de/) - [JFrog](https://jfrog.com/security-and-compliance/) - [Codenotary](https://codenotary.com/) - [Rezilion](https://www.rezilion.com/platform/sca-dynamic-sbom/) - [VigilantOps](https://www.vigilant-ops.com/products/) Diese Liste ist sicherlich nicht vollständig. Unter dem Strich wäre der aktuelle Stand und die genannten Mängel für uns aber kein Grund, SBOMs nicht jetzt zu nutzen. Wichtig wäre es aber, bei Fehlern Tickets zu erstellen und darin die eigenen Anforderungen klar zu äußern. ## Wie gut ist das Ergebnis? Bei der SBOM-Erstellung für Maven oder NPM-Projekte wird die Qualität maßgeblich davon beeinflusst, inwieweit das Buildsystem oder die Ergebnisse des Build korrekt ausgewertet werden. Ist dies nicht der Fall, sinkt die Qualität schnell. Beim Scannen von Docker-Containern sehen wir Unterschiede in den unterstützten Distributionen sowie bei der Erkennung von Artefakten außerhalb des Paketsystems der Distribution. Bei der Erkennung von CVEs haben wir den Eindruck, dass die Werkzeuge bei gleicher Informationsbasis, in diesem Fall der SBOM, zu sehr ähnlichen oder gar zu gleichen Ergebnissen kommen. Hier ist aktuell scheinbar die Wahl des Werkzeugs für die SBOM-Generierung oder die verwendete Datenbank entscheidender als das Werkzeug, mit dem die CVEs gesucht wird. Unterschiede und größere Anzahl von „False Positives“ entstehen dann, wenn die SBOM keine Versionen oder redundante Einträge mit unterschiedlicher Qualität beinhaltet. Die Relevanz der Nutzung von CPE ist uns unklar. Wir konnten keine offensichtlichen Unterschiede in den Ergebnissen bei Verwendung oder Nicht-Verwendung sehen. ## Welches Werkzeug nehme ich dann? Wenig überraschend können wir nicht den einen Weg skizzieren. Zu viele Faktoren spielen hinein, die wichtig sein könnten und die Wahl maßgeblich beeinflussen. Wir sehen aber folgende Abwägungskriterien: - **Präferenz: Tools, die nah an der semantischen Quelle arbeiten** und so z. B. Informationen direkt aus dem Build-System ziehen. Dies führt tendenziell zu einer höheren Qualität – aber vermutlich auch zu der Nutzung mehrerer Werkzeuge. - **Präferenz: Minimierung der Werkzeuganzahl.** Grundsätzlich möglich, kann abhängig von den zu unterstützenden Stacks aber zu Qualitätsverlusten führen. Wir empfehlen, hier nicht zu dogmatisch zu sein. - **Präferenz: Standard.** Hier dominieren dann ggf. Werkzeuge, die SPDX als Format unterstützen. Auch dies kann zu Qualitätsverlusten führen. Die Relevanz eines ISO- Standards ist für uns schwer einzuschätzen und vermutlich stark abhängig vom konkreten Projekt-Kontext. - **Präferenz: Qualität:** Man nimmt die Kombination von Werkzeugen, die zu der besten SBOM und den besten Reports führt. - **Präferenz: Ergebnis CVEs.** Abhängig davon, ob wir den SBOM-basierenden Prozessen folgen und die entsprechenden Möglichkeiten ausreizen oder nur schnell und einfach einen CVE-Report haben wollen, kann sich die Werkzeugauswahl unterscheiden. ## Wie sehen wir den Markt? Wir sehen, dass es historisch eine Reihe von Werkzeugen gibt, die sich funktional mit der Werkzeugpalette im Kontext SBOM überschneiden. So gibt es Tools zum Asset Management und zur Lizenzanalyse, die auch Scanner nutzen und entsprechende Reports erzeugen. Des Weiteren sehen wir einen Open-Source-Markt, der auf Basis von CycloneDX und SPDX entsprechende Werkzeuge erstellt. Hinter Teilen dieser Werkzeuge stehen allerdings kommerzielle Firmen. Dadurch können die bekannten Risiken entstehen, wie das Verschieben von relevanter Funktionalität in eine kommerzielle Version oder eine Relizensierung des aktuell freien Produkts. Eine entsprechende Risikoabwägung sollte daher in üblicher Weise durchgeführt werden, der Umgang des Herstellers mit dem Werkzeug beobachtet werden. Eine Alternative können Portal oder SaaS-Lösungen sein, die z. B. auf Basis von Repository Scans zahlreiche Dienstleistung, intuitive Oberflächen und auch Workflow-Unterstützung anbieten. Da wir diese Werkzeuge hier nicht analysiert haben, können wir zu den Features aber auch zu den Lizenzkosten nichts sagen. Grundsätzlich tun sich hier wie auch in anderen Bereichen zwei verschiedene Wege auf. 1. Der kleinteilige, scheinbar wirtschaftlich günstige Weg mit mehr Eigenleistung im Bereich der zugehörigen Prozesse 2. Das „All in One“-Tool, das alle Aspekte abdeckt und klare Prozesse vorgibt, dafür aber möglicher Weise mehr Kosten erzeugt. ## Wie gehe ich denn nun vor? Insgesamt würden wir empfehlen, klein anzufangen und erst einmal pragmatisch und mit konkreten Zielen (CVEs, Automatisierung der Erstellung und Analyse) mit einer Integration für ein einzelnes Projekt oder Produkt zu beginnen. Hierfür sind die evaluierten Werkzeuge völlig ausreichend. Ziel sollte sein, ein Gefühl für die Qualität sowie die gewünschten Prozesse zu bekommen – ohne gleich den Anspruch zu haben, die Prozesse technisch vollständig zu lösen. Ebenso würden wir bei der Tool-Auswahl pragmatisch vorgehen und nicht versuchen, alles mit einem Werkzeug zu lösen. Wichtig: Sich hierbei detailliert mit den konkreten Inhalten der SBOM, deren Ursprung und deren gewünschten Qualität auseinandersetzen! Speziell im Bereich Docker Images oder VM o.ä. empfehlen wir, Verantwortlichkeiten klar zu definieren: Wer erstellt die SBOM für die eigentliche Software? Wer erstellt eine SBOM für das Docker-Image? Wer prüft auf CVEs und reagiert mit welchen Maßnahmen? Für die Lizenzauswertung wäre zu klären, ob auf eine SBOM-basierende Analyse gesetzt wird oder ob weiterhin mit einem separaten Prozess und ggf. auch Liefergegenstand gearbeitet werden soll. Speziell ist hier zu klären, inwieweit eine ggf. vorhandene klassische Low-Level-Lizenzanalyse von einer Lizenzbewertung auf Basis einer SBOM zu trennen ist. Erst nachdem Erfahrungen – dann auch später in mehreren Projekten – gesammelt wurden, würden wir die nächsten Schritte empfehlen und überlegen, wie weiter skaliert und zentralisiert werden kann. Dies vor allem auch in Bezug auf die Professionalisierung der Werkzeugauswahl. # Bisherige Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Wenn Titelstorys die IT-Security vor sich hertreiben – SBOMs](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) **Published:** Februar 2, 2024 **Author:** Tim Teulings **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 1: Über den nachlässigen Umgang mit bekannten Sicherheitslücken **2017** wurde die größte Wirtschaftsauskunftei in den USA, Equifax, gehackt. Dabei wurden 143 Millionen Personendaten inklusive Sozialversicherungsnummer und teilweise Führerscheinnummer gestohlen. Darüber hinaus Kreditkartennummern von 209.000 US-Bürger:innen. Des Weiteren hatten 182.000 US-Bürger:innen Korrekturen an ihren Daten verlangt – auch die dazu nötigen Detailinformationen wurden von den Hackern entwendet. Die Plattform wurde zeitweise abgeschaltet. Vermutet wird, dass eine zum Zeitpunkt bekannte Sicherheitslücke in Apache Struts für den Einbruch genutzt wurde. Einen Fix der Sicherheitslücke gab es bereits, dieser wurde aber bei Equifax über längere Zeit nicht eingespielt. Auch die beiden folgenden Sicherheitslücken gingen durch die Presse: **Ende 2021:** Die Sicherheitslücke Log4Shell (CVE-2021-44228) führte zu zahlreichen Angriffen auf unterschiedlichste Systeme, darunter vieleVMWare Produkte. Das Bundesamt für Sicherheit in der Informationstechnik (BSI) ging auf Warnstufe Rot und rief eine kritische Bedrohungslage aus. Weltweit prüften Hersteller und Betreiber, ob sie betroffen sind. Laut verschiedener Schätzungen lagen die summarischen Kosten möglicherweise im Bereich mehrerer Milliarden Dollar. **2022:** Die kritische Zero-Day-Sicherheitslücke Spring4Shell (CVE-2022-22965) hatte ein ähnliches Gefahrenpotential. Da Spring in sehr vielen Applikation genutzt wird, findet man noch heute im Internet Statements in denen Firmen erklären, ob sie von dieser Lücke betroffen waren oder nicht. Sicherheitsprobleme großer Anbieter oder Plattformen aber auch kleinerer Software-Komponenten, die aber in Tausenden von Software-Instanzen verwendet werden, gehen mittlerweile durch die Presse und schaffen es in die Tagesschau. Gleiches gilt für Einbrüche in IT-Systeme, die zu Datendiebstählen im sechsstelligen Bereich oder größer führen. In einer dritten, weiteren Variante brechen Hackerbanden in IT-Systeme ein und verschlüsseln Daten, um für die Freischaltcodes Geld zu erpressen. ## Die Lage wird brenzliger Dies hat in den Vereinigten Staaten aber auch in Deutschland dazu geführt, dass IT-Systeme nach einem Vorfall über längere Zeit heruntergefahren werden mussten. Gefühlt ist aktuell in Deutschland immer mindestens eine kommunale Stadtverwaltung „down“. Zum Zeitpunkt dieses Artikels ist die „Südwestfalen-IT“ nach einem Cyberangriff Ende Oktober 2023 nur mit Basisdiensten online. Rund 170 Personen arbeiten – nach eigenen Angaben – weiterhin an der Bewältigung der Folgen. In die Presse gelangen solche Vorfälle auch deshalb, weil sie zu merkbarem gesellschaftlichen Schaden und Beeinträchtigungen führen. Bürgerinnen und Bürger aber auch Firmen sind großflächig betroffen und müssen temporäre Einschränkung in ihrem Leben hinnehmen. ## Welche Ursachen stehen dahinter? Was sind die Ursachen dafür, dass sich solche Vorfälle häufen und die Auswirkungen massiver werden? Eine Reihe von Punkten lassen sich hier nennen: ### 1. Fortschreitende Digitalisierung Grundsätzlich sorgt die fortschreitende Digitalisierung dafür, dass es einfach immer mehr IT-Systeme gibt. Durch die Digitalisierung stehen viele dieser Systeme direkt oder indirekt auch im Internet und sind stärker untereinander vernetzt, damit Kunden oder konkret auch Bürger über eine Webseite oder per App den Dienst nutzen können. Die Angriffsfläche ist so sicherlich einfach erheblich größer als sie es noch vor 10 oder 20 Jahren war. ### 2. Komplexere Systeme Gründe dafür, dass IT-Systeme komplexer werden, sind ebenfalls in der Digitalisierung zu finden (einfach „mehr machen mit Software“). Aber auch im wachsenden Anspruch an die Software bzgl. Funktionalität und Qualität. Komplexität kommt aber auch durch die stärkere Vernetzung von System und Datenquellen zustande. Für die Systemsicherheit ist der letzte Punkt, also die übergreifende Vernetzung, sicherlich ein besonders kritischer Faktor. ### 3. Kostendruck Software in ihrer Komplexität anzugehen wie ein in der Komplexität vergleichbares „klassisches“ Planungsprojekt („Hochhaus? Flugzeugbau? Raumschiff?) ist oft nicht bezahlbar oder methodisch nicht durchführbar. Dennoch wird entsprechende Software erstellt, was Risiken mit sich bringt. Das es zu Qualitätsmängeln kommt und Risiken tendenziell eher unterschätzt werden, ist daher nicht überraschend. ### 4. Einsatz von Standards Der Komplexitätsreduzierer „Standards“ wird nicht so stark genutzt wie in andere Branchen. Software will man, um sich abzugrenzen (die Software soll es ja explizit anders – nämlich „besser machen“, als bei der Konkurrenz). ### 5. Stetige Veränderung Die IT ist Innovationstreiber und unterliegt einem stetigen, hohen Verbesserungs- und Änderungsprozess, der darin resultiert, dass 100% Qualität und Stabilität oft eher sekundäre Faktoren sind. Software hat oft nicht mehr die Zeit, „fertig“ zu werden. ## Sicherheit als essenzielles Qualitätsmerkmal Lange Zeit wurde IT-Sicherheit eher als „sekundärer Faktor“ betrachtet; die IT unterlag dem Irrglauben, dass es ausreicht, entsprechende Risiken aufzunehmen, die sich managen und kontrollieren lassen. Die oben gezeigten Fälle zeigen, dass dies nicht immer gelingt. Wenn wir wollen, dass Digitalisierung erfolgreich ist, müssen wir unsere Sichtweise auf IT-Sicherheit ändern. Mangelnde Sicherheit im Software-Umfeld ist in den letzten Jahren unternehmenskritisch und in Teilen sogar gesellschaftskritisch geworden. Sowohl Hersteller als auch Nutzende und Beauftragende einer Software sind dabei unterschiedlich aber am Ende doch gleichermaßen betroffen. Häufige Folgen: - Erhebliche Datenverluste und damit Datenschutzverletzung mit entsprechenden Strafen - Reputationsverlust bei Kunden - Arbeit und Weiterentwicklung stehen still und müssen aufgeholt werden. Die Konsequenz sind Stress, Unzufriedenheit, Überstunden, hohe Kosten – d. h. die Bilanz eines solchn Quartals kann man schon mal vergessen. - Ungeplante Kosten, weil im Worst Case ganze IT-Infrastrukturen neu aufgesetzt werden müssen, man sich mindestens sehr gut bezahlte Fachleute ins Haus geholt hat oder einfach ein Großteil der Belegschaft seine Arbeit über einen längeren Zeitraum nicht machen kann. ## Typische Reaktionen nach dem Bekanntwerden einer großen potentiellen Sicherheitslücke Geht ein Sicherheitsproblem durch die Presse – und ist das eigene Unternehmen, die eigene IT ein mögliches „Opfer“ der Zustände, die wir selbst geschaffen haben – folgen darauf meist typische Handlungsmuster: - Zunächst brechen Hektik und Panik auf Grund von mangelnder prozessualer Vorbereitung aus. - Es folgen Fragen wie „Sind wir betroffen?“ „Benutzen wir potenziell verwundbare Komponenten?“ - Darauf folgt die Gründung einer Task Force oder ähnlicher Konstrukte, die untersuchen, ob und wo in genutzten, releasten, verkauften Applikationen oder Systemen das verwundbare Softwareartefakt verwendet wird. - In der Regel sind die Fragen aus Punkt 2 dann nicht schnell eindeutig zu beantworten („Ja, aber …“, „Müssen wir uns genauer anschauen“), was spätestens jetzt dazu führt, dass Systeme sicherheitshalber heruntergefahren werden. Oft ist der Exploit ja trickreich und die Antwort keine einfache Ja/Nein-Frage. Eine potenzielle Mitigation kommt ggf. erst Tage später. - Schnell steht damit die Frage im Raum, ob ein Update gemacht werden muss oder eine Mitigation zu erhoffen ist. Bei einer Fremdsoftware ist hier in der Regel spätestens Schluss. Denn hier kann weder sicher gesagt werden, ob die Komponente genutzt wurde, noch ob das System angreifbar ist. Es kann also nichts weiter getan werden, als das System auf Verdacht herunterzufahren oder den entsprechenden Dienstleister zu kontaktieren. - Wildes Blättern im Branchen-Buch nach einem Sicherheitsexperten. - Wenn schließlich alle Fakten auf dem Tisch liegen, ist die Frage, wie und vor allem wie schnell man in der Lage ist, die identifizierten Probleme an den unterschiedlichen Stellen zu beseitigen. Dabei hat man manches selbst in der Hand (selbstentwickelte Software), anderes hingegen nicht (COTS-Lösungen). - Wenn man Glück hat, ist man mit den Updates in wenigen Monaten durch und es ist nichts passiert. Zweiteres wird aber leider seltener. Das meiste davon muss nicht zwingend so passieren. Dieses fiktive Drehbuch zeigt sich aber leider immer noch viel zu oft in der Realität und offenbart grundlegende Probleme mit dem Thema Security in der IT. Kurz: Unternehmen sind nicht gut auf solche Situationen vorbereitet, Prozesse und Vorgehen sind oft nicht klar oder zu behäbig. Die Datenbasis ist im Fall der Fälle nicht ausreichend, was zu längeren Recherchen und Analysen führen kann. Und grundsätzlich hätte man ggf. schon früher reagieren können, bevor man durch die Presse aufmerksam gemacht wird. ## Wir alle sind betroffen Längst nicht jedes Sicherheitsproblem geht durch die Presse. Schaut man für den 12.01.2024 auf cvedetails.com steht dort: - 201 CVEs seit gestern(!) angelegt und 642 wurden aktualisiert! - 846 CVEs in den letzten 7 Tagen angelegt und 1755 wurden aktualisiert. - Aktuell gibt es 7 ausgenutzte „Vulnerabilities“, 11 in den letzten 30 Tagen! Und wer auf die Statistik der letzten 10 Jahre schaut, sieht, dass die Tendenz bei CVEs im Schnitt eher bei „schwerwiegend“ als bei „unkritisch“ liegt. Wobei ja nur die bekannten Sicherheitslücken betroffen sind. Jede Lücke davon könnte uns selbst angehen! ## Fazit Sei es in selbstentwickelten Lösungen oder in zugekauften Systemen: Wir müssen sensibel mit dem Thema umgehen. Dazu gehört vor allem, Transparenz darüber zu schaffen, welche Abhängigkeiten der genutzten Softwarelösungen existieren. Hier wäre es hilfreich, eine Art „Inhaltsangabe“ für Software zu haben und diese „Inhaltangaben“ an zentraler Stelle für möglichst jede erstellte oder genutzte Software zu sammeln und einfach auswertbar zu haben. So könnte man an entscheidenden Stellen im obigen Szenario schneller reagieren. Hierfür gibt es tatsächlich bereits Lösungen: Stichwort SBOMs. Mehr darüber im nächsten Teil … ## Quellen [https://www.bsi.bund.de/DE/Service-Navi/Presse/Pressemitteilungen/Presse2021/211211\_log4Shell\_WarnstufeRot.html](https://www.bsi.bund.de/DE/Service-Navi/Presse/Pressemitteilungen/Presse2021/211211_log4Shell_WarnstufeRot.html) # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber-Angriff, Cyberattack, gehackt, Hackerangriff, IT Security, SBOM --- ### [Mit Software-Stückliste wirksam auf Sicherheit prüfen: SBOMs](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) **Published:** Februar 7, 2024 **Author:** Tim Teulings **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 2: Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten Um Angriffe auf IT-Systeme, mit denen kriminelle Banden uns in Gefahr bringen, und auf die wir leider oft nur unzureichend reagieren können, darum ging es im [ersten Teil dieser Serie über die Software-Stückliste SBOMs](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/). Aber was macht uns so handlungsunfähig? Klar, Kriminelle sind schwer in den Griff zu bekommen, wohl aber unseren Umgang mit bekannten Sicherheitsproblemen! Hier kommen SBOMs ins Spiel. Was SBOMs können, und mit welchen Grundfunktionalitäten, sie helfen, unsere IT im Griff zu behalten, darum geht es in diesem 2. Teil der Serie. ## SBOMs als Pflichtprogramm In den Vereinigten Staaten führte die Gefährdungslage 2021 zu einer Anordnung des Präsidenten, der Executive Order 14028. Darin ist eine Auflistung zahlreicher konkreter Maßnahmen zu finden mit recht kurzfristigen Zielterminen von 30 bis 120 Tagen. Unter anderem diese: - Behörden werden angewiesen, Verträge zu prüfen und zu überarbeiten - Neue Konzepte und Strategien sind aufzusetzen - Informationen werden eingefordert - Kommunikationsketten werden definiert - Sicherheitsmaßnahmen wie Multi-Faktor-Authentifizierung werden grundsätzlich verpflichtend gemacht Die Maßnahmen dieser Anordnung dienen dem Ziel, die Sicherheit im Software-Umfeld in kürzester Zeit drastisch zu verbessern. Zumindest im Kontext diverser Regierungsdienste und deren Partner, Lieferanten und Dienstleister. Mit der Executive Order 14028 wird – um zum eigentlichen Thema zu kommen – auch die Lieferung von sogenannten Software Bills of Material, kurz: SBOMs verpflichtend. Bei diesen SBOMs handelt es sich dabei genau um die Stücklisten über den Inhalt von Softwarekomponenten, die wir im ersten Teil erwähnt haben. ## Welche Informationen liefern SBOMs? SBOMs beinhalten Informationen wie diese: - Beschreibung der Komponente - Verwendete (abhängige) Software-Komponenten und deren Lizenzen - Beschreibung von Services und einzelnen Dateien - Jeweils eindeutige Koordinaten zur eindeutigen Identifikation, wie Name und Version - Hashes für alle Elemente Damit dienen SBOMs als standardisiertes Austauschformat für die sicherheitsrelevanten Elemente einer Software. Mit folgenden großen Vorteilen: 1. Einfachheit: Die zentrale Sammlung von Informationen zu eigenen und Fremdprodukten in einer Datenbank wird vereinfacht 2. Transparenz: Hersteller und Nutzende erhalten entsprechende Informationen, ohne, dass die Software an sich „offen“ gelegt wird. ## Weniger Aufwand und schnellere Prozesse Ein weiterer Vorteil ist die Vereinfachung einiger Prozesse – sowohl bei Herstellern als auch bei Nutzenden oder ggf. zwischengeschalteten Dienstleistern. Hier drei Beispiele: - Eine schnellen Suche nach der Verwendung eines bestimmten, vulnerablen Software-Artefakts im Bestand wird möglich. Also eine schnelle Antwort auf die Fragen „Nutzen wird das?“ und „Wo und in welcher Version nutzen wir das?“. - Regelmäßig wird ein Scan der eigenen und fremden Software-Komponenten auf bekannte Sicherheitslücken durchgeführt. D. h. wir haben wir immer eine Antwort auf die Frage „Sind wir vulnerable?“, ohne eigene Detailanalysen anstellen zu müssen. - Software-Komponenten werden auf Aktualität geprüft. So bekommen wir Antworten auf die Fragen “Benutzen wir die aktuelle Version?“, „Wie viele neue Versionen gibt es?“ und „Müssen wir jetzt aktualisieren?“. Standarddaten und ein darauf aufbauendes Tooling schrauben den Aufwand, insbesondere für Softwarenutzende, erheblich herunter. ## Schutz vor selbstgemachten Sicherheitsproblemen Damit schützen SBOMs nicht vor Sicherheitslücken – diese verschwinden dadurch ja nicht und die Software wird auch nicht automatisch besser. Wovor SBOMs uns schützen, sind selbstgemachte Sicherheitsprobleme durch Ignorieren bekannter Fixes. So spricht der „9th Annual State of the Software Supply Chain“ von Sonartype – bekannt durch das statische Codeanalyse Werkzeug SonarQube – von im Schnitt 150 Abhängigkeiten, die ein Software-Projekt besitzt, mit in Summe pro Jahr 1500 Änderungen in den Abhängigkeiten. Ebenso haben 96 % der heruntergeladenen Software-Artefakte im Java-Umfeld bekannte Sicherheitsprobleme, obwohl bereits ein Fix existiert. Diese unnötigen Lücken lassen sich mithilfe von SBOMs schließen. ## Software als lebendes Produkt verstehen Die Verwendung von SBOMs ermöglicht also großen Teilen der Software-produzierenden oder -konsumierenden Gesellschaft, autonomer, schneller, dezentraler und auch aktiver auf bekannte Sicherheitslücken zu reagieren. Darüber hinaus führt es zu einem anderen Qualitätsanspruch, zu einer anderen Erwartungshaltung und zu einem anderen Verständnis von Software –nämlich als dauerhaftes, lebendes Produkt. Damit sind Softwaresysteme nicht mehr etwas, das wie ein Möbelstück in einem Möbelhaus gekauft, aufgestellt und genutzt wird, sondern eher vergleichbar mit einem Auto, das regelmäßig überprüft und gewartet werden muss und bei dem hin und wieder schadhafte Teile ausgetauscht werden. Auch in Deutschland gibt es mit der „Technical Guideline TR-03183, Part 2: Software Bill of Materials (SBOM)“ eine erste Einschätzung und Einordnung durch das BSI. Diese Richtlinie verweist explizit auf den aktuell noch im Entscheidungsprozess befindlichen Cyber Resilience Act der EU, der ggf. für Organisationen im öffentlichen Bereich die Erstellung und Auslieferung von SBOMs verpflichtend machen würde. ## Fazit SBOMs sind mehr als nur der Traum einiger Technikfreaks, die gerne alles dokumentieren, in Schubladen packen und kategorisieren wollen. SBOMs geben uns schnell und automatisiert Antworten auf Fragen, die für unsere Sicherheit entscheidend sein können. Spätestens bei der nächsten Gefährdungslage werden wir heilfroh sein, dass wir sie eingesetzt haben. Doch es geht nicht nur um die großen Angriffe: Wie wir gesehen haben, helfen SBOMs bereits jetzt, hier und heute, unsere IT sicherer zu machen. Aber wie sieht eine SBOM denn jetzt genau aus? Welche Formate gibt es? Welche Tools gibt es? Und welche davon sollten wir verwenden? Was ist möglich, wie gut funktioniert es und was geht ggf. noch nicht so gut? Und wie kann ich entsprechende Werkzeuge integrieren? Denn oft steht und fällt mit der Wahl der Werkzeuge die Qualität des Ergebnisses. Aber auch auf die richtige Umsetzung von Prozessen und ein gesundes Maß an Pragmatismus kommt es an. Auf diese Fragen wollen wir in den folgenden Teilen dieser Blog-Serie eingehen. Dafür haben wir uns einige Tools angeschaut und schildern unseren Eindruck … und natürlich sprechend wir die ein oder andere Empfehlung aus. ## Quellen [https://www.bsi.bund.de/DE/Themen/Unternehmen-und-Organisationen/Standards-und-Zertifizierung/Technische-Richtlinien/TR-nach-Thema-sortiert/tr03183/TR-03183\_node.html](https://www.bsi.bund.de/DE/Themen/Unternehmen-und-Organisationen/Standards-und-Zertifizierung/Technische-Richtlinien/TR-nach-Thema-sortiert/tr03183/TR-03183_node.html) # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [SBOM-Formate im Vergleich](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) **Published:** März 4, 2024 **Author:** Tim Teulings **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 3: CycloneDX und SPDX Die zunehmende Komplexität und Interkonnektivität von Softwareanwendungen führt dazu, dass es immer mehr Fremdabhängigkeiten in der Software gibt. IT-Verantwortliche stehen vor der Herausforderung, den Überblick zu behalten und die Zusammensetzung und Herkunft von Softwarekomponenten transparent und nachvollziehbar zu dokumentieren. Wie wichtig diese Dokumentation für die Sicherheit, Compliance und Effizienz des gesamten Softwareentwicklungs- und Bereitstellungsprozesses ist, haben die ersten beiden Teile dieser Reihe gezeigt. Für alle die neu dabei sind: In dieser Blogserie wird die Bedeutung von Software Bill of Materials (SBOM) als Instrument zur Identifizierung, Verfolgung und Analyse von Softwarekomponenten diskutiert. Wir nehmen euch mit in die Praxis, stellen euch Tools und Funktionalitäten vor. Während es in den beiden ersten Teilen der Serie um grundsätzliche Fragen rund um die Software-Stücklisten ging, haben wir für diesen dritten Teil die beiden führenden SBOM-Formate, CycloneDX und SPDX, genauer untersucht und miteinander verglichen. Hier kannst du einen Blick in die ersten beiden Teile der Blogserie werfen: - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) Aber nun zurück zu diesem 3. Teil: CycloneDX und SPDX bieten IT-Verantwortlichen Möglichkeiten, um Informationen über die Komponenten von Softwareanwendungen strukturiert zu erfassen und zu kommunizieren, wobei jedes Format seine eigenen Stärken und Einsatzbereiche aufweist. Diese Untersuchung zielt darauf ab, IT-Fachleuten einen fundierten Einblick in die beiden gängigen Standards für SBOMs zu geben. ## Wie sind die SBOM-Formate CycloneDX und SPDX entstanden? Für SBOMs gibt es zwei relevante Standards: SPDX (Software Package Data Exchange) und CycloneDX, die sich in nur wenigen Aspekten voneinander unterscheiden. Auch dies ist beiden gemeinsam: Beide Standards sind Open Source und wurden von gemeinnützigen Organisationen entwickelt: - **SPDX** wurde 2011 von der Linux Foundation entwickelt und ist seit 2021 ein ISO-Standard (ISO/IEC 5962:2021). Ursprünglich entwickelt wurde SPDX, um in Open Source Projekten Lizenzinformationen zu verwalten. Im Laufe der Zeit wurde der Standard erweitert, um zusätzlich Information zu Sicherheitslücken und weiteren Aspekte aufzunehmen. - **CycloneDX** ist ein Standard des OWASP (Open Web Application Security Projects), der 2017 entwickelt wurde. Sein Fokus liegt darauf, Anwendenden zu ermöglichen, Sicherheitslücken in Ihrer Software zu identifizieren, insbesondere in deren Abhängigkeiten. ## Wo liegen die Unterschiede? SPDX und CycloneDX sind heute nahezu deckungsgleich. Beide enthalten Attribute für Metadaten, Softwareabhängigkeiten und externe Dienste oder Dateien, die eingebunden werden. Damit ist jeder Standard nahezu gleichwertig einsetzbar. ### **Abhängigkeiten** - CycloneDX unterteilt Abhängigkeiten explizit in direkte und transitive Abhängigkeiten. - SPDX hingegen hat ein eigenes Feld, um Relationen zwischen den verschiedenen Elementen in einer SPDX SBOM abzubilden. Zudem sieht SPDX explizit ein Feld vor, um einen Review der SBOM zu dokumentieren. ### **Fokus Compliance oder Cybersicherheit?** Die Wahl eines Standards hängt vom Kontext der Verwendung der SBOM ab: Möchte man in erster Linie die Lizenzen einer Software im Auge behalten, bietet sich historisch SPDX an, da dies explizit dafür entwickelt wurde. CycloneDX hingegen wurde speziell für das Verwalten von Sicherheitslücken entwickelt. Allerdings sind beide Standards mittlerweile so weit entwickelt worden, dass man sie in der Praxis für beides einsetzen kann. ## Wie steht es um die Kompatibilität? Eine Konvertierung zwischen den beiden Standards ist möglich, beide Projekte stellen dafür Tools bereit. Allerdings muss hierbei beachtet werden, dass nicht alle Attribute der jeweiligen Standards in dem anderen abgebildet werden können. Dies wird in den Tools beider Projekte dokumentiert ([cyclonedx-cli](https://github.com/CycloneDX/cyclonedx-dotnet-library#high-level-overview-of-information-lost-during-conversion) und [cdx2spdx](https://github.com/spdx/cdx2spdx#design-and-implementation-notes)) Zu prüfen ist allerdings, mit welchem Unternehmen die SBOMs ausgetauscht werden sollen, da diese einen Standard vorgeben könnten. So arbeitet Microsoft bspw. mit SPDX und IBM mit CycloneDX. ## Beispiele für den Aufbau der SBOMs ![Beispiel für den Aufbau einer CyclonDX SBOM](https://thecattlecrew.net/wp-content/uploads/2024/02/cc-blog-2024-02-sboms-teil3_bild01.jpg)Beispiel 1: Aufbau einer CyclonDX SBOM (Quelle: ) ![Beispiel für den Aufbau einer SPDX SBOM](https://thecattlecrew.net/wp-content/uploads/2024/02/cc-blog-2024-02-sboms-teil3_bild02.jpg)Beispiel 2: Aufbau einer SPDX SBOM (Quelle: ) ## Summary Gibt es also eine klare Empfehlung für einen der beiden Standards? Aus unserer Sicht: Nein. Für die Wahl des geeigneten Standards ist es – wie wir in den folgenden Artikeln zeigen werden – relevanter mit welchen Tools man arbeiten will und welchen Standard diese unterstützen. Ebenso sollte man den Standard und die Werkzeuge so wählen, dass eine Konvertierung zwischen den Standards vermieden wird. # Wie geht es weiter? Im nächsten Teil stellen wir uns die Frage: Was ist eine gute SBOM? Wir stellen Kriterien und das Setting für unsere Versuchsreihe vor und nehmen Tools für die Erzeugung von SBOMs unter die Lupe. Danach geht es weiter mit Fragen wie : - Was können die Vulnerability Scanner? - Wie kann ich auf kompatible Lizenzen prüfen? - Wie integriere ich SBOMs in den Software-Development-Prozess? - Was ist beim Start in die SBOM-Welt zu beachten? - Was ist von den Konzepten hinter SBOM zu halten? - Summary und Tipps für den Start # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Was ist eine gute SBOM?](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) **Published:** März 20, 2024 **Author:** Dominik Kloke **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 4: Das Versuchssetting Nach grundsätzlichen Fragen rund um die Software-Stücklisten und dem Vergleich der beiden führenden SBOM-Formate, CycloneDX und SPDX stellen wir in diesem vierten Teil unser Versuchssetting vor. Das Setting war die Basis für diverse Tests, mit denen wir in dieser Blogserie der Frage nach einer guten SBOM auf den Grund gehen wollen. Du bist neu dabei? Hier kannst du einen Blick in die ersten drei Teile der Blogserie werfen: - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) - [Teil 3: SBOM-Formate im Vergleich – CycloneDX versus SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/ "SBOM-Formate im Vergleich") ## Welche Ziele haben wir uns gesetzt? Ziel dieser Blogserie ist es, unterschiedliche Werkzeuge für die Erstellung von SBOMs unter die Lupe zu nehmen. Dazu gehörte es, uns die Auswertung bzgl. potenzieller CVEs, Reportings von Software-Lizenzen oder die Erkennung von Lizenzverstößen näher anzuschauen. Auch wenn grundsätzlich mit einer SBOM mehr möglich ist, scheinen uns diese die essenziellen Kernprozesse zu sein. ## Welche Werkzeuge haben wir getestet? Getestet wurden vor allem: - (kostenlose) Open-Source-Werkzeuge - Werkzeuge, die sich grundsätzlich in eine CI-Pipeline integrieren lassen und damit den Wunsch nach Automatisierung unterstützen - die korrekte Aufzählung von **Software-Abhängigkeiten** eines Software-Produkts. D. h. wir hatten nicht den Anspruch, dass jedes Dateiartefakt korrekt erkannt, aufgezählt und verarbeitet wird. Ebenso bewerteten wir nicht die Erkennung von CVEs von Distributionspaketen des Betriebssystems der Docker-Images. Der Fokus lag also auf dem Erkennen von Abhängigkeiten einer Software, nicht der Umgebung, in der sie ausgeführt wird. - Rein SBOM-basierende Prozesse. D. h. wir haben die Strecken außer Acht gelassen, in denen ein Werkzeug scannt und CVEs auswertet, ohne dabei intermediär eine SBOM zu nutzen. - Praktikabilität der Werkzeuge. D. h. wir haben nicht die Korrektheit der SBOM validiert, sondern untersucht, wie gut Werkzeuge mit der SBOM in der Praxis arbeiten können. ## Welcher Technologie-Stack wurde untersucht? Bei der Wahl des Technologie-Stacks haben wir uns an einen typischen Stack orientiert, den wir bei unseren Kunden immer wieder vorfinden. - Java Maven Projekte - Angular / NPM Projekte - Docker Images (hier wiederum mit Fokus auf den dort installierten Software-Artefakt) - Die Dokumentation einer Betriebssysteminstallation ## Welcher Code stand im Fokus? Welchen Code galt es zu begutachten bzw. anhand von welchem Code wollten wir die Werkzeuge prüfen? Hier haben wir uns für Varianten der PetClinic entschieden, eines der Demo-Projekte im Java-Umfeld. Konkret: - Das Projekt zum Stand von Mitte Dezember (also ohne die nachfolgende Spring-Boot-Aktualisierung). - Das Projekt ebenfalls zum Stand von Mitte Dezember. - Folgende Docker-Images: tomcat:9, tomcat:9-alpine, tomcat:9-jdk21-corretto-al2 - Der Arbeitsrechner unter Windows 11 sowie eine WSL2-Umgebung auf Basis von Ubuntu 22.04. ## Unsere Testkriterien Eine Empfehlung braucht klare Kriterien. Deshalb haben wir unsere Anforderungen an die Werkzeuge vorab definiert. Drei Gütekriterien wurden dabei unterschieden: ### 1. Eignung für Continuous Integration (CI) - Die Integrationsfähigkeit in einen CI-Build ist maßgeblich. Generierung und Prüfung sollte bei Änderungen automatisch neu angestoßen werden können. - Dies bedingt auch, dass z. B. sinnvolle Warnungen oder Fehler erzeugt werden und die Verarbeitung abgebrochen werden kann, wenn im Test ein Fehler entdeckt wird. D. h. auch die Ausgaben sollten „CI-geeignet“ sein. - Das Werkzeug sollte möglichst wenig Installations- und Pflege-Aufwand bei der Installation auf einem Arbeitsrechner oder einem CI-Rechner erzeugen ### 2. Qualität - Von Vulnerability Scannern erwarten wir, dass die gängige Bewertung einer Sicherheitslücke mit angegeben wird. - Grundsätzlich erwarten wir ein Minimum an „false positive“- und „false negative“-Meldungen und natürlich eine vollständige Liste der korrekt identifizierten Vulnerabilities. - Die Präsentation des Ergebnisses muss auch für Nicht-Techniker nachvollziehbar sein ### **3. Geschwindigkeit** Die Ausführung sollte zügig erfolgen. Das hieß für uns: Die Ausführung sollte mit Blick auf die Gesamtausführungszeit der Build-Pipeline angemessen sein. Idealerweise liegt die Ausführung bei einigen wenigen Sekunden. ## Woran erkennen wir eine gute SBOM? Fangen wir mit den Eigenschaften einer guten SBOM an: Zunächst sollte die SBOM grundsätzlich vollständig und korrekt sein – in Bezug auf die zu dokumentierende Komponente sowie auf die oben genannten Ziele. Um diese Eigenschaft zu bewerten, haben wir in unseren Tests vier Punkte gecheckt: ### **1. Alle relevanten Abhängigkeiten müssen aufgezählt werden!** - Dokumentieren wir ein Software-Projekt, sollten alle Komponenten sowie deren transitiven Abhängigkeiten vollständig aufgelistet werden. - Dokumentieren wir einen Docker-Container sollten z. B. alle Packages der Linux Distribution sowie zusätzlich manuell installierte Software, wie ein JDK, aufgezählt werden. - Dokumentieren wir ein Betriebssystem, gilt das gleiche für Software-Packages, Systemkonfigurationen und Systemeigenschaften. ### **2. Die Listeneinträge müssen eindeutig sein!** Es sollten eindeutige IDs verwendet werden, um eine Komponente schnell unterscheiden zu können von - anderen Komponenten, - anderen Komponentenversionen - oder gleichnamigen Komponenten anderer Hersteller. ### **3. Folgende Informationen sollten vorliegen, damit die SBOM entsprechend ihrem Zweck ausgewertet werden kann!** - Jede Komponente ist eindeutig über Namen und Version zu identifizieren. - Am besten werden weitere IDs wie die Common Platform Enumeration (CPE) verwendet. - Die Quelle des Artefakts wird eindeutig genannt, z. B. mit der Download-URL. - Angaben zu Lizenzen oder Lizensierungsmöglichkeiten der Komponente werden gemacht. - Informationen bzgl. Nutzung oder Einbindung der Komponente, wie Typ („Library“) oder Einbindungsart im Kontext des Builds („scope: test“) stehen zur Verfügung. ### **4. Die Korrektheit der Angaben muss überprüfbar sein!** Über Hashes kann geprüft werden, ob die vormals dokumentierte Komponente und die Komponente, die uns aktuell vorliegt, inhaltlich identisch sind – die Komponente also nicht modifiziert wurde. ## Summary Mit den Kriterien, die wir oben genannt haben, setzten wir bei unserer Analyse den Fokus schwerpunktmäßig auf diese Aspekte: - praktische Nutzbarkeit bzgl. der Identifikation von CVEs bzgl. Lizenzen, - Korrektheit der Angaben, - typische Software-Stacks - und abhängige Software-Artefakte. # Wie geht es weiter? Für den nächsten Teil dieser Blogserie haben wir Tools für die Erzeugung von SBOMs getestet. Die Ergebnisse rangieren von „empfehlenswert“ bis „durchgefallen“. Danach geht es weiter mit Fragen wie : - Was können die Vulnerability Scanner? - Wie steht es um die Kompatibilität von Lizenzen? - Wie integriere ich SBOMs in den Software-Development-Prozess? - Was ist beim Start in die SBOM-Welt zu beachten? - Was ist von den Konzepten hinter SBOM zu halten? - Summary und Tipps für den Start # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Mit welchen Werkzeugen werden gute SBOMs gemacht?](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) **Published:** März 27, 2024 **Author:** Dominik Kloke **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 5: Tools für die SBOM-Erzeugung im Vergleich Am Beginn unserer Reise durch die SBOM-Welt steht die Erzeugung der SBOMs. Aber welches Werkzeug hat die Nase vorn, wenn es um die Erzeugung präziser und aussagekräftiger SBOMs geht? Um das herauszufinden, sind wir in diesem Teil der Blogserie in die Welt der SBOM-Erstellungstools eingetaucht. Wir haben getestet, welches Werkzeug unsere Anforderungen am besten erfüllt. Wir wollten herausfinden, welche Tools wirklich gute SBOMs herstellen – und damit uns allen (hoffentlich!) die Auswahl des optimalen Werkzeugs erleichtern. Du bist neu dabei? Hier kannst du einen Blick in die ersten vier Teile der Blogserie werfen: - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) - [Teil 3: SBOM-Formate im Vergleich – CycloneDX versus SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) - [Teil 4: Was ist eine gute SBOM – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) Bei unseren Tests der Erstellungstool für SBOMs ging es um eine Reihe von Fragen: Welche Werkzeuge eignen sich, um gute SBOMs zu erzeugen? Gibt es das eine Werkzeug für alles oder sind es eher mehrere Werkzeuge, die sich je nach Situation am besten eignen? ## Welche Werkzeuge eignen sich? Hier zunächst die Liste der Werkzeuge für die Erzeugung von SBOMs, die wir nach intensiverer Recherche gefunden und entsprechend geprüft haben: **Werkzeug****URL****Einsatzbereich**cdxgenMaven, NPM, Docker, OScyclonedx-maven-pluginMavenbuild-info-goMaven, NPMSyftJava, NPM, Dockersbom-toolJava, NPM, Dockerspdx-sbom-generatorMaven, NPMspdx-maven-pluginMavenscancode-toolkitMaven, NPMcyclonedx/cyclonedx-npmNPMTrivyMaven, NPM, DockerDiese Werkzeuge haben wir für unsere Tests entweder auf Linux oder Windows installiert und eine SBOM mittels eines entsprechenden Aufruf auf Basis der Dokumentation erzeugt. Die daraus resultierenden SBOMs wurden dann gemäß unserer Testkriterien miteinander verglichen. Die Bewertungen fielen sehr unterschiedlich aus: ### Prädikat: Durchgefallen! Drei Tools sind in unseren Tests durchgefallen. Sie erfüllten die Kriterien nicht oder unzureichend und sind daher aus unserer Sicht aktuell nicht zweckdienlich: #### **spdx-sbom-generator** - Die erzeugte SBOM beinhaltete keine Lizenzinformationen für die Maven Artefakte. - Vereinzelt fehlten Versionsnummern, was vermuten lässt, dass die durch Maven dokumentierten Abhängigkeiten nicht sauber ausgewertet werden. - Das Projekt an sich scheint aktuell nicht im aktiven Zustand zu sein: Es gab keine signifikanten Commits in der letzten Zeit dafür eine Reihe offener Pull Requests. - Vereinzelt hatten wir Abstürze. #### **scancode-toolkit:** - Das Maven Projekt wird nicht im Ansatz vollständig abgebildet (es wurde nur eine Dependency gefunden). - Die SBOM beinhaltet auch hier keine Lizenzen für die Maven Artefakte. - Die Ausführung dauerte sehr viel länger als bei anderen Tools (ohne entsprechendem „mehr“ an Qualität). - Das Projekt hat eine große Anzahl offener Tickets. Bei dem NPM-Projekt haben wir die Ausführung nach langer Zeit abgebrochen. Hier scheint scantool überfordert. #### **build-info-go:** - Der SBOM fehlen aktuell die Lizenzinformationen der einzelnen Maven Artefakte. - Sie beinhaltet gefühlt nur das Notwendigste. - Für Angular scheint das Werkzeug Dependencies und auch Vulnerabilities zu finden, die SBOM ist aber faktisch leer (siehe z. B. ). Diese Tools erfüllten in unterschiedlicher Güte unsere Kriterien von „Empfehlenswert!“ über „Ganz in Ordnung“ bis „Naja …“: ### Prädikat: Empfehlenswert! - **cdxgen** für Maven und NPM-basierende Projekte. (wobei für Maven Projekte intern das cyclonedx-maven-plugin nutzt, in der Nachverarbeitung aber in Details patzt). Hier hat auch der Detailierungsgrad der Informationen beeindruckt, wenn man cdxgen eine SBOM für eine Betriebssystem (Linux, Windows) erstellen lässt. Für Docker-Images liefert syft bei mehr Distribution die gewünschte Qualität. - Eben das besagte **cyclonedx-maven-plugin** für Maven Projekte. - **cyclonedx-npm** für NPM-Projekte. - **syft** für Docker-Images (hier klar bevorzugt vor cdxgen, welches nicht alle getesteten Distributionen unterstützt) aber grundsätzlich auch mit leichten Abstrichen für Maven -Projekte. Hier ist wichtig zu verstehen, dass die Auswertung der Maven POM von syft „naiv“ ist, syft in der Praxis die SBOM aber nahezu gleichwertig durch die Auswertung der gebauten Jars erstellen kann. Hier ist die SBOM genau zu analysieren und ggf. die Cataloger entsprechend zu konfigurieren. Im NPM-Kontext werden die Dev-Dependencies mit gelistet, was uns nicht sinnvoll erscheint. - **Trivy** für Docker-Images mit leichten Abstrichen gegenüber syft (manuelle installierte JDKs nicht erkannt). Ebenso nutzbar für Maven Projekte und NPM-Projekte, wobei bei NPM-Projekten oft die Lizenzangaben fehlten. - **spdx-maven-plugin**: Im direkten Vergleich sehen wir das cyclonedx-maven-plugin als besser an und nehmen es auch als aktiveres Projekt war. ### Prädikat: Ganz In Ordnung Wesentlicher formaler Mangel bei **cylonedx-npm**, **cyclonedx-maven-plugin** sowie **cdxgen** ist die unzureichende Unterstützung für CPEs. Das scheint aber bei der Auswertung bzgl. CVEs aktuell nicht entscheidend zu sein. ### Prädikat: Naja … Das **sbom-tool** konnte uns in keiner der Projektarten wirklich überzeugen. Es liefert in allen Varianten eher rudimentäre Informationen. ## Summary Wir waren von der doch stark unterschiedlichen Qualität zugegebenermaßen überrascht, sind doch die Werkzeuge entweder schon länger verfügbar oder haben eine kommerzielle Firma im Rücken. Unser Gefühl ist, dass viele Werkzeuge ihren Schwerpunkt auf die Analyse von Inhalten von Docker-Images setzen, was aus unserer Sicht nicht falsch ist (den die dort manuell installierte Software oder in den Paketen der genutzten Linux-Distribution können ja auch Sicherlücken haben). Allerdings sieht man auch klar, dass bzgl. der abhängigen Software-Komponenten die Werkzeuge, die die Build-Informationen sauber auswerten, zu vollständigen und auch qualitativ besseren Informationen kommen, Daher wird man aktuell entweder in der Praxis mit mehreren Werkzeugen arbeiten müssen, oder eben bei einem Tool ggf. qualitative Abstriche in Kauf nehmen müssen. # Wie geht es weiter? Im nächsten Teil werdet ihr sehen, inwiefern die Qualität des Vulnerability Scannings direkt mit der Qualität der SBOM zu tun hat. Danach geht es weiter mit Fragen wie diesen: - Wie steht es um die Kompatibilität von Lizenzen? - Wie integriere ich SBOMs in den Software-Development-Prozess? - Was ist beim Start in die SBOM-Welt zu beachten? - Was ist von den Konzepten hinter SBOM zu halten? - Summary und Tipps für den Start # Bisherige Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Vulnerability Scanner für SBOMs unter der Lupe](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) **Published:** Mai 10, 2024 **Author:** Dominik Kloke **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 6: Was können die Vulnerability Scanner Trivy und Grype? SBOMs helfen, Sicherheitslücken zu erkennen, die sich im eigenen Code befinden. Dafür werden Vulnarability Scanner gebraucht. Im Folgenden möchten wir zwei Tools vorstellen, die bei diesem Problem helfen können: **Name****Mögliche Scan-Ziele** **Verwendete Datenbanken** Trivyfs, image, sbom[Trivy-db](https://github.com/aquasecurity/trivy-db/tree/main) siehe [Sources](https://aquasecurity.github.io/trivy/v0.19.2/vulnerability/detection/data-source/)Grypefs, image, sbom*Du bist neu dabei? Hier kannst du einen Blick in die ersten fünf Teile der Blogserie werfen:* - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) - [Teil 3: SBOM-Formate im Vergleich – CycloneDX versus SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) - [Teil 4: Was ist eine gute SBOM – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) - [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) ## Was können die Scanner von SBOM-Dateien? Scanner wie Trivy und Grype unterstützen das Scannen verschiedenster Ziele. Hierbei ist allerdings zu beachten, dass die Scanner – je nach Ziel des Scans – verschiedene Ansätze haben. Im Falle einer SBOM versucht der Scanner nicht selbst, weitere Softwareabhängigkeiten zu ermitteln, sondern gibt nur für die in der SBOM eingetragenen Abhängigkeiten CVEs aus. ## Vergleich der Vulnerability Scanner Trivy und Grype In diesem Abschnitt werden die Ergebnisse der Tools *Trivy* und *Grype* gegenübergestellt. Dabei wurden beide Scanner jeweils gegen die mit verschiedenen Werkzeugen generierten SBOMs sowie gegen das zugrunde liegende Java Maven-Projekt ausgeführt. ### Trivy **Ziel des Scans** **Anzahl gefundener CVEs** **Anmerkungen**Dateisystem Low: 0 Medium: 6 High: 7 Critical: 0 Gesamt: 13 Cdxgen SBOM spring-pestclinic-rest Low: 0 Medium: 7 High: 8 Critical: 2 Gesamt: 17 Zusätzlich werden CVEs gefunden in: [org.springframework.security:spring-security-config ]() [org.springframework.boot:spring-boot-actuator-autoconfigure](spring-boot-actuator-autoconfigure) Maven Cyclonedx Plugin SBOM spring-pestclinic-restLow: 0 Medium: 7 High: 8 Critical: 2 Gesamt: 17 Identisch zu cdxgen-java-bom.jsonSyft SBOM spring-pestclinic-rest Low: 1 Medium: 9 High: 22 Critical: 13 Gesamt: 45Findet zusätzliche CVEs in: [com.fasterxml.jackson.core:jackson-databind](http://com.fasterxml.jackson.core:jackson-databind) [mysql:mysql-connector-java](mysql-connector-java) [org.postgresql:postgresql](postgresql) [org.hsqldb:hsqldb ](hsqldb)SBOM Tool SBOM spring-pestclinic-rest Low: 0 Medium: 6 High: 8 Critical: 0 Gesamt: 14Zusätzliche CVE in: [net.minidev:json-smart](json-smart)Trivy SBOM spring-pestclinic-rest *Projekt pom.xml:* Low: 0 Medium: 7 High: 8 Critical: 2 Gesamt: 1 */target/generated/pom.xml:* Low: 0 Medium: 8 High: 10 Critical: 0 Gesamt: 18 Scannt die pom.xml im Projekt und die generierte in [/target/generated-sources/openapi/pom.xml](/target/generated-sources/openapi/pom.xml) ### Grype **Ziel des Scans** **Anzahl gefundener CVEs** **Anmerkungen**Dateisystem Low: 1 Medium: 15 High: 32 Critical: 23 Gesamt: 71 Grype erkennt hier nicht immer die tatsächlich installierte Version einer Bibliothek und findet so *False Positives*. Cdxgen SBOM spring-pestclinic-rest Low: 0 Medium: 7 High: 8 Critical: 2 Gesamt: 17 Identisches Ergebnis wie Trivy Maven Cyclonedx Plugin SBOM spring-pestclinic-restLow: 0 Medium: 7 High: 8 Critical: 2 Gesamt: 17 Identisches Ergebnis wie Trivy Syft SBOM spring-pestclinic-rest Low: 1 Medium: 9 High: 22 Critical: 13 Gesamt: 45Identisches Ergebnis wie Trivy SBOM Tool SBOM spring-pestclinic-rest Low: 0 Medium: 6 High: 8 Critical: 0 Gesamt: 14 Identisches Ergebnis wie Trivy Trivy SBOM spring-pestclinic-rest Low: 0 Medium: 13 High: 12 Critical: 2 Gesamt: 27 Reportet mehr CVEs als Trivy für die im Projekt verwendeten Bibliotheken## Fazit Vergleicht man die Resultate des SBOM Scannings, sieht man direkt, dass sich beide Tools nicht viel nehmen. Dies liegt nach unserem Verständnis daran, dass die zugrundeliegenden CVE-Datenbanken nahezu identisch sind. Entscheidender scheint vielmehr zu sein, mit welchem Tool die SBOM erstellt wurde. - Beim Scannen der SBOMs von syft fällt auf, dass mehr CVEs gefunden werden. Dies liegt aber daran, dass syft für einige Softwareabhängigkeiten keine Version findet und in der Folge CVEs gefunden werden, von denen du nicht betroffen bist. - Eine Besonderheit von Trivy sei an dieser Stelle hervorgehoben: Trivy kann selbst SBOMs in den gängigen Standards generieren. Deshalb könnte das Tool eine „Rundumlösung“ darstellen. - Grype findet beim Scannen des Filesystems mehr CVEs als Trivy. Das liegt daran, dass es mit seinem „Katalog“ mehr Softwarekomponenten erkennt. Allerdings findet er nicht immer ihre Version. Das heißt das Ergebnis ist garantiert nicht frei von „falsch positiven“ Treffern. - Beide Tools haben eine JSON-Ausgabe, um einen Custom Report mit anderen Tools zu erstellen. ### Bewertung und Empfehlung Möchte man sich möglichst umfassend und korrekt absichern, macht die Kombination von Syft und Grype Sinn. Beide Tools sind Open Source und kommen von der Firma Anchore. Im Gegensatz zu Trivy kannst du mit Syft mehr Einfluss darauf nehmen, wie Abhängigkeiten im Projekt erkannt werden. Hierfür stellt Anchore verschiedene Mechanismen (sogenannte„Kataloge“) zur Verfügung. Möchtest du nur ein Tool einsetzten, empfehlen wir Trivy. Denn Trivy kann beide Aufgaben erledigen und stellt damit wie oben erwähnt eine Rundum-Lösung dar. Allerdings solltest du immer auch die Nachteile beachten, die bei der Generierung der SBOM mit Trivy entstehen. # Wie geht es weiter? Im nächsten Teil werfen wir einen Blick auf die Möglichkeit, mithilfe von SBOMs die Kompatibilität von Lizenzen auszuwerten. Danach geht es weiter mit Fragen wie diesen: - Wie integriere ich SBOMs in den Software-Development-Prozess? - Was ist beim Start in die SBOM-Welt zu beachten? - Was ist von den Konzepten hinter SBOM zu halten? - Summary und Tipps für den Start # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Mit SBOMs die Lizenzierung überprüfen](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) **Published:** Juni 25, 2024 **Author:** Dominik Kloke **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 7: Lizenzchecks Grundsätzlich beinhaltet die SBOM auch Lizenzinformationen. Das gilt sowohl für die durch die SBOM beschriebene Komponente selbst, aber insbesondere auch für deren zahlreiche Abhängigkeiten. Speziell bei der Verwendung von Open-Source-Abhängigkeiten mit ihren verschiedensten, möglichen Lizenzen liegt es so nahe, die SBOM auch als Basis für ein Reporting oder einen Check auf gewollte, kompatible (Whitelist) oder im Unternehmen verbotene Lizenzen (Blacklist) zu nutzen und damit ein ggf. bereits bestehendes Tooling zur Lizenzprüfung abzulösen. Welche Werkzeuge für Lizenzchecks oder Reportings aus unserer Sicht geeignet sind und was diese genau können, haben wir uns daher für diesen Beitrag genauer angesehen. *Du bist neu dabei? Hier kannst du einen Blick in die ersten sechs Teile der Blogserie werfen:* - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) - [Teil 3: SBOM-Formate im Vergleich – CycloneDX versus SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) - [Teil 4: Was ist eine gute SBOM – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) - [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) - [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) ## Kriterien für die Lizenzauswertung Für ein Reporting sind aus unserer Sicht drei Kriterien relevant: 1. **Vollständigkeit:** Hier fokussieren wir uns erst einmal auf die Softwarekomponenten und ignorieren OS, Packages o. ä. Wir verzichten an dieser Stelle auch auf Hashes und Fingerprints oder den Abgleich gegen eine zentrale Datenbank. 2. **Sprache:** Der Report sollte auch in deutscher Sprache bereitgestellt werden können. In der Praxis ist dies am einfachsten zu realisieren, wenn das Template für einen Report selbst erstellt werden kann. 3. **Konfigurierbarkeit:** – Die angezeigten Attribute, die Sortierung sowie die allgemeine Darstellung sollten konfigurierbar sein. – Bei kombinierten Java- und Angular-Projekten ist es relevant anzuzeigen, ob es sich um ein Maven- oder NPM-Artefakt handelt. – Auch die GroupId hilft, das Artefakt besser einzuordnen. – Ggf. kann zusätzlich eine Beschreibung des Artefakts in der SBOM angezeigt werden. – Schließlich wäre es gut, wenn man auf die Sortierung Einfluss nehmen könnte. – Ist der Report nicht konfigurierbar, sollte dieser dennoch sinnvoll auswertbar und auch für Nicht-Techniker verständlich sein. Für eine Prüfung der Lizenzen gegen eine Whitelist oder Blacklist ergeben sich weitere Anforderungen: - Grundsätzlich muss es möglich sein, entsprechende White- oder Blacklists überhaupt definieren zu können. Am besten wäre es, wenn diese Definition zentral erfolgt. So läßt sich vermeiden, dass in einzelnen Projekten mit einer älteren oder anderen Version der Liste gearbeitet wird. - Hierzu gehört auch die Möglichkeit, organisatorische Prozesse auf diese Liste(n) abzubilden, um beispielsweise Änderungen protokollieren zu können. Hierfür reicht im einfachsten Fall die Verwendung von Textdateien in einem Git-Repository aus. - Wichtig ist auch die Möglichkeit, manuell nicht-SPDX-konforme Lizenzangaben nach der Prüfung korrigieren zu können. - Ebenso ist es hilfreich, wenn man zu einer Lizenz-Expression (z. B. „MIT OR BSD-2-Clause“) definieren kann, welche der möglichen Lizenzoptionen gewählt wurde. Diese Auswahl kann – muss aber nicht – auch automatisch geschehen. ## Welche SBOM-Werkzeuge haben wir untersucht? Zu den genannten Kriterien haben wir uns diese Werkzeuge angeschaut: **Werkzeug****URL****Einsatzbereich**sbomgr (SBOM Grep) [https://github.com/interlynk-io/sbomgr ](https://github.com/interlynk-io/sbomgr)Report jqassistant-cyclonedx-plugin [https://github.com/jqassistant-plugin/jqassistant-cyclonedx-plugin ](https://github.com/jqassistant-plugin/jqassistant-cyclonedx-plugin)Report/Check sbom-utility[https://github.com/CycloneDX/sbom-utility ](https://github.com/CycloneDX/sbom-utility)Report/Checkjq[https://jqlang.github.io/jq/ ](https://jqlang.github.io/jq/)Report mdBOM[https://haro87.github.io/mdbom/0.3.0/ ](https://haro87.github.io/mdbom/0.3.0/)Report sbom2docReport LicenseComplianceTool[https://github.com/medavis-gmbh/LicenseComplianceTool ](https://github.com/medavis-gmbh/LicenseComplianceTool)Report license-checker-cyclonedx-maven-plugin[https://github.com/remisbaima/license-checker-cyclonedx-maven-plugin ](https://github.com/remisbaima/license-checker-cyclonedx-maven-plugin)CheckDependency Track [https://dependencytrack.org/ ](https://dependencytrack.org/)Report/Check**Hinweis:** Grundsätzlich existieren weitere Werkzeuge zum Reporting oder zur Prüfung der verwendeten Lizenz. Beispiele hierfür sind u. a. Sonarqube Licensecheck, der Gradle-License-Report, der NPM License Checker, die Möglichkeiten der Maven Site oder auch das License Maven Plugin. Diese Werkzeuge wurden hier nicht betrachtet, weil sie nicht auf Basis einer SBOM arbeiten. ## Kein Werkzeug überzeugte zu hundert Prozent Um es vorwegzunehmen: Keines der betrachteten Werkzeuge konnte uns völlig überzeugen. Im Bereich Reporting sind sbomgr, sbom-utility sowie sbom2doc Werkzeuge, die man sich anschauen kann, aber auch aus unserer Sicht aktuell offensichtliche Mängel haben. Alternativ sind manuelle Auswertungen auf Basis jq möglich. Im Bereich der Prüfung ist der Einsatz von Dependency Track vermutlich noch am sinnvollsten – mit entsprechend großem Setup-Aufwand. Wer bereits jQAssistant nutzt, ist mit der Integration vertraut und kann hiermit bzgl. Reporting als auch Prüfung grundsätzlich viele der Anforderungen schnell und elegant umsetzen. Wer jQAssistant noch nicht nutzt, muss sich hierzu allerdings erst in jQAssistant einarbeiten (was es aus Sicht der Autoren grundsätzlich wert ist) und sollte es auch für seinen eigentlichen Zweck („Software Analytics“ und „Living Documentation“) nutzen wollen. ## Die Ergebnisse Hier die detaillierteren Erkenntnisse zu den einzelnen Werkzeugen: - **sbomgr:** Grundsätzlich ist ein Text-Report erzeugbar. Die Form des Reports erlaubt allerdings keine einfache, automatisierte Auswertung. Es gibt kein Templating. - **jqassistant-cyclonedx-plugin:** Siehe oben. Prozesse müssen auf Basis von jQAssistant realisiert werden. Reporting würde man auf Basis Asciidoc realisieren. Ein Abgleich gegen eine Whitelist oder Blacklist ist grundsätzlich möglich. Eine automatische Auswertung von Lizenz-Expressions würde die Möglichkeiten von jQAssistant vermutlich überschreiten. - **sbom-utility:** Ein Report kann erzeugt werden. Uns gefällt aber die Darstellung nicht (Auswertbarkeit). Es gibt kein Templating. Bzgl. einer Überprüfung können Lizenzen kategorisiert werden. Die Kategorisierung ist schön, hat aber den entscheidenden Nachteil, dass sbom-utility keine entsprechenden Return-Codes erzeugt oder die Verarbeitung abbricht. Für einen Check müsste daher der Report noch selbst manuell ausgewertet werden. - **jq:** Wir waren mit etwas Aufwand in der Lage, mittels jq eine neue JSON-Datei auf Basis einer CycloneDX SBOM mit den für einen Report relevanten Rohdaten zu erzeugen. Ein weiterführendes Reporting oder Überprüfung müsste dann auf Basis dieser neuen Datei mit eigenen Mitteln erzeugt werden. - **mdBOM:** Hier ist grundsätzlich ein Templating möglich, allerdings wird die SBOM „von Hand“ nach nur einer kleinen Untermenge von Attributen geparsed. Wir haben das Tool daher nicht weiter betrachtet. - **sbom2doc:** Hier sind die Reports grundsätzlich ansehnlich, aber in keiner Weise beeinflussbar. Für unsere Zwecke wären es aber notwendig, sie inhaltlich anzupassen. Das PDF-Ergebnis scheint fehlerhaft. - **License Compliance Tool:** Grundsätzlich scheint das Tool gut zu sein, es ist allerdings für einen anderen Zweck (Aggregation von Lizenztexten) erstellt worden. Ein Tailoring für unsere Zwecke scheint nicht so einfach möglich zu sein. - **license-checker-cyclonedx-maven-plugin:** Grundsätzlich interessant. Leider scheint dieses Tool aber nicht mehr weiterentwickelt zu werden. Auch ist es sehr auf Maven zugeschnitten, so dass sich in der Praxis schnell integrative Probleme ergeben. - **Dependency Track:** Unterstützt grundsätzlich viele unsere Anforderungen (Reporting-Sichten sowie die Möglichkeit Policies für Lizenzen zu definieren) und auch vieles mehr – ist aber in dem Sinne keine Lösung für eine einfache Integration im CI Build und kommt mit dem entsprechenden Setup-Kosten daher. ## Fazit und Empfehlung Im Summe sehen wir sinnvolle und pragmatische und vermutlich auch völlig ausreichende Ansätze in den einzelnen Werkzeugen. Wie schon erwähnt, fehlt uns das *eine* Werkzeug, das *alles* in entsprechender Qualität kann. Es sein denn, wir bauen auf jQAssistant oder Dependency Track auf, die aber entsprechende Einarbeitungs- und Setup-Kosten mit sich bringen. ### Pragmatisch & einfach Allen, die hohe Kosten und Aufwand vermeiden wollen, empfehlen wir einfache, pragmatische Ansätze, um z. B. mittels jq Input für ein Reportingwerkzeug oder für einen einfachen automatisierten Abgleich zu erzeugen. ### Herausfordernd & mehr Möglichkeiten Wer die Herausforderung annimmt, wagt sich für eine automatische Bearbeitung evtl. an License-Expressions. Hiermit muss in der Praxis ein pragmatischer Umgang gefunden werden. ### Blick in die Zukunft Wir vermuten, dass der aktuelle, ernüchternde Status im Bereich Lizenzreporting und -check etwas damit zu tun hat, dass es für die Lizenzprüfung bereits Werkzeuge gibt, die zwar nicht auf der SBOM arbeiten, dafür aber bereits länger existieren und daher schon – mit ausreichender Zufriedenheit – entsprechend verbreitet sind. Hier wäre im Einzelfall zu entscheiden, ob wir mit einem potenziellen Delta zwischen dieser Prüfung und den Informationen in einer SBOM leben können oder längerfristig doch auf die SBOM umschwenken, die ja zukünftig ein Auslieferungsgegenstand sein könnte. Besteht die Möglichkeit, schnell zu einer leichtgewichtigen und akzeptablen Lösung zu kommen, kann der Schwenk frühzeitig durchgeführt werden. Ansonsten empfehlen wir, abzuwarten und das Werkzeugangebot weiter zu beobachten! # Wie geht es weiter? Im nächsten Teil geht es um die Frage, wie wir SBOMs in den Software-Development-Prozess eingliedern können. Danach geht es weiter mit Fragen wie diesen: - Was ist beim Start in die SBOM-Welt zu beachten? - Was ist von den Konzepten hinter SBOM zu halten? - Summary und Tipps für den Start # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Was machen SBOMs mit der Softwareentwicklung?](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) **Published:** Juli 23, 2024 **Author:** Dominik Kloke **Content:** # SBOMs, die Software-Stückliste für mehr IT-Sicherheit – Teil 8: SBOMs im Softwareentwicklungsprozess Wie könnten in der SBOM-Welt mögliche Software-Entwicklungsprozesse aussehen? Wo würde ich welches Werkzeug verwenden? Was würde dies für meine CI-Pipeline bedeuten? Und wie wirkt sich das Ganze jeweils z. B. auf Rollen aus wie - Software-Produzierende, - Software-Betreibende, - Software-Nutzende, - Software-Verkaufende - oder Beauftragende des Softwareprodukts *Du bist neu dabei? Hier kannst du einen Blick in die ersten sieben Teile der Blogserie werfen:* - [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) - [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) - [Teil 3: SBOM-Formate im Vergleich – CycloneDX versus SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) - [Teil 4: Was ist eine gute SBOM – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) - [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) - [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) - [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) ## SBOM-Prozesse für **Software-Produzierende** Hier gehen wir von der Prämisse aus, dass Software-Produzierende bei der Softwareentwicklung grundsätzlich eine CI-Pipeline “Build” durchlaufen, die immer dann ausgeführt wird, wenn sich etwas am Softwarestand ändert. Typische Elemente einer solchen Pipeline sind - der eigentliche **Build**, - die Ausführung von **Tests**, - eine Reihe weiterer **Prüfungen** wie z. B. eine statische Code-Analyse. - Die Pipeline endet in der Regel mit dem **Erzeugen eines Deployment-Artefakts** - und der **Installation auf einer Testumgebung**. ## Variante 1 In der SBOM-Welt würden nun weitere Schritte hinzukommen: ![Ablauf des Entwicklungsprozesses mit SBOMs](https://thecattlecrew.net/wp-content/uploads/2024/05/sbom-serie-teil7-ablauf-e1715334400242.png) Das Ergebnis dieses zusätzlichen Schritte wäre - entweder ein Abbruch der Pipeline, wenn es zu Fehlern kommt (z. B. bei neuen CVEs oder problematischen Lizenzen) - oder im positiven Fall hätten wir neben dem eigentlichen Produkt nun zusätzlich die SBOM als Build-Ergebnis. In der Regel werden diese Ergebnisse in einem lokalen Repository des Unternehmens gespeichert. - Zusätzlich könnte an dieser Stelle die SBOM z. B. auch in ein zentrales System wie *Dependency Track* eingespielt werden, um so eine projekt- und versionsübergreifende Abfrage und Auswertung zu ermöglichen. Als Werkzeuge kommen diejenigen in Frage, die in der Lage sind, SBOMs auf Basis der vorliegenden Software-Artefakte zu erstellen (siehe [Teil 5](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/)). ## Pipeline „Release“ In einer weiteren Pipeline „Release“ folgen weitere mögliche Schritte. Diese Pipeline wird aufgerufen, sobald es eine offizielle neue Version gibt. Das kommt bei Continuous-Delivery-Ansätzen durchaus häufig vor und kann im Anschluss an die Build Pipeline erfolgen: ![](https://thecattlecrew.net/wp-content/uploads/2024/05/sbom-serie-teil7-bild02-e1715334999428.png)Wie die Abbildung zeigt, werden hier die SBOMs mehrerer Teilprodukte in eine SBOM zusammengeführt. Diese SBOM wird mit der Software paketiert und für die Nutzer der Software bereitgestellt. Hier wäre es u. U. angebracht, die Prüfungen auf CVEs aus dem „Build“ noch einmal durchzuführen. Damit ließe sich ggf. im letzten Moment noch ein Release verhindern. Für das Zusammenführen von SBOM gibt es Werkzeuge wie *cyclonedx-cli* oder *sbommerge*. ## Prüfen auf CVEs Ein dritter Prozess ist das regelmäßige Prüfen bestehender, relevanter Stände des Produkts auf neue CVEs. Relevante Stände sind dabei z. B. der aktuelle Entwicklungsstand sowie alle veröffentlichen und noch supporteten Releases. ![](https://thecattlecrew.net/wp-content/uploads/2024/05/sbom-serie-teil7-bild03-e1715335018757.png)In diesem Prozess wird erneut auf die SBOMs zugegriffen. Diese werden daraufhin auf der Grundlage einer oder mehrerer Vulnerability-Datenbanken ausgewertet. Im Falle neu entdeckter Vulnerabilities, können diese bzgl. ihrer Kritikalität auf Basis z. B. der CVSS-Scores bewertet werden. Im Anschluss kommt es zu einem Alerting, dem eine zeitnahe manuelle Detailanalyse folgen muss. Der Zugriff auf den eigentlichen Quelltext ist hierbei nicht mehr notwendig. An dieser Stelle haben wir einen CI-basierenden Ansatz skizziert. Grundsätzlich wäre aber auch ein Vorgehen auf Basis z. B. von Dependency Track denkbar, dass obige Schritte selbstständig intern außerhalb eienr CI-Pipeline ausführt. Dies ist auch die Stunde von [Vulnerability Scannern wie Grype oder Trivy](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/). ## SBOM-Prozesse für weitere Rollen Wie sehen die Prozesse mit integrierter SBOM-Erzeugung für die anderen Rollen aus? Grundsätzlich kann man sagen: Immer sehr ähnlich. Deshalb beschränken wir uns hier auf eine kurze Zusammenfassung: ### Prozess 1: SBOM entgegennehmen und speichern Die von den Software-Produzierenden gelieferte SBOM ist entgegenzunehmen und mit den SBOMs der anderen Softwareprodukte zentral zu speichern. Relevant an dieser Stelle ist, dass die SBOMs gepflegt werden. So sollten SBOMs zu alten Softwareständen, die nicht mehr eingesetzt werden, zum Beispiel gelöscht werden. ![](https://thecattlecrew.net/wp-content/uploads/2024/05/sbom-serie-teil7-bild04-e1715335035186.png) ### Prozess 2: Regelmäßige Prüfung auf CVEs In einem zweiten Schritt werden diese SBOMs regelmäßig auf neue CVEs geprüft. Das Vorgehen ist hier analog wie beim Software-Produzenten: ### ![](https://thecattlecrew.net/wp-content/uploads/2024/05/sbom-serie-teil7-bild03-e1715335018757.png)Schritte nach dem Alerting Nach dem Alerting sehen die Prozessschritte für jede Rolle etwas anders aus: - **Software-Betreibende** würden im Rahmen der Analyse unabhängig vom Hersteller ggf. nach einer möglichen Mitigation recherchieren, um so das Risiko zu minimieren und die definierten Service-Level zu halten. - **Software-Nutzende** würden vermutlich auf den Hersteller zugehen. - **Personen, die Software verkaufen**, würden ihre Kunden entsprechend informieren, - während diejenigen, die die **Umsetzung beauftragen,** sich eng mit den Software-Produzierenden abstimmen und den Fokus mehr auf das resultierende Projekt- und Risko-Management setzen. ## Fazit Beim Einsatz von SBOMs beobachten wir im Gesamtprozess vor allem drei Vorteile: 1. Keine Rolle muss auf andere Rollen warten. 2. Die einzelnen Schritte sind transparent, sodass alle Beteiligten die Risiken sehr gut abschätzen können. 3. Die Zeit bis zur maßgeblichen Reaktion kann sich erheblich reduzieren. # Wie geht es weiter? Im nächsten Teil verraten wir euch Tipps und Tricks für den Start in die SBOM-Welt. Danach erwarten euch noch zwei abschließende Teile: - Was ist von den Konzepten hinter SBOM zu halten? - Zusammenfassung der Reihe # Alle Teile ansehen: [Teil 1: Wenn Titelstorys die IT-Security vor sich hertreiben – Über den nachlässigen Umgang mit bekannten Sicherheitslücken](https://thecattlecrew.net/2024/02/02/wenn-titelstorys-die-it-security-vor-sich-hertreiben/) [Teil 2: Mit Softwarelieferscheinen effizient auf Sicherheit prüfen – Wie Sie mit SBOMs Ihre Softwarekomponenten im Blick behalten](https://thecattlecrew.net/2024/02/07/mit-software-lieferscheinen-effizient-auf-sicherheit-pruefen/) [Teil 3: SBOM-Formate im Vergleich – CycloneDX und SPDX](https://thecattlecrew.net/2024/03/04/sbom-formate-im-vergleich/) [Teil 4: Was ist eine gute SBOM? – Das Versuchssetting](https://thecattlecrew.net/2024/03/20/was-ist-eine-gute-sbom/) [Teil 5: Mit welchen Werkzeugen werden gute SBOMs gemacht? – Tools für die SBOM-Erzeugung im Vergleich](https://thecattlecrew.net/2024/03/27/mit-welchen-werkzeugen-werden-gute-sboms-gemacht/) [Teil 6: Vulnerability Scanner für SBOMs unter der Lupe – Was können die Vulnerability Scanner Trivy und Grype?](https://thecattlecrew.net/2024/05/10/vulnerability-scanner-fuer-sboms-unter-der-lupe/) [Teil 7: Mit SBOMs die Lizenzierung überprüfen – Lizenzchecks](https://thecattlecrew.net/2024/06/25/mit-sboms-die-lizenzierung-ueberpruefen/) [Teil 8: Was machen SBOMs mit der Softwareentwicklung? – SBOMs im Softwareentwicklungsprozess](https://thecattlecrew.net/2024/07/23/was-machen-sboms-mit-der-softwareentwicklung/) [Teil 9: Halten SBOMs, was sie versprechen?](https://thecattlecrew.net/2024/08/23/halten-sboms-was-sie-versprechen/) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Cyber Resilience, IT Security, SBOM --- ### [Das Analytics Yin und Yang](https://thecattlecrew.net/2024/07/15/das-analytics-yin-und-yang/) **Published:** Juli 15, 2024 **Author:** Sebastian Pospiech **Excerpt:** Über das Zusammenspielen von Fachbereichen und Entwicklungsteams im Analytcs Umfeld erklärt am chinesischen Yin und Yang. **Content:** In Organisationen sind wir es gewohnt, mit Strukturen und Prozessen zu arbeiten. Egal ob hierarchisch oder flach, es gibt klare Verantwortlichkeiten mit Abgrenzungen, Schnittstellen und Übergabepunkten. Wir malen Prozessdiagramme mit Rollen, die ihre Aufgaben nacheinander oder nebeneinander zu erledigen haben. Als Übergabemedien fungieren in der Regel Daten. Das können einzelne Events sein, Informationen über ein Ergebnis oder ganze Dokumente, die einen bestimmten Status erreichen. So fand ich mich bei der Vorbereitung von Janine Ellners und meiner Vortragsreihe „DDC Meets Change“ wieder, als ich solche Diagramme erstellte. Weitere [Informationen](https://thecattlecrew.net/2020/03/25/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-1/) zu Datadriven Company findet ihr hier im [Cattle Crew Blog](https://thecattlecrew.net/2020/03/25/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-1/) oder in einem [Beitrag im BI Spektrum](https://www.opitz-consulting.com/kompetenz/ein-tool-allein-macht-noch-nicht-data-driven) . Für die Ausgangssituation gelang mir das gewohnt leicht. Die Fachseite stellt einen Anforderungs-CR, eine User-Story, erstellt vom Product Owner geht daraus hervor und wird an die Entwickler übergeben. Am Ende des Sprints kommt ein Produktinkrement dabei heraus. Das geht zurück an die Fachabteilung, die dann übernehmen soll. Einfach, sequenziell und das Sinnbild des agilen Stille-Post Analytics-Kreislaufs. Die Fachseiten dürfen dann mal gucken, was für eine Kennzahl entstanden ist und wie man diese nutzt. # Hürden und wie man sie überwindet Um genau die Hürden, die damit verbunden sind aufzulösen, hat Janine mit ihren Kollegen im Kundenprojekt ein Vorgehen erarbeitet, das mehr als Miteinander gestaltet ist: Im besten Fall wird nicht nur eine User-Story unter dem Türschlitz hindurch ins Refinement Meeting geschoben. Sondern der Anforderer kommt gleich mit dazu (durch die geöffnete Türe, wenn möglich). Product Owner, Entwickler und Anforderer sitzen an einem Tisch, konzipieren, priorisieren, schätzen gemeinsam. Während der Entwicklung unterstützt man sich bei Rückfragen. Nach der Entwicklung von Datenhaltung, Datenaufbereitung, Kennzahlen und Dimensionen geht es gemeinsam an die Auswertung. Egal ob klassischer Report, Dashboard oder erste Ad-hoc Analysen. Im Pairing zwischen Entwicklern und Fachseite soll gemeinsam das erste Outcome produziert, die ersten Analysen erstellt und die ersten Erkenntnisse interpretiert werden. Der Entwickler wird zum Coach für das, was er gebaut hat. Zum „You build it, you run it“, was man DevOps Teams gerne andichtet, kommt ein „We built it, we celebrate it” zwischen Entwickler und Fachseite dazu. Die Inhalte entstehen gemeinsam. Der Versuch, das mit unseren gängigen Prozessdiagrammen darzustellen, misslang mir völlig. Ein „normales“ Prozessdiagramm brachte die Message kaum rüber. Ich habe herumgeschoben, weitere Beziehungspfeile eingezeichnet und am Ende war ein urhässliches Prozess-Ei geboren, maximal unleserlich und unverständlich. Aus Jugendschutzgründen habe ich es irreversibel entfernt und kann es an dieser Stelle leider nicht zeigen. Nach weiteren versuchen und vernichtendem Feedback der KollegInnen folgte ich einer Eingebung und malte ein Yin-Yang Symbol in den Farben, die in unserem Vortrag Entwickler und Fachseite repräsentierten, um das Miteinander dieser oft gegensätzlich anmutenden Rollen darzustellen. Der klassische Punkt auf der jeweils anderen Seite gefiel mir sofort, denn er impliziert etwas ganz wichtiges, damit oben beschriebene Arbeitssymbiose gelingen kann: Das Gegenseitige lernen und sich annähern. Die Empathie für die andere Seite. # Beide Seiten im Detail ![](https://thecattlecrew.net/wp-content/uploads/2024/07/Screenshot-2024-07-05-170722-1024x472.png)Ein Fachbereich, der nicht nur Self-Service können, sondern auch Refinements beiwohnen soll, braucht zumindest ein rudimentäres Verständnis dafür, wie Kennzahlen und Dimensionen funktionieren, wie man Dinge über Zeitbezüge auffächern kann und welche Rolle Granularitäten in semantischen Modellen bedeuten. Er braucht aber auch ein Stück Verständnis für Aufwände, die aus technischen Schulden oder Datenschutzanforderungen entstehen und nicht immer direkten Mehrwert bieten. Ein Entwickler sollte sich auf der anderen Seite davon lösen, ein „null“-Value nur als technisch zu behandelndem Vorkommnis zu werten, sondern die Bedeutung interpretieren und im besten Fall übersetzen: Haben wir keine Informationen über den Kündigungsgrund, weil der Kunde ihn nicht angeben wollte, oder wurde der Kunde gar nicht erst gefragt? Wie können wir zu einer schlüssigen fachlichen Aussage kommen? Steckt mehr dahinter als nur „Die Daten sind halt nicht da?“. Es ist wichtig zu verstehen, für wen entwickelt wird. Für einen versierten Nutzer, der sich viele Freiheiten wünscht und gerne selbst filtert? Oder für einen Nutzer, der möglichst schnell und einfach eine Kennzahl hinzuziehen möchte, in der alle Storni und uninteressanten Status bereits gefiltert sind? Ein Geldautomat wird für ein breites Publikum designt und kommt schließlich ohne Linux-Konsole als Frontend daher, selbst wenn man damit weniger Entwicklungskosten hätte und evtl. flexibler in der Bedienung wäre. Das leuchtet ein. Software wurde spätestens mit dem Siegeszug von Smartphones immer intuitiver wo es nötig war und es gibt heute für jede Zielgruppe oder Persona ein passendes Human-Computer-Interaction Design auf den Endgeräten. Die Zielgruppe und deren Fertigkeiten wird bei jeder neuen App und Software mitgedacht. Wieso tut man dies nicht auch bei den Daten? # Was kann man aus Yin und Yang lernen? Zurück zum Yin-Yang: Jeder bleibt auf seinem Gebiet Experte, versteht aber die andere Seite. Nur gemeinsam kann ein gutes Ergebnis entstehen. Ohne die andere Seite geht es nicht. So weit funktioniert die Analogie gut. In Vorbereitung auf diesen Artikel habe ich das getan, was alle guten Informatiker tun: Sie googlen. “Yin-Yang”. Dabei finde ich heraus, das Yin-Yang Symbol aus der chinesischen Philosophie heißt genau genommen Taijitu oder Taji, „das Äußerste“, und soll so eine Art Weltformel für die Funktionsweise unseres Universums sein. Keine Angst, so größenwahnsinnig bin ich (noch) nicht. Dennoch, je mehr ich mich damit beschäftige, desto mehr gefällt mir das Symbol als Metapher für unsere neue Analytics-Arbeitsweise: Das Yin bezeichnet den Nordhang eines Berges, das Yang die Südseite. Die beiden Seiten sind notwendigerweise untrennbar miteinander verbunden. Sie machen den Anschein, Gegensätze zu sein (die eine schattig und kühl, die andere sonnig und heiß), aber stehen im Einklang zueinander. Ohne Analytics-Anforderung braucht es keine Entwicklung. Ohne Entwicklung kann man sich die Anforderungen sparen. Es gibt eine gemeinsame Bergspitze. Will man auf den Analytics-Zenit, so gelingt das nur gemeinsam. Als Betrachter von außen muss man viele Meilen machen, um herumzulaufen und beide Seiten zu sehen und zu verstehen. Jede Seite hat individuelle Eigenarten und Bedürfnisse, ist anders, obwohl es der gleiche Berg mit dem gleichen Gipfel ist. Wohnt man auf einer Seite und kommt nie herum, versteht man die andere Seite nicht, kann die Temperatur- und Lichtunterschiede nicht nachfühlen, den anderen Blickwinkel auf die Spitze nicht begreifen. Im Unternehmen können Change-Begleiter dabei helfen „herumzulaufen“, zu verstehen und zu transportieren. Sie können ermutigen, einen Austausch anregen und moderieren. Es braucht diese mutigen auf beiden Seiten, die starten, sich herum trauen und versuchen das erste Dashboard gemeinsam zu bauen, vielleicht nicht direkt das schwerste. Beide Seiten müssen sich trauen die dummen Fragen zu stellen und die (vermeintlich) einfachen Dinge zu erklären. Für Entwickler ist die Rolle als Coach häufig eine neue Kompetenz, die nur durch Machen gelernt wird. Für Fachseiten ist das Dashboard bauen, selbst in einer datengestützt arbeitenden Organisation oft nur selten durchgeführte Praxis. Eine weitere Interpretation für das Yin-Yang liefert das chinesische „Buch der Wandlungen“, nach welchem die beiden Seiten immer im wechselseitigen Wandel stehen. Auf Bewegung folgt Ruhe, auf ein Hoch ein Tief usw. Kommt euch das bekannt vor? Die agile, iterative Entwicklungsweise passt wunderbar auf diese Metapher. Erst ein POC (Proof of Concept), dann die Entscheidung. Nachfolgend das MVP (Minimal Viable Product) und damit die ersten dauerhaften Mehrwerte. Dann vielleicht ein MLP (Minimal Loveable Product) und daraus resultierend gesteigerte „Gier“ im Unternehmen nach den neuen Zahlen, die wieder zu Folgeanforderungen führen. Das Analytics-Yin-Yang bietet eine überraschend einfache Darstellung für den sehr stark verwobenen Austausch, der zwischen Fachseite und Entwicklungsseite nötig ist. Im Gegensatz zu klassischer Software-Entwicklung, wo Abläufe, Bedienung und Funktionalität im Fokus stehen, spielt das Business-Know-How eine deutlich zentralere Rolle in der Data & Analytics-Entwicklung, da das Verständnis und die Interpretation von Kennzahlen eben nicht nur schwarz oder weiß ist, sondern ganz viel dazwischen und im Zweifel auch alles, je nach Blickwinkel und Anforderung. Dennoch, in der klassischen Software-Entwicklung wird das Endanwenderbedürfnis bereits seit vielen Jahren enorm stark beachtet. Damit die Analytics einen Schritt nach vorne macht braucht es hier beidseitig eine Annäherung. Das ist eine Herausforderung und eine Chance. Das Analytics-Yin-Yang wird auch in Zukunft bei meinen Workshops und Vorträgen zu finden sein und ist vielleicht so eine Art Prozessdiagramm, für alle, die keine Prozessdiagramme mögen. Denn es geht nicht um das du und ihr, sondern um das wir. Vielleicht erreicht dieser Artikel ein paar gleichgesinnte, die ihren DDC-Bestrebungen ein Symbol geben möchten. In dem Fall, bitte bedienen. 🙂 **Kategorien:** Analytics & Insights, Development, Tools & Methoden **Schlagwörter:** Analytics --- ### [Laufzeitvalidierung mit Zod](https://thecattlecrew.net/2024/07/01/laufzeitvalidierung-mit-zod/) **Published:** Juli 1, 2024 **Author:** Waldemar Lehner **Content:** In diesem Blogartikel schauen wir uns die TypeScript-Bibliothek „zod“ an. Dabei gehe ich genauer auf die Einschränkungen von TypeScripts Typen-System zur Laufzeit ein und zeige euch, wie zod diese Probleme löst. # Das Problem mit TypeScript TypeScript baut ein Typen-System um die Web-Programmiersprache JavaScript auf. Mit diesem Typen-System kann ein konkretes Interface für Objekte und Funktionen definiert werden. Wenn ich zum Beispiel versuche, einer Funktion, die eine Zahl erwartet, einen String mitzugeben, dann wirft TypeScripts Compiler `tsc` beim Konvertieren einen Fehler – vorausgesetzt TypeScript ist sich sicher , dass dort ein String übergeben wurde. Wichtig ist dabei, dass diese Überprüfungen nur zur Compile-Zeit passieren, also während der Entwicklung. Nachdem `tsc` die TypeScript-Datei nach JavaScript konvertiert hat, gehen alle Typen-Informationen verloren. JavaScript hat kein Konzept von Typen. Dementsprechend wird auch das Program zur Laufzeit, anders als bei Sprachen wie Java oder C#, keinen Fehler auswerfen, wenn beispielsweise statt einer Zahl ein String übergeben wird. Solange wir unsere TypeScript-Anwendung nicht mit `any`s bestücken, sollte das bei *statischen Daten* keine Probleme mit sich bringen; wenn in eine Variable beispielsweise eine Zahl geschrieben wird, dürfen wir davon ausgehen, dass die Variable zur Laufzeit auch eine Zahl beinhaltet. Bei *dynamischen Daten* sieht das allerdings anders aus. Also bei allem, dessen Struktur nicht zur Compile-Zeit garantiert ist. Erwarten wir beispielsweise von einer API eine JSON mit einer bestimmten Struktur, hilft uns das Typen-System von TypeScript bei der Validierung nicht weiter. Denn, wie schon oben erwähnt, ist das Typen-System nur während der Entwicklung verfügbar. Hier ein kleines Beispiel eines Aufrufs mit `fetch`. ``` interface Body { name: string; id: number; } const result: Body = await fetch('...').then((e) => e.json()); // ^^^^- hier wird der Body explizit definiert // ob hier wirklich ein Body zurückgegeben wird wissen // wir erst zur Laufzeit und müssen es auch zur Laufzeit // überprüfen console.log(result.name); // ^^^^ Dadurch, dass oben result als Body gesetzt ist // geht TS davon aus, dass Result ein Body ist. Würde hier etwas anderes // als id oder name stehen, würde es zu einem Compile-Fehler kommen. ``` Nachdem `tsc` diese Eingabe nach JavaScript konvertiert, gehen die Typen-Informationen verloren: ``` const result = await fetch('...').then((e) => e.json()); console.log(result.name); ``` Ob `fetch` hier ein JSON-Objekt mit der korrekten Struktur zurückgibt erfahren wir nur, indem wir zur Laufzeit den Inhalt überprüfen, beispielsweise über eine Funktion wie: ``` function isBody(body: unknown): body is Body { if (typeof body !== 'object' || body === null) { return false; } if ('name' in body) { if (typeof body.name !== 'string') { return false; } } else { return false; } if ('id' in body) { if (typeof body.id !== 'number') { return false; } } else { return false; } return true; } ``` # Wie Zod helfen kann Statt solche Validierungs-Funktionen „von Hand“ zu schreiben, kann Zod verwendet werden. Zod ist eine Bibliothek, mit der wir mittels TypeScript-Objekten ein Schema definieren können. Gegen dieses Schema können dann Objekte validiert werden. Die oben gezeigte Funktion lässt sich beispielsweise mit Zod wie gefolgt ausdrücken: ``` import { z } from 'zod'; export const BodyZod = z.object({ name: z.string(), id: z.number(), }); ``` Das erstellte Schema kann dann importiert und gegen ein unbekanntes Objekt angewandt werden: ``` const responseUnchecked: unknown = await fetch('...').then((e) => e.json()); try { const response = BodyZod.parse(responseUnchecked); console.log('validated', response); } catch (err) { console.error('failed validation', err); } ``` Bei der Validierung mit der `.parse()`-Methode gibt Zod automatisch aus dem Schema abgeleitete Typen ab. Wir erhalten mit Zod somit eine umfassende Typen-Überprüfung: Sowohl zur Laufzeit als auch zur Compile-Zeit! Beispielsweise wirft `tsc` für folgenden Code-Block einen Fehler aus: ``` const response = BodyZod.parse(responseUnchecked); response.test = 42; // ! Fehler // Property 'test' does not exist on type '{ name: string; id: number; }' ``` Wir können die Typen-Definitionen auch direkt aus dem Schema extrahieren: ``` type Body = z.infer; // identisch zu type Body2 = { name: string; id: number; }; ``` Neben den Typen können auch weitere Beschränkungen definiert werden: So kann ein Validator, der ein Enum oder eine ganze, positive Zahl, die nicht größer als 42 ist, wie folgt definiert werden: ``` const ExampleZod = z .enum(['value1', 'value2']) .or(z.number().int().positive().max(42)); type Example = z.infer; // = number | "value1" | "value2" ``` Ein weiteres Beispiel wäre ein Validator mit zwei Strings, die eine E-Mail und optional einen Regex-konformen String definieren: ``` const Example2Zod = z.object({ email: z.string().email(), alphaNumeric: z .string() .regex(/[a-zA-Z0-9]*/) .optional(), }); ``` Eine Auflistung aller Typen und Beschränkungen findest du auf dieser [Dokuseite.](https://zod.dev/) # Fazit Zod bietet eine intuitive Möglichkeit, einen Zustand, den wir zur Compile-Zeit erwarten und der zur Laufzeit tatsächlich aufgetreten ist, zu synchronisieren. Dies ist wichtig für Anwendungen, die Nutzereingaben oder externe Quellen, beispielsweise über fetch oder Angulars HttpClient, verwenden. Denn hier hilft uns das Typen-System von TypeScript nur während der Entwicklung weiter, während es zur Laufzeit keine Typenüberprüfung gibt. Zusätzlich können mit Zod auch Beschränkungen definiert werden, die über TypeScripts Typensystem hinausgehen. # Dran bleiben! Im [zweiten Teil dieser kleinen Blog-Serie](https://thecattlecrew.net/2024/07/08/validieren-mit-zod-zwischen-frontend-und-backend/ "Validieren mit Zod: zwischen Frontend und Backend") möchte ich dir Zod an einem konkreten Beispiel zeigen. Dafür sehen wir uns die Validierungsschnittstelle zwischen einem Quarkus-Backend und einem Angular-Frontend genauer an. Schau also gerne wieder rein … **Kategorien:** Development, Tools & Methoden **Schlagwörter:** rest, TypeScript, Zod --- ### [Validieren mit Zod: zwischen Frontend und Backend](https://thecattlecrew.net/2024/07/08/validieren-mit-zod-zwischen-frontend-und-backend/) **Published:** Juli 8, 2024 **Author:** Waldemar Lehner **Content:** In meinem [vorigen Blogeintrag „Laufzeitvalidierung mit Zod“](https://thecattlecrew.net/2024/07/01/laufzeitvalidierung-mit-zod/ "Laufzeitvalidierung mit Zod") habe ich dir Zod vorgestellt, eine Bibliothek zur Laufzeitvalidierung im TypeScript-Ökosystem. In diesem zweiten Teil dieser Blogserie zeige ich in an einem konkreten Anwendungsbeispiel, wie du Zod verwenden kannst. Und zwar geht es um die effektive Absicherung der Kommunikation zwischen Front- und Backend. # Worum geht es? Für Fullstack-Anwendungen ist es im Business-Kontext üblich, ein REST-Backend mit Spring Boot oder Quarkus zu implementieren und an eine Single-Page-Application zu verknüpfen. Die SPA kann zum Beispiel mit Angular implementiert sein. Dies hat zur Folge, dass das Frontend über die REST-Schnittstelle mit dem Backend kommuniziert und so JSON-Daten sendet und empfängt. Nun könntest du im Frontend die Zod-Schemas „manuell“ definieren. Für Backends, die nur sehr selten aktualisiert werden, ist dies eine valide Lösung. Doch für Anwendungen, welche aktiv entwickelt werden und viele Releases haben, ist diese Herangehensweise fehleranfällig. Wie wäre es, wenn wir ein Zod Schema automatisch aus dem Backend ableiten könnten? # Von Java POJOs zum Zod Schema Es gibt keine direkte Lösung, um von einer Java Klassendefinitionen ein Zod Schema abzuleiten. Es gibt jedoch einen indirekten Weg zu Lösung: Über ein Plugin, mit dem wir ein JSON Schemas im Java Kontext generieren können. Dies kann mit einer Bibliothek verknüpft werden, mit welcher ein Zod Schemas aus einem JSON Schema im TypeScript-Kontext generieren werden kann. Denn diese beiden Dinge sind vorhanden. ## Exkurs: JSON Schema Das JSON Schema ist eine Spezifikation mit der wir die erwartete Struktur einer JSON (oder YAML)-Datei definieren. Das Schema wird als JSON definiert. Das JSON Schema, das `{"name": "Waldemar", "id": 1234}` validiert, könnte beispielsweise wie folgt aussehen: ``` { "$schema": "http://json-schema.org/draft-07/schema#", "type": "object", "properties": { "name": { "type": "string" "minLength": 1 }, "id": { "type": "int", "minimum": 0 } }, "required": [ "name", "id" ] } ``` Das JSON Schema hat somit eine ähnliche Aufgabe wie eine OpenAPI Spec. Wobei sich das JSON Schema auf ein JSON-Objekt beschränkt, während die OpenAPI Spec den Vertrag für eine ganze API abbildet. # Von Java POJOs zum JSON Schema Mithilfe eines Maven-Plugins (`jsonschema-maven-plugin` aus der `com.github.victools` Gruppe) werden zum `generate`-Step Definitionen für alle DTOs JSON-Schema generiert. Für das Beispiel wurden folgende Abhängigkeiten eingebunden: ``` com.github.victools jsonschema-generator 4.31.1 com.github.victools jsonschema-module-jackson 4.31.1 com.github.victools jsonschema-module-jakarta-validation 4.31.1 ``` Die zwei letzten Abhängigkeiten sorgen dafür, dass Informationen aus den Annotationen von Jackson und Jakarta auch im JSON Schema abgebildet werden. Folgende Java-Klasse ``` import com.fasterxml.jackson.annotation.JsonClassDescription; import jakarta.validation.constraints.DecimalMin; import jakarta.validation.constraints.NotNull; @JsonClassDescription("A very helpful description!") public class SumResponseDTO { @NotNull @DecimalMin("00.00") private final double totalProfit; // ... } ``` wird somit beispielsweise in folgendes Schema umgewandelt: ``` { "type" : "object", "properties" : { "totalProfit" : { "type" : "number", "minimum" : 0.00 }, // ... }, "required" : [ "totalProfit" ], "additionalProperties" : false, "description" : "A very helpful description!", } ``` Die genaue Konfiguration findet sich im Git Repo in der [pom.xml.](https://github.com/opitzconsulting/BLUE-745-Laufzeitvalidierung-im-Frontend-mit-zod/blob/0a0744f2cb2a34b270de4890f18a8d60525de507/zod-example-backend/pom.xml#L113-L155) [Eine Anleitung auf Baeldung.com](https://www.baeldung.com/java-json-schema-create-automatically) geht hier nochmal genauer auf die einzelnen Konfigurationsmöglichkeiten ein. Unser Beispiel basiert ebenfalls auf dieser Anleitung. *Kleine Anmerkung:* Der Weg von Java POJO zu JSON Schema wäre auch anders herum möglich, alsovon einem JSON Schema zu Java DTO Stubs. Dies ist bei der „API First“-Herangehensweise üblich. # Von JSON Schema zum Zod Schema Für diesen Schritt wurden die `json-schema-to-zod`– und `json-refs`-Bibliotheken verwendet. `json-schema-to-zod` konsumiert das JSON Schema und gibt einen String zurück, der das Zod Schema abbildet und in eine Datei geschrieben werden kann. `json-refs` wird hierbei verwendet, um Referenzen innerhalb des JSON Schemas aufzulösen. ``` // Tupel-Array mit dem Namen und Zod Schema const zodifiedData = await Promise.all( jsonFiles.map(async (filePath) => [ basename(filePath).replace('.json', ''), jsonSchemaToZod( await resolveRefs(JSON.parse(readFileSync(filePath, 'utf8'))) ), ]) ); // Dateieinhalt wird zusammengeschrieben. z aus dem zod // Modul wird importiert. const moduleText = [ "import {z} from 'zod';", ...zodifiedData.map( ([name, content]) => ` export const ${name}Zod = ${content}; export type ${name} = z.infer; ` ), ].join('\n'); ``` Der Inhalt wird mithilfe eines Build-Skriptes in eine TypeScript-Datei geschrieben. Das Frontend kann dann die Schemas einfach importieren. ``` import { WeatherDataResponseDTOZod } from '../../generated/backendTypes'; // ... const result = await fetch('...') .then((e) => e.json()) .then((e) => WeatherDataResponseDTOZod.parse(e)) .catch((err) => console.log(err)); ``` # Verhalten bei Updates Wird das Interface des Backends angepasst, werden die JSON Schema-Dateien beim nächsten Build neu generiert. So lange das Build-Skript nicht getriggert wurde, wird das Frontend für die geänderten Endpunkte Fehler werfen, weil die Antwort nicht dem erwarteten Schema entspricht. Wurde das Build-Skript durchlaufen, und dadurch die Zod Schemas angepasst, hören die Fehler wegen dem unerwarteten Schema auf. Ggf. kommt es durch die Anpassung zu Fehlern beim Kompilieren durch `tsc`. Dadurch wird das neue aktualisierte Schema auch automatisch auf die generierten TypeScript-Typen abgebildet. Die Entwicklungsumgebung hilft uns bei neuen Änderungen mit Autovervollständigungen. # Fazit Zod, sowie das darum liegende Ökosystem an anbindenden Plugins, kann verwendet werden um automatisch TypeScript-Typen und Laufzeit-Validatoren aus Java Klassendefinitionen abzuleiten. Dadurch ist es möglich, REST-APIs automatisch zu typisieren und somit mit wenig Mehraufwand viel mehr Sicherheit und Sauberkeit in die Codebase zu bringen. Richtig angewendet kann dadurch der zur Compile-Zeit erwartete Zustand und der zur Laufzeit entstandene Zustand „synchronisiert“ werden. Dadurch können wir nach dem Aufruf des Validators davon ausgehen, das der Typ, den TypeScript uns Vorschlägt, auch tatsächlich zur Laufzeit eingetreten ist. **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Java, json, TypeScript, Zod --- ### [Microfrontends für Angular und React](https://thecattlecrew.net/2024/06/14/microfrontends-fuer-angular-und-react/) **Published:** Juni 14, 2024 **Author:** Waldemar Lehner **Content:** Während sich im Backend eine fachliche Trennung von Monolithen in unterschiedliche Module (Modulithen) oder gar Microservices etabliert hat, ist die Frontend-Welt noch immer stark monolithisch geprägt. In diesem Artikel will ich dir zwei Ansätze zeigen, um mehr Flexibilität in deine Frontend-Architektur zu bringen: Module Federation und Web Components. # Monolithen in der Frontend-Welt In der Angular- und React-Welt ist es üblich, Frontends als Single-Page-Applications aufzubauen. Dabei wird ein inhaltlich leeres HTML-Dokument mithilfe von JavaScript, das im Browser läuft, mit Inhalt befüllt (Client-seitiges Rendering). Außerdem werden alle Komponenten der Webseite in ein großes Bundle transpiliert. Wir haben es also mit einem Monolithen zu tun. Das HTML-Dokument referenziert einen Einstiegspunkt, von dem aus das Framework und die benötigten Komponenten importiert werden. Wie bei monolithischen Backends hat dies einerseits den Vorteil einer Single Source-of-Truth, und somit auch den Vorteil eines zentralen Release-Prozesses. Andererseits gibt es den Nachteil, dass die ganze Anwendung an einer zentralen Stelle definiert wird. Bei größeren Frontends wären die verschiedenen Teams also stark aneinander stark gekoppelt. Zwar ist es möglich, Komponenten in Bibliotheken auszulagern, die von der Anwendung importiert werden. Auch können die einzelnen Komponenten durch ein Refactoring besser voneinander getrennt und entkoppelt werden; der Build wird dadurch dennoch nicht dezentralisiert. Dies ist für kleine Frontends in Ordnung. Bei größeren, von mehreren Teams entwickelten Frontends führt dies – wie im Backend – jedoch schnell zu Konflikten. ![Der grobe Aufbau eines monolithen Frontends. Ein HTML-Dokumentiert importiert einen Entry-Point, welcher die Anwendung mit Inhalt befüllt. Dafür werden vom Entry-Point aus weitere JS-Module aufgerufen.](https://thecattlecrew.net/wp-content/uploads/2024/05/monolith-frontend.drawio-300x205.png)Der grobe Aufbau eines monolithischen Frontends: Ein HTML-Dokument importiert einen Entry-Point, der die Anwendung mit Inhalt befüllt. Dafür werden vom Entry-Point aus weitere JavaScript-Module aufgerufen. ## Microfrontends? Was genau darf man sich darunter vorstellen? In der Backend-Welt gibt es das Konzept der Microservices. Das heißt, Funktionalitäten werden in kleine Backend-Services aufgeteilt, die sich auf eine bestimmte Funktionalität beschränken. Diese Backend-Services können untereinander zum Beispiel mittels REST oder gRPC kommunizieren, können aber unabhängig voneinander entwickelt und deployt werden. Der Microservices-Ansatz ermöglicht dem Team eine höhere Autonomität. Wird der Ansatz richtig umgesetzt, können Teams selbständig arbeiten und deployen, ohne sich gegenseitig in die Quere zu kommen. Es stellt sich die Frage, wie dies in der Frontend-Welt umgesetzt werden kann. Eine Idee dafür nennt sich Microfrontends. Allerdings kann die Realisierung dieser Idee sehr unterschiedlich aussehen. Der Browser als feste Ablaufumgebung setzt hier klare Grenzen, die sich an Web-Standards wie JavaScript, HTTP oder Web-APIs orientieren müssen. Wir schauen uns im Folgenden zwei Optionen näher an: - Module Federation - Web Components Basis für die Umsetzung ist die Modulauflösung in JavaScript. ### Exkurs: Modulauflösung mit JavaScript Historisch gibt es in JavaScript verschiedene Arten von Modulsystemen. Mit ES6 wurde ein neues Modulsystem eingeführt, das in den meisten modernen Browsern unterstützt wird: ECMAScript Modules (ESM). Daher ist ESM seit einigen Jahren das bevorzugte Modulsystem im JavaScript-Ökosystem. Mit ESM können Module weitere Module über zwei Arten einbinden; über einen top-level Import, sowie über den Aufruf der `import(...)` Funktion: ``` import { something } from '../some/module.js'; // ^- sofort verfügbar const { somethingElse } = await import('../another/module.js'); // ^- erst nachdem await fertig ist verfügbar ``` Der Aufruf ist eine Promise. Es wird gewartet bis das Modul sowie alle Top-Level-Abhängigkeiten des Moduls geladen wurden. Top-Level-Imports werden sofort mit dem Einbinden des eigenen Moduls mitgeladen und sind dadurch ohne Promise verwendbar. Imports über `import(...)` werden erst dann ausgeführt, wenn die Funktion tatsächlich ausgeführt wird. Da es sein kann, dass das importierte Modul noch geladen werden muss, wird hier eine Promise zurückgegeben. ## Ansatz 1: Framework-spezifische UI-Komponenten Wie oben erwähnt, habe ich für diesen Blogartikel zwei Strategien genauer unter die Lupe genommen. Erstens: das Einbinden Framework-spezifischer UI-Komponenten in eine Host-Anwendung. Zweitens: das Einbinden Framework-unabhängiger Web Components in eine Host-Anwendung. Für den Framework-spezifischen Ansatz habe ich mir zwei Frameworks angeschaut: Angular und React. Da beim Framework-spezifischen Ansatz Host und die eingebundenen Remote-Frontends mit demselben Framework implementiert werden müssen, wurden zwei separate Anwendungen, eine mit React und eine mit Angular, implementiert. Die Anforderung an die Applikationen war es, eine Komponente, bzw. ein Modul von einem anderen Server zu laden und erfolgreich in die Applikation einzubinden, und Daten in der Anwendung zwischen den lokal und remote zur Verfügung stehenden Komponenten zu übertragen. ![Screenshot der React-Implementation. In Host-Anwendung (React) wird eine Komponente (React) zwei mal eingebunden. Diese Komponente wurde von einem anderen Server mithilfe von Module Federation geladen.](https://thecattlecrew.net/wp-content/uploads/2024/05/microfrontend-react-screenshot.drawio-300x148.png)Screenshot der React-Implementation. In Host-Anwendung (React) wird eine Komponente (React) zwei mal eingebunden. Diese Komponente wurde von einem anderen Server mithilfe von Module Federation geladen. ### Module Federation Für den Framework-spezifischen Ansatz wurde Module Federation mithilfe von `@angular-architects/module-federation` (Angular) und `@originjs/vite-plugin-federation` (Vite/React) realisiert. Da alle modernen Browser ESM direkt unterstützen, ist Module Federation auch ohne diese Plugins möglich. Dafür werden die Remote Frontends im Library-Modus gebaut und als ES-Modul direkt konsumiert. Die Plugins automatisieren diesen Schritt für uns und bauen zudem Polyfills für ältere Browser ein. Module Federation verwendet standardmäßig die `import()` Funktion, um das Remote-Kompilat zu laden. Denn `import()` kann neben relativen Pfaden (`../module.js`) auch URLs (`http://localhost:3001/module.js`) aufrufen. Diese URLs können auch auf Server mit einer anderen Root URL zeigen, solange der Remote Server CORS-Header setzt. Wurde das Frontend nicht im Library-Modus gebaut, können die Remote Module über `import()` nicht direkt aufgerufen werden. Das liegt daran, dass Bundler wie Webpack und Rollup (Vite) die JavaScript-Module umverpacken und für Browser optimieren. Statt `import("../util/myModule.js")` findet sich bei Webpack im Bundle ein minifizierter Aufruf von `__webpack_require__(module_id)`. Die ID ist intern und kann daher nicht „öffentlich“ konsumiert werden. Die `remoteEntry.js` ist hier die Lösung. Sie stellt eine Art Nachschlagewerk bereit. Externe Module importieren die `remoteEntry.js` und rufen das interne Modul über den Namen auf. Hier ein Ausschnitt der nicht minifizierten `remoteEntry.js` aus dem Angular-Projekt: ``` var moduleMap = { './RemoteRoute': () => { return __webpack_require__ .e(44) .then(() => () => __webpack_require__(2044)); }, }; /// ... der Rest der remoteEntry.js ``` ![Die `remoteEntry.js` zeigt einem Konsumenten, wo es im remote Bundle die "öffentlichen" JS-Module finden kann.](https://thecattlecrew.net/wp-content/uploads/2024/05/generic-funcionality.drawio-300x279.png)Die remoteEntry.js zeigt einem Konsumenten, wo er im Remote Bundle die „öffentlichen“ JS-Module finden kann. ### React Das React-Frontend verwendet als Build-Tool Vite, ein relativ neues Entwicklungswerkzeug, das viel Wert auf Entwicklererfahrung setzt und zum Beispiel mittels ESM und Überspringen eines Bundle-Steps während der Entwicklung erheblich schnellere Bauzeiten ermöglicht als es beispielweise bei Webpack der Fall ist. Für Vite gibt es das `vite-plugin-federation`-Modul, welches als Plugin in die Vite-Konfiguration eingebunden werden kann. Über das Plugin lassen sich von diesem Kompilat bereitgestellte, sowie von externen Kompilaten konsumierte JavaScript-Module deklarieren: ``` // vite.config.ts import federation from '@originjs/vite-plugin-federation'; return defineConfig({ ..., plugins: [ ..., federation({ name: 'my-component-name', // Der Remote Entrypoint. Ein externes Modul kann diese Datei aufrufen // und über einen Lookup eine der unter exposes definierten Komponenten // laden. filename: 'remoteEntry.js', // Exposes, wenn dieses Modul Komponenten bereitstellt exposes: { './SomeComponent': './src/components/SomeComponent', './AnotherComponent': './src/components/AnotherComponent', }, // Remotes, wenn dieses Modul externe Komponenten konsumiert, // mit einem Link zum Remote-Entrypoint. remotes: { someRemoteEntry: 'http://localhost:5001/assets/remoteEntry.js', }, // Hier definierte Dependencies werden im Browser effektiv // nur einmal geladen. Es muss also nicht pro Remote Frontend // eine eigene React-Version geladen werden. shared: ['react', 'react-dom'], }), ], }); ``` Bei einem Build sorgt das Plugin dann dafür, dass die `remoteEntry.js`-Datei erzeugt wird. Die Komponenten können dann über den im `remotes`-Objekt definierten Namen eingebunden werden: ``` const RemoteComponent = React.lazy(() => import('someRemoteEntry/SomeRemoteComponent')); return ( ); ``` Das Plugin schreibt den Import während des Builds so um, dass die `remoteEntry.js` vom Remote Server importiert, und darüber die gewünschte Komponente gefunden wird. Hier ist es wichtig, anzumerken, dass ein Top-Level-Import, also ``` import RemoteComponent from 'someRemoteEntry/SomeRemoteComponent'; ``` **nicht** möglich ist, da es sich hier um eine synchrone Operation handeln würde. Das heißt, das Remote-Modul muss zuerst von einem anderen Server geladen werden. Die `import(...)`-Funktion gibt das Modul als Promise zurück, welche gelöst wird, wenn das Modul, sowie alle Top-Level-Importe dieses Moduls aufgelöst wurden. ### Angular Da Angular-Projekte standardmäßig Webpack als Build-Tool verwenden, habe ich dieses Tool mit dem Plugin `@angular-architects/module-federation-plugin` für das Aufrufen und Bereitstellen von Remote-Modulen ausprobiert. Ähnlich wie beim `vite-plugin-federation` kann ein Modul über die `webpack.config.js` über `remotes` und `exposes` Remote-Module konsumieren, bzw. Module für andere Remote-Module bereitstellen. ``` module.exports = withModuleFederationPlugin({ // Wird von diesem Kompilat konsumiert remotes: { 'angular-remote': 'http://localhost:3001/remoteEntry.js', }, name: 'module-name', // Liste der JS-Module, welche von diesem Kompilat bereitgestellt werden exposes: { './ExposedRoute': './packages/angular-remote/src/app/remote-page.module.ts', }, shared: { ...shareAll({ singleton: true, strictVersion: true, requiredVersion: 'auto', }), }, }); ``` Auch ein Einbinden eines Remote-Modules ist unter Angular sehr ähnlich zum React+Vite- Beispiel: ``` const routes: Routes = [ { path: '', component: IndexRoute, pathMatch: 'full', }, { path: 'remoteRoute', // Das Remote Modul wird über eine Promise geladen. Dabei handelt // es sich um ein Angular-Modul, welches ein // RouterModule.forChildren(...) definiert. loadChildren: () => loadRemoteModule({ type: 'module', remoteEntry: 'http://localhost:3001/remoteEntry.js', exposedModule: './RemoteRoute', }).then((m) => m.RemotePageModule), }, ]; @NgModule({ imports: [RouterModule.forRoot(routes)], exports: [RouterModule], }) export class AppRoutingModule {} ``` Auch wenn für Angular unüblich, können hier Remote-Komponenten über das asynchrone Austauschen einer `ViewContainerRef` ohne einen Router eingebunden werden (vgl. [ViewContainerRef Dokumentation](https://angular.io/api/core/ViewContainerRef#usage-notes)). ## Ansatz 2: Framework-unabhängiger Ansatz mit Web Components Für diesen Ansatz wurde eine Host-Anwendung mit Angular implementiert. In diese Anwendung wurden mehrere Web Components eingebunden, implementiert mit Vue, React und „Vanilla TS“. Diese Web Components werden dabei von einem anderen Server bereitgestellt. ![Ein Screenshot der entwickelten Anwendung. In einen Angular-Host wurden mehrere Microfrontend-Komponenten über Web Components eingebunden.](https://thecattlecrew.net/wp-content/uploads/2024/05/webcomponent-screenshot.drawio-300x192.png)Ein Screenshot der entwickelten Anwendung zeigt: In einen Angular-Host wurden mehrere Microfrontend-Komponenten über Web Components eingebunden. ### Web Components Web Components sind eine [in allen gängigen Browsern unterstützte](https://developer.mozilla.org/en-US/docs/Web/API/Web_components#browser_compatibility) API, mit der neue HTML-Elemente definiert werden können. Diese Element können, ähnlich wie bei Vue und Angular, über Props Daten annehmen und über Events zurückgeben. Eine Web Component wird erstellt, indem wir die Klasse `HTMLElement` erweitern. Hier ein Beispiel einer sehr primitiven Web Component. Diese nimmt einen Namen an und rendert den Namen in einen Gruß: ``` class ExampleGreeter extends HTMLElement { #name: string; #root!: ShadowRoot; #htmlElement: HTMLDivElement; get name() { return this.#name; } // Setter wird aufgerufen wenn das name-Prop modifiziert wird. // Der Setter ruft die Render-Funktion auf set name(name: string) { this.#name = name; this.render(); } render() { if (!this.#htmlElement) { return; } this.#htmlElement.innerHTML = `Hello, ${this.#name}!`; } // Code wird aufgerufen wenn das Element aufgebaut wird connectedCallback() { this.#root = this.attachShadow({ mode: 'open' }); this.#htmlElement = document.createElement('div'); this.render(); } // Cleanup Code. Wird aufgerufen wenn das Element entfernt wird disconnectedCallback() {} // Damit eine Web Component im HTML verwendet werden darf muss sie // zuerst angemeldet werden. // Danach kann die Web Component wie gefolgt verwendet werden: // static register() { window.customElements.define('example-greeter', ExampleGreeter); } } ``` Eine wichtige Anmerkung zu Web Components ist, dass diese isoliert zum Rest der Webseite gestylt werden. Der Inhalt der Web Component läuft unter einer Shadow DOM. Die Shadow DOM stellt ein eigenes Dokument bereit. Styles können auf dieses separate Dokument über einen in der Web Component erstellten ``-Knoten oder durch Inline Styles angewandt werden. Diese Styles werden nur auf das eigene Dokument angewandt, die Styles werden also nicht an darunterliegende Web Components oder den Eltern-Knoten übergeben. ### Definition der Remote Frontends Die Remote Frontends wurden so definiert, dass im Kompilat eine `/webcomponent.js` generiert wird. Die Datei definiert ein ES-Modul, welches als `default`-Export eine Funktion bereitstellt, über welche die Web Component im Host angemeldet werden kann. Diese Struktur ist für alle Remote Frontends identisch, sodass ein Remote Frontend aus dem Host über ``` const module = await import(`http://localhost:${PORT}/webcomponent.js`); module.default('component-name-to-use'); ``` geladen und im Host registriert wird. Danach kann im Host eine Komponente mit dem angegebenen Namen (hier `component-name-to-use`) erstellt werden. Für die Remote Frontends wurde Vite als Build-Tool verwendet. Die Standard-Konfiguration bei Vite baut eine Single Page Application. Diese Konfiguration ist so aufgebaut, dass das Resultat auf einem Server gehostet werden kann und eine Webseite bereitstellt. Es gibt aber auch den [Library Mode](https://vitejs.dev/guide/build.html#library-mode). Hier wird eine Code-Datei als Einstiegspunkt referenziert. Statt einer ganzen Webseite wird im Libary Mode dieser Einstiegspunkt, sowie alle Abhängigkeiten, in ein Bundle gepackt. Dieses Bundle lässt sich dann als ES-Modul im Host einbinden. ``` // Die vite Config, welche für die Remote Frontends verwendet wird. // Hier als Beispiel die vite-webcomponent.config.ts des Vue-Microfrontend import { resolve } from 'node:path'; import { defineConfig } from 'vite'; import vue from '@vitejs/plugin-vue'; export default defineConfig({ plugins: [vue()], define: { 'process.env': {}, }, base: 'http://localhost:5002/', build: { lib: { entry: resolve(__dirname, 'src/webcomponent.ts'), formats: ['es'], fileName: 'webcomponent', }, target: 'modules', sourcemap: true, }, }); ``` Die resultierende `webcomponent.js` beinhaltet den ganzen Code, der für diese Web Component benötigt wird. Das beinhaltet die Laufzeit (bpsw. Vue), sämtliche Komponenten, die in der Anwendung definiert und eingebunden wurden, sowie die Logik zum Verpacken und Registrieren der Anwendung als Web Component. Das Anbinden der Frontend-Frameworks an die Web Component hängt vom jeweiligen Framework ab. Vue 3 hat beispielsweise die [`defineCustomElement`](https://vuejs.org/guide/extras/web-components#definecustomelement)-Funktion, die eine Vue Singe File Component in eine Web Component umwandelt. Die genauen Implementationen können [dem Github Repository](https://github.com/opitzconsulting/webcomponent-microfrontends) aus den `webcomponent.ts(x)`-Dateien entnommen werden. ### Einbindung und Kommunikation zwischen Host und Microfrontend-Komponenten In der Host-Anwendung wurde eine Angular-Komponente definiert, die das Laden und Einbinden einer remote Web Component ermöglicht. Kurz gesagt lädt die Komponente über `import(...)` das Remote-Modul, ruft dort den Default Export auf und registriert somit die Web Component. Daraufhin wird eine Instanz der Web Component erstellt und der Zustand zwischen der Host-Anwendung und der Web Component verknüpft. Die Web Components sind so aufgebaut, dass die Host-Anwendung einen Zustand (hier Testweise `count`) übergeben und über Updates auf diesen Zustand informiert werden kann. Für die Information ist die Anmeldung an ein von der Web Component bereitgestelltes `CustomEvent` notwendig. ![Ein Kommunikations-Beispiel zwischen den Web Components und der Host-Anwendung. Die Host-Anwendung übergibt Daten "nach unten" über Props. Aktualisiert eine der Web Components den Zustand, erfährt die Host-Anwendung darüber über das `CustomEvent`. Kommt ein Event an, aktualisiert die Host-Anwendung den eigenen Zustand. Die Änderung wird in die Web Components propagiert, wodurch der neue Zustand in allen Web Components landet.](https://thecattlecrew.net/wp-content/uploads/2024/05/webcomponent-data.drawio-300x176.png)Ein Kommunikations-Beispiel zwischen den Web Components und der Host-Anwendung zeigt: Die Host-Anwendung übergibt Daten „nach unten“ über Props. Aktualisiert eine der Web Components den Zustand, erfährt die Host-Anwendung darüber über das `CustomEvent`. Kommt ein Event an, aktualisiert die Host-Anwendung den eigenen Zustand. Die Änderung wird in die Web Components propagiert, wodurch der neue Zustand in allen Web Components landet. Für das Beispiel wurde ein sehr einfacher Zustand, ein einzelner Counter, verwendet. Es ist jedoch genauso möglich, den Zustand komplexer aufzubauen oder sogar eine Message Queue zu implementieren. # Beide Ansätze im Vergleich Im Grunde können beide Herangehensweisen verwendet werden, um Microfrontends zu realisieren. Der Framework-spezifische genauso wie die Framework-unabhängige. Doch es gibt Unterschiede: Der Framework-spezifische Ansatz hat den Vorteil, dass Frameworks wie *React*, *Vue* oder *Angular* nur einmal eingebunden werden. Somit bleibt das generierte Bundle vergleichsweise klein. Auch bleibt man dadurch im Daten-Konzept des jeweiligen Frameworks (bspw. `:props` und `@events` mit Vue) und kann Komplexität sparen, die durch das Verpacken der Anwendung in eine Web Component entstünde. Der Framework-unabhängige Ansatz mit Web Components hat den Vorteil, dass man sich nicht auf ein bestimmtes Framework beschränkt. Für die Kommunikation zwischen Host und Microfrontends wird eine API verwendet, die im [Living Standard für HTML](https://html.spec.whatwg.org/multipage/custom-elements.html#custom-elements) definiert ist. Man darf davon ausgehen, dass Web Components als Standard stabil sind. Falls verwendete Frameworks in der Zukunft nicht mehr unterstützt werden, wäre der Austausch vergleichsweise einfach. Ein Nachteil dieses Ansatzes ist, dass jedes Microfrontend das verwendete Framework separat einbindet. Dies hat jedoch auch den Vorteil, dass es nicht zu Versionskonflikten kommen kann. Bei der Implementation des Framework-spezifischen Ansatzes bekam ich kryptische Fehler beim Anbinden eines Microfrontends. Nach längerem Debugging entdeckte ich die Ursache: Der Fehler kam aufgrund unterschiedlicher Versionen zwischen Host und Microfrontend zustande. Eine alternative Lösung ist es, in den Web Components und im Host die Frameworks als *externe Abhängigkeiten* einzubinden. Das verhindert einerseits, dass die verwendeten Funktionen des `react`-Moduls in die `webcomponent.js` kopiert werden und sorgt gleichzeitig dafür, dass stattdessen das `react`-Modul auch weiterhin als Top-Level-Import im Kompilat eingebunden wird. Gekoppelt mit einer [Import-Map](https://developer.mozilla.org/en-US/docs/Web/HTML/Element/script/type/importmap) können so mehrere `react`-Imports auf denselben Import abgebildet werden, wodurch das zu ladende JS-Bundle kleiner wird. Beide Ansätze teilen die grundlegenden Probleme mit Microfrontends: - Builds sind schwerer reproduzierbar, weil es keine Single Source-of-Truth gibt. Es müssten also alle Komponenten in einer bestimmten Version deployt werden, um einen Build reproduzierbar zu testen. - Weil es zum Übersetzungzeitpunkt keine Informationen über die Microfrontends gibt, gibt es keine Typsicherheit auf der Schnittstelle # Welche Alternativen gibt es? Zwei alternative Ansätze sollten meines Erachtens nicht unerwähnt bleiben. Mit ihnen lassen sich einige der genannten Probleme lösen: ## 1. Komponenten-Bibliothek Statt die einzelnen Microfrontends dezentral zu deployen und von einem zentralen Host zur Laufzeit die einzelnen Microfrontends einzubinden, könnten die Microfrontends weiterhin dezentral gebaut, aber zentral *zur „Kompilierzeit“* eingebunden werden – oder anders gesagt: Die Microfrontends stellen jeweils Komponenten über ein NPM-Modul bereit, das vom Host konsumiert wird. Dadurch gewinnen wir Typ-Sicherheit und haben Dank der Single Source-of-Truth einen reproduzierbaren und somit deutlich testbareren Build. Die „Microfrontends“ können weiterhin isoliert voneinander entwickelt und getestet werden. Die einzige Konfliktstelle zwischen den verschiedenen Implementationsteams stellt die Host-Anwendung dar. Hier müssen die einzelnen Module in der `package.json` eingebunden und bei Bedarf aktualisiert werden. Der Nachteil: Die einzelnen Microfrontends verlieren an Unabhängigkeit: Sie sind nicht mehr unabhängig deploybar, die Deploymentzeitpunkte sind zeitlich aneinander gekoppelt. ## 2. Multipage-Application (MPA) mit nginx ![Ein Beispiel-Aufbau mit NGINX und Microfrontends im MPA Ansatz](https://thecattlecrew.net/wp-content/uploads/2024/05/example-mpa.drawio-300x101.png)Ein Beispiel-Aufbau mit NGINX und Microfrontends im MPA Ansatz Sind die einzelnen Microfrontends vollständig voneinander isoliert, also nicht verschachtelt, und bilden nur Routen ab, könnte die Verwendung einer Multi Page Application (MPA) mit nginx in Erwägung gezogen werden. Die ganzen Frontends werden separat als *vollständige* Frontends deployt. Die Router der jeweiligen Microfrontends sind so konfiguriert, dass die Wurzel nicht `/` ist, sondern ein dem Frontend zugeordneter Pfad wie `/account` oder `/checkout`. Somit ist beispielsweise ein Microfrontend zuständig für die `/account/**`-Routen, ein anderes für die `/checkout/**`-Routen. Die Frontends werden auf verschiedenen Server unabhängig deployed. Es wird als „Host“ ein Nginx-Deployment erstellt, das die einzelnen Pfade auf die dazugehörigen Frontend-Deployments abbildet. Bleibt der Nutzer auf demselben Microfrontend, so wird der Frontend-interne Router verwendet. Wechselt man zwischen den Microfrontend, dann wird die ganze Seite neu geladen. Dies führt zu etwas längeren Ladezeiten, da das HTML-Dokument, sowie die ganzen Styles und Skripte für das neue Microfrontend geladen und ausgeführt werden müssen. Dieses Problem kann jedoch durch das Setzen eines `` in der aufrufenden Seite eingedämmt werden. Ein weiteres Problem ist geteilter Zustand. Möchte man Daten zwischen den Frontends austauschen, kann nicht der Frontend-interne Store verwendet werden. Ein Lösungsansatz ist es, den geteilten Zustand in die `sessionStorage` zu schreiben. Hierfür muss der Zustand als String abbildbar sein, bspw. als JSON String. Während der `localStorage` einen permanenten Key-Value-Store für eine Webseite darstellt, ist der `sessionStorage` nur für die aktuelle Session aktiv. Wenn eine Webseite auf mehreren Tabs geöffnet wird, wird für jeden Tab eine neue Session erstellt. Wird ein Tab, bzw. der Browser, geschlossen, dann erlischt die Session (vgl. [MDN Docs](https://developer.mozilla.org/en-US/docs/Web/API/Window/sessionStorage)). Dank der nginx Proxy haben alle Frontends für den Browser denselben Origin. Dadurch verfällt die `sessionStorage` nicht bei einem Seitenwechsel auf ein anderes Microfrontend. # Mein persönliches Fazit Microfrontends bieten die Möglichkeit, riesige und hochkomplexe Frontends sinnvoll aufzuteilen und voneinander unabhängig zu machen und somit auch unabhängig daran zu entwickeln. Du solltest dir jedoch gut überlegen, ob die Einbußen in der Entwicklererfahrung, Testbarkeit, Typsicherheit und Reproduzierbarkeit von Builds sich für die dadurch gewonnene Unabhängigkeit der einzelnen Microfrontends lohnen. Für *riesige* Anwendungen kann dies tatsächlich der Fall sein. Doch für die meisten Anwendungen sind Investitionen in bessere Architektur, einen besseren Schnitt der Komponenten und klare Coding-Konventionen eine effizientere Art, um Konflikte zwischen Entwicklungsteams an einem Frontend zu reduzieren. Wenn ich zwischen einer der beiden gezeigten Strategien für Microfrontends wählen müsste, würde ich die framework-unabhängige Herangehensweise empfehlen. Aufgrund von drei Gründen: - Höhere Flexibilität (weil unabhängig von Framework und Version) - Einfachere Austauschbarkeit durch die Verwendung von Web Components - Unterstützung und Unabhängigkeit: Wie erwähnt sind Web Components Teil der HTML-Spezifikation, werden von allen gängigen Browsern unterstützt und bieten somit eine Framework-unabhängige Möglichkeit für die Kommunikation zwischen Microfrontends. # Weiterführende Links - Git-Repo framework-abhängiger Implementation mit Angular: - Git-Repo framework-abhängiger Implementation mit React: - Git-Repo framework-unabhängiger Implementationen: - MDN Docs zu Web Components: [https://developer.mozilla.org/en-US/docs/Web/API/Web\_components](https://developer.mozilla.org/en-US/docs/Web/API/Web_components) - HTML Spezifikation zu Custom Elements: - Bibliothek Microfrontends Angular: - Bibliothek Microfrontends React / Vite: **Kategorien:** Architecture & Process Models, Development **Schlagwörter:** microfrontends, TypeScript, web, web components --- ### [How to ignore errors for unreachable hosts in AWX](https://thecattlecrew.net/2024/06/17/how-to-ignore-errors-for-unreachable-hosts-in-awx/) **Published:** Juni 17, 2024 **Author:** Bartlomiej Sowa **Content:** As many of you already know, Ansible AWX is a great and powerful tool to manage your infrastructure. However even one unreachable host results in entire AWX job being reported as failed regardless of the outcome of all other hosts. If you would like to ignore unreachable hosts and prevent marking jobs as failed just because of host reachability keep reading… # The problem When you run jobs against your entire big inventory (for example to rollout some compliance settings, cmdb update or some checks) very often you target some hosts, that are simply down for any reason whatsoever. Having only one host powered down / not reachable results in `ansible-playbook` returning exit code 4 (BTW [here you find](https://jwkenney.github.io/ansible-return-codes/) excellent description of all exit codes for Ansible and when which code is produced). AWX decides alone based on exit code, whether the entire job was successful or not. And in case of unreachable hosts – **the entire job is reported as failed**. Because of this, such AWX job will very often be failed. Therefore it might be hard to distinguish if there is really a problem with your Ansible code (and the playbook fails for all of the hosts), or this is just because of unreachable hosts. Of course you can each time analyze the task output, but especially when working with slices each time you would need to analyze outputs of each slice manually… just to find out that this is still due to having at least one unreachable host. # Solution There is a quite simple solution – just by using Ansible means, as this is where the problem comes from. Just prepend the main PLAY in the playbook with another one, that checks reachability of hosts. Then execute the main PLAY only on the reachable ones. That way if you get an error for the entire Job, you know for sure that there is a problem that needs to be addressed. Here is how such a playbook might look like: ``` - name: Check host reachability gather_facts: false hosts: "{{ target_hosts }}" tasks: - name: Check connection via explicite fact gathering ansible.builtin.setup: register: reachable_check - meta: clear_host_errors - name: Add to un-/reachable group ansible.builtin.group_by: key: "{{ reachable_check is unreachable | ternary('unreachable','reachable') }}_hosts" - name: MAIN PLAY - Actions with reachable hosts hosts: reachable_hosts gather_facts: true tasks: - .... roles: - ... - name: SUMMARY Play (optional) hosts: localhost gather_facts: false tasks: - name: SUMMARY ansible.builtin.debug: msg: "Playbook executed on {{ groups['reachable_hosts'] | length }}/{{ q('ansible.builtin.inventory_hostnames',target_hosts) | length }} hosts that were reachable." - name: Unreachable hosts with reason for unreachability ansible.builtin.debug: msg: "{{ hostvars[item]['reachable_check']['msg'] }}" with_items: "{{ groups['unreachable_hosts'] }}" ``` By using this extra play before you assign a host either to `reachable_hosts` or `unreachable_hosts` virtual inventory group. Then by running next play only against `reachable_hosts` the main playbook code is executed only against hosts, that were reachable during the time the job was started. As a bonus you get a list of hosts that are not reachable should this be needed like for the summary at the very last play. Also if using `clear_host_errors` be aware that as of moment of writing of this article there was a [still open Bug in Ansible](https://github.com/ansible/ansible/issues/35086), that results in unexpected behavior when there are many tasks between the failing one and the meta task. Make sure that the bug is already fixed or you have just one task before the meta that might fail due to unreachable host. If calling `ansible.builtin.setup` is not wanted (for example when using fact caching and explicite fact collection takes too much time/ressources) you may use any other task like `ansible.builtin.ping` (or `ansible.builtin.win_ping`) as long as it really connects to the host (some do not) and is able to produce `unreachable` status (here again, not all do). # Solution 2 If you do not need extra information about unreachable hosts in the summary, you may skip the register variable and just declare reachable\_hosts group like this: ``` ... tasks: - name: Check connection via explicite fact gathering ansible.builtin.setup: - name: Add to un-/reachable group ansible.builtin.group_by: key: "reachable_hosts" - meta: clear_host_errors ... ``` This way you save the runtime inventory some bytes by not doubling all collected facts. This might seem nothing, but at a scale of thousands of hosts memory can start getting an issue. # Another solution This is of course not the only working solution (as in Ansible, there are always multiple ways to achieve the same result more or less performant). There is also a posibility to use `block:` with `rescue:` and do not use `meta: clear_host_errors` like this: ``` - name: Check host reachability gather_facts: false hosts: "{{ target_hosts }}" tasks: - block: - name: Check connection ansible.builtin.wait_for_connection: timeout: 10 register: reachable_check # ignore_unreachable: true - name: Add to reachable hosts ansible.builtin.group_by: key: "reachable_hosts" rescue: - name: Add to unreachable hosts ansible.builtin.group_by: key: "unreachable_hosts" - name: MAIN PLAY - Actions with reachable hosts hosts: reachable_hosts gather_facts: true tasks: ... ``` Here the `ansible.builtin.wait_for_connection` has been used instead of `ansible.builtin.setup` to save some space in runtime inventory (especially when using fact\_caching and explicite fact gathering is not wanted). This approach however has some drawbacks: - `ansible.builtin.wait_for_connection` does not return unreachable status, only a failure. Changing it to something that returns unreachable would require either to use `ignore_unreachable: true` on the task to conert unreachable into failed (as rescue does not heal not reachable hosts) or `meta: clear_host_errors` as a last task outside block (do not use this meta inside block, as weird things happen) - the `rescue:` block heals failed tasks and there is no information about failure/unreachability (only `rescued` in the standard ansible summary at the very bottom) # Summary The first proposed solution works in a way, that AWX shows the number of unreachable hosts next to number of total and/or failed hosts at the very top of the Job Summary and I personally like it better. ![number of unreachable hosts in awx job summary](https://thecattlecrew.net/wp-content/uploads/2024/06/awx-unreachable-1.png) All solutions work with windows and linux target hosts which also might need do be eventually taken into account when choosing proper check task. Final choice is of course yours, feel free to experiment (as long as it is not on production environment :)) See also other [Ansible](/tags/ansible) or [AWX](/tags/awx) Related articles on [CattleCrew](/). **Kategorien:** Automation, Infrastructure **Schlagwörter:** ansible, Automation, awx, unreachable --- ### [Manage Kubernetes Services with Kong](https://thecattlecrew.net/2024/06/03/manage-kubernetes-services-with-kong/) **Published:** Juni 3, 2024 **Author:** Sven Bernhardt **Content:** Kubernetes (K8s) has become a cornerstone technology for deploying and managing containerized applications. But have you ever wondered how to manage your K8s services efficiently, especially when exposing many services outside the Cluster? By opting for an API gateway over a simple Ingress Controller, you’re simplifying the management of your K8s services and enhancing your control and efficiency. The API Gateway is a single entry point for client requests, abstracting security-related complexities, service discovery, routing, and load balancing. This centralized management of all your APIs running within the Kubernetes Cluster empowers you to handle your services easily. Moreover, an API Gateway opens up new possibilities like API Analytics, further enhancing your capabilities. Additionally, you can expose your services using protocols like TCP, UDP, or gRPC, giving you the flexibility you need. # One Gateway, multiple options With Kong’s flexible API Gateway, you become independent of any platform or runtime. In Kubernetes, you have two variants for deploying and using Kong Gateway. You can deploy it as a regular Kubernetes Service or an Ingress Controller. ## Deployment model: Kong Gateway as Kubernetes Service When you choose to deploy Kong Gateway as a regular Kubernetes deployment, you’re making a decision that significantly benefits your operations. However, it’s important to note that you’ll need to make the Kong Proxy and Admin API services available outside the Cluster. This step, though necessary, is a small price to pay for the enhanced control and management that Kong Gateway brings to your Kubernetes services. With the Kong Gateway in place, you can configure other Kubernetes services to be securely exposed. The Kong Admin API plays a crucial role here. It allows Gateway Admins to update the Gateway’s configuration. Because it can change the Gateway configuration, you must ensure that the [Kong Admin API is adequately secured](https://docs.konghq.com/gateway/latest/production/running-kong/secure-admin-api/#main). The Kong Admin API is a REST API. Therefore, you can integrate it easily with CI/CD pipelines. However, this can be cumbersome due to the imperative nature of a REST interface. Instead of using the Admin API directly, Gateway Admins can use [Kong decK](https://docs.konghq.com/deck/latest/). The tool allows us to manage the Kong Gateway configuration declaratively. In the background, it connects to the Admin API and automatically applies the necessary changes. ![Kong deployed as a regular K8s service](https://thecattlecrew.net/wp-content/uploads/2024/05/gateway-service-300x156.png)Figure 1: Kong deployed as a regular K8s service The API Gateway can also secure Kubernetes traffic internally using this deployment model. If you have such requirements, you should consider using a Service Mesh like [Kuma](https://kuma.io/) to secure and manage your East-West traffic. ## Deployment model: Kong Ingress Controller If you want to manage your Kubernetes services in a Kubernetes-native way, you can use the [Kong Ingress Controller (KIC)](https://docs.konghq.com/kubernetes-ingress-controller/latest/). It defines respective c[ustom resource ](https://docs.konghq.com/kubernetes-ingress-controller/latest/reference/custom-resources/)definitions, so Gateway Admins can use Kubernetes Manifests to configure Kong Gateway. As shown in Figure 2, there’s still a Kong Gateway proxy for exposing Kubernetes services to the outside world. In addition, you can see an Ingress Controller component. As it watches etcd, it is essential for relevant Kong-specific Manifests. KIC translates these into Kong Gateway configurations and applies them to the proxy. In the background, KIC uses Kong Admin API to configure the Gateway proxy. ![Kong Ingress Controller deployment](https://thecattlecrew.net/wp-content/uploads/2024/05/ingress-controller-300x229.png)Figure 2: Kong Ingress Controller deployment The main differences regarding the scenario above are: - You don’t need to expose the Kong Admin API publicly - Gateway configuration in a Kubernetes-native way - Securing Kubernetes internal traffic is not possible # Increasing complexity through API distribution Usually, you have to deal with more than just one Kubernetes cluster. In addition, you’ll also have to deal with non-containerized workloads. Furthermore, you may distribute those workloads over on-prem environments and different public cloud vendors. Now, you may ask how to manage all APIs in that distributed environment consistently. [Kong Konnect](https://konghq.com/products/kong-konnect) is a single-pane-of-glass solution for tackling the challenges of today’s distributed world. It provides a central, global control plane with rich management capabilities. Read [this blog](https://konghq.com/blog/product-releases/kic-in-kong-konnect) to learn more about Konnect. # Seeing is believing Would you like to see this in action? Fortunately, I created a video tutorial that shows how to get started with Kubernetes-native API Management using Kong Konnect and Kong Ingress Controller. Check it out, and let me know your thoughts, impressions, and questions! # Further reading If you want to learn more about the unique features of an API Gateway like Kong, I recommend [this blog](https://konghq.com/blog/engineering/how-to-manage-your-kubernetes-services-with-an-api-gateway). It details when an API Gateway might be more suitable for your needs than a simpler Ingress Controller such as Nginx. **Kategorien:** Development, Integration **Schlagwörter:** API, API Management, cloud native, Kong, Kubernetes, Tutorial --- ### [Lessons Learned Applikationswartung - Eine Retrospektive (Teil 1)](https://thecattlecrew.net/2014/06/22/lessons-learned-applikationswartung-eine-retrospektive-teil-1/) **Published:** Juni 22, 2014 **Author:** **Content:** [![Retrospektive MSA](https://thecattlecrew.net/wp-content/uploads/2014/06/retrospektive-msa2.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/06/retrospektive-msa2.png) Dieser Blogeintrag ist der Anfang einer Serie von Blogeinträgen, in denen ich meine Erfahrungen mit der **Organisation von Wartung und Weiterentwicklung von Individualsoftware** weitergeben möchte. Hierbei betrachte ich in einer Art Retrospektive die Erfahrungen, die ich mit meinem Team bei Opitz Consulting gesammelt habe. Dieses Team erbringt unter dem Namen „Managed Services Applications“ Dienstleistungen für unsere Kunden. Zusätzlich fließen auch viele weitere Projekt- und Wartungssituationen aus den vergangenen Jahren ein, bei denen wir in unterschiedlichsten Konstellationen (gemischte Teams, Beratungsdienstleistungen, Professional Services) uns zum Thema Wartung und Weiterentwicklung bei unseren Kunden eingebracht haben. Wie in einer Retrospektive üblich teile ich meine Erfahrungen in vier Kategorien ein (siehe auch http://www.retrospectives.com/pages/RetrospectiveKeyQuestions.html): - Was war gut und ich würde es weiter so machen? - Was sollte ich beim nächsten Mal anders machen? - Was habe ich gelernt? - Was verwundert mich immer noch? Anfangen möchte ich heute mit einer Erfahrung, die ich aus positiver und negativer Sicht gemacht habe und die somit sowohl unter der Kategorie „Was war gut?“ als auch unter „Was sollte ich beim nächsten mal besser machen“ auftauchen kann: - **„Softwareentwicklung und Softwarewartung durch getrennte Teams verursacht Schmerzen“** - **„Softwareentwicklung und Softwarewartung ist dann erfolgreich, wenn diese aus einer Hand durch ein Team erfolgt“** Meine Erfahrung zeigt, dass in der Praxis häufig die Entwicklung der Lösung (Projekt) und die anschließende Wartung organisatorisch getrennt werden. Auf die Spitze wird dies getrieben, wenn auch kleinere Erweiterungen (CRs) über ein Entwicklungsteam abgewickelt werden, während das Wartungsteam sich nur um die vermeintlich unangenehmen Dinge wie Bug Fixing und Rufbereitschaft kümmern darf. Aus meiner Sicht sprechen viele Gründe gegen diese strikte Trennung. ### Wissenstransfer Der notwendige Wissenstransfer aus dem Entwicklungs- in das Wartungsteam erzeugt hohe Kosten und Reibungsverluste. Dies verschärft sich noch, wenn der Wissenstransfer nicht nur einmal erfolgt sondern kontinuierlich erfolgen muss. Dies ist für viele Systeme, die sich nicht am Ende ihres Lebenszyklus befinden, aber durchaus der Fall. Besonders die agile Softwareentwicklung schreit in diesem Zusammenhang nach Entwicklung und Wartung durch ein Team. Optimaler Weise werden in agilen Entwicklungsprojekten bereits frühzeitig erste Ergebnisse produktiv gesetzt. Die erste Produktivsetzung definiert den Beginn der Wartungsphase. Häufig ist zu einem so frühen Zeitpunkt ein dediziertes Wartungsteam nicht denkbar und ein regelmäßiger Wissenstransfer kaum möglich. Achtung: Eine ausreichende Dokumentation ist trotzdem sinnvoll. Wartung und Entwicklung aus einem Team heraus lässt die Dokumentation im ersten Moment weniger wichtig erscheinen. Hier sollten aber Reviews und ähnliche Maßnahmen dazu führen, dass die Dokumentation nicht vernachlässigt wird. Ich ergänze dies als weitere Karte unter „Was habe ich gelernt?“ ### Auslastung Erfolgt Softwareentwicklung und Wartung aus einem Team heraus ist es deutlich leichter die Teams kontinuierlich zu beschäftigen. Auslastungsschwankungen sollten durch das temporäre Hinzufügen von Entwicklern (ggf. auch Externe) ausgeglichen werden. Am Ruder bleibt immer das langfristig eingesetzte Wartungsteam. Dies ist eine weitere Karte (diesmal in der Kategorie „Was habe ich gelernt?“) wert: „Die Wartung gibt den Ton an“. ### Verantwortung Die Trennung von Wartung und Entwicklung wirkt sich negativ auf das Verantwortungsbewusstsein der beteiligten Personen aus. Entwickler identifizieren sich mit der durch sie entwickelten Software und sind um hohe Qualität bemüht. Wurde die Software durch ein anderes Team entwickelt, kann sich das Wartungsteam leicht auf ein „den Fehler haben die Anderen eingebaut“ zurückziehen. Verschärft wird dieses Problem, wenn auch noch unterschiedliche Vertragspartner Entwicklung und Wartung übernehmen. Hier wird dann gerne und lange über den Verursacher und die Übernahme von Kosten (Gewährleistung ja oder nein) diskutiert. ### Motivation Wartungsaufgaben werden eher als uninteressant empfunden. Gleichwohl sind viele Probleme in der Wartung hochkomplex und benötigen sehr fähige Softwareentwickler für die Analyse und Lösung. Das Zusammenlegen von Entwicklungs- und Wartungsaufgaben in ein Team ermöglicht einen Ausgleich zwischen unterschiedlichen Aufgabentypen. Stärken und Schwächen aber auch Vorlieben einzelner Mitarbeiter können und sollten berücksichtigt werden. ### Abschließende Überlegungen Sinnvoll erscheint die Steuerung des Wartungs- und Entwicklungsteams über **Kanban**. Ich notiere dies auf einer Karte unter der Rubrik „Was verwundert mich immer noch?“ und merke mir dieses Thema für einen späteren Blogeintrag vor. **DevOps** treibt den Gedanken weiter. Betrieb wird ebenfalls ins Team integriert. Auch dies ergänze ich als Karte unter „Was verwundert mich immer noch?“ und betrachte es vielleicht später in diesem Blog im Detail. Und zum Schluss der wichtige Hinweis: **„Jede Situation ist anders!“**. Es gibt keine Standardvorgehensweisen. Höchstens Best Practices und Rahmenwerke, an denen man sich orientieren kann, die am Ende aber immer individuell angepasst und kontinuierlich hinterfragt und verbessert werden sollten. **Kategorien:** DevOps, Tools & Methoden **Schlagwörter:** ALM, Applikationswartung, Managed Services, Management, MSA, Retrospektive, Softwarenentwicklung, Wartung, Weiterentwicklung --- ### [Mobile Team as a Service](https://thecattlecrew.net/2017/07/07/mobile-team-as-a-service/) **Published:** Juli 7, 2017 **Author:** philippleinius **Content:** Das Thema Mobile bewegt uns längst nicht mehr nur im privaten Umfeld sondern auch im Unternehmen. Warum ist das so und wie können Unternehmen dieser Anforderung begegnen? ## Gestiegene Ansprüche & Generationenwechsel Verdeutlichen wir uns den Einsatz von mobiler Software anhand der Glockenkurve von Rogers (Diffusion of Innovations, 1962): ![Diffusion of Innovations](https://thecattlecrew.net/wp-content/uploads/2017/07/diffusion-of-innovations.jpg) Die Innovators des Einsatzes mobiler Software im heutigen Sinne finden sich in den späten 90er- und frühen Nuller-Jahren: Erste Unternehmen nutzten Anwendungen für Pocket PC / Windows Mobile. Ein Beispiel ist allgemein bekannt in Form der „Postboten-Keulen“, Geräten mit resistivem Touchscreen und eingebauter Tastatur. Auch Privatleute besaßen vereinzelt PDAs (Personal Digital Assistant), etwa von der Firma Palm. Die Early Adopters folgten kurz darauf: Immer mehr Unternehmen setzten auf Geräte von Blackberry. Diese ermöglichten, mit ihrer dauerhaft bestehenden Push-Verbindung, eine Verschiebung der asynchronen Kommunikation per Email in Richtung Echtzeit. Die Verwendung mobiler Technologie durch die Early Majority der Konsumenten begann 2007 mit der Vorstellung des iPhones. Ob kostenloses Echtzeit-Messaging, Spiele, Nachrichten oder Nischenwünsche: „There was an App for that“. Im Bereich der Konsumenten sind 10 Jahre später längst die Laggards wie Schwiegermütter und Opas erreicht: Sie haben entweder schon ein Smartphone oder denken darüber nach. Innerhalb von Unternehmen ist heute allerdings erst die Phase der Early Majority . Durch diesen Innovations-Vorsprung sehen sich die Unternehmen einem Erwartungsdruck ausgesetzt: Viele Mitarbeiter und Kunden fragen sich, warum die Anwendungen im professionellen Einsatz, denen aus dem Privatleben nicht das Wasser reichen können. Mit dieser Erkenntnis begeben sich die Unternehmen an die Umsetzung von interner Software in Apps. Richtungsweisend sind hier die Giganten: IBM und SAP haben Partnerschaften mit Apple zur Entwicklung von Enterprise-Apps geschlossen (2014 respektive 2016). Hier sprechen wir von der „2. Welle der Apps“. Darüber hinaus steht bei einigen der Innovators und Early Adopters ein Generationenwechsel an: Die bisher verwendeten Plattformen sind am Ende ihres Lebenszyklus angekommen und nicht mehr wirtschaftlich zu betreiben und/oder zu erweitern. Heute wollen sie entweder auf moderne und ausgereifte Plattformen wie iOS und Android setzen oder speziellen Anforderungen mit Multi-Plattform-Technologien wie ReactNative oder Xamarin begegnen. ## Spezialisten unterstützen den kompletten Lifecycle Wir, als Berater, knüpfen bereits bei ganz grundlegenden Entscheidungen der Unternehmen an: - Wer sind meine Kunden? - Wie erreiche ich Wirtschaftlichkeit für meinen Anwendungsfall? - Welche Technologie ist die richtige für meine besonderen Anforderungen? Entsprechend bieten wir sowohl Workshops zur Auswahl von Engagement- und Geschäfts-modellen als auch solche für die passende Mobile-Technologie an. Wir unterstützen die Konzeption und Implementierung mit Teams aus Spezialisten. Die mobilen Plattformen und Sub-Plattformen, wie watchOS oder Android TV, sind längst so komplex, dass es einer Spezialisierung bedarf um nach dem State of the Art zu arbeiten. Komplette Teams haben darüber hinaus den Vorteil, dass sie sich bereits auf Konventionen und Vorgehensweisen geeinigt und eventuelle persönliche Differenzen überwunden haben, also vom ersten Tag an produktiv sind. Auf Grund einer schlanken Projektleitung können die Teams aus Mobile-Entwicklern um Rollen, wie Product Owner, UX-Spezialisten und Backend-Entwickler ergänzt werden. Schließlich sind wir darauf eingestellt, Apps über ihren kompletten Lebenszyklus zu begleiten: Wir freuen uns, wenn ein Kunden uns nach Konzept und Implementierung auch Betrieb & Wartung seiner Software anvertraut. Unserer Meinung nach entstehen die besten Produkte wenn sie auch in dieser Dimension von vornherein auf geringe Reibung ausgelegt sind. Und nichts gewährleistet das eher, als wenn dieselben Personen für Implementierung und Betrieb zum Einsatz kommen. ## Engagement Model Unternehmen können dabei explizit die mobilen Leistungen als Dienstleistung, als Werk oder aber als Services beauftragen. Dabei ist aber vor allem das Engagementmodel „Mobile Team as a Service“ für Unternehmen interessant. Hierbei kann ein Unternehmen, je nach seinen Bedürfnissen, auf ein Mobile-Team zugreifen und bekommt anhand seiner Kriterien Services für seine Anforderungen geliefert. So ist es denkbar, dass ein Team Unternehmen mit einer gewissen Mannstärke und speziellen Skills in gewissen Servicezeiten zur Verfügung steht. Dabei können Unternehmen je nach Bedarf die Mannstärke skalieren und zusätzliche Services geliefert bekommen, z. B. Usability Engineering und Architekturberatung. Darüber hinaus kann das Unternehmen die benötigte Infrastruktur von der Entwicklung bis zum Betrieb erhalten. ## Fazit Mit dem Modell „Mobile Team as a Service“ können Unternehmen einfach und entspannt die besonderen Herausforderungen der Mobile-Entwicklung angehen. Dabei rufen sie entspannt die Services entspechend ihren Anforderungen ab. Für mehr Informationen zu den Angeboten von Opitz Consulting zum Thema Mobile kontaktieren Sie gerne Philipp Leinius (philipp.leinius@opitz-consulting.com) oder Karsten Will (karsten.will@opitz-consulting.com). **Kategorien:** Development, Tools & Methoden --- ### [Managed Services "“ Engagement-Modelle](https://thecattlecrew.net/2017/07/27/managed-services-engagement-modelle/) **Published:** Juli 27, 2017 **Author:** philippleinius **Content:** Mit diesem Blogeintrag möchten wir einen generellen Überblick über unsere Managed-Services-Angebote geben, die wir als Alternativen zu herkömmlichen Formen der Zusammenarbeit zwischen Kunde und Dienstleister anbieten. Hierbei berichten wir über die Erfahrungen, die wir mit unseren Teams im Laufe unserer Aktivitäten gesammelt haben. ## Warum Managed Services Grundsätzlich steht die IT eines Unternehmen vor einer Vielzahl von Herausforderungen, wenn es darum geht, die Wartung, Weiterentwicklung und Entwicklung seiner Individualsoftware und deren Infrastruktur sicherzustellen. Dies können beispielweise die folgenden Aspekte sein: Die IT „¦ - „¦ muss Personal und dessen Know-how effizient einsetzen. - „¦ muss schnell auf geänderte Geschäftsmodelle reagieren. - „¦ muss den Betriebsübergang von Neuentwicklungen effizient steuern. - „¦ muss die Wartung und Weiterentwicklung von Anwendungen und Infrastruktur sicherstellen. - „¦ muss im Rahmen der Digitalisierung IT-Trends und Innovationen im Blick halten. - „¦ muss das IT-Budget einhalten. Diese Liste lässt sich fast beliebig erweitern. All die genannten Aspekte stellen die Unternehmens-IT vor große Herausforderungen. Eine Lösung könnte sein, die Leistungen nicht intern oder nur zum Teil intern sicherzustellen, sondern diese als Service einzukaufen und somit die Leistungen bei Bedarf komfortabel abzurufen. Hierbei ergeben sich je nach Problemstellung zwei Schwerpunkte, Operation oder Development, und dazu unterschiedliche Engagement-Modelle. ## Managed Services „“ Operation Hat sich ein Unternehmen entschieden, den Betrieb der Individualsoftware und somit die Wartung und Weiterentwicklung über einen externen Dienstleister sicherzustellen, können verschiedene Engagement-Modelle die Basis für die Zusammenarbeit sein. Je nach Wahl des Engagement-Modells trägt der Kunde oder der Dienstleister die Verantwortung für die Aufrechterhaltung des Betriebs der Infrastruktur und/oder der Applikation. Die Engagement-Modelle können dabei folgende Ausprägung haben: ![Managed Services - Operation](https://thecattlecrew.net/wp-content/uploads/2017/07/managed-services-operation.jpg) **Dienstleistungen für Software- und Infrastruktur-Betrieb** Bei diesem klassischen Engagement-Modell hat weiterhin das Unternehmen die alleinige Verantwortung für den Betrieb der Infrastruktur und deren Applikationen. Der Dienstleister unterstützt dabei und stellt dem Kunden je nach Bedarf Experten mit dem entsprechenden Know-how zur Verfügung. Diese Form der Zusammenarbeit ist vor allem zur Abdeckung von kurz- bis mittelfristigen Engpässen im Betrieb sinnvoll oder bei punktueller Expertenunterstützung, beispielsweise bei Migrationsvorhaben. **Betriebskontingent-Service als Managed Services** Mit dem Modell Betriebskontingent-Service als Managed Services wird der Betrieb verstärkt durch den IT-Dienstleister unterstützt. Der Dienstleister stellt je nach den Bedürfnissen des Unternehmens ein Team zur Verfügung und konkrete Unterstützungsleistungen werden individuell zu einem Service zusammengefasst und als Kontingent angeboten. So ist es denkbar, dass ein Team dem Unternehmen mit einer gewissen Personalkapazität und speziellen Skills in gewissen Servicezeiten zur Verfügung steht. Dabei kann das Unternehmen je nach Bedarf die Personalkapazität skalieren und zusätzliche Services geliefert bekommen, z. B. Usability Engineering und Architekturberatung. Die Verantwortlichkeit für den Betrieb (z. B. Hoheit über den Betriebsprozess, Vorgehen und Applikationsstrategie,“¦) bleibt aber weiterhin beim Unternehmen. **Application Management als Managed Services** Bei dem Engagement Modell Application Management als Managed Services liegt die Verantwortung für den Betrieb der Infrastruktur und/oder Anwendung beim Dienstleister. Eine Möglichkeit können die Managed Services Infrastruktur (OC|MSI®) sein. Hiermit wird die Wartung und Weiterentwicklung der Infrastruktur vom Dienstleister anhand definierter Service Level Agreements (SLA) sichergestellt. Oder aber die Leistung Managed Services Applications (OC|MSA®), welche die Wartung und Weiterentwicklung der Individualsoftware anhand definierter SLA im Fokus hat. Dabei sind alle Kombinationen als Managed Services denkbar: - Sicherstellung des Betriebs der Infrastruktur mit oder ohne Sicherstellung des Betriebs der Anwendung - Sicherstellung des Betriebs der Anwendung mit oder ohne Sicherstellung des Betriebs der Infrastruktur **Custom Software as a Service (Custom SaaS) als Managed Services** Bei dem Modell Custom Software as a Service liegt die Verantwortung für die Infrastruktur und Anwendung beim Dienstleister. Bei diesem Service wird zunächst die Entwicklung der Applikation auf Basis der Kundenanforderung auf einer Cloud-basierten Plattform umgesetzt. Der Betrieb der Applikation geschieht als Managed Services für Infrastruktur und Anwendung und der Kunde erhält eine maßgeschneiderte Software. ## Managed Services „“ Development Möchte ein Unternehmen eine neue individuelle Softwarelösung realisieren, gibt es auch verschieden Möglichkeiten der Zusammenarbeit. Auch hier hat je nach Ausprägungsform das Unternehmen oder der Dienstleister die Verantwortung für das Erstellen der Lösung: ![Managed Services - Development](https://thecattlecrew.net/wp-content/uploads/2017/07/managed-services-development.jpg) **Dienstleistung für Software Development und Beratung** Mit dem Modell Dienstleistung für Software-Development und Beratung erhält das Unternehmen die Möglichkeit Expertenwissen z. B. für die Umsetzung seiner Applikation einzukaufen und kann auf entsprechende Berater zugreifen. Die Lösungsverantwortung trägt aber weiterhin der Kunde. **Development-Kontingent-Service als Managed Services** Bei dem Development-Kontingent-Service als Managed Service erhält ein Unternehmen z. B. in definierten Zeiten ein garantiertes Kontingent an Entwicklungskapazitäten. Dabei stellt der Dienstleister dem Kunden ein garantiertes Development-Kontingent zur Verfügung, welches ein zuvor definiertes technisches und methodisches Skillset und ein kundenspezielles fachliches und technisches Know-how umfasst. Die Verantwortung für die Erstellung der Lösung bleibt weiterhin beim Kunden. Der Dienstleiter garantiert aber die Projektkapazität durch ein Development-Kontingent mit den definierten Services. **Individuelle Lösung als Gewerk** Beim Engagement-Modell Individuelle Lösung als Gewerk garantiert der Dienstleister die Umsetzung der Anforderungen des Kunden. Die Lösungsverantwortung für die Applikation trägt der Dienstleister. ## Fazit Wir stellen bei unseren Kunden fest, dass wir viele grundlegende Probleme mit unseren Managed-Services-Modellen lösen können. So ist im Bereich Managed Services „“ Operation das Engagement Model Betriebskontingent-Service als Managed Services besonders gefragt. Aber auch das klassische Application Management als Managed Services ist für viele Kunden interessant. Im Bereich Managed Services „“ Development ist das Development-Kontingent-Service als Managed Services eine gute Möglichkeit, die Entwicklungskapazität abzusichern und weitere Services bei Bedarf abzurufen (beispielsweise [Mobile Team as a Service](https://thecattlecrew.net/2017/07/07/mobile-team-as-a-service/)). Darüber hinaus entwickeln wir mittlerweile ganz neue Service-Modelle, wie z. B. Innovation Lab as a Service (ILaaS). Hier erhalten Unternehmen die Möglichkeit, ihr digitales Labor als Service zu nutzen. Der Kunde kann so beim Aufbau und bei der Evaluierung neuer digitaler Geschäftsmodelle das OC|Lab® nutzen und innovative Ansätze durch Machbarkeitsstudien, Proof of Concepts oder Prototyping eruieren. In den nächsten Blog-Einträgen, möchten wir für die unterschiedlichen Engagement-Modelle darstellen, warum unsere Kunden, welches Model auswählen. Wo lagen ihre Probleme und wie können diese mit welchem Modell gelöst werden? Für mehr Informationen zu unseren Angeboten zum Thema Managed Services kontaktieren Sie gerne unser Competence Center Managed Services (). ## Quellen & Weiterführende Informationen: [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Fact\_Sheet/39-factsheet-oc-msa\_sicher.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/39-factsheet-oc-msa_sicher.pdf) [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Fact\_Sheet/35-factsheet-managed-service-infrastructure-msi\_sicher.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/35-factsheet-managed-service-infrastructure-msi_sicher.pdf) [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Fact\_Sheet/75-factsheet-oc-lab.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/75-factsheet-oc-lab.pdf) **Kategorien:** Tools & Methoden --- ### [Managed Services "“ eine Alternative zur Arbeitnehmerüberlassung](https://thecattlecrew.net/2018/04/09/managed-services-eine-alternative-zur-arbeitnehmerueberlassung/) **Published:** April 9, 2018 **Author:** inesmoeckelopitzconsultingcom **Content:** ### **Was ist ANÜ überhaupt?** Alle reden von ANÜ. Nur warum? Und was ist das überhaupt? Grundsätzlich liegt eine ANÜ (Arbeitnehmerüberlassung) dann vor, wenn Arbeitnehmer (Leiharbeitnehmer) von einem Arbeitgeber (Verleiher) einem Dritten (Entleiher) gegen Entgelt für begrenzte Zeit überlassen werden. Rechte und Pflichten eines Arbeitgebers übernimmt der Verleiher und der Leiharbeitnehmer steht weiterhin in einem Arbeitsverhältnis zum Verleiher. Den rechtlichen Rahmen hierfür bildet das „Gesetz zur Regelung der Arbeitnehmerüberlassung“ (AÜG). Mit der Reformierung zum 01.04.2017 traten einige Ü„nderungen in Kraft, die Auswirkungen mit erheblichen Nachteilen auf verschiedene Auftragsformen in der IT haben. ![Arbeitnehmerübernahme](https://thecattlecrew.net/wp-content/uploads/2018/04/abbildung-blogbeitrag-anc3bc.jpg)Darstellung: Was ist Arbeitnehmerüberlassung? ### **Nachteile von ANÜ** Welche Nachteile sind das? Ein Mitarbeiter, der per ANÜ bei einem Kunden im Einsatz ist, muss nach spätestens 18 Monaten den Kunden wechseln. Mit jedem Wechsel geht dem Kunden Projekt-Know-how verloren, das Mitarbeiter in der IT-Branche im Projektkontext aufbauen. Daraus resultiert, dass mit jedem neuen Mitarbeiter eine erneute Einarbeitung erforderlich wird. Dies belastet jedes Projekt und wirkt sich auch auf den Projekterfolg aus. Ein weiterer Nachteil ist, dass über ANÜ nicht so einfach skaliert werden kann, wenn der Bedarf besteht, weil für jeden Mitarbeiter die ANÜ vertraglich transparent geregelt werden muss. Jeder neue Vertrag benötigt Zeit für die Abstimmung mit den Mitarbeitern (Wer ist der Richtige? Passt er ins Team? Wie lange werde ich ihn brauchen? Will er per ANÜ arbeiten? …) Ein weiteres Problem ist die Themenvielfältigkeit in den Projekten. Ich bin mit den Projektaufgaben an das Know-how der Mitarbeiter gebunden, die ich per ANÜ entliehen habe. Was passiert, wenn temporär neue oder andere Aufgaben entstehen und damit andere Skills benötigt werden? Mit dem aktuellen Mitarbeiter bin ich zufrieden, kann ihn in den nächsten Wochen nur nicht auslasten, da seine Skills nicht passen. Ich benötige diesen Mitarbeiter jedoch später wieder für den Projekterfolg. ### **Managed Services als Antwort** Unsere Antwort auf die Nachteile, die sich mit der ANÜ ergeben sind „“ Managed Services. Trotz des temporären Einsatzes unserer Experten im Unternehmen eines Kunden, grenzen sich OC|Managed Services deutlich von Arbeitnehmerüberlassungen (ANÜ) „“ auch als Leiharbeit bekannt „“ ab. Managed Services bergen somit kein Risiko, in die Falle einer unerlaubten Arbeitnehmerüberlassung zu tappen, die häufig im IT-Projektgeschäft vorgefunden wird. Zunächst sind die Mitarbeiter von OPITZ CONSULTING in der Regel nicht immer vor Ort bei den Kunden, arbeiten mit ihren eigenen Arbeitsmitteln, die sie nicht vom Auftraggeber gestellt bekommen, sondern nutzen eigene Hardware. Über Remote Zugänge und Offsite-Arbeitsplätze lassen sich die Aufgaben in Eigenregie bearbeiten. Unsere Mitarbeiter sind zudem nicht in die Arbeitsabläufe und Prozesse der Kunden eingegliedert. Die beiden letztgenannten Punkte führen oft dazu, dass eine Leistung als ANÜ gewertet wird Die Erfüllung der vertraglichen Verpflichtungen, die häufig in SLAs gemessen werden, erfolgen selbstorganisiert durch die Mitarbeiter und nicht auf Weisung des Auftraggebers. Die Vertragspflicht im Rahmen eines Managed Services endet im Vergleich zur Arbeitnehmerüberlassung nicht mit der Auswahl und Zurverfügungstellung eines Arbeitnehmers und nach 18 Monaten, sondern wir schulden die Erfüllung eines Services. Die eingesetzten Arbeitnehmer sind als Erfüllungsgehilfen zu betrachten und unterliegen weiterhin den Weisungen von OPITZ CONSULTING. Der sogenannte Dritte in diesem Verhältnis, also unser Kunde, kann jedoch entsprechend § 645 Abs. 1 Satz 1 BGB dem Unternehmer oder seinen Erfüllungsgehilfen sogenannte werk-/objektbezogene Anweisungen für die Werkserstellung erteilen. Gleiches gilt bei Dienstverträgen. Ein weiterer Vorteil liegt in der flexiblen Skalierung: Bei unseren Services werden keine dedizierten Mitarbeiter verliehen, sondern ganze Teams. Je nach Thema und Dringlichkeit können also weitere Mitarbeiter hinzugezogen werden. Dies sichert eine qualitativ hochwerte Erfüllung. Getreu dem Motto: „Die Richtige für das richtige Problem.“ sorgen wir für das entsprechende Know-how und dessen Verfügbarkeit. Managed Services stellen also tatsächlich Services dar, die wir dem Kunden anbieten und kein Verleihen von Mitarbeitern. **Kategorien:** Tools & Methoden --- ### [Leb wohl RAC! Hochverfügbarkeit in der Oracle 19c SE2](https://thecattlecrew.net/2019/07/03/leb-wohl-rac-hochverfuegbarkeit-in-der-oracle-19c-se2/) **Published:** Juli 3, 2019 **Author:** Rainier Kaczmarczyk **Content:** Mit Version 19c hat Oracle die Real Application Cluster (RAC) Option aus der Standard Edition 2 genommen. Ein solches Vorgehen hatte sich im Vorfeld bereits angekündigt, da mit der Standard Edition 2 die Anzahl der erlaubten Threads pro Knoten auf 8 beschränkt wurde. Damit war ein 2-Knoten-RAC-System, bedingt durch den verwaltungstechnischen Overhead, bereits weniger leistungsfähig als ein vergleichbares Single Instance System, das auf 16 Threads limitiert ist. Viele Anwender setzten in der Vergangenheit, wenn es um Hochverfügbarkeit ging, genau auf den Einsatzes der RAC Option. Für die Zukunft entfällt diese Möglichkeit ersatzlos. Oracle bietet, im Gegensatz zu Dataguard in der Enterprise Edition, in der Standard Edition 2 keinerlei auch nur annähernd ähnliche Option an. Was nun? Da der Anwender auf interne Mechanismen, die Dataguard verwendet, nicht zugreifen kann bzw. darf, bleibt nur die altbewährte Methode: die Verwendung eines Standby Systems, basierend auf der Oracle Backup/Recovery-Technologie. Eine solche Implementierung wird als physikalische Replikation bezeichnet. Ein solches System kann durch selbstgeschriebene Skripte realisiert werden. Der Aufwand steht in keinem Verhältnis zum Nutzen. Ein Partner von uns bietet ein Produkt an, das genau in diese Bedarfslücke passt und mit dem ich in diesem Umfeld schon sehr gute Erfahrungen machen durfte. Dbvisit Standby ist eine einfach zu bedienende Lösung , um eine effiziente und zuverlässige Hochverfügbarkeit in der Oracle Standard Edition 2 abzubilden. Zudem kann Dbvisit Standby, im Gegensatz zu einem RAC System, sowohl über weite Entfernungen, als auch ganz oder teilweise als hybride Lösung in der Cloud implementiert werden. Mit Dbvisit Standby kann mittels eines sog. Switchover vom Primärsystem auf das Standbysystem innerhalb weniger Minuten ohne Datenverlust umgeschaltet werden. Es erfolgt ein Rollentausch beider Systeme. Im Katastrophenfall, d. h. falls das Primärsystem durch äußere Einflüsse oder auf Grund von Hard- bzw. Softwareproblemen nicht mehr verfügbar sein sollte, kann durch das Aktivieren des „überlebenden“ Standby Systems ein Weiterbetrieb der Datenbank mit einem geringen Datenverlust (in der Regel weniger als 5 Minuten) gewährleistet werden. Wenn in Oracle 19c Standard Edition 2 eine Hochverfügbarkeit weiterhin gewährleistet werden soll, ist Dbvisit Standby eine einfache und kostengünstige Lösung. Falls Sie Interesse an einer Demo oder eine testweisen Implementation von Dbvisit Standby haben, kommen Sie gerne auf mich zu. **Kategorien:** Infrastructure **Schlagwörter:** Hochverfügbar, oracle --- ### [Catastrophic slow backup/restore to Oracle Cloud Infrastructure Object Storage and its fix](https://thecattlecrew.net/2020/08/28/catastrophic-slow-backup-restore-to-oci-object-storage-and-its-fix/) **Published:** August 28, 2020 **Author:** Bartlomiej Sowa **Content:** I used Oracle Zero Downtime Migration Tool to move some databases from OnPrem Exadata to a freshly instantiated OCI Exadata Cloud Service (Quarter Rack to be more precise). I found out then, that the speed and performance of backup and restore to OCI Object Store was more than catastrophical. Instead of advertised ~2,5h for a 5 TB big database over 8 channels, the restore took… more than 20 hours! The backup was not as fast due to connection speed limit, but I assumed that at least within OCI, the restore should run as advertised in [Oracle Cloud Infrastructure Exadata Backup & Restore Best Practices using Cloud Object Storage](https://www.oracle.com/technetwork/database/availability/oci-exa-br-bp-objectstore-5573845.pdf). I was really astonished when I saw that. I opened an SR of course, but after more than 20 days of ping-pong with Oracle eventually found the reason myself. You see – ZDM comes with the libopc.so in version 19.0.0.1. This is exactly the same version that is included in every ORACLE\_HOME in lib subdirectory. You can easily get the version string with following command: ``` [zdm@zdm lib]$ strings libopc.so.original | grep -Po 'DNZ_REL_VER=".*?"' | head -1 DNZ_REL_VER="19.0.0.0.0-Production" ``` On the ExaCS I found, that even for 19.7 database home, the `libopc.so` that is used for automatic backup and bkup\_api is actually an older version, the 12.2.0.1, and it is located under `/var/opt/oracle/dbaas_acfs//opc/libopc.so` ``` [oracle@exa1-node1 ~]$ strings /var/opt/oracle/dbaas_acfs//opc/libopc.so | grep -Po 'DNZ_REL_VER=".*?"' | head -1 DNZ_REL_VER="12.2.0.1.0-Production" ``` I tested both with RMAN running a backup. For that I used a slightly modified SQL (thanks to Mariami Kupatadze) [Script](https://dba010.com/2017/01/17/rman-displaying-current-backup-progress/): ``` select recid  , output_device_type  , dbsize_mbytes  , input_bytes/1024/1024 input_mbytes  , output_bytes/1024/1024 output_mbytes  , (output_bytes/input_bytes*100) compression  , (mbytes_processed/dbsize_mbytes*100) complete ,  to_char(start_time ,'DD-MON-YYYY HH24:MI:SS') started  , to_char(start_time + (sysdate-start_time)/(mbytes_processed/dbsize_mbytes),'DD-MON-YYYY HH24:MI:SS') est_complete  from v$rman_status rs  , (select sum(bytes)/1024/1024 dbsize_mbytes from v$datafile)  where status like 'RUNNING%'  and output_device_type is not null; ``` The results for a 5TB big database were astonishing. First the 12.2.0.1 lib version: ```     RECID      OUTPUT_DEVICE_TYP DBSIZE_MBYTES INPUT_MBYTES OUTPUT_MBYTES COMPRESSION COMPLETE   STARTED                       EST_COMPLETE ---------- ----------------- ------------- ------------ ------------- ----------- ---------- ----------------------------- -----------------------------      8197       SBT_TAPE             4911385.78   162145.547      60951.75  37.5907641 3.30142152 28-AUG-2020 10:08:18          28-AUG-2020 12:37:14 ``` (scroll right and look at STARTED and EST\_COMPLETE). I aborted the backup after few moments as it was already at 3%. Then I started again the same full database backup, but this time with the 19.x version of libopc.so. I had to wait multiple minutes to get to 0.7% to have at least some kind of representative estimation. And there it is: ```      RECID OUTPUT_DEVICE_TYP DBSIZE_MBYTES INPUT_MBYTES OUTPUT_MBYTES COMPRESSION   COMPLETE STARTED                       EST_COMPLETE---------- ----------------- ------------- ------------ ------------- ----------- ---------- ----------------------------- -----------------------------      8201 SBT_TAPE             4911385.78   35671.0469       13269.5  37.1996371 .726292913 28-AUG-2020 10:17:34          29-AUG-2020 07:17:23 ``` So, there you have it. 2,5 hours versus nearly 21 hours. Both over 8 Channels, both within OCI, same bucket, same Database, same Exadata. Ps. Both libraries seem to consume really a lot CPU, so consider this choosing the number of channels. 19.x version uses 100% CPU for each channel thread. The 12 Version showed around 70-90% CPU for each channel. So see, that you have enough free CPUs in your Exadata Node to run given number of channels. **Kategorien:** Cloud, Infrastructure **Schlagwörter:** backup, cloud, ExaCS, Exadata Cloud Service, libopc.so, low, OCI, oracle, Performance, rman, slow, ZDM, Zero Downtime Migration --- ### [Manually catalog backup pieces in Oracle Object Storage (OSB)](https://thecattlecrew.net/2020/10/06/manually-catalog-backup-pieces-in-oracle-object-storage-osb/) **Published:** Oktober 6, 2020 **Author:** Bartlomiej Sowa **Content:** Typically, when working Oracle Secure Backup / libopc you should in general have an RMAN Catalog. Just to be on the safe side. But what if you do not have it and would like to just catalog all backups in OSS Bucket as you could do with CATALOG START WITH? It is not possible to do CATALOG START WITH for the device SBT\_TAPE. But there is hope – oracle allows you to do „CATALOG DEVICE\_TYPE ’sbt\_tape‘ BACKUPPIECE ‚xxxx'“ – you „just“ need to know the names of all backup pieces… Luckilly the repository structure is not as complicated as one could think and it is pretty simple to get all piece names out of Oracle Object Storage (OSS) in a script-friendly matter. You would need to have the OCI Commandline tool configured (~/.oci/config – see [docs](https://docs.cloud.oracle.com/en-us/iaas/Content/API/SDKDocs/cliinstall.htm)) and [jq](https://stedolan.github.io/jq/) installed. with configured oci cli, just enter the following command as one line: ``` oci os object list --all -bn | jq -r '.data[].name|select(test("sbt_catalog.*"))|split("/")[1]|("catalog device type '\''sbt_tape'\'' backuppiece '\''"+.+"'\'';")' > catalog-backup.sql ``` Then feed the generated script into RMAN, ideally inside a run block (for performance). Works fastest with PARALLELISM on SBT\_TAPE configured to 1. ``` rman target / RMAN> RUN { @catalog-backup.sql } ... RMAN> list backup summary; ``` It should be easily possible to adjust the JQ code to work with AWS S3 Object Store and OSB module. **Kategorien:** Cloud, Infrastructure **Schlagwörter:** backuppiece, catalog, cloud, libopc, OCI, oracle, Oracle Cloud, oracle secure bacup, OSB, rman, sbt_tape --- ### [Dbvisit Standby Version 10 ist da!](https://thecattlecrew.net/2021/01/22/dbvisit-standby-version-10-ist-da/) **Published:** Januar 22, 2021 **Author:** Rainier Kaczmarczyk **Content:** ![Dbvisit Standby v10](https://thecattlecrew.net/wp-content/uploads/2022/07/Dbvisit20Standby20v10.png) Auch wenn schon für Dezember letzten Jahres angekündigt, hat die neue Version von Dbvisit Standby nun im Januar „das Licht der Welt“ erblickt. Warum so spät? Ich denke, dass sich die Mütter und Väter dieser Version nicht drängen haben lassen wollen. Qualität geht vor. Erste Tests bestätigen das. Was ist herausgekommen? Eine würdige Nachfolge von Version 9! Was ist neu? Neben vielen anderen, zwei wichtige neue Funktionen! - Vollständige Unterstützung der Pluggable Database mit bis zu drei Datenbanken in der Oracle Standard Edition. - Möglichkeit, die Standby Datenbank als Reporting Datenbank (Dbvisit Snapshots Option) nutzen zu können. Bisher konnte man die Standby Datenbank zu „nichts“ gebrauchen. Sie war da, kostete nur Geld in Form von Strom, Hardware und Lizenzen. Zumindest bot sie Sicherheit. Mit der Snapshot Option ist das anders. Und die kostet nichts extra. Sie ist Teil der Lizenz. Wie funktioniert das ganze? Wie der Name schon sagt, basiert das ganze Konzept auf der Basis von (Linux) Snapshots. Daher, leider, gibt es diese Funktion nur auf Linux basierenden Systemen. Jedenfalls derzeit. Es wird in einem selbst zu definierenden Intervall ein Snapshot der existierenden Standby Datenbank erzeugt (read-only). Es kann auch ein zweiter oder dritter Snapshot gezogen werden (diese werden in einem „round-robin“ Verfahren ständig neu erzeugt). Man könnte die Dbvisit Snapshot Option auch als das kleine Pendant von Oracle Active Data Guard bezeichnen. Damit kann die Standby Datenbank für Test- und Berichtszwecke oder ähnliches verwendet werden. Neugierig? Für Rückfragen und Kommentare bin ich immer offen! Rainier Kaczmarczyk PS: OPITZ CONSULTING ist mit Stand heute (22.01.2021) (www.dbvisit.com) der einzige zertifizierte Partner für die Snapshot Option in Deutschland. **Kategorien:** Infrastructure **Schlagwörter:** datenbank, Dbvisit, Hochverfügbarkeit --- ### [Dbvisit Standby MP: Von der Evolution zur Revolution](https://thecattlecrew.net/2022/02/03/dbvisit-standby-mp-von-der-evolution-zur-revolution/) **Published:** Februar 3, 2022 **Author:** Rainier Kaczmarczyk **Content:** Die Evolution: Dbvisit Standby steht seit über 15 Jahren für die Hochverfügbarkeit von Oracle Datenbanken (vor allem Standard Edition). Das Produkt ist mehr als ausgereift. Das ist die Evolution. Die Revolution: Dbvisit Standby MP — Die MultiPlatform! Nicht mehr nur Oracle als Datenbank wird unterstützt, sondern neu ist der Support für Microsoft SQL Server. In einer integrierten Weboberfläche können in Zukunft sowohl Oracle, als auch SQL Server in Punkto Hochverfügbarkeit administriert werden. MultiPlatform bedeutet „mehr als Eins“. Weitere Datenbanken werden folgen! Kenner der Szene ahnen schon welche. Eine Testversion kann unter www.dbvisit.com heruntergeladen werden. Kommentare und auch Rückfragen: Gerne. **Kategorien:** Infrastructure, Tools & Methoden **Schlagwörter:** Dbvisit, Hochverfügbarkeit, oracle, SQL Server, Standby --- ### [Published CattleCrew Case Management UI](https://thecattlecrew.net/2017/02/23/published-cattlecrew-case-management-ui/) **Published:** Februar 23, 2017 **Author:** Halil Hancioglu **Excerpt:** As a result of our case management experience, we recently released a self-developed case management UI on GitHub to get a better introduction to case management and CMMN 1.1. **Content:** As a result of our case management experience, we recently released a self-developed case management UI on GitHub to get a better introduction to case management and CMMN 1.1. ![Intro](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-intro.png) In addition to the traditional process and rules management, Case Management has established itself as the third standard in the BPM standard Toolkit. Case management is particularly suitable for dynamic business processes, which have a high variance in execution. What BPMN represents for traditional process models is the CMMN standard for case management. The CattleCrew Case Management UI has emerged from the idea of providing an easy introduction to the topic with tool support. We decided for a UI because during our first attempts we noticed that an optimized user interface is a central element for case management. In order to promote the topic with the help of the community, we have published it on GitHub. # **Try it out** After following the [instructions](https://github.com/opitzconsulting/cattlecrew-case-management-ui#try-it-out) on GitHub and invoking the user interface, the overview page opens. By selecting a case you get to the detailed view. ![cccmui-dashboard](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-dashboard.png)Dashboard In the detail view, all the context informations about the current case are displayed in four columns to support the knowledge worker with required information. This includes case“™s history, information from comparable or related cases, and existing documents. In the first column of the left the navigation search functionality for similar or related cases is placed. Below all the associated documents are displayed. In the second column from the left, relevant context information are listed. In the third column you can see the status of the case and what happened so far. The right column shows the activities that can be executed or are currently being processed. ![cccmui-casedetails](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-casedetails.png)Case Details Behind the second tab, the rendered case model is displayed. ![cccmui-casemodel](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-casemodel.png)Case Model Behind the third tab, DMN tables with the input and output parameters are displayed . In the current version, these are displayed only if a BPMN process was started from the case that references a DMN table. ![cccmui-casedetailsdecisionhistory](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-casedetailsdecisionhistory.png)Decision History The fourth tab shows the data you’ve determined and is especially useful for the developer. ![cccmui-casedetailsrawdata](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-casedetailsrawdata.png)Raw Case Data By selecting the „New Case“ button in the main navigation, a new case can be started. ![cccmui-newcase](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-newcase.png)New Case All existing cases in the process engine are listed. After the selection of a case a business key and process variables can be added. ![cccmui-newcasewithvariable](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-newcasewithvariable.png)New Case with Process Variables As soon as a case has been started, you will be directed to the overview page, where the newly started case is also visible. ## **Used process engine** The project requires the Camunda BPM Process Engine. Camunda BPM is one of the first software vendorsthat has integrated CMMN 1.1 into their process engine and also provides a corresponding modeller. Since Camunda 7.6, the „CMMN Monitoring“ feature is also included in the Enterprise version. CattleCrew Case Management UI is flexible designed so that the engine specific implementation can be replaced by another to test the UI with other process engines. In the following figure, the layers are shown in an abstract manner. ![cccmui-architectureoverview](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-architectureoverview.png)Technical Birdview The project can be found on GitHub at . There is also an installation manual. The QR code is ![QR-Code](https://thecattlecrew.net/wp-content/uploads/2017/02/cccmui-qrcode.png?w=150)QR-Code Of course, you are invited to participate to this project, too. If you are interested, please contact us. Have fun on experimenting with case management and CMMN! Feedback is always welcome 😉 **Kategorien:** Architecture & Process Models, Development **Schlagwörter:** ACM, BPM, Camunda, Integration, Modern Clients, Web Developement --- ### [Angular: Release of version 4](https://thecattlecrew.net/2017/07/11/angular-release-of-version-4/) **Published:** Juli 11, 2017 **Author:** pascalmhumbert **Content:** When Angular version 4 was released in March 2017, people wondered „What has happened to version 3?“ And another question of particular concern for (us) developers was „What is new in Angular version 4?“ In this article we address these questions. ## Semantic versioning In order to answer the first question why Angular version 3 has been omitted let us take a look at the versioning convention adopted by the Angular development team. According to Igor Minar in the [opening keynote for version 4](https://www.youtube.com/watch?v=aJIMoLgqU_o), the Angular team uses *semantic versioning* for their releases. By means of the illustration shown in Fig. 1, we explain in the following how this system works. ![ng-semantic_versioning](https://thecattlecrew.net/wp-content/uploads/2017/06/ng-semantic_versioning.png)**Fig. 1:** Example of semantic versioning for Angular releases. Release cycles are indicated.The version specification consists of three numbers: one for major versions, one for minor versions and, lastly, one for patches. A patch is supposed to introduce no new features or breaking changes to Angular. A minor version change can feature new functionalities but no breaking changes. A major version release typically entails new features and potentially breaking changes. As indicated by Fig. 1, new patches are released every week, minor versions every month and major versions every half year. The reason for skipping version 3 is quite subtle. While all but one Angular module were still at major version number 2, the routing module had already advanced to version 3. Eventually, the Angular team desired to have consistent version numbers for all modules. Hence, when the next major release was due, all modules jumped to version 4. Thus, Angular version 3 was omitted. Also, the development team decided to suppress the version number in the name (as it is going to change every half year, anyway,) and just call the framework „Angular“. ## New features in version 4 In this part we talk about what is new in Angular version 4. Note that we do not discuss passive changes like the enhanced performance of the angular-cli or the better compression rate for the distributed app. Instead we demonstrate the appliance of three new features in version 4. These are the new \*ngIf, the new possibility to introduce local variables via the *as* keyword and the email validator. ### The new \*ngIf Since version 4 the *\*ngIf* statement can be extended by a *then* and an *else* statement, both optional. To see how the new \*ngIf works, first, let us take a look at Listing 1 below. \[code language=“html“ firstline=“1″\] This text is only visible if the condition is *true*. This text is only visible if the condition is *false*. \[/code\]**Listing 1:** Example of how the \*ngIf statement used to be formulated in version 2. Consider that in an Angular component we have a boolean *condition*. In our app we want to display different content depending on whether the condition evaluates to *true* or *false*. As shown in Listing 1, in version 2 this was realized by having two separate DOM elements, one checking for *condition* and the other for *!condition* — but wait, this feels a little clumsy. If we test *condition* in line 1 why do we have to repeat this step in line 5 again? Now, since version 4, we can solve this in a more elegant way as illustrated in Listing 2. The html code snippet shown there does the same as the one in Listing 1, only it extends the \*ngIf statement with an else statement to get the result we want. In this example the *elseBlock* defines which content is to be displayed if the condition evaluates to *false*. Note that this content must be encapsulated in an *ng-template* element. In line 5 we also register this element as „elseBlock“ in the DOM (via #elseBlock). Interestingly, the angular-cli does not care *where* the elseBlock is declared in the html. Instead the element with the \*ngIf expression serves as an outlet for the conditional content. \[code language=“html“ firstline=“1″\] This text is only visible if the condition is *true*. This text is only visible if the condition is *false*. \[/code\]**Listing 2:** Example of an \*ngIf-else statement featured since version 4. Finally, in Listing 3, we show an example of an if-then-else statement. In addition to the elseBlock we had before, we now also include a thenBlock. This block is displayed if the condition evaluates to *true*. It is apparent that the thenBlock works in a similar way as the elseBlock. However, it is important to notice that, if a then statement is included into the \*ngIf expression, the content of the element attached to the \*ngIf is completely ignored (as statet in line 2 of Listing 3). \[code language=“html“ firstline=“1″\] This part is completely ignored, now. This text is only visible if the condition is *true*. This text is only visible if the condition is *false*. \[/code\]**Listing 3:** Example of an \*ngIf-then-else statement featured since version 4. Let us summarize what we have learned in this section. With the new \*ngIf we can handle the evaluation of a boolean expression in only one line (cf. Listing 3, line 1). This element is used as outlet for the conditional content. By means of (optional) then and else blocks, which need be embedded in ng-template elements, we can keep our DOM tidy and well organized. ### Create local variables with the *as* keyword Another new feature is the possibility to define a local variable using the *as* keyword. In the example in Listing 4 we label the *index* parameter inherent to \*ngFor *as idx* and insert it in the subsequent line with one-way data binding. The *as* keyword is also quite useful to relabel (lengthy) variable names in order to make our html code cleaner. Another nice application of the *as* keyword in combination with asynchronous data loading is described in [this article](https://juristr.com/blog/2017/06/new-enhanced-ngIf-and-ngFor/). \[code language=“html“ firstline=“1″\] {{idx}}. {{item}} \[/code\]**Listing 4:** Example of an appliance of the *as* keyword featured since version 4. ### The new email validator In many forms an email address is required. Formerly, validity of the address needed be checked against a manually written regex. Since version 4 we can now use the email validator as illustrated in Listing 5 (the validator is the last occurrence of the word „email“). Validating an email address never has been that easy! \[code language=“html“ firstline=“1″\] \[/code\]**Listing 5:** The new email validator featured since version 4.## Conclusion Angular version 4 has brought a lot of improvement in terms of performance of the framework. Many new features like the new \*ngIf, the *as* keyword and the email validator discussed in this article have been introduced to make our life as programmers easier and to help us to keep our code cleaner. With major version releases every six months we are looking forward for many new features yet to come. **Kategorien:** Development **Schlagwörter:** Angular --- ### [React vs. Angular - When to Choose Which?](https://thecattlecrew.net/2017/11/01/react-vs-angular-when-to-choose-which/) **Published:** November 1, 2017 **Author:** Stephan Rauh **Content:** A couple of days ago, Marius Hofmeister and I held a talk about „Angular vs. React“ at the International JavaScript conference iJS at Munich. Which one is better, Angular or React? Truth to tell, we can’t answer the question. Actually, it’s the wrong question, anyway. The real question is „Which one is better for my project?“ ## It depends! Because that’s what we found out during our investigation: During the last couple of years, Angular and React have learned a lot from each other. Each team is watching the progress of the other team. Good ideas tend to be adopted by the other team after a while, provided they match the general philosophy of the framework. So we came to believe you can do anything with either framework. We’ve collected a couple of technical criteria helping you choose the right tool for the job. But you should base your decision on technical considerations alone. ## Take performance, for example For instance, we’ve been frequently asked about performance. Raw speed seems to be an important topic to JavaScript developers. The answer of React.js is: „We’re the fast ones“, and I’m tempted to believe them. On the other hand, the Angular answer is „We’re fast enough. Plus, we’re rapidly catching up!“ That matches my personal experience, too. Granted, there are use cases requiring as much performance as you can get. But these are corner cases. More often than not, being fast enough is all you need. ## Ask your team! Cutting a long story short, we identified a couple of technical considerations you should take in mind. But there are more important topics. I’ve never seen a project failing because of technical problems. But I’ve seen a lot of projects failing because of human factors. So you should ask your team. If your team members have a lot of experience with JavaScript, choose React. If they prefer functional programming over object-oriented programming, choose React. If you’ve got a large web page containing lots of interactive elements, each interacting with each other, choose React. On the other hand, if you’re coming from a Java or C# background, choose Angular. If you’re working for a big enterprise, developing an application consisting of hundreds of forms, you’ll prefer Angular. If you feel familiar with TypeScript after an hour, choose Angular. ## Wrapping it up You get the idea. Most discussions in the blogosphere are sort of misleading. They concentrate on their pet topics: „I hate TypeScript!“ or „I need performance!“. Take them with a grain of salt. Maybe the [slides of our talk](https://www.beyondjava.net/blog/images/slides/Angular-vs-React-Rauh-Hofmeister-IJS.pdf) help you. Plus, you may be interested in [our interview with Jaxenter.com](https://jaxenter.com/angular-5-vs-react-interview-138469.html). It provides you with some additional information neither this article nor our slides cover. There’s also [my previous article comparing Angular with React](https://www.beyondjava.net/blog/ui-roundup-2017-angular-vs-react/) on BeyondJava.net. Not that I’ve published the article during our research phase, so I’m sure it has a couple of issues. Even so, it contains some additional info that didn’t make it into the final slides. **Kategorien:** Development **Schlagwörter:** JavaScript --- ### [GraphQL Demo (3/8) - Dataloader und Batching](https://thecattlecrew.net/2018/08/30/dataloader-und-batching/) **Published:** August 30, 2018 **Author:** Manuel Styrsky **Content:** Der Dataloader stellt Batching und Caching zur Verfügung. Entwickelt wurde er von Facebook. Wir haben ihn für das Batching eingesetzt, so werden nun verschiedene Anfragen, die mit den Chatnachrichten laden, zu einer Anfrage zusammenführt, die dann an die Datenbank gestellt wird. Die geladenen Daten werden im Dataloader gecacht und können später ohne Datenbankzugriff geladen werden. ### **Lizenzierung** Der Dataloader darf kostenfrei verwendet werden, sofern man die Copyright-Notiz von Facebook beibehält und für Facebook durch die Verwendung keinerlei Schaden entsteht. Genaueres [hier](https://github.com/facebook/dataloader/blob/master/LICENSE). ### **Wie man den Dataloader einsetzt** Wir haben unsere Beispielanwendung in TypeScript geschrieben. Demnach sind auch folgende Codefragmente in TypeScript gehalten. 1. Vorausetzungen: Der Dataloader setzt derzeit eine JavaScript-Umgebung voraus, welche die Features von globalen ES6-Promises- und Map-Klassen unterstützt. 2. Den Dataloader im Projekt installieren: > npm install –save dataloader 3. Dataloader in der Klasse verfügbar machen: > let DataLoader = require (‚dataloader‘); 4. Jeder Batch benötigt einen eigenen Dataloader. Ein Dataloader bekommt als Argument eine Funktion, die die entsprechenden Schlüssel über die Batch-Funktion auf die Ergebnisse mappt: > let messageLoaderForUsers = new DataLoader((ids:any) => > batchMessagesUser(ids)); 5. Der Kern liegt in der Batch-Funktion. Sie bekommt mehrere IDs und lädt diese alle auf einmal aus einer Datenbank oder anderen Datenquelle. Sie gibt ein Dictionary zurück, welches als Schlüssel die ID und als Value die geladenen Daten liefert: > async function batchMessagesUser(ids: number\[\]) { > //Messeges from the given authors are filtered > let messages = await Message.findAll({ > attributes: \[‚id‘, ‚authorId‘\], > where: {authorId: { $in: ids }} > }); > > //messages are grouped by author > const groupedMessages = \_.groupBy(messages, „authorId“); > > //We return an array with the IDs as key and the message as value > return ids.map(key => groupedMessages\[key\] || \[\]); > } 6. Wenn die Daten nun abgefragt werden sollen, muss nur noch die Load-Funktion vom Dataloader aufgerufen werden, welche ein Promise zurückgibt: > messageLoaderUser.load(authorID) ### **Herausforderungen beim Dataloader** Der Dataloader stellt nativ keine Unterstützung zur Pagnation zur Verfügung. In einem solchen Fall werden bei jeder Anfrage alle Tabelleneinträge zurückgegeben und die ganze Datenbank abgefragt. Um dieses Problem zu lösen, gibt es zwei Möglichkeiten. Zum einen könnte man ein verschachteltes rekursives Union-All-SQL-Statement bauen, das die angefragten Daten bis zum übergebenen Limit zurück gibt und der Map-Funktion übergibt. Dazu muss aber der batch-Funktion die Pagnation übergeben werden und für jeden Offset und jedes Limit der Pagnation existiert dann ein eigener Batch. Die andere Möglichkeit wäre zunächst alle IDs und Fremdschlüssel über den Dataloader aus der Datenbank laden, auf diese dann die Pagnation ansetzt und anschließend die Datensätze zu den entsprechenden IDs sich über den Dataloader holt (1-1 Beziehung). Das reduziert die aus der Datenbank zu ladenden Daten, im Vergleich dazu, dass alle Felder zu allen Datensätzen geladen werden. Jedoch werden immer noch von allen Einträgen die IDs und Fremdschlüssel geladen, was bei großen Tabellen problematisch wird. > //Loading MessagesInfos (id and authorId) from DataLoader > let messageInfos = await messageLoaderForUsers.load(this.getId()); > if (!offset) {offset = 0;} > > //Pagination and extracting the Ids of the messageInfos > messageInfos = messageInfos.slice(offset, (offset + limit)); > let messageIds = messageInfos.map((message: any) => message.id); > > //Loading the full messages > let results = await messageLoader.loadMany(messageIds); > results = results.map((result: any) => result\[0\]); > > return results; Für jeden Anfragetyp muss ein eigener Dataloader mit entsprechender Batch-Funktion implementiert werden. Zusätzlich muss auch für jede Anfrage, oder zumindest für jeden User, ein eigener Dataloader erstellt werden, um Zugriffe über die Caches der Dataloader auf die Daten anderer Nutzer zu verhindern. Das Problem kann aber durch den Einsatz von entsprechenden Factory-Methoden sehr einfach gelöst werden. ### **Zusammenfassung:** Insgesamt lässt sich sagen, dass der Dataloader vor allem beim Batchen von einzelnen Fremdtypen bzw. 1:1-Beziehungen viel bringt (bis zu Faktor 20 schneller). Bei Listen bzw. 1-n-Beziehungen war der Performance-Vorteil mit eineinhalb bis doppelter Durchsatzrate eher mäßig. Dies würde aber höher ausfallen, wenn Datenbank und Server nicht auf der selben Maschine laufen würden und die RTT (Round Trip Time) höher wäre. Der Dataloader vermindert zusätzlich noch die im Cache der Apollo Engine zu speichernde Datenmenge, da er nur die Attribute zurückgibt, die angefordert werden und nicht der ganze Datensatz im Cache gespeichert wird. Das hat allerdings den Nachteil, dass bei einer neuen Anfrage auf den gleichen Datensatz mit anderen Attributen kein Cache-Eintrag mehr vorhanden ist, da die Attribute nicht im Cache liegen. Problematisch ist aufgrund von Sicherheit, Zugriffskontrolle auch, dass der Dataloader Daten für immer speichert und das kontextunabhängig. Die Kontextunabhänigkeit führt zusätzlich dazu, dass kontextabhängige Daten zu einem späteren Zeitpunkt abhängig vom Kontext, der zur Zeit der Speicherung geherrscht hat, zurückgegeben wird. ### **Anhang „“ Testergebnisse** Wir haben mit unserem Server Loadtesting durchgeführt. Dazu haben wir mit dem Tool JMeter unterschiedlich viele Wiederholungen der selben Anfragen an unseren Server geschickt. Folgende Aspekte haben wir dabei beachtet: - Query: Die Query, die an den Server gestellt wurde - Komplexität Die maximale Anzahl der Knoten, die zurückgegeben werden können - Threads: Die Anzahl der parallelen Anfragen an den Server - Wdhs: Die Anzahl, der Wiederholungen der parallelen Threads - Abgeschlossene Proben: Die Anzahl der Anfragen, die insgesamt während dem Test an den Server geschickt wurden - Durchsatz: Die Anzahl der bearbeiteten Anfragen pro Sekunde - Caching: Gibt an, ob Caching im Server aktiviert war - Dataloader: Gibt an, ob der Dataloader aktiv war - Production Mode: Gibt an, ob der Server im Production Mode gelaufen ist. In der folgenden Tabelle haben wir unsere Testergebnisse dokumentiert: [LoadTest – QraphQL](https://thecattlecrew.net/wp-content/uploads/2018/09/loadtest-qraphql.xlsx "LoadTest - QraphQL") **Kategorien:** Development, Integration **Schlagwörter:** Endpoints, Facebook, GraphQL, Innovation, Internet, JavaScript, Mobile, OC|Lab, rest, TypeScript --- ### [GraphQL Demo (4/8) - Response Caching](https://thecattlecrew.net/2018/09/06/response-caching/) **Published:** September 6, 2018 **Author:** Manuel Styrsky **Content:** Die Apollo Engine stellt eine einfache Möglichkeit zum Response Caching zur Verfügung. Dabei können ganze GraphQL Query Antworten oder auch nur einzelne Felder gecached werden. ### **Warum Caching und was ist das Besondere dabei mit GraphQL?** Caching ist bei GraphQL etwas schwieriger als bei REST-Schnittstellen, da nicht wie beim HTTP oder Netzwerk Caching, Daten zum Beispiel über die URL gecached werden können. Dennoch ist Caching bei Datenbankanwendung, wie in unserem Beispiel, das A&O um schnelle Antwortzeiten zu erlangen. Daher muss Caching bei GraphQL die Queries selber bewerten und Antworten im Cache speichern. Genau das liefert Apollo Engine mit. ### **Wie aktiviere ich den Cache?** Die einzigen Schritte, die dazu gemacht werden müssen, sind das Caching in den Serveroptionen zu aktivieren und die Cache Hints zu setzen. 1. Caching in den Serveroptionen aktivieren: Sowohl *tracing* als auch *cacheControl* müssen auf *true* gesetzt werden. *CacheControl* kann optional auch ein Defaultobjekt übergeben werden, in dem das defaultMaxAge gesetzt wird.> resolve({ schema, > **tracing: true,** > cacheControl: {** > defaultMaxAge: 10,** > },** > context > }); 2. Cache Hints setzen Man kann Cache Hints an zwei verschiedenen Stellen setzen. Entweder direkt im *resolver* oder im *Schema*. Im *Schema* können sowohl ganzen Typen, als auch einzelnen Feldern Cache Hints gegeben werden. Cache Hints bestehen aus zwei Parametern. Dem *maxAge*, welcher angibt, wie lange die Daten maximal gecached werden sollen. Und dem *scope*, dieser kann entweder private oder public sein. Private gecachete Daten sind dann nur in der entsprechenden Session eines bestimmten Clients verfügbar. Der default Wert ist public, die so gecacheten Daten können von allen Clients abgerufen werden. Kürzere *maxAge* Angaben überladen längere in anderen Ebenen (Typen/Felder). Genau dasselbe gilt für private und public beim *scope*.> type User **@cacheControl (maxAge: 120)** { > id: Int > name: String > phone: String > conversations(limit: Int!, offset: Int): \[Conversation\] > messages(limit: Int!, offset: Int): \[Message\] > isViewer: Boolean **@cacheControl (maxAge: 60, scope: private)** > } Würde jetzt hier eine Anfrage an die ID und den Namen der User gestellt werden würden die Daten 120 Sekunden im Public Scope gehalten. Im Gegensatz dazu würde eine Anfrage an das isViever Attribut und den Namen nur 60 Sekunden und auch im nur im Private Scope gehalten werden. 3. Optional können noch die Cache Optionen geändert werden Um private cachen zu können, muss dies auch bei der Konfiguration des Servers beachtet werden. Hierfür reichen die default-Werte nicht mehr aus. Hier für muss“¦ 1. „¦ *stores* mit einem extra Cache initialisiert werden 2. „¦ *sessionAuth* übergeben werden, wie die Session identifiziert wird (HTTP-Header oder Cookie) 3. … im *queryCache* dem *privateFullQueryStore* der zuvor extra angelegte Cache zugewiesen werden > const engine = new ApolloEngine({ > **stores: \[{** > **name: ‚privateResponseInMemoryCache‚** > **}\],** > **sessionAuth: {** > header: ‚authorization‚,** > **},** > **queryCache: {** > **privateFullQueryStore: ‚privateResponseInMemoryCache‚,** > //By not mentioning publicFullQueryStore, we keep it enabled > //with the default empty-string-named in-memory store. > **},** > „¦ > „¦ > }); ### **Wo werden die Daten gespeichert?** Es werden zwei Speichermöglichkeiten für den Cache unterstützt 1. *inMemory* (default) Der Cache liegt innerhalb des Engine Proxys, also auf dem eigenen Server und nutzt die LRU (Least recently used) Verdrängungstechnik. Dadurch, dass der Cache innerhalb eines bestimmten Engine Proxys liegt, kann der Cache zwischen verschiedenen Instanzen nicht gemeinsam genutzt werden ist dafür aber sehr schnell. Die Default Cachegröße liegt bei 50mb, kann aber geändert werden. 2. *Memcache* Memcache nutzt externe [Memcached](https://memcached.org/)„¯Server. Dadurch wird der Cache für mehrere Engine Proxies verfügbar ist aber langsamer als der *inMemory* Cache und liegt nicht mehr auf den eigenen Servern. ### **Ergebnisse bei unserer Demo-Anwendung und Zusammenfassung:** Das Response Caching bringt bei unserer Anwendung bei vielen identischen Anfragen einen Enormen Performance boost (je nach Anfrage: Faktor 20 bis zu 10³). Wichtig ist auch, die im Cache zu speichernde Datenmenge zu reduzieren. Hierbei, hat der Einsatz des [Dataloaders](https://thecattlecrew.net/2018/08/30/dataloader-und-batching) auch positive Nebeneffekte gehabt. Zusammenfassend lässt sagen, dass sich der Cache bei der Apollo Engine sehr leicht mit ein paar Zeilen Code aktivieren lässt und als Response-Cache auch einen deutlichen Performance Boost bei Identischen Anfragen bringt. ### **Anhang „“ Testergebnisse** Wir haben mit unserem Server Loadtesting durchgeführt. Dazu haben wir mit dem Tool JMeter unterschiedlich viele Wiederholungen der selben Anfragen an unseren Server geschickt. Folgende Aspekte haben wir dabei beachtet: - Query: Die Query, die an den Server gestellt wurde - Komplexität Die maximale Anzahl der Knoten, die zurückgegeben werden können - Threads: Die Anzahl der parallelen Anfragen an den Server - Wdhs: Die Anzahl, der Wiederholungen der parallelen Threads - Abgeschlossene Proben: Die Anzahl der Anfragen, die insgesamt während dem Test an den Server geschickt wurden - Durchsatz: Die Anzahl der bearbeiteten Anfragen pro Sekunde - Caching: Gibt an, ob Caching im Server aktiviert war - Dataloader: Gibt an, ob der Dataloader aktiv war - Production Mode: Gibt an, ob der Server im Production Mode gelaufen ist. In der folgenden Tabelle haben wir unsere Testergebnisse dokumentiert: [LoadTest – QraphQL](https://thecattlecrew.net/wp-content/uploads/2018/09/loadtest-qraphql.xlsx "LoadTest - QraphQL") **Kategorien:** Development, Integration **Schlagwörter:** ApolloEngine, Caching, Entpoints, GraphQL, Internet, OC|Lab --- ### [How to solve the 404 HTTP Error for Angular Apps hosted on S3](https://thecattlecrew.net/2018/10/15/how-to-solve-the-404-http-error-for-angular-apps-hosted-on-s3/) **Published:** Oktober 15, 2018 **Author:** Marco Buss **Content:** As described in this [blogpost](https://thecattlecrew.net/2018/10/12/how-to-use-cloudfront-to-serve-private-s3-bucket-as-website/), S3 is very suitable for serving a single Page Web Application. If your users always come through the index page to your site everything will be fine. You have an corresponding HTML file on S3 and your request will be handled like a charm. But it is really common to provide some functionality that is triggered by an HTML request, for example some confirmation links and that URL has no corresponding file in S3 because all the magic stuff is handled by the Angular Router. The result for such an Request is an 404 HTTP error. To solve that problem with our infrastructure, we must instrument CloudFront to handle the 404 HTTP error from S3. To do that we simply define some custom error Response. So go to the „Error Pages“ Tab for your CloudFront Distribution and create a new Custom Error Response. ![custom_error](https://thecattlecrew.net/wp-content/uploads/2018/10/custom_error.png) Now we configured the following. If our Origin (S3) returns a 404 Error CloudFront returns the index.html and the status code 200. With that configuration the content from our index.html is returned but the url itself will be unchanged and that is all to get the Angular Router to do his work. **Kategorien:** Development **Schlagwörter:** Angular, AngularJS, AWS, Frontend, Mobile, S3 --- ### [Personas und äußerst beliebte Designfallen in der Entwicklung von Softwareprodukten](https://thecattlecrew.net/2019/10/23/personas-und-aeusserst-beliebte-design-fallen-in-der-entwicklung-von-software-produkten/) **Published:** Oktober 23, 2019 **Author:** Andreas Lehner **Content:** Personas sind ein nützliches und grundlegendes Design-Werkzeug, um positive Benutzererfahrungen zu entwickeln. Personas unterstützen Produktteams dabei, bessere Design-Entscheidungen zu treffen. Die Basis von Personas ist tiefes Verständnis der Nutzer. Dieses Verständnis wird durch User Research gewonnen, analysiert und aufbereitet und als Nutzer-Archetyp (Persona) für die tägliche Arbeit am Produkt genutzt. Im Idealfall helfen Personas Design-Fallen von Software-Produktteams zu verhindern. Drei der beliebtesten Fallen beschreibe ich hier: # Falle 1: Self-Referential Design Was passiert, wenn wir als Produktteam Design-Entscheidungen treffen ohne die Nutzer zu verstehen? Wir projizieren unsere Ziele, Motivationen, Skills und mentale Modelle \[1\] auf das Produkt. Wir treffen Design-Entscheidungen ausschließlich für uns. Wir selbst verstehen unsere Anwendung sehr gut, weil sie auf unserem „Implementation Model“ \[2\] basiert. Alle anderen jedoch, also auch die Nutzer, verstehen die Anwendung im schlimmsten Fall nicht. Oft tappt man in diese Falle, wenn wir besonders „coole“ Apps bauen wollen (z.B. abgefahrene Animationen, verrückte Interaktionen, crazy AI, usw.) die nur wir als Ersteller verstehen, aber der Rest der Welt nicht. ![](https://thecattlecrew.net/wp-content/uploads/2019/12/Self-Referential.jpg) Personas helfen dabei, diese Falle zu umgehen, da die Persona im Team ein gemeinsames Verständnis über den Nutzer erzeugt. Dennoch kann auch unter Nutzung der Persona etwas geschwindelt werden. Besonders geschwindelt wird dann, wenn wir als Produkt-Team sogenannte „Geister“-Personas erstellen. # Falle 2: Geister-Personas Wir als Produkt-Team treffen Annahmen über die Nutzer. Beispielsweise treffen wir uns in einem Design-Thinking Workshop mit ein paar Stakeholdern, erstellen brav Empathy Maps, entwickeln daraus Persona-Profile, um Geschichten über die Nutzer zu erzählen. Exzellent. Wir verfügen über ein gemeinsames Verständnis über unsere Nutzer und haben eine gemeinsame Basis um Design-Entscheidungen zu treffen. Vorsicht! Wir glauben alles über die Nutzer zu wissen, doch wir haben noch keine unserer Annahmen validiert, etwa durch Daten aus qualitativer User Research. Auf diese Weise entstehen Geister-Personas, die uns durch die komplette Produktentwicklung hin verfolgen. Personas sollten daher immer auf zuverlässigen Daten beruhen. Sei es aus qualitativer Research oder quantitativer Research. UX Researcher sorgen mit entsprechenden Research-Methoden dafür, Sinn aus dem Datenchaos zu entwickeln. Starten wir mit Annahmen über unsere Nutzer, ist es von größter Bedeutung diese Annahmen mit „echten“ Daten zu validieren. ![](https://thecattlecrew.net/wp-content/uploads/2019/12/Ghost-persona.jpg) # Falle 3: Elastic User Wir als Produktteam beabsichtigen natürlich, dass wir mit unserem Produkt die Bedürfnisse der Nutzer befriedigen. Darüber herrscht Einigkeit, keine Frage. Jetzt ist es aber so, dass Timo ein anderes Verständnis über den Nutzer hat, als Freddy. Jedes Teammitglied hat ein unterschiedliches Konzept des Nutzers und seiner Bedürfnisse im Kopf. Kommt der Zeitpunkt Design-Entscheidungen zu treffen, entsteht der „Elastic User“. Am Elastic User wird gezogen und gezerrt, um die individuellen Konzepte bequem zu rechtfertigen und durchzusetzen. So wird aus einem Nutzer mal ein „Power-User“, der durch seine Erfahrung mit komplexen und überladenen Dialogen gut umgehen kann, manchmal wird er zum „First-Time“-User, der unbedingt Wizards benötigt, um seine Tasks in einem Workflow abzuschließen. Auf diese Weise gewinnen wir als Produktteam die Freiheit, zu machen was wir wollen, mit dem Nachteil die Bedürfnisse und Ziele der „echten“ Nutzer ignoriert zu haben. ![](https://thecattlecrew.net/wp-content/uploads/2019/12/Elastic-user.jpg) # Conclusio Personas helfen Produktteams bessere Design-Entscheidungen zu treffen. Dennoch fällt eine Persona nicht einfach vom Himmel, sondern sollte gewissenhaft und sorgfältig erstellt und am Leben erhalten werden. Ein guter Beginn ist es mit Annahmen zu Proto-Personas zu starten. Besser und unverzichtbar für gutes Persona-Gelingen ist es, die Annahmen zu validieren. Auf diese Weise entfalten Personas ihren größten Mehrwert und gängige Design-Fallen wie Elastic User, Geister-User oder Self-Referential-Design können erfolgreich umgangen werden. **Möchtest Du mehr erfahren über User Experience und Design Thinking?** **Kontaktiere uns und lass uns austauschen: https://www.opitz-consulting.com/portfolio/software-development/user-centered-development.html** # Spannende Links und Referenzen \[1\] \[2\] [http://www.jonkolko.com/projectFiles/scad/IACT315\_03\_MentalModelsPersonasScenarios.pdf](http://www.jonkolko.com/projectFiles/scad/IACT315_03_MentalModelsPersonasScenarios.pdf) **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Design Thinking, Empathy, Persona, user experience --- ### [Coloring rows in ClassicReports](https://thecattlecrew.net/2022/02/08/coloring-rows-in-classicreports/) **Published:** Februar 8, 2022 **Author:** Maik Michel **Content:** I often encounter the problem that I want to highlight a row of a Classic Report. Most of the time the logic here is based on the presence of a certain value or status. Every time I implement something like this, I start searching the good old web again. Here comes a new contribution to solve the problem „Coloring rows in ClassicReports“ 😉 Since it is common to separate CSS, i.e. the layout, from the logic, this is also the first choice. So you don’t just color a line by color code, but assign the right class at the right place. As far as classes are concerned, it will be easy to do that, as APEX provides us with 45 classes by default, together with the Universal Theme. [https://apex.oracle.com/pls/apex/apex\_pm/r/ut/color-and-status-modifiers](https://apex.oracle.com/pls/apex/apex_pm/r/ut/color-and-status-modifiers) First we include the CSS class in the query. Either you create the name of the class on the fly or you save it in the respective target table. Like this: ``` select phs_id, phs_name, phs_css_class from crm_phasen order by phs_sortierung, phs_name ``` Unfortunately, APEX does not offer any property by itself, where we can store the column containing the class information. Therefore, we will set this information to an already existing one. Like for example in name field. ``` #PHS_NAME# ``` [![](https://thecattlecrew.net/wp-content/uploads/2022/02/html_expression.png)](https://thecattlecrew.net/wp-content/uploads/2022/02/html_expression.png) Properties of report column Here, the class `row-class` serves me as a marker of the required information. The attribute data-class contains the class I selected. To attach the class `PHS\_CSS\_CLASS` to the line of a Classic Report some Javascript code must be executed after each query. This does nothing else than attaching the class to the appropriate `tr` tag. To do so, create a Dynamic Action on the report for the event: `AfterRefresh`. As action you choose the execution of Javascript code. ``` $('.row-class').each(function() { $(this).closest('tr').addClass($(this).attr('data-class')); }); ``` [![](https://thecattlecrew.net/wp-content/uploads/2022/02/da_execute_javascript.png)](https://thecattlecrew.net/wp-content/uploads/2022/02/da_execute_javascript.png) Properties of DynamicAction It is important to activate the switch for Fire on Initialization, so that the Javascript code is executed directly when the page is loaded. The actual coloring is then done via CSS. This can be done inline on the page itself or better, via static file upload. ``` .oc--u-color-1 {border-left: 8px solid; border-left-color: var(--u-color-1);} .oc--u-color-2 {border-left: 8px solid; border-left-color: var(--u-color-2);} .oc--u-color-3 {border-left: 8px solid; border-left-color: var(--u-color-3);} .oc--u-color-4 {border-left: 8px solid; border-left-color: var(--u-color-4);} .oc--u-color-5 {border-left: 8px solid; border-left-color: var(--u-color-5);} .oc--u-color-6 {border-left: 8px solid; border-left-color: var(--u-color-6);} .oc--u-color-7 {border-left: 8px solid; border-left-color: var(--u-color-7);} .oc--u-color-8 {border-left: 8px solid; border-left-color: var(--u-color-8);} .oc--u-color-9 {border-left: 8px solid; border-left-color: var(--u-color-9);} .oc--u-color-10 {border-left: 8px solid; border-left-color: var(--u-color-10);} .oc--u-color-11 {border-left: 8px solid; border-left-color: var(--u-color-11);} .oc--u-color-12 {border-left: 8px solid; border-left-color: var(--u-color-12);} .oc--u-color-13 {border-left: 8px solid; border-left-color: var(--u-color-13);} .oc--u-color-14 {border-left: 8px solid; border-left-color: var(--u-color-14);} .oc--u-color-15 {border-left: 8px solid; border-left-color: var(--u-color-15);} ``` Done .. 😉 [![](https://thecattlecrew.net/wp-content/uploads/2022/02/final_report.png)](https://thecattlecrew.net/wp-content/uploads/2022/02/final_report.png) Report showing colored rows Have fun developing with APEX > This blog post was orignally published in my personal blog > > **Kategorien:** Analytics & Insights, Development **Schlagwörter:** APEX, Frontend, HowTo, oracle --- ### [APEX: Additional Group Column Heading in ClassicReport](https://thecattlecrew.net/2022/06/25/addionaly-group-column-heading-in-classic-report/) **Published:** Juni 25, 2022 **Author:** Maik Michel **Content:** In my projects it sometimes happens that I have a lot of columns in a classic report. Of course, this has a negative effect on the look and feel. Often it helps here to outsource similarities of the respective columns in an additional heading line. You can find out how to do that right here. We create a Dynamic Action on the corresponding report that fires on the event AfterRefresh. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/APEX_PageBuilder_Attributes_DynamicAction_setColumnGroupHeadings.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/APEX_PageBuilder_Attributes_DynamicAction_setColumnGroupHeadings.png) As the actual action, we choose to execute JavaScript code, which should also be executed on load. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/APEX_PageBuilder_Attributes_ExecuteJavaScript_for-setColumnGroupHeadings-830x1024.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/APEX_PageBuilder_Attributes_ExecuteJavaScript_for-setColumnGroupHeadings.png) Following lines of JavaScript, insert a new line before the actual heading line generated by APEX: ``` apex.jQuery(this.triggeringElement).find('thead').prepend(` + +The Book +Publish + ` ); ``` Done. [You can find a demo here.](https://apex.oracle.com/pls/apex/r/die21/demos/column-groups) > This blog post was orignally published in my personal blog > > https://micodify.de/addionaly-group-column-heading-in-classic-report/ **Kategorien:** Development **Schlagwörter:** APEX, English, Frontend, HowTo, oracle --- ### [Angular Signals: Übersicht und aktueller Stand](https://thecattlecrew.net/2023/11/06/angular-signals-uebersicht-und-aktueller-stand/) **Published:** November 6, 2023 **Author:** Alexander Möller **Content:** State Management und die Reaktion auf State-Veränderungen sind ein wichtiges Thema in Frontend-Applikationen. Aktuell setzt Angular dafür auf die Eigenentwicklung Zone.js. Mit Angular Signals wurde dieses Jahr ein vielversprechendes alternatives Reaktivitätssystem vorgestellt. Als neue „reactive primitives“ bieten Signals eine neue Möglichkeit, auf Änderungen am State zu reagieren und die UI feingranular zu aktualisieren. Damit lässt sich die Change Detection deutlich effizienter durchführen. Das Konzept ist allerdings nicht neu: Preact.js, Solid.js und Vue.js verwenden bereits seit Jahren ähnliche Konstrukte. Als Entwickler stellen sich mir jetzt vor allem drei Fragen: - Wie funktionieren Signals und was sind ihre Vorteile? - Wie werden Signals eingesetzt? - Welche Auswirkungen habe sie auf Angular? Diese Fragen möchte ich im Artikel klären. ## Wie funktionieren Angular Signals? Signals sind Wrapper um eine Variable. Sowohl Lesen als auch Schreiben von Werten der Variablen wird durch Funktionsaufrufe auf den Wrapper umgesetzt. Durch die lesenden Methodenaufrufe kann der Wrapper eine Liste der Konsumenten pflegen. Wird der Wert des Signals geändert können so alle vom Signal abhängigen Konsumenten informiert werden. Wichtig: Sowohl das Lesen als auch das Schreiben eines Signals ist immer synchron! Angular stellt einen readOnly- und einen writable-Typen zur Verfügung. Um Konsumenten eines Signals auf das Lesen von Werten zu beschränken, gibt es die Möglichkeit von einem writableSignal ein readOnly-Signal zu generieren. ``` const readOnlySignal: Signal = signal(0); readOnlySignal() // 0 (= Der Getter) readOnlySignal.set(2) // error const writableSignal: WritableSignal = signal(0); writableSignal.set(2) // 2 writableSignal.update((previousValue) => {return previousValue + 1}) // 3 const readOnlySignal2: Signal = writableSignal. asReadonly(); const writableSignal2: WritableSignal = singal([0]); // [0] const writableSignal2.mutate((val) => val.push(1); // [0,1] Änderung In-Place ``` ### Effects Effects sind Methoden die ein oder mehrere Signals konsumieren und jedes Mal durchgeführt werden, wenn eines der Signals seinen Wert ändert. Ein typischer Anwendungsfall für Effects ist das Loggen von Werten. Achtung: Im Gegensatz zu Signals sind Effects immer asynchron! ``` loggingEffect = effect(() => console.log(writableSignal())) ``` ### Computed Angular Signals Diese Signalart konsumiert beliebig viele Signals und generiert daraus einen Rückgabewert. Ändert sich eines der verwendeten Signals wird der Wert erneut berechnet und alle Konsumenten des Computed Signals werden benachrichtigt. Computed Signals bieten keine Methode zum direkten Setzen eines Wertes an. Computed Signals sind immer asynchron. ``` computedSignal: Signal = computed(() => this.readOnlySignal() + 1); ``` Signals, Effects und Computed Signals sind ab Angular 16 als Developer Preview verfügbar. ## Auswirkungen auf Angular Um die Vorteile von Angular Signals bezüglich Reaktivität nachvollziehen zu können, ist es hilfreich zu verstehen, wie Change Detection in Angular derzeit funktioniert. Dazu hier ein kleiner Exkurs: ### Wie funktioniert Change Detection in Angular? Change Detection beschreibt den Prozess, die UI synchron mit den Änderungen am Model der Applikation zu halten. Framework-agnostisch wird dieser Mechanismus als Reaktivität bezeichnet. Angular stellt dafür einen Ablauf zur Verfügung, der nach einer Änderung am Model angeworfen wird: Der Change Detection Cycle (CDC). Beginnend bei der Root-Komponente werden alle Komponenten sequenziell bis zum letzten Blatt durchlaufen. Dabei werden die von der UI referenzierten Werte auf Änderungen untersucht und gegebenenfalls die UI aktualisiert. Angular geht dabei sehr performant vor. So können mehrere tausend Checks in Millisekunden durchgeführt werden. Dennoch können CDCs in größeren Anwendungen zu einem Performanceproblem werden. ### Was triggert einen CDC? Angular verwendet Zone.js, um beim Hochfahren bestimmte Browser-APIs so abzuändern, dass sie neben ihrer eigentlichen Funktion zusätzlich einen CDC anwerfen. Das Vorgehen, Funktionalität zur Laufzeit zu ändern, wird als Monkey Patching bezeichnet. Ermöglicht wird dies durch Zonen von Zone.js, die Tasks in gesonderten Execution Contexts ausführen und Hooks anbieten, wenn bestimmte Events, wie das vollständige Ausführen aller Tasks, eintreffen. Vor allem bei asynchronen Tasks, wie der Kommunikation mit einem Webserver über HTTP, ist die Ausführung innerhalb von Zonen essenziell. Durch die Hooks kann auf die Events reagiert und ein CDC angeworfen werden. ### Schwächen der aktuellen Lösung Das Triggern eines Zone-Hooks macht lediglich eine Aussage darüber, dass sich etwas geändert haben könnte. Es liefert aber keine Aussage darüber, ob sich überhaupt etwas geändert hat. Und wenn doch, dann wird nicht klar, was sich ändert. Das wird erst im Verlauf des daraufhin ausgelösten CDC festgestellt, der alle Komponenten durchlaufen muss. Hier gibt es also Optimierungspotential und das ist der Punkt an dem Signals aufsetzen. Mit der On-push-Change-Detection-Strategie lässt sich zwar die Anzahl der zu durchlaufenden Komponenten verringern, das Grundproblem, dass deutlich mehr Abgleiche stattfinden als notwendig, bleibt aber bestehen. Um es auf den Punkt zu bringen: Es werden CDCs ausgelöst, die nicht notwendig sind, weil sich nichts geändert hat. CDCs überprüfen jedes Mal unnötig große Teile der Applikation. Diese Probleme werden durch Signals gelöst. ## Angular Signals als alternatives Reaktivitätssystem Die Kombination aus Signals und Effects ermöglicht es Angular, ein alternatives Reaktivitätssystem zu etablieren: - Ein Signal beinhaltet einen Wert, der in der UI angezeigt und aktualisiert werden soll. - Die UI verwendet eine Referenz auf das Signal. - Ein Effekt beobachtet das Signal und aktualisiert jedes Mal die UI, wenn sich der Wert des Signals ändert. Die Synchronisierung der UI mit dem State der Signals verrichtet Angular im Hintergrund. Da Zone.js und Signals sehr unterschiedliche Annahmen bezüglich des Data Flows in Applikationen treffen, wird es zukünftig die Möglichkeit geben auf Komponentenbasis zu entscheiden, ob sie auf Zone.js oder Signals basieren. Beide Komponententypen sollen problemlos in derselben Applikation miteinander interagieren können. So können Entwicklungsteams Komponente für Komponente auf Signals umstellen. Laut Aussage eines Maintainer/Authors des RFC hat Google aktuell keine Pläne, den Support von Zone.js in Angular einzustellen (Kommentar von April 2023). In reinen Signal-Komponenten wird die Change Detection damit deutlich effizienter. Sie wird nur noch dann durchgeführt, wenn sich ein Signal, dass in der UI referenziert wird, ändert. Während ein Zone.js-Hook triggern kann, ohne dass es eine Änderung am State gab, ist dies bei Signals nicht mehr möglich. Des Weiteren ist bekannt, welcher Teil der UI aktualisiert werden muss. Angular bleibt bei dem Konzept, dass nicht individuelle Bindings sondern Bereiche aktualisiert werden. Die Bereiche sind aber wesentlich kleiner als beim Durchlauf eines Zone.js-CDC. Dafür unterteilt Angular Komponenten in kleinere Teile, sogenannte Views, und rendert nur die betroffenen Views neu. Bei einer Mischung von Zone.js- und Signal-Komponenten in einer Applikation werden die Signal-Komponenten beim Durchlaufen des Zone.js-CDC ausgenommen und separat abgehandelt. ### Nutzung von Angular Signals in Komponenten Um die genannten Vorteile von Signals nutzen zu können, ist für die Zukunft angedacht, dass Komponenten entweder als Zone-basierte oder als Signal-basierte Komponente definiert werden. Der aktuelle Vorschlag besteht darin, ein neues Attribut zur @Component-Annotation hinzuzufügen. Signals sind aber nicht auf Signal-basierte Komponenten beschränkt, sondern können auch in Zone-basierten Komponenten verwendet werden. ``` @Component({   signals: true,   … }) ``` Die Verknüpfung des Templates mit einem Signal funktioniert über den Aufruf des Getters: component.ts ``` count = signal(0); ``` component.html ``` Count {{ count() }} ``` Aktuell ist es in der Regel keine gute Idee, im Template Methodenaufrufe zu referenzieren, da diese dann bei jedem CDC erneut ausgeführt würden. Bei Signals gibt es dieses Problem nicht. Im Gegenteil: Es ist explizit erlaubt (und notwendig), da sonst das Signal selbst und nicht der aktuelle Wert des Signals referenziert wird. Ob Nicht-Signal-Bindings erlaubt sein werden und wie damit umgegangen werden wird, ist Bestandteil der aktuellen Debatte. Zum aktuellen Zeitpunkt (Oktober 2023) sind Signal-basierte Komponenten noch in keiner Angular-Version verfügbar. Sie sollen frühestens mit Angular 18 zur Verfügung stehen. ### Angular Signals und RxJS Signals sollen RxJs nicht ersetzen, sondern ergänzen. Dafür wurde ein neues Paket zur Core Library von Angular hinzugefügt: @angular/core/rxjs-interop Darüber werden die Funktionen toObservable und toSignal zur Verfügung gestellt, die es erlauben, die beiden Konstrukte in das jeweils andere umzuwandeln. toObservable ```   countSignal = signal(0);   count$ = toObservable(this.count); ``` Dabei wird im Hintergrund ein Effect gestartet, der bei jeder Änderung des Signals dafür sorgt, dass das Observable den Wert ausgibt: toSignal ```   interval$ = interval(1000);   intervalSignal: Signal = toSignal(this.interval$); ``` Dabei gilt: - Wenn ein Observable einen Wert emitted, wird der Setter des Signals aufgerufen - Wenn ein Observable einen Error emitted, wird der Error von Angular geworfen - Beim Emitten von „Complete“ bleibt der letzte Wert des Signals erhalten Da das Observable keinen initialen Wert besitzt, bis der erste Wert emitted wird, muss „undefined“ in den Typen aufgenommen werden. Um die Typisierung auf umzustellen, kann ein initialer Wert bei der Umwandlung mitgegeben werden: ```   intervalSignal2: Signal = toSignal(this.interval$, {initialValue: 0}); ``` ### Achtung: Angular Signals sind keine Streams Signals geben, im Gegensatz zu Observables, nicht jeden Zwischenwert aus, der ihnen zugewiesen wird. Gibt es mehrere Zuweisungen nacheinander, so werden diese synchron ausgeführt und die Konsumenten erst im Anschluss benachrichtigt. Dadurch entsteht ein Verhalten, das für den Observable-erfahrenen Entwickler auf den ersten Blick überraschend sein kann: ``` const writableSignal: WritableSignal = signal(0); loggingEffect = effect(() => console.log(writableSignal())) writableSignal.set(1); writableSignal.set(2); writableSignal.set(3); ``` Da das Setzen der Werte synchron, das Update durch den Effect aber asynchron stattfinden, werden erst der initale Wert 0 und anschließend der finale Wert 3 geloggt. Das gleiche Verhalten ist auch bei Computed Signals der Fall. Dieser Batch-Verarbeitung sollten wir uns bewusst sein, wenn wir mit Signals arbeiten. ### Einsatz im State Management Signals sind prädestiniert dafür, im Kontext State Management eingesetzt zu werden. Eine eigene Lösung für kleinere Projekte kann auch heute schon über einen State Service implementiert werden. Angular selbst wird dabei keine eigene State Library anbieten. Die verbreiteten State-Management-Bibliotheken NgRx und NGXS haben bereits Diskussionen über den Einsatz von Signals gestartet. ## Fazit Angular arbeitet mit Signals an einem lange ersehntem System, dass das Thema Reaktivität für Entwickler vereinfacht und gleichzeitig die Performance der Change Detection steigert. Damit wird es zudem möglich, sich von der Abhängigkeit der Bibliothek Zone.js zu lösen. Einen Zwang zum Wechsel wird es aber nicht geben. Google hat aktuell keine Pläne, den Support von Zone.js in Angular einzustellen (Kommentar im RFC von April 2023). Aktuell ist der Einsatz von Signals aber noch mit Vorsicht zu genießen: Zwar kann ab Angular 16 mit Signals als Developer Preview experimentiert werden, das bedeutet aber auch, dass die API sich noch mit Breaking Changes ändern kann. Dazu kommt, dass das Herzstück des neuen Reaktivitätssystems, die Signal-basierten Komponenten, erst frühestens mit Angular 18 zur Verfügung stehen werden. Ohne diese wird aber die bessere Performanz nicht erreicht, da unter der Haube weiterhin das alte Change Detection System verwendet wird. Signals und die auf ihnen basierenden Komponenten sehen vielversprechend aus und haben gute Chancen darauf, fester Bestandteil der Zukunft von Angular zu werden. Solange sie nicht veröffentlicht und ihre Auswirkungen noch nicht vollständig bekannt sind, muss ein abschließendes Urteil aber noch auf sich warten lassen. Man wird sich also noch etwas gedulden müssen, bis es richtig losgeht. ## Quellen Offizielles RFC Javascript Execution Contexts Zone.js gepatchte APIs Angular.io Signals RFC Signal API **Kategorien:** Development **Schlagwörter:** Angular, Change Detection, Change Detection Cycle, Computed, Effects, Reaktivität, Signals, Zone.js --- ### [Showdown für den Java Full Stack](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) **Published:** Februar 14, 2024 **Author:** Patrick Boerk **Content:** # Thymeleaf/HTMX versus Vaadin Flow & Hilla – Teil 1: Tools im Vergleich In der sich ständig verändernden Welt der Softwareentwicklung gibt es immer wieder neue Tools und Technologien, die uns dabei helfen sollen, besser und effizienter zu arbeiten. Bei dieser Geschwindigkeit ist es für uns Entwickelnde nicht so leicht, auf dem Laufenden bleiben. Gerade der Ansatz von Technologien, die wir für die Entwicklung von Frontends nutzen können, ist sehr wechselhaft und schwingt häufig von einem Extrem zum anderen. Die Extrempunkte sind dabei: Server-seitiges Rendern und Client-seitiges Rendern. Grob vereinfacht lassen sich folgende Entwicklungsschritte beobachten: - Terminal-basierte UIs aus Großrechnerzeiten: Server-seitig - Swing oder native Windows Clients: Client-seitiges Rendern in einer Client-Server-Architektur - JSF, ASP.net u. a.: Browser basierte UIs mit Server-seitigem Rendern in einer Mehrschichtenarchitektur - Angular, React, Single Page Apps (SPA): Client-seitiges rendern in einer Microservices-Architektur Dabei haben beide Ansätze Vor- und Nachteile: Beispielsweise verursacht ein komplett separierter Client, wie wir ihn aktuell bei SPAs sehen, Overhead, da wir uns um die Kommunikation zwischen Client und Server zusätzlich kümmern müssen. Andererseits haben SPAs Vorteile, weil sie einen hohen Grad an Interaktivität ermöglichen. Doch welche Alternativen gibt es derzeit zu einem reinen SPA-basierten Ansatz? Was zeichnet diese aus? Und für welche Anwendungen sind sie am besten geeignet? Drei Technologien halte ich, aufgrund ihrer breiten Akzeptanz bei der Webentwicklung, persönlich für besonders beachtenswert: - Thymeleaf mit HTMX - Vaadin Flow - Hilla Damit die Entscheidung für das eine oder andere Tool leichter fällt, stelle ich in diesem ersten Teil der Serie „Thymeleaf/HTMX versus Vaadin Flow & Hilla“ wesentliche Charakteristika der Technologien vor und vergleiche sie miteinander. Im zweiten Teil zeige ich dann später Codebeispiele. ## Thymeleaf mit HTMX: Server-seitige Template Engine trifft auf Hypertext Thymeleaf ist eine Server-seitige Engine für Java Templates , die speziell für die Webentwicklung gedacht ist und es ermöglicht, HTML in Server-seitig generierten Templates zu verwenden. Wird Thymeleaf mit HTMX kombiniert, einer leichten JavaScript-Bibliothek, so entsteht ein kraftvolles Werkzeug zur Modernisierung von Webanwendungen. ![Funktionsweise von Thymeleaf](https://thecattlecrew.net/wp-content/uploads/2024/01/thymeleaf.png)Abbildung 1: Funktionsweise von Thymeleaf Wollen wir Anwendungen mit hoher Interaktivität und schnellem Feedback entwickeln, dann sind Thymeleaf und HTMX ein mächtiges Team: Sie manipulieren den HTML-Code direkt im Browser anstatt vollständige Seiten vom Server zu laden. Das macht Webanwendungen schnell und reaktionsfähig und verbessert die Benutzererfahrung. ### Thymeleaf: Natürliche Templates und mehr Thymeleaf verfolgt einen natürlichen und intuitiven Ansatz zur Erzeugung von HTML-Seiten. Mit diesem Tool können wir dynamische Daten sehr einfach in unsere HTML-Templates einfügen. ![Thymeleaf Codebeispiel](https://thecattlecrew.net/wp-content/uploads/2024/01/thymeleaf_code.png)Abbildung 2: In diesem Code werden dynamische Werte (title und message) aus dem Modell in das HTML-Template eingesetzt, sodass wir HTML-Seiten erzeugen können, die auf den jeweiligen Kontext der Anwendenden zugeschnitten sind. ### HTMX: Einfache Server-seitige Interaktivität Thymeleaf ist im Umfeld von Spring seit Jahren etabliert und besitzt ein aktives Ökosystem, das sowohl Framework Integration (Spring) als auch Plug-ins für diverse IDEs bereitstellt. Thymeleaf ist zunächst ohne weitere Integration sehr seitenorientiert, d. h. Interaktionen erfordern ein re-rendering der gesamten Seite. Hier kommt HTMX ins Spiel. ### HTMX: die leistungsstarke JavaScript-Bibliothek Die HTMX JavaScript-Bibliothek hilft uns, die Interaktivität und Benutzerfreundlichkeit unserer Webanwendungen erheblich zu steigern. HTMX erreicht dies durch den Einsatz moderner Webtechnologien wie AJAX, CSS-Transitions, WebSockets und Server-Sent-Events. ![HTMX Codebeispiel Button Klick](https://thecattlecrew.net/wp-content/uploads/2024/01/htmx_code_1.png)Abbildung 3: In diesem Beispiel sendet der Button bei einem Klick eine AJAX-Anforderung an den Pfad /clicked und ersetzt sich selbst mit der Antwort des Servers. Dies ist eine einfache und doch mächtige Möglichkeit, um Interaktivität in unsere Webanwendungen zu bringen ### Thymeleaf und HTMX: Zwei starke, jedoch unterschiedliche Technologien Thymeleaf bietet natürliche HTML-Templates und vielseitige Verarbeitungsmöglichkeiten, einschließlich serverseitiger Validierung und Fehlerbehandlung. Die Syntax ist allerdings komplex und Fehlermeldungen sind manchmal schwer zu interpretieren. Das kann für Unerfahrene eine Herausforderung sein. HTMX hingegen lässt sich einfach einbinden und versetzt uns in die Lage, auch ohne tiefes JavaScript-Wissen dynamisches HTML zu erzeugen. Als JavaScript-Bibliothek hängt es jedoch immer von dessen Verfügbarkeit und Eigenschaften ab. Auch ist seine Dokumentation im Vergleich zu einigen etablierten Technologien weniger umfangreich. Beide Technologien haben also ihre Vorzüge und Herausforderungen. Diese Herausforderungen oder Hürden können aber in der Kombination mit Spring abgemildert werden. So existiert z. B. eine Bibliothek für HTMX im Zusammenspiel mit Spring Boot und Thymeleaf, die eine Reihe von Helferklassen bereitstellt. Das vereinfacht die Integration von HTMX in eine Spring Boot Applikation. () Die Idee von HTMX ist, dass der Server nicht, wie bei SPAs üblich, JSON zurückliefert, sondern HTML-Fragmente. Diese können wiederum mittels Thymeleaf angefertigt werden. Damit erübrigt sich die Entwicklung eines eigenen REST/JSON Modells für die Übertragung von Daten zwischen Client und Server. Als Entwickelnde können wir dann im Server-seitigen Objektmodell bleiben. ### Vaadin Flow: Freies Java-Framework für eine Server-seitige Architektur Vaadin ist ein freies Java Webframework für Rich Internet Application (RIA). Es bietet eine Server-seitige Architektur, sodass der Großteil der Logik auf einem Server ausgeführt wird. Seit Version 10 baut Vaadin mit dem neuen Teilframework Flow auf der Client-seitig auf Web-Komponenten auf und fügt allen Aktionen eine serverseitige Datenvalidierung hinzu. Die Standardkomponenten von Vaadin können mit eigenen Steuerelementen erweitert werden. Neben Open-Source-Erweiterungen bietet Vaadin selbst auch kommerzielle Erweiterungen wie z. B. den Vaadin TestBench für automatisierte Oberflächentests basierend auf Selenium2. Oder Vaadin Charts, einer Bibliothek visueller Komponenten, mit der sich animierte und interaktive Diagramme darstellen lassen. ### Vaadin (Flow) versus Hilla ![Vergleichstabelle Vaadin - Hilla](https://thecattlecrew.net/wp-content/uploads/2024/01/vergleich_vaadin_hilla.png)Tabelle 1:Vaadin (Flow) und Hilla im Vergleich ## Vaadin Flow: Full Stack Java in Aktion Vaadin ist eine Plattform, die es ermöglicht, moderne und kollaborative Web-Applikationen für Java Backends zu realisieren. Sie beinhaltet UI-Components, Frameworks und Tools, wobei die meisten dieser Komponenten geteilt und auch von Vaadin Flow und Hilla benutzt werden. Mit Vaadin Flow können wir Webanwendungen auf dieselbe Weise erstellen wie Desktop-Anwendungen. Allerdings mit der zusätzlichen Effizienz und dem Komfort eines reinen Java-UI-Komponenten-basierten Programmiermodells. Insbesondere wenn es um die Erstellung von Geschäftsanwendungen geht, die hauptsächliche aus Formularen und Tabellen bestehen. ![Featurevergleich - Vaadin, Angular und React](https://thecattlecrew.net/wp-content/uploads/2024/01/vaadin_angular_react.png)Abbildung 4: Feature-Vergleich – Vaadin, Angular und React Wie gesagt ist Vaadin Flow ein Framework, das sich auf die Entwicklung von Webanwendungen konzentriert, indem es ein Java UI-Komponenten basiertes Programmiermodell verwendet. Dies ermöglicht es uns, Webanwendungen wie Desktop-Anwendungen zu bauen – alles in reiner Java-Umgebung, ohne TypeScript oder JavaScript. ![Vaadin Flow Codebeispiel](https://thecattlecrew.net/wp-content/uploads/2024/01/vaadin_flow_example.png)Abbildung 5: Vaadin Flow – ein Code-Beispiel Der größte Vorteil von Vaadin Flow liegt noch woanders: Mit über 20 Jahren Erfahrung im Rücken bietet Vaadin eine ausführliche Dokumentation und eine aktive Community, die bei der Lösung von Problemen hilft. ![Meilensteine von Vaadin](https://thecattlecrew.net/wp-content/uploads/2024/01/vaadin_history.png)Abbildung 6: Die Historie von Vaadin Doch auch Vaadin Flow hat seine : Während Single Page Applikationen (SPA) wie Angular, Vue oder React skalierbar sind, sofern sie keinen Server-State halten müssen, trifft das auf Vaadin leider nicht zu. Da Vaadin sich allerdings darauf konzentriert, Geschäftsanwendungen mit Tabellen und Formen zu bauen, gibt es hier keine Einschränkung. Ebenso ist Vaadin Flow nicht darauf ausgelegt, komplexe und hübsche User Interfaces mit Animationen und Features zu bauen. Zudem sind nicht alle UI-Komponenten kostenlos verfügbar – für fortgeschrittene Features wie Charts und Maps ist ein kommerzielles Preismodell erforderlich. ## Hilla – Das Beste aus beiden Welten Hilla, ist eine kraftvolle Kombination aus einem Spring Boot Java Backend und einem reaktiven TypeScript Frontend. Es vereinfacht die Webentwicklung durch die automatische Generierung von REST-API und Client Code. Damit können wir bei der Entwicklung direkt auf Services und Repositorien über den UI-Code zugreifen. ![Hilla Codebeispiel](https://thecattlecrew.net/wp-content/uploads/2024/01/hilla_frontend.png)Abbildung 7: Hilla – ein Code-Beispiel Einer der größten Vorteile von Hilla ist die , einer von Google entwickelten Boilerplate-Killing-UI-Komponentenbibliothek. Die ermöglicht es, schnelle und leichte Web-Komponenten zu erstellen. Jedoch kann Hilla auch gut zusammen mit React eingesetzt werden. Ein weiteres Merkmal von Hilla ist, dass es nur einen Client-State verwendet. So können TypeScript-Views ohne Server-Session erstellt werden. Das verbessert die Performance und die Effizienz der Webanwendung. ## Fazit Die Wahl zwischen Vaadin Flow, Hilla und Thymeleaf mit HTMX hängt von den Anforderungen unseres Projekts ab. Suchen wir ein einfaches, effizientes und vor allem Java-basiertes Framework, dann ist Vaadin Flow eine ausgezeichnete Wahl. Wollen wir jedoch eine leistungsfähige, reaktive Webanwendung erstellen, die sowohl auf der Client- als auch auf der Server-Seite ausgeführt wird, und möchten wir dabei außerdem die Vorteile von Spring Boot und TypeScript nutzen, dann wäre Hilla das Werkzeug unserer Wahl. Zusammenfassend lässt sich sagen: - Vaadin Flow ist ideal, wenn wir eine Full-Stack Java Entwicklung anstreben und der Schwerpunkt auf der Server-seitigen Logik liegt. - Hilla hingegen eignet sich für Anwendungen, die eine starke Client-seitige Logik erfordern und eine große Anzahl von Nutzern unterstützen müssen. - Die Kombination von Thymeleaf und HTMX bietet eine attraktive Alternative für diejenigen, die sich auf eine Server-seitige Java Template Engine mit der Flexibilität einer leichten JavaScript-Bibliothek verlassen möchten. # Alle Teile ansehen [Teil 1: Showdown für den Java Full Stack – Thymeleaf/HTMX versus Vaadin Flow & Hilla im Vergleich](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) [Teil 2: Deep Dive in den Java Full Stack – Codebeispiele aus Thymeleaf/HTMX, Vaadin Flow & Hilla](https://thecattlecrew.net/2024/02/20/deep-dive-im-java-full-stack/) [Teil 3: Mit Angular Server Side Rendering zur besten UX – Wie Angular Server Side Rendering (SSR) hilft, blitzschnelle Webanwendungen zu entwickeln](https://thecattlecrew.net/2024/05/08/mit-angular-server-side-rendering-zur-besten-ux/) **Kategorien:** Development **Schlagwörter:** Client-seitiges Rendern, Hilla, HTMX, Java Full Stack, JavaScript-Bibliothek, Reactives Webdesign, Rich Internet Application (RIA), Server-seitige Template Engine, Server-seitiges Rendern, single page apps, Spring Boot, Thymeleaf, TypeScript Frontend, Vaadin Flow, Webentwicklung --- ### [Deep Dive im Java Full Stack](https://thecattlecrew.net/2024/02/20/deep-dive-im-java-full-stack/) **Published:** Februar 20, 2024 **Author:** Patrick Boerk **Content:** # Thymeleaf/HTMX versus Vaadin Flow & Hilla, Teil 2: Codebeispiele In unserem [vorherigen Blogpost](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) haben wir die Unterschiede und Merkmale der drei ausgewählten TechStacks – Thymeleaf mit HTMX, Vaadin Flow und Hilla – beleuchtet. Jetzt werden wir tiefer in die technischen Aspekte eintauchen, indem wir Codebeispiele aus jedem der TechStacks betrachten. In diesem Beitrag tauchen wir in vier entscheidende Aspekte ein, die in gängigen Webanwendungen allgegenwärtig sind: - **Benutzerregistrierung und Anmeldung:** Die Implementierung eines Registrierungsprozesses für neue Benutzer und die Möglichkeit für angemeldete Benutzer, sich in der Webanwendung anzumelden. - **Datenverwaltung und Anzeige:** Die Fähigkeit, Daten in einer Liste anzuzeigen, hinzuzufügen, zu aktualisieren und zu löschen. - **Formulare und Validierung:** Die Erstellung von interaktiven Formularen zur Eingabe von Benutzerdaten, einschließlich der serverseitigen Validierung. - **RESTful API-Kommunikation:** Die Interaktion mit externen Diensten über eine RESTful API, um Daten abzurufen oder zu senden. Wir werden nicht nur jeden dieser Aspekte genauer betrachten, sondern auch die Umsetzungen mit unseren ausgewählten TechStacks vergleichen. Dies verspricht nicht nur spannende Einblicke, sondern auch die Möglichkeit, die Vor- und Nachteile verschiedener Ansätze zu erkunden. *Du bist neu dabei? Hier kannst du einen Blick in den ersten Teil der Blogserie werfen:* - [Teil 1: Showdown für den Java Full Stack – Thymeleaf/HTMX versus Vaadin Flow & Hilla im Vergleich](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) ## Thymeleaf mit HTMX Thymeleaf in Kombination mit HTMX ermöglicht es uns, interaktive Webanwendungen mit serverseitigem Rendering zu entwickeln. Hier ist ein einfaches Beispiel, wie wir dynamische Inhalte in eine HTML-Seite einfügen können: ![Codebeispiel 1](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-01.png) In diesem Beispiel verwenden wir Thymeleaf, um dynamische Werte in die HTML-Seite einzufügen, und HTMX, um serverseitige Interaktivität zu ermöglichen. Der Button sendet eine AJAX-Anfrage an den Server und aktualisiert den Inhalt der
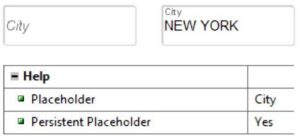
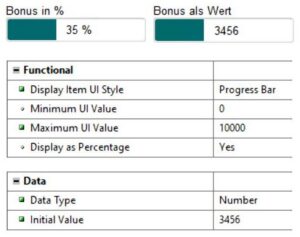
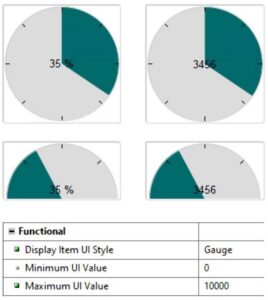
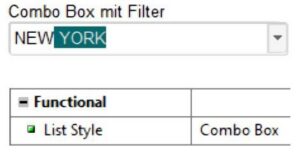
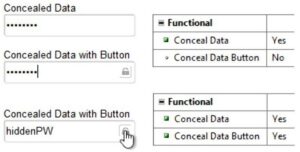
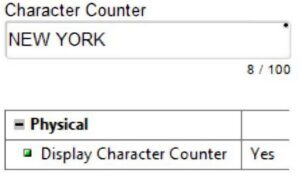
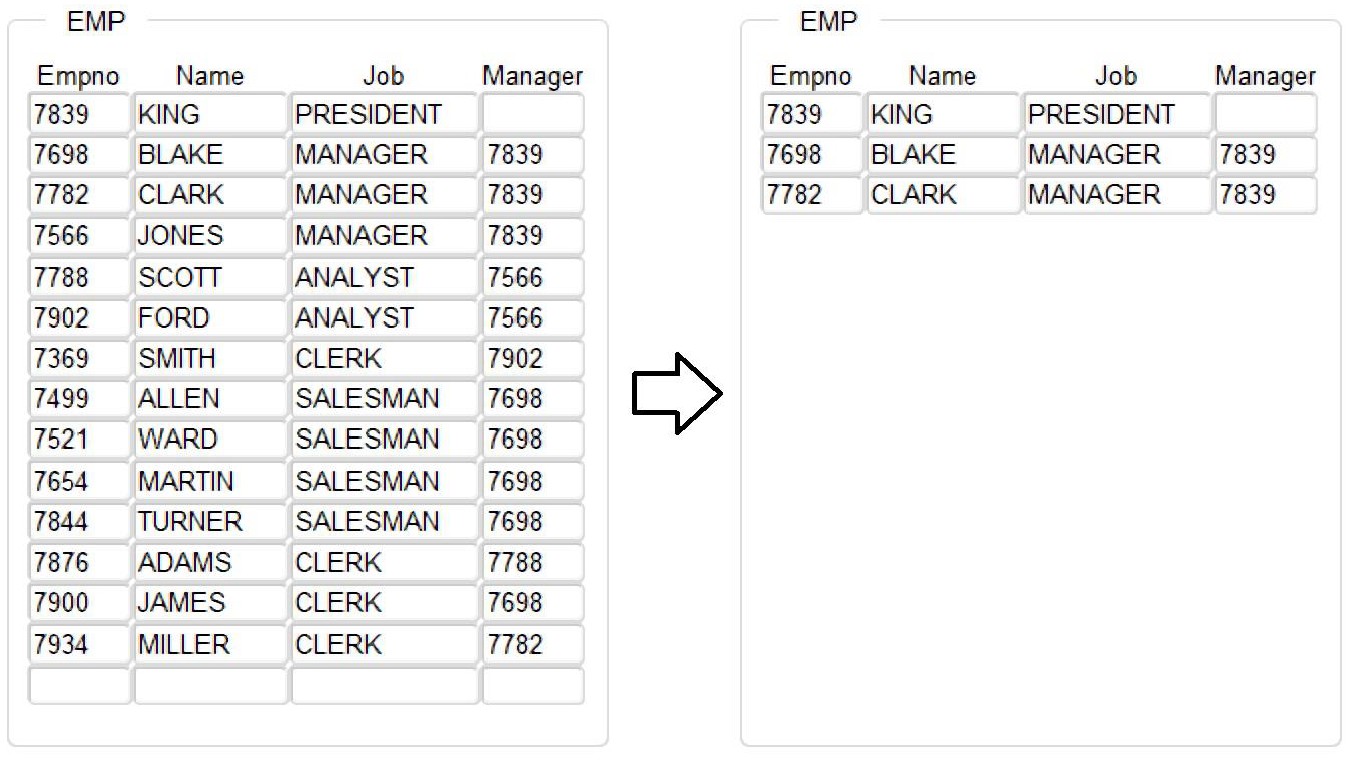
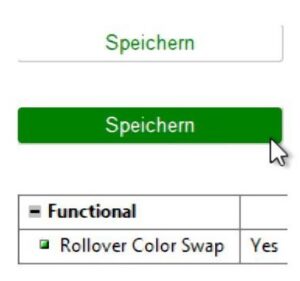
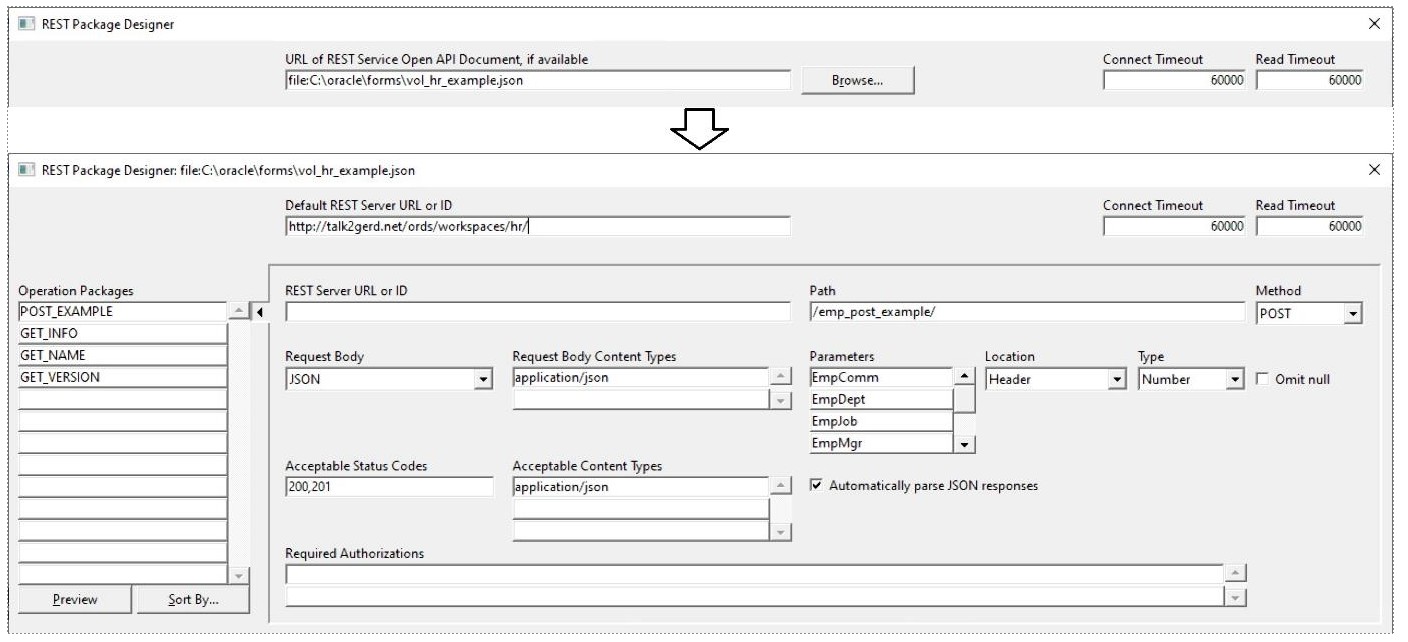
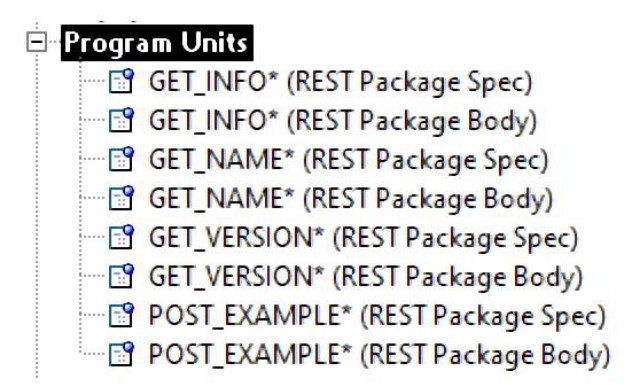
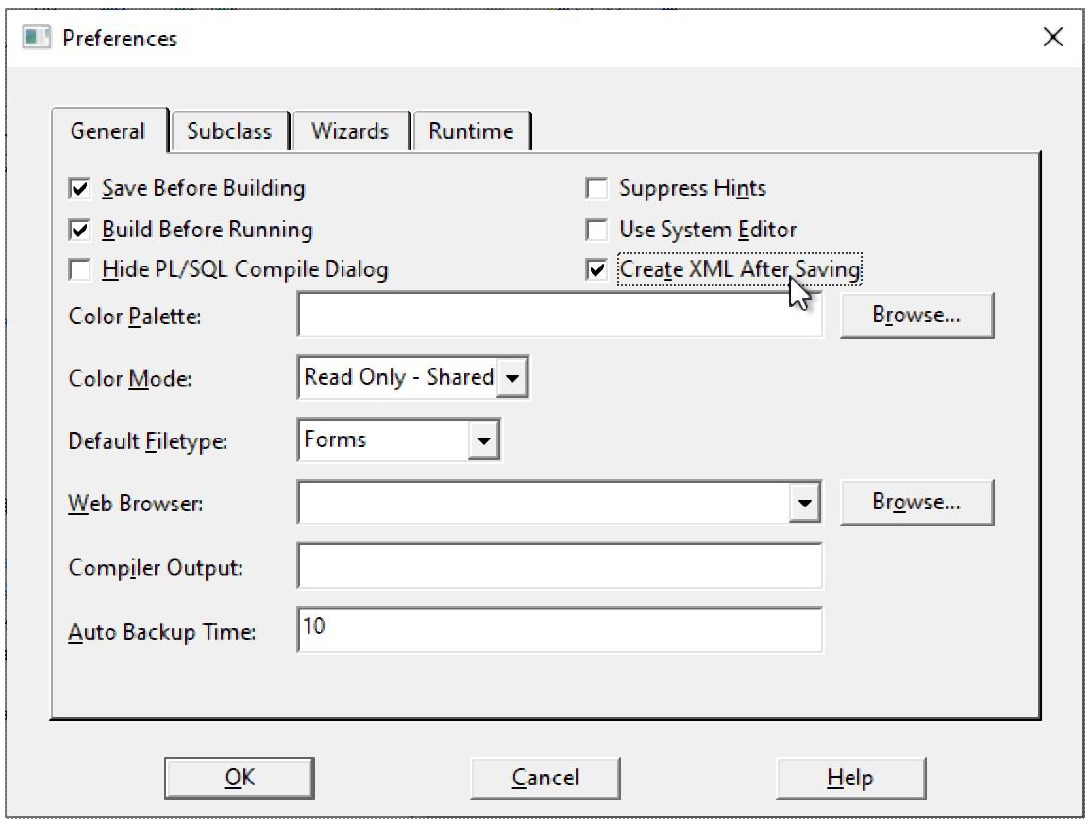
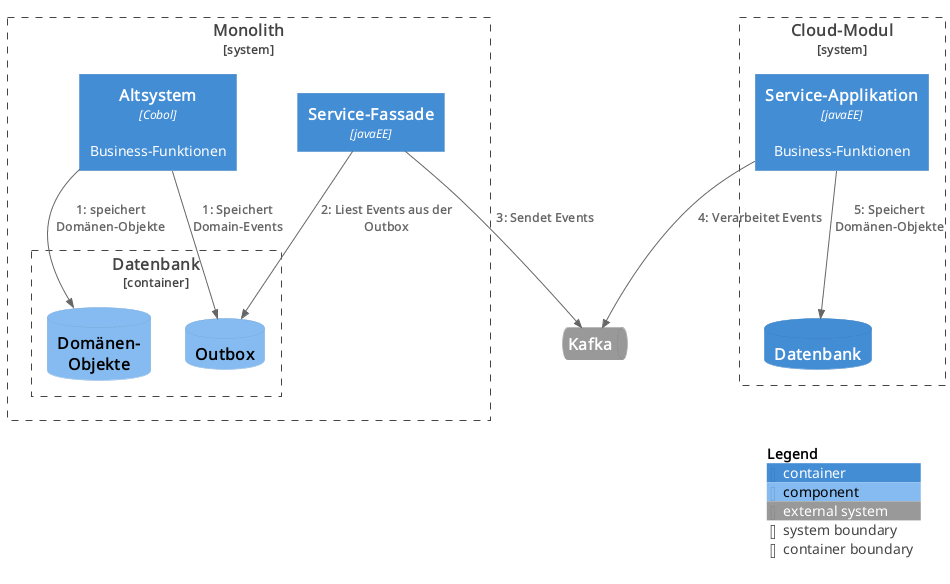
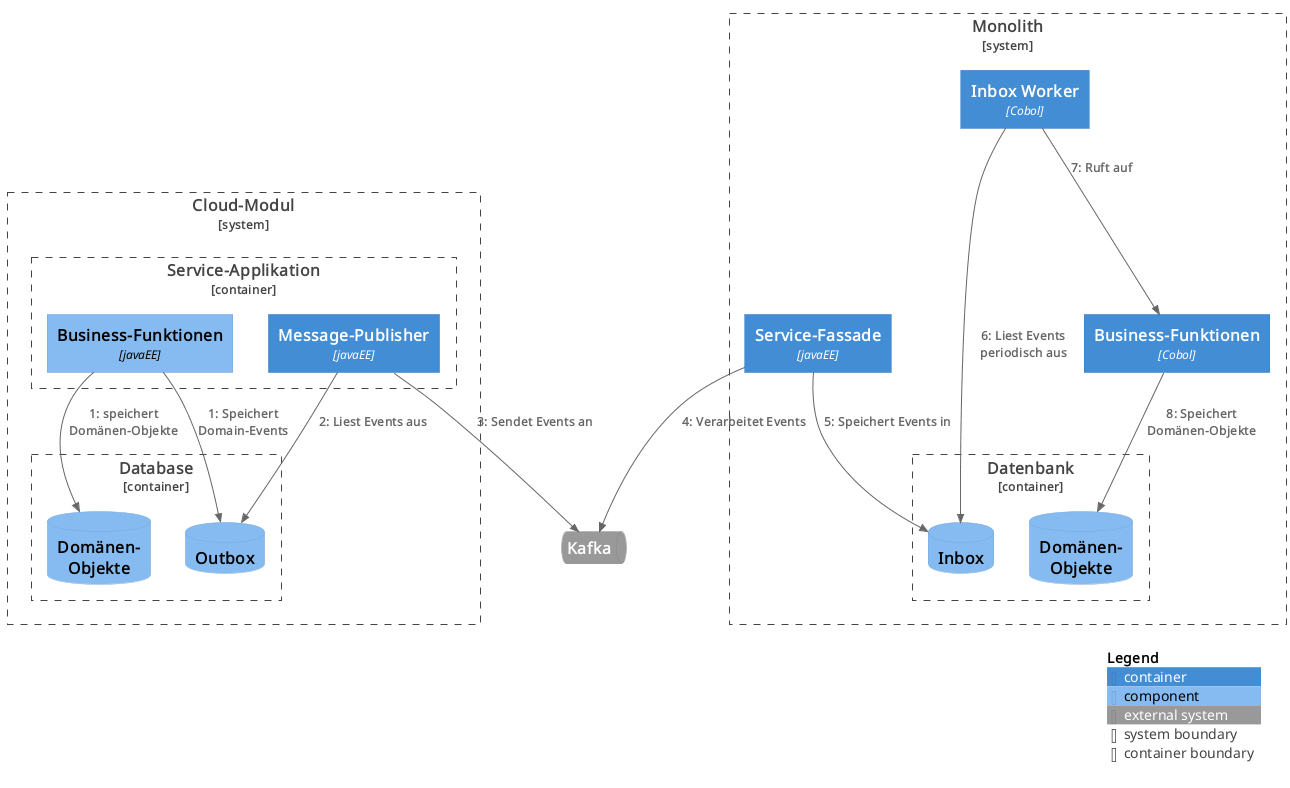
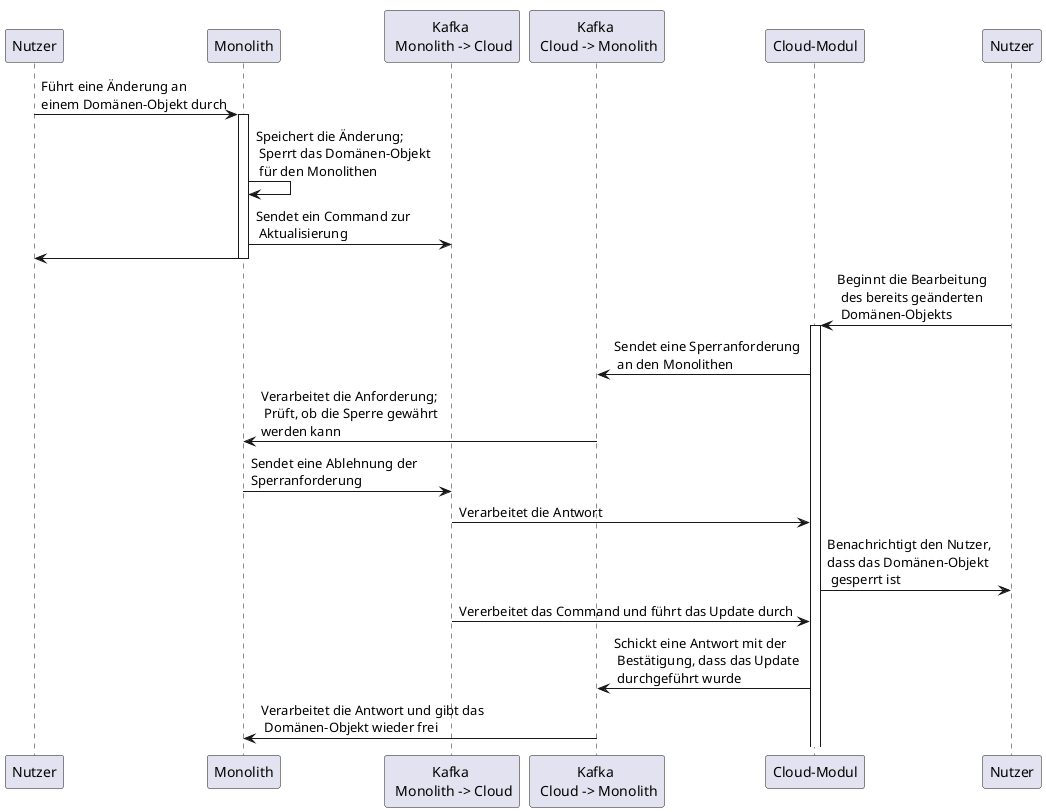
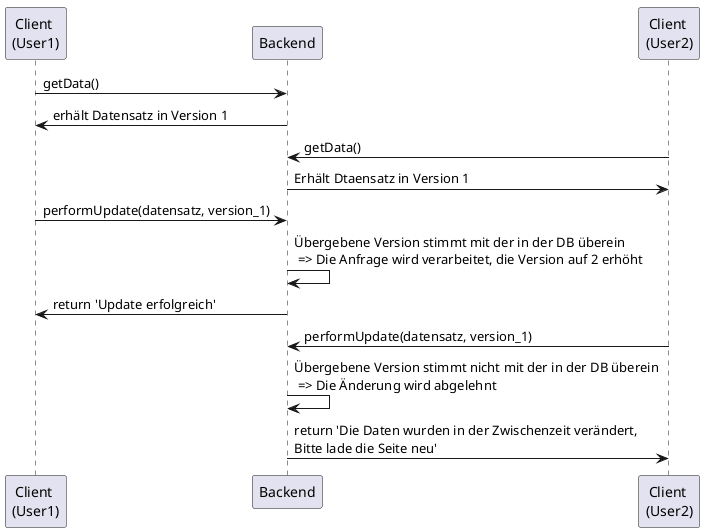
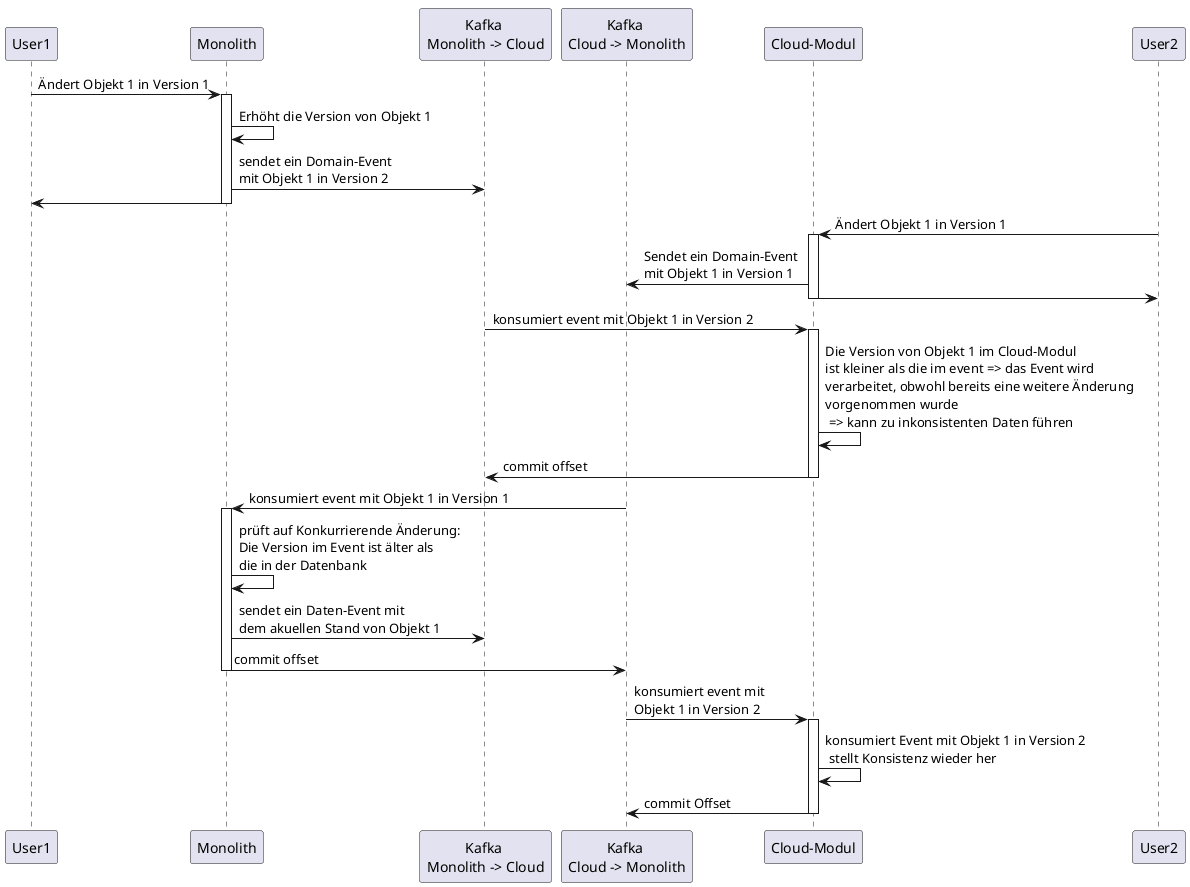
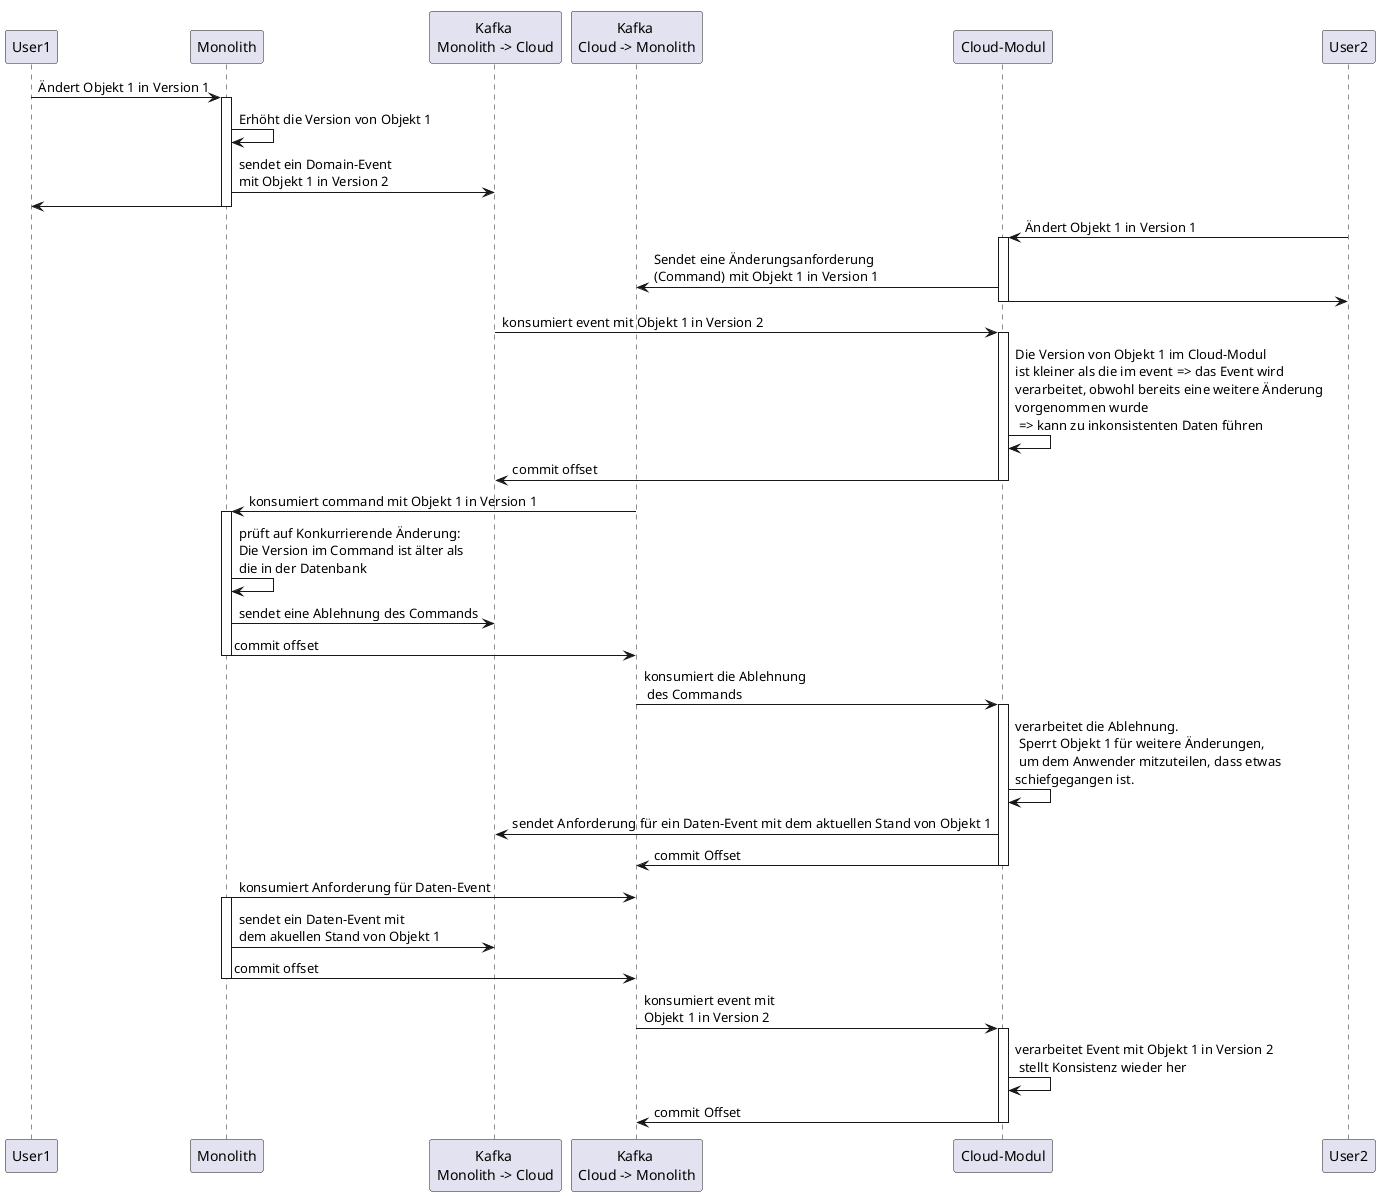
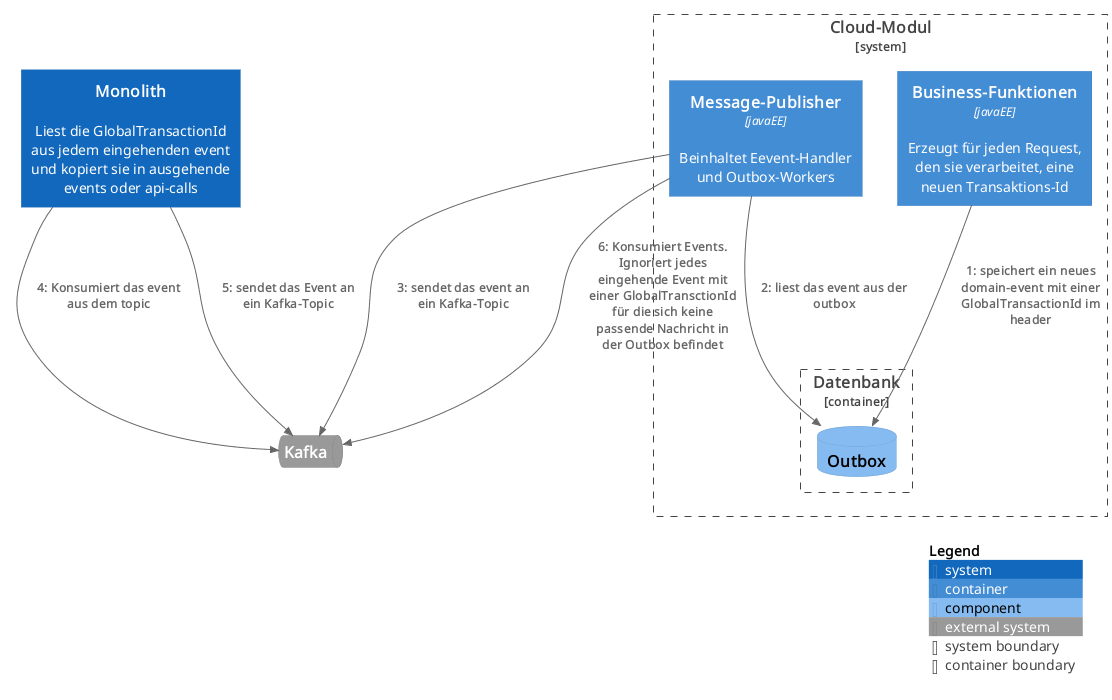
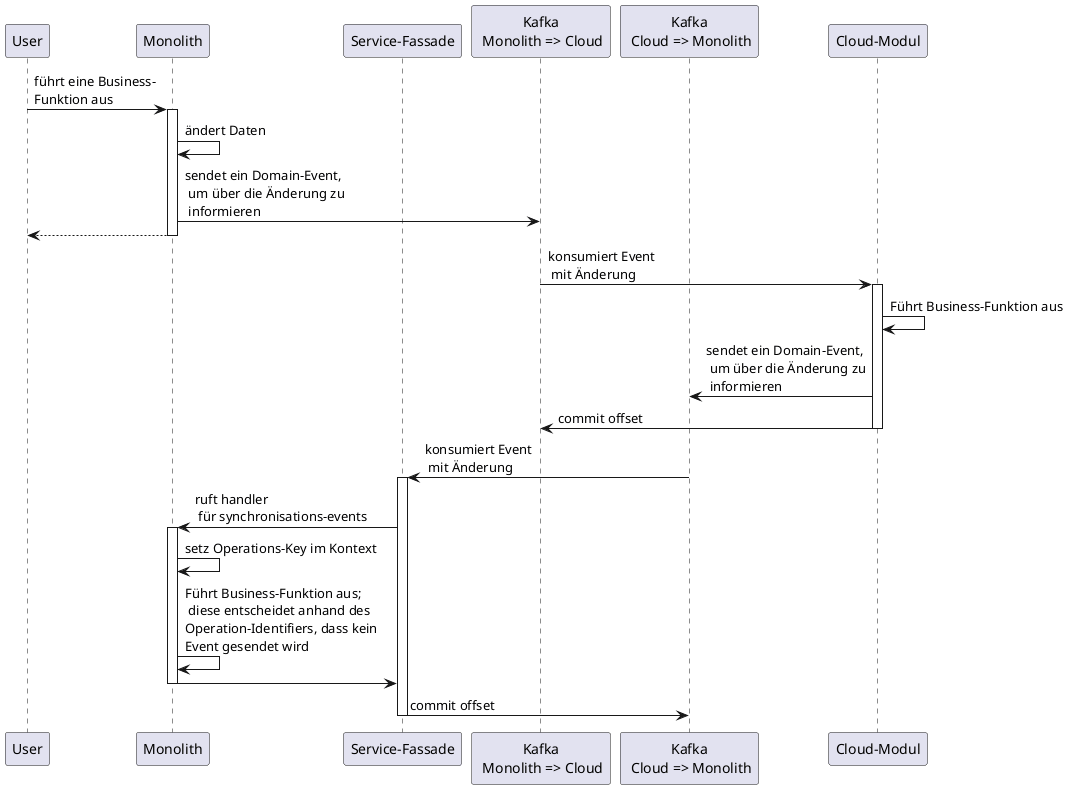
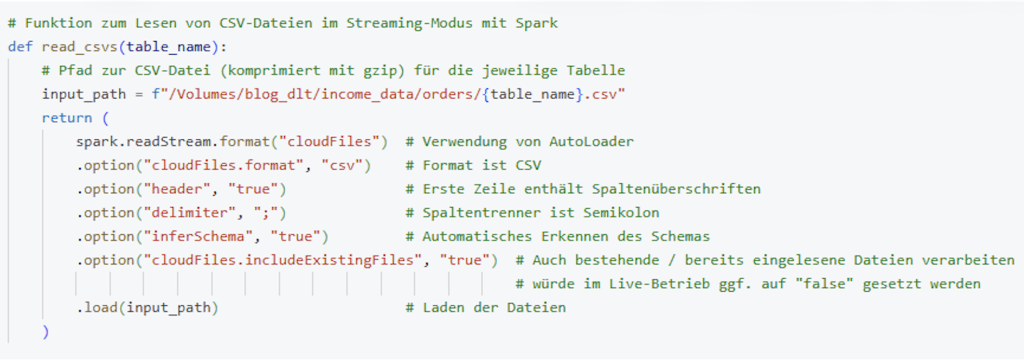
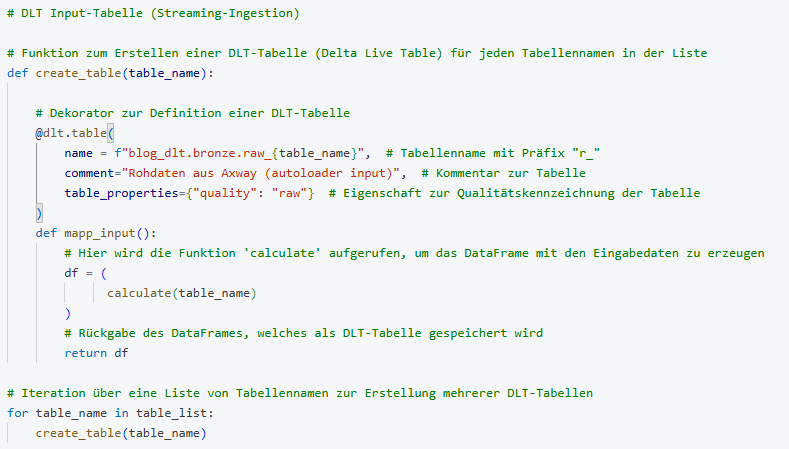
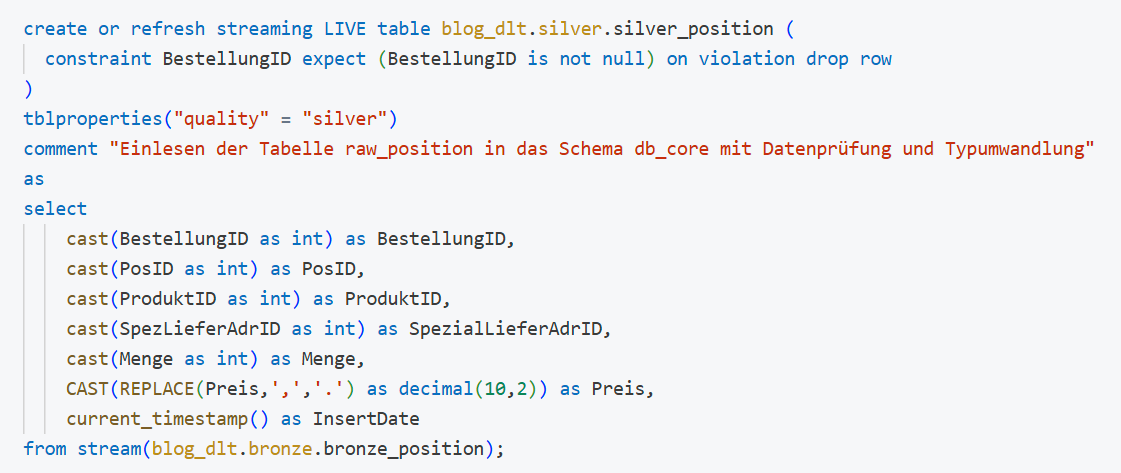
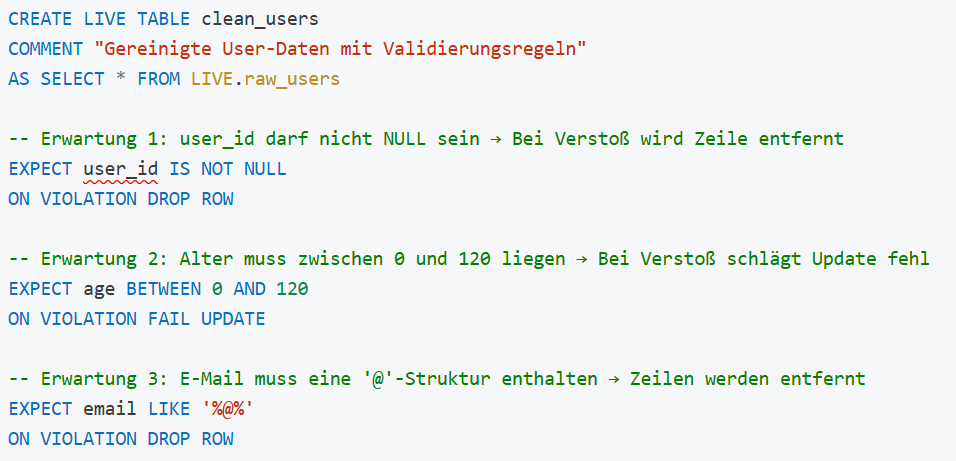
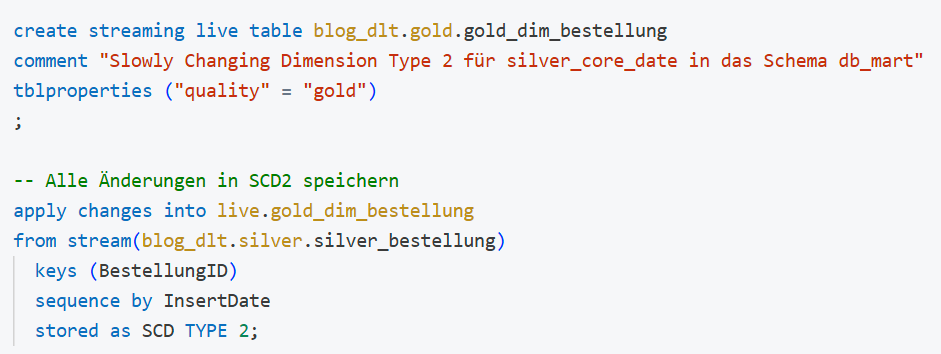
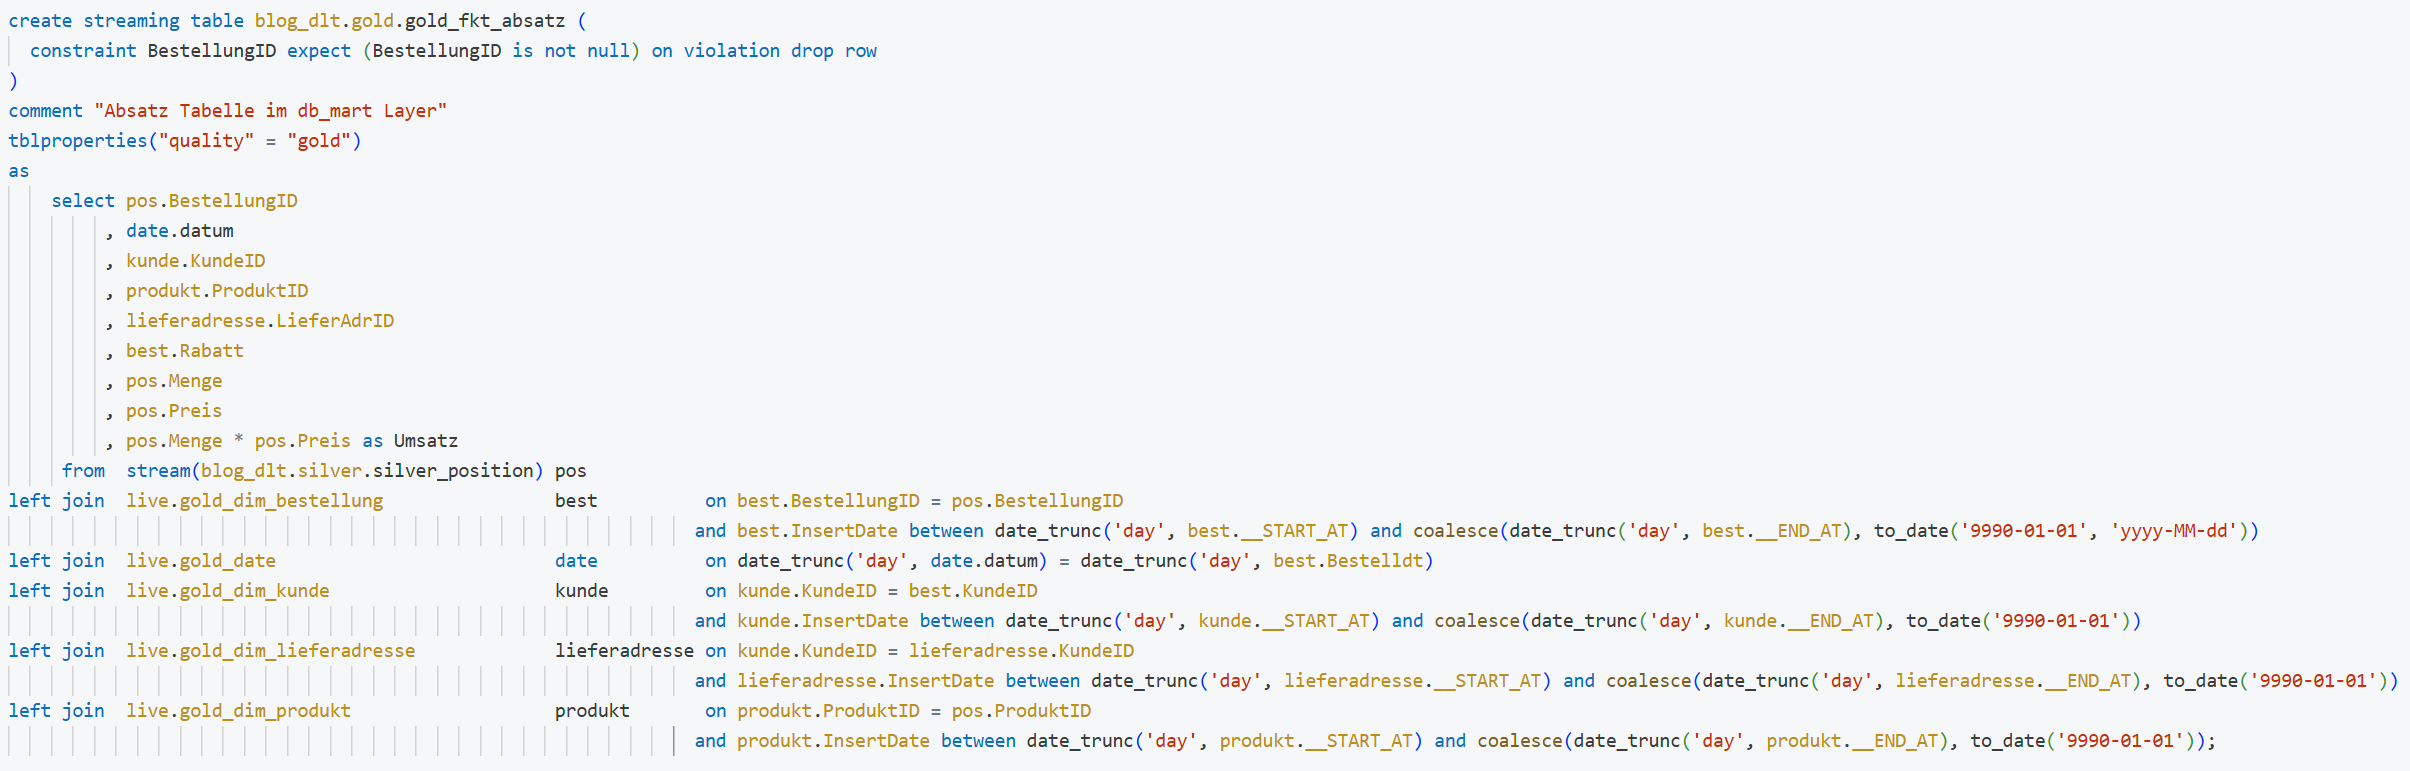
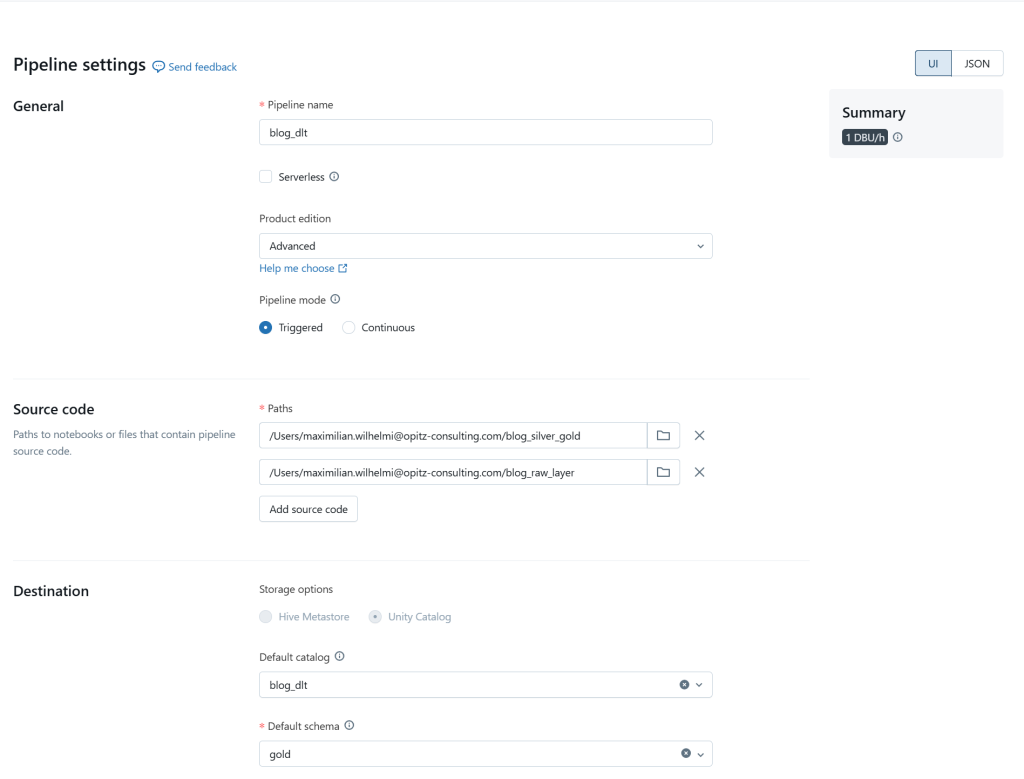
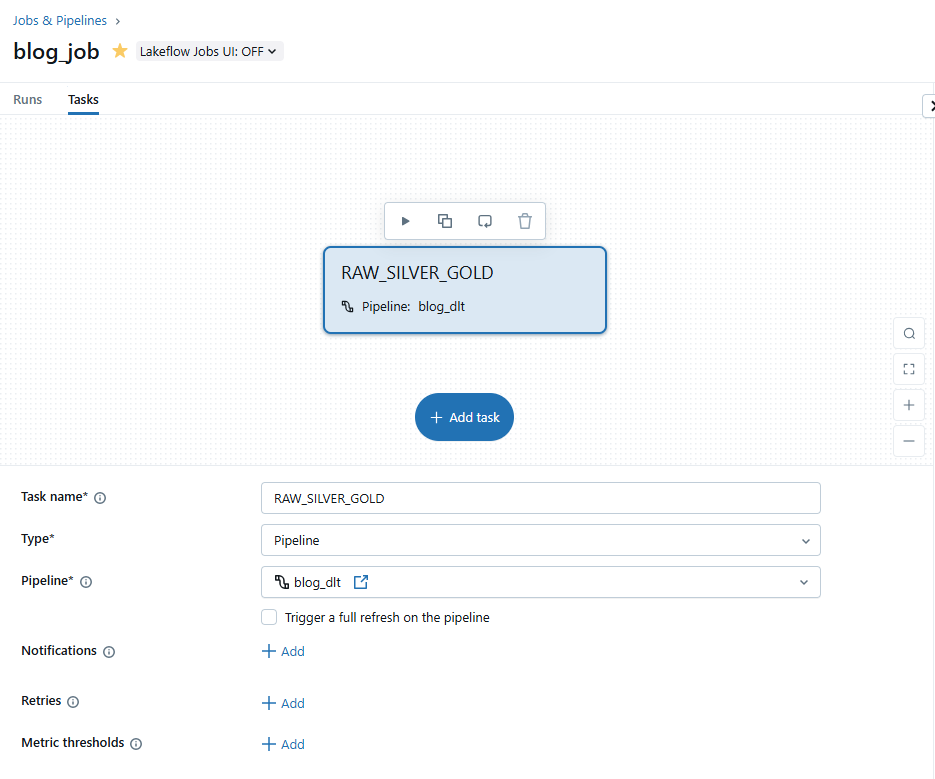
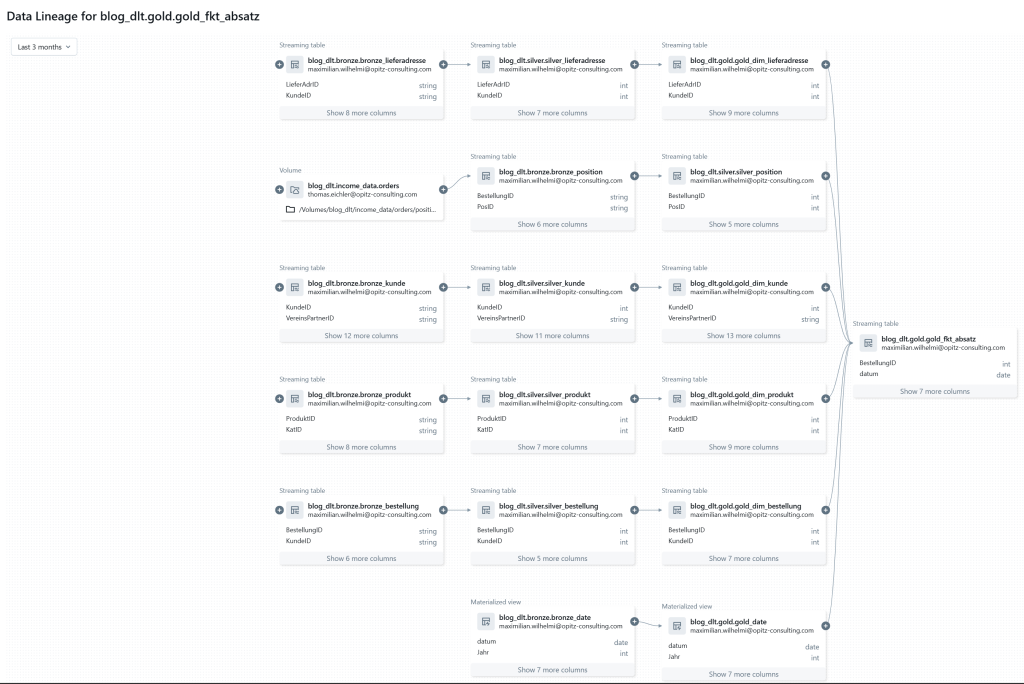

mit der Antwort. ## Vaadin Flow Vaadin Flow ermöglicht die Entwicklung von serverseitigen Java-basierten Webanwendungen. Hier ist ein einfaches Beispiel für eine UI-Komponente in Vaadin Flow: ![Codebeispiel 2](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-02.png) In diesem Beispiel erstellen wir eine einfache UI-Komponente mit einem Button, der eine Benachrichtigung auslöst, wenn er geklickt wird. Vaadin Flow bietet eine Java-basierte Programmierung von Benutzeroberflächen. ## Hilla Hilla kombiniert ein Spring Boot Java Backend mit einem reaktiven TypeScript Frontend. Hier ist ein Beispiel für die Verwendung des Lit-Frameworks in Hilla: ![Codebeispiel 3](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-03.png) In diesem TypeScript-Code verwenden wir das Lit-Framework, um eine einfache Komponente mit einem Button zu erstellen. Lit ermöglicht die schnelle Erstellung von Web-Komponenten. ## Benutzerregistrierung und Anmeldung ### Thymeleaf mit HTMX ![Codebeispiel 4](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-javafullstack-teil2_bild-04.png) In diesem Codebeispiel haben wir eine Seite erstellt, die sowohl die Benutzerregistrierung als auch die Anmeldung ermöglicht. Hier sind die wichtigsten Teile des Codes: - **Registrierungsformular**: Wir haben ein Formular erstellt, das beim Absenden eine POST-Anfrage an /register sendet. Das th:htmx-Attribut ermöglicht die Verwendung von HTMX für die serverseitige Interaktion. Das Ergebnis der Registrierung wird in einem bestimmten
-Element angezeigt. - **Anmeldeformular**: Ähnlich wie bei der Registrierung haben wir ein Formular für die Anmeldung erstellt. Die Anmeldedaten werden ebenfalls an den Server gesendet, und das Ergebnis wird im entsprechenden
-Element angezeigt. - **Benutzerstatus**: Wir haben Bedingungen eingefügt, um den Benutzerstatus zu überprüfen. Wenn ein Benutzer angemeldet ist, wird eine Willkommensnachricht mit dem Benutzernamen und ein Link zur Abmeldung angezeigt. Andernfalls werden die Registrierungs- und Anmeldeformulare angezeigt. ### Vaadin Flow ![Codebeispiel 5](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-05.png)In diesem Codebeispiel haben wir zwei Vaadin Flow Views erstellt, um die Benutzerregistrierung und Anmeldung zu implementieren: - **LoginView**: Diese View enthält ein Textfeld für den Benutzernamen, ein Passwortfeld und einen Anmeldebutton. Beim Klicken des Anmeldebuttons wird die Methode loginUser() aufgerufen, die die Anmelde-Logik implementiert. - **RegisterView**: Diese View enthält ein Textfeld für den Benutzernamen, ein Passwortfeld und einen Registrierungsbutton. Beim Klicken des Registrierungsbuttons wird die Methode registerUser() aufgerufen, die die Registrierungs-Logik implementiert. ### Hilla ![Codebeispiel 6](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-06.png) In diesem Codebeispiel haben wir zwei LitElement-Komponenten erstellt, um die Benutzerregistrierung und Anmeldung mit Hilla umzusetzen: - **RegisterView**: Diese Komponente enthält Eingabefelder für den Benutzernamen und das Passwort sowie einen Registrierungsbutton. Beim Klicken des Buttons wird die Methode register() aufgerufen, die die Registrierungsfunktion aufruft. - **LoginView**: Ähnlich wie bei der Registrierung enthält diese Komponente Eingabefelder für Benutzernamen und Passwort sowie einen Anmeldebutton. Die Methode login() wird beim Klicken des Buttons aufgerufen und ruft die Anmeldefunktion auf. Die eigentliche Implementierung der Registrierungs- und Anmeldefunktionen erfolgt in den entsprechenden Methoden mithilfe von externen API-Aufrufen (zum Beispiel registerUser und loginUser). ## Datenverwaltung und Anzeige ### Thymeleaf mit HTMX ![Codebeispiel 7](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-07.png)In diesem Codebeispiel haben wir eine Seite erstellt, um die Datenverwaltung und Anzeige zu demonstrieren: - **Datenanzeige**: Wir verwenden die Thymeleaf-Schleife th:each zum Durchlaufen der dataList, die die darzustellenden Daten enthält. Für jedes Datenobjekt wird ein
erstellt, das den Namen des Elements anzeigt, sowie ein „Löschen“-Button. Beim Klicken des „Löschen“-Buttons wird das entsprechende Datenobjekt entfernt. - **Datenhinzufügung**: Wir haben ein Formular erstellt, das beim Absenden eine POST-Anfrage an /addItem sendet, um ein neues Element zur Datenliste hinzuzufügen. Das Ergebnis wird im
mit der ID dataList angezeigt. ### Vaadin Flow ![Codebeispiel 8](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-08.png) - **Datenanzeige**: Wir haben eine Grid-Komponente erstellt, um die Daten in tabellarischer Form anzuzeigen. Die Methode addColumn fügt eine Spalte hinzu, um die Daten darzustellen. - **Datenhinzufügung**: Wir haben ein Eingabefeld und einen Button hinzugefügt, um neue Daten zur Liste hinzuzufügen. Beim Klicken des Buttons wird die Methode addData aufgerufen, die die Daten zur Liste hinzufügt und die Grid-Komponente aktualisiert. ### Hilla ![Codebeispiel 9](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-09.png) - **Datenanzeige**: Im firstUpdated-Lifecycle-Hook rufen wir die Methode getDataList() auf, um die Datenliste abzurufen und in der Property dataList zu speichern. Diese Daten werden dann mithilfe von map im Template in Form einer ungeordneten Liste dargestellt. - **Datenhinzufügung**: Wir haben ein Eingabefeld und einen Button hinzugefügt, um neue Daten zur Liste hinzuzufügen. Beim Klicken des Buttons wird die Methode addData() aufgerufen, die die Methode addDataItem() aufruft, um das neue Element hinzuzufügen, und anschließend die Datenliste aktualisiert. ## Formulare und Validierung ### Thymeleaf mit HTMX ![Codebeispiel 10](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-10.png) - **Name**: Das Eingabefeld für den Namen enthält die Attribute required, minlength und maxlength, um die Eingabe zu validieren. Das pattern-Attribut definiert eine RegEx für erlaubte Zeichen (Buchstaben und Leerzeichen). Fehlermeldungen werden mit dem th:errors-Tag angezeigt, wenn die Validierung fehlschlägt. - **E-Mail**: Ähnlich wie beim Namen ist das Eingabefeld für die E-Mail mit dem Attribut required versehen. Fehlermeldungen werden ebenfalls mit th:errors angezeigt. - **Formularabsenden**: Das Formular wird beim Absenden mithilfe von HTMX validiert und an den Server gesendet. Das Ergebnis wird im
mit der ID result angezeigt. ### Vaadin Flow ![Codebeispiel 11](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-11.png) - **Name**: Das TextField für den Namen wurde mit verschiedenen Eigenschaften konfiguriert, um die Validierung durchzuführen. setRequiredIndicatorVisible(true) zeigt den roten Stern an, um anzuzeigen, dass das Feld erforderlich ist. setRequired(true) legt fest, dass das Feld nicht leer sein darf. setMaxLength(20) und setMinLength(3) legen die Längenbeschränkungen fest. setPattern(„\[a-zA-Z \]\*“) definiert eine RegEx für erlaubte Zeichen. Das ErrorMessage wird angezeigt, wenn die Validierung fehlschlägt. - **E-Mail**: Ähnlich wie beim Namen wurde das EmailField konfiguriert. - **Formularabsenden**: Der „Absenden“-Button enthält einen Clicklistener. Wenn das Formular ungültige Eingaben aufweist, wird eine Benachrichtigung angezeigt. Andernfalls wird eine Erfolgsmeldung angezeigt. ### Hilla ![Codebeispiel 12](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-12.png) - **Formularabsenden**: Das Formular verwendet den @submit-Event, um das Absenden des Formulars zu behandeln. Die Methode submitForm() wird aufgerufen, um die Validierung durchzuführen. - **Validierung**: Die Methode validate() aus dem Fusion-SDK wird verwendet, um die Validierung durchzuführen. Wenn das Formular gültig ist, können Sie Ihre Aktionen ausführen. Wenn das Formular ungültig ist, werden Fehlermeldungen im Formular angezeigt. ## RESTful API-Kommunikation ### Thymeleaf mit HTMX ![Codebeispiel 13](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-13.png) - **Datenabruf**: Der Button enthält das th:htmx-Attribut, um eine GET-Anfrage an die URL /loadData auszuführen. Die Ergebnisse werden im Element mit der ID dataContainer angezeigt. ### Vaadin Flow ![Codebeispiel 14](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-14.png) - **Datenabruf**: Der Button loadButton enthält einen Klicklistener, der eine HTTP-Anfrage an die URL /loadData sendet. Die empfangenen Daten werden im dataContainer angezeigt. ### Hilla ![Codebeispiel 15](https://thecattlecrew.net/wp-content/uploads/2024/01/cattle-crew-java-fullstack-teil2_bild-15.png) - **Datenabruf**: Der Button Daten laden enthält einen Klicklistener, der die Methode loadData() aufruft. Diese Methode verwendet die getJson()-Funktion aus dem Fusion-SDK, um Daten von der URL /loadData abzurufen und anzuzeigen. Im nächsten Teil geht es um Angular Server Side Rendering (SSR): Den Schlüssel zu blitzschnellen Webanwendungen. Bleib dabei! # Alle Teile ansehen [Teil 1: Showdown für den Java Full Stack – Thymeleaf/HTMX versus Vaadin Flow & Hilla im Vergleich](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) [Teil 2: Deep Dive in den Java Full Stack – Codebeispiele aus Thymeleaf/HTMX, Vaadin Flow & Hilla](https://thecattlecrew.net/2024/02/20/deep-dive-im-java-full-stack/) [Teil 3: Mit Angular Server Side Rendering zur besten UX – Wie Angular Server Side Rendering (SSR) hilft, blitzschnelle Webanwendungen zu entwickeln](https://thecattlecrew.net/2024/05/08/mit-angular-server-side-rendering-zur-besten-ux/) **Kategorien:** Development **Schlagwörter:** Client-seitiges Rendern, Hilla, HTMX, Java Full Stack, JavaScript-Bibliothek, Reactives Webdesign, Rich Internet Application (RIA), Server-seitige Template Engine, Server-seitiges Rendern, single page apps, Spring Boot, Thymeleaf, TypeScript Frontend, Vaadin Flow, Webentwicklung --- ### [Mit Angular Server Side Rendering zur besten UX](https://thecattlecrew.net/2024/05/08/mit-angular-server-side-rendering-zur-besten-ux/) **Published:** Mai 8, 2024 **Author:** Patrick Boerk **Content:** # Thymeleaf/HTMX versus Vaadin Flow & Hilla, Teil 3: **Wie** **Angular Server Side Rendering (SSR) hilft, blitzschnelle Webanwendungen zu entwickeln** In der dynamischen Welt der Webentwicklung glänzt Angular als eine der führenden Technologien, mit der Entwicklungsteams leistungsstarke Anwendungen gestalten können. Doch selbst bei Angular gibt es Situationen, in denen zusätzliche Optimierung notwendig ist. Hier kommt Angular Server Side Rendering (SSR) ins Spiel. Diese Technik verspricht nicht nur verkürzte Ladezeiten und eine nahtlose Benutzererfahrung, sondern macht Anwendungen auch suchmaschinenfreundlicher. Doch wie steht Angular SSR im Vergleich zu Thymeleaf mit HTMX, Vaadin Flow und Hilla? Tauchen wir ein, um die vielfältigen Möglichkeiten dieses Schlüssels zur blitzschnellen Webentwicklung zu entdecken! *Du bist neu dabei? Hier kannst du einen Blick in die ersten beiden Teile der Blogserie werfen:* - [Teil 1: Showdown für den Java Full Stack – Thymeleaf/HTMX versus Vaadin Flow & Hilla im Vergleich](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) - [Teil 2: Deep Dive in den Java Full Stack – Codebeispiele aus Thymeleaf/HTMX, Vaadin Flow & Hilla](https://thecattlecrew.net/2024/02/20/deep-dive-im-java-full-stack/) ## **Was ist Angular SSR und wozu dient es?** Angular Server Side Rendering (SSR) ist der Schlüssel zur Transformation von Webanwendungen. Statt darauf zu warten, dass JavaScript die Seite im Browser generiert, rendert Angular SSR die Anwendung bereits auf dem Server. Das Resultat? Kürzere Ladezeiten, verbesserte Benutzererfahrung und erhöhte Sichtbarkeit in Suchmaschinen. Klingt das bekannt? Ja, genau so haben serverseitige Frameworks, wie Java Server Faces, Ruby-on-Rails oder PHP früher immer gearbeitet. Man kann sogar noch weiter gehen und ganze Seiten nicht nur auf dem Server generieren, sondern auch pre-rendern. Pre-Rendern bedeutet, dass Seiten schon unabhängig von einem konkreten Request auf dem Server gerendert und als statische Seiten abgelegt werden. Diese statischen HTML-Seiten müssen dann nur noch ausgeliefert werden. Dabei gibt es verschiedene Ansätze, um das Rendern ganzer Webseiten oder bestimmte Teile davon sinnvoll einzusetzen. - **Server-Side Rendering (SSR):** Bei SSR wird der HTML-Inhalt einer Webseite auf dem Server generiert und an den Browser des Benutzers gesendet, wenn eine Anfrage gestellt wird. Das bedeutet, dass jeder Besuch auf der Seite eine Serveranfrage auslöst, um die aktuelle Version der Seite zu erhalten. SSR eignet sich gut für dynamische Inhalte, die sich häufig ändern, da der Server bei jedem Aufruf den aktuellen Zustand generiert. Dies ermöglicht Suchmaschinen-Crawling und ist gut für SEO geeignet. - **Pre-rendering (inklusive der incremental Static Generation):** Pre-rendering ist eine Technik, bei der Teile oder die gesamte Website im Voraus generiert werden, bevor sie an den Benutzer gesendet werden. Incremental Static Generation ist eine Weiterentwicklung des Pre-rendering und ermöglicht es, Seiten statisch zu generieren und bei Bedarf zu aktualisieren. Dies bedeutet, dass statische Seiten vorgeneriert werden, aber sie können auch dynamische Daten enthalten, die zur Laufzeit geladen werden. Diese Methode bietet eine gute Balance zwischen Performance und Aktualisierbarkeit. - **Static Site Generation (SSG):** Bei SSG wird die gesamte Webseite im Voraus erstellt und in HTML-Dateien umgewandelt. Diese Dateien werden dann auf einem Server bereitgestellt und an den Benutzer gesendet, ohne dass eine Serveranfrage erforderlich ist. SSG ist extrem schnell, da keine Serververarbeitung erforderlich ist, aber es ist weniger geeignet für Seiten mit häufig wechselnden Inhalten. Es ist ideal für Websites mit hauptsächlich statischem Inhalt oder solchen, die nicht ständig aktualisiert werden müssen. Die Herausforderung besteht in der nahtlosen Integration von serverseitigem und clientseitigem Rendering. Angular SSR löst dieses Problem, indem es Webanwendungen vorab auf dem Server rendert und dem Benutzer sofortigen Inhalt präsentiert. Das führt zu einer flüssigeren Benutzererfahrung und einer besseren Indexierung in Suchmaschinen. ## **Use Cases: Optimierung von Performance und SEO** Angular Server Side Rendering (SSR) bietet eine breite Palette von Anwendungsfällen, die sich auf zwei Hauptvorteile konzentrieren: Performanceoptimierung und Suchmaschinenoptimierung (SEO). In Bezug auf die Performance ermöglicht Angular SSR die schnelle Bereitstellung von Inhalten, was für E-Commerce-Plattformen, content-orientierte Websites und Progressive Web-Apps (PWAs) von entscheidender Bedeutung ist. Der Server rendert bereits HTML-Seiten vor, was zu verkürzten Ladezeiten führt und eine reaktionsschnelle Benutzererfahrung bietet. Im Bereich der SEO macht Angular SSR-Webanwendungen suchmaschinenfreundlicher. Die bereits gerenderten HTML-Seiten sind leicht indexierbar, was die Sichtbarkeit in den Suchergebnissen verbessert. Dies ist insbesondere für content-orientierte Websites und suchmaschinenoptimierte Anwendungen von großer Bedeutung. Die vielseitigen Anwendungsfälle von Angular SSR unterstreichen seine Bedeutung als leistungsfähiges Tool zur Verbesserung von Performance und SEO für eine breite Palette von Webanwendungen. ## **Die Magie der „Hydration“ in Angular SSR** Die „Hydration“ ist der Prozess, serverseitig gerenderte HTML-Seiten nahtlos in reaktive clientseitige Anwendungen zu überführen. In einfachen Worten: Der Server rendert nicht nur die statischen HTML-Seiten, sondern sendet auch den zugehörigen JavaScript-Code an den Browser. Hier beginnt die „Hydration“, bei der der Client die Kontrolle über die vorhandene DOM-Struktur übernimmt und die dynamischen Funktionen aktiviert, ohne die gesamte Struktur neu zu erstellen. Anders als bei der bisherigen „Destructive Hydration“ in Angular SSR wird nicht die gesamte Seite neu gerendert. Stattdessen ersetzt die „Non-Destructive Hydration“, eingeführt mit Angular 16, nur benötigte Teile des HTML-Codes, was zu einer noch schnelleren Aktualisierung und reaktionsschnelleren Benutzererfahrung führt. Die „Hydration“ ist somit nicht nur ein Feature, sondern der Schlüssel zu einer beeindruckenden Kombination aus Performance und Benutzerfreundlichkeit in Angular SSR. ## **Fazit zu Angular SSR** Angular Server Side Rendering (SSR) bietet eine beeindruckende Lösung für die Entwicklung von Webanwendungen, die auf Performance, SEO-Freundlichkeit und reaktive Benutzeroberflächen abzielen. Das serverseitige Rendern ermöglicht schnellere Ladezeiten, was zu einer verbesserten Benutzererfahrung führt und die Sichtbarkeit in Suchmaschinen erhöht. Die non-destructive Hydration beschleunigt die Aktualisierung und ermöglicht reaktive Anwendungen. Angular SSR eignet sich besonders gut für Projekte, bei denen Performance und SEO eine hohe Priorität haben. Die Flexibilität, universelle Anwendungen zu entwickeln, die sowohl auf dem Server als auch im Browser funktionieren, eröffnet Entwicklern viele Möglichkeiten. Trotz der Komplexität und des steileren Lernverlaufs kann Angular SSR für diejenigen, die auf diese Aspekte Wert legen, eine leistungsstarke Option sein. Das Zwischenfazit zu Angular SSR zeigt, dass diese Technologie in der Lage ist, beeindruckende Ergebnisse zu erzielen, wenn es darum geht, Webanwendungen auf die nächste Stufe zu heben. Mit der richtigen Herangehensweise und Expertise können Entwickler von den Vorteilen profitieren, die Angular SSR bietet. ## **Welcher Lösungsansatz passt für mich?** ### **Thymeleaf + htmx – Einfachheit, die überzeugt** Wenn Sie eine einfachere Lösung suchen, könnte Thymeleaf + htmx Ihre Wahl sein. Diese Kombination überzeugt durch ihre Benutzerfreundlichkeit und SEO-Freundlichkeit. Mit einer schnellen Implementierung und einer geringeren Lernkurve ist sie ideal für Projekte mit weniger komplexen Anforderungen. Doch seien Sie gewarnt, bei hochinteraktiven Anwendungen und komplexen Aufgaben könnte sie an ihre Grenzen stoßen. ### **Vaadin Flow – die Welt der benutzerfreundlichen Komponenten** Betreten Sie die Welt von Vaadin Flow, wo benutzerfreundliche Komponenten im Mittelpunkt stehen. Hier können Sie moderne, ansprechende Benutzeroberflächen mit wiederverwendbaren Komponenten erstellen. Ideal für Unternehmensanwendungen, aber bedenken Sie, dass die Implementierung aufwändiger sein kann und spezifische Kenntnisse erfordert. ### **Hilla – die Low-Code-Plattform** Abschließend werfen wir einen Blick auf Hilla, die aufregende Low-Code-Plattform. Mit einer intuitiven Benutzeroberfläche und vorgefertigten Komponenten können Sie Webanwendungen entwickeln, ohne umfangreiche Programmierung. Perfekt für schnelle Iterationen und einfache Anpassungen, aber bei komplexen Anforderungen und tiefgreifenden Anpassungen könnte es knifflig werden. # Alle Teile ansehen [Teil 1: Showdown für den Java Full Stack – Thymeleaf/HTMX versus Vaadin Flow & Hilla im Vergleich](https://thecattlecrew.net/2024/02/14/showdown-fuer-den-java-full-stack/) [Teil 2: Deep Dive in den Java Full Stack – Codebeispiele aus Thymeleaf/HTMX, Vaadin Flow & Hilla](https://thecattlecrew.net/2024/02/20/deep-dive-im-java-full-stack/) [Teil 3: Mit Angular Server Side Rendering zur besten UX – Wie Angular Server Side Rendering (SSR) hilft, blitzschnelle Webanwendungen zu entwickeln](https://thecattlecrew.net/2024/05/08/mit-angular-server-side-rendering-zur-besten-ux/) **Kategorien:** Development **Schlagwörter:** Hilla, HTMX, Java Full Stack, JavaScript-Bibliothek, Reactives Webdesign, Rich Internet Application (RIA), Server-seitige Template Engine, Server-seitiges Rendern, single page apps, Spring Boot, Thymeleaf, TypeScript Frontend, Vaadin Flow, Webentwicklung --- ### [Klassifikation mit dem Autopiloten von Amazon Sagemaker](https://thecattlecrew.net/2020/07/17/klassifikation-mit-dem-autopiloten-von-amazon-sagemaker/) **Published:** Juli 17, 2020 **Author:** Maximilian Palmer **Content:** Dies ist der erste Beitrag einer zweiteiligen Reihe, die die Möglichkeiten von Amazon SageMaker evaluiert. Nachdem wir uns bereits mit dem Thema [Reinforcement Learning anhand des AWS DeepRacers](https://thecattlecrew.net/2020/04/30/oc-expert-camp-xxl-deepracer-vorfuehrung/) beschäftigten, haben wir nun den Amazon SageMaker untersucht. Dabei lag der Hauptfokus auf den folgenden Fragestellungen: - Welche Funktionen bietet Amazon SageMaker - Liefert automatisiertes maschinelles Lernen (AutoML) einen echten Mehrwert - Welche Performance erreicht das AutoML des Amazon SageMakers, im Vergleich zu manuell entwickelten Machine Learning (ML) Modellen Um diese Fragestellungen zu beantworten wurden zwei verschiedene Datensätze ausgewählt und jeweils ein manuelles ML Modell und ein automatisiertes ML Modell erstellt und verglichen. ## Amazon SageMaker und Amazon SageMaker Autopilot Amazon SageMaker ist ein Service von AWS, um den Prozess der Entwicklung eines ML Modells zu vereinfachen und so die Time to Market zu verkürzen. Der Autopilot ist der zugehörige AutoML Service im SageMaker. AutoML vereinfacht den Prozess der Anwendung von maschinellem Lernen auf Probleme der realen Welt. Dabei wird die gesamte Pipeline vom Rohdatensatz bis zum einsatzfähigen Modell automatisiert. Damit werden Teile des Preprocessing und das komplette Modellieren übernommen. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/image-2.png)Der Amazon Autopilot bietet dabei zwei unterschiedlichen Modi an. Ein Modus erstellt lediglich die Python Scripte und Modellvorschläge, welche anschließend angepasst und manuell ausgeführt werden können. Der zweite Modus hingegen bietet eine graphische Oberfläche und führt das komplette Modellieren inkl. Training automatisch aus. ## Verwendete Datensätze Um SageMaker in seiner vollen Bandbreite zu evaluieren, entschieden wir uns dazu, mit zwei unterschiedlichen Datensätzen und Problemen die Technologie zu verproben. - Beim ersten Datensatz handelt es sich um ein mehrdimensonales Klassifizierungs Problem () Dieser Datensatz enthält bis zu 50 Social Media Posts von einer Person und dem dazugehörigen MBTI Typ der Person - Beim zweiten Datensatz handelt es sich um ein Regressions Problem () Dieser Datensatz enthält Informationen über die Preisentwicklung des Wohnungsmarktes in Boston, sowie Informationen über die jeweilige Immobilie Im Folgenden beschreiben wir unsere Erfahrungen mit dem ersten Datensatz, die Erfahrungen mit dem zweiten Datensatz und ein Fazit folgen in einem zweiten Blogpost. ## Test Case — MBTI Klassifizierung Der Meyer-Briggs Type Indicator (MBTI) ist eine Klassifizierung der Persönlichkeit anhand von 16 Klassen. Dieser Test Case wurde dafür verwendet, um die Performance von SageMaker im Bereich der Multidimensionalen Klassifizierung zu bewerten. Dabei haben die ML Modelle englischsprachige Social Media Posts auf einen von 16 Persönlichkeitstypen zugeordnet. ### Datensatz Um ein Machine Learning Modell zu entwickeln werden sehr viele gelabelte Daten benötigt. Der Datensatz () von Kaggel bietet hierfür die richtige Anzahl and gelabelten Daten. Dieser enthält von eine Vielzahl von Social Media Posts. Pro Person werden bis zu 50 Posts aufgeführt sowie deren MBTI Type. Der MBTI Test ist ein Instrument, mit dem der Persönlichkeitstype erfasst werden kann. Er unterscheidet Typen entlang vier Dimensionen: - I-E (Introversion – Extraversion) - N-S (Intuition – Sensing) - F-T (Feeling – Thinking) - J-P (Judging – Perceiving) Jede Person kann in jeder der vier Dimensionen je eine von zwei Ausprägungen haben. Der Persönlichkeitstyp ist dann die Zusammensetzung der verschiedenen Ausprägungen Daraus entstehen dann 24 = 16 verschiedene Persönlichkeitstypen. (INFJ, ISFJ, …) ### Preprocessing Um Text mit Hilfe von ML zu verarbeiten, muss dieser vorverarbeitet und codiert werden. Dadurch lässt sich eine deutlich bessere Performance bzw. Genauigkeit des späteren Modells erzielen. Für diesen Datensatz wurden zwei spezifische Anpassungen vorgenommen. Zum einen das Trennen des Datensatzes und zum anderen das verarbeiten/auflösen der Links. ##### Aufsplitten der Datensätze Nach einer genaueren Untersuchung des Datensatzes stellte sich heraus, dass die Persönlichkeitsdimensionen jeweils für eine Person direkt kombiniert wurden. Dies lässt den intuitiven Ansatz zu, für jede der vier Dimensionen eine eigene binäre Klassifikation zu erstellen. ##### Verarbeiten von Links Da es sich bei den Datensätzen um Social Media Posts handelt, enthalten diese vermehrt Links. Diese Links beinhalten zum Teil wichtige Informationen über den Post der jeweiligen Person. Deshalb wird der Inhalte der Links extrahiert und der Link mit diesen neu gewöhnen Daten ersetzt. Links die keinen Inhalt, wie bspw. YouTube-Links, besitzen werden durch den Namen des Dienstes ersetzt. Im Beispiel von YouTube bedeutet das, dass der YouTube Link durch das Wort YouTube ersetzt wurde. Links welche wichtigen Informationen, wie bspw. Bildnamen enthielten, wurden beibehalten. Eine Linkauflösung dieses Linkes “ würde friendship-boy-and-girl-wallpaper.jpg ergeben. ##### Vectorizer Im nächsten Schritt muss der Datensatz analysiert und codiert werden. Hierfür wird, wie bei der Textverarbeitung üblich, ein Vectorizer verwendet. Mit dessen Hilfe wird eine Feature Extraction eines Textes, in unseren Fall der Posts, durchgeführt. Hierbei entstehen Kennzahlen/Features wie: Häufigkeit eines Wortes, Satzlänge und TF-IDF-Wert. Das TF-IDF-Maß wird zur Beurteilung der Relevanz von Termen in Dokumenten eingesetzt. Diese Maßeinheit besteht aus der Kennzahl TF (term frequency) und IDF (inverse term frequency). Hierbei gibt TF die Häufigkeit einzelner Terme (Wörter) an und beschreibt wie häufig ein Term im Dokument bzw. Post vorkommt. Mit Hilfe dieser Kennzahl kann nun unser Modell trainiert werden. () ### Modelling Um das Modell von AutoML zu evaluieren, entwickelten wir zwei weiter Modelle selber. Diese beiden Modelle werden im Folgendem kurz beschrieben. **Passive Aggressive Classifier (PAC)** Dieser Klassifizierungs-Algorithmus zeichnet sich durch die, wie schon im Titel angedeutet, Passive und Aggressive Klassifikation aus. Dies bedeutet, dass bei einer korrekten Klassifikation eines Training Samples das Modell unverändert bleibt, bei einer inkorrekten Klassifikation hingegen wird das Model so abgeändert, dass das Training Sample in der korrekten Klassifikation liegt. Der PAC ist simpler Standard Algorithmus, welcher für viele Klassifizierungsprobleme eingesetzt wird und dafür für die ersten Evaluierungen gut geeignet ist. **Linear Support Vector Machine** Dieser Algorithmus ist ebenfalls ein Klassifizierungs-Algorithmus, welcher die zusätzliche Eigenschaft besitzt, dass die beste Hyperebene gefunden wird. Dies bedeutet intuitiv: die Daten werden derart klassifiziert, dass sie einen möglichst großen Abstand zu benachbarten Clustern besitzen. Dieser Algorithmus ist einer der am häufigsten eingesetzten und meistens, am besten geeignet für Textklassifizierung. Also genau das Richtige für dieses Projekt. ### Ergebnis AutoML AutoML hat in den Testdurchläufen jeweils 250 verschiedene Modelle trainiert. Diese setzen sich aus einer von verschiedenen Datenvorverarbeitungsmethoden sowie dem parametrisierbaren Training zusammen. Wir haben den Code von dem besten Modell etwas genauer unter die Lupe genommen. AWS verwendet für das Preprocessing, ebenso, den TF-IDF-Vectorizer von SciKit-Learn „“ Nur mit anweichenden Parametern zu unseren Vectorizer. Für das Training und ML-Modell greift AWS auf den Boosted-Tree Algorithmus von XGBoost zurück. Hierbei werden mehrere schwächere Modelle zu einem kombiniert, welcher bessere Ergebnisse liefert. Dabei greift AWS auf die SciKit-Learn Library zurück. ### Ergebnis „Hand-Coded“ Als Output generierten wir drei trainierte Modelle. Die Accuracy des Passive Aggressive Classifier Modells und des Linear Support Vector Machine Modells lagen dicht zusammen bei ca. 66%. Das Modell der Linear Support Vector Machine erzielte lediglich eine Verbesserung von ca. 2%, welche mit etwas Finetunning und Preprocessing noch weiter gesteigert werden hätte können. ## Fazit / Zusammenfassung Zur genaueren Analyse der Modelle, berechneten wir eine gewichtete Genauigkeit. Diese betrachtet die Vorhersage für jede Dimension des Persönlichkeitstypen einzeln. Somit entsteht eine genauere Abstufung über die Güte der Vorhersage. Beispielsweise wird dadurch mit in Betracht gezogen, dass drei Dimensionen richtig vorhergesagt wurden und nur eine falsch. Dies ergibt somit eine Genauigkeit von 75%. Diese Berechnung ist valide da die einzelnen Persönlichkeitstypen nahezu unabhängig sind. Das beste Modell des Autopiloten hatte eine Genauigkeit von 73% und einer gewichteten Genauigkeit von 91% und ist damit deutlich besser als unsere eigenen Modelle. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/image-3.png)## Ausblick In unseren [nächsten Blogartikel](https://thecattlecrew.net/?p=32188) beschäftigen wir uns mit Regression, um eine Vorhersage der Entwicklung des Immobilienmarktes in Boston zu treffen. **Kategorien:** AI & Data Science **Schlagwörter:** Amazon SageMaker, Artificial Intelligence, AWS --- ### [Using certificates for authentication at M2M communication](https://thecattlecrew.net/2016/01/15/using-certificates-for-authentication-at-m2m-communication/) **Published:** Januar 15, 2016 **Author:** Bernhard Mähr **Content:** Most bigger companies are today building up a enterprise SOA. On of the key characteristic of the enterprise SOA is the machine to machine communication. The communication between the machines has to be secured. Important is 1.) to keep the the content of the sent messages private 2.) ensure only the authorized machine can invoke operations The first point can be achieved using HTTPS communication for webservice calls. ### Username and Password over HTTPS The second point is at user to machine communication often realized using a username and a password combination and can also be used for machine to machine communication. [![BLOG_Certificates_00](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_certificates_00_thumb.gif "BLOG_Certificates_00")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_certificates_00.gif) On the client side (host1) the certificate of the certificate authority is needed to establish a trust to the CA. On the host side there is the host certificate of machine host2 with the associated private key. This certificate is used to make sure machine host1 is really talking to machine host2. The attribute CN inside the certificate must match to the full qualified hostname of machine host2. The username and password is transmitted over the encrypted HTTPS communication. The host verifiers user and password and has an association to the account used for the operation and the rights the caller has. Most IT professionals know this type of communication and authentication. But there is an other well supported option: client certificates. ### Client certificates In this blog post I will describe the basics how a m2m communication with client certificates work. In this picture is the call of a webservice using HTTPS and client certificate described: [![BLOG_Certificates_01](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_certificates_01_thumb.gif "BLOG_Certificates_01")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_certificates_01.gif) On the client side (host1) the client certificate of the system e.g. CRM with the associated private key is needed. This certificate is used to identify the (logical) system to the machine host2. If the system is a cluster the certificate is the same for all machines. On the host side there is the host certificate of machine host2 with the associated private key. This certificate is used to make sure machine host1 is really talking to machine host2. The attribute CN inside the certificate must match to the full qualified hostname of machine host2. Additionally we need the client certificate of the system (e.g CRM) without the private key on machine host2. Inside machine host2 there is a association from the client certificate of the system CRM to an account used for the operation and the rights the caller has. How this association is created depends on the application software on machine host2. On both sides we need the certificate of our CA. This certificate is need to verify, that all other certificates are issued by the trusted CA and not by a third party. Inside the enterprise it is a best practice to trust on the predefined list of trusted CAs and not on the list automatically provided by Java, SAP or an other manufacturer. Instead a custom list containing only the own trusted CA should be used. ### Bidirectional communication with client certificates If the communication can be initiated from both machines or we are using asynchronous webservices we need to double the number of certificates: [![BLOG_Certificates_02](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_certificates_02_thumb.gif "BLOG_Certificates_02")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_certificates_02.gif) On both machines we have a (different) client certificate identifying the system with the associated private key for proofing the identity of the machine. On both machines we have a (different) host certificate with the associated private key matching the full qualified hostname of the machine. Additionally the client certificate of the other system is need for the association with the account used for processing the requests. ### Security considerations – Keep the private key of the client certificate secured. If someone has this private key he can easily do everything the machine is able to do. – Don“™t use wildcard certificates for host certificates because a wildcard certificate can act as every machine of the enterprise and there for with e.g. spoofing of the DNS listen to any communication. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** AI & Data Science, IT-Security --- ### [Hackathon in München 2016](https://thecattlecrew.net/2017/04/04/hackathon-in-muenchen-2016/) **Published:** April 4, 2017 **Author:** ralfseger **Content:** ### 1 Die Aufgabenstellung Details änden sich in Big Data Hackathon zu Community Days (28.10.2016) Kurz gesagt geht es darum, für einem eingehendem Clickstream (Benutzer mit verschiedenen bekannten Attributen, die gerade eine Webseite besuchen) Werbeanzeigen zu platzieren. Diese Anzeigen auf den Benutzer und sein Konsumverhalten angepasst sein. Schließlich kostet die Werbeanzeige auch Geld das über Rückschlüsse aus erfolgreichen Einkäufen verdient werden will. Von der „REST Event Source“ werden Daten aus dem Original-Stream verteilt. Der „Real Time Bidding Agent“ nimmt die Informationen entgegen und versucht, für möglichst wenig Geld die Werbefläche zu ergattern (wenn sich diese Ausgabe lohnt. Wir wollen wie oben erwähnt Geld verdienen. Ist für den Kunden keine lohnende Werbeempfehlung bekannt so sparen wir normalerweise dieses Geld. Um Kundenverhalten modellieren zu können kann alternativ auch ungezielt Werbung geschaltet werden.) Um die Bedürfnisse der Kunden zu erkennen, zieht der „Real Time Analytic Agent“ diese Daten ab um die „EventHistory“(eine Datenbank) dem Analytics Team zur Verfügung zu stellen. Das Analytics Team versucht mit unterschiedlichen Strategien den vom „Real Time Bidding Agent“ erwirtschafteten Ertrag zu optimieren. ![Flows](https://thecattlecrew.net/wp-content/uploads/2017/04/flows.png) ### 2 Es geht los Der Raum Zugspitze ist überfüllt. Fast alle Anwesenden Kollegen versuchen am Hackaton teilzunehmen bzw. einen Platz zum zuschauen zu ergattern. Das Team um Lukas Berle hat in den ersten Momenten die Aufgabe, eine optimierte Antwortstrategie zu entwerfen. Um hier schnell und zielgerichtet antworten zu können, richten die Kollegen einen Storm-Cluster ein und richten eine Topologie ein, welche für die Click-Events Gebote verschickt. Die Datensammler (Team „Real Time Analytic Agent“) setzten eine MongoDB auf, welche alle RestEvents sammelt. Das sind einerseits die Daten aus dem Clickstream mit Benutzerinformationen, die versendeten Gebote und die Information ob mit der angebotenen Werbung Geld verdient wurde. Das Analytics Team welches sich mit Machine Learning, Visualisierung und „HokusPokus“ muss noch auf Analysedaten warten und diskutiert wie man die erwarteten Daten modellieren kann. ### ![FlowsWithFrameworksAndPersons.png](https://thecattlecrew.net/wp-content/uploads/2017/04/flowswithframeworksandpersons.png) ### 3 Die Daten fließen Während der Storm-Cluster hochgezogen wird, sammeln Waldemar und Daniel die Daten in der **MongoDB** (v. 3.0.6) die auf Ralfs Rechner läuft. Ralf hofft hier direkt mit **R** über die **RMongo** Bibliothek mit Analysen starten zu können. Dimitri erklärt interessierten Anwesenden,wie man hier mit Baummodellen und Visualisierung das Kundenverhalten auswerten kann. Für die Auswertung in Weka benötigen wir tabellarische Daten. Eine Möglichkeit, diese Daten zu exportieren,ist mittels Kommandozeile und ``` mongoexport --type=csv --db {hackathon} --collection {..} --fields {..} ``` auszuführen. Da wir die einkommenden Daten (Clicks und die zeitversetzte Information über Kauferfolg) aktuell in zwei Tabellen sammeln, ist diese Methode suboptimal. Ein **JOIN** muss her. Hier stellen wir fest daß die „uralte“ 3.0.6 er MongoDb noch nicht den **$lookup** Aggregator kennt. Dumm gelaufen! Sollen wir jetzt einen MapReduce Job schreiben oder lieber doch auf eine aktuelle MongoDb 3.2.10 migrieren. Können wir die Daten in die neue Version retten? Die MapReduce Jobs liefern nicht in kurzer Zeit das gewünschte Ergebnis und Debuggen kostet zu viel Zeit. Also doch ein Live Upgrade. Wir installieren parallel eine neue MongoDb 3.2.10 auf Ralfs Rechner. Alle 15-20 Minuten exportieren wir die Daten als CSV in einen Ablageordner im Netzwerk. Jetzt wird es spannend. Data Folders kopieren und Neustarten… Und schon läuft MongoDb auf 3.2.10 mit keinem nennenswerten Datenverlust. Daniel stellt die Verbindung, um und wir können endlich die ersehnte Datenmatrix für das „Analytics Team“ bereitstellen. Es ist inzwischen schon nach 13.00. Die Exports der aggregieren CSV können mit 3T MongoChef erstellt werden. Jetzt könnte man die Daten eigentlich schön sichten. Schade,daß RMongo die 14 Spalten nur als JSON versteht. Ist es ein Problem mit der verwendeten Version der R-Bibliothek ? Auf jeden Fall wird hier nur wertvolle Zeit vernichtet (eine aggregierte Abfrage braucht über eine Minute, um einen Dataframe mit ca. 20T Zeilen und einer Spalte zurückzuliefern). Damit hängt das ganze „Analytics Team“ von den Kopien der CSV Exports ab. ### 4 Liefern Sie mal eine neue Strategie! In der Zwischenzeit ist das Team mit dem RealTimeBiddingAgent schon lange so weit, dass es die noch nicht vorhandenen Modelle und Analysen vom „Analytic Team“ in Strategien gießen möchte. Außer allgemeinen Kategorien (die Apple User kaufen nur bei Unterhaltungselektronik und Medien) findet sich leider wenig Gewinnbringendes. 100 Prozent Permiumuser geben richtig viel Geld aus – aber bei nur 14 erkannter User in 8 Stunden bräuchten wir hier schon eine Luxusartikel im Millionenwert, um endlich reich zu werden. ### 5 Wie ist es gelaufen und was haben wir dabei gelernt ? Auch ohne Kanban oder Scrum organisieren sich die Teams – scheinbar haben einige irgendwo heimlich geübt. Vermutlich hätten wir nach Sprintplanung und Schätzmarathon auch erst mittag mit den Umsetzung starten können. Die Gruppen finden sich und werden produktiv. Natürlich klappt mit der vielen neuen Technik nicht alles: - Einige Impressions gehen bei der Datenbank Live Migration verloren. - Die Strategien haben oft „interessante“ Seitenwirkungen. In der knappen Zeit hatten wir nicht mit vielen Anpassungen an der Strategie durch verbesserte Modelle gerechnet. Der RoundTrip hat allerdings geklappt. Bis die interessanten Erkenntnisse entdeckt wurden,war die Zeit dann allerdings zu knapp, um hieraus Strategien abzuleiten. Immerhin können wir inzwischen in MongoDB zwei Tabellen (clicks, impressions) joinen: ``` db.clicks.aggregate([     {       $lookup:         {           from: 'impressions',           localField: 'id',           foreignField: 'clickId',           as: 'joined'         }    },    {$unwind: '$joined'},    {$project:      {          'age': '$age'        , 'gender': '$gender'        , 'location': '$location'        , 'website': '$website'           , 'timestamp': '$joined.timestamp'        , 'profit': '$joined.profit'          , 'job': '$job'        , 'deviceOs': '$device.os'        , 'deviceBrowser': '$device.browser'        , 'deviceType': '$device.type'             , 'productLine': '$joined.winningBid.productLine'        , 'premium': '$joined.winningBid.premium'        , 'team': '$joined.winningBid.team'        , 'bid': '$joined.winningBid.bid'                   }} ] ``` ### 6 Bilder aus dem Analytics Sector ![AnalyticsMondrian.png](https://thecattlecrew.net/wp-content/uploads/2017/04/analyticsmondrian.png) ### 7 Annektoten Noch bevor unsere DataScientists ihre Daten in analysefertiger Form vorliegen hatte, wurden bereits erfahrungsgestützte Modelle vorgeschlagen - Frauen von 30-40 kaufen am meisten Beautyprodukte (diese These wurde vom weiblichen Teilnehmerkreis nicht einstimmig befürwortet und nicht implementiert) - Eine Datenbank die nicht joinen kann ist doof – Da hat Bernhard natürlich recht Deswegen haben wir im Live-Betrieb die MongoDB von 3.0.6 auf 3.2 upgedated. Eine Herkulesaufgabe: Datafiles kopieren. Starten – fertig 🙂 ### 8 Und am Ende Bleibt das Gefühl dass hier richtig Energie in den Hackathon geflossen ist und alle Beteiligten Spaß hatten. Vielen Dank an alle! Besonders herzlichen Dank an Christopher, der die Plattform bereitgestellt hat, um mit den Clicks und Impressions spielen zu können. ### 9 Ein wenig Data Science Leider nicht während des Hackathons fertig geworden Um eine Vorhersage machen zu können, welche Empfehlung wir nach den gewonnenen Erfahrungen aussprechen können trainieren wir ein „MultinomialLogisticRegression“ Modell. Da wir nur Gewinn machen unter der Annahme, dass wir nicht 0 Profit machen können wir die Datenbasis einschränken. ``` > sData0) > attach(sData) > library(MASS) > mn mn.best summary(mn.best) Call: multinom(formula = productLine ~ age + gender, family = binomial()) Coefficients:                      (Intercept)        age genderMALE CONSUMER_ELECTRONICS   -3.126288 0.01288730  3.7243051 FASHION                -2.399828 0.02175771  0.7535859 FURNITURE              -5.444786 0.07223687  2.0731203 MULTIMEDIA             -1.928532 0.01505034  2.1050230 Std. Errors:                      (Intercept)        age genderMALE CONSUMER_ELECTRONICS   0.6032644 0.01527161  0.4461687 FASHION                0.5880367 0.01635363  0.5022316 FURNITURE              0.9091175 0.02057506  0.5599580 MULTIMEDIA             0.4749802 0.01329519  0.3576919 Residual Deviance: 762.211 AIC: 786.211 > predict(mn.best,data.frame(age=40,gender="MALE")) [1] CONSUMER_ELECTRONICS Levels: BEAUTY_CARE CONSUMER_ELECTRONICS FASHION FURNITURE MULTIMEDIA > predict(mn.best,data.frame(age=40,gender="FEMALE")) [1] BEAUTY_CARE Levels: BEAUTY_CARE CONSUMER_ELECTRONICS FASHION FURNITURE MULTIMEDIA ``` Als relevante Faktoren (die wir zum Clickzeitpunkt haben) werden hier nur Alter und Geschlecht als AIC-bestes Modell gefunden. Damit können wir statistisch belegen dass die Frau ab 40 lieber zu Beauty-Care greift währen sich ein Mann mit Consumer-Elektronik begnügt. 🙂 **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** Analytics, Community Day, MongoDB, R, RapidMIner, Realtime, Showcase, Storm, Weka --- ### [Alexa? "“ wie schreibe ich einen Skill?](https://thecattlecrew.net/2018/06/06/alexa-wie-schreibe-ich-einen-skill/) **Published:** Juni 6, 2018 **Author:** Dominik Bial **Content:** Deutschlandweit sammelten sich unsere Kollegen Ende Februar an den einzelnen OC Standorten, um sich ohne Vorwissen auf die Skill-Entwicklung für Alexa zu stürzen. Was war die Idee? Abseits vom typischen Heimbedarf bieten sich Voice Assistants gerade in öffentlichen Bereichen, Bars und auch im Einzelhandel als Schnittstelle für weitere Dienstleistungen an. So lassen sich Informationen über das Produkt, Zusatzprodukte oder Produktbewertungen direkt im Laden erfragen. Als Kontext haben wir uns auf Baumärkte fokussiert und über einen Hackathon an unserem Community Day die Aufgabe gestellt, mit einer beliebigen Technologie einen Voice Assistenten, in den konkreten Fällen einen Alexa Skill, zu schreiben, der Kunden im Baumarkt unterstützt. An jedem unserer Standorte sind Teams zusammengekommen, die eine Idee und ein entsprechendes Konzept mitbrachten. Nach einer kurzen Einführung in die Aufgabe und der Skill-Entwicklung ging es auch schon los. Unsere Hoffnung war, möglichst viele Ideen, Lösungs- und Technologieansätze zu erhalten. So viel schon einmal vorab „“ die Ergebnisse können sich sehen lassen. Zuvor kommen wir aber erst einmal zu unseren Lerneffekten. ## Lerneffekt Nr.1″“ Die vier Säulen der Digitalisierung [![](https://thecattlecrew.net/wp-content/uploads/2018/06/4_pillars_digitalisation.png?w=300)](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_Saeulen-der-Digitalisierung_WEB.pdf)Anhand der Lösungen war schön zu sehen, dass Technologien und Konzepte in der IT immer enger miteinander verzahnt sind und moderne Lösungen, wie im Vier-Säulen-Poster veranschaulicht, alle Säulen betreffen. Bei der Skill-Entwicklung für Alexa geht es hauptsächlich um die Bereitstellung eines REST-Interfaces, sodass wir uns direkt in der Disziplin Integration bewegten. Alexa und Voice Assistants sind der Mensch-Maschine Interaktion zuzuordnen. Die Infrastruktur stammte aus der Cloud oder lief on-Premise. BI Ansätze waren hauptsächlich über Monitoring und Tracking anzutreffen. Das Gedankengut aus dem Poster zum Anfassen, ein schöner Motivator. ## Lerneffekt Nr. 2 „“ Viele Wege aber ein Ziel Eine bunte Vielfalt an Technologien waren im Einsatz, die alle zum Ziel geführt haben: einen funktionierenden Alexa Skill. Hier eine kurze Liste der Ansätze. **Team****Technologie**GummersbachDie Gummersbacher Kollegen haben einen Ansatz mit Python und Flask gewählt. Die Idee war die Kenntnisse in Python zu verstärken und die Vorteile von Flask bei der Alexa Skill Entwicklung zu nutzen.Bad HomburgDie Bad Homburger Kollegen haben mehrere Partnerteams gebildet um ihre Entwickler-Skills individuell zu verbessern. Dabei wurden 4 Technologieansätze verfolgt.· - Java in Eclipse mit AWS Plugin· - Java und Spring· - Python und Flask· - AWS BerlinDie Berliner Kollegen haben sich in der AWS Welt bewegt und sind mit einer Architektur bestehend aus AWS Lambda, CodeCommit und CodeStar losgelaufen.EssenDie Essener Kollegen waren ebenfalls mit mehreren Teilteams unterwegs, um Alexa Skills mit· - APEX· - Spring Boot und Heroku· - IBM Bluemix mit Node-RED zu entwickeln. HamburgDie Hamburger Kollegen legten mit AWS Lambda als auch Python los.MünchenIn München konzentrierte man sich auf einen lokalen Entwicklungsstack und entwickelte den Skill mit einem lokal laufenden Node.js und einer MongoDB.NürnbergIn Nürnberg wurde Node.js mit lokalen AWS Lambda Funktionen erprobt.StuttgartDie Stuttgarter Kollegen starteten mit dem von AWS bereitgestellten Alexa Skills Kit SDK für Java, mit dem sie schnell Ergebnisse erzielen konnten.Jeder dieser Ansätze hatte Vor- oder Nachteile, die je nach Kontext verfolgt werden sollten. Die Lösungsvielfalt ist erstaunlich. ## Lerneffekt Nr. 3 „“ Verteilt aber doch gemeinsam Der Hackathon fand verteilt statt, wie die oben genannten Teams zeigen. Super spannend war zu sehen, wie Technologien beim verteilten Arbeiten unterstützten. In jeder Niederlassung gab es einen Verantwortlichen, der sich um eine Verbindung mit einer Video-Konferenz bemühte. Nach den üblichen, anfänglichen, kleineren Schwierigkeiten, stand diese Konferenz allen Teilnehmern zur Verfügung. Die Konferenz würde für eine initiale Präsentation und zum Austausch zwischen den Teams und bei Fragen an die Organisatoren genutzt. Trotz der Verteilung kam hier ein reger Austausch und gemeinsames Lernen zu Stande. ## Lerneffekt Nr. 4 „“ Hackathon als Methode zum Lernen Hackathons sind für die OC Community Events eine klasse Form um gemeinsames Lernen zu ermöglichen. Darüber hinaus entstehen Demos und Code-Artefakte, die den weiteren Austausch fördern. Wir haben mit diesem Hackathon eine beachtenswerte Anzahl an Alexa Skills erhalten, die unterschiedliche Technologieansätze verfolgen und nun in einem Vergleich münden. Des Weiteren sind die Aufgaben offen genug um spannend zu sein, geben aber einen Rahmen vor, in dem sich die Teams bewegen können. ## Lerneffekt Nr. 5 „“ Begeisterung und Spaß Das tolle an Alexa ist, dass am Ende des Tages etwas entsteht, das man anfassen und ausprobieren kann. Dies steigert die Motivation und Begeisterung soweit, dass sich das Entwickeln und Lernen nicht mehr als Arbeit anfühlt; die beste Voraussetzung fürs Lernen. Mit Spaß bleiben Dinge einfach im Gedächtnis und der Lerneffekt ist riesig. ## Lerneffekt Nr. 6 „“ Videos und Fotos sind ein super Motivator Wir haben unser Ziel erreicht. An jedem Standort ist ein anderer, technischer Ansatz für einen Alexa Skill entstanden und mittels eines Videos, Fotos und Text haben wir das Ganze dokumentiert. Die einzelnen Lösungen lassen sich miteinander vergleichen. Vor- und Nachteile der Lösungen konnten aufgezeigt werden. Gerade in unserer Abschlussrunde kamen noch einmal einige Diskussionen auf, da jeder das Erlebte des anderen Teams mit seinen eigenen Erkenntnissen vergleichen konnte. Die Erlebnisse und Ergebnisse können sich sehen lassen. Am besten schaut ihr euch das folgende Video an und lasst die Lösungen einmal auf euch wirken. Viel Spaß dabei! Alexa, starte Video … **Kategorien:** AI & Data Science --- ### [Möglichkeiten einer Cloud-Plattform für Predictive Maintenance](https://thecattlecrew.net/2019/11/07/moglichkeiten-einer-cloud-plattform-fur-predictive-maintenance/) **Published:** November 7, 2019 **Author:** nilsschlueter **Content:** In den letzten sechs Monaten habe ich mich im Rahmen meiner Masterarbeit ausführlich mit der Entwicklung einer Cloud-Plattform für Predictive Maintenance beschäftigt. In diesem Blog Beitrag möchte ich eine kurze Einführung in das Thema geben und begründen, welche Vorteile die Cloud für Predictive Maintenance Systeme bietet. ### Was ist Predictive Maintenance? Es gibt verschiedene Wartungs- und Instandhaltungsstrategien, welche von Industrieunternehmen bereits seit langer Zeit eingesetzt werden. Klassischerweise werden dabei vor allem zeit- oder produktionsbasierte Instandhaltungsstrategien eingesetzt, also beispielsweise der Austausch eines Teils alle sechs Monate. Bei dieser Wartungsstrategie wird also versucht, auf Grund von Erfahrungen im Umgang mit einer Maschine einen angemessenen Zeitraum zu finden, in dem die Maschine wahrscheinlich nicht ausfällt. Diese Strategie funktioniert jedoch nicht immer. In der folgenden Abbildung sind die Laufzeiten verschiedener Kugellager unter Laborbedingungen gegeben. Die Tests wurden mit identischen Maschinenteilen unter identischen Bedingungen durchgeführt. Dennoch ist zu erkennen, dass die Laufzeit stark variiert „“ zwischen 15 und 300 Stunden. ![](https://thecattlecrew.net/wp-content/uploads/2019/11/skf.png?fit=1024%2C741&ssl=1)Bildquelle: M. Hashemian, H & C. Bean, Wendell. (2011). State-of-the-Art Predictive Maintenance Techniques\*. IEEE Transactions on Instrumentation and Measurement. 60. 3480-3492. 10.1109/TIM.2009.2036347. Auch wenn ein solches Laborexperiment nicht auf alle Anwendungsfälle übertragen werden kann, so zeigt es die Probleme klassischer Wartungsstrategien: Auch identische Teile verhalten sich nicht immer wie erwartet. Abhilfe kann hier Predictive Maintenance schaffen. Bei Predictive Maintenance wird versucht, anhand mehrerer Indikatoren (bspw. Sensordaten) frühzeitig den möglichen Ausfall einer Maschine zu erkennen. Es werden also Daten über die Maschine gesammelt, um eine Aussage über den aktuellen Status der Maschine treffen zu können „“ unabhängig davon, wie lange die Maschine schon in Betrieb ist. Bei Predictive Maintenance wird also nicht davon ausgegangen, dass alle Teile sich gleich verhalten, sondern es wird für jedes Teil individuell nach Indikatoren gesucht, welche auf einen Ausfall hindeuten. Dadurch können durch Predictive Maintenance sowohl Ausfälle als auch das zu Frühe Austauschen von Maschinenteilen verhindert werden. Zur Analyse der Sensordaten werden im Rahmen von Predictive Maintenance häufig Machine Learning Modelle verwendet. Diese werden mit historischen Daten der Maschine trainiert. Da die Sensordaten für jede Maschine unterschiedlich sind, entstehen so individuelle Modelle, welche ideal auf eine Maschine zugeschnitten sind. Durch die Nutzung der Daten, welche die Maschine im Betrieb produziert, können die Modelle so außerdem kontinuierlich verbessert werden. ### Was sind die Vor- und Nachteile einer Cloud-Plattform gegenüber dem lokalen Betrieb? Ein wichtiger Teil von Industrie 4.0 sind cyber-physikalische Produktionssysteme sowie verteilte Produktionsketten. Viele Unternehmen produzieren also nicht mehr nur an einem Ort, sondern haben global verteilte Fabriken. Auch gibt es teilweise Maschinen, welche nur schwer erreichbar sind, beispielsweise bei Offshore-Windparks. Da bei solchen Maschinen die Wartung besonders aufwändig und teuer ist, müssen diese zuverlässig auch aus der Ferne wartbar sein. Die Cloud bietet die Möglichkeit, verteilte oder schwer erreichbare Maschinen zentral zu überwachen. Es wird also eine zentrale Plattform geschaffen, auf der Maschinendaten, unabhängig von dem physischen Ort der Maschine, analysiert werden können. ![](https://thecattlecrew.net/wp-content/uploads/2019/11/windrader-408596_960_720.jpg)Beispiel Offshore-WindparkAuch im Bezug auf Wartbarkeit und Weiterentwicklung der Machine Learning Modelle bietet die Cloud Lösung Vorteile: Statt einzelne Modelle in verteilten Fabriken vor Ort zu betreuen, können Machine Learning Experten zentral auf alle Modelle zugreifen. So kann sichergestellt werden, dass alle Daten jederzeit von aktuellen Modellen analysiert werden. Außerdem muss so in den verteilten Standorten keine zusätzliche Hardware angeschafft werden, da die zum Training der Modelle benötigten Rechenkapazitäten in der Cloud bereitstehen. Nachteile gegenüber lokalen Lösungen entstehen vor Allem durch das Streaming der Sensordaten. Zum Einen muss sichergestellt werden, dass alle Maschinen dauerhaft mit der Cloud verbunden sind, damit diese auch in Echtzeit überwacht werden können. Zusätzlich entstehen bei der dauerhaften Überwachung vieler Maschinen große Datenmengen. Da bei den meisten Cloud-Anbietern nach übertragener Datenmenge abgerechnet wird, entstehen so schnell hohe Kosten. Daher muss genau festgelegt werden, welche und wie viele Daten in die Cloud gestreamt werden. ### Wie ist die Qualität der Vorhersagen verglichen mit lokal betriebenen Modellen? Die Cloud-Plattform bietet lediglich die Möglichkeit, beliebige Machine Learning Modelle auf einem entsprechenden Server auszuführen. Daher ist die Performance der Modelle theoretisch nicht eingeschränkt. Tests im Rahmen der Masterarbeit haben dies bestätigt: In der Cloud laufende Modelle haben auf verschiedenen Datensätzen vergleichbare Ergebnisse wie lokal laufende Modelle erreicht. ### Fazit Eine Cloud-Plattform als Predictive Maintenance Lösung bietet spannende Möglichkeiten, wie ein Predictive Maintenance System innerhalb einer bestehenden Produktion eingeführt werden kann. Die Cloud bietet eine skalierbare, verlässliche Infrastruktur, wodurch der Betrieb, die Wartung und Weiterentwicklung des Systems vereinfacht wird. Außerdem können nach der Einführung der Plattform neue Maschinen mit minimalem Aufwand ebenfalls überwacht werden, da die Sensordaten in die bereits bestehende Infrastruktur gestreamt werden können. Da die Performance außerdem nicht unter dem Streaming in die Cloud leidet, ist eine Cloud Plattform in den richtigen Anwendungsfällen eine sehr gute Alternative zu lokal betriebenen Systemen. **Kategorien:** AI & Data Science, Analytics & Insights, Cloud **Schlagwörter:** Artificial Intelligence, cloud, predictive --- ### [Klassifikation mit dem Autopiloten von Amazon Sagemaker - Teil 2](https://thecattlecrew.net/2020/07/24/klassifikation-mit-dem-autopiloten-von-amazon-sagemaker-teil2/) **Published:** Juli 24, 2020 **Author:** Maximilian Palmer **Content:** ## Einleitung Einer der vielen Use-Cases von Machine Learning (ML), der eine hohe Nachfrage in der heutigen Wirtschaft aufweist, ist die Fähigkeit Geschäftszahlen vorherzusagen. Hierzu werden Regressionsalgorithmen verwendet, um unter anderem Produktpreise, Konsumverhalten oder Immobilienpreise vorherzusagen. Um einen konkreten Use-Case darzustellen, haben wir ein eigenes Regressions-Modell in AWS SageMaker trainiert und evaluiert. Hierfür haben wir den Datensatz „Boston Housing Prices“ zum Trainieren unseres Modells verwendet. Der Datensatz wird dafür benutzt, um die Immobilienpreise im präsenten Markt anhand von 13 verschiedenen Faktoren vorherzusagen. Unser Vorgehen und mehr Details über den Datensatz, erfahren Sie in den nächsten Abschnitten dieses Blogposts. Falls Sie allgemein mehr über SageMaker erfahren möchten, können Sie gerne den [ersten Blogpost zu dieser Reihe](https://thecattlecrew.net/?p=32185) konsultieren. ## Beschreibung des Datensatzes Die Basis für unser Modell ist der Datensatz „Boston Housing Prices“. Dieser enthält 503 eindeutige Werte. Jeder Wert hat 13 Attribute, wie z.B. die Kriminalitätsrate, Luftqualität und Anzahl der Zimmer. Der Datensatz kann über Keras heruntergeladen werden und erleichtert für Machine Learning Anfängern den Einstieg. Das hat den Vorteil, dass die Datenqualität, ohne Preprocessing, für das Training ausreichend ist und man den Fokus auf das ML setzen kann, anstatt auf das Preprocessing. ### Preprocessing Da der Datensatz bereits von Keras, mit einer hohen Qualität, zur Verfügung gestellt wird, ist wenig Preprocessing notwendig, jedoch kann man die Zahlen normalisieren, um das Trainingsprozess zu optimieren. Normalisierung ist eine Technik, die oft als Teil der Datenvorbereitung für ML angewendet wird. Das Ziel der Normalisierung besteht darin, die Werte numerischer Spalten im Datensatz so zu ändern, dass eine gemeinsame Skala verwendet wird, ohne Unterschiede in den Wertebereichen zu verzerren oder Informationen zu verlieren. Die Normalisierung ist auch für einige Algorithmen erforderlich, um die Daten korrekt zu modellieren. Wir benutzen einen `scikitlearn` Container, der von SageMaker angeboten wird, um deren `StandardScaler` zu benutzen, um die Werte zu normalisieren. Es wird ein ‚preprocessing‘ Skript geschrieben und zusammen mit den Daten an eine SageMaker Instanz geschickt. Das Script benutzt die Rechenleistung der Instanz, um das Processing durchzuführen. In unserem Fall werden die Daten auf zwei Instanzen aufgeteilt. Aufgrund der kleinen Größe des Datensatzes wäre dies eigentlich nicht nötig, aber es demonstriert, wie man einen großen Datensatz auf mehrere Instanzen verteilen könnte, um Zeit zu sparen. Bei n Instanzen bekommt jede Instanz 1/n der Trainingsdaten. ### Training Im Training Skript wird ein Modell mit Tensorflow’s High Level API Keras gebaut. AWS SageMaker bietet einen vorgefertigten Container an, indem Tensorflow eingerichtet ist. Dieser Container ermöglicht es dem Entwickler, Skripte, die ähnlich zu denen sind, die auch außerhalb von SageMaker benutzt werden, auszuführen. Dieses Feature von AWS heißt „Script Mode“ und gibt dem Entwickler die Möglichkeit einen Workflow für ein Tensorflow Projekt zu erstellen. Das eigentliche Training findet auf einer leistungsfähigen Instanz von SageMaker statt. Diese Instanz wird durch das Trainingsscript im „Script Mode“ hochgefahren und aufgerufen. Um das Modell zu verbessern kann man normalerweise das „Hyperparameter tuning“ durchführen, bei dem verschiedene Werte ausprobiert werden, um die Auswirkungen auf das Modell zu sehen. Das ist aber ein zeitaufwendiges Verfahren, wenn man es manuell macht. Mit SageMaker können wir diesen Prozess automatisieren. Wir geben an, welche Parameter getuned werden sollen und welchen Wertebereich sie annehmen können. Dann kann man auf mehrere Instanzen parallel trainieren und die besten Ergebnisse leicht aussortieren. ### Deployment Das aus dem Hyperparameter tuning entstandene Modell kann einfach mit einem Befehl auf einen Endpoint in AWS bereitgestellt werden, indem man noch zusätzlich den Typ der Instanz und die maximale Anzahl an Instanzen angibt. Dann können Requests mit Test-Daten an den Endpoint geschickt werden. Diese liefern die Vorhersagen des Modells, die wir benutzen, um es zu evaluieren. ## Ergebnisse Um das Modell zu evaluieren haben wurden 102 Test-Fälle an den Endpoint geschickt. Als Ergebnis hat das Modell die Preise für die Immobilien vorhergesagt. In der folgenden Abbildung sind 10 Beispiele für die tatsächlichen Werte (untere Zeile) und für die von unserem Modell vorhergesagten Werte (obere Zeile) zu sehen: ![](https://thecattlecrew.net/wp-content/uploads/2020/08/image.png)Die meisten Werte konnten relativ genau vorhergesagt werden. Die folgende Grafik stellt eine Visualisierung des Ergebnisses da. Die Y-Achse zeigt die Werte der Vorhersage des Modells an und die X-Achse zeigt die wahren Werte des Datensatzes an. Dementsprechend stellt die Winkelhalbierende alle richtigen Vorhersagen dar. Das heißt, je näher eine Vorhersage an der Winkelhalbierenden ist, desto genauer ist es.es. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/image-1.png)## Bewertung von SageMaker und AutoML SageMaker hat den Vorteil, dass eine Vielzahlt an ML-Frameworks unterstützt werden. Die gängisten Frameworks wie TensorFlow, Scikit-Learn werden unterstützt. Insgesamt sind es neun an der Anzahl. Außerdem bietet SageMaker schon implementierte Algorithmen an um ein Modell zu trainieren. Der Service von SageMaker selbst ist dabei kostenlos. AWS berechnet nur die Kosten für die genutzten Computing Ressourcen, welche sich laut Angaben von AWS mit Spot-Instanzen, um bis zu 90% senken lassen. Ein weiterer Vorteil ist, dass SageMaker auch eine Git-Integration hat. Nun zu dem AutoML-Service von SageMake. Die Performance des SageMakers überzeute uns, in jeden TestCase lieferte das Modell eine bessere Accuracy wie die von unserem entwickelten Modell. Außerdem besitzt der AutoML-Service eine hohe Flexibilität. Es besteht die Möglichkeit mit einem graphischen Interface diesem zu Bedienen oder sich Jupyter Notebooks zu generieren lassen wodurch eine hohe Transparenz und Anpassungsmöglichkeit besteht. Es muss dazu erwähnt werden, um Anpassungen an diesem Code vorzunehmen zu können benötigt es eine große Expertise in dem Umgang mit Sagemaker. Für alle trainierten Modell in der Amazon Cloud besteht die Möglichkeit über ein einfaches graphisches Interface einen Endpoint (EC2 Instanz) zur Verfügung zu stellen. Diese Instanz kann via eines Jupyter Notebooks und der API Boto3 in AWS Sagemaker erreicht werden oder über einen http-Post von extern. **Kategorien:** AI & Data Science, Automation **Schlagwörter:** Amazon SageMaker, Artificial Intelligence, AWS --- ### [Three Ways of Doing Recommendations in AWS](https://thecattlecrew.net/2020/10/13/three-ways-of-doing-recommendations-in-aws/) **Published:** Oktober 13, 2020 **Author:** Maximilian Palmer **Content:** Recommender systems have quickly become prominent everywhere in our daily lives. We have grown accustomed to receiving recommendations for everything, be it for the next song we listen to, movie we watch, or the next product we buy. We are used to having so many options to choose from that it is sometimes hard to make simple decisions, such as which movie to watch tonight. We investigated with the help of Jens several out-of-the-box recommendation services offered by AWS, as well as building our own recommendation solution using the AWS machine learning capabilities. This article provides a basic understanding of recommender systems and why it is important to deal with them. Furthermore, it will give an overview and comparison – according to several criteria – between the several AWS recommender systems and our own recommenders. This will prove helpful for anyone who wants to build and use recommendation systems, whether for customer projects or out of personal interest. The motivation for our research is that recommender systems are present in our daily lives and are used by countless companies to increase their revenue. More and more companies are starting to use their own recommender systems. Therefore, it is essential to build up knowledge and dive deep into the underlying details to be able to offer good consulting to our customers. We investigated several systems in order to find the best individual solution for upcoming projects at Opitz Consulting. The following figure illustrates the main milestones of our project. ![](https://thecattlecrew.net/wp-content/uploads/2020/10/Screenshot-2020-10-13-at-13.11.36.png)Timeline of project activities## Collaborative Filtering vs. Content-based Filtering Recommendation systems are based on two main principles, namely collaborative filtering and Content-based filtering. These two methodologies are best explained using an example in which a movie recommendation system aims to generate good movie recommendations for users based on their tastes. In this example the movies are the items which are supposed to be predicted. ### Content-based filtering: Content-based filtering generates predictions based on the properties of the items it predicts. In our example the movie recommendation examines the properties of the movies to generate predictions. For instance, should a user watch a lot of western movies, the system will recommend movies belonging to the „Western“ genre. \[1\] ### Collaborative Filtering: Recommender systems using collaborative filtering examine the similarity between users and/or items. Thus, the system recommends items to the user which are liked by similar users. \[1\] These approaches are often insufficient on their own, which is why they are combined with other methods. Besides, the field of Deep Learning is growing so fast that Deep Learning models are developed for many different applications. Consequently, such models also exist for the purpose of generating user recommendations. \[1\] Having explained our motivation, we will subsequently present the services and methods we used, namely Amazon Personalize, Amazon AutoML and our own auto-encoder as well as our own content-based model. In conclusion we will additionally provide a comparison between all of them in order to share our experiences, allowing the reader to get a hint at which system is best to use for his/her use case. Machine Learning models are built and trained on data, the goal being to generalize well for unseen new data. Consequently, it is important to find good data sets before training the model, which are big enough to represent the domain well in which the system will be used later on. For all models, we used the same data set in order to be able to evaluate and compare them accurately. In general, we used the ratings table from the MovieLens dataset containing 27 million ratings by 280 000 users on 58 000 movies \[3\]. Due to the fact that we didn’t want to restrict ourselves to only using collaborative filtering, we also used a Kaggle data set providing additional information about every movie such as genre, actors and title \[2\]. Our goal was to take this additional information into account when generating user predictions. ## Using a Service: Amazon Personalize Amazon Web Services (AWS) provides a wide variety of different services. Especially the machine learning services are growing fast. Amazon Personalize is the service directly corresponding to a recommendation system. You simply provide the data in the required format and amazon Personalize takes care of training models and creating an endpoint, which will generate the top predictions for a certain user after feeding in the corresponding user id. We tried the following three different models: HRNN, HRNN metadata and Popularity Count. ### HRNN HRNN stands for hierarchical recurrent neural network and solely uses a data set consisting of user ratings about a specific movie (USER\_ID, ITEM\_ID, RATING, TIMESTAMP). It offers the possibility to weigh recently rated movies more than user movie interactions which took place further in the past. This allows adjustments in case someone’s taste regarding movies changes over time. It might seem strange in that context, but it makes sense in the context of shopping, for example where customers who are single will buy different things than perhaps some years later when they have a family. ### HRNN-Metadata Here, the underlying model consists also of a hierarchical recurrent neural network. In addition to the ratings, it uses additional information about the user, as well as additional information about the items to generate recommendations. For this model we used the second data set to provide additional information about every movie. It takes longer to train since the size of the training data is larger. According to Amazon it achieves better results in the event that it receives high quality metadata about user and item. ### Popularity Count While the previous two models were deep learning models and had to be trained, the popularity count is the simplest one and does not need to be trained. So, it can be generated very quickly. In contrast to the name „Personalize“ the popularity count does not provide a personalized solution. It simply recommends the items which were rated most often. For an item to be recommended it is sufficient to be rated frequently and not necessarily positive. This model is obviously limited but might still provide some good recommendations based on item popularity. All in all, Amazon Personalize is easy to use. The only thing provided by the user are the different data sets adhering to the requirements of Amazon Personalize and a schema explaining each data set. It is time consuming to pre-process the data to the desired format, but afterwards Personalize is easy and fast to use. The time for the pre-processing depends on the given data set. Usually, customer data sets require heavy data preparation, due to the strict guidelines of amazon Personalize. As a side note, amazon Personalize does only provide some items as recommendations for a given user, but it does not provide a predicted rating. ## Using AutoML: Amazon SageMaker Autopilot The other AWS service we used is Amazon SageMaker Autopilot, which belongs to the AWS SageMaker service. It does not directly correspond to recommender systems but can be used for any kind of machine learning problems and is the AutoML module of AWS. Here Amazon decides fully autonomously if the problem is a classification or a regression problem and then creates and trains several pipelines with different models. In the end the best pipeline can be easily deployed, while the predictions have to be generated by sending requests to the mounted endpoint. This is different to Amazon Personalize, where the recommendations can be obtained directly from the GUI, but Autopilot creates more pipelines. The best model according to Autopilot was an xgboost model \[8\], but we also evaluated a linear learner model to see if even a linear model is able to fit the data equally well. Besides we were also interested in how much the pre-processing of the data affects the generated movie predictions for the users. This is why we first fed all the available data (see Figure 1) to Autopilot and then only some pre-selected columns (see Figure 2). In the latter case we discarded all the columns which were either not set for most of the rows or which did not seem to contain additional useful information to us (see Figure 2). After evaluating the linear model and the xgboost model with both configurations we realized that for our problem neither the model nor the pre-processing significantly affects the output. All things considered, it is more costly to use Autopilot than to use Amazon Personalize, since the inference part needs to be done in the code. But in general, it is still easy to use and the user does not need to decide on any model not even if it is a regression or a classification problem. ![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-2.png)Fig. 1: Provided movie metadata of imdb data set![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-6.png)Fig. 2: Movie information which is taken into account for Amazon SageMaker Autopilot### Self-coded: Auto-Encoder After having tried and experimented with the previous presented services, we aimed for creating our own recommendation system aiming to beat the recommendations of AWS. The first approach we tried was to use an Auto-Encoder, encoding the user-items ratings to a subspace and then reconstructing the lower-dimensional data back into the original space. In order to achieve that an Auto-Encoder is a deep learning model that consists of an encoder part with stepwise decreasing number of neurons per hidden layer and an encoder part with stepwise increasing number of neurons per hidden layer. The number of neurons of the input and output are equal. The idea behind that is to extract the relation of a user and its ratings by forcing the model to learn lower-dimensional features and not using all the movie ratings. In general, an auto-encoder is used to learn a lower-dimensional representation of an input. Therefore, it transforms a given input into a lower-dimensional subspace from which it reconstructs the compressed data back into the original space. By that the model learns to represent a user not by every movie rating anymore, it must learn features how movies are connected among each other. The parameters of the model are learnt by minimizing the loss between the original input and the reconstructed output of the Auto-Encoder, where the input consists of the rows of the user-item matrix shown in Figure 1. Figure 3 \[4\] is showing an exemplary user-movie matrix showing the ratings from every user to all movies. This matrix is used to train the model. Single rows correspond to different users. After learning the parameters of the model, it is possible to do inference. So, we fed single row vectors of users with all the movies into the autoencoder and the autoencoder generated ratings for every movie. Figure 4 \[5\] illustrates an exemplary architecture of an auto-encoder where it can be easily seen how the input data is first transformed into a lower-dimensional subspace before transformed back into the original space. \[6\] ![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-5.png)Fig. 3: User-movie matrix containing user ratings for watched movies otherwise empty spaces for movies which haven“™t been watched yet \[5\]![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-4.png)Fig. 4: Exemplary structure of an Auto-Encoder encoding the input data to a lower dimensional subspace(red) and reconstructing this representation to the original space \[5\]Summarizing, our auto-encoder tends to recommend movies which are rated a lot. It would take more effort and time to apply some finetuning to the model so that it is less affected by the most rated movies. ### Self-coded: NLP content-based recommender The autoencoder is based on the idea of collaborative filtering. Therefore, our goal was also to build a content-based recommender system ourselves. Since we all like natural language processing (NLP) we aimed to investigate the contents of the movies and tried to recommend movies which are similar to popular movies. We selected certain columns which describe the movies the best in our opinion, like plot description, title, genre, director and actors. ![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-3.png)Fig. 5: Movie information which is taken into account for NLP content-based recommenderFrom these columns we created a concatenated string for every movie and used a vectorizer in order to obtain a numerical representation of every movie. This is necessary to apply the cosine similarity between every movie vector and every other one. The cosine similarity measures the angle between two given vectors and therefore measures the similarity between two vectors. We obtained a matrix (shown in Figure 6 below \[6\]) containing the similarity between every movie-movie pair. The idea of our NLP based movie recommendation system is that movies having some actors or directors in common or dealing with a similar topic having a similar vector representation and therefore a high cosine similarity. ![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-10.png)Fig. 6: Movie movie similarity matrix, showing how similar two movies are. The higher the value the more similar the movies seem to be \[6\]This cosine similarity is used to generate movie predictions by taking the best twenty movie recommendations from our data and recommending always the most similar movie to each one. Another interesting and promising approach would be to take just the first ten most popular movies and take the two most similar movies to each one as a personal recommendation. After observing our recommendations, we realized that it recommends movies from the same director. The main effort when implementing this was to decide which movie data to consider and then to bring it into a string format the vectorizer can process. There is still some potential to improve. You could think about using a different vectorizer for representing the movies or take different data into account. \[7\] ## Challenges On our way we came across some technical and methodical challenges. We needed to join both data sets to take into account as much information as possible so that our models perform well. The joined data set contains around 8Gb of data, which is too large for being processed by AWS SageMaker. Therefore, we had to decrease the data set in a reasonable way. Additionally, it is important to pay attention on how to process data. In any case it is essential to avoid any iterative approaches if possible, because it takes too much time and, in the end, also money since it has to run on a large machine in SageMaker. As a consequence of that, we learnt to use pandas in an efficient way for data processing. With more time/ budget it would be possible to develop better self-coded models, because the current models are very basic. There is still huge potential to improve these models. ## Overview The following figure shows our subjective evaluation of the different methods. We use a grading system where 5 corresponds to the worst grade and 1 to the best. Amazon Personalize can be used to build recommendation systems in a fast and uncomplicated way, since the user only has to pre-process the data to satisfy the requirements of Amazon Personalize. More complex problems may require more individual solutions. Furthermore, better results might be obtained by using self-coded approaches, but this also requires more time in research as well as in model development. ![](https://thecattlecrew.net/wp-content/uploads/2020/10/Screenshot-2020-10-13-at-12.09.51-1.png)Fig. 7: Grading system![](https://thecattlecrew.net/wp-content/uploads/2020/10/image-9.png)Fig. 8: Evaluation of the presented methods using a grading system from 1 (good) to 5 (bad)#### References: \[1\] Jure Leskovec, Anand Rajaraman, and Jeffrey David Ullman. 2014. Mining of Massive Datasets (2nd. Ed.). Cambridge University Press, USA \[2\] \[3\] \[4\] Di Noia, Tommaso & Ostuni, Vito. (2015). Recommender Systems and Linked Open Data. 10.1007/978-3-319-21768-0\_4. \[5\] \[6\] \[7\] \[8\] **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** Amazon SageMaker, Artificial Intelligence, AWS, Filtering, Recommendation --- ### [SingularityNET - Der KI-Marktplatz der Zukunft?](https://thecattlecrew.net/2021/02/16/singularitynet-der-ki-marktplatz-der-zukunft/) **Published:** Februar 16, 2021 **Author:** Asadulla Ciawasch **Content:** Von der Sentimentanalyse über Gesichtsdetektion bis zu Intelligenten Vorhersagen: Das Unternehmen SingularityNET betreibt einen Online-Marktplatz für Künstliche Intelligenz, auf dem KI-Professionals und -Nerds ihre neuesten Kreationen teilen. Unterschiedlichste Tools, vom kleinen Gimmick bis zum komplexen KI-Service – aus allen Anwendungsbereichen und auf allen Technologieleveln – werden hier angeboten und vermarktet. Alle können mitmachen, bezahlt wird mit Kryptowährung und über Crowdfunding. Mit den Themen Künstliche Intelligenz, Blockchain-Architektur und einem innovativen Finanzierungsmodell über Kryptowährung und Crowdfunding verbindet SingularityNET drei große Hypes anscheinend zu einem ziemlich erfolgreichen Geschäftsmodell. Doch halten die Tools und Services auch, was sie versprechen? Für diesen Artikel habe ich mir das Netzwerk näher angesehen. Mich interessierte dabei, wie sich die Plattform für den Nutzer anfühlt. Und ob sie wirklich in der Lage sein könnte, KI ein Stück weit zu demokratisieren und so den Fortschritt in diesem Bereich noch schneller voran zu treiben. Immerhin wirbt der Anbieter mit diesem weitreichende Ziel und wird dabei von dem renommierten KI-Spezialisten Dr. Ben Goertzel als CEO und Chief Scientist unterstützt. **Unterwegs auf dem AI Marketplace** Mein erster Eindruck war gut: Nach einem einfachen Registrierungsprozess konnte es direkt losgehen. Unter der Rubrik „AI Marketplace“ standen mir am 10. Dezember 2020 genau 46 verschiedene KI-Dienste zur Verfügung. Bild 1 zeigt einen Ausschnitt der Übersichtsseite: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/img_62c6e49122390.png) Bild 1: Ausschnitt AI Marketplace/Übersichtsseite Die drei Services, die ganz oben zu sehen sind, möchte ich euch kurz vorstellen: Der „Minecrafting Service“ ermöglicht es, ein einfaches Foto in ein Foto im Minecraft-Stil umzuwandeln. Ziel des „Real Time Voice Cloning“-Dienstes ist es, aus einer fünfsekündigen Stimmaufnahme einen Sprachavatar zu generieren, der für verschiedene sprachliche Inhalte genutzt werden kann. Bei „DeOldify Photos“ handelt es sich um ein auf Deep Learning basierendes Projekt, mit dem die User alte Bilder restaurieren und kolorieren können. Als Entscheidungshilfe gibt es ein Rating-System, wie wir es von Amazon kennen, bei dem die Nutzer bis zu 5 Sternen vergeben können. Den Dienst „DeOldify Photos“ habe ich an einem Beispielbild für euch ausprobiert. **Alte Fotos ganz neu? – Ein Vorher-Nachher-Vergleich** Die Fotos aus dem Album meiner Großmutter ins Hier und Heute übertragen? Schon eine coole Idee, oder? Nach einem Klick auf den Service mit dem Indianerbild komme ich auf eine Detailseite, wo ich neben einer kurzen Beschreibung und der Nennung des Dienstanbieters, in diesem Fall handelt es sich um SingularityNET selbst, auch schon eine Übersicht über die Kosten bekomme. Ahh, ja, die Kosten – ein guter Punkt! Was kommt hier auf mich zu? Angelehnt an die Blockchain-basierte Architektur der Plattform wird auf der Plattform mit der firmeneigenen Kryptowährung AGI bezahlt. Die Seite https://coinmarketcap.com/de/currencies/singularitynet/ wies zur Zeit meines Aufrufs einen Umrechnungskurs von 0.040891 Euro für diese Währung aus. Konkret hieß dies für mich, dass pro Aufruf des „DeOldify Photos“ Dienstes 0,02 AGI, umgerechnet also ca. 0,1 Euro-Cent, fällig wurden. Als kleiner Bonus stehen neu registrierten Benutzern der Plattform jeweils 15 kostenfreie API Calls zur Verfügung. ![](https://thecattlecrew.net/wp-content/uploads/2022/07/img_62c6e493095f1.png)Bild 2: Ausschnitt der Detailansicht „DeOldify Photos“ Aber jetzt mal sehen, ob sich diese Investition auch lohnt. Dafür habe ich den Dienst mit einem eigenen Schwarz-Weiß-Foto getestet. Hier seht ihr das Foto im Vorher/Nachher-Vergleich:![](https://thecattlecrew.net/wp-content/uploads/2022/07/img_62c6e4946df49.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/img_62c6e495b3f8e.png)Das Ergebnis ist zum Glück weit entfernt von den knallig nachcolorieren Hollywood-Filmen in den 1960ern 😉 und kann sich wirklich sehen lassen. **Usability groß geschrieben! – Vor- und Nachteile im Überblick** Ich habe mir weitere Services angesehen. Hier für euch die wichtigsten Pluspunkte aus meiner Sicht im Überblick: - Das Look and Feel der Plattform überzeugt durch eine einfache und intuitive Benutzeroberfläche. - Die einzelnen KI-Dienste kommen sehr individuell daher. So kann zum Beispiel die Detailansicht an den jeweiligen Dienst angepasst werden. „DeOldify Photos“ verfügt beispielsweise über eine Upload-Maske, um das zu kolorierende Foto hochzuladen. Alle Dienste verfügen über Benutzeroberflächen, die sich an dem zu erwartenden Input und Output orientiert. - Die Bezahlung über die eigene Kryptowährung folgt dem roten Faden des Unternehmens. - Die Mehrheit der Dienste hat eine Demofunktion. - Das Rating-System unterstützt die Entwickler bei der Optimierung der KI-Dienste - Ein weiterer Pluspunkt ist die Möglichkeit, an der Plattform mitzuentwickeln, die zurzeit über 114 Repos auf Github verfügt. - Mit der SingularityNET API können KI-Produzenten einen KI-Algorithmus mit vergleichsweise wenigen Programmierkenntnissen in das eigene Produkt oder in die eigene Website integrieren. **Fazit** Die Ziele von SingularityNET sind durchaus ambitioniert: Eine Plattform zu schaffen, die die KI-Distribution revolutionieren kann – und das basierend auf einer dezentralisierten Blockchain Architektur. Die Idee dahinter, die beiden großen Themen Blockchain und Maschinelles Lernen bzw. Künstliche Intelligenz auf eine innovative Art zu verbinden, um KI einer breiten Masse zugänglich zu machen. SingularityNET wurde im Jahr 2017 gegründet und steckt somit noch in den Kinderschuhen, doch die großen Ziele des Unternehmens lassen auf eine spannende Zukunft hoffen. Der Status Quo hat mich persönlich überzeugt und die nächsten Jahre werden zeigen, wie sich das Projekt im rasant wachsenden KI-Zeitalter etablieren wird. **Links** Hier findet ihr die Links, die ich für diesen Beitrag besucht habe (Stand 12/2020): **Kategorien:** AI & Data Science, Analytics & Insights, Development **Schlagwörter:** Artificial Intelligence, blockchain, Krypto, Open Source --- ### [Verkäufe mit Machine Learning vorhersagen – und wie Microsoft Azure dabei hilft](https://thecattlecrew.net/2022/05/29/forecasting-mit-microsoft-azure-oder-wie-koennen-zukuenftige-verkaeufe-mit-machine-learning-prognostiziert-werden/) **Published:** Mai 29, 2022 **Author:** Arjuna Mittwede **Content:** **Prognosen für die zukünftige Geschäftsentwicklung zu erstellen ist in vielen Bereichen unabdingbar. Doch wie kann dies in der Cloud erfolgen? Welche Möglichkeiten gibt es, Forecasting mit Microsoft Azure durchzuführen? Und welches sind die besten Machine Learning Algorithmen dafür? Auf diese Fragen sollen einige Antworten gegeben werden.** Betrachten wir das Beispiel, dass für ein mittelständisches Unternehmen ein Forecasting über die Entwicklung der Verkaufszahlen für den Folgemonat durchgeführt werden soll. Dabei erfolgt die Vorhersage von zukünftigen Verkaufszahlen auf der Basis von Vergangenheitswerten. Das Forecasting soll für jeden Tag des Folgemonats durchgeführt werden. Ziel des Ganzen sind bessere Planungsmöglichkeiten für notwendige Ressourcen, Personal, Marketingkampagnen und Produktionsvolumen. Dafür betrachten die Datenanalysten zunächst die vorhandenen Daten, wobei die Datenqualität überprüft wird, sowie Eigenschaften wie z.B. saisonale Schwankungen, Trends und Ausreißer untersucht werden. Daraufhin kann mit der Vorgehensplanung begonnen werden. Das geschilderte Szenario wurde anhand der Beispieldatensätze „Predict Future Sales“ von Kaggle verprobt. Diese beinhalten historische Verkaufsdaten auf Tagesbasis des Zeitraums 01.2013 bis 10.2015. Dabei war ein wichtiger Punkt, die Ergebnisse der Forecastings anhand von Kennzahlen evaluieren zu können. Die Evaluierung der verwendeten Modelle erfolgte anhand der folgenden Kennzahlen: - **RMSE:** Der Root Mean Squared Error, ist eine Erweiterung von MSE und ist definiert als die Quadratwurzel des mittleren quadratischen Fehlers. - **MAPE:** Der Mean Absolute Percentage Error ist definiert als der prozentuale Mittelwert der absoluten Differenz zwischen prognostizierten Werten und wahren Werten, geteilt durch den wahren Wert. Doch wie kann das Forecasting nun in der Azure Cloud durchgeführt werden? Dafür zur Einordnung erst ein paar Worte, was Microsoft Azure Machine Learning ist: „Azure ML Ist ein Clouddienst zum Beschleunigen und Verwalten des gesamten Lebenszyklus von Machine Learning-Projekten.“ Es bietet unter anderem folgende Funktionen: - Erstellen und Bearbeiten **von Jupyter Notebooks** und **Data Files** - Ist mit grafischer Benutzeroberfläche und Code nutzbar - Anzeigen von Ausführungen, Metriken, Protokollen, Ausgaben usw. - **Trainieren** und **Bereitstellen** von Modellen - Verwalten von gemeinsamen Ressourcen - Unterstützen von verschiedensten Technologien wie: Python SDK, PyTorch, TensorFlow, Scikit-learn, XGBoost, LightGBM, R, .NET - Einbinden von Daten aus verschiedensten Quellen Doch welche Möglichkeiten hat Microsoft Azure Machine Learning durchzuführen? Insbesondere folgende Möglichkeiten wurden betrachtet: **1. Azure ML: Jupyter Notebooks** Im Azure ML Studio können Jupiter Notebooks Out of the Box verwendet werden. **2. Automated ML** Mit Automated ML ist es in Azure möglich, fertige Machine Learning Pipelines zu verwenden, welche insbesondere für Klassifikation, Regression und Time Series Forecasting spezialisiert sind. **3. Azure ML: Designer** Mit dem Azure ML Designer ist es möglich, Machine Learning Pipelines mit einer grafischen Oberfläche zu erstellen. **4. Azure SDK** Außerdem ist es möglich, mit dem Azure SDK Forecasting Pipelines direkt in Python zu entwickeln. [![](https://thecattlecrew.net/wp-content/uploads/2022/05/image.png)](https://thecattlecrew.net/wp-content/uploads/2022/05/image.png)Bei der Erprobung wurden alle vier Möglichkeiten untersucht. Neben der Fragestellung der Art und Weise, wie das Forecasting durchgeführt werden soll, stellt sich darüber hinaus die Frage, welche Maschine Learning Algorithmen die besten Ergebnisse für die vorliegende Aufgabe liefern und auch zu den Daten passen. Bei der Untersuchung der Forecasting-Möglichkeiten mit dem **Azure Designer** hatten wir festgestellt, dass die begrenzte Anzahl der zur Verfügung stehenden Algorithmen, die Lösungsmöglichkeiten eingrenzt. Das durchgeführte Forecasting mit dem „Boosted Decision Tree Regression“ brachte beispielsweise ein Ergebnis hervor, welches nur einen RMSE von 923,01 hatte. Dies weist darauf hin, dass der Algorithmus nicht ideal für das vorliegende Problem und den dazugehörigen Daten geeignet ist. Denn es sollen Werte für den ganzen Monat vorhergesagt werden und nicht nur ein Wert für einen Folgetag. Das Forecasting Modell im Azure ML Designer: [![](https://thecattlecrew.net/wp-content/uploads/2022/05/image-4-1024x640.png)](https://thecattlecrew.net/wp-content/uploads/2022/05/image-4.png)Bei den anderen Azure Forecasting Möglichkeiten stehen eine wesentlich größere Auswahl an Algorithmen zur Verfügung. In Azure werden die meisten open-source Maschine Learning Frameworks unterstützt, wodurch sich eine Vielzahl von Möglichkeiten ergibt. Um die passende Lösung zu finden, bietet es sich an, eine Vielzahl von Algorithmen auf einmal zu verwenden und diese dann anhand der Evaluierungskennzahlen zu bewerten. Dies ist z.B. mit Automated ML möglich und es wurden in unserem Fall insgesamt 56 Modelle aus verschiedenen Frameworks durchlaufen, darunter zum Beispiel Algorithmen aus der Scikit-Learn Software-Bibliothek. Dabei wurde des Beste Ergebnis mit dem „VotingEnsemble“ Algorithmus erzielt, welches einen RMSE von 546 und ein MAPE von 13,765 aufweist. Das Forecasting für den Folgemonat mit „VotingEnsemble“ sieht wie folgt aus: [![](https://thecattlecrew.net/wp-content/uploads/2022/05/image-6-1024x456.png)](https://thecattlecrew.net/wp-content/uploads/2022/05/image-6.png)**Fazit** Mittels Microsoft Azure ML können sowohl vollständig grafisch basierter Oberfläche als auch nur mit Code, Forecastings erstellt werden. Dabei gibt es jedoch viele Möglichkeiten und der optimale Weg hängt sehr von der Fragestellung und den vorhandenen Daten ab. Es ergibt sich also, dass das beste Ergebnis erzielt werden kann, wenn ein individueller Lösungsweg für die vorliegenden Probleme ermittelt wird. Einerseits stößt der Azure ML Designer bei manchen Fragestellungen an seine Grenzen. Andererseits ist es mit dem Azure SDK möglich, individuelle Erweiterungen zu entwickeln. Bei der durchgeführten Erprobung konnte mit Azure ML das beste Ergebnis erzielt werden, wenn zunächst Automated ML verwendet wurde, um den passendsten Algorithmus zu ermitteln und daraufhin mit Jupiter Notebooks oder dem Azure SDK das Machine Learning Model bzw. deren Parameter weiter zu optimieren. In dem erprobten Beispiel konnte mit dem „Scikit-Learn: Voting Ensemble“ Algorithmus ein RMSE von 546 und ein MAPE von 13,765 ein vergleichsweise gutes Ergebnis erzielt werden. **Kategorien:** AI & Data Science, Cloud --- ### [Textklassifikation - eine Einführung](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/) **Published:** Juni 17, 2022 **Author:** Luca Pomer **Excerpt:** In der heutigen Zeit entsteht eine gewaltige Menge an Daten, die von Menschen nicht in absehbarer Zeit verarbeitet werden können. Ein großer Teil davon sind Texte, in denen wertvolle Informationen stecken können. Mithilfe von Textklassifikation - ein Teilgebiet im Feld des Natural Language Processings, ist es möglich, große Volumen von unstrukturierten Textdaten auf verschiedene Weise zu organisieren und ihnen wichtige Informationen zu entnehmen. Dafür werden Machine-Learning-Modelle entwickelt, deren Ziel ist, einem neuen, noch nie gesehenen Text, eine Kategorie aus einer Gruppe von vorgegebenen Kategorien zuzuweisen. Ein gutes Beispiel für Textklassifikation ist die Spam-Filterung. **Content:** # Textklassifikation – eine Einführung Textklassifikation ist ein Teilgebiet im Feld des Natural Language Processings. Das Ziel dabei ist es, einem neuen, noch nie gesehenen Text, eine Kategorie aus einer Gruppe von vorgegebenen Kategorien zuzuweisen. Ein gutes Beispiel für Textklassifikation ist die Spam-Filterung, bei der E-Mails in eine von zwei Kategorien eingeordnet werden sollen: „Spam“ oder „nicht Spam“. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Screenshot-45.png?fit=300%2C135&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Screenshot-45.png)Nähern wir uns diesem spannenden Thema an, indem wir die drei grundlegenden Fragen beantworten: - *„Warum ist automatisierte Textklassifikation sinnvoll?“* - *„Wo kann Textklassifikation eingesetzt werden?“* - *Was sind die Schritte von den Daten bis zur Klassifizierung?“* ## Warum ist automatisierte Textklassifikation sinnvoll? In der heutigen Zeit entsteht eine gewaltige Menge an Daten, die von Menschen nicht in absehbarer Zeit verarbeitet werden können. Ein großer Teil davon sind Texte. Wir finden sie beispielsweise in E-Mails, Zeitungsartikeln oder Kommentarspalten. In der Regel stecken in ihnen wertvolle Informationen, wie zum Beispiel Stimmungsbilder, die jedoch maschinell nicht ohne Weiteres erfasst werden können. Die Lösung des Problems liegt in der Entwicklung von Machine-Learning-Modellen, die in der Lage sind, große Volumen von unstrukturierten Textdaten auf verschiedene Weise zu organisieren und ihnen wichtige Informationen zu entnehmen. Mit etwas Initialaufwand kann ein Machine-Learning-Modell trainiert werden. Das Modell ist langfristig in der Lage, verschiedene Texte selbstständig zu klassifizieren. Dadurch reduziert sich der Aufwand im laufenden Betrieb auf die Wartung des Systems. Für die Textklassifikation, die andernfalls durch Menschen mit hohem Aufwand und hoher Fehleranfälligkeit umgesetzt werden müsste, ist das ein großer Vorteil. ## Wo kann Textklassifikation eingesetzt werden? Ein typisches Beispiel für den Einsatz von Textklassifikation in der Praxis ist die Klassifizierung von Kundenbewertungen, bei der jede Bewertung bezüglich der geäußerten Haltung als positiv, negativ oder neutral klassifiziert wird. Mit dieser Klassifikation können z.B. Online-Shops positive Trends erkennen oder schnell auf negatives Feedback reagieren. Mithilfe von Textklassifikation ist es auch möglich die Sprache oder die Dringlichkeit des Anliegens in Kundenmails zu erkennen. Das automatisiert die Abläufe im Kunden-Support und führt zu schnelleren Reaktionszeiten. Ein weiteres Beispiel ist die automatisierte Einordnung von Nachrichtenartikeln. Neue Blog- Einträge können direkt in der richtigen Rubrik landen, wie zum Beispiel Sport, Kultur oder Wissenschaft. ## Von den Daten bis zur Klassifikation Die Grundvoraussetzungen für die erfolgreiche Entwicklung eines Machine-Learning-Modells sind eine präzise Formulierung der Problemstellung und ein dazu passender Datensatz. Anschließend werden die folgenden Schritte durchlaufen: [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Screenshot-47-1024x149.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/Screenshot-47.png)### Trainings- und Testdaten vorverarbeiten Sind die Datengrundlage und die Problemstellung geklärt, so ist der erste Schritt der Textklassifikation die Vorverarbeitung. Hierbei werden die Daten bereinigt und je nach Problemstellung optimiert, zum Beispiel durch das Ersetzen von großen durch kleine Buchstaben. Das Ergebnis einer erfolgreichen Vorverarbeitung sind vereinheitlichte Textdaten in einer Form, die für die Machine-Learning-Modelle leicht zu verstehen ist. ### Ein Modell trainieren In diesem Schritt werden Algorithmen auf den berechneten Features angewendet und ein Machine-Learning-Modell trainiert. Das Modell lernt aus den Daten, wie diese einzuordnen sind, und definiert, unter welchen Bedingungen ein Text zu einer Kategorie gehört. ### Das Modell evaluieren Nachdem das Modell trainiert ist, soll es getestet werden. Dafür werden bereits kategorisierte Daten genutzt, die nicht zum Training des Modells verwendet wurden. Die von dem Modell klassifizierten Testdaten werden dann mit den echten bzw. bekannten Kategorien verglichen. Je mehr Übereinstimmungen zwischen den echten und den vorhergesagten Kategorien existieren, desto genauer ist das Modell. ### Weitere Schritte Nun ist der Zeitpunkt für Optimierungen gekommen. In jedem der oben beschriebenen Schritte können Anpassungen vorgenommen werden, mit dem Ziel, die Genauigkeit zu verbessern. Beispielsweise ist es möglich, die Texte weiter zu bearbeiten oder verschiedene Machine-Learning-Algorithmen auszuprobieren. Generell gilt, dass manche Algorithmen besser zu einem Datensatz passen als andere. Das hängt zum Beispiel davon ab, wie groß der Datensatz ist und in wie viele Kategorien klassifiziert werden soll – hier gibt es Spielraum für Experimente! ### Zusammenfassung Textklassifikation ist ein spannendes Thema, das in vielen interessanten Anwendungsfällen eine Lösung anbietet. Es lohnt sich, sich mit dem Thema auseinanderzusetzen und sich zu überlegen: wo könnte Machine Learning gebraucht werden? Wenn ihr bis hier gekommen seid, und Lust auf mehr Details und ein praktisches Beispiel habt, dann schaut in den nächsten Wochen nochmal vorbei! Stay tuned 🙂 **Autoren:** Luca Pomer, Conrad Dollinger, Jeffrey Remien und Galina Angelova ### Alle Teile dieser Serie: [Teil 1: Textklassifikation – eine Einführung](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/ "Zum Artikel") [Teil 2: Textklassifikation – Vorverarbeitung der Daten](https://thecattlecrew.net/2022/08/03/textklassifikation-vorverarbeitung-der-daten/ "Zum Artikel") [Teil 3: Textklassifikation – Modelle trainieren und evaluieren](https://thecattlecrew.net/2023/01/05/textklassifikation-modelle-trainieren-und-evaluieren/ "Zum Artikel") **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** Artificial Intelligence, automatisierung, data analytics, NLP, Python, Spacy, text classification, Text mining, text preprocessing --- ### [Was Pronomen über Harry Potter verraten - Ein Experiment mit NLP, Python und Power BI](https://thecattlecrew.net/2022/07/20/natuerliche-spracherarbeitung-mit-python/) **Published:** Juli 20, 2022 **Author:** Fabian Heidenstecker **Excerpt:** Kann eine Word Cloud Gedanken lesen? Welche Magie steckt hinter NLP, Python und Power BI? In einem Experiment durften wir Harry Potter, Ron und Hermine mit Methoden des Natural Language Processings (NLP) in Word Clouds verwandeln. Was haben wir über sie erfahren? Und haben Harry, Ron und Hermine den Versuch überlebt? Der Tagesprophet traf die Zauberlehrlinge zu einem exklusiven Interview. **Content:** Kann eine Word Cloud Gedanken lesen? Welche Magie steckt hinter NLP, Python und Power BI? „“ In einem Experiment durften wir Harry Potter, Ron und Hermine mit Methoden des Natural Language Processings (NLP) in Word Clouds verwandeln. Was haben wir über sie erfahren? Und haben Harry, Ron und Hermine den Versuch überlebt? Der Tagesprophet\[[1](#Tagesprophet)\] (TP) traf die Zauberlehrlinge zu einem exklusiven Interview. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/HP-Heads-1024x352.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/HP-Heads.png) *Abbildung 1: Von li: Harry Potter, Ron Weasley und Hermine Granger in ihrer „neuen Gestalt“* **TP:** Mir wurde zugetragen, dass ihr in sogenannte „Words Clouds“ verwandelt wurdet. Wenn ich euch so ansehe, besteht ihr jetzt aus farbigen Wörtern verschiedener Größe. Harry, wie fühlst Du dich? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?resize=150%2C150&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry:** Ich fühle mich etwas geplättet, halt zweidimensional, aber auch bis oben hin voll mit Informationen. **TP:** Verstehe. Aber wie konnte das passieren, waren dunkle Mächte im Spiel? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?resize=150%2C150&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine:** Nein, die Muggels\[[2](#Muggels)\] nennen es Data Science und Data Visualisation. **TP:** Aha … !? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine:** Um genau zu sein, haben die dabei Techniken und Methoden des Natural Language Processings (NLP) verwendet. Das ist was Hochtechnisches, das sich aber an der Art, wie natürliche Sprache verarbeitet wird, orientiert. Ziemlich intelligent, hätte ich ihnen gar nicht zugetraut! **TP:** In der Tat … Doch woher kommen denn die Wörter in euren „Wortwolken“? Was soll das bedeuten? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png?fit=192%2C300&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png) **Ron**: Diese Frage kann ich beantworten. Es sind die Dialoge aus allen Harry-Potter-Filmen. Schuld an all dem war die Maven Magic Challenge\[[3](#Maven)\].Diese richtete sich an Data Scientisten und andere Personen , die sich mit Datenvisualisierung beschäftigen. Die Aufgabe war, Harry-Potter-Dialoge im Rahmen eines Wettstreits auszuwerten. Das finden die dann direkt „voll magic“, wie Muggels halt so sind … Auch eine Hand voll OPITZ CONSULTING Muggels nahm an der Challenge teil. Die haben dann auch das mit den Word Clouds verbrochen. **TP:** Ah, ok, die Muggels haben also einen Wettbewerb veranstaltet – und nennen es „Challenge“. Das sieht ihnen ähnlich! Dabei könnte Data Science ja fast ein Teil unserer Welt sein, klingt nach dunklen Künsten, ist da was dran Harry? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Nein, das ist kein Hexenwerk. Aber wie bei der Zauberei braucht es wohl auch für die Data Science eine Menge Erfahrung und Wissen. Die haben versucht, uns einzuweisen, wir haben das echt nicht verstanden. Die Muggels haben sich da ganz schön reingekniet und waren dafür sogar an einer Universität, so was wie Hogwarts\[[4](#Hogwarts)\]für Fortgeschrittene. An der Challenge, in der unsere Word Clouds entstanden sind, machte „“ wie Ron schon sagte „“ auch eine Hand voll OPITZ CONSULTING Muggels mit, ein Team, dessen Mitglieder sowas im Job machen, und die darin noch besser werden wollen, also so eine Art Quidditch Mannschaft\[[5](#Quidditch)\]für Datenanalysetechniken. Vom Besen wären die direkt runtergesegelt, aber mit Daten kennen sie sich aus, das muss man schon sagen. Ihrem Team haben sie dann auch einen echten Kampfnamen gegeben, „C42 Next Level Analytics Community“, damit wollen die wohl ihre Besenuntauglichkeit kompensieren … Fehlten nur die passenden Gewänder … dafür gab es blaue T-Shirts. **TP**: Quidditch ohne Besen, naja … Was aber sollte das Ganze? Und was hat jeder einzelne dabei gemacht? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Ein Teil des Teams hat sich mit der Aufbereitung der Daten beschäftigt, und dazu eine besondere Sprache verwendet. Der andere Teil des Teams hat sich um die Sichtbarmachung, oder wie sie es nennen: „Visualisierung“ gekümmert. **TP:** Eine besondere Sprache? Eine Schlangensprache? Etwa Parsel\[[6](#Parsel)\]? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Nein, aber der Name der Sprache hatte was mit einer Schlange zu tun. Wie hieß die doch gleich „¦? ![](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png)![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Ron und Hermine** gleichzeitig: Python! ![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?resize=150%2C150&ssl=1) **Harry**: Richtig! Python. Wenn ich es richtig verstanden habe, ist Python eine Sprache, die oft für Data-Science-Projekte verwendet wird und besonders für NLP geeignet ist. Es gibt spezielle Pakete, die man mit Python nutzen kann. Eines davon nannten die Muggels Spacy, ein anderes NLTK. **TP**: Mensch, Harry, du wirfst mit Fachbegriffen ja nur so um dich, muss ich mir Sorgen machen? Lasst uns mal über etwas anderes sprechen:. Wenn man euch so anschaut, warum sind denn einige Wörter größer als andere? Hermine, kannst Du das beantworten? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Das ist so bei einer Word Cloud. Die Größe des Wortes steht für die Häufigkeit, wie oft ein Wort verwendet wurde. **TP**: Das kann doch nicht sein! Ich habe eure Filme gesehen und bin mir sicher, dass „you“ oder „and“ viel öfter vorkommen. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Das stimmt zwar, aber „you“ und „and“ zählen nicht. Das sind sogenannte Stoppwörter. Die haben keinen relevanten Inhalt und würden wichtigen Wörter einfach nur den Platz wegnehmen. Deshalb wollten die OPITZ CONSULTING Muggels, die in unseren Word Clouds auch nicht mit drin haben. Eine Liste mit Stoppwörtern ist in den NLP-Paketen drin, und kann durch eigene Begriffe erweitert werden. So kann man mit Python Stoppwörter aus Texten entfernen. **TP**: Trotzdem, die Wörter kommen mir nicht so ganz echt vor … wurden noch weitere Wörter entfernt? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Nicht direkt entfernt, aber bearbeitet. Das machen Data Scientisten anscheinend immer so, die NLP-Pakete für Python helfen ihnen dabei. Zum Beispiel haben sie die Wörter alle „lemmatisiert“. Wenn ich mal eben so drauf los quatsche, spreche ich ja, wenn es um den Baum geht, mal von einem „Baum“, dann von vielen „Bäumen“ oder eines „Baums“. Das System muss dann erst mal lernen, dass damit das gleiche Wort gemeint ist, und aus Bäumen das Wort Baum machen und die dann auch alle richtig mitzählen. Bei Nomen soll das System in der Regel den Singular verwenden: - Bäume -> Baum - Räume -> Raum - Träume -> Traum Bei Verben den aktiven Präsenz: - sprachen, sprach,sprachest -> sprechen - sagen, sagte, sagtest -> sagen - empfehlen, empfahl, empfohlen -> empfehlen Und damit sich dabei nicht ein Muggel die Hand blutig schreiben muss, werden die automatisch in der Rechenmaschine vereinheitlicht, bzw. lemmatisiert. **TP**: So, so, eine Rechenmaschine … die kann euch ja nicht wirklich verstehen, oder? Bringt die dann nicht vieles durcheinander? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Ja, die Gefahr besteht natürlich. Deshalb haben sich die Muggels genaue Aufgaben für sie überlegt, die sie nicht nur schaffen kann, sondern bei denen sie ihnen sogar Haus hoch überlegen ist. Sie zerlegt zum Beispiel im allerersten Arbeitsschritt alle Sätze in ihre Bestandteile. Das nennt sich Tokenisierung. Sprich: Sätze werden in die einzelnen Wörter zerlegt. **TP**: Ja, das klingt schlüssig. Warum aber werden in Abbildung 2 die Wortarten, also Verben, Pronomen, Nomen und so weiter, mit genauen Prozentzahlen aufgeführt? Was soll das bringen? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Magical-Challange-Upload-597x1024.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/Magical-Challange-Upload.png) *Abbildung 2: Auswertung der Wordclouds* [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Diese Kategorisierung kann man in Python automatisch vornehmen lassen, und damit analysieren, welche Wortarten diese Person am häufigsten verwendet. Das sagt etwas über die Art und Weise aus, wie sie spricht, was wiederum etwas über Ihren Charakter aussagen kann.\[[7](#Pennebaker)\] [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png?fit=192%2C300&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png) **Ron**: Ich verwende zum Beispiel viele Pronomen, wie I, you, he, she, it. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Und ich verwende sehr viele Verben. **TP**: Das heißt, die können am Ende eure Gedanken lesen? Schon wieder Zauberei! [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png?fit=300%2C270&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Hermoine-Head.png) **Hermine**: Ja, ein wenig schon. Man kann noch einen Schritt weiter gehen, und aus der Sprache, die wir sprechen, ableiten, ob wir eher gut oder eher schlecht auf eine Sache zu sprechen sind. Die Muggels nennen es Sentiment Analyse. **TP**: Also, nachdem die Texte analysiert wurden und man diese Verarbeitung vorgenommen hat, wie habt ihr denn nun Gestalt angenommen? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Nun, wir sprachen vorhin schon drüber. Ein Teil des Teams hat die Analyse aus der Rechenmaschine herausgeholt und für alle sichtbar gemacht. Das heißt Visualisierung. Dafür brauchen die Muggels keinen Zauberstab, sondern nur ein Computerprogramm namens „Power BI“. **TP**: Zaubern ohne Zauberstab, so ein Wundermittel hätte ich auch gerne! Hab direkt mal nach Power BI gegoogelt … und pah, dort gibt gar keine Word Cloud als Visualisierung. Was sagt ihr jetzt? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Richtig erkannt! Aber es gibt die Möglichkeit, ein Python Script Visual zu verwenden. Damit können Python Visualisierungen einfach in Power BI eingebunden werden. Das ist super praktisch, weil es eine riesige Anzahl von Visualisierungspaketen in Python gibt. Unsere Word Cloud ist nur eins davon. **TP**: Ganz schön clever. Aber wie schafft man es, dass die Word Cloud sogar in eure Köpfe passt und nicht einfach viereckig ist. Sind auch die Farben anpassbar? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Man kann das über die Parameter des Word-Cloud-Pakets steuern. Dort kann man eine Schriftart definieren, eine Farbe als HSL-Wert übergeben und eine Grafik als Maske hinterlegen. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png?fit=192%2C300&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png) **Ron**: Voll krass das mit der Farbe. Über einen Zufallswert kann man da eine Varianz reinbringen, damit sich die Farben ganz leicht unterscheiden, und die Word Cloud somit noch etwas lebendiger wirkt. [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Python-Script-Visual.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/Python-Script-Visual.png) *Abbildung 3: Python Skript Visual in Power BI* **TP**: Nicht schlecht! Kann ich davon für unser Zeitungslayout noch was lernen? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png?fit=192%2C300&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Ron-Head.png) **Ron**: Kann schon sein. Die haben zum Beispiel eine Papiertextur als Hintergrund für die Power BI Anwendung verwendet, Icons eingefügt und auch die Farbpalette nach den Hausfarben ausgewählt, um so eine ansprechende Anwendung zu gestalten. **TP**: Nun mal Hand aufs Herz. Konnten euch die Muggels eure Geheimnisse entlocken? [![](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png?fit=300%2C297&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2022/06/Harry-Head.png) **Harry**: Nein, so weit sind die Muggels noch nicht. Man kann zwar anhand der verwendeten Pronomen gewisse Rückschlüsse auf die Persönlichkeit der Sprecher bzw. der Beziehung von Personen untereinander ziehen, aber wir sind ja fiktionale Charaktere. Das macht es besonders schwierig. Auch hiermit haben sich die Muggels schon beschäftigt, auf einem wissenschaftlichen Niveau, und z.B. ein Programm namens SentiArt entwickelt, um speziell literarische Texte zu analysieren. **TP**: Vielen Dank an euch. Sprache analysieren, Gedanken lesen und das Ganze in einer einzigartigen Gestalt sichtbar machen. NLP mit Python und Power BI, diese Zauberwerkzeuge hätten das Zeug für eine Titelstory. Mal sehen was meine Redaktion dazu meint. **Ergänzung der Redaktion**: Es scheint, als wären Word Clouds tatsächlich eine gute Visualisierungsmöglichkeit, um wichtige Informationen aus Texten zu extrahieren. Diese Möglichkeit kann wohl auch für allerlei weitere Texte verwendet werden, also z. B. für E-Mails aus dem Customer Service, Kommentarbeiträge auf Firmenseiten oder Nachrichten aus den Social-Media-Kanälen. NLP kann man aber nicht nur für die Aufbereitung von Word Clouds benutzen. Ein spannender Anwendungsfall ist die Kategorisierung von E-Mails, indem man das enthaltene Anliegen erkennt. In Kombination mit Maschine Learning, welches mit Vergangenheitsdaten und der getätigten Kategorisierung trainiert wird, kann man dann automatisch kategorisieren. Wir sind gespannt, was sich die Muggels noch so einfallen lassen! Mehr zum Thema Textklassifikation im [Cattle Crew Blog](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/) --- **Index** \[1\] Tagesprophet: Der *Tagesprophet* (im Original: The Daily Prophet) ist, wie es scheint, die größte und bedeutendste Tageszeitung und Print-Publikation in der magischen Welt. (Vgl. [https://harry-potter.fandom.com/de/wiki/Der\_Tagesprophet](https://harry-potter.fandom.com/de/wiki/Der_Tagesprophet)) \[2\] Muggels, so nennen die Magier und Hexen die nicht-Magier. \[3\] Maven Magic Challenge: Das ist so was wie eine Werbeaktion von Maven Analytics. Und das wiederum ist eine Firma, die Kunden dabei hilft, moderne analytische Plattformen aufzubauen. Hier erfahrt ihr mehr über die Maven Magic Challenge: \[4\] Hogwarts heißt die Schule, auf der Harry Potter und seine Freunde das Zaubern lernen. \[5\] Quidditch heißt eine in der Zaubererwelt beliebte Sportart. Sie wird von zwei Mannschaften mit je sieben auf Besen fliegenden Spielern mit insgesamt vier Bällen gespielt. Je Mannschaft dienen drei Ringe, die in 20 Metern Höhe angebracht sind, als Tore. (Vgl. [https://de.wikipedia.org/wiki/Begriffe\_der\_Harry-Potter-Romane#Quidditch](https://de.wikipedia.org/wiki/Begriffe_der_Harry-Potter-Romane#Quidditch)) \[6\] Parsel ist eine Schlangensprache *(Parseltongue), die* angeboren ist und selten vorkommt. Die Mehrheit der Zaubererschaft fürchtet sie, da die meisten Parselmünder Schwarzmagier waren. (Vgl. [https://de.wikipedia.org/wiki/Begriffe\_der\_Harry-Potter-Romane#Parselmund](https://de.wikipedia.org/wiki/Begriffe_der_Harry-Potter-Romane#Parselmund)) \[7\] Es gibt einen Muggel Professor namens James Pennebaker, der sich mit der Erforschung bestimmter verwendeter Wörter aus psychologischer Sicht beschäftigt. So referierte er bei der TED Conference in Austin/Texas über das „geheime Leben der Pronomen“ „“ I, You, Me, We, Us: small words with the tremendous ability to illuminate who we are and how we’re feeling „“ Das solltet ihr euch ansehen: \[8\] SentiArt ist ein Vector Space basiertes Modell zur Analyse literarischer Texte. **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** Data Visualization, NLP, PartOfSpeech, Power BI, Python, Spacy, Text mining, Word Cloud --- ### [Textklassifikation - Vorverarbeitung der Daten ](https://thecattlecrew.net/2022/08/03/textklassifikation-vorverarbeitung-der-daten/) **Published:** August 3, 2022 **Author:** Luca Pomer **Content:** # Textklassifikation – Vorverarbeitung der Daten Im [vorherigen Beitrag](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/) haben wir uns mit den drei Fragen *“Warum ist automatisierte Textklassifikation sinnvoll?”, “Wo kann Textklassifikation eingesetzt werden?”* und *“Was sind die Schritte von den Daten bis zur Klassifizierung?”* beschäftigt. In diesem Blogbeitrag möchten wir den ersten Schritt genauer erläutern, den Daten in einem typischen Textklassifizierungsszenario durchlaufen: Die Datenvorverarbeitung (s. Abbildung 1). ![](https://thecattlecrew.net/wp-content/uploads/2022/08/Screenshot-61-300x52.png)Abbildung 1: Drei Schritte der Textklassifikation: Datenvorverarbeitung, Modelltraining und Modellevaluierung. Als Beispiel dient uns ein Projekt, in dem deutschsprachige Zeitschriftenartikel klassifiziert werden. An ihm lassen sich die Grundlagen der Datenvorverarbeitung sehr gut aufzeigen. Wir haben uns für den Datensatz [“Ten Thousand German News Articles Dataset”](https://tblock.github.io/10kGNAD/) entschieden. Der Datensatz enthält 10.273 Zeitschriftenartikel einer österreichischen Online-Zeitschrift, die in neun Kategorien aufgeteilt sind. Die folgende Abbildung zeigt die Anzahl an Texten je Kategorie: ![](https://thecattlecrew.net/wp-content/uploads/2022/08/Screenshot-62-1-300x175.png)Abbildung 2: Anzahl an Texten in jeder Kategorie des Datensatzes. #### Wie uns Datenvorverarbeitung hilft > *Wer die Vorverarbeitung seiner Daten zu vermeiden probiert,* > > *dessen Modell-Accuracy nie steigen wird.* Der Input für Machine-Learning-Modelle sind numerische Daten. Dementsprechend ist das Ziel der Textvorverarbeitung, die Textdaten in eine berechenbare und analysierbare Form zu bringen, die von Domäne und Ansatz unabhängig ist und als Zahl dargestellt werden kann. Wir stellen euch im Rahmen dieses Beitrags die am häufigsten benutzten Techniken zur Vorverarbeitung von Textdaten für Textklassifikationsaufgaben vor und erläutern, wann diese sinnvoll sind. Jede Vorverarbeitungstechnik wird anhand eines Beispiels und eines Code-Snippets erklärt. Bei der Datenvorverarbeitung haben wir Methoden gewählt, die die folgenden Ziele verfolgen: - Die Daten in eine einheitliche Form bringen - Die relevantesten Daten auswählen Durch Vereinheitlichung soll der Machine-Learning-Algorithmus unterschiedliche Schreibweisen eines Begriffs auf einen Nenner bringen. Zum Beispiel sind die Worte „der Ball”, „des Balles” und „die Bälle” für ein Modell nicht identisch, da ihre Zeichenzusammensetzung anders ist. Durch eine Vorverarbeitung werden alle Wörter in ihren Wortstamm „ball” umgewandelt. Für das Modell wäre es sonst sehr schwierig, in manchen Fällen sogar unmöglich, Zusammenhänge zwischen Wörtern zu erkennen, die unterschiedlich geschrieben sind. Die Selektion hat das Ziel, dem Machine-Learning-Algorithmus nur Daten zu übergeben, die für die Klassifizierung relevant sind. Wir möchten, dass sich das Modell auf das Wesentliche konzentriert, sprich: auf die Wörter mit den Kerninformationen. Ein klassisches Beispiel ist das Entfernen von Artikeln oder Füllwörtern wie „also”, „der”, „ein” etc. Hier geht es darum, den Informationsgehalt der Daten zu optimieren, um den Lernprozess zu beschleunigen. #### Techniken zur Vorverarbeitung von Texten Wir stellen euch neun Vorverarbeitungstechniken vor, die in der Praxis bei der Textklassifikation häufig angewandt werden. Dazu haben wir die bekannten Bibliotheken **NLTK** und **SpaCy** genutzt. Die ersten drei – *Lowercasing*, *Lemmatisierung* und *Stemming –* gehören in den Bereich der Umformung von Daten, und mit den nachfolgenden vier Techniken werden wir *Satzzeichen*, *Stoppwörter*, *Zahlen* und *nicht ASCII konformen Wörtern entfernen*, damit wir nur die relevantesten Daten auswählen. Die Umsetzung jeder der Techniken nacheinander wird anhand des folgenden kleinen Beispieltextes veranschaulicht: > *21-Jähriger fällt wohl bis Saisonende aus. Wien – Rapid muss wohl bis Saisonende auf Offensivspieler Thomas Murg verzichten. Der im Winter aus Ried gekommene 21-Jährige erlitt beim 0:4-Heimdebakel gegen Admira Wacker Mödling am Samstag einen Teilriss des Innenbandes im linken Knie.* #### Lowercasing > *Den Datensatz zu Kleinbuchstaben konvertieren* > > *und dann von großartigen Ergebnissen profitieren…* Um die Bedeutung eines Textes zu verstehen, spielen Klein-und Großbuchstaben keine Rolle. Deshalb werden beim Lowercasing alle Buchstaben in Kleinbuchstaben umgewandelt. In Python gibt es verschiedene Möglichkeiten dafür. Eine der einfachsten ist die Standardmethode *lower()* für Strings: ``` def to_lower(in_string: str):     out_string = in_string.lower()         return out_string ``` Nach den Lowercasing läse sich unser Beispielsatz so: > *21-jähriger fällt wohl bis saisonende aus. wien – rapid muss wohl bis saisonende auf offensivspieler thomas murg verzichten. der im winter aus ried gekommene 21-jährige erlitt beim 0:4-heimdebakel gegen admira wacker mödling am samstag einen teilriss des innenbandes im linken knie.* #### Lemmatisierung und Stemming > *Die Vielfalt an Wörtern reduzieren,* > > *und „schwupps” kann das Modell Texte klassifizieren.* Lemmatisierung ist der Prozess der Umwandlung eines Wortes in seine Grundform (Lemma). Das ist die Form, in der ein Wort im Wörterbuch zu finden wäre. Beispielsweise wird „erlitt” zu „erleiden” umgeformt. Damit wird die Anzahl der Flexionsformen reduziert. Flexionsformen sollen verschiedene grammatikalischen Merkmale ausdrücken. Für die Kategorisierung eines Textes sind sie nicht relevant. Die oben genannten Python-Bibliotheken NLTK und Spacy bieten die Funktionalität zur Lemmatisierung. Wir müssen aber in Gedanken behalten, dass die Ergebnisse der Lemmatisierung von der entsprechenden Bibliothek und von der Implementierung der Technik abhängig sind, und nicht immer grammatikalisch korrekt sind. Das ist auch bei unserem Beispiel zu beobachten. ``` import spacy as sp def lemmatize(in_string: str): nlp = sp.load('de_core_news_md') nlp_object = nlp(in_string) output_lemmatized = ' '.join([x.lemma_ for x in nlp_object]) output_lemmatized = ' '.join(output_lemmatized.split()) return output_lemmatized ``` Der Beispieltext nach Lemmatisierung: > *21-jähriger fällen wohl bis saisonende aus. wien – rapid muss wohl bis saisonende auf offensivspieler thomas murg verzichten. der im winter aus ried gekommen 21-jährige erleiden beim 0:4-heimdebakel gegen admira wacker mödling am samstag ein teilriss der innenbandes im link knien.* Stemming ist eine andere Methode, die – ähnlich der Lemmatisierung – auch zur Vereinheitlichung von verschiedenen Formen eines Wortes benutzt wird. Stemming entfernt Präfixe und Suffixe, um Wörter auf ihren Wortstamm zu reduzieren. In der Praxis gibt es verschiedene Algorithmen, die Stemming anwenden. Einer der bekanntesten für die englische Sprache ist der Porter Stemmer. Aber Achtung: Stemming (wie Lemmatisierung) erzeugt nicht immer das richtige Ergebnis und sollte daher mit Bedacht eingesetzt werden. ``` from nltk.stem.snowball import GermanStemmer def stemming(in_string: str) -> str: stemmer = GermanStemmer() output_stemmed = ' '.join([stemmer.stem(x) for x in in_string.split()]) return output_stemmed ``` Der Beispieltext nach Stemming: > *21-jahrig fallt wohl bis saison aus. wien – rapid muss wohl bis saison auf offensivspiel thomas murg verzichten. der im wint aus ried gekomm 21-jahrig erlitt beim 0:4-heimdebakel geg admira wack modling am samstag ein teilriss des innenband im link knie.* Die nächsten Vorverarbeitungsschritte werden wir auf unseren *Beispielsatz nach Lemmatisierung* anwenden. #### Entfernen von Satzzeichen > *Ohne Punkt und Komma, lohnt sich das? > Prüfe und behalte Augenmaß.* Aus der Sicht eines Modells zur Textklassifikation sind die Satzzeichen weitere Elemente des Textes, deren Bedeutung und Zusammenhang zu den anderen Elementen gelernt werden soll. Das ist oft aber unnötig, denn genau wie die Anfangsbuchstaben, haben die meisten Satzzeichen keine Relevanz für die Textklassifikation. Doch es gibt Ausnahmen: So kann ein Komma dem Modell helfen, verschiedene Repräsentationen von Zahlen und deren Bedeutung zu lernen: So wäre 1998 eine Jahreszahl und 19,98 ein Geldwert. Würden wir hier das Komma entfernen, könnte das Modell den gleichen Input für gänzlich verschiedene Zahlenwerte bekommen: „1998“ und „1998“. Das Komma wäre also wichtig, um die Bedeutung von verschiedenen Zahlenformaten zu lernen. Entfernen lassen sich Satzzeichen mit einer vordefinierten Konstante im String-Modul *string.punctuation* von Python, die die folgenden ASCII-Satzzeichen umfasst: !“#$%&'()\*+,-./:;<=>?@\[\]^\_`{|}~ ``` def remove_punctuation(in_string: str):     out_string = in_string.translate(str.maketrans('', '', string.punctuation))     out_string = ' '.join(out_string.split())         return out_string ``` Nun unser Beispielsatz ohne Satzzeichen: > *21 jähriger fällen wohl bis saisonende aus wien rapid muss wohl bis saisonende auf offensivspieler thomas murg verzichten der im winter aus ried gekommen 21jährige erleiden beim 04heimdebakel gegen admira wacker mödling am samstag ein teilriss der innenbandes im link knien* #### Entfernen von Stoppwörtern > *Wenn Häufigkeit und Bedeutungsgehalt negativ korrelieren,* > > *kannst du davon nicht profitieren.* Im Information Retrieval sind Stoppwörter sehr häufig auftretende Wörter, die gewöhnlich keine Bedeutung für die Erfassung des Inhalts eines Dokuments besitzen. In jeder Sprache gibt es andere Stoppwörter. Für die Arbeit mit dem Algorithmus können feste Stoppwortlisten genutzt werden, die es für viele Sprachen gibt. Stoppwörter zeichnen sich dadurch aus, dass sie sehr häufig in einem Text vorkommen und wichtig sind für die Grammatik. Ohne sie, kann sich das Modell besser auf die eigentlichen Informationen in einem Text konzentrieren. Beispiele für Stoppwörter in der deutschen Sprache sind: - bestimmte und unbestimmte Artikel (z.B. der, die, ein, einer, etc.) - häufige Präpositionen (z.B. an, in, von, etc.), - die Negation *nicht* Wie das Entfernen von Satzzeichen ist auch das Entfernen von Stoppwörtern abhängig von der Lernaufgabe des Modells und vom Datensatz. Diese Vorverarbeitungstechnik wird gerne bei der Suchmaschinenoptimierung oder Informationsextraktion genutzt, bei der Textklassifikation ist sie nicht immer hilfreich. ``` from spacy.lang.de import German def remove_stop_words(in_string: str):     nlp = German()         nlp_object = nlp(in_string)     # Create list of word tokens     token_list = []     for token in nlp_object:         token_list.append(token.text)     # Create list of word tokens after removing stopwords     filtered_sentence = []     for word in token_list:         lexeme = nlp.vocab[word]         if not lexeme.is_stop:             filtered_sentence.append(word)         filtered_sentence = ' '.join(filtered_sentence)     filtered_sentence = ' '.join(filtered_sentence.split())                 return filtered_sentence ``` Hier ist unser Beispielsatz ohne Stoppwörter: > *21jähriger fällen saisonende wien rapid saisonende offensivspieler thomas murg verzichten winter ried gekomm 21jährige erleiden 04heimdebakel admira wacker mödling samstag teilriss innenbandes link knien* #### Entfernen von Zahlen > Zum Verstehen der Bedeutung eines Textes komplett – > > anstatt die Ziffern 1 bis 10, schau dir an die Buchstaben a bis z… Ob das Entfernen von Zahlen dem Modell wirklich hilft, hängt wieder vom Anwendungsfall und vom Datensatz ab. In unserem Fall haben wir uns dafür entschieden, alle Zahlen zu entfernen, denn sie beinhalten keine Bedeutung für die Texte. Dementsprechend helfen sie nicht dabei, die richtige Kategorie den einzelnen Texten zuzuweisen. ``` def remove_numbers(in_string: str):         # A regex pattern that matches all the numbers in a given string     pattern = r'[0-9]'         sentence_no_numbers = " ".join((re.sub(pattern, "", in_string)).split())     sentence_no_numbers = ' '.join(sentence_no_numbers.split())         return sentence_no_numbers ``` Der Beispieltext nach Entfernen der Zahlen: > *jähriger fällen saisonende wien rapid saisonende offensivspieler thomas murg verzichten winter ried gekomm ährige erleiden heimdebakel admira wacker mödling samstag teilriss innenbandes link knien* #### Ersetzen von Zeichen > Komplexe Zeichen solltest du simplifizieren, > > damit sich die Wörter in jeder Kodierung richtig repräsentieren. In unserem Datenset haben wir alle Umlaute – ä, ö, ü, und die Ligatur ß durch durch ae, oe, ue bzw. ss ersetzt. Das ist ein Schritt, der zur Normalisierung von Texten gehört. Das Ersetzen von diakritischen (ä, ö, ü, ß) Zeichen kann in einigen Fällen besonders hilfreich sein. Ein gutes Beispiel dafür ist die Zeichenkodierung in ASCII, die heutzutage immer noch eine der verbreitetsten Arten von Zeichenkodierung ist, aber nur einfache Buchstaben erlaubt – auf Englisch auch als “printable characters” bekannt. Da diakritische Zeichen kein Teil davon sind, ist es nicht möglich deutsche Wörter in ASCII richtig zu repräsentieren, es sei denn, die Umlaute und ß sind ersetzt. Werden diese Zeichen ersetzt, können alle deutschen Wörter komplett mit einfachen ASCII-Zeichen dargestellt werden. ``` def replace_special_letters(in_string: str) -> str:     replacements_dic = {         "ä": "ae",         "ö": "oe",         "ü": "ue",         "ß": "ss"     }     # Checks if parts of the strings match an item from the     # dictionary of predefined replacements     rc = re.compile('|'.join(map(re.escape, replacements_dic)))     # Small helper function to do the replacement if a match     # in the string is found     def translate(match):         return replacements_dic[match.group(0)]     out_string = rc.sub(translate, in_string)     return out_string ``` Der Beispieltext nach Ersetzen von den diakritischen Zeichen: > *jaehriger faellen saisonende wien rapid saisonende offensivspieler thomas murg verzichten winter ried gekommen jaehrige erleiden heimdebakel admira wacker moedling samstag teilriss innenbandes link knien* #### Entfernen von nicht ASCII konformen Wörtern > *Hier werden wir einen berühmten Spruch übertragen –* > > *es ist eine Kunst, mit wenigen Zeichen viel zu sagen…* Eine nach unserem Anwendungsfall erstellte Funktion zur Vorverarbeitung der Texte, ist das Entfernen aller Wörter, die ein nicht einfaches ASCII-Zeichen enthalten. Der Grund dafür ist die Art von Texten mit denen wir arbeiten, und zwar Artikel aus einer Online-Zeitschrift, in denen oft beispielsweise Zitate von fremden Medien in der entsprechenden Sprache vorkommen oder verschiedene fremde Marken (Škoda) erwähnt werden. Jedes einzelne Wort davon hat eine niedrige Häufigkeit, dementsprechend auch keine bedeutende Relevanz zum Informationsgehalt des Textes. Da wir schon Zahlen, Umlaute und ß entfernt oder ersetzt haben, wollten wir nur Wörter aus einfachen ASCII-Zeichen in unseren Texten belassen. Auf diese Weise garantieren wir, dass alle fremdsprachigen Wörter, die keine Bedeutung zur Kategorie des Textes haben, entfernt werden. Deutsche Wörter, die bedeutungstragend sind, gehen so nicht verloren. ``` def remove_non_ascii_words(in_string: str) -> str:     def isascii(s: str):         return len(s) == len(s.encode())         ascii_words = []     for word in in_string.split():         if isascii(word):             ascii_words.append(word)         sentence_only_ascii_words = ' '.join(ascii_words)         return sentence_only_ascii_words ``` Ein kleiner Beispielsatz mit nicht ASCII konformen Wörtern: > *jaehriger odvažovat faellen Škoda saisonende wien offensivspieler* thomas Ergebnis nach Entfernung der Non-Ascii-Wörter: > *jaehriger faellen saisonende wien offensivspieler thomas* ### Fazit Alle hier vorgestellten Techniken können einem Modell dabei helfen, Texte besser zu verstehen und schneller zu verarbeiten. Wichtig ist jedoch, dass keiner dieser Schritte obligatorisch ist. Je nach Art der Daten, dem Anwendungsfall und der Art der Informationen, die man gewinnen möchte, muss individuell entschieden werden, welche Technik sinnvoll ist und in welchem Maße sie angewendet werden sollte. Es gibt viele Schritte, die zu einer erfolgreichen Textklassifizierung führen. In diesem Artikel wollten wir zeigen, dass Textklassifizierung und im Grunde fast alle Machine-Learning-Prozesse, mit einer soliden Vorverarbeitung der Daten beginnen. Diese Schritte können drastische Auswirkungen auf das Ergebnis haben, völlig unabhängig davon, welches Modell oder welcher Algorithmus später verwendet wird und wie dieses/dieser konfiguriert ist. In unserem nächsten Beitrag werfen wir einen Blick hinein ins Modelltraining: Wie lernt eine Maschine? Wie geht sie vor, wenn es zum Beispiel darum geht, verschiedene, Artikelkategorien zu unterscheiden? Es lohnt sich also reinzuschauen. Stay tuned! **Autoren:** Luca Pomer, Conrad Dollinger, Jeffrey Remien und Galina Angelova ### Alle Teile dieser Serie: [Teil 1: Textklassifikation – eine Einführung](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/ "Zum Artikel") [Teil 2: Textklassifikation – Vorverarbeitung der Daten](https://thecattlecrew.net/2022/08/03/textklassifikation-vorverarbeitung-der-daten/ "Zum Artikel") [Teil 3: Textklassifikation – Modelle trainieren und evaluieren](https://thecattlecrew.net/2023/01/05/textklassifikation-modelle-trainieren-und-evaluieren/ "Zum Artikel") **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** Artificial Intelligence, data analytics, data mining, NLP, Spacy, text preprocessing --- ### [Modern Cloud Analytics – Oder: Als wir versuchten, die Wahlen in NRW vorherzusehen*](https://thecattlecrew.net/2022/12/09/modern-cloud-analytics-oder-als-wir-versuchten-die-wahlen-in-nrw-vorherzusehen/) **Published:** Dezember 9, 2022 **Author:** Janine Ellner **Content:** Früher war alles besser? Für Analytics-Projekte gilt das sicherlich nicht. Mit modernen Auswertungstools, Künstlicher Intelligenz und vielen neuen Möglichkeiten der Datenspeicherung und Verarbeitung in der Cloud, sprich Modern Cloud Analytics, stehen uns heute mehr Möglichkeiten offen als je zuvor. Doch eines kann man wahrscheinlich schon sagen: Früher war vieles einfacher. Denn um diese neuen Möglichkeiten voll ausschöpfen zu können, greifen viele Rädchen ineinander. Daten aus verschiedensten Quellen und in unterschiedlicher Form werden gesammelt, aufbereitet, mit Hilfe von Machine Learning angereichert und analysiert – und für jeden dieser Schritte gibt es die unterschiedlichsten Lösungsansätze und die jeweiligen Expert:innen. Oft wird die Komplexität, die hierdurch entsteht, unterschätzt. Im schlimmsten Fall wird jeder Schritt von einem anderen Bereich übernommen – und alle kochen ihr eigenes Süppchen. Das führt dann dazu, dass Daten redundant vorliegen, Machine-Learning-Algorithmen ihr Potenzial nicht ausschöpfen können, die Ergebnisse den Weg ins Reporting nicht finden und vieles mehr … Unsere Firmen-Communitys „Data Integration“ und „Next Level Analytics“ wollten einen Weg finden, diese komplexen Prozesse unter einen Hut zu bringen. Dafür haben wir uns neben unserer täglichen Arbeit ein aktuelles Thema vorgenommen: die Landtagswahlen in NRW. An den Namen der Communitys erkennt man wahrscheinlich bereits die erste Herausforderung: Hier hatten sich Expert:innen aus unterschiedlichen Bereichen versammelt. Die erste Maßnahme war also, die richtigen Personen an einen Tisch zu bekommen und einen Schlachtplan zu entwickeln. *\*Teil 1 aus dem Tagebuch unseres Community Projekts zur NRW-Wahl 2022* # Was wir herausfinden wollten Die Grundidee „wir machen was rund um die Wahl“ stand schnell fest. Doch was wollten wir eigentlich herausfinden? Nach einem gemeinsamen Brainstorming entschieden wir uns für Predictive Analytics, d. h., wir wollten versuchen, die Wahlergebnisse vorherzusehen. Eine solche Prognose wäre ja nicht nur für uns als Außenstehende spannend, sondern gerade für die Parteien sehr wertvoll. Und vielleicht wäre es ja sogar möglich, die Ergebnisse auch auf weitere Wahlen zu übertragen. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild1-300x169.png)Ein kurzer Einblick in unser Dashboard # Die von uns genutzten Daten Um unseren Plan umzusetzen, fehlte uns allerdings noch etwas sehr Wichtiges: Die Daten. Also bestand unsere erste Aufgabe darin, Datenquellen zu suchen, die uns weiterbringen. Wir überlegten, welche Quellen uns frei zur Verfügung stehen. Natürlich gibt es Umfrageergebnisse, die konnten wir zu Analysezwecken per Excel-Dateien nutzen. Auch hatten wir die Ergebnisse der letzten Wahlen und letztendlich auch die der aktuellen NRW-Wahl – denn das Projekt lief über das Ende der Wahlperiode hinaus. Es fehlten aber noch Daten, die unsere Grundlage für den Forecast bilden sollte. Am besten geeignet wären hierfür natürlich die Meinungen der Wähler. Wenn wir diese herausfinden könnten, ließe sich doch sicher eine Vorhersage über den Ausgang der Wahl treffen. Die meisten sozialen Netzwerke, standen uns leider nicht zur Verfügung. Twitter hingegen lässt sich relativ leichtgewichtig abgreifen und mit dessen API konnten wir bereits in anderen Projekten Erfahrungen sammeln. Die Entscheidung war gefallen: Wir würden die Tweets zur Landtagswahl sammeln und nutzen. In Twitterbeiträgen verstecken sich viele spannende Informationen. Neben Texten und Hashtags sind auch die Metadaten von Tweet und User sehr aufschlussreich. Durch die Anzahl der Likes, Retweets, Replies und Follower erfährt man einiges über die Reichweite der Inhalte. Auch die User-Namen sind in diesem Beispiel aussagekräftig, da man über sie die Spitzenkandidaten der Parteien identifizieren kann. Die Orte der User werden auch noch eine Rolle spielen, aber hierzu später mehr. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild2-300x179.png)Das Twitter Datenmodell # Wie es unter der Motorhaube aussah … Die Quellen waren also festgelegt. Nun ging es an die Architektur. Die Daten sollten schließlich verarbeitet und abgelegt werden. Die technischen Details reiße ich in diesem in diesem Beitrag nur ganz kurz an. Denn dazu gibt es in den nächsten Teilen dieser Blogreihe mehr zu lesen. Aber so viel sei verraten: Wir entschieden uns dafür, vollständig in der Azure Cloud zu arbeiten. Hier lassen sich schnell die benötigten Systeme, Datenbanken und Ressourcen zur Verfügung stellen und verbinden. Für die Datenspeicherung haben wir eine Snowflake-Datenbank ausgewählt. Grob gesehen waren dies die nächsten Schritte: - Mit Hilfe von Apache Nifi griffen wir die Tweets ab und schrieben sie in den Data Lake Storage unseres Staging Layers. Nifi ermöglicht uns hierbei einen Echtzeit-Transfer der Daten, d.h. sobald ein Tweet neu erstellt wird, schreiben wir ihn in unser System. - Von dort aus wurden die Daten mit Airbyte aus dem Data Lake Storage in unsere Snowflake Datenbank geschrieben, durch dbt Transformationen aufbereitet und in einem Core-Layer \* persistiert. Die beiden Open Source Tools Airbyte und dbt stellen gerade in Kombination eine gute Alternative zu kommerziellen Tools dar. - Die Daten wurden dann mit Azure Machine Learning weiter analysiert und angereichert. - Den Data Mart\*\* befüllten wir mit Hilfe von ETL-Strecken in Pyramid – auch hier hätten wir dbt verwenden können, wir wollten aber im Zuge des Projekts evaluieren, was uns die breit aufgestellte Decision Intelligence Plattform von Pyramid Analytics alles zu bieten hat. Auch die Visualisierungen wurden dort erstellt. Allen, die es selbst noch nicht erlebt haben, wird spätestens, wenn sie unsere Architekturgrafik sehen, klar werden, wie komplex und vielschichtig Analytics-Themen sind – und ich hatte es ja schon angedeutet: Es werden viele unterschiedliche Skills benötigt. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild3-300x166.png)Unsere Architektur *\*Der Core-Layer stellt die zentrale Datenhaltungsschicht eines Data Warehouse dar. Hier werden die Daten strukturiert und persistent abgelegt.* *\*\* Der Data Mart Layer beinhaltet Informationen, die für fachliche Fragestellung optimiert wurden und in Auswertungen verwendet werden können.* # Wie unser Team zusammengesetzt war In den seltensten Fällen werden derart vielfältige Skills von einer einzelnen Person abgebildet. Auch in unserem Fall gab es Spezialist:innen für die unterschiedlichen Themen. Damit die Abstimmung untereinander leichter wurde, haben wir das ganze Team in mehrere Subteams unterteilt. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Team-1-300x136.png)Die Teams und ihre Aufgaben - Das *Datenaufbereitungs-Team* kümmerte sich um die Datensammlung und Aufbereitung bis in den Core Layer. Es zapfte die API von Twitter an und persistierte die Daten in der Snowflake Datenbank. So kamen mit der Zeit Tausende von Tweets zusammen, die weiterverarbeitet werden konnten. - Auf dieser Basis baute dann das *Textanalyse-Team* auf. Es brachte die Texte mit Hilfe von Preprocessing in eine analysierbare Form und generierte auf dieser Basis alle möglichen Insights. - Das *Forecast-Team* wiederum verwendete die Ergebnisse der beiden zuvor genannten Teams für die Wahlprognosen. - Dem Visualiserungsteam kam dann die Aufgabe zu, alle Ergebnisse mit den weiteren Quellen zu verknüpfen und in einem Data Mart abzulegen. Auf den so aufbereiteten Daten konnte es dann interaktive Dashboards erstellen. In diesem Projekt haben wir wieder einmal erfahren, wie wichtig es ist, dass alle Beteiligten Hand in Hand arbeiten. Häufig wird nur das Endergebnis gesehen und die Arbeit, die auf dem Weg dorthin anfällt, geht unter. Auf diesem Weg muss jedes Team darauf bauen, dass das vorherige Team die Daten so vorbereitet, dass sie im weiteren Verlauf verwendet werden können. Jeder einzelne Baustein in diesem Prozess ist also wichtig, und es besteht eine große Abhängigkeit untereinander. Eine gute Abstimmung ist deshalb Gold wert und kann viel Zeit und Ärger ersparen. # Was wir aus den Daten herausholen konnten Um aus den Tweets verwertbare Informationen zu generieren, benötigten wir ein wenig Magie … – (natürlich!) in Form von Machine-Learning-Algorithmen: - Texte: Zuerst wurden die *Texte auseinandergenommen*. Anhand der Usernamen ordneten wir die Parteien zu – denn für uns war es interessant zu wissen, ob der Verfasser des Tweets selbst Kandidat einer Partei war. Leider war das eine relativ manuelle und zeitintensive Aufgabe, denn die Kandidatenlisten inklusive der Benutzernamen bei Twitter mussten erst durch uns erstellt werden. - Keywords: Mit Hilfe von *Keyword Matching* untersuchten wir die Texte und Hashtags auf Partei- oder Kandidatennamen, um herauszufinden, um welche Partei es in den Tweets geht. Hier konnte leider häufig keine Partei abgeleitet werden oder es wurden gleich mehrere zugeordnet. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild5-300x215.png)Die Parteizuordnung visuell dargestellt - Ordnung mit Wordclouds: Um einen ersten Überblick über die Grundstimmung zu den jeweiligen Parteien zu erhalten, generierten wir *Wordclouds*. Dazu wurden die am häufigsten vorkommenden Wörter zu jeder Partei visuell dargestellt. So bekamen wir auf einen Blick ein erstes Gefühl zur Stimmungslage und konnten wichtige Themen identifizieren. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild6-300x150.jpg)Eine Wordcloud zur CDU - Ordnung mit Sentiment-Analyse: Ein für das spätere Forecasting wichtiger Schritt war die *Sentiment Analyse*. Die Tweet-Texte wurden nach positiven, negativen und neutralen Elementen gewichtet. Je nachdem welcher Stimmungsanteil in ihm überwiegt, entscheidet darüber, in welche der drei Kategorien ein Tweet fällt. So kann man die Stimmung des Tweets nicht nur subjektiv wahrnehmen, sondern auch automatisiert verarbeiten und für weitere Auswertungen verwenden. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Sentiments-300x167.png)Sentiments einfach erklärt - Vorhersage A: Die so klassifizierten Tweets konnten nun für ein Forecasting genutzt werden. Im ersten Schritt wurde die Wahl-Wahrscheinlichkeit für verschiedene Wahlkreise vorhergesagt. Werden in einem Wahlkreis viele positive Tweets zu einer Partei abgesetzt, dann gehen wir davon aus, dass die Partei dort gute Gewinnchancen hat. Hier kommen nun die Nutzer-Informationen ins Spiel, die wir über diejenigen bekommen, die den Tweet geschrieben haben. Die machten es auch möglich, Tweets zu Wahlkreisen zuzuordnen. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild8-300x198.png)Die Tweets pro Wahlkreis - Vorhersage B: Mit Hilfe der *Tweet-Entwicklung über die Zeit* wurde dann vorhergesagt, wie sich das Tweet-Verhalten der Nutzer zu einer bestimmten Partei entwickeln könnte. Es wurde eine Stimmungskurve auf Grundlage der vorliegenden Tweets erstellt. Diese konnte dann in die Zukunft fortgeschrieben werden, um Prognosen zum Wahlausgang zu erstellen. Kleiner Spoiler: Das hat nicht so gut funktioniert, wie wir es uns erhofft hatten. Aber hierzu später mehr … ![](https://thecattlecrew.net/wp-content/uploads/2022/12/Bild9-300x220.png)Eine beispielhafte Darstellung des Tweet-Forecasts - Visuelle Darstellung: Sämtliche Ergebnisse wurden dann in einem Data Mart zusammengeführt. Mit allen Anreicherungen, die wir gewonnen hatten, entstand daraus ein spannendes, interaktives Dashboard mit vielen Insights rund um die NRW-Landtagswahl. # Unsere Herausforderungen ### 1. Zeitdruck Eine unserer größten Herausforderungen war die Zeit – denn alle, die an diesem Projekt mitgewirkt haben, taten dies neben ihrer eigentlichen Arbeit. Da die Ergebnisse der einzelnen Teams voneinander abhängig waren und das nächste Team erst loslegen konnte, wenn das erste Team die Voraussetzungen dafür geschaffen hatte, kam es hier häufig zu Engpässen. Gerade die Forecasting-und Analytics-Themen konnten erst angegangen werden, als die Daten vorlagen und die ersten Ergebnisse der Textanalyse bereitstanden. Die Deadline, die wir uns selbst gesetzt hatten, ließ uns nur wenige Wochen Zeit – denn wir wollten unsere Ergebnisse beim Digital Xchange Bergisches Rheinland vorstellen. Dadurch wurde es dann hinten heraus ordentlich knapp. Aus der Zeitfalle half uns etwas unser agiles Vorgehen. Das schaffte trotz der kurzen Zeit Raum zum Austausch und ermöglichte schnelle Reaktionen, wenn es beispielsweise unverhoffte Änderungen im Projektablauf gab – und die gab es tatsächlich. Zum Beispiel wurde mitten im Projekt die Twitter-API umgestellt. Die zuvor existierenden Entitäten änderten sich damit komplett, sodass wir die Informationen nun in anderer Form abgreifen mussten. Unsere ETL-Strecken brauchten also ein Upgrade – und wir durften keine Zeit verlieren, um nicht zu viele wertvolle Tweets zu verpassen. ### 2. Viele Daten, die zu wenig aussagen Eine weitere Herausforderung brachten die Daten mit sich, die nicht immer hielten, was wir uns von ihnen versprochen hatten. Weiter oben hatte ich bereits beschrieben, wie wir beispielsweise die Tweets bestimmten Parteien zuordnen wollten. Leider gelang uns dies bei vielen Tweets nicht. So hatten wir spannende Tweets mit wertvollen Informationen, die wir für unsere Analysen überhaupt nicht nutzen konnten. Auch waren unsere Forecasts wenig aussagekräftig, weil Twitter als alleinige Quelle aus unterschiedlichen Gründen nicht ausreichte. So liefert Twitter nur die Stimmungsbilder eines sehr kleinen Teils der Bevölkerung. Unterrepräsentiert waren: - Die ältere Generation: Unsere Gesellschaft hat ein relativ hohes Durchschnittsalter, doch gerade die *ältere Bevölkerungsgruppe* nutzt Medien wie Twitter eher selten, um ihre Meinung zu bestimmten Themen kundzutun. - Bestimmte soziale Schichten: Sogenannte *bildungsfernere soziale Schichten*, sind auf Twitter zum Beispiel weniger aktiv. Bei einem „echten“ Projekt sollte also unbedingt Wert auf die Vollständigkeit der Datenquellen gelegt werden. Denn egal wie ausgefeilt die Machine-Learning-Algorithmen auch sein mögen – sie sind immer nur so gut wie die Daten, die ihnen vorliegen. ### 3. Unzureichende fachliche Analyse Die letzte Herausforderung, die ich hier erwähnen möchte, war die Zusammenstellung des Dashboards. Wir hatten uns zum Start des Projekts ein grobes Thema überlegt und uns dann schnell auf eine Datenquelle festgelegt. Vom Dashboard selbst hatten wir keine konkrete Vorstellung, deshalb haben wir uns einfach danach gerichtet, welche Daten wir hatten. Für diese Daten suchten wir dann nach einer guten Darstellungsform. Das Dashboard war damit nur auf diese bestimmten Daten zugeschnitten. Man könnte auch sagen, wir haben das Pferd von hinten aufgezäumt. Ratsamer wäre es gewesen, die fachliche Fragestellung zuvor zu analysieren und sich im Anschluss daran, die Daten zu beschaffen, die dafür nötig sind. Natürlich kriegt man die Lücke nie komplett dicht. Im Verlauf, und wenn die Daten schon vorliegen, werden immer neue Fragestellungen aufkommen – doch der Fokus sollte von Anfang an auf dem fachlichen Problem liegen, als Ausgangspunkt aller Analysen. Ein so konzeptioniertes Dashboard erleichtert den weiteren Prozess ungemein. # Unser Fazit Trotz oder auch wegen der vielen Herausforderungen haben wir in diesem Community-Projekt viele wertvolle Erkenntnisse gewonnen. - Komplexe Analytics-Projekte sollten nicht mal eben vom Zaun gebrochen werden. Sie bedürfen einiger Planung und Vorbereitung – und können dennoch Überraschungen bergen. - Mit einer guten Durchdringung der Fachlichkeit, der Auswahl der richtigen Quelldaten, einem Team, das Hand in Hand arbeitet und ausreichend Flexibilität sind solche Projekte gut handhabbar. - Eine vorherige Planung der Aufgaben, benötigten Ressourcen und Abhängigkeiten kann dabei helfen, mögliche Probleme vorab zu identifizieren und frühzeitig Lösungen zu finden. Eine Vorhersage der Wahlergebnisse konnten wir leider nicht treffen – dennoch war das Projekt der OC Communitys für uns ein voller Erfolg. Weil wir nicht nur unser Vorgehen, sondern auch Technologien an einem echten Use Case ausprobieren und dabei unheimlich viel lernen durften. In unseren nächsten Blogbeiträgen werden wir tiefer in die Technik eintauchen und detailliert auf die Datenintegration, unsere Machine-Learning-Algorithmen und die Arbeit mit [Pyramid Analytics](https://www.pyramidanalytics.com) eingehen. Außerden werden wir euch natürlich einen Einblick in die von uns gewonnenen Erkenntnisse aus Tweets geben. Es bleibt also spannend! #### Alle Blogbeiträge dieser Serie ansehen Teil 1: Teil 2: **Kategorien:** AI & Data Science, Analytics & Insights, Cloud **Schlagwörter:** Analytics, Artificial Intelligence, cloud, data science, Daten, German, predictive --- ### [Textklassifikation – Modelle trainieren und evaluieren](https://thecattlecrew.net/2023/01/05/textklassifikation-modelle-trainieren-und-evaluieren/) **Published:** Januar 5, 2023 **Author:** Luca Pomer **Excerpt:** Im dritten und letzten Teil unserer Artikelreihe zur Textklassifikation geht es mit dem Training und der Evaluation von Modellen tief hinein ins Machine Learning: Das heißt, du wirst dabei sein, wenn wir anhand eines Beispieldatensatzes Modelle trainieren und evaluieren. **Content:** # Textklassifikation – Modelle trainieren und evaluieren Im dritten und letzten Teil unserer Artikelreihe zur Textklassifikation geht es mit dem Training und der Evaluation von Modellen tief hinein ins Machine Learning: Das heißt, du wirst dabei sein, wenn wir anhand eines Beispieldatensatzes Modelle trainieren und evaluieren. Nachdem wir im [ersten Teil](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/) der Serie das Thema Textklassifikation mit einer kurzen allgemeinen Einführung kennengelernt haben und du im [zweiten Teil](https://thecattlecrew.net/2022/08/03/textklassifikation-vorverarbeitung-der-daten/) einiges über den ersten Schritt der Textklassifikation – die Vorverarbeitung der Daten – gelernt hast, geht es in diesem dritten Teil ans eigentliche Machen. Wir hoffen, dich damit neugierig zu machen auf eine spannende Technik und dir falls du dich selbst an das Trainieren und Evaluieren von Machine-Learning-Modellen heranwagen möchtest, einen Vorgeschmack zu geben. Auf jeden Fall bekommst du ein paar Best Practices an die Hand, die es dir leichter machen können. ## Die verwendeten Daten Bevor wir mit dem Training loslegen können, brauchen wir natürlich Daten. Wer unsere Serie verfolgt hat, kennt ihn schon: unseren Datensatz [Ten Thousand German News Articles Dataset](https://tblock.github.io/10kGNAD/). Dieser Datensatz enthält 10.273 Zeitschriftenartikel einer österreichischen Online-Zeitschrift, unterteilt in neun Kategorien. Das Ziel: Nach dem Training und der Evaluation soll unser Modell in der Lage sein, Artikel selbständig einer Kategorie zuzuordnen. Dafür wurden die Daten in Trainings- und Testdaten aufgeteilt. Wie viele Texte in jeder Kategorie vorhanden waren und wie groß der Anteil an Trainings- und Testdaten ist, zeigt Abbildung 1. ![](https://thecattlecrew.net/wp-content/uploads/2023/01/data-1.png)Abbildung 1: Anzahl an Texten per Artikelkategorie Genau betrachtet besteht der Prozess des Trainierens und Evaluierens von Modellen aus drei Einzelschritten: Feature Extraction, Modelle trainieren und Modelle evaluieren. Diese wollen wir uns im Detail ansehen: ## Schritt 1: Feature Extraction und Baseline-Modelle Beim Trainieren eines Machine-Learning-Modells füttern wir den Algorithmus bekanntlich mit Daten. Bei unserer österreichischen Online-Zeitschrift entspricht ein Zeitschriftenartikel einem Datensatz. Jeder Datensatz enthält also genau die Menge an Wörtern, die der Artikel beinhaltet. Vielleicht erinnerst du dich an den Vorgang des Preprocessings aus dem zweiten Teil dieser Serie. Beim Preprocessing bringen wir den Datensatz in eine Form, die ein Machine-Learning-Algorithmus leicht verstehen kann. In eine einheitliche Form, die von Domäne und Ansatz unabhängig ist. Das können wir zum Beispiel durch das Konvertieren in Kleinbuchstaben und das Entfernen von Bindewörtern erreichen. Der nächste Schritt besteht darin, die Artikel in eine numerische Form bringen und sogenannte *Features* zu erstellen, die an das Modell weitergereicht werden. Ein Feature ist eine einzelne, messbare Einheit, die ein Element beschreibt. In unserem Beispiel sind Features also die Wörter, aus den der Artikel besteht, und somit beschreibt. ### Wie stelle ich einen Text als Zahlen da? Es gibt verschiedene Möglichkeiten, Textdaten als Zahlen zu repräsentieren. Wir haben uns für einen Bag-of-Words-Ansatz entschieden. Beim Bag-of-Words Ansatz wird nur das Auftreten von Wörtern betrachtet und nicht die Satzstruktur. Hier wäre also ein Feature und pro Artikel könnte für jedes Wort eine Zahl berechnet werden. Auf diese Weise entsteht eine Dokument-Term Matrix, in der jede Zeile für einen Artikel und jede Spalte für ein Feature bzw. Wort aus diesem Artikel reserviert ist. In den Feldern der Matrix lässt sich seine Ausprägung als Zahlenwert ablesen. Der Zahlenwert Null würde aussagen, dass das Wort in diesem Artikel nicht vorkommt. Wie diese „Ausprägung” genau berechnet wird, hängt vom Verfahren ab. FussballGewonnenMenschKatze…..Artikel 11.201.60Artikel 21.2001.7…Abbildung 2: Beispiel für eine Dokument-Term Matrix Die Python-Bibliothek *scikit-learn*, die wir für die Implementierung benutzen, verfügt über zwei Varianten dieses Ansatzes: 1. *CountVectorizer()*, bei dem *nur die Häufigkeit jedes einzigartigen Wortes in einem Text* betrachtet wird, und 2. *TfidfVectorizer()*, bei dem zusätzlich noch mit einfließt, *wie oft das Wort im kompletten Datensatz* Der TF-Teil des Begriffs steht für die *Vorkommenshäufigkeit* (Englisch: term frequency), und der IDF-Teil steht für die *inverse Dokumenthäufigkeit* (Englisch: inverse document frequency): Gegeben Wort ***w*** und ***N*** Texte ***T***0*, …, T**N-1*** Anzahl von *w* in einem Text = ***count(w)*** Anzahl aller Wörter im Text Ti ***n******i*** Anzahl an Texten, in denen *w* vorkommt ***count(n**i**(w))*** **TF(w) = *count(w) / n**i*** IDF*(w)* = log(*N / count(n**i**(w)))* **TF-IDF(w) = TF(w) x IDF(w) Dabei nimmt der TF-IDF-Wert eines Wortes proportional zu, je häufiger das Wort im Text erscheint. Hingegen nimmt er ab, falls dasselbe Wort in vielen anderen Texten zu finden ist. Je geringer der Wert, umso weniger spezifisch wäre das Wort also für die Kategorie des Artikels. So hilft der TfidfVectorizer() dabei, zu entscheiden, welche Wörter aussagekräftig für eine Kategorie sind. Für unser Vorhaben eine wichtige Eigenschaft! Deshalb nutzen wir diese Variante, um unsere Textdaten in eine sinnvolle numerische Repräsentation umzuwandeln. ### Baseline-Modelle Zunächst gilt: „*je einfacher, desto besser*”, also arbeiten wir mit einfachen, aber aussagekräftigen Baselines. Unter dem Begriff *Baseline* verstehen wir eine erste, möglichst einfache Lösung, an der wir die Machbarkeit des Problems überprüfen können und die uns hilft, das Machine-Learning-Problem besser zu verstehen. Auf dieser Basis können wir später komplexer werden und die Performance immer weiter verbessern. In unserem Fall verwenden wir Standardmodelle, von denen wir wissen, dass sie in den meisten Fällen gute Ergebnisse liefern. Für die Textklassifikation eignen sich beispielsweise das Naive-Bayes-Modell und die Support Vector Machine. Konkret entscheiden wir uns für drei Modelle: zwei Naive-Bayes-Modelle – Multinomial-Naive-Bayes-Klassifikator und Complement-Naive-Bayes-Klassifikator – und einen Support-Vector-Machine. Damit du dir unter den drei Modellen etwas vorstellen kannst, beschreiben wir kurz den mathematischen Hintergrund und schauen uns jeweils ein kleines Beispiel aus unserem Datensatz an. Wir benutzen hier nur vier Klassen aus den neun. (Siehe Abbildung 3) ![](https://thecattlecrew.net/wp-content/uploads/2023/01/amountTrainingData4classespng.png)Abbildung 3: Anzahl von Trainingsdaten nach Klasse ### Multinomial-Naive-Bayes-Klassifikator Der Multinomial-Naive-Bayes-Klassifikator basiert auf einem der wichtigsten Sätze der Wahrscheinlichkeitsrechnung – dem Satz von Bayes – und wird für Klassifikationsaufgaben wie die Textklassifikation benutzt. Features sind hier numerische Werte, die Anzahl der Wörter im Text oder wie in unserem Fall TF-IDF-Werte. Während des Trainings lernt das Modell bestimmte spezifische Merkmale einer Kategorie kennen und nutzt diese Erkenntnisse später bei der Klassifikation. Nach dem Prinzip „*Je mehr Features einer Klasse im Text enthalten sind, desto größer ist die Wahrscheinlichkeit, dass der Text zu der entsprechenden Klasse gehört”* wird die Klasse mit der größten Wahrscheinlichkeit ausgewählt. Nehmen wir an, während des Trainings hat unser Modell gelernt, dass Texte, die zur Kategorie *Web* gehören, bestimmte Wörter in größere Anzahl enthalten wie *Internet*, *online*, *anschauen*, *empfangen*”. In Texten der Kategorie *Sport* kommen hingegen häufiger Wörter vor wie „ *Motorsport*, *Spiel* u. s. w. Ein Beispiel: *Sky Q kann auch rein über **Internet** genutzt werden. Ihr könnt Formula 1 und alle euren Lieblingsinhalte zum Thema **Motorsport** auch **online** im **Internet** **empfangen**.* Dieser Artikel enthält vier Wörter der Kategorie Web (2x *Internet,* 1x *online,* 1x *empfangen*) aber nur ein Wort der Kategorie Sport (1x *Motorsport*). Also ist die Wahrscheinlichkeit größer, dass der Text zur Kategorie *Web* als zur Kategorie *Sport* gehört. #### Complement-Naive-Bayes-Klassifikator Der Complement-Naive-Bayes-Klassifikator ist eine Variante des Multinomial-Naive-Bayes-Klassifikators, die sich für nicht balancierte/unausgeglichene Daten eignet. Damit lässt sich beispielsweise aus dem Balkendiagramm der Abbildung 3 herauslesen, dass deutlich mehr Texte in den Kategorien *Web* und *Panorama* veröffentlicht wurden als in den Kategorien *Sport* und *Wissenschaft*. Bei diesem Klassifikator berechnen wir für jede Klasse die Wahrscheinlichkeit, dass ein Text *nicht* zu dieser Klasse gehört. Folglich wird der kleinste Wert ausgewählt, da es am *unwahrscheinlichsten* ist, dass der Text *nicht* zu der Kategorie gehört, und somit am ehesten dazugehört. Der Complement-Naive-Bayes-Klassifikator erzielt bei der Textklassifikation übrigens regelmäßig eine bessere Performance als der Multinomial-Naive-Bayes-Klassifikator. Für weitere technische Details lohnt es sich, einen Blick in ein Paper der Autorengruppe um Jason Rennie und Lawrence Shih zu werfen, die das Modell entwickelt hat: „[*Tackling the poor assumptions of naive bayes text classifiers*](https://people.csail.mit.edu/jrennie/papers/icml03-nb.pdf)*„* in: Proceedings of the Twentieth International Conference on Machine Learning (ICML-2003), Washington DC, 2003 (Link: ) #### Support-Vector-Machine Support-Vector-Machines können sowohl in Klassifikationsaufgaben als auch zur Regressionsanalyse benutzt werden. Sie können Daten mit sehr vielen Features – wie es bei einer Textklassifikation der Fall ist – effektiv in verschiedene Klassen teilen. Dazu braucht das Modell nicht viel Speicherplatz und erzielt auch auf einer kleinen Datenbasis gute Ergebnisse. Ein Linear-Support-Vector-Klassifikator kann Daten in zwei oder mehr Kategorien unterteilen. Wie eine solche Aufteilung aussehen kann, zeigt Abbildung 4. Mithilfe von farbigen Punkten teilt das Modell die Texte in die vier Kategorien aus unserem Beispieldatensatz. ![](https://thecattlecrew.net/wp-content/uploads/2023/01/linearsvc.png) Abbildung 4: Support-Vector-Machine-Modell für vier Klassen ## Schritt 2: Modelle trainieren Nachdem wir unserer Daten vorbereitet und unsere Modelle ausgesucht haben, kann das Training beginnen. Was bedeutet es eigentlich, ein Modell zu trainieren? Was genau steckt hinter dem Vorgang, den wir „Training“ nennen? Hinter jedem Modell verbirgt sich ein Algorithmus. Trainieren wir das Modells, so erhält der Algorithmus die vorbereiteten numerischen Daten mit der Kategorie zu jedem einzelnen Sample und versucht, die Beziehung zwischen einem Beitrag und seiner Kategorie zu verstehen und zu lernen. ### Trainingsdaten und Testdaten Damit wir unsere Modelle später valide evaluieren können, unterteilen wir unsere Daten in zwei Gruppen: Trainingsdaten und Testdaten: - *Trainingsdaten* benutzen wir beim eigentlichen Training unserer Modelle – das sind die Daten, aus denen das Modell die Zusammenhänge zwischen der Kategorie und dem Beitrag lernt. - *Testdaten* nutzen wir, um unser Modell zu evaluieren. Wie bei einer Klassenarbeit muss das Modell mit ihm unbekannten Daten arbeiten. Hier erfahren wir, wie präzise es das Gelernte auf neue Artikel anwenden kann. Ist dies der Fall, so wird das Modell später auch bei Echtdaten eine gute Performance abliefern. ## Schritt 3: Modelle evaluieren Beim letzten Schritt geht es darum, die Performance unserer Modelle zu testen. Dafür hatten wir ja einen Testdatensatz vorbereitet. Mit Texten dieses Datensatzes füttern wir das Modell, bis es uns eine Kategorie zu jedem Text auswirft. Die Ergebnisse vergleichen wir anschließend mit den echten Kategorien der Texte. Am Ende beweist eine Konfusionsmatrix, wie gut die Prognosequalität unseres Algorithmus war. Wie das in unserem Beispiel bei Artikeln in der Kategorie Sport aussieht, zeigt Abbildung 5. Artikel ist SportartikelArtikel ist kein SportartikelModell hat Artikel als Sport erkannt*Richtig positiv – Modell hat Artikel richtig erkannt**Richtig negativ – Modell hat erkannt das es sich nicht um Sport handelt*Modell hat Artikel als nicht Sport bewertet*Falsch negativ – Modell dachte der Artikel gehört fälschlicherweise zu Sport**Falsch positiv – Modell hat nicht erkannt das der Artikel zu Sport gehört*Abbildung 5: Beispiel für eine Konfusionsmatrix ### Wie nutzten wir die Konfusionmatrix? Es gibt drei Metriken, die zur Evaluierung von Klassifikationsmodellen benutzt werden: *Accuracy*, *Precision* und *Recall*. - Die *Accuracy* berechnen wir, indem wir die Anzahl an richtigen Ergebnissen, also *richtig positiv* und *richtig negativ,* durch die Anzahl aller Ergebnisse teilen.-> (richtig positiv + richtig negativ) / alle Ergebnisse - Die *Precision* wird berechnet als Anteil der relevanten Beispiele (z.B. die richtig positiven) an allen Ergebnissen, die als Mitglieder einer bestimmten Klasse, klassifiziert sind.-> richtig positiv / (richtig positiv + falsch positiv) - Der *Recall* ist der Anteil an Beispielen, die zu einer Klasse klassifiziert werden, geteilt durch alle Beispiele, die in der Tat zu der Klasse gehören.-> richtig positiv / (richtig positiv + richtig negativ) ## Umsetzung in Python Im Folgenden zeigen wir, wie wir die Schritte aus der Theorie in unserem Projekt umgesetzt haben und welche Ergebnisse dabei herausgekommen sind. Für die Umsetzung haben wir in Python die folgenden Bibliotheken benutzt: *pathlib*, *pandas* und *sklearn*. ``` import pandas as pd import pathlib from pathlib import Path from sklearn import metrics ``` ### **Aufteilung in Test- und Trainingsdaten** Zuallererst – noch bevor die Daten an das Modell übergeben werden können, unterteilen wir die Gesamtmenge in Trainingsdaten und Testdaten. Unser Datensatz hatte dafür schon zwei Dateien vorgesehen. Dieses Code-Beispiel zeigt, wie wir mit Hilfe der Bibliothek *pathlib* auf diese beiden Datenmengen zugreifen: ``` # Paths to the csv files training_set = Path("data/train/training_preprocessed.csv") test_set = Path("data/test/test_preprocessed.csv") ``` ### **Einlesen der Daten** Mit Hilfe der Bibliothek *pandas* lesen wir die Daten aus den CSV-Dateien aus und teilen diese auf nach Inhalte (die Wörter des Artikels) und deren Kategorien (z. B. Sport Mit den Features füttern wir das Modell. Die Kategorien bezeichnen das gewünschte Ergebnis. ``` # read and display as data frame df_train = pd.read_csv(training_set_preprocessed, encoding='utf-8', error_bad_lines=False) # split into text -> (x), and category (=label) -> (y) x_train, y_train = df_train['text'], df_train['category'] ``` ### **Feature Extraction** Bei der Feature Extraction werden die Daten in eine numerische Form gebracht, also in Zahlen umgerechnet. Wenn du dich an die Theorie dahinter nicht mehr so genau erinnerst, dann wirf noch einmal schnell einen Blick auf *Schritt 1: Feature Extraction.* Mit der Bibliothek *sklearn* können wir den TF-IDF-Ansatz ganz einfach implementieren: ``` from sklearn.feature_extraction.text import TfidfVectorizer, CountVectorizer, TfidfTransformer count_vect = CountVectorizer() x_train_counts = count_vect.fit_transform(x_train) x_train_tfidf = TfidfTransformer().fit_transform(x_train_counts) ``` Jetzt sind die Daten bereit für die Trainingsphase und haben folgende Dimensionen: ``` 'Train: ((8620, 164288), (8620))' ``` Für uns bedeutet das wir haben 8.620 Artikel mit je 164.288 Features. ### **Trainieren der Modelle** Nun können wir die Modelle aus *sklearn* importieren*.* Wie geplant werden wir zwei Bayes-Modelle – Multinomial-Naive-Bayes und Complement-Naive-Bayes – und eine Support Vector Machine trainieren: ``` from sklearn.naive_bayes import MultinomialNB from sklearn.naive_bayes import ComplementNB from sklearn.svm import LinearSVC ``` Das eigentliche Training wurde von der Bibliothek schon implementiert, sodass wir den Trainingsprozess direkt starten können. Dafür wenden wir die *.fit()-Funktion* jedes Modells auf die Daten an: ``` naive_bayes = MultinomialNB().fit(x_train_tfidf, y_train) complement_nb = ComplementNB().fit(x_train_tfidf, y_train) linear_svc_model = LinearSVC().fit(x_train_tfidf, y_train) ``` ### Ergebnisse Für die Artikel unserer österreichischen Online-Zeitung kann ein Artikel in einer von neun Kategorien eingeordnet werden. Die Konfusionsmatrix zeigt, welche der Kategorien jeweils vom Multinomial Naive Bayes Modell klassifiziert wurden. ![](https://thecattlecrew.net/wp-content/uploads/2023/01/confusionMatrix.png) Abbildung 6: Konfusionsmatrix für das trainierte Multinomial-Naive-Bayes-Modell. Abbildung 6 zeigt die Konfusionsmatrix des Multinomial-Naive-Bayes-Modells. Daraus wird ersichtlich, dass z. B Sportartikel sehr gut erkannt werden. Von 112 Testartikeln wurden 108 korrekt klassifiziert. Im Vergleich wurden bei Artikeln der Kategorie Panorama von 331 Artikeln nur 153 korrekt klassifiziert. Daraus ergibt sich die folgende Genauigkeit (*Accuracy*) pro Kategorie: ``` Etat: 0.059 Inland: 0.66 International: 0.74 Kultur: 0.0 Panorama: 0.92 Sport: 0.9 Web: 0.9 Wirtschaft: 0.73 Wissenschaft: 0.10 ``` Außerdem können wir auch die generelle Genauigkeit für das ganze Modell berechnen. Dafür nutzen wir die Scikit Funktion accuracy\_score, die sich auf die Artikel des Testdatensatzes bezieht, die richtig zugeordnet wurden. ``` sklearn.metrics.accuracy_score(y_true, y_pred, *, normalize=True, sample_weight=None) ``` Bei unserem Multinomial Naive Bayes Modell liegt dieser Wert bei 69.38 %. Dieses Verfahren haben wir für alle Modelle durchgeführt. Der Support Vector Machine liefert die besten Ergebnisse mit einer Gesamtgenauigkeit von 83.35 % und entsprechend hohen Genauigkeitswerten in jeder Kategorie: ``` Etat: 0.64 Inland: 0.80 International: 0.76 Kultur: 0.85 Panorama: 0.82 Sport: 0.97 Web: 0.84 Wirtschaft: 0.86 Wissenschaft: 0.89 ``` ![](https://thecattlecrew.net/wp-content/uploads/2023/01/modelAccuracy.png) Abbildung 7: Vergleich der Genauigkeit der Modelle anhand von dem Testdatensatz ## Wie könnte es weitergehen? … ein Blick in die Zukunft Vielleicht fragst du dich, wie es jetzt in unserem Beispiel weitergeht. Es gibt verschiedene weiterführende Themen, die als nächste Schritte interessant wären. Die Machine-Learning-Modelle könnten zum Beispiel mithilfe des Parameter-Tunings noch weiter optimiert werden. Auch das große Thema neuronale Netzwerke haben wir außen vorgelassen. Diese erzielen oft bessere Ergebnisse, sind jedoch schwieriger nachzuvollziehen. **Autoren:** Luca Pomer, Galina Angelova und Conrad Dollinger ### Alle Teile dieser Serie: [Teil 1: Textklassifikation – eine Einführung](https://thecattlecrew.net/2022/06/17/textklassifikation-einfuehrung/ "Zum Artikel") [Teil 2: Textklassifikation – Vorverarbeitung der Daten](https://thecattlecrew.net/2022/08/03/textklassifikation-vorverarbeitung-der-daten/ "Zum Artikel") [Teil 3: Textklassifikation – Modelle trainieren und evaluieren](https://thecattlecrew.net/2023/01/05/textklassifikation-modelle-trainieren-und-evaluieren/ "Zum Artikel") **Kategorien:** AI & Data Science **Schlagwörter:** Artificial Intelligence, automatisierung, NLP, Python, text classification --- ### [KI für Gutes nutzen: Eine App, die Depressionen erkennt](https://thecattlecrew.net/2023/01/30/ki-fuer-gutes-nutzen-eine-app-die-depressionen-erkennt/) **Published:** Januar 30, 2023 **Author:** Tobias Koch **Content:** Immer mehr Unternehmen setzen Methoden des maschinellen Lernens und der natürlichen Sprachverarbeitung ein, um aus Textdaten einen wirtschaftlichen Nutzen zu ziehen. So auch die Expert.ai, die sich im Bank und Versicherungssektor mit sprachgetriebenen AI-Lösungen mittlerweile einen Namen gemacht hat. Um Talente anzulocken, hatte die Expert.ai im Herbst 2022 für den Hackathon „[Turn Language into Action: a Natural Language Hackathon for Good](https://www.expert.ai/turn-language-into-action-a-natural-language-hackathon-for-good/)“ 10.000 Dollar als Preisgeld und für hochkarätige Trainingsgutscheine ausgeschrieben. Das Geld war das eine, aber für uns gab es definitiv andere Gründe, warum wir im September 2022 bei dem Event dabei sein wollten. Neben der Challenge und dem Austausch mit Fachleuten waren drei Dinge für uns besonders spannend: 1. Die Analysemöglichkeiten der Expert.ai Natural Language API ausprobieren 2. Einen eigenen ML-Algorithmus zur Textklassifikation entwickeln 3. Das Open-Source-App-Framework Streamlit testen Wie schon angedeutet ist Expert.ai ein führendes Unternehmen im Bereich Natural Language Understanding. Beim Hackathon ging es natürlich nicht nur darum, Talente anzulocken, das war etwas lapidar, ich gebe es zu! Dem Unternehmen ging es darum, etwas Gutes zu bewegen und mit der expert.ai Natural Language API eine Anwendung mit gesellschaftlichem Mehrwert zu entwickeln. So lassen sich über die API unter dem Einsatz von Natural Language Processing und Künstlicher Intelligenz beispielsweise bestimmte Emotionen in Texten auffinden, bestimmte Themen oder Hassreden erkennen. Das kann für die Gesellschaft wichtig sein. ## Tweet Depression Detector: Eine App, die bedrückende Tweets entdeckt Unsere Idee für den Hackathon war die Entwicklung einer App namens „Tweet Depression Detector“. Diese App sollte in der Lage sein, depressive Tendenzen und Emotionen in den sozialen Medien aufzufinden. Der gesellschaftliche Mehrwert wäre groß: Immer mehr Menschen entwickeln Depressionen, und ihre Anzahl nimmt stetig zu. Äußere Faktoren wie Inflation und die Pandemie verstärken diesen Trend. Auch die Nutzung von sozialen Netzwerken kann Auslöser von Depressionen sein. Die App kann natürlich keine ärztliche Diagnose oder den Weg zum Therapeuten ersetzen. Aber sie gibt Hinweise auf Tweet-Texte und zeigt Häufungen an, sodass betroffenen Personen Hilfe angeboten werden könnten. ## So wollten wir vorgehen Um unseren Textklassifikationsalgorithmus für die Erkennung von depressiven Tendenzen zu trainieren, wollten wir verschiedene Trainingsdatensätze der Data Science-Plattform Kaggle verwenden. Zusätzlich sollte die Verwendung der Expert.ai API unserer App dabei helfen, 39 verschiedene Emotionen aus Texten herauszufiltern. Über ein Dashboard – das wir mit Streamlit, einem Open-Source-Framework für Machine Learning and Data Science Entwickler, entwickeln wollten – sollte eine Person Tweets eingeben und auf depressive Tendenzen überprüfen können. Diese Tweets werden dafür im Backend der App von einem Machine-Learning-Modell und der Expert.ai API analysiert. Bei Streamlit handelt es sich um eine Open-Source-Bibliothek, mit der Machine-Learning-Modelle schnell und einfach integriert und ansprechende Dashboards gestaltet werden können. ## Was kann die Expert.ai Natural Language API? Expert.ai, der Veranstalter des Hackathons, bietet wie gesagt KI-Technologien im Bereich Natural Language Understanding an, um sprachenintensive Prozesse zu automatisieren und Mehrwerte aus Sprachdaten zu generieren. Die Expert.ai Natural Language API ist ein Cloud-basierter REST-Dienst, der folgende KI-unterstützenden Funktionen bereitstellt: 1. Textkategorisierung: Klassifizierung von Texten in verschiedene Themenbereiche 2. Entitätenerkennung: Erkennung von Personen, Orten, Organisationen und anderen relevanten Entitäten in Texten 3. Emotionserkennung: Erkennung von Emotionen in Texten 4. Textzusammenfassung: Automatische Erstellung von Zusammenfassungen langer Texte 5. Übersetzung: Übersetzung von Texten in verschiedene Sprachen 6. Textgenerierung: Automatische Erstellung von Texten auf Basis von vorhandenen Texten oder Textmustern ### Wie lässt sich die API für die Textklassifikation in unserer App nutzen? Die Emotionserkennung von Expert.ai ergänzt die Depressionserkennung in unserer App. Abbildung 1 zeigt die 39 verschiedenen erkennbaren Emotionen und die zugehörigen Hauptkategorien: ![](https://thecattlecrew.net/wp-content/uploads/2023/01/Bild1.png) *Abbildung 1: Identifizierbare Emotionen durch die Expert.ai Natural Language API* Im folgenden Code seht ihr ein Beispiel dafür, wie die API verwendet werden kann, um Emotionen aus einem Text zu extrahieren: ``` from expertai.nlapi.cloud.client import ExpertAiClient client = ExpertAiClient() def emotional_trait_analysis(text, taxonomy="emotional-traits",language="en"): output = client.classification(body={"document": {"text": text}}, params={'taxonomy': taxonomy, 'language': language}) print("List of emotions found in the text:") for category in output.categories: list_of_labels = [ { "emotional_categories": category.hierarchy[0], "emotional_labels": category.label, "emotional_score": category.score } ] return list_of_labels ``` Die API nimmt als Eingabe einen zu analysierenden Text und eine Sprachdefinition entgegen. Als Ergebnis wird eine Liste zurückgespielt, die für jede im Text gefundene Emotion bestimmte Eigenschaften enthält, wie: Um welche Emotion handelt es sich? Wie häufig wurde sie entdeckt? Außerdem werden Punkte vergeben und die Emotion einer Kategorie zugeordnet. Ein Beispiel: > It is 2 o’clock in the morning. Awake but tired. I need to sleep but my brain has other ideas… i hate my live 🙁 In diesem Tweet entdeckt die API die Emotion „Hass“ aus der Kategorie „Ressentiments“ . ### Vorteile und Schwächen der API Die Installation und Einrichtung der Expert.ai Natural Language API erfolgte mit Python. Die verfügbare Dokumentation half uns dabei, dies schnell und einfach zu realisieren. Auch die Implementierung der verschiedenen Analysen war dank der Dokumentation unkompliziert. Eine Schwäche zeigte sich allerdings auch: Die Rückgabewerte sind etwas schwer verständlich, unzureichend beschrieben und teilweise auch unvollständig. Das führte zum Beispiel dazu, dass der Score einer Emotion nicht weiterverwendet werden konnte. ## Schritt für Schritt zur „fähigen“ App ### Das Training kann beginnen … Wie gesagt, sollte es das Ziel unserer App sein, depressive Äußerungen in Sozialen Netzwerken zu identifizieren. Dafür muss die App Tweets nach depressiven und nicht depressiven Tendenzen unterscheiden, also klassifizieren können. Dabei hilft ihr ein Algorithmus, der sich nach anfänglichem Training immer weiter verbessert. Unsere Aufgabe bestand also darin, ein solches Machine-Learning-Modell zu entwickeln. Dafür haben wir verschiedene Kaggle-Datensätze kombiniert, vorverarbeitet und mit Hilfe der Expert.ai API angereichert. ### Texte klassifizieren Für das Trainieren der Machine-Learning-Modelle benutzten wir die drei Datensätze, die auf der Website Kaggle bereitgestellt werden: - Twitter Dataset + Feature Extraction - Sentimental Analysis for Tweets - Twitter Depression Dataset Nachdem die verschiedenen Datensätze zusammengeführt wurden, ergab sich eine Gesamtzahl von 67.084 Tweets. Davon enthielten 32.230 Tweets Anzeichen von Depressionen, während 34.854 Tweets keine solchen Anzeichen aufweisen. Dies führt zu einer relativ ausgeglichenen Verteilung der Tweets in Bezug auf die beiden Klassen innerhalb unseres Datensatzes. Um ein valides Modell zu trainieren und zu testen, teilten wir den Datensatz in eine Trainings- und eine Testdatenmenge auf. 80 % des Datensatzes wurden als Trainingsdaten verwendet, während die restlichen 20 % als Testdaten dienten. So konnte wir testen, ob unser Modell auch auf unbekannten Daten sicher funktioniert. ![](https://thecattlecrew.net/wp-content/uploads/2023/01/Tweet-Verteilung.png)*Abbildung 2: Verteilung der Anzahl an Tweets auf die Klassen „Tweets mit depressiver Tendenz“ und „Tweets ohne depressive Tendenz“* Zur Veranschaulichung der Trainingsdaten zeigt Abbildung 3 zwei Beispiele. Im Datensatz sind die Tweets in zwei Kategorien eingeteilt: „1“ steht dabei für Tweets mit depressiven Tendenzen und „0“ für Tweets ohne depressive Tendenzen. **Text****Label**„It is 2 o’clock in the morning. Awake but tired. I need to sleep but my brain has other ideas… i hate my live 🙁„1„just had a real good moment. i missssssssss him so much“0*Abbildung 3: Beispiel für die Kategorisierung der Tweets* ### Daten vorverarbeiten Textdaten haben im Allgemeinen eine sehr hohe Anzahl von Merkmalen aufgrund der Vielzahl von Wörtern. Einfache Algorithmen des maschinellen Lernens stoßen bei solch hochdimensionalen Daten an ihre Grenzen. Deshalb kann es beim Natural Language Processing hilfreich sein, die Anzahl der Wörter so weit wie möglich zu reduzieren und die Daten mit ein paar Kniffen auf die Weiterverarbeitung vorzubereiten. Die folgenden Vorverarbeitungsschritte haben wir auf unseren Datensatz angewandt: - Konvertierung in Kleinbuchstaben - Entfernung von Satzzeichen und bestimmten Sonderzeichen - Entfernen von sogenannten Stopwords mit wenig Bedeutung (z. B. „at“ oder „on“) - Lemmatisierung: das heißt, unterschiedliche Wortformen wie „changed“, „changes“ oder „changer“ werden durch das einfache Wort „change“ ersetzt. Betrachten wir wieder unseren bereits bekannten Beispielsatz: > It is 2 o’clock in the morning. Awake but tired. I need to sleep but my brain has other ideas… i hate my live 🙁 Nach Anwendung dieser Schritte ergibt sich dieser vereinfachte Tweet: > oclock morning awake tire need sleep brain idea hate live Abschließend werden die bereinigten Tweets in eine Wort-Dokument Matrix transformiert. Jede Zelle in dieser Matrix enthält die Häufigkeit eines bestimmten Wortes für einen bestimmten Tweet. Diese Matrix wird als Feature-Input für das Training des Machine-Learning-Modells verwendet. Wenn ihr mehr über die Vorverarbeitung von Textdaten lesen möchtet, findet ihr hier einen interessanten Blogeintrag dazu ([Link](https://thecattlecrew.net/2022/08/03/textklassifikation-vorverarbeitung-der-daten/)). ### Algorithmus und Modell trainieren Als Machine-Learning-Modell zur Klassifizierung von Tweets in Depression (=1) oder Nicht-Depression (=0) haben wir uns für den Naive Bayes-Algorithmus entschieden. Dieses probabilistische Lernmodell basiert auf dem Bayes-Theorem und hat einige Vorteile: - Relativ einfach und gut interpretierbar - Relativ geringe Anzahl an Trainingsdaten notwendig - Tendiert nicht zu Overfitting - Gute Performance in vielen Anwendungen (oft als Baseline-Algorithmus in Projekten benutzt) Der Algorithmus basiert auf der Annahme, dass jedes Merkmal (in diesem Fall jedes Wort) in einem gegebenen Text unabhängig von den anderen Merkmalen ist. Diese Annahme ist oft nicht ganz richtig, aber es ermöglicht dem Algorithmus, schnell Schätzungen über die Wahrscheinlichkeiten zu berechnen und Vorhersagen zu treffen. In der Praxis hat sich gezeigt, dass der Naive Bayes Algorithmus oft gute Ergebnisse erzielt und für viele Anwendungen wie Spamfilterung, Sentimentanalyse und Textkategorisierung geeignet ist. Es ist jedoch zu beachten, dass es auch moderne Methoden gibt die besser für Textklassifikation geeignet sind, zum Beispiel die Verwendung von tiefen neuronalen Netzen (Deep Neural Networks) und die Verwendung von Word-Embeddings. Deshalb wird Naive Bayes oft als Basismodell verwendet, um komplexere Methoden damit zu vergleichen. Eine erste Implementierung des Algorithmus kann mit Machine-Learning-Bibliotheken wie **sklearn** sehr einfach erstellt und trainiert werden: ``` from sklearn.naive_bayes import MultinomialNB model_MNB = MultinomialNB() model_MNB.fit(X_train,Y_train) ``` Die Variable „X\_train“ sind beispielsweise die vorverarbeiteten Tweets und „Y\_train“ die zugehörigen Labels (Depressive Tendenz (=1). nicht depressive Tendenz (=0)). Für unser Projekt haben wir zwei Modelle trainiert. Während das Baseline-Modell ausschließlich mit den vorverarbeiteten Texten trainiert wurde, wurden für das Advanced-Modell zusätzlich die erkannten Emotionen der Texte als Features verwendet. ### Ergebnisse evaluieren Nach dem Training sollten unsere beiden Machine-Learning-Modelle in der Lage sein, Tweets hinsichtlich depressiver Tendenzen zu unterscheiden. Bei einem sensiblen Thema wie Depression müssen wir uns auf die Ergebnisse verlassen können. Dafür galt es die Qualität der Textklassifikation gründlich zu evaluieren. Anhand der bereits erwähnten Testdaten, also der Daten, die für das Training der Modelle nicht benutzt wurden und dem Algorithmus daher noch unbekannt waren. Abbildung 4 zeigt eine sogenannte Konfusionsmatrix für das Advanced-Modell: ![](https://thecattlecrew.net/wp-content/uploads/2023/01/bokeh_plot.png)*Abbildung 4: Konfusionsmatrix des erweiterten Modells* Eine Konfusionsmatrix ist ein gängiges Werkzeug zur Bewertung der Leistung von Klassifikationsmodellen. In einer Konfusionsmatrix werden die vorhergesagten Labels hinsichtlich depressiver Tendenzen mit den tatsächlichen Labels aus den Testdaten verglichen. Die Diagonale von oben links nach unten rechts enthält alle richtig klassifizierten Tweets. Das Ergebnis konnte sich sehen lassen: Die Genauigkeit (Accuracy) betrug 0,84. Das bedeutet, dass insgesamt 84% der Tweets im Testdatensatz richtig klassifiziert wurden. ``` Accuracy = (4012 + 2092) / (4012 + 261 + 928 + 2092) = 0.84 ``` Darüber hinaus ergab das erweiterte Modell eine Präzision von 0,89, was bedeutet, dass 89 % aller als depressiv gekennzeichneten Tweets tatsächlich eine depressive Tendenz aufweisen. ``` Precision = 2092 / (2092+ 261) = 0.89 ``` Das Baseline-Modell erreichte dagegen eine Genauigkeit von 79 %, was im Vergleich zum erweiterten Modell eine geringere Leistung darstellt. ### Entwicklung mit Streamlit Zur Entwicklung unserer App haben wir uns wie schon erwähnt für die junge Streamlit-Technologie entschieden. Streamlit ist ein Open-Source-App-Framework in der Sprache Python und besitzt mindestens 5 interessante Vorteile: 1. Einfachheit: Streamlit ermöglicht Entwicklern, schnell und einfach interaktive Anwendungen zu erstellen, ohne dass tiefgreifende Kenntnisse in Webentwicklung erforderlich sind. 2. Skalierbarkeit: Streamlit-Anwendungen können problemlos auf mehrere Prozessoren und Hosts skaliert werden, um die Leistung und die Verfügbarkeit zu verbessern. 3. Open Source: Streamlit ist Open Source und ermöglicht dem Team, die Software an seine Anforderungen anzupassen und erweiterte Funktionen hinzuzufügen. 4. Unterstützt verschiedene Datenformate: Streamlit unterstützt verschiedene Datenformate wie Tabellen, Text, Bilder, Charts, etc. 5. Integrationsfähigkeit: Streamlit kann einfach mit anderen Bibliotheken und Tools wie Pandas, Matplotlib etc. integriert werden. Das Ergebnis konnte sich sehen lassen: Unser Streamlit Dashboard bot eine benutzerfreundliche Oberfläche, über die Anwendende unseren erprobten Algorithmus nutzen konnten, um Textbeiträge auf depressive Inhalten hin zu überprüfen. Das heißt, eine Person gibt einen beliebigen Tweet ein, um diesen über eines der zwei Textklassifikationsmodelle, die wir eingebunden haben, klassifizieren zu lassen. - Modell 1: Das Baseline-Modell verwendet nur den reinen Text als Eingabe. - Modell 2: Das erweiterte Machine-Learning-Modell erkennt zusätzlich Emotionen, die der Expert.ai-API geläufig sind. Durch einen Klick auf den „Evaluate Tweet!“-Button wird der in Python entwickelte Backend-Code mit dem ausgewählten Modell aufgerufen. Ein Erklärvideo, das die Funktionen des Dashboards ausführlicher beschreibt, finder ihr in unserer Einreichung für den Hackathon [(Link)](https://devpost.com/software/depression-detector-5000). ![](https://thecattlecrew.net/wp-content/uploads/2023/01/App.png) *Abbildung 5: Auszug des Tweet Depression Detectors* Abbildung 6 zeigt, wie einfach ein Dashboard implementiert werden kann. Die Implementierung eines Batchs wird ab Zeile 10 beschrieben. Für den Batch selbst wird in Zeile 12 bis 15 ein Radio Button und in Zeile 17 ein einfacher Button ohne Funktion definiert. Die Implementierung mit Streamlit war für uns auch deshalb leicht, weil wir unser Python Backend ohne eine weitere Programmiersprache (z. B. Typescript) nutzen konnten. ![](https://thecattlecrew.net/wp-content/uploads/2023/01/App_und_Code.png) *Abbildung 6: Streamlit Implementierungscode und resultierende App* ## Was wir vom Hackathon mitnehmen Im Laufe des Hackathons haben wir einige Dinge gelernt: - Wir hatten die Möglichkeit, die Natural Language API von Expert.ai kennenzulernen, mit der sich umfangreiche Analysen mit minimalen Entwicklungskosten durchführen lassen. - Wir haben uns noch mehr verdeutlicht, dass Künstliche Intelligenz nicht nur auf die Wirtschaft ausgerichtet sein sollte, sondern auch eine wichtige Rolle bei der Lösung gesellschaftlicher Herausforderungen wie Armut, Gesundheit und Umwelt spielen kann. Es ist wichtig, sowohl wirtschaftliche als auch gesellschaftliche Perspektiven bei der Nutzung von KI zu berücksichtigen, um eine nachhaltige Zukunft zu gestalten. - Wir haben unsere erste Web-Applikation mit Streamlit entwickelt, und das Tool hat uns überzeugt. Unsere Applikation ließ sich damit schnell und einfach entwickeln und bereitstellen. Wir werden das Framework definitiv weiter nutzen. **Kategorien:** AI & Data Science, Sustainability & Awareness **Schlagwörter:** Artificial Intelligence, Hackathon, nachhaltig, NLP, Python, responsibility, social impact, Streamlit, text classification --- ### [Modern Cloud Analytics – Oder: Als wir versuchten, die Wahlen in NRW vorherzusehen (Teil 2)](https://thecattlecrew.net/2023/02/20/modern-cloud-analytics-oder-als-wir-versuchten-die-wahlen-in-nrw-vorherzusehen-teil-2/) **Published:** Februar 20, 2023 **Author:** Robert Loke **Excerpt:** Im zweiten Teil der Blog-Post Serie zeigen wir, wie wir Tweets aus dem Umfeld der Landtagswahl genutzt, aufbereitet und zur Weiterverwendung gespeichert haben. **Content:** *\*Teil 2 aus dem Tagebuch unseres Community-Projekts zur NRW-Wahl 2022* Im ersten Teil dieser Serie „Modern Cloud Analytics – Oder: Als wir versuchten, die Wahlen in NRW vorherzusehen“ hatten wir aus relativ hoher Flughöhe auf unser kleines Community-Projekt zu den Landtagswahlen in NRW geschaut. Wenn du den Beitrag gelesen hast, weißt du schon, dass die Vorhersage, die wir mithilfe einer Twitter-Analyse machen wollten, ihre Tücken hatte. Und wir müssten lügen, wenn das unseren Stolz nicht ein wenig angekratzt hätte. Aber wie bei jeder Forschungsarbeit konnten wir auch in diesem Projekt, Erkenntnisse sammeln, die wir dir nicht vorenthalten möchten: Welche Werkzeuge und Methoden gibt es, um die riesigen unstrukturierte Datenmengen aus sozialen Netzwerken für Vorhersagen zu nutzen? Wie kann Künstliche Intelligenz dabei helfen? ## Die Analytics-Welt hat sich verändert Das sind wichtige Fragen in einer Data-Warehouse-Welt, die sich schneller dreht als wir denken können. So war es vor 20 Jahren noch selbstverständlich, - dass die Datenbank als zentraler Datenspeicher auf einem möglichst mächtigen Server im lokalen Netz installiert war, - Daten mit Skripten oder mit lokal installierten ETL-Werkzeugen in die Datenbank geladen wurden, - Daten meist mit vorgefertigten Abfragen exportiert - und später in den Fachbereichen mit Excel, in vordefinierten Berichten oder in interaktiven Dashboards bereitgestellt und analysiert wurden. Heute sieht es eher so aus: - Data Warehouses werden in der Cloud gespeichert, - die Weiterverarbeitung findet in Cloud-basierten Plattformen statt. - Bei der Datenauswertung bekommen wir längst keine wohlformatierter Endlostabellen mehr vorgelegt, sondern wir können Zahlen und Fakten mit Hilfe ausgeklügelter Präsentationstechniken erklären und visualisieren. - Künstliche Intelligenz hilft uns, (fast) unendlich große Datenmengen zu nutzen und zu kategorisieren. Damit hat sich auch unsere professionelle Rolle verändert: Als Fachleute für Data Analytics müssen wir die Funktionsweisen sowie die Stärken und Schwächen der Werkzeuge kennen. Nur dann können wir Lösungen entwickeln, die den Mitarbeitenden weiterhelfen und der Sache, um die es geht, dienen. ## Was das mit unserem Community-Projekt zu tun hat In der „alten Welt“ wäre es darum gegangen, eine Prozesslandschaft so optimal wie möglich auszugestalten. Heute hingegen kommt es darauf an, einzelne Schritte zu verbessern, damit wir die am Markt gängigen Werkzeuge besser verstehen und einzusetzen lernen. Um eine realistische Umgebung zu schaffen, wählten wir Tools aus, die am Markt verbreitet sind und kostengünstig genutzt werden können. Nun aber endlich zur Sache: ## Wie ist eigentlich ein Tweet-Datensatz aufgebaut? Twitter stellt seine Datensätze in JSON bereit. (Siehe Abbildung 1) Damit enthält jeder Datensatz neben der eigentlichen Nachricht auch diverse Metadaten. Dazu gehören Angaben wie Autor, Ort und Uhrzeit der Erstellung, Verbindungen zu Tweets, die referenziert werden, die Anzahl der Follower des Autors und Referenzen zu Mediadaten wie Bilder und so weiter. Hier ist jedoch anzumerken, dass Twitter nach diesem Projekt eine neue API-Version publiziert hat, die den Zugriff stärker einschränkt. Version 2.0 hat nicht nur wesentlich eingeschränktere Zugriffsmöglichkeiten, sondern ist auch von der Konfiguration her aufwendiger, da hier jeder auszugebende Tag zu konfigurieren ist. Details findest du auf der Firmenhomepage von Twitter Inc. [![](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_Tweet.jpg)](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_Tweet.jpg)Abbildung 1: Auszug aus einem Tweet – Datensatz ## Analyseprozess in fünf Schritten Wie gesagt war unsere Idee, die Landtagswahlergebnisse in Nordrhein-Westfalen auf der Grundlage von Social-Media-Beiträgen vorherzusagen, ein ziemlicher Schnellschuss. Als Datenquelle wurde Twitter auserkoren, auch weil die damalige Schnittstellenversion es uns leicht machte, kostenlos und unkompliziert auf Tweets zuzugreifen. Ein Hashtag genügte. Es reichte also, die Hashtags der Parteien, die im Landtag vertreten waren, und die Hashtags ihrer jeweiligen Spitzenkandidat:innen zu suchen. Zusätzlich wurden Tweets gesammelt, die ein Hashtag enthielten, das auf die Landtagswahl hindeutet, wie #Landtagswahl, #LTWNRW, #LTW22 und so weiter. Wie wir aus dieser Vielzahl an Tweets eine Prognose über die Landtagswahl erstellen wollten, zeigt die Prozesskette in Abbildung 2. [![](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_Processchain.jpg)](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_Processchain.jpg)Abbildung 2: Überblick über die Prozesskette Schritt 1 – Extraktion: Im ersten Schritt wurden die Datensätze mit den definierten Hashtags aus Twitter extrahiert und über den Zeitraum mehrerer Wochen im Data Lake Storage in Form von JSON-Dateien abgelegt. Hierbei wurde jeder Datensatz in eine separate Datei geschrieben. Schritt 2 – Übertrag: Im zweiten Schritt wurden diese Dateien in eine Datenbanktabelle übertragen. Mit separaten Feldern. Da zu diesem Zeitpunkt war noch nicht klar war, in wie vielen Feldern wir am Ende verwertbare Daten finden würden, wurden zunächst sämtliche Felder extrahiert und in eine denormalisierte Tabelle geschrieben. Schritt 3 – Denormalisierung: Im dritten Schritt ging es darum, die Daten aus einer denormalisierten Tabelle in ein normalisiertes Datenmodell zu übertragen, um damit die spätere Aufbereitung in Pyramid oder Azure Machine Learning zu unterstützen. Schritt 4: Datentransfer zu Azure inkl. Rückkanal für die (Zwischen-)Speicherung der Ergebnisse Schritt 5: Datentransfer zu Pyramid inkl. Rückkanal für die (Zwischen-)Speicherung der Ergebnisse ## Genauer hingeschaut: Von der Extraktion bis zur Denormalisierung Lass uns die Schritte 1 bis 3 noch etwas genauer ansehen: 1. **Extraktion** Im ersten Schritt des Analyseprozesses wurden die Datensätze mit Apache NiFi aus Twitter extrahiert und im Data Lake einer Microsoft Azure Instanz gespeichert. Apache NiFi ist eines er beliebtesten Open-Source-Produkte, um große Datenmengen von einer Datenquelle in ein Target zu übertragen. Hierzu werden einzelne Datenpakete (*FlowFiles*) über Serverprozesse verarbeitet und/oder gespeichert. Diese *FlowFile Processors* können über *Connections* miteinander verbunden werden. Dieses Konstrukt hat zweierlei Funktionen: Zum einem werden Datenflüsse definiert, zum anderen dienen die Connections als Zwischenspeicher, sodass die FlowFile Processors mit unterschiedlichen Geschwindigkeiten arbeiten können. In Abhängigkeit von der Datenmenge kann die Rate der verarbeitbaren FlowFiles über die Anzahl paralleler FlowFile Processor skaliert werden. Zur Extraktion der Daten aus Twitter stand, als wir unser Projekt durchführten, ein vorkonfigurierter Connector zur Verfügung, sodass sich ein Job zur Speicherung schnell implementieren ließ. Hierzu bedurfte es lediglich der Konfiguration des FlowFile-Processors zur Definition der gesuchten Hashtags und des Speicherorts. (Siehe Abbildung 3). ![](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_ProcessorConfig.jpg) Abbildung 3: Konfiguration des FlowFile – Processors Die Krux war jedoch, dass hierbei jeder Tweet in eine eigene Datei geschrieben wurde. Krux deswegen, weil wir im zweiten Schritt der Verarbeitung nicht weniger als 158.000 Datensätze zu verarbeiten hatten! Ursprünglich hatten wir für diesen Schritt eine Implementierung in Airbyte geplant. Airbyte ist ein ELT-Werkzeug, das im Cloud-Kontext weit verbreitet ist. Sowohl in einer kommerziellen als auch einer Open-Source -Variante. Zur Anbindung an jeweilige Datenquellen und -speicher bietet das Tool mehr als 300 Konnektoren und erlaubt die einfache Anbindung von Datenquellen in JSON-Format. Zum Zeitpunkt der Implementierung war jedoch ein vorkonfigurierter Konnektor für so eine große Anzahl von Dateien nicht verfügbar. Wir hätten also für jede Datei einen separaten Konnektor konfigurieren müssen. 2. **Übertragung in die Datenbank** Der zweite Schritt der Analyse, die Übertragung der Daten in Datenbanktabellen, läuft in zwei Etappen ab: - Zunächst werden die Daten im JSON-Format abgelegt. - Dann werden die einzelnen Attribute aus der JSON-Datei geparst und in einer Tabelle gespeichert. Sollte eine verschachtelte JSON-Struktur vorliegen, so wird die Substruktur iterativ aufgelöst, wobei zur Verknüpfung eine künstliche Airbyte ID generiert und die Parent-Child-Beziehung über einen Foreign Key abgebildet wird. Zwar stellt Airbyte ein Software Development Kit zur Verfügung, ebenso Hilfen zur Implementierung eines eigenen Konnektors zur Anbindung vieler Dateien in einem Verzeichnis – allerdings war uns die Zeit für die Anbindung zu lang, sodass ein anderer Ansatz gewählt wurde: Wir banden die JSON-Dateien im Data-Lake-Speicher als externe Datenquellen direkt in die Snowflake-Datenbank ein. Die Dateien standen uns dort für die weitere Verarbeitung wie eine externe Tabelle zur Verfügung. Dieses Vorgehen hat jedoch Grenzen: Da das Parsen des JSON-Formats per SQL-Statement erfolgt, gestaltet sich eine Normalisierung der Daten bei verschachtelten JSON-Strukturen sehr aufwendig. 3. **Normalisierung** Beim dritten Schritt der Analyse ging es darum, die Daten aus einer denormalisierten Tabelle in ein normalisiertes Datenmodell zu übertragen, sodass die Daten für die folgende Datenanalyse aufbereitet zur Verfügung stehen. Diesen Schritt haben wir über DBT (einer im Cloudkontext verbreitetem Werkzeug zur Implementierung von Transformations- und Analysealgorithmen in SQL und/oder Python) direkt auf dem Prozessor implementiert. Die Stärke von DBT besteht für uns als Team darin, dass Analyse-Code kollaborativ in einer sehr stark an SQL und Python angelehnten Form erstellt und deployt werden kann. Entsprechend einfach sehen die Statements zur Extraktion der Tweet-Header-Daten aus. (Siehe Abbildung 3) ``` {{     config( materialized='incremental',         unique_key='tweet_id'     ) }} select *   from (select distinct        'STREAM LTWNRW' twitter_search_stream,        TWEET_ID,        CREATED_AT_UTC,        coalesce(FULL_TEXT,TEXT) as TEXT,        IN_REPLY_TO_STATUS_ID as REPLY_TO_TWEET_ID,        IN_REPLY_TO_STATUS_USER_ID as REPLY_TO_USER_ID,        QUOTED_STATUS_ID as QUOTE_TO_TWEET_ID,        RETWEETED_STATUS_TWEET_ID as RETWEET_TO_TWEET_ID,       POSSIBLY_SENSITIVE,        LANG,        "SOURCE",        USER_ID,        to_varchar(PLACE_ID) as PLACE_ID   from {{ ref('stage_twitter') }}    } ``` Abbildung 3: Quellcode zur Auslese der Twitter – Headerdaten Das Zieldatenmodell wurde in einer 2-nf-Architektur aufgebaut und berücksichtigt diverse Kardinalitäten: So ist es nicht unwahrscheinlich, dass ein Benutzer mehrere Tweets schreibt, sich zu unterschiedlichen Zeiten an verschiedenen Orten aufhält und sich beispielsweise mit fortschreiten­der Zeit auch die Anzahl der Follower ändert. Ebenso kann ein Tweet z. B. mehrere Hashtags enthalten. Abbildung 4 zeigt den Ausschnitt des Datenmodells, in das die Twitterdaten aufgenommen und für die Bereitstellung zu weiteren Analysen genutzt wurden. [![](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_DataModelCore.jpg)](https://thecattlecrew.net/wp-content/uploads/2023/02/CCBlog_DataModelCore.jpg)Abbildung 4: Die so aufbereiteten Daten wurden für diese Serie verwendet. ## Summary Zunächst einmal konnten Twitterdaten für die folgenden Analysen bereitgestellt werden. Um für kommende Projekte besser gerüstet zu sein, bot sich hier die Gelegenheit, Werkzeuge zu testen, die im Cloud-Kontext verbreitet sind. Der Einfachheit halber wurden nur Nachrichten über einen Dienst verwertet. Diese Beschränkung war der Einfachheit des Testfalles geschuldet – technisch wäre die Einbindung weiterer Messengerdienste möglich gewesen. Die Einbindung weiterer Datenquellen mittels CSV-Datei war für keines der Werkzeuge ein Hindernis. Dennoch war die Nutzung der Anbindung von Twitter über Nifi eine deutliche Vereinfachung. Einen Komfort, den es zukünftig nicht mehr geben wird, weil diese Nutzung mit der neuen Twitter Version deutlich aufwendiger wird. Künftig müssen die hier abzurufenden Informationen explizit konfiguriert werden. Die verwendeten Werkzeuge erlauben eine Anbindung weiterer Messengerdienste, sofern ein entsprechendes SDK verfügbar ist. Vor diesem Hintergrund wäre jedoch auch zu prüfen, ob, und ggf. inwieweit, die Analyseergebnisse davon betroffen sein könnten. #### Alle Blogbeiträge dieser Serie ansehen Teil 1: Teil 2: **Kategorien:** AI & Data Science, Analytics & Insights, Cloud --- ### [Da steht ein K(C)amel am Ruder](https://thecattlecrew.net/2021/03/22/camel-k-da-steht-ein-kcamel-am-ruder/) **Published:** März 22, 2021 **Author:** Michael Stähler **Content:** In der Java-Welt ist das Integrations-Framework [Apache Camel](https://camel.apache.org/) bereits ein alter Hase. Die vielfältigen [Adapterkomponenten](https://camel.apache.org/components/latest/) lassen kaum Wünsche offen, wenn es darum geht ein (Fremd-)System oder eine bestimmte Schnittstelle zu integrieren. Für den Einsatz in Serverless-Umgebungen auf einem Kubernetes-Cluster gibt es nun eine native Integration, die die Entwicklung von Camel-Routen vereinfachen soll. Dieser Artikel soll einen ersten Einblick in das Camel-Unterprojekt **Camel K** geben. # Was ist Camel K ? [![](https://thecattlecrew.net/wp-content/uploads/2021/03/logo.jpg)](https://thecattlecrew.net/wp-content/uploads/2021/03/logo.jpg) ## Begriffsdefinition [Camel K](https://camel.apache.org/camel-k/latest/) (gelegentlich auch Camel-K oder camel-k geschrieben) ist ein leichtgewichtiges Integrations-Framework auf Basis von [Apache Camel](https://camel.apache.org/), dass nativ auf Kubernetes läuft und für Serverless und Microservice-Architekturen entwickelt wurde. Aus Entwickler-Sicht wird nur die eigentliche `Camel-Route` erstellt und diese z.B. als Groovy, Java etc. Datei deployt. Aktuell (Stand: 18.03.2021) werden 7 unterschiedliche [Sprachen](https://camel.apache.org/camel-k/latest/languages/languages.html) unterstützt. Dazu zählen: - Java - JShell - XML - YAML - Groovy - Kotlin - JavaScript # Installation von Camel K Die Installation von Camel K ist in der [camel-k Dokumentation](https://camel.apache.org/camel-k/latest/installation/installation.html) beschrieben. Im folgenden soll die Installation auf [Minikube](https://github.com/kubernetes/minikube) erläutert werden. ## Installation am Beispiel von Minikube Nach dem Download kann man Minikube auf [VirtualBox](https://www.virtualbox.org/) wie folgt starten: `minikube start --driver virtualbox` Danach muss noch das Registry-Addon aktiviert werden: `minikube addons enable registry` Nachdem Minikube nun gestartet ist, kümmern wir uns um die Installation der [kamel CLI](https://camel.apache.org/camel-k/latest/installation/installation.html#procedure). Damit wird dann auch Camel K in Kubernetes installiert. Nachdem die `kamel CLI` eingerichtet ist, können wir mit `kamel install` den `camel-k-operator` installieren. Dieser kümmert sich um die eigentliche Ausführung der Camel-Routen in Kubernetes. Mit den folgenden Befehlen legen wir einen neuen Namespace (camel-basic) für unser nachfolgendes Beispiel an und installieren darin Camel K: ``` kubectl create namespace camel-basic kubectl config set-context --current --namespace=camel-basic kamel install ``` **TIP** Der Camel-K-Operator wird nur für den jeweils gewählten Kubernetes-Namespace installiert. Wenn ein neuer Namespace angelegt wird, dann muss der `kamel install`-Befehl erneut ausgeführt werden. Die Installation in einem Kubernetes Cluster wird über den Befehl `kamel install --cluster-setup` durchgeführt. In dem Fall wird die Installation über eine Custom Resource Definitions (CRD) im Cluster eingerichtet und benötigt entsprechend Admin-Rechte. Der erste Start kann etwas dauern. Evtl. fehlt auch noch ein [Integration-Kit.](https://camel.apache.org/camel-k/latest/architecture/cr/integration-kit.html) Das kann man mit dem Befehl ``` kamel kit create default ``` nachholen. Der Name `default` ist hier willkürlich gewählt. ## Hello-World-Beispiel Nun können wir unsere erste Camel-Route in Kubernetes starten. Ein einfaches `HelloWorld`-Beispiel kann z.B. so aussehen: ``` from('timer:tick?period=3000') .setBody().constant('Hello world from Camel K') .to('log:info') ``` Die Bespiel-Route kann mit dem Befehl `kamel init hello-world.groovy` angelegt werden. Danach kann man mit dem Befehl ``` kamel run hello-world.groovy ``` die Camel-Route in Kubernetes deployen. Dabei werden folgende Aufgaben vom Kubernetes-Cluster automatisch übernommen: - Auflösung aller benötigten Dependencies - Erstellung der benötigten Deployment Konfiguration - Start des jeweiligen Pods für die Ausführung der Camel-Route Die benötigten Dependencies werden anhand der verwendeten Adapter in der Camel-Route automatisch ermittelt. Mit dem Befehl `kamel get` können alle aktuell ausgeführten `Integrations` abgefragt werden: ``` $ kamel get NAME PHASE KIT helloworld Running kit-c15hl5gfc8h01ii2rung ``` ## Verwendung des DEV-Modes Gerade am Anfang der Entwicklung ist es von Vorteil ein schnelles Feedback über mögliche Fehler beim Start der Anwendung zu bekommen. Dazu bietet Camel K den sog. DEV-Mode. Die Camel-Integration wird dazu mit dem Parameter `--dev` gestartet. Beispiel: Basic.java ``` import org.apache.camel.builder.RouteBuilder; public class Basic extends RouteBuilder { @Override public void configure() throws Exception { from("timer:java?period=1000") .setHeader("example") .constant("java") .setBody() .simple("Hello World! Camel K route written in ${header.example}.") .to("log:info"); } } ``` Das obige Beispiel lässt sich mit `kamel run Basic.java --dev` im DEV-Mode starten. Während man auf der Konsole die Log-Ausgabe sieht kann man den Source-Code abändern (DEV-Loop). Er wird dann automatisch neu deployt. Der Name der `Integration` wird automatisch aus dem Klassennamen abgeleitet und in ein „lower-case“ umgewandelt. Durch Verwendung des `dev`-Modes bekommt man direkt Feedback, ob alle Abhängigkeiten korrekt aufgelöst werden konnten. ## Logs abrufen Ohne den Start im DEV-Mode kehrt der Command-Prompt direkt zurück und man kann sich die Logs des ausgeführten Pods anschauen: ``` kamel logs basic [1] 2021-03-18 09:29:27,895 INFO [info] (Camel (camel-1) thread #0 - timer://java) Exchange[ExchangePattern: InOnly, BodyType: String, Body: Hello World! Camel K route written in java.] ``` Mit `kamel delete basic` kann man die Integration wieder löschen. # Architektur ## Programmiermodell Das Programmiermodell zielt auf die einfache Definition von Camel-Routen und deren Betrieb als Serverless-Funktionen (aka `Functions`) ab. Dabei dient Kubernetes/OpenShift als Laufzeitumgebung dieser Funktionen, die in diesem Fall durch `Camel-Routen` repräsentiert werden. Die Entwicklung der eigentlichen Camel-Routen steht im Vordergrund der Entwicklung. Details rund um Build- und Deploymentmanagement verlagert sich in die Laufzeitumgebung. ### Integrations Camel K Anwendungen werden `Integrations` genannt. Diese Integrations haben einen Lifecycle. Sie können z.B. gestartet und wieder gelöscht werden. Alle Aufgaben werden über das [CLI-Tool](http://localhost:5000/rfc/in_work/camel-k/tooling.html#kamel-cli) `kamel` erledigt. ### Components Components sind die Camel-Adapter, die in Camel-Routen verwendet werden. Sie können entweder programmatisch in der Route oder mit Hilfe von Properties konfiguriert werden. ### Konfiguration Properties von Integrationen können in Properties-Dateien oder in ConfigMaps bzw. Secrets ausgelagert werden. Der jeweilige Wert wird dann in der Camel-Route über eine Expression ermittelt. Beispiel: props.groovy ``` from('timer:props?period=1000').log('{{my.message}}') ``` Eine entsprechende ConfigMap für den Wert von `my.message` könnte dann so aussehen: my-config.yaml ``` apiVersion: v1 kind: ConfigMap metadata: name: my-config data: application.properties: | my.message=Hello World logging.level.org.apache.camel=DEBUG ``` Die ConfigMap muss dann erst in Kubernetes angelegt werden und kann anschließend beim Start der `Integration` referenziert werden. ``` kubectl apply -f my-config.yaml kamel run --configmap=my-config props.groovy ``` ## Plattform Konzepte Das folgende Diagramm gibt einen groben Überlick über die [Architektur](https://camel.apache.org/camel-k/latest/architecture/architecture.html): [![](https://thecattlecrew.net/wp-content/uploads/2021/03/camlk_architektur-1024x489.jpg)](https://thecattlecrew.net/wp-content/uploads/2021/03/camlk_architektur.jpg) Camel K High Level Architektur Die wesentlichen Plattform-Elemente setzen sich aus folgenden Komponenten zusammen: - Operator - Runtime - Traits ### Operator Die Camel-K-Integration in Kubernetes erfolgt über einen [Kubernetes-Operator](https://kubernetes.io/docs/concepts/extend-kubernetes/operator/). Operators sind Erweiterungen in Kubernetes, die sich auf [Custom Resources](https://kubernetes.io/docs/concepts/extend-kubernetes/api-extension/custom-resources/) als Extension der Kubernetes API beziehen. Durch den Aufruf von `kamel install` wird der `camel-k-operator` in dem gewählen Kubernetes-Namespace installiert. Mit dieser Installation können `Integrations` im Kubernetes-Namespace gestartet werden. ### Runtime Die [Runtime](https://camel.apache.org/camel-k/latest/architecture/runtime.html) kümmmert sich um die eigentliche Ausführung der `Integrations` in Kubernetes. Die Default-Runtime ist [Quarkus](https://github.com/apache/camel-k/issues/1513). ### Traits Über [Traits](https://camel.apache.org/camel-k/latest/traits/traits.html) werden „High Level Features“ in Camel K realisiert. Im Wesentlichen ist damit die Integration von Third-Party-Frameworks gemeint, wie z.B. [Knative](https://knative.dev/), [OpenAPI](https://www.openapis.org/), [Prometheus](https://prometheus.io/) etc, oder Basis-Funktionen der Laufzeitumgebung, z.B. Routen und Services in Kubernetes bzw. OpenShift. Traits haben `Profile` und `Eigentschaften`. Profile besagen auf welcher Laufzeitumgebung der jeweilige Trait anwendbar ist, z.B. `Kubernetes` oder `OpenShift`. Eigenschaften eines Traits werden über Properties konfiguriert, mit der weitere individuelle Einstellungen möglich sind. Alle Traits haben beispielweise die Eigenschaft `enabled`. Das Property folgt dem Namensschema `TRAIT_NAME.enabled=true/false`, also z.B. `istio.enabled=true`. Einige Traits sind standardmäßig aktiviert. Beispielsweise ist der Dependency Trait ein Platform Trait, der standardmäßig auf den Plattformen Kubernetes, Knative und OpenShift aktiviert ist. Aktuell gibt es 31 Traits (Stand: 18.03.2021). # Abgrenzung zu Apache Camel ## High-Level-Abstraktionen mit Kamelets [Kamelets](https://camel.apache.org/camel-kamelets/latest/) (**Kamel** route snipp**ets**) basieren auf einem neuem Konzept von Adaptern, um auf externe Systeme zuzugreifen. Alle technischen Details werden dabei in einem Kamelet gekapselt und ermöglichen dadurch eine relativ einfache Verwendung in den Camel Routen. Alle Low-Level-Details werden so in wiederverwendbare Komponenten verpackt. Ein Kamelet besteht aus einer `Source` und einer `Sink`, also der Definition einer Quelle und eines Ziels von einem externen System. ### Verwendung von Kamelets in Camel Routen Kamelets können wir normale Camel-Adapter in Routen verwendet werden. Dabei wird der `kamelet`-Prefix als Adapter-Name verwendet. Beispiel: ``` from("kamelet:telegram-text-source?botToken=XXXXYYYY") .to("kamelet:my-company-log-sink/mynamedconfig") ``` Nach dem Prefix folgt der Name des Kamelets mit anschließenden Konfigurationsparametern. ### Aufbau eines Kamelets Ein Kamelet ist technisch gesehen eine Kubernetes Ressource. In ihrer Konfiguration im YAML-Format ist auch ein Routen-Template enthalten über die grundlegende Funktionsweise des Kamelets. Gekennzeichnet sind die Konfigurationsdateien durch das folgende Namensschema: `yourkamelet.kamelet.yaml`. Über optionale [`Kamelet Bindings`](https://camel.apache.org/camel-k/latest/kamelets/kamelets-user.html#kamelets-usage-binding) kann eine „Brücke“ zu anderen Integrationstechnologien, wie z.B. [Knative](https://knative.dev/) hergestellt werden. Weitere Details finden sich im [Kamelets User Guide](https://camel.apache.org/camel-k/latest/kamelets/kamelets-user.html). ## Testing ### Tests mit YAKS In der offiziellen Dokumentation findet man keinen Hinweis darauf, wie man `Camel K Integrations` testen kann. Es ist aber zu erwarten, dass es eine Unterstützung für das Testing geben wird. Laut dem [Issue-Tracker](https://github.com/apache/camel-k/issues/600) von Camel K in GitHub wurde bereits danach gefragt. Voraussichtlich wird es eine offizielle Unterstützung auf Basis von [YAKS](https://github.com/citrusframework/yaks) geben, das wiederum auf dem [Citrus-Framework](https://citrusframework.org/) basiert und eine Erweiterung für `Cloud Native BDD Testing` auf der Kubernetes-Plattform darstellt. YAKS Tests werden als BBD-Features auf Basis der [Gherkin](https://cucumber.io/docs/gherkin/)-Syntax geschrieben und geben eine definierte Struktur vor, wie sie auch in [Cucumber](https://cucumber.io/)-Tests verwendet wird. Wie `Camel K` selbst muss vor der ersten Testausführung der `YAKS Operator` installiert werden. Das erfolgt, wie auch die spätere Testausführung, über die [YAKS CLI](https://citrusframework.org/yaks/reference/html/index.html#cli). Sobald die `YAKS CLI` installiert ist, kann man den Operator mittels ``` yaks install ``` installieren. Anschließend können wir z.B. einen einfachen `HelloWorld`-Test ausführen: helloworld.feature ``` Feature: Hello Scenario: Print hello message Given print 'Hello from YAKS!' ``` Die erfolgreiche Installation kann mittels `kubectl get customresourcedefinitions -l app=yaks` überprüft werden. Mit ``` yaks test helloworld.feature ``` können wir nun unseren Test ausführen. Der Befehl erstellt als Ergebnis ein `_output`-Verzeichnis mit den Testergebnisssen (`helloworld.json` und `junit-reports.xml`). Die Tests selbst werden als `ConfigMap` im jeweiligen Namespace in Kubernetes gespeichert. ### CI/CD-Pipelines mit Tekton CI/CD-Pipelines werden in Kubernetes über [Tekton](https://tekton.dev/) realisiert. Über die [Tekton CLI](https://tekton.dev/docs/cli/) kann man einzelne Tasks auf der Konsole starten. Tasks sind einzelne Steps in einer Tekton-Pipeline. Dies ist ein einfaches HelloWorld-Beispiel: task-hello.yaml ``` apiVersion: tekton.dev/v1beta1 kind: Task metadata: name: hello spec: steps: - name: hello image: ubuntu command: - echo args: - "Hello World!" ``` Mit dem Befehl `kubectl apply -f task-hello.yaml` wird der Task angelegt und mit `tkn task start hello` ausgeführt. Das Ergebnis kann man sich mit `tkn taskrun logs --last -f` anzeigen lassen. ``` $ tkn taskrun logs --last -f [hello] Hello World! ``` ### Tekton Dashboard Es gibt auch ein [Tekton Dashboard](https://github.com/tektoncd/dashboard), in dem man sich die Pipelines (ähnlich zu Jenkins) anzeigen lassen kann. Mit folgenden Befehlen wird das Dashboard in Minikube installiert und über einen Proxy lokal zugreifbar gemacht: ``` kubectl apply --filename https://github.com/tektoncd/dashboard/releases/latest/download/tekton-dashboard-release.yaml kubectl proxy --port=8080 ``` Anschließend kann das Dashboard im Browser unter [http://localhost:8080/api/v1/namespaces/tekton-pipelines/services/tekton-dashboard:http/proxy](http://localhost:8080/api/v1/namespaces/tekton-pipelines/services/tekton-dashboard:http/proxy/) aufgerufen werden. Unter `Tasks` bzw. `TaskRuns` kann man sich den Task anzeigen lassen. [![](https://thecattlecrew.net/wp-content/uploads/2021/03/tekton-tasks-1024x352.jpg)](https://thecattlecrew.net/wp-content/uploads/2021/03/tekton-tasks.jpg) Tekton Dashboard Über einen [Camel K Integration Task für Tekton](https://camel.apache.org/camel-k/latest/tutorials/tekton/tekton.html) kann Camel K direkt in Tekton Pipelines verwendet werden. ## Unterschiede zwischen Camel und Camel K Wenn eine Serverless-Architektur als Zielplattformumgebung gewünscht ist, so muss an dieser Stelle auf die umfrangreichen Integrationsmöglichkeiten von [Apache Camel](https://camel.apache.org/) nicht verzichtet werden. Im Vergleich zu Apache Camel liegt hier allerdings der Fokus auf der eigentlichen Camel-Route mit deren Integration in die Kubernetes-Laufzeitumgebung sowie der Einbindung und Nutzung entsprechender Serverless- und Microservices-Frameworks, wie z.B. [Knative](https://knative.dev/) und [Quarkus](https://quarkus.io/). Die klassischen Camel-Anwendungen werden üblicherweise als Binärartefakt deployt. Beispielsweise kann man eine Spring-Boot-Anwendung mit Camel aufsetzen und das FAT-JAR-Artefakt direkt starten oder in einem Docker-Container gekapselt betreiben. Das „Drumherum“ passiert also lokal auf dem Entwicker-Rechner (oder entsprechend in der CI/CD-System). Im Vergleich dazu beinhalten die Camel K Anwendungen „einfach“ nur die Camel-Routen-Definitionen als einzelne Datei im jeweils gewünschen Format (z.B. Groovy, Java, XML etc.“‹). Im Endeffekt verlagern sich die Build- und Deployment-Aufgaben eher in Richtung Plattform und werden von dieser automatisch übernommen. Im Folgenden sollen die Vor- und Nachteile von Camel K kurz zusammengefasst werden: ## Vorteile von Camel K - Source-Code auf das Nötigste (aka Camel-Route, Properties etc.) beschränkt - automatische Ermittlung der Abhängigkeiten - automatisches Build- und Deployment nach Kubernetes mit `kamel run...` - automatische Anlage von Services, Routen und ConfigMaps etc. - kein separates Dockerfile oder Source-2-Image(S2I)-Build notwendig - DEV-Mode propagiert automatisch alle Änderungen auch in den laufenden Pod - Servlerless-Ansatz (in Verbindung mit [Knative](https://knative.dev/) oder [OpenShift Serverless](https://www.openshift.com/learn/topics/serverless)) - kurze Startzeiten - Ressourcen werden geschont, wenn sie nicht benötigt werden - geringer Speicherverbrauch - Ausführung bei Bedarf ## Nachteile von Camel K - Verlagerung der Komplexität in die Laufzeitumgebung - höhere Abhängigkeit zur Laufzeitumgebung während der Entwicklung - Fehlersuche kann evtl. recht mühsam werden - Konfigurationsdateien sind ggf. „verstreut“ im System (Abbildung von Properties in ConfigMaps) - (noch) relativ neu - Einige Teile von Camel K oder Knative befinden sich noch im Alpha-Stadium - Dokumentation (noch) unvollständig - setzt grundsätzlich Kubernetes/OpenShift als Laufzeitumgebung voraus # Observability ## Monitoring Das [Camel K Monitoring](https://camel.apache.org/camel-k/latest/observability/monitoring.html) wird über eine Integration mit [Prometheus](https://prometheus.io/) unterstützt. Dafür gibt es einen speziellen [Prometheus Operator](https://github.com/prometheus-operator/prometheus-operator). Das Projekt befindet sich allerdings noch im Beta-Status (Stand: 16.03.2021). Der `Prometheus Operator` wird analog wie der `camel k operator` als Ressource in einem Kubernetes-Namespace installiert. Alle Applikationen, die in dem Namespace laufen, in der auch der Prometheus Operator läuft, können damit überwacht werden. Beim der Installation des `camel k operator` kann das Monitoring auch direkt für alle Integrationen aktiviert werden: ``` kamel install --monitoring=true --monitoring-port=8888 ``` ## Metriken Mit dem [Prometheus Trait](https://camel.apache.org/camel-k/latest/traits/prometheus.html) wird der Prometheus-kompatible Endpunkt konfiguriert. Mittels der [Camel Quarkus MicroProfile Metrik Extension](https://camel.apache.org/camel-quarkus/latest/reference/extensions/microprofile-metrics.html) werden die Metriken im `OpenMetric`-Format bereitgestellt. Neben JVM und OS-bezogenen Metriken gibt es ein paar Camel K spezifische Metriken. Dazu zählen z.B. - Anzahl an Routen - Anzahl an ausgeführten Routen - gesamte Anzahl an erfolgreich ausgeführten Exchanges - gesamte Anzahl an fehlerhaft ausgeführten Exchanges - … Weitere Details siehe [Camel K Integration Monitoring](https://camel.apache.org/camel-k/latest/observability/integration.html). ## Logging Camel K verwendet [Log4j 2](https://logging.apache.org/log4j/2.x/) als Logging-Framework. Der Logging Level kann über Properties angepasst werden. Der folgende Befehlt setzt z.B. das Log-Level auf `DEBUG`: ``` kamel run --property logging.level.org.apache.camel=DEBUG helloworld.groovy ``` ## Service Tracing Es gibt einen [Tracing Trait](https://camel.apache.org/camel-k/latest/traits/tracing.html), der Tracing-Informationen an einen [OpenTracing](https://opentracing.io/)-kompatiblen Collector schicken kann und auch [Jaeger](https://www.jaegertracing.io/) unterstützt. Der Tracing Trait muss separat aktiviert und konfiguriert werden, z.B. ``` kamel run --trait tracing.enabled=true --trait tracing.auto=true helloworld.groovy ``` # Tooling ## Extensions für Visual Studio Code Für [Visual Studio Code](https://code.visualstudio.com/) gibt es das [Tooling for Apache Camel K by Red Hat](https://marketplace.visualstudio.com/items?itemName=redhat.vscode-camelk). Damit kann man neue Camel-K-Dateien anlegen und auch deployen bzw. löschen lassen. In einem Explorer-Fenster werden die Camel-K-Integrations angezeigt. [![](https://thecattlecrew.net/wp-content/uploads/2021/03/grafik.png)](https://thecattlecrew.net/wp-content/uploads/2021/03/grafik.png) Visual Studio Code Plugin für Camel K # Fazit Mit Camel K wurde das beliebte Apache Camel Framework auf die Kubernetes Plattform portiert und fungiert damit als leichtgewichtige ESB-Alternative, das die Vorzüge dieser Plattform versucht bestmöglich auszunutzen. Es positioniert sich als Integrations-Framework für Serverless- und Microservices-Architekturen und integriert dabei Frameworks, die die gleiche Laufzeitumgebung zum Ziel haben (z.B. Quarkus, Knative etc.). Wer sich eine Serverless-Architektur zunutze machen will, der sollte einen Blick auf Camel K werfen. Durch den geringen Ressourcen-Footprint, den Serverless-Anwendungen mit sich bringen, lassen sich durch den Einsatz gerade in Cloud-Umgebungen Kosten sparen und in On-Premises-Umgebungen zumindest Ressourcen effizienter nutzen. Da das Framework noch relativ jung ist und viele Artefakte noch im Alpha-Status sind, sollte ein Einsatz in Produktivumgebungen noch mit Bedacht gewählt werden. Es ist aber zu erwarten, dass sich dieses Risiko im Laufe der Zeit minimieren wird. Zumindest erfreut sich das Projekt einer aktiven Community. Da Camel K auf Kubernetes aufsetzt, sollte klar werden, dass ein lauffähiges Kubernetes-Cluster eine notwendige Voraussetzung für den erfolgreichen Einsatz ist. Das ist kein leichtes Unterfangen; hier sollte man sich im Klaren sein, dass der produktive Betrieb eines Kubernetes-Clusters eine durchaus technische Herausforderung sein kann. Dafür muss das benötigte Wissen im Unternehmen vorhanden sein. Selbst wenn man bei dem Betrieb auf einen Cloud-Provider ausweicht (z.B. [AWS EKS](https://aws.amazon.com/de/eks) oder [Azure AKS](https://azure.microsoft.com/de-de/services/kubernetes-service/)), sollte der Betrieb eines Kubernetes-Clusters nicht unterschätzt werden. Zwar vereinfacht sich die lokale Entwicklung durch Fokussierung auf die reinen Camel-Routen, allerdings verschiebt sich dadurch auch die Komplexität im Hinblick auf die Konfigurationseinstellungen in Richtung des Kubernetes-Clusters selbst. Hier sind einige Konfigurationen vorzunehmen, um alle benötigten Voraussetzungen in Kubernetes zu erfüllen (z.B. Installation und Konfiguration des Camel K Operators, Aktivierung von Traits, Properties etc.). Im Testing-Bereich gibt es erste Ansätze für Integration-Testing mit [Citrus](https://citrusframework.org/) und [YAKS](https://github.com/citrusframework/yaks). Für Unit-Tests muss allerdings auf die „klassische“ Vorgehensweise zurückgegriffen werden. Alles in Allem hat `Camel K` das Potenzial für eine leichtgewichtige ESB-Alternative. Es bleibt abzuwarten, wie sich das Framework weiterentwickelt und auf welche Akzeptanz es in Zukunft in der Praxis stoßen wird. **Links**: - [offizielles Camel K Github-Repo mit Beispielen](https://github.com/apache/camel-k-examples) **Kategorien:** Cloud, Development, Integration **Schlagwörter:** Camel, Camel K, Knative, Kubernetes, OpenShift, Quarkus, Serverless --- ### [Microframework Quarkus - ein erster Einblick](https://thecattlecrew.net/2021/03/26/microframework-quarkus-ein-erster-einblick/) **Published:** März 26, 2021 **Author:** Maximilian Vogel **Content:** In diesem Blog Beitrag geben wir einen kurzen Einblick in das Java-Microframework Quarkus. ![Quarkus has a logo](https://thecattlecrew.net/wp-content/uploads/2022/07/quarkus_blogpost_formallogo.png) Quarkus ist ein Open Source Projekt das unter einer Apache License Version 2.0 veröffentlicht wurde und von Red Hat mitentwickelt wird. Quarkus verfolgt eine „container first“ Philosophie und unterstützt daher eine native Kompilierung die speziell für Container optimiert wird, diese ist aber vollkommen optional. Hierfür wird GraalVM verwendet, welche native Java executables ausführen kann. Diese starten wesentlich schneller und benötigen zusätzlich deutlich weniger Speicher als eine herkömmliche JVM. Aufgrund dessen eignet sich Quarkus ausgezeichnet für Servless-, Cloud- und Kubernetes-Plattformen. Des Weiteren unterstützt Quarkus MicroProfile (aktuell Version 3.3). MicroProfile ist ein Projekt von Eclipse, welches Spezifikationen zur Verfügung stellt mit dem Ziel Enterprise Java Anwendungen für Microservice Architekturen zu standardisieren und zu optimieren. Dies beinhaltet unter anderem verschiedene Mechanismen zur Anwendungskonfiguration, Features zur Verbesserung der Fehlertoleranz, REST Clients, die Erfassung von verschiedenen Metriken und vieles mehr. Quarkus ist außerdem vielfältig konfigurierbar und bietet zahlreiche Erweiterungen, wodurch Quarkus in seiner Funktionalität auch mächtigeren Java-Frameworks in nichts nachsteht. ### Erstellung eines Quarkus Projekts Ein Quarkus Projekt kann sowohl mit Maven als auch Gradle erstellt werden. In diesem Beitrag beziehen wir uns immer auf Gradle, dies macht aber für die Anwendung keine großen Unterschiede. Ein neues Projekt kann einfach über ein beliebiges Terminal erstellt werden, dafür muss beispielsweise folgender Befehl ausgeführt werden: ``` mvn io.quarkus:quarkus-maven-plugin:1.12.2.Final:create \ -DprojectGroupId= \ -DprojectArtifactId= \ -DprojectVersion= \ -DclassName="" \ -Dextensions="resteasy,resteasy-jackson" \ -DbuildTool=gradle ``` Dies initialisiert ein Projekt mit dem angegebenen „buildTool“, in diesem Fall Gradle und mit den angegebenen Extensions, hier „resteasy“ und „resteasy-jackson“. Eine andere Alternative ist das Projekt via zu erstellen. Hier hat man eine ausführliche Übersicht über alle vorhandenen Extensions und kann diese individuell für das zu erstellende Projekt auswählen. Nach dem ausführen des Befehls erhalten wir ein Projekt mit der folgenden Struktur: [![](https://thecattlecrew.net/wp-content/uploads/2021/03/folder-structure.png)](https://thecattlecrew.net/wp-content/uploads/2021/03/folder-structure.png) Abb. 1: Dateistruktur nach dem Anlegen eines Projekts. Diese beeinhaltet neben dem source code in „src/main/java“ auch standardmäßig verschiedene Dockerfiles. Diese sind folgende: - Dockerfile.jvm: baut das JVM kompatible Image der Anwendung - Dockerfile.legacy-jar: ein legacy Dockerfile, welches ebenfalls ein JVM kompatibles Image baut, jedoch mit womöglich langsamerer boot time - Dockerfile.native: baut das native Image, welches für GraalVM verwendet werden kann (ohne JVM) - Dockerfile.native-distroless: baut ebenfalls ein natives Image, jedoch zusätzlich noch distroless, also ohne eigenes Betriebssystem Hier ist also sofort der „container first“ Ansatz sichtbar. Des Weiteren wird auch gleich für die Tests ein separates „native-test“ package generiert. Zusätzlich werden die „application.properties“, welche im Grunde ähnlich der „application.properties“ in Spring Boot sind und die grundlegende Gradle Projektstruktur erzeugt. ### Dependency Injection Quarkus ist ein MicroProfile-kompatibles Framework, welches für Dependency Injection(DI) den JEE-Standard „Contexts and Dependency Injection for Java 2.0“ verwendet. Es ist ebenfalls möglich via Extension Spring DI zu verwenden. Wenn man rein native Anwendungen mit Quarkus entwickeln will muss man bei DI jedoch aufpassen, da hier intern häufig Reflections beim zugriff auf private Attribute verwendet werden. Dies muss für GraalVM explizit kenntlich gemacht werden. ### Extensions Quarkus Anwendungen sind sehr leicht via Extensions erweiterbar. Dies ist wieder einfach über den Befehl: ``` ./gradlew addExtension --extensions="" ``` möglich. Alternativ kann auch einfach die gewünschte Extension in der „build.gradle“ Datei des Projekts unter den dependencies ergänzt werden. Obwohl Quarkus noch relativ jung ist gibt es bereits zahlreiche Extensions. Darunter unter anderem Unterstützung von Kubernetes, OpenApi, ApacheCamel, Hibernate/Panache, HashiCorp Vault, zahlreiche Datenbanken und vieles mehr. ### Konfiguration Die Konfiguration einer Quarkus Anwendung erfolgt wie zuvor schon erwähnt über die „application.properties“. [![](https://thecattlecrew.net/wp-content/uploads/2021/03/applicationProperties.png)](https://thecattlecrew.net/wp-content/uploads/2021/03/applicationProperties.png) Abb. 2: Beispiel einer application.properties Datei Quarkus bietet standardmäßig die drei Konfigurations Profile test, dev und prod an. Die Variablen für ein spezielles Profil können einfach mit „%{profile}.config.key=value“ definiert werden. Das jeweilige Profil kann dann wiederum einfach über die environment Variable QUARKUS\_PROFILE= aktiviert werden. Desweiteren können alle Variablen in den „application.properties“ mit Environment Variablen der jeweiligen Umgebung überschrieben werden. Dafür müssen diese lediglich in einem bestimmten Format gesetzt werden. Ein kleines Beispiel zu dem Code aus Abbildung 2. Um die Variable „quarkus.datasource.jdbc.url“ zu überschreiben, muss lediglich in der Umgebung die Environment Variable ``` QUARKUS_DATASOURCE_JDBC_URL= ``` gesetzt werden. Also jeweils der Name der Variable groß geschrieben und mit Unterstrich statt Punkt verküpft. Dies ist sehr praktisch und erleichtert eine umgebungsspezifische Konfiguration, ohne Environment Variablen in den „application.properties“ mehrfach für verschiedene Umgebungen zu definieren. ### Fehlertoleranz Quarkus bietet eine Implementierung der MicroProfile Fault Tolerance Spezifikation (Extension:“smallrye-fault-tolerance“). Dies ermöglicht unter anderem das einfache Hinzufügen der folgenden Mechanismen.: - Resiliency Retries: bei fehlgeschlagenen Requests wird maxRetries mal versucht die Schnittstelle erneut aufzurufen. Beispiel: ``` @GET @Retry(maxRetries = 4) public List employees(){...} ``` - Resiliency Timeouts: fügt dem Endpoint einen Timeout hinzu, sobald dieser abgelaufen ist wird der Zugriff auf die externe Resource abgebrochen. Vor allem bei optionalen Inhalten ist dies sinnvoll. ``` @GET @Path("/recommendations") @Timeout(250) public List recommendations(){...} ``` - Resiliency Fallbacks: nach einem bestimmten Timeout wird die angegebene Fallback Methode aufgerufen. ``` @Fallback(fallbackMethod = "fallbackRecommendations") public List recommendations(){...} ``` - Resiliency Circuit Breaker: Kann die Anzahl der Fehler die im System auftreten limitieren. Wenn bestimmte Methoden Aurufe zu häufig fehlschlagen kann der circuit breaker für eine bestimmte Zeit Anfragen blockieren um das System wieder in einen stabileren Zuständ zu bringen. Die annotierten Parameter können sogar zur Laufzeit über die „application.properties“ geändert werden. Zum Beispiel: ``` org.acme.EmployeeResource/employees/Retry/maxRetries=6 ``` ### Kubernetes Mit den Extensions „kubernetes“ und „jib“ wird mit jedem build auch ein container image mit jib gebaut. Des Weiteren bietet Quarkus zahlreiche Konfigurationsparameter für die so erstellten images an. Hier können beispielsweise über die „application.properties“ image group, name und tag konfiguriert werden. Ebenso ist es möglich environment variablen des images zu konfigurieren und secretes, sowie volumes zu verwalten. ### Reactive und Vert.x Quarkus basiert auf Vert.x, eine Toolbox für reaktive Anwendungen, welche intern von Quarkus für fast alle netzwerkbezogenen Features verwendet wird aber nach außen kaum sichtbar ist. Dabei wird der Vert.x Event Bus verwendet, um asynchrone Nachrichten zwischen verschiedene Komponenten und weiteren Clients zu verwalten. Um den reaktiven Ansatz zu verdeutlich schauen wir uns ein kurzes Beispiel an in dem die reaktive und die imperative Ausführung eines HTTP Request verglichen werden. Abbildung 3 zeigt dabei den Workflow durch Vert.x bei einem Http Request an Quarkus. [![](https://thecattlecrew.net/wp-content/uploads/2021/03/quarkusReactive.png)](https://thecattlecrew.net/wp-content/uploads/2021/03/quarkusReactive.png) Abb. 3: Workflow mit Vert.x (Quelle: https://quarkus.io/guides/getting-started-reactive) Der Vert.x Server ist dabei in Quarkus eingebettet und leitet die Anfragen entsprechend weiter. Dabei kann der Applikationscode sowohl imperativ (synchron) als auch reaktiv (asynchron) sein. Aufgrund dessen verwendet Vert.x entweder einen normalen synchronen worker Thread, der blockiert bis die Anfrage vollständig ausgeführt und abgearbeitet wurde oder einen asynchronen I/O Thread, der während der Wartezeit bei der Anfrage für andere Prozesse zur Verfügung steht. Die I/O Threads ermöglichen dadurch eine deutlich bessere Ressourcen Auslastung, da Threads deutlich kürzer blockiert werden. Dies kann man sich gut anhand einer Datenbankabfrage über das Netzwerk vorstellen, während man die volle Zeit auf das Ergebnis wartet können in der Zwischenzeit andere Anfragen bearbeitet werden. Erst wenn die Antwort erhalten wird springt der I/O Thread zurück zur ursprünglichen Anfrage und gibt die Antwort zurück an den Client. Um diese Vorteile zu nutzen muss der Code nicht blockierend geschrieben sein. Dafür bietet Quarkus die Unterstützung verschiedener reaktiver Bibiliotheken wie Mutiny an, auf die wir hier aber nicht näher eingehen. ### Fazit Die Landschaft der Java Frameworks und Microframeworks ist vielfältig und im ständigen Wandel. Quarkus schafft es aber hier deutlich hervorzustechen. Quarkus verwendet MicroProfile und verwendet eine reaktive Anwendungs-Engine, die die Vorteile des imperativen und reaktiven Programmierens vereint. Dazu ist Quarkus außerordentlich entwicklerfreundlich mit vielfältigen Konfigurationsmöglichkeiten und einfacher Erweiterbarkeit. Quarkus erscheint besonders interessant, wenn es um die Entwicklung Cloud nativer Anwendungen geht, da Quarkus ganz speziell hierfür ausgerichtete Features bereitstellt. Wenn die Images nativ kompiliert und mit GraalVM ausgeführt werden bietet Quarkus deutlich schnellere Startup Zeiten, sowie eine deutlich niedrigere Arbeitsspeicher Auslastung als beispielsweise das weit verbreitete Java-Framework Spring Boot. Wobei dieses aktuell auch seine erste Beta für einen Native Modus gestartet hat. Ein Nachteil des Ganzen ist aber eine etwas höhere Anfragelatenz, dies muss für den konkreten Anwendungszweck daher natürlich immer abgewogen werden. Wir sind davon überzeugt, dass Quarkus die Chance hat der Platzhirsch unter den Java Frameworks zu werden. Quellen: - - - - - - - - **Kategorien:** Cloud, Development **Schlagwörter:** cloud native, Frameworks, Java, Quarkus --- ### [Service Integration mit Kuma](https://thecattlecrew.net/2021/07/23/service-integration/) **Published:** Juli 23, 2021 **Author:** thecattlecrew **Content:** ## Service Mesh hilft, Cloud-native Applikationen leichter zu händeln. Cloud-native Anwendungen sind oft als eine Sammlung unabhängiger und lose gekoppelter Dienste organisiert, das bringt Flexibilität und Agilität bei sich ändernden Geschäftsanforderungen. Gleichzeitig werden Anwendungslaufzeiten hybrid, so dass wir mit verteilten Cloud- und On-Prem-Workloads umgehen müssen. Dies macht die Welt aus Sicht der Konnektivität noch komplexer, da die Dienste, die eine Anwendung bilden, miteinander und mit bereits vorhandenen monolithischen Anwendungen sowohl vor Ort als auch in der Cloud interagieren müssen. #### Netzwerkkommunikation im Griff behalten Wie wir sehen, ist eine Menge Netzwerkkommunikation involviert, und diese muss auf sichere, zuverlässige und nachvollziehbare Weise erfolgen. Da Effizienz und Agilität heutzutage kritische Faktoren sind, brauchen wir neue, moderne Ansätze, die es den Entwicklungsteams erlauben, autonom zu agieren und sich gleichzeitig auf die wichtigen Dinge zu konzentrieren. Ein Service Mesh kann helfen, diese Herausforderungen im Bereich Sicherheit, Konnektivität und Beobachtbarkeit transparent zu adressieren, indem die Verantwortung von der Anwendungs- auf die Infrastrukturebene verlagert wird. #### Effizienter und unabhängiger entwickeln Gleichzeitig bietet ein Service Mesh den Entwicklungsteams einen Self-Service-Pfad, um die jeweiligen Anforderungen effizienter umzusetzen. Dies bedeutet eine Erweiterung der traditionellen Ansätze zur Handhabung von Konnektivität, bei denen der Datenverkehr durch Firewall-Regeln eingeschränkt wird und explizites Wissen eines Netzwerkteams erforderlich ist. Dies ermöglicht eine effizientere und flexiblere Umsetzung von Geschäftsanforderungen in Bezug auf Konnektivität und Zuverlässigkeit. ## Video: „Service integration made easy with Kuma“ Das Service Mesh #Kuma bietet einen einfachen Einstieg. Unser Chief Architect Sven Bernhardt kennt die Plattform gut und stellte sie im Juli 2021 in einer Meetup-Session vor. Es lohnt sich in die Aufzeichnung reinzuschauen. Ihr erfahrt, warum der Einstieg mit Kuma so einfach ist, und wie sich Kuma von anderen Service-Mesh-Implementierungen unterscheidet. https://www.youtube.com/watch?v=f3GeuKzYrsA Die **Slides** zum Meetup sind ebenfalls verfügbar: **Lesetipp**: Was können Service Meshes wirklich? – Ein Artikel von Sven Bernhardt im Objekt Spektrum: – – – **Wie kann OPITZ CONSULTING bei diesem Thema weiterhelfen?** – – – Mithilfe von Cloud-nativen Lösungen können Unternehmen schneller und flexibler auf neue Anforderungen reagieren. Doch die Lösungen bringen auch eine neue Komplexität mit, die nicht zu unterschätzen ist. Hier kommen Service Meshs ins Spiel. Das bieten wir: - Architekturberatung - Plattformauswahl - Technologie evaluieren - Service-Mesh-Einführung - DevOps-Integration - Training/Coaching - Wartung und Weiterentwicklung *Mehr erfahren:* Service Meshes mit OPITZ CONSULTING: https://www.opitz-consulting.com/kompetenz/service-mesh-ein-boost-fuer-die-cloud-native-app-entwicklung Was kann der Service Mesh von Kong: Mehr zum Theme „IT-Systeme integrieren“: **Kategorien:** Cloud, Integration **Schlagwörter:** Kong, Kuma, Microservices, Service Mesh, Softwarenentwicklung --- ### [Kubernetes and Cloud-native Associate Exam (KCNA)](https://thecattlecrew.net/2022/01/03/kubernetes-and-cloud-native-associate-exam-kcna/) **Published:** Januar 3, 2022 **Author:** Torsten Winterberg **Content:** ![KCNA: Kubernetes and Cloud Native Associate](https://thecattlecrew.net/wp-content/uploads/2022/07/KCNA_badge.png) Kubernetes and cloud-native concepts are key to modern software development. New IT projects typically set these topics very high on their wish list. Of course, there are lots of projects out there that still live on old technology stacks and/or can’t use the benefits of todays containerized world. At the same time, we see more and more companies running software modernization projects or modernizing their digital products. This leads to an increasing demand for professional software developers with deep knowledge in Kubernetes and Cloud-native technology and concepts. The Linux Foundation has a great set of trainings and exams to address this demand, e.g.: - Kubernetes and Cloud Native Associate (KCNA): - Certified Kubernetes Administrator (CKA) - Certified Kubernetes Application Developer (CKAD) - Certified Kubernetes Security Specialist (CKS) The Kubernetes and Cloud Native Associate (KCNA) is an entry kind of exam that demonstrates a user’s foundational knowledge and skills in Kubernetes and the wider cloud native ecosystem. Well, that sounded interesting and so I booked a Black Friday/Christmas bundle for the KCNA exam and the according training to get an impression of the content. The official name of the according training is KUBERNETES AND CLOUD NATIVE ESSENTIALS (LFS250). Officially, it should take about 12-15 hours to go through the material of LFS250. What was my impression: well, LFS250 presents a very, very compact introduction into kubernetes and cloud native. There’s not really much material and it took me only 2.7 hours for a first complete run through the whole stuff. So, is the worth the money? Yes. You get into touch with a lot of the basic concepts and tools that play key roles in modern software development and you learn vocabulary like: kubernetes, container, pod, Deployment, ReplicaSet, containerd, CRI-O, Helm, Jaeger, Prometheus, GitOps, etc. Explanations are short, but to the point. No fluff around defining the topics. There are short demos included and a lot of good hints for further readings. All in all, I can recommend this LFS250 introduction level course if you are new to kubernetes and cloud-native world. As a developer, you definitely will go to other trainings to really learn the tooling and concepts. For a first overview, it’s great material. As a manager who has to work in modern scenarios, it’s absolutely the right level. You get all the concepts, get demos, get some hands-on if needed and with that you have the basic knowledge to talk to the real developers… :-). What about the KCNA exam then? Is the material in LFS250 good enough to pass? The answers is yes: LFS250 is sufficient, I was able to get 84% in the first run. The exam itself is a typical one. You have to identify yourself, have a clean desk, show your room to the operator, kill a lot of „bad“ processes on your machine (took me 20 minutes) and then hope for a stable internet connection. I had three full crashes of the PSI secure browser, which kicked me out of the exam. Fortunately, no data was lost, and I was able to continue. You have 90 minutes for the exam and 60 multiple choice questions. Took me about 45 minutes for a first complete run over all questions and then some of the rest of the time to go over the questions again. They have the typical multiple-choice quality: some are easy, some need a bit thinking, some were not part of LFS250 (but can be answered with a good feeling), some need making 50:50 choices, because context is not fully clear. So, preparing with LFS250 is sufficient, if you do the quick tests with eyes open (and maybe two times) and maybe use the good hints for further study depending on your current level of knowledge. Conclusion: The KCNA exam together with LFS250 essential training is a must-have combination for all IT managers and maybe a good (very first) first contact for developers with the world of Kubernetes and Cloud-native. **Kategorien:** Automation, Cloud, DevOps **Schlagwörter:** cloud native, KCNA, Kubernetes --- ### [About APIs and the central nervous system - a recap of Kong Summit 2022](https://thecattlecrew.net/2022/10/10/of-apis-and-the-central-nervous-system-a-recap-of-kong-summit-2022/) **Published:** Oktober 10, 2022 **Author:** Sven Bernhardt **Content:** Kong Summit 2022 is nearly two weeks ago. After fighting the jet lag successfully and getting back into catching up with daily business, time to step back and just reflect about learnings as well as news and noteworthy from the conference. In advance I must say: it was awesome, absolutely worth and a blast being there! # Facts around Kong Summit Kong Summit was a tow days conference in the beautiful city of San Francisco and took place at the Palace Hotel, which is just a 15 minutes walk away from Kong HQ. Almost 500 attendees from all over the globe came to hear great sessions and see cool demos from 75 speakers. ![OC Kong Champions at Kong Summit](https://thecattlecrew.net/wp-content/uploads/2022/10/IMG_1033-225x300.jpg) From OPITZ CONSULTING Fabian Hardt and me – both of us are members of the [Kong Champions](https://konghq.com/kong-champions) community – attended the conference, where we delivered the following sessions: - [Torch the Light: Implementing Observability for Microservice Architectures](https://www.slideshare.net/bernhasv/torch-the-light-implementing-observability-for-microservice-architectures) (Sven Bernhardt) - [How Service Mesh Fits into the Modern Data Stack](https://www.slideshare.net/FabianHardt/how-service-mesh-fits-into-the-modern-data-stack) (Fabian Hardt) To see all topics that where touched by the session, please have a look to the [full agenda](https://konghq.com/conferences/kong-summit/agenda). # Real-world use cases – Learning from industry leaders One of the most important things when going to conferences is to learn from others, how specific challenges had been addressed with the technologies available. At Kong Summit, we had the opportunity to hear from industry leaders like Mercedes Benz, Ikea, Raiffeisen Bank International and many more how they leverage the power of Kong’s Connectivity platform to solve the challenges they were facing. Just to give an example: Mercedes Benz based their API Management platform on [Kong Open Source Gateway](https://konghq.com/install#kong-community) and are able to manage 1.200 APIs at scale. That’s impressive, especially when taking into account that the number of APIs are supposed to grow constantly. # Platform vision and announcements Kong’s platform consists of different components, where the core elements are: - [Kong API Gateway](https://konghq.com/products/api-gateway-platform) – the world’s mostly downloaded API Gateway - [Insomnia](https://insomnia.rest) – a Collaborative API design platform - [Kong Mesh](https://konghq.com/products/service-mesh-platform) – Enterprise service mesh based on [Kuma](https://kuma.io) - [Kong Konnect](https://konghq.com/products/cloud-api-platform) – SaaS Connectivity platform for multi-cloud environments Using the Kong Connectivity platform allows for managing enterprise connectivity on different levels (edge, app-2-app, in-app) consistently. ## Vision Augusto „Aghi“ Marietti, CEO, President and Co-Founder Kong opens the conference by explaining his vision how the future of enterprise architectures should look like. He used the metaphor of the human brain and its neural network. Speaking of APIs, they form the neural network, as they allow applications to connect and communicate with each other; each single API can be seen as a synapse. Kong Connectivity platform itself forms the central nervous systems that holds everything together and ensures that interactions between the synapses are working reliable without any disturbance. > ?Kicking off [\#KongSummit22](https://twitter.com/hashtag/KongSummit22?src=hash&ref_src=twsrc%5Etfw), our CEO and Co-Founder, Augusto Marietti ([@sonicaghi](https://twitter.com/sonicaghi?ref_src=twsrc%5Etfw)) compares Kong to the central nervous system, as the vital connector ? that helps all functions communicate with each other, and reacts to changes—“Request, Response.” [pic.twitter.com/4MBTygTzkJ](https://t.co/4MBTygTzkJ) > > — Kong Inc. (@thekonginc) [September 28, 2022](https://twitter.com/thekonginc/status/1575161075284295680?ref_src=twsrc%5Etfw) Kong CTO and Co-Founder Marco Palladino reminds us in his opening talk that the value of any API initiative stands and falls with a solid API vision, from which enterprises must work backwards. > ?? Leaders need to be making choices around API decisions by working backward from a vision, especially with APIs touching ALL digital applications and experiences running businesses, says our CTO and Co-Founder, Marco Palladino [@subnetmarco](https://twitter.com/subnetmarco?ref_src=twsrc%5Etfw)[\#KongSummit22](https://twitter.com/hashtag/KongSummit22?src=hash&ref_src=twsrc%5Etfw) [\#APIGateway](https://twitter.com/hashtag/APIGateway?src=hash&ref_src=twsrc%5Etfw) [pic.twitter.com/F6VODQM5uY](https://t.co/F6VODQM5uY) > > — Kong Inc. (@thekonginc) [September 28, 2022](https://twitter.com/thekonginc/status/1575173552365621250?ref_src=twsrc%5Etfw) Marco also points out the relevancy of an [API design-first operating model](https://konghq.com/resources/reports/unlocking-the-api-first-operating-model), which allows to deliver new digital experiences faster and more efficient. A further key learning from the opening talks is that by growing an API ecosystem, enterprises gradually become programmable, which enables a new developer experience that allows for a better developer productivity and hence faster time-2-market. ## Announcements Besides learning about real world use cases and the overall Vision for Kong’s Connectivity platform, new versions and the respective features for the single components were announced. ### Kong Gateway – new major release unveiled With Kong Gateway 3.0 a new major release has been officially announced, which is already general available. As usual for major release, some significant changes has been made under the hood with respect to the overall Gateway architecture. Some of the key enhancements: - **New Router implementation** allowing for better performance while processing a request as well as more optimized expressions for complex routing rules - **In-memory DB (LMDB)** for optimized worker handling, which increases performance and throughput - **Custom plugin ordering** - **FIPS 140-2 compliancy** - **Consistent secure secret storage** across the Gateway and its plugins e.g. using HashiCorp Vault - Support for **WebSockets** and **OpenTelemetry** For further information can be found in the [official announcement blog](https://konghq.com/blog/kong-gateway-3-0) by Michael Heap. With respect to **dynamic plugin ordering**, you can find a detailed explanation on how this works in [Viktor Gamov’s blog post](https://konghq.com/blog/kong-dynamic-plugin-ordering). With respect to Kong Ingress Controller (KIC), the Kubernetes-native way of deploying Kong Gateway, a new **Kong Gateway Operator** for K8s was announced as technical preview. ### Insomnia – improved protocol support For the new release of Insomnia 2022.6.0 the **support for WebSockets** had been announced. This allows users to bi-directional communicate with WebSocket-based APIs. You can read more about it in [this blog post](https://konghq.com/blog/kong-insomnia-2022-6) written by Marco Palladino. As API design-first becomes more critical today, Insomnia should be used at the heart of every API initiative. Consequently, Kong announced an **enterprise tier for Insomnia**, which increases productivity, as through guaranteed SLAs teams will be unblocked faster, and further accelerates the API lifecycle with Kong’s integrations. Furthermore, Marco gave a short sneak into what we can expect down the road for Insomnia in 2023. One of the features, we can expect amongst others is **native API mocking**. I am really excited about all the news and looking forward for more on Insomnia in the future. ### Kong Mesh – Faster and more reliable Kong Mesh is Kong’s Enterprise Service Mesh implementation based on Kuma. Together with Kong Gateway, it forms the backbone of Kong’s Connectivity platform. Same as for Kong Gateway, a **new major version Kong Mesh 2.0** has been announced. The new release can be expected by the end of October and also comes with a significant architectural change, as it will provide support for [eBPF](https://ebpf.io). This will improve the overall Mesh performance by 12% and significantly improves reliability and uptime. Besides that we can also expect **new policies** to manage traffic inside the Mesh. In addition, **support for OpenTelemetry** was announced for Kong Mesh. ### Kong Konnect – rapidly improving SaaS Connectivity platform With Kong Konnect a fully-managed SaaS offering is provided. This means that Kong runs a central Control plane for its customers form that allows for - Distribution and management of Kong Gateway instances to different Clouds as well as to on-prem environments (**Runtime Manager**) - Consistent overview to all Service deployed to all Gateway instances (**Service Hub**) - Central API Registry for Developers to browse through published APIs and register to those (**Developer Portal**) - Monitor API metrics, like throughput, latency, error rate by route, etc. (**API Analytics**) As with many other SaaS solutions, Kong Konnect is evolving rapidly, you can track all changes consistently on the [release notes page in the official documentation](https://docs.konghq.com/konnect/updates/). Some of the major enhancements in the last months are: - **Support for Kong Gateway 3.0** - Introduction of **runtime groups** which allows for securely isolate configuration for sets of runtime instances - **Runtime group dashboard** to manage runtime groups usage across all and individual runtime instances - **Multi-GEO support** (currently US & EU – which is new -, upcoming JP & AU) - **Teams and roles** which enable fine-grained access management, e.g. on a runtime group level - **Custom Reporting** which allows to look at the API metrics from different angles If you wanted to learn more or wanted to have more details, you can also read through Smriti Jaggi’s [announcement blog for Kong Konnect](https://konghq.com/blog/konnect-kong-summit-2022-updates). Besides that, there are many more features on the roadmap for the upcoming months. so stay tuned and have a look to Kong Konnect, if you’re interested. ### Kong Incubator – A look into the Future With [Kong Incubator](https://incubator.konghq.com) Kong launches a landing page, where information about tech previews of features that are currently under development are shared. The community is invited to have a first sneak look into those upcoming features, to play around with them and provide feedback, in case there’s potential for enhancements or bugs. From my opinion this is a great thing for both Kong and the Community, because feedback and ideas can be exchanged at a very early stage and allows for easy adjustments as the products are not into production, but still under development. Currently, we can see the **WASMX support**, the **Kong Gateway Operator for K8s** and **Koko**, which will be the next-level Kong Gateway Control Plane that has been completely rewritten in Go. # Meet with the Kong Champions A highlight for me was to meet with others from the **Kong Champions Community**, which currently has 18 members all over the globe and is growing rapidly. People within this community share the passion for modern software architectures and how challenges can be addressed by using Kong’s products. It was good to learn from each other, to exchange ideas and simply have a good time. Special thanks to Daliya Spasova, the Kong Community Manager responsible for the Champions program, to build such a great valuable community. She also composed a [blog post, how the Kong Champions Community differs from other advocacy programs](https://konghq.com/blog/united-as-one-our-kong-champions-program). ![Kong Champions](https://thecattlecrew.net/wp-content/uploads/2022/10/IMG_2717-300x225.jpg) # Conclusion I already mentioned it in the introduction: Kong Summit had been a blast! I pretty much enjoyed being back in-person, meeting a lot of new, interesting people and chat with them about their daily challenges. This networking capability is what makes conferences so much valuable. It was good to again feel this special conference atmosphere, where the air is filled with energy that gives you so much and motivates to learn new things. This is what I missed so much while doing virtual conferences. From a product perspective, I have to say: Kudos to the Kong team! Its awesome what you guys are doing and how much you appreciate your community. You are not satisfied with the status quo and are constantly working to improve your platform, working backward from a very strong and consistent vision, I am 100% agree with. I already looking forward to next years Kong Summit and all the exciting stuff that Kong bring out in the upcoming months! **Kategorien:** Integration, Tech Events & Networking **Schlagwörter:** API, API design-first, API Management, Insomnia, Kong, Kuma, Service Mesh --- ### [Overcome 4h runtime problem with Ansible AWX](https://thecattlecrew.net/2022/12/06/overcome-4h-runtime-problem-with-ansible-awx/) **Published:** Dezember 6, 2022 **Author:** Bartlomiej Sowa **Excerpt:** Ansible AWX is a great product. Recent change to k8s architecture had some significant complexity implications, but i was really hit hard once finding out, that no job template could run longer than 4 hours without running into a generic failure. Here I would like to describe how to workaround this problem until the issue is finally fixed. **Content:** Ansible AWX is a great product. Recent change to k8s architecture had some significant complexity implications, but i was really hit hard once finding out, that **no job template could run longer than 4 hours** without running into a generic failure. Here I would like to describe how to workaround this problem until the issue is finally fixed. # Problem cause The problem as usually lies between 3rd party layers, that changing to k8s stack has had to include. What is the worst with this is – no side felt responsible for dealing with it and therefore there were several issues opened for so many diverse projects, and apparently none of them (well except for one, but this is very fresh) got solved. Here some of them: - – opened 2022-02-24 – **main ticket** - – predecessor, opened 1 month earlier and closed without resolution… - – AWX Operator issue, opened even earlier, Oct 2021, closed recently as duplicate to main ticket - – issue for CRI, closed but main problem seems still present - – same cause… - – this time issue for k3s Just to summarize the problem – when AWX launches a Job Template, it fires a dedicated k8s pod to perform the job. It attaches to the pod and catches stdout output in order to be able to streeam events in quasi realtime, so that you (or anyone else) can track the progress on AWX console web page. The problem is when this pod runs longer than exactly 4 hours. As i [have been able to find out](https://github.com/ansible/awx/issues/11805#issuecomment-1249169747) the 4h limit got indeed hardcoded in kubelet. It affects the maximum runtime of a HTTP session attaching to a k8s pod. After this timeout, the connection that fetched job output will be just torn down no matter what. And the problem with AWX was – there seemed to be no mechanism implemented to re-connect to the running pod. Instead, there was added a reaper task, that just terminated pods that got out of control and the Job Template after getting disconnected from the automation pod running ansible-playbook got set to Failed state. Implementing this mechanism is not a trivial thing, considering the way pods are pooled, dispatched and managed by AWX itself. The [4h limit enforcement by kubelet](https://github.com/kubernetes/kubernetes/issues/104595) seems appropriate due to [security concerns](https://github.com/containerd/cri/issues/1057#issue-414329803) (so that no one can stay attached to the console of a running pod forever). The fix is therefore needed on AWX side. Before we get to the permanent fix, I would like to present a workaround that might be used to overcome the limitation. # Workaround with Workflow Job Templates As a single Job Template has not to exceed 4 hours of runtime, one might think of cutting a long running AWX Job into smaller ones, and execute them in sequence one after another by using Workflow Job Template. Cool thing is, that Workflow Job Templates are not affected by the limit, as they do not launch dedicated k8s pods. Only Job Templates do. ## Cutting single Job Template into fragments You do not need to write multiple playbook files and define multiple Job Templates to achieve this. By using *tags* you can run a Job Template in a selective way, executing just some of its tasks. This is exactly what we will do here. Let us consider this sample playbook, that will hit the 4h problem: ``` --- - hosts: localhost name: Test 4h failure tasks:   - name: task executing 2 hours     ansible.builtin.pause:       minutes: 120   - name: task executing 2 hours     ansible.builtin.pause:       minutes: 120   - name: task executing 2 hours     ansible.builtin.pause:         minutes: 120 ``` As you see, this playbook includes 3 tasks, that will run 2 hours each. This playbook will fail if executed by one Job Template. To work around the problem, you need to group tasks in blocks, for which it is guaranteed, that no block will run longer than 4 hours and give those tasks appropriate tags like step1, step2 and so on: ``` --- - hosts: localhost name: Test 4h failure tasks:   - name: task executing 2 hours tags: stage1     ansible.builtin.pause:       minutes: 120   - name: task executing 2 hours  tags: stage2     ansible.builtin.pause:       minutes: 120   - name: task executing 2 hours  tags: stage3     ansible.builtin.pause:         minutes: 120 ``` Then configure the Job Template, so that tags will be prompted on Launch: ![](https://thecattlecrew.net/wp-content/uploads/2022/12/prompt-tags-on-launch.png)Then, define a workflow template that executes the same Job Template 3 times, but for each run use different tag – first with stage1, then stage2 and last one – stage3. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/add-wjt-node.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/12/wjt-workaround.png) Running this Workflow template will effectively execute all those tasks, with total runtime exceeding 4 hours without any problem! ## Single long running Task The solution given above Solves some of the problems, but will not allow a **single Ansible task** to run over 4 hours. But there is a solution for that as well, by using Ansynchronous tasks and the *ansible.builtin.async\_status* Ansible module. Define the tasks like that: ```   - name: Start task running longer than 4h     ansible.builtin.shell:       cmd: sleep 5h     async: 86400 # 24h hard timeout value, not needed but recommended     poll: 0      # do not poll by the task, we will poll status with following task     register: long_task     tags: stage1 - name: Wait for task up to 3h   ansible.builtin.async_status:     jid: "{{ long_task.ansible_job_id }}"   register: long_task_result   until: long_task_result.finished   delay: 600   # re-check every 10 minutes   retries: 18 # total 3h waiting time (18 * 10 minutes) failed_when: false # do not fail if not finished in 3h   tags: stage1 - name: Store long_task Artifacts for later step ansible.builtin.set_stats: data: long_task: "{{ long_task }}" long_task_result: "{{ long_task_result }}" aggregate: false tags: stage1 - name: Wait for task ANOTHER 3h in next Job Template   ansible.builtin.async_status:     jid: "{{ long_task.ansible_job_id }}"   register: long_task_result2 # should the task finish in first wait round skip this one:   when: not long_task_result.finished until: long_task_result2.finished   delay: 600   # re-check every 10 minutes   retries: 18 # total 3h waiting time (18 * 10 minutes)   tags: stage2 ``` This may seem a bit complex, but most important thing is **pool: 0** and **async: true** which starts the Task kind of in background without waiting for it to finish. It is also important to capture the result od this task, as it has a job-id that allows **async\_status** module to query the job progress. Ansible immediately proceeds to the next task. Next task uses the already mentioned **async\_status** task which needs a job-id to check. Once the job finishes, its full output will be reported as a result od this check-task. So if the sleep command would produce any stdout, it would be in **long\_task\_result**, not **long\_task**. **long\_task** will not be updated once fired. Now as the task itself is running longer than 3 hours, first round of of wait commands will typically not be sufficient. Next wait attempts for this job to finish need to be done in separate Job Template (separate step of Workflow Job Template). In order to be able to use async\_status module you however need to get the job-id. Now this is really important – each step is to be considered as an individual playbook run, cut to the tasks that are having proper tag set. So therefore it konws nothing about variables like **long\_task**!!! You will have to use the **set\_stats** module to produce Artefacts, that will be passed to next Workflow Job as input external variables. This is exactly the purpose of passing those 2 variables. First one gives the job-id for async\_status to check on. Now the small problem here is, that once **async\_status** finds out the job ended, it REMOVES all job progress data from system. Another execution of async\_status with the same jid will therefore fail. In order to overcome this, we also pass the last value of **long\_task\_result** to next step and use when condition not to execute the module at all once it has really finished. This will override **long\_task\_result** so if you care about the original job output, then you should consider using other variable for capturing the output, as we did here with **long\_task\_result2.** Now the job will for sure finish here within next 3h, and the overall Workflow will be finished successfully ## Skip known wait duration Considering that you know an Async task will for sure run at least x minutes or hours, you may want to wait a given time before proceeding to next stage tag/Job Template. Sadly, Workflow Job Templates do not allow a „Wait“ node to be added. But you can get around this, by adding a dummy Approval Node, with a configured timeout. ![](https://thecattlecrew.net/wp-content/uploads/2022/12/wait-node.png) Be sure to choose Run Type „Always“ for the following node, as when the timeout hits, this Workflow node might be counted as Failed. We want to proceed anyway. This way you can can pass just the original async variable and have just one task waiting for the command output, eliminating all the problems with multiple async_status checks… # Final solution It seems that just recently there are [some developments](https://github.com/ansible/awx/issues/11805#issuecomment-1335555613) and maybe the really long present issue will finally come to an end. See the linked main Issue for progress reports. If you hovewer for any reason possible cannot update to current version that might have the issue permanently fixed, I hope this article will help you to overcome this problem in another way. You may also consider this way of passing variables between steps interesting. Thanks if you got till this point, as this got a pretty long one… **Kategorien:** Cloud, DevOps, Tools & Methoden **Schlagwörter:** ansible, awx, English, workaround --- ### [Kloning von PDBs mit Reflinks im Filesystem](https://thecattlecrew.net/2021/05/26/kloning-von-pdbs-mit-reflinks-im-filesystem/) **Published:** Mai 26, 2021 **Author:** Thorsten Bruhns **Content:** Nachfolgend möchte ich eine Möglichkeit aufzeigen, wie man das Kloning von PDBs im Filesystem auch ohne Multitenant-Option durchaus praktisch nutzen kann. Der Beitrag wird zudem aufzeigen, was Reflinks sind und wofür man sie gut einsetzen kann. Somit ist der Beitrag nicht nur für den Einsatz beim Kloning von PDBs geeignet. ## Wie entstand die Idee? Die Idee entstand im Rahmen eines Projektkontextes und basiert im wesentlich auf [PDB Snapshot Cloning Additional Platform Support](https://docs.oracle.com/database/121/ADMIN/cdb_plug.htm#ADMIN13583). Die Option steht in der SE2 und EE auch ohne lizenzierter Multitenant-Option zur Verfügung. Ein großer Nachteil der Funktionalität ist, das die Klonquelle read only sein muß, solange noch eine abhängige PDB existiert. Damit ist die Funktionalität ohne lizenzierte Multitenant-Option praktisch unbrauchbar, weil mindestens 2 PDBs für einen Klon benötigt werden. Dazu kommt, das die Quelle erst gelöscht werden kann, wenn die abhängigen Klone entfernt wurden. Das sieht auf dem 1. Blick interessant aus, ist in der Praxis jedoch so sehr eingeschränkt, so das ich die Funktionalität als unbrauchbar empfinde. Aus den Tests mit der Option entstand dann die Lösung, die ich im folgenden Blogpost näher beschreiben möchte. ## Pluggable Database find ich gut Oracle zwingt uns ab 21c zur Nutzung von Pluggable Databases – ob wir es wollen oder nicht. Ich persönlich bin ein großer Freund der PDBs, weil sich damit viele neue Möglichkeiten eröffnen, die in der non CDB-Architektur nicht zur Verfügung stehen. Jeder DBA sollte so schnell wie möglich mit PDBs beginnen, damit der spätere Zwang nicht zu heftig wird. Der Einsatz von Reflinks ist nicht auf PDBs beschränkt. Es wird später noch einen weitere Blogpost geben, wo ich die Lösung in einer anderen Architektur zeigen möchte. Hintergrund ist, das die unten beschriebenen Einschränkungen für einige Szenarien zu hart sind und schnell der Wunsch nach Alternativen bzw. Erweiterungen aukommen dürfte. ## Voraussetzungen Bevor wir in die Lösung einsteigen, möchte ich vorab die Voraussetzungen beschreiben. - Linux mit aktivem reflink-Support in XFS OL7/OL8 mit aktuellem UEK oder aktuelle Version von RHEL8. In RHEL7 gibt es Reflinks für XFS noch nicht! - ext4 bietet keinen reflink-Support! - reflink muß während mkfs.xfs aktiviert sein Nachträglich läßt sich die Option nicht aktuvieren. - Quell- und Ziel-PDB müssen im gleichen Filesystem liegen Reflinks funktionieren nur, wenn die Dateien im glecihen Filesystem liegen. Damit ist auch klar, das Quelle und Ziel auf dem gleichen Host sein müssen. - Quell-PDB muß temporär gelöscht werden Damit funktuioniert das Verfahren leider nicht online. Für ein schnelles Kloning in einer Entwicklung ist es dennoch eine interessante Option. - Archivelogmodus nicht erforderlich Ist gerade im Entwicklungsumfeld häufig deaktiviert. - Backup/Recovery im Auge behalten Eine duplizierte PDB wird beim Restore/Recovery ihre Deduplikation verlieren. Wenn möglich, die PDB beim Backup ausschleßen und aus der Quelle neu erstellen. ## Wann sollten Reflinks nicht verwendet werden? - Storage mit HDDs Der verwendete Storge sollte keine Spindeln enthalten. SSDs o.ä. sind Pflicht, weil die Reflinks in den Dateien viele random Reads zur Folge haben. Das kann bei HDDs zu großen Performance-Problemen führen - viele Full-Table-Scans Wenn viele Full-Table-Scans in der Datenbank zu erwarten sind, dann führen die Reflinks zu random reads im Storage. Das kann durchaus Performance-Probleme mit sich bringen, weshalb ich in entsprechenden Systemen davon abraten würde bzw. man damit rechnen sollte, das die IO-Last spürbar steigen wird. - nicht auf produktiven Maschinen Ich würde das nur auf Standby-Servern einsetzen. Wie man sowas mit Hilfe einer Standby-Datenbank lösen kann, wird in einem weiteren Blogpost gezeigt werden. ## Was sind Reflinks? Sie lassen sich schnell erzeugen, weil im Filesystem lediglich ein Eintrag im Verzeichnis erzeugt und bei späteren Änderungen einfach neue Blöcke belegt und in der Blockbelegungstabelle der Datei entsprecend verzweigt werden. Die Möglichkeit von Reflink-Kopien gibt es schon seit vielen Jahren im Linuxkernel. Beim Filesystemsupport sieht es noch etwas mager aus. Von den gängigen Filesystemen in der Oraclewelt sind mir folgende mit Reflink-Support bekannt: - BTRFS Nicht für Datafiles empfohlen! - XFS - OCFS - ACFS - dNFS Reflinks lassen sich sehr einfach erzeugen, da der cp-Befehl die notwendige Option enthält. `cp --reflink ` ## XFS Filesystem mit Reflink-Support anlegen und mounten Nachfolgend ein Beispiel, wie das Filesystem angelegt werden muß. Bitte beachten, das neben reflink=1 zusätzlich der crc-Support aktiviert werden muß. Beim späteren mounten ist nichts extra zu beachten, da der Kernel die Optionen automatisch aktiviert. `[root@localhost ~]# mkfs.xfs -m reflink=1 /dev/testvg/test` reflink not supported without CRC support `[root@localhost ~]# mkfs.xfs -m reflink=1 -m crc=1 /dev/testvg/test` ``` ``` meta-data=/dev/testvg/test isize=512 agcount=4, agsize=12800 blks `````` = sectsz=512 attr=2, projid32bit=1 `````` = crc=1 finobt=1, sparse=1, rmapbt=0 `````` = reflink=1 `````` data = bsize=4096 blocks=51200, imaxpct=25 `````` = sunit=0 swidth=0 blks `````` naming =version 2 bsize=4096 ascii-ci=0, ftype=1 `````` log =internal log bsize=4096 blocks=1368, version=2 `````` = sectsz=512 sunit=0 blks, lazy-count=1 `````` realtime =none extsz=4096 blocks=0, rtextents=0 ``` ``` ## Oracle Pluggable Database und Reflinks in XFS – wie geht das? Ich nutze [ansible-oracle](https://github.com/opitzconsulting/ansible-oracle), um eine Beispielumgebung zu bauen. Dort habe ich ein [Inventory](https://github.com/Rendanic/ansible-oracle-config/blob/master/inventory/dbfs/hosts.yml), das alle notwendigen Einstellungen enthält. (Einen entpsrechenden Blog-Beitrag zum Thema ansible-oracle + Setup wird es bald geben.) Bevor wir nun in die Details einsteigen, noch ein paar Informationen was genau passieren wird: - Quell-PDB: close + open read only open read only, damit garantiert werden kann, das während des Kloning keine strukturellen Änderungen möglich sind. - spool ‚cp -reflink Hier wird mittels spool + Select in SQLPlus eine SQL-Datei mit ‚cp –reflik‘ erzeugt, das später ausgeführt wird. Wichtig! Die Reflinks dürfen erst erzeugt werden, wenn die Quell-PDB geschlossen und das zugehörige XML-File erzeugt wurde. - Quell-PDB: close - Quell-PDB: unplug into “ - Quell-PDB: drop keep datafiles Die PDB muß gelöscht werden, damit der spätere Plugin wieder möglich ist. - kopiere Quell-Datendateien mittels cp –eflink in temporäres reflink-Verzeichnis Jetzt werden die Reflinks der Datendateien der Quell-DB für die Klon-DB erzeugt. - Quell-PDB: create pluggable database Quell-PDB using “ nocopy Nachdem die Datendateien kopiert wurden, kann die Quell-PDB wieder angelegt werden. - Quell-PDB: open read write + save state - Ziel-PDB: create pluggable database using “ move Nun können wir die Ziel-PDB erzeugen. Der ‚move‘ stellt sicher, das die temporär erzeugten kopien in die OMF-Struktur von Oracle verschoben werden. - Ziel-PDB: open read write + save state ## PDB + Reflinks: Vorbereitung Für Oracle habe ich im [SQL-Zauberkasten](https://github.com/Rendanic/SQL-Zauberkasten) ein Beispiel eingefügt. Das Skript erwartet 4 Parameter: - Quell-PDB - Verzeichnis für XML-Datei - Ziel-PDB - Verzeichnis für temporäre Reflink-Kopien Damit die Platzersparnis durch die Reflinks besser sichtbar wird, erzeugen wir zusäzlich einen Tablespace in der Quell-PDB. Das Beispiel zeigt zudem, wie mit Hilfe des SQL-Zauberkasten die Arbeit mit PDBs vereinfacht werden kann: ``` [oracle@db191 oracle]$cd /usr/local/SQL-Zauberkasten/sql/ [oracle@db191 sql]$./sq.sh SQL*Plus: Release 19.0.0.0.0 - Production on Tue May 25 18:25:51 2021 Version 19.7.0.0.0 Copyright (c) 1982, 2020, Oracle. All rights reserved. Connected to: Oracle Database 19c Enterprise Edition Release 19.0.0.0.0 - Production Version 19.7.0.0.0 SYS @ DB191:CDB$ROOT:> create pluggable database orclpdb admin user padmin identified by admin; SYS @ DB191:CDB$ROOT:>@pdb/open_rw orclpdb alter pluggable database orclpdb open read write; Pluggable database altered. SYS @ DB191:CDB$ROOT:>@pdb/save_state orclpdb alter PLUGGABLE DATABASE orclpdb save state; Pluggable database altered. SYS @ DB191:CDB$ROOT:>@pdb/switch orclpdb alter session set container = orclpdb; Session altered. ``` Nun legen wir den Beispieltablespace an und werfen einen Blick auf die Tablespaceübersicht ``` SYS @ DB191:ORCLPDB:>create tablespace test datafile size 2g; Tablespace created. SYS @ DB191:ORCLPDB:>@tbs/tbs % ``` % MaxPoss Max ``` Tablespace Name KBytes Used Free Used Kbytes Used ------------------------------------------------------------------------------------------- SYSAUX 419,840 390,912 28,928 93.1 33,554,416 1.2 SYSTEM 307,200 302,720 4,480 98.5 33,554,416 .9 TEMP 36,864 36,864 0 100.0 33,554,416 .1 TEST 2,097,152 1,024 2,096,128 .0 2,097,152 .0 UNDOTBS1 163,840 163,840 0 100.0 33,554,416 .5 -------------- -------------- -------------- -------------- sum 3,024,896 895,360 2,129,536 136,314,816 SYS @ DB191:ORCLPDB:>select name from v$datafile; NAME -------------------------------------------------------------------------------------------- /u02/oradata/DB19U1/C32CA941DF697B04E053B538A8C0C58B/datafile/o1_mf_system_jbtjb6v9_.dbf /u02/oradata/DB19U1/C32CA941DF697B04E053B538A8C0C58B/datafile/o1_mf_sysaux_jbtjb6vg_.dbf /u02/oradata/DB19U1/C32CA941DF697B04E053B538A8C0C58B/datafile/o1_mf_undotbs1_jbtjb6vh_.dbf /u02/oradata/DB19U1/C32CA941DF697B04E053B538A8C0C58B/datafile/o1_mf_test_jbtjyml8_.dbf ``` Aktuell sieht es im Filesystem wie folgt aus. *Hinweis! Die Datendateien der pdb$seed befinden sich im Verzeichnis der CDB! (Siehe ./datafile weiter unten)* ``` [oracle@db191 sql]$df /u02 Filesystem 1K-blocks Used Available Use% Mounted on /dev/mapper/vgoradata-lvoradata 31437828 9534772 21903056 31% /u02 [oracle@db191 oracle]$cd /u02/oradata/DB19U1/ [oracle@db191 DB19U1]$du 3358632 ./datafile 230412 ./onlinelog 18576 ./controlfile 2988128 ./C32CA941DF697B04E053B538A8C0C58B/datafile 2988128 ./C32CA941DF697B04E053B538A8C0C58B 6595748 . ``` Die Differenz von df /u02 zum du entsteht durch die FRA, die ebenfalls in /u02 liegt. Für die weitere Betrachtung ist nur die Änderung zwischen oben und dem Wert nach dem Erzeugen des reflink-Kons relevant. Nun sind die Vorbereitungen abgeschlossen und es kann mit dem Kloning begonnen werden. ## PDB + Reflinks: Beispielklon mit pdbreflinkcopy.sql Das Skript [pdbreflinkcopy.sql](https://github.com/Rendanic/SQL-Zauberkasten/blob/master/sql/pdb/pdbreflinkcopy/pdbreflinkcopy.sql) befindet sich im SQL-Zauberkasten. ``` [oracle@db191 oracle]$cd /usr/local/SQL-Zauberkasten/sql/ [oracle@db191 sql]$./sq.sh SQL*Plus: Release 19.0.0.0.0 - Production on Tue May 25 19:30:10 2021 Version 19.7.0.0.0 Copyright (c) 1982, 2020, Oracle. All rights reserved. Connected to: Oracle Database 19c Enterprise Edition Release 19.0.0.0.0 - Production Version 19.7.0.0.0 SYS @ DB191:CDB$ROOT:> SYS @ DB191:CDB$ROOT:>@pdb/pdbreflinkcopy/pdbreflinkcopy.sql orclpdb /u02/xml/ test01 /u02/reflink/test01/ SYS @ DB191:CDB$ROOT:>set time off SYS @ DB191:CDB$ROOT:>whenever sqlerror exit rollback SYS @ DB191:CDB$ROOT:>alter session set container=cdb$root; Session altered. SYS @ DB191:CDB$ROOT:>whenever sqlerror continue none SYS @ DB191:CDB$ROOT:>alter pluggable database orclpdb close; Pluggable database altered. SYS @ DB191:CDB$ROOT:>whenever sqlerror exit rollback SYS @ DB191:CDB$ROOT:>alter pluggable database orclpdb open read only; Pluggable database altered. SYS @ DB191:CDB$ROOT:>set termout off feedback off pages 9000 SYS @ DB191:CDB$ROOT:>alter pluggable database orclpdb close; SYS @ DB191:CDB$ROOT:>whenever oserror exit rollback SYS @ DB191:CDB$ROOT:>host rm -f /u02/xml/cloneplug_orclpdb..xml SYS @ DB191:CDB$ROOT:>alter pluggable database orclpdb unplug into '/u02/xml/cloneplug_orclpdb..xml'; SYS @ DB191:CDB$ROOT:>drop pluggable database orclpdb keep datafiles; SYS @ DB191:CDB$ROOT:>PROMPT do reflink copy of datafiles do reflink copy of datafiles SYS @ DB191:CDB$ROOT:>@@/u02/xml/cp_reflink_test01..sql SYS @ DB191:CDB$ROOT:>host cp --reflink -p /u02/oradata/DB19U1/C32DCD521B161DA1E053B538A8C099D0/datafile/o1_mf_system_jbto3c0j_.dbf /u02/reflink/test01/ SYS @ DB191:CDB$ROOT:>host cp --reflink -p /u02/oradata/DB19U1/C32DCD521B161DA1E053B538A8C099D0/datafile/o1_mf_sysaux_jbto3c0q_.dbf /u02/reflink/test01/ SYS @ DB191:CDB$ROOT:>host cp --reflink -p /u02/oradata/DB19U1/C32DCD521B161DA1E053B538A8C099D0/datafile/o1_mf_undotbs1_jbto3c0r_.dbf /u02/reflink/test01/ SYS @ DB191:CDB$ROOT:>host cp --reflink -p /u02/oradata/DB19U1/C32DCD521B161DA1E053B538A8C099D0/datafile/o1_mf_test_jbto448c_.dbf /u02/reflink/test01/ SYS @ DB191:CDB$ROOT:>-- Plugin unplugged PDB SYS @ DB191:CDB$ROOT:>create pluggable database orclpdb using '/u02/xml/cloneplug_orclpdb..xml' nocopy; SYS @ DB191:CDB$ROOT:>alter pluggable database orclpdb open read write; SYS @ DB191:CDB$ROOT:>alter pluggable database orclpdb save state; SYS @ DB191:CDB$ROOT:>-- Create PDB from reflink copy SYS @ DB191:CDB$ROOT:>create pluggable database test01 as clone using '/u02/xml/cloneplug_orclpdb..xml' source_file_directory='/u02/reflink/test01' move; SYS @ DB191:CDB$ROOT:>alter pluggable database test01 open read write; SYS @ DB191:CDB$ROOT:>alter pluggable database test01 save state; ``` ## PDB + Reflinks: Analyse des Ergebnis Wie sehen nun die PDBs aus? ``` 20:08:05 SYS @ DB191:CDB$ROOT:>@pdb/vpdb NAME GUID DBID OPEN_MODE RESTRICTED RECOVERY TS_MB ORCLPDB C32DCD521B161DA1E053B538A8C099D0 3576011439 READ WRITE NO ENABLED 2934 PDB$SEED C316417B89B563B9E053B538A8C06316 1591867463 READ ONLY NO ENABLED 876 TEST01 C32DEE49EFBA2914E053B538A8C06777 3999968580 READ WRITE NO ENABLED 2934 6744 ``` Ein Blick auf das Filesystem: ``` vorher: [oracle@db191 sql]$df /u02 Filesystem 1K-blocks Used Available Use% Mounted on /dev/mapper/vgoradata-lvoradata 31437828 9534772 21903056 31% /u02 nachher: Filesystem 1K-blocks Used Available Use% Mounted on /dev/mapper/vgoradata-lvoradata 31437828 9576876 21860952 31% /u02 ``` Für die neu erzeugte PDB mit 2934 MB wurden durch den ‚cp –reflink‘ nur ~40MB Platz belegt. Wie sieht es denn nun mit du aus? ``` [oracle@db191 sql]$cd /u02/oradata/DB19U1/ [oracle@db191 DB19U1]$du 3358632 ./datafile 230412 ./onlinelog 18576 ./controlfile 2974736 ./C32DCD521B161DA1E053B538A8C099D0/datafile 2974736 ./C32DCD521B161DA1E053B538A8C099D0 2972500 ./C32DEE49EFBA2914E053B538A8C06777/datafile 2972500 ./C32DEE49EFBA2914E053B538A8C06777 9554856 . ``` Neben der enormen Plattersparnis hat der Klon ~ 1 Minute benötigt. Die Laufzeit hängt wesentlich von der Datendateianzahl ab, der Oracle beim unplug und plugin diverse Validierungen durch führt, die von der Dateianzahl abhängig ist. Kann man prüfen, wie der reflink-Anteil in den Dateien wirklich aussieht? ``` ``` [oracle@db191 DB19U1]$xfs_bmap -v ./C32DEE49EFBA2914E053B538A8C06777/datafile/o1_mf_test_jbtontj2_.dbf ``` ./C32DEE49EFBA2914E053B538A8C06777/datafile/o1_mf_test_jbtontj2_.dbf: EXT: FILE-OFFSET BLOCK-RANGE AG AG-OFFSET TOTAL 0: [0..15]: 7617648..7617663 0 (7617648..7617663) 16 100000 1: [16..31]: 8746000..8746015 0 (8746000..8746015) 16 2: [32..57343]: 8746016..8803327 0 (8746016..8803327) 57312 100000 3: [57344..98303]: 8823936..8864895 0 (8823936..8864895) 40960 100000 4: [98304..116735]: 8920512..8938943 0 (8920512..8938943) 18432 100000 5: [116736..118783]: 9050544..9052591 0 (9050544..9052591) 2048 100000 6: [118784..122879]: 9067360..9071455 0 (9067360..9071455) 4096 100000 7: [122880..321535]: 9162288..9360943 0 (9162288..9360943) 198656 100000 8: [321536..462847]: 9364016..9505327 0 (9364016..9505327) 141312 100000 9: [462848..602111]: 9506752..9646015 0 (9506752..9646015) 139264 100000 10: [602112..604159]: 9647536..9649583 0 (9647536..9649583) 2048 100000 11: [604160..610303]: 9652064..9658207 0 (9652064..9658207) 6144 100000 12: [610304..612351]: 9659456..9661503 0 (9659456..9661503) 2048 100000 13: [612352..624639]: 9662160..9674447 0 (9662160..9674447) 12288 100000 14: [624640..647167]: 9676080..9698607 0 (9676080..9698607) 22528 100000 15: [647168..655359]: 9701552..9709743 0 (9701552..9709743) 8192 100000 16: [655360..667647]: 9711712..9723999 0 (9711712..9723999) 12288 100000 17: [667648..686079]: 9732384..9750815 0 (9732384..9750815) 18432 100000 18: [686080..688127]: 9757216..9759263 0 (9757216..9759263) 2048 100000 19: [688128..690175]: 9766416..9768463 0 (9766416..9768463) 2048 100000 20: [690176..692223]: 9771584..9773631 0 (9771584..9773631) 2048 100000 21: [692224..696319]: 9773640..9777735 0 (9773640..9777735) 4096 100000 22: [696320..698367]: 9872816..9874863 0 (9872816..9874863) 2048 100000 23: [698368..4194319]: 9874872..13370823 0 (9874872..13370823) 3495952 100000 ``` Wenn am Ende einer Zeile ‚100000‘ steht, dann ist der Dateiinhalt mit der Quelle geteilt. Nun könnte man den gleichen Befehl auf die Datei der Quell-PDB anwenden und würde dort die gleichen Blockpositionen für geteilte Bereiche sehen. Am Anfang der Datei ist deutlich erkennbar, das Oracle beim Plugin der PDB die Datendateiheader angepaßt hat, daas sich durch den Plugin u.a. die DBID und Checkpoint-SCN geändert hat. Total entspricht Anzahl Blöcke mit 512 bytes. ## PDB + Reflinks: nachträgliche Deduplikation – geht das? Es gibt tatsächlich die Möglichkeit, nachträglich Blöcke wieder zu gemeinsamen Bereichen zusammen zu führen. Auf github gibt es dafür das Projekt [duperemove](https://github.com/markfasheh/duperemove). **Wichtige Hinweise!** - immer alle Daten das Filesystems vor dem Start sichern Normalerweise ist duperemove sicher, weil es offizielle Schnittstellen im Kernel verwendet. - niemals Daten während der Ausführung ändern Duperemove nutzt eine ioctl vom Kernel. Dort wird beim Ändern der Blockbelegung der Bereich in der Datei vor Änderungen gesperrt, damit keine parallelen Änderungen möglich sind. Ich habe es nicht getestet, weshalb ich duperemove m laufenden Betrieb nicht empfehlen würde – auch wenn es technisch möglich sein sollte. - duperemove verwendet offizielle Schnittstellen des Kernels zur Deduplikation - **Das Tool wird auf eigene Gefahr verwendet** - Je nach Filesystemgröße kann duperemove durchaus Stunden benötigen. - duperemove ist für pdb$seed interessant Direkt nach dem Erzeugen der CDB über das Filesystem duperemove laufen lassen und sich freuen, das große Teile der pdb$seed dedupliziert werden, da Inhalte zur CDB sehr ähnlich sind. - duperemove ist im EPEL-Repository enthalten Einfach das RPM `duperemove` installieren `duperemove -r -d /u02/oradata` ## Zusammenfassung Es gab einen Einblick in folgende Themen: - Reflink in XFS-Filesystem - nachträgliche Deduplikation in XFS-Filesystemen mittels [duperemove](https://github.com/markfasheh/duperemove) - Erstellung von [PDBs als Reflink-Kopie](https://github.com/Rendanic/SQL-Zauberkasten/blob/master/sql/pdb/pdbreflinkcopy/pdbreflinkcopy.sql) einer Quell-PDB - [SQL-Zauberkasten](https://github.com/Rendanic/SQL-Zauberkasten) in der Praxis Nun wünsche ich viel Erfolg beim Experimentieren und diskutieren über weitere Möglichkeiten. **Kategorien:** Cloud, Infrastructure **Schlagwörter:** duperemove, HowTo, oracle, Pluggable Database, SQL-Zauberkasten, XFS, XFS Reflink --- ### [Never touch a running Oracle system!?](https://thecattlecrew.net/2023/07/17/never-touch-a-running-oracle-system/) **Published:** Juli 17, 2023 **Author:** Rainier Kaczmarczyk **Content:** # Oracle 11, 12, 18 … läuft doch. Warum also etwas ändern? Provozierend der Titel und auch die Frage. Manche erinnern sich. Es gab einmal Windows XP und Windows 2000. Möglicherweise existieren ohne Internetverbindung noch einige wenige dieser Installationen. Haben Sie sich schon einmal gefragt, warum es nur noch so wenige sind? Vermutlich nicht, denn bei Windows stellt sich diese Frage eigentlich nicht. Hier wissen alle, dass ein Update auf eine neue Version notwendig, ja sogar „lebenswichtig“ ist. Zu groß sind die aktuellen Bedrohungssituationen durch Viren, Ransomware etc. Die Bedrohung betrifft in gleicher Weise ältere bestehende Oracle Installationen. Und doch ist vielen die Gefahrenlage hier weniger bewusst. Daher existieren in vielen Organisationen noch laufende Systeme unter Oracle 11g oder Oracle 12c, und der alte Spruch: „Never touch a running system“ findet hier gerne Anwendung. Welche Argumente also könnten überzeugen, auf Oracle 19c zu gehen? Und warum nicht gleich auf 21c? Oder 23c? # Welche Gründe sprechen für Oracle 19c? - Der Support ist ausgelaufen. Alle Versionen niedriger als 19c sind nicht mehr im „normalen“ Support. Kurz: die Organisation muss für den Support eine höhere Gebühr bezahlen. - Rechtliche Probleme: Fließen sensible Daten aus einer Datenbank ab, steht der Betreiber des Systems in der Haftung. Bei alten Versionen vor Oracle 19c ist die Argumentation schwierig. Es empfiehlt sich daher, zeitnah die vierteljährlichen Patches für 19c oder sogar die inzwischen monatlich verfügbaren Patches einzuspielen. - Warum nicht gleich auf 21c? - - 1.21c ist ein Innovation Release wie 18c. Neue Funktionen sind mit einem Innovation Release verfügbar. Schön! Wer das im aktuellen Projekt benötigt, kann das gerne tun. Für ein aktuelles Produktionssystem ist das keine gute Idee. Es empfiehlt sich die Version 19c mit Long Term Support (LTS). - - Wichtig: der Support für 21c läuft definitiv im April 2024 aus. Es ist zu vermuten, dass das für 19c anders sein wird. Für 19c wird eine längere Laufzeit erwartet. - Warum nicht Oracle 23c? Gute Frage, denn im Moment gibt es diese Version schon. Aber nur als Entwicklerlizenz. Und dies nur mit massiven Einschränkungen. So gibt es zwei Cores, maximal 12 GB Speicherplatz und maximal 2 GB Memory. Daher ist 23c im Moment keine Option für Produktionssysteme. # Was ist bei der Migration zu beachten? Die Migration zu 19c ist kein einfacher Wartungsauftrag. Es gibt verschiedene Wege und diverse Dinge zu beachten: - Sie könnten überlegen, einen Partner hinzuziehen, der einen solchen Upgrade regelmäßig durchführt. - Außerdem gibt es Oracle Skripte, die das Szenario im Vorfeld testen (autoupgrade analyze). - Wie hoch sind die Ansprüche an die Verfügbarkeit? Kann die DB mal einen halben Tag unten sein? Welcher Datenverlust ist im Fehlerfall für meine Organisation ertragbar? - Software von Partnern, die eine sog. „Minimal Downtime“ ermöglichen (Falls benötigt). Meistens liegt die Downtime in solch einem Fall bei maximal 5 Minuten. Das gilt auch für Datenbanken im TByte Bereich. Zudem ermöglicht eine solche Lösung ein „Fallback Scenario“. Kurz: geht etwas schief, kommt man in wenigen Minuten ohne Datenverlust auf den alten Stand zurück. Nur: die Lizenz für solche Software kostet Geld. - Es gibt auch die Möglichkeit, im Rahmen einer solchen Migration von der Enterprise Edition auf die Standard Edition zu migrieren. Das bedeutet einen massiven Kostenvorteil (jährliche Wartungsgebühren). - Für Data Guard gibt es Alternativen, die mit geringen Kosten und einem ähnlichen Leistungsumfang eingesetzt werden können. # Zusammenfassung In Zeiten von DSGVO und GPDR muss ein IT-System aus oben genannten Gründen auf einem aktuellen Stand gehalten werden. Bei Windows ist das jedem bewußt. Oracle Systeme laufen im Hintergrund und führen ein eher stiefmütterliches Dasein. Also unbedingt draufschauen und im Zweifel helfen lassen! **Kategorien:** Infrastructure, IT-Security **Schlagwörter:** Altsystem, datenbank, DB, Legacy, Migration, oracle, Oracle DB --- ### [Fit for Agile: Die Retrospektive](https://thecattlecrew.net/2017/03/10/fit-for-agile-die-retrospektive/) **Published:** März 10, 2017 **Author:** ninanuernberger **Content:** Die Retrospektive gilt als das mächtigste und zugleich anspruchsvollste Werkzeug der Scrum Meetings. Aber auch in klassisch aufgestellten Projekten und Linieneinheiten kann sie den kontinuierlichen Verbesserungsprozess in der Zusammenarbeit und Vorgehensweise bereichern. Nur, wie macht man sowas? Um diese Frage zu beantworten, hat unser Competence Center Agile Softwareentwicklung zusammen mit dem OPITZ CONSULTING Marketing-Team ein Poster zum Thema Retrospektive entwickelt. Es enthält nicht nur die wichtigsten Grundlagen für den gelungenen Aufbau und die Wahl der Teilnehmer sondern zudem hilfreiche Tipps und Tricks, die einen solchen Termin zum Erfolg werden lassen. Das übersichtlich gestaltete Poster erklärt die Grundprinzipien, bietet zu jeder der fünf Phasen einer Retrospektive inspirierende Ideen, benennt typische Fehler und liefert Best Practices für die Vor- und Nachbereitung. Und das Beste ist: Es steckt nicht nur voller Informationen sondern ist dazu auch noch ein Hingucker in jedem Teamraum! Als PDF ist das Poster auf unserer [Homepage](http://www.opitz-consulting.com/portfolio/software-development.html) zu finden. Das Printexemplar kann bei unserem Marketing-Team per [Kontaktformular](http://www.opitz-consulting.com/einzelseiten/kontaktformular.html) bestellt werden. Das Competence Center Agile Softwareentwicklung wünscht allen viel Spaß und Erfolg für die nächsten Retrospektiven. **Kategorien:** Tools & Methoden --- ### [Co-Creation im Workshop: Anstrengend ergebnisreich.](https://thecattlecrew.net/2017/03/15/co-creation-im-workshop-anstrengend-ergebnisreich/) **Published:** März 15, 2017 **Author:** Verena Scheller **Excerpt:** Co-Creation in Workshops ist oft ergebnisreich, meistens aber auch anstrengend. Für Moderator wie Workshopteilnehmer. **Content:** ## Unser Workshop war anstrengend … warum eigentlich? Am 2./3. März verbrachten wir zwei intensive Workshoptage in [Nochen: ](http://www.opitz-consulting.com/ueber-uns/denkfabrik-im-gruenen.html)Ein Teil der OC Community (insgesamt 17 Personen) entwickelte Workshopkonzepte und Ideen rund um die Themen Innovation & Digitalisierung, New IT & IT Strategy sowie (Digital) Change. Am Freitag Abend waren wir „“ was die Gesamtsumme der Endergebnisse anging „“ eigentlich sehr zufrieden. [![](https://thecattlecrew.net/wp-content/uploads/2017/03/img_04571-150x150.jpg)](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/img_04571/) [![](https://thecattlecrew.net/wp-content/uploads/2017/03/img_04581-150x150.jpg)](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/img_04581/) [![](https://thecattlecrew.net/wp-content/uploads/2017/03/img_04591-150x150.jpg)](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/img_04591/) Eigentlich. Denn die beiden Workshoptage waren harte Arbeit, unsere Diskussionen waren zum Teil kontrovers-verwirrend-intensiv und auch kräftezehrend. Wir hatten Spaß beim Arbeiten, keine Frage! Doch manche hatten das Gefühl, dass wir zwischendurch unseren roten Faden verloren hätten, dass wir unsere Ergebnisse als Gruppe homogener und effizienter hätten erarbeiten können. Irgendwie blieb der Eindruck von einem „echt anstrengenden Entscheidungsfindungsprozess“ hängen – trotz des konstruktiven Workshopklimas, des positiven Miteinanders und des guten Gesamtergebnisses. In den letzten Tagen habe ich gegrübelt, woran das liegen könnte (als Moderator überlegt man ja immer, was man bei der Workshopbegleitung hätte verbessern könnte) … Waren die Workshop-Vorbereitungen nicht gut genug? Hätten wir inhaltlich vorarbeiten müssen, um schneller und effizienter in der großen Gruppe entscheiden zu können? Oder hätten wir uns weniger Themen vornehmen sollen? War der Teilnehmerkreis zu groß oder nicht gut ausgewählt? Hätten wir die Moderation straffer durchziehen müssen, mehr auf die Einhaltung von durchgängiger Anwesenheit und Timeboxes achten müssen? ## Erkenntnis #1: Co-Creation in Reinform Beim Blick zurück auf dem Teilnehmerkreis wurde mir nochmals bewusst, dass wir an beiden Workshoptagen wirklich crossfunktional-interdisziplinär aufgestellt waren: Vom Geschäftsführer über das mittlere Management und (Senior) Beratern bis zum (Noch)Studenten waren nahezu alle Hierarchiestufen unseres Unternehmens vertreten. Beteiligt waren Mitarbeiter aus dem Consulting (Architekten, Developer, Strategieberater und Change Facilitatoren), Marketing, Sales, Business Development und das Kompetenzmanagement. Wie bei der Workshopplanung erhofft (und wie es Workshopgurus und Facilitatoren so oft predigen) trat eine bunt gemischte Teilnehmergruppe an. Diese vielfältigen und zum Teil auch kontroversen Ideen und Meinungen unter einen Hut zu bringen, um in definierten Zeitboxen gute Ergebnisse zu erzielen, ist – ganz simpel – HARTE ARBEIT. Und zwar nicht nur für den Moderator des Workshops. Sondern für alle Teilnehmer. Alles gut also! Aber warum dann dieser vermeintliche „emotionale Workshop-Hangover“ im Nachgang? ## Erkenntnis #2: „groan zone emotions“ waren zu Gast! Vorgestern blätterte ich – einmal mehr – durch Sam Kaners Buch „[Facilitator’s Guide to Participatory Decision-Making](https://www.amazon.de/Facilitators-Participatory-Decision-Making-Jossey-Bass-Management/dp/1118404955)“ (ein Facilitator-Klassiker aus dem Jahr 2007). Der dort erläuterte „Diamond of Participatory Decision-Making“ beschreibt genau diese „groan zone“, die wir gemeinsam an diesen beiden Workshoptagen (mehrmals) durchlaufen haben: ![Neue Datei 2017-03-15 08.35.48_1](https://thecattlecrew.net/wp-content/uploads/2017/03/neue-datei-2017-03-15-08-35-48_1.jpg) Nach der Phase des „divergent thinking“ – Ideen werden frei gesammelt, die Diskussion öffnet sich, verschiedene Sichtweisen treffen aufeinander – folgt die „groan zone“ (der Wendepunkt), ehe die Workshopgruppe über das „convergent thinking“ – Sortierung, Fokussierung, Priorisierung – zur Entscheidungsfindung kommt. In jeder Phase des Workshops, bei jeder Themenerarbeitung, bei jeder Entscheidungsfindung in der Gruppe spielen – mehr oder weniger bewusst und individuell unterschiedlich erlebt – Emotionen eine große Rolle. Das ist einfach menschlich. Deshalb war es für mich als Moderator im Nachgang des Workshops wichtig, mir – wieder einmal – in Erinnerung zu rufen: Neben den positiven Emotionen (aus den Phasen des divergent /convergent thinking), gehören die „groan zone emotions“ schlicht ebenfalls zu jedem Workshoperleben dazu. Im besten Fall dauern diese emotionalen Täler nur kurz an, der Workshopmoderator hat diese „groan zones“ fest im Griff und führt die Workshopgruppe dort gut durch. Wenn – wie in unserem Fall – eine sehr heterogene Gruppe (gut für das Gesamtergebnis!) zusammenarbeitet, ist machmal auch die „groan zone“ schlicht heterogener und intensiver spürbar. Grübelei zu Ende. Fast: „when a discussion loses focus or becomes confusing, it can appear to many people that the process is heading out of control. Yet this is not necessarily what’s really going on. Sometimes what appears to be chaos is actually a prelude to creativity.“ (Kaner et al., 2007, S. 5). Danke, Sam! **Kategorien:** Tools & Methoden **Schlagwörter:** Co-Creation, Entscheidungsfindung, Facilitation, Kaner, methoden, Moderation, Workshop, Workshopgruppen, Workshopmethoden, Workshopmoderator --- ### [Usability-Rezept für glückliche Chatbots Ü  la Amazon Alexa, Google Home, Apple Siri & Co](https://thecattlecrew.net/2017/03/18/usability-rezept-fuer-glueckliche-chatbots-a-la-amazon-alexa-google-home-apple-siri-co/) **Published:** März 18, 2017 **Author:** Christian Ochsenkühn **Content:** Wer versucht, die Gestaltung grafischer Oberflächen eins zu eins auf sog. Conversational UIs (Chatbots, Spracheingaben, usw.) zu bringen, merkt schnell, dass diese Rezepte hier nicht greifen. Es müssen stattdessen neue Zutaten hinzugefügt, alte Muster angepasst und einige Zutaten komplett ausgetauscht werden. [In diesem Artikel finden sich 3 Zutaten](https://jaxenter.de/chatbot-alexa-google-home-siri-54265), die Spracheingabe und -ausgabe mit Alexa, Siri, Cortana & Co zu einem Genuss und echtem Mehrwert verhelfen können. Denn gerade das lästige Eintippen von Texten auf kleinen Smartphones macht die Benutzererfahrung von eigentlich guten Applikationen häufig zu einer unangenehmen Sache. Nicht immer sind Sprachbefehle oder gesprochene Antworten die Lösung. Aber in Verbindung mit grafischen Oberflächen lässt sich die Usability deutlich verbessern. Und wer weiß. Vielleicht nutzen wir bald noch ganz andere Interaktionsmöglichkeiten, an die wir bis her noch (sic!) nicht denken. **Kategorien:** AI & Data Science, Development **Schlagwörter:** #OCVoicePioneers, Artificial Intelligence, Conversational UI, Digital Innovation, Modern Clients, usability --- ### [Design Thinking: 6-Hüte-Methode](https://thecattlecrew.net/2017/05/11/design-thinking-6-huete-methode/) **Published:** Mai 11, 2017 **Author:** dimitrigross **Content:** Design Thinking wird oft als Methodik im Zusammenhang mit Prozessoptimierung oder Innovation genannt. Der Design Thinking-Prozess besteht aus mehreren Abschnitten wobei jedem Abschnitt mehrere einschlägige Methoden zugeordnet werden. Diese können je nach Problemstellung verwendet werden. Antworten auf Fragen „Wie könnten wir“¦?“ lassen sich am besten mit Hilfe von Brainstorming evaluieren, um mehrere Optionen möglichst objektiv und aus unterschiedlichen Blickrichtungen zu bewerten empfehlen sich Methoden wie die 6-Hüte-Methode oder die Walt-Disney-Methode. Wir fokussieren uns auf die 6-Hüte-Methode von De Bono. Diese Methode wurde von OC in unterschiedlichen Projektkontexten erfolgreich verwendet. Die Methode ist denkbar einfach. Und in der IT-Welt kennt man sowas ähnliches aus dem Aufwandsschätzungsverfahren, wo in drei Schätzungsiterationen die Arbeitspakete pessimistisch, normal und optimistisch geschätzt werden, anschließend wird der Aufwand normiert. So ähnlich funktioniert auch die 6-Hüte-Methode. Innerhalb einer ausgewählten Stakeholdergruppe geben die Personen jeweils ein Statement aus unterschiedlicher Denkrichtung ab. Die Denkrichtung wird je nach dem „aufgesetztem Hut“ bestimmt. ![6hats.png](https://thecattlecrew.net/wp-content/uploads/2017/05/6hats.png?w=920) - Weißer Hut: analytisches Denken: Konzentration auf Tatsachen, Anforderungen und wie sie erreicht werden können ([objektiv](https://de.wikipedia.org/wiki/Objektivit%C3%A4t)) - Roter Hut: emotionales Denken, Empfinden: Konzentration auf Gefühle und Meinungen ([subjektiv)](https://de.wikipedia.org/wiki/Subjektivit%C3%A4t) - Schwarzer Hut: kritisches Denken: Risikobetrachtung, Probleme, Skepsis, Kritik und Ü„ngste mitteilen (kritisch) - Gelber Hut: optimistisches Denken: was ist das [Best-Case](https://de.wikipedia.org/wiki/Best-Case) Szenario ([spekulativ](https://de.wikipedia.org/wiki/Spekulation)) - Grüner Hut: kreatives, assoziatives Denken: neue Ideen, Kreativität ([konstruktiv](https://de.wikipedia.org/wiki/Konstruktivit%C3%A4t)) - Blauer Hut: ordnendes, moderierendes Denken: Überblick über die Prozesse Nachfolgend wird erklärt, wie die Bewertung stattgefunden hat. Dies soll exemplarisch die Funktionsweise der Methode zeigen. Als Diskussions-/Bewertungsgrundlage wurden 3 zuvor ausgearbeitete Optionen genommen, diese werden hier nicht näher beleuchtet. Zu jeder Option wurden von jedem Stakeholder jeweils ein Vor- und ein Nachteil aus jeder der 5 Denkrichtungen erhoben. 5 Denkrichtungen, weil die 6 Denkrichtung dem Blauen Hut zugeordnet wird und entspricht der Rolle des Moderators. **Fazit** Wurden alle Vor und Nachteile erhoben findet eine Sortierung dieser statt, um Doppelungen zu vermeiden. Anschließend wird gezählt und bewertet. So einfach kommt man mit dieser Methode zum Ziel und die Beteiligten sind dabei begeistert, denn wenn man die Personen geschickt durch den Prozess führt, fällt dieser gar nicht als schwer und langweilig auf. **Kategorien:** Tools & Methoden **Schlagwörter:** Design Thinking, Digital Innovation, Workshopmethoden --- ### [Augmented Reality im Unternehmen - Eine Analyse der Möglichkeiten aktuell verfügbarer Hardware](https://thecattlecrew.net/2017/05/11/augmented-reality-im-unternehmen-eine-analyse-der-moeglichkeiten-aktuell-verfuegbarer-hardware/) **Published:** Mai 11, 2017 **Author:** Jan Hüsson **Content:** Spätestens seit Microsoft mit der HoloLens im Jahr 2015 eine AR-Brille der Ü–ffentlichkeit präsentiert hat, ist das Thema „Augmented Reality“ (AR) in aller Munde. Im Internet finden sich zu Hauf Videos und Bildmaterial, welche mögliche Einsatzszenarien in beeindruckender Weise veranschaulichen. Dabei stehen nicht nur Unterhaltungszwecke im Vordergrund, sondern vor allem auch die Erleichterung und Effizienzsteigerung der alltäglichen Arbeit. Goldman Sachs prognostiziert bereits ein Marktvolumen von $80 Milliarden für VR und AR bis zum Jahr 2025, Digi Capital sieht gar ein Potenzial von $150 Milliarden bis 2020. So haben auch wir bei OPITZ CONSULTING begonnen, uns mit dem Thema Augmented Reality zu beschäftigen. Doch bei aller Euphorie, die aktuell herrscht, gilt es zunächst zu klären, welche Möglichkeiten die aktuelle Hardware bietet und welche Brillen neben der alles überstrahlenden HoloLens existieren. Da sich die Anwendung von Augmented Reality nicht auf Brillen beschränkt, möchten wir zunächst einen Überblick darüber gewinnen, welche weiteren Devices verwendet werden können. Die Devices werden im Kapitel zu den Nutzungsszenarien wieder aufgegriffen. Dort kann ein Eindruck vom Einsatz von Augmented Reality in Unternehmen gewonnen werden. Trotz der Erwähnung von Smartphones und VR-Brillen, liegt der Fokus auf AR-Brillen. Hierzu vergleichen wir im letzten großen Kapitel exemplarisch die AR-Brillen HoloLens, Epson Moverio BT-300 und Vuzix m100 und arbeiten die Herausforderungen für den Einsatz in der Praxis heraus. ## Augemented Reality – Immer das Gleiche? Die HoloLens wird aktuell ohne Zweifel von der Ü–ffentlichkeit wahrgenommen. Es ist nach der Google Glass das zweite Mal, dass eine AR-Brille diese weitreichende Aufmerksamkeit erfährt. Beide Brillen stehen für zwei unterschiedliche Ansätze im Bereich der erweiterten Realität. Zwar wurde die Google Glass mittlerweile eingestellt, doch steht sie auch heute noch sinnbildlich für eine Gruppe von AR-Brillen, die aktuell und vermutlich zukünftig weiterentwickelt werden. Google Glass visualisiert Informationen für lediglich ein Auge und in 2-D, während die HoloLens dazu in der Lage ist, 3-D Objekte im Raum darzustellen und mit ihnen zu interagieren. Microsoft selbst spricht daher von Mixed Reality (MR). Für Brillen, die funktional dem Lager der Google Glass zuzuordnen sind, wird teilweise das Wort „Datenbrille“ verwendet. Sowohl MR-Brillen, als auch Datenbrillen haben gemein, dass die reale Welt trotz virtueller Anreicherung durch Informationen, unmittelbar wahrnehmbar ist. In diesem Punkt unterscheiden sie sich eindeutig von Virtual-Reality-Brillen (VR-Brillen) wie der Oculus Rift, welche den Nutzer, abgekapselt von der realen Welt, komplett in virtuelle Welten eintauchen lassen. Zusätzlich zu den Brillen gibt es noch weitere Devices, die AR unterstützen. So gibt es bereits Smartphones, die mit ToF-Kameras ausgestattet sind. In Kombination mit der Technologie-Plattform Google Tango, können diese Smartphones ebenfalls ihre Umgebung erfassen und vermessen. Sie bieten sich somit für den Einsatz im AR-Umfeld an. Doch selbst herkömmliche Smartphones werden bereits für AR-Anwendungen genutzt. Diese nutzen real existierende Referenzobjekte im Raum, um die virtuellen Objekte auf die richtige Größe und die richtige Perspektive zu skalieren. ## Realistische und utopische Nutzungsszenarien Auf YouTube finden sich viele Videos, die AR visualisieren. Es ist jedoch nicht immer klar, ob es sich um tatsächlich realisierte Projekte handelt, oder um den geschickten Einsatz von Adobe Premiere. Hier seien zunächst zwei Videos genannt, zu denen sich keine tiefergehenden Informationen über praktische Umsetzungen finden ließen: - [Google Glass bei Prosegur](https://www.youtube.com/watch?v=Q50RRmg1MH0) - [SAP & Vuzix im Warenlager](https://www.youtube.com/watch?v=9Wv9k_ssLcI) Im weiteren Verlauf dieses Artikels werden wir auf große Hürden zur Umsetzung der beiden oben verlinkten Videos stoßen. Ob ein Produktiveinsatz möglich wäre, ist fraglich. Doch die Sinnhaftigkeit eines Einsatzes von AR korreliert nicht mit seiner Spektakularität. Im Folgenden liegt daher der Fokus auf der Darstellung der Identifizierten tatsächlich umgesetzten AR-Pilotprojekte. Die verwendeten Technologien bestehen hauptsächlich aus AR-Brillen. Dennoch beschreiben wir bewusst auch Szenarien mit VR-Brillen und Smartphones, um die Möglichkeiten, die sich durch die virtuelle Anreicherung bzw. Überdeckung der Realität ergeben, anzudeuten. ### Remote Support für Onsite-Service-Techniker Die meisten identifizierten Projekte beschäftigen sich mit dem Remote Support. Alle Projekte haben gemein, dass der im Einsatz befindliche Techniker bei komplexen Problemen Unterstützung durch Fachexperten erhalten kann. Diese müssen nicht mehr vor Ort sein und können so Support für viele, an unterschiedlichen Stellen arbeitenden Techniker, bieten. #### Lee Company Zweifelsohne spielt Lee Company seit der Inbetriebnahme von sage und schreibe 500 Vuzix M100 Smart Glasses im Jahr 2016 im vorderen Feld der AR-Pioniere mit. In Zusammenarbeit mit dem auf den professionellen Einsatz von Wearables im klassischen Arbeiterumfeld spezialisierten Unternehmen XOEye Technologies, feilt Lee Company daran, seine Arbeitsprozesse durch den Einsatz von AR effizienter zu gestalten. Lee Company hat sich auf Dienstleistungen im Bereich „Home Services“ spezialisiert. Dazu gehören u.a. die Installation und Wartung von Wärme- und Kältetechnik, Sanitäranlagen, Elektrotechnik und Sicherheitssystemen. Die Datenbrillen ermöglichen den Remote-Support in Echtzeit durch erfahrene Fachexperten. Dabei wird das Sichtfeld des am Einsatzort befindlichen Technikers live per Videostream an den Experten übertragen, was die Qualität des Supports erheblich steigert. Der Experte wiederum kann unmittelbar Hilfestellung geben und auf etwaige Folgeereignisse reagieren. Ist gerade kein Fachexperte verfügbar oder wird weitere Hilfe benötigt, so können Videos ohne weitere Umwege an elektronische Service Tickets angehängt werden. Geeignete Videos werden außerdem archiviert und im internen Schulungssystem bereitgestellt. So können neue Mitarbeiter deutlich effizienter eingearbeitet werden. Was technisch gesehen weit von den eingangs vorgestellten visionären Konzepten entfernt ist, hat sich bei Lee Company im Einsatz als äußerst förderlich herausgestellt. Woche für Woche werden etliche Arbeitsstunden gespart und die Tätigkeiten beim Kunden schneller erledigt. Somit sinken nicht nur unmittelbar die Arbeitskosten, sondern der Kunde ist auch zufriedener mit der Leistung des Unternehmens. Quellen / Weiterführende Informationen:- - #### Caterpillar Remote Assistance Caterpillar geht konzeptionell gesehen zusammen mit der auf AR spezialisierten Softwareschmiede Scope AR einen ähnlichen Weg. Ein großer Unterschied besteht jedoch in der Vermarktung: die Software soll auch anderen Unternehmen zur Verfügung gestellt werden. Durch das auf viele Bereiche übertragbare Konzept, scheinen Skaleneffekte durchaus für möglich. Die „Remote AR“ genannte Software liefert eine Lösung, die komplett auf die Unterstützung von Technikern durch weitere Experten abzielt. Dabei kann der am Einsatzortbefindliche Techniker wahlweise ein Tablet, ein Smartphone oder eine Datenbrille einsetzen. Ruft er den Experten an, so wird das Kamerabild des gewählten Devices übertragen. Der Experte wiederum kann ein Tablet, ein Smartphone, einen Laptop oder einen Desktop benutzen. Beide Parteien können das Video annotieren. So können beispielsweise reale Objekte markiert werden. Die Markierungen bleiben bei der Bewegung des Kamerabildes am realen Objekt haften. Die Verantwortlichen weisen darauf hin, dass die Einsatzorte von Technikern oft keine breitbandige Internetverbindung hergeben. Daher ist ein wichtiger Gesichtspunkt von „Remote AR“, trotz niedriger Bandbreite ein akzeptables Bild zu übertragen. Bei zu schlechter Verbindung kann zusätzlich auf die Funktion der Annotation eines hochauflösenderen Standbildes zurückgegriffen werden. Das Prinzip der App bietet eine Reihe von Einsatzmöglichkeit, die sich nicht zuletzt auf Grund der flexiblen technischen Gestaltung ergeben. Es ließen sich jedoch leider keine Zahlen darüber finden, wie groß der Benefit für Caterpillar oder andere „Remote AR“-benutzende Unternehmen sind. Quellen / Weiterführende Informationen:- - #### Boeing In der Produktion von Flugzeugen werden äußerst komplexe Kabelbäume konstruiert. Die damit betrauten Techniker benutzen in aller Regel tragbare Computer, auf denen PDFs mit Schaltplänen geöffnet sind. Sie sind ständig auf der Suche nach bestimmten Stecker- und Anschlussbelegungen. Dafür wird der übliche STRG+F Shortcut benutzt. Techniker müssen also sehr häufig neben ihrer eigentlichen Arbeit ihre Hände benutzen, um den Computer zu bedienen. Boeing hat bereits vor mehr als 20 Jahren in diesem Bereich einen Optimierungsbedarf erkannt. Im Jahre 1995 starteten Experimente mit damals noch äußerst teuren und unergonomischen AR-Brillen. Diese Experimente wurden ungleich vielversprechender, als Google Glass veröffentlicht wurde. Die mit der Entwicklung einer Softwarelösung betraute Firma APX Labs entwickelt seitdem an einer vielversprechenden Softwarelösung, die aktuell den Namen Skylight App trägt. Die Daten, welche dem Techniker zur Verfügung gestellt werden, werden durch das System nach dem Einscannen von QR-Codes ermittelt. So muss sich der Techniker zunächst über einen am Computer generierten QR-Code authentifizieren. Danach scannt er den QR-Code auf der Box mit den Bauteilen ein. Auf seinem Head-Mounted Display erscheinen daraufhin Status Updates, weitere Notizen und die Informationen über seine nächste Aufgabe. Die Skylight App kann sowohl mit Gesten als auch mit Sprachbefehlen gesteuert werden. Für die Suche bestimmter Stecker- und Anschlussbelegungen müssen die Hände somit nicht mehr benutzt werden. Diese bleiben stattdessen frei für die eigentliche Arbeit. Auch die Skylight App unterstützt das Hinzuziehen eines Experten per Videostream für Probleme, die der Techniker von sich aus nicht lösen kann. Außerdem hat er die Möglichkeit auf ein Videoarchiv zuzugreifen, in dem Möglicherweise bereits Lösungen für das Problem beschrieben sind. Nach der Beendigung der Pilotphase Mitte des Jahres 2016 wurde festgestellt, dass die Montagezeiten der äußerst komplexen Kabelbäume um 25% reduziert werden konnten. Gleichzeitig sind bei der Montage nur noch halb so viele Fehler aufgetreten. Als die beiden größten Herausforderungen in der bisher 5-jährigen Entwicklungszeit, bezeichnen die Entwickler den verlässlichen Datenbezug aus den verschiedenen Legacy Systemen und den Umgang mit sensible Geschäftsdaten. Quellen / Weiterführende Informationen:- #### Thyssen Krupp Fahrstuhl Reparatur Thyssen Krupp geht in mindestens einem Punkt einen anderen Weg als die zuvor beschriebenen Firmen. Die Partnerschaft mit Microsoft und der Einsatz der HoloLens ermöglichen die Interaktion mit 3D-Visualisierungen im realen Raum. So kann bei Auftragseingang bereits ein 3D-Modell des betroffenen Aufzugs angezeigt werden. Für die Ausreizung der Mächtigkeit dieser Funktionalität ist es erforderlich, dass der zu wartende Aufzug mit dem internen IoT-System MAX ausgestattet ist. In diesem Fall wird dem Techniker das betroffene Bauteil im 3D-Modell visualisiert. Auch für Schulungszwecke können die 3D-Modelle herhalten. Per Gestensteuerung kann der Aufzug in seine Einzelteile zerlegt werden, was für ein besseres Verständnis insbesondere beim unerfahrenen Techniker führt. Einen vergleichbaren Ansatz verfolgt Japan Airlines. Ansonsten ist das Einsatzszenario Thyssen Krupps vergleichbar mit den zuvor beschriebenen Fällen. Auch Thyssen Krupp stellt die Hinzuziehung eines Experten über einen Videostream und bidirektionalen Audiokanal zur Verfügung. Ist der Techniker am Einsatzort angekommen, können relevante Informationen über die Reparaturhistorie angezeigt werden. Thyssen Krupp geht davon aus, dass die Arbeit durch den Einsatz der HoloLens nicht nur schneller, sondern auch sicherer verrichtet werden kann. Von dem im letzten Jahr gestarteten Pilotprojekt wurden diesbezüglich jedoch noch keine Zahlen veröffentlicht. Quellen / Weiterführende Informationen:- - ### Vision Picking im Warenlager DHL hat bereits im Jahr 2014 ein groß angelegtes Pilotprojekt in Zusammenarbeit mit Vuzix in einem niederländischen Warenlager begonnen. Die Ergebnisse waren so überzeugend, dass die Erprobungsphase verlängert und auf weitere Warenlager in den Vereinigten Staaten, Großbritannien und dem europäischen Festland ausgeweitet wurde. Im ersten Pilotprojekt in Bergen op Zoom bei der Firma Ricoh wird die Kommissionierung durch den Einsatz einer Datenbrille unterstützt. Die Datenbrille hat sowohl den bisher verwendeten Handscanner als auch die Kommissionierungsliste abgelöst. Die Lageristen haben somit zu jeder Zeit freie Hände. Das betroffene Lager zeichnet sich durch eine hohe Standardisierung aus. Die Lageristen haben haben Trolleys mit Packstücken zu befüllen, deren Lagerort im System mit einer eindeutigen Bezeichnung versehen ist. Beginnt der Lagerist seine Schicht, so scannt er zunächst mit der Datenbrille seinen Dienstausweis ein und begibt sich zum nächsten verfügbaren Trolley. Das Scannen des am Trolley befindlichen Strichcodes sorgt dann für die Einblendung der Aufgabenbeschreibungen mit Informationen zum Standort (Gang- und Regalnummer) des nächsten Packstücks und der benötigten Menge. Außerdem wird der Trolley grafisch dargestellt und diejenigen Boxen visuell hervorgehoben, in die das Packstück einsortiert werden soll. Nachdem alle benötigten Exemplare des ersten Packstücks im Trolley untergebracht sind, werden die entsprechenden Informationen zum nächsten Packstück eingeblendet. DHL und Ricoh stellten als Ergebnis der ersten Tests eine deutliche Steigerung der Produktivität, gesunkene Fehlerraten und eine Steigerung der Zufriedenheit der Mitarbeiter fest. Der positive Einfluss, den Augmented Reality auf die Realität haben kann, war hiermit unter Beweis gestellt. Die Steigerung der Effizienz um 25% war Grund genug, die Erprobungsphase auf viele weitere Warenlager auszuweiten. Quellen / Weiterführende Informationen:- - [http://www.dpdhl.com/de/presse/pressemitteilungen/2016/dhl\_rollt\_globales\_augmented\_reality-programm\_aus.html](http://www.dpdhl.com/de/presse/pressemitteilungen/2016/dhl_rollt_globales_augmented_reality-programm_aus.html) - - ### Die Menschliche Komponente im Online Shopping GoInStore bietet mit seiner Softwarelösung eine Möglichkeit für Händler mit Kunden stärker in Kontakt zu treten. So soll beispielsweise in einem Onlineshop für interessierte Kunden mittels eines Buttons die Möglichkeit bestehen, mit einem Kundenberater in Kontakt zu treten. Auf Grund von Variablen wie der Nähe zum Kunden oder der Expertise des Kundenberaters soll dann automatisch der Kontakt zum bestgeeigneten Berater hergestellt werden. Der Verkäufer trägt die Datenbrille Epson Moverio. Sein Bild wird direkt an den Kunden übertragen. Zeitgleich besteht eine beidseitige Audioverbindung. So soll der Kunde einen besseren Eindruck von vor allem höherwertigen Produkten bekommen. GoInStore verspricht, durch Beratung und emotionale Komponenten eine höhere Conversionrate. Ein aktuelles Pilotprojekt findet gerade in Hotels des Marriott European Convention Networks statt. Es ist zu erwähnen, dass diese Technik bisher nicht im großen Stil umgesetzt wurde. Verlässliche Zahlen darüber, in wie weit Kunden den Service tatsächlich honorieren, ist nicht herauszufinden. Quellen / Weiterführende Informationen:- - - ### Jaguars Auto Neuvorstellung mit einer VR-Brille Doch nicht nur AR, sondern auch VR, könnte nutzenstiftend sein. So hat beispielsweise Jaguar im letzten Jahr vor der Los Angeles Auto Show sein in der Entwicklung befindliches Modell I-PACE rein virtuell vorgestellt. Hier dürfte vor Allem der Showeffekt im Mittelpunkt stehen. Gleichzeitig entfällt die Aufwändige Erstellung eines realen Prototyps. Quellen / Weiterführende Informationen:- ### Platzierung virtueller Möbel im eigenen Zuhause Es gibt eine Reihe von Apps die auf **handelsüblichen Smartphones** funktionieren und den Benutzern bereits heute Augmented Reality ins Wohnzimmer liefern. Hier seien Beispielhaft Apps von vier verschiedenen Firmen genannt: - [Converse](https://www.youtube.com/watch?v=lBQzXi04JpE) - [Lego](https://www.youtube.com/watch?v=0uqxsIQNUPU) - [Ikea](https://www.youtube.com/watch?v=vDNzTasuYEw) - [ViewAR](https://www.youtube.com/watch?v=YgGA0zYKLzg) Während Converse eine virtuelle Schuhanprobe ermöglicht, soll die Lego App für eine bessere Vorstellung von den angebotenen Produkten sorgen. Sowohl die Ikea App als auch ViewAR bieten die Möglichkeit, virtuelle Möbel in real existierenden Räumen zu platzieren. Die Apps benötigen ein Referenzobjekt, welches im Falle von Lego und Ikea die jeweiligen Produktkataloge sind. Die virtuellen Objekte werden daraufhin anhand der im Raum liegenden Produktkataloge ausgerichtet. ## Augmented-Reality-Brillen Die beschriebenen Nutzungsszenarien lassen die Vermutung zu, dass AR-Brillen insbesondere in internen Geschäftsprozessen ihre Stärke ausspielen. Während die Benutzung von VR-Brillen und AR-Technologien auf Smartphones das Endkundenerlebnis steigern soll, werden AR-Brillen dazu eingesetzt, Geschäftsprozesse effektiver und effizienter zu gestalten. Zwar finden wir all diese Technologien äußerst interessant, beschränken uns jedoch in diesem Artikel auf die beschriebenen Geschäftsprozesse und somit auf AR-Brillen. Im Internet finden sich Informationen zu zahlreichen verschiedenen Brillen. Dabei übersteigt das Angebot deutlich die in den Nutzungsszenarien des vorherigen Kapitels eingesetzten Geräte. Eine Bewertung der Ausgereiftheit der einzelnen Produkte würde rein spekulativen Charakter haben. Wir beschränken uns im Folgenden daher auf die in den beschriebenen Projekten eingesetzten Brillen. Wir lassen die Google Glass außen vor, da ihr Vertrieb eingestellt wurde. Somit bleiben drei Brillen für die nähere Untersuchung übrig: Vuzix m100, Epson Moverio BT-300 und Microsoft HoloLens. ### Spezifikationen Wir betrachten zunächst die technischen Spezifikationen der Brillen und stellen diese einander gegenüber. Vuzix m100Epson Moverio BT-300Microsoft HoloLensPreis1,079.99 €849,00 €3.299,00 €Display-ArtUndurchsichtiges LCD-DisplayHalbtransparentes OLED-DisplayPrisma-Projektor (Durchsichtig)Bildschirm-auflösung432 x 2402 \* (1.280 x 720)2 \* (1.268 x 720)Sichtfeld15°23°30°ProzessorDual Core 1,2 GHzIntel® Atomâ„¢ x5, 1.44GHz Quad Core1.04Ghz Intel Atom x5-Z8100RAM1 GB2 GB2 GBInterner Speicher4 GB16 GB64 GBExterner Speicher32 GB (Micro SD)microSD (max. 2 GB), microSDHC (max. 32 GB)–SoundJaJaJaMikrofonJaJaJaKamera1080p Video + 5 MP Foto5 MP2 MP (Auch Hologramme aufnehmbar) + TiefenkameraGPSJaJa–KonnektivitätWLAN, Bluetooth, Micro-USBWLAN, Bluetooth, Micro-USBWLAN, Bluetooth, Micro-USBSteuerung4 control buttons, Remote control app (iOS & Android), Stimme, GestenTouchpad an externer SteuereinheitStimme und HandgestenBetriebssystemAndroid 4.04Android 5.1Windows 10Akkulaufzeit2 h6 h2 hAutarker BetriebJa, kann aber auch mit Smartphone gekoppelt werdenNein, verbunden mit externer SteuereinheitJaDer große Unterschied zwischen der HoloLens und den anderen Geräten wurde bereits in der Einleitung durch die Art der Anreicherung der Umwelt durch virtuelle Objekte beschrieben. Im Folgenden beschreiben wir ergänzend weitere Aspekte, die bei der Planung eines praktischen Einsatzes von AR-Brillen unserer Meinung nach berücksichtigt werden sollten. ### Displays Die Vuzix m100 verfügt lediglich über ein einseitiges Display. Zwar ist die Seite wählbar, jedoch kann immer nur ein Auge das Display sehen. Sie ist außerdem mit einem herkömmlichen Display ausgestattet, das im äußeren Sichtbereich eines Auges platziert wird und somit das Sichtfeld auf die Realität einschränkt, selbst wenn keine Informationen präsentiert werden. Anders bei Epson Moverio BT-300 und der HoloLens, bei denen das transparente Display vor beiden Augen platziert ist. Die Anreicherung der Realität mit weiteren Daten ist somit optional. Die Realität kann bei ausgeschaltetem Display uneingeschränkt wahrgenommen werden. ### Interaktion mit der Brille Ein weiterer großer Unterschied zwischen den Geräten besteht in der Interaktion. So ist es bei der Brille von Epson zwingend erforderlich, eine externe Steuereinheit in der Größe eines Smartphones mitzutragen. Dieses ist über ein Kabel mit der Brille verbunden und stellt ein Touchpad bereit. Sowohl HoloLens als auch Vuzix m100 ermöglichen die Steuerung per Stimme und Gesten. Außerdem stellt die Vuzix m100 darüber hinaus Bedienelemente an der Brille selbst bereit. ### Akkulaufzeit Für den Einsatz von AR-Brillen im Unternehmensalltag ist die Akkulaufzeit von essenzieller Bedeutung. Gerade in diesem Punkt gibt es großen Nachholbedarf. Vuzix m100 und HoloLens machen bereits nach 2 Stunden schlapp. Die Epson Moverio BT-300 profitiert hier vom Platzangebot der externen Steuereinheit in der der verhältnismäßig große Akku untergebracht ist. Dennoch hält sie ohne Pitstop an der Steckdose keinen 8-stündigen Arbeitstag durch. Hier verspricht die Vuzix m300 deutliche Verbesserungen. Externe Akkus sorgen je nach Größe für eine 2 – 12 stündige Laufzeit und können auf Grund der im Brillenrahmen verbauten internen Batterie zur Laufzeit ausgewechselt werden. Die Vuzix m300 ist jedoch aktuell nur für Premium Partner von Vuzix verfügbar. ### Entwicklungsumgebung und verfügbare Apps Die HoloLens arbeitet mit Windows 10. Die Entwicklung findet in C# und Unity statt. Es gibt einen Emulator, so dass die HoloLens bei der Entwicklung nicht verfügbar sein muss. Die beiden anderen vorgestellten Brillen setzen auf Android. Somit haben Entwickler, die sich bereits mit der Entwicklung von nativen Android Apps auseinandergesetzt haben, einen leichteren Einstieg. Neben der Eigenentwicklung von Apps steht Standardsoftware zur Verfügung. Das Angebot der App Stores ist über folgende Links einzusehen: - Vuzix: - Epson Moverio: [https://moverio.epson.com/jsp/pc/pc\_application\_list.jsp](https://moverio.epson.com/jsp/pc/pc_application_list.jsp) - HoloLens: Verschiedene Entwickler stellen die Apps entweder kostenlos oder gegen ein Entgelt bereit. So ist beispielsweise für die Vuzix m100 eine „Collaboration App“ von Atheer erhältlich, welche die Möglichkeit bietet, mit Experten per Livevideo Kontakt aufzunehmen und mit ihnen zu telefonieren. Außerdem können Videos annotiert werden. Es ist somit möglich, mit dieser App bereits einige der obigen Testszenarien zu realisieren. Atheer, der Hersteller der App, hat bereits Partnerschaften mit weiteren Herstellern von AR-Brillen wie recon, Epson und ODG geschlossen. Zum Zeitpunkt des Verfassens des vorliegenden Artikels haben wir die App jedoch nicht im Store von Epson gefunden. ### Outdoor Nutzung Für die Outdoor Nutzung bestehen zwei Anforderungen: eine hohe Bildschirmhelligkeit und eine hohe Robustheit gegenüber äußeren Einflüssen wie Regen, Staub und Stößen. Von den zu betrachtenden Geräten ist keines für seine Wasserdichtigkeit zertifiziert. Es gibt jedoch Geräte auf dem Markt, bei denen dies der Fall ist. Als Beispiel sei die ODG R-7 genannt, welche wir jedoch auf Grund fehlender größerer Pilotprojekte nicht näher betrachten. Dennoch sind sowohl die Vuzix m100 als auch die Epson Moverio BT-300 laut Hersteller Outdoor tauglich. Anders sieht es bei der HoloLens aus. Microsoft hat die HoloLens explizit für den Gebrauch im Innenraum konzipiert. So ist auch der vergleichsweise dunkle Bildschirm zu erklären. Epson löst das Problem der möglicherweise schwierigen Lichtverhältnisse im Außenbereich durch die Bereitstellung von getönten Brillengläsern. Mit ihnen soll es dem Träger möglich sein, das Display selbst bei starker Sonneneinstrahlung abzulesen. ### Navigation Die Navigation ist ein vielversprechender Ansatzpunkt für den Einsatz von AR-Brillen. Dabei kommt es jedoch zu besonderen Herausforderungen. Zur näheren Erläuterung unterscheiden wir die Indoor von der Outdoor Navigation. Die Indoor Navigation ist theoretisch möglich durch: - Beacons (1-3m) - WiFi (5-15m) - UWB (10-30cm, aber zusätzlicher „Locator Tag“ auf Seiten des Nutzers nötig) Die in Klammern angegebenen Messgenauigkeiten wurden durch eine Internetrecherche auf Seiten von spezialisierten Unternehmen gewonnen. Wir halten diese Zahlen für optimistisch. Bei eigenen Tests der Navigation mit der Beacontechnologie und WiFi kamen wir unter realistischen Bedingungen stellenweise auf eine 100% höhere Abweichung. UWB weist im Gegensatz zur Navigation mit Beacons und WiFi eine ausreichende Genauigkeit auf, ist jedoch durch seine hohen Anschaffungskosten und die zusätzliche Belastung des Nutzers durch den „Locator Tag“ nur unter speziellen Bedingungen wirtschaftlich bzw. komfortabel. Die betrachteten AR-Brillen unterstützen allesamt die Navigation mit den drei genannten Techniken. Microsoft bietet mit der HoloLens noch eine weitere Technik. Durch ihre Tiefenkamera ist sie in der Lage, die Umgebung zu erfassen und ein virtuelles 3D-Modell zu erstellen. Ebenso können bereits vorhandene 3D-Modelle in der HoloLens geladen werden. Sie ist in der Lage in diesem Modell punktgenau zu navigieren. Gaze Tracking führt dazu, dass sogar die Lage des Kopfes ermittelt werden kann. Die Genauigkeit der Outdoor Navigation über GNSS für die zivile Nutzung hängt stark von den Empfangsbedingungen ab. Dabei können unter guten Bedingungen die Abweichungen von der realen Position durchaus auf bis zu 3m sinken. In der Regel ist die Abweichung jedoch weitaus größer. In der Praxis ist GNSS hauptsächlich für die Navigation auf Straßen sinnvoll. Anders sieht es aus, wenn kleinere Wege relevant werden, welche dicht beieinander liegen. Dann stoßen selbst softwareseitige Korrekturmaßnahmen an ihre Grenzen. Auf Grund des vorhanden GPS Sensors sind sowohl Vuzix m100 als auch Epson Moverio für die Outdoor Navigation somit eingeschränkt geeignet. Die Navigation mit Hilfe eines 3D-Modells wie oben beschrieben ist grundsätzlich auch im Außenbereich möglich, im Falle der HoloLens jedoch nicht vom Hersteller empfohlen. ## Zusammenfassung und Ausblick Die Nutzungsszenarien der AR-Brillen sind sehr vielversprechend. Die bisher durchgeführten Pilotprojekte zeigen, dass das Potenzial zur Steigerung der Effizienz der Geschäftsprozesse groß ist. Nichtsdestotrotz sollte beachtet werden, dass die Technik noch am Beginn ihrer Entwicklung ist. Viele der zu Promotionszwecken erstellten Videos der Hersteller der AR-Brillen scheinen noch Zukunftsmusik zu sein. Dabei konnten im vorliegenden Artikel vor allem die fehlende Robustheit, die limitierte Akkulaufzeit und die nur eingeschränkt mögliche Navigation als Hemmnisse identifiziert werden. Ergonomie und Optik dürften hingegen insbesondere bei den reinen Datenbrillen keine großen Hürden mehr für einen praktischen Einsatz darstellen. Die Entwicklungen bei den Geräten gehen in eine vielversprechende Richtung. Aktuell sind sie zwar noch nicht uneingeschränkt für den professionellen Einsatz zu empfehlen, jedoch scheinen sie in die richtige Richtung zu gehen. Dennoch kann eine Beschäftigung mit dem Thema AR im Unternehmen und der Einsatz noch nicht ausgereifter AR-Brillen bereits jetzt wertvolle Erkenntnisse liefern. Gesammelte Erfahrungen können sich bereits in einigen Jahren auszahlen. Gerade der Remote Support scheint ein dankbares Einsatzszenario von AR-Technik zu sein. Es ist absehbar, dass bereits in naher Zukunft AR-Brillen soweit sein werden, dass sie komfortabel über einen kompletten Arbeitstag eingesetzt werden können. Bereits jetzt steht Standardsoftware zur Verfügung, die Funktionen für den Remote Support bereitstellt. Sollen Daten aus Legacy Systemen wie im Fall von Boeing bereitgestellt werden, so scheint dennoch eine Individuallösung die einzig mögliche Wahl. Auch das Vision Picking im Warenlager kann bereits in naher Zukunft durch AR-Brillen gut unterstützt werden, sofern die organisatorischen Rahmenbedingungen im Warenlager hierzu geeignet sind. Als realistisches Szenario kann hier das oben beschriebene Pilotprojekt der DHL dienen. Ein Szenario wie es SAP in Zusammenarbeit mit Vuzix visualisiert hat, scheint hingegen noch in weiter Ferne. Darüber hinaus lohnt ein Blick über den Tellerrand. Der Einsatz anderer Devices wie Smartphones oder VR-Brillen kann je nach Szenario die bessere Wahl sein. Zusammenfassend bietet die AR-Technologie vielversprechende Möglichkeiten, die aller Voraussicht nach bereits in naher Zukunft Geschäftsprozesse in Unternehmen sinnvoll unterstützen können. Dennoch sollte eine allzu euphorische Heransgehensweise, die leicht unter dem Einfluss von beeindruckendem Marketingmaterial der Brillenhersteller entstehen kann, vermieden werden. Durch die in diesem Artikel genannten kritischen Aspekte, wollen wir einen Beitrag zum besonnenen Einstieg in das Thema Augmented Reality liefern. Quellen / Weiterführende Informationen:- Van Krevelen & Poelman (2010): A Survey of Augmented Reality Technologies, Applications and Limitations **Kategorien:** AI & Data Science **Schlagwörter:** Augmented Reality, HoloLens --- ### [OPITZ CONSULTING gründet das OC|AB](https://thecattlecrew.net/2017/07/10/opitz-consulting-gruendet-das-ocab/) **Published:** Juli 10, 2017 **Author:** Richard Attermeyer **Content:** Kaum ein Tag vergeht, ohne, dass neue Meldungen über die Digitalisierung veröffentlicht werden, die über Potenziale, Herausforderungen oder neue Technologien berichten. Was steckt aber eigentlich dahinter? Im Grunde genommen lassen sich verschiedene Trends beobachten, die sich gegenseitig treiben: - Auf Seiten der Infrastruktur sind Rechenleistung und Bandbreite extrem gestiegen, sodass immer mehr Features in Softwareprodukten und Plattformen zur Verfügung standen, bis sie schließlich als Cloud Service angeboten werden konnten. Software ist nun spontan buchbar und kann auf reinen Verbrauchskennzahlen abgerechnet werden, was enorme Möglichkeiten bei der Flexibilität und Skalierbarkeit bietet. Dies bildet die technische Grundlage und Infrastruktur für die Realisierung vieler neuer Angebote. - Durch Vernetzung und Cloud Services steht heute dem Speichern großer Datenmengen nichts mehr im Wege. Analysen und Auswertungen können über diese Daten durchgeführt werden, was völlig neue Einblicke und Transparenz ermöglicht. Daten werden nicht mehr gelöscht, sondern für spätere Analysen gespeichert. - Integration und APIs schaffen Schnittstellen, sodass Menschen, Dinge und Maschinen miteinander kommunizieren können. APIs bieten Interaktionspunkte mit der digitalen Welt an. Die Integration übernimmt die Steuerung, sodass benötigte Informationen zum richtigen Zeitpunkt an der richtigen Stelle vorhanden sind. Durch Interaktion und Kommunikation fallen wiederum Daten an, die sich für neue Ideen nutzen als auch analysieren lassen. - Auch Benutzerschnittstellen sind allgegenwärtig. Während Maus und Tastatur lange die Standard-Interfaces für Menschen waren, sind diese im alltäglichen Gebrauch schon lange abgelöst worden. Smartphones, Sprachsteuerung oder auch Kameras und Bewegungserkennungen kommen immer häufiger zum Einsatz und unterstützen Menschen mittlerweile sogar unbewusst bei ihrer Interaktion mit IT-Systemen. Das Spannende bei diesen Trends ist, dass sich die Technologien in eine Richtung entwickelt haben, in der die einzelnen Themen konvergieren und sich nicht mehr separat betrachten lassen. Eine ganzheitliche Sicht auf Business Cases und Geschäftsmodelle, Technologien, Softwarearchitekturen als auch Zukunftsfähigkeit und Ü„nderbarkeit ist notwendig. Dies hat Einfluss bis zu den Organisationsstrukturen und Prozessen, da diese mit der Ü„nderbarkeit umgehen müssen. Dies ist in unserem Vier-Säulen-Poster und unserem E-Book „Dynamikrobuste Architekturen der Digitalisierung“ weiter ausgeführt. Verständnis in der Breite und Expertise in die Tiefe sind daher von essentieller Bedeutung. Um unserem Kunden Zugriff auf dieses Wissen zu ermöglichen, den Austausch innerhalb von OC zu fördern und zukunftssichere Architekturen in unseren Projekten zu konzipieren als auch umzusetzen, haben wir darum das OC|AB, das OPITZ CONSULTING Architecture Board, gegründet, in dem Experten aus den verschiedensten fachlichen Disziplinen zusammenkommen. Diese Experten werden für viele Belange, zum Projektstart, bei Ausschreibungen und für die Architekturkonzeption hinzugezogen, um ihr Wissen in die Projekte zu tragen. Dadurch werden Mehrwerte, Alternativen und neue Potentiale aufgezeigt und der technischen Herausforderung der Digitalisierung begegnet. **Kategorien:** Tools & Methoden --- ### [Was glauben wir eigentlich, wer wir sind?](https://thecattlecrew.net/2017/07/12/was-glauben-wir-eigentlich-wer-wir-sind/) **Published:** Juli 12, 2017 **Author:** ninanuernberger **Content:** **In einer Zeit, in der sich viele Menschen, selbst in westlichen Ländern, offenbar nach autoritärer Staatsführung und Abschottung sehnen, will die IT die Anarchie einführen. Wie kommen wir dazu, zu glauben, dass uns das gelingen wird?** Anarchie ist die Königin aller Staatsformen. Denn sie ist die Abwesenheit von Herrschaft. Das Problem ist, dass sie nur dann funktioniert, wenn eine Gesellschaft reif dafür ist. Auf den ersten Blick mag die Analogie unsinnig wirken. Wenn man sich aber darauf einlässt, wird einem klar, wie utopisch es ist, Agilität als Einstellung und Grundlage für die moderne Arbeitswelt etablieren zu wollen. Laut statistischem Bundesamt waren 2015 19.690.000 Erwerbstätige mindestens 45 Jahre alt. Das bedeutet, dass sie im besten Fall, als Kinder freier Liebe in der blumengeschmückten Obhut von Hippies aufgewachsen sind. Das bedeutet wahrscheinlich aber auch, dass sie in klassischen Rollenbildern als Kinder der Gewinner des Wirtschaftswunders in schmucken Vororten groß geworden sind. In einer Familie, in der Papa arbeitete und den Ton angab, Mutter kochte, wusch und bügelte und jeder sich über das definierte, wovon er mehr hatte als sein Nachbar. Es kann auch sein, dass diese Menschen das Nachkriegsdeutschland wieder aufgebaut haben und selbst Teil des Wirtschaftswunders waren. Vielleicht haben sie den Krieg sogar noch erlebt. Mal abgesehen von den Blumenkindern (nur nebenbei: eine Bewegung, die sich nicht durchgesetzt hat) sind all diese Menschen in klaren Hierarchien aufgewachsen, in denen Strategien, Konzepte und Pläne aller Art von „oben“ entworfen und zur Umsetzung nach „unten“ weitergegeben wurden. Ein Teil dieser Generationen folgte Befehlen und Anweisungen, der andere Teil machte eben jene Vorgaben, kontrollierte ihre Einhaltung und optimierte die Kosten-Nutzen Rechnung. Mir ist schon klar, dass das sehr vereinfacht dargestellt ist. Aber ich bin dennoch der Meinung, dass diese Geschichte einen wahren Kern hat, der nicht zu unterschätzen ist. Wir erleben in unserer täglichen Arbeit unter anderem, wie schwierig es ist, diese Rollen aufzubrechen. Und zwar für beide Teile. Wir kämpfen mit der Angst der klassischen Führungskräfte, dass ihnen die Kontrolle und ihr Posten verloren gehen. Genauso kämpfen wir mit dem Unbehagen derer, die jetzt plötzlich Verantwortung übernehmen sollen, obwohl sie eigentlich gerne nur Befehlsempfänger sind. Haben wir je geprüft, ob wir als Gesellschaft bereit sind für die Veränderungen, die wir im Rahmen der Digitalisierung als Beschleunigung und Motor der Effizienzsteigerung vollziehen? Und noch einen Schritt zurück: Kennen wir überhaupt die Voraussetzungen unter denen eine Gesellschaft willens und fähig ist, so zu arbeiten, wie wir es uns auf schillernden Power Point Folien, bunten Flipcharts und glänzenden Whiteboards ausgemalt haben? Das agile Vorgehen hat seinen Ursprung in der Softwareentwicklung. Die komplexer werdenden Aufgaben und die zunehmende Geschwindigkeit und Menge von Veränderungen machte es erforderlich, flexibel, schnell und in möglichst kleinen Einheiten, unabhängig von anderen Teilen eines Systems oder einer Organisation reagieren zu können. Iterativ inkrementelles Arbeiten in crossfunktionalen Teams: Eine gute Lösung für ein konkretes Problem. Das agile Manifest war die Verschriftlichung der Best Practices aus x-Jahren Softwareentwicklung und kein am Reißbrett erfundenes Framework. Die Unterzeichner standen hinter dem, was sie erarbeitet hatten, weil sie bereits wussten, dass es funktioniert. Aber warum haben wir das Vorgehen aus der Softwareentwicklung in die Arbeitswelt getragen ohne uns zu fragen, ob überhaupt ein Problem besteht, das wir lösen müssen? Ich glaube, das ist die falsche Frage. Wir haben uns sehr wohl gefragt, ob der Bedarf besteht, die Arbeitswelt umzubauen. Wir haben erkannt, dass Konzepte in den Händen derer, die ihre Umsetzung bewerten und bewerkstelligen können, besser aufgehoben sind, dass Anforderungen nicht vom Himmel fallen, sondern derjenige, der sie äußert von Anfang an verstanden und in den Entstehungsprozess der Lösung eingebunden sein muss, dass das Übernehmen von Verantwortung für ein Produkt „“ egal welches auch immer es sein mag „“ die Qualität und die Bindung der Mitarbeiter an ihre Arbeit und ihre Identifikation mit der Organisation erhöht. Wir haben das verstanden, weil wir den Schmerz empfunden haben, der mit starken Hierarchien, langwierigen Entscheidungswegen, fehlender Einbindung von Betroffenen und mangelnder Sensibilität und Wertschätzung einhergeht. Was wir allerdings vergessen haben ist, dass sich die Frage für viele nie gestellt hat. Wir setzen an mit Mindsets, Frameworks und Maßnahmen für Probleme, die andere gar nicht als solche sehen. Unfrei sein ist kein Problem für denjenigen, der seine Ketten mag oder vielleicht gar nicht weiß, dass es da draußen noch mehr gibt. Was steht uns nun als Basis vielfach zur Verfügung? Aus ihrer Erziehung und Erfahrung heraus hierarchisch geprägte Menschen, die den Drang nach Veränderung nicht mitbringen und sie darüber hinaus nicht als zwingend einschätzen. Warum also glauben wir, dass wir vor diesem Hintergrund die Anarchie einführen werden? Weil wir nicht anders können! Weil gegenseitige Achtung, Verantwortung, Gleichberechtigung und Leidenschaft unsere einzige Chance sind, die Gesellschaft in die Zukunft zu führen. Und weil Veränderung schon immer in kleinen Gruppen begann und durch ihren Erfolg nach oben getragen wurde, fangen wir bei einem Software Entwicklungsteam an“¦ **Kategorien:** Tools & Methoden **Schlagwörter:** agile --- ### [Factsheet OC|LeanEAM](https://thecattlecrew.net/2017/07/21/factsheet-ocleaneam/) **Published:** Juli 21, 2017 **Author:** Markus Grünewald **Content:** Ein Angebot aus dem Leistungsportfolio unseres CC Strategy ist OC|LeanEAM. Unser gerade veröffentlichtes Factsheet [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Fact\_Sheet/83-factsheet-lean-eam.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/83-factsheet-lean-eam.pdf) bietet einen guten Überblick über unser Angebot im Bereich Enterprise Architecture Management (EAM). Das Thema EAM ist bei vielen Kunden leider negativ belastet, da es oft als zu komplex und schwerfällig empfunden wird. Mit dem Angebot OC|LeanEAM möchte Opitz Consulting (OC) hier eine leichtgewichtige und pragmatische Methode vorstellen, die Unternehmen bei der Umsetzung ihrer Strategie unterstützt. OC|LeanEAM kann bei Bedarf durch andere Angebote aus dem CC Strategy wie z.B. dem Digitial Awareness Workshop und Change Facilitation ergänzt werden. Mit EAM können ganzheitliche Betrachtungen des Unternehmens entwickelt werden, die fundierte und schnellere Entscheidungen ermöglichen und dabei strategische, businessrelevante als auch technologische Gesichtspunkte berücksichtigen. Die folgende Analogie zur Städteplanung hilft das Thema Enterprise Architecture besser einzuordnen ![EAM_Analogiie](https://thecattlecrew.net/wp-content/uploads/2017/07/eam_analogiie.png) Das folgende Whitepaper bietet weitere Informationen http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Artikel/whitepaper-it-transformation-with-enterprise-architecture\_sicher.pdf **Kategorien:** Architecture & Process Models **Schlagwörter:** EAM, Enterprise Architecture, Strategie, Strategy --- ### [Scrum vs. Kanban - eine Entscheidungshilfe](https://thecattlecrew.net/2019/02/13/scrum-vs-kanban-eine-entscheidungshilfe/) **Published:** Februar 13, 2019 **Author:** Ralph Grabensee **Content:** **Scrum und Kanban sind zwei Methoden im agilen Projektmanagement und haben ihre Wurzeln in der Lean Production. Sie legen das Pull-Prinzip (Hol-Prinzip) zugrunde. Die anfallende Arbeit erteilt nicht ein „Supervisor“, sondern die Arbeiter(-gruppen) holen sich ihre Arbeit, um den Produktionsfluss möglichst fließend zu halten. Der Artikel stellt die Grundsätze beider Frameworks vor und gibt Entscheidungshilfen für den Einsatz in Softwareprojekten.** #### Grundsätze von Kanban *Visualisierung des Arbeitsflusses.* Zentraler Punkt von Kanban ist die Optimierung des Prozess- bzw. Arbeitsflusses. Im Zentrum steht das Kanban-Board. Es visualisiert den aktuellen Stand des Projektes mit Kärtchen für eine Aufgabe. Das Board zeigt den Status der jeweiligen Aufgabe sowie deren Anzahl die sich gleichzeitig in einem Status befinden. *Begrenze die Anzahl der Aufgaben in Bearbeitung.* Fange eine neue Aufgabe nicht an, bevor eine andere erledigt ist. *Konstante Bearbeitung der Aufgaben.* Zwischen Beginn und Fertigstellung einer Aufgabe wird die durchschnittliche Bearbeitungszeit gemessen. Diese ist zu verringern und konstant zu halten. Häufen sich Karten in einem Status ist der „Fluss“ zu optimieren durch: Erhöhung der Ressourcen im angestauten Prozessschritt oder Überdenken der Prozessschritte. So reguliert sich das System kontinuierlich selbst. #### Grundsätze von Scrum Im Mittelpunkt von Scrum stehen kleine, *selbstorganisierte Teams* mit 6±3 Mitgliedern. Das zu entwickelnde Produkt wird in test- und lieferfähige *Inkremente* zerlegt. Die Projektlaufzeit wird in kleine Iterationen von 1 – 4 Wochen, sogenannte *Sprints*, aufgeteilt. Am Anfang eines Sprints steht das *Sprintplanning*, in welchem die Menge an Aufgaben definiert und geschätzt wird. Während des Sprints tauscht sich das Team in einem täglichen Meeting (*Daily*) über geleistete und zu erledigende Arbeiten sowie über Hindernisse aus. Am Ende eines Sprints wird das Produkt dem Auftraggeber präsentiert und Feedback eingeholt (*Sprint Review*). Abschließend werden in einer *Retrospektive* die Projektziele und die Arbeitsweise kritisch beleuchtet und bei Bedarf neu ausgerichtet. #### Welches Framework für welchen Zweck? Welche agile Methode in einem Projekt zum Einsatz kommt, kann unter anderem an der Komplexität der Aufgaben beurteilt werden. Bei kleineren, eher sporadisch auftretenden (Weiter-)Entwicklungen einer bestehenden Software oder Wartungsarbeiten die keinen kontinuierlichen Arbeitsfluss sicherstellen, ist Kanban die richtige Wahl. Diese Arbeiten sind klar umrissen und i.d.R. von geringer Komplexität und zeitlicher Dauer. Scrum ist in einem Umfeld zu bevorzugen, in dem der Anteil an Nichtwissen im Bezug auf konkrete fachliche Anforderungen (Was?) und deren technische Umsetzung (Wie?) größer ist als das Wissen darüber (Stacey Matrix). Der Endzustand des zu entwickelnden Produktes ist nicht klar definiert, sondern eher als Vision mit Features und/oder Stories umrissen. Teamgrößen von ein bis zwei Personen sprechen eher für Kanban sowie ein geringes „Setup“ des Frameworks. Kanban erlaubt im Gegensatz zu Scrum flexibel auf neue oder umpriorisierte Anforderungen zu reagieren. Bei Scrum ist der Umfang für die Dauer eines Sprints festgelegt und i.d.R. nicht erweiterbar. Das Team hat sich zu Beginn eines Sprints gemeinsam auf feste Arbeitsinhalte verpflichtet. Neue Anforderungen müssen auf den nächsten Sprint verschoben werden. Kanban kann diese zusätzlichen Arbeitspakete aufnehmen, solange die Kapazitätsgrenze eines Prozessschrittes nicht überschritten wird. Scrum-Teams sind funktionsübergreifend und benötigen mindestens folgende Rollen: Product Owner, Scrum Master und Entwicklerteam. Das Team handelt selbstorganisiert und eigenverantwortlich. Die Teammitglieder stellen Teaminteressen vor Eigeninteressen und handeln nach dem „Wir“-Prinzip. Sie handeln auf Grundlage des Agilen Manifest für Softwareentwicklung (). Die handelnden Personen stehen dem Team dauerhaft zur Verfügung und schätzen die ritualisierte Zusammenarbeit. Welches Framework für welche Aufgabenstellung geeignet ist entscheidet letztlich das Projektteam selbst. Wobei nichts dagegen spricht, Elemente aus beiden Methoden zu mischen, um das beste Projektergebnis zu erreichen. **Kategorien:** Development, Tools & Methoden --- ### [Das V-Modell XT und Agilität - Passt das zusammen?](https://thecattlecrew.net/2017/08/24/das-v-modell-xt-und-agilitaet-passt-das-zusammen/) **Published:** August 24, 2017 **Author:** anl **Excerpt:** V-Modell XT und agile Frameworks bzw. Methoden lassen sich zu einem innovativen Integrationsmodell kombinieren: Es bietet viel Flexibilität für dynamische Anforderungen. Die Frage ist also: Wie kann man diese unterschiedlichen Vorgehensmodelle miteinander verbinden?... **Content:** Es kommt immer wieder vor, dass OPITZ CONSULTING als Dienstleister von einem Auftraggeber zum Einsatz des V-Modell XT verpflichtet wird, wohlwissend, dass wir agile Vorgehensweisen bei der Projektdurchführung bevorzugen. Eine spannende Herausforderung ist es für uns daher, praktikable Konzepte und Vorgehen zu entwickeln und zu erproben, bei denen unsere gelebten agilen Vorgehensweisen in das etablierte V-Modell eingebettet werden. V-Modell XT und agile Frameworks bzw. Methoden lassen sich zu einem innovativen Integrationsmodell kombinieren: Es bietet viel Flexibilität für dynamische Anforderungen; zudem lässt es sich leicht in mehrere Teilprojekte aufteilen und kostengünstig abwickeln. Auf der einen Seite steht also das V-Modell XT „“ mit seinen mehr als 30 Rollen, über 100 Produkttypen und zahlreichen Entscheidungspunkten („Meilensteinen“) ein hochskalierbares und mit klaren Schnittstellen für die Zusammenarbeit von Auftraggebern und Auftragnehmern ausgestattetes Vorgehensmodell. Auf der anderen Seite finden wir bewährte agile Vorgehensmodelle bzw. Frameworks wie Scrum, Kanban „“ mit wenigen Rollen, einer Handvoll Produkten und einer anderen Meetingstruktur/-Kultur. ## **Die Frage ist also: Wie kann man diese unterschiedlichen Vorgehensmodelle miteinander verbinden?** Generell ist das V-Modell XT darauf ausgelegt, sowohl den Auftraggeber (AG) als auch den Auftragnehmer (AN) von der Projektidee über Ausschreibung, Vertragsschluss und Entwicklung bis hin zum Projektabschluss methodisch durchgängig zu unterstützen. Weiterhin berücksichtigt dieses Vorgehensmodell beispielsweise, ob es sich um ein Entwicklungs- oder ein Wartungsprojekt handelt oder welche Merkmale das Projekt auszeichnen: Geht es rein um Software oder auch um Hardware? Spielen Sicherheit oder Ergonomie eine besondere Rolle? Muss ein Altsystem migriert werden? Sollen Teilleistungen von Unterauftragnehmern erbracht werden? Genau diese vielfältigen Einsatzmöglichkeiten verursachen bei vielen Betrachtern den Eindruck einer enormen „“ vermeintlichen – Komplexität. Um diese aufzulösen, wird der Begriffszusatz „XT“ des V-Modell XT angewandt. Das „XT“ steht für „e**X**treme **T**ailoring“. Dadurch sind mit dem V-Modell XT vielfältige projekt- und organisationsspezifische Anpassungen möglich. In einem konkreten Projekt wird mit Hilfe des Zuschnitts immer nur eine Teilmenge des Modells angewendet, so dass sich nach dem Projekt-Setup mit dem im V-Modell XT enthaltenen Projektassistenten stets eine deutlich reduzierte Dokumentation ergibt, die sich auch auf die möglichen Dokumentenartefakte (hier „Produkte“ genannt) niederschlägt. Dieses integrierte Werkzeug ist eine Open-Source-Lösung zur softwaretechnischen Unterstützung der auszuwählenden Tailoring-Maßnahmen. Auf Basis dieses Projekt-Tailoring wird abschließend im automatisch erstellten Projekthandbuch festgelegt, welche der vorgeschlagenen Produkte überhaupt gepflegt werden soll. So können z. B. unterschiedliche Produkte wie einzelne Spezifikationstypen zu einer Dokumentation zusammengefasst werden. Des Weiteren wird festgelegt, wo bzw. wie die Projektdokumentation gepflegt werden soll (z. B. dateibasiert in Word oder in Excel oder in einem Kollaborationstool wie Confluence). Fazit: Das V-Modell XT bietet spätestens ab der aktuellen Version 2.1 auch offiziell sehr viele Möglichkeiten, um den formalen Aufwand deutlich zu reduzieren. Unter diesen Voraussetzungen fällt es nun schon deutlich leichter, an die Integration agiler Vorgehensweisen in das V-Modell XT zu denken. Eine solche Integration ist darin auch in die Kategorie der „organisationsspezifischen Anpassungen“ ausdrücklich vorgesehen und wird in der Regel nicht projektspezifisch, sondern nur einmalig vorgenommen. Am Ende erhält man damit ein „agiles V-Modell“. ![V-A_1](https://thecattlecrew.net/wp-content/uploads/2017/08/v-a_1.png) ## **Wie könnte eine solche Integration praktisch aussehen?** Im V-Modell XT gibt es Entscheidungspunkte für die Fertigstellung von Dokumenten und Systemelementen, an denen über den weiteren Projektfortschritt entschieden wird. Der genaue zeitliche Ablauf, wann und in welcher Reihenfolge diese Entscheidungspunkte durchlaufen werden, wird durch vordefinierte Strategien, sogenannte „Projektdurchführungsstrategien“, beschrieben. Mit Hilfe dieser Strategien können auf Gesamtsystem-, System-, Hardware- und Softwareebene Iterationen durchgeführt werden. Das V-Modell XT hält neben der „inkrementellen Entwicklungsstrategie“ für die Flexibilität und Anpassungsfähigkeit im Umgang mit Anforderungen bzw. noch unbekannten Technologien auch eine „prototypische Entwicklungsstrategie“ bereit, bei der die Dokumentation erst nach der Fertigstellung der zugehörigen Systemelemente erstellt wird. Diese Strategie könnte damit der Verbindungpunkt für eine Verbindung beider Vorgehensweisen sein. Dies bedeutet nicht, dass wir mit dieser Entwicklungsstrategie als Ergebnis nur Prototypen erzeugen können „“ es entstehen „echte“ Produkte. **Projektsteuerung zusammenführen** Die Projektsteuerung ist im V-Modell XT auf einem anderen Niveau angesiedelt als bei agilen Vorgehensweisen wie Scrum. Die Vorgaben des V-Modell XT, die im Wesentlichen auf das Erreichen von Entscheidungspunkten zielen, bewegen sich auf einer Makro-Management-Ebene. Im Unterschied dazu befindet sich der Scrum-Ablauf, der auf der Realisierung von Anforderungen durch elementare Entwickler-Tasks in kurzen Sprints basiert, im Bereich des Mikro-Management. Diese unterschiedlich hohen Ebenen der Steuerung machen es möglich, beide Prozesse zu kombinieren, indem die Mikro-Steuerung mit Scrum in die Makro-Steuerung nach dem V-Modell XT eingebettet wird. Um eine V-Modell XT konforme Einbettung zu realisieren, d. h. die im Modell definierten Schnittstellen zwischen Auftraggeber und Auftragnehmer nicht zu beeinträchtigen, wird dafür gesorgt, dass an den entsprechenden Entscheidungspunkten die relevanten, vom Auftraggeber geforderten V-Modell-Dokumente (bzw. die Inhalte dieser Produkte) fertiggestellt sind. Ein Schlüsselinstrument, um diese Forderung zu erfüllen, ist das Product Backlog. ### **Schlüsselinstrument Product Backlog** Mit dem Einsatz der beschriebenen prototypischen Projektdurchführungsstrategie erhält das Product Backlog eine zentrale Stellung: Es besteht überwiegend aus Anforderungen an das zu erstellende System, die sich aus dem Lastenheft und „“ später im Projektverlauf „“ aus Ü„nderungsanträgen und Fehlermeldungen ergeben. Die Anforderungen werden nach Bedarf verfeinert und um technische Informationen ergänzt. Die Erstellung von Dokumenten, die nach dem V-Modell XT gefordert sind, werden ebenfalls wie Anforderungen behandelt und in das Product Backlog aufgenommen. Das Scrum-Team hält in seiner „Definition of Done“ fest, dass die Anforderungen für ihre Integration in die Dokumente aktualisiert und „kundenkompatibel“ formuliert werden. Der auf die beschriebene Weise entstandene integrierte Prozess bietet dem Auftraggeber erheblichen Spielraum, sich analog zum Product Owner im Scrum-Vorgehensmodell, in das Auftragnehmerprojekt einzubringen. Die folgende Abbildung stellt eine solche Integration beider Vorgehensweisen dar: ![V-A_2](https://thecattlecrew.net/wp-content/uploads/2017/08/v-a_2.png) Nach dem Entscheidungspunkt „Iteration geplant“ setzen im Scrum-Ablauf die Sprint-Planung und -Durchführung ein. Die nachfolgenden Iterationen sind auf den verschiedenen farbig (blau, grün und rot) markierten Ebenen ineinander verschachtelt. Für jede Ebene gibt es die bekannten agilen Elemente: - Product Backlog - Sprint Backlog - „Definition of Done“-Kriterien Der Inhalt der DoD-Kriterien ergibt sich u. a. aus den Produkten der jeweiligen Entscheidungspunkte des V-Modell XT, die in den jeweiligen Ebenen zusammengefasst sind. Die Entscheidungspunkte „Gesamtsystem entworfen“ „Lieferung durchgeführt“ und „Abnahme erfolgt“ gewährleisten, dass die vom V-Modell XT erforderliche AG-/AN-Schnittstelle bestehen bleibt. Mittels dieser Schnittstelle an den Entscheidungspunkten müssen alle vom Auftraggeber geforderten V-Modell-Dokumente fertiggestellt und vorgelegt werden. ## **Fazit** Die Integration von agilen Vorgehensmodellen in das V-Modell XT ist nicht trivial, aber möglich. Das V-Modell XT unterstützt bei der sinnvollen Aufteilung des Gesamtsystems in Teilsysteme und bei der Definition der Schnittstellen zwischen diesen. Für die Entwicklung jedes dieser Teilsysteme können wiederum die Stärken von agilen Prozessen wie Scrum ausgespielt werden. In diesem Umfeld ist die richtige Zusammenstellung von „cross-funktionalen“ Teams wichtig. Wesentliche Informationen über die benötigten Kompetenzen liefert hierzu das V-Modell XT. Der vorab aufgezeigte Ansatz zeigt eine Möglichkeit, wie man das V-Modell XT und agile Methoden und Frameworks wie Scrum sinnvoll miteinander kombinieren könnte. Die Konformität dieser Lösung ist offiziell zwar noch nicht von der V-Modell-Zertifizierungsstelle freigegeben, aber sie deckt sich mit den Lösungsvorschlägen einer Reihe von anerkannten V-Modell-Autoren (z. B.*D. Rauh, M. Wittmann; V-Modell-XT Konformität und „“Assessment, in: OBJEKT-spektrum 3/2009*und *S. Canditt, D. Rauh, M. Wittmann; Das V-Modell XT mit Scrum inside, in: OBJEKT spektrum Themenspecial Agility 2011*). **Kategorien:** Development, Tools & Methoden --- ### [Crowdfunding for business](https://thecattlecrew.net/2017/08/31/crowdfunding-for-business/) **Published:** August 31, 2017 **Author:** Christian Thielke **Excerpt:** This article is about a crowdfunding thesis of a working student at OPITZ CONSULTING, who publishes the thesis itself via a crowdfunding campaign on Kickstarter. **Content:** ##### This article is about a crowdfunding thesis of a working student at OPITZ CONSULTING, who publishes the thesis itself via a crowdfunding campaign on [Kickstarter](https://www.kickstarter.com/projects/1603754359/crowdception-your-crowdfunding-future-and-my-thesi?ref=3v5dw2). Read more here: [![Crowdfund_our_Ideas_Today (2)a](https://thecattlecrew.net/wp-content/uploads/2017/08/crowdfund_our_ideas_today-2a.png)](https://www.kickstarter.com/projects/1603754359/crowdception-your-crowdfunding-future-and-my-thesi?ref=3v5dw2) Nowadays the term „crowdfunding“ is known to many people. Primary objective is the financing of projects through funds from the crowd „“ the masses of those who are aware of the crowdfunding campaign. Thousands of projects are funded with reward-based crowdfunding and millions of contributions are collected every year. On Kickstarter.com, the best-known platform for reward-based crowdfunding, more than 3.2 billion US $ were pledged by the crowd. Only about 10% of them were not debited from the bank accounts or credit cards of the supporters because the funding target of the campaign could not be reached in time. More than 130,000 successful projects raised about 2.85 billion US $ by funds of nearly 13.5 million different backers worldwide. \[See , 28.08.2017\] ### Not only for startups Crowdfunding does not only have advantages for potential start-ups to realize their ideas. There are advantages for each of us: Both individuals with good (and not yet implemented) product ideas, as well as existing companies which want to change their processes in product development, marketing and market research to fit digitalization or maybe simply want to break new ground in the development of new products. Flat hierarchies and employee co-determination through crowding practices are also possible. With all these topics, I am currently working on my bachelor thesis on reward-based crowdfunding. Behind the long title „šCrowdfunding: An overview of the development and the different models – focus: implementation of reward-based crowdfunding campaigns, including recommendations for business consultancy“™ (in German: „˜Crowdfunding: Ein Überblick über die Entwicklung und die verschiedenen Modelle „“ Schwerpunkt: Durchführung reward-basierter Crowdfunding-Kampagnen einschließlich Handlungsempfehlungen für die Unternehmensberatung“™) is hidden a whole lot: - A general overview of the four different crowdfunding models, - a list of advantages of crowdfunding, - a kind of guidance, how to prepare and handle a reward-based crowdfunding campaign and what to be considered as well as - recommendations for business consultancies (or companies in general) ### Does this have influence on me or my company? The contents of this bachelor thesis will be interesting not only for OPITZ CONSULTING, but for every potential maker as well as every company worldwide. For this reason, I was able to convince my manager to spread my crowdfunding thesis through my own crowdfunding campaign on Kickstarter so that the results of my work can be shared with the whole world. - You“™re a potential maker? - You have great product ideas, which are not yet implemented? - Your company produces end-user products or plans to do so? - Your company is looking for possibilities to involve its employees more closely? - You“™re interested in crowdfunding in general? If you have affirmed only one of the above questions, you should have a look at the thesis by yourself: [https://www.kickstarter.com/projects/1603754359/crowdception-your-crowdfunding-future-and-my-thesi](https://www.kickstarter.com/projects/1603754359/crowdception-your-crowdfunding-future-and-my-thesi?ref=3v5dw2) ### Do not wait „“ create! **Kategorien:** Tools & Methoden **Schlagwörter:** Business Models, communication, Crowdfunding, Crowdsourcing, Digital Innovation, Digitalisierung, Digitization, Events, Feedback, HowTo, Kickstarter, Market Research, Marketing, News, Pioneering, Product Development, Startup, Strategie, Strategy, Student, Workshop --- ### [The journey to user-centric innovation in 5 simple steps](https://thecattlecrew.net/2018/02/13/the-journey-to-user-centric-innovation-in-5-simple-steps/) **Published:** Februar 13, 2018 **Author:** monikaschubert **Content:** „Experience the journey to user-centric innovation in 5 simple steps“ this was the title of our workshop at the [OOP conference](http://www.oop-konferenz.de/oop2018/programm/konferenzprogramm/sessiondetails/action/detail/session/mo-6-1/title/experience-the-journey-to-user-centric-innovation-in-5-simple-steps.html) this year. Our workshop addressed people who are looking for innovations in digital products and services, but run short of new ideas. People who have ideas, but can“™t decide whether they are brilliant or a dead end were welcome as well. So what did we do? During our workshop our participants experienced **Design Thinking** in order to avoid the trap of conventional thought patterns and to boost creativity and innovation to find new solutions for issues that have proven to be tough to crack. The challenge we provided was: *„How might we redesign the **parking situation** in urban environments **to improve the living quality**?“* So how did we start? After a short introduction to Design Thinking we explored all five steps of the Design Thinking process: ![Design Thinking Process](https://thecattlecrew.net/wp-content/uploads/2018/02/design-thinking-process.png) Keep in mind that a core principle of Design Thinking is to question, evaluate and revise your assumptions – what you think you already know – in order to break complacency and bad habits. During the **Empathize-Phase** we tried to dig deeper into our users minds, needs, behaviours and pain points. We opened up the problem space to identify what users really need. During the **Define-Phase** we defined different problems and selected the most promising one. For example: *Laura needs an easy to reach parking lot in order to have more time for her child, doing sports and shopping*. Various ideas emerged during the **Ideation-Phase**. We first collected them silently. After everybody has freed his mind we got together in groups and discussed the various ideas. While presenting ideas to others our participants continuously came up with new ideas. At the end of the Ideation-Phase we selected the most promising one and built a prototype during the upcoming **Prototype-Phase**. For prototyping we provided elements of the story telling box, Lego as well as paper materials. Beyond others prototypes were built for the following ideas: - An autonomous cars that works similar to car sharing providers. - Drones that store the cars either on houses or other car parking places up in the air. - An autonomous trolley that transports the stuff of a sales person from one appointment to another. Finally we did a short **Testing-Phase** using presentations. Here are some impressions: [![](https://thecattlecrew.net/wp-content/uploads/2018/02/oop1-150x150.jpg)](https://thecattlecrew.net/2018/02/13/the-journey-to-user-centric-innovation-in-5-simple-steps/oop1/) [![](https://thecattlecrew.net/wp-content/uploads/2018/02/oop2.jpg)](https://thecattlecrew.net/2018/02/13/the-journey-to-user-centric-innovation-in-5-simple-steps/oop2/) The keep my personal summary short I want to stress three points: - Although the prototypes were cheap and easy made I was pretty **impressed by the quality of the ideas** and how well thought through they were! - The **time** slot was fucking **short**. We only did a half day workshop and we had to keep a good time management to go through all five steps of the Design Thinking process. - And the most beautiful words came from a participant when he noticed, that they **came up with a lot of new ideas during the prototyping**. **Kategorien:** Tools & Methoden **Schlagwörter:** design, Design Thinking, Digital Innovation, English, methoden, Methods, Workshop --- ### [Poster zu BPM Pattern](https://thecattlecrew.net/2018/02/14/poster-zu-bpm-pattern/) **Published:** Februar 14, 2018 **Author:** voigthendrik **Content:** Cloud, Integration of Everything oder Big Data „“ OC besetzt so viele spannende Themen und haut jetzt noch ein neues BPM Poster raus?! Na klar, all die ausgetüftelten Algorithmen, Chatbots, restful 3rd party services und vernetzten „Dinge“ wollen zu etwas Großem kombiniert werden: Zu einem Geschäftsprozess. BPMN 2.0 bietet nach wie vor den besten Kompromiss aus Verständlichkeit, technischer Ausführung und Verbreitungsgrad. Geschäftsprozesse sollten für alle Stakeholder transparent anstatt im Quellcode nur für Entwickler und Compiler lesbar sein. Der Digitalisierungs-Hype rückt zurzeit andere Konzepte ins Rampenlicht, sicherlich auch zurecht. Trotzdem hat BPM nichts an Bedeutung verloren. Deshalb haben wir ein paar wiederkehrende Prozessschnipsel mit Hilfe von BPMN 2.0 als BPM Pattern zusammengetragen und in einem [Poster](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_BPM-Pattern_A1_WEB.pdf) kombiniert. ![OC-Poster_BPM-Pattern-min](https://thecattlecrew.net/wp-content/uploads/2018/02/oc-poster_bpm-pattern-min.jpg) Ich wünsche euch weiterhin einen guten Flow „¦ Liebe Grüße, Hendrik **Kategorien:** Architecture & Process Models, Tools & Methoden --- ### [Ist das noch Scrum oder kann das weg?](https://thecattlecrew.net/2018/07/10/ist-das-noch-scrum-oder-kann-das-weg/) **Published:** Juli 10, 2018 **Author:** Ferhat Göcer **Content:** Das [Agile Manifest](http://agilemanifesto.org/) ist der kleinste gemeinsame Nenner aller agilen Vorgehensmodelle, das in nur vier Sätzen ausdrückt, welche Prinzipien für die agile Entwicklung zugrunde gelegt werden sollten. Scrum und Kanban gehören dabei zu den bekanntesten agilen IT-Projektmethoden und erweitern das Agile Manifest um weitere Leitsätze. Scrum schreibt dabei im Vergleich zu Kanban mehr vor und setzt umfassendere Rahmenbedingungen voraus. Dennoch haben sie beide ihre Daseinsberechtigung. Unter manchen Agilisten wird Scrum jedoch geradezu dogmatisch eingesetzt ohne die Begebenheiten der Organisation und die individuellen Charakterzüge eines Projekts zu betrachten. Dabei sollten beide Ansätze als empirisch aufgefasst werden, die dabei helfen sollen, den Weg einer kontinuierlichen Verbesserung zu finden. Es fällt einem dabei nicht immer leicht, eine Richtung zu finden und glaubt man einmal die richtige Richtung gefunden zu haben, kann sich diese mit der Zeit wieder „falsch“ anfühlen. Anhand der Erfahrung aus einem mittlerweile erfolgreich beendeten Projekt, das als Scrum aufgesetzt wurde und im weiteren Verlauf immer mehr Kanban-Züge erhielt, möchte ich euch konkrete Fragestellungen beschreiben, die damals dafür sorgten, den Kompass neu zu justieren. Ich hoffe, sie helfen auch euch, euer Projekt / eure Situation aus dem Korsett des Scrums zu befreien, um das Kind beim Namen zu nennen: Hallo Kanban! 1. **Ü„ndern sich die Anforderungen bzw. deren Prioritäten schlagartig?** Falls ja, ist dies als Zeichen für ein Kanban-Vorgehen zu werten, da innerhalb von Scrum die Sprints geschützt werden sollten. In einem Sprint committed sich das Team *(neuerdings wird es als Forecast des Teams betrachtet)* darauf, bestimmte Anforderungen innerhalb eines Sprints zu bearbeiten und idealerweise am Ende dessen produktiv auszuliefern. Das Team identifiziert sich vollkommen mit dem Sprintinhalt und ist sich sicher, diese Inhalte am Sprintende auch ausliefern zu können. Ü„ndert sich plötzlich der Inhalt oder Umfang des Sprints, geht das meist auf die Motivation des Teams und die langfristige Teamleistung *(Velocity)*, was sich letztendlich kontraproduktiv auswirkt. In Kanban können dafür neue Anforderungen jederzeit an das Team zugetragen werden. Idealerweise gelingt ein gleichmäßiger Arbeitsfluss. Ergeben sich jedoch neue Erkenntnisse und somit Anforderungen, können laufende Aktivitäten an anderen Anforderungen zurückgestellt oder sogar komplett verworfen werden. Die Auslieferung der Anforderung kann ggf. sofort erfolgen. Die Leistung des Teams *(Cycle Time)* kann sich durch diese Veränderung sogar erhöhen, wenn die neue Anforderung schneller umgesetzt werden kann. 2. **Trägt die Schätzung und die Planung noch zu einem Mehrwert bei?** Im Kontext von Scrum-Projekten hat sich das Schätzen von Anforderungen in abstrakten Einheiten wie Story Points oder T-Shirt-Größen etabliert. Daraus lassen sich die Planbarkeit *(Passt sie noch in den Sprint?)* als auch die Machbarkeit einer Anforderung abschätzen. Nach einer gewissen Projektzeit verlieren diese Informationen an Relevanz. Schätzrunden und Planungsmeetings werden vermehrt als überflüssig angesehen, da die Meetings inhaltliche, sich wiederholende Muster erkennen lassen *(„ist doch alles die gleiche Komplexität“)* oder weil das gemeinsame darüber sinnieren keinen Mehrwert mehr bringt *(„dazu kann ich nichts sagen, das macht dann eh ein anderer“)*. In der IT sind das meist Projekte in der Wartungsphase, wo Teams an ungeplanten Ü„nderungen bzw. Verbesserungen der Software arbeiten. Die Aufgaben sind zumeist auch technisch wie fachlich voneinander unabhängig und können nur von gewissen Teammitgliedern bearbeitet werden. Die Komplexität und der langfristig aufkommende Workload sind in solchen Fällen kaum abschätzbar und somit gestaltet es sich immer schwieriger, stabile Sprints zu bilden. Stattdessen sollte eigentlich ein kontinuierlicher Aufgabenfluss stattfinden, wie Kanban es vorsieht. 3. **Können nur bestimmte Teammitglieder bestimmte Aufgaben erledigen?** Wenn es immer öfter vorkommt, dass anstehende Aufgaben nur von Teammitgliedern erledigt werden können, die spezielles Expertenwissen oder Vorwissen besitzen, sollten die Alarmglocken läuten. In Scrum darf diese Situation nämlich nicht auftreten, da hier jedes Teammitglied über ein cross-funktionales *(T-Shaped)* Wissen besitzt. Das bedeutet, dass jeder Einzelner im Team fähig ist bzw. befähigt werden kann eine anstehende Aufgabe von Anfang bis Ende erfolgreich zu bearbeiten. 4. **Finden Reviews und Retrospektiven nicht mehr (regulär) statt?** Falls Reviews und Retrospektiven immer weniger oder nicht stattfinden, ist das ein Zeichen dafür, dass Scrum nicht (mehr) gelebt wird. Meist ist dies eine Folge der Veränderungen, die sich u.a. auch aufgrund der vorherigen Erläuterungen ergeben haben. Auch wenn beide Projektmethoden eine kontinuierliche Verbesserung anstreben, sind diese beiden Meetings in Scrum so essentiell, dass eine kontinuierliche Verbesserung fast nur durch sie ermöglicht werden. Die kontinuierliche Verbesserung in Kanban erfolgt dagegen meist durch Beobachtung und Anpassung des gelebten Prozesses. Meistens geschieht dies nicht in einem ordentlichen Retrospektive-Meeting, sondern fortwährend *(Stichwort [PDCA-Zyklus](https://de.wikipedia.org/wiki/Demingkreis))*. Wenn dann mögliche „Bottelnecks“ identifiziert und beseitigt werden sollen, wird der Prozess so schnell wie möglich angepasst. Dabei kann er beispielsweise durch „WIP Limit erhöhen oder senken“, „mehr oder weniger Leute im Team“, „Abläufe anpassen“, etc. entsprechend neu justiert, beobachtet und ggf. wieder angepasst werden. 5. ****Die Frage aller Fragen“¦****[![](https://thecattlecrew.net/wp-content/uploads/2018/07/modern_agile_wheel_german.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2018/07/modern_agile_wheel_german.png)Eine moderne Interpretation der agilen Prinzipien. Bildquelle: http://modernagile.org Abgesehen davon sollte man sich stets die Frage aller Fragen stellen: **Leben wir (noch) die agilen Prinzipien?** Wenn nicht, dann könnten der Ehrlichkeit halber nämlich beide weg ;-). **Kategorien:** Development, Tools & Methoden --- ### [UX with neuro-physiological data](https://thecattlecrew.net/2018/08/29/ux-with-neuro-physiological-data/) **Published:** August 29, 2018 **Author:** Dr. Anuja Hariharan **Content:** User centric design is all about putting the users first. Yet, most of our knowledge about users comes only when users themselves report their preferences, which disturbs the inherent variable of interest „“ such as their current level of emotion, or stress level. What if we could use users“™ existing data, to understand behavior, design better interfaces and provide better UX, by capturing their subconscious processes? Today“™s IT products enable us to capture plenty of user information, such as eye movement, mouse hovering patterns, heart rate, or other signals that users keep constantly generating. These subconscious clues are nothing but indicators of what users are likely to do, which products they prefer, which websites they prefer to use, and several such choices. UX Designers can utilize these data, to know their users better and design better. To capture such user information, several platforms have been developed in the recent past, with different subset of features (such as sensor integration, web experiments, user interaction studies, among others, see Hariharan et al. 2017). We present [Brownie](https://im.iism.kit.edu/1093_1100.php), a Java-based open source platform available for use by UX designers and researchers. - Brownie can be used to find out, if a user interface works at all. - It can be used to find out, whether users prefer one design over the other „“ but without users reporting directly. - It can be used which parts of a system a user prefers to use, which interfaces make them react more, and which interfaces do not invoke the users‘ interest. - It can even be used to investigate user errors, unused parts of an application, or other operative issues. Brownie is unique in the following aspects: - Synchronous recording of multiple sensor modalities - Usable across human computer interaction, UX design, practitioners and researchers - Open source and extensible ![UX with neuro-physiological data](https://thecattlecrew.net/wp-content/uploads/2018/08/ux-with-neuro-physiological-data1.png) Figure 1: Human sensor based UX process using Brownie © OPITZ CONSULTING If you are interested to conduct sensor-based UX research for your products/ design human centric IT using Brownie/ would like to request for a workshop to know more, feel free to contact me at anuja.hariharan@opitz-consulting.com Brownie“™s source code can be downloaded [here ](https://bitbucket.org/kit-iism/experimenttool/). **Kategorien:** Development, Tools & Methoden **Schlagwörter:** design, Innovation, Java, usability --- ### [Change your Change. Denn es geht alle an!](https://thecattlecrew.net/2018/11/13/change-your-change-denn-es-geht-alle-an/) **Published:** November 13, 2018 **Author:** Verena Scheller **Excerpt:** IT verändert vieles. Umso wichtiger ist es aus unserer Sicht, dass wir „Techies“ wissen, was bei Veränderungen passiert. Wir möchten mit Euch darüber sprechen, wie "Change" in Zukunft aussieht. Change your change. Denn es geht alle an **Content:** CattleCrew zeigt es Tag für Tag, Beitrag für Beitrag: Wir von OPITZ lieben gut gemachte IT. Wir DOCKERn uns in Leidenschaft, wir tauchen ab in die Cloud, wir kramen in der Blockchain, wir haben die Finger tief im Code und noch tiefer in den Data Lakes, wir hacken mit Alexa, wir erschaffen (Serverless-)Architekturen und Self-Service-BI, wir rocken die Datenbanken und Server, wir jonglieren die Mikroservices und wir SPRINGen. Wir wissen: Die Gegenwart und die Zukunft brauchen gut gemachte IT. Wir gestalten und erschaffen digitale Welten. Mit ganz viel Herzblut. Ganz viel technologischer Expertise. Und Pragmatismus. #### **Und wir wissen. Es braucht mehr!** Überzeugungskraft Richtung Stakeholder in Projekten. Fingerspitzengefühl bei der Einführung neuer Technologien, neuer Software, neuer digitaler Produkte. Politisches Geschick im Projekt- und Programmmanagement. Ein gutes Ohr für Bedarf und Bedürfnisse bei Wartung und Betrieb. Inspirationskraft bei der Weiterentwicklung von Software und Neugestaltung von Architekturen. Tatkraft bei der Verbreitung agiler Vorgehensmodelle. Innovations- und Schaffenskraft bei der Suche nach neuen Ideen. Transformationsfähigkeit bei der Gestaltung von DevOps. #### Ohne „den Faktor Mensch“ gäbe es keine IT. IT verändert vieles. Umso wichtiger ist es aus unserer Sicht, dass wir „Techies“ wissen, was bei Veränderungen passiert. Mit den bestehenden Architekturen und Technologien. Aber auch mit den Menschen, die sie gestalten und nutzen. Und mit den Unternehmen, die sie kaufen und verkaufen. Seit knapp 3 Jahren erlebt deshalb eine unserer Wurzeln ein Revival: Organisationsberatung und Changebegleitung. Mit diesem Anspruch sind unsere Gründer 1990 gestartet. Und im Zuge der digitalen Welle verändert sich auch unser Portfolio und unsere Beratungshaltung. Für unsere Kunden. Und weil wir uns selbst verändern. Ständig und täglich neu erfinden. Beispielsweise in dem wir uns zu Change Coaches und Facilitatoren ausbilden. **Change your change!** Wir machen Change aus der Biosphäre IT heraus. Weil wir diese Welt aus dem Effeff kennen. Uns in ihr pudelwohl fühlen. Und Brücken bauen können zu all den anderen Biosphären des Marketings, des Produktmanagements und der Fachdomänen, der HR, der Unternehmensentwicklung und der Führungsebene. Deshalb haben wir unsere Organisations- und Changeberatung neu konzeptioniert und den Beratungsservice OC|change entwickelt. Und bei uns selbst und bei „friendly customers“ getestet. Mit dem gleichen Herzblut, dem gleichen Teamgeist, der gleichen Lernbereitschaft und dem gleichen Pragmatismus, der uns auch hinsichtlich unserer technologischen Expertise seit 28 Jahren auszeichnet. Denn wir glauben: Wenn sich die Welt ändert, darf sich auch „Change“ ändern. Wir begleiten Veränderungen zupackend und iterativ-inkrementell. Auf Basis fundierten Wissens aus Management, Team- und Organisationsentwicklung, Neuropsychologie, Training, Beratung und Coaching. Systemisch vorgehend. Antidogmatisch und interdisziplinär handelnd. Und kontextsensitiv agierend. Mit Leichtigkeit und doch ernsthaft. Denn wir glauben an Veränderung durch Verantwortung. ![Changeyourchange_VSC](https://thecattlecrew.net/wp-content/uploads/2018/11/changeyourchange_vsc.jpg) Wie genau das aussieht und funktioniert, haben wir nicht nur mit einigen unserer Kunden bereits im realen Leben getestet, sondern auch letzte Woche einem CTO eines großen DAX-Konzerns erzählt. Auch bei unserem Meetup „Change your change“ in München am 15.11.2018 wird es um dieses Thema gehen. Wir freuen uns auf spannenden Austausch mit Euch! **Kategorien:** Tools & Methoden **Schlagwörter:** Change, DevOps, Innovation, News, Product Development, Softwarenentwicklung --- ### [DevOps, DevSecOps, SecDevOps, SecDevSecOps – Was ist das?](https://thecattlecrew.net/2019/02/21/devops-devsecops-secdevops-und-secdevsecops-was-ist-das-mario-nolte/) **Published:** Februar 21, 2019 **Author:** Mario Nolte **Content:** DevOps, SecDevOps, DevSecOps und SecDevSecOps – was haben diese ganzen Abkürzungen zu bedeuten? Gehen wir zuerst auf die Namen ein. Hinter den Abkürzungen stehen diese Begriffe: DevOps = Development & Operations DevSecOps = Development & Secured Operations SecDevOps = Secured Development & Operations SecDevSecOps = Secured Development & Secured Operations Bei der Betrachtung des Vorgehensweise stellt man schnell fest, das einige Praktiken der Automatisierung von Prozessen und Barrierefreiheit zwischen Entwicklern und der IT-Infrastruktur dazu führen schneller, nachvollziehbarer und zuverlässiger Produkte oder Releases, Bugfixes zu entwickeln, zu testen und freizugeben. DevOps als Wettbewerbsvorteil, dies spiegelt sich z. B. in solchen Aussagen wider: ``` "Dank DevOps können wir sehr häufig Releases veröffentlichen, wodurch wir im Wettbewerb einen Vorteil haben. Wir können nun täglich statt nur alle sechs Monate neue Produkte auf den Markt bringen und unseren Kunden Fehlerbehebungen innerhalb weniger Stunden zur Verfügung stellen." ``` *Hamesh Chawla, VP of Engineering bei Zephyr* Eine massgebliche Grundlage von DevOps, SecDevOps, DevSecOps und SecDevSecOps ist die Zusammenarbeit von mehreren Teams in den Bereichen Development und Infrastruktur. Durch die Zusammenarbeit von Teams kommt es zur einer Vertrauensstärkung, die wiederum dazu führt, dass schnellere Software-Release-Wechsel stattfinden, z. B. die Behebung unplanbarer kritischer Fehler. ## Secured Development Secure Development und Secure Deployment werden auch benannt als S-SDLC (Secure Software Deplopment Life Cycle). Es werden in jeder Phase der Entwicklung: Checklisten, Templates für Aktivitäten und Protokolle zum Nachvollziehen benutzt. Ziel ist es, den Benutzern/Entwickern zu helfen, durch Benutzung von Methodiken Security Issues zu vermeiden und so das Security Overall-Level zu erhöhen. Im Entwicklungszyklus sind von folgende Punkte enthalten (je nach Bedarf anzupassen): - Einführung: S-SDLC Framework - Training Guideline: Aufzeigen von Security Problematiken und wie diese zu verhindern sind „“ Training System - Requirements Phase: Risk Evaluation Guideline und Requirements Criteria Doc. - Design Phase: Security Design Review Guideline und Threat Modeling Guideline. - Implement Phase: Security Coding Guide(C/C++、JAVA、PHP,C#) - Validation Phase: Aktivität Level, Security Testing Guideline - Release Phase: Vulnerability Management und Incident Response Guideline ## Secured Operations Secure Operation hilft um ein sichere, rolenbasierte Infrastuktur aufzubauen, zu verwalten und wieder abzubauen. Dabei wird auf gesicherten Pfaden operiert. Dies inkludiert eine Identity Validation und Authentifizierung als auch das Absichern von Netzwerkwegen. Die Secured Operations werden unter RDSIM zusammengefasst (je nach Bedarf anzupassen): - Role-based Access: Die rollenbasierte Zugriffssteuerung unterverwendung von Benutzern, Gruppen und Anwendungen mit benutzerspezifischen Berechtigungen. - Datenspeicherung: Beschränkung von Zugriffen und Speichermedien auf bestimmte Benutzer/Gruppen und Kommunikationswege z.B. https. - Sicherheitsrichtlinien: Verwendung und Bereitstellung von End-To-End-Lösungen, sowie die Dokumentation von Sicherheitsvorfällen und abgeleitete Handlungsweisen. Wie die Empfehlung zur Benutzung neuer Technologien z.B. Next Generation Firewalls. - Identitätsrichtlinien: Sicherung der Identität von Prozessen und Benutzer oder Gruppen mit Hilfer der Verwendung Authentifizierung z.B Single-Sign-One (SSO) und Multi-Faktor Authentifizierung, als auch Step-Up and Step-Down Authentifizierung - Monitoring: Überprüfung und Bewertung von sicherheitsrelevanter Ereignisse bzw. Kritischer Aktivitäten und Anomalieerkennung. Kritische Ereignisse werden einer detizierten Sicherheitsrichtlinie zugeführt. ## DevOps/SecDevOps/DevSecOps/SecDevSecOps meet Agilität Mit dem Ziel des „Continous Delivery“ werden die Besten Teile der Enwickler und Operatoren vereint, um die Effizienz der Automatisierung im Zuge der Digitalisierung zu erhöhen. Agile Techniken wie Scrum, Agile sind beliebte Methoden, um die Zusammenarbeit der Teams und Innovationskraft zu steigern. DevOps ist eine Denkweise, eine Methode, eine Vorgehensweise mit dem Ziel togehter. DevOps und all seine Varianten von Secured sind somit das Netzwerk um zielgerichtete Operations und Verhalten zu ermöglichen. Die dahinterliegenden Tools sind Mittel zum Zweck dieses zu erreichen. **Kategorien:** DevOps **Schlagwörter:** DevOps, DevSecOps, SecDevSecOps, Secured Operation --- ### [Erfolgreiches Backlog Refinement durchführen](https://thecattlecrew.net/2019/04/02/erfolgreiches-backlog-refinement-durchfuehren/) **Published:** April 2, 2019 **Author:** Andreas Lehner **Excerpt:** Ein Leitfaden für jede Person, die ein Backlog Refinement erfolgreich planen und durchführen möchte. **Content:** Ein Leitfaden für jede Person, die ein Backlog Refinement erfolgreich planen und durchführen möchte. ## Was ich mit dem Artikel beabsichtige? Dieser Leitfaden unterstützt die Scrum-Team-Mitglieder bei Vorbereitung, Durchführung und Nachbearbeitung des „Backlog Refinement“-Events. Mit Hilfe des Leitfadens kann jedes Team-Mitglied ein Backlog Refinement durchführen, auch wenn der Product Owner oder Scrum Master mal abwesend ist. ## In welchem Kontext spielt der Artikel? Der Leitfaden entwickelte sich aus: 1. eigenen Erfahrungen in einem bestimmten Projektkontext und Organisationskontext 2. aus nützlichen Hinweisen aus Literatur über Agile Softwareentwicklung Der Leitfaden dient der Orientierung und Inspiration seinen eigenen Refinement-Prozess zu gestalten. Für jede Organisation und jedes Team wird sich ein optimaler Prozess anders entwickeln und gestalten. Die folgenden Abschnitte beschreiben die Prozessschritte, die zu erfolgreichen Backlog Refinements führten. ## 1. Vorbereitung ### Einladung für die relevanten Teilnehmer vor dem Refinement-Termin aktualisieren Termine, Räume und Teilnehmer können sich jederzeit ändern. Damit jeder informiert ist, sollten die Einladungen angepasst werden und rechtzeitig vor dem Termin versandt werden. ### Raum vorbereiten Ist der Raum aufgeräumt? Sind alle notwendigen Materialien (Board, Sticky Notes, Whiteboard, etc.) verfügbar? Funktioniert der Beamer? Gibt es Getränke und Erfrischungen? ### Scrum Board und relevante Inhalte vorbereiten Das Board und Backlog so vorbereiten, dass das Team mit dem Refinement der relevanten Stories ohne Verzögerung beginnen kann. Welche Stories für das Refinement relevant sind, sollte vor dem „Refinement“-Event entschieden sein. Die Inhalte sollten vorab in der Einladung als Agenda mitversendet werden. Diese Entscheidung triff das Produkt-Team mit Hilfe von Priorisierungen und Scoping-Workshops. **TIPP:** nicht einfach das JIRA an die Wand beamen. Viel besser arbeitet es sich an einem physischen Board. Dort kann jeder Notizen, Ergänzungen oder Anpassungen machen. Später kann alles ins JIRA übertragen werden. ### Werkzeug für agiles Schätzen einpacken Scrum Poker ist eine verbreitete Schätzmethode. Im Refinement wird geschätzt. Daher: Scrum Poker nicht vergessen! ### Timer für Time-Box einpacken Jede Story die verfeinert wird, sollte im Rahmen einer Time-Box verfeinert werden. Beispiel: Pro Story eine Time Box von 10 Minuten. ![Refinement Vorbereitung](https://thecattlecrew.net/wp-content/uploads/2019/04/Refinement-Vorbereitung.png)Refinement Vorbereitung## 2. Durchführung des Refinements ### Gemeinsames Verständnis erzeugen Folgende Fragen sollten vom Moderator / Facilitator beantwortet werden um den Sinn, Zweck und die Motivation für das Refinement für jeden verständlich zu machen und in Erinnerung zu rufen. - Warum sind wir hier? - Wer ist hier? - Was ist das allgemeine Ziel eines Refinements? Was ist die Motivation für das Refinement? - Wie gehen wir gemeinsam vor? Z.B. Dauer des Workshops, Time Box, erklären usw. - Was werden wir konkret machen (Agenda)? - ![Refinement Gemeinsames Verständnis](https://thecattlecrew.net/wp-content/uploads/2019/04/Refinement-Gemeinsames-Verständnis.png)Gemeinsames Verständnis über den Workshop erzeugen### Review (Rückblick) durchführen Folgende Fragen sollten vom Moderator / Facilitator beantwortet werden: - Was wurde bisher für das Release geschafft? ### Überblick über das aktuelle Opportunity und Product Backlog geben Folgende Fragen sollten vom Moderator / Facilitator beantwortet werden: - Was sind die aktuellen Prioritäten? - Worauf liegt aktuell der Fokus? ![Refinement review](https://thecattlecrew.net/wp-content/uploads/2019/04/Refinement-review.png)Review und Durchsicht der Backlogs und Prioritäten ### Inhalte „refinen“ Folgende Schritte sind empfehlenswert: - Auswahl und Vorstellen der Stories für die nächsten 1 bis 3 Sprints - Diskutieren der Story - Entscheidung treffen: Kommt die Story in das Produkt-Backlog oder zurück in das Opportunity Backlog (1) - Konkrete Tasks ableiten, um die Story „ready“ zu bekommen. Tipp: Tasks sollten SMART (2) sein. - Erarbeiten von Akzeptanzkriterien - Schätzen der Story - Sind sich alle einig, dass die Story „ready“ ist bzw. die „definition of ready“ erfüllt (3) ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Refinement-refinen.png)„Refinen“ – Verfeinern der Backlog Items### Zusammenfassung der wichtigsten Ergebnisse Folgende Fragen sollten vom Moderator / Facilitator beantwortet werden: - Welche Stories haben wir „refined“? - Wo finden wir die „Stories“ im Product Backlog? ### Ausblick auf die nächsten Workshops geben Folgende Fragen sollten vom Moderator / Facilitator beantwortet werden: - Was sind die nächsten Aktivitäten? - Wie geht es weiter? ![Ende des Workshops mit Zusammenfassung und Ausblick](https://thecattlecrew.net/wp-content/uploads/2019/04/Refinement-Sum-up.png)Ende des Workshops mit Zusammenfassung und Ausblick ## 3. Nachbereitung - Backlog in JIRA aktualisieren - Offene Punkte klären - Nächste Workshops und Refinements planen und vorbereiten ![Tätigkeiten nach dem Refinement-Workshop](https://thecattlecrew.net/wp-content/uploads/2019/04/Refinement-Danach.png)Tätigkeiten nach dem Refinement-Workshop ## Zusammenfassung Das Backlog Refinement zählt zu den wichtigsten Events agiler Software-Entwicklung. Die beschriebenen Schritte und Empfehlungen ermöglichen einen erfolgreichen Ablauf des Backlog Refinements. Auf diese Weise können Stories „ready“ gemacht werden für die Implementierung und das Coding im Sprint. Das Backlog Refinement lebt von der gemeinsamen Zusammenarbeit im Team. Nur so kann das geballte Wissen und die geballte Erfahrungen eines Scrum-Teams nach aussen treten und das Produkt mit dem angestrebten Mehrwert für die Endbenutzer bzw. Kunden bekleiden. **Welche Erfahrungen, positiv wie negativ, machten Sie mit Backlog Refinements?** **Welche Wege haben Sie und ihr Team gefunden „Refinements“ erfolgreich durchzuführen?** Ich freue mich über Austausch und Diskussion. ## Referenzen 1. Patton, Jeff. User Story Mapping . O’Reilly Media. Kindle-Version. 2. https://de.wikipedia.org/wiki/SMART\_(Projektmanagement) 3. https://www.romanpichler.com/blog/the-definition-of-ready/ ## Über den Autor **Andreas Lehner – Product Owner / UX Design** Trainer und Berater bei der OPITZ CONSULTING Deutschland GmbH. Er verfügt über 12 Jahre Erfahrung in der IT-Beratung von Großunternehmen. Seine Schwerpunkte sind die Schnittstellen von Mensch und Maschine. Das Fundament seiner Arbeit und Denkweise sind Design-Methoden sowie agile Prinzipien. **Kategorien:** Tools & Methoden **Schlagwörter:** Backlog, Product Owner, Refinement, Scrum, Workshop --- ### [Warum User Experience (UX) so schwierig ist und welche Modelle helfen, UX besser zu verstehen](https://thecattlecrew.net/2019/04/14/warum-user-experience-ux-so-schwierig-ist-und-welche-modelle-helfen-ux-besser-zu-verstehen/) **Published:** April 14, 2019 **Author:** Andreas Lehner **Content:** „Bitte stellen Sie sich jeden Menschen als in einer Insel lebend vor“. Diesen seltsam klingenden Satz formulierte Vera F.Birkenbihl (+2011), Persönlichkeitsentwicklerin und Managementtrainerin und Leiterin des Instituts für gehirn-gerechtes Arbeiten \[1\]. ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Inselmodell-1-1024x586.png)Zwei Menschen in einer Insel lebend Der Satz beschreibt mit dem einfachen Bild der Insel hochkomplexe Zusammenhänge des menschlichen Lebens. Denn die Insel beinhaltet alles was Sie je erlernt haben, ihre Hoffnungen, Ü„ngste, Motive, Ziele, Meinungen und ihre eigene Beschreibung der Welt. Überschneiden sich die Inhalte der beiden Inseln, so fällt der Umgang und die Kommunikation leicht. Doch dies ist nicht immer der Fall. Mal gibt es mehr Überschneidungen, manchmal weniger. Besonders im Fall von wenigen Überschneidungen ist es nützlich, fähig zu sein Brücken zwischen den Inseln zu bauen. Gute Brückenbauer sind gefragt! ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Inselmodell-2-1024x586.png)Eine Brücke zwischen zwei Inseln ## **Was haben diese Inseln nun mit User Experience zu tun?** Das Inselmodell visualisiert warum User Experience so schwierig ist: **1.User Experience Designer leben in einer eigenen Insel. Benutzer leben in einer eigenen Insel.** Um eine positive Benutzererfahrung zu entwickeln dürfen UX Designer die Brücke zur Insel der Benutzer bauen. Häufig gibt es kaum Überschneidungen zwischen UX Designer und Benutzer. UX Designer arbeiten mit Methoden und Werkzeugen, die es ermöglichen zu den unterschiedlichsten Inseln Brücken zu bauen. Mal ist es die Insel eines Stahlwerkarbeiters, mal ist es die Insel der Fashion-Online-Shopper, mal ist es die Insel von Service-Center Mitarbeitern eines Logistikunternehmens. Essentiell für das Brückenbauen sind die Methoden aus dem Bereich User Research. Ein Beispiel ist der Design Thinking Ansatz, der mit der „Empathy“-Phase den ersten Brückenpfeiler aufzieht \[2\]. **2.Positive User Experience wird in einem interdisziplinären Team entwickelt. Viele Inseln auf einem Fleck.** In den komplexen Systemen innovativer Produktentwicklung spielen interdisziplinäre Teams eine wichtige Rolle. Gemischte Teams aus Entwicklern, Designern und Business arbeiten gemeinsam an Lösungen. Diese Inseln verfügen meist über wenige Überschneidungen. Gute Brückenbauer sind auch hier gefragt. Methoden aus Change Facilitation und Coaching spielen hier eine entscheidende Rolle um aus Team-Inseln mit wenig Überschneidungen, Inseln mit vielen Überschneidungen zu schaffen. Aus einem Team könnte im Idealfall ein Dream-Team werden. ## Zusammenfassung Um herausragende und positive Benutzererfahrungen zu entwickeln sind Brückenbauer zwischen den einzelnen Inseln ein essentieller Bestandteil des Erfolgsrezepts. Empathie durch User Research dient als Brücke von UX Designer zum Endbenutzer. Ansätze und Methoden der Change Facilitation helfen interdisziplinären Teams besser zusammenzuarbeiten. Das Inselmodell eignet sich dabei als Erklärungsmodell warum UX so herausfordernd ist. **Auf welche Inseln sind Sie bereits gestoßen und wie haben Sie es geschafft Brücken zu bauen?** Ich freue mich über Austausch und Diskussion. ## Referenzen 1. https://vera-birkenbihl.de/ 2. https://www.interaction-design.org/literature/article/how-to-develop-an-empathic-approach-in-design-thinking ## Über den Autor **Andreas Lehner „“ Product Owner / UX Design** Trainer und Berater bei der OPITZ CONSULTING Deutschland GmbH. Er verfügt über 12 Jahre Erfahrung in der IT-Beratung von Großunternehmen. Seine Schwerpunkte sind die Schnittstellen von Mensch und Maschine. Das Fundament seiner Arbeit und Denkweise sind Design-Methoden sowie agile Prinzipien. **Kategorien:** DevOps --- ### [Wie sich das Denken für eine leistungsstarke DevOps-Organisation wandeln muss - Live-Webinar am 20.09.2019](https://thecattlecrew.net/2019/08/29/wie-sich-das-denken-fuer-eine-leistungsstarke-devops-organisation-wandeln-muss-live-webinar-am-20-09-2019/) **Published:** August 29, 2019 **Author:** thecattlecrew **Content:** **Webinar: [Infos und Anmeldung](https://www.opitz-consulting.com/einzelseiten/webinar-devops-change-mindset-before-toolset.html)** Es ist schon frappierend: Leistungsstarke DevOps-Organisationen haben im Durchschnitt 46 Mal häufiger als andere Unternehmen ihre Software released und ihre Fehlerrate bei Ü„nderungen um den Faktor 7 reduziert; zu diesem Ergebnis gelangt der [DORA Report zum State of DevOps 2018](http://www.opitz-consulting.de/redirect/F964D9C1D9CFE1CEF137B638FC5E11BC). DevOps besitzt also definitiv das Potenzial, viele Herausforderungen im IT-Umfeld zu bewältigen. Firmen und Organisationen, die DevOps erfolgreich einsetzen „“ [etwa Netflix, Walmart, Amazon oder Facebook](http://www.opitz-consulting.de/redirect/F964D9C1D9CFE1CE03D71FFF137F9635) „“ zeigen, wie DevOps den Weg an die Spitze noch einmal besonders ebnen kann. Mit Vorteilen wie einer kürzeren Time-to-Market, verbesserter Produktqualität und höherer Kundenzufriedenheit ist DevOps bereits der neue Branchen-Standard für Software-Entwicklung. [![](https://thecattlecrew.net/wp-content/uploads/2019/08/webinar-devops_200x200.jpg)](https://www.opitz-consulting.com/einzelseiten/webinar-devops-change-mindset-before-toolset.html) **Webinar: [Infos und Anmeldung](https://www.opitz-consulting.com/einzelseiten/webinar-devops-change-mindset-before-toolset.html)** ### Mehr als nur ein „weicher Faktor“ Auch wenn DevOps in aller Munde ist, stehen doch meist die technologischen und organisatorischen Aspekte im Vordergrund. Der kulturelle Wandel, der mit dem DevOps-Ansatz verbunden ist, wird als *weicher Faktor* häufig vernachlässigt und viele DevOps-Organisationen scheitern genau aus diesem Grund. Für Unternehmen, die DevOps langfristig zum Erfolg führen möchten, ist es enorm wichtig, diese Lücke zu schließen und ihre Mitarbeiter von Anfang an in die „DevOps-Welt“ mitzunehmen. Doch bedeutet DevOps nicht auch eine radikale Veränderung für die ganze Organisation? Und bringt DevOps nicht auch Risiken für Compliance und IT-Sicherheit mit sich? Vor solchen Herausforderungen heißt es, weder zu kneifen noch die Augen zu verschließen, sondern sich sorgsam vorzubereiten und vor allem auch die Mitarbeiter mitzunehmen. Das Zauberwort heißt Cultural Change. Oder in diesem Fall noch etwas konkreter: Mindset before Toolset! ### Webinar „DevOps: Mindset before Toolset“ 20. September 2019, 11 – 12- Uhr „DevOps: Mindset before Toolset“ ist jetzt auch der Titel eines Live-Webinars, das unser DevOps-Experte Halil Hancioglu gerade gemeinsam mit unserer DevOps-Expertin und Change Facilitator Cornelia Spanner für den 20.09.2019 vorbereitet. Es kann sich jetzt schon kostenfrei dazu angemeldet werden! [![](https://thecattlecrew.net/wp-content/uploads/2019/08/webinar-devops_200x200.jpg)](https://www.opitz-consulting.com/einzelseiten/webinar-devops-change-mindset-before-toolset.html) **Webinar:** [ ](http://www.opitz-consulting.de/redirect/F964D9C1D9CFE1CEF1A149B4013763E1)**[Infos und Anmeldung ](https://www.opitz-consulting.com/einzelseiten/webinar-devops-change-mindset-before-toolset.html)** Weitere Infos rund um dieses Thema: [www.opitz-consulting.com/change-for-devops](https://www.opitz-consulting.com/change-for-devops) **Kategorien:** Tech Events & Networking, Tools & Methoden --- ### [Service Design und Service Blueprint - Warum, Was und Wie im Üœberblick als visuelle Sketchnote.](https://thecattlecrew.net/2019/11/18/service-design-und-service-blueprint-warum-was-und-wie-im-ueberblick-als-visuelle-sketchnote/) **Published:** November 18, 2019 **Author:** Andreas Lehner **Content:** „A **service blueprint** is a diagram that visualizes the relationships between different service components „” people, props (physical or digital evidence), and processes „” that are directly tied to touchpoints in a specific customer journey.“ (1) Die Sketchnote zeigt einen Überblick über Service Design und die wichtigsten Bausteine des Service Blueprints. [![](https://thecattlecrew.net/wp-content/uploads/2019/11/Service-Design-Visual-Sketch-Notes.jpg?fit=1024%2C521&ssl=1)](https://thecattlecrew.net/wp-content/uploads/2019/11/Service-Design-Visual-Sketch-Notes.jpg)Welche Methoden nutzt Du, um komplexe Systeme zu visualisieren und auf diese Weise bessere Softwareprodukte und Services zu bauen? Ich freue mich auf Austausch. *Andreas Lehner, Design Thinking und User Experience bei Opitz Consulting Deutschlang GmbH.* Referenzen: (1) https://www.nngroup.com/articles/service-blueprints-definition/ **Kategorien:** Tools & Methoden --- ### [So gelingt deine virtuelle Retrospektive](https://thecattlecrew.net/2020/03/17/so-gelingt-deine-virtuelle-retrospektive/) **Published:** März 17, 2020 **Author:** monikaschubert **Excerpt:** In dieser dynamischen Zeit verbringen viele Menschen Zeit im Homeoffice. Hier gebe ich dir ein paar Tipps mit auf den Weg, wie die Retrospektive in einem Verteilten Team gelingt. **Content:** Um den Corona-Virus einzudämmen arbeiten viele im Homeoffice. Dies trifft auch immer häufiger agile Teams. In diesem Artikel möchte ich dir ein paar Tipps mit auf den Weg geben, wie dir virtuelle Retrospektive gelingt. # Die Technik Bevor du mit der Retrospektive beginnst, solltest du dir über die Technik bzw. die Tools Gedanken machen. Welche Methoden soll das Tool für dich und dein Team unterstützen? Habt ihr schon ein Tool bei dir im Unternehmen oder benötigst du etwas, dass einfach zugänglich ist? In meinem letzten Projekt haben wir eine Telefonkonferenz über Skype aufgesetzt und zusätzlich [Padlet ](https://padlet.com/)zur Unterstützung der Moderation verwendet. Hierbei waren für mich die folgenden Kriterien bei der Toolauswahl entscheidend: - Die Teilnehmer können auch ohne Registrierung teilnehmen - Die Teilnehmer können über Vorschläge abstimmen - Die Teilnehmer können einfach neue Ideen hinzufügen und eine parallele Zusammenarbeit ist möglich [Padlet ](https://padlet.com/)erfüllt diese Punkte und daher verwende ich dieses Tool gerne. Ich bereite die Retrospektive mit einem speziellen Thema, einem Motto oder einer Methode vor und verschicke dann den Link an die Teilnehmer. # Phasen der Retrospektive Für die virtuellen Retrospektiven behalte ich die 5 Phasen bei. Im folgenden findest du eine kurze Beschreibung der jeweiligen Phase zusammen mit meinen Tipps für die Durchführung. ![PhasenRetro](https://thecattlecrew.net/wp-content/uploads/2020/03/PhasenRetro.jpg) ## Phase 1 „“ Set the Stage Das Ziel in dieser Phase ist es eine gute Atmosphäre zu schaffen. Als Scrum Master kannst du einfache Fragen stellen, wie z.B.: - Wo bist du gerade? - Welches positive Erlebnis hattest du in den letzten Tagen im Homeoffice? - Wie ist deine aktuelle Stimmung? (z.B. kombiniert mit der n-Wort-Methode) Meiner Erfahrung nach ist es sehr wichtig, dass diese Frage jeder Teilnehmer beantwortet und vor allem, dass jeder Teilnehmer aktiv etwas beiträgt. ## Phase 2 „“ Gather Data Diese Phase dient dazu Transparenz über den vergangenen Sprint zu schaffen. Was lief gut? Was lief schlecht? Gab es besondere Ereignisse? Wichtig finde ich in dieser Phase, dass jeder Teilnehmer den Sprint aus seiner Sicht schildert und jeder eine aktive Rolle einnimmt. Als ich ein Team moderiert habe, wo die Teilnehmer auf 4 Standorte verteilt waren, bin ich teilweise immer von Standort zu Standort gehüpft. Ein anderes Mal habe ich mir alle Namen auf einen Zettel geschrieben und bin alphabetisch durchgegangen. Die Methode „Freiwillige vor“ funktioniert auch, allerdings darfst du als Moderator sicherstellen, dass jeder zum Zug gekommen ist. Hier liegt aus meiner Sicht die größte Herausforderung bei der Moderation der verteilten Retrospektive. ## Phase 3 „“ Generate Insights Warum sind die Dinge wie sie sind? Dies ist die zentrale Frage in dieser Phase und es geht darum in die Tiefe zu gehen und zu verstehen, warum ein Problem vorhanden ist. Dies ist die Grundlage für die Maßnahmen, die in der nächsten Phase abgeleitet werden. Als Moderator lasse ich hier meist eine spontane Reihenfolge zu. ## Phase 4 „“ Decide what to do Basierend auf den Ergebnissen der Phase 3 „Generate Insights“ werden Maßnahmen abgeleitet und vereinbart. Die Güte der Maßnahmen kann man z.B. über ein Voting auch virtuell gut abbilden. Die Teilnehmer dürfen auch in dieser Phase spontan ihre Ideen sprudeln lassen. Wichtig ist aus meiner Sicht auch die Verantwortung der Maßnahmen festzulegen. ## Phase 5 „“ Close the Retrospektive Hier darfst du als Moderator nochmal kurz einen Blick zurück auf die Retrospektive werfen, um damit ein klares Ende zu setzen. Diese Phase bietet nochmal jedem Teilnehmer die Gelegenheit zu einer kurzen Wortmeldung. Bei mir hat es sich bewährt für diese Phase eine zentrale Frage zu wählen. Beispiele dafür sind: - Mit welchem Gefühl gehst du aus dieser Retrospektive? - War die Zeit sinnvoll investiert? - Was war deine persönliche Erkenntnis aus dieser Retrospektive? Nach der Moderation der ein oder anderen virtuellen Retrospektive, kennst du deine Teilnehmer gut und weißt, wie aktiv sie sich beteiligen. In einem Projekt hatte ich die Herausforderung, dass manche Teilnehmer sehr schüchtern und leise waren. In solchen Fällen ist es besonders wichtig, dass du jeden Teilnehmer persönlich einbindest und die Antworten auf gestellte Fragen abwartest. Welche Erfahrungen hast du mit virtuellen Retrospektiven gemacht? Ich freue mich über einen Kommentar von dir! Du bist auf der Suche nach mehr Informationen zum Thema Retrospektiven? Dies sind aus meiner Sicht sehr wertvolle Seiten: - [FunRetrospectives](https://www.funretrospectives.com/) - [Retromat](https://retromat.org/) **Kategorien:** Tools & Methoden **Schlagwörter:** agilität, Retrospektive, Zusammenarbeit --- ### [Digitalisierung und der Tanz auf dem Vulkan beginnt](https://thecattlecrew.net/2020/05/22/digitalisierung-und-der-tanz-auf-dem-vulkan-beginnt/) **Published:** Mai 22, 2020 **Author:** Mario Nolte **Content:** Heute schon digitalisiert? Hast du Deine Smart Devices unter Kontrolle? Warum lässt sich Digitalisierung nicht im Supermarkt kaufen? Warum heißt es Digitalisierung und nicht 5g, IoT oder KI? Wo fängt Digitalisierung an und wo hört es auf? Wozu braucht es eine digitale Transformation, wenn ich doch Digitalisierung machen möchte. Ich bin schon super digital unterwegs und mache Agile „“ Wozu brauch ich dann noch Digitalisierung? Wir warten mal noch, wir sind ja keine Beta-Tester. **Dies und viele andere Fragen treten immer mehr in den Vordergrund. Nur was ist die beste Strategie damit umzugehen? Gibt es Muster, die ich anwenden oder vermeiden kann?** Hier in der Folge geht“™s es um, Basics rund um die Digitalisierung, Gute und weniger gute Strategien, Ansätze – was alles möglich ist und wie du es auch sehen kannst (und wie immer zählt „“ entscheide selbst was für Dich passt). **Folge 1 – Mit der Digitalisierung Loslegen oder Warten?** Wenn Sie überlegen, ob die Digitalisierung etwas für Sie ist oder nicht, dann sollten Sie handeln. Denn nur so können Sie ankommen! Aufgeschoben oder Los gelegt kann den entscheidenden Unterschied machen. ***Sie haben sich doch schon entschieden – Oder?** Wozu dann also noch warten?* Sollten Sie denken, dass kommt für Sie nicht in Frage. Dann kann es sein, dass Sie schon digital transformiert sind. Wenn ja, schauen Sie vielleicht nochmals genauer rein. Sind da Medienbrüche – also Übergaben, die es erfordern händisch einzugreifen. Vielleicht können Sie diese noch beseitigen. Jeder Medienbruch kostet Zeit und Energie. Müssen die dann sein? Der zweite Grund kann sein, dass es dem Unternehmen nicht so gut geht. Und auch hier möchte ich Ihnen Mut machen. Es gibt viele Unternehmen, den es ähnlich geht. Und es gibt auch diese Unternehmen, die durch eine digitale Ergänzung einen mehr an Sichtbarkeit, Auffindbarkeit erreicht haben und so Ihr Unternehmen gerettet haben. Mal ein praktischer Ansatz: Was meinen Sie, kann ein potentieller Auftraggeber einen Malermeister im Berlin Wedding oder Pinneberg finden, wenn dieser keine digitale Signatur hat (wie Webseite, Facebook, Google, Whatsapp …)? Die Wahrscheinlichkeit ist wohl eher gering. Also schauen Sie doch mal, ob Sie da Ihr Unternehmen besser aufstellen können. Für das Fazit möchte ich ein Zitat von Martin Luther King mitgeben: „***Kein Problem wird gelöst, wenn wir träge darauf warten, dass Gott sich darum kümmert.***„ [Digitalisierung Einstieg](https://www.opitz-consulting.com/index.php?id=368) [Digitalisierung Innovationsworkshops](https://www.opitz-consulting.com/portfolio/digitalisierung/innovationsworkshops.html) ***Folge 2: [Von Problembären und Solutiontigern. Oder: Wie caste ich mein Digitalisierungsprojekt](https://thecattlecrew.net/2020/11/20/von-problembaeren-und-solutiontigern-oder-wie-caste-ich-mein-digitalisierungsprojekt/)[?](https://thecattlecrew.net/?p=32777&_thumbnail_id=32779)*** Weitere Themen sind schon unterwegs: 3\. Digitalisierung und der Irrgarten im Unternehmen? 4\. Digitalisierung oder digitale Transformation? 5\. Digitalisierung als Projekt oder Prozess verstehen? 6\. Strategisches Know-How der Digitalisierung von Innen oder Außen? 7\. Schnelle Erfolge (Quick Wins) oder langfristiger Erfolg? 8\. Erfordert die Digitalisierung den Umbau des Unternehmens? 9\. Organisation im Wandel – Führung weiter im Top-Down oder ? 10\. Widerstand aufgreifen oder liegen lassen? 11\. Alle informieren oder nur Betroffene? 12\. Frisst die Digitalisierung die Tradition? **Kategorien:** Tools & Methoden **Schlagwörter:** Digitalisierung --- ### [Innovation ist der beste Impfstoff gegen Krise](https://thecattlecrew.net/2020/07/01/innovation-ist-der-beste-impfstoff-gegen-krise/) **Published:** Juli 1, 2020 **Author:** Tobias Nehren **Excerpt:** Wenn die Unsicherheit bleibt, dann ist jetzt die Zeit loszulaufen und Innovationen zu treiben. Daraus wird sich ein Vorsprung ergeben. Risiko gehört nun mal zum Geschäft. **Content:** Vor knapp vier Monaten hat Deutschland die Vollbremse gezogen, um die Ausbreitung des Coronavirus und die dadurch bedingte Überlastung unseres Gesundheitssystems zu verhindern. Verständlicherweise haben Unternehmen alles gestoppt, Projekte in Frage gestellt, Ausgaben gestoppt bzw. auf den Prüfstand gestellt, sich und ihre Mitarbeiter erstmal ins Trockene gerettet. Richtig und nachvollziehbar. Nun geht es weiter und die Frage ist, wie man als Organisation mit der aktuellen Situation und der daraus resultierenden Unsicherheit umgeht. Bleibt man im Trockenen, hält das „Ersparte“ zusammen und wartet ab bis alles wieder „normal“ ist oder zumindest klar ist, wie die Zukunft aussieht und die bisherigen Projekte und Prozesse sich vom Lockdown erholen können, um sie dann langsam wieder hochzufahren? Tatsächlich erfordert die aktuelle Situation anderes Handeln: Es wird kein zurück zu einem „Früher“ geben: **Corona ist die Verdichtung eines ohnehin bestehenden Zustands dauernder Unsicherheit und Komplexität.** Die durch Corona ausgelöste Krise ist kein einmaliger Ausbruch des Chaos, nachdem wir aufräumen und alles wird wie es war. In ihren Auswirkungen auf die Wirtschaft beschleunigt sie ohnehin schon existierende Symptome. Unternehmen tun deshalb gut daran sich so anzupassen, dass sie mit diesem dauerhaften Zustand der Unsicherheit zurechtkommen; darin womöglich gedeihen und sich und ihre Wertschöpfungsmodelle immer wieder neu erfinden können. Es gilt Wandlungs- ***und*** (Ich schreibe das absichtlich fett *und* kursiv) Innovationsfähigkeit zu etablieren. Wer sich schnell einstellt, der wird besser aus der Krise kommen, als derjenige, der im Unterstand darauf wartet, dass das Gewitter endlich vorbei geht. Nochmal: Drohende Umschwünge, der Großwetterlage werden zu unserem Alltag gehören. Die zentrale Eigenschaft, um in dieser Unsicherheit zu bestehen, lautet Wandlungsfähigkeit. Ist ein Unternehmen bzw. eine Organisation so flexibel aufgestellt, dass sie auf Änderungen der Umwelt reagieren kann; das gilt für alle Arbeitsbereiche. Und alle Arbeitsbereiche müssen sich fragen, welche Schritte sie gehen müssen, um den Wandel nicht nur zu ertragen, sondern zu treiben, sich neu zu erfinden, um in der neuen Situation mit innovativen Ideen besser dazustehen als die Konkurrenz. Denn wer neue Situationen nicht nur übersteht, sondern die Umstände, sogar für sich zu nutzen weiß, gewinnt mit der Krise. Wer also mit sehnsüchtigem Blick auf die Geschäftsmodelle und Prozesse der Vergangenheit wartet, kann nicht die Themen und Projekte der Zukunft in den Fokus nehmen. Nostalgie ist keine Erfolgsversprechende Handlungsmaxime. Wenn andere Abwarten und die eigenen Mitarbeiter Ressourcen haben, ergeben sich Chancen. Chancen das Portfolio endlich zu hinterfragen und umzubauen. Chancen den Umgang mit Daten im Alltag der Unternehmenssteuerung zu etablieren und die dafür notwendigen technischen Schritte zu gehen. Chancen die Plattform zu bauen, die das Geschäftsmodell in die digitale Zeit tragen könnte. Die Chance Prozesse und Strukturen zu erneuern und ggf. zu digitalisieren. Kurz die derzeitige Situation wir in ein neues Normal übergehen. Das neue Normal wird ein Unsichereres sein. Das gilt für alle; für Mitarbeiter und Marktteilnehmer. Deshalb: Wenn die Unsicherheit bleibt, dann ist jetzt die Zeit loszulaufen und Innovationen zu treiben, um in der neuen Situation als erstes den Claim mit eigenen Ideen abzustecken. Daraus wird sich ein Vorsprung ergeben. Das ist nicht ohne Risiko, aber das gehört nun mal zum Geschäft. **Kategorien:** Tools & Methoden **Schlagwörter:** Digital Innovation, Digitalisierung, Innovation --- ### [Kanban for Colleagues: Wozu eigentlich WIP-Limits?](https://thecattlecrew.net/2020/07/14/kanban-for-colleagues-wozu-eigentlich-wip-limits/) **Published:** Juli 14, 2020 **Author:** Dennis Tölzer **Content:** ![Kanban for Colleagues](https://thecattlecrew.net/wp-content/uploads/2020/07/Kanban-1024x542.jpg "Kanban for Colleagues")#### **Sind jetzt alle beschäftigt?** Häufig neigen Teams in IT-Projekten dazu, die Auslastung einzelner Menschen zu optimieren. In bester Absicht folgen sie dabei der Prämisse „Wenn jeder Mensch jederzeit vollständig ausgelastet ist, kommen wir am besten voran.“ Leider ist diese Annahme oft trügerisch. Das [Gesetz von Little](https://people.cs.umass.edu/~emery/classes/cmpsci691st/readings/OS/Littles-Law-50-Years-Later.pdf) zeigt, wie die Durchlaufzeit von Aufgaben in einem stabilen System ansteigt, wenn der Wert des Work in Progress (WIP), also die Anzahl gleichzeitig verrichteter Aufgaben, zunimmt: ![](https://thecattlecrew.net/wp-content/uploads/2020/07/Formel-1-1024x145.jpg)Weshalb ist das problematisch? Die Agilisten haben es bereits erkannt: #### **Ungünstiger Risikoverlauf** Unter der Annahme, dass jede Aufgabe Wert erzeugt, fällt das mit ihrer Bearbeitung einhergehende Risiko des Misserfolgs erst dann ab, wenn die Aufgabe vollständig bearbeitet wurde. Wenn also die Durchlaufzeit von Aufgaben durch einen hohen WIP-Wert ansteigt, fällt auch das anhaftende Risiko später ab: ![](https://thecattlecrew.net/wp-content/uploads/2020/07/WIP-5-1024x460.jpg)Fünf zeitgleich begonnene Aufgaben, die ein Team einzeln in jeweils einer Stunde bearbeiten könnte, werden gemäß Little“™s Gesetz zeitgleich nach fünf Stunden fertiggestellt. Durch eine Reduzierung des WIP-Wertes verringert sich die Durchlaufzeit einzelner Aufgaben. Werden die Aufgaben dadurch früher abgeschlossen, so fällt deren Risiko und in Folge das kumulierte Gesamtrisiko des Vorhabens früher ab. Unter den vereinfachenden Annahmen, dass Aufgaben voneinander unabhängig sind, im Team effizient bearbeitet werden können und den gleichen Business Value innehalten, stellt sich der Risikoverlauf mit einem geringen WIP-Wert von 1 wie folgt dar: ![](https://thecattlecrew.net/wp-content/uploads/2020/07/WIP-1-1024x460.jpg)Fünf nacheinander bearbeitete Aufgaben werden jeweils nach einer Stunde fertiggestellt. Wenn Aufgaben mit einem unterschiedlichem Business Value priorisiert bearbeitet werden, fällt das Risiko im Zeitverlauf noch stärker ab als dargestellt. #### **Häufige Kontextwechsel führen zu Überlastung** Was das Gesetz von Little nicht zeigt: In einem sozialen System erhöht sich die Durchlaufzeit von Aufgaben überproportional, wenn ein zu hohes oder kein WIP-Limit gewählt wird. Laut Weinberg sinkt in der Wissensarbeit die Produktivität eines Menschen mit jeder zusätzlichen, gleichzeitig verrichteten Aufgabe um 20%. Wird die Kapazität des Gesamtsystems durch Überlastung der darin agierenden Menschen überschritten, bricht die Durchlaufzeit massiv ein. #### **Fehlende Dringlichkeit zur Beseitigung von Hindernissen** „Mit X geht’s gerade nicht weiter. Also habe ich schon einmal mit Y angefangen.“ Insbesondere in unerfahrenen Teams verringern fehlende WIP-Limits die Dringlichkeit zur Beseitigung von Hindernissen, da stattdessen parallel neue Aufgaben begonnen werden können. Ist hingegen der WIP im System oder in einzelnen Arbeitsschritten limitiert, führen Blockaden oder eine Überversorgung unweigerlich zu einer Unterversorgung an anderer Stelle: Es können keine neuen Aufgaben in das System gezogen werden, bis bestehende Aufgaben das System verlassen haben. Wird das Limit eingehalten, steigt die Dringlichkeit zur kollaborativen Auflösung von Engpässen. #### **Fazit** Langfristig kann durch WIP-Limits eine Kultur der kontinuierlichen Verbesserung entstehen, in der sich eine Organisation gezielt mit verschiedenen Quellen von Variabilität auseinandersetzt. Sie können auf unterschiedlichen Ebenen eingesetzt werden, z. B. für Personen, Prozessschritte oder ein Gesamtsystem. In der Praxis sind sinnvolle Limit-Werte empirisch zu ermitteln. Diese sollen einerseits fortwährend die Dringlichkeit zur Optimierung des Systems aufrechterhalten, andererseits den Arbeitsfluss nicht zu häufig blockieren. In diesem Sinne: Stop Starting, Start Finishing, Visit the [Training](https://www.opitz-consulting.com/training.html) 😉 Titelbild in Anlehnung an https://bikablo.com/ **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Kanban, Okaloa Flowlab --- ### [Product Discovery – Entwickeln wir das Richtige?](https://thecattlecrew.net/2023/04/26/product-discovery-101-entwickeln-wir-das-richtige-oder-nur-irgendwas/) **Published:** April 26, 2023 **Author:** Andreas Lehner **Content:** Digitale Produkte sind ein wichtiger Teil unseres täglichen Lebens. Sie helfen uns, unsere Bedürfnisse zu erfüllen und unser Leben einfacher zu gestalten. Aber wie werden solche Produkte entworfen und entwickelt? In diesem Artikel gebe ich einen Überblick über die Welt der Product Discovery und erkläre die wichtigsten Punkte, sodass ihr als Team einen perfekten Start für eure Produktentwicklung findet. ## Was versteht man unter Product Discovery? Die „üblichen Verdächtigen“, also Quellen für zuverlässige Definitionen aus der Welt der digitalen Produktentwicklung, beschreiben Product Discovery so: **Definition 1 von Nielsen Norman Group** > ***A discovery*** *is a preliminary phase in the UX-design process that involves* ***researching*** *the problem space,* ***framing*** *the problem(s) to be solved, and gathering enough* ***evidence*** *and initial direction on what to do next. Discoveries do not involve testing hypotheses or solutions.* (Nielsen Norman Group, NNg) **Definition 2 von Jeff Patton** > *We use product discovery work to get evidence that the problems we’re solving really exist, that our customers want and can use our solutions, and that we can build them predictably.* (Jeff Patton) **Definition 3 von Tim Herbig** > *Product Discovery is the evidence-informed process of reducing uncertainty as you find problems worth solving and solutions worth building. It emerges through a series of nonlinear activities, conducted as a cross-functional team.* (Tim Herbig) **Defintion 4 von Marty Cagan** > *I prefer to think of this phase as “product discovery” more than “requirements and design.” I think this nomenclature emphasizes two all-important points:* > > *– First, you need to discover whether there are real users out there that want this product. In other words, you need to identify your market and validate the opportunity with your customers.* > > *– Second, you need to discover a product solution to this problem that is usable, useful, and feasible. In other words, you need to design your product and validate it with your customers and your engineering team.* (Marty Cagan) ### Die Gemeinsamkeiten dieser Definitionen Alle Definitionen haben vier Aussagen gemeinsam: 1. Es gibt ein Problem. 2. User und Customer wünschen sich eine Lösung für dieses Problem. 3. „Evidence“ wird durch Daten aus „echter“ Research gesammelt. 4. Die Product Discovery sollte zu Beginn der Produktentwicklung stattfinden. Mit Product Discovery beabsichtigen wir also Antworten auf diese eine Fragestellung zu finden: **Woran erkenne ich, bevor ich mit dem Entwickeln beginne, welches Produkt das „RICHTIGE“ ist?** ## Welche Herausforderungen der Produktentwicklung löst Product Discovery? > *The first truth is that at least half of your ideas are just not going to work (*Marty Cagan, Silicon Valley Product Group) Häufig ist es doch so: Du und dein Team delivern ein Produktfeature nach dem anderen. Die Scrum-Sprints laufen hervorragend. Das Team performt. Die Velocity-Kurve in Atlassian ist ein Traum. Die Reviews mit dem Management werden bewundert. Kein Zweifel: Das Produkt ist ein MEGASTAR! Doch genau jetzt ist der Zeitpunkt gekommen, um einen Moment innezuhalten und die Nadel an eine empfindliche Stelle zu setzen. Mit dieser Frage: Bist du dir hundertprozentig sicher, dass ihr das richtige Problem für die richtigen Nutzer und Kunden löst? Oder könnte es sein, dass euer Produkt auf Annahmen von Problemen und Chancen basiert, die ihr euren Ansprechpersonen, Kundenunternehmen, Anwendenden, Stakeholder:innen, eurem Markt und eurem Business „übergestülpt“ habt? Solltest du dir nicht sicher sein, dass ihr auf dem richtigen Weg seid – keine Sorge. Du bist nicht allein: Eine Studie von CBS Insights zeigt: „**42 % of failed start-ups cite ‘no user need’ as a reason for failure.“** Das bedeutet 42 % der Produktentwicklungen scheitern, weil das Team nicht wusste, welches Problem das Produkt lösen muss, damit Unternehmen und Anwendende wirklich etwas davon haben. Und genau an dieser schmerzvollen und empfindlichen Stelle setzt das Konzept der Product Discovery an: Product Discovery hat zum Ziel so früh wie möglich im Produktentwicklungsprozess herauszufinden, ob wir als Produkt-Team das richtige Problem für die richtigen Menschen lösen und mit der richtigen Technologie und bestmöglichen Usability am richtigen Markt anbieten. ## Produktentwicklungsprozesse geben Orientierung Product Discovery zum richtigen Zeitpunkt zu machen Moderne Prozesse der Produktentwicklung können in zwei große Phasen bzw. „Räume“ unterteilt werden: 1. Phase der Discovery bzw. „Problemraum“ 2. Phase der Delivery bzw. „Lösungsraum“ In der Phase der Discovery bzw. im Bereich des Problemraums wird alles dafür getan, um 1. die Probleme und Herausforderungen zu verstehen 2. jenes Problem zu identifizieren und definieren, welches in den Folgephasen (Develop /Delivery) gelöst werden soll Das Ergebnis des Problemraumes bzw. der Phase Discovery ist also ein konkret „definiertes“ Problem“ als Ausgangspunkt und Sprungbrett für den Lösungsraums. Am wirkungsvollsten ist dieses Vorgehen, wenn es viele Unbekannte gibt. Sind die Herausforderungen außerdem komplex, ist die Product Discovery ein Wundermittel, um das Produkt nicht gegen die Wand zu fahren. ![Product Discovery - Double Diamond Prozess](https://thecattlecrew.net/wp-content/uploads/2023/04/Product-Discovery-Double-Diamond-1024x576.jpg)Product Discovery – Double Diamond Prozess --- ## Wie geht Product Discovery? Um einen Überblick über die wichtigsten Schritte der Product Discovery zu erlangen, zerlegen wir den Prozess in 6 kleinere, verdauliche Schritte: 1. Problemraum definieren 2. Ziel definieren 3. Team zusammenstellen 4. Erforschung des Problemraums mit Hilfe von User Research 5. Synthesis, Verfeinerung des Problem-Statements 6. Chancen und Potentiale hervorheben, Lösungsideen generieren ### Schritt 1: Problemraum definieren Der Ausgangspunkt jedes Produktes oder Services ist eine Herausforderung bzw. Problem. Ein Problem kommt meist selten allein, sondern in großer Vielfalt und Menge. Daher stellen sich diese Fragen: - Wo liegt unser Fokus? Worauf wollen wir uns konzentrieren? - Welchen Bereich der Problemwelt sollen wir genauer unter die Lupe nehmen? - Um welchen Bereich der Problemwelt sollen wir einen Rahmen ziehen? - Was ist unser Problem Frame, den wir mit unserer Discovery erforschen wollen? Um diesen Problem Frame zu definieren, gibt es zwei Werkzeuge, die diese Definition vereinfachen: 1. 5 W-Fragen (Wer, Was, Wo, Wann, Warum) 2. Problem Statement Die 5 Ws helfen euch, als Team besser zu verstehen, welche Unbekannten es gibt. Dafür beantwortet ihr diese Fragen: - Was ist das Problem? - Wer ist vom Problem betroffen? - Wo tritt das Problem auf? - Wann tritt das Problem auf? - Warum tritt das Problem auf? - Warum ist das Problem wichtig? Mithilfe der Antworten findet ihr heraus, wie viel ihr schon wisst und wie viel noch unbekannt ist. Die Unbekannten sind dabei ein großartiger Ausgangspunkt den Problem Frame dort zu setzen und um mit Discovery zu starten. Das „Problem Statement“ ist ein Werkzeug, mit dem ihr ein Problem, um das es geht, präzise beschreiben könnt. Es dient im Team und in der Organisation als Alignment-Tool, d. h. es hilft euch, ein gemeinsames Verständnis über den Problemraum herzustellen und im nächsten Schritt ein Ziel für den weiteren Prozess zu formulieren. ## Schritt 2: Ziel definieren Um genauer eingrenzen zu können, in welche Richtung du die Product Discovery betreibst, ist es essenziell, das Ziel der Discovery zu formulieren und mit dem Team zu teilen. Dafür nutzt du die Ergebnisse aus dem „Problem Statement“ in Schritt 1. Während das Problem Statement das Problem beschreibt, das erforscht werden soll, formulierst du mit dem Ziel die Richtung der Discovery. Ich empfehle immer eine Entscheidung als Ziel zu wählen. Hier ein paar Beispiele: - Ziel: Entscheide mithilfe der Discovery, ob es „Chancen gibt die Beteiligung an unseren Workshops zu erhöhen. - Ziel: Entscheide mithilfe der Discovery, was die größten Herausforderungen sind, die mit der mangelnden Beteiligung an unseren Workshop zu tun haben. - Ziel: Entscheide mit Hilfe der Discovery, welche „Chancen“ es gibt, den Zugang zu sauberem Wasser in ländlichen Gebieten Nigerias zu verbessern. Dies solltest du NICHT tun: - Keine versteckten Lösungen einbauen - Keine Technologien erwähnen - Das Problem nicht zu eng formulieren. Stattdessen solltest du es so breit wie möglich fassen, um Raum für die Erforschung zu haben. ### Schritt 3: Team zusammenstellen Eine Product Discovery kann, was den Umfang betrifft, unterschiedlich breit aufgestellt sein. Am wirkungsvollsten ist eine Product Discovery, wenn es um komplexe Problemstellungen mit vielen Unbekannten geht. Dafür braucht die Product Discovery ein wirklich gutes Team. Ein solches Team sollte aus multidisziplinären Rollen zusammengesetzt sein, wie z. B.: - UX Researcher - Facilitator - Team Lead - Sponsor - Owner - Tech Experts, Engineers - Business Analyst ### Schritt 4: Erforschung des Problemraums mit Hilfe von User Research Nachdem ihr im Team den Problem Frame gesetzt habt, das Problem Statement und das übergeordnete Ziel der Discovery formuliert habt, ist es nun an der Zeit, in die „echte“ Welt hinauszugehen und den Problemraum zu erforschen. Das ist der Startschuss, um echte Daten aus eurem Problem Frame zu sammeln, zu sammeln und noch einmal zu sammeln. Dafür bieten sich eine Vielzahl unterschiedlicher Methoden aus der Domäne der User Research an, wie: - User Interviews - Diary Studies - Field Studies - Stakeholder Interviews - Kickoff Workshops - Assumption Mapping Workshops - Research Question Generation Workshops - Affinity Diagramming Workshops - Service Blueprinting Workshops - Problem Framing Workshops Um die Methode zu finden, die sich für dein Vorhaben am besten eignet, orientierst du dich am übergeordneten Ziel der Discovery und sorgst dafür, dass die Daten und die zu erwartenden Ergebnisse und Ziele der Erforschung in das übergeordnete Ziel einzahlen. Spätestens hier zeigt sich, wie wichtig es war, die Ziele der Erforschung so präzise wie möglich zu formulieren und im Team abzustimmen. ### Schritt 5: Synthesis, Verfeinerung des Problem Statements Sobald das Research Team vom „Feld“ mit riesigen Rucksäcken voller Forschungsdaten zurückgekehrt ist, gilt es, alle Daten auf den Tisch zu legen und zu analysieren. In diesem fünften Schritt geht es darum, mithilfe der gesammelten Daten, neue Erkenntnisse zu gewinnen und die Unbekannten in Bekannte zu verwandeln. Auch hier helfen konkrete Methoden der Synthese und der Sinnstiftung wie etwa Affinity Diagramms, Journey Maps oder Service Blueprints. Am Ende dieses Schritts konntest du das ursprüngliche Problem Statement mithilfe von vielen neuen Erkenntnissen verfeinern. Diese verfeinerte Problem Statement dient als Sprungbrett für die Ideengenerierung im nächsten Schritt. ### Schritt 6: Chancen hervorheben, Lösungsideen generieren Mit Schritt 6 beginnt der Übergang in den Lösungsraum. Ideen generieren, Prototypen erstellen, Lösungskonzepte entwickeln und diese frühzeitig testen, mit echten Nutzern, die in der Erforschung befragt und beobachtet wurden, sind die Schlüssel für die ersten Schritte zur erfolgreichen Delivery eurer Produkte. ## Was nimmst du mit? Product Discovery ist ein wichtiger Teil der Produktentwicklung, insbesondere, wenn es zu Beginn viele Unbekannte und komplexe Problemstellungen gibt. Zentral für den Erfolg der Product Discovery ist die User Research an den Stellen, wo Probleme auftreten und Menschen davon betroffen sind. Präzise Zielformulierungen und Problem Statements helfen dem Team zu verstehen, in welche Richtung die nächsten Schritte gehen. Mithilfe einer sorgfältig geplanten und durchgeführten Product Discovery kannst du die Chancen auf ein erfolgreiches Produkt um ein Vielfaches erhöhen. Bleibt mir noch, dir viel Spaß zu wünschen in dieser aufregenden Phase! Hast du noch Fragen zur Product Discovery oder möchtest du mehr wissen? Dann sprich mich gerne an oder hinterlasse einen Kommentar. *Andreas Lehner, Lead Consultant, Product Innovation & UX Design* ## Quellen 1. NNg, [https://www.nngroup.com/articles/discovery-phase/ ](https://www.nngroup.com/articles/discovery-phase/ "Zur Website der nngroup") 2. Jeff Patton, [https://www.dropbox.com/s/1mpek4fzs2qvq5r/Discovery%20Immersion%20QR%20Cards.pdf?dl=0 ](https://www.dropbox.com/s/1mpek4fzs2qvq5r/Discovery%20Immersion%20QR%20Cards.pdf?dl=0 "Zum Artikel von Jeff Patton") 3. Tim Herbig, [https://herbig.co/product-discovery/ ](https://herbig.co/product-discovery/ "Zur Website von Tim Herbig") 4. Marty Cagan, [https://www.svpg.com/product-discovery/](https://www.svpg.com/product-discovery/ "Zur Website von Marty Cagan") 5. CBS Insights, [https://www.cbinsights.com/research/report/startup-failure-reasons-top/](https://www.cbinsights.com/research/report/startup-failure-reasons-top/ "Zur Website von CBS Insights") **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Design Thinking, Innovation, Problem Framing, Product Discovery, Produktentwicklung --- ### [IT-Security: Part 1 to 5 as PDF file](https://thecattlecrew.net/2014/06/30/it-security-1to5/) **Published:** Juni 30, 2014 **Author:** Mohammad Esad-Djou **Content:** **Key words:**IT-Security, Security Challenges, OPSS Architecture, WebLogic Server, JAAS, JAAS LoginModules, Authentication, Basic Authentication, Certificate Authentication, Digest Authentication, perimeter Authentication and Identity Assertion Until now I have published five parts of a series of articles on IT-Security and Oracle Fusion Middleware: 1. [https://thecattlecrew.net/2014/02/17/it-security-weblogic-server\_1/](https://thecattlecrew.net/2014/02/17/it-security-weblogic-server_1/) 2. 3. 4. 5. I“™m going to continue the IT-Security“™s articles and you can access to complete *first five parts* as PDF-file here: [WebLogic-Server\_IT\_Security\_1til5](https://thecattlecrew.net/wp-content/uploads/2014/06/weblogic-server_it_security_1til5.pdf) **Kategorien:** IT-Security **Schlagwörter:** English, Oracle FMW, WebCenter Content, Weblogic --- ### [IT-Security (Part 6): WebLogic Server and Authorization](https://thecattlecrew.net/2014/07/23/it-security-part-6-weblogic-server-and-authorization/) **Published:** Juli 23, 2014 **Author:** Mohammad Esad-Djou **Content:** **Key words:** IT-Security, WebLogic Server, WebLogic Security Framework, Authorization, authorization process, Role Mapping, Roles, Adjudication Process, Security Service Provider Interfaces (SSPIs), Users, Groups, Principals and Subjects **W**e discussed about Authentication in Part 4 and 5[\[1\]](#_edn1); now let us focus on Authorization topic. Authorization is known as access control too and is used to clear main questions such as: „What can you access?“, „Who has access to a WebLogic resource?“, „Is access allowed?“ and in general „Who can do what?“ In order to guarantee integrity, confidentiality (privacy), and availability of resources, WebLogic are restricted accesses to these resources. In other words, authorization process is responsible to grant access to specific resources based on an authenticated user“™s privileges. ## Authorization: What can you access? After authentication one user, it is the first question that system has to answer: „What can you access?“ In this sense, WebLogic Server has to clear, which resources are available for a particular user, that will be cleared by using the user’s security role and the security policy assigned to the requested WebLogic resource. A ***WebLogic resource*** is generally understood as a structured object used to represent an underlying WebLogic Server entity, which can be protected from unauthorized access using security roles and security policies. WebLogic resource implementations are available for[\[2\]](#_edn2): - Administrative resources - Application resources - Common Object Model (COM) resources - Enterprise Information System (EIS) resources - Enterprise JavaBean (EJB) resources - Java Database Connectivity (JDBC) resources - Java Messaging Service (JMS) resources - Java Naming and Directory Interface (JNDI) resources - Server resources - Web application resources - Web service resources - Work Context resources ## The Authorization Process I“™m going to clear whole process in a top-down approach. First of all, we have to see what will be happen in Authorization Process? Figure 1 Authorization Process[\[3\]](#_edn3) shows how WebLogic Security Framework communicated with a particular Security Provider and Authorization providers respectively. [![Authorization Process](https://thecattlecrew.net/wp-content/uploads/2014/07/p6_authorizationprocess.jpg)](https://thecattlecrew.net/wp-content/uploads/2014/07/p6_authorizationprocess.jpg)Authorization Process **Figure 1 Authorization Process** If a user want to use one protected resource, then WebLogic send a request to „Resource Container“ that handles the type of WebLogic resource being requested receives the request (for example, the EJB container receives the request for an EJB resource). It forwards to „WebLogic Security Framework“ and its request parameters, including information such as the subject of the request and the WebLogic resource being requested. The Role Mapping providers use the request parameters to compute a list of roles to which the subject making the request is entitled and passes the list of applicable roles back to the WebLogic Security Framework. On this information will be decided about authorization: e.g. PERMIT and/or DENY. WebLogic Server provides an auditing to collect, store and distribute information about requests and outcomes. It calls Adjudication. It can happened that for Authorization is defined multiple providers. For such cases is an Adjudication provider available. The WebLogic Security Framework delegates the job of merging any conflicts in the Access Decisions rendered by the Authorization providers to the Adjudication provider. It resolves the conflicts and sends a final decision (TRUE or FALSE) to WebLogic Security Framework.[\[4\]](#_edn4) ## WebLogic Security Framework I have mentioned a bit about WebLogic Security Framework in Part 1 and 2[\[5\]](#_edn5). Figure 2 WebLogic Security Service Architecture shows a high-level view of the WebLogic Security Framework. The framework contains interfaces, classes, and exceptions in the weblogic.security.service package. The Framework provides a simplified application programming interface (API) that can be used by security and application developers to define security services. Within that context, the WebLogic Security Framework also acts as an intermediary between the WebLogic containers (Web and EJB), the Resource containers, and the security providers[\[6\]](#_edn6). [![WebLogic Security Framework](https://thecattlecrew.net/wp-content/uploads/2014/07/p6_weblogicsecurityframework.gif?w=660)](https://thecattlecrew.net/wp-content/uploads/2014/07/p6_weblogicsecurityframework.gif)WebLogic Security Framework **Figure 2 WebLogic Security Service Architecture** The Security Service Provider Interfaces (SSPIs) can be used by developers and third-party vendors to develop security providers for the WebLogic Server environment[\[7\]](#_edn7). **Security Provider** Figure 1 Authorization Process presents Security Provider as next module that provides security services to applications to protect WebLogic resources. A security provider consists of runtime classes and MBeans, which are created from SSPIs and/or Mbean types. Security providers are WebLogic security providers (provided with WebLogic Server) or custom security providers. You can use the security providers that are provided as part of the WebLogic Server product, purchase custom security providers from third-party security vendors, or develop your own custom security providers. ## Roles In order to complete authorization process, is Role Mapping within security provider necessary. Simple to say, a role mapper maps a valid token to a WebLogic user. Formerly that we focus on Roles, I would like to clarify a few more terms. ### **Users, Groups, Principals and Subjects** User is an entity that is authenticated in our security provider in last steps (See: Part 4 and 5 – Authentication Process[\[8\]](#_edn8)). A user can be a person or a software entity or other instances of WebLogic Server. As a result of authentication, a user is assigned an identity, or principal. A principal is an identity assigned to a user or group as a result of authentication and can consist of any number of users and groups. Principals are typically stored within subjects. Both users and groups can be used as principals by WebLogic Server. Groups are logically ordered sets of users. Usually, group members have something in common. For example, a company may separate its IT-Department into two groups, Admins and Developers. In this form, it will be possible to define different levels of access to WebLogic resources, depending on their group membership. Managing groups is more efficient than managing large numbers of users individually. For example, an administrator can specify permissions for several users at one time by placing the users in a group, assigning the group to a security role, and then associating the security role with a WebLogic resource via a security policy. All user names and groups must be unique within a security realm[\[9\]](#_edn9). ### **Security Roles** Role is a dynamically computed privilege that is granted to users or groups based on specific conditions. The difference between groups and roles is that a group is a static identity that a server administrator assigns, while membership in a role is dynamically calculated based on data such as user name, group membership, or the time of day. Security roles are granted to individual users or to groups, and multiple roles can be used to create security policies for a WebLogic resource. A security role is a privilege granted to users or groups based on specific conditions[\[10\]](#_edn10). Like groups, security roles allow you to restrict access to WebLogic resources for several users at once. However, unlike groups, security roles[\[11\]](#_edn11): - Are computed and granted to users or groups dynamically, based on conditions such as user name, group membership, or the time of day. - Can be scoped to specific WebLogic resources within a single application in a WebLogic Server domain (unlike groups, which are always scoped to an entire WebLogic Server domain). Granting a security role to a user or a group confers the defined access privileges to that user or group, as long as the user or group is „in“ the security role. Multiple users or groups can be granted a single security role. It can be summarized as follows: Groups are static and defined on Domain level (coarse granularity) and Roles are dynamic and defined on Resource level (fine granularity). Continued“¦ See too last parts of IT-Security and Oracle Fusion Middleware: 1. [https://thecattlecrew.net/2014/02/17/it-security-weblogic-server\_1/](https://thecattlecrew.net/2014/02/17/it-security-weblogic-server_1/) 2. 3. 4. 5. [\[1\]](#_ednref1) See: and [\[2\]](#_ednref2) Oracle® Fusion Middleware Understanding Security for Oracle WebLogic Server, 11g Release 1 (10.3.6), E13710-06 [\[3\]](#_ednref3) Oracle® Fusion Middleware Securing Oracle WebLogic Server 11g Release 1 (10.3.6), E13707-06 [\[4\]](#_ednref4) Oracle® Fusion Middleware Securing Oracle WebLogic Server 11g Release 1 (10.3.6), E13707-06 [\[5\]](#_ednref5) See: [https://thecattlecrew.net/2014/02/17/it-security-weblogic-server\_1/](https://thecattlecrew.net/2014/02/17/it-security-weblogic-server_1/) and [\[6\]](#_ednref6) See: [http://docs.oracle.com/cd/E24329\_01/web.1211/e24484/archtect.htm](http://docs.oracle.com/cd/E24329_01/web.1211/e24484/archtect.htm) [\[7\]](#_ednref7) See: [http://docs.oracle.com/cd/E24329\_01/web.1211/e24446/security.htm#autoId3](http://docs.oracle.com/cd/E24329_01/web.1211/e24446/security.htm#autoId3) [\[8\]](#_ednref8) See: and [\[9\]](#_ednref9) See: [http://docs.oracle.com/cd/E28280\_01/apirefs.1111/e13952/taskhelp/security/ManageUsersAndGroups.html](http://docs.oracle.com/cd/E28280_01/apirefs.1111/e13952/taskhelp/security/ManageUsersAndGroups.html) [\[10\]](#_ednref10) See: [http://docs.oracle.com/cd/E13222\_01/wls/docs81/secwlres/secroles.html](http://docs.oracle.com/cd/E13222_01/wls/docs81/secwlres/secroles.html) [\[11\]](#_ednref11) See: [http://docs.oracle.com/cd/E13222\_01/wls/docs90/secintro/realm\_chap.html](http://docs.oracle.com/cd/E13222_01/wls/docs90/secintro/realm_chap.html) **Kategorien:** IT-Security **Schlagwörter:** English, Oracle FMW, Weblogic --- ### [JDeveloper QuickTip "“ Output Console](https://thecattlecrew.net/2012/03/20/jdeveloper-quicktip-output-console/) **Published:** März 20, 2012 **Author:** **Content:** Ever wondered, where JDeveloper puts its output? It actually prints it on the console. But usually this console is hidden in a Windows environment if you use the pre-installed link. However it“™s quite easy to enable. The pre-installed link points to `YOUR_MIDDLEWARE_HOME\jdeveloper\jdeveloper.exe`. Just change it (or create another link) to point to `YOUR_MIDDLEWARE_HOME\jdeveloper\jdev\bin\jdev.exe` „“ et voilÜ „“ you will now see a console window where JDeveloper puts its (sometimes helpful) output. [![JDeveloper Output Console](https://thecattlecrew.net/wp-content/uploads/2012/03/outputconsole.png "OutputConsole")](https://thecattlecrew.net/wp-content/uploads/2012/03/outputconsole.png) **Kategorien:** Development **Schlagwörter:** JDeveloper, QuickTip --- ### [HTTP Binding für namespacelose Elemente](https://thecattlecrew.net/2012/03/28/http-binding-fur-namespacelose-elemente/) **Published:** März 28, 2012 **Author:** **Content:** In einem Kundenprojekt sollte ein System an die SAO Suite (11.1.1.5) angeschlossen werden, das seine Nachrichten zwar als XML-Strukturen per HTTP-POST verschickt, jedoch keinen Namespace für diese angibt. Die Möglichkeit die einem hierzu wahrscheinlich als Erstes in den Kopf kommt, das HTTP Binding, scheitert aber schon im Wizard mit folgender Meldung: [![Fehlermeldung des HTTP Bindings bei namenlosen Schemata](https://thecattlecrew.net/wp-content/uploads/2012/03/screenshot-1.jpg "screenshot.1")](https://thecattlecrew.net/wp-content/uploads/2012/03/screenshot-1.jpg) Als Alternative den Socket Adapter zu verwenden oder ein Servlet vor das zu erstellende Composite zu schalten klingt nur nach einer sehr mäßigen Lösung. Durch gutes Zureden lässt sich das HTTP Binding dann aber doch zur Verarbeitung von namenlosen XML-Elementen überreden. Nachfolgend werden die hierzu nötigen Schritte beschrieben. Als Ausgangsbasis dient dabei das unten aufgeführte Schema. Zu beachten ist, dass kein Target Namespace oder Default Namespace angegeben ist. \[code language=“xml“\] \[/code\] **1. Target Namespace temporär hinzufügen** Um den Wizard zufriedenzustellen muss zunächst temporär das targetNamespace-Attribut in die Schemadefinition eingefügt werden. Der eingetragene Namespace ist hierbei nicht weiter wichtig. \[code language=“xml“\] \[/code\] **2. HTTP Binding Endpunkt erstellen** Jetzt kann im Wizard das Element zur Erzeugung des HTTP Binding Endpunkts ohne Fehlermeldung ausgewählt werden. **3. Temporären Namespace wieder entfernen** Der eben hinzugefügte Namespace kann nun wieder entfernt werden. **4. WSDL des HTTP Binding Endpunkts anpassen** Da sich der Namespace des Schemas geändert hat, ist die generierte WSDL des HTTP Binding Endpunkts ungültig geworden. In dieser muss das Import-Element, wegen des fehlenden Namespaces, in ein Include-Element geändert und das Namespaceprefix vor dem Message-Type entfernt werden. \[code language=“xml“\] … … \[/code\] **5. Deployment und Test** Der HTTP Binding Endpunkt sollte nun mit Nachrichten ohne Namespace aufrufbar sein. Die Testkonsole im EM quittiert an dieser Stelle ihren Dienst zwar mit einer SoapTestException, *normale* HTTP-POST Nachrichten, etwa per curl, werden jedoch korrekt verarbeitet. Nachfolgend noch zwei Screenshots aus dem EM. [![Ablauf im EM](https://thecattlecrew.net/wp-content/uploads/2012/03/screenshot-3.jpg "screenshot.3")](https://thecattlecrew.net/wp-content/uploads/2012/03/screenshot-3.jpg) Die Nachricht ist im EM erkennbar:[![Nachricht im EM](https://thecattlecrew.net/wp-content/uploads/2012/03/screenshot-4.jpg?w=300 "screenshot.4")](https://thecattlecrew.net/wp-content/uploads/2012/03/screenshot-4.jpg) **6. Viel Spaß damit haben** **Kategorien:** Integration **Schlagwörter:** HTTP Binding, JDeveloper, Namespace --- ### [Composite Management: Undeployment with WLST or ANT](https://thecattlecrew.net/2012/11/03/composite-management-undeployment-with-wlst-or-ant/) **Published:** November 3, 2012 **Author:** Danilo Schmiedel **Content:** Oracle BPM / SOA Suite offers different options to deploy or delete composites. You can use the Enterprise Manager, the Weblogic Scripting Tool (WLST) or ANT. In complex environments with many different composites and versions it is hard to undeploy them one by one and manually. If you are interested in a script solution for this visit my post under [Inside BPM and SOA](http://inside-bpm-and-soa.blogspot.de/2012/11/undeploy-multiple-soa-composites-with.html). **Kategorien:** Architecture & Process Models, Automation **Schlagwörter:** bpel, BPM, Composites, Oracle DB, Weblogic --- ### [IT-Security: WebLogic Server and Oracle Platform Security Services (OPSS)](https://thecattlecrew.net/2014/02/17/it-security-weblogic-server_1/) **Published:** Februar 17, 2014 **Author:** Mohammad Esad-Djou **Content:** IT security is popular in a way never known before! I love it! If I discussed e.g. in a WebLogic Server workshop about that, I heard normally form administrators: That’s not my thing, forget it! But newly, everybody wants to know „how can we secure our data and our information?!“ To be honest, you need to detect your application server that you are using, and if you are not able to use WebLogic Server security features, then this could be your problem. WebLogic Server uses a security architecture that provides a unique and secure foundation for applications that are available via the Web. It is designed for a flexible security infrastructure and enabled to response the security challenges on the Intra- and Internet. We are able to use security capacity of WebLogic Server as a standalone feature to secure WebLogic Server and/or as part of a corporation-wide, security management system. ## Overview In order to achieve a satisfactory level of security, we have to design an integrated security policy: from lack of resources till the increasing complexity of IT systems. The elementary principles in IT security are Confidentiality and/or privacy, availability and integrity. Confidentiality and/or privacy mean information that has to be protected against unauthorized disclosure. Availability means services; IT system functions and information must be available to users when they need it. Integrity means data must be complete and unaltered. Therefore, we understand security policy as a policy that it covers protection objectives and broad-spectrum security measures in the sense of the acknowledged requirements of an organization. Simple to say, security is the protection of information that needs to protected, from unauthorized access. IT security could be helped us through technology, processes, policies and training, so that we can be sure that data stored and secured in a computer or passed between computers is not compromised. Therefor data encryption is the first step in the direction IT-Security. In order to access to specific resources, user needs to provide (normally) his user name and password. Data encryption is the transformation of data into a form that cannot be understood without decryption key(s). ## Security Challenges In a world that we used to work with distributed IT-landscape, we face to with different challenges, e.g. network-based Attacks, heterogeneity on application layer from user interface till to application. It is really difficult to stay on a standard security level for all of team members of development team. We cannot awaiting all of application developers to be able develop solve the security challenges such as privacy, identity management, compliance, audit too. Another area is interfaces between application server and backend database. A simple case is presented on the following diagram: most applications are multi-tiered and distributed over several systems. A client invokes an application or sends a request to server. This case presents how many systems are in transaction involve. We have to check all of critical points and interfaces: network-based attacks, user interface, application Server and so on. See: [http://modjorg.files.wordpress.com/2014/02/security\_challenges\_1.jpg](http://modjorg.files.wordpress.com/2014/02/security_challenges_1.jpg) On these grounds, we need to use an enterprise security framework that allows application developers to pick and choose from a full set of reusable and standards based security services that allow security, privacy, and audit. Oracle Platform Security Services (OPSS) is a security framework that runs on WebLogic Server and is available as part of WebLogic Server. It combines the security features of BEA“˜s internal security (WLS + Oracle Entitlement Server (OES)) and the OAS (Hava Platform Security (JPS) – earlier JAZN) to provide application developers, system integrators, security administrators, and independent SW vendors with a comprehensive security platform framework for Java SE and Java EE applications. In this form, Oracle is able to suggest a uniform enterprise security policy and a self-contained and independent framework with Identity management and audit services across the enterprise. The heart of whole system beats on WebLogic Server. WebLogic Server provides authentication, authorization, and encryption services with which you can guard these resources. These services cannot provide protection, however, from an intruder who gains access by discovering and exploiting a weakness in your deployment environment. Therefore, whether you deploy WebLogic Server on the Internet or on an intranet, it is a good idea to contact an independent security expert to go over your security plan and procedures, audit your installed systems, and recommend improvements. ## References - See too: Do you forget your WebLogic Server password? No problem!, - Oracle Fusion Middleware 11.1.1.5, Security Guides [http://](http://docs.oracle.com/cd/E21764_01/security.htm)[docs.oracle.com/cd/E21764\_01/security.htm](http://docs.oracle.com/cd/E21764_01/security.htm) - Oracle® Fusion Middleware Understanding Security for Oracle WebLogic Server 11g Release 1 (10.3.5) [http://](http://docs.oracle.com/cd/E21764_01/web.1111/e13710/toc.htm)[docs.oracle.com/cd/E21764\_01/web.1111/e13710/toc.htm](http://docs.oracle.com/cd/E21764_01/web.1111/e13710/toc.htm) - Oracle® Fusion Middleware Securing Oracle WebLogic Server [http://](http://docs.oracle.com/cd/E21764_01/web.1111/e13707/toc.htm)[docs.oracle.com/cd/E21764\_01/web.1111/e13707/toc.htm](http://docs.oracle.com/cd/E21764_01/web.1111/e13707/toc.htm) - Oracle Platform Security Services 11gR1 (White Paper) - IT Security Guidelines, IT Baseline Protection in brief, Federal Office for Information Security **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** BPM, IT Security, Oracle Platform Security Services (OPSS), Service Bus, WebCenter Content, Weblogic --- ### [ADF 12.1.3 - Tabellendaten nach CSV exportieren](https://thecattlecrew.net/2014/07/07/jdeveloper-12-3-1-tabellendaten-nach-csv-exportieren/) **Published:** Juli 7, 2014 **Author:** Andrej Flieger **Content:** War es bislang nur möglich, Tabelleninhalte einer Tabelle bzw. einer TreeTable direkt in das Format Microsoft Excel zu exportieren, so erweitert Oracle in der Versin 12.1.3.0 das Tag um die Möglichkeit direkt im CSV-Format zu exportieren. Alles was zu tun ist, ist beim Hinzufügen des Listeners z.B. zu einem CommandButton, wie abgebildet die Option CSV auszuwählen. [![ListenerCSV](https://thecattlecrew.net/wp-content/uploads/2014/07/listenercsv1.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/07/listenercsv1.png) Über das Property ***Filename*** wird dann wie gewohnt gesteuert, ob der Export direkt im Browser angezeit wird oder ob das Download-Fenster aufgeht. [![Property_Filename](https://thecattlecrew.net/wp-content/uploads/2014/07/property_filename1.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/07/property_filename1.png) **Kategorien:** Development **Schlagwörter:** JDeveloper --- ### [OSB: Using current Eclipse version for development](https://thecattlecrew.net/2014/07/11/osb-using-current-eclipse-version-for-development/) **Published:** Juli 11, 2014 **Author:** Bernhard Mähr **Content:** Oracle provides some packages to install an development environment with Eclipse. Unfortunately these packages contains only the over three year old 3.7 (Indigo) release of Eclipse. Even more worse: With SOA-Suite 12c comes the current version of OSB and the development environment is migrated to the JDeveloper. There will be no update for the Eclipse based development in future. But what if you want to use your current Eclipse version to have look inside of the developed OSB projects? Or if you need an update version of Eclipse because of current versions of plugins like SVN? The installation of the OSB development environment is quite complicated and „mythic“. It is described for example [here](https://blogs.oracle.com/middleware/entry/installing_eclipse_for_osb_development). But after some analysis the connections can be found. In fact you need an Eclipse installation with OEPE and then some additional plugins are linked to the Eclipse installation. We take the [Eclipse 4.4 (Luna) OEPE](http://www.oracle.com/technetwork/developer-tools/eclipse/downloads/index.html?ssSourceSiteId=opn "Eclipse 4.4 (Luna) OEPE") as basis, but you can also use an existing eclipse installation and install the [OEPE update](http://download.oracle.com/otn_software/oepe/12.1.3.1/luna/repository "OEPE update"). Next we need the eclipse140 folder from an OSB installation. It can be found in the Oracle\_OSB1 folder. In the dropins folder of the Eclipse installation we create a text file named oracle.osb.ide.link with this content: 1 path=C:/prog/java/OSBEclipsePlugins 2 The path must be the path of the eclipse140 folder containing plugins and features folder. I have renamed it to OSBEclipsePlugins. Additionally we have to set properties of some paths for the eclipse installation. They are appended to the eclipse.ini file: 1 -Dweblogic.home=D:/prog/java/oracle/mw\_osb\_11.1.1.6/wlserver\_10.3 2 -Dharvester.home=D:/prog/java/oracle/mw\_osb\_11.1.1.6/Oracle\_OSB1/harvester 3 -Dosb.home=D:/prog/java/oracle/mw\_osb\_11.1.1.6/Oracle\_OSB1 4 -Dosgi.bundlefile.limit=750 5 -Dosgi.nl=en\_US 6 -Dorg.eclipse.swt.internal.gtk.disablePrinting 7 -Dmiddleware.home=D:/prog/java/oracle/mw\_osb\_11.1.1.6 8 For a Eclipse 3.7 (Indigo) OEPE installation this is all to do but as we use Eclipse 4.4 OEPE there are some more steps necessary. First we need to install the Oracle xmlbeans plugin. The file [oracle.eclipse.tools.xmlbeans\_4.2.0.201112072225.jar](https://www.bmaehr.com/blog/wp-content/uploads/2014/07/oracle.eclipse.tools_.xmlbeans_4.2.0.201112072225.jar) needs to be copied to the plugins directory. I have attached a slightly modified file from the old OEPE installation. The modification is just the removement of the hardcoded version numbers for the references in the MANIFEST.MF. In the file plugins/com.bea.alsb.feature.branding\_1.4.0/META-INF/MANIFEST.MF we remove the references to org.eclipse.update.core and org.eclipse.update.ui. If we now start Eclipse our OSB tooling is working with the new Eclipse version. Only when trying to edit a workflow of the proxy server we don“™t get the correct view. I have hunted the error down and created a patched version of the [messageflow-ui.jar](https://www.bmaehr.com/blog/wp-content/uploads/2014/07/messageflow-ui.jar). This is copied to the plugins/com.bea.alsb.process.messageflow.ui\_1.4.0 folder and replaces the old version. And this is how it finally looks like: [![BLOG_OSB_Luna_01](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_luna_01_thumb.png "BLOG_OSB_Luna_01")](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_luna_01.png) Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Development **Schlagwörter:** English, Oracle FMW, Service Bus --- ### [Finding differences in two Open-Office-Writer documents](https://thecattlecrew.net/2014/07/31/finding-differences-in-two-open-office-writer-documents/) **Published:** Juli 31, 2014 **Author:** Bernhard Mähr **Content:** If you write documents and get feedback from different persons on different versions it is a great pain to merge the documents and changes together. Microsoft Word has a functionality that works quite well. But the function to compare documents in Open Office Writer has never work for me the way I expected. Fortunately OO stores documents in a zip file, containing xml files. The main content of the document is the file content.xml. After changing the extension of the OO Writer document to zip it is possible to open the file with the favorite zip application and extracting the content.xml file. If you do this for both versions you can compare the both files with your favorite text compare tool and you will see „¦ hmmm yes“¦ thousands of changes. This happens especially if the documents have been edited with different versions of Open Office or Libre Office. Most of the changes are not relevant for your comparison. So we would like to eliminate the changes not interested in to get an overview of the real changes. We will do this using [Notepad++](http://notepad-plus-plus.org/ "Notepad++"), the tool I use most for work. Additionally we need for formation the document the [XML Tools Plugin](http://sourceforge.net/projects/npp-plugins/files/XML%20Tools/). Both are free. We open both versions of content.xml with Notepad++ and do a „Linarize XML“ with XML Tools first on both files. In the next step we replace these six regular expressions with an empty string. This is done recursively until no further replace is possible: 1 \[a-zA-Z0-9\\-\]+:\[a-zA-Z0-9\\-\]+=“\[^“\]\*“ 2 <(\[a-zA-Z0-9\\-\]+:)?\[a-zA-Z0-9\\-\]+\\s\*/> 3 <(\[a-zA-Z0-9\\-\]+:)?\[a-zA-Z0-9\\-\]+\\s\*>\\s\*(\[a-zA-Z0-9\\-\]+:)?\[a-zA-Z0-9\\-\]+> 4 .\*?<\\/text:changed\\-region> 5 .\*?<\\/office:annotation> 6 .\*?<\\/text:bookmark-ref> Finally we use the „Pretty print (libxml)“ function of XML Tools to get the XML files formatted. Now it is possible to compare the two files with tool for comparing text files and you will see the real text changes. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Development **Schlagwörter:** English --- ### [IT-Security (Part 7): WebLogic Server, Roles, Role Mapping and Configuring a Role Mapping Provider](https://thecattlecrew.net/2014/08/07/it-security-part-7-weblogic-server-roles-role-mapping-and-configuring-a-role-mapping-provider/) **Published:** August 7, 2014 **Author:** Mohammad Esad-Djou **Content:** **Key words:** *IT-Security, WebLogic Server, Authorization, authorization process, Role Mapping, Roles and XACML Role Mapping Provider* **L**et“™s continue with Authorization topic. We discussed about the Authorization Process and its main components such as WebLogic Security Framework and Security Provider. Now, we look at Security Provider“™s subcomponents: Role Mapping and Security Policies. # The Role Mapping: Is access allowed? Role Mapping providers help to clear, weather a user has the adequate role to access a resource? The Authorization provider can with this role information answer the „is access allowed?“ question for WebLogic resources.[\[1\]](#_edn1) ## The Role Mapping Process Role mapping is the process whereby principals are dynamically mapped to security roles at runtime. The WebLogic Security Framework sends Request Parameter to specific Role Mapping provider that is configured for a security realm as a part of an authorization decision. Figure 1 Role Mapping Process presents how the Role Mapping providers interact with the WebLogic Security Framework to create dynamic role associations. The result is ***a set of roles*** that apply to the ***principals*** stored in a ***subject*** at ***a given moment***.[\[2\]](#_edn2) [![Role Mapping Process](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_1rolemappingprocess.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_1rolemappingprocess.png)Role Mapping Process **Figure 1 Role Mapping Process** Let“™s review each part again[\[3\]](#_edn3): - The request parameters are including information such as the subject of the request and the WebLogic resource being requested. - Role Mapping provider contains a list of the roles. For instance, if a security policy specifies that the requestor is permitted to a particular role, the role is added to the list of roles that are applicable to the subject. - As response, get WebLogic Security Framework the list of roles. - These roles can then be used to make authorization decisions for protected WebLogic resources, as well as for resource container and application code. I“™m going to discuss about that in part 9. ## Configuring a Role Mapping Provider The XACML Role Mapping provider and DefaultRoleMapper are included by WebLogic Server. In addition, you can use a custom Role Mapping provider in your security realm too. By default, most configuration options for the XACML Role Mapping provider are already defined. However, you can set Role Mapping Deployment Enabled, which specifies whether or not this Role Mapping provider imports information from deployment descriptors for Web applications and EJBs into the security realm. This setting is enabled by default. In order to support Role Mapping Deployment Enabled, a Role Mapping provider must implement the DeployableRoleProvider SSPI. Roles are stored by the XACML Role Mapping provider in the embedded LDAP server.[\[4\]](#_edn4) XACML Role Mapping provider is the standard Role Mapping provider for the WebLogic Security Framework. To configure a Role Mapping provider: - In the Change Center of the Administration Console, click Lock & Edit [![Change Center](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_2changecenter.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_2changecenter.png)Change Center **Figure 2 Change Center** - In the left pane, select Security Realms and click the name of the realm you are configuring. [![Domain Structure: Click Security Realms](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_3domainstructure.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_3domainstructure.png)Domain Structure: Click Security Realms **Figure 3 Domain Structure: Click Security Realms** [![Summary of Security Realms](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_4summsecrealm.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_4summsecrealm.png)Summary of Security Realms **Figure 4 Summary of Security Realms** - Select Providers > Role Mapping. The Role Mapping Providers table lists the Role Mapping providers configured in this security realm [![myrealm: Role Mapping](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_5rolemapping.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_5rolemapping.png)myrealm: Role Mapping **Figure 5 myrealm: Role Mapping** - Click New. The Create a New Role Mapping Provider page appears. [![WebLogic Server default Role Mapping Provider: XACMLRoleMapper](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_6xacmlrolemapper.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_6xacmlrolemapper.png)WebLogic Server default Role Mapping Provider: XACMLRoleMapper **Figure 6 WebLogic Server default Role Mapping Provider: XACMLRoleMapper** - In the Name field, enter a name for the Role Mapping provider. From the Type drop-down list, select the type of the Role Mapping provider (e.g. DefaultRoleMapper or XACMLRoleMapper) and click OK. [![a New Role Mapping Provider: Default_1](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_7newrolemappingprovider.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_7newrolemappingprovider.png)a New Role Mapping Provider: Default\_1 **Figure 7 a New Role Mapping Provider: Default\_1** - Select Providers > Role Mapping and click the name of the new Role Mapping provider to complete its configuration. [![Role Mapping Configuration](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_8rolemapingconfig.png)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_8rolemapingconfig.png)Role Mapping Configuration **Figure 8 Role Mapping Configuration** - Optionally, under Configuration > Provider Specific, set Role Deployment Enabled if you want to store security roles that are created when you deploy a Web application or an Enterprise JavaBean (EJB) (See Figure 8 Role Mapping Configuration). - Click Save to save your changes. - In the Change Center, click Activate Changes and then restart WebLogic Server. ## XACML Role Mapping Provider As we discussed above, a WebLogic security realm is configured by default with the XACML Role Mapping provider. It implements XACML 2.0, the standard access control policy markup language (the ***eXtensible Access Control Markup Language***). WebLogic XACML Role Mapping Provider is saved as a ***.dat*** file und available on e.g.: $Domain-Home/***XACMLRoleMapper.dat*** and has the following options (see Figure 8 Role Mapping Configuration): - **Name:** The name of your WebLogic XACML Role Mapping Provider. - **Description:** The description of your Weblogic XACML Role Mapping Provider. - **Version:** The version of your Weblogic XACML Role Mapping Provider. - **Role Deployment Enabled:** Returns whether this Role Mapping provider stores roles that are created while deploying a Web application or EJB. You can see file structure on the following example: ***XACMLRoleMapper.dat*** has different User/Groups. For each User assigned particular Roles, Policies and associated resources. For example, you see description of Group and User „Administrators“ below: [![XACMLRoleMapper.dat: description of Group and User ](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_9xacmlrolemapper_dat.png?w=660)](https://thecattlecrew.net/wp-content/uploads/2014/08/p7_9xacmlrolemapper_dat.png)XACMLRoleMapper.dat: description of Group and User „Administrators“ **Figure 9 XACMLRoleMapper.dat: description of Group and User „Administrators“** You see a policy contains Description, Target and Rule. Each element is associated to different attributes and with this form prepared one „authorization matrix“ that it helps to decide Application Server about a user or a group. Continued“¦ ## References See too last parts of IT-Security and Oracle Fusion Middleware: 1. [https://thecattlecrew.net/2014/02/17/it-security-weblogic-server\_1/](https://thecattlecrew.net/2014/02/17/it-security-weblogic-server_1/) 2. 3. 4. 5. 6. [\[1\]](#_ednref1) Oracle® Fusion Middleware Securing Oracle WebLogic Server 11g Release 1 (10.3.6), E13707-06 [\[2\]](#_ednref2) Oracle® Fusion Middleware Understanding Security for Oracle WebLogic Server 11g Release 1 (10.3.6), E13710-06 [\[3\]](#_ednref3) Oracle® Fusion Middleware Understanding Security for Oracle WebLogic Server 11g Release 1 (10.3.6), E13710-06 [\[4\]](#_ednref4) Oracle® Fusion Middleware Securing Oracle WebLogic Server 11g Release 1 (10.3.6), E13707-06 **Kategorien:** Architecture & Process Models **Schlagwörter:** Authorization, authorization process, English, Oracle FMW, Role Mapping, Roles, Weblogic, XACML Role Mapping Provider --- ### [Microservices: Not a first principle, but an emerging design](https://thecattlecrew.net/2014/10/30/microservices-a-different-view/) **Published:** Oktober 30, 2014 **Author:** Richard Attermeyer **Content:** *Thoughts by: Sven Bernhardt, Richard Attemeyer, Torsten Winterberg, Stefan Kühnlein, Stefan Scheidt* --- Up to now (see our [article ](https://thecattlecrew.net/2014/09/30/microservices-architectures-thoughts-from-a-soa-perspective/ "Microservices architectures ")on Microservices from a SOA perspective) we considered Microservices as an architectural pattern: We discussed the statical structure of your system and the consequences. It seems nowadays that you design explicitely for a microservices architecture. We believe that this is the wrong way to approach the problem. Don’t build the system with the microservices pattern in mind, but ask more important questions about how you want to develop, what are the principles to follow when building a new system… and a microservices architecture emerges naturally. Believers in an agile development methodology we are. But still, if you are trying to implement systems of a certain size, you must do some management work and answer several questions: - What is the right team size? - How to split the teams? - How to minimize dependencies between teams? - What roles should be present on the teams? And beyond team size, you might be considering your development process. If you aim for continuous delivery and potentially continuous deployment you must require other qualities from the system - Isolating dependencies: It should be possible to deploy two different parts of an enterprise application that require different dependencies (Java version, Programming Language, …) - Isolation of orthogonal services: two unrelated services that happen to run on the same machine should not be able to negatively affect one another - Repeatability of deployments: If we need to revert to a previous version of a software, this is easily possible. The release is self-contained (not dependent on any state of the host environment) - Version everything (not only source code, but also infrastructure description) to manage organization and deployment of application / service versions - Team is responsible for development and maintenance (Team size and members may vary over time). Regarding the team aspects, agile development methodologies give us some rules of thumb: - Team size: 7 +/- 2 - All roles present: Developer, Tester, UI, … - Full stack development: split around business functionality not around technology The reason for these aspects is that the team should take as many decisions as possible autonomously. This can best be achieved when the team has full responsibility for a cohesive set of features. Full responsibility includes front-end, back-end, development and operations responsibility. Somehow this can be also seen as another example of Conways law \[1\]. Conways law states „organizations which design systems … are constrained to produce designs which are copies of the communication [structures](http://en.wikipedia.org/wiki/Organizational_structure "Organizational structure") of these organizations“. We believe that an organization that fully implements self-sufficient teams with authority over their area of work will eventually arrive at a microservices architecture. And if you have the whole application lifecycle in mind, you will see, that at some point you might throw away your system and build something new. Design for re-use is hard (very hard indeed). What we have seen quite often is that the step of rebuilding the system was further and further delayed to the future, because of a monolithic application. It was not easy to replace some parts, either all or nothing. So, you should probably not design for reuse, but design for replacement. We have observed on various projects, that following these principles will result in small, self-contained deployment units, nowadays named microservices. So the long debated question: „What is the right size for a Microservice“ is equivalent to ask „How to organize my teams and maximize their output“? [1] [http://en.wikipedia.org/wiki/Conway%27s\_law](http://en.wikipedia.org/wiki/Conway%27s_law) **Kategorien:** Architecture & Process Models **Schlagwörter:** Architecture, English --- ### [Analyse der Software-Qualität mit SonarQube](https://thecattlecrew.net/2014/10/31/analyse-der-software-qualitat-mit-sonarqube/) **Published:** Oktober 31, 2014 **Author:** stefanlack **Content:** # Was ist SonarQube? SonarQube ist ein Werkzeug, das mittels statischer Code-Analyse technische Qualitätsmerkmale von Software erfasst und diese in einer übersichtlichen Oberfläche darstellt. Neben der Analyse von Java-Quellcode können mittels diverser Plugins auch JavaScript, Groovy, PHP, C# und viele weitere Sprachen analysiert werden. Die offizielle [SonarQube Seite](http://docs.codehaus.org/display/SONAR/Plugin+Library) listet die verfügbaren Plugins auf. In diesem Artikel beschränke ich mich auf die Analyse von Java-Projekten mittels SonarQube. SonarQube besteht aus den drei folgenden Komponenten: 1. Das *Analyse-Modul* untersucht den Quellcode. Zum Aufruf der Analyse existieren Plugins für Apache Maven und Apache Ant. Zusätzlich existiert ein eigenständiger SonarQube-Runner. Mittels dieser Tools kann die Quellcode-Analyse innerhalb des Builds (beispielsweise in einem CI-System) automatisiert aufgerufen werden. 2. Die Analyse-Ergebnisse werden in einer *Datenbank* gespeichert, so dass diese im Nachhinein ausgewertet werden können. Dabei wird neben den jeweils neusten Analyse-Ergebnissen auch eine Historie gespeichert, sodass untersucht werden kann, wie sich die Qualitätsmerkmale im Laufe der Zeit ändern. SonarQube kann mit diversen relationalen Datenbanken betrieben werden. 3. Eine *Webanwendung*, mittels der die Analyse-Ergebnisse betrachtet werden können. Die einzelnen Ergebnisse werden zunächst übersichtlich innerhalb eines konfigurierbaren Dashboards angezeigt. Von dieser Übersicht kann man über eine Drill-Down-Funktion weitere Details anzeigen lassen. SonarQube analysiert den Programm-Code hinsichtlich der folgenden Qualitätsbereiche (Quelle [sonarqube.org](http://www.sonarqube.org/ "http://www.sonarqube.org/")) : - Softwarearchitektur & Softwaredesign - Duplikation - Unit tests - Komplexität - Potenzielle Fehler - Quellcode-Richtlinien - Kommentare Intern verwendet SonarQube die folgenden Werkzeuge für die Analyse: - In SonarQube 4.4 existieren noch Rules, welche die Tools Checkstyle, PMD, Findbugs verwenden. Diese Rules werden von dem Hersteller nach und nach abgelöst durch Regeln, welche mit einer SonarQube eigenen Rules-Engine geprüft werden. (Details: [SonarQube Blog](http://www.sonarqube.org/already-158-checkstyle-and-pmd-rules-deprecated-by-sonarqube-java-rules/)) - Darüber hinaus werden auch Analyse-Ergebnisse von diversen Tools zur Ermittlung der Testabdeckung eingelesen und in der SonarQube Datenbank gespeichert. Diese können ebenfalls in der Webanwendung betrachtet werden. # SonarQube Webanwendung Einstiegspunkt in eine Analyse innerhalb der Webanwendung ist das Dashboard. Im linken Bereich werden einige Meta-Informationen wie Anzahl an Klassen, Dateien, Methoden etc. dargestellt. Rechts finden sich die Ergebnisse der Regel-Überprüfungen, direkt darunter Metriken bzgl. der Abhängigkeiten zwischen Dateien. [![01_dashboard](https://thecattlecrew.net/wp-content/uploads/2014/10/01_dashboard.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/01_dashboard.png) In der Ansicht des Dashboards können die Ergebnisse der letzten Analyse mit vorherigen Analysen verglichen werden. So kann schnell erkannt werden, ob sich die Ergebnisse verschlechtern oder verbessern. Auswählbar sind die Ü„nderungen seit der vorherigen Analyse, Unterschiede über die letzten 30 Tage oder Ü„nderungen seit der letzten Version. Die bei der Analyse verwendete Versionsnummer wird bei Maven-Projekten aus dem *Version* Feld der POM entnommen. Bei anderen Projektarten wird die Versionsnummer bei der Analyse über das Property *sonar.projectVersion* festgelegt. In den folgenden Abschnitten werden einige einzelne Analyse-Ergebnisse exemplarisch dargestellt. ## Anzeige der Testabdeckung Im Dashboard werden die Ergebnisse der Testabdeckung angezeigt. Dabei wird unterschieden zwischen Unit- und Integrations-Tests. [![02_testabdeckung](https://thecattlecrew.net/wp-content/uploads/2014/10/02_testabdeckung.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/10/02_testabdeckung.png) *Abbildung 1: Anzeige der Testabdeckung eines Projektes* Die Anzeige der Testabdeckung setzt eine korrekte Projekt-Konfiguration voraus. Um bei der Ausführung der Unit- und Integrationstests die Daten zur Testabdeckung aufzeichnen zu können, muss die Java Virtual Maschine entsprechend instrumentiert werden. Hierzu kann z. B. *JaCoCo* verwendet werden. Eine Beispiel-Konfiguration und Details zum Aufruf der Analyse sind in dem GitHub-Repository [sonar-examples](https://github.com/SonarSource/sonar-examples/tree/master/projects/languages/java/code-coverage/ut/ut-maven-jacoco "sonar-examples") von SonarSource und in der SonarQube Dokumentation ([Konfiguration für Unit-Tests](http://docs.codehaus.org/display/SONAR/Code+Coverage+by+Unit+Tests+for+Java+Project), [Konfiguration für Integration Tests](http://docs.codehaus.org/display/SONAR/Code+Coverage+by+Integration+Tests+for+Java+Project)) zu finden. **Bewertung** > Bei dieser Metrik muss stets beachtet werden, dass eine hohe Testabdeckung alleine noch nicht zwangsläufig eine gute Qualität der Software bedeutet. Beispielsweise ist es möglich, „Tests“ zu schreiben, die kein einziges Assert-Statement enthalten. Weiterhin müssen Tests natürlich auch fachlich korrekt sein, was selbstverständlich nicht von einer Software überprüft werden kann. ## Anzeige der Regelverletzungen Die Regelverletzungen werden nach ihrem Schweregrad gruppiert. Nach Auswahl eines Schweregrads werden die verletzten Regeln angezeigt. Das Bespiel zeigt einige Regeln, welche von SonarQube als Kritisch angesehen werden: [![03_regelverletzungen](https://thecattlecrew.net/wp-content/uploads/2014/10/03_regelverletzungen.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/03_regelverletzungen.png) Nach Auswahl einer Klasse wird diese „“ zusammen mit den Regelverletzungen „“ im unteren Bereich dargestellt: [![04_regelverletzungen](https://thecattlecrew.net/wp-content/uploads/2014/10/04_regelverletzungen.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/04_regelverletzungen.png) Praktisch ist die gute Navigierbarkeit innerhalb der Anwendung. So ist es möglich, andere Verletzungen innerhalb der gerade angezeigten Klasse anzusehen. Zur Erhöhung der Übersichtlichkeit kann die Klasse auch in einem separaten Fenster geöffnet werden. ## Komplexität SonarQube ermittelt die zyklomatische Komplexität (Mc-Cabe-Metrik) des untersuchten Projektes. Zur Bestimmung der Metrik wird die Anzahl der folgenden Schlüsselwörter je Methode bzw. je Klasse gezählt: - if, for, while, case, catch, throw, return (ausgenommen des letzten return-Statements einer Methode), &&, ||, ? Es sollte generell eine kleine Zahl und damit geringe Komplexität von Methoden angestrebt werden, da angenommen wird, dass eine Methode umso schwerer von Menschen verstanden werden kann, je höher die Zahl ist. **Bewertung** > Die Metrik der zyklomatischen Komplexität ist nicht unumstritten. Ein Switch-Statement mit vielen Case-Anweisungen kann z.B. trotz hoher Komplexitäts-Zahl dennoch übersichtlich sein. Im Dashboard werden die Durchschnittswerte der Komplexität angezeigt: [![05_komplexität](https://thecattlecrew.net/wp-content/uploads/2014/10/05_komplexitc3a4t.png)](https://thecattlecrew.net/wp-content/uploads/2014/10/05_komplexitc3a4t.png) Die Gesamtsumme der Komplexität stellt kein Qualitätsmerkmal dar, sondern gibt einen generellen Hinweis auf die Projektgröße. Die Durchschnittswerte der Komplexität je Methode sind alleine nicht sehr aussagekräftig. So wurde im Beispiel ein Projekt gezeigt, in dem unter anderem viele via Hibernate persistierte Domain-Objekte vorhanden sind, welche zumeist einfache Datenhalte-Objekte sind. Diese reduzieren natürlich die durchschnittliche Komplexität. (Laut Martin Fowler sind solche „*blutarmen*“ Domain-Modelle eine Anti-Pattern. Siehe auch [AnemicDomainModel](http://www.martinfowler.com/bliki/AnemicDomainModel.html)) Mittels Klick auf eine der Komplexitätszahlen kann zu der der Detail-Ansicht navigiert werden, in der weiter durch Packages bis hinunter zu den einzelnen Klassen navigiert werden kann. ## Hotspots Um schnell einen Überblick über die Qualität einer Software zu erhalten, eignet sich der Bereich Hotspot. Beispiele: - Hotspot per nicht abgedeckter Quellcodezeilen - Hotspot per Komplexität je Klasse - Hotspot per Komplexität je Methode - Meist verletzte Ressource - etc. ## Design Im Dashboard werden mittels der „Package Design“-Komponente Informationen zu Abhängigkeiten zwischen den Packages und zu zirkulären Abhängigkeiten angezeigt: [![08_design](https://thecattlecrew.net/wp-content/uploads/2014/10/08_design.png)](https://thecattlecrew.net/wp-content/uploads/2014/10/08_design.png) Von dort gelangt man durch Klick auf eine Zahl direkt zur „*Dependency Structure Matrix*„, in der die Abhängigkeiten der Komponenten (d. h. der Java Packages) dargestellt werden. Mit Hilfe dieser Matrix können zirkuläre Abhängigkeiten im Projekt gefunden werden. Gutes Software-Design vermeidet generell zyklische Abhängigkeiten zwischen einzelnen Packages. [![09_dsm_design](https://thecattlecrew.net/wp-content/uploads/2014/10/09_dsm_design1.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/09_dsm_design1.png) Das Diagramm enthält für jedes Package je eine Zeile (mit Beschriftung) und ebenfalls eine korrespondiere Spalte. Innerhalb des Diagramms wird dargestellt, wie viele Klassen eines Packages Klassen aus anderen Packages verwenden. Mögliche zirkuläre Abhängigkeiten können an den rot hinterlegten Zahlen im oberen rechten Bereich der Matrix erkannt werden. **Beispiel** Durch Doppelklick auf eine Zahl (im Beispiel rote „1“ in der Zeile „vorhaben“) werden unterhalb des Diagramms weitere Details der Abhängigkeiten der beiden Packages *vorhaben* und *imp* dargestellt: [![09_dsm_design_uses](https://thecattlecrew.net/wp-content/uploads/2014/10/09_dsm_design_uses.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/09_dsm_design_uses.png) Welche Klassen aus dem Package *imp* (links) verwenden welche Klassen aus dem Package *vorhaben* (rechts) Weitere Details zur Dependency Structure Matrix sind in der SonarQube Dokumentation auf der Seite [Cycles – Dependency Structure Matrix](http://docs.codehaus.org/display/SONAR/Cycles+-+Dependency+Structure+Matrix) enthalten. # Hinweise für den praktischen Einsatz von SonarQube ## Definition von projektspezifischen Qualitätsprofilen Nachdem die SonarQube Analyse eines größeren Projektes mit langer Historie erstmalig ausgeführt wurde, sind häufig sehr viele Metriken diverser Regeln verletzt. In einem großen Projekt können diese Verletzungen nicht unmittelbar durch entsprechende Ü„nderung im Quellcode behoben werden. Dies ist auch nicht in jedem Projekt sinnvoll und notwendig. Vor der regelmäßigen Verwendung von SonarQube sollten sich die Entwickler des Projektes daher zunächst auf eine Menge von Regeln einigen, die im Projekt eingehalten werden sollen. Dazu kann auch gehören, dass man die Kritikalität einzelner Regeln entsprechend der konkreten Projekt-Notwendigkeiten erhöht oder verringert. Für die Konfiguration von solchen projektspezifischen Regeln bietet SonarQube den Einsatz von sogenannten „Quality-Profiles“ an. Durch Qualitätsprofile kann festgelegt werden, welche Regeln für die Analyse verwendet werden sollen und mit welcher Kritikalität Regelverletzungen protokoliert werden sollen. Wird bei der SonarQube-Analyse kein Qualitätsprofil angegeben, verwendet SonarQube per Default das Profil *Sonar-Way*. Alternativ kann durch Setzen des Properties *sonar.profile* der Name des gewünschten Profils beim Aufruf der Analyse angegeben werden. Zur Pflege eines eigenen Profils kann ein bereits vorhandenes Profil kopiert und angepasst werden. Die Anpassung eines Profils wird dabei innerhalb des Bereichs „Rules“ der Anwendung vorgenommen: [![10_rules](https://thecattlecrew.net/wp-content/uploads/2014/10/10_rules.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/10_rules.png) Bei der Auswahl von Regeln sollte auch geprüft werden, ob im verwendeten Profil deaktivierte Regeln (Filter Activation: Inactive setzten!) existieren, welche im Projekt interessant sein könnten. ## Unterdrückung von Validierungen Zur Unterdrückung von Validierungen bietet SonarQube die folgenden Möglichkeiten: - Einfügen des Kommentars //NOSONAR am Zeilenende, wodurch die Analyse für diese Zeile komplett verhindert wird. - Annotation einer Methode mittels @SuppressWarnings(„all“), um die Analyse der gesamten Methode zu unterbinden. - Eine konkreter Validierungsfehler kann auch mittels der Webanwendung als „falsch positiv“ deklariert werden: [![11_falschpositiv](https://thecattlecrew.net/wp-content/uploads/2014/10/11_falschpositiv.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/11_falschpositiv.png) ## Anzeige von Ü„nderungen Bei der Anzeige der Regelverletzung können entweder alle Verletzungen angezeigt werden oder nur das Delta zwischen verschiedenen Analyse-Zeitpunkten. Beispielsweise ist die Anzeige der Veränderung seit der Analyse des letzten Release sinnvoll, um rechtzeitig (z. B. noch vor der Auslieferung eines Releases) erkennen zu können, wenn sich die Qualität (hinsichtlich der Metriken) in der aktuellen Version verschlechtert. Anzeige aller Verletzungen: [![12_aenderungen_1](https://thecattlecrew.net/wp-content/uploads/2014/10/12_aenderungen_1.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/12_aenderungen_1.png) Anzeige der Veränderungen innerhalb der letzten 30 Tage: [![13_aenderungen_2](https://thecattlecrew.net/wp-content/uploads/2014/10/13_aenderungen_2.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/13_aenderungen_2.png) Bei der Anzeige der Regeln werden allerdings nur die Verschlechterungen in der Delta-Anzeige berücksichtigt. Dieser Umstand kann „“ je nach Persönlichkeit des Entwicklers „“ unter Umständen auch demotivierend sein. Umso schöner und motivierender kann daher die Anzeige der Ü„nderung im Dashboard sein: [![14_aenderungen_dashboard](https://thecattlecrew.net/wp-content/uploads/2014/10/14_aenderungen_dashboard.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/14_aenderungen_dashboard.png) Eine Anzeige des Analyseverlaufs über verschiedene Versionen bietet die Seite „Historisch“ (Deutsche Version) bzw. „Time Machine“ (Englische Version): [![15_timemachine](https://thecattlecrew.net/wp-content/uploads/2014/10/15_timemachine.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/10/15_timemachine.png) Hinweis: Die Integration-Tests des Projektes wurden ohne Erfassung der Testabdeckung ausgeführt. ## Quality Gates und das Build-Breaker Plugin Mittels [Quality Gates ](http://docs.codehaus.org/display/SONAR/Quality+Gates)können Grenzwerte definiert werden, welche im Projekt nicht überschritten werden dürfen. Durch die Verwendung des [Build-Breaker](http://docs.codehaus.org/display/SONAR/Build+Breaker+Plugin) Plugins ist es möglich, den Build fehlschlagen zu lassen, wenn die im Quality Gate definierten Anforderungen nicht erfüllt wurden. # Fazit Mit SonarQube wird und ein reichhaltiges und mächtiges Werkzeug für die Qualitätsanalyse von Software-Projekten an die Hand gegeben. Richtig konfiguriert und eingesetzt, liefert SonarQube Informationen zu Schwachstellen in Software-Projekten, welche für die daraus geleitete Qualitätsverbesserung eingesetzt werden können. Bei der Verwendung von SonarQube sollte jedoch immer im Auge behalten werden, welches Ziel mit der Analyse erreicht werden soll. Im Projektteam wird man daher über die verschiedenen Metriken und Regeln diskutieren und sich nach der (hoffentlich eingetretenen) Einigung ein eigenes Qualitätsprofil definieren, welches im Zuge des weiteren Projektverlaufs verwendet wird. Weiterhin führt die Analyse alleine nicht automatisch zu besserer Qualität. So sind nach der Identifizierung von Schwachstellen im Code selbstverständlich entsprechende Refactoring-Maßnahmen notwendig. Darüber hinaus sollte das manuelle, durch einen Projektteam-Kollegen durchgeführte Quellcode-Review auch trotz SonarQube weiter durchgeführt werden, um auch Qualität hinsichtlich fachlicher Korrektheit und guter Verständlichkeit (bspw. Benennung von Klassen, Methoden und Variablen) sicherstellen zu können. **Kategorien:** Development **Schlagwörter:** Architecture, German, Java, Quality --- ### [Erste Schritte mit Orcas oder Continuous Delivery für die Datenbank leicht gemacht](https://thecattlecrew.net/2015/08/04/erste-schritte-mit-orcas-oder-continuous-delivery-fuer-die-datenbank-leicht-gemacht/) **Published:** August 4, 2015 **Author:** Olaf Jessensky **Content:** ### **Aller Anfang ist (nicht) schwer“¦** Vor einigen Wochen habe ich an dieser Stelle unser Framework [Orcas](https://github.com/opitzconsulting/orcas) vorgestellt und erklärt, wie damit die Konzepte von Continuous Integration und Continuous Delivery auch auf Datenbankänderungen angewendet werden können. Demjenigen, der die Probleme mit solchen Ü„nderungen aus der Praxis kennt, haben die Vorteile dieser Vorgehensweise sicher schnell eingeleuchtet. Bis zur Umsetzung und endgültigen Lösung der Probleme ist es aber dennoch gefühlt ein großer Schritt. Schließlich muss nicht nur ein neues Framework eingeführt und der Build-Prozess entsprechend angepasst werden. Es handelt sich auch um einen kleinen Paradigmenwechsel, von dem das Entwicklungsteam und die Projektverantwortlichen überzeugt werden müssen. Umso wichtiger ist es, den Nutzen von Orcas schnell und überzeugend verifizieren und demonstrieren zu können. Dafür soll hier eine Starthilfe gegeben werden. Eine ausführliche [Dokumentation](http://opitzconsulting.github.io/orcas/) mit Beispielen und einer genauen Installationsanleitung findet sich im Orcas-Projekt auf Github. Einen kurzen Überblick über die Funktionsweise und Möglichkeiten von Orcas liefert unser [Whitepaper](http://www.opitz-consulting.com/fileadmin/redaktion/veroeffentlichungen/whitepaper/whitepaper-orcas_sicher.pdf). ### **Benötigte Tools** Um Orcas auf einem Entwicklerrechner oder einem Server betreiben zu können, sind zunächst die folgenden Tools zu installieren. Da Gradle ggf. eine Verbindung zum Maven-Central-Repository aufbaut, muss eine Internetverbindung bestehen. - [Java JDK](http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html) (JRE reicht nicht) ab Version 1.6, es genügt die Standard Edition (SE). Das Installationsverzeichnis muss in der Umgebungsvariablen JAVA\_HOME und „%JAVA\_HOME%\\bin“ in der Umgebungsvariablen PATH eingetragen sein. Test der Installation: javac „“version muss die installierte Versionsnummer anzeigen. - [Ant](//ant.apache.org/bindownload.cgi) in der aktuellsten Version. Die Download-Datei entpacken und das Installationsverzeichnis in die Umgebungsvariable ANT\_HOME eintragen. „%ANT\_HOME%\\bin“ muss in die Umgebungsvariable PATH eingetragen werden. Test der Installation: ant „“version muss die installierte Versionsnummer anzeigen. - [ant-contrib-1.0b3-bin.zip](http://sourceforge.net/projects/ant-contrib/files/ant-contrib/1.0b3/ant-contrib-1.0b3-bin.zip/download) herunterladen, entpacken und ant-contrib-1.0b3.jar nach ANT\_HOME/lib kopieren. Neuere Versionen von ant-contrib sind nicht kompatibel! - Die aktuelle Version von [Gradle](http://gradle.org/) herunterladen und entpacken. Es muss GRADLE\_HOME auf das Installationsverzeichnis gesetzt werden oder es muss der Befehl gradle in die Umgebungsvariable PATH eingetragen werden. ### **Der Oracle Client** Da Orcas mit Hilfe von SQL\*Plus auf die Datenbank zugreift, muss in jedem Fall ein Oracle Client installiert sein. Die Umgebungsvariable ORACLE\_HOME muss auf diesen Client zeigen. Dabei ist ein [Instant-Client](http://www.oracle.com/technetwork/database/features/instant-client/index.html) ausreichend. Die Verbindungsdaten zu den Datenbanken, die bearbeitet werden sollen, werden in der Datei tnsnames.ora eingetragen. Sie liegt beim Oracle-Client im Verzeichnis ORACLE\_HOME/network/admin. Beim Instant-Client muss diese Datei dort manuell angelegt werden. ### **Eine erste Build-Datei** Der Start von Orcas erfolgt über eine Ant Build-Datei. Diese zentrale build.xml kann z. B. in einen Maven-Build integriert werden. Hier zunächst ein Beispiel, das die Benutzung der wichtigsten in Orcas enthaltenen Ant-Tasks illustriert. Eine vollständige Beschreibung der Tasks findet sich in der [Dokumentation](http://opitzconsulting.github.io/orcas/) auf Github. Zunächst wird hier die Datei orcas\_default\_tasks.xml eingebunden, die die von Orcas bereitgestellten Ant-Tasks enthält. Aus einer Properties-Datei werden Parameter wie die Datenbankverbindung und die Userdaten eingelesen. Generell muss ein Datenbankschema in das die Datenbankpackages von Orcas selbst installiert werden, sowie eines, in das die Anwendung installiert werden soll, angegeben werden. Unter bestimmten Voraussetzungen kann auch dasselbe Schema verwendet werden. Vor dem eigentlichen Build muss einmal das Target orcas\_install aufgerufen werden, um Orcas auf der Datenbank zu installieren. Der Build wird in diesem Beispiel mit dem Target build\_all ausgeführt. Zur Vereinfachung enthält unser Projekt nur Tabellen und Views. Der hier gezeigte Ablauf macht Folgendes. - Erweiterung des Orcas-Syntax um benutzerdefinierte Extensions (siehe auch unser [Whitepaper](http://www.opitz-consulting.com/fileadmin/redaktion/veroeffentlichungen/whitepaper/whitepaper-orcas_sicher.pdf)) im Task orcas\_initialize. - Anpassung der Tabellen des Schemas an das im Ordner „tables“ hinterlegte Modell (orcas\_execute\_statics). Der Parameter dropmode, gibt an, ob nicht mehr benötigte Tabellen und Spalten gelöscht werden dürfen. - Orcas\_drop\_replaceables löscht alle Datenbankobjekte des Schemas (in diesem Fall nur Views), die keinen Status halten (wie auch Packages, Trigger, usw.). - Orcas\_execute\_scripts führt SQL-Skripte aus, um den aktuellen Stand dieser Objekte wieder einzuspielen (hier: nur Views). Die Build-Datei kann leicht auf die Bedürfnisse des konkreten Projekts angepasst werden. Anregungen dazu liefern die [Beispielprojekte](http://opitzconsulting.github.io/orcas/docs/examples/) der Dokumentation. ### **Kickstart** Um den Einstieg noch mehr zu erleichtern, enthält Orcas im Verzeichnis orcas\_vagrant für erste Tests eine [Vagrant](https://www.vagrantup.com/) „“Konfiguration. Damit kann man eine VM konfigurieren und starten, die eine Oracle XE Datenbank enthält und in der Orcas direkt lauffähig ist. Dazu muss man nur [Vagrant](https://www.vagrantup.com/) herunterladen, installieren und im Verzeichnis orcas\_vagrant die VM mit dem Befehl vagrant up starten. **Kategorien:** Database, DevOps **Schlagwörter:** agile, Softwarenentwicklung --- ### [Test Smells: A Different View](https://thecattlecrew.net/2017/11/24/test-smells-a-different-view/) **Published:** November 24, 2017 **Author:** Bernhard Mähr **Content:** In the last years I have seen many tests written by various project teams. Some of these tests had produced really headache for me. When comparing the problems of the tests with the known anti-patterns of testing (e.g. [http://xunitpatterns.com/TestSmells.html](http://xunitpatterns.com/TestSmells.html "http://xunitpatterns.com/TestSmells.html")) I found some matches. But much more I was surprised, that some really annoying problems I found aren“™t known as test smells and even as good practice. That“™s why I would like to share a different view to test smells. Some points I will discuss here are IMHO different for unit tests and integration tests. The usual guides focus more on unit tests while I will focus on integration tests here. Let“™s start with the first smell: ### 1.) The name of the test method tells what happening in the test A big NO to this pattern from my side. Having a class with 50 methods and searching the three methods in the class which are failing is really annoying if the method names are like - IfIMadeAFligthBookingAndITryToDoASecondBookingStartingLessThan50MinutesAfterItWillFail - IfIMadeTwoFlightBookingsAndTryToCancleTheFirstOneItWillSucced - IfIMadeAFligthBookingAndIBookASecondOneStartingMoreOrEqualThan50MinutesAfterItWillSucceed It is really difficult to read these method names while trying to understand what they are doing. At least for me, after reading to the end of the method name I have already forgotten the beginning. Additionally, you are not able to find the searched method in the class without using the search tool. I suggest building the names of the methods in a class with some kind of name schema - testTwoFlightsToLowGapException - testCancleFirstFlight - testTwoFlightsSufficientGap If these names are not clear enough there is still the possibility to write one or to lines of inline doc inside the test method. But actually there is no reason why someone should be able to completely understand the method just from the method name. Usually you are looking at a test method because it is failing, then you have to read the whole method in any case. And If you are searching for a method to duplicate and modify it, well even then the long method names doesn“™t really help you. ### 2.) Test should test exactly one thing At the authors define, that a test should not verify too much functionality with a single test. Some developers have interpreted this as „every test should contain only one assert“. This may be right for unit test, but it is really a bad idea for integration test. I would interpret this as „a test should verify an atomic part of a use case“. What happens, if you insist on only one assert per test? In case of an integration test of a method doing the booking of a flight, you for example expect - Method throws / doesn“™t throw an exception - Booking is stored/is not stored into database - Transaction information is stored to the database - Some business information are written to log-file - State of other objects is correct For different conditions executing the booking method you expect different behaviors of these points. If you just test one or even just a part of these points in one test, there will happen one of three things. #### a.) Not everything is tested You may easily forget to test some points. But it could get much worse: I have seen many tests being green, not because everything was as expected but rather because they tested not all expectations. For example a test that verifies there is no booking stored in the database because there is no free seat left succeeds because a new mandatory attribute of the customer is not filled and the booking is canceled many steps before. #### b.) Repeat yourself Mathematics teach us, that with 7 different conditions and 5 points to test you have to implement 35 tests. It is nut just boring to write 35 times the same test just modifying one or two lines. But what if with a later change on the system it is necessary to add an additional line to each of these test? And not only the 17 failing tests and the 8 not failing tests (see also 2a.) of these 35, but at 2734 tests of your 15386 test of the whole system? #### c.) Building complex code To avoid the duplication of the test code like in 2b you can refactor your test code and extract the repeated code in some way. Usually the test code will be much more complex then. Additionally, testing all five points in one test speeds up your integration tests five times because usually the setup and execution of the tests takes much more processing time than the checks. ### 3.) Tests should create an expected object and compare it I have often seen test implementations creating an expected object and comparing it with equals or toString to the object returned by the method to test. In my experience this is not a good idea. Sometimes in the lifecycle of the software there will be the need to modify the object and add or remove attributes which are unessential for your test. But comparing the objects makes it necessary to modify your test. Of course, you could implement the equals or the toString method to just ignore these attributes, but because it is the equals or toString method of an object from the production code and not from the test code, you can do this only for one case and even that only if you don“™t need the method in your production code. A better and much more flexible solution is to write a method to verifying the returned object to the expectations. If you prefer an expected object you can even give the expected object to the method for the verification. ### 4.) Tests should contain everything important in the test method If you write integration tests for complex systems you have often to create complex objects and object structures. It is true that in the test method the important things of the test should be readable. But that doesn“™t mean, that everything should be done in the test method. It would be much better to create helper methods creating the needed objects and providing the important values as parameters. This will reduce the duplication of code, which makes it easier to fix tests after a change on the system made tests fail. Additionally you will get more stable tests: If you write everything you need for the test into the method you will create your objects just with these informations needed to succeed the test. But in fact the constructed object is not a realistic object. And if you extend your production code sometimes your test will fail because of the unrealistic object. By using helper methods you can reuse the code to create the object structures and create realistic test cases. ### 5.) Tests could copy code many times In my opinion it is a bad practice to copy code within test methods. During the hopefully long lifetime of the system there will usually happen many extensions and changes over time. Depending on the change it may last much longer fixing all failing tests then doing the change. And if you don“™t copy code, you have to fix it only on one place instead of many. ### 6.) Test should be in the form given-when-then The „given-when-then“ form is intended to it make easier for the reader to read and understand the test. But in fact some assertions after the setup can make a test much easier to understand e.g. if the method to test increases a value it is a good idea to check if the value is before the call two and after the call three. Additionally, assertions before calling the method to test helps to make sure, that after the setup the conditions are as expected. And last but not least: When do you read a test? In my experience in 90% of the cases that happens only when the test fails. Usually you need some minutes up to hours to fix the test then. Compared to the amount of time for fixing the test the 30 seconds, you need more time to understand the test because it is not in given-when-then form, is insignificant. ### 7.) Test should tell what failed The most important thing for a test to do is telling you, if something is wrong with your system. Of course, it is nice if you can see from the test result exactly where the error happened like in described. But if you write an integration test there are hundreds of possibilities what could go wrong. And it would make the test much bigger and complex, if you test everything possible of the whole execution to exactly locate the problem. Usually if an integration test starts to fail you have to start debugging the code to find the problem and understand what“™s going wrong. And the knowledge you gain while debugging the code is the knowledge you need to fix the code or test afterwards. ### 8.) Tests should document the complete behavior According to tests should be a documentation of the behavior. For me the first and most important documentation of the system is the production code. This is the only source of truth. If the production source code are ten lines of good readable and understandable code, why should I write two hundred lines of test code to define this behavior? Tests are written to guarantee important behaviors. And perhaps they additionally serve to document some behaviors not obvious visible from the source code. But they“™re not intended to define the whole behavior. This is also the fact why I don“™t like the TDD principle: For me TDD focuses too much on the tests. Everything not covered by the test is ignored. IMHO it is important that production code behaves as anticipated also outside the test cases and it is not necessary to enforce every expected behavior with a test (in fact it is even not possible!). ### 9.) Use assertThat and many matchers As stated before, I usually look at a test if it has failed. In this situation one of the most annoying things for me is the failing at an assertThat method with a bunch of matchers. Instead of immediately getting a hint which of the expectations fail, I have to rewrite the statement into multiple statements to see which of the matchers fail. And even then I see only at which expected value the rewritten test fails, not what the real value is. Alternatively, I could inspect the object with the debugger and compare the inspected values with the expected values myself. But that“™s also an error prone and painful approach if you test a complex object hierarchy. And all this pain while searching the problem arises only because you use the „better readable“ assertThat instead of assertEquals and having just one assert statement? ### 10.) Use static imports I also don“™t like the use of static imports. Especially in tests they are often used to „focus“ on the important things. But in bigger projects there are often different libraries used for testing. Some method names like „any“, „and“, „then“, „equals“, „one“, „single“, „¦ and also class names like „Matcher“ are used from these libraries for different methods. It is really confusing if you move from one test class to another and „any“ means something completely different. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** Development **Schlagwörter:** Smells, tdd, Testing --- ### [Agile Retreat v3](https://thecattlecrew.net/2014/11/17/agile-retreat-v3/) **Published:** November 17, 2014 **Author:** Stefan Glase **Content:** Am 19.09.2014 trafen sich eine gut gemischte Truppe von knapp 20 Personen (darunter auch erstmals Mitarbeiter unserer Kunden!) zum **3. Agile Retreat** von OPITZ CONSULTING im beschaulichen Ebersberg in der Nähe von München. Vom Gesellschafter über Studenten bis hin zu einer Vertreterin aus dem Bereich HR, ihnen allen war eines gemeinsam: **Das Interesse an agiler Softwareentwicklung.** [![001](https://thecattlecrew.net/wp-content/uploads/2014/11/001.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/11/001.jpg) Nachdem gegen 18 Uhr der Großteil der Teilnehmer seinen Weg durch das verschlafene Oberbayern gefunden hatte und im idyllischen Landgasthaus eingetroffen war, trafen wir uns zu einem ersten Kennenlernen in lockerer Atmosphäre. In zufälligen Tischgruppen galt es zunächst Fragen zu beantworten. Wichtig dabei: Nur eine Antwort pro Tisch. Also gleich Kopfüber ins Teamwork. Dabei erfuhren wir neben „mit wem wir es zu tun hatten“ auch „die schönsten Erlebnisse im Zusammenhang mit agiler Softwareentwicklung“ sowie die „größten Lehren“ bei eben dieser. Beispielsweise, dass auch bei einem etablierten Scrum-Team in der 16. Retrospektive noch Verbesserungsvorschläge gefunden werden können, die nicht bereits x-Mal thematisiert wurden. Nachdem nun das erste Eis gebrochen war, ging es zum gemeinsamen Abendessen. Während sich die nicht Heimischen durch die diversen angebotenen Biersorten Bayerns probierten, ging der rege Austausch weiter: Von vergangenen und aktuellen Projekten über Privates bis hin zu alten „Kriegsgeschichten“ der Softwareentwicklung vor vielen Jahren. Nach einer kurzen Nacht ging es am Samstag dann mit Vollgas ins Tagesprogramm. Nach einem kurzen Impulsvortrag von Christian und Stefan („Agilität entmystifiziert“), in dem mit den gängigsten Vorurteilen gegenüber Agile aufgeräumt wurde, ging es in Form eines Open Spaces weiter. Somit wurde allen Teilnehmern die Möglichkeit einer aktiven Beteiligung geboten und diese auch intensiv genutzt. Unter anderem wurden folgende Themen beleuchtet und lebhaft diskutiert: - Agil mit kleinen Teams? - Don“™t call it agile „“ Was verstehen wir wirklich unter Agilität und was nicht. - Agile Softwareentwicklung in vielen (verteilten) Teams. - Agile im Softwarecraftmanship? - User Stories in der Migration von Legacy Systemen - Wie Agilität in neuen Teams einführen? - Welche Tools braucht man eigentlich? - Agiles Management - uvm. Mit einer vollen Agenda und drei parallelen 30min-Slots für die jeweiligen Themen konnte sich jeder der Gruppe anschließen, die sein Interesse am Meisten weckte oder eben von Board zu Board schlendern und sehen, wo man hängen blieb. [![002](https://thecattlecrew.net/wp-content/uploads/2014/11/002.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/11/002.jpg) So entfachte sich beispielsweise an einem Board eine spannende Diskussion darüber, wie es besser gelingen kann Entscheider auf Managementebene vom Vorteil agiler SW zu überzeugen und wie viel Controlling in einer agilen Welt möglich und vielleicht auch notwendig ist. Bei einer weiteren Gruppe ging es um die Frage, ob und wie man Prinzipien aus der agilen Welt auch zur Weiterbildung von Mitarbeitern nutzen kann. Ein Werkstudent stellte in diesem Zusammenhang seine fast fertige Bachelorarbeit zum Thema vor. Stefan berichtete über seine eigenen Erfahrungen wie Scrum auch im Großen funktionieren kann. Während vielen von uns der Kopf schwirrte, bei der Vorstellung mehr als 10 abhängige Scrumteams zu koordinieren, erzählte er voll Begeisterung seinen eigenen Lernprozess, von Scrum Master Runden, Review Messe und wir lernten den Begriff des „Termin-Tetris“! Über seine Erfahrungen mit agilem Management berichtete Harald und gab darüber hinaus eine Reihe von Literaturempfehlungen. Die Diskussion über das Thema brachte dann auch noch die Erkenntnis mit sich, dass vor allem ein aktives Vorleben der Prinzipien des agilen Managements wichtig ist. Nach dem Mittagessen mit guter bayerischer Kost half gegen das Suppen-Koma nur noch spielen. Während sich eine Gruppe angeleitet durch Christian via Kanban-Brettspiel (http://getkanban.com/) dem vorher in einer weiteren Session von Harald kurz vorgestellten Thema Kanban spielerisch weiter näherte, erhielt die zweite Gruppe mit Hilfe von jeder Menge Legosteinen eine tolle Methodik zum Einsatz in Retrospektiven vorgestellt. [![003](https://thecattlecrew.net/wp-content/uploads/2014/11/003.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/11/003.jpg) Zum Abschluss des Open Spaces und des gesamten Agile Retreats stand die Zusammenfassung der einzelnen Themen und Erkenntnisse. So durchlebten wir kurzweilig noch einmal die einzelnen Stationen des Tages, vor allem die, an denen wir nicht teilnehmen konnten. Oft mussten wir uns auf die Zunge beißen das ein oder andere Thema nicht direkt wieder aufzunehmen. Nach einem ereignisreichen (halben) Wochenende ging es nun wieder nach Hause. Viele Themen wurden angesprochen und diskutiert. Viele Anregungen mit auf den Weg gegeben. Aber vor allem haben sich hier in Oberndorf motivierte und engagierte Leute zusammengefunden, die mit Feuereifer dabei sind, nach immer besseren Lösungen zu suchen und diese Erfahrung bereitwillig mit anderen teilen möchten. [![004](https://thecattlecrew.net/wp-content/uploads/2014/11/004.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/11/004.jpg) Auch für 2015 sind wir uns sicher, wieder einen Agile Retreat durchführen zu wollen. Denn wie wir gelernt haben: **Auch in der 16. Retrospektive gibt es noch neue Erkenntnisse.** **Kategorien:** Development **Schlagwörter:** agile, agilität, opitz, retreat --- ### [Using log4j 2 in an Oracle ADF 12c Application](https://thecattlecrew.net/2014/11/25/1334/) **Published:** November 25, 2014 **Author:** **Content:** ## Configure ADF12c application to work with log4j2 One of our customers had the requirement to use log4j 2 in his ADF 12c application. When executing his code \[code language=“java“\]import java.io.Serializable; import org.apache.logging.log4j.Logger; import org.apache.logging.log4j.LogManager; import javax.faces.event.ActionEvent; import oracle.adf.view.rich.component.rich.input.RichInputText; public class LoggingBean implements Serializable { private static final long serialVersionUID = 1L; private static final Logger log = LogManager.getLogger(LoggingBean.class.getName()); public LoggingBean() { } public void logText(ActionEvent actionEvent) { log.info(„Text to log“); } } \[/code\] an UnsupportedOperationException was thrown. \[code language=“xml“\]\[…\] Caused by: java.lang.UnsupportedOperationException: setXIncludeAware is not supported on this JAXP implementation or earlier: class oracle.xml.jaxp.JXDocumentBuilderFactory at javax.xml.parsers.DocumentBuilderFactory.setXIncludeAware(DocumentBuilderFactory.java:614) \[/code\] To resolve this issue you can configure your ADF12c application to use a specific implementation of DocumentBuilderFactory. This is quite simple and straightforward. Just configure your weblogic specific deployment descriptor tor use com.sun.org.apache.xerces.internal.jaxp.DocumentBuilderFactoryImpl as application’s DocumentBuilderFactory implementation. This is what worked for us. Other implementations of DocumentBuilderFactory might be a valid, too. To configure the DocumentBuilderFactory you can use JDeveloper tooling: [![weblogic-application_docbuild](https://thecattlecrew.net/wp-content/uploads/2014/11/weblogic-application_docbuild.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/11/weblogic-application_docbuild.png) This will put the following lines into your weblogic-application.xml: \[code language=“xml“\] com.sun.org.apache.xerces.internal.jaxp.DocumentBuilderFactoryImpl \[/code\] To dodge possible other unsupported operations, we also provided values for SAX Parser Factory and Transformer Factory: - SAX Parser Factory: com.sun.org.apache.xerces.internal.jaxp.SAXParserFactoryImpl - Transformer Factory: com.sun.org.apache.xalan.internal.xsltc.trax.TransformerFactoryImpl The screenshot below shows our configuration: [![weblogic-application.xml](https://thecattlecrew.net/wp-content/uploads/2014/11/2014-11-25_1128.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/11/2014-11-25_1128.png) ## Prerequisites The following JARs have been added to project’s classpath: - log4j-api-2.1.jar - log4j-core-2.1.jar - log4j-web-2.1.jar These files are contained within the log4j2 [download package.](http://logging.apache.org/log4j/2.0/download.html) ## Follow ups Without providing any configuration file log4j2 will log our messages on console. To configure another behavior just put a configuration file into your project’s src directory (e.g. /Model/src or /ViewController/src). The configuration file itself can be written in XML, JSON, or YAML. For more information on the expected syntax have a look at log4j2’s [official documentation](http://logging.apache.org/log4j/2.x/manual/configuration.html). **Kategorien:** Development **Schlagwörter:** ADF, JDeveloper, log4j, log4j2, Oracle FMW, unsupported operation, UnsupportedOperationException --- ### [Die ruhrjug ist wieder da!](https://thecattlecrew.net/2014/12/08/die-ruhrjug-ist-wieder-da/) **Published:** Dezember 8, 2014 **Author:** Stefan Glase **Content:** Nach gut anderthalb Jahren Pause haben wir am 27.11.2014 die Java User Group Essen, kurz: [ruhrjug](http://www.ruhrjug.de/), gemeinsam mit [infaktum Veranstaltungen](http://www.infaktum.de/) wieder zum Leben erweckt: mit einem Vortragsabend zum Thema „Rapid Application Development mit AngularJS und Grails“ am OC Standort in Essen. Unsere beiden „Vortragsroutiniers“ Stefan Glase und Stefan Scheidt präsentierten ihre Beiträge in gewohnt unterhaltsamer und informativer Weise. Zunächst gab Stefan Scheidt in 30 Minuten mit ein paar Folien und viel Live Coding eine kurze Einführung in [AngularJS](https://angularjs.org/), anschließend tat es ihm Stefan Glase mit einer Kurzvorstellung von [Grails](https://grails.org/) gleich. Danach dann der wirklich spannende Teil mit der Frage: Wie kann man AngularJS und Grails zusammenbringen? Es wurde gezeigt, wie man mit Grails ein REST-Endpoint für ein Domänen-Objekt bereitstellt und diesen in Angular mittel ngResource-Objekten konsumiert. Kurz wurde der Umgang mit der „Same Origin Policy“ diskutiert und dann zwei Vorgehensweisen zur Projektstruktur vorgestellt: zunächst eine getrennte Behandlung von Grails und Angular in jeweils separaten Projekten und abschließend das Einbetten der Angular-App in die Grails-Applikation mit Hilfe des [Grails Asset Pipeline Plugins](http://bertramdev.github.io/asset-pipeline/). [Hier](http://de.slideshare.net/opitzconsulting/rapid-application-development-mit-grails-und-angularjs2) gibt es die Folien zum Vortrag. Wie gut Themen und Präsentation beim Publikum ankamen, zeigten die vielen interessierten Nachfragen während des Vortrags, die teilweise aus dem Plenum selbst beantwortet wurden. So überraschte es auch nicht, dass sich im Anschluss viele engagierte Diskussionen ergaben, bei denen sich die Speaker und einige anwesende Kollegen und Teilnehmer als kompetente und auskunftsfreudige Ansprechpartner unter Beweis stellten. Dass der ursprünglich geplante Bummel über den Weihnachtsmarkt ausfiel, bedauerte daher niemand. Die Veranstaltung endete nach drei spannenden Stunden gegen 21 Uhr. Zu Beginn der Veranstaltung haben wir die Anwesenden eingeladen, an der weiteren Wiederbelebung und Weiterentwicklung der ruhrjug aktiv teilzunehmen. Hier gibt es nicht nur die Möglichkeit, selbst Themen zu platzieren, sondern man kann sich auch Themen wünschen. Natürlich ist auch Unterstützung in Form von Sponsoring herzlich willkommen. Thematische Ideen für Folgeveranstaltungen gibt es schon einige: Zum Thema Microservices (docker) hat sich mit Peter Roßbach auch schon ein prominenter Speaker angeboten. An dieser Stelle möchten wir auch die Java-Interessierten unter euch zur Beteiligung aufrufen: Bitte macht mit und steigt mit uns in die Detailplanung für regelmäßige Folgeveranstaltungen ein und meldet euch mit Vorschlägen oder Wünschen bei . Momentan wird an einen etwa vierteljährlichen Rhythmus für die Veranstaltung gedacht. Zum Abschluss noch ein paar Impressionen vom Event: [![ruhrjug-impressionen](https://thecattlecrew.net/wp-content/uploads/2014/12/ruhrjug-impressionen.jpg?w=660)](https://thecattlecrew.net/wp-content/uploads/2014/12/ruhrjug-impressionen.jpg) **Kategorien:** Development **Schlagwörter:** AngularJS, Grails, Groovy, Java, JavaScript, ruhrjug --- ### [DOAG 2014 Konferenz: IT-Sicherheit und OFM: Eine Herkulesaufgabe?](https://thecattlecrew.net/2015/01/19/doag-2014-konferenz-it-sicherheit-und-ofm-eine-herkulesaufgabe/) **Published:** Januar 19, 2015 **Author:** Mohammad Esad-Djou **Content:** Es gab am 20. Juni in Nürnberg den DOAG 2014 Konferenz. Mein Kollege Frank Burkhardt und ich haben dort einen Vortrag über „IT-Sicherheit und OFM: Eine Herkulesaufgabe?“. Hier finden Sie unser Abstract und unsere Präsentation: Die Anforderungen, die heute an IT-Sicherheitsexperten gestellt werden, erinnern mitunter an die scheinbar unlösbaren Aufgaben des Herkules in der griechischen Sage. Doch nicht jeder Security-Spezialist ist ein IT-Muskelmann. Und allein die traditionellen IT-Sicherheitsansätze und Maßnahmen reichen nicht aus, um neue technische aber auch organisatorische Fragen zu beantworten. Welche Lösungsansätze bietet Oracle aus diesem Dilemma? Nach einer kurzen Einführung in die Problematik stellen die Referenten die Security-Konzepte von Oracle vor und richten danach einen besonderen Fokus auf Oracle WebLogic Server und Oracle Plattform Security Services (OPSS). Diese Themen stehen dabei Mittelpunkt: – Herausforderungen der IT-Sicherheit in weltweit vernetzten Systeme – IT-Sicherheitsarchitektur und der Ansatz von Oracle – Oracle Fusion Middleware und Bausteine der Sicherheitstechnologie von Oracle: WLS, OAM, OID, OVD, WebGate Sichere Systeme: Best Practice und Erfahrungsberichte zu Authentication, Authorization, Single-Sign-On (SSO), Secure Socket Layer (SSL) und Security Assertion Markup Language (SAML) Link zu unserer Präsentation: [https://thecattlecrew.net/wp-content/uploads/2015/01/it-security\_doag\_20141120.pdf](https://thecattlecrew.net/wp-content/uploads/2015/01/it-security_doag_20141120.pdf) **Kategorien:** IT-Security, Tech Events & Networking **Schlagwörter:** Architecture, Conference, German, IT Security, Oracle FMW, Weblogic --- ### [Ansätze für das Datenbankschema-Management oder wie geht Continuous Integration für die Datenbank](https://thecattlecrew.net/2015/06/30/ansatze-fur-das-datenbankschema-management-oder-wie-geht-continuous-integration-fur-die-datenbank/) **Published:** Juni 30, 2015 **Author:** Olaf Jessensky **Content:** **Das Problem mit der Datenbank“¦** Für Anwendungscode ist es inzwischen die normale Vorgehensweise: Codeänderungen werden regelmäßig in einem Nightly Build gebaut, getestet und häufig auch direkt deployt. Das nennt man Continuous Integration ([CI](http://www.thoughtworks.com/continuous-integration)). Ziel ist, dass die neue Version der Anwendung in jeder beliebigen Umgebung lauffähig ist. Das ist sie aber nur dann, wenn der Zustand der Datenbank zur Anwendungsversion passt. Wie geht man aber mit Datenbankänderungen um, ohne den Grundgedanken von CI zu verletzen? Und was ist an der Datenbank eigentlich anders als an normalem Programmcode? Das besondere an Datenbanktabellen ist, dass die in ihnen gespeicherten Daten beim Deployment einer neuen Version erhalten bleiben müssen. Während normaler Programmcode einfach vollständig neu deployt wird, verlangt die Datenbank eine Behandlung, die den Ist-Zustand des Zielsystems berücksichtigt und unter Erhalt der bestehenden Daten nur die notwendigen Ü„nderungen zum Erreichen des Soll-Zustands durchführt. Mit anderen Worten: die Skripte, die ausgeführt werden müssen, hängen vom Zielsystem ab. Mit der Definition des Sollzustands ist es nicht getan, um ans Ziel zu kommen, brauchen wir auch das Delta zwischen Ist und Soll. Und das kann für jedes Zielsystem ein anderes sein. **Die herkömmliche Vorgehensweise** Normalerweise begegnet man dem Problem einfach damit, dass die Migrationsskripte für jedes konkrete Deployment per Hand geschrieben und vor dem Deployment ausgeführt werden. Häufig greift man dabei auf Toolunterstützung, z. B. durch die bekannten Produkte [Liquibase](http://www.liquibase.org/) oder [Flyway](http://flywaydb.org/) zurück. Damit ist es dann möglich, Skripte für verschiedene Zielumgebungen zu verwalten, und nachzuhalten, welche Skripte auf welchen Umgebungen schon gelaufen sind. Abgesehen davon, dass man die Skripte für jede Ü„nderung manuell erstellen muss, hat das Vorgehen noch einen wichtigen Nachteil: der Zustand der Datenbank ergibt sich nur als Summe aller Migrationsskripte. Es gibt keine Dateien in unserem Sourcecode-Repository, die den Zustand der Datenbanktabellen zu einer beliebigen Softwareversion darstellen würden. **Unser Lösungsansatz: CI für die Datenbank** An dieser Stelle tritt unser Framework Orcas auf den Plan. Zunächst ermöglicht es uns, den Zustand von Tabellen in einer Oracle-Datenbank mit einer SQL-ähnlichen Syntax zu beschreiben, wie in folgendem Beispiel. *create table orders* *(* *ordr\_id number(15) not null,* *version number(15) default „0“ not null,* *bpar\_id number(15) not null,* *orderdate date not null,* *tracking\_number varchar2(20) not null,* *constraint ordr\_pk primary key (ordr\_id),* *constraint ordr\_uc unique (tracking\_number),* *constraint ordr\_bpar\_fk foreign key (bpar\_id) references business\_partners (bpar\_id)* *);* Diese Syntax beschreibt einen Zustand, nämlich den gewünschten Sollzustand der Tabelle. Den Rest erledigt nun Orcas für uns indem es das Delta des Ist-Zustands in der Datenbank zu diesem Soll-Zustand ermittelt und dafür ein Migrationsskript generiert. Dieses Migrationsskript überführt die Datenbank unter Erhaltung aller Daten vom Ist-Zustand in den Soll-Zustand. Orcas kann die Skripte direkt ausführen oder auch für ein späteres Deployment im Dateisystem bereitstellen. Damit schließt es die Lücke, die uns noch von CI für die Datenbank trennte. Unser Sourcecode-Repository enthält nun unsere Orcas-Skripte, die wir genau wie normalen Programmcode einer Versionsverwaltung unterziehen können. Um auf einem Zielsystem eine bestimmte Version unserer Software zu installieren, muss nur ein Aufruf von Orcas mit der entsprechenden Version der Tabellenskripte in den Deployment-Prozess integriert werden. Einen Preis müssen wir für diese Vorteile zahlen. Da Orcas auf das Data Dictionary der Oracle Datenbank zugreift um den Ist-Zustand zu ermitteln, sind wir auf die Benutzung von Oracle RDMS eingeschränkt. Orcas ist bei [Github](https://github.com/opitzconsulting/orcas) als Open Source veröffentlicht. Jeder ist eingeladen, es zu verwenden und sich an seiner Weiterentwicklung zu beteiligen. **Kategorien:** Database, DevOps **Schlagwörter:** agile, Softwarenentwicklung --- ### [Automated UI Tests for an AngularJS Material select item with protractor](https://thecattlecrew.net/2015/03/05/automated-ui-tests-for-an-angularjs-material-select-item-with-protractor/) **Published:** März 5, 2015 **Author:** Pascal Brokmeier **Content:** Testing AngularJS applications using protractor is quiet cool. It automates the UI testing and ensures consistent quality throughout your project. Experimenting with the new Angular Material I ran into a problem: *interacting with select items using the protractor API.* **The problem** There are a few ways you can select an option using protractor. A very elegant solution was proposed on [stackoverflow](http://stackoverflow.com/questions/19599450/how-to-select-option-in-drop-down-protractorjs-e2e-tests). While this works for regular angularjs projects, angular material is a little different. That is because the Tags aren“™t actually inserted into the DOM until you click the . That’s why you cannot go straight for the option tag but you need to click the select first But then they aren“™t a child of the select tag but rather they are inserted at the bottom of the page with an overlay over the rest of the page. [![md-option-browser-developer](https://thecattlecrew.net/wp-content/uploads/2015/03/md-option-browser-developer.png?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/03/md-option-browser-developer.png) If you try the mentioned solution above using a ``` element(by.cssContainingText('option', '10')).click(); ``` you’ll get a ``` NoSuchElementError: No element found using locator: by.cssContainingText("option", "10") ``` There are actually no option (or md-option) tags on the page until you click the select tag. Okay so select.click() first then option.click(), but if you select the option tag right away and proceed to the next select tag an odd error occurs ``` element.all(by.css('md-select')).each(function (eachElement, index) { eachElement.click(); //select the element(by.css('md-option')).click(); //select the first md-option }); ``` ``` unknown error: Element is not clickable at point (253, 520). Other element would receive the click: ``` This is because of the overlay that Angular Material puts on the display. It doesn’t disappear right away. So we need to wait for the material effects to take place. **the solution (quickfix):** ``` element.all(by.css('md-select')).each(function (eachElement, index) { eachElement.click(); //select the select browser.driver.sleep(500); //wait for the renderings to take effect element(by.css('md-option')).click(); //select the first md-option browser.driver.sleep(500); //wait for the renderings to take effect }); ``` now the selection works one at a time and angular material has enough time to take away that overlay which is in the way of clicking our second tag. However this isn’t the most elegant solution. Maybe in future protractor versions, the server waits for angularjs to finish its DOM changes or something. Overall though, both the material design implementation of angularjs as well as TDD using protractor and jasmine / karma work very well. **Kategorien:** Development **Schlagwörter:** AngularJS, English, karma, material design, protractor, Softwarenentwicklung, tdd --- ### [ADF 12c: Uploading a profile picture to database via HTTPServlet](https://thecattlecrew.net/2015/09/28/adf-12c-uploading-a-profile-picture-to-database-via-httpservlet/) **Published:** September 28, 2015 **Author:** Janis Saritzoglou **Content:** In this blog post I will describe how to implement a user profile picture functionality in ORACLE’s ADF 12c. In this case we have a existing ADF application with login functionality which is able to differentiate the current user. [![picture_upload](https://thecattlecrew.net/wp-content/uploads/2015/09/picture_upload.png?w=273)](https://thecattlecrew.net/wp-content/uploads/2015/09/picture_upload.png) The article cotains a part wichs describes how to create a mapping between a HTTP Servlet and adfBindings. This part is based on an article from Timo Hahn. You can find it here [JDev11.1.2.1.0: Handling images/files in ADF](https://tompeez.wordpress.com/2011/12/16/jdev11-1-2-1-0-handling-imagesfiles-in-adf-part-3/) in section ‚2. Using the existing BindingLayer of the application‘. ### **Creating a database table with blob attribute and the matching Entity Object in your ADF application:** The first thing to do is to create a database entity with an attribute to save the profile picture (In this case we use a ORACLE 12c database). The data type of the database attribute should be BLOB. For example you can see our employee table here [![emp_table](https://thecattlecrew.net/wp-content/uploads/2015/09/emp_table.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/emp_table.png) After creating the database entity you have to create a Entity Object in your ADF application which represents your new table. For example:[![EO](https://thecattlecrew.net/wp-content/uploads/2015/09/eo.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/eo.png) ### **Creating the HTTPServlet to load the currents user profile picture:** 1. open your ViewControllers context menu and select ‚New -> From Gallery -> Servlets -> HTTP Servlet‘ [![create_servlet](https://thecattlecrew.net/wp-content/uploads/2015/09/create_servlet.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/create_servlet.png) 2. give your servlet a meaningful name for example ‚ProfilePictureServlet‘ [![create_servlet_2](https://thecattlecrew.net/wp-content/uploads/2015/09/create_servlet_2.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/create_servlet_2.png) 3. click Next and then Finish in the ‚Create HTTP Servlet‘ wizard 4. now copy & paste the following code to your new created servlet (ProfilePictureServlet.java)\[code language=“java“\]package com.opitzconsulting.oscar2.mitaprofil.view; import java.io.BufferedInputStream; import java.io.IOException; import java.io.OutputStream; import java.sql.Blob; import java.sql.Connection; import java.sql.PreparedStatement; import java.sql.ResultSet; import java.sql.SQLException; import javax.naming.Context; import javax.naming.InitialContext; import javax.servlet.ServletConfig; import javax.servlet.ServletException; import javax.servlet.annotation.WebServlet; import javax.servlet.http.HttpServlet; import javax.servlet.http.HttpServletRequest; import javax.servlet.http.HttpServletResponse; import oracle.adf.model.BindingContext; import oracle.adf.model.binding.DCBindingContainer; import oracle.jbo.uicli.binding.JUCtrlActionBinding; @WebServlet(name = „MitaPictureServlet“, urlPatterns = { „/mitapictureservlet“ }) public class MitaPictureServlet extends HttpServlet { private static final String CONTENT\_TYPE = „image/gif; charset=UTF-8“; public void init(ServletConfig config) throws ServletException { super.init(config); } public void doGet(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException { response.setContentType(CONTENT\_TYPE); String imageId = request.getParameter(„mita\_id“); OutputStream os = response.getOutputStream(); Connection conn = null; try { Context ctx = new InitialContext(); /\* Here we access the custom created PageDef which was created for the servlet, to execute the methodAction which calls the ClientInterfaceMethod getCurrentConnection. This allows us to use the current existing database connection, to get the uploaded profile picture of the current user.\*/ BindingContext bCtx = BindingContext.getCurrent(); DCBindingContainer amx = bCtx.findBindingContainer(„com\_opitzconsulting\_oscar2\_mitaprofil\_view\_pageDefs\_MitaPictureServletPageDef“); JUCtrlActionBinding lBinding = (JUCtrlActionBinding) amx.findCtrlBinding(„getCurrentConnection“); lBinding.invoke(); conn = (Connection) lBinding.getResult(); PreparedStatement statement = conn.prepareStatement(„SELECT mita\_id, mita\_picture “ + „FROM mitarbeiter “ + „WHERE mita\_id = ?“); statement.setInt(1, new Integer(imageId)); ResultSet rs = statement.executeQuery(); if (rs.next()) { Blob blob = rs.getBlob(„MITA\_PICTURE“); BufferedInputStream in = new BufferedInputStream(blob.getBinaryStream()); int b; byte\[\] buffer = new byte\[10240\]; while ((b = in.read(buffer, 0, 10240)) != -1) { os.write(buffer, 0, b); } os.close(); } } catch (Exception e) { System.out.println(e); } finally { try { if (conn != null) { conn.close(); } } catch (SQLException sqle) { System.out.println(„SQLException error“); } } } }\[/code\] ### **Add the necessary ADF components for a image upload to your page:** 1. add an af:image component from the component palette [![add_image_compoent](https://thecattlecrew.net/wp-content/uploads/2015/09/add_image_compoent.png)](https://thecattlecrew.net/wp-content/uploads/2015/09/add_image_compoent.png) 2. change the source attribute of your af:image component to point to the profile picture which is served from the HTTP Servlet. The image source should look something like this ‚ /\[urlPatterns\]?\[current\_user\_id\]=#{EmpBean.emp\_id} ‚ [![img_src](https://thecattlecrew.net/wp-content/uploads/2015/09/img_src.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/img_src.png) Note: the ‚current\_user\_id‘ in the af:image source is the id of the currently logged in user. Later in the HTTP Serlvet we use that parameter to determine which picture to load from database. You can see how to access that value in line 29 of the HTTP Serlvet code. 3. add an af:inputFile from component palette which will allows the user to select an image from the hard drive 4. now press the blue gear-symbol from the af:inputFile Binding property to start the ‚Create Managed Bean‘ wizard and create a new managed bean (this step is only to generate a Java bean to implement the image upload functionality later) [![CreateUploadBean](https://thecattlecrew.net/wp-content/uploads/2015/09/createuploadbean.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/createuploadbean.png) 5. set the property Value for the af:inputFile to point to a property/variable in the before created managed bean. For example ‚imageToUpload‘. Important is now to change the type of the bean variable to ‚UploadedFile‘ for example: ‚private UploadedFile imageToUpload;‘ 6. implement the following methods to make the image upload possible\[code language=“java“\]public void uploadPic(ValueChangeEvent valueChangeEvent) { // set the value for the new choosed picture setUploadPicture((UploadedFile) valueChangeEvent.getNewValue()); UploadedFile uploadedFile = (UploadedFile) this.getUploadPicture(); BindingContext bindingctx = BindingContext.getCurrent(); BindingContainer bindings = bindingctx.getCurrentBindingsEntry(); DCBindingContainer bindingsImpl = (DCBindingContainer) bindings; DCIteratorBinding iter = bindingsImpl.findIteratorBinding(„Mitarbeiter1Iterator“); Row row = iter.getCurrentRow(); // set the database attribute MitaPicture (you can look up the attribute name in the EO) of the employees iterator to the selected profile picture row.setAttribute(„MitaPicture“, createBlobDomain(uploadedFile)); ADFUtils.handleNavigation(„doCommit“); ADFUtils.refreshWholePage(); } private BlobDomain createBlobDomain(UploadedFile file) { InputStream in = null; BlobDomain blobDomain = null; OutputStream out = null; try { in = file.getInputStream(); blobDomain = new BlobDomain(); out = blobDomain.getBinaryOutputStream(); byte\[\] buffer = new byte\[8192\]; int bytesRead = 0; while ((bytesRead = in.read(buffer, 0, 8192)) != -1) { out.write(buffer, 0, bytesRead); } in.close(); } catch (IOException e) { e.printStackTrace(); } catch (SQLException e) { e.fillInStackTrace(); } return blobDomain; }\[/code\] 7. don’t forget to remove the Binding property from the af:inputFile, instead you choose it as the Value property [![inputfile_value](https://thecattlecrew.net/wp-content/uploads/2015/09/inputfile_value.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/inputfile_value.png) [![inputfile_value2](https://thecattlecrew.net/wp-content/uploads/2015/09/inputfile_value2.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/inputfile_value2.png) 8. set the AutoSubmit property to true and point the ValueChangeListener property from the af:inputFile to your method which uploads the image. For example ‚#{UploadMitaPictureBean.uploadPic}‘. (We do this to upload the selected image right after the user choosing it from the hard drive, so it is not necessary to select an image an press an extra upload button or something like that.) [![autosubmit_valuechange_input](https://thecattlecrew.net/wp-content/uploads/2015/09/autosubmit_valuechange_input.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/autosubmit_valuechange_input.png) ### **Create a ClientInterfaceMethod to use a existing database connection to select the current users profile picture:** In our case we already have a database connection in our application, so we don’t want to create a new connection. To accomplish this, we create a ClientInterfaceMethod in the ApplicationModuleImpl Java class to receive our current existing connection. 1. open your ApplicationModule, open the Java tab and press the edit-pencil-symbol in the right upper corner to generate the ApplicationModuleImpl [![create_clientinterface_meth](https://thecattlecrew.net/wp-content/uploads/2015/09/create_clientinterface_meth.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/create_clientinterface_meth.png) 2. open the generated ApplicationModuleImpl class and implement a method like\[code language=“java“\]/\*\* \* gets the current existing database connection \* @return Connection-Object \*/ public Connection getCurrentConnection() { Statement st = null; try { st = getDBTransaction().createStatement(0); return st.getConnection(); } catch (SQLException s) { s.printStackTrace(); return null; } finally { if (st != null) try { st.close(); } catch (SQLException s2) { } } }\[/code\] this method can be accessed later from the HTTP Servlet to get the current connection. 3. add your new created method as client interface method to the ApplicationModule [![add_clientInterfaceMethod](https://thecattlecrew.net/wp-content/uploads/2015/09/add_clientinterfacemethod.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/add_clientinterfacemethod.png) 4. to make the client interface method accessible, we need to make another step, we have to create a PageDef for the HTTP Servlet now which registers the client interface method as a ‚methodAction‘ (implemented like Timo Hahn describes in his article…) 1. create a new XML File via New -> From Gallery…“ and save it to your ‚pageDefs‘ package [![createServletPageDef](https://thecattlecrew.net/wp-content/uploads/2015/09/createservletpagedef.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/createservletpagedef.png)[![createServletPageDef2](https://thecattlecrew.net/wp-content/uploads/2015/09/createservletpagedef2.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/createservletpagedef2.png) 2. for the JDeveloper it’s not an PageDef file yet, so you have to copy the source from any other of your PageDef files to the new created XML-File, save and restart the JDeveloper. Now it’s recognized as a PageDef. Further you have to change the id attribute in the PageDef to the name of your XML-Document. Like this\[code language=“xml“\]version="1.0" encoding="UTF-8" ? \[/code\] 3. switch to the Overview-Tab of the PageDef, press the green plus-symbol in the Executables section and select iterator to create a DataControl Binding. This is necessary to get access to the client interface method ‚getCurrentConnection‘ [![createDataControlIteratorBinding](https://thecattlecrew.net/wp-content/uploads/2015/09/createdatacontroliteratorbinding.png?w=243)](https://thecattlecrew.net/wp-content/uploads/2015/09/createdatacontroliteratorbinding.png) 4. now we can create the methodAction binding. To do that press the green plus-symbol, choose ‚Binding‘ and then ‚methodAction‘ 5. in the now opened ‚Create Action Binding‘ wizard search for the client interface method and add it [![create_methodAction_Binding](https://thecattlecrew.net/wp-content/uploads/2015/09/create_methodaction_binding.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/create_methodaction_binding.png) 6. the next step is to register the new created HTTP Servlet PageDef in our DataBindings. Open the DataBindings.cpx file and select a random entry under ‚Page Definition Usages‘. Now look at the structure window (by default down left), right click ‚pageDefinitionUsages‘ and select ‚Insert Inside pageDefinitionUsages‘ [![registerPageDef_in_DataBindings](https://thecattlecrew.net/wp-content/uploads/2015/09/registerpagedef_in_databindings.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/registerpagedef_in_databindings.png) 7. in the following popup we have to enter the id and the path like this [![registerPageDef_in_DataBindings2](https://thecattlecrew.net/wp-content/uploads/2015/09/registerpagedef_in_databindings2.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/registerpagedef_in_databindings2.png) 8. the previous steps allow the HTTP Servlet to use the methodAction binding and so the client interface method getCurrentConnection ### **Register the HTTP Servlet in the application and allow a file upload:** 1. open the web.xml file in Web Content -> WEB-INF 2. press the green plus-symbol in the Servlets-Tab to register the HTTP Servlet 3. now change to the Filters-Tab on the left, choose the entry adfBindings from the table and select the tab Filter Mappings under the table 4. create a new Filter Mappings entry with the green plus-symbol, set ‚Mapping Type‘ to Servlet, select the created servlet as ‚Mapping‘ and choose FORWARD & REQUEST as ‚Dispatcher Type‘ [![setWebXmlFilterForServlet](https://thecattlecrew.net/wp-content/uploads/2015/09/setwebxmlfilterforservlet.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/09/setwebxmlfilterforservlet.png) 5. the final important step is to allow the file upload for users, to do this we open the .jsf or .jspx page which contains the file upload component (af:inputFile) 6. now set the property ‚UsesUpload‘ to true #### **IMPORTANT:** - if you have multiple hierarchical pages, it’s necessary to set the ‚UsesUpload‘ property to true on all overlying pages - if you have ADF libraries from other ADF applications in your application, it’s necessary to make the web.xml configuration for the HTTP Servlet, too **Kategorien:** Database, Development **Schlagwörter:** ADF, FileUpload, Java, JDeveloper, Oracle DB, Oracle FMW, Servlet, Softwarenentwicklung, Weblogic --- ### [Deployment von Datenbankänderungen: new school vs. old school](https://thecattlecrew.net/2015/10/12/deployment-von-datenbankaenderungen-new-school-vs-old-school/) **Published:** Oktober 12, 2015 **Author:** Olaf Jessensky **Content:** ### **Die Frage nach dem richtigen Werkzeug** Wenn sich IT-Anwender mit dem Deployment von Datenbanken auseinandersetzen, kommt sehr schnell die Frage auf, mit welchen Werkzeugen die dabei entstehenden Probleme minimiert werden können. Oft wird das Thema dadurch akut, dass das Deployment der Datenbank eine Schwierigkeit bei der Einführung einer Continuous Delivery Pipeline darstellt. Die Frage nach der richtigen Toolunterstützung wird natürlich auch an uns als Berater herangetragen. ### **Die richtige Deployment-Strategie** Bevor man sich jedoch für ein Tool entscheiden kann, muss man sich zunächst über die Vorgehensweise im Klaren sein. Hier gibt es 2 grundlegend verschiedene Ansätze. - Die klassische Vorgehensweise („old school“): Wir bringen die Produktions-DB in genau den Zustand, indem sich die Abnahme-DB beim Abnahmetest befunden hat. Mit anderen Worten: wir vergleichen 2 Datenbanken, ermitteln das Delta und deployen die erstellten update-Skripte. - Die agile Vorgehensweise („new school“): Die Idee des [Agile Database Development](http://www.se-radio.net/2012/06/episode-186-martin-fowler-and-pramod-sadalage-on-agile-database-development/) betrachtet die Datenbank als Teil der Anwendung. Demzufolge sollten Datenbankänderungen, die zur Codeänderungen benötigt werden, auch als Skripte hinterlegt und zusammen mit dem Code im Sourcecode-Repository verwaltet werden. Der agile Ansatz zeichnet sich dadurch aus, dass die Entwickler die Besitzer der Datenbank sind. Beim klassischen Ansatz wird eher eine Vorgehensweise unterstützt, bei der die Entwickler neue Datenbank-Tabellen beim DBA beantragen, der dann „aus einer Hand“, die Test-, Abnahme-, oder Produktionsumgebung bereitstellt. ### **Marktübliche Tools** Tools, die den klassischen Ansatz unterstützen, werden auch als Compare & Sync „“ Tools bezeichnet. Beispiele dafür sind [Regdate](http://www.red-gate.com/products/sql-development/sql-compare/) oder [DBMaestro](http://www.dbmaestro.com/product/product/). Bekannte Werkzeuge, die einen agilen Ansatz unterstützen, sind z. B. [Liquibase](http://www.liquibase.org/) oder [Flyway](http://flywaydb.org/). Mit ihnen ist es möglich, Skripte für verschiedene Zielumgebungen zu verwalten, und nachzuhalten, welche Skripte auf welchen Umgebungen schon gelaufen sind. Diese Form der skriptbasierten Datenbankentwicklung hat jedoch 2 Nachteile. Zum einen muss man manuell Update-Skripte erstellen, die voraussetzen, dass sich die Zieldatenbank vor dem Deployment tatsächlich in dem erwarteten Zustand befunden hat. Zum anderen ergibt sich der aktuelle Zustand der Datenbank nur aus der Summe aller Update-Skripte. Es gibt immer noch keine Dateien in unserem Sourcecode-Repository, die allein für sich den Zustand der Datenbanktabellen zu einer beliebigen Softwareversion darstellen würden. ### **Es geht auch anders** Dieses Problem wird dadurch gelöst, dass wir in unserem Sourcecode-Repository Skripte verwalten, die den Soll-Zustand der Datenbank beschreiben und nicht nur das Delta zur letzten Version. Um mit solchen Skripten Datenbankänderungen deployen zu können, benötigt man ein Framework, das das Delta zum Ist-Zustand der Datenbank selbst ermittelt und die benötigten Update-Skripte generiert. Damit ist es auch egal, in welchem Zustand sich die Zieldatenbank vorher befunden hat, es wird in jedem Fall der Soll-Zustand hergestellt. Vor einiger Zeit habe ich an dieser Stelle unser Framework [Orcas](https://github.com/opitzconsulting/orcas) vorgestellt, mit dem dieser Ansatz konsequent umgesetzt werden kann. Orcas ist als Open Source erhältlich und beinhaltet die Definition einer domänenspezifischen Sprache, in der die zu realisierenden Datenbankobjekte beschrieben werden. Durch Abgleich mit dem Data Dictionary der Oracle Datenbank, auf die die Anwendung von Orcas beschränkt ist, erkennt Orcas die Abweichungen zwischen Soll- und Ist-Zustand, generiert die benötigten Update-Skripte und führt diese aus. Einen Überblick über die Funktionsweise und Möglichkeiten von Orcas findet sich in unserem kürzlich erschienen [Whitepaper](http://www.opitz-consulting.com/fileadmin/redaktion/veroeffentlichungen/whitepaper/whitepaper-orcas_sicher.pdf). Eine ausführliche [Dokumentation](http://opitzconsulting.github.io/orcas/) mit Beispielen und einer genauen Installationsanleitung findet man im Orcas-Projekt auf [Github](https://github.com/opitzconsulting/orcas). ### **Fazit** Wie man sieht, kann es beim Deployen der Datenbank nicht nur darum gehen, ein Tool zur Unterstützung der Entwickler zu beschaffen. Zunächst sollte man sich überlegen, welche Vorgehensweise zur eigenen Organisation passt, bzw. welche Vorgehensweise man zukünftig im Unternehmen umsetzen möchte. Erst dann erst sollte sich man nach einem passenden Tool umsehen. Der Markt bietet hier Alternativen, die ohne hohe Lizenzkosten professionelle Lösungen ermöglichen. **Kategorien:** Database, DevOps **Schlagwörter:** agile, Softwarenentwicklung --- ### [Steht TypeScript vor dem Durchbruch?](https://thecattlecrew.net/2015/10/21/steht-typescript-vor-dem-durchbruch/) **Published:** Oktober 21, 2015 **Author:** Stephan Rauh **Content:** AngularJS 2.0 bietet viele Neuerungen. Eine besonders auffällige Neuerung ist, dass es nicht mehr in JavaScript entwickelt wird. Es wird in TypeScript entwickelt – einer Sprache, die in native JavaScript-Programme kompiliert wird. Daher entwickelt man AngularJS 2.0-Programme am besten in TypeScript. Das AngularJS-Team betont immer wieder, dass es möglich ist, bei JavaScript zu bleiben. Die TypeScript-Variante sieht aber so viel sauberer aus, dass TypeScript für mich die Sprache der Wahl ist, wenn es um AngularJS 2.0 geht. Zu Beginn meiner Serie von Artikeln über AngularJS 2.0 stehen also fast zwangsläufig einige Artikel über TypeScript. Während meiner Recherchen bin ich über einen interessanten Artikel gestoßen: [The rise of TypeScript?](http://developer.telerik.com/featured/the-rise-of-typescript/). Der Autor nennt einige interessante Gründe, warum TypeScript jetzt abheben könnte. AngularJS 2.0 ist einer davon. Aber es steckt mehr dahinter. Die Zeit ist reif für eine Sprache, die nach JavaScript kompiliert. JavaScript – die Sprache, die in jedem Browser läuft – übernimmt mehr und mehr [die Rolle einer Assemblersprache](http://www.beyondjava.net/blog/future-javascript-assembler-language/). ### **Die JavaScript-Welt hat sich verändert** Vor nicht allzu langer Zeit war einer der Hauptvorteile von JavaScript, dass alles so unkompliziert war. Viel einfacher als bei einer schwergewichtigen Sprache wie Java. Sie brauchen keinen Compiler. Ein einfacher Editor reicht, um produktiv zu werden. Jede Ü„nderung im Code wird sofort nach dem Speichern aktiv. Sie verschwenden keine Zeit mit Kompilieren, geschweige denn mit dem zeitaufwändigen Deployen der Anwendung auf dem Server. JavaScript ist und bleibt eine Interpretersprache (abgesehen vom JIT, der transparent im Hintergrund läuft). Für Leute wie mich, die gerne interaktiv programmieren – viele kleine Ü„nderungen, die sofort getestet werden – ist das ein echter Produktivitätsvorteil. Und heute? TypeScript ist ein Sprache, die erst nach JavaScript kompiliert werden muss, bevor das Programm läuft. Nur ist das gar kein Problem: der Compiler ist enorm schnell. Sie speichern die Datei, der Compiler startet und ist praktisch im gleichen Moment fertig. In der Sekunde, die Sie brauchen, um von Editor zum Browser zu wechseln, ist der Compiler allemal fertig. TypeScript ist eine Compilersprache ohne Produktivitätsnachteil. Das gilt nach meinem ersten Eindruck auch für große Projekte: TypeScript ist JavaScript mit ein paar Ergänzungen, was die Compilierung einfach macht, und es reicht, wenn die Dateien einzeln kompiliert werden. Eine zeitaufwändiges Kompilieren mehrerer Dateien oder gar des ganzen Projektes ist nie notwendig. Einzig die Überprüfung der Typ-Kompatibilität macht es manchmal notwendig, mehrere Dateien zu analysieren. Dafür brauchen sie nur gelesen zu werden, was relativ schnell geht. ### **JavaScript-Entwickler sind geduldig geworden** Vielleicht noch verblüffender ist, dass JavaScript-Entwickler angefangen haben, Tools wie Grunt und Gulp einzusetzen. Damit können sie CSS- und JavaScript-Dateien „minifizieren“. Vielfach werden Gulp und Grunt auch für andere Dinge eingesetzt und stellen einen wichtigen Bestandteil des Entwicklungsprozesses dar. Vor einiger Zeit hatte ich ein Projekt kennengelernt, das JavaScript überhaupt nicht mehr als Interpretersprache verwendet hat. Auch für die kleinsten Veränderungen wurde das gesamte JavaScript- und CSS-Verzeichnis erneut minifiziert, bevor die Ü„nderung getestet wurde. Das dauerte rund 30 Sekunden. Zweifellos kann man die Werkzeuge effizienter einsetzen, aber das ist nicht der Punkt. Die Anekdote zeigt, dass viele JavaScript-Teams im Laufe der letzten fünf Jahre angefangen haben, Compiler einzusetzen. Grunt ist letzten Endes nichts anderes als ein Compiler: Quelltexte, die ein Entwickler lesen und warten kann, werden in kompakte, schnelle, maschinen-lesbare Quelltexte übersetzt. Das dauert seine Zeit. JavaScript-Entwickler haben Geduld gelernt. Zum Glück ist es nach wie vor möglich, mit interpretiertem JavaScript zu arbeiten. Die Entwickler von Compilern, Transpilern und ähnlichen Build-Werkzeugen stehen unter Konkurrenzdruck und werden wahrscheinlich mit schnelleren Tools antworten. ### **Ausgereifte Tool-Chain** Die ausgereifte Tool-Chain ist ein weiterer Grund, warum ich gute Chancen für TypeScript sehe. Es gibt gleich [mehrere gute Editoren](http://www.beyondjava.net/blog/getting-started-with-angularjs-2-0-tools-and-compiler/), um mit TypeScript komfortabel und effizient zu entwickeln. Diese Editoren können die Vorteile typisierter Sprachen ausspielen: neben besseren Fehlermeldungen gibt es eine komfortable Autovervollständigung. Die Typinferenz von TypeScript erlaubt trotzdem einen entspannten Schreibstil. In diesem Beispiel ist aus dem Kontext klar, dass die Variable `mouseEvent` ein `MouseUpEvent` ist. Der Editor – in diesem Fall Atom – erkennt das und bietet die richtigen Autovervollständigungsvorschläge an: \[code language=“JavaScript“\] window.onmouseup = (mouseEvent) => { console.log(mouseEvent.button);} \[/code\] ![TypeScript Autovervollständigung](http://www.beyondjava.net/blog/images/TypeScript/TypeScript-2.png) Neben Atom gibt es noch Visual Studio Code, WebStorm und Sublime als kostenfreie Version. Daneben gibt es natürlich noch den Platzhirsch Visual Studio. IntelliJ verspricht ab Version 15 Support für TypeScript zu implementieren, und es gibt sogar ein Eclipse-Plugin. Die beiden Editoren, die ich bisher getestet habe – Atom und Visual Studio Code – sind beide sehr empfehlenswert, auch wenn sie mit einer über Jahrzehnte gewachsenen IDE wie Eclipse für Java-Entwickler noch nicht mithalten kann. Vielleicht ist das nur eine Frage der Zeit: die Entwicklung der Editoren verläuft stürmisch. ### **Fazit und Ausblick** So riskant der Blick in die Kristallkugel sein mag: die Veränderungen der JavaScript-Welt der letzten fünf Jahre geben Compiler-Sprachen wie TypeScript Raum, sich zu entwickeln. AngularJS 2.0 verspricht TypeScript einen weiteren Schub zu geben. Auf jeden Fall ist TypeScript für Java-Entwickler ein besonders angenehmer Einstieg in die Welt der Client-Programmierung. --- ### **Externe Links** [The rise of TypeScript?](http://developer.telerik.com/featured/the-rise-of-typescript/) Das englischsprachige Original dieses Artikels ist auf [BeyondJava.net](http://www.beyondjava.net/blog/the-rise-of-typescript/) erschienen. **Kategorien:** Development **Schlagwörter:** AngularJS, AngularJS 2.0, German, TypeScript, Web Developement --- ### [Erste Erfahrungen mit dem neuen WebLogic Server 12.2.1: Installation und Konfiguration](https://thecattlecrew.net/2015/11/02/erste-erfahrungen-mit-dem-neuen-weblogic-server-12-2-1-installation-und-konfiguration-2/) **Published:** November 2, 2015 **Author:** Neselovskyi, Borys **Content:** Hier beschreibe ich meine ersten Erfahrungen mit dem WebLogic 12.2.1 und mit der Multitenant Option ## Installation WebLogic Server 12.2.1 ### Software Download Software kann man entweder auf der OTN Seite oder in der Oracle Software Cloud runterladen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr1.png) ## Dokumentation Dokumentation für den WebLogic findet man unter: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr2.png) ### Software Verzeichnisse erstellen As OS User oracle execute following steps: ``` [oracle@wls-sysadm oracle]$ mkdir -p /u01/app/oracle/product/JAVA [oracle@wls-sysadm oracle]$ mkdir -p /u01/app/oracle/product/FMW ``` ### Installation JDK 1.8 ``` [oracle@wls-sysadm oracle]$ cd /u01/app/oracle/product/JAVA [oracle@wls-sysadm JAVA]$ tar xvfz /home/oracle/BetaTests/jdk-8u65-linux-x64.tar.gz [oracle@wls-sysadm JAVA]$ mv jdk1.8.0_65 jdk [oracle@wls-sysadm JAVA]$ ln -s jdk jdk1.8.0_65 [oracle@wls-sysadm JAVA]$ ls -al total 12 drwxr-x--- 3 oracle oinstall 4096 Oct 23 12:11 . drwxr-x--- 4 oracle oinstall 4096 Oct 23 12:07 .. drwxr-x--- 8 oracle oinstall 4096 Oct 7 02:29 jdk lrwxrwxrwx 1 oracle oinstall 3 Oct 23 12:11 jdk1.8.0_65 -> jdk ``` Prüfen Java Version: ``` [oracle@wls-sysadm bin]$ /u01/app/oracle/product/JAVA/jdk/bin/java -version java version "1.8.0_65" Java(TM) SE Runtime Environment (build 1.8.0_65-b17) Java HotSpot(TM) 64-Bit Server VM (build 25.65-b01, mixed mode) ``` ### Installation WebLogic Server 12.2.1 ``` [oracle@wls-sysadm bin]$ export JAVA_HOME=/u01/app/oracle/product/JAVA/jdk [oracle@wls-sysadm bin]$ export PATH=$JAVA_HOME/bin:$PATH [oracle@wls-sysadm bin]$ java -jar /home/oracle/WLS1221/fmw_12.2.1.0.0_wls.jar ``` Welcome Seite: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr3.png) Die Verknüpfung „Install, Patch, and Upgrade führt direkt zu Oracle Dokumentation: Schritt 2: Skip Auto Updates: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr4.png) Schritt 3: Middleware HOME festlegen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr5.png) Schritt 4: Installationsart: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr6.png) Shritt 5: Prüfung von Voraussetzungen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr7.png) Schritt 6: Security Updates: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr8.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr9.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr10.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr11.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr12.png) Die Installation ist abgeschlossen. ## Datenbank vorbereiten: Die Datenbank muss bereits installiert sein. ``` [oracle@wls-sysadm bin]$ cd /u01/app/oracle/product/FMW/oracle_common/bin [oracle@wls-sysadm bin]$ ./rcu ``` ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr13.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr14.png) Datenbank Verbindungsinformationen eintragen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr15.png) Alle Voraussetzungen sind erfüllt: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr16.png) „Common Infrastructure Services“ auswählen und Präfix definieren: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr17.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr18.png) Passwort festlegen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr19.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr20.png) Bestätigen die Erstellung von Tablespaces: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr21.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr22.png) Create: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr23.png) Die Aktion hat 2 Minuten gedauert (sehr schnell im Vergleich zu früheren Versionen): ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr24.png) Logfiles kann man direkt aus dem Installer aufrufen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr25.png) ## Die WebLogic Server MT (multitenancy) Domain erstellen ``` [oracle@wls-sysadm bin]$ cd /u01/app/oracle/product/FMW/oracle_common/common/bin [oracle@wls-sysadm bin]$ ./config.sh ``` ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr26.png) Folgende Templates auswählen: - Basic WebLogic Server Domain (ist bereits aktiviert) - Oracle JRF „“ 12.2.1 \[oracle-common\] (notwendig für MT) - WebLogic Coherence Cluster Extension - Oracle Enterprise Manager „“ 12.2.1 \[em\] ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr27.png) DOMAIN\_HOME festlegen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr28.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr29.png) Password: welcome1 Domain Mode: Production ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr30.png) Auf der Seite die Verbindunginformationen der Datenbank angeben (das Schema TEST\_STB wurde durch Repository Creation Assistant „“ RCU „“ erstellt) und auf „Get RCU Configuration“ drucken: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr31.png) Alle Prüfungen: OK“¦ ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr32.png) Next“¦ ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr33.png) Alle Prüfungen sind erfolgreich beendet: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr34.png) Die Komponente sollen konfiguriert werden: - AdminServer - Node Manager - Managed Servers, Clusters and Coherence - Domain Frontend Host Capture: **neu** ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr35.png) AdminServer Konfiguration: Server Namen und Port festlegen (ich habe die Default Werte gelassen): ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr36.png) NodeManager Konfiguration: NodeManager Benutzer und Passwort festlegen, Speicherort: default ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr37.png) Managed Server hinzufügen: Zwei Managed Server TEST\_MS\_1 und TEST\_MS\_2 erstellen ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr38.png) Cluster Configuration: einen Cluster Namens mycluster\_1 erstellen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr39.png) Beide Manaed Servr zum Cluster hinzufügen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr40.png) Coherence: default Werte lassen ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr41.png) Unix Maschine erstellen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr42.png) AdminServer und zwei Managed Server zur Maschine my\_machine\_1 hinzufügen: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr43.png) Neue Möglichket: „Configure Domain Frontend Host“: wird nicht konfiguriert ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr44.png) Einstellungen prüfen und auf den Knopf „Create“ drucken: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr45.png) ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr46.png) Die Domäne ist erstellt ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr47.png) ## Server starten Node Manager starten: ``` cd /u01/app/oracle/product/FMW/user_projects/domains/base_domain/bin nohup ./startNodeManager.sh & ``` AdminServer starten: ``` cd /u01/app/oracle/product/FMW/user_projects/domains/base_domain/bin ./startWebLogic.sh ``` Managed Server starten ``` cd /u01/app/oracle/product/FMW/user_projects/domains/base_domain/bin ./startManagedWebLogic.sh TEST_MS_1 http://host01.example.com:7001 ./startManagedWebLogic.sh TEST_MS_2 http://host01.example.com:7001 ``` ## Prüfungen ### WebLogic AdminConsole WebLogic Server Administrationskonsole: sieht genauso aus, wie früher: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr48.png) Die Multitenancy Fähigkeit wird unter „Domain Partitions“ konfigurierbar: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr49.png) ### Oracle Enterprise Manager Der Enterprise Manager ist komplett überarbeitet und bekommt jetzt eine neue Oberfläche: ![](http://borysneselovskyi.files.wordpress.com/2015/10/102515_1848_ersteerfahr50.png) **Kategorien:** Development, Tools & Methoden **Schlagwörter:** German, Installation, oracle, Oracle DB, Oracle FMW, Weblogic --- ### [Handling inbound Attachments by Oracle Service Bus "“ Part 2](https://thecattlecrew.net/2015/11/26/handling-inbound-attachments-by-oracle-service-bus-part-2/) **Published:** November 26, 2015 **Author:** Apostolos Varsamis **Content:** ## Accessing the content of the attachments As is mentioned in [Part 1](https://thecattlecrew.wordpress.com/2015/11/23/handling-inbound-attachments-by-oracle-service-bus/), when the multipart message hits the proxy service, then (in conjunction with the Content-type) the attachment/body contains not the content itself but rather a **reference** to it. So, we have to to access the data itself for further processing. We call this the ***materialization* of the content** which might be performed through - a java callout or - a service callout to a simple Proxy-service The next Fig. shows the java-code that gets the reference of the binary content as input, encodes it in base64 and returns the string back. ###### public static String encodeContentToBase64ByRef(byte\[\] content) { return DatatypeConverter.printBase64Binary(content); } A simple Proxy service can also be used in order to materialize the contents of the reference to a binary content: ![inAtt2_bild1](https://thecattlecrew.net/wp-content/uploads/2015/11/inatt2_bild1.png)![inAtt2_bild2](https://thecattlecrew.net/wp-content/uploads/2015/11/inatt2_bild2.png)![inAtt2_bild3](https://thecattlecrew.net/wp-content/uploads/2015/11/inatt2_bild3.png)However this fact needs a little bit more attention: ### Case 1: Let us suppose that the content of the attachment have a Content-Type= application/x-javascript and Content-Transfer-Encoding=base64 with the content, let“™s say PHNjcmlwdD4NCnZhciB4ID0gNTsNCnZhciB5ID0gNjsNCnZhciB6ID0geCArIHk7DQpkb2N1b WVudC5nZXRFbGVtZW50QnlJZCgiZGVtbyIpLmlubmVySFRNTCA9IHo7DQo8L3NjcmlwdD4= Let us further assume that we want to save this content to a file. What we do have is a **reference** to the content held somewhere in the memory; but what in fact held there, is the ***base64-decoded*** content of the attachment, which means that if we get it by a service-callout, what we get back is an UTF-8 string. In this case the String contains the exactly the data behind „PHNjcmlwdD4NCnZh“¦“ and we can use them. In this case everything works fine. ### Case 2 Now let us suppose that the content of the attachment have a Content-Type=image/jpg, Content-Transfer-Encoding=base64 and content, let“™s say: w7/DmMO/w6AgEEpGSUY= etc. Using the same mechanism as mentioned above, what we really get this time, is an UTF-8 string with **no resemblance to the original data** behind the base64 encoded data. In this case this method is **no more reliable**. ## Conclusion So the far more secure way for data materialization (using the term as described above) is a java-callout. **Kategorien:** Integration **Schlagwörter:** Service Bus --- ### [Next-Level-Entwicklungsumgebung](https://thecattlecrew.net/2017/08/23/next-level-entwicklungsumgebung/) **Published:** August 23, 2017 **Author:** djaehrling **Excerpt:** In weniger als 50 Kalendertagen haben wir für einen unseren Kunden einen DevOps-Stack in AWS aufgezogen, der einen Meilenstein in der Softwareentwicklung darstellt. **Content:** In einer superkurzen Zeit von nur wenigen Wochen stellte unser Team remote eine Entwicklungsumgebung vollständig in der Amazon Cloud bereit. Bestückt mit einem MVP-Testvehicle auf Basis von Alexa kam dabei eine Entwicklungsumgebung zustande, die einen Meilenstein der zukünftigen Softwareentwicklungsumgebung markiert. Der technologische Stack kann als Blaupause für „Lean Startups“ dienen. ![Tech-Stack](https://thecattlecrew.net/wp-content/uploads/2017/08/tech-stack.jpg) Mit diesen Tools (und noch ein paar mehr) erstellten wir eine Continuous-Integration-Umgebung, deren Infrastruktur vollständig in Ansible-Scripts und Docker-Containern abgebildet ist. Eine von uns erstellte Provisioning-App versetzt die Entwickler unseres Kunden jetzt in die Lage, sich via erweiterbarer Quickstarter das Projektsetup auszuwählen, das für sein Projekt passend ist (Frontend und/oder Backend). Die Quickstarter stellen einen Basisrumpf einer Applikation in einer bestimmten Technologie dar (z. B. Angular, NodeJS Backend, Sprint Boot Backend, …). Die Provisioning App sorgt dann dafür, dass die notwendigen Projekte in den einzelnen Tools (Jira, Confluence, Bitbucket, OpenShift) angelegt werden. Gleichzeitig installiert es einen Applikationsrumpf, stellt diesen in Bitbucket bereit und richtet Webhooks ein. Es werden notwendige OpenShift-Projekte und Ressourcen erzeugt. Nach Beendigung eines Provisioning-Vorgangs kann der Entwickler den Code aus den neu angelegten Repositories clonen, entwickeln und dann pushen. Ohne weiteres Zutun wird der Code gebaut, unit- und integrationsgetestet und dann auf OpenShift deployed. Es bleibt einzig noch übrig, eine Route einzurichten, wenn die Anwendung aus dem Internet erreichbar ein soll. „The Story behind“ unseres Auftrages beschrieb unser Kunde so: „*Mit vielen kleine Teams wollen wir in der Lage sein mit hoher Geschwindigkeit zu entwickeln und mit Daten zu arbeiten, die wir in einem Data Lake speichern. Es gilt dabei keine Zeit mit Projekt-Setup, Erstellung eines Repositories oder dem sonst üblichen „first week waste“ zu verschwenden. Sobald das Team zusammengestellt und die Technologie, die wir nutzen wollen, klar sind, muss in wenigen Minuten eine Entwicklungsumgebung aufgebaut und zur Verfügung stehen. Als Beispiel ist eine Gruppe von 5 Entwicklern zu nennen, die in Java / Node / Python ein Backend schreiben sollen, welches Daten über JNDI / SSH / REST abruft und es va REST / Websocket einer Frontend-Anwendung auf der Grundlage von Angular 2 bereitstellt. Eine Provisioning-App nimmt die Mitarbeiter-IDs, die Backend-Tech- und Frontend-Tech-Vorgaben auf und initiiert einen Confluence-, Jira- und Git-Bereich sowie eine Jenkins-Pipeline, die automatisch auf einem Master-Branch-Push baut, testet und deployt, sowie ein Peer-Review-Prozesse nach Best-Practice einfordert. Die Entwickler werden über ihre Anmeldeinformationen, die entsprechenden URLs zu den Systemen sowie einer Dokumentation, wie die Systeme zu nutzen sind, informiert. Sie können sofort mit der Codierung/Entwicklung beginnen, ohne dass sie Server, Firewall-Regeln, Wiki-Räume oder den üblichen Overhead anfordern müssen. Wenn die Anwendung ein Erfolg ist, kann der ganze Stack dann in unsere Vor-Ort-Systeme geschoben werden, denn alles ist auf Docker aufgebaut. Die Daten hinter der Applikation sind nun Teil unseres gesamten Data Lake und nicht mehr nur eine in AWS gespeicherte Entwicklung.*„ **Kategorien:** Development, DevOps **Schlagwörter:** Alexa, AWS, Continuous Delivery, Continuous Integration, DevOps --- ### [IT|espresso - 10 unterschätzte Kriterien für eine Mobile Strategie](https://thecattlecrew.net/2017/09/29/itespresso-10-unterschaetzte-kriterien-fuer-eine-mobile-strategie/) **Published:** September 29, 2017 **Author:** philippleinius **Content:** Nativ, Web, Hybrid oder Cross Compiled? Im Rahmen unserer zahlreichen Beratungskontexte haben wir bisher 48 Kriterien für die Auswahl der richtigen Mobile-Strategie ausgemacht. 10 davon die häufig unterschätzt bzw. sogar komplett vergessen werden, wollen wir Ihnen im Rahmen als Impulsvortrag auf unserem IT|espresso vorstellen. Danach freuen wir uns, Sie zu einem hervorragenden Stück Kuchen einzuladen und lebhaft mit Ihnen über das Thema zu diskutieren. Ihre Anmeldung können Sie unter folgenden Link durchführen: [Anmeldung](http://www.opitz-consulting.com/nc/share/suid/101/register/sharedItem/event.html?theater=1). Für mehr Informationen zu den Angeboten von Opitz Consulting zum Thema Mobile kontaktieren Sie gerne Karsten Will (karsten.will@opitz-consulting.com) oder Philipp Leinius (philipp.leinius@opitz-consulting.com). Wir freuen uns auf Ihre Teilnahme! ## Quellen & Weiterführende Informationen: > [Managed Services „“ Engagement-Modelle](https://thecattlecrew.net/2017/07/27/managed-services-engagement-modelle/) **Kategorien:** Development, Tech Events & Networking --- ### [DAS GANZE IST MEHR ALS SEINE TEILE](https://thecattlecrew.net/2017/11/16/das-ganze-ist-mehr-als-seine-teile/) **Published:** November 16, 2017 **Author:** Richard Attermeyer **Excerpt:** Was passiert, wenn wir unsere eigene Methoden auf die Domäne Softwareentwicklung anwenden. Wie können wir eine "Referenzarchitektur" für unsere Domäne entwickeln und gibt es die eine Plattform, welche unsere Probleme löst? **Content:** Am 16.11.2017 haben Torsten Jaeschke und ich einen [Vortrag ](https://de.slideshare.net/opitzconsulting/presentations)zu diesem Thema im Rahmen der Continuous Lifecycle Konferenz in Mainz gehalten. Es ist eine gute Idee sich die Folien als Ergänzung anzusehen. Wir Softwareentwickler beschäftigen uns mit Methoden, wie wir Fachdomänen strukturieren und Prozesse erheben. Aber wann haben wir dies das letzte Mal auf unsere eigene Domäne angewandt? Sind unsere Produktionssysteme, d.h. von der Entwicklungsumgebung, über Ticketsysteme, Versionskontrolle, CI/CD Tools, Staging Umgebungen etc. einfach so gewachsen? Erliegen wir Entwickler, Architekten, IT-Leute also selber zu schnell der Gefahr, dass wir uns mit dem Lösungsraum auseinandersetzen und unseren Problemraum eigentlich gar nicht genau kennen? ## Problem- vs Lösungsraum Was hat es eigentlich mit diesen Begriffen vom Problem- und Lösungsraum auf sich? Warum ist es wichtig, erst das Problem genau zu verstehen und erst dann über die Lösung nachzudenken? Fangen wir mit einem kleinen Beispiel an: Es ist eine nette Anekdote aus dem Raumfahrtprogramm und dem kalten Krieg. Das Problem: Schreiben in der Schwerelosigkeit. Wie haben die USA das Problem verstanden: Die überall beliebten Tintenschreiber funktionieren nicht in der Schwerelosigkeit. Wir brauchen also einen Tintenschreiber der in der Schwerelosigkeit funktioniert. Entwicklungskosten: eine Million US Dollar. Wie haben dir Russen das Problem verstanden: Wir brauchen etwas mit dem wir in der Schwerelosigkeit schreiben können. Tintenschreiber geht nicht. Bleistift funktioniert. Nehmen wir den Bleistift. Das ganze ist zwar ein Mythos, aber er macht doch deutlich, dass man zunächst einmal das Problem richtig verstehen sollte und verschiedene Lösungen abwägen muss. Wenn wir dies nicht machen, dann kommen wir in die typischen Diskussionen: gitlab ist aber viel besser als Bitbucket…. nein… doch… ## Methoden Wie kann man sich jetzt dem Thema nähern. Eigentlich helfen da typische Methoden aus dem Bereich der SW Entwicklung. Wir werden im folgenden kurz Personas + Empathy Maps, Event Storming und Domänenmodellierung ansprechen. ### Personas + Empathy Maps Will man mehr über seinen Kunden erfahren, den man häufig nicht direkt vor sich sitzen hat, dann eignen sich Personas und Empathy Maps gut. Sie sind auch dann interessant, wenn man später nochmal über Typen von Nutzern sprechen will, für die eine ausgewählte Lösung besonders geeignet ist und auf die hin man ggf. seine Auswahl optimiert hat. Aber Achtung: Im eigenen Unternehmen eignen sich kollektive Entscheidungsprozesse besser, um die Architekturtreiber (Qualitätsattribute) festzulegen. Wir haben hier aber mal ein paar Beispiele aufgenommen, die uns in den lezten Jahren im Beratungsalltag begegnet sind um die unterschiedlichen Anforderungen an eine Continuous Delivery Umgebung zu verdeutlichen. Stellen wir sie einmal vor (wir beschränken uns hier wegen der Zeit auf 2 Extreme): **Petra, Head of Advanced Analytical Projects** Petra baut ein separates Team auf, um die Potenziale einer personalisierten Medizin auf Basis von Big Data Technologien zu erforschen. Dazu sollen Produktideen im Rahmen von Schnellbootprojekten verprobt werden. Die Projekte haben eine kurze Laufzeit. Es soll keine Zeit für das Aufsetzen der notwendigen Infrastruktur vergeudet werden. Die Entwickler sollen sich nicht um Infrastrukturfragen kümmern. Es handelt sich um viele kleine eher isolierte Applikationen. Die Umgebung soll vor den ersten Projekten fertig aufgebaut sein. ![Petra](https://thecattlecrew.net/wp-content/uploads/2017/11/petra.png) **Tobias, Leiter Softwareentwicklung** Er steht vor dem Problem neue Methoden der Softwareentwicklung einzuführen. Er möchte auch Continuous Delivery einführen, kann aber keine up-front Investition rechtfertigen. Es fehlt auch an verfügbaren Know How. Er möchte dem Motto „grow-as-you-go“ folgen und möglichst einfach anfangen und nach und nach notwendige Technologien einführen und ergänzen.![Tobias](https://thecattlecrew.net/wp-content/uploads/2017/11/tobias.png) Wir sehen hier schon zwei sehr unterschiedliche Kundenbedürfnisse. Es gibt aber viele Stakeholder für eine solche Plattform. Da wären sicherlich die Entwickler und je nachdem wie die Organisationsstruktur ist auch die Betriebsorganisation. Wir reden zwar viel von DevOps, aber da angekommen sind erst wenige. Einen Kulturwandel kann man nicht erzwingen oder forcieren, sondern nur ermöglichen. Diese beiden Beispiele sind aus unserer Beratungspraxis abstrahiert. Aber wenn man mit Kollegen zu tun hat, dann sollte man die Themen in Workshops erarbeiten. ## Domänenmodell Tun wir mal so, als ob wir Experten in unserer Domäne sind, dann sollten wir doch schon wie für viele Fachdomänen so etwas wie eine Referenzarchitektur erarbeitet haben. Dann könnten wir auch mal sehen, welche unterschiedliche Sichtweisen auf eine Domänenzerlegung es gibt. Sonatype hat mal eine kleine \[Sammlung\](https://de.slideshare.net/SonatypeCorp/nexus-and-continuous-delivery) zusammengestellt. Allerdings sind eine Beispiele schon sehr im Lösungsraum verortet, andere stellen Prozessmodelle dar (die brauchen wir auch, lassen wir aber hier mal außen vor). Allerdings sind keine dieser Modelle so ausgefeilt wie einige Referenzarchitekturen für z.B. den IoT Bereich oder für Banken und Versicherungen. Wir machen hier mal einen Vorschlag. Das hilft zur Strukturierung des Problemraums und hilft später Lösungen darauf abzubilden und zu evaluieren. ![Domänenmodell](https://thecattlecrew.net/wp-content/uploads/2017/11/domc3a4nenmodell.png) Unser Vorschlag auf der ersten Ebene ist wie folgt - Enabling Tools - Runtime Environment - Development Environment - CD Tooling Lasst uns mal in jede Domäne einen kurzen Blick riskieren: ### Enabling Tools Unter der Domäne Enabling Tools sind alle Systeme zusammengefasst, die benötigt werden, um eine Entwicklung zu starten und zu supporten. Mit den Enabling Tools ist eine lokale Entwicklung (auf dem Entwicklerlaptop) schon möglich. Zu den Enabling Tools zählen unserer Sicht nach folgende Subdomänen - VCS Hosting - Ticket System - Wiki - (Binär-) Repositories - Persistent Chat - Provisioning - SSO (IAM) Die Liste erhebt keinen Anspruch auf Vollständigkeit und nicht immer werden alle Aspekte gebraucht. Aber dies sind typische Bereiche, mit denen wir in unseren Projekten immer wieder zu tun gehabt haben. Für jede dieser Subdomänen gibt es eigenständige Systeme, welche optimiert sind. Die meisten Punkte sind selbsterklärend. Insbesondere, wenn es sich um eigenständige Systeme handelt, dann benötigt man noch die letzten beiden Punkte. Die Provisioning Subdomäne kümmert sich, dass für ein neues Projekt die entsprechenden Ressourcen in den anderen Domänen konfiguriert werden. Ebenso wichtig ist im Fall von separaten Systemen ein Single Sign On / Identity and Access Management, so dass man nicht für jedes Systeme anmelden oder gar eigenständige Accounts nutzen muss. Es gibt aber auch integrierte Lösungen, die mehrere oder gar alle Subdomänen umfassen. ### Runtime Environment Unter dieser Domäne verstehen wir alle Funktionen, welche die Ablaufumgebungen für verschiedene Environments (von Build Umgebungen, Dev, Test, UAT, CAP bis hin zu PreProd und Prod) bereitstellt und diese überwacht. Als Subdomänen sehen wir hier - Log Management - Monitoring & Alert Management - Distributed Application Scheduler - Configuration Management - Service Discovery Es ist erst einmal unerheblich, welche Lösung zum Einsatz kommt, etwa VMs oder Container. ### Development Environment Diese Domäne umfasst den „Entwicklungsrechner“, welcher bei den technischen Stakeholdern steht, Entwicklern, Testern, CD Engineer oder den Betriebskollegen. Er umfasst in der Regel IDE / Editor / Entwicklungswerkzeuge. Da Infrastruktur Code ist, gibt es keinen prinzipiellen Unterschied zwischen den Beteiligten. Neben diesen Werkzeugen enthält diese Umgebung in der Regel ein verkleinertes Abbild des Runtime Environments und des CD Toolings. Sei es zum Deployment im Rahmen der Entwicklung, sei es zur Entwicklung der Deployment Pipeline oder administrativen Skripten. ## Nicht funktionale Anforderungen Die Domänen stellen nur eine statische Struktur dar. Was aber erwarten wir von Systemen, welche diese Domänen unterstützen. Was bedeutet für uns gute Qualität? Unterschiedliche Stakeholder an den Tisch zu holen und mit Ihnen die Qualitätsattribute und -szenarien zu definieren und zu priorisieren ist eine gute Idee, wenn man Architekturarbeit betreibt. Viel zu häufig sind diese nicht definiert. Eine Architektur aber ist genau dazu dar, insbesondere diese nicht-funktionalen Anforderungen zu erfüllen. Im Fall von Petra, was können hier nicht-funktionalen Anforderungen sein? Hier kann man in jedem Fall die Usability nennen. Petra möchte nicht, dass ihre Entwickler Zeit verlieren und aus dem Schnellboot ein Schlepper wird. Sie sollen schnell arbeiten können und das Umfeld soll so verständlich sein, dass sie das auch können. Performance ist hier erst einmal zweitrangig. Einfache Bedienbarkeit und das Vorhandensein von Funktionalität zählen hier. Tobias hingegen möchte eine CD Umgebung aufbauen. Hier kommt neben der Funktionalität die Performance ins Spiel. Die beste CD Umgebung bringt keinen Mehrwert, wenn ein manuelles Delivery schneller erfolgen kann. Sofern aber Performance und Funktionalität stimmen, kann Tobias weitere Investitionen rechtfertigen und sein Team vorantreiben. Alleine an diesem kleinen Ausschnitt an Anforderungen erkennt man schon, dass trotz der unterschiedlichen Bedürfnisse dennoch Überschneidungen existieren, auch wenn man Tobias und Petra aus Ihrem Blickwinkel heraus jeweils eine andere Gewichtung legen würden. Die Herausforderung liegt meist darin dies in eine von allen tragfähige Priorisierung zu bringen. Bei der Betrachtung von nicht-funktionalen Anforderungen fließen natürlich auch Überlegungen wie „Bin ich aufgrund der Unternehmenspolicy bereits auf einen bestimmten Stack festgelegt?“ mit ein. Man sollte aber, wenn dies der Fall ist, dennoch über den Tellerrrand schauen und Alternativen anhand der gemeinsam erarbeiteten Anforderungen prüfen und auch persönliche Vorlieben („das nutzen wir schon immer“) außer Acht lassen. ## Event Storming Wir haben hier ein kleines Domänenmodell aufgeführt und die Architekturtreiber definiert. Wie aber sehen die konkreten Prozesse im Rahmen der Softwareentwicklung und des Continuous Deliveries für unterschiedliche Projekte aus? Vielfach optimieren wir einzelne Domänen, aber das eigentliche Problem liegt genau in den Prozessen dazwischen, welche die unterschiedlichen Domänen verbinden. Eine Workshop taugliche Form sich diesen Prozessen zu nähern und auch verschiedene Varianten gleichzeitig darzustellen ist das Event Storming. Ein gegenseitiges Verständnis der Prozesse, der Architekturtreiber und Randbedingungen kann dazu führen, dass man Trade-offs akzeptiert. Diese Trade-offs wird man immer haben, wenn man sich auf einen Technologiestack einigt. Andererseits kann es auch sein, dass man bewusst entscheidet, dass man mit mehr als einer Lösung leben will. ## Beispiele Ohne jetzt auf die einzelnen ausgewählten Technologien genau einzugehen, hier mal die Lösungen, welche für die oben dargestellten Probleme von Jens und Petra von unseren Kunden gewählt wurden. Dies ist also eine mögliche Implementierung aus dem gesamten Lösungsraum. ### Langläufer ![Tobias Lösung](https://thecattlecrew.net/wp-content/uploads/2017/11/tobiaslc3b6sung.png)Tobias Lösung Tobias hat sich dazu entschieden einige Lösungen zu übernehmen, die im Unternehmen etabliert sind, wie Atlassian Confluence und Jira oder auch Gitlab. Die gesamte Plattform wurde auf Basis von freien Tools basierend auf Docker aufgesetzt. Wichtig war hier, dass keine unnötigen Technologien genutzt wurden, sondern immer so viel, wie nötig war, um die parallel zum Projekt aufkommenden Herausforderungen zu meistern. Daher wurde bewusst nicht Kubernetes eingesetzt, sondern z.B. Docker Swarm, da die Administration einfacher war. Die Gesamte Entwicklungsplattform für 24 Entwickler und Tester wurde dabei von zwei externen Mitarbeitern aufgebaut und betreut, die sich eine Stelle teilten (ca 6 Tage / Woche von beiden erbracht). ### Schnellbootprojekte Petra wiederum entschied sich aufgrund der Konzernstrategie auf OpenShift zu setzen und in der AWS Cloud zunächst automatisiert einen Atlassian Stack bauen und über eine Provisioning App Projekte dort automatisiert mit allen benötigten Ressourcen aufsetzen zu können, so dass es von der Anlage eines Projekts bis zum clonen eines Projekts, Push und Build weniger als 5 min dauert. In den ersten 3 Monaten wurden schon 12 Schnellbootprojekte entwickelt. ![Petras Lösung](https://thecattlecrew.net/wp-content/uploads/2017/11/petraslc3b6sung.png)Petras Lösung ## Plattformen Das letzte Beispiel geht davon aus, dass soweit wie möglich eine aPaas Plattform genutzt werden soll. Man selber hat keine Arbeit und kann sich komplett auf das Entwickel konzentrieren. Gerade dieser Ansatz verdient es genauer betrachtet zu werden. Aus unserer Beraterpraxis heraus kann man sagen, dass es hier nicht den goldenen Weg gibt. Jede Plattform hat ihre Fallstricke, so dass man seine Anforderungen sehr genau kennen muss, um herauszufinden, ob eine Plattform mit ihren Trade-Offs das ist, was man haben möchte. Man sollte immer die Lernkurve für die Handhabung der Plattform berücksichtigen, da jede Plattform ihre properitäre Nomenklatur mitbringt und meist gibt es Grenzen, die man auf den ersten Blick nicht erwartet hat, wie Unterschiede zwischen Cloud und On-Premise Varianten. Wären wir in der Welt des Kochens, könnte man eine Plattform als das Maggie für das Essen sehen. Man kann sein Essen damit würzen, erhält aber noch viele andere Geschmacksvarianten hinzu, die man unter Umständen nicht haben möchte, während man mit der richtigen Kombination einzelner erlesener Gewürze genau das Aroma produziert, das man haben möchte. ## Resümee Wir sehen, es gibt eine große Bandbreite. Und vieles haben wir bisher nur aus der Sicht der Entwickler und CD Engineers betrachtet und noch nicht so sehr aus der Sicht eines klassischen Administrators. Wir Entwickler preisen überall gerade Microservices an. Ein wesentliches Argument für Microservices ist die Replacability. Wenn Sie eine Plattform einsetzen ist unser Rat: Fragen Sie sich, ob und mit welchem Aufwand es möglich ist eine Subdomäne durch ein anderes System unterstützen zu lassen. Klären Sie daher im Vorfeld ihre Architekturtreiber und Prozesse, um sich später nicht rechtfertigen zu müssen. **Kategorien:** Architecture & Process Models, Development --- ### [Live-Webcast: 10 vernachlässigte Kriterien bei der Auswahl einer Mobile-Strategie](https://thecattlecrew.net/2017/11/23/live-webcast-10-vernachlaessigte-kriterien-bei-der-auswahl-einer-mobile-strategie/) **Published:** November 23, 2017 **Author:** philippleinius **Content:** Nativ, Web, Hybrid oder Cross Compiled? Im Rahmen unserer zahlreichen Beratungskontexte haben wir bisher 48 Kriterien für die Auswahl der richtigen Mobile-Strategie ausgemacht. 10 davon die häufig unterschätzt bzw. sogar komplett vergessen werden, wollen wir Ihnen im Rahmen als Webinar vorstellen. Ihre Anmeldung können Sie unter folgenden Link durchführen: [Anmeldung](https://www.opitz-consulting.com/nc/share/suid/108/register/sharedItem/event.html?theater=1). Für mehr Informationen zu den Angeboten von Opitz Consulting zum Thema Mobile kontaktieren Sie gerne Karsten Will (karsten.will@opitz-consulting.com) oder Philipp Leinius (philipp.leinius@opitz-consulting.com). Wir freuen uns auf Ihre Teilnahme! ## Quellen & Weiterführende Informationen: [https://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Fact\_Sheet/91-factsheet-mobile-team-a-a-service.pdf](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/91-factsheet-mobile-team-a-a-service.pdf) **Kategorien:** Development, Tech Events & Networking --- ### [AngularConnect 2017 - Day 1](https://thecattlecrew.net/2017/11/27/angularconnect-2017-day-1/) **Published:** November 27, 2017 **Author:** janniklaswortmann **Content:** The 7.11 and 8.11 were totally great days for everyone who is loving angular and its community. My name is Jan-Niklas Wortmann and I visited the AngularConnect 2017 in London. For everyone who is not knowing this lovely event (shame on you!), it is the largest Angular conference in Europe. There were up to 5 tracks at the same time, so in each case there is a topic you will( or should be) interested in. I will explain some of them in more detail below. But the best part of this event was the community and discussions you got by talking to each other. There were really interesting stories from people facing problems with angular and even more stories of people solving such problems. # But let’s start with the beginning…. The conference was opened by the keynote presented by Jules Kremer and Igor Minar. The keynote was very well presented. Jules and Igor talked about the Angular platform. They talked about the community which is an integral part of angular and its ecosystem. Due to current events, Igor told about the steps the Angular-team took, up to release version 5. He presented a huge performance improvement just by upgrading. Furthermore Jules presented shortly integral parts of the angular platform, like PWAs, animation, Server-Side-Rendering, …, and introduced some of the presentations of the next days. # Service Worker After a short break, (coffee, private talks, and so on) Maxim Salnikov presented Service Workers and their use in PWAs. Maxim explained enthusiastically, but also calmly, the benefits of using Service Worker. Service Worker improve performance of an angular application by reducing network request. They also improve the usability of an application by offering the possibility to handle push notification, like the natively implemented ones. And the best of it, angular-cli in it’s newest version, is already able to configure completely Service Worker for your application. To get an overview about this topic I can highly recommend Maxim’s talk, to dig deeper I would point to his blog article about [Service Worker](https://medium.com/@webmaxru/a-new-angular-service-worker-creating-automatic-progressive-web-apps-part-1-theory-37d7d7647cc7). # Accessibility the First Uri Shaked presented in his Talk „Breaking the Eyes“ easy steps developer should take to improve the accessibility of an application. He clearly demonstrates the importance of accessibility. Just by using common HTML-Attributes like ‚tabindex‘ and ‚role‘ you can improve accessibility so much and [ChromeLens](https://chrome.google.com/webstore/detail/chromelens/idikgljglpfilbhaboonnpnnincjhjkd) make it even easy to test your application manually. Great Advices. Great Talk! # Web Security Dominik Kundel, who is working for Twilio, presented highly interactive web security. He implemented a common web application and performed a security audit live on stage. On top of that he pushed his code to [Github](https://github.com/dkundel/onesie-life) and explained very detailed how such attacks are working and how to prevent them. On top of that, he presented this, normally dry subject in funny way, which made listening easy. Strong recommendation for his talk ([slides](https://github.com/dkundel/onesie-life)). Later that day I get personally in touch with him. He’s a really fun guy and a whisky lover, which makes him sympathic by definition! # Performance improvements „[Purely Fast](https://speakerdeck.com/mgechev/purely-fast)“ was the title of the Minko Gechev’s presentation. He implemented a demo application and showed techniques to improve the runtime performance of an angular application. The talk was very informative and very well presented. This was my fist personal highlight of the first day of AngularConnect. I can just recommend it each angular developer. For example, he showed the differences of using a pipe to a plain function. Very interesting! On top of that it was very easy to understand. I can just repeat myself and recommend it strongly! Afterwards Minko started a [blog](http://blog.mgechev.com/2017/11/11/faster-angular-applications-onpush-change-detection-immutable-part-1/) series for this topic, which is also very interesting. # Accessibility the Second After the lunch Svetlana Kouznetsova had a presentation about accessibility just with sign language due to her deafness. It was translated by another person. I was kind of flashed of the courage and the enthusiasm of this woman. I was literally overwhelmed. In her presentation, she talked about captions for example, which is obviously important for deaf people. But she also talked about the quality of caption. Interesting talk by a great woman. # Advanced Concepts The next talk was my second highlight of the first day, Alex Rickabaaugh’s talk about „[Advanced Angular Concepts](https://www.youtube.com/watch?v=JhNo3Wvj6UQ&t=2612s)„. He showed advanced techniques of using dependency injections and queries in an angular application. But I don’t want to talk too much about this presentation to encourage everyone watching it. If you would just want to watch one presentation, I would recommend this one. # Pre-Rendering The afternoon sessions were introduces by Jeff Cross with his talk about „[Pre-Rendering Strategies](https://drive.google.com/file/d/1EHJqMNygBWjDp7ymgWPnD1-CxHjGuFTT/view)„. In this talk, Jeff demonstrate the concept of pre-rendering. In addition to that he talked about strategies, which means, that he showed some ways to handle highly dynamic content for example and pre-render it anyway. This was also a very interesting talk for me because I hadn’T seend pre-rendering till that day before, but I will definitely keep in mind for my next project. „Angular Animations: Motion Makes Meaning“ by Lukas Ruebbelke was prepared in cooperation with Matias Niemela aka. [yearofmoo](https://twitter.com/yearofmoo). Lukas presented very interesting techniques to animate an angular application. Furthermore his slides were the presentation as well. Take a look at , then you are going to understand, what I have tried to say. Anyway, the animations with its implementation seemed to be just a little effort but the results were stunning! He also presented a way to construct the animations dynamically which means you could make context sensitive animations, completely programmatically, just by injecting the AnimationBuilder. Pretty interesting! # The last session The last session at the jupiter stage was the „[ng-game-show](https://www.youtube.com/watch?v=JhNo3Wvj6UQ&t=13115s)“ presented by Shai Reznik. Despite minor technical difficulties, this game show was very entertaining and informative as well. Shai asked a question to three participants. Each correct answered questions gave points and of course the participant with the most points won the game show. Quite similar to every common game show. But after some questions one of the participants had to fulfill some „silly“ tasks, like performing the „chicken“ dance. To be honest, some of the questions were quite easy, but some required a deep knowledge of angular. Shai who is a really charismatic made this event really funny. He handled the unplanned difficulties in such a relaxed way. Furthermore, he tried to blame some of the open source contributor, who were also attendant, for the problems. Really amusing. These were the short summaries of the presentation I attended at the first day of the AngularConnect 2017. Day 2 will be coming soon! **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** Angular, AngularJS 2.0, Conference, Events, IT Security, Mobile, Softwarenentwicklung, Web Developement --- ### [Kriterien für die Bewertung von CI/CD Tools](https://thecattlecrew.net/2017/11/28/kriterien-fuer-die-bewertung-von-ci-cd-tools/) **Published:** November 28, 2017 **Author:** Serdar Nurgün **Content:** **Teil 1 der Serie** Schnelles Feedback bei der Auslieferung von Software ist wichtiger denn je. Für den Fachbereich ist echtes Anwenderfeedback wesentlich. Hier setzt Continuous Delivery an und automatisiert die Lieferkette bis in die Produktion. Gegenwärtig stehen eine Menge Continuous Integration/Continuous Delivery (CI/CD) Tools hierfür unterstützend zur Verfügung. Diese haben alle ihre Daseinsberechtigung mit ihren Stärken und Schwächen. Anhand eines Kriterienkatalogs starten wir nun eine Blogserie, worin die Alternativen Jenkins (), GitLab () und Concourse () bewertet werden. ![](https://upload.wikimedia.org/wikipedia/commons/thumb/e/e9/Jenkins_logo.svg/2000px-Jenkins_logo.svg.png) ![Grafik](https://upload.wikimedia.org/wikipedia/commons/thumb/1/18/GitLab_Logo.svg/2000px-GitLab_Logo.svg.png) ![Grafik](https://thecattlecrew.net/wp-content/uploads/2017/11/concourseci_logo.png?w=300) Jenkins ist in dieser Blogserie mit dabei, weil es die größte Verbreitung unter den CI/CD Tools hat. Folglich stellt es einen Standard dar. GitLab wurde in dem Forrester Wave Report Q3 2017 als Leader im CI/CD Segment eingestuft () und spielt daher eine essentielle Rolle unter den CI/CD Tools. Und als eine weitere Alternative haben wir uns für Concourse, einen Newcomer, entschieden. In Expertenforen erfreut sich Concourse gegenwärtig großer Beliebtheit, weil es neue Konzepte im CI/CD Segment etabliert, die wir unter die Lupe nehmen werden. Für die Erhebung der relevanten Kriterien haben wir eine unternehmensweite Umfrage durchgeführt. Auf Basis dieser Umfrage ist ein Kriterienkatalog entstanden, der sich aus den folgenden Kategorien zusammensetzt. - Kostenkriterien „“ Der Kostenaspekt sollte vorab gut durchleuchtet werden, damit später keine überraschenden Kosten entstehen, die das Projektbudget überfordern. Betrachtet werden hierbei die On-Premises- und die SaaS-Lösungen des jeweiligen Anbieters, um auch bei einer notwendigen Migration in keine hohen Kosten zu laufen. - Kriterien für die Skalierung „“ Bedingt durch mehrere Faktoren, wie z.B. die Architektur oder der Geschäftserfolg, steigt rasch die Anzahl von Teams in einem Projekt. Hierdurch entsteht mehr Last für ein CI/CD Tool. Teams müssen länger auf die Ressourcen warten und erhalten folglich sehr spät ein Feedback. Den meisten Tools liegt ein Remote-Agent-Konzept zugrunde, um die Last auf mehrere Maschinen zu verteilen und so den Entwicklungsanforderungen zu genügen. Doch, ermöglicht dieses Konzept auch die effiziente Nutzung der Ressourcen mit mehreren Teams, und können auch Projekte hierfür priorisiert werden? - Kriterien für Build-Möglichkeiten „“ Moderne Anwendungen setzen sich aus mehreren Komponenten zusammen. Die Entwicklung verläuft parallel und unabhängig voneinander. Verschiedene Programmiersprachen kommen hierfür zum Einsatz. Diese Heterogenität spiegelt sich auch in den Build Tools wieder. In dieser Kategorie recherchieren wir, welche Build Tools unterstützt werden und wie granular die Konfiguration erfolgt. - Kriterien für Rechteverwaltung von Benutzern und Gruppen „“ Die Umfrage hat gezeigt, dass eine durchdringende Rechteverwaltung immer mehr an Bedeutung gewinnt. Entwicklungsteams arbeiten meistens in mehreren Projekten und haben jeweils verschiedene Rollen und Rechte. Der Fokus richtet sich hierbei auf die Konfiguration auf Rollen- und Projektebene. - Kriterien für Container-Management – Immer mehr Anwendungen laufen gekapselt in Containern. Weshalb auch immer mehr Unternehmen auf den Zug springen und dabei auf die Unterstützung von containerbasierten Laufzeitumgebungen zählen. Je besser die Anbindung zwischen einem CI/CD Tool und der Laufzeitumgebung ist, desto einfacher kann das Produkt dem Endkunden zur Verfügung gestellt werden. - Kriterien für Notifications & Monitoring „“ Schnelles Feedback ist ein wichtiges DevOps-Prinzip. Um ein schnelles Feedback zu erhalten, ermöglichen CI/CD Tools die Konfiguration von Notifications und die Überwachung (Monitoring) von Ereignissen und Abläufen. Bspw. kann eine Benachrichtigung über den Build-Status an ein ChatOps Tool versendet werden. Oder der Buildstatus wird zur Laufzeit visuell dargestellt. - Anderweitige Kriterien „“ Kriterien, die sich in den zuvor genannten Kategorien nicht widerspiegeln, aber dennoch zu einer Auf- oder Abwertung eines CI/CD Tools führen, sind in diesem Abschnitt aufgeführt. Wie z. B. die Erweiterbarkeit in Form von Plug-Ins oder der Support durch die Community. Resultierend kann der Kriterienkatalog für jedes CI/CD Tool verwendet werden, um eine solide Bewertung zu erhalten. Ergänzend zu den o. g. Kategorien, sind allerdings die spezifischen Anforderungen für eine Toolauswahl immer vorerst zu ermitteln. Die wesentlichen Bestandteile hierfür sind die eingesetzte Ausführungsumgebung, das Branching Modell, das Staging Konzept, die Teststrategie und die Organisationsstruktur. Diese können dann in weiteren Kategorien ergänzt werden. **Kategorien:** DevOps, Tools & Methoden --- ### [Usability-Tests "“ Empfehlung für die Praxis](https://thecattlecrew.net/2018/01/10/usability-empfehlung-fuer-die-praxis/) **Published:** Januar 10, 2018 **Author:** alexanderludwig **Excerpt:** Es gibt so viele Usability-Tests und die meisten haben bestimmt hier und da ihre Daseinsberechtigung, aber viele Tests können schnell teuer werden und bringen meist quasi keinen oder nur einen kleinen Nutzen. Welches Vorgehen eignet sich also für den täglichen Gebrauch? **Content:** „‹Heute wird so viel von Usability gesprochen und dass man überall Usability machen sollte, weil man damit alles etwas besser machen kann „¦ JA, stimmt „¦ und man sollte so viele Usability-Tests wie möglich machen, denn nur so kann man alle Fehler schnell finden „¦ OK, das würde ich so nicht unterstützen „¦ und außerdem bekommt man die Kosten, auch bei sehr vielen Tests, durch die verkürzte Entwicklungs- und Testzeit wieder rein „¦ OK, jetzt bin ich raus! Es gibt so viele Usability-Tests und die meisten haben bestimmt hier und da ihre Daseinsberechtigung, aber viele Tests können schnell teuer werden und bringen meist quasi keinen oder nur einen kleinen Nutzen. Oder bringen Verwirrung oder geben vielleicht sogar eine falsche Richtung vor. **Beispiel: EyeTracking** Die Personen sind alleine vor ihrem Rechner und arbeiten frei mit der Anwendung oder arbeiten Aufgaben ab. Jetzt schauen 2 oder 3 User der Gruppe häufig in dieselbe Ecke. OK, wir wissen jetzt, das der User in die Ecke schaut, aber warum können wir nur vermuten. Vielleicht ist da ein Icon was der Person gefällt oder sie an etwas erinnert, etwas das ihnen nicht gefällt „¦ Alles Vermutungen und vielleicht hat jeder einen anderen Grund“¦ In den meisten Fällen bringt dieser Test nur sehr wenig und Aufwand und Kosten sind recht hoch, weil es Zeit, Probanden und Ausstattung kostet. Hier sind ein paar Tests, die Sie als Grundlage nutzen sollten. Je nach Einsatzgebiet könne Sie diese Tests natürlich sinnvoll erweitern. Aber halten Sie die Menge der Tests möglichst klein. Für die Praxis empfehle ich 3 Schritte, die dann während der Entwicklung in einem Kreislauf durchlaufen werden können und auch sollten. 1. **Kundenworkshops** 2. **Mockups und Reduzierte Prototypen** 3. **Prototyp und Vereinfachte Benutzertests** ## 1. Kundenworkshops Einer der wichtigsten Punkte bei gutem Usability Engineering sollte immer der Kontakt mit dem Kunden bzw. dem wirklichen Endanwender sein. Auch wenn man glaubt die Probleme zu kennen, der Endanwender kennt sie immer etwas besser. **Erstkontakt und „Das Kind des Kunden“ erkennen“¦** Als ersten Kontakt zwischen Kunde und Usability Engineer sollte der Workshop das Mittel der Wahl sein und die Besetzung durch den Kunden sollte möglichst homogen sein. Haben Sie im Workshop nur Personen aus dem Management, bekommen Sie zwar einen guten Überblick über die Anforderungen, erkennen aber vielleicht nicht alle Probleme der täglichen Arbeit, die nur der Endanwender kennt. Bei Workshops in denen Sie die Probleme mit dem Kunden betrachten sollten die Lösungsvorschläge und Anforderungen auf rein fachlicher Ebene betrachten. Die Implementierung bzw. Umsetzung sollte in diesem Kontext nicht thematisiert werden! Als Außenstehender können Sie nicht einschätzen, ob es innerhalb des Kunden schon Meinungen für oder gegen eine Lösungsvariante gibt. Sollten Sie also so einen Punkt mit einer konkreten Umsetzungsmöglichkeit ansprechen, kann es schnell zu Diskussionen führen und der Workshop schnell in eine falsche Richtung gehen. Außerdem weiß der Kunde zwar oft was er will, aber nicht was er wirklich haben kann und was eigentlich möglich ist. Bei einem Workshop mit ihrem Kunden, kommt es in erster Linie darauf an zu erkennen was der Kunde will und wonach er sucht. Die meisten Kunden haben ein Problem das gelöst werden soll und dafür werden Sie gerufen! ## 2. Mockups und Reduzierte Prototypen Der nächste Schritt nach dem Workshop ist das Finden von potentiellen Lösungsmöglichkeiten. Da die möglichen Lösungen bisher nicht thematisiert wurden können Sie dem Kunden nun verschiedene Möglichkeiten aufzeigen. Häufig hat der Kunde zwar schon eine Vorstellung von dem was er haben möchte, aber eben nicht davon was er haben kann und was möglich wäre. Sie sollten dem User jetzt aber nicht nur Premiumlösungen zeigen, die später sein Budget sprengen. Erstellen Sie mehrere Varianten, damit der Kunde die für sich passende Lösung finden kann. Warum nur Mockups und Reduzierte Prototypen? Selbstverständlich macht ein Prototyp in Form eines professionellen Renderings oder gar in lauffähiger Form mehr her, aber bedenken Sie, dass Sie noch in der Phase der Lösungsfindung sind. Ein Prototyp sollte nur so konkret wie nötig sein. Zu viel Design lenkt von der Lösungsfindung ab und bietet Potential für die Diskussionen die nicht in den Kontext der Usability gehören. Das UX-Design ist ein Bereich der später einfließen kann und außerdem sind Mockups und Papierprototypen unschlagbar günstige Varianten, die zudem noch in Echtzeit änderbar sind. Besprechen Sie die Mockups mit dem Kunden und lassen Sie Wünsche oder Verbesserungen des Kunden in die Konzepte einfließen. Diese Absprachen sollten Sie solange wiederholen bis der Kunde zufrieden ist. Durch die vielen möglichen Ü„nderungszyklen zeigt sich wieder warum Mockups und Papierprototypen wesentlich billiger sind als Renderings oder lauffähige Prototypen. ## 3. Prototypen und vereinfachte Benutzertests Jetzt ist ein erstes Lösungskonzept mit dem Kunden abgestimmt und Sie können sich mit der Umsetzung der ersten lauffähigen Prototypen beschäftigen. Auch hier sollten Sie noch nicht zu viel Zeit in die Schönheit der Oberflächen investieren, denn Usability ist nicht „Schöne Masken und runde Ecken““¦ aber die Zeiten von Windows 98 sind auch vorbei! Bevor Sie mit der Implementierung starten ist es ratsam sich Aufgaben/Storys zu überlegen die die User später im Zuge der Benutzertests erledigen sollen. Hiermit legt man auch schon eine Reihenfolge für die Implementierung der Masken und Features fest. Wenn alle Masken und Features zu einer Aufgabe/Story implementiert sind wird es Zeit für die Tests mit Usern. Hier eigenen sich besonders die „Thinking Aloud Tests“ um schnelle und günstige Ergebnisse zu erzielen. Durch diese Art der Tests gewinnen Sie aber nur Erkenntnisse aus den subjektiven Eindrücken der User. Aussagen über Punkte wie z.B. Performance können hierbei nicht getroffen werden. Ein System sollte weitestgehend selbsterklärend sein, den User bei seiner Arbeit unterstützen und ihm Aufgaben abnehmen und genau zu diesen Punkten liefert dieser Test die nötigen Erkenntnisse. Da es die Nutzer meist nicht gewohnt sind alles zu kommentieren was Sie denken, startet ein Test meist schleppend und die Benutzer werden mit der Zeit auch wieder ruhiger oder verstummen. Um diesem Verhalten vorzubeugen kann es auch ein adäquates Mittel sein den Test mit 2 Usern pro System durchzuführen, da die User so in einen Gesprächsfluss kommen. Außerdem sollte ein Test immer anonym durchgeführt werden damit sich ein User sicherer fühlt. Der Usability Engineer macht sich während des gesamten Tests Notizen um die Aktionen und Auffälligkeiten zu protokollieren. Die so gesammelten Daten wertet der Usability Engineer später aus und die Erkenntnisse fließen zurück in die Lösungskonzepte, die wieder mit dem Kunden im Zuge von Workshops und Mockups besprochen werden. Wir wären also wieder bei den Workshops und der Kreislauf schließt sich. **Kategorien:** Development --- ### [Camunda Roadshow 2018 München - BPM und Microservices](https://thecattlecrew.net/2018/01/29/camunda-roadshow-2018-muenchen-bpm-und-microservices/) **Published:** Januar 29, 2018 **Author:** alexanderdaeubler **Content:** Am Freitag, den 19.01., war ich zusammen mit meinem Kollegen Stefan Frena zu Gast bei der Camunda Roadshow 2018 in München. Es wird langsam zur Tradition, dass das Camunda-Team Anfang des Jahres zwei Wochen lang durch ganz Deutschland (und natürlich auch Ü–sterreich und die Schweiz) zieht um in komprimierter Form (drei Stunden müssen reichen) den aktuellen Stand des Camunda Produktportfolios zu präsentieren. In letzter Zeit hört man immer öfter Aussagen wie „BPM ist tot, das macht heutzutage doch eh keiner mehr“; da stellt sich dann natürlich auch für uns als OPITZ Consulting die Frage, ob das denn eigentlich richtig ist und ob wir noch auf Camunda als Partner setzen sollten. Und auch wenn es auf den ersten Blick widersprüchlich wirkt: man muss beide Fragen mit einem klaren „Ja“ beantworten! Der Hype um BPM ist schon längst vorbei und viele Hersteller haben Probleme damit ihre BPM-Lösungen an den Kunden zu bringen. Diese suchen nämlich nach in jeglicher Hinsicht flexiblen Tools „“ sei es was das Lizenzmodell betrifft oder auch die Integrationsmöglichkeiten in ihre bestehende Enterprise-Architektur. Hier punktet Camunda ganz enorm: man kann es klassisch als Prozessengine auf dem Server laufen lassen aber auch als Modul mit in einen Microservice packen. Dazu gab es von Bernd Rücker, einem der beiden Mitbegründer von Camunda, eine beeindruckende Präsentation zu sehen. Und genau hier liegt dann auch aus unserer Sicht der Grund für den immer weiter zunehmenden Erfolg von Camunda: man will den Kunden keine Suite verkaufen auf der alle Geschäftsprozesse eines Unternehmens laufen sollen (Stichwort: Enterprise BPM). Da wurde in der Vergangenheit in vielen Firmen erst mal sehr viel Geld investiert um dann auf halber Strecke stehen zu bleiben. Vielmehr sollte man Camunda als Baustein sehen den man individuell in seiner Architektur verwenden kann „“ sobald man es mit einem Workflow zu tun hat dessen Zustand gespeichert werden muss, lohnt es sich an Camunda zu denken. Wer das Thema vertiefen will: unter findet man beispielsweise einen Artikel von Bernd Rücker in dem er erläutert wie man Stateless Functions durch die Verwendung von Camunda orchestrieren kann – es muss ja schließlich eine Instanz geben, die das Wissen hat, in welcher Reihenfolge diese Funktionen gerufen werden und was passieren soll wenn beispielsweise mal bei einem Aufruf ein Fehler passiert. Sehr empfehlenswert! Diesen technischen Exkurs in Richtung Microservices fand ich wie schon erwähnt superinteressant. Der Rest der Agenda zielte dann eher auf die Besucher aus den Fachbereichen ab: hier waren einige Vertreter von Firmen vor Ort, die noch gar keine Prozesslösung im Einsatz haben aber aktuell drüber nachdenken es zu tun. Hier schlummert also definitiv noch jede Menge Potential, das wir als seit dem Sommer 2017 offiziell zertifizierter Camunda Partner gerne angehen werden. Was lässt sich nun zusammenfassend sagen? Vielen Dank an das Camunda-Team für eine wie immer super organisierte und sehr gut besuchte Veranstaltung. Wir werden auch im kommenden Jahr wieder gerne dabei sein! **Kategorien:** Architecture & Process Models, Tech Events & Networking **Schlagwörter:** BPM, Camunda, Microservices --- ### [Coding Dojo am 01.02.2018 an der TH Köln in Gummersbach](https://thecattlecrew.net/2018/01/23/coding-dojo-am-01-02-2018-an-der-th-koeln-in-gummersbach/) **Published:** Januar 23, 2018 **Author:** Christian Olsson **Content:** ![Programmierabend180122](https://thecattlecrew.net/wp-content/uploads/2018/01/programmierabend180122.png) Wir laden euch ein zum ersten Coding Dojo in diesem Jahr an der TH Köln am Campus Gummersbach. Thema wird diesmal wieder das Lösen einer Coding Kata sein, um daran die eigenen Programmierfertigkeiten auf die Probe zu stellen und zu verbessern. Welche Technologie dabei verwendet wird, ist jedem freigestellt. Wir beginnen um 18 Uhr in Raum 0.503 im Neubau, dauern wird der Abend etwa zwei Stunden. Für das leibliche Wohl ist selbstverständlich gesorgt. Bei Interesse meldet euch bitte bei mir persönlich per E-Mail an: **Kategorien:** Development, Tech Events & Networking --- ### [Orcas @ REAL](https://thecattlecrew.net/2018/02/23/orcas-real/) **Published:** Februar 23, 2018 **Author:** Torsten Jaeschke **Content:** On January 17th, I had the opportunity to introduce our open source schema management tool for Oracle databases [Orcas](http://opitzconsulting.github.io/orcas/) to an audience of the [Red Expert Alliance (REAL)](https://www.redexpertalliance.com/). Orcas is an acronym for Oracle adaptive schemas and offers the possibility to manage the structural data of an Oracle database in an infrastructure as code approach, but I won“™t reveal too much but recommend the video below too you for further information. \[youtube https://www.youtube.com/watch?v=X0VGtG705YU?rel=0&w=560&h=315\] **Kategorien:** Infrastructure, Tools & Methoden --- ### [Coding Dojo am 19.04.2018 an der TH Köln in Gummersbach](https://thecattlecrew.net/2018/04/03/coding-dojo-am-19-04-2018/) **Published:** April 3, 2018 **Author:** Christian Olsson **Content:** ![Programmierabend-20180419](https://thecattlecrew.net/wp-content/uploads/2018/04/programmierabend-20180419.png) Wir laden wieder ein zum Coding Dojo an der TH Köln am Campus Gummersbach. Thema des Abends ist dieses Mal „Wie setze ich ein Projekt richtig auf? Ein vertikaler Schnitt“. Wir werden mit Euch von Grund auf ein neues Projekt für eine grafische Java-Anwendung aufbauen und dabei auf Projektverwaltungs-Tools wie Maven, Gradle und Git eingehen. Wir beginnen um 18 Uhr in Raum 0.503 im Neubau, dauern wird der Abend etwa zwei Stunden. Für das leibliche Wohl ist selbstverständlich gesorgt. Bei Interesse meldet euch bitte per E-Mail an: **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** Coding Dojo --- ### [Bewertung des CI/CD Tool Jenkins](https://thecattlecrew.net/2018/04/09/bewertung-des-ci-cd-tool-jenkins/) **Published:** April 9, 2018 **Author:** Serdar Nurgün **Content:** **Teil 2 der Serie** Nach der Definition eines Kriterienkatalogs im ersten Teil der Serie (https://thecattlecrew.net/2017/11/28/kriterien-fuer-die-bewertung-von-ci-cd-tools/) beginnt nun die Bewertung der CI/CD Tools. Ich fange mit Jenkins an, welches als das Tool mit der größten Verbreitung unter den CI/CD Tools gilt. Bekannt ist es vor allem durch die populäre Erweiterbarkeit mit Plugins. Bei Jenkins handelt es um ein in Java geschriebenes Tool, dass unter der MIT-Lizenz verfügbar ist. Darauf folgen unter anderem Bewertungen der CI/CD Tools GitLab CI und Concourse CI. **Skalierung** Jenkins ermöglicht durch die Unterstützung von Remote-Agents die Skalierung der Ausführung auf mehreren Maschinen. Die Maschinen werden als Slaves bezeichnet. Mit den Slaves wurde die Distributed Architecture eingeführt, die es ermöglicht, mehrere Slaves anzulegen und diese mit dem Master zu verbinden. Dadurch kann die Ausführung von Jobs auf die Slaves verteilt werden, um die Abarbeitung von Jobs zu beschleunigen. Es gibt verschiedene Varianten diese zu starten. Dazu zählen *via SSH*, *on Windows*, *own Script*, *via Java Web Start* und *headlessly*. Die Slaves können on-premises betrieben oder über eine SaaS-Lösung wie Cloudbees in Anspruch genommen werden. Weitere Details sind unter den folgenden Links zu finden: **Build-Möglichkeiten** Jenkins bietet mit Distributed Builds, Parallel Builds und Triggered Builds eine Vielzahl an Build-Möglichkeiten. Bei Distributed Builds handelt es sich um die Verteilung von Build Jobs auf mehreren Servern. Ein Knoten beinhaltet dabei eine alleinstehende Installation des Masters vom Jenkins, der alle Aufgaben für das Build System steuert. Meistens werden dazu, wie im vorherigen Abschnitt erwähnt, auf anderen Systemen sogenannte Slaves aufgesetzt, auf die man die Aufgaben verteilen kann. So wird vermieden, an die Grenzen der Maschine zu kommen, auf der der Master installiert ist. Damit übernimmt der Master lediglich die Steuerung und baut die Builds nicht selbst. Das Bauen der Builds übernehmen die Slaves. Aber auch Parallel Builds, bei denen parallele Stages ausgeführt werden können, werden durch die Jenkins Pipeline ermöglicht. Ein gutes Beispiel hierfür wäre das Parallelisieren von Tests, um JUnit-Tests parallel mit Integrationstests durchzuführen. Zu guter Letzt gibt es natürlich auch noch die Möglichkeit, Builds über Trigger anzustoßen. Es kann zum Beispiel eingestellt werden, dass ein Build in Abhängigkeit von dem Ergebnis eines anderen Builds ausgeführt werden soll. Weitere Details sind unter den folgenden Links zu finden: https://wiki.jenkins.io/display/JENKINS/Distributed+builds https://wiki.jenkins.io/display/JENKINS/Pipeline+Plugin **Rechteverwaltung von Benutzern und Gruppen** Jenkins bietet per Default keine Unterstützung für die Rechteverwaltung auf Rollen- oder Projektebene an. Doch wie Sie vielleicht bereits erahnen können, gibt es auch hierfür ein Role Strategy Plugin, mit dem man globale Rollen wie Admin oder Job Creater definieren kann. Aber auch die Erstellung von Projektrollen, die nur auf Projektbasis Jobs anlegen und ausführen können, ist mit dem Plugin möglich. Es ist zu empfehlen, diese Form der Rechteverwaltung nur zu nutzen, wenn es der Use Case wirklich erfordert, da diese sehr flach und einfach gehalten ist. Weitere Details sind unter den folgenden Links zu finden: **Container Management** Es gibt in Jenkins keine native Container Unterstützung. Konkret gibt es für die Container Engine aber Support durch ein entsprechendes Plugin. Dazu muss das Docker Plugin installiert werden, um dann mit Jenkins einen Docker Host zu kontrollieren, der wiederum Builds in Form von Containern anstoßen kann. Eine Möglichkeit wäre die Nutzung einer externen Registry, wie z.B. der Service EC2 Container Registry von Amazon, in Jenkins zu integrieren. Aus eigener Erfahrung weiß ich, dass ein erfolgreicher Build über Jenkins nicht unbedingt bedeutet, dass der Docker Container fehlerfrei läuft. Um sicherzugehen, dass der Jenkins-Container wirklich fehlerfrei läuft, wären zusätzliche Überprüfungen notwendig. Weitere Details sind unter den folgenden Links zu finden: **Notifications und Monitoring** Das Notification-Plugin erlaubt es, Job Status Notifications im JSON und XML Format zu versenden. Dabei können das Format (JSON/XML), das Protokoll (HTTP, TCP, UDP), das Event (Job started, Job completed, all events), die URL, an die versendet werden soll, und ein Timeout angegeben werden. Diese werden dann per E-Mail zugestellt, wozu natürlich vorher ein SMTP-Server konfiguriert werden muss. Neben der E-Mail sind noch weitere Wege möglich, um über Ereignisse zu informieren. Dazu gehören zum Beispiel Notifications über Slack, Rocket.Chat, Telegram und vieles mehr. Da Jenkins Open-Source ist, sind viele Kanäle bereits durch Plugins abgedeckt oder werden in Zukunft noch abgedeckt. Wie für die Notifications existiert auch für das Monitoring ein Plugin, bei dem per Default JavaMelody verwendet wird. Java Melody ist ein Monitoring-Framework für Java oder JavaEE Applikationen, mit dem sehr viele Details grafisch in Form von Charts angezeigt werden können. Neben JavaMelody gibt es auch noch andere Möglichkeiten. Weitere Details sind unter den folgenden Links zu finden: **Anderweitige Evaluierung** Durch die hohe Anzahl an Plugins ist die Flexibilität des Tools sehr hoch und damit auch sein Funktionsumfang. Jedoch ist hier Vorsicht geboten, weil viele Plugins unter Umständen nicht aktuell sind und damit sicherheitstechnische Lücken beinhalten können. Zudem machen es Plugins dem Anwender schwer, zu erkennen, ob ihr Einsatz für ein bestimmtes Szenario sinnvoll ist oder nicht. Ein Blick in den Issue Tracker vom Jenkins, der einmal für den Jenkins selbst existiert aber auch für jedes einzelne Plugin kann dabei helfen, zu erkennen, ob ein Plugin sehr veraltet ist oder ob es regelmäßig aktualisiert wird. Wichtig dabei ist eine gute Dokumentation, die von Jenkins leider nicht an allen Stellen gegeben ist. Zum Jenkinsfile zum Beispiel fehlen in der offiziellen Dokumentation Befehlsreferenzen. Wenn man sich auf die Suche nach diesen macht, landet man also schnell im Source Code. Nichts desto trotz ist Jenkins sehr weit verbreitet. Die zahlreichen Erweiterungen in Form von Plugins und auch der Open-Source-Faktor spielen dabei eine sehr große Rolle. Dazu steht eine starke und hilfsbereite Community hinter Jenkins, weswegen ein gewisser Coolness Faktor gegeben ist. Bei Problemen kann man sich über GitHub an die Community wenden und erhält bereits nach kurzer Zeit Antworten. **Continuous Delivery** Die Einführung der Jenkins Pipeline DSL ermöglicht es den Benutzern, Pipeline as Code zu verwenden. Dabei werden mehrere Stages in einem Jenkinsfile definiert, dass wiederum als Code neben dem eigentlichen Code gesehen wird. In dem Jenkinsfile können dann Stages wie Build, Test oder Upload definiert werden, die alle erfolgreich verlaufen müssen, damit die Pipeline als erfolgreich angesehen wird. Dadurch ist eine hohe Flexibilität gegeben und die Unterstützung für Continuous Delivery gewährleistet. Weitere Details sind unter den folgenden Links zu finden: **Kosten** Zu guter Letzt kommen wir zu den Kosten. Dabei wurde als Faktor ein Entwicklerteam von 30 Entwicklern ausgewählt. Da es sich bei Jenkins um ein Open-Source-Tool handelt, entstehen on-premises keinerlei Kosten bei der Nutzung des Tools. Dies gilt auch für die Remote Agents, die man on-premises ausführt. Um einen Vergleich zu erhalten, wurde der Software as a Service Anbieter CloudBees ausgewählt, der eine Lösung für Jenkins bereitstellt. Leider müssen in dem Fall die Preise individuell angefragt werden, da mehr Faktoren als die Größe des Teams in den Preis einfließen. **Fazit** Jenkins bietet als Open-Source-Tool sowohl für den Continuous Integration als auch für den Continuous Delivery Bereich eine Vielzahl an Unterstützungsmöglichkeiten. Dies wird vor allem durch die hohe Anzahl an Plugins gewährleistet. Diese hohe Flexibilität spricht für das Tool und macht Jenkins auch in Zukunft zu einem einsetzbaren Kandidaten für Projekte. Das Plugin-Ü–kosystem ist aber auch zugleich die Kehrseite der Medaille. Es spricht sehr stark gegen das Prinzip des Single Source of Truth und erschwert die Update Strategie, weil die Kompatibilität zwischen den Plugins und Jenkins sichergestellt werden muss. Dazu kommt der initial sehr verwirrende administrative Aufwand, der zu einem hohen Einarbeitungsaufwand führt. Nichts desto trotz ist Jenkins ein mächtiges Tool, das dem Entwickler immer noch sehr viele Möglichkeiten bietet.. **Kategorien:** DevOps, Tools & Methoden --- ### [Automatisierung von fachlichen UI-Tests mit Selenium (1/2)](https://thecattlecrew.net/2018/07/24/automatisierung-von-fachlichen-ui-tests-mit-selenium-1-2/) **Published:** Juli 24, 2018 **Author:** Ferhat Göcer **Content:** Mit der zunehmenden Agilität in der Softwareentwicklung und somit immer kürzeren Entwicklungszyklen sind manuell durchgeführte Oberflächentests oft nicht mehr umfassend möglich oder wirtschaftlich angemessen. Die automatisierte Ausführung dieser Tests nimmt deshalb in Unternehmen eine zunehmend wichtige Stellung ein. Automatisierte Oberflächentests bringen dort den größten Nutzen, wo früher manuelle Tester mühselig nach einem vorgegebenen Testplan die Software (teilweise mehrfach auf unterschiedlichen Umgebungen) abgeklickt und geprüft haben. Sie eignen sich jedoch nicht unbedingt dazu, die subjektiven Eigenschaften einer Software zu testen, sprich den menschlichen Umgang damit (Usability / User Experience). ## Die Vorteile von Testautomatisierung Die Umstellung von manuellen auf automatisierte Oberflächentests kann und sollte nicht beiläufig passieren, da sie einen großen Initial- und laufenden Pflegeaufwand benötigt. Dieser Aufwand zahlt sich jedoch langfristig nicht nur monetär, sondern auch qualitativ aus und legt die Basis für eine gute und beständige Softwarequalität. Die Testautomatisierung hilft nämlich nicht nur dabei, die Oberflächentests ressourcenschonend und beliebig oft wiederkehrend ausführbar zu machen, sie hilft auch dabei, menschliche Fehler, die beim manuellen Testen entstehen können, zu reduzieren und je weniger Fehler die Software hat, desto glücklicher sind die Kunden. Außerdem sind die Fachexperten, die vorher manuelle Tests durchführten, es nicht mehr leid, in einer hoch monotonen Folge Testpläne abzuarbeiten. Sie haben nun mehr die Möglichkeit, neu hinzugekommene Funktionen ausgiebig zu testen oder tiefer gehende User Experience-Analysen durchzuführen, um die Erwartungshaltung der Kunden an die Software zu erfüllen oder sie möglicherweise sogar darüberhinaus zu begeistern. Auch erfahren die Softwareentwickler eine wunderbare Unterstützung bei ihrer Entwicklungsarbeit: Durch die Einbindung der Testautomatisierung in ihre Continuous Integration bzw. Delivery Pipeline erhalten sie ständiges Feedback über den Zustand der entwickelten Software und ihrer Codeänderungen, und somit mögliche Anknüpfungspunkte für die Fehlersuche und die anschließende Fehlerbehebung. Spezielle Test-Frameworks unterstützen die Realisierung automatisierter Oberflächentests sehr gut. Bis auf einige Ausnahmen sind die meisten dieser Frameworks jedoch kostenpflichtig und teilweise auch komplex in der Handhabung bzw. Integration in die eigene IT-Landschaft. ## Selenium: Einfach handhabbar und kostenfrei In diesem Artikel stelle ich euch deshalb das einfach handhabbare und kostenfrei unter der Apache-2.0-Lizenz veröffentlichte Framework [*Selenium*](https://www.seleniumhq.org/) vor, das sich insbesonders für die Automatisierung browserbasierter Oberflächentests eignet. Weitere OpenSource-Projekte wie *[Appium](http://appium.io/)* oder *[Protractor](https://www.protractortest.org/)* bauen ebenso auf *Selenium* auf und ermöglichen die Testautomatisierung von nativen und hybriden mobilen Apps. Auf diese Erweiterungen wird hier nicht weiter eingegangen. Ich persönlich habe *Selenium* mittlerweile in drei Softwareprojekten erfolgreich eingeführt, eingesetzt bzw. erweitert und bin von seinem funktionellen Umfang und der einfachen Bedienbarkeit begeistert. Auch höre ich immer wieder im Austausch mit Kollegen, dass sich Erfolgserlebnisse sehr schnell einsetzen und es auch ihnen auf Dauer richtig Spaß macht, mit *Selenium* eigene Oberflächentests zu entwickeln. Letztere Punkte sind eigentlich schon Gründe genug, sich dieses Framework näher anzuschauen, da die Akzeptanz bei denen, die sich täglich damit beschäftigen müssen, für den Erfolg einer Automatisierungsstrategie entscheidend ist. *Eine kleine Randnotiz: Die nachfolgenden Quellcode-Beispiele basieren auf Java und die weiteren Beschreibungen sowie die Namensgebung beziehen sich auf den Versionsstand 3.x von Selenium. Diese Information ist wichtig, da Selenium 1 mit dem mittlerweile „deprecated“-Modul „Selenium RC“ architektonisch anders und im Vergleich weniger performant und unflexibler aufgesetzt war.* ## Die Architektur bietet eine hohe Flexibilität Die große Akzeptanz und der Erfolg von *Selenium* liegt neben der OpenSource-Veröffentlichung sicher auch darin begründet, weil damit auf den gängigsten Betriebssystemen (*Windows*, *Linux* und *OS X*) sowie den am meist verbreitetsten Browsern (*Mozilla Firefox, Internet Explorer, Google Chrome, Opera, Safari*, etc.) Oberflächentests durchgeführt werden können. Darüberhinaus bietet es die Flexibilität, die Testskripts in beliebigen und unterschiedlichen Programmiersprachen (auch innerhalb desselben Projekts) zu erstellen und diese durch den *Selenium WebDriver* in ausführbare Tests übersetzen zu lassen. Seit der Version 2 wurde mit *Selenium Grid* außerdem die Möglichkeit der parallelen und verteilten Ausführung der Testskripts geschaffen. Dieser neue Ansatz ermöglicht neben hoher Testdurchsätze auch die Sicherstellung einer hohen Verfügbarkeit der Testsysteme. ## Selenium im praktischen Einsatz Die Einbindung von Selenium, bspw. in ein Java-Projekt erfolgt ganz einfach über [Maven](https://docs.seleniumhq.org/download/maven.jsp). Jedes Testvorhaben startet dann mit der Erstellung eines Testskripts. Ein Testskript kann u.a. mit dem Testframework *JUnit* erstellt werden und enthält neben den Testbefehlen, auch die anschließende Evaluierung der Ergebnisse. Die Testbefehle beschreiben die gewünschten Nutzeraktionen, die *Selenium* später auf der Anwendung, dem Testobjekt, simulieren soll. Die für das Testskript verfügbaren Testbefehle werden dabei vom entsprechenden *Client API* gezogen, das für die gängigsten Programmiersprachen bereitgestellt wird. Gängige Praxis ist aber auch, dass das Testskript mit einem PageObject interagiert, das eine bestimmte Seite der Anwendung repräsentiert und die für diese Seite notwendigen WebDriver-Funktionalitäten in sich kapselt ([weiterführende Infos zum PageObject-Pattern](https://github.com/SeleniumHQ/selenium/wiki/PageObjects)). ### Selenium IDE An dieser Stelle wollen wir es nicht unerwähnt lassen: Für die Erstellung der Testbefehlsketten gibt es nämlich auch ein semi-hilfreiches Tool namens *Selenium IDE*, welches eigentlich ein Add-On für die Browser [Firefox ](https://addons.mozilla.org/en-US/firefox/addon/selenium-ide/)und [Chrome ](https://chrome.google.com/webstore/detail/selenium-ide/mooikfkahbdckldjjndioackbalphokd)ist. Dieses Add-On kann die auf der zu testenden Anwendung ausgeführten Aktionen aufzeichnen, wieder abspielen und als generisches Testskript bereitstellen. Es ist somit eine Art Makro-Editor für browserbasierte Anwendungen und stellt kein Tool dar, das die Testautomatisierung steuert und verwaltet (wie der Name vielleicht vermuten ließe). Im Alltag wird der ein oder andere Entwickler deshalb möglicherweise schnell merken, dass er mit dem Tool auf seine Grenzen stößt. Es hilft einem jedoch dabei, einen ersten Wurf eines Testskripts zu erstellen, anschließend in eine der unterstützen Programmiersprachen zu exportieren und im eigenen IDE weiter zu verfeinern. ### Selenium WebDriver Bei der Ausführung eines Testskripts werden die einzelnen Befehle, die normalerweise ein manueller Tester ausführen würde, vom *Selenium WebDriver* peu Ü peu interpretiert und über den Browser in die entsprechenden Aktionen in der Anwendung umgesetzt. Die einzelnen *WebElemente* in der Anwendung werden dabei zuerst über unterschiedliche Wege lokalisiert (FindBy-Methoden, u.a.). Auf diesen Elementen können dann abhängig vom Elementtypen unterschiedliche Aktionen ausgeführt werden. Beispiel: Die zu testenden Elemente werden in der Anwendung lokalisiert \[1,4\] und anschließend werden darauf Aktionen ausgeführt \[2,3,5\]. ``` [1] WebElement element = driver.findElement(By.name("elementID")); [2] element.click(); [3] element.sendKeys("MyUsername"); [4] WebElement submitElement = driver.findElement(By.id("submit")); [5] submitElement.click(); ``` Die obigen Zeilen in Worten ausgedrückt: „Lokalisiere das Element mit dem Attributsnamen ‚elementID‚, klicke in das Element und gebe darin den Text ‚MyUsername‘ ein. Lokalisiere danach das Element mit der ID ’submit‘ und klicke darauf.“. Um dem Test noch einen Sinn zu verleihen, müsste eigentlich anschließend noch eine Prüfung (z.B. über [Assertions](http://junit.sourceforge.net/javadoc/org/junit/Assert.html)) eingebaut werden, ob beispielsweise der User erfolgreich eingeloggt werden konnte. Der *Selenium WebDriver* wird also vom *Client API* angesprochen und ist eigentlich selbst eine API, das in mehreren Implementierungen zur Verfügung steht. Es gibt für jeden unterstützten Browser eine spezifische Implementierung des *WebDriver*-Interfaces, die mit seinem jeweiligen Counterpart interagieren kann. Der große Vorteil dieses API-Designs ist, dass ein Testskript, geschrieben in einer beliebigen Programmiersprache, alle verfügbaren *WebDriver*-Implementierungen bedienen kann. Ein einziges Testskript kann also auf allen vorgesehenen Browsern und Browserversionen ausgeführt werden (Cross Browser Testing). ### Lokal testen ![localSelenium](https://thecattlecrew.net/wp-content/uploads/2018/07/localselenium5.png)Lokal testen mit Selenium *Selenium* unterstützt neben der ferngesteuerten (remote) auch die lokale Ausführung der Oberflächentests, z.B. auf dem eigenen Entwicklerrechner. Vorausgesetzt, die zu testende Anwendung ist über diesen Rechner erreichbar (ggf. auch mit einer HTTP-Authentifizierung, die unterstützt wird). Dabei spricht das Testskript/Client API direkt mit dem *Selenium WebDriver*, dessen entsprechende Implementierung wiederum den lokal installierten Browser startet und ihn steuert. Ein *Selenium Server* muss für lokal ausgeführte Tests nicht mehr aufgesetzt werden *(im Vergleich zu Version 1 von Selenium, wo das Selenium RC-Modul, den Browser fernsteuerte und, egal ob lokal oder remote, nur über einen laufenden Selenium Server angesprochen wetrden konnte).* ### Remote, verteilt und parallelisiert testen Noch spannender wird die Sache jedoch, wenn eine verteilte und parallelisierte Lösung für die Testautomatisierung angestrebt wird. Im [zweiten Teil](https://thecattlecrew.net/2018/08/01/automatisierung-von-fachlichen-ui-tests-mit-selenium-2-2/) dieser Artikelreihe gehen wir deshalb auf das interessanteste Feature von *Selenium* ein: dem *Selenium Grid*. **Kategorien:** Automation, Development, Tools & Methoden --- ### [Automatisierung von fachlichen UI-Tests mit Selenium (2/2)](https://thecattlecrew.net/2018/08/01/automatisierung-von-fachlichen-ui-tests-mit-selenium-2-2/) **Published:** August 1, 2018 **Author:** Ferhat Göcer **Content:** Im [ersten Teil](https://thecattlecrew.net/2018/07/24/automatisierung-von-fachlichen-ui-tests-mit-selenium-1-2/) unserer Artikelreihe haben wir euch die Vorteile automatisierter Oberflächentests, die Besonderheiten des Test-Frameworks *Selenium* sowie das Vorgehen damit beim lokalen Testen dargelegt. Für weniger anspruchsvolle Zwecke sollte das bis dahin vermittelte Wissen auch ausreichend sein, um im kleinen Rahmen schnell und einfach eine erste Lösung aufzusetzen. Das volle Potenzial der Testautomatisierung kann sich jedoch erst in einem *Selenium Grid* am besten entfalten. Damit wird nämlich auch eine saubere Lösung in Richtung Continuous Delivery möglich. ## Mit Selenium Grid verteilt und parallelisiert testen Die *Selenium Grid*-Architektur baut im Prinzip auf einen Proxy-Ansatz auf, der vereinfacht ausgedrückt, die Weiterleitung der Tests von einem Punkt an entfernt liegende Punkte ermöglicht. Das Ziel dahinter ist, eine einfache Möglichkeit zu bieten, Tests verteilt und auf mehreren Rechnern parallel ausführbar zu machen. ### Hub + Node(s) = Selenium Grid Im *Selenium Grid* gibt es dazu die beiden Rollen Hub und Node, die ihre entsprechende Rolle beim Start einer *Selenium*-Instanz zugeteilt bekommen. Ein *Selenium Hub* wird dabei mit mehreren *Selenium Nodes* zu einem Grid zusammengefasst. Der Hub ist der verwaltende Teil des Grids, d.h. er vermittelt die an ihn zugetragenen Testskripte ressourcen- und bedarfsgerecht an die ihm bekannte Nodes. Die Nodes wiederum führen die vom Hub übermittelten Testskripte aus. Vorher jedoch registriert sich jeder Node direkt am Hub und teilt seine individuelle Testkonfiguration mit, wie z.B. welchen Browser und Browserversion er unterstützt oder welches Betriebssystem darauf installiert ist (siehe nachfolgende Abbildung). ![Selenium Grid](https://thecattlecrew.net/wp-content/uploads/2018/07/seleniumhubnodes1.png)*Verteiltes und parallelisiertes Testen mit Selenium* Dieser Architekturansatz hat zudem den Vorteil, dass die Testkonfigurationen aus dem direkten Umfeld der Testskripte gelöst zentral an einer Stelle (Hub) verwaltet werden. Das sorgt nicht nur für eine saubere Trennung, sondern die Testskripte lassen sich gleichzeitig auf einer Vielzahl von unterschiedlichen Umgebungen ausführen. ### Der Allrounder unter den WebDrivern: RemoteWebDriver Beim lokalen Testen mit *Selenium* interagieren die Testskripte unter Verwendung eines browserspezifischen *WebDrivers* (*FirefoxDriver*, *ChromeDriver*, etc.) direkt mit dem dazugehörigen Browser und der vorgegebenen Testkonfiguration. In einem *Selenium Grid* bedient man sich jedoch der konkreten *WebDriver*-Implementierung *RemoteWebDriver*. Dieser steht zusätzlich zu den übrigen *WebDriver*-Implementierungen zur Verfügung und bietet als einziger *WebDriver* die Möglichkeit, Testskripte ferngesteuert auf beliebig vielen und unterschiedlich konfigurierten Testrechnern ausführen zu lassen. Damit lassen sich nicht nur der Hub in einem Grid ansprechen, sondern auch verteilte Container-Lösungen (wie Docker) oder ein externer Testrechner, der sich nicht in einem Grid befindet. ### Die Funktionalität im Überblick Wie bereits beschrieben, interagieren die Testskripte mit dem Hub mittels des speziellen *RemoteWebDriver*. Vor jedem Testlauf kann der Hub anhand einer zusätzlich übergebenen [DesiredCapabilities](https://seleniumhq.github.io/selenium/docs/api/java/org/openqa/selenium/remote/DesiredCapabilities.html)-Klasse erkennen, welche Anforderungen ein Testskript an die Testrechner-Konfiguration hat, auf dem es laufen soll. Auf Basis dieser Informationen sucht der Hub unter den bei ihm registrierten Nodes (sowie deren mitgeteilten Konfigurationen) nach den angeforderten „Capabilities“ und findet hoffentlich einen Node, der diese erfüllen kann. Danach läuft alles wie gehabt. Der Hub übermittelt die vom Testskript erhaltenen Testbefehle an den Node, worauf der Node über den bei ihm laufenden browserspezifischen *WebDriver* die Befehle im entsprechenden Browser ausführt. ## Selenium Grid im CI-Prozess Ebenso werden auf die Funktionalitäten des *Selenium Grids* zugegriffen, um die automatisierten Oberflächentests in den Entwicklungsprozess einzubinden. Im weit verbreiteten CI-Tool *[Jenkins](https://jenkins.io/)* kann ein solcher CI-Grid mit Hilfe eines OpenSource [Plug-Ins](https://plugins.jenkins.io/selenium) eingerichtet werden. Das Plug-In richtet auf dem *Jenkins*-Server ein *Selenium Grid* ein und erstellt gleichzeitig auf dem *Jenkins-Master* einen Hub*.* Die Installation stößt man einfach über die *Jenkins*-Weboberfläche („Manage Jenkins / Manage Plugins“) an. Nach erfolgter Installation erscheint die Erweiterung in der Seitenleiste des *Jenkins*-Dashboards. Mit einem Klick darauf erhält man Informationen über den aktuellen Status des Hubs, wie z.B. erfolgte Konsolenausgaben oder einen Überblick über die Nodes, die sich am Hub registriert haben. Auch findet man dort die *WebDriver*-URL, von den Testskripten für Testläufe genutzt werden muss, damit diese im CI-Grid laufen können. Zudem bietet die Erweiterung die komfortable Möglichkeit, *Jenkins*-Slaves direkt über die *Jenkins*-Weboberfläche zu Nodes zu konfigurieren und diese über wenige Klicks dem Grid hinzufügen. Die Konfigurationsmöglichkeiten eines Nodes können auf der *Jenkins*-Weboberfläche teilweise limitierend sein (bspw. weniger Browserauswahl). Mit einer selbst erstellten *JSON*-Datei, die als Konfiguration herangezogen wird, kann die Konfiguration eines Nodes individuell festgelegt werden. Heutzutage werden Testrechner zumeist auch außerhalb der CI-Infrastruktur aufgesetzt, die nach Bedarf angefordert werden (z.B. in der Cloud). In diesen und ähnlichen Fällen müssen die externen Nodes sich eigenständig direkt am CI-Hub registrieren. ## Fazit Nun haben wir viel von Testautomatisierung geschwärmt. Doch eines muss festgehalten werden: Das manuelle Testen sollte nicht komplett aufgeben werden. Stattdessen sollte dieser wichtigen Tätigkeit in der Qualitätssicherung ein höherer Sinn verliehen werden. Dies kann beispielsweise dadurch geschehen, in dem vorhandene Skills in interessanteren und wertschaffenderen Aufgaben eingesetzt werden wie Usability Testing, User Experience Analysen, Testfalldesign, etc. Denn für stupide, monotone Tätigkeiten kosten diese Spezialisten enorm wichtige Ressourcen: Zeit, Geld und Nerven. Wenn also Software routiniert und immer wieder auf die exakt gleiche Art und Weise auf mögliche Fehler geprüft werden soll, sind automatisierte Tests unschlagbar. Sie sind nicht nur schneller, beständiger und langfristig ressourcenschonender, sondern im Vergleich zum manuellen Testprozess exakt und beliebig oft wiederholbar und entsprechen genau den Anforderungen der immer kürzer werdenden Entwicklungszyklen. Diese Artikelreihe sollte daher aufzuzeigen, wie einfach Testautomatisierung mit *Selenium* möglich ist. Das Ziel war dabei nicht nur einen kompakten Überblick über die Thematik zu geben, sondern auch dafür zu sorgen, ein umfassendes Verständnis des *Selenium*-Konzepts zu vermitteln, um schlussendlich euch zu motivieren, den ersten Schritt auf dem Weg zu automatisierten Oberflächentests zu machen. In diesem Sinne: Frohes Testen! **Kategorien:** Automation, Development, Tools & Methoden --- ### [OC|Expert Camp Machine Learning auch in Essen ein voller Erfolg](https://thecattlecrew.net/2018/09/07/ocexpert-camp-machine-learning-auch-in-essen-ein-voller-erfolg/) **Published:** September 7, 2018 **Author:** Thomas Temme **Content:** Nachdem das OC|Expert Camp zum Thema Machine Learning in München ein voller Erfolg war [(The Cattle Crew berichtete)](https://thecattlecrew.net/2018/08/10/computer-ist-das-eine-katze), kam der Entschluss auf, dieses Erfolgsmodell auch in andere Niederlassungen zu exportieren. So fand am 18. August der HackAirThon in unserer Essener Niederlassung statt. Organisiert wurde es von Pascal Stieber, Serdar Nurgün, Hannes Olivier, Tomasz Krajewski, Falk Ißmer und Thomas Temme. Dank dem guten Wetter störte es auch garnicht, dass es mit circa 40 Leuten recht voll war, da sich ein Großteil der Teilnehmer zum Coding nach draußen in den Innenhof zurückziehen konnte: ![Bestes Wetter und gute Laune](https://thecattlecrew.net/wp-content/uploads/2018/09/dk3-gc8x0aahgqj.jpg) *Dank bestem Wetter wurde der HackAIRthon seinem Namen gerecht* Nach einem ausgiebigen gemeinsamen Frühstück und einer kurzen Einführung in Machine & Deep-Learning ging es auch schon mit dem Coding los. Genau wie beim Hackathon in München war die Challenge ein neuronales Netz zu entwickeln, welches mit möglichst hoher Genauigkeit Bilder von Hunden und Katzen unterscheiden kann. Diesmal kam anstelle von TensorFlow mit Python jedoch Deeplearning4j mit Java zum Einsatz. Deeplearning4j bietet eine sehr gute Anbindung an Frameworks wie Apache Spark, Kafka und Hadoop und bietet sich daher insbesondere für den Einsatz im Enterprise-Umfeld, auf Rechenclustern und der Cloud an. Da für rechenintensive Operationen per JNI Interfaces auf native Bibliotheken zurückgegriffen wird, gibt es keine Geschwindigkeitsnachteile gegenüber anderen Frameworks. So bietet Deeplearning4j die Möglichkeit beim Tranining auf Grafikkarten via NVIDIA CUDA zurückzugreifen. Die erste Hürde für die Teilnehmer war die Vorverarbeitung der Daten. Bei der Arbeit mit großen Datensätzen muss man sich zunächst einmal Gedanken darum machen, wie man seine Daten in ein einheitliches Format bekommt, auf dem ein neuronales Netz trainiert werden kann. Dazu wurden zunächst einmal die Bilder entsprechend validiert und gefiltert. Im Anschluss musste der Datensatz in eine Trainings- und Testmenge unterteilt werden. Dank der DataVec ETL-Bibliothek von Deeplearning4j war die Vorverarbeitung jedoch kein großes Problem, sodass es schnell an den Kern der Sache gehen konnte: Das vorgegebene neuronale Netz funktionierte zwar, lieferte jedoch nicht besonders tolle Ergebnisse und passt sich nach kurzem Training schon zu sehr an die Daten aus der Trainingsmenge an, sodass die Genauigkeit dieses Netz nicht wesentlich größer als 55 Prozent wurde. Also wurde fleißig recherchiert, welche Netzarchitekturen sich besonders für die Objekterkennung eignen. Diese lassen sich sehr einfach in Deeplearning4j via Builder-Pattern aufsetzen: ![AlexNet in Deeplearning4j](https://thecattlecrew.net/wp-content/uploads/2018/09/layeralexnet2.png) *Via Builder-Pattern lassen sich in Deeplearning4j Netzarchitekturen für eigene tiefe neuronale Netze sehr leicht definieren* Nachdem das neuronale Netz aufgesetzt wurde, muss man es für eine möglichst lange Zeit in Ruhe trainieren lassen. Dies war der perfekte Zeitpunkt um den Grill anzuwerfen und etwas zu Netzwerken. Nachdem alle Steaks, Würstchen und Grillkäse verspeist war, ging es mit Spannung zurück an die Rechner: Was hat das eigene neuronale Netz in der Zwischenzeit gelernt und wie gut ist es geworden? Zwei Teams schafften sogar in der sehr kurzen Zeit des Hackathons ein neuronales Netz aufzusetzen und zu trainieren, welches eine Genauigkeit von über 70 Prozent erreichte. Herzlichen Glückwunsch zu dieser Leistung! Alle Teilnehmer konnten erste praktische Erfahrung in der Anwendung und im Aufsatz eines tiefen neuronalen Netzes in Deeplearning4j sammeln. Besonderer Dank geht an dieser Stelle auch nochmal an Philipp Kohl der das Event Remote aus seinem Urlaub heraus gerettet hat, indem er morgens noch das WLAN für den Hackathon repariert hat. Wer bisher keine Gelegenheit hatte an den OC|Expert Camps zum Machine Learning teilzunehmen, kann den Hackathon auch zuhause ausprobieren. Dazu einfach das nachfolgende Github Repo klonen und den Schritten in der Anleitung folgen: Für Java mit Deeplearning4j: https://github.com/thtemme/Deeplearning4j-Hackathon Für Python mit TensorFlow: https://github.com/pfehrmann/ML-Example-Steps Das nächste OC|Expert Camp zum Thema [*Go Serverless mit AWS Lambda* findet am 15. September am Münchner OC Standort statt](https://www.meetup.com/de-DE/OC-Expert-Camp-Munchen/events/253680732/). Darauf folgt in Gummersbach das OC|Expert Camp am 18.10. an der TH Köln. Thema an diesem Abend wird die [Elevator Saga](http://play.elevatorsaga.com/) sein. Eine Einladung dazu wird in Kürze veröffentlicht. Das nächste Event in unserer Essener Niederlassung ist der [*Global Day of Code Retreat* am 17. November](https://www.meetup.com/de-DE/JUG-Essen/events/254203335/). **Kategorien:** AI & Data Science, Tech Events & Networking **Schlagwörter:** Artificial Intelligence, OC|Expert Camp --- ### [What we can learn for our business applications from designing IT for the elderly](https://thecattlecrew.net/2018/09/15/what-we-can-learn-for-our-business-applications-from-designing-it-for-the-elderly/) **Published:** September 15, 2018 **Author:** Dr. Anuja Hariharan **Content:** When designing with the users in mind, we are required to design for specific groups of people, rather than for specific business requirements. For instance, a hospital examination system is most likely to be used by nurses, who are most likely to be females. An online pension system might mostly be used by the elderly, to monitor or withdraw their pension. In Germany, the percentage of population over 65 years rose to 21%, and remains the second highest in Europe. Understanding their needs, and providing technological support for the right services (such as paying bills, booking tickets, online shopping), instead of thrusting communication medium (such as Whatsapp or Facebook) and overloading them is the way to go. However, these systems are often not designed differently, as per the expectations and preferences, and taking into account that elderly have what has been termed as a digital threshold (Arnstad, 2018). This failure has led to more skepticism and poorer adoption of technologies despite being extremely useful for everyday activities. In this article, I summarize a few pointers for application designers to consider for IT systems for the elderly, based on surveying extant literature. ![UX Elderly 1](https://thecattlecrew.net/wp-content/uploads/2018/09/ux-elderly-1.png) Figure 1: Summary of design guidelines for the elderly © OPITZ CONSULTING 1. ***Easy access:*** The important content needs to be readily and easily available on the system, and additional information is to be avoided as much as possible (Advertisments, mutliple tabs, long scrollable pages, etc.). Thus, like in several effective systems, the users should receive an instant reward using the system that they can achieve their goals, and hence are motivated to continue using it. For e.g. „“ in online payment systems, the user login screen could be typically placed upfront so they are not left searching for it. Links to pages about summary and main actions should be readily provided, and features not regularly used should be avoided altogether. 2. ***Time on task:*** Studies show that elderly users take atleast twice as more to complete a certain task than the younger users. Time pressure on the users would be a big no when designing such systems. Hence, design forms with longer session time out and longer overall session duration. 3. ***Minimal changes:*** Generally speaking, the elderly population tends to have stable and fixed preferences. They are like to have a predictable routine, and avoid changes to these routines as much as possible. Hence, a system for the elderly, should factor this in. Designers should minimize product release cycles, and aim for one shot systems which are designed as simply and adequately as possible. The look and flow of main processes shoud not be changed often. In the case changes have to be made, they need to be communicated diagrammatically in a timely manner, with a detailed help page which explains changes from previous system, if required. 4. ***Fonting:*** Consider good sizing and spacing when designing touch interfaces, or interfaces with button inputs. Consider good and clear font styles; avoid serif fonts (e.g. Arial, Helvetica are preferred over Book Antiqua). Make sure users can increase their preferred font size readily on the system, especially on smaller devices (mobiles, tablets). 5. ***Detailed user scenarios:*** Older people might have higher expectations to detail, and use cases which the average population, or the lesser experienced developer or designer might not think of. Hence, designers need to take time to think of scenarios which might be expected by their target users, and give a bigger bandwidth for mistakes and helpful messages guiding them through the process. The range of information fields and input combinations available in a form, date of birth or legal or procedural systems which might have existed earlier, options in dropdowns, or validating inputs with special characters and extreme cases. 6. ***Polite and gentle wording*** on the website might motivate elderly to use the website. 7. ***Regular usage feedback*** needs to be gathered, to „listen“ to their discomforts, and make changes where appropriate. Even small pilot usability tests of 2-3 people could inform design substantially. 8. ***Neurophysiological measures to integrate in usability study of the elderly*** Finally, mouse tracking methods such as the screenshot shown below is a novel technique to study website usage patterns of users (Jung et al. 2018). The package **BrownieR** could be used to examine in a half an hour session, which URL“™s the user visited, which areas were navigated, and the duration of navigation on each URL. The below analysis and summary of mouse movements was performed using the BrownieR package, available for [download](https://rdrr.io/github/Fiddleman/BrownieR/) here. Although the detailing level is not as high as the eye-tracking devices, the information provided by such mouse movements could definitely be a first step to identifying erraneous moves by the users, or poorly designed pages. The Brownie workspace and R script used to generate these analysis is attached here. ![UX elderly 3](https://thecattlecrew.net/wp-content/uploads/2018/09/ux-elderly-3.png) References 1. 2. Coyne, P. K. (2003). Web usability for senior citizens: design guidelines based on usability studies with people age 65 and older. *Nielsen Normal Group Report*. 3. https://www.researchgate.net/publication/326147055\_BrownieR\_-\_The\_R-Package\_for\_Neuro\_Information\_Systems\_Research 4. http://sciencenordic.com/seniors-and-technology-help-family-members-not-always-best-solution [Code examples](https://thecattlecrew.net/wp-content/uploads/2018/09/code-examples.docx "Code examples") **Kategorien:** Architecture & Process Models, Tools & Methoden **Schlagwörter:** Browser, design, Innovation, Java, usability --- ### [Reaktive Programmierung mit Spring und R2DBC](https://thecattlecrew.net/2018/10/22/reaktive-programmierung-mit-spring-und-r2dbc/) **Published:** Oktober 22, 2018 **Author:** nilsschlueter **Content:** Auf der Spring One 2018 [stellte Pivotal eine API namens R2DBC](https://www.youtube.com/watch?v=idApf9DMdfk&app=desktop) für den Zugriff auf relationale Datenbanken mit Reactive Streams vor. R2DBC steht für „Reactive Relational Database Connectivity“. Pivotal versucht mit dieser API die Vorteile reaktiver Programmierung auf Systeme mit relationalen Datenbanken zu übertragen. Im Artikel stelle ich R2DBC genauer vor und erläutere, warum es in Zukunft von Bedeutung sein könnte. ## Reaktive Programmierung Das [Reactive Manifesto](https://www.reactivemanifesto.org/) definiert ein reaktives System als ein System, das „responsive, resilient, elastic and message driven“ ist. Das System soll demnach also schnelle Antworten liefern, auch bei Fehlern weiterhin verfügbar und bedienbar bleiben und mit wechselndem Workload zurechtkommen. Ein Kernaspekt vieler reaktiver Systeme ist es daher, mit asynchronen Datenströmen zu arbeiten, um nicht auf blockierende Aktionen warten zu müssen. Wird in einem reaktiven System beispielsweise auf eine Datei zugegriffen oder eine Anfrage an einen Server geschickt, so muss das System nicht auf eine Antwort warten, sondern kann parallel andere Aktionen ausführen. Sobald es eine Antwort erhält, kann die Verarbeitung des Datenstroms fortgeführt werden. Durch die asynchrone Verarbeitung von Datenströmen wird also die Effizienz eines Systems erhöht. In modernen Architekturen, die häufig stark verteilt aufgebaut sind, gewinnt reaktive Programmierung daher auch immer mehr an Bedeutung. Deshalb unterstützen auch immer mehr Sprachen und Frameworks reaktive Programmierung. So gibt es beispielsweise seit Java SE 9 die [Flow API](https://docs.oracle.com/javase/9/docs/api/java/util/concurrent/Flow.html), die reaktive Programmierung in Java ermöglicht. Zusätzlich existieren im Java Umfeld einige bekannte Libraries wie beispielsweise [Vert.x](https://vertx.io/), [Akka Streams](https://akka.io/) oder [RxJava](http://reactivex.io/), die reaktive Programmierung beispielsweise mittels Callbacks oder FutureObjects ermöglichen. ## Reaktive Programmierung im Spring Umfeld Auch bei Spring gibt es bereits seit einiger Zeit Ansätze zur reaktiven Programmierung. Seit Spring 5 sind diese Ansätze bereits in Spring Data enthalten, allerdings nur für spezielle NoSQL-Datenbanken. Viele Spring-Anwendungen basieren jedoch noch auf relationalen Datenbanken. Das Problem relationaler Datenbanken ist, dass diese den Datenfluss bei reaktiver Programmierung stoppen. Der Rest der Anwendung kann also reaktiv implementiert sein, dies bringt jedoch kaum Vorteile, wenn der Datenbankzugriff immer noch blockierend ist. Im Spring-Umfeld wird bislang JDBC (Java Database Connectivity) für den Zugriff auf relationale Datenbanken genutzt. Damit ist ein nicht-blockierender Zugriff jedoch nicht sauber möglich. Mit R2DBC bietet Pivotal jetzt eine Alternative an, welche speziell für die reaktive Programmierung entwickelt wurde. R2DBC stellt den Entwicklern die nötigen Methoden zur Verfügung, um nicht-blockierende Zugriffe auf relationale Datenbanken durchzuführen. Damit lassen sich Systeme mit bestehenden relationalen Datenbanken in Zukunft reaktiv machen. Im folgenden Beispiel wird gezeigt, wie mit R2DBC asynchrone Transaktionen auf einer PostgreSQL-Datenbank durchgeführt werden können: ![code_example_r2dbc](https://thecattlecrew.net/wp-content/uploads/2018/10/code_example_r2dbc.png) Wie zu sehen ist, werden die Ergebnisse der Transaktionen asynchron abgerufen. Das System muss also nicht auf die Ausführung der einzelnen Statements warten. Die hierbei verwendeten Methoden (thenMany, subscribe) sind Methoden aus der [ProjectReactor](https://projectreactor.io/) Library, die als Grundlage für R2DBC genutzt wird. ## Einschätzung R2DBC ist nicht der einzige Weg, asynchronen Zugriff auf relationale Datenbanken zu ermöglichen. Alternativ gibt es beispielsweise die Oracle ADBA (Asynchronous Database Access API), die ebenfalls dafür entworfen wurde, nicht-blockierenden Zugriff auf relationale Datenbanken zu ermöglichen. Im Gegensatz zu R2DBC nutzt ADBA allerdings nicht die Flow API von Java 9, sondern CompletableFuture-Objekte, die nach Meinung der R2DBC-Ersteller keine richtige reaktive Programmierung ermöglichen. Daher soll das R2DBC-Projekt laut Pivotal in Zukunft auch eher als Beispiel für Oracle dienen, das zeigt, wie bei ADBA reaktive Programmierung umgesetzt werden könnte. Die Entwickler würden nämlich lieber die zukünftige Entwicklung von ADBA beeinflussen, statt eine eigene Library mit ähnlichen Funktionen weiterzuentwickeln. R2DBC ist also als Experiment zu verstehen und wurde somit auch noch nicht vollständig umgesetzt. Beispielsweise werden momentan nur PostgreSQL- und H2-Datenbanken unterstützt, und es fehlen noch wichtige Features. Daher sollte R2DBC auch noch nicht im Produktivbetrieb eingesetzt werden. Aktuell kann R2DBC also nur genutzt werden, um Testapplikationen zu erstellen und sich mit dem Konzept der reaktiven Programmierung im Umfeld relationaler Datenbanken vertraut zu machen. Ob und wann das Projekt in Zukunft so weit ist, produktiv eingesetzt zu werden, bleibt abzuwarten. Der Ansatz bleibt aber vielversprechend und könnte (auch durch den Einfluss auf ADBA) in Zukunft durchaus dazu beitragen, reaktive Programmierung auch mit relationalen Datenbanken voranzutreiben. **Kategorien:** Cloud, Development **Schlagwörter:** API, Java, oracle, Pivotal --- ### [Native plattformübergreifende Anwendungen "“ Erste Erfahrungen mit Flutter](https://thecattlecrew.net/2019/04/09/erfahrungen-mit-flutter/) **Published:** April 9, 2019 **Author:** Daniel Felten **Excerpt:** Ich möchte euch ein wenig an meinen ersten Erfahrungen mit Flutter teilhaben lassen. Flutter ist ein Open Source Framework von Google, mit dem native mobile Anwendungen für iOS und Android entwickelt werden können. Zukünftig sollen auch weitere Plattformen wie Mac, Windows und das Web unterstützt werden. **Content:** Ich möchte euch ein wenig an meinen ersten Erfahrungen mit Flutter teilhaben lassen. Flutter ist ein Open Source Framework von Google, mit dem native mobile Anwendungen für iOS und Android entwickelt werden können. Zukünftig sollen auch weitere Plattformen wie Mac, Windows und das Web unterstützt werden. ## Was ist Flutter? ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Google-flutter-logo-300x150.png)Flutter Apps sind in Googles eigener Sprache Dart geschrieben, die viele Gemeinsamkeiten mit JavaScript hat. Spannend an Flutter ist die Möglichkeit, wirklich native Anwendungen mit nur einer Code-Basis zu entwickeln. Trotz der gemeinsamen Code-Basis sind Anpassungen für die unterschiedlichen Plattformen möglich, und selbst nativer plattformspezifischer Code kann mittels sogenannten Platform Channels verwendet werden. ### Aufgebaut aus Widgets Flutter Apps bestehen grob gesagt aus einer Ansammlung von Widgets in einer Baumstruktur. Jedes angezeigte Element ist ein Widget, jeder Button, jeder Text und selbst die App als Ganzes ist ein Widget. Ein Button ist beispielsweise ein Widget, in dem sich wiederum ein Text-Widget befindet. Die Anordnung von Widgets geschieht ebenfalls über andere Widgets wie Container, Columns oder Rows. Flutter bietet eine Reihe von Widgets an, die den Richtlinien von Googles Designsprache Material Design entsprechen und auf iOS und Android eine entsprechend an die Plattform angepasste Optik besitzen. So sehen die Komponenten nativ aus. ### Performance Anders als beispielsweise bei React Native, wo der Code erst zur Laufzeit in nativen Code umgewandelt wird, wird der mit Dart geschriebene Code auf den jeweiligen Plattformen als nativer Code kompiliert. Das liefert eine bessere Performance, da keine Bridge notwendig ist. Das UI wird mit Flutter auf einem Screen Canvas mittels der Grafikbibliothek Skia gezeichnet und verwendet somit keine nativen Komponenten. Stattdessen ist eine Flutter-App als Ganzes eine native Anwendung, die eher einem Spiel gleicht und daher sehr performant ist. Flutter bietet sogenannte Reactive Views. So werden bei Ü„nderungen des States nur die dazugehörigen Widgets neu gerendert. Bereits bestehende unveränderte Widgets werden aus dem Cache neu geladen, was sehr schnell ist. ### Developer Experience Für Entwickler ist die Funktion „Hot Stateful Reloading“ besonders spannend. Eine Ü„nderung im Code erscheint damit in extrem kurzer Zeit auf dem Emulator oder dem Gerät (teilweise unter einer Sekunde). Gerade Ü„nderungen an der UI können so sehr schnell im Detail angegangen werden. Anders als bei einigen anderen Frameworks liefert Flutter gleich verschiedene Test-Möglichkeiten mit. Es gibt Unit-Tests, Widget-Tests und Integration-Tests. Flutter eignet sich also auch für Test Driven Development. Entwickeln lassen sich Flutter Apps mit allen gängigen Entwicklungsumgebungen. IntelliJ oder Visual Code haben beispielsweise offizielle Plugins, die von den Flutter Entwicklern selber geschrieben wurden. Auch Debuggen funktioniert wie aus der nativen Entwicklung gewohnt sehr komfortabel. ## Apps mit Flutter Das Aufsetzen einer App mit Flutter geht vergleichsweise schnell. Erste kleinere Anwendungen lassen sich mit Flutter erfahrungsgemäß schneller erstellen als native, da Flutter Apps sehr leichtgewichtig sind und der Aufbau eines UIs dank den Widgets übersichtlich ist. Sie funktionieren direkt plattformübergreifend, sowohl für Android und iOS, sodass Flutter gerade für MVPs die ideale Lösung darstellt. Neben kleineren Anwendungen sind auch größere komplexere Anwendungen mit Flutter möglich. Einige große Unternehmen wie beispielsweise Alibaba und Google selbst setzen bei ihren Apps mittlerweile auf Flutter. Auch ich habe bereits einige kleinere Beispielsprojekte realisiert und wurde bin begeistert von der schnellen Realisierung. Bislang habe ich kein Problemen erlebt, das sich in Flutter nicht lösen ließ. Das meiste, was ich brauchte, war bereits Bestandteil von Flutter, und wenn doch mal was fehlte, halfen mir die unzähligen Bibliotheken mit Zusatzfunktionen sofort weiter. Wenn Sie weitere Infos zu Flutter haben möchten, schauen Sie am besten mal auf der offiziellen Seite nach. Dort finden Sie hilfreiche Guides, um Flutter auf dem Rechner einzurichten und selbst eine kleine App aufzusetzen. **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Android, Apps, Flutter, iOS --- ### [Erste Erfahrungen mit Oracle Mobile Server 11g](https://thecattlecrew.net/2012/03/07/erste-erfahrungen-mit-oracle-mobile-server-11g/) **Published:** März 7, 2012 **Author:** **Content:** Nach dem erfolgreichen Einsatz des Oracle Mobile Server 10g stand für unseren Kunden der Wechsel auf die 11g an. Der Grund für den Wechsel ist die Nutzung eines neuen mobilen Endgerätes und das Supportende der Version 10g zum Ende des Jahres. Der Kunde schickt seine WinCE Geräte auf Rente und will nun Android Tablets oder Smartphones für den Außendient verwenden. Die alte Anwendung setzte auf Oracle Database Lite als Datenbank auf dem Client. Der Support für diese Datenbank wurde von Oracle ersatzlos gestrichen und stellt auch keine Version für Android zur Verfügung. Aufgrund der Supportproblematik fiel die Entscheidung für den neuen Mobile Server 11g nicht schwer. Er unterstützt die Datenbanken Oracle Berkeley DB und SQlite auf dem mobilen Endgerät. Da alle Android Geräte bereits eine SQlite Datenbank beinhalten (inklusive passender Zugriffsschicht), fiel die Wahl nicht schwer. Aber warum setzen wir den Mobile Server überhaupt ein und entwickeln das Backend für diese Anwendung nicht selbst? Diese Frage lässt sich sehr einfach mit den Features des Oracle Mobile Server 11g beantworten: - Einfache Replikation und Synchronisation der Daten mit einer Oracle Datenbank - Nutzung der SQlite Datenbank auf dem Gerät - Device Management durch den Mobile Server - Automatische Synchronisation durch Server Push - Offlinefähigkeit der Anwendung bis auf die Synchronisation wird unterstützt Die Migration von 10g zu 11g haben wir durch eine einfache Neuinstallation des Servers bewerkstelligt. Der Server arbeitet offiziell mit den Applikationsserver Oracle WebLogic 11g und Glassfish 3.1 zusammen. Wir haben ihn auf beiden Plattformen zum Laufen bekommen. Die Testinstallation läuft mit Glassfish und das Produktivsystem wird später mit Oracle WebLogic betrieben. Bei der Migration der Datenbank wurden nur die Publikationen für die Anwendung in den neuen Server eingespielt und schon funktionierte die Synchronisation. Für Android gibt eine Beispielanwendung im Mobile Development Kit, womit man den Oracle Mobile Server testen kann. Die Datenbank auf dem Endgerät kann mit den Entwicklerwerkzeugen für Android ausgelesen und verifiziert werden. Nach der erfolgreichen Migration und Nutzung des Oracle Mobile Servers 11g wird nun der Client für Android komplett neu entwickelt. Wobei die Entwickler nun auf die bereitgestellte Datenbank aufsetzen können und damit der Fokus der Entwicklung wieder auf das Wesentliche gerichtet wird. An diese Stelle sei aber auch auf die negativen Seiten des neuen Mobile Servers hingewiesen: - Unterstützung für Oracle iAS 10g nicht vollständig, da auch hier das Supportende naht (aber wegen WLS/Glassfish kein wirkliches Problem) - Die neue Datenbank auf dem Client löst Anpassungen im Client aus - Support für Oracle Mobile Server 10g endet dieses Jahr - Lizenzierung für Server per CPU und pro Oracle Berkeley DB Client (Mindestabnahme 100000 Stück) - Migrationspfad von 10g auf 11g nicht vorhanden bzw. in Arbeit - Weboberfläche wirkt angestaubt, aber fast identisch zu 10g Für unser Projekt hat sich der Einsatz des neuen Oracle Mobile Server 11g schon vor Fertigstellung gelohnt, da wir viel Zeit einsparen konnten für die Neuimplementierung der Synchronisation mit dem Endgerät. **Kategorien:** Infrastructure **Schlagwörter:** Mobile --- ### [WLS jdbc Anbindung von iSeries AS400/DB2](https://thecattlecrew.net/2012/03/13/wls-jdbc-anbindung-von-iseries-as400db2/) **Published:** März 13, 2012 **Author:** Apostolos Varsamis **Content:** ##### Allgemeines In diesem Artikel wird die Verbindung zwischen einem WLS und einer DB2 Instanz , die in einem mainframe läuft. Für eine DB2 Instanz, die unter linux, solaris etc. läuft gelten andere Regeln. ##### JDBC Treiber In der iSeries As400 (Mainframe) gibt es das IFS Verzeichnis mit dem File: `/QIBM/ProdData/HTTP/Public/jt400/lib/jt400.jar` Die Datei jt400.jar von dort downloaden, weil genau diese jdbc Datei ist mit dieser Version des BS kompatibel. **SOA Datasource erstellen:** jt400.jar unter - `user_projects/domains/DOMAINNAME/lib ` und - `/server/lib` kopieren. Unter `/common/bin/commEnv.sh` den classpath erweitern so, dass jt400.jar berücksichtigt wird. ##### NonXA Datasource erstellen. Tab Connection Pool: URL`jdbc:as400://IP/library`Driver Class Name`com.ibm.as400.access.AS400JDBCDriver`Tab Transactions: Supports Global Transactions ist deaktiviert ##### DB Adapter update Danach wie gewöhnt den DB Adapter erweitern um den connection pool und updaten. Hiermit dürfte die jdbc Verbindung zwischen SOA Suite und AS400/DB2 funktionieren. **Kategorien:** Development **Schlagwörter:** Weblogic --- ### [Java WebService-Client: Endpunkt-URL dynamisch setzen basierend auf der Adresse des WLS Managed Servers](https://thecattlecrew.net/2012/03/15/java-webservice-client-endpunkt-url-dynamisch-setzen-basierend-auf-der-adresse-des-wls-managed-servers/) **Published:** März 15, 2012 **Author:** **Content:** Während man die Zieladressen von Service-Referenzen innerhalb eines Composites komfortabel per Config-Plan ändern kann, funktioniert dieses Vorgehen nicht für Java Web-Service Clients – selbst wenn diese Teil eines Composites sind (z.B. innerhalb eines Mediator Callouts). Oft hat man mehrere Umgebungen, z.B. Test, Integration und Produktion, und es soll jeweils so konfiguriert werden, dass die Services auf demselben Host aufgerufen werden. Der offensichtliche Weg wäre, als Adresse einfach „localhost“ zu verwenden. Das bringt allerdings ein paar Probleme mit sich, etwa dass man dann aus der Entwicklungsumgebung heraus nicht testen kann oder, dass es nicht funktioniert, weil der Weblogic gar nicht auf dem Loopback-Interface „lauscht“. Eine Möglichkeit zur Lösung des Problems ist, jeweils dynamisch die Endpunkt-Adresse zu setzen, basierend auf der im Weblogic hinterlegten Listen Address. Dies passiert, nachdem man den Port des Webservices geholt hat, jedoch bevor man den Call auf dem Port ausführt. Die „DefaultURL“ des lokalen WLS bekommt man aus einem MBean. Sobald man diese hat, setzt man auf dem Port die entsprechende Property für die Endpoint Adresse. Ein Beispiel für eine entsprechende Java-Methode: \[sourcecode language=“java“\] private void setEndpointAddressToLocal(MeinService\_ptt port) throws Exception { // Obtain local listen address ObjectName service = new ObjectName( „com.bea:Name=RuntimeService,Type=weblogic.management.mbeanservers.runtime.RuntimeServiceMBean“); InitialContext ctx = new InitialContext(); MBeanServer mBeanServer = (MBeanServer) ctx.lookup(„java:comp/env/jmx/runtime“); ObjectName rt = (ObjectName) mBeanServer.getAttribute(service, „ServerRuntime“); String defaultUrl = (String) mBeanServer.getAttribute(rt, „DefaultURL“); String newAddress = defaultUrl.replaceAll(„t3://“, „http://“); newAddress += „/soa-infra/services/default/MeinServiceComposite/MeinService“; log.info(„Setting endpoint address to “ + newAddress); // Set new address BindingProvider bp = (BindingProvider)port; Map context = bp.getRequestContext(); context.put(BindingProvider.ENDPOINT\_ADDRESS\_PROPERTY, newAddress); } \[/sourcecode\] Vielen Dank an folgende Quellen, die bei der Lösungssuche sehr hilfreich waren: - - - Weblogic MBean-Browser im Enterprise Manager **Kategorien:** Development **Schlagwörter:** Java, JAX-WS, Weblogic, Webservice --- ### [JDeveloper QuickTip - Assigning more memory](https://thecattlecrew.net/2012/07/10/jdeveloper-quicktip-assigning-more-memory/) **Published:** Juli 10, 2012 **Author:** **Content:** Did you ever have the problem that JDeveloper crashes each day during your lunch break? Worry no more. It’s most likely a problem with too less memory. JDeveloper memory settings are stored in $MIDDLEWARE\_HOME/jdeveloper/ide/bin/ide.conf. [![JDeveloper IDE configuration](https://thecattlecrew.net/wp-content/uploads/2012/07/ide-conf.png "ide.conf")](https://thecattlecrew.net/wp-content/uploads/2012/07/ide-conf.png) Change the following lines to settings of your liking. A maximum heap size of around 1,5 GB seems to be a good setting if your working heavily with SOA projects (and have enough memory on your machine). `AddVMOption -Xmx640MAddVMOption -Xms128M` Hope this helps to reduce your regular JDeveloper shutdowns and low memory warnings. **Kategorien:** Development **Schlagwörter:** JDeveloper --- ### [Buchveröffentlichung: Mobile Web-Apps mit JavaScript](https://thecattlecrew.net/2012/08/23/buchveroffentlichung-mobile-web-apps-mit-javascript/) **Published:** August 23, 2012 **Author:** Torsten Winterberg **Content:** ![](http://www.opitz-consulting.com/uploads/pics/Buch_Mobile-Web-Apps-mit-JavaScript_01.jpg) Es herrscht ein regelrechter Hype um mobile Lösungen, erst recht seitdem androidbasierte Smartphones massenhaft auf den Markt drängen. Einen ähnlichen Aufschwung erlebt JavaScript, denn mit der enormen Ausbreitungsgeschwindigkeit von HTML5 wird diese Sprache immer interessanter. **Leitfaden für die professionelle Entwicklung** Dieses Buch richtet sich an Entwickler, die sich bewusst für den Weg der mobilen JavaScript Web-App entschieden haben und lernen möchten, wie man ein gutes Softwaredesign implementiert. Es entstand aus dem Wunsch nach einer kompletten, durchgehenden Anleitung, wie man professionell auf hohem Niveau Webanwendungen für mobile Endgeräten schreibt. Die Autoren Tobias Bosch, Stefan Scheidt und Torsten Winterberg vollführen dabei einen kompletten End-to-End-Durchlauf über alle relevanten Implementierungsbestandteile und der Leser erhält einen hervorragenden Einstieg in die Programmierung mobiler Web-Apps, in die testgetriebene Entwicklung für JavaScript und das Schreiben von Clean Code. **Bestellen Sie jetzt Ihr persönliches Exemplar vor!** Das Buch „Mobile Web-Apps mit JavaScript – Leitfaden für die professionelle Entwicklung“ (ISBN: 978-3-86802-085-4) erscheint voraussichtlich im August 2012 im Verlag [entwickler.press](http://entwickler-press.de/). Bestellen Sie [hier](http://entwickler-press.de/ep/psecom,id,2,buchid,251.html) schon heute ein Exemplar vor. **Kategorien:** Development **Schlagwörter:** JavaScript, News --- ### [Weblogic Application Server - Free for developers](https://thecattlecrew.net/2012/09/19/weblogic-application-server-free-for-developers/) **Published:** September 19, 2012 **Author:** Torsten Winterberg **Content:** That’s good news and solves part of the licensing problem we always had: You don’t have to have a separate license of WLS for every developer, using it on their development machines. Find details in Bruno’s blog: [https://blogs.oracle.com/brunoborges/entry/weblogic\_server\_free\_for\_developers](https://blogs.oracle.com/brunoborges/entry/weblogic_server_free_for_developers) **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Weblogic --- ### [BEA-002616: Failed to listen on channel on listenAddress:port](https://thecattlecrew.net/2013/01/21/bea-002616-failed-to-listen-on-channel-on-listenaddressport/) **Published:** Januar 21, 2013 **Author:** Mohammad Esad-Djou **Content:** Autor: Mohammad Esad-Djou **Technology, KeyWords:** WebLogic Server 10.3, Cluster, Exception; Too many open files, Socket, Linux, SLES, Error Message: **Problem:** **Description** Weblogic declaration from: [http://docs.oracle.com/cd/E23549\_01/apirefs.1111/e14397/Server.html](http://docs.oracle.com/cd/E23549_01/apirefs.1111/e14397/Server.html) BEA-002616 Critical: Failed to listen on channel „channel“ on listenAddress:port, failure count: fails1, failing for secs2 seconds, e3 - **Description:** The server listener will retry the listen after a short delay. - **Cause:** The server got an exception while trying to accept client connections. It will try to backoff to aid recovery. - **Action:** The OS limit for the number of open file descriptor (FD limit) needs to be increased. Tune OS parameters that might help the server to accept more client connections (e.g. TCP accept back log). **More detail and Background information:** „Tune OS parameters“ depends on OS which you use. For Linux, kernel parameters need adjustment- exact details depend on the distribution. There are individual user limits for open files. You can use `*ulimit -a*` command to find out the Linux for the user that owns. You can find information regarding the important parameters e.g. number of „open files“ or similar entry. Please consider, in AIX, the user limits apply as well as a system OS configuration for the total number of open files allowed on the host. **Solution** Here is an example how can you check and isolate the position of error. 1- Check linux configuration (e.g. on host XXX): > ulimit „“a core file size (blocks, -c) 1 data seg size (kbytes, -d) unlimited scheduling priority (-e) 0 file size (blocks, -f) unlimited pending signals (-i) 127575 max locked memory (kbytes, -l) 64 max memory size (kbytes, -m) 13887980 open files (-n) 65600 Ü OK pipe size (512 bytes, -p) 8 POSIX message queues (bytes, -q) 819200 real-time priority (-r) 0 stack size (kbytes, -s) 8192 cpu time (seconds, -t) unlimited max user processes (-u) 127575 virtual memory (kbytes, -v) 17749200 file locks (-x) unlimited The open file descriptor limit is at 65600 as recommended by Oracle. 2- Check currently open files - Find PID of Managed Server > ps -fea|grep myManagedServer - Check open files Please use lsof (list open files) that lists information about files opened by processes You see list of open files via (e.g.PID is here 1234) >lsof -p 1234 In order to findour the number of open files: > lsof -p 1234 | wc „“l In this case, we observed that application has 13 thousand connections on „CLOSE\_WAIT“ status. This usually happens when the application doesn’t close the connections properly: *CLOSE\_WAIT* The remote end has shut down, waiting for the socket to close. It“™s reason why they are reaching the 65600 limit. \*\*\* After more analyses this case, it is cleared, the issue is a result of weblogic cluster configuration. „Open files“ are waiting to close cluster communication between two nodes. See **Refernces** - Additional information regarding is available on MOS: WebLogic Server Support Pattern: How To Troubleshoot Too Many Open Files Problems \[ID 867492.1\] - [http://docs.oracle.com/cd/E23549\_01/apirefs.1111/e14397/Server.html](http://docs.oracle.com/cd/E23549_01/apirefs.1111/e14397/Server.html) - **Kategorien:** Development **Schlagwörter:** Cluster, oracle, Oracle DB, Weblogic --- ### [BEA-003108: Unicast receive error: java.io.EOFException](https://thecattlecrew.net/2013/01/30/bea-003108-unicast-receive-error-java-io-eofexception/) **Published:** Januar 30, 2013 **Author:** Mohammad Esad-Djou **Content:** **Technology, KeyWords:** WebLogic Server 10.3, Cluster, Unicast, Exception;JAVA.IO.EOFEXCEPTION Error Message: **Problem:** If I restart one Managed Server in a Cluster, I get the following error: **Description** Weblogic declaration from: [http://docs.oracle.com/cd/E17904\_01/apirefs.1111/e14397/ClusterExtension.html](http://docs.oracle.com/cd/E17904_01/apirefs.1111/e14397/ClusterExtension.html) Error: Unicast receive error: e An error occurred while trying to receive a message over the cluster broadcast. **Cause** An error occurred while trying to receive a message over the cluster broadcast. **Action** Make sure that the NIC is functioning properly. If you believe there no environment problems exist, contact Oracle Customer Support and provide the stack trace for further analysis. **More detail and Background information:** Note: Sometimes you get Error Message: and it can be a logical effect of error BEA-003108. The issue “ Solution To resolve this issue, the cluster debug flags need to be enabled consistently: either disabled on all the servers of the cluster or enabled on all of them. In a production environment, debugging should be disabled. Cluster debug flags should be enabled only while debugging a problem with the Unicast cluster. ***Solution via AdminServer:*** 1. Click on Domain Structure and select your Server 2. Select debugging tab 3. Select items, that you want to disable or/enable, e.g. Disable weblogic debugging by click on „disable“(german: „deaktivieren“) 4. Check Log files, wether the issue is solved. Refernces - Screenshots: - [http://docs.oracle.com/cd/E17904\_01/apirefs.1111/e14397/ClusterExtension.html](http://docs.oracle.com/cd/E17904_01/apirefs.1111/e14397/ClusterExtension.html) - - MOS: WebLogic Server: Getting“Unicast receive error: java.io.EOFException“ Exceptions in Logs \[ID 1289389.1\] **Kategorien:** Development **Schlagwörter:** Cluster, oracle, Oracle DB, QuickTip, Weblogic --- ### [weblogic.server.ServerLifecycleException: Cannot get to the relevant ServerRuntimeMBean for server MGSRV](https://thecattlecrew.net/2013/09/02/weblogic-server-serverlifecycleexception-cannot-get-to-the-relevant-serverruntimembean-for-server-mgsrv/) **Published:** September 2, 2013 **Author:** Mohammad Esad-Djou **Content:** Lately, I got the following error: weblogic.server.ServerLifecycleException: Can not get to the relevant ServerRuntimeMBean for server MGSRV. … weblogic.management.scripting.ScriptException: Error occured while performing shutdown : Error shutting down the server : Can not get to the relevant ServerRuntimeMBean for server MGSRV. Use dumpStack() to view the full stacktrace It“™s happened, when I wanted to shutdown a managed server via WebLogic Server script „stopManagedWebLogic.sh“. In addition, nodemanger-utility was not able to shutdown managed server via administration console. After review the issue, I faced to an Oracle Document: **WebLogic Managed Server shutdown failing when using SSL t3s Admin Server address as ADMIN\_URL (Doc ID 851065.1)** The main reason for this issue is: „JMX clients using secure protocols were not able to invoke operations on MBeans registered in the Domain Runtime MBeanServer of the AdminServer. Authentication of JMX clients was not correctly performed.“ It seems that is a bug **(Bug 8359946):** „Not able to shutdown the managed serves using t3s protocol in the WLST scripts. The same script with t3 protocol is working fine. Adminserver is shutting down fine with either protocol. Not able to shutdown the managed server using WLST. Getting, connecting to successfully connected to Admin Server ‚adminserver‘ that belongs to domain…“ You can test it with following steps: 1\) Create a domain for WLS 10.3 with 1 Admin and 1 Managed server. 2\) Enable SSL and configure the Demo Identity and Demo trust for the Keystores on both the Admin and Managed server.set ADMIN\_URL=t3s://localhost:7002 And add the -Dweblogic.security.TrustKeyStore=DemoTrust 4\) Start the Admin server. 5\) Start the Managed server. 6\) Stop the Managed server. Then: Error What is the solution? Quick and dirty solution: You can kill managed server with kill -9 of MGSRV and using administration console for start/stop with nodemanager. · Advantage: You have a uniform start/stop method for managed server via administration console. · Disadvantage: Automatic start/stop of managed server(s) via script(s) and operating system is not possible. Oracle solution: The bug is fixed in: 12.1.1, for previous WebLogic Server versions are patches available: WLS Version Patch Number 10.0.1 Patch 8589531 10.0.2 Patch 8359946 10.3.0 Patch 8359946 Please note that patches are applied per WLS installation and not per domain. That is, if you apply this patch on one WLS installation, then all of the servers from all the domains in that installation will have this patch. On the other hand, if you have a managed server in another machine in a domain (that is, set up with its own WLS installation), you need to install this patch on that other machine as well. Generally, patches can only be applied while the server is not running because WLS locks the needed files while it is running. If, however, you are able to apply a patch while WLS is running, you must restart WLS before the patch will take effect. **Kategorien:** Development **Schlagwörter:** Bugs, Patch, Weblogic --- ### [PS4: Error for Updating OSB Domain after applying the latest Patch Set](https://thecattlecrew.net/2014/01/20/ps4-error-for-updating-osb-domain-after-applying-the-latest-patch-set/) **Published:** Januar 20, 2014 **Author:** Mohammad Esad-Djou **Content:** ## Problem: The customer does the following steps as PS4 Doc regarding „Updating OSB Domain after applying the latest Patch Set“ (See 3.8.9.1 Updating an Oracle Service Bus Domain After Applying the Latest Patch Set in http://docs.oracle.com/cd/E21764\_01/doc.1111/e16793/patch\_set\_installer.htm) Perform the following steps for each domain to be upgraded: 1\. Make sure you have backed up and shut down all domains to be upgraded. 2\. Under each Oracle Service Bus 11gR1 domain to be upgraded, open a command window and run the DOMAIN/bin/setDomainEnv.cmd/sh command. 4\. In the command window, switch to the directory in which the upgrade scripts resides: OSB\_ORACLE\_HOME/common/lib/upgrade 5\. On the command line, runs the appropriate script for your operating system: Linux/Solaris: java weblogic.WLST ./domainUpgrade.py java weblogic.WLST ./domainUpgrade.py Initializing WebLogic Scripting Tool (WLST) … Welcome to WebLogic Server Administration Scripting Shell Type help() for help on available commands AND he gets the following error: Problem invoking WLST – Traceback (innermost last): File „/oracle/fmw/Oracle\_OSB1/common/lib/upgrade/./domainUpgrade.py“, line 368, in ? File „/oracle/fmw/Oracle\_OSB1/common/lib/upgrade/./domainUpgrade.py“, line 16, in replaceOSBServerModuleVersion ValueError: substring not found in string.index ## Solution: This issue happens if the upgrade script has been run more than once and cannot find the proper substring in the configuration because it has already been changed. „To resolve this issue first verify that the upgrade was not already run by examining the time-stamp of the DOMAIN\_HOME/config/config.xml of the domain begin upgraded. If this file has recently changed then it is likely that the upgrade ran to completion. You can also look at the config.xml file and verify the version in the section: 10.3.4.0“ if you upgraded more than once, then you can solve the issue in two ways: 1. Do not do anything and continue with the next steps of your upgrade, because script had already been run. 2. (my suggestion) Please restore from backup and re-run **your upgrade again,** because you can be sure your upgrade is fully correct and you do not lost your time for problem analysis, if you find that there are other problems after the upgrade. ## Refernces: The following note will help you: Running The Domainupgrade.Py Script Gives Error: „substring not found in string.index“ (Doc ID 1313321.1) **Kategorien:** Development **Schlagwörter:** Oracle FMW, OSB, Patchset, Weblogic --- ### [Did you forget your WebLogic Server password? No problem!](https://thecattlecrew.net/2014/01/27/did-you-forget-your-weblogic-server-password-no-problem/) **Published:** Januar 27, 2014 **Author:** Mohammad Esad-Djou **Content:** It is a frequently question that I receive from time to time: „I“™ve lost my password, how can I change the AdminServer Password in WebLogic Server?“ In addition, normally administrators want to change the WLS password regularly, because of the security policy. I try to make it easy, but please try it first in a test environment! Make a Backup from your domain and do the following steps for WebLogic Server 11g and/or 12c: 1- Check your Middleware-Home“™s ($MW\_HOME) and WLS-Domain-Home“™s ($DOMAIN\_HOME) paths. You can set up the environments under Linux with export command, e.g.: $>export MW\_HOME=/u01/app/oracle/middleware $>export DOMAIN\_HOME=$MW\_HOME/user\_projects/domains/MyDomain 2- shut down the WebLogic domain, e.g. $DOMAIN\_HOME/bin/stopWebLogic.sh 3- Rename the data folder in $DOMAIN\_HOME/servers/AdminServer/data 4- set the environment variables with using, e.g.: $DOMAIN\_HOME/bin/setDomainEnv.sh \### Now is the main command that you can change AdminServer“™s password: $> cd $DOMAIN\_HOME/security $> java weblogic.security.utils.AdminAccount . \# Create and/or update „boot.properties“ in „$DOMAIN\_HOME/servers/AdminServer/security/ directory with your username and NEWpassword: username= password= \# Start the WebLogic domain. $ $DOMAIN\_HOME/bin/startWebLogic.sh ## Refernces: - [How to Change the WebLogic Server Administrator Password \[ID 1082299.1\]](https://support.oracle.com/epmos/faces/DocContentDisplay?id=1082299.1) - - How to Reset Oracle VM Manager Weblogic Administrator Password (Doc ID 1579140.1) - How to Change Superadmin User Password for Agile PLM Running on Weblogic (Doc ID 1552408.1) - 12c Cloud Control: Steps for Modifying the Password for Weblogic and Nodemanager User Accounts in the Enterprise Manager Installation (Doc ID 1450798.1) - WCC 11.1.1.7 – Problem Resetting the Weblogic User Password (Doc ID 1589360.1) **Kategorien:** IT-Security **Schlagwörter:** Troubleshooting, Weblogic --- ### [Mit der Oracle Mobile Security Suite die BYOD-Risiken beherrschen](https://thecattlecrew.net/2014/05/27/mit-der-oracle-mobile-security-suite-die-byod-risiken-beherrschen/) **Published:** Mai 27, 2014 **Author:** Marius Keppler **Content:** Derzeit nutzen viele Mitarbeiter ihre privaten Geräte im Unternehmensumfeld und speichern Unternehmensdaten darauf. Der als „Bring Your Own Device“(BYOD) bezeichnete Trend birgt für Unternehmen viele Gefahren, welche die Oracle Mobile Security Suite zu beherrschen versucht. Die Oracle Mobile Security Suite wurde von dem Start-Up Bitzer Mobile entwickelt, später von Oracle gekauft und in die Produktpalette integriert. ## Herausforderungen bei BYOD Bei der Nutzung der eigenen mobilen Endgeräte im Unternehmensumfeld sind die Unternehmensdaten mehr Gefahren ausgesetzt, als bei unternehmenseigenen Geräten. Falls der Mitarbeiter zum Beispiel den Unternehmens-Exchange Server auf seinem eigenen Smartphone konfiguriert, ist es dem Mitarbeiter jederzeit möglich auf seine E-Mails, Kalender und Kontakte zuzugreifen. Dies erhöht zwar die Erreichbarkeit und Produktivität, bringt jedoch auch einige Gefahren mit sich. Bei Verlust des Smartphones sind auch die Zugänge und die auf dem Handy befindlichen Daten verloren. Dies gilt natürlich gleichermaßen für private und geschäftlich Geräte, doch bei privaten Geräten ist die Handlungsfähigkeit des Unternehmens eingeschränkt. Da die privaten und geschäftlichen Daten auf dem Smartphone nicht klar voneinander getrennt sind, ist es dem Unternehmen nicht gestattet, Daten des Smartphones zu löschen. Dadurch würden auch die privaten Daten des Mitarbeiters gelöscht werden. Darüber hinaus ist es dem Unternehmen nicht möglich, Richtlinien für die geschäftlichen Daten zu aktivieren bzw. deren Einhaltung zu kontrollieren, ohne das dies auch die privaten Daten betreffen würde. ## Funktionen der Oracle Mobile Security Suite Die Oracle Mobile Security Suite adressiert diese Probleme durch die Möglichkeit private und geschäftliche Daten klar voneinander zu trennen. Ausgangspunkt dafür ist ein sogenannter Container, der die geschäftlichen Apps und deren Daten kapselt. Unternehmensanwendungen werden nur innerhalb des Containers installiert und dadurch in einer abgesicherten Umgebung ausgeführt. Jegliche Zugriffe von Apps aus dem Container heraus sind durch eine Art VPN-Tunnel grundsätzlich verschlüsselt, ein Zugriff von privaten Applikationen in den Container herein ist nicht möglich. Der Container ist selbstverständlich passwortgeschützt (Anbindung an Enterprise Active-Directory o.ä. möglich) und jegliche Daten innerhalb des Containers werden verschlüsselt abgespeichert. [![Oracle Mobile Security Suite](https://thecattlecrew.net/wp-content/uploads/2014/05/oraclemsscontainer.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/05/oraclemsscontainer.png) Um nun ein Gerät mit der Oracle Mobile Security Suite auszurüsten, muss im ersten Schritt die Container-App installiert werden. Die Container-App sieht auf den ersten Blick wie eine normale App aus, nach Start der Container-App muss man sich zuerst erfolgreich authentifizieren, dann erscheint der Unternehmens-Workspace. Dieser Unternehmens-Workspace beinhaltet einen App-Katalog und die installierten Apps. Der App-Katalog wird verwendet um weitere Applikationen innerhalb des Containers zu beziehen. Innerhalb des App-Katalogs stehen per Default ein sicherer Browser, Mail, Kalender, Kontakte-App zur Verfügung. In den App-Katalog können aber auch individuelle Apps hinzugefügt werden, von denen die kompilierte aber nicht signierte App zur Verfügung steht. Um eine App in den App-Katalog aufzunehmen, steht die Mobile Security Administrative Console zur Verfügung. Sowohl auf iOS, als auch auf Android Geräten wird dadurch der plattformspezifische App-Store umgangen. Auf Apple Geräten ist daher kein App-Review durch das iOS-Team notwendig, um eine App in dem App-Katalog zu listen. [![Oracle Mobile Security Suite](https://thecattlecrew.net/wp-content/uploads/2014/05/oraclemsstunel.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/05/oraclemsstunel.jpg) Die Mobile Security Administrative Console ermöglicht die Verwaltung der Berechtigungen, Apps und installierter Container. Es ist möglich einzelne Container zu sperren oder zu löschen (wipen). Bei dem wipen eines Containers bleiben alle privaten Daten des mobilen Gerätes unberührt, nur die Daten innerhalb des Containers werden gelöscht. Damit dieser Löschvorgang ausgeführt wird muss das mobile Gerät eine Netzwerkverbindung besitzen, der Container aber nicht gestartet sein (Push-Benachrichtigung). Durch ein Rechtesystem ist es möglich bestimmten Mitarbeitern bzw. Rollen den Zugriff auf Apps oder anderer Funktionen anhand verschiedener Parameter (z.B. Location, Uhrzeit, Netzwerkverbindung) zu kontrollieren. Dadurch ist es z.B. möglich einem Mitarbeiter nur Zugriff auf besonders kritische Apps zu erlauben, wenn er sich innerhalb des Unternehmens-Campus oder WLAN-Netzwerkes befindet. Es gibt auch eine Möglichkeit um neue Versionen von Apps hochzuladen und das Update auf Mitarbeitergeräte zu erzwingen. Mehr Informationen zur Mobile Security Suite gibt es unter: **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Bitzer, BYOD, Mobile --- ### [IT-Security: WebLogic Server and Authentication "“ Part 4](https://thecattlecrew.net/2014/06/05/it-security-weblogic-server-and-authentication-part-4/) **Published:** Juni 5, 2014 **Author:** Mohammad Esad-Djou **Content:** As I mentioned, JAAS is able for two important tasks: authentication and authorization of users. Now, let us see more about them. ## Authentication: Who are you? Authentication verifies that the user is who she/he claims to be. But user is also an entity and could be a person, a software entity or other instances of WebLogic Server (so called „resources“). WLS performs proof material typically through a JAAS LoginModule and JAAS authentication is implemented in a pluggable method. A user“™s identity is confirmed through the credentials presented by that user, such as: 1. something one has, e.g. credentials issued by a trusted authority such as a passport or a smart card 2. something one knows, e.g. a shared secret such as a password, 3. something one is, e.g. biometric information A combination of several types of credentials is known as „strong“ authentication; e.g. using an ATM card (credential 1) with a PIN or password (credential 2).[\[1\]](#_edn1) ## Types of Authentication WebLogic Server is able to perform the different types of authentication, because it can use the WebLogic Authentication provider or custom security providers. Administrators are able to define a user and password with WebLogic Authentication provider. The all passwords will be encrypted. Users may be placed into groups or be related with security roles. [![p4_wls_usr_grp](https://thecattlecrew.net/wp-content/uploads/2014/06/p4_wls_usr_grp.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/06/p4_wls_usr_grp.jpg) ### Basic Authentication: Username/Password Basic authentication is defined via The Internet Engineering Task Force (IETF®) so: „The „basic“ authentication scheme is based on the model that the client must authenticate itself with a user-ID and a password for each realm. The realm value should be considered an opaque string which can only be compared for equality with other realms on that server. The server will service the request only if it can validate the user-ID and password for the protection space of the Request-URI. There are no optional authentication parameters.“[\[2\]](#_edn2) In this type of authentication will be user/password requested. WebLogic scenario looks like this: the user and sent ID/PW to WebLogic Server. It checks them and if it is reliable, gives access to the protected WebLogic resource. In background, WebLogic Server checks the security policy of the WebLogic resource and the principal (that the user has been assigned) to make sure that the user has the obligatory permissions to continue. [![p4_login](https://thecattlecrew.net/wp-content/uploads/2014/06/p4_login.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/06/p4_login.jpg) In addition, you can use https. User/password will be encrypted between client and server through SSL communication. It is an extra advantage that the transaction between client and server will not be performed in clear text. ### Certificate Authentication We are going to discuss about Secure Sockets Layer (SSL) in the next articles. SSL delivers protected connections. The SSL-communicating authenticate identity of two entity and/or application that communicate through a network connection. In addition, the whole SSL-communication is encrypted. WebLogic Server provides a pure-Java implementation of SSL and supports One-Way- and Two-Way- SSL authentication. Simple to say, if a WLS to authenticate to a client, then we have a One-Way SSL. If a client to authenticate to a WLS, then we have Two-Way SSL. One-Way SSL is obligatory but Two-Way SSL is optional. During „handshaking“ exchange the applications and/ or entities digital certificates. The digital certificate is supplied by an entity, which authenticates the identity of WebLogic Server. Afterwards, the both sides, also WebLogic Server and client, decide on the encryption algorithms to be used. As third step, SSL-connection generates the encryption keys to be used for the remainder of the session. The encryption keys is a hybrid encryption approach that it uses advantages of asymmetric and symmetric encryption therefore, it is known as a good combination between better performance and security in network communication. ### Digest Authentication We are going back to this topic for deeper discussion. As an introduction, we can start with the definition of The Internet Engineering Task Force (IETF®): „Like Basic Access Authentication, the Digest scheme is based on a simple challenge-response paradigm. The Digest scheme challenges using a nonce value. A valid response contains a checksum (by default, the MD5 checksum) of the username, the password, the given nonce value, the HTTP method, and the requested URI. In this way, the password is never sent in the clear. Just as with the Basic scheme, the username and password must be prearranged in some fashion not addressed by this document.“[\[3\]](#_edn3) Weblogic Server supports digest authentication and is resistant to replay attacks. „The implementation maintains a cache of used nonces/timestamps for a specified period of time. All requests with a timestamp older than the specified timestamp are rejected as well as any requests that use the same timestamp/nonce pair as the most recent timestamp/nonce pair still in the cache. WebLogic Server stores this cache in a database.“[\[4\]](#_edn4) I“™m going to continue with Authentication“™s topic in next part of IT-Secrutity and WebLogic Server. [\[1\]](#_ednref1) See Oracle Fusion Middleware Security Overview [http://docs.oracle.com/cd/E23943\_01/core.1111/e12889.pdf](http://docs.oracle.com/cd/E23943_01/core.1111/e12889.pdf) Oracle Fusion Middleware 11.1.1.5, Security Guides [http://docs.oracle.com/cd/E21764\_01/security.htm](http://docs.oracle.com/cd/E21764_01/security.htm) Oracle® Fusion Middleware Securing Oracle WebLogic Server [http://docs.oracle.com/cd/E21764\_01/web.1111/e13707/toc.htm](http://docs.oracle.com/cd/E21764_01/web.1111/e13707/toc.htm) Oracle Platform Security Services 11gR1 (White Paper) [\[2\]](#_ednref2) Request for Comments: 2617: The Internet Engineering Task Force (IETF®): [\[3\]](#_ednref3) Request for Comments: 2617: The Internet Engineering Task Force (IETF®): [\[4\]](#_ednref4) Oracle® Fusion Middleware Understanding Security for Oracle WebLogic Server 11g Release 1 (10.3.5) [http://docs.oracle.com/cd/E21764\_01/web.1111/e13710/toc.htm](http://docs.oracle.com/cd/E21764_01/web.1111/e13710/toc.htm) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** Authentication, Certificate, Digest Authentication, English, Weblogic --- ### [IT-Security (Part 5): WebLogic Server, perimeter Authentication and Identity Assertion](https://thecattlecrew.net/2014/06/22/it-security-part-5-weblogic-server-perimeter-authentication-and-identity-assertion/) **Published:** Juni 22, 2014 **Author:** Mohammad Esad-Djou **Content:** I tried to discuss about „perimeter authentication“ in one extra part of IT-Security“™s blogs, because this authentication“™s process is an essential approach in a heterogonous world of systems, applications and technologies that they need to trust and communicate to each other. Generally, we discussed about perimeter authentication, if a remote user requires an asserted identity and some form of proof material to an authentication server that performs the verification and then passes an artifact, or token, to the application server domain.[\[1\]](#_edn1) If we want to identify a *remote user outside* of the WebLogic server domain, as an authentication server, then we need to another approach for authenticating“™s process instead basic authentication with username and password[\[2\]](#_edn2). This authentication“™s process is called perimeter authentication. It establishes trust via a passphrase, e.g. tokens. Tokens will be generated as part of the authentication process of users or system processes and could have many different types and / or vendors, e.g. Kerberos and Security Assertion Markup Language (SAML). WebLogic Server is able to use the token(s) so that users are not requested to sign on more than once. This form of authentication operates with authentication agent. It performs an authentication process that outcomes in a token. It contains the authentication information of user and guarantees for the user“™s identity. The Figure1 Perimeter Authentication[\[3\]](#_edn3) presents the sequence of events in authenticating process: Remote User sends a request with passphrase to Authentication Agent. It creates a token and sends to WebLogic Server to access resources and / or application(s). The WebLogic Server perform perimeter authentication via Identity Assertion. [![Perimeter Authentication](https://thecattlecrew.net/wp-content/uploads/2014/06/p5_perimeterauthentication_1.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/06/p5_perimeterauthentication_1.jpg)Perimeter Authentication **Figure 1 Perimeter Authentication** We can define the Identity Assertion provider, as a *specific form of Authentication provider* that permits users or applications to assert their identity using tokens. With other words, it supports user“™s mappers, which map a valid token to a WLS-User. It is possible to develop your own or use a third-party security vendor’s Identity Assertion providers. Identity assertion can use perimeter authentication schemes such as the Security Assertion Markup Language (SAML), the Simple and Protected GSS-API Negotiation Mechanism (SPNEGO), or enhancements to protocols such as Common Secure Interoperability (CSI) v2 and support single sign-on.[\[4\]](#_edn4) The WebLogic Identity Assertion providers support the following token types[\[5\]](#_edn5) (here is *a selected list* of token types): - AU\_TYPE, for a WebLogicAuthenticatedUserused as a token. - X509 is an ITU-T standard for a public key infrastructure (PKI) and Privilege Management Infrastructure (PMI) and RFC 4158 provides information and guidance for certification path building.[\[6\]](#_edn6) - X509\_TYPE, for an X509 client certificate used as a token: - CSI\_X509\_CERTCHAIN\_TYPE, for a CSIv2 X509 certificate chain identity used as a token. „The Negotiate Identity Assertion provider is used for SSO with Microsoft clients that support the SPNEGO protocol. The Negotiate Identity Assertion provider decodes SPNEGO tokens to obtain Kerberos tokens, validates the Kerberos tokens, and maps Kerberos tokens to WebLogic users. The Negotiate Identity Assertion provider utilizes the Java Generic Security Service (GSS) Application Programming Interface (API) to accept the GSS security context via Kerberos. The Negotiate Identity Assertion provider is for Windows NT Integrated Login.“ [\[7\]](#_edn7) - AUTHORIZATION\_NEGOTIATE, for a SPNEGO internal token used as a token. - WWW\_AUTHENTICATE\_NEGOTIATE, for a SPNEGO internal token used as a token. „The SAML Identity Assertion providers handle SAML assertion tokens when WebLogic Server acts as a SAML destination site. The SAML Identity Assertion providers consume and validate SAML assertion tokens and determines if the assertion is to be trusted (using either the proof material available in the SOAP message, the client certificate, or some other configuration indicator).“[\[8\]](#_edn8) I am going back to SAML topic in an additional article(s). - SAML\_ASSERTION\_B64\_TYPE, for a Base64 encoded SAML.assertion used as a token. - SAML\_ASSERTION\_DOM\_TYPE, for a SAML DOM element used as a token. - SAML\_ASSERTION\_TYPE, for a SAML string XML form used as a token. - SAML2\_ASSERTION\_DOM\_TYPE, for a SAML2 DOM element used as a token. - SAML2\_ASSERTION\_TYPE, for a SAML2 string XML form used as a token. - SAML\_SSO\_CREDENTIAL\_TYPE, for a SAML string consisting of the TARGET parameter concatenated with the assertion itself and used as a token. I introduced about Digest Authentication[\[9\]](#_edn9) in previous blog and WebLogic supports für Web Service application the following Digest type: - WSSE\_PASSWORD\_DIGEST\_TYPE, for a username token with a password type of password digest used as a token. ## The Authentication and Identity Assertion Process Now, we can compare Basic authentication Process with Identity Assertion Process. On Figure 2 Authentication Process (Principal Validation Process)[\[10\]](#_edn10) shows the authentication process for a fat-client login. A user attempts to log into a system using a username/password combination. WebLogic Server establishes trust by calling the configured Authentication provider’s LoginModule, which validates the user’s username and password and returns a subject that is populated with principals per Java Authentication and Authorization Service (JAAS) [\[11\]](#_edn11) requirements. In this way, an authentication context will be established and user can access to certain resource and / or components in WebLogic Domain. [![Authentication Process (Principal Validation Process)](https://thecattlecrew.net/wp-content/uploads/2014/06/p5_authenticationprocess_2.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/06/p5_authenticationprocess_2.jpg)Authentication Process (Principal Validation Process) **Figure 2 Authentication Process (Principal Validation Process)** Figure 3 Perimeter Authentication presents the perimeter authentication process[\[12\]](#_edn12). 1. A token from *outside* of WebLogic Server is passed to an Identity Assertion provider that is responsible for validating tokens of that type and that is configured as „active“. 2. If the token is successfully validated, the Identity Assertion provider maps the token to a WebLogic Server username, and sends that username back to WebLogic Server, which then continues the authentication process as described above. It requires the same components[,](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/atn.htm) but also adds an Identity Assertion provider. Specifically, the username is sent via a Java Authentication and Authorization Service (JAAS)CallbackHandlerand passed to each configured Authentication provider’s LoginModule, so that the LoginModule can populate the subject with the appropriate principals. [![Perimeter Authentication](https://thecattlecrew.net/wp-content/uploads/2014/06/p5_perimeterauthentication_3.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/06/p5_perimeterauthentication_3.jpg)Perimeter Authentication **Figure 3 Perimeter Authentication** If you compare the two ways of authentication, then you can find out a core security characteristic of WebLogic Server too. It is mean; WebLogic Server security architecture has a consistence modular structure and therefore can response rapid to new challenges and technologies in security area. This architecture is capable to expand its features und integrate new security components in itself. [\[1\]](#_ednref1) Oracle® Fusion Middleware: Understanding Security for Oracle WebLogic Server, 11g Release 1 (10.3.6), E13710-06 [\[2\]](#_ednref2) For „Basic Authentication: Username/Password“ see: [\[3\]](#_ednref3) Oracle® Fusion Middleware: Understanding Security for Oracle WebLogic Server, 11g Release 1 (10.3.6), E13710-06 [\[4\]](#_ednref4) Oracle® Fusion Middleware Developing Security Providers for Oracle WebLogic Server, 11g Release 1 (10.3.6), Part Number E13718-05, [http://docs.oracle.com/cd/E23943\_01/web.1111/e13718/ia.htm](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/ia.htm) [\[5\]](#_ednref5) Oracle® Fusion Middleware Developing Security Providers for Oracle WebLogic Server, 11g Release 1 (10.3.6), Part Number E13718-05, [http://docs.oracle.com/cd/E23943\_01/web.1111/e13718/ia.htm](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/ia.htm) [\[6\]](#_ednref6) See: [\[7\]](#_ednref7) Oracle® Fusion Middleware Developing Security Providers for Oracle WebLogic Server, 11g Release 1 (10.3.6), Part Number E13718-05, [http://docs.oracle.com/cd/E23943\_01/web.1111/e13718/ia.htm](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/ia.htm) [\[8\]](#_ednref8) Oracle® Fusion Middleware Developing Security Providers for Oracle WebLogic Server, 11g Release 1 (10.3.6), Part Number E13718-05, [http://docs.oracle.com/cd/E23943\_01/web.1111/e13718/ia.htm](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/ia.htm) [\[9\]](#_ednref9) See [\[10\]](#_ednref10) See: [http://docs.oracle.com/cd/E23943\_01/web.1111/e13718/atn.htm#i1141106](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/atn.htm#i1141106) [\[11\]](#_ednref11) IT-Security (Part 3): WebLogic Server and Java Security Features: [\[12\]](#_ednref12) See [http://docs.oracle.com/cd/E23943\_01/web.1111/e13718/ia.htm](http://docs.oracle.com/cd/E23943_01/web.1111/e13718/ia.htm) **Kategorien:** IT-Security, Tools & Methoden **Schlagwörter:** authentication’s process, English, Identity Assertion, JDeveloper, perimeter authentication, Principal Validation Process, Privilege Management Infrastructure (PMI), public key infrastructure (PKI), SAML, Service Bus, WebCenter Content, Weblogic, X509 --- ### [OSB: Using Tuxedo transport with eclipse development environment](https://thecattlecrew.net/2014/06/27/osb-using-tuxedo-transport-with-eclipse-development-environment/) **Published:** Juni 27, 2014 **Author:** Bernhard Mähr **Content:** When doing development for the OSB I usually don“™t do this with the sbconsole, I use eclipse instead. There are some reasons: - It is my usual development environment - It is directly connected to the concurrent version tool - The build and deploy scripts are used and tested from the start of the project - The debugging feature of the OSB is not blocked - Multiple developers are able to work concurrently on one OSB - Copying or moving parts of the message flow is possible In my current project we use the WTC to connect from the OSB to the Oracle Tuxedo server. Inside the OSB it is possible to create a business service for the tuxedo protocol. This can be done inside the sbconsole but also inside eclipse. The problem occurs when we try to configure the endpoint uri at the Transport tab. Using sbconsole it was possible to use for resourcename and remotename the values configured in WTC import. But when setting the same values with eclipse validation errors popped up. [![BLOG_OSB_Tuxedo_01](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_tuxedo_01_thumb.png "BLOG_OSB_Tuxedo_01")](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_tuxedo_01.png) And I can understand eclipse! Eclipse doesn“™t have a connection to the OSB server and doesn“™t know what kind of resources are defined there. I was not able to create a connection to the OSB server ore configure something to fix this issue. That“™s why I was not able to finish the configuration for the business service with eclipse. My workaround for the problem was to configure the business service with sbconsole, export the project as a jar file, extract the business service form the jar file and place it to the correct position on my eclipse project. I was able to use the business service inside of the message flow of the proxy service without any errors. Also the build and deployment was possible without any errors. Only when opening the business service inside of eclipse the errors popped up again. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Development, Tools & Methoden **Schlagwörter:** English, Oracle FMW, Service Bus --- ### [Encrypted credentials in Maven with jasypt](https://thecattlecrew.net/2016/01/08/encrypted-credentials-in-maven-with-jasypt/) **Published:** Januar 8, 2016 **Author:** Bernhard Mähr **Content:** When developing enterprise applications it is best practice check in the source code into a version control system. Additionally to the code also configuration settings and credentials are often checked in. This is usually no problem for test environments, but configurations for the production environments perhaps should not be readable for everyone having access to the version control system. This can be solved using some type of access control on the version control system. Or the credentials can be entered as parameters during the build or deployment for production. That is only a feasible solution for one or two credentials. An other solution is to encrypt the confidential data and decrypt it with a master password. This solution is supported by the java library [jasypt](http://www.jasypt.org/). Credits for the basic implementation with ant goes to my former colleague Mr. Wiedemann. I have adapted the solution for the use with Maven. Jasypt doesn“™t provide a Maven plugin. That’s why we need some type of glue code to use the jasypt library. We use the language groovy to write the glue code. For Maven there exists a plugin to execute groovy code in an easy way. The final solutions looks like this: 1 2 org.codehaus.gmaven 3 groovy-maven-plugin 4 5 6 decrypt-passwords 7 validate 8 9 execute 10 11 12 13 import org.jasypt.properties.EncryptableProperties 14 import org.jasypt.encryption.pbe.StandardPBEStringEncryptor 15 16 if(properties\[„jasypt.encryption.password“\]==null){ 17 ant.echo „\[INFO\] jasypt.encryption.password not set, passwords will not be decrypted.“ 18 return 19 } 20 21 StandardPBEStringEncryptor encryptor = new StandardPBEStringEncryptor() 22 encryptor.setPassword(properties\[„jasypt.encryption.password“\]) 23 24 Properties props = new EncryptableProperties((Properties)properties, encryptor); 25 26 props.propertyNames().each { 27 if(!it.startsWith(„resolved“)){ 28 project.properties\[it\] = props.getProperty(it) 29 } 30 } 31 32 33 34 35 36 37 org.jasypt 38 jasypt 39 1.9.2 40 41 42 If the property jasypt.encryption.password is not set the plugin prints an info message and does nothing. Otherwise the plugin decrypts every encrypted property and replaces the value with the decrypted value. The encryption of the value can be done [with the command line](http://www.jasypt.org/cli.html). The encrypted value has to be embedded into ENC(). Finally the property looks like this: 1 admin.password=ENC(RJJ37UPsM2CstIQPohskn7Yn05gtrIK0) At the dependencies section we add the library of jasypt. The plugin should run during the validate phase. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** Development, IT-Security, Tools & Methoden **Schlagwörter:** Web Developement --- ### [Close the containing parent popup component without binding using an actionEvent](https://thecattlecrew.net/2016/01/20/close-the-containing-parent-popup-component-without-binding-using-an-actionevent/) **Published:** Januar 20, 2016 **Author:** Marvin Muuß **Content:** When using popups in ADF we suffered the problem to close the popup after finishing the activity. So this is the request: We have a table providing data with an info facet holding buttons for adding, editing and deleting a selected row. While the add and edit button open a popup with a form the delete button opens a dialog to confirm the delete action. This is realized with a showPopupBeavior. Of course there is a cancel button in all of these popups closing it immediately and rolling back. ![popup](https://thecattlecrew.net/wp-content/uploads/2015/09/popup.png?w=300) So this is an example what a popup might look like. As the cancel button immediately rollbacks, the save button immediately commits the made changes. [![delete](https://thecattlecrew.net/wp-content/uploads/2015/09/delete.png)](https://thecattlecrew.net/wp-content/uploads/2015/09/delete.png) This is the delete popup This cancel button is just out of the box, closing the dialog and not rolling back because there is nothing to rollback. But delete executes this action, commits and closes the dialog. **How is this implemented?** Every button has an actionListener property which we will use. After completing out task in the code before we will call a closePopup method. \[code language=“java“\]public void closePopup(ActionEvent actionEvent) { UIComponent tmpComponent; tmpComponent = actionEvent.getComponent().getParent(); while (!(tmpComponent instanceof RichPopup)) { tmpComponent = tmpComponent.getParent(); } RichPopup popup = (RichPopup) tmpComponent; popup.hide(); }\[/code\] So we are going the parent of the calling component until we hit an UIComponent, which is an instance of a RichPopup we can close. **What“™s the advantage of this?** First of all this code is reusable for every situation where we want to close the parent popup. Secondly it“™s irrespective of binding the component to the bean. Even though we did not experience problems with this technique closing the popup, we are not aware of following problems. If you know some issues that may appear, please let us know in the comments! **Kategorien:** Development, Integration **Schlagwörter:** ADF, English, Java, JDeveloper, oracle, Oracle DB, Oracle FMW, Softwarenentwicklung, Weblogic --- ### [Setting up a own CA for the enterprise](https://thecattlecrew.net/2016/01/20/setting-up-a-own-ca-for-the-enterprise/) **Published:** Januar 20, 2016 **Author:** Bernhard Mähr **Content:** Inside an enterprise there are a lot of machines communicating with each other. It is necessary to keep these communications secure and private. This can be achieved through encryption. In the enterprise SOA the most important protocol is HTTP. The encrypted version is HTTPS and needs at least one certificate. The certificate is the host certificate of the server and must be trusted on client side. For details have a look at [this post](https://thecattlecrew.net/2016/01/15/using-certificates-for-authentication-at-m2m-communication/). The needed certificate can be bought with a yearly fee of some euros from an official certificate authority. An other possibility is to just use the certificates generated by the systems themselves („˜snakeoil“™ certificate). But if the enterprise needs many certificates a better solution is to set up a own certificate authority for the enterprise. Don“™t underestimate the effort for having your own CA. The effort is not in first place for setting up the CA or generating the certificates. Much more time is needed for the education of the employees handling the CA, the organizational processes and the documentation of issued certificates, keys and their lifetime. At official certificate authorities there are hundreds of folders describing how the employees have to act in different situations, who has the permissions to do what, who can substitute key persons and so on. Even if you don“™t need such complex processes there should be some definitions about the confidentiality of the CA and the generated certificates and substations for the employee handling the CA. I will describe how to do the serveral actions with openssl on a linux machine. Of course a current version of openssl should be used. ### openssl.cnf The first step for setting up the CA is to create or modify the file openssl.cnf. When I started to set up the CA I was surprised how difficult to understand and bad the documentation of this file was. In fact I was missing an example of the file with current settings and without everything else which is not really needed. The extension system of the openssl.cnf file makes it quite difficult to understand. If some reader has suggestions to improve it, I would be very appreciated. 1 \# 2 \# OpenSSL example configuration file. 3 \# This is mostly being used for generation of certificate requests. 4 \# 5 6 \# This definition stops the following lines choking if HOME isn’t 7 \# defined. 8 HOME = . 9 RANDFILE = $ENV::HOME/.rnd 10 11 \#################################################################### 12 \[ ca \] 13 default\_ca = CA\_default # The default ca section 14 15 \#################################################################### 16 \[ CA\_default \] 17 18 dir = ./CA # Where everything is kept 19 certs = $dir/certs # Where the issued certs are kept 20 crl\_dir = $dir/crl # Where the issued crl are kept 21 database = $dir/index.txt # database index file. 22 \#unique\_subject = no # Set to ’no‘ to allow creation of 23 # several ctificates with same subject. 24 new\_certs\_dir = $dir/newcerts # default place for new certs. 25 26 certificate = $dir/cacert.pem # The CA certificate 27 serial = $dir/serial # The current serial number 28 crlnumber = $dir/crlnumber # the current crl number 29 # must be commented out to leave a V1 CRL 30 crl = $dir/crl.pem # The current CRL 31 private\_key = $dir/private/cakey.pem # The private key 32 RANDFILE = $dir/private/.rand # private random number file 33 34 default\_days = 365 # how long to certify for 35 default\_crl\_days = 30 # how long before next CRL 36 default\_md = default # use public key default MD 37 preserve = no # keep passed DN ordering 38 39 \# A few difference way of specifying how similar the request should look 40 \# For type CA, the listed attributes must be the same, and the optional 41 \# and supplied fields are just that 🙂 42 policy = policy\_match 43 44 \# For the CA policy 45 \[ policy\_match \] 46 countryName = match 47 stateOrProvinceName = optional 48 organizationName = match 49 organizationalUnitName = optional 50 commonName = supplied 51 emailAddress = optional 52 53 \#################################################################### 54 \[ req \] 55 default\_bits = 2048 56 default\_md = sha256 57 default\_keyfile = privkey.pem 58 distinguished\_name = req\_distinguished\_name 59 attributes = req\_attributes 60 61 \# This sets a mask for permitted string types. There are several options. 62 \# default: PrintableString, T61String, BMPString. 63 \# pkix : PrintableString, BMPString (PKIX recommendation before 2004) 64 \# utf8only: only UTF8Strings (PKIX recommendation after 2004). 65 \# nombstr : PrintableString, T61String (no BMPStrings or UTF8Strings). 66 \# MASK:XXXX a literal mask value. 67 \# WARNING: ancient versions of Netscape crash on BMPStrings or UTF8Strings. 68 string\_mask = pkix 69 70 \[ req\_distinguished\_name \] 71 countryName = Country Name (2 letter code) 72 countryName\_default = DE 73 countryName\_min = 2 74 countryName\_max = 2 75 76 stateOrProvinceName = State or Province Name (full name) 77 78 localityName = Locality Name (eg, city) 79 localityName\_default = Muenchen 80 81 0.organizationName = Organization Name (eg, company) 82 0.organizationName\_default = opitz-consulting 83 84 organizationalUnitName = Organizational Unit Name (eg, section) 85 organizationalUnitName\_default = IT Department 86 87 commonName = Common Name (eg, your name or your server\\’s hostname) 88 commonName\_max = 64 89 90 emailAddress = Email Address 91 emailAddress\_max = 64 92 93 \[ req\_attributes \] 94 challengePassword = A challenge password 95 challengePassword\_min = 4 96 challengePassword\_max = 20 97 98 unstructuredName = An optional company name 99 100 \#################################################################### 101 \[ root\_ca\_extensions \] 102 \# This (basicConstraints = critical,CA:true) is what PKIX recommends but some broken software chokes on critical extensions. So we do this instead: 103 basicConstraints = CA:true 104 105 \# Key usage: this is typical for a CA certificate. However since it will 106 \# prevent it being used as an test self-signed certificate it is best 107 \# left out by default. 108 keyUsage = keyCertSign, cRLSign 109 110 \# PKIX recommendations harmless if included in all certificates. 111 subjectKeyIdentifier = hash 112 authorityKeyIdentifier = keyid:always,issuer 113 114 115 \#################################################################### 116 \[ client\_ca\_extensions \] 117 \# This goes against PKIX guidelines but some CAs do it and some software 118 \# requires this to avoid interpreting an end user certificate as a CA. 119 basicConstraints = CA:false 120 121 \# This is typical in keyUsage for a client certificate. 122 keyUsage = keyEncipherment,nonRepudiation,digitalSignature,keyAgreement 123 124 \# This is required for TSA certificates. 125 \# extendedKeyUsage = critical,timeStamping 126 extendedKeyUsage = 1.3.6.1.5.5.7.3.1,1.3.6.1.5.5.7.3.2 127 128 \# PKIX recommendations harmless if included in all certificates. 129 subjectKeyIdentifier =hash 130 authorityKeyIdentifier =keyid,issuer 131 132 133 \#################################################################### 134 \[ server\_ca\_extensions \] 135 \# This goes against PKIX guidelines but some CAs do it and some software 136 \# requires this to avoid interpreting an end user certificate as a CA. 137 basicConstraints = CA:false 138 139 \# This is typical in keyUsage for a host certificate. 140 keyUsage = keyEncipherment,nonRepudiation,digitalSignature,keyAgreement 141 142 \# This is required for TSA certificates. 143 \# extendedKeyUsage = critical,timeStamping 144 extendedKeyUsage = 1.3.6.1.5.5.7.3.1,1.3.6.1.5.5.7.3.2 145 146 \# PKIX recommendations harmless if included in all certificates. 147 subjectKeyIdentifier = hash 148 authorityKeyIdentifier = keyid,issuer 149 150 In the first section CA\_default the location of different files is described. The line „˜default\_ca = CA\_default“™ is an inclusion of the CA\_default extension. If unique\_subject = no is commented out, it is necessary to [revoke](https://en.wikipedia.org/wiki/Revocation_list) every old certificate until a new one with the same subject can be generated. The value default\_days = 365 issues by default certificates with the validity of a year. The extension policy\_match defines how certificate requests to be signed by this CA must be. It is activated by the line „˜policy = policy\_match“™. Next one is the extension req. It will be activated if we are creating a [certificate signing request](https://en.wikipedia.org/wiki/Certificate_signing_request). We set the default rsa key length to 2048 bit and the default algorithm to [SHA-2](https://en.wikipedia.org/wiki/SHA-2). With req\_distinguished\_name we set up the defaults for the CN and the other attributes of the certificate. After that I decided to create three different extensions for the three different use cases: root\_ca\_extensions, client\_ca\_extensions and server\_ca\_extensions. The used extension is selected during the signing of the csr. In my first tries the client\_ca\_extensions and server\_ca\_extensions had different extendedKeyUsage settings: 1.3.6.1.5.5.7.3.2 for the client and 1.3.6.1.5.5.7.3.1 for the server. In my opinion this should be enough, but I later found some unexpected behaviors on one system perhaps triggered by this so I didn“™t do further research and added both key usages to both certificates. For the field keyUsage I found a good describing comment on [stackexchange](https://security.stackexchange.com/questions/24106/which-key-usages-are-required-by-each-key-exchange-method). To sum up: Needed usages depends on the cipher suite, that’s why it is recommend to add all 4. ### Creating the CA key and self signing the CA certificate First we generate the private key of the root CA and store it encrypted in a file: 1 openssl genrsa -out ${ROOT\_CA\_KEY} 4096 -des3 ROOT\_CA\_KEY is the encrypted private key file of the root certificate of the CA. The second step is to create the certificate of the root CA: 1 openssl req -x509 -new -days 3650 -md sha256 -config /etc/pki/tls/openssl.cnf -extensions root\_ca\_extensions -key ${ROOT\_CA\_KEY} -out ${ROOT\_CA\_CRT} -passin pass:${ROOT\_CA\_PWD} ROOT\_CA\_PWD is the password for the private key of the root certificate. ROOT\_CA\_CRT is the root certificate of the CA. Now our CA is ready to create certificates with associated private keys and signing certificate signing requests. ### Creating a client certificate with the associated private key I have implemented for all three use cases the same two steps, even if they could be combined or are not necessary in some cases: - Create a certificate signing request and a private key (file extensions csr and key) - Signing the certificate signing request and generating the certificate (file extension crt) In many examples the private key file and the certificate file use the extension pem. I prefer the extensions key and crt to make it more clear, what is inside the file. In this use case we create the csr and the key with the command: 1 openssl req -sha256 -days 365 -newkey rsa:2048 -nodes -keyout ${KEY} -out ${CSR} -subj „/C=DE/L=Muenchen/OU=IT Department/O=opitz-consulting/CN=${CERT\_CN}/emailAddress=${CERT\_EMAIL}„ KEY is the filename with path of the generated private key file CSR is the filename with path of the generated certificate signing request file CERT\_CN is the identifier of the user/system using this client certificate. This could be e.g. Mister Someone or CRM. CERT\_EMAIL is the mail address of the user or using system. The second step is to sign the csr and create the certificate: 1 openssl ca -keyfile ${ROOT\_CA\_KEY} -cert ${ROOT\_CA\_CRT} -config /etc/pki/tls/openssl.cnf -extensions client\_ca\_extensions -notext -batch -days 365 -md sha256 -in ${CSR} -out ${CRT} -passin pass:${ROOT\_CA\_PWD} CRT is the filename with path of the generated certificate file We use the client\_ca\_extensions for creating this certificate. It is highly recommend not just to execute the two command on the shell. Instead the commands should be wrapped into shell script having only one or two parameters and defining the folders, filenames, pattern for naming and so on. Otherwise, especially if different employees are issuing certificates, the overview about the certificates will be lost very soon. ### Creating a host certificate with the associated private key In this use case we create the csr and the key with the command: 1 openssl req -sha256 -days 365 -newkey rsa:2048 -nodes -keyout ${KEY} -out ${CSR} -subj „/C=DE/L=Muenchen/OU=IT Department/O=opitz-consulting/CN=${CERT\_CN}„ KEY is the filename with path of the generated private key file CSR is the filename with path of the generated certificate signing request file CERT\_CN is the full qualified hostname of the machine. The second step is to sign the csr and create the certificate: 1 openssl ca -keyfile ${ROOT\_CA\_KEY} -cert ${ROOT\_CA\_CRT} -config /etc/pki/tls/openssl.cnf -extensions server\_ca\_extensions -notext -batch -days 365 -md sha256 -in ${CSR} -out ${CRT} -passin pass:${ROOT\_CA\_PWD} CRT is the filename with path of the generated certificate file We use the server\_ca\_extensions for creating this certificate. ### Signing a host certificate request In this use case the csr is created on an other system and provided for signing. Also the private key file associated to the certificate signing request stays on the other system and is not needed for the signing process. Only the second step is to sign the csr and create the certificate is excuted: 1 openssl ca -keyfile ${ROOT\_CA\_KEY} -cert ${ROOT\_CA\_CRT} -config /etc/pki/tls/openssl.cnf -extensions server\_ca\_extensions -notext -batch -days 365 -md sha256 -in ${CSR} -out ${CRT} -passin pass:${ROOT\_CA\_PWD} CSR is the filename with path of the certificate signing request file provided CRT is the filename with path of the generated certificate file We use the server\_ca\_extensions for creating this certificate. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** Development, IT-Security --- ### [Beitrag in exklusiver Blog-Serie: Neue Flexibilität mit Forms 12c](https://thecattlecrew.net/2016/02/02/beitrag-in-exklusiver-blog-serie-neue-flexibilitaet-mit-forms-12c/) **Published:** Februar 2, 2016 **Author:** Holger Lehmann **Content:** Seit Oktober 2015 ist das neue Forms 12c draußen und bringt eine Menge neuer Features mit. Leider sind diese Neuerungen immer noch nicht ordentlich dokumentiert und in keiner Präsentation zugänglich. Zeit also, sich damit zu beschäftigen und diese herauszufinden! Ein paar Features hat der Oracle Forms Product Manager in Webinaren und Präsentationen vorgestellt, andere sind in der Online Hilfe zu finden und der Rest schlummert noch im Verborgenen. Da ich persönlich dieses Tool sehr liebe und mich damit gerne auseinandersetze, habe ich die Veröffentlichungshistorie im Vorfeld schon in etlichen Webinaren mit dem Oracle Forms Product Manager gemeinsam mit Mia Urman von Auraplayer verfolgt. Als dann im Oktober die News über die neue Version 12 draußen waren, ging es direkt los mit dem Installieren einer VM und viel, viel Ausprobieren. Über meine gesammelten Erfahrungen und die neuesten Infos von Oracle berichte ich regelmäßig in meinem persönlichen [Blog](http://hollipolli2904.blogspot.de/) und verfolge außerdem diverse andere Quellen, die sich mit dem Thema beschäftigen. Vor kurzem kam dann der Aufruf von Auraplayer zu Gastbeiträgen für ein Whitepaper der Forms Community, die nach und nach online gestellt werden sollen – Sozusagen eine Sammlung von Tipps und Tricks von Anwendern für die Forms Community weltweit. Ich fühlte mich also berufen und habe einen Beitrag eingereicht, der jetzt ganz aktuell als erster der Serie unter folgendem [Link](http://oracleformsinfo.com/2016/02/01/oracle-forms-12c-run-oracle-forms-without-a-browser-new-runtime-options-for-more-flexibility-without-a-browser/) veröffentlicht worden ist. Weitere Einträge werden wohl bald folgen. Mein Post beschäftigt sich mit neuen Wegen, über die eine Applikation unter Forms 12c laufen kann. Hintergrund sind Ankündigungen von Microsoft und Google, dass neue Browserversionen das Java-Applet nicht mehr unterstützen und somit keine Forms Applikationen mehr im Browser laufen werden. Darauf musste Oracle reagieren, um mit der neuen Version wettbewerbsfähig zu bleiben. Zum Abschluss möchte ich noch sagen, dass mit der neuen Forms-Version scheinbar ein kleiner Hype ausgelöst worden ist, sei es in Richtung der Modernisierung von Applikationen oder in Bezug auf die Wahrnehmung von Forms in der Außenwelt. Das Thema ist momentan ein fester Bestandteil diverser DOAG Veranstaltungen, anderer Oracle Konferenzen und bald auch ein Hauptschwerpunkt des kommenden DOAG DevCamps in Bonn, bei dem OC stark vertreten sein wird. **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Configuration, Java, Oracle Forms --- ### [Softwarewartung meets Microservices](https://thecattlecrew.net/2016/02/05/softwarewartung-meets-microservices/) **Published:** Februar 5, 2016 **Author:** Tobias Krämer **Content:** Wenn eine Applikation schon mehrere Jahre im Produktionsbetrieb ist, dann haben Fehlerbehebungen und die vielen Erweiterungen, die im Laufe der Zeit sicherlich vorgenommen wurden, gegebenenfalls ihre Spuren hinterlassen. Dies kann sich durch eine Verschlechterung der Wartbarkeit bemerkbar machen. Oft wurde die Applikation in einem Projektteam entwickelt und dann an ein Wartungsteam übergeben, was naturgemäß zu einem mehr oder weniger großen Verlust von Wissen führt. Je nach Umfang des Wissensverlusts trägt auch dieser zur Verschlechterung der Wartbarkeit bei. Viele weitere Faktoren sind denkbar. Die Verbesserung der Testbarkeit kann oft dem Wartungsteam dabei helfen, die Wartbarkeit zu erhöhen. Doch welche Arten von Tests sollten vorhanden sein? In welcher Quantität? Was kann von aktuellen Themen der Softwareentwicklung adaptiert werden? Diese oder noch weitere Fragen entstehen in solch einer Situation. Das Thema Testbarkeit wird auch im Kontext von Microservices-Architekturen diskutiert. Mögliche Antworten auf die oben stehenden Fragen liefert ein Artikel auf der Internetseite von Martin Fowler. Zu Beginn wird die Microservices-Architektur definiert und dann die verschiedenen Teststrategien vorgestellt. Teststrategien im Überblick: > … > – **Unit tests**: exercise the smallest pieces of testable software in the application to determine whether they behave as expected. > – Integration tests : verify the communication paths and interactions between components to detect interface defects. > – **Component tests**: limit the scope of the exercised software to a portion of the system under test, manipulating the system through internal code interfaces and using test doubles to isolate the code under test from other components. > – **Contract tests**: verify interactions at the boundary of an external service asserting that it meets the contract expected by a consuming service. > – **End-to-end tests**: verify that a system meets external requirements and achieves its goals, testing the entire system, from end to end. > … Fazit: Martin Fowler“˜s Artikel liefert mögliche Teststrategien, die sicherlich im Wartungskontext älterer Applikationen nützlich sind, aber auch weitere Ideen für einen bevorstehenden Umbau zur Verbesserung der Testbarkeit. **Kategorien:** Architecture & Process Models **Schlagwörter:** ALM, Architecture, German, Java, Microservices, Quality, Refactoring, Softwarenentwicklung, tdd, Wartung, Weiterentwicklung --- ### [Ambitionierte Geeks für Innovationsprogramm gesucht!](https://thecattlecrew.net/2016/02/09/ambitionierte-geeks-fuer-inkubator-programm-gesucht/) **Published:** Februar 9, 2016 **Author:** Torsten Winterberg **Content:** **Passt du zu uns? Passen wir zu dir? Probier“˜ es aus!** Wenn sieben oder mehr der folgenden Punkte auf dich zutreffen, passen wir perfekt zusammen: - Dein Smartphone ist mehr als nur ein Telefon? - Du hast Bücher gelesen wie „Blackout“ oder „The Circle“ und sagst dir, das ist gar nicht so unrealistisch? - Eine hitzige Diskussion über neue Ideen im Team macht dir keine Angst? - Du findest Gadgets aller Art wie Smart Watches und Fitnessarmbänder cool? - „Quantified Self“ klingt für dich nicht abschreckend? - Eine große Informationsflut macht dir keine Angst? - Du entwickelst gerne innovative Lösungen? - „Google Tango“ ist für dich kein Tanz? - Du bist neugierig, willst hinter die Dinge schauen und sie nutzbringend einsetzen? - Du hast Interesse, selbst Artikel und Blogeinträge zu publizieren und deine Themen auf Konferenzen zu präsentieren? - Du möchtest Kunden von deinen Themen überzeugen, Projekte initiieren, als Architekt begleiten und Teams enablen? - Du brennst für deine Themen und überzeugst auch Skeptiker freundlich davon, gemeinsam voranzugehen? - Du suchst einen Schnelleinstieg in ein IT-Projekt und Beratungshaus über einen ungewöhnlichen Ansatz, mit einem extrem schnell wachsenden, persönlichen Netzwerk? **Mach den ersten Schritt und bewirb dich bei uns!** Ob Student, Absolvent, Young Professional oder gestandener Architekt „“ Wir suchen dich an allen unseren Standorten für Projekte rund um Digitalisierung, Internet of Things, Big Data, Moderne Clients und Cloud Computing unter Einsatz von Lean-Startup-Ansätzen. Wenn du dich angesprochen fühlst und Freude am Finden von Lösungen, Neugier und einen irgendwie gearteten informationstechnischen Hintergrund hast, freuen wir uns auf deine Bewerbung! **Kontakt: geeks@opitz-consulting.com** ![Innovationsprogramm](https://thecattlecrew.net/wp-content/uploads/2016/02/inkubator.jpg) **Kategorien:** Tech Events & Networking **Schlagwörter:** Big Data, cloud, IoT, Softwarenentwicklung --- ### [Listening address Change in Weblogic 12.2.1 with OWSM](https://thecattlecrew.net/2016/03/31/listening-address-change-in-weblogic-12-2-1-with-owsm/) **Published:** März 31, 2016 **Author:** Grzegorz Lysko **Kategorien:** Development **Schlagwörter:** Weblogic --- ### [JavaLand 2016](https://thecattlecrew.net/2016/04/06/javaland-2016/) **Published:** April 6, 2016 **Author:** Stephan Rauh **Content:** Conferences are different if your are a speaker. Listening to talks is still important. So are the usual chores, like hunting for a cup of coffee from a dwindling supply just before the next exciting talk starts. But it’s not as important as it usually is. I’d rather use the time to prepare myself for our speech! Talking of mundane things like coffee, lunch and the location in general, I can’t help but praise the JavaLand 2016 organization. They did a great job. There we’re up to ten talks in parallel, each starting and ending at the same time. But the conference area was large enough to take the sting out of the rush hours. Of course, the organization team already had some experience. It was the third JavaLand conference, taking place at the Phantasialand, which is a picturesque location. At the time, winter returned vigorously. So we had a lot of icy fog at the first day, and a lot of sunshine at the second day. Both made for beautiful photographies. Unfortunately, German law forbids me to publish my photos, but a quick [Google search](https://www.google.de/search?q=phantasialand+germany+mainstreet&site=&tbm=isch) may give an impression. Plus, the [JavaLand conference page is worth a visit](https://www.javaland.eu/de/archiv-2016/). By the way, you can also [download the slides of every talk](https://www.javaland.eu/de/archiv-2016/downloads/). That’s an impressive collection of 77 slide decks. In other words: 246 megabytes of knowledge. Back to the topics of the conference: Java, the JVM ecosystem and what happens in the browser. There were plenty of talks. Too bad I missed so many of them due to booth service and to my own talk. So I browsed the conference program and the internet to find out about current trends, and I asked a work mate of mine to help me. ## **Trends in the Java world** First of all, I observed that the JavaLand conference is very Java-centric. All these other languages that stirred up the Java world a couple of years ago seem to have fallen into oblivion. With the exception of JavaScript, which starts to overtake Java, even if it’s a lot less mature than the Java ecosystem. Just think of „NPM-gate“. As for languages running on the JVM, only Groovy counts more than one talk at the conference. In part, the success of Groovy may be due to Gradle. The only Scala talk I saw in the conference program (and missed in real life) was about Gatling. Gatling is a framework to run load tests using a Scala DSL. I’ve got aware of Gatling only recently, so I can’t really say a lot about it, but at first glance, it looks promising. The future of Java and JavaEE were the topic of several talks. I’ll come back to that in a minute. Security was also covered by a couple of talks. However, taking into account how important security is, and how much money is invested in criminal activities, I was sort of disappointed by the small number of talks dealing with security. Granted, most attendees are developers who consider security boring (and rightfully so), but that doesn’t stop security from being important. It’s not enough to delegate these things to the security department of your company! Trends I did not see at the conference were Angular2, TypeScript, reactive programming and flux-like architecture. Granted, there were talks about these topic, but not as much as I’d expected to see. Maybe that’s because the conference focuses a lot on Java. Still, it surprises me, because in my perception these topics attract a lot of attention in the Java world in particular and in the world of web applications in general. However, two trends that were impossible to miss on the JavaLand conference were Docker and Microservices. This clearly shows in my co-workers report. ## **A closer look at a couple of talks** My co-worker visited Josh Long’s talk about the Spring cloud stack. Josh Long is well-known in the Java world and the Spring community, and he kept up to the expectations. His talk was awesome. Josh took the risk to do the talk without slides. 100% live coding. Apparently, the gamble payed off. Keywords are Eureka, config-server, API gateway and Zuul-client. After that, my co-worker attended a series of talks about Microservices. Microservices are currently en vogue in the Java world, so it’s no surprise this trend also shows at the JavaLand conference. Lars Röwekamp held an interesting talk about „the perfect microservice“. Lars claims that Domoin Driven Design is a good match for Microservices. Arek Czarnik and Alwin Mark talked about the „Big Pipe“ concept they use at Rewe Digital. They are working at a webshop in a highly competitive area, so they need a lot of flexibility. Their project setup may be too complex for many projects, but there’s a lot to learn from their slides. ## **BootsFaces and AngularFaces @ JavaLand** And then there was our talk. As you can imagine, we went there early. That was good luck, because the talk before our talk was about security, a topic I’m highly interested in. Plus, it was presented like a Shakespeare performance: a talk in five acts. Roel Spilker and Reinier Zwitserloot are great speakers. It was a lot of fun to listen to them, even if two-factor authentication is a fairly dry topic. Along the way, they busted quite a few popular myths. For instance, your security experts keep telling you that you must not tell the user whether they entered the wrong password or the wrong user name. Nonsense, Roel and Reinier say. Nowadays, this doesn’t stop hackers. It doesn’t even slow them down. But it does annoy users, so it’s the wrong approach to security, they say. By the way, the conference hall we held our talk at wasn’t a conference hall at all. It was a circus tent. The home page of the conference location, the Phantasialand, may [give you an impression](http://www.phantasialand.de/de/business-to-pleasure/top-locations/besondere-locations/lilaque/). It was a great place to talk. Our talk was about – guess what! – BootsFaces and AngularFaces. I goes without saying I could talk many hours about either topic. Currently a university student even is writing his thesis about AngularFaces. So you can imagine our 40 minutes talk was very compact. We didn’t use traditional PowerPoint slides, but decided to „eat our own dog food“. We wrote a small presentation application with BootsFaces and AngularFaces following the style of reveal.js. Mind you: in 2016, developer productivity has risen to such a high level, especially if it’s supported by powerful frameworks like BootsFaces and AngularFaces, that it can be a sensible decision to write your presentation software instead of buying it. Roughly fifty, maybe even sixty developers took the opportunity to listen to Riccardo Massera, the founder of the BootsFaces, and myself. A good outcome, considering that we help our talk in the [hinterlands of the conference](https://twitter.com/edburns/status/707565619160457216). You had to walk roughly five to ten minutes through the windy chill of winter. In case you’ve missed our talk: you can see our slides at [Slideshare](http://de.slideshare.net/opitzconsulting/bootsfaces-and-angularfaces-modern-html5-for-jsf-developers). Plus, the BootsFaces version of our talk is hosted at [AngularFaces.net/BootsFacesPresentation](http://www.angularfaces.net/BootsFacesPresentation/index.jsf). After our talk, we chatted a couple of minutes with a couple of attendees. Among them was Ed Burns, the JSF specification lead, who encouraged us to submit our talk to the JavaOne conference. Both BootsFaces and AngularFaces seem to have piqued his curiosity. ## **The future of Java and JavaEE** Needless to say, there were a couple of talks about the future of Java and JavaEE. Keywords are [value types](http://www.beyondjava.net/blog/java-8-types-revamping-javas-type-system/) which may be part of Java 9 or later, the G1GC garbage collector, CDI 2.0, MVC 1.0 (aka Ozark). There was even a „JVM deep dive“ talk explaining such advanced topic like [safepoints](http://www.beyondjava.net/blog/childs-garden-cache-effects/). A talk I’d like to point out was „CDI 2.0 deep dive“ by Mark Struberg and Thorben Janssen. It was an interesting preview to the next version of CDI. But the really interesting thing was that Mark explained why they designed things the way they did. It was exciting to have a look behind the stages. He also asked us a couple of times to vote about open design decisions. So visiting a conference doesn’t simply make you smarter. Sometimes it also gives you an opportunity to influence the direction of the JavaEE ecosystem! After the talk Mark invited me to have a cup of coffee with him. It turned out to be a very interesting chat. This guy clearly has something to say! It was a pity duty called so early. I had to do booth service at our company’s exhibition booth. This year, our principal goal was recruiting. It paid: Our initiative [„ambitious geeks wanted!“](http://karriere.opitz-consulting.com/index.php/stellenangebote/articles/fasttrack_bdi.html) was warmly received, and our company managed to establish a number of interesting contacts. Even if you’re not a student looking for a job, the German readers among you may want to follow the link. It’s a fun read! ## **Summary** JavaLand is a developer conference. If you want to learn something about programming, it’s the conference for you. There’s a wide range of topics, from the introductory level to the advanced level, from live coding to talks about architecture. Highly recommended. Next year I’m game again! ## **Sneak preview to the JAX 2016 conference** Talking of which: if you happen to visit the JAX conference in April, don’t miss the opportunity to visit our booth. I plan to be there Tuesday and Wednesday, so if you want to have a chat about BeyondJava.net, AngularFaces and BootsFaces, the JAX conference is the way to go for you. Plus, I’m the head of our company’s competence center for modern clients and agile architectures. Would you like to learn about the impact of innovative UI devices like Google Glasses, Microsoft Hololens, the Myo wristband or the myriad of sensors of your smart phone? Head for the booth of OPITZ CONSULTING in the exhibition area. Oh, and we’ve prepared a surprise for you. Visiting our booth is going to be fun! ## **Dig deeper** [The slides of every talk](https://www.javaland.eu/de/archiv-2016/downloads/) (77 slides, 246 megabytes) [The 5 key trends of JavaLand 2016](https://ordina-jworks.github.io/conferences/2016/03/10/JavaLand2016.html) by Bart Blommaerts [MVC 1.0 (aka Ozark)](https://speakerdeck.com/ivargrimstad/mvc-1-dot-0-by-example-at-javaland-2016) by Ivar Grimstad [Introduction to JVM performance](http://de.slideshare.net/RafaelWinterhalter/an-introduction-to-jvm-performance) by Rafael Winterhalter [A very disturbing keynote](http://www.security-explorations.com/materials/se-javaland.pdf) about Java Security (and the lack thereof) [Two days in JavaLand (2016)](http://www.thoughts-on-java.org/2-days-javaland-2016/) by Thorben Janssen **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** Conference, English, Java --- ### [Customer maintainable Tests with cucumber](https://thecattlecrew.net/2016/05/13/customer-maintainable-tests-with-cucumber/) **Published:** Mai 13, 2016 **Author:** marcelsoulieropitzconsultingcom **Content:** Automated tests must be instrumented with executable code and maintained by developers, which is a common problem. Often they are not even understandable by people without a developer background. On the other hand only a few people, who know the business case, have this special knowledge. Therefore the majority of potential testers cannot be directly involved in creating automated test cases that describe the business of the customer. This problem is addressed by the „cucumber“ BDD framework. In „cucumber“, test cases are defined in text files called „feature files“. They contain exactly one „feature“ with one or more „scenarios“. The scenarios follow the BDD pattern of given, when, then to define „steps“ that must be taken to complete the test case. Feature files can contain additional comments or descriptions. They can even be localized in different languages. Below an example of a feature file ``` Feature: Browse OC Website Scenario: Test navigation to "Über uns" page       Given I visit the website "www.opitz-consulting.com"       When I click "ÜBER UNS" Then I see the page with the title "Über uns" ``` But how does the text above end up as an automated test? The solution is called the „gherkin parser“ which parses the feature files and tries to find matching code for each line starting with one of the keywords. In our case keywords are defined as „Given“, „When“ and „Then“. The programmatic code to execute the actual test is called „step definition“ and can be written in many different programming languages. The following example is written in Java. ``` public class MyStepDefinitions{       @Given("I visit the website \"([^\"]*)\"")       public void openWebsite(String site){                   }       @When("I click \"([^\"]*)\"")       public void clickLink(String link){                   }           @Then("I see the page with the title \"([^\"]*)\"")       public void checkPageTitle(String title){                   } } ``` The Java example above uses a single JUnit Test Class to run all the Features. ``` @RunWith(Cucumber.class) Public class CucumberTests{ } ``` Of course the test code itself has to be implemented using an appropriate framework. For our current example, where the test is navigating on a website, this could be „WebDriver“. In other cases it might be something else. In summary „cucumber“ provides a way to keep the specification of the tests in plain text. This way the test can be maintained by those who understand the business case and contains no instrumentation code like it is used in many other BDD frameworks. More examples, other features of „cucumber“ and descriptions of how to add the required libraries to your project can be found on the cucumber website: [https://cucumber.io](https://cucumber.io/). **Kategorien:** Development, Tools & Methoden **Schlagwörter:** bdd, cucumber, Web Developement --- ### [Auf dem Weg von Continuous Integration zu Continuous Delivery](https://thecattlecrew.net/2016/06/09/auf-dem-weg-von-continuous-integration-zu-continuous-delivery/) **Published:** Juni 9, 2016 **Author:** Michael Stähler **Content:** Bei der Einführung von Continuous Delivery im Unternnehmen muss man sich zu einigen Themen Gedanken machen, die es zu berücksichtigen gilt. In dem Artikel [Auf dem Weg von Continuous Integration zu Continuous Delivery](http://www.informatik-aktuell.de/entwicklung/methoden/devops-in-der-praxis-von-continuous-integration-zu-continuous-delivery.html) werden die dafür wichtigen Themen und Herausforderungen betrachtet. **Kategorien:** DevOps **Schlagwörter:** Cloud Computing, Continuous Delivery, Java, Web Developement --- ### [Mule ESB "“ The anatomy of a flow](https://thecattlecrew.net/2016/09/06/mule-esb-the-anatomy-of-a-flow/) **Published:** September 6, 2016 **Author:** Dominik Bial **Content:** Mulesoft“™s Anypoint Platform is an integration platform which is especially interesting for Java developers. It is based on the Spring framework and leverages Java technologies like CXF or JAXB which are well known Java software frameworks. Therefore, Java developers are able to get along with the platform fast. As the developers have direct access to the underlying Spring framework, the Mulesoft“™s platform can be easily extended by own components, beans and additional functionality. A pattern based architecture style is supported, that, in combination with Spring and the Mulesoft testing framework MUnit provides a rich feature set for testing. However, let us dive a little bit deeper into integration with Mulesoft. Let us assume that we want to build a soap based webservice proxy. As we do not want to start from scratch, we have a look at the [Anypoint Exchange](https://www.mulesoft.com/exchange), which is a webportal provided by Mulesoft to share examples, connectors and more. It is always a good starting point when having a new use case. The [*Proxying a soap API example*](https://www.mulesoft.com/exchange/#!/proxying-SOAP-api-gateway) is exactly what we are looking for which can be easily imported to the Anypoint Studio via the downloadable zip file. The Anypoint studio is an Eclipse based IDE for the Anypoint platform. [![mule_flow_components](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_components.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_components.png) The integration logic is structured with the help of flows. A flow consists typically of three parts (see image above): 1. An inbound connector, which triggers the execution of an integration flow 2. The processors which contain some logic, for example transformations 3. An outbound connector to communicate to other systems. In the example, the inbound endpoint (1) is a http-listener listening for requests on port 8080. [![mule_flow_http](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_http.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_http.png) The listener is followed up by several processors. The configuration for a soap based webservice is done via the CXF component which determines namespaces, service and port as well as the computation logic. [![mule_flow_cxf](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_cxf.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_cxf.png) This is followed by a proxy client definition, which prepares the flow to send a request to another service configuration and a http request component which actually performs the request execution and executes the soap http post. [![mule_flow_proxy](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_proxy.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_proxy.png) Basically, you need at least 4 components to proxy a service: - The inbound endpoint, which is the http listener - The CXF component to configure the soap based webservice endpoint - Another CXF component to act as a client - And a http request However, in the example we have 6 components because a sub flow with the name *copy-headers* is called twice. Mule provides the functionality to extract reoccurring patterns and to place them into sub flows that can be called by other flows similar to methods or functions. In the example http headers are copied from the request to the client request as well as from the client response to the service response. The XML-view of the flow gives further details about what actually happens inside of the sub flow. [![mule_flow_xml](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_xml.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_flow_xml.png) In the example there is no difference between the WSDL for the service and client call. The actual request body is simply passed through. Usually, some kind of transformation of the body request is necessary which can be easily achieved via a huge variety of mule components, for example data weave, a language provided by mule to simplify transformation logic, XSLT, XQUERY and XPATH as well as Java or Groovy. A full overview of these components is provided by the Mulesoft [documentation](https://docs.mulesoft.com/mule-fundamentals/v/3.7/mule-components). **Kategorien:** Integration **Schlagwörter:** Architecture, English, Integration, Java --- ### [Demystifying API Management: Concepts and Demarcations](https://thecattlecrew.net/2016/09/15/demystifying-api-management-concepts-and-demarcations/) **Published:** September 15, 2016 **Author:** Sven Bernhardt **Content:** I tried to clean up with confusions about basic terms in the area of API Management… **Kategorien:** Integration --- ### [Mulesoft Anypoint Platform "“ Running QUARTZ Scheduler Jobs](https://thecattlecrew.net/2016/09/27/mulesoft-anypoint-platform-running-quartz-scheduler-jobs/) **Published:** September 27, 2016 **Author:** Dominik Bial **Content:** The Java [QUARTZ Job Scheduler framework](http://www.quartz-scheduler.org/) is a common piece of software and can be found in many environments. Although the Mulesoft Anypoint Platform provides its own [scheduling API](https://docs.mulesoft.com/mule-user-guide/v/3.7/poll-reference), it is a common task to use the QUARTZ framework instead. Especially, if scheduling might be centralized among different applications and might not only be used for the Mule ESB. Luckily, you can use the QUARTZ Connector in the Anypoint Studio if you come across such use cases. [![mule_quartz](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_quartz.png)](https://thecattlecrew.net/wp-content/uploads/2016/09/mule_quartz.png) In combination with the Spring support inside Mule, you can achieve a very flexible and powerful combination to run different QUARTZ jobs even in a clustered environment. In the following, you can find a short outline how such a setting can be achieved. **Spring Bean Definitions** First of all, make sure that all required libraries are in your classpath. Dragging a QUARTZ component into your canvas and creating a flow should actually be enough as Anypoint Studio should add all dependencies automatically to your project. Afterwards, you have to ask yourself where the configuration of the QUARTZ scheduler comes from. As I mentioned before, we use Spring for the configuration. To do this, we need a spring:beans section in one of the mule-config XML-Files as shown in the example bellow: \[code language=“xml“\] … AUTO … .. org.quartz.impl.jdbcjobstore.JobStoreTX … QRTZ\_ … … \[/code\] spring:beans tells Mule that inside of the tags Spring beans are defined. The quartzSchedulerFactory is the first bean we initialize. It is of the type org.springframework.scheduling.quartz.SchedulerFactoryBean. Via XML we simply add our QUARTZ configuration via a spring property definition. As we want to use these configuration in a clustered environment and we want to prohibit, that jobs are executed more than once we use the JobStoreTX. However, as a side effect, we need a database connection to synchronize different nodes. Therefore, we have to define a datasource to tell QUARTZ about the jobs“™ configuration and synchronization. This is done with the quartzDataSource bean with the help of a com.zaxxer.hikari.HikariDataSource class. **QUARTZ Connector Config** \[code language=“xml“\] \[/code\] **QUARTZ Connector** \[code language=“xml“\] \[/code\] With such a configuration you can easily realize scheduled jobs inside sthe Anypoint Platform which is connected to your existing QUARTZ environment. Of course you have to change some of the settings above according to your environment. **Kategorien:** Development, Tools & Methoden **Schlagwörter:** Architecture, English, Integration --- ### [Creating SSLContext for up-to-date HTTPS communiction with client certificate](https://thecattlecrew.net/2016/10/10/creating-sslcontext-for-up-to-date-https-communiction-with-client-certificate-2/) **Published:** Oktober 10, 2016 **Author:** Bernhard Mähr **Content:** If you try to implement with Java the client side for a HTTPS communication with client authenification and google for it, you will find many examples. But with most of the examples you find, have the one or other problem, if you really try it. That“™s why I want to wrap it up and bring it together to one class. Important are: - Working with Java 1.7 or newer - Support for the latest used TLS version 1.2 - Support for the JSSE implementation - Support for the latest cipher suites like TLS\_RSA\_WITH\_AES\_128\_GCM\_SHA256 or TLS\_ECDHE\_RSA\_WITH\_AES\_256\_GCM\_SHA384 - Support for different password for keystore (JKS) and private key - Manual selection of which client certificate to use I have created a class SSLUtil handling this all and creating an SSLContext. First we create a inner class inside SSLUtil helding the necessary information form keystores, passwords and keys. ``` [sourcecode language='java' padlinenumbers='true'] static class SSLConfig { private final String keyStoreFile; private final String keyStorePassword; private final String keyName; private final String keyPassword; private final String trustStoreFile; private final String trustStorePassword; public SSLConfig(final String keyStoreFile, final String keyStorePassword, final String keyName, final String keyPassword, final String trustStoreFile, final String trustStorePassword) { super(); this.keyStoreFile = keyStoreFile; this.keyStorePassword = keyStorePassword; this.keyName = keyName; this.keyPassword = keyPassword; this.trustStoreFile = trustStoreFile; this.trustStorePassword = trustStorePassword; } public String getKeyStoreFile() { return this.keyStoreFile; } public String getKeyStorePassword() { return this.keyStorePassword; } public String getKeyName() { return this.keyName; } public String getKeyPassword() { return this.keyPassword; } public String getTrustStoreFile() { return this.trustStoreFile; } public String getTrustStorePassword() { return this.trustStorePassword; } }; [/sourcecode] ``` Creating the SSLContext looks like this. ``` [sourcecode language='java' wraplines='true'] public static SSLConfig createSSLConfig(final String keyStoreFile, final String keyStorePassword, final String keyName, final String keyPassword, final String trustStoreFile, final String trustStorePassword) { return new SSLConfig(keyStoreFile, keyStorePassword, keyName, keyPassword, trustStoreFile, trustStorePassword); } public static SSLContext getSSLContext(final SSLConfig sslConfig) throws NoSuchAlgorithmException, KeyStoreException, UnrecoverableKeyException, IOException, CertificateException, KeyManagementException { SSLContext sslContext = null; if (sslConfig != null) { sslContext = SSLContext.getInstance("TLS"); final KeyManager[] keyManagers = SSLUtil.getKeyManagers(sslConfig.getKeyStoreFile(), sslConfig.getKeyStorePassword(), sslConfig.getKeyName(), sslConfig.getKeyPassword()); final TrustManager[] trustManagers = SSLUtil.getTrustManagers(sslConfig.getTrustStoreFile(), sslConfig.getTrustStorePassword()); sslContext.init(keyManagers, trustManagers, new SecureRandom()); } else { final SSLContextBuilder sslContextBuilder = new SSLContextBuilder(); sslContextBuilder.loadTrustMaterial(null, new TrustStrategy() { @Override public boolean isTrusted(final X509Certificate[] chain, final String authType) throws CertificateException { return true; } }); sslContext = sslContextBuilder.build(); } return sslContext; } [/sourcecode] ``` ``` [sourcecode language='java' wraplines='false'] public static SSLConfig createSSLConfig(final String keyStoreFile, final String keyStorePassword, final String keyName, final String keyPassword, final String trustStoreFile, final String trustStorePassword) { return new SSLConfig(keyStoreFile, keyStorePassword, keyName, keyPassword, trustStoreFile, trustStorePassword); } public static SSLContext getSSLContext(final SSLConfig sslConfig) throws NoSuchAlgorithmException, KeyStoreException, UnrecoverableKeyException, IOException, CertificateException, KeyManagementException { SSLContext sslContext = null; if (sslConfig != null) { sslContext = SSLContext.getInstance("TLS"); final KeyManager[] keyManagers = SSLUtil.getKeyManagers(sslConfig.getKeyStoreFile(), sslConfig.getKeyStorePassword(), sslConfig.getKeyName(), sslConfig.getKeyPassword()); final TrustManager[] trustManagers = SSLUtil.getTrustManagers(sslConfig.getTrustStoreFile(), sslConfig.getTrustStorePassword()); sslContext.init(keyManagers, trustManagers, new SecureRandom()); } else { final SSLContextBuilder sslContextBuilder = new SSLContextBuilder(); sslContextBuilder.loadTrustMaterial(null, new TrustStrategy() { @Override public boolean isTrusted(final X509Certificate[] chain, final String authType) throws CertificateException { return true; } }); sslContext = sslContextBuilder.build(); } return sslContext; } [/sourcecode] ``` ``` [sourcecode language='java' padlinenumbers='true'] public static SSLConfig createSSLConfig(final String keyStoreFile, final String keyStorePassword, final String keyName, final String keyPassword, final String trustStoreFile, final String trustStorePassword) { return new SSLConfig(keyStoreFile, keyStorePassword, keyName, keyPassword, trustStoreFile, trustStorePassword); } public static SSLContext getSSLContext(final SSLConfig sslConfig) throws NoSuchAlgorithmException, KeyStoreException, UnrecoverableKeyException, IOException, CertificateException, KeyManagementException { SSLContext sslContext = null; if (sslConfig != null) { sslContext = SSLContext.getInstance("TLS"); final KeyManager[] keyManagers = SSLUtil.getKeyManagers(sslConfig.getKeyStoreFile(), sslConfig.getKeyStorePassword(), sslConfig.getKeyName(), sslConfig.getKeyPassword()); final TrustManager[] trustManagers = SSLUtil.getTrustManagers(sslConfig.getTrustStoreFile(), sslConfig.getTrustStorePassword()); sslContext.init(keyManagers, trustManagers, new SecureRandom()); } else { final SSLContextBuilder sslContextBuilder = new SSLContextBuilder(); sslContextBuilder.loadTrustMaterial(null, new TrustStrategy() { @Override public boolean isTrusted(final X509Certificate[] chain, final String authType) throws CertificateException { return true; } }); sslContext = sslContextBuilder.build(); } return sslContext; } [/sourcecode] ``` ``` [sourcecode language='java' ] public static SSLConfig createSSLConfig(final String keyStoreFile, final String keyStorePassword, final String keyName, final String keyPassword, final String trustStoreFile, final String trustStorePassword) { return new SSLConfig(keyStoreFile, keyStorePassword, keyName, keyPassword, trustStoreFile, trustStorePassword); } public static SSLContext getSSLContext(final SSLConfig sslConfig) throws NoSuchAlgorithmException, KeyStoreException, UnrecoverableKeyException, IOException, CertificateException, KeyManagementException { SSLContext sslContext = null; if (sslConfig != null) { sslContext = SSLContext.getInstance("TLS"); final KeyManager[] keyManagers = SSLUtil.getKeyManagers(sslConfig.getKeyStoreFile(), sslConfig.getKeyStorePassword(), sslConfig.getKeyName(), sslConfig.getKeyPassword()); final TrustManager[] trustManagers = SSLUtil.getTrustManagers(sslConfig.getTrustStoreFile(), sslConfig.getTrustStorePassword()); sslContext.init(keyManagers, trustManagers, new SecureRandom()); } else { final SSLContextBuilder sslContextBuilder = new SSLContextBuilder(); sslContextBuilder.loadTrustMaterial(null, new TrustStrategy() { @Override public boolean isTrusted(final X509Certificate[] chain, final String authType) throws CertificateException { return true; } }); sslContext = sslContextBuilder.build(); } return sslContext; } [/sourcecode] ``` If the parameter sslConfig is null we create an SSLContext accepting every HTTPS connection and not using client certificate. Important is the parameter „TLS“ instead of „SSL“ to support TLS 1.2. Loading the keystore is straight forward. ``` [sourcecode language='java' ] private static KeyStore loadKeystore(final String keystorePathAndFilename, final String keyStorePassword) throws KeyStoreException, IOException, NoSuchAlgorithmException, CertificateException { final KeyStore clientKeyStore = KeyStore.getInstance("JKS"); final InputStream keystoreAsStream; final File ksFile = new File(keystorePathAndFilename); if (ksFile.exists()) { try { keystoreAsStream = new FileInputStream(ksFile); } catch (final FileNotFoundException e) { AppTestUtil.LOGGER.error("Could not read keystore file '" + keystorePathAndFilename + "'!", e); throw new KeyStoreException("Could not read keystore file '" + keystorePathAndFilename + "'!", e); } AppTestUtil.LOGGER.info("Keystore in file '" + keystorePathAndFilename + "' found, trying to load..."); } else { AppTestUtil.LOGGER.error("Could not find keystore file '" + keystorePathAndFilename + "'!"); throw new KeyStoreException("Could not find keystore file '" + keystorePathAndFilename + "'!"); } clientKeyStore.load(keystoreAsStream, keyStorePassword.toCharArray()); return clientKeyStore; } [/sourcecode] ``` And also creating the trust manager is nothing special. ``` [sourcecode language='java' ] private static TrustManager[] getTrustManagers(final String keystorePathAndFilename, final String keyStorePassword) throws NoSuchAlgorithmException, KeyStoreException, IOException, CertificateException { final TrustManagerFactory trustFactory = TrustManagerFactory.getInstance(TrustManagerFactory.getDefaultAlgorithm()); final KeyStore trustKeyStore = SSLUtil.loadKeystore(keystorePathAndFilename, keyStorePassword); trustFactory.init(trustKeyStore); final TrustManager[] trustManagers = trustFactory.getTrustManagers(); return trustManagers; } [/sourcecode] ``` Additionally we need to create the key manager. ``` [sourcecode language='java' ] private static KeyManager[] getKeyManagers(final String keystorePathAndFilename, final String keyStorePassword, final String privateKeyAlias, final String privateKeyPassword) throws NoSuchAlgorithmException, KeyStoreException, UnrecoverableKeyException, IOException, CertificateException { final KeyManagerFactory keyFactory = KeyManagerFactory.getInstance("NewSunX509"); final KeyStore keyStore = SSLUtil.loadKeystore(keystorePathAndFilename, keyStorePassword); keyFactory.init(keyStore, privateKeyPassword.toCharArray()); final KeyManager[] keyManagers = keyFactory.getKeyManagers(); if ((privateKeyAlias != null) && (privateKeyAlias.trim().length() > 0)) { for (int i = 0; i < keyManagers.length; i++) { final KeyManager keyManager = keyManagers[i]; if (keyManager instanceof X509KeyManager) { keyManagers[i] = new AliasPreferingX509KeyManager((X509KeyManager) keyManager, privateKeyAlias); } } } return keyManagers; } [/sourcecode] ``` Here are two important things: The parameter "NewSunX509" allows to use different password for the key store and the private key. Additional it uses the JSSE implementation supporting the new cipher suites. Second important thing is the AliasPreferingX509KeyManager I found as an example in the blog post . ``` [sourcecode language='java' ] private static class AliasPreferingX509KeyManager implements X509KeyManager { private final X509KeyManager x509KeyManager; private final String alias; private AliasPreferingX509KeyManager(final X509KeyManager x509KeyManager, final String alias) { this.x509KeyManager = x509KeyManager; this.alias = alias; } @Override public String[] getClientAliases(final String keyType, final Principal[] issuers) { return this.x509KeyManager.getClientAliases(keyType, issuers); } @Override public String chooseClientAlias(final String[] keyType, final Principal[] issuers, final Socket socket) { for (int i = 0; i < keyType.length; i++) { final String[] clientAliases = getClientAliases(keyType[i], issuers); if (clientAliases != null) { for (int j = 0; j < clientAliases.length; j++) { if (clientAliases[j].equals(this.alias) || clientAliases[j].endsWith("." + this.alias)) { return clientAliases[j]; } } } } return this.x509KeyManager.chooseClientAlias(keyType, issuers, socket); } @Override public String[] getServerAliases(final String keyType, final Principal[] issuers) { return this.x509KeyManager.getServerAliases(keyType, issuers); } @Override public String chooseServerAlias(final String keyType, final Principal[] issuers, final Socket socket) { return this.x509KeyManager.chooseServerAlias(keyType, issuers, socket); } @Override public X509Certificate[] getCertificateChain(final String alias) { return this.x509KeyManager.getCertificateChain(alias); } @Override public PrivateKey getPrivateKey(final String alias) { return this.x509KeyManager.getPrivateKey(alias); } }; [/sourcecode] ``` That"™s now a complete solution for creating a SSLContext for HTTPS connections. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** DevOps, IT-Security **Schlagwörter:** Java, Softwarenentwicklung, Web Developement, Weblogic --- ### [Oracle Forms 12c "“ Höchste Zeit zum Upgrade](https://thecattlecrew.net/2016/11/25/oracle-forms-12c-hoechste-zeit-zum-upgrade/) **Published:** November 25, 2016 **Author:** Holger Lehmann **Content:** Im Dezember 2016 läuft der Premier Support von Oracle für Forms und Reports 11gR2 aus. Um weiterhin den vollen Support bis 2020 (extended 2023) zu erhalten, müssen Anwender auf die neue Version 12c wechseln. Das Upgrade hat weitere Vorteile: Oracle hat seinem 4GL-Werkzeug nämlich nicht nur einige neue Features spendiert, sondern auch einen Zuwachs an Geschwindigkeit. Knapp ein Jahr ist es mittlerweile her, dass Forms 12c erschienen ist. Seitdem sind schon 2 Folge-Patches erschienen, die Bugs beseitigen und kleine Optimierungen mitbringen. Vielen Kunden fragen sich nun, ob sie denn nun noch den Schritt zur neuen Version machen sollen ? Diese Frage läßt sich eindeutig mit einem Ja beantworten und das Interesse an der neuen Forms Version ist doch sehr groß. Wir unterstützen unsere Kunden gerne bei der Beantwortung dieser Frage, indem wir Ihnen bei einem kostenlosen Workshop die neuen Features von Forms 12c erläutern und gemeinsam klären, welche Maßnahmen und Anforderungen für die neue Infrastruktur der 12c-Umgebung notwendig sind. Der Workshop geht über einen halben Tag, bei Bedarf auch einen kompletten Tag lang und wird individuell auf die Kunden-Bedürfnisse zugeschnitten. Das erste große Projekt beim Kunden mit einem Upgrade von Forms/Reports 11g nach 12c auf 4 Servern haben wir erfolgreich umgesetzt. Auch wird auf allen 4 Umgebungen der Weblogic Server zur Anbindung von APEX genutzt. Weitere Informationen zu Forms 12c und dem Workshop finden Sie in unserem [Fact Sheet](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/77-factsheet-forms-12c.pdf). **Kategorien:** Development, Infrastructure **Schlagwörter:** German, Oracle Forms, Weblogic --- ### [Advanced OHS Configuration in Oracle Forms 12.2.1.2](https://thecattlecrew.net/2017/01/20/advanced-ohs-configuration-in-oracle-forms-12-2-1-2/) **Published:** Januar 20, 2017 **Author:** Neselovskyi, Borys **Kategorien:** Development **Schlagwörter:** Configuration, Forms, HTTP Server, Integration, OHS, oracle, Oracle DB, Oracle FMW, Oracle Forms, Weblogic, WebTier 12c --- ### [Moderne Webanwendungen entwickeln - Frameworks für 2017](https://thecattlecrew.net/2017/01/24/moderne-webanwendungen-entwickeln-frameworks-fuer-2017/) **Published:** Januar 24, 2017 **Author:** Andreas Lehner **Content:** Die Auswahl des richtigen Frameworks oder der richtigen Library zur Entwicklung hochmoderner Webanwendungen und UIs wird auch in 2017 nicht leicht fallen. 2016 entpuppte sich als kleines Wettrennen zwischen React und Angular. Zwischen diesen Welten tummeln sich dutzende spezifische javaScript basierte Frameworks und Bibliotheken. Aber auch Java Frameworks weilten nicht im Dornröschen-Schlaf, sondern wappneten sich mit modernen HTML5 Features. So entwickelt etwa Stephan Rauh, Leiter des Competence Centers für Moderne Clients bei Opitz Consulting das JSF-Frameworks BootsFaces. Dieser Artikel gibt eine Einführung in BootsFaces. Der Artikel war sogar unter den Top 10 der meistgelesenen Geschichten im renommierten jaxenter Magazin. Hier geht es zum Artikel von Stephan: 2017 bleibt also ein ebenso spannendes Jahr für die Entwicklung von benutzerzentrierten Anwendungen. In nächsten Artikeln präsentieren wir Entscheidungshilfen, die die Wahl des frameworks vereinfachen. **Kategorien:** Architecture & Process Models, Development **Schlagwörter:** Java, Modern Clients, Web Developement --- ### [Oracle SB12c QuickTip: Fix HTTP 403 on calling SOAP/REST Proxy Services](https://thecattlecrew.net/2017/01/29/oracle-sb12c-quicktip-fix-http-403-on-calling-soaprest-proxy-services/) **Published:** Januar 29, 2017 **Author:** Sven Bernhardt **Content:** New Oracle SOA QuickTip available: Solving 403 error occurring when testing Servicebus 12c proxies **Kategorien:** Development **Schlagwörter:** oracle --- ### [Usability - Weit mehr als "žsieht schick aus"œ](https://thecattlecrew.net/2017/02/06/usability-weit-mehr-als-sieht-schick-aus/) **Published:** Februar 6, 2017 **Author:** Andreas Lehner **Content:** ***Von Alexander Ludwig*** ## Was ist Usability? Als Usability-Engineer erlebt man in Gesprächen häufig, dass bei Usability nur an Oberflächen gedacht wird. „Ach, da kommen die Jungs und Mädels, die unsere Masken hübsch und die Ecken rund machen …“ oder „Unsere Anwendung hat eine gute Usability, die Masken sind total schick …“. Usability aber ist weit mehr als nur schöne Masken und die Einsparung von Klicks! Usability betrachtet die Optimierung der Oberflächen, der Abläufe und der Schnittstellen. Usability ist essentiell für den Erfolg jeder Anwendungen. Drei wichtige Grundprinzipien sind: - Optimale Unterstützung der Arbeitsabläufe Eine Anwendung soll nicht nur dem Auge des Users schmeicheln, sie muss ihn auch in allen Punkten seiner Arbeit optimal unterstützen. Der Benutzer muss seine Aufgaben ohne unnötige Umwege erfüllen können. - Ergebnisse effizient und effektiv erzielen Ein Produkt sollte den Benutzer in die Lage versetzen, die gewünschten Ergebnisse zu erzielen (effektiv). Zudem müssen die Aufgaben mit adäquatem Aufwand erfüllbar sein (effizient). - Keine Benachteiligung des Benutzers durch schlechtes Design Die Arbeit des Users darf nicht durch lange Wartezeiten und ein unübersichtliches Design benachteiligt werden. Der User sollte intuitiv erkennen, wo er die gesuchten Informationen finden kann, um den zeitlichen Aufwand zu minimieren (zufriedenstellend). ## Warum sollte in Usability investiert werden? Eine Faustregel der Usability sagt „Jeder Euro, der in Usability investiert wird, spart 10 bis 100 Euro“. Entwicklungsprojekte sollten etwa 10% ihres Budgets in Usability investieren. Nach einem Re-Design unter Usability-Aspekten können Webseiten ihre Usability um durchschnittlich steigern[\[i\]](#_edn1). Die Auswirkungen guter Usability sind vielseitig. In B2C Anwendungen etwa ist Usability erfolgskritisch: - Benutzer sind zufriedener und somit eher dazu bereit das Produkt zu empfehlen - Support Kosten können drastisch reduziert werden, weil das Produkt einfach besser benutzt werden kann - Benutzer können ihre gewünschten Tasks schneller erfüllen, wie etwa den Abschluss eines Einkaufs im online Shop. Im B2B Bereich macht sich Usability ebenfalls bezahlt: - Fehlerquoten bei der Durchführung von Arbeits-Task sinken merklich - Trainingskosten können drastisch reduziert werden - Produktivität steigt, da der Spaß an der Arbeit steigt oder umgekehrt die Frustration über veraltete und „unbedienbare“ Anwendungen sinkt ## Wie sollte Usability Engineering zum Einsatz kommen? Usability wird bei der Entwicklung von Software entweder bei der Neuentwicklung oder bei der Weiterentwicklung genutzt. Für den Aufbau des Entwicklungsprozesses gibt es mehrere Modelle, die die Entwicklung in unterschiedliche Phasen aufteilen. Ein Beispiel ist das Prozessmodell der DaimlerChrysler-Forschung. Das Model separiert 5 Phasen der Entwicklung: 1. Projektmanagement (10%), 2. Anforderungsanalyse (40%), 3. User-Interface-Entwurf (30%), 4. Evaluation (10%) und 5. Einführung, Dokumentation, Schulungen (10%). Usability kann in der 2. (Anforderungsanalyse), 3. (User-Interface-Entwurf) und 4. (Evaluation) Phase eingesetzt werden. Eine Empfehlung ist: so früh wie möglich Usability in den Prozess zu integrieren. Je später mit Usability begonnen wird, umso höher sind die Kosten und desto geringer die Verbesserungen. In der Regel spricht man davon, dass die Kosten für Usability in der 4. Phase im Vergleich zur 2. Phase mindestens 30% höher sein werden. So konnte etwa American Airlines seine Kosten zur Beseitigung von Usability-Problemen um 60-90% senken, indem Usability-Probleme bereits in der Designphase beseitigt wurden[\[ii\]](#_edn1) (Phase 3 – User-Interface-Entwurf). ## Discount Usability „“ Viel Mehrwert für wenig Geld Usability-Methoden gibt es viele. Von teuren Labors, die Investitionen von mehreren Tausend Euro erfordern („Luxus-Usability“) bis hin zu einfachen und kostengünstigen Methoden. Ein empfehlenswertes Beispiel für ein „viel Mehrwert für wenig Geld“-Verfahren ist „Discount-Usability“. Discount-Usability hat sich bewährt und bietet gute Qualität bei vergleichsweise niedrigen Kosten. Obwohl Discount-Usability bereits vor über 20 Jahren definiert wurde, ist das Vorgehen noch immer empfehlenswert. Discount-Usability besteht aus „vereinfachten Benutzertests“, „reduzierten Prototypen“ und „heuristischer Evaluation“. 1. **Vereinfachte Benutzertests.** 5 Endnutzer arbeiten identische Aufgaben am System ab. Die Anzahl von 5 Nutzern hat sich mit der Zeit als ein optimaler Wert herausgestellt. Etwa 85% der Usability-Probleme und „“Fehler können damit gefunden werden. Bei der Abarbeitung der Aufgaben soll der Endbenutzer laut denken und alles aussprechen was ihm auffällt, stört oder fehlt. Ein Usability Engineer sitzt neben ihm und schreibt alles mit, ohne ihn bei seinen Handlungen zu beeinflussen. Durch Analyse der Notizen können die Probleme später dokumentiert und konkrete Anforderungen abgeleitet werden. 2. **Reduzierte Prototypen (Papierprototypen).** Papierprototypen sind schnell zu erstellen, leicht veränderbar, vermitteln einen guten Eindruck über das Ziel und sie sind vor allem unschlagbar günstig. 3. **Heuristische Evaluation** ist die Überprüfung des Designs an Hand von etablierten Usability-Regeln und Standards (z.B. Prinzipien der Dialoggestaltung). ***„Discount-Usability liefert oft bessere Resultate als „Luxus-Usability“****, weil ihre Methoden den Schwerpunkt auf frühe und schnelle Iterationen mit schnell wechselndem Usability-Input legen.“ „Einfache Benutzer-Tests mit 5 Teilnehmern, Papier-Prototyping und heuristischen Evaluation bieten eine preiswerte, schnelle und frühzeitige Fokussierung auf Benutzerfreundlichkeit, sowie viele Runden iterativen Designs“.* [\[iii\]](#_edn1) ## Über den Autor Alexander Ludwig ist Usability Engineer im Competence Center für Moderne Clients bei Opitz Consulting und hilft Unternehmen bei der Umsetzung von innovativer und zukunftsorientierter Software durch Usability. **Lesen Sie auch das Opitz Consulting White Paper zu „Usability in the Enterprise“** [DOWNLOAD: ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-usability-in-the-enterprise_sicher.pdf) [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Artikel/whitepaper-usability-in-the-enterprise\_sicher.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-usability-in-the-enterprise_sicher.pdf) ## Referenzen [\[i\]](#_ednref1) *Nielsen, Jakob; Giluz, Shuli: Usability Return on Investment, 2nd edition.* [\[ii\]](#_ednref1) *Bias, R. G. & Mayhew, D.J. (1994) Cost-Justifying usability.* [\[iii\]](#_ednref1) *Jakob Nielsen’s Alertbox, September 14, 2009* **Kategorien:** Sustainability & Awareness, Tools & Methoden **Schlagwörter:** usability, usability engineering, user experience, ux, Web Developement --- ### [Erfahrungen aus der Einführung des Usability-Prozesses](https://thecattlecrew.net/2017/02/09/erfahrungen-aus-der-einfuehrung-des-usability-prozesses/) **Published:** Februar 9, 2017 **Author:** monikaschubert **Content:** In diesem Artikel präsentieren wir die Erfahrungen, die wir bei der Einführung des Usability-Prozesses bei einem unserer Kunden gemacht haben. Grundlage für das Projekt war ein Usability-Gutachten, das eine komplexe Systemlandschaft mit unterschiedlichen Interaktionspattern aufzeigte. Die größten Schwachstellen waren: - Für die Ausführung eines Geschäftsprozesses musste ein Anwender bis zu vier unterschiedliche Anwendungen verwenden. - Die Anwendungen nutzen eine Sprache, die stark durch IT-Begriffe geprägt war. - Die Anwender mussten unterschiedliche Ausgabeformate kennen und mit diesen umgehen können und sich außerdem in nicht offensichtlichen Verzeichnisstrukturen zurechtfinden und Dateien kopieren. Unser Projekt bekam die Aufgabe, diese Systemlandschaft zu vereinheitlichen und benutzerfreundlich zu gestalten. Zu Projektbeginn sahen wir uns zunächst vor einer Fülle an Anwendungen mit mangelnder Softwarequalität und fehlender Usability. Wo sollten wir anfangen? Was waren die wesentlichen Punkte, die dem Endanwender das Arbeiten erleichtern würden? ## Der Usability-Prozess Das Ziel war definiert: Die Anwendungen sollen über eine hohe [Usability ](https://thecattlecrew.net/2017/02/06/usability-weit-mehr-als-sieht-schick-aus/)verfügen. Um dieses Ziel zu erreichen, stellten wir den Anwender mit seinen Aufgaben, Zielen und Eigenschaften in den Mittelpunkt des Entwicklungsprozesses und führten den Usability-Prozess ein. Die kontinuierliche Kommunikation mit den Anwendern ist ein wesentlicher Baustein des Usability-Prozesses. Der Usability-Prozess befasst sich mit den Prinzipien der menschenzentrierten Gestaltung sowie mit deren Organisation und Anwendung. „Menschenzentrierte Gestaltung“ bezeichnet dabei eine Herangehensweise der Softwareentwicklung, die die Usability von Systemen erhöht, indem sie sich auf die Nutzung des Systems konzentriert. Der Usability-Prozess lässt sich in mehrere Phasen unterteilen: ![usabilityprozess](https://thecattlecrew.net/wp-content/uploads/2017/02/usabilityprozess.png?w=300) ### (1) Analyse des Nutzungskontexts Der Nutzungskontext ist in [ISO 9241-11](https://www.din.de/de/mitwirken/normenausschuesse/naerg/entwuerfe/wdc-beuth:din21:242466601/toc-2360211/download) definiert als „Die Benutzer, Arbeitsaufgaben, Ausrüstung (Hardware, Software und Materialien) sowie physische und soziale Umgebung, in der das Produkt genutzt wird.“ Aus dieser Definition lassen sich die zentralen Fragen in Bezug auf den Nutzungskontext ableiten: - Wer sind meine Anwender? - Welche Ziele verfolgen sie mit der Anwendung? - Was sind ihre Arbeitsaufgaben? - Wie sind sie ausgestattet (Hardware, Software)? - In welcher Arbeitsumgebung arbeiten sie? Ein Usability-Experte versucht diese Fragen durch Befragung oder durch Beobachtung der Anwender zu beantworten. Die Ergebnisse bilden den Nutzungskontext. Diesen hält der Usability-Experte anhand von Ablaufdiagrammen, Aufgabenmodellen etc. fest. Der Nutzungskontext bildet die Grundlage für die nächste Phase. ### (2) Ableitung der Nutzungsanforderungen Auf Basis des Nutzungskontexts kann der Usability-Experte die Erfordernisse des Anwenders an die Software identifizieren. Sie bilden die Grundlage für die Nutzungsanforderungen, die häufig auch als Usability Requirements bezeichnet werden. Nutzungsanforderungen beschreiben, welche konkreten Handlungen der Anwender an dem System ausführen kann. Dabei können Nutzer nur drei Arten von „Aktionen“ an einem interaktiven System ausführen: - Etwas eingeben - Etwas auswählen - Etwas erkennen ### (3) Benutzerfreundliche Gestaltung Auf Basis der Nutzungsanforderungen entwirft der Usability-Experte typische Szenarien, Simulationen oder Prototypen. Dabei orientiert er sich an den sieben [Dialoggrundsätzen](http://www.fit-fuer-usability.de/archiv/einfuehrung-in-die-iso-9241-110/) für interaktive Systeme: - Aufgabenangemessenheit - Selbstbeschreibungsfähigkeit - Erwartungskonformität - Fehlertoleranz - Steuerbarkeit - Individualisierbarkeit - Lernförderlichkeit Die erstellten Ergebnisse stimmt der Usability-Experte im weiteren Prozess mit den Anwendern und den Entwicklern regelmäßig ab und begleitet somit die Entwicklung des Systems. ### (4) Usability-Analysen Eine wesentliche Aufgabe des Usability-Experten ist die Abstimmung der Gestaltungskonzepte mit den Anwendern. Die Rückmeldung der Anwender lassen Rückschlüsse auf den Grad der Umsetzung der Nutzungsanforderungen zu. Zusätzlich kann der Usability-Experte neue Informationen über die Erfordernisse der Anwender sammeln. ## Unsere Erfahrungen Der Usability-Prozess bietet uns den organisatorischen Rahmen, um die Anwender in den Softwareentwicklungsprozess einzubinden. Die folgenden Aktivitäten haben wir durchgeführt und in diesem Rahmen wichtige Erfahrungen gesammelt. ### Analyse des Nutzungskontexts und Ableitung der Nutzungsanforderungen Um den Nutzungskontext der Anwender besser zu verstehen, haben wir Kontextinterviews mit unterschiedlichen Benutzergruppen durchgeführt. In den Kontextinterviews wurden Anwender anhand von 16-24 Leitfragen zu ihrer täglichen Arbeit mit den Systemen und zu möglichen Verbesserungsvorschlägen befragt. Aus den Antworten wurden anschließend die Nutzungsanforderungen formuliert. Diese haben wir zusammen mit weiteren Systemanforderungen priorisiert. ![kontextinterviews](https://thecattlecrew.net/wp-content/uploads/2017/02/kontextinterviews.png) Die folgenden Punkte haben wir als positiv mitgenommen: - Wir bekamen einen Einblick in die tägliche Arbeitsweise der Anwender mit all ihren täglichen Herausforderungen. - Zu Projektbeginn gab es kaum konkrete Anforderungen. Die Kontextinterviews halfen uns, Anforderungen aus Anwendersicht zu spezifizieren und zu priorisieren. Die folgenden Punkte sind uns negativ aufgefallen: - Kontextinterviews sind sehr zeitaufwändig. Ein Interview dauert ca. 2 Stunden, exklusive Vor- und Nachbereitung. - Der Informationsgewinn ist bei den ersten Kontextinterviews sehr hoch, nimmt allerdings mit zunehmender Anzahl an Interviews ab, da viele Anwender vor denselben Herausforderungen stehen. Dennoch ist es notwendig, genügend Kontextinterviews durchzuführen, um häufige Probleme zu erkennen und die resultierenden Nutzungsanforderungen valide zu priorisieren. Im Allgemeinen konnten wir bei den Kontextinterviews wichtige Fakten über unsere Benutzer lernen. Aufgrund der zu begrenzten Zeit haben wir im weiteren Projektverlauf jedoch kaum darauf zurückgegriffen. ### Benutzerfreundliche Gestaltung Basierend auf den Nutzungsanforderungen haben wir die Benutzeroberfläche mit einem Modellierungstool gestaltet. Diese sogenannten UI Mockups sind im Wesentlichen nur Zeichnungen und haben damit nicht die Wirkung einer richtigen Software. Sie verhelfen zu frühen Feedbacks und bilden eine Diskussionsgrundlage. Nach der Implementierung der Software werden aber erneut Ü„nderungswünsche geweckt, die ein Mockup durch den Technologiebruch im Vorfeld nicht auffangen kann. Wichtiges Take-away: Je früher Ü„nderungen bekannt werden, umso billiger ist deren Umsetzung. Unsere Erfahrungen - Das einfache Erstellen und Verteilen ermöglichte uns ein schnelles Feedback durch die Anwender. Zusätzlich vereinfachten die Mockups die Kommunikation der Anforderungen von den Anwendern zu den Entwicklern. - Die visuelle Darstellung ermöglichte uns, die geplante Umsetzung auch für Nicht-Techniker erfassbar zu machen. Bei der Diskussion mit den Anwendern stellten wir fest, dass die Vorstellungskraft dazu, wie das System später aussehen wird, sehr divergent war. - Für die Erstellung der Mockups werden kaum Entwickler-Ressourcen benötigt. Die Erstellung kann somit parallel zur Entwicklung erfolgen. Aufgrund unserer überwiegend positiven Erfahrung werden wir auch weiterhin intensiv mit Mockups arbeiten. ### Usability-Analysen Zur Prüfung der Gestaltungskonzepte organisierten wir Fokusgruppen. Fokusgruppen sind Diskussionsgruppen mit ca. 5-8 Anwendern zu einem speziellen Thema. Sie begleiten den Entwicklungsprozess, um zeitnahe Feedback zu erhalten. In den ersten Fokusgruppen haben wir die Mockups diskutiert. Im weiteren Verlauf konnten wir Details auch direkt an der bereits vorhandenen Anwendung abstimmen. ![fokusgruppen](https://thecattlecrew.net/wp-content/uploads/2017/02/fokusgruppen.png) Unsere Erfahrungen mit den Fokusgruppen - Die Diskussionen bieten ein konsolidiertes Feedback. Einsichten wie „Was, bei dir ist das soundso? Bei mir ist das ganz anders „¦“, kommen immer wieder vor und sind ausgesprochen wertvoll. - Eine Herausforderung bei der Durchführung ist, die Diskussion sinnvoll zu steuern. Leicht läuft man Gefahr, dass gewünschte Anforderungen überhand nehmen oder die Diskussion abschweift. Um den Fokus nicht zu verlieren, braucht es einen aufmerksamen Moderator. - Die Einbindung der Anwender in den Entwicklungsprozess schafft zusätzlich Akzeptanz. Insbesondere bei der Erstellung von Individualsoftware ist es deshalb wichtig, die Anwender mit ins Boot zu holen. Die Fokusgruppen wurden von allen sehr geschätzt, deshalb haben wir sie regelmäßig durchgeführt. Zusätzlich zu den Fokusgruppen haben wir auch Usability-Tests durchgeführt. Dabei bekamen die Anwender eine Aufgabe, die sie mit Hilfe der Anwendung lösen mussten. Dabei beobachtet der Usability-Experte den Anwender und identifiziert Verbesserungspotenzial, um z. B. die Navigation zu vereinfachen. ![usability-tests](https://thecattlecrew.net/wp-content/uploads/2017/02/usability-tests.png) Unsere Erfahrungen mit Usability-Tests: - Die Usability-Tests mit Anwendern ermöglichten uns, zu komplexe Masken bzw. Maskenflüsse frühzeitig zu identifizieren zu vereinfachen. Wir konnten unnötige Klicks entfernen und wichtige Informationen präsenter darstellen. - Bei den Usability-Tests ist es unbedingt notwendig, sich im Vorfeld genau zu überlegen, welche Aufgabenstellungen man dem Anwender stellt. Des Weiteren haben wir festgestellt, dass es einen großen Unterschied macht, ob der Anwender die Anwendung bereits kennt oder noch nicht. - Die Usability-Tests ermöglichten es uns, die Anwendung an die Fachsprache der Anwender anzupassen. Die Usability-Tests haben uns sehr geholfen, die Anwendung zu tunen. Sie sind sowohl in der Vorbereitung als auch in der Durchführung zeitintensiv. Unsere Erkenntnisse durch die Usability-Tests waren jedoch so wertvoll, dass wir den damit verbundenen Aufwand in Kauf nehmen. ## Fazit Die Einführung und Etablierung des Usability-Prozesses hat uns geholfen, die Anwender in den Mittelpunkt der Softwareentwicklung zu stellen und somit auf ihre tatsächlichen Anforderungen einzugehen. ## Weiterführende Literatur: [DAkkS-Prüfverfahren für den Usability-Engineering-Prozess auf der Grundlage von DIN EN ISO 13407 ](http://www.dakks.de/content/leitfaden-usability) [Handbuch Usability nach DIN EN ISO 9241](http://www.handbuch-usability.de/iso-9241.html) [BITV Test](http://www.bitvtest.de/) **Kategorien:** Architecture & Process Models, Tools & Methoden **Schlagwörter:** design, German, Java, Modern Clients, Quality, usability, usability engineering, user experience, ux, Web Developement --- ### [Prototyping "“ Mit geringen Mitteln zu viel Erfolg](https://thecattlecrew.net/2017/02/13/prototyping-mit-geringen-mitteln-zu-viel-erfolg/) **Published:** Februar 13, 2017 **Author:** Andreas Lehner **Content:** *„If a picture is worth 1000 words, a prototype is worth 1000 meetings.“* (IDEO.com) Die Entwicklung der User Experience einer App ohne Erstellung von Prototypen ist unvorstellbar. Zu wichtig und erfolgsentscheidend sind die Aufgaben, die Prototyping übernehmen kann: - Kommunikation von Ideen zwischen den Stakeholdern (Business, Technologie, Design) - Testen, Erproben und bewerten von Lösungsansätzen - Lernen, lernen, lernen darüber ob das Problem richtig verstanden wurde oder ob der Lösungsansatz valide ist. Doch noch nicht genug der Vorteile: Prototyping ist super billig. Keine Sorge: Prototyping kann auch teurer werden. Z.B. wenn die günstigere Variante für das angestrebte Lernziel nicht mehr ausreicht. Beispiele, wann welche Form von Prototype besonders geeignet ist: - Möchte ich etwa erfahren ob der Task-Flow meiner App verstanden wird und nachvollziehbar ist, reicht ein Lo-Fi - Möchte ich bereits erste Interaktionen auf einem Device probieren, reicht Papier nicht mehr aus (Mid-Fi) - Möchte ich realistische Daten in der App testen, sollte schon mal Code geschrieben werden (Hi-Fi) Hilfreich ist die Orientierung an diesen Kategorien von Prototypen: 1. Lo-Fi Prototype 2. Mid-Fi Prototype 3. Hi-Fi Prototype ## Lo-Fi Prototype z.B. einfache Sketches auf Papier „“ schnell erstellt, schnell geändert, schnell verworfen ![image001.png](https://thecattlecrew.net/wp-content/uploads/2017/02/image001.png)Einfache Sketches als Prototype ## Mid-Fi Prototype z.B. Wireframes oder interaktive Protoypen mit speziellen Tools wie Balsamiq oder InVision ![image003.png](https://thecattlecrew.net/wp-content/uploads/2017/02/image003.png)Visueller, interaktiver Prototype ohne Daten mit dem Tool InVision Quelle Bild: ## Hi-Fi Prototype Mit grafischem Design und repräsentativen Daten, aber ohne vollem Funktionsumfang und Backend-Anbindung. Hier kann schon mal drauf los „ge-coded“ werden. ![image005.png](https://thecattlecrew.net/wp-content/uploads/2017/02/image005.png)Code eines Angular2 Prototypen ## Zusammenhang zwischen Kosten und Zeit bei der Erstellung von Prototypen Den Zusammenhang zwischen Fidelity-Typ (Lo-Fi, Mid-Fi, Hi-Fi), Kosten und zeitlichem Aufwand zeigt diese einfache Abbildung. Je höher der Fidelity Grad, desto höher die Kosten und der zeitliche Aufwand ![image007.png](https://thecattlecrew.net/wp-content/uploads/2017/02/image007.png)Progression von Prototypen *Abbildung adaptiert von Mark.W Newman, University of Michigan* ## Fazit Die Einteilung in Lo, Mid, Hi dient zur Orientierung und um den Fokus im breiten Feld rund um Prototyping zu bewahren. Einfach ausprobieren, lautet die Devise! Nur so kann ein Gefühl und Erfahrung entwickelt werden, mit welchen Methoden die definierten Ziele erreicht werden können. Die Erfahrung lehrte uns, dass Prototyping extrem wirkungsvoll ist und Ziele effizienter erreicht werden können und Risiken von kostspieligen Misserfolgen minimiert werden können. Wie wird in Ihrem Unternehmen Prototyping eingesetzt? Welche Erfahrungen haben Sie damit gemacht? ## Weitere interessante Artikel zum Thema Usability und User Experience Design - [Erfahrungen aus der Einführung des Usability-Prozesses](https://thecattlecrew.net/2017/02/09/erfahrungen-aus-der-einfuehrung-des-usability-prozesses/) - [Usability „“ Weit mehr als „sieht schick aus“](https://thecattlecrew.net/2017/02/06/usability-weit-mehr-als-sieht-schick-aus/) ## Links und Referenzen - Prototyping Tool: Invision, [https://www.invisionapp.com/assets/img/home/animations/new/mockup-4.png ](https://www.invisionapp.com/assets/img/home/animations/new/mockup-4.png) - Prototyping Tool: [Balsamiq](https://balsamiq.com/) - [Mark.W Newman, University of Michigan](http://mwnewman.people.si.umich.edu/) ## Über den Autor Andreas Lehner ist Experte für User Experience und Digital Design Thinking bei Opitz Consulting. Er entwickelt gemeinsam mit Experten aus Technik und Business innovative Lösungen für die digitale Transformation. **Kategorien:** Sustainability & Awareness, Tools & Methoden **Schlagwörter:** Mobile, Prototying, prototype, usability, user experience, ux, Web Developement --- ### [Introduction to html2canvas and jsPDF](https://thecattlecrew.net/2017/02/28/introduction-to-html2canvas-and-jspdf/) **Published:** Februar 28, 2017 **Author:** Julius Kaiser **Content:** Sometimes it’s useful to get an image for a specific object (e.g. table, a text field) from your web page by simply clicking a button. At other times, you may want to just take a screenshot of an object and place it into a specific section on your web page as an image. I’ve found two JavaScript libraries to get these jobs done: [html2canvas](https://html2canvas.hertzen.com/) and [jsPDF](http://rawgit.com/MrRio/jsPDF/master/docs/index.html). Both libraries are available free of charge. The first library includes the logic for building a screenshot based on the DOM. The second library saves the canvas as a PDF-File. ## Scenario To illustrate the syntax of the libraries, I’m going to give you a quick example of a use case from a little private project of mine. Card games like Texas Hold’em Poker are strategic games. This means, that it is a good idea to have a winning strategy when you play it. A strategy, in turn, is a game plan for your play in specific situations against different opponents. For example, what kind of starting hands you want to raise (2Bet) in the first position (UTG = Under The Gun) and which hands you want to 4Bet (re-re-raise) if someone is re-raising (3Bet) you after you opened a hand. To illustrate the strategy it’d be nice to have a chart which gives the user a quick overview. So we end up with a table showing starting hands for Texas Hold’em Poker. Furthermore, the user can manipulate the table to mark hands they are willing to play with their specific holding. In this example, the user wants to illustrate the situation described above. I’ve implemented this as an application running in a browser. Basically, it looks like this: ![initialrange](https://thecattlecrew.net/wp-content/uploads/2017/02/initialrange.jpg)initial state ![range](https://thecattlecrew.net/wp-content/uploads/2017/02/range.jpg)defined strategy by a user My project displays this table on the screen. But wouldn’t it be nice to save the resulting table with a click on a button as a picture? For example, in order to learn your strategy or to share it with your friends? ## Code To save the resulting HTML table as a PDF-File you just need to insert the mentioned libraries above in your HTML head tag. ![headtaghtml2canvas](https://thecattlecrew.net/wp-content/uploads/2017/02/headtaghtml2canvas.jpg) Next, define a button to trigger the event ‚Save as PDF‘. ![buttonhtml2canvas](https://thecattlecrew.net/wp-content/uploads/2017/02/buttonhtml2canvas.jpg) For this example, I’ve been using AngularJS, so I just added the following code in the controller.js-file. That’s all it takes. ![controllerhtml2canvas](https://thecattlecrew.net/wp-content/uploads/2017/02/controllerhtml2canvas.jpg) ![outputhtml2canvas](https://thecattlecrew.net/wp-content/uploads/2017/02/outputhtml2canvas.jpg) ## Wrapping it up In my opinion, this is a good way to quickly save specific elements of a web page as an image. However, there’s a catch: the quality of the canvas object isn’t really high compared to the real representation. That’s because it doesn’t make a real screenshot. Instead, it builds the screenshot based on the information available on the page. What about the future of these libraries? A glance at the Google statistics doesn’t yield a clear view. On the one hand, both libraries are relatively unpopular. But on the other hand, both libraries increase their level of awareness year by year. Judging by this measure, choosing these libraries probably is a good choice. ![statisticshtml2canvas](https://thecattlecrew.net/wp-content/uploads/2017/02/statisticshtml2canvas.jpg) **Kategorien:** Development **Schlagwörter:** English, Web Developement --- ### [Some Jenkins Magic](https://thecattlecrew.net/2017/03/10/some-jenkins-magic/) **Published:** März 10, 2017 **Author:** Marco Buss **Content:** The last days I worked on an automated Jenkins installation for a customer with Ansible. The plain installation was pretty easy. I followed the Ansible Role ([jenkins-role](https://galaxy.ansible.com/geerlingguy/jenkins/)) provided by Jeff Geerling. Jeff Geerling is also the author of the great book [Ansible for DevOps](https://www.ansiblefordevops.com/) In addition to this plain installation I had some other requirements for the automatic installation. - Enable security so that no actions are permitted without login - Create two kinds of security credentials. One username password credential for authentication against a subversion repository and an ssh keybased credential for Ansible connection on the target hosts. - Create a seed job which creates all our deployment jobs. ## Enable Security First of all I permit all actions without login. Jenkins runs all groovy scripts found in {{ jenkins\_home }}/init.groovy.d/ The following script creates a new user and activates matrix-based project security. For matrix-based security you need the [Matrix Authorization Strategy Plugin:](https://wiki.jenkins-ci.org/display/JENKINS/Matrix+Authorization+Strategy+Plugin) \[code language=“groovy“\] \#!groovy import hudson.\* import hudson.security.\* import jenkins.model.\* def instance = Jenkins.getInstance() println „–> Checking if security has been set already“ if (!instance.isUseSecurity()) { println „–> creating local user ‚admin'“ // with new HudsonPrivateSecurityRealm(true) self registration for new Users is enabled def hudsonRealm = new HudsonPrivateSecurityRealm(false) hudsonRealm.createAccount(‚{{ jenkins\_admin\_username }}‘, ‚{{ jenkins\_admin\_password }}‘) instance.setSecurityRealm(hudsonRealm) def strategy = new ProjectMatrixAuthorizationStrategy() strategy.add(instance.ADMINISTER, „{{ jenkins\_admin\_username }}“) // enables global read to anonymous strategy.add(Permission.READ, instance.ANONYMOUS.getName()) // activates read permission to complete Jenkins instance to authenticated users strategy.add(instance.READ, „authenticated“) instance.setAuthorizationStrategy(strategy) instance.save() } \[/code\] ## Creating Credentials For creating the credentials I used the Jenkins Rest-Interface. To create a ssh key-based credential the following request can be used: \[code language=“bash“\] curl -X POST ‚http://{{ jenkins\_admin\_username }}:{{ jenkins\_admin\_password }}@{{ jenkins\_hostname }}:{{ jenkins\_http\_port }}/credentials/store/system/domain/\_/createCredentials‘ \\ –data-urlencode ‚json={ „“: „0“, „credentials“: { „scope“: „GLOBAL“, „id“: „ssh-credentials“, „username“: „key-user“, „password“: „“, „description“: „“, „privateKeySource“: { „stapler-class“: „com.cloudbees.jenkins.plugins.sshcredentials.impl.BasicSSHUserPrivateKey$FileOnMasterPrivateKeySource“, „privateKeyFile“: „/home/{{ jenkins\_user }}/id\_rsa“ }, „$class“: „com.cloudbees.jenkins.plugins.sshcredentials.impl.BasicSSHUserPrivateKey“ } } \[/code\] If folders are used and the credential is for a specific folder the url must be changed into something like this: \[code language=“bash“\] http://{{ jenkins\_admin\_username }}:{{ jenkins\_admin\_password }}@{{ jenkins\_hostname }}:{{ jenkins\_http\_port }}/job/{{ folder }}/job/{{ subfolder }}/credentials/store/folder/domain/\_/ \[/code\] The creation of a username password credentials is very similar: \[code language=“bash“\] curl -X POST ‚http://{{ jenkins\_admin\_username }}:{{ jenkins\_admin\_password }}@{{ jenkins\_hostname }}:{{ jenkins\_http\_port }}/credentials/store/system/domain/\_/createCredentials‘ \\ –data-urlencode ‚json={ „“: „0“, „credentials“: { „scope“: „GLOBAL“, „id“: „svn-credentials“, „username“: „user“, „password“: „“, „$class“: „com.cloudbees.plugins.credentials.impl.UsernamePasswordCredentialsImpl“ } } \[/code\] ## Create Seed Job For creating the seed job I created the job on another Jenkins instance and extracted the job.xml. This can be done by using the cli. \[code language=“bash“\] java -jar jenkins-cli.jar -s http://{{ jenkins\_hostname }}:{{ jenkins\_http\_port }}/ get-job JOB \[/code\] Or copying the job.xml from the filesystem. This job.xml can now be used to create the Job on the new Jenkins installation with the cli. \[code language=“bash“\] cat seed-job.xml | java -jar {{ jenkins\_jar\_location }} -s http://{{ jenkins\_hostname }}:{{ jenkins\_http\_port }}/ create-job seed-job –username {{ jenkins\_admin\_username }} –password {{ jenkins\_admin\_password }} \[/code\] ## Conclusion Based on the initial Jenkins Role provides by Jeff Geerling it was realy time consuming to find out how these three Tasks can be achieved. It feel like magic when it works on the end of the day. I hope this would help some people saving time when it comes to automatic Jenkins installations. **Kategorien:** Development **Schlagwörter:** jenkins --- ### [Building a visual feedback service for angular http calls with material](https://thecattlecrew.net/2017/03/20/building-a-visual-feedback-service-for-angular-http-calls-with-material/) **Published:** März 20, 2017 **Author:** Pascal Brokmeier **Content:** **Update: I improved this** [here](https://thecattlecrew.net/2017/03/20/visual-feedback-service-for-angular-http-calls-v2/)**.** Read on for educational purposes, but make sure to read the article linked as well since it makes the whole code prettier and more architecturally neat. ![](https://media.giphy.com/media/l4FGDrrcqqH3PcoTu/giphy.gif)Building web applications using angular is fun, we all know that. With angular material, it“™s also pretty to look at. So let“™s build a service that gives us some convenience regarding visual feedback for users while performing http requests. Angular Material has a cool [progress spinner component](https://material.angular.io/components/component/progress-spinner) and it also includes toasty notifications that pop from the bottom which they call [snack bar](https://material.angular.io/components/component/snack-bar). When performing simple CRUD operations on an arbitrary data structure, wouldn“™t it be nice to give a generic feedback system that can be used while developing? Every time we have an http request, it gives feedback, in the form of a progress spinner and optionally also with these little pop up notifications that tell us if everything went right or if problems occurred. ## Plan with tests and implement We need a service that wraps the MdSnackBar Service provided by the MaterialModule. This service can then also manage any spinner components that can register as a listener to this service and get notifications of any ongoing http calls so that they show visual feedback using the spinner. So we create these two: - VFeedbackService - WorkingSpinnerComponent First let“™s look at the VFeedbackService or rather its spec since we do this test driven: \[code language=“javascript“\] let snackSpy = jasmine.createSpyObj(’snackBar‘, \[‚open‘\]); //… //….beforeEach, TestBed configurations etc //… it(’should let listeners subscribe‘, function () { expect(service.\_listeners.length).toBe(0); service.addListener({ onLoading: () => { }, onLoadingComplete: () => { } }); expect(service.\_listeners.length).toBe(1); }); it(’should remove listeners on removal‘, function () { expect(service.\_listeners.length).toBe(0); let listener = { onLoading: () => { }, onLoadingComplete: () => { } }; service.addListener(listener); service.addListener(listener); service.addListener(listener); expect(service.\_listeners.length).toBe(3); service.removeListener(listener); expect(service.\_listeners.length).toBe(0); }); it(’should notify spinners of processing events and completion‘, fakeAsync(() => { let listenerSpy = jasmine.createSpyObj(‚listenerSpy‘, \[‚onLoading‘, ‚onLoadingComplete‘\]); service.addListener(listenerSpy); let obs = new Observable(subscribe => { subscribe.next(‚foobar‘); subscribe.complete(); }); service.spinUntilCompleted(obs); //wait one async cycle tick(); expect(listenerSpy.onLoading).toHaveBeenCalledTimes(1); expect(listenerSpy.onLoadingComplete).toHaveBeenCalledTimes(1); })); it(’should not notify spinners if observable has not been completed‘, fakeAsync(() => { let listenerSpy = jasmine.createSpyObj(‚listenerSpy‘, \[‚onLoading‘, ‚onLoadingComplete‘\]); service.addListener(listenerSpy); let obs = new Observable(subscribe => { subscribe.next(‚foobar‘); }); service.spinUntilCompleted(obs); //wait one async cycle tick(); expect(listenerSpy.onLoadingComplete).toHaveBeenCalledTimes(0); })); it(’should call MdSnackBar on successful response from observable‘, done => { service.showMessageOnAnswer(‚hooray!‘, null, new Observable(sub => { sub.next(‚fake server response‘); sub.complete(); })) //inside observable subscription of service .subscribe(next => { expect(snackSpy.open).toHaveBeenCalledWith(‚hooray!‘, undefined, {duration: 1500}) }, null, done); }); it(’should call MdSnackBar with error on failed response from observable‘, done => { service.showMessageOnAnswer(‚hooray!‘, ‚fail :(‚, new Observable(sub => { sub.error(); sub.complete(); })) //inside observable subscription of service .subscribe(next => { expect(snackSpy.open).toHaveBeenCalledWith(‚fail :(‚, undefined, {duration: 1500}); }, null, done); }); \[/code\] As is visible from the specs, the service manages a list of listeners and offers http services to hand over their observables so that the service gives feedback once they succeeded or failed. The tests use angulars async helper functions to properly test all the observables and such. They mock away the SnackBar service as well as any listener components that subscribe to the service Now that we have the spec, we can simply implement the service. It“™s straight forward from the specs but I“™ll share it anyways \[code language=“javascript“\] import {Injectable} from „@angular/core“; import {MdSnackBar, MdSnackBarRef, SimpleSnackBar} from „@angular/material“; import {Observable} from „rxjs“; import {LoadingEventListener} from „./LoadingEventListener“; @Injectable() export class VFeedbackService { \_listeners: LoadingEventListener\[\] = \[\]; constructor(private snackBar: MdSnackBar) { } public addListener(listener: any) { this.\_listeners.push(listener); } public removeListener(listener: any) { this.\_listeners = this.\_listeners.filter(item => item !== listener) } /\*\* \* \* @param forthis: The observable to watch and spin for \*/ public spinUntilCompleted(forthis: Observable): void { //start up all listeners this.triggerAllListeners(); //on end of observable call complete for all listeners forthis.subscribe(null, null, () => { this.completeAllListeners() }) } /\*\* \* \* @param successMessage \* @param failMessage \* @param observableRequest \* @param actionText \*/ public showMessageOnAnswer(successMessage: string, failMessage: string, observableRequest: Observable, actionText?: string): Observable> { let obs = new Observable(sub => { observableRequest .subscribe( null, err => { let snack = this.snackBar.open(failMessage, null, {duration: 1500}); sub.next(snack); sub.complete() }, () => { sub.next(this.snackBar.open(successMessage, actionText, {duration: 1500})); sub.complete() }) }).publish(); obs.connect(); return obs; } private triggerAllListeners() { this.\_listeners.forEach((listener) => { if (listener) listener.onLoading(); }); } private completeAllListeners() { this.\_listeners.forEach(listener => { if(listener)listener.onLoadingComplete(); }); } } \[/code\] This service is not yet perfect. If you have several http requests running in parallel, the first one that completes stops all listeners and therefore stops them from spinning. This can be averted by keeping track of the number of calls to spinUntilCompleted and only notify all listeners of a stop, once all subscriptions are completed. Feel free to add that to your code if you have the need for it. Now let“™s look at the spinner components. They are so simple, writing tests for them is almost not worth it. I skipped it. \[code language=“javascript“\] import {Component, OnInit, OnDestroy} from „@angular/core“; import {LoadingEventListener} from „../../services/LoadingEventListener“; import {VFeedbackService} from „../../services/vfeedback.service“; import {\_keyValueDiffersFactory} from „@angular/core/src/application\_module“; @Component({ selector: ‚app-working-spinner‘, template: ``, styleUrls: \[‚working-spinner.component.scss‘\] }) export class WorkingSpinnerComponent extends LoadingEventListener implements OnInit, OnDestroy { private \_visible: boolean; constructor(public vfeedbackService: VFeedbackService) { super(); } onLoading() { this.\_visible = true; } onLoadingComplete() { this.\_visible = false; } ngOnInit() { this.vfeedbackService.addListener(this); } ngOnDestroy(): void { this.vfeedbackService.removeListener(this); } } \[/code\] ## Using it in our services \[code language=“javascript“\] public orderPost(offerId: string, takeaway: boolean): Observable { //http call prep code … //… let obs = this.http.post(path, orderBooking, requestOptions) .map((response: Response) => { if (response.status === 204) { return undefined; } else { return response.json(); } }) .publish(); //ensuring we only have one subscription to pass around, otherwise you get multiple http calls every time obs.connect(); //here we tell the feedback service what we want. we’d like spinning and toasting this.vfeedback.showMessageOnAnswer(‚Order placed!‘, ‚Oops‘, obs); this.vfeedback.spinUntilCompleted(obs); return obs; } \[/code\] As you can see, we just create an http call and then pass it to our service so it can hook into the event process. If we only want spinners, we just use spinUntilCompleted, if we also want a message, we call both methods. It“™s important to note here that failing to ensure you are working with a single subscription (using .share() or .publish() ), the VFeedbackService triggers a secondary http call by subscribing to your observable. So be sure to keep that in mind. #### Next steps Next, it would be nice to hook into the http calls event system to automate the spinner and clean this code out of our services. The http service doesn“™t care about the visual feedback, it just does what it has to do. But our spinner should be able to know when http calls are performed and act upon it. **Option A:** Wrap http and use the wrapping service instead of http directly. A similar approach has been chosen by [Auth0](https://github.com/auth0/angular2-jwt), to attach a jwt token to every http request to ensure its authenticated. **Option B**: Hook into the stuff that angulars http uses behind the scences, namely BrowserXhr. I will investigate this in a future post. ## Wrapping it up I showed how to create a service that can quickly be used to allow for user feedback using angular material in angular 2 projects. You can replace my component using an md-progress-spinner by a dancing chicken or whatever you please. Hooking into the BrowserXhr will be explained in a follow up post, once I got the code clean and put a bow tie on it. **Kategorien:** Development --- ### [Getting started mit React - Teil 1](https://thecattlecrew.net/2017/03/28/getting-started-mit-react-js-teil-1/) **Published:** März 28, 2017 **Author:** Jonas Stein **Excerpt:** React wurde 2013 von Facebook als Open-Source-JavaScript-Bibliothek vorgestellt. Das Framework erfreut sich zunehmender Beliebtheit und hat seine Fähigkeiten mehrfach unter Beweis gestellt. Wenig überraschend ist, dass Facebook selbst React nutzt, aber auch andere Größen wie AirBnb oder Instagram laufen mit der JavaScript-Bibliothek. **Content:** React wurde 2013 von Facebook als Open-Source-JavaScript-Bibliothek vorgestellt. Das Framework erfreut sich zunehmender Beliebtheit und hat seine Fähigkeiten mehrfach unter Beweis gestellt. Wenig überraschend ist, dass Facebook selbst React nutzt, aber auch andere Größen wie AirBnb oder Instagram laufen mit der JavaScript-Bibliothek. Der Kern der Bibliothek basiert auf Komponenten-Design: Eine Anwendung wird in möglichst unabhängige, wiederverwendbare Komponenten zerlegt und aus deren Zusammensetzung entsteht letztendlich die Web-Anwendung. Eine Komponente enthält hierbei alle Informationen, um unabhängig zu agieren, das heißt auch der Style (CSS, SASS, LESS) liegt innerhalb einer Komponente. Diese Tatsache kritisieren manche Entwickler an React. Ein wesentlicher Nachteil entsteht daraus aber nicht. Der große Vorteil von React ist der virtuelle DOM. Dieser stellt den HTML-Teil der Webanwendung im Speicher dar und wird bei jeder Ü„nderung komplett neu gerendert. Der springende Punkt hierbei ist allerdings, dass React den virtuellen DOM benutzt um die tatsächlichen Ü„nderungen im Vergleich zum DOM-Baum im Browser zu erkennen. Nur die geänderten Elemente werden neu gerendert. Dieser Ansatz verhilft React zu einer einwandfreien Performance. Trotz intensiven Ü„nderungen am DOM, während der Laufzeit, können problemlos hoch dynamische Webseiten betrieben werden. ## Projekt aufsetzen und erste Schritte React ist im Kern ja wie gesagt eigentlich nur eine JavaScript-Bibliothek und kann überall, wo JavaScript eingesetzt wird, verwendet werden. In der Regel laufen React Projekte wie alle JavaScript-Projekte ab. In der Praxis kristallisieren sich allerdings einige besondere Vorgehensweisen heraus und es entsteht ein häufig verwendeter Technologie-Stack. Node.JS und npm sind meistens mit von der Partie. Für den Build-Prozess kommen häufig [Webpack ](https://github.com/webpack/webpack)und [Babel](https://babeljs.io/) zum Einsatz, um eine Anwendung lauffähig machen. Für die Codequalität werden sogenannte Linter eingesetzt, wie [ES-Lint](http://eslint.org/) oder [JS-Lint](http://www.jslint.com/). Die Linter werden innerhalb des Projekts über eine Config-Datei konfiguriert und unterstützen den Entwickler bei der Einhaltung des Code-Styles, ja zwingen ihn sogar dazu. Als Entwicklungstool reicht ein Texteditor, es kann aber auch jede andere IDE eingesetzt werden. [WebStorm ](https://www.jetbrains.com/webstorm/), [Sublime ](https://www.sublimetext.com/)und [Atom](https://atom.io/) werden immer wieder gern genutzt. Damit man als Entwickler nicht tagelang damit zubringt, sein Projekt aufzusetzen, gibt es Skripts, die das erledigen. Ein sehr einfaches und effektives Skript wäre z. B. [create-react-app](https://github.com/facebookincubator/create-react-app). Es kümmert sich genau richtig, nicht zu viel und nicht zu wenig um das Wesentliche. Am Ende hat man ein passendes Projekt, das nicht überladen ist, und die wichtigsten Sachen wie Babel und Webpack sind vorkonfiguriert. In der package.json sind auch schon fertige npm-Kommandos (z. B. zum Starten des Servers) vorhanden. Sollten jemandem die Konfigurationsmöglichkeiten zu eingeschränkt sein, kann man das Projekt auch „ejecten“, dann werden alle embedded-Skripte in den Projektordner kopiert. Dies ist allerdings kein bidirektionaler Vorgang, d. h. einmal „ejectete“ Projekte bleiben wie sie sind. Will man ein React-Projekt starten, muss man vorher npm und Node.JS installiert haben. Wenn man sich mittels npm das Package „*create-react-app“* installiert, kann man es direkt nutzen, um sich eine Projektstruktur erzeugen zu lassen. Für IDEs wie WebStorm, gibt es auch ein Plugin und man kann sich das React-Projekt wie jedes andere anlegen lassen. ## Einführung in JSX Was sich nach einer eigenen Programmiersprache anhört ist eigentlich ein Hybrid aus JavaScript und HTML. In React schreibt man seinen JavaScript- und HTML-Code in eine Datei. Theoretisch könnte man auch den CSS-Code dazu packen, aber eine Trennung von Style und Code sollte wenigstens so weit gehen, dass diese in verschiedenen Dateien landen. JSX wird zu JavaScript-Code transpiliert, ähnlich wie bei Angular 2 und TypeScript. Apropos: Wer TypeScript mag, für den könnte TSX interessant sein, das TypeScript-Pendant zu JSX. Um das Transpilieren muss man sich nicht kümmern, das übernimmt Babel zur Laufzeit. JSX-Code sieht folgendermaßen aus: \[code language=“javascript“\] const element = ( # Hello! ## Good to see you here. ); \[/code\] Man muss eigentlich nicht viel dabei verstehen, es reicht, wenn man akzeptiert, dass es HTML jetzt auch innerhalb des JavaScript-Codes gibt, aber es macht die ganze Sache erheblich einfacher, wie wir gleich sehen werden. ## Die erste Komponente Wie bereits zu Anfang erwähnt, basiert React auf Komponenten. Eine Komponente entspricht in der Realität einer JavaScript-Datei und kann natürlich auch innerhalb anderer Komponenten verwendet werden. Um Komponenten zu erstellen, gibt es zwei mögliche Wege. Es gibt die Komponenten-Klassen und die funktionalen Komponenten. Wir beginnen mit den Komponenten-Klassen: ### Komponenten-Klassen Bevor wir uns an die eigentliche Struktur der React-Klasse machen, erläutern wir kurz, wie eine React Komponente aufgebaut ist. Denn allein mit der Klasse ist es nicht getan, üblicherweise besteht eine Komponente aus folgenden Dateien: ![image2017-2-28 14-0-47](https://thecattlecrew.net/wp-content/uploads/2017/03/image2017-2-28-14-0-47.png) - App.css - Enthält die Style Informationen. - App.js - Enthält den Quellcode (JSX) - App.test.js - Enthält die Unit-Tests - index.js - Für den globalen export. Schauen wir uns den Inhalt der App.js genauer an: \[code language=“javascript“\] import React, { Component } from ‚react‘; import ‚./App.css‘; class App extends Component { constructor(props) { super(props); } componentWillMount(){ } componentDidMount(){ } componentWillUnmount(){ } render() { return ( ); } } export default App; \[/code\] Gehen wir den Quellcode einmal durch: **import** Nichts Überraschendes, an dieser Stelle werden die Abhängigkeiten importiert. Das sind in der Regel Libraries oder andere React Komponenten. Die zeile „*import React, { Component } from ‚react'“* braucht man immer für eine klassenbasierte Komponente, alles andere ist optional. Die Style-Informationen werden einfach mit einem Import in die Komponente geladen und stehen für den HTML-Teil sofort zur Verfügung. **Klassendeklaration** Wie auch in anderen Programmiersprachen üblich, folgt nun die Klassendeklaration. Wichtig hierbei ist nur der „extends“-Teil. Eine React-Klasse erbt immer von Component. ***constructor*** Der Konstruktor dient eigentlich nur einem Zweck und zwar der Initialisierung des *state*. Zu *state* und *props* kommen wir aber später. In diesem konkreten Fall ist der Konstruktor überflüssig und dient nur der Veranschaulichung. Wichtig ist aber, dass der Aufruf super(props) immer vorhanden ist und zwar als erste Zeile innerhalb des Konstruktors. ***componentWillMount*** Dies ist die erste der Lifecycle-Methoden. Diese Methode wird vor der render und vor dem Einhängen im DOM ausgeführt. Die properties stehen zur Verfügung und der Aufruf *setState* ist erlaubt. Dieser Code wird serverseitig ausgeführt und wird hauptsächlich genutzt, um initialen Code auszuführen. ***componentDidMount*** Diese Methode wird automatisch nach der *render-*Methode ausgeführt. Ab hier stehen nun die *refs* zur Verfügung die *setState-*Methode löst ein erneutes Rendern aus. Perfekt, um asynchrone Calls auszuführen und die Seite bei Erfolg neu zu rendern. ***componentWillUnmount*** Der Gegenpart zu componentWillMount wird aufgerufen, unmittelbar bevor die Komponente aus dem DOM entfernt wird. Hier ist der richtige Zeitpunkt um ressourcen wieder freizugeben. Ein erneutes rendern kann hier nicht ausgelöst werden. ***render*** der wichtigste Teil passiert in der *render*-Methode. Denn hier wird der HTML-Teil, also das was wir später im Browser sehen, erzeugt. Der komplette Lebenszyklus lässt sich nun wie folgt zusammenfassen: ***constructor >> componentWillMount >> render >> componentDidMount >> componentWillUnmount*** ### Funktionale Komponenten Die funktionalen Komponenten kommen im Vergleich mit einer Klassen-Komponente mit sehr viel weniger Code aus: \[code language=“javascript“\] import ‚./App.css‘; const App = props => ( ); export default App; \[/code\] Diese funktionale Komponente liefert genau denselben Effekt wie die klassen basierte und braucht dabei viel weniger Codezeilen. Letztendlich erfüllt sie aber alle Anforderungen einer React Komponente, denn sie bekommt properties als Input und liefert HTML als output. React Komponenten leben von genau diesem Konzept: Bei funktionalen Komponenten sieht das ganze so aus: ***props >> React Komponente >> HTML*** Bei React Klassen hängen dazwischen noch die Lifecycle Methoden ***props >> constructor >> componentWillMount >> render >> HTML*** Der Unterschied beläuft sich also darauf, dass die funktionalen Komponenten keine Lifecycle-Methoden, sowie keinen *state* haben. ### Deklaration funktionaler Komponenten Die Deklaration einer funktionalen Komponente wie oben gezeigt, funktioniert nur, wenn im Rumpf direkt der *return*-Wert eingetragen wird. Also: \[code language=“javascript“\] const App = props => ( ); \[/code\] Der return Wert steht hier in zwischen den ( ). Will man nun aber noch etwas mehr Logik in seiner Komponente unterbringen, dann ändert sich die Syntax leicht: \[code language=“javascript“\] const App = (props) => { //your code goes here return ( ); } \[/code\] ### Funktional oder klassenbasiert Die Entscheidung ist relativ leicht getroffen. Wenn man innerhalb einer Komponente den state oder die Lifecycle Methoden braucht, dann nutzt man Klassen Komponenten. Ansonsten bevorzugt man funktionale Komponenten, da der Quellcode hier meist kürzer und einfacher ist. Außerdem soll in den kommenden React releases besondere Performance Verbesserungen für die funktionalen Komponenten kommen. Daher ist es von Vorteil so viele wie möglich davon zu haben. Derzeit ist der Unterschied in der Produktion nicht zu merken, es könnte aber in naher Zukunft von Vorteil sein wenn man bereits jetzt auf den funktionalen Ansatz setzt. ### Properties und State Zuvor wurden schon mehrfach die *Begriffe props* und *state* erwähnt, diesen gehen wir nun näher auf den Grund: Properties sind Eigenschaften die der Komponente übergeben werden. Entweder im Konstruktor oder als Parameter in funktionalen Komponenten. Die Properties sind als Objekt dann innerhalb der Klasse verfügbar und können verwendet werden, um verschiedene HTML-Ausgaben zu erzeugen oder auch, um die Kommunikation zwischen Komponenten zu ermöglichen. Man kann z. B. über die Properties eine Funktion übergeben, die dann als Callback aufgerufen werden kann und Ereignisse in der Elternklasse auslöst. Properties sind Read-only und somit *immutable*. Der *state* wiederum steht nur Klassen-Komponenten zur Verfügung und kann gelesen und beschrieben werden. Eine Ü„nderung im *state* löst in der Regel einen erneuten Aufruf der *render-*Methode aus, wodurch der DOM-Baum aktualisiert wird. ### Properties definieren In React definiert man die Properties außerhalb der Komponente: \[code language=“javascript“\] class App extends Component { render() { return ( ); } } App.PropTypes = { color: React.propTypes.string.isRequired, shape: React.propTypes.object, } export default App; \[/code\] Die Syntax ist hierbei relativ einfach: *Komponentenname.PropTypes* wird ein Objekt zugewiesen. Innerhalb dieses Objekts werden die einzelnen Properties definiert. Die React Type-Syntax wird wie folgt angewandt: *React.propTypes.isRequired*, der letze Teil (isRequired) ist hierbei optional. Wenn eine Property nicht als required deklariert wird, sollte ein Default-Wert gesetzt werden: \[code language=“javascript“\] App.defaultProps = { shape: ‚rectangle‘, } App.PropTypes = { color: React.propTypes.string.isRequired, shape: React.propTypes.string, } \[/code\] Sollte eine Property (die nicht den Status *required* hat) nun den Wert *null* oder *undefined* zugewiesen bekommen (das passiert wenn man nichts für diese Property übergibt), dann fällt React automatisch auf die Default-Werte zurück. Die Properties werden der Komponente im HTML Teil übergeben. Grundsätzlich rendert man in React eine Komponente wie jedes andere DOM-Element: \[code language=“javascript“\] import React, {Component} from ‚react‘; import Header from ‚../Header‘; import ‚./App.css‘; class App extends Component { render() { return ( ); } } export default App; \[/code\] Die Komponente *App* importiert hier eine andere Komponente names *Header*, die zwei Properties entgegennimmt: *tabs* und *orientation*. Die Properties werden einfach als Attribute im führenden HTML-Tag übergeben und stehen der Header-Komponente unter *this.props.tabs* bzw. *this.props.orientation* bei Klassen-Komponenten, oder als *props.tabs* bei funktionalen Komponenten zur Verfügung. ### *State* in Klassen-Komponenten Der *state* ist ein Objekt, das nur Klassen-Komponenten zur Verfügung steht. Der *state* wird nicht von außen beeinflusst sondern nur von der Komponente selbst. Man kann der Komponente über Callbacks allerdings mitteilen, dass sich der *state* ändern soll. In der Praxis sieht das wie folgt aus: \[code language=“javascript“\] class App extends Component { constructor(props) { super(props); this.state = { color: ‚red‘, shape: ‚rectangle‘, } } someCallbackFunction (color) { this.setState({ color: color }); } render() { return ( selected color: {this.state.color} ); } } \[/code\] Hier kamen jetzt einige neue Sachen hinzu, die wir der Reihe nach durchgehen. Im Konstruktor wird der *state* erstmals initialisiert, dabei wird die Struktur des *state*-Objekts bestimmt, sowie die Default-Werte. Die Funktion *someCallback* wird an die Komponente Header als Property übergeben und kann dort aufgerufen werden: \[code language=“javascript“\] class Header extends Component { onClick() { this.props.onCallback(‚green‘); } render() { return ( Change color to green ); } } Header.PropTypes = { onCallback: React.propTypes.func.isRequired, } \[/code\] Bei einem Klick auf den Button wird nun die lokale Methode *onCallback* aufgerufen, die wiederum ruft die übergebene Funktion aus der App-Komponente mit dem Parameter *green* auf. In der App-Komponente wird dann *state.color* mit dem Aufruf *setState* auf *green* gesetzt. Weil sich der *state* ändert, wird die *render*-Methode neu ausgeführt und React aktualisiert den DOM im Browser. Wo vorher in der Zeile *selected color: {this.state.color}* der Wert *red* angezeigt wurde, wird nun *green* angezeigt. Der *state* wird oft genutzt, um Komponenten ein- bzw. -auszublenden und man setzt ihn innerhalb von Funktionen. Dadurch erreicht man seine Dynamik innerhalb einer Komponente. ### „Smarte“ oder „dumme“ Komponenten Die Bezeichnung Smart Components und Dumb Components sowie Presentional und Container Components werden in React Tutorials häufig verwendet. Beides meint im Prinzip das gleiche, im folgenden Absatz nutzen wir daher nur die Bezeichnung Smart (Container) und Dumb (Presentional) Components. Es gibt Komponenten, die *smart* sind oder als Container fungieren. Diese Komponenten haben in der Regel einen *state* und beinhalten eine oder mehrere Dumb bzw. Presentional Components. Über den *state* der Smart Components wird das Verhalten der Applikation gesteuert. Die Dumb Components werden jedes Mal mit veränderten Properties neu gerendert und wissen eigentlich nichts über ihre Elternklassen oder den *state*. Die Smart Components stellen meistens eine View in der Applikation dar und beinhalten kleinere Komponenten, die je nach *state* der Applikation unterschiedlich angezeigt werden. Smart Components steuern ihren *state* selbst und reagieren auf Benutzereingaben. Smart Components werden häufig als Klassen-Komponenten geschrieben, wohingegen die Dumb Components oft funktional daherkommen. ## Fazit React verfolgt einen vielversprechenden Ansatz. Durch die Aufteilung in Komponenten kann innerhalb eines Teams meist unabhängig gearbeitet werden und der Austausch oder die Ü„nderung einzelner Komponenten kann ohne große Mühe erfolgen. Auch können Komponenten leicht wiederverwendet werden und unabhängig gestylt sein. React ist kein kompliziertes Framework sondern eine sehr mächtige JavaScript-Bibliothek. Man muss keine komplizierte Syntax o. ä. lernen, sondern kommt meist mit der EcmaScript-Spezifikation aus. Die Community ist ziemlich groß und es gibt eine Menge vorgefertigter Komponenten, die sich ohne viel Aufwand in ein Projekt einbinden lassen. Die einzige Schwäche ist meiner Meinung nach, dass bei großen Projekten die Kommunikation zwischen den Komponenten schnell einen sehr komplexen Quellcode zur Folge hat. Aber auch dafür gibt es bereits Abhilfe durch Redux bzw. das Flow-Konzept. **Kategorien:** Development **Schlagwörter:** Browser, Frontend, JavaScript, React, Web Developement --- ### [Apache Lucene Basics](https://thecattlecrew.net/2017/04/27/apache-lucene-basics/) **Published:** April 27, 2017 **Author:** Jonas Stein **Excerpt:** Hat man sich denn nicht immer mal gefragt was so hinter dem Vorhang bei Suchmaschinen abläuft. Warum sind sie so schnell? Wie lautet der Such-Algorithmus von Google? Vielleicht können wir wenigstens eine der beiden Fragen klären. Google hütet sein Geheimnis gut, aber wer z.B. auch alternative Suchmaschinen wie DuckDuckGo kennt, der kann hier einmal hinter die Kulissen schauen. Den DuckDuckGo funktioniert mit der Suchmaschinen API Lucene. Apache Lucene ist eine hochperformante Suchmaschinen Bibliothek, die komplett in Java geschrieben ist. Wer direkt in die Tiefen der API eintauchen will kann sich das Projekt von der Homepage runterladen und in den Quellcode reinschnuppern: Apache Lucene. Wer aber erst einmal ein grobes Verständnis über die Technologie dahinter erhalten möchte, kann sich den Einstieg auch mit diesem Artikel erleichtern. **Content:** Wollten Sie nicht immer schon mal wissen, was im Hintergrund einer Suchmaschine abläuft. Warum sind Search Engines so schnell? Wie lautet der Such-Algorithmus von Google? Vielleicht können wir wenigstens eine dieser beiden Fragen klären. Google hütet sein Geheimnis gut, aber wer z. B. auch alternative Suchmaschinen wie [DuckDuckGo](https://duckduckgo.com/) kennt, der kann hier einmal hinter die Kulissen schauen. Denn DuckDuckGo funktioniert mit der Suchmaschinen-API Lucene. Apache Lucene ist eine hochperformante Suchmaschinen-Bibliothek, die komplett in Java geschrieben ist. Wer direkt in die Tiefen der API eintauchen will, kann sich das Projekt von der Homepage runterladen und in den Quellcode reinschnuppern: [Apache Lucene](https://www.drupal.org/files/project-images/lucene_0.png). Wer aber nur ein grobes Verständnis über die Technologie dahinter erhalten möchte, kann sich den Einstieg auch mit diesem Artikel erleichtern: ## Abgrenzung zu Solr und Elastic Search Bekannte Suchmaschinen im Bereich Big Data oder Software Engineering sind Elastic Search und Solr. Wie passt hier Lucene rein? Nun, Lucene ist einfach formuliert die Basis für das, was unter der Haube passiert. Sowohl Elastic Search als auch Solr bauen auf Lucene auf und bieten dem Anwender einen einfachen Zugang zu einer Bibliothek, in Form von Webschnittstellen und fertigen Implementierungen verschiedener Anwendungsfälle. Lucene wird für das Erstellen und Verwalten des Such-Indexes verwendet, der erst einmal nicht mehr ist als ein Dokumentenspeicher. Für eine erfolgreiche Volltextsuche braucht es aber doch noch etwas mehr. Schauen wir uns dazu einmal die grundlegenden Probleme bei einer Volltextsuche anhand von relationalen Datenbanken an: ## Was ist ein Index? Jeder hat vermutlich schon einmal den Satz gehört: „Die Datenbank ist etwas langsam, wir sollten Indizes verwenden“. Was steckt denn eigentlich hinter diesen Indizes? Die Antwort ist einfach: Sie machen die Suche auf der Datenbank schneller. Interessant ist aber das Warum. Werfen wir einen Blick in eine ganz normale Datenbanktabelle einer relationalen Datenbank wie der Oracle DB: IDSURNAMENAMEADDRESSTEL\_NUMBER1SmithJohnGroove Street55512GardnerHellenAny Town55523LambertZachariahFirst Street5553Hier sehen wir erst einmal nichts Besonderes. Wir führen ein klassisches Select-Statement aus: *SELECT \* FROM TABLE WHERE NAME=’John‘*. Was jetzt intern passiert, ist, dass die Datenbank die Spalte *NAME* durchsucht und uns alle Treffer in einem *Result Set* zurückgibt. Da die Datenbank selbst aber nicht weiß, wie viele Johns es in der Tabelle gibt, muss sie wohl oder übel alle Einträge überprüfen. Denn selbst wenn sie, wie in unserem Fall, direkt im ersten Eintrag schon einen Treffer hat, gibt es keine Garantie, dass es nicht weiter unten noch einen John gibt. Versteht sich von selbst, dass dieses Vorgehen nicht besonders performant sein kann. Vor allem dann nicht, wenn wir 1.000.000 Einträge durchsuchen müssten. Wir legen nun einen Index über die Spalte *NAME*, was zur Folge hat, dass die Datenbank eine zweite Tabelle anlegt: NAMERECORD\_POINTERHellen0 … 0xffffffffJohn0 … 0xffffffffJohn0 … 0xffffffffZachariah0 … 0xffffffffIn dieser Tabelle sind die Einträge anhand des Namens sortiert. Die zweite Spalte RECORD\_POINTER ist ein Pointer auf den Eintrag in der Haupttabelle. Wenn wir jetzt wieder nach dem Namen John suchen, durchsucht die Datenbank diese Tabelle, findet den Eintrag John, fügt den Eintrag in das *Result Set* (über den Pointer kann der echte Eintrag in der Haupttabelle referenziert werden) und schaut in der nächsten Reihe nach. Bei einem weiteren Treffer kommt auch dieser Eintrag in das Result Set, bis es keine weiteren Treffer mehr gibt. Das passiert, wenn der nächste Eintrag Zachariah lautet. Diesmal steht aber fest, dass es keine weiteren Johns mehr in der Tabelle gibt und es muss nicht weiter gesucht werden. Der Vollständigkeit halber sollte noch erwähnt werden, dass die Einträge in einer Tabelle standardmäßig anhand des Primary Keys sortiert werden und dieser somit automatisch einen Index hat. Für alle weiteren Indizes wird eine neue kleine Tabelle angelegt. Man kann sich natürlich ausmalen, wie sinnvoll das Ganze für eine Volltextsuche ist, nämlich gar nicht. Wenn man in einem Feld nun nicht einfach einen Namen, sondern ein ganzes Textdokument ablegt und möchte dann herausfinden ob Schlagwort „X“ darin vorkommt, dann helfen die Indizes der Datenbank nicht weiter. Ihr bleibt dann nichts anderes übrig, als einen Full Table Scan durchzuführen. ## Was macht Lucene anders? Lucene ist eine NoSQL-Datenbank bzw. ein Dokumentenspeicher. Es nutzt keine relationalen Tabellen, aber trotzdem existiert auch in Lucene ein Index, der einer Datenbanktabelle recht nah kommt. In diesem Index werden aber nicht ganze Texte gespeichert mit dem Verweis zu welchem Dokument sie gehören, sondern sogenannte Tokens. Ein Token kann ein einzelnes Wort sein, eine E-Mail-Adresse oder eine Telefonnummer. Im Prinzip besteht ein Text aus mehreren Tokens. Damit man einen größeren Text effizient durchsuchen kann, muss er vorher in Tokens zerlegt werden. Bei Lucene heißt dieser Prozess *Analyze*. Folgendes Schaubild soll den Prozess verdeutlichen: ![LuceneAnalyzeProzess](https://thecattlecrew.net/wp-content/uploads/2017/03/luceneanalyzeprozess.png) Hangeln wir uns einmal kurz durch die drei Schritte: ### Tokenizer Der Tokenizer zerlegt den Text in einzelne Wörter. In der Praxis gibt es natürlich verschiedene Implementierungen für den Tokenizer. Manche werden von Lucene mitgeliefert, man kann sie aber auch selbst implementieren. Solr und Elastic Search bieten selbst noch ein paar weitere Implementierungen an. Sollte man also nicht vorhaben das „nackte“ Lucene direkt zu verwenden, braucht man sich um diesen Schritt, in einfachen Anwendungsfällen, eigentlich keine großen Sorgen machen. Wichtig ist nur zu wissen, dass der Tokenizer den Text in kleine Einheiten zerlegt, die in der Regel ein Wort beinhalten. ### Stemmer Der Stemmer bringt Wörter in seine Grundform. Dass heißt aus Wörtern wie „ging“, „Hauses“, „Bäume“ wird „gehen“, „Haus“, „Baum“. Das ist wichtig, weil man bei einer Suche nach dem Wort „Baum“ vielleicht auch Treffer haben möchte in denen das Wort Bäume vorkommt. ### Filter Der Filter entfernt unbrauchbare Wörter wie Konjunktionen, Präpositionen, Artikel etc. Wer bei einer Suchmaschine einfach das Wort „und“ sucht, sollte sich sowieso nicht auf zutreffende Ergebnisse freuen, warum das ganze also speichern. Der Filter kann natürlich auch angepasst werden. Z.B. könnte es ja eventuell doch Sinn haben, bei einer Filmdatenbank das Wort „der“ nicht rauszufiltern, um Treffer wie „Der Fluch der Karibik“ trotzdem zu bekommen. Wir veranschaulichen das ganze noch einmal: ![LuceneAnalyzeExample](https://thecattlecrew.net/wp-content/uploads/2017/03/luceneanalyzeexample.png) Der Text wurde nun in 6 Tokens zerlegt. Diese Tokens werden in Lucene in einem sogenannten *Inverted Index* gespeichert. ### Inverted Index Der Begriff Inverted Index sorgt manchmal für ein wenig Verwirrung, weil er oft ohne den Kontext dahinter verwendet wird. Grundsätzlich unterscheidet man im Kontext von Suchmaschinen einfach zwei Arten von Indizes. Einmal den Forwarded Index und zum anderen den Inverted Index. Der Forwarded Index ist eine Tabelle, in der alle Dokumente in der linken Spalte stehen und in der rechten Spalte die zugehörigen Tokens. Bei einem Inverted Index stehen in der linken Spalte die Tokens und in der rechten Spalte alle Dokumente, in denen diese Tokens vorkommen. Eine einfache Darstellung haben wir hier: ![ForwardedVSInvertedIndex](https://thecattlecrew.net/wp-content/uploads/2017/03/forwardedvsinvertedindex.png) Der Vorteil entsteht dadurch, dass die Tokens eigentlich genau den Schlagworten in einer Suche entsprechen. Wenn wir jetzt nach dem Wort \[brown\] suchen, bekommen wir direkt alle Dokumente geliefert, die das Wort \[brown\] enthalten. Dadurch, dass der Index anhand der Tokens sortiert ist, muss nicht der gesamte Index durchsucht werden, was sich positiv auf die Performance auswirkt. ### Halt, war Lucene nicht ein Dokumentenspeicher? Ja, richtig. Wie am Anfang dieses Artikels erwähnt, handelt es sich bei dem Index auch um einen Dokumentenspeicher. Insgesamt besteht der Index aus mehreren Dateien, die direkt auf der Platte oder gar in einem Hadoop HDFS abgelegt werden. In diesen Dateien finden sich vielerlei Informationen, neben dem Inverted Index liegen hier aber auch die Dokumente. Ein Dokument in Lucene besteht aus mehreren Feldern, die wiederum aus *Keys* und *Values* bestehen. Zur Veranschaulichung hier ein Dokument im JSON Format: { „title“:“buying a house“, „author“:“james gumberfield“, „price“:“15$“ „text“:“some content“ … } Die Values in diesem Dokument werden beim Indexieren durch den *Analyze*-Prozess in Tokens zerlegt. Lucene merkt sich aber natürlich, zu welchem Feld diese Tokens gehören. Über den Inverted Index können diese dann nach potenziellen Treffern durchsucht werden und die Dokumente, die diese Tokens enthalten, werden als Ergebnis zurückgeliefert. ### Suchen auf dem Lucene Index Lucene bietet eine eigene Query-Struktur an, mit der man Suchanfragen ausführen kann. Die Suche erfolgt immer in den Werten der Felder, also z. B. im Feld *Title* wird nach dem Wort *Buying* gesucht. Die Query dazu würde so aussehen: ``` title:buying ``` Also *Feldname* gefolgt von einem *:* und anschließend der Suchterm *buying*. Gibt man keinen Feldname an, wird im Default-Feld gesucht. Das Default-Feld ist implementierungsabhängig. Gehen wir in unserem Beispiel davon aus, dass wir die Felder *title* und *text* haben. Eine Suche mit einem einzelnen Wort haben wir bereits gesehen, doch wie sieht es mit einer Wortphrase aus? Dabei muss man lediglich daran denken, die Phrase in Anführungszeichen zu setzen: ``` title:"buying a house" ``` Würde man folgende Suche ausführen … ``` title:buying a house ``` … würde Lucene nach dem Wort *buying* im Feld *title* suchen und anschließend nach den Wörtern *a* und *house* im Default-Feld. Die Suchen können mithilfe von Booleschen Operatoren verknüpft werden: **OR** Der OR Operator ist der Default-Wert. Das heißt, wenn kein Operator zwischen zwei Termen steht, dann wird automatisch OR genutzt: ``` Finde alle Dokumente mit "buying" im Feld title oder "house" im Default-Feld. title:buying OR house ``` **AND** ``` Finde alle Dokumente mit den Wörtern "buying" und "house" im Feld title. title:buying AND title:house ``` **NOT** ``` Finde alle Dokumente mit den Wörtern "new house" und nicht "new home" im Feld title. title:"new house" NOT title:"new home" Beim NOT Operator müssen mindestens zwei Suchterme eingegeben werden, sonst bleibt das Ergebnis leer. ``` **+** Der „+“ Operator setzt den darauffolgenden Term auf *required*. ``` +house ``` Findet Dokumente die das Wort „house“ enthalten. Der + Operator kann auch als Ü„quivalent zu AND verwendet werden, wenn man Folgendes schreibt: ``` +house +home ``` **–** „-“ ist der Gegenpart von „+“ (welch eine Überraschung ;-)) und verbietet den folgenden Term in der Ergebnismenge: ``` +house -home ``` Das Ergebnis ist identisch mit dem NOT Operator, allerdings kann „-“ auch mit nur einem Suchterm verwendet werden. **Wildcards** Wildcards werden ebenfalls unterstützt mit den Operatoren „?“ und „\*“. Der Unterschied ist, das „?“ für einzelne Zeichen und „\*“ für mehrere gilt. ``` te?t ``` Findet z.B. test und text. ``` Wohn* ``` Findet wohnen, wohnung, wohnheim etc. **Fuzzy search** Lucene unterstützt auch eine unscharfe Suche mit dem „~“ Operator. ``` house~ ``` … findet ähnliche Wörter wie „house“. Optional kann man über eine Zahl zwischen 0 und 1 einen Faktor bestimmen, der den Grad der Ü„hnlichkeit der Wörter angibt. ``` house~0.8 ``` Standardmäßig wird der Faktor 0.5 verwendet. **Boosting** man kann einzelnen Suchtermen unterschiedliche Prioritäten einräumen. Der Operator „^“, gefolgt von einer positiven Zahl, beeinflusst die Reihenfolge der Ergebnisliste. Die Zahl kann auch kleiner als 1 sein (0.8 z.B.). ``` house^4 home ``` … findet alle Dokumente, die die Wörter „house“ und „home“ beinhalten. Die Treffer mit „house“ erhalten eine höhere Priorität und werden am Anfang der Ergebnismenge zurückgegeben. **Grouping** Mit Klammern kann man einzelne Suchkommandos zusammenfassen ``` (house OR home) AND new ``` **Range search** Eine Bereichssuche kann mit den Operatoren „\[ \]“ und „{ }“ erfolgen, wobei die Suche mit „\[\]“ die Randwerte mit einschließt, „{ }“ schließt diese hingegen aus. ``` date:[01012017 TO 01052017] ``` … findet alle Einträge zwischen und inklusive dem 01.01.2017 und dem 01.05.2017. ``` title:{A TO Z} ``` … findet alle Einträge zwischen A – Z wobei A und Z nicht in der Ergebnismenge enthalten sind. Dies waren die wichtigsten Operatoren im Überblick. Die gesamte Doku dazu, befindet sich [hier](https://lucene.apache.org/core/2_9_4/queryparsersyntax.html#-). ## Fazit Lucene ist ausgereift und robust. Man kann es ohne schlechtes Gewissen in der Produktion einsetzen. In der Praxis werden aber meist Elastic Search und Solr genutzt. Beide Technologien haben Lucene auf den nächsten Level gehoben. Viele Standardprobleme sind damit bereits gelöst und man muss sich nicht so viel mit der Implementierungen herumschlagen, sondern bekommt gleich das All-Around-Paket. In der Praxis kommt es natürlich oft vor, dass viel Feintuning erforderlich ist. Der Grund ist, dass die Suche immer anhand sehr spezifischer Anforderungen implementiert wird, trotzdem spart man sich viel Initialaufwand. Wer mehr über wissen will, sollte sich einmal die jeweilige Homepage anschauen: Wer trotzdem mit Lucene starten möchte kann sich [hier die Doku dazu ](http://lucene.apache.org/core/6_5_0/index.html)anschauen. Derzeit ist die Version 6.5.0 aktuell. **Kategorien:** Cloud, Tools & Methoden **Schlagwörter:** Apache Lucene, Apache Solr, Big Data, Elastic Search, German, SearchEngines --- ### [Published an automation tool for process instance migration - Camunda-Migrator](https://thecattlecrew.net/2017/07/03/published-an-automation-tool-for-process-instance-migration-camunda-migrator/) **Published:** Juli 3, 2017 **Author:** Halil Hancioglu **Content:** We are happy to annouce publishing an automation tool for process instance migration with Camunda BPM on GitHub. It helps you to have continuously a current process state with the latest features. Therefor all previous process versions will be migrated automaically to the newest process definition version. It can be used to interact with the process engine from outside the application server and deliver information for a automatic process instance migration. No running application server is required for this because its set up as a SpringBoot application. For example, you can integrate it into your CI/CD system to run the migration on all existing environments during software delivery. And also it can be integrated into your actual BPM project as a Maven project submodule, too. During the execution, all the information can be logged out in a central logging system (e.g. PapterTrail or Graylog) and locally on the console. Have a look at our webinar together with Camunda BPM about best practices to deal with frequent model changes of long running processes to get more information about the need of process instance migration automation. You can find it on vimeo [in english](https://vimeo.com/209532444) and [in german](https://vimeo.com/209532368). The [slides ](https://de.slideshare.net/opitzconsulting/best-practices-to-deal-with-frequent-model-changes-of-long-running-processes)are uploaded on slideshare, too. ## Try it out The project can be found on GitHub at . And there is also a demo project on GitHub at [https://github.com/satspeedy/camunda-migrator-demo ](https://github.com/satspeedy/camunda-migrator-demo)to try out the migration. Of course, you are invited to participate to this project, too. If you are interested, please contact us. Have fun on implementing new features without fear of the process instance migration! Feedback is always welcome 😉 **Kategorien:** Architecture & Process Models, Automation --- ### [How to configure the WebLogic AdminServer for High Availability](https://thecattlecrew.net/2017/07/16/how-to-configure-the-weblogic-adminserver-for-high-availability/) **Published:** Juli 16, 2017 **Author:** Neselovskyi, Borys **Kategorien:** Infrastructure, Integration **Schlagwörter:** AdminServer, Configuration, High Availability, oracle, Oracle DB, Oracle FMW, shared storage, vip, Weblogic, WebLogic Domain --- ### [Microservices in der Praxis](https://thecattlecrew.net/2019/09/03/microservices-in-der-praxis/) **Published:** September 3, 2019 **Author:** pascalstieber **Content:** **Spring Cloud (Netflix OSS) vs. Kubernetes** In der Praxis hat sich das Spring Framework als das Microservices Framework durchgesetzt. Pivotal (das Unternehmen hinter Spring) bietet mit dem Spring Cloud Projekt eine supportete Version des Netflix OSS Stacks. Dieses wiederum bietet eben jene zur Umsetzung von Microservices benötigten Technologien: - Zuul (API Gateway, Edge Service) - Eureka (Service Discovery) - Ribbon (IPC Library + Load Balancer) - etc. Darüber hinaus liefert Spring Cloud Config den dedizierten Konfigurations-Service, der mit Hilfe eines Git-Repositories automatisch (und vor allem versioniert) unsere SpringBoot-Services für die verschiedenen Umgebungen (Dev, Test, Pilot, Prod, …) konfiguriert. Metriken zum Zustand der Spring Boot-Applikationen erhalten wir über die Actuator Endpunkte, die bei Bedarf über die (gute alte) application.properties enabled werden können. Weitere Projekte zu den Themen Messaging, Security (SSO), Resilience, Logging, Monitoring und Tracing bietet Spring Cloud selbstverständlich ebenfalls, sodass sich eine recht homogene Entwicklungslandschaft zum Entwickeln und Betreiben von Microservices Architekturen nutzen lässt. **Anmerkung:** Wer mehr über den Spring Cloud Stack wissen möchte, dem wird die „Microservice in der Praxis“ Schulung ans Herz gelegt. Dort werden angesprochene Themen und weitere behandelt. Wer neu im Spring Universum ist, dem sei die dreitägige Spring Boot Schulung empfohlen. Ich persönlich war lange Fan des Spring Cloud (respektive Netflix OSS) Stacks. Spring Cloud hat nur einen großen Nachteil. Jeder dieser einzelnen Services (Zuul, Eureka, etc „¦) die man in einer Microservices Architektur benötigt, muss jedoch auch betrieben werden. So kommen für diese Laufzeitumgebungs-/Infrastruktur-Services Themen wie Ausfallsicherheit (und daraus resultierendes Clustering) und/oder Monitoring ins Spiel und machen die Dinge in meinen Augen unnötig komplex. Wünschenswert ist eine Laufzeitumgebung, die Microservice Architekturen nativ unterstützt und die Entwicklung bzw. den Betrieb (mit Augen auf DevOps kaum von einander zu unterscheiden 😉 ) von dem künstlich aufgesetzten Infrastruktur-Pain befreit. Hier sind wir also bei Kubernetes als Orchestrierer und Istio als Service Mesh angelangt. Doch eins nach dem anderen. Auf der offiziellen Webseite wird folgendes über das Produkt geschrieben: *„Kubernetes (K8s) ist ein Open-Source-System zur Automatisierung der Bereitstellung, Skalierung und Verwaltung von containerisierten Anwendungen.“* Also die Rede ist von „containerisierten Anwendungen“, meint also Applikationen werden in Docker Containern betrieben. Keine Sorge zur Beunruhigung: Docker ist mittlerweile der de facto Industriestandard. Ich war der Meinung, es gäbe eigentlich kaum nennenswerte Alternativen, musste mich jedoch von einem Kollegen eines Besseren belehren lassen. HashiCorp Nomad ist ebenfalls eine Art Orchestrierer & Skalierer für legacy Applikationen (Nicht- Container-Applikationen), Batch Jobs und Container-Applikationen. Im Übrigen: Auch Spring Boot / Cloud Anwendungen werden häufig in einer Docker Umgebung betrieben, wenn nicht gerade eine Pivotal Cloud Foundary (PCF) Platform zur Verfügung steht. Dort könnte man Spring Boot Anwendung mehr oder weniger nativ betreiben. Zurück zu Kubernetes: Google (Unternehmen hinter Kubernetes) wirbt weiterhin mit Skalierung von Anwendungen. Das ist gegenüber dem Plain-Old-Docker-Dienst ein weiteres Alleinstellungsmerkmal. Kubernetes kann anhand von Metriken einzelner Services automatisch neue Service-Instanzen starten. So lassen sich Lastspitzen zu Peek-Zeiten abfangen und ausbalancieren. Dies liegt außerhalb der Möglichkeit von Spring Cloud (ohne PCF Platform). Umgekehrt benötigen wir neben automatischer Skalierung und Verwaltung von besagten containerisierten Applikationen eben auch Dinge wie einen ApiGateway als Router/Filter für Http-Anfragen, EdgeService im Generellen für Autorisierung und Single-Point of Contact, als auch Service Discovery zum Auffinden von Services anhand von Namen anstatt IP-Adresse und Port. Istio wird (wie Kubernetes Features ebenso) als Docker Container auf der virtuellen Maschine gestartet und implementiert für Microservices Applikationen ein sogenanntes SideCar. Dieses SideCar ist ein eigenständiger Container innerhalb des Pods des Microservices und nimmt Http-Anfragen entgegen und leitet sie an den eigentlichen Container entsprechend weiter. Wer mehr über SideCars wissen möchte, dem sei das Buch „Designing Distributed Systems: Patterns and Paradigms for Scalable, Reliable Services“ von Brendan Burns empfohlen. **„Was ist eigentlich mit CLOUD?“** Das Eine schließt das Andere nicht aus. Im Gegenteil: Die meisten Cloud Provider bieten Managed Kubernetes Cluster an. Diese weitere Abstraktionsschicht verschafft Portabilität und etwas Unabhängigkeit zwischen den Cloud Providern. **Fazit:** Spring Boot respektive Spring Cloud stellen eine solide Grundlage für Microservices Architekturen dar. Auch einige unserer Kunden vertrauen und implementieren auf Basis dieses Technologie-Stacks. Berücksichtigt man betriebliche Aspekte, sind weitere infrastrukturelle Umgebungen nötig. Dazu wurde Kubernetes samt Istio kurz vorgestellt. In dem nächsten Artikel gehe ich konkreter auf die Kubernetes / Istio API ein und bringe KNative als weiteres Feature zum Betreiben von Serverless Applikationen auf Kubernetes ins Rennen. Zusätzlich stelle ich eine Microservices Demo Applikation (Bee-Amazing – next generation webshop) auf Basis von Spring Boot, Thymeleaf (als Frontend), Mongo DB zur Persistierung und natürlich Kubernetes vor. **Kategorien:** Architecture & Process Models --- ### [Recap on Event-driven Microservices Conference 2019 by AxonIQ](https://thecattlecrew.net/2019/10/21/recap-on-event-driven-microservices-conference-2019-by-axoniq/) **Published:** Oktober 21, 2019 **Author:** Marat Aukhadiev **Content:** ![](https://thecattlecrew.net/wp-content/uploads/2022/07/For_blog-3.jpg) #### The Framework with the rocketing popularity Now, a few days after the *Event-driven Microservices Conference 2019* in Amsterdam it“™s time to share a recap about a great event, organized by the AxonIQ team at the end of September. It was a one-day conference on event sourcing and CQRS patterns in microservices. The highlight was of course, the rapidly gaining popularity Axon Framework which reached 2,5 Million downloads in the last year, a double of the year before. The conference talks were full of fair critics, useful tips and insights, and the audience was purely specialists: developers and architects. It was opened with a keynote by Alberto Brandolini on importance of DevOps, explaining and showing on examples how architectural choices shape the interactions and the culture of an organization. Starting such an event with a DevOps talk might first seem confusing. But as the speaker pointed out, such things as creative culture and perfect clearness are vital for DevOps to enable delivery at high velocity. Those can be provided by sharply defined bounded contexts when using domain-driven design. After an inspirational keynote, Allard Buijze continued with insights into the upcoming versions of Axon Framework and Axon Server. For example - Graceful shutdown of the framework - Improved „exception resilience“ - Axon Server status APIs - API & UI improvements and - Backup nodes & Multi-tier storage. to improve Operations. Regarding modeling & design it“™s planned to improve/introduce - Dead-letter queues - Ephemeral events - Improve Event scheduling - Aggregate polymorphism and - Saga & Process Manager API. In addition, Axon Server telemetry and Routing statistics in the next release will improve the observability. The hottest news is that there will be a SaaS cloud solution for the Axon Server as a commercial product with SLA-backed support by AxonIQ. It is currently in pre-pre beta phase, available for test use by subscription on the Axon website. #### Hard reality of Event Sourcing in Production The audience then split to „Axon Inspiration“ talks and „Axon In-depth“ talks. The title „Day 2 problems in CQRS and Event Sourcing Building Axon-powered“ immediately attracted our attention. The point was that despite of numerous benefits of CQRS and event sourcing, one faces big challenges after the „honeymoon phase“. The speaker Joris Kuipers (Trifork) warned and gave some tips: - Rule of Thumbs for „Eventing“: Ignore what you don“™t know - App version compatibility: Implement forwards compatibility, accept downtime as inevitable - Event Sourcing Overhead: Snapshots and aggregate caching is necessary ![](https://thecattlecrew.net/wp-content/uploads/2022/07/IMG_20190927_112923-1.jpg)Topics also mentioned: - Unmarshalling tagged events - External event Processor Tips - Expanded Aggregate State - Dealing with Invalid Snapshots - Query Projection Changes - Deployment Planning All this should be considered when deciding to use CQRS and event sourcing. The conference further continued with hands-on workshops offered to get in touch with - Event Storming - Hands-on Event-Driven Microservices with Axon Framework (see ) - Reliable Event-Driven Systems through Chaos engineering and the value of event stores with time-series analysis ![](https://thecattlecrew.net/wp-content/uploads/2022/07/for-blog-2.jpg)After a coffee-break, Ben Runchy from Revel Health shared his experience in introducing the Axon Framework and how it helped his company to achieve a clearer architecture. By the way, we had great conversations with Ben – hope to meet you soon again Ben 😉 #### Critics of the Microservices practices Finally, Allard Buijze (CTO of AxonIQ) talked about „Microservices, the sense, the nonsense and a way forward“. It was one of the fair critics talks, where he sensitized the participants to the challenges of microservice architectures, the biggest of which is „Event thinking“. The speaker explained what the typical mistakes are when designing microservices. Often modularity is mixed up with the number of deployment units. Domain-driven design in practice turns into the „*Noun-driven design*„, i.e. for each new business notion a new microservice is created. Allard also emphasized the need to consider commands and queries as much as events when designing event-sourced systems. ![](https://thecattlecrew.net/wp-content/uploads/2019/10/for-blog-3.jpg?fit=1024%2C699&ssl=1)#### Summary The conference has shown, that event sourcing and Axon Framework could be a good option for companies that are confronted with compliance and auditing requirements to be more backward transparent over a range of time. The other direct benefit for companies is the opportunity to analyze data to squeeze out more value. It was a great developer’s event without any marketing. It was cool to talk directly with the developers of the Axon framework to get answers and solution recommendations for problems met in a project and to get insights to the Axon Framework“™s architecture. Axon has a very active rapidly growing community all over the world, which we are very happy to join. Hope to get the chance to visit this event next year and meet the Axon community again! **Kategorien:** Architecture & Process Models, Tech Events & Networking **Schlagwörter:** Axon, Axon framework, Conference, CQRS, DDD, Event Sourcing, Event-driven, Microservices --- ### [Einen Chatbot ohne eine Zeile Code erstellen "“ Ein Traum!?](https://thecattlecrew.net/2019/11/04/einen-chatbot-ohne-eine-zeile-code-erstellen-ein-traum/) **Published:** November 4, 2019 **Author:** Sven Thomas **Content:** Seit unserem [letzten Update auf The Cattle Crew](https://thecattlecrew.net/2019/07/18/oc-digital-assistant-ein-chatbot-fuers-unternehmen/) zum OC Digital Assistant hat sich bei dessen Entwicklung einiges getan. Diesmal möchten wir euch einen kurzen Einblick in einen alternativen Ansatz zur Entwicklung eines Chatbots geben, der uns in den letzten Tagen zufällig über den Weg gelaufen ist. Die Technologie dahinter halten wir für super spannend. Es handelt sich um eine No-Code Lösung zur Erstellung und Einrichtung eines Chatbots in den Messenger Teams von Microsoft. Bei unserer Recherche und Entwicklung rund um das Thema „Digitaler Assistent“ stießen wir in einem einen recht aktuellen Blogpost von NidhiShandilya in der Microsoft Tech Community auf diese Lösung. Mit dem Titel „Modernize employee experience with this no-code chatbot in Teams“ weckte er unser Interesse, denn eine No-Code Variante konnten wir uns für unser Chatbot-Projekt gut vorstellen, um den Entwicklungsaufwand noch etwas zu verringern. Wir haben uns den Blogpost also sehr genau durchgelesen und führten daraufhin mit dem beschriebenen No-Code Bot umfangreiche Tests durch. **Features und Vorteile des No-Code Bots** Was bietet die No-Code-Lösung und welche technologischen Anforderungen stellt sie? Es klingt wie ein Traum: Entwickler erhalten bei dieser Lösung einen fertigen Chatbot, ohne dafür auch nur eine Zeile Code anrühren zu müssen. Hier die wichtigsten Facts & Features: - Der Chatbot wird in das Messenger-System „Teams“ von Microsoft eingebunden. - Der Chatbot kann häufig gestellte Fragen, also sogenannte FAQs, beantworten. Das Wissen über die Fragen und Antworten wird dabei über einen dafür vorgesehenen Cloud-Service von Microsoft, den QnA-Maker, verwaltet. - Zusätzlich zur Beantwortung der FAQs ist es möglich, über bei der Antwort beigefügte Buttons sowohl Feedback über die Antwort zu geben, als auch einen Experten zu fragen. Diese „Ask an Expert“-Funktion ist eine Art Ticketsystem. Der Nutzer kann über eine gegebene Card, wie beispielhaft im unterstehenden Bild zu sehen, einen Betreff und eine Beschreibung einfügen. Das erstellte Ticket wird vom Bot verwaltet und das Expertenteam, repräsentiert durch ein Team in Teams, erhält darauf hin im Team-Chat eine Nachricht des Bots. Das Ticket kann dann von einem Experten bearbeitet und im persönlichen Chat mit dem Fragesteller geklärt werden. Im Hintergrund wird das Ticket dabei vom Bot über ein Azure Speicherkonto bis zur Lösung des Problems persistiert. ![](https://thecattlecrew.net/wp-content/uploads/2019/10/NoCodeBot-ExampleCard.png) - Der Bot selbst läuft in der Azure Cloud und ist zum Monitoring in die Azure Application Insighs eingebunden. Wer noch weitergehende Informationen dazu nachlesen möchte, kann dies im originalen Blogpost von NidhiShandilya machen: **Der No-Code Bot im Test** Das klang für uns sehr interessant. Wäre es eventuell möglich, ein umfangreiches Feature wie die Ask an Expert Funktion so einfach zu bekommen? Das wollten wir natürlich herausfinden. Also setzten wir den Bot selbst auf und unterzogen ihn umfangreichen Praxistests. Um es vorwegzunehmen, unser Fazit lautete: Es kommt drauf an“¦ Doch beginnen wir vorne. Als wir uns die No-Code-Lösung genauer ansahen und uns mit dem öffentlich zugänglichen Quellcode befassten, stellten wir fest, dass es sich hierbei im Grunde nur um ein Template für einen Chatbot handelt, der auf dem Microsoft Bot Framework aufbaut. Und genau hier ist auch schon der entscheidende Punkt: Wenn von Anfang an klar ist, dass man einen Chatbot mit genau den Funktionen haben möchte, die das Template liefert, und in naher Zukunft auch keine Ü„nderungen an den Funktionen plant, dann ist die No-Code-Lösung super geeignet. Soll der Funktionsumfang aber über die des No-Code-Bots hinaus gehen, oder möchte man sogar vorhandene Funktionen ändern bzw. ganz entfernen, würden wir dringend empfehlen auf einen selbst erstellten Bot setzen. Der Vorteil des No-Code-Ansatzes, nämlich dass man sich nicht mit dem Code auseinandersetzen muss und alles einfach funktioniert, geht bei einer Ü„nderung oder Erweiterung leider verloren. Jetzt muss man sich in den vorhandenen Code einarbeiten, und das kann „“ vor allem wenn die Erfahrungen im Umgang mit dem Bot Framework noch recht schmal ausfallen „“ schwierig werden und mehr Zeit in Anspruch nehmen als wenn der Bot von Anfang an selbst mit dem Bot Framework erstellt wurde. Zusammengefasst würden wir eine Entscheidungsvorlage folgendermaßen formulieren: - Möchte man einen Chatbot haben, der genau die Funktionen der vorgestellten Lösung haben soll, und plant auch in Zukunft keine Ü„nderungen am Funktionsumfang, kann ohne Bedenken die No-Code Lösung genutzt werden. - Möchte man einen Bot mit Anderen oder mehr Features entwickeln und benötigt zudem auch nicht unbedingt die „Ask an Expert“-Funktion des Bots, dann hilft diese No-Code Lösung nicht weiter. - Möchte man die „Ask an Expert“-Funktion des Bots nutzen, und zwar genauso wie sie ist, dann könnte die No-Code-Lösung durchaus empfehlenswert sein. In diesem Fall kann es tatsächlich unkomplizierter sein, sich in den vorhandenen Code einzuarbeiten als diese Funktion selbst nachzubauen. Tja, und in unserem Chatbot-Projekt bei OPITZ CONSULTING werden wir damit auch weiterhin selbst coden. Denn wie ihr wisst wollen wir ja einen deutlich weiteren Funktionsumfang nutzen – und ein Reverse-Engineering möchten wir lieber umgehen. Wir freuen uns, euch weiterhin auf dem Laufenden zu halten und werden euch über die neuen Entwicklungen in dem Projekt informieren. **Kategorien:** AI & Data Science, Development **Schlagwörter:** Artificial Intelligence, digitaler Assistent, Microsoft, No-Code, Teams --- ### [Apache Zeppelin für OpenDevStack](https://thecattlecrew.net/2020/01/08/apache-zeppelin-fuer-opendevstack/) **Published:** Januar 8, 2020 **Author:** Eric Nguyen **Content:** Aufgrund einer Projektpause haben wir uns mit einem Projekt des OCLabs beschäftigt, dessen Ziel es ist, Apache Zeppelin in einem Docker Container auf OpenDevStack zu deployen. ## Was ist Apache Zeppelin? Apache Zeppelin bietet die Möglichkeit ähnlich wie Jupyter Notebook, Notebooks zu erstellen, um Daten zu analysieren. Ein Notebook zeichnet sich dadurch aus, dass man Code- und Fließtext miteinander vermischen kann und den Code gleichzeitig im Notebook ausführen kann. Das führt dazu, dass die Ergebnisse direkt im Notebook sichtbar sind und man keine IDE braucht. Es unterstützt jedoch mehrere verschiedene Interpreter und grenzt sich somit zu Jupyter Notebook ab, das hauptsächlich Python unterstützt. Beispielsweise werden Apache Spark, R und Scala unterstützt. ## Was ist OpenDevStack? OpenDevStack basiert auf OpenShift von RedHat und ist eine Managementplatform für Container. OpenDevStack bietet den Vorteil beim Start eines Projekts die notwendigen Softwarekomponenten effizient und schnell durch Container bereitzustellen. Dadurch muss sich der Entwickler nicht mehr um das Aufsetzen der Architektur kümmern. ## Wie sind wir vorgegangen? Zu Beginn haben wir probiert Apache Zeppelin mit Docker lokal laufen zu lassen, wofür wir das offizielle Dockerfile von Apache Zeppelin aus Docker Hub benutzt haben. Dies hat ohne Probleme funktioniert! 😊 Der nächste Schritt war also Apache Zeppelin auf OpenDevStack zum Laufen zu bringen. Dabei stellten sich die drei folgenden Probleme heraus: 1. OpenDevStack benötigt memory limits, damit ein Container hochgefahren werden kann. Diese Limits werden jedoch nicht automatisch gesetzt und müssen deswegen manuell nachträglich in OpenDevStack eingetragen werden. 2. Beim Start des Docker Containers werden Ordner unter anderem für Logs angelegt. Damit dies fehlerfrei funktioniert, muss im Dockerfile noch Code hinzugefügt werden, um Zugriff zu bekommen. 3. Der Container konnte nun fehlerfrei hochgefahren werden, jedoch konnte man noch nicht auf die Anwendung zugreifen. Aus diesem Grund haben wir letztlich noch eine Route zu der Anwendung hinzugefügt, die nun Apache Zeppelin erreichbar macht. Viel Spaß! 😊 Euer Martin Meinel und Eric Nguyen. **Kategorien:** DevOps **Schlagwörter:** Apache Zeppelin, Docker, OpenDevStack --- ### [User Experience auf der Strecke?! Warum scheitern viele Software-Produkte immer noch an der UX?](https://thecattlecrew.net/2020/01/24/user-experience-auf-der-strecke-warum-scheitern-viele-software-produkte-immer-noch-an-der-ux/) **Published:** Januar 24, 2020 **Author:** thecattlecrew **Content:** Eins ist klar: Eine optimale User Experience, also das positive und effektive Nutzererlebnis entscheidet heute mehr denn je über den Erfolg eines Software-Produkts. Ohne ein positives Erlebnis kein Spaß und kein Erfolg bei der Arbeit – Ohne Spaß und Erfolg keine Akzeptanz bei den Usern – ohne Akzeptanz bei den Usern keine effektive Arbeit – Und so weiter und so fort … Wie schnell sind Aufwand und Geld in ein Produkt geflossen, das niemand mehr haben will und das sogar die Effizienz des ganzen Unterenhmens blockiert? Eine von Anfang an sorgfältig entwickelte User Experience ist aber natürlich nicht für lau zu haben. Oft liegt es also auch am Geld, wenn die User Experience nicht wirklich gut ausfällt. Es mangelt also häufig immer noch an Überzeugung, warum eine herausragende UX Gold wert ist, jedenfall ist diese Überzeugung noch nicht ganz bis zu den Stakeholdern vorgedrungen. Aber wir haben auch schon sehr häufig erlebt, dass der Grund für eine miese User Experience ganz woanders liegen kann: In einem „Zuviel des Guten“. Einige Projekte scheitert an den den verschiedenen Sichtweisen von Menschen, die alle nur das Beste im Sinn haben … an der Unterschiedlichkeit von Menschen, an ihren unterschiedlichen Rollen und Sichtweisen. Und das obwohl sie alle nur den Erfolg für das Projekt im Sinn haben. In unserem nächsten **Live-Webinar** geht es genau darum. Wir stellen Methoden und Tools vor, die dabei helfen, Projektteams für die Umsetzung einer herausragende User Experience optimal aufzustellen und das kritische Spannungsfeld zwischen UX Design, Softwareentwicklung und Business aufzulösen. Als Speaker für das Webinar konnten wir unsere Agile- und UX-Experten Andreas Lehner und Manuel Juschkewitz gewinnen. Es wird spannend. Seien Sie dabei! [![](https://thecattlecrew.net/wp-content/uploads/2020/01/titelbild-ux-webinar.jpg)](https://www.opitz-consulting.com/einzelseiten/ux-webinar/?utm_source=cattlecrew&utm_medium=link&utm_campaign=webinar-ux)**Live-Webinar „Woran scheitert eine gute UX?“** **Termin: 13. Februar 2020, 11 – 12 Uhr** (kostenfrei) [Jetzt anmelden](https://www.opitz-consulting.com/einzelseiten/ux-webinar/?utm_source=cattlecrew&utm_medium=link&utm_campaign=webinar-ux) **Kategorien:** Development --- ### [Spring Security "“ JSON Web-Token-Authentifizierung (1/3)](https://thecattlecrew.net/2020/01/27/spring-security-json-web-token-authentifizierung-1-3/) **Published:** Januar 27, 2020 **Author:** Szymon Stuszek **Content:** Die Sicherheit von Web-Applikationen (Web-Apps) ist eine wichtige Aufgabe. Bei statischen Webseiten, deren Inhalt man nur lesen kann, wie z. B. bei Blogs oder Informationseiten, ist die Sache ziemlich einfach. Das Problem beginnt, wenn wir dem Nutzer die Möglichkeit eröffnen, Daten und Dateien mittels eines Formulars an den Server zu schicken oder wenn wir Benutzer in unserer App registrieren. Hier öffnen wir das System eventuell für einen schädlichen Code oder riskieren, dass Unberechtigte Zugriff auf Dateien bekommen, die sie eigentlich nicht sehen sollten. Wenn alle Nutzer einen unbeschränkten Zugriff auf alle Inhalte hätten, wäre ein heilloses Chaos noch das harmloseste Szenario. Das Spring Framework bietet hier eine gute Lösung: Es enthält ein ganzes Kontingent an Hilfsmitteln, die uns den Schutz unserer App erleichtern. Die Bibliothek liefert uns zum Beispiel mehrere fertige Bestandteile, wie Filter, die einkommende Requests überprüfen oder ein Gerüst für eine User-Rollen-Verwaltung. Wir können definieren, welche Ressourcen in unserer App öffentlich erreichbar sind und welche eine Authentifizierung fordern. Spring Security bietet damit reichlich Optionen auf diesem Gebiet. Das möchte ich im Folgenden am Beispiel einer Spring Web-App zeigen, die am Backend eine JSON Web Token Authentication implementiert. In der Beispiel-App kann man über ein öffentlich zugängliches Formular einen Versicherungsantrag einreichen. Es gibt die Möglichkeit, sich auf der Webseite zu registrieren. Wenn man ein Konto angelegt hat, kann man alle Anträge sehen und sie akzeptieren oder ablehnen. Diese Technologien und Tools kamen dabei zum Einsatz: - Spring - Maven - Spring Security - Postman - Hibernate - MySQL - Lombok - Frontend: Angular ## **Welche Arten der Authentifizierung gibt es?** Wenn sich ein User in einer Web-App anmeldet, läuft im Hintergrund eine Authentifizierungsroutine ab. Hier gibt es unterschiedliche Methoden, wie z. B. **Sessions** Nach der erfolgreichen Authentifizierung wird eine Session auf dem Server erstellt. Benutzer- und Session-Details werden dort gespeichert. Der Administrator hat dadurch zwar mehr Kontrolle über Sessions und angemeldete Benutzer, aber diese Herangehensweise verlangt auch relativ viel Aufwand vom Server „“ die Sessions müssen irgendwo, also entweder im Arbeitsspeicher oder in einer Datenbank aufbewahrt werden. Ein weiteres Problem entsteht, wenn wir unsere Applikation skalieren wollen und weitere Server hinzufügen. Die Sessions müssen dann synchronisiert werden, was die Komplexität der Implementierung erhöht und zu Bugs führen kann. **JSON Web Tokens (JWTs)** Der Server legt in diesem Fall keine Sessions an. Seine Rolle ist darauf beschränkt, Requests zu überprüfen und Tokens zu erstellen. Es ist dann die Aufgabe des Clients, diese zu behalten. Die Anmeldung erfolgt beispielsweise über ein HTML-Formular, indem der User wie gewohnt seinen Benutzernamen, seine E-Mail-Adresse und sein Passwort eingibt. Das Backend prüft, ob die eingegebenen Daten mit den gespeicherten in der Datenbank übereinstimmen. Sollte das der Fall sein, wird ein JWT generiert und als Response an das Frontend versendet. Von der Client-Seite wird das Token übernommen und mit den nächsten Requests in die Headers hinzugefügt. Das Token enthält ein verschlüsseltes Claim, das uns den Zugriff auf bestimmte Resourcen berechtigt. Falls dieses Claim von jemandem modifiziert wird, wird das im Backend erkannt, und der Request wird abgelehnt. Das hat gleich zwei Vorteile: Erstens belastet diese Methode den Server geringer, weil die Session-Informationen auf der Client-Seite aufbewahrt werden. Zweitens eignet sie sich gut für Microservices-Architekturen. **OAuth** Der Terminus OAuth kommt im Umfeld von Security-Themen sehr oft vor, aber was bedeutet er eigentlich? Laut Definition ist OAuth ein offenes Authorisierungsprotokoll, das beschreibt, wie unabhängige Services Zugang zu ihren Ressourcen erlauben können, ohne initiale Credentials miteinander zu teilen. Die Authentifizierung erfolgt durch einen zwischengeschalteten Server, der die Anmeldedaten des Users überprüft. Das kann der Server eines Anbieters wie Github, Facebook oder LinkedIn sein. Nach Eingabe von Login und Passwort erhalten wir ein Token, das unsere Identität bestätigt. Dank dieser Methode braucht sich der Anwender nicht in unserer Web-App zu registrieren. Die Authentifizierung erfolgt beim externen Provider. Vorausetzung dafür ist, dass der Anwender bereits ein Konto bei diesem hat. Auch JWTs können diese Methode benutzen. ![](https://thecattlecrew.net/wp-content/uploads/2020/01/image-1.png) Beispiel einer Oauth-Anmeldung bei exercism.io. (Hier meldet sich der User über ein Konto bei Github an) ## **Aufbau und Funktionalität** Spring Security „baut“ eine zusätzliche Schicht für unsere Applikation. Einkommende Requests gehen durch diese Schicht hindurch. Wie die Requests behandelt werden, wird in der Konfigurationsklasse definiert. Im JWT-Workflow wird ein Request zuerst gefiltert. Dabei wird überprüft, ob das Token korrekt ist. Sollte das nicht der Fall sein, wird der Request abgelehnt. Andernfalls wird er zu den Endpoints weitergeleitet. D**ie Anmeldung** Für die Anmeldung schicken wir einen Request zu einem Auth Endpoint „“ der natürlich freigegeben sein sollte. Der AuthenticationManager hält eine Referenz zum UserDetailsService. Dieser gleicht die Credentials mit unserer Datenbank ab. Wenn die Daten übereinstimmen, wird ein Authentication Object gebaut, das als Basis für die Generierung eines JWT“˜s dient. Wenn der Vorgang beendet ist, sendet der Server die Antwort mit dem Token zurück. Das Frontend muss ihn übernehmen und lokal abspeichern. Bei den nächsten Requests wird er in den Headers hinzugefügt. Auf diese Weise können wir die gewünschten Ressourcen erreichen. ![Dieses Bild hat ein leeres Alt-Attribut. Der Dateiname ist image-2.png](https://thecattlecrew.net/wp-content/uploads/2020/01/image-2.png) Projektstruktur aus unserem Beispiel. Pakete die nicht relevant für die Security sind, werden versteckt. 1. **Benutzerregistrierung** Fangen wir mit der Benutzerregistrierung an: Wenn wir ein Konto zu erstellen möchten, senden wir einen RegisterRequest an einen öffentlichen Endpoint. Die Klasse benutzt einen von Spring gelieferten PasswordEncoder und ein Autowired ApplicationUserRepository. Beim RegisterRequest haben wir eine einfache Validierung implementiert, damit Benutzername oder Password nicht null oder leer sind. Nach der Validierung wird der Benutzer in der Datenbank gespeichert. Im Projekt nutzen wir die Java Bibliothek Lombok „“ deswegen müssen wir Getters und Setters nicht manuell schreiben. Die @Data Annotation generiert uns auch einen Constructor mit allen notwendigen Feldern inklusive hashCode() und equals()-Methoden. R**egisterController:** ``` @RestController @RequestMapping("/v1/claimapp/users/") public class RegisterController { private ApplicationUserRepository applicationUserRepository; private PasswordEncoder passwordEncoder; public RegisterController(ApplicationUserRepository applicationUserRepository, PasswordEncoder passwordEncoder) { this.applicationUserRepository = applicationUserRepository; this.passwordEncoder = passwordEncoder; } @RequestMapping(method = RequestMethod.POST, value = "register") public void signUp(@RequestBody @Valid RegisterRequest registerRequest) { ApplicationUser user = new ApplicationUser(); user.setUsername(registerRequest.getUsername()); user.setPassword(passwordEncoder.encode(registerRequest.getPassword())); applicationUserRepository.save(user); } } ``` **RegisterRequest:** ``` @Data public class RegisterRequest { @NotNull @NotBlank @Size(min = 4) private String username; @NotNull @NotBlank @Size(min = 4) private String password; } ``` **ApplicationUser:** ``` @Entity @Data public class ApplicationUser { @Id @GeneratedValue(strategy = GenerationType.IDENTITY) private long id; @NotNull @NotBlank @Size(min = 4) private String username; @NotNull @NotBlank @Size(min = 4) private String password; } ``` **ApplicationUserRepository:** ``` public interface ApplicationUserRepository extends JpaRepository { Optional findByUsername(String username); } ``` --- [Spring Security „“ JSON Web-Token-Authentifizierung (2/3)](https://thecattlecrew.net/?p=29823&preview=true) | [Spring Security „“ JSON Web-Token-Authentifizierung (3/3) ](https://thecattlecrew.net/?p=29645&preview=true) **Kategorien:** Development **Schlagwörter:** Java, JWT, Spring --- ### [Spring Security "“ JSON Web-Token-Authentifizierung (3/3)](https://thecattlecrew.net/2020/01/27/spring-security-json-web-token-authentifizierung-3-3/) **Published:** Januar 27, 2020 **Author:** Szymon Stuszek **Content:** 4\. **Sicherheitseinstellungen** **SecurityConfig** SecurityConfig ist die Hauptklasse für die Security-Einstellungen. In der zweiten configure()-Methode bestimmt man welche Pfäde öffentlich erreichbar sind und für welche Nutzer angemeldet sein müssen. Des Weiteren werden Filter für die Request-Verfizierung umgesetzt. Da die Applikation ein separates Frontend hat, das auf einem anderen Port erreichbar ist, sind die allowedOrigins-Parameter freigeschaltet. So sind „externe“ Anfragen möglich. ``` @Configuration @EnableWebSecurity public class SecurityConfig extends WebSecurityConfigurerAdapter { @Autowired private UserDetailsService userDetailsService; @Autowired private RestSecurityErrorHandler restSecurityErrorHandler; @Bean public JwtAuthTokenFilter authenticationJwtTokenFilter() { return new JwtAuthTokenFilter(); } @Bean public PasswordEncoder passwordEncoder() { return new BCryptPasswordEncoder(); } @Bean @Override public AuthenticationManager authenticationManagerBean() throws Exception { return super.authenticationManagerBean(); } @Override protected void configure(AuthenticationManagerBuilder auth) throws Exception { auth.userDetailsService(userDetailsService) .passwordEncoder(passwordEncoder()); } @Override protected void configure(HttpSecurity http) throws Exception { http.cors().and().csrf().disable() .authorizeRequests() .antMatchers(HttpMethod.POST, SIGN_UP_URL).permitAll() .antMatchers(HttpMethod.GET, CLAIM_TYPES_URL).permitAll() .antMatchers(HttpMethod.POST, CREATE_CLAIM_URL).permitAll() .antMatchers(HttpMethod.GET, EMAIL_CHECK_URL).permitAll() .antMatchers(HttpMethod.POST, LOGIN_URL).permitAll() .anyRequest().authenticated() .and() .exceptionHandling().authenticationEntryPoint(restSecurityErrorHandler) .and() .sessionManagement().sessionCreationPolicy(SessionCreationPolicy.STATELESS); http.addFilterBefore( authenticationJwtTokenFilter(), UsernamePasswordAuthenticationFilter.class ); } @Bean public CorsConfigurationSource corsConfigurationSource() { final UrlBasedCorsConfigurationSource source = new UrlBasedCorsConfigurationSource(); CorsConfiguration config = new CorsConfiguration(); config.addAllowedOrigin("http://localhost:4200"); config.setAllowedMethods(Collections.singletonList("*")); config.setAllowedHeaders(Collections.singletonList("*")); source.registerCorsConfiguration("/**", config); return source; } } ``` **JwtAuthTokenFilter** ``` @Slf4j public class JwtAuthTokenFilter extends OncePerRequestFilter { @Autowired private JwtProvider jwtProvider; @Autowired private UserDetailsServiceImpl userDetailsService; @Autowired public static final Logger LOGGER = LoggerFactory.getLogger(JwtAuthTokenFilter.class); @Override protected void doFilterInternal(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, FilterChain filterChain) throws ServletException, IOException { try { String jwt = getJwt(httpServletRequest); if(jwt != null && jwtProvider.validateToken(jwt)) { String username = jwtProvider.getUsernameFromToken(jwt); UserDetails userDetails = userDetailsService.loadUserByUsername(username); UsernamePasswordAuthenticationToken authenticationToken = new UsernamePasswordAuthenticationToken(userDetails, null, userDetails.getAuthorities() ); authenticationToken.setDetails(new WebAuthenticationDetailsSource() .buildDetails(httpServletRequest)); SecurityContextHolder.getContext().setAuthentication(authenticationToken); } } catch (Exception e) { LOGGER.error("Cannot set user authentication -> Message: {}", e); } filterChain.doFilter(httpServletRequest, httpServletResponse); } private String getJwt(HttpServletRequest request) { String authHeader = request.getHeader("Authorization"); if (authHeader != null && authHeader.startsWith("Bearer ")) { return authHeader.replace("Bearer ", ""); } return null; } } ``` **SecurityConstants** ``` public class SecurityConstants { public static final String SECRET = "SecretKeyToGenJWTs"; public static final long EXPIRATION_DATE = 800000000L; public static final String TOKEN_PREFIX = "Bearer "; public static final String HEADER_STRING = "Authorization"; public static final String SIGN_UP_URL = "/v1/claimapp/users/register"; public static final String EMAIL_CHECK_URL = "/v1/claimapp/usercheck"; public static final String CLAIM_TYPES_URL = "/v1/claimapp/claimtypes"; public static final String CREATE_CLAIM_URL = "/v1/claimapp/claims"; public static final String LOGIN_URL = "/auth/login"; } ``` **SecurityInitializer** ``` public class SecurityInitializer extends AbstractSecurityWebApplicationInitializer { } ``` **UserDetailsServiceImpl:** ``` @Service public class UserDetailsServiceImpl implements UserDetailsService { @Autowired private ApplicationUserRepository applicationUserRepository; @Override public UserDetails loadUserByUsername(String username) throws UsernameNotFoundException { ApplicationUser applicationUser = applicationUserRepository .findByUsername(username) .orElseThrow( () -> new UsernameNotFoundException("User not found") ); return UserDetailsImpl.build(applicationUser); } } ``` ## Zusammenfassung Die Implementierung eines Authentifizierungsprozesses ist ein umfangreiches Thema und auf keinen Fall eine triviale Aufgabe. JWTs haben in den letzten Jahren an Popularität gewonnen. Man sollte aber wissen, dass sie nicht immer optimal sind. Ein großes Problem bei den Tokens sind einige Sicherheitslücken, die bei sessionbasierten Implementierungen nicht so gravierend sind. Wird ein Token gestohlen, kann ein größerer Schaden entstehen, da sie im Gegensatz zu Sessions schwieriger zu deaktivieren sind. Deswegen werden die JWTs weiterentwickelt, um die Sicherheit zu verbessern. Momentan wird an einem neuen Standard gearbeitet „“ PASETO (Platform-Agnostic Security Tokens), der aktuelle Sicherheitsprobleme von Tokens beheben sollte. Beim Verwenden von JWTs ist es wichtig, sich an bestimmte Regeln zu halten: - Halte die Tokens nie in local- oder session-Storage des Browsers – schädliche Skripte können Tokens stehlen! - Tokens sollten möglichst kurzlebig sein „“ das verringert das Risiko von potenziellen Schäden! - Kenne den Alogrithmus, mit dem du die JWTs encodierst „“ beachte die Anforderungen, um die Tokens sicher zu verschlüsseln! Und ganz wichtig: Unabhängig davon, welches Authentifizierungsmodell gewählt wurde, sollte man nie vergessen, eine Web-App durch ein HTTPS-Zertifikat zu sichern „“ das ist eine der wichtigsten Vorkehrungen, um sich vor Gefahren zu schützen. ## Links Mehr über JWTs und Implementationsbeispiele: [Angular Spring Boot JWT Authentication example | Angular 6 + Spring Security + MySQL Full Stack „“ Part 2: Build Backend](https://grokonez.com/spring-framework/spring-security/angular-spring-boot-jwt-authentication-example-angular-6-spring-security-mysql-full-stack-part-2-build-backend) --- [Spring Security „“ JSON Web-Token-Authentifizierung (1/3)](https://thecattlecrew.net/?p=29598&preview=true) | [Spring Security „“ JSON Web-Token-Authentifizierung (2/3)](https://thecattlecrew.net/?p=29823&preview=true) **Kategorien:** Development **Schlagwörter:** Java, JWT, Spring --- ### [Testcontainers - Unleash Your (Unit) Tests Using Docker (1/3)](https://thecattlecrew.net/2020/02/05/testcontainers-unleash-your-unit-tests-using-docker-1-3/) **Published:** Februar 5, 2020 **Author:** Benjamin Thiel **Excerpt:** Testcontainers is an MIT-licensed Java library that enables you to easily launch and wire up Docker containers from within unit tests. **Content:** Are you responsible for writing the [JUnit](https://junit.org/) or [Spock](http://spockframework.org/) tests in a Java project? Do you already have loads of unit tests that use mocks and somehow feel „I wonder if this code works in real life“? Fret no more, [Testcontainers](https://www.testcontainers.org/) has got you covered! ## What is Testcontainers? Testcontainers is an MIT-licensed Java library that enables you to easily launch and wire up [Docker](https://www.docker.com/) containers from within unit tests. These containers provide „real“ application instances that your system under test (SUT) depends upon, which would otherwise have to be mocked. As a result, you can use your favorite testing framework for automating tests „higher up“ the [test pyramid](https://martinfowler.com/articles/practical-test-pyramid.html), such as integration tests and UI tests. ![](https://thecattlecrew.net/wp-content/uploads/2020/02/testing_pyramid.png) The test pyramid There are different flavors of tests pyramids out there, but they all share the same fundamental idea. The size of each segment indicates how many tests of each kind you should aim for. Typically, unit tests are „white box“ tests, whereas UI tests are „black box“ tests in which you don“™t care about *how* it is implemented, but *what* is implemented. Integration tests are often „grey box“ tests that have a limited knowledge about how things are implemented by testing against their interfaces and interactions instead. Generally, the cost of creating and maintaining tests increases the higher up you go in the pyramid, whereas their execution speed decreases. Where unit tests mostly test small, relatively trivial units, integration tests depend on larger pieces of software or third-party tools and applications. As a result, automated integration tests are often built „“ if at all „“ against „test doubles“ (think stunt „doubles“ in movies), because using the „real“ object would be too cumbersome. There are „“ [amongst others](https://martinfowler.com/articles/mocksArentStubs.html) „“ several kinds of test doubles: - **Mocks** are throw-away objects usually created by a mocking framework that conform to the signature of the object they are impersonating. Their behavior is typically configured during the test, forming a specification of how the real object would allegedly behave. - **Fakes** are a real-world implementation of the interface of said objects, albeit with a much simpler implementation that suits the needs of the test(s), e.g. an in-memory database instead of the database used in production. While using test doubles is perfectly valid in unit testing, it has some downsides in integration testing: - The confidence in the test is diminished: One can never be certain that the tested code would work equally well with the real objects, i.e. that the fake persistence service that uses an in-memory database behaves like the real service, which is backed by another database. - Not using the real object also incurs maintenance costs: If the specification of the real object changes - the implementations of fake objects have to be adapted accordingly. - the behavior of mocks has to be adapted in many places, as the specification of their behavior is often distributed across several tests. - Error conditions (networks being down etc.) are rarely tested, as anticipating how the real object would behave in such scenarios is very hard and implementing this behavior in a fake object is even harder. Testcontainers tackles these problems by simplifying the usage of real objects by making it easy to satisfy their dependencies using Docker images. It offers several ready-to-use modules for various databases and other appliances, as well as the ability to create custom modules for applications not yet covered. In short: Anything you can „dockerize“, you can use with Testcontainers. ## Basic Usage You can either manage the lifecycle of your containers manually or use the provided annotations to do this work for you. The following code should give you a basic idea of how it works in JUnit 5 (the annotations for JUnit 4 are different, but conceptually equal): ``` @Testcontainers public class RedisBackedCacheIntTest { private RedisBackedCache underTest; @Container public GenericContainer redis = new GenericContainer("redis:5.0.3-alpine").withExposedPorts(6379); @BeforeEach public void setUp() { String address = redis.getContainerIpAddress(); Integer port = redis.getFirstMappedPort(); // Now we have an address and port for Redis, no matter where it is running underTest = new RedisBackedCache(address, port); // Without Testcontainers, we would likely rely on a hard-coded instance that might not be reachable from anywhere the test is run // underTest = new RedisBackedCache("localhost", 6379); } @Test public void testSimplePutAndGet() { underTest.put("test", "example"); String retrieved = underTest.get("test"); assertEquals("example", retrieved); } } ``` The `@Container` annotation tells JUnit to notify this field about various events in the test lifecycle. In this case, a GenericContainer, configured to use a specific Redis image from Docker Hub, and configured to expose a port. Behind the scenes Testcontainers: - was activated before our test method ran - discovered and quickly tested our local Docker setup - pulled the image if necessary - started a new container and waited for it to be ready - shut down and deleted the container after the test Furthermore, it is possible to: - set up Docker networks for communication between containers - execute arbitrary commands in a container - map local files or files from the Java classpath into a container - wait for containers with custom applications to be ready - access the logs of a container - start custom containers specified in Dockerfiles Learn more about some exciting use cases this powerful toolbox inspires in our [follow-up post](https://thecattlecrew.net/2020/02/24/testcontainers-unleash-your-unit-tests-using-docker-2-3/). **Kategorien:** DevOps **Schlagwörter:** Docker, E2E Testing, Integration Testing, Java, JUnit, Mocks, Service Testing, Spock, Test Pyramid, Testcontainers, UI Testing, unit test --- ### [Testcontainers - Unleash Your (Unit) Tests Using Docker (2/3)](https://thecattlecrew.net/2020/02/24/testcontainers-unleash-your-unit-tests-using-docker-2-3/) **Published:** Februar 24, 2020 **Author:** Benjamin Thiel **Content:** In a [previous post,](https://thecattlecrew.net/2020/02/05/testcontainers-unleash-your-unit-tests-using-docker-1-3/) we learned what Testcontainers is; now you’ll see some examples of its use. ## Use Case: Integration Tests with Database Imagine, your production system makes use of a Postgres database. Without Testcontainers, you would typically set up an in-memory database like H2 to back your persistence service. If you“™re lucky, H2 supports all the features you need, if not, you“™ll have to develop expensive workarounds. With Testcontainers, you can easily setup a real Postgres database within a Docker container, giving you more confidence that your code behaves the same in production as in the tests. Furthermore, in contrast to manually maintaining a database installation in a VM for example, you don“™t need to worry about remnants of test data of previous tests. Instead, you“™ll always start from a known state. ![](https://thecattlecrew.net/wp-content/uploads/2020/02/uc_postgres.png) Test setup without (left) and with Testcontainers (right) Starting a Postgres instance becomes as simple as this: ``` public class SimplePostgreSQLTest extends AbstractContainerDatabaseTest { @Test public void testSimple() throws SQLException { try (PostgreSQLContainer postgres = new PostgreSQLContainer()) { postgres.start(); ResultSet resultSet = performQuery(postgres, "SELECT 1"); int resultSetInt = resultSet.getInt(1); assertEquals("A basic SELECT query succeeds", 1, resultSetInt); } } } ``` Another use case might be testing for database independence by running the same tests against multiple database that are to be supported by the SUT. This is facilitated by the modules for several (non-)SQL database that are already provided: ![](https://thecattlecrew.net/wp-content/uploads/2020/02/db_cloud.png) Databases supported out-of-the-box ## Use Case: Cross-Browser Testing Testcontainers also offers support for testing web interfaces using the industry standard [Selenium](https://selenium.dev/) framework. You should read [this great article](https://thecattlecrew.net/2018/07/24/automatisierung-von-fachlichen-ui-tests-mit-selenium-1-2/) (in German) if you want to familiarize yourself with Selenium. As of today, there are two browsers supported out-of-the-box: Firefox and Chrome. This is due to the restriction of Docker that it (usually) virtualizes Linux-based images. The modules for these browsers offer a `RemoteWebDriver` instance that can be used like any local WebDriver instance. ``` public class BaseWebDriverContainerTest { protected void doSimpleWebdriverTest(BrowserWebDriverContainer rule) { RemoteWebDriver driver = setupDriverFromRule(rule); driver.get("http://www.google.com"); WebElement search = driver.findElement(By.name("q")); search.sendKeys("testcontainers"); search.submit(); List results = new WebDriverWait(driver, 15) .until(ExpectedConditions.visibilityOfAllElementsLocatedBy(By.cssSelector("#search h3"))); assertTrue("the word 'testcontainers' appears in search results", results.stream() .anyMatch(el -> el.getText().contains("testcontainers"))); } } ``` A huge advantage of this approach is the fact that these tests run on headless containers, so there is zero chance of manual user interactions interfering with the UI tests. What“™s more, a screen recording „“ of either all or just failing runs, which can be configured „“ is just one line of code away. A short sample of the above code in action can be seen here: https://videopress.com/v/Lg0KeAwt?loop=true&preloadContent=metadata Recording of a simple Selenium test: Performing a Google search Under the hood, the VNC stream provided by the container is recorded, which implies that during test development or long-running tests, it could also be observed manually using any VNC client. As these browser containers start up fairly quickly, it is feasible and advisable to start a new one for each test. This way, you can also be sure to start off from a „clean“ browser instance, i.e. a known state. Furthermore, this makes cross-browser testing for Chrome and Firefox quite effortless, by simply running the same tests against both containerized browsers. ![](https://thecattlecrew.net/wp-content/uploads/2020/02/uc_cross_browser.png) Test setup for cross-browser testing ## Use Case: Resilience Testing with Toxiproxy Automated integration tests usually don“™t incorporate chaos in the form of unreliable network connections, as they exist in the real world. Rather, these tests run on perfectly working localhost connections. In a world increasingly embracing microservices and their interdependence, this borders on negligence. A sneaky tool to test your application under adverse networking conditions is [Toxiproxy](http://toxiproxy.io/). With Testcontainers, it is simple to wire up your (not necessarily containerized) applications and configure so-called „toxics“ for their TCP connections such as: - Latency and jitter (in ms) - Bandwidth (in KB/s) - Slow close (in ms): Delays the TCP socket from closing until delay has elapsed. - Timeout (in ms): Stops all data from getting through and closes the connection after timeout. - Slicer: Slices TCP data up into small bits, optionally adding a delay between each sliced „packet“. - Data limit (in bytes): Closes connection when transmitted data exceeded limit. ![](https://thecattlecrew.net/wp-content/uploads/2022/07/uc_toxi.png) Setup for resilience testing using Toxiproxy The above example (with another $System omitted for brevity) looks like this in code: ``` public class ToxiproxyTest { // Create a common docker network so that containers can communicate @Rule public Network network = Network.newNetwork(); // the target container - this could be anything @Rule public GenericContainer redis = new GenericContainer("redis:5.0.4") .withExposedPorts(6379) .withNetwork(network); @Rule public ToxiproxyContainer toxiproxy = new ToxiproxyContainer() .withNetwork(network); @Test public void testConnectionCut() { final ToxiproxyContainer.ContainerProxy proxy = toxiproxy.getProxy(redis, 6379); final Jedis jedis = new Jedis(proxy.getContainerIpAddress(), proxy.getProxyPort()); jedis.set("somekey", "somevalue"); assertEquals("access to the container works OK before cutting the connection", "somevalue", jedis.get("somekey")); proxy.setConnectionCut(true); assertThrows("calls fail when the connection is cut", JedisConnectionException.class, () -> { jedis.get("somekey"); }); proxy.setConnectionCut(false); assertEquals("access to the container works OK after re-establishing the connection", "somevalue", jedis.get("somekey")); } } ``` ## Need Anything Else? As of now, there are several other modules for further use cases already available: ![](https://thecattlecrew.net/wp-content/uploads/2020/02/uc_other_modules.png) If you don“™t find a module for your use case, you can either start your containerized application explicitly and implement the communication with it directly or package this knowledge into your own module to make it reusable. The building blocks like [wait strategies](https://www.testcontainers.org/features/startup_and_waits/) (waiting for a containerized application to become available, e.g. respondings to HTTP connections on a port or waiting for a certain log output) are already there. To learn how to integrate Testcontainers with container-based CI systems, take a look at [this follow-up post](https://thecattlecrew.net/2020/03/02/testcontainers-unleash-your-unit-tests-using-docker-3-3/). **Kategorien:** DevOps **Schlagwörter:** Cross-Browser Testing, Docker, E2E Testing, Integration Testing, Java, JUnit, Resilience Testing, Selenium, Service Testing, Testcontainers, Toxiproxy, UI Testing, unit test --- ### [Flutter und Jenkins auf OpenDevStack](https://thecattlecrew.net/2020/02/26/flutter-und-jenkins-auf-opendevstack/) **Published:** Februar 26, 2020 **Author:** Sebastian Liedl **Content:** ## Ein Erfahrungsbericht Die Studenten des OC Lab“™s beschäftigen sich immer wieder mit neuen Technologien und Herausforderungen. So haben wir uns auch in diesem Projekt mit Openshift bzw. dem OpenDevStack beschäftigt. Der OpenDevStack ist eine Weiterentwicklung von Openshift, welche Opitz Consulting entwickelt hat. Wir haben uns das Ziel gesetzt, einen Quickstarter, d.h. eine schnelle Möglichkeit mit dem Entwickeln von Flutter Applikationen zu starten, zu erstellen. Als Zielumgebung sollte wie bereits erwähnt alles im OpenDevStack laufen. ### Was ist Flutter? Bevor wir genau in die Umsetzung einsteigen, besteht natürlich die Frage was denn genau Flutter ist. Flutter ist ein von Google entwickeltes Framework, mit dem man Applikationen für verschieden Plattformen bauen kann. Das heißt die Entwickler müssen nicht für iOS eine Swift App, für Android eine Kotlin App und für das Web eine JavaScript Anwendung entwickeln. Sie haben die Möglichkeit mit Hilfe von Flutter all diese Plattformen mit nur einer Codebase zu bedienen. Dadurch können die Entwicklungszeiten für neue Plattformen deutlich reduziert werden. ### Warum Jenkins? Wenn man bereits in einem Softwareprojekt mitgewirkt hat, stellt sich immer wieder die Frage, wie man am Besten die Applikation testet und auf Fehler überprüft. Die beste Vorgehensweise ist, wenn man den Code regelmäßig testet und auf Fehler überprüft. Genau hier kommt Jenkins ins Spiel. Mit Jenkins lässt sich ganz einfach eine Continuous Integration und Continuous Delivery Pipeline aufbauen. Somit ist es relativ einfach einen neuen Pull Request zu testen und ihn nur zusammenzuführen, wenn er auch fehlerfrei läuft. ### Wie sind wir vorgegangen? Wir haben uns dazu entschieden, ein Docker Image zu verwenden, um dort sowohl Flutter als auch Jenkins zu installieren. Deshalb haben wir zuerst das neuste Docker Image von Jenkins heruntergeladen und installiert. Anschließend benötigt das Docker Image noch Flutter, damit Jenkins die Flutter Applikation auch bauen kann. Nachdem Flutter installiert wurde, haben wir FlutterDoctor verwendet, um schnell zu checken, ob Flutter auch richtig installiert wurde. Zu guter Letzt benötigt das Image bzw. der User, der in dem Image definiert wurde bestimmte Zugriffe auf Ordner in OpenDevStack. Deswegen fügten wir ebenfalls noch den Befehl ein, dass der User zu der Benutzergruppe hinzugefügt wird, die auf die entsprechenden Ordner Zugriff haben. Nun war das Docker Image fertig und wir konnten es zum Docker Hub pushen und es auf OpenDevStack deployen. Dies ging sehr einfach, da der OpenDevStack eine native Möglichkeit bietet, Docker Images direkt vom Docker Hub zu pullen und auf OpenDevStack auf einem Pod zu installieren. Somit konnten wir den ersten Pod starten, welcher Jenkins und Flutter beinhaltet. Damit der Pod auch richtig startet, mussten wir die Ressourcen des Pods anpassen. So hoben wir den Speicher auf mind. 100 MiB und max. 2 GiB an. Und schon lief der Pod einwandfrei. ### Probleme auf die wir gestoßen sind Nachdem der Pod lief, versuchten wir ein Beispielprojekte in Flutter aufzuziehen, um die Funktionalität von Jenkins zu überprüfen. Dabei stellte sich heraus, dass Jenkins aktuell noch Berechtigungen fehlen, um ein bestimmtes File zu schreiben. Bisher konnten wir leider noch nicht genau feststellen woran dieser Fehler liegt, weshalb der Fehler aktuell noch präsent ist und kein Flutter Projekt getestet werden kann. ### Zusammenfassung Die Grundlage für den Quickstarter für OpenDevStack wurde gelegt. Sowohl Jenkins als auch Flutter sind auf einem Docker Image installiert und können auf OpenDevStack deployed werden. Einzig der Fehler mit der Berechtigung muss noch gefixt werden, da sonst das Docker Image nicht für den Einsatz auf OpenDevStack geeignet ist. **Kategorien:** DevOps, Tools & Methoden --- ### [Testcontainers - Unleash Your (Unit) Tests Using Docker (3/3)](https://thecattlecrew.net/2020/03/02/testcontainers-unleash-your-unit-tests-using-docker-3-3/) **Published:** März 2, 2020 **Author:** Benjamin Thiel **Content:** In a [previous post,](https://thecattlecrew.net/2020/02/24/testcontainers-unleash-your-unit-tests-using-docker-2-3/) we learned about some interesting use cases of Testcontainers; now you’ll see how to integrate it into CI systems running within Docker containers themselves. ## Integration with OpenShift If you are using a CI environment that runs itself in Docker container, like Jenkins in [the highly recommended OpenDevStack](https://thecattlecrew.net/2019/09/25/eat-your-own-opendevstack/) (which is based on [RedHat OpenShift](https://www.openshift.com/), which is in turn based on [Kubernetes](https://kubernetes.io/)), you’ll run into some challenges. Your Testcontainers-based tests try to spawn Docker containers of their own within the container the CI environment is running in; this does not work out-of-the-box. In general, there are two approaches to tackle this problem: 1. **Docker-in-Docker:** By building a custom Docker image of your CI system and providing it with a working Docker daemon. However, this is [not advisable for various reasons](http://jpetazzo.github.io/2015/09/03/do-not-use-docker-in-docker-for-ci/) and should only be used a method of last resort. 2. **Docker wormhole pattern:** By exposing the docker daemon that your CI container was spawned by into said container. Containers started by Testcontainers will then be „siblings“ to your CI container. In the following, we’ll discuss the latter approach. Although [RedHat warns](https://access.redhat.com/solutions/4213701) about security and stability risks, this can be a viable approach if you keep an eye on them. ![](https://thecattlecrew.net/wp-content/uploads/2022/07/2020-01-14-14_22_52-Connecting-to-docker.sock-in-OpenShift-Red-Hat-Customer-Portal.png) The docker deamon is listening on the UNIX socket `/var/run/docker.sock`, which we need to expose into our CI container. First of, `ssh` into your OpenShift installation to determine the group id of the docker group that the deamon is running in by issuing a command like `getent group`: ``` [docker@minishift ~]$ getent group ... docker:x:1000:docker [docker@minishift ~]$ ``` In our case, the determined group id is `1000`. Then, log in to your OpenShift web interface and edit the deployment config of your CI system (Jenkins in this case) by adding these lines (marked green) to it: ![](https://thecattlecrew.net/wp-content/uploads/2020/02/jenkinsDeploymentConf.png) This instructs OpenShift to run the Jenkins container within the group of the docker deamon and to expose its socket by mounting it into the container. Normally, containers in OpenShift run with restricted privileges. In order to allow mounting volumes (or sockets, in this case) of the host into the container, we need to add an appropriate [Security Context Constraint](https://docs.openshift.com/container-platform/4.2/authentication/managing-security-context-constraints.html) (SCC) that includes the `hostPath` plugin to the user that runs the Jenkins container. We can do this by issuing a command like `oc adm policy add-scc-to-user hostaccess jenkins` as OpenShift administrator. You could also define your own SCC rather than using `hostaccess` provided by OpenShift. One might think that we were done by now. However, if you try to run your tests at this point, you’ll get a `permission denied` error upon accessing `docker.sock`. Why is that? OpenShift runs on CentOS which has [SELinux](https://wiki.centos.org/HowTos/SELinux) activated. In order to lift its constraints, `ssh` into your OpenShift installation to download and build [selinux-dockersock](https://github.com/dpw/selinux-dockersock). With this small SELinux policy added, you should finally see some whales merrily [spouting](https://emojipedia.org/spouting-whale/) into your Jenkins console: ![](https://thecattlecrew.net/wp-content/uploads/2020/02/jenkinsLog.png?fit=1024%2C533&ssl=1)Happy testing! 🐳 ## Conclusion Testcontainers simplifies the usage of „real“ services the system under test depends upon by providing convenient methods to start, wire-up, communicate with and exchange data with dockerized applications. The only remaining dependency of the executing system is a working Docker installation. Furthermore, Testcontainers can be run from within Docker images themselves, as might be the case for some continuous integration (CI) systems, albeit extra care has to be taken as shown above. Naturally, the performance of a Docker container with a complex application starting and shutting down cannot compete with mocks, but „“ if used wisely „“ such tests offer a greater insight into the behavior of the mimicked parts of the productive system, thus inspiring greater confidence in these tests. Another advantage is the fact that containers always start from the known state of their image, thereby avoiding errors introduced by „leaking state“ as might be the case in a database running in a VM managed manually for example. It follows that any configurative changes to these images have to be performed in code, leading to a „(test) infrastructure as code“ approach with the added benefit of simultaneously serving as documentation. After much praise, I“™d like to end on a more cautious note. Please keep in mind that we are not removing complexity here, we are just abstracting it away, or as the saying goes: > All problems in computer science can be solved by another level of indirection“¦ except for the problem of too many layers of indirection. > > David Wheeler **Kategorien:** DevOps **Schlagwörter:** Java, jenkins, JUnit, OpenDevStack, OpenShift, SELinux, Testcontainers, Testing, unit test --- ### [Die Entwicklung von KaHaWa-Mobile - Herausforderungen und Take-Aways](https://thecattlecrew.net/2020/04/02/die-entwicklung-von-kahawa-mobile-herausforderungen-und-take-aways/) **Published:** April 2, 2020 **Author:** Eduard Selenzow **Content:** **Wer oder was ist KaHaWa?** [KaHaWa](https://getkahawa.com/start) ist ein junges Startup, das sich zum Ziel genommen hat, die Kaffeevirtuosen zu unterstützen, die wissen, wie sie ihren idealen Kaffee haben wollen. Zu den Gründern des Startups zählt Jan Lukas Braje, ein junger Mitarbeiter von OC am Standort Hamburg. Nach dem Start im Web auf *getkahawa.com,* hieß es für KaHaWa den nächsten Schritt zu gehen und ihren Service auf die Smartphones der Kaffee-Liebhaber zu bringen. Mit dem Smartphone können die Nutzer über NFC (Near Field Communication) einen Tag an der Kaffeemaschine auslesen und die Zubereitung ihres Kaffees in ihrer gewünschten Konfiguration starten. Falls der Begriff NFC nicht geläufig ist: Es wird z.B. beim kontaktlosen Bezahlen mit EC-Karte verwendet. Für die Entwicklung von KaHaWa-Mobile hat Jan das OC|Lab beauftragt. Wie die Entwicklung ablief, welche Technologie verwendet wurde, welche Herausforderungen es gab und was die Take-Aways sind, beschreiben wir im Folgenden. **Was wurde für die Entwicklung verwendet?** Da das Team von KaHaWa mit einer Webpräsenz die Entwicklung einer Mobile-App im OC|Lab beauftragt hat, stellte KaHaWa eine Schnittstelle zu ihrem Backend zur Verfügung. Vom OC|Lab wurde *Flutter* für die Entwicklung der Mobile-App ausgewählt. Flutter ist eine Multiplattform-Technologie mit der auf Grundlage einer Codebasis eine App für Mobile, Web und Desktop entwickelt werden kann. Die Entscheidung für Flutter basiert auf der Anforderung sowohl iOS als auch Android zu unterstützen, welche von Flutter erfüllt wird. **Herausforderungen bei der Entwicklung** - Wahl eines State Management Ansatzes - Abhängig vom State Management Ansatz ist die Architektur der App. - Auf der Google I/O empfiehlt das Entwicklerteam von Flutter den State Management Ansatz [Bloc](https://www.youtube.com/watch?v=RS36gBEp8OI&feature=youtu.be&t=1389) - Wahl einer geeigneten Architektur - Architektur muss für eine Weiterentwicklung und Large-Scale geeignet sein - Abhängig vom Bloc Ansatz wird die Architektur angepasst - Wer das Pattern **MVVM** kennt, sieht eine Ü„hnlichkeit zu Bloc. Die *Business Logic Component* (**Bloc**) übernimmt die Rolle des *View-Model*. Bloc unterscheidet sich von MVVM in der asynchronen Kommunikation mit dem Data Layer und der Abstraktionsebene *Repository* Die folgende Abbildung zeigt die Architektur eines B in abstrahierter Form: ![A close up of a logo Description automatically generated](https://thecattlecrew.net/wp-content/uploads/2020/04/Screenshot-2020-04-01-at-11.50.39-1.png)Die Architektur zeigt, dass ein Bloc die verbindende Instanz zwischen UI und Data ist. Die UI bekommt vom Bloc sogenannte States, durch die in der UI spezifiziert ist, wie die Oberfläche auszusehen hat. Über die Oberfläche werden sogenannte Events an den Bloc gesendet, z.B. der Tap auf einen Button. Der Bloc führt die Business Logik für das jeweilige Event aus, die beispielsweise die Abfrage von Daten aus dem Data beinhalten kann, und liefert der UI den entsprechenden State. - Implementierung von NFC - Nutzer sollen die Zubereitung ihrer Kaffeekonfiguration mit dem Lesen eines NFC Tag an der Maschine einleiten können. - NFC in iOS funktioniert erst ab dem iPhone 6 und iOS 13 - Package auf [pub.dev](https://pub.dev/) finden, dass die Schnittstelle zu den nativen NFC Funktionen des Geräts bietet und die benötigten Funktionalitäten bereitstellt - Implementierung der Funktionen mit Bloc - Implementierung von Google Maps - Implementierung der Funktionen mit Bloc - Das Package für Google Maps bietet keinen Zugriff auf die Location eines Nutzers - Package für die Location musste extra hinzugefügt werden - Design Anforderungen umsetzen - Flutter bietet eine implementierte Navigation - Die Implementierung einer individuellen Navigation lief gegen das Framework und hat für Probleme gesorgt. Z.B. wurden die Gestik-Funktionen in der Google Map nicht mehr unterstützt, wenn die Navigation von Seite zu Seite über das Swipen von rechts nach links implementiert wurde. **Take-Aways** Aus diesem lehrreichen Projekt konnten wir einiges an Erfahrungen mitnehmen: - State Management bei einem MVP - Für die Entwicklung eines MVP hat die Wahl und Einhaltung des Bloc Pattern zu Verzögerung geführt - **Fazit**: die einfachste Form von State Management verwenden, wenn sie die Aufgabe erledigt - Genaue Definition einer API - Bei der Entwicklung der Mobile-App ging viel Zeit verloren, da der definierte Datentyp in der API-Dokumentation und der vom Backend erwartete Datentyp unterschiedlich waren - Dart ist stark typisiert und erwartet bei der Decodierung einer JSON die Angabe des Datentyps - **Fazit**: genaue Definition der Datentypen in der API einhalten - Deployment in TestFlight (iOS) und Google Playstore (Android) - iOS verlangt das Hinzufügen der Capability Push Notification. Egal ob die App Push Notifications verwendet oder nicht. Wird die Capability nicht hinzugefügt, wird die App vom automatisierten Test von Apple abgelehnt. - iOS benötigt bei jedem hochgeladenen Build eine Beantwortung von mehreren Fragen, die in der Aufforderung enden pro Jahr 1 Export Compliance an die verantwortliche Abteilung des Amerikanischen Governments zu schicken - Android hat verschiedene „Tracks“ unter der die Anwendung released werden kann, wie z.B. den Alpha Track. - Android ist unübersichtlich, was den Stand der Prüfung der App betrifft. Es wurde gesucht, warum kein Link generiert wird, damit Tester eingeladen werden können **Zusammenfassung** Das OC|Lab empfiehlt für die Entwicklung von Mobile-Apps *Flutter*, da es nicht nur Spaß macht, sondern auch die Anforderungen an Mobile-Apps erfüllt. Zusätzlich bietet es den großen Vorteil, dass die Grundlage einer Codebasis für Android und iOS hilfreich für die Wartung und Weiterentwicklung einer App ist. **Kategorien:** Development **Schlagwörter:** Architecture, css, Flutter, OC|Lab, Softwarenentwicklung --- ### [OPITZ CONSULTING unterstützt die Digitalisierung des Landes Nordrhein-Westfalen](https://thecattlecrew.net/2020/05/12/opitz-consulting-unterstuetzt-die-digitalisierung-des-landes-nordrhein-westfalen/) **Published:** Mai 12, 2020 **Author:** Andreas Fröhlich **Content:** Ende 2019 erhielt OPITZ CONSULTING in einem Konsortium unter Federführung der COSINEX GmbH aus Bochum den Zuschlag für einen Rahmenvertrag im Bereich Java-spezifischer Individualentwicklung durch die d-NRW AöR. Dieser Rahmenvertrag ist Teil der langfristigen Digitalisierungsstragie des Landes Nordrhein-Westfalen zur Realisierung von Grundlagenprojekten (wie etwa dem Online-Zugangsgesetz (OZG)), sowie der Vorgaben des IT-Planungsrats und werden in Nordrhein-Westfalen federführend durch die d-NRW AöR ([www.d-nrw.de](http://www.d-nrw.de)) gesteuert. Weitere Informationen zu unserer Expertise im öffentlichen Sektor finden Sie unter [www.opitz-consulting.com/public](https://www.opitz-consulting.com/portfolio/partner-fuer-politik-und-verwaltung.html) **Kategorien:** Architecture & Process Models --- ### [Evaluierung Java Microframeworks - Setting the scene](https://thecattlecrew.net/2020/07/01/evaluierung-java-microframeworks-setting-the-scene/) **Published:** Juli 1, 2020 **Author:** Meryem Cigdem **Content:** In letzter Zeit haben Microframeworks wie Javalin, Ktor, Spring Fu oder Micronaut in der Java-Welt zunehmend an Bedeutung gewonnen. Anhand eines internen Projektes haben wir zwei Microframeworks evaluiert, um herauszufinden wie sich diese bewähren und für welche Kontexte sich die Frameworks eignen. Die Frameworks, die im Rahmen der Evaluierung betrachtet wurden, waren Javalin und Micronaut. In diesem Beitrag zeigen wir zuerst den detaillierten Anwendungsfall. Bevor wir anfangen den Anwendungsfall aufzuzeigen, sollten wir vielleicht eine Frage beantworten; Was versteht man unter einem Microframework? Ein Microframework ist ein minimalistisches Webanwendungs-Framework und bietet im Gegensatz zu Full-Stack Frameworks, wie z.B. Spring Boot, nur die hierfür notwendigen Funktionalitäten an. Es fehlen hierbei bspw. Funktionen, wie: „¢ Konten, Authentifizierung, Autorisierung, Rollen „¢ Datenbankabstraktion über eine objektrelationale Zuordnung „¢ Eingabevalidierung und Eingabebereinigung „¢ Web Template Engine In der Regel erleichtert ein Microframework das Empfangen und Weiterleiten einer HTTP-Anforderung an einen Controller, die Verarbeitung durch den Controller sowie das Zurückgeben einer HTTP-Antwort. Microframeworks kommen in diesem Zusammenhang häufig bei der Erstellung von APIs für einen anderen Dienst oder eine andere Anwendung zum Einsatz. #### **Technologiemanagementsystem** Nun kommen wir zurück auf unser Projekt namens Technologiemanagementsystem. Das Technologiemanagementsystem ist eine Single Page Applikation, in der unterschiedliche Technologien gespeichert und bewertet werden können. Es sollte eine Microservices Architektur mit wenigen Microservices realisiert werden, in der die einzelnen Frameworks verglichen werden können. Bei dem beispielhaft zu entwickelnden Technology Microservice handelt es sich um einen simplen Service, der ein REST Backend bereitstellt, welches Zugriffe auf eine relationale Datenbank (PostgreSQL) zulässt. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/Unbdxfsdfsdfenannt.png)Der Backend Technology Microservice (Rest API) ermöglicht, dass über eine in Angular entwickelte Single Page Applikation (siehe Abbildung 1) Technologien gepflegt und gemanaged werden können. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/07/image2020-1-22_12-9-17.png?fit=1024%2C413&ssl=1) Abbildung 1 – Startseite in Angular entwickelte Single Page ApplikationDazu bietet der Microservice grundlegende Funktionalitäten an. Über dieser Startseite kann der Microservice die Liste der aktuell eingepflegten Technologien zeigen. Neue Technologien können angelegt werden, vorhandene Technologien können geupdatet werden und nicht mehr benötigte Technologien können ebenso gelöscht werden. Außerdem erkennt das Backend Ü„hnlichkeiten und verhindert dadurch Doppeleingaben. Der Filter am linken Rand der Anwendung ermöglicht einen Filter über mehrere Tags in Kombination mit mehreren Bewertungskriterien. Die Erkenntnisse über Frameworks, die wir während der Evaluierung gewonnen haben, werden in den kommenden Beiträgen dargestellt. **Kategorien:** Development **Schlagwörter:** Java, Javalin, micronaut, Microservices --- ### [Preparing for Spring Boot 3 - Choose the right Java 17 base image](https://thecattlecrew.net/2022/11/07/preparing-for-spring-boot-3-choose-the-right-java-17-base-image/) **Published:** November 7, 2022 **Author:** Philipp Kürsten **Content:** As a Java developer you have definitely heard of Spring Boot and probably already used it in version 2.X. The Spring team is planning to release Spring Boot 3 in November 2022 and this version will require Java 17. Since older Spring Boot versions are also compatible with Java 17, now is the time to upgrade to the latest LTS version of Java for a smooth migration to Spring Boot 3 when it is released. With this in mind, I began to identify the most used Java vendors and made some tests regarding their technical fit for our customer projects. ## Criteria Today, almost all of our Java applications are running containerized. So the goal is to find a good base image that meets typical cloud-native requirements: - **Image-Size**: The size of the base image should be as small as possible to speed up the pull and push process to the registry. Also, a smaller image usually results in fewer dependencies. - **Security**: In an ideal world, a base image should have no security vulnerabilities. This is only possible if the base image contains as few dependencies as possible. Therefore, it might make sense to set these two requirements. - **JRE only**: At runtime, our Java applications no longer need the full Java Development Kit (it is already developed and built at this point). So we only need the Java Runtime Environment (JRE) for our base image. - **Alpine flavour**: Normally, the Alpine base images are quite small. Therefore, they generally contain fewer dependencies than other Linux variants. - **Easy to use in CI-Pipeline**: Developers are lazy, me too. That’s why I would be happy to have an official Maven image to build the application inside a CI pipeline with the same Java as in my base image. ## Test Results The following list gives an overview of the Java images I identified and the results according to the above criteria: NameImageCompressed SizeAlpineJREMavenAdoptium Eclipse Temurin`eclipse-temurin:17-jre-alpine`58 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)Azul Zulu / Zing`azul/zulu-openjdk-alpine:17-jre`66 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gelbes-ausrufezeichen.png)BellSoft Liberica JDK`bellsoft/liberica-openjre-alpine-musl:17`49 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gelbes-ausrufezeichen.png)IBM Semeru Runtime`ibm-semeru-runtimes:open-17-jre`89 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)Amazon Corretto`amazoncorretto:17-alpine-jdk`185 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gruenes-haekchen.png)Microsoft Build of OpenJDK`mcr.microsoft.com/openjdk/jdk:17-mariner`168 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gelbes-ausrufezeichen.png)Red Hat OpenJDK`registry.access.redhat.com/ubi8/openjdk-17`137 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)GraalVM`ghcr.io/graalvm/graalvm-ce:ol9-java17`409 MB![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/rotes-kreuzchen.png)![](https://thecattlecrew.net/wp-content/uploads/2022/11/gelbes-ausrufezeichen.png) These Java variants are not published directly under the official `maven` Docker repository. Instead, they are published under `csanchez/maven`. Nevertheless, both docker repositories are provided by the same upstream [GitHub repository](https://github.com/carlossg/docker-maven/tree/ac292f26884bf2be9fe69f6e397da3b124c1e35c "https://github.com/carlossg/docker-maven/tree/ac292f26884bf2be9fe69f6e397da3b124c1e35c"). > The heavily used AdoptOpenJDK base image with Java 8 and Java 11 is now obsolete and has been transferrred to the „Adoptium Eclipse Temurin“ project. ### Security Risks & Vulnerabilities I also checked all these images for security risks using two different image scanners: - [trivy](https://github.com/aquasecurity/trivy "https://github.com/aquasecurity/trivy") - [Artifactory XRay](https://jfrog.com/xray/ "https://jfrog.com/xray/") The results are summarized in the following list (as of November 10, 2022): NameImageTrivyXRayAdoptium Eclipse Temurin`eclipse-temurin:17-jre-alpine`Total: 1 (UNKNOWN: 0, LOW: 0, MEDIUM: 0, HIGH: 1, CRITICAL: 0)Total: 9 (UNKNOWN: 0, LOW: 0, MEDIUM: 2, HIGH: 7, CRITICAL: 0)Azul Zulu / Zing`azul/zulu-openjdk-alpine:17-jre`Total: 0 (UNKNOWN: 0, LOW: 0, MEDIUM: 0, HIGH: 0, CRITICAL: 0)Total: 9 (UNKNOWN: 0, LOW: 0, MEDIUM: 2, HIGH: 7, CRITICAL: 0)BellSoft Liberica JDK`bellsoft/liberica-openjre-alpine-musl:17`Total: 0 (UNKNOWN: 0, LOW: 0, MEDIUM: 0, HIGH: 0, CRITICAL: 0)Total: 7 (UNKNOWN: 0, LOW: 0, MEDIUM: 2, HIGH: 5, CRITICAL: 0)IBM Semeru Runtime`ibm-semeru-runtimes:open-17-jre`Total: 17 (UNKNOWN: 0, LOW: 13, MEDIUM: 4, HIGH: 0, CRITICAL: 0)Total: 10 (UNKNOWN: 0, LOW: 7, MEDIUM: 3, HIGH: 0, CRITICAL: 0)Amazon Corretto`amazoncorretto:17-alpine-jdk`Total: 0 (UNKNOWN: 0, LOW: 0, MEDIUM: 0, HIGH: 0, CRITICAL: 0)Total: 7 (UNKNOWN: 0, LOW: 0, MEDIUM: 2, HIGH: 5, CRITICAL: 0)Microsoft Build of OpenJDK`mcr.microsoft.com/openjdk/jdk:17-mariner`Total: 10 (UNKNOWN: 0, LOW: 2, MEDIUM: 2, HIGH: 4, CRITICAL: 2)Total: 46 (UNKNOWN: 0, LOW: 5, MEDIUM: 28, HIGH: 8, CRITICAL: 5)Red Hat OpenJDK`registry.access.redhat.com/ubi8/openjdk-17`Total: 88 (UNKNOWN: 0, LOW: 44, MEDIUM: 44, HIGH: 0, CRITICAL: 0)Total: 111 (UNKNOWN: 0, LOW: 38, MEDIUM: 59, HIGH: 11, CRITICAL: 3)GraalVM`ghcr.io/graalvm/graalvm-ce:ol9-java17`Total: 7 (UNKNOWN: 0, LOW: 0, MEDIUM: 1, HIGH: 6, CRITICAL: 0)Total: 0 (UNKNOWN: 0, LOW: 0, MEDIUM: 0, HIGH: 0, CRITICAL: 0) ## Conclusion For a new project based on Java, I would first choose the **Adoptium Eclipse Temurin** project. The image is tiny, meets all my criteria and has almost no vulnerable security holes. Also, the official Maven image supports this Java version, which is a perfect match for me. Nevertheless, other Java vendors are also quite interesting. Especially if you use Spring and the official image plugin for Maven and Gradle, you end up with the **BellSoft Liberica JDK** by default. This blog post is intended to make you aware that you should not just randomly select a Java base image. Instead, you should define some basic criteria based on your use case and choose the Docker image that fits best. **Kategorien:** Development, Tools & Methoden **Schlagwörter:** CI, Java, Java image, JRE, Spring --- ### [Nachhaltigkeit trifft Software-Architektur](https://thecattlecrew.net/2023/07/13/nachhaltigkeit-trifft-software-architektur/) **Published:** Juli 13, 2023 **Author:** Ramon Anger **Content:** Wenn wir heute über nachhaltige IT sprechen, liegt unser Fokus oft auf der IT-Infrastruktur aus Servern, Netzwerk und Endgeräten. Welchen Einfluss die Software, für deren Nutzung diese IT-Infrastruktur aufgebaut wurde, auf den Energiebedarf hat, spielt oft nur eine untergeordnete Rolle. Dabei ist der Energiebedarf einer Software ein wesentlicher Aspekt von Nachhaltigkeit. In diesem Post fokussiere ich mich auf energetische Nachhaltigkeit. Teilweise gehe ich auf die Nachhaltigkeit weiterer Ressourcenarten wie Entwicklungskapazität ein. # Der Strombedarf in der IT steigt weiter Nach einer Schätzung des [BITKOM](https://www.bitkom.org/Presse/Presseinformation/Deutsche-Rechenzentren-Wachstum-Effizienz#_) wird der Strombedarf allein in deutschen Rechenzentren von 18 TWh im Jahr 2023 bis zum Jahr 2030 auf 27 TWh bis 34 TWh steigen. Das wäre eine Steigerung um 50 bis 90 Prozent bis 2030. Dieser Bedarf kann nur durch eine Erhöhung der lieferbaren Energiemenge gedeckt werden. Dabei spielt der Ressourcenhunger von IT-Anwendungen und -Services eine entscheidende Rolle. Je stärker eine Software nach nachhaltigen Gesichtspunkten entworfen und entwickelt wird, desto weniger Energie wird am Ende benötigt. # Digitalisierung als Treiber für Energiebedarf Das Voranschreiten der Digitalisierung in Deutschland kann grundsätzlich einen positiven Einfluss auf den Ressourcenbedarf der betroffenen Organisationen und Individuen haben, indem beispielsweise Papier, Zeit und Wege eingespart werden. Nachteil ist, dass die Digitalisierung den Energiebedarf weiter steigen lässt. Und auch hier spielt die verwendete Software und deren Nachhaltigkeit eine wesentliche Rolle. # Architektur beeinflusst Nachhaltigkeit Schon während des Designs und der Entwicklung eines Software-Systems können die Weichen für die Nachhaltigkeit dieses Systems gestellt werden. Die Architektur eines Software-Systems hat dabei einen starken Einfluss. Leider ist die Nachhaltigkeit einer Software-Architektur nicht direkt messbar. Wir können allerdings typische Qualitätskriterien von Software-Systemen als Vehikel verwenden, um ihre Wirkung auf die Architektur und damit auf die Nachhaltigkeit der Architektur selbst abschätzen zu können. > Eine hohe Skalierbarkeit eines IT-Systems ermöglicht es, die Ressourcennutzung an aktuelle Anforderungen anzupassen. Durch eine automatische Anpassung der verfügbaren Systemleistung an den tatsächlichen Bedarf kann also ein übermäßiger Energieverbrauch vermieden werden. # Qualitätskriterien als Messgröße für Nachhaltigkeit Die [ISO 25010](https://iso25000.com/index.php/en/iso-25000-standards/iso-25010) beschreibt typische Qualitätskriterien von Software-Systemen. Zu diesen Kriterien gehören beispielsweise Verfügbarkeit, Performance, Wartbarkeit, funktionale Vollständigkeit, Benutzbarkeit und Sicherheit. Solche Qualitätskriterien beeinflussen die Nachhaltigkeit einer Software-Architektur entweder positiv oder negativ, sofern sie für ein Software-System Geltung haben. In diesem Post können wir uns mit diesem Zusammenhang zwischen Qualitätskriterien und Nachhaltigkeit nicht allumfänglich widmen, da es einfach sehr viele Qualitätskriterien gibt. Zur Veranschaulichung des Zusammenhangs sollen deshalb sechs Beispiele dienen. ## 1. Funktionale Vollständigkeit Software-Systeme verfügen über Funktionalitäten, die mit besten Absichten für eine spätere Nutzung eingebaut wurden … sowohl in funktionaler als auch in technischer Hinsicht. Spätestens seit das Mantra YAGNI – [You ain’t gonna need it](https://martinfowler.com/bliki/Yagni.html) – in der Software-Entwicklung zum geflügelten Wort wurde, wissen wir, dass das der investierte Aufwand schlicht verschwendet ist. Das Problem dabei: Jede Funktionalität innerhalb einer laufenden Software benötigt Speicher, CPU und im Fall einer Cloud-Lösung auch Netzwerkbandbreite für die Kommunikation. Handelt es sich also um Funktionen, die nicht oder nur selten verwendet werden, spricht das eher nicht für eine nachhaltige Ressourcen-Nutzung – sowohl im laufenden System als auch bei der Software-Entwicklung. In den [John Lewis Engineering Principles](https://engineering-principles.jlp.engineering/) finden wir mit [Design for Emergent Reuse](https://engineering-principles.jlp.engineering/principles/design/design-for-emergent-reuse/) ein Architektur-Prinzip, dass davon abrät, von vorn herein Wiederverwendbarkeit als Design-Ziel zu verwenden. Die Empfehlung lautet, Design auf reale Anwendungsfälle auszurichten und das Design erst im konkreten Fall hin zu Wiederverwendung weiterzuentwickeln. ## 2. Sicherheit Maßnahmen zum Schutz von IT-Systemen, Daten oder der Privatsphäre kosten immense Ressourcen. Allerdings wird heute kaum jemand die Notwendigkeit derartiger Schutzmaßnahmen in Frage stellen. In der Software-Entwicklung spielen Schutzmaßnahmen wie [Schwachstellenanalyse](https://pentest24.de/blog/was-ist-ein-vulnerability-scan/) oder [Injection Prevention](https://cheatsheetseries.owasp.org/cheatsheets/Injection_Prevention_Cheat_Sheet.html) eine große Rolle. Eine gute Quelle für Sicherheitsmaßnahmen auf Architektur-Ebene ist und bleibt [OWASP](https://owasp.org/www-project-top-ten/) mit seinen [Secure Design Principles](https://cheatsheetseries.owasp.org/cheatsheets/Secure_Product_Design_Cheat_Sheet.html) und der [Security Architecture](https://owaspsamm.org/model/design/security-architecture/). Alle diese Sicherheitsmaßnahmen verursachen einen hohen Energiebedarf, sind aber essenziell und notwendig. Sicherheit muss also gegenüber Nachhaltigkeit immer priorisiert behandelt werden. ## 3. Performance Die hohe Performance eines Service im Sinne von schneller Antwortzeit bei Nutzeranfragen spricht auf den ersten Blick für eine nachhaltige Lösung. Andernfalls dürfte kaum eine schnelle Antwort möglich sein, oder? Abfragen in einer Datenquelle mit Milliarden Einträgen, die Übertragung von Millionen von Datensätzen aus dieser Quelle an einen Servicenutzer, der nur die ersten 10 dieser Datensätze verwendet sind in modernen Cloud-Umgebungen innerhalb wenigen Sekunden möglich. Die energetischen Kosten können immens sein. ### **Also beeinflusst hohe Performance als Qualitätskriterium die Nachhaltigkeit einer Lösung negativ?** Nein. Die Zahl der möglichen [Design-Praktiken,](https://patterns.greensoftware.foundation/catalog/cloud/) um derartige Herausforderungen ressourceneffizient zu lösen, ist gerade im Cloud-Umfeld groß. Ob sich ein Lösungsmuster aus Sicht der Software-Architektur eines Systems eignet und angemessen ist, ist daher stark kontextabhängig. Und: Eine gute Performance wirkt sich positiv auf weitere Qualitätskriterien wie [Verfügbarkeit](#verfuegbarkeit) und [Benutzbarkeit](#benutzbarkeit) aus. ## 4. Verfügbarkeit Verfügbarkeit beschreibt den Grad, zu dem ein System, eine Anwendung, ein Service oder eine Komponente den Anwendenden zur Verfügung steht. Verfügbarkeit lässt sich teilweise auf Hardware-Ebene unterstützen. Stark vereinfacht könnten wir sagen, mehr eingesetzte Hardware bringt eine höhere Verfügbarkeit. Mehr Hardware bedeutet aber auch einen höheren Energiebedarf zum Nachteil der Nachhaltigkeit. Innerhalb der Software-Architektur eines Services wird die Verfügbarkeit z. B. durch den Einsatz von [Resilience Patterns](https://www.jrebel.com/blog/microservices-resilience-patterns) beeinflusst. Diese werden verwendet, um - zu verhindern, dass ein Service nicht mehr verfügbar ist (z. B. Rate Limiting) - Durchsatz, Latenz oder Zuverlässigkeit auf ein noch vertretbares Maß abzusenken, während der betroffene Service grundsätzlich verfügbar bleibt ([Service Degradation](https://de.wikipedia.org/wiki/Graceful_degradation) bei Video-Qualität) - die schnellstmögliche Wiederverfügbarkeit eines Services nach einem Ausfall unterstützen ([Failover](https://www.datacenter-insider.de/was-ist-failover-a-53668d46b9c30c5a7fdacc8d9504642c/)) - Informationen über den Zustand eines Services sammeln und bereitstellen, um einen Ausfall zu verhindern oder ein System, dass diesen Service verwendet, zu informieren (Alerting/Alarming) ### **Beeinflusst die Verwendung von Resilience Patterns die Nachhaltigkeit eines Services positiv oder negativ?** Resilience Patterns in eine Architektur zu integrieren, kostet zusätzlichen Aufwand und Energie. Wenn sich die Verfügbarkeit eines Services mit Hilfe der verwendeten Architektur erhöhen lässt, ist dieser Weg gegenüber der Aufrechterhaltung der Verfügbarkeit durch zusätzliche Hardware zu Gunsten energetischer Nachhaltigkeit zu bevorzugen. ## 5. Wartbarkeit Wartbarkeit beschreibt, wie effektiv und effizient ein System verändert werden kann, um es zu verbessern, um Fehler zu beseitigen oder um Funktionalität zu verändern. Je leichter ein Service an sich ändernde Anforderungen anpassbar ist, desto besser werden nachhaltige Aspekte unterstützt. Das bedeutet aus Architektur-Sicht allerdings nicht, dass ein Service von vornherein auf alle Teilaspekte der Wartbarkeit laut [ISO 25010](https://iso25000.com/index.php/en/iso-25000-standards/iso-25010) vorbereitet werden soll oder muss: - Modularität beschreibt u. a. die Fähigkeit Änderungen in einer Komponente ohne Änderungsbedarf in anderen Komponenten durchführen zu können. Der Bedarf gemeinsamer Änderungen ist schwer vorherzusehen und kann über die Zeit zu einem geänderten Schnitt von Modulen führen. - Wiederverwendbarkeit ist nicht für jede Komponente notwendig. Hier bitte [anwendungsfallgetrieben](https://engineering-principles.jlp.engineering/principles/design/design-for-emergent-reuse/) vorgehen. - Analysierbarkeit: Eine Unterstützung von Analysierbarkeit ist grundsätzlich eine wünschenswerte Eigenschaft. Konkrete Bedarfe ergeben sich meist über die Zeit. - Modifizierbarkeit: Der Bedarf nach Modifizierbarkeit ergibt sich u. a. aus dem Änderungsbedarf. Komponenten, die sich nie oder selten ändern, müssen nicht zwangsläufig leicht modifizierbar sein. - Testbarkeit ist vor allem mit Blick auf Regression eine häufig wünschenswerte Eigenschaft, auch mit Blick auf Nachhaltigkeit. Sofern eine hohe Wartbarkeit bedarfsgetrieben unterstützt wird, geht sie mit Nachhaltigkeit konform. Wenn ein Service nach zwei Jahren Lebenszeit komplett neu entwickelt werden muss, weil keine Wartbarkeit gegeben ist, ist dieser Service mit Blick auf Entwicklungsressourcen ebenso wenig nachhaltig wie aus energetischer Sicht. Die Ursachen hierfür können gern im Umfeld der Software-Architektur gesucht werden. ## 6. Hohe Benutzbarkeit, einfachere Lösung Ein hoher Automatisierungsgrad, Medienbruchfreiheit, intuitive Bedienbarkeit und möglichst wenige Klicks durch beteiligte Benutzer sprechen für ein eher nachhaltiges Design. Solche Eigenschaften unterstützen potenziell ein einfaches Software-Design und können auf Qualitätskriterien wie Wartbarkeit und Sicherheit einzahlen. Andererseits können schlechte Bedienbarkeit und viele manuelle Aktionen zu vielschichtigen Fehlern führen, die aufwändig im Service abgefangen und behandelt werden müssen. Wenn eine hohe Benutzbarkeit mit aufwändigem grafischen Design einhergeht, kann die energetische Nachhaltigkeit also negativ beeinflusst werden. Gerade im Umfeld des [nachhaltigen Webdesigns](https://sustainablewebdesign.org/) gibt es heute Erkenntnisse darüber, dass Einfachheit die Benutzbarkeit positiv beeinflussen kann. # Fazit Die Nachhaltigkeit von Software-Architekturen ist offenbar ein relevanter Aspekt unserer IT. Bisher gibt es wenige Organisationen, die ihre Software unter dem Gesichtspunkt hoher Nachhaltigkeit entwickeln oder entwickeln lassen. Und nun? Wie können wir es schaffen, mehr Nachhaltigkeit in unsere Software zu kriegen? In Zeiten hoher Energiepreise ist Nachhaltigkeit im Kontext von Kosten gut greifbar. Oft gilt: niedrige Kosten, hohe Nachhaltigkeit. Da viele Organisationen unter Berücksichtigung von Kosten- und Wirtschaftlichkeitsaspekten agieren, ist eine Verbesserung der Nachhaltigkeit von Software-Systemen mit Blick auf Betriebs- und Wartungskosten unter Umständen einfacher voranzutreiben. Die Energiekrise könnte also indirekt Initiativen für mehr Nachhaltigkeit anschieben. Ebenso regulatorische Maßnahmen, die die Preise für Energie und weitere Ressourcen beeinflussen. **Kategorien:** Architecture & Process Models, Sustainability & Awareness **Schlagwörter:** Design-Prinzipien, Energieeffizienz, Nachhaltigkeit, Qualitätskriterien, Software-Architektur --- ### [Introducing the Oracle IoT Cloud "“ Part IV: The REST API](https://thecattlecrew.net/2015/12/15/introducing-the-oracle-iot-cloud-part-iv-the-rest-api/) **Published:** Dezember 15, 2015 **Author:** Pascal Brokmeier **Content:** Picking up my colleagues series about the Oracle IoT Cloud, it’s now time to show the core of the product. The API. Using the UI is all good and well to learn the product, understand what it can do and what it can’t and how it works. But no system administrator wants to add 40.000 sensors one at a time and enter its serial number, vendor ID, manufacturer and Lat/Lon data by hand. This is where the REST API comes in. Sensors can be manufactured, their data digitally transferred from the manufacturer to the buyer and can then be automatically imported into the IoT Cloud using a given set of API’s. Let’s first look at the general structure of the [REST API](https://docs.oracle.com/cloud/latest/iot/IOTRP/index.html). ## The prerequisites In order to be able to communicate with your IoT Clouds‘ REST API, you first need the following things: - A REST Call tool. I would recommend [POSTman for Chrome](https://chrome.google.com/webstore/detail/postman/fhbjgbiflinjbdggehcddcbncdddomop?hl=en) if you like a GUI, but of course you can always go cURL if you prefer a CLI. - A username / password for the IoT Cloud. - a registered device to have an endpoint to talk to - \[a OAuth2 Authorization Token. I will get to this later\] ## A first call Since everyones URL for their IoT Cloud will be different, I will only specify the URN part of the request. To see the conventions on the Oracle IoT Clouds URL structure, check the [API docs](https://docs.oracle.com/cloud/latest/iot/IOTRP/Conventions.html). Let’s consider the following device in our system: ![Screen Shot 2015-12-14 at 10.55.13](https://thecattlecrew.net/wp-content/uploads/2015/12/screen-shot-2015-12-14-at-10-55-13.png) In order to call the IoT Cloud and ask it for information regarding this device we use the following call: GET https:///iot/api/v1/endpoints/0-CI/ Note that we also added authorization to the request, using a Basic authentication. ![Screen Shot 2015-12-14 at 10.57.12](https://thecattlecrew.net/wp-content/uploads/2015/12/screen-shot-2015-12-14-at-10-57-12.png) This is our response: (note that our URL’s are different because we have manipulated our hosts file pointing to a specific IP with „iotserver“. This is due to the fact that we were working with our own instance of the cloud in the closed beta we participated in.) > ``` > { > "enabled":true, > "resources":{ > "links":[ > { > "rel":"canonical", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI/resources" > } > ] > }, > "connectivityStatus":"OFFLINE", > "softwareRevision":"", > "hardwareRevision":"", > "state":"ACTIVATED", > "serialNumber":"123", > "children":{ > "links":[ > { > "rel":"canonical", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI/children" > } > ] > }, > "type":"DIRECTLY_CONNECTED_DEVICE", > "id":"0-CI", > "oui":0, > "created":"2015-11-06T09:17:32Z", > "activationTime":"2015-11-06T09:30:14Z", > "description":"", > "manufacturer":"OC", > "configurations":{ > "links":[ > { > "rel":"canonical", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI/configurations" > } > ] > }, > "endpointName":"OCAutomatNürnberg", > "deviceUID":"0-CI-OC-ABC-123", > "modelNumber":"ABC", > "sharedSecret":"", > "metadata":{ > "links":[ > { > "rel":"canonical", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI/metadata" > }, > { > "rel":"self", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI/metadata" > } > ] > }, > "links":[ > { > "rel":"canonical", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI" > }, > { > "rel":"self", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI" > }, > { > "rel":"endpoints", > "href":"https://iotserver:7102/iot/api/v1/endpoints" > } > ] > } > ``` As you can see in the response, there is already a bunch of information included in the response with links to further possible interactions. This is a HATEOS type response, meaning in various responses, a client always receives links to additional information, rather than having to hard-code or provide special-case handling of responses to construct subsequent links. ## Calling a device resource If you continue to call e.g. the /iot/api/v1/endpoints/0-CI/resources endpoint, you’ll receive data about the resources, the device exposes to the cloud. In this context resources are things, the thing can do. This Endpoint doesn’t return anything, unless the client code includes resources that it exposes to the cloud. If you update the client code and add further resources, the list will grow. Our device exposes one such resource that we call „onlinesale“. If someone buys something online, this resource takes a POST message ordering the device to release the purchased product. > ``` > { > "methods":[ > "POST" > ], > "id":"0-AU", > "description":"onlineSale", > "endpointId":"0-CI", > "url":"onlinesale", > "links":[ > { > "rel":"canonical", > "href":"https://iotserver:7102/iot/api/v1/endpoints/0-CI/resources/onlinesale" > } > ] > } > ``` As you can see, the returned data gives an address that describes the URI to the resource as well as the HTTP method but it doesn’t provide a description on how the message needs to be structured to be understood by the client. So for now, this has do be well documented, e.g. in the client code documentation. If you send a data message to the specified resource, a confirmation message is received. Since the IoT Cloud acts like a message broker, it only accepts the incoming message and returns a confirmation without waiting for the message to be actually transmitted. However, it includes an ID for the request as well as a URI to check the transmission state. > ``` > { > "id": "5cfdcba7-9c26-4bd5-9388-0dfb939a0f76", > "requestTime": "2015-12-14T10:21:10Z", > "status": "RECEIVED", > "method": "POST", > "endpointId": "0-CI", > "url": "onlinesale", > "links": [ > { > "rel": "canonical", > "href": "https://iotserver:7102/iot/api/v1/endpoints/0-CI/resources/onlinesale" > }, > { > "rel": "self", > "href": "https://iotserver:7102/iot/api/v1/endpoints/0-CI/resources/onlinesale" > }, > { > "rel": "endpoints", > "href": "https://iotserver:7102/iot/api/v1/endpoints" > }, > { > "rel": "requests", > "href": "https://iotserver:7102/iot/api/v1/endpoints/requests/5cfdcba7-9c26-4bd5-9388-0dfb939a0f76" > } > ] > } > ``` Your application can use this endpoint to keep checking for a successful delivery of the message and, if necessary, take action if the message isn’t delivered in the desired time. ## Registering a new device using the API If you want to [register a device](https://docs.oracle.com/cloud/latest/iot/IOTRP/op-iot-api-v1-registrations-post.html), or many devices at once, there is an API endpoint for this. It requires you to transmit a CSV file containing all the data needed for the devices. A row in the CSV could look like this: test\_device\_0,GDVC,test\_manufacturer,ModelNo\_device\_0,SerialNo\_device\_0,DeviceUID\_device\_0,,Key1,Value1,Key2,Value2 And the response by the IoT Cloud looks like this ![Screen Shot 2015-12-14 at 12.13.40.png](https://thecattlecrew.net/wp-content/uploads/2015/12/screen-shot-2015-12-14-at-12-13-40.png) This causes the cloud to have taken in the data but another call is needed to actually have it register the devices. Perform a POST on the URI provided in the response and in the Body of the request, declare the conflictResolution strategy. It can be either of 5 possible ways described in the [API docs](https://docs.oracle.com/cloud/latest/iot/IOTRP/op-iot-api-v1-registrations-%7Bregistration-id%7D-post.html). Once the POST call has been succesfull, a new device has been added to the cloud (row 4) ![Screen Shot 2015-12-14 at 12.18.23](https://thecattlecrew.net/wp-content/uploads/2015/12/screen-shot-2015-12-14-at-12-18-23.png) There are many more options in the API. You can CRUD on enterprise endpoints, read metrics of your IoT Cloud instance, add software artifacts for your devices to support a OTA software update process etc. In a couple of days we’ll describe the essentials to connect an actual Java client to the cloud, so again: Stay tuned! **Kategorien:** Cloud **Schlagwörter:** English, IoT --- ### [IoT prototype - an architectural overview (part 2)](https://thecattlecrew.net/2014/06/18/iot-prototype-an-architectural-overview-part-2/) **Published:** Juni 18, 2014 **Author:** Pascal Brokmeier **Content:** With our prototype we had a few goals: 1. learn about the technologies that are involved in the IoT space 2. Follow a good architectural principle 3. get the attention (and trigger their curiosity) of visitors at different events Of course there were also the functional requirements of being able to effectively know *when a user is present or not*, the *management of different lamps & devices* as well as the *implementation of rules* that determine what actions should be taken if certain events are triggered. We have had many projects in the **Java** enterprise application space so naturally we looked at frameworks in this domain. Having worked with **Spring MVC** before, it seemed to suit our needs just fine. A good environment to deploy a well structured **REST API** and have services that can take care of logic and handling different situations. Also using **Hibernate** as an interface to a **H2 database**, we didn’t have to worry about our database model. The frontend was supposed to be multi-platform and just while starting our project, the first alpha version of the [ionic framework](http://ionicframework.com/) came out, a framework that is based on **AngularJS**, a very popular and powerful MVC JavaScript framework. Since this was all about learning new technologies, it got thrown in the mix. Lets talk Hardware: A **Raspberry Pi** as well as a **433mhz sender module** attached to its GPIO pins were needed as base. Of course some radio controlled power plugs to test the system were needed as well. We used Java **JNI** to create the connection between the 433mhz module attached to the GPIO pins and our Spring application. This closes the gap from native C code to our platform independent Java application. So this was a good place to start. However, due to other developments we had a few more things to look at: **Camunda BPM** to be integrated into Spring, managing the process of reacting to a user state change to show the capability of Camunda’s BPM framework and have this then running on a Pi. Also **Oracle’s CEP** was asked for, since they recently also got involved in the whole IoT trend and use it on their gateway devices to perform some logic before sending events to backends in the cloud. We were curious about this so we included this technology as well, although as a separate module, not within Spring. We needed a second raspberry pi for this, since two Java applications for one Pi is a bit much. This wasn’t too bad though, since it underlines the idea of IoT, being several devices talking to each other and creating an interesting application through interaction with each other. Lastly we decided to include **Drools** as well, to model our business rules in a unified way. We integrated drools in camunda to access the rules from our user state change process. All of this together and the project architecture (maven modules) looks like this: [![project_structure](https://thecattlecrew.net/wp-content/uploads/2014/05/project_structure.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/05/project_structure.png) Now we have a system that can control lights based on users presence / absence (or rather their smartphones presence/absence, which in todays world correlates with the user in 99% of the cases) To summarize this all I found a sketching I created in the beginning of the project rather fitting, so here it is: [![iot doku pieces - Page 3](https://thecattlecrew.net/wp-content/uploads/2014/05/iot-doku-pieces-page-3.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/05/iot-doku-pieces-page-3.png) A few important sidenotes: - Where possible we use REST API’s. We like to think this is a potential common language many devices that are TCP/IP capable could speak. Anything lower-level would then be managed with a gateway between the lower-level protocols and TCP/IP. - Through our Service layer we could integrate further technologies like zigbee controlled devices etc. and publish them through one uniform rest service - The parts are modular and could be replaced by some other technology (e.g. native iOS or Android app that integrated the user login/logoff through a geo fencing logic) To keep on reading check the other posts about our prototype: - [Introduction](http://wp.me/p2fG8x-bm "Introduction") (part 1) - [an architectural overview (part 2)](http://wp.me/p2fG8x-bo) - [IoT prototype – low level thoughts on Oracle CEP Embedded (part 3)](http://wp.me/p2fG8x-bJ) - [low-level thoughts about the 433mhz communication (part 4)](http://wp.me/p2fG8x-bW) - [Retrospective. What did we learn. What did we miss. What should also be considered (part 5)](http://wp.me/p2fG8x-c0) **Kategorien:** Automation, Integration **Schlagwörter:** BPM, Camunda, English, IoT, Java, prototype, Raspberry Pi --- ### [IoT prototype - low level thoughts on Oracle CEP Embedded (part 3)](https://thecattlecrew.net/2014/06/18/iot-prototype-low-level-thoughts-on-oracle-cep-embedded-part-3/) **Published:** Juni 18, 2014 **Author:** Pascal Brokmeier **Content:** In our prototype we used an Oracle CEP Embedded application running on a separate Raspberry Pi to scan the network for arriving / leaving devices and link them to our users. We could have left this logic in our Spring server and have it running in our service layer but we wanted to learn more about Oracle CEP and this seemed a good way to start. What needed to be done: - Notice new devices on the network - link networks to users already created in the system (on the spring server / in its DB) - send the server a notification about an arrived user or one that left the premises - allow for short states of users missing (e.g. a phone rebooting or short connection loss) - send all found network nodes to the server on a regular base so we can link users to existing network devices in our frontend application Okay so once we had these necessities settled we started checking out a few tutorials about CEP. There’s an Eclipse plugin that one uses to build the CEP application and its all about event flows. There are three central files (plus your code that is) that one needs to look at: ![](http://docs.oracle.com/cd/E14571_01/doc.1111/e14301/img/project-structure-1.gif)Oracle CEP imporant files The context.xml file is all about defining all sorts of beans and is where the framework generates the Event Processing Network graphic from. This is how the two look like (code & generated design) [![context.xml](https://thecattlecrew.net/wp-content/uploads/2014/05/bildschirmfoto-2014-05-29-um-21-43-08.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/05/bildschirmfoto-2014-05-29-um-21-43-08.png) [![EPN ](https://thecattlecrew.net/wp-content/uploads/2014/05/bildschirmfoto-2014-05-29-um-21-43-15.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/05/bildschirmfoto-2014-05-29-um-21-43-15.png) What we then do is this: 1. We scan the network every 15 seconds for all network nodes (phones, tablets, pc, laptop,…) and stream them along. Each of the nodes is considered an *event* 2. The networkNodeOutputAdapter sends those nodes to the server every few minutes as a bulk list, containing when it was last seen etc. 3. The UserNodeBean gets a HashMap from our Spring server that links users to devices (which one has to configure of course. Basically it is „this iPhone XY is mine“) 4. The UserDeviceProcessingBean then filters all events to only pass along those nodes that actually belong to a user 5. the stateCalculatingBean then compares those found nodes with the users and sees if any user has a changed state. If a node was found that hasn’t been seen in a while the state changes from offline to online. of course this also applies the other way around but with a certain delay (2-5 minutes depending on the preferences) [![States](https://thecattlecrew.net/wp-content/uploads/2014/05/bildschirmfoto-2014-05-29-um-21-50-21.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/05/bildschirmfoto-2014-05-29-um-21-50-21.png) **Java vs. CQL** [CQL (](http://docs.oracle.com/cd/E16764_01/doc.1111/e12048/intro.htm)[Continuous Query Language)](http://docs.oracle.com/cd/E16764_01/doc.1111/e12048/intro.htm) is something that Oracle uses to filter events. While this is surely a great tool for people that are used to sql, it wasn’t anything for me, so I stuck to my java beans, which do the same job just fine. But I bet for database specialists this is a welcome tool. **Notable things about OCEP:** Though I am usually a big fan of open source projects and prefer them over proprietary products, I was rather fond of this one. The installation was very easy and even though I’m usually a big fan of IntelliJ, if I must use something else I prefer Eclipse over jDeveloper, so this was a welcome change. Also the trial and error round cycles are really short, since one doesn’t need to redeploy a whole lot, it only takes a few seconds to republish changes on the code to the CEP server. Also once it works in the VM (there is a VM created by Oracle that I used which had everything already set up for SOA development) one can almost directly pull the .jar onto the Pi, start the server there and see it take off. No difficult configuration necessary. Having an ssh connection to both Pi’s lets me still work on one Computer and not have to switch between things. Also I found this really easy to learn, since it doesn’t have as many components as e.g. BPM frameworks of these days. I was able to model my process with the EPN tool but could still keep all my actual logic and magic within my java code. If you’d like to check the sourcecode, look on [Github](github.com/Ineffective/Pi-jAutomation433) for my project. To keep on reading check the other posts about our prototype: - [Introduction](http://wp.me/p2fG8x-bm "Introduction") (part 1) - [an architectural overview (part 2)](http://wp.me/p2fG8x-bo) - [IoT prototype – low level thoughts on Oracle CEP Embedded (part 3)](http://wp.me/p2fG8x-bJ) - [low-level thoughts about the 433mhz communication (part 4)](http://wp.me/p2fG8x-bW) - [Retrospective. What did we learn. What did we miss. What should also be considered (part 5)](http://wp.me/p2fG8x-c0) **Kategorien:** Automation, Integration **Schlagwörter:** English, IoT, network nodes, Oracle CEP Embedded application, prototype, Raspberry Pi --- ### [IoT prototype - low-level thoughts about the 433mhz communication (part 4)](https://thecattlecrew.net/2014/06/18/iot-prototype-low-level-thoughts-about-the-433mhz-communication-part-4/) **Published:** Juni 18, 2014 **Author:** Pascal Brokmeier **Content:** This prototype started off as a personal project. So it’s not a big surprise why the 433mhz plugs were chosen as a first tech. They are in every household and I wanted to retrofit what was already there to become a bit smarter. Being able to group, manage and remotely control these plugs is an idea many have had before and there are several ways of controlling these out there. But while these primitive plugs are maybe not the most elegant way of controling things, they are still just what they are. Primitive things that are a great way to learn how things look, once you leave the ground of TCP based error corrected communication over the web and step into the real world with all its different environments. No automatic error correction, just plain old radio signals. So if I wanted to keep track of which lights are on and which are off, I needed to make sure the plugs will receive my message. I read a bit about radio signal strengths and its limits set up by the government. The [433mhz emitters are cheap](http://www.ebay.de/itm/433Mhz-RF-Wireless-Transmitter-Receiver-Link-Kit-Module-Arduino-CP06003-J41-/271412358657?pt=Wissenschaftliche_Ger%C3%A4te&hash=item3f316fee01), but thats also why they can be problematic. But there turned out to be a really easy fix: [![433 mhz antenna](https://thecattlecrew.net/wp-content/uploads/2014/05/20140529_221827.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/05/20140529_221827.jpg) while the default was only able to send its signal a few meters at most before the signal became too weak, adding the middle piece of a coat hanger as an antenna increased the range dramatically. It has something to do with half the length of the wavelength or something, I stopped reading the forums here, because it got way into physics and it worked for me so I could turn my mind to the more important tasks, the software. The point is, the signal is so strong now, that with about 200 tests, not once did my lamp not receive my signal. Also I send the same signal three times within a second when trying to change a plugs state so if one gets lost the other two probably will get through. **Native stack** In order to control the Pi’s GPIO plugs, I needed a mediator between my Spring application and the hardware. Luckily there was already somebody who created a few libraries that managed the most fundamental of problems, sending the codes out via the GPIO pins: This allowed me to write some Java Native Interface adapters that accessed the shared C library and use its functionality. I had to rewrite some code however, because the library did not support all DIP switch configurations I wanted. A 433mhz Elro chip based plug has 2×5 binary dip switches. So e.g. 01101 00101 would be an address. But the library only allowed one bit to be 1 in the second group. no 01110 11101 was allowed, just 01101 10000 for example. I wanted to have more addresses at my disposal so I changed the code a bit but not too much (see github changelog from sept 2013). So once this worked and the JNI methods were in place and had access to the libraries (which was quite a hassle believe me), I was able to control any plug in my house from java. yay! But there were still some steps ahead. But before I continue lets look at what I learned from the native work - C is a language for the really intense ones. I can’t imagine being as productive in C as I am in Java. But maybe thats just a thing of practice.. - Things in the IoT context can be of all different shapes and sizes. So integration and adapters are tools one cannot get around. There will have to be clean and well documented interfaces between the different worlds. I wish I had REST on this level…. - Cheap devices and cheap hardware open the gates for great solutions. But it’s not the 3€ chip in the power outlet that will make the difference, its the software based solution and service built around it To keep on reading check the other posts about our prototype: - [Introduction](http://wp.me/p2fG8x-bm "Introduction") (part 1) - [an architectural overview (part 2)](http://wp.me/p2fG8x-bo) - [IoT prototype – low level thoughts on Oracle CEP Embedded (part 3)](http://wp.me/p2fG8x-bJ) - [low-level thoughts about the 433mhz communication (part 4)](http://wp.me/p2fG8x-bW) - [Retrospective. What did we learn. What did we miss. What should also be considered (part 5)](http://wp.me/p2fG8x-c0) **Kategorien:** Automation, Integration **Schlagwörter:** English, IoT, prototype --- ### [IoT prototype - Retrospective. What did we learn? What did we miss? (part 5)](https://thecattlecrew.net/2014/06/18/iot-prototype-retrospective-what-did-we-learn-what-did-we-miss-part-5/) **Published:** Juni 18, 2014 **Author:** Pascal Brokmeier **Content:** Okay so controlling our lights now works automatically based on entering and leaving the building, thats great! But what did we learn from all this? What do we believe can be transferred to a general concept found in (almost) all possible IoT projects? ### What did we learn? **Communication takes more than one way** Meaning, there won’t be just TCP/IP based traffic. Rather there will be diverse forms of communicatons, all having different characteristics concerning error correction, message validation, energy consumption, range, bandwitdth, protocol support, … A satellite based communication is just as unnecessary for a UPS parcel being delivered in a metropolitan area as a 3G based communication is useless for a container on a freight ship. This means for every form of data we send/receive or intend to do so we need to look at the transport way of this data. If the transport is not ensured by another component we need to be aware that data must not always reach its destination and that lots of data may or may not be rather expensive (in form of energy or financially). **Thing data can be diverse** Thankfully this can be immediately handed off to our Big Data guys. They have enough knowledge about handling heterogenous forms of data and create value from these. Sending data to devices on the other hand could become difficult. Here generic instruction structures could help, which can then either be interpreted by the device or transformed to a special protocol form the device understands. Interfaces & gateways between devices and servers won’t be rare. **Event Processing can help keep complexity to a minimum** Making sure every level of our architecture only sends the necessary data to the next layer is key to making sure nothing gets more data than really necessary. Sending every single temperature reading of every sensor in a managed facility to a headquarter is both unnecessary and costly. But having a gateway that processes events (temperature readings) and if something abnormal happens, sends an event to the headquarter is an obvious better solution. This could be directly compared to reporting structures in companies. A Manager only reports the information to his superiors if he thinks they find the information relevant. Of course the higher levels must be able to modify this reporting behavior if needed. Which leads to the next point: **Device Management is essential** While some companies already see what happens if you don’t manage your employees smartphones the way they should be, not managing all network enabled devices within your company in 2020 could be a major risk. One should always be able to report necessary metadata about the devices such as location, energy state, configuration, workload, time until expected replacement is needed, … **IoT more than ever before shows the necessity of a project based organization** If one intends to „start ones own“ or expand an existing system in the IoT domain, more than ever before, things will always be different than last time. This means a good project management is essential to the success of a new system. Making sure risks have been reflected upon, development will be successful and solutions will reflect the expected results are goals that are never easy to achieve so if one doesn’t have the necessary manpower or expertise, one should always ask for help. Of course OC intends to do just that, help its customers achieve their goals. **Known concepts can be applied** Thankfully not everything is new. Star vs Mesh vs Bus based communication strategy? These structures are already known with all their pro’s and con’s considered in different areas. Error correction in new protocols can learn from existing ones. Data handling can make use of Big Data, BI and Data Warehouse concepts. Device Management can learn from current experiences in the mobile device environment. And integration of different sensor networks follows the same rules as integration of enterprise information systems in general. ### What did we miss? **Transaction based communication** Let’s consider this example: In a smart home, the home knows what food available and what not. Now it could offer its inhabitant the service of always making sure dinner is possible. So if the fridge is empty and the inhabitant declares the inability of purchasing something before he/she gets home, the home would order food from a known service in the area that the inhabitant enjoys. Now the home orders pizza and the service provider receives the request. Even though on a technical level the home knows, the order has been received (TCP based communication), a functional order approval should be returned as well. Now if this order is not returned should the home order somewhere else? How long should it wait before ordering somewhere else? And what if it orders somewhere else and then receives an approval? Such use cases were not covered in our prototype. We had (very) stupid things, they take commands and either don’t even send a response (433mhz) or do so but only on a technical level (Philips Hue with REST API). But in the case of transactions, there need to be functional messages in both directions. **Working with changing environments** Our prototype was stationary. That doesn’t mean we didn’t try it in different environments but once set up, it didn’t move. Now a mobile IoT application would have to work with changing network connectivity capabilities and adapt accordingly. Sometimes, communication may not be possible at all so it needs to cache requests for an unknown time period and sync once connection is possible again. This could e.g. happen when technicians keep moving in and out of reception because they work in basements often. Oracle as an example offers a good solution for such data synchronization issues: [Database Mobile Server](http://www.oracle.com/technetwork/database/database-technologies/database-mobile-server/overview/index.html) takes care of syncing data between several mobile devices and a main database. **Being even more generic** We built a prototype, so of course it could have been done better. Our rules for changing lights based on user events are written in a Drools file that is deployed with the entire application. This means all rules must be known at the time of deployment. Nice would be a generic Event->Action framework, where users can tie generic events which could be selected from a pool of possible events (e.g. temperature from online services, rain probability, time of sunrise/set, user presence events, …) to actions concerning lights and light groups. So then a user could pick&mix events like so „if I get home and the sun has already set do X“. **Having a diverse set of things to work with** We only had the 433mhz plugs and smartphones of the users + our server & scanning Pi as *things*. We did (not yet at least) connect any heating systems, A/C’s, fridges etc. to our system. Of course with every new device type the complexity rises since those things can often interact with many other things and enable us to do cool new things. E.g. start playing the same music I just heard on my phone / in my car once I get home and am still alone. Opening my top floor windows once it’s getting cool outside during the summer days and start the fan so the hot air gets blown out. Or even more advanced things like collaborative automatic music selection. Imagine 5 people standing in one room. The smart home could access all their music profiles on known portals such as spotify, iTunes, Google Music, …. and find their intersecting set which would then be the music to be played that everyone likes. Or a group meeting room that knows who enters it and sets the temperature according to the people’s preferences from past settings in their personal offices so that no one freezes and no one breaks a sweet. ### Conclusion We built this prototype to learn from the experiences we make and see what lies ahead if we try to play with IoT. This wasn’t a full blown project, but it still helped us understand the trend better and learn more about it. We set up an architecture that we believe can work with an enterprise IoT structure: [![IoT Architektur](https://thecattlecrew.net/wp-content/uploads/2014/06/iot-architektur.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/06/iot-architektur.png) We believe this structure is what it takes to work with a big scale network of devices, their data and their actions possible. While many concepts are found here (BPM, \[No\]SQL, BigData, BI, Device Mgmt, ServiceGateways, Event Processing, …) it is still a realistic project concept that shouldn’t be avoided. Rather companies should sit their divisions together in a creative space, explain to everybody the concepts and ideas behind IoT and then see what their departments could imagine working, both in their own domain as well as across departments. If you want help or guidance with your project idea or problem solution findings, contact us! We’ll be happy to work with you on your first IoT project! Other parts of this series: - [Introduction](http://wp.me/p2fG8x-bm "Introduction") (part 1) - [an architectural overview (part 2)](http://wp.me/p2fG8x-bo) - [IoT prototype – low level thoughts on Oracle CEP Embedded (part 3)](http://wp.me/p2fG8x-bJ) - [low-level thoughts about the 433mhz communication (part 4)](http://wp.me/p2fG8x-bW) - [Retrospective. What did we learn. What did we miss. What should also be considered (part 5)](http://wp.me/p2fG8x-c0) **Kategorien:** Automation, Integration **Schlagwörter:** BPM, Camunda, communication, English, IoT --- ### [Quick thought: Develop Software on embedded device using IntelliJ](https://thecattlecrew.net/2015/05/08/quick-thought-develop-software-on-embedded-device-using-intellij/) **Published:** Mai 8, 2015 **Author:** Pascal Brokmeier **Content:** Last week I had to develop a quick prototype on a raspberry pi. A [nodeJS](https://nodejs.org/) app that counts pulses from a liquid throughput sensor which forwards the data to a SAP Hana backend. Using a software mock for my sensor only helped until a certain point. In the end I had to test the actual sensor on the actual device. And that is where I was a little annoyed. I use a ssh shell to connect to my Pis and I use Github to push software to my devices. but constantly performing commits on my developing machine and pulls on the device is „pretty“. So this is what I came up with: 1\. install [Fuse for OSX](https://osxfuse.github.io/) + [SSHFS](http://fuse.sourceforge.net/sshfs.html) with [homebrew](http://brew.sh/) 2\. Mount RPI via Network 1\. `sshfs pi@192.168.200.4:/ ~/Desktop/rpi\_mount/` in the Mac Terminal 3\. Open mounted folder with Intellij 4\. connect to Pi with SSH 5\. install [nodemon](https://github.com/remy/nodemon) and start nodejs application with `nodemon app.js` 6\. edit files, watch live reload happen on Pi MacFuse lets me mount non OS X file systems on my mac. SSHFS lets me mount filesystems via sftp/ssh. Now I can develop in my known IDE and see my application live reloading on the embedded device. Every time I change a file, the nodemon tool reloads the application. I get responses to my development progress within 1-2 seconds. Very handy! **Kategorien:** Development **Schlagwörter:** English, IoT, Softwarenentwicklung --- ### [iot-toolkit.net went live](https://thecattlecrew.net/2015/05/08/iot-toolkit-net-went-live/) **Published:** Mai 8, 2015 **Author:** Dominik Bial **Content:** A little spin off of the cattle crew blog just went live: [iot-toolkit.net](http://Iot-toolkit.net "iot-toolkit went live") The purpose of the website is to collect articles, talks and other information with a strong IoT background and to give interested persons a focused overview over the topics. However, blogging is still done here;-) **Kategorien:** Automation, Integration **Schlagwörter:** English, IoT, News --- ### [3 Articles in the upcoming Business Technology Magazine](https://thecattlecrew.net/2015/09/20/3-articles-in-the-upcoming-business-technology-magazine/) **Published:** September 20, 2015 **Author:** Dominik Bial **Content:** At the moment digitalization and IoT are taking off and belong to the hottest trends in information technology. Because of the experience OC has in Business Intelligence, Integration and Software Development we were able to publish 3 articles in the upcoming Business Technology, which is completely issued for the Internet of Things. The articles are: - Etablierung digitaler Geschäftsmodelle „“ Innovationen etablieren: organisatorische Aspekte - Digitale Ethik „“ Ethische Implikationen von digitalen Geschäftsmodellen - Digitalisierung in der Sammellogistik „“ neue Potenziale für Logistikketten durch Mobile, IoT und Cloud Enjoy Reading ![bt_logistik](https://thecattlecrew.net/wp-content/uploads/2015/09/bt_logistik.jpg?w=213) **Kategorien:** Tools & Methoden **Schlagwörter:** IoT --- ### [Understanding the Past to Predict the Future](https://thecattlecrew.net/2015/11/30/understanding-the-past-to-predict-the-future/) **Published:** November 30, 2015 **Author:** Dominik Bial **Content:** Internet of Things (IoT), Big Data and Business Intelligence (BI) are very hot topics at the moment everybody is talking about. All of these trends are interesting for themselves as they promise deeper insides into a business and therefore lead to better business decisions. - Internet of Things enables businesses to gather data and to control devices in real-time. Real-Time Dash Boards and a deeper process automation can be achieved. - Big Data describes the collection and computation of a huge amount of data. - Business Intelligence is the systematic analysis of data to show optimization potential and to back up predictions. These IT-trends have one importing thing in common „“ all three of them are about data. Therefore, it is not really surprising that especially their combination leads to the use of their full potential. Let us imagine the following scenario, which each of us is regularly in contact with. When you buy any product at Amazon or Zalando today, a huge supply chain is triggered that finally delivers a parcel with the bought product to your home. Typically, the product is fetched by some logistic service provider, brought into a logistic network and transported via several nodes inside of the network until it reaches its destination. A lot of things can happen to delay such a transport. Let us assume something simple like a traffic jam. Although a traffic jam is time boxed and affects only a small location it can drastically affect the delivery of goods. Usually, steps in a supply chain are tightly coupled so that a delay affects the whole chain. Simply put: If you are delayed at your first stop you will be late at the other stops, too. Delays cost time and money. [![understandingthepast_map](https://thecattlecrew.net/wp-content/uploads/2015/11/understandingthepast_map.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/11/understandingthepast_map.png) IoT enables businesses to gather near real-time information of the processes at the operation level of a company. With the help of a process modelling language like BPMN and a process execution platform you are able to model supply chains and, in combination with IoT, businesses are able to track and control the process execution. Let us have a look at the example above again: as soon as it is detected that the first stop is not reached in time, another vehicle could be informed to take over some of the steps in the chain. With the use of a BPM platform, you could monitor the execution time for driving and delivering as shown in the picture above. If a threshold is reached, an alarm could be raised. A handheld device could be used to acknowledge each delivered good and to send this information to the business company. This allows the optimization of operational processes and to increase the quality of the provided service „“ the delivery of goods. The benefit of the usage of a process execution platform is adaptability and efficiency to model such scenarios. Furthermore, such models can be read by non-tech-savvy people. As soon as a larger amount of data is gathered over months, further statistical methods can be applied to the data to predict the future up to a certain degree. With a certain probability events in the real world can be predicted, for example, that a vehicle is delayed. Each new data source (e.g. IoT devices) improves the data quality and therefore the prediction precision of business events. As a result, a control loop evolves which is a combination between BI, IoT and Big Data as shown in the following diagram. [![understandingthepast_cycle](https://thecattlecrew.net/wp-content/uploads/2015/11/understandingthepast_cycle.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/11/understandingthepast_cycle.png) IoT allows us to add further data sources to improve the insight into a company“™s processes. Collected data can be used to identify patterns that inform about problems but also chances during the process execution. Handling this data can be achieved with Big Data principles; the better the data, the better the prediction of future business events. **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** BI, Big Data, English, IoT --- ### [Mobile Payment as a Chance for new Business Models](https://thecattlecrew.net/2016/04/24/mobile-payment-as-a-chance-for-new-business-models/) **Published:** April 24, 2016 **Author:** Dominik Bial **Content:** Digitalization is and has been a very hot topic for the last years. Current IT trends like Internet of Things, Mobile and Cloud drive innovation and, therefore, push new business models as well as IT support for business processes. Today, a technical foundation exists that supports businesses in a way that, technically, was not possible a few years ago. Classic business models and domains are under pressure and stressed by new ideas. These have the power to completely replace the classic business models. A famous conflict in this area is, for example, the classic model of taxi companies versus Uber. It is not really surprising that new ways for billing and payment are researched in this area as well. This resulted in the term Mobile Payment which describes the possibility to pay via a smartphone. It promises new ways of interaction and additional services. Currently, there are three Mobile Payment scenarios on the market which may be interesting for you and your company. Nowadays, smartphones are companions which provide access to a huge amount of information and services while on the go. Smartphones already changed the way we surf the web as people tend to receive information directly instead of doing Internet research. If anything is unclear, a specialized app on the mobile gives the answer. People rather forget their keys than their smartphone. Therefore, payment scenarios or Mobile Payment are just a logical consequence. **Scenario 1 „“ direct payment** Modern Google, Apple and Samsung phones have NFC capabilities and contain an API for payment (SamsungPay, ApplePay, AndroidPay). Internally, these APIs differ, although their concept is similar. Providing billing information to the API providers, the smartphone is capable of simulating credit or debit cards which support contactless payment. This is often offered at cashpoints. Basically, your phone acts like a credit or debit card while it is swiped over a contactless payment terminal. [![MobilePayment_NFC](https://thecattlecrew.net/wp-content/uploads/2016/04/mobilepayment_nfc.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/04/mobilepayment_nfc.png) The huge advantage of such a solution is that as soon as contactless payment is used, it does not matter if somebody pays by card or phone. The complexity is handled by the API and app provider. Chances - Big players as providers - Future-proof - Standard NFC based cards may be used as well Challenges - Not accepted by all users, e.g. Germany - Changes at hardware may be necessary - Security and data **Scenario 2-indirect payment** Alternatives are provided for smartphones which do not support NFC. The interaction and communication is mainly based on QR Codes. Nevertheless, other technologies can be used to identify yourself or your bought goods at payment terminals. If a marker is shown on a phone, it basically acts like a receipt. It does not really matter when and where you bought something. With the help of the marker on your phone you can collect goods at shops, terminals and machines. This can be interesting for webshop scenarios. [![MobilePayment_QR](https://thecattlecrew.net/wp-content/uploads/2016/04/mobilepayment_qr.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/04/mobilepayment_qr.png) If markers are shown on a cashpoint or machine, they are mediums for communication. Typically, the marker initiates the billing process. After authorizing the payment to be correct with a PIN the final payment is started. Chances - Probably easier to integrate in processes - Shop and collect scenarios are supported Challenges - Not accepted by all users, e.g. Germany - Usage is more complicated - Display is needed at selling point **Scenario 3 – custom app** This leads us actually to the last scenario. It is the most complex way for mobile payment but it also promises the most benefits: the development of a custom built app. As soon as an own API and structure is used processes can be met best. The provider holds the responsibility over the architecture and data. With the help of modern customer analysis based on frequently gathered data from user interactions with the app, user profiles, personal advertisement, trends and much more can be computed. Of course, one has to think about the effort to implement such as solution and the data has to be kept. [![MobilePayment_CUSTOM](https://thecattlecrew.net/wp-content/uploads/2016/04/mobilepayment_custom.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/04/mobilepayment_custom.png) - Be a pioneer and support transformation at your company - Supports new business models - Tightly coupled to processes - Personalization possible Challenges - Additional effort for conception and development - Changes at software and hardware are likely **Conclusion** The current field of mobile payment APIs and services are fragmented and complex. It can be difficult to find the right solution for you needs. Nevertheless, there are huge advantages especially when correlating gathered data with the company“™s business processes. This is where the action is! These digital solutions make it possible to gather information about users, user interactions and the service itself which makes it possible to improve the service continuously. New business models and products can arise. Therefore, mobile payment can be an interesting way to start with innovation and digitalization or to think about new ideas. **Kategorien:** Architecture & Process Models **Schlagwörter:** Analytics, Big Data, English, IoT --- ### [Microsoft Azure IoT - Ein Üœberblick](https://thecattlecrew.net/2016/08/23/microsoft-azure-iot-ein-ueberblick/) **Published:** August 23, 2016 **Author:** Otto Fitz **Content:** Internet der Dinge, Industrie 4.0 und- Digitalisierung begegnen uns als Begriffe mittlerweile beinahe täglich. Daher ist es nicht verwunderlich, dass diese Themen auch Einzug im Bereich Cloud gehalten haben. Mittlerweile gibt es eine Vielzahl an Herstellern, die mittels einer Cloud verschiedene IoT relevante Funktionen anbieten, wie zum Beispiel die Azure IoT Suite von Microsoft. Im Rahmen dieses Artikels wird eine Übersicht über die Funktionen der Microsoft Azure IoT Cloud Lösung gegeben und deren Funktionen dargestellt. Möchte man Azure speziell für das Internet der Dinge nutzen, steht ein Set an Features über die Azure IoT Suite zu Verfügung. Die IoT Suite bietet alle nötigen Dienste für das Internet der Dinge an. Für den schnellen Start in die IoT Welt von Azure steht in der IoT Suite vollständig konfigurierte Lösung zur Remoteüberwachung und zur vorbeugenden Wartung von Maschinen bereit. Auf die Cloud aufbauende Lösungen können individuell an eigene Anforderungen angepasst und konfiguriert werden. In einer Vorkonfigurierte Lösung ist eine hohe Anzahl an Diensten gebucht die in einem Nutzungsbasierten Account nach Ressourcenverbrauch abgerechnet werden. Die in der IoT Suite gebuchten Dienste werden nach Zeit, Größe von Messages, Anzahl der Messages und nach dem Standort abgerechnet. Für die vorkonfigurierten Lösungen sind mehrere simulierte Geräte implementiert die einen hohen Ressourcenverbrauch generieren und damit hohe Kosten verursachen. Beim Testen der IoT Suite darauf achten das nicht benötigte Dienste und Geräte deaktiviert werden. Man erhält zum Testen 170€ Guthaben, diese sind aber je nach Testfall und Dienst in ein paar Tagen ausgeschöpft. Die unten stehende Abbildung beschreibt die IoT Lösung im Microsoft Azure Umfeld, auf die im Folgenden weiter Bezug genommen wird. Im Device connectivity werden die erzeugten Daten der IoT-Geräte erfasst und dem IoT-Solution-Backend zu Verfügung gestellt. Im Data processing and analytics werden die Daten verarbeitet und übermittelt an die Business-Anwendung zur Integration in bestehende Geschäftsprozesse oder in ein Dashboard zur Visualisierung und Interaktion mit einem Benutzer. ![](https://ycn82a-sn3302.files.1drv.com/y3mAFEXeEhZI-tJgzqfNm0TLVZmXaLuhv0vDnXhytZ5ppI4W0pNthobv4k6qoYma5LMzk7hr7_7xCQp1FQT5Txg44B007I3IFgubO2JGDGNA1Q6ovfjlxbe0ERLnn9Bm9sFwI2KAhzM4yiWJ1f0Aw5nZs8GQY4bxWw6ZMwoYwen_cs?width=675&height=478&cropmode=none) Microsoft Azure IoT Reference Architecture Quelle: https://azure.microsoft.com/de-de/updates/microsoft-azure-iot-reference-architecture-available/ IoT Geräte werden im Device connectivity mit dem Cloud Gateway verbunden. Die IoT Geräte haben andere Client Eigenschaften als mobile Apps oder Browser. IoT Geräte können Sensoren sein die physisch sehr schwer zu erreichbar sind und ohne menschliches Eingreifen Daten erzeugen. Die Leistungsfähigkeit, Stromversorgung, Netzwerkverbindung sowie branchenspezifische Protokolle machen das Bedienen der Geräte mit herkömmlichen Technologien sehr kompliziert und kostspielig. Die Microsoft Azure IoT Lösung bietet eine sichere, bidirektionale Kommunikation zwischen Geräten und Back-End an. Die Lösung umfasst spezielle Dienste und IoT-Geräte-SDKs um eine Implementierung spezieller Fachanforderungen so einfach wie möglich zu gestallten. Mit .NET-, Java-, Node-, Python-, Ruby- und PHP- SDK biete Azure eine große Auswahl um an Cloud-Ressourcen und Dienste zugreifen zu können. Der Cloud Gateway bietet Funktionen zur Verwaltung, Registrierung, Steuerung der Kommunikation und zur Überwachung des Status der Geräte. Die Kommunikation findet mit AMQP, MQTT und HTTP direkt mit einem Endpunkt eines Cloud Gateway“˜s statt. Die Geräte mit branchenspezifischen Protokollen können durch einen IoT Hub- Protokollgateway in eines der unterstützenden Protokolle übersetz werden. Der Cloud Gateway entscheidet was mit den von IoT Geräten erzeugten Daten geschehen soll und leitet die Daten dementsprechend an einen zuständigen Dienst weiter. Aus der Cloud heraus können auch Befehle an ein bestimmtes Gerät gesendet werden. Die Datenverarbeitung erfolgt in dem IoT Solution Back End. Das Solution Back End filtert und aggregiert die Telemetriedaten. Die Daten werden an einen Dienst weitergeleitet der aufgrund aktueller Begebenheiten einen Befehl an einen Gerät aussendet oder Daten in einem Dashboard visualisiert. Die Präsentation und Business Connectivity ermöglicht einem End-Benutzer die Daten visuell bereitzustellen und bietet Interaktionsmöglichkeiten mit den Geräten an. Der Benutzer kann mit einem Dashboard mit dem verbundenen Gerät interaktiv kommunizieren und die erzeugten Werte in Echtzeit einsehen. Die Business Connectivity ermöglicht die Integration der IoT Lösung in die bestehenden Geschäftsprozesse um automatisiert auf Ereignisse anhand der erzeugten Telemetriedaten reagieren zu können. Die IoT Lösungen können mit den angebotenen Diensten in der Azure Cloud erstellt und verwaltet werden dazu wird eines der von Microsoft angebotenen Accounts benötigt. Microsoft bietet fünf Variationen an, um einen Account zu erstellen: - Nutzungsbasierter Account *-wird mit standardmäßigen Sätzen nach Nutzung abgerechnet* - Kostenloser Default Account *– 170€ Startguthaben zum Testen der Dienste* *– kann jederzeit in ein Nutzungsbasierten- Account umgewandelt* - Abonnement Account *– Vorauszahlung für 12 Monate* *– 5% Rabatt auf die gebuchten Azure Dienste* *– Mindestbetrag beträgt 5060€* *– Nach 12 Monaten verfällt das nicht verbrauchte Guthaben* - Microsoft Reseller Volumenlizenzen *– Open Lizenz Programm welches über Vertragshändler erworben wird* - Enterprise Agreements *– Individuelle Verträge für Großunternehmen* Die Verwaltung des angelegten Accounts erfolgt auf account.windowsazure.com. In diesem Verwaltungsportal können laufende Kosten und Nutzungsdetails der Dienste eingesehen werden. Des Weiteren kann das Profil und die Zahlungsart bearbeitet werden. ![](https://ozycyw-sn3302.files.1drv.com/y3m6T-e-bM-P-sdRdpUOHYgiZkXpKXGFAZlt6XM0-cmE6GxZm2N7tY8wMzhj_wcVvRlCBxt1MzkyMUSVP6oe-UZcaVyQDPzplrh619_9wUC_VuMPOIdCfBzVwzwxuwi_M_9qFcnW21bgbZL4EUypz_i-isrfuYWWf8UI3kampL_osQ?width=957&height=222&cropmode=none) Das Portal auf portal.azure.com bietet eine Übersicht der gebuchten und zu buchenden Dienste an. Hier können einzelne Dienste konfiguriert und eingesehen werden. Es können auch Kosten und Ressourcenverbrauch der einzelnen Dienste nachverfolgt werden. Des Weiteren bietet das Portal Benutzerverwaltung an, in der man Benutzer anlegen und dem Benutzer Rechte vergeben kann. ![](https://x8n92a-sn3302.files.1drv.com/y3mN6PqRPmgK2NNYGT7NmS6bAHQeKF5DDRnsYcq8Y-o7REGGw-qOXeFFKpsyiWo60OVddOY9v6_dxy2fYLuvvjYUvpTkFUHUvniNcplmwUAkdzRJGdFHsEqbIIoI_FQNOvTSlXw4R5w7q_2Q5kGH5x6f6KkEMA5DLO5-TzavdjxSfQ?width=512&height=637&cropmode=none) **Kategorien:** Cloud **Schlagwörter:** cloud, Cloud Computing, German, IoT --- ### [OPC UA "“ Bridging Manufacturing and Enterprise IT](https://thecattlecrew.net/2016/09/15/opc-ua-bridging-manufacturing-and-enterprise-it/) **Published:** September 15, 2016 **Author:** Dominik Bial **Content:** Between the automation/manufacturing area and the enterprise information technology has been a disruption that is historically driven. Automation is closer to hardware so that the software evolved differently than software used on enterprise level. Moreover, it is easier to replace a business application than machines and controller in production lines. This is why different principles have been applied to both domains. Nevertheless, disciplines in computing are getting closer which is driven by the digitalization as well as fastening innovation cycles. As a result, the wish to have production data and, therefore, insights into production processes is mentioned often. Moreover, Internet of Things even promises to influence processes from a business perspective. From the perspective of the automation area it means, that integration with the enterprise sector is required. One huge challenge you come across is the underlying software stack when integrating enterprise and manufacturing solutions. Former manufacturing technologies like OPC (Open Platform Communication, newly called OPC Classic) are based on windows COM/DCOM interfaces to control actuators and consume messages from sensors. This differs completely compared to the approach used in enterprise applications. Today, communication between systems and applications is mainly based on web technology while in manufacturing other industry protocols are used. To overcome this disruption and to enable communication between manufacturing and enterprise, OPC UA (Open Platform Communication „“ Open Architecture) was designed, which brings us one huge step closer to Industry 4.0 ideas. Basically, OPC UA is a kind of middleware and, therefore, a bridge to the enterprise IT. [![opc_ua_pyramide](https://thecattlecrew.net/wp-content/uploads/2016/09/opc_ua_pyramide.jpg)](https://thecattlecrew.net/wp-content/uploads/2016/09/opc_ua_pyramide.jpg) There are several controller systems on the market which are able to connect to an OPC UA Server. These controllers have typically sensors and actuators attached which can be controlled by OPC UA. Moreover, OPC UA provides a SOAP based API that can be called by any kind of client. Processes, dashboards and other kinds of applications can therefore request data from sensors and can interact with actuators. With the help of an enterprise service bus this API can even made be available as an enterprise wide business service. With such a setup it is possible to leverage data from manufacturing and production to enhance enterprise applications. BPM applications, Big Data principles and analysis, modern clients, dashboards and much more topics can suddenly be combined with production data. Furthermore, these applications can be used to control processes as well as devices. Therefore, in production we gain the same control loop that can be found in IoT scenarios. [![opc_ua_controlloop](https://thecattlecrew.net/wp-content/uploads/2016/09/opc_ua_controlloop.png)](https://thecattlecrew.net/wp-content/uploads/2016/09/opc_ua_controlloop.png) As an example: imagine, sales acquired a highly prioritized order for some technical goods that needs to be produced. As soon as the order is entered into the company“™s order management platform automated processes start to reorganize the production plans and to inform machines in the production lines. Machines are updated with the new specification so that the newly ordered goods are produced. As a result, OPC UA has the chance to play a big role in Industry 4.0 and is a piece of technology one should definitely have an eye on. **Kategorien:** Automation, Integration **Schlagwörter:** Architecture, English, IoT --- ### [MQTT und Dashboards II. Nie wieder (in Helsinki) im Regen warten](https://thecattlecrew.net/2016/10/20/mqtt-und-dashboards-ii-nie-wieder-in-helsinki-im-regen-warten/) **Published:** Oktober 20, 2016 **Author:** Daniel Rock **Content:** Der Helsingin Seudun Liikenne (HSL), der Verkehrsbetrieb für die Region Helsinki/Finnland, bietet eine MQTT über WebSockets-API\[1\] an, über die man in Echtzeit an die Verkehrsdaten gelangen kann. Auf der Seite wird unter anderem die Zusammensetzung des Topics und die Nutzdaten der JSON-Antwort erklärt. Mit dem Dashboard Freeboard\[2\] sollen bestimmte Daten ausgewertet und im Browser angezeigt werden. Damit MQTT-Daten in Freeboard verwendet werden können, muss ein Plugin und die Paho MQTT Javascript Bibliothek installiert werden. Diese werden unter \[3\] bereitgestellt und die Installation erklärt. Im Beispiel, das im Github heruntergeladen werden kann \[4\], ist das Plugin bereits installiert und auf die HSL-API konfiguriert. Zusätzlich liegt dem Beispiel die Datei freeboard.json bei, in der die Dashboards und die Datenquelle eingestellt sind. Listing Ausschnitt aus freeboard.json: ``` "datasources": [ {     "name": "Tram",         "type": "paho_mqtt",         "settings": {         "server": "mqtt.hsl.fi",             "port": 1883,             "use_ssl": false,             "client_id": "Client_134312",             "username": "",             "password": "",             "topic": "/hfp/journey/tram/RHKL00205/#",             "json_data": true         }     } ] ``` Über den Button „Load Freeboard“ kann die Konfiguration geladen werden. Vorher müssen jedoch zwei Einstellungen vorgenommen werden. Zuerst muss die „client\_id“ geändert werden, damit keine zwei User mit derselben ID auf die Schnittstelle zugreifen. Danach muss das „Topic“ angepasst werden. Auf der Seite \[5\] werden alle aktuellen Daten aufgelistet. Dort kann man beispielsweise nach „tram“ suchen und sich ein Topic aussuchen. Das Topic der Tram mit der ID RHKL00098, die als Linie 10 fährt, ist: „/hfp/journey/tram/RHKL00098/1010/#“. Auf der Seite \[6\] kann auf einer Landkarte geprüft werden, ob die Tram aktiv ist oder nicht an der Endhaltestelle angekommen ist und dadurch das Dashboard an Informationsgehalt weniger aussagekräftig ist. Wenn alles korrekt eingestellt und freeboard.json geladen wurde, kann man folgendes Dashboard sehen: ![screenshot](https://thecattlecrew.net/wp-content/uploads/2016/10/screenshot.jpg) Angezeigt wird die Verspätung in Sekunden, die Linie, die Geschwindigkeit in km/h und die Position. Eine Ü„nderung des Topics ist nach dem Laden nicht mehr möglich. Dazu muss die Datei freeboard.json bearbeitet und erneut geladen werden. Links: \[1\] \[2\] \[3\] \[4\] [https://sahnebutterhupfdohle.github.io/mqtt\_and\_dashboards\_example/](https://sahnebutterhupfdohle.github.io/mqtt_and_dashboards_example/) \[5\] \[6\] [http://dev.hsl.fi/tmp/mqtt/map/#&topic=/hfp/journey/tram/RHKL00098/1010/#](http://dev.hsl.fi/tmp/mqtt/map/#&topic=/hfp/journey/tram/RHKL00098/1010/) **Kategorien:** AI & Data Science, Automation **Schlagwörter:** mqtt --- ### [MQTT und Dashboards I. Wo ist meine Bahn - und kommt sie pünktlich?](https://thecattlecrew.net/2016/10/18/mqtt-und-dashboards-i-wo-ist-meine-bahn-und-kommt-sie-puenktlich/) **Published:** Oktober 18, 2016 **Author:** Daniel Rock **Content:** MQTT\[1\] (Message Queue Telemetry Transport) hat sich in den letzten Jahren zu einem wichtigen Nachrichtenprotokoll im Bereich IoT durchgesetzt. Mit ihm können Informationen leichtgewichtig nach dem Publish/Subscribe Pattern übermittelt werden. Dabei verbindet sich eine Vielzahl von Clients an einen Server („Broker“) und abonniert wichtige Nachrichten bzw. veröffentlicht Nachrichten zu einem bestimmten Thema („Topic“). Der Broker sammelt die Nachrichten und verschickt sie automatisch („push“) an die Clients, die das Topic abonniert haben. Über die Quality of Service kann jeder Client festlegen, wie die Nachrichtenübertragung garantiert wird. Das reicht von maximal ein Mal (Level 0) über mindestens ein Mal (Level 1) zu genau ein Mal (Level 2). So kann beispielsweise eine automatische Fahrplanauskunft entwickelt werden. In Bussen werden GPS-Empfänger installiert, die ihre Position jede Sekunde oder an jeder Haltestelle publishen. Der Broker sendet die Position an eine Anwendung, die die Ist-Position mit der Soll-Position vergleicht und damit eine eventuelle Verspätung berechnet. Die Anwendung veröffentlicht die ermittelte Verspätung im Broker, der alle digitalen Fahrplananzeiger benachrichtigt, die die Buslinie abonniert haben. Die wartenden Fahrgäste können so direkt informiert werden. An diesem Beispiel kann man sehen, wie passend das Publish/Subscribe Pattern für IoT ist. Einfache Daten werden von „Dingen“ (hier: Fahrplananzeigern) geteilt, an Abonnenten weitergeschickt, verarbeitet und führen schließlich zu einem Mehrwert: Transparenz und Informationen für die Fahrgäste. Abgesehen davon, dass Benutzer direkten Einblick in die Fahrplandaten haben, lassen sich über die erfassten Daten komplette Routen aktualisieren und optimieren „“ also in einer weiterführenden Verarbeitung einsetzen. Weitere Fälle, wie zum Beispiel die direkte Erfassung von Statistiken verspäteter Linien, sind denkbar. Seit der Version 3.1.1 unterstützt MQTT das WebSocket-Protokoll\[2\], das eine aktive bidirektionale Verbindung zwischen einem Client und Server herstellt. Hierbei kann der Server Nachrichten an den Client übermitteln, ohne dass erneut eine Client-Server-Verbindung hergestellt werden muss. MQTT über WebSockets bietet damit die Möglichkeit, Daten „live“ im Browser darzustellen. Um Daten übersichtlich aufbereitet anzuzeigen, werden sogenannte Dashboards verwendet. Die Daten aus dem Beispiel der Fahrplanauskunft können erstklassig für ein Dashboard verwendet werden. Eine Anwendungsmöglichkeit wäre, das Dashboard im Eingangsbereich einer Firma zu installieren und so Kunden und Mitarbeiter über die nächsten Busverbindungen und Verspätungen zu informieren. In der Leitzentrale des Verkehrsbetriebs könnten Dashboards die Verantwortlichen über Verspätungen informieren und dazu führen, dass beispielsweise Ersatzbusse kurzfristig auf den Weg geschickt werden, um Verspätungen zu kompensieren. Dashboards bieten eine Vielzahl an Vorteilen: - Mit ihnen kann eine direkte, schnelle Kommunikation mit dem Endverbraucher aufgebaut werden. - Der Kunde wird sofort mit allen wichtigen Informationen versorgt, die er benötigt. - Die Dienstleitung erhält eine gesteigerte Qualität auf Basis offener Informationen. Im Internet findet man verschiedene Dashboard-Bibliotheken, die den Entwickler bei der Arbeit unterstützen. Im Folgenden sollen fünf Dashboards näher betrachtet werden, die MQTT-kompatibel sind: **Crouton**\[3\] ist OpenSource und bietet zehn verschiedene Typen von Kacheln an, mit denen die Daten angezeigt werden. Neben einfachen Ausgaben und Diagrammen gibt es die Möglichkeit, mittels Buttons, Schieberegler und Umschalter die Zustände der Clients zu manipulieren. So kann beispielsweise die Helligkeit einer Lampe oder deren Farbenwert geregelt werden. Für den Einstieg und eine einfache Datendarstellung ist Crouton eine gute Wahl. Das Projekt wird jedoch vom Entwickler nicht weitergeführt. **Freeboard**\[4\] stellt acht Anzeigetypen bereit, ist OpenSource und kann kostenlos über den Anbieter gehostet werden, so lange das Dashboard öffentlich einsehbar ist. Für geschützte Dashboards gibt es in Abhängigkeit der Anzahl verschiedene Stufen und Preise. Die Bedienung ist einfach. Für jeden Anzeigetyp kann eine Datenquelle angegeben werden. Für die Unterstützung von MQTT muss ein Plugin installiert werden, das sich unter dem folgenden Link findet \[5\]. Die Installation funktioniert nicht bei den live gehosteten Dashboards. Für MQTT muss Freeboard aus diesem Grund auf einem eigenen Server laufen. Da es OpenSource ist, können weitere Anzeigetypen implementiert werden. Seit Februar 2016 wurden fast keine Commits mehr am Projekt durchgeführt. **Node-RED**\[6\] bietet einen interessanten Ansatz zum „Verdrahten“ des Internets der Dinge. Über eine grafische Oberfläche können Komponenten („Nodes“) zu Abläufen („Flows“) verbunden werden. Jeder Node kann Nachrichten senden, empfangen oder verarbeiten. Dabei können auch mehrere Nachrichten in einen Node laufen bzw. aus einem Node mehrere Nachrichten gesendet werden. Node-RED baut auf Node.js auf, ist OpenSource und stellt ca. 600 Nodes und 300 Flows auf der Homepage zu Verfügung. Flows werden im JSON-Format gespeichert und können einfach importiert und exportiert werden. Um Dashboards generieren zu können, wurden in einem Projekt ca. 10 Nodes von der OpenSource-Community entwickelt \[7\]. **Highcharts JS**\[8\] stellt eine sehr breite Palette an Anzeigetypen zur Verfügung. Für nicht-kommerzielle Zwecke ist Highcharts JS kostenlos. Eine einzelne Lizenz ohne Support kostet ca. 400 Dollar. Unter Github\[9\] gibt es ein Beispiel, wie Livedaten von einem MQTT-Topic über Highcharts JS ausgegeben werden können. Für kommerzielle Anwender, die Wert auf Wartung und Support des Herstellers legen, könnte Highcharts JS eine Lösung sein. **Arbela**\[10\] ist die Implementierung einer Referenzarchitektur\[11\], die der Autor entwickelt hat. Es ist OpenSource und hält drei generische Anzeigetypen bereit. Die Dokumentation ist sehr dünn, die Referenzarchitektur ist jedoch einen Blick wert. Arbela unterstützt zurzeit nicht die Browser Opera und Chrome. Wenn kein weiterer Ausbau erfolgt, kann das Dashboard nur für extrem einfache Tests verwendet werden. Weitere kommerzielle Anbieter für Dashboards wie **Geckoboard**\[12\] oder **Jaspersoft**\[13\] bieten keine direkte Unterstützung für MQTT. Da Jaspersoft eine Javascript-Schnittstelle anbietet und Geckoboard JSON als Eingabe für die Dashboards akzeptiert, sollte eine Verbindung mit MQTT-Daten jedoch kein Problem sein. Für AngularJS werden verschiedene Lösungen im Internet angeboten. Fazit: Die Unterstützung von Dashboards für MQTT ist nicht weit verbreitet. Die meisten Lösungen sind sehr einfach und erfordern weiteren Implementierungsaufwand. Dies gilt für den kommerziellen Bereich wie für Open-Source-Anwendungen. Links: \[1\] [https://de.wikipedia.org/wiki/MQ\_Telemetry\_Transport](https://de.wikipedia.org/wiki/MQ_Telemetry_Transport) \[2\] \[3\] \[4\] \[5\] \[6\] \[7\] \[8\] \[9\] \[10\] \[11\] \[12\] \[13\] **Kategorien:** AI & Data Science, Automation **Schlagwörter:** mqtt --- ### [Chatbots im Enterprise - früher als gedacht?](https://thecattlecrew.net/2017/01/15/chatbots-im-enterprise-frueher-als-gedacht/) **Published:** Januar 15, 2017 **Author:** Christian Ochsenkühn **Content:** Der Analyst des CES-Veranstalters – Shaw DuBravac – hat auch dieses Jahr wieder eine [Prognose zum CES-Start](https://www.heise.de/newsticker/meldung/Der-CES-Blick-in-die-Zukunft-Sprachsteuerung-loest-grafische-Benutzeroberflaeche-ab-3588624.html) gegeben: Gesprochene Kommandos und Sprachausgaben werden in Zukunft ein großes Ding sein. In diesem Punkt sind sich auch IT-Größen wie Google, Apple, Facebook, Microsoft oder Amazon einig: die Mensch-Gerät-Interaktion [per Sprache wird wachsen](http://www.cnbc.com/2016/09/20/google-bought-a-chatbot-start-up-for-a-future-where-well-all-be-talking-to-robots.html). Diese sog. Chatbots, von denen derzeit häufig als Text-Bots für diverse Messenger im Endverbraucher-Umfeld zu lesen ist, könnten sich bald in Unternehmenssoftware verbreiten. ## Von der Consumerization of IT… Vor einigen Jahren machte der Begriff der „Consumerization of IT“ die Runde. Oft im Zusammenhang mit der Cloud oder Smartphones bzw. Mobile genannt, [beschreibt dieses Schlagwort](http://www.bss-it.de/userdata/file/Marketing/IDC_Whitepaper_CloudComputing_CoIT.pdf) die Entwicklung, dass sich Trends zunächst im Privatbereich verbreiten und anschließend im Enterprisebereich adoptiert werden. Dieses Phänomen war und ist durchaus häufiger anzutreffen. So nutzten Anwender zunächst nur privat Smartphones und Apps, mittlerweile aber auch im beruflichen Kontext. Ü„hnlich sieht es mit der Nutzung von Cloud- oder Social Media-Anwendungen aus. [Erst nachdem](http://www.pcwelt.de/ratgeber/Business-privates-Was-ist-eigentlich-Consumerization-of-IT-6069567.html) sich soziale Netzwerke im Alltag durchsetzten, verbreiteten sich in Unternehmenssoftware großflächig Bestandteile des Web 2.0, wie Activity Streams, Chats o.ä. ## …zur Re-Enterprisation der IT Dass diese Verbreitung in einigen Bereichen zunehmend genau anders herum stattfinden wird, hat [Deloitte bereits 2015 vorausgesagt](https://www2.deloitte.com/au/en/pages/technology-media-and-telecommunications/articles/tmt-pred-re-enterprization-of-it.html). Im Zuge dieser „Re-Enterprisation“ werden neue Technologien zwar auch im Konsumenten-Kontext besprochen, setzen sich aber zunächst im Enterprise-Umfeld durch. Beispiele hierfür finden sich zum Beispiel bei 3D-Druckern oder im [Internet of Things](https://www.informatik-aktuell.de/betrieb/netzwerke/fuenf-must-haves-fuer-die-user-experience-im-internet-of-things.html). Beide Bereiche haben das Potential den Endverbraucher und den Unternehmensbereich aufzumischen. Die größere Verbreitung findet aktuell jedoch in letzterem statt. So ist das Internet der Dinge im [B2B-Umfeld bereits reifer](https://www.prophet.com/thinking/2015/02/3-things-b2b-can-teach-b2c-about-the-internet-of-things/)[ als im B2C.](https://www.informatik-aktuell.de/betrieb/netzwerke/fuenf-must-haves-fuer-die-user-experience-im-internet-of-things.html) ## Chatbots im Enterprise Ebenso haben Chatbots die große Chance im Enterprise-Umfeld etwas zu bewegen und zur Produktivität am Arbeitsplatz beizutragen. Wo im Konsumentenbereich noch viele Bots Spielereien sind oder nur als Weiterleitung zum eigentlichen Produkt dienen, könnten wir in Unternehmen [früher als vermutet](http://venturebeat.com/2016/07/26/chatbots-will-make-a-splash-in-the-enterprise-first/) eine Verbreitung von sinnvollen „[Produktivitäs-Bots](https://thecattlecrew.net/2016/12/03/conversational-ui-wenn-ein-bot-erste-hilfe-leistet/)“ erleben. Chatbots oder Spracheingabe können die komplexen und oft verteilten Anwendungen, die die Mitarbeiter eines Unternehmens verwenden, nicht ersetzen. Das sollen sie aber auch nicht. Sie sollen vielmehr als zusätzliche Möglichkeit zur Interaktion dienen. Denn in manchen Szenarien macht solch ein Bot Sinn und spart dort Zeit ein. In anderen Fällen wiederum ist ein herkömmliches User Interface deutlich nützlicher. Erst **eine Kombination dieser Ansätze** (UI + Chatbots per Text- oder Spracheingabe) bringen uns einen Schritt näher zur [optimalen User Expercience](https://www.informatik-aktuell.de/betrieb/netzwerke/fuenf-must-haves-fuer-die-user-experience-im-internet-of-things.html) im Enterprise. **Kategorien:** AI & Data Science, Automation **Schlagwörter:** #OCVoicePioneers, Artificial Intelligence, Conversational UI, IoT, Modern Clients, Smart --- ### [Die weite Welt der Integration in Zeiten der Digitalisierung "“ Die 3 Ebenen](https://thecattlecrew.net/2017/02/28/die-weite-welt-der-integration-in-zeiten-der-digitalisierung-die-3-ebenen/) **Published:** Februar 28, 2017 **Author:** Dominik Bial **Content:** Eine gut geplante, zukunftsfähige Integrationsplattform ist essentiell um schnell und agil neue Geschäftsmodelle zu etablieren, vorhandene zu erweitern oder Produkte und Dienstleistungen anzupassen. Ohne einen geeigneten Integrationsansatz lassen sich Potentiale aus dem IoT, Cloud und Mobile nur eingeschränkt nutzen, weil gerade erst durch die Kommunikation zwischen Anwendungen/Dingen/Menschen Mehrwerte entstehen. Ein Zusammenspiel der Technologien und der einzelnen Disziplinen ist notwendig, was im Folgenden anhand kleinerer Beispiele verdeutlicht wird. ## Wege der Integration „“ die 3 Ebenen Betrachtet man die gezeigte Pyramide, fällt auf, dass vor einigen Jahren noch der Hauptaugenmerk von Integrationden oberen Ebenen galt. [![digitalisierungspyramide](https://thecattlecrew.net/wp-content/uploads/2017/02/digitalisierungspyramide.png?w=230)](https://thecattlecrew.net/wp-content/uploads/2017/02/digitalisierungspyramide.png) Es wurde insbesondere auf Basis von Prozessen und Daten Integration betrieben. Die Integration fand in den oberen Ebenen massiv zwischen diesen Elementen statt. Durch IoT verändert sich nun dieser Fokus. Plötzlich stehen Geräte und damit Informationen als auch steuerbare Einheiten in der operativen Ebene zur Verfügung, die ebenfalls in die Anwendungslandschaft einbezogen werden können. Dadurch besteht die Möglichkeit Prozesseffizienz und Qualität massiv zu steigern sowie völlig neue Geschäftsmodelle zu entwickeln. Gleichzeitig bringt dies aber auch neue Herausforderungen und Trends mit sich, wie zum Beispiel: - Stärkerer Einsatz von Event-basierten Systemen - Schnellerer Austausch und kürzere Lebensdauer der Daten - Ü–ffnung der IT über APIs oder Ü„hnliches - Kommunikation mit neuen Services und Produkten - Direkte Interaktion mit den Kunden Rund um diese Trends sind neue Produkte entstanden, die sich in drei verschiedene Bereiche einordnen lassen, die wir als die „Drei Ebenen der Integration“ bezeichnen. Die einzelnen Ebenen haben einen anderen Betrachtungswinkel auf die Digitalisierung und Integration, sodass sich anhand dieser Betrachtungswinkel die Technologien und Mehrwerte besonders herausstellen und diskutieren lassen. Die einzelnen Bereiche, in denen integriert wird, sind: - Durchführungs-Ebene - Pre-Integration Stage - Backbone Verarbeitung [![iotintegration](https://thecattlecrew.net/wp-content/uploads/2017/02/iotintegration1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2017/02/iotintegration1.png) ## Integration in der Durchführung-Ebene In der Durchführungs-Ebene sind die eigentlichen Dinge, Maschinen aber auch Smartphones oder Menschen zu finden. Innerhalb dieser Ebene findet die eigentliche Interaktion statt, die entweder durch ein zentrales System gestützt wird oder auch direkt zwischen Geräten und Menschen erfolgen kann. Erfolgt die Kommunikation direkt, muss eine entsprechende Logik im Ding oder aber in so genannten Gateways erfolgen. Ein Gateway ist dabei ein smarter Knotenpunkt, der andere Dinge steuert, aber einen lokalen Bezug zu den Dingen hat. Spannend ist, dass in diesem Bereich ein starker Bezug zu Client Technologien beziehungsweise Mensch-Maschine-Interaktion erkennbar ist. Dies ist zwangsläufig gegeben, falls eine direkte Interaktion zwischen Ding und Maschine stattfinden soll. Beispiel: Ein weiterverbreiteter Ansatz für IoT Gateways findet sich im Smart Home Bereich. Sensoren im Haus werden über einen Gateway zentral angebunden. Einzelne Informationen werden von dem Gateway an Plattformen im Internet versendet. Ü„hnliche Ansätze sind auch in der Industrie zu finden. Ein Beispiel für eine direkte Interaktion mit einem Ding sind Mobile Payment Szenarien im Zusammenhang mit Vending Machines. Auswahl interessanter Technologien: - IoT Geräte - Smartphones - IoT Gateways ## Pre-Integration Stage Die so genannte Pre-Integration Stage beschreibt eine Integrationsschicht, die vor der eigentlichen Unternehmens-IT liegt. Einsatzzweck ist vor allem die Aggregation und Filterung von Daten, bevor diese an die weiter verarbeitenden Prozesse gelangen. Des Weiteren wird die Kommunikation von und zu den Geräten erleichtert. Argumente für eine entsprechende Schicht können die Trennung der notwendigen Infrastruktur aus Security Sicht oder der Einsatz bestimmter Technologien sein. Gerade durch den Einsatz von Cloud Lösungen kann eine entsprechende Pre-Integration Stage entstehen. Cloud Lösungen können dabei On-Premise oder als Public Lösung eingesetzt werden. Sie bieten neben dem eigentlichen Entgegennehmen und Weiterleiten von Daten eine Vielzahl weiterer Features aus den Bereichen Security, Privacy, Device Management, Notification Services und vor allem Analytics. Der Aufbau einer eigenen Lösung ist durchaus möglich. Dies geht allerdings mit einer starken Komplexität einher und birgt dadurch ein entsprechend großes Risiko. Interessant ist eine Kombination von Eigenentwicklung und Cloud Lösung, bei der fehlende Funktionen ergänzt werden. Beispiel: Die Einsatzgebiete von IoT Cloud Lösungen sind vielfältig. Sie bieten sich aber immer gerade dann an, wenn Datenströme „eventisiert“ werden sollen und kein direkter Bezug zu weiteren Unternehmensdaten notwendig ist. Gehen wir von einem Predictive Maintenance Fall aus, bei dem Assets, zum Beispiel Fahrräder an Fahrradvermietstationen, überwacht werden, lassen sich die Ströme miteinander kombinieren. Meldet ein Fahrrad eine Erschütterung, kann von einem einfachen Umfallen eines Rades gesprochen werden. Wird diese Information von mehreren Rädern an der gleichen Vermietstation versendet, kann von einem Unfall oder einer mutwilligen Beschädigung ausgegangen werden. Auswahl interessanter Technologien: - IoT Cloud Lösungen wie Q-loud, Microsoft Azure, Amazon AWS, Oracle IoT Cloud - Broker Technologien wie MQTT ## Backbone Verarbeitung Die dritte Schicht beschreibt die Verarbeitung im eigenen Backbone. Dabei werden Schnittstellen oder APIs geschaffen, sodass eine direkte Interaktion zwischen Geräten und Unternehmensprozessen möglich ist. Dieser Integrationsansatz ist vor allem dann interessant, wenn zur weiteren Verarbeitung und Aufbereitung ein Zugriff auf die Unternehmensdaten erfolgen soll. Gleichzeitig sollte man aber nicht vergessen, dass über diesen Ansatz eine größere Ü–ffnung des Unternehmens nach außen geschieht. Hervorzuheben ist die Kombination der Integrationsansätze aus dem IoT mit Big Data Prinzipien. Hierunter fällt insbesondere Fast Data, da direkt und in nahezu Echtzeit auf Events reagiert werden kann. Werden die Daten zentralisiert in einem so genannten Data Lake abgelegt, lassen sich IoT Daten nachträglich analysieren und wiederkehrende Muster entdecken, die beispielsweise zur Optimierung herangezogen werden können. Des Weiteren können diese für Simulationen genutzt werden. Beispiel: Eine Störungsmeldung, die über ein IoT Gerät eingeht, wird an eine Streaming Engine kommuniziert. Diese greift die Nachricht auf, holt sich Informationen über jeden Monteur aus den Stammdaten und dessen aktuellen Standort. Parallel startet für jeden Monteur eine Bewertung bezüglich der Anpassung seiner Tour. Anschließend ermittelt die Streaming Engine die optimale Tourenanpassung und damit den Monteur, der kurzfristig die Störung beheben soll. Eine entsprechende Nachricht wird an den Monteur versendet. Auswahl interessanter Technologien: - Streaming Engines - Maschinelles Lernen - API Management - Process Engines Der Einsatz aller drei Stages ist nicht zwingend notwendig, vielmehr zeigen diese auf, welche Vorteile die einzelnen Ansätze für unterschiedliche Szenarien bieten. Eine Kombination dieser ergibt aber durchaus Sinn; insbesondere um über die Ebenen hinweg Events höherwertig mit weiteren Informationen anzureichern und zu aggregieren. **Kategorien:** Integration **Schlagwörter:** Architecture, German, Integration, IoT --- ### [Datenabfrage von der Q-loud IoT Plattform](https://thecattlecrew.net/2017/03/02/datenabfrage-von-der-q-loud-iot-plattform/) **Published:** März 2, 2017 **Author:** Otto Fitz **Content:** Q-loud ist- eine einfache zu verwendende und qualitativ hochwertige IoT Cloud, aus der wir mit einem Client die Daten abfragen und analysieren wollen. Im Video unten sehen wir eine Maschine von der Q-loud als Beispiel aus dem Produktionsumfeld. Zwei Magazine in der Maschine sorgen dafür, dass ausreichend Material für die Produktion der Würfel zur Verfügung steht. Aus zwei Materialien, die sich in der Farbe und in der chemischen Zusammensetzung unterscheiden, wird ein Würfel produziert. Die Magazine sind unsortiert mit den verschiedenen Materialien gefüllt, die nach einander in die Produktion gelangen. Die Aufgabe der Maschine ist, das Material zu prüfen und ggf. auszusortieren, wenn es für das Voreingestellte Endprodukt nicht benötigt wird. Das Video zeigt deutlich wie die Sensoren das Material erfassen, welches dazu führt, dass sich die Zustände der Maschine mehrmals pro Sekunde ändern. Die Zustände werden in Echtzeit in der IoT Cloud in einem JSON Format bereitgestellt. Das Datenmodell für die Industriemaschine hat diese JSON Struktur: \[code language=“java“\] „data“: { “ 1487165498220 „: \[0, 0, 1, 23, 1, 2, 7, 81, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 12, 25\] } \[/code\] Wie man die Daten der Industriemaschine abfragt, ist in der Q-loud REST API Dokumentation übersichtlich und mit Beispielen beschrieben. Um die Live -Zustände der Maschine in Echtzeit abzufragen, erstellen wir zuerst eine gültige Session, indem wir einen POST auf die Session-URL mit unseren LogIn Daten im Body ausführen: \[code language=“java“\]http://api.cospace.de/api/session“\[/code\] Die „response“ enthält den Server und die SID im JSON Format, mit denen wir eine sichere Kommunikation mit dem Q-loud Server herstellen können: \[code language=“java“\] { „sid“: „boajw93gwservfZdbfdGa84Afib“, „did“: „iaEiawdfsa4aobpEPRkva98“, „server“: „https://api43.service.de:1234“, „status“: „ok“, „auth“: „true“ } \[/code\] Nachdem wir erfolgreich einen Server und eine SID zugewiesen bekommen haben, verwenden wir diese um die Kommunikation zwischen dem Client und der Q-loud für einen gewünschten Zeitraum aufzubauen. Der Zeitraum für die Live „“Kommunikation kann bis zu zehn Stunden abonniert werden. Nach Ablauf der Abonnementszeit muss das Abonnement der Maschine aktualisieren werden, um weitere Live -Daten abfragen zu können. Das Abonnieren erfolgt mit der UUID der Industriemaschine die von der Q-loud mitgeteilt wird. Wir führen ein GET mit den Parametern Session Server, Session SID, Maschinen UUID und dem Timeout folgendermaßen aus: \[code language=“java“\]http://api43.service.de:1234/api/sensor/uuid/event?timeout=36000&sid=boajw93bawgfbfZdbfdGa84Afib\[/code\] Im Header geben wir die Session SID mit \[code language=“java“\]conn.setRequestProperty(„Authorization“, „Bearer “ +sid);\[/code\] Wenn das Abonnieren erfolgreich gewesen ist, erhalten wir eine leere Response: \[code language=“java“\] „{}“ \[/code\] Nach dem wir jetzt die Maschine abonniert haben, können wir über das Longpolling die Live-Daten abfragen. Für das Abfragen der Daten sind die Parameter Longpolling -Timeout und der Next -Wert von Bedeutung. Mit dem Timeout geben wir an, wie lange der Client auf die Antwort von der IoT Cloud warten soll. Der Timeout kann von 1-300 Sekunden gesetzt werden. Ist der Timer abgelaufen und wir haben keinen Wert von der Cloud bekommen, müssen wir sicherstellen das der Client diese Abfrage wiederholt. Auch beim Empfang einer Nachricht innerhalb der Zeit, wird die Abfrage abgebrochen und muss für den Empfang weiterer Nachrichten neu aufgebaut werden. Die Nachrichten sind mit dem Next -Wert versehen. Dieser Wert ist wie eine eindeutige Nachrichten Id in der abonnierten Session. Der Next -Wert ist eine Id der nächsten Nachricht, ergibt sich also aus Next -Wert-1 der aktuell empfangenen Nachricht. Der Wert wird immer von der Cloud mitgesendet und um eins erhöht. Die JSON Struktur der Nachricht: \[code language=“java“\] { „next“:1, „event“:\[\], „status“:“ok“ } \[/code\] Der Inhalt ist der Next -Wert, Event und Status. Next gibt uns den Wert der nächsten Nachricht an, Event enthält den Payload der Industriemaschine und mit Status: ok, wissen wir, dass unsere Session aktiv ist und wir berechtigt sind, Daten abzufragen. Um die Nachricht zu erhalten, setzen wir einen GET Request ab mit der SID, dem next-Wert, dem Timeout und zu Authentifizierung geben wir wie im Header wie oben beschrieben die SID mit: \[code language=“java“\] http://api43.service.de:1234/api/event?sid= oajw93bawjckbja2ZdbfdGa8&next=1&timeout=300\[/code\] Sollten wir \[code language=“java“\]“status“:“no-session“\[/code\] bekommen, ist die Session nicht mehr gültig und muss neu angefordert werden. Um den GET Request mit dem neuen Next -Wert und einem neuen Timeout wiederholt auszuführen, führen wir die Abfrage in einer „While Schleife“ aus. Mit parsen der Response -Nachricht erhalten wir den Payload der Industriemaschine. Der Payload mit den Zuständen der Maschine ist das Json-Object „data“, welches im Json -Array event\[\] enthalten ist. Auf das Response Json-Object führen wir folgendes: \[code language=“java“\]JSONArray jsonEvent = responseJsonObject.getJSONArray(„event“);\[/code\] mit \[code language=“java“\]JSONObject jsonMachineData = jsonEvent .getJSONObject(„data“);\[/code\] erhalten wir die Live -Zustände der Industriemaschine: \[code language=“java“\] „data“: {“ 1487165498220 „: \[0, 0, 1, 23, 1, 2, 7, 81, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 12, 25\]} \[/code\] Die Zustände in einem JSON Format stehen uns nun zu Verfügung und wir können mit dem Analysieren der Daten fortfahren. Wir filtern die Daten für ein Echtzeit Produktions „“Dashboard, welches jederzeit online abgerufen werden kann. Das Dashboard, wie unten im Bild, visualisiert den aktuellen Zustand der Maschine, sowie gibt in Echtzeit Auskunft über die produzierte Menge der Produkte. ![produktionDashbaord](https://thecattlecrew.net/wp-content/uploads/2017/03/produktiondashbaord.png) Desweiteren werden die Daten in einer Datenbank abgelegt, die dann jederzeit z.B. für einen Geschäftsbericht mit einem BI Tool wie Tableau, Qlik oder PowerBI analysiert werden können. **Kategorien:** Automation, Cloud **Schlagwörter:** IoT, Java, json, longpolling, q-loud, rest --- ### [Bosch ConnectedWorld 2017 - Bosch's IoT Conference in Berlin](https://thecattlecrew.net/2017/04/13/bosch-connectedworld-2017-boschs-iot-conference-in-berlin/) **Published:** April 13, 2017 **Author:** tjkrajewski **Content:** Vom 14. bis 16. März durfte ich an der IoT Konferenz von Bosch, der Bosch ConnectedWorld 2017, teilnehmen. In diesem Blogeintrag möchte ich meine Eindrücke von der Konferenz und vom Hackathon und mit euch teilen. Als Student habe ich mich im Voraus für ein kostenloses Ticket beworben. Da ich in Berlin an der TUB früher als Austauschstudent studiert hatte, habe ich dort noch Kontakte und konnte bei einer guten Freundin übernachten. Ein paar Stunden vor meiner Reise hatte ich dann aber plötzlich ein riesiges Problem: Mein Flug wurde wegen eines Streiks in Berlin abgesagt. Ich hatte zwei Möglichkeiten: Entweder bleibe ich zu Hause in München oder ich nehme einen Nachtbus. Diese Entscheidung war nicht so schwierig, weil es mein Traum war, an der Konferenz teilzunehmen. Wegen des Nachtbusses war ich am Dienstag dann schon in aller Frühe in Berlin und konnte den ganzen Tag in unserem Berliner Büro arbeiten. Am Berliner Standort wurde ich sehr herzlich von den Kollegen empfangen. ## Das Hackathon Da ich ein kostenloses Ticket bekommen hatte, musste ich an der Hackathon-Konferenz teilnehmen. Dabei war ich immer gegen Hackathons, weil ich der Meinung war, dass man doch fast nichts in solch kurzer Zeit schaffen kann. Aber ich habe mich total geirrt: Es hat viel Spaß gemacht und ich konnte viele interessante neue Freunde kennenlernen. Ich habe dort viel gelernt und konnte die neusten Technologien ausprobieren. Die Konferenz startete am Dienstag um 18 Uhr mit einer Begrüßung und dem anschließenden Team Building. ![1.jpg](http://skni.org/zdj/1.jpg) Jedes Mitglied konnte sich für einen Bereich entscheiden. Zur Auswahl standen: Mobility, Manufacturing, Building&City und Open Hacking. Eigentlich wollte ich etwas in jeder Kategorie machen und habe alle Begrüßungsvorträge angehört. Am Ende habe ich mich aber für Building&City entschieden. Mein Team hat innerhalb von zwei Tagen ein System erarbeitet, das den Menschen im Katastrophenfall helfen soll. Es bestimmt die Anzahl an Leuten in einem Gebäude und erkennt mittels Bosch Kameras gleichzeitig deren Emotionen (z. B. Panik). Wir haben leider nicht gewonnen aber jedoch hatten wir alle viel Spaß und ich konnte einiges neues Neues dazulernen. Mein Team: ![2.jpg](http://skni.org/zdj/2.jpg) Das Hackathon-Team BERSS (Building Emergency Response Support System): ![3.jpg](http://skni.org/zdj/3.jpg) Wir konnten viele neue Technologien und Geräte benutzen. Auf dem Bild ist ein 3D-Drucker zu sehen: ![4.jpg](http://skni.org/zdj/4.jpg) Eines der besten Dinge! Bosch lehrt IoT sogar den Kindern. Hackathon für die Jüngsten:![5.jpg](http://skni.org/zdj/5.jpg) Hackathon-Projekte und Sensoren waren überall. Hier in der Minibar: ![6.jpg](http://skni.org/zdj/6.jpg) Ein Microsoft Mitarbeiter (links) zeigt mir, wie Azure funktioniert: ![7.jpg](http://skni.org/zdj/7.jpg) Alle haben sehr fleißig gearbeitet: ![8.jpg](http://skni.org/zdj/8.jpg) Mit Marita Klein von Bosch. Sie war für Hackathon verantwortlich: ![9.jpg](http://skni.org/zdj/9.jpg) Die offizielle Party. Zeit für Networking: ![10.jpg](http://skni.org/zdj/10.jpg) Werden wir in Zukunft öfters Vermisstenanzeigen für Roboter vorfinden? Oder ist das nur tolle Werbung? 😉 ![11.jpg](http://skni.org/zdj/11.jpg) ## Die Konferenz Ich bin ganz sicher, dass dem Internet der Dinge die Zukunft gehört. Es geht hier nicht nur um die Erfassung, das Management, den Transport, und die Analyse entstehender Sensordaten, sondern insbesondere darum, wie Entscheidungen besser getroffen, Kunden neue Services und Produkte angeboten und komplett neue Geschäftsmodelle verwirklicht werden können. Das Internet of Things ist doch der Wegbereiter für die digitale Transformation von Organisationen aller Branchen. Diesem Transformationsprozess wird sich in Deutschland bald kein Unternehmen entziehen können. IDC, der weltweit führende Anbieter von Marktinformationen prognostiziert, dass die Anzahl der vernetzten Dinge von derzeit 12,1 Mrd. (2016) auf weltweit 30,3 Mrd. bis zum Jahr 2020 ansteigen wird (Cisco glaubt, es kann sogar bis 50 Mrd. sein!). IDC geht davon aus, dass der IoT-Markt im Jahr 2020 ein Volumen von 1,7 Billionen Dollar haben wird. Das macht schon einen guten Eindruck, oder? Die Konferenz teilte sich an beiden Tagen in unterschiedliche Themenslots auf: ● Connected Mobility ● Connected Manufacturing ● Connected Logistics & Supply Chain ● Connected City & Building ● Connected Agriculture ● Autonomous Driving ● IoT Cloud ● IoT Networks ● Silicon IoT ● Augmented Reality Es gab dort viele unterschiedliche Firmenstände unter anderem von Bosch, SAP, Telekom Deutschland, Amazon Web Services, Eclipse Foundation, IBM, General Electric, Cisco, SalesForce, Intel und nVidia. ## Es folgen die Ideen, welche ich persönlich am interessantesten fand: Dank der neuen AV(Autonomous Vehicles) werden wir einen neuen mobilen Raum haben, wo alle selbstfahrenden Autos vernetzt sind. Was man bis heute zu Hause oder am Arbeitsplatz gemacht hat, kann man nun auch im Auto erledigen.Während der Konferenz hat inVidia gezeigt, wie ihr System funktioniert. Die Firmen der Autoindustrie müssen dank nVidia keines eigenen Systems mehr entwickeln. Sie können es einfach kaufen und somit viel Entwicklungskosten sparen: Mehr dazu: ![14.jpg](http://skni.org/zdj/14.jpg) Bosch hat eine Wagen-Visualisierung gezeigt. Werden wir wirklich in 5 Jahren mit solchen Autos fahren? Die Leute, mit denen ich auf der Konferenz gesprochen habe, waren davon total überzeugt! ![15.jpg](http://skni.org/zdj/15.jpg) T-Mobile hat einen Roboter vorgestellt, der alle Bewegungen einer Person nachahmt. Hierfür muss man einen Handschuh und eine Jacke mit Sensoren anziehen. Dank der Brillen kann man auch sehen, was der Roboter gerade sieht. Es ist wichtig zu erwähnen, dass die Grenzen zwischen echter, Augmented Reality und Virtual Reality langsam verschwimmen. Unternehmen entwickeln kombinierte Angebote aus AR und reiner VR. Laut Fjord Trends 2017 von Accenture soll der Markt für AR und VR im Jahr 2025 80 Milliarden US-Dollar erreichen. ![16.jpg](http://skni.org/zdj/16.jpg) Fujitsu hat ein IoT Management System gezeigt, welches betriebswirtschaftliche Informationen in einem Dashboard visualisiert. Man konnte bei ihrem Stand einen Kaffee trinken und danach sofort alle Details zu meiner Bestellung auf dem Dashbaord ablesen. Die Kaffee war umsonst, aber bei dem guten Kaffee hätten sie viel Geld einnehmen können;) Über ein solches System kann man auch dynamische Preise einführen. Ist heute der White Kaffee nicht beliebt? Dann machen wir eine Preissenkung von 20 %! **![17.jpg](http://skni.org/zdj/17.jpg)** Der Tug (so heißt das Gerät) von Aethon kann selbst die Paketen durch einem Lager transportieren. Das Gerät hat viele Sensoren eingebaut, weshalb es auch mit Menschen in einem Lager zusammenarbeiten kann. Es wurde ein Video gezeigt und man konnte einen Tug Ausstellungsstück anschauen.Die Produkte von Aethon funktionieren bereits im medizinischen Bereich und sehen echt klasse aus. ![18.jpg](http://skni.org/zdj/18.jpg) Ich bin noch immer von AWS (Amazon Web Services) begeistert. Meiner Meinung nach sind sie jetzt viel besser als Microsoft Azure oder Oracle IoT.AWS IoT ist der Cloud-Service für das Internet der Dinge. Dank diesem Service kann man tausend Geräte haben und sie sind über das Amazon Framework verbunden. Damit können die Nutzer solche Objekten oder Geräten „miteinander reden“ lassen. Es ist auf jeden Fall einfacher zu verwalten und man hat nur eine Architektur. Aber das Wichtigste ist: Amazon kümmert sich selbst um die Security (die größte Herausforderung in IoT Welt). AWS unterstützt HTTPS, Websockets und das MQTT-Protokoll. Mithilfe von AWS kann man Daten von global vernetzten Geräten speichern, verarbeiten und analysieren. AWS bietet unter anderem AWS Lambda, Amazon API Gateway, Amazon DynamoDB, Amazon Kinesis, Amazon S3 oder Amazon Redshift und erlaubt die Verknüpfung dieser zu einer robusten IoT-Anwendung. Cicsco hat eine Kleidung gezeigt, welche technische Mitarbeiter tragen können. Die Brille ermöglichte die Nutzung von AR: ![22.jpg](http://skni.org/zdj/22.jpg) Die Zuckerwatte wurde von einem Roboter zubereitet:![23.jpg](http://skni.org/zdj/23.jpg) Ich finde es super, wenn man für Marketingzwecke Gamifizierung nutzt. Hier konnte man einfache Videospiele spielen und neue Information über Bosch Technologien erlernen: ![24.jpg](http://skni.org/zdj/24.jpg) Ich möchte mich nochmal bei Alexander Däubler, Dominik Bial und Torsten Winterberg bedanken, dass Sie mich unterstützt haben und mir erlaubt haben, dass ich an dieser Konferenz teilnehmen konnte. Ich habe viele neue Leute kennengelernt und konnte neue Technologie und Geräte testen. Ich war zum ersten Mal auf einer solchen großen internationalen Konferenz und einem Hackathon. Ich werde versuchen, das auf der Konferenz erlernte Wissen in meine Arbeit bei OC einfließen zu lassen. **Kategorien:** Automation, Tech Events & Networking --- ### [Alexa, frag Opitz! Entwicklung eines Alexa Skills](https://thecattlecrew.net/2017/05/05/alexa-frag-opitz-entwicklung-eines-alexa-skills/) **Published:** Mai 5, 2017 **Author:** Christian Ochsenkühn **Content:** Auf der [InspireIT](http://www.inspire-it.de/) sprachen Besucher bereits mit der ersten Version unseres Alexa Skills. Dieser Chatbot erklärt dem interessierten Nutzer das OC Wimmelbild. Doch beginnen wir von vorne. ![Echo_Dot](https://thecattlecrew.net/wp-content/uploads/2017/05/echo_dot.png) ## Alexa, die Stimme des Amazon Echo Alexa ist die Stimme (und Intelligenz) des Amazon Echo. Dieser kann viele Anfragen, wie Fragen nach dem Wetter oder das Abspielen von Musik, bereits von Haus aus umsetzen. Um Alexa aber zusätzliche Fragen stellen zu können, müssen wir sog. Skills aktivieren. **Ein Skill entspricht in etwa einer App** auf dem Smartphone. Ü„hnlich wie den App Store gibt es hierzu eine ebenfalls einen [Skill-Marktplatz](https://www.amazon.de/b?node=10068460031), wo man neue Skills findet und aktivieren kann. ![alexa_skills_rezensionen](https://thecattlecrew.net/wp-content/uploads/2017/04/alexa_skills_rezensionen.png) Der Screenshot links zeigt die durchschnittlichen Kundenrezensionen von Alexa Skills (Stand 24.04.2017). Wie man sieht ist der Großteil noch ziemlich schlecht bewertet. **Es lohnt sich also jetzt loszulegen und einen wirklich guten Skill auf den Markt zu bringen.** Und wie schaffe ich es, dass mein Skill nicht auch unter den 1-Sterne-Bewertungen landet, sondern einer der 230 Top-Skills wird? (*Man stelle sich nur einmal vor, es gebe nur 230 gute Apps. Da hätte man die Aufmerksamkeit mit einem Nutzer-zentrierten und qualitativ hochwertigen Produkt auf jeden Fall sicher.)* Die folgenden Fragen helfen beim Entwickeln eines Chatbots: - Welcher Service bringt meinen Nutzern einen Mehrwert, wenn sie ihn über Text oder Sprache bedienen können? (Und wo macht ein User Interface mehr Sinn?) - [Chatbots brauchen ein neues Verständnis von Usability](https://jaxenter.de/chatbot-alexa-google-home-siri-54265). Habe ich das konsequent umgesetzt (und nicht einfach die GUI eins zu eins umgebogen)? - Was ist technologisch bereits möglich? Letzteres zeigen wir im Folgenden anhand unseres Praxisberichts. ## Unser Alexa Skill erklärt das OC Wimmelbild ![opitz-consulting-wimmelbild_500](https://thecattlecrew.net/wp-content/uploads/2017/05/opitz-consulting-wimmelbild_500.jpg)Wimmelbild „Überraschend mehr Möglichkeiten“ ([Download als PDF](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Sonstiges/opitz-consulting-wimmelbild.pdf))[](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Sonstiges/opitz-consulting-wimmelbild.pdf) In obigem Wimmelbild sind eine Menge spannender Geschichten aus unseren Digitalisierungsprojekten verarbeitet. Jede dieser Geschichten kann uns Alexa nun in einer Kurzfassung erzählen. **Tomasz**: „Erzähle mir etwas zum Brummi-Werk!“ **Alexa**: „Dank OC gibt es weniger störungsbedingte Produktionsausfälle. Durch gemeinsam entwickelte Industrie 4.0 Strategien werden die Just-in-time-Produktion optimiert und Lagerkosten gesenkt.“ **Tomasz**: „Cool. Und wer ist da der Ansprechpartner?“ **Alexa**: „Ansprechpartner für dieses Projekt sind Erika Musterfrau und Max Mustermann. Möchten Sie…“ Nachdem Alexa also über eines der Projekte auf dem Bild gesprochen hat, **hält sie den Kontext** und kann weitere Fragen zu diesem Projekt beantworten. Neben den Antworten zu den Projekten (und einigen Easter Eggs) hat der Skill noch einiges mehr auf Lager. So ist eine Webseite als „Ding“ (wie im Internet der Dinge) an den Skill angebunden und zeigt jeweils zum aktuell angefragten Projekt des Wimmelbilds einen **passenden Ausschnitt eines Videos**. Das folgende Youtube-Video zeigt dieses Feature im Detail: \[youtube https://www.youtube.com/watch?v=Xdc5m6hfFFc?rel=0&controls=0&showinfo=0&w=560&h=315\] Als kleines Proof of Concept (PoC) kann der Skill außerdem eine SMS mit den Ansprechpartnern eines Projekts an den Nutzer senden. Dazu muss er nur seine Handynummer angeben. **Alexa**: „Ansprechpartner für dieses Projekt sind Erika Musterfrau und Max Mustermann. Darf ich Ihnen eine SMS mit deren Kontaktdaten schicken?“ **Tomasz**: „Ja“ **Alexa**: „Dann nennen Sie mir bitte jetzt Ihre deutsche Handynummer. Ziffer für Ziffer.“ **Tomasz**: „0 1 7 1…“ **Alexa**: „Danke. Ich schicke die SMS als an 0171… Ist das korrekt?“ **Tomasz**: „Ja“ **Alexa**: „Die SMS wurde erfolgreich versendet. Sie können…“ ## Die Technik hinter dem Skill Nach einem ersten Prototypen in Python haben wir technisch auf **node.js und Javascript** gesetzt, da es dort deutlich mehr Dokumentation, Support und ein fortgeschritteneres SDK (Software Development Kit) gibt. Spreche ich einen Satz zu Alexa, so wandert dieser in die Cloud (zu Amazon), wird dort analysiert und einem **Intent** zugeordnet. Dieser Intent wird dann an einen Server geschickt, auf dem unser Javascript-Code liegt, der diesen Intent anschließend verarbeitet. Solch ein Server kann zum Beispiel ein eigener node.js Server oder Amazon AWS Lambda sein. Die Antwort, die Alexa dann sprechen soll, senden wir wieder (als JSON) an die Amazon-Cloud zurück, welche den entsprechenden Antwortsatz dann an „Alexa“ weitergibt. ![alexa-skill-architektur](https://thecattlecrew.net/wp-content/uploads/2017/05/alexa-skill-architektur.png)Abstrakte Architektur eines Alexa Skills \[Quelle Server-Icon: [icons8](https://icons8.com/web-app/11873/cloud-storage)\]Details zur technischen Umsetzung inkl. unserer Entwicklungsumgebung (Unit Tests, Analytics usw. für Alexa Skills) gibt es demnächst in einem separaten Blogeintrag. **Kategorien:** AI & Data Science, Development **Schlagwörter:** #OCVoicePioneers, Alexa, Alexa Skill, Artificial Intelligence, Digital Innovation, JavaScript --- ### [OPITZ CONSULTING's own IoT prototype to demonstrate capabilities (part 1)](https://thecattlecrew.net/2014/06/18/opitz-consultings-own-iot-prototype-to-demonstrate-capabilities-part-1/) **Published:** Juni 18, 2014 **Author:** Pascal Brokmeier **Content:** In the last few months, there has been so much talk about IoT it must have been hard not to stumble across a news about it. But even though, everyone talks about it, its hard to get a grasp on things. What is IoT really? Is it a method like BPM or concept like Big Data? Or is it a technology that was recently invented and is now ready for use like WebRTC? Well for us it is a a trend or a vision of how things could look like on a broader scale but in order to make this vision come true lots of small things and technologies need to be integrated in a system and work together as a team and communicate openly with other systems. But the IoT that is described in so many talks and posts these days is not the one we need in order to profit from it. There doesn’t need to be a fully automated city that guides its inhabitants autonomous vehicles to the right parking spot in order to save a few minutes of searching, before we can join the trend and profit from all of this as well. Any medium sized company can sit down and think about the opportunities that arise from recent tech development and think about how they can use this to make their own business a bit smarter or more controllable or how to create new services that haven’t been seen before. Many such examples already exist: ![Bildschirmfoto 2014-06-18 um 09.11.57](https://thecattlecrew.net/wp-content/uploads/2014/06/bildschirmfoto-2014-06-18-um-09-11-57.png?w=595) Once many do this, lots of small systems will arise that can start talking to each other and provide services that can be consumed by each other, closing the gaps between them and lead to the ultimate goal. ![Bildschirmfoto 2014-06-18 um 09.12.31](https://thecattlecrew.net/wp-content/uploads/2014/06/bildschirmfoto-2014-06-18-um-09-12-31.png?w=595) ### Our motivation So why do we at OPITZ CONSULTING are so eager about IoT? Well first its necessary to know as much as you can about a technology trend everybody is talking about. But while doing our research we also found that most of the pieces necessary to build this puzzle that is IoT, we already have in our skill-set. BigData, BPM or Adaptive Case Management (ACM), BI, Enterprise Applications, as well as Project Management skills they are all key parts to a successful IoT story. What we lack as a software company is a deep knowledge of building little sensors and pieces that connect to the net and allow us to sense the environment or act within it. But thankfully these are only the enabling technology and we dont need to know how to build these in order to take part of this development. Lots of Hardware producing companies out there, we focus on the software, the part where the magic happens. #### Lets build a prototype! Still we wanted to know more about the underlying parts so we decided to develop a prototype, integrating some key parts such as BPM, Event Processing, Java, some native code running on the low level parts of devices, a different communication stack than TCP/IP which is so well known by now and so on. Also we wanted to build a prototype that can show the actual potential of IoT and not just a technology demo of a small children’s toy robot being controlled by a smartphone app. The ultimate goal after all is generating some form of value for our customers. There is a [great infographic about IoT](http://postscapes.com/what-exactly-is-the-internet-of-things-infographic) (also the source of the pictures above) that also shows the expected business impact for several categories such as *transport* or *buildings & infrastructure. This infigraphic has been created by [Harbor Research](http://harborresearch.com/),* a consulting firm that has been around since 1984 and has always been focusing on what is now hyped as the Internet of Things. So both the idea and the concepts aren’t new, but rather the market just recently realized the potential. a prototype in this area would be both interesting on a personal level as well as relevant from a business perspective. Curiously our prototype addresses one of their example compound applications what they call „Smart Buildings + Mobility“. [![Bildschirmfoto 2014-06-18 um 09.16.15](https://thecattlecrew.net/wp-content/uploads/2014/06/bildschirmfoto-2014-06-18-um-09-16-15.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/06/bildschirmfoto-2014-06-18-um-09-16-15.png) Our protoype is a **event & rule based home/office lights automation system** that reacts to the presence & absence of users and controls lights and other simple devices accordingly. While this started as a hobby project to control radio controlled power plugs from a smartphone, it is now a pretty good example of what is possible with IoT technologies. We work with different technologies, 3G, Wifi, 433mhz radio and maybe soon zigbee. Through this we learned all sorts of things about the heterogenous environment that our devices are deployed in. To give you an idea of what our system does lets consider two examples: - A family using our system has all their lights set up using this concept. Now if any one of them returns home from work/school/college, their smartphone logs into the local wifi. This is registered by our network scanning utility and the device is mapped to a user. An event is triggered, saying that User „Shelly“ has just returned from school and is now home. A user state change process is triggered in our system and the business rules are looked at to see if any apply. Since Shelly is the first user, but its already beginning to get dark outside, all lights in the entry way are lit up as well as the kitchen and the living room. Now Shelly could also set up a rule that makes sure her private room’s lights are turned on as well. - A worker in a insurance company leaves his workplace. He shares his office with two other coworkers. Both left work early, so he’s the last one to leave the office. Once his smartphone logs off from the companies Wifi, the user goes „missing“. After 5 minutes he’s considered offline and an event is fired again. The rules state that any office that is uninhabited should not be lit up so all lights turn off in this office. Since no one else on the floor is still at work as well, the entire 15th floor’s lights are shut down as well. Our prototype was supposed to be able to control such situations. To see how we did it, see these other posts going into greater detail about some parts of the prototype: - [Introduction](http://wp.me/p2fG8x-bm "Introduction") (part 1) - [an architectural overview (part 2)](http://wp.me/p2fG8x-bo) - [IoT prototype – low level thoughts on Oracle CEP Embedded (part 3)](http://wp.me/p2fG8x-bJ) - [low-level thoughts about the 433mhz communication (part 4)](http://wp.me/p2fG8x-bW) - [Retrospective. What did we learn. What did we miss. What should also be considered (part 5)](http://wp.me/p2fG8x-c0) Sources: Images from [Harbor Research Infographic](http://harborresearch.com/wp-content/uploads/2014/03/Harbor-Postscapes-Infographic_March-2014.pdf) **Kategorien:** Automation **Schlagwörter:** BPM, Camunda, English, IoT, Mobile --- ### [Realisierung der IoT Steuerung mit Hilfe der Microsoft HoloLens und Cloud Computing](https://thecattlecrew.net/2017/04/24/realisierung-der-iot-steuerung-mit-hilfe-der-microsoft-hololens-und-cloud-computing/) **Published:** April 24, 2017 **Author:** Otto Fitz **Content:** Die Industriemaschine ist per Retrofitting smart gemacht, also IoT-enabled. Dies ermöglicht die SPS-Steuerung der Maschine in der Cloud zu exponieren, womit neue Steuerungsmöglichkeiten entstehen wie das untere Bild es veranschaulicht. ![Technical_holo-qloud](https://thecattlecrew.net/wp-content/uploads/2017/04/technical_holo-qloud.png) Die [Steuerung der Industriemaschine](https://thecattlecrew.net/2017/04/06/iot-steuerung-mit-hilfe-der-microsoft-hololens-und-cloud-computing/) erfolgt mit den zwei Grundkonzepten GAZE und GESTURE der HoloLens. Mit Gaze wird die Blickrichtung erfasst, womit das Fokussieren der modellierten 3D Objekte möglich ist. Nach dem Fokussieren eines Objektes, erfolgt die Interaktion mit Gesture. Das Gesture Konzept erkennt das Tippen mit dem Zeigefinger als eine Geste und führt in einem C#- Script hinterlegten Programmcode aus. Im Bild unten ist ein virtuell modelliertes Objekt mit einem C#-Script dargestellt, welches die Interaktion ermöglicht. ![unity-cube1.png](https://thecattlecrew.net/wp-content/uploads/2017/04/unity-cube1-e1491561317877.png) Das C#-Script enthält die Methode onSelect(), welche nach der „Air Tap“ -Geste ausgeführt wird. \[code language=“csharp“\] void OnSelect() { changeS7300SetUp(RestfulServices.sessionInformationCredintials); playAudio(); } \[/code\] Diese Methode ändert die Produktion der Maschine und gibt akustisch einen Signal zurück, dieses bestätig, dass das Produktion -Setup der Maschine geändert worden ist. Das Ü„ndern des Produktion -Setups erfolgt in drei Schritten: 1. IoT Cloud Authentifizierung 2. Abonnieren der Events der Maschine 3. Einen POST des neuen Produktions-Setups ausführen Die Authentifizierung und das Abonnieren der Events ist [hier](https://thecattlecrew.net/2017/03/02/datenabfrage-von-der-q-loud-iot-plattform/) dokumentiert. Die Ü„nderung des Setups ist weiter im Text beschrieben. Das Setup der Maschine also die Steuerung, kann wie folgt in der IoT Cloud hinterlegt sein: \[code language=“csharp“\] „0cgh2eb10-dfasd-11e5-a699-0asdf73fd04“:{ „type“: „xobject“, „owner“: „ccasdfd90-da25-13e5-9fbb-0025wer342ac08“, „time“: 1456241720, „description“: „0,2,1“, „tag“: \[„ccasdfd90-da25-13e5-9fbb-0025wer342ac08“\] } \[/code\] Der Key „description“ enthält die Werte, die bestimmte Funktionen der Maschine repräsentieren. Nachdem ein POST mit den neuen Werten durch die Geste „AirTap“ mit der HoloLens ausgeführt wird, ändert sich der Key in der IoT -Cloud und die smarte Industriemaschine bekommt ein Befehl das Produktion -Setup zu ändern. Das ändern des Produktions -Setups in C#, erfolgt in dieser Methode: \[code language=“csharp“\] void changeS7300SetUp(SessionInformationModel sessionCredintials) { string jsonBody = („{\\“description\\“:\\“0,1,0\\“}“); Dictionary headers = new Dictionary(); headers.Add(„Content-Type“, „application/json“); headers.Add(„Authorization „, „Bearer “ + sessionCredintials.sid); byte\[\] body = System.Text.Encoding.UTF8.GetBytes(jsonBody); //POST WWW www = new WWW(sessionCredintials.server + „/api/xobject/0c02eb10-da43-asd-a699-00259073fd04?sid=“+sessionCredintials.sid, body, headers); StartCoroutine(WaitForChangeS7300SetUp(www, sessionCredintials)); } \[/code\] Hier wird ein JSON-String mit den Produktionswerten erzeugt, der dann an die Maschine über die IoT Cloud, im Body per POST gesendet wird. Diese Art der Steuerung einer Industriemaschine bietet in vielerlei Hinsicht einen Mehrwert. Die Originalsteuerungs-UI der Industriemaschinen unterscheiden sich je nach Hersteller und sind selten intuitiv. Die Steuerungs-UI der HoloLens kann jedoch personalisiert und auch mit Zugriffsrechten versehen werden. Durch die Augmented Reality werden den Mitarbeiter die Informationen geboten, die zu diesem Zeitpunkt und abhängig vom Ort gerade benötigt werden. Des Weiteren bietet die virtuelle Steuerung höhere Sicherheit da die Interaktivität nicht direkt an der Maschine stattfindet. **Kategorien:** AI & Data Science, Automation **Schlagwörter:** Cloud Computing, HoloLens, IoT, Microsoft, q-loud, Unity --- ### [MQTT "“ Eine Einführung in weniger als 345 Worten](https://thecattlecrew.net/2017/05/04/mqtt-eine-einfuehrung-in-weniger-als-345-worten/) **Published:** Mai 4, 2017 **Author:** Daniel Rock **Content:** MQTT\[1\] (Message Queue Telemetry Transport) hat sich in den letzten Jahren zu einem wichtigen Nachrichtenprotokoll im Bereich IoT durchgesetzt. Mit ihm werden Informationen leichtgewichtig nach dem Publish-Subscribe Pattern übermittelt. Gerade bei einem hohen Nachrichtenaufkommen kann eine Broker-Architektur von Nutzen sein. Mit ihr werden periodische Abfragen von Nachrichten nach dem „Request-Reply“ Muster vermieden. Das ist einer der Gründe, warum die IoT-Plattformen der großen Anbieter Oracle, Microsoft und Amazon dieses Protokoll unterstützen. Auch mit den Ansätzen im IoT-Umfeld passt es gut zusammen, Zustandsänderungen und damit Events/Ereignisse zu kommunizieren. ![MQTT](https://thecattlecrew.net/wp-content/uploads/2017/05/mqtt.gif) Abbildung 1: Architektur Im Zentrum der Kommunikation steht ein Server („**Broker**„), der Nachrichten sammelt und verteilt. Mit ihm verbinden sich „**Clients“** und veröffentlichen Nachrichten bzw. abonnieren sie zu einem bestimmten Thema („**Topic**„). Der Broker nimmt die Nachrichten entgegen und verschickt sie automatisch („**push**„) an die Clients, die das Topic abonniert haben. Topics werden hierarchisch aufgebaut und mit einem „/“ getrennt. Beispiel: /Wohnung/Wohnzimmer/Heizung/Temperatur. Um mehrere Topics zu einer Ebene zu abonnieren, gibt es **Wildcards**. Mittels „+“ wird eine Ebene abonniert, über „#“ können mehrere Ebenen abonniert werden. /Wohnung/+/Heizung/Temperatur abonniert beispielsweise die Heizungstemperatur in allen Zimmern, /Wohnung/Badezimmer/# alle Badezimmerdaten. Über die **Quality of Service** kann jeder Client festlegen, in welchem Umfang die Nachrichtenübertragung garantiert werden soll. Das reicht von maximal ein Mal (Level 0) über mindestens ein Mal (Level 1) zu genau ein Mal (Level 2). Je höher der Level ist, desto mehr Daten müssen für die Sicherstellung des Levels gesendet werden. Die Verfügbarkeit IoT-fähiger Geräte kann stark schwanken. Beispielsweise können Straßenbahnen die Verbindung zur Zentrale verlieren, wenn sie in einen Tunnel fahren. In diesem Fall kann der Client beim Broker eine Nachricht hinterlegen, die bei einem Verbindungsabbruch gesendet wird. Dies wird als „**Last Will and Testament**“ bezeichnet. Im Fall der Straßenbahn könnte das die letzte ermittelte Position sein. Damit Clients bei einem neu abonnierten Topic nicht darauf warten müssen, bis ein neuer Wert gepusht wird, kann die zuletzt gesendete Nachricht standardmäßig an den neuen Abonnenten verschickt werden. Nachrichten, die vom Client dafür markiert wurden, werden „**Retained Messages**“ genannt. \[1\] **Kategorien:** Automation --- ### [BuildingIoT2017 "“ Our Impressions and Learnings from this year"™s Conference](https://thecattlecrew.net/2017/05/11/buildingiot2017-our-impressions-and-learnings-from-this-years-conference/) **Published:** Mai 11, 2017 **Author:** Dominik Bial **Content:** Starting from the Star Wars Day (04/05/2017, probably a good sign;-) to the 05/05/2017 the [BuildingIoT ](https://www.buildingiot.de)2017 took place in Heidelberg. Otto Fitz and Dominik Bial went there to represent OC at our booth (we were gold sponsors) and with the talk „[IoT als zentraler Treiber der Digitalisierung (IoT as Enabler for Digitisation)](https://www.buildingiot.de/veranstaltung-5732-iot-als-zentraler-treiber-der-digitalisierung-%E2%80%93-use-cases%2C-technologien%2C-mehrwerte-%5Bsponsored-talk%5D.html?id=5732)„. The talk was given by Dominik and Christian Pereira from Q-loud. Networking and meeting people were a lot of fun. Besides that, we had great discussions at our booth. Security, integration and projects were the key topics this year. Moreover, a lesson we already learned at the Hannover Messe 2017, analytics is becoming more important as a key skill and, therefore, it is interesting for partnerships. As soon as there is the data, concepts and knowledge are needed to come to insights. Luckily, OC has already a strong background in analytics, so that we can look forward to new, interesting projects. Our favorite three talks were: - Sicherheit & IoT „“ Stand der Gefährdung 2017 (Security and IoT „“ State of Threats 2017) by Stefan Strobel: A talk about new approaches for hacking - Praxisbericht: Eine Big-Data- und Microservices-Landschaft für IoT-Daten (A report about a big data and microservice acrchitecture) by Marc Jäckle, Sebastian Wöhrl: Great justification of our architectures) - Auf dem Weg zu einer offenen IoT-Cloud-Plattform (On the way to an open IoT cloud platform) by Steffen Evers, Kai Zimmerman: Great insights about designing own IoT Clouds. [![](https://thecattlecrew.net/wp-content/uploads/2017/05/building_iot_2017_programm2.jpg?w=225)](https://thecattlecrew.net/wp-content/uploads/2017/05/building_iot_2017_programm2.jpg) [![](https://thecattlecrew.net/wp-content/uploads/2017/05/building_iot_2017_programm1.jpg?w=225)](https://thecattlecrew.net/wp-content/uploads/2017/05/building_iot_2017_programm1.jpg) The Q-loud sorter showcase in combination with the Hololens was definitely an eye catcher which attracted people and resulted in a lot of discussions. If you are interested, Otto published a video on [youtube](https://youtu.be/7KRStX7bzS8). [![](https://thecattlecrew.net/wp-content/uploads/2017/05/building_iot_2017_booth.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2017/05/building_iot_2017_booth.jpg) Overall, the conference was a great success and brought together developers, innovators and managers. We are looking forward to next year. **Kategorien:** AI & Data Science, Automation, Tech Events & Networking --- ### [Analyzing Wikipedia using Apache Storm](https://thecattlecrew.net/2017/06/21/analysing-wikipedia-using-apache-storm/) **Published:** Juni 21, 2017 **Author:** Lukas Berle **Excerpt:** This article describes some functionalities of Apache Storm and how it can be used to analyze changes of Wikipedia. **Content:** Apache Storm is one of the dinosaurs within the large set of big data technologies – especially in the stream processing area. This article will introduce you to Apache Storm by demonstrating how to create a small project. Many tutorials about streaming technologies use the Twitter API to demonstrate their framework. In this tutorial we will use the public available wiki data stream that continuously sends data whenever an article in one of Wikimedia’s wikis has been changed. ## Apache Storm Basics The most important concepts in Storm are the spouts, the bolts and the topology: - **Spouts:** Are responsible to get data from outside into the Storm Cluster - **Bolts:** Are responsible to do something with the data and potentially send them to the next bolt - **Topology:** Defines how spouts and bolts interact and determines the parallelism Another important concept is the groupings. Groupings are defined in the topology and tell Storm which data tuple must be distributed to which of the bolt’s tasks. The most important grouping types are: - **Shuffle Grouping:** Tuples are distributed randomly to the bolts‘ task - **Fields Grouping:** Tuples having the same value in a field defined in the topology are sent to the same task - **All Grouping:** All data tuples go to all tasks. Typically used to send configuration data - **Global Grouping:** All tuples go to exactly one task There are some other groupings that can be found [here](http://storm.apache.org/releases/1.1.0/Concepts.html). ## Our Task That’s enough technical stuff! Let’s get into the problem! Which data is sent to us? Everytime there is a change in a wiki, the stream sends us JSON data in real time in the following structure: ![wiki](https://thecattlecrew.net/wp-content/uploads/2017/06/wiki.png) So we have a comment, we have the information in which wiki the change was made, and we know if the change was made by a bot. Furthermore we have some other information we don’t care about here. Let’s define our goals! We want to know which wikis are the most active ones! And we don’t care about changes made by bots. To make the objectives as clear as a test in school: Write a Storm application using Java which regulary writes a new .txt file which contains the name of the wikis and the number of changes that happened there. Ignore all bot changes! The text file shall have this format: > https://ms.wikipedia.org 1 > > https://fr.wikipedia.org 49 > > https://nl.wikipedia.org 8 > > https://sv.wikipedia.org 3 > > https://bs.wikinews.org 1 > > https://te.wikipedia.org 1 > > https://zh.wikipedia.org 29 In each line we want to have the name of the wiki and the number of changes. ## The Concept We learned about the topology, spouts and bolts before. At first we need a spout which receives data from the wiki stream and brings the data in our topology. Let’s call it WikiSpout. The WikiSpout sends the data tuples to a bolt called RemoveBotsBolt which removes all tuples from the data stream which contain the attribute bot:true. In the last step the data must be sent to the ServerCounterBolt which finally tracks the number of changes in the wikis. So our topology looks like this: ![topology](https://thecattlecrew.net/wp-content/uploads/2017/06/topology.png) ## Let’s start! ### The POM First of all we create a project using this pom.xml \[code language=“xml“\] 4.0.0 de.opitz.bigdata wikireader 0.0.1-SNAPSHOT org.apache.maven.plugins maven-compiler-plugin 3.1 1.71.7 1.7 org.apache.storm storm-core 1.0.2 provided org.apache.commons commons-io 1.3.2 \[/code\] ### The Main Let’s start with our main class: \[code language=“java“\]public class Main { public static void main(String\[\] args) throws Exception { Config conf = new Config(); conf.setDebug(false); conf.setNumWorkers(2); // We want to use 2 Worker processes LocalCluster cluster = new LocalCluster(); // We define a LocalCluster which is perfect for developing puposes TopologyBuilder topologyBuilder = new Topology().build(); cluster.submitTopology(„WikiTopology“, conf, topologyBuilder.createTopology()); } }\[/code\] This class seems to be more or less self-explanatory: We get a configuration, define the number of worker processes we want to use, tell Storm that we are just using a LocalCluster for testing and finally submit our topology. ### The Topology It’s becoming interesting: We define our topology! So let’s go to the class Topology: \[code language=“java“\]public class Topology { public TopologyBuilder build() { TopologyBuilder topologyBuilder = new TopologyBuilder(); topologyBuilder.setSpout(„WikiSpout“, new WikiSpout(), 1); topologyBuilder.setBolt(„RemoveBotsBolt“, new RemoveBotsBolt(), 3).shuffleGrouping(„WikiSpout“); topologyBuilder.setBolt(„ServerCounterBolt“, new ServerCounterBolt(), 1).globalGrouping(„RemoveBotsBolt“); return topologyBuilder; } }\[/code\] At first we tell Storm that we want to have a spout called „WikiSpout“ which implementation is in WikiSpout.java and that we only want one task that executes this spout. That should be enough since the spout just receives data and sends them to the bolt. In the next line we define our first bolt, the RemoveBotsBolt. We define a parallelism of 3, because we assume that the complexity of this process needs 3 tasks. (Of course that’s not realistic and just for demonstration purposes) Finally we define a global grouping from the RemoveBotsBolt to ServerCounterBolt. Why a global grouping? If we would use a shuffle grouping and define a parallelism > 1, the data tuples sometimes go to task1 and sometimes to task2 and so on. We cannot seriously count our data tuples since both tasks have their „own“ counter and we have also no database to synchronize the counters in this example. Additional Question: What would you do, if there is so much data that one task of ServerCounterBolt cannot deal with this? —-> We have to increase the parallelism, and we have to think about using field-grouping in order to achieve correct results. Try it! ### Some Helper Classes Before we continue we create two small classes which will help us later: \[code language=“java“\]public class Util { public static final String SERVER = „server“; public static final String USER = „user“; public static final String TITLE = „title“; public static final String BOT = „bot“; }\[/code\] and \[code language=“java“\]public class Change { private String serverName; private String title; private String user; private boolean bot; \+ Getters & Setters! }\[/code\] ### Our Wiki-Spout At first we need a library that is able to read the wiki stream. We decided to use [this socket.io-java-client from Github](https://github.com/Gottox/socket.io-java-client) and compiled it and imported it to the build path. Now let’s create a class called WikiSpout extending BaseRichSpout. Before writing any methods we start with defining following variables: \[code language=“java“\] private SpoutOutputCollector collector; private List changes; final Lock lock = new ReentrantLock(); \[/code\] First of all we need to overwrite the method nexTuple(). This method is invoked continuously by Storm (imagine a while loop invoking this method over and over). The goal of this method is to send all data we have in our list „changes“ to the next bolt: \[code language=“java“\]lock.lock(); for (Change change : changes) { collector.emit(new Values(change.getServerName(), change.getUser(), change.getTitle(), change.isBot())); } changes = new ArrayList(); lock.unlock();\[/code\] We needed a lock here, since it is possible that while invoking nextTuple() the List „changes“ is used by another method. This is the method open(Map arg0, TopologyContext context, SpoutOutputCollector collector): It is invoked only when the task gets started. At first we create some variables: \[code language=“java“\]this.collector = collector; SocketIO socket = null; changes = new ArrayList(); \[/code\] And then we try to invoke the wiki stream: \[code language=“java“\] try { socket = new SocketIO(„http://stream.wikimedia.org/rc“); } catch (MalformedURLException e1) { throw new RuntimeException(e1); }\[/code\] After we start listening to this socket: \[code language=“java“\]socket.connect(new IOCallback() { public void onMessage(JSONObject json, IOAcknowledge ack) { } public void onMessage(String data, IOAcknowledge ack) { } public void onError(SocketIOException socketIOException) { System.out.println(„an Error occured“); socketIOException.printStackTrace(); } public void onDisconnect() { System.out.println(„Connection terminated.“); } public void onConnect() { System.out.println(„Connection established“); } public void on(String event, IOAcknowledge ack, Object… args) { System.out.println(„Server triggered event ‚“ + event + „‚“); if (args\[0\] instanceof JSONObject) { JSONObject changeJson = (JSONObject) args\[0\]; try { Change change = new Change(); change.setUser(changeJson.get(„user“).toString()); change.setTitle(changeJson.get(„title“).toString()); change.setServerName(changeJson.get(„server\_url“).toString()); change.setBot(Boolean.valueOf(changeJson.get(„bot“).toString())); lock.lock(); changes.add(change); lock.unlock(); } catch (JSONException e) { e.printStackTrace(); } } } });\[/code\] The most interesting thing here is the on(…) method. It is invoked whenever a change in a wiki was done. Then we get a JSON Object according to the example described in the text above. Now we extract the data we want from the JSON, create a „Change“ object and add it to the list. Finally we tell the socket to subscribe to each tuple that is sent by the stream: \[code language=“java“\]socket.emit(„subscribe“, „\*“);\[/code\] The last thing we have to do is to tell Storm what the names of the fields we send to the next bolts are: \[code language=“java“\]public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields(Util.SERVER, Util.USER, Util.TITLE, Util.BOT)); }\[/code\] So what did we do? The method on() is continuously invoked when a change in wiki happened and adds a „Change“ object to a list. Method nextTuple() is continuously invoked by Storm. If the list mentioned above contains elements they get emitted, which finally means that they will be sent to the next bolt(s). ### Remove Bots Bolt The task of the RemoveBotsBolt is to eliminate all tuples that have a flag „true“ for the attribute bots. So we create a new class, RemoveBotsBolt.java extending from BaseRichBolt. Before writing a method we define the collector: \[code language=“java“\]private OutputCollector collector; \[/code\] In the prepare method, we set it: \[code language=“java“\] public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) { this.collector = collector; }\[/code\] The execute method should look like the following: \[code language=“java“\]public void execute(Tuple input) { Boolean bot = input.getBooleanByField(Util.BOT); String server = input.getStringByField(Util.SERVER); if (!bot) { collector.emit(new Values(server)); } }\[/code\] The method execute(…) is invoked by Storm when a new data tuple comes in. We extract the data from this tuple, and if we get a bot, we do nothing; otherwise we emit the name of the server. This time we know the next bolt is just interested in the name of the server (for example ‚de.wikipedia.org‘). So we tell Storm the name of our single output field: \[code language=“java“\]public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields(Util.SERVER)); }\[/code\] ### Finally: The Server Counter Bolt The last class we are writing is called ServerCounterBolt extending from BaseRichBolt. This time the methodes prepare and declareOutputFields can be left empty. But we need two variables at the beginning of the class: \[code language=“java“\] private HashMap counts = new HashMap(); private int totalCount = 0;\[/code\] - **counts:** contains the name of the server and the number of occurences - **totalCount:** contains the total number of tuples that came in So let’s write a helper method that writes a file having the current date and time in its name: \[code language=“java“\] private void writeFile() { DateFormat df = new SimpleDateFormat(„MMdd-HH-mm-ss“); String dateTime = df.format(new Date()); File file = new File(dateTime + „.txt“); List lines = new ArrayList(); for (String key : counts.keySet()) { lines.add(key + “ “ + counts.getOrDefault(key, 0)); } try { FileUtils.writeLines(file, lines); } catch (IOException e) { throw new RuntimeException(e); } }\[/code\] This method iterates through our „counts“ map and writes its contents to a file. Finally we have to overwrite the execute-Method: \[code language=“java“\] public void execute(Tuple input) { totalCount++; String server = input.getStringByField(Util.SERVER); Integer count = counts.getOrDefault(server, 0); count++; counts.put(server, count); if (totalCount % 200 == 0) { writeFile(); } }\[/code\] That’s it! Now we can start the main class and need to wait a few seconds to get the first file with results. This article just describes the absolute basics of Storm. Many things, for example acknowledgments are not dealt with here. So have fun to dive deeper into Storm’s technology! I hope you got a first idea how Storm works. **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Big Data, Hadoop, Storm, Stream Processing --- ### [Thoughts about using API in IoT Scenarios](https://thecattlecrew.net/2017/07/19/thoughts-about-using-api-in-iot-scenarios/) **Published:** Juli 19, 2017 **Author:** tjkrajewski **Content:** The number of IoT (Internet of Things) devices increases rapidly day by day. According to Gartner Institute, 8.4 billion connected things will be in use worldwide already this year. It means an increase of more than 30 percent comparing to the previous year. The IT research firms expect that this number will be much bigger and can result from 21 billion (Gartner) to 37 billion (Cisco) by 2020! To imagine how our world is going to change, it is worth to mention that all those forecasts do not even include PCs, tablets and smartphones. IoT projects contain not only large number of devices but also various application programming interfaces (APIs) and huge amounts of data. The easiest and the most efficient way to interact with these are APIs. IoT devices are connected to data located in cloud-based services. They are like a sky bridge there „” IoT solutions on one side, data and capabilities on the other. APIs make IoT useful, turns limited little things into powerful bridges of possibilities. You can imagine APIs like something as an inter-connector which provide the interface between the global network and the Things. APIs expose the data that enables multiple devices to be combined and connected to solve new and interesting workflows. Because of that it should be ensured an easy way for communication which will be managed in an efficient and secure system. It cannot be forgotten that with new IoT devices it comes big risk which gives hackers and cyber criminals more possibilities to attack. The nature of electronic devices operated by the human beings plus the importance of some of the things that connect to each other (satellites, traffic lights, vehicles) raise critical issues as well. That is the main reason that APIs need to be more protected. APIs are a fundamental enabler of the Internet of Things but without management system, IoT devices can easily lead to catastrophe, especially when it comes to: - versioning and supporting for using devices - management developers and device registrations - devices visibility and analytics - performance and scalability - full control of permissions # What is API Management in the IoT area? It is a set of technologies and processes for creating, managing, securing, analyzing and scaling the APIs from IoT connected devices. A developer portal enables companies to provide everything that internal, partner and third party developers need to be effective and productive building the APIs. [![](https://thecattlecrew.net/wp-content/uploads/2017/07/api-ca-figure.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2017/07/api-ca-figure.jpg) ###### (source:) The APIs allow devices to talk to each other in a consistent and structured way that makes it really easy to get them to communicate. Writing about IoT we need to mention about various of protocols (CoAP, XMPP, MQTT, WAMP, OMG DDS, Stomp) and frameworks (Web RTC, [ASP.NET](http://ASP.NET) SignalR, webSocket.org, Couchbase, Socket IO, Meteor) so it leads that IoT API management system also integrates IoT devices environment. The next very important issue is the security. API Management system creates secure user-friendly identity. It ensures secure connections to devices across mobile and the IoT environment. Besides using a platform it is much easier to identify and neutralize SQL injection, DoS attacks and other online threats # Future world example To prove how important is using API and API Management, let us take a look at an example. According to Intel predictions the coming flood of data in autonomous vehicles will reach level of ca 4 000 GB per day. Let“™s add that „BI Intelligence“ estimated that there will be 10 million self-driving cars on the road by 2020[\[1\]](#_ftn1). Those information show us how important it will be to ensure right and stable communication in the IoT world. ###### [![](https://thecattlecrew.net/wp-content/uploads/2017/07/autonomous-vehicle-data-intel-100697604-large.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2017/07/autonomous-vehicle-data-intel-100697604-large.jpg)Source: http://images.techhive.com/images/article/2016/12/autonomous-vehicle-data-intel-100697604-large.jpg Imagine situation that a car needs to send data as soon as possible in case of accident. The best way for it would be using API solution. # Example payload Most web applications support RESTful APIs which rely on HTTP methods. The open source Swagger framework helps to design and maintain APIs. The framework provides the OpenAPI Specification for creating RESTful API documentation formatted in JSON or YAML. In this article will be showed YAML file because it is much easier to read. `swagger.YAML`Listening 1 An Example of Swagger API documentation. Thanks to API definition a car can easily communicate with an emergency center during the accident. It can use the following methods to send data into datacenter. There are several HTTP methods used to achieve this goal. **POST** **/accident** Add a new accident to emergency center Although car processes a lot of data locally it should send only most valuable of them. The payload shouldn“™t be too big so that it will not slow down communication and can be processed fast. In this very simple example let“™s imagine that car is sending the following information: - car model - car number plates - accident time - owner name - GPS Location - Average speed - Passenger numbers - Status of accident - Injury of passengers Actually a vehicle could send much more data which will be crucial in an emergency center where artificial intelligence can decide what kind of help should be sent. Example Value Model of POST method ``` {   "CarModel": "Toyota Yaris II 2014",   "carNumberPlates": "D65261",   "accidentTime": "1985-04-12T23:20:50.52Z",   "owner": "Wojtek Konowal",   "location": "[47.4925, 19.0513]",   "averageSpeed": 110,   "passangers": 1,   "status": "registred",   "injury": "Serious" } ``` After getting the first help, damaged vehicle updates easily and fast it“™s status, which can indicate when passenger“™s health gets worse so that medical center should decide for example to send a helicopter to get injured passenger faster into hospital. This function is ensured by the PUT method. **PUT** **/accident** Update an existing accident ``` { "CarModel": "Toyota Yaris II 2014", "carNumberPlates": "D65261", "accidentTime": "1985-04-12T23:20:50.52Z", "owner": "Wojtek Konowal", "location": "[47.4925, 19.0513]", "averageSpeed": 110, "passangers": 1, "status": "Service is pending", "injury": "Critical" } ``` API solutions can be used also for gathering data by big data center which later can easily find patterns in tautened of accidents and use machine learning to train artificial intelligence to send better help to the accident location next time. **GET** **/accidents/all** Returns all accidents by status We need to remember that a right API design cannot be done without implementing the efficient API Managment solutions. The above described example is directly connected with rescuing people“™s life area. Every car should use oAuth2 to authorize device access. Managed API ensures also proper access control, request routing, buffering, stats collection, monitoring, alerting and decision making. # Summarize It is obvious that APIs are becoming crucial in the new developing IoT world but these APIs must be managed to achieve optimal results. The API management helps company to monitor, analyze, report and use policy management. Without an effective API management strategy, an organization cannot take right care of the usage of its APIs. If company neglects this thing it can be not only a threat to their business but also to their users and customers. --- [\[1\]](#_ftnref1) http://www.businessinsider.com/report-10-million-self-driving-cars-will-be-on-the-road-by-2020-2015-5-6?IR=T **Kategorien:** Automation, Integration **Schlagwörter:** API Managment, IoT --- ### [Mit Impact Mapping dem Ziel einen Schritt näher](https://thecattlecrew.net/2017/08/22/mit-impact-mapping-dem-ziel-einen-schritt-naeher/) **Published:** August 22, 2017 **Author:** monikaschubert **Content:** Zwei meiner Kollegen haben sich intensiv mit **Alexa** als Chatbot und der Erstellung von Alexa Skills beschäftigt. Ihre Erfahrungen möchten sie nun in Chatbot-Projekten bei Kunden weiterhin praktisch anwenden und damit mit dem Kunden einen weiteren Schritt Richtung Digitalisierung gehen. Unsere Vertriebs-Pipeline enthält derzeit wenige Alexa-/Chatbot-Projekte und so stellten wir uns der Frage: **Was müssen wir tun, um mehr Alexa- und Chatbot-Projekte bei Kunden zu durchführen zu können?** Mein erster Gedanke: „Eine super Fragestellung, um die Methode Impact Mapping anzuwenden“. [**Impact Mapping**](https://www.impactmapping.org) ist ein Kommunikationsmittel, welches das gegenseitige Verständnis fördert und unterschiedliche Perspektiven zulässt. Uns dient diese Methode als **strategisches Planungsinstrument**. Der Ausgangspunkt der Impact Map ist unser **Ziel**. Dieses war schnell gefunden: „Wir wollen mindestens 3 Alexa-Projekte in den nächsten 6 Monaten durchführen“. Dies beantwortet auch schon die erste Frage des Impact Mappings und zwar jene nach dem „Warum?“. ![Impact Mapping - Warum?](https://thecattlecrew.net/wp-content/uploads/2017/08/warum.png?w=150) Im nächsten Schritt haben wir uns die Frage gestellt: **Wer kann uns dabei unterstützen unser Ziel zu erreichen?** Bzw. wer kann uns dabei behindern? Analog zu der Mindmapping-Methode sind wir von unserem Ziel ausgegangen und identifizierten einige Personengruppen, die uns helfen können unser Ziel zu erreichen: Anwender von Chatbots, unsere Consulting Mitarbeiter, unser Marketing bzw. Business Development und unser Vertrieb. Aus der Vergangenheit haben wir gelernt, dass auch unser Datenschützer eine wichtige Rolle spielt und so haben wir ihn ebenfalls in die Impact Map aufgenommen. ![Impact Mapping - Wer?](https://thecattlecrew.net/wp-content/uploads/2017/08/wer.png?w=1024) **Wie können uns nun diese Personengruppen unterstützen oder behindern unser Ziel zu erreichen?** Das offensichtlichste ist, dass Kunden bzw. Anwender von Chatbots unsere Leistungen in Anspruch nehmen. Des weiteren können unsere Consulting Mitarbeiter in ihren vorhandenen Projekten ihren Kunden zeigen, dass wir auch Chatbots programmieren können. Der Vertrieb könnte Kunden aktiv auf Chatbots ansprechen und ihnen die Mehrwerte, welche durch Chatbots erreicht werden, aufzeigen. Marketing und Business Development können Materialien zur Verfügung stellen, Factsheets veröffentlichen oder die Organisation eines Meetups unterstützen. Der Datenschützer kann uns behindern unser Ziel zu erreichen, in dem er Ü„ngste verbreitet bzw. die Anschaffung von Chatbots oder weiteren Alexas verhindert. ![wie](https://thecattlecrew.net/wp-content/uploads/2017/08/wie.png) **Was können wir nun tun, um das Verhalten dieser Personengruppen zu beeinflussen?** Kunden bzw. Anwender können wir zu unserem Meetup einladen, sodass sie unsere Leistungen in Anspruch nehmen. Eine weitere Aktion ist, dass wir für unsere Consulting Mitarbeiter Material zur Verfügung stellen, sodass sie ihren Kunden zeigen können, was wir im Bereich Chatbots schon alles können bzw. gemacht haben. So sind uns noch einige weitere Möglichkeiten eingefallen, die in der folgenden Grafik dargestellt sind. ![was](https://thecattlecrew.net/wp-content/uploads/2017/08/was.png) Nun haben wir den Raum für viele unterschiedliche Aktionen geöffnet. Der nächste Schritt liegt in der **Bewertung der Möglichkeiten**. Was wollen wir als nächstes in Angriff nehmen? Dabei haben wir uns entschlossen ein Meetup zum Thema: [„Alexa – cool oder gruselig“ in München](https://www.meetup.com/de-DE/Digital-Experience-behind-the-scenes/events/241873058/?eventId=241873058&chapter_analytics_code=UA-104776332-1) als ersten Schritt zu unternehmen. **Fazit** Mit der Methode Impact Mapping sind wir schnell zu einer Vielzahl an möglichen Aktionen gekommen, von denen wir anschließend die vielversprechendste Aktion ausgewählt haben. **Links** [Impact Mapping](https://www.impactmapping.org) [Von der Impact Map zu User-Storys: Wie Stakeholder und Entwickler gemeinsam eine Strategie verfolgen](https://www.sigs-datacom.de/uploads/tx_dmjournals/schubert_OS_02_2016_CZ3J.pdf) **Autor** Monika Schubert arbeitet am unscharfen Beginn der Produktentwicklung bei OPITZ CONSULTING. Sie hilft Unternehmen ihre Produkte so zu definieren und anzupassen, dass die Anwender sie lieben und gerne benutzen. Neben ihrer Projekttätigkeit treibt sie als Leiterin des Kompetenzteam Anforderungs- und Testmanagement aktiv die Recherche, die Weiterentwicklung und den Wissenstransfer neuer Konzepte voran. **Kategorien:** Tools & Methoden **Schlagwörter:** agile, agilität, Alexa, Artificial Intelligence, ImpactMapping, methoden, Workshop --- ### [Vision Picking Showcase mit der Vuzix M300](https://thecattlecrew.net/2017/11/29/vision-picking-showcase-mit-der-vuzix-m300/) **Published:** November 29, 2017 **Author:** Jan Hüsson **Content:** Ein Warenlager am Messestand? Dazu noch mit der Vuzix M300 Datenbrille verknüpft? Geht das überhaupt? In einem Showcase haben wir auf mehreren Fachkonferenzen, unsere Lösung präsentiert, darunter WJAX, Continuous Lifecycle und DOAG Konferenz. Natürlich vom realen Warenlagen abstrahiert, aber für einen Eindruck der Arbeitsweise der Datenbrille optimal. Welche Erfahrungen wir (Sebastian Lechte, Edgar Filipsen, Manuel Fink und Jan Hüsson) bei der Entwicklung gesammelt haben und wie letztlich das Feedback zu dem Case war, erfahrt ihr in diesem Artikel. ## Der Entwicklungsprozess mit der Vuzix M300 Die Vuzix M300 ist eine klassische Datenbrille mit einem Head-Mounted-Display. Ein kleiner Monitor ist am Brillengestell befestigt und vor einem Auge positioniert. Er schränkt somit den Sichtbereich dieses Auges ein. Das andere Auge ist komplett frei. Die Brille läuft mit Android 6.0, somit kann Android Studio als Entwicklungsumgebung genutzt werden. Ein Emulator mit passendem Theme steht zur Verfügung. Wer schon einmal Android Apps erstellt hat, findet sich somit schnell zurecht. ![vuzix_face](https://thecattlecrew.net/wp-content/uploads/2017/11/vuzix_face.png) Es könnte also alles so einfach sein. Doch beim Anschluss der Vuzix M300 an den Computer kam die erste Ernüchterung. Die Erkennung der Vuzix funktionierte nicht, wie beim Smartphone gewohnt, per Plug & Play. Stundenlanges Ausprobieren mit den USB- Treibern führte uns jedoch letztlich zum gewünschten Ergebnis. Von nun an lief die Entwicklung unproblematisch. Auch wenn die reine Implementierung der Android-App so ähnlich funktioniert wie bei einer Smartphone App , so gibt es doch einige Unterschiede. Die Fokussierung auf ein bestimmtes Gerät wie der Vuzix M300 erleichtert natürlich die Entwicklung und Kompatibilitätsproblematiken entfallen weitestgehend. Andererseits ist auf ein gänzlich anderes Bedienkonzept zu achten. Zwar gibt es vier Knöpfe und auch einen kleinen Touchbereich an der Brille, diese sollten jedoch weitestgehend aus dem Bedienkonzept herausgehalten werden, da sonst der Vorteil der Datenbrille, beide Hände frei zu haben, verloren ginge. Eine passendere Art der Navigation ist visueller Natur: die Navigation per QR-Codes. Hierfür liefert Vuzix eine Bibliothek mit, die wunderbar mit der M300 kompatibel ist. Da uns die Brille nicht während der gesamten Entwicklungszeit zur Verfügung stand, mussten wir uns eine Lösung überlegen, um unsere App dennoch zu testen. Die native Entwicklung in Android Studio mit Java kam uns entgegen. Warum nicht unseren Showcase einfach auf einem Android Smartphone testen, dachten wir. Doch die Vuzix Bibliothek für QR-Codes machte uns hier einen Strich durch die Rechnung. Eine Alternative war in Form der frei verfügbaren ZXing Bibliothek schnell gefunden. Da diese jedoch zwar auf dem Smartphone gut funktionierte, bei der Vuzix aber äußerst unsensitiv war, mussten wir uns noch eine andere Lösung überlegen. Letztlich fragten wir programmatisch die Hardware ab und setzten je nach Gerät die passende Bibliothek ein. Somit lief der Showcase auf der m300 und Android Smartphones. ## Der Vision Picking Showcase im Detail Unser Showcase besteht aus einem Schubkasten mit 16 einzelnen Boxen, in denen sich wiederum verschiedene Formen befinden. Die Aufgabe besteht darin, bestimmte Formen aus den Boxen zu nehmen und in eine weitere Zielbox zu räumen. Die dafür notwendigen Informationen werden auf dem Display der Vuzix angezeigt. Sowohl die einzelnen Boxen, als auch die Formen sind mit QR-Codes beklebt, damit die Vuzix die einzelnen Objekte erkennen kann. Dadurch ist es möglich, jeden Schritt zu dokumentieren und den Standort der Objekte in einer Datenbank zu speichern. [![](https://thecattlecrew.net/wp-content/uploads/2017/11/vuzix_showcase1-150x150.jpg)](https://thecattlecrew.net/2017/11/29/vision-picking-showcase-mit-der-vuzix-m300/vuzix_showcase/) [![](https://thecattlecrew.net/wp-content/uploads/2017/11/vuzix_screenshot1-150x150.png)](https://thecattlecrew.net/2017/11/29/vision-picking-showcase-mit-der-vuzix-m300/vuzix_screenshot/) [![](https://thecattlecrew.net/wp-content/uploads/2017/11/vuzix_jobkarte1-150x150.jpg)](https://thecattlecrew.net/2017/11/29/vision-picking-showcase-mit-der-vuzix-m300/vuzix_jobkarte/) Gestartet wird mittels spezieller Auftragskarten. Diese bestimmen die Anzahl der Teile, die gesammelt werden müssen. Unsere App generiert dann zufällig einen Auftrag und ein Algorithmus ermittelt die passenden Boxen, um in möglichst wenigen Schritten alle gesuchten Formen zu finden. Zum Schluss wird die Zielbox angezeigt, und sobald alle Gegenstände dort hineingelegt wurden, ist der Auftrag erledigt. ## Unsere gesammelten Erfahrungen Auf den Messen gab es großes Interesse an unserem Showcase und viele Besucher schlüpften selbst in die Rolle eines Lagerarbeiters. Das Feedback war dabei größtenteils positiv. Schon nach einer kurzen Einführung konnten alle Besucher den Auftrag erfolgreich abschließen und sich eine entsprechende Anwendung vorstellen. Die Brille wurde als leichtgewichtig empfunden und hielt mit der externen Powerbank viele Stunden durch. Die Kamera ist hochauflösend und ermöglicht der Software, auch kleine QR-Codes mit hoher Zuverlässigkeit zu erkennen. Dennoch gab es auch Kritik. Diese war vor allem dem Konzept der Brille geschuldet. Die Einschränkung des Sichtfeldes durch einen letztlich doch sehr kleinen Monitor führte zu Schwierigkeiten bei der Fokussierung mit dem Auge. Wir als Entwickler hatten anfangs die gleichen Schwierigkeiten, konnten uns nach längerem Testen jedoch daran gewöhnen. Zusätzlich saß das Brillengestell nicht bei allen Anwendern gleich gut. In wenigen Fällen hatte die Brille gar keinen Halt auf der Nase. Außerdem konnten wir ebenfalls in wenigen Fällen das Einfrieren der kompletten Brille feststellen. Dies lässt sich vermutlich auf eine Beschädigung an der Buchse der Haupteinheit zurückführen, da die Brille während der Messen stark beansprucht wurde. Zudem sahen einige Besucher aus der Logistikbranche die Gefahr, dass durch das verdeckte Sichtfeld Gefahren wie z. B. Gabelstapler im Lager nicht oder zu spät erkannt werden könnten. Für uns selbst haben wir festgestellt, dass wir den Showcase zunächst zu groß geplant haben. Ursprünglich sollten zwei Besucher gegeneinander antreten. Einer mit und einer ohne Brille und dabei mehrere Aufträge abschließen. Da die meisten Besucher nur kurz testen wollten, verzichteten wir am Ende auf den Wettbewerb und ließen die Besucher nur einen Auftrag abschließen. Das hatte den Vorteil, dass der Showcase nicht so lange dauerte und mehr Nutzer die Brille ausprobieren konnten. ## Fazit Wie wir aus dem Feedback gelernt haben, muss die Möglichkeit eines produktiven Einsatzes in einem größeren Rahmen überprüft werden. Dennoch konnte der Showcase sehr gut darstellen, was mit der aktuellen Technik möglich ist, welche Limitierungen es noch gibt und wie eine Datenbrille in Zukunft den Arbeitsalltag der Logistikbrache unterstützen könnte. **Kategorien:** AI & Data Science --- ### [Automatisierung trifft auf die IT](https://thecattlecrew.net/2017/12/06/automatisierung-trifft-auf-die-it/) **Published:** Dezember 6, 2017 **Author:** Otto Fitz **Content:** Industrie 4.0 und OPC UA sind Buzzwords, die man immer wieder hört, wenn es um die Digitalisierung in der Industrie geht. Um besser zu verstehen, was die deutsche Industrie darunter versteht, haben wir vom 28.-30.11.17 zusammen mit einem mittelständischen Maschinenbaukunden die SPS IPC Drives Fachmesse in Nürnberg besucht. ![Unbenannt](https://thecattlecrew.net/wp-content/uploads/2017/12/unbenannt.png) **Die neue Hightech-Strategie** Bei diesem Besuch stellten wir fest, dass Industrie 4.0 schon längst kein abstrakter Begriff mehr ist. Sie ist beispielsweise ein zentraler Bestandteil der neuen Hightech-Strategie, Innovation für Deutschland, deren Ausbau von der Bundesregierung gefördert wird. Die Regierung möchte damit die Position von kleinen und mittelständischen Unternehmen in Deutschland stärken um ihre Vorreiterstellung in der Welt verteidigen. ![Unbenannt2](https://thecattlecrew.net/wp-content/uploads/2017/12/unbenannt2.png) ###### Quelle: https://www.hightech-strategie.de/index.php **Die Treiber der Industrie 4.0** Doch wer sind die Treiber der Industrie 4.0? Es ist ganz einfach: Robotik, M2M Kommunikation, Big Data sowie Datensicherheit. Das sind die Industrie-4.0-Themen, mit denen die Maschinenbauer in Deutschland die digitale Transformation angehen müssen, um den Wettbewerbsvorteil nicht zu verlieren. Aus dieser Vision ist jetzt Realität geworden, und das wurde auf der Messe auch stolz demonstriert. Die heutigen Maschinen sind vernetzt und organisieren die Produktion selbständig, sie kommunizieren mit den Produkten und bestellen die benötigten Rohstoffe just-in-time. Die Realisierung solcher Systeme ist durch das Verschmelzen der Bereiche IT und Automatisierung möglich geworden, die zusammen die Herausforderungen am Markt meistern und damit das Label „Made in Germany“ verteidigen möchten. **Innovation Lab as a Service** Doch die Realisierung der Industrie-4.0-Projekte, erfordert derzeit noch immer Mut. Längst nicht jeder Mittelständer traut sich das Experiment anzugehen und dafür Ressourcen bereitzustellen. Um das finanzielle Risiko im Rahmen von innovativen Technologien für den Kunden zu verringert, bieten wir eine Lösung mit unserem „Innovation Lab as a Service“ an. Unser regionaler Maschinenbauer setzt bereits auf dieses Modell und erprobt seitdem Schritt für Schritt, erfolgreich seine digitalen Geschäftsmodelle. **Ausbildung/Personal** Die Messe hat deutlich gezeigt, dass ein Arbeitstag mit Industrie 4.0 erheblich schneller geworden ist und die Ausbildung des Personals sowie die Arbeitszeitmodelle neu überdacht werden müssen. Es reicht nicht mehr, ein Seminar zu besuchen, die Schulung muss Tag für Tag am Arbeitsplatz stattfinden, um mit der Entwicklungsgeschwindigkeit mithalten zu können. **Fazit** Die mittelständischen Unternehmen brauchen dringend personelle und beratende Unterstützung, um Innovationen voranzutreiben und Möglichkeiten zu schaffen, neben den qualitativ hochwertigen Produkten, auch smarte digitale Services anzubieten. Die Bundesregierung fördert die mittelständischen Unternehmen die Innovationen in deutschen Betrieben vorantreiben, um den Wirtschaftsstandort Deutschland in der Welt zu verteidigen. **Kategorien:** Automation --- ### [Alexa for Business: was ich jetzt wissen muss](https://thecattlecrew.net/2017/12/15/alexa-for-business-was-ich-jetzt-wissen-muss/) **Published:** Dezember 15, 2017 **Author:** Christian Ochsenkühn **Content:** Amazon hat Ende November auf der [AWS Reinvent](https://thecattlecrew.net/2017/11/30/oc-amazon-reinvent-part-1/) neben der Ankündigung von Notifications und Stimmerkennung auch **Alexa for Business** (A4B) enthüllt. Mit dieser Plattform sollen Amazons Sprachassistenten nicht mehr nur in zig privaten Haushalten, sondern zukünftig auch im Büro Einzug nehmen. Dort können zum Beispiel Besprechungen per Sprache gestartet, Geräte in Konferenzräumen gesteuert oder wiederkehrende Aufgaben am Schreibtisch automatisiert werden. \[youtube https://www.youtube.com/watch?v=ViB3XhsTLuo&rel=0&controls=0&showinfo=0&w=560&h=315\] Was muss ich wissen, wenn ich Alexa for Business jetzt in meinem Unternehmen einführen möchte? ## Was ist der Unterschied zur „normalen“ Alexa? Grundsätzlich bietet Alexa for Business zwei Arten, wie die Amazon Echo Geräte im Unternehmen verwendet werden können. Zum einen können registrierte „unternehmenesweite Alexa-Geräte“ (die sog. **Shared Devices**) an öffentlichen Plätzen – wie in Konferenzräumen oder am Empfang – platziert und dort auch von allen benutzt werden. Sie sind dann an den Unternehmensaccount gebunden. Zum anderen können Geräte an den Arbeitsplätzen der Mitarbeiter (die sog. **Enrolled Users**) stehen, wo diese sich zusätzlich mit ihren persönlichen Accounts anmelden können. Das ermöglicht eine wechselseitige Beziehung der Accounts: an meinem Arbeitsplatz kann ich auch Skills nutzen, die ich auf meinem Echo zuhause aktiviert habe. Und zuhause kann ich über Alexa auch meinen Arbeitskalender abfragen, da dieser an Alexa for Business gekoppelt ist. ### Shared Devices ![alexa-for-business_shared-devices](https://thecattlecrew.net/wp-content/uploads/2017/12/alexa-for-business_shared-devices.png)Diese Alexa-Geräte können unternehmensweit von allen genutzt werden. Bild: [Amazon](https://aws.amazon.com/de/alexaforbusiness/features/) Mögliche Szenarien für diese Shared Devices: - Alexa, finde einen freien Konferenzraum - Alexa, fahre die Rollos nach unten - Alexa, bestelle mehr Papier für Drucker XYZ - Alexa, rufe ein Shuttle zu Gebäude 2. ### Enrolled Users ![alexa-for-business_enrolled-users](https://thecattlecrew.net/wp-content/uploads/2017/12/alexa-for-business_enrolled-users.png) Diese Nutzer können Business-Skills mit ihrem persönlichen Account nutzen. Bild: [Amazon](https://aws.amazon.com/de/alexaforbusiness/features/) Mögliche Szenarien für Enrolled Users: - Alexa, erinnere mich, den Leistungsbericht um 9 Uhr zu drucken - Alexa, was steht heute alles an - Alexa, sage mein 14 Uhr Meeting ab - Alexa, schreibe ‚Präsentations vorbereiten‘ auf meine To-Do-Liste ### Alexa Skills for Business Wie auch für die private Alexa, können Unternehmen ihre eigenen Skills programmieren lassen und diese, ohne sie im [Alexa Skills Store](https://www.amazon.de/b?node=10068460031) veröffentlichen zu müssen, mit all ihren Geräten benutzen. **Wir entwickeln Ihren Alexa Skill | #OCVoicePioneers** Sie möchten einen Skill für Ihre Kunden, eine Messe oder für die Mitarbeiter Ihres Unternehmens? Kontaktieren Sie uns gerne, z.B. unter . Für Alexa for Business Skills gibt es zudem noch einige weitere Schnittstellen, die es ermöglichen den Standort eines Alexa-Gerätes innerhalb eines Gebäudes anzugeben oder auch spezielles Equipment eines Konferenzraums anzusprechen. ## Wie sieht das preislich aus? Alexa for Business ist kostenpflichtig. Amazon greift dabei auf ein monatliches Abomodell zurück. Jedes unter dem Unternehmen registrierte Alexa-Gerät kostet dann $7 pro Monat (Preise in Deutschland bzw. in Euro sind leider noch nicht bekannt). Das Gerät an sich muss dazu im Vorfeld auch käuflich erworben werden und ist nicht im Abo enthalten. Zudem kostet jeder „Enrolled User“ (also jeder Mitarbeiter, der seinen persönlichen Account mit dem Business-Account verbindet) $3 pro Monat. Unternehmen können Alexa for Business aber auch komplett ohne Enrolled User nutzen. Ein Unternehmen, das 13 Echos bzw. Echo Dots bei sich aufstellt, und in dem 30 Mitarbeiter ihren privaten Account verknüpfen möchten, würde demnach im Monat $181 zahlen. - $7 pro Alexa-Gerät / Monat - $3 pro Enrolled User / Monat ## Dann wäre da noch der Datenschutz…? Wenn ein Echo im Raum steht, hört er gesprochene Sätze, verarbeitet diese aber initial nur auf dem Gerät. Erst wenn er das Wake-Word („Alexa!“) hört, dann werden die darauffolgenden Sätze an Amazon bzw. deren Cloud geschickt. In [deren FAQs](https://aws.amazon.com/de/alexaforbusiness/faqs/) stellt sich Amazon nun die Frage „**Werden Inhalte, die von Alexa for Business verarbeitet werden, auch außerhalb der AWS Region verwendet, in der ich Alexa for Business nutze?**„. Für Deutschland gibt es zum Beispiel die AWS Region „EU (Frankfurt)“. Würde Amazon auf die gestellte Frage also mit einem klaren „Nein“ antworten, so lägen alle über Alexa übermittelte Daten innerhalb Deutschlands. Leider hält sich Amazon mit der Antwort sehr vage und spricht von einige Teilen der Inhalte, die auch in eine andere AWS Region geschickt werden könnten. Wie viele und welche Teile das sind, steht dort aber nicht. Der genaue Wortlaut: „*Any content processed by Alexa for Business is encrypted and stored at rest in the AWS region where you are using Alexa for Business. Some portion of content processed by Alexa for Business may be stored in another AWS region solely in connection with the continuous improvement and development of your Alexa for Business customer experience and other Amazon machine learning and artificial intelligence services.*“ ([Amazon AWS](https://aws.amazon.com/de/alexaforbusiness/faqs/#Privacy_and_data_security)) **Aber**: Speziell für Deutschland gibt es bisher noch keine genaueren Angaben zum Datenschutz. An dieser Stelle muss und wird Amazon sicherlich noch nachliefern. Es bleibt also spannend im Bereich der Sprachassistenten. **Würdest du Alexa for Business am Arbeitsplatz nutzen?** **Kategorien:** AI & Data Science **Schlagwörter:** #OCVoicePioneers, Alexa, Amazon, Conversational UI, Sprachassistenten, Voice First, VUI --- ### ["œHilfe, die Roboter kommen!" - Fake News oder 5 vor 12?](https://thecattlecrew.net/2018/01/22/hilfe-die-roboter-kommen-fake-news-oder-5-vor-12/) **Published:** Januar 22, 2018 **Author:** monikaschubert **Content:** „Hilfe, die Roboter kommen“, „**Roboter nehmen uns die Arbeitsplätze weg**„ diese und ähnliche Schlagzeilen gehen immer wieder durch die Medien. Die digitale Revolution der letzten Jahrzehnte hat unsere Gesellschaft kräftig umgekrempelt, und ist noch lange nicht fertig. Sie war nicht der erste technologische Umbruch und wird auch nicht der letzte gewesen sein. Mit Hilfe der zur Verfügung stehenden Informationstechnologien wird der Fortschritt in der Automatisierung noch einmal beschleunigt. Speziell die Robotik profitiert von neuen Erkenntnissen im Bereich des künstlichen Intelligenz und der Verarbeitung riesiger Datenmengen. Immer wieder berichten Nachrichtenagenturen (z.B. [Reuters](https://www.reuters.com/article/us-davos-meeting-employment/robots-new-working-ways-to-cost-five-million-jobs-by-2020-davos-study-says-idUSKCN0UW0NV)), dass **bis 2020 rund 5.1 Millionen Arbeitsplätze** durch Automatisierung und Roboter ersetzt werden. Viele Leute die dies glauben unterschätzen dabei die Komplexität von einfachen Tätigkeiten. Wie schwer kann es schon sein jeden Tag Kleidung zu falten? Roboter haben heute noch Schwierigkeiten mit so einer Aufgabe. Amazon hat 2015 sogar eine Challenge ins Leben gerufen, bei dem die Roboter bestimmte Elemente aus Regalen entnehmen und in einen Behälter legen muss. Wie weit die Roboter in diesem Bereich sind, kann man auf dem [Blog der Amazon Picking Challenge](http://www.amazon-logistikblog.de/innovationen/pickingchallenge/) nachlesen. Was glaubt ihr? Wie wird sich unsere Arbeitswelt in der Zukunft verändern? Werden wir gemischte Teams aus Robotern und Menschen haben? Oder werden wir komplett von den Robotern ersetzt. Diskutiert mit uns bei unserem [Meetup am 25.1.2018 in Berlin](https://www.meetup.com/de-DE/Digital-Experience-von-digitalen-Machern-fur-digitale-Macher/events/246264821/). Damit der Einstieg in die Diskussion leichter fällt, gibt uns [Dr. Raphael Deimel](http://www.user.tu-berlin.de/raphael.deimel/researchprofile.html) von der TU Berlin einen kurzen Überblick über die aktuellen Forschungen und Entwicklungen. **Kategorien:** AI & Data Science **Schlagwörter:** automatisierung, industrie4.0, Robotik --- ### [AWS News KW 25 und KW 26](https://thecattlecrew.net/2018/07/24/aws-news-kw-25-und-kw-26/) **Published:** Juli 24, 2018 **Author:** Marco Buss **Content:** ## SQS als AWS Lambda Trigger Eine Neuerung auf die sicher Viele gewartet haben. [AWS Lambda](https://aws.amazon.com/ambda/) bietet ab sofort die Möglichkeit eine Funktion mit einer [SQS ](https://aws.amazon.com/sqs/)Nachricht zu triggern. Damit verbindet AWS einen der ersten Dienste Simple Queue Service (Erster Service von AWS aus 2004) mit einem der neueren AWS Lambda (veröffentlicht auf der re:Invent 2014). Um das ganze Setup zu vereinfachen und für eine bessere Integration in einen „typischen“ serverless Workflow wird der neue Trigger auch direkt vom [AWS Serverless Application Model (SAM)](https://github.com/awslabs/serverless-application-model/blob/master/versions/2016-10-31.md) und vom [serverless Framework](https://serverless.com/framework/docs/providers/aws/events/sqs/) unterstützt. Weitere Informationen zum neuen Trigger [hier](https://docs.aws.amazon.com/de_de/lambda/latest/dg/with-sqs.html). ## Amazon Polly WordPress Plugin Update Anfang des Jahres (siehe [Blogpost](https://thecattlecrew.net/2018/02/12/aws-news-kw-4-6/)) veröffentlichte Amazon ein WordPress Plugin mit dem jeder Artikel von Polly, Amazons Text to Speach Engine vorgelesen werden kann. Mit dem Update wird [Amazon Translate](https://aws.amazon.com/de/translate/) integriert und damit ist es jetzt möglich den Post in mehreren Sprachen als Audio zur Verfügung zu stellen. Weitere Informationen zum Plugin [hier](https://wordpress.org/plugins/amazon-polly/). ## Collaboratives Editieren und Microsoft Office Support für Amazon WorkDocs Für alle Office 365 Nutzer eine uninteressante News. Amazon WorkDocs bietet ab sofort die Möglichkeit gemeinsam Dokumente zu bearbeiten sowie eine Unterstützung für Microsoft Office Dokumente. Weiter Informationen zu Amazon WorkDocs [hier](https://aws.amazon.com/workdocs/). ## Amazon Linux WorkSpaces Amazon erweitert sein Angebot für die WorkSpaces um eine Linux Option. Amazon WorkSpaces bietet virtualisierte Windows/Linux Desktops auf die von vielen Endgeräten Zugegriffen werden kann. Weitere Informationen zu Amazon WorkSpaces [hier](https://aws.amazon.com/de/workspaces/). ## Asynchrone Batch Operationen für Amazon Comprehend Amazons Textanalyse Service Comprehend bietet ab sofort asynchrone Batch Operationen für Beispielsweise Spracherkennung, Schlüsselwort Extrahierung und Erkennung ob der Text positiv oder negativ ist. Mit der Verwendung der Asynchronen Batch Operationen haben sich vor allem die Limits für zu analysierende Texte erhöht. Mit den anderen Operationen sind lediglich Texte bis maximal 5000 Bytes möglich. Batch Operationen bieten im Gegensatz dazu folgende Limits: Maximale Größe (UTF-8 Characters) für Schlüsselwort Extrahierung100 KBMaximale Größe (UTF-8 Characters) für Spracherkennung1 MBMaximale Größe (UTF-8 Characters) für positiv/negativ Erkennung5 KBGesamt für alle Dateien eines Batches5 GbMaximale Anzahl Dateien (Ein Dokument pro Datei)1,000,000Maximale Anzahl Zeilen (Ein Dokument pro Zeile)1,000,000Damit entfällt in vielen Fällen das mühsame aufteilen des zu analysierenden Textes in mehrere passende Blöcke. Weitere Informationen zu Amazon Comprehend [hier](https://aws.amazon.com/comprehend/). **Kategorien:** Cloud **Schlagwörter:** Amazon Polly, Amazon Translate, Amazon WorkDocs, AWS --- ### [AWS News KW 27 und KW 28](https://thecattlecrew.net/2018/07/30/aws-news-kw-27-und-kw-28/) **Published:** Juli 30, 2018 **Author:** Marco Buss **Content:** ## AWS Storage Gateway Updates AWS Storage Gateway ist ein Service der lokal eine Verbindung zu S3 herstellt und als File System, Lokale Disk oder als Virtuelles Tape Laufwerk konfiguriert werden kann. Dieser Dienst hat in der letzten Zeit folgende Updates erhalten. **SMB Support:** Neben dem bereits verfügbaren NFS Protokoll unterstützt AWS Storage Gateway nun auch das SMB Protokoll für den Zugriff. **Cross-Account Permissions:** Dadurch wird folgende Konfiguration optimal unterstützt. Der Gateway läuft unter Account A aber die Objekte werden in einem Bucket von Account B abgelegt. Dieses Setup dient vor allem dafür die Kosten für S3 einzelnen Kostenstellen zuzuordnen. **Requester Pay´s:** Im Normalfall zahlt der Eigentümer der Daten für die Datenhaltung sowie für den Datentransfer. Wie bei S3 gibt es jetzt die Möglichkeit den Requester der Daten für den Datentransfer zahlen zu lassen. **File Upload Benachrichtigung:** Sobald eine Datei zu S3 hochgeladen wurde wird ein CloudWatch Event erzeugt auf das entsprechend reagiert werden kann. **Cache Refresh Event:** Dieser Event wird ausgelöst, wenn der lokale Cache wieder in sync mit dem entfernten S3 Bucket ist. Weitere Informationen zu AWS Storage Gateway [hier](https://aws.amazon.com/de/storagegateway/). ## Lifecycle Management für Amazon EBS Snapshots Amazons neues Tool „Data Lifecycle Manager“ hilft bei der automatischen Erstellung, Speicherung und Löschung von EBS Snapshots. Musste das Management der Snapshots bisher selbständig erfolgen wird mit dem neuen Tool eine Policy angelegt, die von entsprechend getaggten EBS Volumes, in festgelegten Abständen einen Snapshot anlegt und diese nach ebenfalls definierter Zeit wieder löscht. Wie der generische Name vermuten lässt, soll der Data Lifecycle Manager im Laufe der Zeit auch für andere Dienste verwendet werden. Weitere Informationen zum Data Lifecycle Manager [hier](https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/snapshot-lifecycle.html). ## Amazon Kinesis Video Stream – HLS Outputstream Support [Amazon Kinesis Video Stream](https://aws.amazon.com/kinesis/video-streams/) ist ein Dienst für die Aufnahme, Verarbeitung und Speicherung von Videodaten für Analyse und ML von einem oder auch Millionen Quellen. Das neueste Feature für diesen Dienst ist die Möglichkeit HTTP Live Streaming als Outputquelle zu definieren. Damit ist es möglich Livestreaming oder On-Demand Streaming der Videodaten bereit zu stellen. Der Vorteil ist, das HLS bereits ein Standart ist und von vielen Browsern direkt unterstützt wird und daher leicht in eigene UI´s einzubinden ist. Weitere Informationen zu HLS für Kinesis Video Stream [hier](https://docs.aws.amazon.com/kinesisvideostreams/latest/dg/how-hls.html). **Kategorien:** Cloud **Schlagwörter:** Amazon Kinesis, AWS --- ### [Wie programmiert man Google Home Assistent Skill? Node.js, Express App und Dialogflow (1/2)](https://thecattlecrew.net/2018/08/16/wie-programmiert-man-google-home-assistent-skill-node-js-express-app-und-dialogflow/) **Published:** August 16, 2018 **Author:** tjkrajewski **Content:** Laut einer Studie von Canalys werden bis Ende 2018 weltweit rund 100 Millionen intelligente Lautsprecher verkauft. [\[1\]](https://www.canalys.com/newsroom/smart-speaker-installed-base-to-hit-100-million-by-end-of-2018) Dazu gehören unter anderem Google Home, Amazon Alexa und Apple HomePod. Nach Schätzungen von einer anderen Firma, Tractica wird die Anzahl der Benutzer dieses Typs Geräte bis 2025 voraussichtlich auf eine Milliarde ansteigen [\[2\]](https://www.tractica.com/newsroom/press-releases/enterprise-virtual-digital-assistant-users-to-surpass-1-billion-by-2025/). Der gleiche Rapport prognostiziert, dass der ganze Markt bis 2025 für Virtual Digital Assistenten Software 7.7 Milliarden Dollar wert sein wird. Wir können erwarten, dass die Zukunft der Internetlösungen in vielen Bereichen auf Sprachassistenten basieren wird. Dabei werden vor allem die Firmen profitieren bei denen zeitkritische Anwendungen die größte Rolle spielen. Die Sprachassistenten lassen langwierige und zeitraubende manuelle Suchen auf der Tastatur obsolet werden und befreien uns davon, von einer Masse von Inhalten überwältigt zu werden, die uns bei der aktuellen Suche nicht interessieren. Sprachsuche ist der nächste Schritt auf dem Gebiet der Digitalisierung von medialen Inhalten. Es ersetzt die manuelle Suche, die im Moment die vorherrschende Form der Kommunikation zwischen Mensch und Computer darstellt. Der Assistent wird diesen Prozess straffen und ihn direkter und zugänglicher machen. Es ist auch eine Chance für Menschen, die zum Beispiel aus gesundheitlichen Gründen eingeschränkt sind, im Internet zu surfen. Höchste Zeit daher für Entwickler sich mit der Programmierung von Sprachassistenten zu beschäftigen. In diesem Artikel werden wir die Grundlagen der Programmierung von Google Home Assistant vermitteln und zeigen wie man einen einfachen Skill bauen kann. (Amazon Alexa wurde von uns bereits in einem anderen Blogartikel beschrieben). Google Assistant wurde vor zwei Jahren auf der Google I/O 2016 Konferenz vorgestellt. Er ist offiziell in 14 Ländern verfügbar und kommuniziert mit seinen Nutzern in acht Sprachen: Französisch, Japanisch, Italienisch, Deutsch, Portugiesisch, Englisch, Spanisch und Koreanisch. Die Anzahl der Sprachen ist noch nicht allzu groß, aber es zeigt auch, in welchen Märkten sich das Unternehmen am meisten konzentriert. Aus diesem Grund wurde während der diesjährigen I/O Konferenz 2018 mitgeteilt, dass Google Home Assistant bis Ende des Jahres in 52 Ländern verfügbar sein wird und mit den Nutzern in 25 Sprachen kommunizieren kann. Im weiteren Teil des Artikels werden wir zeigen, wie man einen einfachen Google Home Assistant Skill für Radfahrer schreibt, der uns sagen wird, welches Wetter zu erwarten ist. 1\. Erstellen Sie zuerst ein neues Projekt in Google Actions (Dazu benötigen Sie ein Google Konto). Klicken Sie „add/Import Project“ und geben Sie dem Projekt einen Namen (der Name ist irrelevant) und klicken Sie dann auf „create project“. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome.jpg) Auf der nächsten Seite einfach „skip“ auswählen. 2. In Actions definieren Sie die Invokation für den Skill, d.h. wie man den Skill aufrufen kann. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome2.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome2.png) Sie haben ihr erstes Projekt erstellt. Der Simulator ist noch nicht aktiv. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome3.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome3.png) Deswegen müssen wir DialogFlow öffnen. 4. Erstellen Sie einen Agenten. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome4.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome4.png) **Vergessen Sie nicht ihr erstelltes Projekt von Google Actions in DialogFlow zu importieren**. Der Name in Dialogflow ist frei wählbar. 5. Im nächsten Schritt fügen Sie ein neues Intent „welcomeIntent“ hinzu. Intent ist quasi eine Funktion darauf Google Home Assistant reagiert wird. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome5.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome5.png) 6\. Wenn Sie „welcomeIntent“ selbst in ihrem Code definieren möchten, müssen Sie „Enable webhook call for this intent“ aud der Ende der Seite aktivieren und „save“ klicken. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome6.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome6.png) 7. Fügen Sie noch einen Intent hinzu, der die Wetterberichte holt. Geben Sie diesem Intent den Namen „getWeatherForcastIntent“. Als Traning Phrases fügen Sie die folgenden Sätze ein: > Tell me the weather for Essen > > Berlin DialogFlow wird Essen automatisch als @sys.geo-city (also als einen Parameter) definieren. So können Sie in dem Skill nach allen Städten in der Welt fragen. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome7.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome7.png) Zusätzlich müssen Sie auch Fulfillment als „Enable webhook call for this intent“ aktivieren. 8. **Clonen Sie danach bitte mein Git Projekt:** > 9\. Ü–ffnen Sie 2 Terminal Tabs. Im ersten Tab führen Sie folgenden Befehl aus: > cd googleHomeAssistantExpressNodeJS > > ./ngrok http 5000 [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome12.png)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome12.png) Ngrok sichert, dass ihr Rechner ein Server für ihren Skill ist. Sie bekommen eine zufällige Adresse: 10. Wenn Sie kein node.js haben, installieren Sie es https://nodejs.org/en/download/ und dazu noch nodemon > npm install -g nodemon [(https://www.npmjs.com/package/nodemon](https://www.npmjs.com/package/nodemon) es hilft uns die Ü„nderungen sofort zu berücksichtigen) 11\. Starten Sie den Skill > cd googleHomeAssistantExpressNodeJS > > nodemon index.js Jetzt können wir zum Dialogflow zurückkommen und „Fullfilment“ Addresse einfügen. Es führt zu ihrem Rechner. In meinem Fall war es: [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome9.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome9.png) [https://5f04bf42.ngrok.io/](https://5f04bf42.ngrok.io/bikebuddy-8448e/us-central1/myApp) Und „save“ Am Ende gehen Sie in Dialogflow zu Integrations und wählen Sie Google Assistant. [![](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome10.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome10.png) Erstellen Sie explicit eine Invocation als welcomeIntent! Jetzt können Sie Ihren Skill im Actions Simulator testen. Klicken Sie unten Test. Sie können auch ihr Skill mit Google Home Lautsprecher testen. Für diesen Google Home Assistant Skill haben wir node.js als Programiersprache gewählt, weil es relativ einfach ist. Wir haben uns für die Node.js Express App entschieden, weil man die Applikation überall einfach als web-app hosten kann (AWS, Firebase, Heroku oder alle node.js https Servers) In dem nächsten Blogartikel schreiben wir wie man unseren Skill bei Heroku deployen kann. Falls Sie mehr über die Programmierung von Google Home Assistant lernen wollen, laden wir Sie herzlich zu unserem Google Home Assistant Hackathon in München ein. Wir planen ein Event im Oktober oder im November 2018 zu veranstalten. Alle Termine finden Sie bald in unserem MeetUp Profile: Tomasz Krajewski und Christina Resing References: \[1\] \[2\] **Kategorien:** AI & Data Science, Development **Schlagwörter:** Alexa, express app, express applikation, Google Home Assistant, Node.js, sprachassistent, Sprachassistenten --- ### [Integrationsansätze mit AWS](https://thecattlecrew.net/2018/08/29/integrationsansaetze-mit-aws/) **Published:** August 29, 2018 **Author:** christophrein **Content:** Im Zusammenhang mit Cloud- und Serverless-Architekturen stellt sich oft die Frage, wie mit den neuen Ansätzen Integrationsszenarien realisiert werden können. Im Folgenden werden speziell Technologien im AWS-Umfeld, die in einem solchen Szenario zum Einsatz kommen können, genauer betrachten. Besonders im Zusammenhang mit Serverless-Architekturen bietet AWS einige interessante Werkzeuge. Ein Integrationsprozess kann in drei Abschnitte unterteilt werden, die Eventquelle, die durch einen Auslöser den Prozess startet, die Logikebene, in der die eigentliche Verarbeitung läuft und ein Ziel, an welches das Ergebnis gesendet wird. Der Kernbestandteil der Logikebene bilden eine oder mehrere AWS Lambda-Funktionen, welche die Logik als Reaktion auf einen Eventtrigger ausführen. Der Vorteil von sogenannten „Serverless Functions“ wie AWS Lambda ist dabei, dass keine Infrastruktur zur Ausführung des Codes benötigt wird: Die Laufzeitumgebung steht in der Cloud zur Verfügung. ![AWS Integrationsprozess - Ebenen](https://thecattlecrew.net/wp-content/uploads/2018/08/aws-integrationsprozess-ebenen.png) Abbildung 1: AWS Integrationsprozess – Ebenen ### **Dynamische Eventquelle** Den Start eines Integrationsprozesses stellt ein Event dar. Dafür gibt es verschiedene Eventquellen, die als Auslöser für den Prozess fungieren können. **Veränderung von Daten:** Die Auslöser lassen sich in verschiedene Kategorien unterteilen. Eine Kategorie sind Datenspeicher. Dabei wird ein Integrationsprozess als Reaktion auf eine Datenänderung gestartet. Hierzu gehören beispielsweise benutzerdefinierte Aktionen in Reaktion auf die Veränderung einer DynamoDB-.Tabelle. Ein weiteres Beispiel wären Lambda-Funktionen, mit denen Datensätze aus einem Kinesis-Stream gelesen und verarbeitet werden, wenn solche Datensätze im Stream erkannt werden. Neben push-basierten Eventquellen sind also auch Pull-Methoden möglich, die nach Ü„nderungen in einer Quelle suchen. **Anfragen an Endpunkte:** Eine gängige Methode, um Applikationen bestehend aus einer oder mehreren Lambda-Funktionen zu veröffentlichen, ist das API Gateway. Das Gateway übernimmt dabei die Aufgabe, den einkommenden Request in ein für die Lambda-Funktion verständliches und verarbeitbares Event zu übersetzen und so die jeweilige Funktion aufzurufen. Dies ist notwendig, da Lambda-Funktionen keine HTTP-basierten Requests oder Responses verarbeiten können, sondern rein event-basiert laufen. **Event- oder Nachrichten-Services:** Eine weitere Trigger-Kategorie sind Event- oder Nachrichten-Services. Ein Beispiel hierfür ist der AWS Simple Notification Service (SNS). Mittels SNS können Nachrichten einfach an Clients und Endpunkte weitergeleitet werden. Nachrichten können dabei direkt per Push an autorisierte Services wie eine AWS Lambda-Funktion gesendet werden. Ein weiteres Beispiel für diese Kategorie sind Cron Events oder der Amazon Simple Email Service (SES) zum Versand von E-Mails. ### **Orchestrierung und Logik** **AWS Lambda:** Wie bereits erwähnt ist Lambda die Basis für eine AWS Serverless-Architektur und damit ein Kernbestandteil eines Integrationsprozesses. Innerhalb der Applikation können Datenvalidierung, Filterung, Sortierung oder andere Transformationen durchgeführt werden. Unterstützt werden dabei verschiedene Sprachen wie Node.js, Java, C# oder Python. Mithilfe von API Gateways lassen sich Lambda-Funktionen einfach in bestehende Architekturen einbinden, da das Gateway beispielsweise einfache REST-Calls empfangen und umwandeln kann. Dies wird in den meisten bestehenden Architekturen bereits ohne zusätzliche Ü„nderungen unterstützt. **AWS Step Functions:** AWS Step Functions erleichtern die Koordination der Komponenten verteilter Anwendungen und Microservices mithilfe visueller Workflows. In einer serverlosen Plattform übernimmt Step Functions die Orchestrierung der verschiedenen Lambda-Funktionen einer Applikation. In einem Integrationsprozess können somit mehrere Lambda-Funktionen orchestriert werden. Diese bilden damit die Logik der Applikation ab. ### **Ziel** Das Ziel als letzte Ebene kann jeder AWS oder Custom Service sein. Im Zielsystem können zum Beispiel transformierte Daten gespeichert oder weitere Aktionen wie der Versand von E-Mails oder der Aufruf einer neuen Funktion getriggert werden. Das Ziel stellt in einem One-way-Prozess das Ende eines AWS Integrationsprozesses dar. Jedoch sind auch Szenarien denkbar, in denen das Zielsystem wiederum als Trigger fungiert. In einem konkreten Fall könnten also Daten aus einem Input File gelesen, mithilfe einer AWS Lambda-Funktion verarbeitet und am Ende in einer DynamoDB gespeichert werden. ### **Fazit** Mit den Komponenten, die Amazon Webservices bietet, bestehen einige Möglichkeiten, ein Integrationsszenario zu verwirklichen. Besonders in Verbindung mit Lambda-Funktionen kann ein solcher Prozess in passenden Szenarien einige Vorteile wie Kostenersparnisse bringen. **Kategorien:** Cloud, Integration **Schlagwörter:** Serverless --- ### [Low Power Wide Area Networks](https://thecattlecrew.net/2018/09/13/low-power-wide-area-networks/) **Published:** September 13, 2018 **Author:** Jan Lukas Braje **Content:** ### Wieso LPWAN? In Zeiten von Digitalisierung, Internet der Dinge und Industrie 4.0 treffen wir immer wieder auf Sensoren, die Daten für die neue Welt liefern. Bei dem Ziel, in jedem Kontext, für alles und überall Sensoren zu platzieren kommt man zwangsläufig zu dem Punkt, dass nicht jeder Sensor mit einem Strom- und Internetkabelanschluss versehen werden kann. Wenn wir dann überlegen, einen mobilen, batteriebetriebenen Sensor via Mobilfunk ins Internet zu bringen, stellen wir jedoch schnell fest, wie teuer und vor allem batterietechnisch kurzlebig diese Lösung ist. Bei der Lösungssuche kommen wir früher oder später auf sogenannte Low Power Wide Area Networks (LPWAN). ### Was ist LPWAN? Grundsätzlich handelt es sich um eine Mobilfunktechnik. Jedoch ist diese, wie der Name schon sagt, auf geringen Energieverbrauch und große Reichweiten spezialisiert. Einziger Wehrmutstropfen ist der Datendurchsatz. Diese drei Parameter stehen ähnlich wie genügend Schlaf, Sozialleben und gute Noten in der Schule zueinander: 2 kann man optimieren, der dritte Parameter muss sich anpassen. ![Dreieck LPWAN](https://thecattlecrew.net/wp-content/uploads/2018/09/dreieck-lpwan.jpg?w=300) Dementsprechend ist dies Technologie nur sinnvoll einzusetzen, wenn Datenmengen im Bereich von Byte (B) und kByte (kB) zu übertragen sind. ### Beispiel: Anhand eines allseits bekannten Beispiels lässt sich der Vorteil der Technik sehr einfach erkennen. In einer Mietwohnung müssen an allen Heizungen Messgeräte für die Zählung der Heizleistung angebracht sein. Früher wurden diese Messgeräte händisch durch einen Mitarbeiter des Versorgers abgelesen. Doch ein Hausbesuch gestaltet sich teuer und die menschliche Interaktion ist zusätzlich fehleranfällig. Ein Sensor, der die Messdaten automatisch an das Abrechnungssystem des Versorgers schickt, behebt dieses Problem. Eben solche Sensoren senden ihre Informationen über ein LPWAN: Dank der Datenübertragungen nur alle paar Tage oder Wochen und der geringen Datenmenge können die Vorteile von Reichweite und Batterielanglebigkeit voll ausgenutzt werden. Mit gerade einmal 10-20 Funkmasten können dann bereits Großstädte wie München komplett abgedeckt und eine Laufzeit von teils mehr als 10 Jahren erreicht werden. ### Selbst nutzen: Dank des immer größer werdenden Bedarfs und Markts an mobilen, langlebigen Sensoren gibt es inzwischen diverse Anbieter und Variationen der Technologie. Damit geht einher, dass sich neben einer eigenen Umsetzung des Systems verschiedene Anbieter von Sensornetzwerken für eine Nutzung anbieten. Die „großen“ Mobilfunkanbieter bieten mit ihren NB-IoT Angeboten vorrangig Vorzüge bei höherem Datendurchsatz, geringer Latenz und geringer Fehlertoleranz, Alternativen wie [LoRa](https://lora-alliance.org/) oder [Sigfox](https://www.sigfox.com/en) fokussieren sich hingegen eher auf extrem energiesparende und auf geringen Datendurchsatz optimierte Systeme. Mit diesem Pool an Angeboten lässt sich jeder mobile Sensor mit dem Internet verbinden. Die Welt der Sensoren kann kommen. **Kategorien:** Automation, Integration --- ### [Großhirn an Blutdruck "“ MQTT-Hackathon am Community Day 23.11.2018](https://thecattlecrew.net/2018/12/12/grosshirn-an-blutdruck-mqtt-hackathon-2018/) **Published:** Dezember 12, 2018 **Author:** Daniel Rock **Content:** MQTT hat sich in den letzten Jahren als de facto Standardprotokoll für das Internet der Dinge etabliert. Ob Amazon Alexa oder die internetfähige Heizungssteuerung, fast alle Geräte kommunizieren mittels MQTT. Die Architektur von MQTT basiert auf dem Publish/Subscribe Pattern. Im Zentrum der Kommunikation steht ein Server („Broker“), der Nachrichten sammelt und verteilt. Mit ihm verbinden sich „Clients“ und veröffentlichen Nachrichten bzw. abonnieren sie zu einem bestimmten Thema („Topic“). Der Broker nimmt die Nachrichten entgegen und verschickt sie automatisch an die Clients, die das Topic abonniert haben. Durch den Broker wird ein verteiltes, heterogenes System entkoppelt. So ist es möglich, dass voneinander unabhängige Komponenten auf einfache Art zusammenarbeiten können. MQTT bietet verschiedene Features an, die eine zuverlässige Kommunikation in unzuverlässigen Netzwerken gestatten. Da die Kommunikation nur dann erfolgt, wenn sie erforderlich ist, ist MQTT ideal für ressourcenbegrenzte Geräte. Beim MQTT-Hackathon zum niederlassungsübergreifenden Community Day von OPITZ CONSULTING stand der menschliche Körper im Mittelpunkt. Dabei war das folgende Video von Otto Waalkes die Grundlage (ab 0:43): Es wurde eine „Organbörse“ mit diversen Organen und ihren Topics angeboten, auf der die Teams ein Organ wählen konnten und die Topics notierten, die sie bereitstellten. Unter anderem waren das: - /Koerper/Nase/Geruch - /Koerper/Haut/Temperatur - /Koerper/Leber/Leberwert - /Koerper/Blut/Alkoholgehalt - /Koerper/Blase/Fuellstand ![hackathon1.JPG](https://thecattlecrew.net/wp-content/uploads/2018/12/hackathon1.jpg)Team Bad Homburg beim Hacken Durch einen zentral bereitgestellten Broker konnten die Niederlassungsorgane deutschlandweit miteinander kommunizieren und so ein lebendiges Netzwerk bilden. Für die Implementierung der MQTT-Clients wurden die verschiedensten Programmiersprachen verwendet, was die Heterogenität der möglichen Geräte in einem MQTT-Netzwerk verdeutlichte. ![mqtthackathon2](https://thecattlecrew.net/wp-content/uploads/2018/12/mqtthackathon2.jpg)Für die Programmierung wurden die verschiedensten Sprachen verwendet Jedes Organ konnte seine Topics versenden und andere Topics abonnieren, auf die durch eine Veränderung der eigenen Werte reagiert werden konnte. Beispielsweise führte bei einem Team ein sehr hoher Blutalkoholwert im Magen dafür, dass der Inhalt spontan abgestoßen wurde. Ein anderes Team hatte für ihr „Organ“ Ohren die Wörter abonniert, die von der Zunge gesprochen wurden. Wie man die Nachrichten visualisieren kann, zeigte ein weiteres Team. Mittels Grafana und Prometheus wurden unter anderem die Anzahl der Nachrichten pro Topic in einem Dashboard ausgegeben. ![mqtthackathon3.JPG](https://thecattlecrew.net/wp-content/uploads/2018/12/mqtthackathon3.jpg)Grafana Dashboard mit Prometheus-Metriken zu den Nachrichten in den MQTT Topics Insgesamt war der Hackathon ein großer Erfolg. Die Kolleginnen und Kollegen hatten Spaß dabei, MQTT mit einer anderen Herangehensweise kennenzulernen. Dabei wurde klar, dass MQTT kein Hexenwerk ist. Die Architektur ist leicht zu verstehen und Clients können schnell programmiert werden. Für den nächsten Community Day haben sich in Bad Homburg bereits Kollegen verabredet, um weiter an MQTT zu arbeiten. Ein weiterer Kollege hat für das Thema Feuer gefangen und überlegt sich, wie er MQTT demnächst in seinem Haushalt anwenden kann. **Kategorien:** Architecture & Process Models, Tech Events & Networking --- ### [Re-engineering für Produktionssysteme in der Automotive-Branche](https://thecattlecrew.net/2020/03/26/re-engineering-fuer-produktionssysteme-in-der-automotive-branche/) **Published:** März 26, 2020 **Author:** thecattlecrew **Content:** ## Fallstudien zur IT-Modernisierung in der Praxis (Teil 1) Von Rolf Scheuch Mit einer Fallstudie zum Re-engineering für Produktivsysteme in der Automotive-Branche starten wir eine Reihe an Fallstudien aus der Praxis der IT-Modernisierung. Damit möchten wir Ihnen spannende Impulse für Ihren ganz eigenen Weg mitgeben. Weitere Fallstudien werden wir in den nächsten Wochen in diesem Blog veröffentlichen. Bleiben Sie also gerne dran und folgen Sie uns! Viel Spaß beim Lesen! ### Warum Unternehmen IT-Systeme und Anwendungen gerade jetzt modernisieren müssen Der zunehmende Wettbewerbsdruck erfordert Anpassungen von Geschäftsmodellen und unterstützenden Geschäftsprozesse in immer kürzer werdenden Zyklen. Gleichzeitig wird durch die Globalisierung und die digitale Vernetzung der Unternehmen die Interaktion mit externen Geschäftspartnern und Kunden immer entscheidender für den Unternehmenserfolg. Mit Ausnahme einiger Start-ups ist die bestehende Systemarchitektur wie auch die IT-Organisation der meisten Unternehmen in Altlasten gefangen. Zu lange hat man dem Denkmuster *Big is beautiful* gefrönt und hat komplexe, integrierte Gesamtsysteme erschaffen. Im Ergebnis sanken zwar die IT-Kosten, die Prozesssicherheit war gewährleistet, aber die Nutzung der neuen technologischen Möglichkeiten zur Implementierung digitaler Geschäftsmodelle war nicht in der geforderten Geschwindigkeit möglich. Jeder Release-Wechsel wird zu einem Abenteuer und erfordert einen Kraftakt der gesamten Organisation. Dies darf nicht so bleiben! Wir brauchen ein Vorgehen und eine Methodik, wie eine Transformation hin zu dynamisch robusten Architekturen bzw. evolutionären Architekturen gelingen kann. Als Folge der umfassenden Vernetzung im Zuge der Digitalisierung wird der verlässliche Informationsaustauch mit qualitativ hochwertigen und geschützten Daten auf einer umfassenden Plattform entscheidend. Diese Herausforderungen setzen die bislang gewachsenen Systemlandschaften unter Druck und erfordern eine grundlegende Veränderung und Transformation der unterliegenden Architekturkonzepte, wie in **-> Abb. 1** aufgeführt \[1\]. Wir benötigen zukünftig evolutionäre Anwendungsarchitekturen \[2\], die durch das Architekturprinzip *Design for Change* eine stetige und gezielte Veränderung der Architektur ermöglichen. ### Zielbild ist eine evolutionäre Architektur ![](https://thecattlecrew.net/wp-content/uploads/2020/03/abbildung-01-1.jpg?fit=1024%2C548&ssl=1)Abb. 1 -> Zielbild ist eine evolutionäre ArchitekturAnalog zu einer Plattformstrategie beim Auto besteht die Systemlandschaft aus Modulen, die in sich Innovation, Austausch und Veränderung erfahren, ohne das Gesamtsystem zu kompromittieren. Hierzu benötigen wir, ähnlich dem BUS-System im Auto, eine transparente, beherrschbare Kopplung der Systemkomponenten untereinander. In der Folge wird unsere Systemwelt zu einer Plattform für eigene, aber fremde \[3\] Systemkomponenten, die definiert und mit der minimal notwendigen Kopplung miteinander kommunizieren. Denn wir wollen eine Applikationslandschaft mit Systemen, die möglichst unabhängige Release-Zyklen besitzen und damit eine unabhängige Innovation und Dynamik möglich machen. So können wir unsere Softwareprodukte als *software assets* nutzen und neue Produkte auf bereits bestehenden, robusten Produkten und Services aufbauen. ### Status quo: Strukturell zukunftsunfähig? Die Wirklichkeit sieht leider noch etwas anders aus! Eine Vielzahl deutscher Unternehmen ist in der Wartung und Stabilisierung monolithischer Systemwelten gefangen. Es bleibt keine Kraft, um die neuen Herausforderungen anzugehen. Lünendonk spricht in seiner Studie „Software-Modernisierung“ von einer *strukturellen Zukunftsunfähigkeit* bei vielen Alt-Systemen; genauer schreibt Lünendonk: *„Trotz ihres aktuellen Nutzens für die Unternehmen ist Alt-Software strukturell zukunftsunfähig. Das liegt an ihren Charakteristika und den daraus erwachsenden Risiken für das eigentliche Geschäft“[**\[1\]**](#_ftn1)*. Eine bei deutschen CIOs durchgeführte Studie im Jahr 2014 unterstreicht diese Aussage mit ihren Umfrageergebnissen. Diese strukturelle Zukunftsunfähigkeit hinsichtlich der Weiterentwicklung und Evolution der Applikationslandschaft wird somit zu einem Risiko bei der Optimierung der Business Capabilities oder der Verfolgung neuer digitaler Geschäftsmodelle. Diese Systemlandschaften basieren oft auf umfänglichen, aufwendig zu integrierenden Applikations-Suiten, auch Monolithen genannt, und erweisen sich als veränderungsresistent. Daher muss ein Umdenken hinsichtlich der zukünftigen Systemlandschaften und Applikationsarchitekturen stattfinden: Nicht mehr *Big is beautiful*, sondern mit dem Denkmuster eines *Design for Change[**\[2\]**](#_ftn2)* mit dem Zielbild einer evolutionären Architektur müssen wir uns zukünftig in der VUCA-Welt[\[3\]](#_ftn3)behaupten. Das Ziel ist, mit Applikationsarchitekturen adaptiv und agil auf neue Anforderungen zu reagieren und in der Folge veränderungsfähig zu sein. Warum? Um die Dynamik im Markt zum eigenen Vorteil gestalten und fachlich getriebene Anforderungen umsetzen zu können, die wir heute noch gar nicht kennen. Diese evolutionären Architekturen dienen dann als Blueprint für die Modernisierung von monolithischen Anwendungslandschaften. **Wir empfehlen als Zielbild eine dynamikrobuste, evolutionäre Systemwelt mit einer produktzentrierten Applikationsstrategie!** Die nun folgende Fallstudie zeigt, wie eine erfolgreiche Modernisierung in der Praxis aussehen kann. Sie bezieht sich auf ein Re-engineering der bestehenden Manufacturing-Execution-Systeme (MES) für den Shop-Floor bei der Produktion und Montage im Automotive-Umfeld. Die zukünftige Lösung soll für die nächsten Jahre eine stabile Basis bilden, aber kontinuierlich Innovationen aus dem Industrie-4.0-Umfeld ermöglichen. Feature Freeze ist keine Option! Letztlich war die Erwartungshaltung, dass auf einer robusten Basis stets spezifische neue Technologien zum Einsatz kommen, dringliche Ü„nderungen vorgenommen werden und kurzfristige Erweiterungen erfolgen können. Zudem musste sich die unterliegende Architektur evolutionär weiterentwickeln können, ohne jeweils kostenintensive und risikoreiche Migrationsprojekte durchführen zu müssen. Evolutionär muss es sein! Das Vorhaben zum Reengineering und zur Harmonisierung auf dem Shop-Floor wird von der Produktionsleitung einer Sparte getrieben und von den weltweiten Werken unterstützt. Die aktuellen MES-Lösungen sind in Teilen individuelle Applikationen, die umfangreich auf die Spezifika der unterschiedlichen Werke eingehen. Diese Chance soll genutzt werden, um notwendige architektonische Vorbereitungen für Industrie-4.0-Prozesse im Zeitablauf durchzuführen. Darüber hinaus sollen neue Ansätze zu einer Reduktion der Prozesskosten, einem verbesserten Eskalationsmanagement sowie der Nutzung der werksübergreifenden Schwarmintelligenz auf Shop-Floor-Ebene führen und ein generelles mobiles Arbeiten ermöglichen. Durch Big-Data-Ansätze soll eine verbesserte werksübergreifende Mustererkennung von Schwachstellen und ein längerer gesicherter Blick in die Zukunft möglich werden, damit die JIT-Produktion stabiler wird. Die grundlegenden Eckdaten des Mandates haben wir in einem Steckbrief in **-> Tabelle 1** zusammengefasst. ![](https://thecattlecrew.net/wp-content/uploads/2020/03/tabelle1.jpg)Tabelle 1 -> Steckbrief: System of Systems als Treiber von Industrie 4.0### Ausgangspunkt und Zielarchitektur Ausgangspunkt war eine heterogene Systemwelt, die im Zeitablauf gewachsen war und über unterschiedlichste Integrationsmechanismen Daten austauschte. Glücklicherweise war die ursprüngliche Strukturierung der Systeme nach den unterstützten Prozessen sehr hilfreich, jedoch wurde die domänenspezifische Ausrichtung im Zeitablauf verwässert und es fehlten klare Integrationsprinzipien einer losen Kopplung, sodass sich die Systemwelt als monolithisch ineinander verwoben darstellte, wie auch aus **-> Abb. 2** ersichtlich wird. Jede größere Anpassung führte zu einem Release-Abenteuer mit einem hohen Zeitaufwand an Qualitätssicherungsmaßnahmen. Grundlage und Herzstück des MES waren Oracle-Forms-Client/Server-Anwendungen mit eigenen Datenbank-Schemata, aber einer Vielzahl an Database-Links, die zu einer engen Kopplung führten. Die Geschäftslogik war überwiegend in PL/SQL Stored Procedures abgebildet. Die Portfoliosteuerung erfolgte über isolierte Projekte und wurde durch die Systemverantwortlichen der Module aus der IT gesteuert. Das gemeinsam abgestimmte Zielbild sieht das MES als ein ganzheitliches digitales Produkt mit domänenspezifischen, in sich unabhängigen Lösungen, die über eine lose Kopplung miteinander kommunizieren können. Ü„nderungen der internen Datenmodelle sollten ohne externe Abhängigkeiten möglich sein und somit die Robustheit erhöhen und die Cycle-Times senken. Die Gesamtsicht des Zielbilds liegt als Grafik in **-> Abb. 2**vor. Weiterhin war eine harte Rahmenbedingung, dass der Produktiveinsatz auf dem Shop-Floor ohne Downtime bei der Produktion selbst erfolgen musste. Hieraus ergibt sich sofort, dass mehrere (abwärtskompatible) Versionen gleichzeitig nutzbar sein müssen und eine Begrenzung der Systemkomplexität durch klare Systemgrenzen erfolgen sollte. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/03/abbildung2-1.jpg?fit=1024%2C363&ssl=1) Abb. 2 -> Modernisierung der Systemwelt in Richtung evolutionärer Architekturen durch Separation of Concerns mit einem Anti Corruption Layer, kurz ACL (Ausgangslage und Zielbild bei MES) Als fachliches Zielbild wurde die „alte“ Idee einer Systemfamilie aufgegriffen und ein System-of-System-Ansatz verfolgt, wobei jedes System eine unabhängige Release-Einheit bilden sollte. Den hohen Aufwänden der Qualitätssicherung beim Release-Wechsel sollte durch ein großes Maß an Testautomatisierung begegnet werden. **-> Abb. 2** fasst Ausgangslage und Zielbild zusammen. ### Vorgehensweise Um das Zielbild zu verfolgen, mussten wir an mehreren Fronten „angreifen“. Nachdem das Zielbild abgestimmt war, haben wir uns über organisatorische Hemmnisse unterhalten. Beginnend beim Fachbereich, konnten wir Wunsch wie auch Bereitschaft erzeugen, aus der fachlichen Sicht wieder das Produktmanagement für das MES zu übernehmen und bei agilen Vorgehensweisen den Product Owner zu stellen. Da wir einen Application-Management-Services-Vertrag für das MES hatten, stellten wir selbst das agile Team mit dem technischen Architekten. Damit sind wir in der Rolle des technischen Produktmanagements und somit, aus der architektonischen Sicht, der Hüter der Vision. Der Mandant führte in der Folge die Projekte inhaltlich über den Product Owner und stellte seitens der IT die notwendigen Betriebsressourcen sicher, damit wir DevOps-Themen frühzeitig und in Abstimmung mit OPs angehen konnten. Hier waren Coaching-Maßnahmen als Facilitation nötig, um die agilen Denkweisen im Mindset zu verankern und dem Product Owner wie auch der Betriebsmannschaft die Chance zu geben, entsprechend ihrer Rolle zu agieren. Das gesamte MES wurde als Produkt betrachtet und unterliegt einem Produktportfolio-Management. Entscheidend für die Verfolgung der Vision war, dass ein Teil des Budgets für Refactoring und Restrukturierung vorbehalten war, damit die evolutionäre und gesteuerte Verfolgung des Zielbilds möglich wurde. Nach nunmehr 10 Jahren Wartung und inkrementeller Restrukturierung erfolgt nun alle drei Wochen ein neues Release einiger Sub-Systeme auf dem Shop-Floor. Dank der Testautomatisierung hatten wir seit Jahren keine produktionsrelevante Störung mehr auf dem Shop Floor „“ dynamisch, aber robust! Seitens der Applikationsarchitektur wurde der Blueprint eines digitalen, integrierten Arbeitsplatzes verfolgt. -> Abb. 3 zeigt auf, wie sich das System of Systems (SoS) aus einzelnen Self-contained Systems (ScS) zusammensetzt, wobei die Integration über eine Event-Driven Architecture erfolgt. Hierbei kommunizieren die Backend-Prozesse miteinander, und nur im Eskalationsfall werden Incidents „geworfen“ und ein manuelles Einschreiten wird zur Optimierung bzw. Fehlerbehebung notwendig. Das höchste architektonische (und somit auch implizite kaufmännische) Ziel liegt in der Unabhängigkeit (Autonomie) der einzelnen Self-contained-Systeme, den Sub-Systemen. Martin Fowler führt aus: „*Gather together those things that change for the same reason, and separate those things that change for different reasons.“* Die notwendige Kommunikation mit anderen Sub-Systemen und zentralen prozess- und auftragsübergreifenden Services erfolgt über den Anti Corruption Layer (ACL), dessen Versionierung der Interfaces auch die notwendige lose Kopplung und Robustheit ermöglicht. ![](https://thecattlecrew.net/wp-content/uploads/2020/03/abbildung3.jpg?fit=1024%2C547&ssl=1)Abb. 3 -> Evolutionärer Ansatz durch Seperation of Concerns mit einem ACL als Vorgehensweise beim Re-engineeringDurch die nun (endlich wieder) saubere Trennung der Daten-Schemata pro Sub-System und Delegation der Prozessfunktionalitäten an die zugehörigen Sub-Systeme haben die realisierten ScS nur noch systeminterne Abhängigkeiten und Ü„nderungen an der Datenhaltung sind deutlich weniger komplex. In der Folge wird bei einem Release-Wechsel das Risiko übersichtlicher und die Cycle-Time für Innovationen und Erweiterungen sinkt. **-> Abb. 4** beschreibt das MES als SoS aus einer fachlichen Sicht. Bei der Analyse wurde offensichtlich, dass auftrags- und prozessübergreifende Sichten zur Steuerung notwendig sind und das Qualitätsmanagement-System trotz der Qualitätssicherung an den Maschinen ein eigenes Sub-System darstellt. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/03/abbildung4.jpg?fit=1024%2C454&ssl=1)Abb. 4 -> System-of-Systems: Design an der Wertschöpfung ausgerichtet (Das SoS-Design für das digitale Produkt MES)### Lessons Learned 1. **Man braucht einen langen Atem!** Rückblickend hat es fast ein Jahrzehnt gedauert, bis die Vision des SoS mit eigenständigen ScS Wirklichkeit wurde und die Dynamik plötzlich auch umsetzbar wurde. Ein wunderbarer Seiteneffekt ist die Ruhe in den Portfolio-Meetings. Wurde früher gekämpft, damit eine benötigte Funktionalität ins neue Release kam, so herrscht nun viel Gelassenheit, da durch die vielen Releases der eigene Punkt bestimmt in den nächsten 3″“4 Monaten produktiv wird! 2. **Agilität braucht Coaching und am Anfang eine permanente Energiezufuhr:** Die Fachbereiche müssen als Product Owner wieder lernen, Verantwortung zu übernehmen, und wir als Service Provider mussten lernen, proaktiv mitzuarbeiten und nicht „stumpf“ Features umzusetzen. 3. **Parallelläufe und Schattenprozesse:** Natürlich ist die Testautomatisierung der Hebel für Qualität, aber wo kommen die Testdaten her? Neben der Nutzung von mittlerweile Tausenden von Testfällen lassen wir neu implementierte Systeme teilweise wochenlang als Schattenprozess nebenherlaufen und vergleichen automatisiert die Ergebnisse aus dem laufenden Produktivsystem mit den Ergebnissen der Schattenprozesse. Erst wenn wir eine verschwindend geringe Fehlerquote haben, schalten wir auf das neue System um. 4. **Nicht zu viel auf einmal!** Dies ist natürlich eine Binsenwahrheit, aber in der Praxis sind alle Seiten durch kaufmännische Eckdaten getrieben. Die Gefahr ist uns allen bekannt: Zu viel führt zu verlängerten Laufzeiten und einer sinkenden Qualität. Tatsächlich ist dies durch die kurzen Cycle-Times deutlich entspannter, da nun der Product Owner situativ weitere Features aus dem Backlog realisieren kann. --- \[1\] Wir haben Abb. 1 auf Englisch gehalten, da die englischen Begriffe aussagekräftiger sind \[2\] Neal Ford et al., Building Evolutionary Architectures, O“™Reilly Media, Inc., USA 2017 \[3\] Lünendonk® White Paper, Software-Modernisierung, Lünendonk, 2015 \[4\] https://www.opitz-consulting.com/portfolio/digitalisierung/e-book-dynamikrobuste-architekturen-der-digitalisierung.html \[5\] https://www.vuca-welt.de/ ### Spannendes Live-Webinar zum Thema [![](https://thecattlecrew.net/wp-content/uploads/2020/03/webinar-wohin-mit-dem-monolithen_300x250-it-verlag.jpg)](https://register.gotowebinar.com/register/7773184775004115212?source=Opitz)Live-Webinar mit Rolf Scheuch und Torsten Winterberg am 14. Mai 2020, 11 – 12 Uhr [Jetzt anmelden!](https://register.gotowebinar.com/register/7773184775004115212?source=Opitz)#### Lesetipp: Whitepaper „Wohin mit dem Monolithen? Das Thema IT-Modernisierung ist gerade aktuell für Unternehmen sehr wichtig. Deshalb haben wir ein Whitepaper zum kostenlosen Download bereitgestellt und weitere Informationen dazu im Web aufbereitet: [www.opitz-consulting.com/it-modernisierung](https://www.opitz-consulting.com/portfolio/software-development/it-modernisierung.html) [![](https://thecattlecrew.net/wp-content/uploads/2020/03/whitepaper-wohin-mit-dem-monolithen_300x250-1.jpg)](https://www.opitz-consulting.com/portfolio/software-development/it-modernisierung.html) **Kategorien:** Architecture & Process Models, Integration --- ### [Augmented Reality mit der HoloLens und was man für die Entwicklung von Hologrammen benötigt.](https://thecattlecrew.net/2017/03/10/augmented-reality-mit-der-hololens-und-was-man-fuer-die-entwicklung-von-hologrammen-benoetigt/) **Published:** März 10, 2017 **Author:** Otto Fitz **Content:** Mit Microsoft HoloLens ist auch Windows Holographic – eine neue Version des Betriebssystems – vorgestellt worden. Windows Holographic ist ein Derivat von Windows 10, dessen Innovation darin besteht, in einer dreidimensionalen Welt zu interagieren. ![HoloLens](https://thecattlecrew.net/wp-content/uploads/2017/03/hololens.png) ### HoloLens Hardware Die Hardware besteht aus der **HoloLens**, einem **Klicker** und einem **Micro-USB Ladegerät**. Das Gewicht der HoloLens beträgt **579 Gramm,** was bei nicht allzu langen Einsätzen kaum negativ auffällt. Auf dem Bild rechts ist der **HoloLens – Klicker** abgebildet, der wie ein Hardware-Button agiert und eine Alternative für die AirTap-Geste darstellt. Die weiteren Hardware-Specs der HoloLens: - Holographic Processing Unit (HPU) Intel 32 Bit Prozessor![Klicker](https://thecattlecrew.net/wp-content/uploads/2017/03/klicker.png) - 2 GB RAM - 64 GB Speicher - WLAN - Bluetooth Die wichtigsten Komponenten der HoloLens sind jedoch die Kameras. Die HoloLens verfügt über ganze sechs Kameras. - 4 Kameras für die Umgebung - 1 Tiefen Kamera - 1 HD Kamera 2 MP Weitere Komponenten: - 1 Lichtsensor - 1 Infrarotsensor - 2 Lautsprecher die auf das Ohr gerichtet sind - 4 Mikrofone - 1 Lagesensor - 1 Beschleunigungssensor - 2 Displays mit jeweils 4 Schichten für RGGB Die Kombination aus HPU, den Kameras und zahlreichen Sensoren ermöglichen eine qualitative Interaktion mit den virtuellen Objekten in der realen Welt. ### Der Entwicklungsprozess Für die Entwicklung von HoloLens-Applikationen muss man sich unter anderem mit den folgenden Grundkonzepten beschäftigen: - **Gaze** - Blickrichtung, was sehe ich - **Gesture** - Gesten, die von der HoloLens erkannt werden können - **Voice Input** - Spracherkennung der HoloLens - **Spatial Sound** - Eine räumliche Audioquelle ermöglicht die Zuordnung von Sounds zu bestimmten Objekten in der realen Welt - **Spatial Mapping** - Orientierung in der realen Welt Auf Windows Holographic laufen ausschließlich Universal Windows Apps, die auch nur mit Windows 10 64-Bit entwickelt werden können. Hat man die HoloLens nicht zur Hand, kann man den HoloLens Emulator verwenden. Dieser setzt jedoch die Hypervisor-basierte Virtualisierungstechnik voraus. Auf der HoloLens können 2D- und 3D-Anwendungen deployed werden. Die 2D Anwendungen werden dann als Fenster in einem Raum positioniert, wie das untenstehende Bild veranschaulicht. Beispiele sind etwa der Browser, welcher in greifbarer Nähe am Schreibtisch platziert wird oder das Skype-Hologramm, welches das klassische Schreibtisch-Telefon ersetzt. ![holo-arbeitsplatz](https://thecattlecrew.net/wp-content/uploads/2017/03/holo-arbeitsplatz.png) Die Entwicklung einer HoloLens Anwendung findet mit der Unity-Engine statt. Da Unity für die Spielindustrie gedacht ist, muss man sich mit deren Konzepten auseinander setzen. Dazu gehört unter anderem der Programmcode, welcher in Unity als Skript bezeichnet wird. Skripte lassen sich in Visual Studio importieren und werden in der Programmiersprache C# geschrieben. Darüber hinaus besteht die Möglichkeit, C++ als Programmiersprache zu nutzen. Open Source wird auch vom MS HoloLens-Team praktiziert. MS stellt Hilfsmittel in einem HoloToolkit zu Verfügung, welches Skripte und Assets enthält, die in der Entwicklung mit Unity unterstützend wirken. Die HoloToolkit-Sammlung ist auf GitHub unter zu finden. Der Entwicklungsprozess einer HoloLens-Anwendung besteht aus mehreren Stufen. Als erstes werden in Unity die 3D-Objekte erstellt und mit Skripten versehen. Ist die 3D Welt modelliert, wird das Projekt mit der Option **Virtual Reality Supported** in Visual Studio importiert und die Skripte in C# programmiert. Der Programmcode wird dann als UWP-Anwendung auf der HoloLens deployed. Da HoloLens auf Windows 10 basiert, kann die Anwendung wie eine klassische App in der HoloLens gestartet werden. Auf dem ersten Blick scheint die Entwicklung einer UWP-Anwendung mit Hologrammen „“ also den 3D-Objekten „“ relativ einfach zu sein. Doch in der Praxis ist die Entwicklung virtueller Objekte und die Verbindung dieser mit der realen Welt kompliziert und fordert etwas mehr Entwicklungszeit. Sollten die individuellen 3D-Objekte nicht zu Verfügung stehen, müssen diese erst modelliert werden. Erst dann können diese Objekte in einer HoloLens-Anwendung als Hologramm dargestellt werden. **Kategorien:** AI & Data Science **Schlagwörter:** C#, HoloLens, Microsoft, Unity, Visual Studio --- ### [IoT Steuerung mit Hilfe der Microsoft HoloLens und Cloud Computing](https://thecattlecrew.net/2017/04/06/iot-steuerung-mit-hilfe-der-microsoft-hololens-und-cloud-computing/) **Published:** April 6, 2017 **Author:** Frank Hoppe **Content:** Die digitale Transformation ist derzeit überall zu lesen, zu sehen oder zu hören. Digitalisierung in Deutschland bedeutet insbesondere Industrie 4.0, aber auch Big Data, Cloud, Internet of Things, Augmented Reality oder Deep Learning. Die Liste der Schlagwörter und der Veröffentlichungen von Teilaspekten ist lang. Aber Digitalisierung ist ein sehr weites Feld und man sollte nicht immer nur einen Ausschnitt betrachten. Wir verstehen die Digitalisierung als Zusammenspiel von vier technischen Teilaspekten und den betroffenen Menschen. Die vier grundlegenden Säulen der Digitalisierung können dabei als erster Blueprint für eine mögliche Zielarchitektur dienen. - Zukunftsorientierte Mensch-Maschine-Interaktion - Ganzheitliche Integrationsarchitekturen - Effektive Analytics und Business Insights - Reaktionsfähige hybride Infrastrukturen Wenn Sie hier mehr erfahren möchten, kann ich ihnen unser [Whitepaper](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-die-vier-saeulen-der-digitalisierung_sicher.pdf) zu den vier Säulen der Digitalisierung empfehlen. Oder gleich das eBook „Dynamikrobuste Architekturen der Digitalisierung“. In unserem [OC|Lab](https://thecattlecrew.net/2017/03/02/oclab-day-2017/) haben wir einen PoC umgesetzt, der alle Teilaspekte der Digitalisierung vereint. Aufgesetzt auf dem [Retrofitting Projekt](https://thecattlecrew.net/2017/02/21/geschichten-aus-dem-oclab-retrofitting-am-beispiel/), welches die Anbindungen einer Industrie Maschine von [Q-loud](http://www.q-loud.de) [(www.q-loud.de)](http://www.q-loud.de) mit IoT Techniken an die Cloud gewährleistet, wurde mit Hilfe der [Microsoft HoloLens](https://thecattlecrew.net/2017/03/10/augmented-reality-mit-der-hololens-und-was-man-fuer-die-entwicklung-von-hologrammen-benoetigt/) die direkte Steuerung der Maschine ermöglicht. Im Sichtfeld wird auf der linken Seite ein Dashboard über produzierte Teile angezeigt. Im zentralen Sichtfeld sind Informationen über den Zustand der Maschine visualisiert und Fehlermeldungen direkt angezeigt. Auf der rechten Seite werden mögliche Produktionskombinationen zur Auswahl angeboten, welche über Gestensteuerung ausgewählt werden können. Somit ist es nicht nur möglich, Informationen auf der HoloLens anzuzeigen, sondern auch direkt in die Steuerung der Maschine einzugreifen. Befehle, die über die Gestensteuerung eingegeben werden, landen über die Cloud und einer IoT Lösung direkt auf der Maschine. Das Beispiel demonstriert eindrucksvoll das Zusammenspiel der einzelnen Säulen: - die Microsoft HoloLens als zukunftsorientierte Mensch-Maschine-Interaktion, - die ganzheitlichen Integrationsarchitekturen realisiert über die Anbindung der Maschine mit Hilfe der Q-loud Lösung, - die Einbindung eines (fast) Realtime Dashboards zur effektiven Darstellung von Business Insights - und die Speicherung der Daten in der Cloud Digitalisierung ist mehr als nur der Blick in eine Domäne, probieren Sie es aus. **Kategorien:** AI & Data Science, Cloud **Schlagwörter:** cloud, IoT, Microsoft, Mobile, OC|Lab, q-loud --- ### [AWS News KW 1 - 3](https://thecattlecrew.net/2018/01/22/aws-news-kw-2-3/) **Published:** Januar 22, 2018 **Author:** Marco Buss **Content:** ## Bestandene C5-Testierung des BSI AWS hat offiziell die C5 Testierung in 2017 bestanden. C5 steht für [Cloud Computing Compliance Controls Catalog (C5)](https://www.bsi.bund.de/SharedDocs/Downloads/DE/BSI/CloudComputing/Anforderungskatalog/Anforderungskatalog.pdf?__blob=publicationFile&v=6) *„Die C5-Testierung dient den AWS-Kunden sowie deren Compliance-Beratern, das durch AWS angebotene Sicherheitsversprechen einordnen zu können, während sie ihre Workloads in die Cloud bringen. C5 liefert den regulatorisch definierten IT-Security-Level, der vergleichbar mit dem um die Cloud Controls erweiterten IT-Grundschutz ist.“* Weitere Informationen zum C5 Testat [hier](https://aws.amazon.com/de/compliance/bsi-c5/). ## AWS Autoscaling Autoscaling ist an sich nichts neues in AWS. Es ist vielmehr einer der Gründe für Cloud Anbieter. Es muss nicht vorher bestimmt werden wie hoch die zu erwartende Last sein wird. Vielmehr können die benötigten Ressourcen ja nach Bedarf erzeugt oder gelöscht werden. Autoscaling ist das Werkzeug um genau diesen Prozess zu automatisieren. Autoscaling musste bisher für jeden Service der es unterstützt einzeln konfiguriert werden. Mit AWS Autoscaling kann nun für einen Cloudformation Stack Autoscaling vereinfacht konfiguriert werden. Nach der Auswahl des Stacks kann für verschiedene Ressourcen aus folgenden Möglichkeiten gewählt werden: - **Optimierung für Verfügbarkeit:** Es werden tendenziell mehr Ressourcen bereit gestellt um plötzliche Lastspitzen abzufangen. - **Optimierung der Kosten:** Die Ressourcen werden knapp kalkuliert. - **Balance zwischen Kosten und Verfügbarkeit** - **Individuell** Je nach gewählter Variante werden die Grenzwerte für das Autoscaling automatisch erzeugt und endsprechend hinterlegt. Das Feature ist ab sofort in den Regionen US East (Northern Virginia), US East (Ohio), US West (Oregon), EU (Ireland), and Asia Pacific (Singapore) verfügbar und wird nach und nach auf andere Regionen erweitert. Weitere Informationen zu AWS Autoscaling [hier](https://aws.amazon.com/autoscaling/). ## 3. Availability Zone für London In der Region London wurde eine 3. Availability Zone eröffnet. Damit besteht das AWS Netzwerk aus 50 Availability Zones. Alleine in Europa stehen jetzt 12 Availability Zones zur Verfügung. Jeweils 3 in Irland, London, Frankfurt und Paris. Weitere Informationen zur AWS Infrastruktur [hier](https://aws.amazon.com/about-aws/global-infrastructure/). ## EC2 Spread Placement Groups Spread Placement Groups sorgen dafür, das die EC2 Instanzen dieser Gruppe nicht auf der selben Hardware laufen. Dadurch kann verhindert werden, das kritische Systeme die auf wenigen Instanzen laufen durch einen einzelnen Hardwaredefekt ausfallen. Folgende Punkt sind bei der Verwendung von Spread Placement Groups zu beachten: - **Availability Zones:** Eine Placement Group kann mehrer AZ´s umfassen mit der Einschränkung von 7 Instanzen pro AZ pro Gruppe - **Unique Hardware:** Der Launch Request für eine Gruppe kann fehlschlagen wenn nicht genug unique Hardware vorhanden ist. - **Instanz Typen:** Folgende Instanz Typen können verwendet werden M4, M5, C3, R3, R4, X1, X1e, D2, H1, I2, I3, HS1, F1, G2, G3, P2, und P3 Weitere Informationen zu Spread Placement Groups [hier](https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/placement-groups.html). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [How to build and deploy your Spring Boot App to Oracle Container Service Classic with Wercker](https://thecattlecrew.net/2018/01/25/how-to-build-and-deploy-your-spring-boot-app-to-oracle-container-service-classic-with-wercker/) **Published:** Januar 25, 2018 **Author:** Marco Buss **Content:** In the last days i was searching a way to package my little Spring Boot app as a docker container and deploy that container to the Oracle Container Service Classic (OCSC). My first idea was to use the Oracle Developer Cloud Service to do that. ![project-overview](https://thecattlecrew.net/wp-content/uploads/2018/01/project-overview.png)Oracle Developer Cloud Service – Project Overview My naive first thought was: „Hey two Oracle Cloud Services, that must be an easy task.“ But no, it was not an easy task, involved only some klicks on the console. It can be just easy, when i want to deploy simply the created .war file but docker containers… no. But what was the problem? Well, the Developer Cloud Service uses Hudson to build the code. So far so god. The problem here is, we have no docker installation an we can´t install it during the build. In the end, building the project is no problem, creating the container is actually impossible. On that point a colleague tells me about that new Service Oracle has bought, Werker. Wercker is a build system based on docker containers. Every build step is running in a docker container. And the best part of it, you can deploy that docker container directly to a docker registry of your choice. ## Creating your Buildpipeline After logging in on you can create a new Application. ![Jan.-12-2018 16-35-44](https://thecattlecrew.net/wp-content/uploads/2018/01/jan-12-2018-16-35-44.gif) The first step is to choose your SCM provider. Actually Github, Bitbucket und Gitlab are supported. On Step two you must select the project you want to create an application from. After that you only have to configure the access and on the last step review your input. After that you are ready to build the app. ## Building the app All the Wercker stuff is defined in an configuration file named wercker.yml in your project root folder. To build your project using maven simply add the following pipeline configuration to your wercker.yml \[code\] \# (1) defining the box box: maven:latest \# (2) name of our pipeline build: steps: # (3) a build step – xenoterracide/maven: goals: package spring-boot:repackage – script: name: copy package to output # (4) copy artefact to output code: | cp ./target/\*.jar $WERCKER\_OUTPUT\_DIR/cloud-ci-vergleich.jar \[/code\] 1. Defines the docker container you want to use for that build. Here i use the Wercker container for maven builds. 2. Defines a logical name for that pipeline block. We need this later 3. These are the build steps. The first is the maven build step which only runs the specified maven goals 4. The last step for now is to copy the resulting jar file to the wercker output dir. Every file in that dir will be copied as input for the next part of the building workflow. It is possible to push that container directly as the resulting container. That has the drawback, that this container is larger than necessary so we pass only the artifact to the next pipeline. After you created your app on the Wercker web app. One pipeline is available as default, named „build“. We have named our pipeline configuration also „build“ so that this pipeline will be run. ![wercker-pipelines](https://thecattlecrew.net/wp-content/uploads/2018/01/wercker-pipelines.png) Wercker installs also a webhook so that every commit to your repository will trigger the workflow that build your application. ## Creating the container and push it to the registry After building the artifact it is time to create the container and to push that container to a registry. In the example i will push the container to [Docker Hub](https://hub.docker.com/). To build and publish the container we extend the wercker.yml with the following configuration. \[code\] \# (4) create an name for that pipeline deploy: # (5) configure the container box: id: openjdk tag: 8-jre-alpine cmd: /bin/sh # see: http://devcenter.wercker.com/docs/faq/alpine-faq steps: # (6) moving our artifact to the final location – script: code: | mv $WERCKER\_SOURCE\_DIR/cloud-ci-vergleich.jar /cloud-ci-vergleich.jar touch /cloud-ci-vergleich.jar # (7) pushing the container to Docker Hub – internal/docker-push: # (8) that is defined in the wercker console as protected environment variables username: $DOCKER\_USERNAME password: $DOCKER\_PASSWORD tag: latest repository: $DOCKER\_REPOSITORY # (9) configuration similar to dockerfile ports: „8080“ volumes: „/tmp“ entrypoint: java -Djava.security.egd=file:/dev/./urandom -jar /cloud-ci-vergleich.jar – script: code: | touch $WERCKER\_OUTPUT\_DIR/deploy-me \[/code\] 4. Already defining an name for that pipeline so we can configure Wercker 5. Finally we use the openjdk apline docker container as our base container. Please be aware of the *cmd:* configuration. 6. On the first step we move the artifact from the input directory. 7. And now the important step. Pushing that image to Docker Hub. The Details about pushing the conatiner and also information to push to other registries can be found [here](http://devcenter.wercker.com/docs/containers/pushing-containers). 8. The $DOCKER\_USERNAME and $DOCKER\_PASSWORD are defined in the Wercker app as protected variables so they are also masked in the log files.![define-environment](https://thecattlecrew.net/wp-content/uploads/2018/01/define-environment1.png) 9. Here we define some information for our container. The parameters are similar to that used in a standard dockerfile. For all available parameters see [here](http://devcenter.wercker.com/docs/steps/internal-steps#docker-push). Before we can push the change of our wercker.yml to the repository, we must configure our build workflow so that our new pipeline will be executed. ![define-deploy-pipeline](https://thecattlecrew.net/wp-content/uploads/2018/01/define-deploy-pipeline.gif) The new pipeline must now be added to the workflow. To do that click on the + sign right on our build step and fill out the popup form. ![add-new-pipeline](https://thecattlecrew.net/wp-content/uploads/2018/01/add-new-pipeline.png?w=264) After pushing the changed wercker.yml. The container will be build and deployed to the Docker Hub registry. After the build completes the container can be found in the Docker Hub registry. ![registry-entry](https://thecattlecrew.net/wp-content/uploads/2018/01/registry-entry.png)The container deployed to the registry ## Deployment to Oracle Container Cloud Classic And now the final Step. Deploying the container to the Oracle Container Cloud Classic. For that we use the available RestAPI for that Oracle Service. In order to get the deployment running some new environment variables must be set. - **OCCS\_DEPLOYMENT\_ID:** The name for our deployment - **OCCS\_BASE\_URL:** The URL from the master node for the Oracle Container Cloud Classic - **OCCS\_API\_KEY:** The API Key that is required to access the RestAPI. ![api-token](https://thecattlecrew.net/wp-content/uploads/2018/01/api-token.png) \[code\] update-deplyoment: steps: – script: name: Update OCSC deployment code: | # (10) Defining the Deployment Config DEPLOYMENT\_CONFIG='{ „deployment\_id“:“‚“$OCCS\_DEPLOYMENT\_ID“‚“, „deployment\_name“:“‚“$OCCS\_DEPLOYMENT\_ID“‚“, „desired\_state“:1, „placement“:{„pool\_id“:“default“}, „quantities“:{„DevOpsDemo“:1}, „stack“: { „service\_id“: „DevOpsDemo“, „service\_name“: „DevOpsDemo“, „subtype“: „service“, „content“: „version: 2\\nservices:\\n DevOpsDemo:\\n image: marcobuss/cloud-ci-oracle\\n environment:\\n – \\“occs:availability=per-pool\\“\\n – \\“occs:scheduler=random\\“\\n – \\“occs:description=Demo Project to show Wercker integration\\“\\n ports:\\n – \\“8080:8080/tcp\\“\\n“ } }‘ # (11) Check if the deployment allready exists STATUS=$(curl -sk -o /dev/null -w ‚%{http\_code}‘ -X „GET“ -H „Authorization: Bearer ${OCS\_API\_KEY}“ „${OCCS\_BASE\_URL}/api/v2/deployments/${OCCS\_DEPLOYMENT\_ID}“) echo „Queried Deployment and get response ${STATUS}“ if \[ $STATUS -eq 200 \]; then # (12) if the deployment allready exists, we can initialize the restart of the deployment echo „Reload Container Deployment“ RESET\_URL=“$(curl -sk -X „PUT“ -H „Authorization: Bearer ${OCCS\_API\_KEY}“ „${OCCS\_BASE\_URL}/api/v2/deployments/${OCCS\_DEPLOYMENT\_ID}/webhook/restart“ -d ‚{„enabled“:true}‘ | grep full\_url\_path | cut -d'“‚ -f4)“ echo „Reset URL: ${OCCS\_BASE\_URL}${RESET\_URL}“ curl -sk -X „POST“ „${OCCS\_BASE\_URL}${RESET\_URL}“ break else # (13) creating the deployment from scratch echo „Try to create new deployment“ curl -sk -X „POST“ -H „Authorization: Bearer ${OCCS\_API\_KEY}“ „${OCCS\_BASE\_URL}/api/v2/deployments/“ -d „${DEPLOYMENT\_CONFIG}“ fi \[/code\] 10. That block defines the configuration of the deployment. 11. Here we check if the deployment exists. 12. If the deployment exists. We must get the webhook URL to restart the service and invoke that URL to trigger an restart, which automatically checks if a new container version is available. 13. If the deployment did not exist, the deployment will be created. Like the step before, we must add the new pipeline to the wercker build workflow as the last step. ![final-workflow](https://thecattlecrew.net/wp-content/uploads/2018/01/final-workflow.png)The resulting workflow After checking in the final wercker.yml the new deployment will be created and after one build we find the deployment in the admin console of OCSC. ![deplyoment](https://thecattlecrew.net/wp-content/uploads/2018/01/deplyoment.png) And now finally the service can be invoked with :8080/greeting?name= and we are ready to use the service. ![invoke-service](https://thecattlecrew.net/wp-content/uploads/2018/01/invoke-service.png) The complete source code for that example can be found [here](https://github.com/marcobuss/cloud-ci-oracle). **Kategorien:** Cloud **Schlagwörter:** Cloud Computing, DevOps, Oracle Cloud, Wercker --- ### [AWS News KW 4](https://thecattlecrew.net/2018/01/29/aws-news-kw-4/) **Published:** Januar 29, 2018 **Author:** Marco Buss **Content:** ## Mehr Netzwerkbandbreite für EC2 Amazon hat die zur Verfügung stehende Bandbreite für EC2 Instanzen erhöht. - **EC2 zu S3:** Erhöhung von 5 Gbps auf 25 Gbps - **EC2 zu EC2**: Für Instanzen innerhalb einer Region gilt, bis zu 5 Gbps für single-flow traffic und bis zu 25 Gbps für multi flow Verbindungen (Ein „flow“ definiert eine einzelne Point to Point Verbindung). - **EC2 zu EC2 (Cluster Placement Group)**: EC2 Instanzen einen Cluster Placement Group können jetzt mit 10 – 25 Gbps kommunizieren. Weitere Informationen [hier](https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/enhanced-networking.html). ## Github Enterprise als Quelle für CodeBuild Ab sofort ist es möglich, Github Enterprise Repositories als Quelle für AWS CodeBuild zu verwenden. Weitere Informationen zu CodeBuild [hier](https://aws.amazon.com/documentation/codebuild/). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [Compliance "“ ein immer wieder unterschätztes Risiko](https://thecattlecrew.net/2018/02/09/compliance-ein-immer-wieder-unterschaetztes-risiko/) **Published:** Februar 9, 2018 **Author:** andreasstroebel **Content:** Wer spricht denn heute noch von Software-Lizenzen, im Zeitalter von Open Source, Digitalisierung und Cloud? Nun, für die Zukunft mag das Thema Lizenzierung an Relevanz verlieren. Aber dass es sich derzeit noch lohnt, die eigene Lizenzsituation unter die Lupe zu nehmen „“ oder vielmehr: dass das essentiell wichtig ist „“ zeigt das folgende Beispiel. Aber der Reihe nach „¦ Im Anschluss an eine Veranstaltung zum Thema Lizenzierung von Oracle Software kam ein Teilnehmer auf mich zu und bat mich, einmal persönlich bei ihm und seinem Chef vorbeizukommen. Er habe da so ein ungutes Gefühl „¦ Einige Tage später nun saßen wir zusammen und sprachen über die Situation, die bei meinem Gegenüber das besagte ungute Gefühl erzeugt hatte. Nach einer ersten Diskussion und einer groben Abschätzung der Rahmenbedingungen entschieden wir, die Compliance der Oracle Datenbanken des Unternehmens einmal im Detail zu überprüfen. Insgesamt war das alles gar nicht so viel. Es ging um knapp 50 Datenbank-Instanzen, die größtenteils als Oracle Standard Edition (SE) lizenziert und weltweit in verschiedenen unternehmenseigenen Rechenzentren installiert und betrieben wurden. Ein paar Datenbanken der Oracle Enterprise Edition (EE) waren auch darunter. Mithilfe eines Vermessungsskripts analysierten wir sämtliche Instanzen, sammelten zusätzliche Informationen über die eingesetzte Hardware- und Betriebssystem-Infrastruktur und nahmen natürlich auch den Lizenzbestand auf. Schon bei der technischen Analyse der Instanzen gab es erste Überraschungen: Einige der SE Datenbanken waren tatsächlich als EE Datenbanken installiert. Teilweise wurden Optionen eingesetzt (z. B. Partitioning, Advanced Compression), und auch die Enterprise Management Packs waren größtenteils freigeschaltet und daher auch teilweise in Verwendung, hier insbesondere Funktionalitäten der Diagnostics und Tuning Packs. Die Lizenzsituation war also nicht ganz „sauber“. Alles in allem waren die Unstimmigkeiten in diesem Bereich aber noch überschaubar und hätten im Falle eines formalen Audits durch Oracle zwar zu ärgerlichen Nachzahlungen geführt, blieben aber noch in einem vertretbaren Rahmen. Bei der Analyse der Hardware- und Betriebssystem-Infrastruktur stellte sich die Lizenzsituation dann schon kritischer dar. Wie in vielen Unternehmen üblich trennte auch dieser Kunde den Sytembetrieb vom Betrieb der Oracle Datenbanken. Und so passierte, was passieren musste: Die Rechenzentren waren weltweit komplett mittels VMware virtualisiert. Sie konnten untereinander so transparent kommunizieren, dass von jedem Standort aus jedes System erreichbar war. Die Systeme wurden zwar in diversen vCentern verwaltet, aber eine weitergehende Trennung gab es nicht. Und eines Tages wurden sämtliche VMware-Umgebungen der Reihe nach auf die Version 6.0 aktualisiert. Wer sich ein wenig mit der Lizenzpolitik von Oracle auskennt, weiß, dass dieser Umstand unweigerlich zu großen Problemen führt. In den Lizenzbedingungen von Oracle (Oracle Master Agreement, OMA) heißt es wörtlich „“¦ *alle Prozessoren, auf denen die Oracle Programme installiert sind und/oder ablaufen*.“ Die Lizenzierung entsprach schon unter VMware 5.5 nicht ganz dieser Regel. Durch das Upgrade auf 6.0 musste nun die virtualisierte Hardware komplett aufgenommen und durchkalkuliert werden. Zum Hintergrund: Durch vMotion Live Migration kann jede virtuelle Maschine vCenter-übergreifend in der gesamten Infrastruktur des Unternehmens verschoben werden, und zwar zur Laufzeit. Entsprechend nimmt Oracle an, dass **auf allen Systemen eine Installation vorliegt** „“ und da gemäß der Regelung im Oracle Master Agreement „*alle Prozessoren, auf denen die Oracle Programme installiert sind und/oder ablaufen*“ zu lizenzieren sind, wird dies auch hier verlangt. Dazu kommt, dass SE und EE als **zwei verschiedene Produkte** auch für die komplette Umgebung zu berücksichtigen sind. Das heißt, das Unternehmen meines Gesprächspartners hätte seine komplette Infrastruktur nicht nur einmalig weltweit lizenzieren müssen , sondern sogar **doppelt**, einmal für SE, einmal für EE inkl. einiger Optionen und Enterprise Management Packs. Um die Größenordnung einzuschätzen: Nach Listenpreisen hätte sich für diesen Kunden eine Lizenzunterdeckung in Höhe von ca. 95 Mio. Euro ergeben, zuzüglich 22 % Support pro Jahr! Man reagierte unvermittelt: Die Verantwortlichen gingen umgehend und mit höchster Priorität an die Bereinigung der Situation. Heute ist die Umgebung neu aufgesetzt und entsprechend den Lizenzbedingungen von Oracle installiert und konfiguriert. Ein Audit fand bislang nicht statt, aber man wäre dafür nun bestens gewappnet. Compliance ist eben doch ein relevantes Thema „¦ **Kategorien:** IT-Security --- ### [AWS News KW 4 - 6](https://thecattlecrew.net/2018/02/12/aws-news-kw-4-6/) **Published:** Februar 12, 2018 **Author:** Marco Buss **Content:** ## DynamoDB Verschlüsselung Ab sofort ist es möglich Daten in DynamoDB automatisch verschlüsselt abzulegen. Die Verschlüsselung muss dafür lediglich beim Erzeugen der Tabelle aktiviert werden. Ist die Option aktiv, werden alle Daten mit AES-256 und einem service-default [KMS](https://aws.amazon.com/de/kms/) key verschlüsselt. Mit der Datenbank kann wie gehabt gearbeitet werden. Die Verschlüsselung hat dabei keine Auswirkungen auf die Performance. Das neue Feature ist ab sofort für die Regionen US East (N. Virginia), US East (Ohio), US West (Oregon), und EU (Ireland) kostenlos verfügbar. Es werden lediglich Kosten für die Anfragen an KMS abgerechnet. Weitere Informationen zu DynamoDB Verschlüsselung [hier](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/EncryptionAtRest.html). ## WordPress Polly Plugin Nutzer von WordPress haben ab sofort die Möglichkeit [Amazon Polly](https://aws.amazon.com/polly/) als WordPress Plugin einzubinden. Mit Amazons Text to Speech Engine Polly ist es damit möglich die Blogposts vorlesen zu lassen. Die Erzeugten MP3 Dateien können entweder in WordPress direkt oder in S3 abgespeichert werden. Eine kleine Kostprobe von Polly: [https://thecattlecrew.net/wp-content/uploads/2018/02/speech\_20180212121845655.mp3](https://thecattlecrew.net/wp-content/uploads/2018/02/speech_20180212121845655.mp3) Weitere Informationen zum WordPress Plugin [hier](https://github.com/awslabs/amazon-polly-wordpress-plugin). **Kategorien:** Cloud **Schlagwörter:** Amazon Polly, AWS --- ### [AWS News KW 7-8](https://thecattlecrew.net/2018/02/26/aws-news-kw-7-8/) **Published:** Februar 26, 2018 **Author:** Marco Buss **Content:** ## AWS Serverless Application Repository ![serverless-application-repository](https://thecattlecrew.net/wp-content/uploads/2018/02/serverless-application-repository.png) Mit dem Serverless Application Repository bietet Amazon die Möglichkeit direkt fertige Serverless Applikationen zu deployen. Die fertigen Applikationen kann jeder veröffentlichen. Eine Qualitätskontrolle findet aktuell nicht statt. Die Auswahl an Anwendungen ist aktuell noch überschaubar, bietet aber bereits jetzt einige Dopplungen sowie viele Applikationen die nur wenig weiter gehen als einfache Demos. Interessant ist allerdings, das die Anwendungen auch „privat“ geteilt werden können z.B. nur innerhalb einer Organisation. Weitere Informationen zum Serverless Application Repository [hier](https://aws.amazon.com/serverless/serverlessrepo/). ## Längere Resource ID´s für EC2 Instanzen Durch das stetige Wachstum von AWS werden die ID´s im alten Format (Ressourcenkennung + 8 stellige Zeichenkette z.B. ec2-1234567890) langsam knapp. Aus diesem Grund unterstützt EC2 ab sofort längere ResourceID´s im Fomat ec2-1234567890abcdef0. Übergangsweise kann noch bis Juni für neue Instanzen das alte Format verwendet werden. Amazon empfiehlt bis Juni die eigenen Anwendungen auf die Kompatibilität mit dem neuen Format hin zu überprüfen und ggf. anzupassen. Weitere Informationen [hier](https://aws.amazon.com/de/ec2/faqs/#longer-ids). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [Managing your AWS RDS instance via Bastion Host](https://thecattlecrew.net/2018/03/02/managing-your-aws-rds-instance-via-bastion-host/) **Published:** März 2, 2018 **Author:** Michael Stähler **Content:** It is best practise to place your database servers into a private subnet. By definition a private subnet in Amazon Web Service (AWS) is not reachable from the internet. So there is no internet gateway assigned to it. With proper security groups configured you restrict the database access to that (web) servers which need access only. But that configuration makes it more complicated for managing the database servers, e.g. connecting with SQL clients. Instead of putting your database instance into a public subnet you can configure a bastion host (aka jump box) for acting as an intermediate server. The following picture gives you a quick overview: ![aws_architecture](https://thecattlecrew.net/wp-content/uploads/2018/03/aws_architecture.jpg) You place a small EC2 instance (e.g. t2.nano) into a public subnet within your VPC. After that you can connect with e.g. Putty (for Windows) to establish a SSH connection and configure it to create an SSH tunnel for the database port. Please note your security group settings. The bastion host has inbound access for port 22 and your source IP address only (or more which is not recommended). The security group for the RDS instance will allow inbound access for port 3306 (for MySQL) with restriction to the security groups which needs access to the database server (in our case the bastion host). With that configuration you limit the database access to the minimum needed. ## Configuring Putty At first enter the hostname with ec2-user. This is the public IP address of your bastion host: ![putty1](https://thecattlecrew.net/wp-content/uploads/2018/03/putty1.jpg) After that you define your private key for authentication: ![putty2](https://thecattlecrew.net/wp-content/uploads/2018/03/putty22.jpg) In the last step you enter the SSH tunnel settings for your database instance. In this example we create a tunnel for port 3306 on your local computer to port 3306 on the RDS instance host (DNS name). This is possible, because the bastion host and the database instance are placed within the same VPC and the routing table allows the communication between both subnets. ![putty3](https://thecattlecrew.net/wp-content/uploads/2018/03/putty3.jpg) After establishing the putty connection we can connect to our database on localhost, port 3306: ![dbweaver1](https://thecattlecrew.net/wp-content/uploads/2018/03/dbweaver1.jpg) ## Making it more convenient … This is all fine but we can do it even more convenient. One solution is to place all Putty settings into a batch file: ``` @ECHO OFF SET PUTTY_EXE=C:\Putty\putty.exe start %PUTTY_EXE% ec2-user@18.197.56.5 -i d:\my_private_key.ppk -L 3306:demo.abc.eu-central-1.rds.amazonaws.com:3306 ``` After saving it to a batch file we can start the SSH tunnel by a double-click. Another solution depends on your SQL Client. In some clients like e.g. [DBWeaver](https://dbeaver.jkiss.org/) or the [MySQL Workbench](https://www.mysql.com/de/products/workbench/) you can configure a TCP connection over SSH directly. With that option you can configure it all in that client. No Putty configuration or batch file to be started. ![mysql_workbench](https://thecattlecrew.net/wp-content/uploads/2018/03/mysql_workbench1.jpg) Be sure to select „Standard TCP/IP over SSH“ and the correct private key format. **Kategorien:** Cloud **Schlagwörter:** AWS, IT Security --- ### [AWS News KW 9 - 11](https://thecattlecrew.net/2018/04/03/aws-news-kw-9-11/) **Published:** April 3, 2018 **Author:** Marco Buss **Content:** ## AWS Dokumentation Open Source auf Github verfügbar Die Dokumentation für eine Vielzahl von Services ist jetzt Open Source verfügbar und auf Github gehostet. Dadurch kann jeder helfen die Dokumentation zu verbessern und Fehler zu beheben. Um eine Ü„nderung zu veröffentlichen genügt es einen entsprechenden Pull Request zu erzeugen. Die Sourcen der Dokumentation findet man [hier](https://github.com/awsdocs). ## Nutzungsbasiertes Zahlungsmodel für Amazon Chime Amazon Chime ist Amazons Online Collaboration Tool. Es unterstützt Chats sowie Onlinemeetings inclusive Screensharing und Aufnahmefunktionen. Der Dienst ist für die meisten Funktionen kostenlos. Für das Organisieren eines Onlinemeetings mit mindestens 3 Personen ist allerdings ein Pro Account notwendig. Bisher kostete der Pro Account 15$ pro Monat und erlaubte eine unbegrenzte Anzahl an Meetings. Dieses Model wird ab dem 1.4. 2018 angepasst. Für jeden Tag an dem mindestens ein Meeting gehostet wird werden 3$ in Rechnung gestellt, bis zu einem Maximum von 15$. Weitere Informationen zu Amazon Chime [hier](https://aws.amazon.com/chime/). ## AWS Fargate unterstützt ISO, PCI, SOC und HIPAA regulierte Workloads Mit [AWS Fargate](https://aws.amazon.com/fargate/) können Container basierte Workloads ausgeführt werden, ohne das Server oder Cluster verwaltet werden müssen. AWS Fargate stellt automatisch die benötigten Ressourcen bereit. Container, die auf dem AWS Fargate Launch Type ausgeführt werden, erfüllen nun die Kriterien für die ISO-, PCI-, SOC 1-, SOC 2- und SOC 3-Compliance sowie die Kriterien für die HIPAA-Berechtigung. Dies bedeutet, dass Container-Workloads auf AWS Fargate nun regulierte Finanzdaten oder geschützte Gesundheitsinformationen (PHI) verarbeiten können. Weitere Informationen zu Compliance bei AWS [hier](https://aws.amazon.com/compliance/services-in-scope/). ## Amazon Aurora mit PostgreSQL-Kompatibilität in EU-London verfügbar Amazon Aurora mit PostgreSQL-Kompatibilität ist jetzt mit EU-London in 11 Regionen verfügbar. Weitere Informationen zu Amazon Aurora [hier](https://aws.amazon.com/rds/aurora/). ## Unterstützung skalarer JSON und ION Dateien für Amazon Redshift Spectrum JSON oder ION Dateien, z.B. Client-Weblogs die in S3 gespeichert sind können jetzt direkt mit [Amazon Redshift Spectrum](https://aws.amazon.com/de/redshift/spectrum/) verarbeitet werden. Damit können diese Dateien direkt mit bereits vorhandenen Business Intelligence Tools Analysiert werden. Weitere Informationen zu Amazon Redshift [hier](https://aws.amazon.com/de/redshift/). ## AWS Storage Gateway Unterstützung für S3 Buckets mit „Zahlung durch Anforderer“ AWS Storage Gateway unterstützt einen hybriden Cloud Ansatz, indem es S3 Ressourcen lokal zur verfügung stellt. Um Latenzen und Datentransfer zu minimieren, wird ein lokaler Cache der Daten und Metadaten angelegt. Ab sofort können auch S3 Buckets die als „Zahlung durch den Anforderer“ definiert sind verwendet werden. Normalerweise zahlt der Bucket Eigentümer für den Datentransfer bei diesen Buckets werden die Kosten allerdings dem Anforderer in Rechnung gestellt. Weitere Informationen zu AWS Storage Gateway [hier](https://aws.amazon.com/storagegateway/). ## Amazon Elasticsearch Service unterstützt jetzt direkte Zugriffsrichtlinien-Updates Ü„nderungen an Zugriffsrichtlinien für Amazon Elasticsearch Service werden jetzt innerhalb von Sekunden aktualisiert. Zugriffsrichtlinien werden zur Steuerung der IAM-Benutzer oder Rollen und IP-Adressen, die berechtigt sind, Elasticsearch Service zu nutzen verwendet. Weitere Informationen zu Amazon Elasticsearch [hier](https://aws.amazon.com/de/elasticsearch-service/). **Kategorien:** Cloud **Schlagwörter:** Amazon Aurora, Amazon Chime, Amazon Elastic Search, Amazon Redshift, AWS --- ### [Eindrücke vom AWS Dev Day in Köln](https://thecattlecrew.net/2018/04/16/eindruecke-vom-aws-dev-day-in-koeln/) **Published:** April 16, 2018 **Author:** Michael Stähler **Content:** Am 12.04.2018 fand in Köln der [AWS Dev Day](https://aws.amazon.com/de/events/aws-devdays-germany-2018/) statt. Ich hatte das Glück bei dem ausgebuchten, kostenfreien Event dabei sein zu dürfen. Der AWS Dev Day fand in der beeindruckenden Eventlocation [Pattenhalle](http://pattenhalle.de/) in Ehrenfeld statt. Gleich nach der Registrierung gab es einen kleinen Frühstücks-Snack. Das lässt man sich natürlich nicht entgehen. Ein zweites Frühstück hat noch keinem geschadet… 😉 ![20180412_083926](https://thecattlecrew.net/wp-content/uploads/2018/04/20180412_083926.jpg) Frisch gestärkt hatte ich die Wahl mich zwischen vier parallelen Tracks zu entscheiden: Artificial Intelligence, Database Analytics, Serverless und Containers. Ich entschied mich für „Serverless: State of the Union“. ![Agenda](https://thecattlecrew.net/wp-content/uploads/2018/04/agenda.jpg) Der Track gab einen guten Überblick über die aktuellen Entwicklungen im Bereich „Serverless“. Interessant fand ich das [AWS Serverless Application Repository](https://aws.amazon.com/de/serverless/serverlessrepo/). Darin findet man bereits eine Menge an Beispielapplikation für typische Anwendungsfälle. Das erleichert den Einstieg in dieses Thema enorm, wenn man sich an bereits lauffähigen Anwendungen orientieren kann. Weiterhin interessant war der Support von [XRay](https://aws.amazon.com/de/xray/) in Lambda, womit ein Tracing der Aufruf-Requests komfortabel ermöglicht wird, sowie [Serverless Aurora](https://aws.amazon.com/de/rds/aurora/serverless/), bei der das Serverless-Paradigma auch auf Datenbankebene Einzug hält. Weiter ging es in dem Track „Containers“ mit dem Vortrag zu „Deep Dive on Amazon Elastic Container Service (ECS)“. Entgegen dem Titel ging es nicht so weit in die Tiefe; der Vortrag gab aber einen guten Einstieg in das Thema Containermanagement auf der AWS Plattform. Interessant fand ich den [Amazon ECR Credential Helper](https://github.com/awslabs/amazon-ecr-credential-helper), der das Token-Handling der Authentifizierung ohne docker login am ECR Repository automatisiert. Als nächsten Track besuchte ich „Amazon Elastic Container Service for Kubernetes (Amzon EKS)“. Mit Amazon EKS wird der Aufbau eines gemanagten, hochverfügbaren Kubernetes-Cluster extrem vereinfacht. Dabei erkennt Amazon EKS automatisch degenerierte Master-Knoten und stellt Versions-Upgrades und Patches für die Master bereit. In der Mittagspause wurden die Teilnehmer mit leckerem Chili Con Carne versorgt. Dabei kam auch die Möglichkeit sich mit anderen Gleichgesinnten auszutauschen nicht zu kurz, bevor ich mich dann weiter in den nächsten Containers-Track stürzte. Diesmal ging es um „Deep Dive on Fargate“. In dem Track wurde noch mal ausführlicher erläutert, um was es sich bei [AWS Fargate](https://aws.amazon.com/de/fargate/) eigentlich handelt. AWS Fargate ist eine Buchungsoption innerhalb von AWS ECS, bei der man sich nicht selbst um die Verwaltung der genutzten EC2-Instanzen und Cluster kümmern muss. Diese Option soll es sowohl bei ECS, als auch bei EKS zukünftig geben. Der Entwickler kann sich damit noch mehr auf die eigentliche Entwicklung der Anwendung innerhalb des Containers konzentrieren, ohne sich um die Verwaltung der Server (z.B. Patching der Amazon Machine Images (AMI) etc.) selbst kümmern zu müssen. Der letzte Vortragsslot war ein Sponsored-Talk mit dem Titel „Future Mobility Platform on AWS: Global Rollout with Gitlab and Kubernetes“. Dieser Vortrag war ein Erfahrungsbericht aus einem Real-Life-Projekt auf der AWS-Plattform. Hier ging es um das IoT-Thema „Connected Car“ mit Hilfe von Kubernetes auf AWS mit mehreren Regions und verteilen Teams. ## Fazit Der Tag war eine schöne „Aus-Zeit“ vom Alltag, um sich noch mal über die neuesten Entwicklungen auf der AWS-Plattform informieren zu können. In den vier parallen Tracks konnte sich jeder die für ihn interessantesten Themen heraussuchen. Die Vorträge von AWS selbst, wie von den Sponsored-Talks waren durchgängig mit Live-Demos ergänzt, so dass die Zuhörer gleich den praktischen Einsatz direkt miterleben durften. In den Pausen und nach der Veranstaltung blieb genug Zeit mit den AWS-Mitarbeitern in Kontakt zu treten, sowie sich mit anderen Teilnehmern auszutauschen. Die hervorragende kulinarische Versorgung, sowie das frühlingshafte Wetter machte das Event zudem zu einem echten Erlebnis. **Kategorien:** Cloud, Tech Events & Networking --- ### [AWS News KW 12](https://thecattlecrew.net/2018/05/09/aws-news-kw-12/) **Published:** Mai 9, 2018 **Author:** Marco Buss **Content:** ## Service-Erkennung für ECS Amazon Elastic Container Service ([ECS](https://aws.amazon.com/de/ecs/)) bietet ab sofort eine Service-Erkennung. Damit bietet ECS jetzt eine eigene Lösung für ein immer wiederkehrendes Problem mit Docker Containern. Wie kann ich Services aufrufen von denen ich nicht weis wie viele Instanzen es gibt und unter welcher URL sie erreichbar sind? Amazon löst das Problem durch den Einsatz der Route 53 Auto Naming API. Die Service-Erkennung ist aktuell in folgenden Regionen nutzbar, USA Ost (Nord-Virginia), USA Ost (Ohio), USA West (Oregon) und EU (Irland). Weitere Informationen zur Service-Erkennung [hier](https://docs.aws.amazon.com/AmazonECS/latest/developerguide/service-discovery.html). ## Längere ID´s für mehr Amazon EC2 Resourcen Nachdem längere Ressource ID´s für wenige EC2 Ressourcen angekündigt wurden, werden die längeren ID´s jetzt auf alle EC2 Ressourcen ausgerollt. Bis Juli 2018 können die neuen ID´s noch auf Opt-In Basis zum testen verwendet werden. Ab July 2018 werden alle neu angelegten Ressourcen mit den neuen ID´s erzeugt. Bereits bestehende Ressourcen mit den alten ID`s bleiben weiterhin bestehen. Weitere Informationen zu den Ressource ID´s [hier](https://docs.amazonaws.cn/en_us/AWSEC2/latest/UserGuide/resource-ids.html). ## Echtzeit Hotspot Erkennung für Amazon Kinesis Analytics Kinesis Data Analytics ist Amazons fully managed Stream Processing Engine. Es ist möglich mit SQL Querrys in Echtzeit Datenstream zu analysieren. Zu den bereits vorhandenen Analysemöglichkeiten ist jetzt noch die Erkennung von Hotspots in Daten hinzugekommen. Weitere Informationen zu Kinesis Data Analytics [hier](https://aws.amazon.com/kinesis/data-analytics/). **Kategorien:** Cloud --- ### [Integration in der Cloud - Ein Serverless Ansatz](https://thecattlecrew.net/2018/05/09/integration-in-der-cloud-ein-serverless-ansatz/) **Published:** Mai 9, 2018 **Author:** Dominik Bial **Content:** Integration hat in Zeiten der Digitalisierung nicht an Bedeutung verloren „“ vielmehr wird diese Disziplin immer wichtiger, um Menschen, Dinge und Maschinen mit den Informationen zu versorgen, die sie benötigen. Integration muss dabei nicht on-Premise und mit großen, zentralen Integrationsplattformen erfolgen. Cloud und Container haben die Disziplin Integration ebenfalls nachhaltig beeinflusst. Hier sind einige „Platform as a Service“-Produkte entstanden, die eine gute Alternative zu klassischen Integrationsplattformen darstellen. Beispielsweise sind so genannte „Serverless Functions“ entstanden, die unter anderem „AWS Lambda“ und „Azure Functions“ genannt werden. Die Laufzeitumgebung wird dabei von der Cloud zur Verfügung gestellt, sodass keine direkte Server-Infrastruktur benötigt wird. Mittels dieser Funktionen würde in Integrationsumgebungen die Transformations- und Geschäftslogik abgebildet. In Kombination mit weiteren Services wie Messaging, Cloud-Speicher, API Gateways und weiteren Diensten lassen sich somit schnell Integrationsprozesse erstellen. [![](https://thecattlecrew.net/wp-content/uploads/2018/05/trigger-logic-target.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/05/trigger-logic-target.png)Quelle – Logik – Senke Komplexere Prozesse lassen sich mit bekannten Konzepten aus dem Integrationsumfeld realisieren. Nutzt man Beispielsweise eine Orchestrierungs-Engine in der Cloud oder extern, lassen sich die Funktionsaufrufe miteinander kombinieren. Über einen Messaging Layer lassen sich Konzepte einer Message-Oriented Middleware oder Enterprise Integration Patterns umsetzen. [![](https://thecattlecrew.net/wp-content/uploads/2018/05/orchestrierung.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/05/orchestrierung.png)Orchestrierung von Funktionen über Dritt-Tool [![](https://thecattlecrew.net/wp-content/uploads/2018/05/choreographie.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/05/choreographie.png)Message-orientierter Ansatz über Queues und Topics Ein entsprechender Ansatz bietet einige Vorteile: - Es fallen nur Kosten für die Integration an, wenn diese wirklich benötigt wird. Typischerweise kommen Pay-by-Use-Modelle zum Einsatz. - Kosten für Wartung und Betrieb der Infrastruktur existieren nicht beziehungsweise werden diese vom Cloud Provider übernommen. - Verantwortung für die Infrastruktur wird an den Cloud Provider abgegeben, sodass ein Fokus auf Fachlichkeit und Entwicklung gesetzt werden kann. - Man erreicht eine schnellere Time-to-Market. - Die Strukturen der Cloud Provider enthalten bereits einen komponentenorientierten Ansatz, sodass ein Service-Schnitt und anteiliges Deployment vereinfacht wird. Gleichzeitig verbessert dieser Ansatz die Code-Strukturen für das automatisierte Testen. Die Nachteile sind: - Kosten für „Pay by Use“-Modelle sind schwer abzuschätzen. Wenn Ausführung und Nutzung nicht im Detail bekannt sind, können Kosten rasant steigen. - Man hat keine Hoheit über die Infrastruktur und Laufzeitumgebung. Sind Probleme mit Konnektivität oder Performanz vorhanden, sind der eigenen Analyse Grenzen gesetzt. - Es fallen zusätzliche Kosten in der Cloud für weitere Stages neben der Produktions-Stage an. - Cloud-Dienste unterliegen einem stetigen Wandel, sodass Unsicherheiten vorhanden sind und spätere Anpassungen notwendig werden können. - Erfahrungen und Wissen auf dem Markt sind rar. Werden neue Integrationsstrecken geplant, könnte eine Serverless Architecture interessant sein. Insbesondere in Unternehmen mit einer kleinen IT-Abteilung, bei einer gut kalkulierbaren Nutzung der Integrationsplattform oder, falls ein Betrieb in der Cloud bereits angedacht ist, sollte eine Serverless-Architektur für die Integration in Betracht gezogen werden. **Kategorien:** Cloud, Integration --- ### [Alexa, wieviel wiege ich? Hackathon: Voice meets IoT in München](https://thecattlecrew.net/2018/05/13/alexa-wieviel-wiege-ich-hackathon-voice-meets-iot-in-muenchen/) **Published:** Mai 13, 2018 **Author:** tjkrajewski **Content:** Im April haben Christian Ochsenkühn und ich (Tomasz Krajewski) an einem Internet of Things (IoT) Voice Hackathon mit dem Titel *Voice meets IoT* in München teilgenommen. ![1_1](https://thecattlecrew.net/wp-content/uploads/2018/05/1_1.jpg) An dem großen Event haben 80 Entwickler aus ganz Deutschland teilgenommen, um Voice Skills für eine Vernetzung zwischen Smart Speakern und Dingen zu entwickeln. # Unsere Idee Als aktive Menschen finden wir es wichtig Sport zu treiben! Sport ist entscheidend für die Gesundheit und das körperliche Wohlbefinden. Die Zahl der Menschen mit Übergewicht hat sich seit 1975 fast verdreifacht und im Jahre 2016 waren mehr als 1,9 Milliarden Erwachsene übergewichtig. Davon waren über 650 Millionen fettleibig. Mit nur 30 Minuten körperlicher Aktivität an 5 Tagen pro Woche ließen sich die gesundheitlichen Risiken, die durch Übergewicht und Bewegungsmangel entstehen, vermeiden. Daher haben wir uns entschieden einen Skill für den Smart Speaker Alexa zu entwickeln, der den Nutzern helfen soll ihr Körpergewicht zu kontrollieren und sportlich aktiver zu werden. Dazu haben wir eine handelsübliche Badezimmerwaage gehackt und mit einem Controller verbunden. Zusätzlich sollte der Controller die Anzahl an sportlichen Trainingseinheiten zählen. Da der Hackathon nur 24 Stunden umfasste, haben wir nur den ersten Teil unserer Idee umsetzen können. Unsere Lösung soll den Nutzern helfen ihre Gewichtsdaten digital zu speichern. Mit Hilfe dieser Daten soll Alexa den Nutzer so zum Beispiel Ratschläge geben können, ob man mehr trainieren soll oder nicht. Alexa soll die Nutzer motivieren ihre Trainingseinheiten einzuhalten und nicht aufzugeben, wenn sich nicht sofort Ergebnisse feststellen lassen. Abnehmen und der Aufbau von Muskulatur braucht Zeit und damit ein gutes Durchhaltevermögen. Alexa kann dabei helfen die Motivation aufrechtzuerhalten. Folgendes Showcase soll unsere Idee grafisch verdeutlichen: ![HackathonDiagram(1)](https://thecattlecrew.net/wp-content/uploads/2018/05/hackathondiagram1.jpg) Die folgenden Videos zeigen, wie der Skill funktioniert: \[youtube https://www.youtube.com/watch?v=5cpYPHzSBgw&w=560&h=315\] \[youtube https://www.youtube.com/watch?v=Wu9Jj2EKUl0&w=560&h=315\] Der Benutzer definiert nur einmal seine Körperdaten. Beim nächsten Mal kennt Alexa alle Grunddaten über den Benutzer und man kann sofort die Waage benutzen und sein Gewicht ermitteln lassen. # Zur Entwicklung des Skills auf dem Hackathon Die handelsübliche Badezimmerwaage haben wir mit HX-711 Kontroller und Arduino verbunden. ![waage](https://thecattlecrew.net/wp-content/uploads/2018/05/waage.png) Ein bisschen knifflig war der Aufbau. Wir haben nur die günstigsten Komponenten als auch die günstigste Waage (ca. 5 Euro) auf dem Markt gekauft. Wir hatten keinen Multimeter zur Hand und mussten sehr genau löten. Das war eine Herausforderung am Anfang! Nicht alle unsere Sensoren waren richtig verbunden und wir haben lange Zeit nur falsche Daten empfangen. Wir mussten auch HX-711 Sensor genau kalibrieren. Erst gegen 10 Uhr morgens haben wir es geschafft, dass alle Komponenten richtig miteinander kommunizierten und mit der Waage korrekt verbunden waren. Diszipliniertes Arbeiten durch die ganze Nacht war notwendig; umso glücklicher waren wir, dass am Ende alles funktioniert hat. Mit der Entwicklung unseres Skills haben wir den 4. Platz erreicht und waren damit im obersten Viertel. Wir haben sogar eine Kleinigkeit gewonnen, wie ihr im unteren Bild sehen könnt. ![1_2](https://thecattlecrew.net/wp-content/uploads/2018/05/1_2.jpg) Zwei Kollegen in unserem Team waren Neueinsteiger hinsichtlich Arduino und Alexa Entwicklung. Sie haben eine steile Lernkurve während des Hackathons absolviert und tatkräftig unterstützt. Leider musste Christian am Samstag früher nach Hause fahren, weil er eine wichtige Familienfeier hatte. Es war aber sehr nett von ihm, dass er uns trotzdem für ein paar Stunden unterstützen wollte. Das zeigt, was für engagierte Mitarbeiter wir bei Opitz Consulting haben! Leider haben wir am Ende nicht alles Geplante zeigen können, was wir wollten. Die Hürden waren an einigen Stellen doch zu hoch. Dennoch hatten wir sehr viel Spaß in einem tollen Team. Ich hatte das Glück dieses Mal eine koordinative Rolle miteinnehmen zu dürfen und habe dabei eine Menge gelernt. Einfach war es nicht;-) Ich hatte viel Stress und habe kaum geschlafen. Dennoch war dies für mich eine tolle Erfahrung, da ich so einige meiner Soft und Projektmanagement Skills erproben konnte. Mit dem vierten Platz bin ich mehr als zufrieden. Als Team haben wir uns vorgenommen, dass wir in der gleichen Konstellation noch einmal auftreten wollen und uns als Team noch weiter verbessern wollen! # Unser Vorgehen und Projekt Wir haben uns zuerst auf das Backend fokussiert und eine einfache und unabhängige continuous integration (CI) Server Umgebung aufgesetzt. Wenn man in einem Team einen Skill entwickelt, ist dies einfacher als alles erstmal lokal zu entwickeln. So lässt sich alles mit dem alexa-cli und dem CI Server erledigen! Der Ansatz war praktisch, richtig und lieferte für uns schnell Ergebnisse. Wenn ein Teammitglied seine Ü„nderungen mit Hilfe des SCM Tools git pushed, wird unser Skill sofort deployed und unser Interaktions-Model wird zeitgleich im Developer Portal aktualisiert! Dadurch verliert man keine Zeit etwas händisch im Alexa Portal zu ändern und hat damit eine gute Zeitersparnis erreicht. Die Umgebung haben wir mit einem Raspberry Pi aufgebaut. Im Folgenden eine kurze Beschreibung, wie wir dies gemacht haben. ### Raspberry Pi Configuration 1. Wir haben einen alten raspberry pi zero benuzt. Zuerst wäre gut alles zu aktualiesieren: ``` sudo apt-get update sudo apt-get upgrade ``` 2. Man muss git-server installieren ``` sudo apt-get install git-core ``` Anlegen eines ersten Repositories ``` mkdir -p /home/pi/project/repository/hack && cd /home/pi/project/repository/hack ``` 3. Starten des git Repository ``` git init --bare ``` ### PC Konfiguration (Pushen) 1. Ü–ffnen des Repository ``` git init ``` 2. Hinzufügen eines remote GiT Repository ``` git remote add hack pi@192.168.43.47:/home/pi/project/repository/hack ``` 3. Jetzt können wir Standard GiT Befehle starten ``` git add . ``` ``` git commit -m "Our first commit" ``` ``` git push hack master ``` ### PC Konfiguration (Clonen) 1. Um die Files zu clonen schreiben wir in die Console ``` git clone pi@192.168.1.108:/home/pi/project/repository/hack ``` Jetzt können wir einen einfachen CI Konzept implementieren: 1. Gehen wir zu unserem Repository: ``` cd ~/project/repository/hack/hooks ``` 2. Erstellen wir ein CI Skript ``` sudo nano post-receive ``` 3. Fügen wir hinzu: ``` #!/bin/bash TEMP="/home/pi/project/temp" TARGET="/home/pi/project/deployedSkillHackathon/" REPO="/home/pi/project/repository/hack/" while read oldrev newrev ref do     if [[ $ref =~ .*/master$ ]];     then         echo "Master ref received. Deploying master branch to production..."                 mkdir -p $TEMP                 echo "temp folder created"                 git --work-tree=$TEMP --git-dir=$REPO checkout -f                 echo "checking if I need to install npm modules"                 if cmp $TEMP/package.json $TARGET/package.json; then                         echo "Ha you havent changed anything in node modules I have less work! "                 else                         cd $TEMP                         npm install                 fi                 echo "target folder deleted"                 rm -rf $TARGET                 mv $TEMP $TARGET     else         echo "Ref $ref successfully received.  Doing nothing: only the master branch may be deployed on this server."     fi done ``` 4. Rechte hinzufügen ``` sudo chmod +x post-receive ``` 5. Wir sind fertig zu deployen! In einem nächsten Blog Artikel werde ich Skill Eigenschaften genauer beschreiben und ich zeige auf einem neuen Video wie schnell man den Skill mit Raspberry Pi und einfachen CI Server deployen kann. **Kategorien:** AI & Data Science, Tech Events & Networking **Schlagwörter:** Alexa node.js, Alexa sdk, Alexa-cli, continuous integration Raspberry pi, Hacking Waage, HX-711 --- ### [Azure Functions "“ Simple JavaScript Tutorial](https://thecattlecrew.net/2018/05/16/azure-functions-simple-javascript-tutorial/) **Published:** Mai 16, 2018 **Author:** davidgreineropitz **Content:** Bevor wir in das Tutorial einsteigen, sollten wir uns erst einmal anschauen, was Azure Functions überhaupt sind: Bei Azure Functions handelt es sich um eine Lösung, mit der man kleinere Codefragmente (Funktionen) erstellen und in der Cloud ausführen kann. Bei der Implementierung kann man sich ganz auf das Lösen des jeweiligen Problems konzentrieren und muss sich nicht auch noch um die Infrastruktur kümmern (Serverless Computing). Die Funktionen können unter anderem mit C#, JavaScript, F# und Java entwickelt werden. Eine Einschränkung gibt es aber bezüglich Java: Unterstützung gibt es erst ab der Version 2.x der zugrundeliegenden Azure Functions Runtime. Darüber hinaus befindet sich diese Version im Vorschaustatus, kann also nicht für Produktivsysteme genutzt werden. Weitere Informationen zu den unterstützten Sprachen gibt es unter . In der Runtime Version 1.x, die wir auch in unseren Beispielen nutzen werden, unterstützen nur C#, JavaScript und F# alle Features der Azure Functions. Das Schöne an der Azure Functions Runtime ist, dass diese Open Source ist und unter eingesehen werden kann. Das Gegenstück in der AWS Welt wären die AWS Lambdas. Wie auch bei AWS Lambdas ist die Laufzeit einer Funktion zeitlich begrenzt. Standardmäßig erfolgt ein Timeout nach 5 Minuten, dieses kann noch auf 10 Minuten erweitert werden. Danach ist aber definitiv Schluss. Ein weiteres Limit definiert der maximal nutzbare Arbeitsspeicher von 1.536 MB. In dem Beispiel mit dem wir gleich anfangen, nutzen wir NodeJs. Unsere kleine Beispielanwendung (Keine Angst, kein Hello World!) erstellen wir direkt über das Azure Portal. Neben der direkten Erstellung im Portal gibt es auch die Option, den Code lokal in der gewohnten Entwicklungsumgebung zu bauen. Dieser kann dann mittels GitHub, BitBucket, OneDrive etc. bereitgestellt werden. In diesem Fall werden die neusten Updates per Pull nach Azure übertragen und sind sofort live. Nun aber zu unserem Beispiel: Das Ziel unserer Azure Funktion ist es, alle 120 Sekunden mittels der Random User Generator API einen User zu beziehen. Zur Kontrolle geben wir den Namen des Users aus und zusätzlich die kompletten Daten, die wir über den REST-Endpoint erhalten haben. Nach dem Einloggen im Azure Portal () befinden wir uns auf dem Dashboard (Abbildung 1). Am Anfang ist hier noch nicht viel zu sehen. Wenn wir die Funktion erstellt haben, werden wir diese unter dem Punkt „Alle Ressourcen“ wiederfinden und können darüber direkt zur Funktion springen. Abbildung 1 ![Abbildung_1](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_1.png) Um eine Funktion anlegen zu können, müssen wir zuerst eine Funktionen-App erstellen. Die Funktionen-App hostet unsere eigentlichen Funktionen. Und da eine Funktionen-App mehrere Funktionen hosten kann, können wir Funktionen zu logischen Einheiten gruppieren. Um nun eine neue Funktionen-App anzulegen, drücken wir auf den Punkt „Ressource erstellen“ (Abbildung 2, roter Pfeil). In den Bereich, der nun aufpoppt, können wir aus einer Vielzahl angebotener Services wählen. Azure Functions sind unter dem Punkt „Compute“ zu finden. Abbildung 2 ![Abbildung_2](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_2.png) Nach der Auswahl der Funktionen-App können die nötigen Einstellungen vorgenommen werden. Wir geben unserer App den Namen „Function-UserData“ und wählen als Standort „Westeuropa“ aus. Den Rest lassen wir so wie er ist (Abbildung 3). Nach dem Drücken des Buttons „Erstellen“ werden unsere Angaben überprüft und die Funktionen-App wird bereitgestellt. Dieser Vorgang kann etwas dauern. Wenn die Bereitstellung erfolgt ist bekommen wir eine Mitteilung. Diese kann auch nachträglich angesehen werden, wenn wir auf die Glocke im oberen rechten Bereich des Portals drücken. Abbildung 3 ![Abbildung_3](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_3.png) Nach dem Anlegen gelangen wir z. B. über den Favoriten „Funktionen-Apps“ zu unserer gerade erstellten Funktionen-App (Abbildung 4). Wenn wir unsere Function-UserData aufklappen könnten wir mit dem Plus-Symbol am Punkt „Funktionen“ unsere eigentlichen Funktionen anlegen. Als Szenario wählen wir den Timer und als Sprache JavaScript (Abbildung 5). Bei dieser Ansicht handelt es sich um den Schnellstart, der uns die gängigsten Szenarien zum Starten oder Triggern einer Funktion anzeigt. Darüber hinaus wird die Funktion mit Beispiel-Code erstellt. Unter dem Link „Benutzerdefinierte Funktion“ werden uns alle unterstützten Trigger angeboten. Nach dem Anlegen landen wir direkt im Code Editor und sehen dort, wie oben erwähnt, den Beispiel-Code, den wir auch ausführen können. Abbildung 4 ![Abbildung_4](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_4.png) Abbildung 5 ![Abbildung_5](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_5.png) Eine Funktion besteht aus drei Dateien. Einer „function.json“, einer „index.js“ und einer „readme.md“. Die „function.json“ ist die Konfigurations-Datei unserer Funktion. Hier können wir in unserem Beispiel den ausgewählten Trigger (Timer-Trigger) einsehen und bearbeiten. Den Quellcode unserer Funktion finden wir in der „index.js“. Die „readme.md“ dient der Dokumentation. Die genannten Dateien können in der Editor-Ansicht unter dem Punkt „Dateien anzeigen“ angezeigt werden. Unsere Funktion sollte ja wie eingangs erwähnt alle zwei Minuten Random-User-Daten über die Random User Generator API () beziehen. Dazu öffnen wir die „index.js“ und ändern den Code ab, so wie es in Abbildung 6 zu sehen ist. Die roten Pfeile zeigen die Ü„nderungen an. Abbildung 6 ![Abbildung_6](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_6.png) Nach dem Speichern und Ausführen sollten wir unter „Protokolle“ das Ergebnis sehen (grüner Pfeil in Abbildung 6). Glückwunsch! Die Funktion ruft nun die Random User Generator API auf und bezieht User Daten. Aktuell passiert dies aber noch im Fünf-Minuten-Takt. Damit die Funktion alle zwei Minuten ausgeführt wird, müssen wir den Timer Trigger abändern. Diese Ü„nderung kann man in der „function.json“ vornehmen, in dem man beim Key „schedule“ die 5 durch eine 2 ersetzt („0 \*/2 \* \* \* \*“). Alternativ kann man auch über den Punkt „Integrieren“ (Abbildung 7) die Eigenschaften des Timer Triggers ändern. Abbildung 7 ![Abbildung_7](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_7.png) Führen wir die Funktion nun wieder im Code Editor aus, sehen wir unter dem Punkt „Protokolle“, dass dieser alle zwei Minuten ausgeführt wird. Damit sind wir schon am Ende unseres kleinen Beispiels angekommen, das hoffentlich zeigen konnte, wie einfach das Erstellen einer Azure Funktion mittels des Code-Editors von der Hand geht. Man hat die Möglichkeit eine Funktion sowohl programmatisch wie auch über die Oberfläche des Portals zu ändern (siehe Ü„nderung des Trigger-Intervalls). Durch das direkte Arbeiten in der Azure Cloud bekommt man direktes Feedback ob der eigene Code lauffähig ist. Im nächsten Blog erweitern wir die hier erstellte Funktion um eine Anbindung zum ServiceBus und verlagern die Entwicklung aus dem Azure Portal in die lokale Umgebung. **Kategorien:** Cloud --- ### [Integration in der Cloud mit Microsoft Azure](https://thecattlecrew.net/2018/05/23/integration-in-der-cloud-mit-microsoft-azure/) **Published:** Mai 23, 2018 **Author:** Dominik Bial **Content:** Im Artikel „[Integration in der Cloud – Ein Serverless Ansatz](https://thecattlecrew.net/2018/05/09/integration-in-der-cloud-ein-serverless-ansatz/)“ haben wir Serverless Integrationsansätze für die Cloud vorgestellt, die wir gerne noch einmal technisch betrachten wollen. In diesem Artikel wollen wir uns dabei auf Microsoft Azure beziehen. Mit dem vorgestellten Ansatz „Trigger, Integration Logic, Target“ werden im folgenden ausgewählte Technologien für Integrationsansätze in der Azure Cloud vorgestellt. [![](https://thecattlecrew.net/wp-content/uploads/2018/05/azure_integration_overview.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2018/05/azure_integration_overview.png) ## Trigger Trigger sind für den Start eines Integrationsprozesses verantwortlich. Hier kommen alle Dienste in Frage, die ein Ereignis übermitteln oder auslösen. Für Integrationsplattformen auf Basis von Azure Technologie sind daher insbesondere folgende Services interessant. ### Servicebus Der Servicebus ist ein klassischer Messaging Layer, der mittels Queues und Topics Daten an Clients übermittelt. Mit dem Servicebus lassen sich Konzepte aus dem Bereich der Message-oriented Middleware oder den Enterprise Integration Patterns umsetzen. ### Event Grid Das Event Grid nutzt ebenfalls Events aus Apps und anderen Diensten, um Berechnungslogiken zu starten. Hierbei wird ein Publish-Subscribe Modell genutzt, sodass über Topics Daten zwischen Applikationen ausgetauscht werden können. Der Unterschied zum Servicebus ist vor allem die Größe des Event Grids. Das Event Grid wird für reaktive Systeme empfohlen. ### Event Hub Der Event Hub ist vor allem für die Integration von Millionen von Geräten empfohlen, zum Beispiel für mobile oder IoT Kontexte, und kann Millionen von Ereignisse pro Sekunde verarbeiten. Dieser Service bietet sich vor allem dann an, wenn eingehende Events analysiert werden sollen und Prinzipien aus dem Fast Data zum Einsatz kommen. ### API Management Das API Management ist für die Erstellung und Verwaltung von Schnittstellen in Azure relevant. Hier können REST basierte Schnittstellen erstellt werden, die dann Anfragen an Backing Services weiterrouten. ### Scheduler Der Scheduler Service kann zum Starten von zeitgesteuerten Jobs verwendet werden. Dabei können Nachrichten in Queues, Topics und über Http versendet, aber auch direkt Logik ausgeführt. ## Integration Logic Die Logik Schicht ist eine Kombination aus Orchestrierung, Transformation und Rerouting. Es finden Ü„nderungen auf dem ursprünglichen Payload statt, bis schließlich das Zielsystem oder die Zielfunktion erreicht wird. ### Logic Apps Logic Apps dienen der einfachen Orchestrierung. Dabei können sowohl Azure Functions, externe Systeme über Konnektoren als auch Aufrufe an weitere Azure Services ausgeführt werden. Einfache Kontrollflüsse lassen sich graphisch erstellen, die dann die Orchestrierung durchführen. ### Azure Functions Über Azure Functions lassen sich Funktionen, also ausprogrammierte Logik, abbilden. Über Functions hat man alle Freiheiten einer Programmiersprache, um eine Funktion, ein kleines Programm, zu realisieren, das dann aus anderen Bausteinen oder manuell aufgerufen werden kann. Im Kontext der Integration lassen sich über Functions Mappings, Transformationen oder Payload-Anreicherungen und Filterungen realisieren, aber auch Partnersysteme aufrufen. ## Ziel Das Ziel beendet typischerweise einen Integrationsprozess. Ziele können Partnersysteme oder aber weitere Logik sein, für die der Payload adaptiert wurde. In Request/Reply Patterns ist das Zielsystem das aufrufende System. Im Grunde genommen kommen hier alle Services in Betracht, wie Mailing, externe Partnersysteme und Datenbanken. Im Sinne einer Serverless Architektur werden zum Großteil Azure Functions eingesetzt, um, zum Beispiel, externe Systeme aufzurufen. Man sieht „“ die Azure Plattform bietet viel Potential um neue Integrationsansätze zu realisieren. Ein Blick auf Azure lohnt sich. **Kategorien:** Cloud, Integration --- ### [Azure Functions "“ Vollgas mit dem Service-Bus](https://thecattlecrew.net/2018/05/30/azure-functions-vollgas-mit-dem-service-bus/) **Published:** Mai 30, 2018 **Author:** davidgreineropitz **Content:** In „[Azure Functions „“ Simple JavaScript Tutorial](https://thecattlecrew.net/2018/05/16/azure-functions-simple-javascript-tutorial/)“ haben wir unsere erste Azure Funktion geschrieben. Die erstellte Funktion lädt Random-User-Daten über einen Rest Endpoint und zeigt diese aktuell als Log-Mitteilung im Azure Portal an. Unser Wunsch ist es aber, die erstellte Funktion als Importer zu nutzen, der die Daten anderen Applikationen und Funktionen zur Verfügung stellt. Um das Bereitstellen der Daten zu verwirklichen, werden wir in unserem heutigen Beispiel den Azure Service Bus nutzen. Der Service Bus besteht aus einer Komponente für die asynchrone unidirektionale Kommunikation (Brokermessaging) und einer Komponente für die synchrone bidirektionale Kommunikation (Relays). Vergleichbare Broker-Messaging-Lösungen wären z. B. ActiveMQ, Kafka etc. Der Service Bus ist Microsofts cloudbasiertes Messaging-as-a-Service Lösung. Weitere führende Informationen findet man unter . Im Rahmen des Beispiels werden wir den Service Bus als Messaging Broker nutzen und zu diesem Zweck eine Warteschlange (Queue) erstellen. Lasst uns nun aber endlich mit dem Beispiel beginnen 😊. Ich erwähnte ja schon im Beitrag „[Azure Functions „“ Simple JavaScript Tutorial](https://thecattlecrew.net/2018/05/16/azure-functions-simple-javascript-tutorial/)“ , dass man Funktionen entweder direkt im Portal oder auch lokal entwickeln kann. Wir werden uns mal anschauen, wie das lokale Entwickeln aussehen könnte und wie man den „Code“ auf die Azure Plattform bekommt. Um den letztgenannten Punkt zu erfüllen, müssen wir zuerst ein leeres Git Repository erstellen. Für dieses Beispiel habe ich der Einfachheit halber auf GitHub ein neues Repository erstellt, man kann auch ein lokales Repository erstellen oder Bitbucket nutzen. Das erstellte Git Repository legen wir nun erst einmal beiseite und erstellen zunächst den benötigten Service Bus. Dazu begeben wir uns ins Azure Portal und erstellen eine neue Ressource. Der Service Bus ist unter Enterprise Integration zu finden (Abbildung 1). Abbildung 1 ![Abbildung_1](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_11.png) Im nächsten Schritt wählen wir einen sprechenden Namen aus und ändern die Pricing Tier auf „Basis“. Falls noch nicht vorhanden, erstellen wir eine neue Ressourcen-Gruppe und zu guter Letzt vergewissern wir uns, dass als Standort Westeuropa ausgewählt ist (Abbildung 2). Abbildung 2 ![Abbildung_2](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_21.png) Nach einer gefühlten kleinen Ewigkeit sollte die Bereitstellung beendet sein, und wir können zu unserem neuen Service Bus wechseln. Jetzt fehlt uns nur noch eine Queue, die wir später mit Nachrichten füllen können. Um eine solche zu erstellen drücken wir in der Overview auf das „+Queue“ . Der Queue geben wir den Namen „userDataQueue“ und setzen die Lock Duration auf eine Minute (Abbildung 3). Zum Schluss müssen wir noch den Primary Connection String des Service Bus zwischenspeichern, diesen werden wir anschließend beim Konfigurieren unserer Funktions-App benötigen. Der Primary Connection String ist unter dem Punkt „Shared access policies“ zu finden. Dort wird uns eine Policy angeboten und zwar die „RootManageSharedAccessKey“. Wählen wir diese aus, können wir den Primary Connection String kopieren. Das war es auch schon mit dem Service Bus. Ab sofort können wir Nachrichten verschicken und der erstellte Service Bus fungiert für uns als Messaging-Broker. Abbildung 3 ![Abbildung_3.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_31.png) Da unser Service Bus nun steht, machen wir weiter und erstellen eine neue Azure Funktionen-App, die wir mit dem Git Repository, das wir erstellt haben, verbinden. Die Funktionen-App ist unter „Compute“ zu finden . Der Funktionen-App geben wir einen Namen, wählen als Standort Westeuropa aus und erstellen diese (Abbildung 4). Abbildung 4 ![Abbildung_5](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_51.png) Auch hier warten wir kurz die Bereitstellung ab und wechseln dann zu der erstellten Funktion. Dort angekommen, wechseln wir zu den Plattform-Features und wählen die Bereitstellungsoptionen aus (Abbildung 5a). In dem neu geöffneten Fenster erstellen wir ein neues Setup und wählen die Quelle aus (Abbildung 5b), in unserem Fall GitHub. Um GitHub nutzen zu können, müssen wir uns in den Bereitstellungsoptionen mit unserem Account autorisieren und das erstellte Repository als Projekt auswählen (Abbildung 5c). Ab sofort bezieht Azure alle Ü„nderungen im Master per Pull. Achtung: Alle Ü„nderungen am Master gehen sofort live. Falls man sich für diese Option beim Continuous Deployment entscheidet, sollten Entwicklungen in einem separaten Branch erfolgen und mittels Pull Request in den Master gemergt werden. Abbildung 5a ![Abbildung_6a](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_6a.png) Abbildung 5b ![Abbildung_6b](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_6b.png) Abbildng 5c ![Abbildung_6c](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_6c.png) Bevor wir zur eigentlichen Programmierung kommen, müssen wir den eben kopierten Primary Connection String in den Anwendungseinstellungen unserer Funktionen-App hinterlegen. Wir wechseln in der Übersicht zu den Anwendungseinstellungen (Abbildung 6a). Dort angekommen fügen wir unter dem Punkt „Anwendungseinstellungen“ eine neue Einstellung hinzu. Als Name geben wir „ServiceBusConnection“ ein und als Wert den kopierten Primary Connection String. Das Ganze speichern wir (Abbildung 6b). Mit der angelegten Eigenschaft, in diesem Fall einer Verbindungseigenschaft, können sich die Funktionen, die in dieser Funktionen-App gehostet werden, mit dem Service Bus verbinden. Abbildung 6a ![Abbildung_7a](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_7a.png) Abbildung 6b ![Abbildung_7b.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_7b.png) Jetzt können wir mit dem Programmieren loslegen. Das erstellte Repository klonen wir und importieren es in unsere Entwicklungsumgebung. In dem nun importierten Projekt erstellen wir jeweils ein Verzeichnis (directory) für „FunktionServiceBus“ und „FunktionServiceBusReader“ (Abbildung 7). Abbildung 7 ![Abbildung_8.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_8.png) Aus jedem Unterverzeichnis des Projekts wird später eine Azure Funktion. Der Name des Verzeichnisses fungiert als Name der Funktion. Auf der gleichen Ebene wie die Unterverzeichnisse kann noch eine host.json-Datei abgelegt werden. Diese enthält globale Konfigurationsoptionen, die sich auf alle Funktionen auswirken (). Eine mögliche Option wäre z. B. der Timeout der Funktionen. Als nächstes erstellen wir in jedem Unterverzeichnis folgende Dateien (Abbildung 8): - function.json - index.js - readme.md Wie man sieht, haben die Unterverzeichnisse die gleiche Struktur wie Funktionen, die direkt im Portal erstellt werden. Abbildung 8 ![Abbildung_9](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_9.png) Die FunktionServiceBus erweitern wir an zwei Stellen. Als erstes fügen wir der Funktion eine Bindung (binding) hinzu. Azure Funktionen können mehrere Eingabe- und Ausgabe-Bindungen beinhalten. Diese Bindungen bieten eine deklarative Möglichkeit, Verbindungen zu unterstützen Diensten zwecks Daten Austausch herzustellen. Unter sind die möglichen Bindungen aufgelistet. Wir erstellen nun eine Ausgabe-Bindung zu unserem Service Bus (Abbildung 9a). Der Wert des Attributs „name“ gibt an, unter welchem Namen wir auf das erstellte Binding im Quellcode zugreifen können. Als typ geben wir an, dass es sich um einen serviceBus handelt. Als queueName hinterlegen wir den Namen der weiter oben erstellten Queue userdataqueue. Bei connection geben wir den Namen der weiter oben erstellten Verbindungseigenschaft ein (ServiceBusConnection). Im Anschluss wird noch angegeben, ob es sich um eine Eingabe- oder um eine Ausgabe-Bindung handelt. Abbildung 9a ![Abbildung_10a](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_10a.png) Zuletzt ändern wir die index.js so um, dass wir die Daten aus dem REST Endpoint in die Warteschlange unseres Service Bus übermitteln (Abbildung 9b). Hier nehmen wir den context und weisen unserer erstellten Bindung die zu übermittelnde Nachricht zu. Mehr müssen wir nicht tun, um eine Nachricht zu übermitteln. Abbildung 9b ![Abbildung_10b.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_10b.png) Schauen wir uns jetzt noch die andere Seite an: Um die Nachrichten in der Warteschlange zu empfangen, haben wir zu Beginn ein weiteres Unterverzeichnis („FunktionServiceBusReader“) erstellt. Wir öffnen dort nun die function.json und erstellen einen Trigger für diese Funktion (Abbildung 10a). Achtung: Jede Funktion kann nur einen Trigger besitzen. Wir nennen in queueItem und als „typ“ hinterlegen wir serviceBusTrigger. queueName und connection sind die gleichen wie bei der FunktionServiceBus. direction ist hier nun in statt out. Abbildung 10a ![Abbildung_11a](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_11a.png) Nun müssen wir noch testen, ob wir wirklich die Nachrichten aus der Warteschlange bekommen. Dazu geben wir die erhaltenen Nachrichten im Log aus (Abbildung 10b). Haben wir alle Ü„nderungen vorgenommen, können wir diese in unser Repository pushen. Abbildung 10b ![Abbildung_11b.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_11b.png) Schauen wir nun ins Azure Portal unsere Funktionen-App an, sollten wir dort unter dem Punkt „Funktionen“ unsere beiden Funktionen wiederfinden (Abbildung 11). Abbildung 11 ![Abbildung_12.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_12.png) Im Rahmen dieses Beispiel haben wir einen Service Bus angeschlossen und die Entwicklung aus dem Portal in unsere Entwicklungsumgebung verlagert. Mit der Anbindung von Git haben wir darüber hinaus ein Continuous Deployment eingerichtet. Zusammenfassend kann man sagen, dass uns Microsoft sowohl mit den bereitgestellten Bindungen wie auch den Bereitstellungsoptionen einiges an Arbeit abnimmt. Möchten wir mehr Kontrolle beim Erstellen, Senden und Empfangen von Nachrichten haben, können wir den Service Bus auch mittels des Azure SDK anbinden. Für NodeJs gibt es das AzureSB Packet (), dass uns die nötigen Funktionen bereitstellt. Der Vorteil an diesem Paket ist, dass wir nicht das gesamte SDK in unsere Funktion laden müssen. Abbildung 12 und 13 zeigen abschließend die Protokoll-Ansicht der beiden Funktionen. In Abbildung 12 sieht man, dass eine Nachricht geschickt wurde und in Abbildung 13 kann man erkennen, dass eine Nachricht aus der Warteschlange geladen wurde. Im nächsten Blog gehen wir einen Schritt weiter und schauen uns an welche Möglichkeiten wir haben die nun lokal Entwickelten Funktionen zu testen und zu debuggen. Abbildung 12 ![Abbildung_13.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_13.png) Abbildung 13 ![Abbildung_14.png](https://thecattlecrew.net/wp-content/uploads/2018/05/abbildung_14.png) **Kategorien:** Cloud --- ### [AWS News KW 29 und KW 30](https://thecattlecrew.net/2018/08/20/aws-news-kw-29-und-kw-30/) **Published:** August 20, 2018 **Author:** Marco Buss **Content:** ## Amazon Translate: Support für Japanisch, Russisch, Italienisch, traditionelles Chinesisch, Türkisch und Tschechisch Amazon´s Übersetzungs Service Amazon Translate der auch für das Polly WordPress Plugin zum Einsatz kommt (siehe [hier](https://thecattlecrew.net/2018/07/24/aws-news-kw-25-und-kw-26/)) unterstützt ab sofort auch Japanisch, Russisch, Italienisch, traditionelles Chinesisch, Türkisch und Tschechisch. Weitere Informationen zu Amazon Translate [hier](https://aws.amazon.com/de/translate/). ## EC2 Instanzen für Snowball Edge Amazon bietet die Möglichkeit EC2 Instanzen auf [Snowball Edge](https://aws.amazon.com/snowball-edge/) Geräten laufen zu lassen. Sownball Edge ist ein Stand Alone Gerät um große Datenmengen zu AWS zu exportieren indem einfach das komplette Device per Post an Amazon gesendet wird. Mit der Möglichkeit eigene Amazon Machine Images auf diesen Geräten ausführen zu können, können die lokal anfallenden Daten effektiv vor-verarbeitet werden. Besonders nützlich kann dieses Szenario in Umgebungen mit keiner oder nur eingeschränkter Internet Konnektivität sein. Weitere Informationen zu Snowball Edge Funktionen [hier](https://aws.amazon.com/snowball-edge/features/). ## EC2 – Neue Instanztypen **z1d** Dieser neue Instanztyp basiert auf Intel Xenon Prozessoren mit bis zu 4.0 GHz und ist besonders für Rechenintensive Workloads beispielsweise HPC Anwendungen interessant. Darüber hinaus können Anwendungen die pro CPU bezahlt werden wie einige Datenbanken von der Mehrleistung pro CPU profitieren. Der Instanztyp ist in folgenden Konfigurationen verfügbar. **Instance Name****vCPUs****Memory****Local Storage****EBS-Optimized Bandwidth****Network Bandwidth****z1d.large**216 GiB1 x 75 GB NVMe SSDUp to 2.333 GbpsUp to 10 Gbps**z1d.xlarge**432 GiB1 x 150 GB NVMe SSDUp to 2.333 GbpsUp to 10 Gbps**z1d.2xlarge**864 GiB1 x 300 GB NVMe SSD2.333 GbpsUp to 10 Gbps**z1d.3xlarge**1296 GiB1 x 450 GB NVMe SSD3.5 GbpsUp to 10 Gbps**z1d.6xlarge**24192 GiB1 x 900 GB NVMe SSD7.0 Gbps10 Gbps**z1d.12xlarge**48384 GiB2 x 900 GB NVMe SSD14.0 Gbps25 Gbps**R5 und R5d** R5 ist der Nachfolger des R4 Instanztyps und basiert auf Intel CPU´s mit bis zu 3.1 GHz und ist für Anwendungen die sehr viel Arbeitsspeicher benötigen gedacht. Die R5d Instanzen haben die selben Spezifikationen wie die R5 Instanzen, besitzen aber schnelleren Plattenspeicher der per NVMe angebunden ist. R5 Instanzen sind mit folgenden Spezifikationen verfügbar. **Instance Name****vCPUs****Memory****EBS-Optimized Bandwidth****Network Bandwidth****r5.large**216 GiBUp to 3.5 GbpsUp to 10 Gbps**r5.xlarge**432 GiBUp to 3.5 GbpsUp to 10 Gbps**r5.2xlarge**864 GiBUp to 3.5 GbpsUp to 10 Gbps**r5.4xlarge**16128 GiB3.5 GbpsUp to 10 Gbps**r5.12xlarge**48384 GiB7.0 Gbps10 Gbps**r5.24xlarge**96768 GiB14.0 Gbps25 GbpsWeitere Informationen zu EC2 Instanz Typen [hier](https://aws.amazon.com/ec2/instance-types/). ## Amazon Polly: Zeit basierter Satzrhythmus und asynchroner Aufruf Amazon Polly bietet ab sofort die Möglichkeit den Satzrhythmus (Prosody) zu beeinflussen. Der Satzrhythmus wird durch die Angabe einer Maximalzeit für einen Textabschnitt variiert. Jeder Block kann dabei maximal 1500 Zeichen aufnehmen. Um lange Texte in Sprache zu synthetisieren bietet Amazon jetzt eine asynchrone Schnittstelle die bis zu 100k Zeichen pro Aufruf erlaubt und das Ergebnis direkt in S3 speichert. Nach erfolgreiche Synthese erhält der Aufrufer eine entsprechende Mail. Weitere Infos zu Amazon Polly [hier](https://aws.amazon.com/polly/). ## Amazon SageMaker Batch Transform und Pipe Input Mode für Tensorflow Container Amazons ML Model Training Tool SageMaker hat die neuen Features Batch Transform für die Transformierung von großen Sätzen an Eingangsdaten, sowie Pipe Input Mode für Tensorflow Container erhalten. **Batch Transform** Dieses neue Feature kann Beispielsweise für die Objekterkennung in einer großen Anzahl von Bildern genutzt werden. **Pipe Input Mode für Tensorflow** Trainingsdatensätze können jetzt direkt von S3 in den Container gestreamt werden. Das neue Feature bietet eine deutlich gesteigerte Performance gegenüber der File Input Variante bei der Die Daten zuerst auf das EBS Volume kopiert werden mussten. Das hat zur Folge das der Trainingsjob schneller startet und auch weniger Plattenplatz benötigt und damit die Kosten für das trainieren des ML Models sinken. Weiter Informationen zu SageMaker [hier](https://aws.amazon.com/sagemaker/). **Kategorien:** Cloud **Schlagwörter:** Amazon Polly, Amazon SageMaker, Amazon Translate, AWS --- ### [GraphQL Demo (2/8) - GraphQL vs REST](https://thecattlecrew.net/2018/08/23/graphql-vs-rest/) **Published:** August 23, 2018 **Author:** Manuel Styrsky **Content:** GraphQL ist wie REST vor allem für die Schnittstellen-Definition da. Doch wie schlägt sich GraphQL im Vergleich mit REST? ### **Die Basics** Beide Standards können über eine Vielzahl an Protokollen genutzt werden. Jedoch werden REST und GraphQL hauptsächlich über HTTP genutzt. Da HTTP weit verbreitet ist, vergleichen wir im Folgenden zunächst die Umsetzung mit HTTP. GraphQL und REST setzen auf menschenlesbare Anfragen und Antworten. Bei beiden Protokollen müssen die Anfragen in HTTP zum Teil speziell kodiert werden. ### **Endpunkte** Ein Endpunkt beschreibt eine URL, die sich aus verschiedenen Teilen zusammensetzen kann. In REST werden verschiedene Ressourcen definiert, jede Ressource stellt dabei einen eigenen Endpunkt dar. Auf einer Ressource können wiederum verschiedene Aktionen erlaubt sein. Zu diesen Aktionen gehören meist . Die verschiedenen Aktionen werden dabei durch verschiedene HTTP-Verben unterschieden, so wird für READ beispielsweise GET, für Delete das Delete-Verb genutzt. In GraphQL hingegen spielen die HTTP-Verben keine Rolle. Hier gibt es auch nur einen einzigen Endpunkt. An diesen Endpunkt wird eine Query gesendet. Ob diese Query per GET oder POST gesendet wird, hängt wiederum von den vom Server angebotenen Methoden ab. Die meisten Server unterstützen GET- und POST-Anfragen. Beide Methoden haben einen Parameter, der die Query beinhaltet. In der Query gibt es dann zwei verschiedene Arten von Wurzelelementen: Queries und Mutations. Mutations sind für Ceate, Update und Delete zuständig. Sie werden jeweils über ihren Namen unterschieden. Hier fällt also die implizite Semantik von REST weg und wird durch explizite Namen ersetzt. Die Queries können einzelne Felder und auch Felder von Feldern abfragen. Je nach benötigter Logik müssen aber genauso wie in REST die einzelnen Operationen manuell definiert werden. ### **Queries vs Ressourcen** Die Verwendung von Queries ist einer der Vorteile von GraphQL gegenüber der Verwendung von Ressourcen in REST. In einem REST Interface werden oft viele Daten übergeben. Je länger die API besteht, desto mehr Felder werden erfahrungsgemäß mit der Zeit hinzukommen und desto mehr Daten werden übertragen. Für einige Clients sind vielleicht alle Daten von Interesse, für andere hingegen ist vielleicht nur ein Bruchteil der Daten interessant. Hier bietet GraphQL die Möglichkeit, über einen Client nur die Daten anzufordern, die der Server wirklich braucht. Das verringert die Datenmenge, die der Client empfangen muss, erheblich. Auch lassen sich mit einer Anfrage bereits Details zu Listenelementen abfragen. Ebenso zu deren Kinderelementen. Und zu deren Kinderelementen. Diese Reihe lässt sich beliebig lange weiterführen. Unter REST müsste mindestens für jede weitere Ebene eine neue Anfrage gestellt werden, wenn die API ungeschickt entworfen wurde, sogar für jedes Element. In einem klassischen REST Interface ist diese Aufgabe mit wesentlich mehr HTTP-Calls verbunden. Ein Beispiel dazu: > { > me { > conversations(limit: 30) { > messages(limit: 1){ > text > writtenAt > } > } > } > } Hier werden mit einer einzigen Anfrage die letzten eigenen Conversations und von diesen jeweils die letzte Nachricht mit Text und Erstellzeitpunkt zurückgegeben. Unter REST müssten hier Anfragen für die Conversations und zusätzlich Anfragen für die Messages gestellt werden. In GraphQL hingegen werden alle Daten mit einer Anfrage übermittelt. Da die einzelnen Anfragen in GQL mehrere verschiedene Daten enthalten, können noch andere Methoden eingesetzt werden, um die Anzahl an Anfragen, die an die Datenbank gehen, zu reduzieren. Aber das behandeln wir später in einem weiteren Blogpost 😉 Zwar kann mit REST Interfaces eine ähnliche Funktionalität umgesetzt werden (z. B. über die Angabe von benötigten Feldern), aber das ist immer mit einem erhöhten Aufwand für den Enwickler und für die Wartung der Anwendung verbunden. In GraphQL ist diese Funktionalität hingegen Standard. ### **Dokumentation** Wenn wir schon beim Thema Standards sind, in GraphQL ist das Schema grundsätzlich für alle öffentlich zugänglich. Das heißt, jeder Client weiß, welche Möglichkeiten er bei der Abfrage hat. Bei REST Interfaces hingegen gibt es keinen einheitlichen und erzwungenen Standard. Eine Möglichkeit, REST Schnittstellen zu dokumentieren, bietet Open API Specification (OAS, ehemals Swagger). Aber auch dort ist es jedem freigestellt, eine solche Dokumentation zu pflegen. Wenn „richtiges“ REST genutzt wird, bietet HATEOAS eine ähnliche Möglichkeit, hier werden bei einer Anfrage weitere Endpunkte angegeben, die mehr Informationen über die einzelnen Felder zur Verfügung stellen. Jedoch wird dieser Ansatz in den meisten Anwendungen nicht umgesetzt. ### **Versionierung** Auch bei der Versionierung fällt der Aufwand bei GraphQL geringer aus. In GraphQL können sehr einfach neue Felder hinzugefügt werden. Wenn die Queries sich nicht ändern, bleiben auch Datenmenge und Struktur, die zurückgegeben werden, unverändert bestehen. Bei REST Interfaces werden beim Hinzufügen von Feldern immer auch die neuen Daten mitgegeben. Die Meinung, dass bei GraphQL im Vergleich zu REST nicht mehr versioniert werden muss, stimmt aber nur begrenzt. Wenn „richtiges“ REST eingesetzt wird, ist es durchaus vorgesehen, dass einzelne Felder als „deprecated“ markiert und nach einer bestimmten Zeit entfernt werden können. Damit sind in „echtem“ REST auch keine verschiedenen Versionen nötig. Die gleichen Mechanismen gibt es in GraphQL. Der Unterschied von GraphQL zu REST besteht aber weiterhin darin, dass bei GraphQL neue Felder nicht automatisch zurückgegeben werden. Aber ein häufiger Anwendungsfall in GraphQL sind sogenannte Static Queries, die bereits vorberechnet werden können. Diese Queries profitieren nicht von einer Erweiterung des Datenmodells, da sie auf Serverseite angepasst werden müssen. Vielmehr erhöhen sie den Aufwand, den ein Entwickler leisten muss. Doch diese Queries lassen sich gut cachen. ### **Caching** Ein weiterer wichtiger Punkt ist das Caching. Zu dem Thema haben wir daher auch schon einen eigenen [Blogeintrag](https://thecattlecrew.net/2018/09/06/response-caching) vorbereitet. Aber kurz vorne weg: Unter REST können die einzelnen neuen Endpunkte und Ressourcen über ihre URL eindeutig identifiziert und einfach gecacht werden. Unter GraphQL gibt es nur einen Endpunkt, das Caching ist hier aufwändiger. ### **Subscriptions** Unter REST gibt es für Subscriptions keine standardisierte Methode für Subscriptions. Unter GraphQL gibt es dafür im Standard noch keine Methoden und Schnittstellen, aber z. B. im Apollo Server sind diese Neuerungen bereits enthalten. Damit kann der Server bei Bedarf aktualisierte Informationen zum Client schicken, ohne dass dieser regelmäßig danach fragt. Da sowohl REST als auch GraphQL HTTP nutzen, können solche Lösungen grundsätzlich mit beiden umgesetzt werden. Doch unter GraphQL besteht die Aussicht, dass die Lösungen standardisiert werden, während REST so etwas nicht vorsieht. ### **Autorisierung** Welcher User welche Daten nutzen darf, kann unter REST auf jedem Endpunkt einfach geprüft werden. Da REST „stateless“ ist, sind alle Informationen, die für die Autorisierung verfügbar sind, immer zwangsweise vorhanden. Unter GraphQL sind nicht alle Informationen in allen Szenarien verfügbar. Lest darüber mehr in unserem Beitrag zum Thema Autorisierung 😊 ### **Ratelimiting** Unter REST ist Ratelimiting kein großes Problem: Ein Client darf jede Stunde 1000 Calls an die API abgesetzt werden. Die Calls können einfach gezählt und ggf. auch unterschiedlich gewichtet werden. Da unter GraphQL jedoch eventuell wesentlich mehr Daten vom Server abgeholt werden als mit einem Aufruf einer REST API, fällt das Thema Ratelimiting hier wesentlich komplexer aus. Auch können in GraphQL die Queries rekursiv erfolgen und sofern sie nicht weiter kontrolliert werden, geben diese unter Umständen so viele Daten zurück, dass der Server lahmgelegt wird „“ also quasi ein DOS Angriff mit einer einzigen Anfrage. Wie dieses Problem gelöst wird, beschreiben wir in unserem Blogeintrag zum Thema Ratelimiting. ### **Zusammenfassung** REST und GraphQL sind in vielen Punkten verschieden, basieren aber auf den gleichen Technologien und können mit entsprechendem Aufwand die gleichen Funktionalitäten anbieten. Jedoch sind in GraphQL viele der Möglichkeiten standardisiert und werden auch schon umgesetzt, wohingegen unter REST viele Probleme zwar Standardlösungen haben, diese aber nicht erzwungen werden. GraphQL ist allerdings noch eine sehr neue Technologie, die noch viele Probleme nicht gelöst hat. Auf einige davon werden wir in den nächsten Blogeinträgen noch näher eingehen, andere zeigen sich vielleicht noch. REST bietet an dieser Stelle eine Vielzahl an Tools und Lösungen, die schnell eingebunden werden können und dem Entwickler so eine Menge Aufwand abnehmen, der bei GraphQL dazukommen kann. **Kategorien:** Cloud, Development **Schlagwörter:** communication, Endpoints, GraphQL, Internet, OC|Lab, rest --- ### [AWS News KW 33 und KW 34](https://thecattlecrew.net/2018/09/03/aws-news-kw-33-und-kw-34/) **Published:** September 3, 2018 **Author:** Marco Buss **Content:** ## Amazon Kinesis Data Streams Enhanced Fan-Out und HTTP/2 Support [Kinesis Data Streams](https://aws.amazon.com/kinesis/data-streams/) (KDS) ist ein Service von AWS der es erlaubt Streaming Daten in Echtzeit zu sammeln, zu verarbeiten und auszuwerten. Ein Stream ist dabei in „Shards“ definiert. Ein Shard steht für eine Kapazität von 1 MB/Sekunde oder 1000 Nachrichten/Sekunde Eingangs- und 2 MB/Sekunde Ausgangskapazität. Bisher teilten sich alle Consumer die Ausgangskapazität. Fan-Out war daher ein oft genutztes Pattern um den Output für Consumer zu erhöhen. Beim Fan-Out wurde ein Stream an mehrere andere Streams weitergeleitet mit denen wiederum die Consumer verbunden waren. Ab sofort ist dieser Umweg nicht mehr notwendig da jeder Consumer sich jetzt für den vollen Output registrieren kann. Der Output skaliert dabei wie gehabt mit der Anzahl der Shards die dem Stream zur Verfügung gestellt werden. Mit dem neuen Feature verringert sich also der Adminstrationsaufwand für diesen Usecase. Mit der Einführung von HTTP/2 für die Kommunikation von Kinesis kann durch die Verwendung von beispielsweise [HPACK](https://www.rfc-editor.org/rfc/rfc7541.txt) und Connection Multiplexing die Durchlaufzeit von Producer zu Consumer signifikant reduziert werden. AWS spricht hier von 65 – 70 Millisekunden. Weitere Informationen zu Enhanced Fan-Out [hier](https://docs.aws.amazon.com/streams/latest/dev/introduction-to-enhanced-consumers.html). ## EC2 – T3 Instanztyp Der neue T3 Instanztyp bietet gesteigerte Kosteneffizienz im Vergleich zum Vorgänger T2. AWS empfiehlt allen Nutzern der M4 oder M5 Instanzen, die die gebotene Rechenleistung nicht brauchen einen Umstieg auf die neuen T3 Instanzen. Mit einer T3 Instanz erhält man eine kostengünstige EC2 Instanz die bei Bedarf oder bei Lastspitzen auch skalieren „bursten“ kann. T3 Instanztypen können in folgenden Konfigurationen gestartet werden. **Name****vCPUs****Baseline Performance / vCPU** **Memory** **Price / Hour (Linux)****Price / Hour (Windows)****t3.nano**25%0.5 GiB$0.0052$0.0098**t3.micro**210%1 GiB$0.0104$0.0196**t3.small**220%2 GiB$0.0209$0.0393**t3.medium**220%4 GiB$0.0418$0.0602**t3.large**230%8 GiB$0.0835$0.1111**t3.xlarge**440%16 GiB$0.1670$0.2406**t3.2xlarge**840%32 GiB$0.3341$0.4813Die Baseline beschreibt dabei immer die maximal CPU Auslastung über einen Tag gesehen, für die der Basispreis gilt. Mit aktiviertem Bursting kann dieser Wert überschritten werden. Die Kosten belaufen sich dann auf 0,05$/vCPU-Stunde. Für T3 Instanztypen ist das Bursting per default angeschaltet. Das kann zu unvorhergesehenen Kosten führen und sollte daher immer im Hinterkopf behalten werden. Zur Sicherheit also immer einen Billing Alarm einrichten! Weitere Informationen zum T3 Instanztyp [hier](https://aws.amazon.com/ec2/instance-types/t3/). ## Amazon Lightsail – Mehr Instanzgrößen und Preisreduktion Amazon Lightsail ist der Virtual Privat Server Dienst von AWS. Angeboten werden mehrere Größen für Windows sowie Linux basierte Server. Nachfolgend eine Übersicht über die verfügbaren Maschinen mit den neuen monatlichen Preisen im vergleich zu den alten Preisen. Linux: **512 MB** **1 GB****2 GB****4 GB****8 GB****16 GB****32 GB**Old$5.00$10$20$40$80„“„“New$3.50$5$10$20$40$80$160Windows: **512 MB****1 GB****2 GB****4 GB****8 GB****16 GB****32 GB**Old$10$17$30$55$100„“„“New$8$12$20$40$70$120$240Weitere Informationen zu Amazon Lightsail [hier](https://aws.amazon.com/lightsail/). **Kategorien:** Cloud **Schlagwörter:** Amazon Kinesis, Amazon Lightsail, AWS --- ### [DevOps und Identity](https://thecattlecrew.net/2019/03/06/devops-und-identity/) **Published:** März 6, 2019 **Author:** Mohammad Esad-Djou **Content:** ## Was definiert eine Identity? Eine Identity wird durch eine ein-eindeutige Zuweisung an eine Person, Gruppe oder einen Prozeß dargestellt. Diese Identity ist Grundlage für Authentifizierung und Autorisierung. Die Ein-Eindeutigkeit der Identity muß gewährleistet sein. ## Wann wird eine Identity benutzt? Eine Identity kommt immer dann zum Tragen, wenn auf ein rollenbasiertes System zugegriffen wird. ## Wann gilt eine Identity als kompromittiert? Eine Identity wird als unsicher/kompromittiert gekennzeichnet, sobald diese mit Authentifizierungsdaten zur Verfügung steht. Dabei ist es unabhängig ob ein Passwort im Klartext oder als Hash nutzbar ist. Eine beliebte Form des Identity-Diebstahls ist das Sharen von Passwörtern im öffentlichen Bereichen z. B. Source-Einträge in einer Datei auf Dropbox oder Github. Eine Identity gilt auch dann als kompromittiert, wenn diese über ein Backdoor genutzt werden kann. Dies wäre z.B. der Fall, wenn ein Trojaner ein User Kerberos Token oder eine Session-/Cookie-ID aus dem Browser nutzen kann. ## Identity-Diebstahl – und welcher Schaden entsteht? Folgen wir der Publikation im CT Magazin für Computer und Technik in der Ausgabe vom 16.2.2019 mit dem Titel: „Im Namen des anderen“, dann war 2016 fast jeder dritte Bundesbürger Opfer von einem Identity-Diebstahl betroffen. Bei 29% der Betroffenen kam es zu einem Schaden von durchschnittlich 1.366 Euro. Solche Zahlen und der immer noch anhaltende Trend zu solchen „gängigen und lukrativen Geschäftsmodellen“, so das Bundeskriminalamt \[im oben genannten Artikel zitiert die CT dazu aus dem „Bundeslagebild Cybercrime 9/2018“\] lässt sich erkennen, dass das Schützen der Identity oberstes Ziel sein muss. **Daraus kann für DevOps nur folgen, dass sicheren Methoden im Umgang mit Identitys höchste Priorität einzuräumen sind.** In einen nachfolgenden Post: „**DevOps und Authentifizierung/Autorisierung**“ möchte ich einige Möglichkeiten hierfür genauer betrachten/darstellen. **Kategorien:** Cloud, DevOps **Schlagwörter:** DevOps, IT Security --- ### [Apache Kafka - Eine Einführung (Teil 1)](https://thecattlecrew.net/2017/03/30/apache-kafka-einfuehrung/) **Published:** März 30, 2017 **Author:** Martin Münn **Excerpt:** Apache Kafka ist eine verteilte Streaming-Plattform und wird benötigt um verschiedenste Datenströme zu verteilen. Mit seiner Skalierungsfähigkeit und dem extrem hohen Datendurchsatz ist Kafka wie geschaffen für die Big Data Welt. In dieser kleinen Serie werde ich Kafka vorstellen und eine kurze Einführung geben. **Content:** ### Was ist Kafka? Apache Kafka ist eine verteilte Streaming-Plattform und wird benötigt um verschiedenste Datenströme zu verteilen. In dieser Hinsicht ist es sehr ähnlich zu normalen Message-Queues. Der wesentliche Vorteil von Kafka besteht aber darin, dass es zum einen die Datenströme speichern kann und dabei Fehlertolerant ist und zum anderen sehr hoch skalierbar und Ressourcensparend ist. ([Siehe hier)](https://engineering.linkedin.com/kafka/benchmarking-apache-kafka-2-million-writes-second-three-cheap-machines) Ursprünglich wurde Kafka von linked.in entwickelt, ist aber seit 2012 unter Apache-Lizenz und damit Teil der [Apache Software Foundation](https://de.wikipedia.org/wiki/Apache_Software_Foundation). Der prinzipielle Aufbau eines Kafka-Setups sieht wie folgt aus: ![Kafka Basic - Page 1](https://thecattlecrew.net/wp-content/uploads/2017/03/kafka-basic-page-1.png) Die Producer senden Nachrichten an Kafka. Um die Nachrichten „thematisch“ zu unterscheiden muss jeder Producer angeben zu welchem Topic die Nachricht gehört. Ist die Nachricht bei Kafka angekommen und gespeichert kann ein Consumer sie abgreifen. Dabei kann er sich einem oder mehreren Topics subscriben. Prinzipiell kann auch jeder Producer Nachrichten an verschiedene Topics schreiben und Consumer können ein oder mehrere Topics abgreifen. Zusätzlich kann die Kommunikation vom Producer zum Consumer synchron oder asynchron erfolgen. Im asynchronen Fall kann der Consumer sich auch entscheiden welche Nachrichten er erhalten möchte. Dazu muss er nur die id Nummer, genannt Offset, der Nachricht angeben und bekommt diese dann zugesendet. Kafka benötigt zwingend [Apache Zookeeper](https://en.wikipedia.org/wiki/Apache_ZooKeeper) und wird deshalb auch immer damit ausgeliefert. Zookeeper kümmert sich um die Organisation der Server innerhalb des Kafka Clusters. Wie zum Beispiel welcher Server sich um welche Topics kümmert oder andere Server spiegelt. Fällt ein Server aus kümmert sich Zookeeper darum, dass klar ist welcher andere Server den Job übernimmt usw. ### Use Cases Wie schon eingangs erwähnt ist ein typischer Anwendungsfall für Kafka ähnlich zu Nachrichtensystemen wie RabbitMQ. Der Vorteil Kafkas liegt hier in der hohen Skalierbarkeit und Ausfallsicherheit. So nutzt Spotify Kafka um alle Logdateien aller Hosts abzugreifen und in Ihren Hadoop Cluster zu schicken. Auch Twitter nutzt Kafka in ähnlicher Weise, wobei sie auch den Fakt ausnutzen, dass Kafka Persistenz bietet. Für Twitter ist Kafka neben einer Message Queue auch ein Zwischenspeicher für mehrere Stunden, bevor sie die Daten über [Apache Storm](https://en.wikipedia.org/wiki/Storm_(event_processor)) in Ihren Amazon Speicher legen. Ein weiteres Beispiel wäre Datenverarbeitung die in mehreren Schritten abläuft, sogenanntes Pipelining. Man könnte den Inhalt von Websites crawlen und dies unter dem Topic Websites speichern. Dann werden diese Websites aufbereitet und unter einem neuen Topic gespeichert. Im Weiteren analysiert man diese aufbereiteten Websites und erstellt Topics zu den entsprechenden Themen und speichert sie entsprechend ab. Außerdem könnte man dann zu jeder Website auch das Themenspektrum abspeichern und abrufbereit halten. Und alles theoretisch in einem Kafka Cluster. In der Praxis wären allerdings meist noch andere Dienste Teil der Pipeline und es würden auch verschiedene unabhängige Kafka Cluster für verschiedene Aufgaben genutzt. So zum Beispiel bei Netflix, wo Kafka Teil des Echtzeit-Monitoring und der Event-Processing Pipeline ist oder Blizzard wo es Teil der Datacollection Pipeline ist. **Kategorien:** Analytics & Insights, Tools & Methoden --- ### [Oracle Code Berlin - Personal impressions from a surprisingly different conference](https://thecattlecrew.net/2017/04/25/oracle-code-berlin-personal-impressions-from-a-surprisingly-different-conference/) **Published:** April 25, 2017 **Author:** Sven Bernhardt **Content:** You want to learn about my impressions about the Oracle Code conference in Berlin? Then read my blog 🙂 **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** API Management, Artificial Intelligence, Conference, Microservices, OracleCode --- ### [OPITZ CONSULTING berichtet vom AWS Summit Berlin - Teil 1 mit Fokus "Cloud Adoption"](https://thecattlecrew.net/2017/05/19/opitz-consulting-berichtet-vom-aws-summit-berlin-teil-1-mit-fokus-cloud-adoption/) **Published:** Mai 19, 2017 **Author:** Tommy Ziegler **Content:** Am 18. Mai 2017 fand in Berlin eine weitere Auflage des [AWS Summit](https://aws.amazon.com/summits/berlin/) statt. Mit über 3000 Teilnehmern, mehr als 70 Ausstellern, über 60 Breakout Sessions, einem Innovation Lab und mehreren technischen Demos befindet sich das Event weiter auf Wachstumskurs. OPITZ CONSULTING war ebenfalls mit einem Team vor Ort und teilt in diesem Post die Eindrücke. ![AWS-Summit](https://thecattlecrew.net/wp-content/uploads/2017/05/aws-summit.png) Den Auftakt lieferte eine inspirierende [Keynote ](https://www.youtube.com/watch?v=eY5VctKBQPc)von Glenn Gore (Chief Architect AWS). Neben der Evolution der AWS Cloud bildeten die Themen Alexa, DevOps, Microservices, Datenbank-Migration und Machine Learning auf Basis des AWS Stacks den Kern der Session. Interessant waren dabei die verschiedenen Anwendungsbeispiele aus der Praxis, die demonstrierten, wie es Kunden geschafft haben mit AWS ihr Geschäft zu digitalisieren und zu optimieren. Besonders zu erwähnen ist hierbei der hybride Cloud-Ansatz der Deutschen Bahn (vorgetragen von Oliver Krülle, CIO, DB Vertrieb GmbH) zum Ausgleich von Lastspitzen sowie die Lösung zur Warnung von Wasserschäden von der GROHE AG (vorgetragen von Bert Depiere, Director Digital Innovations). Übrigens wem dieser Text hier zu lang ist, der sollte sich genauer mit Sprachassistenten und der Kombination aus AWS Polly, Lex und Rekognition auseinandersetzen. Für die neue deutsche Stimme [Vicki](https://aws.amazon.com/about-aws/whats-new/2017/05/amazon-polly-introduces-a-new-german-female-voice-vicki/) stellen nun auch Anglizismen kein Problem mehr dar. Aufgrund des fortgeschrittenen Reifegrades eignet sich die Sprachausgabe sogar zum Erlernen von Fremdsprachen, wie von Dr. Ralf Herbrich (Director of Machine Learning) am Beispiel von [duolingo](https://aws.amazon.com/blogs/ai/powering-language-learning-on-duolingo-with-amazon-polly/) erwähnt wurde. ![Datei 19.05.17, 10 30 21](https://thecattlecrew.net/wp-content/uploads/2017/05/datei-19-05-17-10-30-21.jpeg) # Takeaways aus den Sessions #### **The Digital Innovation Program by AWS** Diese Session lieferte einen Überblick zum AWS Digital Innovation Program und dem „working backwards“ Ansatz. Dabei starten Kunden zunächst mit einem Press Release und schärfen darin die Vision und das Ziel Ihrer geplanten Innovationsprojekte. Ein interessanter Ansatz, um sich von Anfang an auf den tatsächlich angestrebten Mehrwert zu konzentrieren, ohne sich in technischen Details zu verlieren. Danach folgt i.d.R. ein MVP, der in cross-functional Teams erstellt wird. Das Programm bietet hilfreiche Ansätze, welche – angereichert mit unseren Erfahrungen und Methoden – auch im Rahmen unseres [Zukunftsworkshops zur Cloud Strategie](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/68-factsheet-cloud-strategie.pdf) näher erläutert werden. #### **The future is already here! How new technologies are changing the game at Deutsche Bahn Kommunikationstechnik GmbH** In diesem Vortrag wurde auf die digitale Transformation typischer Anwendungsfälle bei der Deutschen Bahn eingegangen. Anhand von Cloud und dem österreichischen ivii.assist zeigte der Vortrag, wie die Digitalisierung die gemeinsame Bearbeitung komplizierter Probleme geographisch getrennten Teams verbessert bzw. überhaupt erst ermöglicht. Ganz konkret wurden hier folgende Anwendungsfälle genannt: - Remote Support - Qualitätssicherung - Ausbildung - Unterstützung planbarer Aktivitäten. Fazit: Anregende Session mit vielerlei Parallelen zu unseren Schwerpunktthemen im Competence Center IoT ([Mit Retrofitting und Cloud in die Digitalisierung](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/objekt-spektrum-ots-2016-iot_retrofitting_bial-scheuch-winterberg_sicher.pdf); [IoT Steuerung mit HoloLens & Cloud](https://thecattlecrew.net/2017/04/24/realisierung-der-iot-steuerung-mit-hilfe-der-microsoft-hololens-und-cloud-computing/)). #### **Building Apps in the Cloud to Reduce Costs up to 90%** Hier lieferte Christian Petters (AWS Solutions Architect) vielerlei nützliche Informationen, wie sich mit Hilfe sogenannter [EC2 Spot Instances](https://aws.amazon.com/de/ec2/spot/) deutliche Kosteneinsparungen erzielen lassen. Der Ansatz ist insbesondere für Dev- und Test Umgebungen spannend. Die größten Einsparungen lassen sich erzielen, wenn die Architektur Rücksicht auf bewährte Best Practices wie Stateless, Fault Tolerance, Multi-Availability Zones und lose Kopplung nimmt. Besonders hilfreich war die Diskussion zu typischen Vorurteilen bzw. Fragestellungen, die kurze Vorstellung des Spot Bid Advisors sowie die Auflistung geeigneter UseCases. Insgesamt eine sehr gute Session, deren Inhalte in das OPITZ Angebot zur [Cloud Kostenoptimierung und zum Lizenzmanagement](http://www.opitz-consulting.com/portfolio/oracle-lizenzmanagement/managed-services-compliance.html) einfließen werden. #### **AWS Cloud Adaption Framework 2017 „“ Starting a Structured Cloud Initiative** In dieser Session wurde das [AWS Cloud Adoption Framework (AWS CAF)](https://aws.amazon.com/de/professional-services/CAF/) vorgestellt. Zweck des Frameworks ist es, Organisationen dabei zu helfen einen effizienten und effektiven Plan für den Weg in die Cloud zu entwickeln. Der Planungsvorgang ist in sieben Perspektiven gegliedert: Business, Plattform, Reife, Mitarbeiter, Prozesse, Betriebsablauf und Sicherheit. Guter Hinweis von Referent Marcus Fritsche (IT Transformation Consultant), dass mind. 50% einer erfolgreichen Cloud Initiative von der Organisation, den Menschen sowie der Governance abhängen – das entspricht ganz klar auch unseren Erfahrungen. Das Framework umfasst eine Vielzahl an Inhalten, welche auch Ihren Platz in unseren [Cloud Workshop-Angeboten](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/68-factsheet-cloud-strategie.pdf) besitzen. #### **10 Best Practices for your Cloud Migration** In der knappen Zeit von 30 Minuten wies Jeremias Reith (Senior Consultant) in seinem gut gegliederten Vortrag auf folgende Best Practices hin: 1. Do create a Cloud Center of Excellence (CCoE) 2. Do a pre-migration migration 3. Do build a minimal landing zone and iterate (!) 4. Be agile 5. Do leverage specialiced migration factories 6. Do track and communicate Progress 7. Apply lessons learned to existing organization 8. Do let the CCoE build re-usable building blocks 9. Do a post-migration migration 10. Do engage partners or AWS Professional Services #### **Getting Started with AWS Database Migration Service** Gelungener Vortrag mit vielen relevanten Praxisinhalten, um Datenbanken mit minimaler Downtime zu migrieren. Das dies jedoch nicht zwangsläufig mit einer Ablösung der bestehenden Datenbank einhergehen muss, wurde anhand vieler verschiedener Einsatzgebiete dargestellt. Diese können im Rahmen einer Modernisierung, Migration und/oder der Replikation angesiedelt sein. Weitere Use Cases können dem nachfolgenden Foto entnommen werden. ![Datei 19.05.17, 14 23 16](https://thecattlecrew.net/wp-content/uploads/2017/05/datei-19-05-17-14-23-16.jpeg?w=1024) Die Session vermittelte einen guten Einblick in die Werkzeuge ([DMS & SCT](https://aws.amazon.com/de/dms/)) und die Herausforderungen, die im Rahmen einer Datenbankmigration bestehen (z.B. Kostenbetrachtung, technische Hürden). Trotz der ausgereiften Werkzeuge wurde deutlich, dass eine Datenbankmigration keine „One-Button-Click“ Aufgabe ist. Eine Erkenntnis, die wir in unserer langen Historie als [Datenbankspezialist und Managed Service Provider](http://www.opitz-consulting.com/ueber-uns.html) vollends bestätigen können. In [Teil 2](https://thecattlecrew.net/2017/05/22/opitz-consulting-berichtet-vom-aws-summit-berlin-teil-2/) berichten wir vom AWS Summit mit dem Fokus auf Next Generation Applications. **Kategorien:** Cloud, Tech Events & Networking --- ### [OPITZ CONSULTING berichtet vom AWS Summit Berlin "“ Teil 2](https://thecattlecrew.net/2017/05/22/opitz-consulting-berichtet-vom-aws-summit-berlin-teil-2/) **Published:** Mai 22, 2017 **Author:** Marco Buss **Content:** Im [ersten Teil](https://thecattlecrew.net/2017/05/19/opitz-consulting-berichtet-vom-aws-summit-berlin-teil-1-mit-fokus-cloud-adoption/) unseres Berichts über den AWS Summit 2017 in Berlin ging es hauptsächlich um das Thema Cloud Adoption. Im zweiten Teil möchten wir weitere besuchte Sessions, hauptsächlich aus dem Track „Next Generation Applications“ vorstellen: #### Amazon Polly: Voice Your App In dieser Session zeigten Rafal Kuklinski und Remus Mois Amazons Text to Speach Engine Polly. Die Session zeigte an verschiedenen Beispielen, welche Möglichkeiten die Engine bietet. Erfreulich war die Tatsache, dass die Beispiele für den deutschen Sprachraum erstellt wurden. Gestartet wurde mit einem Goethe Zitat (gesprochen von der neuen Stimme Vicky) [https://thecattlecrew.net/wp-content/uploads/2017/05/speech\_20170522181632070.mp3](https://thecattlecrew.net/wp-content/uploads/2017/05/speech_20170522181632070.mp3) Ein Highlight war aber sicherlich das Beispiel für die neue „Flüstern“ Funktionalität. ![IMG_0965 (1)](https://thecattlecrew.net/wp-content/uploads/2017/05/img_0965-1.jpg) [https://thecattlecrew.net/wp-content/uploads/2017/05/speech\_20170522172649151.mp3](https://thecattlecrew.net/wp-content/uploads/2017/05/speech_20170522172649151.mp3) #### **7 Things** You **Must Know to Build Better Alexa Skills** Da wir bei Opitz Consulting auch einen eigenen [Alexa Skill](https://thecattlecrew.net/2017/05/05/alexa-frag-opitz-entwicklung-eines-alexa-skills/) und sprachbasierte Interfaces sich immer mehr verbreiten, konnte es nicht schaden, sich Tips eines Alexa Entwicklers zu holen. Memo Doring zeigte sieben Punkte, die seiner Meinung nach für einen guten Alexa Skill wichtig sind. 1. Design for the ear 2. Use the skill builder 3. Be mindful of your training data 4. Leverage States 5. Persistence 6. Voice requires cognitive processing 7. Listen to how people actually talk Einige der aufgeführten Punkte sind auch im [Artikel](https://jaxenter.de/chatbot-alexa-google-home-siri-54265) von Christian Ochsenkühn zu finden. #### Real-time Streaming Applications on AWS, Patterns and Use Cases Hier wurde von Dr.Steffen Hausmann aufgezeigt, welche Möglichkeiten AWS mit [Kinesis](https://aws.amazon.com/de/kinesis) für die Verarbeitung von Streaming Daten bietet. Christian Deger untermalte die erwähnten Möglichkeiten im Anschluss mit greifbaren Anwendungen von Kinesis Streams, Analysis und Firehose am Beispiel von Autoscout24. #### Analyzing Streaming Data in Real-time with Amazon Kinesis Analytics Aufbauend auf der vorherigen Session ging Dr. Steffen Hausmann nunmehr ins Detail von Kinesis Analytics. Er wählte als Beispiel die Analyse eines Twitter Streams. Er zeigte live die Filterung der eintreffenden Daten nach Fussballclubs und die anschließende Auswertung, welche fünf Clubs in der letzten Stunde am meisten Erwähnung fanden. Ganz nebenbei wurden diese Ergebnisse noch in Elastic Search gespeichert. Beeindruckend, was alles mit ein wenig Konfiguration und wenigen Zeilen SQL Möglich ist. #### DevOps at Amazon: A Look at Our Tools and Processes Hier war es beruhigend zu sehen, dass Amazon auch nur mit Wasser kocht. Alle vorgestellten Tools und Vorgehensweisen waren einem DevOps Praktizierenden bereits bekannt. Relativ unbekannt ist allerdings der AWS Service [CodeStar](https://aws.amazon.com/de/codestar). Dieser Service beinhaltet alles, um eine komplette Delivery Pipeline mit wenigen Clicks bereit stellen zu können. Angefangen beim Code Repository bis zum automatischen Deploy der Anwendung in EC2. #### Fazit Der AWS Summit 2017 war ein tolles Event. Viele interessante Talks, und jede Menge neue Möglichkeiten wurden aufgezeigt. Die Liste mit Dingen, die ausprobiert werden müssen, ist um viele viele Punkte angewachsen. **Kategorien:** Cloud, Tech Events & Networking --- ### [AWS News KW 28](https://thecattlecrew.net/2017/07/17/aws-news-kw-28/) **Published:** Juli 17, 2017 **Author:** Marco Buss **Content:** ## .NET Core Support für AWS CodeStar und AWS Codebuild AWS CodeStar, ist seit wenigen Monaten verfügbar und bietet Entwicklerteams die Möglichkeit schnell Anwendungen zu entwicklern, zu bauen und zu deployen. Bisher Unterstützte AWS Codestar das Deployment für EC2, Elastic Beanstalk und Lambda für die Sprachen HTML5, Java, JavaScript, PHP, Python und Ruby. Neben diesen Sprachen ist es jetzt auch möglich AWS Codestar für .NET Anwendungen zu verwenden. Damit öffnen sich die Vorteile von AWS Codestar und AWS Codebuild auch für .NET Entwickler. ![CodeStarTemplates](https://thecattlecrew.net/wp-content/uploads/2017/07/codestartemplates.png) Mehr Informationen [hier.](https://aws.amazon.com/de/about-aws/whats-new/2017/06/announcing-net-core-support-for-aws-codebuild-and-aws-codestar/) ## Target Tracking Policies für EC2 Auto Scaling Nutzt einen Auto Scaling Gruppe Target Tracking wird für eine bestimmte CloudWatch Metrik eine Zielgröße definiert. Auto Scaling sorgt dann dafür das diese Zielgröße erreicht wird, indem Instanzen hinzugefügt oder abgebaut werden. Folgende CloudWatch Metriken sind möglich: - Application Load Balancer Request Count Per Target (ebenfalls neu) - Average CPU Utilization - Average Network In/Out - eigene Metriken Mehr Information [hier.](https://docs.aws.amazon.com/autoscaling/latest/userguide/as-scaling-target-tracking.html) **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [AWS News KW 29](https://thecattlecrew.net/2017/07/24/aws-news-kw-29/) **Published:** Juli 24, 2017 **Author:** Marco Buss **Content:** ## Neue GPU-Powered EC2 Instanzen (G3) Ab sofort ist der neue G3 Instance Typ für die Regionen US East (Ohio), US East (Northern Virginia), US West (Oregon), US West (Northern California), AWS GovCloud (US), and EU (Ireland) verfügbar. Die Leistungsdaten der drei neuen Instanztypen sehen wie folgt aus. **Model****GPUs****GPU Memory****vCPUs****Main Memory****EBS Bandwidth****g3.4xlarge**18 GiB16122 GiB3.5 Gbps**g3.8xlarge**216 GiB32244 GiB7 Gbps **g3.16xlarge**432 GiB64488 GiB14 GbpsGPU-Powered EC2 Instanzen sind eine gute Wahl für 3D Rendering und Visualisierung, virtual Reality, video encoding, machine learning and many more. Nähere Infos zu den neuen Instance Types [hier.](https://aws.amazon.com/de/ec2/instance-types/) ## Lambda@Edge verfügbar Mit Lambda@Edge kann eine Lambda Funktion nahe dem Endbenutzer auf [CloudFront](https://aws.amazon.com/de/cloudfront/) Ereignisse reagieren. mögliche Anwendungsfälle sind unter anderem: - Auswertung von Cookies und URL-Rewriting für A/B Testing - Senden spezifischer Objekte basierend auf User-Agent Header - Implementierung von Access Control durch die Auswertung spezifischer Header vor dem Aufruf des eigentlichen Ziels. Nähere Infos zu Lambda@Edge [hier](http://Lambda@Edge). ## Server-Side Encryption for Amazon Kinesis Streams Ab sofort können Daten eines Kinesis Stream serverseitig verschlüsselt werden. Die Verschlüsselung der Daten ist in vielen Usecases wichtig um regulatorischen Vorgaben erfüllen zu können. Kinesis Streams werden mit dem AES-256 GCM Algorithmus verschlüsselt. Die Verschlüsselung kann für jeden vorhandenen und neuen Stream per AWS Konsole und AWS SDK gestartet, gestoppt und verändert werden. Nähere Infos zu SSE für Kinesis Stream [hier](https://docs.aws.amazon.com/streams/latest/dev/server-side-encryption.html). ## Resource Data Sync (S3 Sync) für den EC2 Systems Manager Amazons EC2 Systems Manager ist ein Management Service für die Erstellung von System Images, die Sammlung von Inventories, die Verwaltung von Windows und Linux Konfiguration sowie das Einspielen von System Patches. Mit Resource Data Sync (S3 Sync) ist es nun möglich gesammelte Inventory Daten automatisch in S3 zu aggregieren. Mit [Amazon Athena](https://aws.amazon.com/de/athena/) können nun Suchanfragen auf den gesammelten Daten durchgeführt werden. Mit [Amazon QuickSight](https://quicksight.aws/) können die Daten bei Bedarf auch visualisiert werden. Nähere Infos zu Resource Data Sync [hier.](http://docs.aws.amazon.com/systems-manager/latest/userguide/sysman-inventory-walk.html#sysman-inventory-resource-data-sync) **Kategorien:** Cloud --- ### [AWS News KW 30](https://thecattlecrew.net/2017/07/31/aws-news-kw-30/) **Published:** Juli 31, 2017 **Author:** Marco Buss **Content:** ## CloudFormation StackSets für Multi Account und Region Provision [CloudFormation](https://aws.amazon.com/de/cloudformation/) ist Amazons Infrastructure as Code Framework. Ü„hnlich wie Puppet wird der Endzustand des gewünschten Systems (Stacks) beschrieben. Ein Nachteil von CloudFormation war bisher, dass ein Stack nicht in mehreren Regions oder für mehrere Accounts komfortabel deployt werden konnte. Vielmehr musste der Stack für alle Kombinationen separat deployt werden. Mit StackSets wurde jetzt eine Möglichkeit geschaffen, Multi Account und Multi Region Deplyoments mit wenigen Klicks zu konfigurieren und auszuführen. Dabei wird der Stack sequentiell in den konfigurierten Regions deployt. Die Reihenfolge kann dabei festgelegt werden. Innerhalb der Region wird gleichzeitig in den konfigurierten Accounts deployt. Der Grad der Parallelität kann ebenfalls konfiguriert werden. Weitere Informationen zu CloudFormation StackSets [hier](http://docs.aws.amazon.com/AWSCloudFormation/latest/UserGuide/what-is-cfnstacksets.html). ## GPU Powered Streaming Instanzen für AppStream 2.0 [Amazon AppStream 2.0](https://aws.amazon.com/de/appstream2/) ist ein Service von Amazon. Er bietet die Möglichkeit Windows Applikationen in einem Browser zu verwenden. Dafür wird der Remote Desktop zum Browser gestreamt. Für grafikintensive Anwendungen stehen ab sofort die G2 Instanztypen zur Verfügung. Sie sind für Anwendungen ausgelegt die CUDA, DirectX oder OpenGL für das Rendering nutzen. Für High-End und High-Performance Anwendungen, die entweder NVIDIA Api´s oder viel Speicher benötigen können auch die eben erst eingeführten [G3 Instanztypen]() verwendet werden. Die Preise für die einzelnen Instanzen beginnen bei 0,50 $/h für G2 Instanzen oder 2,05 $/h für G3 basierte Instanzen. ## High-Resolution Custom Metrics und Alarme für Amazon CloudWatch [CloudWatch](https://aws.amazon.com/de/cloudwatch/), Amazons zentraler Monitoring Service zeichnet per Default Metriken im 5 Minuten Intervall auf. Bei Bedarf kann dieser Wert mit Hilfe des sogenannten [Detailed Monitoring](https://aws.amazon.com/de/blogs/aws/amazon-cloudwatch-basic-monitoring-for-ec2-at-no-charge/) auf 1 Minute verkürzt werden. Um bestimmte Ereignisse zu erkennen reicht oft ein 1 Minuten Intervall nicht aus. Daher ist es ab sofort möglich eigene Metriken per High-Resolution Metrics jede Sekunde zu erfassen und Alarme alle 10 Sekunden auszuwerten. Weitere Informationen zu Custom Metrics [hier](http://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/publishingMetrics.html). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [AWS News KW 31](https://thecattlecrew.net/2017/08/07/aws-news-kw-31/) **Published:** August 7, 2017 **Author:** Marco Buss **Content:** Auch bei Amazon hat die Feriensaison begonnen. In der letzten Woche waren die News sehr überschaubar. ## Amazon Connect und Amazon Lex Integration [Amazon Connect](https://aws.amazon.com/de/connect/) ist ein cloud basiertes Self-Service Contact Center, das es jedem Unternehmen ermöglicht, seinen Kunden einen besseren Service zu geringeren Kosten bereitzustellen. [Amazon Lex](https://aws.amazon.com/de/lex/) ist ist ein Service zur Erstellung von Konversationsschnittstellen für Sprache und Text. Amazon Lex nutzt dabei die selben Deep Learning Methoden die auch Alexa verwendet. Durch die Kombination beider Services ist es möglich auf mehr Wünsche der Kunden automatisch zu reagieren. Beide Seiten profitieren gleichermaßen. Als Kunde kann ich mein Anliegen schneller klären, da ich nicht auf einen freien Mitarbeiter warten muss. Als Anbieter profitiere ich zum einen durch geringere Kosten und andererseits durch eine größere Kundenzufriedenheit. Weitere Informationen zu Connect [hier](http://docs.aws.amazon.com/connect/latest/adminguide/connect-ag.pdf) und zu Lex [hier](http://docs.aws.amazon.com/lex/latest/dg/API_Reference.html) **Kategorien:** Cloud **Schlagwörter:** Amazon Connect, Amazon Lex, AWS --- ### [Wie Ansible bei der Installation einer Big-Data-Distribution helfen kann? "“ Vorbereitungstasks einer Cloudera Installation](https://thecattlecrew.net/2017/08/07/wie-ansible-bei-der-installation-einer-big-data-distribution-helfen-kann-vorbereitungstasks-einer-cloudera-installation/) **Published:** August 7, 2017 **Author:** Simon Hahn **Content:** Ansible hat sich in den letzten Jahren zu einem einsteigerfreundlichen und wichtigen Tool der Automatisierung entwickelt. Durch die Einfachheit können tägliche, sich wiederholende Arbeiten simpel automatisiert werden. Durch die zunehmende Digitalisierung rückt auch Big Data immer mehr in den Vordergrund. Das Datenwachstum nimmt exponentiell zu. Traditionelle Datenbanklösungen reichen oft nicht mehr aus und neuere „Open Source“-Technologien drängen in den Markt. Big-Data-Distributionen vereinen diese verschiedenen Technologien und Services und stellen diese dem Kunden in einer übersichtlichen Administrationsoberfläche zur Verfügung. Dieser Blogeintrag handelt von einer Installation eines Big Data Clusters mit Hilfe von Ansible, welches das Grundgerüst darstellt. Playbooks werden zur Vorbereitung einer manuellen Cluster-Installation via Cloudera Manager auf die Nodes ausgerollt. Es stellt sicher, dass die Nodes im Verbund mit gleichem OS, Packages, Parametern usw. aufgebaut werden. Weiterführende Informationen gibt es zum Beispiel im DOAG Artikel – : [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Artikel/red-stack-magazin-2016-05\_Warum-Ansible-fuer-DevOps-eine-gute-Wahl-ist\_Simon-Hahn\_sicher.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/red-stack-magazin-2016-05_Warum-Ansible-fuer-DevOps-eine-gute-Wahl-ist_Simon-Hahn_sicher.pdf) In einem Cloudera Cluster übernimmt jeder Node unterschiedliche Rollen. Unterteilt wird in NameNode, StandbyNode, DataNode, EdgeNode, Cloudera-ManagerNode (Siehe Abbildung). ![grafik_bd_showcluster](https://thecattlecrew.net/wp-content/uploads/2017/08/grafik_bd_showcluster.jpg) NN: Der NameNode ist die zentrale Master-Komponente und verwaltet die Metadaten für alle gespeicherten Daten auf allen DataNodes*.* Dazu unterhält er eine Liste mit den aktuellen Speicherorten der Blöcke von Verzeichnissen und Dateien sowie ein Journal-File mit den aktuellen Dateioperationen. Auf Basis dieser beiden Dateien kann er Anfragen nach Dateien jederzeit beantworten, speichert aber selbst keine Daten. SN: Der StandbyNode übernimmt die Aufgabe des NameNode im Falle eines Ausfalls. CM: Cloudera Manager stellt die Oberfläche zur Installation, Verwaltung und Administration des Clusters. EN: Der EdgeNode gilt als Interface zwischen äußerem Netzwerk und internem Cluster. Auf ihm werden oftmals Datenintegrationstools wie Scoop und andere Applikationstools installiert. DN: DataNodes sind die Slave-Komponenten der Architektur, die lediglich für die Datenspeicherung zuständig sind. Sie sind „einfach“ gestrickte Elemente, über die die Skalierung des Clusters erreicht wird. O|M|P = Cloudera Manager benötigt eine Oracle oder MySQL oder Postgres. Der Clusterunterbau läuft auf dem javabasierten, verteilten Dateisystem Hadoop, bzw. HDFS. Über dieses werden die Daten blockweise in einzelnen DataNodes gespeichert. ### **Ansible 2.1.0 als Hilfe** In meinem Git verwaltetem Ansible Cloudera Projekt werden die einzelnen Nodes in der „hosts“-Datei von Ansible definiert. hosts: *\[cloudera\_manager\]* *cloudera-cm* *\[cloudera\_edgenodes\]* *cloudera-en* *\[cloudera\_namenodes\]* *cloudera-nn* *cloudera-sn* *\[cloudera\_nodes\]* *cloudera-dn1* *cloudera-dn2* *cloudera-dn3* *cloudera-dn4* In den einzelnen „yml“-Dateien (cloudera-cm.yml) im „host\_vars“-Verzeichnis werden explizit spezielle Parameter gesetzt. Beispiel: cloudera-cm.yml *—* *\# SYSTEM Parameter hostname: cloudera-cm* *ip\_address\_public: 192.168.56.70* *domain: localdomain* *common\_root\_password: XXXXX* *\# Kernelparameter* *kernelparameter:* *– { name: ‚vm.swappiness‘, value: ’10‘ }* *\# MYSQL Parameter for cloudera\_cm* *# https://github.com/geerlingguy/ansible-role-mysql* *overwrite\_global\_mycnf: yes* *mysql\_user\_home: /root* *mysql\_user\_name: root* *mysql\_user\_password: nicht\_wichtig J* *mysql\_root\_password\_update: yes* *mysql\_enabled\_on\_startup: yes* *mysql\_port: „3306“* *mysql\_bind\_address: ‚0.0.0.0‘* *mysql\_datadir: /var/lib/mysql* *\# RECOMMENDED CLOUDERA MANAGER MYSQL PARAMETER* *mysql\_transaction\_isolation: READ-COMMITTED* *mysql\_key\_buffer\_size: 32M* *mysql\_max\_allowed\_packet: 32M* *mysql\_thread\_stack: 256k* *mysql\_thread\_cache\_size: 64* *mysql\_query\_cache\_limit: 8M* *mysql\_query\_cache\_size: 64M* *mysql\_query\_cache\_type: 1* *mysql\_max\_connections: 550* *mysql\_binlog\_format: mixed* *mysql\_read\_buffer\_size: 2M* *mysql\_read\_rnd\_buffer\_size: 16M* *mysql\_sort\_buffer\_size: 8M* *mysql\_join\_buffer\_size: 8M* *mysql\_innodb\_file\_per\_table: 1* *mysql\_innodb\_flush\_log\_at\_trx\_commit: 2* *mysql\_innodb\_log\_buffer\_size: 64M* *mysql\_innodb\_buffer\_pool\_size: 4G # angepasst auf 4 GB, da VM nur 8GB hat* *mysql\_innodb\_thread\_concurrency: 8* *mysql\_innodb\_flush\_method: O\_DIRECT* *mysql\_innodb\_log\_file\_size: 512M* *mysql\_sql\_mode: STRICT\_ALL\_TABLES* *mysql\_databases:* *– name: amon* *encoding: utf8* *– name: rman* *encoding: utf8* *– name: metastore* *encoding: utf8* *– name: sentry* *encoding: utf8* *– name: nav* *encoding: utf8* *– name: navms* *encoding: utf8* *– name: cmf* *encoding: utf8* *– name: oozie* *encoding: utf8* *– name: hue* *encoding: utf8* *– name: hive* *encoding: utf8* *mysql\_users:* *– name: amon* *host: „%“* *password: XXXXX* *priv: „amon.\*:ALL“* *– name: rman* *host: „%“* *password: XXXXX* *priv: „rman.\*:ALL“* *– name: metastore* *host: „%“* *password: metastore* *priv: „metastore.\*:ALL“* *– name: sentry* *host: „%“* *password: XXXXX* *priv: „sentry.\*:ALL“* *– name: nav* *host: „%“* *password: nav* *priv: „nav.\*:ALL“* *– name: navms* *host: „%“* *password: XXXXX* *priv: „navms.\*:ALL“* *– name: cmf* *host: „%“* *password: cmf* *priv: „cmf.\*:ALL“* *– name: oozie* *host: „%“* *password: oozie* *priv: „oozie.\*:ALL“* *– name: hue* *host: „%“* *password: XXXXX* *priv: „hue.\*:ALL* *– name: hive* *host: „%“* *password: XXXXX* *priv: „hive.\*:ALL“* Beispiel: cloudera-dn1.yml *\# SYSTEM Parameter* *hostname: cloudera-dn1* *ip\_address\_public: 192.168.56.61* *domain: localdomain* *common\_root\_password: xxxxxxx* *kernelparameter:* *– { name: ‚vm.swappiness‘, value: ’10‘ }* Mit weiteren Rollen, wie „cloudera\_manager“, „cloudera\_manager\_agent“ und „cloudera\_prereqs“, die zuvor erstellt wurden, wird angegeben, was und welche Parameter auf dem jeweiligen Linux Host installiert werden. Als Betriebssystem dient Centos 7.1, das zuvor für jeden Host installiert wurde. Weiterführende Anpassungen werden nun per Ansible Playbook deployed, welches jede oben genannte Rolle auf den Servern ausführt. Als grundlegende Datenbank für den Cloudera Manager wurde per frei erhältlichem „ansible-role-mysql“ eine MySQL-Datenbank auf den Cloudera Manager Host (CM) mit entsprechenden Benutzern ausgerollt und installiert. Diese wird für die manuelle Installation des Cloudera Clusters benötigt. Weitere Rollen sind nur teilweise aufgelistet. Sie beinhalten grundlegende Schritte wie Installation von Paketen, Grundvoraussetzungen für eine optimierte Installation. Siehe Link: [https://www.cloudera.com/documentation/enterprise/release-notes/topics/rn\_consolidated\_pcm.html](https://www.cloudera.com/documentation/enterprise/release-notes/topics/rn_consolidated_pcm.html) Beispiel: cloudera\_manager.yml *—* *# cloudera\_manager and cloudera\_manager\_agent installation via ansible* *\# dnsmasq* *– name: Install dnsmasq* *yum: pkg=dnsmasq state=present* *tags: packages* *ignore\_errors: yes* *\# dnsmaq einschalten* *– name: Ensure dnsmasq is enabled on boot.* *service: „name=dnsmasq.service state=started enabled=yes“* *register: dnsmasq\_service\_configuration* *tags: dnsmasq\_service\_configuration* *\# copy dnsmasq.conf* *– name: copy template dnsmasq.conf* *template: src=dnsmasq.conf.j2 dest=/etc/dnsmasq.conf mode=0644 owner=root group=root* *tags: copy\_dnsmasq\_config* *– name: add cloudera-cdh5 Repo* *yum\_repository:* *name: cloudera-cdh5* *description: Packages for Cloudera’s Distribution for Hadoop, Version 5, on RedHat or CentOS 7 x86\_64* *baseurl: https://archive.cloudera.com/cdh5/redhat/7/x86\_64/cdh/5/* *gpgkey: https://archive.cloudera.com/cdh5/redhat/7/x86\_64/cdh/RPM-GPG-KEY-cloudera* *gpgcheck: yes* *– name: add cloudera-manager Repo for RedHat 7* *yum\_repository:* *name: cloudera-manager* *description: Packages for Cloudera’s Distribution for Hadoop, Version 5, on RedHat or CentOS 7 x86\_64* *baseurl: https://archive.cloudera.com/cm5/redhat/7/x86\_64/cm/5/* *gpgkey: https://archive.cloudera.com/cm5/redhat/7/x86\_64/cm/RPM-GPG-KEY-cloudera* *gpgcheck: yes* *tags: cloudera\_installation* *when: ansible\_os\_family == „RedHat“ and ansible\_distribution\_major\_version == „7“* *– name: add cloudera-manager Repo for RedHat 6* *yum\_repository:* *name: cloudera-manager* *description: Packages for Cloudera’s Distribution for Hadoop, Version 5, on RedHat or CentOS 7 x86\_64* *baseurl: https://archive.cloudera.com/cm5/redhat/6/x86\_64/cm/5/* *gpgkey: https://archive.cloudera.com/cm5/redhat/6/x86\_64/cm/RPM-GPG-KEY-cloudera* *gpgcheck: yes* *tags: cloudera\_installation* *when: ansible\_os\_family == „RedHat“ and ansible\_distribution\_major\_version == „6“* *– name: add cloudera-manager Repo for Redhat 5* *yum\_repository:* *name: cloudera-manager* *description: Packages for Cloudera’s Distribution for Hadoop, Version 5, on RedHat or CentOS 7 x86\_64* *baseurl: https://archive.cloudera.com/cm5/redhat/5/x86\_64/cm/5/* *gpgkey: https://archive.cloudera.com/cm5/redhat/5/x86\_64/cm/RPM-GPG-KEY-cloudera* *gpgcheck: yes* *tags: cloudera\_installation* *when: ansible\_os\_family == „RedHat“ and ansible\_distribution\_major\_version == „5“* *\# Install Cloudera Manager Server* *– name: Install cloudera-manager-daemons* *yum: pkg=cloudera-manager-daemons state=present* *tags: cloudera\_installation* *ignore\_errors: yes* *– name: Install cloudera-manager-server* *yum: pkg=cloudera-manager-server state=present* *tags: cloudera\_installation* *ignore\_errors: yes* *– name: Overwriting db.properties* *template: src=db.properties.j2 dest=/etc/cloudera-scm-server/db.properties owner=cloudera-scm group=cloudera-scm mode=0644* *ignore\_errors: yes* *tags: copy\_templates* *\# test* *– name: Ensure Cloudera is started and enabled on boot.* *service: „name=cloudera-scm-server state=stopped enabled=yes“* *register: cloudera\_service\_configuration* *tags: cloudera\_service\_configuration* *– name: Ensure Cloudera is started and enabled on boot.* *service: „name=cloudera-scm-server state=started enabled=yes“* *register: cloudera\_service\_configuration* *tags: cloudera\_service\_configuration* Sobald die einzelnen DataNodes per „Ansible Playbook“ vorbereitet und ausgerollt wurden, wird automatisch der „Cloudera Manager Server Service“ und der „Cloudera Manager Agent Service“ auf den entsprechenden Nodes gestartet und die manuelle grafische Installation der Cloudera Distribution kann per Browser beginnen. ### **Software Installation** Basierend auf möglichst gleich vorkonfigurierten Systemen, wird über den Cloudera Manager die weitere Clustereinrichtung getätigt. Durch Starten des „cloudera-scm-servers“ kann über die Weboberfläche der Cluster konfiguriert werden. Standardport ist 7180. http://cloudera-cm:7180 ### **Clusterkonfiguration** #### Step 1 – Auswahl der zu installierenden Dienste ![1_clustereinrichtung](https://thecattlecrew.net/wp-content/uploads/2017/08/1_clustereinrichtung.png) Auswahl der Pakete, die entsprechend installiert werden müssen. #### Step 2 „“ Rollenzuweisungen ![2_clustereinrichtung_rollenzuweisung](https://thecattlecrew.net/wp-content/uploads/2017/08/2_clustereinrichtung_rollenzuweisung.png) ![3_clustereinrichtung_rollenzuweisung](https://thecattlecrew.net/wp-content/uploads/2017/08/3_clustereinrichtung_rollenzuweisung.png) ![4_clustereinrichtung_rollenzuweisung](https://thecattlecrew.net/wp-content/uploads/2017/08/4_clustereinrichtung_rollenzuweisung.png) #### Step 3 „“ Datenbank-Setup MySQL-Zugangsdaten werden hier manuell eingetragen. Diese stimmen mit den Ansible MySQL-Passwörtern überein. ![dbsetup](https://thecattlecrew.net/wp-content/uploads/2017/08/dbsetup.png) #### Step 4 – Clusteränderungen [![](https://thecattlecrew.net/wp-content/uploads/2017/08/6_clustereinrichtung_aenderungen-150x150.png)](https://thecattlecrew.net/2017/08/07/wie-ansible-bei-der-installation-einer-big-data-distribution-helfen-kann-vorbereitungstasks-einer-cloudera-installation/6_clustereinrichtung_aenderungen/) [![](https://thecattlecrew.net/wp-content/uploads/2017/08/7_clustereinrichtung_aenderungen-150x150.png)](https://thecattlecrew.net/2017/08/07/wie-ansible-bei-der-installation-einer-big-data-distribution-helfen-kann-vorbereitungstasks-einer-cloudera-installation/7_clustereinrichtung_aenderungen/) [![](https://thecattlecrew.net/wp-content/uploads/2017/08/8_clustereinrichtung_aenderungen-150x150.png)](https://thecattlecrew.net/2017/08/07/wie-ansible-bei-der-installation-einer-big-data-distribution-helfen-kann-vorbereitungstasks-einer-cloudera-installation/8_clustereinrichtung_aenderungen/) Gegebenenfalls anpassen. #### Step 5 „“ Cluster-Konfigurationsausführung ![10_clustereinrichtung_aenderungen](https://thecattlecrew.net/wp-content/uploads/2017/08/10_clustereinrichtung_aenderungen.png) #### Step 6 – Cloudera wurde erfolgreich installiert ![11_clustereinrichtung_aenderungen](https://thecattlecrew.net/wp-content/uploads/2017/08/11_clustereinrichtung_aenderungen.png) #### Step 7 – Übersicht der Cloudera Standardseite ![13_cloudera_run_ohne_Fehler_da_dns_unterdrueckt](https://thecattlecrew.net/wp-content/uploads/2017/08/13_cloudera_run_ohne_fehler_da_dns_unterdrueckt.png) **Links für Oracle DBAs** - [https://www.cloudera.com/documentation/enterprise/release-notes/topics/rn\_consolidated\_pcm.html](https://www.cloudera.com/documentation/enterprise/release-notes/topics/rn_consolidated_pcm.html) - [http://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Artikel/red-stack-magazin-2016-05\_Warum-Ansible-fuer-DevOps-eine-gute-Wahl-ist\_Simon-Hahn\_sicher.pdf](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/red-stack-magazin-2016-05_Warum-Ansible-fuer-DevOps-eine-gute-Wahl-ist_Simon-Hahn_sicher.pdf) - **Kontakt:** *Simon Hahn* *simon.hahn@opitz-consulting.com* **Kategorien:** Analytics & Insights, Cloud **Schlagwörter:** ansible, automatisierung, bigdata, cloudera --- ### [AWS News KW 32](https://thecattlecrew.net/2017/08/14/aws-news-kw-32/) **Published:** August 14, 2017 **Author:** Marco Buss **Content:** Genau wie [letzte Woche](https://thecattlecrew.net/2017/08/07/aws-news-kw-31/) gibt es diese Woche nur eine wichtige Meldung von AWS, die ist dafür aber um so interessanter. ## AWS SAM Local Vor einen Jahr veröffentlichte Amazon das [Serverless Application Model (SAM) ](https://github.com/awslabs/serverless-application-model)um Entwicklern das Deployment von Serverless Anwendungen per [Cloudformation](https://aws.amazon.com/de/cloudformation/?nc2=h_l3_dm) zu erleichtern. ![aws_sam_introduction-1024x286](https://thecattlecrew.net/wp-content/uploads/2017/08/aws_sam_introduction-1024x286.png) SAM local erlaubt es nun die entsprechenden Templates vor dem deployment lokal zu testen. Besonders spannend ist dabei die Möglichkeit [Lambda Funktionen](https://aws.amazon.com/de/lambda/) ebenfalls lokal aufzurufen und damit zu testen und zu debuggen. Werden von den Lambda Funktionen lediglich AWS Services angesprochen, die ebenfalls lokal gestartet werden können z.B. [DynamoDB](https://aws.amazon.com/de/dynamodb/) ist für das Testen nichmal eine Internetverbindung notwendig. Weitere Informationen zu AWS SAM Local [hier](https://github.com/awslabs/aws-sam-local). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [Die OC DevOps Community startet durch](https://thecattlecrew.net/2017/08/16/die-oc-devops-community-startet-durch/) **Published:** August 16, 2017 **Author:** Halil Hancioglu **Content:** DevOps intensiviert die Schaffung einer Kultur und die Etablierung von Prinzipien zur kontinuierlichen Verbesserung der ganzheitlichen Leistung. Es umfasst viele Praktiken angefangen von CI/CD, Konfigurationsmanagement, Compliance-Einbindung und Infrastructure-as-Code über die Optimierung des Arbeitsflusses bis hin zur Fokussierung auf einen effizienten ROI. Dabei experimentieren Teams in kurzen Feedbackzyklen, unterstützt durch einen hoch performanten Auslieferungsstrang zur Verbesserung des Endprodukts. Eine weitere Besonderheit ist die Kontinuität, mit der nachhaltig der Fortschritt beibehalten wird. ![Devops-toolchain](https://thecattlecrew.net/wp-content/uploads/2017/08/devops-toolchain.png)Phasen einer DevOps Toolchain (By Kharnagy – Own work, CC BY-SA 4.0, https://commons.wikimedia.org/w/index.php?curid=51215412) Um solch eine Transformation in Unternehmen zu forcieren, muss ein entsprechendes Mindset entwickelt und ein zugeschnittenes Toolset aufgebaut werden. So muss auch das Umdenken von getrennten Aufgabenbereichen hin zu Teams mit gemeinsamen Produktzielen stattfinden. Die methodischen Ansätze sowie die Toollandschaft sind enorm und entwickeln sich rasch voran. Hierfür sind das Verständnis in der Breite und die Expertise in der Tiefe von essenzieller Bedeutung. Um unsere Kunden bei der DevOps Transformation zu unterstützen und zeitgleich die Kompetenz kontinuierlich zu verbessern, haben wir die *OC DevOps Community* gegründet, in dem Kollegen aus allen Niederlassungen in regelmäßigen Abständen sich austauschen und gemeinsam neues Wissen erarbeiten. Sie können uns direkt unter der Mailadresse kontaktieren oder über unsere Website [http://www.opitz-consulting.com](http://www.opitz-consulting.com/) den Kontakt herstellen. Wir freuen uns auf die Zusammenarbeit! Die *OC DevOps Community* **Kategorien:** DevOps, Tech Events & Networking **Schlagwörter:** Continuous Delivery, Continuous Integration, DevOps, Softwarenentwicklung --- ### [AWS News KW 33](https://thecattlecrew.net/2017/08/21/aws-news-kw-33/) **Published:** August 21, 2017 **Author:** Marco Buss **Content:** In der letzten Woche war der [AWS Summit in New York](https://aws.amazon.com/de/summits/new-york/). Auf dem Event wurden viele Neuerungen bekannt gegeben und daher ist diese Woche mehr zu berichten als die beiden vorangegangenen Wochen. ## AWS Macie Mit AWS Macie hat Amazon einen sehr interessanten neuen Service gestartet. Macie kann dabei helfen unberechtigten Zugang zu vertraulichen S3 Daten zu erkennen und zu verhindern. AWS Macie analysiert und klassifiziert in S3 gespeicherte Daten. Mit Hilfe von Maschine Learning Algorithmen werden die Zugriffe auf diese Daten analysiert, so das bei Anomalien im Zugriffsverhalten Alarm geschlagen werden kann. Weitere Informationen zu AWS Macie [hier](https://aws.amazon.com/macie/). ## AWS Migration Hub Für die Migration von Services in die Cloud können die Dienste [AWS Application Discovery Service](https://aws.amazon.com/de/application-discovery/), [AWS Server Migration Service](https://aws.amazon.com/de/server-migration-service/) und [AWS Database Migration Service](https://aws.amazon.com/de/dms/) den Nutzer unterstützen. Mit AWS Migration Hub steht ab sofort eine einheitliche Oberfläche für diese Tools sowie Migrationstools von Partnern bereit. Für die Nutzung von AWS Migration Hub fallen keine Zusätzlichen Kosten an. Es muss lediglich die Nutzung der verwendeten Services bezahlt werden.![AWS-Migration_hub_Dashboard.png](https://thecattlecrew.net/wp-content/uploads/2017/08/aws-migration_hub_dashboard.png) Weitere Informationen zu AWS Migration Hub [hier](https://aws.amazon.com/de/migration-hub/). ## Neue Regeln für AWS Config Mit Hilfe von [AWS Config](https://aws.amazon.com/de/config/) werden alle Resourcekonfigurationen überwacht. Neben weiteren Funktionen bietet AWS Config die Möglichkeit Ü„nderungen an Konfigurationen historisch zu betrachten. Mit AWS Config Rules können Resourcen auf die Einhaltung definierter Regeln überprüft werden. Neben eigenen Regeln existieren auch „gemanagte“ Regeln. Ab sofort stehen zwei neue Regeln für S3 bereit. **s3-bucket-public-write-prohibited:** Markiert alle Buckets die globale öffentliche Schreibrechte aktiviert wurden. **s3-bucket-public-read-prohibited:** Markiert alle Buckets die für jeden lesbar sind. Weitere Informationen zu managed AWS Config Rules [hier](http://docs.aws.amazon.com/config/latest/developerguide/evaluate-config_use-managed-rules.html). ## AWS CloudTrail automatisch aktiviert für alle AWS Nutzer Mit AWS CloudTrail können alle Aktivitäten eines Accounts bis zu 7 Tage in der Vergangenheit betrachtet und analysiert werden. Ab sofort ist der Dienst für alle Nutzer verfügbar und per default aktiviert. Weitere Informationen zu AWS CloudTrail [hier](https://aws.amazon.com/de/cloudtrail/details/). ## AWS CloudHSM Update AWS CloudHSM bietet hardware-based Key Management in der Cloud. Mit dem Update wurde die Verwendung an vielen Punkten vereinfacht. Die wichtigsten Punkten sind der Wechsel zum Pay as you Go Model und der Übergang zu einen fully managed Service. Weitere Informationen zu AWS CloudHSM [hier](https://aws.amazon.com/cloudhsm/). ## AWS Glue Glue ist ein fully managed extract transform load (ETL) Service. Glue ist serverless, so das sich der Anwender nicht um die Skalierung kümmern muss und Kosten nur dann entstehen wenn der ETL Job wirklich läuft. Weitere Informationen zu AWS Glue [hier](https://aws.amazon.com/de/glue/). ## Encryption at Rest für EFS Amazon Elastic File System (Amazon EFS) stellt einen einfachen, skalierbaren Dateispeicher für Amazon EC2-Instanzen in der AWS Cloud bereit. Mit Encryption at Rest können jetzt Daten vollkommen transparent und mit minimalen Auswirkungen auf die Performance verschlüsselt werden. Der Schlüssel kann entweder von Amazon erzeugt werden oder er wird vom Anwender bereitgestellt. Weitere Informationen zu EFS [hier](https://aws.amazon.com/efs/). ## VPC Endpoints für Amazon DynamoDB Um aus einem VPC heraus den managed Service [Amazon DynamoDB](https://aws.amazon.com/dynamodb/) nutzen zu können, war es bisher notwendig den Umweg über das Internet zu wählen. Mit Blick auf Security Belange sowie Performance ist dieser Weg nicht optimal. Ab sofort ist es möglich einen Endpoint für ein VPC zu definieren, so das Ressourcen innerhalb des VPC DynamoDB ohne Umweg über das Internet nutzen können. Weitere Informationen zu VPC Endpoints für Amazon DynamoDB [hier](http://docs.aws.amazon.com/amazondynamodb/latest/developerguide/vpc-endpoints-dynamodb.html). ## SES Dedicated IP Pool Die meisten Benutzer von Amazon Simple Email Service ([SES](https://aws.amazon.com/ses/)) werden das shared IP Konzept beim versenden Ihrer E-Mails nutzen. Übersteigt das Mailaufkommen einen bestimmten Wert, lohnt sich der Einsatz einer dedizierten IP. Die Verwaltung mehrere dedizierter IP´s wird durch die Dedicated IP Pool´s vereinfacht. Weitere Informationen zu Dedicated IP Pool´s [hier](http://docs.aws.amazon.com/ses/latest/DeveloperGuide/dedicated-ip-pools.html). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [Upgrade Grid Infrastructure 12.1 to 12.2 + Install the 2017 August Release Update (RU) on Exadata](https://thecattlecrew.net/2017/08/26/upgrade-grid-infrastructure-12-1-to-12-2-install-the-2017-august-release-update-ru-on-exadata/) **Published:** August 26, 2017 **Author:** Neselovskyi, Borys **Kategorien:** Cloud, Infrastructure **Schlagwörter:** ASM, Bundle patch, Exadata, Grid Infrastructure 12.2, HowTo, oracle, Oracle DB, Release Update, RU, Upgrade --- ### [AWS News KW 34](https://thecattlecrew.net/2017/08/28/aws-news-kw-34/) **Published:** August 28, 2017 **Author:** Marco Buss **Content:** ## AWS Cost Explorer Update Der AWS Cost Explorer wurde 2014 eingeführt und erfreut sich seitdem großer Beliebtheit. Er kann genutzt werden um die Kosten und Benutzung von EC2 Instanzen im Auge zu behalten. In der letzten Woche gab es für den Cost Explorer ein größeres Update. Es erfolgte ein Redesign der Oberfläche sowie Anpassungen der Filter, Reports und Gruppierung der Daten. Hinzugekommen sind ebenfalls neue Default Reports für die Anzeige relevanter Informationen zu Reserved Instances. ![CostExplorer](https://thecattlecrew.net/wp-content/uploads/2017/08/costexplorer.png) Weitere Informationen zum Cost Explorer [hier](https://docs.aws.amazon.com/awsaccountbilling/latest/aboutv2/cost-explorer-what-is.html). ## Amazon AppStream 2.0 Neuerungen In der letzten Zeit gab es einige Neuerungen in [Amazons AppStream](https://aws.amazon.com/appstream2/) Service. ### Microsoft Active Directory Domains Anbindung von AppStream 2.0 an das eigene Microsoft Active Directory (AD). ### User Management und Webportal Vereinfacht das Erstellen und Verwalten von Benutzern wenn kein Active Directory verwendet wird. Sobald ein User angelegt wurde erhält er eine Begrüßungsemail die Ihn zum Webportal leitet. Hier muss er nur noch ein Passwort für AppStream festlegen und kann danach die Ihm zugeordneten Anwendungen nutzen. ### Persistent Storage Dieses Feature erlaubt Nutzern von AppStream das persistente Speichern von Daten zwischen mehreren AppStream Sessions. Jeder Nutzer erhält ein Home-Verzeichnis das in S3 abgelegt wird. Beim Start einer Session wird das Verzeichnis entsprechend bereitgestellt. ### Simple Network Setup Das Erzeugen eines Netzes für AppStream war ein mehrstufiger Prozess. Mit dem Update hat sich die Konfiguration wesentlich vereinfacht und kann nun komplett aus der AppStream Konsole heraus erfolgen. ### Custom VPC Security Groups Eigene VPC Security Groups können zugeordnet werden. Damit ist eine detaillierte Kontrolle von inbound und outbound Traffic möglich. ### Audio-In Analoge und USB Mikrophone, Mix Konsolen und andere Audio Input Devices können jetzt mit Streaming Applikationen genutzt werden. Weitere Informationen zu AppStream 2.0 [hier](https://aws.amazon.com/appstream2/details/). **Kategorien:** Cloud **Schlagwörter:** Amazon AppStream, AWS --- ### [AWS News KW 35](https://thecattlecrew.net/2017/09/04/aws-news-kw-35/) **Published:** September 4, 2017 **Author:** Marco Buss **Content:** ## Amazon Cognito: App Integration und Identity Federation Amazon Cognito ist ein managed Cloud Service für Authentifizierung, Authorisierung und User Management. Für Cognito sind jetzt folgende neuer Features verfügbar: ### App Integration Stellt eine gehostete Anmeldeseite bereit. Die Seite kann per CSS angepasst und mit einem eigenen Logo versehen werden. ### Identity Federation Es können externe Identity Provider integriert werden. Zur Verfügung stehen: Login with Amazon, Google, Facebook und SAML Identity Provider. Weitere Informationen zu Cognito [hier](https://aws.amazon.com/cognito/). ## Amazon EC2 Elastic GPUs für Windows Mit dem neuen Feature Elastic GPU für Windows ist es jetzt möglich GPU Kapazität für die Verarbeitung von Rendering Workloads beliebigen Instanzen zuzuweisen. Elastic GPU´s werden in den Größen medium (1GB), large (2GB), xlarge (4GB) und 2xlarge (8GB) angeboten. Elastic GPU´s bieten eine günstigere Variante für Grafikanwendungen als die Verwendung von G Instanz Typen. Weitere Informationen zu Elastic GPU´s [hier](https://aws.amazon.com/ec2/elastic-gpus/). ## Amazon Aurora Datenbank Cloning Durch die von [Aurora](https://aws.amazon.com/rds/aurora/) genutzte verteilte Storage Engine ist es möglich eine Kopie der Datenbank sehr schnell zu erzeugen. Die Dauer für das Erstellen einer Kopie ist nicht von der Größe abhängig. Es ist beispielsweise Möglich Terrabyte große Datenbanken innerhalb von Minuten anstatt Stunden zu kopieren. Weitere Informationen zu Aurora Datanbank Cloning [hier](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Aurora.Managing.Clone.html). ## Beschreibungen für Security Group Rules Ab sofort ist es möglich für Recurity Group Rules Beschreibungen zu hinterlegen. Dadurch ist es möglich den Sinn der Regel direkt an der Regel zu hinterlegen. Die Beschreibungen können 255 Zeichen lang sein und können mit der Management Console, der CLI oder AWS Api´s erstellt werden. ## Application Load Balancing via IP Address Application Load Balancer können nun Traffic explizit zu IP´s weiterleiten. Dieses Feature ist für viele Usecases hilfreich. Ein Beispiel wäre eine Migration zu AWS, bei der noch Teile On-Premise laufen. Ist das eigene Rechenzentrum mit [AWS Direct Connect](https://aws.amazon.com/directconnect/) angebunden, können die lokalen Ressourcen per IP in das Loadbalancing integriert werden. Weitere Informationen zu Application Load Balancing [hier](https://aws.amazon.com/elasticloadbalancing/applicationloadbalancer/). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [AWS News KW 36](https://thecattlecrew.net/2017/09/11/aws-news-kw-36/) **Published:** September 11, 2017 **Author:** Marco Buss **Content:** ## Network Load Balancer [Elastic Load Blanacing](https://aws.amazon.com/elasticloadbalancing/) ist seit der Einführung 2009 ein wichtiger Teil von AWS. Neben den bereits bekannten Classic Load Blancer und dem neueren Application Load Blancer wurde letzte Woche der Network Load Balancer vorgestellt. Der Network Load Balancer ist in der Lage mehrere Millionen Anfragen mit einem Hohen Durchsatz und geringer Latenz zu verarbeiten. Darüber hinaus ist er API kompatibel mit dem Application Load Blancer. Wichtige Feature des neuen Load Balancers sind: - **Statische IP Adressen** pro angeschlossener Availability Zone (AZ). Jede AZ wird einer IP zugeordnet. Das kann entweder automatisch passieren oder die IP wird explizit angegeben. Das kann in Situationen mit Firewalls von Vorteil sein. - **Source Address Preservation**. Die original Source IP und source Ports bleiben unverändert. Damit können normale Firewall Regeln inclusive VPC Security Groups auf den Zielinstanzen verwendet werden. - **Long-running Connections**. Verbindungen die über einen sehr langen Zeitraum geöffnet bleiben werden unterstützt. Weitere Informationen zu Network Load Balancer [hier](https://aws.amazon.com/elasticloadbalancing/details/#aws-element-2d8b736f-a572-46a6-8d2b-ca53a8bccc8e-2). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [AWS Cloud9 First Steps - Creating the environment](https://thecattlecrew.net/2017/12/01/aws-cloud9-first-steps-creating-the-environment/) **Published:** Dezember 1, 2017 **Author:** Marco Buss **Kategorien:** Cloud **Schlagwörter:** AWS, Cloud9 --- ### [AWS News KW 37](https://thecattlecrew.net/2018/09/18/aws-news-kw-37-2/) **Published:** September 18, 2018 **Author:** Marco Buss **Content:** ## Shell Zugang per AWS System Managers Session Manager [AWS System Manager](https://aws.amazon.com/systems-manager/) ist ein Service der Administratoren die Verwaltung von EC2 Instanzen, S3 Buckets und RDS Instanzen vereinfacht. Oft kann die Infrastruktur vor allem in der Transitionsphase nicht als „Herde“ betrachtet werden, sondern es existieren weiterhin Systeme die liebevoll installiert und gewartet werden wollen. Oftmals ist dafür eine Shell Zugriff notwendig. Mit dem Session Manager des AWS System Managers ist es ab sofort einfacher auf entsprechende Instanzen zuzugreifen. Der Zugriff kann dabei vom Browser aus oder über eine Shell erfolgen. Die Vorteile des Session Managers sind dabei folgende. **Sicherer Zugang:** Es muss kein zusätzlicher Port geöffnet werden, die Instanzen benötigen lediglich einen aktuellen System Manager Agent auf den Maschinen **Zugangskontrolle:** Der Zugriff auf die Shell kann per IAM gesteuert werden. Es müssen keine SSH Keys verteilt werden. Der Zugriff kann auch auf einzelne Zeitfenster begrenzt werden. **Auditierbarkeit:** Ein- und Ausgaben können in CloudWatch oder ein S3 Bucket geloggt werden. **Interaktiv:** Kommandos werden synchron in einer interaktiven bash oder PowerShell Umgebung ausgeführt. Weitere Informationen zum Session Manager [hier](https://docs.aws.amazon.com/systems-manager/latest/userguide/session-manager.html). **Kategorien:** Cloud **Schlagwörter:** Amazon RDS, AWS, S3 --- ### [AWS News KW 38](https://thecattlecrew.net/2018/09/24/aws-news-kw-38/) **Published:** September 24, 2018 **Author:** Marco Buss **Content:** ## Parallel Querys für Amazon Aurora [Amazon Aurora](https://aws.amazon.com/rds/aurora/) ist Amazons Hauseigene SQL Datenbanklösung mit MySQL und PostgreSQL Kompatibilität. Intern werden die Daten auf einen verteilten Dateisystem abgelegt. Die Daten werden dabei mehrfach Redundant, in voneinander unabhängigen Rechenzentren gespeichert. Mehr zum Aufbau von Amazon Aurora [hier](https://www.slideshare.net/AmazonWebServices/aws-reinvent-2016-getting-started-with-amazon-aurora-dat203-70508626). Jeder verwendete Storage Knoten bietet neben schnellen SSD´s auch eine gute Portion Rechenpower. Diese Power kann nun mit parallel Querys noch besser genutzt werden um Abfragen auf großen Datenbeständen mit eine Vielzahl von Joins zu beschleunigen. Weitere Informationen zu Parallel Querys [hier](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-mysql-parallel-query.html). ## AWS Storage Gateway Hardware Appliance [AWS Storage Gateway](https://aws.amazon.com/storagegateway/) ist eine Möglichkeit AWS Storage Dienste wie [S3](https://aws.amazon.com/de/s3/) oder [Amazon Galcier](https://aws.amazon.com/glacier/) mit dem eigenen Rechenzentrum zu verbinden. AWS Storage Gateway lief bisher in einer virtuellen Umgebung wie VMware ESXi, Microsoft Hyper-V oder Amazon EC2 und war in folgenden Ausprägungen im System Sichtbar. **File Gateway:** Sichtbar per NFS oder SMB. **Volume Gateway:** Virtuelle Festplatten, die per iSCSI lokal angebunden werden können. Von diesen Virtuellen Platten können auch EBS Snapshots erzeugt werden, die dann direkt für EC2 Instanzen verwendet werden können. **Tape Gateway**: Ist eine virtuelle Tape Library (VTL). Damit kann alte Tape Infrastruktur in die Cloud verlagert werden ohne das sich am bisherigen Workflow etwas ändern muss. Für alle Kunden die keine Infrastruktur oder kein entsprechendes IT Know How vor Ort haben aber trotzdem AWS Storage Gateway verwenden möchten, bietet AWS ab sofort eine vorkonfigurierte Hardware Appliance in Form eines [Dell EMC PowerEdge R640 Rack Servers](https://www.amazon.com/dp/B079RBVX3M) an. Diese kann einfach vor Ort in eine entsprechendes Rack installiert werden. Danach sind nur noch wenige Schritte Notwendig und der AWS Storage Gateway kann lokal verwendet werden. Weitere Informationen zu AWS Storage Gateway [hier](https://docs.aws.amazon.com/de_de/storagegateway/latest/userguide/WhatIsStorageGateway.html). **Kategorien:** Cloud **Schlagwörter:** Amazon Aurora, Amazon Glacier, AWS, S3 --- ### [AWS News KW 39](https://thecattlecrew.net/2018/10/08/aws-news-kw-39/) **Published:** Oktober 8, 2018 **Author:** Marco Buss **Content:** ## Amazon CloudWatch Graphen für externe Anwendungen Die [CloudWatch](https://aws.amazon.com/cloudwatch/) API wurde um einen neuen sehr Interessanten Aufruf erweitert. Mit der Funktion **GetMetricWidgetImage** kann ein Snapshot eines CloudWatch Graphen als PNG abgerufen werden. Das Bild kann dann in beliebige eigene Tools außerhalb der AWS Console integriert werden. Der API Aufruf hat ein Limit von 20 Aufrufen pro Sekunde und es dürfen pro Graph maximal 100 Metriken enthalten sein und der Payload darf 100kb nicht überschreiten Weitere Informationen zur neuen Funktion [hier](https://docs.aws.amazon.com/AmazonCloudWatch/latest/APIReference/API_GetMetricWidgetImage.html). ## Amazon Aurora unterstützt Start und Stop von DB-Clustern [Amazon Aurora](https://aws.amazon.com/rds/aurora/) unterstützt ab sofort das Starten und Stoppen von Datenbank Clustern. Dadurch wird die Verwendung von Clustern für Entwicklung und Test wesentlich vereinfacht. Während der Cluster gestoppt ist, kann ein Point-In-Time Recovery zu jedem Zeitpunkt innerhalb der Retention Time gemacht werden. Wird der Cluster wieder gestartet erhält er wieder alle vorherigen Konfigurationen. Ist der Cluster gestoppt, fallen lediglich Kosten für den Cluster Storage, manuelle Snapshots und Backups an nicht aber Kosten für Datenbank Instanz Stunden. Ein Cluster kann bis zu 7 Tage gestoppt werden und wird nach Ablauf der Zeit automatisch wieder gestartet. Weitere Informationen zum Start/Stop von DB Clustern [hier](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-cluster-stop-start.html). ## Amazon RDS unterstützt Deletion Protection Analog EC2 Instanzen können jetzt [Amazon RDS](https://aws.amazon.com/rds/) Instanzen vor versehentlichen Löschen geschützt werden. Die Option ist für Produktiv Systeme automatisch aktiviert, kann für alle anderen ebenfalls bei Bedarf aktiviert werden. Instanzen mit aktivierter Deletion Protection können von keinem User gelöscht werden. Die Deletion Protection muss in diesem Fall explizit vorher deaktiviert werden. Weitere Informationen zur Deletion Protection für RDS Instanzen [hier](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/USER_DeleteInstance.html). ## EC2 Instanztypen mit 6, 9 und 12 TB RAM Für alle die große SAP Hana Instanzen in der Cloud betreiben wollen eignen sich die neuen High Memory Instanztypen mit folgenden Leistungsmerkmalen. **Instance Name****Memory****Logical Processors** **Dedicated EBS Bandwidth****Network Bandwidth****u-6tb1.metal**6 TiB44814 Gbps25 Gbps**u-9tb1.metal**9 TiB44814 Gbps25 Gbps**u-12tb1.metal**12 TiB44814 Gbps25 GbpsDie Instanzen sind SAP Hana Zertifiziert. Im Gegensatz zu anderen Instanztypen sind die High Memory Instanzen nur als Dedicated Host mit einem 3 Jahresvertrag zu bekommen. Für nähere Informationen zum Preis muss das zuständige Accountteam kontaktiert werden. Weitere Informationen zu High Memory Instanztypen [hier](https://aws.amazon.com/ec2/instance-types/high-memory/). **Kategorien:** Cloud **Schlagwörter:** Amazon Aurora, Amazon CloudWatch, Amazon RDS, AWS --- ### [Use Amazon S3 to serve your Website](https://thecattlecrew.net/2018/10/12/use-s3-to-serve-your-website/) **Published:** Oktober 12, 2018 **Author:** Marco Buss **Content:** An Amazon S3 bucket is very suitable to serve your static content in an serverless way. You don´t have to waste even a single thought on scaling. It makes no difference if you must serve one file per second or thousands and you pay only for the traffic your site is generating. This post provides an overview of how to use S3 as an Webserver for static Content. It starts with the most simple way and goes down to more advanced options. ## Enable Website Hosting for a Bucket This is the most trivial option to use an S3 bucket to serve the static content of a website is to enable this feature on the „Properties“ Tab for that S3 bucket or to use the [CLI](https://docs.aws.amazon.com/cli/latest/reference/s3/website.html). ![S3_Website_Hosting](https://thecattlecrew.net/wp-content/uploads/2018/09/s3_website_hosting1.png) > aws s3 website s3://my-bucket/ –index-document index.html This solution has several drawbacks and is also not the AWS preferred way. - The URL ist not very readable - Only HTTP is supported - The S3 bucket and every object that should be served must be public ## Using Route 53 and enabled Website Hosting Option Two is a combination of enabled Website Hosting and the use of [Amazon Route 53](https://aws.amazon.com/route53). Route 53 is Amazons DNS Service. If your Site domain is managed by Route 53 it is possible to configure a S3 bucket as an DNS alias e.g to serve your content under example.com. The picture shows that configuration for my private domain. The only prerequisite is that the S3 bucketname is equal to your DNS Record Name. For the domain marcobuss.de the bucketname must be also marcobuss.de. Because bucketnames are globally it is possible that your needed name is already used by an other user. ![Route_53_S3_alias](https://thecattlecrew.net/wp-content/uploads/2018/09/route_53_s3_alias.png) With this option we get a more convenience url, but your content is also available under the S3 default URL, HTTPS is not supported and all Content must be public readable. ## Use CloudFront and Route 53 to deliver Content from S3 At the End the most advanced options that gives plenty of options and is the AWS preferred way for deliver static content from an S3 bucket. We use CloudFront and Route 53 in combination. The following picture shows that solution. With such a setup it is possible to map every bucketname to your domain name, the bucket can be private and we can restrict the access to allow only https. For a more detailed Description and an example read the following [blogpost](https://thecattlecrew.net/2018/10/12/how-to-use-cloudfront-to-serve-private-s3-bucket-as-website/). ![Overview_Diagram](https://thecattlecrew.net/wp-content/uploads/2018/09/overview_diagram.png) **Kategorien:** Cloud **Schlagwörter:** Amazon Route53, AWS, S3 --- ### [How to use CloudFront to serve private S3 Bucket as Website](https://thecattlecrew.net/2018/10/12/how-to-use-cloudfront-to-serve-private-s3-bucket-as-website/) **Published:** Oktober 12, 2018 **Author:** Marco Buss **Content:** The preferred way to use S3 for your static site content should be to use a CloudFront Distribution. For other options look at that [blogpost](https://thecattlecrew.net/2018/10/12/use-s3-to-serve-your-website/). ## Overview CloudFront is Amazons Contend Delivery Network designed to serve your content as close to your customers as possible. To do that CloudFront provides a howl bunch of so called „Edge Locations“ that act as a cache for the content. With a CloudFront Distribution it is possible to serve content from a private S3 Bucket and you can map every bucketname to our domain name with Route 53. The picture shows how that solution works. ![Overview_Diagram](https://thecattlecrew.net/wp-content/uploads/2018/09/overview_diagram.png) 1. 1. A client requests the url. 2. The request is routed to our CloudFront Distribution by Route 53 3. If the requested Object can be served from the cache it will be delivered immediately by CloudFront. \* If the content is not cached. CloudFront uses a signed URL to request the Object. \*\* S3 returns the content to CloudFront > **Signed URL´s:** Signed URL´s can be used to access private Objects in S3 Buckets. These URL´s contains information to grant access to that resources. ## Example In my example i will provide a site under [cognito-hosted-ui.marcobuss.de](http://cognito-hosted-ui.marcobuss.de) with content from the private bucket „aws-cognito-hosted-ui-159501877559“. The domain marcobuss.de is managed by Route 53, which makes some steps simpler. If your domain is not managed by Route 53 some additional steps will be required. ### Create a Certificate In the end for security reasons the site should only be accessible with https. To support that, a SSL certificate is required for the domain. For https you can select the CloudFront Certificates or use your own certificate. CloudFront provides his own certificates for https, if these certificate is used the browser will cause an error when accessing the site with your domain because the certificate is issued for the CloudFront domain not for your domain. ![certificate](https://thecattlecrew.net/wp-content/uploads/2018/10/certificate.png) The certificate is managed by the AWS [Certificate Manager](https://aws.amazon.com/certificate-manager). I also created my certificate here. It is really easy to get the certificate for your domain, it is even simpler if your domain is managed by Route 53 itself. The required DNS entries for the generate certificate can be inserted automatically for Route 53 managed domains. For all other domains you must create the required DNS entries so the certificate can be validated. ![certificate2](https://thecattlecrew.net/wp-content/uploads/2018/10/certificate22.png) ### Create the CloudFront Distribution After the certificate was successfully validated the CloudFront Distribution can be created. Go to the CloudFront [Console](https://console.aws.amazon.com/cloudfront/home) and create a new Distribution. ![CloudFront_Origin](https://thecattlecrew.net/wp-content/uploads/2018/10/cloudfront_origin.png) The first part are the Origin Settings. As „Origin Domain Name“ you must select your S3 Bucket, the „Origin ID“ is set automatically. To use a bucket that is complete private the „Restrict Bucket Access“ must be yes. CloudFront now uses signed URL´s for requesting new assets and you must use an existing identity or let CloudFront create a new one. CloudFront can update your bucket policy or you can do it by your own. I recommend the CloudFront option. The following policy was created for my bucket. ``` { "Version": "2008-10-17", "Id": "PolicyForCloudFrontPrivateContent", "Statement": [ { "Sid": "1", "Effect": "Allow", "Principal": { "AWS": "arn:aws:iam::cloudfront:user/CloudFront Origin Access Identity EHYYXUMX6R0TJ" }, "Action": "s3:GetObject", "Resource": "arn:aws:s3:::aws-cognito-hosted-ui-159501877559/*" } ] } ``` The next part configures some caching options. Just copy the configuration. As i wrote, the content is only accessible through https, so i defined that every http request is redirected to https. I have also configured that all Cookies and Query Strings must be forwarded. ![CloudFront_Behavior](https://thecattlecrew.net/wp-content/uploads/2018/10/cloudfront_behavior.png) In the last part you can define some options about the distribution itself. For coast optimization i only use the U.S., Canada and Europe CloudFront Locations. I also must define the subdomain for the project as Alternate Domain Name and I must specify to use my previously created SSL Certificate. All other options i leave as default in this section. ![CloudFront_Dist_Settings](https://thecattlecrew.net/wp-content/uploads/2018/10/cloudfront_dist_settings.png) After that, you can create your distribution. That takes aprox. 15 Minutes. After that time you have an CloudFront URL for your Distribution and your site is accessible through this url. For my Distribution the url is [d2ssd8b2tt0m87.cloudfront.net](http://d2ssd8b2tt0m87.cloudfront.net) ### Create the Route 53 Alias After creating the CloudFront Distribution you can configure a [Route 53](https://console.aws.amazon.com/route53/home?#Dashboard:) Record Set. Go to your Hosted Zone for your domain and create a new Record Set. ![Route_53_Record_Set](https://thecattlecrew.net/wp-content/uploads/2018/10/route_53_record_set.png) Define your Record Set to be an „Alias“ and select the CloudFront Distribution from the Alias Target list. Wait some time, the list update is very slow. After the Record Set is saved, your S3 bucket is available under the url you defined. **Kategorien:** Cloud --- ### [Using brand new AWS Lambda Layers to save your time](https://thecattlecrew.net/2018/12/07/using-brand-new-aws-lambda-layers-to-save-your-time/) **Published:** Dezember 7, 2018 **Author:** Marco Buss **Content:** One of my highlights from this years re:Invent announcements where the [Lambda Layers](https://docs.aws.amazon.com/lambda/latest/dg/configuration-layers.html). With Lambda Layers AWS offers a way to separate own code or librarys in an extra Layer which can be used by Lambda functions. These Layers can be stacked up to 5 layers and are hierarchically. That means the content from a higher layer overwrites conflicting items from a lower layer. All Layers plus the Lambda code can´t be exceed the 250MB Limit. But why are Layers such a big thing? That´s pretty easy. The most of use (or better should use) the [serverless framework](https://serverless.com/) or the [serverless application model (SAM)](https://docs.aws.amazon.com/serverless-application-model/latest/developerguide/what-is-sam.html) to deploy their functions with the help of CloudFormation. To do that every Tool zips the code and all library´s that the lambda needs and uploads that zip to S3. Bigger zip´s results in much longer deployment times. If you deploy often that can be a massive time wasting thing or even makes it impossible to deploy e.g. while sitting in a train with very low bandwidth and on the other side it is totally boring waiting for 60 megs or more to be uploaded to S3. For an example here are the artifact sizes for one of my Alexa Skills. ![](https://thecattlecrew.net/wp-content/uploads/2018/12/image.png?fit=1024%2C134&ssl=1)4.9 MB before extracting all librarys to a layer versus 5.1 KB after. That results in a massiv saving for the deployment time. #### Creating the Layer Bevor introducing the layer my project had a folder structure like this. All my code and the librarys are located under a src directory, because SAM zips the whole directory as described earlier. ![](https://thecattlecrew.net/wp-content/uploads/2018/12/image-1.png)For my first Layer i moved the package.json on step up and so the node\_modules folder was also moving one step up resulting in the following folder structure. ![](https://thecattlecrew.net/wp-content/uploads/2018/12/image-2.png)At the moment SAM supports Layers but not like Lambda Functions. SAM will not automatically zip the content and uploads it to S3. To do that i write a little bash script that does that for me and deploys the layer as a CloudFormation Stack. ``` #!/usr/bin/env bash # Create random artifact name LAYER_ARTIFACT="layer-${RANDOM}${RANDOM}.zip" # Creating the required folder structure for the layer rm -rf nodejs >/dev/null 2>&1 mkdir nodejs >/dev/null 2>&1 mkdir nodejs >/dev/null 2>&1 cp -R ./node_modules nodejs zip -rq ${LAYER_ARTIFACT} nodejs/ rm -rf nodejs >/dev/null 2>&1 AWS_REGION=eu-west-1 echo "Getting AWS Account ID" AWS_ACCOUNT_ID=$(aws sts get-caller-identity --output text --query 'Account') echo "Using AWS Account with ID: ${AWS_ACCOUNT_ID}" DEPLOYMENT_BUCKET="${AWS_ACCOUNT_ID}-ask-layer" # Creating the Bucket and enable encryption echo "Using ${DEPLOYMENT_BUCKET} for deployment artifacts" aws --region ${AWS_REGION} s3 mb s3://${DEPLOYMENT_BUCKET} >/dev/null 2>&1 aws s3api put-bucket-encryption --bucket ${DEPLOYMENT_BUCKET} --server-side-encryption-configuration '{"Rules": [{"ApplyServerSideEncryptionByDefault": {"SSEAlgorithm": "AES256"}}]}' >/dev/null 2>&1 # Upload Layer aws --region ${AWS_REGION} s3 cp $(pwd)/${LAYER_ARTIFACT} s3://${DEPLOYMENT_BUCKET} # Cleanup rm ${LAYER_ARTIFACT} TEMPLATE_FILE=packaged-layer-template.yaml # Deploy the layer aws --region ${AWS_REGION} cloudformation package --template-file layer-template.yaml --s3-bucket ${DEPLOYMENT_BUCKET} --output-template-file ${TEMPLATE_FILE} aws --region ${AWS_REGION} cloudformation deploy --template-file ${TEMPLATE_FILE} --stack-name ask-layer --parameter-overrides ContentBucket=${DEPLOYMENT_BUCKET} ContentKey=${LAYER_ARTIFACT} ``` And here is the SAM Template for that layer. ``` AWSTemplateFormatVersion: 2010-09-09 Transform: - AWS::Serverless-2016-10-31 Parameters: ContentBucket: Type: String ContentKey: Type: String Outputs: LayerARN: Description: The ARN for that Layer Value: !Ref AskLayer Export: Name: !Sub "${AWS::StackName}-LayerARN" Resources: AskLayer: Type: AWS::Serverless::LayerVersion Properties: LayerName: AskLayer Description: Base Layer for my Alexa Skills ContentUri: Bucket: !Ref ContentBucket Key: !Ref ContentKey CompatibleRuntimes: - nodejs6.10 - nodejs8.10 RetentionPolicy: Retain ``` The important thing in this template is the Outputs block where the layer ARN is exported so that it can be imported to other stacks. In the SAM Template for my lambda function i only have to import this Output. ``` AlexaSkillFunction: Type: AWS::Serverless::Function Properties: Handler: index.handler Runtime: nodejs8.10 CodeUri: ./src Layers: - Fn::ImportValue: !Sub "${AskLayerStackName}-LayerARN" ``` And as the result the Lambda function is using this layer. ![](https://i2.wp.com/thecattlecrew.net/wp-content/uploads/2018/12/layer.png?fit=1024%2C260&ssl=1)And now i don´t have to upload the librarys on every code change in my lambda. To extract 3rd party librarys to an extra Lambda function is going to my best practices list for lambda functions an will save me a lot of time in my future work. **And i will recommend this to every Lambda developer.** And the last words: Thank you AWS for that feature!!! **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [AWS News KW 2](https://thecattlecrew.net/2019/01/15/aws-news-kw-2/) **Published:** Januar 15, 2019 **Author:** Marco Buss **Content:** ## Amazon DocumentDB (mit MongoDB Kompatibilität) Zu allen Datenbank Optionen die AWS bisher anbietet hat sich jetzt noch Amazon [DocumentDB](https://aws.amazon.com/documentdb/) hinzugesellt. Amazon DocumentDB ist eine MongoDB 3.6 kompatible Dokumenten Datenbank mit den folgenden Features. - **Skalierbarkeit**: - 10 GB bis 64 TB Storage - 6 Instanztypen von 15,25 GB bis 488GB Arbeitsspeicher - bis zu 15 Read Replicas - **Performance:** Millionen von Leseoperationen pro Sekunde im Millisekundenbereich - **Reliability:** - 6 fache Datenreplication sichert hohe Verfügbarkeit - Failover von Primary zu Replica in 30 Sekunden - **Fully Managed:** Das Monitoring, Fehlererkennung und Failover wird von Amazon übernommen. Snapshots können automatisch jeden Tag oder jederzeit manuell erstellt werden. Ein Point-In-Time Recovery ist ebenfalls verfügbar. - **Security:** - Encryption at Rest kann aktiviert werden - Encryption at Transit ist per default aktiviert, ebenso wie Authentication Weitere Informationen zu Amazon [DocumentDB](https://aws.amazon.com/documentdb/) hier. ## AWS Fargate Preis Reduktion bis zu 50% [AWS Fargate](https://aws.amazon.com/fargate/), ist eine Möglichkeit Docker Container „Serverless“ zu betreiben. Es ist kein Clustermanagement notwendig. Der Einsatz der auf der re:Invent 2018 vorgestellten [Firecracker](https://firecracker-microvm.github.io/) Virtualisierung konnten Kostenersparnisse erzielt werden, die jetzt an die Kunden weitergegeben werden. **vCPU****GB Memory****Effective Price Cut**0.250.5-35.00%0.251-42.50%0.252-50.00%0.51-35.00%0.52-42.50%0.53-47.00%0.54-50.00%12-35.00%13-39.30%14-42.50%15-45.00%16-47.00%17-48.60%18-50.00%24-35.00%25-37.30%26-39.30%27-41.00%28-42.50%29-43.80%210-45.00%211-46.10%212-47.00%213-47.90%214-48.60%215-49.30%216-50.00%48-35.00%49-36.20%410-37.30%411-38.30%412-39.30%413-40.20%414-41.00%415-41.80%416-42.50%417-43.20%418-43.80%419-44.40%420-45.00%421-45.50%422-46.10%423-46.50%424-47.00%425-47.40%426-47.90%427-48.30%428-48.60%429-49.00%430-49.30% **Kategorien:** Cloud **Schlagwörter:** Amazon DocumentDB, AWS --- ### [AWS DeepRacer @ OC](https://thecattlecrew.net/2019/01/29/aws-deepracer-oc/) **Published:** Januar 29, 2019 **Author:** Marco Buss **Content:** ## DeepRacer Vorstellung (28.11.2018) Wie auf der re:Invent 2017 war Opitz Consulting auch auf der re:Invent 2018 mit drei Kollegen vor Ort. Einer der drei glücklichen war ich und somit hatte ich die Gelegenheit, die für mich bisher beeindruckendste Konferenz vor Ort mitzuerleben. ![](https://i2.wp.com/thecattlecrew.net/wp-content/uploads/2019/01/DeepRacerIntro.png?fit=1024%2C351&ssl=1)In der Keynote am Mittwoch wurde dann der AWS DeepRacer vorgestellt. Eine Plattform, um maschinelles Lernen jedem Entwickler zugänglich zu machen. Da bei mir dieser Gamification Ansatz sehr gut funktioniert, war ich direkt Feuer und Flamme. Leider wird der DeepRacer erst ab 06.03.2019 ausgeliefert, aber nicht nach Deutschland. Auf der Keynote wurde allerdings verkündet, dass man DeepRacer bei einem Wettbewerb gewinnen konnte. Also war schnell klar, dass wir das doch probieren können und werden. Beim Veranstaltungsgelände angekommen, waren wir schon begeistert. AWS hat keine Mühen gescheut und die Sportarena des MGM Grand für dieses Event hergerichtet. ![](https://i2.wp.com/thecattlecrew.net/wp-content/uploads/2019/01/DeepRacer-Event.jpg?fit=1024%2C269&ssl=1)Es waren mehrer Tracks verfügbar und das Ganze wurde auch professionell moderiert. Wie ich später erfahren hatte, war der Moderator ein in den USA bekannter Indy Car Moderator. Leider konnten wir an diesem Tag keinen DeepRacer ergattern. Am Abend erfuhren wir dann, dass jeder Teilnehmer am DeepRacer Workshop ein Auto erhält. Glücklicherweise wurde der Workshop am nächsten Tag noch einige Male wiederholt, aber natürlich waren schon alle reservierbaren Plätze vergeben. Also hieß es am nächsten Morgen anstehen, um einen der freien Plätze zu ergattern. ## Workshop Tag (29.11.2018) Am Donnerstag ist traditionell die Keynote von Werner Vogels, die ich mir als Stream im MGM Grand ansehen wollte, da dort ebenfalls die Workshops stattfanden. Mein Plan war einfach, vor Ende der Keynote zum Workshop Raum zu gehen. Vor der Keynote wollte ich noch erkunden, wo sich der Workshopraum befand. Zu meinem Erstaunen warteten bereits ca 15 Leute vor dem Eingang und das knapp 5h bevor der Workshop losgehen sollte. Gut, dann war ich halt Nummer 16 und die Keynote wurde per Handy verfolgt. Was für eine Spannung in die letzte Stunde bevor der Workshop losging. Ständig wurde die Schlange, die mittlerweile bestimmt 50-60 Leute umfasste, durchgezählt, aber keiner der Verantwortlichen sagte wieviele Plätze noch frei waren. Glücklicherweise waren mehr als 16 freie Plätze verfügbar, so dass ich 15 Minuten vor Workshopbegin im Raum war. Nach 2.5h Workshop war dann auch klar, dass es für jeden Teilnehmer einen DeepRacer zur Belohnung geben wird. Der DeepRacer wurde dann auch von uns abgeholt und gebührend bewundert. Auch hier zeigte sich wieder die großartige Organisation der Konferenz, denn neben dem DeepRacer befand sich im Karton auch ein FedEx Gutschein für den Versand. Das sollte allerdings noch fast in einer Katastrophe enden. ## Ungeduld (20.12.2018) Da ich noch nie etwas aus den USA verschickt hatte, aber mit Nachricht vom (langsamen) Zoll gerechnet hatte, habe ich mich erst am 20.12. über den Verbleib der Sendung informiert. Der freundliche FedEx Mitarbeiter sagte mir dann, dass das Packet nicht durch den Zoll gekommen ist und nach einer Frist von 10 Tagen an den Absender zurück geschickt wurde. Schöner Mist!!! Naja, noch war ich optimistisch, dass sich so eine Sendung ja auch wieder umleiten lassen sollte, das wollte der Mitarbeiter dann auch veranlassen und es würde ich jemand melden… ## FedEx Support (Anfang Januar) Nachdem sich niemand gemeldet hatte, habe ich den Support noch mehrfach kontaktiert, bis ich am 9.1.2019 dann die Information hatte das die Lieferung zerstört wurde. Was FedEx in so einem Fall laut AGB auch darf. Gut, damit waren dann alle Pläne für den DeepRacer geplatzt. ## Unverhofft kommt oft (18. Januar 2019) Ja, der 18. Januar 2019 war schon ein Highlight. Am späten Nachmittag stand plötzlich ein Kurier vor meiner Haustür mit einem Packet, das mit einem Zoll Klebeband versehen war. Da ich nichts im Ausland bestellt hatte, konnte das nur eines bedeuten. **Der DeepRacer wurde doch nicht zerstört.** ![](https://i2.wp.com/thecattlecrew.net/wp-content/uploads/2019/01/DeppRacer.png?fit=1024%2C848&ssl=1)Die erste große Freude wurde dann auch direkt beim Auspacken wieder getrübt. Der DeepRacer hatte einige Blessuren abbekommen und noch viel schlimmer: es fehlten wichtige Teile und das Netzkabel war natürlich auch nicht für Deutschland gedacht. - Als erstes fehlte die Hauptbatterie für den Rechner. Nach ein wenig Recherche stellte sich heraus, dass es lediglich eine Powerbank ist. Also habe ich fix eine mit halbwegs passenden Maßen bestellt. ([Link](https://www.amazon.de/dp/B019BZTVZY)) - Da das Netzteil lediglich ein USB-C Netzteil war, konnte ich einfach das Netzteil meines MacBook´s verwenden - Das Ladegerät für den Autoakku fehlte ebenfalls. Der Akku ist ein üblicher LiPo Akku, wie er bei Modellautos und zu meinem Glück auch Flugzeugen verwendet wird. Da ich genau solche Modelflugzeuge habe, war auch die passende Ladetechnik vorhanden. Da der DeppRacer jetzt einsatzbereit ist, kann endlich die Planung für die nächsten Aktionen erfolgen. Wer den DeepRacer live sehen möchte, hat dazu die Gelegenheit auf dem [AWS Summit in Berlin](https://aws.amazon.com/de/events/summits/berlin/) am 26.2. und 27.2. am Stand von OC oder auf der [Digital XChange](https://digital-xchange.de/) am 25.5. in Gummersbach. **Kategorien:** AI & Data Science, Cloud **Schlagwörter:** AWS --- ### [AWS News KW 3 - 4](https://thecattlecrew.net/2019/02/04/aws-news-kw-3-4/) **Published:** Februar 4, 2019 **Author:** Marco Buss **Content:** ## TLS Termination für Network Load Balancers (NLB´s) Um eine Webseite sicher per HTTPS aufzurufen tauschen Browser und Server im Vorfeld eine Menge Informationen aus um die Endgültige Verschlüsselung zu vereinbaren. Grob gesprochen ist TLS ([Transport Layer Security](https://de.wikipedia.org/wiki/Transport_Layer_Security)) das „S“ in HTTPS. Durch die Unterstützung von TLS Termination wird die ganze Last der Verschlüsselung auf den Load Balancer ausgelagert. Dadurch ergeben sich folgende Vorteile - Der Server hat mehr CPU Kapazitäten da er keine Ver- und Entschlüsselung mehr handhaben muss - Das Zertifikat für die Verbindung muss nicht mehr auf jedem Server abgelegt werden. Dadurch verringert sich der Management Aufwand und die Sicherheit wird auch erhöht da das Zertifikat nicht auf vielen Instanzen verteilt ist. - Zero-day Patching. Im Falle eines Fehlers im TLS Protokoll muss ein Patch lediglich auf dem NLB aufgespielt werden, was dankenswerter Weise von AWS übernommen wird. Weitere Informationen zu TLS Termination für NLB´s [hier](https://docs.aws.amazon.com/elasticloadbalancing/latest/network/create-tls-listener.html). ## CloudFormation UpdateReplacePolicy Attribut [AWS CloudFormation](https://aws.amazon.com/cloudformation/) ist das Infrastructure as Code Tool für AWS. Wird ein CloudFormation Stack aktualisiert kann es vorkommen das Ressourcen neu angelegt werden müssen da sich ein nicht veränderbares Attribut im Template verändert hat. Muss eine Ressource neu angelegt werden, wird diese Ressource erzeugt und im Anschluss alle Referenzen auf die alte Ressource angepasst. Danach wird die alte Ressource gelöscht. Mit dem neuen UpdateReplacePolicy kann dieses Verhalten angepasst werden. Die alte Ressource kann wie bisher gelöscht werden. Sie kann bestehen bleiben oder, falls unterstützt, kann ein Snapshot angelegt werden. Weitere Informationen zum UpdateReplacePolicy Attribut [hier](https://docs.aws.amazon.com/AWSCloudFormation/latest/UserGuide/aws-attribute-updatereplacepolicy.html). ## AWS Backup AWS Backup ist ein neuer Dienst der eine Zentrale Sicht auf Backup´s eines AWS Accounts liefert. Viele Services unterstützen bereits Backups, aber mit AWS Backup existiert jetzt eine zentrale Stelle für die Verwaltung von Backups. Es können Policy basierte Backuppläne erstellt werden, der Status laufender Backups kann eingesehen werden. Natürlich kann auch ein Restore direkt in AWS Backup gestartet werden. Folgende Dienste werden aktuell unterstützt. Wobei weitere im Laufe der Zeit hinzugefügt werden. - EBS Volumes - EFS Dateisysteme - Storage Gateway Volumes - RDS Datenbanken - DynamoDB Tabellen Weitere Informationen zu AWS Backup [hier](https://aws.amazon.com/backup/). ## Amazon Work Link [Amazon Work Link](https://aws.amazon.com/worklink/) ist ein neuer Service der den mobilen Zugriff auf geschützte Unternehmens Webseiten und Anwendungen vereinfachen soll. Amazon Work Link teil sich in zwei Komponenten auf. Zum einen wäre da die „Server“ Komponente die im AWS Netzwerk läuft und den Content gerendert an den Client liefert. Der „Client“ ist ein App die aktuell nur für iOS 12 verfügbar ist. Die App fungiert als first-tier DNS Resolver und richtet auch ein entsprechendes VPN für den Zugriff ein. Der Service kostet 5$ pro aktivem User und pro Monat. Er ist in US und EU Regionen ab sofort verfügbar. Weitere Informationen zu Amazon Work Link [hier](https://aws.amazon.com/worklink/resources/). **Kategorien:** Cloud **Schlagwörter:** Amazon WorkLink, AWS, Network Load Balancer --- ### [How to build a DeepRacer Track](https://thecattlecrew.net/2019/02/12/how-to-build-a-deepracer-track/) **Published:** Februar 12, 2019 **Author:** Marco Buss **Excerpt:** This blogpost shows how to build a transportable DeepRacer track based on the original re:Invent Track. **Content:** Now as the [DeepRacer](https://aws.amazon.com/deepracer/) arrived after a long yourney it is time to plan the next steps with that maschine learning „tool“. We want to host some workshops and so we need a real DeepRacer track that is transportable. This blogpost shows how to build a transportable DeepRacer track based on the original [re:Invent Track.](https://docs.aws.amazon.com/deepracer/latest/developerguide/deepracer-build-your-track.html) ## Designing the Track The original track has a dimension of 7,34m x 4,59m. I will use 60cm x 60cm EVA Foam Interlocking Tiles for the floor. Based on that numbers a field of 13 columns and 8 rows with 104 tiles are required. That are to much tiles and so i optimized the the track. First i shrinked the width so that the track fits into 12 columns. After that i painted the track in a matrix to see which tiles are absolutely necessary. In the end i only need 64 tiles to construct the track. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2019/02/image.png?fit=1024%2C679&ssl=1)32 tiles are not necessary## Needed Tools and Material - 60cm x 60cm EVA Foam Interlocking Tiles for the floor of the track. That Tiles are ideal to make the track transportable - Gaffer Tape white 5cm x 50m for the track border - Gaffer Tape yellow 3cm x 50m for the middle line - Whiteboard marker - Utility knife and scissors - Mason Line used with whiteboard marker as compass for marking the turning radius - Ruler - Right angle square ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2019/02/IMG_1982.jpg?fit=768%2C1024&ssl=1)## Building the Track After planning the track i ordered the calculated amount of tiles and the tape. And than building the track is just put the tiles together and place the tape on the tiles. But here are some details i like to share. **Curves:** to construct the curves i used the mason line. I taped the string on the center of the curve and make a mark for the outlines from the inner and outer part on the string. Than at a regular interval i marked the curve on the tiles. After that it was easy to follow the dots with the tape. - [![](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1958-1-768x1024.jpg)](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1958-1-768x1024.jpg)Mark the outlines with dots - [![](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1957-1-768x1024.jpg)](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1957-1-768x1024.jpg)More dots - [![](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1961-1-768x1024.jpg)](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1961-1-768x1024.jpg)Final result **Dimensions:** I think only a few of us have the estate with a free space of 7,30m x 4,90m which is needed to layout all required tiles. I don´t have that space so i had to construct the track bit by bit. - ![](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1977.jpg?fit=768%2C1024&ssl=1) - ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2019/02/IMG_1971.jpg?fit=964%2C1024&ssl=1) - ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2019/02/IMG_1975.jpg?fit=903%2C1024&ssl=1) **Long straight lines:** As seen in the pictures i used for long straight lines the mason line. That saves so much time, align the string and than no measurement for that line anymore. **Transportable:** To make the track transportable just cut the tape on the join points of the tiles. For easier reassembling of the tiles i extend the „tiles minimized“ plan with column and row numbers and than placed a mark on the back of every tile so everybody can see where the tile belongs and also orientation of the tile. - ![](https://thecattlecrew.net/wp-content/uploads/2019/02/track-1024x684.jpg) - ![](https://thecattlecrew.net/wp-content/uploads/2019/02/IMG_1983-1024x768.jpg) ## Summary Building the DeepRacer track was a lot of fun for me and it was really straight forward. The next time i think i will switch the used side of the EVA Foam tiles. The next step for me is to build a nice box for easy transportation of the tiles. I will also mirror the great right curve to have a much smaller track for presentations with limited space. More Information about DeepRacer @OC [here](https://thecattlecrew.net/?s=AWS+DeepRacer). **Kategorien:** AI & Data Science, Cloud **Schlagwörter:** AWS --- ### [AWS Summit 2019 Berlin (Teil 1)](https://thecattlecrew.net/2019/03/12/aws-summit-2019-berlin-teil-1/) **Published:** März 12, 2019 **Author:** Danilo Schmiedel **Content:** Über 6000 Teilnehmer allein am ersten Tag sprechen eine deutliche Sprache: AWS ist auch im deutschen Raum in den meisten Unternehmen ein Thema. Case Studies von Finanzen (N26), Health Care (MLL), eCommerce (Zalando), Wandlung von Consulting Company zum SaaS Anbieter (IFR), Industrie (Siemens), Food Processing (Baader), uvm. zeigen die ganze Bandbreite von AWS im Markt. Die STATION-BERLIN mit Ihren 23.000 m² platzte fast aus allen Nähten. Die Teilnehmer konnten sich in ca. 120 Fachvorträgen begeistern und inspirieren lassen. Vom Messebereich zum Networking bis zum Chillout- Bereich war alles dabei. Auch ein eigens eingerichteter Bereich namens „StartUp Central“ mit dem Fokus auf Gründung und Ideenaustausch war vorhanden. ![](https://thecattlecrew.net/wp-content/uploads/2019/03/20190226_110728968_iOS-e1552394986813-1024x768.jpg)Marco Buss und Danilo Schmiedel mit dem AWS DeepRacer Als Bronze Sponsor waren wir in diesem Jahr mit einem eigenen Stand auf der Konferenz vertreten. Über die gesamten zwei Tage führten wir viele interessante Gespräche zu unseren Fokusthemen: Data as a Service, Data Lake Architekturen, DWH Modernisierung, Serverless, Analytics, Predictive Maintenance und die Migration von On-Prem Datenbanken nach AWS. Gerade das Thema Machine Learning war dabei in fast jedermanns Munde. „Put Machine Learning in the Hands of every developer“, war die Aussage von Dr. Werner Vogels in seiner [Keynote](https://youtu.be/gdS-K_sYig0). Um genau das zu erreichen eignet sich ein Gamification-Ansatz sehr gut, d.h. sich spielerisch mit **MachineLearning** auseinanderzusetzen. Wir sind stolz, dass wir an unserem Stand mit dem [AWS DeepRacer](https://thecattlecrew.net/2019/01/29/aws-deepracer-oc/) zeigen konnten, wie das konkret aussehen kann. Schaut Euch dazu gern den Mitschnitt von unserem letzten Community Day an. Machine Learning mittels Gamification lernenViele Gespräche am Stand führten wir zu **[DatabaseFreeedom](https://aws.amazon.com/de/blogs/enterprise-strategy/1128-2/)**, was auch prominent auf unseren T-Shirts zu lesen war. AWS bietet unterschiedliche Datenbanken genau passend für unterschiedliche Anwendungsfälle (siehe Slideshare Foliensatz – [Datenbanken auf AWS](https://www.slideshare.net/opitzconsulting/database-migration-124369612)). Dazu zählen: Relationale DBs, NoSQL DBs, Graph DBs, Document DBs, Caches, etc… Mit unserer fundierten Kompetenz im Bereich Datenbanken sind wir die Richtigen, wenn es um die Migration von Datenbanken nach AWS geht. Wir haben das technische KnowHow, kennen die Hürden und können zu Lizenzen und Kosten beraten. Einen Überblick zu einem Teil unseres Angebotes gibt es in diesem [Factsheet](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/103-factsheet-migration-oracle-nach-aws.pdf). Auf der Konferenz selbst standen die Themen Serverless, Analytics, Big Data und Container im Fokus. Wir von [OPITZ CONSULTING](https://www.opitz-consulting.com/) waren mit 24 Personen stark vertreten und haben über Social Media ([Twitter](https://twitter.com/OC_Wire), [LinkedIn](https://www.linkedin.com/company/opitz-consulting-deutschland-gmbh/)) intensiv vom Event berichtet. ![](https://i2.wp.com/thecattlecrew.net/wp-content/uploads/2019/03/20190226_195633263_iOS.jpg?fit=1024%2C768&ssl=1)AfterWork Party von OC auf dem AWS Summit 2019 Für diejenigen, die nicht dabei sein konnten: die aufgezeichneten Sessions und die Slides sind auf der [AWS-Event-Page ](https://aws.amazon.com/de/events/summits/berlin/presentations/?sc_channel=em&sc_campaign=EMEA_field_T1_summit-berlin_20190226&sc_medium=em_128826&sc_content=ACQ_t1_field&sc_geo=emea&sc_country=de&sc_outcome=acq&trkCampaign=dach19_summitberlin&trk=em_thankyou_dach19_summitberlin&mkt_tok=eyJpIjoiWVRWaU5HTXlNek5tT0RKaCIsInQiOiI3VGR5SG54R2J1UHdWV0pJZWhhR0dUVHdCaTNpR0xHUG1pRERaOGhpU0pJczNya3NmRHd4TVZtSldJc3pLSzZjRmk2bDYya2ZLMUNVU3Vzd3BDN2JWdkhHcGVLbW50MjRkZTJZVHpaSWJmcHhVTzNYK29DbVlCRmNNNVFUaElveHJNdEhJeURwb25lSWVZMmdTTmh2UUE9PSJ9)verfügbar. Weitere Team-Eindrücke von der Konferenz folgen in weiteren Posts. Stay tuned… **Kategorien:** Cloud **Schlagwörter:** AWS, DBFreedom, Migration --- ### [Zero Day vulnerability in Oracle WebLogic Servers - Oracle Patch available](https://thecattlecrew.net/2019/05/06/zero-day-vulnerability-in-oracle-weblogic-servers-oracle-patch-available/) **Published:** Mai 6, 2019 **Author:** Markus Knies **Content:** Oracle released the quarterly critical patch updates on April 16th, 2019. Only one week later a zero-day vulnerability was identified by the KnownSec-404 security team. The vulnerability exists in Oracle Weblogic Server and has been labeled as CVE-2019-2725 and is also reported by the BSI (Bundesamt für Sicherheit in der Informationstechnik, Zero-Day-Schwachstelle in Oracle WebLogic Server, 25.04.2019). Affected modules for this vulnerability are the wls9\_async\_response package with its components wls9\_async and wls-wsat. With the help of these two modules it is possible to execute malicious content with elevated privileges. Oracle reacted fast, broke the regular patch process, and launched an independent emergency patch on April 26th,2019: Oracle reports that there is only an impact at the following versions: Oracle WebLogic Server, versions 10.3.6.0 and 12.1.3.0. The BSI announces that all versions of Oracle WebLogic-Server are affected (also including the currently actual version 12.2.1.3). The vulnerability CVSS score for this issue is 9.8. It is highly recommended to install this patch as soon as possible in affected systems. **Related Links:** Oracle – Oracle Security Alert Advisory: F5L2019 – F5 Labs: Twitter-Meldung: Pag2019 – Pierluigi Paganini: „Zero-day vulnerability in Oracle WebLogic“: Heise – Oracle WebLogic Server via Zero-Day-Lücke aus der Ferne angreifbar (26.04.2019): Heise – Oracle patcht kritische Lücke in WebLogic Server außer der Reihe (29.04.2019): [https://www.heise.de/security/meldung/Oracle-patcht-kritische-Luecke-in-WebLogic-Server-ausser-der-Reihe-4409153.html?wt\_mc=rss.security.beitrag.atom](https://www.heise.de/security/meldung/Oracle-patcht-kritische-Luecke-in-WebLogic-Server-ausser-der-Reihe-4409153.html?wt_mc=rss.security.beitrag.atom) **Kategorien:** Cloud, IT-Security **Schlagwörter:** Oracle FMW, Oracle WebLogic --- ### [OC|Expert Camp "“ Container Orchestration mit OpenShift/OKD](https://thecattlecrew.net/2019/05/20/oc-expert-camp-meetup-container-orchestration-mit-openshift-okd/) **Published:** Mai 20, 2019 **Author:** philpz **Content:** Am 08. Mai 2019 veranstalteten wir in München ein weiteres Meetup aus unserer Reihe von Coding Katas. Angekündigt hatten wir unser Meetup wie immer in den beiden Gruppen [München Coding Dojo Meetup](https://www.meetup.com/de-DE/Munchen-Coding-Dojo-Meetup/) und [OC|Expert Camp München](https://www.meetup.com/de-DE/OC-Expert-Camp-Munchen/). Von den 20 angemeldeten Teilnehmern erschienen 14. Die No-Show Rate lag damit bei erfreulich niedrigen 30 % Prozent. Wir starteten das Meetup mit einigen Slides, um eine Einführung in OpenShift bzw. OKD zu geben. Die nicht ganz klare Bedeutung des Akronyms *OKD* ([Origin community distribution of Kubernetes that powers Red Hat OpenShift](https://blog.openshift.com/okd310release/)) nahmen die Teilnehmer mit Humor auf. In Folge wurde auf die Unterschiede zwischen Kubernetes, OpenShift und OKD eingegangen, um im Anschluss die wichtigsten Ressourcen-Typen und Konzepte zu erläutern (Namespace, Label, Pod, ConfigMap, Service und Route). ![Meetup München OpenShift 08. Mai 2019](https://thecattlecrew.net/wp-content/uploads/2019/05/meetupMucOKD-08-05-2019-1024x768.png)Philipp (OKD-Experte) und Manuel (Organisator) von OPITZ CONSULTING Da das Meetup als Coding Kata bzw. als Meetup mit Hands-on beworben wurde, lag der Fokus auf dem praktischen Anteil. In der ersten Aufgabe wurde – noch gemeinsam – ein Docker Image mit einer Spring Boot Applikation als Pod deployed und die Commands des OpenShift CLIs ausgetestet. Im Folgenden durften sich die Teilnehmer daran versuchen, die Spring Boot Applikation in dem Docker Image über eine ConfigMap-Ressource mit Umgebungsvariablen zu konfigurieren und über eine Service-Ressource Load Balancing und Service Discovery bereitzustellen. Um die Applikation über den Browser erreichbar zu machen, galt es, noch eine Route zu definieren. Die ultimative Aufgabe bestand darin, eine Dummy-Applikation namens *Dogbook* (geschrieben in NodeJS) als DeploymentConfig zu deployen, inklusive Service, Route und ConfigMap. Besondere Features von DeploymentConfigs auf OpenShift sind unter anderem: - Automatische Rollouts basierend auf Triggern - Rolling Updates - History der letzten *n* Versionen - Rollback-Funktion zu letzten *n* Versionen (automatisch/manuell) ![Dogbook Screen Recording](https://thecattlecrew.net/wp-content/uploads/2019/05/dogbook.gif)Dogbook Screen Recording Als Hilfsmittel während des Hands-ons konnte die teils lückenhafte Dokumentation von OpenShift herangezogen werden. Um den Lerneffekt zu steigern, sollte die Web Console von OpenShift explizit nicht verwendet werden. Stattdessen hieß es: > YAMLs schreiben!!! ## Lessons Learned - Nicht jeder kennt sich mit YAML-Syntax aus. Eine kurze Einführung kann daher nicht schaden. - Bei einem Meetup mit Hands-on braucht man auf jeden Fall Unterstützung durch mindestens eine weitere Person, die in dem Thema technisch versiert ist. Während man am Tischende sitzt und vorprogrammiert, kann es auf Teilnehmerseite zu so einigen Fragen oder Problemen kommen. - Virtuelle Maschinen in der Cloud (AWS EC2) eignen sich perfekt für ein solches Meetup, da sie ein großes Zeitersparnis bieten. Die Teilnehmer müssen so keine Installationen auf dem lokalen Rechner ausführen und Works-on-my-Machine Probleme gehören (theoretisch) der Vergangenheit an. Alle können sich direkt an die Aufgaben setzen und gemeinsam beginnen. - Bei der Verteilung der IP-Adressen und Hostnamen für die virtuellen Maschinen haben wir noch Verbesserungsbedarf. Bei Hostnamen wie *ec2-01-234-567-89.eu-central-1.compute.amazonaws.com* kann man schnell einen Fehler beim Abtippen machen. → Irgendwie digital verteilen. - Visual Studio Code eignet sich mit dem Light-Theme perfekt für das YAML-Schreiben auf dem Beamer, da Einrückungen über vertikale Striche dargestellt werden und die Farben auch auf dem Beamer gut erkennbar sind. Andere Editoren zeigen meist zusätzlich alle Leerzeichen an, was bei den Teilnehmern beim Abtippen schnell zu Verwirrung führen kann: ![](https://thecattlecrew.net/wp-content/uploads/2019/05/grafik-2.png)YAML für eine DeploymentConfig in Visual Studio Code (Ligth Theme) Wenngleich die Zeit knapp war und das YAML-Schreiben zu so später Uhrzeit viel Konzentration erforderte, waren die Teilnehmer von OpenShift bzw. OKD durchweg begeistert. Ein Teilnehmer nahm sich sogar vor, in der nächsten Woche einige der Applikationen bei ihm auf der Arbeit nach OpenShift zu migrieren. Wie immer rundeten Pizza und Bier den Abend ab. **Kategorien:** Cloud, Tech Events & Networking **Schlagwörter:** Meetup, München, OKD, OpenShift --- ### [Part 2: Create the Oracle APEX Database in Amazon Relation Data Service (RDS)](https://thecattlecrew.net/2019/06/06/part-2-create-the-oracle-apex-database-in-amazon-relation-data-service-rds/) **Published:** Juni 6, 2019 **Author:** Neselovskyi, Borys **Content:** This is the second part of my blog series about the installation and configuration an APEX database in the Amazon Cloud. Refer to following posts for the explanation of the whole solution: - [Create Oracle APEX Environment in the Amazon Cloud with RDS: Part 1 – Overview](https://thecattlecrew.net/2019/06/06/create-oracle-apex-environment-in-the-amazon-cloud-with-rds:-part-1---overview) - [Part 3: Configure APEX with Oracle Rest Data Service (ORDS) in the EC2 Container](https://thecattlecrew.net/2019/06/06/part-3:-configure-apex-with-oracle-rest-data-service-(ords)-in-the-new-ec2-container) - [ Part 4: Configure APEX with ORDS, Apache-Tomcat und Nginx](https://thecattlecrew.net/2019/06/06/part-4:-configure-apex-with-ords,-apache-tomcat-und-nginx) ## Create the Virtual Private Cloud (Network) in AWS At first, I will create my customer network in AWS. In the AWS Console navigate to VPC and click on „Create VPC“. Specify the IPv4 IP Range (CIDR Block) and try „Create“: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create1.png)Navigate to created VPC und enable the DNS Resolution: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create2.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create3.png)Enable DNS Hostnames: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create4.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create5.png)Verify the created VPC ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create6.png)### Create Internet gateway Now we will create the Internet gateway to connect the VPC to the Internet ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create7.png)Attach Internet Gateway to VPC ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create8.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create9.png)### Create three public subnets in Frankfurt Region At this time, we will create three subnets in our VPC Subnet 1 ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create10.png)Subnet 2 ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create11.png)Subnet 3 ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create12.png)Enable Auto-Assign Ip-Address For all three Subnets enable the Auto Assign IP-Addresses ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create13.png)### Create and Configure the Route Table Now we will create the route table to handle to enable for all instances the internet access: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create14.png)Add Routes ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create15.png)Check: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create16.png)Now we will associate the created route table with three subnets: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create17.png)Check: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create18.png)## Create the Oracle Database in the RDS (Relation Database Service) in AWS Now we will create the oracle managed database in AWS. ### Create the Security Group for the Database At first, we will create the database subnet group. It will be referenced by creating the database. In the EC2 Console navigate to Security Groups and create a Security Group: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create19.png)Add Tag (unique name) for the security group: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create20.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create21.png)Create Inbound Rules ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create22.png)Check: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create23.png)### Create DB Subnet Group Now we will create the database subnet group. It will be used by creating the database. RDS -> Create DB Subnet Group ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create24.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create25.png)Create Outbound Rules ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create26.png)### Create an Option Group with APEX Software: Per default, the APEX is not enabled by the creating of the database. We will now create the Option Group that includes APEX: RDS -> Option Groups -> Create Option Group ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create27.png)Create Then „Add Option“: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create28.png)Add APEX and APEX\_DEV: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create29.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create30.png)### Create the database: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create31.png)Choose Database Vendor: Oracle ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create32.png)And Edition: Oracle Standard Edition Two: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create33.png)Specify the Use Case: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create34.png)Specify the database configuration: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create35.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create36.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create37.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create38.png)Define the admin user (in my case: bne) and set and save the master password for the database. You will able to connect to the database with the admin-user and the master password. Network Settings: You can choose already created network (VPC) and the security group: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create39.png)Database settings: Choose the created Option Group, that includes APEX: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create40.png)The Storage Encryption is for this instance type disabled (for the production environment enable the encryption): ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create41.png)We will configure the backup retention: 1 Day (only for the tests): ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create42.png)Monitoring: let defaults: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create43.png)Additional Settings: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create44.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create45.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create46.png)Create Database“¦ ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create47.png)The installation takes about 30 minutes. ### Test the DB Connection Check and Save the Endpoint (Server Name) and Listener Port: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create48.png)In the SQL Developer „Create Connection“: ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create49.png)Connect“¦ ![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create50.png)![](http://borysneselovskyi.files.wordpress.com/2019/06/060619_0653_part2create51.png)APEX is now installed“¦ Previously Blog post in this series: - [Create Oracle APEX Environment in the Amazon Cloud with RDS: Part 1 – Overview](https://thecattlecrew.net/2019/06/06/create-oracle-apex-environment-in-the-amazon-cloud-with-rds:-part-1---overview) Next Blog post in this series: - [Part 3: Configure APEX with Oracle Rest Data Service (ORDS) in the EC2 Container](https://thecattlecrew.net/2019/06/06/part-3:-configure-apex-with-oracle-rest-data-service-(ords)-in-the-new-ec2-container) - [Part 4: Configure APEX with ORDS, Apache-Tomcat und Nginx](https://thecattlecrew.net/2019/06/06/part-4:-configure-apex-with-ords,-apache-tomcat-und-nginx) **Kategorien:** Cloud **Schlagwörter:** Apache, APEX, AWS, Configuration, HowTo, Installation, IT Security, Nginx, oracle, ORDS, RDS, SYSDBA, Tomcat, VPC --- ### [Part 3: Configure APEX with Oracle Rest Data Service (ORDS) in the new EC2 Container](https://thecattlecrew.net/2019/06/06/part-3-configure-apex-with-oracle-rest-data-service-ords-in-the-new-ec2-container/) **Published:** Juni 6, 2019 **Author:** Neselovskyi, Borys **Content:** In my previous blog posts, I have described how to create the customer Oracle Database in the RDS with APEX Component: - [Create Oracle APEX Environment in the Amazon Cloud with RDS: Part 1 – Overview](https://thecattlecrew.net/2019/06/06/create-oracle-apex-environment-in-the-amazon-cloud-with-rds:-part-1---overview) - [Part 2: Create the Oracle APEX Database in Amazon Relation Data Service (RDS)](https://thecattlecrew.net/2019/06/06/part-2:-create-the-oracle-apex-database-in-amazon-relation-data-service-(rds)/) In this post, I will explain the configuration of Middleware components needed to present apex content in web. We will build the separate VM (EC2 Container) in AWS and configure following components: ORDS, Apache Tomcat und Nginx Server. ## Installing and Configuring the VM for the APEX Listener Create EC2 Container for the APEX: - AMI: Amazon Linux 2 AMI (HVM), SSD Volume Type – ami-09def150731bdbcc2 - Shape: t2.micro ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config1.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config2.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config3.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config4.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config5.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config6.png)I downloaded the SSH Key Pair in the directory on my laptop: /drives/d/Documents/Job/OC/KnowHow/Cloud/AWS/Netzwerke ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config7.png)Connect to the already created ec2 container: I used the SSH Client MobaXterm. Navigate to the directory with saved private SSH key and connect to the VM in AWS: \[my laptop\] cd /drives/d/Documents/Job/OC/KnowHow/Cloud/AWS/Netzwerke \[my laptop\] ssh -i ./bnekeypair.pem ec2-user@ Change to root and start the OS update: \[ec2-user@\]$ sudo -i \[root@\]# yum update Create a nonprivileged OS user to own the APEX Listener installation. The following command creates a new user named apexuser. \[root@\]# useradd -d /home/apexuser apexuser \[root@\]# passwd apexuser ## Configure and check the connectivity from the EC2 Container to the Database I used the new Tool SQLCLI for the connect to the database. The tool need the Java runtime. Install Open JDK: \[root@\]# yum install java Check: \[root@\]# java -version Output: openjdk version „1.8.0\_201“ OpenJDK Runtime Environment (build 1.8.0\_201-b09) OpenJDK 64-Bit Server VM (build 25.201-b09, mixed mode) Then I installed the Tool Oracle SQL Developer Command Line (SQLcl): is a free command line interface for Oracle Database. I copied the SQLcl installation zip file on my Laptop and copied it to the EC2 Container \[my laptop\] scp -i ./bnekeypair.pem sqlcl-19.1.0.094.1619.zip [ec2-user@:/home/ec2-user](mailto:ec2-user@xx.xxx.xxx.xxx:/home/ec2-user) And installed the Tool under apexuser: \[root@\]# cp /home/ec2-user/sqlcl-19.1.0.094.1619.zip /home/apexuser/ \[root@\]# chmod 777 /home/apexuser/sqlcl-19.1.0.094.1619.zip \[root@\]# su – apexuser \[apexuser@\]# unzip sqlcl-19.1.0.094.1619.zip \[apexuser@\]$ export JAVA\_HOME=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.201.b09-0.amzn2.x86\_64/jre \[apexuser@\]$ alias sql=“/home/apexuser/sqlcl/bin/sql“ \[apexuser@\]$ export PATH=$JAVA\_HOME/bin:$PATH Check the connection to the database: \[apexuser@\]$ sql /nolog SQL> conn bne/“ It works!!! ## Configuring RESTful Services for Oracle APEX To configure RESTful services in APEX, use SQL\*Plus to connect to your DB instance as the master user, and then run the rdsadmin.rdsadmin\_run\_apex\_rest\_config stored procedure. When you run the stored procedure, you provide passwords for the following users: - APEX\_LISTENER - APEX\_REST\_PUBLIC\_USER Execute in the SQLPlus: - APEX\_LISTENER - APEX\_REST\_PUBLIC\_USER Execute in the SQLPlus: ``` SQL> exec rdsadmin.rdsadmin_run_apex_rest_config("šapex_listener_password"˜,"™apex_rest_public_user_password"˜); ``` Unlock APEX User: SQL> alter user APEX\_PUBLIC\_USER identified by ; SQL> alter user APEX\_PUBLIC\_USER account unlock; ## Download and Install APEX Download APEX from [http://download.oracle.com/otn/java/appexpress/apex\_19.1.zip](http://download.oracle.com/otn/java/appexpress/apex_19.1.zip) Copy APEX from the local PC to the EC2-Container: \[my laptop\] cd /drives/d/Documents/Job/OC/KnowHow/Cloud/AWS/Netzwerke \[my laptop\] scp -i ./bnekeypair.pem apex\_18.1.zip [ec2-user@:/home/ec2-user](mailto:ec2-user@xx.xxx.xx.xx:/home/ec2-user) Access the EC2 Container: \[my laptop\] ssh -i ./bnekeypair.pem ec2-user@ Change to root and install APEX in the EC2 Container: \[ec2-user@\]$ sudo -i \[root@\]# cp /home/ec2-user/apex\_18.1.zip /home/apexuser/ \[root@\]# chmod 777 /home/apexuser/apex\_18.1\_en.zip \[root@\]# su „“ apexuser \[apexuser@\]$ cd /home/apexuser \[apexuser@\]$ unzip apex\_18.1.zip APEX is in the EC2 Container now installed ## Download and install ORDS Now download the Oracle REST Data Services: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config8.png)And copy to ec2 /home/apexuser: \[my laptop\] cd /drives/d/Documents/Job/OC/KnowHow/Cloud/AWS/Netzwerke \[my laptop\] scp -i ./bnekeypair.pem ords-18.4.0.354.1002.zip [ec2-user@:/home/ec2-user](mailto:ec2-user@xx.xxx.xx.xx:/home/ec2-user) Connect to the EC2 Container and install the ORDS: \[my laptop\] ssh -i ./bnekeypair.pem [ec2-user@:/home/ec2-user](mailto:ec2-user@xx.xxx.xx.xx:/home/ec2-user) In the EC2 Container change to OS user root and install ORDS: \[ec2-user@\]$ sudo -i \[root@\]# cp /home/ec2-user/ords-18.4.0.354.1002.zip /home/apexuser/ \[root@\]# chmod 777 /home/apexuser/ords-18.4.0.354.1002.zip \[root@\]# su „“ apexuser apexuser@\]$ mkdir /home/apexuser/ORDS \[apexuser@\]$ cd /home/apexuser/ORDS \[apexuser@\]$ unzip ../ords-18.4.0.354.1002.zip ## Setup ORDS as apexuser Before you start the ORDS configuration get following data: - Database Hostname: Database Endpoint: refer to Chapter „Test the DB Connection“ in the - Database SID and Listener Port: refer to Chapter „Test the DB Connection“ in [Part 2: Create the Oracle APEX Database in Amazon Relation Data Service (RDS)](https://thecattlecrew.net/2019/06/06/part-2:-create-the-oracle-apex-database-in-amazon-relation-data-service-(rds)/) - Password for the Database User APEX\_PUBLIC\_USER: refer to Chapter „Configuring RESTful Services for Oracle APEX“ in this Blogpost - Password for the Database User APEX\_LISTENER: refer to Chapter „Configuring RESTful Services for Oracle APEX“ in this Blogpost - Password for the Database APEX\_REST\_LISTENER: refer to Chapter „Configuring RESTful Services for Oracle APEX“ in this Blogpost \[apexuser@\]$ cd /home/apexuser/ORDS \[apexuser@\]$ java -jar ords.war setup Enter the location to store configuration data:/home/apexuser/ORDS Enter the name of the database server \[localhost\]: Enter the database listen port \[1521\]: Enter 1 to specify the database service name, or 2 to specify the database SID \[1\]:2 Enter the database SID \[xe\]: orcl Enter 1 if you want to verify/install Oracle REST Data Services schema or 2 to skip this step \[1\]:2 Enter 1 if you want to use PL/SQL Gateway or 2 to skip this step: 2 If using Oracle Application Express or migrating from mod\_plsql then you must enter 1 \[1\]: Enter the PL/SQL Gateway database user name \[APEX\_PUBLIC\_USER\]: Enter the database password for APEX\_PUBLIC\_USER: Confirm password: Enter 1 to specify passwords for Application Express RESTful Services database users (APEX\_LISTENER, APEX\_REST\_PUBLIC\_USER) or 2 to skip this step \[1\]: 1 Enter the database password for APEX\_LISTENER: Confirm password: Enter the database password for APEX\_REST\_PUBLIC\_USER: Confirm password: Apr 30, 2019 4:30:44 PM INFO: reloaded pools: \[\] ## Set a password for the APEX admin user (for the APEX GUI) \[ec2-user@\]$ sudo -i \[root@\]# su „“ apexuser \[apexuser@\]$ sql bne/“@myservice SQL> @/home/apexuser/apex/apxchpwd.sql Output: =========================================================================== This script can be used to change the password of an Application Express instance administrator. If the user does not yet exist, a user record will be created. =========================================================================== Enter the administrator’s username \[ADMIN\] (User for the APEX GUI) Enter ADMIN’s password \[\] (Define password for the APEX GUI User ADMIN) Enter value for EMAIL: Changed password of instance administrator ADMIN. ## Start ORDS (as apexuser) Bei the first start of the ORDS some settings will be set: \[apexuser@\]$ cd /home/apexuser/ORDS \[apexuser@@S\]$ java -jar ords.war Apr 30, 2019 4:35:30 PM oracle.dbtools.rt.config.setup.MigrateV2 migrate INFO: Migrating Oracle REST Data Services configuration files from 2.0.x to current version. Migrate Database Configuration apex with connection host: bnedborcl.xxxxxxxxx.eu-central-1.rds.amazonaws.com port: 1521 sid: orcl Apr 30, 2019 4:35:30 PM INFO: reloaded pools: \[|apex||, |apex|al|, |apex|rt|\] Enter 1 if you wish to start in standalone mode or 2 to exit \[1\]:1 Enter the APEX static resources location:/home/apexuser/apex/images Enter 1 if using HTTP or 2 if using HTTPS \[1\]: 2019-04-30 16:37:40.454:INFO::main: Logging initialized @133213ms to org.eclipse.jetty.util.log.StdErrLog Apr 30, 2019 4:37:40 PM INFO: HTTP and HTTP/2 cleartext listening on port: 8080 Apr 30, 2019 4:37:40 PM INFO: Disabling document root because the specified folder does not exist: /home/apexuser/ORDS/ords/standalone/doc\_root 2019-04-30 16:37:42.116:INFO:oejs.Server:main: jetty-9.4.z-SNAPSHOT; built: 2018-05-03T15:56:21.710Z; git: daa59876e6f384329b122929e70a80934569428c; jvm 1.8.0\_201-b09 2019-04-30 16:37:42.180:INFO:oejs.session:main: DefaultSessionIdManager workerName=node0 2019-04-30 16:37:42.181:INFO:oejs.session:main: No SessionScavenger set, using defaults 2019-04-30 16:37:42.182:INFO:oejs.session:main: node0 Scavenging every 600000ms Apr 30, 2019 4:37:44 PM WARNING: The pool named: |apex|| is invalid and will be ignored: The username or password for the connection pool named |apex||, are invalid, expired, or the account is locked Apr 30, 2019 4:37:45 PM WARNING: The pool named: |apex|al| is invalid and will be ignored: The username or password for the connection pool named |apex|al|, are invalid, expired, or the account is locked Apr 30, 2019 4:37:46 PM WARNING: The pool named: |apex|rt| is invalid and will be ignored: The username or password for the connection pool named |apex|rt|, are invalid, expired, or the account is locked Apr 30, 2019 4:37:46 PM INFO: Oracle REST Data Services initialized Oracle REST Data Services version : 18.4.0.r3541002 Oracle REST Data Services server info: jetty/9.4.z-SNAPSHOT 2019-04-30 16:37:46.617:INFO:oejsh.ContextHandler:main: Started o.e.j.s.ServletContextHandler@52a86356{/ords,null,AVAILABLE} 2019-04-30 16:37:46.618:INFO:oejsh.ContextHandler:main: Started o.e.j.s.h.ContextHandler@5ce81285{/i,null,AVAILABLE} 2019-04-30 16:37:46.638:INFO:oejs.AbstractConnector:main: Started ServerConnector@a0e705e{HTTP/1.1,\[http/1.1, h2c\]}{0.0.0.0:8080} 2019-04-30 16:37:46.638:INFO:oejs.Server:main: Started @139397ms I received the following warnings: WARNING: The pool named: |apex|| is invalid and will be ignored: The username or password for the connection pool named |apex||, are invalid, expired, or the account is locked WARNING: The pool named: |apex|al| is invalid and will be ignored: The username or password for the connection pool named |apex|al|, are invalid, expired, or the account is locked WARNING: The pool named: |apex|rt| is invalid and will be ignored: The username or password for the connection pool named |apex|rt|, are invalid, expired, or the account is locked To solve the problem, I performed the following step: I have unlocked users and reset the password: SQL> alter user ORDS\_PUBLIC\_USER account unlock; SQL> alter user APEX\_PUBLIC\_USER account unlock; SQL> alter user APEX\_LISTENER account unlock; SQL> alter user ORDS\_PUBLIC\_USER identified by ; SQL> alter user APEX\_PUBLIC\_USER identified by ; SQL> alter user APEX\_LISTENER identified by ; Then I added the database passwords into the ORDS configuration files: vi /home/apexuser/ORDS/ords/conf/apex\_rt.xml Saved on Thu May 02 07:36:22 UTC 2019 „“ APEX\_REST\_PUBLIC\_USER vi /home/apexuser/ORDS/ords/conf/apex.xml Saved on Thu May 02 09:21:57 UTC 2019 „“ APEX\_PUBLIC\_USER vi /home/apexuser/ORDS/ords/conf/apex\_al.xml Saved on Thu May 02 09:21:57 UTC 2019 „“ APEX\_LISTENER Then restart the ORDS: \[apexuser@\]$ java -jar ords.war ## Add new Rule to the Securty Group We must create the new Rule to allow the Access to APEX via the Port 8080: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config9.png)Now I was able to connect to my APEX Application: http://xxxxxxxxxxxxx.eu-central-1.compute.amazonaws.com:8080/ords/ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config10.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/060619_1000_part3config11.png) Previously Blog posts in this series:- [Create Oracle APEX Environment in the Amazon Cloud with RDS: Part 1 – Overview](https://thecattlecrew.net/2019/06/06/create-oracle-apex-environment-in-the-amazon-cloud-with-rds:-part-1---overview) - [Part 2: Create the Oracle APEX Database in Amazon Relation Data Service (RDS)](https://thecattlecrew.net/2019/06/06/part-2:-create-the-oracle-apex-database-in-amazon-relation-data-service-(rds)/) Next Blog post in this series: - [Part 4: Configure APEX with ORDS, Apache-Tomcat und Nginx](https://thecattlecrew.net/2019/06/06/part-4:-configure-apex-with-ords,-apache-tomcat-und-nginx) **Kategorien:** Cloud **Schlagwörter:** Apache, APEX, AWS, Configuration, HowTo, Installation, IT Security, Nginx, oracle, ORDS, RDS, SYSDBA, Tomcat, VPC --- ### [Reporting Database mit Dbvisit Standby 9.0.06](https://thecattlecrew.net/2019/11/21/reporting-database-mit-dbvisit-9-0-06/) **Published:** November 21, 2019 **Author:** Rainier Kaczmarczyk **Content:** Seit dieser Woche ist Dbvisit Standby 9.0.06 verfügbar. Nach .02 und .04 das dritte Release der Software. Was ist daran denn schon besonderes? Nun, was das Dbvisit Team hier entwickelt hat, ist fast zu schön, um wahr zu sein! Neu ist in dieser Release die Snapshot Option. Was macht diese Option so besonders? Auf der Standby Seite kann, basierend auf der Standby Datenbank, eine weitere Instanz gestartet werden, die ihre Daten aus einem Linux Snapshot bezieht. Und diese Instanz kann lesend geöffnet werden! Die Informationen in dieser Instanz sind Konzept bedingt maximal 5 Minuten älter als die Daten der Primärinstanz. Somit eignet sich diese neue Instanz auf der Standby Seite hervorragend für Reportingzwecke und entlastet massiv das Primärsystem! Wer nun an die Oracle Option Active Dataguard denkt, liegt gar nicht so falsch. Nur das die Snapshot Option auch für die Standard Edition 2 von Oracle verfügbar ist! ![](https://support.dbvisit.com/hc/en-us/article_attachments/360002852255/3466437b1a4d47d05154008bf492d60352fa9d20b38afc6279e775981b51dbb4.jpeg)Alternativ kann die Snapshot Option auch zum Testen von aktuellen Daten (in diesem Fall wird die Instanz Read/Write geöffnet) oder für Tests hinsichtlich Versionsupgrade von Oracle verwendet werden. Derzeit ist Snapshot Option nur für Linux verfügbar und ist separat zu lizenzieren. Der Preis der Option ist niedriger als der der Lizenz für den Betrieb eines Standard Dbvisit Standby Systems. Mit dieser Option ist es erstmals möglich, die Standby Maschine sinnvoll zu nutzen. Ein weiteres Alleinstellungsmerkmal einer Hochverfügbarkeitslösung gegenüber einem Active/Passive Cluster. Hut ab zu dieser genialen Idee! Danke an das Dbvisit Team! **Kategorien:** Cloud **Schlagwörter:** Hochverfügbarkeit, reporting --- ### ["žOrchestrator"œ: IT-Paradigmenwechsel im Zeitalter des Cloud Computing](https://thecattlecrew.net/2013/11/25/orchestrator-it-paradigmenwechsel-im-zeitalter-des-cloud-computing/) **Published:** November 25, 2013 **Author:** Mohammad Esad-Djou **Content:** Es gab am 6. Juni in Mainz den DOAG 2013 IMC Summit, unter dem Motto „Infrastruktur meets Middleware“. Ich habe dort einen Vortrag über ***„Orchestrator“: IT-Paradigmenwechsel im Zeitalter des Cloud Computing*** gehalten, das ich als eine Erweiterung des „DevOps“-Konzepts betrachte. Hier finden Sie mein Abstract und meine Präsentation: Orchestration ist eine riesige Symphonie verschiedenster Komponenten im IT-Bereich. Der „Orchestrator“ ist daher mehr als nur ein klassischer Administrator. Er ist eine neue Generation von Experten im Zeitalter des Cloud Computing, der veränderten Herausforderungen in einer verteilten, heterogenen und noch mehr komplexen IT-Welt gegenüber steht. In diesem Vortrag wird gezeigt, dass allein die traditionellen IT-Ansätze und Maßnahmen nicht ausreichen, um neue technische aber auch organisatorische Fragen im IT-Bereich zu beantworten. Obwohl Experten von unterschiedlichen Perspektiven das Problem aus betrachten können, erreichen sie meistens eine gemeinsame Lösung: Orchestration! Themen wie (HW und SW) Virtualization, Cloud Computing, SOA, etc. aber auch die Infrastruktur sind vom IT-Paradigmenwechsel betroffen. Nach einer kurzen Einführung in die Problematik werden verschiedene Lösungsansätze vorgestellt. Ein besonderer Fokus wird dabei auf die Herausforderungen und Solutions gelegt, welche sich aus der Sicht der IT-Infrastruktur ergeben. Link zu meiner Präsentation: http://modj.org/wp-content/uploads/2018/09/Mohammad\_Esad-Djou\_Orchestrator\_V1.pdf **Kategorien:** Cloud **Schlagwörter:** cloud, Conference --- ### [Cloud Integration statt Anwendungs-Chaos](https://thecattlecrew.net/2015/10/23/cloud-integration-statt-anwendungs-chaos/) **Published:** Oktober 23, 2015 **Author:** Torsten Winterberg **Content:** [![cloud-campaign](https://thecattlecrew.net/wp-content/uploads/2015/10/cloud-campaign.jpg?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/10/cloud-campaign.jpg) Die IT eines Unternehmens wächst mit dessen Bedürfnissen, nicht nach einem Masterplan. Klar, dass dann irgendwann jeder Unternehmensbereich mit eigenen, speziellen Anwendungen arbeitet „“ von lokalen Business-Applikationen bis zur SaaS-Lösung in der Cloud. Probleme entstehen dann, wenn der Austausch zwischen all den Systemen nicht reibungslos läuft: das kostet unnötig Zeit, Nerven und Geld. Viele Firmen nutzen bereits Integrationsplattformen als Schnittstellen zwischen einzelnen Systemen. Aber kann eine solche verzweigte Integrationslandschaft in Sachen Datenvolumen und Dynamik mit den neusten Entwicklungen mithalten? Wie Sie sich den Überblick zurückholen, ihre Prozesse optimieren und bei der Integration wieder auf eigenen Beinen stehen können „“ darüber informiert Opitz Consulting ganz aktuell unter www.auf-eigenen-beinen.de. Neben einem Überblick zu möglichen cloud-basierten Integrationslösungen, zum Beispiel zur Oracle SOA-Suite, haben Sie dort auch die Möglichkeit, einen individuellen Beratungstermin mit den Integrations-Experten von Opitz zu vereinbaren. Ein kleiner Schritt für Ihre IT-Fachleute „“ vielleicht aber ein großer für Ihr Unternehmen! http://bit.ly/auf-eigenen-beinen **Kategorien:** Cloud, Integration **Schlagwörter:** cloud, Cloud Computing, German, Integration, News --- ### [Introducing the Oracle IoT Cloud - Part I: Overview](https://thecattlecrew.net/2015/12/06/introducing-the-oracle-iot-cloud-part-i-overview/) **Published:** Dezember 6, 2015 **Author:** Attila Nemeth **Content:** Oracle released its newest cloud product, the Oracle Internet of Things (IoT) Cloud Service, a couple of days ago. We have shared our experience with the product at the DOAG 2015 conference ([https://www.doag.org/formes/servlet/DocNavi?action=getFile&did=7522146&key=](https://www.doag.org/formes/servlet/DocNavi?action=getFile&did=7522146&key=)) where we have also shown a showcase demonstrating the capabilities of the IoT Cloud Service. With this article we are starting a series of posts showing some key aspects of the product. First of all, a brief introduction: what is IoT and what does the Oracle IoT Cloud Service provide? More than a year has passed since we have built our first IoT demo. The article gives a good overview about what the Internet of Things is, how the architecture can be set up, etc. The retrospective at the end of our pilot project back then () shows the key aspects for a successful adoption. The high level view of the Oracle IoT Cloud Service is shown in the picture below. [![oracle_iot_cloud_architecture](https://thecattlecrew.net/wp-content/uploads/2015/11/oracle_iot_cloud_architecture.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/11/oracle_iot_cloud_architecture.png) Data from „things“ – devices somewhere around the world – is sent to the Oracle IoT Cloud Service. This can be a direct connection if the device supports it or an indirect one in which case the device communicates with a gateway (possibly even over a proprietary protocol) and the gateway forwards the data to the IoT Cloud Service. All these devices and their connections are managed by the product. Metadata attributes like device category or location can be added to devices to help find devices quickly (for example to locate a faulty device). Data sent to the cloud can be either forwarded directly to backend systems (which can be either in the cloud or on premise) or it can be analysed in the cloud and the result of the analysis can be forwarded to other systems – for example to a BI System for producing more detailed reports or to an ERP system to keep track of the assets. Thus the concept of Oracle with the IoT Cloud Service capsules all the key aspects we have identified during the pilot project (see the aspects in the retrospective post above): - *Communication takes more than one way*: with the help of gateways, any protocol can be made „cloud-compatible“ and all messages can be processed in the Oracle IoT Cloud. - *Thing data can be diverse*: with the help of analysis capabilities in the product, a common view can be created from different data formats (even data from multiple devices with multiple data formats can be joined). - *Event Processing can help keep complexity to a minimum*: event processing is a core concept in the product – starting from gateways capable of filtering/aggregating data locally to the powerful analysis capabilities of the Oracle IoT Cloud Service. - *Device Management is essential*: device management is fully supported by the Oracle IoT Cloud Service, analysed data can be enriched by the product (for example adding device metadata like location data). - *Known concepts can be applied*: the Oracle IoT Cloud Service is built on top of established standards and is made up internally of proven Oracle products. In the following posts we are going to dive deeper into the product and cover the topics device management, analysis of data, forwarding data to enterprise systems as well as give some guidance about the interfaces of the Oracle IoT Cloud Service and the ways devices or enterprise systems can interact with them. [>> Next part of the series: Device management](https://thecattlecrew.wordpress.com/2015/12/09/introducing-the-oracle-iot-cloud-part-ii-device-management/) **Kategorien:** Cloud, Integration **Schlagwörter:** cloud, English, IoT, Oracle IoT Cloud --- ### [Introducing the Oracle IoT Cloud - Part II: Device management](https://thecattlecrew.net/2015/12/09/introducing-the-oracle-iot-cloud-part-ii-device-management/) **Published:** Dezember 9, 2015 **Author:** Attila Nemeth **Content:** The first step in using the Oracle IoT Cloud Service is registering the devices sending the raw data. There are two categories of devices: - *Directly connected devices* are devices with a direct connection to the internet and thus to the IoT Cloud servers. These devices are capable of directly sending the data to the cloud. - *Gateways* are devices which collect (and maybe even filter) data from other devices – for example because those devices are not able to communicate over the internet – and forward the data they receive to the cloud. Registering a new device using the user interface is pretty straight-forward: you use the menu *Registration* on the tab *Devices*. First of all, single device or batch registration must be chosen. [![iot_cloud_register_1](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_1.png)Batch registration is useful if a large amount of devices is to be registered at once – for example if you have a list of vending machines you own with their attributes and you want to register them all – we will come to this point later. For now, lets consider a single device registration. [![iot_cloud_register_2](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_2.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_2.png)The next step is to decide whether the newly connected device is a directly connected device or a gateway (see the explanation above). Regardless of your choise the further steps are identical. [![iot_cloud_register_3](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_3.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_3.png)Next comes the configuration screen where you can enter all the details of the device. The fields are self-explanatory, therefore I will only highlight two important fields: - *Name* is the name of the device under which it can later be found in the list for devices. Although it is not required it is good idea to keep the names unique for easy filtering of devices. - *Shared secret* is basically the password used for initial authentication of the device. The device must first connect to the IoT Cloud Service using this password. Having successfully connected once, the device will receive a private key. This key should be stored at a safe location on the device and can be then used to start further authentication requests. [![iot_cloud_register_4](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_4.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_4.png)Having filled out all the fields, the last screen comes up. A unique ID is automatically assigned to the device, the device must use this ID for starting authentication requests (this ID basically serves as the user name). The newly configured device can now be found in the *Management* menu. This is the menu where all the registered devices can be monitored. The most important properties are state and connectivity status. Connectivity status tells you if the device is online (sending at least ping messages to the IoT Cloud) or not. State is used for device activation. [![iot_cloud_register_5](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_5.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_register_5.png)The newly configured device is currently in the state *Registered*. At this point, all of the device properties can still be edited. Having successfully connected the device to the IoT Cloud Service once, its state will move to *Activated*. From now on, the shared secret of the device cannot be modified (all other properties can still be edited). The messages sent by the device can now be live found in the menu *Messages* on the tab *Data*. [![iot_cloud_messages](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_messages.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_cloud_messages.png)Note that each message must contain a unique format identifier, this identifier describes the payload structure. These identifiers must be registered with the IoT Cloud – this can be done by selecting a message with the given format and clicking on the button *Register Message Format*. By clicking the button, the payload structure is automatically analysed. If this step is omitted, the messages are received by the IoT Cloud but cannot be be further processed (neither analysed, nor forwarded to other systems). A message format is of course not unique to a device, multiple devices may send messages with the same format. In this case, the format must be registered only once. We have shown a single device can be registered using the user interface. The wizard guides the registration process nicely but its usage is still cumbersome if you have a lot of devices to register. In this case the batch registration can be used. Here you have to upload a CSV file containing the device data row by row. The fields each row must contain from left to right are: - Device name - Device type (Gateway = GWAY, Directly connected device = DDVC) - Manufacturer - Model number - Serial number - Device id - Share secret Please note that while using batch registration, the device id is not assigned automatically, you have to guarantee that the ids you assign are unique. Having registered devices with the IoT Cloud Service and received the first data packets, the next step is to analyse/filter these and forward the analysis results (or even the raw data) to external systems. These aspects will be covered in the next part. [<< Previous part of the series: Overview](https://thecattlecrew.wordpress.com/2015/12/06/introducing-the-oracle-iot-cloud-part-i-overview/) [>> Next part of the series: Analysing data](https://thecattlecrew.wordpress.com/2015/12/12/introducing-the-oracle-iot-cloud-part-iii-analysing-data/) **Kategorien:** Cloud, Integration **Schlagwörter:** cloud, English, IoT, Oracle IoT Cloud --- ### [Introducing the Oracle IoT Cloud "“ Part III: Analysing data](https://thecattlecrew.net/2015/12/12/introducing-the-oracle-iot-cloud-part-iii-analysing-data/) **Published:** Dezember 12, 2015 **Author:** Attila Nemeth **Content:** Raw data collected from devices is in most cases not directly relevant for further processing. Data must be analysed and the results are interesting for external systems. Lets take a vehicle for example. The engine temperature can be monitored and will vary some. We are only interested in the temperature if it is nearing critical values, that is, we can filter the data and only forward data packets to external systems where the temperature reading is higher than the threshold we have set. A more complex example can be monitoring fuel consumption. Here we are not interested in the raw data at all but in the average fuel consumption (l / 100 km) per day. We must aggregate the raw values for a day and only forward the aggregated results to the external system. If we also apply a filter we can also achieve that only days with a high fuel consumption are forwarded and need to be processed further. The component in the Oracle IoT Cloud Service making the analysis possible is called Stream Explorer. Two different type of objects are of primary interest to us: - A **stream** is the continuous flow of the raw data packets coming into the IoT Cloud. - An **exploration** is the filtering / grouping / joining of other objects. Source objects can be streams or other explorations and the result is a continuous flow itself As you can see, analysis results can be chained and each (even intermediary) result can be used for multiple purposes. You can view the streams you have defined in the *Analytics* menu on the tab *Data* in the user interface of the IoT Cloud. [![iot_analysis_1](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_analysis_1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_analysis_1.png) There are two lists here: - *Device Data and Alerts for Analysis* shows the streams you have configured. - *Analyzed Data* shows the explorations you have created and published (more on publishing an exploration later). Note that by default the data received by the IoT Cloud is not forwarded to Stream Explorer (no stream is active). [![iot_analysis_2](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_analysis_2.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_analysis_2.png) You can easily create the streams which are interesting for analysis using the user interface. A stream is always constructed from messages with a common message format. Please note that metadata information like the location of the device can also be added (either to use for analysis or just to have this information in the result of the exploration). Once the required streams are set up, the explorations can be configured with Stream Explorer. Stream Explorer is part of the IoT Cloud Service and can also be directly accessed from the IoT Cloud UI by selecting the *View* button of one of the streams. The exploration configuration screen is shown below. [![iot_stream_explorer](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_stream_explorer.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_stream_explorer.png) - In the middle of the screen the live output data is shown. At the beginning, this is equal to the input data. If the input stream is active and producing data the result of the configuration can be immediately seen here. - On the right-hand sing above the table with the live data the properties can be configured. Here columns can be selected/deselected to be included in the output. - In the upper section on the top the sources can be found. You can add multiple sources here. The source selected while creating the exploration is prefilled. - In the *Filters* section filters can be configured. In the example, if you only want to output events where the amount is more than 1000, you can configure that here. Filters can only be applied to the input data but the comparison can be done not only against a fix value but also against another input field (for example temperature greater than threshold if both values are sent by the device). Multiple filters can be joined together either by AND or by OR. - The *Summaries* section makes aggregations possible. Here you can select aggregate functions (MAX, MIN, AVG, COUNT, etc.) based on input columns to generate virtual output columns. Filters can also be applied to these newly created columns. - The aggregate functions only make sense if a time period is set up for aggregation. This can be done with the clock symbol on the right side of the sources. For each source the range can be selected here. The range can be anything from no aggregation (default) to unbounded (maximum possible aggregation). Having completed the exploration, its result can be inspected with the help of the live data browser. Is the result equal to what you would the exploration can be published (using the *Actions* menu). Published explorations appear in the IoT Cloud UI and can be set up for transfer to external systems. Editing a published exploration creates a draft version of it, leaving the published version ontouched and running. Only if you are satisfied with the draft version and publish it will the published version change. In the next part we will show you how to do all these operations from the API of the IoT Cloud Service. Having the analysis results and the raw data you require these need to be forwarded to external systems which can automatically react to certain situations like a BPM system starting a process where a technician can be sent to fix a faulty device. These aspects will be covered in the part after that. [<< Previous post in the series: Device management](https://thecattlecrew.wordpress.com/2015/12/09/introducing-the-oracle-iot-cloud-part-ii-device-management/) [>> Next post in the series: The REST API](https://thecattlecrew.wordpress.com/2015/12/15/introducing-the-oracle-iot-cloud-part-iv-the-rest-api/) **Kategorien:** Cloud, Integration **Schlagwörter:** cloud, English, IoT, Oracle IoT Cloud --- ### [Introducing the Oracle IoT Cloud "“ Part V: Forwarding data to external systems](https://thecattlecrew.net/2015/12/17/introducing-the-oracle-iot-cloud-part-v-forwarding-data-to-external-systems/) **Published:** Dezember 17, 2015 **Author:** Attila Nemeth **Content:** Having collected the data from devices and filtered/aggregated them as required, the results must be forwarded to external systems which can automatically react to certain situations. For this purpose, the Oracle IoT Cloud Service allows the registration of enterprise systems. These can be configured to receive messages from the IoT cloud, but can also use the operations provided by the devices registered in the cloud. Lets stay at the vehicle example: the engine temperature can be monitored and if it is nearing critical values, a BPM system can be notified. The process started can include multiple steps for checking the current situation and depending on the result the BPM process can notify the engine controller to limit the engine perfomance so that the engine does not overheat. Enterprise applications can be configured in the menu *Integration*. These are applications you control, they can be either in the cloud or on premise, they must only provide a URL where REST messages can be sent to. [![iot_enterprise_app_1](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_enterprise_app_1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_enterprise_app_1.png) For the configuration of an enterprise application only the name and the connection URL is required. The connection can also be secured, meaning that the IoT cloud will authenticate itself against the enterprise application. [![iot_enterprise_app_2](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_enterprise_app_2.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_enterprise_app_2.png) Once the registration is complete, the enterprise application is assigned an ID and a secret. The application can use this data to authenticate itself against the IoT cloud (the authentication works just like in case of devices, for authentication details see [device management](https://thecattlecrew.wordpress.com/2015/12/09/introducing-the-oracle-iot-cloud-part-ii-device-management/)). Having authenticated itself, the application can call operations provided by devices registered with the IoT cloud. [![iot_enterprise_app_3](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_enterprise_app_3.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_enterprise_app_3.png) In the menu *Streams* you can configure which streams or explorations should be forwarded to the enterprise application. Having configured these, the *Messages* menu shows the messages which are really sent to the application. Please note that the application must acknowledge this data with an HTTP return code 200, otherwise the IoT cloud will mark the endpoint as failed and will not forward messages to the endpoint for a couple of seconds. Apart from configuring enterprise applications, data can also be sent to the Oracle BI Cloud Service. Generally this is a good idea because this way analysis can be made on data accumulated over a longer period of time (the IoT cloud is not meant to store the data for years). [![iot_bi_cloud](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_bi_cloud.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/iot_bi_cloud.png) Having registered a BI cloud instance, the *Integration* menu can be used to configure the connection between the IoT cloud and the BI cloud. Simply enter the details you have received from Oracle while signing up for the instance. Streams or explorations can then be added. For each stream or exploration you must enter the name of the database table in BI cloud where the data will be stored. The table will be generated at the first synchronisation automatically. Note that messages from configured streams and explorations are not automatically sent to the BI cloud (contrary to the integration of enterprise applications). The synchronisation has to be started manually by pushing the button in the UI. All messages gathered by the IoT cloud since the last synchronisation fulfilling the configuration of the BI cloud instance will be then pushed to the BI cloud. [![bi_cloud_import](https://thecattlecrew.net/wp-content/uploads/2015/12/bi_cloud_import.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/12/bi_cloud_import.png) The data is pushed to the configured table. As mentioned above, the table is automatically generated if it does not exist. We have shown how to gather data from devices, analyse it and forward the analysis results to external systems. Next, we will show you how to implement the communication with the IoT cloud – both from a device as well as from an enterprise application. [<< Previous post in the series: The REST API](https://thecattlecrew.wordpress.com/2015/12/15/introducing-the-oracle-iot-cloud-part-iv-the-rest-api/) **Kategorien:** Cloud, Integration **Schlagwörter:** cloud, English, IoT, Oracle IoT Cloud --- ### [Was ist der OC Innovationsworkshop?](https://thecattlecrew.net/2016/01/05/was-ist-der-oc-innovationsworkshop/) **Published:** Januar 5, 2016 **Author:** Dominik Bial **Content:** Zwei Szenarien: 1. Ihr Geschäftsmodell bricht zusammen, andere haben technologische Innovationen genutzt. Sie gehen pleite. 2. Es herrscht Goldgräberstimmung: Sie brauchen nur eine IoT-/Industrie-4.0-Kampagne aufzusetzen und verdrängen damit spielend Ihre Mitbewerber. Ihr Kurs steht auf Verdrängung und Wachstum. Damit es zu Szenario 1) nicht kommt und um zu verstehen, was mit Szenario 2) für Sie und Ihr Unternehmen möglich ist, lesen Sie hier weiter, wie unser eintägiger Innovationsworkshop neue Möglichkeiten generieren kann. [![OC_Innovationsworkshop](https://thecattlecrew.net/wp-content/uploads/2016/01/oc_innovationsworkshop.png?w=211)](https://thecattlecrew.net/wp-content/uploads/2016/01/oc_innovationsworkshop.png)Das Internet der Dinge (Internet of Things, IoT) ist Treiber und Enabler für neue und digitale Geschäftsmodelle. Klassische Geschäftsmodelle und damit auch die Unternehmen, die an jenen Modellen festhalten, geraten zunehmend durch neue IT-Trends und Technologien unter Druck. **Beispiel 1:** Die Nutzung klassischer Enzyklopädien in Buchform nimmt immer weiter ab. Informationen stehen meist digital zur Verfügung, sodass diese ein schnelleres und zielgerichteteres Suchen ermöglichen. **Beispiel 2:** Car Sharing und Fahrradvermietstationen fordern die klassischen, Shop-basierten Modelle heraus, da die neuen Angebote für den Endkunden flexibler zu nutzen sind und keine Geschäftszeiten eingehalten werden müssen. Selbst große Domänen wie Logistik, Energie oder Produktion müssen sich dem Wandel stellen. Klassische Vertriebswege und Absatzmärkte brechen ein. Gleichzeitig bietet dies Potenzial dafür, sich mittels einer Anpassung des Geschäftsmodells auf dem Markt neu zu positionieren. Bei diesen neuen Ansätzen stehen immer Informationen im Vordergrund. Entweder sind diese schneller verfügbar, sodass sich anders agieren lässt, oder die Informationen ermöglichen kürzere Vertriebswege. Der OC Innovationsworkshop ist ein eintägiges Workshop-Format, bei dem unter Anleitung unserer Moderatoren und mithilfe von Kreativitätstechniken Potenziale für neue Geschäftsmodelle entwickelt werden. In möglichst gemischten Gruppen werden Ideen verfolgt, dokumentiert und weiter ausgearbeitet, sodass am Ende des Tages mehrere Skizzen für Geschäftsmodelle zur Verfügung stehen, die weiter verfolgt werden können. > „Wir haben den Workshop genutzt, um Mitarbeiter aus unterschiedlichen Bereichen über IoT sprechen zu lassen und gemeinsam neue Ideen zu finden. Die methodische Gestaltung des Workshoptages hat uns sehr gut geführt, auch wenn das Timeboxing anstrengend war. Das Engagement und Interesse der Mitarbeiter ist dadurch deutlich gestiegen. Eine der in einem dieser Workshops generierten Ideen wird bereits in einem PoC umgesetzt.“ > *Thomas Z.; Enterprise IT in einem weltweit agierenden Unternehmen aus Deutschland* Weitere Informationen finden Sie in unserem [Fact Sheet](http://www.opitz-consulting.com/fileadmin/redaktion/veroeffentlichungen/factsheet/59-factsheet-iot-workshop_sicher.pdf). **Kategorien:** Tools & Methoden **Schlagwörter:** Analytics, Cloud Computing, German, IoT --- ### [Was Sie über die Oracle Public Cloud Machine wissen müssen](https://thecattlecrew.net/2016/05/10/was-sie-ueber-die-oracle-public-cloud-machine-wissen-muessen/) **Published:** Mai 10, 2016 **Author:** Neselovskyi, Borys **Content:** *In diesem Beitrag stelle ich die Features der Oracle Cloud Machine von Oracle vor und betrachte sie hinsichtlich wichtiger Fragen, die Unternehmen im Vorfeld bewegen.* ## Public Cloud: Vorteile und Probleme Die Cloud-Technologie ist heute nicht mehr wegzudenken. Viele Unternehmen nutzen bereits Public Cloud Dienste oder betreiben einige Teile ihrer Infrastruktur in der Cloud. Oracle bietet eine Reihe von Cloud Services für seine Kunden an. Man kann die gesamte Infrastruktur (IaaS) oder nur die Datenbank (DaaS) in der Cloud betreiben. Oder man hostet eigene Java- bzw. SOA-Anwendungen in der Java bzw. SOA Cloud. Die Verwaltung und den Austausch von Dokumenten kann man bequem in der Document Cloud durchführen. Die großen Datenmengen können z. B. in der Oracle Big Data Cloud manipuliert (analysiert, archiviert und administriert) werden. Das Angebot von Cloud-Lösungen ist also bereits jetzt sehr breit und wird ständig ausgeweitet. Die Vorteile der Cloud sind offensichtlich: Unternehmen können ihre gesamte Infrastruktur in der Cloud betreiben lassen und sich auf ihr Kerngeschäft konzentrieren. Einige Probleme und offene Fragen machen den Umzug in die Public Cloud für viele Unternehmen allerdings noch sehr schwierig bis fast unmöglich. Fragen wie „Sind sensible Firmendaten in der Cloud sicher?“, „Wie funktioniert das Zusammenspiel zwischen Cloud- und On-Premise-Komponenten?“ oder „Wer ist für die Performance und Sicherheit in hybriden Umgebungen verantwortlich?“ können momentan nur sehr schwer und unvollständig beantwortet werden. ## Einsatzgebiet der Oracle Public Cloud Machine Viele Firmen würden gerne die Cloud Angeboten nutzen, die Daten aber lieber in einem eigenen Rechenzentrum aufbewahren. Genau für diese Anforderungen hat Oracle vor kurzem die Oracle Public Cloud Machine auf den Markt gebracht. Die neue Maschine wird im Kundenrechenzentrum integriert, was dem Endbenutzer den Zugriff auf alle Oracle Cloud Dienste ermöglicht. Man kann sie als Infrastruktur as a Service oder als Platform as a Service betreiben. Oder man baut eine SOA bzw. Java (WebLogic) Anwendung in der Cloud. Die Maschine steht dabei aber nicht „irgendwo“, sondern beim Kunden On-Premise. Diese Lösung hat folgende Vorteile: - Die Cloud Machine wird in die Sicherheitsinfrastruktur des Unternehmens integriert. - Die Netzwerklatenz ist sehr gering, da die Maschine im internen Netzwerk betrieben wird \[Quelle 2\]. - Einige Firmen bzw. Behörden dürfen keine Daten in der Public Cloud ablegen \[Quelle 2\]. - Man kann die Cloud Services zuerst ohne Zeitdruck in der Cloud Machine ausprobieren, bevor man die Migration in die Public Cloud macht. - Man kann die Anwendungen zwischen der Cloud Machine und der Public Cloud verschieben. - Es ist auch die Kombination von der Public Cloud und der Cloud Machine denkbar. Zum Beispiel werden die Anwendung On-Premise (auf der Cloud Machine) und der Webserver in der Public Cloud betrieben. ## Technische Informationen Die Oracle Public Cloud Machine kann man in drei Varianten bestellen: - Das „Modell 1080“ wird mit 1080 OCPU \[Quelle 3\] und 7,5 TB RAM ausgeliefert - Das „Modell 576“ stellt mit 576 OCPU \[Quelle 3\] und 4 TB RAM eine kleinere Variante dar. - Und die kleinste Machine „Modell 288“ ist mit 288 OCPU \[Quelle 3\] sowie 2 TB RAM ausgestattet. ## Support und Wartung Die Mitarbeiter der Abteilung Oracle Cloud Operations übernehmen den Support und die Wartung der Public Cloud Machine. Zu ihren Tätigkeiten zählen die erste Installation und Konfiguration und das regelmäßige Patchen der Machine, Auch die Überwachung und das Handling von Incidents sowie Change Management (nach ITIL) gehören zum Service-Angebot. ## Was kann man auf der Public Cloud Machine betreiben? Momentan können folgende Cloud Dienste auf der Machine genutzt werden \[Quelle 1\]: - Java Cloud Service (beinhaltet den WebLogic Server und Loadbalancer/ Traffic Director) - Integration Cloud ServiceGeplant sind die weiteren Dienste \[Quelle 1\]: - Database Cloud Service - Messaging Cloud Service - Application Container Cloud Service ## Quellen: \[1\] Oracle Public Cloud Machine Data Sheet: http://www.oracle.com/us/solutions/cloud/oracle-cloud-machine-ds-2949541.pdf \[2\] White Paper: Oracle Cloud Machine Delivers the Cloud in Your Data Center: http://www.oracle.com/us/solutions/cloud/cloud-in-your-data-center-wp-2949557.pdf \[3\] OCPU „“ Erklärung (https://cloud.oracle.com/compute?tabname=PricingInfo): *An OCPU provides CPU capacity equivalent of one physical core of an Intel Xeon processor with hyper threading enabled. Each OCPU corresponds to two hardware execution threads, known as vCPUs.* **Kategorien:** Cloud **Schlagwörter:** cloud, Cloud Computing, Integration, MSA, ON-Premise, oracle, Oracle Cloud, Oracle Engineered Systems --- ### [FredBet "“ Ein Tippspiel auf dem Weg in die Cloud](https://thecattlecrew.net/2016/06/09/fredbet-ein-tippspiel-auf-dem-weg-in-die-cloud/) **Published:** Juni 9, 2016 **Author:** Michael Stähler **Content:** Nur noch ein Tag und die Fußball-Europameisterschaft öffnet ihre Tore in Frankreich. Wenn auch nur alle zwei bzw. vier Jahre (EM bzw. WM), so ist das gemeinsame Wetteifern unter Freunden und Kollegen ein großer Spaß. Mit Bier und Grillwurst bewaffnet fiebert man dem Weiterkommen der deutschen Mannschaft bis zum Schlusspfiff entgegen. Um dem Wetteifern noch mehr Nachdruck zu verleihen fehlt es nur noch an einem kleinen Tippspiel, bei dem man seine Kenntnisse über die vermeintlich bessere Mannschaft unter Beweis stellen kann. Der Artikel [FredBet „“ Ein Tippspiel auf dem Weg in die Cloud](http://opitzconsulting.github.io/2016/05/30/fredbet-cloud/) beschreibt, wie das für die Fußball-Europameisterschaft 2016 entstandene Tippspiel entstanden ist und in der Docker Cloud betrieben werden kann. **Kategorien:** Cloud, Development **Schlagwörter:** cloud, Cloud Computing, Java, Softwarenentwicklung, Web Developement --- ### [Designing the digital enterprise: Cloud2On-Prem integrations using Oracle ICS](https://thecattlecrew.net/2016/09/22/designing-the-digital-enterprise-cloud2on-prem-integrations-using-oracle-ics/) **Published:** September 22, 2016 **Author:** Sven Bernhardt **Kategorien:** Cloud, Integration **Schlagwörter:** oracle --- ### [OTN Appreciation Day : Integration Cloud Service (ICS) On-Premises Connectivity Agent](https://thecattlecrew.net/2016/10/11/otn-appreciation-day-integration-cloud-service-ics-on-premises-connectivity-agent/) **Published:** Oktober 11, 2016 **Author:** Sven Bernhardt **Content:** My favourite feature in Oracle ICS. #ThanksOTN **Kategorien:** Cloud, Integration --- ### [Conversational UI: Wenn ein Bot "Erste Hilfe" leistet](https://thecattlecrew.net/2016/12/03/conversational-ui-wenn-ein-bot-erste-hilfe-leistet/) **Published:** Dezember 3, 2016 **Author:** Christian Ochsenkühn **Content:** **User Story** User Stories beschreiben fiktive Ideen und Umsetzungsmöglichkeiten zu Zukunfts- und Hype-Themen. Sie sollen diese Themen greifbarer machen um reale Anwendungsfälle daraus generieren zu können. Die Nachtschicht hat kaum 30 Minuten begonnen, und schon streikt die Maschine wieder. Sven ist genervt. Tagsüber würde er einfach zu seinem Vorgesetzten oder zum Experten für die Maschine gehen. Nachts geht das nicht, da sind nur wenige hier. Er kennt das Problem ja eigentlich. Vor einem halben Jahr haben die selben Lichter geblinkt. Aber ihm fällt partout nicht ein, wie es damals gelöst wurde. Das bedeutet dann wohl mal wieder: Stillstand. Dieser Zustand ist der Firma, in der Sven arbeitet, schon länger ein Dorn im Auge. So ein Stillstand kostet bares Geld. Einen speziell ausgebildeten Mitarbeiter die ganze Nachschicht dort abzustellen, ist aber auch zu teuer. Eine andere Lösung muss her. ## Bob der Bot – ein selbstlernendes FAQ Svens Firma hat heute eine Lösung für das Problem gefunden, genauer gesagt eine Software-Lösung. Mittlerweile leistet in solch einem Problemfall ein Bot „Erste Hilfe“. Tritt also ein Problem auf, so wendet sich der entsprechende Mitarbeiter über einen Bildschirm per Texteingabe an diese Anwendung. „Bob der Bot“ ist eine selbstlernende FAQ-Anwendung, die über einen Grundbestand an Wissen zu den Maschinen verfügt und daher weiß, welche Fragen er stellen muss, damit dem Mitarbeiter geholfen wird. Jedes gelöste Problem hilft aber nicht nur in diesem direkten Fall, sondern nutzt dem Bot auch für weiteres Lernen. Denn konnte der Mitarbeiter eine Lösung finden, so teilt er dem System mit, ob die (bzw. welche) Vorschläge ihm dabei geholfen haben. Hat ein Vorschlag den Mitarbeiter auf die richtige Idee gebracht, und er hat aber noch andere oder zusätzliche Schritte ausführen müssen, so soll er das dem Bot ebenfalls mitteilen. Und zwar in natürlicher Sprache. ## Natürliche Interaktion via Conversational UI ``` Bob der Bot: Konntest du das Problem mit Maschine 3b durch einen meiner genannten Vorschläge lösen? 1) Vorschlag 1: ... 2) Vorschlag 2: ... 3) Vorschlag 3: ... Du (XYZ): Ja, Vorschlag 2 hat mir geholfen. Ich musste aber noch das kleine Bauteil R austauschen. Bob der Bot: Schön, dass es geklappt hat und vielen Dank für die Info. ``` Wie man sieht, soll die Interaktion mit dem Bot möglichst natürlich erscheinen. Er bedient sich dazu vorgefertigter Phrasen und kann Antworten des eingebenden Nutzers interpretieren und die Informationen daraus weiter verwerten. In Zukunft sollen außerdem Lautsprecher und Mikrofone zum Einsatz kommen, damit die Mitarbeiter mit dem Bot gleich per Spracheingabe interagieren können. Hier wird momentan noch mit diversen Technologien experimentiert. ## Zufriedene Mitarbeiter, zufriedene Firma Interessanterweise wurden durch den Bot aber auch die tagsüber agierenden Vorgesetzten und Experten entlastet, da sich die Mitarbeiter an den Maschinen bei Problemen auch hier zunächst an den Bot wenden. Auch Sven ist froh über seinen neuen „Kollegen“ Bob. Denn der Bot merkt sich wirklich alles und kann ihm nicht nur mit seinen eigenen Erfahrungen, sondern auch mit den Erfahrungen der anderen Mitarbeiter dienen. **Kategorien:** AI & Data Science **Schlagwörter:** #OCVoicePioneers, Artificial Intelligence, Bot, Conversational UI, German, Modern Clients, Smart --- ### [Buchempfehlung: Silicon Germany - Wie wir die digitale Transformation schaffen](https://thecattlecrew.net/2017/01/02/buchempfehlung-silicon-germany-wie-wir-die-digitale-transformation-schaffen/) **Published:** Januar 2, 2017 **Author:** Torsten Winterberg **Content:** Christoph Keese hat mit seinem aktuellen Buch „Silicon Germany – Wie wir die digitale Transformation schaffen“ eine wunderbare Zusammenfassung zum Status Quo bzgl. der Digitalisierung in Deutschland verfasst.Wunderbar deshalb, weil sich das Buch zum einen sehr angenehm lesen lässt – der Schreibstil ist doch deutlich wahrnehmbar weit entfernt vom klassischen, eher trockenen IT-Buch. Aber um IT geht es auch nur auf hohem Level. Wunderbar zum anderen, weil nicht wilde Thesen oder Behauptungen aus der Luft gegriffen werden, wie das so häufig bei Büchern zu digitaler Transformation der Fall ist, weil immer irgendjemand seine Marketingbotschaften und damit letztlich Werbung für das eigene Geschäft unterbringen möchte. Keese analysiert ganz sauber und vor allem aus Sicht von Deutschland (!), nicht aus Sicht einer einzelnen Firma, was passieren müßte, um uns als Land nach vorne zu bringen. ![keese](https://thecattlecrew.net/wp-content/uploads/2017/01/keese.jpg) Gleich zu Beginn wird die Absicht in aller Deutlichkeit offen angesprochen: Wenn Deutschland nichts tut, sich nicht öffnet für die Digitalisierung, dann laufen wir Gefahr, vom Land der Hochtechnologie abzurutschen und ein zweites Shenzhen zu werden. Aber Moment: wäre das wirklich die schlimmste Option? Die Sonderwirtschaftzone vor Hongkong ist ein unglaublicher Erfolg! Wir dürfen uns also glücklich schätzen, wenn wir „nur“ auf das Niveau eines Shenzhen abrutschen… Die schlechteste Variante wäre, wir bekommen die Kurve gar nicht und dann bleibt nur die Bedeutungslosigkeit. Diesen Gedanken entwickelt Keese durch das Buch hindurch konsequent weiter. Natürlich aus seiner subjektiven Sicht. Aber, so hat man zumindest das Gefühl beim Lesen, extrem sauber recherchiert. Aus einem Gedanken wird eine These. Auf die These folgt: Eine Validierung mit einem oder mehreren Gesprächspartnern aus unterschiedlichen Kontexten. So wird etwa das Bosch Digitalisierungs-Flagship, der Indigo Connect Rasenmäher, als Beispiel für deutschen Fehlschlag und Verpassen einer Chance im Sinne des Silicon Valley Denkens vorgestellt. Dabei bleibt es nicht bei Gedanken: Die Besuche und Interviews in den entsprechenden Produktionsstätten erläutern sehr genau, was Keese meint, wenn er dieses „Silicon Valley Denken“ fordert. Ausgesprochen interessant, was an Schlussfolgerungen gezogen wird. So wird der Leser bombardiert mit interessanten Ideen – Hunderten! Über das komplette Buch verstreut. Hinzu kommen noch die Berge an Ideen, die in den eigentlichen Ideen-Kapiteln, nach Branchen sortiert, gelistet werden. Sehr inspirierend. Aus dem Inhalt: 4 Gründe, warum es Deutschland schwer hat: 1\) Vernetzung: Wir verbinden Systeme nicht 2\) Produktion: Wir verlassen uns zu sehr auf alte Stärken 3\) Spezialisierung: Wir denken in Fachgebieten und meiden Risiken 4\) Management: Wir belohnen Perfektion und bestrafen Fehler 4 Herausforderungen, mit denen wir umgehen lernen müssen: 1\) Technologie: Durchbrüche revolutionieren die Wirtschaft 2\) Plattformen: Produzenten werden an den Rand gedrängt 3\) Disruption: Alte Märkte kollabieren, neue springen hervor 4\) Geschäftsmodelle: Das Wie entscheidet über den Erfolg Szenarien, wie sich Branchen ändern werden: 1\) Automobil 2\) Banken 3\) Versicherungen 4\) Telekommunikation 5\) Energie 6\) Wohnen 7\) Handel 8\) Logistik 9\) Gesundheit Was Unternehmen tun sollten: 1\) Strategie: In die eigenen Kannibalen investieren 2\) Führung: Vom Anspruch auf Allwissen verabschieden 3\) Innovation: Großes Denken, Neues wagen 4\) Standort: Dorthin gehen, wo Talente sind 5\) Transformation: Kritische Masse durch Lernen schaffen 6\) Integration: Freiheit lassen, nicht erdrosseln 7\) Organisation: Netze flechten und Pyramiden verkleinern Was Politik und Gesellschaft tun sollten: 1\) Regierung: Ein Digitalministerium gründen und Kommunikationsnetze ausbauen 2\) Regulierung: Freiräume für Innovationen schaffen 3\) Finanzierung: 30 Milliarden pro Jahr für Start-ups organisieren 4\) Justiz: Schnell eintragen, kompetent Recht sprechen 5\) Bildung: Wissenschaft stärken, Universitäten reformieren 6\) Werte: Eine Charta der digitalen Rechte und Chancen schreiben Mein Fazit: Extrem gut geschrieben. Eine hervorragende Zusammenfassung der Gedankenwelt um Digitalisierung. Must-read für alle Unternehmer, Architekten und Digitalisierungsberater (und die, die es werden wollen). Christoph Keese: Danke dafür! **Kategorien:** Tools & Methoden **Schlagwörter:** Digital Innovation, Innovation --- ### [Ein Informationsbündel für die Digitalisierung](https://thecattlecrew.net/2017/02/16/ein-informationsbuendel-fuer-die-digitalisierung/) **Published:** Februar 16, 2017 **Author:** Dominik Bial **Content:** Vertriebsgespräche haben den interessanten Nebeneffekt, dass man die eigenen Inhalte reflektiert. Im Anschluss meines letzten Gespräches haben wir eine Auswahl an Materialien zusammengestellt, um eine Übersicht über unsere Expertise darzustellen. Dabei ist die folgende Auswahl entstanden „“ und das ist noch nicht alles! Zu unserem Verständnis der Digitalisierung - [Poster: Die 4 Säulen der Digitalisierung ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_Saeulen-der-Digitalisierung_WEB.pdf) - [Whitepaper: Die 4 Säulen der Digitalisierung ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-die-vier-saeulen-der-digitalisierung_sicher.pdf) Eine Auswahl zu IoT und Cloud - [Mit Retrofitting und Cloud Computing in die Welt der Digitalisierung – Der Einstieg in IoT kann einfach sein!](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/objekt-spektrum-ots-2016-iot_retrofitting_bial-scheuch-winterberg_sicher.pdf) - [Zukunftsworkshop „Cloud Strategie“](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/68-factsheet-cloud-strategie.pdf) - [IoT in der Cloud – Ein Vergleich verschiedener Plattformen](https://www.heise.de/developer/artikel/Dominik-Bial-Frank-Hoppe-IoT-in-der-Cloud-Ein-Vergleich-verschiedener-Plattformen-3492698.html) Rund um Architektur und DevOps: - [Context Aware Frontend Architecture ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-context-aware-frontend-architecture_sicher.pdf) - [DevOps: Hilfe bei der Automatisierung – warum Ansible für DevOps eine gute Wahl ist ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/red-stack-magazin-2016-05_Warum-Ansible-fuer-DevOps-eine-gute-Wahl-ist_Simon-Hahn_sicher.pdf) - [Microservices brauchen ein neues Monitoring ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/business-technology-2016-03_microservices-brauchen-ein-neues-monitoring_fichtner_sicher.pdf) - [Arcitecting for the Internet of Things](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/objekt-spektrum-online-themenspecial-20151112_iot_scheuch-bial_sicher.pdf) Methodisches - [Innovation zum Anfassen: OC|Design Thinking ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/79-factsheet-design-thinking.pdf) - [Changeability: zentraler Baustein der Digitalen Transformation ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/jahrbuch-digitale-transformation-2017_changeability_menne-scheller_sicher.pdf) - [Managing IT Transformation with Enterprise Architecture ](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-it-transformation-with-enterprise-architecture_sicher.pdf) Unser OC|Lab - [OC|Lab](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/75-factsheet-oc-lab.pdf) Überraschend mehr Möglichkeiten:-) **Kategorien:** Cloud **Schlagwörter:** Architecture, Cloud Computing, German, IoT --- ### [Geschichten aus dem OC|Lab: Retrofitting am Beispiel](https://thecattlecrew.net/2017/02/21/geschichten-aus-dem-oclab-retrofitting-am-beispiel/) **Published:** Februar 21, 2017 **Author:** Frank Hoppe **Content:** In loser Folge werden wir hier aus Projekten berichten, die mit Hilfe des OC|Lab umgesetzt wurden. Über Digitalisierung wird derzeit viel gesprochen und geschrieben. Viele scheuen sich aber vor dem Invest, den ein solcher Einstiegt eventuell bedeutet. Vor allem dann, wenn man große Maschinen hat, deren Abschreibungszyklus länger ist. Mit Retrofitting ergibt sich hier aber eine Möglichkeit, bestehende Hardware „smart“ zu machen. Das galt es einmal im realen Leben auszuprobieren. Wir sind also mit der Idee des Retrofittings zu Q-loud (vergleiche älterer Post zu Q-loud) gegangen und haben hier über konkrete Ideen gesprochen. Zur Demonstration der Funktionalitäten der eignen Lösung hat Q-loud eine Maschine, die Würfel aus verschiedenen Unter- und Oberteilen zusammenbaut. Die Steuerung erfolgte über eine Siemens SPS. Die Arbeitsteilung war schnell klar, Q-loud sorgte für eine sichere Bereitstellung der Daten in der Cloud und wir waren für die Auswertung und optische Aufbereitung verantwortlich. So wurden die Daten von der Maschine durch einen zusätzlichen Sensor abgerufen und sofort an die IoT-Cloud von Q-loud gesendet. Auf Basis der dort vorliegenden historischen und aktuellen Daten hat sich das Team aus dem Lab überlegt, zwei Dashboards zu bauen: eines für das Management und eines für die Produktion. ![dashboards-entwurf](https://thecattlecrew.net/wp-content/uploads/2017/02/dashboards-entwurf.png) Aus dem Entwurf wurden dann Dashboards, die die Daten in quasi Realtime (der Delay ergibt sich aus der Dauer der Übertragung der Daten, und auf Messen ist das WLan meist stark beansprucht) angezeigt und analysiert haben. ![dashboards-prototyp](https://thecattlecrew.net/wp-content/uploads/2017/02/dashboards-prototyp.png) Auf der OOP 2017 konnten wir dann das Ergebnis präsentieren und sind auf großes Interesse gestoßen. In kurzer Zeit und mit relativ geringem Aufwand wurde eine Maschine, wie sie in vielen Fertigungen steht, „smart“ gemacht und die dort anfallenden Daten mit anderen Daten kombiniert und über weitere Lösungen Mehrwerte geschaffen, die an der Maschine direkt nicht möglich gewesen wären. Danke an das Team, der Retrofitting Test war damit bestanden. **Kategorien:** Analytics & Insights, Cloud **Schlagwörter:** Big Data, cloud, Cloud Computing, Conference, German, IoT, OC|Lab --- ### [OC|Lab Day 2017](https://thecattlecrew.net/2017/03/02/oclab-day-2017/) **Published:** März 2, 2017 **Author:** Frank Hoppe **Content:** Auch in diesem Jahr haben sich alle Mitglieder des OC|Lab im wunderschönen [Nochen](http://www.opitz-consulting.com/ueber-uns/denkfabrik-im-gruenen.html) getroffen. Diesmal stand das Treffen unter dem Motto „Bier und coole Projekte“. Um 18:00 Uhr sollte es mit einer langweiligen Vorstellungsrunde losgehen … Viele hatten zwar schon miteinander telefoniert, aber ein persönliches Treffen hat auf Grund der bundesweiten Verteilung und Arbeit noch nicht stattgefunden. Und langweilig war die Vorstellung nicht, da jeder ein Buch empfehlen sollte, das ihn beeindruckt hatte. Aber Bücherlesen scheint nicht mehr im Trend zu liegen, es gab auch einige Serien- und Film-Empfehlungen. ![foto-28-02-17-20-36-09](https://thecattlecrew.net/wp-content/uploads/2017/03/foto-28-02-17-20-36-09.jpg) Nach Pizza und mit Bier ging es in den Kreativmodus. Mit Hilfe von Design-Thinking-Ansätzen wurde eine Projektidee in verschiedenen Gruppen verfeinert. Wow, das war cool und hat echt viele neue Ideen für einen SaaS Service gebracht, den wir demnächst verproben werden. Am nächsten Tag, dem eigentlichen OC|Lab Day ging es recht früh mit dem Aufbau des Walk of Fame los. Der Aufruf lautete nämlich, die aktuellen und abgelaufenen Projekte des letzten Jahres sowie die Abschlussarbeiten vorzustellen. Die Top-3-Projekte sollen Anfang April auf unserer Best-Practices-Konferenz [inspire|IT](http://www.inspire-it.de) vorgestellt werden. ![foto-01-03-17-14-35-37](https://thecattlecrew.net/wp-content/uploads/2017/03/foto-01-03-17-14-35-37.jpg) Die Projekte rankten sich rund um die Themen der Digitalisierung: Big Data, IoT, Cloud. Auch Themen wie Mobile und Business Intelligence wurden gestriffen. Es gab verschiedene PoCs mit der Microsoft HoloLens, Amazons Alexa oder einem Google Tango Tablet. Highlight war der selbstgebaute Rasenmäher – ja, selbst gebaut und steuerbar mit einem Handy über einen Rasperry Pi, der sich seine Routen merkt und dieses Gebiet dann automatisch abfährt. Da war sehr schnell klar, dass die Projektauswahl sehr schwer fallen würde. Und es kam, wie es kommen musste: Die Jury konnte sich nicht entscheiden. Und so gehen nun vier Projekte auf die [inspire|IT](http://www.inspire-it.de), eins auf die [Building IoT](https://www.buildingiot.de), eins auf die [WJax](https://jax.de/blog/news/w-jax-2016-gratis-tablet-und-guenstige-tickets/) und eins auf die [TDWI Konferenz](http://www.tdwi-konferenz.de/tdwi2017.html). In Summe war es ein vollgepackter Tag, der sehr viel Spaß gemacht hat und voll von Kommunikation und Information war. Auf geht’s in neue Projekte und an die Umsetzung innovativer Ideen! **Kategorien:** Tech Events & Networking **Schlagwörter:** Events, German, News, OC|Lab --- ### [Oracle Data Integration Cloud Service](https://thecattlecrew.net/2017/09/13/oracle-data-integration-cloud-service/) **Published:** September 13, 2017 **Author:** danielzellmann **Content:** Hi everyone, in May and June I wrote my Bachelor thesis in cooperation with the OC|Lab about „Nutzung einer Datenintegrationsplattform am Beispiel einer Cloudlösung“ (utilization of a data integration platform cloud service). Within this thesis I did research about data integration itself, the concept of data integration platforms, Cloud computing overall and the existing synergies when using these platforms as cloud service. Furthermore I focused on the challenges of data integration in companies with various data sources all over the complex system landscape especially when facing Big Data scenarios. After finishing the theoretic part I looked at the „Oracle Data Integrator“ as data integration platform. Afterwards I used the on-premise ODI to implement a mapping that integrates data from different sources into a target database to show some of the functionalities of the tool. Then I started to examine the Oracle Cloud to provide the ODI Cloud Service. In this part I focused on the requirements and the provisioning on the different layers to implement the tool as Cloud Service. If you“™re interested in the Oracle Data Integration Cloud Service or the provisioning of Cloud Infrastructure stay tuned! I“™m currently working with some colleges on a Webcast and Factsheet about these topics. The content will include the findings of this thesis e.g. the comparison of the on-premise ODI and the Cloud Service or the setup of the Cloud Stack. Here is a Link if you want to sign up for a Newsletter: **Kategorien:** Cloud **Schlagwörter:** cloud, ODI, oracle --- ### [Neuer Cloud-Trend auf dem Prüfstand: Ist Serverless-Computing ein Vendor Lock-In?](https://thecattlecrew.net/2017/09/13/neuer-cloud-trend-auf-dem-pruefstand-ist-serverless-computing-ein-vendor-lock-in/) **Published:** September 13, 2017 **Author:** Jannik Blähser **Content:** Die Entwicklung, dass sich immer mehr Verwaltungsaufgaben zum Cloud Anbieter verlagern, ist bereits seit einiger Zeit zu beobachten. Die aktuellste Weiterentwicklung in diesem Bereich wird als „Serverless“ bezeichnet und ist derzeit in aller Munde. Der bekannteste Serverless-Computing-Dienst ist dabei wohl „Lambda“ von Amazon Webservices (AWS). Das Pendant dazu von Microsoft heißt „Azure Functions“. Serverless-Computing bietet dabei einige Vorteile gegenüber dem „klassischen“ Entwicklungsmodell. Hier wird die komplette Umgebung (Physikalische Maschinen, Betriebssystem, Laufzeitumgebung, „¦) durch den Cloud Anbieter verwaltet. Dies erlaubt es dem Entwickler, sich voll auf die Implementierung seiner Anwendung zu konzentrieren. Bei der Entwicklung von Anwendungen in diesem Umfeld stellt sich jedoch auch die Frage, wie stark man sich bei der Entwicklung einer Anwendung in diesem Umfeld, vom jeweiligen Cloud Anbieter abhängig macht und ob eine Migration zu einem anderen Anbieter (mit vertretbarem Aufwand) möglich ist. Gründe für einen Anbieterwechsel könnten zum Beispiel Kostenvorteile oder sich ändernde rechtliche Rahmenbedingungen sein. Dieser Frage nach der Anbieter(un)abhängigkeit bin ich im Rahmen meiner Bachelorarbeit bei OPITZ CONSULTING nachgegangen, indem ich ein kleines Beispielprojekt von AWS zu Azure migriert habe. Ein Teil der Ergebnisse soll im Folgenden kurz vorgestellt werden. **Kompatible Programmiersprache** Zunächst einmal fällt bei einem Vergleich auf, dass Azure Functions und AWS Lambda nicht die gleichen Programmiersprachen unterstützen. Derzeit werden nur diese Programmiersprachen von beiden Anbietern unterstützt: JavaScript bzw. NodeJS, Python und C#. Verwendet man eine andere Programmiersprache bleibt einem im Falle einer Migration nichts anderes übrig, als den kompletten Code neu zu schreiben. Daher empfiehlt es sich eine dieser Sprachen zu verwenden. Das Angebot wird jedoch stetig ausgebaut. **Der Functionhandler** Des Weiteren unterscheiden sich die Functionhandler, also die zu implementierende Schnittstelle, der beiden Anbieter leicht voneinander. Dies sind jedoch hauptsächlich Unterschiede in der Namensgebung der Attribute bei Objekten, welche beim Aufruf übergeben werden. Hier müssen im Falle einer Migration die Namen entsprechend abgebildet werden. Eine von Beginn an saubere Trennung der Implementierung der Schnittstelle von der eigentlichen Geschäftslogik erleichtert diesen Schritt enorm. Vereinzelt unterscheidet sich auch die Formatierung der Werte, zum Beispiel der Pfad der aufgerufenen HTTP-Schnittstelle, falls man die Funktion über eine solche aufruft. Diese müssen dann ebenfalls angepasst werden. **Integration weiterer Dienste** Anders sieht es hingegen aus, wenn man spezielle Dienste von AWS wie DynamoDB oder S3 verwendet. Abgesehen von der Migration des jeweiligen Dienstes müssen dann nämlich sämtliche API-Calls in Lambda angepasst werden (also jeder Zugriff auf einen angebundenen Dienst!), wenn man das gesamte Projekt migrieren möchte. Auch hier kann eine saubere Kapselung dieser API-Calls im Falle einer Migration viel Aufwand vermeiden und die eigentliche Geschäftslogik unberührt lassen. Abhilfe kann hier das Verwenden von anbieterunabhängigen Services wie MongoDB zur Datenspeicherung anstelle von DynamoDB schaffen, da man dann die jeweiligen API-Calls nicht weiter anpassen muss. Dies bringt aber wiederrum den Nachteil mit sich, dass man auf die Vorteile des vollständig verwalteten Datenbankservices DynamoDB verzichtet. Hier gilt es im Einzelfall abzuwägen ob man dies in Kauf nehmen möchte. Um eine Migrationsfähigkeit des Gesamtprojektes sicherzustellen, muss natürlich jeder verwendete Dienst mitbetrachtet werden. Im Falle des Beispielprojektes stellte der Dienst „Cognito“ ein Vendor Lock-In dar, da es (zu diesem Zeitpunkt) nicht möglich ist, das Nutzerverzeichnis zu exportieren oder auf andere Art zu migrieren. **Fazit** Die Serverless-Computing-Dienste AWS Lambda und Azure Functions stellen grundsätzlich kein Vendor Lock-In dar und die entsprechenden Funktionen lassen sich aus Entwicklersicht relativ leicht migrieren. Das Problem bilden vielmehr herstellerspezifische Dienste, auf die man aus der Funktion heraus, über die API, zugreift. **Kategorien:** Cloud **Schlagwörter:** AWS, Cloud Computing, Microsoft, Serverless --- ### [Opitz Consulting @ Oracle PaaS Summer Camp 2017](https://thecattlecrew.net/2017/09/14/opitz-consulting-oracle-paas-summer-camp-2017/) **Published:** September 14, 2017 **Author:** alexanderdaeubler **Content:** In the last week of August the 7th annual Oracle PaaS Summer Camp (formerly known as the Oracle Fusion Middleware Summer Camp) took place „“ once again close to the beautiful city of Lisbon. More than 100 participants attended the event involving six different tracks covering the full range of PaaS offerings by Oracle. This year a group of four people from Opitz Consulting attended the event; these are the tracks we visited: - API Cloud Platform Service & Integration Cloud Service - Cloud Application Development: JET + DevCS, ACCS, Stacks + CCS, Wercker as Docker centric DevOps tool & Management Cloud Service - Chatbots, Mobile Cloud Service & JET Quite a number of different services, right? My colleagues Verena Otter-Grail, Jan Winkels and Waldemar Kubassa will tell you more about the particular trainings and their experience of the Summer Camps in separate blog posts to be published within the next few days. In case that you have any questions on one (or more) of those products or plan to improve your business by using them, feel free to contact us at any time! And last but not least: special thanks to Jürgen Kress for the excellent organization of the event! It“™s always a pleasure to return for the Summer Camps „“ it was already my third time there and I“™m already looking forward for the fourth one“¦ **Kategorien:** Cloud, Tech Events & Networking **Schlagwörter:** oracle, Oracle FMW, PaaS, Summer Camp --- ### [CA Policy Manager. How can you activate CORS?](https://thecattlecrew.net/2017/09/14/ca-policy-manager-how-can-you-activate-cors/) **Published:** September 14, 2017 **Author:** tjkrajewski **Content:** Opitz Consulting started to cooperate with CA in the API management area a few months ago (more can be found here: ) and therefore it is straight-forward to use the CA API Policy Manager to secure the access to our new internally developed canteen system. The new solution includes apps for Android, IoS but our API“™s can also be accessed by web browsers. In the latter case CORS needs to be taken into account. In this blog post we will explain what CORS actually stands for and how its usage was implemented in our CA policies. ### What is CORS? *Cross-origin resource sharing (CORS) is a mechanism that allows restricted resources (e.g. fonts) on a web page to be requested from another domain outside the domain from which the first resource was served. A web page may freely embed cross-origin images, stylesheets, scripts, iframes, and videos. Certain „cross-domain“ requests, notably Ajax requests, however, are forbidden by default by the same-origin security policy. CORS defines a way in which a browser and server can interact to determine whether or not it is safe to allow the cross-origin request. It allows for more freedom and functionality than purely same-origin requests, but is more secure than simply allowing all cross-origin requests. (Source: Wikipedia)* Lets try to explain CORS by an easy example. If a.com makes a request to b.com it means that they have a different origin. ![1](https://thecattlecrew.net/wp-content/uploads/2017/09/1.jpg) For security reasons these types of requests have been prohibited by browsers. However to improve web applications, webdevelopers asked browser vendors to allow cross-domain requests. 1. Client a.com sends a GET request b.com/foo to server b.com 2. b.com answers with code response 200 {foo: „˜bar“™} Header: Access-Control-Allow-Origin (ACAO): a.com Access-Control-Allow-Origin is correct and because of that b.com sends a right answer. CORS (Cross-Origin Resource Sharing) is a way for the server to say „I will accept your request, even though you came from a different origin.“ We are using the CA Policy Manager Application to manage access to our new canteen API. We built our WebApp using Angular2 so we occurred very easily to the CORS problem. Let us see how to switch on the CORS settings in the CA Policy Manager. There are some rules you need to follow: - The service (i.e. the API) must have the OPTIONS method enabled. - The „Process CORS Request“ assertion has to appear before any authentication assertions in our policy. - There should be some policy logic that returns HTTP status 200 immediately upon all successful CORS preflight requests. Let us go into further detail on those three topics: ### I. The service must have the OPTIONS method enabled. 1\. Open your CA Policy Manager 2\. Find your API“™s service properties ![2a](https://thecattlecrew.net/wp-content/uploads/2017/09/2a.jpg) 3\. In the HTTP/FTP tab additionally choose „OPTIONS“ as an allowed HTTP Method ![3a](https://thecattlecrew.net/wp-content/uploads/2017/09/3a.jpg) The OPTIONS method is not allowed by default in the CA Policy Manager. If you don“™t switch on this feature you might encounter an error like this when receiving an API web request: [![](https://thecattlecrew.net/wp-content/uploads/2017/09/cors8.jpg)](https://thecattlecrew.net/wp-content/uploads/2017/09/cors8.jpg) It is important to enable this because without access for the „OPTIONS method“ you won“™t be able to execute preflight requests (point III). ### II. the Process CORS Request assertion must appear before any authentication 1\. It is crucial that „Process CORS Request“ is placed before any authentication policy ![11a](https://thecattlecrew.net/wp-content/uploads/2017/09/11a.jpg) 2\. Do not check the „Require CORS“ option in the properties of the assertion to ensure that other clients (as Android or IoS apps) will also be able to work with your API. ![5a](https://thecattlecrew.net/wp-content/uploads/2017/09/5a.jpg) 3\) The OPTIONS method must also be allowed in the scope of the assertion (Process CORS Request Properties -> Allowed Methods. It is a last tab in the image above). ### III. There should be policy logic that returns HTTP status 200 immediately upon all successful CORS preflight requests. 1\) According to the CORS standard, a browser sends a „preflight“ request to determine whether it has permission to perform the action. Only when the backend server approves, the browser will send the actual request with the HTTP request method, so you need to add a „Compare Expression“ Policy. Variable ${cors.isPreflight} needs to return „true“ if the request is a preflight. Please use settings as shown below: ![6a](https://thecattlecrew.net/wp-content/uploads/2017/09/6a.jpg) 2\) API Policy Gateway must answer with 200 HTTP status. To achieve this aim choose a policy „Return Template Response to Requestor“. You can also define a response body as we have done. ![7a](https://thecattlecrew.net/wp-content/uploads/2017/09/7a.jpg) ### **After those simple 3 steps you can use your API with IoS, Android and web clients.** **Kategorien:** Cloud, Integration **Schlagwörter:** API Management, CA, CORS --- ### [Cloud Application Development](https://thecattlecrew.net/2017/09/18/cloud-application-development/) **Published:** September 18, 2017 **Author:** janwinkels **Content:** I visited the [Oracle Summer Camps in Lisbon](https://thecattlecrew.net/2017/09/14/opitz-consulting-oracle-paas-summer-camp-2017/). First of all: Thanks to all who were responsible for organizing and actually running the event. It has been a great time and I took more than a lot of new Ideas back home with me. So what was it about: I have been listening to the slot **Cloud Application Development: JET + DevCS, ACCS, Stacks + CCS, Wercker as Docker centric DevOps tool & Management Cloud Service**. A lot of stuff right? The first two days we were told what Oracle JET is. To summarize: Oracle JET is mainly a UI Library using a lot of KnockoutJS and requireJS. And we“™re hitting the main point here. It“™s absolutely important to know knockoutJS, if you want to learn OracleJET, first do some knockoutJS Tutorial. Apart from that, OracleJET is pretty cool. Especially when you“™re using the new ojet CLI. It makes it really easy to get started. So go and try it! My personal highlights of the Oracle Cloud Service Hands on Labs have been the lift and shift option of the JCS (Java Cloud Service) and especially the OCCS (Oracle Container Cloud Service). You could pull directly from your Docker Repository, build some Wercker Workflows and wrap it up together as a Stack in OCCS. That is a really cool feature! JCS should be considered a possibility in every WLS migration project. The point about it: You get, for example, a preconfigured, scalable, load-balanced WLS environment where you can host your formerly on premise-application easily. DevCS (Developer Cloud Service) is a nice possibility to organize your Development Process. It is possible to create Tasks, Sprints and watch the Burn-down chart when you finish the Tasks. But when you are using the Atlassian Stack in your organization you will miss some of the features like the commit to Task connection. A pretty cool feature I have often used in my Projects and deliver a great benefit to the poor fellow who has to review the Code changes. But apart from that, it is a good solution that covers the DevOps circle almost completely. Other benefits are: You can either use the hosted Git repository or bring your own repository; you can easily create a continuous integration process because a Hudson instance is integrated in the Service. If you want more information just visit: [https://cloud.oracle.com/en\_US/developer-service](https://cloud.oracle.com/en_US/developer-service) Except for the monitoring part, DevCS delivers all features you need for the DevOps circle. The Monitoring part is covered in the Management Cloud Service and in more detail Application Performance Monitoring (APM). In APM you have a lot of metrics you can watch and configure to monitor your Application Performance. In the Hands on Labs we got a quick introduction in installing APM and watched some metrics of an Application that has been deployed using DevCS. If you ask me, the installing and configurations process could be improved, but the information you get out of APM is very detailed. So it is a really good extension to DevCS! More information about APM you get here: [https://cloud.oracle.com/en\_US/application-performance-monitoring](https://cloud.oracle.com/en_US/application-performance-monitoring) At last I want to thanks the trainers Maciej Gruszka, Geertjan Wielenga, Volker Linz and Peter Nagy and congratulate them all: You have been doing a great Job! If I forgot to mention something, please do not be offended, it was a lot of amazing stuff you guys presented! Looking forward to see you again! **Kategorien:** Cloud, Development --- ### [AWS News KW 37](https://thecattlecrew.net/2017/09/19/aws-news-kw-37/) **Published:** September 19, 2017 **Author:** Marco Buss **Content:** ## EC2 Instanzen mit 4 TB Arbeitsspeicher verfügbar Anfang des Jahres gab Amazon bekannt, das geplant ist EC2 Instanzen mit bis zu 16 TB Arbeitsspeicher anzubieten. Seit letzter Woche ist die nächste Ausbaustufe für dieses Ziel verfügbar. Die neuen **x1e.32xlarge** Instanzen haben 4 TB Arbeitsspeicher und 4 Intel Xeon E7 8880 v3 Haswell Prozessoren mit 2,3Ghz (128 vCPUs). Damit sind die Instanzen bestens gerüstet für SAP/HANA sowie andere Arbeitsspeicher intensiven Anwendungen wie Apache Spark. Die x1e.32xlarge Instanzen sind in den Regionen EU (Irland), US East (Northern Virginia), US West (Oregon) und Asia Pacific (Tokyo) verfügbar. Weitere Informationen zu EC2 Instanztypen [hier](https://aws.amazon.com/ec2/instance-types/). ## AWS CodeBuild unterstützt Secrets AWS CodeBuild ist ein fully managed Buildservice der Code compiliert, Tests ausführt und deploybare Artefakte erzeugt. Ab sofort können Geheimnisse wie Datenbank Credentials etc., die während des Builds benötigt werden aus dem [Systems Manager Parameter Store](http://docs.aws.amazon.com/systems-manager/latest/userguide/systems-manager-paramstore.html) bezogen werden. Der System Manager Parameter Store stellt eine sichere Speicherung von Konfigurationsparametern dar. Weitere Informationen zu AWS CodeBuild [hier](https://aws.amazon.com/codebuild/). **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [Die Lambda-Architektur in der Praxis](https://thecattlecrew.net/2017/09/19/die-lambda-architektur-in-der-praxis/) **Published:** September 19, 2017 **Author:** Lukas Berle **Content:** In der IT ist es kaum noch möglich, dem Word „**Lambda**“ zu entgehen: Die **Lambda**-Ausdrücke in Java 8, Amazons AWS **Lambda** für Cloud-Berechnungen und auch im Big-Data-Bereich ist die **Lambda-**Architektur ein zentrales Architektur-Pattern für datengetriebene Systeme. Was eine Lambda Architektur genau ist und vor allem mit welchen Tools aus dem ![blogPic](https://thecattlecrew.net/wp-content/uploads/2017/09/blogpic1.png)Hadoop Ü–kosystem sie realisiert werden kann, erfahren Sie in unserem Whitepaper [„Lambda-Architektur in der Praxis“](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-big-data-lambda-architektur_sicher.pdf). Im Whitepaper demonstriere ich des Weiteren den Aufbau einer Lambda Architektur im Anwendungsfall eines Automatenherstellers. Für Unternehmen bieten wir außerdem einen eintägigen Workshop an, in dem sich alles um die Themen Hadoop, NoSQL, In-Memory Stream Processing und Big Data dreht. Mehr dazu in unserem Factsheet [„Mit Big Data in die Digitalisierung starten“](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Fact_Sheet/87-factsheet-big-data-und-digitalisierung.pdf). PS: Und wen auch die anderen ebenfalls erwähnten Lambdas interessieren, der sei nach [hier](https://www.sigs-datacom.de/uploads/tx_dmjournals/guenther_lehmann_JS_03_13_va54.pdf) und [hier](https://aws.amazon.com/de/lambda/) verwiesen. **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** Big Data, Hadoop, Lambda Architecture --- ### [Chatbots @ Oracle PaaS Summer Camp](https://thecattlecrew.net/2017/09/21/chatbots-oracle-paas-summer-camp/) **Published:** September 21, 2017 **Author:** waldemarkubassa **Content:** *Conversational User Interfaces such as chatbots will certainly change the way we use software for casual purposes so I was very excited about the „Oracle Mobile, Chatbot and JET Training“ of [Oracle PaaS Summer Camp 2017 ](https://thecattlecrew.net/2017/09/14/opitz-consulting-oracle-paas-summer-camp-2017/) in Lisbon I was accepted for!* *Oracle will provide chatbots development as part ot the new version of [Oracle Mobile Cloud Enterprise](https://cloud.oracle.com/mobile) (MCE – follower of Mobile Cloud Service), and we had the possibility to test it out.* Armed with hands-on and samples, we played around with the new chatbots features of Mobile Cloud Enterprise, and there is a lot of cool stuff inside. To name only a few:* - *visual conversation flow builder allowing you to train and test the bot on the fly* - *custom components that connect to your REST APIs in the outside world* - *out of the box Facebook integration (it was really fascinating to chat with your own chatbot directly in the Facebook Messenger!).* The next big part was the introduction to Oracle JET and finally integrating the previously developed chatbot in a JavaScript component that is accesible on your Website.* *We were amazed how easy it is to get started with Oracle JET. Coming into modern frontend JS development has never been so simple!* In Summary: it was a great event – with a lot of cool new developments and ideas to pick up, and a perfect place for relaxed networking.* **Kategorien:** AI & Data Science, Cloud, Tech Events & Networking **Schlagwörter:** Artificial Intelligence, oracle, PaaS, Summer Camp --- ### [Linux Patching with AWS Systems Manager](https://thecattlecrew.net/2017/09/22/linux-patching-with-aws-systems-manager/) **Published:** September 22, 2017 **Author:** Grzegorz Lysko **Kategorien:** Cloud --- ### [API Platform Cloud Service & Integration Cloud Service @ Oracle PaaS Summer Camp 2017](https://thecattlecrew.net/2017/09/25/api-platform-cloud-service-integration-cloud-service-oracle-paas-summer-camp-2017/) **Published:** September 25, 2017 **Author:** verenaottergrail **Content:** The [PaaS Summer Camp 2017 in Lisbon](https://thecattlecrew.net/2017/09/14/opitz-consulting-oracle-paas-summer-camp-2017/) was a great experience! Especially for me as a former Oracle employee it felt a bit like ‚coming home‘. The whole event was very well organized with six different PaaS training tracks to chose from. In the area I had chosen – **API Platform Cloud Service** (APIPCS) & **Integration Cloud Service** (ICS) – we had the opportunity to get some hands on to the latest and greatest release of **APIPCS**: We tested to - design - implement - secure - deploy - document and register an API to an application. Also in the area of **ICS** we simulated real world use cases, e.g. an integration of an ERP system. The aim was not to follow step-by-step instructions but to try things out, play around and ask questions to gather some feeling for and experience with the product. As the training was delivered by the Product Managers themselves it was a great opportunity to grow your network to be able to contact the relevant people for future projects in this area. Besides that we had great company of colleagues, Oracle partners and Oracle employees themselves in a wonderful city. I can really encourage everybody to take part in this great event! **Kategorien:** Cloud, Tech Events & Networking **Schlagwörter:** Oracle Cloud, PaaS, Summer Camp --- ### [Solve digital transformation challenges using Oracle Cloud](https://thecattlecrew.net/2017/09/27/solve-digital-transformation-challenges-using-oracle-cloud/) **Published:** September 27, 2017 **Author:** Sven Bernhardt **Content:** Digital transformation is an omnipresent topic today, providing a lot of challenges as well as chances. Due to that, customers are asking about how to deal with those challenges and how to leverage from the provided chances. Frequently asked questions in this area are: - How can we modernize existing applications? - What are the key elements for a future-proven strategy IT system architecture? - How can the flexibility as well as the agility of the IT system landscape be ensured? But from our experience there“™s no common answer for these questions, since every customer has individual requirements and businesses, but it is necessary to find pragmatic solutions, which leverage from existing best Practices „“ it is not necessary to completely re-invent the wheel. With our new poster „**Four Pillars of Digitalization based on Oracle Cloud**“ (Download it [here](http://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_Four-Pillars-of-Digitalization-Based-on-Oracle-Cloud_Web.pdf)) , we try to deliver a set of harmonized reference models which we evolved based on our practical experience, while conceiving modern, future-oriented solutions in the area of modern application designs, integrative architectures, modern infrastructure solutions and analytical architectures. The guiding principle, which is the basis for our architectural thoughts is: **Design for Change**. If you want to learn more, you can refer to our corresponding Ebook (find the Ebook [here](http://business-services.heise.de/it-management/infrastruktur-management/beitrag/exklusives-ebook-dynamikrobuste-architekturen-der-digitalisierung-3137.html), only available in German at the moment). Usually the technological base for modern application architectures today is based on Cloud services, where the offerings of different vendors are constantly growing. Here it is important to know which Cloud services are the right ones to implement a specific use case. Our poster „Four Pillars of Digitalization based on Oracle Cloud“ shows the respective Cloud services of our strategic partner **Oracle**, which can be used to address specific challenges in the area of digitalization. **Kategorien:** Cloud **Schlagwörter:** cloud, Digitalization, oracle --- ### [Reduzierte Big Data Kosten mit AWS Spot Instanzen](https://thecattlecrew.net/2017/10/01/reduzierte-big-data-kosten-mit-aws-spot-instanzen/) **Published:** Oktober 1, 2017 **Author:** Bodo Clausen **Content:** Wer sich heutzutage mit Big Data Themen kombiniert mit Amazon Web Services (AWS) beschäftigt, benötigt in der Regel schon ein eigenes kleines Wörterbuch für die ganzen Abkürzungen und Toolnamen aus beiden Welten. Ein weiteres Thema ist die eigene Problemstellung in dieser neuen Welt zu implementieren. Das sich dieser Weg durchaus auf verschiedenen Ebenen lohnt, möchte ich in diesem Blogartikel aufzeigen. ## Was ist AWS EMR Amazon bietet eine eigene Big Data Distribution an. Diese hat neben dem Resourcen Manager (Yarn), einem Hadoop File System und Spark noch einige andere Tools wie Sqoop, Oozie und Zeppelin. Durch den Elastic Map Reduce (EMR) Dienst wird ein Big Data Cluster komplett erzeugt, inklusive ausgewählter Hardware und Software. Wenn das entsprechende „Create Cluster“ Kommando verwendet wird dauert es ca. 7 Minuten bis der neue Cluster Einsatzbereit ist und alle Instanzen den Status „running“ haben. Der Cluster kann beispielsweise über die AWS Console (AWS Webseite) konfiguriert werden oder über das AWS Kommandozeilentool. Das zuletzt genannte Tool stellt eine spannende Option für Automatisierungen dar. AWS EMR kostet ein einen kleinen Betrag extra zu den anfallenden Kosten für die Instanzen. In diesem Beispiel werden m4.large Instanz Typen in der Region EU(Frankfurt) verwendet. Diese kosten in diesem Moment 0,12 US Dollar pro Instanz und Stunde. Der EMR Aufschlag beträgt 0,03 US Dollar pro Stunde und Instanz. Dies ist exklusive der Mehrwertsteuer. Es gibt zwar noch Transfer und Storage Gebühren und vieles mehr, aber die genannten Kosten und die Mehrwertsteuer stellen den absolut größten Teil der Kosten dar und können für eine grobe Kosteneinschätzung verwendet werden. Weitere Informationen hierzu können direkt auf der [AWS Pricing Webseite](https://aws.amazon.com/de/emr/pricing/) nachgelesen werden. Aufgerundet exklusive Mehrwertsteuer kostet jede Instanz pro Stunde 0,15 US Dollar. ## Spot Instanzen AWS bietet Spot Instanzen an. Die Idee ist, dass Kunden statt einem fixen Preis, wie bei den bisher hier verwendeten On-Demand Instanzen (m4.large 0,12 US Dollar pro Instanz pro Stunde), wie bei einer Auktion ein Gebot für die Nutzung der Instanzen abgeben. Dies kann dazu führen, dass Instanzen 90% unter dem On-Demand Preis zur Verfügung gestellt werden können. Daraus können bei richtiger Nutzung großartige Mehrwerte gezogen werden. Es muss nur definiert werden, was das Ziel sein soll. Eines könnte die Reduzierung der Kosten sein. ## Ü„nderung der Abrechnungseinheiten von Stunden auf Sekunden Eine aktuelle Ü„nderung in der Preisgestaltung von AWS ist die Umstellung der Abrechnungsintervalle zum 02.10.2017. Bisher wurden alle Instanzen Stundenweise abgerechnet, wenn eine Verarbeitung 125 Minuten dauert, dann wurden 3 Stunden für jede Instanz im Cluster berechnet. Dies wird jetzt auf sekundengenaue Abrechnung umgestellt. Nachlesen können sie die Details bei AWS direkt [new-per-second-billing-for-ec2-instances-and-ebs-volumes](https://aws.amazon.com/de/blogs/aws/new-per-second-billing-for-ec2-instances-and-ebs-volumes/). Es gibt eine Mindestabnahmezeit pro Instanz von 60 Sekunden, danach wird sekundengenau abgerechnet. In unserem Beispiel (125 Minuten Verarbeitung) alte Berechnung: Prei pro Instanz pro Stunde: 0,12 $ (Instanz) + 0,03 $ (EMR) (Steuern entfallen als Vereinfachung) Preis in $InstanzenStundenGesamtsumme in $ %Alte Berechnung0,1533,001,35100,00Neue Berechnung0,1532,080,9469,43Natürlich ist beim Beispiel mit 125 Minuten der Effekt fast maximal. In diesem Beispiel wurden über 30% Kosten eingespart, durch die Veränderung der Abrechnungseinheiten # Was für Gruppen gibt es im EMR: Master, Core, Task Das AWS EMR bietet durch die verwendete Hadoop Technologie basierend auf dem Hadoop File System (HDFS) und dem Resourcen Manager (YARN) eine perfekte Umgebung, um AWS Spot Instanzen zu verwenden. Sowohl Instanzen aus der Master Gruppe, wie auch aus der Core Gruppe, sollten nicht mit Spot Instanzen verwendet werden. In der Master Gruppe laufen in der Regel die Master Prozesse von Anwendungen, also zum Beispiel der HDFS NameNode oder den Applications Manager, welcher einen Teil des Yarn Resource Manager ist. An dieser Stelle müssen On-Demand Instanzen verwendet werden, da die Instanzen nicht wegfallen dürfen. Auch in der Core Gruppe sollten keine Instanzen wegfallen. In dieser Gruppe liegen die DataNodes des HDFS. Wenn von diesen DataNodes zu viele wegfallen, kann es trotz impliziter Replikation zu Datenverlusten kommen. Die Task Gruppe und ihre Instanzen sind optional und haben weder NameNode noch DataNode Prozesse. Es werden hier also keine HDFS Daten persistiert sondern lediglich Resourcen für die Verarbeitung zur Verfügung gestellt. Aus HDFS Sicht sind die Task Nodes also nicht existent, für Yarn stellen sie jedoch zusätzliche Verarbeitungs-Resourcen zur Verfügung. Dies hat zur Folge, dass vorhandene Task Instanzen die Verarbeitung beschleunigen. Sollten diese Instanzen mitten in der Verarbeitung nicht mehr verfügbar sein, wie es bei Spot Instanzen der Fall sein kann, ist dies kein Problem. Der Resourcen Manager stellt fest, dass Verarbeitungs-Resourcen weggefallen sind und verteilt deren Aufgaben an andere Instanzen die verfügbar sind und Kapazitäten frei haben. Dies kann sich nur auf die Laufzeit nicht aber auf den Erfolg der Verarbeitung auswirken. ## Beispielsetup mit einer Task Gruppe die aus Spot Instanzen besteht Dies ergibt spannende Möglichkeiten. Wenn die Verarbeitung mit einer Master und 8 Core On-Demand Instanzen durchgeführt wird und 125 Minuten dauert, berechnen wir die EC2 und EMR Kosten für diese Verarbeitung. Wenn weitere 8 Task Spot Instanzen hinzukommen reduziert sich die Laufzeit auf 65% von 125 Minuten (2,08 Stunden) ergibt 81,25 Minuten (1,35 Stunden) Laufzeit. Der Preis pro Instanz pro Stunde für On-Demand setzt sich zusammen aus (0,12 $ Instanz, 0,03 $ EMR). Der Preis pro Stunde für Spot Instanzen setzt sich zusammen aus (0,03 $ Instanz und 0,03 $ EMR). Preis in $InstanzenStundenGesamtsumme in $ %1 Master 8 Core0,1592,082,81100,001 Master 8 Core0,1591,351,828 Task0,0681,350,65Summe neu2,4787,98Durch das Hinzufügen von 8 Spot Instanzen als EMR Task Gruppe wurde die Laufzeit der Verarbeitung um 35% reduziert und das zu etwa 12,02% reduzierten Kosten. Im Positivfall wurde sowohl Geld gespart als auch eine deutlich kürzere Verarbeitungszeit benötigt. Der Negativfall, wir bekommen die Spotinstanzen nicht zu dem gewünschten Preis, bedeutet 100% Laufzeit und 100% Kosten wir haben also den Status Quo. Dies stellt nur ein einfaches Beispiel dar, was mit etwas Kreativität möglich ist. Natürlich skalieren verschiedene Daten und Programme unterschiedliche und der geneigte Leser muss eigene Tests durchführen, welches Setup das Passende ist. Dabei sind nicht nur Kostenoptimierungen, sondern auch Laufzeitoptimierungen als Ziel möglich. Wie verschiedene Instanz Typen (M4.Large in diesem Beispiel) zu der eigenen Verarbeitung passen wurde ebenfalls komplett ausgeblendet. Auch hier bietet sich noch einiges an Optimierungspotential. **Kategorien:** Analytics & Insights, Cloud --- ### [Autonomous databases, Blockchains and Cloud-native architectures - an OOW 17 recap](https://thecattlecrew.net/2017/10/09/autonomous-databases-blockchains-and-cloud-native-architectures-an-oow-17-recap/) **Published:** Oktober 9, 2017 **Author:** Sven Bernhardt **Content:** Oracle Open World (OOW) 2017 just ended on thursday last week. As usual, it was a great and inspiring conference, which nevertheless felt slightly different than the years before. ## Why does it felt different? A different spirit seemed noticeable, because Oracle starts to put more focus on the **developer community** – more power to the developers! For the first time, an Oracle Code track took place as part of Java One. Oracle Code was established between last years OOW and this years conference and was run at several locations all over the world. This promising new format explicitly addresses developers, so the tracks are more technical and are not necessarily focusing Oracle products and technologies, but are also covering Open Source technologies, like Kafka, etc. With respect to **Open Source** it is also interesting to see that Oracle integrates, uses and thrives respective technologies in their platform services, which will be discussed in the following. ## News and worth mentioning ### Autonomous Database One of the most polarizing announcements was a new version of Oracle flagship, the **database Oracle 18c**. This version implements a new and revolutionary concept, of a self-driving **autonomous database**, which needs less human interactions; typical DBA tasks like patch, tune, back up, and upgrade are done by the database autonomously. > „This is a big deal, by the way. No one else does this. This is the most important thing we“™ve done in a long, long time.“ (Larry Ellison, Oracle Executive Chairman and CTO) The autonomy of the database is achieved by leveraging **Machine Learning (ML)** algorithms. A very exciting and outstanding development, which will of course changes the role of DBAs in the future. But DBAs will not become superfluous; they need to rethink their roles. - - ### Container native app development of the future Oracle announced their new development platform for Cloud-native applications, which consists of - **Container Pipelines**, a.k.a. as [Wercker](http://www.wercker.com) for managing container builds and deployments, - **Container Registry Service**, implemented as a full Docker v2 comptabile private registry - **Container Engine**, which is a Fully-managed Kubernetes Service; This service was announced to be available soon. I addition, a **new Serverless platform** based on [Fn](http://fnproject.io) (http://fnproject.io), which is a Open Source container native serverless platform, was announced. The main advantage of this approach is that serverless functions can be developed and tested locally before deploying it to a runtime. The target runtime the so defined Serverless functions is the Managed Kubernetes Service (Container Engine), which is capable to execute Containers and Serverless functions. - - ### Blockchain – the next big thing in IT A topic, which was impressively present at this years OOW was **Blockchain**. The corresponding sessions were always completely packed. The sessions where covering different aspects beginning with an introduction, what Blockchain is and how it can be implemented. Furthermore it was shown, how Oracle will approach the topic with a new **fully-managed Blockchain Cloud Service**. This upcoming service is based on [Hyperledger](https://www.hyperledger.org), which is hosted by the Linux Foundation, where Oracle recently joined. > „Blockchain hold the promise to fundamentally transform how business is done, making business-to-business interactions more secure, transparent, and efficient.“ (Amit Zavery, Senior Vice President Oracle Cloud Platform) So, let’s stay tuned for more and see, if Blockchain becomes significantly game changing as discussed nowadays. - - ### Simplified Cloud adoption through improved subscription model In the past, Oracle’s subscription model was not flexible enough, since customers need to specify what kind of Cloud Services are needed. Now, Oracle introduces so called **Universal credits**, which makes life easier. Customers, buy credits and have access to all IaaS and PaaS offerings. More flexibility at lower costs that is the key promise – sounds great! In addition, a new **Bring your own licence (BYOL)** model has been introduced which allows customers to use existing on premise licenses for respective Cloud Services. Another interesting offering to existing on premise licenses, to get started with Cloud. - ### Further interesting facts Besides the aforementioned points, it was also noticeable that the Oracle Cloud offerings become more and **more integrated**. In the near future Cloud Services will be grouped in reasonable packages. Examples for that are: - Oracle Mobile Cloud enterprise (OMCe) - Mobile Cloud Service - Intelligent Bots - Customer Experience Analytics - Oracle Integration Cloud (OIC) - Integration Cloud Service (ICS) - Process Cloud Service (PCS) - Visual Cloud Builder Service (VBCS) - Analytics - Deeper integration of Oracle API Platform Cloud Service and Apiary to allow a full API Management Further relevant topics, which were dominating the conference were: - Machine Learning and Artifical intelligence (Oracle Analytics Cloud) - Chatbots (Oracle Intelligent Bots Service) - API Management ## Summary As it can be seen from this article, there was again tons of new information, which can be taken home from the conference. It again showed the relevance of OOW for daily business, because learning about newest products, roadmaps and concepts is essential. It is important to sharpen the view on diverse topics and how the way, to position Oracle’s portfolio at customers can be improved and how those can add significant value by implementing Oracle Cloud solutions. **Kategorien:** Cloud, Database, Tech Events & Networking **Schlagwörter:** autonomous, blockchain, cloud, cloud native, Conference, oracle --- ### [Nicht verpassen: Cloud Roadshow by OPITZ CONSULTING](https://thecattlecrew.net/2017/10/27/nicht-verpassen-cloud-roadshow-by-opitz-consulting/) **Published:** Oktober 27, 2017 **Author:** Danilo Schmiedel **Content:** **Mit der Cloud in den digitalen Wandel!** Verpassen Sie nicht unsere **deutschlandweite Cloud|Roadshow!** Los geht es am 08.11.2017 in München. Denn um zu beurteilen, wie viel und welche Cloud Sie tatsächlich benötigen, müssen Sie schon heute eine Cloud-Gesamtstrategie für Ihr Unternehmen aufbauen. Die Anzahl der angebotenen Services der unterschiedlichen Hersteller ist beträchtlich, und sie sind schwer miteinander zu vergleichen. Wir helfen Ihnen, primär eine generelle Cloud Strategie zu erstellen, geben Ihnen einen Überblick über interessante Ansätze mit der Oracle Cloud Plattform und beantworten u.a. folgende Fragen: - Autonome Datenbanken, Blockchain, Cloud-Native, Serverless, Microservices, DevOps und Co – Welche Neuerungen gibt es von der diesjährigen **Oracle Open World 2017**? - Cloud Strategie „“ Worauf muss ich achten? - Welche Applikationen eignen sich für die Cloud? - Wie können Anwendungen migriert werden? - Public Cloud, Bare Metal, Cloud Machine „“ Was und Wofür? - Oracle Cloud Services für NON-Oracle Kunden? - Ein Blick in den Geldbeutel – Was kostet die Cloud? - Praxisbeispiele: Was ist notwendig, um durchzustarten? Die Oracle Cloud gilt als eine der umfangreichsten und am stärksten integrierten Public Clouds der Branche. Erfahren Sie im Rahmen unserer kostenfreien Cloud|Roadshow mehr über die vielfältigen Möglichkeiten, die Sie mit Cloud Computing haben. **Melden Sie sich jetzt kostenfrei an: [Details und Anmeldung](http://www.opitz-consulting.com/nc/share/suid/102/register/sharedItem/event.html?theater=1)** **Cloud|Roadshow-Termine**: - 08. November 2017 in München ([zur Anmeldung](http://www.opitz-consulting.com/events/event-anmeldung/register/show/Registration/168/Oracle%20Cloud%7CRoadshow/102/08.11.2017%20-%2001%3A00%20--%20.html)) - 15. November 2017 in Berlin ([zur Anmeldung](http://www.opitz-consulting.com/events/event-anmeldung/register/show/Registration/169/Oracle%20Cloud%7CRoadshow/102/15.11.2017%20-%2001%3A00%20--%20.html)) - 28. November 2017 in Hamburg ([zur Anmeldung](http://www.opitz-consulting.com/events/event-anmeldung/register/show/Registration/170/Oracle%20Cloud%7CRoadshow/102/28.11.2017%20-%2001%3A00%20--%20.html)) - 05. Dezember 2017 in Düsseldorf ([zur Anmeldung](http://www.opitz-consulting.com/events/event-anmeldung/register/show/Registration/171/Oracle%20Cloud%7CRoadshow/102/05.12.2017%20-%2001%3A00%20--%20.html)) - 13. Dezember 2017 in Frankfurt ([zur Anmeldung](http://www.opitz-consulting.com/events/event-anmeldung/register/show/Registration/172/Oracle%20Cloud%7CRoadshow/102/13.12.2017%20-%2001%3A00%20--%20.html)) Wir freuen uns, Sie bei einem unserer Cloud|Roadshow-Termine begrüßen zu dürfen! **Kategorien:** Cloud, Tech Events & Networking --- ### [AWS News KW 38 - 43](https://thecattlecrew.net/2017/11/03/aws-news-kw-38-43/) **Published:** November 3, 2017 **Author:** Marco Buss **Content:** Da ich die letzten Wochen Urlaub hatte, gab es keine Zusammenfassung der AWS News. Während meines Urlaubs war ich auch in Seattle und entdeckte durch Zufall das das Hotel nur eine Straße vom Amazon HQ entfernt war. ![_1060088](https://thecattlecrew.net/wp-content/uploads/2017/10/1060088.jpg) Die Kugeln sind nicht das HQ sondern nur zukünftige Meetingräume. Das Gebäude links davon ist das HQ. Schön fand ich vor allem, das die Mitarbeiter animiert werden Ihre Hunde mit ins Büro zu bringen. Im Ergebnis gibt es dann auch ein Auslaufgebiet direkt am Haupteingang. Nun aber zu den eigentlichen News. ## Amazon Aurora mit PostgreSQL Kompatibilität Wie bereits auf dem AWS Summit in Berlin erwähnt und als Preview verfügbar kann ab sofort Aurora als PostgreSQL kompatible Datenbank betrieben werden. Aurora ist dabei zu PoastgreSQL Version 9.6.3 kompatibel. Alle bekannten Features von Aurora sind verfügbar. Besonders zu erwähnen sind dabei die autoscaling Funktion bis zu 64TB Speicher, 6-fache Datenreplikation und die out of the Box verfügbaren Monitoring Informationen. Amazon spricht von bis zu 3-facher Performance im Vergleich zu einer gewöhnlichen PostgreSQL Installation. Weiter Informationen zu Aurora [hier](https://aws.amazon.com/rds/aurora). ## Amazon Linux AMI 2017.09 Eine neue Version des von Amazon verwalteten Linux AMI wurde released. Mehrere Bibliotheken wurden aktualisiert. Weitere Informationen zum AMI [hier](https://aws.amazon.com/amazon-linux-ami/). ## Microsoft SQL Server 2017 für EC2 Es können jetzt mehrere AMI´s für EC2 Instanzen gewählt werden, die Windows Server 2016 sowie SQL Server 2017 in den Versionen Web, Express, Standard und Enterprise beinhalten. Als Lizensierungsoptionen existieren folgende Varianten: - Pay As You Go: Ist vor allem geeignet wenn keine langfristigen Lizenzmodelle gewünscht sind. Beispielsweise für Evaluierungen - License Mobility und Bring Your Own Licenses: Sind gute Modelle für bereits vorhandene Lizenzen. Weitere Informationen zu Microsoft SQL Server 2017 [hier](https://www.microsoft.com/en-us/sql-server/sql-server-2017). ## Support für mehrere TLS/SSL Zertifikate für den Application Load Balancer mit SNI Ab sofort unterstützt der [Application Load Balancer](https://aws.amazon.com/elasticloadbalancing/) mehrere TLS/SSL Zertifikate. Eine wildcardbasierte Auswahl der Zertifikate war bereits möglich. Hinzugekommen ist der Support für SNI ([Server Name Indication](https://tools.ietf.org/html/rfc6066#page-6)). Weitere Informationen zum ALB [hier](https://aws.amazon.com/elasticloadbalancing/details/). ## Gluon, ein Maschine Learning Framework von AWS und Microsoft AWS und Microsoft haben gemeinsam das Gluon Framework entwickelt. Es soll den Einstieg sowie die Implementierung von Deep Learning Methoden vereinfachen. Weitere Informationen zu Gluon [hier](https://github.com/gluon-api/gluon-api/). ## Amazon Lightsail Unterstützung von Windows Lightsail, Amazons Dienst für Virtuelle Private Server unterstützt ab Sofort Windows. Angeboten werden die Versionen Windows Server 2012 R2, Windows Server 2016 sowie Windows Server 2016 mit SQL Server 2016 Express. Die Server selber haben 512MB – 8GB Arbeistspeicher, 1 oder 2 vCPU´s und bis zu 80GB SSD Speicher. Die Preise beginnen bei 10 Dollar pro Monat. Die kleinste Instanz ist für den ersten Monat kostenlos. Das neue Feature ist ab sofort in folgenden Regionen verfügbar. US East (Northern Virginia), US East (Ohio), US West (Oregon), EU (London), EU (Ireland), EU (Frankfurt), Asia Pacific (Singapore), Asia Pacific (Mumbai), Asia Pacific (Sydney), und Asia Pacific (Tokyo). Weitere Informationen zu Amazon Lightsail [hier](https://amazonlightsail.com/). ## VPC Support für Amazon Elasticsearch Bisher war es notwendig um von innerhalb eines VPC aus auf Elasticsearch zuzugreifen dieses VPC für das Internet zu öffnen, da Amazon Elasticsearch nur per Internet erreichbar war. Mit dem VPC Support ist dies in Zukunft nicht mehr notwendig und das VPC muss nicht für das Internet geöffnet werden, was die Sicherheit erhöht. Weitere Informationen zum VPC Support für Amazon Elasticsearch [hier](https://docs.aws.amazon.com/elasticsearch-service/latest/developerguide/es-vpc.html). ## Cost Allocation Tags für Amazon Simple Queue Service Mit dem Support von Tags können Kosten anhand dieser Tags überwacht werden. Mit diesem Feature ist es Beispielsweise möglich die Kosten einer bestimmten Abteilung im Blick zu behalten. Nachdem in den letzten Jahren immer mehr Services Tag Support erhalten haben (DynamoDB, Lambda …) ist dieses Feature ab sofort auch für [SQS](https://aws.amazon.com/sqs) aktiv. Weitere Informationen zu Tags in SQS [hier](http://docs.aws.amazon.com/AWSSimpleQueueService/latest/SQSDeveloperGuide/sqs-queue-tags.html). ## EC2 Instanzen mit bis zu 8 NVIDIA Tesla V100 GPU´s Mit den neuen P3 Instanz Typen erweitert Amazon sein Angebot GPU optimierter Instanztypen. Die Instanzen sind in folgenden Konfigurationen in den Regionen US East (Northern Virginia), US West (Oregon), EU (Ireland), und Asia Pacific (Tokyo) verfügbar. **Model****NVIDIA Tesla V100 GPUs****GPU Memory****NVIDIA NVLink****vCPUs****Main Memory****Network Bandwidth****EBS Bandwidth****p3.2xlarge**116 GiBn/a861 GiBUp to 10 Gbps1.5 Gbps**p3.8xlarge**464 GiB200 GBps32244 GiB10 Gbps7 Gbps **p3.16xlarge**8128 GiB300 GBps64488 GiB25 Gbps14 GbpsDiese Instanztypen eigenen sich vor allem für grafikintensive Anwendung oder für Machine Learning. Natürlich könnten sie auch genutzt werden um Bitcoins zu schürfen. Die Preise beginnen bei ca 3$ pro Stunde für die p3.2xlarge und enden bei knapp 25$ pro Stunde für die p3.16xlarge. Weitere Informationen zu den neuen P3 Instanzen [hier](https://aws.amazon.com/ec2/instance-types/p3/), **Kategorien:** Cloud **Schlagwörter:** Application Load Balancer, Artificial Intelligence, AWS, Big Data, Elastic Search, Lightsail, SQS --- ### [AWS News KW 44](https://thecattlecrew.net/2017/11/06/aws-news-kw-44/) **Published:** November 6, 2017 **Author:** Marco Buss **Content:** ## 100 CloudFront Points of Presence Amazon CloudFront ist Amazons Content Delivery Network. Mit der Eröffnung des 5. Endpoints in Tokio besteht das Netzwerk jetzt aus 100 „Points of Presence“ die sich wiederum aufteilen in 89 Edge Locations und 11 regionale Edge Caches. Weitere Informationen zu CloudFront [hier](https://aws.amazon.com/cloudfront/). ## AWS Direct Connect Gateway Mit DirectConnect ist es möglich das eigene Netz mit einem VPC zu verbinden. Bisher war für jedes VPC eine eigene Verbindung notwendig. Mit dem Direct Connect Gateway können nun mehrere VPCs mit einer Verbindung angebunden werden. Vorausgesetzt sie haben keine überlappenden CDIR Konfigurationen. Weitere Informationen zu Direct Connect [hier](https://aws.amazon.com/directconnect/). ## IAM Authorisierung für RDS Aurora und MySQL Ab sofort kann IAM für die Autorisierung für RDS Aurora und MySQL verwendet werden. Dadurch muss beim Zugriff auf die Datenbank nicht mehr der Benutzername und das Passwort verwendet werden. Stattdessen werden temporäre Credentials benötigt, die durch den IAM Security Token Service erstellt werden. Weitere Informationen zur IAM Autorisierung für RDS Aurora und MySQL [hier](http://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/UsingWithRDS.IAMDBAuth.html). ## SES Reputation Dashboard Bei der Verwendung von Amazons E-Mail Service SES müssen einige Dinge beachtet werden. Der Grund dafür ist, das Amazon sehr viel Wert darauf legt, das Ihre Endpunkte nicht dafür bekannt sind als Spam Sender zu gelten. Das neue Dashboard liefert mehrere Informationen die zeigen ob man vor einer Sperrung steht, da die eigenen Mails zu oft als Spam angesehen werden. Weiter Informationen zu neuen Dashboard [hier](http://docs.aws.amazon.com/ses/latest/DeveloperGuide/reputation-dashboard-dg.html). ## 16 weitere Services HIPAA und HITECH kompatibel Folgende Services sind jetzt HIPAA und HITECH konform. - Amazon Aurora mit PostgreSQL - Amazon Cloudwatch Logs - Amazon Connect - Amazon ElastiCache for Redis - Amazon Kinesis - Amazon RDS für MariaDB - Amazon RDS SQL Server - Amazon Route53 - AWS Batch - AWS CloudHSM - AWS Key Management Service - AWS Lambda - Lambda@Edge - AWS Snowball Edge - AWS Snowmobile - AWS Storage Gateway **Kategorien:** Cloud **Schlagwörter:** AWS --- ### [Besuch der Anwenderkonferenz Internet of Things / Industrial Internet in Berlin](https://thecattlecrew.net/2017/11/13/besuch-der-anwenderkonferenz-internet-of-things-industrial-internet-in-berlin/) **Published:** November 13, 2017 **Author:** Dominik Bial **Content:** Am 08.11.2017 fand in Berlin die[ IoT Anwenderkonferenz](http://veranstaltungen.gito.de/Internet-of-Things_2017) statt, die als Folgetermin eines IoT Workshops und über den GITO Verlag gemeinsam mit der Uni Potsdam organisiert wurde. Wir hatten das Glück um einen Vortrag gebeten zu werden, so dass Daniel Rock und Dominik Bial mit ihrem Talk „Mit Volldampf in die Digitalisierung „“ IoT als zentraler Treiber“ vor Ort waren. Inhalte des Vortrages waren: - Smarte Produkte und Retrofitting als Grundlage der Digitalisierung - Anwendungsbeispiele aus aktuellen IoT Kontexten - Lösungsansätze über IoT Cloud Produkte [![](https://thecattlecrew.net/wp-content/uploads/2017/11/171108_091819.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2017/11/171108_091819.jpg) [![](https://thecattlecrew.net/wp-content/uploads/2017/11/171108_gito_iot_konferenz_web_0063.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2017/11/171108_gito_iot_konferenz_web_0063.jpg) Die Konferenz war ein voller Erfolg. Neben der üblichen Kontaktpflege und spannenden Diskussionen haben vor allem folgende Beiträge begeistert: - Die IoT Plattform „“ der Schlüssel für einfache und nachhaltige Industrie 4.0: Vorstellung notwendiger Plattformfeatures wie Device Management und wie diese Features zur Realisierung neuer Geschäftsmodelle genutzt werden. - Sicherheit im Internet der Dinge „“ Zukunft ist Vergangenheit: Wertvolle Hinweise und Zusammenhänge im Themenfeld IoT und Security - Wirtschaftliche Potenziale durch das Internet of Things „“ So erkennen Sie den Mehrwert für Ihr Unternehmen: Keynote durch Prof. Gronau Ein weiteres Highlight war der Besuch des IoT Anwenderzentrums, das gerne auch weiteren Delegationen offensteht. Einen guten Eindruck erhält man durch das Image Video: Bleibt uns noch zu sagen: Wir haben viel gelernt, haben viele Leute getroffen und kommen gerne wieder! **Kategorien:** Cloud, Tech Events & Networking --- ### [AWS News KW 45 und 46](https://thecattlecrew.net/2017/11/27/aws-news-kw-45-und-46/) **Published:** November 27, 2017 **Author:** Marco Buss **Content:** ## Neuer Instanztyp C5 mit neuem Hypervisor AWS bietet mit den neuen C5 Instanztypen ein Update für die auf Rechenleistung optimierten C Instanzen. Die C5 Instanzen sind in folgenden Ausprägungen verfügbar und bieten damit ein um bis zu 25% besseres Preis/Leistungsverhältnis. **Instanz Name****vCPUs** **RAM** **EBS Bandwidth****Network Bandwidth****c5.large**24 GiBUp to 2.25 GbpsUp to 10 Gbps**c5.xlarge**48 GiBUp to 2.25 GbpsUp to 10 Gbps**c5.2xlarge**816 GiBUp to 2.25 GbpsUp to 10 Gbps**c5.4xlarge**1632 GiB2.25 GbpsUp to 10 Gbps**c5.9xlarge**3672 GiB4.5 Gbps10 Gbps**c5.18xlarge**72144 GiB9 Gbps25 GbpsJede vCPU ist ein Hardware Hyperthread eines 3.0 GHz [Intel Xeon Platinum](https://www.intel.com/content/www/us/en/products/processors/xeon/scalable/platinum-processors.html) 8000-series Prozessors. Viel interessanter als die reinen Leistungsdaten ist der in einem Nebensatz erwähnte neue Hypervisor. AWS nutzte bisher einen angepassten Zen Hypervisor und führ jetzt mit den neuen C5 Instanzen einen eigenen ein. Genauere Details zum neuen Hypervisor sollen auf der re:Invent folgen. Ich bin gespannt. Die C5 Instanzen sind ab sofort in den Regionen US East (Northern Virginia), US West (Oregon), und EU (Ireland) verfügbar. ## EC2 Convertable Reserved Instanz Update Ab sofort sind Convertable Reserved Instanzen (CRI) auch mit einem Jahr Laufzeit verfügbar. Darüber hinaus ist es jetzt möglich den eigenen Pool der Reserved Instanzen anzupassen. Reserved Instanzen bieten bisher die Möglichkeit die Availability Zone, die Instanzgröße und den Netzwerktyp anzupassen. CRI bieten darüber hinaus die Option den Instance Type , das Betriebssystem und die Bezahlmethode anzupassen. Weitere Informationen zu CRI´s [hier](https://aws.amazon.com/ec2/pricing/reserved-instances/). ## 5 Neue Instanzengrößen für X1e Mit dem X1e Instanztypen bietet Amazon die Grundlage für memoryhungrige Anwendungen. Die Instanzen können bis zu 4TB Arbeitsspeicher enthalten und eigenen sich damit für alle Anwendungen die von solch großen Speicher profitieren können. Die 5 neuen Instanzgrößen bieten folgenden Leistungsdaten: **Model****vCPUs****Memory (GiB)****SSD Storage (GB)****Networking Performance****x1e.xlarge**4122120Up to 10 Gbps **x1e.2xlarge**8244240Up to 10 Gbps**x1e.4xlarge**16488480Up to 10 Gbps**x1e.8xlarge**32976960Up to 10 Gbps**x1e.16xlarge**641,9521,92010 Gbps**x1e.32xlarge**1283,9043,84025 Gbps## Neue Sicherheit´s Features für S3 Ab sofort sind folgende 5 neuen Sicherheitsfeatures für S3 verfügbar. 1. Default Encryption: Bisher war es nur möglich per Policy nicht verschlüsselte Dateien die in ein S3 Bucket abgelegt werden sollen abzuweisen. Mit der neuen default Encryption Policy können unverschlüsselte neue Dateien einfach verschlüsselt werden. 2. Permission Checks: Die Console zeigt jetzt sehr prominent ob auf einem Bucket public Access aktiviert wurde.![new-s3-public-marker](https://thecattlecrew.net/wp-content/uploads/2017/11/new-s3-public-marker.png) 3. Cross Region Replication ACL Overwrite: Bei der Replikation von Buckets in einen anderen AWS Account wurden bisher alle ACL´s und Tags mit kopiert. mit der neuen ACL Overwrite Funktionalität können die ACL´s überschreiben werden um dem Zielaccount vollen Zugriff zu gewähren. 4. Cross Region Replication mit KMS: Es können jetzt mit KMS Key´s verschlüsselte Dateien repliziert werden, ohne das diese vorher entschlüsselt werden müssen. 5. Detaillierter Inventory Report: Der Inventory Report enthält jetzt für jedes Objekt den Verschlüsselungsstatus. Der Report selbst kann ebenfalls verschlüsselt werden. Weitere Informationen zu S3 [hier](https://aws.amazon.com/s3/). ## AWS PrivateLink für AWS Services: Kinesis, Service Catalog, EC2 Systems Manager, Amazon EC2 APIs und ELB APIs im eigenen VPC Mit PrivateLink Endpoints ist es möglich innerhalb des eigenen VPC Ressourcen außerhalb des VPC´s zu erreichen. Ohne diese Links wäre ein Internet Gateway, NAT Gateway oder ein Firewall Proxy notwendig und der Datenverkehr würde durch das Internet laufen. Durch den Einsatz von PrivateLinks muss das VPC nicht für das Internet geöffnet werden und der Datenverkehr bleibt geschützt in Amazons eigenem Netzwerk. Seit einigen Tagen können PrivateLinks neben S3 und DynamoDB auch für die folgenden Services angelegt werden. - Kinesis, - Service Catalog - EC2 Systems Manager - Amazon EC2 API´s - ELB API´s Weitere Informationen zu PrivatLinks [hier](http://docs.aws.amazon.com/AmazonVPC/latest/UserGuide/vpc-endpoints.html). ## Amazon ElastiCache „“ Online Resizing für Redis Cluster Amazon ElastiCache ist Amazons Angebot für Caching. Es werden Memcached und Redis unterstützt. Für Redis basierte ElastiCache Cluster ist es nun möglich, ohne Downtime oder einen „kalten“ Cache ein Resharding vorzunehmen um auf sich ändernden Lastanforderungen Reagieren zu können. Weitere Informationen zu Amazon ElastiCache für Redis [hier](https://aws.amazon.com/elasticache/redis/). ## AWS OpsWorks for Puppet Enterprise AWS OpsWorks unterstützt ab sofort auch Puppet Enterprise. Mit AWS OpsWorks for Puppet Enterprise wird das Management des Puppet Masters komplett von Amazon übernommen. Zusätzlich erhält man Unterstützung bei den Themen Installation, Upgrades und Backup. Weitere Informationen zu AWS OpsWorks for Puppet Enterprise [hier](https://aws.amazon.com/opsworks/puppetenterprise/). **Kategorien:** Cloud **Schlagwörter:** AWS, ElastiCache, S3 --- ### [AWS News KW 47](https://thecattlecrew.net/2017/11/28/aws-news-kw-47/) **Published:** November 28, 2017 **Author:** Marco Buss **Content:** ## AWS Cost Explorer API Mit dem AWS Cost Explorer können die Kosten für die einzelnen AWS Services gut Visualisiert werden. Bisher war das lediglich über eine Oberfläche von AWS möglich. Mit der neuen Cost Explorer API ist es jetzt möglich die Daten direkt abzufragen und damit in eigene Tools zu integrieren. Die API bietet auch mehr Möglichkeiten als die Weboberfläche und liefert daher einen noch detailliertere Blick auf die Kosten von AWS. Jede Abfrage wird dabei mit 0,01$ berechnet, was in meinen Augen ein recht hoher Preis ist. Im Vergleich zu der Entwicklung einer eigenen Lösung um die Daten aus der Oberfläche zu extrahieren aber durchaus vertretbar ist. Weitere Informationen zu AWS Cost Explorer API [hier](http://docs.aws.amazon.com/awsaccountbilling/latest/aboutv2/cost-explorer-api.html). ## Amazon QuickSight Update Amazon QuickSight ist ein BI Tool von Amazon. Mit der Hilfe von QuickSight können Daten aus vielen Quellen, unter anderem S3, Redshift oder RDS visualisiert werden. Die wichtigsten neuen Features von QuickSight sind. **Geospatial Visualization** „“ Es ist jetzt möglich Daten mit Geoinformationen entsprechend mit Karten zu Visualisieren. **Private VPC Access** „“ Es ist jetzt möglich auf Daten in einem VPC zuzugreifen ohne einen Endpunkt einzurichten der über das Internet erreichbar ist. Es ist ebenfalls möglich mit [AWS DirectConnect](https://aws.amazon.com/directconnect/) per VPN auf Daten im eigenen Rechenzentrum zuzugreifen. **Flat Table Support** „“ Neben Pivot Tabellen können jetzt auch normale Tabellen für tabellarische Reports verwendet werden **Calculated SPICE Fields** „“ Support für run-time Berechnungen auf SPICE Daten als Teil der Analyse. **Wide Table Support** „“ Support für Tabellen mit bis zu 1000 Spalten. Weitere Informationen zu Amazon QuickSight [hier](https://quicksight.aws/). ## Neues Pricing Model für AWS IoT Bisher basierte das Pricing Model für AWS IoT auf der Anzahl der Messages die versendet wurden. Ab dem 01.01.2018 tritt ein neues Preismodel in Kraft, bei dem jeder Teil von AWS IoT extra berechnet wird. Je nach Nutzung spricht Amazon von einer Preisreduzierung von 20% – 40%. Die einzelnen Teile werden wie folgt berechnet (US East – Northern Virginia): **Connectivity** „“ Die Verbindung wird im Minutentakt pro Device berechnet. 0.08$ pro 1 Mio. Minuten. Das entspricht 0.042$ pro Device und Jahr. Der keep alive Ping darf dabei im Intervall von 30 Sekunden und 20 Minuten liegen. **Messaging** „“ 1$ bis 0,70$ pro 1 Mio. Nachrichten a 5kb (vorher 512b) mit einer Maximalen Größe von 128kb. **Rules Engine** „“ 0,15$ pro 1 Mio. Rules die getriggert werden und 0.15$ pro Mio. Aktionen die ausgeführt werden. Zu beachten ist hier das auch die Messagegröße ins Gewicht fällt. Die Abrechnungsgröße hierbei ist 5KB. Das bedeutet, dass eine Message mit 8KB Daten als zwei Regelausführungen berechnet werden. **Device Shadow & Registry Updates** „“ 1,25$ pro 1 Mio. Operationen. Auch hier spielt die Größe der Nachrichten analog der Rules Engine ein Rolle. Die Inkrementgröße beträgt aber 1KB. Die Priese für andere Regionen sind ab Januar auf der [Pricing Seite](https://aws.amazon.com/iot-platform/pricing/) von AWS IoT zu finden. Weitere Informationen zu AWS IoT [hier](https://aws.amazon.com/iot-platform/). **Kategorien:** Cloud **Schlagwörter:** AWS, QuickSight --- ### [OC @ Amazon re:Invent (part 1)](https://thecattlecrew.net/2017/11/30/oc-amazon-reinvent-part-1/) **Published:** November 30, 2017 **Author:** Danilo Schmiedel **Content:** This week Grzegorz, Siegfried an myself have the pleasure to attend to [Amazon re:Invent](https://reinvent.awsevents.com/) in Las Vegas, USA. So far it has been a fantastic event and a great experience. According to Andy Jassy (CEO of Amazon) the conference has about 43.000 attendees. The program is full of so many interesting breakout sessions, workshops, hackathons, hands-on labs and demos „“ I wish it would run for two weeks instead of just one. In this blog series we will share with you some of the things we“™ve learned during the conference. [![](https://thecattlecrew.net/wp-content/uploads/2017/11/reinvent2-150x150.jpg)](https://thecattlecrew.net/2017/11/30/oc-amazon-reinvent-part-1/reinvent2/) [![](https://thecattlecrew.net/wp-content/uploads/2017/11/reinvent-e1512030278624-150x150.jpg)](https://thecattlecrew.net/2017/11/30/oc-amazon-reinvent-part-1/reinvent/) [![](https://thecattlecrew.net/wp-content/uploads/2017/11/aws-150x150.jpg)](https://thecattlecrew.net/2017/11/30/oc-amazon-reinvent-part-1/aws/) In this post I start with a list of announcements that we“™ve heard in the keynote today. The key topics are Serverless, Machine Learning and IoT. 1. [Amazon Elastic Container Service for Kubernetes (EKS)](https://aws.amazon.com/eks/) – a managed service to run Kubernetes on AWS without needing to install and operate your own Kubernetes clusters. 2. [AWS Fargate](https://aws.amazon.com/fargate/) – a technology for Amazon ECS and EKS to run containers without having to manage servers or clusters. 3. [Amazon Aurora Serverless](https://aws.amazon.com/blogs/aws/in-the-works-amazon-aurora-serverless/) – an on-demand auto-scaling configuration for Aurora where the database will automatically start-up, shut down, and scale up or down capacity based on the application’s needs. 4. [Aurora Multi-Master](https://aws.amazon.com/about-aws/whats-new/2017/11/sign-up-for-the-preview-of-amazon-aurora-multi-master/) – a feature of Aurora edition, that adds the ability to scale out write performance across multiple Availability Zones. 5. [DynamoDB Global Tables](https://aws.amazon.com/dynamodb/global-tables/) – replicate your Amazon DynamoDB tables automatically across your choice of AWS regions 6. [DynamoDB Backup and Restore](https://aws.amazon.com/dynamodb/backup-restore/) – create full backups of your DynamoDB tables data for data archival. 7. [Amazon Neptune](https://aws.amazon.com/neptune/) – a fully-managed graph database service to build and run applications that work with highly connected datasets. 8. [S3 Select](https://aws.amazon.com/about-aws/whats-new/2017/11/amazon-s3-select-is-now-available-in-limited-preview/) – a new Amazon S3 capability designed to pull out only the data you need from an object in S3 by using SQL expressions. 9. [Glacier Select](https://aws.amazon.com/blogs/aws/s3-glacier-select/) – a new Amazon Glacier capability designed to pull out only the data you need from an object in Glacier by using SQL expressions. 10. [Amazon SageMaker](https://aws.amazon.com/sagemaker/) – a fully-managed service that enables developers and data scientists to build, train, and deploy machine learning models. 11. [AWS DeepLens](https://aws.amazon.com/deeplens/) – a wireless, deep learning enabled video camera for developers. 12. [Amazon Rekognition Video](https://aws.amazon.com/about-aws/whats-new/2017/11/introducing-amazon-rekognition-video/) – a deep learning powered video analysis service that tracks people, detects activities, and recognizes objects, celebrities, and inappropriate content. 13. [Amazon Kinesis Video Streams](https://aws.amazon.com/kinesis/video-streams/) – securely stream video from connected devices to AWS for analytics, machine learning (ML), and other processing. 14. [Amazon Transcribe](https://aws.amazon.com/transcribe/) – an automatic speech recognition (ASR) service to add speech to text capability to applications. 15. [Amazon Comprehend](https://aws.amazon.com/comprehend/) – a natural language processing (NLP) service that uses machine learning to find insights and relationships in text. 16. [AWS IoT 1-Click](https://aws.amazon.com/iot-1-click/) – a service that makes it easy for cloud-connected, single-purpose devices like buttons, badge readers, asset trackers, and motion sensor to trigger [AWS Lambda](https://aws.amazon.com/lambda/) functions that execute a specific action. 17. [AWS IoT Device Management](https://aws.amazon.com/iot-device-management/) – a service to securely onboard, organize, monitor, and remotely manage IoT devices at scale. 18. [AWS IoT Device Defender](https://aws.amazon.com/iot-device-defender/) (not GA yet) – a fully managed service that helps to secure a fleet of IoT devices by continuously auditing security policies. 19. [AWS IoT Device Analytics](https://aws.amazon.com/iot-analytics/) – a fully-managed service to run sophisticated analytics on massive volumes of IoT data. 20. [Amazon FreeRTOS](https://aws.amazon.com/freertos/) – an operating system for microcontrollers that makes small, low-power edge devices easier to program, deploy, secure, connect, and manage. It is based on the FreeRTOS kernel, a popular open source operating system for microcontrollers. 21. [Greengrass ML Inference](https://aws.amazon.com/greengrass/ml/) – run local compute, messaging, data caching, and sync capabilities for connected devices in a secure way and perform ML inference locally on them. An exciting day and we cannot wait to try the things above in our lab and by ourself. Stay tuned! **Kategorien:** Cloud, Tech Events & Networking **Schlagwörter:** Artificial Intelligence, AWS, IoT, Serverless --- ### [Quick Tipp: Message Properties in der Azure-Queue](https://thecattlecrew.net/2018/06/05/quick-tipp-message-properties-in-der-azure-queue/) **Published:** Juni 5, 2018 **Author:** christophstephanopitz **Content:** Das Ein- und Auslesen von Messages einer Queue gehört zu den Standardaufgaben bei Message basierter Integration. Müssen viele Informationen übergeben werden und sollen daher die Properties einer Message genutzt werden, um beispielsweise darüber bestimmte Routingoptionen anzugeben, ist dies beim Erstellen einer Nachricht ohne weiteres möglich. Auch das Senden der Messages inklusive Properties funktioniert wie vermutet. Nehmen wir allerdings die Message aus der Queue heraus und versuchen – wie beim Erstellen – die Properties zu erreichen, bekommen wir eine Fehlermeldung, dass die Property *undefined* ist. Dies liegt daran, dass die Properties beim Herausnehmen nicht mehr mit der Message verknüpft sind. Lediglich der Body einer Message bleibt dem Message-Objekt erhalten. ![QuickTip01](https://thecattlecrew.net/wp-content/uploads/2018/06/quicktip01.png)Abbildung 1: Message für die Queue **Die Lösung:** Um die Properties trotzdem verwenden zu können, wird auf *context.bindingData.properties* zugegriffen. Dort werden die Properties nach wie vor aufgeführt und zugänglich gemacht. ![QuickTip02](https://thecattlecrew.net/wp-content/uploads/2018/06/quicktip02.png)Abbildung 2: Beispiel zum Zugriff auf Properties **Kategorien:** Cloud --- ### [AWS News KW 13 und KW 14](https://thecattlecrew.net/2018/06/11/aws-news-kw-13-und-kw-14/) **Published:** Juni 11, 2018 **Author:** Marco Buss **Content:** ## AWS Secrets Manager AWS Secrets Manager ist ein Dienst zum verwalten von Geheimnissen. Das sind im allgemeinen Zugangsdaten für andere Dienste. Damit bietet Amazon einen Dienst ähnlich Spring Vault für die Zentrale Ablage von Geheimnissen und erleichtert damit beispielsweise das Rotieren von Passwörtern. Ohne solch einen Dienst müssten im schlimmsten Fall alle Anwendungen die dieses Geheimnis nutzen neu deployt werden. Aus Sicherheitsgründen ist das Rotieren von Passwörtern wichtig. AWS Secrets Manager bietet auch hierfür spezielle Unterstützung an. Es kann eine Lambda Funktion definiert werden, die in einem definierbaren Zeitintervall aufgerufen wird, um ein neues Passwort zu generieren. Jedes Geheimnis das im AWS Secrets Manager abgelegt wird kostet 0.40$ pro Monat und 10.000 API Calls werden mit 0.05$ berechnet. Weitere Informationen zu AWS Secrets Manager [hier](https://aws.amazon.com/secrets-manager/). ## Amazon Translate verfügbar Auf der re:invent 2017 als Preview vorgestellt ist Amazon Translate ab sofort für alle verfügbar. Im ersten Jahr sind 2 Millionen Zeichen pro Monat frei danach kosten 1 Million Zeichen 15$. Mit dem neuen Dienst ist es möglich auf einfache Weise Texte übersetzen zu lassen. Es ist sehr einfach den Dienst in einer Lambda Function zu verwenden und dadurch ist er in vielen weiteren AWS Services nutzbar. Aktuell können bis zu 5000 Zeichen pro Request übersetzt werden. Die Quellsprache kann automatisch ermittelt werden und es ist im Moment möglich von folgenden Sprachen von und nach Englisch zu übersetzen - Arabisch - Chinesisch (vereinfacht) - Deutsch - Französisch - Portugisisch - Spanisch Die Sprachen Japanisch, Russisch, Italienisch, Chinesisch (traditionell) Türkisch und Tschechisch Weitere Informationen zu Amazon Translate [hier](https://aws.amazon.com/translate/). ## Amazon Transcribe verfügbar Amazon Transcribe ist Amazons automatische Spracherkennung. Mit diesem neuen Dienst reicht ein einfacher API Aufruf und die Aufnahme eines Gesprächs um ein entsprechendes Transkript zu erzeugen. Für Aufnahmen mit speziellem Vokabular, beispielsweise eine Meetingaufzeichnung mit speziellen Fachbegriffen kann ein extra Vokabular mitgeliefert werden, so das auch diese Wörter zuverlässig erkannt werden. Amazon Transscribe ist ab sofort für die Regionen US East (N. Virginia), US West (Oregon), US East (Ohio) und EU (Ireland) verfügbar. Innerhalb der ersten 12 Monate sind 60 Minuten Audio pro Monat im kostenlosen Kontingent, danach betragen die Kosten $0.0004 pro Sekunde bei 15 Sekunden Mindestlänge. Weitere Informationen zu Amazon Transcribe [hier](https://aws.amazon.com/transcribe/). ## Continuous Backups und Point in Time Recovery für DynamoDB Nachdem [DynamoDB](https://aws.amazon.com/dynamodb/) seit einiger Zeit eine Backup und Restore Funktionalität bietet ist der nächste Schritt ein Continuous Backup und Point in Time Recovery (PITR) der Daten. Nachdem das Feature aktiviert wurde werden fortlaufende Backups der letzten 35 Tage angelegt. Mit diesem neuen Feature liefert AWS eine zusätzliche Versicherung gegen versehentliches Löschen oder andere „Missgeschicke“, da die Tabellen für jeden Zeitpunkt der letzten 35 Tage wiederhergestellt werden können. Der Preis richtet sich nach der Tabellengröße und beträgt z.B. 0,2448 $ pro Monat und GB an Daten in der Region Frankfurt. Weitere wichtige Infos zum Feature: - funktioniert mit verschlüsselten Tabellen - hat keine Auswirkungen auf die Performance oder Verfügbarkeit - Wird das Feature deaktiviert und später wieder aktiviert wird der Startzeitpunkt zurückgesetzt - Stream, TTL und PITR Einstellungen sowie Tags, Cloudwatch Alarme und Auto Scaling Policies werden nicht in die Wiederhergestellten Tabellen kopiert - Jede Wiederherstellung wird in CloudTrail aufgezeichnet Weitere Informationen zu DynamoDB PITR [hier](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/PointInTimeRecovery.html). ## Support von weiteren Instanztypen für Amazon SageMaker [Amazon SageMaker](https://aws.amazon.com/sagemaker/) ist eine vollständig verwaltete Plattform für Machine Learning Aufgaben. Ab sofort unterstützt SageMaker eine ganze Liste weiterer EC2 Instanztypen. Dadurch ist der Einsatz noch flexibler und es kann eine bessere Preis/Performance erreicht werden. Weitere Informationen zu SageMaker [hier](https://aws.amazon.com/sagemaker/). ## One Zone-IA als neue S3 Storage Class Die neue Storage Class speichert Daten lediglich in einer Availability Zone anstatt in mindestens Drei. Die Storage Class bietet ebenfalls 99,999999999 Durability wie die anderen Klassen, ist aber nicht gegen den kompletten Ausfall einer AZ durch Erdbeben Flut oder ähnliche Katastrophen gewappnet. Sie ist geeignet für Sekundäre Backups, Wiederherstellbare Daten und bietet einen 20% Kostenvorteil gegenüber der normalen IA Storage Klasse. Weitere Informationen zu One Zone-IA [hier](https://aws.amazon.com/s3/storage-classes/). ## S3 Select Mit S3 Select ist es möglich Subsets von Daten aus Dateien in S3 zu laden. Das Feature ist für Daten die im CSV oder JSON Format vorliegen sehr hilfreich, da bei größeren Dateien nicht mehr die komplette Datei übertragen werden muss sondern nur noch die Datensätze die von Interesse sind. Die Daten die Übertragen werden sollen können wie der Name des Features vermuten lässt in einer Anfragesprache ähnlich SQL definiert werden. Weitere Information zu S3 Select [hier](https://docs.aws.amazon.com/AmazonS3/latest/dev/selecting-content-from-objects.html). ## AWS Config Rules – Über Regionen und Accounts aggregierte Daten AWS Config Rules bietet jetzt die Möglichkeit die Einhaltung der Complience Regelungen die per AWS Config und AWS Config Rules festgelegt wurden über mehrere Accounts und Regionen aggregiert darzustellen. Weitere Informationen über AWS Config [hier](https://aws.amazon.com/config/). ## Encryption in Transit für EFS Ab sofort bietet Elastic File System neben der Möglichkeit die Daten verschlüsselt abzulegen auch die Möglichkeiten Daten schon verschlüsselt zu transportieren. Weitere Informationen über EFS [hier](https://aws.amazon.com/efs/). **Kategorien:** Cloud **Schlagwörter:** Amazon Transcribe, Amazon Translate, AWS --- ### [AWS Summit Berlin 2018 - It's a wrap!](https://thecattlecrew.net/2018/06/13/aws-summit-berlin-2018-its-a-wrap/) **Published:** Juni 13, 2018 **Author:** Danilo Schmiedel **Excerpt:** Am 6. und 7. Juni fand in Berlin der AWS Summit statt. In diesem Post berichtet OPITZ CONSULTING von der gelungenen Veranstaltung. **Content:** Am 6. und 7. Juni war es wieder soweit. AWS lud zum jährlichen AWS Summit im [STATION Berlin](https://www.station-berlin.de/en/) ein. Selbe Location wie in 2017, aber erneut wurden die Zahlen aus dem [vergangenen Jahr](https://thecattlecrew.net/2017/05/19/opitz-consulting-berichtet-vom-aws-summit-berlin-teil-1-mit-fokus-cloud-adoption/) in allen Belangen gesteigert: mehr Sessions, mehr Besucher, mehr Partner und mehr Inhalte. Das Team von OPITZ CONSULTING war als AWS Partner ebenfalls auf dem Event vertreten. ![IMG_0672.jpg](https://thecattlecrew.net/wp-content/uploads/2018/06/img_0672.jpg) In komprimierter Form berichteten wir auf Twitter und LinkedIn über das Event. Nachfolgend ein Auszug: 1. Ab 1. Juli werden Verträge in EMEA mit AWS Europe geschlossen, nicht mehr mit US Inc… Good News fuer [@**OC\_WIRE**](https://twitter.com/OC_WIRE) at [\#**AWSSummit** ](https://twitter.com/hashtag/AWSSummit?src=hash) 2. [\#**OpitzConsulting**](https://twitter.com/hashtag/OpitzConsulting?src=hash) wurde beim [\#**AWS**](https://twitter.com/hashtag/AWS?src=hash) Partner Event mit dem Innovation Award für ausgezeichnet! Danke an [\#**AWS**](https://twitter.com/hashtag/AWS?src=hash) – das ist eine Riesenmotivation! 3. [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) I like the statement from Daniel Barthelmes (OTTO): „If you run a datacenter, you should have a cloud strategy.“ 4. Puenktlich zum [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) gibt es den **[Channel Guide](https://files.vogel.de/vogelonline/vogelonline/files/9955.pdf)** von IT-Business. Neben interessanten Artikeln gibt es darin das [\#**AWS**](https://twitter.com/hashtag/AWS?src=hash) Angebot von [@**OC\_WIRE**](https://twitter.com/OC_WIRE) mit [\#**OCLab**](https://twitter.com/hashtag/OCLab?src=hash) [\#**OpenDevStack**](https://twitter.com/hashtag/OpenDevStack?src=hash) und Case Studies unserer Kunden (Seite 31). ![AWS-Channel-Guide-OPITZ](https://thecattlecrew.net/wp-content/uploads/2018/06/aws-channel-guide-opitz.png) 5. Proud that [@**OC\_WIRE**](https://twitter.com/OC_WIRE) has been mentioned by Peter Prahl in the [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) Thursday keynote with our successful [**customer case**](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/97-css-bsh.pdf) 6. Useful tips & tricks from **[Daniel Geske](https://twitter.com/btx94)** in his session „Building Cost-effective mobile backends for scale and security“ ![IMG_5884.jpg](https://thecattlecrew.net/wp-content/uploads/2018/06/img_5884.jpg) 7. Interesting talk from [\#**BMW**](https://twitter.com/hashtag/BMW?src=hash) at [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) on how they migrated their Car Configuration Platform to [\#**AWS**](https://twitter.com/hashtag/AWS?src=hash). Good insights! 8. [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) Lessons learned from [\#**BMW**](https://twitter.com/hashtag/BMW?src=hash) during the transition to AWS. ![IMG_5870](https://thecattlecrew.net/wp-content/uploads/2018/06/img_5870.jpg) 9. [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) One big strength of [\#**AWS**](https://twitter.com/hashtag/AWS?src=hash) -> Security & Certifications. 10. Getting started with [\#**AWS**](https://twitter.com/hashtag/AWS?src=hash) [\#**EKS**](https://twitter.com/hashtag/EKS?src=hash) [https://docs.aws.amazon.com/eks/latest/userguide/getting-started.html „¦](https://t.co/uNMdKw4s2i "https://docs.aws.amazon.com/eks/latest/userguide/getting-started.html") [\#**demotime**](https://twitter.com/hashtag/demotime?src=hash) [\#**AWSSummit** ](https://twitter.com/hashtag/AWSSummit?src=hash) 11. [\#**AWSSummit**](https://twitter.com/hashtag/AWSSummit?src=hash) Day 2 just started. Impressive how this event has evolved over the last few years!![AWS-Summit-Berlin-2018-Opitz](https://thecattlecrew.net/wp-content/uploads/2018/06/aws-summit-berlin-2018-opitz.jpg) Großes Highlight des Events war für uns die Verleihung der AWS Partner Awards. Stellvertretend für das Cloud Competence Center von OPITZ CONSULTING nahmen [Tom Gansor](https://twitter.com/tgansor) und [Danilo Schmiedel](https://twitter.com/dschmied) den Preis in der Kategorie „Innovation“ entgegen. Weiterführende Informationen dazu gibt es in unserer **[Presseinfo](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/pm-aws-innovation-award.pdf)**. Wenn Sie mehr zu unserer Sichtweise über die Innovation im digitalen Wandel erfahren wollen, so [bestellen Sie sich doch unser gleichnamiges Buch](https://www.opitz-consulting.com/know-how/innovation-im-digitalen-wandel.html) sowie die [komprimierte Darstellung als Poster](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/oc-poster-innovation-im-digitalen-wandel.pdf). Alles in allem eine tolle Konferenz mit unzähligen Anregungen. Wir freuen uns diese in Projekten wie der [Serverless Bonus-Berechnung](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/97-css-bsh.pdf) und [DevOps in der Cloud](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Referenzen/80-css-ppi.pdf) einfließen zu lassen. GO BUILD 🙂 **Kategorien:** Cloud, Tech Events & Networking **Schlagwörter:** Award, AWS, Berlin, cloud, Innovation --- ### [Azure: Eine Mail-Anbindung zu SendGrid](https://thecattlecrew.net/2018/06/14/azure-eine-mail-anbindung-zu-sendgrid/) **Published:** Juni 14, 2018 **Author:** christophstephanopitz **Content:** In diesem Artikel möchte ich euch zeigen, wie ihr in eurem Azure Projekt eine Mail über SendGrid verschickt. SendGrid ist ein cloudbasierter Mailprovider, der mit dem Azure Portal verbunden werden kann. SendGrid ist grundsätzlich kein kostenloses Produkt. Allerdings gibt es in der Kombination mit Azure ein kostenloses Abonnement, bei dem 25.000 E-Mails pro Monat verschickt werden können. Bei höheren Mailzahlen muss normal gezahlt werden. Beginnen wir mit dem Aufsetzten der verschiedenen Bestandteile. Eine Function App besitzen wir bereits. Falls ihr mehr Informationen über das Erstellen einer Function App braucht, schaut euch den Beitrag „[Azure Functions – Simple JavaScript Tutorial](https://thecattlecrew.net/2018/05/16/azure-functions-simple-javascript-tutorial/)“ an. Uns fehlt ein SendGrid Account. Um diesen zu erstellen, erzeugen wir im Portal eine neue Ressource (siehe Abb. 1). Anschließend füllen wir die notwendigen Felder aus, wählen ein monatliches Maillimit und bestimmen damit gleichzeitig die Bezahlung. In diesem Fall entscheide ich mich für die kostenlose Variante (siehe Abb. 2). ![SendGrid_01_1](https://thecattlecrew.net/wp-content/uploads/2018/06/sendgrid_01_1.png)Abbildung 1: SendGrid Account erstellen ![SendGrid_02_1](https://thecattlecrew.net/wp-content/uploads/2018/06/sendgrid_02_1.png)Abbildung 2: Sendgrid Bezahlmodelle Um SendGrid verwenden zu können, müssen wir den Account freischalten. Dazu gehen wir über *Manage* (im Untermenü der Ressource, siehe Abb. 3) auf die Website von SendGrid. Dort werden wir aufgefordert unseren Account über die vorher angegebene E-Mail-Adresse freizuschalten. Als letzten Schritt erstellen wir auf der SendGrid Website einen API-Key. Dieser dient der Verknüpfung zwischen SendGrid und unserer Funktion und ist vergleichbar mit dem Connectionstring einer Queue. Um einen API-Key zu erstellen, gehen wir unter *Settings* und wählen dort *API-Key*. Hier können wir unsere Keys erstellen, und verwalten. Zu beachten ist, dass der API-Key nur bei der Erstellung angezeigt wird. Im Anschluss haben wir keine Möglichkeit mehr diesen auszulesen. Sichert den Key daher gut! ![SendGrid_03_1](https://thecattlecrew.net/wp-content/uploads/2018/06/sendgrid_03_1.png)Abbildung 3: Hier gelangen wir zur SendGrid Website Jetzt können wir unsere Function einrichten und beginnen mit der Verbindung zum SendGrid. Im Bereich *Integrieren* unserer Function fügen wir eine neue Ausgabe hinzu und wählen dabei SendGrid aus. Nun geben wir die Defaultwerte für den Mailversand an. Außerdem erstellen wir eine neue App-Einstellung und verwenden dazu den API-Key aus dem vorigen Teil. Nun können wir mit dem Schreiben der Funktion beginnen. Als Beispiel habe ich bereits eine kleine Function geschrieben (siehe Abb. 4), die eine Message aus einer Service Bus Queue ausliest und den Text anschließend als Mail verschickt. Wenn wir die Funktion nun testen indem wir eine Nachricht in die Service Bus Queue schicken, erhalten wir eine Mail mit den angegebenen Informationen. ![SendGrid_07](https://thecattlecrew.net/wp-content/uploads/2018/06/sendgrid_07.png)Abbildung 4: Beispielfunction zum Senden einer Mail Ihr habt jetzt gesehen, wie ihr eine Mail mittels SendGrid versenden könnt. Abschließend möchte ich sagen, dass bei der Arbeit das SendGrid Portal mit seinen Monitoring-Möglichkeiten sehr hilfreich war. Es kann also nicht schaden, sich diesen Bereich einmal anzusehen. **Kategorien:** Cloud --- ### [Azure Functions "“ Lokales Testing](https://thecattlecrew.net/2018/06/20/azure-functions-lokales-testing/) **Published:** Juni 20, 2018 **Author:** davidgreineropitz **Content:** In den letzten beiden Einträgen [Azure Functions „“ Simple JavaScript Tutorial](https://thecattlecrew.net/2018/05/16/azure-functions-simple-javascript-tutorial/) und [Azure Functions „“ Vollgas mit dem Service-Bus](https://thecattlecrew.net/2018/05/30/azure-functions-vollgas-mit-dem-service-bus/) haben wir unsere Azure Funktionen entwickelt und diese im Azure Portal getestet. Ist man in einer Azure Subscription unterwegs, die als Spielwiese oder fürs Testen gedacht ist, kann es noch praktikabel sein, etwas direkt im Portal zu entwickeln bzw. zu testen. Laufen jedoch bereits Produktiv-Systeme in der Subscription kommt man damit sehr schnell in Teufels Küche. Man stelle sich mal vor, dass wir nach dem Testen die falsche Funktion löschen oder wir uns verschrieben haben und unsere Testdaten in der Produktiv Queue landen „¦ Ich könnte noch weitere Beispiele nennen, aber ich denke, wir sind uns schon jetzt einig, dass dies nicht der Ideale Weg sein kann. Bei [Azure Functions „“ Vollgas mit dem Service-Bus](https://thecattlecrew.net/2018/05/30/azure-functions-vollgas-mit-dem-service-bus/) haben wir die Entwicklung unserer Funktionen daher schon aus dem Portal in unsere lokale Umgebung verlagert. Da wäre es jetzt natürlich noch super, wenn wir diese auch lokal testen und debuggen könnten. Vorneweg gesagt, ja man kann lokal debuggen und testen, doch nicht alles „¦ dazu aber später mehr. Für das lokale Entwickeln und testen bietet uns Microsoft die Azure Functions Core Tools an. Die Azure Functions Core Tools sind eine lokale Version der Function Runtime. Daher gibt es zwei Versionen der Core Tools, zum einen für die Runtime Version 1.x und zum zweiten für die Version 2.x. Für unsere Beispiele haben wir die Version 1.x der Runtime genutzt, weil nur diese aktuell für Produktiv-Umgebungen zugelassen ist. Die Version 1.x nutzt das .NET-Framework und unterstützt so nur die Plattform Windows. Beide Versionen der Core Tools stehen als npm Pakete zur Verfügung und könnten mittels nodeJS installiert werden. Wer es noch nicht installiert hat, findet nodeJs für Windows unter . Nach der Installation kann man mittels dem Node.js Command Prompt oder der Windows Eingabeaufforderung (CMD) die Azure Functions Core Tools installieren (Abbildung 1). Abbildung 1 ![Abbildung_1](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_1.png) Nach der erfolgreichen Installation können wir mittels func init ein lokales Azure Funktionen-Projekt erstellen (Abbildung 2). Dabei wird auch ein lokales Git Repository generiert. Wir führen diesen Befehl in dem in [Azure Functions „“ Vollgas mit dem Service-Bus](https://thecattlecrew.net/2018/05/30/azure-functions-vollgas-mit-dem-service-bus/) erstellten Projekt Ordner aus. In unserem Fall wird kein lokales Git Repository erstellt, da wir schon mit unserem Remote Repository verbunden sind. Wie in Abbildung 2 zu sehen, werden einige Dateien erstellt. In der host.json können übergreifende Einstellungen für die Funktionen hinterlegt werden. In der local.settings.json stehen die nötigen Einstellungen für das lokale Ausführen der Funktionen. In der launch.json finden sich die benötigten Informationen, um die Funktionen lokal im Visual Studio Code () zu debuggen. Neben func init gibt es den Befehl func new. Mit func new können wir eine Funktion erstellen. Dabei werden anhand des gewählten Templates die function.json und die index.js erstellt. Der Befehl unterstützt folgende Optionen: - –language -l Damit können wir die Sprache für die Funktion angeben (C#, JavaScript“¦) - –template -t Name der Vorlage, die genutzt werden soll, z. B. HTTP Trigger wenn man eine Funktion mit einem HTTP Trigger entwickeln möchte. - –name -n Name der Funktion. Lässt man die Optionen weg, bekommt man eine Auswahl der verfügbaren Sprachen und Templates angezeigt und kann unter diesen die passenden wählen (Abbildung 1b). Abbildung 1b ![Abbildung_1b](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_1b2.png) Abbildung 2 ![Abbildung_2](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_2.png) So, Schritt eins ist nun geschafft. Einige Trigger bzw. Bindungen haben eine Connection-Eigenschaft, die im Portal in der Funktionen-App konfiguriert wird. Beim lokalen Ausführen müssen diese Verbindungseigenschaften in der local.settings.json hinterlegt werden. Es gibt zwei Wege, um dies zu erfüllen. Der erste besteht darin, die Informationen aus einer Funktionen-App zu beziehen. Das bedeutet, dass z. B. Nachrichten in einer Warteschlange (Queue) abgelegt werden, die in der Funktionen-App konfiguriert ist. Nutzt man diesen Weg sollte man eine Warteschlange (Azure Service Bus) und eine Funktionen-App für Testzwecke anlegen. Dafür führt man folgenden Befehl aus: func azure functionapp fetch-app-settings (Abbildung 3). Abbildung 3 ![Abbildung_3.png](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_3.png) Abbildung 4 ![Abbildung_4](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_4.png) Wie am Anfang erwähnt, kann nicht alles lokal getestet werden. Für den Azure Service Bus gibt es meines Wissens aktuell keinen Emulator. Wer seine Subscription nicht für Testzwecke nutzen möchte, kann in diesem Falle ein Service Bus für Windows Server installieren (). Zur Vereinfachung nutzen wir in diesem Beispiel unsere Azure Subscription. Der Vollständigkeit halber sei erwähnt, dass es für den Azure Storage einen Emulator gibt. Der Azure Speicheremulator emuliert die Blob-, Warteschlangen- und Tabellendienste von Azure. Weitere Informationen findet man unter . Dort werden auch die Unterschiede zwischen dem Emulator und den Azure Storage aufgezählt. Bei der Warteschlange handelt es sich um eine Storage Queue, nicht um eine Service Bus Queue. Wie man den Speicheremulator installiert und konfiguriert, zeige ich kurz am Ende des Beitrags. Nun aber zurück zu unserem Beispiel. Mit dem Befehl func host start werden die Trigger für alle Funktionen im Projekt (Funktion-App) aktiviert. Mit der Option – – debug vscode wird das Debuggen mittels Visual Studio Code (VSCode) ermöglicht (Abbildung 5). Weitere Optionen von host start können Abbildung 5a entnommen werden. Abbildung 5 ![Abbildung_5](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_5.png) Abbildung 5a ![Abbildung_5a](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_5a.png) Nach dem Starten der Funktionen kann mittels F5 bzw. über den Menüpunkt „Debuggen“ /“Debuggen starten“ im Visual Studio Code der Debugger aktiviert werden. In Abbildung 6 sieht man im unteren Bereich des VSCode, dass sich der Debugger an die Funktionen des Projekts „functionServiceBusTest“ gebunden hat. Dem Debuggen steht nun nichts mehr im Weg. Abbildung 6 ![Abbildung_6](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_6.png) Benötigt die Funktion Testdaten, können diese mit Hilfe von HTTP Testtools wie cURL oder Postman übermittelt werden. Die Aufruf URL der Funktionen baut sich wie folgt auf: *http://localhost:{port}/api/{function\_name}*. Bei einer Funktion mit einem HTTP Trigger, der einen Übergabeparameter erwartet, würde der Aufruf wie in Abbildung 7 aussehen. Abbildung 7 ![Abbildung_7](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_7.png) Bei Funktionen die nicht mittels eines HTTP Triggers ausgelöst werden, lautet die Aufruf-URL *http://localhost:{port}/admin/functions/{function\_name}*. Wir werden nun mit Postman unsere Funktion „FunktionServiceBusReader“ aufrufen und als Nachricht „Mein Text“ übermitteln. Dazu erstellen wir bei Postman einen neuen POST Request und geben dort die Aufruf *URL http://localhost:9090/admin/functions/FunktionServiceBusReader* ein. Als Content Typ wird im Reiter „Headers“ application/json ausgewählt. Im Reiter „Body“ geben wir den Content wie folgt ein: { „input“: „Mein Text“ } und senden den Request ab (Abbildung 8). Hat alles funktioniert, sollten wir im CMD (Windows Eingabeaufforderung) bzw. dem Node.js Command-Prompt-Fenster die Ausgabe ServiceBus Message Mein Text sehen (Abbildung 9). Abbildung 8 ![Abbildung_8](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_8.png) Abbildung 9 ![Abbildung_9](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_9.png) Somit können wir nun unsere Funktionen lokal debuggen und zum Teil lokal testen. Beim Einsatz des Service Bus ist es aktuell, wie erwähnt, nicht möglich, komplett lokal zu testen. Wie weiter oben angekündigt, schauen wir uns zum Schluss noch an, wie man den Azure Speicheremulator installiert und konfiguriert. Der Azure Speicheremulator benötigt eine lokale Microsoft SQL Server Instanz. Zu diesem Zweck können wir die SQL Server 2017 Express Edition nutzen (). Nach der Installation der SQL Server 2017 Express Edition müssen wir noch den Speicheremulator installieren ([https://go.microsoft.com/fwlink/?linkid=717179&clcid=0x409](https://go.microsoft.com/fwlink/?linkid=717179&clcid=0x409)). Nach Abschluss der Installationen wählen wir die Schaltfläche Start aus, geben dort „Azure Storage Emulator“ ein und wählen diesen aus. Daraufhin wird der Speicheremulator gestartet und initialisiert. Zuerst wird dabei geprüft, ob es eine MSSQLLocalDB-Instanz gibt. Da dies bei uns nicht der Fall ist, wird geprüft, ob es eine andere SQL-Instanz auf dem System gibt. Wie man in Abbildung 10 sieht, findet das System die eben installierte SQL Express Instanz und konfiguriert sie. Nach Abschluss der Konfiguration läuft der Speicheremulator und kann von unseren Funktionen lokal genutzt werden. Abbildung 10 ![Abbildung_10.png](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_10.png) Um nun den Speicheremulator nutzen zu können, muss die local.settings.json angepasst werden. Dazu weisen wir AzureWebJobsStorage den Wert UseDevelopmentStorage=true zu (Abbildung 11). Die Endpoints z. B. für den Blob Storage bekommen wir mit dem Befehl AzureStorageEmulator.exe status angezeigt und können diese bei Bedarf in die local.settings.json übernehmen (Abbildung 12). Abbildung 11 ![Abbildung_11.png](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_11.png) Abbildung 12 ![Abbildung_12](https://thecattlecrew.net/wp-content/uploads/2018/06/abbildung_12.png) Wie wir gesehen haben, können wir unsere Funktionen debuggen und mit einigen Einschränkungen lokal testen. Mit dem Einsatz des Azure Speicheremulators und dem Service Bus für Windows Server kann man auch komplett losgelöst von einer Azure Subscription arbeiten. Gesagt sei das wir mit den Emulatoren die Azure Plattform nicht zu 100% abbilden können. Die aktuell praktikabelste Lösung ist die Erstellung einer Development / Testing Stage in der Cloud. So können die benötigten Komponenten, in unserem Beispiel der ServiceBus, direkt in der Laufzeitumgebung getestet werden. Durch eine eigene Stage hat man auch eine Saubere Trennung zur Live Umgebung. Falls man aus den kostenfreien Kontingenten herausläuft, kann die separate Stage bei nicht Nutzung ausgeschaltet werden. **Kategorien:** Cloud --- ### [GraphQL Demo (1/8) - Einführung in GraphQL und unsere Demo-Anwendung](https://thecattlecrew.net/2018/08/16/einfuehrung-in-graphql-und-unsere-demo-anwendung/) **Published:** August 16, 2018 **Author:** Manuel Styrsky **Content:** Zunächst kurz zu uns: Wir, Phillip Fehrmann und Manuel Styrsky sind beide als Werkstudenten in der Software Entwicklung bei Opitz Consulting Deutschland GmbH beschäftigt und haben uns um Zuge dessen in das Thema GraphQL eingearbeitet und dabei auch ein Backend für eine kleine Chat-App auf Basis von GraphQL entwickelt. In dieser Blogserie wollen wir auf die Punkte von GraphQL eingehen, die uns während dem Projekt besonders aufgefallen sind und vor allem Unterschiede zu REST ausarbeiten. ### **Was ist GraphQL?** GraphQL ist eine neuere Schnittstellentechnik und soll als Query Language für Schnittstellen eine Alternative zu REST darstellen. GraphQL kann in jeder Programmiersprache in Kombination mit beliebigen Datenbanken und anderen Datenquellen umgesetzt werden, viele Frameworks und Codebeispiele sind jedoch in JavaScript gehalten, ebenso die Referenzimplementierung von GraphQL. Dabei werden Anfragen an die Schnittstelle in Form von Queries gestellt, die der Client nach seinen Datenbedürfnissen aufsetzt und die anschließend vom Server bearbeitet werden. Antworten werden entsprechend der Anfragen als JSON-Objekte zurückgegeben und enthalten nur die angefragten Daten. Die Vorteile sind unabhängigere, flexiblere Clients, weniger Anfragen an den Server und keine Übermittlung ungenutzter Daten. Einen genaueren [Vergleich mit REST](https://thecattlecrew.net/2018/08/23/graphql-vs-rest), in dem wir näher auf Vor- und Nachteile eingehen, kommt demnächst in dieser Blogserie. ### **Unsere Demo Anwendung** Um das Thema zu vertiefen und gleichzeitig eine GraphQL-Schnittstelle zu entwickeln, haben wir eine kleine Demo-Anwendung geschrieben, die einen einfachen Backend Server für eine Chat-App darstellt. Diese läuft als NodeJS Server mit dem Apollo Framework und einer MariaDB SQL-Datenbank und wurde in TypeScript geschrieben. Bei der Entwicklung des Backends haben wir einige Techniken zur Entwicklung von GraphQL-Schnittstellen ausprobiert, sind auf Hindernisse gestoßen, haben Lösungen gefunden und stießen natürlich auch auf Probleme, die wir noch nicht lösen konnten. So haben wir uns unter anderem mit [Caching](https://thecattlecrew.net/2018/09/06/response-caching), [Batching mit dem Dataloader](https://thecattlecrew.net/2018/08/30/dataloader-und-batching), Ratelimiting, Authorization und Monitoring beschäftigt. Auch Schema Stitching und Remote Schemas haben wir mit zwei Microservices und einem Gateway genutzt. Zu all diesen Themen veröffentlichen wir nun demnächst tiefer gehende Blogeinträge. ### **Unsere Einschätzung** Grundsätzlich halten wir die Idee hinter GraphQL für sehr nützlich: Ein Client bestimmt die Daten, die ein Server liefert und dieser benötigt dazu nur sehr wenige Aufrufe. Jedoch sind Dokumentationen und Lösungen zu Problemen bei GraphQL an vielen Stellen noch sehr unausgereift. Meist können zwar einfache Teilprobleme mit wenig Aufwand bewältigt werden, während andere Problemfälle nicht abgedeckt werden. Um die verschiedenen Probleme und unsere Lösungen dazu geht es in den folgenden Einträgen. Dranbleiben lohnt sich! **Kategorien:** Cloud, Development **Schlagwörter:** communication, Facebook, GraphQL, Innovation, Internet, JavaScript, Mobile, OC|Lab, rest, TypeScript --- ### [Cloud Control: the Graph in the Performance Top Activity view shrinks to left](https://thecattlecrew.net/2018/07/14/cloud-control-the-graf-in-the-performance-top-activity-view-shrinks-to-left/) **Published:** Juli 14, 2018 **Author:** Neselovskyi, Borys **Kategorien:** Cloud **Schlagwörter:** Cloud Control, HowTo, oracle, Troubleshooting --- ### [AWS News KW 21 und KW 22](https://thecattlecrew.net/2018/07/09/aws-news-kw-21-und-kw-22/) **Published:** Juli 9, 2018 **Author:** Marco Buss **Content:** ## Eingebaute Autorisierung für Application Load Balancer Ab sofort ist es möglich die Autorisierung von Nutzern direkt im Application Load Balancer zu behandeln und somit bestimmte URL´s nur von angemeldeten Benutzern aufrufen zu lassen. Der ALB nutzt dabei das OpenID Connect Protokoll um mit dem Identity Provider zu kommunizieren. Am besten ist die Integration vom Hauseigenen [Cognito](https://aws.amazon.com/cognito/) IdP, der wiederum eine Integration von z.B. Facebook, Google, Amazon und über einen SAML Connector auch des eigenen Active Directories erlaubt. Weitere Informationen zur Autorisierung im ALB [hier](https://www.exampleloadbalancer.com/auth_demo.html). ## Amazon Neptune Generally Available Amazons fully managed Graphen Datenbank ist ab sofort für alle in den Regionen US East (N. Virginia), US East (Ohio), US West (Oregon) und EU (Ireland) verfügbar. Damit erweitert AWS sein Portfolio um eine Datenbank, speziell für Daten mit vielen Verbindungen zueinander und bietet damit eine gute Grundlage für Recommendation Engines und Knowledge Graphen u.s.w. Als Abfragesprachen können für Amazon Neptune Apache TinkerPop Gremlin und SPARQL verwendet werden. Folgendes [Git Repository](https://github.com/awslabs/amazon-neptune-tools/) beinhaltet eine Reihe von Tools für Amazon Neptune unter anderem ein Script zum umwandeln von GraphML Dateien in das CSV Format von Neptune. Weitere Informationen zu Amazon Neptun [hier](https://aws.amazon.com/neptune/). ## Amazon QuickSight Updates Amazons Bi Tool QuickSight hat in der letzten Zeit folgendes Updates erhalten. **Pay-Per-Session Pricing:** QuickSight liefert eine große Funktionsvielfalt, für die meisten Nutzer ist aber eine eingeschränkte Funktionalität im täglichen Geschäft vollkommen ausreichend, daher bietet QuickSight ab sofort Drei Rollen die einzelne Nutzer einnehmen können. - Authors: Haben Zugriff auf den vollen Funktionsumfang von Quicksight. Sie können Datenbank Verbindungen einrichten, neue Daten hochladen, ad-hoc Visualisierungen erstellen und Dashboards veröffentlichen. Der Preis Pro Nutzer beträgt dabei 9$ pro Monat für die Standard Edition und 18$ für die Enterprise Edition. - Readers: Können Dashboards ansehen und in Daten navigieren, sowie Daten als CSV herunterladen. Die Kosten betragen dabei 0.30$ pro 30 Minuten bei maximalen Kosten von 5$ pro Nutzer im Monat. - Admins: Haben vollen Zugriff wie Autoren und können zusätzlich Nutzer einladen. **Neue Region:** Amazon QuickSight ist jetzt auch in der Asia Pacific (Tokyo) Region verfügbar. **Stündlicher Daten Refresh:** Enterprise Edition Spice Data Sets können jetzt jede Stunde aktualisiert werden anstatt nur 5 mal am Tag. **On Screen Parameter:** Dashboards können ab sofort Parameter enthalten die mit diversen On-Screen Elementen angepasst werden können. Die Elemente können hierbei mit benutzerspezifischen Default Werten belegt werden. **Zusätzlich:** - Zugriff auf Daten in privaten VPC´s - URL Actions für verlinkte Dashboards - Dashboard Sharing - größere SPICE Tabellen (maximal 25GB) Weitere Informationen zu Amazon QuickSight [hier](https://aws.amazon.com/de/quicksight/). ## Amazon SageMaker Updates Amazon SageMaker hat folgende Updates erhalten - Neue Region Asia Pacific (Tokyo) - CloudFormation Support - New ML Framework [Chainer](https://chainer.org/) Weitere Informationen zu Amazon SageMaker [hier](https://aws.amazon.com/sagemaker/). **Kategorien:** Cloud **Schlagwörter:** AWS, QuickSight, SageMaker --- ### [AWS News KW 23 und KW 24](https://thecattlecrew.net/2018/07/18/aws-news-kw-23-und-kw-24/) **Published:** Juli 18, 2018 **Author:** Marco Buss **Content:** ## Amazon EKS Generally Available ![1_BOkrdzBWX7p7j7il3v8mAA](https://thecattlecrew.net/wp-content/uploads/2018/07/1_bokrdzbwx7p7j7il3v8maa.png) Die Nachricht auf die ich persönlich schon lange gewartet habe. Amazons gemanagter Kubernetes Cluster ist endlich verfügbar. Kubernetes ist „die“ Plattform für Docker Container und wird ebenfalls von, Beispielsweise Azure als gemanagter Cluster angeboten. Der Einsatz von Containern bietet viele Vorteile unter anderem erleichtert der Einsatz eine Multi-Cloud Strategie. Der neue Dienst ist für alle Kunden gedacht, die sich auf ihre Anwendungen konzentrieren möchten und weniger mit dem Management eines Kubernetes Clusters. Der Dienst bietet die Möglichkeit diverse andere AWS Dienste zu Nutzen. Einige Beispiele dafür sind. **Multi-AZ:** Der Api Server sowie etcd (Control Plane) laufen im High-Availability Modus verteilt über 3 Availability Zonen und werden permanent überwacht und automatisch ersetzt wenn es zu einem Fehler kommt. Patches werden ebenfalls automatisch aufgespielt. **IAM Integration:** Nutzung des [Heptio Authenticators](https://github.com/heptio/authenticator) für die Authorisierung. IAM Rollen können dadurch verwendet werden **Load Balancer Support:** Traffic kann per Network Load Balancer, Application Load Balancer und classic Load Balancer zu den Worker Nodes geleitet werden. **EBS:** Kubernetes [PersistentVolumes](https://kubernetes.io/docs/concepts/storage/persistent-volumes/) werden als EBS Volumes bereitgestellt. **Route 53:** Mit Hilfe von [External DNS](https://github.com/kubernetes-incubator/external-dns) können Services im Cluster per Route 53 DNS Records angesprochen werden. Das erleichtert das Service Discovery und bietet Load Balancing **Auto Scaling:** Der Cluster kann die Möglichkeiten von Auto Scalling verwenden und sich so dynamisch der Last anpassen. Wichtig zu erwähnen ist noch der Punkt, das der Dienst auf dem shared-responsibility Model aufbaut. AWS ist verantwortlich für die Control-Plane Nodes und der Nutzer für die eigentlichen Worker Nodes. Der Service ist aktuell in den Regionen US East (N. Virginia) und US West (Oregon) verfügbar und wird Schritt für Schritt auf weitere Regionen ausgeweitet. Die Kosten setzen sich aus den üblichen Kosten für verwendete EC2, EBS usw. Resourcen zusammen sowie 0.20$ pro Stunde für das Management der Control Plane Instanzen. Weitere Informationen zu Amazon EKS [hier](https://aws.amazon.com/eks/). ## EC2 Instance Update – M5 Nachdem bereits die C5 Instanz Typen die Option auf NVMe SSD Local Storage erhalten haben, ist das Update jetzt auch für M5 Instanzen möglich. Die M5 Instanzen sind für Workloads die ein ausgeglichenes Verhältnis von CPU und Ram benötigen gedacht und mit folgenden Specs als M5d verfügbar. Die Preise sind dabei lediglich geringfügig teurer als die normalen M5 Instanztypen. **Instance Name****vCPUs****RAM****Local Storage****EBS-Optimized Bandwidth****Network Bandwidth****m5d.large**28 GiB1 x 75 GB NVMe SSDUp to 2.120 GbpsUp to 10 Gbps**m5d.xlarge**416 GiB1 x 150 GB NVMe SSDUp to 2.120 GbpsUp to 10 Gbps**m5d.2xlarge**832 GiB1 x 300 GB NVMe SSDUp to 2.120 GbpsUp to 10 Gbps**m5d.4xlarge**1664 GiB2 x 300 GB NVMe SSD2.210 GbpsUp to 10 Gbps**m5d.12xlarge**48192 GiB2 x 900 GB NVMe SSD5.0 Gbps10 Gbps**m5d.24xlarge**96384 GiB4 x 900 GB NVMe SSD10.0 Gbps25 Gbps## Amazon SageMaker Automatic Model Tuning Amazon SageMaker bietet ab sofort die Möglichkeit Hyperparameter automatisch zu optimieren. Hyperparameter sind Parameter die die Algorithmen des Models und dessen Performance beeinflussen. Die Optimierung dieser Parameter ist ein oft langwieriger manueller Prozesse. Amazon SageMaker vereinfacht diesen Prozess durch den Einsatz von ML Techniken. Es müssen lediglich die zu optimierenden Parameter mit einer entsprechenden Range angegeben werden sowie die Anzahl der Trainingsjobs die durchlaufen werden sollen sowie die Anzahl der parallel laufenden Jobs. Die Anzahl der Parallel laufenden Jobs hat dabei für das Endergebnis eine Signifikante Auswirkung. Je höher der Wert gesetzt wird, desto schneller ist die Optimierung abgeschlossen, bei einer geringen Anzahl ist aber das finale Ergebnis besser. Weitere Informationen zu Amazon SageMaker Automatic Model Tuning [hier](https://docs.aws.amazon.com/sagemaker/latest/dg/automatic-model-tuning.html) ## AWS DeepLens verfügbar AWS DeepLens ist eine Video Kamera die Deep Learning Modele direkt auf dem Device ausführen kann. Sie bildet einen solide Basis um in das Feld der Bilderkennung einzusteigen. ![deeplens_attn_2](https://thecattlecrew.net/wp-content/uploads/2018/07/deeplens_attn_2.png) Nachdem das Device auf der letzten re:Invent angekündigt wurde und seither von Amazon bei einigen Challenges und Hackathons verwendet wurde kann AWS DeepLens ab sofort bestellt werden. Vorerst lediglich in den USA aber weitere Länder sollen folgen. Weitere Informationen zu AWS DeepLens [hier](https://aws.amazon.com/deeplens/). ## Redis 4.0 für Amazon ElastiCache Redis 4.0 ist ab sofort als Engine für Amazons ElastiCache verfügbar. Damit stehen alle [neuen Features](http://antirez.com/news/110) der 4.0 Version von Redis Amazon ElastiCache zur Verfügung. Weitere Informationen zu Amazon ElastiCache [hier](https://aws.amazon.com/elasticache/). **Kategorien:** Cloud **Schlagwörter:** Amazon EKS, Amazon SageMaker, Artificial Intelligence, AWS --- ### [Wie programmiert man Google Home Assistent Skill? Node.js, Express App und Dialogflow. Heroku Deployment (2/2)](https://thecattlecrew.net/2018/08/26/wie-programmiert-man-google-home-assistent-skill-node-js-express-app-und-dialogflow-heroku-deployment-2-2/) **Published:** August 26, 2018 **Author:** tjkrajewski **Content:** In unserem vorherigen Cattle Crew Blog Artikel *Wie programmiert man Google Home Assistant Skill? Node.js, Express App und Dialogflow* haben wir beschrieben wie man mit Express, Node.js und DialogFlow einen einfachen Skill für Google Home programmieren kann. Um den Skill im Google Home Assistant testen zu können, haben wir ngrok verwendet. In diesem Artikel werden wir zeigen, wie man seinen Skill auf Heroku deployen kann. 1\. Zunächst brauchen Sie einen Heroku Account. Melden Sie sich dazu unter . Das Anlegen eines Accounts und das Deployen von Anwendungen ist kostenlos. 2\. Laden Sie den Heroku CLI herunter. 3\. Klonen Sie unseren Google Home Assistant Skill (Ordner DialogFlow in Github) Das neuste Dialogflow Interaction Model können Sie im Zip-Format über die Funktion *Export and Import* aktualisieren ![GoogleHome2_1](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome2_1.png) 4\. Gehen Sie zum Ordner, wo Sie unser Projekt gespeichert haben > cd googleHomeAssistantExpressNodeJS 5\. Führen Sie die folgenden shell commands aus: > heroku login > > heroku apps:create –region eu > > git add . > > git commit -m „my first commit“ > > git push heroku master > > heroku ps:scale web=1 > > heroku logs –tail 6\. Wenn Sie sich nochmal in Heroku anmelden, werden Sie Ihre App sehen Ihre App wird verfügbar sein unter: > https://**\[ihrDomain\]**.herokuapp.com/ Bei uns war es: > 7\. Jetzt müssen Sie nur noch webhooks Dialogflow mit ihrer Heroku Adress aktualisieren: ![GoogleHome2_2](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome2_2.png) 8\. Wenn Sie mit > cd googleHomeAssistantExpressNodeJS in den Ordner des Projektes wechseln und > heroku logs „“tail ausführen, sehen Sie sehen die logs von Heroku. ![GoogleHome2_3](https://thecattlecrew.net/wp-content/uploads/2018/08/googlehome2_3.png) Wenn Sie den Simulator auf Google actions starten und den Skill testen, werden Sie alle Ü„nderungen sehen. Wir haben uns für Heroku entschieden, weil es im Gegensatz zu Amazon Web Services oder Firebase kostenlos ist und zum Beispiel API Calls keine zusätzlichen Kosten verursachen. Viel Spaß beim Ausprobieren! Christina Resing & Tomasz Krajewski **Kategorien:** AI & Data Science, Development **Schlagwörter:** express app, express applikation, Google Home Assistant, Heroku, Node.js, sprachassistent, Voice Assistant --- ### [AWS News KW 35](https://thecattlecrew.net/2018/09/03/aws-news-kw-35-2/) **Published:** September 3, 2018 **Author:** Marco Buss **Content:** ## Amazon RDS on VMware (Preview) Mit Amazon RDS von VMware hält die einfache Bereitstellung und Verwaltung von Db Instanzen mit Amazon RDS Einzug ins eigenen Rechenzentrum. Das Konzept hört sich sehr interessant an. Die eigene vSphere Umgebung dient in diesem Szenario als zusätzliche AWS Availability Zone (AZ) und wird per VPN Tunnel, über das Internet oder per [AWS Direct Connect](https://aws.amazon.com/directconnect/) verbunden. Dadurch ist eine Mischung von on-premise und Cloud in allen möglichen Varianten möglich. Produktionsumgebung in der Cloud Failover on-premise, Backup on-premise und/oder in der Cloud u.s.w. Registrierung für die Preview [hier](https://aws.amazon.com/rds/vmware/). ## Over-the-Air (OTA) Updates für Amazon FreeRTOS [Amazon FreeRTOS](https://aws.amazon.com/freertos/) ist ein Betriebssystem für Microcontroller von AWS, welches die Einbindung der Geräte in die AWS IoT Umgebung erleichtert. IoT Geräte haben oft das Problem, das sie nicht aktiv vom Nutzer verwaltet werden um beispielsweise mit Updates versorgt zu werden. Das hat zur Folge, das immer mehr Viren für diese Kategorie Computer entstehen. Um den Prozess des Updates zu vereinfachen unterstützt FreeRTOS ab sofort ein Over-the-Air Update mit folgenden Highlights. **Security:** Updates können signiert werden, werden über eine TLS gesicherte Verbindung übertragen und auf dem Gerät wird die Signatur überprüft. **Fehler Toleranz:** Unterstützung für resilient und partielle Updates. **Skalierbarkeit:** Eine große Anzahl an Endgeräten kann in Gruppen aufgeteilt werden die dann jeweils unabhängig mit dem Update versorgt werden können. **Sparsamkeit:** Die oft begrenzten Ressourcen der Endgeräte werden optimal genutzt durch die Verwendung von einer TLS Verbindung und der Verwendung des MQTT Protokolls. Um OTA nutzen zu können muss auf dem Endgerät die OTA Updates Library vorhanden sein. Diese Library enthält den Agent der den kompletten Prozess verwaltet. Weitere Informationen zu OTA [hier](https://docs.aws.amazon.com/freertos/latest/userguide/dev-guide-ota-workflow.html). **Kategorien:** Cloud **Schlagwörter:** Amazon FreeRTOS, Amazon RDS, AWS --- ### [Chatbots @ Oracle Summer Camps 2018](https://thecattlecrew.net/2018/09/12/chatbots-oracle-summer-camps-2018/) **Published:** September 12, 2018 **Author:** waldemarkubassa **Content:** These year’s edition of Oracle PaaS Summer Camps is history, and was again a pleasant composition of laid-back networking and exploring innovative themes like chatbots, blockchain and augmented reality. This time I attended the advanced chatbots training – we had 4 days of not only digging deeper into the new features of Autonomous Mobile Cloud Enterprise but also discussing topics like UX design for bots, doing a small hackathon and having a look into the advanced analytics which is scheduled for the upcoming version. But what’s new in Intelligent Chatbots Cloud version 18.2.3 ? A plenty of improvements and new developments have been implemented since the first version presented last year: - A new JavaScript API for custom component development including lots of samples: the new API brings a Conversation Messaging Model which standardises the message layer between the bot and the custom components, also a command line tool for local testing and debugging is now provided as a NPM module, which should also support the compatibility over new upcoming versions of the API. These leverage greatly the local development of custom components. - Question and Answers feature for the development of typical hotline / FAQ bots: these have been now decoupled from the „domain“ dialog flow and as a result there is no longer any need to declare the whole conversation for it - Common Response Component is supposed to succeed all previous ways of providing rich choice-menus to the user: different card layouts are available for example to display some pictures of hotelroooms to book for, also a paging functionality is included - New Channels (Android, iOS, Web, Generic HTTP Webhook): the Web channel seems to be the easiest and fastest option to use now as it allows binding of the chatbot as a messenger widget on a website communicating with your own chat server (provided in the API samples) - Instant apps over Chatbox integration: useful for showing the user his complete order at the end of the conversation, or letting him change only a small detail by not forcing him to go through the whole conversation again. This brings literally the entire functionality of Chatbox including the GUI for creating the formulars that can be called from the chatbot - Multilanguage support over Microsoft or Google translation API - Still there is no graphical designer for the conversational states of a bot, but adding new states in the yaml editor has been slightly improved by providing templates, now one can choose a component and the state it should be added next to. The components have also been sorted into logical groups. It’s virtually impossible to name all features, as each of them definetely deserves it’s own article. In summary the latest developments bring far more maturity into the product and some crucial traits that makes it more complete and brings it closer to the ever growing demands of customers (and developers!). **Kategorien:** AI & Data Science, Tech Events & Networking **Schlagwörter:** Artificial Intelligence, Events, Innovation, Mobile, Summer Camp --- ### [Application Development@Oracle PAAS Summercamp 2018](https://thecattlecrew.net/2018/09/12/application-developmentoracle-paas-summercamp-2018/) **Published:** September 12, 2018 **Author:** janwinkels **Content:** Und da sind wir wieder: Oracle PAAS Summercamp in Lissabon. Ich durfte dieses Jahr zum zweiten Mal nach 2017 das Oracle Paas Summercamp besuchen. Im Folgenden möchte ich meine Erfahrungen aus dem Track Application Development mit Microservices und Containern mit euch teilen. Thema des Tracks war: Lerne die verschiedenen Möglichkeiten zum Entwickeln von Software in der Oracle Cloud kennen. Und so umfasste der Track auch diverse Themen rund um Application Development wie Anwendungsentwicklung mit JavaScript (Oracle JET), DevOps Tools und diverse Möglichkeiten zum Ausliefern von Applikationen auf ein bestimmtes Zielsystem. Der Teil des Trainings, der sich mit Programmierung befasste wurde von Geertjan Wielenga (Product Manager Oracle JET) geleitet. Wir durften erleben, wie einfach es ist mit Oracle JET 5.2.0, Oberflächen für Desktop Anwendungen zu programmieren. Dank des CLI „ojet“ sind Tasks, wie das Initialisieren einer Applikation, oder das Anlegen eines Composites (eine Gruppierung von JET UI Komponenten), einfache Einzeiler. Das Anwenden der Oracle JET UI Komponenten sind auch dank des [Cookbooks](https://www.oracle.com/webfolder/technetwork/jet/jetCookbook.html) eine einfache Aufgabe. Wichtig für alle, die sich im Moment Fragen was ist Oracle JET überhaupt? Oracle hat das Rad hier nicht neu erfunden. JET steht für „JavaScript Extension Toolkit“ und beschreibt eine Sammlung von JavaScript-Libraries. In JET enthalten sind ausschließlich Business Ready Libraries wie Knockout, RequireJS oder JQuery. Das einzige was Oracle dazu beisteuert sind einige UI Komponenten und etwas Logik auf der Model-Ebene. Mehr zur Oracle JET Architektur gibt es [hier](https://docs.oracle.com/en/middleware/jet/5.2/develop/oracle-jet-architecture.html#GUID-293CB342-196F-4FC3-AE69-D1226A025FBB). Was hat Oracle JET dann mit der Oracle Cloud zu tun? Die gesamte Oberfläche der neuen Oracle Cloud Infrastructure (OCI) Umgebung ist in JET gebaut worden. Oracle nutzt also das Tool selbst zur Entwicklung ihrer eigenen Produkte. Das sorgt dafür, dass die Weiterentwicklung und Verbesserung von Oracle JET im eigenen Interesse von Oracle ist und somit auch vorangetrieben wird. Zur Entwicklung steht außerdem der Visual Builder Cloud Service zur Verfügung, der eine Low Code Umgebung zur Oracle JET Entwicklung bereitstellt. Nachdem man dann mit JET (oder auch Angular oder Java) seine Anwendung gebaut hat, stellt die Oracle Cloud seinen Nutzern auch Services zur Verfügung, die zur Auslieferung und dem Hosten derselben genutzt werden können. ![builder.png](https://thecattlecrew.net/wp-content/uploads/2018/09/builder.png) Der (Autonomous) Developer Cloud Service stellt an sich selbst den Anspruch den DevOps-Zyklus (teilweise) zu unterstützen. Der Developer Cloud Service soll Projektteams bei der Durchführung von Softwareentwicklungsprojekten unterstützen. Dabei stellt er Werkzeuge zum Issue-Tracking, sowie zur Versionskontrolle in Git, über Continous Integration Tools wie Hudson bis hin zu Dokumentationsplattformen wie Confluence o.ä. zur Verfügung. Das Großartige: Die Provisionierung und Konfiguration des Services ist in unter 10 Minuten erledigt und das Beste: Er ist kostenfrei. In den Build und Deploy Tools können selbstverständlich andere Services integriert werden. So kann zum Beispiel SQL-Code auf einer Datenbank ausgeführt werden oder ein Maven oder Gradle Build angestoßen werden (siehe Bild rechts). Nachdem man nun den Build erstellt hat, möchte man das Programm natürlich auch auf ein Zielsystem ausliefern. Auch dafür bietet der Developer Cloud Service entsprechende Funktionen. Die Zielsysteme sind in diesem Fall entweder der Java Cloud Service oder der Application Container Cloud Service. Der Java Cloud Service stellt im Grunde eine Weblogic Instanz in der Cloud bereit. Das beeindruckende in diesem Moment ist, dass er mit einer variablen Anzahl von Managed Servern (einer, zwei oder vier), provisioniert werden kann. Er bietet außerdem ein Out-of the Box Load-Balancing. Weitere Informationen über den Java Cloud Service findet ihr [hier](https://cloud.oracle.com/java). ![applications.png](https://thecattlecrew.net/wp-content/uploads/2018/09/applications2.png) Der Application Container Cloud Service stellt Funktionalität zum Hosten eines Docker Containers bereit. Hier können aber „nur“ Container für Anwendungen, die in einer bestimmten Programmiersprache geschrieben sind ausgeführt werden und zwar für die Sprachen, für die es ein entsprechendes Image für eine Laufzeitumgebung bei Oracle oder im DockerHub gibt, das von den Application Container Cloud Services angeboten wird (siehe Bild rechts). Zuguterletzt möchte ich noch kurz auf die Serverless Alternative „ProjectFN“ von Oracle eingehen. Was bedeutet nun Serverless? Für Oracle bedeutet es „Online-Funktionen“ die Input in einen Output verwandeln. Funktionen sind dabei nichts anderes als Code gepackt in einem Docker Container mit allen notwendigen Abhängigkeiten. Der Unterschied zu einem Container im eigentlichen Sinn ist, dass die Funktion tatsächlich ausschließlich eine Laufzeitumgebung für eine ganz spezielle Funktionalität bereitstellt, wie zum Beispiel das Berechnen einer Summe. Eine Funktion ist also der kleinste denkbare Container. Es ist dabei egal, in welcher Sprache die Funktion geschrieben ist, wenn es einen entsprechenden Container zum Ausführen der Funktion gibt, kann nahezu jede beliebige Sprache verwendet werden. Der Use-Case für ein solches Konstrukt könnten z.B. Rest-Endpunkte sein, die von einem Mobilen Client aufgerufen werden. Wichtig zu erwähnen ist: Es existiert kein Vendor Lock! Wenn gewünscht, können Oracle Functions (ProjectFN) auch on Premise, in AWS oder sonst wo betrieben werden. Die Oracle Cloud bietet jedoch auch hier Vorteile, wie zum Beispiel die OCI Registry, die eine Docker Registry bereitstellt. Wichtig im Bezug auf Oracle Functions: Wenn Oracle Functions in der Oracle Cloud betrieben werden, bezahlt man FaaS pro Aufruf der Funktion. Wenn die Funktion nicht genutzt wird, entstehen auch keine Kosten. Wenn ihr FunctionFN ausprobieren wollt: [Hier](https://github.com/fnproject/fn) gibt es ein GetStarted! Ein Tipp von meiner Seite: Nutzt ein Unix-basiertes System! Es gibt eine Windows Integration, die steckt aber noch in der Entwicklung. Das Projekt befindet sich mit Version „**0.3.551″** aber auch noch in der Beta-Phase. **Kategorien:** Cloud, Development, Tech Events & Networking --- ### [AWS News KW 36](https://thecattlecrew.net/2018/09/17/aws-news-kw-36-2/) **Published:** September 17, 2018 **Author:** Marco Buss **Content:** ## CloudFormation Macros Amazons Infrastructure as Code, [CloudFormation](https://aws.amazon.com/cloudformation/) bietet ab sofort eine Unterstützung für Macros. Damit kann die Funktionalität von CloudFormation deutlich erweitert werden. Die Grundlage für Macros ist schon länger in CloudFormation vorhanden und wird sehr stark vom [Serverless Application Model](https://github.com/awslabs/serverless-application-model/blob/master/versions/2016-10-31.md) (SAM) verwendet. Das Herzstück jedes Macros ist eine Lambda Function die für die eigentliche Transformation zuständig ist. Diese Neuerung bietet meiner Meinung nach eine Menge Potential. Es bietet z.B. die Möglichkeit bestimmte Defaults für Ressourcen einzuhalten. Es kann jetzt einfach ein Macro erstellt werden und mit wenigen Angaben im Template kann eine ganze Reihe von Ressourcen nach den jeweiligen Vorgaben erzeugt werden. Ein Beispiel dafür ist bereits auf Github zu finden (). Weitere Informationen zu CloudFormation Macros [hier](https://docs.aws.amazon.com/AWSCloudFormation/latest/UserGuide/template-macros.html). ## AWS X-Ray API Gateway Unterstützung und Sampling Rule API In modernen Architekturen ist es oft schwierig Probleme zu debuggen da für die Beantwortung einer Anfrage oft mehrere Services verwendet werden. Es ist daher essentiell zu wissen zu welcher Anfrage einzelne Bearbeitungsschritte im System gehören. Um genau diese Fragen zu beantworten existiert [AWS X-Ray](https://aws.amazon.com/xray/). ![scorekeep-gettingstarted-servicemap-after-github](https://thecattlecrew.net/wp-content/uploads/2018/09/scorekeep-gettingstarted-servicemap-after-github.png)https://docs.aws.amazon.com/xray/latest/devguide/aws-xray.html Ab sofort unterstützt AWS X-Ray das [Amazon API Gateway](https://aws.amazon.com/api-gateway/). Aufrufe die über das API Gateway kommen können nun automatisch ins Tracing aufgenommen werden. Als weitere wichtige Neuerung ist die Sampling Rate API zu nennen. Per Default wird immer der erste Request pro Sekunde geloggt und 5% der weiteren Aufrufe innerhalb dieser Sekunde. Mit der Sampling API kann diese Rate entsprechend verändert werden. Die Anpassung kann dabei auf einem sehr feingranularen Level erfolgen. Es ist beispielsweise möglich das Tracing nur auf einem Teil der Ressourcen wie EC2 Instanzen oder Lambda Functions zu beschränken. Weitere Informationen zu AWS X-Ray und der Sampling Rate API [hier](https://aws.amazon.com/xray) und [hier](https://docs.aws.amazon.com/xray/latest/devguide/xray-console-sampling.html). **Kategorien:** Cloud **Schlagwörter:** Amazon API Gateway, AWS --- ### [OC|Expert Camp: Stream Processing with Apache NiFi](https://thecattlecrew.net/2019/07/28/ocexpert-camp-stream-processing-with-apache-nifi/) **Published:** Juli 28, 2019 **Author:** Alexis Premet **Content:** Am Samstag, den 6. Juli, um 13 Uhr bei heißen 30°C fand unser neues Meetup in München statt. Wir setzten unser Programm aus den Meetup-Gruppen [OC-Expert-Camp](https://www.meetup.com/de-DE/OC-Expert-Camp-Munchen/) und [München Coding Dojo](https://www.meetup.com/de-DE/Munchen-Coding-Dojo-Meetup/) dieses Mal mit einen spannenden Hackathon rund um die Big Data-Technologie **Apache NiFi** fort. ![](https://thecattlecrew.net/wp-content/uploads/2023/02/S_bwmdo_-XUA2t2SZdeO6qw9NduV7OfJcT-NV7t3TaO1GDna6_Rny4ALVEyghsYywa3ZUpNWAzS9ScX2ha7NFX-Jr6B5gMpdXvG1n3n7tLgjuuGyzehdPYYfMpDxrVwGJsK7cH.png)Unsere beiden Big Data Experten Philipp Perez und Alexis Premet begrüßen die Teilnehmer. In der Münchner Niederlassung empfingen wir die Teilnehmer, unter denen sich sogar ein Kind befand, mit erfrischenden Getränken. Damit der Einstieg in NiFi so schnell und so einfach wie möglich erfolgte, gaben wir den Teilnehmer eine etwa 30-minütige Einführung in die wichtigsten Grundlagen der Technologie. Anschließend gruppierten sich die Teilnehmer in Teams und fanden sich in dem Use-Case, den wir uns für den Hackathon ersonnen hatten, in der Rolle eines Entwicklers für einen **Online-Shop** wieder. Ihre E-Commerce-Plattformen bekamen von uns durch Kafka-Topics **Kundenbestellungen** und bearbeiteten diese dann, um **Lieferungen** in einem weiteren Kafka-Topic zu produzieren. Für diese Prozedur nutzten sie Apache NiFi. Diese von der NSA entwickelte Technologie besitzt eine in Prozesse und Datenströme gegliederte Web-UI, die das Implementieren von Stream-Processing-Applikationen ermöglicht. ![](https://thecattlecrew.net/wp-content/uploads/2023/02/wdFf5GtDhaWk55P7_0QEy7isJsc2cwQ52JVRil9yEzBTs_6Mtg1qPPnohFe3vESISR5A7Ht8jY6fv_5EEEe7hAi20CDC8M_8AQ5eACu9zgFdlQmuO-8Th_qHHGHkNj2C8P6xxJcj.png)Die Teams bekommen die Bestellungen von einem Kafka-Topic und erstellen anschließend Lieferungen in einem weiteren.Ziel für die Teams war es den höchsten Gewinn zu erwirtschaften. Jede erfolgreiche Lieferung erhöhte den Umsatz. Was dabei echt tricky war: Manche Bestellungen kamen von Betrügern, die die Teilnehmer erstmal identifizieren mussten. Ansonsten wurde der Betrag dem Online-Shop vom Gewinn abgezogen. Die Teilnehmer waren mit Einsatz dabei und hatten viel Spaß bei der Entwicklung der „besten“ Lösung. Sie nahmen die Herausforderung dann schnell in die Hand und zeigten rasch gute Fortschritte. Als Energie-Booster versorgten wir die fleißigen Hacker mit Pizza und Getränken. Die ersten Lieferungen gingen in unserem Kafka-Topic nach etwa einer Stunde ein. Allerdings wurden sie zunächst nicht von unserer Go-Applikation, die die Validierung verantwortete, akzeptiert – die Lieferungen brauchten nämlich ein bestimmtes Format. Dieses hatten wir natürlich in einer Dokumentation angegeben, doch anscheinend hatten die Teams sie nicht komplett gelesen „¦ 😉 An dieser Stelle haben wir bei uns noch Verbesserungspotential entdeckt: Es wäre schön, wenn die Teams die Möglichkeit gehabt hätten, zu sehen, wie die Lieferungen aus ihrem Shop aussehen. Dies würde insbesonder bei so einem kurzen Hackathon das Debugging erheblich erleichtern. Dank unserer Metriken-Dashboards behielten die Teilnehmer (und auch wir :)) während der gesamten Zeit die Übersicht über die relevanten Kennzahlen wie etwa Gewinn, Verlust oder verbleibende Zeit. Die eingehenden Lieferungen trackten wir mit unserer App in Echtzeit. Sobald die erste Bestellung erfolgreich abgeschlossen wurde, sahen die Teams ihre Score in Bewegung: ![](https://thecattlecrew.net/wp-content/uploads/2023/02/cuwoGhRHECuowyDne2W5QZk3BTMXhRBtUvbvk196IrUMYmuPeFOjGpWXGNcwDCUQJ45jT6i2oauzvUrTYM0ZqAyug7SmkyIqp2vS6qJCN2rk-GdegMEVXX4si1mUqpZTt-fTeWDj.png)Prometheus-Übersicht Anhand dieser Metriken war es auch möglich, die Betrugsfälle zu identifizieren und so schnell wie möglich in NiFi auszusieben, damit nicht zu viel Geld verloren geht. Der Endstand betrug schließlich 7,37 Millionen Euro Gewinn zu 0,89 Millionen Euro. Das Sieger-Team war zudem sehr schnell und setzte mit fast 30 Minuten Vorsprung ihr Minimal Viable Product um. Die Gewinner erhielten eine Siegerurkunde inklusive eines Einkaufsgutscheins für AWS. ![](https://thecattlecrew.net/wp-content/uploads/2023/02/image.png)Siegerurkunde Nach der Siegerehrung gaben wir den Hackern noch einen Blick hinter die Kulissen. Alle Applikationen hatten wir im Vorfeld auf AWS deployt, nachdem wir diese lokal programmiert hatten. Das hatte den Vorteil, einen stabilen, performanten und vor allem skalierbaren Big-Data Hackathon für viele Teilnehmer anzubieten. Es kamen viele unterschiedliche AWS-Services zum Einsatz, wie unten in der Architektur-Skizze gezeigt. ![](https://thecattlecrew.net/wp-content/uploads/2023/02/6YBOueV8_MFdg9cAILKEQ3wXFnm9GNdoTSuo4IGcAEqnRMEFImfR6dREsZtDJeRsFKAHzieD01L0PhqP_IIpCA9BJWW2baqF3Ks-j6BMcCBBicWW4OuH_4ILVAVYA9kr2_Vwv4s.png)AWS-ArchitekturDie Vorbereitung für den Hackathon hat uns allen viel Spaß gemacht und wir haben viel dabei gelernt. Auch haben uns die Teilnehmer wertvolles Feedback zu unserer Veranstaltung gegeben, um den Hackathon beim nächsten Mal noch besser zu machen. Aktuell arbeiten wir daran, das Aufbauen der AWS-Infrastruktur mit Terraform zu automatisieren, um die verschiedenen Installationen und Deployments zu erleichtern. Unser Ziel dabei ist den Hackathon möglichst einfach wieder zu veranstalten. So ist es denkbar ihn im Rahmen einer Schulung durchzuführen, bei einem Community Day oder bei einem Meetup in einer anderen Niederlassung. Hast du Interesse? Dann wende dich gerne an [Pascal Humbert](mailto:pascal.humbert@opitz-consulting.com?subject=Nifi%20Hackathon%20CattleCrew). Wir bedanken uns sehr herzlich bei Nathalie Kirches für ihre freundliche Unterstützung beim Schreiben des Artikels. **Kategorien:** Tech Events & Networking, Tools & Methoden **Schlagwörter:** Big Data, Hackathon, München, OC|Expert Camp, opitz --- ### [Eat your own OpenDevStack](https://thecattlecrew.net/2019/09/25/eat-your-own-opendevstack/) **Published:** September 25, 2019 **Author:** voigthendrik **Content:** In diesem Artikel stelle ich das Open-Source-Projekt OpenDevStack kurz vor und erkläre, wie und warum OPITZ CONSULTING den OpenDevStack als Entwicklungsplattform auch intern nutzt. Mehr Informationen und Beispiele aus der Praxis gibt es übrigens in unserem OC|Webinar am Donnerstag, 10. Oktober 2019 von 16 bis 17 Uhr. Hier geht es direkt zur Anmeldung: **Was ist der OpenDevStack?** Das Open-Source Projekt OpenDevStack stellt eine Entwicklungsumgebung auf Basis von Red Hat OpenShift und dem Atlassian Toolstack bereit. Mit vordefinierten Continuous-Delivery-Prozessen und Best-Practices-Project-Templates erzielen wir eine größere Einheitlichkeit der eingesetzten Werkzeuge, Frameworks und Prozesse (Compliance) bei gleichzeitig drastisch verkürzter Ramp-up-Zeit für den Start eines Entwicklungsprojekts (Innovationsfähigkeit). Wie und warum nutzt OPITZ CONSULTING den OpenDevStack intern? **Automatisierung und Standardisierung des Ramp-ups von Entwicklungsprojekten** OC führt vermehrt MVPs oder kleinere Kundenprojekte durch. Bei einer Projektlaufzeit von wenigen Wochen stehen die Bereitstellungszeiten und Aufwände für Einrichtung sowie Betrieb von VMs, Jira, Wiki oder AWS Accounts in einem ungünstigen Verhältnis zum Gesamtaufwand und lassen sich dem Auftraggeber gegenüber kaum zu verargumentieren und fakturieren. Zudem führt die Nutzung eigener VMs teilweise zu einer unkontrollierten Schatten-IT. Durch die Bereitstellung ausgewählter Quickstarter reduziert sich das technische Setup auf wenige Minuten, sodass von Beginn an am eigentlichen Projektziel gearbeitet werden kann. Natürlich setzt dieser Ansatz auch eine gewisse Flexibilität des Auftraggebers voraus. Wilde Technologie-Mixe wie JSP, Struts & Co werden aktuell und vermutlich auch in Zukunft nicht unterstützt. **Compliance und Security** Die Deployment Pipelines nutzen vordefinierte und aktuell gehaltene Basis-Images (Patch-Management). Zudem werden Docker Security Scanner und Docker Repositories eingebunden. In Kombination mit dem automatischen Abräumen wird die Sicherheit und Compliance signifikant erhöht. **Kompetenzmanagement und Technologie-Radar** Der OPITZ CONSULTING Technologie-Radar listet und priorisiert die für uns relevanten Technologien und Frameworks. Die im OpenDevStack vordefinierte Projektarten bilden diese strategischen Arbeiten ab und reduzieren zugleich die Vielfalt eingesetzter Technologien und Frameworks. Infolgedessen lassen sich Projekte erstens einfacher „staffen“ und zweitens strategisch favorisierte Technologien als attraktiv gestaltete Vorgabe in der Mannschaft verankern. **Direkte Kosteneinsparungen** Die Migration von VMs auf Container erhöht die Packungsdichte und durch ein automatisiertes Abräumen werden Ressourcen frühzeitig wieder freigegeben. Dadurch sinkt der Bedarf an virtueller bzw. physischer Hardware, und das Unternehmen spart direkte Kosten. **Mehr erfahren „¦** Weiterführende Informationen und Angebote rund um den OpenDevStack: Direkt zum Projekt: **Kategorien:** Development, DevOps **Schlagwörter:** DevOps, OpenShift, Red Hat --- ### [Application Development@Oracle PaaS SummerCamp 2019](https://thecattlecrew.net/2019/09/26/application-developmentoracle-paas-summercamp-2019/) **Published:** September 26, 2019 **Author:** Torsten Jaeschke **Content:** Nearly a month has passed since I had the possibility to attend to the Oracle PaaS Summercamp in Lisbon featuring different tracks from Integration over Digital Assistent to Modern Application Development with Oracle Cloud. I participated in the Track „Modern Application Development with Oracle Cloud“ and I want to share the experience and findings I had. Like the track title suggests the whole track dealt with development and development experience, not only with Oracle Cloud, but also with the underlying software. Beside presentations we worked with well structured hands-on labs, supported by very good and competent trainers. The first two days dealt with Oracle JET and the Visual Builder Cloud Service. Oracle JET, where JET is an acronym for „Java Extension Toolkit“, is a Javascript toolkit bundeling different Business Ready Libraries like jQuery, Knockout and RequireJS along with UI components and some model logic provided by Oracle. It eases the creation and development of Javascript based applications and is really easy to handle. It“™s not bleeding edge, but provides a mature and stable impression with well known base libraries. Especially in enterprise environments, where stability is an important requirement, in my opinion, Oracle JET should be considered for building Javascript based applications. The Visual Builder Cloud Service provides a low code environment to develop Oracle JET applications and is a part of the Oracle Integration Cloud, but can also be ordered separately. If you are not familiar with developing Javascript applications the service enables you to create such applications on your own. For further information on Oracle JET visit [oraclejet.org](http://oraclejet.org). The third day dealt with the Developer Cloud Service, Autonomous Database, Kubernetes and Terraform to setup the needed cloud infrastructure. The Developer Cloud Service supports team in software development projects by providing a documentation space, CI/CD mechanics and the important basics you need in a DevOps lifecycle. It was quite handy to setup the infrastructure using Terraform and even if you are not familiar with Terraform and Kubernetes the hands on practices were good to understand. The fourth day started with an introduction to the Weblogic operator for Kubernetes. It was interesting to see this work, especially the auto scaling. If you are familar with Kubernetes and the way Weblogic works, you could imagine the work that had been invested to get this done. The Weblogic part was followed with my personal Summercamp highlight, Helidon Project. Helidon is a set of Java Libraries for writing Microservices in Java and comes in two flavors. Helidon SE, which provides a small, functional style API and Helidon MP, which provides a Micro Profile implementation on top oft he Helidon libraries. The dependencies are handled with Maven and you can build your project skeleton with Maven also. The easy integration of tracing across services, interconnection between services and the whole interoperation with Kubernetes and Prometheus was impressive. Additionaly it“™s easy with the provided Dockerfile to build a Docker image and use it for example in Kubernetes. You have also the possibility to build GraalVM native images and if you have the possibility to use GraalVM, you should use it. The startup times in comparison to traditional JVM startup times are really impressive. I wasn“™t aware of Helidon, but for me it is a project you should keep in mind, I will for sure. If you want to know more about Helidon and I think you should give it a try if you use or plan to use Microservices in Java, visit the project website . The last day dealt with Oracle Functions (FaaS) and the underlying FN Project. FN Project is a container-native serverless platform that you can run anywhere where you can run containers and most important, you don“™t have a vendor lock-in. Oracle Functions is the supported version in Oracle Cloud and fully interoperable with the Open Source project. This enables you to run FN Project locally for testing your functions and then deploying them to the cloud. To summarize, I learned a lot during this well-organized week about the Oracle Cloud, got aware of interesting projects, escpecially Helidon, to mention it again and got to know kind people from all over the world. So, if you are able to attend, I would recommend to do so. **Kategorien:** Development, Tech Events & Networking --- ### [Automatischer Failover mit Dbvisit Standby Version 9](https://thecattlecrew.net/2019/11/25/automatischer-failover-mit-dbvisit-standby-version-9/) **Published:** November 25, 2019 **Author:** Rainier Kaczmarczyk **Content:** Ein wenig untergegangen ist ein neues Feature in Version 9: das automatische Aktivieren der Standby Datenbank, wenn die primäre Datenbank nicht mehr erreichbar ist. Hierzu setzt Dbvisit einen sog. Observer Prozess (komisch, der Name kommt mir irgendwie bekannt vor) ein. Dieser sollte weder auf der primären noch auf der Standby Datenbank installiert sein. Es bietet sich die Maschine an, auf der der Dbvisit Webserver installiert ist. Die Konfiguration ist sehr einfach. Nur warum für den Observer Prozess das Passwort „admin900“ lautet, wird wohl immer ein Rätsel bleiben ;-). ![](https://dbvisit.atlassian.net/wiki/download/attachments/1460142127/observer-diagram.jpg?version=1&modificationDate=1562895356689&cacheVersion=1&api=v2) Die Diskussion, ob solch ein automatisches Umschalten wirklich sinnvoll ist, ist so alt wie die Möglichkeit selbst. Wer eine solche Option aber benötigt, für den ist sie sowohl unter Linux als auch unter Windows in Version 9 verfügbar! Zudem hat man bei dem Observer die Möglichkeit die Funktionalität auch nur zu testen. Das bedeutet, dass der Prozess lediglich meldet, dass er eine Situation erkannt hat, die ein Umschalten auslösen würde. Mit einem einfachen Mausklick kann das Umschalten dann auch scharf geschaltet werden. Das automatische Umschalten ist in der Standardlizenz von Dbvisit Standby enthalten. Es entstehen keine Zusatzkosten. **Kategorien:** Database, Tools & Methoden **Schlagwörter:** Hochverfügbarkeit, oracle --- ### [OC|ExpertCamp "“ Serverless mit Knative](https://thecattlecrew.net/2019/11/29/ocexpertcamp-serverless-mit-knative/) **Published:** November 29, 2019 **Author:** Manuel Styrsky **Content:** Am 07.11.2019 fand erneut eine Coding Kata der OC|ExpertCamp Reihe in München statt. Stefan Kühnlein und Andrej Flieger brachten interessierten Entwicklern und Kollegen Knative näher. Knative ist ein Serverless Framework und erweitert Kubernetes um einen Satz von Middleware Komponenten, die für die Erstellung von containerbasierten Anwendungen notwendig sind. Knative wird ständig weiterentwickelt, was uns in der Vorbereitung vor einige technische Herausforderungen stellte. Nachdem diese gelöst waren und wir den Teilnehmern einen laufenden OpenShift 4 zur Verfügung stellen konnten, ging es dann am 07.11.2019 um 18:00 Uhr los. Begonnen haben wir mit einer theoretischen Einführung in das Thema Serverless, Function as a Service (Faas) und natürlich auch Knative selber. Nach einer Pizza-Pause ging es dann auch schon direkt mit der Praxis los. Jetzt konnte jeder seinen eigenen Container bauen und dort einen Knative Service deployen. Mit ca. 15 Teilnehmern hatten wir hierbei eine super Atmosphäre, in der jeder seine Fragen stellen konnte und auch persönlicher Austausch nicht zu kurz kam. Damit geht unsere diesjährige Meetup Serie in München so langsam auf das Ende zu. Wir sind dankbar für die vielen Besucher und freuen uns schon aufs nächste Jahr!! Stefan, Andrej und Manuel **Kategorien:** Cloud, Tech Events & Networking --- ### [Digitalisierung - Als die Identität wandern ging ...](https://thecattlecrew.net/2020/01/09/digitalisierung-als-die-identitaet-wandern-ging/) **Published:** Januar 9, 2020 **Author:** Mario Nolte **Content:** Unternehmen mussten sich im Laufe der Zeit immer wieder neu erfinden. Und so ist es kaum verwunderlich, dass sich die Identity und das Identity Management verändern. Hier nun ein kleiner Abriss der Entwicklung und ein Ausblick was uns wohl erwartet wird. **Aber zuerst, warum ist das Identity Management so wichtig für Unternehmen?** Das Identity Management hat sich die Aufgabe gestellt, die Verwaltung und Organisation von Unternehmen zu unterstützen. Dabei greift das Identity Management an das Herz und die DNA eines Unternehmens. Das Herz sind die Personen und die DNA sind die Rollen einer Organisation. Mit einem geeignetes Rollenmodell lassen sich Unternehmensprozesse erheblich vereinfachen. Durch die Automatisierung von Geschäftsprozessen lassen sich so leichter veränderte Abläufe umsetzen und verleiht den Unternehmen mehr Flexibilität und somit mehr Agilität. ***Das Identity Management kann als ein tragender Pfeiler der Digitalisierung angesehen werden.*** Mit den Wandel der Unternehmen ging auch ein Wandel des Identity Management einher. Der Wandel des Identity Management selbst lässt sich durch mehrere Phasen beobachten. Gehen wir etwas in der Zeit zurück und betreten die Phase A. ***Phase A: Unterstützende Identity-Prozesse*** Ausgehend von einer Phase, wo es viele Systeme und viele Verantwortliche gibt, um Systeme zu verwalten und zu administrieren. Diese Situation soll in Abbildung 1 dargestellt werden. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/01/ident1.png?fit=1024%2C663&ssl=1) **Abbildung 1: viele, weit verstreute Identitys** In dieser Zeit konzentrierten sich viele Lösungen um die Identity hauptsächlich auf die Digitalisierung administrativer Tätigkeiten. Zu nennen wären hier: Reisekosten-, Gehaltsabrechnungen, Arbeitszeiten Erfassung & Auswertung, Zeugnisgeneration buchen von Seminaren oder Schulungen. Untersützt werden diese Prozesse durch „sharende“ Abläufe, Prozesse und Tools wie das NFS oder die Nutzung von Sharepoint. Durch diese ersten Prozesse konnten Abläufe verschlankt werden. Auch heute befinden sich noch immer eine erhebliche Anzahl von Unternehmen in dieser Phase -so die Start-Up-Unternehmen mit mehreren Personen. *Wie ging es weiter?* Die Unternehmen werden größer, sind schon recht erfolgreich am Markt. Es haben sich Strukturen im Unternehmen gebildet und die IT eines Unternehmens kommt mehr und mehr zu den Punkt Berechtigungen zu verteilen und zu administrieren. Damit gehen wir über in die Phase B. ***Phase B: User-Berechtigungen*** In dieser Phase wird die Basis für Identity-Berechtigungen inkl. Einsatzmöglichkeiten von strukturellen- und kontextabhängigen Berechtigungen geschaffen. In der Infrastruktur von Identitys wird verstärkt auf zielgerichteter Identity-Replikation gesetzt. Erste Systeme werden zentral verwaltet, um eine Vereinfachung des Benutzer- und Identity-Management zu erreichen. Teilautomatisierungen prägen diesen Zeitabschnitt. Teils Prozess gesteuert, werden Accounts auf anderen Systemen angelegt. Das Management wird mehr und mehr in eine Hand gelegt, so das ein ganzheitlicher Ansatz für das Identity Management verfolgt werden kann. Abbildung 2 stellt diese Prozesse dar. ![](https://www.macmario.com/blog/wp-content/uploads/2020/01/ident2.png) **Abbildung 2: Erste Identitys werden zentral verwaltet.** Diese Struktur wird in vielen aufstrebenden Unternehmen beobachtet. Die Triebfeder hier ist meist, um einer Lücke in den Prozessen oder Strukturen zu begegnen. Identity-Replikation und Access Management treten immer mehr in den Vordergrund. Diese Entwicklung kann sich je nach Unternehmen über mehrere Jahre ziehen. Mit der Zeit lässt sich feststellen, das bestimmte Prozesse und Verfahren, die Flexibilität einschränken. Das ist dann der Zeitpunkt für die Phase B++. ***Phase B++: ESS/MSS (Employee Self-Services / Manager Self-Services)*** In diesem zweiten Schritt der Phase B (B++) wird darauf gebaut, dass mehr ESS/MSS entwickelt werden. Einfache administrative Tätigkeiten können jetzt durch den Mitarbeiter erbracht werden. So müssen Mitarbeiter sich nicht für alle Vorgänge an die Personalabteilung oder das IT-Personal wenden. Sie können Applikationen benutzen wie den Abwesenheitsassistenten oder sich in Rufbereitschaften Ein-, Austragen und Ü„ndern ohne das spezielle Meldungen an das Personalbüro oder Betriebsrat speziell eingereicht werden müssen. Viele Vorgänge, wie das Passwort-Reset können selbst angestoßen und Ü„nderungen an einzelnen Stammdaten selbst vorgenommen werden. Basis hierfür sind die Self-Services Diese Self-Services haben das Ziel, dem Benutzer die Möglichkeit zu geben, einfache administrative Tätigkeit eigenverantwortlich zu übergeben. Damit einhergehend ist eine spürbare Entlastung im Tagesgeschäft zu spüren. Die betroffenen Abteilungen haben so die Möglichkeit, die freiwerdenden Kapazitäten nachhaltiger weiter für den Unternehmenserfolg einzusetzen. Dafür braucht es immer mehr vollautomatisierte Prozesse. Um so optimierter und automatischer der Prozessablauf ist, um so mehr nähern wir uns der Phase C. ***Phase C: Digitalisierung von Identity-Kernprozessen (on-premises)*** Parallel zu ESS/MSS aus Phase B++ wurde die Entwicklung von Anwendungen zum Management von Kernprozessen vorangetrieben. Vollständige On-Premises-Suiten sind etabliert. Die wesentlichen operativen Prozesse und Ablaufe sind abgebildet. Neben den Lösungen für administrative Aufgaben werden auch andere Bereiche wie Recruiting, Talent Management, Performance und Skill Management oder auch Change Management im Identity Management abgebildet. Es werden immer mehr Matrix-Automatisierungen aufgebaut. Abbildung 3 zeigt die prinzipiellen Abläufe und ihre Vereinfachung. So ist es möglich Accounts voll automatisiert auch über Approval-Strecken hinweg zu verwalten, ohne dabei spezielle Kenntnisse zu speziellen Operating System wie Unix, Linux, Windows oder SAP zu besitzen. Das beinhaltet das Anlegen, Löschen, Stilllegen eines Benutzers ebenso wie die Verwaltung von Berechtigungen. Schnelle angelegte Excel Anwendungen weichen vollautomatisierten Lösungen. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/01/ident3.png?fit=1024%2C658&ssl=1) **Abbildung 3: zentrales IDMS für Identitys** Single-Sign-On als Bestandteil des Access Managements kommt immer mehr zum Einsatz (mehr zu SSO/Single-Sign-On: [https://de.wikipedia.org/wiki/Single\_Sign-on](https://de.wikipedia.org/wiki/Single_Sign-on)). Jetzt sah es schon fast so aus, als ob ein gewisses Ende damit erreicht ist. Nun, die Anforderungen ändern sich und damit auch die Notwendigkeit der Weiterentwicklung eines Identity-Management-System und damit erreichen wir die Phase D. ***Phase D: Management von Identity-Kernprozessen aus und in die Cloud*** Diese Phase ist geprägt von dem Umstand, dass sich Unternehmen mehr auf ihre Kernthemen und ihr Kerngeschäft konzentrieren möchten. Lästige Dinge wie Erreichbarkeit, Ausfälle durch Wartung und Instandhaltung, Fragen nach der Nutzung der aktuellsten Software-Version, wie skaliert die gesamte Infrastruktur mit dem Unternehmen, wie dynamisch sind Ausgründungen oder Eingliederungen möglich, treten immer mehr in den Vordergrund und stellen sehr große Kostentreiber dar. Jetzt werden oft Entscheidungen getroffen, in welchen Unternehmen ihre Systeme in die Cloud verlagern. Dabei ist die Cloud sowohl als Private als auch als Public Cloud möglich. Hybride Ansätze über mehrere Cloud Provider werden mehr und mehr genutzt. Die Verwaltung und die Nutzung externer Services erfordern einen kontinuierlichen Umbruch von Identity und Verwaltungseinheiten. Abbildung 4 soll dies darstellen. ![](https://thecattlecrew.net/wp-content/uploads/2020/01/ident4.png?fit=1024%2C654&ssl=1) **Abbildung 4: Einbindung externer Dienste ins IDMS** Mit dem Erreichen dieser nächsten Stufe kann von einer neuen Evolutionsstufe des Identity Managements gesprochen werden. Hier kommen Herausforderungen hinzu, wie die externe Verwaltung der Identitys „“ unterstützt wird diese Phase sehr stark von Identity Federation mit die Protokollen SAML und STS (Secure-Token-Services). Mit den neuen Herausforderungen, die die Komplexität von Identity und Access Management mit sich bringt, rücken Modelle in den Fokus, die eine Identity Governance aus der Cloud notwendig machen. Startup-Unternehmen nutzen diese Möglichkeit ganz bewusst. Dies führt uns in die Phase E. ***Phase E: Identity Governance aus der Cloud*** In Zukunft werden ganze Bereiche wie HR-Strategie, Organisationsentwicklung, Identity Management und Controlling-Systeme von intelligenten IT-Lösungen unterstützt. Algorithmen helfen, riesige Datenmengen in Echtzeit auszuwerten und zukünftige Entwicklungen zu optimieren und zu skalieren. Unternehmen können so einfacher und schneller bessere Entscheidungen treffen „“ und dass in allen Bereichen des Identity und Access Management. Die Einflüsse sind heute schon sichtbar. So arbeiten Hersteller wie Google, Microsoft, Amazon (AWS) und Apple an einer gemeinsamen Authentifizierungsmethode – der FIFO2. Bei dieser Methode werden biometrischen Informationen zur Authentifizierung herangezogen. Auch die Bildung von Identity-Netzwerken wird immer wichtiger, um mit der Komplexität Schritt zu halten. Die Anbindung eigener Firmen-Identitys an externe Dienstleiter wie Github, WordPress oder Office 365 sind Meilensteine dieser Entwicklung. Die Abbildung 5 soll dies schematisch darstellen. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/01/ident5-1.png?fit=1024%2C654&ssl=1) **Abbildung 5: IDMS mit Unterstützung von anderen Cloud Services** Seitens der Applikationen und Anwendungen wird es immer wichtiger werden, sich auf die Vorgänge des Identifizierens und Autorisierens zu konzentrieren. Und so entstehen immer mehr digitale Netzwerke. Diese digitalen Netzwerke ermöglichen Unternehmen den Zugang zu einer wachsenden Zahl neuer Anbieter und Services, die sämtliche Prozesse für die Verwaltung interner und externer Mitarbeiter und Dienstleistungen (einschließlich Beschaffung) in einem Unternehmen abdecken. Darüber hinaus erhalten Anwender im Laufe der Zeit Zugriff auf weitere Lösungen zum Beispiel für Planung und Analysen, Gehaltsabrechnung und Compliance, Rechnungen und Steuern, Zeiterfassung, Lieferantenqualifizierung, Personalmanagement oder Lernsysteme. Darüber hinaus wird auf verschiedene (bevorzugte) Lösungsanbieter zurückgegriffen und so können schneller geeignete Mitarbeiter gefunden werden. Dies ermöglicht Bewerber leichter zu prüfen und die erforderlichen Aufgaben beim Eintritt oder Ausscheiden des Mitarbeiters (intern als auch extern) zu erledigen. Die erforderliche Dokumentation ist dabei automatisiert, was zusätzlich mehr Effizienz und Nachvollziehbarkeit gewährleistet. Digitale Anbieter von Enterprise-Lösungen sind bereits netzwerktechnisch unterwegs, sodass ihre Lösungen mehr und mehr genutzt werden können. Sie bieten beispielsweise Lösungen an, die herkömmliche Kanäle zur Personalbeschaffung, des Identity Management ergänzen und einen schnelleren Zugang zu Fachkräften ermöglichen. **Ein Ausblick** Die Erfahrung zeigt, dass mittlere und große Unternehmen meist etwas verzögert in den Markt drängen, und so wird diese Evolutionsstufe möglicherweise noch 5-6 Jahre beanspruchen. Wenn wir die Veränderungen der letzten Zeit anschauen, so möchte ich auch die Prognose wagen, das wir an einer Technologieschwelle stehen. Waren wir in den Neunzigern und im ersten Jahrzehnt der Zweitausender noch mit drei parallelen Technologien konfrontiert, so mehren sich die Anzeichen, das wir in das Zeitalter von neun parallelen Technologien eintreten. Welches die Vielfalt und die Komplexität stark anwachsen lässt. Es wird somit eine der größten Herausforderung sein, diesem Drang auf Veränderung mit eigenen Ideen und Lösungen entgegenzutreten und dadurch voranzutreiben. Die Zeit von KI & IoT steht schon vor der Tür und wird das Identity und Access Management in neue Höhen treiben. BYOD-Modelle (Bring your Own Device) sind da nur die Spitze des Eisbergs. Man stelle sich vor, wie Geräte Berechtigungen automatisch wechseln, wenn man als Anwender zum Beispiel einen Tesla besteigt oder ein Aktivierungscode verlangt wird, wenn bedingt, berechtigte Personen zugegen sind und auf schützenswerte Informationen zugegriffen werden soll. Es geht somit immer mehr um einen Identity Circle of Trust (ICOT) oder die Trigonometrie der Identity. Es erwartet uns eine spannende Zeit voller Veränderungen. **Die Zukunft ist schon anwesend – wir müssen sie nur noch lenken und gestalten.** **Kategorien:** Cloud **Schlagwörter:** Artificial Intelligence, Bring your own Device, BYOD, Digitalisierung, Federation, ICOT, Identity, Identity Circle of Trust, IoT, Self-Service, Trigonometrie der Identity --- ### [Containerize Java, Part 1 - the JVM](https://thecattlecrew.net/2020/03/12/containerize-java-part-1/) **Published:** März 12, 2020 **Author:** Tobias Unger **Content:** Tobias Unger, Tunahan Cizek „“ Opitz Consulting Deutschland GmbH The Java universe has created a bunch of frameworks claiming to be cloud-native. These frameworks especially offer support to create container images of an application. For example, Quarkus publishes pre-built Docker files \[1\]. However, the images created by these Dockerfiles are not necessarily the best for running the application: Sometimes the images must be optimized regarding special performance and resource consumption requirements. One aspect here is the JVM itself. If one aims for minimizing the image size or the JVM“™s startup time, one might have to create a custom image. Minimizing resource consumption is of special interest in cloud environments, because of the usage-based payment in public clouds. Another aspect is the large number of JVM variants that have emerged recently. Some of these JVMs contain their own optimizations, e.g. Amazon Corretto \[2\] or Eclipse OpenJ9 \[3\], which affect size and resource consumption. In the further course, we use OpenJDK HotSpot and Eclipse OpenJ9 provided by AdoptOpenJDK \[4\] to show the practical impact of these differences. The versions of OpenJDK (build 11.0.6+10) and Open J9 (build openj9-0.18.1) used are listed in the appendix. Below we will share a few of our experiences on this topic. ## JVM Type During our daily work, we see a lot of containers containing a complete JDK. This is not a problem if one does not care about the image size. If the size of the image is to be minimized, it is worth taking a closer look here. Instead of using JDK, one can use the JRE. The JRE needs significantly less space in the image because it does not contain all the tools necessary for developing applications such as the compiler (javac). Most applications only require a JRE, especially if they were created with a cloud-native framework such as Quarkus, Micronaut \[5\], Helidon \[6\], or SpringBoot \[7\]. Hence, Dockerfiles provided by these Frameworks rely on JRE. An example for which a JDK is required are Java Server Pages (JSPs) because JSPs are compiled at runtime. Another option to reduce the storage footprint is to use the headless version of the JDK/JRE. For example, Debian provides headless packages of the JVM and the JDK/JRE. These packages omit all packages required for graphical interfaces. Jlink \[8\] was introduced in Java 9 and allows to build a custom runtime image. It allows assembling a Java application and its dependent modules into the custom image. The real purpose of Jlink is to turn module-based applications into an image. However, you can also use Jlink to create a tailored JVM image. Helidon, for example, integrates Jlink directly in its build tools \[10\]. An example of how to create a JVM image for a Quarkus application is shown below. ``` #!/bin/bash $JAVA_HOME/bin/jlink --add-modules java.sql,java.rmi,\\ jdk.management.agent,java.transaction.xa,java.logging,\\ java.xml,java.management,jdk.unsupported,java.datatransfer,\\ jdk.internal.jvmstat,java.instrument,java.security.jgss,\\ jdk.management,java.naming,java.desktop,java.compiler,\\ java.prefs,java.security.sasl,jdk.jconsole,\\ java.management.rmi,jdk.attach,java.base \\ --output $IMAGE_NAME --strip-debug --no-header-files \\ --no-man-pages --compress 2 ``` Figure 1 shows a size comparison between a standard JDK, a standard JRE and a generated JVM image based on Jlink for OpenJDK as well as for OpenJ9. The size refers to the uncompressed size of the JVM layer within the container image. To measure this, we packed the JVM in its own layer. The difference in layer size between JDK, JRE, and Jlink is clearly visible. Note that compression of the JVM image may impact startup time. Furthermore, the Jlink JVM image must be created specific for each application. This is the only way to ensure that all required JVM modules are included in the JVM image. ![image-size](https://thecattlecrew.net/wp-content/uploads/2020/03/image-size.png) Figure 1: VM size comparison ## Startup Time Fast application startup time plays a big role in cloud environments. On the one hand, many serverless services start application instances as soon as a request comes in. Also, the instances are only held for a defined period of time. On the other hand, an application should scale almost without delay as the number of requests increases. To achieve these requirements, the JVM must start the application as quickly as possible. The influence of the application on the start speed is not taken into account in this blog. We define startup time as the duration it takes to bring up the Docker container, the JVM, and the Quarkus example application. The application is based on the Quarkus Hibernate ORM and RESTEasy Quickstart \[13\]. However, we deactivated entity caching. The application is considered started, as soon as we receive the first response. The first two bars of Figure 2 show the start application start time for OpenJDK and OpenJ9 without any optimization. This is too slow for the requirements of modern cloud environments. Please note that about one second is required to start the container. However, OpenJ9 offers an interesting option to reduce startup time. This is presented in the next section. ![startup-time](https://thecattlecrew.net/wp-content/uploads/2020/03/startup-time.png) Figure 2: Startup Time of our Quarkus application ## Class Data Cache OpenJ9 provides an option to reduce the memory footprint and startup time. One can define a cache for (shared) class data. The cache can contain bootstrap and application classes, metadata, and ahead-of-time (AOT) compiled code \[9\]. Using this cache, OpenJ9 can decrease startup time of an application significantly. We tested two scenarios: the cache is part of the imaged (1) and the cache is stored on a volume (2). Figure 2 shows that using a cache might not reduce startup time in any case. Storing a populated cache (warm) with the image showed only a negligible reduction in our setup. Apparently, Docker needs it“™s time to load the image or data access to the layers is slow. Also, squashing the image to a single layer doesn“™t help. The startup time decreased as we outsourced the cache to a volume (locally attached SSD). However, it is important to create the cache during the build (warm). If the cache is activated and not populated (cold) startup time increases. ## CPU & Memory Consumption Figure 3 and Figure 4 show CPU & memory consumption of our Quarkus application during startup and under load. Interestingly, OpenJ9 has a higher CPU utilization but doesn“™t claim as much memory as OpenJDK. It seems that the lower memory consumption is at the expense of CPU usage. ![openjdk-jre](https://thecattlecrew.net/wp-content/uploads/2020/03/openjdk-jre.png) Figure 3: CPU & Memory Consumption of OpenJDK ![openj9-jre](https://thecattlecrew.net/wp-content/uploads/2020/03/openj9-jre.png) Figure 4: CPU & Memory Consumption of OpenJ9 ## Go native? One might argue that the emergence of GraalVM \[11\] solves a lot of problems. Especially startup time is decreased significantly by compiling a native image of the application. In principle, that is correct. So far, not every application can be compiled natively. Reflection is one prominent issue. We also tested GraalVM and leave discussing the results to a future blog post. ## Conclusion Containerization of Java applications requires to consider a lot of aspects. The selection of the JVM and the appropriate JVM configuration alone offers a wide range of options. With this blog, we want to encourage you to do your own tests in your setting as there is no general solution. Our measurements show directions for optimizations. All in all, we think that the Jlink approach looks promising in terms in terms of image size. Whether or not to use the J9″™s class cache is a more difficult decision. On the one hand the startup time can be shortened, on the other hand the cache itself needs storage space again. In addition, the cache must be populated during the image build. ## Want to know more? If you want to know more about containerized application development, visit the [Containers and Cloud-Native Roadshow](https://www.opitz-consulting.com/containers-and-cloud-native.html) Essen on March 26th, 2020 \[12\]. You will gain a lot of insight in container technology and learn, how to build cloud-native applications. The Containers and Cloud-Native Roadshow Essen will be postponed due to the corona virus. Therefore we decided to start a small series of articles about containers based on this article. Stay safe and healthy!! ## References \[1\] https://quarkus.io \[2\] https://aws.amazon.com/de/corretto/ \[3\] https://www.eclipse.org/openj9/ \[4\] https://adoptopenjdk.net/ \[5\] https://micronaut.io/ \[6\] https://helidon.io/#/ \[7\] https://spring.io/projects/spring-boot \[8\] https://docs.oracle.com/javase/9/tools/jlink.htm#JSWOR-GUID-CECAC52B-CFEE-46CB-8166-F17A8E9280E9 \[9\] https://www.eclipse.org/openj9/docs/xshareclasses/ \[10\] https://github.com/oracle/helidon-build-tools/tree/master/helidon-maven-plugin#goal-jlink-image \[11\] https://www.graalvm.org/ \[12\] https://www.opitz-consulting.com/containers-and-cloud-native.html \[13\] https://github.com/quarkusio/quarkus-quickstarts/tree/master/hibernate-orm-quickstart **Kategorien:** Cloud, Development **Schlagwörter:** Container, Docker, Image, Java, JVM --- ### [OpenShift 3.11 - Reduce hostSubnetLength without downtime](https://thecattlecrew.net/2020/03/16/openshift-3-11-reduce-hostsubnetlength-without-downtime/) **Published:** März 16, 2020 **Author:** Bartlomiej Sowa **Excerpt:** According to OpenShift Documentation - it is not possible to change this after performing the installation! Here how you can do it. **Content:** Have you ever had a situation, where you installed OpenShift 3.11 and after it got taken into production it needed adding way more new nodes as expected? Additionaly – did it happen to you, that you could not extend cluster network anymore because your IT did not want to give you even more IP Addresses? I faced such a situation and realised, that altough setting hostSubnetLength to 8 (reservind 250 IP for pods on each node) I never came even close to half of it before the node got fully saturated. In such a situation you may think (at least I did so) – why then not to **reduce hostSubnetLength** to 7, giving each node 126 IP addresses for pods, while it would still be more than needed. At the same time it would allow **to double** the number of nodes without the need of ip range expansion… Sounds straight forward, but… it isn’t. According to [OpenShift Documentation](https://docs.openshift.com/container-platform/3.11/install_config/configuring_sdn.html#configuring-the-pod-network-on-masters) – it is not possible to change this after performing the installation! [![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/02/image.png?fit=1024%2C234&ssl=1)](https://docs.openshift.com/container-platform/3.11/install_config/configuring_sdn.html#configuring-the-pod-network-on-masters)Well – googling the internet in and out did not give a satisfying result, so here is how I did it (even without downtime, as my cluster is a multi-master environment). ## Disclaimer *This procedure is **not officially supported by RedHat** and **may render you cluster unusable**. Make sure to test it on a non-production cluster first. You should also have a fully-recoverable backup at hand, should things get terribly wrong! There are some troubleshooting hints at the end of this article, but make sure you read it completely and understand what is being done before continuing! You have been warned.* First, just to save initial state perform and save the results of `oc adm diagnostics networkcheck` on any master node to make sure there are no network problems in the cluster before we even begin. Now, you have to adjust the configuration in your installation ansible inventory, just to stay in sync should you need to re-run some of the playbooks in future (like scaling up the cluster with new nodes). This is one of the simplest things to do – just replace old `osm_host_subnet_length` with new one (smaller). ``` os_sdn_network_plugin_name=redhat/openshift-ovs-networkpolicy openshift_portal_net=10.1.128.0/23 osm_cluster_network_cidr=10.1.120.0/21 osm_host_subnet_length=7 ``` Then, save your current clusternetwork (just for any case, should things get wrong): ``` [root@master1 ~]# oc get clusternetwork NAME CLUSTER NETWORKS SERVICE NETWORK PLUGIN NAME default 10.1.120.0/21:8 10.1.128.0/23 redhat/openshift-ovs-networkpolicy oc get clusternetwork -o yaml > clusternetwork-backup.yml [root@master1 ~]# ``` Then edit **on all master nodes** `/etc/origin/master/master-config.yaml`, in particular this section, to specify new `hostSubnetLength`: ``` networkConfig: clusterNetworks: - cidr: 10.1.120.0/21 hostSubnetLength: 7 externalIPNetworkCIDRs: - 0.0.0.0/0 networkPluginName: redhat/openshift-ovs-networkpolicy serviceNetworkCIDR: 10.1.128.0/23 ``` After editing it on all master nodes delete current default cluster network and restart master api and controllers on each master node. Pause between nodes, to allow the api and controllers being restartet to fully start. New cluster network definition should show: ``` [root@master1 ~]# oc delete clusternetwork --all clusternetwork.network.openshift.io "default" deleted [root@master1 ~]# master-restart api; master-restart controllers 2 2 [root@master2 ~]# master-restart api; master-restart controllers 2 2 [root@master3 ~]# master-restart api; master-restart controllers 2 2 [root@master1 ~]# oc get clusternetwork NAME CLUSTER NETWORKS SERVICE NETWORK PLUGIN NAME default 10.1.120.0/21:7 10.1.128.0/23 redhat/openshift-ovs-networkpolicy ``` This still does not change hostsubnet for existing hosts (see /24 mask). In order to do this, you need to change hostsubnet objects: ``` [root@master1 ~]# oc get hostsubnet NAME HOST HOST IP SUBNET EGRESS CIDRS EGRESS IPS infra1.lan infra1.lan 10.1.118.15 10.1.123.0/24 [] [] infra2.lan infra2.lan 10.1.118.16 10.1.126.0/24 [] [] infra3.lan infra3.lan 10.1.118.17 10.1.124.0/24 [] [] master1.lan master1.lan 10.1.118.10 10.1.122.0/24 [] [] master2.lan master2.lan 10.1.118.11 10.1.121.0/24 [] [] master3.lan master3.lan 10.1.118.12 10.1.120.0/24 [] [] node01.lan node01.lan 10.1.118.20 10.1.125.0/24 [] [] node02.lan node02.lan 10.1.118.21 10.1.127.0/24 [] [] ``` You cannot however do this via `oc edit hostsubnet` as openshift will not allow it. In order to edit this you have first to create a yaml dump of current version and edit it with your preferred text editor: ``` [root@master1 ~] oc get hostsubnet -o yaml > hostsubnet.yaml [root@master1 ~] vi hostsubnet.yaml ``` Edit the file and change all `subnet: 10.1.xxx.0/24` to a smaller **subset** of the subnet. Here it would be just changing `/24` to `/25`. Make sure, that new smaller subnet is inside previous bigger subnet, as the cluster will be restarted in rolling-way. (Theoretically it should be possible to change this to entire new address space, but first I would edit master-config on all master nodes and shutdown all nodes except one master, but this has not been tested or even tried. Feel free to test on a test system) Now the tricky part – how to update non-updateable hostSubnet entries? Re-create them. ``` [root@master1 ~]# oc delete hostsubnet --all hostsubnet.network.openshift.io "infra1.lan" deleted hostsubnet.network.openshift.io "infra2.lan" deleted hostsubnet.network.openshift.io "infra3.lan" deleted hostsubnet.network.openshift.io "master1.lan" deleted hostsubnet.network.openshift.io "master2.lan" deleted hostsubnet.network.openshift.io "master3.lan" deleted hostsubnet.network.openshift.io "node01.lan" deleted hostsubnet.network.openshift.io "node02.lan" deleted [root@master1 ~]# oc apply -f hostsubnet.yaml hostsubnet.network.openshift.io/infra1.lan created hostsubnet.network.openshift.io/infra2.lan created hostsubnet.network.openshift.io/infra3.lan created hostsubnet.network.openshift.io/master1.lan created hostsubnet.network.openshift.io/master2.lan created hostsubnet.network.openshift.io/master3.lan created hostsubnet.network.openshift.io/node01.lan created hostsubnet.network.openshift.io/node02.lan created [root@master1 ~]# oc get hostsubnet NAME HOST HOST IP SUBNET EGRESS CIDRS EGRESS IPS infra1.lan infra1.lan 10.1.118.15 10.1.123.0/25 [] [] infra2.lan infra2.lan 10.1.118.16 10.1.126.0/25 [] [] infra3.lan infra3.lan 10.1.118.17 10.1.124.0/25 [] [] master1.lan master1.lan 10.1.118.10 10.1.122.0/25 [] [] master2.lan master2.lan 10.1.118.11 10.1.121.0/25 [] [] master3.lan master3.lan 10.1.118.12 10.1.120.0/25 [] [] node01.lan node01.lan 10.1.118.20 10.1.125.0/25 [] [] node02.lan node02.lan 10.1.118.21 10.1.127.0/25 [] [] ``` Now it is time to do restart of each node in the cluster to allow docker to start with new configuration. To avoid downtime this has to be done one by one, waiting for all nodes to fully start before draining next one. I would suggest that you start with master nodes, then with remaining other nodes, but you may as well do this starting from worker nodes, and finishing with master nodes. Make sure to have enough nodes of each role, so that after draining any node there is still room left in the cluster. Otherwise partial downtime may occure. Do the restart one by one by following this procedure for each one: 1. `oc adm drain master1 --ignore-daemonsets --delete-local-data` 2. login to master1 and do `shutdown -r now` 3. **wait** until node reboots and `oc get node` shows node as `Ready,SchedulingDisabled` 4. re-enable node with `oc adm uncordon master1` 5. repeat steps 1-4 for other master nodes 6. repeat steps 1-4 for all other nodes After starting, you should not be able to run more than 126 pods on each node. You may want to edit node description to specify new maxpods value. You can test it with trying to start multiple small pods with node-selector of a given node until you reach an scheduling error like: `failed to allocate for range 0: no IP addresses available in range set: 10.1.124.1-10.1.124.126` After this operation you should check the cluster for stability, especially for inter-node connectivity. This can be done by running the `oc adm diagnostics networkcheck` command from master node. It should not notice any errors or warnings. You should also be able to add new nodes to a cluster, that until now seemed not extensible due to not enough host subnets inside cluster network. It would just allocate `10.1.xxx.128/25` networks for up to 8 additional new nodes. Hope this helps you, at least this is how I managed to extend such a cluster without the need of allocating new address ranges. ### Possible troubleshooting If after performing this steps you observe problems inside cluster (that did not existed before), especially with SDN or inter-node connectivity you may try to re-create all SDN pods by running this commands: ``` [root@master1 ~]# oc delete pod -n openshift-sdn -l app=sdn [root@master1 ~]# oc delete pod -n openshift-sdn -l app=ovs ``` After adding some new nodes make sure that they got subnets that **do not overlap**! Should this happen you may need to re-edit hostsubnet so that they do not overlap and restart affected nodes. If after correcting hostsubnet still inter-node communication problems occure, re-create the sdn/ovs pods as shown above. This should not happen, but it happened at once for me, maybe because I re-applied saved hostsubnet after adding nodes. It is however worth checking Should this not help, you can always take back the changes done by re-applying this procedure with previous host Subnet Length. **Kategorien:** Cloud **Schlagwörter:** clusternetwork, host subnet length, hostsubnetlength, OpenShift, reduce, sdn --- ### [OC | Expert Camp XXL - DeepRacer Vorführung](https://thecattlecrew.net/2020/04/30/oc-expert-camp-xxl-deepracer-vorfuehrung/) **Published:** April 30, 2020 **Author:** Thomas van Loo **Content:** Am Dienstag, den 03. März 2020 veranstaltete unser Büro in München das OC|Expert Camp XXL. Dabei hielten unsere Experten von Opitz Consulting interessante Präsentationen, die einen detaillierten Einblick in die verschiedenen Bereiche unserer Branche gegeben haben. Das Studententeam in München wurde zu diesem Anlass beauftragt, vor Ort eine Demo mit dem AWS DeepRacer vorzubereiten, um den Besuchern die außergewöhnliche Hardware vorzuführen. Dieses exklusive Modellauto hat die Fähigkeit nach entsprechendem Training autonom auf dafür vorgesehenen Rennstrecken zu fahren. Opitz Consulting hatte das Auto schon mal auf den „Digital Xchange Days 2019“ in Gummersbach vorgestellt, jedoch war die Strecke, die damals benutzt wurde, zu groß für unsere Räumlichkeiten, weshalb wir ein neues gebaut haben (). In diesem Artikel stellen wir den Prozess vor, wie wir dieses kleine Auto dazu gebracht haben, völlig autonom auf unserer selbstgebauten Rennstrecke zu fahren. Das Erste, worum wir uns kümmerten, war der Bau unserer Rennstrecke. Also recherchierten wir ein wenig, stellten eine Liste der benötigten Materialien zusammen und machten uns auf den Weg zum Baumarkt, um alles einzukaufen. Die Rennstrecke bauten wir so, dass sie leicht auf- und abzubauen ist. So können wir sie jeder Zeit auch an einem anderen Ort mitnehmen. Wir kauften genügend puzzleförmige Schaumstoffmatten, um eine 4×3 Meter große Fläche abzudecken, die die Basis und die „Straße“ unserer Bahn bilden würde. Als Nächstes besorgten wir grüne Farbe für die „Grasfläche“ außerhalb der Strecke sowie weißes und gelbes Klebeband als Grenz- und Mittellinien der Straße. Wir sind mit allen Utensilien zurück ins Büro gekommen und haben angefangen die Matten zusammen zu bauen, unsere Rennstrecke darauf aufzuzeichnen und zu malen! ![](https://thecattlecrew.net/wp-content/uploads/2020/04/dr1.png)![](https://thecattlecrew.net/wp-content/uploads/2020/04/dr2.png)Nachdem die Farbe getrocknet war, legten wir das Klebeband aus. Somit war unsere Bahn fertig! ![](https://thecattlecrew.net/wp-content/uploads/2020/04/dr3.png)Als Nächstes kam der technische Teil: die Erstellung und das Training eines maschinellen Lernmodells, das wir auf das Auto laden konnten und es ihm ermöglichen würde, sich selbstständig auf unserer Strecke zu bewegen, indem es nur eine Kamera an der Vorderseite des Fahrzeugs benutzt. Dieser gesamte Prozess wird im AWS in einem speziell für den DeepRacer vorgesehenen Bereich durchgeführt. Das Modell lernt mit Hilfe einer Machine Learning Strategie, die als „Reinforcement Learning“ bezeichnet wird. Dies wird als Standardansatz im Bereich der Robotik angesehen. Jeder von uns hat selbst schon mal reinforcement learning erlebt und man kann sich vorstellen, dass es genau wie das Hundetraining ist: Wenn der Hund sitzt, wenn wir es ihm sagen, bekommt er ein Leckerli. Wenn er etwas tut, was er nicht tun soll, wie z.B. auf das Bett zu springen, wird er bestraft. Wir verstärken sein gutes Verhalten und bestrafen das Schlechte. Das hat die Folge, dass der Hund gutes Verhalten mit einer Belohnung in Form des Leckerlis assoziiert. Mit einer Methode, die als „Reward Function“ bezeichnet wird, können wir die gleiche Taktik auf den Deepracer anwenden. In dieser Funktion können wir dem Modell mit Hilfe von Python-Code mitteilen, welches Verhalten belohnt und bestraft wird. Dabei werden hier die Leckerchen durch ein einfaches Punktesystem ersetzt. Wenn das Auto so fährt, wie wir es wollen, so erhält es Punkte. Wenn es stattdessen vom Kurs abweicht, werden ihm Punkte abgezogen. Nachdem man die Reward Function festgelegt hat, kann man einen von AWS angebotenen virtuellen Parcours auswählen, auf dem das Modell für eine festgelegte Zeitspanne trainieren kann. In einer virtuellen Simulation wird die Fahrt des Autos dargestellt. Dabei endet ein Versuch, wenn das Auto von der Straße abkommt oder eine ganze Runde zurücklegt hat. Nach jedem Versuch berechnet das Modell die Belohnung, die es erhalten hat und verbessert seine Fahrt, um die Punkteanzahl zu maximieren. All dies wird von AWS visualisiert, so dass der Fortschritt des Modells während desTrainings mitverfolgt werden kann. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2020/04/dr4.jpg?fit=1024%2C447&ssl=1)Trainingsimulation – Der Graph zeigt den durchschnittlichen Reward-verlaufDer einzige Sensor am Auto ist die Kamera an der Vorderseite, die 15 Bilder pro Sekunde aufnimmt. Jedes dieser Bilder wird durch das Modell geleitet, welches dann- basierend auf seiner Erfahrung aus dem Trainingsprozess – festlegt, welche Aktion in der aktuellen Situation am wahrscheinlichsten ist, um die Belohnung zu maximieren (links fahren? rechts? geradeaus?). Das Auto führt anschließend diese Aktion aus. Nach mehreren Versuchen eine gute Strategie für unsere Reward Function zu finden (die alle darin endeten, dass das Auto gegen die Wand fuhr), beschlossen wir, einen einfacheren Ansatz zu wählen: Das Auto sollte einfach der Mittellinie unserer Strecke folgen. AWS stellt Parameter zur Verfügung, um die Mittellinie sowie die Abstände auf der Strecke innerhalb der Reward Function zu erkennen. Dies ermöglicht uns Markierungen auf der Strecke aufzustellen: Ist das Auto maximal 6 cm von der Mitte entfernt, erhält es eine hohe Belohnung. Ist es zwischen 6 und 10 cm von der Mitte entfernt, wird es weniger belohnt und wenn es weiter wegfährt, werden Punkte abgezogen. Wir wählten eine virtuelle Rennstrecke aus, die unserer eigenen ähnelte und starteten eine 3-stündigen Trainingsarbeit. Als wir das produzierte Modell geladen und im Auto fertig hatten, hatten wir trotz anfänglicher Schwierigkeiten den ersten Erfolgsmoment, da das Auto schließlich seine erste volle Runde auf unserer Strecke absolvierte! Da das Auto oftmals aus der vorgegebenen Bahn rausgekommen ist, mussten wir zurück an unseren Computer, um das gleiche Modell über längere Zeiträume zu trainieren. Nach etwa 9 Stunden Training ist das Auto fast jede Runde fehlerfrei gefahren. Wir fühlten uns zuversichtlich und bereit unsere Arbeit bei dem bevorstehenden Event zu präsentieren. Am Veranstaltungstag fuhr das Auto einwandfrei und beeindruckte unsere Zuschauer. Außerdem entwickelten sich viele interessante Gespräche mit neugierigen Besuchern über die modernen Technologien, die bei diesem anspruchsvollen und sehr lustigen Projekt eingesetzt wurden. Die Demo war ein großer Erfolg und wir sind froh, dass unser Team daran beteiligt war. **Kategorien:** AI & Data Science, Tech Events & Networking **Schlagwörter:** Artificial Intelligence, AWS, OC|Expert Camp --- ### [Energieeffizienz im Rechenzentrum](https://thecattlecrew.net/2023/07/24/energieeffizienz-im-rechenzentrum/) **Published:** Juli 24, 2023 **Author:** Ramon Anger **Content:** CO2-neutral und energieeffizient arbeitende Rechenzentren sind en vogue. Welcher Anbieter von Cloud-Dienstleistungen mag nicht damit werben, dass seine Services CO2-neutral erbracht oder ausschließlich mit erneuerbaren Energien betrieben werden. Treiber auf diesem Entwicklungspfad sind aktuell die [Hyperscaler](https://www.storage-insider.de/was-ist-ein-hyperscaler-a-986939/) von [AWS](https://sustainability.aboutamazon.com/environment/the-cloud?energyType=true), [Google Cloud Platform](https://www.google.com/about/datacenters/cleanenergy/) und [Microsoft Azure](https://azure.microsoft.com/en-us/blog/sharing-the-latest-improvements-to-efficiency-in-microsoft-s-datacenters/), die dabei nicht nur auf die Verwendung von erneuerbaren Energien setzen. Die Nutzung energiesparsamer Hardware und die Erhöhung der Effektivität beim Einsatz von Energie bilden aktuell die weiteren Trittsteine dieses Entwicklungspfades. Wenn wir bedenken, dass Rechenzentren in Frankfurt (Main) für [20% des Stromverbrauchs](https://www.datacenter-experience.com/frankfurt-am-main_de.html) der Stadt verantwortlich sind und dieser Anteil am Verbrauch tendenziell weiter steigt, erscheint Energieeffizienz nicht von ungefähr als eine erstrebenswerte Eigenschaft jedes Rechenzentrums. Wie gehen also die Hyperscaler vor? # Sparsame Hardware Energiesparsame Hardware, genauer der Einsatz von [ARM-Prozessoren](https://www.giga.de/artikel/was-bedeutet-arm-prozessor-einfach-erklaert/), bildet eine Basis für die Veränderung des CO2-Fußabdrucks der großen Cloud-Anbieter. Während [Azure](https://azure.microsoft.com/en-us/blog/azure-virtual-machines-with-ampere-altra-arm-based-processors-generally-available/) und [Google](https://www.servethehome.com/google-cloud-adds-ampere-altra-with-new-tau-t2a-instances/) auf Lösungen von [Ampere Computing](https://amperecomputing.com/products/processors) setzen, hat man bei AWS mit der [Graviton](https://en.wikipedia.org/wiki/AWS_Graviton)-Familie eigene Prozessoren entwickelt. Energiesparsam bedeutet bei weitem nicht weniger leistungsfähig. Im Gegenteil: Beide Ansätze – Ampere und Graviton – sind überaus leistungsfähig und [vergleichbar](https://amperecomputing.com/briefs/ai-altra-vs-graviton). Und sie müssen sich nicht [hinter x86-Prozessoren verstecken](https://www.computerbase.de/2021-12/amazon-graviton-3-neue-cpu-nimmt-es-mit-intel-und-amd-auf/). Die großen Anbieter erzeugen mit ihren energiesparenden Lösungen einen Druck auf andere Anbieter von Cloud-Dienstleistungen. Das dürfte mittelfristig dazu führen, dass die Verwendung energiesparsamer Hardware zum Standard wird. # PUE Wenn ich erkennen will, wie effizient ein Rechenzentrum ist, ist die [Stromverbrauchs-Effektivität](https://www.nutanix.dev/2023/05/04/digging-into-data-center-efficiency-pue-and-the-impact-of-hci/) (PUE – Power Usage Effectiveness) ein guter Startpunkt. PUE beschreibt, wieviel der in einem Rechenzentrum eingesetzten Energie tatsächlich für dessen Kernaufgaben verwendet wird. Je näher dieser Wert an 1 liegt, desto effektiver arbeitet das Rechenzentrum. ``` PUE = insgesamt verbrauchte Energie / für die Infrastruktur verbrauchte Energie ``` zum Beispiel ``` 150 GWh / 100 GWh = 1.5 (GWh - Gigawattstunde) ``` Werte von 1.1 oder 1.2 deuten auf eine exzellente Effektivität hin, Werte von 2 oder höher eher in die entgegengesetzte Richtung. Je größer ein Rechenzentrum ist, desto leichter ist es häufig, eine höhere Effektivität zu erreichen. Eine geringere Effektivität kann beispielsweise durch aufwendige, teure Kühlung der Hardware entstehen. Die Hyperscaler ([AWS](https://aws.amazon.com/de/energy/sustainability/), [Google](https://www.google.com/about/datacenters/efficiency/) und [Azure](https://azure.microsoft.com/en-us/blog/sharing-the-latest-improvements-to-efficiency-in-microsoft-s-datacenters/)) veröffentlichen die Verbrauchseffektivität ihrer Rechenzentren regelmäßig und erzeugen auch damit Druck auf ihre Konkurrenz. Welcher Anbieter will schon mit einer schlechten Effektivität dastehen, wenn die Konkurrenz weit bessere Werte veröffentlicht? Auch hier können wir erwarten, dass hohe Effektivität zum Standard wird. # Die Erneuerbaren 2022 mussten Microsoft und AWS die [Erweiterung ihrer Cloud-Kapazität](https://www.derstandard.at/story/2000138547311/irland-hat-nicht-mehr-genug-strom-fuer-neue-rechenzentren-von) in Dublin (Irland) verwerfen, weil der dortige Stromversorger keine zusätzlichen Kapazitäten für Elektroenergie aufbringen konnte. Man war unter anderem mit dem Leerkaufen des dortigen Energiemarktes gescheitert. Nicht nur als Konsequenz aus dieser Entwicklung schließen die Hyperscaler mit Energieanbietern [langfristige Lieferverträge](https://news.microsoft.com/de-de/cloud-rechenzentren-setzen-auf-erneuerbare-energie/) (PPA – Power Purchase Agreements) ab, die dafür sorgen, dass keine bereits verfügbare Energie aus dem Markt abgezogen wird, sondern neue Kapazitäten errichtet werden, die dann zusätzlich zur Verfügung stehen. Wenn die hiesigen Cloud-Anbieter von den Hyperscalern etwas lernen sollten, dann dies: > Das Leerkaufen des Marktes für erneuerbare Energien ist nicht nachhaltig. Die Cloud-Anbieter müssen langfristige Verträge mit Energieerzeugern abschließen, damit diese ihre Kapazitäten für Erneuerbare ausbauen. Die Notwendigkeit dazu kann früher entstehen als uns heute bewusst ist. Es gibt einen aktuellen Gesetzesentwurf des Wirtschaftsministeriums, nachdem Rechenzentren in Deutschland bis 2027 [CO2-neutral](https://netzpolitik.org/2022/energieeffizienzgesetz-wie-rechenzentren-klimaneutral-werden-sollen/) sein müssen. Natürlich besteht eine gute Chance, dass dieser Zeitpunkt weiter nach hinten verschoben wird. Aufgeschoben ist aber nicht aufgehoben. # Also alles grün? Die Initiative der Hyperscaler hin zu erneuerbaren Energien und effektivem Energieeinsatz bezieht sich auf den Energiebedarf für den Betrieb der Rechenzentren. Andere Aspekte bleiben außen vor. Dazu gehören beispielsweise diese drei: - Bau von Rechenzentren Der CO2-Ausstoß für den Bau eines neuen Rechenzentrums ist immer noch hoch. 2020 erzeugten Bauprojekte ca. [38% der weltweiten CO2-Emissionen](https://www.solarify.eu/2020/12/17/331-0-rekord-co2-ausstoss-im-baubereich/). Neu gebaute Rechenzentren haben auch daran ihren Anteil. Ziel muss es sein, künftig bei der Planung und beim Bau neuer Rechenzentren einen [vertretbaren CO2-Ausstoß](https://www.connect-professional.de/datacenter-netzwerke/rechenzentren-gruener-bauen.192170.html) zu erreichen. - Kühlung mit Wasser Speziell für die Kühlung und die Nutzung der Abwärme der Rechenzentren sind nachhaltige Ideen gefragt. Hier gibt es viel [Verbesserungspotential](https://www.datacenterdynamics.com/en/news/drought-stricken-holland-discovers-microsoft-data-center-slurped-84m-liters-of-drinking-water-last-year/). Ein mittleres Rechenzentrum verbraucht zwischen [vier und sieben](https://www.lebensraumwasser.com/rechenzentren-und-wasser-was-datennutzung-mit-wasserkonflikten-zu-tun-hat/#:~:text=Ein%20mittleres%20Rechenzentrum%20(%E2%80%9EColocation%E2%80%9C,Wasserbedarf%20einer%20mittleren%20deutschen%20Gro%C3%9Fstadt.) Millionen Kubikmeter Wasser pro Jahr. Dabei handelt es sich häufig um Trinkwasser. - Hardware-Herstellung Die Herstellung und der Transport der Hardware, die im Rechenzentrum betrieben wird, ist nicht CO2-neutral. Auch energiesparsame ARM-Prozessoren müssen energieaufwändig hergestellt werden. Hardware ist ein gute Beispiel dafür, dass CO2-Emissionen ganzheitlich über die gesamte [Wertschöpfungskette](https://plana.earth/academy/what-are-scope-1-2-3-emissions) betrachten werden müssen. Nur dann erkennen wir, wo Optimierungspotential liegt. ## Zertifizierung mit dem Blauen Engel Den [Blauen Engel](https://www.blauer-engel.de/de/zertifizierung/vergabekriterien#UZ228-2022) als Zertifikat für den energieeffizienten Betrieb von Rechenzentren gibt es seit inzwischen zehn Jahren. Das Zertifikat lässt Energiekosten und Emissionen beim Bau oder bei der Hardwareherstellung aktuell noch vollständig außer Acht. # Fazit Die Energieeffizienz der Rechenzentren verändert sich gerade rapide. Der Verbrauch erneuerbarer Energien in Rechenzentren steigt ebenso. Gerade deshalb stellt sich die Frage, was das für Organisationen bedeutet, die Cloud-Dienstleistungen anbieten oder nutzen. - Neue Energiekonzepte Der CO2-neutrale Betrieb aller Rechenzentren in Deutschland wird in wenigen Jahren Realität sein. Das können Unternehmen, die Cloud Services anbieten, über den Kauf von [CO2-Emmissions-Berechtigungen](https://www.dehst.de/DE/Nationaler-Emissionshandel/nEHS-verstehen/nehs-verstehen_node.html) erreichen. Wer nicht in den Verdacht geraten will, Green-Washing zu betreiben, stellt selbst auf erneuerbare Energien um. [Energiekonzepte](https://www.datacenter-insider.de/energiekonzepte-fuer-rechenzentren-teil-1-d-41954/?cmp=cop-el-dl-lead-VITebookDCIenergie1-20210902) für Rechenzentren mit Blick auf Effizienz und Erneuerbare gibt es viele. - Nachhaltige Speichertechnologie Die Zukunft der Notstromversorgung von Rechenzentren liegt in Batterien statt in Dieselaggregaten. [Dunkelflauten](https://de.wikipedia.org/wiki/Dunkelflaute) – also Zeiten ohne ausreichende Sonneneinstrahlung und Wind – und Stromausfälle – lassen sich so nachhaltiger überbrücken. Die alten Dieselaggregate für die Notstromversorgung werden in Deutschland ohnehin [nicht mehr lange betrieben werden dürfen](https://www.datacenter-insider.de/streng-reguliert-netzersatz-mit-diesel-notstromtechnik-a-b428ff95411d6e1e90ec329ea957fe6c/). - Sparsame Prozessoren Cloud-Nutzende tun gut daran, sich mit der ARM-Kompatibilität Ihrer Services auseinanderzusetzen. Auch Unternehmen, die hierzulande Cloud Services anbieten, tauschen mit der Zeit die Infrastruktur ihrer Rechenzentren aus. Was liegt da näher, als auf energieeffiziente ARM-Prozessoren zu wechseln. Allerdings nicht jede x86-Anwendung läuft problemlos auf einem ARM-Prozessor. ## Hindernis: Energie-Effizienz-Paradoxon Wird durch die Initiativen von Unternehmen und Hyperscalern hin zu erneuerbaren Energien und effektivem Energieeinsatz alles gut? Leider nein. Wir leben in einer Welt, in der das [Energie-Effizienz-Paradoxon](https://de.wikipedia.org/wiki/Jevons-Paradoxon) (Jevons-Paradoxon) gilt: Technischer Fortschritt – hier der effektive Einsatz von Energie – führt demnach häufig nicht zu Einsparungen. Weil durch den effektiven Einsatz von Energie die Kosten für Cloud-Dienstleistungen potenziell sinken, entstehen neue Bedürfnisse, und es steigt der Verbrauch. Dass zudem die Digitalisierung in Deutschland sehr viel Energie kostet und den [Strombedarf erhöht](https://www.en-former.com/digitalisierung-deutschlands-benoetigt-mehr-strom/), ist sicher keine Überraschung. Das bedeutet: Wenn wir erneuerbare Energien einsetzen und Energie effektiv nutzen, können wir das Jevons-Paradoxon abfedern, aber nicht ausgleichen. **Kategorien:** Cloud, Sustainability & Awareness **Schlagwörter:** Energieeffizienz, Hyperscaler, Infrastruktur, Nachhaltigkeit, Stromverbrauch --- ### [Ein Bot mit echtem Security-Know-how](https://thecattlecrew.net/2024/02/09/ein-bot-mit-echtem-security-know-how/) **Published:** Februar 9, 2024 **Author:** Arjuna Mittwede **Content:** # Wir bauen einen Chatbot für den IT-Grundschutz – Teil 1: Grundgedanken und Handwerkszeug Die Welt der Informationstechnologie und IT-Sicherheit entwickelt sich rasant weiter. Unternehmen und Organisationen stehen vor der Herausforderung, mit immer wieder anderen Anforderungen und immer mehr Informationen Schritt zu halten. Eine, vielleicht die größte Herausforderung besteht darin, Wissen effizient und nutzerfreundlich zu vermitteln. Das heißt, die Informationen, die wir brauchen, müssen einfach und schnell zu finden sein. Wenn es um spezialisiertes, fachliches Wissen geht, müssen die Ergebnisse zudem zuverlässig, sicher und vollständig sein. Ein Chatbot, der sein Wissen aus einer besonderen Wissensbasis herausziehen kann, wäre dafür prädestiniert. In dieser Blogserie skizziere ich die Entwicklung eines Chatbots für ein Security-Fachthema mithilfe von Azure Cognitive Search und Open AI ChatGPT. Inklusive unserer Erfahrungen im ersten Einsatz. Bevor das Team loslegen konnte, gab es einiges zu bedenken, und wir mussten uns für ein bestimmtes Handwerkszeug entscheiden. Was, warum und wieso, darum geht es in diesem ersten Teil. ## IT-Grundschutz als perfekter Use Case Es war ein kleines Team, mit dem wir unseren Security-Fachwissen-Chatbot entwickeln wollten. Ein Use Case war schnell gefunden: Das Handbuch zum IT-Grundschutz des Bundesministeriums für Sicherheit in der Informationstechnik eignete sich hier perfekt. Es bietet einen großen Umfang an speziellem Wissen rund um IT-Sicherheit, zu Themen wie Webservices, Datenbanken und Patches/Updates. Aber warum braucht es hier ein Assistenzsystem? Für viele IT’ler:innen ein Buch mit sieben Siegeln, ist das Handbuch zum IT-Grundschutz selbst für Security-Fachleute eine lästige Bürde. Es enthält eine umfassende Sammlung an Dokumenten, insgesamt über 100 Bausteine, die sich nicht nur theoretisch mit verschiedenen Aspekten der IT-Sicherheit befassen, sondern wichtige Vorgaben enthalten, die uns sagen sollen, was regelmäßig zu überprüfen ist, bzw. in praktische Maßnahmen überführt werden muss. Die Anzahl und die Detailtiefe der Maßnahmen machen es jedoch schwierig, einen Überblick zu behalten, insbesondere wenn es darum geht, IT-Projekte oder Ausschreibungen mit den entsprechenden Regelungen zu erfüllen. ### Warum ein Chatbot? Chatbots sind in der Lage, auf natürliche Art und Weise mit Benutzern zu kommunizieren. Das macht es leicht, sie im Arbeitsalltag zu verwenden. Durch die Nutzung natürlicher Sprachverarbeitungstechnologien können Benutzer in Echtzeit Antworten auf ihre Fragen erhalten, ohne sich durch umfangreiche Dokumentationen zu wühlen. Doch sind Chatbots für Spezialwissen überhaupt geeignet? Die Antwort lautet: Ja. Mithilfe von Technologien wie RAG und Semantischer Suche ist es heute möglich, einen Chatbot zum Spezialisten oder zur Spezialistin auszubilden, auf deren Antworten wir uns zu 100 % verlassen können. Auch Microsoft Azure und OpenAI bieten Möglichkeiten, um das Wissen aus dem BSI IT-Grundschutzhandbuch abzurufen und es den Nutzern sehr einfach zur Verfügung zu stellen. Damit schließen wir die Lücke, die bisherige LLM-Systeme immer wieder offenlassen. ### Eigene Wissenbasis auf Standardsystemen Vielleicht fragst du dich, warum wir uns die Mühe machen, eine eigene Wissensbasis in der Cloud aufzubauen, statt ChatGPT einfach so zu verwenden? Der Grund ist einfach: Als allgemeines Large Language Modell bietet ChatGPT kein spezialisiertes oder tiefgehendes Wissen in bestimmten Fachgebieten. Fehlt Wissen, halluziniert das System auch schon mal abstruse Informationen herbei. Darüber hinaus greift ChatGPT auf viele verschiedene Quellen zu, welche nicht immer zuverlässig sind oder die richtigen Informationen beinhalten. Insgesamt kann die Qualität der Antworten nicht gewährleistet werden. Dazu kommt, dass die Wissensbasis von ChatGPT derzeit vom letzten Trainingsstand im Januar 2022 stammt. Und warum nicht etwas eigenes bauen mit [RAG und Semantischer Suche](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/)? In diesem Fall wollten wir das Rad nicht neu erfinden. Azure Cognitive Services und OpenAI boten uns alles, was wir brauchten, um das Modell an unseren Branchen Anwendungsfall anzupassen. Mit den Features, die wir durch die Integration eines Open-AI-Modells in die Azure Cloud bekamen, konnten wir den Chatbot schnell und leichtgewichtig entwickeln. Langfristig profitieren wir von der Flexibilität und Aktualität, die diese beiden Standardsysteme mit sich bringen. Das sind Vorteile gegenüber der aufwendigeren [Entwicklung eines eigenen Chatbots mit RAG und semantischer Suche](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/). Wobei wir bei der Nutzung der Standardsysteme natürlich eine Abhängigkeit von Microsoft und OpenAI in Kauf nehmen. ## Die wichtigsten Komponenten und ihr Zusammenspiel Die Kombination von Azure Cognitive Search und OpenAI bietet die Möglichkeit, automatisch Suchindizes zu erstellen oder zu aktualisieren. Die Integration ermöglicht auch die Anpassung der Modelle an spezifische Branchen oder Anwendungsfälle. Durch das Zuschneiden der Indizes auf spezifischen Daten können genauere und personalisierte Suchergebnisse erzielt werden. Für die Entwicklung unseres Chatbot-Prototyps brauchten wir drei wesentliche Komponenten: 1. **Datenquellen:** Die Grundlage für den Chatbot bildet der Zugriff auf aussagekräftige Datenquellen. Dies können im allgemeinen strukturierte Informationen aus internen Datenbanken, Dokumentationen oder anderen unternehmensspezifischen Quellen sein. Die Qualität und Relevanz dieser Datenquellen beeinflussten maßgeblich die Genauigkeit und Effizienz des Chatbots. In der hier erstellten Anwendung greifen wir auf Dateien zu, welche sich in einem Azure-Blob-Storage befinden. 2. **Azure Cognitive Search:** Um die Daten durchsuchen zu können, wird Azure Cognitive Search eingesetzt. Diese Komponente ermöglicht eine schnelle und präzise Suche in den bereitgestellten Datenquellen. Die Integration von Azure Cognitive Search gewährleistet, dass der Chatbot in der Lage ist, auf eine Vielzahl von Quellen zugreifen zu können. 3. **OpenAI ChatGPT:** Als Herzstück des Chatbots fungiert OpenAI ChatGPT, als Large Language Model, das die natürliche Sprache verstehen kann und kontextbezogene Antworten generiert. Die Integration von ChatGPT ermöglicht es dem Chatbot, nicht nur auf Daten zuzugreifen, sondern auch auf eine menschenähnliche Weise mit Benutzern zu kommunizieren. Wie die Komponenten zusammenwirken und miteinander arbeiten, zeigt die Referenzarchitektur in Abbildung 1. ![Zusammenspiel der Komponenten für einen Chatbot mit Microsoft Azure und Open AI](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-chatbot-it-grundschutz-teil1_bild01.png)Abbildung 1: Referenzarchitektur des Chatbots für den IT-Grundschutz (Quelle: [Microsoft](https://learn.microsoft.com/de-de/azure/ai-services/document-intelligence/concept-retrieval-augumented-generation?view=doc-intel-4.0.0)) Nur weil die Komponenten so nahtlos miteinander agieren, ist unser Chatbot in der Lage auf eigene Daten zuzugreifen, Anfragen zu verstehen und präzise Antworten zu generieren. Damit kann er also - Wissen effizient vermitteln - und Informationen einfach bereitstellen Check! ## Umsetzung mit Microsoft Azure und OpenAI Jetzt ging es an die konkrete Umsetzung: Dafür fokussierten wir uns zunächst auf die drei Kernkomponenten Datenquellen, Cognitive Search und ChatGPT. Den Appserver zur Orchestrierung, welcher in der Referenz-Architektur aufgeführt wird, brauchten wir für den Prototyp nicht. Abbildung 2 zeigt, wie unser Plan für die Umsetzung grob aussah: ![Skizze des Vorgehens](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-chatbot-it-grundschutz-teil1_bild02.png)Abbildung 2: Skizze für die Umsetzung (Quelle: [Microsoft)](https://learn.microsoft.com/de-de/azure/ai-services/document-intelligence/concept-retrieval-augumented-generation?view=doc-intel-4.0.0) Soweit unsere Einführung und die Grundlagen. Im nächsten Teil gehen wir mehr in die Tiefe und werden uns genauer mit den Komponenten befassen. ## So geht es weiter In **Teil 2** dieser Blogserie sehen wir uns die drei **Komponenten** genauer an und erklären euch die **Einstellungsmöglichkeiten**, die ihr habt. Außerdem werfen wir einen Blick auf die **Oberfläche unseres Chatbots.** In **Teil 3** der Blogserie teilen wir mit euch die **ersten Testergebnisse** und verraten euch, wie der Einsatz gelaufen ist, und welche **Best Practices** wir daraus mitgenommen haben. Es lohnt sich also dran zu bleiben! 🙂 ## Weitere Artikel zum Thema [Was steckt hinter RAG und Semantischer Suche](https://thecattlecrew.net/2024/01/29/was-steckt-hinter-rag-und-semantischer-suche/) [RAG und Semantische Suche in der Praxis](https://thecattlecrew.net/2024/01/29/spezialwissen-fuer-chatbots/) **Kategorien:** AI & Data Science **Schlagwörter:** Artificial Intelligence, Assistenzsystem, cloud, IT-Grundschutz, Microsoft, Open AI, Spezialwissen --- ### [Ein Überblick über CNI-Plugins](https://thecattlecrew.net/2024/03/08/ein-ueberblick-ueber-cni-plugins/) **Published:** März 8, 2024 **Author:** Tim van der Meulen **Content:** Es gibt verschiedene Gründe sich im Kubernetes-Umfeld Gedanken zur Netzwerkkonfiguration zu machen. Zum Beispiel steht ein neues Projekt an, man hat es endlich geschafft einen Schritt in Richtung Containeriserung zu machen oder es wurden neue Richtlinien eingeführt, die mit der aktuellen Netzwerkkonfiguration nicht umgesetzt werden können. In diesem Zusammenhang lohnt es sich einen Blick auf die Innovationen im Bereich Container Network Interface (CNI) zu werfen. Doch welche gibt es, wie unterscheiden sich die Implementierungen und wie wählt man das richtige CNI aus? Ich stelle euch die verbreitetsten CNI-Plugins für Kubernetes vor und vergleiche diese am Ende in einer Tabelle, damit ihr euch besser orientieren könnt. # Was ist ein CNI-Plugin? Das Container Network Interface Plugin ist eins der Herzstücke von Kubernetes und bestimmt, wie die Kommunikation im Cluster aussieht. Dazu gehören z. B. Konfigurationen, die festlegen, wie die Verschlüsselung der Kommunikation erfolgt und wer mit wem reden darf. Während große Cloudanbieter wie AWS und Azure jeweils eigene CNI-Plugins für ihre Plattform anbieten, existieren auch unabhängige CNI-Plugins aus der Open-Source Community, die weit verbreitet sind und plattformunabhängig eingesetzt werden können. Da sie alle die CNI-Spezifikation umsetzen, sind sie untereinander austauschbar und unterscheiden sich lediglich in ihren Funktionalitäten. # Wie wähle ich das richtige CNI-Plugin aus? Welches CNI-Plugin man nun wählt, hängt natürlich von der spezifischen Situation und den damit einhergehenden Anforderungen ab. Normalerweise hat jede Kubernetes-Distribution ein CNI-Plugin als Default vorkonfiguriert. Sollten also keine besonderen Anforderungen an das Netzwerk des Clusters bestehen, ist die Entscheidung einfach: Es wird einfach das bereits vorkonfigurierte Plugin der Kubernetes Distribution genutzt. Dabei entstehen keine Aufwände und das Cluster kann direkt produktiv eingesetzt werden. Oftmals ist dies aber nicht ganz so leicht. Denn sobald das vorkonfigurierte Plugin eine benötigte Funktionalität nicht unterstützt, benötigt man eine Alternative. Zu den Kriterien, die dabei beachtet werden müssen, zählen unter anderem: - Die verwendete Kubernetes Distribution (Vanilla, Rancher oder Cloudanbieter spezifisch) - Unterstützte Funktionalitäten des CNI-Plugins (z. B. [Netzwerkrichtlinien](https://kubernetes.io/docs/concepts/services-networking/network-policies/) oder Routingprotokolle) - Technische Limitierungen wie eine maximale Anzahl an Pods pro Knoten und IP-Versions-Support - Verfügbarkeit von professionellem Support - Marktverbreitung und Community - Wie verbreitet ist das Plugin bzw. wie beliebt ist das Projekt auf Github? - Gibt es reguläre Updates? # Die bekanntesten Plugins im Vergleich Um die Entscheidung für ein bestimmtes Plugin zu vereinfachen, werden die bekanntesten Plugins nun kurz vorgestellt und danach in einer übersichtlichen Tabelle Seite an Seite gegenübergestellt. Die Tabelle dient dabei dem schnelleren Überblick, während die Vorstellungen der einzelnen Plugins zusätzliche Informationen zu den Plugins beinhalten können, die nicht für das Format einer Tabelle geeignet sind. Zu den betrachteten CNI-Plugins gehören - Flannel - Calico - Cilium - Weave - AWS VPC CNI - Azure CNI Neben diesen existieren natürlich noch weitere Optionen. Ich habe mich auf die fokussiert, die uns häufig im Projektalltag begegnen. ## Flannel Flannel ist ein Open Source CNI-Plugin, das versucht, möglichst kompatibel und einfach zu sein. In vielen Fällen funktioniert es daher ohne eine zusätzliche Konfiguration. Obwohl es im Vergleich mit anderen CNIs keins der fortgeschrittenen Features umsetzt. Flannel wird häufig von simplen Kubernetes Distributionen (z. B. K3s) als Default CNI verwendet. Es bietet eine schnelle und einfache Netzwerkkonfiguration mittels VXLan Overlay Network, aber keine Unterstützung für Netzwerkrichtlinien. Alternativ kann Flannel für den Support von Netzwerkrichtlinien mit einer anderen Implementierung wie z. B. Calico, kombiniert werden. Diese Kombination verwendet auch Rancher selbst als „Canal“. Leider wird Flannel bei den meisten Cloud-Anbietern nicht out-of-the-box unterstützt und muss daher selbst installiert werden. ## Calico Calico ist ein von Tigera entwickeltes Open-Source-Projekt und setzt vor allem auf Flexibilität und Performance. Es besteht aus zwei Komponenten, die zusammen oder auch getrennt genutzt werden können. Diese beiden Komponenten sind das CNI und die Suite für Netzwerkrichtlinien. Wie die Namen bereits verraten, unterstützt Calico somit Netzwerkrichtlinien und kann sogar allein für diese mit anderen CNIs wie Flannel kombiniert werden. In den Kubernetes Distributionen von Google (GKE) und Azure (AKS) werden von Calico sogar nur die Netzwerkrichtlinien out-of-the-box unterstützt, während die Kombination mit Flannel in Rancher bereits vorkonfiguriert ist. Insgesamt bietet Calico umfassende Möglichkeiten, um Netzwerk und Routing des Clusters einzurichten. Dazu gehören unter anderem der [eBPF](https://docs.tigera.io/calico/latest/operations/ebpf/use-cases-ebpf) Support oder das Routen mittels [BGP](https://aws.amazon.com/de/what-is/border-gateway-protocol/#:~:text=Das%20Border%20Gateway%20Protocol%20(BGP)%20wird%20je%20nachdem%2C%20wohin,kleineren%20autonomen%20Systemen%20in%20ihnen). Dadurch wird es einfacher, Pakete zurückzuverfolgen und den Datenverkehr anhand von komplexen Regeln zu steuern. Für zusätzliche Sicherheitsvorkehrungen ist es außerdem möglich, einen Service Mesh zu integrieren. Neben [Istio](https://istio.io/latest/about/service-mesh/) haben wir dabei auch mit [Kuma](https://github.com/kumahq/kuma) gute Erfahrungen gesammelt. ## Canal Canal ist eine Kombination aus Calico und Flannel. Das ursprüngliche Ziel des Projekts war es, die Funktionalitäten beider in einem einfachen Deployment zu vereinfachen. Da jedoch beide Projekte mittlerweile auf ihre Kompatibilität achten, wurde die Entwicklung von Canal eingestellt. Canal wird dennoch weiterhin als Bezeichnung für die Kombination von Flannel mit Calico genutzt. In diesem Sinne wird es auch als Default CNI in Rancher eingesetzt. ## Cilium Cilium ist ebenfalls ein Open Source CNI-Plugin, das eine sehr detaillierte Netzwerkkonfiguration und beinahe unbegrenzte Skalierung erlaubt. Genau wie Calico unterstützt es diverse Möglichkeiten, das Routing z. B. mit VXLan oder BGP zu konfigurieren und setzt sogar eBPF per Default ein. Durch die tiefgreifenden Konfigurationsmöglichkeiten können mit Cilium sogar Richtlinien erstellt werden, die den Datenverkehr auf Applikationsebene steuern. Mit dem auf Cilium aufbauenden Überwachungstool Hubble erhält man somit sehr einfach Einblick in den Datenverkehr des Clusters. Außerdem unterstützt es nicht nur Netzwerkrichtlinien, sondern erweiterte diese mit Cilium Network Policies. Seit Oktober 2023 gilt Cilium als [CNCF „graduated“](https://www.cncf.io/announcements/2023/10/11/cloud-native-computing-foundation-announces-cilium-graduation/), wird also von der CNCF als stabil und etabliert anerkannt. Vor allem die Beliebtheit in der Community ist auch an den GitHub Sternen ablesbar, da das Projekt mit mittlerweile fast 18.000 Sternen weit mehr Sterne besitzt als die anderen CNI-Plugins, die ich hier vorstelle. Googles „GKE Dataplane V2“ basiert ebenfalls auf Cilium. Cilium kann mit Hilfe von [CNI Chaining](https://docs.cilium.io/en/stable/installation/cni-chaining/) auch mit anderen CNIs kombiniert werden, um diese mit den eigenen Funktionalitäten zu erweitern. ## AWS VPC CNI AWS VPC CNI ist das Default CNI von Amazons EKS. [Out-of-the-box](https://docs.aws.amazon.com/eks/latest/userguide/alternate-cni-plugins.html) ist es auch das einzige offiziell unterstützte CNI-Plugin dieser Cloud. Sofern kein Fargate genutzt wird, können andere CNI-Plugins mit Hilfe von externem Support jedoch ebenfalls eingerichtet werden. Ein großer Vorteil von AWS VPC ist, dass es ohne gesonderte Konfiguration das native AWS-Netzwerk nutzen kann, während die nicht Cloud-spezifischen CNIs ein neues virtuelles Netz aufspannen. Von AWS VPC erhält also jeder Pod eine IP-Adresse aus dem bereits existierenden Subnetz. Dadurch werden die Pods leichter erreichbar und Netzwerkrichtlinien vereinfacht. Andererseits verbraucht dieses Vorgehen mehr IP-Adressen, was bei hohen Skalierungen zu Problemen führen kann. Wie die meisten anderen CNI-Plugins unterstützt auch dieses die Integration eines Service Meshs. Darunter auch das hauseigene AWS APP Mesh. Netzwerkrichtlinien können mit dem Network Policy Manager ebenfalls eingerichtet werden. ## Azure CNI Azure CNI ist der Default des Azure Kubernetes Service (AKS) und gleichzeitig neben Kubenet das einzige offiziell unterstützte CNI-Plugin. Calico wird ebenfalls unterstützt, allerdings nur für Netzwerkrichtlinien. Im Januar 2024 hat Microsoft zudem einen Beitrag auf seiner Lernplattform veröffentlicht, in dem der Hersteller beschreibt, wie Azure CNI mit Cilium kombiniert werden kann, um von dessen Vorteilen zu profitieren. Wie auch AWS VPC ermöglicht Azure CNI es den Containern, im Subnetz der Azure Cloud zu laufen und bietet somit die entsprechenden Vor- und Nachteile für AKS. ## Weave Weave von Weaveworks setzt ebenfalls auf Einfachheit. Allerdings bekam das Plugin bereits seit zwei Jahren kein Update und im Februar 2024 verkündete Weaveworks offiziell, den Handelsbetrieb künftig einzustellen. # Übersicht Zur besseren Übersicht habe ich die Plugins mit ein paar mehr Details in einer Tabelle gegenübergestellt: [![](https://thecattlecrew.net/wp-content/uploads/2024/03/CNI-Plugins-Tabelle-1024x493.png)](https://thecattlecrew.net/wp-content/uploads/2024/03/CNI-Plugins-Tabelle.png) [Download Tabelle](https://thecattlecrew.net/wp-content/uploads/2024/03/BLUE-693-Blog.xlsx) Um einige potenzielle Fragen vorwegzunehmen, hier ein paar Erklärungen zu der Tabelle: Canal taucht in der Tabelle nicht explizit auf, da damit nur noch die Kombination aus Calico und Flannel referenziert wird. Die in der Tabelle aufgelistete Unterstützung bezieht sich lediglich auf die vom Cloud-Anbieter unterstützten Plugins. Oftmals ist es aber dennoch möglich ein beliebiges CNI-Plugin zu nutzen. Dies geschieht dann jedoch in Eigenverantwortung oder mit externem Support. Die Cloud-Anbieter nennen unter Umständen [Kooperationspartner](https://docs.aws.amazon.com/de_de/eks/latest/userguide/alternate-cni-plugins.html). Dennoch scheint dies seine Grenzen zu haben, denn AWS schreibt explizit in seiner Dokumentation, dass die [Installation anderer Plugins auf Fargate Knoten scheitert.](https://docs.aws.amazon.com/eks/latest/userguide/alternate-cni-plugins.html) # Fazit Nachdem wir uns nun die bekanntesten CNI-Plugins angeschaut haben, wird eines schnell klar: Welches Plugin ihr wählt, hängt stark ab - von den Rahmenbedingungen, - von den Anforderungen an das Cluster, - von den deployten Applikationen. Eine allgemeingültige Empfehlung gibt es also wie so häufig nicht. Generell ist jedoch erkennbar, dass Flannel bevorzugt genutzt wird, wenn keine besonderen Anforderungen an das Netzwerk gestellt werden. Werden jedoch Netzwerkrichtlinien benötigt, muss man es mit Calico kombinieren oder gleich eine alternative CNI-Implementierung wählen. Calico hingegen ist bereits deutlich vielseitiger und unterstützt mittlerweile auch tiefgreifendere Funktionalitäten, wie Netzwerkrichtlinien, Service Mesh Integration und eBPF-Support. Mit Calico Enterprise seid ihr auf der sicheren Seite und könnt im Notfall auf professionellen Support zurückgreifen. Calico ist daher in vielen Szenarien eine gute Wahl, um ein funktionalitätsreiches Netzwerk zu konfigurieren. Stößt ihr selbst mir Calico auf Limitierungen oder greift vorzugsweise auf ein CNCF Graduated Plugin zurück, erfüllt Cilium die Anforderungen. Mit den detailreichen Konfigurationsmöglichkeiten und der hohen Skalierbarkeit ist Cilium das beliebteste der hier vorgestellten CNI-Plugins auf GitHub. Gründe dafür könnten die tiefgreifende Kontrolle über Datenverkehr, sogar auf Applikationsschicht und das vereinfachte Monitoring sein. Bewegt man sich in der Cloud, bieten die Cloud-eigenen Lösungen zu Teilen besondere, Cloud-spezifische Funktionalitäten, die mit anderen Plugins gar nicht oder nur mit hohem Aufwand zu erzielen sind. Der allgemeine Funktionsumfang ist jedoch geringer als der Funktionsumfang anderer CNIs. Möchtet ihr den Aufwand des Deployments und der Updates besonders niedrig halten, vereinfachen die out-of-the-box unterstützten Plugins die Arbeit, da diese Aufgaben mit wenigen Klicken in der Benutzeroberfläche der Clouds erledigt sind. **Kategorien:** Cloud, DevOps **Schlagwörter:** CNI, Kubernetes, Plugin, Vergleich --- ### [Erfahrungen mit SOA Suite 11g Patchset Upgrade (11.1.1.3 auf 11.1.1.5)](https://thecattlecrew.net/2012/02/28/erfahrungen-mit-soa-suite-11g-patchset-upgrade-11-1-1-3-auf-11-1-1-5/) **Published:** Februar 28, 2012 **Author:** **Content:** Das Update der SOA Suite 11g von PS2 (11.1.1.3) auf PS4 (11.1.1.5) ist bei unserem Kunden sehr problemlos verlaufen. Die Installation vor Ort läuft auf einer Xen Virtualisierung. Da es auch für andere Projekte hilfreich sein könnte, hier die wichtigsten Eckpunkte, wie vorgegangen wurde: 1. Eine neue VM aufsetzen mit der aktuellen Oracle Linux Version\* 2. Eine neue SOA Suite 11.1.1.3 auf dieser VM installieren\* 3. Konfiguration und Datenbank der alten VM kopieren (auf konsistenten Stand achten) 4. Neue SOA Suite starten und testen, ob alles läuft 5. Mit Hilfe des Patch Set Assistant aus MOS (My Oracle Support) das Upgrade auf 11.1.1.4 aufspielen; danach testen ob alles geht 6. Den letzten Schritt für das Upgrade auf 11.1.1.5 wiederholen 7. Alte VM abschalten und den DNS auf die neue VM umstellen 8. Fertig! (\* Eine Alternative wäre, die aktuelle VM zu klonen) Das Update lief erstaunlich gut ab. Lediglich der PSA hat sich einmal beim Upgrade der Datenbank verabschiedet. Die DB-Admins konnten die Upgrade-Skripte jedoch problemlos von Hand nachfahren. Ansonsten gab es keine Probleme. Der ganze Vorgang wurde vorher einmal getestet, bevor er mit den echten SOA Suite Umgebungen ausgeführt wurde. Die beschriebene Upgrade-Prozedur dauerte bei uns pro Server ca. 1 Tag „“ das dürfte jedoch schwanken, je nachdem, wie viele Daten umkopiert werden müssen. Insgesamt kann ich das Upgrade nur jedem empfehlen. Zahlreiche, teils nervige Bugs aus der 11.1.1.3 wurden mit den neuen Releases behoben (es gibt dafür selbstverständlich wieder ein paar neue) und es gibt einige neue Features, z.B. die Unterstützung von BPEL 2.0. Wir sind nun bereits seit ca. 2 Monaten auf der neuen Version und haben auch operativ keine größeren Probleme feststellen können. Insgesamt fühlt sich die SOA Suite nun deutlich reifer an. **Kategorien:** Tools & Methoden **Schlagwörter:** oracle --- ### [Road to 12c - Oracle SOA Suite 12c und BPM Suite 12c](https://thecattlecrew.net/2012/02/29/road-to-12c-oracle-soa-suite-12c-und-bpm-suite-12c/) **Published:** Februar 29, 2012 **Author:** Torsten Winterberg **Content:** Die Reise der Oracle Fusion Middleware in Richtung 12c ist in vollem Gange. Mit der Weblogic Application Server 12c ist die Basis der Fusion Middleware Familie bereits in der Zukunft angekommen. Die Featureliste des WLS 12c ist beeindruckend, die ersten praktischen Erfahrungen ebenso. Man merkt deutlich, dass die Integration des alten Oracle Application Servers, der BEA Containers und auch der Glassfish-Features nun zu einem sehr runden Produkt geführt hat. Es hat gedauert „“ aber das Warten hat sich gelohnt. Wie aber sieht es bei der SOA Suite aus? Diese wird vermutlich erst Anfang 2013 als 12c Release zur Verfügung stehen. Das Feature-Set ist hochbeeindruckend. Die Basisfunktionalitäten sind in 11g bereits komplett, in 12c kommt all das hinzu, was das Leben deutlich einfacher macht. Unter dem Schlagwort „Industrial SOA“ kommen Optimierungen in den Bereichen Performance&Scalability (Memory-Bedarf runter!), Diagnosability, Upgrade, Build-in Governance und Developer Productivity (Download&Installation mit One-Click-HelloWorld-Erfahrung). Sollte man dann nun warten auf SOA Suite 12c und was passiert mit Migrationen von 11g auf 12c? Hier liegt die gute Nachricht. Oracle hat verstanden, was den Kunden in der Vergangenheit aufgestoßen ist. Es wird ein Seamless-Upgrade auf 12c einer laufenden 11g SOA Suite Plattform geben, inklusive Übernahme aller laufenden Instanzen. Super! Und BPM Suite 12c? Hier werden erste öffentliche Informationen in der Keynote auf den SOA, BPM, Integration Days direkt vom Oracle Product Management zu hören sein (). Mit dem Patchset PS5 hat die BPM Suite 11g bereits nicht nur ein Fehlerupdate, sondern ein komplettes Feature-Update bekommen. In 12c, vermutlich zeitglich zur SOA Suite 12c, erwarten uns Dinge wie ACM, Social, erweiterte Modellierungswerkzeuge, optimiertes Modellieren direkt im Browser, uvm. Fazit: Treffen Sie heute ihre Vorbereitungen, schaffen sie Mehrwerte über die 11g Plattform und freuen sie sich auf den Innovations-Boost, den die 12c Plattform ermöglichen wird. Und freuen sie sich auf das erste Major-Update, dass sie einfach so werden einspielen können. Es bleibt spannend“¦ **Kategorien:** Architecture & Process Models **Schlagwörter:** BPM, Weblogic --- ### [Nachlese SOA, BPM & Integration Days 2012 Spring](https://thecattlecrew.net/2012/03/03/nachlese-soa-bpm-integration-days-2012-spring/) **Published:** März 3, 2012 **Author:** Sven Bernhardt **Content:** Bei den SOA, BPM & Integration Days (29.02.-01.03) gab es auch diesmal wieder interessante Vorträge und Workshops zu aktuellen Themen aus den Bereichen Adaptive Prozesse, SOA-Security und Systemintegration. Auch abseits der Vorträgen und Workshops gab es zudem genügend Freiräume für einen Meinungs- und Erfahrungsaustausch zwischen den anwesenden Speakern und anderen Experten aus unterschiedlichen Bereichen. Am ersten Tag gab es je Themenbereich vier Vorträge. Themen hierbei waren unter anderem: - Bewältigung der Komplexität adaptiver Prozesse - Bedeutung und Rolle des Adaptive Case Management (ACM) - Herausforderungen bei der Integration heterogener Systeme - Verbindung von Master Data Management (MDM) und Integrationsansätzen - Vorstellung eines transparenten Vorgehens für die Identifikation von SOA Services - Herausforderungen aus dem Bereich SOA Security Zum Auftakt des Tages wurde das Thema adaptive Prozesse von Ralf Müller im Rahmen einer Keynote motiviert und dabei auf die Möglichkeiten der Umsetzung mit der Oracle BPM Suite eingegangen. In einer zweiten Keynote von Sebastian Schreiber wurden im Rahmen eines Live-Hackings verschiedene Systemangriffe, wie beispielsweise über die Manipulation eines Barcodes eine SQL-Injection durchgeführt werden kann, demonstriert. Zum Abschluss des Tages gab es noch ein, von Jürgen Kress moderiertes, Speaker-Panel, in dem die Frage „Wozu braucht man überhaupt BPM-Lösungen in Deutschland?“ diskutiert wurde. Hierbei waren alle Konferenzteilnehmer dazu eingeladen von ihren Projekterfahrungen mit dem Thema BPM zu berichten. Es entstand eine spannende Diskussion in deren Verlauf die dem Thema BPM inhärente Komplexität kontrovers diskutiert wurde, die von einigen Panelteilnehmern als Grund dafür identifiziert wurde, dass es zurzeit nur wenige BPM-Projekte in Deutschland gibt. Am zweiten Konferenztag wurden in sechs verschiedene Workshops die am Vortag motivierten Themen noch einmal tiefergehend behandelt. Hier gab es unter anderem einen sehr guten Workshop zum Thema BPMN von Dr. Volker Stiehl. Mein Fazit zu der Veranstaltung: Sehr gelungen! Es wurden aktuelle Probleme und Herausforderungen aus den Bereichen SOA, BPM & Integration adressiert und zudem ein Forum geboten, um Erfahrungen und Erkenntnisse auszutauschen sowie aktuelle Entwicklungen in diesen Bereichen zu diskutieren. Ich freue mich schon auf die nächsten SBI-Days! **Kategorien:** Integration, Tech Events & Networking **Schlagwörter:** BPM, Conference --- ### [BPEL Transactions und Threads in der SOA Suite 11g](https://thecattlecrew.net/2012/03/09/bpel-transactions-und-threads-in-der-soa-suite-11g/) **Published:** März 9, 2012 **Author:** **Content:** Was entscheidet in der SOA Suite (mindestens bis 11.1.1.6) darüber, ob ein BPEL Prozess synchron oder asynchron ausgeführt? Und was darüber, ob dafür eine neue Transaktion geöffnet wird oder nicht? Intuitiv würde man davon ausgehen, dass das (teilweise) in der WSDL modellierte Message Exchange Pattern (MEP) über die Art der Ausführung entscheidet. Demnach würden beispielsweise Prozesse mit Request und Reply synchron ausgeführt werden und solche, die nur einen Request (One-Way) oder möglicherweise einen späteren Invoke als „asynchrone“ Antwort haben, asynchron. (Letzterer Fall ist aus der WSDL nicht direkt ersichtlich, aber es gibt dort dann i.d.R. einen zweiten Port Type, der auf den Client zutrifft). Nur „“ das MEP ist nicht entscheidend! In der SOA Suite gibt es dafür eine Property, die für einen BPEL Component in der `composite.xml` gesetzt werden kann, und zwar die `bpel.config.oneWayDeliveryPolicy`. Mögliche Werte sind: - `sync` „“ führt den Prozess synchron aus. - `async.persist` „“ führt den Prozess asynchron aus; die Message wird dabei in der Datenbank zwischengespeichert. - `async.cache` „“ führt den Prozess asynchron aus; die Message wird dabei nur im Arbeitsspeicher gehalten. Da dadurch keine Fehlertoleranz gewährleistet werden kann, sollte diese Einstellung nur nach gründlicher Überlegung verwendet werden „“ normalerweise ist `async.persist` die bessere Wahl. In diesem Zusammenhang ist ebenso wichtig, ob der Transaktionskontext vom Aufrufer übernommen wird (z.B. bei Aufrufen aus Adaptern oder anderen BPEL-Prozessen) oder, ob eine eigene Transaktion gestartet wird. Darüber entscheidet die Property `bpel.config.transaction`: - `required` „“ übernimmt die Transaktion des Aufrufers, sofern vorhanden. Falls nicht, wird eine neue erstellt. - `requiresNew` „“ es wird immer eine neue Transaktion gestartet. Diese beiden Einstellungen haben gemeinsam auch Auswirkungen auf das Rollback-Verhalten und die Fault-Propagation. Ab 11.1.1.6 fragt der JDeveloper aktiv nach den Einstellungen für einen neuen BPEL Prozess, da die Standardwerte nur für einen kleinen Teil der Prozesse korrekt sind. Dafür müssen die Einträge von Hand in der `composite.xml` eingetragen werden. Die Details und alle möglichen Kombination beschreibt die offizielle Oracle Dokumentation ([http://docs.oracle.com/cd/E23943\_01/dev.1111/e10224/soa\_transactions.htm](http://docs.oracle.com/cd/E23943_01/dev.1111/e10224/soa_transactions.htm)) „“ ein absolutes Must-Read für alle BPEL Entwickler! **Kategorien:** Architecture & Process Models **Schlagwörter:** bpel, oracle, Oracle DB --- ### [Dehydrierungsverhalten von Prozessinstanzen in Oracle SOA Suite](https://thecattlecrew.net/2012/03/12/dehydrierungsverhalten-von-prozessinstanzen-in-oracle-soa-suite/) **Published:** März 12, 2012 **Author:** Danilo Schmiedel **Content:** Im Lebenszyklus eines BPEL-Prozesses werden dessen Prozessinstanzen mit Statusinformationen im Repository der Oracle SOA Suite gespeichert. Diesen Speichervorgang nennt man im BPEL-Umfeld auch Dehydration und die dazugehörige Datenbank ist der Dehydration Store. Sobald eine laufende Instanz (an bestimmten Aktivitäten im Prozess) dehydriert wurde, entfernt der BPEL Server diese aus dem Memory. Wenn daraufhin etwa ein Callback eines asynchronen Service-Aufrufes eintrifft oder ein abgelaufender Timer „feuert“, holt sich der BPEL Server die passende Instanz aus dem Dehydration Store zurück in den Memory und fährt mit der Ausführung fort. Einerseits sichert dieser Vorgang die Ausfallsicherheit, da laufende Instanzen nach einem Neustart des BPEL Servers oder nach einem fehlerhaften Aufruf automatisch am letzten Dehydrierungspunkt fortgesetzt werden können. Andererseits kann die Dehydrierung in einem Umfeld mit High-Performance-Anforderungen und einer enormen Anzahl an Prozessinstanzen kritisch sein. Wann und wie die Dehydration ausgeführt wird, hängt vom gewählten Prozesstyp ab. Die Oracle BPEL Engine unterscheidet hierbei zwischen „transient“ und „durable“. Transiente Prozesse verursachen keine Dehydration während der Ausführung der Instanz. In Summe werden transiente Prozesse nur einmal am Ende des Prozesses dehydriert. Beispiele hierfür sind kurzlaufende synchrone Request-Response-Szenarios. Prozesse vom Typ „durable“ werden mehr als einmal „“ jeweils an bestimmten Aktivitäten (z. B. Receive, OnMessage, Wait) „“ dehydriert. Prozesse, für die im Betrieb sehr viele Instanzen zu erwarten sind, sollten daher als transienter Prozesstyp umgesetzt werden. Im Allgemeinen sind hierfür die folgenden Anforderungen zu erfüllen: - Keine Receive-Aktivitäten innerhalb des Prozessflusses - Keine Wait-Aktivitäten - Keine OnMessage-Aktivitäten - Eine synchrone Schnittstellenbeschreibung Sind diese Voraussetzungen erfüllt, müssen auf Composite- Ebene weitere Attribute gesetzt werden, um eine vollständige Ausführung des Prozesses im Memory zu gewährleisten. Diese werden nachfolgend aufgelistet und kurz beschrieben. **inMemoryOptimization=true** Der Standardwert dieses Parameters ist „false“. Die Eigenschaft kann nur gesetzt werden, wenn keine der o. g. Aktivitäten im Prozess enthalten ist. Steht der Wert auf „true“, wird für Instanzen dieses Prozesses eine Speicheroptimierung bei Wertzuweisungen vorgenommen. **completionPersistPolicy=faulted** Diese Property definiert, welche Prozessinstanzen gespeichert werden. Mit dem Setzen des Wertes auf „faulted“ werden nur fehlgeschlagene Instanzen gespeichert. **oneWayDeliveryPolicy=sync** Der Parameter setzt die Persistenz-Eigenschaften des Prozesses im Delivery Layer. Mit der Zuweisung des Wertes „sync“ wird erreicht, das die instanzerzeugende Nachricht nicht temporär im Delivery Layer gespeichert wird. Die Engine benutzt den Speicher für das Erzeugen der Nachricht. Das Setzen der Werte führt bei synchronen Prozessen zur Steigerung der Performance und zur Reduktion der Laufzeitdaten, die in das Repository geschrieben werden. Gemäß den Erfahrungen aus unterschiedlichen Projekten konnte damit ein messbarer Geschwindigkeitsvorteil realisiert werden. **Kategorien:** Architecture & Process Models **Schlagwörter:** bpel, oracle, Oracle DB --- ### [Server offline and soa-infra down: How-to undeploy SOA composites](https://thecattlecrew.net/2012/03/23/server-offline-and-soa-infra-down-how-to-undeploy-soa-composites/) **Published:** März 23, 2012 **Author:** Danilo Schmiedel **Content:** Did you already have the problem that you couldn“™t restart your server because of a certain (maybe broken) composite? Did you ever wish to perform an undeployment of your composites while soa-infra is down? Read my blogpost under [inside-bpm-and-soa](http://inside-bpm-and-soa.blogspot.de/2012/03/undeployment-of-composites-when-soa.html "inside-bpm-and-soa") to see how-to get rid of thos composites even when the soa-infra is not available. [](http://inside-bpm-and-soa.blogspot.de/2012/03/undeployment-of-composites-when-soa.html "inside-bpm-and-soa") **Kategorien:** Architecture & Process Models **Schlagwörter:** BPM, Composites, MDS, Oracle DB, Weblogic --- ### [First impressions from Oracle Open World 2013](https://thecattlecrew.net/2013/09/23/first-impressions-from-oracle-open-world-2013/) **Published:** September 23, 2013 **Author:** Danilo Schmiedel **Content:** Oracle Open World 2013 started today and San Francisco is ready to rock. This year approx. 60.000 visitors are attending to this great event – this is a 20% increase compared with last year. Very impressive! From my point of view there is no other event where you can get so many useful information in just five days. Keynotes with the latest anouncements, many customer cases, sessions, networking, demos, hand-on labs and of course personal meetings with certain members of the product management team – a perfect combination to be prepared for our daily business and to be successful in our projects. [![2013-09-22 19.35.49](https://thecattlecrew.net/wp-content/uploads/2013/09/2013-09-22-19-35-49.jpg?w=225)](https://thecattlecrew.net/wp-content/uploads/2013/09/2013-09-22-19-35-49.jpg) This year our schedule is full with the following topics: Big Data / Fast Data, Real Time Analytics, Event Processing, Governance with Oracles Enterprise Repository, large File Transfers, Business Intelligence, Web Center, Oracle ADF, Internet of Things (IoT), Mobile and of course SOA & BPM. This is going to be a very busy week 🙂 In his Welcome keynote Oracle CEO Larry Ellison was in a good mood because Oracle Team USA won two America’s Cup races today. Overall he came with the following announcements: **Oracle Database In-Memory Option** With Oracle’s new In-Memory option, he explained, queries are going to run at least 100-times faster, INSERT of rows run 3- to 4-times faster, UPDATES are 2-times faster and the JOIN of tables are at least 10-times faster. Furthermore reports run 20-times faster without predefined cubes. How is that possible? As Larry Ellison described transactions run faster in row format and analytics run faster in column format. Oracle 12c stores the same data in row AND column format simultaneously – it is a Dual Format In-Memory database. But how can you do more things in less time? Replace the indexes with the In-Memory columnar technology. Indexes work well for predictable access patterns. They are mostly used for analytic queries but the administrator needs to decide what to index and what not to index. Larry Ellison described that the column store replaces the analytic indexes which means less tuning and less administration. Oracle In-Memory requires zero application changes. It requires no restrictions on SQL and will be turned on with the following three steps: 1. Configure Memory Capacity (inmemory\_size = XXX GB) 2. Configure tables & partitions to be in memory (ALTER TABLE …) 3. Drop analytic indexes Afterwards Larry Ellison showed a live demonstration on a two socket server and a database table with 3 billion rows about searches that people have done on wikipedia. A traditional database with index achieved 2005 million row scans / second. Without index the result was much less – only 5 million row scans / second. Finally after enabling the In-Memory option the same test achieved an outstanding value – 7151 million rows / second. **Big Memory Machine M6-32** The second announcement was a new member of Oracle’s Engineered System family, the Big Memory Machine M6-32. It contains 32 Terabytes of DRAM memory and 32 SPARC M6 Chips. Larry Ellison said: „It’s the fastest machine in the world for databases stored in memory“. The live demonstration with this machine was again impressive – 341072 million row scans / second. **M6-32 SuperCluster** The third announcement was that the M6-32 is also available in SuperCluster form. **Oracle Database Backup, Logging, Recovery Appliance** The last announcement was the one with a name that is definitely distinctive, the „Oracle Database Backup, Logging, Recovery Appliance“. It is architected for the protection of critical business data. While the database is running the delta / changes are shipped to the appliance. The backup appliance is designed to backup databases (not files) and it doesn’t have to be in the same data center. The key characteristics of the product are: - Real-time log shipping - Fast restore to any time point - Real time log & change deltas Oracle is also offering the product as a public cloud service. It allows the backup of databases directly to the cloud while the data is encrypted at source. The first day was already great and we are looking forward to take a lot of useful content with us. **Kategorien:** Tech Events & Networking **Schlagwörter:** Conference, oow --- ### [Adaptive Case Management Poster available](https://thecattlecrew.net/2013/10/10/adaptive-case-management-poster-available/) **Published:** Oktober 10, 2013 **Author:** Torsten Winterberg **Content:** Knowledge-driven processes are typically unpredictable in their execution. Experts working on them decide what“™s the next best action to take. This is in contrast to traditional BPM, in which all possible paths of a process are predetermined and modeled into the process. Case management is a way to control and implement these unstructured processes. With the poster below we’d like to bring some of the key aspects of Adaptive Case Management (ACM) on one page. [![acm-in-practice_poster](https://thecattlecrew.net/wp-content/uploads/2013/10/acm-in-practice_poster.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2013/10/acm-in-practice_poster.jpg) Feel free to download this [ACM-Poster](https://thecattlecrew.net/wp-content/uploads/2013/10/ACM.pdf) if you are interested in - What is ACM? - Why should I use ACM? - How can ACM user interfaces look like? - What are the main building blocks of an ACM solution? - How to visualize ACM cases with CMMN 1.0? --- **Send your feedback with *\#acmposter*:** **[![msoa](https://thecattlecrew.net/wp-content/uploads/2013/10/msoa.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2013/10/msoa.jpg)** **Kategorien:** Architecture & Process Models **Schlagwörter:** ACM, Poster --- ### [Using Credential Store Framework when communicating with Oracle Human Workflow API](https://thecattlecrew.net/2013/12/17/using-credentials-store-when-communicating-with-oracle-human-workflow-api/) **Published:** Dezember 17, 2013 **Author:** Sven Bernhardt **Content:** For connecting to Oracle Human Workflow Engine via the provided client API, username and password of an admin user are needed. These credentials could also be useful during task processing, when actions on a task has to be performed on behalf of a user, for example in case of holidays or illness. But how can to manage the admin users credentials in secure way, independent from the target environment? A first approach is to use a mechanism where the credentials were provided as context parameters in the web.xml, of a Facade Web Service in front of the client API to hide complexity and to force upgrade protection in case of API changes. When deploying this Web Service facade, the parameters are replaced using a deployment plan. This solution works, but has the disadvantage that username and password of the admin user are contained in the deployment plan as clear text. From a SysOps perspective this mechanism is not appropriate. So another possibility must be found to manage user credentials in a consistent and secure way. An approach to ensure the secure management of credentials is to use the Oracle Credential Store Framework (CSF), provided by Oracle Platform Security Services (OPSS). Configuring and using CSF is quite simple and done in a few steps: 1\. Create Credentials Store in EM (Right click on Weblogic domain > \[Domainname\] and then choose Security > Credentials from the Dropdown menu) [![Create_CS](https://thecattlecrew.net/wp-content/uploads/2013/12/create_cs1.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2013/12/create_cs1.png) 2\. Configure System Policy to authorize access to the configured Credential Store (Right click on Weblogic domain > \[Domainname\] and then choose Security > Credentials from the Dropdown menu) [![Create_System_Policies](https://thecattlecrew.net/wp-content/uploads/2013/12/create_system_policies.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2013/12/create_system_policies.png) The configurations, needed to allow read-only access from an application, contains the following information \[code language=“text“\] Type: Codebase Codebase: file:${domain.home}/servers/${weblogic.Name}/tmp/\_WL\_user//- Permission: Permission Class: oracle.security.jps.service.credstore.CredentialAccessPermission Resource Name: context=SYSTEM,mapName=WORKLIST-API,keyName=\* Permission Actions: read \[/code\] 3\. Deploy the application Managing the credentials in the Credential Store may also be done by using WLST functionalities, which would be more maintainable from a SysOps perspective. Details on that could be found [here](http://docs.oracle.com/cd/E21764_01/core.1111/e10043/csfadmin.htm). The system policies may be directly edited in /user\_projects/domains//config/fmwconfig/system-jazn-data.xml. But this approach may be error-prone and often not appropriate in clustered production environments, when OPSS configuration is done in a database or LDAP. Accessing the so configured Credential Store by a server application is done by using the lines of code below. For developing the shown CSF access, jps-api.jar must be in the classpath of the application. At runtime the needed dependencies are provided by Oracle Weblogic Server. \[code language=“java“\] package com.opitzconsulting.bpm.connection; import java.security.AccessController; import java.security.PrivilegedActionException; import java.security.PrivilegedExceptionAction; import oracle.security.jps.service.JpsServiceLocator; import oracle.security.jps.service.credstore.CredentialStore; import oracle.security.jps.service.credstore.PasswordCredential; public final class CsfAccessor { static PasswordCredential readCredentialsfromCsf(String pCsfMapName, String pCsfKey) { try { return AccessController.doPrivileged(new PrivilegedExceptionAction() { @Override public PasswordCredential run() throws Exception { final CredentialStore credentialStore = JpsServiceLocator.getServiceLocator().lookup(CredentialStore.class) return (PasswordCredential) credentialStore.getCredential(pMapName, pKey); } }); } catch (Exception e) { throw new RuntimeException(String.format(„Error while retrieving information from credential store for Map \[%s\] and Key \[%s\]“, pCsfMapName, pCsfKey), e); } } } \[/code\] When having more applications that need to access credentials from the Credentials Store, it is recommended to implement the access to CSF centrally and provide the functionality as a shared library within Weblogic Server. Otherwise you have to configure the corresponding System Policies, which authorizes the access to CSF, separate for every new application that needs to have access to CSF. Using the shared library approach, only the shared library itself has to be authorized for accessing the Credentials Store. Applications that need to access CSF must only specify the dependency to the shared library in the application’s deployment descriptor file, like weblogic-application.xml. \[code language=“xml“\] csf-accessor-shared-lib 1.0.0 \[/code\] In order to encapsulate the access to CSF and to avoid the publication of the *PasswordCredential* object instance, we decided to further encapsulate the CSF access by a special Connection object, which establishes the connection to the Human Workflow API and can provide a WorkflowContext for the corresponding admin user. \[code language=“java“\] package com.opitzconsulting.bpm.connection; import java.util.Map; import oracle.bpel.services.workflow.client.IWorkflowServiceClient; import oracle.bpel.services.workflow.client.IWorkflowServiceClientConstants.CONNECTION\_PROPERTY; import oracle.bpel.services.workflow.verification.IWorkflowContext; import oracle.bpm.client.BPMServiceClientFactory; import oracle.security.jps.service.credstore.PasswordCredential; public class HumanWorkflowApiConnection { private IWorkflowServiceClient workflowServiceClient; public HumanWorkflowApiConnection(Map pProperties) { final BPMServiceClientFactory bpmServiceClientFactory = BPMServiceClientFactory.getInstance(pProperties, null, null); workflowServiceClient = bpmServiceClientFactory.getWorkflowServiceClient(); } public IWorkflowServiceClient getWorkflowServiceClient() { return workflowServiceClient; } public IWorkflowContext createWorkflowContextForAdmin(String pCsfMapname, String pCsfKey) { final PasswordCredential passwordCredential = CsfAccessor.readCredentialsfromCsf(pCsfMapname, pCsfKey); try { return workflowServiceClient.getTaskQueryService().authenticate(passwordCredential.getName(), passwordCredential.getPassword(), „jazn.com“); } catch (Exception e) { throw new RuntimeException(String.format(„Exception while authenticating Admin User \[%s\]“, passwordCredential.getName()), e); } } } \[/code\] Links: 1. [http://docs.oracle.com/cd/E28280\_01/apirefs.1111/e10660/toc.htm](http://docs.oracle.com/cd/E28280_01/apirefs.1111/e10660/toc.htm) 2. [http://docs.oracle.com/cd/E21764\_01/core.1111/e10043/csfadmin.htm](http://docs.oracle.com/cd/E21764_01/core.1111/e10043/csfadmin.htm) 3. **Kategorien:** Integration **Schlagwörter:** BPM, Weblogic --- ### [BPM & Integration Days 2014](https://thecattlecrew.net/2014/01/10/bpm-integration-days-2014/) **Published:** Januar 10, 2014 **Author:** Danilo Schmiedel **Content:** ## Vom 24. bis 25. Februar 2014 präsentiert das Business Technology Magazin in München das große Trainingsevent für BPM & Integration. Lernen Sie in 18 Sessions und sechs Workshops tiefgehendes Know-how für die tägliche Arbeit und für strategische Entscheidungen in Ihrem Unternehmen. Die BPM & Integration Days konzentrieren sich diesmal besonders auf die praktischen Synergien von BPM mit Systemintegration, Mobile, BI und Cloud, gepaart mit Erkenntnissen aus vielen Jahren Projekterfahrung aller Referenten. Insgesamt erwarten Sie: - 18 Sessions und sechs intensive Workshops mit klarem Praxisbezug. - Interessante Keynote und Speaker Panel am ersten Tag. - Erstklassige Speaker & Experten vor Ort erleben. - Eine ideale Plattform für Erfahrungsaustausch & Networking. - All-inclusive-Verpflegung mit Erfrischungen und Snacks in den Pausen, leckeres Mittagsbuffet. - Come Together am Montagabend für bestes Networking – mit Freibier und Snacks. - Sie erhalten alle Materialien und Codebeispiele sämtlicher Workshops und Sessions in elektronischer Form zum bequemen Download. - Sie erhalten ein persönliches Entwickler-Akademie-Zertifikat, das Ihnen Ihre erfolgreiche Teilnahme bescheinigt. - Gratis-Magazine, kostenloser Internetzugang, hochwertige Laptoptasche u.v.m. Am ersten Tag freuen wir uns auf ein spannendes Programm mit drei parallelen Tracks zu „Modellierung und Ausführung“, „Auswertung und Semantik“, „Integration“. [![zeitplaner_montag_21739_1200px_v3](https://thecattlecrew.net/wp-content/uploads/2014/01/zeitplaner_montag_21739_1200px_v3.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/01/zeitplaner_montag_21739_1200px_v3.jpg) Am zweiten Tag werden die wichtigsten Schwerpunktthemen in vier Halbtagesworkshops und in einem ganztägigen Workshop intensiv vertieft. [![Zeitplaner_21739.indd](https://thecattlecrew.net/wp-content/uploads/2014/01/zeitplaner_dienstag_21739_1200px.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/01/zeitplaner_dienstag_21739_1200px.jpg) Wir freuen uns als Sprecher in diversenSessions wieder mit dabei sein zu dürfen. Ein Anlass den Sie auf keinen Fall verpassen sollten! Weitere Infos finden Sie auf [www.bpm-integration-days.de](http://www.bpm-integration-days.de.). **Kategorien:** Integration, Tech Events & Networking **Schlagwörter:** BPM, BPMCon, Business Technology Magazin, Conference, Integration --- ### [Üœberblick über Oracle-Technologien: Oracle Webcenter Suite](https://thecattlecrew.net/2014/01/20/uberblick-uber-oracle-technologien-oracle-webcenter-suite/) **Published:** Januar 20, 2014 **Author:** Mohammad Esad-Djou **Content:** Wie Howard Beader (Vice President, Oracle Fusion Middleware) in „Musings on Fusion Middleware ®Oracle OpenWorld 2013“ \[siehe 1\] geschrieben hat, kommen aus dem Standpunkt einer Fusion Middleware vier Kern-Themen in Oracle OpenWorld konsequent vor: Cloud, Mobile, Business User Friendly Middleware, Oracle AppAdvantage. Über „Business User Friendly Middleware“ schreibt er: „Business User Friendly Middleware „“ Another core theme that came across in all the Fusion Middleware sessions was focus on business user experience. Simplifying the tools so that business users who leverage solutions such as WebCenter Portal can easily assemble their own application dashboards or so that marketers leveraging WebCenter Sites can easily update their external web site presence continues to be top of mind for us.“\[1\] Es zeigt die zunehmende Bedeutung des Oracle WebCenter Portal im gesamten Portfolio der Oracle Fusion Middleware. Seit September 2011 präsentiert sich Oracle WebCenter Portal als „Intuitive User Experiences for Enterprise Applications“. Aber was steckt dahinter? Welche Möglichkeiten bietet uns Oracle WebCenter Suite? Hier versuche ich einen kurzen Überblick über die Oracle WebCenter Suite zu geben. \*\*\* Ein Portal ermöglicht es, mit Informationen aus vielen verschiedenen Quellen über eine einzige Schnittstelle zu interagieren. In Oracle Portal wird diese Schnittstelle eine Seite (Page) genannt. Das Portal selbst ist dabei eine Sammlung von Seiten. Die Oracle WebCenter Suite stellt standardbasierte Komponenten zur Verfügung, die vorhandene Portale und Websites mit Web 2.0-Funktionen unterstützen. Die Suite enthält Komponenten von Oracle WebCenter und Oracle WebCenter Interaction (früher AquaLogic User Interaction) und besteht aus Enterprise Portals, Content Management, Web Experience Management und Collaboration. Folgende sind Komponenten von WebCenter Suite Plus: ## WebCenter Content Oracle WebCenter Content (vorher: Universal Content Management System – UCM) ist ein Enterprise Content Management (ECM) System und wurde 2006 mit Stellent als Nachfolger des CMSDK gekauft. WebCenter Content bündelt Oracle-Lösungen für Content Management, Record Management und Imaging. Oracle WebCenter Content bietet eine unternehmensweite Lösung für Content Management System. WebCenter Content besteht aus: 1. Content Management ist das Kern-System mit klassischem Dokumenten Management Site Studio SSXA Web Content Management 1. Document Management 2. Digital Asset Management (DAM) 3. Web Content Management (WCM) 4. Desktop Integration Suite 5. Oracle WebCenter Content Conversion 6. Content Server 7. Content Server System Components 8. Content Server Standard Components: Document Management, Web Content Management, Folders, Inbound Refinery, Integration: BPELIntegration, Integration: SESCrawlerExport, Integration: IPMRepository, Integration: WebCenterConfigure 9. Record Management 10. Imaging: WebCenter Imaging Oracle WebCenter Content ist ein Content Management System mit einer Datenhaltung in der Oracle Datenbank und einer Systemsoftware auf WebLogic Server Basis. Es ermöglicht die Verwaltung von Content unterschiedlichen Typs, aber es ist noch keine volle Integration in Weblogic Server (Mbeans usw.) vorhanden. Deshalb besitzt WebCenter Content (11g) eine eigene Administrationskonsole. Ein ContentTyp wird bestimmt durch seine Metadaten, die individuell definiert werden können. Jedes Content-Objekt wird einem Typ zugeordnet und muss entsprechend den Vorgaben aus dem Metadatenmodell beschrieben werden. Die Metadaten werden sowohl zur Selektion oder Filterung von Content aus dem Portal genutzt (z.B. selektiere alle Artikel zum Thema Kindergeld des aktuellen Monats) als auch für die Form der Darstellung (z.B. Grafik oder Text). Ü„nderungen an vorhandenem Content erzeugen neue Revisionen der Content-Objekte. Somit wird also auch die Historie des Contents verwaltet. Der Zugriff auf den Content wird durch Security-Gruppen kontrolliert. So kann innerhalb des Projekts festgelegt werden, welche Gruppen welche Rechte zur Pflege oder Ansicht von Content erhalten. Zugriffsrechte werden oft durch hierarchische Strukturierung des Contents in Verzeichnissen, ähnlich einem Dateisystem, festgelegt. Sie können jedoch auch an Content-Typen und somit an Metadaten geknüpft werden. Mit WebDAV (Web-Based Distributed Authoring and Versioning) steht sogar ein HTTP-basiertes Protokoll für den Zugriff auf den Content über die Verzeichnisstruktur z.B. aus dem Microsoft Windows Explorer zur Verfügung. ## WebCenter Portal: Integrationsframework Oracle WebCenter Portal bündelt Oracle-Lösungen für Transactional Web Sites, Enterprise Portals, Team Collaborative Workspace und Composite Application und besteht aus: 1. WebCenter Portal: eine browserbasierte Software-Umgebung für den Aufbau und den Betrieb von Unternehmensportalen. 2. WebCenter Spaces: ist ein fertiges Kollaboration-Portal entwickelt mit dem Webcenter Portal Framework 3. WebCenter Framework ist das erste Java Server Faces (JSF)-basierte Framework, das die Einbettung reichhaltiger, AJAX-basierter Komponenten, Portlets und Inhalte zur Erstellung kontextreicher, kundenspezifisch anpassbarer Anwendungen ermöglicht und erweitert das Framework ADF um folgenden Portal Funktionalitäten 1. Unterstützung für JSR-168 und JSR-286 Portlet Anwendungen, sowie PDK-Java Portlets 2. Integration von Content Systemen mittels JCR-170, z.B. des Oracle Content Server oder von Datei Systemen 3. Exportieren von JSF Seiten oder Oracle Task-Flow Applikationen als Portlet Anwendungen über die Oracle JSF Portlet Bridge 4. Natives Navigationsmodell durch Task-Flows 5. Seiten können frei entwickelt oder während Runtime generiert werden. Sie können entweder auf Skins oder Templates basieren 6. Durchführen von Ü„nderungen im laufenden Betrieb des Portals mittels Oracle Composer 7. Personalisierung von Seiten ist über den Webcenter Personalization Service möglich 8. WebCenter Web 2.0 Services, werden standartmäßig mit Webcenter ausgeliefert: 1. Wikis, blogs, RSS, lists, discussions, commenting, sharing, polls, search, etc. 2. andere wichtige Services sind: REST, WSRP (Web Services for Remote Portlets), pagelets, Activity Stream und analytics 3. WebCenter Analytics 4. WebCenter Content Adapter: Siebel, E-Business Suite und PeopleSoft Adapters sind alle in „WebCenter Applications Adapter“ 5. WebCenter Ensemble (früher AquaLogic Ensemble) unterstützt einen REST-basierten Portal Assembly-Mechanismus, der sich ideal für Szenarios wie die DMZ-basierte Bereitstellung eignet. 6. BPEL Worklist 7. JSR 168 Container 8. Oracle Portlet Bridge 9. WebLogic Portal 10. GroupWare Portlets for Lotus Notes and Microsoft Exchange 11. WebCenter Interaction (früher AquaLogic User Interaction) können Unternehmensportale, Communitoes, zusammengesetzte und soziale Anwendungen aufgebaut werden. Die plattformübergreifende mehrsprachige Lösung unterstützt sowohl Java als auch .NET Framework. 12. WebCenter Collaboration 13. WebCenter Application Accelerator for .NET 14. WebCenter Console for Microsoft SharePoint 15. WebCenter Content Services for Lotus Notes, Microsoft Exchange, EMC Documentum, and Microsoft Files (WebCenter Adapter for 3rd Party) 16. WebCenter Interaction Container for WSRP 17. WebCenter Interaction Identity Service 18. WebCenter Web Control Consumer for .NET 19. Oracle Entitlements Server Basic: Provides role based access control based on authorization policies Oracle WebCenter Portal ist ein modernes Portal Framework, mit dem Enterprise Portale und Websites effektiv auf Java-Basis entwickelt werden können. Das Framework ermöglicht es Entwicklern und Business-Anwendern, Webseiten aus statischem und dynamischem Content zusammenzustellen. Dazu können Content-Systeme, Dialoge auf Basis sogenannter Pageflows sowie Portal Services auf Basis von Standard WSRP Schnittstellen miteinander kombiniert werden. Die so erstellte Portalanwendung kann auf einem WebLogic-Cluster verteilt werden. ## WebCenter Sites Oracle-Lösungen für Web Content Management (WCM) besteht aus folgenden Technolgie-Komponenten: 1. Analytics (früher AquaLogic Analytics) unterstützt das Auffinden von Inhalten und Fachwissen durch die Extraktion von Daten über die tatsächliche Nutzung von Informationen. 2. Community Server 3. Content Integration Platform 4. Content Server 5. CS-Engage 6. Gadget Server 7. Language Packs 8. Satellite Server ## References: - [https://blogs.oracle.com/fusionmiddleware/entry/musings\_on\_fusion\_middleware\_oracle?msgid=3-9157121901](https://blogs.oracle.com/fusionmiddleware/entry/musings_on_fusion_middleware_oracle?msgid=3-9157121901) - [http://docs.oracle.com/cd/E23943\_01/doc.1111/e14860/wls\_basic.htm](http://docs.oracle.com/cd/E23943_01/doc.1111/e14860/wls_basic.htm) - - [http://docs.oracle.com/cd/E17904\_01/core.1111/e10103/title.htm](http://docs.oracle.com/cd/E17904_01/core.1111/e10103/title.htm), Oracle® Fusion Middleware, Concepts Guide, 11g Release 1 (11.1.1), E10103-08, January 2011 - An Oracle White Paper, Oracle WebCenter Portal: Intuitive User Experiences for Enterprise Applications, September 2011, PDF Download: [http://modj.org//fileadmin/user\_upload/04\_WebCenterSuiteEinführungFinal.pdf](http://modj.org/http:///fileadmin/user_upload/04_WebCenterSuiteEinführungFinal.pdf) **Kategorien:** Tools & Methoden **Schlagwörter:** Oracle FMW, WebCenter Content, WebCenter Portal --- ### [Das Thema Systemintegration ist wichtiger denn je](https://thecattlecrew.net/2014/01/23/das-thema-systemintegration-ist-wichtiger-denn-je/) **Published:** Januar 23, 2014 **Author:** Torsten Winterberg **Content:** JAXenter hat ein Interview von mir publiziert, das ein paar Ideen hinter der BPM Integration Days erläutert: Das klassische Thema Business Process Management (BPM) steht vor der Herausforderung, neue Trends wie Social, Mobile, Internet of Things mit in den Blick zu nehmen. Weshalb die System-Integration hierbei eine immer wichtigere Rolle spielt, erklärt Torsten Winterberg, Program Chair der [BPM Integration Days](http://bpm-integration-days.de/2014/) (24. bis 25. Februar 2014, München), im JAXenter-Interview. **JAXenter: Worauf lag als Program Chair der BPM Integration Days Ihr Augenmerk bei der Auswahl der Themen?** **Torsten Winterberg:** Die BPM Integration Days haben es sich zum Ziel gesetzt, die beiden Themenbereiche Systemintegration und Prozessautomatisierung voranzubringen. Die Zeiten, in denen wir über neues aus der SOA-Welt berichten konnten, sind langsam vorbei. Dennoch ist das Thema Systemintegration wichtiger denn je. Der Trend geht immer mehr zum Einsatz von Standardsoftware, die aufgrund der Globalisierung für immer mehr Einsatzfelder in Frage kommt. Diese Softwareblöcke wollen natürlich in die eigene Landschaft integriert werden. Sei es direkt oder auch Cloud-basiert. Zudem kommt mit dem Internet der Dinge eine ganze Klasse neuer Integrationsthemen auf uns zu, so dass Integration immer wichtiger wird. Und für BPM ist es natürlich auch eine wichtige Grundvoraussetzung. Nur was ich integrieren kann, kann ich auch in automatisierten Prozessketten ansprechen. BPM selber als zweiter Schwerpunkt des Events ist ein sehr weites Feld. Für die BPM Integration Days fokussieren wir uns auf den Teil von BPM, der sich rund um die Ausführung von Prozessen und die Erstellung Prozess-orientierter Anwendungen dreht. **JAXenter: Welche Trends zeichnen sich im Business Process Management ab und welchen sollte man folgen?** **Torsten Winterberg:** Der Prozessausführungsgedanke hinter BPM wird immer wichtiger, die BPM-Plattformen werden immer mächtiger. Automatisierung von Routinearbeit ist nach wie vor ein großer Treiber, über den viel Unternehmensgewinn realisiert werden kann. Aber auch Möglichkeiten zur Unterstützung von Nicht-Routinearbeit drängen auf den Markt (z.B. ACM) und werden auf unserem Event im Detail beleuchtet. Umgebende Trends wie Mobile, IoT und Social erlauben völlig neue Geschäftsprozesse und eröffnen ganz neue Möglichkeiten für Unternehmen. Zudem wächst die klassische Business Intelligence oder Analytics Disziplin immer mehr mit der BPM-Welt zusammen. All dies sind Themen, die wir diskutieren wollen. **JAXenter: Können Sie kurz die aktuellen Herausforderungen im BPM beschreiben?** **Torsten Winterberg:** Aus unserer Sicht ist es sehr wichtig, das breite Einsatzfeld von BPM besser zu verstehen und zu vermitteln. Dies kann über eine BPM-Methodik geschehen, die wir im Rahmen der Enterprise BPM Alliance auf den BPM Integration Days vorstellen möchten. Sicherlich gehört ein Verständnis dazu, welche Arten von BPM-Plattformen es am Markt gibt und welche Vor-/Nachteile diese bieten, welche für die eigenen Zwecke in Frage kommen, seien es kommerzielle oder Open-Source-Plattformen. Die Unterschiede sind extrem vielfältig, eine sinnvolle Auswahl fällt ohne Erfahrungsaustausch sehr schwer. Auch die organisatorischen Aspekte von BPM sind nicht zu vernachlässigen. Wir lassen viel Raum für Diskussionen, um diesen Erfahrungsaustausch zu unterstützen, z.B. in den Pausen, aber auch mit unserem Panel „Nutzen und Schmerzen von BPM im Unternehmen „“ Was muss besser werden“. Hier kann gemütlich und entspannt bei Snacks und Freibier angesprochen werden, was gut läuft, was immer schon schlecht war, und alle werden von den Antworten vieler einzelner Unternehmen und Experten profitieren. **JAXenter: Vielen Dank für dieses Gespräch!** **Kategorien:** Integration **Schlagwörter:** BPM, News --- ### [Bericht vom ersten DOAG BarCamp Development](https://thecattlecrew.net/2014/01/31/bericht-vom-ersten-doag-barcamp-development/) **Published:** Januar 31, 2014 **Author:** Enno Schulte **Content:** Am 30.01.2014 veranstaltete die DOAG zum ersten mal eine Konferenz im BarCamp-Format. Mit etwa 70 Besuchern wurde in der Münchener Allianz Arena spontan und offen diskutiert. Dafür standen vier Streams zu Verfügung die zu Beginn der Veranstaltung von den Teilnehmern mit Leben gefüllt wurden. Dabei entstand ein bunter Flickenteppich an Themen der von agilen Vorgehensmodellen über Forms und ADF bis Mobile und DWH sicherlich für jeden Anwesenden etwas zu bieten hatte. Neben den Streams konnten die Räumlichkeiten genutzt werden um intensiv zu networken. [![Networking beim DOAG BarCamp Development](https://thecattlecrew.net/wp-content/uploads/2014/01/dsc030071.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/01/dsc030071.jpg)Networking beim DOAG BarCamp Development Mit einer Besichtigung der Allianzarena wurde der gemütliche Abschluss der Veranstaltung eingeläutet. Gut organisiert und mit einer genialen Location kann man sagen, dass das erste DOAG BarCamp ein voller Erfolg war und hoffentlich mehr Veranstaltungen in einem offenen Format folgen werden. [![Der Ausblick beim BarCamp](https://thecattlecrew.net/wp-content/uploads/2014/01/dsc03006.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/01/dsc03006.jpg)Der Ausblick beim BarCamp **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** DOAG --- ### [ADF Hackers Event aka Fitness Center in München](https://thecattlecrew.net/2014/02/04/adf-hackers-event-aka-fitness-center-in-munchen/) **Published:** Februar 4, 2014 **Author:** Enno Schulte **Content:** Im Anschluss an das [DOAG BarCamp Development](http://barcamp.doag.org "DOAG BarCamp Development") (Rückblick [hier](https://thecattlecrew.net/2014/01/31/bericht-vom-ersten-doag-barcamp-development/ "hier")) wurde am Freitag das ADF Fitness Center in der Oracle Geschäftsstelle München veranstaltet. Anders als das BarCamp, welches sich keiner gesonderten Technologie widmete, war das ADF Fitness Center eine Mekka für ADF Entwickler. Von Anfängern bis Profis gab sich alles, was im deutschen ADF Umfeld Rang und Namen hat, die Klinke in die Hand. [![ADF Fitness Center 14](https://thecattlecrew.net/wp-content/uploads/2014/02/dsc03056.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/02/dsc03056.jpg) Wie im letzten Jahr gab es erneut die Möglichkeit, auf eine Exalogic Umgebung zu deployen. Im Fokus des Events stand jedoch die Entwicklung mit Oracle ADF Mobile. Einen Tag zuvor veröffentlichte Oracle ADF Mobile in Version 11.1.2.4 und sorgte damit zusätzlich für Gesprächsstoff und neue Dinge zum Ausprobieren. Ein Beispiel dafür ist das neue „mobileAlta-Skin“ was sich am Design von iOS 7 orientiert. Zur Erinnerung erhielt jeder Teilnehmer ein T-Shirt, welches bei einigen sogar individualisiert wurde. Im Vorfeld hatten die Teilnehmer des Events die Möglichkeit, via Twitter ihren Twitter-Account mitzuteilen. So konnten die jeweiligen Accounts zuvor ausgedruckt und vor Ort auf das T-Shirt gebracht werden. Dazu war lediglich ein wenig Übung und ein Bügeleisen notwendig. Auf der Rückseite stand „ADF Fitness Center 2014“. Dieser Eintrag soll nach und nach bei kommenden Events erweitert werden. Dazu wird das selbe Verfahren wie bei den Twitter-Accounts angewandt. Ein Beispiel für ein solches Event ist die DOAG Development im Juni. [![Die T-Shirts bereits zum aufbügeln.](https://thecattlecrew.net/wp-content/uploads/2014/02/dsc03045.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/02/dsc03045.jpg)Die T-Shirts bereits zum aufbügeln. [![IMG_2120](https://thecattlecrew.net/wp-content/uploads/2014/02/img_2120.jpg?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/02/img_2120.jpg)Das Ergebnis von @LegendaryEnno Alles in allem war das ADF Fitness Center ebenso wie das DOAG BarCamp Development ein voller Erfolg für alle Beteiligten. Das Ziel des Events war der Austausch mit Experten zu echten Problemen. Wie bereits im letzten Jahr, konnte dieses Ziel erreicht werden. Dazu war es lediglich nötig genügend Freiraum zum Hacken und die richtigen Personen in einen Raum zu bekommen. Der Dank gilt an dieser Stelle Oracle und der deutschen ADF Community. **Kategorien:** Development, Tech Events & Networking **Schlagwörter:** Oracle ADF --- ### [Nachlese der BPM Integration Days 2014](https://thecattlecrew.net/2014/02/27/nachlese-der-bpm-integration-days-2014/) **Published:** Februar 27, 2014 **Author:** Sven Bernhardt **Content:** Am Montag, den 24.02.2014, öffneten die diesjährigen BPM Integration Days ihre Pforten. Die Besucher erlebten zwei spannende Tage, die sich mit aktuellen Themen aus den Bereichen - Integration - Business Process Management (BPM) - Adaptive Case Management (ACM) - Process Mining und Analytics - Fast Data / Event Processing - Internet of things (IoT) - Cloud beschäftigten. Wir von OPITZ CONSULTING waren diesmal an 5 Sessions und 3 Workshops beteiligt (siehe [https://thecattlecrew.net/2014/01/10/bpm-integration-days-2014](https://thecattlecrew.net/2014/01/10/bpm-integration-days-2014 "https://thecattlecrew.net/2014/01/10/bpm-integration-days-2014")). Die insgesamt 18 Sessions und 6 Workshops legten wieder sehr viel Wert darauf, die theoretischen sowie konzeptionellen Inhalte mit praktischen Bezügen zu untermauern, um so den Teilnehmern ein besseres Verständnis zu ermöglichen. Kernbotschaften der Konferenz waren unter Anderem: - Entscheidungen in Unternehmen sollten IT-technisch unterstützt werden, können jedoch nicht immer automatisiert getroffen werden - Vorhandenen Informationen, interne wie externe, sollten dazu verwendet werden Unternehmensentscheidungen bestmöglich zu unterstützen (Context-specific Decision Making) - Anwender im Unternehmen sollten wieder mehr in den Fokus rücken und sind in ihrer täglichen Arbeit optimal IT-technisch zu unterstützen - Kreativität der Anwender ist zu fördern, Anwender müssen als Wissensarbeiter verstanden werden („Empower the knowledge worker“) - Trend geht weg von vollständiger Automatisierung von Prozessen hin zu Guided Humans bzw. Adaptiven Prozessen - Guided Human: Alle Aktivitäten eines Ablaufes sind bekannt, allerdings nicht die Transitionen dazwischen - Adaptiv: Aktivitäten eines Ablaufes sind nicht von vornherein bekannt, zur Laufzeit wird auf der Grundlage von Wissen, das sich auch zur Laufzeit ändern kann bspw. durch neue, externe Einflüsse, entschieden welcher Schritt als nächstes notwendig ist („Living Knowledge“) - Unterschiedliche Disziplinen, wie bspw. BPM und BI, haben viele Berührungspunkte und müssen für die optimale Unterstützung des Business in Ihrer Gesamtheit betrachtet werden Im Panel, mit dem Thema „Nutzen und Schmerzen von BPM im Unternehmen – Was muss besser werden?“, wurde der aktuelle Status Quo von BPM sowie das zukünftige Potential von BPM und BPMN diskutiert. Outcome dieses Panels war: - BPM-Initiativen halten zunehmend Einzug in Unternehmen, ist allerdings noch kein Mainstream - Für eine erfolgreiche Implementierung eines ganzheitlichen BPM-Ansatzes sollten Fachbereich und IT noch enger zusammen arbeiten - BPM wird mittel- oder langfristig Mainstream werden, unter Anderem aufgrund der standardisierten BPMN Notation Insgesamt waren es wieder zwei sehr interessante Tage, die neue Denkanstöße, Perspektiven sowie aktuelle Trends und Innovationen für das Daily Business aufgezeigt haben. Man darf gespannt sein, was sich im Laufe dieses Jahres in den diskutierten Bereichen passiert, welche neuen Entwicklungen und Trends sich ergeben. Spätestens zu den nächsten BPM Integration Days 2015 wissen wir mehr darüber… Links: - [Announcement SBI Days und Sessionüberblick](https://thecattlecrew.net/2014/01/10/bpm-integration-days-2014/ "Announcement SBI Days und Sessionüberblick") - [Unsere Vorträge im OC Slideshare-Channel](http://de.slideshare.net/opitzconsulting "Unsere Vorträge im OC Slideshare-Channel") - [OC Twitter Stream mit Beiträgen zu der Veranstaltung ](https://twitter.com/OC_WIRE "OC Twitter Stream mit Beiträgen zur Veranstaltung") - [ACM Poster in elektronischer Form](https://thecattlecrew.net/?s=Poster "ACM Poster in elektronischer Form") **Kategorien:** Architecture & Process Models, Tech Events & Networking **Schlagwörter:** ACM, BPM, Conference, German --- ### [IT-Security (Part 2): WebLogic Server and Oracle Platform Security Services (OPSS)](https://thecattlecrew.net/2014/03/05/it-security-part-2-weblogic-server-and-oracle-platform-security-services-opss-2/) **Published:** März 5, 2014 **Author:** Mohammad Esad-Djou **Content:** # OPSS Architecture As we discussed (), OPSS is Oracle proposals regarding enterprise security services. It is as a framework that provides a comprehensive set of security services. These services based on Java technologies and have a consistent approach for design and apply security policies to Java EE and resources. We look at OPSS architecture from two different perspectives, which are connected to each other very closely. I try to review the advantages of OPSS for developers and administrators from Application“™s perspective and present the cooperating of technology components such as LDAP, Application Server and Oracle Fusion Middleware from Component“™s perspective. Thereby, we can determine the main OPSS“™s benefits that Oracle says: - Allows developers to focus on application and domain problems - Supports enterprise deployments - Supports several LDAP servers and SSO systems - Is certified on the Oracle WebLogic Server - Pre-integrates with Oracle products and technologies ## Application“™s point of view Oracle Platform Security Services (OPSS) is both a security framework exposing security services and APIs, and a platform offering concrete implementation of security services. It includes these elements: - Common Security Services (CSS), the internal security framework on which Oracle WebLogic Server is based - Oracle Platform Services - User and Role APIs - Oracle Fusion Middleware Audit Framework Figure 1 Application’s perspective illustrations OPSS“˜s architecture from application point of view. Such architecture allows OPSS to support different security and identity systems without changing the APIs. OPSS is integrated with Oracle Fusion Middleware“˜s management tools to administrate and monitor the security policies implemented in the underlying identity management infrastructure. Therefore, OFM technologies such as Oracle SOA, Oracle WebCenter Suite, Oracle Application Development Framework (ADF), Oracle Web Services Manager (OWSM) and“¦ could use OPSS capacities. OPSS offers abstraction layer APIs those isolate developers from security and identity management implementation details. In this way, developer can invoke the services provided by OPSS directly from the development environment (e.g. JDeveloper) using wizards. Admin can configure the services of OPSS into the WLS. As you see in Figure, the uppermost layer consists of Oracle WebLogic Server and the components and Java applications running on the server; below this is the API layer consisting of Authentication, Authorization, CSF (Credential Store Framework), and User and Role APIs, followed by the Service Provider Interface (SPI) layer and the service providers for authentication, authorization, and others. The final and bottom layer consists of repositories including LDAP and database servers. [![Figure 1 Application's perspective](http://modjorg.files.wordpress.com/2014/02/opss_1.jpg)](http://modjorg.files.wordpress.com/2014/02/opss_1.jpg)Figure 1 Application’s perspective ## OFM-Component“™s point of view Figure 2 OFM-Component’s perspective shows the various security components as layers. The top layer includes the OPSS security services; the next layer includes the service providers, and the bottom layer includes the OPSS security store with a repository of one of three kinds. OPSS provides auditing capabilities for components too. The second layer \[Security Services Provider Interface (SSPI)\] has the capability that works with Java EE container security „“ named Java Authorization Contract for Containers (JACC) mode and in resource-based (non-JACC) mode, and resource-based authorization for the environment. SSPI is a set of APIs for implementing pluggable security providers. A module implementing any of these interfaces can be plugged into SSPI to provide a particular type of security service. Therefore, OPSS has a consistent structure and is able to meet the requirements for integrating JEE Applications generally and specially OFM-Components and Oracle Security technologies, such as OAM, OID and so on. [![Figure 2 OFM-Component's perspective](http://modjorg.files.wordpress.com/2014/02/opss_2.jpg)](http://modjorg.files.wordpress.com/2014/02/opss_2.jpg)Figure 2 OFM-Component’s perspective ## References - See too: Do you forget your WebLogic Server password? No problem!, - Oracle Fusion Middleware 11.1.1.5, Security Guides [http://](http://docs.oracle.com/cd/E21764_01/security.htm)[docs.oracle.com/cd/E21764\_01/security.htm](http://docs.oracle.com/cd/E21764_01/security.htm) - Oracle® Fusion Middleware Understanding Security for Oracle WebLogic Server 11g Release 1 (10.3.5) [http://](http://docs.oracle.com/cd/E21764_01/web.1111/e13710/toc.htm)[docs.oracle.com/cd/E21764\_01/web.1111/e13710/toc.htm](http://docs.oracle.com/cd/E21764_01/web.1111/e13710/toc.htm) - Oracle® Fusion Middleware Securing Oracle WebLogic Server [http://](http://docs.oracle.com/cd/E21764_01/web.1111/e13707/toc.htm)[docs.oracle.com/cd/E21764\_01/web.1111/e13707/toc.htm](http://docs.oracle.com/cd/E21764_01/web.1111/e13707/toc.htm) - Oracle Platform Security Services 11gR1 (White Paper) - IT Security Guidelines, IT Baseline Protection in brief, Federal Office for Information Security - - Oracle® Fusion Middleware: Understanding Security for Oracle WebLogic Server 12c Release 1, (12.1.1), E24484-02, January 2012: [http://docs.oracle.com/cd/E24329\_01/web.1211/e24484.pdf](http://docs.oracle.com/cd/E24329_01/web.1211/e24484.pdf) - For details, see OPSS Architecture Overview in the Oracle Fusion Middleware Application Security Guide: [http://docs.oracle.com/cd/E23943\_01/core.1111/e10043.pdf](http://docs.oracle.com/cd/E23943_01/core.1111/e10043.pdf) - Oracle® Access Manager Integration Guide: [http://docs.oracle.com/cd/E12530\_01/oam.1014/e10356/weblogic.htm](http://docs.oracle.com/cd/E12530_01/oam.1014/e10356/weblogic.htm) **Kategorien:** IT-Security **Schlagwörter:** BPM, English, IT Security, Mobile, Oracle Platform Security Services (OPSS), Service Bus, WebCenter Content, Weblogic --- ### [Dynamic endpoint binding in Oracle SOA Suite](https://thecattlecrew.net/2014/03/06/dynamic-endpoint-binding-in-oracle-soa-suite/) **Published:** März 6, 2014 **Author:** alexanderdaeubler **Content:** **Why is dynamic endpoint binding needed?** Sometimes a BPEL process instance has to determine at run-time which implementation of a web service interface is to be called. We’ll show you how to achieve that using dynamic endpoint binding. Let“™s imagine the following scenario: we“™re running a car rental agency called *RYLC (Rent Your Legacy Car)* which operates different locations. The process of renting a car is basically identical for all locations except for the determination which cars are currently available. This is depicted in the following diagram: [![get_available_cars](https://thecattlecrew.net/wp-content/uploads/2014/03/get_available_cars.jpg)](https://thecattlecrew.net/wp-content/uploads/2014/03/get_available_cars.jpg) There are three different implementations of the *GetAvailableCars* service. But how can we achieve calling them dynamically at run-time using Oracle SOA Suite? **How to dynamically set the service endpoint** There are just a couple of implementation steps we need to perform to enable dynamic endpoint binding: - create a new SOA project in JDeveloper - add a *CarRental* BPEL process - add an external reference to the *GetAvailableCars* service within the composite - create a DVM file containing the URI’s by which the services for the different locations can be accessed - set the *endpointURI* property on the Invoke component calling the *GetAvailableCars* service (value is taken from the DVM file) Those steps are described in more detail here: [http://sgrosjean.blogspot.de/2013/01/how-to-set-endpointuri-dynamically-in.html](http://sgrosjean.blogspot.de/2013/01/how-to-set-endpointuri-dynamically-in.html "How to set the service endPoint URI dynamically in SOA Suite 11g") The composite view should now be similar to this: [![ohne_mock_carrental](https://thecattlecrew.net/wp-content/uploads/2014/03/ohne_mock_carrental.jpg)](https://thecattlecrew.net/wp-content/uploads/2014/03/ohne_mock_carrental.jpg) **Decouple composite design from specific endpoints** We need to allocate a concrete implementation of the *GetAvailableCars* service to the composite when deploying it. We could use the implementation of any of the location specific services (e.g. the Berlin service) but that is generally not a good idea as once the particular service is unavailable the composite can no longer be deployed. Therefore we decouple the *CarRental* composite from any specific endpoint by adding the *GetAvailableCars* interface as an exposed service: [![mit_mock_carrental](https://thecattlecrew.net/wp-content/uploads/2014/03/mit_mock_carrental.jpg)](https://thecattlecrew.net/wp-content/uploads/2014/03/mit_mock_carrental.jpg) The mocked *GetAvailableCars* process is just there for decoupling a certain location from the caller during deployment time. During run-time the mock will not be called but replaced with one of the services configured in the DVM. However, if the dynamic call fails the mocked *GetAvailableCars* process returns an appropriate error message. In the config plan used for deploying the composite we must set the location of the external reference so that the composite seems to be calling itself: [![configplan](https://thecattlecrew.net/wp-content/uploads/2014/03/configplan.jpg)](https://thecattlecrew.net/wp-content/uploads/2014/03/configplan.jpg) Thereby we don’t have any dependencies on location specific services while deploying the composite. At run-time, however, the *endpointURI* property will override the deployed settings. For the sake of completeness we must not forget that the dynamic call as described here (using Oracle SOA Suite only) could also be achieved using the Oracle Service Bus (OSB) and its Dynamic Routing component. In scenarios where no service bus is available, however, our approach is certainly worth consideration. **Kategorien:** Architecture & Process Models **Schlagwörter:** bpel, Composites, Dynamic, English, Oracle DB, Run-time, Service Bus --- ### [OPITZ CONSULTING gewinnt ORACLE BPM Partner Community Award](https://thecattlecrew.net/2014/03/10/opitz-consulting-gewinnt-oracle-bpm-partner-community-award/) **Published:** März 10, 2014 **Author:** Torsten Winterberg **Content:** **Pressemitteilung:** Beim Oracle Fusion Middleware Partner Forum am 18.2.2014 auf Malta zeichnete Oracle den Beitrag von OPITZ CONSULTING zur BPM-Community mit seinem „Oracle BPM Community Award für Outstanding BPM Contribution 2014“ aus. Maßgeblich für diese Entscheidung war, dass die Experten der IT-Beratung ihre Erfahrungen aus Projekten im Bereich Business Process Management mit den Systemen Oracle SOA Suite und Oracle BPM Suite regelmäßig in Blogeinträgen, Artikeln und Konferenzbeiträgen mit der Community teilen. Zudem würdigt der Preis die zahlreichen Kontributionen im Umfeld der noch recht neuen BPM-Disziplin des „Adaptiven Case Managements (ACM)“, wie zum Beispiel ein Poster mit einer Übersicht zum Thema ACM, zahlreiche Fachartikel und Vorträge sowie Beiträge zu Büchern ([Link zum ACM-Poster](https://thecattlecrew.wordpress.com/2013/10/10/adaptive-case-management-poster-available/)). [![BPM Award 2014](https://thecattlecrew.net/wp-content/uploads/2014/03/award_bpm_2014.jpg?w=225)](https://thecattlecrew.net/wp-content/uploads/2014/03/award_bpm_2014.jpg) **Alistair Hopkins**, VP Sales & Strategy Technology Solutions bei Oracle, lobt die Verdienste des Beratungshauses mit den folgenden Worten: *„OPITZ CONSULTING is established as a leading Oracle Fusion Middleware Partner in Germany with a focus on BPM, SOA and integration projects. With their experience from many successful customer projects and with their quest for high quality delivery of solutions OPITZ CONSULTING is a strong implementation partner for our customers. The label „Specialized Partner“ has been achieved for SOA, BPM, Business Intelligence , Application Grid and Application Development Framework (ADF ) as well as several DB specializations e.g. Exadata, RAC, etc. and shows the technical Oracle power OPITZ CONSULTING has built. This underlies their outstanding position in the German market significantly. Oracle wishes to reward this investment and the outstanding projects delivered through the presentation of the Oracle EMEA BPM Partner Community Award and wishes OPITZ CONSULTING an ongoing success“* Torsten Winterberg verantwortet im Business Development & Innovation bei OPITZ CONSULTING das Thema BPM und legte immer schon großen Wert auf die Community-Arbeit seiner Berater. Er statiert: *„Das Erarbeiten und Teilen von Fachwissen bringt nicht nur unsere eigenen Experten weiter, sondern hilft auch grundsätzlich dabei, wichtige Marktthemen weiterzuentwickeln. Das kommt letztlich unseren Kunden zugute, die zu Recht „State-of-the-Art“-Leistungen von uns erwarten und diese aufgrund des hohen Engagements vieler auch geliefert bekommen. Umso mehr freuen wir uns daher über den Gewinn des Community-Awards. Ich möchte mich bei der SOA- und BPM-Community von Oracle für das zurückgespiegelte Vertrauen in Form des Preises herzlich bedanken, insbesondere bei Jürgen Kress, der die Gemeinschaft führend aufgebaut hat und das kontinuierliche Wachstum und die Weiterentwicklung der Community treibt. Gemeinsam sind wir stärker. Danke!“* **Kategorien:** Architecture & Process Models, Tech Events & Networking **Schlagwörter:** BPM, German, News --- ### [OPITZ CONSULTING tritt Enterprise BPM Alliance bei](https://thecattlecrew.net/2014/03/12/opitz-consulting-tritt-enterprise-bpm-alliance-bei/) **Published:** März 12, 2014 **Author:** Torsten Winterberg **Content:** Seit dem 1. Dezember 2013 sind wir Teil der Enterprise Business Process Management Alliance (EBPMA). In der neuen Vereinigung stellen unabhängige BPM-Anwender ihre praktischen Erfahrungen und ihr Know-how in einer offenen Methodik für BPM bereit. Wir freuen uns, dem Netzwerk künftig unsere Erfahrungen zur Verfügung zu stellen und weitere Unternehmen mit ins Boot zu holen: „Wir möchten unseren Kunden schon in Strategie-Phasen die richtigen Impulse ermöglichen. Die neue Alliance mit ihrer gebündelten Erfahrung und ihrem präzise aufbereiteten Know-how ist dafür der perfekte Partner!“ [![logo_ebpma](https://thecattlecrew.net/wp-content/uploads/2014/03/logo_ebpma.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/03/logo_ebpma.jpg) Auch Dirk Slama, Mitgründer und Vorstand der BPM-Alliance ist davon überzeugt, dass Business Process Management in all seinen Facetten einen ganz wesentlichen Beitrag zum Unternehmenserfolg leistet: „Die Ausprägungen reichen von strategischen BPM-Initiativen in Verbindung mit Enterprise Architecture Management (EAM) bis hin zur Realisierung von Geschäftsprozessautomati-sierungen mit Process Engines in einer global verbundenen und mobilen Welt der Systeme und Dinge.“ Als Grundlage für ihre Arbeit dient der Alliance das Business Process Management Frame-work (BPMF) sowie das Buch „Enterprise BPM“, an dem sich Anwender bei der Durchfüh-rung von Projekten orientieren können. Die Mitglieder der BPM Alliance profitieren von der Erfahrung und dem Wissen anderer Anwender durch den regelmäßigen Erfahrungsaus-tausch im Vereinsnetzwerk. Darüber hinaus erhalten sie durch den Zugriff auf aktuelle Dokumentationen aus dem BPM-Framework Wissen aus erster Hand und können Fragen direkt mit den „Machern“ klären. Aktuelle Informationen stellt das Bündnis auf seiner Website, im Blog und via Newsletter bereit. Die Alliance veranstaltet regelmäßig Workshops in Arbeitsgruppen und präsentiert die Arbeitsergebnisse und Erkenntnisse auf verschiedenen Konferenzen. Link: **Kategorien:** Architecture & Process Models, Tech Events & Networking **Schlagwörter:** BPM, German, News --- ### [Was ist neu in camunda BPM 7.1?](https://thecattlecrew.net/2014/03/29/was-ist-neu-in-camunda-bpm-7-1/) **Published:** März 29, 2014 **Author:** Stefan Glase **Content:** Am 21. März war es endlich soweit und die neue camunda BPM 7.1 Version wurde vorgestellt. In einem einstündigen [Live Webinar](http://www.bpm-guide.de/2014/02/28/camunda-bpm-7-1-live-webinar/) haben [Jakob Freund](https://twitter.com/jakobfreund) und [Daniel Meyer](https://twitter.com/meyerdan) die neuesten Features der Version 7.1 vorgestellt. Nach einem kurzen Einstieg und Überblick über das camunda BPM Ü–kosystem inklusive eines interessanten Rückblicks über die letzten zwölf Monate camunda BPM ging es auch direkt an’s Eingemachte! ### Neue Features Damit Prozesse ganz im Sinne des Rapid Prototyping möglichst schnell ausprobiert werden können besteht für die User Tasks die Möglichkeit sich auf einfache Art und Weise **Formulare generieren** zu lassen und diese nach dem Gewinn neuer Erkenntnisse weiter anzupassen. Der Eclipse basierte **camunda Modeler** wird kontinuierlich verbessert und hat einige interessante und das effiziente Prozessdesign sehr stark unterstützende Features bekommen. Der Modeler ist für mich kaum noch vergleichbar mit dem Modeler für den wir Anfang 2012 noch den einen oder anderen Feature-Request oder Bugreport eingestellt haben. Ein weiteres spannendes Feature ist die **Job Suspension**, um laufende Instanzen an einer bestimmten Stelle anzuhalten (beispielsweise beim Ausfall einer Schnittstelle) und später aktiv wieder anzustarten. Spannendes Detail an der Stelle: Die Job Suspension ist auch über die neue **Java API** erreich- und steuerbar und damit lässt sich dann auch programmatisch auf bestimmte Situationen in der eigenen Prozessanwendung reagieren. Und besonders beim Betrieb von camunda BPM basierten Prozessanwendungen hilft auch die verbesserte **Process History** weiter, mit der über einzelne und alle Prozessinstanzen Abfragen möglich sind und damit Prozessdurchläufe analysiert werden können – natürlich inklusive grafischer Darstellung im camunda cockpit. Kleiner Wermutstropfen: Dieses Feature ist nur in der Enterprise Edition verfügbar. Mit dem neuen **Support für JBoss AS 7.2 und JBoss EAP 6.1 / 6.2** werden nun in Summe sechs verschiedene Container und sechs verschiedene Datenbanken als Laufzeitumgebung für die camunda BPM Process Engine unterstützt. Bei so vielen neuen Features stellt sich der Softwareentwickler natürlich die Frage, ob sich diese Verbesserungen negativ auf die **Performance** niederschlagen. Doch auch an dieser Baustelle wurde die camunda BPM Engine optimiert und profitiert nun noch mehr von Multi-Threading und reduziert für diverse BPM-Elemente die Anzahl der erforderlichen Datenbankzugriffe. ### Ausprobieren Der [Einstieg](http://camunda.org/get-started/) in die Entwicklung von Prozessanwendungen mit camunda BPM wird durch die mittlerweile vielen Ressourcen wie der umfangreiche [User Guide](http://docs.camunda.org/latest/guides/user-guide/), die vielen [Tutorials](http://camunda.org/bpmn/tutorial.html) und [Beispiele](http://docs.camunda.org/latest/real-life/examples/) möglichst einfach gemacht. Wer dennoch den Erstkontakt scheut dem kann von camunda selber oder einem der Partnerunternehmen [Unterstützung bei der Einführung](http://camunda.org/support.html) durch Workshops oder einen Proof of Concept („Nicht wir sondern Sie machen das und es läuft nicht bei uns sondern auf Ihrer eigenen Maschine!“) angeboten werden. Ferner gibt es noch das [camunda BPM network](http://network.camunda.org/), wo man sich mit anderen BPM Interessierten vernetzen kann, diverse [Community Meetings](http://network.camunda.org/meetings) und natürlich die [BPMCon 2014](http://www.bpmcon.de/) in Berlin, die schon im letzten Jahr viele Anwender und Interessierte begeistern konnte. ### Ausblick Im anschließenden Q&A sind die beiden Sprecher noch auf viele der gestellten Fragen eingegangen. So auch die Frage zur weiteren Entwicklung der camunda BPM Process Engine. Auf der Roadmap stehen gerade neben vielen kleinen Optimierungen und Weiterentwicklungen drei große Themen: - Weitere Verbesserung der Tasklist - Implementierung von Adaptive Case Management - Programmiermodell zur Transformation von XML- und JSON-Datenströmen Die Stunde war viel zu schnell rum und für mich bleibt ein sehr gelungenes und interessantes Live Webinar mit wenigen aber informativen Folien und einer Menge echter Demos und Code-Beispiele in Erinnerung. Die neuen Features machen das nächste BPM Projekt mit der camunda BPM Process Engine noch um einiges interessanter als Projekte dieser Art bisher schon waren! **Kategorien:** Architecture & Process Models **Schlagwörter:** BPM, Camunda, German, update, webinar --- ### [Car registration process: A BPMN real-life use-case](https://thecattlecrew.net/2014/04/19/car-registration-process-a-bpmn-real-life-use-case/) **Published:** April 19, 2014 **Author:** Thomas Schlagbauer **Content:** Lately I faced the challenge to transfer my car registration from Austria to Poland. In other words, I wanted to register my car in Poland which has been registered in Austria previously. It took quite a lot of time and effort to figure out how all the steps work together, however the visualization I created throughout this little „private project“ helped a lot in understanding. This BPMN process is the result. I showed it to a bunch of people not acquainted with BPMN and without domain knowledge. It was amazing to see how these people immediately comprehended the process and felt confident to solve the problem. Perhaps someone might benefit from it. Although the process may slightly differ to other countries when it comes to necessary kinds of documents, the basic steps remain the same. [![Car registration BPMN process](https://thecattlecrew.net/wp-content/uploads/2014/04/bpmndiagram_2.png)](https://thecattlecrew.net/wp-content/uploads/2014/04/bpmndiagram_2.png) **Kategorien:** Architecture & Process Models **Schlagwörter:** English --- ### [Orchestrierung der IT-Sicherheit: Wie sieht es mit der Oracle Fusion Middleware aus?](https://thecattlecrew.net/2014/05/16/orchestrierung-der-it-sicherheit-wie-sieht-es-mit-der-oracle-fusion-middleware-aus/) **Published:** Mai 16, 2014 **Author:** Mohammad Esad-Djou **Content:** Es gab am 06. März 2014 in Hochschule für angewandte Wissenschaften München den DOAG Regionaltreffen München/Südbayern. Ich habe dort einen Vortrag über „Orchestrierung der IT-Sicherheit: Wie sieht es mit der Oracle Fusion Middleware aus?“ gehalten. Hier finden Sie mein Abstract und meine Präsentation: Orchestrierung ist eine riesige Symphonie verschiedenster Komponenten im IT-Bereich. Die Orchestrierung der IT-Sicherheit ist daher mehr als nur eine klassische administrative Aufgabe, die auf Netzwerkebene zu realisieren ist. IT-Sicherheit ist eine Herausforderung im Zeitalter des Cloud Computing, der veränderten Herausforderungen in einer verteilten, heterogenen und noch mehr komplexen IT-Welt. In diesem Vortrag wird gezeigt, dass allein die traditionellen IT-Sicherheitsansätze und Maßnahmen nicht ausreichen, um neue technische aber auch organisatorische Fragen zu beantworten. Nach einer kurzen Einführung in die Problematik werden Lösungsansätze von Oracle vorgestellt. Ein besonderer Fokus wird dabei auf Oracle WebLogic Server und Oracle Plattform Security Services (OPSS) gelegt. [Orchestrator\_Security\_V2.3\_Kurz](https://thecattlecrew.net/wp-content/uploads/2014/05/orchestrator_security_v2-3_kurz.pdf) **Kategorien:** IT-Security **Schlagwörter:** Conference, German, WebCenter Content, Weblogic --- ### [OMG released formal version of CMMN 1.0](https://thecattlecrew.net/2014/06/13/omg-released-formal-version-of-cmmn-1-0/) **Published:** Juni 13, 2014 **Author:** Danilo Schmiedel **Content:** In May 2014 the OMG released version 1.0 of the Case Management Model and Notation (CMMN). You can access the documents associated with it under . Great to see that the specification also includes the „CMMN – Claims Management Example“ (page 78) from our „[ACM in Practice](https://thecattlecrew.net/2013/10/10/adaptive-case-management-poster-available/)„ poster. [![Image](https://thecattlecrew.net/wp-content/uploads/2014/06/claimsmanagement-cmmn.jpg?w=650)](https://thecattlecrew.net/wp-content/uploads/2014/06/claimsmanagement-cmmn.jpg) **Kategorien:** Architecture & Process Models **Schlagwörter:** ACM, Case Management --- ### [IoT prototype - low-level thoughts about camunda BPM and Drools Expert (part 6)](https://thecattlecrew.net/2014/06/23/iot-prototype-low-level-thoughts-about-camunda-bpm-and-drools-expert-part-6/) **Published:** Juni 23, 2014 **Author:** Halil Hancioglu **Content:** As already mentioned in the [second part](https://thecattlecrew.net/2014/06/18/iot-prototype-an-architectural-overview-part-2/ "IoT prototype ") of this series, building systems of this type consists of several components. In this part we describe the integration of a BPMN 2.0 capable workflow management system and a business rule engine in our IoT prototype. #### Why do we need such things Currently we live in times of a knowledge society and fast changing business requirements. Business flexibility is needed more than ever and also requires flexible business processes in companies. This could be realized through the cooperation of IT and business to develop automated BPMN 2.0 models. But this is not appropriate in an environment with many complex business rules which are changing multiple times in a short period. In such cases, business departments cannot wait at the next planned release of an application. So this scenario is predestined for the use of a business rule engine. It allows to externalize business rules from an application and develop and manage it in an unified way. Thus, a process engine in combination with a business rule engine makes it possible to have modifiable automated processes and application-independent development of business rules. Many companies have already recognized the need of a process engine and a business rule engine. Accordingly we focused to improve our experience in integration of already existing technologies in many companies with IoT. From the perspective of a company, it could be a key factor to keep already made investments in IT save and integrate it with IoT for new market potential. Based on our focus and expertise, we decide to use camunda BPM as BPMN 2.0 capable workflow management system and Drools Expert by JBoss as business rule engine. #### Use of camunda BPM We have embedded the process engine inside our Spring application. In this way we could still use our Spring expertise. The integration went well in a few easy steps which are described in short below. After adding the necessary project dependencies to our Maven project we extend the web.xml with a DispatcherServlet and configure the embedded camunda ProcessEngine and the ProcessApplication inside it as shown below. \[code wraplines=“false“ language=“xml“ collapse=“true“\] ${hibernate.hbm2ddl.auto} ${hibernate.dialect} ${hibernate.schema.name} ${hibernate.show\_sql} ${hibernate.format\_sql} com.opitz.iotprototype.entities \[/code\] Next we have configured a deployable process archive by the descriptor file processes.xml like below. \[code wraplines=“false“ language=“xml“ collapse=“true“\] version="1.0" encoding="UTF-8" ? default false true \[/code\] That was all for extending our application with camunda BPM. Afterwards we start with development of our BPMN 2.0 model. We have realized the use cases to react to the presence & absence of users. The main steps in both cases are - check if user is first/last, - switch Kitchen plugs on/off, - switch special plugs on/off (injected as business rules), - switch user assigned plugs on/off and - finally set current user state. The BPMN 2.0 model looks finally as shown below: [![PlugSwitchProcess modeled with camunda BPM](https://thecattlecrew.net/wp-content/uploads/2014/06/plugswitchprocess.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2014/06/plugswitchprocess.png)PlugSwitchProcess modeled with camunda BPM After completing the BPMN 2.0 model, we start to enrich it with Java implementations. Therefore we defined so-called delegates (in some cases with field injection) in DispatcherServlet and used CDI to link these delegates with our model. Following code snippet shows a few definitions. \[code wraplines=“false“ language=“xml“ collapse=“true“\] \[/code\] Next we link the delegates with the BPMN 2.0 model via camunda Modeler properties view. Following image illustrates this step. [![camunda BPMN 2.0 Modeler properties view](https://thecattlecrew.net/wp-content/uploads/2014/06/camundamodelerpropertiescdidelegate.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/06/camundamodelerpropertiescdidelegate.png)camunda BPMN 2.0 Modeler properties view And in fact if a building has no kitchen, we have modeled a boundary Error Event as a business error as shown below. [![camunda boundary error event](https://thecattlecrew.net/wp-content/uploads/2014/06/camundaboundaryerrorevent.png)](https://thecattlecrew.net/wp-content/uploads/2014/06/camundaboundaryerrorevent.png)camunda boundary error event #### Use of Drools Expert We have embedded the rule engine inside our Spring application by adding the necessary project dependencies to our Maven project, too. Afterwards we add Business Rule Tasks to the BPMN 2.0 process model for use of the rule engine as shown below. [![camunda BPM Business Rule Task](https://thecattlecrew.net/wp-content/uploads/2014/06/camundabpmwithdrools.png)](https://thecattlecrew.net/wp-content/uploads/2014/06/camundabpmwithdrools.png)camunda BPM Business Rule Task The implementations are linked as delegates, too. First a KnowledgeBase (Production Memory) with a corresponding business rule file (\*.drl) is created. We defined business rule files for both cases and add these files to our project as resources. Following code snippet shows the part for reacting to presence of the user ‚jack‘. \[code wraplines=“false“ language=“text“ collapse=“true“\] package com.opitz.iotprototype import com.opitz.iotprototype.entities.User; import java.util.HashSet; rule „Switch ON special rooms for jack“ when u : User( username == „jack“ ) then HashSet specials = new HashSet(); specials.add( „meetingroom“ ); specials.add( „office123“ ); insert( specials ); System.out.println( „## drools: special rule to switch ON special rooms for jack ##“ ); end \[/code\] Of course, it’s possible to store these files elsewhere outside the project. The next steps were to create a new session (Working memory) by the production memory and add the current data, so-called facts, to the working memory. This has the effect that the business rule engine applies pattern matcher on both memories and response the matched results in so-called agenda. Afterwards we filter out the resulted plug names from the session. Following image illustrates the mentioned parts of Drools Expert. [![Drools Expert overview](https://thecattlecrew.net/wp-content/uploads/2014/06/businessruleengine.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/06/businessruleengine.png)Drools Expert overview #### Accumulated Experience We have noticed that such heterogeneous systems need some new management tasks, e.g., device management, and even more alignment among different areas. Another point is that we embedded camunda BPM inside our Spring application and communicate with the process engine by the Java API. Alternatively it’s possible to separate camunda BPM and Drools Expert from Spring and use camunda REST-API to communicate with the process engine. In our prototype, we have only a few business rules. So it takes some time to parse these few rules, which is not adequately. A rule engine is more efficient for complex rules with a number greater than 25. Thus whenever a device trigger an event it’s processed by Oracle CEP and fired via REST to our Spring application. Next it’s forwarded to camunda BPM which use Drools Expert to determine special rules for given user and execute it. As you can see, integration of well-established technologies like Java, Spring and REST with the world of IoT is really possible. Finally, the interaction among already established technologies and IoT enable new business and technical possibilities for companies and become more important soon. If you would like to check the source code, look on [GitHub](https://github.com/Ineffective/Pi-jAutomation433) for our project. Or check out the other parts of this series: - [Introduction (part 1)](https://thecattlecrew.net/2014/06/18/opitz-consultings-own-iot-prototype-to-demonstrate-capabilities-part-1/ "OPITZ CONSULTING") - [an architectural overview (part 2)](https://thecattlecrew.net/2014/06/18/iot-prototype-an-architectural-overview-part-2/ "IoT prototype ") - [low level thoughts on Oracle CEP Embedded (part 3)](https://thecattlecrew.net/2014/06/18/iot-prototype-low-level-thoughts-on-oracle-cep-embedded-part-3/ "IoT prototype ") - [low-level thoughts about the 433mhz communication (part 4)](https://thecattlecrew.net/2014/06/18/iot-prototype-low-level-thoughts-about-the-433mhz-communication-part-4/ "IoT prototype ") - [Retrospective. What did we learn. What did we miss. What should also be considered (part 5)](https://thecattlecrew.net/2014/06/18/iot-prototype-retrospective-what-did-we-learn-what-did-we-miss-part-5/ "IoT prototype ") **Kategorien:** Architecture & Process Models **Schlagwörter:** BPM, Camunda, English, IoT --- ### [Oracle BPM 12c - Quick Start Installation (uncensored)](https://thecattlecrew.net/2014/06/28/oracle-bpm-12c-quick-start-installation-uncensored/) **Published:** Juni 28, 2014 **Author:** Danilo Schmiedel **Content:** **Getting started in 15 minutes!** One of the challenges with previous releases was, that SOA & BPM composites couldn’t be deployed and tested on the JDeveloper integrated Weblogic server. Therefore a separate installation of SOA/BPM Suite or a virtual image was necessary to start developing. Now with the new release Oracle introduced a single-click installer for SOA & BPM Suite. Among other new features (like debugging & testing capabilities, templating, optimized foodprint, etc.) this really helps to increase developer productivity. The video below demonstrates that with Oracle SOA & BPM 12c it just takes 15 minutes to get started – install JDeveloper, start the Weblogic server, develop a simple Hello World, deploy the process and test it from Enterprise Manager. \[youtube https://www.youtube.com/watch?v=JoPOSAt2VGo&w=560&h=315\] Do you feel inspired? Just download the software from OTN and try it yourself ([SOA-Download](http://www.oracle.com/technetwork/middleware/soasuite/downloads/index.html); [BPM-Download](http://www.oracle.com/technetwork/middleware/bpm/downloads/index.html)). Have fun! **Kategorien:** Architecture & Process Models **Schlagwörter:** BPM, Oracle DB, Oracle FMW, Weblogic --- ### [OSB: Deleting corrupt projects](https://thecattlecrew.net/2014/07/04/osb-deleting-corrupt-projects/) **Published:** Juli 4, 2014 **Author:** Bernhard Mähr **Content:** Usually it is no problem to delete OSB projects from the server. This can be done by the sbconsole. But today we had a problem with a misconfigured OSB project. There was no possibility to modify the project, because activating the changes always resulted to a error message. Deleting was not possible and overwriting with a correct project failed also. Additionally the project had some influences to other projects and lead to crashes on them. Before doing a complete reinstallation of the OSB I wanted to try to fix this deadlock. On the Weblogic I found some mysterious deployed EAR files, but stopping and undeploying them didn“™t have an effect. After some searching I finally found the folder /oracle/fmwhome/user\_projects/domains/dev\_soasuite/osb/config/core. Inside the folder there where a some folders named like the deployed projects and some additional folders. I decided to delete all folders with names matching to the names of the folders of my deployed (and sometimes previously deployed!) projects and leaving the folders - \_binary - default - \_index - \_static - System unchanged. Of course I did this while the OSB was shut down. After starting up all projects in the sbconsole were disappeared and I didn“™t observe any problems after this interference. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Integration **Schlagwörter:** English, Oracle FMW, Service Bus --- ### [OSB: Java Callout with XML input and output parameter](https://thecattlecrew.net/2014/07/09/osb-java-callout-with-xml-input-and-output-parameter/) **Published:** Juli 9, 2014 **Author:** Bernhard Mähr **Content:** With the Oracle Service Bus (OSB) it is possible to extend the functionality by using java callouts. Java callouts are static operations implemented in Java and packaged in a jar file. The jar file and all dependencies have to be included into the OSB project. Then it is possible to select the operation in the java callout node. Basic types like int and String are supported for the parameters and the return value of the callout (the full list and a good tutorial is available at [Simple Java Callout Example](http://soawork.blogspot.de/2013/03/osb-java-callout-simple-example.html "Simple Java Callout Example")). But much more interesting, because in OSB everything is about XML processing, is to use XML snippets for parameter and return value. First we create a proxy service with a java callout. [![BLOG_OSB_JavaColloutXML_01](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_javacolloutxml_01.png?w=300)](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_javacolloutxml_01.png) Then we implement the java class for the java callout. The static method called by the OSB: 1 public static XmlObject test(String name, final XmlObject inputXmlData) { 2 Element inputElement = (Element) inputXmlData.getDomNode().getFirstChild(); 3 processInput(inputElement); 4 final XmlObject result = createOutput(); 5 return result; 6 } We need a method processing the input XmlObject and doing something with the containing elements: 1 private static void processInput(Element inputElement) { 2 // Iterate over input 3 final NodeList fieldsNodeList = inputElement.getChildNodes(); 4 for (int i = 0; i < fieldsNodeList.getLength(); i++) { 5 final Node fieldsNode = fieldsNodeList.item(i); 6 if (fieldsNode.getNodeType() == Node.ELEMENT\_NODE) { 7 String nodeName = fieldsNode.getLocalName(); 8 if (nodeName == null) { 9 nodeName = fieldsNode.getNodeName(); // Depends on XML library 10 } 11 // Do something with it 12 } 13 } 14 } For the return value we create a new XmlObject containing e single resultElement element. Inside this element the real return values are located. 1 private static XmlObject createOutput() { 2 // Create XmlObject and wrapping element 3 final XmlObject result = XmlObject.Factory.newInstance(); 4 final Node resultDomNode = result.getDomNode(); 5 final Document resultDocument = resultDomNode.getOwnerDocument(); 6 final Element resultElement = resultDocument.createElement(„resultElement„); 7 resultDomNode.appendChild(resultElement); 8 // Create result nodes 9 for(int i=0; i<10; i++) { 10 String name = „test„ + i; 11 String value = Integer.toString(i); 12 final Element element = resultDocument.createElement(name); 13 resultElement.appendChild(element); 14 element.appendChild(resultDocument.createTextNode(value));; 15 } 16 return result; 17 } After compiling this class to a jar file and adding the jar file, xmlbeans and stax-api to the OSB project we can select our implemented method inside the java callout. [![BLOG_OSB_JavaColloutXML_02](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_javacolloutxml_02.png?w=300)](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_javacolloutxml_02.png) Finally we can deploy the whole thing to OSB and test it with the debug window. [![BLOG_OSB_JavaColloutXML_03](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_javacolloutxml_03.png?w=300)](https://stumblingblog.files.wordpress.com/2014/07/blog_osb_javacolloutxml_03.png) Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Integration **Schlagwörter:** English, Oracle FMW, Service Bus --- ### [OWSM Custom Assertion zur Absicherung einzelner Services per IP-Adresse](https://thecattlecrew.net/2012/04/05/owsm-custom-assertion-zur-absicherung-einzelner-services-per-ip-adresse/) **Published:** April 5, 2012 **Author:** **Content:** An diesem Beispiel soll die Erstellung einer OWSM (Oracle Web Services Manager) Custom Assertion vorgestellt werden. Die Custom Assertions erlauben es, nahezu beliebige Policies zu erstellen, die wie die von Oracle vorgefertigten Policies auf Service-Endpunkte, SOA Komponenten oder auch Service-Referenzen angewendet werden können. Typischerweise kümmern sich diese Policies um Authentifizierung und Autorisierung. Unser Anwendungsfall: wir möchten einen bestimmten Service nur für bestimmte IP-Adressen zugreifbar machen. Die Vorstellung ist, dass wir eine Liste mit gültigen IP-Adressen für den jeweiligen Service konfigurieren. Alle Requests, die von anderen Adressen kommen, sollen abgelehnt werden. Diese Funktionalität ist in der SOA Suite leider nicht Out-Of-The-Box vorhanden. ### 1. Projekt-Setup Um das Projekt aufzusetzen wird in JDeveloper einfach ein Standard-Java-Projekt erstellt. Bevor die Entwicklung starten kann, müssen einige Bibliotheken für OWSM und SOA in den Build-Pfad eingebunden werden. Die genaue Beschreibung spare ich mir an dieser Stelle – wer möchte kann jederzeit die aktuelle Liste aus dem fertigen Projekt (siehe unten) kopieren (Tipp: Einfach die .jpr-Datei mit einem Texteditor bearbeiten und sämtliche Library References rüberkopieren – nach einem Refresh in JDev, sind die Bibliotheken dort bekannt). ### 2. Grundstruktur der Assertion-Klasse Grundsätzlich ist eine Custom Assertion lediglich eine einzige Klasse, die von `oracle.wsm.policyengine.impl.AssertionExecutor` erbt. Hier ist unser erstes Grundgerüst: \[code language=“java“\] public class ClientIpAssertion extends AssertionExecutor { private final static Logger LOG = Logger.getLogger(ClientIpAssertion.class.getName()); protected IAssertion mAssertion = null; protected IExecutionContext mEcontext = null; protected oracle.wsm.common.sdk.IContext mIcontext = null; public IResult execute(IContext iContext) { // Hier wird die Assertion ausgefuehrt } public void init(IAssertion iAssertion, IExecutionContext iExecutionContext, IContext iContext) { mAssertion = iAssertion; mEcontext = iExecutionContext; mIcontext = iContext; } public void destroy() { } } \[/code\] Die Methode `init()` wird vom OWSM zum Initialisieren aufgerufen. Hier kommen schonmal grundsätzlich einige Umgebungsobjekte mit, die später noch wichtig sind, um z.B. die Parameter auszulesen. Die Methode `destroy()` wird beim Zerstören der Klasse aufgerufen. Falls man irgendwelche Ressourcen belegt hat, kann man diese hierin freigeben. ### 3. Metadaten Neben der Implementierung der Assertion benötigt man noch eine XML-Datei (ClientIpAssertion.xml) mit einigen Metadaten zur Assertion. \[code language=“xml“\] com.opitzconsulting.clientipassertion.ClientIpAssertion 127.0.0.1 \[/code\] Hierin wird z.B. die ID der Assertion festgelegt (hier: „ClientIp“), woran die Policy angehängt werden kann (hier: „generic“, sprich kann überall verwendet werden – man könnte es auch auf Service-Endpunkte, SOA Komponenten oder SOA Referenzen einschränken) und weitere allgemeine Infos wie ein Anzeigename, Beschreibung, usw. Im Tag „orawsp:Implementation“ wird der vollständige Name der Implementierungsklasse angegeben. Besonders interessant ist der nächste Abschnitt, der die möglichen Konfigurationsparameter der Assertion zusammen mit Standardwerten enthält. Hier: Ein Parameter „allowedIpAddresses“ vom Typ „string“ mit dem Standardwert „127.0.0.1“. Diese Konfigurationsparameter können später im Enterprise Manager konfiguriert werden, wenn man sich aus den Assertions eine eigene Policy zusammenbaut (siehe Deployment). ### 4. IP-Vergleich Kommen wir zum Kern der Assertion: Vergleich der Client IP Addresse mit einer Liste von erlaubten IP-Addressen. Da dieser Vergleich für jeden Aufruf ausgeführt werden muss, erfolgt die Implementierung vollständig in der execute()-Methode. \[code language=“java“\] public IResult execute(IContext iContext) { IResult result = new Result(); result.setStatus(IResult.FAILED); // Abschnitt A IMessageContext.STAGE stage = ((IMessageContext)iContext).getStage(); LOG.fine(„stage=“ + stage); if (stage != IMessageContext.STAGE.request) { LOG.fine(„Nothing to process on this stage“); result.setStatus(IResult.SUCCEEDED); return result; } // Abschnitt B SOAPBindingMessageContext soapbindingmessagecontext = (SOAPBindingMessageContext)iContext; String remoteAddress = soapbindingmessagecontext.getRemoteAddr(); String\[\] allowedIpAddresses = new String\[\] { „127.0.0.1“ }; boolean clientIpValid = false; for (String allowedIpAddress : allowedIpAddresses) { if (allowedIpAddress.equals(remoteAddress)) { clientIpValid = true; } } // Abschnitt C if (clientIpValid) { result.setStatus(IResult.SUCCEEDED); } else { WSMException exception = new WSMException(„Client IP address “ + remoteAddress + “ is not allowed“); result.setFault(exception); result.setStatus(IResult.FAILED); } return result; } \[/code\] Als allererstes initialisieren wir ein `IResult`-Objekt mit einem Fehlerstatus – per Default soll ein Fehler zurückkommen. Im Abschnitt A geht es zunächst darum, zu prüfen, in welchem Stage wir uns befinden. Die Policy wird grundsätzlich für Request und Reply ausgeführt. Da für unsere Policy nur der Request Stage interessant ist geben wir für alle anderen Fälle ein `SUCCEEDED `zurück und beenden an dieser Stelle die Bearbeitung. In Abschnitt B holen wir uns zuerst die Remote IP Addresse aus dem `SOAPBindingMessageContext`. Hinweis: Es könnte auch sein, dass hier kein `SOAPBindingMessageContext` vorliegt, falls der Aufruf nicht über ein SOAP Binding erfolgt, sondern z.B. über ein Direct Binding. Dieser Fall wird hier vernachlässigt. Dann legen wir – vorerst hardcodiert – ein Array mit gültigen IP-Adressen ein. Trifft der Vergleich einer IP-Adresse dieser Liste mit der Remote-Adresse zu, so wird die Variable clientIpValid auf true gesetzt. In Abschnitt C wird ein entsprechendes Result gesetzt auf Basis von `clientIpValid`. Interessant ist hier vor allem der Fehlerfall. Hier sollte man eine brauchbare Fehlerbeschreibung eintragen, da diese bei Fehlschlag an den Aufrufer zurückgesandt wird. Hinweis: Es gibt keinen Flow Trace und keine Composite Instance, falls eine der eingehenden Policies fehlschlägt – dadurch wird diese Fehlermeldung doppelt wichtig, wenn man nicht lange Zeit Logs durchwühlen möchte. Die Assertion kann nun deployed werden und wird nur noch Requests von 127.0.0.1 durchlassen. ### 5. Parameter übergeben Natürlich wollen wir die IP-Adressen nicht hardcodieren, vor allem, weil man dann für jede Ü„nderung der IP-Adressen die komplette SOA Suite neustarten müsste – außerdem kann man die Assertion dann nicht wiederverwenden. Wir haben den Parameter in den Metadaten oben bereits definiert. Nun brauchen wir also noch eine Möglichkeit, diesen in der Assertion auszulesen. Dazu verwenden wir folgendes Code-Schnipsel: \[code language=“java“\] private Properties configProps = new Properties(); private void retrieveConfiguration() { IAssertionBindings bindings = ((SimpleAssertion)(mAssertion)).getBindings(); if (bindings != null) { List cfgl = bindings.getConfigs(); if (!cfgl.isEmpty()) { IConfig cfg = cfgl.get(0); List configProperties = cfg.getProperties(); if (configProperties != null) { for (IProperty configProperty : configProperties) { String propName = configProperty.getName(); String propValue = configProperty.getValue(); if (propValue == null || propValue.trim().isEmpty()) propValue = configProperty.getDefaultValue(); if (propValue != null) configProps.setProperty(propName, propValue); } } } } } public void init(IAssertion iAssertion, IExecutionContext iExecutionContext, IContext iContext) { mAssertion = iAssertion; mEcontext = iExecutionContext; mIcontext = iContext; retrieveConfiguration(); // Dieser Aufruf wurde hinzugefügt } \[/code\] Diese Methode sollte am Besten aus der `init()`-Methode aufgerufen werden, da OWSM die `init()`-Methode immer aufrufen wird, wenn eine Ü„nderung der Konfiguration erfolgt und sich somit die Policyversion erhöht. Nun stehen alle Properties in dem privaten Property-Objekt `configProps` und können von dort verwendet werden. Da wir davon ausgehen, dass hier eine „,“-separierte Liste mit IP-Adressen drin steht, ersetzen wir unsere zuvor hardcodierte Liste durch folgendes: \[code language=“java“\] String\[\] allowedIpAddresses = ScenarioUtils.getConfigPropertyValue( „allowedIpAddresses“, soapbindingmessagecontext, configProps, null) .split(„,“); \[/code\] Und schon wird die konfigurierte Liste an erlaubten Adressen für die Prüfung herangezogen. ### 6. Deployment Das Deployment erfolgt mit den folgenden Schritten: - JAR mit der Assertion in `DOMAIN_HOME/lib` kopieren - SOA Suite neustarten - Im EM unter Weblogic-Domain -> Web Services -> Policies -> Assertion Templates die Assertion importieren (`ClientIpAssertion.xml`) - Im EM unter Weblogic-Domain -> Web Services -> Policies eine neue Policy erstellen - In die Policy die Assertion „custom/ClientIp“ einfügen und unten unter „Assertion-Inhalt“ die Liste mit IP-Addressen vom Standard-Wert aus abändern Nun kann die Policy analog anderer Sicherheitspolicies an Service-Endpunkte angehängt werden, die dann nur noch von bestimmten IP-Adressen aus aufgerufen werden können. ### Zusammenfassung Die Entwicklung eigener Policies ist immer dann hilfreich, wenn man in der SOA Suite eine bestimmte Anforderung in Bezug auf Security umsetzen möchte, die nicht Out-Of-The-Box geboten ist. Auf diese Weise haben wir beispielsweise auch eine Weitergabe der Authentifizierung im Payload realisiert, so dass unsere BPEL-(Geschäfts-)Prozesse frei von Authentifizierungsdetails bleiben. Das komplette Projekt mit der oben erstellen Policy gibt es hier zum Download: [ClientIPAssertion.zip](http://dl.dropbox.com/u/1963578/ClientIPAssertion.zip) **Kategorien:** Architecture & Process Models, IT-Security **Schlagwörter:** IT Security, JDeveloper, Oracle DB, OWSM --- ### [Oracle Identity Management - 30000 feet view](https://thecattlecrew.net/2012/05/25/oracle-identity-management-30000-feet-view/) **Published:** Mai 25, 2012 **Author:** Torsten Winterberg **Content:** OIM (Oracle Identity Management) consists of a large set of useful tools, grouped in three areas: Identity Governance, Access Management and Directory Services. [![](https://thecattlecrew.net/wp-content/uploads/2012/05/idm.png?w=1024 "idm")](https://thecattlecrew.net/wp-content/uploads/2012/05/idm.png) **OIM: Oracle Identity Manager** Used for account provisioning. On- and off- boarding of new users. **OAM: Oracle Access Manager** Used to protect URLs. **OES: Oracle Entitlement Server** Used for role and privilege based access. **OIF: Oracle Identity Federation** Used for cross domain authorization (google.com/amazon.com). **Enterprise Single Sign On** Used to Auto-Fill legacy login dialogs **Adaptive Access Manager** Used for intrusion detection (ip localization, „¦) **OEG: Oracle Enterprise Gateway** Used as XML firewall (large data attacks, schema attacks, „¦). SOAP/REST translation. **Identity Analytics** Used for achieving data quality if organizational data is too bad. **Directory Server EE** LDAP server from SUN **OUD: Oracle Unified Directory** New Java-based LDAP server **OID: Oracle Internet Directory** Classic database-based LDAP server **OVD: Oracle Virtual Directory** Used to achieve combined view on several different ldap servers **OPSS: Oracle Plattform Security Services** Extension of JAAS. Offers API for all Oracle IDM products. **Oracle Connect:** New tooling for iOS and Android based security **Kategorien:** IT-Security --- ### [Macht SOA ohne MDM Sinn?](https://thecattlecrew.net/2012/05/25/macht-soa-ohne-mdm-sinn/) **Published:** Mai 25, 2012 **Author:** rolfscheuch **Content:** Der Titel ist gewiß etwas reisserich „“ bringt die Kernfrage aber auf den Punkt. In etlichen Retrospektiven der SOA-Programme taucht immer wieder ein Problem auf. Wie gehen wir mit den grundlegenden Business Services um, die Daten und vor Allem Stammdaten betreffen? Zur Einstimmung auf die Herausforderung eine kurze Einleitung. Ein wesentlicher Nutzen der SOA liegt in der losen Kopplung der IT-Komponenten. Hierdurch wird die Wiederverwendung der Komponenten forciert und die Flexibilität beim Einsatz dieser Komponenten zur Unterstützung neuer Funktionalitäten bzw. Prozessabläufe vereinfacht. Hierbei werden allgemeingültige Komponenten (bzw. Services) für die konsistente Datenpflege und Abfrage der Stammdaten benötigt. Es werden zwei unterschiedliche Sichten hierdurch unterstützt: - Wiederverwendbare Geschäftslogik zur Pflege und Validierung der Stammdaten (Stammdaten Business Services) - Wiederverwendbare Informationen zur Nutzung in den Geschäftsprozessen (Stammdaten Information Services) Führt man imRahmeen der SOA eine Service-Dekomposition durch, erkennt man, dass im Rahmen der wiederverwendbaren Services auch Dienste benötigt werden, die servicedomänenübergreifend zentrale Aufgaben für die Verwaltung des Lebenszyklus der Stammdaten übernehmen. In diesem Zusammenhang wird man auf der Ebene der Datenzugriffe, auch unabhängig von einem Stammdatenvorgaben-Vorhaben, auf typische Schwierigkeiten bei der Verwaltung und Pflege der Stammdaten stoßen: - Probleme bei der einheitlichen Prüfung der Qualität der Stammdaten - Performanceprobleme bei der Propagierung der Daten in die Sub-Systeme - Herausforderungen beim Datenschutz und der Datensicherheit in Abhängigkeit vom Lebenszyklusstadium der Daten **Stammdaten Business Services** Der Zugriff auf Stammdatenobjekte wie Produkt, Kunde oder Geschäftspartner wird über alle Unternehmensbereiche und somit quer zu den Funktions- und Verwaltungsbereichen benötigt. Jan Werner Schemm (siehe auch „Zwischenbetriebliches Stammdatenmanagement“, Springer, 2009) meint hierzu, dass „durch ihren hohen Wiederverwendungswert und die vergleichsweise einfache Standardisierung bildet der Zugriff auf Stammdatenobjekte ideale Servicekandidaten.“ Dieser Meinung sind auch die Masons oft SOA, die die Zugriffe auf Stammdatenobjekte als „Business Entity Services“ auffassen und aufzeigen, dass Stammdatenservices einen erheblichen Anteil der entwickelten Dienste in der SOA ausmachen. Hier zudem ist auch ein Trend erkennbar, der wiederum Schemm schön zusammenfasst: „Die zu beobachtende Bündelung von Stammdatenservices in eigenständigen Anwendungsdomänen nimmt die Entwicklung von Applikationsarchitekturen vorweg: Zukünftig werden zentrale Stammdatensysteme, die Dienste für den Zugriff auf globale Stammdatenobjekte anbieten, eine noch bedeutendere Rolle in den Anwendungsarchitekturen spielen“ . Somit wird das Stammdatenmanagement ( MDM, Master Data Management) zu einen fundamentalem Baustein der SOA selbst. Mit Etablierung einer SOA im Unternehmen wird die Häufigkeit der Nutzung von zentralen Stammdatendiensten steigen und somit implizit die Wiederverwendung. Somit ist die Etablierung zentraler verwalteter Dienste für den Datenzugriff und deren Verarbeitung ein sinnvoller nächster Schritt. [![](https://thecattlecrew.net/wp-content/uploads/2012/05/mdm12.jpg "mdm1")](https://thecattlecrew.net/wp-content/uploads/2012/05/mdm12.jpg) **MDM Information Services** Bei der Service-Dekomposition entsteht die Notwendigkeit von zentralen Stammdaten-Services. Diese unterstützen den weiterführenden, eher strategischen Ansatz der Implementierung einer „Information-as-a-Service (IaaS)“. Die grundlegende Idee ist recht einfach: Damit nicht jede Anwendung oder jeder Service selbst den Zugriff auf die Daten implementieren muss, wird eine Facade genutzt, die den Zugriff an das IaaS delegiert. Das könnte man sogar als eine Virtualisierung der Datenzugriffe sehen, da die Datenquellen nun transparent zu der aufrufenden Schicht sind. So erlangt man eine zentrale Kontrolle über die typischen CRUD-Operationen auf den benötigten Stammdaten. Die Kontrolle über die Validierungen ist nun gewährleistet und die Inkonsistenzen bei der Wartung der unterschiedlichen Anwendungen und Services wurden gelöst. [![](https://thecattlecrew.net/wp-content/uploads/2012/05/mdm2.jpg "mdm2")](https://thecattlecrew.net/wp-content/uploads/2012/05/mdm2.jpg) Verfolgt man diesem Ansatz im Rahmen der MDM, so können über technische bzw. organisatorische Maßnahmen die drei grundlegenden Herausforderungen durch den Ansatz „Information-as-a-Service (IaaS)“ bewältigt werden. Aus Sicht des Konsumenten bedeutet dies: **Definition:** Die Bedeutung (Semantik) von Stammdaten und deren Attributen müssen einheitlich und konsistent implementiert sein. Hierzu gehören auch die Verfügbarkeit der Definition und die Eineindeutigkeit der selbigen Definition. **Qualität**: Die Prüfung der Datenqualität kann jetzt auf einer „virtualisierten“ Plattform stattfinden, komplett transparent für den Consumer, der die Stammdaten verändern. Das Repository der IaaS sichert eine gemeinsame Semantik und ein Regelwerk für die Validierung. Auch dies verhindert Inkonsistenzen. **Governance**: Der letzte Punkt ist nun das Management des Lebenszyklus der Services der IaaS. Dieses lässt sich sofort über die etablierten Governance-Ansätze für das Management von Services im SOA-Umfeld abdecken. Zusammengefasst folge ich hieraus, dass eine SOA ohne MDM-Ansätze immer ein wenig zu kurz geraten wird und eine Unzufriedenheit bei der Nutzbarkeit (Datenqualität) der Stammdaten bestehen bleiben wird. Die Empfehlung kann nur lauten: Im Rahmen der SOA auch das Thema Stammdatenmanagement behutsam anzugehen. Ein kurzer **Werbeblock** in eigener Sache: Das Buch „Master Data Management: Strategie, Organisation, Architektur“ () beschreibt, wie man zu einer abgestimmten Vision in seinem MDM-Vorhaben gelangt und wie man messbare Ziele entwickelt. Es werden Methoden und Vorgehensweisen beschrieben, damit schon bei der Planung des MDM-Vorhabens ein klares Bild über die notwendige Aufbau- und Ablauforganisation entsteht und das MDM-Vorhaben durch einen passenden Architekturentwurf unterstützt wird, sodass die meist mehrjährige Entwicklung zielgerichtet erfolgen kann. Letztlich beschreiben wir Ansätze zur Entwicklung einer Einführungsstrategie und Roadmap für MDM. Als Ergebnis ist ein fast 500-seitiges Handbuch zur Planung von MDM entstanden **Kategorien:** Architecture & Process Models **Schlagwörter:** IaaS, MDM, Stammdaten --- ### [Standard-based integration of human interaction in SOA](https://thecattlecrew.net/2012/05/26/standard-based-integration-of-human-interaction-in-soa/) **Published:** Mai 26, 2012 **Author:** Sven Bernhardt **Content:** IT infrastructures and systems following the SOA paradigm are build upon standards. In such scenarios BPMN 2.0 can be used for the automation of business processes for example. The processes can be executed by a process engine. In such business processes the integration of human actors is often needed, to make complex decisions that cannot be made by a machine. The communication between the human actor and the process engine is done by tasks, which are often managed by separate task engines. Authorized users are able to work on the tasks using a provided task UI, a so called inbox or tasklist application. As one can see there are at least two consumers for the services provided by a task engine: the task UIs and the process engines. Although a specification, the WS-HT (WS Human Task) specification, for the standard-based integration of human interaction in SOA is available, task engine interfaces are vendor-specific and not standard-based actually, e.g. using RMI or native Java method invocation for communication. This leads to the following problems: - Portability issues - Interoperability issues - Tight coupling To deal with the problems of vendor-specific interfaces in the area of human interaction, I defined a adapter framework, the Generic Human Interaction Adapter (GHIA), which provides a interface that is based on the definitions propagated by the WS-HT specification. Features of the GHIA-Framework are a standard-based interface (SOAP based on WS-HT and REST) and the opportunity to transparently communicate with more than one task-engine, e.g. for the synchronization of different inboxes. Scenarios where the GHIA-Framework can be used, delivering a great benefit, are: - Integration scenarios (more than one task-engine is used) - Decoupling scenarios (e.g. for decoupling task UIs from the vendor-specific inerfaces) - Migration scenarios (when moving from one release to a higher one, to ensure that long running process with human interaction can be ended within the older versioned plattform) To validate the framework I have implemented a prototyp, using a subset of the operations defined by WS-HT, where the task-enignes from the Oracle BPM Suite 11g and the Activiti BPM Platform 5.8 are integrated transparently behind one standard-based interface. For this scenario using the GHIA framework leads to the following architectural layout: [![](https://thecattlecrew.net/wp-content/uploads/2012/05/with_ghia.png?w=300 "Architecture using the GHIA framework")](https://thecattlecrew.net/wp-content/uploads/2012/05/with_ghia.png) The prototyp shows that the intended expectations I made before starting the implementation of the framework could be met. As a result a lightweight and easily extendable framework has been created which will be refined, and extended over the next months. Interested readers will be kept updated about the further evolution of the GHIA framework in this blog. **Kategorien:** Architecture & Process Models **Schlagwörter:** BPM --- ### [OPITZ CONSULTING gained several new Oracle Specializations](https://thecattlecrew.net/2012/06/22/opitz-consulting-gained-several-new-oracle-specializations/) **Published:** Juni 22, 2012 **Author:** Torsten Winterberg **Content:** We express our increased commitment to Oracle and especially to Oracle Fusion Middleware with several new specializations. So currently we are specialized in: **Middleware** Oracle Application Development Framework (ADF) Oracle Application Grid 11g (Weblogic) Oracle Service-Oriented Architecture 11g (SOA) Oracle Unified Business Process Management 11g (BPM) Oracle Business Intelligence Foundation 10 (BI) **Database** Oracle Exadata Oracle Database 11g Oracle Database 11g Performance Tuning Oracle Real Application Clusters Oracle Data Warehousing **Server And Storage System** Oracle Linux 5 Oracle VM 2 **Kategorien:** Tech Events & Networking **Schlagwörter:** oracle --- ### [SOA Spezial 2 verfügbar - Industrialized SOA](https://thecattlecrew.net/2012/09/07/soa-spezial-2-verfugbar/) **Published:** September 7, 2012 **Author:** Torsten Winterberg **Content:** Die überarbeitete und ergänzte Neuauflage unseres SOA Spezial Sonderheftes ist nun erschienen, im Format einer kompletten Ausgabe des Business Technologie Magazins. Hier die Ankündigung des Verlags: [![](https://thecattlecrew.net/wp-content/uploads/2012/09/bt_soa.jpg "Cover Business Technology")](https://thecattlecrew.net/wp-content/uploads/2012/09/bt_soa.jpg) **Industrialized SOA „“ Thema des Business Technology Magazin 3.12** Auch wenn es ruhiger geworden ist um SOA, beerdigt ist das Konzept noch lange nicht. Ganz im Gegenteil, über die Jahre hat es einen neuen Maturity Level erreicht. Hype-Themen wie Cloud Computing oder Big Data haben SOA aus den Schlagzeilen verdrängt, aber „ersetzen die neuen Hype-Themen die Serviceorientierung nicht, sondern bauen darauf auf“. Die Autoren dieser zählen im deutschsprachigen Raum zu den SOA-Pionieren. Für diese Ausgabe von Business Technology haben Sie ihr kollektives Wissen zusammengetragen und eine einzigartiges Bild, des aktuellen Zustands von SOA geschaffen. Nach ihrer Überzeugung entwickelt sich SOA evolutionär weiter, in Richtung Fabrikansatz, in Richtung Industrialisierung, in Richtung „šganzheitliche Plattform“˜“ zu einer neuen Industrialized SOA. **Die Ausgabe 3.12 des BT Magazins bekommen Sie** als iPAD-App ([http://it-republik.de/business-technology/bt-magazin-ipad-app](http://it-republik.de/business-technology/bt-magazin-ipad-app "Link")), per Post ([http://it-republik.de/business-technology/bt-magazin-ausgaben/Industrialized-SOA-000516.html](http://it-republik.de/business-technology/bt-magazin-ausgaben/Industrialized-SOA-000516.html "Link")) oder am Kiosk! Weitere Informationen auf www.bt-magazin.de **Kategorien:** Architecture & Process Models **Schlagwörter:** News --- ### [Oracle Open World 2012: Our session about Oracle BPM / Oracle ADF Integration Best Practices](https://thecattlecrew.net/2012/10/11/oracle-open-world-2012-our-session-about-oracle-bpm-oracle-adf-integration-best-practices/) **Published:** Oktober 11, 2012 **Author:** Danilo Schmiedel **Content:** Many end-to-end business processes require human interactions within the process. For example, user interaction may be needed for approvals, exception management, or performing activities required to advance the business process. Before designing processes with human tasks in Oracle BPM Suite, it is important to understand the design and runtime concepts. A typical task consists of a subject, priority, task participants, task parameters or data, deadlines, notifications or reminders, and task forms. However in complex scenarios you might want to reuse some of these artifacts in order to ease maintenance, migrations and to improve the performance. During Oracle Open World 2012 we demontrated some of our Best Practices in the session „Oracle BPM / Oracle ADF Integration Best Practices“. We focused on reusability, separation of data and architecture design. [Andrejus Baranovskis](http://andrejusb.blogspot.de/2012/10/oow12-oracle-business-process.html) did a great job explaining Oracle ADF related topics. You can download our presentation from [inside-bpm-and-soa](http://inside-bpm-and-soa.blogspot.de/2012/10/oow-2012-oracle-bpm-oracle-adf.html) or [slideshare](http://de.slideshare.net/opitzconsulting/oracle-bpmadfintegrationoow2012schmiedelbaranovskisopitzconsultingred-samurai-consulting). **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM, Conference --- ### [BPM & Integration Days in München am 28.2. und 1.3.](https://thecattlecrew.net/2012/12/20/bpm-integration-days-in-munchen-am-28-2-und-1-3/) **Published:** Dezember 20, 2012 **Author:** Torsten Winterberg **Content:** Wir sind wieder mit einigen Vorträgen auf den nächsten BPM & Integration Days vertreten. Seien Sie gespannt auf die Urlaubsabenteuer unserer Kuh… 🙂 ![BPM & Integration](http://it-republik.de/konferenzen/bpm_integration_days2013/img/layout/teaser.png) http://bpm-integration-days.de/ BPM abgegrast – Eine Kuh geht auf Reisen Erleben Sie die maritimen Abenteuer unserer Kuh, und misten Sie gemeinsam mit uns den Stall aus. Was ist bereits ausgeschlachtet? Was käuen wir gerne wieder? BPM, BI, Mobile, Cloud und ACM gehören ins Gepäck und machen die Reise zu einem unvergesslichen Erlebnis, inkl. Livedemo. Danilo Schmiedel OPITZ CONSULTING Sven Bernhardt OPITZ CONSULTING Benjamin Huskic OPITZ CONSULTING **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM --- ### [Buchbesprechung zu "žProzessgesteuerte Anwendungen entwickeln und ausführen mit BPMN"œ](https://thecattlecrew.net/2013/01/14/buchbesprechung-zu-prozessgesteuerte-anwendungen-entwickeln-und-ausfuhren-mit-bpmn/) **Published:** Januar 14, 2013 **Author:** Torsten Winterberg **Content:** Untertitel: Wie flexible Anwendungsarchitekturen wirklich erreicht werden können. Von Volker Stiehl. Volker Stiehl führt in seinem neuen Buch sehr anschaulich und leicht verständlich in die Welt der prozessgesteuerten Anwendungen ein. Dabei bleibt er nicht nur auf theoretischem Niveau, sondern untermauert alle Kernaussagen mit praktischen Beispielen, was mir sehr gut gefallen hat. So erhält der Leser einen ausreichend tief gehenden Architekturüberblick, wie man fachliche Prozesse mit BPMN zur Ausführung bringen kann. Nicht immer ganz konform gehe ich mit den Aussagen zu „SOA-Services“, denen Volker Stiehl nicht die aus meiner Sicht notwendige tiefere Wertschätzung entgegenbringt. Das tut dem Buch aber keinen Abbruch, weil eine saubere „Servicevertrag-Implementierungsschicht“ eingeführt wird, die die eigentlichen Systeme wegkapselt, so dass es zunächst „egal“ ist, wie hier Systemzugriffe implementiert werden. Das spannendste an diesem Buch ist für mich die Sichtweise der SAP, die hier immer wieder durchscheint, auch wenn die Konzepte natürlich plattformneutral funktionieren. So wird stark der Fokus auf die Erstellung von prozessgesteuerten Anwendungen gelegt, mit dem Ziel, diese mehrfach in unterschiedlichen Anwendungslandschaften zu installieren und auf die dort vorliegenden Gegebenheiten anzupassen. Dazu passt, dass zu integrierende Systeme dann etwa mehrere SAP-Instanzen sein können. Dies steht im Gegensatz zu vielen prozessorientierten Projekten, die eine Mehrfachinstallation gar nicht zum Ziel haben, sondern die BPMN nutzen, um für den einen Fall die notwendige Flexibilität und Transparenz inkl. der gemeinsamen Sprache von Fachbereich und IT zu schaffen. Als starker Verfechter von BPMN zur Erstellung von prozessorientierten Anwendungen, also von BPMN-Modellierung mit dem Ziel der Prozessautomatisierung, kann ich die Lektüre dieses Buches trotzdem nur jedem ans Herz legen, da viele Denkansätze wichtig für das eigene Verständnis sind. Auch lässt sich die Entscheidung, was als „fachlicher“ Prozess, was als technischer Integrationslayer (auch in BPMN) umgesetzt werden sollte, damit besser für den eigenen Fall verstehen und auch begründen, warum man ggf. andere Ansätze gewählt hat. Daumen hoch! ![](http://ecx.images-amazon.com/images/I/41Q8Yt7LZXL._BO2,204,203,200_PIsitb-sticker-arrow-click,TopRight,35,-76_AA300_SH20_OU03_.jpg) **Kategorien:** Automation **Schlagwörter:** BPM, News --- ### [OSB 11g: Stuck Threads when using inbound database adapter](https://thecattlecrew.net/2013/02/20/osb-11g-stuck-threads-when-using-inbound-database-adapter/) **Published:** Februar 20, 2013 **Author:** Sven Bernhardt **Content:** Using a polling database adapter in a OSB proxy service, one may have noticed the following behaviour in Weblogic server: - an exception in the server logs about one or even more stuck threads like this: > *<\[STUCK\] ExecuteThread: '10' for queue: 'weblogic.kernel.Default (self-tuning)' has been busy for "705" seconds working on the request "weblogic.work.SelfTuningWorkManagerImpl$WorkAdapterImpl@21b9db0", which is more than the configured time (StuckThreadMaxTime) of "600" seconds. Stack trace:* > *Thread-118 „\[STUCK\] ExecuteThread: ’10‘ for queue: ‚weblogic.kernel.Default (self-tuning)'“ {* > *— Waiting for notification on: oracle.tip.adapter.db.InboundWork@21b8e86\[fat lock\]* > *java.lang.Object.wait(Object.java:???)* > *oracle.tip.adapter.db.InboundWork.run(InboundWork.java:498)* > *oracle.tip.adapter.db.inbound.InboundWorkWrapper.run(InboundWorkWrapper.java:43)* > *weblogic.work.ContextWrap.run(ContextWrap.java:39)* > *weblogic.work.SelfTuningWorkManagerImpl$WorkAdapterImpl.run(SelfTuningWorkManagerImpl.java:528)* > *weblogic.work.ExecuteThread.execute(ExecuteThread.java:203)* > *weblogic.work.ExecuteThread.run(ExecuteThread.java:170)* > *}>* - and/or server health state from OSB managed server changing from state „Ok“ to state „Warning“ Such a behaviour alerts administrators, thinking that something is wrong with the deployed applications or OSB services. Looking in the [Oracle documentation](http://docs.oracle.com/cd/E13159_01/osb/docs10gr3/jcatransport/transport.html#wp1107788 "OSB documentation") one can find the information that this is behaviour by design and that it can be ignored. To verify the OSB proxy service’s database adapter as the source for this the proxy service has to be simply disabled in OSB console. Doing so makes the stuck threads disappear. The behaviour seems strange at the – so why this? When defining an inbound database adapter, Weblogic threads are used to perform the polling on events occurring in the defined database. Because OSB is designed to deliver high performance and throughput, a number of threads, which depends on the *numberOfThreads* property in the adapter’s JCA file, is exclusively reserved for the database adapter to perform the inbound polling. Such reserved threads will, due to performance reasons, never be released and never be returned to the corresponding thread pool. After the configured thread timeout, which is by default about 600 seconds, the stuck thread behaviour occurs. Although this is the default behaviour, it is really confusing and could lead into serious problems, if real threading problems occur in deployed applications/services that are not caused by the adapter threads and which will not be noticed and handled in time. So what can be done to get rid of the stuck adapter threads? The Oracle documentation proposes to define a separate Work manager and configure this with the proxy service transport’s dispatch policy. To do so, the following steps has to be performed: - Define a custom global Work manager using weblogic console with the OSB managed server as deployment target [](https://thecattlecrew.net/wp-content/uploads/2013/02/work_manager.png)[![work_manager](https://thecattlecrew.net/wp-content/uploads/2013/02/work_manager1.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2013/02/work_manager1.png) - Configure the new defined Work manager to ignore stuck threads [![ignoreStuckThreads_wm_config](https://thecattlecrew.net/wp-content/uploads/2013/02/ignorestuckthreads_wm_config.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2013/02/ignorestuckthreads_wm_config.png) - Configure OSB proxy service transport’s dispatch policy to use the new defined Work manager [![OSB_proxy config](https://thecattlecrew.net/wp-content/uploads/2013/02/osb_proxy-config.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2013/02/osb_proxy-config.png) Afterwards the stuck threads behaviour caused the OSB proxy service or by its configured inbound database adapter should not show up again. **Kategorien:** Automation **Schlagwörter:** Oracle DB --- ### [Automate processes for knowledge workers with Oracle BPM Suite PS6](https://thecattlecrew.net/2013/04/08/automate-processes-for-knowledge-workers-with-oracle-bpm-suite-ps6/) **Published:** April 8, 2013 **Author:** Danilo Schmiedel **Content:** You introduced BPM in your company? All of your process automations are a huge success? Stop reading – this might be the wrong article for you. Your processes are unpredictable; complex; they keep on changing and they are difficult to model? The users of your software complain that they cannot make proper business decisions because they are forced to certain process steps? Your processes rely on worker knowledge and involve human participants? Good „“ with Oracle BPM Suite 11.1.1.7 and its new case management functionalities we are now ready to address those requirements. For more information read my article about this hot topic on [Inside BPM and SOA](http://inside-bpm-and-soa.blogspot.de/2013/04/new-case-management-functionalities-in.html). **Kategorien:** Automation **Schlagwörter:** ACM, BPM, Case Management, Oracle DB --- ### [Industrial SOA - An article series about service-orientation](https://thecattlecrew.net/2013/04/22/industrial-soa-an-article-series-about-service-orientation/) **Published:** April 22, 2013 **Author:** Danilo Schmiedel **Content:** Today we would like to point you to a new article series termed as „Industrial SOA“ authored by the „[Masons of SOA](http://www.soacommunity.com)„. The series is dedicated to the exploration of contemporary SOA topics and issues and highlights some of the more recent innovations in practice that will especially be of interest to those who want to learn some techniques that go beyond the academic essentials. > Abstract: *„SOA and service-orientation have laid the foundation for a variety of emergent service technology innovations, while the original building blocks of SOA and service-orientation continue to evolve by embracing fundamental service technologies, concepts and practices. These new technology innovations do not replace service-orientation; they use it as their basis. Service-orientation continues to evolve towards a factory approach, towards industrializing integrated platforms, such as BI, master data management (MDM), mobile front-ends, BPM, adaptive processes, Big Data and Cloud Computing „“ all of which add architectural layers upon SOA-based infrastructure. All of these technologies can interface via standardized data and functions, published as service contracts, in order to avoid redundancy „“ that’s service-orientation.“* [![Industrial SOA](https://thecattlecrew.net/wp-content/uploads/2013/04/servicetechnologymagazine.jpg?w=233)](https://thecattlecrew.net/wp-content/uploads/2013/04/servicetechnologymagazine.jpg) The 14 part series begins with a preface by Oracle veteran Juergen Kress, and then moves on to the first of thirteen articles. The articles are & will be published on [OTN](http://www.oracle.com/technetwork/articles/soa/ind-soa-toc-1934143.html) and the [Service Technology Magazine](http://www.servicetechmag.com/index). Send your feedback to [@twitter/dschmied](https://twitter.com/dschmied) #industrialSOA. **Kategorien:** Automation **Schlagwörter:** Articles, News --- ### [OPITZ startet BPM Roadshow im Juni 2013](https://thecattlecrew.net/2013/04/29/opitz-startet-bpm-roadshow-im-juni-2013/) **Published:** April 29, 2013 **Author:** Torsten Winterberg **Content:** Mit Business Process Management werden Sie schneller, transparenter, günstiger, … gääähn – alles schon gehört! Erleben Sie ein nicht ganz alltägliches Event mit OPITZ CONSULTING als Gastgeber für zwei höchst unterschiedliche Protagonisten: Zum einen **Camunda**, bekannt für die leichtgewichtige, pragmatische und Java-nahe Open-Source-Plattform camunda BPM. Und zum anderen **Oracle**, mit der hochskalierbaren Oracle BPM Suite als umfassende Lösung für prozessgesteuerte Anwendungen. [![BPM Roadshow](https://thecattlecrew.net/wp-content/uploads/2013/04/tmp.jpg)](https://thecattlecrew.net/wp-content/uploads/2013/04/tmp.jpg) Lernen Sie Einsatzgebiete und Nutzenversprechen dieser beiden aktuellen Business-Process-Management-Plattformen kennen. Finden Sie heraus, was zu Ihren Anforderungen am besten passt. Entdecken Sie, wie BPM viele Ihrer akuten Problemstellungen lösen kann. Diskutieren Sie mit den Fachleuten von Camunda, Oracle und OPITZ CONSULTING darüber, welche Vorteile Open-Source-Lösungen mit sich bringen und was die BPM-Lösung eines führenden Herstellers auszeichnet. Profitieren Sie dabei von den Erfahrungswerten unserer Experten, die aus ihrem Projektalltag berichten und über konkrete, erfolgreich gelöste Herausforderungen sprechen. Machen Sie sich selbst ein Bild und sehen Sie, wie viel Spaß BPM mit den richtigen Partnern machen kann! ****10.06.2013 | Berlin**** **11.06.2013 | Hamburg** **25.06.2013 | Köln** **26.06.2013 | Bad Homburg** **27.06.2013 | München** [**Details und Anmeldung**](http://www.opitz-consulting.com/bpm_roadshow_2013.php) **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM --- ### [BPM: Open Source vs. Red Stack](https://thecattlecrew.net/2013/05/07/bpm-open-source-vs-red-stack/) **Published:** Mai 7, 2013 **Author:** Torsten Winterberg **Content:** [![roadshow](https://thecattlecrew.net/wp-content/uploads/2013/05/roadshow.png)](https://thecattlecrew.net/wp-content/uploads/2013/05/roadshow.png) Schönes Blog Posting von Jakob Freund, warum alle BPM-Interessierten diesen Showdown nicht verpassen sollten…: **Kategorien:** Tools & Methoden **Schlagwörter:** BPM --- ### [Industrial SOA - Now chapters 1 to 5 available](https://thecattlecrew.net/2013/07/03/industrial-soa-now-chapters-1-to-5-available/) **Published:** Juli 3, 2013 **Author:** Torsten Winterberg **Content:** You find us in Oracle Technet (OTN): And in Thomas Erl“™s Service Technology Magazine: Content: **Industrial SOA** is a 13-part article series focused on service orientation, written collaboratively by a group of recognized experts and community leaders in service oriented architecture. „SOA and service-orientation have laid the foundation for a variety of emergent service technology innovations such as cloud computing and big data, while the original building blocks of SOA and service-orientation continue to evolve by embracing fundamental service technologies, concepts and practices.“ - [Chapter 1: Industrial SOA](http://www.oracle.com/technetwork/articles/soa/ind-soa-preface-1934606.html) - [Chapter 2: SOA Blueprint](http://www.oracle.com/technetwork/articles/soa/ind-soa-1-blueprint-1934607.html) - [Chapter 3: Service Categories](http://www.oracle.com/technetwork/articles/soa/ind-soa-canonizing-language-1957510.html) - [Chapter 4: SOA Maturity](http://www.oracle.com/technetwork/articles/soa/ind-soa-maturity-1967696.html) - [Chapter 5: Enterprise Service Bus (ESB)](http://www.oracle.com/technetwork/articles/soa/ind-soa-esb-1967705.html) - Chapter 6: Security - Chapter 7: Transactions and Compensation - Chapter 8: SOA and User Interaction (UI) - Chapter 9: Mobile - Chapter 10: Events - Chapter 11: MDM and SOA - Chapter 12: BPM and ACM - Chapter 13: SOA and Cloud ![](https://thecattlecrew.net/wp-content/uploads/2013/07/204f2-image001-762361.png) **Kategorien:** Integration --- ### [OSB: Creating meaningful SOAP exceptions](https://thecattlecrew.net/2013/08/26/osb-creating-meaningful-soap-exceptions/) **Published:** August 26, 2013 **Author:** Bernhard Mähr **Content:** The OSB is usually used to transform and route messages. But sometimes something goes wrong and we have to return the caller an exception. This can happen in two situations: - We want to create a new exception because a special situation - We want to create a new exception because of an exception thrown by a called service The exceptions we want to create should be of the type soap:exception. And we want to include as much information as possible. For example information provided by the caller like user information or environment, time of the creation of the exception and id of the message the exception is a response for. It should also be possible to create the exceptions with a few lines of code. The best solution is to create a generic XQuery constructing the exception. Because we have two use cases we create two XQuerys: FaultParameterized.xq and FaultFromFault.xq. In a first step we add a pipeline with an assign the content of body to bodyIncoming. This is necessary because during the flow usually the content of the variable body is changed and it would not be possible to access the original incoming message. [![BLOG_OSB_Exception_01](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_01_thumb.png "BLOG_OSB_Exception_01")](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_01.png) Depending on the operation called we execute a branch of the operational branch. But if caller provides a non existing operation we want to return an exception. The implementation for this situation is the FaultParameterized.xq 1 xquery version „1.0“ encoding „UTF-8“; 2 (:: pragma bea:global-element-parameter parameter=“$inbound“ ::) 3 (:: pragma bea:global-element-parameter parameter=“$bodyIncoming“ ::) 4 (:: pragma bea:global-element-parameter parameter=“$messageID“ type=“xs:token“ ::) 5 (:: pragma bea:global-element-parameter parameter=“$errorType“ type=“xs:token“ ::) 6 (:: pragma bea:global-element-parameter parameter=“$errorCode“ type=“xs:token“ ::) 7 (:: pragma bea:global-element-parameter parameter=“$errorMessage“ type=“xs:string“ ::) 8 9 declare namespace con = „http://www.bea.com/wli/sb/context“; 10 declare namespace exception = „http://opitz-consulting.com/data/common/BusinessExceptionTypes/V1“; 11 declare namespace request = „http://opitz-consulting.com/data/common/RequestInformationTypes/V1“; 12 declare namespace soap = „http://schemas.xmlsoap.org/soap/envelope/“; 13 declare namespace xf = „http://opitz-consulting.com/data/common/transformations/FaultParameterized/“; 14 15 declare function xf:FaultParameterizied($inbound as element(\*), $bodyIncoming as element(\*), $messageID as xs:token, $errorType as xs:token, $errorCode as xs:token, $errorMessage as xs:string) as element(\*) { 16 17 soap:Serverfaultcode> 18 { $errorCode }faultstring> 19 20 { 21 element{ fn:expanded-QName(xs:string(namespace-uri($bodyIncoming/\*\[1\])), concat(data($inbound/con:service/con:operation), $errorType)) } { 22 element exception:faultHeader { 23 element request:Message { 24 element request:CreationDate { current-dateTime() }, 25 element request:MessageType { „fault“ }, 26 element request:MessageID { $messageID }, 27 element request:MessageVersion { „1.0“ }, 28 element request:MessageReferenceID { data($bodyIncoming//request:Message/request:MessageID) } 29 }, 30 element request:Caller { 31 element request:SourceSystemName { data($bodyIncoming//request:Caller/request:SourceSystemName) }, 32 element request:Environment { data($bodyIncoming//request:Caller/request:Environment) }, 33 element request:User { 34 element request:UserID { data($bodyIncoming//request:Caller/request:User/request:UserID) } 35 } 36 }, 37 element request:Operation { 38 element request:Operation { data($inbound/con:service/con:operation) } 39 }, 40 element request:Response { 41 element request:ProcessingInformation { 42 element request:ServerName { „unknown“ }, 43 element request:InstanceID { „unknown“ }, 44 element request:ExecutionContextID { „unknown“ } 45 46 } 47 } 48 }, 49 element exception:Fault { 50 element exception:ErrorCode { $errorCode } , 51 element exception:ErrorMessage { $errorMessage } 52 } 53 } 54 } 55 detail> 56 soap:Fault> 57 }; 58 59 declare variable $inbound as element(\*) external; 60 declare variable $bodyIncoming as element(\*) external; 61 declare variable $messageID as xs:token external; 62 declare variable $errorType as xs:token external; 63 declare variable $errorCode as xs:token external; 64 declare variable $errorMessage as xs:string external; 65 66 xf:FaultParameterizied($inbound, $bodyIncoming, $messageID, $errorType, $errorCode, $errorMessage) 67 We insert the replace into the default branch. [![BLOG_OSB_Exception_02](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_02_thumb.png "BLOG_OSB_Exception_02")](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_02.png) And provide the needed parameters. [![BLOG_OSB_Exception_03](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_03_thumb.png "BLOG_OSB_Exception_03")](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_03.png) Now we can try to make a call to the non-existing dummyOperation with this request: 1 2 3 4 2014-07-17T17:33:57.544+02:00request:CreationDate> 5 requestrequest:MessageType> 6 1234345667890request:MessageID> 7 1.0request:MessageVersion> 8 request:Message> 9 10 testSystemrequest:SourceSystemName> 11 DEVrequest:Environment> 12 13 testUserrequest:UserID> 14 request:User> 15 request:Caller> 16 request:Header> 17 message:dummyOperationRequest> We get this error response including some information we sent with the request: 1 xml version=“1.0″?> 2 3 4 5 6 soap:Serverfaultcode> 7 ERROR\_UNKNOWN\_OPERATIONfaultstring> 8 9 10 11 12 2014-07-17T17:56:38.249+02:00v12:CreationDate> 13 faultv12:MessageType> 14 5480523608781123005–3df23bc.1471b27a72f.-7f99v12:MessageID> 15 1.0v12:MessageVersion> 16 1234345667890v12:MessageReferenceID> 17 v12:Message> 18 19 testSystemv12:SourceSystemName> 20 DEVv12:Environment> 21 22 testUserv12:UserID> 23 v12:User> 24 v12:Caller> 25 26 27 v12:Operation> 28 29 30 unknownv12:ServerName> 31 unknownv12:InstanceID> 32 unknownv12:ExecutionContextID> 33 v12:ProcessingInformation> 34 v12:Response> 35 v11:faultHeader> 36 37 ERROR\_UNKNOWN\_OPERATIONv11:ErrorCode> 38 The requested operation is not implementedv11:ErrorMessage> 39 v11:Fault> 40 v1:UnknownOperation> 41 detail> 42 soapenv:Fault> 43 soapenv:Body> 44 soapenv:Envelope> 45 For the route it is possible to implement an error handler. In the error handler a correct exception should be created adding the additional information from the thrown error. In this situation we use FaultFromFault.xq 1 xquery version „1.0“ encoding „UTF-8“; 2 (:: pragma bea:global-element-parameter parameter=“$inbound“ ::) 3 (:: pragma bea:global-element-parameter parameter=“$bodyIncoming“ ::) 4 (:: pragma bea:global-element-parameter parameter=“$messageID“ type=“xs:string“ ::) 5 (:: pragma bea:global-element-parameter parameter=“$errorType“ type=“xs:string“ ::) 6 (:: pragma bea:global-element-parameter parameter=“$fault“ ::) 7 (:: pragma bea:global-element-parameter parameter=“$body“ ::) 8 9 declare namespace con = „http://www.bea.com/wli/sb/context“; 10 declare namespace conDetail = „http://www.bea.com/wli/sb/stages/transform/config“; 11 declare namespace exception = „http://opitz-consulting.com/data/common/BusinessExceptionTypes/V1“; 12 declare namespace request = „http://opitz-consulting.com/data/common/RequestInformationTypes/V1“; 13 declare namespace soap = „http://schemas.xmlsoap.org/soap/envelope/“; 14 declare namespace xf = „http://opitz-consulting.com/data/common/transformations/FaultFromFault/“; 15 16 17 declare function xf:FaultFromFault($inbound as element(\*), $bodyIncoming as element(\*), $messageID as xs:string, $errorType as xs:string, $fault as element(\*), $body as element(\*)) as element(\*) { 18 { 19 element faultcode { 20 if ($fault/con:details//conDetail:faultcode) then 21 data($fault/con:details//conDetail:faultcode) 22 else 23 „soap:Server“ 24 }, 25 element faultstring { 26 if ($fault/con:details//conDetail:faultstring) then 27 data($fault/con:details//conDetail:faultstring) 28 else 29 data($fault/con:errorCode) 30 }, 31 element detail { 32 element{ fn:expanded-QName(xs:string(namespace-uri($bodyIncoming/\*\[1\])), concat(data($inbound/con:service/con:operation), $errorType)) } { 33 element exception:faultHeader { 34 element request:Message { 35 element request:CreationDate { current-dateTime() }, 36 element request:MessageType { „fault“ }, 37 element request:MessageID { $messageID }, 38 element request:MessageVersion { „1.0“ }, 39 element request:MessageReferenceID { data($bodyIncoming//request:Message/request:MessageID) } 40 }, 41 element request:Caller { 42 element request:SourceSystemName { data($bodyIncoming//request:Caller/request:SourceSystemName) }, 43 element request:Environment { data($bodyIncoming//request:Caller/request:Environment) }, 44 element request:User { 45 element request:UserID { data($bodyIncoming//request:Caller/request:User/request:UserID) } 46 } 47 }, 48 element request:Operation { 49 element request:Operation { data($inbound/con:service/con:operation) } 50 }, 51 element request:Response { 52 element request:ProcessingInformation { 53 element request:ServerName { „unknown“ }, 54 element request:InstanceID { „unknown“ }, 55 element request:ExecutionContextID { „unknown“ } 56 57 } 58 } 59 }, 60 element exception:Fault 61 { 62 element exception:ErrorCode { 63 if ($body//exception:Fault/exception:ErrorCode) then 64 data($body//exception:Fault/exception:ErrorCode) 65 else 66 data($fault/con:errorCode) 67 }, 68 element exception:ErrorMessage { 69 if ($fault/con:details//conDetail:faultstring) then 70 data($fault/con:details//conDetail:faultstring) 71 else if ($body//exception:Fault/exception:ErrorMessage) then 72 data($body//exception:Fault/exception:ErrorMessage) 73 else if ($body//soap:Fault/faultstring) then 74 data($body//soap:Fault/faultstring) 75 else 76 data($fault/con:reason) 77 }, 78 element exception:ErrorDetail { 79 $fault/con:details, 80 $fault/con:location 81 } 82 } 83 } 84 } 85 } soap:Fault> 86 }; 87 88 declare variable $inbound as element(\*) external; 89 declare variable $bodyIncoming as element(\*) external; 90 declare variable $messageID as xs:string external; 91 declare variable $errorType as xs:string external; 92 declare variable $fault as element(\*) external; 93 declare variable $body as element(\*) external; 94 95 xf:FaultFromFault($inbound, $bodyIncoming, $messageID, $errorType, $fault, $body) 96 We insert the replace into the error handler. [![BLOG_OSB_Exception_04](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_04_thumb.png "BLOG_OSB_Exception_04")](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_04.png) And provide the needed parameters. [![BLOG_OSB_Exception_05](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_05_thumb.png "BLOG_OSB_Exception_05")](https://thecattlecrew.net/wp-content/uploads/2014/07/blog_osb_exception_05.png) Now we can try to make a call to the operation getServiceInfo, which makes a callout to a non existing service, with this request: 1 2 3 4 2014-07-17T17:33:57.544+02:00request:CreationDate> 5 requestrequest:MessageType> 6 1234345667890request:MessageID> 7 1.0request:MessageVersion> 8 request:Message> 9 10 testSystemrequest:SourceSystemName> 11 DEVrequest:Environment> 12 13 testUserrequest:UserID> 14 request:User> 15 request:Caller> 16 request:Header> 17 message:getServiceInfoRequest> 18 We get this error response including some information we sent with the request: 1 xml version=“1.0″?> 2 3 4 5 6 soap:Serverfaultcode> 7 BEA-380002faultstring> 8 9 10 11 12 2014-07-17T18:01:32.055+02:00v12:CreationDate> 13 faultv12:MessageType> 14 5480523608781123005–3df23bc.1471b27a72f.-7f95v12:MessageID> 15 1.0v12:MessageVersion> 16 1234345667890v12:MessageReferenceID> 17 v12:Message> 18 19 testSystemv12:SourceSystemName> 20 DEVv12:Environment> 21 22 testUserv12:UserID> 23 v12:User> 24 v12:Caller> 25 26 getServiceInfov12:Operation> 27 v12:Operation> 28 29 30 unknownv12:ServerName> 31 unknownv12:InstanceID> 32 unknownv12:ExecutionContextID> 33 v12:ProcessingInformation> 34 v12:Response> 35 v11:faultHeader> 36 37 BEA-380002v11:ErrorCode> 38 www.google.comv11:ErrorMessage> 39 40 41 routeGetServiceInfocon:node> 42 request-pipelinecon:path> 43 con:location> 44 v11:ErrorDetail> 45 v11:Fault> 46 v1:getServiceInfoUnexpectedError> 47 detail> 48 soapenv:Fault> 49 soapenv:Body> 50 soapenv:Envelope> 51 Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Infrastructure **Schlagwörter:** English, Oracle FMW, Service Bus --- ### [Oracle Open World 2013 - Wrap up](https://thecattlecrew.net/2013/09/30/oracle-open-world-2013-wrap-up/) **Published:** September 30, 2013 **Author:** Sven Bernhardt **Content:** OOW 2013 is over and we’re heading home, so it is time to lean back and reflecting about the impressions we have from the conference. First of all: OOW was great! It was a pleasure to be a part of it. As already mentioned in our last blog article: It was the biggest OOW ever. Parallel to the conference the America’s Cup took place in San Francisco and the Oracle Team America won. Amazing job by the team and again congratulations from our side! Back to the conference. The main topics for us are: - Oracle SOA / BPM Suite 12c - Adaptive Case management (ACM) - Big Data - Fast Data - Cloud - Mobile Below we will go a little more into detail, what are the key takeaways regarding the mentioned points: **Oracle SOA / BPM Suite 12c** During the five days at OOW, first details of the upcoming major release of Oracle SOA Suite 12c and Oracle BPM Suite 12c have been introduced. Some new key features are: - Managed File Transfer (MFT) for transferring big files from a source to a target location - Enhanced REST support by introducing a new REST binding - Introduction of a generic cloud adapter, which can be used to connect to different cloud providers, like Salesforce - Enhanced analytics with BAM, which has been totally reengineered (BAM Console now also runs in Firefox!) - Introduction of templates (OSB pipelines, component templates, BPEL activities templates) - EM as a single monitoring console - OSB design-time integration into JDeveloper (Really great!) - Enterprise modeling capabilities in BPM Composer These are only a few points from what is coming with 12c. We are really looking forward for the new realese to come out, because this seems to be really great stuff. The suite becomes more and more integrated. From 10g to 11g it was an evolution in terms of developing SOA-based applications. With 12c, Oracle continues it’s way – very impressive. **Adaptive Case Management** Another fantastic topic was Adaptive Case Management (ACM). The Oracle PMs did a great job especially at the demo grounds in showing the upcoming Case Management UI (will be available in 11g with the next BPM Suite MLR Patch), the roadmap and the differences between traditional business process modeling. They have been very busy during the conference because a lot of partners and customers have been interested 🙂 **Big Data** Big Data is one of the current hype themes. Because of huge data amounts from different internal or external sources, the handling of these data becomes more and more challenging. Companies have a need for analyzing the data to optimize their business. The challenge is here: the amount of data is growing daily! To store and analyze the data efficiently, it is necessary to have a scalable and flexible infrastructure. Here it is important that hardware and software are engineered to work together. Therefore several new features of the Oracle Database 12c, like the new in-memory option, have been presented by Larry Ellison himself. From a hardware side new server machines like Fujitsu M10 or new processors, such as Oracle’s new M6-32 have been announced. The performance improvements, when using one of these hardware components in connection with the improved software solutions were really impressive. For more details about this, please take look at our previous blog post. Regarding Big Data, Oracle also introduced their Big Data architecture, which consists of: - Oracle Big Data Appliance that is preconfigured with Hadoop - Oracle Exdata which stores a huge amount of data efficently, to achieve optimal query performance - Oracle Exalytics as a fast and scalable Business analytics system Analysis of the stored data can be performed using SQL, by streaming the data directly from Hadoop to an Oracle Database 12c. Alternatively the analysis can be directly implemented in Hadoop using „R“. In addition Oracle BI Tools can be used to analyze the data. **Fast Data** Fast Data is a complementary approach to Big Data. A huge amount of mostly unstructured data comes in via different channels with a high frequency. The analysis of these data streams is also important for companies, because the incoming data has to be analyzed regarding business-relevant patterns in real-time. Therefore these patterns must be identified efficiently and performant. To do so, in-memory grid solutions in combination with Oracle Coherence and Oracle Event Processing demonstrated very impressive how efficient real-time data processing can be. One example for Fast Data solutions that was shown during the OOW was the analysis of twitter streams regarding customer satisfaction. The feeds with negative words like „bad“ or „worse“ have been filtered and after a defined treshold has been reached in a certain timeframe, a business event was triggered. **Cloud** Another key trend in the IT market is of course Cloud Computing and what it means for companies and their businesses. Oracle announced their Cloud strategy and vision – companies can focus on their real business while all of the applications are available via Cloud. This also includes Oracle Database or Oracle Weblogic, so that companies can also build, deploy and run their own applications within the cloud. Three different approaches have been introduced: - Infrastructure as a Service (IaaS) - Platform as a Service (PaaS) - Software as a Service (SaaS) Using the IaaS approach only the infrastructure components will be managed in the Cloud. Customers will be very flexible regarding memory, storage or number of CPUs because those parameters can be adjusted elastically. The PaaS approach means that besides the infrastructure also the platforms (such as databases or application servers) necessary for running applications will be provided within the Cloud. Here customers can also decide, if installation and management of these infrastructure components should be done by Oracle. The SaaS approach describes the most complete one, hence all applications a company uses are managed in the Cloud. Oracle is planning to provide all of their applications, like ERP systems or HR applications, as Cloud services. In conclusion this seems to be a very forward-thinking strategy, which opens up new possibilities for customers to manage their infrastructure and applications in a flexible, scalable and future-oriented manner. As you can see, our OOW days have been very very interresting. We collected many helpful informations for our projects. The new innovations presented at the confernce are great and being part of this was even greater! We are looking forward to next years‘ conference! Links: - - [https://thecattlecrew.net/2013/09/23/first-impressions-from-oracle-open-world-2013](https://thecattlecrew.net/2013/09/23/first-impressions-from-oracle-open-world-2013/) **Kategorien:** Tech Events & Networking **Schlagwörter:** oracle --- ### [BPMCon 2013](https://thecattlecrew.net/2013/10/04/bpmcon-2013/) **Published:** Oktober 4, 2013 **Author:** Alexander Holbreich **Content:** Last friday i was visiting an outstanding conference on BPM – [BPMCon 2013](http://www.bpmcon.de/) in Berlin. BPMCon is hosted by Camunda Services GmbH a company which is behind [Camunda BPM Platform](http://www.camunda.com/). Camunda BPM is now independent fork of the well known [Activiti BPM Platform](http://www.activiti.org/). I noticed that the community behind Camunda is constantly growing. I enjoyed the chance to meet a lot of enthusiastic java developerswho are „coding“ BPM 😉 . I also enjoyed the possibility to speak to the core developers of that platform, its committers and customers of Camunda as well. At the beginning, a brilliant and provocative key note was given by [Gunter Dueck](https://twitter.com/wilddueck) with a very funny metaphor of cats and dogs (IT guys v.s. „normal“ people). Then key features of Camunda has been presented by two founders Jakob Freund and Bernd Rücker. They argued that Camunda BPM is lightweight and developer-friendly (especially for java developers) BPM solution. The development of Camunda BPM Platform focuses on BPM Process modeling and execution and does not try to offer to many features out of the box. It is also Open Source and agile developed from release to release. More success stories has been presented from a couple of companies e.g. HASPA, Zalando, myToys or the patent department of Switzerland. Especially Zalando seems to do some innovative work, but I‚m unsure if they share their work back to the community… Last but not least we saw interesting tools in a field of Process Mining. e.g. Fluxicon and emerging Start-Up company cupenya. Both got much attention of theaudience. Also SAP people presented integrated „end-to-end“ Process Monitoring and control system. Another highlight of the conference was Fishbowl discussion – a new discussion format to me. Changing discussants were involved in an interesting talk about general problems in companies that starting adopt BPM and switch to „Process Driven“ organizations. I enjoyed that conference especially industry feedback and as well the possibility to get direct information on the future development of Camunda BPM Engine. Great Conf! I‚m waiting for next year! **Kategorien:** Tech Events & Networking **Schlagwörter:** BPMCon, Camunda, Conference --- ### [JAX-WS: How to input and output XML AnyType](https://thecattlecrew.net/2014/07/10/jax-ws-how-to-input-and-output-xml-anytype/) **Published:** Juli 10, 2014 **Author:** Bernhard Mähr **Content:** JAX-WS works in a very simple and effective way if you have defined all objects in a XML Schema definition. But sometimes you can’t define a schema for an operation because e.g. it is a generic operation and accepts or returns dynamic XML. Nevertheless we would like to use for this operation the same tool chain with JAX-WS which is working perfectly for other operations. In the first step we define the interface of the operation testXMLCall in the WSDL (better the XSD referenced by the WSDL). 1 2 > 3 4 5 =’1′ maxOccurs=’1′ name=’requestXMLData‘ type=’xsd:anyType’/> 6 > 7 xsd:complexType> 8 xsd:element> 9 10 > 11 12 13 > 14 xsd:complexType> 15 xsd:element> From this WSDL we generate the interface PortType of the webservice. The implementation of the interface needs an operation of this definition: 1 @WebMethod(action = „http://localhost/testXMLCall„) 2 @WebResult(name = „responseXMLData„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„) 3 @RequestWrapper(localName = „testXMLCall„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„, className = „com.oc.soa.sample.ws.v1.messages.TestXMLCall„) 4 @ResponseWrapper(localName = „testXMLCallResponse„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„, className = „com.oc.soa.sample.ws.v1.messages.TestXMLCallResponse„) 5 public Object testXMLCall( 6 @WebParam(name = „name„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„) 7 String name, 8 @WebParam(name = „requestXMLData„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„) 9 Object requestXMLData); We make an implementation: 1 @WebMethod(action = „http://localhost/testXMLCall„) 2 @WebResult(name = „responseXMLData„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„) 3 @RequestWrapper(localName = „testXMLCall„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„, className = „com.oc.soa.sample.ws.v1.messages.TestXMLCall„) 4 @ResponseWrapper(localName = „testXMLCallResponse„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„, className = „com.oc.soa.sample.ws.v1.messages.TestXMLCallResponse„) 5 public Object testXMLCall( 6 @WebParam(name = „name„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„) 7 String name, 8 @WebParam(name = „requestXMLData„, targetNamespace = „http://opitz-consulting.com/interfaces/TestMessages/V1„) 9 Object requestXMLData) { 10 TestXMLCallResponse result = new TestXMLCallResponse(); 11 if (requestXMLData instanceof Element) { 12 Element requestXMLDataElement = ((Element) requestXMLData); 13 LOG.info(„XML in: \\n„ + getPrintString(requestXMLDataElement)); 14 XmlObject xmlResult; 15 try { 16 xmlResult = doSomething(requestXMLDataElement); 17 } catch (RuntimeException e) { 18 LOG.error(„Error while doSomething with XML: \\n„ + getPrintString(requestXMLDataElement), e); 19 throw e; 20 } 21 LOG.info(„XML out: \\n„ + getPrintString(xmlResult.getDomNode())); 22 result.setResponseXMLData(xmlResult.getDomNode().getFirstChild()); 23 } else if (requestXMLData == null) { 24 LOG.error(„Data is null.„ ); 25 } else { 26 LOG.error(„Unknown data of type ‚„+ requestXMLData.getClass() + „‚.„ ); 27 } 28 return result; 29 } We make an implementation of the method getPrintString for a readable output of the XML. 1 public static String getPrintString(Node node) { 2 try { 3 DOMSource domSource = new DOMSource(node); 4 StringWriter writer = new StringWriter(); 5 StreamResult result = new StreamResult(writer); 6 TransformerFactory tf = TransformerFactory.newInstance(); 7 Transformer transformer = tf.newTransformer(); 8 transformer.transform(domSource, result); 9 writer.flush(); 10 return writer.toString(); 11 } catch (TransformerException e) { 12 LOG.warn(„Unable to convert XML-Node ‚„ + node.toString() + „‚ of class ‚„ + node.getClass() + „‚ to string representation.„, e); 13 return „\[non printable xml\]„; 14 } 15 } And finally the method doSomething processing the xml element and returning an XmlObject needs to be implemented. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/ "OPITZ-CONSULTING") published at [https://thecattlecrew.net/](https://thecattlecrew.net/ "https://thecattlecrew.net/") **Kategorien:** Integration **Schlagwörter:** English, Weblogic --- ### [You've Got Mail: Inbound Email Processing in WLS/OSB integration scenarios](https://thecattlecrew.net/2014/07/13/youve-got-mail-inbound-email-processing-in-wlsosb-integration-scenarios/) **Published:** Juli 13, 2014 **Author:** Sven Bernhardt **Content:** In an integration project we are currently replacing an available integration platform using Oracle Service Bus 11g. Different incoming and outgoing message formats and protocols (HTTP, FTP, SMTP, etc.) are used from the external partners of our customer and therefore have to be supported. With OSB no problem at all, but polling a MS Exchange server for new e-mails is simply not possible with OSB standard tooling. Debt is a bug in MS Exchange server, which advertises that it supports plain authentification for login, but it does not (\[1\], search for AUTH=PLAIN). So when trying to access an exchange inbox from a proxy service ends up with failures, which cannot be worked around. So we decided to implement a custom Java service that does the polling, because with plain Java the bug can be worked around by setting the corresponding Java Mail session parameters described in \[1\]. The challenge from a implementation perspective is that in a clustered environment, a service is in general active on all cluster nodes and so parallel access and therefore multi processing for one specific e-mail is possible. So the service has to be implemented as a Weblogic Singleton service \[2\] to avoid this. A Singleton service is physically deployed to the cluster and so available on all nodes, but it is only active on one specific cluster node. In case of problems on the node where the service is active, it might be activated on another node in the cluster automatically, depending on the failover configuration in the cluster. Basically Singleton services may be implemented in two different fashions: **Standalone application** When implementing a Singleton service as a standalone application, it has to be bundled as a JAR-File and must be placed under /lib folder. Dependend third-party libs not provided by Weblogic must be also available within this folder, with a reference in the Singleton JARs manifest. Afterwards the servers has to be restarted and the Singleton service has to be registered in the Cluster using Weblogic Console. [![SingletonStandaloneConfig](https://thecattlecrew.net/wp-content/uploads/2014/07/singletonstandaloneconfig.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/07/singletonstandaloneconfig.png) **Part of an enterprise application** When implementing a Singleton service as part of an enterprise application, it has to be packaged inside an EAR-File which has to be deployed to the cluster. The registration of the Singleton to the Cluster is done by adding an entry to weblogic-application.xml. \[code wraplines=“false“ collapse=“true“ language=“xml“\] com.opitzconsulting.mail.MailClientRunner mail-client \[/code\] Deploying a singleton service as part of an enterprise application is the more flexible alternative and less invasive way regarding changes in the singleton implementation, because a simple redeployment of the application is sufficient. Using the standalone variant, a server restart is needed in case of changes in the Singletons implementation logic. In our concrete scenario we decided to implement the Mail Singleton service as part of an enterprise application. After deploying the Singleton application to the cluster it will be activated on one of the cluster nodes and starts polling the specified email account. When stopping the server, where the Singleton service is currently active on, it will be deactivated on this node and directly be activated on another node. Observing the server logs shows this behaviour because of corresponding log outputs in the Singleton implementations activate() and deactivate() methods. \[code wraplines=“false“ collapse=“true“ language=“text“\] osb\_server1.out 23:20:04.341 \[\[ACTIVE\] ExecuteThread: ‚0‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailClientRunner – SingletonService MailClientRunner is initiated… 23:20:05.461 \[\[ACTIVE\] ExecuteThread: ‚5‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailClientRunner – SingletonService MailClientRunner is activated… 23:20:06.736 \[\[ACTIVE\] ExecuteThread: ‚5‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – FROM: \[„Bernhardt, Sven“ \] 23:20:06.736 \[\[ACTIVE\] ExecuteThread: ‚5‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – SENT DATE: \[Sat Jul 12 23:15:03 CEST 2014\] 23:20:06.736 \[\[ACTIVE\] ExecuteThread: ‚5‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – SUBJECT: \[Singleton Service Testmail\] 23:20:07.001 \[\[ACTIVE\] ExecuteThread: ‚5‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – CONTENT: \[Hello, this is a test mail. BR, Sven \] 23:21:16.131 \[\[ACTIVE\] ExecuteThread: ‚0‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailClientRunner – SingletonService MailClientRunner has been deactivated… \[/code\] \[code wraplines=“false“ collapse=“true“ language=“text“\] osb\_server2.out 23:21:22.967 \[\[STANDBY\] ExecuteThread: ‚1‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailClientRunner – SingletonService MailClientRunner is activated… 23:21:24.220 \[\[STANDBY\] ExecuteThread: ‚1‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – FROM: \[„Bernhardt, Sven“ \] 23:21:24.220 \[\[STANDBY\] ExecuteThread: ‚1‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – SENT DATE: \[Sat Jul 12 23:15:03 CEST 2014\] 23:21:24.220 \[\[STANDBY\] ExecuteThread: ‚1‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – SUBJECT: \[Singleton Service Testmail\] 23:21:24.481 \[\[STANDBY\] ExecuteThread: ‚1‘ for queue: ‚weblogic.kernel.Default (self-tuning)‘\] INFO MailReaderClient – CONTENT: \[Hello, this is a test mail. BR, Sven \] \[/code\] Finally let’s have a short look on the implementation of the Singleton service: \[code wraplines=“false“ collapse=“true“ language=“java“\] package com.opitzconsulting.mail; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import weblogic.cluster.singleton.SingletonService; public class MailClientRunner implements SingletonService { private static final Logger log = LoggerFactory.getLogger(MailClientRunner.class.getSimpleName()); private MailReaderClient mailReaderClient; public MailClientRunner() { log.info(String.format(„SingletonService MailClientRunner is initiated…“)); } @Override public void activate() { log.info(String.format(„SingletonService MailClientRunner is activated…“)); mailReaderClient = new MailReaderClient(); mailReaderClient.readMail(); } @Override public void deactivate() { log.info(String.format(„SingletonService MailClientRunner has been deactivated…“)); } } \[/code\] The interaction between Oracle Service Bus and the Singleton Mail service has been implemented using JMS Queues. The Mail service reads the mails, coverts the content (CSV, XML) from the mail body or from attachments, creates a uniform message format which is independent from protocol as well as format and enqueues it into the corresponding queues. From here OSB dequeues the messages and does the further processing. The logic from this point on is the same, used for other interfaces. With this implementation approach, by combining the strenghts of of JEE and OSB, we created a flexible, maintainable and standard-based way to integrate inbound email processing in our final integration architecture. Links: 1. [http://www.oracle.com/technetwork/java/faq-135477.html](http://www.oracle.com/technetwork/java/faq-135477.html "http://www.oracle.com/technetwork/java/faq-135477.html") 2. [http://docs.oracle.com/cd/E23943\_01/web.1111/e13709/service\_migration.htm#i1051668](http://docs.oracle.com/cd/E23943_01/web.1111/e13709/service_migration.htm#i1051668 "http://docs.oracle.com/cd/E23943_01/web.1111/e13709/service_migration.htm#i1051668") **Kategorien:** Integration **Schlagwörter:** Integration, Oracle FMW, OSB, Service Bus, Weblogic --- ### [Oracle Application Testing Suite (OATS) - One tool for the whole testing process](https://thecattlecrew.net/2014/07/13/oracle-application-testing-suite-oats-one-tool-for-the-whole-testing-process/) **Published:** Juli 13, 2014 **Author:** Andrej Flieger **Content:** One of the most challenging things, apart from test definition, during the process of testing an application is to keep the overview over the entire process, i.e. knowing the status of the current test progress. Here you want to know (obviously there are more things): - what requirements need be tested - what are the tests belonging to them, i.e. each others association - test status, i.e. how many tests are executed yet, and which of them failed - the issues resulting out of failed test executions (issue tracking) For all that Oracle provides you the Oracle Application Testing Suite. **OATS – TestManager** --- This is the central tool, that allows you to cover all aspects of the whole appication testing process, i.e. defining testing plans, add your requirements, whole issue tracking process adding tests, including JUnit Tests over existing ANT-File and 3rd Party Test via an executable file. OATS also provides reports for the several categories right out of the box and the ability to export each report either to Microsoft Excel or HTML. Obviously via an Administration tool you could control user access based on roles. And as a goody the most important roles are already on board, i.e. Planner, QA-Engineer, Developer, Tester, Read-Only Role and Full Access ****OATS – OpenScript**** --- This is the development environment based on Eclipse where the Scripts that could be chosen in the TestManager’s *„add Test“* functionality are developped. OpenScript gives you the possibility of developping Scripts for the so called Functional Testing which is simply automated Browser/GUI testing as well as the possibility of creating Scripts for Load-Testing for e.g. of Oracle Forms, Oracle ADF applications, etc.. Further more OATS comes along with OpenScript Addons for Mozilla Firefox (at least Versoin 30 is not supported yet) and Microsoft Internet Explorer (IE 11 works fine on my machine), that gives you the abilty to start recording Scripts from the development environment. **OATS – LoadTest** --- Within this part of OATS on the one hand you may define several scenarios under which the script should run., e.g. the amount of concurrent users. You also have the possibility to run the tests simulating different browsers, such as Chrome, Firefox, MSIE, Safari, etc. as well as Connection speed simulation. As second part of this tool it gives you the possibility to gather Server Statistics, depending on predefined metric profiles that exist for Oracle Weblogic and on database side for SQL-Server and Oracle database. **Further Information** --- Download the latest Version at: http://www.oracle.com/technetwork/oem/downloads/index-084446.html Further information obtain here: http://www.oracle.com/technetwork/oem/app-test/etest-101273.html **Kategorien:** Tools & Methoden **Schlagwörter:** English, Oracle FMW --- ### [New ACM book: Thriving on adaptability](https://thecattlecrew.net/2015/01/26/new-acm-book-thriving-on-adaptability/) **Published:** Januar 26, 2015 **Author:** Torsten Winterberg **Content:** Keith Swenson published his new book on ACM titled „Thriving on Adaptability“. Find details here: [futstrat.com/books/ThrivingOnAdaptability.php ](http://futstrat.com/books/ThrivingOnAdaptability.php "futstrat.com/books/ThrivingOnAdaptability.php ") [![image001-712782](https://thecattlecrew.net/wp-content/uploads/2015/01/image001-712782.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/01/image001-712782.jpg) We are very proud that we were able to contribute a whole chapter to this book: **Ontology-based ACM – The Need for Truly Adaptive Systems** **Jürgen Kress, Clemens Utschig-Utschig, Hajo Normann, Torsten Winterberg** After seven months of traveling Curiosity lands on Mars. The engineers in NASA mission control are excited to start scientific research. These scientists have a special challenge; the Mars rover is so far away and the signal takes so long, that they need to rely on automation in order to maintain control in the wildest scenarios. There are many decisions that must be made on a daily, and even on a minute-to-minute basis. Involving the scientist in every possible decision, given the round trip time to consult and answer, would slow the research to „“ literally „“ a crawl. The scientists who operate the rover are knowledge workers. Just like knowledge workers in a business setting, they must figure out how to accomplish goals, as they uncover new information that affects their goals. The automation that they use built into Curiosity is very much like the business processes that businesses use to achieve their goals: the process works fine as long as the situation matches what was expected. But what happens to a business process when confronted with something unexpected? This chapter takes us on an exploration of how to adapt to the unexpected–including a Little Green Man–using the Mars Curiosity as an entertaining, but highly enlightening example. **Kategorien:** Tools & Methoden **Schlagwörter:** ACM --- ### [DOAG Konferenz 2014: WebLogic Server auf ODA: Erfahrungen aus einem Kundenprojekt](https://thecattlecrew.net/2015/03/07/doag-konferenz-2014-weblogic-server-auf-oda-erfahrungen-aus-einem-kundenprojekt/) **Published:** März 7, 2015 **Author:** Neselovskyi, Borys **Content:** Eine Oracle Database Appliance (ODA) ist als eine gute Plattform für das Betreiben von Oracle Datenbanken bekannt. Die Oracle RAC- oder One Node RAC Datenbanken können sehr schnell und unkompliziert auf einer ODA Maschine installiert und betrieben werden. Seit der ODA Version 2.7 ist es möglich, auch einen WebLogic Server auf ODA zu betreiben. Der Vortrag befasst sich mit der Installation und Konfiguration eines WebLogic Server Clusters auf Oracle Database Appliance. Folgende Themen sind hier erläutert: - WebLogic Server Architektur in Verbindung mit ODA - Erfahrungen mit der Virtualisierung von ODA - Was muss man beachten bei der Installation von WebLogic Cluster auf ODA? - Was ist OTD (Oracle Traffic Director) und wie funktioniert OTD mit dem WebLogic Server auf einer ODA? - Bugs / Probleme: Lösungen / Workarounds - Tipps und Tricks - Das Testen der Hochverfügbarkeit - Performancetests - Disaster Recovery: was ist möglich? \[slideshare id=43609650&doc=2014borysneselovskyiweblogicserveraufodapraesentation-150117042122-conversion-gate01\] **Kategorien:** Tech Events & Networking **Schlagwörter:** Engineered System, Oracle Database Appliance, Weblogic --- ### [Danilo Schmiedel erhält Award für Outstanding BPM/ACM Contribution](https://thecattlecrew.net/2015/03/11/danilo-schmiedel-erhalt-award-fur-outstanding-bpmacm-contribution/) **Published:** März 11, 2015 **Author:** hendrikvoigt **Content:** Im Rahmen des Oracle Fusion Middleware Partner Community Forums, welches vom 03.03.2015 bis zum 06.03.2015 in Budapest stattfand, erhielt unser SOA/BPM-Experte Danilo Schmiedel zusammen mit seinem „Oracle ACE Director“-Kollegen Andrejus Baranovskis den Oracle Fusion Middleware Partner Community Award 2015 für Outstanding BPM & ACM Contribution. Nach der Verleihung zeigten sich beide sehr erfreut: „Der Erhalt des Titels ist uns eine große Ehre. Die stetig wachsende Oracle Fusion Middleware Community liefert ununterbrochen eine fantastische Arbeit, die uns alle in der täglichen Arbeit unterstützt und weiterbringt. In einer globalisierten Wirtschaft geht dabei Partnerschaft ganz klar vor Konkurrenz. Die Herausforderungen in der heutigen IT-Welt sind so komplex, dass es wichtig ist Kräfte zu bündeln und gemeinsam nach Lösungen zu suchen, um den Anforderungen unserer Kunden so optimal wie möglich zu entsprechen. Das Teilen von Best Practices und bewährten Architektur-Pattern gehört dabei ebenso dazu, wie die Marktreife neuer Technologien kritisch zu diskutieren und zu bewerten. Wir bedanken uns herzlich für diese Auszeichnung und freuen uns auch in Zukunft auf die Zusammenarbeit in der Community.“ [![schmiedel-baranowski-acm-award](https://thecattlecrew.net/wp-content/uploads/2015/03/schmiedel-baranowski-acm-award.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/03/schmiedel-baranowski-acm-award.jpg) Nach dem Erfolg im letzten Jahr ([Oracle BPM Partner Community Award 2014](http://http://www.opitz-consulting.com/unternehmen/partner/oracle/oracle_auszeichnungen/oracle_bpm_partner_community_award_2014.php)) freuen wir uns, dass wir den Titel erneut in unseren Reihen halten dürfen. ## Community-Arbeit ausgezeichnet Mit dem BPM Community Award würdigt Oracle Projektrealisierungen, Konferenzbeiträge und Veröffentlichungen. In diesem Jahr bezieht sich die Auszeichnung explizit auf die Arbeit von Andrejus Baranovskis und Danilo Schmiedel im Themenkomplex der unstrukturierten Geschäftsprozesse. In gemeinsamen Projekten konzipierten und entwickelten die beiden Lösungen auf Basis von Oracle ACM (Adaptive Case Management). Die gesammelten Erfahrungen teilten Sie in mehreren Vorträgen und Artikeln mit der Community. In diesem Zusammenhang möchten wir auch auf unser äußerst gefragtes [ACM-Poster](https://thecattlecrew.wordpress.com/2013/10/10/adaptive-case-management-poster-available/) mit der noch jungen CMMN-Notation (Case Management Model and Notation) hinweisen. [![oracle partner awards 2014](https://thecattlecrew.net/wp-content/uploads/2015/03/oracle-partner-awards-2014.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/03/oracle-partner-awards-2014.png) ## Warum wir die BPM-Community unterstützen Die Community-Arbeit hat für uns einen sehr hohen Stellenwert, denn das Erarbeiten und Teilen von Fachwissen bringt nicht nur unsere eigenen Berater weiter, sondern hilft uns auch dabei, wichtige Marktthemen weiterzuentwickeln. Davon profitieren letztlich unsere Kunden, die zurecht „State-of-the-Art“-Leistungen von uns erwarten, und genau diese bekommen sie auch dank des hohen Engagements der Gemeinschaft. **Kategorien:** Tech Events & Networking **Schlagwörter:** ACM, BPM --- ### [Oracle BPEL - Performance optimization of payload transformations within loops](https://thecattlecrew.net/2015/03/23/oracle-bpel-performance-optimization-of-payload-transformations-within-loops/) **Published:** März 23, 2015 **Author:** alexanderdaeubler **Content:** In a recent project (developed using SOA Suite 11g) one of the requirements was to filter out certain lines of an order as these lines should not be forwarded to the business partners. In a first version we looped over all lines of the order and used a transformation activity within the loop to add each line to the response element. In case the line should not be added to the response we just ignored it. The loop looked like this:[![LoopWithTransformation](https://thecattlecrew.net/wp-content/uploads/2015/03/loopwithtransformation.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/03/loopwithtransformation.jpg) The actual process contained more logic but for reasons of simplification I removed all activities that are not related to the topic of this blog post. The XSL transformation logic was as follows: Basically, for each iteration of the loop the old order was cloned and the current line was attached to that order (except for ignored orders, of course). This approach worked absolutely fine, but when running the process with a large order of more than 500 lines we encountered severe performance issues. The loop“™s execution took about 250 seconds on our development environment; after we had set the log level to PRODUCTION we could reduce it to about 100 seconds, still much too long from our perspective. So we started to use assign activities instead of the transformation. Generally, I prefer using transformations as they give you more flexibility and the maintenance of namespaces is also much easier from my perspective. The modified loop now looks as follows: [![LoopWithAssign](https://thecattlecrew.net/wp-content/uploads/2015/03/loopwithassign.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/03/loopwithassign.jpg) The first line is inserted after the header element of the order, all other lines are added to the line collection. The same test setup as described further above now just took about 5 seconds to execute. As already mentioned the actual loop is more complex than depicted here so the run-time was now perfectly acceptable. In a nutshell the usage of transformation activities within loops can“™t be recommended from our side. It should either be replaced by assign activities or the transformation must be placed outside of the loop. In addition to that one should generally test all processes with large records, as our developer“™s tests didn“™t reveal the issue at first as we were using rather small orders to test the basic functionality of the process only. **Kategorien:** Integration **Schlagwörter:** Assign, bpel, JDeveloper, Loop, Optimization, oracle, Oracle DB, Oracle FMW, Performance, Refactoring, Transformation --- ### [Gartner Business Process Management Summit London 2015](https://thecattlecrew.net/2015/03/25/gartner-business-process-management-summit-london-2015/) **Published:** März 25, 2015 **Author:** Benjamin Huskic **Content:** Ich habe am diesjährigen BPM Summit in London teilgenommen und möchte meine Eindrücke mit euch Teilen. Zu Beginn habe ich mir die Session „Introduction to BPM“ angehört, um zu schauen wie Gartner das Thema den noch nicht Erfahrenen vermittelt. Als Opener werden Projektreferenzen genannt, durch welche großen Potentiale gehoben wurden. New York Tax konnte z.B. durch BPM die Kosten der Verwaltung um $100 Mio. senken und im gleichen Zug verhindern, dass $1,2 Mrd. an zweifelhaften Auszahlungen getätigt wurden \[1\]. Als weiteres Beispiel wird Carphone Warehouse aufgeführt die es geschafft haben, nach dem Rollout in 815 Geschäftsstellen, einen ROI von 1100% im ersten Jahr zu erzielen. Dabei ist die Kundenzufriedenheit um 25% gestiegen und im gleichen Jahr wurden die Kosten um £5 Mio. gesenkt. Zusätzlich werden pro Jahr £50.000 im Telefonsupport gespart \[2\]. Der Vortragende John Dixon Verwendete „Autofahren“ als Analogie zum BPM. Dabei wurden folgende drei Punkte hervorgehoben: 1. Awareness (Talking to Wife while Driving) „“ Identify and Bring Processes Out 2. Productivity (Switching Gears) „“ Easy way of Flowchart execution 3. Change (React on Broken Bridge) „“ Agility and ability to adapt Es fielen aber auch die Schlagworte: ACM, IoT, CFO, Messbarkeit und dass 60% des Projekterfolgs auf Marketing in eigener Sache beruhen. Eine besonders tolle Session war die Keynote von Hamish W. Taylor „Driving Business Transformation Through Customer Centricity“ in der das Loslegen bzw. Starten motiviert worden ist. Dabei wurden Unternehmen genannt, die den Wechsel verschlafen haben. Dazu gehören Kodak, welche die digitale Fotografie zwar erfunden haben und den Wert der selbigen nicht erkannt haben, aber auch Borders Books & Music, Blockbuster Videotheken, Comet Elektronikfachgeschäft und HVM Entertainment. Dem Gegenüber standen die allseits bekannten erfolgreichen der heutigen Zeit. Der sehr charismatische Hamish hat aus seiner Historie einige Beispiele genannt, wie Fragestellungen pragmatisch gelöst werden können. Dazu gehörte z.B. die Einführung der ersten Schlafplätze auf Linienflügen der British Airline. Das Design lieferte nicht das interne Innenraumdesign-Team, welches sich hauptsächlich um Bestimmungen und Spezifikationen Sorgen gemacht hat, sondern ein Innenraumdesigner für Yachten. Eine besondere Wertschätzung gilt dem Colonel John Boyd der den OODA Loop erfunden hat und dieser heute noch Gültig hat \[3\]. Sehr spannend und innovativ war die Session über Continous Process Improvement des niederländischen ING Teams. Hier wurde sehr schön dargestellt wie mit Hilfe von Process Mining und Process perfomance Mangement im eignen Unternehmen ein deutlicher Mehrwert geschaffen werden kann. Das Projekt ist IT getrieben, mit der Unterstützung eines Geldgebers, als U-Boot gestartet. Die Kollegen von der ING mussten aktiv internes Marketing betreiben, damit sie Prozesse in ihr neues Programm aufnehmen konnten. Hier hat man sich die Prozesseigner gesucht, welche Interesse an neuen Ansätzen hatten. Kritiker, so die Vortragende, hat man einfach zur Kenntnis genommen, links liegen gelassen und sich nach Befürworten umgeschaut. Der Erfolg gab dem Team Recht. Aktuell müssen sich nicht mehr nach willigen Prozesseignern suchen, sondern können vor Anfragen nicht mehr retten. Mit 16 Millionen Kunden hat es ING so geschafft, 95% der Benutzeranfragen in Time abzuhandeln und die Waste-Generierung von 16% auf 1% zu reduzieren. Die nun zur Verfügung gestellten Metriken können von allen Mitarbeitern eingesehen werden, so dass sich die Mitarbeiter selber optimieren und in den Dialog treten. Die Managementmeetings haben eine deutlich höhere Effizienz, da man nun faktenbasierend diskutieren kann und zeitaufwendige Reports nicht mehr erstellt werden müssen. FAZIT Alles in allem waren viele Vorträge auf einer großen Flughöhe. Die wenigen konkreten Erfahrungsberichte aus dem Alltag frischten die Konferenz auf. Als wichtigste Erkenntnis habe ich mitgenommen, dass für Innovation und erfolgreiche Projekte im Großteil die Grundprinzipien, einfach machen, respektvoller Umgang mit allen Parteien, Wertschätzung, Disziplin und Ehrgeiz ausreichend sind. Für den Rest braucht man spannende Technologien und Methoden. \[1\] [http://www.ibm.com/smarterplanet/us/en/leadership/nystax/assets/pdf/0623-NYS-Tax\_Paper.pdf](http://www.ibm.com/smarterplanet/us/en/leadership/nystax/assets/pdf/0623-NYS-Tax_Paper.pdf) \[2\] \[3\] [http://en.wikipedia.org/wiki/OODA\_loop](http://en.wikipedia.org/wiki/OODA_loop) **Kategorien:** Tech Events & Networking **Schlagwörter:** ACM, BPM, Conference, IoT, Process Mining --- ### [OBIEE 11.1.1.9 Installation on Linux OEL 6: Step by Step](https://thecattlecrew.net/2015/05/23/obiee-11-1-1-9-installation-on-linux-oel-6-step-by-step/) **Published:** Mai 23, 2015 **Author:** Neselovskyi, Borys **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Business Intelligence, oracle, Oracle DB, Oracle FMW, Weblogic --- ### [Camunda BPM 7.3 Release Webinar](https://thecattlecrew.net/2015/06/02/camunda-bpm-7-3-release-webinar/) **Published:** Juni 2, 2015 **Author:** Tim Kopplow **Content:** Mit dem Webinar vom 02.06.15 zum aktuellen Release wurden die Feature Highlights mit Hilfe von verschiedenen Live Demos präsentiert. Dazu gehörten die aus den Camunda News bekannten Neuerungen, wie - Konfigurierbare Autorisierungen für Zugriffe auf Prozesse, Aufgaben und Prozessinstanzen - Live-Anpassung laufender Prozessinstanzen, z.B. um im Prozess vor- oder zurückzuspringen - Start neuer Prozessinstanzen an einer beliebigen Stelle im Prozessmodell - Nachvollziehbarkeit aller durchgeführten Jobs mit dem „Historic Job Log“ - Mächtige Suchfunktionen für Prozessinstanzen im Cockpit - Anpassbarkeit der Tasklist über zusätzliche und eigene Plugins (analog zum Cockpit) Wir möchten mit diesem Blog-Eintrag unsere Gedanken zu den vorstellten Neuerungen wiedergeben. ### Live-Anpassungen laufender Prozessinstanzen Mit diesem Feature ist es möglich die laufende Prozessinstanz eines komplexen Geschäftsprozesses, per drag and drop, in einen beliebigen Vorgang (Aktivität, HumanTask, ServiceTask) zu verschieben und dort in einen anderen Zustand zu überführen. Da dieses Vorgehen keinerlei Validierung und Überprüfung unterliegt, sei unserer Meinung nach ein umsichtiger Einsatz empfohlen. ### Konfigurierbare Autorisierungen für Zugriffe auf Prozesse, Aufgaben und Prozessinstanzen Mit dem Release 7.3 führt Camunda ein Rollenmanagement ein mit dem es möglich ist autorisierte Zugriffe zu verwalten. Die Rollen können im Camunda Cockpit definiert und mit Rechten ausgestattet werden. So können beispielsweise die Angehörigen bestimmter Benutzergruppen nur bestimmte Geschäftsprozesse sehen, starten oder verändern können. Mittels der differenzierten Rechtevergabe ist es des Weiteren möglich die Verwendung von Live-Anpassungen laufender Prozessinstanzen optimal zu steuern. ### Start neuer Prozessinstanzen an einer beliebigen Stelle im Prozessmodell Über das Cockpit UI können Geschäftsprozesse durch den Anwender an einem beliebigen Vorgang(Aktivität, HumanTask, ServiceTask) gestartet und mit Variablen befüllt werden. Diese Möglichkeit des variablen Prozesseinstiegs kann ebenfalls über die Java API genutzt werden. # Additional Zu dem wurden mögliche Erweiterungen für die Arbeit mit Camunda BPM 7.3 vorgestellt. Dazu gehörten der Camunda plugin store und bpmn.io. ### Camunda plugin store Der plugin store bietet jedem Anwender die Möglichkeit sein eigenes Plugin zu implementieren und mit der Community zu teilen oder existierende Plugins in seinem Cockpit zu integrieren. Eines der besonders herausgestellten Plugins, ist die Heatmap. Dieses Plugin bildet die Häufigkeit der Prozessdurchläufe grafisch in einer Heatmap ab und wurde durch Mitarbeiter von Opitz Consulting bereitgestellt. ### bpmn.io Bpmn.io ist ein Browser basierter HTML 5 Modeller der den BPMN 2.0 Standard entspricht. Dieses Tool wird vollumfänglich mit der Version 7.4 eingeführt und stellt das Pendant zum Signavio Process Editor dar. Die in bpmn.io erstellten Modelle können ins Cockpit bzw. in die Ecplise IDE importiert werden. # Next Steps Nach dem Webinar fokussieren wir uns jetzt darauf, wie sich die präsentierten Features im Cockpit und in der IDE integrieren und handhaben lassen. Besonders interessant werden dabei die ersten praktischen Erfahrungen im Umgang mit der konfigurierbaren Autorisierung von Zugriffen sowie des variablen Prozesseinstieges. **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM, Camunda, German --- ### [OPITZ CONSULTING Polska becomes the first local Partner of WSO2 in Poland](https://thecattlecrew.net/2015/06/18/opitz-consulting-polska-becomes-the-first-local-partner-of-wso2-in-poland/) **Published:** Juni 18, 2015 **Author:** **Content:** **Partnership brings together expertise of OPITZ CONSULTING Polska, leading project specialist for individual IT solutions, with WSO2″™s comprehensive open source enterprise middleware platform.** Krakܳw, Poland „“ 3rd June 2015 „“ OPITZ CONSULTING Polska (part of the OPITZ CONSULTING Group) announced that is has become the first Polish local partner of WSO2, the creator and developer of the popular open-source middleware platform. The partnership represents an important step in joint solution development and delivery in Poland, backed by extensive support services offered by WSO2. OPITZ CONSULTING has already delivered successful projects based on WSO2 technology „“ with a portal solution backed with WSO2 Enterprise Service Bus for Miejskie PrzedsiÄ™biorstwo Komunikacyjne (a public transport company) in Cracow, being the first of them. Currently, the company is also helping other organizations to successfully adopt WSO2 technology and build solutions on top of this platform. The announcement is being made in conjunction with WSO2″™s news at WSO2Con Europe 2015 today that the company has achieved a 155% growth in partner-driven revenue in Q1 2015 over Q1 2014. Grzegorz Tajchman, Business Development and Innovation Manager at OPITZ CONSULTING Polska, actively participated in forming the cooperation with WSO2; he stated: > „This partnership will help us to promote and deliver efficient integration solutions on the comprehensive WSO2 platform. It is also a strategic step towards establishing our presence as independent middleware and integration expert in the Polish market.“ > > „OPITZ brings 25 years of expertise in implementing IT solutions for the Polish market. Through our partnership with OPITZ, Polish enterprises have a powerful solution for implementing robust integration solutions based on our comprehensive open source WSO2 platform,“ said WSO2 Vice President of Channel Sales Lindsey Anderson. **About WSO2** WSO2 delivers on the promise of the connected business with the only completely integrated enterprise platform that enables businesses to build, integrate and manage their APIs, applications, and Web services on-premises, in the cloud, and on mobile devices. Leading enterprise customers worldwide rely on WSO2″™s award-winning 100% open source platform and its robust governance and DevOps functionality for their mission-critical applications. Today, these businesses represent nearly every sector: health, financial, retail, logistics, manufacturing, travel, technology, telecom and more. Visit or check out the WSO2 community on the [WSO2 Blog](http://wso2.com/blogs), [Twitter](http://twitter.com/#%21/wso2), [LinkedIn](http://www.linkedin.com/groups?gid=876687&oback=.gdr_1221799737953_1) and [Facebook](https://www.facebook.com/WSO2Inc).. **About OPITZ CONSULTING** OPITZ CONSULTING, the leading project specialist for individual IT solutions, was founded with the vision to establish a one-stop-shop for consulting and implementation of IT projects. The company’s ambition is to help organizations to be better than their competitors through effective use of IT during whole application lifecycle (OC ALM). Established in 1990, OPITZ CONSULTING Group has several locations in Germany, as well as in Cracow and Warsaw as OPITZ CONSULTING Polska. The group employs more than 400 consultants and has developed business relations with more than 600 customers from various sectors and verticals. **Kategorien:** Tech Events & Networking **Schlagwörter:** English, News --- ### [WSO2-based integration at MPK Cracow: Project case study](https://thecattlecrew.net/2015/06/19/wso2-based-integration-at-mpk-cracow-project-case-study/) **Published:** Juni 19, 2015 **Author:** **Content:** This article describes a project case study of delivering a custom portal solution for MPK Krakܳw – the main transport services provider in city of Cracow, Poland. Apart from describing project genesis, system’s functionality and key benefits, it focuses on the role of WSO2-based integration platform in the system’s architecture. # Project genesis ## Background information about MPK Cracow ![mpk_logo](https://thecattlecrew.net/wp-content/uploads/2015/06/mpk_logo.jpg?w=150)Miejskie PrzedsiÄ™biorstwo Komunikacyjne S.A. w Krakowie „“ further referred to as MPK „“ is main public transport services provider in Cracow. The company is responsible for bus and tram transport in the city, organizing ticket distribution and fare control as well. With more than 2200 regular employees, MPK is one of the largest transport companies in Poland. ## IT landscape IT system landscape at MPK comprises of multiple systems and applications, with several key ERP and domain systems acting as IT backbone, supporting main operations and business processes. Systems and applications are heterogeneous and are running on different platforms and databases. The ERP platform used at MPK is an IFS system, while main core system for transport planning and dispatch domains was delivered by IVU Traffic Technologies AG. Some systems and applications have been integrated with each other and exchange data „“ still, before the introduction of WSO2 during the project described below, there was no common integration platform or service bus in place. ## The business case MPK manages more than 2000 vehicle drivers (own employees + contractors), whose daily work requires access to up-to-date information about their duty and monthly schedule. Meanwhile, due to the specifics of their work and licensing aspects, drivers have no access to the MPK systems. This limits the information available directly to the drivers as well as restricts their direct participation in many simple yet useful business processes. Direct supervisors – bus and tram depot managers – act as intermediaries here, with much information shared via bulletin boards and paper documents. Issues described above were the main drivers for launching a project of development and delivery of the Information System for Vehicle Drivers (pol: *System Informacji dla ProwadzÄ…cych*), further referred to as SIDP. Key business goals were: - Facilitating communication between MPK as employer (depot managers, planning inspectors, dispatchers, HR and other back-office employees) and employees (vehicle drivers). - Providing a web platform accessible via Internet for sharing crucial information, as well as enabling selected business operations for vehicle drivers and related depot, planning and dispatch personnel. Secondary goal, relevant to the IT at MPK, was to introduce a SOA based approach for systems integration, required for the new platform, as the first step towards broader „soa-fication“ in the organization. # SIDP – project and platform description ## Overall system“™s architecture The SIDP platform was designed as a portal solution, with independent portlets providing functionality to the end-users. Necessary data and services were exposed on the middleware platform in a uniform way (SOAP and REST services), virtualizing various technologies of underlying core systems and services. ![sidp_1](https://thecattlecrew.net/wp-content/uploads/2015/06/sidp_1.png) As the platform was to be exposed via the Internet, additional proxy layer with HTTP server was used. ## Role of WSO2 ESB and implemented services The WSO2 platform is a central component of the system“™s architecture. It performs roles of an abstraction, mediation and translation layer, acting as an intermediary between portal and core systems. Key feature sets of the Carbon platform are the WSO2 Data Services Server and the WSO2 Enterprise Service Bus. Services configuration is stored and managed in the local WSO2 registry. Simplified system layers and components are depicted on schema below: ![sidp_2](https://thecattlecrew.net/wp-content/uploads/2015/06/sidp_2.png)Data and functionality from core systems like SI-LOK, IVU and IFS, provided as database views or stored procedures, are exposed as uniform XML via data and proxy services. Services and their adequate operations correspond to the required data sets for the portal views, as well as API calls for invoking business operations with necessary parameters. In some cases, data output from services is transformed (using XSLT) to the form more adequate for portlet needs. In other cases, proxy services encapsulate data processing logic with custom sequences. One of the more complex components exposed on ESB is also acting as a notification service, processing notifications from the IFS system about new, changed or deleted employee information and orchestrating necessary changes in the portal and the dedicated mail server. Another interesting service is an automated document publication service, which extracts attachments from email messages sent to a particular inbox and automatically publishes them in a document repository using the portal“™s API. ## System functionality Information and functionality exposed on the WSO2 service bus allows data provisioning for several custom-built portlets, that present relevant information for authenticated employees and allow them to perform particular business operations. These include: - Up-to-date, confirmed daily duty, with detailed fare plan of the driver - Current monthly employee schedule as well as yearly graph - Announcements of managers, planers, dispatchers (integrated with document library) - Basic HR employee data (holidays allowance, uniform provided, expiring licenses) - Viewing and printing monthly pay slip, with appropriate notification in the HR system - Request for change of planned uniform provisioning with adequate exchange rules - E-mail communication adjusted to MPK needs A screenshot demonstrating some of above functionalities is presented below: ![sidp_screenshot](https://thecattlecrew.net/wp-content/uploads/2015/06/sidp_screenshot.png?w=660) ## Project delivery The project and solution delivery was divided into two main stages: During the first stage (Q4 2012 „“ Q1 2013) the SIDP platform was installed and configured (WSO2 ESB + Liferay Portal), alongside the first set of services, portlets and necessary user accounts setup. The portal was officially launched for the vehicle drivers in March 2013, providing information about duty, schedule, notifications, etc. Second project stage (Q3-Q4 2013) expanded the portal functionality delivered some more advanced features, like requesting change of planned uniform provisioning with adequate exchange rules and access to monthly pay slip of the employee. The necessary set of services on ESB was also agreed upon and created. Regarding the project staffing, a cross-functional team of 3-4 OPITZ consultants and developers participated in the project implementation. During the whole project lifecycle, MPK employees actively participated in project work, both on IT and subject domain levels. A partially agile approach, bi-weekly status meetings involving all stakeholders, with prototype demonstrations as well as scoping, prioritizing and planning sessions – helped both OPITZ and MPK to drive the project forward, despite tight schedule and limited project budget. # Benefits and further development ## Business benefits The project allowed MPK to provision their employees with necessary information using modern and highly available (comparing to traditional ones) means of extranet platform. In the effect, communication between vehicle drivers and their supervisors became much easier and less error-prone, eliminating paperwork and many time consuming direct phone enquiries or updates. Employees gained direct insight into information relevant for their daily work, including duty details and schedule, notifications, e-mail or electronic documents repository. ## Current role and roadmap of WSO2 platform From the IT perspective, MPK gained a common systems“™ integration platform, based on WSO2 Enterprise Service Bus, with many reusable services available for further use. This enabled faster delivery of new business functionalities as well as helped with introducing common SOA standards, patterns and best practices. Currently, the WSO2 platform is actively developed and used as middleware layer in other IT projects, acting as a central integration layer, where services and data from ERP/domain systems are exposed and provided in a standardized manner. Taking other project needs into account, MPK considers expanding their WSO2-based integration platform with the WSO2 Business Process Server, in order to be able to implement and deploy process oriented solutions and services. The WSO2 Business Activity Monitor is also considered, as an event analysis platform for real-time KPI monitoring. **Kategorien:** Integration **Schlagwörter:** Architecture, English --- ### [Webinare: Salesforce und SAP verbinden "“ Integrationsplattform in der Cloud oder On-Premise](https://thecattlecrew.net/2015/06/23/webinare-salesforce-und-sap-verbinden-integrationsplattform-in-der-cloud-oder-on-premise/) **Published:** Juni 23, 2015 **Author:** Torsten Winterberg **Content:** Auch in Deutschland gewinnt das Thema Cloud an Fahrt. Zunehmend werden Softwarepakete als SaaS-Lösungen gleich in der Cloud angeschafft, weil die Vorteile, sich nicht um den Betrieb kümmern zu müssen und die damit einhergehende Flexibilität, starke Treiber sind nicht nur in der IT, auch in den Fachbereichen. Diese SaaS-Systeme müssen mit der bestehenden Anwendungslandschaft integriert werden: schnell, übersichtlich, qualitativ hochwertig und wartungsoptimal. Dieses Webinar stellt Möglichkeiten und Architekturen vor, wie eine Integration mit Cloudsystemen aussehen kann und diskutiert auch gleich die Frage, ob die passende Integrationsplattform dann nicht auch in der Cloud stehen sollte. iPaaS ist hier das magische neue Buzzword: Integration Platform as a Service. Wir zeigen an einem Livebeispiel, wie sich Salesforce als Cloudsystem und SAP als typische On-Premise Installation für den Anwendungsfall des Ordermanagements miteinander verbinden lassen. Es wird zwei unterschiedliche Webinare geben, einmal mit der Oracle BPM Suite 12c/ SOA Suite 12c als Plattform, am 31.7.2015, von 10:00-11:00 Uhr: [www.opitz-consulting.com/webinar-sap-salesforce-integration-mit-oracle](http://www.opitz-consulting.com/webinar-sap-salesforce-integration-mit-oracle) Und einmal auf Basis der Talend-Plattform, am 4.8.2015, von 10:00 bis 11:00 Uhr: [www.opitz-consulting.com/webinar-sap-salesforce-integration-mit-talend](http://www.opitz-consulting.com/webinar-sap-salesforce-integration-mit-talend) **Kategorien:** Cloud, Integration **Schlagwörter:** BPM, German, Integration, News, SAP --- ### [VirtualBox Image not starting up](https://thecattlecrew.net/2015/06/24/virutalbox-image-not-starting-up/) **Published:** Juni 24, 2015 **Author:** Torsten Winterberg **Content:** I often have the situation that I get a pre-installed VirtualBox image with some new Oracle stuff to test. Sometimes these images don“™t start with this error message: „This kernel requires an x86-64 CPU, but only detected an i686 CPU. Unable to boot „“ please use a kernel appropriate for your CPU“ The solution here is not to „Enable Intel VT-x/AMD-V from BIOS“. But this is a necessary option, too. The solution is to change the setting of the vm before starting and switch it from e.g. „Ubuntu 32bit“ to „Ubuntu 64bit“. **Kategorien:** Development **Schlagwörter:** Oracle FMW, QuickTip, tip --- ### [Whitepaper Serie: Integration](https://thecattlecrew.net/2015/07/16/whitepaper-serie-integration/) **Published:** Juli 16, 2015 **Author:** Markus Grünewald **Content:** (english version see below) Mit den diversifizierenden Trends Mobile und Cloud Computing hat das Thema Integration noch mehr an Bedeutung gewonnen. Deshalb haben wir eine Whitepaper Serie speziell zu diesem Thema entwickelt. In dem folgenden Whitepaper dieser Serie wird in die Thematik eingeführt und ein Gesamtüberblick gegeben [http://www.opitz-consulting.com/fileadmin/redaktion/veroeffentlichungen/whitepaper/whitepaper-systemintegration-ueberblick\_sicher.pdf](http://www.opitz-consulting.com/fileadmin/redaktion/veroeffentlichungen/whitepaper/whitepaper-systemintegration-ueberblick_sicher.pdf) Das Whitepaper beschreibt an einem konkreten UseCase (Closed-Loop Order Management) die diversen Aspekte der Integration. Dabei wird mit Absicht eine sehr hohe Abstraktionsebene genutzt mit Fokus auf den fachlichen Nutzen. Für die mehr technisch Interessierten Leser gibt es zusätzlich den folgenden Blog in dem die Integration eines onPremise SAP Systems mit der Cloud Application Salesforce auf Basis der Oracle SOA Suite 12c detailliert beschrieben wird. — English Version —- Whitepaper Series: Integration With the diversification trends mobile and cloud computing the importance of integration has significantly increased. Therefore we dedicated a whitepaper series to this topic. Unfortunately the whitepapers are currently only available in German. As soon they are available in English I will repost it here. However, a more technical description of a sample how to integrate an onPremise SAP system with the cloud application Salesforce is available in this blog **Kategorien:** Integration **Schlagwörter:** English, Integration --- ### [Resolve JCA connection error in Oracle EBS to SAP integration with OSB 11g](https://thecattlecrew.net/2015/07/20/resolve-jca-connection-error-in-oracle-ebs-to-sap-integration-with-osb-11g/) **Published:** Juli 20, 2015 **Author:** Sven Bernhardt **Content:** Doing a Oracle EBS to SAP integration with Oracle Service Bus 11g (OSB) I noticed a strange exception at runtime. During the establishment of a connection to the SAP system via the iWay SAP adapter the following error occurs in the adapter logs: > servicebus:/WSDL/ebs2sap-data-integration/Sap/v2.0/jca/BAPI\_ORACLE\_SYNCHRO\_RESPONSE\_invoke \[ BAPI\_ORACLE\_SYNCHRO\_RESPONSEPortType::BAPI\_ORACLE\_SYNCHRO\_RESPONSE(input\_BAPI\_ORACLE\_SYNCHRO\_RESPONSE,output\_BAPI\_ORACLE\_SYNCHRO\_RESPONSE) \] – : The JCA Binding Component was unable to establish an outbound JCA CCI connection due to the following issue: java.lang.IllegalArgumentException: Adapter ‚MySAP‘ not available. Names are case sensitive. > Please make sure that the JCA connection factory and any dependent connection factories have been configured with a sufficient limit for max connections. Please also make sure that the physical connection to the backend EIS is available and the backend itself is accepting connections. At first glance I suspect a typo or a general error within the connection configuration of the adapter to be responsible for this error. After double checking the configuration I wasn’t able to detect a configuration issue, everything seems to be fine. I restarted the servers, the complete domain – nothing changed, the exception remains. So I decided to double check the general adapter setup. Walking through all setup steps, I finally discovered the root of all evil: I simply forgot to copy the SAP JCO libraries to the *$MW\_HOME/user\_projects/osb\_domain/lib* folder. After placing the libraries at the corresponding place and restarting the domain, everything worked as intended. Now the data could be transmitted to SAP without any problems. Small cause, big effect – it takes me some time to find the root cause of the reported exception, whose message is really misleading in my opinion. I would expect to find something like a ClassNotFoundException, if needed libraries cannot be found in the classpath. But never mind, finally it worked. I hope I can save you some time with the post, if you are facing similar or the same error, when using SAP adapter in an Oracle Service Bus 11g or Oracle SOA Suite 11g environment. **Kategorien:** Integration **Schlagwörter:** Integration, Oracle DB, Oracle FMW, Oracle Service Bus, OSB, QuickTip, SAP --- ### [Get an Oracle E-Mail notification via User Messaging Service Running before your coffee gets cold](https://thecattlecrew.net/2015/07/23/get-an-oracle-e-mail-notification-via-user-messaging-service-running-before-your-coffee-gets-cold/) **Published:** Juli 23, 2015 **Author:** Benjamin Huskic **Content:** I often get asked to help developers with setting up UMS, but in fact mostly focusing on the SMTP server. In the next steps I will show how you can setup a HelloWorld notification Service with reviewing the results in less than five minutes. # Prerequisites: Installed SOA or BPM Quickstart. See Danilos post for details : Get FakeSMTP.jar on your development machine: # Step 1 „“ Start WLS Start the IntegratedWebLogicServer # Step 2 – Start the Fake SMTP Enter in the command line: java -jar fakeSMTP-2.0.jar After the Application has started up click the „Start Server“ button. [![fake_smtp_cmd](https://thecattlecrew.net/wp-content/uploads/2015/07/fake_smtp_cmd.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/07/fake_smtp_cmd.png) [![fake_smtp_UI](https://thecattlecrew.net/wp-content/uploads/2015/07/fake_smtp_ui.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/07/fake_smtp_ui.png) # Step 3 „“ Configure UMS in the Enterprise Manager Log into EM Edit the Email Driver Properties [![ums_1](https://thecattlecrew.net/wp-content/uploads/2015/07/ums_1.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/07/ums_1.png) Create a new Configuration with the name localhost and the outgoing mail server localhost and save it. [![ums2](https://thecattlecrew.net/wp-content/uploads/2015/07/ums2.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/ums2.png) # Step 4 „“ HelloWorld Notification Composite Create a new SOA Application with a SOA Project [![bpel1](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel1.png) Create a Synchronous BPEL with standard settings [![bpel2](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel2.png)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel2.png) [![bpel3](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel3.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel3.png) Add an UMS as a reference, add only outbound notification details, set Message as String type and wire it to the BPEL [![bpel5](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel5.png)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel5.png) [![bpel6](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel6.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel6.png) Edit the BPEL Flow Add an invoke of the UMS reference and create a new input variable for the UMS reference. [![bpel7](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel7.png)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel7.png) Add an Assign before the Invoke and map the BPEL input string to the message payload. [![bpel8](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel8.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/bpel8.png) Deploy the composite to the application server and test your service via EM # And there you go. [![finish1](https://thecattlecrew.net/wp-content/uploads/2015/07/finish1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/finish1.png) [![finish2](https://thecattlecrew.net/wp-content/uploads/2015/07/finish2.png)](https://thecattlecrew.net/wp-content/uploads/2015/07/finish2.png) [![finish3](https://thecattlecrew.net/wp-content/uploads/2015/07/finish3.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/07/finish3.png) **Kategorien:** Automation **Schlagwörter:** BPM, Service Bus, Weblogic --- ### [New book is out: Design Principles for Process-driven Architectures Using Oracle BPM and SOA Suite 12c](https://thecattlecrew.net/2015/07/24/new-book-is-out-design-principles-for-process-driven-architectures-using-oracle-bpm-and-soa-suite-12c/) **Published:** Juli 24, 2015 **Author:** Torsten Winterberg **Content:** **A design handbook to orchestrate and manage flexible process-driven systems with Oracle BPM and SOA Suite 12c**. This book was written in a joined approach by several experts from the Oracle ACE and ACE director team, three of them from OPITZ CONSULTING: [Matjaz B. Juric](http://www.amazon.de/s/ref=ntt_athr_dp_sr_1?_encoding=UTF8&field-author=Matjaz%20B.%20Juric&search-alias=digital-text&sort=relevancerank), [Sven Bernhardt](http://www.amazon.de/s/ref=ntt_athr_dp_sr_2?_encoding=UTF8&field-author=Sven%20Bernhardt&search-alias=digital-text&sort=relevancerank), [Hajo Normann](http://www.amazon.de/s/ref=ntt_athr_dp_sr_3?_encoding=UTF8&field-author=Hajo%20Normann&search-alias=digital-text&sort=relevancerank), [Danilo Schmiedel](http://www.amazon.de/s/ref=ntt_athr_dp_sr_4?_encoding=UTF8&field-author=Danilo%20Schmiedel&search-alias=digital-text&sort=relevancerank), [Guido Schmutz](http://www.amazon.de/s/ref=ntt_athr_dp_sr_5?_encoding=UTF8&field-author=Guido%20Schmutz&search-alias=digital-text&sort=relevancerank), [Mark Simpson](http://www.amazon.de/s/ref=ntt_athr_dp_sr_6?_encoding=UTF8&field-author=Mark%20Simpson&search-alias=digital-text&sort=relevancerank), [Torsten Winterberg.](http://www.amazon.de/s/ref=ntt_athr_dp_sr_7?_encoding=UTF8&field-author=Torsten%20Winterberg&search-alias=digital-text&sort=relevancerank) [![book12c](https://thecattlecrew.net/wp-content/uploads/2015/07/book12c.jpg?w=244)](https://thecattlecrew.net/wp-content/uploads/2015/07/book12c.jpg) - Learn key principles to model business processes with BPMN and BPEL, and execute them in an SOA environment. - Use best practices for composite applications, including service design and human interactions, and apply them in your daily projects. - Design, implement, and optimize business processes with real-world examples illustrating all key concepts ## Who This Book Is For This book is intended for BPM and SOA architects, analysts, developers, and project managers who are responsible for, or involved in, business process development, modelling, monitoring, or the implementation of composite, process-oriented applications. The principles are relevant for the design of on-premise and cloud solutions. ## What You Will Learn - Design principles to model business processes and business architectures - Best practices to produce executable business processes in BPMN - Principles when designing reusable services and composite applications - Advanced approaches to human interactions in business processes, including patterns and Adaptive Case Management - Business rules management and principles for rule design and implementation, including using rules in BPMN and BPEL processes - Prepare process applications for mobile and multichannel/omnichannel - Explore the best practices and principles of Business Activity Monitoring to define and monitor Key Performance Indicators - Extend the processes to Internet of Things devices and processing complex events ## In Detail This book is a design handbook and provides skills to successfully design, implement, and optimize business processes on top of SOA. Starting with business process modeling, it shows design principles to architect sound process architectures. It presents best practices for modeling business processes using BPMN, together with design principles for services and composite applications. It provides detailed coverage of how to prepare business processes for execution. An in-depth explanation of human interactions is given and also principles and best practices for using rules. Moving on, Adaptive Case Management principles are explained, along with the reach of business processes to mobile devices and ensuring multichannel interactions. Business activity monitoring, event-driven architectures, complex event processing in relation to business processes, and enabling integration with events and IoT devices are explained. The design principles and best practices are demonstrated in a practical way on a rental car use case. **Kategorien:** Tools & Methoden **Schlagwörter:** BPM, English, IoT, Mobile, Oracle FMW --- ### [Row-Level-Security mit Oracle Virtual Private Database](https://thecattlecrew.net/2015/08/11/row-level-security-mit-oracle-virtual-private-database/) **Published:** August 11, 2015 **Author:** Torsten Mandry **Content:** Virtual Private Database (VPD) ist ein Security Feature der Oracle Database Enterprise Edition (eingeführt mit Version 8i, teilweise auch unter der Bezeichnung Fine Grained Access Control – FGAC bekannt). Es bietet eine sehr einfache und verlässliche Möglichkeit zur Umsetzung von Row-Level-Security Konzepten, d.h. der Einschränkung der Sichtbarkeit (und Ü„nderbarkeit) auf Ebene einzelner Datensätze. ## Beispiel Bestellsystem Nehmen wir als Beispiel ein Bestellsystem in welchem Kunden Aufträge platzieren können. Üblicherweise wird sich in der Datenbank eines solchen Systems eine Tabelle ORDERS mit allen Aufträgen aller Kunden wiederfinden. Jeder ORDER Datensatz enthält eine CUSTOMER\_ID als Foreign Key auf den Kunden der den Auftrag platziert hat. ``` +-------------+               +-------------+ | ORDERS      |               | CUSTOMERS   | +-------------+               +-------------+ | ORDER_ID    |---------------| CUSTOMER_ID | | CUSTOMER_ID | *           1 | NAME        | | ...         |               | ...         | +-------------+               +-------------+ ``` In der zugehörigen Anwendung soll ein konkreter Anwender i.d.R. immer nur Zugriff auf seine eigenen Aufträge haben. Egal ob die Anwendung über einen technischen Nutzer oder mit einem personalisierten Account des konkreten Anwenders auf die Datenbank zugreift, sie kann (die notwendigen SELECT Rechte vorausgesetzt) zunächst einmal alle Datensätze aus der Tabelle ORDERS auslesen. ``` SELECT * FROM ORDERS;   ORDER_ID CUSTOMER_ID ORDER_DATE ---------- ----------- ------------------     100001         123 13-MAR-15      100002         234 17-MAR-15      100003         123 21-MAR-15     100004         345 25-MAR-15     ... ``` Es liegt oft in der Verantwortung der Anwendung nur die Datensätze des aktuell angemeldeten Anwenders abzufragen und anzuzeigen. ``` SELECT * FROM ORDERS WHERE CUSTOMER_ID = 123;   ORDER_ID CUSTOMER_ID ORDER_DATE ---------- ----------- ------------------     100001         123 13-MAR-15      100003         123 21-MAR-15 ``` ## Verlagerung der Security Regeln in die Datenbank Mit VPD kann diese Verantwortung in die Datenbank verlagert werden. Vereinfacht ausgedrückt kümmert sich VPD darum, dass jede Query welche auf die geschützte Tabelle zugreift automatisch um die oben genannte WHERE-Bedingung ergänzt wird und das transparent und in jedem Fall. Die Verlagerung der Security Regeln in die Datenbank ist insbesondere dann interessant, wenn über verschiedene Wege (z.B. Applikation, Service-Schnittstellen und evtl. sogar direkt per SQL Client) auf die Daten zugegriffen wird. Security Regeln werden auf diesem Weg einmalig und zentral definiert/hinterlegt und in allen Fällen angewendet. Aber auch wenn ausschließlich eine Anwendung auf die Datenbank zugreift kann die Verlagerung in die Datenbank Sinn machen um den eher querschnittlichen Security Aspekt nicht in jedem einzelnen SQL-Statement der Anwendung berücksichtigen zu müssen. ## Aufbau und Arbeitsweise einer VPD Nachfolgend beschreibe ich die wesentlichen Komponenten einer VPD sowie deren Bedeutung und Zusammenspiel anhand des konkreten Beispiels von oben. Um die beschriebenen Schritte ausführen zu können benötigt der verwendete DB User neben den üblichen Privilegien (CREATE SESSION, CREATE TABLE, CREATE PROCEDURE, usw.) die folgenden speziellen Privilegien: ``` CREATE ANY CONTEXT EXECUTE ON DBMS_SESSION EXECUTE ON DBMS_RLS ``` Mit VPD ist es prinzipiell möglich alle Zugriffe (SELECT, INSERT, UPDATE und DELETE) auf einzelne Datensätze, und sogar auf einzelne Spalten, einzuschränken. Im weiteren Verlauf betrachte ich jedoch nur das Lesen (SELECT) von vollständigen Datensätzen. Für weiterführende Informationen sei auf die unten aufgeführten Quellen verwiesen. ## Security (Policy) Function Die **Security Policy Function** (kurz auch Security Function) ist eine herkömmliche PL/SQL Function (auch Package Function möglich) welche die WHERE-Bedingung (Predicate) erzeugt die von VPD automatisch an die Queries gehängt wird. Sie definiert die Anwendungsspezifische Logik nach der die Security-Einschränkungen ermittelt werden. Die Function muss zwei Input-Parameter für den Schema- sowie den Objekt-Namen des Objects (Table, View, Synonym) erwarten und als Rückgabewert die WHERE-Bedingung zurückliefern, die beim Zugriff auf das Objekt verwendet werden soll. ``` CREATE OR REPLACE FUNCTION orders_sec_fnc( p_schema IN VARCHAR2, p_object IN VARCHAR2) RETURN VARCHAR2 IS BEGIN RETURN 'CUSTOMER_ID = ' || ; END orders_sec_function; / ``` Eine Security Function kann für mehrere Objekte verwendet werden, wenn die WHERE-Bedingungen identisch oder zumindest ähnlich sind. Es können jedoch auch individuelle Security Functions für jedes zu schützende Objekt definiert werden. ## Application Context Häufig greifen Security Functions auf einen **Application Context** zu um daraus die notwendigen individuellen Informationen für die WHERE-Bedingung herauszulesen. In unserem Fall zum Beispiel die CUSTOMER\_ID des zugreifenden Anwenders. Ein Application Context muss explizit angelegt werden und ist mit einem Package verbunden welches die API zum Ablegen und Auslesen von Inhalten bereitstellt. ``` CREATE OR REPLACE CONTEXT orders_sec_ctx USING orders_sec_ctx_pkg; ``` In meinen bisherigen Projekten erfolgt die Identifizierung und Authentifizierung des Anwenders außerhalb der Datenbank in der Applikation. Daher muss diese die notwendigen Informationen ggf. vor der Ausführung einer Query in den Application Context der Datenbank schreiben. Als API dient das Application Context Package. ``` CREATE OR REPLACE PACKAGE orders_sec_ctx_pkg IS PROCEDURE set_customer_id(p_customer_id IN NUMBER); END; / ``` ``` CREATE OR REPLACE PACKAGE BODY orders_sec_ctx_pkg IS  PROCEDURE set_customer_id(p_customer_id IN NUMBER)  AS  BEGIN     DBMS_SESSION.SET_CONTEXT('orders_sec_ctx',                  'customer_id', p_customer_id);  END set_customer_id; END; / ``` Die Security Function kann die Customer ID des aktuellen Anwenders nun aus dem Application Context auslesen. ``` CREATE OR REPLACE FUNCTION orders_sec_fnc( p_schema IN VARCHAR2, p_object IN VARCHAR2) RETURN VARCHAR2 IS BEGIN RETURN 'CUSTOMER_ID = SYS_CONTEXT(''orders_sec_ctx'', ''customer_id'')'; END orders_sec_fnc; / ``` ## Security Policy Die **Security Policy** verbindet die Security Function mit einem zu schützenden Objekt (Tabelle, View, Synonym). Sie wird mit Hilfe des Packages DBMS\_RLS angelegt. Die Parameter Object Schema und Name definieren dabei das zu schützende Objekt, in unserem Fall die ORDERS Tabelle. Über den Parameter Policy Name gebe ich der Policy einen sprechenden Namen. Die Parameter Function Schema und Policy Function definieren die zu verwendende Security Policy Function. Der Parameter Statement Types definiert, dass die Policy ausschließlich für SELECT Statements angewendet werden soll. ``` BEGIN  DBMS_RLS.ADD_POLICY (    object_schema    => 'vpd_owner',     object_name      => 'orders',     policy_name      => 'orders_sec_policy',     function_schema  => 'vpd_owner',    policy_function  => 'orders_sec_fnc',     statement_types  => 'select'); END; / ``` ## VPD in Aktion Mit dem Anlegen der Security Policy ist VPD für diese Tabelle „scharf geschaltet“. Das wird unmittelbar sichtbar wenn ich auf die ORDERS Tabelle zugreife. ``` SELECT * FROM ORDERS; no rows selected ``` Standardmäßig sehe ich erst einmal gar nichts mehr. Erst wenn ich eine gültige Customer ID in den Application Context schreibe kann ich danach die zugehörigen Ergebnisse sehen. ``` BEGIN orders_sec_ctx_pkg.set_customer_id(123); END; / SELECT * FROM ORDERS; ORDER_ID CUSTOMER_ID ORDER_DATE ---------- ----------- ------------------ 100001         123 13-MAR-15 100003         123 21-MAR-15 ``` ## Links \[1\] \[2\] \[3\] [http://docs.oracle.com/cd/B28359\_01/network.111/b28531/vpd.htm#DBSEG80081](http://docs.oracle.com/cd/B28359_01/network.111/b28531/vpd.htm#DBSEG80081) **Kategorien:** Database, IT-Security **Schlagwörter:** German, IT Security, Oracle DB, Softwarenentwicklung, VPD --- ### [OFM Summer Camps V 2015: Cloud and above the cloud"¦](https://thecattlecrew.net/2015/08/22/ofm-summer-camps-v-2015-cloud-and-above-the-cloud/) **Published:** August 22, 2015 **Author:** Mohammad Esad-Djou **Content:** The OFM Summer Camps 2015 is finished successful (August 17th „“ 21st 2015 Lisbon Portugal) and Oracle Fusion Middleware community could review new capabilities of Oracle Cloud Service in different areas. More than 100 participants attended the event, learning much new stuff about new features and enhancements of Oracle Cloud Computing. [![OPITZ Consulting Team in Sommer Camp 2015](https://thecattlecrew.net/wp-content/uploads/2015/08/img-20150820-wa0002.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/08/img-20150820-wa0002.jpg)OPITZ Consulting Team in Sommer Camp 2015 The four hands-on training were organized about the following topics: - Mobile and Mobile Cloud Service - BPM Suite 12c and Process Cloud Service - Hybrid Integration with Integration Cloud Service, SOA Suite Cloud Service and SOA 12c - Java Cloud Service I try to give a short overview regarding Java Cloud technical workshop. As you know, Oracle Java Cloud Service is a part of the platform service offerings in Oracle Cloud. Powered by Oracle WebLogic Server, it provides a platform on top of Oracle’s enterprise-grade cloud infrastructure for developing and deploying new or existing Java EE applications.[\[i\]](#_edn1) With Java Cloud, you have an Environment to Build, Deploy, and Manage Java Enterprise Applications. Cosmin Tudor, Oracle Principal Product Manager, presented in 4 days technical workshop the different steps and capabilities of Java Cloud. Oracle Public Cloud Strategy suggests a flexible solution that the customer can combine the private and public cloud approaches. From my point of view, the security aspects are not enough cleared in public cloud and therefore my advice regarding critical data and information is private cloud! I see an advantage that oracle can provide a stable solution regarding private cloud. We can use hybrid Oracle Cloud approach not only as PaaS and IaaS, but also DaaS and SaaS is now available in public cloud too. Developer Cloud Service, as a Platform as a Service (PaaS) Development Environment for the Enterprise, can simplify development with an automatically provisioned development platform that supports the complete development lifecycle. Oracle Data as a Service (DaaS) for Business allows businesses to use data as a standalone asset and connect with partner data to make smarter decisions. Oracle DaaS is a service in Oracle Cloud that offers the most variety, scale, and connectivity in the industry, including cross-channel, cross-device, and known and anonymous data. Use Oracle DaaS to drive intelligent actions for B2B and B2C organizations[\[ii\]](#_edn2). In order to prepare our environment in technical workshop, we worked on Database Cloud Service too. Preparing Oracle Database in the Cloud was very fast and stable and we can await Oracle Database achieve new levels of efficiency, security, and availability. In addition, working with Weblogic 12.1.3 and its new features was very amazing, specially using Oracle Traffic Director, JCS configuration „“ e.g. JCS network rules configuration, and Coherence clusters. It was important that many parts of workshop“™s materials can be used as PoC for different needs of customer. Our working and training present us that Oracle Java Cloud Service is a complete platform with Oracle WebLogic Server as the application container, Oracle Coherence as a caching and data grid tier, and Oracle Traffic Director as the software load balancer. I can summarize OFM Sommer Camp 2015 as bellow: A lot of things are done, a lot of things need to be done, and a lot of new ideas are here! Special thanks to Jürgen Kress for the excellent organization of the event! Thanks Simon Haslam for Foto and his comment: This is the room the \*real\* work is being done in – Cosmin’s JCS lab! [\[i\]](#_ednref1) See: [http://docs.oracle.com/cloud/latest/jcs\_gs/index.html](http://docs.oracle.com/cloud/latest/jcs_gs/index.html) [\[ii\]](#_ednref2) See: [![Java Cloud Service Training - Sommer Camp 2015](https://thecattlecrew.net/wp-content/uploads/2015/08/jcs_training_2015_1.png)](https://thecattlecrew.net/wp-content/uploads/2015/08/jcs_training_2015_1.png)Java Cloud Service Training – Sommer Camp 2015 **Kategorien:** Tech Events & Networking **Schlagwörter:** ADF, Conference, English, JDeveloper, News, Oracle ADF --- ### [OFM Summer Camps 2015: Simplify Integration with ICS and SOA Suite CS](https://thecattlecrew.net/2015/08/25/ofm-summer-camps-2015-simplify-integration-with-ics-and-soa-suite-cs/) **Published:** August 25, 2015 **Author:** Cornelia Spanner **Content:** At this year“™s Oracle Fusion Middleware Summer Camps in Lisbon (see also the [post](https://thecattlecrew.wordpress.com/2015/08/22/ofm-summer-camps-v-2015-cloud-and-above-the-cloud/) from our colleague Mohammed Esad-Djou) four Opitz consultants were attending the „Hybrid Integration with Integration Cloud Service, SOA Suite Cloud Service and SOA 12c“ track. With this post we want to give you a short overview of the topics that have been covered within this week. Let“™s start with a recap of the main topic of our track, the Integration Cloud Service (ICS). With ICS Oracle offers cloud to cloud and cloud to on premise integration flows which can be developed very easily and quickly directly in the browser. There are even recommendations on the most common data mappings to render the integrations as easy as possible. From our perspective it“™s a great tool to quickly deliver Software as a service (SaaS) solutions which are not too complex: at the moment only point to point connections can be implemented. But there is also the option of an additional enrichment call in order to get more details into the data mapping. More complex integrations in the cloud can be handled using the SOA Suite Cloud Service (SOA Suite CS) which provides its users with the whole set of SOA Suite“™s capabilities. Users can either configure their SOA Suite and / or OSB on a single node „environment“ or in a clustered mode. SOA Suite CS is not released yet but will be available pretty soon. Especially for smaller companies it might be an interesting approach to directly start working with SOA without having to invest in hardware and licenses first. The browser-based development can start without the need of special tools or elaborated configurations, so the expenditure can be invested in the product itself right from the beginning. The third product we focused on was Oracle Stream Explorer, a web-based application, which allows users to deal with big data and event streams in real time. It enables users to create event processing tools and applications without having to write a single line of code: a great occasion for business users with little knowledge in programming but the need to create such applications! One of the most promising features we were introduced to was the Cloud Adapter SDK which enables developers to write their own cloud adapters. In ICS there are already a lot of predefined cloud adapters available for connecting to Salesforce.com, RightNow, Oracle Sales Cloud and many more. The Oracle Marketplace will be used to publish such prebuilt cloud adapters written by Oracle or its partners. With the SDK new adapters can be built to be used within ICS but can also be imported into JDeveloper (or be used in parallel by both, of course). Eventually all JCA adapters will be rebuilt using the SDK, so there hardly seem to be any limits as far as the development is concerned. We“™re very excited to see the first adapters developed by the community! In a nutshell, we had a wonderful week in Lisbon: our trainers (Yogesh Sontakke, Ramkumar Menon, Robert Wunderlich and Simeon Greene) did a great job and provided us with a lot of information. We were able to do plenty of hands-on labs and meet so many great people from the community. A special highlight for Opitz was that two of our consultants were invited to present a session on Closed-Loop-Ordermanagement using the Salesforce and SAP adapters within a BPMN process. The feedback was overwhelming: it“™s great to show that the theory also works in a real life scenario. Last but not least there is one special person that we want to mention: thanks a lot to Jürgen Kress for organizing this event so perfectly: the food was great and the SOA Community event at a wineyard near Lisbon was also fantastic. Get specialized!! **Kategorien:** Tech Events & Networking **Schlagwörter:** Conference, English, Integration, Oracle FMW --- ### [Customizing af:listView to get list element](https://thecattlecrew.net/2015/09/23/customizing-aflistview-to-get-list-element/) **Published:** September 23, 2015 **Author:** Marvin Muuß **Content:** This is our use case: By clicking on an element in a listView we trigger a master-detail view on the right hand of the page. This section labeled the master row in top displaying an unspecified amount of elements in an af:listView underneath it with a ratingGauge next to the labeled component „“list selection should be disabled due to improved usability. Clicking on a ratingGauge triggers a valueChangeEvent instantly committing the new value. [![employeManagement](https://thecattlecrew.net/wp-content/uploads/2015/09/employemanagement.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/09/employemanagement.png) The employee management -On the left hand we fetch every employee on the right hand we show the managed ones We experienced the problem that we did not know which row was triggered because row selection was disabled. So we tried to customize the id of the ratingGauge component extending it with the following expression *\#{item.bindings.EmployeeId}*. Unfortunately the id attribute does not support EL Expression. **So how can we solve this problem?** > By adding a custom attribute! Just with adding *customId=“#{item.bindings.EmployeeId}“* to the ratingGauge we can access this attribute in the triggered valueChangeEvent. Let“™s take a look at that. \[code language=“java“\]public void ratingChanged(ValueChangeEvent valueChangeEvent) { if (!valueChangeEvent.getComponent().getAttributes().containsKey(„customId“)) { showMessage(„I have no attribute called ‚customId‘.“); } else { String id = valueChangeEvent.getComponent().getAttributes().get(„customId“).toString(); StringBuilder strbu = new StringBuilder(); strbu.append(„I am No. “ + id + “ „); strbu.append(„My id is “ + valueChangeEvent.getComponent().getAttributes().get(„id“).toString()); showMessage(strbu.toString()); /\*\* \* Now we can access the row with the specified employeeId to change its rating \* and commit this \*/ } } \[/code\] So if there is no attribute called customId given we will show a message that there is something missing respectively handle this case as it“™s needed. If we can access the attribute value we will show it in a message together with the id which we tried to customize with the EL Expression as well „“to see it does not work. [![id](https://thecattlecrew.net/wp-content/uploads/2015/09/id.png?w=251)](https://thecattlecrew.net/wp-content/uploads/2015/09/id.png) So this message will appear. 146 means the employeeId we set in the customId attribute and we see the id of the component did not change. Hopefully this will help you and solve some problems. An example application can be downloaded below. [ListViewExample.zip](https://thecattlecrew.net/wp-content/uploads/2015/09/listviewexample-zip.docx) (Just remove the .docx ending) **Kategorien:** Development **Schlagwörter:** ADF, Customize, English, JDeveloper, ListView, oracle, Oracle DB, Weblogic --- ### [Datenbank-Replikation im Expertentest "“ Oder: Drei Wege führen nach Rom](https://thecattlecrew.net/2015/09/29/replikation-oder-drei-wege-fuehren-nach-rom/) **Published:** September 29, 2015 **Author:** Christian Ballweg **Content:** ## Was ist eigentlich Replikation? Der Begriff „Replikation“ bezeichnet laut [Wikipedia](https://de.wikipedia.org/wiki/Replikation_%28Datenverarbeitung%29) „die mehrfache Speicherung derselben Daten an meist mehreren, verschiedenen Standorten und die Synchronisation dieser Datenquellen“. Eine reine Kopie von Daten einer Quelle und die anschließende Verfügbarmachung auf dem Ziel ist die simpelste Variante und nennt sich „unidirektionale Replikation“. Komplexer ist es, diesen Vorgang zeitgleich in der Gegenrichtung zu betreiben „“ oder sogar zwischen mehr als zwei Instanzen, z.B. im Ring oder einer sogenannten Nabe/Speiche- oder Hub/Spoke-Technologie. In allen Varianten vergeht zwischen der Erstellung des Datums auf der Quelle und dessen Erscheinen auf dem Ziel eine gewisse Zeitspanne (Latenz), deren Größe insbesondere bei der bi-direktionalen Replikation eine Rolle spielt. Dadurch könnten zum Beispiel auf der Zielseite Datensätze neu erstellt werden, die den gleichen Schlüssel haben, wie noch nicht eingetroffene Datensätze der Quelle. Die Möglichkeit einer Konfliktauflösung ist dabei essenziell, z.B. eine Vereinbarung wie: „Der neueste Datensatz gewinnt.“ oder „Eine der beteiligten Seiten hat Vorrang.“ ## Wann macht Replikation Sinn? Themen, die für die Wahl einer Replikation eine Rolle spielen können, sind unter anderem: - **Downtime- und Risiko-Minimierung:** kein oder nur geringer Einfluss auf Produktion! - **Implementierungsaufwand:** nötiges Know-how und zeitlicher Aufwand - **Betriebsstabilität:** Transaktionelle Sicherheit, Monitoring, Fehlerbehandlung - **Fallbackstrategien bei Fehlern der Replikation**, z.B. durch unaufgelöste Konflikte Doch warum möchte man überhaupt eine Replikationssoftware einsetzen, wo doch die Datenbank interne Mechanismen (Materialized Views, CDC, Streams, Logical DataGuard „“ oder binäridentische Kopie mittels Physical DataGuard) zur Verfügung stellt? Die Notwendigkeit einer logischen Replikation ergibt sich zum Beispiel in diesen Fällen: - **Ablösung:** Seit dem Erscheinen von Oracle Database 12cR1 gelten Oracle Streams und Oracle Advanced Replication als „deprecated“ und werden mit dem eingefrorenen Funktionsumfang von Oracle Database 11gR2 ausgeliefert. - **Minimal bzw. (near) Zero Downtime Migrationen** wegen Hardware-Wechsel oder -Upgrades, Standort- oder OS-Wechsel, Cloud, … - **Wechsel des Charactersets** - **Konsolidierung** - **Distribution:** Data Marts, Query oder Backup Offloading **Vor- und Nachteile der datenbankeigenen Tools für den Transfer von Oracle zu Oracle:** [![Known_ProsCons](https://thecattlecrew.net/wp-content/uploads/2015/09/known_proscons.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/09/known_proscons.jpg) Aus der Tabelle ergibt sich zwar, dass alle innerhalb der Oracle Datenbank bekannten Lösungen für Replikationsszenarien einsetzbar sind, jedoch bieten nur die Lösungen Ex/Import sowie CDC und Materialized Views einen allgemeingültigen Ansatz für die Verwendung unterschiedlicher Datenbankversionen, wobei Materialized Views nicht den vollen Umfang in der Standard Edition besitzen. Da alle genannten Techniken Nachteile gegenüber Lösungen haben, die auf einer reinen SQL-Anwendung basieren und außerhalb der Datenbank verwaltet werden, kommt der Wunsch nach den im Titel genannten Database Replication Tools auf. Diese minimieren den Einfluss auf die Quelle und garantieren durch ihre Datenbankunabhängigkeit „“ das erfasste SQL wird in einem proprietären Format transferiert und kann für das Zielsystem umgeschrieben werden „“ vielfältigste Anwendbarkeit bis hin zu einem heterogenen Transfer von und zu Non-Oracle Systemen (z.B. auch in der Cloud). ## Die Tests Um die Handhabung und Funktionsweise der drei unterschiedlichen Produkte im administrativen Kontext zu beurteilen, setzten sich acht erfahrene Datenbankadministratoren von OPITZ CONSULTING intensiv mit diesen Replikationslösungen auseinander. Ziel war es, erste Eindrücke zu sammeln, den Leistungsumfang zu bewerten und abschließend eine Einschätzung dazu vorzunehmen, wie sich die Produkte im Praxiseinsatz bewähren und welche Vorteile das einzelne Produkt gegenüber den anderen aufweist. Die Tests wurden in drei Kategorien durchgeführt, so dass ein Vergleich der Installation, Konfiguration sowie im Bereich des Betriebs und der Fehlerbehandlung stattfinden konnte. ### 1. Installation Erste Unterschiede zeigten sich bereits bei der Installation. Hier hat Oracle bei *GoldenGate* den Schritt zu einem graphischen Installer gemacht, der jedoch leider nichts weiter ist, als ein „geführtes Entpacken“ der Dateien in ein Hauptverzeichnis. Das Verzeichnis sollte unter Linux/UNIX tatsächlich ein Unterverzeichnis sein und kein Mountpoint „“ ansonsten führt die Existenz des Ordners lost+found zu der Fehlermeldung „Zielverzeichnis nicht leer“. Im Übrigen bleibt es alles wie gehabt: Die Installation endet erst einmal in einem „Wust“ von Dateien, deren Funktion nur dem erfahrenen *GoldenGate*-Anwender klar ist. Ab hier muss die Konfiguration manuell vorgenommen werden. Diese besteht aus der Erstellung und Parametrisierung einer Datei für den Managementprozess und bis zu drei Dateien für die *Extract*-, *Pump*– (Übertragung) und *Replicat*-Prozesse. Abschließend werden die jeweiligen Prozesse noch über das Client-Interface (*ggsci*) gestartet. Die beiden anderen Kandidaten setzen hier auf einen Kommandozeilen-Wizard, der mehr oder weniger detailliert durch das Setup des Replikationsprozesses leitet: *SharePlex* verwendet einen allgemeinen Ansatz, bei dem die grundsätzliche Einrichtung vorgenommen wird, Details allerdings im Konfigurationsfile vorzunehmen sind. Dbvisit *Replicate* fragt dagegen schon während des Setups Details wie Schema und Tabellen zur gewünschten Replikation ab. ### 2. Konfiguration Ergänzend zum vorigen Kapitel kann angefügt werden, dass einzig *SharePlex* die gesamte Replikationkonfiguration mit nur einem einzigen File auf der Quellseite beschreibt. Dbvisit *Replicate* ist hier ein wenig unübersichtlicher, da je Replikationssetup 2-3 Files angepasst werden müssten, wenn man dies nicht über den Wizard machen würde. *GoldenGate* ist dem ähnlich, es sei jedoch darauf hingewiesen, dass es sich hier nicht nur um eine optionale Anpassung handelt, da kein Wizard vorhanden ist. ### 3. Betrieb und Fehlerbehandlung Deutlich besser als *GoldenGate* wurde der Betrieb von *SharePlex* und Dbvisit *Replicate* bewertet, da hier eine sehr übersichtliche Darstellung auf Kommandozeile geliefert wird. *GoldenGate* ist ähnlich gut zu betreiben, Solange keine Fehler auftreten. Schwierig wird es hier einem Fehler auf den Grund zu gehen. Durch die Aufteilung in drei separate Prozesse existieren auch drei separate Logfiles: zwei auf Quell- und eins auf Zielseite. ### 4. Funktionsvielfalt Bei der Funktionsvielfalt spielt *GoldenGate* seine gesamte Macht aus. Lediglich *SharePlex* ist fast auf Augenhöhe, was die Datentypunterstützung angeht. Dbvisit macht zwar auch einen sehr guten Job, aber letztendlich bekommen beide Mitbewerber den Nachteil zu spüren, nicht an der Quelle der Datenbank-Features von Oracle zu sitzen. Ganz eklatant unterscheiden sich die Lösungen in ihrer Heterogenität. Keines der Konkurrenzprodukte ist derart heterogen und kann (bidirektional) eine derart große Vielfalt von Systemen unterstützen wie *GoldenGate*: #### *SharePlex* *Quelle: Oracle Ziel: Oracle + Files und via ODBC bzw. JMS: Sybase Adaptive Server Enterprise, Hadoop* ### *Dbvisit Replicate* *Quelle: Oracle Ziel: Oracle + MySQL, Microsoft SQL Server, Amazon Web Service RDS, Hadoop, CSV Files* #### *GoldenGate* *Quelle: Oracle + HP NonStop, IBM DB2, Informix, Microsoft SQL Server, MySQL, Sybase Ziel: Oracle + HP NonStop, IBM DB2, Informix, Microsoft SQL Server, MySQL, Sybase + Teradata und diverse weitere via ODBC/JDBC/JMS, z.B. Netezza, Greenplum, Hadoop* ### Übersicht: Bewertung nach Kriterien [![rating](https://thecattlecrew.net/wp-content/uploads/2015/09/rating.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/09/rating.jpg) ## Zusammenfassung Zusammenfassend lässt sich feststellen, dass alle drei Produkte durchaus produktiv einsetzbar sind. Welches Produkt dabei den Vorrang erhält, liegt an den jeweiligen Präferenzen. Spielt die Funktionsvielfalt und Heterogenität keine Rolle und kann man sich im schlimmsten Fall bei möglicherweise auftretenden Problemen die (sehr schnelle) Reaktionszeit des Herstellers leisten, ist das recht junge Produkt Dbvisit *Replicate* gerade aufgrund seines deutlichen Preisvorteils einen näheren Blick wert. Steht jedoch die Verlässlichkeit im Mittelpunkt und dominiert diese gegenüber neuesten Oracle-Features bei einer reinen Oracle-Replikation oder z.B. unidirektional heterogen (Oracle zu beliebigem Ziel mittels JMS), dann ist aufgrund der Reife des Produkts und den ausnehmend positiven Erfahrungen in der Vergangenheit *SharePlex* vielleicht die bessere Wahl. Der Preis liegt immer noch unter dem von *GoldenGate* „“ allerdings doch merklich über dem Dbvisit Produkt. *GoldenGate* ist der absolute Gewinner, was Features und Heterogenität angeht, benötigt aber den höchsten Einarbeitungs- und Betreuungsaufwand. Diese Kosten müssen als Betriebskosten neben den hohen Anschaffungskosten für das Produkt berücksichtigt werden. Dafür wird man allerdings auch mit dem vollen Herstellersupport aus einer Hand belohnt! Anhand der oben zusammengefassten Argumente haben unsere Experten diese Platzierung vorgenommen, wobei die Bewertungen zu Reife, Komplexität und Preis dem Konsens entspricht: [![ranking](https://thecattlecrew.net/wp-content/uploads/2015/09/ranking1.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/09/ranking1.jpg) \*Termlicense möglich **Kategorien:** Database **Schlagwörter:** Architecture, Integration, News --- ### [Retrospektive mit einem verteilten Team](https://thecattlecrew.net/2016/02/18/retrospektive-mit-einem-verteilten-team/) **Published:** Februar 18, 2016 **Author:** Christian Metzler **Content:** Vor einiger Zeit wurde die Frage an mich herangetragen, wie Retrospektiven in verteilten Teams durchgeführt werden können. Es wurde vorgeschlagen, dies einmal mit einem eigenen Team auszuprobieren. Der Vorteil war, dass ich dieses Team schon recht gut kannte und wir gemeinsam auf eine gewisse Retrospektivenerfahrung zurückblicken konnten. Somit starteten wir Anfang Februar das gemeinsame Experiment: Das Team teilte sich auf in eine Gruppe, die im gewohnten Besprechungsraum sitzen blieb, drei weitere Kollegen hingegen gingen zurück an ihren Arbeitsplatz. Technologisch habe ich mich entschieden für: - Audio: Telefonkonferenz über unsere normalen Telefone - Video: Google Hangout - Retrospektivenwerkzeug: Stormz (stormzhangout.com, bietet ein virtuelles Board mit Bewertungsfunktion und lässt sich in Google Hangout integrieren) Wie zu erwarten gab es die wenigsten Probleme bei der Telefonkonferenz. Bis der Hangout auf allen Notebooks funktionierte, dauerte es etwas länger – allerdings hatten dann auch nur drei von sechs Kollegen ein Bild. Das Werkzeug Stormz konnte recht schnell eingerichtet werden, wobei es nicht alle Kollegen direkt im Hangout nutzen konnten, da das Tool über einen IFrame eingebunden wird und heutige Browser das nicht ohne Weiteres erlauben. Nachdem diese Anfangshürden genommen waren, ging es dann endlich an die Retrospektive, die etwa zwei Stunden umfasste. Zusammenfassend kann man sagen, dass Stormz grundsätzlich ganz gut funktioniert hat, die zwischenmenschliche Ebene bei dem Format aber weitestgehend auf der Strecke blieb (was ich auch nicht anders erwartet hatte). Zuerst wurden Karten (Themen und Ereignisse) von allen Teilnehmern geschrieben, die vorerst nur von ihnen gesehen wurden. Danach wurden im nächsten Schritt die Karten für alle sichtbar und diese kurz erläutert. Nach dem Clustern (etwas mühselig) konnten alle Teilnehmer für die Themenblöcke Punkte vergeben, um darüber zu bestimmen, worüber sie reden wollten. Dann wurden für die einzelnen Karten in den Blöcken nach mancher Diskussion wenn möglich konkrete Todos definiert. Grundsätzlich hat das Experiment funktioniert, wenn auch mit den erwähnten Einschränkungen, aber die waren ja wie gesagt auch zu erwarten. Die Rückmeldung der Teilnehmer gibt das Ergebnis noch einmal in der Summe wieder: - Das Tool Stormz hat grundsätzlich gut funktioniert - Das GEMEINSAME fehlt/kommt zu kurz - Die nonverbale Kommunikation und damit die Informationen daraus fehlen komplett - Es ist eher eine Telko, da alle vor ihrem Rechner sitzen und nichts Interaktives dabei ist - Man ist schneller abgelenkt (liest Mails etc.“¦) - die Teilnehmer brauchen deutlich mehr „Rüstzeit“ - Das Tool bietet einen eher starren Ablauf und viele Möglichkeiten, die analoge Mittel haben, hat man hier nicht - Gefühlt war das Ergebnis deutlich dünner als in den vergangenen Retrospektiven - Die Themen waren eher technischer Natur und weniger emotional - Das Vorgehen ist deutlich ermüdender als eine „normale“ Retro - Die Sprachqualität über die Freisprechfunktion war nicht immer zufriedenstellend - Die typischen „Spielchen“ oder „Sonderlocken“ einer Retrospektive sind nicht machbar Wir haben auf jeden Fall eine Menge dazu gelernt. In einer weiteren verteilten Retrospektive würden wir alle mit Headsets arbeiten, um die Sprachqualität deutlich zu verbessern. Außerdem könnte ein etwas „freieres“ Werkzeug, wie beispielsweise padlet.com, die Kreativität der gesamten Gruppe mehr fördern. Hinzu kommt, dass solche Werkzeuge meistens auf den Geräten der Teilnehmer ohne Installation problemlos funktionieren. Wir sind auf jeden Fall gespannt auf das nächste Experiment! **Kategorien:** Tools & Methoden **Schlagwörter:** agile, German, Retrospektive, verteilteteams --- ### [Reliable restart of the weblogic server](https://thecattlecrew.net/2016/02/20/reliable-restart-of-the-weblogic-server/) **Published:** Februar 20, 2016 **Author:** Bernhard Mähr **Content:** Everyone doing CI using an application server knows the problem: After some time you get OutOfMemoryError because of the excessive deployments. The solution for this is to restart the application server periodically. But before you can start the application server, you must be sure to shut the application server down. This can be done for the weblogic with the stopWebLogic.sh script. But what happens if the application server is already out of memory or has an other problem and is not going to shut down? This can be solved by killing the process on OS level. Because I don“™t want to kill the process always, I have written a script to first shutdown the server gracefully and if it doesn“™t work, to kill the process. The script is executed from hudson remotely by a cron rule. ``` [sourcecode language='bash' ] #!/bin/bash # Hudson doesn't start a login shell, that's why we need to set some environment Variables HOSTNAME=my-weblogic-server.opitz-consulting.com export HOSTNAME env DOMAIN_NAME=base_domain DOMAIN_HOME="/u01/app/oracle/middleware/user_projects/domains/${DOMAIN_NAME}" echo Trying to stop CI for 60 seconds ... cd ${DOMAIN_HOME} ( ${DOMAIN_HOME}/bin/stopWebLogic.sh ) & sleep 60 ; kill $! echo Killing CI if not stopped now ... pkill -f ${DOMAIN_NAME} echo Waiting 30 seconds ... sleep 30 rm nohup.out echo Starting CI ... nohup ${DOMAIN_HOME}/bin/startWebLogic.sh 2>&1 & echo Waiting 3 minutes ... sleep 180 tail nohup.out echo Finished! [/sourcecode] ``` The script additionally appends the last lines of the server output after the restart to the log of the hudson job. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** Development **Schlagwörter:** Oracle FMW, Weblogic --- ### [Bericht vom DOAG DevCamp 2016 in Bonn](https://thecattlecrew.net/2016/02/24/bericht-vom-doag-devcamp-2016-in-bonn/) **Published:** Februar 24, 2016 **Author:** Holger Lehmann **Content:** Heute hat das 2-tägige DOAG DevCamp 2016 in Bonn geendet. An den beiden Tagen waren wir von OPITZ CONSULTING mit 5 Kollegen am Start, insgesamt ca. 70 Teilnehmer. Für mich war es die erste Teilnahme an so einer Veranstaltung. Vorweg: Es hat sich sehr gelohnt. Was kann man sich unter einem DevCamp vorstellen? In diesem Fall handelte es sich um eine Mischung aus reinen Vorträgen und einer Art Open Space mit Themenvorschlägen, die in verschiedenen Slots am Morgen ausgesucht und vorgestellt wurden. Pro Tag gab es 1-2 Keynotes, hier hießen sie Impulsvorträge. Als Location war das Kameha Grand Bonn auserkoren, hier ein Bild vom Innenhof. ![2016-02-24 08.23.56](https://thecattlecrew.net/wp-content/uploads/2016/02/2016-02-24-08-23-56.jpg) Als Hauptthemen waren vorher auf der Homepage des Events folgende Punkte genannt worden: - Workshops mit Hand-ons zum Testen der Oracle Produkte - Die Digitalisierung im Fokus - Die Oracle Entwicklungswerkzeuge unter der Lupe Hier nun die tatsächlichen Themenpunkte von Tag 1 und 2 ![2016-02-23 10.56.17](https://thecattlecrew.net/wp-content/uploads/2016/02/2016-02-23-10-56-17.jpg)![2016-02-24 11.00.20](https://thecattlecrew.net/wp-content/uploads/2016/02/2016-02-24-11-00-20.jpg) Für mich als Forms Experte natürlich besonders spannend: Oracle Forms war am 1. Tag das treibende Thema: Was macht man mit dem Invest, Ablösung oder Modernisierung? Treiben des Themas und natürlich das neue Forms 12c. Als Konsequenz beschlossen wir am Ende, zu versuchen, eine Interessensgruppe zum Thema Forms in der DOAG zu etablieren, geplant ist ein Oracle Forms Day als ganztägiges Event. Daneben soll mit Hilfe der DOAG versucht werden, einen gewissen Druck auf Oracle aufzubauen, um neue Features zu etablieren. Neben technischen und inhaltlichen Themen stand beim DevCamp ganz klar Networking im Vordergrund, dazu gab es in diversen Pausen gründlich Gelegenheit. Am 2. Tag wurden die Themen behandelt, die wegen des Schwerpunkts „Forms“ am Tag zuvor noch nicht behandelt wurden. ![2016-02-23 09.46.21](https://thecattlecrew.net/wp-content/uploads/2016/02/2016-02-23-09-46-21.jpg) Man war sich einig, dass es derzeit zwar wieder einen Forms Hype gibt, die anderen Oracle Oberflächentechniken abhängig vom Anwendungsfall aber auch eine Daseinsberechtigung haben. Es gibt eben nicht nur die eine sinnvolle Technologie! Andere spannende Sessions waren: - Manipulation von Mitarbeitern/Chefs - PL/SQL und APEX Konventionen - Wie viel Innovation braucht man wirklich ? - Ist der Entwickler eine reine Ressource ? - Mobile Cloud und Cloud im Allgemeinen - Der Hype Oracle JET Das DevCamp war gut organisiert und mit einer tollen Location ausgestattet. Für mich war es ein voller Erfolg, vor allem auf Grund der vielen spannenden Themen, des offenen Formats, des Austauschs auf vielen Ebenen und des Teilens von Wissen allerseits. Ich hoffe, dass es nächstes Jahr wieder so ein Event gibt, dann wäre ich wieder gerne dabei. **Kategorien:** Tech Events & Networking **Schlagwörter:** Cloud Computing, IoT, Oracle ADF, Oracle Forms, Weblogic --- ### [DOAG Regionaltreffen APEX](https://thecattlecrew.net/2016/03/03/doag-regionaltreffen-apex/) **Published:** März 3, 2016 **Author:** Thimo Fußbroich **Content:** Am 16.02.2016 fand das erste diesjährige DOAG Regionaltreffen der APEX Community. Die Community trifft sich drei bis viermal im Jahr zur Vorstellung und zum Austausch aktueller und interessanten Themen rund um APEX. Seit letztem Jahr sind auch wir dort regelmäßig vertreten und werden im Herbst auch Gastgeber eines Treffens sein. Der Abend war mit rund 25 Teilnehmern, vier Vorträgen sowie ausreichend Pausen zum Networking sehr interessant und gelungen. Den Auftakt gab Oliver Lemm (MT AG) mit einem Vergleich zwischen dem alten htmldb\_get und dem neuen apex.server.process. Als zweites war mein Vortrag zu dynamischen Oberflächen in APEX an der Reihe. Eine kleine Beispiel-Anwendung bietet die Möglichkeit über nur zwei Seiten Daten in eine beliebige Tabelle einzufügen und anzuzeigen. Durch dynamische Oberflächen kann die Anzahl an einzelnen Seiten in einer Anwendung deutlich reduziert und damit die Übersichtlichkeit und Benutzerfreundlichkeit verbessert werden. Wer Interesse oder Fragen zur Anwendung hat, kann diese gerne unter runterladen oder mich fragen. Im Anschluss hat Kai Donato (MT AG) einen Vortrag mit Live-Demo zu serverseitigem JavaScript mit NodeJS erzählt. Zu guter Letzt hat Till Albert (MT AG) etwas zur doch noch recht spartanischen Baumstruktur in APEX 5 und möglichen alternativen externen Lösung gezeigt. Hoffen wir, dass Bäume in APEX zukünftig noch mehr Möglichkeiten wie Drag and Drop bietet. ![Bild](https://thecattlecrew.net/wp-content/uploads/2016/03/bild.jpg) Nächste Termine: 07.06.2016 bei der DOAG in Düsseldorf 25.10.2016 bei OPITZ CONSULTING in Essen **Kategorien:** Tech Events & Networking **Schlagwörter:** DOAG --- ### [Austausch des Test-SSL-Zertifikats durch ein Unternehmens-ROOT-Zertifikat im Umfeld von Oracle Cloud Control](https://thecattlecrew.net/2016/03/09/austausch-des-test-ssl-zertifikats-durch-einen-unternehmens-roor-zertifikat-im-umfeld-von-oracle-cloud-control/) **Published:** März 9, 2016 **Author:** Neselovskyi, Borys **Content:** ## Vorwort Der Enterprise Manager (EM) Cloud Control ist ein gutes Werkzeug für die Administration und Überwachung von komplexen Umgebungen. Nach der Installation und Konfiguration kann man sich ganz bequem über ein HTTPS-Protokoll mit dem Enterprise Manager verbinden und sofort arbeiten. Man sollte aber berücksichtigen, dass der EM standardmäßig mit einem Test-SSL-Zertifikat installiert ist. Laut Oracle dient das Zertifikat nur zu Testzwecken und muss für die produktive Umgebung sofort durch ein gültiges, unternehmenssigniertes Zertifikat ersetzt werden. In diesem Beitrag beschreibe ich alle notwendige Schritte, die für den Austausch des Zertifikates auf der Ebene des Oracle HTTP-Servers notwendig sind. ### Schritt 1: Wallet erstellen. Eine Wallet ist für die Speicherung von Zertifikaten zuständig. Wallet-Verzeichnis auf der Betriebssystem Ebene erstellen: ***mkdir /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs*** Wallet generieren: ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet create -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs -auto\_login*** Während der Ausführung des Kommandos fragt das Tool nach einem Wallet-Passwort, das mindestens acht Zeichen lang sein muss: Oracle PKI Tool : Version 11.1.1.7.0 Copyright (c) 2004, 2013, Oracle and/or its affiliates. All rights reserved. Enter password: PKI-01002: Invalid password. Passwords must have a minimum length of eight characters and contain alphabetic characters combined with numbers or special characters. Enter password: Enter password again: Passwort: welcome12 Damit ist die Wallet erstellt und kann abgefragt werden. Wallet abfragen: ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet display -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs*** Ausgabe: Requested Certificates: User Certificates: Trusted Certificates: Subject: OU=Class 2 Public Primary Certification Authority,O=VeriSign\\, Inc.,C=US Subject: OU=Class 3 Public Primary Certification Authority,O=VeriSign\\, Inc.,C=US **Subject: CN=My\_Unternehmen Root CA,O=My\_Unternehmen,C=DE** ### Schritt 2: Unternehmens-ROOT-CA-Zertifikat anfordern und in die Wallet importieren: In unserem Beispiel heißt die Datei: My\_Unternehmen\_Root-CA.pem ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet add -wallet -trusted\_cert -cert -pwd *** Beispiel: ./orapki wallet add -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs -trusted\_cert -cert /var/tmp/My\_Unternehmen\_Root-CA.pem -pwd welcome12 Wallet abfragen: ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet display -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs*** Ausgabe: Requested Certificates: User Certificates: Trusted Certificates: Subject: OU=Class 2 Public Primary Certification Authority,O=VeriSign\\, Inc.,C=US Subject: OU=Class 3 Public Primary Certification Authority,O=VeriSign\\, Inc.,C=US Subject: CN=My\_Unternehmen Root CA,O=My\_Unternehmen,C=DE Subject: CN=GTE CyberTrust Global Root,OU=GTE CyberTrust Solutions\\, Inc.,O=GTE Corporation,C=US Subject: OU=Class 1 Public Primary Certification Authority,O=VeriSign\\, Inc.,C=US ### Schritt 3: CSR (Certificate Signing Request) erstellen: Mittels Kommando orapki soll ein server-bezogenes Zertifikat erstellt werden, das später von einer PKI (Public Key Infrastructure) Stelle signiert werden soll: ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet add „“wallet -dn ‚cn=‘ „“keysize 2048 „“pwd *** Beispiel: ***./orapki wallet add -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs -dn ‚cn=my\_cloudcontrol\_server‘ -keysize 2048 -pwd welcome12*** Als Ergebnis wird eine Datei namens „my\_cloudcontrol\_server.pem“ generiert. Mithilfe des Tools OpenSSL kann der Inhalt der Datei geprüft werden: ***openssl req -in /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/console/my\_cloudcontrol\_server.pem -noout „“text*** Ausgabe: Certificate Request: Data: Version: 0 (0x0) Subject: CN=my\_cloudcontrol\_server Subject Public Key Info: Public Key Algorithm: rsaEncryption Public-Key: (2048 bit) ### Schritt 4: Zertifikat signieren lassen Diese Datei soll zwecks Signierung an die zuständige Public-Key-Infrastruktur-Abteilung gesendet werden. Das signierte Zertifikat (in unserem Fall also die Datei „my\_cloudcontrol\_server.pem“) kann nun in die Wallet importiert werden. Schritt 4: Signiertes Zertifikat in die Wallet importieren Die Aktion erfolgt mittels des Kommandos orapki: ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet add „“wallet -user\_cert „“cert „“pwd *** Beispiel: **.*/orapki wallet add -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs -user\_cert -cert /home/oracle/my\_cloudcontrol\_server.pem -pwd welcome12*** Wallet abfragen: ***cd /u01/app/oracle/oms12cr5/oracle\_common/bin*** ***export JAVA\_HOME=/u01/app/oracle/oms12cr5/jdk16/jdk*** ***./orapki wallet display -wallet /u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs*** Ausgabe: Requested Certificates: User Certificates: **Subject: CN=my\_cloudcontrol\_server,O=My\_Unternehmen,C=DE** Trusted Certificates: **Subject: CN=My\_Unternehmen Root CA,O=My\_Unternehmen,C=DE** ### Schritt 5: Datei ssl.conf anpassen Der Oracle HTTP-Server muss wissen, wo die Wallet gespeichert ist. Dafür muss der Pfad zur Wallet in die Datei ssl.conf eingetragen werden: **SSLWallet file:/u01/app/oracle/gc\_inst/WebTierIH1/config/OHS/ohs1/keystores/ohs** ### Schritt 6: Oracle HTTP-Server neu starten: **cd /u01/app/oracle/gc\_inst/WebTierIH1/bin** **./opmnctl restartproc ias-component=ohs1** Status prüfen: ***./opmnctl status*** Processes in Instance: instance1 Processes in Instance: instance1 ———————————+——————–+———+——— ias-component | process-type | pid | status ———————————+——————–+———+——— ohs1 | OHS | 17554 | **Alive** ### Schritt 7: Zertifikat überprüfen Mittels Kommando openssl: ***openssl s\_client -connect localhost:7802*** Ausgabe: CONNECTED(00000003) depth=2 C = DE, O = My\_Unternehmen, CN =My\_Unternehmen Root CA verify error:num=19:self signed certificate in certificate chain verify return:0 — Certificate chain 0 s:/C=DE/O=My\_Unternehmen/CN=my\_cloudcontrol\_server 1 s:/C=DE/O=My\_Unternehmen/CN= My\_Unternehmen Root CA i:/C=DE/O=My\_Unternehmen/CN= My\_Unternehmen Root CA ``` ``` Und im Browser: ![bbb](https://thecattlecrew.net/wp-content/uploads/2016/03/bbb.png) ## Summary: Der Austausch von Zertifikaten gehört zu den Kernaufgaben eines Web-Administrators. Eine gute Vorbereitung ist die Voraussetzung für den reibunglosen Ablauf der Tätigkeit. **Kategorien:** Cloud, Development **Schlagwörter:** ADF, Administration, Enterprise Manager, Integration, IT Security, oracle, Oracle FMW, SSL, Weblogic --- ### [Prospects: Cloudy - OFM Middleware and PaaS Community Forum 2016 @Valencia](https://thecattlecrew.net/2016/03/20/prospects-cloudy-ofm-middleware-and-paas-community-forum-2016-valencia/) **Published:** März 20, 2016 **Author:** Sven Bernhardt **Content:** On friday the 22nd Fusion Middleware and PaaS Community Forum ends. Time to lean back and recap, what happened the last days. To summarize it shortly: It was a unique event and a great experience being part of this professional conference, as the following facts will show: - 2 days with tons of information about the Oracle Middleware on Premise and PaaS offerings, - 2 days with very good and interesting hands-on bootcamps leaded by technical experts, - 180 attendees consisting of a lot of experts, ACE“™s and ACED“™s - A huge contingent of members from Oracle“™s Product management team, - Great location with the Las Arenas hotel at the awesome city of Valencia, where the Fallas de Valencia (http://www.fallasfromvalencia.com/en) were taking place So the surrounding conditions were excellent and announced exciting days, offering best conditions for networking, exchanging information and best practices. The first day was mainly marked by strategy. So the latest information regarding Oracle“™s strategy for their cloud (PaaS, IaaS) and Middleware offerings were provided. This was very useful to give us as partners the opportunity to guide customers on the right path in their direction to the cloud. On the second day more technical topics came to the focus. The attendees could choose out of four different breakout sessions covering diverse aspects regarding the current Middleware and PaaS offerings: - SOA, integration and SOA Cloud Service track, - BPM, Process Cloud Service and user experience track, - Weblogic, Java Cloud Service and Engineered systems track, - Mobile and Internet of things track Within these sessions, the newest and upcoming features, information regarding the further roadmap for the products and also thoughts about current themes, like Microservices or API management and what is Oracle“™s understanding of these topics, which gives the attendees great insights where things are headed. As a highlight of this day, the ACEDs Lucas Jellema, Lonneke Dikmanns, Mark Simpson and Torsten Winterberg presented a showcase where diverse PaaS services (9! in numbers) where used to implement a voting platform. This shows how the diverse cloud services can be combined with each other, which was very impressive. The last two days were marked by more practical stuff. Here six different bootcamps were offered, each having different focusses: - Weblogic 12.2.1 WLS Multitenancy - Mobile and Mobile Cloud Service - Integrated PasS - SOA 12c and PaaS cool & new - Hybrid process applications - Internet of things (IoT) In all of those bootcamps a lot of theoretical and practical information were provided by the instructors. In addition, the attendees could get their hands on the newest versions of Middleware and PaaS products to get a first impression on the possibilities which are provided by the latest features of these products. At the same time, it was possible to give direct feedback to the instructors, consisting mainly of members of the Product management or Product development. So the feedback went directly the the right persons and can be used to further improve the current products and services. All in all, and as I already stated initially, it was a great and valuable conference. The vision of Oracle“™s Middleware and PaaS strategy was depicted crystal clear and the chances for partners and customers were explained very well. Regarding the current Middleware products and PaaS services, it can be said that those become more and more mature, with a clear vision and a predictable as well as consistent roadmap with monthly updates for the cloud services. It is really great to see those evolvements. The future for Oracle, theier partners and customers is looking very promising. Last, but not least I want to specifically mention Jürgen Kress, who makes such an impressive event happening and bringing such many great people together at an awesome location. Thank you Jürgen! **Kategorien:** Cloud **Schlagwörter:** Architecture, Cloud Computing, Conference, Integration, IoT, Mobile, OFMForum, Oracle Cloud, Oracle FMW, PaaS, Weblogic --- ### [Migrating Business Processes using Camundas Version Migration Plugin](https://thecattlecrew.net/2016/06/23/migrating-business-processes-using-camundas-version-migration-plugin/) **Published:** Juni 23, 2016 **Author:** Stefan Frena **Content:** In a recent project, I was faced with several versions of a process model and a lot of instances for each version. This increased the work of keeping every case in mind for example when it came to new backend developments (which are centralized and have to work for all versions). I had the idea of simply migrating all older instances to the latest version to keep life simple. I checked out Camundas [Version Migration Plugin](https://github.com/camunda/camunda-cockpit-plugins/tree/master/cockpit-plugin-version-migration) for Cockpit because I was hoping to get some order in the mess. Here is what I did. First of all, I installed the plugin. For that, I cloned the project and simply built the jar using mvn install. After that I found the jar in the target folder. I put that jar into the lib folder of camunda on my tomcat (../apache-tomcat-7.0.62/webapps/camunda/WEB-INF/lib/) and started the server. The cockpit plugin appears as a newly added tab in instance view, see picture below. ![8](https://thecattlecrew.net/wp-content/uploads/2016/06/8.png) If you havent had a strange feeling about version migration in your stomache already, you will have it now, reading „you are playing with fire!“. I strongly recommend reading the linked Risks and Limitations section, you can find on git. Brave as I am, I started playing with fire. My first step was to deploy a simple one-usertask-process and to start several instances for migration: ![1.png](https://thecattlecrew.net/wp-content/uploads/2016/06/1.png) Done that, I slightly changed the process model and deployed it in a version 2. I just added another usertask. After deployment, I started the migration: ![2](https://thecattlecrew.net/wp-content/uploads/2016/06/2.png) After migration, I was directly transferred into the model view of my V2, seeing the successfully deployed instance. So far so good. ![3](https://thecattlecrew.net/wp-content/uploads/2016/06/3.png) Now, I improved the model by adding a check on a process variable which did not exist in previous versions: ![6](https://thecattlecrew.net/wp-content/uploads/2016/06/6.png) Well, migration worked, but as you can imagine, after completing usertask 2, I was left with this message: ![4](https://thecattlecrew.net/wp-content/uploads/2016/06/4.png) Don’t panic! This is not an migration error, but a normal process-model-isn’t-very-sophisticated-error. The instance just rolled back to the last transaction – usertask 2. After adding the demanded variable (simply use cockpit/tasklist) the process instance ran just fine. As you might have noticed, I also added a service task, calling a delegate. I even used that same delegate as a execution listener on usertask 2 (event type: end) where the activity/token was waiting atm. After migrating instances to that version I successfully tested that delegate-call as well. Then I intentionally broke the recommended limitations and tried to migrate an instance, waiting at usertask 1 to a version not containing any activity going by UserTask\_1. As planned it did not work: ![8](https://thecattlecrew.net/wp-content/uploads/2016/06/82.png) ![7](https://thecattlecrew.net/wp-content/uploads/2016/06/7.png) But hey! My instance was still not burning. The migration simply was not successfull. The instance still lived in its original version. I am keeping on playing around with business process migration and will share new knowledge. Until then: Short conclusion: - The subject of process migration is more stable than I thought - Adding stuff won’t break the migration (and /or instance), as long existing activities can be found in the new version as well. - If you mess up, you are beeing warned, the migration does not go on (no guarantee :-)) - If you did not think about needed variables in later switches, the instance will just roll back as we are used to it (no guarantee :-)). - The Plug-In lets you migrate only on instance level. That means a lot of clicking but also more security. - Carefully check the delta between an older version and another. Find whats new and add that. Use API, Cockpit, Tasklist for variables - Carefully check if it is better to migrate all older versions (V1, V2) directly to the latest (V3) or to migrate from version to version (V1 -> V2 -> V3). - Always keep that the examples above are pretty basic. You should always test production migration with similar complexity (e.g. number of activities), before pushing the button. Before I am going to migrate instances of productive processes, I will carefully investigate them looking for existing activities (including boundary events), variables and so on. I will test the constellations on other stages first. I will only do that for instances of currently implemented processes because I fear the risk of overlooking / missing details of older implementations… until customer forces me 🙂 Happy migrating, Stefan **Kategorien:** Tools & Methoden **Schlagwörter:** Camunda --- ### [Camunda "“ Jetzt auch eine Zero-code BPM Lösung?](https://thecattlecrew.net/2016/07/12/camunda-jetzt-auch-eine-zero-code-bpm-loesung/) **Published:** Juli 12, 2016 **Author:** joergwissmeier **Content:** Camunda wirbt ja schon sehr lange damit, dass Ihre Lösung die richtigen Dinge umsetzt und die Vorteile von Individualentwicklung mit denen sog. BPM-Suites verbindet. BPM-Suites versprechen sehr häufig eine Automatisierung der Geschäftsprozesse ohne IT Unterstützung, also zero-code BPM oder wie camunda auch sagt „Bullshit BPM“. In der Praxis kennt man das ja, der Fachabteilung ist die IT häufig noch ein Rätsel. Umsetzung neuer Funktionen erscheinen schwierig und benötigen viel Zeit. Doch der Fachbereich möchte die Umsetzung der Anforderungen immer zügiger und der Wunsch nach Selbstbestimmung wird laut. Es wird vom Fachbereich also nach Lösungen gesucht, BPM als Synonym für BPM-Suites und damit zero-code scheinen die richtige Wahl zu sein. Anbieter werden eingeladen und evaluiert, auf den ersten Blick sieht es nach der ultimativen Lösung aus. Leider scheitern viele dieser Ansätze. Die Lösungen können die Erwartungshaltungen häufig nicht erfüllen und man stößt an vielen Stellen an die Grenzen der Möglichkeiten. Die teure Suite scheint sich also nicht bezahlt zu machen. Camunda hat bisher einen anderen Ansatz vertreten und sich eben auf die Ausführungsebene (die Process Engine) konzentriert. Zur Umsetzung von Geschäftsprozessen wird die IT also weiterhin benötigt, die für die Fachabteilung eigentlich wichtigen Punkte werden dabei adressiert. Transparenz (ein gemeinsames BPMN Modell) und Umsetzungsgeschwindigkeit (die Engine bringt schon vieles mit und entlastet den Entwickler). So weit so gut, doch was ist jetzt mit camunda los? Wird camunda auch zu einer zero-code BPM Lösung? Seit der neuen Version 7.5, die am 31.05.2016 veröffentlicht wurde, ist nun ein neues Feature enthalten. Die sog. „Element Templates“. Die Element Templates ermöglichen es, durch Vorfertigung von parametrisierten Java-Klassen und einer XML-Beschreibung, dass auch Nicht-Entwickler bzw. fachbereichsnahe Entwickler (citizen developers) durch Konfiguration über den camunda Modeller viele Dinge selbst erledigen können. Eine hohe Wiederverwendung der so erstellten Java-Klassen wird dadurch außerdem gewährleistet. Ein gutes Anwendungsszenario dürften wohl Emails sein, die aus Prozessen heraus versendet werden sollen. Für dieses Beispiel möchte ich auf den camunda Blog verlinken: Weitere Anwendungsszenarien könnten sein: - Templates für System-Connectoren (z.B. ERP, CMS, DMS..) - Customizing von Workflows/Prozessen (z.B. für Mandanten) - Bereitstellung einer anpassbaren Standardsoftware - Uvm. Element Templates können auf viele BPMN Typen angewandt werden, darunter aktuell „Activities“, „Sequence Flow“ (conditions) und „Process“. Durch die breite Basis, freue ich mich schon auf die vielen Einsätze in der Praxis. Mit dem neuen Feature hält camunda also eine sinnvolle Ergänzung bereit und bleibt seiner Linie, die richtigen Dinge zu tun, auch weiterhin treu. Für mich persönlich ist dieses Feature eines der Wichtigsten aus dem neuen Release 7.5. **Kategorien:** Tools & Methoden **Schlagwörter:** BPM, Camunda, German --- ### [Servicebus 12c: Using configuration files for customizing service deployments](https://thecattlecrew.net/2016/07/17/servicebus-12c-using-configuration-files-for-customizing-service-deployments/) **Published:** Juli 17, 2016 **Author:** Sven Bernhardt **Content:** # Introduction In my last projects I faced different challenges in the area of how to manage environment-specific artefact configurations that need to be adjusted during rollout of a particular service component. As a result from that, I decided to write down my experiences and solution approaches regarding the corresponding topics. This article is the starting point for a short blog series dealing with different challenges in this area, where the following topics will be covered: - General: Using configuration files for customizing service deployments - Adjust environment-specific configurations at deployment time - Evaluating environment-specific configurations at runtime - Security: Approaches for credentials management # Configuration files in Servicebus During its lifecycle a specific service component needs to pass different quality gates to ensure quality, correctness and stability before it will be approved for production rollout. For that reason deployments to different environments have to be done. This usually means changes in configurations like service endpoints or timeout parameters, which must be possible without changing a components implementation and rebuilding the component. In Oracle Servicebus this can be achieved by using so called [configuration files](https://docs.oracle.com/middleware/1213/osb/administer/GUID-6FBDE1BB-CAF5-40FC-BC88-D590828AB66C.htm#OSBAG1357) (aka customization files in OSB 11g). With those it is possible to consistently change service properties and configurations for implementation artefacts like proxy services, service pipelines and business services. Within a configuration file you define actions like replace or search and replace to adjust the corresponding configurations. Generating a basic configuration file can be done using Servicebus console. ![Create_Customization_File](https://thecattlecrew.net/wp-content/uploads/2016/07/create_customization_file.png) As it can be seen in the screenshot above the services that should be adjusted by the configuration file can be selected. Doing so, a file is generated containing replace rules for all configurations that are adjustable. One thing to notice, when working with Servicebus configuration files is that actions, which are used to replace parameters may throw errors at deployment time, if services are referenced explicitly by name and the referenced services are: - not part of the current deployment, - already deployed on the server yet. # Approaches for using configuration files Depending on the requirements, it can be chosen between a local and a global approach while working with configuration files. The main differences regarding these approaches is the level of granularity in which adjustments are possible, the way the configuration file is defined and the way how configuration files are organized. ## Central configuration management using property files A common detail for both approaches: The configuration file is used in a template style, where specific configurations are expressed as properties, like hostnames or ports.The values for the properties are defined in environment-specific property files. At deployment time, the property file for the target environment is used for replacing the corresponding properties in the configuration file template. This can for example be done by using the [maven replacer plugin](https://code.google.com/archive/p/maven-replacer-plugin/wikis/UsageGuide.wiki). Using that approach ensures that only one configuration file needs to be maintained, instead of one per environment. A property file may look like the following: ``` sbserver.clusteraddress=sbcluster.test helloworld.retryCount=0 ``` ## Local configuration file approach A local approach demands an explicit configuration file per Servicebus project. So in case a new service is implemented, a new configuration file needs to be created, which should be explicitly used for this service. In addition the central property files have to be adjusted to contain the newly created properties. Because every project has its own configuration file, the approach is very powerful regarding the granularity of how configuration parameter replacements can be defined, as the replacements are clearly related to a specific service. One difficulty of this approach is that an explicit configuration file needs to be maintained per service, which can become a bit messy. In the following an example for a fine grained, service-specific action is shown: ``` BusinessService service/v1/HelloWorldService Service URI 0 http://${sbserver.clusteraddress}/HelloWorldSvc Service URI Table http://${sbserver.clusteraddress}/HelloWorldSvc 0 Service Retry Count ${helloworld.retryCount} ``` ## Global configuration file approach Using a global approach, only one central configuration fileis needed, which defines the replacements for all services. So if a new service is created, only the central configuration file and the property files need to be adjusted, to replace the respective configurations of the new service. As the configuration file is global and used every time a service is deployed, there are limitations regarding the actions to be used and so also regarding the configuration parameters that can be replaced. It works without any problems, when all actions used do not reference a service by name explicitly. The actions should only specify the type of service, which should be touched (proxy or business service). So those replacement rules are generic and very flexible. Usually configuration files defined in this style are clear and comprehensible, but limited regarding the granularity of the replacements. It is perfectly fine and easy to manipulate service endpoints (hostname, ports, URLs), but properties like HTTP connection timeout or other numeric configuration parameters are hard to replace using global configuration files, because usually those configurations are specific to a explicit service. An example for a generic action is a search and replace, which may look like the following: ```         BusinessService true http://devserver.com:7101 false https://${sbserver.clusteraddress} ``` # Conclusion The decision, if the local or the global approach is more applicable, should be clarified depending on the requirements in a particular project. In most of the projects, in which I was involved, the global approach described in this article was adequate. Usually it is sufficient to just replace information regarding the service endpoints. But if more control regarding replacements is needed, the local approach is definitely the one to prefer. In the next article of this series, it will be shown, how to deal with configurations, which cannot be directly manipulated with the configuration files. An example for that is that depending on the current environment a different API key is needed in the header of the HTTP request. **Kategorien:** Integration **Schlagwörter:** oracle, Oracle DB, Oracle FMW --- ### [SOA Suite 12.2.1.1.0: Create, configure and tune a SOA/OSB Domain](https://thecattlecrew.net/2016/08/21/soa-suite-12-2-1-1-0-create-configure-and-tune-a-soaosb-domain/) **Published:** August 21, 2016 **Author:** Neselovskyi, Borys **Content:** ### Introduction This post focuses on the creation, configuration and tuning of an initial SOA Suite 12.2.1.1.0 Domain. The WebLogic Server is a necessary requirement, and must already be installed. For instruction how to install the WebLogic Server 12.2.1.1 please refer to my previous post: [WebLogic Server 12.2.1.1.0: Installation on the Linux OS](https://borysneselovskyi.wordpress.com/2016/07/31/weblogic_server_12-2-1-1_installation/) The following tasks will be implemented: - Preparing the Operating System for the installation of the WebLogic Server 12.2.1.1, Installation JDK 1.8 and the WebLogic Server 12.2.1.1: [WebLogic Server 12.2.1.1.0: Installation on the Linux OS](https://borysneselovskyi.wordpress.com/2016/07/31/weblogic_server_12-2-1-1_installation) - Creating of database schemas - Creating a SOA Suite Domain - Post-Installation Tasks: - Configuring of components - Creating of Start & Stop scripts for the automatic start/stop of components - SOA Suite Domain Tuning and Troubleshooting The SOA/OSB Domain will be installed without BAM (different Domain) because of: – Oracle Best Practices and our experience – In order to stabilize the system (BAM is unstable at the moment) The Domain will be created on two servers (OS OEL 6.7): - host01.example.com - host02.example.com We will configure four clusters: - OWSM Cluster (Oracle Web Services Management) - ESS Cluster (Enterprise Scheduler Services) - SOA Cluster - OSB Cluster (Oracle Service Bus) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_1.png) ### Installation SOA / OSB 12.2.1.1 **Note: All tasks described in this chapter must be running on both servers: host01 and host02** #### Prepare Software Download and extract the following software from the Oracle Software Delivery Cloud: https://edelivery.oracle.com: – SOA Suite 12.2.1.1.0 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_2.png) – OSB 12.2.1.1.0 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_3.png) #### Installation SOA Suite 12.2.1.1 (as OS User oracle) **Note: All tasks described in this chapter must be running on both servers: host01 and host02** Navigate to software directory, extract the SOA software, set the environment and start the installation: ``` [oracle@host01 Oracle_Home]$ cd /u01/app/oracle/software/SOA_Suite/ [oracle@host01 SOA_Suite]$ unzip V138472-01.zip [oracle@host01 SOA_Suite]$ export JAVA_HOME=/u01/app/oracle/product/JAVA/jdk [oracle@host01 SOA_Suite]$ export PATH=$JAVA_HOME/bin:$PATH [oracle@soa01 SOA_Suite]$ java -jar ./fmw_12.2.1.1.0_soa.jar ``` On the Welcome page click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_4.png) Enable „Skip Auto Updates“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_5.png) Set the Oracle Home to /u01/app/oracle/product/FMW/Oracle\_Home: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_6.png) Activate „Fusion Middleware Infrastructure“: Activate „SOA Suite“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_7.png) Prerequisite Checks: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_8.png) Verify the Summary of the Installation and click the button „Install“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_9.png) Verify installation“¦Next: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_10.png) Check installed components and click „Finisch“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_11.png) The Installation Oracle SOA Suite 12.2.1.1.0 is now completed #### Installation Oracle Service Bus 12.2.1.1 (as OS User oracle) **Note: All tasks described in this chapter must be running on both servers: host01 and host02** ``` [oracle@host01 SOA_Suite]$ cd /u01/app/oracle/software/OSB/ [oracle@host01 OSB]$ unzip V138477-01.zip [oracle@host01 OSB]$ export JAVA_HOME=/u01/app/oracle/product/JAVA/jdk [oracle@host01 OSB]$ export PATH=$JAVA_HOME/bin:$PATH [oracle@host01 OSB]$ java -jar ./fmw_12.2.1.1.0_osb.jar ``` On the Welcome page click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_12.png) Enable „Skip Auto Updates“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_13.png) Set the Oracle Home to /u01/app/oracle/product/FMW/Oracle\_Home: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_14.png) Activate the button „Service Bus“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_15.png) Prerequisite Checks: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_16.png) Verify the Summary of the Installation and click the button „Install“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_17.png) Verify installation“¦Next: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_18.png) Check installed components and click „Finish“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_19.png) The Installation Oracle Servce Bus 12.2.1.1.0 is now completed #### Create Database Schemas (as OS User oracle) Note: The creating of the database schemas must be running only once on the first server: host01 The database must be already created and prepared for the WebLogic Server Domain. For more information about the preparing the database please refer to the documentation: [http://docs.oracle.com/html/E73100\_01/toc.htm#GUID-85F0EAF9-3ACE-421D-BD72-F1A8E6B91116](http://docs.oracle.com/html/E73100_01/toc.htm) Login to the server as user oracle, navigate to oracle\_common directory, and start the Repository Creation Utility (RCU): ``` [oracle@host01 oracle]$ cd /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/bin [oracle@host01 bin]$ ./rcu ``` Step 1: the Welcome page: click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_20.png) Step 2: Create Repository: For the new SOA Installation choose „Create Repository“ and „System Load and Production Load“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_21.png) Step 3: Database Connection Details: On this Page provide the database connection information: Database Type: Oracle Database Host Name (database host): host02.example.com Port (Database Listener Port: 1521) Service Name (Service Name of the repository database): orcl Username & Password: Administration Account of the SOA Database: sys/xxx Role (Database Admin Role: SYSDBA or SYSOPER): SYSDBA „¦ „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_22.png) The Installer checks the database connectivity: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_23.png) Step 4: Select Components and the Prefix for database schemas: Following are mandatory selected components: - Common Infrastructure Services (Mandatory selected components cannot be deselected) Additionally I selected „Oracle Platform Security Services“, „SOA Infrastructure“ and „Oracle Enterprise Scheduler“. ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_24.png) The installer will check database prerequisites: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_25.png) Step 5: Set the password for all database schemas: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_26.png) Step 6: Choose the size of the SOA Repository (small, medium or high): Medium ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_27.png) Step 7: Map Tablespaces: On this page you can change the tablespace settings: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_28.png) In the next step the installer asks for the creating tablespaces for the soa repository: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_29.png) Tablespaces will be created: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_30.png) Step 8: Summary: check the details and click „Create“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_31.png) Check detail and click „Close“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_32.png) The SOA Repository Creation is now completed ### Create the SOA / OSB Domain (as OS User oracle) Note: The creating of the WebLogic Server Domain must be running only once on the first server: host01. Navigate to the oracle\_common directory and start the Configuration Wizard: ``` [oracle@host01 bin]$ cd /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin [oracle@host01 bin]$ ./config.sh ``` Choose „Create a new Domain“ and set the „Domain Location“ to /u01/app/oracle/user\_projects/domains/soa\_domain: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_33.png) On the next page you can add several WebLogic Server and SOA „“ OSB Templates. Select „SOA Suite“, „Oracle Service Bus“, „Oracle API Manager“, „Oracle Enterprise Scheduler Service Basic“, „Oracle User Messaging Service Basic“ and „Oracle OPSS REST Service Application“ (additional prerequisite components Coherence and JRF will be selected automatically). For more information about templates please refer to oracle documentation: [https://docs.oracle.com/middleware/1221/wls/WLDTR/fmw\_templates.htm#WLDTR227](https://docs.oracle.com/middleware/1221/wls/WLDTR/fmw_templates.htm) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_34.png)![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_35.png)![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_36.png) Specify an „Application Location“: /u01/app/oracle/user\_projects/applications/soa\_domain: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_37.png) Set the Name and Password for the WebLogic Administrator: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_38.png) Choose „Domain Mode“: Production and check the JDK location: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_39.png) Configure the database details: Specify the correct schema prefix: SOATST\_STB and the information what were specified when you previously ran RCU (Chapter „Create Database Schemas“). Then click on the Button „Get RCU Configuration“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_40.png) Installer checks database connectivity“¦ „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_41.png) Let default values and click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_42.png) The installer checks the database connections: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_43.png) We don’t configure the Key Store. Let default values and click „Next“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_44.png) Activate check boxes for Administration Server, Node Manager and Topology for the advanced configuration: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_45.png) On the next page configure the Administration Server: Name: AdminServer Listen Address: 192.168.75.32 (IP Address Server host01.example.com) Listen Port: 7001 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_46.png) Configure the Node Manager: Set Node Manager Type to „Per Domain Default Location“ „“ default Enter Node Manager Credentials: Username: nodemanager ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_47.png) On the page „Managed Servers“ add 8 Managed Servers with following settings: **Managed server****Listen Address****Port****Server Group**soa\_server1192.168.75.327003SOA-MGD- SVRS-ONLYosb\_server1192.168.75.327004OSB-MGD-SVRS-ONLYess\_server1192.168.75.327005ESS-MGD-SVRSowsm\_server1192.168.75.327006JRF-MAN-SVR, WSM-CACHE-SVR, WSMPM-MAN-SVRsoa\_server2192.168.75.337003SOA-MGD- SVRS-ONLYosb\_server2192.168.75.337004OSB-MGD-SVRS-ONLYess\_server2192.168.75.337005ESS-MGD-SVRSowsm\_server2192.168.75.337006JRF-MAN-SVR, WSM-CACHE-SVR, WSMPM-MAN-SVR In this example we will create eight managed servers for soa, osb, scheduler and webservices. We will place the four managed server (soa\_server1, osb\_server1, ess\_server1 and owsm\_server1) on the server host01.example.com (IP Address: 192.168.75.32) and the four managed server (soa\_server2, osb\_server2, ess\_server2 and owsm\_server2) on the host02.example.com (IP Address: 192.168.75.32). Server groups in the Middleware 12c allow to target and execute of middleware components (such soa or osb) on managed servers. For example the server group SOA-MGD-sRVC-ONLY is responsible to execute the SOA content. Server groups JRF-MAN-SVR and WSM-CACHE-SVR / WSMPM-MAN-SRV ensure that Oracle JRF and Oracle Web Services Manager (OWSM) services target Managed Servers you are creating. For more info about Server Groups please refer to: [https://docs.oracle.com/middleware/1221/core/INFIN/GUID-CA80A6E9-8903-4E19-81D7-A3647A11D0A6.htm#INFIN332](https://docs.oracle.com/middleware/1221/core/INFIN/GUID-CA80A6E9-8903-4E19-81D7-A3647A11D0A6.htm) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_48.png) Create 4 Clusters: soa\_cluster1, osb\_cluster1, ess\_cluster1 and owsm\_cluster1. Leave all another fields default „¦ „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_49.png) Add Managed Servers to clusters: ess\_cluster1: ess\_server1, ess\_server2 osb\_cluster1: osb\_server1, osb\_server2 owsm\_cluster1: owsm\_server1, owsm\_server2 soa\_cluster1: soa\_server1, soa\_server2 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_50.png) Specify the Coherence Cluster Listen Port: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_51.png) Create two Unix Machines: one for the host host01.example.com and the second UNIX Machine for the host02.example.com): **Name****Listen Address****Port**host01.example.com192.168.75.325556host02.example.com192.168.75.335556 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_52.png) Add Managed Servers to machines: host01.example.com: AdminServer, ess\_server1, osb\_server1, owsm\_server1, soa\_server1 host01.example.com: ess\_server2, osb\_server2, owsm\_server2, soa\_server3 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_53.png) In this example we don’t configure „Virtual Targets“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_54.png) We don’t create „Partitions“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_55.png) Check configuration summary and press the button „Create“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_56.png) The Creation of initial Domain is now completed“¦ „Next“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_57.png) The SOA Domain is now created, „¦“Finish“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_58.png) ### Post-Installation Tasks #### Disabling the Derby Database Note: All tasks described in this chapter must be running on both servers: host01.example.com and host02.example.com ``` [oracle@host01]$ cd /u01/app/oracle/product/FMW/Oracle_Home/wlserver/common/derby/lib/ [oracle@host01 lib]$ mv derby.jar disable_derby.jar ``` #### Start the AdminServer via script Enter the values for the Administration User (weblogic) and passwort when prompted: ``` [oracle@host01 bin]$ cd /u01/app/oracle/user_projects/domains/soa_domain/bin [oracle@soa01 bin]$ ./startWebLogic.sh Enter username to boot WebLogic server:weblogic Enter password to boot WebLogic server:xxx ``` #### Shutdown the AdminServer via script: ``` [oracle@host01 bin]$ cd /u01/app/oracle/user_projects/domains/soa_domain/bin [oracle@soa01 bin]$ ./stopWebLogic.sh ``` #### Create the file boot.properties on the server host01 ``` [oracle@host01]$ cd /u01/app/oracle/user_projects/domains/soa_domain/servers/AdminServer [oracle@host01 AdminServer]$ mkdir security [oracle@host01 AdminServer]$ cd security/ [oracle@host01 security]$ echo -e "username=weblogic\npassword=welcome1" > boot.properties [oracle@host01 security]$ cat boot.properties username=weblogic password=welcome1 ``` #### Copying the Domain configuration from the server host01 to the host02 Save the Domain configuration on the server host01: ``` [oracle@host01 oracle]$ cd /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin [oracle@host01 bin]$ ./pack.sh -domain=/u01/app/oracle/user_projects/domains/soa_domain -template=/home/oracle/soa_domain.jar -template_name=soa_domain ``` Output: ``` > succeed: read domain from "/u01/app/oracle/user_projects/domains/soa_domain" > succeed: write template to "/home/oracle/soa_domain.jar" > succeed: close template ``` Copy the file host01:/home/oracle/soa\_domain.jar to the server host02 ``` [oracle@host01 ~]$ scp /home/oracle/soa_domain.jar host02.example.com:/home/oracle ``` Extract the domain configuration on the server host02.example.com: ``` [oracle@host02 oracle]$ mkdir -p /u01/app/oracle/user_projects/domains [oracle@host02 oracle]$ mkdir -p /u01/app/oracle/user_projects/applications [oracle@host02 oracle]$ cd /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin [oracle@host02 bin]$ ./unpack.sh -user_name=weblogic -password=welcome1 -domain=/u01/app/oracle/user_projects/domains/soa_domain -overwrite_domain=true -template=/home/oracle/soa_domain.jar -log_priority=DEBUG -log=/tmp/unpack.log -app_dir=/u01/app/oracle/user_projects/applications ``` Output: ``` > succeed: read template from "/home/oracle/soa_domain.jar" > succeed: set config option AppDir to "/u01/app/oracle/user_projects/applications" > succeed: find User "weblogic" as u1_CREATE_IF_NOT_EXIST > succeed: set u1_CREATE_IF_NOT_EXIST attribute Password to "********" > succeed: set u1_CREATE_IF_NOT_EXIST attribute IsDefaultAdmin to "true" > succeed: write Domain to "/u01/app/oracle/user_projects/domains/soa_domain" > succeed: close template ``` #### NodeManager configuration (as OS User oracle) Server host1: Edit file nodemanager.properties: ``` [oracle@host01 ~]$ cd /u01/app/oracle/user_projects/domains/soa_domain/nodemanager [oracle@host01 nodemanager]$ vi nodemanager.properties ``` Change parameter: Old: CrashRecoveryEnabled=false New: CrashRecoveryEnabled=true Start NodeManager: ``` [oracle@host01 bin]$ cd /u01/app/oracle/user_projects/domains/soa_domain/bin [oracle@host01 bin]$ nohup ./startNodeManager.sh & ``` Server host02: Edit file nodemanager.properties: ``` [oracle@host02 ~]$ cd /u01/app/oracle/user_projects/domains/soa_domain/nodemanager [oracle@host02 nodemanager]$ vi nodemanager.properties ``` Change parameter: Old: ListenAddress=192.168.75.32 CrashRecoveryEnabled=false New: ListenAddress=192.168.75.33 CrashRecoveryEnabled=true Start NodeManager: ``` [oracle@host02 bin]$ cd /u01/app/oracle/user_projects/domains/soa_domain/bin [oracle@host02 bin]$ nohup ./startNodeManager.sh & ``` Start AdminServer via NodeManager and WLST on the Server host01 (as OS User oracle) Start wlst: ``` [oracle@host01 oracle]$ /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` wlst> nmConnect('nodemanager','welcome1', '192.168.75.32','5556','soa_domain','/u01/app/oracle/user_projects/domains/soa_domain') ``` Start AdminServer: ``` wls:/nm/soa_proddomain> nmStart('AdminServer') ``` Output: ``` Starting server AdminServer ... Successfully started server AdminServer ... ``` Execute nmEnroll commando on the second server: host02.example.com (as OS User oracle) Start wlst: ``` [oracle@host02]$ /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to AdminServer (AdminServer must be running): ``` wls:/offline> connect('weblogic','welcome1','t3://192.168.75.32:7001') ``` Execute nmEnroll commando: ``` wls:/soa_domain/serverConfig/> nmEnroll('/u01/app/oracle/user_projects/domains/soa_domain','/u01/app/oracle/user_projects/domains/soa_domain/nodemanager') ``` Output. ``` Enrolling this machine with the domain directory at /u01/app/oracle/user_projects/domains/soa_domain ... Successfully enrolled this machine with the domain directory at /u01/app/oracle/user_projects/domains/soa_domain. ``` Restart the NodeManager: ``` [oracle@host02 bin]$ cd /u01/app/oracle/user_projects/domains/soa_domain/bin [oracle@host02 bin]$ ./stopNodeManager.sh [oracle@host02 bin]$ nohup ./startNodeManager.sh & ``` #### Start all Managed Servers via AdminConsole Open the Browser and go to Starting all Managed Servers via WebLogic Server Admin Console: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_59.png) All Managed Servers are running: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_60.png) #### Get your familiar with the new look of the Enterprise Manager: Open the page: : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_61.png) #### Prepare the WebLogic Server domain for the auto start Server host01: Create directory (as OS User oracle): ``` [oracle@host01 ~]$ mkdir /u01/app/oracle/scripts [oracle@host01 ~]$ chmod 744 /u01/app/oracle/scripts [oracle@host01 ~]$ cd /u01/app/oracle/scripts ``` Create scripts in the directory /u01/app/oracle/scripts (as OS User oracle) Create script /home/oracle/scripts/fmw\_nodemanager.sh: ``` #!/bin/bash ## fmw_nodemanager.sh DOMAIN_HOME=/u01/app/oracle/user_projects/domains/soa_domain WORK_DIR=/u01/app/oracle/scripts export DOMAIN_HOME WORK_DIR case "$1" in start) nohup ${DOMAIN_HOME}/bin/startNodeManager.sh > ${WORK_DIR}/nodemanager.out 2>&1 & ;; stop) ${DOMAIN_HOME}/bin/stopNodeManager.sh ;; *) echo "usage: $0 [start|stop]" exit 2 ;; esac ``` Create script /u01/app/oracle/scripts/fmw\_admin\_and\_ms.sh: ``` #!/bin/bash ## fmw_admin_and_ms.sh DOMAIN_HOME=/u01/app/oracle/user_projects/domains/soa_domain ORACLE_HOME=/u01/app/oracle/product/FMW/Oracle_Home WORK_DIR=/u01/app/oracle/scripts export DOMAIN_HOME ORACLE_HOME WORK_DIR WLST=${ORACLE_HOME}/oracle_common/common/bin/wlst.sh export WLST case "$1" in start) ${WLST} ${WORK_DIR}/start_admin.py ${WLST} ${WORK_DIR}/start_ms.py ;; start_admin) ${WLST} ${WORK_DIR}/start_admin.py ;; start_ms) ${WLST} ${WORK_DIR}/start_ms.py ;; stop) ${WLST} ${WORK_DIR}/stop_ms.py ${WLST} ${WORK_DIR}/stop_admin.py ;; stop_admin) ${WLST} ${WORK_DIR}/stop_admin.py ;; stop_ms) ${WLST} ${WORK_DIR}/stop_ms.py ;; *) echo "usage: $0 [start|start_admin|start_ms|stop|stop_admin|stop_ms]" exit 2 ;; esac ``` Create script /u01/app/oracle/scripts/start\_admin.py: ``` nmConnect('nodemanager','welcome1, '192.168.75.32','5556','base_domain','/u01/app/oracle/user_projects/domains/soa_domain') nmStart('AdminServer') ``` Create script /u01/app/oracle/scripts/stop\_admin.py: ``` nmConnect('nodemanager','welcome1, '192.168.75.32','5556','base_domain','/u01/app/oracle/user_projects/domains/soa_domain') nmKill('AdminServer') ``` Create script /u01/app/oracle/scripts/start\_ms.py: ``` nmConnect('nodemanager','welcome1, '192.168.75.32','5556','base_domain','/u01/app/oracle/user_projects/domains/soa_domain') nmStart('owsm_server1') nmStart('osb_server1') nmStart('soa_server1') nmStart('ess_server1') ``` Create script /u01/oracle/scripts/stop\_ms.py: ``` nmConnect('nodemanager','welcome1, '192.168.75.32','5556','base_domain','/u01/app/oracle/user_projects/domains/soa_domain') nmKill('ess_server1') nmKill('soa_server1') nmKill('osb_server1') nmKill('owsm_server1') ``` Set permissions: ``` [oracle@host01 scripts]$ chmod -R 747 /u01/app/oracle/scripts ``` Integrate start-stop-scripts in Linux run-level (as OS user root) Create script /etc/init.d/oracle (as root): ``` #!/bin/sh # chkconfig: 345 99 10 # description: Oracle auto start-stop script. # Set ORA_OWNER to the user id of the owner of the export HOME=/u01/app/oracle/scripts ORA_OWNER=oracle if [ ! -f ${HOME}/fmw_nodemanager.sh \ -o ! -f ${HOME}/fmw_admin_and_ms.sh     \ -o ! -f ${HOME}/start_admin.py     \ -o ! -f ${HOME}/stop_admin.py     \ -o ! -f ${HOME}/start_ms.py     \ -o ! -f ${HOME}/stop_ms.py ] then echo "Oracle FMW startup: cannot start" exit fi case "$1" in 'start') su $ORA_OWNER -c "$HOME/fmw_nodemanager.sh start" sleep 120 su $ORA_OWNER -c "$HOME/fmw_admin_and_ms.sh start" ;; 'stop') su $ORA_OWNER -c "${HOME}/fmw_admin_and_ms.sh stop" su $ORA_OWNER -c "${HOME}/fmw_nodemanager.sh stop" ;; esac ``` Integrate the script /etc/init.d/oracle in run-levels (as root): ``` [root@host01 init.d]# chmod 700 /etc/init.d/oracle [root@host01 init.d]# cd /etc/init.d [root@host01 init.d]# chkconfig --add oracle ``` Check ( as root): ``` [root@host01 init.d]# chkconfig --list oracle oracle 0:off 1:off 2:off 3:on 4:on 5:on 6:off ``` Server soa02 Create directory (as OS User oracle): ``` [oracle@host02 ~]$ mkdir /u01/app/oracle/scripts [oracle@host02 ~]$ chmod 744 /u01/app/oracle/scripts [oracle@host02 ~]$ cd /u01/app/oracle/scripts ``` Create scripts in the directory /u01/app/oracle/scripts (as OS User oracle) Create script /u01/app/oracle/scripts/fmw\_nodemanager.sh: ``` #!/bin/bash ## fmw_nodemanager.sh DOMAIN_HOME=/u01/app/oracle/user_projects/domains/soa_domain WORK_DIR=/u01/app/oracle/scripts export DOMAIN_HOME WORK_DIR case "$1" in start) nohup ${DOMAIN_HOME}/bin/startNodeManager.sh > ${WORK_DIR}/nodemanager.out 2>&1 & ;; stop) ${DOMAIN_HOME}/bin/stopNodeManager.sh ;; *) echo "usage: $0 [start|stop]" exit 2 ;; esac ``` Create script /u01/app/oracle/scripts/fmw\_ms.sh: ``` #!/bin/bash ## fmw_ms.sh DOMAIN_HOME=/u01/app/oracle/user_projects/domains/soa_domain ORACLE_HOME=/u01/app/oracle/product/FMW/Oracle_Home WORK_DIR=/u01/app/oracle/scripts export DOMAIN_HOME ORACLE_HOME WORK_DIR WLST=${ORACLE_HOME}/oracle_common/common/bin/wlst.sh export WLST case "$1" in start) ${WLST} ${WORK_DIR}/start_ms.py ;; stop) ${WLST} ${WORK_DIR}/stop_ms.py ;; *) echo "usage: $0 [start|stop]" exit 2 ;; esac ``` Create script /u01/app/oracle/scripts/start\_ms.py: ``` nmConnect('nodemanager','welcome1, '192.168.75.33','5556','base_domain','/u01/app/oracle/user_projects/domains/soa_domain') nmStart('owsm_server2') nmStart('osb_server2) nmStart('soa_server2') nmStart('ess_server2') ``` Create script /u01/app/oracle/scripts/stop\_ms.py: ``` nmConnect('nodemanager','welcome1, '192.168.75.33','5556','base_domain','/u01/app/oracle/user_projects/domains/soa_domain') nmKill('ess_server2') nmKill('soa_server2') nmKill('osb_server2') nmKill('owsm_server2') ``` Set permissions: ``` [oracle@host02 scripts]$ chmod -R 747 /home/oracle/scripts ``` Integrate start-stop-scripts in Linux run-level (as OS user root) Create script /etc/init.d/oracle (as root): ``` #!/bin/sh # chkconfig: 345 99 10 # description: Oracle auto start-stop script. # Set ORA_OWNER to the user id of the owner of the export HOME=/u01/app/oracle/scripts ORA_OWNER=oracle if [ ! -f ${HOME}/fmw_nodemanager.sh \ -o ! -f ${HOME}/fmw_ms.sh     \ -o ! -f ${HOME}/start_ms.py     \ -o ! -f ${HOME}/stop_ms.py ] then echo "Oracle FMW startup: cannot start" exit fi case "$1" in 'start') su $ORA_OWNER -c "$HOME/fmw_nodemanager.sh start" sleep 120 su $ORA_OWNER -c "$HOME/fmw_ms.sh start" ;; 'stop') su $ORA_OWNER -c "${HOME}/fmw_ms.sh stop" su $ORA_OWNER -c "${HOME}/fmw_nodemanager.sh stop" ;; esac ``` Integrate the script /etc/init.d/oracle in run-levels (as root): ``` [root@host02 init.d]# chmod 700 /etc/init.d/oracle [root@host02 init.d]# cd /etc/init.d [root@host02 init.d]# chkconfig --add oracle ``` Check (as root): ``` [root@host02 init.d]# chkconfig --list oracle oracle 0:off 1:off 2:off 3:on 4:on 5:on 6:off ``` ### Tuning and Troubleshooting the SOA Domain #### Tuning JVM (as OS User oracle) We will customize the settings for the Java Heap size and for WebLogic Server Start parameters by the creating the File setUserOverrrides.sh. We will tune the Java heap size for the Admin Server and for each Managed Server. We will set some WebLogic Server start Parameter: - -Dweblogic.MaxMessageSize=300000000 # increase the MessageSize - -Dweblogic.threadpool.MinPoolSize=1024 # Tuning the WebLogic ThreadPool For more information about the customizing of Java settings please refer to my article Creating the File setUserOverrides.sh on both hosts: host01.example.com and host02.example.com: ``` [oracle@host01 ~]$ cd /u01/app/oracle/user_projects/domains/soa_domain/bin [oracle@host01 bin]$ cat setUserOverrides.sh ``` Content of setUserOverrides.sh: ``` #!/bin/bash echo "Setting from UserOverrides.sh" # global settinga (for all servers)s export JAVA_OPTIONS="$JAVA_OPTIONS -Dweblogic.MaxMessageSize=300000000 -Dweblogic.threadpool.MinPoolSize=1024" # customer settings for each server if [ "${SERVER_NAME}" = "AdminServer" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms512m -Xmx1g" fi if [ "${SERVER_NAME}" = "soa_server1" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms1g -Xmx2g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=1g" echo "Customizing JAVA_OPTIONS for SERVER_NAME ${SERVER_NAME}" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" # Coherence Settings export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.localhost=192.168.75.32" export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.wka1=192.168.75.32 -Dtangosol.coherence.wka2=192.168.75.33" export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.localport=8090" export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.localport.adjust=true" fi if [ "${SERVER_NAME}" = "soa_server2" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms1g -Xmx2g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=1g" echo "Customizing JAVA_OPTIONS for SERVER_NAME ${SERVER_NAME}" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" # Coherence Settings export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.localhost=192.168.75.33" export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.wka1=192.168.75.33 -Dtangosol.coherence.wka2=192.168.75.32" export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.localport=8090" export JAVA_OPTIONS="${JAVA_OPTIONS} -Dtangosol.coherence.localport.adjust=true" fi if [ "${SERVER_NAME}" = "osb_server1" -o "${SERVER_NAME}" = "osb_server2" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms1g -Xmx2g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=1g" echo "Customizing JAVA_OPTIONS for SERVER_NAME ${SERVER_NAME}" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" fi if [ "${SERVER_NAME}" = "owsm_server1" -o "${SERVER_NAME}" = "owsm_server2" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms512m -Xmx1g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=512m" echo "Customizing JAVA_OPTIONS for SERVER_NAME ${SERVER_NAME}" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" fi if [ "${SERVER_NAME}" = "ess_server1" -o "${SERVER_NAME}" = "ess_server2" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms512m -Xmx1g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=512m" echo "Customizing JAVA_OPTIONS for SERVER_NAME ${SERVER_NAME}" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" fi echo "End setting from UserOverrides.sh" ``` #### Tuning Fusion Middleware Control (as OS User oracle) > Reference: MOS Note „How to Enable Discovery Cache To Avoid Long Delay During Login To Fusion Middleware Control (Doc ID 1423893.1)“ On the server host01 login to wlst with weblogic user and connect to domain environment: ``` [oracle@host01 ~]$ /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to the AdminServer: ``` wls:/offline> connect('weblogic','welcome1','t3://192.168.75.32:7001') ``` Change location to domain custom tree ``` wls:/base_domain/serverConfig/> domainCustom() ``` Set variables: ``` wls:/soa_domain/domainCustom/> myMBean=ObjectName('emoms.props:Location=AdminServer,name=emoms.properties,type=Properties,Application=em') wls:/soa_domain/domainCustom/> types=['java.lang.String', 'java.lang.String'] wls:/soa_domain/domainCustom/> type=['java.lang.String'] ``` Set property oracle.sysman.emas.discovery.wls.FMW\_DISCOVERY\_USE\_CACHED\_RESULTS=true: ``` wls:/soa_domain/domainCustom/> params=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_USE_CACHED_RESULTS', 'true'] wls:/soa_domain/domainCustom/> mbs.invoke(myMBean,'setProperty',params,types) ``` Set property oracle.sysman.emas.discovery.wls.FMW\_DISCOVERY\_MAX\_CACHE\_AGE=7200000: ``` wls:/soa_domain/domainCustom/> params=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_CACHE_AGE','7200000'] wls:/soa_domain/domainCustom/> mbs.invoke(myMBean,'setProperty',params,types) ``` Set property oracle.sysman.emas.discovery.wls.FMW\_DISCOVERY\_MAX\_WAIT\_TIME=10000: ``` wls:/soa_domain/domainCustom/> params=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_WAIT_TIME','10000'] wls:/soa_domain/domainCustom/> mbs.invoke(myMBean,'setProperty',params,types) ``` Invoke getProperty operations to display and confirm parameter values (Values returned by wlst are in red): Display changes added: ``` wls:/soa_domain/domainCustom/> param=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_USE_CACHED_RESULTS'] wls:/soa_domain/domainCustom/> mbs.invoke(myMBean,'getProperty',param,type) 'true' wls:/soa_domain/domainCustom/> param=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_CACHE_AGE'] wls:/soa_domain/domainCustom/> mbs.invoke(myMBean,'getProperty',param,type) '7200000' wls:/soa_domain/domainCustom/> param=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_WAIT_TIME'] wls:/soa_domain/domainCustom/> mbs.invoke(myMBean,'getProperty',param,type) '10000' ``` #### Tuning the WebLogic Server Start: Avoiding JVM Delays Caused by Random Number Generation Change the JVM random generation from /dev/random to /dev/urandom. For more Information refer to the Oracle Documentation: [https://docs.oracle.com/cd/E13209\_01/wlcp/wlss30/configwlss/jvmrand.html](https://docs.oracle.com/cd/E13209_01/wlcp/wlss30/configwlss/jvmrand.html) Go to the file java.security and change the parameter securerandom.source: Server host01 (as OS User oracle): ``` [oracle@host01 ~]$ vi /u01/app/oracle/product/JAVA/jdk/jre/lib/security/java.security ``` Old value: securerandom.source=file:/dev/random Change to: securerandom.source=file:/dev/urandom Repeat the step on the Server host02.example.com. Restart the Admin and all Managed Servers. #### Configure the SOA Purging via Enterprise Manager Fusion Middleware Control Go to Fusion Middleware Control Navigate to SOA -> soa-infra: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_62.png) Then to SOA Infrastructure -> SOA Administration -> Auto Purge: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_63.png) The Purge Configuration Page appears. You can set the scheduling options, Type of Purge (single or parallel) and another settings: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/082016_1443_64.png) enjoy 🙂 **Kategorien:** Infrastructure **Schlagwörter:** Cluster, Coherence, Domain, Heapsize, HowTo, JVM Runing, oracle, Oracle DB, Oracle FMW, Oracle Service Bus, OSB, Start-Stop, Weblogic, WLST --- ### [How to customize Java Virtual Machine Settings in Oracle WebLogic Server 12 on OS Linux / UNIX](https://thecattlecrew.net/2016/07/24/how-to-customize-java-virtual-machine-settings-in-oracle-weblogic-server-12-on-os-linux-unix__trashed/) **Published:** Juli 24, 2016 **Author:** Neselovskyi, Borys **Kategorien:** Infrastructure **Schlagwörter:** oracle, Oracle DB, Oracle FMW, tuning garbage collection, tuning jvm, Weblogic --- ### [WebLogic Server 12.2.1.1.0: Create, configure and tune a Domain](https://thecattlecrew.net/2016/07/31/weblogic-server-12-2-1-1-0-create-configure-and-tune-a-domain/) **Published:** Juli 31, 2016 **Author:** Neselovskyi, Borys **Kategorien:** Infrastructure **Schlagwörter:** Cluster, HowTo, JVM Tuning, oracle, Oracle DB, Oracle FMW, Weblogic --- ### [Oracle SB 12c QuickTip: Resolve NoClassDefFoundError during Maven deployment](https://thecattlecrew.net/2016/09/02/oracle-sb-12c-quicktip-resolve-noclassdeffounderror-during-maven-deployment/) **Published:** September 2, 2016 **Author:** Sven Bernhardt **Kategorien:** Development **Schlagwörter:** Deployment, Maven, NoClassDefFoundError, oracle, Oracle FMW, OSB, SB --- ### [OOW 16: My thoughts and experiences](https://thecattlecrew.net/2016/09/29/oow-16-my-thoughts-and-experiences/) **Published:** September 29, 2016 **Author:** Sven Bernhardt **Content:** Not able to attend Oracle Open World 2016? You are curious to learn about what was happening there? Then read my latest blog, where I tried to summarize my personal thoughts and experiences! **Kategorien:** Integration **Schlagwörter:** oracle --- ### [Q-loud "“ Eine Deutsche IoT Plattform](https://thecattlecrew.net/2016/09/29/q-loud-eine-deutsche-iot-plattform/) **Published:** September 29, 2016 **Author:** Dominik Bial **Content:** Die QSC AG bietet umfangreiche Cloud Angebote an. Darunter fällt auch eine Plattform für IoT Use Cases, die nun im aktuellen Jahr (2016) eine prominente Stellung erhält. Die Tochtergesellschaft [Q-loud GmbH](http://www.q-loud.de) vertreibt die Plattform als auch komplette Dienstleistungen („full-stack“) rund um eine Deutsche IoT Cloud. Besonders spannend hierbei ist, dass gerade der deutsche Mittelstand mit dieser Lösung adressiert wird und die Plattform unter deutsches Recht fällt. Ein weiterer, außergewöhnlicher Faktor ist die Kombination der IoT Cloud Plattform mit der Geräte-Infrastruktur, beziehungsweise Device Entwicklung. Neben der reinen Neuentwicklung von Devices sticht gerade das sogenannte „Retrofitting“ heraus. Dabei werden vorhandene Strukturen und Geräte „IoT enabled“. Sind Geräte wie Feuermelder, Vending Machines oder andere Strukturen vorhanden, werden diese durch einen Eingriff fit für das IoT gemacht. Ein Beispiel: Häufig werden Zustände mit Hilfe von Dioden direkt an Geräten visualisiert. Eine entsprechende Farbänderung ließe sich durch das Abgreifen relevanter Ströme erfassen und dann kommunizieren. Ist die Infrastruktur bereits im Feld vorhanden und sollen auch bereits vorhandene Geräte in digitalen Geschäftsmodellen eingesetzt werden, ist Retrofitting eine gute Alternative, die kostengünstiger ausfallen kann. Damit erhält man nicht nur Unterstützung bei der Integration und Verarbeitung von Events, sondern auch beim direkten Abgreifen von Zuständen und der Steuerung von Geräten im Feld. Die Hürde, Daten im Feld abzugreifen und diese dann einer IoT Plattform zuzuführen, wird mit dem Angebot erheblich verringert. OPITZ CONSULTING hat aktuell die Möglichkeit, die IoT Plattform genauer zu evaluieren und sich mit verschiedenen Lösungsszenarien auseinander zu setzen. Ein kleines Gateway ermöglicht es uns, Daten in die Q-loud Cloud zu senden und Aktionen auszuführen. [![q-loud_gw](https://thecattlecrew.net/wp-content/uploads/2016/09/q-loud_gw.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/09/q-loud_gw.png) Eine Portallösung für den Temperatursensor im Gateway erlaubt das direkte Einsehen von Informationen, sodass man ein Gefühl dafür bekommt, wie entsprechende Dashboards im größeren Stil aussehen könnten. [![q-loud_devicemanager](https://thecattlecrew.net/wp-content/uploads/2016/09/q-loud_devicemanager.png?w=294)](https://thecattlecrew.net/wp-content/uploads/2016/09/q-loud_devicemanager.png) Über die REST API, die zur IoT Cloud Plattform gehört, erfolgt das weitere Management der Devices. Über die API lassen sich Regeln, Aktionen, weitere Sensoren und vieles mehr konfigurieren und definieren. Mit der REST API beschäftigen wir uns gerade gesondert. Ziel ist es, einen Vending Machine Showcase auf Basis der Q-loud Plattform zu erstellen. [![qloud-vending-machine](https://thecattlecrew.net/wp-content/uploads/2016/09/qloud-vending-machine.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/09/qloud-vending-machine.jpg)[![soap_ui_q-loud](https://thecattlecrew.net/wp-content/uploads/2016/09/soap_ui_q-loud.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/09/soap_ui_q-loud.png) Kommen Sie bei Interesse gerne auf uns zu. Der ein oder andere Blog-Eintrag wird zu diesem Thema sicherlich noch folgen. **Kategorien:** Integration **Schlagwörter:** Architecture, cloud, Cloud Computing, German, Integration, IoT --- ### [Impressionen von der DOAG 2016](https://thecattlecrew.net/2016/11/24/impressionen-von-der-doag-2016/) **Published:** November 24, 2016 **Author:** nathaliekirches **Content:** Bei der DOAG Konferenz am 15. bis 17. November 2016 in Nürnberg präsentierte sich unsere IT-Beratung diesmal im neuen Gewand: Mit einem brandneuen High-Tech-Stand konnten wir uns bei den Besuchern glaubwürdig als „Partner für die digitale Transformation“ positionieren. Das Hauptinteresse der Oracle Anwender lag bei der Konferenz eindeutig bei aktuellen Themen wie Cloud Computing, API Management und Modernen Oberflächen. Entsprechend großen Anklang fand die Hololenses-Aktion an unserem Stand, bei der sich Besucher mit einer VR-Brille beim virtuellen, freischwebenden Tetris beweisen durften. Mit insgesamt 20 Fachvorträgen waren unsere Experten in diesem Jahr in allen innovativen Themenfeldern gut vertreten. Einige Säle waren so gut besucht, dass nicht mehr alle Zuschauer hineingingen. [Unser Programmheft](http://www.opitz-consulting.com/fileadmin/user_upload/Events/2016/DOAG_Vortra_ege_Web.pdf) Sie konnten nicht dabei sein oder haben einen Vortrag verpasst? Auf Slideshare sind viele unserer Präsentationen zu finden: [www.slideshare.net/opitzconsulting](http://www.slideshare.net/opitzconsulting) [![doag-bild1](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild1.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild1.jpg) [![doag-bild2](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild2.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild2.jpg) [![doag-bild3](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild3.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild3.jpg) [![doag-bild4](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild4.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild4.jpg)[![doag-bild5](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild5.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild5.jpg)[![doag-bild6](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild6.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild6.jpg)[![doag-bild7](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild7.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild7.jpg)[![doag-bild8](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild8.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild8.jpg)[![doag-bild9](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild9.jpg?w=200)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild9.jpg)[![doag-bild10](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild10.jpg?w=200)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild10.jpg)[![doag-bild11](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild11.jpg?w=200)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild11.jpg)[![doag-bild12](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild12.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild12.jpg)[![doag-bild13](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild13.jpg?w=200)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild13.jpg)[![doag-bild14](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild14.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2016/11/doag-bild14.jpg) **Kategorien:** Tech Events & Networking **Schlagwörter:** agile, ALM, Architecture, BI, BPM, Camunda, cloud, Cloud Computing, Digitalisierung, DOAG, Events, Installation, Integration, IoT, Master Data Management, Mobile, Modern Clients, Oracle FMW, Web Developement --- ### [Oracle Forms & Reports 12.2.1.2.0: Create and Configure on the OEL 7.2 Server](https://thecattlecrew.net/2016/12/17/oracle-forms-reports-12-2-1-2-0-create-and-configure-on-the-oel-7-2-server/) **Published:** Dezember 17, 2016 **Author:** Neselovskyi, Borys **Content:** # Introduction This post focuses on the creation, configuration and tuning of an initial Forms & Reports 12.2.1.2.0 Domain on the OEL 7.2 Server. The WebLogic Server is a necessary requirement, and must already be installed. For instruction how to install the WebLogic Server 12.2.1.2 please refer to my previous post: [WebLogic Server 12.2.1.2.0: Installation on the Linux OEL 7: step by step instruction](https://borysneselovskyi.wordpress.com/2016/12/17/weblogic-server-12-2-1-2-0-installation-on-the-linux-oel-7-step-by-step-instruction) The following tasks will be implemented: - Preparing the Operating System for the installation of the WebLogic Server 12.2.1.2, Installation JDK 1.8 and the WebLogic Server 12.2.1.2: - Creating of database schemas - Installing and Configuring a Forms & Reports Domain - Post-Installation Tasks: - Configuring of components - Creating of Start & Stop scripts for the automatic start/stop of components - Tuning and Troubleshooting The Domain will be created on the one OEL 7.2 server: host03.example.com (IP 192.168.75.35) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms1.jpg) # Installation Forms & Reports 12.2.1.2 ## Prepare Software Download and extract the following software from the [Oracle Software Delivery Cloud: ](https://edelivery.oracle.com)Forms & Reports 12.2.1.2.0 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms2.png) ## Installation Forms & Reports 12.2.1.2 (as OS User oracle) Navigate to software directory, extract the software, set the environment and start the installation: ``` [oracle@host01 Oracle_Home]$ cd /u01/app/oracle/software/FMW/12.2.1.2.0/Forms_12.2.1.2 [oracle@host03]$ unzip V789399-01.zip [oracle@host03]$ export JAVA_HOME=/u01/app/oracle/product/JAVA/jdk [oracle@host03]$ export PATH=$JAVA_HOME/bin:$PATH [oracle@host03]$ ./fmw_12.2.1.2.0_fr_linux64.bin ``` On the Welcome page click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms3.png) Enable „Skip Auto Updates“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms4.png) Set the Oracle Home to /u01/app/oracle/product/FMW/Oracle\_Home: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms5.png) Choose „Forms and Reports Deployment“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms6.png) Prerequisite Checks: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms7.png) Verify the Summary of the Installation and click the button „Install“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms8.png) Verify installation“¦Next: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms9.png) Check installed components and click „Finisch“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms10.png) The Installation Oracle Forms & Reports 12.2.1.2.0 is now completed # Create Database Schemas (as OS User oracle) The database must be already created and prepared for the WebLogic Server Domain. The database must be running. Login to the server as user oracle, navigate to oracle\_common directory, and start the Repository Creation Utility (RCU): ``` [oracle@host03]$ cd /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/bin [oracle@host03]$ ./rcu ``` On the Welcome page: click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms11.png) For the new Oracle Forms and Reports Installation activate „Create Repository“ & „System Load and Production Load“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms12.png) Step 3: Database Connection Details: On this Page provide the database connection information: Database Type: Oracle Database Host Name (database host): host03.example.com Port (Database Listener Port: 1521) Service Name (Service Name of the repository database): orcl Username & Password: Administration Account of the Database: sys/xxx Role (Database Admin Role: SYSDBA or SYSOPER): SYSDBA „¦ „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms13.png) The Installer checks the database connectivity: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms14.png) Set the Prefix „TST“ for database schemas and select following components: Oracle Platform Security Services Audit Services Audit Services Append Click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms15.png) The installer will check database prerequisites: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms16.png) Set the password for all database schemas: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms17.png) On this page you can change settings for tablespaces“¦ click on the button „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms18.png) Tablespaces will be created: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms19.png) Verify the Summary of the Installation and click the button „Create“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms20.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms21.png) Check the summary“¦ „Close“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms22.png) The Forms and Reports Repository Creation is now completed # Create Domain (as OS User oracle) Navigate to the oracle\_common directory and start the Configuration Wizard: ``` [oracle@host03]$ cd /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin [oracle@host03]$ ./config.sh ``` Choose „Create a new Domain“ and set the „Domain Location“ to /u01/app/oracle/user\_projects/domains/forms\_domain: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms23.png) On the next page select following components: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms24.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms25.png) Specify an „Application Location“: /u01/app/oracle/user\_projects/applications/forms\_domain: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms26.png) Set the Name and Password for the WebLogic Administrator: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms27.png) Choose „Domain Mode“: Production and check the JDK location: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms28.png) Configure the database details: Specify the correct schema prefix: TST\_STB and the information what were specified when you previously ran RCU (Chapter „Create Database Schemas“). Then click on the Button „Get RCU Configuration“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms29.png) Installer checks database connectivity“¦ „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms30.png) Let default values and click „Next“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms31.png) JDBC Test: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms32.png) Activate check boxes for Administration Server, Node Manager, Topology and System Components for the advanced configuration: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms33.png) Configure AdminServer: Let default values: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms34.png) Configure the NodeManager: Set Node Manager Type to „Per Domain Default Location“ „“ default Enter Node Manager Credentials: Username: nodemgr ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms35.png) **Managed server****Listen Address****Port****Server Group**WLS\_FORMS192.168.75.359001FORMS-MAN-SVRWLS\_REPORTS192.168.75.359002REPORTS-APP-SERVERS ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms36.png) On the page „Clusters“ let default values: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms37.png) „Server Templates“ let default values: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms38.png) „Dynamic Templates“: let default values: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms39.png) „Assign Servers to Clusters“: let defaults: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms40.png) „Coherence clusters“: let defaults: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms41.png) Change the machine settings: **Name****Type****Listen Address****Port**UnixMachine\_1Unix Machine192.168.75.355556 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms42.png) Add the AdminServer, WLS\_FORMS and WLS\_REPORTS to the Machine UNixMachine\_1: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms43.png) Don’t configure virtual targets: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms44.png) Don’t configure partitions: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms45.png) System Components: **System Component****Component Type****Restart Interval Seconds****Restart Delay Seconds**forms1FORMS36000ohs1OHS36000 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms46.png) Configure System Component ohs1: Admin Host: 192.168.75.35 Admin Port: 7779 Listen Address: 192.168.75.35 Listen Port: 7777 SSL Listen Port: 4443 Servername: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms47.png) Assign System Components forms1 and ohs1 to the Machine UniyMachine\_1: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms48.png) Check the summary and click on „Create“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms49.png) After the creation of Domain click „Next“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms50.png) „¦ and „Finish“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms51.png) The Creation of Forms & Reports Domain is now completed. # Post-Installation Tasks ## Disabling the Derby Database ``` [oracle@host03]$ cd /u01/app/oracle/product/FMW/Oracle_Home/wlserver/common/derby/lib/ [oracle@host03]$ mv derby.jar disable_derby.jar ``` ## Initial Start / Shutdown the AdminServer Start the AdminServer via script. Make sure the repository database and the listener are running! Enter the values for the Administration User (weblogic) and passwort when prompted: ``` [oracle@host03]$ cd /u01/app/oracle/user_projects/domains/forms_domain/bin [oracle@host03]$ ./startWebLogic.sh Enter username to boot WebLogic server:weblogic Enter password to boot WebLogic server:xxx ``` Shutdown the AdminServer via script: ``` [oracle@host03]$ cd /u01/app/oracle/user_projects/domains/forms_domain/bin [oracle@host03]$ ./stopWebLogic.sh ``` ## Create the file boot.properties ``` [oracle@host03]$ cd /u01/app/oracle/user_projects/domains/forms_domain/servers/AdminServer [oracle@host03]$ mkdir security [oracle@host03]$ cd security/ [oracle@host03]$ echo -e "username=weblogic\npassword=welcome1" > boot.properties [oracle@host03]$ cat boot.properties username=weblogic password=welcome1 ``` ## NodeManager configuration Edit file nodemanager.properties: ``` [oracle@host03]$ cd /u01/app/oracle/user_projects/domains/forms_domain/nodemanager [oracle@host03]$ vi nodemanager.properties ``` Change parameter: Old: ``` CrashRecoveryEnabled=false ``` New: ``` CrashRecoveryEnabled=true ``` Start NodeManager: ``` [oracle@host03]$ cd /u01/app/oracle/user_projects/domains/forms_domain/bin [oracle@host03]$ nohup ./startNodeManager.sh & ``` ## Start AdminServer via NodeManager and WLST Start wlst: ``` [oracle@host03]$ /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` wls:/offline> nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Start AdminServer: ``` wls:/nm/forms_domain> nmStart('AdminServer') ``` ## Start all Managed Servers via AdminConsole Open the Browser and go to http://host03.exmple.com:7001/console Starting all Managed Servers via Adminconsole: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms52.png) All Managed Servers are running: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms53.png) ## Reports Server Configuration ### At first we must create ReportsToolsInstance (via wlst) Start wlst: ``` [oracle@host03]$ /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to the AdminServer (the AdminServer and WLS\_REPORTS must be running): ``` wlst> connect('weblogic','welcome1', 't3://host03.example.com:7001') ``` Create the reports server instance: ``` wls:/forms_domain/serverConfig/> createReportsToolsInstance(instanceName='reptools1',machine='UnixMachine_1') ``` ### Enable Reports Webaccess: Edit the File rwservlet.prpoerties: ``` vi /u01/app/oracle/user_projects/domains/forms_domain/config/fmwconfig/servers/WLS_REPORTS/applications/reports_12.2.1/configuration/rwservlet.properties ``` Add the Line (red): ```    rep_wls_reports_host03    no    yes    L2 ``` Restart the Managed Server WLS\_REPORTS ### Create the stand alone reports server: my\_rersrv Start wlst: ``` [oracle@host03]$ /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to the AdminServer (the AdminServer and WLS\_REPORTS must be running): ``` wlst> connect('weblogic','welcome1', 't3://host03.example.com:7001') ``` Create ReportsServerInstance: ``` wls:/forms_domain/serverConfig/> createReportsServerInstance(instanceName='my_repsrv',machine='UnixMachine_1') ``` ### Disable the Single Sign On for the Reports Server: Edit the File rwserver.properties: ``` vi /u01/app/oracle/user_projects/domains/forms_domain/config/fmwconfig/components/ReportsServerComponent/my_repsrv/rwserver.conf ``` Change the Line: ```      ``` To: ```    ``` Start the standalone reports server and save the NodeManager Password: ``` cd /u01/app/oracle/user_projects/domains/forms_domain/bin ./startComponent.sh my_repsrv storeUserConfig ``` You will be prompted to try the nodemanager user password: ``` Please enter Node Manager password: xxx ``` Problem: by starting of the reports server we received the error message: Error: Error occurred while performing nmStart : Error Starting server my\_repsrv : Received error message from Node Manager Server: \[Server start command for ReportsServerComponent server ‚my\_repsrv‘ failed due to: \[Server failed to start up but Node Manager was not aware of the reason\]. Please check Node Manager log and/or server ‚my\_repsrv‘ log for detailed information.\]. Please check Node Manager log for details. The Logfile my\_repsrv.out contains the following messages: /u01/app/oracle/product/FMW/Oracle\_Home/bin/rwserver: error while loading shared libraries: libXm.so.3: cannot open shared object file: No such file or directory) The Solution is in the MOS Note „Reports Builder / Server Fails to Start in 12c With “ libXm.so.3: cannot open shared object file: No such file or directory“ Only on Linux 7 (Doc ID 2073755.1)“described: > Changes: > > New installation on Linux OEL7 or RedHat7. > > Cause: > > This version of the motif library (libXm.so.3) is not available on OEL7 or RedHat7. > > Solution: > > The workaround is to create a symbolic link between the new motif library and the old one. > > ln -s /usr/lib64/libXm.so.4.0.4 /usr/lib64/libXm.so.3 Try as root: ``` [root@host03 ~]# ln -s /usr/lib64/libXm.so.4.0.4 /usr/lib64/libXm.so.3 ``` Restart all Components: NodeManager, AdminServer, Managed Server WLS\_FORMS, Managed Server WLS\_REPORTS Start the reports server as oracle: ``` cd /u01/app/oracle/user_projects/domains/forms_domain/bin ./startComponent.sh my_repsrv storeUserConfig ``` Output: ``` Successfully Connected to Node Manager. Starting server my_repsrv ... Successfully started server my_repsrv ... Successfully disconnected from Node Manager. ``` ### Check the Reports Server (Browser): http://host03.example.com:9002/reports/rwservlet/showenv?server=my\_repsrv ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms54.png) ## Configuring Forms and Reports for the using HTTP Server The HTTP Server must be started once, for the directories associated with „ohs1“ instance to be created Start OHS via NodeManager and WLST Start wlst: ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` wlst> nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Start OHS Component: ``` wls:/nm/forms_domain> nmStart(serverName='ohs1', serverType='OHS') ``` Output: ``` Starting server ohs1 ... Successfully started server ohs1 ... ``` Edit the Forms Configuration: the forms.conf file: ``` vi /u01/app/oracle/product/FMW/Oracle_Home/forms/templates/config/forms.conf ``` Add following lines: ```           SetHandler weblogic-handler         WebLogicHost host03.example.com         WeblogicPort 9001 ``` Edit Reports Configuration: the reports\_ohs.conf file: ``` vi /u01/app/oracle/product/FMW/Oracle_Home/reports/conf/reports_ohs.conf ``` Add following lines: ```         SetHandler weblogic-handler         WebLogicHost host03.example.com         WeblogicPort 9002 ``` Copy forms.conf and reports\_ohs.conf to the directory OHS\_INSTANCE\_HOME/moduleconf: ``` cp /u01/app/oracle/product/FMW/Oracle_Home/forms/templates/config/forms.conf \ /u01/app/oracle/user_projects/domains/forms_domain/config/fmwconfig/components/OHS/instances/ohs1/moduleconf cp /u01/app/oracle/product/FMW/Oracle_Home/reports/conf/reports_ohs.conf \ /u01/app/oracle/user_projects/domains/forms_domain/config/fmwconfig/components/OHS/instances/ohs1/moduleconf ``` Restart OHS Server Component: Start wlst: ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` wlst> nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Restart OHS Component: ``` wls:/nm/forms_domain> nmKill(serverName='ohs1', serverType='OHS') wls:/nm/forms_domain> nmStart(serverName='ohs1', serverType='OHS') ``` # Check Installation: Check the WebLogic Admin Console via Browser: : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms55.png) Check the Enterprise Manager via Browser: : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms56.png) Check OHS via Browser: : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms57.png) Check Forms Base URL via Browser: : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms58.png) Check Forms via Base HTTP URL (Browser): : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms59.png) Check Reports Base URL via Browser: : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms60.png) Check Reports via Base HTTP URL (Browser): : ![](https://thecattlecrew.net/wp-content/uploads/2022/07/121716_1145_oracleforms61.png) Check Stand Alone Reports Server my\_repsrv via URL (Browser): Managed Server Port: [http://host03.example.com:9002/reports/rwservlet/showenv?server=my\_repsrv](http://host03.example.com:9002/reports/rwservlet/showenv?server=my_repsrv) HTTP Server Port: [http://host03.example.com:7777/reports/rwservlet/showenv?server=my\_repsrv](http://host03.example.com:7777/reports/rwservlet/showenv?server=my_repsrv) # Where are configuration files stored? Forms **File****Path**formsweb.cfg/config/fmwconfig/servers/WLS\_FORMS/applications/formsapp\_12.2.1/configdefault.env/config/fmwconfig/servers/WLS\_FORMS/applications/formsapp\_12.2.1/configTemplates/config/fmwconfig/components/FORMS/instances/forms1/serverregistry.dat/config/fmwconfig/servers/WLS\_FORMS/applications/formsapp\_12.2.1/config/oracle/forms/registryftrace.cfg/config/fmwconfig/components/FORMS/instances/forms1/serverwebutil.cfg/config/fmwconfig/components/FORMS/instances/forms1/server Reports: **File****Path**rwserver.conf/config/fmwconfig/servers/WLS\_REPORTS/applications/reports\_12.2.1/configurationrwnetwork.conf/config/fmwconfig/servers/WLS\_REPORTS/applications/reports\_12.2.1/configurationrwservlet.properties/config/fmwconfig/servers/WLS\_REPORTS/applications/reports\_12.2.1/configuration Reports Instances Configuration Directories: Example for the Reports server my\_repsrv: /config/fmwconfig/components/ReportsServerComponent/my\_repsrv # Tuning and Troubleshooting Oracle Forms and Reports ## Tuning JVM We will customize the settings for the Java Heap size and for WebLogic Server Start parameters by the creating the File setUserOverrrides.sh. We will tune the Java heap size for the Admin Server and for each Managed Server. We will set some WebLogic Server start Parameter: - -Dweblogic.MaxMessageSize=300000000 # increase the MessageSize - -Dweblogic.threadpool.MinPoolSize=1024 # Tuning the WebLogic ThreadPool For more information about the customizing of Java settings please refer to my article [How to customize Java Virtual Machine Settings in Oracle WebLogic Server 12 on OS Linux / UNIX](https://borysneselovskyi.wordpress.com/2016/07/24/how-to-customize-java-virtual-machine-settings-in-oracle-weblogic-server-12-on-os-linux-unix/) ### Create file UserOverrides.sh: ``` cd /u01/app/oracle/user_projects/domains/forms_domain/bin ``` cat setUserOverrides.sh (an Example): ``` #!/bin/bash echo "Setting from UserOverrides.sh" # global settinga (for all servers)s export JAVA_OPTIONS="$JAVA_OPTIONS -Dweblogic.MaxMessageSize=300000000" export USER_MEM_ARGS="-Xms256m -Xmx512m" # customer settings for each server if [ "${SERVER_NAME}" = "AdminServer" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms1024m -Xmx1536m" fi if [ "${SERVER_NAME}" = "WLS_FORMS" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms2g -Xmx2g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=1g" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" fi if [ "${SERVER_NAME}" = "WLS_REPORTS" ] then echo "Customizing USER_MEM_ARGS for SERVER_NAME ${SERVER_NAME}" export USER_MEM_ARGS="-Xms2g -Xmx2g -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:NewSize=1g" export JAVA_OPTIONS="$JAVA_OPTIONS -Djava.awt.headless=true" fi echo "End setting from UserOverrides.sh" ``` ### Restart the AdminServer, all Managed Server and OHS: Start wlst: ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Stop all components: ``` wls:/nm/forms_domain> nmKill('WLS_FORMS') wls:/nm/forms_domain> nmKill('WLS_REPORTS') wls:/nm/forms_domain> nmKill(serverName='ohs1', serverType='OHS') wls:/nm/forms_domain> nmKill('AdminServer') ``` Start all components: ``` wls:/nm/forms_domain> nmStart('AdminServer') wls:/nm/forms_domain> nmStart(serverName='ohs1', serverType='OHS') wls:/nm/forms_domain> nmStart('WLS_REPORTS') wls:/nm/forms_domain> nmStart('WLS_FORMS') ``` ### Tuning Fusion Middleware Control (as OS User oracle) Reference: MOS Note „How to Enable Discovery Cache To Avoid Long Delay During Login To Fusion Middleware Control (Doc ID 1423893.1)“ Start wlst and connect to the AdminServer (the AdminServer must be running): ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh wls:/offline> connect('weblogic','welcome1','t3://host03.example.com:7001') ``` Change location to domain custom tree ``` wls:/forms_domain/serverConfig/> domainCustom() ``` Setting variables: ``` wls:/forms_domain/domainCustom/> myMBean=ObjectName('emoms.props:Location=AdminServer,name=emoms.properties,type=Properties,Application=em') wls:/forms_domain/domainCustom/> types=['java.lang.String', 'java.lang.String'] wls:/forms_domain/domainCustom/> type=['java.lang.String'] ``` Set property oracle.sysman.emas.discovery.wls.FMW\_DISCOVERY\_USE\_CACHED\_RESULTS=true: ``` wls:/forms_domain/domainCustom/> params=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_USE_CACHED_RESULTS', 'true'] wls:/forms_domain/domainCustom/> mbs.invoke(myMBean,'setProperty',params,types) ``` Set property oracle.sysman.emas.discovery.wls.FMW\_DISCOVERY\_MAX\_CACHE\_AGE=7200000: ``` wls:/forms_domain/domainCustom/> params=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_CACHE_AGE','7200000'] wls:/forms_domain/domainCustom/> mbs.invoke(myMBean,'setProperty',params,types) ``` Set property oracle.sysman.emas.discovery.wls.FMW\_DISCOVERY\_MAX\_WAIT\_TIME=10000: ``` wls:/forms_domain/domainCustom/> params=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_WAIT_TIME','10000'] wls:/forms_domain/domainCustom/> mbs.invoke(myMBean,'setProperty',params,types) ``` Invoke getProperty operations to display and confirm parameter values (Values returned by wlst are in bold): Display changes added: ``` wls:/forms_domain/domainCustom/> param=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_USE_CACHED_RESULTS'] wls:/forms_domain/domainCustom/> mbs.invoke(myMBean,'getProperty',param,type) 'true' wls:/forms_domain/domainCustom/> param=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_CACHE_AGE'] wls:/forms_domain/domainCustom/> mbs.invoke(myMBean,'getProperty',param,type) '7200000' wls:/forms_domain/domainCustom/> param=['oracle.sysman.emas.discovery.wls.FMW_DISCOVERY_MAX_WAIT_TIME'] wls:/forms_domain/domainCustom/> mbs.invoke(myMBean,'getProperty',param,type) '10000' ``` # Start & Stop of Components Order by starting: 1\. NodeManager 2\. AdminServer 3\. All Managed Servers 4\. Reports Servers 5\. OHS Order by shutting down: 1\. OHS 2\. Reports Servers 3\. All Managed Servers 4\. AdminServer 5\. NodeManager ## Start / Stop NodeManager ### Start: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain nohup ${DOMAIN_HOME}/bin/startNodeManager.sh > ${DOMAIN_HOME}/nodemanager.out 2>&1 & ``` ### Stop: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/stopNodeManager.sh ``` ## Start / Stop Oracle HTTP Server ### Start / Stop via script (requirement: the NodeManager must be running): ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain $DOMAIN_HOME/bin/startComponent.sh ohs1 $DOMAIN_HOME/bin/stopComponent.sh ohs1 ``` ### Start / Stop via wlst (Note: the NodeManager must be running): Start wlst: ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Start / Stop OHS via wlst: ``` nmStart(serverName='ohs1', serverType='OHS') ``` ``` nmKill(serverName='ohs1', serverType='OHS') ``` ## Start / Stop the AdminServer ### Start / Stop AdminServer via script: #### Start: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/startWebLogic.sh ``` #### Stop: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/stopWebLogic.sh ``` ### Start / Stop AdminServer via wlst and NodeManager (Note: the NodeManager must be running): Start wlst: ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Start / Stop AdminServer: ``` wlst> nmStart('AdminServer') wlst> nmKill('AdminServer') ``` ## Start / Stop Managed Servers: ### Start / Stop via script: Start: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/startManagedWebLogic.sh WLS_FORMS ${DOMAIN_HOME}/bin/startManagedWebLogic.sh WLS_REPORTS ``` Stop: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/stopManagedWebLogic.sh WLS_FORMS ${DOMAIN_HOME}/bin/stopManagedWebLogic.sh WLS_REPORTS ``` ### Start / Stop all Managed Servers via wlst and NodeManager (Note: the NodeManager must be running): Start wlst: ``` /u01/app/oracle/product/FMW/Oracle_Home/oracle_common/common/bin/wlst.sh ``` Connect to NodeManager: ``` nmConnect('nodemgr','welcome1','host03.example.com','5556','forms_domain','/u01/app/oracle/user_projects/domains/forms_domain') ``` Start / Stop all Managed Servers: ``` wlst> nmStart('WLS_FORMS') wlst> nmStart('WLS_REPORTS') wlst> nmKill('WLS_REPORTS') wlst> nmKill('WLS_FORMS') ``` ## Start / Stop Report Server (Note: NodeManager and MS WLS\_REPORTS must be running): Start: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/startComponent.sh my_repsrv ``` Stop: ``` export DOMAIN_HOME=/u01/app/oracle/user_projects/domains/forms_domain ${DOMAIN_HOME}/bin/stopComponent.sh my_repsrv ``` ## Start / Stop In-Process Reports Server via Browser: Start: ``` http://host03.example.com:9002/reports/rwservlet/startserver ``` Stop: ``` http://host03.example.com:9002/reports/rwservlet/stopserver ``` ## Forms Web Start via Browser: Start via Managed Server Port: ``` http://host03.example.com:9001/forms/frmservlet?config=webstart ``` Start via HTTP Server Port: ``` http:// host03.example.com:7777/forms/frmservlet?config=webstart ``` # Documentation - Certifications matrix: http://www.oracle.com/technetwork/middleware/fusion-middleware/documentation/fmw-122110certmatrix-3050412.xlsx - System requirements: http://docs.oracle.com/html/E73100\_01/toc.htm#GUID-37C51062-3732-4A4B-8E0E-003D9DFC8C26 - Installing and Configuring Oracle Forms and Reports: https://docs.oracle.com/middleware/12211/formsandreports/install-fnr/FRINS.pdf - Forms Services Deployment Guide: https://docs.oracle.com/middleware/12211/formsandreports/deploy-forms/FSDEP.pdf - Release Notes for Oracle Forms and Reports: https://docs.oracle.com/middleware/12211/formsandreports/releasenotes-fnr/FRREL.pdf - Publishing Reports to the Web with Oracle Reports Services: https://docs.oracle.com/middleware/12211/formsandreports/use-reports/RSPUB.pdf - Administering Oracle HTTP Server: https://docs.oracle.com/middleware/12211/webtier/administer-ohs/HSADM.pdf - Oracle Fusion Middleware Tuning Guide: http://docs.oracle.com/middleware/12211/wls/PERFM/PERFM.pdf - How to Enable Discovery Cache To Avoid Long Delay During Login To Fusion Middleware Control (Doc ID 1423893.1) - Reports 12c Relevant Notes and Links Index Support Note 2073820.1 - Oracle Reports 12c: First Step to Complete After a New Forms/Reports 12c Install and Configuration Environment (Doc ID 2072671.1) - Reports Builder and Forms Builder Wont Start After a New 12c Configuration Environment (Doc ID 2074173.1) - How to Create a Standalone Reports Server in Reports 12c (Doc ID 2070762.1) - How to Start/Stop the Reports Server in Reports 12c (Doc ID 2070689.1) - Reports Builder / Server Fails to Start in 12c With “ libXm.so.3: cannot open shared object file: No such file or directory“ Only on Linux 7 (Doc ID 2073755.1) - How to Use Oracle Forms 12c with OHS (HTTP Listener) (Doc ID 2096843.1) **Kategorien:** Development **Schlagwörter:** Configuration, English, Forms, Installation, JVM Tuning, OHS, oracle, Oracle DB, Oracle FMW, Oracle Forms, Reports, Reports Server Stand Alone, Start-Stop, Weblogic, WLST --- ### [Handle REST requests in Mule ESB and forward it to Camunda BPM](https://thecattlecrew.net/2017/02/03/handle-rest-requests-in-mule-esb-and-forward-it-to-camunda-bpm/) **Published:** Februar 3, 2017 **Author:** Dominik Bial **Content:** Writing a REST Interface with JSON schema-validation and some Java transformations with Mule ESB is really easy and can be developed in a very short time. We want to show a sample application to demonstrate how easy Camunda can be used with Mule in an approver scenario for Slack. ## **Mule2CamundaFlow** In Mule Anypoint Studio we first define a simple flow (in our example Mule2Camunda-GatewayFlow) that receives incoming JSON messages via a REST-Interface and validates incoming data. This can be done with a HTTPListener Configuration and an APIkit Router straight behind. The APIkit Router expects a REST API definition file based on [RAML](http://raml.org/). We place our RAML File in the APIkit Router component which maps all incoming and valid (!) JSON messages to the TransformerFlow.![camunda_meets_mule_slack_mapping](https://thecattlecrew.net/wp-content/uploads/2017/02/camunda_meets_mule_slack_mapping.png?w=640) ![camunda_meets_mule_raml](https://thecattlecrew.net/wp-content/uploads/2017/02/camunda_meets_mule_raml.png?w=640) ## **JSON SCHEMA** The RAML (RESTful API Modeling Language) is the heart of our small interface as it defines resource, request methods as well as body and response messages. The body part includes an example JSON message and a helpful JSON schema, so we have the possibility to check every JSON message before processing it. For every client-submitted data we currently check for required objects and data types. This actually helps a lot as it prohibits invalid requests to be transported into background systems or logic. Invalid requests are rejected at the border to the application network. In our case, both fields „name“ and „text“ are defined as Strings. As we always need both fields to successfully post a slack message they are set to be required. Using a [JSON Schema](http://json-schema.org/) validation even allows us to check against regex patterns, so this kind of validation can block non-secure JSON requests if needed. Sending any invalid message will be denied with a http status 500 – BadRequestException response. \[code language=“json“\] { „$schema“: „http://json-schema.org/draft-04/schema#“, „type“: „object“, „properties“: { „name“: { „type“: „string“ }, „text“: { „type“: „string“ } }, „required“: \[ „name“, „text“ \] } \[/code\] ## **TransformerFlow** After successfully checking incoming JSON data we pass the JSON to our TransformerFlow which also happens in the APIKitrouter (you remember the mapping?). The TransformerFlow then converts JSON values to a HashMap and we convert it again in plain Java Code to JSON format and send it directly to Camunda via HttpRequest. This transformation part is needed when we have to add or aggregate data before sending the JSON request against Camunda. In this case we just put the data into a Camunda-readable JSON format and can send it with the HttpRequest-Handler. ![camunda_meets_mule_flow](https://thecattlecrew.net/wp-content/uploads/2017/02/camunda_meets_mule_flow.png?w=438) So, that“™s it. We have a running REST/JSON Interface with JSON validation and could easily do more fancy stuff with it. **Kategorien:** Integration **Schlagwörter:** BPM, Camunda, English, Java --- ### [camunda BPM - Mocking subprocesses with BPMN Model API](https://thecattlecrew.net/2014/07/18/camunda-bpm-mocking-subprocesses-with-bpmn-model-api/) **Published:** Juli 18, 2014 **Author:** Halil Hancioglu **Content:** A common way to call a reusable subprocess is to use a call activity in the BPMN 2.0 model. By using a call activity it is only necessary to add the process key of the subprocess to call and the version of it to the call activity properties. Thus, the modeling can be continued. Apart from this it is possible to define process variables to pass between the main and the subprocess. But during unit testing the main process and all subprocesses referenced by the defined process keys must exist in the process engine repository. The easiest way to solve this problem is to replace the defined process by the process key of a mock process which must exist in repository. But it is not advisable to change a process model for testing purposes only. It takes time to undo these changes when the real subprocess is completed. Moreover such changes could be forgotten, cause it is already tested successfully. Creating a mock process with the same process key of the real subprocess is not convenient if there exist more than a few subprocesses which is often the reality. A handy alternative since version 7.1 of camunda BPM is the use of the BPMN Model API. It makes it possible to create, edit and parse BPMN 2.0 models as pure Java code. #### Let’s make an example The following process model consists of a main process with two call activities. [![Main Proces with two Call-Activities](https://thecattlecrew.net/wp-content/uploads/2014/07/mocksubtestmainprocess.png)](https://thecattlecrew.net/wp-content/uploads/2014/07/mocksubtestmainprocess.png)Main Proces with two Call-Activities To have a reusable solution, a helper method is created and used by the test. It creates a model instance by using BPMN Model API and deploys it in the given process engine repository as shown below. \[code wraplines=“false“ language=“java“ collapse=“true“\] /\*\* \* Create and deploy a process model with one logger delegate as service task. \* \* @param origProcessKey \* key to call \* @param mockProcessName \* process name \* @param fileName \* file name without extension \*/ private void mockSubprocess(String origProcessKey, String mockProcessName, String fileName) { BpmnModelInstance modelInstance = Bpmn .createExecutableProcess(origProcessKey).name(mockProcessName) .startEvent().name(„Start Point“).serviceTask() .name(„Log Something for Test“) .camundaClass(MockLoggerDelegate.class.getName()).endEvent() .name(„End Point“).done(); repositoryService().createDeployment() .addModelInstance(fileName + „.bpmn“, modelInstance).deploy(); } \[/code\] The primary goal of this test is to ensure that the main process is ended successfully. Therefore a model instance for each call activity is created and deployed in the given repository. The main process is deployed via @Deployment annotation. Following code snippet illustrates the implementation. \[code wraplines=“false“ language=“java“ collapse=“true“\] @Test @Deployment(resources = „mainProcess.bpmn“) public void shouldEnd() { // mock first sub process this.mockSubprocess(„firstSubProcessKey“, „Mocked First Sub Process“, „mockedFirstSubProcess“); // mock second sub process this.mockSubprocess(„secondSubProcessKey“, „Mocked Second Sub Process“, „mockedSecondSubProcess“); // start main process ProcessInstance mainInstance = runtimeService().startProcessInstanceByKey( „mainProcessKey“); assertThat(mainInstance).isEnded(); } \[/code\] The created model instances look equally – it consists of a start event, a service task which references a delegate and an end event. Following code snippet shows the simple implementation of the used delegate. \[code wraplines=“false“ language=“java“ collapse=“true“\] public class MockLoggerDelegate implements JavaDelegate { private final Logger LOGGER = Logger.getLogger(MockLoggerDelegate.class .getName()); @Override public void execute(DelegateExecution execution) throws Exception { LOGGER.info(„\\n\\n …“ + MockLoggerDelegate.class.getName() \+ “ invoked by “ + „processDefinitionId=“ \+ execution.getProcessDefinitionId() + „, activtyId=“ \+ execution.getCurrentActivityId() + „, activtyName='“ \+ execution.getCurrentActivityName() + „‚“ + „, processInstanceId=“ \+ execution.getProcessInstanceId() + „, businessKey=“ \+ execution.getProcessBusinessKey() + „, executionId=“ \+ execution.getId() + “ \\n\\n“); } } \[/code\] Of course, it’s possible to individualize these mocks dependant on your test case. For example, you could create a delegate for each sub process which set specific process variables. This example demonstrates only the capability of this solution. Keep in mind, it is not recommended to replace your process models by using the BPMN Model API. But it is very useful to solve small problems in a simple way – just a few lines of Java code. After completion a subprocess it is advisable to test the interaction with the main process, too. And of course, do not forget to write automated integration tests 😉 **Kategorien:** Integration **Schlagwörter:** BPM, Camunda, English --- ### [Short recap on OFM Summer Camps 2014](https://thecattlecrew.net/2014/08/11/short-recap-on-ofm-summer-camps-2014/) **Published:** August 11, 2014 **Author:** Sven Bernhardt **Content:** Last week the Oracle Fusion Middleware summer camps took place in Lisbon. More than 100 participants attended the event, learning much new stuff about new features and enhancements, arriving with the recently available FMW 12c release. In four parallel tracks the highlights of the new major release were presented to the attendees; hands-on labs allows to get a first impression regarding the new platform features and the markedly increased productivity delivered by the enhanced, consolidated tooling. The four tracks had different focuses, regarding the new features of the 12c release of Oracle Middleware platform: - **SOA 12c** – focusing on application integration, including Oracle Managed File Transfer (MFT), and fast data with Oracle Event Processing (OEP) - **BPM 12c** – focusing on Business Process Management, the new enhanced Business Activity Monitoring (BAM) and Adaptive Case Management (ACM) - **SOA/BPM 12c (Fast track)** – Combined track, covering the most important enhancements and concepts with reference to SOA and BPM 12c - **Mobile Application Framework (MAF) Hackathon** – Development of mobile applications using the newly released MAF (formerly known as ADF mobile) The main topics addressed by the new OFM 12c release are: - Cloud integration - Mobile integration - Developer’s performance - Industrial SOA **Cloud integration** Integrating Cloud solutions in grown IT system landscapes is complex. With SOA Suite 12c, Oracle provides a coherent and simple approach for integrating enterprise applications with existing cloud solutions. Therefore new JCA-based cloud adapters, e..g. for integrating with Salesforce, as well as a Cloud SDK are available. Service Bus might be used in this context to care about transformation, routing and forms the backbone of a future-oriented, flexible as well as scalable cloud application architecture. **Mobile integration** Mobile-enablement of enterprise applications is a key requirement and a necessity for application acceptance today. The new JCA REST adapter can be used to easily REST-enable existing applications. In combination with Oracle MAF and Service Bus, Oracle provides a complete Mobile Suite, where seamless development of new mobile innovations can be done. **Developer’s performance** To enhance development performance, the new SOA and BPM Quickinstalls are introduced. Using those allows the developers to have a complete SOA or BPM environment installed in 15 minutes (see the [blog post](https://thecattlecrew.net/2014/06/28/oracle-bpm-12c-quick-start-installation-uncensored/ "blog post") of my colleague). Furthermore new debugging possibilities, different templating mechanisms (SOA project templates, Custom activity templates, BPEL subprocesses and Service Bus pipeline Templates) as well as JDeveloper as the single and only IDE deliver a maximum good development experience. **Industrial SOA** Industrializing SOA is a main goal, when starting with a SOA initiative: Transparent monitoring and management and a robust, scalable and performant platform are key to successfully implementing SOA-based applications and architectures. These points are addressed by the new OFM 12c release through the following features: - Lazy Composite Loading – Composites will be loaded on demand and not at platform startup - Modular Profiles – Different profiles provided, which enables only the features currently needed (e.g. only BPEL) - Improved Error Hospital and Error Handling - Optimized Dehydration behaviour - Integrated Enterprise Scheduler (ESS) Further main enhancements that where introduced regarding SOA and BPM Suite 12c were: - Oracle BPM Suite 12c: Definition of Business Architecture, including definition of Key Performance Indicators (KPI) and Key Risk Indicators (KRI) to provide an integral overview from a high-level perspective; ACM enhancements in the direction of predictive analytics - Oralce BAM 12c: Completly re-implemented in ADF, allows operational analytics based on the defined KPIs and KRIs - Oracle MFT: Managed File Transfer solution for transferring big files from a specified source to a defined target; integration with SOA/BPM Suite 12c can be done by new JCA-based MFT adapters Looking back, a great and very interesting week lays behind me, providing a bunch of new ideas and impressions on the new Fusion Middleware 12c release. I’m looking forward to use some of this great new stuff soon, in real world’s projects. Special thanks to Jürgen Kress for the excellent organization of the event! I’m already looking forward for next SOA Community event… **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM, Mobile, Oracle FMW, Service Bus --- ### [SOA & BPM Suite 12c - Erfahrungsberichte und Live Demos für Architekten und Entwickler](https://thecattlecrew.net/2014/09/05/soa-bpm-suite-12c-erfahrungsberichte-und-live-demos-fur-architekten-und-entwickler/) **Published:** September 5, 2014 **Author:** Torsten Winterberg **Content:** Die neuen Oracle 12c Versionen sind da!![](http://www.opitz-consulting.com/fileadmin/redaktion/bilder/mail/launch-events-oracle-bpm-soa-suite-12c.jpg) SOA Suite & BPM Suite Launch Events vom Oracle Platinum Partner OPITZ CONSULTING 23.10.14 Düsseldorf | 28.10.14 München Sehr geehrte Damen und Herren, die SOA Suite ist Oracle’s Lösung für Systemintegrationen jeglicher Art. Die BPM Suite bietet alles zur Prozessautomatisierung und zum Bau von Workflowlösungen mit BPMN 2.0. Erleben Sie in einem komprimierten Abendprogramm in lockerer Atmosphäre bei Getränken, Snacks und einem anschließenden Abendessen, warum wir als Projekthaus die neuen 12c Versionen beider Suiten für einen großen Wurf halten. Wir bleiben dabei marketingfrei, zeigen viele Live Demos und diskutieren in den Pausen gerne bis in beliebige Tiefen der neuen Produkte. Es erwarten Sie diese Themen: - **Oracle SOA Suite & BPM Suite 12c:** Was bringen mir die neuen Versionen? - **Neue Features SOA Suite:** Erfahrungen aus einem SOA Suite 11g Upgrade auf 12c - **BPM Suite 12c live:** Workflows erstellen auch mit komplexen Formularen - **Internet der Dinge:** Live Demo mit Raspberry Pi, SOA Suite, BPM Suite und Oracle Event Processing 12c \_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_ **Jetzt kostenfrei anmelden:** **23. Oktober 2014, Oracle Deutschland, Geschäftsstelle Düsseldorf** **28. Oktober 2014, Oracle Deutschland, Geschäftsstelle München** [Details und Anmeldung ](http://www.opitz-consulting.com/alle_veranstaltungstermine/auf_einen_blick.php?vid=1076) \_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_ Wir freuen uns auf Ihren Besuch! Mit herzlichen GrüßenTorsten Winterberg Business Development & Innovation OPITZ CONSULTING Deutschland GmbH ![Torsten Winterberg, Business Development & Innovation, OPITZ CONSULTING](http://www.opitz-consulting.com/fileadmin/redaktion/kontakt_bilder/twi_70.jpg)[![OPITZ CONSULTING](http://www.opitz-consulting.com/img/mail/oc-logo.gif)](http://www.opitz-consulting.com/go/10-8-11)[![OPITZ CONSULTING, Oracle PlatinumPartner](http://www.opitz-consulting.com/fileadmin/redaktion/bilder/allgemein/logo_oracle_platinumpartner_204.gif)](http://www.opitz-consulting.com/unternehmen/partner/oracle.php) **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM, German, News --- ### [Eindrücke vom ADF Community Meeting](https://thecattlecrew.net/2014/09/17/eindrucke-vom-adf-community-meeting/) **Published:** September 17, 2014 **Author:** Enno Schulte **Content:** Am gestrigen Dienstag fand das Meeting der Deutschen ADF Community im CVC der Oracle Niederlassung in Berlin statt. Der Fokus lag dieses Mal weniger auf den technischen Feinheiten des Frameworks, sondern auf dem Thema „Vertrieb“. Aufgrund des Themenschwerpunkts waren neben altbekannten Teilnehmern auch viele neue Gesichter aus den Tiefen des Vertriebs der verschiedenen Partnerunternehmen anwesend. OPITZ CONSULTING war gleich mit drei Teilnehmern vertreten und gab somit schon alleine durch die Mannstärke ein eindeutiges Commitment zu ADF ab. Das bunte Programm ließ keine Wünsche offen. Wie agil die ADF Community auf neue Anforderungen reagieren kann, zeigte bereits der erste Vortrag zum Thema „Enterprise Mobility“. Aufgrund von Schwierigkeiten mit der Flugverbindung konnte der Referent nicht physisch anwesend sein, so dass kurzerhand eine Web- und Telefonkonferenz aufgesetzt wurde. Die Runde war sich weitestgehend einig, dass mobile Lösungen im Enterprise-Bereich in Zukunft eine stärkere Rolle einnehmen werden und sieht ADF in diesem Zusammenhang durch das Mobile Application Framework (MAF) und den Zukauf von Bitzer gut aufgestellt. Diesem Trend folgend drehte sich auch der zweite Beitrag dieses Tages auf um das Thema MAF. Michael Krebs von esentri referierte dabei sehr bildlich über „Oracle MAF und die Positionierung einer mobilen Unternehmensstrategie“. Am Nachmittag folgten dann noch Vorträge zu „ADF im Kontext der Oracle Fusion Middleware“ (Ingo Prestel, Oracle), „Oracle ADF und Forms-Modernisierung“ (Andreas Gaede, PITSS). ![IMG_1028](https://thecattlecrew.net/wp-content/uploads/2014/09/img_1028.jpg?w=660) Jochen Rieg von virtual7 moderierte eine interaktive Session zu „Oracle ADF als Basis für moderne Unternehmens-Anwendungen“. Dabei wurden von den Teilnehmern fachliche Einsatzszenarien, USPs von ADF, sowie eine Statistik zu Branchen in denen ADF Projekte bereits umgesetzt werden, erarbeitet. Es wurde in diesem Zusammenhang deutlich, dass derzeit die meisten Partnerunternehmen Projekte für Kunden im „public sector“ umsetzen. Da wir die Statistik selbst „gefälscht“ hatten gab es keinen Grund ihr in diesem Punkt nicht zu trauen. Neben den spannenden Sessions diskutierte die Runde sehr lebhaft und konstruktiv über mögliche Vertriebswege von ADF. Die Teilnehmer waren sich einig, dass die Technologie deutliche Vorteile im Vergleich zu anderen Frameworks aufweist, im Markt aber noch zu unbekannt sei. Die zahlreichen Aktivitäten der ADF Community werden in Zukunft sicher ihren Teil dazu beitragen, dies zu ändern. Erste Anzeichen sind in diesem Bereich schon wahrzunehmen. So wird beispielsweise bei der diesjährigen Konferenz der Deutschen Oracle Anwendergruppe zum ersten Mal ein eigener Slot für die ADF Community reserviert. Alles in allem kann man wieder einmal von einem sehr gelungenen Treffen der ADF Community sprechen. Die thematische Ausrichtung auf das Thema „Vertrieb“ sorgte für interessante Diskussionen. Wir freuen uns, Teil dieser lebendigen Community zu sein und werden gerne am nächsten Community-Meeting teilnehmen. **Kategorien:** Tech Events & Networking **Schlagwörter:** ADF --- ### [Microservices architectures "“ Thoughts from a SOA perspective](https://thecattlecrew.net/2014/09/30/microservices-architectures-thoughts-from-a-soa-perspective/) **Published:** September 30, 2014 **Author:** Sven Bernhardt **Content:** *Thoughts by: Sven Bernhardt, Richard Attemeyer, Torsten Winterberg, Stefan Kühnlein, Stefan Scheidt* --- A frequently discussed topic these days is the Micorservices architectural paradigm. Discussions on various internet blogs and forums are showing the trend that proponents of this approach are not tired of emphasizing why Microservices are different to a holistic SOA approach, when dealing with breaking up or avoiding monolithic software architectures. For this reason it“™s time for the Cattle Crew team, to take a closer look on this arising architectural style and the corresponding discussions from a different perspective. **Microservices Architectures** Amongst others Martin Fowler published a blog about what is characteristic for Microservices and applications build on the foundation of this architectural style \[[1](http://martinfowler.com/articles/microservices.html "http://martinfowler.com/articles/microservices.html")\]. According to this and other blog posts (see also \[[2](http://microservices.io/patterns/microservices.html "http://microservices.io/patterns/microservices.html")\], \[[3](http://www.infoq.com/articles/microservices-intro "http://www.infoq.com/articles/microservices-intro")\]), the goal of a Microservices approach is to avoid software systems to become monolithic, inflexible and hardly manageable, by splitting a system into modular, lightweight and maximum cohesive services. Applications build on this architecture should ensure the agility regarding changes caused by changed business requirements, because affected services of an application can simply be adapted and be redeployed independently from other components. Effectively a Microservice is a in itself cohesive, atomic application, which fulfills a dedicated purpose. Therefore it encapsulates all needed elements, e.g. UIs, logic components, may also have its own separated persistent store and may run in a separate JVM, to ensure as less impairment to other services as possible. Furthermore the implementation technologies for a specific service may vary. For each service the best-fitting technology should be used; there should be no restrictions regarding the used technologies. To ensure consistency as well as compatibility with already existing components in case of changes and to guarantee seamless release management of changed components, a Continuous Delivery procedure is indispensable for succeeding. In addition the implementation efficiency benefits from the Microservices approach, because different components may be developed in parallel. Communication between the services, if needed, is done via lightweight protocols such as HTTP. Well defined interfaces are depicting the service contracts. **Where there is light, there is also shadow“¦** One of the basic questions, we asked ourselves when discussing the Microservices approach, is how to determine respectively which metrics to use for evaluating, if a service is a Micorservice or not. Resulting from that it would be interesting what if it is no longer a Microservice: is it directly a monolithic service? A clear definition about what are the differentiating and unique characteristics of a Microservice cannot be found. Metrics like lines of code or number of classes are no appropriate characteristics, so something spongy, like specific business functionality has to be taken as a distinctive mark for a real Microservice. But that“™s not really measureable“¦ Besides the missing clarification about the Microservice term as such, building business applications using a modular Microservices architecture means a higher complexity than when using a classical monolithic approach. From conception to delivery to the operating this higher complexity may raise the following challenges: - Right level of service granularity; not too coarse grained, not too fine-grained - Comprehensible service distribution for scalability reasons and the corresponding monitoring - Complex testing procedures because of loose coupling and service distribution - Consistent and tolerant Error-handling, because a referenced service might be down for maintenance reasons (Timeouts, Retry mechanisms, etc.) - Reliable message delivery - Consistent transaction handling, because of cross-service communications using non-transactional protocols like HTTP mean the establishment of complex compensation mechanisms - Guarantee of data synchronization and consistency, when services have their own and exclusive persistent stores - Sophisticated Service Lifecycle Management, because every service has its own lifecycle including challenges like how to deal with incompatible interface changes Another risk we see with a naive implementation of the Micorservices architecture is a fall-back to the days of distributed objects: Calling a magnitude of services is not a good idea because of latency and (missing) stability. **Microservices and SOA** When dealing with the Microservices approach it is conspicuous that at least one paragraph could often be found, stating something like „Microservices vs. SOA“, where it is depicted that Microservices and SOA are conceptually different. In this context the idea of SOA is often reduced to technology terms like WS\* or ESB and therefore referred to as heavyweights. This definition of SOA only covers possible implementation details, because from a conceptual perspective SOA is also an architectural paradigm, making no premises regarding implementation details or the corresponding technologies to use for a concrete SOA implementation. When looking at the sections before, describing Microservices-based architectures and its challenges, it can be stated that very similar concepts and challenges arise in SOA-style architectures, because characteristics for Service-oriented architectures are loose-coupling, standard-based and stable service contracts, distributed services and flexibility as well as agility regarding changing business requirements. The resulting challenges are nearly the same. As a reason for this, in our opinion the both approaches aren“™t so different essentially. SOA-style architectures historically often use SOAP-style communications. But regarding this fact we are observing a change: the number REST-style SOA services is growing. A trend which is mainly influenced by the increasing need of multi-channel support, e.g. for mobile devices, where REST-style communications by using a JSON-based data format is the preferred variant. The big software vendors, e.g. Oracle, also recognize this trend and therefore have extended out-of-the-box support for REST services. In system architectures that are based on the SOA paradigm, an ESB is often used to integrate different enterprise applications. Classically it cares about routings, protocol as well as data transformations and service virtualization. So point-to-point integrations between systems can be avoided and makes an IT system landscape more flexible regarding adding new applications as well as services. In our opinion this can“™t be called heavyweight and is indispensable for increasing agility. Furthermore the microservices proponents do not say any word about service governance. This is also ok for some sorts of SOA services. We often differentiate services into public and private services. Systems consisting of multiple components are often organized as a set of collaborating private services \[[4](http://www.oracle.com/technetwork/articles/soa/ind-soa-canonizing-language-1957510.html "http://www.oracle.com/technetwork/articles/soa/ind-soa-canonizing-language-1957510.html")\]. These interfaces are not published enterprise-wide and must therefore not adhere to more strict policies applied to public services. The offical / public interfaces of a system are in contrast published as public services. Thus from our perspectives, Microservices are nothing new, but rather an implementation of the concept of private services. **Summary** Microservices architectures are primarily focusing on a local, application-based scope and provide a very flexible as well as modular approach for developing easy-to-extend applications. In summary it can be said that the Microservices architectural paradigm seams to deliver great benefits though it must be stated that the approach is not a completely new concept. Compared to that a SOA approach has a farsighted, global scope aiming at the enterprise level. From a SOA perspective, Microservices could be understood as private services, not necessarily exposing their functionalities for reusing them in other systems or services. But that is ok, because in service-oriented architectures one does not expose a service, when there is no need „“ which means no need for reuse in other applications or services „“ for it. Taking all points discussed in this article into account, we would recommend that discussions about differences between Microservices and SOA should be avoided. Instead it should be evaluated how and if a coexistence of these two very similar approaches is possible to deliver the most valuable benefit for system architectures as possible, making IT system landscapes more flexible and therefore promoting business agility. \[1\] \[2\] \[3\] \[4\] **Kategorien:** Integration **Schlagwörter:** Architecture, Microservices --- ### [Using JMS Unit-of-Order in a High Availability Environment](https://thecattlecrew.net/2014/10/01/using-jms-unit-of-order-in-a-high-availability-environment/) **Published:** Oktober 1, 2014 **Author:** Apostolos Varsamis **Content:** # Abstract The WLS JMS Unit-of-Order feature (UOO) is well documented in various papers and blogs; it mainly enables numerous message producer to group messages into a single unit that is processed sequentially in the order the messages were created. Until message processing for a message is complete, the remaining unprocessed messages for that Unit-of-Order are blocked. This behavior makes the usage of UOO essential in cases that a specific processing order must be adhered to. But what happens in a High Availability Environment using distributed queues, when a node breaks down? How can the processing order be guaranteed under these circumstances? This article is a practice report answering these questions. # Preparing the test For our tests we are using an OSB cluster with two nodes and an Admin server in the Version 11.1.1.7; the WLS is in the version 10.3.6. **Configuring the JMS Server** Use the Admin Console (Admin Server) to perform the following steps: 1. Define a data source (e.g. jdbc/jmsDS) 2. Define a persistence store on each OSB Cluster-Node using the data source from Step1 e.g.: – JDBCStore4JMS1 targets osb\_server1 (migratable) – JDBCStore4JMS2 targets osb\_server2 (migratable) [![pic1](https://thecattlecrew.net/wp-content/uploads/2014/10/pic11.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/10/pic11.png) 3. Define a JMS Server on each OSB Cluster Node targeting a migratable target. **Note:** When a JMS server is targeted to a migratable target, you have to use a custom persistence store which must be configured and targeted to the same migratable target. [![pic2](https://thecattlecrew.net/wp-content/uploads/2014/10/pic2.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/10/pic2.png) 4. Define a JMS Module targeting both JMS Servers; define an appropriate connection factory and a distributed queue. [![pic3](https://thecattlecrew.net/wp-content/uploads/2014/10/pic3.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/10/pic3.png) [![pic4](https://thecattlecrew.net/wp-content/uploads/2014/10/pic4.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/10/pic4.png) 5. Pointing at the distributed queue, you can now see both queues and the messages holding by them [![pic5](https://thecattlecrew.net/wp-content/uploads/2014/10/pic5.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/10/pic5.png) # Performing the test A message producer sends 14 messages using UOO KEY1, KEY2, and KEY3 in the following way: - 3 messages with UOO: **KEY1** - 2 messages with UOO: **KEY2** - 9 messages with UOO: **KEY3** The following was observed: 1. The messages were received by the queue and distributed to the configured persistence stores 2. Messages with the same UOO were stored in the same persistence store 3. After a cluster node was shut down, all new messages containing the same UOO as those processed by the JMS Server (and the persistence store) pinned to the disconnected node, have been rejected; all other messages continued to be enqueued (and dequeued) 4. After the migration of the JMS Server (and its persistence store) which was pinned to the shutdown node, to another working node – which took approximately 10 sec.- all rejected messages were processed and the distributed queue regained fully functionality. # Conclusion The processing order of messages can be guaranteed in a clustered Environment when using JMS Unit-Of-Order. If a cluster node crashes the distributed queue is not able to receive messages of a certain UOO for approximately 10 sec. which might be for the most cases a sufficient small amount of time. **Kategorien:** Development **Schlagwörter:** JMS, Oracle DB, unit of order, Weblogic --- ### [Patch SOA/BPM VM to WebCenter 11.1.1.8](https://thecattlecrew.net/2014/11/10/patch-soabpm-vm-to-webcenter-11-1-1-8/) **Published:** November 10, 2014 **Author:** alexanderdaeubler **Content:** At one can find the latest 11g SOA/BPM Virtual Machine (VM) which also contains Webcenter. Unfortunately, Webcenter has been added in version 11.1.1.7 to that VM; as there are major enhancements in Webcenter 11.1.1.8 it generally makes sense to upgrade the VM to that version. At [http://docs.oracle.com/cd/E29542\_01/doc.1111/e16793/patch\_webcenter.htm#BABGAFDE](http://docs.oracle.com/cd/E29542_01/doc.1111/e16793/patch_webcenter.htm#BABGAFDE) a documentation for upgrading from 11.1.1.7 to 11.1.1.8 can be found. In this post I want to describe which steps of the update guide I actually executed in order to upgrade my VM and which ones I skipped as they seem to be optional. The particular steps are also described in full detail here: [http://docs.oracle.com/cd/E29542\_01/doc.1111/e16793/patch\_webcenter.htm#CCHJFGDG](http://docs.oracle.com/cd/E29542_01/doc.1111/e16793/patch_webcenter.htm#CCHJFGDG) **Pre-Patching Tasks** I skipped all pre-patching tasks, as we“™re starting with a VM that does not contain any data so far and which already contains an up to date Weblogic installation. **Installer for WC Portal and WC Content** The installers for upgrading WC Portal and WC Content can be downloaded from the Oracle support page at support.oracle.com using the following patch ID“™s: 17068143 (WC Portal) 17068216 (WC Content) Just start the VM and run the installer scripts (when asked for a JDK/JRE location, enter „/oracle/javahome/jdk1.6.0\_45/jre“), first the one for WC Portal, followed by the one for WC Content. When asked for it within the installation, skip software updates. Apart from that generally use the installer’s default values. I skipped the Oracle SES installation, as the feature isn’t required for training and/or proof of concept matters. **Applying the Patch Set** Additional information can be found here: [http://docs.oracle.com/cd/E29542\_01/doc.1111/e16793/patch\_set\_assistant.htm#BABEBGEJ](http://docs.oracle.com/cd/E29542_01/doc.1111/e16793/patch_set_assistant.htm#BABEBGEJ) The schema check performed on the initial DB was successful (query *SELECT OWNER, VERSION, STATUS, UPGRADED FROM SCHEMA\_VERSION\_REGISTRY*), so you can skip this step. The psa script needed to start the patch set assistant can be found at „/oracle/fmwhome/oracle\_common/bin“. I didn“™t upgrade all schemas, just the following ones: - WEBCENTER - DISCUSSIONS - DISCUSSIONS\_CRAWLER - OCS - OCSSEARCH The first three schemas are for WC Portal, the last two for WC Content. The other schemas for those two applications couldn“™t be updated successfully (e.g. ACTIVITIES, this schema seems to not exist on the VM so it obviously can“™t be updated) but so far I didn’t encounter any problems when working with the VM. Use the following database credentials: - Connection: „localhost:1521“ - User „sys as sysdba“ - Password „welcome1“ NOTE: for the OCSSEARCH schema you must add the prefix „DEV\_“ to the schema name when trying to connect to the DB in the wizard. **Post-Patching Tasks** The Webcenter permissions definitely need to be updated. Otherwise, both the PortalBuilder and the administration pages in WC Portal can not be opened. Detailed information can be found here: [http://docs.oracle.com/cd/E29542\_01/doc.1111/e16793/patch\_webcenter.htm#CCHFIIDI](http://docs.oracle.com/cd/E29542_01/doc.1111/e16793/patch_webcenter.htm#CCHFIIDI) The wlst.sh can be found at „/oracle/fmwhome/wlserver\_10.3/common/bin“. Now the VM should be successfully updated to Webcenter 11.1.1.8. I would recommend to directly apply the latest patches for both WC products which can be downloaded from the Oracle support page at support.oracle.com. We used the following Patch ID’s when this blog post was created: 19194669 (WC Portal 11.1.1.8.5) 19334406(WC Content 11.1.1.8.7) The WC Portal patch contains the „NewAssetBP3.zip“ file. To use the assets (new templates and skins), unzip the folder and upload the ear files to the portal using the SharedAssets section in the portal administration. Having executed all of these steps the VM should contain Webcenter Portal and Content in the latest version of 11.1.1.8. If you encounter any problems when working with WC Portal and/or Content on the VM then please let us know. **Kategorien:** Integration **Schlagwörter:** Patchset, Upgrade, VM, WebCenter Content, WebCenter Portal --- ### [Using the Camunda Workflow API to control timer events and process instances](https://thecattlecrew.net/2014/11/18/example-tutorial-using-the-camunda-workflow-api-timer-events-process-instances/) **Published:** November 18, 2014 **Author:** Stefan Frena **Content:** This post shows an example of using the Camunda Workflow API. It can be a handy and easy-to-use interface, if you want to dive into your workflow environment a little deeper. In a recent client project, we were confronted with the need to dynamically switch on and off a timer event, triggering email reminders for the user. The interesting part was that this should also happen for other process instances of the same user. Since a single process instance did not know any of the other „siblings“, the Camunda Workflow API came in handy. To help you understand, we want to show you a model of the facilitated business use case (Image 1). [![Lease-A-Car Business Process](https://thecattlecrew.net/wp-content/uploads/2014/11/newdiagram_11.png)](https://thecattlecrew.net/wp-content/uploads/2014/11/newdiagram_11.png)Image 1 – Lease-A-Car Business Process Imagine we want to lease a car. Let“™s say we are interested in 3 different manufacturers so we configure 3 different cars and start one leasing request process for each one of these cars. After our leasing company calculated the monthly rates, we want to be able to select the car with the most reasonable rate. The 3 processes will remind us to do so, in case we wait too long. So far so good. Imagine now, we choose one rate out of our 3 inquiries and the relevant process instance will make sure next step „check credit-worthiness“ is triggered. Besides that, the two other instances remain at the point to choose the rate. So while we wait and hope that our credit-worthiness goes through, we still get emails to remind us checking the rates for cars, we aren’t interested in any more… Why don’t we just delete the other instances? Good question: We had the requirement, that the specific rate is part of the credit-worthiness check. In case it fails, the customer might want to order another car (hence instances are still ticking at this point). But yes, to avoid instance-zombies after a car was successfully ordered, the remaining instances will be deleted at the end of the process. This requirement resulted in the following considerations. To stop reminder emails, we have to filter active timer events and suspend the resultset. To do so, we need three types of information. - CustomerId (to get all instances for) - processDefinitionKey (to distinguish from instances of other processes) - BoundaryEventName (to request the right subset) This is the code, we came up with: \[code language=“java“\] public void suspendTimerEventInOtherProcessInstances(String processDefinitionKey, Long customerId, String boundaryEventName) { List timerJobs = getTimersForProcessByCustomerIdAndJobName(processDefinitionKey, customerId, boundaryEventName); for (Job job : timerJobs) { managementService.suspendJobById(job.getId()); } } private List getTimersForProcessByCustomerIdAndJobName(String processDefinitionKey, Long customerId, String boundaryEventName) { List processInstanceList = runtimeService.createProcessInstanceQuery().processDefinitionKey(processDefinitionKey) .variableValueEquals(ProcessVariables.CUSTOMER\_ID, customerId).list(); List jobList = new ArrayList(); for (ProcessInstance processInstance : processInstanceList) { List timerJobs = managementService.createJobQuery().processInstanceId(processInstance.getId()).timers() .active().list(); for (Job job : timerJobs) { if (((org.camunda.bpm.engine.impl.persistence.entity.TimerEntity) job) .getJobHandlerConfiguration().equals(boundaryEventName)) { jobList.add(job); } } } return jobList; \[/code\] You will notice that Camundas RuntimeService enables us to query ProcessInstances by processDefinitionKey and ProcessVariables (CustomerId). That gave us a list of matching process instances. So far so good. We now used this list to extract every active timer job of each instance, using Camundas ManagementService. To ensure to exclusively hold the requested timers in hand (one process instance might include further timers), we needed to compare each timer jobs „name“ with the given boundaryEventName. The necessary information can be found in field JobHandlerConfiguration, made available by casting the job to TimerEntity, supplying a matching getter (images 2 and 3). ![timerEntity](https://thecattlecrew.net/wp-content/uploads/2014/11/timerentity.png)Image2 ![inspect job](https://thecattlecrew.net/wp-content/uploads/2014/11/inspect-job.png)Image3 OK – after we got hands on the requested TimerJobs, we suspended them. The second step, after a car was ordered was to delete the other, now unimportant, instances: To delete all the other process instances of cars we aren“™t interested anymore, we called this piece of code in the end of a successful process: \[code language=“java“\] public void deleteAllOtherMultibidProcessesOfUser(String processDefinitionKey, Long customerId, String instanceIdToStayAlive){ List processInstanceList = runtimeService.createProcessInstanceQuery().processDefinitionKey(processDefinitionKey) .variableValueEquals(ProcessVariables.USER\_ID, customerId).active().list(); for (ProcessInstance processInstance : processInstanceList) { if (!instanceIdToStayAlive.equals(processInstance.getId())) { runtimeService.deleteProcessInstance(processInstance.getId(), „Instance deleted because user ordered other car.“); } } } \[/code\] Again, we used - CustomerId (to get all instances for) - processDefinitionKey (to distinguish from instances of other processes) while we introduced - instanceIdToStayAlive. This seemed to be the easiest way to make sure not to delete the actual calling instance. As you can see, we use RuntimeService again to query process instances by ProcessDefinitionKey and CustomerId. After that, we only kept alive the one instance, that was still relevant for handling the customers car-leasing. I hope this post was useful, Stefan **Kategorien:** Integration **Schlagwörter:** BPM, Camunda, Java --- ### [Resolving INSTALL_FAILED_CONTAINER_ERROR when deploying MAF app to android emulator after system upgrade to Mac OS X Yosemite](https://thecattlecrew.net/2015/01/03/resolving-install_failed_container_error-when-deploying-maf-app-to-android-emulator-after-system-upgrade-to-mac-os-x-yosemite/) **Published:** Januar 3, 2015 **Author:** **Content:** During our Oracle MAF Hackathon we wanted to deploy our app to both android emulator and iOS simulator. Feeling giddy because of having XCode5 and Android SDK installed on my Mac I wanted to show our crowd that apps built with MAF are really multi-platform compliant. Confident of victory because deployment to android emulator succeeded a few weeks ago I started deployment. But this time an INSTALL\_FAILED\_CONTAINER\_ERROR error occurred: [![deployment_error](https://thecattlecrew.net/wp-content/uploads/2015/01/deployment_error.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/01/deployment_error.png) After copying the command from log messages window into console a more detailed error message was shown. ![bash](https://thecattlecrew.net/wp-content/uploads/2015/01/bash.png?w=300) Actually this error message does not point out the issue“™s cause. In our case deployment failed because I upgraded my Mac OS X from Maverick to Yosemite what entailed the Intel Hardware Accelerated Execution Manager (HAXM) did not longer work. The emulator“™s android virtual device (AVD) I used for deployment was configured to run with hardware accelerated „Intel Atom (x86)“ CPU instead of ARM. Switching this back to „ARM“ solved the problem with the side-effect of losing hardware accelaration. Recognizing that something with HAXM went wrong I decided to upgrade my HAXM installation via Android SDK Manager. HAXM can be found under node „extras“: ![sdk_manager](https://thecattlecrew.net/wp-content/uploads/2015/01/sdk_manager.png?w=300) After upgrading my HAXM installation there were two dmg packages: One for Mac OS installations below 10.9 and one for Mac OS X 10.9 and above. [![haxm_10_9_above](https://thecattlecrew.net/wp-content/uploads/2015/01/haxm_10_9_above.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/01/haxm_10_9_above.png) Re-installing the appropiate package for Maverick/Yosemite (10.9 or higher) re-enabled me to deploy our Oracle MAF app to an android emulator“™s AVD that uses an Intel CPU with hardware acceleration. ![deployment_success](https://thecattlecrew.net/wp-content/uploads/2015/01/deployment_success.png?w=300) Maybe this helps someone out there to save time for investigating the cause of the error message we got during deployment. **Kategorien:** Integration **Schlagwörter:** ADF, Mobile --- ### [Oracle Service Bus 12c: Retrieving Username from HTTP Basic authentication token](https://thecattlecrew.net/2015/01/12/oracle-service-bus-12c-retrieving-username-from-http-basic-authentication-token-2/) **Published:** Januar 12, 2015 **Author:** Sven Bernhardt **Content:** Using HTTP Basic authentication is a common mechanism to check user’s authenticity, when creating REST-enabled API’s to prevent applications and it’s functionalities from unathorized access. Service Bus 12c (SB) supports this authentication method by using a OWSM security policy. The corresponding authentication information are transported in the HTTP header. In some cases, for example when only user-relevant data should be determined when querying information from Enterprise Information Systems (EIS), the information about the current user that are available in the HTTP header might be helpful. As an alternative the username information could be transported in the payload of each Service Call, e.g. as a query parameter. In the following I will describe, which steps are needed to extract the username from the HTTP header, so transporting the same information twice, in the header and the payload, can be avoided. Starting point is a simple HelloWorld service, which expects a valid HTTP Basic authentication token. In the example a corresponding OWSM policy is used to realize this. The service as such has an operation „greet“ that takes no parameter. As result, it returns a personalized salution based on the passed authorization header. [![Enabling_HTTP_Basic_Auth_on_Proxies](https://thecattlecrew.net/wp-content/uploads/2015/01/enabling_http_basic_auth_on_proxies.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/01/enabling_http_basic_auth_on_proxies.png)Enabling HTTP basic authentication on proxy services In the Proxy Service configuration it has to be ensured that the option „Get all headers“ is enabled in the transport configuration. Unfortunately setting this option is not sufficient, because SB removes Security information from the HTTP header before entering the processing pipeline. To force SB to keep the authentication information the additional java option „*-Dcom.bea.wli.sb.transports.http.GetHttpAuthorizationHeaderAllowed=true*“ has to be added in setDomainEnv.sh. A server restart is needed to enable the updated JVM settings. Parsing out the username from the HTTP basic authentication token is done by a Java Callout that call a static method from a Java class that does the needed „magic“. ``` public class UsernameExtractor { public static String extract(String pHttpAuthenticationToken) { final String authenticationTokenWithoutBasicPrefix = pHttpAuthenticationToken .substring(6); final String base64DecodedAuthorizationString = new String(DatatypeConverter .parseBase64Binary(authenticationTokenWithoutBasicPrefix)); return base64DecodedAuthorizationString.split(":")[0]; } } ``` The Java class from above is packaged in form of a JAR file, which is added to the corresponding HelloWorld project. The invocation is done by using a Java callout during message processing in the pipeline. [![Parsing_username_from_HTTP_Basic_auth_token](https://thecattlecrew.net/wp-content/uploads/2015/01/parsing_username_from_http_basic_auth_token.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/01/parsing_username_from_http_basic_auth_token.png)Parsing out the username from HTTP header using a Java Callout After deploying the HelloWorld SB service to Oracle Service Bus 12c, the service can be tested using SOAP UI. [![SoapUI_Test_HelloWorldService](https://thecattlecrew.net/wp-content/uploads/2015/01/soapui_test_helloworldservice.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/01/soapui_test_helloworldservice.png)Resulting salutation after service invocation As it can be seen from the result, the service works as expected. The resulting salutation contains the username passed with the corresponding authentication information in the HTTP header. **Kategorien:** Integration **Schlagwörter:** Authentication, Oracle FMW, Oracle Service Bus, Weblogic --- ### [Automated Unittesting of XQueries in Oracle OSB](https://thecattlecrew.net/2015/09/29/automated-unittesting-of-xqueries-in-oracle-osb/) **Published:** September 29, 2015 **Author:** Pascal Brokmeier **Content:** In order to support a more agile project environment, OPITZ CONSULTING developed a Java/JUnit based SOA Unit Testing Framework. Among others, the framework was capable of using the Oracle libraries to run XQuery tests locally and verify their correctness. Over the course of time, Oracle released 12c and with it, changed its xquery files. A new extension (.xqy instead of .xq) was introduced and with it additional syntax. Oracle added a`(:: OracleAnnotationVersion "1.0" ::)` . After this, the testing framework needed to be updated to support such tags. Without an update, executing a query with the above annotation gave the following error: ``` java.lang.RuntimeException: weblogic.xml.query.exceptions.XQueryStaticException: line 3, column 1: {err}XP0003: Invalid expression: either 'pragma' or 'extension' is required inside (:: ::) at com.opitzconsulting.soa.testing.AbstractXQueryTest.setQuery(AbstractXQueryTest.java:56) at de.home24.SalesOrderErrorListener.TransformationTest.testPrepareResponseTransformation(TransformationTest.java:25) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at com.intellij.junit4.JUnit4IdeaTestRunner.startRunnerWithArgs(JUnit4IdeaTestRunner.java:78) at com.intellij.rt.execution.junit.JUnitStarter.prepareStreamsAndStart(JUnitStarter.java:212) at com.intellij.rt.execution.junit.JUnitStarter.main(JUnitStarter.java:68) at com.intellij.rt.execution.application.AppMain.main(AppMain.java:140) Caused by: weblogic.xml.query.exceptions.XQueryStaticException: line 3, column 1: {err}XP0003: Invalid expression: either 'pragma' or 'extension' is required inside (:: ::) at weblogic.xml.query.exceptions.XQueryStaticException.create(XQueryStaticException.java:579) at weblogic.xml.query.exceptions.XQueryException.create(XQueryException.java:127) at weblogic.xml.query.exceptions.XQueryException.create(XQueryException.java:175) at weblogic.xml.query.compiler.parser.ParserUtil.lineColException(ParserUtil.java:69) at weblogic.xml.query.compiler.parser.ParserUtil.makeXQueryExceptionFrom(ParserUtil.java:91) at weblogic.xml.query.compiler.parser.XQueryMainLexer.reportError(XQueryMainLexer.java:106) at weblogic.xml.query.compiler.parser.XQueryMainLexer.mEXPR_COMMENT(XQueryMainLexer.java:3495) at weblogic.xml.query.compiler.parser.XQueryMainLexer.nextToken(XQueryMainLexer.java:588) at antlr.TokenStreamSelector.nextToken(TokenStreamSelector.java:65) at weblogic.xml.query.compiler.parser.LexerManager.nextToken(LexerManager.java:59) at antlr.TokenBuffer.fill(TokenBuffer.java:69) at antlr.TokenBuffer.LA(TokenBuffer.java:80) at antlr.LLkParser.LA(LLkParser.java:52) at weblogic.xml.query.compiler.parser.XQueryParser.prolog(XQueryParser.java:1818) at weblogic.xml.query.compiler.parser.XQueryParser.mainModule(XQueryParser.java:1881) at weblogic.xml.query.compiler.parser.XQueryParser.module(XQueryParser.java:1267) at weblogic.xml.query.compiler.parser.XQueryParser.parseModuleEntryPoint(XQueryParser.java:1167) at weblogic.xml.query.compiler.parser.XQueryParser.parseQuery(XQueryParser.java:470) at weblogic.xml.query.xdbcimpl.XqueryStatement.parse(XqueryStatement.java:172) at weblogic.xml.query.xdbcimpl.AbstractStatement.compile(AbstractStatement.java:261) at weblogic.xml.query.xdbcimpl.AbstractStatement.prepare(AbstractStatement.java:253) at weblogic.xml.query.xdbcimpl.XQueryPreparedStatementImpl.init(XQueryPreparedStatementImpl.java:77) at weblogic.xml.query.xdbcimpl.XQueryPreparedStatementImpl.(XQueryPreparedStatementImpl.java:64) at weblogic.xml.query.xdbcimpl.XDBCConnection.prepareStatement(XDBCConnection.java:99) at com.opitzconsulting.soa.testing.AbstractXQueryTest.setQuery(AbstractXQueryTest.java:53) ... 11 more ``` Updating the Testing Framework, we were able to continue unit testing xqueries using the following syntax: ``` java OXQDataSource dataSource = new OXQDataSource(); XQConnection connection = dataSource.getConnection(); OXQEntity entity = new OXQEntity(query); OXQConnection ocon = OXQView.getConnection(connection); XQPreparedExpression expression = ocon.prepareExpression(entity); expression.executeQuery(); ``` However, in queries there are also other functions allowed. Among others `{fn-bea:($soapbody)}` would be a valid bea function. The above code however is not capable of handling such custom functions, resulting in the following error: ``` javax.xml.xquery.XQQueryException: line 49, column 27: {http://www.w3.org/2005/xqt-errors}XPST0081: The prefix "fn-bea" used in the qualified name "fn-bea:serialize" can not be resolved at oracle.xml.xquery.xqjimpl.OXQCUtils.createXQQueryException(OXQCUtils.java:992) at oracle.xml.xquery.xqjimpl.OXQCPreparedExpression.(OXQCPreparedExpression.java:92) at oracle.xml.xquery.xqjimpl.OXQCConnection.prepareExpressionImpl(OXQCConnection.java:421) at oracle.xml.xquery.xqjimpl.OXQCConnection.prepareExpression(OXQCConnection.java:210) at oracle.xml.xquery.xqjimpl.OXQCConnection$OXQConnectionView.prepareExpression(OXQCConnection.java:528) at com.opitzconsulting.soa.testing.AbstractOXQueryTest.setOXQuery(AbstractOXQueryTest.java:32) at com.opitzconsulting.soa.testing.selftest.OXQuerySelfTest.testsetOXQuery(OXQuerySelfTest.java:29) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at com.intellij.junit4.JUnit4IdeaTestRunner.startRunnerWithArgs(JUnit4IdeaTestRunner.java:78) at com.intellij.rt.execution.junit.JUnitStarter.prepareStreamsAndStart(JUnitStarter.java:212) at com.intellij.rt.execution.junit.JUnitStarter.main(JUnitStarter.java:68) at com.intellij.rt.execution.application.AppMain.main(AppMain.java:140) Caused by: oracle.xml.xquery.exceptions.XQueryStaticException: line 49, column 27: {http://www.w3.org/2005/xqt-errors}XPST0081: The prefix "fn-bea" used in the qualified name "fn-bea:serialize" can not be resolved at oracle.xml.xquery.exceptions.XQueryStaticException.create(XQueryStaticException.java:696) at oracle.xml.xquery.exceptions.XQueryException.create(XQueryException.java:92) ... ``` Our theory: Oracle created a superset of xquery implementing both the above mentioned Oracle `(:: ::)` annotations as well as the `{fn-bea: ... }` custom functions which were created by bea. Analyzing the files opened by jDeveloper indicated the correctness of this theory. [![opened files by jdeveloper](https://thecattlecrew.net/wp-content/uploads/2015/09/1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/09/1.png) As can be seen in the above image, the jDeveloper Process opened several .jar files while opening a .xqy xQuery. Jar files with `oxquery` as well as `bea` can be spotted. The former contained the Classes used in the above java snippet, which enabled us to parse the Oracle specific annotations. We suspect the latter to be capable of parsing xQueries with bea specific functions. However we could not find a way to parse a query that contains both forms. Now the interesting part. The file activity list also includes an `oxquery-xmlbeans-interop.jar` which can be expected to be capable to interoperate with *something*, probably the bea xquery parsing utilities. What is the problem? Well this is as far as we got. We looked into the .jar files trying to find Classes and Methods that suggest being capable of parsing queries that both contain *bea*and *Oracle* specific syntax but we were not able to perform a successful test. If anyone has also tried Unit-Testing the new 12c xQueries we“™d be happy to hear their solution. Below is a view of the contents in the `interop.jar` files. Somehow we suspect there has to be a solution. However without proper documentation or an API, it“™s hard to create a successful piece of code ![](http://opitzconsulting.github.io/blog/assets/img/2015-09-29-Automated-Unittesting-of-XQueries-in-Oracle-OSB/2.png) **Kategorien:** Development **Schlagwörter:** English, Service Bus --- ### [Erste Erfahrungen mit dem neuen Oracle Forms 12c (12.2.1.0)](https://thecattlecrew.net/2015/10/28/erste-erfahrungen-mit-dem-neuen-oracle-forms-12c-12-2-1-0/) **Published:** Oktober 28, 2015 **Author:** Holger Lehmann **Content:** Gerade erst wurde das neue Oracle Forms 12c auf der [\#**oow15**](https://twitter.com/hashtag/oow15?src=hash) vorgestellt. Eine große Überraschung an sich, da das neue Forms sowieso schon verspätet ist und viele nicht mehr mit einer Vorstellung in 2015 gerechnet haben. Die Sourcen und weitergehende Informationen gibt es unter: http://www.oracle.com/technetwork/developer-tools/forms/overview/index.html [![otn forms](https://thecattlecrew.net/wp-content/uploads/2015/10/otn.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/10/otn.jpg) **Installation und Konfiguration** 1. Hardwarevoraussetzungen Min 8 Gb RAM Static IP (or Loopback Adapter for Windows) Deactivate AntiVirus + Firewall Installation JDK 1.8 2. eigentliche Installation Weblogic installieren: *java -jar fmw\_12.2.1.0.0\_infrastructure.jar Forms & Reports Installation ohne Konfiguration* per RCU ein Datenbank-Repository für die Forms-WLS-Domäne erstellen (Datenbank sollte AL32UTF8 Zeichensatz haben und eine Enterprise-Edition sein) config.bat ausführen und die Domäne konfigurieren, zuvor erstelltes Repository angeben und erstellen lassen 3. Nodemanager starten, Admin-Server starten und WLS-Forms starten Alternativ gibt es die Möglichkeit, nur den Formsbuilder ohne Domain-Erstellung zu installieren. Praktisch, wenn man seine Forms sowieso woanders deployed und nur entwickeln will (Option Standalone Formsbuilder). [![inst](https://thecattlecrew.net/wp-content/uploads/2015/10/inst.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/10/inst.jpg) Hat man das alles geschafft, kann man direkt testen, ob es läuft: http://SERVERNAME:PORT/forms/frmservlet [![forms12](https://thecattlecrew.net/wp-content/uploads/2015/10/forms12.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/10/forms12.jpg) **Erfahrung mit der ersten Anwendungsmigration** Die erste Migration einer Forms 11 Anwendung hat sich als sehr einfach rausgestellt. Wie bei einem vorherigen Releasewechsel des öfteren progagiert, mußten alle Module einmal kompiliert und deployed werden. Die nötigen Jar-Files mußten in das richtige Verzeichnis kopiert, ein neuer Abschnitt in der formsweb.cfg angelegt und eine entsprechende env-Datei für die Anwendung angelegt werden. Danach ließ sich die Applikation problemlos unter Forms 12 aufrufen. Prima 🙂 **Jetzt das persönliche Ja aber…** Endlich ist das neue Forms draußen, da haben wir ja lange drauf gewartet und wurden immer weiter vertröstet. Was Stand heute noch bei Oracle auf der Webseite fehlt, ist die New Features Liste. So weiß man erstmal nicht, was neu gegenüber der letzten Version ist. Heute haben 2 Kollegen und ich in den Formsbuilder geschaut und dachten zuerst, es wäre der 11er Formsbuilder. Offensichtlich neu ist da das browserunabhänginge Starten einer Forms Applikation per Java WebStart. Das gibt einen dicken Daumen nach oben, ist aber auch anderen Browser-Herstellern geschuldet, die das Java Plugin nicht mehr unterstützen. Eine andere Sachen mit einem „Geschmäckle“ ist die zwingende Installation eines Metadaten-Repositories bei Erstellung einer Weblogic-Domain für Forms. Das war bisher schon beim Oracle Discoverer so, setzt sich nun auch bei Forms 12 inkl. Weblogic 12 fort. Persönliches Fazit momentan: Gefühlt ist die Installation schwieriger geworden, die benötigten Ressourcen größer, die veröffentlichten New Features sind noch unklar, dafür ist die Migration einer Forms 11 Anwendung trivial. Stay tuned… **Kategorien:** Development **Schlagwörter:** Forms, Oracle DB, Oracle FMW, Softwarenentwicklung, Weblogic --- ### [Oracle OpenWorld 2015 "“ A new Era of Utility Computing (Part 1)](https://thecattlecrew.net/2015/11/01/oracle-openworld-2015-a-new-era-of-utility-computing-part-1/) **Published:** November 1, 2015 **Author:** Danilo Schmiedel **Content:** Exciting days are behind us. As every year we visited Oracle OpenWorld in San Francisco. Thousands of customers, hundreds of partners, and millions of virtual attendees from more than 141 countries were curious to see a lot of innovation, technology and entertainment. Oracle OpenWorld is the industry“™s preeminent business and technology show featuring over 2,500 sessions, 3,000 speakers, and more than 400 Oracle demos. More than 45 Oracle products and services have been unveiled throughout the conference. [![OOW-2015](https://thecattlecrew.net/wp-content/uploads/2015/11/oow-2015.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/11/oow-2015.png) You might have seen the tweets that we shared with you during the last couple of days. Let me list a few of our highlights here: [![twitter](https://thecattlecrew.net/wp-content/uploads/2015/11/twitter1.png?w=150)](https://thecattlecrew.net/wp-content/uploads/2015/11/twitter1.png)[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)Pre-OOW present: FMW 12.2.1 has been released, including SOA and BPM Suite #SOA12c. [goo.gl/cE5YQ](http://goo.gl/cE5YQ) @soacommunity @OC\_WIRE[![twinterberg_normal](https://thecattlecrew.net/wp-content/uploads/2015/11/twinterberg_normal.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/twinterberg_normal.jpg) Wow. Enjoying live demo of new and upcoming version of Oracle Integration Cloud Service (ICS). This is useful now!! Watch out![![DSL_normal](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg) Get valuable metrics out of integration flows with Realtime Integration Insight – great new feature presented by @SOASimone @soacommunity[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png) Today seems to be announcement day, all for making Oracle #1 in Cloud market. #oow15 @OC\_WIRE [pic.twitter.com/ojxQK0xh3L](http://pic.twitter.com/ojxQK0xh3L)[![DSL_normal](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg) Had an exciting day at OracleHQ @oracleace briefing @soacommunity [pic.twitter.com/wQCN0ueJTU](http://pic.twitter.com/wQCN0ueJTU)[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png) Announcement: Oracle Private Cloud Machine for PaaS and IaaS. There will be a reference manual for the name @larryellison #oow15 @OC\_WIRE[![DSL_normal](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg) Great to see how you can provision a new SOA environment in just a few minutes using SOA CS #oow15 @soacommunity [pic.twitter.com/9gKxNmUdIC](http://pic.twitter.com/9gKxNmUdIC)[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)Software features for security implemented in silicon. Larry Ellison announces M7 microprocessor. #oow15 @OC\_WIRE [pic.twitter.com/P372K1XkcL](http://pic.twitter.com/P372K1XkcL)[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png) NextGen: Cooperation of Oracle and Samsung to make wearables more beneficial to enterprises [goo.gl/b9AhwT](http://goo.gl/b9AhwT) @OracleMobile @OC\_WIRE[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png) Great news: Finally also the @oraclewebcenter products are now part of the 12c family! [goo.gl/UCIx3Q](http://goo.gl/UCIx3Q) @soacommunity @OC\_WIRE[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png) OracleJET demystified: JavaScript Extension Framework builds the foundation for Cloud Service UIs #oow15 @OC\_WIRE [pic.twitter.com/xstArRXQjT](http://pic.twitter.com/xstArRXQjT)[![twinterberg_normal](https://thecattlecrew.net/wp-content/uploads/2015/11/twinterberg_normal.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/twinterberg_normal.jpg) It’s all about Business User Empowerment: Oracle Application Builder Cloud Service. #oow15 @OC\_WIRE[![sbernhardt](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png)](https://thecattlecrew.net/wp-content/uploads/2015/11/sbernhardt.png) @WunderlichRd on @OracleSOA new Features of Servicebus #oow15, especially on Native REST and E2E JSON [pic.twitter.com/2GAt3qgUz5](http://pic.twitter.com/2GAt3qgUz5)[![DSL_normal](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/dsl_normal.jpg) Exciting day with @soacommunity Bike Tour in San Francisco. Thanks a lot for all the networking opportunities! [pic.twitter.com/7fzH2umPyV](http://pic.twitter.com/7fzH2umPyV)My colleague Sven Bernhardt (OracleACE) was also invited to participate in the following two sessions as a speaker: **High-Performance Oracle SOA Suite Customer Panel \[CON8115\]** Service integration is critical in allowing the business to remain agile by bringing together islands of information. As the business discovers the value of information, the expectation is to have information and to be able to make decisions rapidly. This panel discussion hosts some key Oracle service integration customers using products like Oracle Service Bus, Oracle SOA Suite, and more to achieve very high performance around their integration requirements. Hear real-world examples and learn how Oracle enables integration to bring value to the business. **Boost SaaS and On-Premises Connectivity: Leverage Oracle Cloud Adapters \[CON7993\]** An ever-growing number of organizations have made software-as-a-service (SaaS) applications their system of interaction for customer experience, employees, and wider ecosystems. Learn how to generate huge business value by integrating these cloud apps with on-premises applications by leveraging Oracle Cloud Adapters. This session discusses diverse capabilities of various Oracle Cloud Adapters and how they deliver faster, declarative, and robust SaaS-to-SaaS or SaaS-to-on-premises integrations on Oracle“™s integration-platform-as-a-service (iPaaS) and Oracle SOA Suite platforms. I had the pleasure to contribute to the session **Oracle SOA Suite 12c Success Stories \[CON7996\]**. Together with Lonneke Dikmans (SOA Expert and Oracle ACE Director from eProseed NL), Rahul Sood (Manager, Software Architecture and Development at RTD) and Antony Reynolds (Product Strategy Director, Oracle) we shared our experiences from several SOA Suite 12c implementations. **Session Abstract** Oracle SOA Suite 12c greatly improved the upgrade experience for its customer base. The results are seen in faster adoption by customers and their enthusiasm to leverage new features of the platform. Join this session to meet some customers and partners who have been on this journey and want to share their experiences. In the [next post](https://thecattlecrew.wordpress.com/2015/11/09/oracle-openworld-a-week-full-of-highlights-part-2/) we are going to wrap up our Open World highlights and major announcements that have been made during this amazing event. **Kategorien:** Tech Events & Networking **Schlagwörter:** Conference, English, News, oow --- ### [Forms 12c: neue Runtimeoptionen für mehr Flexibilität auch ohne Browser](https://thecattlecrew.net/2015/11/05/forms-12c-neue-runtimeoptionen-fuer-mehr-flexibilitaet-auch-ohne-browser/) **Published:** November 5, 2015 **Author:** Holger Lehmann **Content:** Beim letzten Mal habe ich mich vornehmlich mit der Installation des neuen Forms 12c auseinander gesetzt, die ja doch an der ein oder anderen Stelle sehr geklemmt hat. Heute möchte ich auf 2 neue Runtimeoptionen beim Starten einer Applikation eingehen, bei deinen Oracle auf jeden Fall in Richtung Zukunft geblickt hat. 1. Der Standardfall (Browser mit Plugin) Der normale Weg sieht klassischerweise vor, die Forms Anwendung aus dem Browser heraus zu starten. Hierbei muss der Browser aber das Java Plugin unterstützen. [![Variante1](https://thecattlecrew.net/wp-content/uploads/2015/11/var1.jpg?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/11/var1.jpg) 2. Mit Java Web Start In der neuen Forms 12c Version ist Java Web Start offiziell als Startmethode zertifiziert und supported. Dabei muss ebenfalls Java auf dem Client installiert sein, der Aufruf geht beispielsweise über[http://w7x6412c-rdbms:9001/forms/frmservlet?config=webstart&form=lab\_540&userid=user/passwort@db](http://w7x6412c-rdbms:9001/forms/frmservlet?config=webstart&form=lab_540&userid=user/passwort@db) [![Variante2](https://thecattlecrew.net/wp-content/uploads/2015/11/var2.jpg)](https://thecattlecrew.net/wp-content/uploads/2015/11/var2.jpg) [![var2b](https://thecattlecrew.net/wp-content/uploads/2015/11/var2b.jpg?w=427)](https://thecattlecrew.net/wp-content/uploads/2015/11/var2b.jpg) [![var2c](https://thecattlecrew.net/wp-content/uploads/2015/11/var2c.jpg?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/11/var2c.jpg) Dabei gelten gewisse Einschränkungen: – keine Java Script Unterstützung, da nicht im Browser laufend – kein SSO, kein SSO Logout 3. als Standalone Client (Oracle Forms Stand-alone Application Launcher – FSAL)Zitat aus der HTML-Seite „Overview: The Oracle Forms Stand-alone Application Launcher (FSAL) offers an alternative way for end-users to run Oracle Forms applications. FSAL offers a browser-less, more client/server-like interface. As a result of not using a browser, FSAL does not use the Java Plugin component of a Java Runtime Environment (JRE) or Java Developer Kit (JDK). All that is required to run FSAL on the end-user machine is a Java installation. This can be either the JDK or the JRE. To determine which Java versions are supported, please contact your administrator.“Ausgehend von der [fsal.htm](http://w7x6412c-rdbms:9001/forms/html/fsal.htm) kann man die zugehörige frmsal.jar auf den Client laden. Also ganz einfach, funktioniert auch ohne Browser! Aber auch wieder mit JDK oder JRE auf dem Client. Der Aufruf geht beispielsweise mit einer Batch-Datei mit folgendem Inhalt:[java -jar C:\\Oracle\\Middleware\\Oracle\_Home\\forms\\java\\frmsal.jar -url „http://w7x6412c-rdbms:9001/forms/frmservlet?config=daylightstandaloneapp&form=lab\_540&userid=]()[user/passwort@db](http://w7x6412c-rdbms:9001/forms/frmservlet?config=webstart&form=lab_540&userid=hr/hr@xe)[„]()[![Variante3](https://thecattlecrew.net/wp-content/uploads/2015/11/var3.jpg?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/11/var3.jpg)[![var3a](https://thecattlecrew.net/wp-content/uploads/2015/11/var3a.jpg?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/11/var3a.jpg) **Fazit** Man sieht also, dass der klassische Weg zum Starten eines Forms-Moduls nach wie vor funktioniert. Aber durch den kommenden Wegfall der Plugin-Unterstützung in neueren Bowsern, sah sich Oracle gezwungen zu reagieren und neue Wege zu gehen. Weiter so! **Kategorien:** Development **Schlagwörter:** Forms, Oracle DB, Oracle FMW, Softwarenentwicklung, Weblogic --- ### [Oracle OpenWorld 2015 "“ A week full of Highlights (Part 2)](https://thecattlecrew.net/2015/11/09/oracle-openworld-a-week-full-of-highlights-part-2/) **Published:** November 9, 2015 **Author:** Danilo Schmiedel **Content:** Of course some of the main events at Oracle OpenWorld are the Tuesday keynotes of Thomas Kurian and Larry Ellison (you can get them as on demand video on [oracle.com](https://www.oracle.com/openworld/on-demand/index.html)). A message that has clearly been communicated there: Oracle will compete hard in all three tiers of the cloud technology landscape“”applications, platforms, and infrastructure. All three tiers are delivered as a service via global network: - Applications: Software as a Service „“ **SaaS** - Platform: Database, Middleware, Analytics, Integration“¦ as a Service „“ **PaaS** - Infrastructure: Storage, Compute, Network as a Service „“ **IaaS** **Larry Ellison during his keynote:** > „We are in the middle of a generational shift in computing that is no less important than our shift to personal computing; when mainframes and minicomputers dominated our industry“ > > „We went into the SaaS business and came to understand that required us to be in the platform business. And we went into the platform business and came to understand we had to be in the infrastructure-as-a-service business. That“™s how we got to where we are today.“ > > „You can“™t change a cloud application, but you can extend a cloud application.“ > > „We need much better security“ and „It“™s better to have it at a lower level.“ (Silicon-Based) > > „In this new world of cloud computing, everything has changed. And almost all of our competitors are new“ > > „Our two biggest competitors, the two companies we watched most closely over the last two decades, have been IBM and SAP, and we no longer pay any attention to either one of them.“ Furthermore Larry Ellison explained that in the SaaS-business the main competitors are Salesforce.com and Workday. „We virtually never, ever see SAP. This is a stunning change.“ he said. In the PaaS sector, Oracle“™s biggest competitors are Microsoft, again Salesforce.com, and Amazon. In the IaaS sector Oracle mainly competes with Amazon. Thomas Kurian highlighted a couple of new data analysis cloud services, which are made for three different tiers of knowledge workers: data scientists, analysts and end-users. Data scientists can manage and analyze huge data sets with Oracle Big Data Cloud Service, Oracle Big Data Preparation Cloud Service and Oracle Big Data Discovery Cloud Service. End-users can use the Oracle Data Visualization Cloud Service to create a chart-driven analysis without detailed technical skills. Thomas Kurian explained it like this: „You can do analysis, and there are only two guiding principles to it. You only need to have a spreadsheet. And you only need to have a browser. You load your data with spreadsheets, you do analysis from a browser or phone.“ [![integrated-cloud-platform](https://thecattlecrew.net/wp-content/uploads/2015/11/integrated-cloud-platform.png?w=660)](https://thecattlecrew.net/wp-content/uploads/2015/11/integrated-cloud-platform.png) Again it was a great experience to attend to these keynotes live and in color. But the list of OpenWorld highlights is much longer. Read the summary below to get a rough overview what“™s happening especially in the platform area. **Oracle Cloud Platform – Highlights** - **New PaaS Services** – Available - SOA Cloud Service, API Manager, IoT, Big Data Preparation, Application Container Cloud with Java SE and Node - **New PaaS Services** „“ Announced - Application Builder, GoldenGate, Sites, Data Visualization, Big Data Discovery, Identity, Management Cloud - **Private Cloud** - Java and Integration Cloud Services on Exalogic Elastic Cloud - **Oracle Fusion Middleware 12.2.1** - WebLogic Server Multitenant - WebLogic Server and SOA Continuous Availability --- **Java Cloud Service – Highlights** **Major New Features for Java Cloud** - **New** Cloud Services Available - Application Container Cloud Service - Polyglot Platform for Lightweight Applications Running on Docker Infrastructure - New HA with Oracle RAC Integration with Exadata Cloud - One click Vertical and Horizontal Scalability - Agility for Testing/Staging with Instance Cloning - Resiliency with Standby Disaster Recovery - Hybrid Management with Enterprise Manager --- **Oracle SOA Suite & iPaaS – Highlights** For me especially the iPaaS and integration content was very interesting. In more than 30 sessions, 6 Hands-on labs and 8 Demo Pods the conference provided a lot of useful information in this sector. See the summary below: - **New Services :** - SOA Cloud Service (SOA CS), API Manager Cloud Service (CS) - **Integration Cloud Service** - New Cloud Adapters - Conditional Routing - Scheduling, Batching - **SOA Suite 12.2.1** - With Continuous Availability Option (12.2.1) - Integration Insight - **API Management Platform** - **Stream Explorer v2** - Geo-streaming - Business Rules - Machine Learning & Time Series Analytics --- **Development Tools & Frameworks – Highlights** - Oracle Application Builder Cloud Service „“ Coming Soon - Empower business users to build apps - Oracle JET – Available - Oracle“™s framework for JavaScript UI development - For more details visit the excellent [JET page](http://www.oracle.com/webfolder/technetwork/jet/index.html) - Developer Cloud Service Extended Scope - Integration with new cloud services (Java SE, Node.JS, MCS, SOA) - Oracle ADF 12.2.1 and Oracle MAF 2.1.3 - ADF – New features for responsive UI and REST enablement - MAF „“ New security integration --- **Content and Collaboration – Highlights** - **Documents Cloud Service** - Built-in social cloud, tight integration with MS Office - Hybrid ECM, hybrid capture to cloud integration - **Process Cloud Service** - Process based apps for the line of business - 1st class documents and social collaboration - **Sites Cloud Service** - New Sites Cloud to easily build mobile optimized and content rich sites & communities of engagement - **Integrated Suite for Business Agility and Engagement** - Redefine engagement, connect faster and simplify self service - SaaS and on-premise app extensions for engagement and process automation - Out-of-the-box or custom mobile solutions --- **IoT – Highlights** - IoT Cloud Service – scale your applications rapidly as your business evolves - **Connect**: Reliably and securely collect data from devices - **Analyze**: Perform real-time, Big Data and predictive analytics on IoT streams and events - **Integrate**: Seamlessly extend enterprise Applications and processes with IoT data --- **Mobile – Highlights** - Strong Customer and Partner Momentum - Mobile Application Accelerator (MAX) - Business User Friendly Mobile App Composition in the Cloud - Browser-based Development - No Coding Required - Easily Map to Business Services --- **Data Integration – Highlights** - **New Product** - Big Data Preparation Cloud Service - **Cloud and Big Data Support** - GoldenGate Cloud Service - GoldenGate for Big Data support for Kafka - OEMM 12.2.1 support for HDFS - EDQ 12.2.1 support for Hive - **Expanded product capability** - GoldenGate Studio - ODI 12.2.1 new LCM features --- **BI – Highlights** - **New** Oracle Data Visualization Cloud Service - Intuitive Visual Analytics - Easy data blending - Zero IT support required - **Updated** Big Data Discovery Cloud Service - Explore data lakes, transform big data, and discover insights from data natively, in minutes - **New** BI 12c - Simplified Administration and Lower TCO - Advanced Analytics for everyone - Enhanced Mobile Experience - Alta UI Design System --- **Identity Management – Highlights** - Identity Cloud Service (IDCS) - Federated SSO - OAUTH Enforcement Point for AuthN and AuthZ - Active Directory Sync - SCIM Identity Provider - User Administration Portal --- **More Cloud Services – Highlights** - Management Cloud Services - Application Performance Monitoring - Log Analytics - IT Analytics Cloud Service - Cloud For Manufacturing --- As you can see the list of highlights is massive and it is challenging to list everything in one post. If you are interested you can get more information on oracle.com: - [Watch Oracle OpenWorld Keynotes on Demand](https://www.oracle.com/openworld/on-demand/index.html) - [Oracle PaaS](https://www.oracle.com/cloud/paas.html) - [Oracle IaaS](https://www.oracle.com/cloud/iaas.html) - [Oracle SaaS](https://www.oracle.com/cloud/saas.html) **Kategorien:** Tech Events & Networking **Schlagwörter:** Conference, oow --- ### [Camunda BPM 7.4](https://thecattlecrew.net/2015/11/13/camunda-bpm-7-4/) **Published:** November 13, 2015 **Author:** Christoph Ortmann **Content:** On Novenber 30th, 2015 the team around [Camunda BPM](https://camunda.org/) will release version 7.4 of its open source Business Process Management Platform which will include lots of improvements and new features. In this post I want to introduce two new features: DMN support and escalation events in BPMN-processes. Both can be tested already with the current [Alpha2 – release](http://blog.camunda.org/post/2015/10/camunda-740-alpha2-released/). ## DMN [DMN](http://www.omg.org/spec/DMN/) – Decision Model And Notation – is an OMG-standard for modeling business rules which was released in September 2015. Similar to BPMN 2.0 this standard defines both graphical representation and execution semantics. A decision model is decribed on two levels: Decision Requirements and Decision Logic. On the requirements level decisions are shown in relation to their influencers – Input data, Knowledge sources and Business knowledge. On the logic level Business knowlege is described in further detail for example using decision tables. In version 7.4 Camunda BPM introduces a DMN-engine capable of evaluating decision tables according to DMN-standard. Based on [bpmn.io](http://bpmn.io/) there is a web-modeler for decision tables which can be evaluated [here](https://camunda.org/dmn/demo/). [![decision_table](https://thecattlecrew.net/wp-content/uploads/2015/11/decision_table.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/11/decision_table.png)example decision table used in Camunda’s modeler demo In the example decison table shown above each row describes a rule, each input-column shows a condition in the current rule (AND-join). Normally rules should not overlap: One set of input values triggers exactly one rule. In the case of overlapping rules rule evaluation is guided by a Hit-Policy. Depending on the chosen policy only the first rule matching the input values might be triggered or all rules might bet triggered; in this case each rules‘ results are an entry in a result list. These are just two examples, there are more policies defined in DMN. According to the release notes hit policies are supported by Camunda’s DMN-engine but as of now the demo-modeler does not allow to specify a policy in a decision table. To use a decision table in a BPMN-process the dmn-file just needs to be added as a resource to a process application. Rule evaluation can then be triggered either by a Java-API-call or by referencing the decision in a BPMN rule task. This configuration is not supported by Camunda’s Eclipse-based modeler yet so we need to do this in the XML representation of our business process. Before executing the rule task the input-parameters must be set as process variables. After the rules are evaluated the output is added in a process variable holding a map of parametes which are accessible through EL-expressions. To unit-test the decision table together with a business process just add the dmn-file as another deployment-resource to each process test. ## Escalation Events Escalations are a means of letting a subprocess notify a parent process like in this example where our customer should receive an email to inform her that we need some more time if we dont have the ordered article in stock but need to contact our supplier. [![order_process](https://thecattlecrew.net/wp-content/uploads/2015/11/order_process.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/11/order_process.png)example order process Here the escalation event is used trigger our customers‘ notification – modeled as a non-interrupting boundary event to our subprocess. This is more a deviation from the regular process flow than an error which we used to model the case that we cannot deliver at all. Configuring an escalation in BPMN is similar to configuring a message: First we need to define an escalation for the whole model which we then reference in our escalation events. Again we need to do this in the XML editor. **Kategorien:** Integration **Schlagwörter:** BPM, Camunda --- ### [Installation ODI 12.1.3: step by step"¦](https://thecattlecrew.net/2015/11/16/installation-odi-12-1-3-step-by-step-2/) **Published:** November 16, 2015 **Author:** Neselovskyi, Borys **Content:** This document describes the installation of Oracle Data Integrator Version 12.1.3 on the Linux (OEL) Server. ## Prepare the Installation ### Minimal Server Requirements Check the Oracle Documentation for the Prerequisites. Your Server must have following (min.) Settings; RAM: 8 GB Disk: 20 GB Temp: 2 GB Swap: 8 GB ## Enable Unicode Support Oracle Documentation: *Your operating system configuration can influence the behavior of characters supported by Oracle Fusion Middleware products.* *On UNIX operating systems, Oracle highly recommends that you enable Unicode support by setting the LANG and LC\_ALL environment variables to a locale with the UTF-8 character set. This enables the operating system to process any character in Unicode* Check if Unicode is enable on the Server: ``` [root@myodisrv ]# locale LANG=de_DE.UTF-8 LC_CTYPE="de_DE.UTF-8" LC_NUMERIC="de_DE.UTF-8" LC_TIME="de_DE.UTF-8" LC_COLLATE="de_DE.UTF-8" LC_MONETARY="de_DE.UTF-8" LC_MESSAGES="de_DE.UTF-8" LC_PAPER="de_DE.UTF-8" LC_NAME="de_DE.UTF-8" LC_ADDRESS="de_DE.UTF-8" LC_TELEPHONE="de_DE.UTF-8" LC_MEASUREMENT="de_DE.UTF-8" LC_IDENTIFICATION="de_DE.UTF-8" LC_ALL= ``` ### Kernel Parameter Set the Value for the Parameter SHMMAX to min. 4294967295 (as root): ``` vi /etc/sysctl.conf kernel.shmmax = 4294967295 ``` Apply changes: ``` /sbin/sysctl -p ``` ### Kernel und Packages Supported Linux Oracle Linux 6 (UL1+) x86 64-bit Operating System Versions, Packages, and Patches: Kernel: 2.6.32-100.2 8.5.el6 Packages: ``` binutils-2.20.51.0.2-5.28.el6 compat-libcap1-1.10-1 compat-libstdc++-33-3.2.3-69.el6 for x86_64 compat-libstdc++-33-3.2.3-69.el6 for i686 gcc-4.4.4-13.el6 gcc-c++-4.4.4-13.el6 glibc-2.12-1.7.el6 for x86_64 glibc-2.12-1.7.el6 for i686 glibc-devel-2.12-1.7.el6 for i686 libaio-0.3.107-10.el6 libaio-devel-0.3.107-10.el6 libgcc-4.4.4-13.el6 libstdc++-4.4.4-13.el6 for x86_64 libstdc++-4.4.4-13.el6 for i686 libstdc++-devel-4.4.4-13.el6 libXext for i386 libXtst for i386 libXi for i386 openmotif-2.2.3 for x86_64Footref 2 openmotif22-2.2.3 for x86_64Footref 2 redhat-lsb-4.0-3.el6 for x86_64 sysstat-9.0.4-11.el6 uln-internal-setup-1.0.1-1.el6.noarch.rpm   ``` Are the Packages already installed (as root): ``` rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' binutils ``` ``` binutils-2.20.51.0.2-5.42    .el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' compat-libcap1 compat-libcap1-1.10-1 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' compat-libstdc++-33 compat-libstdc++-33-3.2.3-69.el6 (x86_64) compat-libstdc++-33-3.2.3-69.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' gcc gcc-4.4.7-11.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' gcc-c++ gcc-c++-4.4.7-11.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' glibc glibc-2.12-1.149.el6 (x86_64) glibc-2.12-1.149.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' glibc glibc-2.12-1.149.el6 (x86_64) glibc-2.12-1.149.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' glibc-devel glibc-devel-2.12-1.149.el6 (x86_64) glibc-devel-2.12-1.149.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libaio libaio-0.3.107-10.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libaio-devel libaio-devel-0.3.107-10.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libgcc libgcc-4.4.7-11.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libstdc++ libstdc++-4.4.7-11.el6 (x86_64) libstdc++-4.4.7-11.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libstdc++-devel libstdc++-devel-4.4.7-11.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libXext libXext-1.3.2-2.1.el6 (x86_64) libXext-1.3.2-2.1.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libXtst libXtst-1.2.2-2.1.el6 (x86_64) libXtst-1.2.2-2.1.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' libXi libXi-1.7.2-2.2.el6 (x86_64) libXi-1.7.2-2.2.el6 (i686) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' openmotif openmotif-2.3.3-8.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' openmotif22 openmotif22-2.2.3-19.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' redhat-lsb redhat-lsb-4.0-7.0.1.el6 (x86_64) rpm -q --qf '%{NAME}-%{VERSION}-%{RELEASE} (%{ARCH})\n' sysstat sysstat-9.0.4-27.el6 (x86_64) ``` .. if not: search the missing package with „yum search “ and install „yum install …“ ### NTPL Installation If you plan to use the Oracle HTTP Server, the operating system needs to set Native POSIX Threads Library (NPTL) as the default threads-implementation. To check for this, run the following command: ``` getconf GNU_LIBPTHREAD_VERSION ``` Expected min. value: „NTPL 2.3.4“ ### Set the OS Limits Set open file limit to min. 4096: Check this with Commando ulimit: ``` $ ulimit -n ``` Change OS Limits in two files (as root): ``` vi /etc/security/limits.conf ``` ``` * soft nofile 4096 * hard nofile 65536 * soft nproc 2047 * hard nproc 16384 ``` ``` vi /etc/security/limits.d/90-nproc.conf ``` ``` root soft nproc unlimited pcube soft nproc 10240 * soft nofile 4096 * hard nofile 65536 * soft nproc 2047 * hard nproc 16384 ``` ### Create User and Group for the ODI Installation ``` groupadd -g 1001 oinstall useradd -u 501 -g oinstall -d /home/oracle -m -s /bin/bash oracle ``` ### Configure the Oracle Environment Set umask for OS User oracle to „027“: ``` su "“ Oracle echo "umask 027" >> .bash_profile ``` ### Create Installation Directories and download the Software As OS User oracle: ``` cd /u01/app/oracle/ mkdir ODI_Software mkdir -p MW_ODI/JAVA chmod -R 775 MW_ODI ODI_Software cd /u01/app/oracle/ODI_Software mkdir WLS_12.1.3 JDK ODI_12.1.3  ``` Download the Software - jdk1.7.0\_85 - WebLogic Server 12.1.3 Go to „Oracle Software Delivery Cloud“ Choose Product und Platform and prsee „Continue“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio2.png) Enable „Oracle Fusion Middleware 12c Infrastructure (12.1.3): ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio3.png) And download the file. - Patch 20838345: WLS PATCH SET UPDATE 12.1.3.0.4 Go to MOS (My Oracle Support): adownload the patch: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio4.png) - ODI 12.1.3 ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio5.png) Copy the Software to directories: ``` mv fmw_12.1.3.0.0_infrastructure_Disk1_1of1.zip WLS_12.1.3 mv p20838345_121300_Generic.zip WLS_12.1.3 mv fmw_12.1.3.0.0_odi_Disk1_1of1.zip ODI_12.1.3 mv p13079846_17000_Linux-x86-64.zip JDK mv obi_LINUXX64_11.1.1.9.0_4of5.zip OBI_11.1.1.9 mv obi_LINUXX64_11.1.1.9.0_5of5.zip OBI_11.1.1.9 mv rcuHome.zip RCU_11.1.1.9 ``` ## Enterprise Installation ODI 12.1.3 ### JDK 1.7 Installation **Important: run all the Steps as OS User oracle:** ``` cd /u01/app/oracle/ODI_Software/JDK unzip p13079846_17000_Linux-x86-64.zip cd /u01/app/oracle/ODI_JAVA tar xvfz /u01/app/oracle/ODI_Software/JDK/jdk-7u85-linux-x64.tar.gz mv jdk1.7.0_85 jdk touch jdk1.7.0_85 ``` Verify the JDK Installation: ``` cd /u01/app/oracle/ODI_JAVA/jdk/bin ./java "“version ``` Output: ``` java version "1.7.0_85" Java(TM) SE Runtime Environment (build 1.7.0_85-b15) Java HotSpot(TM) 64-Bit Server VM (build 24.85-b06, mixed mod ``` ### WebLogic Server 12.1.3 Installation **Important: run all the Steps as OS User oracle:** ``` cd /u01/app/oracle/ODI_Software/WLS_12.1.3 unzip fmw_12.1.3.0.0_infrastructure_Disk1_1of1.zip export JAVA_HOME=/u01/app/oracle/ODI_JAVA/jdk $JAVA_HOME/bin/java -jar fmw_12.1.3.0.0_infrastructure.jar ``` Check the Inventory Directory and press „OK“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio6.png) Next ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio7.png) Determine the Oracle (Middleware) Home: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio8.png) Choose „Fusion Middleware Infrastructure“ and press „Next“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio9.png) all checks must be successful“¦ „Next“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio10.png) „¦ „Install“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio11.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio12.png) Check the WebLogic Server Installation: ``` cd /u01/app/oracle/MW_ODI/wlserver/server/bin source setWLSEnv.sh java weblogic.version "“verbose  ``` Output: ``` WebLogic Server 12.1.3.0.0 Wed May 21 18:53:34 PDT 2014 160433 ``` ### Installation Patch 20838345: WLS PATCH SET UPDATE 12.1.3.0.4 **Important: run all the Steps as OS User oracle:** ``` cd /u01/app/oracle/ODI_Software/WLS_12.1.3 unzip p20838345_121300_Generic.zip cd 20838345 export JAVA_HOME=/u01/app/oracle/ODI_JAVA/jdk export PATH=/u01/app/oracle/MW_ODI/OPatch:$PATH mkdir -p /opt/oraclebi/product/MW_ODI/Oracle_Home/OPatch/inventory opatch apply -jdk $JAVA_HOME ... OPatch succeeded. ``` Verify the Installation: ``` export PATH=/u01/app/oracle/MW_ODI/OPatch:$PATH opatch lsinv ``` Output: ``` Interim-Patches (1) : Patch 20838345 : applied on Tue Sep 22 12:30:51 CEST 2015 Unique Patch ID: 18910091 Patch description: "WebLogic Server 12.1.3.0.4 PSU Patch for BUG20838345 July 2015" Created on 20 May 2015, 21:43:06 hrs PST8PDT   ``` ``` Bugs fixed: 19265688, 18305935, 20523619, 18276961, 18671042, 18727635, 18964349 19988824, 19066738, 18289179, 18729264, 17012341, 18538501, 19339238 20266379, 20814890, 20906638, 18432174, 19268444, 19033547, 18859387 20985893, 18589879, 19942900, 19576633, 18753794, 18968900, 18691894 19287842, 21107126, 18376812, 19730967, 18912482, 19287874, 19533331 17721032, 18481239, 19556868, 21069524, 19852007, 19936917, 19459949 18922324, 20206879, 19080525, 19907066 ``` ## Installation ODI 12.1.3 **Important: run all the Steps as OS User oracle:** ``` cd /u01/app/oracle/ODI_Software/ODI_12.1.3 unzip fmw_12.1.3.0.0_odi_Disk1_1of1.zip export JAVA_HOME=/u01/app/oracle/ODI_JAVA/jdk $JAVA_HOME/bin/java -jar fmw_12.1.3.0.0_odi.jar ``` ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio13.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio14.png) Choose Enterprise-Installation ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio15.png) Prerequisite Checks -> „Next“ Press „Install“ to install the ODI Software: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio17.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio19.png) ### Configure Database Schemas: RCU Configuration **Important: run all the Steps as OS User oracle:** Prerequisites: The Database is already installed (in my case 12c Database) ``` RDBMS Version:        12.1.0.2.0 Required Option:    JVM Datenbank Benutzer:    SYS Zeichensatz:        AL32UTF8 ``` Start Repository Creation Utility: ``` export JAVA_HOME=/u01/app/oracle/ODI_JAVA/jdk cd /u01/app/oracle/MW_ODI/oracle_common/bin ./rcu ``` Welcome „“> Next ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio20.png) Choose „Create Repository“, then „System Load and Product Load“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio21.png) Database Connection Details: - database server name or IP address - database listener port - database service name - database user (with DBA or SYSDBA Rights) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio22.png) The following screen will appear“¦ „OK“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio23.png) Choose Components: „AS Common Schemas“ and „Oracle Data Integrator“ Define Prefix and click on „Next“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio24.png) Checking Prerequisites -> „Ok“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio25.png) Set password for database users“¦ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio26.png) Define: - Supervisor Password - Work Repository Type: ,choose E (for execution) or D (or development) - Work Repository Password ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio27.png) Map and create tablespaces“¦ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio28.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio29.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio30.png) Details“¦ „Create“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio31.png) done ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio32.png) ## Configuration: Create the ODI Domain **Important: run all the Steps as OS User oracle:** Configuring the Domain for the Java EE Agent ``` cd /u01/app/oracle/MW_ODI/odi/common/bin ./config.sh ``` Enable „Create a new domain“ and choose the location: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio33.png) Enable following Templates: - Basic WebLogic Server Domain „“ 12.1.3.0 \[wlserver\]\* - Oracle Enterprise Manager Plugin for ODI – 12.1.3.0 \[em\] - Oracle Enterprise Manager – 12.1.3.0 \[em\] - Oracle Data Integrator – Agent – 12.1.3.0 \[odi\] - Oracle Data Integrator – Agent Libraries – 12.1.3.0 \[odi\] - Oracle Data Integrator SDK Shared Library Template – 12.1.3.0 \[odi\] - Oracle Data Integrator – Console – 12.1.3.0 \[odi\] - Oracle JRF – 12.1.3.0 \[oracle\_common\] - WebLogic Coherence Cluster Extension – 12.1.3.0 \[wlserver\] ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio34.png) Next“¦ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio35.png) Enable „Production Mode“ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio36.png) Add the database connection information for schema \_STB (configured via repository creation utility RCU). ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio37.png) Check the database connection information (schema, passwords, database service, listener port and hostname): created via RCU: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio38.png) Add Supervisor username and password (created via RCU): ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio39.png) „¦ ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio40.png) Configure Admin Server: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio41.png) Configure Node Manager: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio42.png) Configure ODI Managed Server: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio43.png) Next (configuration without cluster): Leave default: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio45.png) Configure Unix Machine: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio46.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio47.png) Add the AdminServer and ODI\_server1 to the unix machine: Add System Component: ODI: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio49.png) Configure ODI System Component: Add ODI System Component to the Unix Machine (Node Manager): ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio51.png) Check Configuration Summary and press „Create“: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio52.png) ![](https://thecattlecrew.net/wp-content/uploads/2022/07/102515_1408_installatio53.png) The Domain Creation is complete! ## Check the ODI Installation Check following URL’s in the Internet Browser: WLS Konsole: http://:8001/console EM Konsole: http://:8001/em ODI Konsole: http://:15200/odiconsole # Postinstallation Tasks ## WebLogic Server configuration **Wichtig: Important: run all the Steps as OS User oracle:** - Create the file boot.properties: ``` mkdir -p /u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/servers/AdminServer/securiy echo -e "username=weblogic\npassword=welcome1" > /u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/servers/AdminServer/security/boot.properties ``` - Start WLS Services ``` cd /u01/app/oracle/MW_ODI/Oracle_Home/user_projects/domains/odi_domain/bin source ./setDomainEnv.sh java weblogic.WLST wlst> nmConnect('nodemgr','welcome1', '','5700','odi_domain','/u01/app/oracle/MW_ODI/user_projects/domains/odi_domain','ssl') wlst> nmStart('AdminServer') wlst> nmStart('ODI_server1') ``` ### Node Manager configuration **Important: run all the Steps as OS User oracle:** Edit the file nodemanager.properties: ``` cd /u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/nodemanager/ vi nodemanager.properties ``` Change following rows (red): ``` #Node manager properties #Tue Sep 22 19:08:08 CEST 2015 DomainsFile=/u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/nodemanager/nodemanager.domains LogLimit=0 PropertiesVersion=12.1 AuthenticationEnabled=true NodeManagerHome=/u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/nodemanager JavaHome=/u01/app/oracle/ODI_JAVA/jdk LogLevel=INFO DomainsFileEnabled=true StartScriptName=startWebLogic.sh ListenAddress=xxx.xxx.xxx.xxx NativeVersionEnabled=true ListenPort=5700 LogToStderr=true SecureListener=true LogCount=1 StopScriptEnabled=false QuitEnabled=false LogAppend=true StateCheckInterval=500 CrashRecoveryEnabled=true StartScriptEnabled=true LogFile=/u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/nodemanager/nodemanager.log LogFormatter=weblogic.nodemanager.server.LogFormatter ListenBacklog=50 ``` Start the Node Manager: ``` cd /u01/app/oracle/MW_ODI/user_projects/domains/odi_domain/bin nohup ./startNodeManager.sh & ``` ### Create Start Stop Scripts **Important: run all the Steps as OS User oracle:** Das Verzeichnis /u01/app/oracle/etc erstellen: ``` mkdir /u01/app/oracle/etc ``` Create following scripts:: ``` cd /u01/app/oracle/etc ls /u01/app/oracle/etc wls_start_stop_odi.sh wls_start_odi.py wls_stop_odi.py ``` The Main-Script wls\_start\_stop\_obi.sh usage: ``` ./wls_start_stop_odi.sh [start|stop] ``` The script /opt/oraclebi/etc/wls\_start\_stop\_odi.sh: ``` #!/bin/bash ORACLE_BASE=/u01/app/Oracle export ORACLE_BASE MW_HOME_ODI=${ORACLE_BASE}/MW_ODI export MW_HOME_ODI DOMAIN_HOME_ODI=${MW_HOME_ODI}/user_projects/domains/odi_domain export DOMAIN_HOME_ODI JAVA_HOME=${ORACLE_BASE}/ODI_JAVA/jdk export JAVA_HOME WORK_DIR=${ORACLE_BASE}/etc export WORK_DIR case "$1" in start) nohup ${DOMAIN_HOME_ODI}/bin/startNodeManager.sh & sleep 120 source ${DOMAIN_HOME_ODI}/bin/setDomainEnv.sh java weblogic.WLST ${WORK_DIR}/wls_start_odi.py ;; stop) source ${DOMAIN_HOME_ODI}/bin/setDomainEnv.sh java weblogic.WLST ${WORK_DIR}/wls_stop_odi.py ${DOMAIN_HOME_ODI}/bin/stopNodeManager.sh sleep 60 pkill -f MW_ODI ;; *) echo "usage: $0 [start|stop]" exit 2 ;; esac ``` The Script /u01/app/oracle/etc/wls\_start\_odi.py: ``` nmConnect('nodemgr','welcome1', '','','odi_domain','/opt/oraclebi/product/MW_ODI/Oracle_Home/user_projects/domains/odi_domain','ssl') nmStart('AdminServer') nmStart('ODI_server1') ``` The Script /u01/app/oracle/etc/wls\_stop\_bi.py: ``` nmConnect('nodemgr','welcome1', '','','odi_domain','/opt/oraclebi/product/MW_ODI/Oracle_Home/user_projects/domains/odi_domain','ssl') nmKill('ODI_server1') nmKill('AdminServer') ``` set the permission: ``` chmod -R 755 /u01/app/oracle/etc ``` ### Configuring Autostart As **root**: Create the Script /etc/init.d/odiora: ``` # # chkconfig: 35 99 10 # description: Start and stop the Oracle Fusion Middleware # WORK_DIR=/u01/app/oracle/etc export WORK_DIR ORA_OWNER=Oracle export ORA_OWNER if [ ! -f $WORK_DIR/wls_start_stop_odi.sh \ -o ! -f $WORK_DIR/wls_start_odi.py \ -o ! -f $WORK_DIR/wls_stop_odi.py ] then echo "Oracle startup / shutdown: cannot start / stop" exit fi case "$1" in 'start') # Start the Oracle Fusion Middleware su - $ORA_OWNER -c "$WORK_DIR/wls_start_stop_obi.sh start" su - $ORA_OWNER -c "$WORK_DIR/wls_start_stop_odi.sh start" touch /var/lock/subsys/fmwora ;; 'stop') # Stop the Oracle Fusion Middleware su - $ORA_OWNER -c "$WORK_DIR/wls_start_stop_obi.sh stop" su - $ORA_OWNER -c "$WORK_DIR/wls_start_stop_odi.sh stop" rm -f /var/lock/subsys/fmwora ;; esac ``` File permissions: ``` chmod 700 /etc/init.d/odiora ``` Configure autostart: ``` cd /etc/init.d /sbin/chkconfig --add odiora ``` Check: ``` cd /etc/init.d /sbin/chkconfig --list odiora ``` Output: ``` fmwora 0:off 1:off 2:off 3:on 4:off 5:on 6:off ``` **Kategorien:** Database **Schlagwörter:** Integration, oracle, Oracle Data Integrator, Oracle DB, Oracle FMW, Weblogic --- ### [Handling inbound Attachments by Oracle Service Bus](https://thecattlecrew.net/2015/11/23/handling-inbound-attachments-by-oracle-service-bus/) **Published:** November 23, 2015 **Author:** Apostolos Varsamis **Content:** ## Introduction Oracle Service Bus ***message context*** is a set of properties, so called ***context variables***, that hold message content as well as information about messages as they are routed through Oracle Service Bus (OSB). The ***Message Context Schema*** specifies the element types for the predefined message context variables. Such a predefined context variable is the variable ***attachments.*** Fig. 1 shows in an excerpt of the Message Context Schema the definition of the element ***attachmens***. ###### ###### ###### ###### ###### ###### Fig. 1 Obviously the attachment body can hold either a reference of the content or the content itself! In this article we analyze what contains exactly the element **/mc:attachments/mc:attachment/mc:body** and how we can handle its contents. First of all let us focus on the variables - Content-Types - Content-Transfer- Encoding their meanings and their possible values. ### Content-Type According to the W3 specifications (s. \[1\]) Fig. 2 contains an excerpt of the main characteristics of the variable Content-Type: ###### *An initial set of seven Content-Types is defined by this document. This set of top-level names is intended to be substantially complete. It is expected that additions to the larger set of supported types can generally be accomplished by the creation of new subtypes of these initial types. In the future, more top-level types may be defined only by an extension to this standard. If another primary type is to be used for any reason, it must be given a name starting with „X-“ to indicate its non-standard status and to avoid a potential conflict with a future official name.* ###### *In the Extended BNF notation of RFC 822, a Content-Type header field value is defined as follows:* ###### Content-Type := type „/“ subtype \*\[„;“ parameter\] ###### type := „application“ / „audio“ / „image“ / „message“ / „multipart“ / „text“ / „video“ / x-token ###### *Note also that a subtype specification is MANDATORY. There are no default subtypes.* Fig. 2 ### Content-Transfer- Encoding According to the W3 specifications (s. \[1\]) Fig. 3 contains an excerpt of the main characteristics of the variable Content-Transfer-Encoding: ###### *Unlike Content-Types, a proliferation of Content-Transfer- Encoding values is undesirable and unnecessary. However, establishing only a single Content-Transfer-Encoding mechanism does not seem possible. There is a tradeoff between the desire for a compact and efficient encoding of largely-binary data and the desire for a readable encoding of data that is mostly, but not entirely, 7-bit data. For this reason, at least two encoding mechanisms are necessary: a „readable“ encoding and a „dense“ encoding.* ###### *The Content-Transfer-Encoding field is designed to specify an invertible mapping between the „native“ representation of a type of data and a representation that can be readily exchanged using 7 bit mail transport protocols, such as those defined by RFC 821 (SMTP). This field has not been defined by any previous standard. The field’s value is a single token specifying the type of encoding, as enumerated below. Formally:* ###### Content-Transfer-Encoding := „BASE64“ / „QUOTED-PRINTABLE“ / „8BIT“ / „7BIT“ / „BINARY“ / x-token Fig. 3 Both variables play a role when a **multipart message** hits a proxy service that accepts messaging request. ## Contents of attachment/body We can gather the possible combinations of Content-Type and Content-Transfer-encoding in a 2-dimensional Matrix. We ignore the possible values „x-token“ as special cases that are out of scope of this analysis. We will also omit the value „message/\*“ as a special case of mail mime attachments, but we will add the possibility of missing one or both of them. When the content of the attachment body is a reference to a binary content, we need some kind of ***[materialization](https://thecattlecrew.wordpress.com/2015/11/26/handling-inbound-attachments-by-oracle-service-bus-part-2/)*** of the content in order to analyze it, which might be performed through - a java callout or - a service callout to a simple Proxy-service ###### ###### **application/\*** ###### **audio/\*** ###### **Image/\*** ###### **Text/\*** ###### **Video/\*** ###### **none** ###### **BASE64** ###### **By Reference** ###### Content has to be **base64 encoded** otherwise the attachment is empty. ###### **Reference points to decoded** data. ###### **By Reference** ###### Content has to be **base64 encoded** otherwise the attachment is empty. ###### **Reference points to decoded data.** ###### **By Reference** ###### Content has to be **base64 encoded** otherwise the attachment is empty. ###### **Reference points to decoded** data. ###### **By Value** ###### Content has to be **base64 encoded** otherwise the attachment is empty. ###### **attachment/body** contains **decoded** data. ###### **By Reference** ###### Content has to be **base64 encoded** otherwise the attachment is empty. ###### **Reference points to decoded** data. ###### **By Value** ###### Content has to be **base64 encoded** otherwise the attachment is empty. ###### **attachment/body** contains **decoded** data. ###### **QUOTED-PRINTABLE** ###### **By Reference** ###### **Reference** points to the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value**. ###### **attachment/body** contains **the original data** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value** ###### **attachment/body** contains **the original data** ###### **8BIT** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value**. ###### **attachment/body** contains **the original data** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value** ###### **attachment/body** contains **the original data** ###### **7BIT** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value**. ###### **attachment/body** contains **the original data** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value** ###### **attachment/body** contains **the original data** ###### **Binary** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** contains the original data ###### **By Value**. ###### **attachment/body** contains **the original data** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value** ###### **attachment/body** contains **the original data** ###### **none** ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Reference** ###### **Reference** **points to** the original data ###### **By Value**. ###### **attachment/body** contains **the original data** ###### **By Reference** ###### **Reference** **points to** the original data ###### not valid Exceptional case ###### **application/xml or application/xhtml+xml** ###### **BASE64** ###### **By Value** ###### if the decoded string is a xml-structure then attachment/body contains this xml-structure rather than a reference to it. If the decoded string is not an xml-structure then the attachment will be rejected. ###### **QUOTED-PRINTABLE** ###### **By Value** ###### the data will be passed if contain a valid xml-structure otherwise will be rejected. ###### **8BIT** ###### **By Value** ###### the data will be passed if contain a valid xml-structure otherwise will be rejected. ###### **7BIT** ###### **By Value** ###### the data will be passed if contain a valid xml-structure otherwise will be rejected. ###### **Binary** ###### **By Value** ###### the data will be passed if contain a valid xml-structure otherwise will be rejected. ###### **none** ###### **By Value** ###### the data will be passed if contain a valid xml-structure otherwise will be rejected. Using this matrix one can take the appropriate steps in order to process the contents of the attachments. # Literature \[1\] The Content-Type Header Field s. [http://www.w3.org/Protocols/rfc1341/4\_Content-Type.html](http://www.w3.org/Protocols/rfc1341/4_Content-Type.html) \[2\] The Content-Transfer-Encoding Header Field s. [http://www.w3.org/Protocols/rfc1341/5\_Content-Transfer-Encoding.html](http://www.w3.org/Protocols/rfc1341/5_Content-Transfer-Encoding.html) \[3\] MIME (Multipurpose Internet Mail Extensions) Part One: Mechanisms for Specifying and Describing the Format of Internet Message Bodies **Kategorien:** Integration **Schlagwörter:** Service Bus --- ### [How to create a CSV file and store it to a FTP server in conjunction with Oracle Service Bus 12c](https://thecattlecrew.net/2015/12/07/how-to-create-a-csv-file-and-store-it-to-a-ftp-server-in-conjunction-with-oracle-service-bus-12c/) **Published:** Dezember 7, 2015 **Author:** stefaniewitzke **Content:** In my last projects I had to generate a CSV file out of some data in the OSB (Oracle Service Bus) and upload it on a ftp server. The requirement was to realize it with the Oracle Service Bus 12c. This article describes a way to generate a CSV file and store it. As precondition you should have a WSDL-file (with XSD schema) which describes the remote data source and at least a example CSV file, to specify the result. ### Generate FTP adapter on Weblogic Server (WLS) In the first step we generate the ftp adapter on the WLS. Therefore start your WLS and open the admin console. Switch to the *Outbound Connection Pools* via *Deployments > FtpAdapter > Configuration > Outbound Connection Pools* and press new for the generation of the ftp adapter. Then select the *ConnectionFactory* and click next. Now we“™ve to define the JNDI name, for example **eis/Ftp/test**. Press finish and the creation of ftp adapter processes. ![osb_generateCSV_01](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_01.jpg) The configuration of the adapter is some kind of standard, that’s why we“™ve to adapt the *username*, *password* and the *host* at this point. So we select the generated adapter in *Outbound Connection Pools* and are able to adapt the preferences. **Hint**: After filling in the credentials/host you should immediatly push enter. Otherwise it could be possible that changes has not been taken. Then press the save button. Now we have to make the changes valid. Open the *Deployments*, put a hook in the box of FtpAdapter and then press the *Update* button. The FTP adapter has been created and we can start implementing the CSV file creation. ![osb_generateCSV_03](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_03.jpg) ### Generate schema (XSD) for the CSV file Now we“™ve to import the WSDL and its XSD file into our existing service bus project. (I“™m not going to explain how to create the application and the service bus project at this point. Please read further tutorials if you“™re starting from scratch.) See the next screenshot to get in touch with the folder structure that we use in the next steps. „” We“™ve generated the proxy service with the WSDL *Order* and the related pipeline already. ![osb_generateCSV_04](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_04.jpg?w=300) Next we create the ftp adapter as a business service. In *External Services* drag in *FTP* (*Component > Technology*) ![osb_generateCSV_06](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_06.jpg) Enter the desired name of the FTP Adapter. In this example we use **PutCsvToFtp** as the reference name. ![osb_generateCSV_07](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_07.jpg) We don’t have a schema for the *Adapter Interface* yet, but the CSV example file. That’s why *Define from operation and schema (specified later)* is selected now. ![osb_generateCSV_08](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_08.jpg) In step 3 of 4 fill in the JNDI name of the FTP adapter on the WLS we“™ve created before (see above) „” in this example it is **eis/Ftp/test**. Click *next*. Yes, it is somehow confusing but now we are in step 4 of 7 😉 We“™ve to choose the operation of the FTP adapter. The file type of a CSV file is ASCII and for the operation type we select *Put File*, because we want to put (oracle slang for upload) our text-based file to the ftp server: ![osb_generateCSV_10](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_10.jpg) The upload directory is defined in the next step and should be entered in the *Physical Path* input field. We name it **TestFolder**. If the directory doesn“™t exist it“™ll be created upon upload. Here you can fill in a path, where the folder is located, but I choose it simple and let the folder be on the root directly. The *File Naming Convention* is not relevant for us, because we will overwrite it in our pipeline with a generic filename later. ![osb_generateCSV_11](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_11.jpg) Now it’s time to build the XSD schema for the CSV file. Press the gearwheel and a wizard for NXSD will open. Fill in the *file name* (in this example it is **tableSchema**) and the *directory* where it should be stored. Click *next*, select *Delimited* and click again *next*. Then we need to define the *File Description*. At first we specify the example. That means, open the example csv. Here the **exampleCsv.csv** has the following content: ``` "order_number", "reclamation_type", "reclamation_reason" "cde158749635","204","M54" "cfm245756325","200","Z21" ``` If the content of the CSV file is correct and valid it will look like this: ![osb_generateCSV_14](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_14.jpg) If the preview window shows crazy stuff, then your CSV file is not correct (like different number of commas in the single lines or something like this). We decide whether our file contains only one record ore multiple records as we choose it in this example: *Multiple records are of single type* In step 5 of 8 the namespace is set to **http://com.opitz-consulting/PutCsvToFtp**, the root-element gets the name **Order** and the record-element should be named **OrderElement**. ![osb_generateCSV_16](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_16.jpg) After this configurations we specify the delimiters. This is easy to choose: Our values are delimited by *comma* and the record by *eol* (End of Line). If the first Row should be used as XSD tags, select the checkbox. This does not mean that it will generate a header in the CSV file automatically. It just names the fields in the XSD like the entries in the first record. This is a good option, because it’s easier to map the fields from the incoming order-element to this XSD file later. ![osb_generateCSV_18](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_18.jpg) The configuration for the XSD-generation is nearly finished. Just one last eye on the *generated native format schema file*. And you can see, there is no header. But we want a header, so we need to put nxsd:outboundHeader after nxsd:headerLines=“1″. Like in our example **nxsd:outboundHeader='“order\_number.“,“reclamation\_type“,“reclamation\_reason“ ${eol}‘** : ![osb_generateCSV_20](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_20.jpg) Click *next* and *finish* and the XSD-file is generated. The JDeveloper jumps back to the FTP Adapter Configuration Wizard automatically and now the URL to our new schema file is set: ![osb_generateCSV_21](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_21.jpg) Again press *next* and *finish* and the FTP Business Service will be created. Its files are stored in the folder *resources*. Maybe you need to change the path to the *tableSchema.xsd* in the *PutCsvToFtp.wsdl*. Then everything should be green and the pipeline can be wired with the FTP Adapter. ![osb_generateCSV_22](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_22.jpg) ### Transform incoming data to CSV format and change filename of the CSV file Now it’s time to map the incoming data (order-element) to our CSV file. This will be done by a XQuery transformation. But before we want to change the filename of the CSV file. The filename should be concatenated with an „order\_“ and the ordernumber from the incoming order-element. At first we add an *Assign* to the *Request Action*. The name of the variable is **ftpFilename** and the Value is **concat(‚order\_‘,$body/v1:orderUpdateMessage/v1:update/v1:base\_data/v1:order/@order\_number,‘.csv‘)**. This concats the order\_ with the specific order\_number of the order-element. In our exmple the filename would be something like this order\_cde158749635.csv ![osb_generateCSV_23](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_23.jpg?w=699) We add a *Transport Header* after the *Assign* and select *Outbound Request* as *Direction*. In the *Headers* *section* we select **ftp** as *Protocol* and press the *plus* button for adding a new row. In this row the *Action* is **Set**. The *Name* has to be **jca.ftp.FileName** and the *Value* is our variable **$ftpFilename**. With this transport header properties, the filename will be replaced with the correct generic input. ![osb_generateCSV_24](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_24.jpg?w=699) After this we need to create a XQuery Transformation with the name **TransformOrderToCsv**. As *Sources* we select the message from the incoming **Order.xsd** from the proxy service. The *Target* is the Order (the root element) of the **tableSchema.xsd** from the FTP Adapter Business Service (see above). Generate the XQuery and map the corresponding values: ![osb_generateCSV_25](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_25.jpg) Last step: Add a *Replace* between the *Assign* and the *Transport Header*. The Location is **body ./\*** and the value is the **TransformOrderToCsv XQuery**. Now the binding needs to be filled. As the XQuery expects the message from the incoming order-element, we will choose it from the body. ![osb_generateCSV_26](https://thecattlecrew.net/wp-content/uploads/2015/12/osb_generatecsv_26.jpg) After deploying the application it will create CSV files and store them to the ftp server. Have fun 🙂 **Kategorien:** Integration **Schlagwörter:** CSV, FTP, Oracle DB, Oracle Service Bus, OSB --- ### [OSB: Configuration with custom XQuery functions](https://thecattlecrew.net/2015/12/22/osb-configuration-with-custom-xquery-functions-2/) **Published:** Dezember 22, 2015 **Author:** Bernhard Mähr **Content:** The OSB supports a mechanism of customization. Unfortunately this mechanism is very limited and is not able to change all values. There are hundreds of situations where some kind of configuration is needed and which can“™t be solved with customization: - A configurable value need to be added to a request - Username and password can“™t be provided with a service account because they are not transferred as basic authentication - The behavior of a proxy service should be able to be changed by a switch - Paths for reading and writing files from should be configurable For these cases we decided to implement an old fashioned configuration file. But how should we access the values from the configuration file? One possibility would be java callouts. But it is cumbersome to add a java callout for each needed value. A better solution for this kind of framework functionality is custom XQuery functions. First we create a java project in our favorite java development tool. For the XQuery we have to create a class with static methods. Simple parameters are supported and overloading the methods is ok. For our configuration XQuery we use this java class ConfigXQueryFunctions: 1 package com.opitzconsulting.osb.xquery.config; 2 3 import com.opitzconsulting.osb.util.ConfigUtil; 4 5 public class ConfigXQueryFunctions { 6 7 public static String getServerName() { 8 return System.getenv(„HOSTNAME„); 9 } 10 11 public static String getEnvironmentVariable(final String envName) { 12 return System.getenv(envName); 13 } 14 15 public static String getSystemProperty(final String propertyName) { 16 return System.getProperty(propertyName); 17 } 18 19 public static String getSystemProperty(final String propertyName, final String defaultValue) { 20 return System.getProperty(propertyName, defaultValue); 21 } 22 23 public static String getConfigFileName() { 24 return ConfigUtil.getFileName(); 25 } 26 27 public static String getEnvironment() { 28 return ConfigXQueryFunctions.getConfigMandatoryValue(„env.name„); 29 } 30 31 public static String getConfigValue(final String configValueName) { 32 return ConfigXQueryFunctions.getConfigValue(configValueName, null); 33 } 34 35 public static String getConfigValue(final String configValueName, final String defaultValue) { 36 return ConfigUtil.getValue(configValueName, defaultValue); 37 } 38 39 public static int getConfigValue(final String configValueName, final int defaultValue) { 40 return ConfigUtil.getValue(configValueName, defaultValue); 41 } 42 43 public static boolean getConfigValue(final String configValueName, final boolean defaultValue) { 44 return ConfigUtil.getValue(configValueName, defaultValue); 45 } 46 47 public static String getConfigMandatoryValue(final String configValueName) { 48 return ConfigUtil.getMandatoryValue(configValueName); 49 } 50 51 public static int getConfigMandatoryValueInt(final String configValueName) { 52 return ConfigUtil.getMandatoryValueInt(configValueName); 53 } 54 55 public static boolean getConfigMandatoryValueBoolean(final String configValueName) { 56 return ConfigUtil.getMandatoryValueBoolean(configValueName); 57 } 58 59 } 60 The class references here another class holding the real configuration information. It is a good idea to implement an auto-reload of the configuration to support on the fly changes. The method signatures in the example don“™t have a parameter for a file or a OSB project, so there can be only one configuration file for the OSB. After writing the java code and some unit tests (unit tests are a very good idea here because it is much work to do a redeployment of the XQuery lib for doing a change) the code should be compiled into a jar file. Additionally we need a xml file describing the XQuery functions. 1 xml version=“1.0″ encoding=“UTF-8″?> 2 3 4 5 6 getServerNamexpf:name> 7 Returns the hostname of the server.xpf:comment> 8 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 9 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 10 java.lang.String getServerName()xpf:method> 11 truexpf:isDeterministic> 12 Pipelinexpf:scope> 13 SplitJoinxpf:scope> 14 xpf:function> 15 16 17 getEnvironmentVariablexpf:name> 18 Returns the value of the environment variable with the name given by the parameter.xpf:comment> 19 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 20 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 21 java.lang.String getEnvironmentVariable(java.lang.String)xpf:method> 22 truexpf:isDeterministic> 23 Pipelinexpf:scope> 24 SplitJoinxpf:scope> 25 xpf:function> 26 27 28 getSystemPropertyxpf:name> 29 Returns the value of the system property with the name given by the parameter.xpf:comment> 30 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 31 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 32 java.lang.String getSystemProperty(java.lang.String)xpf:method> 33 truexpf:isDeterministic> 34 Pipelinexpf:scope> 35 SplitJoinxpf:scope> 36 xpf:function> 37 38 39 getSystemPropertyDefaultxpf:name> 40 Returns the value of the system property with the name given by the parameter. If the system property is not set the default value given by the second parameter is returned.xpf:comment> 41 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 42 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 43 java.lang.String getSystemProperty(java.lang.String, java.lang.String)xpf:method> 44 truexpf:isDeterministic> 45 Pipelinexpf:scope> 46 SplitJoinxpf:scope> 47 xpf:function> 48 49 50 getConfigFileNamexpf:name> 51 Returns the name and the path of the file containing the configuration.xpf:comment> 52 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 53 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 54 java.lang.String getConfigFileName()xpf:method> 55 truexpf:isDeterministic> 56 Pipelinexpf:scope> 57 SplitJoinxpf:scope> 58 xpf:function> 59 60 61 getEnvironmentxpf:name> 62 Returns the name of the environment the configuration is designated.xpf:comment> 63 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 64 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 65 java.lang.String getEnvironment()xpf:method> 66 truexpf:isDeterministic> 67 Pipelinexpf:scope> 68 SplitJoinxpf:scope> 69 xpf:function> 70 71 72 getConfigValuexpf:name> 73 Returns the value of the configuration entry with the name given by the parameter. If the configuration entry doesn’t exist null is returned.xpf:comment> 74 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 75 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 76 java.lang.String getConfigValue(java.lang.String)xpf:method> 77 truexpf:isDeterministic> 78 Pipelinexpf:scope> 79 SplitJoinxpf:scope> 80 xpf:function> 81 82 83 getConfigValueDefaultxpf:name> 84 Returns the value of the configuration entry with the name given by the parameter. If the configuration entry doesn’t exist the default value given by the second parameter is returned.xpf:comment> 85 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 86 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 87 java.lang.String getConfigValue(java.lang.String, java.lang.String)xpf:method> 88 truexpf:isDeterministic> 89 Pipelinexpf:scope> 90 SplitJoinxpf:scope> 91 xpf:function> 92 93 94 getConfigValueIntxpf:name> 95 Returns the value of the configuration entry with the name given by the parameter as an integer value. If the configuration entry doesn’t exist or the conversion fails the default value given by the second parameter is returned.xpf:comment> 96 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 97 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 98 int getConfigValue(java.lang.String, int)xpf:method> 99 truexpf:isDeterministic> 100 Pipelinexpf:scope> 101 SplitJoinxpf:scope> 102 xpf:function> 103 104 105 getConfigValueBooleanxpf:name> 106 Returns the value of the configuration entry with the name given by the parameter as a boolean value. If the configuration entry doesn’t exist or the conversion fails the default value given by the second parameter is returned.xpf:comment> 107 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 108 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 109 boolean getConfigValue(java.lang.String, boolean)xpf:method> 110 truexpf:isDeterministic> 111 Pipelinexpf:scope> 112 SplitJoinxpf:scope> 113 xpf:function> 114 115 116 getConfigMandatoryValuexpf:name> 117 Returns the value of the configuration entry with the name given by the parameter. If the configuration entry doesn’t exist an exception is thrown.xpf:comment> 118 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 119 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 120 java.lang.String getConfigMandatoryValue(java.lang.String)xpf:method> 121 truexpf:isDeterministic> 122 Pipelinexpf:scope> 123 SplitJoinxpf:scope> 124 xpf:function> 125 126 127 getConfigMandatoryValueIntxpf:name> 128 Returns the value of the configuration entry with the name given by the parameter as an integer value. If the configuration entry doesn’t exist or the conversion fails an exception is thrown.xpf:comment> 129 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 130 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 131 int getConfigMandatoryValueInt(java.lang.String)xpf:method> 132 truexpf:isDeterministic> 133 Pipelinexpf:scope> 134 SplitJoinxpf:scope> 135 xpf:function> 136 137 138 getConfigMandatoryValueBooleanxpf:name> 139 Returns the value of the configuration entry with the name given by the parameter as a boolean value. If the configuration entry doesn’t exist or the conversion fails an exception is thrown.xpf:comment> 140 http://opitz-consulting.com/osb/custom/functions/configxpf:namespaceURI> 141 com.opitzconsulting.osb.xquery.config.ConfigXQueryFunctionsxpf:className> 142 boolean getConfigMandatoryValueBoolean(java.lang.String)xpf:method> 143 truexpf:isDeterministic> 144 Pipelinexpf:scope> 145 SplitJoinxpf:scope> 146 xpf:function> 147 148 xpf:category> 149 xpf:xpathFunctions> 150 The category id while be the text shown in eclipse while using the functions. And also the namespace is important: Eclipse is generating while using the function a prefix out of the namespace. If you change the namespace afterwards you have to change the prefix on every location you used the XQuery function. The names of the XQuery functions should NOT be overloaded here. Overloaded names didn“™t work for me and I have not found out how to fix it. Now we have to deploy the XQuery to the OSB and to Eclipse. It is a drop in deployment: You have to copy the JAR archive and the XML file to the folder Oracle\_OSB1/config/xpath-functions. After that a restart of the OSB / Eclipse is necessary. Now you can use your custom XQuery functions inside of XQuerys [![BLOG_OSB_CustomXQuery_01](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_customxquery_01_thumb.png "BLOG_OSB_CustomXQuery_01")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_customxquery_01.png) or inside the proxyservice [![BLOG_OSB_CustomXQuery_02](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_customxquery_02_thumb.png "BLOG_OSB_CustomXQuery_02")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_customxquery_02.png) Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** Integration **Schlagwörter:** Configuration, Oracle FMW, Service Bus --- ### [Oracle SOA 12c QuickTip: Enable Servicebus message tracing in DefaultDomain](https://thecattlecrew.net/2015/12/23/oracle-soa-12c-quicktip-enable-servicebus-message-tracing-in-defaultdomain/) **Published:** Dezember 23, 2015 **Author:** Sven Bernhardt **Content:** Messsage or execution tracing in Servicebus (SB) allows insight into the message exchange between Servicebus and it’s communication partners (Client applications and Service providers) as well as the message processing within a pipeline. Informations about incoming and outgoing messages, the corresponding headers, the course of variable manipulations and other things are written to the diagnostic logs and can be inspected there, when the tracing is active. By default the message and execution tracing are disabled, due to performance reasons and so it should only be enabled in development environments for debugging purposes. Enablement of message tracing for proxy or business service or execution tracing on the pipeline level, can be done using Fusion Middleware Control (Enterprise Manager).Under a specific SB project, the corresponding services and pipelines can be found. Enabling the tracing can be simply done by checking the options for message tracing respectively execution tracing in the Operations tab. [![Servicebus12c_msgTracing_1_marked](https://thecattlecrew.net/wp-content/uploads/2015/12/servicebus12c_msgtracing_1_marked1.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/12/servicebus12c_msgtracing_1_marked1.png) Per default the tracing detail level is set to *Terse*, which means that the logging information are not that detailed. Change the logging granularity can be done within the details of a specific component (proxy or business service and pipelines). In the example below, the tracing detail level has been set to *Full*. [![Servicebus12c_msgTracing_2_marked](https://thecattlecrew.net/wp-content/uploads/2015/12/servicebus12c_msgtracing_2_marked.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/12/servicebus12c_msgtracing_2_marked.png) Afterwards it should be checked, if the Log configuration on SB level is set to *Notification* at least. The **default configuration for a DefaultDomain is** *Warning*, which means that no logs are written to the diagnostics logs, even if the configuration on the component level is defined as described before. [![Servicebus12c_msgTracing_3_marked](https://thecattlecrew.net/wp-content/uploads/2015/12/servicebus12c_msgtracing_3_marked.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/12/servicebus12c_msgtracing_3_marked.png) The last step is the most important and it took me a while to find out why the tracing information are not written to the diagnostic logs. Please not that the configuration for the log level that has been adjusted in the last step, is not persisted and has to be reconfigured after a server restart! **Kategorien:** Integration **Schlagwörter:** Debugging, English, Oracle FMW, QuickTip, Servicebus, Tracing --- ### [OSB: Configurable basic authentication](https://thecattlecrew.net/2015/12/28/osb-configurable-basic-authentication/) **Published:** Dezember 28, 2015 **Author:** Bernhard Mähr **Content:** Basic authentication is still a very common approach for securing web services. It is widely supported and can be tested with a browser. If used over a HTTPS connection also the credentials are encrypted. To use basic authentication the usual way with OSB it is necessary to select „˜Basic“™ at the authentication section and a service account for the business service: [![BLOG_OSB_BasicAuthentication_01](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_01_thumb.png "BLOG_OSB_BasicAuthentication_01")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_01.png) For the service account the OSB supports three settings: [![BLOG_OSB_BasicAuthentication_02](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_02_thumb.png "BLOG_OSB_BasicAuthentication_02")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_02.png) - Pass Through: The credentials provided to the proxy service are forwarded to the business service. - Static: You enter the credentials to the service account file. - Mapping: You create inside the service account file a mapping from local usernames to remote usernames and passwords. There is a problem with all three selections: If you are on enterprise level where you use a version control system, build OSB projects with a build process and want to deploy the project on different stages with different credentials, they will not support this. It is not possible to modify the service account file with the customization mechanism. A working solution is to create different service account files for each stage and select the needed one by customization. But there is still the problem, that you need to check in the production credentials into the version control system. A workaround for this would be to have an apart configuration project with restricted access referenced by the project containing the business service. I would like to show another solution here. As described in [this blog post](osb-configuration-with-custom-xquery-functions-2/) we have chosen to store all kind of settings of the OSB projects in a configuration file on the OSB server. Access to these settings happens through custom XQuery functions. Using this we are able to get username and password stored in an OSB variables. For details look at [this topic](osb-configuration-with-custom-xquery-functions-2/). How we can use these credentials? First we have to build a basic authentication string. According to [wiki](https://en.wikipedia.org/wiki/Basic_access_authentication#Client_side) we have to concatenate username and password and then do a base64 encoding. This can be done with a java callout or the already base64-encoded string can be stored in the configuration file. [![BLOG_OSB_BasicAuthentication_03](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_03_thumb.png "BLOG_OSB_BasicAuthentication_03")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_03.png) Then we change the authentication of the business service to „˜None“™. The service account is not needed anymore. [![BLOG_OSB_BasicAuthentication_04](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_04_thumb.png "BLOG_OSB_BasicAuthentication_04")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_04.png) The last step is to add the basic authentication header to the outbound request. This can happen inside the routing or the service callout. [![BLOG_OSB_BasicAuthentication_05](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_05_thumb.png "BLOG_OSB_BasicAuthentication_05")](https://thecattlecrew.net/wp-content/uploads/2016/01/blog_osb_basicauthentication_05.png) Now we can configure the credentials we want to pass to the business service in our configuration file. Bernhard Mähr @[ OPITZ-CONSULTING](http://www.opitz-consulting.com/) published at **Kategorien:** Integration **Schlagwörter:** Configuration, Oracle FMW, Service Bus --- ### [Oracle SOA 11g: BPEL instance timeout while invoking asynchronous Java web method (JAX-WS)](https://thecattlecrew.net/2016/01/12/oracle-soa-11g-bpel-instance-timeout-while-invoking-asynchronous-java-web-method-jax-ws/) **Published:** Januar 12, 2016 **Author:** Thomas Fischer **Content:** Are you struggling with a long running asynchronous Java web method that behaves like a synchronous process when being invoked by an asynchronous BPEL process? Then you may like to know how threading might help you to get rid of the timeout! ### Use case We“™ve set up a SOA composite application on Oracle SOA 11.1.1.6 having an asynchronous service implemented using BPEL (1.1/2.0). A Java web application offers a long running asynchronous web method using JAX-WS, which is invoked by the composite application. Both applications are deployed to the same SOA cluster where we have a timeout of 300s for synchronous BPEL processes (*SyncMaxWaitTime*): [![1](https://thecattlecrew.net/wp-content/uploads/2016/01/11.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/01/11.png) *Image 1-Oracle JDeveloper – BPEL Process* ***Java web application with web method:*** @SOAPBinding(parameterStyle = SOAPBinding.ParameterStyle.BARE) @Action(input = „asyncJavaApplicationOperation“) @WebMethod @Oneway public void asyncJavaApplicationOperation(@WebParam(name = „asyncJavaApplicationRequestElement“, partName = „payload“, targetNamespace = „urn:AsyncJavaApplication“) AsyncJavaApplicationRequestType payload) { // pause process {…} try { Thread.sleep(request\_payload.getWaitTimeInMinutes() \* 60 \* 1000); } // send response {…} ### Pain If the long running Java web method takes longer than the defined value in the property *SyncMaxWaitTime*, the instance fails due to a timeout in the BPEL process. If you have a look on the instance via Enterprise Manager, you clearly see its state: faulted, but still running. The Invoke task of the BPEL process which calls the Java application is trapped in a pending state. But why does an asynchronous web method behave like a synchronous one and is blocking the caller? [![2](https://thecattlecrew.net/wp-content/uploads/2016/01/2.png)](https://thecattlecrew.net/wp-content/uploads/2016/01/2.png) *Image 2-Enterprise Manager – Service Dashboard* [![3](https://thecattlecrew.net/wp-content/uploads/2016/01/3.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/01/3.png) *Image 3-Enterprise Manager – Instance audit trail – Invoke is pending* ### Solution The BPEL process expects an acknowledgement by the Java web method. Otherwise it is processed like a synchronous request. The Java application does not send an acknowledgement until its web method has finished. To get rid of this behavior, create a new thread in your Java application and put your long running tasks into that thread: @SOAPBinding(parameterStyle = SOAPBinding.ParameterStyle.BARE) @Action(input = „asyncJavaApplicationOperation“) @WebMethod @Oneway public void asyncJavaApplicationOperation(@WebParam(name = „asyncJavaApplicationRequestElement“, partName = „payload“, targetNamespace = „urn:AsyncJavaApplication“) AsyncJavaApplicationRequestType payload) { {…} **Thread t1 = new Thread(new Runnable() {** **public void run() {** **letMeWaitBeforeCallingMeBack(request\_payload,response\_payload);** **}** **});** **t1.start();** **}** **private void letMeWaitBeforeCallingMeBack(AsyncJavaApplicationRequestType request\_payload, AsyncJavaApplicationResponseType response\_payload){** // pause process {…} try { Thread.sleep(request\_payload.getWaitTimeInMinutes() \* 60 \* 1000); } // send response {…} } By starting a new thread, the Java web method now can finish and returns the acknowledgement to the invoking BPEL process. The Invoke task now is completed immediately and the process will go on to the Receive task to keep on waiting for the callback -> Receive task now is pending instead of the Invoke task (compare Image 3 with Image 4). [![4](https://thecattlecrew.net/wp-content/uploads/2016/01/4.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/01/4.png) *Image 4-Enterprise Manager – Instance audit trail – Receive is pending* Once the long running process has finished as well, the callback is sent to the BPEL process without struggling with timeouts. [![5](https://thecattlecrew.net/wp-content/uploads/2016/01/5.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2016/01/5.png) *Image 5-Enterprise Manager – Instance audit trail – Receive was successful* **Kategorien:** Development, Integration **Schlagwörter:** Architecture, asynchronous, English, Integration, Java, JAX-WS, JDeveloper, web application --- ### [Quicktipp: WebLogic Server 12c and BEA-101104: java.net.ProtocolException](https://thecattlecrew.net/2016/01/14/1001_wls/) **Published:** Januar 14, 2016 **Author:** Mohammad Esad-Djou **Content:** The issue ist reported newly as a Bug from Oracle… **Technology, KeyWords:** WebLogic Server 12.1.3.0.0., 10.3, Exception; java.net.ProtocolException Error Message: **Problem**: We have deployed our application on weblogic (12.1.3.0.0). In the deployed application there is a (or more) link(s) which executes an application jar. The Links are not available in browser and if we check log-files of WLS-Domain, we find the following error: \####… <$Host> <$ManagedServer> <\[ACTIVE\] ExecuteThread: '12' for queue: 'weblogic.kernel.Default (self-tuning)'> <> <> <> „¦ java.net.ProtocolException: Didn’t meet stated Content-Length, wrote: ‚0‘ bytes instead of stated: ‚-1‘ bytes. at weblogic.servlet.internal.ServletOutputStreamImpl.ensureContentLength(ServletOutputStreamImpl.java:481) at weblogic.servlet.internal.ServletResponseImpl.ensureContentLength(ServletResponseImpl.java:1549) at Weblogic.servlet.internal.ServletResponseImpl.send(ServletResponseImpl.java:1623) at weblogic.servlet.internal.ServletRequestImpl.run(ServletRequestImpl.java:1582) at weblogic.servlet.provider.ContainerSupportProviderImpl$WlsRequestExecutor.run(ContainerSupportProviderImpl.java:255) at weblogic.work.ExecuteThread.execute(ExecuteThread.java:311) at weblogic.work.ExecuteThread.run(ExecuteThread.java:263) **Description** Weblogic declaration from: [https://docs.oracle.com/cd/E17904\_01/apirefs.1111/e14397/HTTP.html](https://docs.oracle.com/cd/E17904_01/apirefs.1111/e14397/HTTP.html) **BEA-101104** **Error:** Servlet execution in servlet context „ctx0“ failed, t1. **Description** Servlet execution in servlet context „ctx0“ failed, t1. Cause** Unexpected error occurred while serving the request. This is not a simple client connection reset error. **Action** Check the error message for the exact cause. But further analysis and newly reported Bug from Oracle help to solve this issue. **More detail and Background information:** Regarding the … There is newly the Bug-Fix (Patch 20446229) available. Perhaps help you. **Solution** The Bug is reported in the following document: Bug 20446229 : BEA-101104 JAVA.NET.PROTOCOLEXCEPTION TRYING TO ACCESS JAVAWEBSTART RESOURCE Please go simply to „Patches and Updates“ on the Oracle Support Portal and search for patch number 20446229. The Patch is available for 10.3.6 and 12.1.3.0.0 **Refernces** - [https://docs.oracle.com/cd/E17904\_01/apirefs.1111/e14397/HTTP.html](https://docs.oracle.com/cd/E17904_01/apirefs.1111/e14397/HTTP.html) MOS: BEA-101104 Java.net.ProtocolException While Downloading And Executing Webstart Resource (Doc ID 1988048.1) **Kategorien:** Integration **Schlagwörter:** English, QuickTip, Weblogic --- ### [Testing-Concepts and Considerations in a SOA landscape that uses the Oracle Service Bus Framework](https://thecattlecrew.net/2016/01/18/testing-concepts-and-considerations-in-a-soa-landscape-that-uses-the-oracle-service-bus-osb-framework/) **Published:** Januar 18, 2016 **Author:** Apostolos Varsamis **Content:** ## Introduction Due to the ever growing complexity and multiple dependencies of software components in an enterprise landscape, „Automated Testing“ is no longer an optional feature of the software development process but a crucial ingredient of the development process and plays a significant role in every successfully launched software project. Software Development in a SOA environment has its own challenges that differ from, let“™s say, purely Java components. One reason is the fact that software testing needs **invariant laboratory conditions**; but exactly this is hard to achieve in a complex service landscape. So when designing tests it is very important to determine isolation conditions to meet these requirements. Another point worth keeping in mind is the fact that frameworks -like Oracle Fusion Middleware- follow a declarative development approach; this means that testing is possible only **after** the deployment and never before (because the services are de-facto built up during the deployment). Some artifacts can be tested before the deployment but we get to it later. In this article focusing **on Oracle Service Bus** we outline a feasible testing strategy that allows us to implement automated testing of arbitrary complexity; starting from simple service-testing up to end-to-end tests that involve a whole service chain spread over one or more domains. ## Test Categories We assume that the reader is familiar with service classification concepts like „elementary services“ or „composite services“. We also assume that the basic concepts of OSB like XQueries, Proxy and business services are well known concepts as well. Let us focus for the moment on transformation logic. The tools offered by OSB are XQueries and XSLT transformations. These files describe, roughly speaking, how a certain XML structure should be transformed to another one, or how a piece of information can be extracted from it. Hence they can be regarded as functions that receive an XML structure as input and provide another XML structure or simple data as an output. These artifacts can be tested by java Junit means **before** deployment. One might consider of it as an unnecessary testing step; but it is enormous important, because it guarantees us that no side effects would remain undetected in case e.g. a namespace or a structural modification in a XML schema has to be carried out. So keeping these points in mind, one can make the following distinction: ### Pre-deployment Tests These are tests mainly using Junit techniques and may be considered as „low-level“ or basic tests. They should guarantee that basic transformation logic of data structures meets the requirements. Testing the XQuery components help us ensure the XQuery language correctness as well and help us avoid namespace inconsistency and confusion. ### Post-deployment Tests These tests can be performed after the deployment of the OSB artifacts has been accomplished and can be distinguished in two main categories. 1. Tests that affect a single service. They usually consist of a single call to a service provided by the OSB server and the analysis of the response. 2. End-to-end Tests; these are much more complex and require mock-services in order to simulate a whole service landscape and perform Lab conditions. ![Testing-Pyramid](https://thecattlecrew.net/wp-content/uploads/2016/01/testing-pyramid.png) Figure 1 Testing Pyramid Let us focus now in the testing processes themselves. ### Simple Service Tests These tests guarantee that a given a certain input the service responses in the expected way. ![simple-servie-tests](https://thecattlecrew.net/wp-content/uploads/2016/01/simple-servie-tests.png) Figure 2 Simple Service Tests ### Complex End-To-End Tests These tests define in general a dedicated entry point and a dedicated exit point where the assertions have to be performed. Everything in the middle can be considered as a „black box“. Further on, in order to guarantee the so called laboratory conditions i.e. avoid side effects the assertion point such as one or more services in the middle has to be replaced by mock services. ![complex-servie-tests](https://thecattlecrew.net/wp-content/uploads/2016/01/complex-servie-tests.png) Figure 3 Complex End-To-End Tests ### Implementation schema In the following we briefly outline the main implementation schema. The Java test-process can be separated in the following steps: 1. Via JMX the java Test application connects to the OSB server and manipulates the end point of a certain business server. 2. The client-side establishes a Java mock-service having all the required characteristics of the OSB-service that has to be mocked. 3. The test is initiated i.e. the test-request is send 4. The service established by Step2 is waiting for a request from the OSB service that has been replaced by a mockup in Step1. 5. All the designed assertions are made 6. All changes made in OSB Artifacts are rollbacked. ![end-to-end-tests.png](https://thecattlecrew.net/wp-content/uploads/2016/01/end-to-end-tests.png) Figure 4 End-To-End Tests The whole testing process can be automatized using a deployment server e.g. Jenkins. In order to enable the system to perform the tests both deployment server and weblogic-managed-servers (OSB Server or cluster) has to be accessible to each other. ![deployment.png](https://thecattlecrew.net/wp-content/uploads/2016/01/deployment.png) ### Conclusion The testing framework might need quite a lot of implementation efforts in order to cover the entire requirement that arise from a complex SOA environment. However we emphasize that all the implementation efforts will be well rewarded in terms of quality and stability. **Kategorien:** Integration **Schlagwörter:** Integration, Servicebus --- ### [Rückblick zur Camunda 7.4 Release Roadshow](https://thecattlecrew.net/2016/02/04/rueckblick-zur-camunda-7-4-release-roadshow/) **Published:** Februar 4, 2016 **Author:** Christoph Ortmann **Content:** Am 22. Januar fand in Düsseldorf mit vier spannenden Vorträgen um die Themen Camunda BPM und DMN die Camunda BPM 7.4 Release Roadshow statt. Unser Partner Camunda präsentierte hier die neue Version seiner BPM-Plattform, die seit Anfang November zum Download verfügbar ist. Wir von OPITZ CONSULTING waren mit einem Praxisbeitrag beteiligt. Jakob Freund stellte in einer Live-Demo den neuen Camunda Modeler vor. Das Tool ermöglicht es Fachanwendern und Entwicklern, BPMN-Prozesse und DMN-Regelwerke zu modellieren und ausführbar zu machen. Michael Ferber führte das Publikum dann in DMN, einen relativ jungen OMG-Standard zur Modellierung und Ausführung von Geschäftsregeln ein. Er demonstrierte dabei auch die Modellierung von Business Rules mit dem neuen Modeler. Im Anschluss daran zeigte Bernd Rücker in einer Live-Hacking-Demo, wie die zuvor erstellten Modelle in der BPM-Plattform deployed und ausgeführt werden können. Die Vortragsreihe wurde mit einem Projektbericht von Halil Hancioglu und Christoph Ortmann von OPITZ CONSULTING abgeschlossen. Darin zeigten wir, wie Knowledge Worker einer Versicherung durch Case Management und Business Rules bei der Schadensbearbeitung unterstützt werden können. Insgesamt war es ein gelungener Vormittag, der einen guten Einblick in die Möglichkeiten der neuen Version von Camunda BPM vermittelt hat. Mit der Unterstützung von DMN wird ein wichtiger Schritt getan, die Zusammenarbeit von Fachseite und Entwicklung bei der Umsetzung von Business Rules zu verbessern. Der neue Modeler macht einen guten Eindruck und unterstützt bereits die wichtigsten Features im Umgang mit BPMN-Prozessen und DMN-Regelwerken. **Kategorien:** Tech Events & Networking **Schlagwörter:** BPM, Camunda --- ### [Using the Mule Slack Component](https://thecattlecrew.net/2017/02/11/using-the-mule-slack-component/) **Published:** Februar 11, 2017 **Author:** michaelrinus **Excerpt:** An overview how to use the MuleSoft Anypoint Slack-component to integrate Slack-messaging into processes **Content:** # Mule meets Slack ## Components The Mule Slack component is another interesting piece of software which you can find as a part of the [MuleSoft Anypoint Platform](https://www.mulesoft.com/platform/enterprise-integration). [Slack](https://slack.com/) is a chat and messenger application which can be used as an alternative to email. One huge advantage of Slack compared to email is the lean and responsive environment for collaboration. Furthermore, Slack is hosted as a cloud service so there is no infrastructure necessary. That“™s why many startups rely on Slack for communication. The Slack component can be used as an inbound and outbound component, which means, that a Mule flow can listen for Slack events and also perform several operations towards Slack. Therefore, there are many use cases the component can be used in. One example is related to the term Multi-Channel enablement, which describes a systematic and integrative approach to read from and post data to different communication channels. The Slack connector could be used to filter and aggregate data from Twitter, Facebook and news sites to report those topic based to different Slack channels. So subscribers of these channels can be informed topic wise by Slack messages instead of following the sources directly. This reduces mails and results in a centralized information platform where only interested people are notified. Moreover, people can discuss these imported news and posts, posts can be discussed internally on Slack and even a task list could be created if a post is configured to represents a task. On the other hand slack can also be used as a data source itself. ## Flows In the following, we describe a Mule application, which provides a REST interface to accept messages which are forwarded to Slack, which is basically done with 3 different flows: ![mulemeetsslack_01_flows](https://thecattlecrew.net/wp-content/uploads/2017/02/mulemeetsslack_01_flows.png)Flows – graphical representation The flow **mulemeetsslack-main** provides our HTTP based REST interface, where the HTTP traffic is handled and our small API is published. The incoming requests are handled by the [RAML ](https://www.raml.org)based API description which configures the APIkit Router component. As soon as a POST message with a messageText is received, the request is forwarded to the **post:mulemeetsslack-config** flow by the APIkit Router. There, the incoming payload is stored as a variable, a log entry is created and then the message is posted to Slack via the Slack component. The flow **mulemeetsslack-console** provides a HTTP based documentation and test console, we will later use for testing. ## RAML ![mulemeetsslack_02_raml](https://thecattlecrew.net/wp-content/uploads/2017/02/mulemeetsslack_02_raml.png) ## Slack component Let us have a look at the Slack component. The last element of the post:mulemeetsslack-config flow described by „Post message on Slack anonymously“ is using the component. The component is provided by the Anypoint platform and can be added to the flow via drag and drop. (If you try this and the component is not available on your system, you can install it either via Mule Exchange) ![mulemeetsslack_03_mulemeetsslack-config](https://thecattlecrew.net/wp-content/uploads/2017/02/mulemeetsslack_03_mulemeetsslack-config.png)Slack component configuration Clicking on the component opens the property panel, where we can configure the component. First of all, the Slack component needs a configuration containing a token, so that Slack knows which customer the message belongs to. For authentication OAUTH2 or a token could be used, we chose to generate a token, which you can do via is you have an active Slack account and are logged in. Afterwards we can choose from the operations, which action we would like to perform. As we want to post to an existing channel, we select Chat-Post message. Then we have to provide the channel id, the message we want to post and a name, which is as a kind of author. When Mule Anypoint Studio connects to Slack you can choose the appropriate channel from a Drop-down-List. This results in the following XML representation of the flow. ``` ``` That“™s it! That is all which needed to be done to configure the adapter. ## APIkit Console For testing purposes we use the APIkit Router Console to send a POST request to our interface. The console is rendered by the Mule Anypoint Platform and is another component which is contained in our third flow mulemeetslack-console. The console also uses the RAML specification to generate the user interface and even to add examples. ![mulemeetsslack_04_api_console](https://thecattlecrew.net/wp-content/uploads/2017/02/mulemeetsslack_04_api_console.png)APIkit Console As we specified such an example and have, so far, only one interface, we simple need to click on the post button to send a message, which directly results in a new entry in Slack. ## Slack Message ![mulemeetsslack_05_slack-post](https://thecattlecrew.net/wp-content/uploads/2017/02/mulemeetsslack_05_slack-post.png) There are plenty other connectors provided by Mulesoft“™s Anypoint Platform which can be found on the [Anypoint Exchange](https://www.mulesoft.com/exchange). The usage of those components is usually straightforward and easy. They are usually provided with working examples you just have to adapt to your purpose. As soon as the platform concepts are understood, it takes only a couple of minutes to realize such scenarios. **Kategorien:** Integration, Tools & Methoden **Schlagwörter:** English, Integration, IoT --- ### [Quicktipp: Working with more than one package name in a JAXB Context Config in Mule ESB](https://thecattlecrew.net/2017/02/12/quicktipp-working-with-more-than-one-package-name-in-a-jaxb-context-config-in-mule-esb/) **Published:** Februar 12, 2017 **Author:** Dominik Bial **Content:** If you want to structure your code with packages for different JAXB annotated classes, for example after generating JAXB from different WSDLs, do not try to define severall jaxb context elements in Mule ESB, as this is going to fail at runtime. ``` ``` This results in: org.mule.api.registry.RegistrationException: More than one object of type class javax.xml.bind.JAXBContext registered but only one expected. The right way to this is to separate packages via a „:“. ``` ``` **Kategorien:** Integration **Schlagwörter:** Architecture, English, Integration, QuickTip --- ### [Approve messages in Camunda BPM with DMN and forward via Camunda HTTP Connector](https://thecattlecrew.net/2017/02/20/approve-messages-in-camunda-bpm-with-dmn-and-forward-via-camunda-http-connector/) **Published:** Februar 20, 2017 **Author:** Erzen Hyko **Content:** While I was watching today a video of Jakob Freund talking about „[Camunda in the cloud](https://vimeo.com/186233425)„, I understood better the simple process modelled by my colleagues and me a couple of days ago. In this speech at the BPMCon 2016 he was talking about clients, who used Camunda, not being interested in the zero code case as much as the other advantages of BPM. Most of them see the ability to distribute work easily, handling events, asynchronous processing and the visibility of the process in the case of „Workflow“ as the most important advantages. From my developer point of view, he is completely right. On one hand, BPM helps us to talk to our customers. On the other hand, it helps us in development a lot when we have to route tasks or data to other people or systems. The visualization helps developers to understand the application behavior, simplifies the operation of an application, helps even to structure code during development and much more. Especially, through the digitalization we will get much more scenarios in which applications will talk to each other or processes which are started by events from mobile phones or things. BPM and, therefore, Camunda can be one approach to prepare for future by anticipating changes and adapting quickly and flexibly to changes on process side. In our process we took advantage of event handling, which is offered by BPMN 2.0 but in the simplest way. ![slack-approval.png](https://thecattlecrew.net/wp-content/uploads/2017/02/slack-approval.png) What I mean is, we modelled just one Start- and two End-Events. The process can be started with only two pieces of information, namely the message to be post on slack and the name of the author writing this message. We didn“™t provide any API to call and start this process in Camunda. We just used the Camunda REST API for that. The URL would be: http://:/engine-rest/process-definition/key/slack-approval/start Also using a JSON body: ``` {"variables": { "name": {"value" : "Muster Human", "type": "String"}, "text": {"value" : "this is a test message", "type": "String"} } } ``` ## DMN Table One of my favorite automations in this process is the DMN Table. We decided to create a black list with forbidden words, which are not allowed to get published on slack channels. So we would fill our table with rules checking for forbidden words in the message. ![check_forbidden_words_narrow.PNG](https://thecattlecrew.net/wp-content/uploads/2017/02/check_forbidden_words_narrow.png) As you can see we use Juel as the expression language for defining the rules. This is just our preference as Java developers. You could use FEEL or any other language supported by the Camunda engine. We check for null or empty string in the first rule of the table. This can also be done in other ways. You could do this check before the table is invoked. We decided to put this as a rule on the table for more visibility and demonstration purposes. There is one disadvantage with that though. The Camunda engine would evaluate every rule in a DMN Table, regardless of the output of any rule and the hit policy of the table. That means you have to make every rule null safe in order to avoid exceptions. To see an example, just check out the rules in the above table. ## Tasks ### Approve message At the beginning of this blog entry we said asynchronous processing is a big advantage of BMPN 2.0. We use a user task for a human check of every message to be post on slack. While we can argue if it“™s meaningful or not, this is a demo and it achieves its purpose as an example of asynchronous processing that should be done by a human. Also an advantage: you can easily assign different tasks to different people and distributing work as you want. ### Send Rejection As there are quite a few sorts of tasks available in BMPN 2.0 we tried to be as specific as possible when modelling. In this case, if a message contains forbidden words or it is not approved by the approver, the message is rejected and the *token* passes through the „Send rejection“ Task. We could leave this task as a normal service task but we chose to model it as a „Send task“ to be more accurate. At the moment this tasks only logs out the denial of posting the message. But it could as well notify somebody or write some auditing data. ### Push message to slack Now it“™s time for the second most interesting tasks in this case. The first one was the DMN Table. I am talking about the „Push message to slack“ task. Functionally it should do a REST call with two parameters: name and text. So you probably are asking yourself, where is the interesting part? Well, we didn“™t use any Java code here to make the REST call. Instead we used the Http Connector provided by the Camunda engine. Using the http connector is much more elegant and easier than doing a REST call in Java. Nevertheless, testing is extremely time consuming, especially, when using the framework Wiremock. It is not that easy to get it running, which is why we used SoapUI in the end. So, be aware, if you use a Http Connector component, testing might be challenging. ## Important: If you could take only three important topics from this blog entry, according to us those would be: 1. In many cases you don“™t need an extra (REST) API. Just use the API of the Camunda engine to minimize the workload. The security issue must be considered here. 2. DMN Table is easy to use for automatically checking rules and perfectly integrated in the Camunda engine. Just keep in mind EVERY rule will be evaluated. 3. Http Connectors are really handy to configure in the model. Furthermore is this e great feature for fans of „zero code“ solutions. Testing this scenario is much more difficult though than making and testing the http call in Java. **Kategorien:** Integration **Schlagwörter:** Camunda, English, Integration, Java --- ### [A tiny MQTT-Broker docker image](https://thecattlecrew.net/2017/02/24/a-tiny-mqtt-broker-docker-image/) **Published:** Februar 24, 2017 **Author:** michaelrinus **Content:** # Intro Some time ago I started to get a look at [MQTT](http://mqtt.org/documentation) and needed a broker to start with. Eclipse Mosquitto ([http://mosquitto.org/](https://mail.opitz-consulting.de/owa/redir.aspx?C=yMOHSCRRdEWn0ydrCvESQ2WlM5iuYNQIHmkHFRwFSv9TESOGE5vl6QOzXoAu2Wm-lPGekksxd5w.&URL=http%3a%2f%2fmosquitto.org%2f)) was a logical choice for a quick start and as I am a fan of docker containers for not polluting your local system installation whilst trying new software stacks, I searched for a docker image with Mosquitto. Of course, there were many, but I was a bit astonished about their size. **500MB** and **more**? That“™s not what I expected from an efficient docker build result. I started to check what the exact technical requirements of Mosquitto were and actually, it doesn“™t need so much to run. ## Approach The most simple way would be a small Linux coming at least with a package manager to get it up and running, as it is pointed out here: [https://mosquitto.org/download/](https://mail.opitz-consulting.de/owa/redir.aspx?C=yMOHSCRRdEWn0ydrCvESQ2WlM5iuYNQIHmkHFRwFSv9TESOGE5vl6QOzXoAu2Wm-lPGekksxd5w.&URL=https%3a%2f%2fmosquitto.org%2fdownload%2f). The [OpenWRT](https://mail.opitz-consulting.de/owa/redir.aspx?C=yMOHSCRRdEWn0ydrCvESQ2WlM5iuYNQIHmkHFRwFSv9TESOGE5vl6QOzXoAu2Wm-lPGekksxd5w.&URL=https%3a%2f%2fopenwrt.org%2f) approach seemed to be the most interesting, as it is available for various CPU types and its known to be damn small. ## Solution A short time later the Dockerfile was written and an image which was packed below 4MB. I“™d call that a success J You can find the results right here [https://hub.docker.com/r/mrinus/docker-openwrt-mosquitto/](https://mail.opitz-consulting.de/owa/redir.aspx?C=yMOHSCRRdEWn0ydrCvESQ2WlM5iuYNQIHmkHFRwFSv9TESOGE5vl6QOzXoAu2Wm-lPGekksxd5w.&URL=https%3a%2f%2fhub.docker.com%2fr%2fmrinus%2fdocker-openwrt-mosquitto%2f) or by doing a docker pull on *mrinus/docker-openwrt-mosquitto* and run the image by: > docker run -p 1883:1883 -d mrinus/docker-openwrt-mosquito [Dockerfile](https://hub.docker.com/r/mrinus/docker-openwrt-mosquitto/~/dockerfile/) ## BTW Just to mention it: Nowadays there is an official image locatable as [*eclipse/mosquito*](https://hub.docker.com/_/eclipse-mosquitto/) which has an even smaller footprint. As they did not provide a build tagged *latest* you can run it by giving the latest build tag: > docker run eclipse/mosquitto:1.4.8 „“p 1883:1883 Have fun exploring MQTT! **Kategorien:** Integration **Schlagwörter:** Integration, IoT, QuickTip --- ### [Camunda meets Mule - A java based flexible approach for Integration and APIs](https://thecattlecrew.net/2017/02/27/camunda-meets-mule-a-java-based-flexible-approach-for-integration-and-apis/) **Published:** Februar 27, 2017 **Author:** Halil Hancioglu **Content:** Finding the right architectural integration approach for one“™s business is becoming more important. One reason for this is the digitalisation. There are more and more devices like smartphones, IoT devices and gadgets but also applications and systems that communicate with each other. The power behind digitalisation is not a single technology or device. It is the network of systems, devices and people and the combination between technologies that promises huge benefits and new business models. The first, major step to gain these benefits is integration or: the integration of everything. In integration of everything a combination of technologies will be found which is a mixture of classical approaches paired with other principles. Topics like device to process, process to device, streaming technologies, Big Data, API management, API monetization and much more are crossing classical integrational themes. One huge challenge in these environments is to get a flexible and easy to adapt system architecture. [Camunda BPM](https://camunda.org/) and [Mulesoft’s Anypoint](https://www.mulesoft.com/platform/enterprise-integration) platform can provide such a system architecture. During our monthly [Opitz Consulting](http://www.opitz-consulting.com/) Community Day we started a project under the top name `Camunda meets Mule` to demonstrate how easy [Camunda BPM](https://camunda.org/) and [Mulesoft Anypoint](https://www.mulesoft.com/platform/enterprise-integration) can be combined. We started a demo project to demonstrate the API design features as well as the usefulness of connectors from Mulesoft. The processing layer is based on Camunda and is responsible for routing and business logic. We started to think about a simple Use Case for our project that can be realised in a couple of hours. This resulted in a simple API, that allows sending messages via REST and JSON to Mule. Camunda starts a process to publish this information in [Slack](https://slack.com/) via Mule. Moreover, we wanted to approve messages, before they will be „live“. # Architectural Bird view Here is an initial sketch we created during our initial discussion. ![Camunda meets Mule Idea](https://thecattlecrew.net/wp-content/uploads/2017/02/camundameetsmule_idea.png) Different parts we created are described in the following blog posts: - [Handle REST requests in Mule ESB and forward it to Camunda BPM](https://thecattlecrew.net/2017/02/03/handle-rest-requests-in-mule-esb-and-forward-it-to-camunda-bpm/) - [Approve messages in Camunda BPM with DMN and forward it via Camunda HTTP Connector](https://thecattlecrew.net/2017/02/20/approve-messages-in-camunda-bpm-with-dmn-and-forward-via-camunda-http-connector/) - [Using the Mule Slack component](https://thecattlecrew.net/2017/02/11/using-the-mule-slack-component/) # Our Team And here is another picture of our group having fun during the project. ![Team](https://thecattlecrew.net/wp-content/uploads/2017/02/img_2652-e1488205776739.jpg) Feedback from some of my colleagues was….. Dominik Bial, Lead of the Competence Center Internet of Things: > „I am still impressed, that it took us less than 4 hours from idea to our first prototype. Great frameworks and powerful combination!“ Erzen Hyko, Professional Developer: > „This project showed that Mule and Camunda can be very easily and fast combined together, providing a solid base for integrating APIs and model business processes.“ Alexander Rüsberg, Senior Consultant: > „Both frameworks provide a very fast and intuitive approach on integration without the usual ramp up and training effort that is necessary for most of their competitors.“ And finally my personal feedback on it: > „I“™m still working with [Camunda BPM](https://camunda.org/) in several projects and had always to work with different integration layers. In most cases it is a mixture of multiple systems and thus more than one publisher teams. Some tools are very powerful and some of them need more communication to define an interface. The main advantage when you recap your integration layer to one software tool like [Mulesoft Anypoint](https://www.mulesoft.com/platform/enterprise-integration) is, it increases your Time to Market due to the fact that you minimize and optimize the communication between the publishers and consumers. That“™s an important point for successful integration solutions.“ **Kategorien:** Integration **Schlagwörter:** Architecture, Camunda, Integration, Java --- ### [How to hide passwords and account information in WLST scripts (WebLogic Server)](https://thecattlecrew.net/2017/03/11/how-to-hide-passwords-and-account-information-in-wlst-scripts-weblogic-server/) **Published:** März 11, 2017 **Author:** Neselovskyi, Borys **Kategorien:** IT-Security **Schlagwörter:** Weblogic --- ### [WS-Security with Username Token Profile on Oracle Weblogic Server](https://thecattlecrew.net/2017/03/22/ws-security-with-username-token-profile-on-oracle-weblogic-server/) **Published:** März 22, 2017 **Author:** Christoph Ortmann **Excerpt:** WS-Security Username Token Profile is a simple authentication scheme for SOAP-webservices using username an password sent in the requests' WS-Security headers. The password is hashed using a salt and a timestamp (password digest) to prevent replay attacks. It is specified in this document. As this does not involve any message encryption it should not be used without transport encryption. In this post I will show how I configured this for a webservice to be deployed on a recent Weblogic Server (12.2.1.2). **Content:** WS-Security Username Token Profile is a simple authentication scheme for SOAP-webservices using username an password sent in the requests‘ WS-Security headers. The password is hashed using a salt and a timestamp (*password digest*) to prevent replay attacks. It is specified in [this](https://www.oasis-open.org/committees/download.php/16782/wss-v1.1-spec-os-UsernameTokenProfile.pdf) document. As this does not involve any message encryption it should not be used without transport encryption. In this post I will show how I configured this for a webservice to be deployed on a recent Weblogic Server (12.2.1.2). ## WS-Policy configuration On Weblogic webservices security is configured using policy files following WS-Policy standards. The easiest way to secure a webservice is to configure one of the prebuilt policy files shipped with Weblogic, in this case `Wssp1.2-2007-Https-UsernameToken-Digest.xml` which enforces both authentication and transport level security. How to enable this manually after the service is deployed is described in the [Admin Console Online Help](http://docs.oracle.com/middleware/12212/wls/WLACH/taskhelp/webservices/ConfigureWSPolicyFile.html). In my case I just wanted to test authentication without bothering with certificates so I deployed my own policy file which does not enforce the use of transport level encryption: ``` ``` Custom policies are stored under `/WEB-INF/policies` in the webservice war file. Automatic activation after deployment can be achieved either by use of a deployment plan or by annotating the service implementation class with the `weblogic.jws.Policy` annotation as described in the [Oracle documentation](http://docs.oracle.com/middleware/12212/wls/WSSOV/ws-security-message.htm#GUID-CCB6D8CA-8D3F-44F9-8DF3-CE1A7E288DD5). The downside of this approach is that our code now depends on server-specific libraries but in our case this was the easiest way. ## Configuring the security realm Weblogic uses security realms to manage users and groups for authentication. In our case we used the default realm which is configured when setting up the default admin user. By default this security realm does not support password digest authentication, so we need to enable this using the WLS Admin Console: After selecting our default realm *„myrealm“* in the **Security Realms** overview we change to the **Providers**-tab. ![wls_providers](https://thecattlecrew.net/wp-content/uploads/2017/03/wls_providers1.png) There we first select the *DefaultAthenticator* and switch to its **Provider Specific**-tab. There we check the **Enable Password Digest**-checkbox and save our changes. ![default_authenticator](https://thecattlecrew.net/wp-content/uploads/2017/03/default_authenticator.png) Back in the *myrealm* |**Providers**-tab we now select the *DefaultIdentityAsserter*. On its **Configuration**-tab we add `wsse:PasswordDigest` to the list of **active authentication types**. ![default_asserter](https://thecattlecrew.net/wp-content/uploads/2017/03/default_asserter.png) We save our changes and restart Weblogic. As we changed the way Weblogic stores its users‘ passwords we need to reset the passwords of all users we want to access our webservice with. ## Testing In most cases I use SoapUI for manually testing webservices. It supports password digest authentication but unfortunately at least the version I used seems to add a binary nonce to the SOAP-header which Weblogic cannot understand. I therefore built a Java-Client using only standard JDK-features following the description in [this](https://sarathslogbook.wordpress.com/2015/06/22/jax-ws-spring-web-service-client-with-password-digest-authentication/) blog post. ## Wrapping it up To configure a webservice to use authentication following the WS-Security Username Token Profile we need to add a corresponding WS-Policy file. To make password-digest-authentication work we also need to configure our security realm to support this feature. Testing a webservice using password-digest-authentication might be a little inconvenient depending on the tools you use. **Kategorien:** IT-Security --- ### [Opitz Consulting und CA - zwei starke Partner in Sachen API Management](https://thecattlecrew.net/2017/07/07/opitz-consulting-und-ca-zwei-starke-partner-in-sachen-api-management/) **Published:** Juli 7, 2017 **Author:** alexanderdaeubler **Content:** Digitalisierung ist das Gebot der Stunde: alles was vernetzt werden kann wird auch vernetzt. Laut Gartner werden beispielsweise im Jahr 2020 bereits über 20 Milliarden „Dinge“ miteinander kommunizieren. Dadurch ergeben sich komplett neue digitale Geschäftsmodelle, an denen kein Unternehmen mehr vorbei kommen wird „“ sprich: jedes Unternehmen wird ein digitales Unternehmen sein (müssen). Wie bietet ein Unternehmen seine Dienste aber so an, dass diese überall auf der Welt verwendet werden können aber gleichzeitig auch sichergestellt ist, dass sensible Daten und Prozesse vor feindseligen Angriffen geschützt sind? Willkommen beim Thema API Management, denn APIs sind die Bausteine der digitalen Transformation! Der Überlieferung nach hat Jeff Bezos bei Amazon bereits im Jahr 2002 seine Developer dazu verpflichtet, dass Daten und Services ausschließlich via APIs zur Verfügung gestellt werden. APIs sind also beileibe kein neues Thema „“ seit vielen Jahren planen und erstellen wir von Opitz Consulting bei unseren Kunden Services und Schnittstellen um unterschiedlichste Applikationen innerhalb der Unternehmen miteinander zu integrieren. API Management verschiebt hier aktuell den Fokus von internen auf externe Schnittstellen. Viele der dabei verwendeten Architekturansätze sind uns als erfahrenem Systemintegrator nur allzu vertraut, insofern ist es ein mehr als logischer Schritt, dass wir im Bereich API Management einen unserer strategischen Schwerpunkte setzen. Seit dem Frühjahr 2017 besteht eine offizielle Partnerschaft im Bereich API Management zwischen CA und Opitz Consulting. Alle führenden Reports von Analysten verzeichnen das API Tooling von CA im Bereich der Marktführer bzw. Leader, hier exemplarisch die Forrester Waveâ„¢ für API Management Tools: ![forresterWaveAPICA](https://thecattlecrew.net/wp-content/uploads/2017/07/forresterwaveapica.jpg) Doch wie sieht nun das Portfolio von CA im Sachen API Management aus? Die folgende Grafik verdeutlicht sehr anschaulich die einzelnen Bestandteile: ![CA_API_Overview](https://thecattlecrew.net/wp-content/uploads/2017/07/ca_api_overview.jpg) API Gateway Im Zentrum steht das API Gateway. Dieses nimmt sämtliche API Aufrufe (von Apps auf mobilen Endgeräten, „Dingen“, Applikationen von Geschäftspartnern etc.) entgegen und prüft den Aufruf gegen die zur API hinterlegten Policies. Damit kann beispielsweise in wenigen Schritten sichergestellt werden, dass nur über eine HTTPS Verbindung auf die API zugegriffen werden kann. Wird festgestellt, dass es sich um einen ungültigen Aufruf handelt, dann wird er zurückgewiesen. Mehr als 250 sogenannter Assertions (mehrere solcher Assertions können zu einer Policy verknüpft werden) decken alle erdenklichen Anforderungen an eine API ab, keines der Konkurrenzprodukte bietet aktuell eine solche Bandbreite an vorgefertigten Bausteinen. Developer Portal Doch wie kommt der Konsument einer API (beispielsweise als Entwickler einer App die Daten eines bestimmten Unternehmens benötigt) eigentlich an Detailinformationen? Dies ermöglicht das Developer Portal „“ hier kann man durch alle verfügbaren APIs navigieren und sich beispielsweise auch als Applikation für eine bestimmte API registrieren um sie überhaupt benutzen zu können. Auch Auswertungen zur Verwendung von einzelnen APIs sind über dieses Portal möglich (z.B. „wie oft wurde meine API in den vergangenen 24 Stunden aufgerufen?“). API Live Creator Die Entwicklungsgeschwindigkeit wird in der IT immer elementarer „“ die richtige Idee muss so schnell wie möglich an den Markt gebracht werden sonst ist die Konkurrenz schneller. Dies gilt natürlich auch für APIs und wird vom API Live Creator aufgegriffen. Dieses Tool ermöglicht die schnelle Erstellung von APIs auf Basis existierender Datenquellen (wie beispielsweise Datenbanken, aber auch Applikationen wie SAP und Salesforce) und erhöht die Time-to-Market dramatisch. Solution Kits Neben diesen drei elementaren Bausteinen des CA API Toolings gibt es noch diverse Solution Kits, die Templates für immer wiederkehrende Anwendungsfälle enthalten und somit ebenfalls die Entwicklungsgeschwindigkeit erhöhen. Beispiele hierfür sind - OTK (OAuth Toolkit): enthält Policies zur Prüfung von OAuth-Aufrufen und diverse weitere OAuth-Tools - MAS (Mobile Application Services): erleichtert die Integration von API-Calls in mobilen Apps, beispielsweise über SDKs für diverse mobile Plattformen wie iOS und Android Dies nur als kurze Einführung in die CA API Plattform. In den kommenden Wochen und Monaten werden wir hier im Blog immer wieder von unseren Erfahrungen rund um das CA Tooling berichten. Ebenso sind Webcasts und weitere Events im Bereich API Management in Planung, Details dazu werden wir ebenso hier im Blog bekannt geben. Willkommen im API-Zeitalter – seien Sie dabei! **Kategorien:** Integration --- ### [Holiday replacement using camunda candidate groups](https://thecattlecrew.net/2018/04/06/holiday-replacement-camunda-candidate-groups/) **Published:** April 6, 2018 **Author:** Stefan Frena **Content:** #### In a recent project I was faced by a real classic in user task management. The age old question about how to handle holiday replacement the right way. In this post I am going to explain my approach using as much of camunda ready-to-use functionality to avoid overhead. > Situation: Jack needs holidays and leaves for a week. John, the substitute, jumps in. He now has to deal with all of Jacks existing and newly created tasks. A simple approach often working fine is to postpone user assignment to the very last second before a user task is created. This can be done by some piece of code e.g. asking ldap for help. ![diagram_1-1](https://thecattlecrew.net/wp-content/uploads/2018/04/diagram_1-1.png) But what about tasks already assigned to Jack? How can John get them to show up in his task list? The above mentioned solution does not work here. The solution I was thinking of had to handle the following requirements: 1. assign new user tasks to the substitute collegue(s) 2. assign already existing user tasks to the substitute collegue(s) 3. holiday jack still can access all of his tasks (including new ones) 4. do not iterate over every single task and update the assignee This is what I did: Instead of filling the assignee field of a user task during process modelling I made use of [candidate groups](https://docs.camunda.org/manual/7.8/reference/bpmn20/tasks/user-task/#candidate-groups). A candidate group contains all the users that have the right to work on a task. ![task-2](https://thecattlecrew.net/wp-content/uploads/2018/04/task-2.png) For simplicity, lets call the *candidate group* „jacks\_tasks“. You can create it in camunda cockpit or using camunda’s [identity service](https://docs.camunda.org/manual/7.8/user-guide/process-engine/identity-service/) at runtime. Create a user Jack and add him to his own candidate group. Something like this (using IdentityService): ``` Group jacksGroup = identityService.newGroup("jacks_tasks"); identityService.saveGroup(jacksGroup); User jack = identityService.newUser("Jack"); identityService.saveUser(jack); identityService.createMembership(jack, jacksGroup); ``` I used a listener on task creation which ran the code in order to set up group and user straight before assignment. To make sure Jack gets his task list filled (while not on holidays) you don’t query for him as *assignee* but *task candidate user* (even the effort of refactoring this in an existing project isn’t that bad): ``` List list = taskService.createTaskQuery().taskCandidateUser("Jack").list(); ``` **Note**: the user Jack here is just a simple camunda user even without permission to log into camunda task list. Use any (external) user id you prefer and/or need in order to retrieve usertasks. # Now comes the substitution part Create (even on the fly) a user *John*, add him to the candidate group *jacks\_tasks* and John will have access to all of Jacks tasks immediately with this **single configuration step**. ``` User john = identityService.newUser("John"); identityService.saveUser(john); identityService.createMembership(john, jacksGroup); ``` You don’t need to iterate over dozens of tasks and update the assignee! Add more users to the group if John needs backup. Jack (member of the group) still can access his tasks. Nice and shiney. Further thoughts: 1. Yes I know, it is not very likely that Jack just leaves the office without notice. But think about a scenario where he calls in sick… But still, what about a foreseeable absence coming up? For that purpose we built a self-service for Jack and his collegues to configure substitution for a certain timespan. A util process takes care of the rest: ![scheduler](https://thecattlecrew.net/wp-content/uploads/2018/04/scheduler.png) 2. To prevent the camunda workflow engine from containing tons of generated users without any task (and hence purpose), you could clean up users and candidate groups in intervals/at process end. Take a look at this: ``` //get all users in jacks_tasks List userList = identityService.createUserQuery().memberOfGroup("jacks_tasks").list(); for (User user : userList) { List list = taskService.createTaskQuery().taskCandidateUser(user.getId()).list(); //delete user if he has not tasks atm if(list.size() == 0){ identityService.deleteUser(user.getId()); } } List list = taskService.createTaskQuery().taskCandidateGroup("jacks_tasks").list(); //delete group if it has no tasks atm if(list.size() == 0){ identityService.deleteGroup(groupId); } ``` # check out and run the code Please find the code on [blog.frena.de](https://blog.frena.de/holiday-replacement-camunda-candidate-groups/) ![process](https://thecattlecrew.net/wp-content/uploads/2018/04/process.png) Let me know if I can help you to understand this better. This was just a rough nutshell. **Kategorien:** Integration --- ### [SOAP and Attachments](https://thecattlecrew.net/2018/05/09/soap-and-attachments/) **Published:** Mai 9, 2018 **Author:** Apostolos Varsamis **Content:** # Introduction Service-clients and service-providers are often facing the need for transmitting both binary content and text data in a reliable and efficient way. This document presents implementation outlines for this scenario. The service-provider has been implemented using the Oracle Service Bus (version 11.1.1.7) while the service-client has been realized using SOAPUI. ## W3C Notes and Recommendations. This document follows the documents [SOAP Messages with Attachments: W3C **Note** 11 December 2000](https://www.w3.org/TR/SOAP-attachments) and the [SOAP Message Transmission Optimization Mechanism: W3C **Recommendation** – 25 January 2005](https://www.w3.org/TR/soap12-mtom/) that describe standards on SOAP Message Transmission. # SOAP-with-Attachments (SwA) The „SOAP Messages with Attachments: W3C Note 11 December 2000“ states: *„This document defines a binding for a SOAP 1.1 message to be carried within a MIME multipart/related message in such a way that the processing rules for the SOAP 1.1 message are preserved. The MIME multipart mechanism for encapsulation of compound documents can be used to bundle entities related to the SOAP 1.1 message such as attachments. Rules for the usage of URI references to refer to entities bundled within the MIME package are specified.“* ![swa](https://thecattlecrew.net/wp-content/uploads/2018/05/swa.png)## Implementation ### Service Provider We define the xml schema as follows: ``` ``` We use a file adapter for saving the attachment. Since the file adapter needs a base64-encoded-string we have to use a Java Callout to encode the byte array from: ``` $attachments/ctx:attachment/ctx:body/ctx:binary-content ``` The result string will be passed straight forward to the file adapter. ### Service Client For the Service-Client we use a default request from SOAPUI. Example: **Request** ``` MASTERING_BLOCKCHAIN.pdf /home/oracle/Downloads/ some text ``` **Response:** ``` MASTERING_BLOCKCHAIN.pdf ok some text. Message contains 1 attachment ``` ## Load Tests The detailed results: Various files (pdf, zip, docx, etc.) have been transmitted, with a total of 137 MB. The mean total time was 23 sec., which means an average throughput of 5,9MB/sec. Attachments over 70 MB were rejected by an Out-Of-Memory Exception. ![swa_kpi](https://thecattlecrew.net/wp-content/uploads/2018/05/swa_kpi.png) # SOAP Message Transmission Optimization Mechanism (MTOM) MTOM optimizes element content that is in the canonical lexical representation of the xsd:base64Binary data type. ## Implementation ### Service Provider We define the xml schema as follows: ``` ``` We use a file adapter for saving the attachment. Since the file adapter needs a base64-encoded-string we have to use a Java Callout to encode the byte array from `$body/mtom:payload/mtom:document/ctx:binary-content` The result will be passed straight forward to the file adapter. ### Service Client In SOAPUI we create a Request and we enable the MTOM parameter ![mtom-enable](https://thecattlecrew.net/wp-content/uploads/2018/05/mtom-enable.png) Example: **Request** ``` MASTERING_BLOCKCHAIN.pdf /home/oracle/Downloads/ some Text cid:9781787125445-MASTERING_BLOCKCHAIN.pdf ``` **Response:** ``` MASTERING_BLOCKCHAIN.pdf ok some Text ``` ### Load-Tests The detailed results: Various files (pdf, zip, docx, etc.) have been transmitted, with a total of 137 MB. The mean total time was 15 sec., which means an **average throughput of 9.1 MB/sec.** Attachments over 70 MB were rejected by an out-of-Memory Exception. ![mtom_kpi](https://thecattlecrew.net/wp-content/uploads/2018/05/mtom_kpi.png) # Simple base64 Java Encoder The following code for the java base64-encoder can be used by the Java Callout ``` package de.svi.att.tools; import weblogic.utils.encoders.BASE64Encoder; public class SVIBase64Encoder{ public static String encode(byte[] bytes){ BASE64Encoder encoder = new BASE64Encoder(); String encodedString = encoder.encodeBuffer(bytes); return encodedString; } } ``` # Conclusion We have implemented a client using SOAPUI and a service provider using OSB and a VM with the oracle SOA Suite Appliance 11.1.1.7 in order to compare the methods SwA and MTOM. The MTOM mechanism has a performance advantage of 15%-30% compared to the SwA method. None of the load tests led to a drop of server-performance due to garbage collection actions. No Problems when dealing with special characters have been observed. **Kategorien:** Integration **Schlagwörter:** Attachements, SOAP --- ### [Opitz Consulting became Camunda certified System Integrator](https://thecattlecrew.net/2018/05/11/opitz-consulting-became-camunda-certified-system-integrator/) **Published:** Mai 11, 2018 **Author:** Tobias Unger **Content:** It is over half a year ago that Opitz Consulting became a Camunda certified System Integrator. A lot of time passed since then. In this post, I will share some experiences around the certification as well as the topics of process modeling and architectural decisions. ## Camunda Partner Program The Camunda partner program for system integrators provides three partnership levels: Basic, Certified, and Advanced. Opitz Consulting graduated from level basic to level certified \[1\]. One might ask for the advantage for our customers and ourselves. I think the subtitle of the certified level on the Camunda website provides the best description: Proven Camunda skills. That“™s also why Opitz is a Camunda Certified partner. The knowledge allows us to provide a high quality service to our customers. ![camunda-certified-partner-logo](https://thecattlecrew.net/wp-content/uploads/2018/04/camunda-certified-partner-logo.png) „Proven“ means that the partner has at least three certified consultants, developers, or engineers that passed the exam. I also took the exam and have to say that this exam was not the easiest I ever passed. The exam covers the whole Camunda ecosystem. The most important area is of course the BPM platform. Another important area comprises questions about BPMN, CMMN, and DMN. Finally, some questions cover the BPM Life cycle from modeling to monitoring. In other words, it touches every relevant field of a Camunda project. As a candidate, one is forced to deal with the whole range of Camunda“™s features, even if they“™re not part of your daily project work. This ensures a consistent quality level, if working with any Camunda Certified Engineer. ## Lessons Learned From time to time, I am asked how we support customers to introduce and operate BPM and Camunda. Of course, there is no clear answer to that as we adapt our approach to the client and the project. Nevertheless, there are also subject areas that are at least touched in each project and these will be discussed below. Based on our long-lasting project experience we can guide our customers through all project phases of a BPM project. Even though we are doing a lot of implementation work, there are also other important fields of work, in which we support our customers. Two of them are especially important when starting a BPM project: architectural decisions and process modeling. ### Architectural Decisions The beauty of Camunda is that it can be used in many architectural setups. It’s possible to integrate the Camunda engine with a lot of architecture styles. We see applications based upon a microservice architecture as well as applications based upon a monolithic architecture. I don“™t want to judge on architecture styles in this post but we see sustainable, evolvable architectures basing upon different styles. Even if they are modern, microservices are not the holy grail of architecture. I would propose to decide based on context, constraints, and requirements which style to use. This flexibility, however, requires careful architecture work. One of the most important decision to be taken is the integration of the engine with the application. For example, one can use a Shared Engine that can be used by a bunch of applications in parallel or one can use an embedded engine configuration that provides the engine for the application exclusively. In my view it“™s important to make such decisions explicitly. That helps one to estimate the risks and consequences of the decision. For example, a consequence of using embedded engines for an application is that one doesn“™t have a unified task list containing all the tasks from the different applications out of the box. In this case, one has to come up with a custom integration solution that provides the unified task list. In such cases we can provide our customers with a rich set of architecture decision which must be taken. That allows to speed up architecture work and ensures a certain level of quality. Based on our experience we created a catalog with generic architecture decisions that came up in a lot of projects. From the catalog we have derived a questionnaire that can be used at a new project. The questionnaire helps to speed up the initial project phase and also improves the quality of the decisions. It is highly recommended to document decisions. This helps to track the decisions over the entire course of a project. At the moment we experiment with Architecture Decision Records (ADR) to further formalize the documentation \[2\]. Furthermore, we pursue current efforts to place the decisions directly in the source code: The Embedded Architectural Decision Records (E-ADR) \[3\]. ### Process Modelling As soon as I come to a customer, I ask about the processes that we should automate. In most cases if the processes don“™t match the level of quality, we need to run the process with Camunda. Most process models I see at customers only reflect the happy path, i.e., they lack in showing alternative paths or error handling. Furthermore, we ask the customers about metrics and SLA, because these are also important topics for process modeling. Hence, we help our customers in a first step to model better processes, by providing guidelines, conventions, patterns, and examples to improve process modeling. My advice is not to underestimate the effort to model business processes, as high quality process models, in my experience, lead to a significantly more reliable execution and more meaningful monitoring. In most companies, process knowledge is spread over the whole organization. In order to gather the knowledge we help the customer by doing interviews or organizing workshops. The difficulty lies less in the organization than in the different perspectives that different stakeholders have on the process. These different views must be combined to one executable view that covers the engines perspective. Data flow is also an underestimated dimension of process modeling. We observe that the data flow is at least as complex as the control flow. Furthermore, a lot of complex transformations are necessary, while integrating existing services within a process. Therefore, the data flow should already be considered during the modeling. Otherwise, there is a risk that too many almost identical transformations will occur during the implementation. We also give our customer the advice not to observe a business process as static. The assumption that a process is modeled once and remains valid for ever simply doesn“™t hold. In contrast, the process will evolve. In my current project, we deploy up to three process versions a year. This must also be reflected in the (project) organization. I quite often recognize the pattern where processes are modeled from a business perspective upfront and the people who modeled the processes aren“™t available later during the refinement phases. Besides organizational impact, changes of process models also have a technical implication. Long running process instances must be migrated to the new model possibly. Therefore, migration of process instances is an area in which we support our customers. Finally, we help our customers to implement their own modeling method and convention. A list of basic methods is listed in \[4\]. ## Conclusion Process management is a broad and exciting field of work. Getting started may be a bit complex, but this is exactly where we come in: making process management easy for our customers. I hope by reading this blog post you got an impression what problems we are solving together with our customer and what advantages you have in working with a certified partner: proven knowledge. ## References 1. [https://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Artikel/pm-camunda-bpm-certified-partner.pdf](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/pm-camunda-bpm-certified-partner.pdf) 2. [https://github.com/joelparkerhenderson/architecture\_decision\_record](https://github.com/joelparkerhenderson/architecture_decision_record) 3. 4. **Kategorien:** Integration **Schlagwörter:** BPM, BPMN, Camunda --- ### [Deleting corrupt project in OSB Service Bus Console 12C](https://thecattlecrew.net/2019/02/08/deleting-corrupt-project-in-osb-service-bus-console-12c/) **Published:** Februar 8, 2019 **Author:** binyaoopitz **Content:** **Problem**: Normally we can deploy, update or delete OSB projects directly in OSB Service Bus Console (SBconsole). But last month I faced an issue with updating a corrupted OSB project in SBconsole. As I tried to update this OSB project, I got the error message `java.lang.NoClassDefFoundError: com/bea/wli/sb/transports/file/FileRequestHeaders at weblogic.utils.StackTraceDisabled.unknownMethod()` Removing the project didn“™t work either with same error message. So, I was basically stuck with a corrupt OSB project and couldn“™t delete and redeploy the new version of this project. **Solution**: After investigating for a while, I finally figured it out that I had to delete the project manually through the server. In the following I“™ll depict the steps that were needed to fix my issue: **Infrastructure topology: One Admin Server and a OSB Cluster with two nodes** I did the following steps to resolve this problem: 1. Only stop the Admin Server. **Very important: you don“™t need to stop managed OSB servers!!!** 2. Find the corresponding project of your service in „/osb/configfwk/core/ „. In the „/osb/config/core“ directory, every OSB project is stored inside one folder with the same name as the deployed project. For this environment there are 3 locations to store the corrupt OSB project. Principally the Servicebus (SB) console refers only to the project in Admin Server and shows it on the SB consle. At runtime the same projects in the 2 Managed Servers are used to run the instance. **Attention: For safety you need to remove the corrupt project from all 3 servers with the same location in each server** 3. Additionally, there are also other folders In the „/osb/config/core“ directory like 1. \_binary 2. default 3. \_index 4. \_static 5. System inside the core folder. For example, in the binary directory stored some binary files associated with some OSB projects, such as referenced jar files (could imagine that should be called from java callouts in OSB). Leave those folders unchanged! 4. Clear cache and tmp folder in „/servers/AdminServer“ directory for the Admin Server 5. Start the Admin Server, if you check the SB consle now, the corrupt OSB project has been removed 6. You can redeploy the same project again via SB consle 7. Test your project in SB console These steps helped me to remove the corrupt OSB project, after redeployment I didn“™t observe any problems with any OSB projects. **Kategorien:** Integration **Schlagwörter:** AdminServer, Oracle FMW, OSB --- ### [Frohe Ostern / Happy Easter](https://thecattlecrew.net/2012/04/08/frohe-ostern-happy-easter/) **Published:** April 8, 2012 **Author:** **Content:** Wir wünschen allen unseren Lesern frohe Ostern und ein paar erholsame Ostertage! We’d like to wish happy easter and some joyful easter holidays to all our readers! **Kategorien:** Tech Events & Networking **Schlagwörter:** News --- ### [The Cattle Crew - Betriebsausflug](https://thecattlecrew.net/2012/03/02/the-cattle-crew-betriebsausflug/) **Published:** März 2, 2012 **Author:** thecattlecrew **Content:** [![](https://thecattlecrew.net/wp-content/uploads/2012/03/image001.png "image001")](https://thecattlecrew.net/wp-content/uploads/2012/03/image001.png) **Kategorien:** Tech Events & Networking **Schlagwörter:** News --- ### [Wiederverwendung von Daten und Services in Oracle SOA / BPM Suite](https://thecattlecrew.net/2012/10/21/wiederverwendung-von-daten-und-services-in-oracle-soa-bpm-suite/) **Published:** Oktober 21, 2012 **Author:** Danilo Schmiedel **Content:** Ein wichtiger Aspekt in einer Serviceorientierten Architektur ist die Veröffentlichung von Metadaten potenziell wiederverwendbarer SOA-Artefakte. Mit den Metadata Services (MDS) bietet die Oracle SOA/BPM Suite eine solche Komponente an, um die zentrale Verwaltung und Bereitstellung von Schnittstellen (WSDL), Daten (XSD), Geschäftsregeln (Rules), FaultPolicies (XML) und Geschäftsereignissen (EDL) zu ermöglichen (siehe nachfolgende Abbildung). Somit können Daten und Dokumente zur Design- und Laufzeit applikationsübergreifend angeboten werden und die Duplizierung von Code wird reduziert. [![](https://thecattlecrew.net/wp-content/uploads/2012/10/share_data_with_mds.jpg?w=300 "Wiederverwendung von Daten und Services mittels MDS")](https://thecattlecrew.net/wp-content/uploads/2012/10/share_data_with_mds.jpg) Ohne eine solche Komponente müssten derartige Artefakte entweder für verschiedene Projekte dupliziert abgelegt oder direkt auf dem Applikationsserver referenziert werden. Diese beiden Ansätze bringen jedoch Nachteile mit sich. Während die lokale Mehrfachspeicherung von Schnittstellen (WSDL) und Datenbeschreibungen (XSD) in unterschiedlichen Projekten zu Inkonsistenzen führen kann, ist die direkte Referenzierung auf einen Applikationsserver an dessen Erreichbarkeit gebunden. Ist dieser etwa aus Wartungsgründen vorübergehend nicht verfügbar, so würde die Entwicklung in dem Moment ebenfalls gestört werden. Die Verwendung des MDS führte in unseren SOA-Projekten zu folgenden Erkenntnissen und Best Practices: - Die Versionierung von Services und Daten ist für den Betrieb einer SOA unumgänglich und muss bereits im Rahmen des Service-Designs berücksichtigt werden (Service Lifecycle Management). Dies gilt insbesondere für Schnittstellen und Datenobjekte, die in verschiedenen Projekten wiederverwendet werden sollen. Andernfalls bedeuten Ü„nderungen an diesen Komponenten einen erhöhten Entwicklungsaufwand und wenig Potenzial für Wiederverwendung. - Das MDS unterstützt die Software-Entwicklung nach dem „Contract-first Prinzip“. Nach dem Design der Schnittstelle durch den Service-Architekten, wird diese in das MDS geladen und steht dem Service-Entwickler zur Implementierung bereit. - Als Best Practice hat sich zur Entwicklungszeit die Verwendung eines lokalen MDS-Repositories bewährt. Dieses wird bereits mit der Standard-Installation des Oracle JDevelopers bereitgestellt. Auf performante Art und Weise kann somit die zukünftige Speicherung von verteilten Artefakten in einem zentralen Repository von Beginn an berücksichtigt werden. Besonders vorteilhaft ist dabei auch, dass jeder Entwickler eine eigene Lokation für seine Metadaten besitzt und nicht jeder Entwicklungsschritt sofort deployed werden muss. - Zur Laufzeit stellt die Oracle SOA Suite ein zentrales MDS-Repository auf dem Server bereit, in welches die verteilten Schnittstellen, Daten, Event-Definitionen und Fault-Policies im Rahmen des Applikations-Deployments bereitgestellt werden. - Unabhängig ob das lokale oder das Server-MDS verwendet werden soll, so erfolgt die Referenzierung der Inhalte aus einem SCA Composite mit Hilfe einer einheitlichen URL: oramds:/apps//.wsdl. Somit ist beim Wechsel zwischen lokalem und zentralem MDS keine gesonderte Code-Anpassung erforderlich. - Die Bereitstellung zentraler Schnittstellen bringt den Vorteil mit sich, dass beispielsweise beim Neustart des Applikationsservers alle SOA-Applikationen völlig unabhängig voneinander gestartet werden können und somit nicht an eine spezielle Reihenfolge gebunden sind, da alle Schnittstellenbeschreibungen von Beginn an verfügbar sind. - Die Administration des MDS Repositories zum Export, Import oder Löschen der Metadaten kann über den Enterprise Manager, ANT oder das Weblogic Scripting Tool (WLST) erfolgen. **Kategorien:** Integration **Schlagwörter:** BPM, oracle, Oracle DB, Weblogic --- ### [Access multiple SOA / BPM Virtual Machines from different computers in your network](https://thecattlecrew.net/2013/01/06/access-multiple-soa-bpm-virtual-machines-from-different-computers-in-your-network/) **Published:** Januar 6, 2013 **Author:** Danilo Schmiedel **Content:** In this article I“™d like to explain how to share multiple instances of [Oracle’s Pre-built Virtual Machine for SOA Suite and BPM Suite](http://www.oracle.com/technetwork/middleware/soasuite/learnmore/vmsoa-172279.html) across different computers in your network. Three requirements we had to address: 1. Call of external services like GeoNames (http://www.geonames.org/postal-codes/) from within the BPM Suite VM 2. Connection to multiple BPM Suite VMs from Host (e.g. JDeveloper and Browser) 3. Connection to multiple BPM Suite VMs from different developer computers in the network 4. Share data between VMs and developer computers via FTP The default options already support connections between host and client. However the target here was to address multiple independent VMs from different computers in the same network. I described the approach in my article on [Inside BPM and SOA.](http://inside-bpm-and-soa.blogspot.de/2013/01/connect-to-multiple-soa-bpm-virtual.html) Have fun! **Kategorien:** Integration **Schlagwörter:** BPM, oracle, Oracle DB, Virtual Box --- ### [Improve performance and maintenance of heavily used SOA composites](https://thecattlecrew.net/2013/03/10/improve-performance-and-maintenance-of-heavily-used-soa-composites/) **Published:** März 10, 2013 **Author:** Attila Nemeth **Content:** As stated in a previous [post](https://thecattlecrew.net/2012/03/12/dehydrierungsverhalten-von-prozessinstanzen-in-oracle-soa-suite "post"), heavily used transient BPEL processes should be configured with some well-defined parameters in order to avoid storing too much data in the database, thus optimizing performance. However, even if BPEL processes inside the composite are configured this way, data of other components like mediators and the composite itself are all stored in the database. How much information is stored can be influenced by the audit level setting. As of documentation, the audit levels are defined as follows: - **Off**: No composite instance tracking and payload tracking information is collected. No more composite instances can be created. No logging is performed. Note that disabling logging and the display of instances in Oracle Enterprise Manager Fusion Middleware Control Console can result in a slight performance increase for processing instances. Instances are created, but are not displayed. - **Development**: Enables both composite instance tracking and payload detail tracking. However, this setting may impact performance. This level is useful largely for testing and debugging purposes. - **Production**: Composite instance tracking is collected, but the Oracle Mediator service engine does not collect payload details and the BPEL process service engine does not collect payload details for assign activities (payload details for other BPEL activities are collected). This level is optimal for most normal production operations. Generally, the SOA Infrastructure audit level is set to **Production** or **Development** „“ depending on the environment „“ and the composites are set to inherit this audit level. In case of an intensively used composite this means that a lot of data is persisted in the database. The audit level, however, can be overridden for every composite. Since the data from the transient, short-lived composites is not needed, the setting **Off** for the relevant composite should be an interesting option to consider. Three questions must be answered: 1. How much information is persisted from the composite instance? 2. How much information is persisted from the component instances inside the composite? 3. What happens in case of an error? Our tests have shown that although the instances successfully complete, no information is stored in the database at all. Neither for the composite instance, nor for any business rule, BPEL or mediator instances inside it. In case of an unhandled error, however, the erroneous component instance is persisted in the database with the details of the error. The composite instance is not saved. This means that the error is seen in the error handling console, it can even be handled if a fault policy is configured, but no information about the corresponding composite instance can be obtained. The composite instance id is set to **Unavailable**. [![faults](https://thecattlecrew.net/wp-content/uploads/2013/03/faults.png?w=595)](https://thecattlecrew.net/wp-content/uploads/2013/03/faults.png) We have seen that setting the composite level to **Off** in case of transient composites causes less data to be stored in the database, thereby increasing performance. The more instances of the composites created per day, the higher the benefit of this approach. We have also seen, however, that the composites should be well tested before setting this option because it can be quite cumbersome to track the origin of the error. This setting is therefore ideal for a production environment with heavy load, but suboptimal for a development environment with only a handful of instances but the need for extensive testing. This calls for a different setting in each environment. The audit level setting of a composite can be modified via Enterprise Manager but it can also be defined during deployment, the latter one being more efficient in this case. In order to do so, the following property needs to be added to the composite.xml: `Off` The setting here will be treated as the default setting but like many other properties, this setting can be overridden with a deployment plan containing the following: `` Development "¦ By using deployment plans, the problem of needing different audit level settings in different environments can be easily solved: the audit level of an intensively used transient composite can be set to **Off** in a production environment whereas the **Development** setting can be used in a development environment. **Kategorien:** Integration --- ### [Purging of failed SOA components](https://thecattlecrew.net/2013/04/02/purging-of-failed-soa-components/) **Published:** April 2, 2013 **Author:** Attila Nemeth **Content:** In the previous [post](https://thecattlecrew.net/2013/03/10/improve-performance-and-maintenance-of-heavily-used-soa-composites/) the preferred settings of heavily used SOA composites was demonstrated. It was shown that with the correct settings applied only failed component instances are persisted in the database. This post discusses the purging possibilities of such component instances. As stated in the earlier post, we are now facing a situation where the composite instance itself is not persisted, only its failed component instances. Since the composite is heavily used, even a short outage of a system used by the composite can lead to a huge amount of failures. Having resolved these faults, the need often arises to clear these faults from the system so that fault monitoring is not disturbed by them. Instances without faults are not persisted in this case because no information from the composite is needed, so a straightforward approach would be to delete the failed instances with Enterprise Manager. In this case, however, this is not possible because the composite instance itself is not persisted and instance purging in Enterprise Manager is based on the composite instance. Another possibility is to use the database purging scripts supplied by Oracle. These scripts are automatically present in the SOAINFRA schema once the schema is created with the RCU utility. If purging is done with the help of these scripts, the failed orphaned component instances are deleted with the purging run. However, purging generally has fixed time slots and it might be difficult to bring that slot forward if the failed component instances are to be deleted sooner. The functions used by the purging scripts, however, are also available on their own. A sample script to delete the failed orphaned components could therefore be constructed by using the functions present in the SOAINFRA schema. The same functions can also be found in the scripts which are automatically supplied with every SOA Suite and JDeveloper installation and can be found in the subdirectory *rcu/integration/soainfra/oracle/soa\_purge* under the installation directory. `DECLARE` min\_creation\_date TIMESTAMP; max\_creation\_date TIMESTAMP; batch\_size INTEGER; retention\_period TIMESTAMP; composite\_dn VARCHAR2(125); soa\_partition\_name VARCHAR2(10); composite\_name VARCHAR2(100); composite\_revision VARCHAR2(10); mediator\_deleted BOOLEAN; decision\_deleted BOOLEAN; bpel\_deleted BOOLEAN; fabric\_deleted BOOLEAN; BEGIN min\_creation\_date := to\_timestamp(‚2013-01-01′,’YYYY-MM-DD‘); max\_creation\_date := to\_timestamp(‚2013-03-31′,’YYYY-MM-DD‘); batch\_size := 20000; retention\_period := max\_creation\_date; soa\_partition\_name := ‚PARTITION‘; composite\_name := ‚TestProcess‘; composite\_revision := ‚1.0‘; IF soa\_partition\_name IS NOT NULL THEN composite\_dn := soa\_partition\_name; IF composite\_name IS NOT NULL THEN composite\_dn := composite\_dn || ‚/‘ || composite\_name; IF composite\_revision IS NOT NULL THEN composite\_dn := composite\_dn || ‚!‘ || composite\_revision; END IF; END IF; END IF; bpel\_deleted := soa\_orabpel.deleteNoCompositeIdInstances( p\_min\_creation\_date => min\_creation\_date, p\_max\_creation\_date => max\_creation\_date, p\_older\_than => retention\_period, p\_rownum => batch\_size, soa\_partition\_name => soa\_partition\_name, composite\_name => composite\_name, composite\_revision => composite\_revision); mediator\_deleted := soa\_mediator.deleteNoCompositeIdInstances( p\_min\_creation\_date => min\_creation\_date, p\_max\_creation\_date => max\_creation\_date, p\_older\_than => retention\_period, p\_rownum => batch\_size, composite\_dn => composite\_dn); decision\_deleted := soa\_decision.deleteNoCompositeIdInstances( p\_min\_creation\_date => min\_creation\_date, p\_max\_creation\_date => max\_creation\_date, p\_older\_than => retention\_period, p\_rownum => batch\_size, composite\_dn => composite\_dn); fabric\_deleted := soa\_fabric.deleteNoCompositeIdInstances( min\_created\_date => min\_creation\_date, max\_created\_date => max\_creation\_date, retention\_period => retention\_period, batch\_size => batch\_size, composite\_dn => composite\_dn); IF (bpel\_deleted OR mediator\_deleted OR decision\_deleted OR fabric\_deleted) THEN dbms\_output.put\_line(‚Further instances may be present in the system, please rerun the script to delete these‘); ELSE dbms\_output.put\_line(‚All orphaned instances deleted‘); END IF; END; / This script can be executed in the SOAINFRA schema on demand „“ even without starting the purging run „“ thereby assuring fault monitoring efficiency. Keep in mind that while the script is running in the database, performance of the application might be slightly lower because of increased database load. Therefore it is advisable to limit the run time of the script by narrowing the number of processed component instances „“ either by selecting the composite itself or if that is not possible selecting an appropriate batch size, thereby limiting the number of deleted component instances in one run. **Kategorien:** Integration --- ### [Options for removing data in MDS Repository](https://thecattlecrew.net/2013/08/21/options-for-removing-data-in-mds-repository/) **Published:** August 21, 2013 **Author:** Danilo Schmiedel **Content:** The two main database schemas in the Oracle SOA Suite database repository are: \_SOAINFRA and \_MDS. Composite instance and runtime information are stored in the SOAINFRA schema. Commonly used metadata like WSDLs, XSDs, rules, fault policies, etc. as well as composite deployments are stored within the MDS schema. With every deployment / import of the metadata artifacts a new document version will be created in the MDS. This means that re-importing an updated WSDL-file into the MDS does not delete the previous version of the document. Furthermore we sometimes need to remove unnecessary and unwanted files from the repository. If this is not considered you might end in problems like below: ` ` `ORA-01654: unable to extend index DEV_MDS.MDS_PATHS_U2 by 128 in tablespace DEV_MDS ORA-06512: at "DEV_MDS.MDS_INTERNAL_COMMON", line 865 ORA-06512: at "DEV_MDS.MDS_INTERNAL_COMMON", line 1021 ORA-06512: at "DEV_MDS.MDS_INTERNAL_COMMON", line 1121 ORA-06512: at "DEV_MDS.MDS_INTERNAL_COMMON", line 1216 ORA-06512: at "DEV_MDS.MDS_INTERNAL_COMMON", line 1872 ORA-06512: at line 1 ` In order to avoid production problems because of a full MDS tablespace you should clean up the schema from time to time. My post „[Remove data in Oracle MDS](http://inside-bpm-and-soa.blogspot.de/2013/08/remove-data-in-oracle-mds.html)“ explains the following options to remove contents from MDS: - Remove directories and files from MDS using WLST - Remove directories and files from MDS using ANT - Remove files from MDS using WLST - Remove files from MDS using MBean Browser - Purge Metadata Version History using Fusion Middleware Control **Kategorien:** Integration **Schlagwörter:** BPM, MDS, oracle, Oracle DB --- ### [Monitoring large flow traces with Oracle SOA Suite (Part 1)](https://thecattlecrew.net/2013/11/12/monitoring-large-flow-traces-with-oracle-soa-suite/) **Published:** November 12, 2013 **Author:** **Content:** End-to-end monitoring of BPEL process instances across composite borders is a great feature of Oracle SOA/BPM Suite 11g. It is shown in nearly every PreSales presentation and when you were used to know SOA Suite 10g or to work with other kinds of distributed, heterogenous systems it is a real improvement. But when you implement large process chains you might realize that the newly won process transparency can raise new challenges. Imagine you have a root process which creates several instances of sub-processes. In such a case without doing any extra work you will get one flow trace for the process and all of its sub-process instances. For large process chains you need to consider the following facts: – **Transparency:** Although it shows an end-to-end view of the whole execution tree, trying to find a faulted sub-process might be a real challenge. It doesn“™t matter if you start the search from the root process instance or from one of the sub-processes „“ the flow trace always displays all components of the execution context. When you click on a sub-process and you go back to the flow trace you might have to expand all child nodes again and again. – **DataSetTooLargeException:** When your flow trace becomes longer and longer, you will observe, that there is a maximum size for the audit trail that can be displayed by Enterprise Manager. Usually it results in a java.lang.RuntimeException: oracle.soa.management.facade.DataSetTooLargeException: Requested audit trail size is larger than threshold „¦ chars For large execution trees, sub-process instances might not be displayed or you might not be able to see things in detail. – **Low Memory:** It is not only the visible representation of your instance, which struggles. A huge audit trail implicitly means that your needed memory allocation for executing your process instance grows. It can grow to this extent that your process instance crashes because of running low in memory. – **Purging:** With large flow traces you should always have an eye on the capacity of your soa-infra database. Why is it so? Usually you should have purging routines installed to keep your system healthy – regular deletion of „old“ instances from the dehydration store. To say it in a nutshell, the purging routines eliminate „completed“ instances. If one of your sub-process instances goes into a faulted state, all processes in the same execution context are ignored from being purged (except when you define the ignore\_state attribute to true). This means, although 99 percent of your instances have been executed correctly and could be purged the whole instance data, which can be huge as we stated earlier, are kept in your dehydration store. So, how to deal with all these challenges? There are two relatively small changes which we describe in the following two posts: 1\) Splitting large flow traces by setting a new execution context 2\) Using the CompositeInstanceTitle-Property and composite sensors to simplify instance identification via the Enterprise Manager **Kategorien:** Integration **Schlagwörter:** BPM --- ### [BPM / SOA 12c: Re-configure a compact domain to use a DB-based MDS instead of a File-based MDS](https://thecattlecrew.net/2014/11/06/bpm-12c-file-based-mds-to-db-based-mds-in-compact-domain/) **Published:** November 6, 2014 **Author:** thecattlecrew **Content:** *Posted by: Sven Bernhardt, Danilo Schmiedel* The Oracle SOA Suite and Oracle Business Process Management Suite offers different domain configuration types applicable for different use cases. For details check out the two guides: [Installing SOA Suite and Business Process Management Suite Quick Start for Developers](http://docs.oracle.com/middleware/1213/core/SOAQS/usecases.htm#CHDGGGHB) as well as [Installing and Configuring Oracle SOA Suite and Business Process Management](http://docs.oracle.com/middleware/1213/core/INSOA/configure_soa.htm#CDECHBDE). Default DomainStandalone DomainCompact DomainFull DomainDescriptionIntegrated WebLogic Server from JDeveloperStandalone Admin Server with SOA/BPMStandalone Admin Server with SOA/BPMFull installation with separate servers for SOA, OSB, BAM, Admin Server, etc.Installed viaQuick Start distributionQuick Start distributionQuick Start distributionFMW 12c Infrastructure + FMW 12c SOA Suite and Business Process ManagementUsed forLocal development and debugging, especially for demos or evaluation purposesLocal development and debugging, especially for developers who want to use the Oracle Service Bus Design Time Console instead of JDeveloperLocal development with SOA components that are incompatible with JavaDB (ESS, MFT, B2B, Heathcare, BAM, ACM API)All stages Development (shared), Integration, Test, ProductionRepositoryPre-configured Java DBPre-configured Java DBOracle Database (please note that MDS and OWSM are file-based)Oracle Database For all of the domain options which are installed via quickstart distributions, SOA and B2B use the MDS file system. This means that the edit function in SOA Composer is not supported and so Business Rules and Domain Value Maps cannot be changed during runtime & without a new deployment . For the development in our projects we very often use the compact domain. The change of business rules without re-deployment is quite important for us because we work a lot with Adaptive Case Management – and there Business Rules and live changes without re-deployment are a key benefit (which we also like to show in demos / POCs / etc.). This post concentrates on the compact domain and its re-configuration of the underlying MDS setup, so that a DB-based repository is used instead of a File-based one. After going through the steps below it should be possible to edit rules and DVMs during runtime. **Please note:** The following steps should only be applied to a fresh & clean compact domain without any composite deployments and instance data. The following approach is not documented in the Oracle documentation, which means that it is not officially supported. ## **Approach** - Check if your SOA database already contains a MDS schema. If not, use RCU to create schemas in the new repository, as described in [Administering Oracle Fusion Middleware.](http://docs.oracle.com/middleware/1213/core/ASADM/repos.htm#CIHCAHEJ) - Start WLST (\\soa\\common\\bin) and connect via WLSTconnect ``` 'weblogic','welcome1','t3://localhost:7001' ``` - Export current content of SOA-MDS (file-based MDS) ``` exportMetadata(application='soa-infra', server='AdminServer', toLocation='[YOUR-EXPORT-DIR]', docs='/**') ``` - Shutdown soa-infra via WLS Console - Deregister the file-based MDS - Open EM and right-click your domain under Weblogic Domain > Other Services > Metadata Repositories - Select mds-soa under „File-Based Repositories“ and click on **Deregister** - Please note: If you try to deregister from another page or context, you’ll receive the following error message: „*The selected repository mds-soa cannot be deregistered from within the context of itself. Select domain node from the navigation tree and deregister the repository from the Metadata Repositories page.*„ - Register a new DB-based Repository - Delete existing mds-soa datasource before from WLS Console > Data Sources - Open EM and right-click your domain under Weblogic Domain > Other Services > Metadata Repositories and select **Register** under „Database-Based Repositories“ - Enter the connection details appropriate to your MDS-schema [![Register_MDS-SOA_12c](https://thecattlecrew.net/wp-content/uploads/2014/11/register_mds-soa_12c.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/11/register_mds-soa_12c.jpg) - Create a new Repository Partition and name it **soa-infra** [![Create_partition_soa-infra_12c](https://thecattlecrew.net/wp-content/uploads/2014/11/create_partition_soa-infra_12c.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/11/create_partition_soa-infra_12c.jpg) - Use WLST to import exported metadata into the new MDS-Partition ``` importMetadata(application='soa-infra', server='AdminServer', fromLocation='[YOUR-EXPORT-DIR]', docs='/**') ``` - Restart the server ## **Post-Start checks** After the server restart, you should do the following checks, to ensure that the applied configuration has been applied correctly. - Check connection between soa-infra application and the new metadata repository (MDS-SOA, Right-click EM Domain Home -> Other Services -> Metadata Repositories > soa-infra > Applications) [](https://thecattlecrew.net/wp-content/uploads/2014/11/applications_using_soa-infra_partition_12c.jpg)[![Applications_using_soa-infra_partition_12c](https://thecattlecrew.net/wp-content/uploads/2014/11/applications_using_soa-infra_partition_12c.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/11/applications_using_soa-infra_partition_12c.jpg) - Open BPM Composer and check if any errors are displayed when using it - Check SOA Composer for having „Create Session“ Button [](https://thecattlecrew.net/wp-content/uploads/2014/11/soa_composer_12c.jpg)[![SOA_Composer_12c](https://thecattlecrew.net/wp-content/uploads/2014/11/soa_composer_12c.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/11/soa_composer_12c.jpg) If these tests are successful: Congratulations! Your domain is ready to use a DB-based MDS repository for soa-mds. **Kategorien:** Integration **Schlagwörter:** BPM, MDS, oracle, Oracle DB, Oracle FMW --- ### [Test-driven development using the Oracle SOA Suite](https://thecattlecrew.net/2015/01/06/test-driven-development-using-the-oracle-soa-suite/) **Published:** Januar 6, 2015 **Author:** Attila Nemeth **Content:** As in all software projects, quality assurance with thorough testing in integration projects is a key factor to success. Test-driven development focuses exactly on this aspect: unit and integration testing of integration elements must be done as soon as possible. The tests used in these phases must also be reproducible so that they can be run automatically in case of changes in the integration logic, thus guaranteeing that no unintended changes are made. Oracle SOA/BPM Suite is a powerful tool suite for integration. This article shows how test-driven development can be done with the Oracle tooling. Integration elements built with Oracle SOA/BPM Suite are SCA composites made up of several components. Since mainly the integration layer is concerned, there is quite often heavy usage of external web services, database adapters, etc. The composites also usually have an inbound interface the invocation of which is the starting point of the integration logic. As it can be seen from above, the key to testing SCA composites is to define an inbound message and assert the data found in various other messages during the integration logic. Some easy scenarios can instantly be identified. XSLT transformations within the composites can be unit-tested without the complete logic itself for example. Likewise, end2end testing is also easily done „“ at least for a web service interface „“ thus assuring at least that the result is what we expected. The problem is that for end2end testing, the correct functionality of back-end systems is a prerequisite. If the back-end functionality is developed parallel to the integration logic, end2end testing is far away from test-driven development. There is, however, a possibility offered by the tooling itself: the composite test framework. With the help of this framework incoming messages can be defined and for each wire (a connection between two components or „“ more importantly for our purpose „“ a connection between a component and an external service/adapter) assertions and emulates can be specified. That means if a service is not yet available, its responses can be emulated within Oracle SOA/BPM Suite. Furthermore, outbound service requests and responses for services already available can be checked for correctness with the help of assertions. Multiple test scenarios can be defined and deployed with the composite itself. After deployment, the defined test cases can be started and the test results examined. There are also Ant scripts available so that a nightly test of all integration elements can theoretically be integrated into an appropriate continuous integration run. More information on the composite test framework can be found [here ](http://docs.oracle.com/middleware/1213/soasuite/develop-soa/soa-composite-unit-testing.htm#SOASE1263 "here")for example. This framework is, however, not completely adequate for real test-driven development. As stated before, assertions and emulates are defined on the wires „“ meaning that the wires (which are defined as part of the integration logic development) are required first before tests can be created. In case of reorganization of the integration logic, wires are often dropped and recreated. Dropping a wire means that all assertions and emulates in all tests are dropped too. Complex XML structures can be externalized so that they are still available in this case but the assertions and emulates need to be defined again after the wire is recreated. Another difficulty are the static emulates and assertions required by the tooling. In case of loops for example where a component calls an external service multiple times, defining an emulation of the service means that the services always return the same response which is not always satisfactory. Although the composite test framework itself is not extensible, a lot of functionality is available through the help of the public APIs. With the help of these APIs and some Java knowledge an own test framework not having these limitations can be constructed. The goal is to have a single framework supporting all test aspects of the integration layer. Unit testing of XSLT artifacts can be easily integrated into this Java framework. Following functionality is an excerpt of what is possible by using the SOA Suite APIs: - Rerouting external references to a mock service implemented in the same framework (in Java) including changing references to standard web services so that database or file adapters can also be mocked for example - Human task handling (finishing the human task with a predefined outcome and predefined values) - BPMN queries (traversal of BPMN nodes, checking of payload at given nodes) The APIs are offering a lot more, so that the custom framework can easily support multiple test aspects required by the projects. Additionally, by extending the framework with the usage of the OSB APIs, integration elements implemented with OSB can also be tested in the same way. We are using the possibility of a custom test framework in almost all of our integration projects. To see the custom framework in action, take a look at our [session](https://www.youtube.com/watch?v=LGgb4pVAdHY "session") held at the JAX conference (in German language). Test creation can be truly done parallel to the integration logic development with the help of this custom framework. Only some SCA data (composite name and revision) and component data (service reference name for mocking, human task component name for human task mocking) is required to bind the assertion or emulation (mock services) defined in Java code to the correct location in the composite. Since everything is implemented in Java, dynamic mocks are not a problem at all. The possibilities that can be found in JUnit can also be easily applied to the test cases. A reorganization of the integration logic is not a problem because the test cases only reference logical names „“ these do not change often and even in case of a change during the refactoring, the tests can be easily modified to use the correct logical names. Since we are using standard JUnit tests, an integration into a continuous integration environment is also common practice. We have seen that although the built-in testing possibilities of the SOA/BPM Suite are not completely adequate for a truly test-driven approach, the rich APIs provided by the tool suite makes the creation of a custom test framework possible. This custom framework is capable of supporting the thorough testing requirements of integration elements. **Kategorien:** Database, Integration **Schlagwörter:** BPM --- ### [SOA Suite auf einer ODA? Mit O-Box ein Kinderspiel!](https://thecattlecrew.net/2015/03/28/soa-suite-auf-einer-oda-mit-o-box-ein-kinderspiel/) **Published:** März 28, 2015 **Author:** Neselovskyi, Borys **Content:** [![O-Box](https://thecattlecrew.net/wp-content/uploads/2015/03/o-box.png)](https://thecattlecrew.net/wp-content/uploads/2015/03/o-box.png)Eine Oracle Database Appliance (ODA) ist als geeignete Plattform für den Betrieb von Oracle Datenbanken bekannt. Oracle RAC oder One Node RAC Datenbanken lassen sich sehr schnell und unkompliziert auf einer ODA Maschine installieren und betreiben. Seit der Version 2.6 ist es möglich, auch einen WebLogic Server auf ODA zu betreiben, und das neben der Datenbank. Dafür muss die ODA mit einem Image bespielt werden, das Virtualisierung unterstützt. Mit wenigen Installationsschritten bekommt man eine umfangreiche WebLogic Umgebung mit: - einer oder mehreren WebLogic-Domänen - einem redundant ausgelegten Load Balancer (Oracle Traffic Director) Wenn aber ein WebLogic Server auf einer ODA läuft, warum dann nicht auch gleich die SOA Suite? Genau das fragten sich auch Lonnecke Diekmans und Simon Haslam, als sie die Firma O-box gründeten. O-box ermöglicht eine automatisierte Installation der Oracle SOA Suite auf einer ODA Maschine. Wir haben uns diese Lösung einmal näher angeschaut und getestet. Die Lösung von O-box setzt Folgendes voraus: 1. Die initiale ODA Installation, also die Verkabelung und die Inbetriebnahme, sollte bereits abgeschlossen sein. 2. Die Virtualisierung der ODA: Ein so genanntes ODA Base Setup sollte mit dem Kommando „oakcli deploy oda\_base“ erstellt werden. Dabei entstehen zwei virtuelle Linux Server. 3. Die Installation von Oracle Software auf ODA Base Node 0/1: Grid Infrastructure und (optional) Oracle Datenbank (RAC oder One Node RAC). 4. Installation eines Webservers, der von ODA während der O-box Installation erreichbar sein muss. Zur Vorbereitung hat uns Simon Haslam ein Formular mit Fragen zur Verfügung gestellt, das wir online ausfüllten und abgesendeten. Die Fragen bezogen sich auf die Installation der SOA Suite. Einige Fragen, wie etwa „Wie lautet das ODA Modell?“, konnten sehr schnell beantwortet werden. Fragen zu den Netzwerkeinstellungen mussten wir mit den Verantwortlichen des Rechenzentrums abstimmen. Im Anschluss konnte O-box die Installation starten: Im ersten Schritt erfolgte die vollautomatische Installation der VM mit dem O-box Manager (OBM). Im zweiten Schritt starteten wir die Installation und die Konfiguration von Oracle WebLogic und Traffic Director, was leider nur teilweise automatisch erfolgen konnte. Die Bereitstellung der Oracle SOA Suite Software auf dem WebLogic Server erfolgte am Ende dann wieder voll automatisiert. Für die SOA Suite Installation benötigen wir acht IP-Adressen bzw. Hostnamen und müssen diese im DNS definieren. Dabei wurden sechs VMs installiert. Die Oracle SOA Suite war dann über die virtuelle IP-Adresse erreichbar. Wir haben 2,5 Tage für die gesamte Installation gebraucht, in dieser Zeit konnten wir die SOA Suite auf der Oracle Database Appliance lauffähig bereitstellen. Einen Tag davon nahm das initiale Aufsetzen der ODA in Anspruch. Unser Fazit: Die O-box Lösung funktionierte bei unseren Tests einwandfrei. Wir bekamen sehr schnell (und fast automatisch) eine vollwertige SOA Suite Installation auf ODA. Bei kleinen Problemen bekamen wir Support durch das O-box Support-Team. Als Vorteil empfanden wir, dass O-box sich nicht nur auf die automatische SOA-Installation beschränkt. So ist eine weitere Option die automatische Aktualisierung der SOA Suite auf einer ODA. Sobald die neuen Patches (CPU und PSU) erscheinen, testet das O-box Team intern, erzeugt ein Installationspaket und benachrichtigt die Kunden. Die Installation von Patches erfolgt per Knopfdruck. Des Weiteren überzeugte uns die O-box Lösung durch ihre Variabilität, was die Unterstützung von SOA Versionen und Konfigurationen angeht: - SOA Suite in Versionen 11g und 12c werden unterstützt. - Mehrere SOA-Domänen können installiert und betrieben werden. Dies ermöglicht die logische Trennung von Testumgebung und Produktion. Oder man isoliert eine reine SOA-Domäne von OSB (Oracle Service Bus). Kurz: Die O-box Lösung vereinfacht die Installation und die Wartung einer SOA Suite auf einer ODA Maschine und ist eine echte Hilfe für die ohnehin überlasteten IT-Abteilungen. **Kategorien:** Database **Schlagwörter:** German, Installation --- ### [TDWI Young Guns Barcamp](https://thecattlecrew.net/2017/04/04/tdwi-young-guns-barcamp/) **Published:** April 4, 2017 **Author:** clarissamoeller **Excerpt:** Am vergangenen Freitag (31.03) hat erstmalig ein Barcamp der TDWI Young Guns stattgefunden. Wie der Name Barcamp bereits vermuten lässt, hat die Veranstaltung in einer Bar in Köln stattgefunden. In der Bar haben sich trotz sommerlichen Temperaturen und Sonnenschein einige Dutzende junge BI-ler versammelt, um einen gemeinsamen Nachmittag und Abend zu verbringen. Darunter Studenten, Berufseinsteiger und auch einige, die bereits ein paar Jahre Berufserfahrung sammeln konnten. **Content:** Am vergangenen Freitag (31.03.2017) fand erstmalig ein Barcamp der TDWI Young Guns statt. Wie der Name Barcamp bereits vermuten lässt, war die Location der Veranstaltung eine Bar, und zwar in Köln. In der Bar versammelten sich sich trotz sommerlicher Temperaturen und Sonnenschein einige Dutzende junge BI-ler, um einen gemeinsamen Nachmittag und Abend zu verbringen. Darunter Studierende, Berufseinsteiger und auch einige, die bereits ein paar Jahre Berufserfahrung sammeln konnten. Zu Beginn der Veranstaltung sollten wir uns zunächst mit drei Hashtags vorstellen. Meine Hashtags waren #OPITZCONSULTING, #ETL und #Motorradfahren. Häufig genannte Tags waren auch #Neugierde, #IchWilllNeuesLernen, #FC und #Sommer. ![youngguns](https://thecattlecrew.net/wp-content/uploads/2017/04/youngguns-e1491304211674.jpg)\#TDWI #YoungGuns #Barcamp #KunstbarKöln Die Organisatoren erkannten schnell die Fragezeichen in den Gesichtern der Nachwuchs-BI-Experten, als es um das Thema Young Guns und Barcamp ging. Denn genau wie ich fragten sich einige andere auch, was diese Begriffe denn eigentlich zu bedeuten hatten. Hier nun die Erläuterung: Die TDWI Young Guns sind die junge Generation des TDWI. Dabei handelt es sich um eine in den Kinderschuhen steckende Initiative, die dem Nachwuchs die Möglichkeit geben möchte, sich miteinander auszutauschen. Ein Barcamp bietet dafür auch ein lockeres und attraktives Medium. Bei dieser Meeting-Form, die auch „Unkonferenz“ genannt wird, stehen Diskussionen und Gespräche im Mittelpunkt. Typisch hierfür war auch, dass wir die Agenda für den Verlauf des Nachmittags ad hoc vor Ort ausgearbeitet haben. Jeder, der über ein Thema sprechen oder eine Fragestellung diskutieren wollte, sollte sich hinter der Theke versammeln. ![20170331_165142.jpg](https://thecattlecrew.net/wp-content/uploads/2017/04/20170331_165142-e1491304364898.jpg?w=5574)Agenda des Tages #SpannendeVorträge #Diskussionen #BI #Analytics Herzlich Willkommen waren hierbei auch spontane Vorträge, ohne fertige PowerPoint-Präsentation. Die Chance haben Christian Lenzhölzer und ich ergriffen und uns mit den Themen Data Vault/Datenmodellierung und ETL-Tools hinter die Theke gestellt. Am Ende standen neben unseren Themen unter anderem noch Sentiment-Analysen, Internet of Things und CRM-Analysen mithilfe von Geo-Marketing auf der Agenda. Pro Session hatten wir 30 Minuten zur Verfügung. Zu Beginn war ausdrücklich darauf hingewiesen worden, dass es keine Folienschlacht und auch keine Monologe geben sollte, damit Zeit für Diskussionen bleibt. Christian erörterte in seinem Vortrag zuerst die Unterschiede zwischen Inmon, Kimball und Linstedt. Im Anschluss daran regte er eine Diskussion an und bat darum, Erfahrungen mit den jeweiligen Modellen zu teilen. Er wollte außerdem wissen, welche Besonderheiten den Young Guns dabei aufgefallen waren. Viel wurde insbesondere über Data Vault gesprochen, da es für viele Unternehmen noch Neuland ist. Es wurde darüber diskutiert, wie determiniert werden kann, ob Data Vault eine sinnvolle Modellierungstechnik für ein Data Warehouse ist und von welchen Faktoren diese Entscheidung beeinflusst wird. Als mögliche Faktoren wurden hierbei die fachliche Komplexität, die Ü„nderungshäufigkeit des Datenmodells und das Know-how der Mitarbeiter genannt. Auch das Thema der Automatisierung wurde in diesem Zusammenhang besprochen. Hier konnte Fabian Hardt Einblicke in die Funktionen und Möglichkeiten des MID Innovator einbringen. In meinem Vortrag berichtete ich zunächst, mit welchen ETL-Tools ich in den letzten Projekten gearbeitet habe. Dazu gab ich meine persönliche Einschätzung zu den jeweiligen Stärken und Schwächen der Tools ab. Zusammen mit den anderen BI-lern konnte ich eine große Palette an ETL-Tools abdecken. Weiterhin habe ich versucht mit den Young Guns zu evaluieren, ob es möglicherweise einen Standardansatz zur Entwicklung von ETL-Mappings gibt, der unabhängig vom Tool ist. Als Fazit dieser Diskussion stellten wir fest, dass die Dokumentation der einzelnen Schritte im Mapping sehr wichtig ist und wir Standardtransformationen empfehlen würden, sofern diese vorhanden sind. Außerdem wurde angeregt, dass ein Mapping jeweils nur eine Zieltabelle befüllen sollte, um die Übersichtlichkeit zu wahren. Die zehn Minuten zwischen den jeweiligen Sessions füllten die Teilnehmer durch das Fortführen von Diskussionen aus den Vorträgen, sowie durch allgemeines Netzwerken und das Schnabulieren von Snacks und Obst. Ab 18 Uhr bot sich dann bei einem Glas guten Kölsch, wie es sich in der Domstadt gehört, noch mehr Gelegenheit, mit den anderen Besuchern ins Gespräch zu kommen. Das Ziel der Veranstaltung, die Kommunikation und den Wissensaustausch zwischen Young Professionals zu fördern, ist in jedem Fall geglückt. Hierbei ist ein guter Blick über den Tellerrand ermöglicht worden. Die Einblicke in verschiedene Tools, Methoden und Vorgehen konnten den Wissensdurst der nächsten Generation stillen und sie motivieren, sich noch mehr mit dem Bereich BI auseinander zu setzen. Das Barcamp ist für mich wirklich eine ideale Plattform, um sich mit gleichgesinnten, jungen BI-Kollegen auszutauschen! ![20170331_165751.jpg](https://thecattlecrew.net/wp-content/uploads/2017/04/20170331_165751-e1491304440869.jpg)OC Young Guns #WirSindOPITZCONSULTING Mit einer Truppe von sechs Young Guns war OPITZ CONSULTING sehr gut vertreten. Ich freue mich darauf, noch viele weitere Male an einer solchen Veranstaltung teilzunehmen. **Kategorien:** Tech Events & Networking **Schlagwörter:** Analytics, Business Intelligence, TDWI --- ### ["Digital Transformation - Behind the Scenes" - Das war die inspire|IT 2017](https://thecattlecrew.net/2017/04/28/digital-transformation-behind-the-scenes-das-war-die-inspireit-2017/) **Published:** April 28, 2017 **Author:** Frank Hoppe **Content:** Unter dem Motto „Digital Transformation Behind the Scenes“ fand vom 03. bis 04. April 2017 die 4. Ausgabe unserer Best-Practices-Konferenz inspire|IT in Frankfurt statt. Jetzt können wir wirklich schon von einer Tradition sprechen. Zwei Tage mit unterschiedlichen Tracks und Hands-on waren voll gepackt mit Informationen, Vorträgen und Demonstrationen und ganz vielen informativen Gesprächen. Zur Eröffnung gab es eine spannenden Keynote von Tom Gansor über digitalen Pragmatismus (einfach mal machen!). Die einzelnen Thementracks am ersten Tag beschäftigten sich mit Development & Mensch Maschine Interaktion sowie Business Insights und Big Data. Nach einem spannenden ersten Tag, stand dem ersten Bier nur noch eine weitere Keynote im Weg. Die Abstinenz hat sich nach einhelliger Meinung mehr als gelohnt: Robert Schröder, Check Pilot und Mitglied der Flugunfalluntersuchungskommission der Lufthansa, referierte zur Entwicklung der Fehlerkultur in der Luftfahrt und zeigte, was wir für unseren Berufsalltag daraus lernen können. In einer sehr unterhaltsamen, kurzweiligen und authentischen Art berichtetet Schröder aus mehr als 25 Jahren Erfahrung und regte diverse Male zum Nachdenken an. Mehr als 90 Teilnehmer blieben zum anschließenden Networking Dinner, wo bei exzellenter Küche und gutem Wein oder gepflegtem Bier noch lebhaft weiter diskutiert wurde. Der intensive und inzwischen informelle Austausch wurde danach an der Hotelbar ausgiebig weitergeführt. ![inspireIT](https://thecattlecrew.net/wp-content/uploads/2017/04/inspireit.jpg) Der zweite Tag startete mit den zwei Workshops Multi-Cloud-Strategie und Design Thinking. Trotz des aktiven Networking am Vorabend, wurde hier schon wieder sehr intensiv diskutiert. Nach den Workshops ging es in den Tracks Infrastruktur & Cloud sowie IoT & Integration of Everything weiter. Die Veranstaltung endete mit einem Denkanstoß von Rolf Scheuch in seiner Keynote „Die Digitalisierung frisst Ihre Kinder“. Das Programm war insgesamt sehr praxisbezogen und hatte viele spannende Highlights mit konkreten Beiträgen unter anderem von ista, Mercedes Benz Vans, innogy, F.A.Z, Securitas, TH Mittelhessen, Duale Hochschule BaWü und einigen mehr. In einem parallelen Side-Track boten wir zusätzlich an beiden Tagen einen Hands-On-Cloud-Workshop mit Oracle an. Auch das OC|Lab war in einer Abordnung vertreten und hat in den Pausenzeiten spannende Use Cases vorgestellt. Neben der Demonstration von Chat Bot Möglichkeiten auf Basis von Amazon Alexa und oder einem Augmented Reality Projekt auf Basis von Google Tango war die Microsoft HoloLens ein echtes Highlight. Hiermit lies sich die über Q-loud ins Internet eingebundene Industriemaschine steuern. Wir freuen uns, dass wir von allen Seiten sehr viel positives Feedback zum Programm und zur Organisation der inspire|IT bekommen haben. Im vierten Jahr hat sich die Veranstaltung zu einer festen Größe im jährlichen Eventkalender etabliert, mit rund 140 Teilnehmern war es der bislang erfolgreichste Event und eine gute Basis für die Zukunft. 2018 kann kommen. **Kategorien:** Tech Events & Networking **Schlagwörter:** Cloud Computing, Digital Innovation, Digitalisierung, News, OC|Lab --- ### [Oracle API Platform Cloud Service - The Next-Gen API Management Platform](https://thecattlecrew.net/2017/06/15/oracle-api-platform-cloud-service-the-next-gen-api-management-platform/) **Published:** Juni 15, 2017 **Author:** Sven Bernhardt **Content:** Curious to know how to build Next-gen APIs using a API First Desing approach? Go on reading … **Kategorien:** Integration --- ### [Unser erstes Summer-Teamevent in Essen](https://thecattlecrew.net/2017/07/04/erstes-oc-essen-summer-team-event/) **Published:** Juli 4, 2017 **Author:** Richard Attermeyer **Content:** Am 22.06.2017 hat es endlich geklappt: Nach mehreren (zaghaften) Anläufen in den vergangenen Jahren haben wir in diesem Jahr erstmalig ein Summer-Team-Event für alle Essener Mitarbeiter durchgeführt. Bei hochsommerlichen Temperaturen und ziemlich schwüler Luft haben wir auf dem Gelände der DLRG in Essen den Grill angeworfen und ein paar sehr chillige Stunden am Ufer des Baldeneysees verbracht. [![](https://thecattlecrew.net/wp-content/uploads/2017/07/vogelperspektive20grillen-150x150.jpg)](https://thecattlecrew.net/2017/07/04/erstes-oc-essen-summer-team-event/vogelperspektive-grillen/) vogelperspektive grillen [![](https://thecattlecrew.net/wp-content/uploads/2017/07/baldeneysee20hochformat-150x150.jpg)](https://thecattlecrew.net/2017/07/04/erstes-oc-essen-summer-team-event/baldeneysee-hochformat/) Baldeneysee Hochformat [![](https://thecattlecrew.net/wp-content/uploads/2017/07/hagelkorn-150x150.jpg)](https://thecattlecrew.net/2017/07/04/erstes-oc-essen-summer-team-event/hagelkorn/) Hagelkorn [![](https://thecattlecrew.net/wp-content/uploads/2017/07/platzregen20mit20hagel-150x150.jpg)](https://thecattlecrew.net/2017/07/04/erstes-oc-essen-summer-team-event/platzregen-mit-hagel/) Platzregen mit Hagel Besondere Erwähnung verdient die DLRG-Location: fantastisch gelegen, optimal ausgestattet und Dank Andreas Wageners gutem Draht zur DLRG auch sehr flexibel für uns buchbar. Vielen Dank noch mal an Andreas! Die Resonanz auf die Einladung war hervorragend und alle Kollegen hatten einen sehr schönen Nachmittag. Einzig der Abschluss war dann nicht ganz optimal, bleibt dafür aber in besonderer Erinnerung. Ein heftiges Gewitter mit Sturmböen trieb alle in den Bootshangar, von wo aus wir dann das Spektakel aus sicherer und trockener Distanz beobachten konnten. Leider blieb es nicht bei Platzregen, sondern es begann auch noch heftig zu hageln. Am Ende haben die PKWs vor Ort leider einige Hagelschäden davongetragen. Trotz des Unwetters zum Schluss war es ein rundum gelungener Nachmittag, den wir hoffentlich im nächsten Jahr so oder ähnlich noch einmal wiederholen können. **Kategorien:** Tech Events & Networking --- ### [Hackathon @ TDWI Young Guns](https://thecattlecrew.net/2017/07/13/hackathon-tdwi-young-guns/) **Published:** Juli 13, 2017 **Author:** Christian Lenzhölzer **Content:** ## *— „Mögen die Daten mit euch sein!“ —* [![](https://thecattlecrew.net/wp-content/uploads/2017/07/bild-1-e1499953931653.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2017/07/bild-1.jpg) *Einwahldaten und Zugangscode #ChrisBacca* Unter dem Motto: „Mögen die Daten mit euch sein!“ begann am Mittwoch, den 28.06.2017 auf der TDWI Konferenz in München der Star Wars Hackathon. Als TDWI Young Guns möchten wir euch einen kurzen Eindruck über die Veranstaltung geben. Bereits um 9 Uhr trafen wir uns im Raum E124 um mit dem Hackathon zu starten. Nach einer kurzen Präsentation über „Cognitive Computing“ folgte eine Vorstellung der TDWI Young Guns. Wie es bereits auf dem Young Guns Barcamp in Köln ([Link](https://thecattlecrew.net/2017/04/04/tdwi-young-guns-barcamp/)) üblich war, stellten sich die rund 15 Teilnehmer mit ihren drei persönlichen Hashtags vor. Anschließend wurde der Showcase vorgestellt und die grobe Aufgabenstellung erläutert. Dabei fragten wir uns, ob es möglich ist, neue und vor allem verwertbare Erkenntnisse aus unstrukturierten Daten mithilfe von „Cognitive Computing“ automatisiert in wenigen Stunden zu generieren. [![](https://thecattlecrew.net/wp-content/uploads/2017/07/bild-2.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2017/07/bild-2.jpg) \#Vorstellung und Teamfindung Ziemlich schnell zeigten sich nach ein paar organisatorischen Informationen wie Benutzername und Wlan die ersten großen Fragezeichen über den Teilnehmern. Wir sollten Teams mit gleichen Interessen und Zielen innerhalb des Hackathons bilden. Denn jedes Team hatte eine andere Aufgabe bzw. Analyse vorzubereiten. Zur Auswahl standen: \#PersonalityInsights Identifiziert aus transaktionsorientierten- und Social-Media-Daten (Psychologische Charaktermerkmale) \#ToneAnalyzer Identifiziert anhand des Tonfalls in einem Text Emotionen wie zum Beispiel Ü„rger, Ekel, Furcht, Freude und Traurigkeit und erkennt soziale Eigenschaften (Offenheit, Gewissenhaftigkeit, Extrovertiertheit und Freundlichkeit). \#NaturalLanguageUnderstandig Analysiert semantische Merkmale von Texteingaben in unstrukturierten Texten. Diese Merkmale können sein: Kategorien, Konzepte, Emotionen, Entitäten, Schlüsselwörter, Metadaten, Beziehungen, semantische Rollen und Stimmungen. \#NaturalLanguageClassifier Verwendet Algorithmen für maschinelles Lernen, um für kurze Texteingaben die vordefinierten Klassen zurückzugeben, die die höchste Übereinstimmung aufweisen. Das hörte sich extrem spannend an und alle wollten sofort loslegen und die hinterlegen Star Wars Daten mit den entsprechenden Funktionen analysieren. Allerdings fiel es den meisten Teilnehmern schon relativ schwer, sich in der neuen Oberfläche von IBM Bluemix zurecht zu finden. Die erste Zeit war man tatsächlich mehr damit beschäftigt, einen groben Überblick über Bluemix und die Services zu bekommen, als mit der eigentlichen Aufgabe zu starten. Nach der etwas länger ausfallenden Einarbeitung haben wir uns innerhalb unseres Teams darauf geeinigt, uns mit dem #NaturalLanguageClassifier zu beschäftigen. In unserem Szenario wollten wir herausfinden, welche Texteingaben, in unserem Fall Filmzitate, zu welchem Star Wars Charakter gehören. Dafür war es notwendig, die bereits vorhandenen Textdokumente mit allen entsprechenden Filmzitaten aufzubereiten und zu trainieren. Dabei wurden die Daten für Trainingszwecke des Algorithmus in Trainings- und Testdaten, im Verhältnis 80%/20%, aufgeteilt. Hiermit sollte der Algorithmus ausreichend trainiert werden, um die richtigen Resultate zu zeigen. In der Theorie hört sich dies tatsächlich bedeutend leichter an als in der Praxis. Die Trainingsdaten reichten bis zum Ende einfach nicht aus, um gute Trefferquoten bei eingegebenen Zitaten zu erhalten. Dies ließ sich auch nach mehrfachem Trainieren nicht signifikant verbessern. [![](https://thecattlecrew.net/wp-content/uploads/2017/07/bild-3.jpg?w=640)](https://thecattlecrew.net/wp-content/uploads/2017/07/bild-3.jpg) \#Abschlusspräsentation Alles in allem war der Hackathon eine sehr spannende und lehrreiche Veranstaltung. Wir haben viel Neues über Machine-Learning-Verfahren und auch ein wenig über Star Wars gelernt. 😉 Von daher“¦ \#Danke #YoungGuns #MögeDieMachtMitEuchSein! Viele Grüße Fabian und Christian **Kategorien:** Tech Events & Networking --- ### [OPITZ CONSULTING beim B2RUN](https://thecattlecrew.net/2017/07/20/opitz-consulting-beim-b2run/) **Published:** Juli 20, 2017 **Author:** Christian Kaul **Content:** Wie jedes Jahr war auch 2017 ein Team von OPITZ CONSULTING beim B2RUN in München am Start. 16 laufbegeisterte Kolleginnen und Kollegen aus München und Nürnberg schalteten ausnahmsweise einmal den Rechner etwas früher aus, um beim größten deutschen Firmenlauf mit rund 30.000 Teilnehmern dabei zu sein. Ob aus der Niederlassung, aus dem Homeoffice oder direkt vom Kunden: Am 13. Juli trafen sich alle im Olympiastadion, um sich gemeinsam auf den Lauf einzustimmen. Auch einige Angehörige waren gekommen, um das Team moralisch zu unterstützen. Gegen 19 Uhr fiel schließlich der Startschuss. Nun würde sich zeigen, ob sich das Training der letzten Wochen und Monate ausgezahlt hatte. ![OC B2RUN 2017](https://thecattlecrew.net/wp-content/uploads/2017/07/oc-b2run-2017.jpg) Eine 6 Kilometer lange Strecke, die sich durch den Münchner Olympiapark bis zum Ziel im Olympiastadion schlängelte, war zu überwinden. Alle Mitglieder des OPITZ CONSULTING Teams kamen erfolgreich ins Ziel. Einige konnten sich über eine neue persönliche Bestzeit freuen und fünf Teammitglieder knackten sogar die 30-Minuten-Marke. Bei Bananen, Butterbrezen und dem ein oder anderen Bier klang der Abend aus. Nächstes Jahr sind wir natürlich wieder dabei beim B2RUN München! **Kategorien:** Tech Events & Networking --- ### [Digital Experience - behind the scenes](https://thecattlecrew.net/2017/09/04/digital-experience-behind-the-scenes/) **Published:** September 4, 2017 **Author:** pascalmhumbert **Content:** Seid ihr genervt vom ganzen Blabla rund ums Thema Digitale Transformation? Seid ihr inspiriert, skeptisch oder besorgt, wenn ihr an die digitale Zukunft denkt? Wollt ihr Digitalisierung und Change hautnah miterleben? Dann seid ihr beim MeetUp [Digital Experience – behind the scenes](https://www.meetup.com/de-DE/Digital-Experience-behind-the-scenes/?utm_campaign=2017-10-01-MeetupDigitalExperienceFounded&utm_source=thecattlecrew&utm_medium=blogpost) genau richtig! ## MeetUp-Gründung in München Am 20. Juli 2017 haben wir, [OPITZ CONSULTING](http://www.opitz-consulting.com/), zusammen mit unseren Partnern von [abc cross media](https://www.abccrossmedia.com) und [Cambiana](http://www.cambiana.com/) das MeetUp Digital Experience – behind the scenes in München gegründet. Seitdem konnte sich die Gruppe eines gewaltigen Zuwachses von mittlerweile mehr als 150 Mitgliedern erfreuen! Wir bieten eine offene Plattform für anregende Diskussionen im No-Conference-Style. Im Zentrum der Veranstaltungen stehen die Teilnehmer und der Dialog. Anhand von Beispielen aus dem echten Leben, eurem und unserem Projektalltag wird das MeetUp zu einer authentischen Erfahrung. ## Upcoming events ### [04.10.2017, Episode 1: Alexa & Co. – gruselig oder cool?](https://www.meetup.com/de-DE/Digital-Experience-behind-the-scenes/events/241873058/?utm_campaign=2017-10-04-MeetupEpisode01&utm_source=thecattlecrew&utm_medium=blogpost) Möglicherweise stehen Alexa, Siri, Cortana und Co auch schon in Deinem Wohnzimmer? Wir fragen uns: Wie lassen sich die kleinen Helferlein im Unternehmenskontext einsetzen? Wo und wann sind sie sinnvoll, nützlich, hilfreich? Und wo und wann wird ihr Einsatz gruselig, verstörend, beängstigend? Wenn Du über dieses [Video](http://daserste.ndr.de/extra3/sendungen/extra-3-Familie-Leben-mit-Sprachassistenten,extra13146.html) gleichzeitig lachen und nachdenken musst, bist Du bei unserem ersten MeetUp-Event genau richtig. An diesem Abend zeigen wir Anwendungsfälle rund um Alexa, insbesondere für das Storytelling im Unternehmenskontext. Und wir nehmen Dich mit auf eine spannende, interaktive Diskussionsreise rund um das Für und Wider von Chatbots. Hast Du Lust, unser Treffen zu bereichern? Wir freuen uns auf Dich! PS: Unser erstes MeetUp-Treffen wird auch unser Testflug. Hier experimentieren wir mit dem Modus: Wie werden wir zukünftige Treffen gestalten? Mit oder ohne Vorträge? Im Stile eines BarCamps? Völlig offen und locker oder sauber durchmoderiert? Lasst es uns ausprobieren! ### [Voraussichtlich 23.11.2017, Episode 2: Smart City oder „Polizeitstaat“? Wie können wir München ein kleines Stück digitaler machen?](https://www.meetup.com/de-DE/Digital-Experience-behind-the-scenes/?utm_campaign=2017-10-01-MeetupDigitalExperienceFounded&utm_source=thecattlecrew&utm_medium=blogpost) Informationen folgen auf der MeetUp-Seite. **Kategorien:** Tech Events & Networking --- ### [OC @ Berlin Expert Days 2017](https://thecattlecrew.net/2017/09/25/oc-berlin-expert-days-2017/) **Published:** September 25, 2017 **Author:** Marco Buss **Content:** Bereits zum siebenten mal fand in Berlin die [Berlin Expert Days](http://bed-con.org/) (Bed-Con) Konferenz statt. Die BedCon ist als kleine Entwicklerkonferenz bekannt und beliebt, was auch an der stetig steigenden Teilnehmerzahl zu sehen ist. Dieses Jahr war Opitz Consulting als Sponsor der Konferenz aktiv und war daher mit einem eigenen Stand im Foyer zu finden. ![IMG_1089](https://thecattlecrew.net/wp-content/uploads/2017/09/img_1089.jpg) Neben unserem Stand hatten wir auch zwei Vorträge zur Konferenz beigesteuert. Marius Hofmeister hat sich dem Thema Websicherheit gewidmet und einen Vortrag zur Veröffentlichung der OWASP Top 10 2017 gehalten. Es handelt sich hierbei um eine Liste der zehn größten Sicherheitsrisiken für Anwendungen im Web. Wen die Thematik näher interessiert, der hat im November auf der W-JAX erneut die Gelegenheit, den Vortrag zu hören. Als weiteren Vortrag war ich mit einem kleinen Spaßprojekt, dem sprechenden Kickertisch vertreten. Vortragen durfte ich im größten Saal den die Konferenz zu bieten hatte. Für mich als unerfahrenen Speaker auf den ersten Blick beängstigend aber auch spannend. ![IMG_1090](https://thecattlecrew.net/wp-content/uploads/2017/09/img_1090.jpg) In dem Talk gab es einen Überblick über AWS Iot, Amazon Voice Services und das Alexa Skill Kit und wie man diese 3 Techniken verwenden kann um einen Tischkicker zu digitalisieren. Der Kickertisch war auch die ganze Zeit über am Stand und wurde rege genutzt. Ich denke das war nicht die letzte Veranstaltung bei der er zum Einsatz kommt. ![IMG_1091](https://thecattlecrew.net/wp-content/uploads/2017/09/img_1091.jpg) Passend dazu gab es am Stand auch einen Echo Dot zu gewinnen. ![IMG_1094](https://thecattlecrew.net/wp-content/uploads/2017/09/img_1094.jpg) Uns haben die Berlin Expert Day´s in jedem Fall Spaß gemacht. Die Organisatoren haben einen guten Job gemacht. Die Vorträge waren durchweg von guter Qualität. Für alle die dieses Jahr nicht dabei waren kann ich nur sagen. Kommt einfach nächstes Jahr vorbei. Es lohnt sich. **Kategorien:** Tech Events & Networking --- ### [Hochverfügbarkeit mit Dbvisit Standby in der Cloud](https://thecattlecrew.net/2018/01/26/hochverfuegbarkeit-mit-dbvisit-standby-in-der-cloud/) **Published:** Januar 26, 2018 **Author:** Rainier Kaczmarczyk **Content:** Bei einem Single Instance Oracle System in der Standard Edition, das hohen Verfügbarkeitsanforderungen genügen muss, bietet sich die Verwendung einer Replikationslösung mittels Dbvisit Standby an. Ein Problem stellen die initial hohen Kosten dar für die neue Hardware und für die Lizenzen von Oracle und Dbvisit Standby. Je nach System kann das ein Betrag im mittleren fünfstelligen Euro Bereich sein. Betreibt man aber das Standby System in der Cloud, beispielsweise bei Amazon oder Oracle, ergeben sich je nach Systemgröße Kosten von einigen Hundert Euro monatlich. Dies auch inclusive des hohen Kostenanteils für die Oracle Lizenzen! Kosten können zudem eingespart werden, indem eine geringe CPU-Leistung für den Normalbetrieb im Standby Modus definiert wird, da lediglich die Ü„nderungen der Primärdatenbank eingearbeitet werden müssen. Nur im Fall eines Switch- oder Failover kann die CPU-Leistung entsprechend des Bedarfs für den Betrieb als Primärdatenbank angepasst werden. **Welche Unterschiede bringt die Cloud-Lösung mit sich und was ist besonders zu beachten?** Der Betrieb der Standby Lösung in der Cloud unterscheidet sich in keiner Weise von dem einer lokalen Lösung. Lediglich beim Setup sind ein paar Dinge zu beachten, die im Folgenden noch für die technisch interessierten Leser beschrieben werden. Was sich für den Administrator ändert, ist vor allem, dass ein tieferes Verständnis in den Bereichen Netzwerk und Sicherheit vorhanden sein sollte. Beispielsweise empfiehlt es sich, den kompletten SQL Netzwerkverkehr zu verschlüsseln. Der Aufwand ist nur gering und es fallen schon seit längerem keine zusätzlichen Lizenzkosten dafür an. Dbvisit Standby verschlüsselt den systemeigenen Netzwerkverkehr per Default. Natürlich müssen die unten genannten Ports in der firmeneigenen Firewall freigeschaltet werden. Ist dies nicht möglich, ist eine Replikation in die Cloud leider keine Alternative. Ein nicht zu unterschätzender Aspekt ist auch die Netzwerkanbindung vom lokalen Standort in die Cloud. Die Hauptfrage ist hier, ob die Verbindung den Anforderungen gewachsen ist. Der notwendige Durchsatz der Anbindung hängt von der verwendeten Applikation ab. Eine Messung des Durchsatzes der Netzwerkkarte des lokalen Datenbankservers liefert hier eine erste valide Orientierung. Was ist nun technisch zu beachten? - Für den Betrieb der Remotedatenbank muss zunächst ein sogenannter Key Pair definiert werden. - Die Firewalls müssen für die benötigten Ports freigeschaltet werden (Default sind hier 1521 für den Oracle Listener und 4433, 7890 und 7891 für die Dbvisit Funktionalitäten). Ob dies der Fall ist, kann durch den Befehl *telnet* überprüft werden. - In den Dateien *$DBV\_HOME/dbvagent/conf/dbvagent.conf* *und* *$DBV\_HOME/dbvnet/conf/dbvnetd.conf* muss der Eintrag *listener\_address=* von auf *0.0.0.0* gesetzt werden. - Wichtig ist auch, die IP-Adresse des Primärsystems im öffentlichen Netzwerk zu kennen (Ermittlung z. B. mittels ). **Fazit** Eine Internetanbindung, die nicht leistungsfähig genug ist, stellt aber ebenso ein Hindernis für diesen Lösungsansatz dar, wie sehr sensible Informationen, z. B. Patientendaten. Für viele andere Anwendungen aber ist eine solch hybride Architektur, der Betrieb sowohl lokal, als auch in der Cloud, eine kostengünstige und wenig aufwändige Lösung. PS: Hier noch ein Screenshot einer Konsole eines so definierten virtuellen Cloud Standby Systems: ![xx](https://thecattlecrew.net/wp-content/uploads/2018/01/xx.jpg) **Kategorien:** Infrastructure --- ### [AWS Cloud EC2 and RDS experiences (part 1)](https://thecattlecrew.net/2019/04/20/aws-cloud-ec2-and-rds-experiences-part-1/) **Published:** April 20, 2019 **Author:** Steffen Nothmann **Content:** This article, and maybe some more to come, will describe my way to get ready for Oracle data base migration projects to AWS. A lot of people speaking about cool stuff like Cloud Compute Services , accelaration of project implementations or simply very fast deployments including Data Base Migrations to the Cloud etc. Also I heart about security features and the ease of use. Many things are available, inclusive various operational data base types. ![](https://thecattlecrew.net/wp-content/uploads/2019/04/things_are_possible_2019-04-20_021842.jpg)Saying that, I think it’s time to checkout by myself ! Would I be able to get something ready from scratch within minutes as Amazon and other provider are offering ? But what I need to do in real ? – Thinking „¦ Requirements: - I need a project and a plan of course how to go for ? - which cloud is to use ? there are a lot of providers and a ranking maybe too - need to learn about compute instances, because some web apps in the client space are required - as we are going for data base migrations to opensource, database knowhow required for different databases like Oracle and PostgreSQL - also some certifications are required for later use, so I need to know an AWS Certification Path Solutions: - a project was found very fast, my Boss can be so helpful .. it’s awesome 😉 - Okay, The provider was already set .. ( desicion for AWS ) so don’t need to waste brain resources about that one. => provider = Amazon Web Services - AWS EC2 is it called @AWS and has a great granularity of compute instances in terms of sizing, so I’d choose a very small one for the first test and going the quick way with Amazon Image (AMI), later I’ll look for a solution to use my own AMI ( did I really wrote this ???? ) => Red Hat Enterprise Linux 7.5 (HVM), SSD Volume Type – ami We are RedHat Business partner – so it’s must 😉 First things first, get into the Portal and do a quick start with the EC2 stuff“¦ ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Step-1_start_solution_ec2_2019-04-19_234802-1-1024x687.jpg) Step 1 After Login Start an EC2 Solution ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Step-2_Instance_type_2019-04-19_235950-1-1024x333.jpg) Step 2 choose an Instance Type ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Step-2a_Launch_2019-04-20_001007-1.jpg) ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Step-7_some_steps_skiped_Launch_2019-04-20_001007-1.jpg?fit=1024%2C506&ssl=1) The security group enables me to limit the acces from „outer space“, just my location should have acces in the first step. ![](https://thecattlecrew.net/wp-content/uploads/2019/04/Step-8_Launched_Started_2019-04-20_003655-1.jpg) Great ! It’s running. ![](https://thecattlecrew.net/wp-content/uploads/2019/04/git-bash-access_censored_2019-04-20_004827-1.jpg) taking the DNS resolveable hostname provided by AWS to get SSH access to my newly created host ![](https://thecattlecrew.net/wp-content/uploads/2019/04/git-bash-output_censored_2019-04-20_004827-1.jpg) checking the instance tosee what we got ![](https://thecattlecrew.net/wp-content/uploads/2019/04/httpd_status_2019-04-20_012149-1.jpg) As we have a normal Redhat, I installed an Apache Webserver and started the service ![](https://thecattlecrew.net/wp-content/uploads/2019/04/WebServer_Testpage_2019-04-20_011822-1.jpg?fit=1024%2C955&ssl=1) As a Result we can see the Test Page of Apache within the web-browser on my Home Location Fazit: It took me round about 5min. to start the EC2 instance with a secure access from my laptop and the Apache Webserver accessable running as well. That’s really nice. Next I’ll try to start some instances for the test of Oracle XE and PostgreSQL, which I also deploy in a vagrant multihost environment. This will be then another article: „DevOps Stuff meets Database on premise and with cloud“ **Kategorien:** Infrastructure **Schlagwörter:** AWS, cloud, Database, oracle --- ### [Das erste Coding Dojo in 2020](https://thecattlecrew.net/2020/03/05/das-erste-coding-dojo-in-2020/) **Published:** März 5, 2020 **Author:** Eduard Selenzow **Content:** Zu Beginn des Jahres wurde es für OC mal wieder Zeit für ein Coding Dojo. Das Thema des ersten Coding Dojos am 21. Januar 2020 war **Flutter**. Viele fragen sich an dieser Stelle bestimmt: ,,Was ist Flutter?“ Der Wortlaut erinnert an das Flattern der Flügel von Vögeln. Doch geht es bei Flutter wirklich um Vögel? Ihr könnt es euch nun natürlich einfach machen und die Antwort googeln. Oder aber ihr lest weiter und erfahrt, wie OC Flutter definiert. ### Das Event Wie auch bei unseren letzten Veranstaltungen lief die Organisation über Meetup. Wenn euch dieser Beitrag gefällt, dann schaut euch unsere Meetup Gruppe [OC|Expert Camp Gummersbach](https://www.meetup.com/de-DE/OC-Expert-Camp-Gummersbach) an. Mit Überraschung durften wir feststellen, dass Flutter ein Thema von großem Interesse ist. Sage und schreibe 30 Leute haben sich über Meetup für unser Coding Dojo angemeldet und weitere 8 per Email. Wahnsinn! Wenn man bedenkt, dass wir das Event nur eine Woche zuvor angekündigt hatten, ist die Anmeldezahl beeindruckend. Die positive Resonanz warf die Frage auf – Kann es sein, dass Flutter ein populäres Thema ist? Bei der Aussage „Kommt zum Coding Dojo an der TH Köln Campus Gummersbach und seid dabei, wenn wir zeigen, was LEGO mit Flutter zu tun hat!“ kann es natürlich auch sein, dass die Teilnehmer sich erhofft haben mit LEGO spielen zu können. Letztendlich waren es 36 Teilnehmer – ein neuer Rekord für das Team in Gummersbach! ### Der Ablauf Pünktlich um 18 Uhr haben wir mit dem Vortrag gestartet. Angefangen hat Eduard Selenzow mit einem theoretischen Einstieg in Flutter, Dart, sowie Unterschiede und Vorteile von Flutter gegenüber React Native und Ionic. Die Slides der Präsentation findet ihr [hier](https://docs.google.com/presentation/d/1zd6VJOqURNtPuP6p4duzWCbTxYFBa8MomPuToBEfQZA/edit?usp=sharing). ![](https://thecattlecrew.net/wp-content/uploads/2022/07/eddy-blog-1.png)Dann übernahm Daniel Felten die Leitung für seine praktische Einführung in Flutter mit einer Live Demo. Diese bestand aus dem Entwickeln einer kleinen Flutter App. Den Code stellte Daniel den Teilnehmern in einem [Github-Repository](https://github.com/DFelten/flutter-coding-dojo.git) zur Verfügung. Doch bevor alle mit dem Coding starten konnten, wurde unsere Veranstaltung unterbrochen. Der Schuldige war der Pizzalieferant und sind wir mal ehrlich, über eine Unterbrechung durch Pizza können wir nicht böse sein. Es war Zeit für unsere Essenspause. ![](https://thecattlecrew.net/wp-content/uploads/2020/03/daniel-blog.png?fit=1024%2C575&ssl=1)Während der Pause hatten wir mit technischen Problemen zu kämpfen, die wir aber überraschenderweise flexibel lösen konnten. Ein mehr oder weniger großes Problem war, dass einige Teilnehmer vergessen haben Flutter, Dart und eine Entwicklungsumgebung einzurichten. Zum Glück ist Flutter an der Stelle flexibel und statt Android Studio installieren zu müssen, konnten einzelne Teilnehmer Flutter in Google Chrome nutzen. Letztendlich war es irrelevant, ob die Teilnehmer Visual Studio Code, IntelliJ oder Android Studio zum Entwickeln verwendet haben. Nach der Pizzapause übernahm Daniel wieder die Leitung. Er demonstrierte, wie man die App startet und machte direkt auf eines der Features von Flutter aufmerksam „“ den Hot Reload. Er änderte eine Textzeile im Code, die einen Text in der App anzeigt und nach Speichern der Ü„nderung, war diese direkt in der App zu sehen. Bei der gemeinsamen Entwicklung der App ging Daniel iterativ vor und hat jeden relevanten Zwischenstand in einem eigenen Branch festgehalten, sodass die Teilnehmer immer wieder neu einsteigen konnten, wenn sie einmal nicht bei der Präsentation oder den Coding-Aufgaben mitgekommen sind. ![](https://thecattlecrew.net/wp-content/uploads/2024/05/beide-blog.png)### Ergebnisse Das Ziel des Coding Dojos war es, einen Einstieg in Flutter zu bieten. Dieses Ziel haben wir durch einen Mix aus Theorie und Praxis erreicht! Um auf unsere Frage vom Anfang zurück zu kommen: Flutter ist ein SDK und Framework aus dem Hause Google. Mit Flutter kann man auf Grundlage einer Codebasis (Programmiersprache Dart) eine native Anwendung für Mobile, Desktop und Web schreiben. Dabei wird mithilfe der Canvas bzw. Skia-Engine jeder Pixel der Plattform kontrolliert und so in Form von Widgets eine UI gezeichnet. Widgets sind Flutters Bausteine, die für alles in der UI verwendet werden. Und mit alles, meinen wir wirklich alles. Egal ob Scaffold, Button oder Text, alles ist ein Widget. Weitere Infos könnt ihr den vorher verlinkten Slides entnehmen. Wenn ihr uns fragt, eignet sich Flutter ideal dafür, einen Prototype zu entwickeln. Probiert es doch einfach selber aus! Und um die Frage aus den Details vom Meetup „“ Was hat LEGO mit Flutter zu tun „“ zu beantworten: Jedes Widget ist wie ein LEGO-Baustein, nur statt Burgen mit LEGO zu bauen, baut ihr jetzt Burgen in Form von Apps mit Widgets. **Kategorien:** Development **Schlagwörter:** Coding Dojo, Flutter --- ### [Daten Integrieren mit Airbyte – Teil 3: Wie funktioniert Data Ingestion genau?](https://thecattlecrew.net/2023/05/17/daten-integrieren-mit-airbyte-teil-3-wie-funktioniert-data-ingestion-genau/) **Published:** Mai 17, 2023 **Author:** Caroline Aretz **Content:** In den ersten beiden Teilen dieser Artikelserie habe ich dir die [Konfiguration von Airbyte über die Weboberfläche](https://thecattlecrew.net/2023/03/28/daten-integrieren-mit-airbyte-teil-1-einfuehrung-installation/ "Zum Blogbeitrag") und das [Command-Line-Tool Octavia-cli](https://thecattlecrew.net/2023/04/28/daten-integrieren-mit-airbyte-teil-2-octavia-cli/ "Zum Blogbeitrag") vorgestellt. Schnell stellte sich für mich die Frage, was da eigentlich hinter den Kulissen von Airbyte passiert. Also habe ich tiefer gegraben und werde dir im abschließenden dritten Teil zeigen, wie Airbyte im Inneren funktioniert. Abbildung 1 weiter unten zeigt, wie der Prozess abläuft, wenn Airbyte Daten von einer Quelle in ein Ziel synchronisiert: - Zunächst werden in Airbyte Daten aus einem einzelnen Datensatz der Quelle (SOURCE DATA) extrahiert - und als JSON-Format an die Destination gesendet. - Das JSON-Format wird dort erst einmal unverändert als Rohdatensatz (RAW DATA) in einer Spalte vom Format Binary Large Object (BLOB) gespeichert. Dies ist wichtig, denn es gilt der zentrale Grundsatz der ELT-Philosophie: keine Änderung der Daten durch die E- und L-Prozesse! - Wenn es sich beim Ziel um eine relationale Datenbank handelt, dann kann das JSON-Format in eine relationale Tabelle (NORMALIZED DATA) umgewandelt werden. ![Skizze des internen Prozesses bei Airbyte](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild1.png)Abbildung 1: Von der Quelle zum Ziel – Der interne Prozess bei Airbyte (Quelle: [https://airbyte.com/tutorials/full-data-synchronization](https://airbyte.com/tutorials/full-data-synchronization "Zur Bildquelle")) Intern nutzt Airbyte übrigens dbt, um SQL-Statements zu erstellen und die Daten zu transformieren. Kurz zur Erklärung: dbt oder „data build tool“ ist ein Open-Source-Datenintegrationstool, mit dem sich über SQL Select Statements sogenannte Data Models definieren lassen. Nähere Details zu dbt findest du auf [https://www.getdbt.com](https://www.getdbt.com "Mehr Details zu dbt"). Wenn die SQL Statements per dbt run zur Ausführung gebracht werden, werden Views oder Tabellen erstellt, je nach Konfiguration. Du möchtest mehr über dbt erfahren? In den nächsten Monaten ist eine eigene, ausführliche Blogserie zu diesem Thema geplant. Schau also gerne wieder in den CattleCrew Blog rein. Jetzt aber weiter zu den einzelnen Schritten im Airbyte Prozess: # Schritt 1: von SOURCE DATA zu RAW DATA Ist das Ziel eine Datenbank, dann hat Airbyte dort Tabellen angelegt, in denen die JSON-Formate aus den Source-Datensätzen gespeichert werden: *\_airbyte\_raw\_*. Nehmen wir an, wir möchten ganz simple Kundendaten mit den Attributen id und name extrahieren. In diesem Fall könnten wir den Streamnamen „customer“ verwenden. Es gäbe also in der Zieldatenbank die Tabelle *\_airbyte\_raw\_customer* mit folgendem Format: - \_airbyte\_ab\_id: eindeutige Hash-ID, die vom System generiert wird - \_airbyte\_data: JSON-Format der Datensätze - \_airbyte\_emitted\_at: Datum und Zeitstempel, an dem die Daten an die Destination gesendet wurden. ## Zwischenschritt: Temporäres Speichern Während die Datensynchronisation zwischen Source und Destination läuft, werden die Daten noch nicht direkt in die Tabelle *\_airbyte\_raw\_customer* geschrieben, sondern zunächst in einer temporären Tabelle gesammelt: *\_airbyte\_tmp\_\_customer*. ** steht hierbei für ein dreistelliges Buchstabenkürzel, das sich bei jedem Lauf ändert, damit der Name der temporären Tabelle eindeutig ist. Über die temporären Tabellen wird sichergestellt, dass kein inkonsistenter Datenbestand in der \_airbyte\_raw-Tabelle landet, wenn der Prozess während des Lesens aus der Quelle plötzlich abbrechen sollte. Sobald alle Daten aus der Quelle gelesen wurden, wird der Inhalt der temporären Tabellen in die \_airbyte\_raw-Tabelle übertragen. Dies passiert mit folgendem simplen Statement: ``` INSERT INTO _airbyte_raw_customer SELECT * FROM _airbyte_tmp__customer ``` Anschließend wird die temporäre Tabelle wieder gelöscht. Dieser Schritt wird in Airbyte als „Table Finalization“ bezeichnet. ![Tabellen beim Prozess der Finalisierung](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild2.png)Abbildung 2: Beladung der Rohdaten # Schritt 2: von RAW DATA zu NORMALIZED DATA Wenn in der Airbyte-Konfiguration die Funktion „Normalization“ aktiviert ist, wie in diesem Screenshot (Abbildung 3) … ![Screenshot: Aktivierung der Funktion "Normalization"](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild3.png)Abbildung 3: Konfiguration eines Streams, Normalisierung der Daten … dann wird das JSON-Format aus *\_airbyte\_raw\_customer.\_airbyte\_data* per dbt in eine relationale Datenbanktabelle überführt (siehe Abbildung 4). ![Darstellung des Prozesses der Normalisierung mit dbt](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild4.png)Abbildung 4: Normalisierung mittels dbt Wie du siehst, wird zu jedem JSON-Key eine Spalte angelegt, in die der entsprechende JSON-Wert übernommen wird. *\_airbyte\_normalized\_at* ist eine Metadatenspalte, die Datum und Zeitstempel der Normalisierung enthält. Über die konkatenierten Attribute id und name wird ein Hashwert gebildet, der in der Spalte *\_airbyte\_customer\_hash\_id* gespeichert wird und als Unique Key verwendet werden kann. Die Hashwertbildung über alle konkatenierten Attribute zur Erzeugung eines eindeutigen Schlüssels ist ein übliches Vorgehen im Data Warehousing. ## Basic Normalization in drei Schritten Bevor wir uns die Basic Normalization, die in drei Schritten abläuft, genauer ansehen, braucht es wieder einen kleinen Exkurs in das data build tool (dbt): Wie oben erwähnt, ist dbt in Airbyte integriert und wird bei der Basic Normalization genutzt. Dazu diese Hinweise: - Die dbt-Modelle, die in allen drei Schritten der Basic Normalization definiert werden, sind vom Typ „emphemeral“, d. h. es werden weder Views noch Tabellen auf der Datenbank erzeugt, sondern die Common Table Expressions existieren nur zur Laufzeit. - Die Zieltabelle, in unserem Beispiel *customer*, ist als inkrementelles Modell (Typ „incremental“) angelegt. Das bedeutet, dass diese Tabelle fortgeschrieben und nicht bei jedem Lauf neu angelegt wird. Die Daten aus dem Normalisierungsvorgang werden also zunächst in eine temporäre Zwischentabelle geschrieben und anschließend per Delete/Insert-Strategie in die Zieltabelle übertragen. Die SQL-Statements sehen wir uns im nächsten Absatz an. Doch nun zu den Schritten der Normalisierung: ### 1. Parsing (Model-Suffix \_ab1): - Extraktion der Spalten aus dem JSON-Format - Verschachtelte JSON-Formate werden wieder als JSON-Format in einer eigenen Spalte abgeleg ### 2. Casting (Model-Suffix \_ab2): - Cast der Spalten in das richtige Format ### 3. Hashing (Model-Suffix \_ab3): - Erzeugen eines Hashwerts über alle konkatenierten Attribute - Dieser Hashwert kann als Unique Key verwendet werden ## Welche SQL-Statements brauchst du? Je nach eingesetzter Zieldatenbank (PostgreSQL, Snowflake, MSSQL, Oracle usw.) können die Statements variieren. Unser Beispiel bezieht sich auf PostgreSQL, weil ich diese Datenbank im Kundenprojekt eingesetzt habe. Das Statement sieht in der für dbt typischen Jinja-Schreibweise für die temporäre Tabelle so aus: ``` create temporary table "customer__dbt_tmp121704956331"   as (   with __dbt__cte__customer_ab1 as ( -- Parsing select     _airbyte_ab_id,     _airbyte_emitted_at,     jsonb_extract_path_text(_airbyte_data, 'id') as "id",     jsonb_extract_path_text(_airbyte_data, 'name') as "name"   from my_db_name.my_schema._airbyte_raw_customer') }}  ), __dbt__cte__customer_ab2 as ( -- Casting select     _airbyte_ab_id,     _airbyte_emitted_at,     cast(id as {{ dbt_utils.type_integer() }}) as id,     cast(name as {{ dbt_utils.type_text() }}) as name -- Referenzierung (ref) auf das erste emphemeral Model   from {{ ref('__dbt__cte__customer_ab1') }} ), __dbt__cte__customer_ab3 as (  -- Hashing select a.*,        -- dbt-Utility zur Erzeugung eines Hashwertes        {{ dbt_utils.surrogate_key([           id,           name]) }} as _airbyte_customer_hashid,        now() _airbyte_normalized_at -- Referenzierung (ref) auf das zweite emphemeral Model    from {{ ref('__dbt__cte__customer_ab2') }} a ) select * -- Referenzierung (ref) auf das dritte emphemeral Model   from  {{ ref('__dbt__cte__customer_ab3') }} ``` Dies wäre das Statement zur Beladung von *customer*: ``` -- Delete-Insert-Stragegie bei incremeantal Models  delete from "my_db_name"."my_schema"."customer"     where (_airbyte_ab_id) in (         select (_airbyte_ab_id)         from "my_db_name"."my_schema"."customer__dbt_tmp121704956331"     );       insert into "my_db_name"."my_schema"."customer"     ("_airbyte_ab_id", "id", "name", "_airbyte_emitted_at",      "_airbyte_normalized_at", "_airbyte_customer_hash_id")     select "_airbyte_ab_id", "id", "name", "_airbyte_emitted_at",      "_airbyte_normalized_at", "_airbyte_customer_hash_id"       from "my_db_name"."my_schema"."customer__dbt_tmp121704956331"; ``` **… und was passiert mit verschachtelten JSON-Formaten?** Wahrscheinlich fragst du dich jetzt, wie die Normalisierung funktioniert, wenn im JSON-Format verschachtelte JSON-Formate enthalten sind. Schauen wir uns hierzu folgendes Beispiel an: ``` JSON-Format in _airbyte_raw_cars._airbyte_data: {   "make": "alfa romeo",   "model": "4C coupe",   "powertrain_specs": { "horsepower": 247, "transmission": "6-speed" } } ``` Die erste normalisierte Tabelle *cars* (siehe Abbildung 5) resultiert aus der Normalisierung von *\_airbyte\_raw\_cars*. Sie enthält die Attribute *make, model* und *powertrain\_spec* (JSON-Format), sowie den Hashwert (*\_airbyte\_cars\_hash\_id*) der konkatenierten Attribute. ![Normalisierte abelle Cars](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild5.png)Abbildung 5: Tabelle cars Um das JSON-Format *powertrain\_specs* zu normalisieren, wird die Tabelle *cars* als Input für einen weiteren Normalisierungsschritt verwendet. Das Resultat ist die Tabelle *powertrain\_specs* (s. Abbildung 6) mit den Attributen horsepower und transmission, sowie dem Hashwert (*\_airbyte\_powertrain\_specs\_hash\_id*) über diese konkatenierten Attribute. Ferner hat *powertrain\_specs* eine Foreign-Key-Beziehung zu cars über die *\_airbyte\_cars\_foreign\_hash\_id*. ![Tabelle powertrain](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild6.png)Abbildung 6: Tabelle powertrain Mir ist keine Begrenzung der JSON-Verschachtelung bzw. des Normalisierungslevels bekannt. D.h. wenn es n-fach-verschachtelte JSON-Formate in der airbyte-raw-Tabelle gibt, finden n Normalisierungen statt. Daraus entsteht eine Tabellenhierarchie mit Foreign-Key-Beziehungen. ## Die verschiedenen Synchronisierungsmodi Jetzt kommen wir noch zu den Synchronisierungsmodi, kurz Sync-Modes, die ich in erwähnt habe, als es um die Konfiguration der Verbindungen ging. Die Sync Modes setzen sich aus zwei Teilen zusammen. Der erste Teil bezieht sich auf das Verhalten in der Quelle (wie wird gelesen?) und der zweite auf das Verhalten im Ziel (wie wird gespeichert?). ### **Verhalten in der Quelle** Full Refresh: Alles aus der Source wird gelesen Incrementa: - Nur das Delta seit der letzten Synchronisation wird gelesen - Setzt ein Datumsfeld voraus, an dem der Zeitpunkt der letzten Synchronisation erkennbar ist – z. B. *modified\_date* - Verwendung des *modified\_date* als Cursor-Field in der Connection-Konfiguration Du fragst dich, was das Cursor-Field *modified\_date* bewirkt? Ein Maximalwert des *modified\_date* wird am Ende der Synchronisation ermittelt. Dieses Datum wird für jede Connection in der Airbyte Metadatentabelle *state* gespeichert. Bei der nächsten Synchronisation einer Connection braucht dann nur das *modified\_date* aus der Metadatentabelle *state* ausgelesen zu werden, und schon kennen wir den Aufsetzpunkt für die neue Synchronisation. Voilà! ### **Verhalten im Ziel** Overwrite: Alles wird überschrieben Append: - Neue Daten werden eingefügt, ohne alte zu löschen - IDs sind nicht eindeutig, wenn Änderungshistorien existieren Dedup History: - Insert oder Update in der Zieltabelle, so dass die IDs eindeutig sind - Änderungshistorie wird in einer zusätzlichen Tabelle mit dem Suffix \_scd gespeichert - \_scd-Tabelle ist vom Typ Slowly Changing Dimension 2 (SCD2) - Setzt voraus, dass ein Primary Key definiert ist, über den zwischen der Zieltabelle und \_scd-Tabelle eine Foreign Key Beziehung hergestellt werden kann - Zusätzliche Spalten in der Zieltabelle: \_airbyte\_unique\_key = Hashwert über Primary Key Feld - Zusätzliche Spalten in der \_scd-Tabelle: \_airbyte\_unique\_key = Foreign Key zur Zieltabelle \_airbyte\_unique\_key\_scd = eindeutiger Schlüssel der \_scd-Tabelle \_airbyte\_start\_at = Beginn der Zeitscheibe \_airbyte\_end\_at = Ende der Zeitscheibe \_airbyte\_active\_row = Flag, ob aktuell (1) oder Historie (0) Abbildung 7 zeigt, wie das Resultat von Dedup History für die Tabelle *customer* aussehen könnte: ![Dedub History für die Tabelle customer](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild7.png)Abbildung 7: Beispiel der Historisierung beim Synchronisierungsmodus „Dedup History“ ### **Kombinationsmöglichkeiten der Synchronisierungsmodi** Folgende Kombinationsmöglichkeiten aus Verhalten in der Quelle und Verhalten im Ziel sind in Airbyte als Sync Modes verfügbar: - Full Refresh | Overwrite - Full Refresh | Append - Incremental | Append - Incremental | Dedup History Full Refresh bietet sich für Tabellen mit geringem Datenvolumen an, weil keine Performanceprobleme zu erwarten sind. Die Entscheidung, ob Full Refresh mit Overwrite oder Append kombiniert wird, hängt davon ab, ob im Zielsystem die Änderungshistorie benötigt wird. Falls im Quellsystem immer nur der aktuelle Stand ohne Änderungshistorie verfügbar ist und im Zielsystem der aktuelle Stand ausreicht, solltest du die Kombination Full Refresh | Overwrite verwenden. Incremental hat für Tabellen mit großem Datenvolumen beim Lesen aus der Quelle einen Performancevorteil gegenüber Full Refresh. Denn es wird immer nur die Deltamenge gelesen. Werden die Sync Modes Append und Dedup History im Zielsystem verwendet, bläht sich das Datenvolumen hingegen sehr auf. Insbesondere, wenn sich die Daten im Quellsystem häufig ändern. Mir persönlich fehlt die Sync Mode Kombination Incremental | Overwrite. Diese böte einen echten Vorteil für Tabellen mit großem Datenvolumen und häufigen Änderungen, wenn ich im Zielsystem nur den aktuellen Stand benötige. ### **Wenn du Daten zurücksetzen musst** Für den Fall, dass in einem Airbyte Stream die Daten aus dem Quellsystem komplett neu geladen werden müssen, gibt es den Reset-your-data-Button (siehe Abbildung 8) ![Screenshot zum Reset der Daten](https://thecattlecrew.net/wp-content/uploads/2023/05/Bild8.png)Abbildung 8: Daten können über die Oberfläche „zurückgesetzt werden“, sprich ein Full-Load kann damit in die Wege geleitet werden Das passiert, wenn du auf den Button „Reset your data“ klickst: - Alle Daten in den Ziel-Tabellen werden gelöscht (\_airbyte\_raw, normalisierte Zieltabelle) - Die Ziel-Tabellen werden aber nicht gedroppt - Im Falle von Incremental in der Metadatentabelle *state* wird die Information zur letzten Synchronisation zurückgesetzt, so dass wieder von Anfang an gelesen wird. # Fazit Die Normalisierung im Data-Ingestion-Prozess erleichtert uns die Arbeit ungemein, weil die relationalen Rohdaten für das DWH schon entsprechend aufbereitet werden. Etwas nachteilig finde ich, dass bei der Data Ingestion immer alle Felder aus der Quelltabelle verarbeitet werden. Denn es ist aktuell leider nicht möglich, bei der Konfiguration der Airbyte Connection nur bestimmte Felder auszuwählen. Gerade vor dem Hintergrund der Datenschutz Grundverordnung (DSGVO) wäre das aber sehr wichtig. Da dieses Thema verstärkt bei Airbyte angefragt wurde, wurde dieses Feature schon für spätere Releases in Aussicht gestellt. Wir dürfen also gespannt sein, wann es so weit ist. Die Incremental-Sync-Modes bieten insbesondere bei der Extraktion Performancevorteile. Das Laden per Append oder Dedup History macht meiner Meinung nach aber nur Sinn, wenn die Änderungshistorie auch tatsächlich benötigt wird. Andernfalls bläht sich das Datenvolumen unnötig auf. Und bitte nicht vergessen, dass auch das Datenvolumen der \_airbyte\_raw-Tabellen bei Append und Dedup History stetig wächst, weil der Inhalt dieser Tabellen vor der nächsten Synchronisation nicht gelöscht, sondern fortgeschrieben wird! In meinem Kundenprojekt habe ich die Erfahrung gemacht, dass man die \_airbyte\_raw-Tabellen nach erfolgreicher Normalisierung mit dem truncate-Befehl leeren kann, ohne Gefahr zu laufen bei der nächsten Synchronisation Daten zu verlieren. Den truncate-Befehl musste ich allerdings selbst in den ELT-Prozess implementieren, da Airbyte ein Truncate der \_airbyte\_raw-Tabellen nicht vorsieht. Damit wäre ich auch schon am Ende des letzten Teils der Airbyte Trilogie angekommen. Ich hoffe, dass ich dir Airbyte etwas näherbringen konnte. Wenn dir diese Serie gefallen hat, dann bleib gerne dabei: Weitere interessante Blogbeiträge zum Thema Modern Data Stack sind schon in Arbeit 🙂 [Teil 1: Daten integrieren mit Airbyte – Teil 1: Einführung & Installation](https://thecattlecrew.net/2023/03/28/daten-integrieren-mit-airbyte-teil-1-einfuehrung-installation/) [Teil 2: Daten integrieren mit Airbyte – Teil 2: Octavia-cli](https://thecattlecrew.net/2023/04/28/daten-integrieren-mit-airbyte-teil-2-octavia-cli/ "Zum Blogbeitrag") [Teil 3: Wie funktioniert Data Ingestion genau?](https://thecattlecrew.net/2023/05/17/daten-integrieren-mit-airbyte-teil-3-wie-funktioniert-data-ingestion-genau/ "Zum Blogbeitrag") **Kategorien:** Integration, Tools & Methoden --- ### [Dbvisit: Der Elefant steht im Raum. Für alle sichtbar!](https://thecattlecrew.net/2023/10/10/die-revolution-geht-weiter-der-elefant-steht-im-raum-fuer-alle-sichtbar/) **Published:** Oktober 10, 2023 **Author:** Rainier Kaczmarczyk **Content:** Servus, im März diesen Jahres habe ich in meinem letzten Blog angedeutet, dass Dbvisit StandbyMP ein „drittes Kind“ bekommt. Deshalb nun endlich die Neuigkeit: Nachdem die Technologie mit Oracle groß geworden war und danach Microsoft SQL Server dazu bekommen hatte, erblickt jetzt der nächste Zuwachs das Licht der Welt. Der Elefant ist für alle sichtbar: Wie erwartet heißt er PostgreSQL! Der neue Riese kann nun also mit Oracle und SQL Server gemeinsames in einer Konsole ein glückliches Leben führen. ![Die "Kinder" Oracle, Microsoft und PostgreSQL](https://thecattlecrew.net/wp-content/uploads/2023/10/Postgres.png)Und ach. Ein viertes Kind kündigt sich bereits an … Mehr dazu im nächsten Jahr. Rainier **Kategorien:** Database, Infrastructure --- ### [Berichte erstellen mit disy Cadenza – ein Erfahrungsbericht](https://thecattlecrew.net/2024/05/06/berichterstellung-mit-disy-cadenza-ein-erfahrungsbericht/) **Published:** Mai 6, 2024 **Author:** Robert Loke **Content:** An sich ist die Visualisierung von Daten – und hier insbesondere von größeren Datenmengen – in Form von Tabellen, Graphen oder Zeitreihen mittlerweile ein Standard, der von allen marktgängigen Reporting-Werkzeugen beherrscht wird. Es gibt allerdings durchaus auch Fragestellungen, bei denen die tabellarische Darstellung eher aussagelos ist oder keine oder nur eingeschränkte Interpretation der Daten zulässt. Insbesondere sind hier Daten betroffen, deren Interpretation von geografischen Rahmenbedingungen abhängt. Hier muss man wissen, dass ca. 80% der Daten einen Ortsbezug haben und somit bei entsprechender Fragestellung in Verbindung mit Kartenmaterial auszuwerten sind. Diese Lücke haben einige Anbieter – und hier insbesondere die großen Anbieter von Werkzeugen zur Berichtserstellung – erkannt und ihr Portfolio ergänzt. Allerdings erweisen sich hier vielfach die bestehenden Architekturen und Versionen als „Klotz am Bein“ und die Notwendigkeit, zu anderen Tools kompatibel sein zu müssen und die im Laufe der Jahre historisch gewachsenen Features weiter unterstützen zu müssen (eine neue Version soll ja in der Regel immer mehr können als die Vorgängerversion) als hinderlich. Diese „ökologische Nische“ bietet daher den Nährboden für kleinere Anbieter, die mit schlanken Werkzeugen ohne ellenlange (Versions-)Historie diesen Markt für sich in Anspruch nehmen können. Einer dieser Anbieter ist die in Karlsruhe ansässige Firma „[DISY Informationssystem GmbH](https://www.disy.net/de/)„. Disy bietet mit seinem Tool Cadenza ein vollständig Browser-basiertes Reportingwerkzeug an, das die interaktive Darstellung von Daten auf Kartenmaterial zur seinem besonderem Anliegen erklärt hat. Das Tool hat sich mittlerweile bewährt und insbesondere in den Verwaltungen von Bund, Ländern und Kommunen Fuß gefasst. Bei OPITZ CONSULTING haben wir uns disy Cadenza sehr genau angesehen. Wie unsere ersten Schritte und Erfahrungen aussahen, erfahrt ihr in diesem Blogartikel. ## Was macht disy Cadenza so besonders? Disy Cadenza ist ein Reporting-Werkzeug, mit dem du klassische Berichte erstellst und Daten in Tabellen und Diagrammen visualisierst. Der eigentliche Clou dieses Tools ist jedoch die interaktive Darstellung von Kennzahlen auf Kartenmaterial – sofern sich die Daten in räumlichen Kontexten analysieren lassen. „Interaktiv“, weil die Möglichkeit besteht, Daten „räumlich“ durch entsprechende grafisch zu definierende Filter einzugrenzen. Wenn dies entwicklungsseitig eingestellt wurde, wirken die so definierten Filter auf alle Elemente der Arbeitsmappe. Zusätzlich besteht die Möglichkeit, Reichweiten mithilfe eines Layers darzustellen („Welche Orte sind binnen eines definierten Zeitraumes zu erreichen?“) und Wegstrecken mit speziellen Infos anzureichern (z. B. Berechnung der Fahrtstrecke zwischen zwei Orten). Die Besonderheit dieses Tools liegt weniger in der Form der Darstellung (andere Reportingwerkzeuge bieten auch die Option der Darstellung von Daten auf Karten) – es ist die weitreichende Integration dieser Visualisierung in die Administrations- und Reportingmöglichkeiten dieses Tools. Für Analyselösungen mit diesen Möglichkeiten wurde der Begriff der „Business- und Location-Intelligence-Lösung“ geprägt. In Disy Cadenza ist seit dem Frühjahrsrealease 2024 eine Schnittstelle verfügbar, um eigene Skripte zu integrieren, z. B. in R oder Python. Diese Schnittstelle ermöglicht es, die Ergebnisse eigener, beliebiger Analysen im gegebenen Reportingkontext zu integrieren und so auch die Ergebnisse komplexer Analysen über ein zentrales Portal zugänglich zu machen. ## Am Anfang steht … die Installation Cadenza kann in verschiedenen Varianten betrieben werden: Als Stand-Alone-Variante in einer lokalen Installation auf einem Desktop, als Web-Variante in einer Serverinstallation, die in einen Browser dargestellt wird oder über die Mobile-Variante, welche den Betrieb der Anwendung auf mobilen Endgeräten unterstützt. Zur Evaluation wird für die beiden erstgenannten Varianten eine Demoversion mit ausgeliefert. Grundlage für diesen Artikel ist die Analyse der Demoversion für die Web-Variante. Die Installation gestaltet sich sehr einfach: Die gelieferte Archivdatei entpacken – fertig! Das Ergebnis ist ein Zielverzeichnis, welches alle zum Betrieb erforderlichen Dateien enthält: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/cadenza_unpack.jpg) Zum Start der Web-Version ist der mitgelieferte Applikationsserver (Apache Tomcat) mit dem Skript „startup“ im Unterverzeichnis „CadenzaWeb/bin“ zu starten, die Arbeit kann dann losgehen. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/cad_browser-1024x581.png) Ich muss hier anmerken, dass dieses Vorgehen deswegen so einfach funktioniert, weil die vor-konfigurierte Demoversion verwendet wird. Sie hat den Vorteil, dass die Verbindung zur Repository-Datenbank konfiguriert ist, die Konfiguration einer anderen Datenbank als Repository ist jedoch möglich und wird später gezeigt werden. Darüber hinaus können die Eigenschaften des Applikationsservers über Konfigurationsdateien angepasst werden. Der andere Teil der Wahrheit ist, dass ein Repository in einer ORACLE- oder PostgreSQL – Datenbank liegen muss. Andere Datenbanken werden aktuell für das Cadenza Repository nicht unterstützt – allerdings zeigt sich disy auch gerne bereit, die Liste der unterstützten Datenbanken auf Nachfrage zu erweitern. ## Zuerst die Pflicht: Der „klassische Bericht“ Jedes Reporting-Werkzeug muss Daten darstellen können. Diese eher „archaische“ Variante der Tabellensilos ist hierbei ebenso das Pflichtprogramm wie die aufbereitete Darstellung in Form von Diagrammen. Die Berichte werden in Arbeitsmappen gespeichert – diese Ordnung hilft dir, deinen Bericht in der Vielzahl der verfügbaren Berichte wiederzufinden. Alternativ gibt es auch die Möglichkeit nach Stichworten zu suchen, um damit in Verbindung stehende Berichte zu finden. Die gewünschten Informationen sind noch nicht verfügbar? OK. Wir müssen einen neuen Bericht anlegen. Der Einfachheit halber legen wir zunächst eine Arbeitsmappe an und in diese Arbeitsmappe einen Bericht. Nachdem das Icon angeklickt und der gewünschte semantische Layer ausgewählt worden ist, gelangst du zur Oberfläche für die Berichtserstellung. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/ReportDesign1-1024x537.png) Auf den ersten Blick erinnert das Frontend an das Konkurrenzprodukt Microsoft PowerBI. Hier können wir einen Bericht definieren. Dafür wählen wir die darzustellenden Daten und Attribute aus, die in Filtern Anwendung finden sollen. Im ersten Schritt müssen wir die Datenquelle in der rechten Spalte „Datenmanager“ auswählen. Sobald die gewünschte Darstellungsform ausgewählt ist, können wir in unserer Funktion als Datenmanager die gewünschten Attribute per Drag and Drop in den Designer ziehen. Die Ausprägungen des ausgewählten Attributes werden sofort in der gewählten Darstellung visualisiert. Die Darstellung berücksichtigt dabei die im „semantischen Layer“ – auf diesen komme ich später noch einmal zurück – definierte Hierarchie der Objekte. Die Reihenfolge der Spalte, die du in der Abbildung siehst, lässt sich über die Reihenfolge im Designer festlegen. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/ReportDesignTable-1024x572.png) Ebenso ist die Einbindung von Diagrammen problemlos: Anstelle des Visualisierungstyps „Tabelle (aggregiert)“ wählst du den passende Diagrammtyp aus und schon wird die aktuelle Darstellung konvertiert. Hierbei bleiben auch Filter etc. erhalten. ## Zur Kür: Die Darstellung von KPIs auf Karten Soweit – so gut. Kommen wir zurück zur eigentlichen Domäne von Cadenza: der Darstellung bestimmter Kennzahlen, also KPIs, auf Kartenmaterial. Dieses erfolgt in den gleichen Strukturen wie in einem klassischen Bericht mit der gleichen Methode: Es sind Dimensionsdaten und Kennzahlen auszuwählen. Ebenso können Filter definiert werden. Nur wird als Visualisierungstyp hier ein Element aus der Gruppe „Karten“ ausgewählt und bei den Dimensionen muss darauf geachtet werden, dass diese einen Ortsbezug aufweisen. „Ortsbezug“ bedeutet hier, dass die Attributwerte geocodiert sein müssen. ### Beispiel: Gastronomie in Heidelberg Ist das Datenmaterial vorhanden, ist die Erstellung einer Liste von Gastronomiebetrieben geübte Praxis. Die folgende Abbildung zeigt, wie das in Cadenza aussieht. Dazu sei angemerkt, dass auf der linken Seite des Fensters, das die Abbildung zeigt, Filter definiert wurden um Betrieb mit unvollständiger Adresse auszuschließen. Ein weiterer Filter erlaubt die Einschränkung auf den Ort – in diesem Beispiel ist noch keine Einschränkung erfolgt. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/ReportDesignTable_HD-1024x556.png) Interessiere ich mich für Betriebe in der Nähe eines bestimmten Standorts, so kann die Darstellung auf Kartenmaterial hilfreicher sein: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/ReportDesignTableMap_HD-1024x510.png) Da es nun ein wenig unübersichtlich wird, wird eine Einschränkung auf den Ort eingefügt (z.B. „Dossenheim“). Der Filter wirkt auf beide Elemente des Arbeitsblatts: Links in der Liste werden die Betriebe auf Dossenheim beschränkt. Auch auf der Karte finden sich nur die gefilterten Datenpunkte. Um die Lage der Gastronomiebetriebe besser begutachten zu können, kann ich in die Karte hineinzoomen und das Restaurant mit der passenden Lage auswählen. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/ReportDesignTableMapFilterZoom_HD-1024x537.png) Das in diesem Beispiel verwendete Kartenmaterial stammt von OpenStreetMap. Hier sind jedoch auch Karten anderer Dienste verwendbar – ebenso proprietäre Dienste zur Geocodierung der Attributwerte. ## Perspektivisch immer wichtiger: Die API zu externen Inhalten Weil extensive Datenanalyse auch mit Mitteln künstlicher Intelligenz zunehmend wichtiger wird, hat auch Integrierbarkeit dramatisch an Bedeutung gewonnen. Das heißt, wir brauchen Schnittstellen zu externen Programmen und Skripten. Das Herbstrelease, das seit 2023 verfügbar ist, deckt diesen Bedarf ab, frühere Versionen weniger. Wer eine ältere Version nutzt, sollte daher dringend über ein Update nachdenken! Ein „externer Inhalt“ kann ein Analyse-Skript sein (hier werden mit R und Python die im Datenanalysekontext gängigen Programmiersprachen unterstützt), genauso gut kann es jedoch auch die Bereitstellung von Daten sein oder eine weitere Form der Datenvisualisierung kann über diese Schnittstelle bereitgestellt werden. Zur Einbindung der externen Inhalten gibt es in der Management-Konsole den Menüpunkt „Analyse-Erweiterung“. Hier können zuvor erstellte Inhalten eingebunden, mit erforderlichen Berechtigungen in Cadenza versehen und entsprechend ihrer Funktion kategorisiert werden. Der Prozess zur Durchführung der Analyse läuft dann so ab: - Überprüfung der Berechtigung, - Cadenza stellt dem Skript die Eingangsdaten als Input zur Verfügung - das Programm oder Skript startet und stellt den Output zur Visualisierung bereit, - Cadenza nimmt die Daten entgegen und visualisiert die Daten in einer Arbeitsmappe Da hier ggf. Berechtigungen zur Nutzung der bereitgestellten Daten beachtet werden müssen, sind entsprechende Mechanismen zur Beschränkung der Visualisierung zu definieren. Wer hierzu mehr erfahren möchte: Mit der genaueren Darstellung dieser Schnittstelle nebst einiger Beispiele für deren Nutzung wird sich ein weiterer Blogbeitrag beschäftigen. ## Definition der semantischen Schicht Mit Cadenza soll Cadenza jede Person einer Fachabteilung in der Lage sein, mit den vorhandenen Daten eine Visualisierung zu erstellen. Um das zu erreichen, müssen wir die physikalische Datenmodellierung, die sich bekanntlich eher technisch optimieren möchte als an Anwendungsfreundlichkeit, so „umzuformulieren“, dass Fachanwender damit arbeiten können. Diese logische Sicht auf die Daten nennt sich „semantische Schicht“. Es ist also klar, dass ein großer Teil der Magie von BI-Tools in der Bereitstellung der Daten stattfindet. Schauen wir uns diesen Teil genauer an. Die Ausgangslage ist, dass die Nutzdaten – also die Daten, mit denen die Anwendenden arbeiten sollen – in einer Datenbank vorliegen. Anders als bei der Repository-Datenbank kann das jede via JDBC verfügbare Datenbank sein. Im ersten Schritt ist diese Datenbank anzubinden. Hierzu ist die „Management Console“ zu verwenden. Die Management Console ist das universelle Administrationswerkzeug von CADENZA und wird uns im folgenden häufiger begegnen. Diese Console zu ist über das Zahnradsymbol in der Menuleiste (durch roten Kreis in Abbildung XY markiert) zu öffnen, sofern der Benutzer über Administratorprivilegien verfügt. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter-1-1024x503.png)Übersichtsseite des Management Centers ### 1. Schritt: Anlegen des Repositories Zum Anlegen eines Repositories nutzen wir die Schaltfläche „Repositorys“. Es erscheint eine weitere Maske, die zum eine Liste der verhandenen Repositories enthält (und die durch anklicken des jeweiligen Repositorynamens dann geändert werden können). ![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter_repoliste-1024x501.png)Auswahlliste der verfügbaren Repositorys Zum Anlegen ist der Menupunkt „Neues Repository“ (rechts oberhalb der Repositoryliste) anzuklicken. In dem sich öffnenden Fenster sind zum einem der Name des Repositorys anzugeben (hierbei ist es sinnvoll darauf zu achten, dass der Name sprechend und eindeutig ist!) sowie die beiden Optionen „Projekte“ und „Veröffentlichungskontrolle“ zu definieren. Unter „Veröffentlichungskontrolle“ verbirgt sich die Option, die Versionen des Repositorys jeweils zu speichern und damit auch die Möglichkeit, auf ältere Versionen zurückspringen zu können. Die Option bedingt, dass später ein CDS („Cadenza Data Storage“) definiert wird. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter_reponame-1024x500.png) Nach Eingabe des Namens und Wahl der beiden Optionen auf „Erstellen“ klicken und schon ist die Hülle des Repositorys erstellt. In den folgenden Schritten wird diese Hülle mit Inhalt gefüllt. (Hinweis: Die beiden Wahlmöglichkeiten sind optional. Da sie ggf. weiteren Aufwand nach sich ziehen, solltest du diese nur auswählen, wenn sie wirklich gewünscht werden.) ### 2. Schritt: Anbinden der Datenbank Das Anbinden einer Datenbank als Datenquelle ist eine eher unkomplizierte Angelegenheit. Ausgehend von der Startseite nach Anmeldung (Wichtig: Der Anwender muss über Administratorprivilegien verfügen!) ist unter dem Menupunkt „Datenquellen“ die Option zur Anbindung neuer Datenquellen verfügbar. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/NSrc1-Window-1024x245.png) Anklicken dieser Option öffnet ein weiteres Fenster, in die Zugangsdaten einzutragen sind: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/NSrc2-Credentials.png) Nach erfolgreichem Test wird die Datenquelle durch Anklicken von „Erstellen“ verfügbar gemacht. Die Auswahl möglicher Datenquellen ist aktuell auf diese acht beschränkt: - ArcGIS Feature Service - Elasticsearch - H2 - Microsoft SQL Server - Oracle Locator/Spatial - PostgreSQL/PostGIS - WFS - SAP HANA (seit Release 9.3 (Herbst 2023)) Die auf den ersten Blick nicht allzu üppige Unterstützung verschiedener Quellsysteme verdient indes einen zweiten Blick: Hier handelt es sich um gängige Vertreter von relationalen und File-basierten Datenbanken ebenso wie die Möglichkeit zur Anbindung von Big-Data-Umgebungen. Und sollte eine gewünschte Datenbank nicht unterstützt werden: Frag‘ am besten bei disy nach – hier ist man gerne bereit, die Liste verfügbarer Datenbanken zu ergänzen, sofern der Bedarf besteht. ### 3. Schritt: Definition der Präsentationschicht Ist die Datenbank mit den Quelldaten erst einmal angebunden, bleibt noch die Aufgabe, die Spalten in der Datenbanktabellen als Attribute des Metalayers für die Endanwender sichtbar zu machen und die erforderlichen Berechtigungen zu vergeben. Hierzu dient das Item „Objekttyp“ in der Administrationskonsole: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypen-1024x597.png) Ein „Objekttyp“ ist zunächst analog zu einer „Tabelle“ auf einer Datenbank zu verstehen. Es handelt sich also um ein generalisiertes Objekt, das die verschiedenen Datenobjekte (Attribut, Parameter o.ä.) enthält, die zur Darstellung in einem Bericht oder in einer Analyse vorgesehen sind. Durch Anklicken von „Objekttypen“ öffnet sich die Liste der bereits definierten Objekttypen nebst der Möglichkeit, neue Objekttypen anzulegen: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypliste-1024x487.png) Beim Anklicken von „Neuer Objekttyp“ ergeben sich zwei Optionen zum weiteren Verfahren: 1. Die Option „Einfachen Objekttyp erstellen …“ bietet die Möglichkeit, einen Objekttyp aus einer vorhandenen Datenquelle einzubinden. Hierbei werden per default alle Objekte des ausgewählten Typs übernommen. Es besteht jedoch die Möglichkeit, die darzustellenden Objekte auszuwählen. 2. Die Option „Zusammengesetzten Objekttyp erstellen …“ bietet die Möglichkeit, Objekte verschiedener zuvor erstellter, einfacher Objekttype zu einem neuen Objekttyp zusammenzufügen. Diese Option hilft bei der Zusammenstellung von Objekten, die für definierte Analysen erforderlich sind und vereinfacht hierbei insbesondere die Vergabe von Zugriffrechten. ### Einfachen Objekttyp erstellen Zur Erstellung eines einfachen Objekttyps diese Option wählen, sodass die Liste der zuvor definierten Datenquellen erscheint und zur Auswahl der gewünschten Datenquelle auffordert: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypen_create1-300x300.png)Nach Auswahl der Datenquelle wird die Liste der verfügbaren Objekte abgerufen und zur Auswahl gestellt: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypen_create2.png) Nach Auswahl der Objekt kann noch der Name des Objekts angepasst werden (hier ist ein für den (Fachbereichs-)Anwender sprechender Name zu bevorzugen!). Zur weiteren Bearbeitung wird nun die Liste der verfügbaren Attribute dargestellt: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypen_create3-1024x545.png) Da die Daten einer Tabelle oder eines Objekttyps allein in der Regel keine Aussagen darstellen, sind die Verknüpfungen zwischen den Objekttypen zu definieren. Dieses geschieht unter dem Punkt „Assoziationen“. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypen_create4.png) Durch Anklicken von „Erstellen“ wird wieder das zu erstellende Artefakt, in diesem Fall die Assoziation, angelegt und kann dann im weiteren Verlauf genutzt werden. Last but not least muss noch die Zugriffsberechtigung zugewiesen werden. Hierzu auf den Reiter „Zugriffsberechtigungen“ wechseln. ![](https://thecattlecrew.net/wp-content/uploads/2023/09/240324_objekttypen_create5.png) Hier ist zunächst die Gruppe bzw. der Anwender auszuwählen, dem die Berechtigung zugewiesen werden soll um dann zu definieren, in wie weit der Anwender bzw. die Gruppe die Daten verwenden darf. Durch „Erstellen“ wird die Berechtigung dann zugewiesen. Darüber hinaus wird an dieser Stelle noch die Möglichkeit geboten, neben der horizontalen Einschränkung der Daten (durch Auswahl der verwendbaren Objekte) die Daten auch vertikal einzuschränken. Hierzu können „statische Dateneinschränkungen“ definiert werden. Diese Bedingungen sind können von Anwendenden nicht umgangen werden und beschränken somit die verfügbaren Daten. In diesem Punkt unterscheidet sich diese Option übrigens von der Möglichkeit, Dateneinschränkungen benutzerbezogen zu definieren. Letztgenannten Option ist optionaler Bestandteil der Berechtigungsvergabe und auch auf diesem Arbeitsblatt zu definieren. Einbindung von Advanced Analytics In der vorliegenden Version sind die Möglichkeiten für elaborierte Analysen eher begrenzt: Die mitgelieferten Mittel der Visualisierung entsprechenden den Standards der retrospektiven Betrachtung. Hier werden durch die Integration von Kartenmaterial durchaus weitergehende Möglichkeiten eröffnet. Allerdings genügt dieses nicht mehr den aktuellen Stand, wo prädikative Analysen mit verschiedenen Analysemöglichkeiten erforderlich wären. Diesem trägt der Hersteller jedoch mit zukünftigen Releases Rechnung: So ist das Frühjahrsrelease 2024 um die Möglichkeit ergänzt worden, beliebige Skripte in R oder Python zur Generierung darstellbarer Datasets auszuführen. Diese Option ermöglicht natürlich auch die Nutzung neuronaler Netze u. ä. zur Datenanalyse. Wir dürfen also auf die Erweiterungen in den zukünftigen Releases gespannt sein. ## Verwaltung der Zugriffsrechte ### Anforderung Die Verwaltung der Zugriffsrechte ist bei BI-Frontends immer ein leidiges Thema: Niemand schränkt diese Rechte gerne ein und eigentlich hätte jeder Nutzer gerne uneingeschränkte Berechtigungen. Doch es gibt regulatorische Anforderungen, z. B. durch DSGVO, Verträge und juristische Rahmenbedingungen, die diese Rechte einschränken und einen sicheren Umgang mit Daten vorschreiben. Somit sind Datenzugriffe in einer Organisation immer zu begrenzen, sowohl horizontal (Einschränkung der verfügbaren Attribute) oder auch vertikal (Einschränkung der Datenmenge an Hand von Merkmalsausprägungen). Auf der einen Seite ist hierfür eine weitgehende Detaillierung erforderlich, die aber auch Fehlermöglichkeiten birgt. Daher sollte ein Frontend zur Vergabe der Zugriffsrechte optimalerweise so gestaltet sein, dass die Rechtevergabe - zum einen auf verschiedenen Ebenen möglich ist, - diese aber so übersichtlich gestaltet wird, dass nachvollziehbar bleibt, welche Rechte jeweils effektiv vergeben sind. ### Realisierung der Rechtevergabe bei disy Cadenza Um den verschiedenen Benutzer nicht individuell Rechte zuweisen zu müssen – das würde bei großen Benutzerkreisen zu unübersichtlich und aufwändig werden – werden Benutzer mit gleichen Bedarfen in Gruppen zusammengefasst. Entsprechend werden die Berechtigungen auch an Gruppen vergeben. Dieses Vorgehen entspricht dem Standard und wird von Cadenza unterstützt. Die Verwaltung der Zugriffsrechte erfolgt in der Managementkonsole unter den Menüpunkten „Benutzergruppen“ und „Benutzerrollen, Freigabestufen“. Um die Benutzergruppen zu erstellen, klickst du auf den Punkt „Benutzergruppen“:![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter_grant-1024x477.png)Daraufhin erscheint dieses Fenster: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter_grant_group-1024x447.png) Der Hersteller hat standardmäßig vier Benutzergruppen vordefiniert und mit entsprechenden Rechten versehen: ![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter_grant_group_default1.png) ![](https://thecattlecrew.net/wp-content/uploads/2023/09/MgmtCenter_grant_group_default2.png) In den meisten Fällen kommt man mit diesen vier Gruppen schon sehr weit – im Bedarfsfall können aber zusätzliche Gruppen angelegt werden. Sind die Benutzergruppen definiert, müssen noch die Berechtigungen zugewiesen werden. ## Mein Fazit In „kleinen“ Systemen, bei denen eine enge Zusammenarbeit zwischen Entwicklern, Administratoren und Anwendern möglich ist und nicht zu viele Anwender mit dem Tool arbeiten, bietet dieses Tool alles, was ein Anwenderherz begehrt. Das gilt umso mehr, wenn der Entwickler fehlende Funktionalitäten durch Erstellen von R- und Python-Skripten ergänzen kann. Hast du große Anwenderkreise, sehr komplexer Datenmodelle mit vielen Objekten oder stark regulierte Kontexte, bleibt disy Cadenza meiner Meinung nach noch ein wenig Luft nach oben für weitere Entwicklungen: - Aktuell geht ab einem gewissem Punkt der Überblick über erteilte Berechtigungen verloren - und es fehlt eine schnelle Möglichkeit zur Analyse erteilter Berechtigungen. Es ist jedoch davon auszugehen, dass dieses Problem im Zuge der weiteren Entwicklung behoben wird. Ein wenig Luft verbleibt noch bei der Vergabe von Berechtigungen: Prinzipiell sind die für die meisten Installationen ausreichend. Nicht zuletzt aufgrund gesetzlicher Anforderungen können Berechtigungen sehr granular vergeben werde. Daher ist hier besondere Sorgfalt an den Tag zu legen. Wünschenswert wäre daher eine Übersicht über effektiv erteilte Privilegien auf Benutzerebene um eine etwaige Fehlersuche insbesondere bei großen Systemen mit vielen Benutzern zu unterstützen. Im Grenzfall umfangreicher Datenmodelle wird der Anwender dann vor die Herausforderung gestellt, den Überblick über die je Benutzerrolle erteilten Berechtigungen zu bewahren. Jenseits dieser Grenzfälle und für alle, die auf der Suche nach einem leichtgewichtigen, Browser-basierten Reportingwerkzeug mit allen nötigen Funktionen sind, lohnt sich hingegen ein detaillierter Blick auf disy Cadenza. **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** Advanced Analytics, Disy, geo-located --- ### [Kollegin oder Konkurrenz? – Was kann ChatGPT in der IT? Ein Praxistest](https://thecattlecrew.net/2023/06/12/chat-gpt/) **Published:** Juni 12, 2023 **Author:** Fabian Heidenstecker **Content:** Geht es dir auch so: Jeden Tag finde ich Artikel über ChatGPT in meiner LinkedIn-Timeline. Ebenso auf Twitter und Facebook. Aber auch die Nachrichtenseiten sind voll davon. Sogar die Tagesschau berichtete über den genialen Textbot des Konsortiums OpenAI, der für alle kostenfrei verfügbar ist. Letztens habe ich mir ein Buch über Datenstrategie gekauft. Der Autor hat sich beim Schreiben von ChatGPT unterstützen lassen. ChatGPT begegnet mir einfach überall. # Was ist dran am Hype? Für mich selbst ist das Thema nicht neu. Immerhin beschäftige ich mich seit einigen Jahren mit Maschinellem Lernen und Künstlicher Intelligenz. Aber jetzt habe ich das Gefühl, dass die KI dank ChatGPT im Mainstream angekommen ist und ich frage mich: Wo stehen wir wirklich? Und werden die Auswirkungen nicht maßlos überschätzt? Gerne würde ich mit meinen Kolleginnen und Kollegen in den Austausch gehen und darüber diskutieren, ob sie ChatGPT bereits bei der Arbeit einsetzen. Ich checke meinen Terminkalender. Demnächst steht eine interne Veranstaltung an, und es werden noch Beiträge gesucht. Nur noch wenige Wochen bis zum Termin. Bis dahin bekomme ich doch nie etwas vorbereitet … Aber hey, es gibt doch jetzt ChatGPT! Das Versprechen von ChatGPT lautet: „Ich helfe dir wann immer du mich brauchst und mache deinen Arbeitsalltag leichter.“ Wie wäre es, wenn ich ChatGPT für die Vorbereitung nutze? Dabei könnte ich zwei Fliegen mit einer Klappe erwischen: - Ich kann herausfinden, was wirklich dran ist an dieser Wunder-KI - und dazu einen Vortrag (hoffentlich!) mit der Hilfe meiner „neuen Kollegin“ ChatGPT noch kurzfristig vorbereiten. Kurz zweifle ich: Könnte es nicht unethisch sein, eine KI einzusetzen, um meine Arbeit zu erledigen? Ich möchte einfach herausfinden, wie sich das anfühlt, vielleicht ist es auch nur ein komisches Gefühl, weil es ein ungewohntes Tool ist ? Ich werde es einfach mal probieren und meine Präsentation, die ich als Impuls nutzen möchte, um die Diskussion zu starten, mithilfe von ChatGPT erstellen. # Der Praxistest Für meinen Praxistest nutze ich einen Impulsvortrag über den Wert und den Nutzen von ChatGPT, den ich in den nächsten Tagen vor meinen Kolleg:innen halten werde. ChatGPT soll mir helfen, den Vortrag über sie selbst schnell und einfach vorzubereiten indem sie mir Inhalte für meine Powerpoint Präsentation liefert. Bin gespannt, wie es wird … ## Mein Vorgehen Ich möchte versuchen, mir sämtliche Inhalte von ChatGPT generieren zu lassen. Auch zu Gliederung und Aufbau möchte ich mich beraten lassen, und mich bei der Ideenfindung inspieren lassen, bzw. diese im besten Fall komplett übernehmen. ChatGPT wird mir also Inhalte und Themen vorschlagen, die ich auf ihren Nutzen für mich bewerten werde. Das wird meine erste Frage an meine virtuelle „Kollegin“ sein. Weitere Fragen werden sich daraus im Verlaufe des Beitrags ergeben. ## Anmelden, und los geht’s … Die Anmeldung bei ChatGPT ist kostenlos und geht schnell von der Hand. Ich entscheide mich erst mal für die kostenlose Variante. Eine kostenpflichtige Variante wird für 20 $ / Monat angeboten: Für meinen Test habe ich mit GPT-3.5 gearbeitet. Es existiert bereits die neue Version GPT-4, die sich durch ein noch größeres Modell von der bisherigen Version unterscheidet. Außerdem ist GPT-4 in der Lage, Bilder zu interpretieren und zu beschreiben. ## Im Prompt Nach der Anmeldung öffnet sich der „Prompt“. Der Prompt ist sozusagen das Sprachrohr von ChatGPT. Hier kann ich intuitiv und einfach mit ChatGPT interagieren, in dem ich ihr Fragen stelle. Diese immer wieder neu kombiniere und verfeinere. Unsere Konversationen werden in einer Art Verlauf, wie man ihn beispielsweise von WhatsApp kennt, organisiert. So kann ich auch auf frühere Fragestellungen zurückgreifen. Irgendwie clever. ![](https://thecattlecrew.net/wp-content/uploads/2023/05/Prompt-1024x540.png)Der Chat GTP Prompt # Was kann ChatGPT? Aber was kann Chat GPT nun wirklich, und wie erleichtert sie die Arbeit. Fragen wir sie doch mal. ## Frage 1: Wie kann ich mit ChatGPT meine Arbeit erleichtern? Mit ChatGPT kannst du auf verschiedene Weisen deine Arbeit erleichtern: 1. Informationen suchen: ChatGPT kann dir helfen, Informationen zu recherchieren und Antworten auf spezifische Fragen zu finden. Du kannst Fragen zu einem bestimmten Thema stellen und erhältst relevante Informationen und Erklärungen. 2. Textgenerierung: ChatGPT kann dir dabei helfen, Texte zu erstellen. Du kannst beispielsweise eine grobe Struktur vorgeben und ChatGPT füllt den Rest für dich aus. Dies kann nützlich sein, wenn du Artikel, Berichte, Präsentationen oder andere schriftliche Arbeiten verfassen musst. 3. Ideenfindung: Wenn du Schwierigkeiten hast, neue Ideen zu entwickeln oder in einer Denkblockade steckst, kannst du ChatGPT um Vorschläge oder Inspiration bitten. Du kannst eine Beschreibung deines Problems oder deiner Herausforderung geben und ChatGPT kann dir dabei helfen, neue Perspektiven und Lösungsansätze zu finden. 4. Sprachliche Unterstützung: Wenn du Texte in einer anderen Sprache verfassen musst, in der du nicht so versiert bist, kann ChatGPT als Sprachassistent dienen. Du kannst Sätze oder Abschnitte auf Englisch eingeben und ChatGPT übersetzt sie für dich in die gewünschte Sprache. 5. Grammatik- und Rechtschreibprüfung: Du kannst ChatGPT nutzen, um deine Texte auf Grammatik- und Rechtschreibfehler zu überprüfen. Einfach den Text eingeben und ChatGPT kann dir bei der Korrektur helfen. Es ist jedoch wichtig zu beachten, dass ChatGPT ein KI-Modell ist und nicht immer perfekte oder vollständige Antworten liefern kann. Verwende die generierten Informationen als Ausgangspunkt und überprüfe sie immer kritisch auf Richtigkeit und Relevanz. ChatGPT liefert mir hier fünf Anknüpfungspunkte. Find ich gut. Diese werde ich für den „Roten Faden“ meiner Präsentation (und für die Struktur dieses Beitrags) nutzen. Okay, den Disclaimer werde ich beherzigen. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/five-stars.png) # Funktion „Informationen suchen“ Ich kann also nach Informationen suchen. Schön, dann benutze ich das doch gleich, um mehr Informationen darüber zu erhalten, was ChatGPT eigentlich ist. ## **Frage 2: Was ist ChatGPT?** ChatGPT ist ein fortschrittliches Sprachmodell, das auf der GPT-3.5-Architektur von OpenAI basiert. GPT steht für „Generative Pre-trained Transformer“ und bezieht sich auf das zugrunde liegende neuronale Netzwerk, das speziell für die Verarbeitung natürlicher Sprache entwickelt wurde. ChatGPT wurde darauf trainiert, menschenähnliche Unterhaltungen zu führen und auf eine breite Palette von Fragen und Anfragen zu antworten. Es kann Text verstehen, kontextbezogene Antworten generieren und in Echtzeit mit Benutzern interagieren. Das Modell wurde durch maschinelles Lernen auf großen Mengen an Textdaten trainiert, um ein Verständnis für Sprache, Grammatik, semantische Beziehungen und sogar menschliche Schreibstile zu entwickeln. Es kann Wissen zu verschiedenen Themen abrufen, Informationen geben, Anleitungen geben, Fragen beantworten und mehr. Es ist wichtig anzumerken, dass ChatGPT ein KI-Modell ist und seine Antworten auf den ihm zur Verfügung gestellten Daten basieren. Es kann keine persönlichen Erfahrungen haben oder aktuelle Ereignisse nach dem Trainingsdatum (September 2021) kennen. Gut, aber zu lang. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/three-stars.png) Vielleicht kann ChatGPT das ja verkürzen, sagen wir auf drei Bullet Points für meine Präsentation? ## **Frage 3: Fasse diese Informationen zu drei Stichpunkten zusammen. Die Stichpunkte sollen maximal 10 Wörter lang sein** 1. Fortschrittliches Sprachmodell für menschenähnliche Unterhaltungen. 2. Trainiert auf natürlicher Sprache und Kontextverständnis. 3. Kann Fragen beantworten, Informationen geben und interaktiv kommunizieren. Cool, das war ja einfach. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/four-stars.png) Bei meinem Vortrag werden einige Informatikerinnen und Informatiker dabei sein. Für die ist das bestimmt zu „seicht“. Ich erinnere mich daran, dass man ChatGPT bitten kann, etwas für eine bestimmte Gruppe zu formulieren: ## **Frage 4: Erkläre was ist ChatGPT für einen Informatiker** 1. Neuronales Sprachmodell für konversationsbasierte Anwendungen. 2. Basierend auf GPT-3.5-Architektur mit maschinellem Lernen. 3. Bietet natürliche Sprachverarbeitung und kontextbezogene Antworten. Perfekt. Damit ist meine erste Folie fertig. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/five-stars.png) Die Funktion „Informationen suchen“ hat schon mal geklappt. Ob die Informationen korrekt sind, kann ich nicht ohne Weiteres sagen. ## Frage 5. Auf die Frage, woher die Informationen stammen, bekomme ich folgende Antwort Die Informationen über ChatGPT stammen von OpenAI, dem Unternehmen, das das Modell entwickelt hat. Als Teil meines Trainings habe ich Zugang zu einer Vielzahl von Online-Ressourcen, darunter wissenschaftliche Artikel, technische Dokumentationen und offizielle Ankündigungen von OpenAI. Diese Informationen wurden auf der Grundlage meines Wissensschatzes als KI-Modell bis September 2021 aktualisiert. Immerhin, so habe ich einen Anhaltspunkt für die weitere Recherche und weiß, woher und von wann die Daten stammen. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/three-stars.png) # Funktion „Textgenerierung“ Als nächstes möchte ich weitere Infos zu ChatGPT bekommen – am liebsten in einer Form, die ich direkt in meiner Präsentation einbauen kann. Daher nutze ich als zweite Funktion „Textgenerierung“ und öffne dafür einen neuen Chat. Hier kann ich ohne Kontext auf einer frischen Instanz von ChatGPT starten. ## **Frage 6: Schreibe mir einen Text mit drei Kapiteln zum Thema ChatGPT** **Dabei bat ich ChatGPT, das erste Kapitel über die Entstehungsgeschichte von GPT-Modellen zu schreiben, Kapitel 2 über den Aufbau von ChatGPT und Kapitel 3 über die Einsatzgebiete.** **Kapitel 1: Die Entstehungsgeschichte von GPT-Modellen** Die Entstehungsgeschichte von GPT (Generative Pre-trained Transformer)-Modellen reicht zurück in das Jahr 2018, als OpenAI die erste Version, GPT-1, veröffentlichte. Das Ziel war es, ein neuronales Netzwerk zu entwickeln, das auf großen Mengen unstrukturierten Textdaten trainiert werden konnte, um menschenähnlichen Text zu generieren. GPT-1 basierte auf der Transformer-Architektur, die eine bahnbrechende Methode zur Verarbeitung natürlicher Sprache darstellte. Das Modell wurde auf einem riesigen Datensatz trainiert, der aus Büchern, Artikeln, Webseiten und anderen Textquellen bestand. Durch das Vor-Training auf diesem vielfältigen Korpus konnte GPT-1 eine beeindruckende Fähigkeit entwickeln, kohärente und zusammenhängende Texte zu erzeugen. **Kapitel 2: Der Aufbau von ChatGPT** Der Aufbau von ChatGPT baut auf den Erfolgen von GPT-1 auf und erweitert das Modell, um spezifisch für die Aufgabe des Chatbot-Dialogs optimiert zu sein. ChatGPT nutzt eine ähnliche Architektur wie GPT-1, besteht jedoch aus mehreren aufeinander gestapelten Encoder-Decoder-Blöcken. Der Encoder-Teil des Modells nimmt die Eingabe, zum Beispiel die Frage eines Nutzers, entgegen und wandelt sie in eine darstellbare Form um. Der Decoder-Teil generiert dann die Antwort basierend auf dem verarbeiteten Eingabe-Encoder und dem internen Kontext des Modells. Um die Qualität der generierten Antworten zu verbessern, wurde ChatGPT mit einer Methode namens „Fine-Tuning“ verfeinert. Dabei wurde das Modell auf spezifische Chat-Datensätze trainiert und anhand von menschlichen Bewertungen optimiert. Durch diesen Prozess konnte ChatGPT ein tieferes Verständnis von menschlicher Sprache und ein präziseres Reagieren auf Benutzeranfragen entwickeln. **Kapitel 3: Die Einsatzgebiete von ChatGPT** ChatGPT hat eine Vielzahl von Einsatzgebieten und findet in verschiedenen Bereichen Anwendung. Eines der Hauptanwendungsgebiete ist der Kundenservice. Unternehmen setzen ChatGPT ein, um automatisierte Chatbots bereitzustellen, die Kundenanfragen beantworten können. ChatGPT ist in der Lage, häufig gestellte Fragen zu erkennen und entsprechende Antworten zu generieren, wodurch die Effizienz des Kundensupports gesteigert wird. Ein weiteres Einsatzgebiet von ChatGPT ist die virtuelle Assistenz. Mit Hilfe von ChatGPT können virtuelle Assistenten wie Alexa, Siri oder Google Assistant natürlichere und kontextbezogene Unterhaltungen mit den Benutzern führen. Die Fähigkeit von ChatGPT, komplexe Dialoge zu verstehen und darauf zu reagieren, ermöglicht eine verbesserte Benutzererfahrung und eröffnet neue Möglichkeiten für die Interaktion mit sprachgesteuerten Geräten.Darüber hinaus wird ChatGPT auch in der Bildung, der Medizin und anderen Fachbereichen eingesetzt. Es kann als Werkzeug zur Informationsbereitstellung, zum Lernen und zur Unterstützung von Fachkräften dienen. Durch die Interaktion mit ChatGPT können Benutzer schnell relevante Informationen erhalten und komplexe Probleme diskutieren. Insgesamt hat ChatGPT die Art und Weise, wie wir mit Computern und künstlicher Intelligenz interagieren, revolutioniert. Mit seiner Fähigkeit, natürliche Sprache zu verstehen und menschenähnliche Antworten zu generieren, eröffnet es neue Horizonte für den Einsatz von KI in verschiedenen Bereichen des täglichen Lebens. Die Antwort klingt schlüssig, aber das ist ganz schön viel Text. Den bringe ich lieber auf der Tonspur. Bewertung ![](https://thecattlecrew.net/wp-content/uploads/2023/05/four-stars.png) Aber was schreibe ich auf meine Folien? Fragen wir die KI: ## **Frage 7:** **Wie könnte ich diesen Text auf drei PowerPoint Folien darstellen?** **Folie 1:** Titel: Entstehungsgeschichte von GPT-Modellen – GPT-1 wurde 2018 von OpenAI veröffentlicht – Trainiert auf großen Mengen unstrukturierter Textdaten – Basierend auf der Transformer-Architektur **Folie 2:** Titel: Aufbau von ChatGPT – ChatGPT erweitert die GPT-1-Architektur – Verwendet Encoder-Decoder-Blöcke – Fine-Tuning für bessere Qualität der Antworten **Folie 3:** Titel: Einsatzgebiete von ChatGPT – Kundenservice: Automatisierte Chatbots für Kundenanfragen – Virtuelle Assistenz: Natürlichere und kontextbezogene Unterhaltungen – Bildung, Medizin und andere Fachbereiche: Informationsbereitstellung und Unterstützung **Hinweis:** Die Folien können angepasst und erweitert werden, um relevante Grafiken, Diagramme oder Beispiele hinzuzufügen und den Inhalt visuell ansprechender zu gestalten. Ja okay, das passt. Danke für den Hinweis, liebe ChatGPT! (Frage an mich: Werden wir tatsächlich schon Kollegen?) Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/four-stars.png) Eine Grafik wäre jetzt noch schön. Mal sehen was ChatGPT hier zu bieten hat: ## **Frage 8: Wo finde ich eine Grafik zum technischen Aufbau von ChatGPT?** Leider kann ich als textbasiertes KI-Modell keine direkten Links oder Dateien bereitstellen. Jedoch gibt es einige Ressourcen und Online-Plattformen, auf denen Sie Grafiken und Diagramme zum technischen Aufbau von ChatGPT finden können: **OpenAI Blog:** Besuchen Sie die offizielle OpenAI-Website und suchen Sie nach Blogartikeln oder technischen Dokumentationen zu ChatGPT. OpenAI veröffentlicht häufig Informationen über ihre Modelle, darunter auch Visualisierungen und technische Details. **Forschungsarbeiten:** Suchen Sie nach wissenschaftlichen Publikationen zu ChatGPT oder verwandten Modellen. In diesen Arbeiten finden Sie oft detaillierte Diagramme und Erläuterungen zum Aufbau des Modells. **Online-Communitys und Foren:** Es gibt Online-Communitys und Foren wie GitHub, Reddit oder Stack Overflow, in denen Entwickler und KI-Enthusiasten ihre Erkenntnisse und Visualisierungen zu ChatGPT teilen. Durchsuchen Sie diese Plattformen nach relevanten Diskussionen und Beiträgen. **KI-Forschungsplattformen:** Plattformen wie arXiv oder Google Scholar beherbergen eine Vielzahl von wissenschaftlichen Artikeln zu künstlicher Intelligenz und NLP (Natural Language Processing). Suchen Sie nach relevanten Veröffentlichungen, die möglicherweise Visualisierungen des technischen Aufbaus von ChatGPT enthalten. Indem Sie diese Ressourcen nutzen, sollten Sie in der Lage sein, Grafiken und Diagramme zu finden, die den technischen Aufbau von ChatGPT veranschaulichen. Okay, immerhin habe ich eine paar Anlaufstellen, wo ich fündig werden kann. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/two-stars.png) Die Textgenerierung funktioniert gut. Mein Highlight ist hier die Möglichkeit, aus längeren Textpassagen eine Zusammenfassung generieren zu lassen. # Funktion: „Ideenfindung“ Die Funktion „Ideenfindung“ habe ich bereits kennengelernt, als ich nach den Verwendungsmöglichkeiten von ChatGPT gefragt habe. Das hatte für mich hervorragend funktioniert. Sollte als Grundlage für meinen Test reichen. Also, Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/five-stars.png) # Funktion „Sprachliche Unterstützung“ ChatGPT kann Texte von einer Sprache in die andere übersetzen und damit wissen auch für Personen zugänglich machen, die das Original vielleicht gar nicht oder nur schlecht verstehen würden. Um diese Funktion einmal zu testen habe ich mir einen englischsprachigen Artikel aus dem Internet herausgesucht. Der Artikel der Washington Post ([link](https://www.washingtonpost.com/technology/2023/04/27/chatgpt-messages-privacy/)) beschäftigt sich mit ChatGPT und wirft Fragen bezüglich der Sicherheit von Informationen auf, welche man in ChatGPT eingibt. Ich bitte ChatGPT darum, den Artikel ins Deutsche zu übersetzen. ## **Frage 9: Übersetze mir bitte folgenden Text: \[Artikel der Washington Post\]** Man kann leider keinen Link angeben, sondern muss den Text per Copy & Paste einfügen. Das war schnell erledigt. Der Vorgang selbst dauert jedoch einige Zeit. Zwischendurch muss ich immer wieder bestätigen, dass die Generierung fortgesetzt werden soll. Dafür kann ich mit dem Ergebnis aber zufrieden sein: Der Text ist gut lesbar und verständlich. Hier hat sich offensichtlich im Lauf der letzten zwei Jahre einiges getan. Du kennst sicher auch diese maschinell übersetzten Inhalte und Texte, die sich seltsam lesen, wie mit dem Wörterbuch übersetzt. Diesen Effekt konnte ich hier nicht feststellen. Gut finde ich die Möglichkeit, ChatGPT anschließend Fragen zum Inhalt des Artikels zu stellen. Zum Beispiel interessierte mich das Thema Datenschutz. Ich fordere ChatGPT heraus und stelle eine Frage zu einem spezifischen Inhalt aus dem Artikel. Dort ist die rede von Googles Sprachmodell „Bard“. Dies kann ChatGPT nicht kennen, da es erst im Jahr 2023 veröffentlicht wurde. ## **Frage 10: Wie lange werden Daten in in Google Bard gespeichert?** Gemäß dem Artikel speichert Google einige Unterhaltungen für Überprüfung und Anmerkung und behält sie bis zu vier Jahre lang. Es wird jedoch nicht spezifiziert, wie lange genau die Daten in Bard gespeichert werden. ChatGPT beantwortet also meine Frage mit dem Wissen aus diesem Artikel. Das finde ich stark. Zu den Implikationen auf das Thema Sicherheit und Datenschutz dazu später mehr. Selbstverständlich kann man den Artikel auch wieder zusammenfassen lassen. Die Übersetzung funktioniert einwandfrei und klingt ähnlich wie in der Antwort zu Google Bard. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/five-stars.png) *Anmerkung: Aus Gründen der Lesbarkeit habe ich darauf verzichtet, den ganzen Artikel hier mit aufzunehmen.* # Funktion „Grammatik- und Rechtschreibprüfung“ Um diese Funktion unter die Lupe zu nehmen, bat ich ChatGPT, meinen ursprünglichen Einleitungstext für diesen Blogartikel zu überprüfen und die Grammatik des Textes zu bewerten. ## **Frage 11:** **Kannst Du bitte folgenden Text auf Rechtschreibfehler prüfen und die Grammatik bewerten?** ![](https://thecattlecrew.net/wp-content/uploads/2023/05/Abgleich-1024x479.png) Für den Abgleich zwischen den Versionen nutzte ich ein Tool, um die Unterschiede zwischen Texten anzeigen zu lassen. Der Vergleich ergab einige Tippfehler und Fehler in der Zeichensetzung. Fehler bei Groß- und Kleinschreibung erkennt ChatGPT zuverlässiger als andere Hilfen, wie sie z. B. Microsoft Word anbietet. Außerdem wurden Formulierungen angepasst. Ich ändere meinen ersten Blog-Abschnitt entsprechend. Du darfst jetzt natürlich die finale Fassung lesen! Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/five-stars.png) Was aber hielt ChatGPT grammatikalisch von meiner Einleitung? ## **Frage 12:** **Kannst du die Grammatik bewerten?** Ja, gerne bewerte ich die Grammatik des Textes: – Die Satzstruktur und der Satzbau sind im Allgemeinen gut. Es gibt jedoch einige Stellen, an denen die Satzkonstruktion etwas umständlich wirkt. Zum Beispiel: „Jetzt habe ich das Gefühl, dank Chat GPT ist das Thema im Mainstream angekommen.“ Hier könnte man den Satz besser formulieren, z.B. „Jetzt habe ich das Gefühl, dass das Thema dank Chat GPT im Mainstream angekommen ist.“ – Es gibt einige Kommasetzungsfehler, z.B. „Nur noch wenige Wochen bis zum Termin. Bis dahin bekomme ich doch nie was vorbereitet…“ Hier sollte nach „Termin“ ein Komma gesetzt werden, um den Satz zu trennen. – In einigen Fällen könnten bestimmte Ausdrücke oder Formulierungen präziser sein. Zum Beispiel: „Ich habe zwar noch Bedenken, ob es nicht unethisch ist, eine KI einzusetzen, um seine Arbeit zu erledigen, aber was soll’s.“ Hier könnte man statt „um seine Arbeit zu erledigen“ präziser sagen „um meine Arbeit vorzubereiten“ oder „um bei meiner Arbeit zu unterstützen“. Insgesamt ist der Text gut verständlich, aber es gibt einige kleine Verbesserungsmöglichkeiten in Bezug auf Rechtschreibung, Interpunktion und Formulierungen.Das klingt doch gut: Mein Text wird als verständlich eingestuft. Ich übernehme nicht alle Vorschläge, freue mich aber über das Feedback. Bewertung: ![](https://thecattlecrew.net/wp-content/uploads/2023/05/four-stars.png) # Ergebnisse Was hat mein Praxistest nun aber konkret ergeben? In Zahlen sieht es so aus: Ich habe ChatGPT zwölf Fragen gestellt. Zähle ich die vergebenen Sterne aus meiner „subjektiven Bauch-Bewertungsskala“ zusammen, komme ich auf 49 von 60 möglichen Sternen. Ein gutes Ergebnis. ## Vor- und Nachteile auf einen Blick ### **+ + Positive Aspekte** - Textgenerierung, Umformulierung und Zusammenfassung sind sicherlich die Stärken von ChatGPT. Die Texte waren beeindruckend formuliert, auch auf Deutsch. - Die Vielfalt an Ideen und Impulsen hat mir geholfen, Blockaden zu lösen und einen Ansatz zu finden. - Die Übersetzungsfunktion ist qualitativ hochwertig. ChatGPT kann sogar Klingonisch oder Altdeutsch, obwohl das nicht explizit trainiert wurde. ### **+ – Neutrale Aspekte** Hier Grammatik- und Rechtschreibprüfung sowie Vorschläge zur verbesserten Lesbarkeit könnten mir die Arbeit erleichtern. Diese Funktionen sind aber auch in Programmen wie Microsoft Word integriert. ### **– – Hier ist Vorsicht geboten** Die Informationssuche lieferte plausibel klingende Ergebnisse, allerdings ist ChatGPT ein Sprach- und keine Wissensmodell. Es ist optimiert darauf, gefällig klingende Texte zu formulieren, unabhängig von der Korrektheit der Fakten. ## Summary Mein Fazit fällt insgesamt positiv aus: ChatGPT konnte mir helfen, den Impulsvortrag vorzubereiten und mir dabei eine Menge Arbeit abnehmen. Die Arbeit im Prompt ging schnell und flüssig von der Hand. Die Texte ließen sich problemlos nach PowerPoint übertragen. Trotzdem habe ich gemerkt, dass es ein Umstieg für mich ist. Immerhin bin ich ein Mensch, der seit mehr als 20 Jahren herkömmliche Suchmaschinen nutzt und es gewohnt ist, dort Keywords mit Wildcards zu kombinieren. ChatGPT braucht viel mehr Prosa. Erklärungen und Beispieltexte. Dafür kann ich die Ergebnisse im Prompt Schritt für Schritt verfeinern. Je mehr Kontext und Details ich mitgebe, umso genauer wird das Ergebnis. Fast wie in einem Gespräch mit einer echten Kollegin oder einem echten Kollegen. Für mich steht fest, ich werde ChatGPT im beruflichen Alltag weiterhin nutzen. Allerdings sehe ich auch „Schattenseiten“. An dieser Stelle daher noch einige Mahnungen: ### Vorsicht bei sensiblen Daten OpenAI, der Hersteller von ChatGPT, speichert alle Eingaben und verwendet diese unter anderem zur Verbesserung des Modells. Das hat bereits zur Sperrung des Dienstes in Italien geführt ([Die Tagesschau](https://www.tagesschau.de/ausland/europa/chatgpt-italien-100.html) berichtete darüber). Daher würde ich niemals relevante interne Informationen dort eingeben. Gleiches gilt für private Daten, da man sich über einen personalisierten Account registriert. ### Achtung: falsche Informationen! Das präsentierte Wissen würde ich ebenfalls immer hinterfragen bzw. checken. Es gibt Fälle, in denen ChatGPT Informationen einfach erfindet, um eine Antwort zu liefern. Das nennt man im KI-Umfeld „Halluzination“. Ich würde daher immer raten, bei Themen, die du selbst nicht beherrschst, eine Fachperson über die Texte lesen zu lassen. ### Einfacher in die Arbeit integrieren? Im Sinne der Bequemlichkeit warte ich schon auf eine Integration von ChatGPT in die Office Welt. Z. B. mit einem Feature, das mir hilft, PowerPoint Folien direkt zu erstellen. Der [Microsoft CoPilot](https://www.youtube.com/watch?v=ebls5x-gb0s) macht dies bereits vor. Die kommende Zeit wird sehr spannend, da die Entwicklung von künstlicher Intelligenz und maschinellem lernen rasant voranschreitet. # Wie wirkt sich die KI auf Mensch und Gesellschaft aus? Unser OC Podcast „KI Heute“ beleuchtet rechtliche Fragestellungen aus dem Bereich der künstlichen Intelligen oder beleuchtet die Auswirkung von künstlicher Intelligenz auf ganze Branchen und Berufszweige, wie z.B. den Journalismus. - [KI Heute Folge 39](https://www.opitz-consulting.com/kompetenz/grenzen-der-freiheit) – Hinkt die Gesetzgebung der Künstlichen Intelligenz hinterher? - [KI Heute Folge 38](https://www.opitz-consulting.com/kompetenz/macht-chat-ai-den-journalismus-kaputt) – KI im Journalismus – Fluch oder Segen? # Schlussworte der KI Am Ende meiner Präsentation und damit auch am Ende dieses Beitrags lasse ich ChatGPT noch einmal selbst zu Wort kommen. Dafür fragte ich sie, mit welchen Worten sie das Thema abschließen würde. Hier die Antwort: Innovationen in der Technologie haben die Art und Weise, wie wir kommunizieren und Informationen austauschen, revolutioniert. Chat GPT ist ein beeindruckendes Beispiel dafür, wie künstliche Intelligenz unseren Alltag prägt. Von der Unterstützung beim Kundenservice bis hin zur kreativen Textgenerierung hat Chat GPT das Potenzial, zahlreiche Branchen zu transformieren. Wir haben in diesem Blog-Artikel einen Blick auf die Grundlagen von Chat GPT geworfen, seine Funktionsweise und seine Anwendungsbereiche untersucht. Wir haben gesehen, wie sich dieser sprachgesteuerte KI-Assistent als wertvolles Werkzeug erweisen kann, um uns in unserem täglichen Leben zu unterstützen. Es ist faszinierend zu beobachten, wie Chat GPT weiterentwickelt wird und wie es sich an die Bedürfnisse und Anforderungen der Nutzer anpasst. Mit jedem neuen Update und jeder Verbesserung kommen wir der Vision einer nahtlosen menschlichen Interaktion mit KI einen Schritt näher. Während wir uns über die aufregenden Möglichkeiten von Chat GPT freuen, sollten wir auch bedenken, dass mit solch fortschrittlicher Technologie auch Verantwortung einhergeht. Die Entwicklung von robusten Ethikrichtlinien und die Berücksichtigung von Datenschutz- und Sicherheitsaspekten sind von entscheidender Bedeutung, um den positiven Nutzen von Chat GPT zu gewährleisten. Insgesamt ist Chat GPT ein aufregender Fortschritt in der Welt der künstlichen Intelligenz und des maschinellen Lernens. Es bietet uns die Möglichkeit, Informationen abzurufen, Ideen auszutauschen und die Kommunikation auf ein neues Niveau zu heben. Während wir uns auf die Zukunft vorbereiten, können wir gespannt sein, welche weiteren Innovationen und Anwendungen Chat GPT mit sich bringen wird. Lassen Sie uns weiterhin die Grenzen der Technologie erkunden und uns von den unendlichen Möglichkeiten inspirieren, die uns Chat GPT und ähnliche Technologien bieten. Gemeinsam können wir eine Welt schaffen, in der menschliche Kreativität und künstliche Intelligenz Hand in Hand gehen, um neue Horizonte zu erschließen. # **Feedback willkommen!** Was sind eure Erfahrungen im Umgang mit ChatGPT? Habt ihr spezielle Vorgehensweisen oder Prompts, die euch schneller ans Ziel führen? Ich freue mich über Kommentare und Nachrichten. Mehr Artikel zum Thema findest du in der [Kategorie Artificial Intelligence ]() **Kategorien:** AI & Data Science, Tools & Methoden **Schlagwörter:** Artificial Intelligence, Assistant, Conversational AI --- ### [Mehr als eine Wand voll Post-its!](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) **Published:** Januar 25, 2024 **Author:** Tim Teulings **Content:** # Anschub für IT-Modernisierung – Teil 1: Wie Event Storming & Co das Neue beflügeln Ich habe ein Bestandsystem, und es geht nicht mehr. Ich muss modernisieren! Mit Trick 17 und zahllosen Work Arounds lässt sich ein alter Dampfer lange über Wasser halten. Doch irgendwann gerät ein solches Schiff unweigerlich in Schieflage, und alles, was sich darauf befindet. In dieser Schieflage können ganze Geschäftszweige hinten runterkippen. Wo aber liegt der Kipppunkt? ## Klare Zeichen für die Softwaremodernisierung Erfahrungsgemäß gibt es klare Zeichen, die Ihnen zeigen, dass Ihre IT-Systeme tiefgreifend modernisiert oder neu aufgebaut werden müssen: - Ist Ihre Software nicht mehr wartbar? - Haben sich Ihre Geschäftsprozesse geändert, aber Ihre Software nicht? - Scheitert z. B. die neue Vertriebsstrategie an der bestehenden Software? - Steht der IT-Leiter vor Ihnen und weist Sie darauf hin, dass es – außer Günther, der bald in Rente geht – niemanden gibt, der das System kennt, und auf dem Stellenmarkt möchte diesen Job niemand mehr machen? - Denken Sie über mehr oder weniger Standardlösungen nach? - Antworten Sie deprimiert mit „Cobol“, wenn der Vorstand das Thema „Digitalisierung oder gar „KI“ auf den Tisch bringt? Dann ist es Zeit für eine grundlegende Modernisierung, also der Schritt-für-Schritt-Anpassung, Ergänzung und Ersetzung von Teilen des Bestandsystems bis hin zur schlussendlichen Ablösung durch eine neue Lösung. ### Was nun? Häufig läuft es so ab: Der Fachbereich schreibt eine lange Wunschliste, die aber eher die Fehler und Mängel des Bestandsystems aufzählt, als dass sie ein neues, innovatives System beschreibt. Als Verantwortliche holen Sie alte Konzepte hervor, die irgendwie aber auch nicht mehr passen. Das Entwicklungsteam will alles modern und in der Cloud machen – kann aber nicht erklären, warum dies fachlichen Mehrwert bringt. Von KI hat einfach niemand Ahnung. Währenddessen ist Spezialist Günther damit beschäftigt, das System am Leben zu halten. Für mehr fehlt ihm die Zeit. ### Und Sie? Kennen Sie dieses Gefühl: Sie stehen auf der Tribüne und um Sie herum wissen alle, wie es besser geht. Jede einzelne Person gibt alles. Aber trotz des großen Engagements aller Stakeholder kommen Sie in Summe nicht zu einem gemeinsamen Bild, drehen sich immer wieder im Kreis? Sie sehen das große Ganze nicht. Sie brauchen Anschubhilfe! ## Event Storming: Nicht nur ein paar Klebezettel In dieser Situation führen wir im Rahmen unseres strukturierten Vorgehensmodells gerne Event Storming Workshops mit unseren Kunden durch – begleitet durch weitere Maßnahmen wie z. B. das Context Mapping sowie einer tiefgreifenderen Analyse der resultierenden Arbeitsergebnisse. Diese Methoden nutzen wir bei OPITZ CONSULTING, um uns mit dem Kunden zusammen zu fokussieren. Dabei entwickeln wir mit den verschiedenen Stakeholdern ein gemeinsames Bild: das Big Picture. Erfahrungsgemäß gibt es keinen besseren Weg, um den gefühlten gordischen Knoten zu lösen! Doch nicht nur das: Event Storming und Co. helfen uns auch, in den nächsten Schritten über fachliche Bausteine, technische Schnitte und Projekt- und Team-Organisation zu reden. Und sie können helfen, das Modernisierungsprojekt richtig anzugehen und frühe, schnelle Erfolge zu erzeugen. Im Folgenden möchte ich genauer zeigen, wie wir vorgehen und erläutern, woran wir bei diesen Methoden den Wert für unsere Kunden festmachen – über eine Wand mit bunten Zetteln als offensichtliches Ergebnis hinaus. ### Agil und iterativ vorgehen Der Punkt, an dem über man über Abriss und Neubau redet, ist der Punkt, an dem klar ist, dass am Ende einer langen Modernisierung (da Abriss und Neubau eben in der Praxis doch nicht geht) eine neue Software entstanden sein wird, da die notwendigen Änderungen tiefgreifend sein werden und genau diese Änderungen vom Kunden auch gewollt sind, um dem aktuellen Business wieder gerecht zu werden. Eine Modernisierung, die viel tiefgreifender ist. In Konsequenz geht es dann schnell eher um die Definition eines neuen Ziel-Systems und damit z.B. um folgende Themen: - Mehr Digitalisierung, eine aktuelle und zukunftsorientierte Sicht auf die Fachlichkeit - Neue, bessere Prozesse für Mitarbeiter, Partner und Kunden - Ersatz selbst entwickelter Elemente durch Standard-Systeme - Eine komplett neue technologische Basis, die das möglich macht, was das Bestandsystem nie können wird Dies ist der Zeitpunkt, in dem Wunschlisten entstehen, erste Konzeptbilder gemalt werden, alte Konzepte, die nie realisiert wurden, herausgekramt werden und Diskussionen um die richtige Lösung beginnen. Oft eben aber auch der Zeitpunkt, an dem der Kunde mit der Bitte um methodische Unterstützung auf uns zu kommt. Grundsätzlich empfehlen wir dem Kunden das folgende Vorgehen, um gemeinsam, iterativ mit dem Kunden den Ist-Zustand zu erfassen und zu einem gemeinsamen Zielbild und dann zu einer initialen Realisierung zu kommen und somit wieder zu einer nachhaltigen Produktpflege und Weiterentwicklung zu kommen [![Die Grafik zeigt unser Vorgehen zur IT-Modernisierung in neun Schritten](https://thecattlecrew.net/wp-content/uploads/2024/01/blog-teulings-abb-vorgehen.png)](https://thecattlecrew.net/wp-content/uploads/2024/01/blog-teulings-abb-vorgehen.png)Abbildung 1: Modernisierungsprozess mit entsprechenden iterativen Feedbackschleifen. In Blau die Schritte, in denen wir bei Bedarf die hier vorgestellten Methoden anwenden. Wie erwähnt nutzen wir hierbei eine Kombination aus einer Reihe von Event-Storming und Context-Mapping Workshops, vor allem, wenn das zu migrierende System „groß“ ist, eine Modularisierung fachlich sinnvoll und eine einfache Lösung nicht einfach und offensichtlich ist. Dies verbinden wir mit weiteren Ansätzen aus dem Umfeld des Domain-Driven Designs (DDD). ## Summary Diese Methodiken helfen uns, einen guten fachlichen „Schnitt“ zu identifizieren. Aber die Vorteile reichen noch weiter. Das in Kontakt treten, der übergreifende Austausch sorgt dafür, dass fachliche, geschäftliche und technologische Fragen immer wieder auf den Tisch kommen. Dabei können Lösungen entstehen, an die zuvor im Traum noch niemand gedacht hatte. Insbesondere Event Storming eignet sich, um mit den relevanten Stakeholdern in einer offenen und kollaborativen Atmosphäre einen neuen, frischen Blick auf den Möglichkeitsraum zu eröffnen. ### Mehr lesen? In diesem ersten Teil wurde die Frage: „Wie funktionieren Event Storming und Context Mapping – und warum geht es nicht nur um ein Bild, das sie uns liefern, sondern um weitere Informationen für das Projekt-Setup?“ nur angerissen. In den nächsten Teilen geht es mehr in die Tiefe. Es wird u. a. darum gehen, was die Methoden mit Fragen zu tun haben wie: - Wie erfolgt die fachliche und technische Zerlegung? - Wie strukturiere ich meine Teams? - Wie gehe ich mit Abhängigkeiten um? - Wie schaffe ich ein Minimum Viable Product, das mir erste Ergebnisse liefert? Sie dürfen also gespannt sein! ## Die ganze Serie lesen: [Teil 1: Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) [Teil 2: Die Teile dahin legen, wo sie passen könnten – Context Mapping und seine Bausteine](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) [Teil 3: Erkennen, was wie voneinander abhängt – Wie hilft Context Mapping, die Modernisierung erfolgreich aufzusetzen?](https://thecattlecrew.net/2024/03/22/erkennen-was-wie-voneinander-abhaengt/) [Teil 4: Wie Sie Context Mapping nicht machen sollten … – Negativbeispiele und ihre Lösung](https://thecattlecrew.net/2024/04/19/wie-sie-context-mapping-nicht-machen-sollten/) **Kategorien:** Architecture & Process Models --- ### [Die Teile dahin legen, wo sie passen könnten](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) **Published:** Februar 16, 2024 **Author:** Tim Teulings **Content:** # Anschub für IT-Modernisierung – Teil 2: Context Mapping und seine Bausteine Im ersten Teil [Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) haben wir verstanden, dass es mehrere Varianten von Event Storming mit unterschiedlichen Zielrichtungen gibt. Wir haben erklärt, warum die Ergebnisse des Event Stormings für Migrationen so wertvoll sind. Dann haben wir noch gezeigt, warum wir parallel ein Glossar einführen und auch eine Context Description erstellen. Man mag versucht sein, nun gleich in Architekturfragestellungen abzutauchen oder gar die Entwicklung zu starten. Aber … ## Halt, einen habe ich noch! Bevor wir nun für jeden unserer identifizierten Kontexte in die Architekturkonzeption oder gar direkt in die Entwicklung gehen – und dabei vielleicht noch “Microservices” mit einer gewissen Euphorie im Gesicht murmeln –, sind aus meiner Sicht noch Fragen offen und damit auch weitere Todos und Arbeitsschritte. Blenden wir kurz die Euphorie über ein mögliches „neues System“ aus, dann sehen wir immer noch eine bereits bestehende Applikation, die wir nicht mehr oder weniger ungepflegt weiterlaufen lassen können, während man mehrere Jahre parallel eine neue Lösung entwickelt. In der Praxis sind die eigenen Entwickler mit aller Kraft beschäftigt, dass Altsystem (noch) am Leben zu erhalten und das Management kann und will eine Modernisierung bzw. Neuentwicklung, nur finanzieren, wenn diese möglichst schnell wertschöpfend ist, was ebenfalls verständlich ist. Dieses Dilemma lässt sich nur auflösen, wenn wir uns intensiv Gedanken über eine Migrationsstrategie machen: - Wie löse ich Teile aus der Bestandsapplikation raus, wie verknüpfe ich die neuen Teile mit der bestehenden Funktionalität der Altapplikation? - Muss ich ggf. erst sogar Teile der Altapplikation verbessern, bevor ich sie dann neu realisieren und ablösen kann? - Wo fange ich an, damit das Management schnell auch fachliche und wirtschaftliche Erfolge sieht? - Wie sieht meine Zielarchitektur aus? - Wie bekomme ich das Vorhaben überhaupt organisatorisch gestemmt? Das sind Fragen, die wir uns stellen sollten. Natürlich soll es möglichst schnell gehen – denn eine Migration bedeutet Stress für die ganze Organisation. Daher wollen wir vermutlich mit mehreren Teams parallel an verschiedenen Kontexten arbeiten. Aber welche Teams? Wie groß sollten sie sein? Und wie schaffe ich es, dass zwei Teams in der Praxis tatsächlich doppelt so viel Arbeit schaffen, wie ein Team – statt andauernd aufeinander zu warten oder gemeinsam in Meetings sitzen? Die Lösung heißt Context Mapping. ## Was macht Context Mapping? Um die Fragen zu beantworten und die oben genannten Entscheidungen treffen zu können, brauchen wir mehr Fakten. Deshalb empfehle ich den Kunden, mit denen ich zusammenarbeite, im Anschluss an das Event Storming mit einem Context Mapping Workshop weiter zu machen. In diesem Workshop geht es um zwei wesentliche Fragestellungen: 1. Wie beeinflussen sich Modelle? 2. Wie kommunizieren Teams? Im DDD bezeichnet ein Bounded Context den Geltungsbereich eines Modells, also der Begriffe und Regeln. Aber innerhalb einer Organisation und in einem System wird ein einzelner Bounded Context selten isoliert existieren. Er hat Schnittstellen zu anderen Systemen und Kontexten. Und der Name verrät es: Eine Schnittstelle „schneidet“ und verletzt damit eine Grenze. Wie bei einem Schnitt in den Daumen, entsteht eine Wunde. Ich könnte es so sagen: Entweder blutet etwas heraus (in dem Fall aus dem Modell) oder aber es dringen Schmutz und Bakterien in die offene Stelle. Zurück zur Methode: Beim Context Mapping geht es darum, zu identifizieren, welchen Einfluss das Modell eines Kontexts auf andere hat. Wir gehen an dieser Stelle davon aus, dass die Methode [Context Mapping](https://github.com/ddd-crew/context-mapping) sowie die zugehörigen Muster grundsätzlich bekannt sind. Für das Verständnis des Textes wiederholen wir hier aber dennoch kurz die gängigen Kollaborationsmuster: ![Tabelle 3 zeigt das Kriterium der logischen Kardinalität der Kommunikationspartner](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-anschub-modernisierung_teil2_tabelle-03.jpg)Daneben werden noch folgende *Beziehungsformen* definiert, von den „Upstream/Downstream“ am häufigsten explizit modelliert wird: ![Tabelle 1 zeigt gängige Kollborationsmuster](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-anschub-modernisierung_teil2_tabelle-01.jpg) Daneben werden noch folgende Beziehungsformen definiert, von den „Upstream/Downstream“ am häufigsten explizit modelliert wird: ![Tabelle 2 zeigt, welche Beziehungsformen definiert werden](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-anschub-modernisierung_teil2_tabelle-02.jpg)Context Mapping ist bei der IT-Modernisierung nur der erste Schritt Im Kontext von Modernisierungsprojekten reicht es nicht, den Context Mapping Workshop zu machen und gut. Hier müssen weitere Schritte folgen. Meiner Idee nach wären es insgesamt diese vier: 1. Context-Mapping durchführen (Schritt 1) 2. Das Ergebnis formal auswerten 3. Schnittstellen validieren und ggf. noch einmal ändern 4. Weitere Erkenntnisse bzgl. der Struktur der Lösung, der Reihenfolge der Migrationsschritte, sowie möglicher Organisationsstrukturen gewinnen ### Schritt 1: Durchführung Context Mapping Das Context Mapping wird, wie allgemein dokumentiert (zum Einstieg siehe [DDD-Crew](https://github.com/ddd-crew/context-mapping)), durchgeführt. Man betrachtet die ein- und ausgehenden Schnittstellen jeweils *eines* Kontextes (diese hat man ja im vorherigem Event Storming identifiziert) und weist den jeweiligen Schnittstellen und Schnittstellenpartnern die entsprechenden Beziehungsformen und Patterns zu. Im Modernisierungskontext ist hierbei zu klären, inwieweit die finale Zielarchitektur oder nur die ersten Modernisierungsschritte betrachtet werden sollen. Ich empfehle im Rahmen der Modernisierung auf jeden Fall ein Mapping mit dem Scope der *ersten* Migrationsschritte durchzuführen. Input für das Mappings sind dabei: - Der Einfluss, den der jeweilige Kontext auf die Schnittstelle hat. Auch hier können Organisationsstrukturen, Business-Treiber vs. Commodity, Vertragssituation o.ä. relevant werden. Das Maß an fachlich nötiger Kopplung wird so pro Schnittstelle bestimmt. - Die technische Form der Schnittstelle, wenn z. B. durch ein externes System bereits vorgegeben. In Summe ist das Ergebnis des Mapping dabei eine “Map”, die Kontexte, Schnittstellen, sowie Kommunikationsmuster und Beziehungstypen zwischen den Schnittstellenpartnern identifiziert. Die Muster geben also entweder (verschiedene) Namen für die jeweiligen Beziehungsseiten vor oder „nur“ einen Namen für die „Beziehung“ an sich an. Hinweis: Beim Konsolidieren der Information pro Kontext in die Map bitte immer abgleichen und sicherstellen, dass die Eigenschaften einer Schnittstelle über alle beteiligten Kontexte konsistent ist. Damit ist das Mapping formal abgeschlossen. Tatsächlich hat das Mapping aber weitere Ebenen, die im Kontext eines ggf. stattfindenden Folgeworkshops mitberücksichtigt werden sollten. ### Schritt 2: Formale Konsistenz zwischen den gewählten Mustern herstellen Leider ist es nicht so, dass alle Muster konzeptionell gleichwertig nutzbar sind und in beliebiger Kombination eingesetzt werden können. Die Muster sind ursprünglich meist aus der konkreten Beobachtung entstanden. Deshalb folgen sie keinem systematischen Ansatz. Einige definieren beide Beziehungsseiten (Partnership, Customer/Supplier, Shared-Kernel, Published Language), einige nur die Beziehung für eine Seite (Conformist, Open-Horst-Service) und andere sind additiv (Anticorruption-Layer). Dieser systemische Mangel hat mich lange gestört, eine Bereinigung hat sich aber als nicht trivial herausgestellt 😉[](#_ftn1) Beispiele: - Conformist und Anticorruption Layer an einer Beziehung machen wenig Sinn, da die Intentionen beider Seiten immer widersprüchlich sein werden. Beim Conformist wollen wir aus verschiedenen Gründen das Modell übernehmen, beim Anticorruption Layer wollen wir unser eigenes Modell schützen und auf keinen Fall das Schnittstellenmodell nutzen. - Beide Seiten einer Schnittstelle können nicht Downstream Mehr Struktur und Systematik bekommen wir, wenn wir die Schnittstellen nach verschiedenen Kriterien kategorisieren. So lassen sich auch Regeln aufbauen, die dabei helfen, die Sinnhaftigkeit und Umsetzbarkeit der Map weiter zu überprüfen. Tabelle 3 zeigt, einen Anfang dafür. Sie zeigt die Betrachtung des Kriteriums der (logischen) Kardinalität der Kommunikationspartner. Da es um die Anzahl der Kommunikationspartner geht, wurde Separate Ways hier weggelassen: ![Tabelle 3 zeigt das Kriterium der logischen Kardinalität der Kommunikationspartner](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-anschub-modernisierung_teil2_tabelle-03.jpg) [W](#_ftnref1)ir sehen, dass Open-Host-Service, Conformist, Shared-Kernel, Supplier und Partner keine höheren Kardinalitäten erlauben oder diese zumindest wenig sinnvoll sind. Ebenso ist Customer/Supplier zu hinterfragen, wenn auf Dauer genau ein Customer existiert. Das nächste Kriterium wäre “Kontrolle”. Welche Muster machen Sinn, wenn wir in einem bestimmten Maß Einfluss auf die Schnittstelle und den Schnittstellenpartner haben. Teilweise Einfluss entspräche dabei in der Regel dem Beziehungstyp Mutually Dependent, während andernfalls eine Upstream/Downstream Beziehung vorliegt. Ein Anticorruption Layer kommt in der Praxis eher auf der Kommunikationsseite vor, die entweder keinen Einfluss oder nur teilweise Einfluss hat. Dies führt zu folgender Tabelle: ![Tabelle 4 zeigt den Einfluss des Anticorruption Layers](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-anschub-modernisierung_teil2_tabelle-04.jpg)*Hinweis: In den obigen Tabellen habe ich die semantischen Regeln von Context Mapper berücksichtigt, siehe hierzu auch . Context Mapper erlaubt eine Modellierung von Kontexten und Beziehung mittels einer Domain-specific Language (DSL) und realisieren darüber hinaus entsprechende Prüfungen.* In der Praxis begegnen wir meist folgenden gängigen Kombinationen: ![Tabelle 5 zeigt gängige Kombinationen](https://thecattlecrew.net/wp-content/uploads/2024/02/cattle-crew-anschub-modernisierung_teil2_tabelle-05.jpg) ## Wie geht es jetzt weiter? Gut, jetzt haben wir eine Context Map und damit noch mehr über unser System gelernt. Können wir dann jetzt … Microservices? Nein! Aber wir können mit Schritt 3 und 4 aus den gesammelten Informationen noch mehr für unser Modernisierungsprojekt herausziehen. Mehr dazu in Teil 3 … ## Die ganze Serie lesen: [Teil 1: Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) [Teil 2: Die Teile dahin legen, wo sie passen könnten – Context Mapping und seine Bausteine](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) [Teil 3: Erkennen, was wie voneinander abhängt – Wie hilft Context Mapping, die Modernisierung erfolgreich aufzusetzen?](https://thecattlecrew.net/2024/03/22/erkennen-was-wie-voneinander-abhaengt/) [Teil 4: Wie Sie Context Mapping nicht machen sollten … – Negativbeispiele und ihre Lösung](https://thecattlecrew.net/2024/04/19/wie-sie-context-mapping-nicht-machen-sollten/) **Kategorien:** Architecture & Process Models **Schlagwörter:** Building Blocks, Change, Context Mapping, IT-Modernisierung, Legacy System, Moderne IT, Systemintegration --- ### [Erkennen, was wie voneinander abhängt](https://thecattlecrew.net/2024/03/22/erkennen-was-wie-voneinander-abhaengt/) **Published:** März 22, 2024 **Author:** Tim Teulings **Content:** # Anschub für IT-Modernisierung – Teil 3: Wie hilft Context Mapping, die Modernisierung erfolgreich aufzusetzen? Im letzten, 2. Teil dieser Serie haben wir mit dem Kunden gemeinsam eine Context Map erstellt. In diesem 3. Teil der Serie geht es ins Detail: Das heißt, du erfährst, was uns die Inhalte der Context Map sagen wollen, und was die dort dokumentierten Abhängigkeiten und Kopplungen für unser Modernisierungsprojekt wertvoll macht. *Du steigst gerade erst ein? Hier kannst du Teil 1 und Teil 2 dieser Serie nachlesen:* [Teil 1: Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) [Teil 2: Die Teile dahin legen, wo sie passen könnten – Context Mapping und seine Bausteine](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) Aber jetzt auf zu Teil 3! ## Warum helfen Context Maps? Wie in Teil 1 angesprochen gilt es, vor allem diese Herausforderungen im Kontext einer Modernisierung zu lösen: - Die Modernisierung darf Pflege und Weiterbetrieb des Bestandssystems nicht über die Maßen behindern. - Die Migration oder Neuentwicklung selbst darf aber auch nicht zu sehr behindert werden. - Die Migration soll möglichst schnell wertschöpfend werden. - Die Migration muss zügig vonstattengehen und organisatorisch skalieren. - Die Migration lindert die dringendsten Probleme zuerst. - Die Organisation des Modernisierungsprojektes muss „passend“ sein. Speziell sollte jedem Kontext ein Team zugeordnet werden. - Das Team muss zum Kontext passen. D. h. es muss „fähig“ sein oder entsprechend „befähigt“ werden. Ebenso sollte das für den Kontext erforderliche Maß an Agilität zur Arbeitsweise des Teams passen. Du kannst dir sicher vorstellen, wie wichtig Beziehungstypen und Kollaborationsmuster zwischen den Kontexten einer möglichen Neuentwicklung aber auch zum Bestandsystem und anderen umliegenden Systemen hierbei sind. Ihr Einfluss ist nicht zu unterschätzen, wenn es darum geht, inwieweit und wie gut obige Ziele erreicht werden können! Erfahrungsgemäß zeigt die Context Map anfänglich eher eine Lösung auf Basis der Ist-Organisation und deren Kommunikationsbeziehungen auf. Es wird eher versucht, die Modernisierung in das Bestehende zu integrieren oder bestehende Strukturen zu ergänzen. Aus der resultierenden Context Map ist in Konsequenz erkennbar, wie dies auf die Migration wirken wird. Hier gilt Conway’s Law, das besagt, dass die bestehenden Kommunikationsbeziehungen die technische Struktur vorgeben. Hintergründe der initialen Modellierung sind dabei in der Regel Einschätzungen bzgl. Wirtschaftlichkeit („Alternative viel zu aufwändig“), gefühlte Komplexität („Puh, das wird sonst zu kompliziert”) oder eben die Ist-Organisation („an der Teamstruktur des Altsystems wollen wir nichts ändern“). ### Ein Beispiel Was aber, wenn beim Context Mapping mit obigen Ansätzen im Zuge einer Migrationsbetrachtung herauskommt, dass die Teams Schnittstellen zum Bestandssystem benötigen? Im Rahmen einer Migration ist das sicherlich nicht ungewöhnlich. Allerdings wird diese Context Map in diesem Fall aufzeigen, dass die „Neu-Kontexte“ und damit deren Umsetzungsteams in mehr oder weniger starker organisatorischer Abhängigkeit zu den Teams des „Bestandssystems“ stehen. Hinweise wären hier „Downstream“, „Conformist“, „Partnership“ auf Seiten der „Neu-Kontexte“. Ebenso könnten entsprechende Modell-Abhängigkeiten sichtbar werden – erkennbar durch „Shared Kernel“ oder „Open-Host-System“. #### Was heißt das für den Erfolg der Modernisierung? Zu befürchten ist, dass so der Fortschritt der „Neu-Kontexte“ für die Modernisierung bei mangelnder Priorität, Zeit und Kapazität aufseiten des Bestandssystems durch dieses behindert wird. Die Modernisierung steht still, wenn die Teams des Bestandssystems diese nicht explizit ausreichend unterstützen. Es ist klar, dass dies nicht passieren darf! Wie lässt sich das Problem lösen? Wie so oft hilft der Blick über den Tellerrand: In der Regel sind die technischen und organisatorischen Abhängigkeiten zwischen den beteiligten Systemen, Teams und einzelnen Person sowie die System-Architektur die entscheidenden Faktoren. Diese sind daher bzgl. der Modernisierung zu optimieren und speziell initial identifizierte Constraints oder Entscheidungen zu hinterfragen. Kosten und Komplexität sind z.B. nicht für jeden Kontext einzeln, sondern über das Gesamtsystem und aus den Blick des Erfolgs des Modernisierungsprojektes zu betrachten. Wenn die Organisation den Gesamtkontext begreift, kann sie Strukturen und bestimmte Patterns vorgeben. Auf diese Weise lassen sich Beziehungs- und Kommunikationsmuster ändern und sogar Einfluss auf die Architektur nehmen. Aber vor allem lassen sich organisatorische Ziele erreichbar gestalten. Dies hat weitere Vorteile: Resultierende Architektur und Kommunikation wirkt im Sinne des „Inverse Conway Maneuvers” verstärkend und positiv. Das heißt, die Kommunikationsstruktur des Systems prägt die organisatorische Struktur. Hierfür besitzt die Context Map die richtige Abstraktionsebene und die richtigen Inhalte und ist somit ein geeignetes Modell. Mit ihr können wir einfach die fachliche und technische, aber eben auch speziell die *organisatorische Machbarkeit* einer Migration prüfen und frühzeitig Risiken zu erkennen und die Lösungsidee iterativ so anzupassen, dass sie nicht nur „passt“, sondern eben auch im Sinne der Migration tatsächlich „funktioniert“. ## Wie bewerten wir die Abhängigkeiten? Bevor wir sie bewerten, sollten wir uns die Frage stellen: Wie und warum entstehen Abhängigkeiten zwischen Teams, die sich dann auch entsprechend auf die gemeinsamen Schnittstellen auswirken? Die Antwort lautet: Abhängigkeiten zwischen Kontexten und Teams entstehen durch eine entsprechende Kopplung. In folgender Tabelle zeige wir möglichen Arten der Kopplung auf. ![](https://thecattlecrew.net/wp-content/uploads/2024/03/blog-anschub-modernisierung_teil3_bild01.png) Aus obiger Betrachtung und Argumentation heraus interessieren wir uns in diesem Schritt hauptsächlich für die organisatorische Kopplung, die in der Regel aus der Kopplung über die Domäne oder entsprechende Prozesse resultiert. Leider geben die Muster nur bedingt Hinweise über Details wie Ursache und Maß der organisatorischen Kopplung. Mit „Upstream“ und „Downstream“ gibt es in Rahmen der Context Map eine weitere Modellierungsmöglichkeit. Allerdings gibt es hier mehrere abweichende bzw. unklare Definitionen: “Often one subsystem feeds the other; the downstream component performs analysis or *other functions that feed back very little into the upstream component, and all dependencies go one way.”* *Eric Evans, Domain-driven Design, Seite 356* *“A relationship between two groups in which the “upstream” group’s actions affect project success of the “downstream” group, but the actions of the downstream do not significantly affect projects upstream. (e.g. If two cities are along the same river, the upstream city’s pollution primarily affects the downstream city.)* *The upstream team may succeed independently of the fate of the downstream team.”* Eric Evans, [DDD Reference](https://www.domainlanguage.com/ddd/reference/) “One of the most important things to know is the direction of the relationship between two contexts. DDD uses the terms upstream or downstream: an upstream context will influence the downstream counterpart while the opposite might not be true. This might apply to code (libraries depending on one another) but also on less technical factors such as schedule or responsiveness to external requests.” Alberto Brandolini, [InfoQ Artikel](https://www.infoq.com/articles/ddd-contextmapping/) *“Upstream/downstream refer to the actual, organization power dynamics among teams/context. These may not align with technical dependencies (runtime or development time).”* Stefan Tilkov, [X Chat](https://twitter.com/stilkov/status/1010057514195484672) Wir empfehlen daher zwar, mit Upstream und Downstream zu arbeiten, aber sich vorab entweder explizit auf *eine* der obigen Definitionen zu einigen oder eine alternative Definition zu nutzen. #### Reichen Upstream und Downstream aus? Upstream und Downstream sind aus unserer Sicht allerdings nicht ausreichend, um die Abhängigkeitsbeziehung weiter zu konkretisieren und zu bewerten und damit obige Fragestellungen zu klären. Bei Upstream und Downstream geht es ja um die Frage, von wo nach wo die Modelle Einfluss haben. Das kann mit organisatorischem Einfluss korrelieren, muss es aber nicht. Denn Upstream und Downstream können je nach Schnittstelle zwischen zwei Teams unterschiedlich verteilt sein, aber organisatorisch kann es zwischen Teams eigentlich nur *eine* Power-Beziehung geben. Ein starker gestalterischer Einfluss (Upstream) kann sich z. B. aus folgenden Gründen ergeben – mit einem entsprechend unscharfen Mapping auf Upstream und Downstream: ## ![](https://thecattlecrew.net/wp-content/uploads/2024/03/blog-anschub-modernisierung_teil3_bild02-1.png)Eine reine Sachebene gibt es nicht Wir haben die Einflüsse, die wir im Rahmen der Modellierung auf der Sachebene für relevant halten, in der Tabelle mit einem Unterstrich markiert. Es handelt sich um die Einflüsse „Vertrag“, „Spezifikation“ und „Business Value“. Entscheidungen aufgrund der „Organisationstruktur” sind natürlich nicht grundsätzlich falsch, sie ignorieren aber die Tatsache, dass die Struktur ja änderbar ist. Wir halten es im Rahmen einer Modernisierung außerdem für sinnvoll, „Termin” und „Innovation“ als weitere, temporäre Gründe heranzuziehen – im Bewusstsein, dass sich Schnittstellen und die Map hierbei später noch einmal ändern können. Eine neutrale, gleichgewichtige Kopplung ergäbe sich nur, wenn rein auf der Sachebene diskutiert würde, sich beide Seiten in einer einfachen Win-Win-Situation befänden und obige Aspekte vollständig ausgeklammert werden könnten: ![Tabelle 3](https://thecattlecrew.net/wp-content/uploads/2024/03/blog-anschub-modernisierung_teil3_bild03.png) In der Realität gibt es über die Sachebene hinaus allerdings „Interessen“. Eine Context Map, die viele Schnittstellen mit dem Muster Partnership definiert, ist daher zu hinterfragen. Sie bildet oft eher einen frommen Wunsch des Managements ab. Nach dem Motto: „die Teams werden sich schon sinnvoll einigen!“. Was mit hoher Wahrscheinlichkeit nicht der zukünftigen Projekt-Realität entspricht. Für die faktisch aus den Durchsetzung der „Interessen“ entestehende „schwache“ Seite ergeben sich in der Regel nur noch folgende Optionen, Einfluss zu nehmen: ## ![Tabelle 4](https://thecattlecrew.net/wp-content/uploads/2024/03/blog-anschub-modernisierung_teil3_bild04.png)Veto und Widerstand Hier möchten wir speziell auf die nicht-konstruktiven Verhaltensweisen „Veto“ und „Stiller Widerstand“ hinweisen, die in der Praxis nicht selten auftreten. Sollte man vermeiden! Aber wie? Bei der Kommunikation *innerhalb* der Organisation ist „Wechsel“ vermutlich auch nicht realistisch und ein „Separate Ways“ wäre eher überraschend. Daher empfehle ich beim Context Mapping, die jeweilige Beziehung – soweit wir sie schon kennen – über zusätzliche Eigenschaften expliziter zu erfassen. Denn damit können wir die reale oder modellierte Beziehung besser verstehen: ![Tabelle 5](https://thecattlecrew.net/wp-content/uploads/2024/03/blog-anschub-modernisierung_teil3_bild05.png)Für die nachfolgende dritte Sicht (nächster Artikel der Serie) kann es auch sinnvoll sein, folgende weitere Eigenschaften in einer ersten Einschätzung mit zu erfassen: ![Tabelle 7](https://thecattlecrew.net/wp-content/uploads/2024/03/blog-anschub-modernisierung_teil3_bild06.png) ## Wie geht es jetzt weiter? In diesem Teil haben uns detailliert mit den Informationen befasst, die in der Context Map enthalten sind. Wir haben gelernt, wie und warum Abhängigkeiten entstehen können und erfahren, dass es wichtig ist, weitere Informationen über Schnittstellen zu erfassen. Grundsätzlich können wir festhalten, dass die Context Map und deren Bewertung und Anpassung ein entscheidender Baustein für den Erfolg unserer Migration sein können. Im 4. und letzten Teil wollen wir uns Negativbeispiele ansehen, und damit eine weitere, finale Sicht auf die Context Map kennenlernen. ## Die ganze Serie lesen: [Teil 1: Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) [Teil 2: Die Teile dahin legen, wo sie passen könnten – Context Mapping und seine Bausteine](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) [Teil 3: Erkennen, was wie voneinander abhängt – Wie hilft Context Mapping, die Modernisierung erfolgreich aufzusetzen?](https://thecattlecrew.net/2024/03/22/erkennen-was-wie-voneinander-abhaengt/) [Teil 4: Wie Sie Context Mapping nicht machen sollten … – Negativbeispiele und ihre Lösung](https://thecattlecrew.net/2024/04/19/wie-sie-context-mapping-nicht-machen-sollten/) **Kategorien:** Architecture & Process Models **Schlagwörter:** context map, Context Mapping, IT-Modernisierung, kopplung, Migration --- ### [Wie Sie Context Mapping nicht machen sollten ...](https://thecattlecrew.net/2024/04/19/wie-sie-context-mapping-nicht-machen-sollten/) **Published:** April 19, 2024 **Author:** Tim Teulings **Content:** # Anschub für IT-Modernisierung – Teil 4: Negativbeispiele und ihre Lösung Ich hatte es versprochen: Nach den eher theoretischen Überlegungen des dritten Teils dieser Blogserie, präsentiere ich euch zum Abschluss ein paar Negativbeispiele. Damit nehmen wir einen weiteren Betrachtungswinkel ein, der uns hilft, IT-Modernisierung „gut“ anzugehen und aus Event Storming und Context Mapping das Maximale „herauszuholen“. *Du steigst gerade erst ein? Hier kannst du die vorangegangenen Teile dieser Blogserie nachlesen:* [Teil 1: Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) [Teil 2: Die Teile dahin legen, wo sie passen könnten – Context Mapping und seine Bausteine](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) [Teil 3: Erkennen, was wie voneinander abhängt – Wie hilft Context Mapping die Modernisierung erfolgreich aufzusetzen?](https://thecattlecrew.net/2024/03/22/erkennen-was-wie-voneinander-abhaengt/) Nun aber weiter zu Teil 4: ## Last Steps Starten wir mit einem kurzen Recap: Im zweiten Teil dieser Blogserie ging es um die Bausteine des Context Mappings. Dabei wurde deutlich: Mit dem einfachen Erstellen der Context Map alleine ist es nicht getan! Den Weg, der notwendig ist, um Modernisierungsprojekte auch mittels Context Mapping anzuschieben, hatte ich in vier Schritten skizziert: **1. Schritt:** Erstellung einer gemeinsamen, formal sauberen Context Map. **2. Schritt:** Inhaltliche Korrektheit sicherstellen. **3. Schritt:** Abhängigkeiten zwischen Kontexten bewerten. **4. Schritt:** Im finalen Schritt die Context Map bezüglich struktureller Anti-Patterns bewerten. Um den finalen vierten Schritt geht es in diesem Teil der Blogserie. Dafür schauen wir uns aus verschiedenen Blickwinkeln eine Reihe fiktiver Context Maps auf der Suche nach Anti-Patterns an. Bitte nicht wundern: Die Context Maps habe ich bzgl. der dargestellten Situation vereinfacht und überspitzt skizziert, damit das Anti-Pattern offensichtlicher wird. ## Szenario: Angemessene Autonomie Die zugrundeliegende Fragestellung ist: Hat der Kontext über die Summe seiner Schnittstellen ausreichend Autonomie, um sein Ziel und damit das allgemeine Migrationsziel zu erreichen? Um diese Frage zu klären, schauen wir uns ein Negativbeispiel an, das so auch im Rahmen einer Migration grundsätzlich vorkommen könnte: ![Beispiel für den Aufbau einer IT-Systemlandschaft](https://thecattlecrew.net/wp-content/uploads/2024/04/anschub-modernisiserung-teil4_bild01.png)Wir sehen hier, dass bei der Kommunikation mit „*Bestandsystem\_A*“ eine bestehende Schnittstelle des Systems für den Datenaustausch genutzt wird. Bei „*Bestandsystem\_B*“ wird kollaborativ („müssen wir uns gemeinsam anschauen“) eine neue Schnittstelle entstehen. Und hinter dem Shared Kernel mit „*Bestandsysytem\_C*“ steht aus „historischen Gründen“ ein direkter Zugriff auf die Datenbank des Systems. Bei „*Externes\_System*“ handelt es sich um einen Zugriff auf ein externes System, welches im Rahmen der Migration initial eingebunden werden soll. Wie wir in diesem Beispiel sehen, ist unser „*Neuer\_Kontext*“ bei allen Schnittstellen entweder Downstream – hat also eingeschränkten Gestaltungsspielraum – oder muss explizit stark mittels „Partnership“ und „Shared Kernel“ mit den Altsystemen kollaborieren. Grundsätzlich bedingt eine Migration (oft auch schmerzhafte) Kompromisse, aber in dieser Konstellation ist zu befürchten, dass die zahlreichen technischen und organisatorischen Abhängigkeiten einen offensichtlichen negativen Einfluss auf den eigenen Projektfortschritt haben. Die neue Lösung kämpft mit zu vielen Altlasten und zusätzlich mit der Anbindung neuen Schnittstellen. Der Projekterfolg ist daher möglicherweise in Gefahr. ### Mit diesen Optionen können wir das verhindern: - Prüfung der Anpassbarkeit der Kollaboration, um einen sinnvollen und realistischen Zuwachs an Autonomie zu erreichen. Kann z. B. das Team „*Neuer\_Kontext*“ die Schnittstelle zu „*Bestandssystem\_B*“ selbst erstellen? - Anpassung der Projektprioritäten und Timeline. So wird ggf. die Realisierung einiger Schnittstellen geschoben und stattdessen initial mit einem Mock und Testdaten gearbeitet. Hier zeigt sich die Relevanz der Informationen aus dem Context Mapping für das Migrations-Setup und das Projekt-Management der Migration. Die Context Map macht es beispielsweise möglich, gemeinsam mit anderen Kriterien an der Tafel entsprechende Planspiele durchzuführen, auf der Grundlage guter, objektiver Bewertungskriterien. ## Szenario: Akzeptabler Kommunikationsbedarf Fragestellung: Ist der Kommunikationsbedarf für das verantwortliche Team noch zu handhaben? Hierzu ein weiteres fiktives Negativszenario: ![Ein Beispiel für die Frage beim Context Mapping zum akzeptablen Kommunikationsbedarf](https://thecattlecrew.net/wp-content/uploads/2024/04/anschub-modernisiserung-teil4_bild02-1.png)In diesem Fall ist der Kontext „*Neues\_System\_A*“ Downstream eines externen Systems „Customer/Supplier“ und gleichzeitig selbst Upstream für ein „*Externes\_System\_B*“ ebenfalls „Customer/Supplier“. Es besitzt jeweils eine „Partnership“ zu zwei weiteren „eigenen“ Kontexten „*Neues\_System\_B*“ und „*Neues\_System\_C*„. Zusätzlich besteht noch eine „Shared-Kernel“-Beziehung zum „Bestandssystem“. Das Bild lässt befürchten, dass der Kontext und das entsprechende Team mit der Koordination der Schnittstellen und den hier notwendigen Anpassungen ausgelastet oder möglicherweise sogar überlastet ist. – Speziell dann, wenn für die eigene Customer/Supplier-Schnittstelle weitere Customer hinzukommen. Vor meinem inneren Auge sehe ich Projektverantwortliche und Entwickler:innen von einem Abstimmungstermin zum nächsten laufen, um die Migration ans Laufen zu bekommen. Parallel versucht das Team vermutlich fieberhaft mit internen und externen Schnittstellenpartnern zu kollaborieren. Priorisierungskonflikte sind da vorprogrammiert. Stellt sich wieder die Frage: Was können die Beteiligten tun, um ihren Kontext in den Griff zu bekommen? ### Diese Optionen könnten helfen: - Weiteres Zerlegen des Kontextes. Dieser könnte gegebenenfalls auf mehrere Teams verteilt werden. - Anpassung der Kommunikationsmuster einzelner Schnittstellen. - Anpassung von Prioritäten und Timeline. - Trennen der Verantwortlichkeit für interne und externe Schnittstellenpartner. Dies kann zwischen den Verantwortlichen wiederum zu mehr Kommunikationsbedarf führen. ## Szenario: Passende Schnittstellen Fragestellung: Passen die Schnittstellen zu den aktuellen Herausforderungen meiner Organisation? ![Schnittstellen in gewachsenen Systemlandschaft](https://thecattlecrew.net/wp-content/uploads/2024/04/anschub-modernisiserung-teil4_bild03-300x223.png)Die Abbildung zeigt ein „*Batch\_System*„, das Daten aus einer bestimmten Quelle („*Batch\_Quelle*„) verarbeitet und das Ergebnis – vermutlich eine Berechnung oder eine Transformation – an zwei nachfolgende Kontexte („*Batch\_Senke\_1*“ und „*Batch\_Senke\_2*„) weiterreicht. Auf Grund eines „speziellen Wunsches“ – es könnte sich um ein spezifisches Kontroll- und Reporting-Bedürfnis des Managements, einen strategischen Wunsch der Fachseite oder den dringenden Wunsch eines wichtigen Kunden handeln – soll nun zusätzlich mit einer „*High Traffic UI*“ kommuniziert werden. Diese UI könnte z. B. die Visualisierung eines aktuellen Datenstandes im „*Batch\_System*“ ermöglichen. Auf Grund des Termindrucks wird dabei das Team, welches die UI realisieren soll, als organisatorisch führend aufgehängt („Task Force“). Unser neuer Kontext wäre damit Downstream (im Sinne des Datenflusses und der Kollaboration) seiner Datenquelle (fachliche Core-Domäne), sowie (organisatorisch) Downstream der „*High Traffic UI*“ und (zumindest Datenfluss-technisch) Upstream zweier Datensenken („*Batch\_Senke\_1*“ und „*Batch\_Senke\_2*„). Dabei fordert die „*High Traffic UI*“ einen hohen SLA. Dies würden wir über entsprechende Eigenschaftswerte im Rahmen des Context Mappings erfassen. ### Herausforderungen gibt es auf mehreren Ebenen: - Fachliche Ebene: Es gibt Potenzial für einen Zielkonflikt. Wäre beispielsweise die zeitnahe Abarbeitung des Batches wichtiger oder die Reaktivität der UI? - Betriebsebene: Hier sehen wir uns mit zwei gegensätzlichen SLAs konfrontiert: Zum einen einem relativ entspannten SLA für das Batching mit hoher Laststabilität. Nur langsame Skalierung ist notwendig, kleinere Ausfallzeiten sind unkritisch. Auf der anderen Seite ein „hoch interaktiver“ SLA für das Frontend mit ggf. starken Lastschwankungen, dynamischer Skalierung, Near-Zero-Ausfallzeit etc. - Technologische Ebene: Wir stehen vor technischen Herausforderungen, um die unterschiedlichen Anforderungen der beiden Upstream-Systeme in einem Service zu realisieren. Letztendlich bedeutet diese Konstellation vermutlich, dass in der Umsetzung der technische Aufwand durch das Frontend getrieben wird, obwohl Batching eigentlich die führende Aufgabe ist. Das verantwortliche Team wird dadurch möglicherweise gezwungen, zeitnah nicht unerhebliche Änderung an seinem System durchzuführen. Es ist mit Qualitätsproblemen zu rechnen. Das Team für „*High Traffic UI*“ wird erheblich Druck ausüben. Konflikte sind vorprogrammiert. Die Ziele von „*Batch\_System*“ und „*High Traffic UI*“ wären in Gefahr. ### Zwei Optionen können hier weiterhelfen: - Technisch entkoppeln: Zum Beispiel Zerlegung des Kontexts und Replikation der Daten, die für die UI relevant sind, über in einen zweiten Kontext. Dieser Kontext kann die Anfragen der UI über das Replikat lokal bedienen, auf Kosten der Aktualität der Daten. - Anpassung von Prioritäten und SLAs. Klärung der Zielkonflikte. ## Szenario: Transitivität Auch Transitivität ist ein wichtiger Aspekt, wenn man holistischer auf die gesamte Context Map schaut. Nehmen wir dafür die folgende Context Map an, um zu sehen, wie man es nicht machen sollte: ![Ist in dieser Context Map Transitivität gegeben?](https://thecattlecrew.net/wp-content/uploads/2024/04/anschub-modernisiserung-teil4_bild04-177x300.png) „*Service\_A*“ hat eine „Customer/Supplier“-Schnittstelle zu einem externen System. Da der Einfluss der Schnittstelle überschaubar ist, wurde auf einen „Anti-Corruption-Layer“ verzichtet. Gleichzeitig ist „*Service\_A*“ aber ein „Open-Host-Service“ für „*Service\_B*“ und dieser wiederum für „*Service\_C*„, ohne dass diese sich mittels eines Anti-Corruption-Layer isolieren. Im Gegenteil: Die Modelle werden im Sinne des Conformist 1:1 übernommen. Damit ist zu befürchten, dass Teile des Modells von „*Externes\_System*“ an alle anderen Kontexte weitergereicht werden. Eine Änderung in der Schnittstelle zu „*Externes\_System*“ oder ein Austausch des Schnittstellenpartners kann so zu notwendigen und aufwändig zu koordinierenden Anpassungen in **allen** Kontexten führen. Noch unangenehmer würde es, wenn „*Service\_A*„, „*Service\_B*“ und „*Service\_C*“ nicht zum gleichen Bounded Context gehören würden und Teile des Modells von „*Externes\_System*“ in eine andere Domäne diffundierten. Möglicherweise ist dieser Sachverhalt der anderen Domäne noch nicht einmal bewusst. #### Was bleibt zu tun? - Gerade an System- und Domänengrenzen muss sichergestellt werden, dass Modelle der Außenwelt oder einer anderen Domäne nicht ins 1:1 ins Innere weitergeleitet werden. Dafür wäre unter anderen ein Anti-Corruption-Layer auf Seiten des „*Service\_A*“ sinnvoll. - Das Weiterreichen von Modellen muss für die komplette Context Map geprüft werden. Transitive Strecken über mehr als zwei Kontexte sind zu prüfen und im Zweifel durch entsprechende Anpassungen und die Einführung eines Anti-Corruption-Layers zu unterbinden. ## Zusammenfassung Hoffentlich konnte ich mit meinen Beschreibungen, Erklärungen und Beispielen zeigen, wie mächtig die Kombination aus Event Storming, Context Exploration und Definition, Glossar und Context Mapping sind. Wenn ich zumindest andeute konnte, wie dieser Handwerkskasten helfen kann, in Modernisierungsprojekten schnell wichtige Klärungen herbeizuführen und damit konkrete Migrationsschritte vorzubereiten, wäre für mich persönlich schon ein wichtiges Ziel erreicht. Aus meiner Sicht ist obige Kombination der perfekte „Knotenlöser“ für lange Diskussionen und Abstimmungsmeetings! Hierzu die wichtigsten Argumente nochmals auf einen Blick: - *Event Storming* ist nicht nur eine leichtgewichtige Methode, um sich explorativ die Zielkontexte und Zielprozesse des modernisierten oder gar neuen Systems zu erarbeiten. Die Methode zwingt die Beteiligten auch, einen Konsens bezogen auf **Vision**, **Geschäft** und **Arbeitsweise** zu schließen. Es liefert die relevante Fachbegriffe für ein *Glossar* und damit erste Bausteine für eine bessere Verständigung über eine gemeinsamen **domänen-spezifischen Sprache**. - Mit dem Ausfüllen der *Context Description* während oder nach dem Big Picture Event Storming erreichen wir eine gemeinsame Definition der **Aufgaben** des Kontextes. Diese führt zu einer gemeinsamen Einschätzung des **Wertbeitrags** des Kontextes und seiner **strategischen Bedeutung** und liefert wichtige Informationen für die folgende Erstellung der *Context Map.* - Über die Bewertung der Schnittstellen der einzelnen Kontexte entsteht mithilfe der *Context Map* ein Modell der **fachlichen** und **technischen** **Kommunikation** im jeweiligen System. Daraus kann auch ein Bild entstehen über die **organisatorische** Kommunikation, die im Projekt zwischen den Teams notwendig wäre. So wird es möglich, die organisatorischen, technischen und fachlichen Ebenen in **Einklang** zu bringen – dies effizient durch entsprechende Anpassungen an Context Map und Planung. Ein besonders wichtiger Punkt in Modernisierungsprojekten! - Gemeinsamkeit und Konsens führen unterm Strich zu Ergebnissen, die **belastbar** und **robust** sind. Die Folge sind **Risikoreduzierung** und **Sicherheit**. - Zu guter Letzt können die leichtgewichtigen Modelle und Modellierungsansätze auch im weiteren Projektverlauf herangezogen werden, um zusammen an Wand, Tafel oder Board über Details zu sprechend und Anpassungen zu diskutieren. So ist Event Storming – wie Anfangs versprochen – nicht nur Zettel kleben, die Context Definition nicht nur ein Formular, das Glossar nicht nur eine Verstichwortung und die Context Map keine statische Abbildung technischer Schnittstellen. Ich hoffe, ich konnte euch überzeugen!? Welche Erfahrungen habt ihr gemacht? Ich freue mich auf weitere Diskussion! *\* Die Context Map Diagramme wurden mit den Visual Studio Code Plugin für ContextMapper erstellt. Mehr zu ContextMapper findest du unter * ## Die ganze Serie lesen: [Teil 1: Mehr als eine Wand voll Post-its – Wie Event Storming & Co das Neue beflügeln](https://thecattlecrew.net/2024/01/25/mehr-als-eine-wand-voll-post-its/) [Teil 2: Die Teile dahin legen, wo sie passen könnten – Context Mapping und seine Bausteine](https://thecattlecrew.net/2024/02/16/die-teile-dahin-legen-wo-sie-passen-koennten/) [Teil 3: Erkennen, was wie voneinander abhängt – Wie hilft Context Mapping, die Modernisierung erfolgreich aufzusetzen?](https://thecattlecrew.net/2024/03/22/erkennen-was-wie-voneinander-abhaengt/) [Teil 4: Wie Sie Context Mapping nicht machen sollten … – Negativbeispiele und ihre Lösung](https://thecattlecrew.net/2024/04/19/wie-sie-context-mapping-nicht-machen-sollten/) **Kategorien:** Architecture & Process Models **Schlagwörter:** context map, Context Mapping, IT-Modernisierung, kopplung, Migration --- ### [SQL-Migration mit jOOQ Unterstützung](https://thecattlecrew.net/2024/03/11/sql-migration-mit-jooq-unterstuetzung/) **Published:** März 11, 2024 **Author:** Richard Attermeyer **Content:** IT-Modernisierungsprojekte enthalten oft die Herausforderung, über die Jahre umfangreich gewachsene Bestandsdaten in die Zielarchitektur zu migrieren. In diesem Artikel werfen wir einen kurzen Blick auf die folgenden Themengebiete: - Was ist bei einer Bulk Migration von Daten zwischen Datenbanken zu beachten? - Was ist die Herausforderung, wenn sich das Zielschema aufgrund von Entwicklungstätigkeiten ändert? - Wie kann jOOQ dabei unterstützen, das Risiko für Prozessfehler zu minimieren? # Migration nach PostgreSQL Sehen wir uns ein Beispiel an: Wir haben eine Anwendung, die in einer Oracle Datenbank betrieben wird und deren Daten in eine PostgreSQL-Datenbank migriert werden sollen. Die Datenbank wurde mittels `ora2pg` in ein Schema „Staging“ in PostgreSQL migriert. Dieses Schema halten wir dabei in derselben Datenbank wie das spätere Zielschema. Warum wählen wir diesen Ansatz? Der Ansatz hilft uns, einfache SQL-Abfragen für die Migration zu nutzen. Alternativ kann es sinnvoll sein, das Staging-Schema in einer eigenen Datenbank, bzw. Datenbankcluster zu halten, um die Datenbanken zu entkoppeln. Dazu können wir Postgres Foreign Data Wrapper nutzen, um genauso einfach auf die Daten zugreifen zu können. Dies kann wichtig sein, etwa um den zusätzlichen Speicher für das Staging Schema wieder freigeben zu können. Bei vielen Cloud-Anbietern kann der einmal einer DB zugewiesene Speicher nicht wieder freigegeben werden. Liegt das Staging-Schema in einem eigenen Datenbankcluster, kann der gesamte Server einfach gelöscht werden. ## Frühzeitig beginnen! Wir halten es für sinnvoll, möglichst frühzeitig mit der Entwicklung der Migrationsskripte zu beginnen. Häufig stellen wir fest, dass die Altdaten Konstellationen enthalten, die man im zukünftigen Schema nicht mehr zulassen möchte. Dann stellt sich die Frage, wie mit den Altdaten umgegangen werden soll. ## Tests mit realistischen Datenmengen Migration und Re-Implementierung der Anwendung finden gleichzeitig statt. Dieser Umstand erweist sich als Glücksfall, denn die Migration sorgt so als Treiber für einen Datenbank-First-Ansatz. Für die Re-Implementierung ist es hilfreich, dass wir bereits mit den (anonymisierten) Altdaten arbeiten können. Dies liefert eine realistische Datenmenge, denn Abfragen auf leeren Tabellen sind ja immer schnell. Die Nutzung von Produktionsdaten zu Testzwecken ist dagegen ein anderes Thema. Immer, wenn sich das Zielschema ändert, müssen die Daten-Migrationsskripte angepasst werden. Was gehört zu einer performanten Migration? Es gibt verschiedene Arten von Migrationen. In der Regel ist es sinnvoll, bei IT-Systemen eine inkrementelle Migrationsstrategie zu verfolgen. Das kann bedeuten, dass Teile des IT-Systems jeweils in einem Schritt migriert werden (Big Bang). Eine performante Migration der Daten ist dann wichtig. Beim Bulk-Load von Daten in eine PostgreSQL-Datenbank oder zwischen Tabellen gibt es einiges zu beachten, um eine möglichst gute Performanz zu erzielen. Ähnliches gilt auch für andere Datenbanken. Angelehnt an die Liste von [EDB](https://www.enterprisedb.com/blog/7-best-practice-tips-postgresql-bulk-data-loading) sind folgende Punkte wichtig für unser Szenario (PostgreSQL/PostgreSQL mittels SQL): - Tabellen in die migriert werden sollen, sollten vorher leer sein. - Tabellen sollten „unlogged“ sein. - Tabellen sollten keine Indizes haben. - Tabellen sollten keine Constraints haben. - Tabellen sollten keine Triggers haben. - Tabellen sollten keine Foreign Keys haben. Im nächsten Schritt werden die Daten mittels SQL-Skripten geladen. Danach werden die Indizes, Constraints, Triggers und Foreign Keys wiederhergestellt. Zum Abschluss sollte ein `analyze` ausgeführt werden, um die Statistiken zu aktualisieren. # Was ist die Herausforderung bei gleichzeitigen Entwicklungstätigkeiten? Wird die Anwendung neu entwickelt, so ändert sich das Zielschema. Dabei sind insbesondere die Änderungen an den Zieltabellen interessant in die hinein migriert wird. Typische Änderungen die Auswirkung auf die Migrationsskripte haben sind: - Neue Indizes - Neue Constraints (inklusive Foreign Keys) - Neue Trigger - Umbenennungen von Spalten - Neue Not-Null Spalten Es ist wichtig, dass diese Änderungen entweder automatisch erkannt und berücksichtigt werden oder vor Ausführung der Skripte auffallen. Da die Laufzeiten für die Migrationen sehr lang sein können (Stunden bis Tage), müssen Fehler möglichst früh erkannt werden. Sonst kann die (unbeobachtete) Probemigration erst nach vielen Stunden fehlschlagen und wird nicht abgeschlossen. Damit werden viele Stunden wertvoller Projektzeit verschwendet. # Wie kann jOOQ helfen? [jOOQ](https://www.jooq.org) generiert aus einem Datenbankschema ein Klassenmodell. Dieses beinhaltet Informationen über die gängigen Datenbankobjekte wie Tabellen, Spalten, Indizes, Constraints, Triggers und Foreign Keys. Mittels dieses Klassenmodells kann man dann einfach alle Indizes oder Constraints einer Tabelle entfernen oder neu erzeugen. Das Beispielprojekt nutzt jOOQ, um die SQL-Migrationsskripte zu erzeugen, ohne die eigentliche Migration durchzuführen. Wenn wir dabei alle Tabellen mittels eines [topologischen Sortieralgorithmus](https://en.wikipedia.org/wiki/Topological_sorting) sortieren, dann können wir die Tabellen in der richtigen Reihenfolge behandeln. Dies ist wichtig, damit wir Constraints in der richtigen Reihenfolge löschen und wiederherstellen. Dies gilt im Kontext dieses Blog-Post zumindest solange, wie der „Tabellengraph“ keine Zyklen enthält. Wir nutzen die generierten SQL-Skripte für die Behandlung der Indexe und Constraints. Dadurch vergessen wir keine Objekte zu löschen oder zu erzeugen, die im Rahmen der Weiterentwicklung noch entstehen oder gelöscht werden. Der Hintergrund für den Umweg über die SQL-Skripte ist, dass wir die Skripte auch in anderen Umgebungen ausführen können. Generell sollten die Aktionen nicht vom Notebook eines Entwicklers oder einer Entwicklerin ausgeführt werden, sondern von einem dedizierten Migrationssystem (virtuelle Maschine). Wenn ihr die Migration manuell startet, solltet ihr darauf achten, dass dies unter einem Terminal-Multiplexer wie `tmux` oder `screen` geschieht. Damit die Ausführung nicht abbricht, wenn der ausführende Benutzer die Verbindung beendet. Die Dauer der Migration hängt stark von der Größe der Datenbank ab. Selbst für einige kleine Datenbanken mit < 250 Mio Einträgen und mehreren Tabellen kann die Migration mehrere Stunden dauern. Bei größeren Migrationen ist sicherlich noch eine gesonderte Betrachtung notwendig, um Laufzeiten zu optimieren. Ein weiterer Vorteil kann die Nachbearbeitung der Skripte sein. Etwa wenn ihr beim Umgang mit den Constraints leichte Anpassungen vornehmen müsst, weil die Datenbank doch Zyklen enthält. # Beispielprojekt auf Github Das Beispielprojekt ist auf [GitHub](https://github.com/opitzconsulting/jooq-migration) verfügbar. Eine etwas ausführlichere Dokumentation findet sich auf den zugehörigen [Github Pages](https://opitzconsulting.github.io/jooq-migration/jooq-migration/main/index.html). ## Datenbank aufsetzen Die PostgreSQL Datenbank kann mittels Docker Compose aufgesetzt werden. ``` docker compose up -d ``` Verbinden könnt ihr euch mittels des Nutzers `jooq_demo_admin` und dem Passwort `jooq_demo_admin`. Dieser Nutzer hat die notwendigen Rechte auf der Datenbank und den Schemas. Es gibt die folgenden Schemas: jooq\_demoDas Zielschema, das später von der Anwendung genutzt werden soll.stagingDas Staging-Schema, welches aus der Oracle Datenbank migriert wurde.extensionsDas Schema, in dem die Erweiterungen für die Datenbank liegen (z. B. uuid-ossp), die nicht zu viele eigene Funktionen und Objekte bereitstellen. Wenn die Datenbank läuft, dann können die Tabellen mittels ``` ./gradlew :db:update ``` erzeugt werden. Die Ausführung von liquibaseUpdate triggert auch die Erzeugung der jOOQ Klassen. Es wird eine minimale Web-Oberfläche mittels [Adminer](https://www.adminer.org) bereitgestellt, die unter erreichbar ist. Wer sich darüber anmelden möchte, der kann die folgenden Daten verwenden: Attribut Wert Datenbank System PostgreSQL Server postgres Benutzer jooq\_demo\_admin Passwort jooq\_demo\_admin Datenbank jooq\_demo ## Spring Shell bauen Bei der Anwendung, welche die Testdaten generiert, Migrationsskripte erstellt und ausführt, handelt es sich um eine Spring Shell Anwendung. Ein Gradle Build erzeugt die Anwendung. ``` ./gradlew build ``` ## Testdaten erzeugen Jetzt benötigen wir Testdaten in der Staging Datenbank. Die Daten werden mittels [DataFaker](http://datafaker.net) erzeugt und mittels jOOQ in die Datenbank geschrieben. ``` java -jar library-migration/build/libs/library-migration-0.0.1-SNAPSHOT.jar generateData ``` ## Migrationsskripte erstellen Jetzt geht es darum, die eigentlichen Migrationsskripte erstellen zu lassen. ``` java -jar library-migration/build/libs/library-migration-0.0.1-SNAPSHOT.jar generateScripts ``` Die Migrationsskripte werden im `scripts` Verzeichnis des Sub-Projekts `library-migration` abgelegt. Es wird ein Skript `0000_run_all.sql` erzeugt, welches mittels `psql` ausgeführt werden kann. Dieser Schritt enthält die eigentliche Magie. Wenn wir jetzt einmal die Skripte anschauen, die erzeugt werden, so sehen wir folgende Liste: ``` 0000_run_all.sql 0010_disable_indexe.sql 0020_drop_constraints.sql 0030_unlog_tables.sql 1010_create_mapping_tables.sql 1020_members.sql 1030_books.sql 1040_checkout.sql 2040_log_tables.sql 2050_add_constraints.sql 2060_enable_indexe.sql 2070_analyze_tables.sql ``` Die Skripte spiegeln die oben genannten Schritte für einen Bulk-Load wieder. Einige Dateien sind aktuell leer, wie disable\_indexe und enable\_indexe, da keine expliziten Indexe definiert sind. Wir erkennen aber alle Schritte wieder, die wir im Rahmen eines Builds durchführen würden. Wir brauchen aber nur die Skripte schreiben, welche die wirkliche Migration der Daten durchführen. Book Mapping using a lookup table ``` var sql = dsl.insertInto( target, target.ID, target.INSTANCE_ID, target.MEMBER_ID, target.CHECKOUT_DATE, target.RETURN_DATE, target.ACTUAL_RETURN_DATE) .select(dsl.select( Routines.uuidGenerateV7(), instance.ID, mappingMembers.UUID, source.CHECKOUT_DATE, source.RETURN_DATE, source.ACTUAL_RETURN_DATE) .from(source) .join(mappingBooks) .on(source.ISBN13.eq(mappingBooks.ISBN13)) .join(mappingMembers) .on(source.MEMBER_ID.eq(mappingMembers.MEMBER_ID)) .join(instance) .on(instance.BOOK_ID.eq(mappingBooks.UUID))) .onConflictDoNothing() .getSQL(); ``` Dieses Beispiel befindet sich in der Klasse `LibraryMigration`, welche die Methode `migrateTables` unserer `FullMigrationSupport` Oberklasse überschreibt. Überschriebene Methode `migrateTables` ``` @Override protected void migrateTables() throws Exception { createBookMappingTables(migrationScriptsCollector.newScript("1010_create_mapping_tables.sql")); mapMembers(migrationScriptsCollector.newScript("1020_members.sql")); mapBooks(migrationScriptsCollector.newScript("1030_books.sql")); mapCheckouts(migrationScriptsCollector.newScript("1040_checkout.sql")); } ``` ## Migrationsskripte ausführen Jetzt müssen die Daten mittels der Skripte migriert werden. ``` java -jar library-migration/build/libs/library-migration-0.0.1-SNAPSHOT.jar applyScripts ``` Das führt einfach die Skripte aus (mittels Spring `ScriptUtils` Klasse). Häufig werden die Skripte aber auch mittels `psql` ausgeführt, ggf. sogar für die Produktivmigration von entsprechenden DBAs. ## Simulation von Entwicklungstätigkeiten im Zielschema Mit den folgenden Aktionen simulieren wir Entwicklungstätigkeiten im Zielschema und schauen, wie sich das in den Migrationsskripten widerspiegelt. ### Zusätzlichen Index erstellen Wir wollen einen zusätzlichen Index auf der Tabelle `book` erstellen. Dieser sollte dann auch automatisch in den Migrationsskripten gedroppt und neu erstellt werden. ``` ./gradlew :db:update -PliquibaseExtraArgs="contexts=demo-1" ./gradlew --no-build-cache clean build java -jar library-migration/build/libs/library-migration-0.0.1-SNAPSHOT.jar generateScripts ``` Das Skript `0010_disable_index.sql` enthält jetzt den Befehl zum Löschen des Indexes und entsprechend `2060_enable_indexe.sql` enthält den Befehl zum Erstellen des Indexes. Es gibt also keine Indexe, die man vergessen kann zu löschen und zu erstellen. Das ist schon mal sehr hilfreich. Was hier passiert ist, dass an ein Liquibase Update (mittels `./gradlew :db:update`) den Task `jooqCodegen` auslöst. Damit wird das jOOQ Klassenmodell aktualisiert. Wir schauen uns jetzt einmal an, was passiert, wenn wir eine Spalte umbenennen. ### Spalte umbenennen Wir nennen in der Tabelle `checkout` die Spalte `return_date` in `borrowed_until_date` um. ``` ./gradlew :db:update -PliquibaseExtraArgs="contexts=demo-2" ./gradlew --no-build-cache clean build ``` Der Build schlägt fehl, da es die Spalte mit dem alten Namen nicht mehr gibt. Fehlermeldung ``` /Users/rat/devel/playground/jooq-migration/library-migration/src/main/java/com/opitzconsulting/cattlecrew/jooqmigration/migration/LibraryMigration.java:90: Fehler: Symbol nicht gefunden target.RETURN_DATE, ``` Da es nur ein Demo ist, können wir die Spalte wieder umbenennen und den Build wiederholen. ``` ./gradlew :db:rollbackCount -PliquibaseCommandValue=1 -PliquibaseExtraArgs="contexts=demo-2" ``` Wer noch mehr ausprobieren möchte, der kann das natürlich auch einfach mittels SQL auf der Datenbank machen. ### Was nicht funktioniert Wenn ihr eine neue Not-Null-Spalte hinzufügt, wird nicht automatisch erkannt, dass in den Abfragen kein Wert für die Spalte bereitgestellt wird. Wer sich die Datenbankdefinition genau angesehen hat, wird feststellen, dass ein PostgreSQL-spezifisches Exclusion Constraint auf der Checkout-Tabelle definiert ist. Dieses wurde vom Meta-Modell nicht erkannt und auch nicht in den Skripten berücksichtigt. Daher ist es immer noch wichtig, sich die generierten Skripte anzuschauen und ggf. zu prüfen und zu ergänzen. Gleiches gilt auch, wenn zyklische Abhängigkeiten zwischen Tabellen bestehen. ## Fazit Auch wenn Änderungen nicht erkannt werden, ist die Nutzung von jOOQ für die Erstellung von Migrationsskripten sehr hilfreich und kann einige Fehlerquellen adressieren, die bei gleichzeitiger Entwicklungstätigkeit auftreten können, wenn das Zielschema nicht eingefroren ist. Notwendige Ergänzungen können im Code oder in den generierten Skripten vorgenommen werden. **Kategorien:** Automation, Database **Schlagwörter:** Datenbankmigration, Datenmigration, IT-Modernisierung --- ### [Von Co-Pilot bis CodeWhisperer: Was können Code-Assistenten?](https://thecattlecrew.net/2024/01/19/von-co-pilot-bis-codewhisperer-was-koennen-code-assistenten/) **Published:** Januar 19, 2024 **Author:** Emrah Birsin **Content:** Seit ChatGPT von Open AI der Öffentlichkeit zugänglich gemacht wurde, sind KI-Textgeneratoren in aller Munde. Viele versuchen derzeit auch im Job die Grenzen und die Möglichkeiten dieser Assistenzsysteme auszuloten. Textgeneratoren wurden schon dazu genutzt, Kinderbücher zu schreiben oder helfen dabei, Formulierungen zu verfeinern. Andere nutzen Textgeneratoren als Tandem Partner zum Sprachenlernen. Ein Anwendungsgebiet, das speziell für IT-Firmen interessant ist, ist die Nutzung beim Schreiben von Code. Dieser Blogbeitrag schaut sich Textgeneratoren an, die schon weit verbreitet sind und für das Erstellen von Code und Codedokumentation trainiert wurden. Vier Dienste sollen genauer beleuchtet werden: Code-Suggestion von GitLab, Copilot von Github, AI Assistant von JetBrains und CodeWhisperer von AWS. # Integration in die Entwicklungsumgebung Die derzeitigen Code-Assistenten lassen sich mit Plugins in verschiedenste IDEs einbauen. Vorneweg ist hier VS Code zu erwähnen. Hier lassen sich alle vier Assistenten integrieren und nutzen. Selbst AI Assistant, der sonst nur für die JetBrains IDEs vorgesehen ist, funktioniert hier. Auch die IDEs von JetBrains werden im Allgemeinen unterstützt, mit der Einschränkung, dass die zusätzliche Kosten mit sich bringen. Benutzt man AWS Glue Studio Notebook, JupyterLab oder Amazon SageMaker Studio und will einen Code-Assistenten nutzen, so steht derzeit nur CodeWhisperer zur Wahl. ![](https://thecattlecrew.net/wp-content/uploads/2024/01/Code-Assistenten-IDEs-1.png) # Welche Sprachen werden unterstützt? Alle Assistenten unterstützen die gängigsten Programmiersprachen wie C++, Java und Python. Der Copilot von Github rühmt sich auch damit, dass er mit allen Programmiersprachen umgehen kann, die in Github Repositories vorkommen. Dies bedeutet, dass Copilot potenziell alle Programmiersprachen beherrscht, wobei auch Copilot zugibt, dass die Qualität hier sehr abhängig davon ist, wie häufig die Sprache in Github vorkommt, sodass für selten genutzte Programmiersprachen auch schlechtere Ergebnisse erzeugen werden. In Tabelle 2 ist eine Übersicht der derzeit unterstützten Programmiersprachen zu finden. Diese Liste ist nicht vollständig und es kommen immer wieder neue Sprachen hinzu. Tabelle 2: Übersicht der unterstützten Programmiersprachen ![](https://thecattlecrew.net/wp-content/uploads/2024/01/Code-Assistenten-Sprachen-1.png) # Sicherheit und Datenschutz Wenn es um die Nutzung von KI in Unternehmen geht, sind Sicherheit und Datenschutz sensible Themen. Wie werden Daten genutzt und gespeichert? Um diese Frage zu beantworten, sind mehrere Aspekte zu beachten: ## Verschlüsselung Um im Code-Assistenten ein Resultat zu generieren, müssen gewisse Codeteile an den Textgenerator gesendet werden. – Hierfür benutzen alle vier Dienste, die ich untersucht habe, eine verschlüsselte Übertragung. Diese Codeteile werden im Allgemeinen nur temporär gespeichert, bis eine Antwort generiert wurde und dies in verschlüsselter Form. ## Nutzungsdaten Typischerweise werden auch Nutzungsdaten wie genutzte Sprache, Länge des Prompts u. s. w. gesammelt. Diese Daten werden anonymisiert und verschlüsselt gespeichert. – Copilot sticht hier mit einer außerordentlichen Transparenz heraus: So ist bekannt, dass alle Daten, die gespeichert werden, mittels Microsoft Azure’s data encryption gemäß FIPS Publication 140-2 Standards verschlüsselt werden. Der Service von Copilot wird zudem auditiert und erfüllt die Voraussetzungen für SOC 2, ISO 27001 und FedRAMP Tailored Zertifikate. Weiterhin besteht die Möglichkeit als Enterprise Kunde nach der Unterzeichnung eines NDAs Einsicht in externe Penetration Tests zu bekommen. ## Nutzung für das Training der KI Der dritte Punkt, der viele Unternehmen beim Thema Sicherheit interessiert, ist: „Wird mein Code zum weiteren Trainieren von Code-Generatoren benutzt?“ Alle Dienste bis auf CodeWhisperer verneinen dies explizit. Bei CodeWhisperer konnte ich keine Aussage hierzu finden. Da dieser Code-Generator jedoch ausschließlich auf Open Source Code trainiert wird, ist es sehr wahrscheinlich, dass der eigene Code auch hier sicher ist. AI Assistant bietet die Möglichkeit zu einer erweiterten Datenverarbeitung als reinen Opt-in an. Wird diese gestattet, werden ganze Textblöcke aus der Kommunikation zwischen Nutzer und Code-Generator sowie Codeteile von AI Assistant zum weiteren Training genutzt. Diese Daten werden maximal ein Jahr lang verschlüsselt gespeichert. Generell gibt es einen Unterschied zwischen den bezahlten Varianten, die hier betrachtet wurden und kostenlosen Varianten. Letztere erlauben oft die Verwendung der gesendeten Daten zum Training, bzw. schließen dies nicht aus. Hier gilt es sich genau zu informieren. # Funktionalität im Vergleich Beim Funktionsumfang gibt es die größten Unterschiede zwischen den Assistenten. ## Schreibvorschläge Code Suggestions hat derzeit die geringste Funktionalität anzubieten. Hier bietet der Assistent nur zwei Möglichkeiten der Interaktion. 1. Zum einen gibt der Assistent während des Code-Schreibens Vorschläge dafür, was man wahrscheinlich als nächstes schreiben will. So kann der Assistent zum Beispiel bei einem Return Statement in einer Funktion eine Variable mit dem richtigen Datenformat vorschlagen. 2. Die zweite Funktionalität ist die Codegenerierung aus Kommentaren. So wird aus einem Kommentar wie „Prints out the Sum of the first ten integers” Code generiert, der eine Schleife über die ersten zehn ganzen Zahlen laufen lässt und zu einer Variablen hinzuaddiert. ## Chatbot-Funktion Die anderen Assistenten bieten neben der Codegenerierung während der Eingabe auch einen Chatbot, mit dem man über den Code der derzeitig geöffneten Datei reden kann. Das können Fragen sein wie „Was macht diese Funktion?“ oder man kann auch direkt Code generieren lassen wie das Schreiben von Tests zu dem Programm. Der Chatbot erlaubt es auch, Fehlermeldungen zu analysieren und gegebenenfalls auch Lösungen zu finden. ## Texte für Pull Requests und Commit Messages Copilot und AI Assistant haben neben der direkten Codegenerierung auch die Funktonalität Texte für Pull Requests (Copilot) oder Commit Messages (AI Assistant) anhand der Änderungen zu schreiben. ## CodeWisperer kann noch mehr Die folgenden drei Features sind ausschließlich bei CodeWhisperer zu finden und machen das Tool derzeit einzigartig. 1. Erstens ist der Assistent auf AWS-Dienste spezialisiert. D. h. CodeWhisperer kann dabei helfen, die Einbindung der Dienste in Skripte zu verbessern. 2. Zweitens kann CodeWhisperer den Code auf Sicherheitslücken untersuchen. So können z. B. die Top 10 Sicherheitslücken des Open Worldwide Application Security Project (OWASP) direkt geprüft werden. 3. Punkt drei ist die Kennzeichnung von Open Source Code. Entdeckt CodeWhisperer Code, der unter der Open-Source-Lizenz läuft, egal ob durch den Nutzer eingegeben oder durch CodeWhisperer erzeugt, so wird dieser Code gekennzeichnet. Es steht dann im eigenen Ermessen, ob man die entsprechende Erwähnung vorzunehmen möchte oder den Code zu entfernen lässt, um das Problem anders zu lösen. # Was kosten die Code-Assistenten? Bis auf Code Suggestions, das während der Betaphase kostenlos ist, sind alle Code Assistenten mit monatlichen Kosten pro Nutzer verbunden. CodeWhisperer und AI Assistant bieten einen kostenlosen Einstieg an, die im Fall von CodeWhisperer eingeschränkt in der Nutzung ist und im Fall von AI Assistant zeitlich auf sieben Tage begrenzt ist, dafür aber alle Funktionalitäten der bezahlten Version hat. Die Kosten schwanken dabei sehr, AI Assistant bietet mit 16,67 Euro pro Monat pro Nutzer den günstigsten Assistenten an, hier kommen jedoch noch die Kosten der benutzten IDE hinzu. Copilot und CodeWhisperer bieten beide eine Grundversion für 19 Dollar pro Monat pro Nutzer an, Code Suggestions verlangt hier 29 Dollar. Für 39 Dollar gibt es noch eine Enterprise Version von Copilot. AI-Suggestions bietet auf Anfrage noch eine Enterprise-Version an, die neben einer On-Premise-Installation noch höhere Schutzfunktionen bietet. # Fazit Obwohl es noch sehr neu ist, Textgeneratoren zum Schreiben von Code zu benutzen, gibt es inzwischen doch einige interessante Möglichkeiten. Zum einen helfen Codevorschläge – ähnlich wie klassische Vorschläge von IDEs – um Standardcode schneller zu schreiben. Die KI erlaubt darüber hinaus aber auch den Vorschlag von Funktionalitäten. Nach einiger Gewöhnung, fühlt sich der Chatbot wie ein:e Kolleg:in an, der oder die beim Programmieren hilft. Mit dem Vorteil, dass dieser jederzeit verfügbar ist und auch bei den dümmsten Fragen Ruhe bewahrt. Natürlich ist nicht jeder Code, der produziert wird, sofort funktionsfähig oder arbeitet korrekt. Man sollte immer damit rechnen, dass der Code fehlerhaft sein kann. Aber auch hier hilft die Chatbot Funktion weiter. Einfach bei Code, den man nicht sofort nachvollziehen kann, nachhaken und herausfinden, was der Code genau macht. Kommt es bei der Codeausführung zu einer Fehlermeldung, so kann der Assistent erklären, warum es zu diesem Fehler kommt. Im Gegensatz zu einer normalen Google Suche kann der Assistent den Kontext mitberücksichtigen, was hilfreich sein kann. Ich bin davon überzeugt, dass Code-Assistenten in der Softwareentwicklung immer stärker zum Einsatz kommen werden. Sie werden bei einfachen Problemen genutzt werden, wie bei der Namensvergabe für Variablen, könne aber auch bei der Analyse von komplexem Code helfen. Sie werden die lästige Arbeit der Dokumentation und der Codekommentierung vereinfachen oder sie den Entwicklungsteams vielleicht ganz abnehmen. **Kurz: Alle, die heute mit Programmierung beschäftigt sind, sollten sich mit diesem Thema auseinandersetzen!** **Kategorien:** AI & Data Science, Development, Tools & Methoden **Schlagwörter:** Artificial Intelligence, Code Assistent, Code Generator, LLM, Programmieren, Softwarenentwicklung --- ### [Wieviel Strom frisst meine Software?](https://thecattlecrew.net/2024/01/22/wieviel-strom-frisst-meine-software/) **Published:** Januar 22, 2024 **Author:** Ramon Anger **Content:** Wollen wir den CO2-Fußabdruck einer Software-Anwendung reduzieren, müssen wir vor allem ihren Stromverbrauch unter die Lupe nehmen. Denn dieser steht mit dem CO2-Fußabdruck in einem direkten Zusammenhang. Wird die Software in einem Rechenzentrum betrieben, kommen noch die Kosten für die Kühlung hinzu. Je nach Kühlungsstrategie werden hier neben Strom auch Wasser, Kühlmittel oder Luft verbraucht. In diesem Post geht es in erster Linie darum, wie wir den Stromverbrauch einer Software-Anwendung messen. Zum Energieverbrauch für die Bereitstellung von Daten, für den Netzwerkverkehr oder für die Clients plane ich weitere Posts. ## Messung in der Cloud Die Cloud basiert auf einem hochverteilten System. Sie setzt sich zusammen aus einer Vielzahl häufig dezentral bereitgestellter, physischer Computer und Peripheriegeräte. Diese Geräte kommunizieren kabelgebunden oder kabellos miteinander. Nutzen wir die Cloud, greifen wir dabei nicht direkt auf die physischen Geräte zu, sondern mieten und nutzen virtuelle Hardware oder Services, die auf diesen Geräten laufen. Uns ist dabei nicht transparent, welche und wie viele der physischen Geräte wir tatsächlich verwenden. Wir teilen unsere physischen Ressourcen möglicherweise mit vielen anderen Benutzern in der Cloud. Basis vieler Cloud-Dienste ist das Betriebssystem Linux, sei es für Datenhaltung, für Container- und Orchestrierungs-Plattformen oder für virtuelle Maschinen. Ein Manko von Linux ist, dass die Messung von Energieverbräuchen nicht oder nicht gut genug unterstützt wird. Nun versuchen wir, den Energieverbrauch der von uns genutzten, verteilten, Linux-basierten Cloud-Dienste zu messen. Dies erscheint unter den oben beschriebenen Umständen nicht gerade einfach. ### Wie Etsy Cloud Jewels helfen, Näherungswerte zu finden Dass die Messung des Energieverbrauchs von Cloud-Diensten schwierig sein kann, hat auch die IT-Abteilung von Etsy, einem Online-Marktplatz für Kunst und Kunsthandwerk, festgestellt. 2017 setzte man sich bei [Etsy](https://www.etsy.com/codeascraft/cloud-jewels-estimating-kwh-in-the-cloud) das Ziel, den Energieverbrauch des Unternehmens bis 2025 um 25 % zu reduzieren. Hier rückten natürlich die genutzten IT-Dienste ins Blickfeld. Eine erste signifikante Verbesserung brachte dabei schon die Migration von den eigenen physischen Servern (Stromverbrauchs-Effektivität: 1,39) in die Google Cloud (Stromverbrauchs-Effektivität: 1,1). Die [Stromverbrauchs-Effektivität](https://www.rechenzentren.org/rechenzentrum-klimatisierung/der-pue-wert-power-usage-effectiveness-eines-rechenzentrums/) beschreibt, wie viel der eingesetzten Elektroenergie in einem Rechenzentrum tatsächlich für die Bereitstellung und den Betrieb von IT-Services genutzt wird. Je näher der Wert bei 1 liegt, desto höher ist die Effektivität. Im nächsten Schritt sollte bei Etsy gemessen werden, wieviel Energie die virtuellen Maschinen, ihr RAM, ihre Festplatten oder der Netzwerkverkehr kosten. Weder Google noch Azure oder AWS stellten ihrer Kundschaft zu diesem Zeitpunkt verlässliche Informationen zur Verfügung. Ausgehend von der auf Tagesebene heruntergebrochenen Rechnung von Google Cloud Services, Annahmen bezüglich der genutzten virtuellen Ressourcen und der mit diesen verbundenen Stromkosten als Näherungswerte berechneten die Leute bei Etsy ihren Energieverbrauch. Aus dieser Vorgehensweise entstanden die [Etsy Cloud Jewels](https://github.com/etsy/cloud-jewels). Dies ist eine Methodik zur Ermittlung der Energiekosten in einem Cloud-Umfeld. Die Cloud Jewels wurden vom Etsy Team auf Github unter einer MIT Lizenz zur Nachnutzung bereitgestellt. So können alle Organisationen, die die Google Cloud verwenden, ihren eigenen Stromverbrauch näherungsweise ermitteln. Glücklicherweise haben die drei Hyperscaler heute verstanden, dass ihre Kunden ein großes Interesse daran haben, die Auswirkungen ihrer Services auf die Umwelt genau zu kennen. So bietet Microsoft inzwischen das [Emission Impact Dashboard](https://www.microsoft.com/en-us/sustainability/emissions-impact-dashboard) an. Von AWS gibt es das [Customer Carbon Footprint Tool](https://aws.amazon.com/de/blogs/aws/new-customer-carbon-footprint-tool/) und Google liefert seinen Kunden [Carbon Footprint](https://cloud.google.com/carbon-footprint). ### Mit Kepler den realen Energieverbrauch messen Näher an der realen Messung des Energieverbrauchs von Software-Anwendungen ist das Tool Kepler. [Kepler](https://sustainable-computing.io/) steht für Kubernetes-based Efficient Power Level Exporter. Das Tool ist ein weitestgehend in [Go](https://go.dev/) geschriebener Metrik-Exporter für das Monitoring-Werkzeug [Prometheus](https://prometheus.io/). Um zu erklären, was Kepler genau tut, müssen wir etwas tiefer in die Linux-Welt eintauchen und ein paar wesentliche Begriffe klären: - [eBPF](https://www.syseleven.de/blog/ebpf-der-neue-stern-am-cloud-native-himmel/) (extended Berkeley Packet Filter) bezeichnet ein Framework, mit dessen Hilfe ereignisgesteuerte Programme in den Linux-Kernel geladen und dort ausgeführt werden können. Diese Ereignisse können System-, Funktionsaufrufe oder Netzwerkereignisse sein. - [cgroups](https://man7.org/linux/man-pages/man7/cgroups.7.html) (Control Groups) ist eine Linux-Kernel-Funktion, die zur Kontrolle, Priorisierung und Isolation von Prozessressourcen innerhalb eines Betriebssystems verwendet wird. cgroups ermöglichen die effiziente Verwaltung von Ressourcen wie CPU, Arbeitsspeicher, Festplattenspeicher und Netzwerkbandbreite für Prozesse oder Gruppen von Prozessen. - [sysfs](https://man7.org/linux/man-pages/man5/sysfs.5.html) (System Filesystem) ist ein virtuelles Dateisystem des Linux-Kernels, das Informationen über den Kernel, verschiedene Kernel-Subsysteme, Hardware und Geräte-Treiber durch virtuelle Dateien bereitstellt. sysfs dient als Schnittstelle zwischen dem Linux-Kernel und Benutzeranwendungen, um wichtige Systeminformationen und Konfigurationsparameter zugänglich zu machen. Kepler verwendet eben jene eBNF, um CPU-Leistungsindikatoren und Kernel Tracepoints zu messen. Die so ermittelten Daten bilden gemeinsam mit den zugehörigen Statistiken von cgroups und sysfs die Basis für die Machine-Learning-Modelle des [Kepler Model Servers.](https://sustainable-computing.io/kepler_model_server/get_started/) Mit deren Hilfe wiederum wird der Energieverbrauch von [Kubernetes Pods](https://kubernetes.io/de/docs/concepts/workloads/pods/) gemessen bzw. geschätzt. ### Scaphandre: ein Mess-Tool, das sich vielversprechend entwickelt Eine Alternative zu Kepler ist [Scaphandre](https://github.com/hubblo-org/scaphandre). Das Tool ist ein Software-Agent, der auf die Messung des Stromverbrauchs von Linux Bare-Metal-Servern und virtuellen Maschinen auf Basis von [QEMU/KVM](https://www.qemu.org/) fokussiert. Die resultierenden Daten können so aufbereitet werden, dass sie von gängigen Monitoring- und Überwachungswerkzeugen wie [Prometheus](https://prometheus.io/) oder [Grafana](https://grafana.com/) sinnvoll interpretiert und ausgewertet werden können. Der Einsatzbereich von Scaphandre ist aktuell (noch) etwas eingeschränkt, weil für die Messungen [Intel RAPL](https://www.intel.com/content/www/us/en/developer/articles/technical/software-security-guidance/advisory-guidance/running-average-power-limit-energy-reporting.html) (Running Average Power Limit) oder [AMD Power Gadget](https://github.com/trulyspinach/SMCAMDProcessor) Daten von Prozessoren ausgelesen werden müssen. Prozessoren die diese Features nicht besitzen, können von Scaphandre aktuell nicht ausgelesen werden. Apple-ARM-Prozessoren werden heute beispielsweise nicht unterstützt. Scaphandre funktioniert auch auf Kubernetes-Umgebungen und ist weitestgehend in [Rust](https://www.rust-lang.org/) geschrieben. Für die Anbindung weiterer Prozessortypen und -familien benötigt das Projekt Scaphandre daher gern weitere Mitstreiter. ## Direkte Messung des Stromverbrauchs Für viele Programmiersprachen gibt es heute Frameworks zur Messung des Energieverbrauchs. Das geschieht über Programmcode in der jeweiligen Sprache. Zwei Beispiele möchte ich hier vorstellen: ### CodeCarbon Auf die Messung des Energieverbrauchs virtueller oder realer Maschinen fokussiert das Projekt [CodeCarbon](https://codecarbon.io/). Mit Hilfe öffentlich zugänglicher Daten zum regional angebotenen Strommix wird zusätzlich der momentane CO2-Fußabdruck des gemessenen Verbrauchs ermittelt. Das Projekt ist mit [Python](https://www.python.org/) / [Jupyter Notebook](https://jupyter.org/) geschrieben. Mit CodeCarbon lässt sich der Stromverbrauch von Python Programmen oder der Gesamtverbrauch eines Computers messen. Will man den Verbrauch einer Software-Anwendung messen, bietet es sich an, eine Differenzmessung durchzuführen: 1. Wie hoch ist der Stromverbrauch des Computers ohne die zu messende Software? 2. Wie hoch ist der Stromverbrauch mit der zu messenden Software? 3. Aus der Differenz der Werte (2. minus 1.) lässt sich näherungsweise der Verbrauch der Software ableiten. Mit Hilfe so ermittelter Verbrauchswerte für eine bestimmte Zeiteinheit lassen sich auch die Entwicklungen beim Verbrauch ermitteln und bewerten, wenn sich Software oder Laufzeitbedingungen ändern. Nach der Installation von CodeCarbon mittels [pip](https://pypi.org/project/pip/) wird eine eindeutige *experiment\_id* erzeugt: ``` ! codecarbon init ``` Anschließend kann die Messung gestartet werden: ``` codecarbon monitor ``` Alle 20 Sekunden wird ein Messwert erzeugt und ausgegeben: ``` [codecarbon INFO @ 18:18:47] Energy consumed for all CPUs : 0.003071 kWh. Total CPU Power : 42.5 W ``` Alle fünf Minuten wird der Stromverbrauch in CO2 Äquivalente umgerechnet und eine Schätzung für den CO2 Ausstoß der Messung für ein ganzes Kalenderjahr berechnet: ``` [codecarbon INFO @ 18:19:27] 0.005533 g.CO2eq/s mean an estimation of 174.48031279157075 kg.CO2eq/year ``` ### JoularJX Für Programme aus der Java Welt bietet sich die Nutzung von [JourlarJX](https://github.com/joular/joularjx) an. JoularJX ist ein Java basierter Agent mit dem sich der Energieverbrauch von Java Programmen zur Laufzeit messen lässt. JoularJX funktioniert für Intel und AMD Prozessoren, aber auch für [Apple ARM](https://en.wikipedia.org/wiki/Apple_silicon) Prozessoren. Für Apple Prozessoren benötigt der Agent sudo Rechte für den Zugriff auf [powermetrics](https://srdbranding.medium.com/ultimate-guide-to-power-metrics-for-mac-os-x-9a678b48607e). Für eine Messung wird eine startbare Java-Klasse oder ein Jar-File mittels Java Runtime unter Benutzung des Agents gestartet: ``` java -javaagent:joularjx-2.8.0.jar ../../PowerConsumption/src/PowerConsumer.java ``` oder: ``` java -javaagent:joularjx-2.8.0.jar -jar PowerConsumer.jar ``` JoularJX liefert den Energieverbrauch nicht in Watt, sondern in Joule. Warum? Leistung wird üblicherweise in Watt oder Kilowatt gemessen, Energieverbrauch in Joule oder Kilojoule. Z. B. lässt sich dieser Ausgabewert: ``` 10/11/2023 07:11:46.244 - [INFO] - Program consumed 99,19 joules ``` bequem in Watt umrechnen: 1 Joule = 0.000278 Watt ``` 99,19 Joule = 0,02757482 Watt ``` ### Stromverbrauch in anderen Programmiersprachen messen Auch wenn du Software nicht in Python oder Java entwickelst, gibt es Möglichkeiten, den Stromverbrauch zu messen. So gibt es inzwischen eine Vielzahl von Tools, die den Stromverbrauch des Systems, auf dem ein Programm bzw. eine Programmiersprache läuft, auf Hardware-Ebene messen. Beispiele hierfür sind [Intel PCM](https://github.com/intel/pcm), [CPU Energy Meter](https://github.com/sosy-lab/cpu-energy-meter) oder [RAPL-formula](https://github.com/powerapi-ng/rapl-formula). ## Fazit Die Hürden für die Messung des Energieverbrauchs von Software-Anwendungen sinken. Für virtuelle und reale Hardware stehen inzwischen viele Messwerkzeuge und Schätzverfahren zur Verfügung mit deren Hilfe sich der Energieverbrauch konkret messen lässt. Einige Werkzeuge wie CodeCarbon bieten darüber hinaus die Möglichkeit, aus dem Stromverbrauch den CO2 Fußabdruck abzuleiten. Dazu kommen immer mehr Open-Source-Werkzeuge, mit denen sich der Energieverbrauch von Software-Anwendungen konkret messen lässt. Gerade im Bereich der Software-Entwicklung lässt sich so feststellen, welche Auswirkungen eine Code-Änderung oder eine Änderung der Konfiguration auf den Energieverbrauch hat. **Kategorien:** Development, Sustainability & Awareness **Schlagwörter:** CO2-Fußabdruck, Energieeffizienz, Energieverbrauch, Nachhaltigkeit, Software-Architektur, Softwarenentwicklung --- ### [Ökobilanzierung: Wie nachhaltig sind unsere IT-Services?](https://thecattlecrew.net/2024/01/16/oekobilanzierung-wie-nachhaltig-sind-unsere-it-services/) **Published:** Januar 16, 2024 **Author:** Sebastian Pospiech **Content:** Ende November veranstaltete der Innovation Hub Bergisches Rheinland in Gummersbach bei Köln ein Bootcamp zum Thema Nachhaltigkeit und Ökobilanzierung. Eine Gelegenheit, die wir uns als Community zu „Bewusster IT“ bei einem IT-Dienstleister wie OC nicht entgehen lassen konnten. Angereist sind wir mit zwei IT-Fachleuten, Architekturen, Erwartungen und vor allem: mit Fragen! In dem 2-tägigen, aktiven Workshop-Format durften wir uns mit anderen Firmen aus der Region austauschen über verschiedenste Themen, aber auch Sorgenfalten. ## Warum eine Ökobilanz? Klar ist, aus unser aller Verantwortung heraus, dass wir nachhaltig werden möchten; nachhaltig sein möchten. Das „werden“ ist aber genau genommen erst die zweite Frage. Die erste ist: Woher wissen wir, ob und wann wir nachhaltig sind? Oder, wie weit wir noch entfernt sind? Wie messen wir das? Nachhaltigkeit heißt, “die Bedürfnisse der Gegenwart so zu befriedigen, dass die Möglichkeiten zukünftiger Generationen nicht eingeschränkt werden. \[…\] wirtschaftlich effizient, sozial gerecht, ökologisch tragfähig – gleichberechtigt”, definiert das Bundesministerium für wirtschaftliche Zusammenarbeit und Entwicklung. Der Fokus des Workshops lag dabei vor allem auf den Aspekten der ökologischen Tragfähigkeit. Es drehte sich vieles um den berühmt-berüchtigten CO2-Fußabdruck. ## Wo liegen neuralgische Punkte? Wir durften lernen, wie wir die aus CO2-Sicht neuralgischen Punkte unseres Produktportfolios identifizieren und wie wir Ansatzpunkte finden können, um unseren CO2-Fußabdruck zu verringern. Hierzu nutzten wir verschiedene Tools und schauten uns Datenbanken an, mit denen ein Carbon Footprint für die Scopes 1 (direkte Emissionen), 2 (indirekte Emissionen der Versorger), 3 (indirekte Emissionen über die gesamte Lieferkette) berechnet werden kann. Ein Ecodesign Assessment kann etwas informeller helfen, den Optimierungsgrad der eigenen Produkte im Hinblick auf Kategorien wie Design , Ressourcen, Herstellung, Vertrieb, Nutzung, Entsorgung und Business Modell zu bewerten und Indikatoren für versteckte Potentiale zu entdecken. Eine Betrachtung des kompletten Lifecycles hingegen kann helfen, die Wiederverwertbarkeit eines Produkts oder zumindest von Produktteilen oder Rohstoffen zu optimieren. ## Das Pareto-Prinzip Beim Üben und Anwenden all dieser Tools wurden zwei Erkenntnisse schnell offensichtlich: ### Erkenntnis 1 Je detaillierter wir werden wollen, desto komplizierter wird es, eine gute Einordnung zu schaffen. ### Erkenntnis 2 Jede Branche, teilweise auch jede Unternehmung hat ihre ganz eigenen Herausforderungen. Deshalb ist eine wichtige Erkenntnis methodischer Art für uns, sich auf das Pareto-Prinzip zu berufen. Die Key-Faktoren, die für 80% unseres C02-Fußabdrucks verantwortlich sind zu identifizieren und an diesen zu arbeiten. Und das ist für einen Autoteilehersteller oder für medizinische Produkte eine ganz andere Nummer als für einen IT-Dienstleister, wie wir es sind. Unser Produkt als IT-Service-Manufaktur besteht im ersten Schritt aus einer individuellen Arbeitsleistung, die im Kopf der Berater stattfindet. Wir fragen, konzipieren, besprechen oder dokumentieren zunächst die Bedarfe und Wünsche des Kunden. Danach wird eine Individuallösung implementiert. Eine Software, oder ein Software-Verbund, der auf Hardware entwickelt und schlussendlich betrieben wird. Daraus ergibt sich Erkenntnis Nummer drei: ### Erkenntnis 3 Eine Bewertung, ob unsere Leistungen ökologisch effizient sind, lässt sich pauschal oft nicht sagen, sondern hängt auch davon ab, auf welchen Aspekt man fokussiert. ## Welchen Fokus legen? Auf das obige Beispiel bezogen stellte sich für uns die Frage, ob wir die Perspektive der Hardware oder der Software einnehmen sollten. So bedeutet ein effizienter Umgang mit Hardware etwa, dass diese möglichst stromsparende Prozessoren nutzt, möglichst lange verwendet wird, oder möglichst effizient skaliert und ausgelastet wird. Man kann auch hinterfragen, ob das Rechenzentrum beispielsweise mit grünem Strom betrieben und möglichst klimafreundlich klimatisiert wird. Wie viel Redundanz ist nötig und muss diese ohne spürbare Ausfallzeit einsatzbereit sein? Im Fall der Software wäre der Blick ein anderer. Folgende Kriterien könnten relevant sein: Ist die Software so flexibel gestaltet, dass sie auf viele Jahre mit moderaten Anpassungen für die Bedarfe des Kunden geeignet ist? Wie kann der Wiederverwendungsgrad erhöht werden durch die Nutzung von Frameworks? Kann in Teilen auf Standardsoftware zurückgegriffen werden, die am besten auch möglichst nachhaltig entwickelt und vertrieben wird? Denn letztlich bedarf jede Entwicklung auch einer Infrastruktur, Entwickler-Hardware, Testumgebungen etc. und fordert Dienstfahrten zum Kunden oder zumindest intensivere Remote-Kommunikationsaktivitäten. Das flexible und langlebige Produkte auch ökonomisch sinnvoll sind, leuchtet schnell ein. Spinnt man das Rad weiter, entdeckt man aber auch schnell die Wechselwirkungen zwischen Hardware und Software. Eine in Maschinensprache entwickelte Software kann viel effizienter und damit energiesparender mit der Hardware umgehen, ist aber unter Umständen nicht so langlebig, da sie unflexibler ist. ## Fazit Diese Diskussion kann man noch sehr lang und weit stricken und einen hundertprozentig genauen CO2-Fußabdruck für die eine konkrete Dienstleistung zu erstellen, ist kaum möglich. Dafür müsste man jede einzelne Dienstfahrt aller Berater und Beraterinnen, die CO2-Emission jeder Sprachnachricht, die im Laufe des Projektes entsteht, und jede Büroklammer im Aktenordner des Betriebshandbuchs erfassen. Man kann aber nach Pareto festhalten, dass der große Treiber unserer Branche sich vermutlich auf den Strombedarf festlegen lässt. Strom durch die Arbeit mit und an Computern, den Betrieb von Rechenzentren und auch durch ständiges Aktualisieren und Hochskalieren von Hardware, welche in der Produktion sehr CO2-teuer ist. Hier dürfen wir, hier müssen wir lernen, nachhaltige, effiziente Lösungen zu entwickeln, die einen langen Lebenszyklus haben und möglichst wenig Hardwareressourcen verbrauchen. Um das Thema vollständig zu durchdringen, reichten die 2 Tage in Gummersbach keinesfalls. Um eine Idee zu bekommen, wo Hebel sein könnten, und welche Tools helfen können, war das Event eine gelungene, runde Veranstaltung. Danke an den Innovation Hub! [Details zum Bootcamp](https://www.innovation-hub.de/events/bootcamp_nachhaltigkeit_und_oekobilanzierung "Details") **Kategorien:** Sustainability & Awareness **Schlagwörter:** Bewusste IT, Carbon Footprint, CO2-Fußabdruck, Ecodesign, Nachhaltigkeit, Ökobilanz --- ### [Tesseract OCR – Texterkennung mit drei Zeilen Code](https://thecattlecrew.net/2023/11/13/tesseract-ocr-texterkennung-mit-drei-zeilen-code/) **Published:** November 13, 2023 **Author:** Sven Anders **Content:** Ich persönlich brenne für das Thema KI (künstliche Intelligenz), insbesondere für NLP-Technologien (Verarbeitung von natürlicher Sprache). Was lag also näher, als in einem Projekt ein eigenes KI-Model anzulernen und auf bestimmte Bedürfnisse anzupassen? Gesagt, getan. Modelle, die ich hierfür nutzen wollte, waren schnell gefunden, auch eine Datenbasis in Form von 800 PDF-Dokumenten habe ich zur Verfügung gestellt bekommen. Dann die Ernüchterung: Wie bekomme ich diese Texte, die größtenteils eingescannte Papiere sind, in eine für mich nutzbare Form? Unweigerlich musste ich mich somit mit OCR-Technologien auseinandersetzen und bin dabei auf Tesseract gestoßen. Damit habe ich es geschafft, eine Datenbasis aufzubauen, um meine Modelle zu trainieren. ## **Was ist OCR?** Optical Character Recognition oder Optische Zeichenerkennung, kurz OCR, ist die Umwandlung von gescannten oder gedruckten Textbildern und handgeschriebenem Text in bearbeitbaren Text zur maschinellen Weiterverarbeitung. Diese Technologie ermöglicht es Maschinen, den Text automatisch zu erkennen. Patel et al. (2012) beschreiben sie wie eine Kombination aus Auge und Verstand des menschlichen Körpers. Das Auge kann den Text auf den Bildern sehen, aber eigentlich verarbeitet und interpretiert das Gehirn den mit dem Auge gelesenen Text. *(Vgl. Patel, C., Patel, A., Patel, D., Tesseract: A Case Study, 2012, S. 50.)* ## **Tesseract** Das Open-Source-Anwendung Tesseract wurde zwischen 1984 und 1994 bei HP entwickelt und 1995 noch einmal modifiziert und verbessert, um eine höhere Genauigkeit bei der Bilderkennung zu erreichen. Obwohl ursprünglich von HP entwickelt, wurde es nie selbst von HP produktiv eingesetzt. Bis zur Freigabe 2005 als Open Source stand die Entwicklung von Tesseract still, wurde dann aber von Google bis 2018 fortgesetzt. Nach 2018 wurde das Projekt von der GitHub- Community übernommen und wird dort bis heute weiterhin gepflegt. (https://github.com/tesseract-ocr/tesseract) ## **Wie arbeitet Tesseract?** Tesseract arbeitet schrittweise wie in Abbildung 1 auch dargestellt: 1. Der erste Schritt ist die adaptive Schwellenwertbildung, das Bild wird durch ein Schwellenwertverfahren in Binärdaten umgewandelt. 2. Der nächste Schritt ist die Analyse der verbundenen Komponenten. Zeilen und Regionen werden auf festen Abstand oder proportionalen Text analysiert. 3. Die Suche nach Zeilen und Wörtern. Der Text wird mit Hilfe von definierten Leerzeichen und Zeichenabständen in Wörter unterteilt. 4. Es folgt die Texterkennung in zwei Schritten. Im ersten Durchgang wird versucht, jedes Wort des Textes zu erkennen. Jedes zufriedenstellend erkannte Wort wird an einen adaptiven Klassifikator als Trainingsdaten weitergegeben (Pass1). Durch das Training des Klassifikators soll dieser im zweiten Schritt dazu befähigt werden, ein noch besseres Ergebnis liefern zu können (Pass2). 5. Im letzten Schritt wird der fertig extrahierte Text als String zurückgeliefert. ![](https://thecattlecrew.net/wp-content/uploads/2023/11/Tess-Ablauf-230x300.png)Abbildung 1: Workflow Tesseract ## **Einbinden von Tesseract in Python-Code** Tesseract lässt sich als Konsolenprogramm installieren, was auch die Grundvoraussetzung für die Nutzung in Python oder R ist. Eine Installationsanleitung findet sich unter . Unter Windows kann es ggf. noch nötig sein, auf die entsprechenden Sprachmodelle via Systemvariable zu zeigen. Dazu wird einfach die Variable TESSDATA\_PREFIX, welche auf den Ordner tessdata im Tesseract Installationsverzeichnis zeigt, angelegt. ![](https://thecattlecrew.net/wp-content/uploads/2023/11/Tess-Conf-300x46.png)Abbildung 2: Umgebungsvariablen für Tesseract in Windows setzen Die Nutzung in R und Python lässt sich über die entsprechenden Bibliotheken abbilden. Welche Programmiersprache genau benutzt wird, hängt vom Anwendungsfall und auch von den Präferenzen des Entwicklers ab. Im Hintergrund nutzen alle Lösungen immer die entsprechend installierte Tesseract-Version. ![](https://thecattlecrew.net/wp-content/uploads/2023/11/Tess-Example-300x105.png)Abbildung 3: Einfaches Beispiel mit Tesseract in Python Code Das Einbinden von Tesseract in Python-Code gestaltet sich sehr einfach. Als Schnittstelle zu Tesseract dient in Python die Bibliothek „pytesseract“. Mit nur ein paar Zeilen Code, wie in Abbildung 3 zu sehen, lässt sich bereits der Text aus einem Bild auslesen und danach im Quellcode weiterverwenden ## **Wenn die OCR-Technologie an Grenzen stößt** Bei der Nutzung eines computergestützten OCR-Systems können einige Probleme auftreten. Zwischen einigen Buchstaben und Ziffern gibt es nur einen sehr geringen sichtbaren Unterschied, den ein Computer nicht verstehen kann. Zum Beispiel ist es schwierig, zwischen der Ziffer „0“ und dem Buchstaben „O“ zu unterscheiden. Ebenfalls kann es sehr problematisch sein Text zu extrahieren, der in einen sehr dunklen Hintergrund eingebettet oder auf andere Wörter oder Grafiken gedruckt ist, da das OCR-System ggf. Umrisse von Buchstaben oder Symbolen nicht erkennt oder falsch interpretiert. Außerdem muss berücksichtigt werden, dass OCR eine Technologie ist, die sich in der kontinuierlichen Weiterentwicklung befindet und die verfügbare Software unterschiedliche Genauigkeitsstufen bietet. So existieren auch in der Tesseract-Community mehrere Sprachmodelle, welche laufend weiterentwickelt werden, mit unterschiedlichen Anwendungsbereichen und Genauigkeiten. (https://github.com/tesseract-ocr/tessdata/) Die besten Ergebnisse werden in der Regel mit einer Lösung erzielt, die auf den Anwendungsfall angepasst ist. Dies beinhaltet aber das Anlernen von eigenen Sprachmodellen, was genügend Trainingsdaten und Ressourcen voraussetzt sowie entsprechender Aufbereitung der einzulesenden Dokumente. Vorgefertigte, allgemeine OCR-Systeme haben daher meist eine wesentlich breitere Akzeptanz, die sofortige Einsatzfähigkeit ist dabei von besonderem Interesse. Je nach Qualität der einzulesenden Dokumente kann es aber auch hier notwendig sein, Anpassungen an den Dokumenten vorzunehmen. ## **Etwas nachgeholfen: Tricks und Kniffe für die Texterkennung mit Tesseract** In der Praxis wird man selten nur perfekt skalierte und optisch klare Bilder für die Texterkennung vorfinden, wie im vorangegangenen Beispiel in Abbildung 3. Häufig kommt es durch unterschiedliche Bildqualitäten zu Fehlern. Da Tesseract sich aber direkt in Python-Code einbinden lässt, stehen uns alle Möglichkeiten der Programmiersprache zur Verfügung, um ein besseres Ergebnis zu erzielen. Vor dem Auslesen durch Tesseract lassen sich z. B. durch die Bibliothek cv2 die Bilder entsprechend nachbearbeiten. So wird im folgenden Beispiel die Umwandlung in Schwarz-Weiß vorgenommen und das Bild entsprechend skaliert: ![](https://thecattlecrew.net/wp-content/uploads/2023/11/Tess-Code1-300x22.png)Abbildung 4: Bilder vorbereiten Aber auch nach dem Auslesen lässt sich der gewonnene Text aufbereiten. Hier zwei Beispiele, die sich einfach umsetzen lassen: 1\. Eine schnelle und effektive Möglichkeit ist das Definieren einer Funktion, wie im folgenden Codebeispiel dargestellt. Die Funktion befreit den extrahierten Text von unerwünschten Zeichen und Symbolen, sowie überflüssigen Leerzeichen, die andernfalls zu Fehlinterpretationen führen können. In Python ist dies durch reguläre Ausdrücke und Replace-Methoden schnell umsetzbar. ![](https://thecattlecrew.net/wp-content/uploads/2023/11/Tess-Code2-1-300x101.png)Abbildung 5: Einfache Methode zur Textbereinigung in Python 2\. Bei Tesseract lassen sich Optionen setzen, um die Texterkennung von vornherein auf die vorhandene Datenbasis vorzubereiten. Im folgenden Codebeispiel wurde die Textsprache beispielsweise auf Englisch (-l eng) gesetzt und der PSM-Wert auf 6 (–psm 6), was Tesseract dazu veranlasst, einen Blocktext zu erwarten. Der OEM-Wert (–oem 1) bestimmt die Engine, die für die Bilderkennung genutzt wird. Tesseract unterstützt derzeit drei verschiedene Engine Modes, die sich hinsichtlich Performance und Genauigkeit unterscheiden. ![](https://thecattlecrew.net/wp-content/uploads/2023/11/Tess-Code3-300x11.png)Abbildung 6: Setzen der Optionen Mehr Infos und weitere Optionen rund um Tesseract sind im offiziellen Github-Projekt zu finden: ## **Wann ist Tesseract die richtige Wahl?** Tesseract ist als Open Source kostenlos verfügbar. Damit bietet sich das Programm für alle an, die erste Schritte in der Texterkennung gehen wollen oder kleinere Anwendungsfälle haben und nicht direkt in eine Lösung der großen Softwarehersteller investieren wollen, also für kleinere Projekte, bei denen große OCR-Lösungen Oversized und zu teuer wären. Was aber nicht ausschließt das auch Tesseract für große Projekte genutzt werden kann, da wie bereits erwähnt die Möglichkeit besteht Modelle für den eignen speziellen Anwendungsfall zu generieren, wenn eine entsprechende Datenbasis vorhanden ist. Zusätzlich hat sich Tesseract als Vorfilterungssystem bewährt. Das heißt, bevor Dokumente z. B. Microsofts Forms Recognizer zugeführt werden, werden sie von Tesseract nach Stichpunkten durchsucht und auf Relevanz geprüft. Wir von Opitz Consulting konnten so in einem aktuellen Projekt die Kosten für den Kunden aktiv reduzieren, da nur relevante Seiten dem Micorosoft Forms Recognizer zugeführt wurden, in dem jede gelesene Seite Kosten verursacht. ## Quellen Hegghammer, Thomas: OCR with Tesseract, Amazon Textract, and Google Document AI: a benchmarking experiment, in: Journal of Computational Social Science, Nr. 1, S. 861–882, DOI: https://doi.org/10.1007/s42001-021-00149-1 Hoffstaetter, Samuel: Python-tesseract is a python wrapper for Google’s Tesseract-OCR, Patel, Chirag, Patel, Atul, Patel, Dharmendra: Optical Character Recognition by Open source OCR Tool Tesseract: A Case Study, in: International Journal of Computer Applications, S. 50–56, DOI: http://dx.doi.org/10.5120/8794-2784 Smith, Ray: An Overview of the Tesseract OCR Engine, in: Ninth International Conference on Document Analysis and Recognition (ICDAR 2007), S. 629–633, DOI: https://doi.org/10.1109/ICDAR.2007.4376991 Tesseract-OCR: Tesseract Open Source OCR Engine, **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** Artificial Intelligence, NLP, OCR, Tesseract --- ### [Ist meine Programmiersprache ein Klimakiller?](https://thecattlecrew.net/2023/11/10/ist-meine-programmiersprache-ein-klimakiller/) **Published:** November 10, 2023 **Author:** Ramon Anger **Content:** Nachhaltigkeit ist besondern im Bereich des Software-Designs ein vielschichtiges Thema. Das [Karlskrona Manifest für nachhaltiges Design](https://arxiv.org/pdf/1410.6968.pdf) von Software unterscheidet beispielsweise ökonomische, ökologische, technologische, soziale und zusätzlich individuelle Nachhaltigkeit. Diese unterschiedlichen Dimensionen sind eng verbunden mit dem Energieverbrauch von IT-Systemen, was zu einer komplexen Ursache-Wirkungskette führt, die es zu verstehen gilt. Aktuell liegt unser Fokus meist auf der umweltbezogenen Nachhaltigkeit von IT-Systemen. Genauer auf dem CO2-Fußabdruck und dem Energieverbrauch. Ein hoher Energieverbrauch kann zu hohen Kosten führen und die ökonomische Nachhaltigkeit beeinträchtigen. Dabei kann der Energieverbrauch eines IT-Systems durch verschiedene Faktoren beeinflusst werden. Nehmen wir als Beispiel die Programmiersprache eines Softwaresystems. Die Wahl einer ungünstigen Programmiersprache kann zu einem höheren Energieverbrauch eines IT-Systems führen. So kann ein PHP-Programm bis zu 30-mal mehr Energie verbrauchen und auch eine 30-mal längere Ausführungszeit haben als sein in [Rust](https://www.rust-lang.org/) geschriebenes Gegenstück. > Warum sollte die verwendete Programmiersprache eine Rolle beim Energieverbrauch meines IT-Systems spielen? Das sind doch immer Schleifen und Verzweigungen, egal in welcher Sprache. Das mag grundsätzlich korrekt sein. Dennoch hängt die Energieeffizienz einer Programmiersprache von verschiedenen Kriterien ab, darunter - Threading Modell - Interpreter- oder Compilersprache - Optimierungsoptionen - Unterstützung asynchroner Programmiermodelle - Speicherbedarf - Speicherverwaltung - Ausführungsgeschwindigkeit - Umfang von verwendeten Bibliotheken - Portabilität (Übertragbarkeit) - Verwendung energieeffizienter Schnittstellen und Protokolle Diese Aspekte werden in den folgenden Abschnitten jeweils kurz beschrieben. ## Welche Rolle spielt das Threading-Modell? Ob eine Programmiersprache [Single-Threaded](https://pediaa.com/what-is-the-difference-between-single-thread-and-multi-thread-in-java/) arbeitet oder [Multi-Threading](https://pediaa.com/what-is-the-difference-between-single-thread-and-multi-thread-in-java/) unterstützt, ist solch ein Kriterium. Ein Thread meint hier einen Ausführungsstrang im Programmcode. In der Vergangenheit wurden IT-Anwendungen häufig in [COBOL](https://de.wikipedia.org/wiki/COBOL) und [Fortran](https://de.wikipedia.org/wiki/Fortran) entwickelt. Viele dieser Anwendungen werden z. B. im Banken- und Versicherungssektor immer noch verwendet. Sowohl COBOL als auch Fortran arbeiten Single-Threaded. Sie werden auf funktionaler Ebene also strikt sequenziell ausgeführt. Diese sequenzielle Abarbeitung von Code führt in Folge zu einer eher langsamen Ausführungsgeschwindigkeit. Um dennoch viele Anfragen an ein solches IT-System bewältigen zu können, wird auf sehr leistungsfähige, aber auch sehr teure und energieineffiziente Großrechner zurückgegriffen. Modernere Programmiersprachen wie [C++](https://isocpp.org/), [Java](https://dev.java/) oder [Go](https://go.dev/) unterstützen Multi-Threading und können mehrere Funktionen gleichzeitig ausführen. In solchen Programmiersprachen entwickelte IT-Anwendungen sind prinzipiell auf preiswerterer und virtualisierter Hardware lauffähig. Für die Wahl einer Programmiersprache kann es auch eine Rolle spielen, wie stark der Bedarf für parallele Verarbeitung oder Multi-Threading überhaupt ist. ### Single-Threaded, aber auch nicht Einige modernere Programmiersprachen wie [JavaScript](https://blog.hubspot.de/website/javascript) oder [node.js](https://nodejs.org/en) laufen im Browser generell Single-Threaded (sequenziell) ab. Sie können aber durch Konzepte wie [Async/Await](https://javascript.info/async-await), [Promises](https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/Promise) oder [Web Worker](https://wiki.selfhtml.org/wiki/JavaScript/Web_Worker) ebenfalls mehrere Aufgaben parallel bearbeiten. ## Wie energieintensiv sind Interpreter- oder Compiler-Sprachen? [Interpreter](https://www.dev-insider.de/der-unterschied-von-compiler-und-interpreter-a-742282/) führen den Quellcode direkt aus, ohne ihn zu kompilieren. Dies kann zu höherem Energieverbrauch führen, da der Interpreter den Code während der Ausführung analysieren und interpretieren muss. Der Code wird in Echtzeit ausgeführt, was zusätzliche CPU-Ressourcen verbrauchen kann. [Compiler-Sprachen](https://www.dev-insider.de/der-unterschied-von-compiler-und-interpreter-a-742282/) übersetzen den Quellcode in Maschinencode, der direkt von der verwendeten Hardware ausgeführt wird. Der Code wird bereits vor der Ausführung optimiert. Dies kann zu einer schnelleren Ausführung und einer insgesamt geringeren CPU-Belastung führen. So sind kompilierte Programme in der Regel energieeffizienter und meist auch schneller als interpretierte Programme. ## Wie entscheidend ist Code-Optimierung? Die Fähigkeit zur Code-Optimierung kann den erzeugten Maschinencode verbessern, zum Beispiel die Verwendung von Inline-Funktionen, Loop-Optimierungen und Compiler-/Interpreter-Optimierungen. Dies kann IT-Anwendungen energieeffizienter machen. ## Warum asynchrone Programmiermodelle beim Energiesparen helfen Programmiersprachen mit nativer Unterstützung für asynchrone Programmiermodelle können nicht blockierende Operationen erleichtern, was die CPU entlastet, während auf externe Ressourcen gewartet wird. Dies kann zu einem geringeren Energieverbrauch führen gegenüber Programmiersprachen, die nur synchrone und damit blockierende Programmiermodelle unterstützen. ## Speicherbedarf als wichtiger Faktor für Energieeffizienz Programmiersprachen mit einem niedrigen Speicherbedarf nutzen den verfügbaren Speicher offenbar effizienter als andere Sprachen. Das kann dazu beitragen, den Bedarf an RAM innerhalb einer IT-Anwendung zu reduzieren und ihren Energieverbrauch zu minimieren. Dieser Aspekt ist unter anderem auf Geräten mit begrenztem Speicher wie Mobiltelefonen oder IoT-Devices relevant. ## Speicherverwaltung Der Speicherbedarf einer Programmiersprache hängt stark von der Methodik ab, mit der der Speicher verwaltet wird. Sprachen mit automatischer Speicherbereinigung ([Garbage Collection](https://www.c64-wiki.de/wiki/Garbage_Collection)) übernehmen das Management nicht mehr benötigter Speicherressourcen. Eine effiziente Garbage Collection minimiert den Speicherverbrauch und kann so den Energieverbrauch der IT-Anwendung reduzieren, indem dann unnötige Speicheroperationen vermieden werden. ## Ausführungsgeschwindigkeit als Maß für Energieeffizienz Leider können wir den Energieverbrauch einer Programmiersprache in einem bestimmten Kontext oft gar nicht genau messen. Als Stellvertreter für die Feststellung des Energieverbrauchs dient uns deshalb häufig die Performance . Eine höhere Ausführungsgeschwindigkeit einer IT-Anwendung bedeutet normalerweise, dass Aufgaben schneller erledigt werden können. Das führt zu einer kürzeren aktiven Laufzeit. Folglich wird weniger Energie verbraucht. Dieser Zusammenhang mag nicht in jedem Fall stimmen, ist aber einer der besten Indikatoren für Energieeffizienz, den wir im Moment haben. ## Umfangreiche Bibliotheken als Energiefresser Umfang und Inhalt von Laufzeitbibliotheken können den Energieverbrauch einer IT-Anwendung ebenfalls beeinflussen. Auf der einen Seite können große, umfassende Bibliotheken die Größe einer IT-Anwendung erhöhen und zusätzliche Ressourcen während der Ausführung beanspruchen. Auf der anderen Seite können gut optimierte Bibliotheken den Bedarf an benutzerdefiniertem Code verringern. Das führt zu geringerer Ausführungszeit und somit zu einer geringeren Energieaufnahme. Wenn eine IT-Anwendung lokal oder in der Cloud neu ausgeliefert und gestartet werden soll, bestimmt beispielsweise die Größe der Anwendung die Startdauer und den Stromverbrauch der IT-Anwendung beim Start. Zur horizontalen Skalierung und zur Gewährleistung hoher Verfügbarkeit werden Service-Instanzen in der Cloud üblicherweise mehrfach parallel gestartet. Dabei summiert sich die Startzeit über alle Instanzen und folglich die für den Start verbrauchte Energie schnell zu größeren Zahlen auf. Deshalb gilt: Je schneller ein Service startet, desto weniger Energie wird für den Start verbraucht. ## Portabilität bzw. multiple Plattformunterstützung sind von Vorteil Programmiersprachen, die auf einer Vielzahl von Plattformen und Betriebssystemen lauffähig sind, ermöglichen es, energieeffiziente Anwendungen für verschiedene Geräte und Umgebungen zu entwickeln. Außerdem kann eine IT-Anwendung für eine bestimmte Plattform kompiliert und optimiert werden, so dass für diese Plattform eine optimale Ressourcen-Nutzung ermöglicht wird. ## Welche Schnittstellen und Protokolle sind zu empfehlen? Grundsätzlich gilt: Je moderner je effizienter! Moderne Programmiersprachen bzw. deren neueren Versionen nutzen auch moderne Protokolle und Schnittstellen. Nehmen wir als Beispiel [HTTP/2](https://www.hosteurope.de/blog/http-2-der-standard-fuer-schnellere-ladezeiten/): Bei Verwendung von Programmiersprachen bzw. deren Versionen, die das Protokoll HTTP/2 unterstützen, lassen sich Dauer und Datenvolumen beim Datenaustausch gegenüber HTTP/1.1 u.a. durch Header-Komprimierung um ca. ein Neuntel reduzieren. Java unterstützt HTTP/2 beispielsweise seit der Version 9. Läuft eine IT-Anwendung noch in Java 8, kann HTTP/2 vermutlich nur über Drittbibliotheken verwendet werden. Go unterstützt HTTP/2 seit Version 1.6, Python unterstützt HTTP/2 seit Version 3.6.0. Je älter die Sprachversion einer IT-Anwendung ist, desto unwahrscheinlicher ist die Fähigkeit zur Verwendung von HTTP/2. HTTP/2 wurde bereits 2015 als Standard verabschiedet. Bereits seit Juni 2022 gibt es [HTTP/3](https://www.rfc-editor.org/info/rfc9114) als vorgeschlagenen Standard. Diese Version verspricht gegenüber HTTP/2 eine weitere Effizienzsteigerung u. a. durch die Verwendung von [QUIC](https://en.wikipedia.org/wiki/QUIC) anstelle von [TCP](https://de.wikipedia.org/wiki/Transmission_Control_Protocol) als zugrunde liegendem Netzwerkprotokoll. Ausgehend vom Beispiel HTTP/2 fallen Eigenschaften moderner Schnittstellentechnologien und Protokollen wie Komprimierung, effiziente Verschlüsselung, Verwendung optimierter Datenformate oder auch die Nutzung von Caching Optionen ein, die bei Verwendung eine deutlich höhere Energieeffizienz versprechen. ## Die Liste ist lang … Es gibt also eine Reihe von Indikatoren, an denen sich ablesen lässt, ob eine Programmiersprache energieeffizienter ist als eine andere. Dies war nur ein Anfang. Wer sich tiefer informieren möchte, findet hier weitere Quellen: ### Energy Efficiency across Programming Languages Die beste Quelle ist vermutlich [Energy Efficiency across Programming Languages](https://greenlab.di.uminho.pt/wp-content/uploads/2017/09/paperSLE.pdf). Hier wurden der Energieverbrauch und die Ausführungsdauer typischer Algorithmen für 27 gebräuchliche Programmiersprachen gemessen. Allerdings stammt die Auswertung aus dem Jahr 2017 und ist somit heute mit Bedacht zu interpretieren. In diesem Dokument wurde beispielsweise festgestellt, dass Java-Programme im untersuchten Kontext etwa doppelt so viel Energie und Zeit verbrauchten wie ihr Pendant in C oder Rust. Mit Python und Perl wurde sogar mehr als das 75-fache an Energie und Zeit verbraucht als mit C und Rust. ### Web Framework Benchmarks Eine neuere und jährlich aktualisierte Quelle sind die [Web Framework Benchmarks](https://www.techempower.com/benchmarks/#section=data-r21&test=composite). Diese Messreihe legt einen Schwerpunkt auf die Performance von Web Frameworks. Dabei basieren die untersuchten Frameworks meist auf einer oder mehreren etablierten Programmiersprachen. [Spring](https://spring.io/) und [Quarkus](https://quarkus.io/) liegt beispielsweise die Programmiersprache [Java](https://dev.java/) zu Grunde. Das Webserver-Framework [salvo](https://salvo.rs/) wird auf Basis der Sprache [Rust](https://www.rust-lang.org/) entwickelt. Unter der Annahme, dass eine hohe Geschwindigkeit eine effiziente Ressourcen-Nutzung und damit auch Energieeffizienz bedeutet, lassen sich so Rückschlüsse auf die Energieeffizienz einzelner Programmiersprachen treffen. ### Programming Language Benchmark Game Eine dritte Quelle ist das [Programming Language Benchmark Game](https://benchmarksgame-team.pages.debian.net/benchmarksgame/index.html), das sich inhaltlich sehr nah an den oben genannten [Energy Efficiency across Programming Languages](https://greenlab.di.uminho.pt/wp-content/uploads/2017/09/paperSLE.pdf) orientiert. Lediglich die Programmiersprachen [Hack](https://hacklang.org/), [TypeScript](https://www.typescriptlang.org/) und [JRuby](https://www.jruby.org/) wurden mit [Julia](https://julialang.org/) und [Smalltalk](https://www.geeksforgeeks.org/introduction-to-smalltalk/) ersetzt. Das [Repository](https://salsa.debian.org/benchmarksgame-team/benchmarksgame) des Benchmark Games wird immerhin ein bis zweimal pro Jahr aktualisiert. ## Hilfe, meine Programmiersprache ist ein Klima-Killer! > Ich habe da eine IT-Anwendung, die ein echter Klima-Killer sein muss. Die ist in [Python](https://www.python.org/) geschrieben und das ist ja eine echt langsame Interpreter Sprache ist. Und sie braucht außerdem echt lange, um diese monatliche Berechnung durchzuführen. Da sollte ich die Anwendung neu schreiben lassen. Am besten in [C](https://de.wikipedia.org/wiki/C_(Programmiersprache)) oder [Rust](https://www.rust-lang.org/) … Bitte nicht so schnell! Es kann gut sein, dass die aktuelle Lösung in Python eine ausgezeichnete Energieeffizienz gegenüber anderen Lösungen aufweist. Python ist zwar eine interpretierte Sprache. Sie verwendet aber im Hintergrund häufig Bibliotheken, die zumindest teilweise unter Benutzung effektiver Compilersprachen wie C oder C++ erstellt wurden. Im Umfeld von [Maschinellem Lernen](https://de.wikipedia.org/wiki/Maschinelles_Lernen) und [Künstlicher Intelligenz](https://de.wikipedia.org/wiki/K%C3%BCnstliche_Intelligenz) gehören dazu beispielsweise diese Bibliotheken: - [TensorFlow](https://github.com/tensorflow/tensorflow) (56% C++) - [SciPy](https://github.com/scipy/scipy) (16% Fortran, 16% C) - [NumPy](https://github.com/numpy/numpy) (36% C) - [PyTorch](https://github.com/pytorch/pytorch) (42% C++) ## Fazit Nur weil eine IT-Anwendung auf einer Interpreter-Sprache basiert, muss sie keine Energieschleuder sein und neu geschrieben werden. Die verwendete Programmiersprache ist einer von mehreren Aspekten, die den Energieverbrauch einer IT-Anwendung beeinflussen. Also nur ein Aspekt von vielen. Auf weitere Einflussfaktoren wie z. B. übertragene Datenmengen, die Entfernung zwischen Benutzern und Servern oder Nutzungsfrequenz von Services und Anwendungen oder deren Nutzungsdauer wird es in späteren Posts gehen. Also am besten ab und zu mal reinschauen. **Kategorien:** Development, Sustainability & Awareness **Schlagwörter:** Energieeffizienz, Green IT, Nachhaltigkeit, Programmiersprachen, Softwarenentwicklung --- ### [Speed Consulting - 6 Fragen zum Thema Data-Driven](https://thecattlecrew.net/2023/11/03/speed-consulting-6-fragen-zum-thema-data-driven/) **Published:** November 3, 2023 **Author:** Janine Ellner **Content:** Das Thema Data-Driven ist aktuell in aller Munde und wird immer häufiger zum Unternehmensziel erklärt. Da mir persönlich das Thema Data-Driven Culture sehr am Herzen liegt, haben meine Kollegen 6 Fragen vorbereitet, die ich innerhalb von 30 Sekunden beantworten durfte. Diese Videoreihe nennt sich Speed Consulting. Wie ihr euch wahrscheinlich vorstellen könnt, ist es mir sehr schwergefallen, ein so wichtiges Thema in so kurze „Speed-Antworten“ zu verpacken. Dabei musste ich einiges herunterschlucken, was ich gerne noch losgeworden wäre! Deshalb nutze ich den Blog, um ganz ohne Zeichenbegrenzung noch einige ergänzende Informationen loszuwerden, die mir wichtig sind. Alle, die noch etwas tiefer ins Thema blicken möchten, sind dazu eingeladen, weiterzulesen. Natürlich findet ihr in diesem Blogpost ganz unten auch mein Speed-Consulting-Video. Oder [hier.](https://www.opitz-consulting.com/kompetenz/how-be-data-driven) ## Sollten wir alle datengetrieben handeln? Was ist neu an dem Hype ### Was ich gesagt habe: Ja, wir sollten alle datengetrieben handeln. Ich würde Data-Driven aber nicht als „Hype“ bezeichnen. Mit Daten zu arbeiten, ist nicht neu. Unternehmen steuern schon sehr lange auf Grundlage von Daten. Durch neue Technologien haben wir aber mehr Möglichkeiten, Daten zu generieren und auszuwerten, und das tun Unternehmen nun. ### Was ich gern noch gesagt hätte: Ein neuer Aspekt der Arbeit mit Daten ist, dass Unternehmen eine Datenkultur aufbauen. Mitarbeitenden soll ermöglicht werden, die Arbeit mit Daten in den Alltag zu integrieren. Ziel ist es, das Bauchgefühl durch fundierte Erkenntnisse abzulösen und nicht mehr nur mit Daten zu arbeiten, wenn gerade eine Präsentation im Führungskreis ansteht, sondern durchgehend. ## Was können Data-Driven Companies, was andere nicht können? ### **Was ich gesagt habe:** Data-Driven Companies betrachten nicht nur die Vergangenheit. Sie können Erklärungen dafür finden, warum etwas passiert ist. Auch ist es ihnen möglich, Simulationen durchzuführen und dadurch Entscheidungen zu begründen. Das hilft ihnen, ihr Unternehmen besser voranzutreiben. ### **Was ich gern noch gesagt hätte:** Im Gegensatz zu anderen Unternehmen ist es Data-Driven Companies möglich, über den Tellerrand zu schauen. Durch die ganzheitliche Betrachtung eines Kunden, einer Situation o.ä. können Beziehungen hergestellt und Insights generiert werden, die über das Offensichtliche hinausgehen. Und da in einer Data-Driven Company Daten ein Teil der Kultur sind, wird das generierte Wissen geteilt und kann so besser genutzt werden. ## Was sind die Erfolgsfaktoren für eine Data-Driven Culture? ### **Was ich gesagt habe:** Der Mensch ist zentraler Erfolgsfaktor. Denn nur durch sie kann überhaupt erst eine Kultur entstehen. Wenn Mitarbeitende keinen Sinn in der Arbeit mit Daten sehen, dann ist Data- Driven zum Scheitern verurteilt. ### **Was ich gern noch gesagt hätte:** Also stellt, egal was ihr tut und plant, die Menschen in den Mittelpunkt. Nehmt sie mit, bezieht sie ein, gebt ihnen einen Sinn. Die Menschen in euren Unternehmen sind diejenigen, die sich und ihre Arbeit ändern müssen, damit Data-Driven funktionieren kann. Macht es ihnen so einfach wie möglich! ## Was sind gute Schritte auf dem Weg zu einer Data- Driven Company? ### **Was ich gesagt habe:** Bezieht eure Mitarbeitenden möglichst früh mit ein, denn so schafft ihr Akzeptanz. Entwickelt sie, damit sie in der Lage sind, ihren Aufgaben gerecht zu werden und gebt ihnen die Zeit, die sie dafür benötigen. Und stellt die Kultur in den Fokus, sodass Data-Driven auch gelebt wird. ### **Was ich gern noch gesagt hätte:** Überlegt euch, was eure Ziele sind, und kommuniziert diese. Schafft Transparenz in allem, was ihr tut, und unterschätzt den Change-Prozess nicht, der mit dem Weg zu einer Data-Driven Company verbunden ist! ## Existiert die eine universelle analytische Plattform? ### **Was ich gesagt habe:** Jein! Die meisten Plattformen unterstützen die gängigen Standard-Features. Spannend wird es, wenn ihr ins Detail geht und euch überlegt, was darüber hinaus benötigt wird. Wie sind die Daten aufgebaut? Braucht ihr bestimmte Features wie Kollaboration, Simulation, ML-Unterstützung? Auf die Feinheiten kommt es an. ### **Was ich gern noch gesagt hätte:** Für mehr Informationen lies gern unseren Artikel [Ein Tool allein macht noch nicht Data-Driven | Opitz Consulting (opitz-consulting.com)](https://www.opitz-consulting.com/kompetenz/ein-tool-allein-macht-noch-nicht-data-driven) ## Wie hilfst du Organisationen dabei, data-driven zu werden? ### **Was ich gesagt habe:** Ich versuche erst einmal herauszufinden, weshalb die Organisation Data-Driven werden möchte, und entwickle dann gemeinsam mit den Ansprechpartnern einen passen den Weg. Für die weiteren Schritte spielen unterschiedliche Aspekte wie Unternehmensstrukturen, Personas und Ähnliches eine wichtige Rolle. ### **Was ich gern noch gesagt hätte:** Es gibt also nicht „den einen Weg“ zur Data-Driven Company. Was ein Unternehmen braucht, hängt von vielen unterschiedlichen Faktoren ab, nicht zuletzt von seinem Mindset. Ich hoffe, ich konnte euch mit meinen Antworten einen kleinen Einblick in die Themen Data-Driven Company und Data-Driven Culture geben. Gerne unterstütze ich euch und eure Organisation auf diesem Weg! Ach ja, und hier natürlich auch noch das Video 🙂 **Kategorien:** Analytics & Insights **Schlagwörter:** Big Data, data analytics, data driven, Daten, Datenstrategie --- ### [Using Authenticator Based MFA in Oracle APEX](https://thecattlecrew.net/2023/10/11/38201/) **Published:** Oktober 11, 2023 **Author:** Maik Michel **Content:** Many of you are certainly familiar with multifactor authentication, or MFA for short. With MFA, another factor is requested in addition to the user name and password, which basically represents the first factor. An additional one-time password is generated, sent and requested by the application or service to which you want to log in. Usually, an SMS or email is sent to a previously configured account or mobile phone. This contains a small password or a token that must be entered in the corresponding application. Another possibility for MFA is the use of an authenticator application. There are various applications for the most common mobile phone operating systems. In my company, for example, we use the Microsoft Authenticator. Such an authenticator app supports several authentication methods. Among others also the TOTP method. See: [https://de.wikipedia.org/wiki/Time-based\_One-time\_Password\_Algorithmus](https://de.wikipedia.org/wiki/Time-based_One-time_Password_Algorithmus) In general, an encrypted secret is exchanged and the validity is calculated with an algorithm. The calculated token changes every 30 seconds. ### How to implement such an MFA in APEX? A few years ago, someone on the Oracle forum posted the actual code for the generation. See: We use this code as the basis for calculating a token that is based on a secret assigned to the user. We wrap the code from the forum in its own method and return the determined token here. We have to compare this with the user’s input at the appropriate locations. Please understand that I cannot show the whole code here. Unfortunately, I cannot host a demo application on [https://apex.oracle.com](https://apex.oracle.com/) because the package **dbms\_crypto** is not available there. So to set up the second factor, we create a secret and then store it with the user. ```sql C_BASE32_CHARS constant varchar2(32) := 'ABCDEFGHIJKLMNOPQRSTUVWXYZ234567'; function generate_random_base32_string(length number) return varchar2 is l_random_string varchar2(32767); begin for i in 1..length loop l_random_string := l_random_string || substr(C_BASE32_CHARS, 1 + floor(dbms_random.value(0, 32)), 1); end loop; return l_random_string; end; ``` In order to make the whole process as simple as possible for the user, we offer him **(1)** a corresponding Authenticator App directly for installation. ![Configuring a MFA](https://thecattlecrew.net/wp-content/uploads/2023/10/Untitled.png)The user can then enter the generated secret **(2)** manually into the application or simply scan the QR code **(3)**. This has a special structure (see code excerpt). ```sql C_OTP_AUTH_LINK constant varchar2(1000) := 'otpauth://totp/%0?secret=%1&issuer=%2&algorithm=SHA1&digits=6&period=30'; function get_otpauth_link(p_secret in varchar2, p_name in varchar2, p_issuer in varchar2, p_prefix in varchar2 default null) return varchar2 is l_otp_auth_link varchar2(4000); begin l_otp_auth_link := apex_string.format(p_message => C_OTP_AUTH_LINK, p0 => p_name, p1 => p_secret, p2 => p_issuer); return p_prefix || case when p_prefix is null then l_otp_auth_link else apex_util.url_encode(l_otp_auth_link) end; end; ``` The image, in my case an SVG image, of the QR code is created here with the package ZT\_QR from the repo: As soon as the user has scanned the QR code, a new entry for authentication is displayed in his Authenticator app. With the code displayed there, they can then confirm directly in the application **(4)** that the authentication works using the additional factor. ![Recording of config MFA service using 2FAS Application](https://thecattlecrew.net/wp-content/uploads/2023/10/record_mfa_validation.gif) Here you can see what the process might look like. The next step is then only to implement the additional factor in the login screen of the actual application. Here, the user name and the password must first be validated. Then the input fields for the token are displayed. Only after validation of this input does the actual login to the application become valid. ![Screenshot with enter Token to Sign In process](https://thecattlecrew.net/wp-content/uploads/2023/10/Screenshot-2023-10-11-125721.png) Crossposting with *Featured image by Mahesh Patel from Pixabay* **Kategorien:** Database, Development, IT-Security **Schlagwörter:** APEX, Development, LowCode, oracle --- ### [OCCD - OC Community Day - ein Experiment mit Wiederholungsbedarf](https://thecattlecrew.net/2016/02/09/occd-oc-community-day-ein-experiment-mit-wiederholungsbedarf/) **Published:** Februar 9, 2016 **Author:** Holger Lehmann **Content:** An unserem Standort Gummersbach und parallel dazu in München wurde am 29. Januar ein Experiment gestartet, der **OCCD** – Opitz Consulting Community Day. Das hört sich vielleicht beim ersten Lesen hochtrabend an, ist aber ein Begriff, der zumindest bei mir im Nachhinein mächtig Eindruck hinterlassen hat. Was es damit auf sich hat und vieles mehr, darüber möchte ich heute berichten. Der verwendete Slogan intern wirbt mit: Der OC Community Day ist ein Tag für Dich. Für mich. Für uns. Für das **Wir**. Grundaussage darin ist: am letzten Freitag des Monats kann ich mich mit fast allem beschäftigen, mit dem ich möchte. Es soll weder ein normaler Office-Day sein, noch soll ich die Spesenabrechnung machen oder mich mit dem eigentlichen Projektgeschäft befassen. Vielmehr wird mir und meinen Kollegen Freiraum geschaffen, mich mit Sachen zu beschäftigen, die vielleicht sonst in der Freizeit passieren, die nach dem Projektgeschäft erst gemacht werden oder vielleicht sogar nie. Das muss natürlich an die Kunden kommuniziert werden, dass man an diesem Tage nicht zur Verfügung steht, sehr wichtig und notwendig Ziele des Tages sind unter anderem: Wissensaufbau, Networking, Ausarbeiten von Vorträgen oder anderen Papers, Selbststudium, Einarbeitung in neue Technologien, persönlicher Freiraum, Austausch mit Vorgesetzten und vieles andere noch. Ja ich betone nochmals, es ist ein **Experiment**, was vollkommen neu ist. Wo wir nicht wissen, ob es ein Erfolg wird oder es vorzeitig abgebrochen wird, weil es scheitert. Damit das nicht passiert, ist der Input und Einsatz der Kollegen von zentraler Bedeutung, denn ohne Beteiligung und Ausprobieren wird das nichts werden. Jetzt muss natürlich noch die Frage gestellt werden, lohnt sich denn so ein Tag? Betriebswirtschaftlich wird es weniger Umsatz geben, aber es wird in das Wissen und die Weiterbildung der Mitarbeiter investiert. Diesen Effekt sollte man sehr hervorheben, mit Zahlen wird man die Auswirkungen des Tages frühestens in einem halben Jahr messen können, wenn überhaupt. Für mich persönlich sind solche Experimente eine wertvolle Bereicherung des Alltags, vieles womit im Vorfeld des OCCD geworben wurde, erinnert mich an die Kanban-Methode. Stichworte z.B.: stetiger Wandel, kontinuierliche Verbesserung, fördere Leadership. Noch ein Teil des Mottos: Ein Tag, der uns die Freiheit gibt Themen und Ideen zu verfolgen und zu verwirklichen. Ganz ohne Zwang. Ohne Kontrolle. Frei. Er lebt und stirbt also von und mit unserem Engagement. Vorgeschlagene Arbeitsaspekte waren dabei u.a.: 1. Bearbeitung eines Themas alleine oder in Kleingruppen 2. Andere von seinem Wissen teilhaben lassen und auf eine breitere Basis verteilen 3. andere Termine können noch mehr zentral auf den OCCD gelegt werden, weil sowieso schon viele Kollegen vor Ort sind Vor dem eigentlichen Beginn des Tages worden bereits Themenspeicher angelegt, Räume geplant und schon erste Gruppen gebildet. Für mich persönlich sah der Tag dann so aus: 1. mehrere Themen in den Speicher gelegt 2. eines priorisiert, an dem ich arbeiten wollte 3. mit anderen Kollegen aus dem Forms- und Java-Bereich zusammengetan 4. das Thema angegangen und auf der grünen Wiese angefangen, Ideen auszuprobieren 5. unsere Arbeit soll nun ins Git wandern und noch bei folgenden Terminen weiter wachsen und entwickelt werden Mein Fazit des Tages laut also: Daumen hoch, Experiment weiterverfolgen und wiederholen. Dieses Feedback habe ich dann auch an anderer Stelle eingetragen. Bleibt zu hoffen, dass dieser Tag auch bei vielen anderen so positiv aufgenommen wurde und weiterleben kann. Klar, es war alles neu am Anfang, muss sich erstmal setzen. Man muss den Tag verinnerlichen, verarbeiten und auf sich wirken lassen. Es kommen aber so viele neue Ideen zusammen, die Kreativität wird gefördert und das Arbeiten in einer gemischten Gruppe mit Leuten aus diversen Technologien war super. Der nächste Community Day ist schon in Sicht, eigentlich schon wieder verplant und ich freue mich sehr darauf. Also vielen Dank an die Vorgesetzten und die Geschäftsleitung, die dieses Experiment wagen und erst möglich gemacht haben. **Kategorien:** Tech Events & Networking **Schlagwörter:** German, News --- ### [Visual Feedback Service for angular http calls v2](https://thecattlecrew.net/2017/03/20/visual-feedback-service-for-angular-http-calls-v2/) **Published:** März 20, 2017 **Author:** Pascal Brokmeier **Content:** **TL;DR:** A Service for hooking into the xhr events of all http calls. Use it to make spinners spin, turkeys dance or whatever floats your boat while your app fetches data and the user needs to know. --- So I started writing a feedback service for angular“™s http calls. The idea is simple. **When my app does http calls, I want my spinner to spin!** Now you don“™t want to constantly set a „˜loading“™ flag in your components somewhere or manually show loading overlays all the time right? All you want is a small spinner in the top right that spins on activity. Maybe you also want a toast or some notification to be shown on completed transactions. I started building this and wrote about it in [this blog post](https://medium.com/curiouscaloo/building-a-visual-feedback-service-for-angular-http-calls-with-material-f811da75142c#.n5u6x4m49), so if you want to read the full story, read that one first. ### Version 2: Pulling the UI feedback code out of the API Service In my previous post, you had to call the vFeedbackService from somewhere when you did an http call and pass it the observable. That was ugly! Sure you could get spinners and toasts in 2 lines of code, but you want 0 lines of code in your components! Just a spinner, is that too much to ask? So new plan: 1. Hook into the code that angular uses to make HTTP calls. Grab those events! 2. Create an observable based on those events. Use it to notify spinner components of stuff going on 3. Write a spinner component that hooks into this and spins every time when HTTP calls are going on. All other code is untouched ### Digging through the Angular code *If you don“™t care about this, just skip below to the solution.* Digging into the [http code of Angular 2](https://github.com/angular/angular/tree/master/packages/http/src), it becomes clear how it works and what to do. Http uses a *ConnectionBackend* which is used to create a connection. This connection is created using *BrowserXhr.build()* (in the browser). So if we wrap this, returning the original object (XMLHttpRequest) but hooking into its events, we“™re good. We get all http requests and their open, load, error, abort and progress events. ### Creating the new Service to subscribe to To hook into the events, we override the *build()* method of *BrowserXhr* to ensure we grab the events before handing back the original object. \[code language=“javascript“\] //imports … export class CustomBrowserXhr extends BrowserXhr { private \_observable: Observable; private \_subscriber: Subscriber; constructor() { super(); this.\_observable = Observable.create(subscriber => { this.\_subscriber = subscriber; }).share(); } get observable(): Observable { return this.\_observable; } build(): any { let xhr = super.build(); if (!this.\_subscriber) return xhr; //at the beginning, we create an event that notifies an opening of a connection this.\_subscriber.next({type: ‚open‘, event: {}}); xhr.onprogress = (event) => { this.\_subscriber.next({type: ‚progress‘, event: event}); }; xhr.onload = (event) => { this.\_subscriber.next({type: ‚load‘, event: event}); }; xhr.onerror = (event) => { this.\_subscriber.next({type: ‚error‘, event: event}); }; xhr.onabort = (event) => { this.\_subscriber.next({type: ‚abort‘, event: event}); }; return xhr; } } \[/code\] Now, we have something to subscribe to. To ensure this is actually used, we of course also need to override the default BrowserXhr \[code language=“javascript“\] @NgModule({ declarations: \[ AppComponent \], imports: \[ //… CustomBrowserXhr // <<< \], providers: \[{provide: BrowserXhr, useExisting: CustomBrowserXhr}\], //!!! <<< bootstrap: \[AppComponent\] }) \[/code\] Now, we have successfully wrapped an angular internal injectable with our code! Let“™s build a spinner (I am using angular material) that shows on ongoing http events and hides when they are all completed/aborted/cancelled or otherwise closed \[code language=“javascript“\] @Component({ selector: ’steak-working-spinner‘, template: „, styleUrls: \[‚working-spinner.component.scss‘\] }) export class WorkingSpinnerComponent implements OnInit, OnDestroy { private \_visible: boolean; private \_subscription: AnonymousSubscription; private \_connectionCounter = 0; constructor(public browserXhr: CustomBrowserXhr) { } ngOnInit() { this.\_subscription = this.browserXhr.observable.subscribe(next => { console.log(next.type + ‚ next received in spinner‘); switch (next.type) { case ‚open‘: this.\_connectionCounter++; break; case ‚load‘: this.\_connectionCounter–; break; case ‚abort‘: this.\_connectionCounter–; break; case ‚error‘: this.\_connectionCounter–; break; } this.\_visible = this.\_connectionCounter > 0; //if larger 0, its visible! otherwise hide us }); } ngOnDestroy(): void { if (!this.\_subscription) return; this.\_subscription.unsubscribe(); this.\_subscription = null; } } \[/code\] This can now be placed anywhere in the app, as often as you want and whereever a process should be indicated. It can also be any UI, all it needs is react to the events of the http calls. The code above also ensures, the spinner only stops spinning on all http calls being finished. This is helpful, if users quickly perform calls or if they click once but this triggers 2+ http calls. ### The resulting UI ![Untitled.mov](https://thecattlecrew.net/wp-content/uploads/2017/03/untitled-mov.gif) If you like this, maybe you can help: I have built this and would like to share it. But I am unsure how to „˜correctly“™ publish it as an npm module for others to just import and use. **Kategorien:** Development --- ### [Testing Angular components using MdDialog](https://thecattlecrew.net/2017/03/21/testing-angular-components-using-mddialog/) **Published:** März 21, 2017 **Author:** Pascal Brokmeier **Content:** When testing a component that dynamically opened a dialog using Angular Material (2), I was getting an error I didn’t immediately expect. The MdDialogModule was added to the imports, so my TestBed knew what was going on but my dynamically loaded Component caused problems. > Error: Error in ./AdminHomeComponent class AdminHomeComponent – inline template:21:24 caused by: No component factory found for OfferFormDialogComponent. Did you add it to @NgModule.entryComponents? Okay, researching the problem online gave me an [issue on Github](https://github.com/angular/angular/issues/10760) for the angular repository. It suggested the following in the beforeEach block: \[code language=“javascript“\] TestBed.overrideModule(BrowserDynamicTestingModule, { set: { entryComponents: \[OfferFormDialogComponent\], }, }); \[/code\] Sure, this solved the problem but it then causes an actual dialog to be opened during our tests. Well I really just want to test if the framework class gets called. I don’t want to test if the framework actually does what it promises. ![Screen Shot 2017-03-21 at 17.46.10](https://thecattlecrew.net/wp-content/uploads/2017/03/screen-shot-2017-03-21-at-17-46-10.jpg)The tests and the created but uninvited dialog It turns out, the solution is much cleaner, if you just mock instead of actually calling the MDDialog method. So instead of \[code language=“javascript“\] spyOn(component.dialog, ‚open‘).and.callThrough(); \[/code\] we do \[code language=“javascript“\] let mockDialogRef = new MdDialogRef(new OverlayRef(null,null,null,null),{}); mockDialogRef.componentInstance = new OfferFormDialogComponent(null, null); spyOn(component.dialog, ‚open‘).and.returnValue(mockDialogRef); \[/code\] and later in the test spec \[code language=“javascript“\] it(’should open the dialog on clicking the button‘, fakeAsync(() => { expect(component.dialog.open).toHaveBeenCalledTimes(0); clickAddNewButton(component, fixture); fixture.detectChanges(); tick(); expect(component.dialog.open).toHaveBeenCalled(); })); \[/code\] This way, a clean test of the component without too many dependency is possible. Yes, I am creating a new instance of my OfferFormDialogComponent, but since its constructor doesn’t do anything anyways, and its not active itself, it’s OK. The whole test and class can be found on github/gist [Tests](https://gist.github.com/pascalwhoop/ef2c2bfb53f453c796888570d2ca8589) [Component](https://gist.github.com/pascalwhoop/057f9ec439d5de220de337a3d4c8e038) **Kategorien:** Development --- ### [Was in Modul 1 der DevClass geschah ...](https://thecattlecrew.net/2017/09/25/was-in-modul-1-der-devclass-geschah/) **Published:** September 25, 2017 **Author:** clarissamoeller **Content:** Am 11. Und 12. September fand erstmalig das erste Modul der Neuauflage der BI Associate Schulung statt „“ die DevClass. Diese unterteilt sich in drei verschiedene Module und unterscheidet sich gänzlich von dem Aufbau der ehemaligen Associate Schulung. Bei dieser war es so, dass in den einzelnen Modulen immer ein Thema wie ETL, Reporting oder Datenmodellierung im Detail besprochen wurde. Bei der DevClass ist es nun so, dass in jedem Modul von der Modellierung über ETL bis hin zum Reporting alle Aspekte besprochen werden. In Modul 1 ging es neben den Grundlagen von BI um die dritte Normalform, PL/SQL und SAP BO. Von dieser Umstrukturierung erhoffen wir uns, dass der Zusammenhang zwischen den einzelnen Disziplinen klarer wird. Ein weiterer Vorteil dieses Aufbaus ist, dass die Reihenfolge in der man die Module besucht nicht so ausschlaggebend ist wie bei der Associate Schulung. Die Grundlagen zu BI haben Fabian Hardt und ich zusätzlich noch in einem Screencast-Video zusammengefasst. Damit erhalten Teilnehmer, die an Modul 1 noch nicht teilgenommen haben, eine kurze Einführung bevor sie Modul 2 oder Modul 3 besuchen. ![DevClass_Modul1](https://thecattlecrew.net/wp-content/uploads/2017/09/devclass_modul1.jpg?w=300) Mit acht Teilnehmern haben wir zwei tolle Schulungstage in Nochen erlebt. Einige Inhalte waren für die Teilnehmer nicht ganz unbekannt, aber trotzdem war es gut die Themen noch einmal aufzufrischen. Besonders bei der Gruppenarbeit für die Datenmodellierungsaufgabe gab es viele produktive Diskussionen. Für die PL/SQL und SAP Übungen haben wir eine VM zur Verfügung gestellt, wo jeder Teilnehmer an seinem eigenen Rechner die Aufgaben lösen konnte. Für den Reporting-Teil mit SAP BO haben wir uns Janine Ellner als Expertin dazu geholt. Janine hat eine sehr gute Live Demo des SAP Information Design Tools und SAP WebIntelligence präsentiert. Im Anschluss daran hat sie uns tatkräftig bei der Übung unterstützt. Am 9. und 10. Oktober geht es mit Modul 2 weiter. Hier werden Arthur Arendt und Luka Galov die multidimensionale Modellierung thematisieren. Außerdem werden sie ETL und Reporting mit den Tools von Oracle vorstellen. Das Spezialthema des zweiten Moduls ist Big Data. Am 23. und 24. November werden Christian Lenzhölzer und Thomas Kopp die DevClass mit Modul 3 abschließen. Im letzten Modul wird Data Vault als Modellierungsmethode behandelt. Hier stehen das ETL-Tool und das Reporting-Tool von Microsoft im Mittelpunkt. Neben diesen Themen ist Cloud in Modul 3 das Spezialthema. **Kategorien:** Tech Events & Networking --- ### [ChatbotConf 2017: Chatbots, Startups und Walzer](https://thecattlecrew.net/2017/10/13/chatbotconf-2017-chatbots-startups-und-walzer/) **Published:** Oktober 13, 2017 **Author:** Christian Ochsenkühn **Content:** Mit dem rechten Fuß nach vorne. Der linke Fuß wandert schräg nach links. Und der rechte zieht hinterher. Ich bin in Wien und tanze Walzer. Passt ja irgendwie. Aber war ich nicht auf der ChatbotConf 2017? Stimmt… Ich starte wohl besser von vorne. ## Community Day der ChatbotConf Der erste Tag dieser Konferenz ist anders als das, was man gewöhnlich unter einer Konferenz versteht. Einer der Teilnehmer beschreibt es so: „This first day is is a little weird.“ Er hat nicht ganz unrecht. Die Macher der ChatbotConf nennen es „Community Day“. Alle Events diesen Tages haben einiges gemeinsam: Sie drehen sich um Chatbots oder Voice, und sie kommen von der Community für die Community. Was sie nicht gemeinsam haben, ist der Veranstaltungsort. „Talks, panels, workshops and meetups all over Vienna.“ Los ging es in der Vienna Business Agency mit einem Welcome Breakfast. Diese Agentur – ein Service der Stadt Wien – sieht sich als ersten Kontaktpunkt für Unternehmen, die sich in Wien niederlassen möchten und bietet Beratung sowie Kontakte zur Wiener Startup-Szene. In dieser Szene tummeln sich mehr (angehende) Startups mit Chatbot-Bezug, als erwartet. So sprach Emanuelle Capparelli – CEO von [heroes.ai](http://www.heroes.ai/) – auch von einer der offensten und einladensten Communities überhaupt. Man müsse sich jedoch mit den kulturellen Gepflogenheiten Wiens auseinandersetzen: „For example, you should know what ‚[oida](http://www.heute.at/oesterreich/wien/story/Oida--Schaupielerin-erklaert-den-Amis-Wienerisch-41666329)‚ means“. All weiteren Events fanden nun an unterschiedlichen Orten, verteilt über Wien, statt. Die meisten davon in einem Coworking-Space namens Sektor5. Abends fand dort zum Beispiel der erste Wiener Facebook Developer Circle statt. Diese [Developer Circles](https://developers.facebook.com/developercircles) verteilen sich mittlerweile über die ganze Welt und vernetzen Entwickler, die sich für die neuesten Facebook-Technologien, wie Chatbots im Messenger, interessieren. ### Ask me anything (AMA) about Amazon AWS + Conversational UI Da wir bei Opitz und ich privat bereits einige Alexa Skills entwickelt haben, war das AMA mit drei Mitarbeitern der Amazon Web Services für mich ein besonders spannender Slot. Zwei Solution Architects von AWS werden auch noch am kommenden Konferenztag über eine Chatbot-Lösung sprechen, die verspricht einen Bot in allen Sprachen verfügbar zu machen. Doch dazu später mehr. Die Fragen des AMAs drehten sich sowohl um Alexa, als auch um Lex – Amazons textbasierte Chatbot-Lösung. So stand die Frage im Raum, wann man denn über Chatbots via Amazon Payment bezahlen könne. Eine konkrete Antwort gab es leider nicht, das Thema werde aber bearbeitet. Auch ich hatte eine Herausforderung, die mich in puncto Alexa Skills bereits einige Male beschäftigte: Unsere Skills hosten wir in AWS als [Lambda Function](https://aws.amazon.com/de/lambda/details/). Wenn nun der Skill einige Zeit nicht benutzt wird, so „schläft“ diese Function. Der anschließende erste Invoke (das wieder Aufwachen) dauert dadurch länger als die darauffolgenden Aufrufe. Laut den Jungs von Amazon sei das aber durchaus normal. Eine Lösung wäre es, die Funktion per Zeit-getriggertem Ereignis (z.B. jede Minute) immer wieder aufzurufen und somit wach zu halten. ### Innovation into Business – oder auch: der Walzer Nachdem leider einige der weiteren Events bereits überfüllt waren und ich nicht mehr rein kam, entschloss ich mich kurzerhand den Slot von ondewo aufzusuchen. Erstens klang die Location ziemlich spannend: INiTS (Innovation into Business) – ein Inkubationsprogramm für Startups und Partner für Kooperationen mit Startups. Zweitens klang auch das Event an sich interessant und nach etwas anderem als dem Üblichen. Da war ich dann also: Viennese Waltz Class. Der Name war Programm. Normalerweise arbeitet das Team von [ondewo](http://www.ondewo.com/) am Chatbot ihres Startups. Dieser Bot verbindet Nutzer mit alltäglichen Services (wie einem Friseur), um dort schnell und unkompliziert Termine zu vereinbaren. Heute aber lernten sie einer kleinen Gruppe von Teilnehmern aus der ganzen Welt das Walzer-Tanzen. Neben einer Menge Lachen brachte diese Art des „Networking“ (insofern man dieses Wort überhaupt benutzen möchte) eine äußerst interessante Möglichkeit mit sich, mehr über seine Gegenüber zu erfahren. ## Der Konferenztag – was läuft in der internationalen Chatbot-Szene? Am eigentlichen „echten“ Konferenztag wartete die ChatbotConf dann mit vielen interessanten Speakern auf. Leider kann man sich nicht alle Slots anhören. Doch ich möchte zumindest einige Eindrücke mitbringen, was die Chatbot-Szene aktuell so bewegt. ### A bot that speaks any language (Renato Barbosa & Fernando Sapato, **Amazon**) Die beiden Brasilianer zeigten ihr AWS Framework, mit dem ein Chatbot per Machine Learning jede Sprache sprechen kann. Dies ist vor allem für Länder sinnvoll, in deren Sprache noch keine gute „Natural Language Processing“-Unterstützung besteht. So hat zum Beispiel am vorherigen Community Day eine Mitarbeiterin der TBC Bank aus Georgien von diesen Problemen erzählt. Daraufhin haben sie den ersten Chatbot überhaupt entwickelt, der[ in der Sprache Georgiens](http://cbw.ge/banking/tbc-innovation-clients-receive-information-banking-products-messenger/) interagieren kann. ### Building Conversational Experiences (Michael Finkler, **Google**) Auch Google setzt weiterhin stark auf Conversational UI und Chatbots. Mit ihrem Framework DialogFlow (früher API.ai) wollen sie daran teilhaben, wenn mehr als 85% der Kundeninterkationen in wenigen Jahren ohne einen Menschen auf der Gegenseite ablaufen werden. [![tweet_chatbotconf_2017_google](https://thecattlecrew.net/wp-content/uploads/2017/10/tweet_chatbotconf_2017_google.png)](https://twitter.com/oxnkeen/status/915183957888684032) ### How human do we want our bots to be? (Elen Churilova, **Ophi**) Wenn Chatbots oder Roboter versuchen, zu menschlich zu sein, dann wirkt das auf uns Menschen häufig abschreckend (siehe Video). Daher sollten Chatbots immer zu Erkennen geben, dass sie Bots sind. Weitere Gedanken sollten Unternehmen sich machen, ob ihr virtueller Assistent ein Geschlecht hat, und wenn ja welches. \[youtube https://www.youtube.com/watch?v=CdggQr05LAA&rel=0&controls=0&showinfo=0&w=560&h=315&start=21\] ### Designing Conversational UI for the workplace (Helen Zeng, **Slack**) Chatbots auf Slack sollen noch bessere User Expecience für die Nutzer bieten. Dafür sei es wichtig zu verstehen, dass man nicht versuchen soll, seine komplette Anwendung via Bot abzubilden, sondern ausgewählte und vor allem passende Features dort mit aufzunehmen. ### Competing with character (Ashley D’Arcy, **Poncho**) Der [Wetter-Chatbot Poncho](https://poncho.is/) versucht durch eine tägliche Notification immer im Blickfeld seiner Nutzer zu bleiben und konnte so eine beachtliche Reichweite aufbauen. In Zukunft will das Team hinter Poncho deren Maskottchen noch stärker als Marke positionieren. ![poncho_half_logo](https://thecattlecrew.net/wp-content/uploads/2017/10/poncho_half_logo.png)Der Chatbot „Poncho“ soll noch stärker als Marke positioniert werden ### Meet booking.com’s virtual assistant (Ilze Dreyer, **Booking.com**) Die Macher hinter booking.com’s Chatbot, der aktuell nur auf dem Facebook Messenger verfügbar ist, versuchen es erst garnicht, einen „Super-Bot“ zu erstellen, der alle Kundenanfragen abarbeiten kann. Stattdessen setzten sie darauf, sehr häufig gestellte und einfache Fragen automatisch beantworten zu lassen. Alles weiteren und komplexeren Anfragen werden an einen menschlichen Kundenberater weitergeleitet. Zum Einsatz kommt deren Bot im After-Booking Bereich, z.B. da Kunden häufig fragen, ob ihr gebuchtes Hotel auch wirklich gebucht wurde. Sie wollen also nur eine kurze Bestätigung. ### Bot Analytics Uncovered (Mor Shemesh, **Microsoft**) Diesen Vortrag konnte ich leider nicht hören. Ich hatte aber das Glück, bereits am Vortrag mit Mor zu sprechen. Er ist Developer im Microsoft Israel R&D Center, wo der Großkonzern zusammen mit Start-Ups an Open Source Lösungen baut, so dass diese wiederum Microsoft-Lösungen einsetzen und mit ihren Produkten verbinden können. Eines dieser Open Source Produkte ist ein [Analytics Framework für Chatbots](https://www.microsoft.com/developerblog/2017/09/26/custom-analytics-dashboard-application-insights/), was eine zusätzliche Sentiment-Analyse ausführt, um zu erkennen, ob eine Nutzer gerade wütend oder freundlich mit dem Bot spricht bzw. schreibt. Solche Lösungen entstehen teilweise in Hackathons und werden immer unter MIT-Lizenzen veröffentlicht. ## Fazit Insgesamt fällt auf, dass in diesem Bereich viele kreative und innovative Leute unterwegs sind. Und sie alle haben eines gemeinsam: sie wollen für die Nutzer irgendetwas besser, schneller oder automatisiert machen. Es passiert sehr viel und wir bei Opitz sind vorne mit dabei. Einfach super! **Kategorien:** Tech Events & Networking **Schlagwörter:** #OCVoicePioneers, Alexa, Artificial Intelligence, Conversational UI, Erfahrungsbericht, Moderne Clients, Voice --- ### [Im Ideenreich des Professor Kohls](https://thecattlecrew.net/2017/10/23/im-ideenreich-des-professor-kohls/) **Published:** Oktober 23, 2017 **Author:** karstenwill **Content:** Vor kurzem hatten Arne Christmann und ich erneut die Gelegenheit, einen der drei Innovationsräume auf dem Campus der TH Köln in Gummersbach zu besuchen, das „ideenreich“ von Professor Kohls. So sieht es dort aus: ![IMG_8952.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8952.jpg) ![IMG_8953.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8953.jpg) Wir hatten uns zwei Ziele gesetzt: Primär wollten wir den Raum besser verstehen, um ihn im Rahmen von Workshops nutzen zu können, sowohl extern als auch intern. Da das so allein sehr trocken geworden wäre, haben wir uns als Sekundärziel eine konkrete Frage gestellt, die wir dort erörtern wollten: „Wie schaffen wir Arbeitsorte, die Mitarbeiter maximal motivieren?“ Oder alternativ „“¦ mininimal demotivieren?“, da wir ja alle wissen, dass die beste Motivation, die intrinsische ist 😉 Für diejenigen die das ideenreich methodisch einsortieren wollen, hier ein Mapping auf zwei bekannte Designprozesse: ![design thinking.png](https://thecattlecrew.net/wp-content/uploads/2017/10/design-thinking.png) Im „Design Thinking“ ist es für die ersten drei Phasen geeignet, „EMPATHIZE“ bis „IDEATE“. ![BDC double diamond.png](https://thecattlecrew.net/wp-content/uploads/2017/10/bdc-double-diamond.png) Im „BDC Double Diamond“ ist es“‹ für die ersten drei Phasen geeignet, „Discover“ bis „Develop“. Um aus der Fülle der Werkzeuge auszuwählen, setzten wir uns eine Timebox von 15 Minuten, in der jeder seine Favoriten für die Aufgabenstellung suchte. Anschließend stellten wir sie uns gegenseitig vor. Hier sehen Sie unsere Auswahl: ![IMG_8596.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8596.jpg) Daraus wählten wir gemeinsam zwei aus: Das „Design Studio Pro“ (von den Machern der bekannten „Story Cubes“), um dem Prozess einen Rahmen zu geben und für zusätzliche Impulse, da es um Orte ging, das „MethodKit – Cities“. ![IMG_8591.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8591.jpg) Notwendig für Lösungen mit Menschen im Mittelpunkt ist Empathie. Eine klassische Methode für Empathie sind Personas. Das Design Studio Pro geht hier einen interessanten Weg und gibt völlig überzeichnete fiktive Personas vor, die „Extraordinaires“. Da Zufall und die durch ihn erreichten neuen Verknüpfungen fantastische Mittel für Kreativität sind zogen wir blind drei Personas: „Knight“, „Future Child“ und „Time Traveller“. Auf der Vorderseite jeder Karte befindet sich ein großes Bild des jeweiligen Extraordinaires, auf der Rückseite ist er oder sie in typischen Lebenssituationen zu sehen. Die Extraordinaires auf unseren Problemraum einer „fiktiven IT-Unternehmensberatung mit Zentrale im Oberbergischen“ anzuwenden, verlangte ein Mapping auf reale Mitarbeitergruppen: - Den „Knight“ hielten wir eindeutig für einen Repräsentanten der „Projekt-Pendler“. Regelmäßig „schärft er sein Schwert“ mittels Software Craftsmanship und „kämpft gemeinsam mit anderen gegen den Drachen“ Komplexität (beides Bilder von der Rückseite der Karte). ![IMG_8587.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8587.jpg) - Das „Future Child“ deuteten wir als unseren Nachwuchs: Studenten sowie alle anderen die „noch nicht bei uns arbeiten“. Im vulkanischen Gruß, der in der Zeichnung zu sehen ist, sahen wir die „Logik der reinen Lehre“, die sie mitbringen, z. B. von der Uni. Kritisch ist dabei immer wieder der Konflikt mit Autoritäten um die Deutungshoheit. ![IMG_8588.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8588.jpg) - Die „Time Traveller“ interpretierten wir als „Leute die an/in der Zukunft arbeiten“, also BDI und andere Visionäre im Unternehmen. Aus verschiedenen Zeiten und von verschiedenen Orten bringen sie „Trophäen“ mit, wichtig für ihr Wohlbefinden ist ein jeweils „passendes Outfit“, das Schneider sicherstellen und eine gut ausgestattete „Werkstatt“ (alles Bilder von der Rückseite). ![IMG_8589.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8589.jpg) Mit diesem Verständnis und immer wieder zwischen der Metapher der fiktiven Welt und unserer realen hin und her springend folgten wir zunächst weiter dem Prozess des Design Studio Pro und zogen für jede Persona eine „Design Challenge“: - Der Ritter brauchte einen „Place for Ceremony“, was wir als Ort, um Projekterfolge zu feiern und sich auszutauschen, interpretierten. Dieser sollte dicht am Geschehen sein, damit die Zeremonie zeitnah stattfinden kann. - Das Kind der Zukunft brauchte „something for carrying things“. Das haben wir im Kontext als Community verstanden, die die Person im Sinne von Aus-/Weiterbildung und Karriere „trägt“. - Die Zeitreisende verlangte es nach „somewhere to sit“. Das deuteten wir als „Heimat“: eine Komfortzone, wo Trophäen ausgestellt werden und das Bedürfnis nach Selbst-Transzendenz befriedigt wird. Der nächste Schritt im Prozess des Design Studio Pro ist „improve“ mit zwei zufälligen Karten pro Extraordinaire und Design Challenge: - Für den Zeremonien-Ort des Projekt-Ritters waren die Hinweise „Sustainability“ und „Decoration“. Für die Umweltfreundlichkeit notierten wir uns, dass der Ort Bio-Produkte verwenden und auch anderweitig benutzt werden sowie sozial-integrativ sein sollte. Für die Dekoration fielen uns Personalisierung für IT und Konsistenz ein. - Für die Community des Zukunft-Kindes zogen wir „Adaptability“ sowie „Integration“. Dazu schrieben wir Toofreiheit mit BYOD/S, externe Visibilität, Themenfreiheit und Gamification auf. - Für die Heimat der Zeitreisenden zogen wir „Exaggeration“ und „Automation“. Dazu fielen uns der Koffer als mobile Werkstatt und Smart Home ein. Wir kamen zu drei Ergebnissen, einem pro Persona: - Der Ritter braucht einen Ort, um zusammen mit Kollegen aber auch mit Kunden-Mitarbeitern (z. B. den „Einwohnern Thyssenhausens“) zu feiern. Der letzte Schritt im Design Studio Pro ist, dem Ergebnis einen Namen zu geben. Diesen Ort nannten wir „Taverne“. - Das Kind der Zukunft braucht eine Community für die Weitergabe von Wissen mit Vertrauen als Basis. Die Hierarchie dort sollte ausschließlich auf Kompetenz beruhen, die Organisation sollte ortsungebunden und asynchron sein. Diesen Ort nannten wir „Starfleet Academy“ - Die Zeitreisende braucht als Ruhepol und Ausgleich eine Heimat. Diese nannten wir „Secret Lair“. Natürlich gibt es eine Menge Synergie-Effekte zwischen den drei Orten. Die „Taverne“ kann z. B Teil des Netzwerks der „Starfleet Academy“ sein, wo wiederum die Time Traveller lehren. Das „Secret Lair“ der Time Traveller dient mit seinen Trophäen allen als Inspiration. Das wurde noch klarer als wir aus dem „Method Kit – Cities“ drei Karten als zusätzlichen Input für unsere Arbeitsorte zogen und passend platzierten: - „Research & Innovation“ - „Local Knowledge“ - „Networks“ Hier sehen Sie das fertige Gedankenmodell: ![IMG_8595.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8595.jpg) Zusammenfassend war die Arbeit im ideenreich fantastisch. An einer Menge Stellen erkennt man Prof. Kohls Liebe zum Detail: - Die Mechanik zur Einstellung der Arbeitshöhe des riesigen Tischs in der Mitte scheint 1:1 aus der Metall-Industrie zu stammen, die Platte ist aus dickem, naturbelassenem Holz, welches man gerne anfasst. - Überhaupt der Tisch: Man könnte denken, dass kein großer Unterschied zwischen Post-Its auf einer vertikalen Wand und einer horizontalen Oberfläche besteht. Es ist aber hilfreich, um das gemeinsame Gedankenmodell herumlaufen und es aus verschiedenen Perspektiven betrachten zu können. Ebenso können 3D-Objekte oder Materialien die man weder kleben noch pinnen will benutzt und platziert werden. - Die gigantische Menge an Werkzeugen ist über Jahre zusammengestellt und wird stetig erweitert. Prof. Kohls ganzes Netzwerk sucht dabei eifrig mit: In einer Kartenspiel-Box fanden wir etwa einen Geburtags-Glückwunsch. Natürlich könnten wir sehr stolz sein, falls OC-eigene Materialien wie Storytelling-Box oder Glaubenssatz-Kartenspiel mit in die Sammlung aufgenommen würden. Dieses irgendwann zwischendurch entstandene Lego-Objekt schliesst den Kreis zwischen Fragestellung und Ergebnis: ![IMG_8593.jpg](https://thecattlecrew.net/wp-content/uploads/2017/10/img_8593.jpg) Wie schaffe ich Arbeitsorte die Mitarbeiter maximal motivieren? Mit Räumen, real oder virtuell, wo man schon mit Freude die Tür öffnet, weil überall die Liebe zum Detail spürbar ist. Wie z. B. im ideenreich 😎 Falls Sie jetzt Lust bekommen haben, auch das ideenreich zu besuchen: Hervorragend 😀 Sehr gerne stehen Arne Christmann (arne.christmann@opitz-consulting.com) oder ich (karsten.will@opitz-consulting.com) für die Buchung halb- oder ganztägiger Workshops und als Moderatoren zur Verfügung. Karsten Will **Kategorien:** Tools & Methoden --- ### [Alle Jahre wieder"¦ was macht ein Berater so bei OC? (1. Advent)](https://thecattlecrew.net/2017/12/03/alle-jahre-wieder-was-macht-ein-berater-so-bei-oc-1-advent/) **Published:** Dezember 3, 2017 **Author:** clarissamoeller **Content:** Das Jahr 2017 neigt sich dem Ende. Im TV werden bald die ganzen Jahresrückblick-Shows ausgestrahlt und die ersten Türchen des Adventskalenders dürfen geöffnet werden. Neben dem ganzen Weihnachtsstress wie Geschenke kaufen, Weihnachtsmarktbesuche und Weihnachtsfeiern, sollte diese Zeit des Jahres doch auch die Zeit der Ruhe und Besinnlichkeit sein. Gerne wird in dieser Zeit auch das letzte Jahr Revue passiert. Genau das habe ich auch für mein Jahr gemacht und möchte das gerne mit euch teilen. **Ende 2016 bis Februar 2017** Nach sechs Monaten in Berlin habe ich im November wieder in ein heimatnahes Projekt in Köln gewechselt. Am Anfang „“ und dieses Gefühl hat sicher jeder schon mal in seinem Beraterleben empfunden „“ bin ich überwältigt von der so komplexen Fachlichkeit und auch von dem Dschungel an technischen Konstrukten, die ich dort vorgefunden habe, gewesen. Es ist zum einen Überwältigung gewesen, zum anderen ist da auch ein wenig Furcht gewesen, diese Komplexität niemals in Gänze zu durchdringen. In den ersten Wochen habe ich eine Einführung in die Fachlichkeit und auch in die Technik bekommen. Ganz nebenbei habe ich mich noch von dem bisher kennengelernten Wasserfallmodell verabschiedet und das agile Vorgehensmodell kennen gelernt. Das Bedürfnis nicht nur neben jemandem zu sitzen und zuzuhören, sondern selbst Mappings zu bauen und selbst Code zu schreiben ist in dieser Phase sehr groß gewesen. Zum Ende des Jahres 2016 hin habe ich mich bereits aktiv ins Team einbringen können. Aber meine eigentliche Entwicklung hin zu einem vollwertigen Teammitglied hat erst im Laufe des Jahres 2017 stattgefunden. Die Freude eigene Task-Zettel, die ich ganz alleine ohne Unterstützung bearbeitet habe, als erledigt zu markieren ist sehr groß gewesen. Das soll jetzt nicht den Eindruck erwecken, dass ich jeden Task-Zettel ab diesem Zeitpunkt alleine erarbeitet habe. Immer wieder sitze ich mit Kollegen aus meinem Team zusammen und wir helfen uns gegenseitig. Wir sind ein Team mit einer gemeinsamen Mission. Da hilft man sich gerne und man sollte sich auch nie scheuen jemanden um Hilfe zu bitten. Das gilt auch nicht nur für den beruflichen Kontext. Im Februar habe ich außerdem das zweite Mal einen neuen OC-Kollegen als Mentor begrüßen dürfen. Als Mentor steht man dem Mentee besonders in der Anfangszeit mit Rat und Tat zur Seite. Man unterstützt bei organisatorischen Angelegenheiten wie Zeiterfassung und Spesen. Außerdem bietet unser Mentoringprogramm auch die Möglichkeit zum Austausch bei einem Kaffee oder Eis. Hierzu eine kleine Anekdote: Mein Mentor ist mit mir in meiner Anfangszeit Eis essen gewesen. Mein Mentee und ich haben uns aufgrund der Jahreszeit eigentlich für ein CafÜ© entschieden. Das ausgewählte CafÜ© in der Nähe von Gummersbach auf dem Land hatte leider geschlossen. Auch unsere zweite Anlaufstelle hat uns vor verschlossenen Türen stehen lassen. Aus der Ferne haben wir ein goldenes „M“ leuchten sehen und haben ganz unkonventionell unser erstes Mentoring-Gespräch mit einem Cheeseburger verbracht. Es war so nicht geplant, aber dennoch haben wir ein sehr lockeres und anregendes Gespräch gehabt. Als Mentor sollte man auch stets eine Vertrauensperson sein und ein offenes Ohr haben. So viel zum Anfang des Jahres. Nächste Woche möchte ich euch erzählen wie es von März bis September für mich weiterging. Euch allen einen schönen ersten Advent! Clarissa **Kategorien:** Tech Events & Networking **Schlagwörter:** Beraterleben, OC-Familie --- ### [Alle Jahre wieder"¦ was macht ein Berater so bei OC? (2. Advent)](https://thecattlecrew.net/2017/12/10/alle-jahre-wieder-was-macht-ein-berater-so-bei-oc-2-advent/) **Published:** Dezember 10, 2017 **Author:** clarissamoeller **Content:** Wie im [ersten Teil](https://thecattlecrew.net/2017/12/03/alle-jahre-wieder-was-macht-ein-berater-so-bei-oc-1-advent/) dieser kleinen Advents-Serie angekündigt, möchte ich euch heute von der Zeit März bis September berichten. **März 2017 bis Juni 2017** Das Kerngeschäft eines Beratungshauses ist natürlich die Dienstleistung vor Ort beim Kunden. Aber bei OC wird neben der Gemeinschaft, die ich später noch aufgreifen möchte, auch die Förderung und Schulung groß geschrieben. So hat für mich im März die erste Schulung angestanden: Anforderungsmanagement für IT-Projekte. In den drei Tagen in unserem eigenen Schulungszentrum habe ich viel zu Vorgehensweisen, wie Anforderungen aufgenommen und verarbeitet werden können, gelernt. Außerdem habe ich so trivial es klingen mag auch gelernt, was eine Anforderung genau definiert. Auch im Alltäglichen sprechen wir von Anforderungen. Aber diese auf den DWH-Kontext zu beziehen und auch von anderen Begriffen abzugrenzen ist gar nicht so einfach gewesen. In den nächsten Monaten habe ich neben vielen Feiertagen, Urlaub und einem gebrochenen Fuß weiter das DWH-Projekt mitgestaltet und vorangetrieben. In dieser Zeit hat uns insbesondere ein Datenschutzthema beschäftigt. Das Thema hat sich aber super geeignet, um in alle Ecken des DWHs hinein zu schnuppern. Ende Juni hat ein großes Event bei OC angestanden: der OC Digital Day! Zum ersten Mal hat dieser Tag, der wie der Name schon vermuten lässt, ganz im Zeichen der Digitalisierung stand, stattgefunden. Place to be ist an dem Tag die FH Köln Campus Gummersbach gewesen. Es haben sich alle Mitarbeiter aus allen Niederlassungen von OC, Kunden und Studenten versammelt gehabt, um gemeinsam spannenden Themen rund um die Digitalisierung zu bearbeiten. Auf der Agenda haben neben vielen interessanten Vorträgen auch Workshops und Bootcamps auf dem Programm gestanden. Im Anschluss an dem ereignisreichen Tag hat es noch nebenan in der Halle 32 eine Party gegeben. Neben Fingerfood und dem ein oder anderen Kölsch hat es noch Zeit zum Kontakte knüpfen und Austausch zwischen Kollegen gegeben, die man nicht allzu häufig sieht. ([OC Digital Day Agenda](https://www.opitz-consulting.com/fileadmin/user_upload/Events/2017/OCDigital_Day/20170529_OCDigital_Day_2017_Agenda.pdf) und [OC Digital Day Video](https://www.youtube.com/watch?v=h1rT7KZK9gA) ) In diesem Zuge möchte ich das Thema Gemeinschaft bei OC noch einmal aufgreifen. Einmal im Monat findet der sogenannte Community Day statt. An dem Tag kehren alle Berater, die sonst beim Kunden sitzen, in die Niederlassung ein. Beim Community Day kann jeder, der möchte, ein Thema oder auch ein Problem vorstellen, über das er diskutieren möchte. Der Community Day ist eine Plattform zum fachlichen Austausch, aber auch zum Netzwerken. **Juli bis September 2017** Man könnte es auch das Sommerloch nennen. Genau so leer wie die Büros sind auch die Straßen gewesen. Im Sommer macht es auch wieder Spaß täglich 150 km zu fahren. Im Büro angekommen hat sich gähnende Leere breit gemacht. Da jeder zu unterschiedlichen Zeiten seinen Urlaub genommen hat, sind wir im Büro häufig nur dünn besetzt gewesen. Dennoch haben wir auch im kleinen Team die Weiterentwicklung des DWHs beim Kunden voran getrieben. Außerdem hat im Sommer auch in die heiße Phase der Vorbereitung der DevClass begonnen. Die DevClass ist die Schulung für Neu- und Quereinsteiger in die BI-Welt bei OC. Im Jahre 2016 hat sie bereits schon mal unter dem Namen Associate Schulung stattgefunden. Bereits seit dem Frühjahr 2017 haben fünf Kollegen und ich an einer kompletten Umstrukturierung der Schulung gearbeitet. Im September ist es dann so weit gewesen und ein Kollege und ich haben die neuen OC-Kollegen in Modul 1 der DevClass mit den Grundlagen zu BI & Analytics vertraut gemacht. ( [Was in Modul 1 der DevClass geschah…](https://thecattlecrew.net/2017/09/25/was-in-modul-1-der-devclass-geschah/)) Das ist alles in der Zeit zwischen März und September alles passiert. Nächste Woche möchte ich euch dann von den letzten Monaten im Jahr 2017 berichten. Ich wünsche euch allen einen schönen 2. Advent! Clarissa **Kategorien:** Tech Events & Networking **Schlagwörter:** Beraterleben, OC-Familie --- ### [Global Day of Coderetreat der JUG Essen](https://thecattlecrew.net/2017/12/14/global-day-of-coderetreat-der-jug-essen/) **Published:** Dezember 14, 2017 **Author:** marwinwiechert **Content:** Am 18.11.2017 haben wir an unserem Standort in Essen erneut am Global Day of Coderetreat (GDCR) teilgenommen. Neben Kollegen von OPITZ CONSULTING konnten wir auch mehrere Studenten aus Bochum und Dortmund als Teilnehmer gewinnen. Moderiert und durch den Tag geführt haben unser Experte Halil Hancioglu und Birgit Kratz von der JUG Essen – Vielen Dank an dieser Stelle! Beim GDCR haben Entwickler aller Erfahrungsstufen die Möglichkeit, ohne Zeitdruck an ihren Fertigkeiten zu feilen. Es wird generell im Paar und idealerweise „Test first“ gearbeitet. Unter Beachtung der [Four Rules of Simple Design](https://martinfowler.com/bliki/BeckDesignRules.html) haben wir auch diesmal die Kata [Game of Life](https://de.wikipedia.org/wiki/Conways_Spiel_des_Lebens) bearbeitet. An diesem Tag ging es wie immer um das Meistern der Übungen ohne den täglichen beruflichen Stress. Der Fortschritt stand nicht im Fokus. Nach jedem 45-Minuten-Block wurde der Code gelöscht und es wurden neue Paare gebildet. Für jede Iteration überlegten sich die Moderatoren neue Challenges. ![full](https://thecattlecrew.net/wp-content/uploads/2017/12/full.png)![half](https://thecattlecrew.net/wp-content/uploads/2017/12/half.png) Insgesamt war das Feedback für die Veranstaltung sehr positiv, und wir überlegen gerade, ob wir Veranstaltungen dieser Art im kleineren Rahmen – kein kompletter Samstag – öfter anbieten sollten. Das Feedback der Studenten war sehr positiv, und der Wunsch nach mehr Werbung an den Unis für solche Events wurde auch mehrmals geäußert. Ich möchte mich noch einmal bei allen Beteiligten bedanken, besonders bei Hannes für die Unterstützung bei der Organisation und Petra für die super Verpflegung. Die Planungen für das nächste Jahr laufen bereits! Weitere Infos gebe ich gerne auf Anfrage. **Kategorien:** Tech Events & Networking --- ### [Alle Jahre wieder"¦ was macht ein Berater so bei OC? (3. Advent)](https://thecattlecrew.net/2017/12/17/alle-jahre-wieder-was-macht-ein-berater-so-bei-oc-3-advent/) **Published:** Dezember 17, 2017 **Author:** clarissamoeller **Content:** In den [letzten zwei](https://thecattlecrew.net/2017/12/10/alle-jahre-wieder-was-macht-ein-berater-so-bei-oc-2-advent/) Beiträgen habe ich euch über die Zeit von Ende 2016 bis hin zum September diesen Jahres berichtet. Heute möchte ich euch erzählen, wie mein Jahresende bei OC ausgesehen hat bzw. aussehen wird. **Oktober bis November 2017** Im Oktober hat für mich ein kleiner Schulungs- und Konferenzmarathon begonnen. Ich habe dieses Jahr an der TDWI Advanced BI-Engineering Schulung teilgenommen. Diese setzt sich zusammen aus einem Pflichtmodul Strategie & Governance sowie zwei Wahlmodulen. Bei den Wahlmodulen habe ich mich für Big-Data-Technologien und ETL- Architektur und Modellierung von ETL-Prozessen entschieden. Die Seminare sind sehr interessant gewesen und sind von sehr fachkundigen Referenten gehalten worden. Für Big-Data-Technologien hat es mich nach Frankfurt verschlagen, für Strategie & Governance nach Stuttgart und für das ETL-Seminar nach Hamburg. Drei sehr verschiedene Städte, aber alle mit ihrem ganz eigenen Charme. Die Schulung wird mit einer Zertifizierungsprüfung abgeschlossen, welche aktuell noch aussteht. Außerdem habe ich im Oktober noch die Data Modeling Zone in Düsseldorf besucht. Das ist eine zweitägige internationale Konferenz mit diversen Vorträgen zum Thema Datenmodellierung. Bei der Data Modeling Zone hat insbesondere Data Vault im Vordergrund gestanden. Hier ist es spannend gewesen über die internationalen Unterschiede zu diskutieren. Denn so verbreitet wie das 3NF-Core Modell in Deutschland ist, so ist es das in den USA nämlich nicht. Neben interessanten Vorträgen und sehr guten Speisen hat es genügend Gelegenheit gegeben neue Kontakte zu knüpfen. Außerdem haben dort Anbieter von Data Vault-Automatisierungstools dort ihren Stand aufgebaut gehabt und sind bereit gewesen Fragen zu beantworten. Im Oktober hat es noch eine sehr abwechslungsreiche und spaßige Aufgabe für mich gegeben. Ich habe Teil unserer Marketing-Kampagne für #meinlieblingsjob sein dürfen. Im Rahmen dieser Kampagne wollen wir auf einem eher unkonventionellen Weg zeigen, für welche Werte wir im Unternehmen stehen. Ja, wir bieten hochprofessionelle Dienstleistungen an, aber wir sind trotzdem eine Familie! Die OC-Familie ist füreinander da und hat gemeinsam Spaß! Vor dem Videodreh war ich doch etwas aufgeregt. Ich bin mit drei verschiedenen Outfits und jeder Menge Vorfreude nach Gummersbach angereist. Vor Ort ist dann schon ein Profi-Team mit einer Kamera, Drohne und einer Tonangel, die ich sonst nur aus dem Fernsehen kannte gewesen. Der Videodreh hat sehr viel Spaß gemacht und schaut selbst was dabei herum gekommen ist: [\#meinlieblingsjob](https://mein-lieblings-job.de/) (auf “ Spiel Starten“ klicken). **Dezember 2017** Nun sind wir schon im Dezember. Wenn ich mir so anschaue, wie viel Spannendes, Weiterentwicklung und Lehre darin steckt, bin ich baff. Am zweiten Wochenende im Dezember hat unsere Weihnachtsfeier statt gefunden! Für die Kollegen aus der Niederlassung Gummersbach hieß es : „Ab aufs Schiff!“. Wir sind von Köln nach Düsseldorf geschippert und haben uns dabei an einem sehr reichhaltigen und leckerem Buffet die Bäuche voll geschlagen. Begleitet wurde das gute Essen mit dem Duft von Glühwein, den es an Board gab. Auf dem Rückweg von Düsseldorf nach Köln habe ich die Zeit genutzt mit den Kollegen zu sprechen, die ich nicht allzu oft sehe. Trotzdem habe ich auch spannende Gespräche mit den Kollegen, die ich täglich im Büro sehe, geführt. Das Schöne an der Weihnachtsfeier – wie auch beim Sommerfest – ist, dass auch hier die Partner und Partnerinnen herzlich Willkommen sind. Die Weihnachtsfeier auf dem Schiff ist etwas Besonderes gewesen und hat viel Spaß gemacht! Nun freue ich mich auf die letzten drei Tage beim Kunden und dann heißt es Entspannung und Festessen für mich! Euch allen einen schönen 3. Advent und frohe Weihnachten. Und einen guten Rutsch! Clarissa **Kategorien:** Tech Events & Networking --- ### [München Coding Dojo Meetup](https://thecattlecrew.net/2017/12/18/muenchen-coding-dojo-meetup/) **Published:** Dezember 18, 2017 **Author:** pascalmhumbert **Content:** In der Münchner Niederlassung hatten wir dieses Jahr schon viele spannende und spaßige Coding Katas. Am 30.11.2017 fand die Kata nun zum ersten Mal im neuen Meetup-Format statt. Für dieses [Event](https://www.meetup.com/Munchen-Coding-Katas-Meetup/events/245450034/) reiste unser OC|Lab Guru Philipp Perez extra aus Hamburg an und gab uns eine Einführung in Docker. ## Das Event Die Meetup-Gruppe [München Coding Dojo Meetup](https://www.meetup.com/de-DE/Munchen-Coding-Dojo-Meetup/) hatten wir drei Tage zuvor spontan gegründet und das Event gepostet. An dem Tag der Kata schneite es in München zum ersten Mal (siehe Fotos). Trotzdem kamen von den 28 angemeldeten Teilnehmern fast 20, was in unseren Augen einen echten Erfolg darstellt. Den übrigen war es wahrscheinlich zu kalt 😉 und zu weit draußen. ![11](https://thecattlecrew.net/wp-content/uploads/2017/12/11.jpg)Tagsüber war das Wetter noch ok.![2](https://thecattlecrew.net/wp-content/uploads/2017/12/2.jpg)Am Abend schneite es und war echt kalt und winterlich „¦![3](https://thecattlecrew.net/wp-content/uploads/2017/12/3.jpg)Und wir sorgten dafür, dass die Teilnehmer bei uns in der Niederlassung gut mit Knabbersachen und Getränken versorgt waren.## Der Abend Um 18 Uhr fingen wir an. Die erste halbe Stunde begrüßten wir die Gäste und begannen mit der Networking-Session. Aus Nürnberg schalteten sich unsere Kollegen Waldemar, Karina, Attila und Dong dazu, die an der Kata remote teilnahmen. Wir hatten auch mit technischen Problemen zu kämpfen. Die Anmeldung in unserem Gast-WLAN klappte nicht bei allen Besuchern unseres Meetups. Und die Skype-Verbindung nach Nürnberg war leider sehr instabil. Die Bildübertragung funktionierte. Die Audio-Übertragung brach aufgrund von Netzwerkproblemen häufig ab, sodass wir auf ein Handy umsteigen mussten. Auch der Handyempfang war leider nicht optimal, doch auf jeden Fall konnten unsere Nürnberger Kollegen uns wieder hören, wohingegen auf unserer Seite der Leitung nur „Klingonisch“ ankam. Überraschend war für uns, dass die meisten Teilnehmer die Software VirtualBox von Oracle weder kannten noch installiert hatten. Durch diesen Umstand verloren wir zum Anfang der Veranstaltung etwas Zeit, bis wir dann beginnen konnten. Unser Learning hieraus: Bei der Meetup-Einladung ganz klar alle technischen Voraussetzungen (VirtualBox sollte installiert sein) angeben und eventuell unsere VM bereits im Voraus zum Download anbieten. Im ersten Teil der Kata erläuterte Philipp die Theorie und Funktionsweise von Docker. ![4](https://thecattlecrew.net/wp-content/uploads/2017/12/4.jpg)Die theoretische Einführung dauerte bis 20 Uhr.Agenda (1. Teil): - Getting Started with Docker (Theory) - Docker Container Platform - Containers vs. Virtual Machines - Docker Terms: Docker Layer, Docker Image, Docker Container and Dockerfile ![5](https://thecattlecrew.net/wp-content/uploads/2017/12/5.jpg)Wo sind denn alle?![ok](https://thecattlecrew.net/wp-content/uploads/2017/12/ok.jpg)Ach ja, wir hatten Pizza für das Abendessen und dabei lernten wir auch die externen Gäste kennen.Im zweiten Teil gingen wir gemeinsam Schritt für Schritt den Workflow von Docker anhand einer Golang-Anwendung durch. Zum Abschluss bekamen alle die Aufgabe, eine Python-Anwendung in einem Container zu verpacken und das fertige Image über eine Docker Registry bereitzustellen. Agenda (2. Teil): - Working with Docker (Practice) - Pulling Docker Images - Running Docker Containers - Building Images - Publishing Images to a Docker Registry - Sharing Data with your containers - Useful Docker Commands - Docker on Windows - Exercise: creating a Docker image for a python app ![7](https://thecattlecrew.net/wp-content/uploads/2017/12/7.jpg)Philipp half jedem gern. Arthur programmierte sogar ohne Laptop. Mit Docker und OC ist alles möglich, oder? 😉![8](https://thecattlecrew.net/wp-content/uploads/2017/12/8.jpg)Die Aufgaben waren nicht einfach. Dank des guten Teamworks schafften es alle.![9](https://thecattlecrew.net/wp-content/uploads/2017/12/9.jpg)Das Event dauerte bis 22 Uhr. Was uns sehr gefreut hat, ist, dass fast alle externen Gäste bis zum Ende geblieben sind!An dieser Stelle abschließend noch ein Dankeschön an: Philipp, der eine super Veranstaltung vorbereitet und durchgeführt hat! Verena für Inspiration und Vorbereitungen. Ulli für Snacks! ## Das Feedback von MeetUp Event **([München Coding Katas MeetUp](https://www.meetup.com/de-DE/Munchen-Coding-Katas-Meetup/))** Zitat von Teilnehmer Ludwig: > „Das Meetup hat mir trotz technischer Schwierigkeiten gefallen und war sehr informativ. Hier könnte man vielleicht vorab in der Beschreibung bereits die Voraussetzungen für das Meetup nennen um eine Vorbereitung vor allem für außenstehende zu ermöglichen. Sonst top und (hoffentlich) bis zum nächsten Mal.“ Zitat von Teilnehmer Alois: > „Ich hatte keine techn. Probleme. Ludwig“™s Feedback ist eine gute Idee. (Tech und Know-how Voraussetzungen) > Gibt“˜s die Folien noch? Den Part mit der Docker Registry konnte ich nicht mitmachen. > Orga, Location sowie Vortrag waren echt klasse.“ ## Die Zukunft Wir haben den Eindruck gewonnen, dass alle Teilnehmer mit der Kata glücklich und zufrieden waren. Das motiviert uns, direkt weiter zu machen. Daher wird es am 09.01.2018 bereits das nächste München Coding Dojo Meetup zu [Amazon Alexa 101](https://www.meetup.com/de-DE/Munchen-Coding-Dojo-Meetup/events/245877670/) geben! Vorgetragen wird das Thema von unserem Developer und Bastler Tomasz Krajewski. Und es sind weitere Meetups für 2018 in Planung „“ es lohnt sich also in Hörweite zu bleiben 😉! **Kategorien:** Tech Events & Networking **Schlagwörter:** Coding Dojo, Events, Marketing, News --- ### [AWS News KW 49 - 52](https://thecattlecrew.net/2018/01/03/aws-news-kw-49-52/) **Published:** Januar 3, 2018 **Author:** Marco Buss **Content:** Nach der re:invent Anfang Dezember fühlt es sich an, also ob AWS sich in den Winterschlaf verabschiedet hat. Ganz ohne Neuigkeiten kamen aber auch die letzten Wochen des Jahres 2017 nicht aus. ## Zwei neue Regionen Im Dezember erblickten zwei neue AWS Regionen das Licht der Welt. Zum einen ist das China (Ningxia) und für den Europäer wichtiger EU (Paris). Damit erhöht sich die Zahl der Regionen in Europa auf 4 und in China auf 2. Insgesamt stehen damit 17 Regionen zur verfügung. Weitere Informationen zu den Regionen [hier](https://aws.amazon.com/de/about-aws/global-infrastructure/). ## Neuer Amazon CloudWatch Agent AWS hat einen neuen CloudWatch Agent veröffentlicht, der sowohl auf Cloud sowie on-premise Instanzen laufen kann. Er unterstützt dabei Linux sowie Windows Server. Die wichtigsten Features sind: - Single Agent: Der Agent sammelt Metriken und Logfiles gleichermaßen. - Cross-Platform / Cross-Environment: Der Agent läuft in der Cloud und on-premise. Unterstützt 64-bit Linux und 64-bit Windows - Configurable: Der neue Agent sammelt die wichtigsten Metriken automatisch, kann aber so konfiguriert werden, das viele andere ebenfalls überwacht werden. - CloudWatch-Friendly: Der neue Agent unterstützt 1-Minute Metriken sowie die neuen 1-Second high-resolution Metriken für CloudWatch. Weitere Informationen zum neuen CloudWatch Agent [hier](https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Install-CloudWatch-Agent.html). ## Amazon Linux 2 Amazons Basis Linux Distribution ist in Version 2 verfügbar. Einige der neuen Features sind: - Long-Term Support: Der Amazon Linux 2 LTS build bietet Security Updates, Bugfixes und API Kompatibilität für 5 Jahre und ist für alle Nutzer gedacht die über einen längeren Zeitraum auf der gleichen Linux Basis bleiben wollen. - Systemd: Als init System. - Wide Availability: Amazon Linux 2 ist in allen AWS Regionen als AMI, Docker Image oder Virtual Maschine Image verfügbar. Weitere Informationen zu Amazon Linux 2 [hier](https://aws.amazon.com/de/amazon-linux-2/). **Kategorien:** Infrastructure --- ### [Call for Papers: DigitalXchange "“ Bergisches RheinLand - 23. Juni 2018](https://thecattlecrew.net/2018/03/02/call-for-papers-digitalxchange-bergisches-rheinland-23-juni-2018/) **Published:** März 2, 2018 **Author:** Torsten Winterberg **Content:** **Innovation fördern „“ Netzwerke knüpfen „“ Transformation gestalten** Die Digitalisierung hat inzwischen alle wirtschaftlichen und gesellschaftlichen Facetten in Deutschland erfasst. Die Frage ist nicht mehr ob, sondern wie der digitale Wandel erfolgt. Wie können wir die Digitalisierung gestalten um vom getrieben zum Treiber des digitalen Wandels werden? Welche Chancen ergeben sich für die Wirtschaft und die Region? In Kooperation mit der TH-Köln, den Kreisen Rhein-Sieg, Rhein-Berg und Oberberg , der IHK-Köln, der REGIONALE 2025 Agentur GmbH und OPITZ CONSULTING laden wir am 23. Juni 2018 zum Digital Exchange „“ Bergisches RheinLand auf den Campus Gummersbach der TH-Köln ein. [www.digital-xchange.de](http://www.digital-xchange.de/) ![conf](https://thecattlecrew.net/wp-content/uploads/2018/03/conf.jpg) Unser Ziel ist es: - Politik, lokale Wirtschaft, lokale Interessensvertretungen und den Standort GM der TH-Köln zu vernetzen um Lösungen und Ansätze für die regionalen Herausforderungen der Digitalen-Transformation gemeinsam zu entwickeln und damit die nachhaltige Attraktivität des Wirtschaftsstandortes „Bergisches-RheinLand“ zu sichern. - Die Bündelung der verschiedenen Kompetenzen aus Politik, Wirtschaft, Forschung, IT und Produktion bietet die Chance voneinander zu lernen, miteinander die Digitalisierung zu meistern und damit gemeinsam erfolgreich zu sein. - Unternehmen und Organisationen bei der Steigerung ihrer Innovationsfähigkeit zu unterstützen. In ca. 70 Vorträgen, Keynotes und Diskussionsrunden laden wir zum Austausch ein. Eingeladen sind alle Studenten und Dozenten, Vertreter der lokalen Wirtschaft, Politik und Organisationen und alle die Interesse am Thema Digitalisierung in der Region Bergisches-RheinLand haben. Die Teilnahme ist kostenfrei. Wir möchten Sie/Dich einladen unser Programm zu bereichern. Wir freuen uns über Beiträge rund um die Themen Digitale-Transformation und Innovation von Studenten, Dozenten, Vertretern der Wirtschaft oder von Verbänden und anderen Organisationen. Im Detail suchen wir Einreichungen in den folgenden Themenkategorien: - Business: Digitalisierung als Treiber für Innovation und Geschäftsmodelle - Business: Veränderung der lokalen Wirtschaft durch die Digitalisierung - Methoden: New Work Patterns - Methoden: Auf dem Weg zur agilen Organisation - Methoden: Hubs, Labs, klassisch „“ modernes Innovationsmanagement - Tech: Cloud Computing - Tech: Moderne SW-Architekturen / Development - Tech: Machine Learning / KI - Tech: Industrie 4.0, IOT - Tech: Big Data / Analytics - Hands-On: Digitalisierung und IOT zum anfassen **Bis zum 16.03.2018 können Beiträge eingereicht werden!** Das Programmkomitee bestehend aus Vertretern der TH-Köln und OPITZ CONSULTING freut sich auf viele spannende Beiträge. Beitrag einreichen: Mehr Informationen zum DigitalXchange: [www.digital-xchange.de](http://www.digital-xchange.de/) Wir freuen uns auf einen spannenden Tag! **Kategorien:** Tech Events & Networking --- ### [Alexa, starte Hackathon!](https://thecattlecrew.net/2018/03/21/alexa-starte-hackathon/) **Published:** März 21, 2018 **Author:** Yuri Babich **Content:** ### Wir fanden die Idee toll, machten mit, fingen mit Ratlosigkeit an, hatten dann aber Spaß und ließen uns vom Alexa-Virus infizieren. Wir, das waren ein Dutzend Kollegen an den Standorten Bad Homburg und Stuttgart von OPITZ CONSULTING. Die Idee, einen Alexa-Hackathon im Rahmen unseres internen Community Day zu veranstalten, kam ursprünglich von Kollegen an anderen Standorten, die bereits Erfahrung mit der Alexa-Skill-Programmierung hatten. Im Rahmen des Hackathons wollten wir einen Baumarkt-Skill entwickeln. Während des Anmeldezeitraums wuchs unser Team allmählich, und als der Hackathon startete, kamen sogar noch ein paar Kollegen spontan dazu. Sehr schön! ![Alexa_Hackathon_OC_HG_20180223_092136_Wo_ist_Alexa__web.jpg](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_092136_wo_ist_alexa__web.jpg) Im Vorfeld des Hackathons einigten wir uns „“ in sicherem Halbwissen „“ darauf, gemeinsam mit Lambdas zu starten und generell komplett im Amazon-Technologiestack zu bleiben. Erst schlossen wir uns an die Konferenz mit den anderen Standorten an und richteten die Laptops auf den Tischen ein. ![Alexa_Hackathon_OC_HG_20180223_092141_Da_geht_es_los__web.jpg](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_092141_da_geht_es_los__web.jpg) Aufmerksam verfolgten wir die Präsentation unseres Kollegen Tomasz aus München … ![Alexa_Hackathon_OC_HG_20180223_093608_Wir_folgen_der_Live-Uebertragung__web.jpg](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_093608_wir_folgen_der_live-uebertragung__web.jpg) … aber nicht lange: Der Drang, loszulegen, veranlasste uns schon bald, uns den eigenen Bildschirmen zuzuwenden. Wir wollten eh nur die Lambdas. Doch da wir nur ungefähr wussten, was zu tun wäre, kam die Präsentation unseres Kollegen Marco aus Berlin dann noch gerade rechtzeitig. Jetzt hatten wir verstanden und wollten das Gezeigte so schnell wie möglich anwenden. ![Alexa_Hackathon_OC_HG_20180223_105712_Das_zweite_Team_versucht_verzweifelt_die_Umgebung_einzurichten_12pc.jpg](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_105712_das_zweite_team_versucht_verzweifelt_die_umgebung_einzurichten_12pc.jpg) Schnell zeigte sich, dass wir es doch noch nicht „drauf hatten“. Zwar hatten einige wenige von uns bereits etwas Erfahrung mit Alexa mitgebracht, das aber auf unterschiedlichen technischen Wegen. Die Einrichtung des Projekts fiel uns sehr schwer, es kamen Fehlermeldungen, die wir nicht verstanden, und die oft an fehlenden Berechtigungen lagen; hey, Marco, wie oft haben wir dich angerufen? Wir haben es nicht gezählt. Schnell bildeten sich Teilteams, die die unterschiedlichen Ansätze versuchen wollten: 1. *Stephan, Ralph und Yuri: Java in Eclipse mit AWS-Plugin + Developer Console* 2. *Andreas, Daniel, Anuja und zwei Michaels: Java mit Spring* 3. *Qianhao und Luka: Flask-Ask / Python* 4. *Felix und Sumit: AWS / JSON* Team 3 hat sich für Flask-Ask entschieden, und weil die Technologie bereits bekannt war, widmete es sich zunächst der Architektur und der Konzeption. ![Alexa_Hackathon_OC_HG_20180223_120050_Das_dritte_Team_startet_mit_Konzeption_und_Architektur__web](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_120050_das_dritte_team_startet_mit_konzeption_und_architektur__web.jpg?w=600) ![Alexa_Hackathon_OC_HG_20180223_155946_Team_drei_hat_einen_Plan__web](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_155946_team_drei_hat_einen_plan__web.jpg?w=600) Team 4 ging methodisch vor: Weil keiner wusste, wie man Alexa Skills entwickelt, wurden Online-Tutorials studiert. Mittlerweile „“ um das Mittagessen herum „“ verzeichneten Teams 1 und 2 den ersten Erfolg: die Entwicklungsumgebungen standen! ![Alexa_Hackathon_OC_HG_20180223_134057_Team_eins_kommt_voran__web.jpg](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_134057_team_eins_kommt_voran__web.jpg) ![Alexa_Hackathon_OC_HG_20180223_134033_Durchbruch_bei_Team_zwei__web](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_oc_hg_20180223_134033_durchbruch_bei_team_zwei__web.jpg?w=600) Ab jetzt ging es viel entspannter, wenngleich konzentriert weiter, endlich „hackten“ wir Alexa-Skills. ![Alexa_Hackathon_HG_Intents_12pc.jpg](https://thecattlecrew.net/wp-content/uploads/2018/03/alexa_hackathon_hg_intents_12pc.jpg) Ach ja, wir haben bereits verabredet, uns unsere Lösungswege beim nächsten lokalen Community Day gegenseitig vorzustellen. Wer weiß, vielleicht geht es dann weiter mit Alexa@OC-Südwest … P.S. Kollegen schreiben jetzt noch an einem weiteren Blog-Beitrag, der die Veranstaltung aus einer anderen Perspektive beleuchtet, über die Ergebnisse berichtet und das Geschehen an den anderen Standorten einbezieht. Schaut wieder vorbei! **Kategorien:** Tech Events & Networking --- ### [Manuelle Intervention](https://thecattlecrew.net/2018/04/04/manuelle-intervention/) **Published:** April 4, 2018 **Author:** Christoph Ortmann **Content:** Wie modelliere ich das Aussteuern eines Prozesses an einen Sachbearbeiter im Fehlerfall? Diese Frage stellte sich uns bereits in verschiedenen fachlichen Kontexten – immer dann, wenn die eigentlich automatisiert ablaufender Prozess aufgrund eines Fehlers nicht fortgeführt werden kann. Häufig werden Fehler danach unterschieden, ob sie fachlichen oder technischen Ursprungs sind. Ist zum Beispiel ein benötigtes System nicht verfügbar oder nicht erreichbar, können wir technisch sicherstellen, dass der fehlerhafte Aufruf zu einem späteren Zeitpunkt wiederholt wird. Doch was ist zu tun, wenn Daten unvollständig oder falsch eingegeben wurden? In diesem Fall besteht häufig der Wunsch, den Prozess an einen Mitarbeiter auszusteuern, um ein Nacherfassen der fehlenden Daten zu ermöglichen, ehe der Prozess fortgesetzt wird. ![manueller_eingriff](https://thecattlecrew.net/wp-content/uploads/2018/03/manueller_eingriff.png)Reaktion auf einen fachlichen Fehler in einem Service-Task In unserem Beispiel tritt beim Schreiben in ein Backend-System ein fachlicher Fehler auf, möglicherweise weil Daten zuvor fehlerhaft eingegeben wurden. Der Fehler wird über ein Error-Event bekannt gemacht. Die Process-Engine erstellt daraufhin einen Human Task und weist den Vorgang einem Sachbearbeiter zu. Dieser kann nun die Daten prüfen und gegebenenfalls korrigieren. War die Korrektur erfolgreich, kann der Aufruf mit den korrigierten Daten wiederholt werden. Das gezeigte Modell besteht aus zwei Pools, von denen der untere durch eine Process-Engine ausgeführt werden sollte. Der obere dient in erster Linie der Veranschaulichung, könnte aber auch einen Maskenfluss einer einer Anwendung, die zur Datenerfassung genutzt wird, beschreiben. Durch das Boundary Event an dem Service-Task machen wir deutlich, dass der ’normale‘ Prozessfluss den Task über die Kante zum End-Event verlässt und dass es sich bei der dargestellten Aussteuerung lediglich um eine Ausnahme handeln sollte. --- *Dieses und weitere Prozessmuster finden Sie auch auf unserem Poster [‚Erfolgreiche BPM-Pattern aus der Praxis‘](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_BPM-Pattern_A1_WEB.pdf)* **Kategorien:** Architecture & Process Models --- ### [Prozess-Synchronisation](https://thecattlecrew.net/2018/04/04/prozess-synchronisation/) **Published:** April 4, 2018 **Author:** Christoph Ortmann **Content:** Wie stelle ich als Prozessmodellierer sicher, dass bestimmte Prozessaktivitäten nur einmalig ausgeführt werden – auch dann, wenn für denselben Kunden mehrere Prozessinstanzen gestartet wurden? Diese Frage stellte sich uns bei der Modellierung eines Prozesses zur Abwicklung eines Telefonanbieterwechsels: Eine Bestandskundin möchte den Anbieter wechseln und dabei ihre Nummer mitnehmen. Sie lässt sich mehrere Angebote unterbreiten, was dazu führt, dass jeder potenzielle neue Anbieter die Kündigung des Vertrages und die Übergabe der Nummer anfragt. Wir müssen gewährleisten, dass die Nummer nur an einen Anbieter übertragen wird. Dazu stellen wir sicher, dass ein Prozessteil nur von einer Prozessinstanz zur Zeit (Korrelation über einen fachlichen Schlüssel, z.B. Kundennummer, Vertragsnummer) betreten wird. Die Process-Engine prüft dabei, ob für einen fachlichen Schlüssel eine weitere Instanz desselben Prozesses besteht. Ist das der Fall, wartet die Instanz darauf, dass die andere Instanz beendet wird oder einen Status erreicht, der eine Fortführung erlaubt. Nach Beendigung des zu synchronisierenden Teilprozesses prüft die Process-Engine, ob für den fachlichen Schlüssel eine weitere Instanz besteht, die auf die aktuelle Instanz wartet. In diesem Szenario wird die andere Instanz benachrichtigt, dass sie fortgesetzt werden kann. ![synchronisation_zwei_pools](https://thecattlecrew.net/wp-content/uploads/2018/03/synchronisation_zwei_pools.png)Beispiel einer Prozess-Synchronisation Das Bild zeigt exemplarisch, wie die Synchronisation modelliert werden kann. Wir haben eine Darstellung mit zwei Pools gewählt, um die Kommunikation zwischen den beiden Instanzen mithilfe eines Nachrichtenflusses verdeutlichen zu können. Ursprünglich waren wir aber von zwei Instanzen desselben Prozesses ausgegangen, die in derselben Process-Engine ablaufen. In unserem Beispiel wird die Benachrichtigung der wartenden Instanz durch einen Send-Task ausgedrückt. Hier hätte genauso gut ein Intermediate Throw-Event stehen können. Welche Möglichkeit wir wählen ist letztlich Geschmackssache: Unserer Meinung nach hat ein Send-Task hier den Vorteil, dass deutlich wird, dass hier eine Aktivität – nämlich die Benachrichtigung der wartenden Instanz – erfolgen muss. Im anderen Fall warten wir auf das Eintreten eines Ereignisses, nämlich das Eintreffen einer Nachricht. Alternativ zur Nachricht hätten wir auch ein Signal nutzen können. Dies hätte zum gleichen Ergebnis geführt, allerdings mit einer leicht veränderten Sematik: Die Nachricht stellt eine gerichtete Kommunikation dar, das heißt, der Sender muss entscheiden, wem er die Nachricht schickt. Das Signal hingegen stellt eine ungerichtete Kommunikation dar. In diesem Fall ist es Aufgabe des Empfängers, zu entscheiden, ob das Signal relevant ist, die Prozessinstanz also weiterlaufen darf oder nicht. --- *Dieses und weitere Prozessmuster finden Sie auch auf unserem Poster [‚Erfolgreiche BPM-Pattern aus der Praxis‘](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_BPM-Pattern_A1_WEB.pdf)* **Kategorien:** Architecture & Process Models --- ### [Dynamische Genehmigung](https://thecattlecrew.net/2018/04/06/dynamische-genehmigung/) **Published:** April 6, 2018 **Author:** Christoph Ortmann **Content:** Wie modelliere ich eine Situation, in der Entscheidungen durch verschiedene Personen geprüft werden sollen? Das Thema Vier-Augen-Prinzip kennen sicher viele, die sich hin und wieder mit Prozessmodellierung beschäftigen: Als Bank möchte ich beispielsweise sicherstellen, dass die Kreditentscheidung eines Mitarbeiters von einer Kollegin geprüft und diese Prüfung dokumentiert wird. Ähnliche Anforderungen begegnen uns, wenn in einer Versicherung eine Risikoentscheidung getroffen werden soll. ![vier_augen_prinzip](https://thecattlecrew.net/wp-content/uploads/2018/04/vier_augen_prinzip.png)Genemigung mit zwei Genehmigern Ein einfacher Weg, diese Situation zu modellieren, ist die Nutzung eines Human Task für jeden Genehmigungsschritt: Die Process-Engine erstellt einen Human Task und weist den Fall einem Genehmiger zu. Dieser prüft den Fall und dokumentiert seine Entscheidung. Ist die Anfrage genehmigt, wird der Fall über einen Human Task einem weiteren Genehmiger vorgelegt, anderenfalls endet der Prozess. Der zweite Genehmiger prüft nun den Fall und dokumentiert seine Entscheidung. Hat auch er genehmigt, gilt die Anfrage als genehmigt, sonst ist der Fall abgelehnt. Doch was tun, wenn fallweise weitere Genehmiger hinzukommen sollen, beispielsweise weil ab einer gewissen Auftragshöhe der Fall einem Abteilungsleiter oder einer Geschäftsführerin vorgelegt werden soll? Wir könnten unser Modell um weitere Human Tasks und Gateways, die die Entscheidung abbilden, erweitern. je nach Komplexität kann das aber sehr schnell sehr unübersichtlich werden. Einfacher ist es, diese Dynamik bereits im Prozessmodell zu berücksichtigen. ![dynamische_genehmigung](https://thecattlecrew.net/wp-content/uploads/2018/04/dynamische_genehmigung.png)Dynamische Genehmigung mit Rule-Task und Mehrfach-Instanzen In unserem Beispiel wird anhand eines Regelwerks für den vorliegenden Fall eine Liste von Genehmigern ermittelt. Damit verstecken wir die Details der Entscheidung vor dem Betrachter unseres Prozessmodells. Die Modelierung und Auswertung der Regeln erfolgt gesondert, zum Beispiel mithilfe der DMN. Für jeden Eintrag der so ermittelten Liste wird sequentiell ein Human Task erzeugt und einem Genehmiger zugewiesen. Sobald ein Genehmiger die Anfrage ablehnt, gilt der Fall insgesamt als abgelehnt, es werden somit keine weiteren Human Tasks mehr erzeugt. Das Beispiel kann noch flexibler gestaltet werden, indem die Genehmiger parallel anstatt sequentiell benachrichtigt werden. Die BPMN bietet zudem die Möglichkeit, eine Bedingung für die Beendigung einer Mehrfach-Ausführung zu formulieren. Damit könnten wir beschreiben, dass der Fall per Mehrheitsbeschluss genehmigt ist, sobald zwei von drei Genehmigungen vorliegen. Alternativ könnten wir ein Regel-Set definieren, um nach Erhalt aller Rückmeldungen über die Fallgenehmigung zu entscheiden, beispielsweise um einzelnen Stimmen mehr Gewicht zu verleihen. --- *Dieses und weitere Prozessmuster finden Sie auch auf unserem Poster [‚Erfolgreiche BPM-Pattern aus der Praxis‘](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/OC-Poster_BPM-Pattern_A1_WEB.pdf)* **Kategorien:** Architecture & Process Models --- ### [Oracle Security Reporting Tool - DBSAT](https://thecattlecrew.net/2018/04/19/oracle-security-reporting-tool-dbsat/) **Published:** April 19, 2018 **Author:** Simon Hahn **Content:** Hallo Community, aus gegebenen Anlass möchte ich ein paar Worte über Oracle DBSAT – Database Security Assessment Tool verlieren. Ein kleines, kostenloses aber sehr mächtiges Security Reporting Tool für Oracle Datenbanken. Wir hatten die Möglichkeit das Tool auf der Inspire IT in Frankfurt einigen Kunden vorzustellen. Sowohl die Verprobung des Tools an sich wie auch die Veranstaltung hat uns sehr viel Spaß bereitet. Grundsätzlich ist das nichts Neues „“ Security und Datenschutz sind wichtig und auch teuer, sollten dennoch immer im Unternehmen gelebt werden. Spätestens dann, wenn Firmendaten im Internet für jeden ungewollt einsehbar sind, wurde etwas gänzlich falsch gemacht und nicht selten wird das Unternehmen einen riesigen Imageschaden über Jahre hinweg davontragen. –> Security und Datenschutz nicht ernst zu nehmen, kann demnach sehr, sehr nachhaltig und gnadenlos sein. Daher lieber vorsorgen. 🙂 Im Zuge der neuen EU-weiten Datenschutzverordnungen (GDPR und DSGVO) zum Stichtag 25.5.2018 sollten Datenbanken entsprechend vielleicht doch noch mal überprüft und sicherer gemacht werden. Und genau da kommt DBSAT ins Spiel: Es gibt immer wieder kleine hilfreiche, kostenlose Tools, die das Leben eines DBA für Oracle Datenbanken einfacher machen und dies gehört wie auch schon OraChk definitiv in diese Liste. Als langjähriger Admin weiß ich, dass einem Schema oftmals „sysdba“ Rechte herausgegeben werden, „um mal eben kurz etwas in der DB mit Admin Rechten zu machen“, was leider aber auch genauso häufig und schnell wieder vergessen wird. Das darf nicht sein! Regelmäßiges Reporting zeigt unter anderem solche Schwachstellen und kann alarmierend und vorsorglich helfen. Ein kleiner DBSAT Daemon, der zum Beispiel wöchentlich oder täglich gescheduled und regelmäßige Security Reports in unterschiedliche Formate HTML, JSON, XLS zieht, wirkt wahre Wunder. Obendrauf gibt es noch für den DBA über das HTML Format noch diverse „Best Practice“ Anweisungen für eine sichere Datenbank. DBSAT unterscheidet sich im Prinzip in drei Kategorieren: Collector – führt die SQL- und OS-Kommandos aus – schreibt die gesammelten Daten in eine Json-Datei Reporter – analysiert die gesammelten Daten – generiert einen DBSAT-Report in HTML, Excel und Text-Format und packt diese in ein verschlüsseltes Zip-File Discoverer – durchsucht das Datemodell nach Datenschutz- und Sicherheits-relevanten Spalten – führt SQL-Abfragen aus und sammelt Daten basierend auf Config-Files – generiert einen „Sensitive Data“ Report im HTML- und CSV-Format Format und packt diese in ein verschlüsseltes Zip-File. Je nach Anwendungsfall bleiben dem Anwender mehrere Einsatzmöglichkeiten, wenn der Security-Bericht noch genauer und spezieller erzeugt werden soll. Anwendungsbeispiel: ![dbsat1](https://thecattlecrew.net/wp-content/uploads/2018/04/dbsat11.png) Daten sammeln: ![dbsat3](https://thecattlecrew.net/wp-content/uploads/2018/04/dbsat31.png) Erstellung des Reports: ![dbsat2](https://thecattlecrew.net/wp-content/uploads/2018/04/dbsat2.png) ![dbsat_neu](https://thecattlecrew.net/wp-content/uploads/2018/04/dbsat_neu.png) HTML Ergebnis des Security Berichtes: ![dbsat_erg1](https://thecattlecrew.net/wp-content/uploads/2018/04/dbsat_erg1.png) ![dbsat_erg2](https://thecattlecrew.net/wp-content/uploads/2018/04/dbsat_erg2.png) Was überprüft DBSAT? Auf der Agenda stehen natürlich die einhergehenden Benutzerkonten, Berechtigungen und Rollen plus deren Berechtigungsteuerung, wie auch Datenverschlüsselung, Zugriffssteuerung und Audit-Richtlinien. Datenbank, Listenener-Konfiguration, Dateiberechtigungen und sensitive Daten werden ebenso überprüft. Durch einfache Installation, also Herunterladen, Entpacken und Ausführen des Kommandozeilen Tools kann kurzerhand ein Security Report ohne große Vorkenntnisse erstellt werden. Es ist anzuraten, diese Reports „secure“ und gesondert auf einem Server bzw. in einer DB aufzubewahren, da es sich um sicherheitsrelevante Daten handelt. Da eine Ausgabe im JSON-Format super weiterverarbeitet werden kann, leite ich dieses in Kibana/Splunk oder gar Spark Graphx weiter, um angepasste Graphen zu basteln. Muss man nicht, aber alleine die Option, andere Tools über JSON mit anzubinden, finde ich sehr löblich. DBSAT kann ab 10g bis 18c Oracle DB’s eingesetzt werden, dabei kann es sich um ein 64-Bit Linux, Solaris, AIX, HPUX oder Windows handeln. Benötigt werden Python ab 2.6 (Collector+Reporter) bzw. Java ab 1.6 (Discoverer). Ein kurzer Screenshot zeigt die Vorgehensweise unter Linux. Dies kann sowohl als System Benutzer ausgeführt werden als auch als expliziter DBSAT Benutzer innerhalb der Oracle Datenbank. Dann müssen aber minimale Rechte je nach Version an das DBSAT Schema gegeben werden. CREATE SESSION \* SELECT on SYS.REGISTRY$HISTORY Role SELECT\_CATALOG\_ROLE \* Role DV\_SECANALYST \* (if Database Vault is enabled) Role AUDIT\_VIEWER (12c and later) Role CAPTURE\_ADMIN (12c and later) SELECT on SYS.DBA\_USERS\_WITH\_DEFPWD (11g and later) SELECT on AUDSYS.AUD$UNIFIED (12c and later) (\*: ausreichend für den Discoverer) Zusammengefasst hat DBSAT den Nutzen: – Sensible Daten in der Datenbank zu finden und vor Dritten zu schützen, wenn resultierende Maßnahmen durch DBA ergriffen werden – Identifizieren von Risiken durch Fehlkonfigurationen – Datenbankbenutzer und deren Berechtigungen hinterfragen – Empfehlungen von Sicherheitsmaßnahmen zur Unterstützung von Compliance-Anforderungen Apropos: nochmals vielen Dank an Oracle, dass die Deutsche Sprachdatei „sensitive\_de.ini“ für den Discoverer, welche aktuell noch nicht in Version 2.0.1 enthalten war, uns bei OPITZ CONSULTING noch rechtzeitig vor der Konferenz erreichte. DBSAT ist natürlich wie sein Vorgänger für Oracle-Kunden kostenfrei. Jeder Kunde mit einem aktiven Supportvertrag kann dieses Werkzeug unter Oracle Support Document 2138254.1 beziehen. Noch ein paar abschließende Links: - Overview http://www.oracle.com/technetwork/database/security/dbsat/overview/index.html - Youtube (Feature des Monats) https://www.youtube.com/watch?v=-dIIWOqvUSk&feature=youtu.be - Allgemeiner Einstieg in die Härtung von Oracle-Datenbanken: http://www.oracle.com/us/products/database/securing-oracle-database-primer-2522965.pdf Hier noch mal der Hinweis: EU-Datenschutz-Grundverordnung (EU-DSGVO) verabschiedet! Die EU-Datenschutz-Grundverordnung (EU-DSGVO) ist am 14. April 2016 durch das EU-Parlament beschlossen worden. Sie ist am 04.05.2016 im Amtsblatt der Europäischen Union veröffentlicht worden und tritt damit am 25.05.2016 in Kraft. Anwendbar ist sie damit ab dem 25. Mai 2018. **Kategorien:** IT-Security **Schlagwörter:** datenbank, dbsat, reporting --- ### [Deep Learning Workshop am 08.05.2018 an der TH Köln in Gummersbach](https://thecattlecrew.net/2018/05/03/deep-learning-workshop-am-08-05-2018-an-der-th-koeln-in-gummersbach/) **Published:** Mai 3, 2018 **Author:** philippleinius **Content:** Im Rahmen der Wahlpflichtveranstaltung „Berufspraxis Informatik“ an der TH Köln führt OPITZ CONSULTING einen Deep Learning Workshop durch. Neben einer kurzen Einführung in Deep Learning probieren wir praktische Codebeispiele mit Deeplearning4j aus.Wir werden den Computer darauf trainieren, Hochlandrinder von Hunden zu unterscheiden. Die Veranstaltung „Berufspraxis Informatik“ bietet Informatik-Studenten einen qualifizierten Einblick in typische Berufsfelder für Informatiker und hilft dabei, Kontakte zu Unternehmen herzustellen (insbesondere für Projekte, Abschlussarbeiten, spätere Berufstätigkeit). Studenten die sich für Deep & Machine Learning interessieren sind genauso herzlich eingeladen, wie Studenten, die etwas über den Arbeitsalltag bei OPITZ CONSULTING erfahren möchten. Die Veranstaltung findet am 8. Mai um 15 Uhr in Raum 3104 statt. Wir freuen uns, euch das spannende Thema Deep Learning vorzustellen! Falls ihr teilnehmen möchtet und die Veranstaltung „Berufspraxis Informatik“ dieses Semester nicht belegt habt, schreibt bitte kurz eine Mail an damit wir die Teilnehmerzahl für die PC Arbeitsplätze planen und euch ggf. Updates zum Raum senden können. **Kategorien:** Tech Events & Networking --- ### [AWS News KW 15 und KW 16](https://thecattlecrew.net/2018/06/20/aws-news-kw-15-und-kw-16/) **Published:** Juni 20, 2018 **Author:** Marco Buss **Content:** ## AWS AppSync verlässt Preview Status AWS AppSync ist ein AWS Dienst für Datengetriebene iOS, Android, JavaScript und React Apps. Es bietet Unterstützung für Real-Time Updates und offline Funktionalität und basiert auf [GraphQL](https://graphql.org/). Ab sofort ist der Dienst „generally Available“ mit folgenden neuen Features. - **Konsolen Zugriff:** Zugriff auf CloudWatch aus der AppSync Console heraus - **Testen mit Mock-Daten:** Möglichkeit für Tests mit Mock-Daten aus der AppSync Console heraus - **Subscription Resolvers:** Nutzung von Resolvern für AppSync Subscriptions - **Batch GraphQL Operations für DynamoDB:** Nutzung der DynamoDB Batch Operationen über mehrere Tabellen - **CloudWatch Unterstützung:** Support für CloudWatch Metriken und Logs für AppSync Api Aufrufe - **CloudFormation Support:** Definieren von Schemas, Data Sources, und Resolvern mit CloudFormation Templates. Weitere Informationen zu AWS AppSync [hier](https://aws.amazon.com/appsync/). ## AWS Blockchain Template Mit AWS Blockchain Templates bietet AWS die Möglichkeit schnell und einfach ein [Ethereum](https://www.ethereum.org/) oder eine [Hyperledger Fabric](https://www.hyperledger.org/projects/fabric) Netzwerk aufzubauen. Es gibt zum einen die Möglichkeit das Netzwerk in einem ECS Cluster oder auf mehreren EC2 Instanzen zu betreiben. Weitere Informationen zu AWS Blockchain Templates [hier](https://aws.amazon.com/de/blockchain/templates/). **Kategorien:** Infrastructure --- ### [Coding Dojo am 05.07.2018 an der TH Köln in Gummersbach](https://thecattlecrew.net/2018/06/20/coding-dojo-am-05-07-2018/) **Published:** Juni 20, 2018 **Author:** Christian Olsson **Content:** ![Programmierabend_20180705_blog](https://thecattlecrew.net/wp-content/uploads/2018/06/programmierabend_20180705_blog1.png) Wir laden wieder ein zum Coding Dojo an der TH Köln am Campus Gummersbach. Dieses Mal führen wir mit Euch einen kurzen Code Retreat durch. Dabei geht es darum in mehreren Iterationen unter verschiedenen Einschränkungen anhand einer leichten Aufgabe die eigenen Fähigkeiten zu verbessern. Wir beginnen um 18 Uhr in Raum 0.503 im Neubau, dauern wird der Abend zwei bis drei Stunden. Für das leibliche Wohl ist selbstverständlich gesorgt. Bei Interesse meldet euch bitte per E-Mail an: **Kategorien:** Tech Events & Networking **Schlagwörter:** Coding Dojo --- ### [Mein Erfahrungsbericht als "Geek" im OC|Lab](https://thecattlecrew.net/2018/06/26/mein-erfahrungsbericht-als-geek-im-oclab/) **Published:** Juni 26, 2018 **Author:** Christian Ochsenkühn **Content:** Ein Jahr „Geek-Zeit“ im OC|Lab liegen hinter mir. Was das eigentlich ist, was ich in dieser Zeit alles erlebt habe und warum das eine großartige Möglichkeit ist, dich in einem Spezialthema zu etablieren, das erfährst du in diesem Beitrag. ## Geeks gesucht für Innovationsprogramm Dein Smartphone ist mehr als nur ein Telefon? Du entwickelst gerne innovative Lösungen? Du hast Interesse, selbst Artikel und Blogeinträge zu publizieren und deine Themen auf Konferenzen zu präsentieren? Diese und noch einige weitere Fragen aus der [Stellenanzeige für das Innovationsprogramm](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/karriere-geeks-gesucht-fuer-innovationsprogramm.pdf) haben bei mir genau ins Schwarze getroffen. Digitalisierung, Moderne Clients und Lean-Startup-Ansätze? Japp, japp, japp, das klingt doch top! Also direkt eine Bewerbung geschrieben. Alles geklappt. Und ein paar Wochen später ging es auch schon los. ## First Day, first project An meinem ersten Tag fuhr ich für mein Onboarding nach München, wo mich die Office Managerin Uli gleich freudig in Empfang nahm und mir allerhand Infos, meinen Laptop und das Diensthandy überreichte. Als ich dann meinen Laptop einrichtete, stellte ich fest, dass ich in 30 Minuten gleich meinen ersten Termin hatte: eine Telefonkonferenz. Alles klar, dann brauchte ich nur noch ein Telefon und musste herausfinden, wie ich an der Konferenz teilnehmen kann. Auf Grund der netten Kollegen vor Ort war das natürlich kein Problem. Eine knappe Stunde später hatte ich dann **bereits mein erstes Projekt**. Hui, das geht ja schnell hier. In drei Wochen sei ein Workshop bei einem Kunden in Berlin, wo ich einen Teil dieses Workshops halten sollte. Nachdem ich mich in diesen Wochen unter anderem auf meinen Teil vorbereitet hatte, fuhr ich also mit der Bahn von Nürnberg nach Berlin, hielt am nächsten Tag meinen Part und flog direkt im Anschluss wieder nach München. Denn ich konnte ja die Weihnachtsfeier nicht verpassen. 😉 ## Erstens kommt es anders… In diesen ersten drei Wochen habe ich mich aber zudem auf die Suche nach einem Spezialthema für mich gemacht, in dem ich mich vertiefen und zum „Leuchtturm“ werden wollte. Vielleicht [Smart Apps](https://www.mendix.com/smart-apps/) mit Machine Learning und Predictive Analytics? Ich setzte also das Android Studio auf und probierte einiges aus. Künstliche Intelligenz passt da natürlich auch super dazu. Und alles zusammen… Chatbots! Das ist es. Da wollte ich hin. Aber wie es das Schicksal so wollte, brauchte einer unsere Kunden für einen Monat Unterstützung in einem Angular-Projekt, um den Release-Termin einhalten zu können. Da ich bereits Erfahrung mit dem Framework [Angular](https://angular.io/) hatte, setzte ich meine Geek-Zeit also vorübergehend aus und unterstützte das Kundenprojekt. ## „¦ und zweitens als man denkt Aus dem einen Monat wurden schnell zwei und dann hieß es eine Entscheidung zu treffen. Einerseits wollte der Kunde mich für die nächste Phase des Projekts behalten und mir machtes es dort auch riesig Spaß (tolle Kollegen, Scrum, interessante Technologien und einen Kickertisch). Andererseits wollte ich aber auch nicht die Möglichkeiten aufgeben, die *das Geek sein* und das OC|Lab boten. Was also tun? Flexibel wie wir bei Opitz sind, haben wir einen **passenden Kompromiss** gefunden: vier Tage im Projekt beim Kunden und einen Tag Zeit für das Lab. So sahen dann also die Wochen des letzten Jahres für mich aus – meine Geek-Zeit war auf ca. ein Jahr festgelegt. An meinem Lab-Tag beschäftigte ich mich anfangs noch mit Chatbots allgemein, spezialisierte mich dann aber zusehends auf [Voice UIs](https://en.wikipedia.org/wiki/Voice_user_interface) bzw. Amazons Sprachassistentin [**Alexa**](https://developer.amazon.com/de/alexa). ## Mein Lab-Tag: Alexa, Konferenzen, Artikel und mehr In diesem Jahr konnte ich wirklich haufenweise spannender Erfahrungen machen. Ein paar davon möchte ich mit euch teilen. Nachdem ich zusammen mit meinem Kollegen [Tomasz Krajewski](https://thecattlecrew.net/author/tjkrajewski/) unseren ersten [Alexa Skill für Opitz](https://thecattlecrew.net/2017/05/05/alexa-frag-opitz-entwicklung-eines-alexa-skills/) veröffentlichte, schrieb ich immer wieder **Artikel über Voice und Alexa**: - zum Beispiel bei Jaxenter über „[3 Zutaten für glückliche Chatbots: Usability-Rezept für Amazon Alexa, Google Home, Apple Siri & Co](https://jaxenter.de/chatbot-alexa-google-home-siri-54265)„, - im [Red Stack Magazin 6/2017](https://www.doag.org/de/mitmachen/zeitschriften/): „Mit Chatbots und Voice zum flexiblen, Kontext-unterstützenden Arbeiten in der digitalen Welt“ - und [diverse Artikel hier](https://thecattlecrew.net/author/chrisyeah/) im Blog. Daneben konnte ich auf den verschiedensten **Konferenzen** neue Leute kennenlernen, mein Wissen erweitern und mich weiterentwickeln. So war ich beispielsweise auf der [*Chatbot Conf*](https://orat.io/chatbotconf) in Wien (einen [Erfahrungsbericht gibt es hier](https://thecattlecrew.net/2017/10/13/chatbotconf-2017-chatbots-startups-und-walzer/)), habe Vorträge auf der [*DOAG*](https://2018.doag.org/de/home) und innerhalb der [*Webweek*](http://nm.webday.io/index.php?page=past&number=11) Nürnberg gehalten, hatte einen Stand zu Alexa auf unserer Best-Practices-Konferenz [*inspire|IT*](https://inspire-it.de/), und habe unseren Stand auf der [*OOP*](https://www.oop-konferenz.de/) in München mit betreut. Außerdem folgten in diesem Jahr noch weitere Vorträge, Hackathons, Workshops, Meetups und Projekte **rund um Alexa**. Und, und, und (bestimmt habe ich noch einige Highlights vergessen, die mir gerade nicht einfallen). **Da bleibt mir nur noch zu sagen: was für ein Geek-Jahr. 😉** ###### Titelbild Quelle: [Unsplash](https://unsplash.com/photos/Ra8x8H7GToE), Lizenz: cc0 **Kategorien:** Tech Events & Networking **Schlagwörter:** Alexa, Erfahrungsbericht, Geek, MeinLieblingsJob, OC|Lab --- ### [Co-Creation in Workshops - anstrengend, aber ergebnisreich](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/) **Published:** Juli 12, 2018 **Author:** Verena Scheller **Content:** Unser Workshop = ein anstrengendes Workout … warum nur? Am 2./3. März verbrachten wir zwei intensive Workshoptage in [Nochen: ](http://www.opitz-consulting.com/ueber-uns/denkfabrik-im-gruenen.html)Ein Teil der OC Community (in Summe 17 Personen) entwickelte Workshopkonzepte und Ideen rund um die Themen Innovation & Digitalisierung, New IT & IT Strategy sowie (Digital) Change. Am Freitag Abend waren wir „“ was die Gesamtsumme der Endergebnisse anging „“ eigentlich sehr zufrieden. [![](https://thecattlecrew.net/wp-content/uploads/2017/03/img_04571-150x150.jpg)](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/img_04571/) [![](https://thecattlecrew.net/wp-content/uploads/2017/03/img_04581-150x150.jpg)](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/img_04581/) [![](https://thecattlecrew.net/wp-content/uploads/2017/03/img_04591-150x150.jpg)](https://thecattlecrew.net/2018/07/12/co-creation-in-workshops-anstrengend-aber-ergebnisreich/img_04591/) Eigentlich. Denn die beiden Workshoptage waren harte Arbeit, unsere Diskussionen waren zum Teil kontrovers-verwirrend-intensiv und auch kräftezehrend. Wir hatten Spaß beim Arbeiten, keine Frage! Doch manche hatten das Gefühl, dass wir zwischendurch unseren roten Faden verloren hätten, dass wir unsere Ergebnisse als Gruppe homogener und effizienter hätten erarbeiten können. Irgendwie blieb der Eindruck von einem „echt anstrengenden Entscheidungsfindungsprozess“ hängen – trotz dem konstruktivem Workshopklima, dem positiven Miteinander und dem guten Gesamtergebnis. In den letzten Tagen habe ich gegrübelt, woran das liegen könnte“¦ Waren die Workshop-Vorbereitungen nicht gut genug? Hätten wir inhaltlich vorarbeiten müssen, um schneller und effizienter in der großen Gruppe entscheiden zu können? Oder hätten wir uns weniger Themen vornehmen sollen? War der Teilnehmerkreis zu groß oder nicht gut ausgewählt? Hätten wir die Moderation straffer durchziehen müssen, mehr auf die Einhaltung von durchgängiger Anwesenheit und Timeboxes achten müssen? Hätten wir bei der Moderation stärker „Gleichschritt und ähnliches Gedankentempo“ forcieren müssen? Erkenntnis #1: Co-Creation in Reinform Beim Blick zurück auf dem Teilnehmerkreis fiel mir auf, dass wir an beiden Workshoptagen sehr crossfunktional-interdisziplinär aufgestellt waren. Fast idealtypisch: Vom Geschäftsführer über das mittlere Management und (Senior) Beratern bis zum (Noch)Studenten waren nahezu alle Hierarchiestufen unseres Unternehmens vertreten. Beteiligt waren Mitarbeiter aus dem Consulting (Architekten, Developer, Strategieberater und Change Facilitatoren), Marketing, Sales, Business Development und das Kompetenzmanagement. Also so, wie es Workshopgurus und Facilitatoren so oft predigen: Diese vielfältigen und zum Teil auch kontroversen Ideen und Meinungen unter einen Hut zu bringen, um in definierten Zeitboxen gute Ergebnisse zu erzielen, ist – ganz simpel – HARTE TEAMARBEIT. Alles gut also! Erkenntnis #2: „groan zone“ ist wertvoll Noch klarer wurde diese Gefühl der Erkenntnis, als ich vorgestern – einmal mehr – durch Sam Kaners Buch „[Facilitator’s Guide to Participatory Decision-Making](https://www.amazon.de/Facilitators-Participatory-Decision-Making-Jossey-Bass-Management/dp/1118404955)“ (ein Facilitator-Klassiker aus dem Jahr 2007) blätterte. Der dort erläuterte „Diamond of Participatory Decision-Making“ beschreibt genau diese „groan zone“, die wir gemeinsam in diesen beiden Workshoptagen (mehrmals) durchlaufen haben: Nach der Phase des „divergent thinking“ – hier werden Ideen frei gesammelt, die Diskussion öffnet sich, verschiedene Sichtweisen treffen aufeinander – folgt die „groan zone“ (der mühsame Wendepunkt), ehe die Workshopgruppe über das „convergent thinking“ – zur Entscheidungsfindung kommt. Und genau diese „groan zone emotions“ haben wir an beiden Workshoptagen, bei der Erarbeitung der einzelnen Themen, durchlebt: „when a discussion loses focus or becomes confusing, it can appear to many people that the process is heading out of control. Yet this is not necessarily what’s really going on. Sometimes what appears to be chaos is actually a prelude to creativity.“ Ein bekanntes Prinzip aus dem Team Facilitation, aus dem Design Thinking, aus dem Coaching … und es lohnt sich immer wieder, sich als Moderator dieses Prinzip in Erinnerung zu rufen. Grübelei zu Ende. **Kategorien:** Tools & Methoden --- ### [Homogene Spring Cloud Microservices: Sichere Microservices mit OAuth2 und das Zuul Api Gateway Dilemma.](https://thecattlecrew.net/2018/09/27/homogene-spring-cloud-microservices-sichere-microservices-mit-oauth2-und-das-zuul-api-gateway-dilemma/) **Published:** September 27, 2018 **Author:** pascalstieber **Content:** Hoch verfügbar, strapazierfähig, robust und hoch skalierbar sind großartige Eigenschaften einer modernen Software Architektur. Spring Boot ist das Framework der Wahl für Microservice Architekturen. Angereichert mit dem Spring Cloud Stack (zu großen Teilen Netflix OSS) ergibt sich unter Berücksichtigung einiger Spielregeln eine homogene Microservice Architektur. Das Thema „Sicherheit“ in verteilten Systemen wird erfahrungsgemäß selbst in behördlichen Einrichtungen häufig vernachlässigt. Seit Spring Boot 2 wird dem Nutzer das Thema jedoch etwas deutlicher präsentiert: Spring Security ist ab sofort per default aktiviert, sodass sich der versierte Spring Entwickler von nun an Gedanken über Sicherheit machen muss. Weiterhin können URL Redirects, wie sie z.B. bei dem Protokoll OAuth2 vorkommen, in virtualisierten Umgebungen zu Problemen führen. Dieser Artikel wirkt einigen Pitfalls entgegen und zeigt die Korrekte Konfiguration für eine auf Spring Cloud basierende Microservices Applikation. Grundkenntnisse in Spring Cloud Applikationen werden vorausgesetzt. # Architektur der Gesamtapplikation Als Grundlage nehmen wir folgendes simples Architekturschaubild: ![microservice_architektur_schaubild](https://thecattlecrew.net/wp-content/uploads/2023/09/microservice_architektur_schaubild.png) Weiterhin werden folgende Annahmen getroffen: - In diesem Fall, laufen alle Services (Client, Zuul, Eureka, OAuth2) in einem eigenen Docker Container. - Alle Docker Container befinden sich im gleichen Netzwerk. - Die Host IpAdresse lautet: 192.168.99.101 - Der Zuul Service lauscht auf dem Port 9999. Damit die Applikationen in virtualisierten Umgebungen laufen und Zuul die korrekten IpAdressen verwendet, sind diverse Konfigurationen an den Services über die Property-Dateien nötig. # Autokonfiguration mittels **Eureka Service Discovery** Die gute Nachricht zuerst: Zuul als API Gateway lässt sich mit einer Dependency zu spring-cloud-starter-netflix-eureka-client und einer @EnableDiscoveryClient Annotation automatisch „vor-„konfigurieren. Zuul holt sich die Informationen von dem Eureka Service und legt automatisch die Routen zu dem Namen des Services an. Ein Get-Request auf den routes\[1\] Endpoint des Zuul Services sollte dann etwa folgendes Ergebnis für den Client Service liefern: { „/client/\*\*“: „id“: „client“, „fullPath“: „/client/\*\*“, „location“: „client“, „path“: „/client/\*\*“, „retryable“: false, „customSensitiveHeaders“: false, „prefixStripped“: true },“¦ Das Problem bei der automatisch erzeugten Route ist allerdings schnell nach einem Test der Applikation ersichtlich. # **strip-prefix**-Attribute: Zuul schneidet den Präfix der angeforderten Resource nach einem Redirect weg. Bspw.: wird aus einer URL (bzw. der URI /client/login) die URL (respektive der URI /login) angefordert. Zuul erkennt ohne den Präfix „/client“ nicht mehr, um welchen Service es sich ursprünglich gehandelt hat. Dazu ist die von Eureka ermittelte Route mit einer Property zu überschreiben. In der application.yml des Zuul Services ist lediglich folgender Eintrag nötig: zuul: routes: client: service-id: client strip-prefix: false Damit wird die Konfiguration des Service „client“ mit dem Attribut strip-prefix: false (default ist true) überschrieben. Weiterhin ist es nötig die Property server.servlet.contextPath in der application.yml des Client Service auf den Wert /client zu ändern. Dies zwingt jeden request ein /client voranzustellen. Wir nutzen diese Konvention um die Weiterleitung durch den Zuul Service auf den Client Service zu gewährleisten. Da jeder request ein /client vorangestellt hat, „šmatched“˜ es mit der routing Konfiguration die wir weiter oben in dem Abschnitt „Autokonfiguration mittels Eureka Service Discovery:“ durch Eureka vorkonfiguriert bekommen haben. *Anmerkung:* Evtl. Ist es in bestehenden Anwendung nicht möglich den contextPath zu ändern oder einfach schlichtweg nicht gewünscht. Man kann die Route auch feingranularer Konfigurieren, jedoch möchte ich mir dies mittels Konvention ersparen. (Stichwort: Convention over Konfiguration) # **sensitive-headers** Attribute Der Zuul Service in seiner default Konfiguration gibt empfindliche Informationen wie Cookies und Authorisierungsheader nicht an den angefragten Service weiter, sodass diese bei der Authentifizierung beim angefragten Authorisierungs-Service fehlen. Für unser Szenario erweitern wir die Zuul Konfiguration für alle Routen mit dem Attribut SensitiveHeader mit einem leeren Wert, sodass alle Informationen an den Downstream weitergegeben werden. Unsere Konfiguration sieht in etwa wie folgt aus: zuul: sensitive-headers: routes: client: service-id: client strip-prefix: false *Anmerkung:* Auch hier kann kann es sinnvoll sein das Attribute auf dem Level einer bestimmten Route eines Services zu konfigurieren. Statt auf dem Root Level der Zuul Konfiguration würden die Header Informationen nur für einen oder mehrere bestimmte Services weitergereicht werden. # **add-host-header** Attribute Ist eine OAuth2 Dependency im Classpath vorhanden und es wird eine Resource requested, die nicht auf einer Whitelist\[2\] steht, wird automatisch ein redirect auf den Endpoint /login abgesetzt. Zuul würde in den Standardkonfiguration versuchen, den Request auf die Ip-Adresse des Hosts abzusetzen. Im Falle von Container Virtualisierungslösung (Docker) oder Cloud Infrastrukturen (Aws, Azure) würde man eine Timout-Exception erwarten dürfen. Sieht man sich den angefragten Request Header des /login Endpoints einmal an sieht man in dem Attribut Location die IpAdresse (Bspw: 172.0.0.8) der Container Instanz. Diese ist meist nur in dem eigenen virtuellen Netzwerk erreichbar und nicht von außerhalb bzw. dem Browser. Um eine Weiterleitung an den Service gewährleisten zu können, benötigt man die Host Adresse des Zuul Services. Damit ist die Host Adresse (Bspw: 192.168.99.101) der Docker Machine und der Port zu dem Zuul Service, der in der docker-compose.yml mittels Port: „“ 9999:9999 nach Außen bekannt gemacht wurde gemeint. Dazu wird die Zuul Konfiguration in der application.yml wie folgt erweitert: zuul: sensitive-headers: add-host-header: true routes: client: service-id: client strip-prefix: false # Fazit Wenn es um Microservice Architekturen geht, ist Spring Boot / Cloud das Framework der Wahl. Mit Spring Cloud erhalten wir die Netflix Oss Abhängigkeiten, jedoch mit der Möglichkeit des Supports von Pivotal. Entscheidet man sich für das automatisch erzeugte Routing in Zuul mittels Eureka Service Discovery (wie weiter oben beschrieben) sollte man berücksichtigen, dass die erzeugten Routen anzupassen sind, sofern die Applikation nicht nur auf „Localhost“ sondern in virtualisierten Umgebungen wie bspw. Docker laufen. Die wichtigsten Änderungen in den Zuul Properties sind: - add-host-header: true - sensitive-header: - strip-prefix: false --- \[1\] Neuer Actuator Endpoint in Spring 2: \[2\] Wird die Klasse WebSecurityAdapter überschrieben und mittels @Configuration zum ApplicationContext hinzugefügt, kann man die Methode @Override public void configure(HttpSecurity http) throws Exception {} überschreiben und Ausnahmen hinzufügen. **Kategorien:** Integration --- ### [OC|Expert Camp am 18.10.2018 an der TH Köln in Gummersbach](https://thecattlecrew.net/2018/10/09/ocexpert-camp-am-18-10-2018-an-der-th-koeln-in-gummersbach/) **Published:** Oktober 9, 2018 **Author:** Christian Olsson **Content:** ![Programmierabend.png](https://thecattlecrew.net/wp-content/uploads/2018/10/programmierabend.png)Wir laden wieder ein zum Coding Dojo an der TH Köln am Campus Gummersbach. Diesmal haben wir als Thema die Elevator Saga ausgesucht. Stellt Eure Javascript-Fertigkeiten auf die Probe oder baut sie auf, indem ihr in mehreren, aufeinander aufbauenden, Aufgaben Aufzüge mit Logik ausstattet. Ihr benötigt dafür lediglich einen eigenen Rechner, programmiert wird direkt im Browser. Wir geben eine kurze Einführung in die Problemstellung sowie die Entwicklungs-API und stehen Euch den Abend über mit Rat und Tat zur Seite. Wir beginnen um 18 Uhr in Raum 0.503 im Neubau, dauern wird der Abend zwei bis drei Stunden. Für das leibliche Wohl wird selbstverständlich gesorgt. Bei Interesse meldet euch entweder bei Meetup oder per Mail an. Meetup: Mail: **Kategorien:** Tech Events & Networking --- ### [Warum OPITZ CONSULTING dir deinen Lieblingsjob bietet? Teil 3/4](https://thecattlecrew.net/2018/09/24/warum-opitz-consulting-dir-deinen-lieblingsjob-bietet-teil-3-4/) **Published:** September 24, 2018 **Author:** hendrikvoigt **Content:** # Nutze deinen Vorgesetzten als persönlichen Coach Was gibt es schöneres für eine Führungskraft, aussichtsreiche Talente zu verlässlichen Key Playern zu entwickeln? Wenn ich als Führungskraft keinen Nachwuchs heranziehe, darf ich mich nicht wundern, wenn auch während meines Urlaubs an mir gezerrt und gezogen wird. Dabei sollten sich Führungskräfte, die aufgrund von Leistung und Befähigung Karriere gemacht haben, nicht vor neuen Talenten fürchten, sondern diese eher als Chance der Entlastung sehen. Sie können verantwortungsvolle Aufgaben delegieren und sich dann zurecht damit rühmen, dass ihr Verantwortungsbereich wie geschmiert läuft und viele Zellen autonom erfolgreich arbeiten. Führungskräfte bei OPITZ CONSULTING stehen für einen Dialog auf Augenhöhe und können einschätzen, welche Fähigkeiten für welche Rolle benötigt werden. Sie helfen dir auch, mit typischen Kulturmustern zu brechen. Möchtest du später selbst mal „Chef“ sein, weil du so sozialisiert wurdest oder handelt es sich um einen intrinsischen Drang, führen zu wollen? Was kennzeichnet eigentlich die Aufgaben im nächsten Karriereschritt? Welche Stärken sollte man einbringen? Welches Grundrüstzeug ist unabdingbar? Bei uns kannst du jeden Manager einfach fragen, was seine Rolle im Alltag ausmacht und erhältst offen und ehrliche Antworten. Folgende Situation beoachte ich in einer gewissen Regelmäßigkeit: Ein Mitarbeiter äußert den Wunsch, dass er mal den nächsten Schritt wagen wolle und interessiert sich für das Projektmanagement. Das Managen von Projekten erfordert dabei ganz andere Fähigkeiten und Neigungen als die Anforderungsanalyse oder Softwareentwicklung. Als Projektmanager muss ich mich vor mein Team stellen können und es vor unberechtigten Zugriff von außen schützen, in hitzigen Diskussionen ruhig bleiben und Lösungs-orientiert moderieren. Ich muss auch mal unangenehme Fakten wie Terminverzug oder Qualitätsprobleme ansprechen und darf demzufolge nicht konfliktscheu sein. Es gibt viel zu organisieren, hochzurechnen, zu berichten, uvm. Wenn sich dann herausstellt, dass dem Kollegen die Softwareentwicklung viel Spaß macht und er einfach größeren Einfluss auf Architekturentscheidungen haben möchte, um sich nicht mit schlechten Entscheidungen anderer seinen Programmieralltag versauen zu lassen, ist der Karrierepfad „Projektmanagement“ schlichtweg die falsche Wahl. Dagegen könnte ein Methoden-Training zu Software-Architekturen und Soft Skills wie Überzeugen passgenau sein. Genau hierbei begleitet dich dein Vorgesetzter als persönlicher Coach und bei OPITZ CONSULTING gilt, dass die Fachkarriere z.B. als Architekt gleichwertig mit disziplinarischer oder fachlicher Teamverantwortung angesehen wird. So passiert es, dass ein Vorgesetzter in der gleichen Karrierestufe wie einer seiner Mitarbeiter sein kann und jeder bringt seine individuellen Stärken ein. Flache Hierarchien klingen zwar hip und modern, funktionieren meiner Einschätzung aber nur dann, wenn ich fast ausnahmslos erfahrene Mitarbeiter im Unternehmen habe. Gerade für Young Professionals eignen sich diese Strukturen tendenziell nicht. Über Mentoren-Programme kann sicherlich viel kompensiert werden. Sie ersetzen aber nicht die kontinuierliche Förderung, die gerade durch eine klare Zuordnung zu einem Vorgesetzten sichergestellt wird. Zudem sind ja auch Unternehmensinteressen bei der Weiterentwicklung von Mitarbeitern zu berücksichtigen und Vorgesetzte sind Profis in der Abwägung von Mitarbeiter-Interessen, Unternehmenszielen sowie Kundenbedarfen. **Kategorien:** Tech Events & Networking --- ### [Warum OPITZ CONSULTING dir deinen Lieblingsjob bietet? Teil 2/4](https://thecattlecrew.net/2018/09/17/warum-opitz-consulting-dir-deinen-lieblingsjob-bietet-teil-2-4/) **Published:** September 17, 2018 **Author:** hendrikvoigt **Content:** # Vernetze dich innerhalb des Unternehmens Ein gutes Netzwerk hilft bei fast allen operativen bis strategischen Vorhaben. Zugleich ist dieses Netzwerk auch für die persönliche Weiterentwicklung von Bedeutung. Ein gutes Netzwerk im Unternehmen unterstützt dich dabei … - … deine Schwerpunkte bei den zahlreichen IT-Trends zu legen, - …durch eine Community den Austausch mit anderen Gleichgesinnten zu finden (Community of Practice), - … bei Showstoppern oder Produktionsproblemen gezielt schnelle Hilfe zu identifizieren, - … offenes, ehrliches und auch wohlwollendes, dir als Person zugewandtes Feedback einzuholen und - … ein soziales Umfeld aufzubauen, in dem jeder Arbeitstag Spaß macht und in belastenden Situationen auch Rückhalt und Fürsprache zu erhalten. Machen wir es konkret: Das Blockchain Konzept wird zurzeit gehypt und deine Neugier ist entfesselt. Mathematik fandest du schon immer klasse und du interessierst dich für die Analyse von Blockchain Strukturen. Die Konzepte und Werkzeuge für das Parsen und die Mustererkennung saugst du förmlich auf. Aber wer stellt dir das benötigte Hadoop-Cluster zur Verfügung? Zudem sind Kenntnisse zur IT Security und Kryptographie für Blockchains essentiell. Mit wem kannst du diese Facette beleuchten? Und eine gern unterschätzte, aber zentrale Frage lautet: Wie sehen möglichen Anwendungsfälle aus und wie kann man damit Geld verdienen? Eigentlich benötigst du eine Community, in der du dich austauschen kannst, deine Stärken einbringst und von anderen profitierst. Bei OPITZ CONSULTING schaffen wir Rahmenbedingungen, in denen derartige Communities gedeihen können. Wir ziehen Selbstorganisation der Steuerung vor. In den Kundenprojekten, auf lokalen Community Days oder überregionalen OC Digital Days triffst du Gleichgesinnte, tauscht dich auch und vereinbarst einfach mal etwas anzuschieben. Formale Management-Prozesse und Quality Gates werden auf ein Minimum reduziert. Was solltest du dennoch beachten: - Tue Gutes und rede darüber: Biete Sessions für Kollegen an und stelle deine Erkenntnisse zur Verfügung. Binde auch andere Org-Einheiten wie Sales oder Marketing mit ein. Schreibe am Besten direkt einen Blog-Beitrag (). - Arbeite zielorientiert: Um das Potential eines Trends oder Themas erkennen zu können, muss man es natürlich erst verstehen. Im Anschluss sollte das Potential direkt kritisch hinsichtlich der Dimensionen Aufwand/Investition, Chancen und Risiken analysiert werden. Erarbeite einen Kundennutzen, launche dein erstes Minimum Viable (Consulting) Product und hole dir unmittelbar Feedback aus deinem Netzwerk sowie potentiellen Kunden ein. - Ein gutes Netzwerk zu Vertriebsverantwortlichen ist dabei Gold wert. - Übrigens benötigt man nicht immer ein MVP für diesen Lean Startup Ansatz. Ganz zu Beginn darftst du gerne risikoavers und „noch ein wenig faul“ sein. Konstruiere einfach ein Experiment mit dem herausfindest, ob Kunden wirklich kaufen. Notfalls ruderst du zurück, erklärst dein Vorgehen und kündigst das Produkt bzw. den Service für einen späteren Zeitpunkt an. Hier empfehle ich den Blog-Beitrag von Mark Poppenborg: **Kategorien:** Tech Events & Networking --- ### [Computer, ist das eine Katze?](https://thecattlecrew.net/2018/08/10/computer-ist-das-eine-katze/) **Published:** August 10, 2018 **Author:** pascalmhumbert **Content:** # Volles Haus bei Machine Learning Hackathon in der Münchner Niederlassung Am 09. Juni 2018 fand im Rahmen des OC|Expert Camps der Hackathon „Intro in Machine Learning“ statt. Mit insgesamt etwa 40 Teilnehmern und viel Coding und guter Laune war das Event für uns ein voller Erfolg! ![oc-expert-camp-1](https://thecattlecrew.net/wp-content/uploads/2018/08/oc-expert-camp-1.jpg)*Volles Haus und gute Laune.*Dieses OC|Expert Camp lief etwas anders als die Events zuvor. Nicht nur, dass die Teilnehmer alle (über-)pünktlich da waren, es kamen auch doppelt so viele Leute wie wir erwartet hatten. Für gewöhnlich haben wir bei den über meetup.com angekündigten Veranstaltungen Show-Rates im Bereich 20 % – 30 %. Bei diesem Hackathon lag sie bei 38 %. Um die vielen Studenten und Entwickler in der Niederlassung unterzubekommen, wandelten wir kurzer Hand Büroräume, Küche und auch die Terrasse mit „Garten“ in Hackathon-gerechte Arbeitsflächen um. Gleich mehrere Faktoren können zu der großen Teilnehmerzahl geführt haben: - Das Thema Machine Learning ist derzeit sehr populär. - Das Event fand zum ersten Mal an einem Samstag statt. - Wir führen momentan zwei Meetup-Gruppen parallel mit ca. 300 bzw 50 Mitgliedern. Insgesamt kamen wir damit für den Hackathon auf 80 individuelle Anmeldungen. - Statistische Fluktuation. Unsere Presenter waren Thomas Temme, Developer bei OC und Promovent in Informatik mit Schwerpunkt Machine Learning an der Uni Bochum, und Philipp Fehrmann, Werksstudenten bei OC, der sich in seinem Studium mit Machine Learning beschäftigt. Die beiden haben den Hackathon inhaltlich konzipiert und gaben den Teilnehmern zu Beginn einen etwa einstündigen Crash-Kurs in Machine Learning. Danach begannen wir direkt mit dem „Hacking“. Bei dem Hackathon ging es darum einen Algorithmus zu trainieren, dem es gelingt Katzen und Hunde auf Bild-Dateien zu erkennen. Die Teilnehmer stellten sich der Challenge „Wer implementiert die höchste Accuracy?“. Die Accuracy gibt an, wie viele Vorhersagen des Algorithmus relativ zur gesamten Zahl der Vorhersagen zutreffen. Die glücklichen Sieger, eine 5-er Gespann rund um unseren Werksstudenten Manuel Styrsky mit einer Accuracy von 73,6 %, durften schließlich als stolze Besitzer vier cooler Lego-Technik-Bausätze nach Hause gehen. ![oc-expert-camp-2](https://thecattlecrew.net/wp-content/uploads/2018/08/oc-expert-camp-2.jpg)*Die Sieger des OC|Expert Camp Machine Learning Hackathons.*Du hast diesen Hackathon verpasst? Kein Problem: Am 18. August 2018 findet in Essen ein [ganz ähnlicher Machine Learning Hackathon](https://www.meetup.com/de-DE/OC-Expert-Camp-Essen/events/251946350/) statt und Thomas ist auch wieder mit dabei! Desweiteren findet bei uns in München auch schon bald der nächste Hackathon statt, diesmal zum Thema Amazon Webservices und serverless – alle Infos dazu findest du [hier](https://www.meetup.com/OC-Expert-Camp-Munchen/events/253680732/). **Kategorien:** Tech Events & Networking **Schlagwörter:** Events, Hackathon, Marketing --- ### [Warum OPITZ CONSULTING dir deinen Lieblingsjob bietet? Teil 1/4](https://thecattlecrew.net/2018/09/11/warum-opitz-consulting-dir-deinen-lieblingsjob-bietet-teil-1-4/) **Published:** September 11, 2018 **Author:** hendrikvoigt **Content:** Grau, lieber Bewerber, ist alle Theorie, blühend und bunt ist das hoch-dynamische, Kunden-zentrierte Ü–kosystem bei OPITZ CONSULTING. Gut, mit Goethe können und wollen wir es nicht aufnehmen, aber Softwareentwicklung liegt in unserer DNA. Damit du dir die Anwendung von Konzepten, Methoden, Programmiersprachen und Prozessen „abgucken“ kann, benötigst du ein entsprechendes Umfeld. Ein Unternehmen wie OPITZ CONSULTING mit seinen zahlreichen Experten bietet dir als komplexes, sozio-ökonomisches System genau ein solches Umfeld. Du kannst von Kollegen lernen, dir unbürokratisch Hilfe holen, Ideen einbringen und diskutieren und dadurch viel schneller Lernen als ein Einzelkämpfer. Aber ein Unternehmen an sich kann seine Mitarbeiter nicht entwickeln. Vielmehr entwickelt man sich im Kontext eines Unternehmens. Ich trage die Eigenverantwortung für meine Weiterentwicklung und darf diese nicht delegieren. Dafür ist die persönliche Weiterentwicklung in Zeiten des stetigen dynamischen Wandels und der verkürzten Innovationszyklen zu wichtig. Diese Selbstbestimmung halte ich insbesondere in einer Hochtechnologie-Branche wie der IT für entscheidend, denn für mich relevante Inhalte lerne ich lieber und nachhaltiger. Und was für mich relevant ist, entscheide immer noch ich. Glaubenssätze wie „du bist doch mein Vorgesetzter und musst mich entwickeln“ gelten nicht. Was ist denn nun für meine persönliche Weiterentwicklung im Kontext eines Unternehmens relevant? Die Beantwortung dieser Frage ist sehr individuell und entspricht einer lebenslangen Reise, bei der man das Ziel wie bei einem moving target nie vollends erreicht. Im Folgenden gebe ich dir ein paar Tipps, die du unbedingt in den Koffer für deine Lernreise einpacken solltest. ### Hole dir regelmäßig Feedback Feedback ist essentiell, um von den Beobachtungen anderer zu lernen und dadurch positive Verhaltensweisen zu fördern (unknown knows) bzw. aufmerksamer für unbewusstes oder unangebrachtes Handeln zu werden (unknown unknows). Außerdem hilft mir Feedback, die Selbst- und Fremdwahrnehmung abzugleichen. Leitfragen für das Feedback könnten sein: - Welche Stärken siehst Du bei mir? An welchen Stellen profitiert OC von mir? - Wo sollte ich noch an mir arbeiten? Wie kann ich mich weiterentwickeln? - Was wünschst Du Dir von mir? Was wolltest du mir schon immer mal sagen? Deshalb haben wir bei OPITZ CONSULTING das sogenannte Feedback-orientierte Jahresgespräch eingeführt, bei dem man sich im Vorfeld von Kollegen, Kunden, Partnern und anderen Weggefährten Feedback einholt und seinen persönliches Kompass regelmäßig mit dem Umfeld abgleicht. Du bist schon richtig gut? Du lernst schnell und autodidaktisch? Dann empfehle ich den überaus lesenswerten und unterhaltsamen Blog zu Expert Beginner (vgl. [https](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[://www.daedtech.com/how-](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[developers](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[-stop-learning-](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[rise](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[-of-](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[the](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/)[-expert-beginner/](https://www.daedtech.com/how-developers-stop-learning-rise-of-the-expert-beginner/) – hier musste ich spontan an meine Lernkurve beim Tischkickern denken, berufliche Parallelen erwähne ich an dieser Stelle lieber nicht). Ob eine gewählte Architekturentscheidung wirklich nachhaltig ist, weiß man halt häufig erst Jahre später. Häufig hört man auch Sätze wie „Das haben wir schon immer so gemacht“. Ein wenig Demut, gewissenhafte Selbstreflexion und aktiv andere Meinungen einholen sind für mich Stärken, die zu besseren Ergebnissen und einer vertrauensvolleren Zusammenarbeit führen. Und wie sagt man so schön: „Ob ein Mensch klug ist, erkennt man an seinen Antworten. Ob ein Mensch weise ist, erkennt man an seinen Fragen.“ **Kategorien:** Tech Events & Networking --- ### [Warum OPITZ CONSULTING dir deinen Lieblingsjob bietet? Teil 4/4](https://thecattlecrew.net/2018/10/16/teile-dein-wissen-und-lerne-von-anderen/) **Published:** Oktober 16, 2018 **Author:** hendrikvoigt **Content:** Das wichtigste „Asset“ einer Unternehmensberatung sind die Mitarbeiter mit ihren Erfahrungen, Qualifikationen und Fähigkeiten, Top-qualifizierte Mitarbeiter machen schließlich den Unterschied. Das tolle an „Wissen“ ist doch, dass wir es durch beliebig häufige Teilung vermehren können und es sich nicht verbraucht. Eine bessere Shared Economy kann ich mir überhaupt nicht vorstellen. # Teile dein Wissen und lerne von anderen! Vieles ist einfacher, wenn ich anderen einfach mal über die Schulter gucken kann. - Software Craftmanship: Programmierskills lassen sich am Schnellsten durch Pair Programming weiterentwickeln. - IT-Trends: Die Möglichkeit mit Kollegen über ihre Praxis-Erfahrung beispielsweise zu Microservices-Architekturen zu diskutieren ist total wertvoll und kann durch keinen noch so guten Blog ersetzt werden. # Weiterbildung Eine Schulungsempfehlung eines geschätzten Kollegen ist deutlich aussagekräftiger als jede dokumentierte Kurzbeschreibung und Agenda. - Bei OPITZ CONSULTING bieten wir verschiedene Formate an und jeder kann selbst entscheiden, wie er am Effektivsten lernt. Wähle deinen Mix aus E-Learning, Classroom-Schulungen, Coaching und Selbststudium. - Der Austausch von Kollegen wird durch unsere monatlichen Community Days und deutschlandweiten OC Days gefördert. Die einzelnen Standorte kümmern sich um Programmierabende, Hackatons und ähnliches. - Für stark wettbewerbsdifferenzierendes Know-how wie Big Data und DevOps konzipieren wir exklusiv für unsere Mitarbeiter eigene Schulungen. - Du möchtest eine bestimmte Konferenz besuchen und Koryphäen live und in Farbe sehen. Feel free! - Aufgrund deiner privaten Situation lernst du gerne autodidaktisch mit Online-Medien. Wir kooperieren mit e-Learning Anbietern und stellen dir Zugänge zur Verfügung. - Die OC Academy bündelt dieses Markt- und Kompetenz-orientiertes Weiterbildungsportfolio und ergänzt es um zahlreiche Softskill-Schulungen. Wir schlüsseln Wissensmonopole auf, die durch die hochspezialisierten Projekteinsätze systembedingt immer wieder entstehen. Wir entwickeln deshalb Mitarbeiter gerne zu Trainern der OC Academy, damit jeder sein Wissen teilt und alle gemeinsam voneinander profitieren **Kategorien:** Tech Events & Networking **Schlagwörter:** Fortbildung, OC Academy, Sharing, Wissen --- ### [GraphQL Demo (5/8) - Authorization](https://thecattlecrew.net/2019/03/04/graphql-demo-5-8-authorization/) **Published:** März 4, 2019 **Author:** Manuel Styrsky **Content:** Nach einer längeren Pause geht unsere Blogserie zum Thema GraphQL nun weiter. Viel Spaß beim lesen! Das Thema Autorisierung ist unter GraphQL von besonderem Interesse. In klassischen REST APIs haben wir verschiedene Ressourcen, auf denen bestimmte Aktionen definiert sind. Nehmen wir als Beispiel eine Kalender Anwendung. Ein Endpoint unter REST wäre z.B. example.com/events. Mit POST werden neue erstellt, mit GET wird eines abgerufen. Welche Aktionen ich durchführen darf, lässt sich relativ einfach festlegen, alle dazu benötigten Informationen lassen sich aus der Anfrage ableiten. Unter GraphQL haben wir diese einfache Unterscheidung zwischen den einzelnen Ressourcen nicht. Vielmehr haben wir hier nur einen einzigen Endpunkt, der wiederum verschiedene Queries und Mutations zulässt. Und in dem Ergebnis einer Query können einzelne Knoten aus der Query enthalten sein, oder mit einem Fehler geblockt werden. Welche dieser Knoten angefragt und welche geblockt werden, kann wieder von Anfrage zu Anfrage verschieden sein. In diesem Blogeintrag werden wir Queries und Mutations gleichbehandeln, denn auch wenn jetzt vielleicht der ein oder andere widersprechen will: der einzige echte Unterschied zwischen einer Query und einer Mutation ist der Name und die angedachte Semantik, aber die kann ich als Entwickler biegen und brechen, wie es mir beliebt. Zurück zum Thema, ein kleines Beispiel. Wir haben wieder unsere Chat-App mit ihren zwei Microservices und dem kleinen Gateway. Hier wäre es nicht sehr vorteilhaft, wenn wir als Durchschnittsuser die Nachrichten von allen anderen Usern sehen könnten. Doch wie können wir das verhindern? ### **Drei Möglichkeiten für die Autorisierung** Eine Möglichkeit sind Direktiven. Diese können einfach an einen Typen oder ein Feld geschrieben werden. Bevor dieses Feld ausgewertet wird, werden die Direktiven ausgewertet. Wenn eine solche Direktive zu False auswertet oder bei der Auswertung ein Fehler geworfen wird, wird das Feld nicht dargestellt. Damit lassen sich im Schema die einzelnen Rechte darstellen. Das Problem hierbei ist, dass das Schema dadurch mit Informationen überladen wird, die nicht das Datenmodell definieren, sondern andere Aufgaben erfüllen. Auch muss das Schema auf dem System existieren, das den Server definiert. Bei Remote Schemas besteht oft keine Möglichkeit, auf die Direktiven zuzugreifen, zumindest nicht, wenn Introspect Queries genutzt werden, um das Schema auszulesen. Andererseits hat dieses Vorgehen den Vorteil, dass es genau eine Quelle der Wahrheit für eine Schnittstelle gibt und die Informationen nicht über das gesamte System verstreut liegen. Die Prüfung kann auch in den Resolvern der Felder selbst passieren. Wenn beim Aufruf von Resolve ein Fehler auftritt (z.B. „AuthenticationError: Unauthorized“), wird das Feld auch nicht dargestellt. Das kann jedoch schnell zu einer gewissen Vermischung von Anwendungslogik und Rechteverwaltung führen. Natürlich kann die Architektur dementsprechend gestrickt werden, dass die Vermischung nicht zustande kommt, aber es ist recht wahrscheinlich, dass es dennoch passiert. Es gibt auch verschiedene Frameworks, mit denen man diese Aufgaben bewältigen kann. So zum Beispiel graphql-shield oder GraphQL Resolvers. Die einzelnen Endpunkte können so recht einfach mit Autorisierungsmethoden umschlossen und geschützt werden. Dieser Ansatz trennt die Autorisierung und die Anwendungslogik klar voneinander. In vielen Fällen, in denen GraphQL nur als dünne Schicht über einer bestehenden Anwendung zum Austausch von Daten genutzt wird, ist aber eine dedizierte Autorisierung nicht nötig, da diese im Hintergrund in der bestehenden Businesslogik passiert. ### **Über einfache und komplexere Autorisierungsfälle** Bei der Autorisierung gibt es verschiedene Anwendungsfälle. Einer der einfacheren Fälle ist die Frage, ob ein User eine bestimmte Rolle hat. So dürfen in unserer Chat-App z.B. nur Administratoren alle User einsehen. Das lässt sich recht einfach umsetzten, über die vorangegangene Autorisierung ist die Identität des Users bereits bekannt, eine Zuordnung zu einer Rolle ist recht einfach. Das ist aber nur ein „Alles oder Nichts“ Szenario. Wir könnten uns eine Regel überlegen, die lautet „nur ich darf meine Unterhaltungen sehen“. In diesem Fall müssen wir prüfen, ob der Nutzer, den ich gerade Anfrage, auch tatsächlich ich bin. Auch Anfragen an einen dedizierten Server für die Autorisierungslogik sind denkbar. Da wir in unserer Chat-App die Autorisierung an einem zentralen Gateway umsetzen wollen und dort Remote Schemas benutzen, müssen wir die Informationen, die wir für die Autorisierung benötigen, ggf. explizit selbst vom Server holen, da wir der User nicht zwingen wollen, diese Informationen anzugeben. Dazu haben wir das Schema des Gatways, das wir über die Introspect Queries von unseren Microservices bekommen und zusammengesetzt haben, erweitert. So werden immer alle Informationen für die Autorisierung, wie die ID eines Users, mit abgefragt. Der Apollo Server filtert diese Daten dann selbst wieder raus und gibt nur die vom Nutzer angefragten Daten zurück. Das ist ein Ansatz, der auch häufig beim Schema Stitching verwendet wird, da dort oft Informationen benötigt werden, die nicht vom User angefordert wurden. ### **Umsetzung in der Chat-App** Für unsere Chat-App haben wir einen kleinen Wrapper mit Hilfe der GraphQL-tools und dem Package GraphQL Resolvers geschrieben, der das Schema für uns erweitert. Damit können wir einfach ein Feld angeben, das wir für die Autorisierung benötigen und eine Methode, die mit diesem Feld (beispielsweise der UserId eines Users), die Rechte prüft. Die Konfiguration erfolgt dann über ein Objekt, das z.B. so aussehen kann: > const authorization = { > Query: { > users: { resolver: isAdmin }, > me: { resolver: anyUser } > }, > User: { > conversations: { > dependsOn: ‚id‘, > resolver: isMe, > } > } > } Damit können wir zu jedem Feld angeben, welche Abhängigkeiten es vom Parent-Objekt hat und welche Methode die Rechte prüfen soll. Wir können auch eine Standardfunktion angeben, die geprüft wird, wenn für ein Feld keine Funktion angegeben ist. Damit kann der Zugriff z.B. auf Administratoren beschränkt werden, außer der Zugriff auf ein Feld wird explizit erlaubt (Whitelisting). Mit dieser Lösung haben wir auch sauber die Autorisierung von der Logik getrennt, die Autorisierung kann so auch an unser Gateway ausgelagert werden. ### **Schlussworte** Autorisierung ist möglich und die Möglichkeiten dazu sind sehr vielfältig. Grundsätzlich empfiehlt es sich, den Zugriff auf ganze Knoten oder gar Typen nach bestimmten Kriterien einzuschränken. Wenn nur lokale Schemata benutzt werden, sind häufig mehr Informationen vorhanden, als der User anfragt, oder zusätzliche Informationen können einfach aus der Datenbank gelesen werden. Wenn jedoch Remote Schemas genutzt werden, ist die Sache etwas kniffliger, aber auch sauber zu lösen. **Kategorien:** Integration --- ### [GraphQL Demo (6/8) - Monitoring](https://thecattlecrew.net/2019/03/11/graphql-demo-6-8-monitoring/) **Published:** März 11, 2019 **Author:** Manuel Styrsky **Content:** Jeder, der eine Serveranwendung betreibt, möchte diese gerne überwachen und Reports über Zustand und Anfragen bekommen. So geht es auch uns bei unserer Chat-App, die mit Apollo Server läuft. Wer für seine GraphQL-Anwendung Apollo Server nutzt, kann damit ganz einfach über die Apollo Engine seinen Server überwachen. So können Performance, Cache Hits, Fehler, Warnungen und Auflistungen darüber welche Daten wie oft angefragt wurden ausgelesen werden und das sowohl für jeden Anfragetyp einzeln, als auch für den gesamten Server. Zusätzlich können automatische Reports per Slack verschickt werden, welche die häufigsten und zeitintensivsten Anfragen sowie Anfragen, die viele Fehler hervorgerufen haben anzeigen. Die Slack-Reports werden über Slack WebHooks gesteuert. [![](https://thecattlecrew.net/wp-content/uploads/2019/03/gql-300x147.png)](https://thecattlecrew.net/wp-content/uploads/2019/03/gql.png) Für das Monitoring muss [hier](https://engine.apollographql.com/login) ein Account erstellt werden. Im nächsten Schritt muss ein Service auf der Seite angelegt werden. Der API Key, den man so für den Service bekommt, muss im Setup der Engine einfügen werden und dann kann über Account die Anwendung überwacht werden. Wenn noch kein explizites Setup existiert, also das Default Setup genutzt wird, kann es einfach erstellen werden. In dem Setup kann man unter anderem auch das private Caching aktivieren (siehe Blogeintrag Caching). > const engine = new ApolloEngine({ > „¦ > **apiKey: „yourAPIKey“ //Starts with „˜service:yourUserName-„¦“˜** > }); Insgesamt erfüllt schon die kostenlose Community-Version von Apollo Engine die grundlegenden Bedürfnisse vom Monitoring während der Entwicklungsphase. So werden die Daten zwar nur über einen Tag gespeichert und es können nur maximal eine Millionen Anfragen gesendet werden, was aber für Entwicklungs- und Testzwecke vollkommen ausreicht. In der kostenpflichtigen Pro-Version ist die Begrenzung der Anfragen aufgehoben und es gibt weitere Features wie Alerts für bestimmte Performancekriterien und längere Speicherung der Nutzungs- und Analysedaten. Alle Performancedaten werden in der Cloud von Apollo gespeichert. **Kategorien:** Infrastructure --- ### [GraphQL Demo (7/8) - Ratelimiting](https://thecattlecrew.net/2019/03/18/graphql-demo-7-8-ratelimiting/) **Published:** März 18, 2019 **Author:** Manuel Styrsky **Content:** In klassischen REST Services ist Ratelimiting ein bekanntes Problem mit bekannten Lösungen. Hier hat jeder Endpoint und jede Aktion, die auf diesem Endpoint ausgeführt werden kann, bestimmte Kosten. Wird einer dieser Endpoints aufgerufen, werden die Kosten von einem Konto des Clients abgezogen. In REST ist das eine sehr einfache Methode, da die Kosten, die dem Betreiber durch das Aufrufen eines Endpoints entstehen, sehr berechenbar sind. Bei GraphQL hingegen sieht die Sache anders aus. Hier gibt es nur einen einzigen Endpoint. Auch die Quries, die an den Server gestellt werden (und die am ehesten den althergebrachten Endpoints entsprechen), können sich in ihrer Komplexität erheblich voneinander unterscheiden. Das ist genau der Punkt, den GraphQL so stark von REST unterscheidet und der in Vergleichen oft als positiver Punkt für GraphQL aufgefasst wird. Doch diese Anpassbarkeit macht es schwerer und gleichzeitig absolut notwendig, ein Ratelimiting einzuführen. Ohne Ratelimiting könnte man mit einer einzigen Anfrage einen Server lahmlegen, in dem man rekursiv Daten abruft. Okay, es gibt zwar keine echte Rekursion in GraphQL, aber die Queries können sehr[\[SM1\]](#_msocom_1) [\[FP2\]](#_msocom_2) tief werden, was dann ziemlich nah an Rekursion herankommt. Es gibt Plugins, die die Tiefe begrenzen, aber ohne diese kann der User eine Query erstellen, die beliebig tief sein kann. Für das Ratelimiting muss eine geeignete Metrik gefunden werden, die sowohl einfach berechnet, als auch bei einem Kunden abgebucht werden kann. Für eine solche Metrik gibt es verschiedene Optionen. Die wahrscheinlich einfachste Möglichkeit wäre es, die Zeit, die ein Aufruf benötigen darf, zu begrenzen. Doch einige Queries werden länger benötigen, andere werden schneller ausgeführt werden. Daher ist es schwer, eine sinnvolle Obergrenze zu finden. Wenn die Query, die realistisch vorkommt und am längsten benötigt, 0.5 Sekunden braucht, haben alle Queries 0.5 Sekunden Zeit. Aber auch in dieser Zeit kann bereits erheblicher Schaden angerichtet werden. In dem Fall könnte für das tatsächliche Ratelimiting wieder die Anzahl an Anfragen gezählt werden. Ein User weiß immer vorher, wie viel die Query kosten wird, nämlich immer gleich viel. Aber Queries, die nicht viele Daten zurückgeben sollen und schnell ausgeführt werden, werden damit im Vergleich zu komplexeren Queries sehr teuer. In einem ähnlichen Modell kann als Metrik auch die tatsächlich verbrauchte Zeit genutzt werden. Das ist aber für den User allerdings sehr schwer zu erfassen, da der User nicht weiß, wie lange eine bestimmte Query für die Ausführung braucht und welche Aktionen er dementsprechend durchführen will. Hier können höchstens mit der Zeit Erfahrungswerte gesammelt werden und Statistiken genutzt werden. Aber wenn die Last auf dem GraphQL Server steigt und dieser für die Bearbeitung der einzelnen Queries länger braucht, werden auch die Queries teurer. Das ist nicht unbedingt im Sinne des Betreibers oder Users. Eine andere Metrik ist die Komplexität der Query. Diese kann in bestimmten Situationen sehr einfach berechnet und auch begrenzt werden. Wenn die Komplexität der Anfrage bestimmt wurde, kann sie sowohl als Metrik für das Ratelimiting, als auch als Schutz vor DOS Angriffen durch sehr komplexe Anfragen dienen. Zur Bestimmung der Komplexität bekommt jedes einzelne Feld eine Komplexität. Die Komplexität der einzelnen Knoten einer Query wird addiert. Wenn die Komplexität ein bestimmtes Maß überschreitet, wird die Ausführung der Query unterbunden. Wenn ein Knoten eine Liste zurückgibt, sollte die Anzahl an Elementen, die zurückgegeben werden können, bekannt sein. Dazu können Parameter auf den Listen Elementen wie limit und offset genutzt werden. Das ist wichtig, da die Komplexität der Query und maximale Anzahl an Elementen, die von der Query zurückgegeben werden können, vor der Ausführung bekannt sein muss, um sie vor der Ausführung abzulehnen. Diese Art der Begrenzung hat den Vorteil, dass es für einen Nutzer einfach nachzuvollziehen ist, wie sich sein aktueller Verbrauch zusammensetzt. Für den Serverbetreiber steigt zwar der Verwaltungsaufwand, aber auch nur gering. Um die Kosten und die Komplexität zu bestimmen, müssen Informationen über das Schema hinterlegt werden. Diese Informationen können entweder direkt im Schema mit Direktiven oder in einer gesonderten Cost Map angegeben werden. Die Angabe im Schema hat den Vorteil, dass keine Informationen doppelt gespeichert werden. Wenn jedoch Schemastitching genutzt wird, kann auf diese Informationen nicht zugegriffen werden. Auch wird in diesem Fall das Schema mit Informationen angereichert, die nicht unbedingt zum Schema gehören. Wenn die Kosten in einer Map angegeben werden, können auch beim Schemastiching die Kosten berechnet werden. Da unser Server Schemastitching verwendet (und der Use Case einfach interessanter ist :P), haben wir im folgenden Beispiel die Variante mit der Map umgesetzt. Ein kleines Beispiel, um die Kosten zu verdeutlichen. > { > me { > > conversations(limit: 10) { > messages(limit: 10) { > author { > conversations(limit: 10) { > messages(limit: 3) { > **text** > } > } > } > } > } > } > } Hier berechnen sich die Kosten wie folgend: > cost = > costs.me + > (costs.conversations + 10 \* > (costs.messages + 10 \* > (costs.author + > (costs.conversations + 10 \* > (costs.messages + 3 \* > (costs.text) > ) > ) > ) > ) > ) Wenn für jedes Element die Kosten 1 angenommen werden, bedeutet das, dass wir hier bereits Kosten von 4212 haben! Es können auch bis zu 3000 Elemente zurückgegeben werden. Wenn jetzt die Queries noch tiefer geschachtelt werden, steigen die Kosten enorm an. Jedes Objekt und Feld hat hier die gleiche Komplexität und damit die gleichen Kosten. Wenn ein Objekt aber wesentlich größer oder selbst komplexer ist, als andere, kann für jedes Element die Kosten individuell angepasst werden. Ein anderer Faktor für die Kosten eines Feldes können auch die bei der Gewinnung der Daten entstandenen Kosten sein. Eine einfache Möglichkeit die Komplexität zu bestimmen, ist das Plugin [graphql-cost-analysis](https://github.com/pa-bru/graphql-cost-analysis). Andere Plugins sind [graphql-validation-complexity](https://github.com/4Catalyzer/graphql-validation-complexity) oder [GraphQL Query Complexity Analysis for graphql-js](https://github.com/ivome/graphql-query-complexity). Alle gängigen GraphQL Server bieten die Möglichkeit Regeln zur Validierung der eingehenden Query zu definieren. Wir benutzen das Plugin graphql-cost-analysis. Das Plugin kann als eine solche Regel einfach eingebunden werden. Wenn die Komplexität ein bestimmtes Maximum überschreitet, wird die Ausführung abgebrochen. Im Nachgang kann die Komplexität noch von einem Konto für einen User abgezogen werden. Wenn das Konto vom User leer ist, kann die Query auch abgelehnt werden. Nach welchem Muster einem User Guthaben zur Verfügung gestellt wird, kann von der Anwendung abhängen. Eine Möglichkeit wäre es, pauschal eine gewisse Summe pro Stunde zur Verfügung zu stellen. Andere Möglichkeiten sind das Leaky Bucket Prinzip, oder eigene geeignete Modelle. Hier kann auch eine Schnittstelle für die Monetarisierung erfolgen. Wenn ein Nutzer mehr zahlt, als ein anderer, kann ihm mehr Guthaben gegeben werden, als anderen. In dem Fall sollte die Verwaltung der Kontingente an einen anderen Service ausgelagert werden, um die Domänen sauber zu trennen. In unserem Beispiel hat jeder Nutzer in einer Stunde ein Guthaben von 500.000 Punkten. Eine Stunde nach der ersten Anfrage wird das Konto zurückgesetzt. Jede Anfrage zieht dem Nutzer Punkte ab, auch wenn sie wegen ihrer Komplexität abgelehnt wird. Deshalb sollten User die Komplexität ihrer Anfrage im Vorfeld berechnen. Also zusammengefasst: Ratelimiting in GraphQL ist mit einigen Plugins sehr einfach. Beim Verwenden von Remote Schemas sind die Möglichkeiten manchmal etwas eingeschränkt, da Direktiven nicht unbedingt zur Verfügung stehen. Aber einige Plugins bieten auch hier die Möglichkeit, damit umzugehen. **Kategorien:** Infrastructure --- ### [GraphQL Demo (8/8) - Schema Stitching und RemoteSchemata](https://thecattlecrew.net/2019/03/25/graphql-demo-8-8-schema-stitching-und-remoteschemata/) **Published:** März 25, 2019 **Author:** Manuel Styrsky **Content:** Einer der großen Vorteile von GraphQL gegenüber REST ist, dass es nur einen Endpunkt gibt. Aber das ist auch kein Muss, nur eine Empfehlung (und in meinen Augen Best Practice). Doch wenn jetzt mehrere Micro-Services bestehen, ist dieser Vorteil wieder verschwunden. Um das zu beheben, gibt es in den Apollo GraphQL-Tools das Schema-Stitching. Damit ist es möglich, mehrere Schemata zu einem zusammen zu fassen. Mit den RemoteSchemata können auch Schemata, die auf einem oder mehreren Microservices liegen, angesprochen werden und an einem zentralen Punkt zusammengefasst werden. ### **Schema-Stitching** In unserer Chat App haben wir den Fall, dass wir einen Microservice haben, der sich mit dem eigentlichen Chat befasst und einen Service, der ein Kontaktbuch für jeden Nutzer bereitstellt. Die einzelnen Schema Definitionen sind vollständig voneinander getrennt, die beiden Services kennen sich also nicht. Aber ich könnte auf die Idee kommen, dass ich alle Chats von meinen eigenen Kontakten sehen möchte (und bevor Fragen aufkommen: ja, wir haben noch einen eigenen Blogeintrag zum Thema Autorisierung . Aber mein Kontakte-Microservice kennt die Gespräche nicht, wie kommen wir also an die Daten? Das Schema-Stitching bietet hier Ansätze. Dazu müssen wir in der Chat-App eine Schnittstelle anbieten, die es uns erlaubt, einen User mit seiner ID zu finden. Wenn wir jetzt die ID von einem Kontakt kennen, können wir die Anfrage einfach an den GraphQL Server vom Chat weiterleiten. Aber die Frage ist: Kennen wir denn die ID überhaupt? Der User wird in den meisten Fällen diese ID abfragen, doch er muss sie nicht abfragen. In dem Fall bekommen auch wir die ID nicht unbedingt (siehe hierzu den Abschnitt Remote Schema und den Blogeintrag zur Autorisierung). Wir können aber Fragmente definieren, die mit abgefragt werden. So können wir sicherstellen, dass wir die User ID haben und dann so problemlos den entsprechenden User abfragen. Aber an lebendem Code kann man solche Dinge besser erklären, deswegen hier ein bisschen davon. Hier ein Auszug aus dem Schema der Chat-Komponente > type Query { > me: User > userById(id: Int!): User > } > > type User @cacheControl(maxAge: 120) { > id: Int > conversations(limit: Int!, offset: Int): \[Conversation\] > } Hier ein Auszug aus dem Schema für die Kontaktliste. > type Query { > contacts(limit: Int!, offset: Int): \[Contact\] > contactsByUserId(id: Int!, limit: Int!, offset: Int): \[Contact\] > } > > type Contact { > id: Int > userId: Int > birthdate: String > contacts: \[Contact\] > } Beide Schemata lassen es zu, dass nach einem User mit seiner ID gesucht wird. Damit wird die Kommunikation zwischen den beiden Server ermöglicht. Hier noch ein Auszug aus dem Schema des API-Gateways, das die beiden Schemata zusammenfasst: > extend type User { > contacts(limit: Int!, offset: Int): \[Contact\] > } > > extend type Contact { > user: User > } Es erweitert jeweils die Typen User und Contact aus den beiden Server erweitert. Damit werden die beiden Schemata vereint, nach außen hin sind dann sowohl die Funktionen der beiden einzelnen Server, als auch die erweiterten Funktionen sichtbar. Die entsprechenden Resolver werden auch im Gateway definiert. Hier als Beispiel der Resolver für die Kontakte eines Users: > User: { > contacts: { > fragment: `fragment UserFragment on User { id }`, > resolve(parent: any, args: any, context: any, info: any) { > const id = parent.id; > return mergeInfo.delegate( > ‚query‘, > ‚contactsByUserId‘, > { > id, > limit: args.limit, > offset: args.offset > > }, > context, > info, > ); > }, > }, > }, Der Resolver gibt ein Fragment mit an, welches dazu führt, dass beim Abfragen eines Users immer die ID mit an den Server gegeben wird. Wenn die ID von einem Client nicht mit abgefragt wurde, wird sie nicht zurückgegeben. Die eigentliche Resolve Funktion extrahiert zunächst die UserID aus dem Objekt und gibt dann die Anfrage an das Schema der Kontakt-Komponente weiter. Dass das Schema dabei ein Remote Schema ist, spielt keine Rolle. ### **RemoteSchemata** Für das SchemaStitching ist es egal, wo ein Schema definiert ist, es muss lediglich ein ausführbares Schema sein. Doch vor allem in Bereichen, die von Gateways abgedeckt werden, sind die Schemata nicht immer auf dem gleichen Server. Um dieses Problem zu beheben, gibt es in den GraphQL Tool die RemoteSchemata. Diese benötigen zwei Dinge: Ein Schema, welches angibt, welche Queries und Typen verfügbar sind und eine Verbindung zum Server, der das Schema bereitstellt. Um das Schema zu bekommen gibt es im groben zwei Möglichkeiten. Zum einen können Introspect Queries genutzt werden. Diese fordern von einem Server das Schema an und ermöglichen so nur unter Kenntnis der Adresse des Remote Schemata den Zugriff auf das Schema. Die Einzige Anforderung ist hier, dass die Server erreichbar sind, wenn das Gateway gestartet wird. Unter Umständen muss auch eine Autorisierung für die Introspect Query erfolgen. Die andere Möglichkeit ist, das Schema direkt anzugeben. Diese Option bietet sich an, wenn man selbst die Microservices betreibt, auf die Zugegriffen werden soll. Hier muss aber der Quellcode für die Schemata zur Verfügung stehen. Dafür müssen hier die Server nicht zwangsweise laufen, wenn das Gateway gestartet wird. Für die Ausführung einer Query müssen sie dann logischerweise aber doch laufen. Die Verbindung zum Server kann über verschiedene Bibliotheken hergestellt werden. Es gibt hier auch immer die Möglichkeit, die Anfrage zu manipulieren, z.B. durch das Hinzufügen von Headern für die Autorisierung. Die einzelnen Informationen können entweder statische sein, oder über den Kontext bei jeder Query einzeln in die Anfrage angefügt werden. Die [Dokumentation der GraphQL Tools](https://www.apollographql.com/docs/graphql-tools/remote-schemas.html) bietet hier noch weitere Einblicke. ### **Probleme** Beim Zusammenfassen der APIs in einem Gateway könnte man auf die Idee kommen, die Autorisierung in dem Gateway durchzuführen. In dem Fall muss man sich aber im Klaren sein, dass bei Verwendung von RemoteSchemata grundsätzlich nur die Daten zur Verfügung stehen, die der User angefragt hat „“ Außer man weißt den Server ausdrücklich drauf hin, mehr Daten anzufragen. Das geht zum Beispiel auch über das Schema Stitching. Näheres dazu steht in unserem Blogeintrag zum Thema Autorisierung. ### **Zusammenfassung** Auch mehrere Server lassen sich mit GraphQL Tools zu einem einzigen Endpunkt zusammenfassen und die Funktionalität mit SchemaStitching erweitern. Remote Server können problemlos eingebunden werden, auch Autorisierungsinformationen wie JWTs können bei jeder Anfrage an diese mitgereicht werden. Nur die Autorisierung wird dadurch etwas aufwändiger, aber auch die Probleme sind lösbar. **Kategorien:** Integration --- ### [OC|Expert Camp - Die Verwandlung mit Kafka](https://thecattlecrew.net/2019/05/07/ocexpertcamp-die-verwandlung-mit-kafka/) **Published:** Mai 7, 2019 **Author:** Eric Nguyen **Content:** Am 21.03.2019 fand wieder ein Coding Kata der OC|Expert Camp Reihe in der Münchner Niederlassung statt. Das Event wurde von uns Werkstudenten, Sebastian Liedl, Manuel Styrsky und Eric Nguyen abgehalten. Das Ziel dieser Veranstaltung war es, interessierten Entwicklern eine kurze Einführung in die Big-Data- Technologie „Apache Kafka“ zu geben. Kafka wurde von LinkedIn zur Bearbeitung von Datenströmen entwickelt. Unterstützung bei der Organisation erhielten wir dabei von Pascal Humbert und Theresa Andla. ## **Introduction** Wir starteten um 18 Uhr mit ca. 20 Teilnehmern. Zu Beginn erhielt jeder Teilnehmer eine IP-Adresse und einen SSH-Key, um sich mit seiner persönlichen EC2-Instanz zu verbinden. Die EC2-Instanz wurde später für das Hands On Hacking verwendet, da dort das Kafka System schon vorinstalliert war. Anschließend begannen wir mit einer Erklärung der Kafka Basics, in der wir näher auf die Eigenschaften und die Grundkomponenten von Apache Kafka eingegangen sind. Danach wurden die nötigen Konfigurationen mit der Gruppe besprochen und durchgeführt. Das Setup zur SSH-Verbindung und der Verbindung zur Datenbank hat etwas Zeit in Anspruch genommen, da alle Security Maßnahmen und SSH-Tunnel beachtet werden mussten. Letzten Endes haben es natürlich alle geschafft! ## **Hands On Hacking!** Nach dem die Konfigurationen erledigt waren, fand nun der Part mit dem Hands On Hacking statt. Die Aufgabe bestand darin die Schnittstellen eines Kafka Systems, nämlich einen Kafka Producer, Kafka Streams und Kafka Consumer mittels Java zu implementieren. Die Rahmengeschichte für das Hands On Hacking stellte ein Zoo dar, aus dem die Tiere (unsere Daten) ausgebrochen sind. Auf dem Weg zum Paradies (die Datenbank) haben die Tiere natürlich noch Hunger und andere Zustandsänderungen hinter sich zu bringen. Dafür stellten wir den Teilnehmern ein Codegerüst zur Verfügung, welches den Einstieg erleichtert hat. Die erste Komponente war ein Producer, der zufällig Tiere erstellt. Die Teilnehmer sollten diese Daten an das Kafka-System schicken, welches mit der Streams API den Datensatz (das Tier) mit zusätzlichen Informationen anreichert. Der letzte Teil der Aufgabe bestand darin, mittels des Kafka Consumers, die Nachrichten (die Tiere) von Kafka auszulesen und in einer Datenbank persistent zu speichern. Mit dieser Aufgabe wollten wir das theoretische Basiswissen, welches davor in der Präsentation vorgestellt wurde, zur Anwendung bringen. Währenddessen gab es wie immer Pizza, Snacks und Getränke für alle! ## **Conclusion & Feedback** Zudem halfen wir bei Fragen oder Problemen gerne weiter und es war ebenfalls genügend Raum für spannende Diskussionen. Abgerundet hat das Meetup eine Feedbackrunde, in der die Teilnehmer ihre Eindrücke zum Meetup und Kafka im Allgemeinen teilen konnte. Die Teilnehmer waren wirklich sehr begeistert und würden gerne wiederkommen! Eines der besten Feedbacks, die uns in Erinnerung geblieben ist, war „Opitz kann stolz auf seine Werkstudenten“ sein. Ein super Meetup! ![](https://thecattlecrew.net/wp-content/uploads/2023/09/20190321_211327.jpg) **Kategorien:** Tech Events & Networking --- ### [Lebensrettungs-Award für Dr. Andreas Wagener](https://thecattlecrew.net/2019/07/08/lebensrettungs-award-fuer-dr-andreas-wagener/) **Published:** Juli 8, 2019 **Author:** Falk Ißmer **Content:** Zum ersten Mal zeichnete die Deutsche Lebens-Rettungs-Gesellschaft (DLRG) Mitglieder des Vereins, die durch uneigennützigen Einsatz Menschen aus Wassergefahren gerettet haben, mit dem Lebensrettungs-Award aus. Zu diesen Mitgliedern gehört auch unser Kollege Andreas Wagener, der im März den Award für die Rettung eines Tauchers überreicht bekam. Andreas ist nicht nur ein geschätzter Kollege, sondern auch privat sehr engagiert, wie beispielsweise als Taucheinsatzführer bei der DLRG im Bezirk Essen. Bei einem seiner Einsätze in Haltern am See wurden zur technischen Kontrolle eines Schwimmstegs zwei Tauchstellen eingerichtet. Als Andreas seinen Suchtauchgang an einer der beiden Einsatzstellen beendet hatte, wurde plötzlich festgestellt, dass der zweite Taucher nicht mehr auf Signale reagierte. Andreas beschloss, trotz eines hohen Eigenrisikos, nach dem Kollegen zu suchen und stellte fest, dass sich dessen Lungenautomat in der eigenen Signalleine verfangen hatte, sodass kein Atemgas mehr zugeführt werden konnte. Andreas schaffte es, den bewusstlosen Kameraden, der bereits einen Herzkreislaufstillstand erlitten hatte, an die Oberfläche zu bringen. Dank der schnellen Handlung konnte der Taucher reanimiert werden und diesen schwerwiegenden Unfall ohne bleibende Schäden überleben. Auf Grund dieser herausragenden Leistung wurde Andreas von Reiner Wiedenbrück, Präsident des Landesverbandes DLRG Nordrhein e.V. und Carina Gödecke, Landtagsvizepräsidentin NRW, im Düsseldorfer Landtag am 12.03.19 der wohlverdiente Lebensrettungs-Award überreicht. Wir gratulieren Andreas zu dieser Auszeichnung und freuen uns, Mitarbeiter zu haben, die genau wie OC, Werte wie Hilfsbereitschaft und kollegialen Einsatz vertreten. **Kategorien:** Tech Events & Networking --- ### [OC Digital Assistant – ein Chatbot fürs Unternehmen](https://thecattlecrew.net/2019/07/18/oc-digital-assistant-ein-chatbot-fuers-unternehmen/) **Published:** Juli 18, 2019 **Author:** Leon Sienknecht **Content:** Chatbots werden immer häufiger im Unternehmenskontext eingesetzt. Denn Menschen lieben auch bei der Arbeit bequeme Lösungen und brechen Suchaktionen häufig ab, solange sie diese selbst durchführen müssen. Chatbots können den Service an dieser Stelle erheblich verbessern. Außerdem können sie in einem Unternehmen zu spürbaren Kosteneinsparungen führen, wenn durch ihren gezielten Einsatz, z. B. im FAQ-Bereich, personelle Ressourcen woanders besser eingesetzt werden können. Es gab also einen guten Grund, uns im Digitallabor von OPITZ CONSULTING mit dem Thema zu beschäftigen. Am Anfang des Projekts war noch gar nicht klar, wo die Reise für uns hingehen würde. Wir, ein Studierendenteam, näherten uns dem Thema zunächst, indem wir eine Marktübersicht über alle existierenden Chatbot-Frameworks und -Plattformen erstellten und eine Shortlist evaluierten. Parallel suchten wir nach eindeutigen Definitionen, um herauszufinden, was einen Chatbot eigentlich ausmacht. Kurzgefasst könnte die Definition so lauten: *„Der Chatbot ist ein System, das Nutzeranfragen auf der Basis von Text- oder Spracheingaben selbständig beantworten kann. Die Antworten des Chatbots können dabei entweder „hard-gecoded“ sein oder durch eine künstliche Intelligenz verarbeitet werden.“* Letzteres lässt auch offenere Fragen zu. Bei der Recherche zum Thema Chatbots stießen wir immer wieder auf den Begriff Conversational User Interface (UI). Dabei handelt es sich um das Medium, das die Konversation mit dem Nutzer und dem Chatbot, also die Text- oder Spracheingabe, simuliert. Eine weitere Frage, die uns interessierte, war, ob es evtl. auch noch andere Einsatzmöglichkeiten für einen Chatbot geben könnte, die über das einfache „Frage-Antwort-Spiel“ hinausgehen. Dabei fiel uns das Konzept des Digital Assistant ins Auge. Digital Assistants kennt heutzutage fast jeder aus dem täglichen Leben. Nutzern eines iPhones sind sie beispielweise als Siri bekannt. Besitzer eines Smartphones von Samsung sind garantiert schon mal auf die „Bixby“-Taste gekommen und viele haben heute schon eine Amazon Alexa im Wohnzimmer stehen. Dies sind alles Beispiele für einen Digital Assistant. Sie besitzen die Grundfunktionalitäten eines Chatbots, können darüber hinaus aber bestimmte Aufgaben für den Nutzer ausführen. Der Digital Assistant wertet in der Regel personenbezogene Daten sowie historische Nutzerdaten aus, um den Dienst zu personalisieren. *Das gab uns die entsprechende Motivation: Wie cool wäre es, wenn auch unser Unternehmen einen Digital Assistant hätte“. Schon war ein spannendes innovatives Projekt geboren.* Seit kurzem arbeiten wir nun daran, einen Digital Assistant für die unternehmensinterne Verwendung zu entwickeln. Auf diese Weise erkunden wir, welche Möglichkeiten ein Digital Assistant für den Einsatz in einem Unternehmen zu bieten hat. Vielleich auch für unsere Kunden eine interessante Option! Angedacht sind daher Funktionalitäten wie Buchungen in unser Zeiterfassungssystem, das Erstellen von Tickets für Supportanfragen oder Reisebuchungen, aber auch die eigenständige Beantwortung von Fragen aus den Bereichen IT, Personalwesen oder Fuhrparkmanagement. Vielleicht kann der Digital Assistant ja nicht nur die tägliche Arbeit unserer Kollegen erleichtern, sondern sogar komplexere Aufgaben, wie das Onboarding für neue Mitarbeiter, unterstützen. Der Digital Assistant ist sowohl am Arbeitsplatz als auch mobil in einer eigenen App geplant. Schon bald soll ein erster Prototyp seine Arbeit aufnehmen. Wir sind also schon sehr gespannt und werden weiter berichten. **Kategorien:** AI & Data Science --- ### [Flexibel wie Lego: Wie uns das agile Rahmenwerk OKR hilft, die Unternehmensstrategie umzusetzen](https://thecattlecrew.net/2023/06/05/flexibel-wie-lego-wie-uns-das-agile-rahmenwerk-okr-hilft-die-unternehmensstrategie-umzusetzen/) **Published:** Juni 5, 2023 **Author:** Melanie Deutschmann **Content:** Bei OPITZ CONSULTING gab es in den letzten 10 Jahren immer wieder kluge und für die Zeit richtige Strategieinitiativen. Aber vielleicht kennst du das auch: Der Plan kann noch so gut sein. Spätestens am Jahresende stellen wir fest, dass wir unsere Strategie nicht so konsequent umgesetzt bekommen wie gedacht. Waren wir zu statisch? Als IT-Unternehmen kennen wir uns mit agilen Methoden aus. Also fragten wir uns: War es möglich, eine Unternehmensstrategie so agil zu entwickeln wie eine Software? Oder eine Legostadt? So kamen wir zu OKR. # Warum OKR? OKR (Objectives and Key Results) bietet für Strategien und ihre Umsetzung ein elegantes und mächtiges Rahmenwerk: Ein einheitliches Format, um über Ziele zu sprechen und diese zu verfolgen. Ein kontinuierlicher OKR-Prozess hilft, die angestrebten Ergebnisse zu operationalisieren. Die OKR-Architektur macht die Beziehungen zwischen den Zielen sichtbar, um lang- und kurzfristige Ziele der Organisation zu synchronisieren. Mit OKR wollten wir von nun an mehr Konsequenz, Wucht und Kontinuität in die Umsetzung unserer Unternehmensstrategie bekommen. Statt wie bisher ausgefeilte Strategien zu präsentieren – bis ins Detail ausdefiniert, in langen Sitzungen und mit viel Energie auf Papier gebracht – erlaubt OKR es, nachzusteuern, zu schauen, was funktioniert und anzupassen. Die Welt verändert sich rasant schnell und das agile Framework hilft uns, nicht an Zielen aus einer Welt von gestern festzuhalten. Das Framework bringt uns bei, dass wir uns iterativ – also immer wieder neu – darüber verständigen, was getan werden darf, wenn wir die angestrebten lang- und oder mittelfristigen Ziele erreichen wollen. Dieser Austausch erzeugt ein gemeinsames Verständnis für Herausforderungen und macht es möglich strategische Ziele gemeinsam zu verfolgen. - **Messen und überprüfen:** Die Messbarkeit, die OKR mitbringt, sorgt dafür, dass das Bauchgefühl aus der Bewertung verschwindet und konkrete Maßstäbe in die Umsetzung einziehen. Die mit definierten Ziele sind eindeutig und somit gnadenlos. Diese Klarheit zwingt uns die Frage auf: Was können wir besser oder anders machen, um die Ziele zu erreichen, die wir uns gegeben haben? - **Vernetzt arbeiten:** Auf Leitungsebene gesetzte Ziele sickern durch die Organisation und werden dezentral umgesetzt. Statt eine Strategie von oben nach unten von der Geschäftsführung bis in die kleinste Einheit Schritt für Schritt auszurollen, sind wir heute in der Lage, über Regionen verteilt gemeinsam und gut vernetzt daran zu arbeiten, Ziele zu definieren und umzusetzen. Hier leben wir auch ganz klar das Prinzip Könnerschaft vor Hierarchie und ermöglichen, dass die jeweiligen Experten an ihren Themen arbeiten können. - **Vielfältige Funktionen und Abteilungen einbinden:** Mit OKR können wir ohne Probleme in interdisziplinären Teams zusammenarbeiten und darüber hinaus auch die Intelligenz der Organisation nutzen. Klar ist auch: Das funktioniert alles noch nicht reibungslos oder gar total effizient. Aber mit der Klarheit darüber, wo wir hinwollen, sind wir heute besser als wir es 2021 waren und wissen, dass wir 2024 besser sein können als wir es heute sind. # Wie wir OKR eingeführt haben Seit der Einführung des Frameworks bei OC sind anderthalb Jahre vergangen. In den ersten zwölf Monaten haben sehr viel falsch gemacht und dadurch noch mehr gelernt. Zuerst haben wir die Methode im Führungskreis eingeführt. Dann wurde sie auf Teile des Managements ausgeweitet. Es war gut, in diesem geschützten Raum zu starten. So waren wir freier, Fehler zuzulassen und hatten einen geschützten Lernraum. ## Vom MOAL zum Jahresziel Im ersten Jahr haben wir bei OC mit rein qualitativen Zielen, sogenannten Midterm Goals, kurz MOALs, gearbeitet. Für den Anfang bieten sich diese Art der Ziele an, weil es noch keine messbaren Ergebnisse gibt, bzw. geben kann. 2023 haben wir unsere Ziele um eine quantitative Komponente erweitert und arbeiten seitdem mit Jahres-OKRs, die der Organisation Orientierung und Richtung für die Umsetzung geben. Damit erhalten wir auch mittelfristig messbare Key-Results, an denen wir auf Jahresebene Erfolge und Misserfolge eindeutig einordnen können. ## Eine Zielarchitektur bauen Unsere Strategie hat einen übergeordneten Namen bekommen: #zukunftswirksam. Darunter können wir Jahres- und Trimester-OKRs einordnen. Aus den Jahres-OKRs entstehen Initiativen, an denen interdisziplinäre Teams arbeiten. Diese Teams verfolgen bestimmte Ziele, die auf die Strategie einzahlen. Diese werden vom Führungskreis priorisiert und geben sich Trimesterziele, die jeweils auf ein oder mehrere Jahres-OKRs einzahlen. Stein für Stein können wir so unsere strategische „Zielwelt“ und die operativ-wirtschaftliche Jahresplanung zusammenbringen und eine Zielarchitektur errichten, die eine klare Orientierung schafft. # Wie agil sind wir heute? Jede Form des agilen Arbeitens braucht einen inhaltlichen Fixpunkt. Eine Vision, die klar macht, wohin es gehen soll. Und eine Strategie, die den Weg dahin beschreibt. Und diese Strategie darf dann von allen Beteiligten gleichermaßen verstanden und angenommen werden. Das klingt auf den ersten Blick logisch oder gar marginal. Aber tatsächlich ist genau das in vielen Unternehmen nicht geklärt. ## Nährboden schaffen Da wird OKR oder ein anderes Framework mit den besten Absichten und einer Sehnsucht nach mehr Selbstorganisation eingeführt und scheitert krachend an einer Firmenkultur, die diese agilen Keimzellen nicht aufzunehmen vermag. Oder sie abstößt. Um das zu verhindern, hat unsere Geschäftsführung mit der Strategie #zukunftswirksam viele Grundsteine gelegt und einen Nährboden geschaffen, auf dem wir jetzt agile Zusammenarbeit im gesamten Unternehmen kultivieren können. Die Strategie beantwortet Fragen wie - Wo wollen wir hin? - Was wollen wir in 1, 3, 5 Jahren erreicht haben? ## Mit dem Mandat der Geschäftsführung Dazu kommt, dass sich die Geschäftsführung bei strategischen Fragen mit der Methode OKR arbeitet. Wir beide, also Melanie und Tobi, wurden als OKR Coaches mandatiert. So können wir mit einem klaren Auftrag aus der Geschäftsleitung arbeiten und gemeinsam mit dieser und dem Führungskreis die Strategie durch die Organisation tragen und für Orientierung, Richtung und Drive in der Umsetzung sorgen. ## Agil in Grautönen Was die Agilisierung der alltäglichen Umsetzung angeht so sind wir ehrlicherweise sehr unterschiedlich unterwegs. Einige Teams arbeiten in sehr reifer agiler Vorgehensweise an ihren Zielen. Andere sind eher Hands-On unterwegs und arbeiten einfach mit festen Zeitslots und Aufgaben, die sie sich gegenseitig zuweisen. Was alle eint ist, dass wir eine Richtung beobachten können, in die die Arbeit geht und das ist die Richtung der OKRs, die sich die Teams geben. Dies und die transparente Kommunikation dazu sind ein großer Fortschritt. ## OKR Master begleiten den Prozess Wir haben beim Start angefangen, eine OKR Master Gruppe auszubilden, die die Initiativen unterstützen und begleiten. Durch den Aufbau dieser internen Kompetenz mit ca. 6 OKR-Mastern, geben wir den Teams Sicherheit im Framework und Ansprechpartner bei Schwierigkeiten. Die Ausbildung bestand dabei – wie so oft – aus Theorie und Praxis. Im Doing geht es für uns alle darum zu lernen, was die Teams brauchen, um gut orientiert zu sein. Welche Fragen helfen? Welche Vehemenz ist angemessen? Und was braucht es in der Rolle des OKR-Masters? In dieser Zeit haben wir alle sehr viel gelernt und lernen jeden Tag dazu. Auch das ist Agilität. So laufen wir jetzt ganz anders durch die Zyklen als früher. Weniger dogmatisch als am Anfang, angepasster an unsere Organisation und unseren Reifegrad und bestimmter dort, wo wir überzeugt sind, dass Dinge noch nicht sauber formuliert sind oder Ziele konsequent verfolgt werden. Das war ein Lernprozess; ausprobieren, sich mit der Methode vertraut machen, die ersten OKRs zu formulieren und dann kontinuierlich zu überlegen, wie wir besser werden können. Als OKR-Master unterstützen wir uns auch intern, indem wir mit draufsehen und in dem wir uns untereinander gut vernetzen. Wir tauschen uns untereinander und mit einer externen Beratung aus, unterstützen und hinterfragen uns, um uns gegenseitig besser zu machen. Am Ende zählt das Gesamtpaket, alles, was dazu führt, dass wir die Teams gut durch die Zyklen, bringen können, ist willkommen. Genauso dankbar sind wir, wenn wir als OKR-Master Feedback aus den Teams bekommen. Dann können wir Anpassungen vornehmen und überlegen: „Okay, der eine Punkt, der grauen Theorie ist, ist tatsächlich passend für uns und der zweite vielleicht nicht.“ # Wo stehen wir heute? Wurde OKR schon komplett ausgerollt? Wir sind auf einem guten Weg, aber noch längst nicht am Ziel. ## Alignment vor Kaskadierung Zuerst brauchten wir ein Alignment über die Strategie und darüber, wie sie kaskadiert, in welchen Stufen sie ausgerollt werden kann und welche Veränderungen das nach sich zieht. Vor allem aber war es wichtig, Klarheit zu schaffen und zu erklären, wo es hingehen soll, bevor es an die Umsetzung geht und alle loslaufen. ## Gerüstet für Neues Hier ist eine agile Methode von Vorteil: Wir können explorieren, Hypothesen aufstellen, Neues ausprobieren, Fehler machen, gegebenenfalls Ansätze verwerfen und uns neu aufstellen. Das ist manchmal unbequem und für viele ungewohnt. Doch mit alten Denkweisen lassen sich viele neue Probleme nicht mehr lösen. Deshalb ist es wichtig, andere Wege zu suchen. Insgesamt gelingt uns das schon gut. Aber wir haben auch Raum für Verbesserungen. ## Und was machen eigentlich … wir Coaches? Wir fühlen tatsächlich wie Coaches, die dem Unternehmen folgen – immer da, immer nah. Der Begriff passt für uns besser als „Master“. Wir haben nicht das Gefühl in etwas eine Meisterschaft erlangt zu haben, sondern sind lernende Prozessunterstützer:innen. Dabei wollen wir die Beteiligten aber auch alle anderen befähigen, die entscheidenden Schritte selbst zu gehen. Dafür schulen wir, moderieren, vermitteln und begleiten. Wir erklären und kommunizieren die Idee hinter OKR. Zum Beispiel hier in diesem Blogbeitrag. Wir helfen alte Strukturen aufzubrechen und neue aufzubauen. Moderieren Workshops und begleiten die Organisation über viele Jahre. Drei Punkte möchten wir zum Abschluss noch erwähnen: - **Zeit geben:** Denn auch die Strategie #zukunftswirksam wird nicht an einem Tag erbaut. Zu OKR gehört es, Erkenntnissen die Zeit zu geben, reifen zu können, Sicherheit zu geben, wenn es mal eine blutige Nase gibt. Damit sich Mut und Spaß an der Umsetzung entwickeln können. - **Wissensbasis aufbauen:** Was uns in der aktuellen Transformation wahnsinnig hilft, ist das wir im Unternehmen bereits jede Menge Know-how rund um Prozesse und kulturelle Aspekte der Changeability und des Change Managements haben. Es hilft uns, Orientierung und Sicherheit zu stiften. Die Mitarbeitenden kennen diese und ähnliche Prozesse aus ihrer täglichen Arbeit – das macht es für alle Beteiligten leichter. Wir sprechen hier also mit Sehenden. - **Gemeinsame Ergebnisse zählen:** An diesen Punkt müssen wir uns alle immer wieder erinnern: OKR ist kein Tool, mit dem wir Performance messen. Sondern ein Vorgehen, mit dem wir gemeinsam Ergebnisse erzeugen; durch Fokus, Taktung, Überprüfung und stetige Verbesserung. **— Mehr darüber „hören“?** Im #DNO Podcast durften wir darüber sprechen, wie wir OKR bei OC eingeführt haben: [https://digitaleneuordnung.de/blog/okr-im-unternehmen-einfuhren](https://digitaleneuordnung.de/blog/okr-im-unternehmen-einfuhren?ppplayer=1eccdd7558e52a27478bae09fef24528&ppepisode=538c4dd4ed58f6454bf0512aab1c78aa "Zum Podcast") – Um den Podcast zu hören, einfach unter „Quick Wins“ auf das Podcast Icon klicken! **Tiefer ins Detail eintauchen?** In unserem nächsten Blogpost werden wir noch genauer auf das OKR Framework und methodische Aspekte eingehen. Bleibt also gerne dran 🙂 **Kategorien:** Tools & Methoden **Schlagwörter:** Agil, Agile Methode, Agility, Key Results, Objectives, OKR, Strategie, Unternehmensstrategie, Ziele, zukunftswirksam --- ### [Mit Open Source in den Data Lake](https://thecattlecrew.net/2023/05/10/mit-open-source-in-den-data-lake/) **Published:** Mai 10, 2023 **Author:** Robert Loke **Content:** Wer mehr weiß, kommt schneller voran. Deshalb sind Informationen so wichtig für Unternehmen und Organisationen. Ob technologisch, wirtschaftlich oder organisatorisch: Die Daten, die einem Unternehmen helfen, besser zu werden, gibt es heute in großen Mengen. Sie sind verschiedenartig und stammen aus den unterschiedlichsten Quellen. Diese Datenmengen zu beherrschen, ist also keine leichte Aufgabe. Neben den Produkten großer Anbieter kommerzieller Softwarelösungen haben sich im Laufe der letzten Jahre einige neue Initiativen gegründet, die qualitativ hochwertige Softwarelösungen als Open Source der Öffentlichkeit zur Verfügung stellen. Damit lässt sich die Abhängigkeit von kommerziellen Lösungen deutlich reduzieren. Kommerzielle Software kann entweder vollständig ersetzt werden oder deutlich reduziert werden, z. B. bei der Migration von einem Anbieter zu einem anderen. Denn die Open-Source-Konkurrenz stärkt die Position der Anwendenden, wenn es um Lizenzkosten geht. Open Source bietet die Vorteile, zunächst ohne Lizenzen auskommen zu können und in der Regel die Unterstützung sachkundiger Nutzer der Software in Anspruch nehmen zu können. Allerdings verweisen kommerzielle Anbieter nicht zu Unrecht darauf, mit ihren Lösungen wohldefinierte Services (sowohl in Form von „service level agreements“ („SLAs“) mit zugesicherten Antwortzeiten und Eskalationspfaden als auch in Form von geplanter Produktweiterentwicklung) und somit einen Werterhalt ihrer Softwarelösung anzubieten. Trotzdem weist Open Source BI Software (OSBI) einen Reifegrad auf, der eine intensivere Betrachtung dieser Softwarelösungen rechtfertigt. ## Ein Data Lake im Open-Source-Biotop ![](https://thecattlecrew.net/wp-content/uploads/2023/03/DL_DWH_Struktur-229x300.png) Aus Sicht des Datenanalysten ist es unerheblich, wo und wie genau die Daten gespeichert werden. Entscheidend ist, dass die Daten schnell zur Verfügung stehen, die Daten sollen vor unberechtigtem Zugriff geschützt und vor Verlust gesichert werden. Gleichzeitig sollen – aus betriebswirtschaftlicher Sicht – die Kosten für die Datenspeicherung so gering wie möglich gehalten werden. Daher werden eher teure Speicher verwendet, um häufig abgefragte Datenbestände schnell bereitstellen zu können. Seltener genutzte Teile des Gesamtdatenbestandes werden in kostengünstigere Speicher mit eher langsamen Zugriffen ausgelagert. Gleichzeitig hat sich in den letzten Jahren ein Trend zu diversen Datenformaten etabliert: Waren vor 10 Jahren noch alle Datenquellen wohl strukturiert, ist es in modernen Umgebungen erforderlich, auch semi- und unstruktuierte Daten in Analysen einbeziehen zu können. Zudem hat nicht die Expansion der zu behandelnden Datenvolumina dazu geführt, dass Daten sukzessiv weniger in lokalen Server(-farmen) gehalten sondern eher in Cloud-Umgebungen ausgelagert werden. Um die technische Umsetzung der Datenspeicherung von der logischen Datenmodellierung zu separieren, wird durch die Kapselung die physikalische Architektur der Speichermedien und -netze sowie die konkreten Speicherformate (als CSV- oder Parquetdateien oder in relationalen Datenbanken) verborgen. Für den Analysten sollten alle Entitäten gleich aussehen. Deshalb wird idealerweise die physische Datenmodellierung schon auf Geschäftsentitäten abgebildet. ### Kapselung der physikalischen Speicherarchitektur mit MinIO [MinIO](https://min.io/) ist ein Open-Source-Produkt zur Kapselung der physikalischen Speicherarchitektur und Automatisierung von Speicherprozessen. Es wird die Speicherung on Objekten auf lokalen Festplatten ebenso unterstützt wie auf den Cloudplattform von AWS (S3), Google Cloud (Google Cloud Storage) und Microsoft (Azure Blob Storage). Ebenso werden S3-kompatible Speicher unterstützt. Daten auf unterschiedlichen Plattformen zu speichern bietet auch die Möglichkeit, dass Daten automatisiert und für den Benutzer transparent repliziert werden können. Das schützt sie gegen Datenverlust, verbessert die Verfügbarkeit und verringert die Abhängigkeit von einem Cloudservice – Anbieter. Mehr Transparenz für den Anwendenden entsteht dadurch, dass es einen Serverprozess gibt, der die Verbindungen zu den diversen Speichern unterhält und in einem Metadatenspeicher die Lokalisation der einzelnen Objekte hinterlegt hat. Dieser zentrale Knoten ist es letztendlich auch, der die Replikation der Daten über die Grenzen des jeweiligen Speichers hinweg regelt, Daten verschlüsselt, Zugriffe auf die Objekte steuert und die Last auf die verschiedenen Speichersystem verteilt. Zur Verschlüsselung der Daten können sowohl interne als auch externe Schlüssel verwendet werden. In jedem Fall ist es ratsam, einen auch extern bekannten Schlüssel zu verwenden, um im Störfall (sollte MinIO nicht verfügbar sein) immer noch der Zugriff auf die verschlüsselten Daten zu gewährleisten. ### Datenabfrage mit Trino Zur Abfrage der Daten bietet sich die Query Engine [Trino](https://trino.io/) an. Trino ist die Open-Source-Variante des kommerziellen Pakets „Starburst“, bietet eine weitgehende Integration in die MinIO-interne Query Engine und ermöglicht via spezifischer Adapter und/oder JDBC eine Anbindung an praktisch alle anderen Datenbanken und Werkzeuge. ### Transformation und Analyse geladener Daten mit DBT und DBeaver Eines der aktuell favorisierten OSBI-Werkzeuge zur Datentransformation ist [DBT](http://http_//www.getdbt.com). Dieses sowohl als Cloud- als auch On-Premise-Variante verfügbare Tool erlaubt die Transformation von Daten in SQL. Um mit einem SQL-Editor auf die Datenbasis zuzugreifen, bieten sich für interaktive Tätigkeiten SQL-Editoren wie der [DBeaver an](https://dbeaver.io/), der in seiner Community – Version ebenfalls als Open Source – Variante verfügbar ist. ## Die Werkzeuge genauer betrachtet Um es vorweg zu nehmen: Die unter Open-Source-Lizenzen verfügbaren Werkzeuge bieten oft gute Lösungen für spezifische Aspekte des Gesamtkonstrukts „Data Warehouse“ – aber keine umfassende Lösung. Entscheidend ist daher weniger das einzelne Werkzeug, sondern viel mehr die Interoperabilität der verwendeten Werkzeuge. Von daher ist auch ein detaillierter Blick auf die Werkzeuge sowie deren Konfiguration für ein gutes Zusammenwirken sinnvoll. ### Installation und Konfiguration von MinIO Die Anwendung MinIO besteht aus einem Server- und einem Clientprozess sowie einem SDK. Das SDK wird insbesondere zur Implementierung der Beladungsprozesse erforderlich werden, auf die ich in diesem Post nicht näher eingehe. Der Clientprozess ist eine Kommandozeilenschnittstelle (CLI) und erweist sich für den Regelbetrieb als etwas zu unhandlich, im Störungsfall kann er aber sehr nützlich sein. Das Herz der Anwendung ist jedoch der Serverprozess. Dieser ist für das Prozessmanagement zuständig, regelt die Datenzugriffe und nimmt die Anfragen entgegen. #### Installation des Serverprozesses Alle zur Installation erforderlichen Dateien sind auf der [Homepage des Projekts](http://min.io) verfügbar. Voraussetzung für die Installation ist ein 64-bit Betriebssystem, wahlweise Windows, Linux oder macOS. Darüber hinaus stehen auch Container für Docker oder Kubernetes zum Download bereit. Beispielhaft wird hier die Installation unter RHEL 9.1 beschrieben. Für die Installation unter RHEL 9.1 bietet sich der Weg über rpm/yum an. Hierbei ist jedoch zu beachten, dass die Installation selbst unter dem Administrator-Account stattfindet. Entsprechend werden die ausführbaren Dateien auch unter /usr/local/bin installiert. Für die reguläre Arbeit sind die Administratorprivilegien jedoch nicht erforderlich. ``` #Installation des RPM-Pakets yum -y install https://dl.min.io/server/minio/release/linux-amd64/minio-20230322063624.0.0.x86_64.rpm #Umgebungsvariablen export MINIO_ROOT_USER=admin export MINIO_ROOT_PASSWORD=password #Start des Serverprozesses minio server --console-address ":" ``` Der „MinIO Pfad“ ist ein Verzeichnis auf dem lokalen Filesystem. Der Benutzer, unter dem MinIO gestartet wird, benötigt auf diesem Pfad Schreib- und Leserechte. In diesem Verzeichnis werden (ggf. temporär) Daten sowie Log-Dateien gesichert. Der im Grunde frei zu definierende Port darf lediglich nicht von einem anderen Prozess belegt sein. Nach dem Start des Serverprozesses ist die Administrationskonsole im Browser zu öffnen. In diesem Beispiel wurde der Serverprozess auf dem Port 9090 gestartet: ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_console-1024x582.png)Abbildung 1: Screenshot des MinIO-Dashboard Sobald der Serverprozess läuft kann mit der Konfiguration begonnen werden, die den späteren Datenzugriff ermöglicht. #### Konfiguration von MinIO für den Zugriff durch Trino Damit MinIO Daten speichern kann, muss der jeweilige Speicherort definiert werden. Zudem ist es empfehlenswert, einen Benutzer zu definieren, mit dem Trino auf das System zugreift. Diese Schritte werden im folgenden Abschnitt demonstriert. ##### Anlegen eines Benutzers Nach dem Öffnen der Administrationskonsole wird nach Auswahl von „Identity“ (1) -> „Users“(2) eine Eingabemaske eingeblendet, die zunächst die Liste vorhandener User anzeigt. Durch Anklicken von „Create User“ (3) wird dieser Liste ein neuer Anwender hinzugefügt. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_create_user-1024x634.png)Abbildung 2: Benutzerverwaltung in MinIO Hierzu wird eine weitere Eingabemaske aufgeblendet, welche die Parameter des neuen Benutzers abfragt. Nach Eingabe des Benutzernamens (1) und des Passwortes (2) sind noch die Berechtigungen („policies“) hinzuzufügen. Dieses geschieht entweder durch direkte Zuordnung der Policies durch Auswahl der entsprechenden Auswahlboxen (3) oder indirekt durch Zuordnung des Benutzers zu den entsprechenden Gruppen (4). Bei der indirekter Zuordnung erhält der User die Policies, die der Gruppe zugeordnet wurden. Darüber hinaus ist eine Mischform der Zuordnung möglich: Der Benutzer kann einer Gruppe zugeordnet werden und zusätzliche Policies direkt zugeordnet bekommen. Hierbei kann es zu der Situation kommen, dass zugeordnete Policies einander widersprechen. In diesen Situationen gilt, dass - direkt zugeordnete Policies Vorrang (Priorität) gegenüber indirekt zugeordneten Policies erhalten - bei gleichen Prioritäten gilt die restriktivere Policy. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_define_user-1024x637.png)Abbildung 3: Anlegen eines neuen Benutzerkontos in MinIO ##### Konfiguration der Zugriffsschlüssel Insbesondere im Cloud-Kontext erfolgt die Authentifizierung nicht mit Benutzername und Passwort sondern über Zugriffsschlüssel. Auch diese Verfahren werden von MinIO unterstützt. Hierbei werden personifizierte Zugriffsschlüssel (also solche, die einem Benutzer zugeordnet sind) und nicht-personifizierte Zugriffsschlüssel unterschieden. Zur Anlage von personifizierten Zugriffsschlüsseln ist nach der Anlage des entsprechenden Benutzers dieser durch Anklicken des stilisierten Bleistifts zur Modifikation geöffnet. Es erscheint die Eingabemaske ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_create_access_key-1024x571.png)Abbildung 4: Liste der Zugriffsschlüssel Durch Anklicken von „Create“ wird der Access Key angelegt. Allerdings sollte nicht versäumt werden, den Secret Key zu sichern – dieser kann später nicht mehr angezeigt werden. Per default „erbt“ dieser Access Key aller Policies, die dem Account zugeordnet sind. Durch Anklicken des Access Keys lässt sich ein Editorfenster öffnen, in dem die Policies explizit definiert werden können. Nähere Infos hierzu sind der [Dokumentation](https://min.io/docs/minio/linux/administration/identity-access-management/policy-based-access-control.html) zu entnehmen. Zur Definition von nicht-personifizierten Zugriffschlüsseln ist unter der dem Menüpunkt „User“ der Unterpunkt „Access Key“ (1) auszuwählen. Wie bei den Benutzern erscheint auch hier zunächst die Liste bereits angelegter Zugriffsschlüssel sowie die Buttons zur Verwaltung dieser Liste. Hier können die vorhandenen Zugriffsschlüssel sowohl gelöscht oder verändert, aber auch neue Schlüssel angelegt werden. Zur Anlage neuer Schlüssel ist der Button „Create Access key“ (3) anzuklicken. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_create_user_access_key-1024x573.png)Abbildung 5: Anlegen eines neuen Zugriffsschlüssels Eine Anmerkung: Zwar könnte unter „Change Password“ der „Secret Key“ verändert werden, da es allerdings keine Liste gibt, an Hand derer nachvollziehbar wird, an welchen Stellen dieser Secret Key verwendet wird, sollte diese Änderung nur im Notfall geschehen. Denn eine Änderung kann zur Folge haben, dass vorhandene Skripte/Programme keine Verbindung zu MinIO aufbauen können. Nach Anklicken von „Create Access Key“ erscheint eine weitere Eingabemaske, mit der die generierten Keys überschrieben werden können. Vor dem Speichern sollte man jedoch unbedingt den Secret Key notieren und das Key-Paar (Access Key und Secret Key) lokal sichern. Insbesondere der Secret Key kann zu einem späteren Zeitpunkt nicht mehr eingesehen werden. Dieses Fenster ist anschließend durch Anklicken des Kreuzes in der rechten, oberen Ecke zu schließen. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_create_access_credentials_download.png)Abbildung 6: Anzeige des Secret Keys (unbedingt sichern!) ##### Anlegen eines Datenspeichers Die Datenspeicher sind in Buckets (analog zu den Verzeichnissen) organisiert. Jeder Bucket wird einem physikalischen Speicher zugeordnet. Dieser kann im lokalen Filesystem liegen aber genauso gut auch in einer Cloud, wahlweise in der Google Cloud, AWS Cloud oder einem Azure Blob Store. Zum Anlegen eines Buckets wird der Menüpunkt „Buckets“ (1) ausgewählt. Auch hier erscheint wieder die Liste der bereits definierten Buckets. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_bucket_create-1024x567.png)Abbildung 7: Liste bereits definierter Buckets Durch Anklicken von „Create Bucket“ (2) wird eine Eingabemaske dargestellt, mit der die Eigenschaften des Buckets definiert werden: ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_minio_bucket_eigenschaften-1024x567.png)Abbildung 8: Anlegen eines neuen Buckets Hierzu ist zunächst der Name des Buckets anzugeben. Darüber hinaus können weitere Optionen definiert werden. So kann bei „Versioning“ (2) mehrere Versionen eines Objekts gespeichert werden. „Object Locking“ (3) gewährleistet, dass ein gespeichertes Objekt nicht überschrieben werden kann. Zudem kann mit „Quota“ (4) die maximale Größe des im Bucket vorhandenen Speichers beschränkt werden. Wird diese Option aktiviert, ist konsequenterweise auch die Größe des Speichers (5) zu definieren. Durch Klicken von „Create Bucket“ (6) wird der Bucket mit diesen Optionen angelegt. Last but not least ist dem Bucket noch der physikalische Speicherort zuzuordnen. Hierzu ist der Menüpunkt „Object Browser“ anzuklicken und in der dargestellten Liste der gesuchte Bucket auszuwählen. Mit dem Button „Create New Path“ ist der Speicherort zu definieren. Anschließend können Daten in diesen Bucket geladen werden. ##### Einschränkungen in MinIO Für die Serverprozesse von MinIO sind nur die Objekte existent, die im Metastore vorhanden sind – also nur die auch über den MinIO – Server in den Datenspeicher gelangen. Werden Dateien direkt in den Datenspeicher geschrieben, so sind diese außerhalb des MinIO-Scopes und werden somit nicht durch MinIO – Prozesse erfasst. ### Trino als Query Engine #### Installation und Konfiguration von Trino Trino hat eine Prozessarchitektur, die zwischen Coordinator and Worker unterscheiden. Jeder Cluster besteht aus einem Coordinator-Prozess und mindestens einem Worker-Prozess. Der Coordinator nimmt die Anfragen entgegen und steuert die Aktivität der Worker und die Worker beabeiten die eingegangenen Abfragen und liefern die Ergebnismengen an den anfragenden Prozess. Zur Verbesserung der Performance sollte eine Serverarchitektur mit dedizierter Hardware für Coordinator- und Workerprozesse angestrebt werden. Ähnlich wie MinIO ist Trino über den Download-Link auf der [Trino-Homepage](https://trino.io/) herunterzuladen. Hier gibt es entweder das Installationspaket als Tar-Ball oder als RPM-Paket für eine Serverinstallation oder die Container für Docker oder Kubernetes. Zur Serverinstallation habe ich den Tar-Ball heruntergeladen und entpackt. Bevor der Server gestartet werden kann, sind jedoch einige Konfigurationen erforderlich: 1. Anpassung des Betriebssystems Voraussetzung ist ein 64-Bit-Linuxsystem, wobei neuere Versionen des Betriebssystems zu bevorzugen sind. Zudem ist eine JRE von JAVA 17 erforderlich, mindestens in der Version 17.0.3, wobei die Java-Versionen 18 und 19 aktuell noch nicht unterstützt werden. Zudem ist noch die Installation von Python in einer der Versionen 2.6.x, 2.7.x oder 3.x notwendig. Darüber hinaus sind Anpassungen in der Datei /etc/security/limits.conf erforderlich, zu verhindern, dass die Anzahl gleichzeitig offener Dateien durch das Betriebssystem beschränkt wird: ``` trino soft nofile 131072 trino hard nofile 131072 ``` Nach Entpacken des Tar-Balls findet sich in dem Verzeichnis, in das der Tar-Ball entpackt worden ist, ein weiteres Verzeichnis „etc“ und dort das Unterverzeichnis „catalog“. In diesem Verzeichnis sind folgende Dateien anzulegen: 1. etc/node.properties Ein Knoten („node“) ist eine Installationsinstanz von Trino auf einem Server. Dieser wird durch die node.id eindeutig identifiziert. Daher muss der Wert dieses Parameters entsprechend angepasst werden. Folgende Parameter sind mindestens anzugeben: ``` node.environment=production node.id=ffffffff-ffff-ffff-ffff-ffffffffffff node.data-dir=/var/trino/data ``` 2. etc/jvm.config Die Ansprüche an die JVM, innerhalb der Trino laufen wird, sind jenseits der Standardeinstellungen. Daher sind folgende Optionen zu spezifizieren: ``` -server -Xmx16G -XX:InitialRAMPercentage=80 -XX:MaxRAMPercentage=80 -XX:G1HeapRegionSize=32M -XX:+ExplicitGCInvokesConcurrent -XX:+ExitOnOutOfMemoryError -XX:+HeapDumpOnOutOfMemoryError -XX:-OmitStackTraceInFastThrow -XX:ReservedCodeCacheSize=512M -XX:PerMethodRecompilationCutoff=10000 -XX:PerBytecodeRecompilationCutoff=10000 -Djdk.attach.allowAttachSelf=true -Djdk.nio.maxCachedBufferSize=2000000 -XX:+UnlockDiagnosticVMOptions -XX:+UseAESCTRIntrinsics # Disable Preventive GC for performance reasons (JDK-8293861) -XX:-G1UsePreventiveGC ``` 3. etc/config.properties Wie oben beschrieben muss für jeden Knoten spezifiziert werden, welche Aufgabe (Coordinator oder Worker) der jeweilige Knoten übernehmen soll. Diese Definition wird in der config.properties getroffen. Für einen Coordinator sind folgende Spezifikationen aufzuführen: ``` coordinator=true node-scheduler.include-coordinator=false http-server.http.port= discovery.uri=http://: ``` Für einen Worker sind hingegen mindestens die folgenden Festlegungen zu treffen: ``` coordinator=false http-server.http.port= discovery.uri=http://: ``` Jenseits von Performance-Anforderungen spricht nichts dagegen, einen Knoten so aufzusetzen, dass beide Typen auf einem Knoten laufen: ``` coordinator=true node-scheduler.include-coordinator=true http-server.http.port= discovery.uri=http://: ``` 4. etc/log.properties Diese Datei ist optional und dient dazu, den Log-Level festzulegen (und damit den Informationsgehalt der während des Starts und Betriebs entstehenden Log-Dateien). Hier gibt es die vier Level in absteigender Reihenfolge des Informationsflusses: DEBUG, INFO, WARN und ERROR. Die Datei enthält dann: ``` io.trino=INFO ``` 5. Catalog-Eigenschaften Zugriffe auf Daten erfolgen in Trino über Connectors. Jeder Connector ist naturgemäß zu spezifizieren. Der Catalog enthält zunächst initial die Eigenschaften der verfügbaren Verbindungen zu den diversen Datenspeichern, dann aber auch die Metadaten zu den Objekten (Tabellen, Views, …) in den jeweiligen Datenspeichern. Schlussendlich sind es dann diese Daten, die es der Query Engine in Trino ermöglichen, Abfragen über verschiedene Datenquellengrenzen hinweg („Data Federation“) auszuführen und die Ergebnismengen der verschiedenen Unterabfragen miteinander zu verknüpfen. Der Connector für einen Zugriff auf JMX sieht folgendermaßen aus: ``` connector.name=jmx ``` Diese Datei muss als jmx.properties unter etc/catalog abgelegt werden. Für den Zugriff auf MinIO ist auch ein Connector zu spezifizieren. Hierbei wird ausgenutzt, dass MinIO wie ein S3-kompatibler Speicher zu behandeln ist. Die hierzu gehörende Property-Datei minio.properties sieht dann so aus: ``` connector.name=hive hive.metastore=file hive.metastore.catalog.dir=file:///data/minio hive.s3.endpoint=hhtp://: hive.s3.path-style-access=true hive.s3.aws-ecret-key= hive.s3.socket-timeout=1m hive.storage.format=CSV hive.allow-drop-table=true hive.temporary-staging-directory-path=file:///data/tmpq ``` Mit dieser Konfiguration werden sowohl die Metastore-Daten als auch temporäre Daten als Datei im lokalen Filesystem des Servers gespeichert. #### Start des Knotens Nach Konfiguration des Knotens kann dieser gestartet werden. Hierzu dient das Kommando /bin/launcher start : wobei das Installationsverzeichnis des Trino-Servers ist und ein beliebiger aber unbelegter Port auf dem jeweiligen Knoten. Mit der Kommandooption „start“ wird der Serverprozess als Hintergrundprozess gestartet. Weitere Optionen: `run`Startet den Serverprozess im Vordergrund (und blockiert damit das Terminal …). Zum Beenden, Ctl+C im entsprechenden Terminal abesetzen oder „launcher stop“ von einer anderen Shell absetzen.`start`Startet den Server im Hintergrund und gibt process ID zurück.`stop`Beendet den Serverprozess durch das Signal SIGTERM.`restart`Beendet einen laufenden Serverprozess (sofern ein Prozess läuft) und startet einen neuen.`kill`Beendet evtl. hängende Serverprozesse mit einem SIGKILL – Signal.`status`Gibt den Prozessstatus zurück.Wurden alle Konfigurationen korrekt durchgeführt startet der Server und das Kommando „launcher start :“ quittiert den erfolgreichen Start des Servers mit der aktuellen Prozess-ID. In diesem Fall ist dann auch das Trino-Dashboard in einem Browser aufrufbar: ![](https://thecattlecrew.net/wp-content/uploads/2023/03/scs_trino_dashboard_overview-1024x573.png)Abbildung 9: Trino – Dashboard ## Direkter Zugriff auf MinIO – Daten mit DBeaver Eines der Goodies bei der Verwendung von Trino ist, dass angebundene Objektspeicher wie SQL-Datenbanken abgefragt werden können. Eines der am weitesten verbreiteten Werkzeuge zur Datenbankabfrage aus dem Open-Source-Segment ist die Community-Edition des [DBeaver.](https://dbeaver.io/) Nach Download und Entpacken der Installationsdatei kann DBeaver gestartet werden. Zur Konfiguration der Verbindung mit Trino sind folgende Schritte erforderlich: - Auswählen der Option „Neue Verbindung anlegen“ - Aus der Liste möglicher Verbindungen die Option „Trino“ auswählen - Auf dem Tab „Allgemein“ einen Verbindungsnamen eingeben - Auf dem Tab „Verbindungseinstellungen“ -> „Allgemein“ und „Host“ den Namen des Trino-Servers (genauer: den Namen des Servers, auf dem der Coordinator läuft) eingeben, unter Port den Port des Coordinator-Prozesses - Auf dem Tab „Verbindungseinstellungen“ -> „SSH“ die Kenndaten der SSH – Verbindung (Host -> Name des Trino – Coordinator – Servers, Port -> Port des SSH – Protokolls (default: 22), Betriebssystemuser und dessen Passwort) eingeben. Beachte: Es ist ein Verbindungsaufbau zum Server, nicht zu Trino. SSH dient lediglich als Carrier zur gesicherten Datenübermittlung. Beim ersten Öffnen der Verbindung wird der Metastore gelesen. Alle dortigen Objekte werden in einer Datenbanktabelle angezeigt. Sie können mit SQL-Statements abgefragt werden. ## Datentransformation mit DBT Ein Werkzeug zur Datentransformation, das in der lokal zu installierenden „core – Variante“ unter der Apache 2.0 – Lizenz kostenfrei verfügbar ist, ist [DBT](http://www.getdbt.com). Mit DBT können Datentransformationen in Form von Transformationsvorschriften erstellt werden, die in einer dem Standard-SQL sehr ähnlichen Sprache verfasst werden. Genauso gut sind Python-Skripte in DBT einfach einzubinden. Anders als ETL/ELT-Werkzeuge werden Daten nicht von einer Datenquelle abgeholt, transformiert und in ein Target-Objekt geschrieben. Vielmehr beschränkt sich DBT „auf das T in ETL“ – der Transformation von Daten. Entsprechend können Daten nur von einer Datenquelle abgeholt und auch in den gleichen Datenspeicher zurückgeschrieben werden. Insofern ist Trino eine gute Ergänzung zu DBT, da hier die genaue Datenherkunft gekapselt werden kann, sodass Trino als die einzige Datenquelle für die Transformationen in DBT erscheint. Die Anbindung der Datenspeicher an die Transformationsengine von DBT erfolgt mittels Konnektoren. Ein Teil der Konnektoren wird vom Hersteller angeboten, die Mehrzahl wurde jedoch von Mitgliedern der Community erstellt und anderen Anwendenden zur Verfügung gestellt. So gibt es für den Verbindungsaufbau zwischen Trino und DBT einen dedizierten Connector (dbt-trino), der auf Linux-Servern mittels ``` pip install dbt-trino ``` installiert werden kann. Zur Konfiguration dieses Konnektors bedarf es einer Ergänzung der Datei profiles.yml (befinet sich per default im Verzeichnis $HOME/.dbt) um die Verbindungsdaten für Trino. Ein Beispiel hierfür: ``` shop_test: #Connection name outputs: dev: # environemnt type: trino method: none #authentication method, might be one of {none|kereros|ldap} user: trino # in my case, trino is the technical user to connect to trino password: # only required if method is ldap or kerberos host: '' port: #port the trino server is looking at schema: # the schema name in trino is identical to the bucket name MinIO thread: 4 #number of parallel threads to exchange data with trino http_schema: http session_properties: query_max_run_time: 4h # query gets aborted if procesing takes more than 4 hours exchange_compression: True ``` Die so definierte Datenquelle kann in der Quelldefinition sources.yml in DBT referenziert werden, sofern sie im Projektpfad abgelegt ist: ``` version 2: sources: - name: shop_test #use connection name as defined in profiles.yml database: schema: tables: - name: customers description: customer data for shop XY columns: - name: id description: customer id as the tables primary key tests: - unique - not_null ... ``` Mit dieser Quelldefinition können die hier definierten Tabellen als Datenquelle in den Transformationen referenziert werden. Die definierten Tests werden automatisch bei der Befüllung der jeweiligen Tabelle für die jeweilige Spalte ausgeführt. ## Fazit Schauen wir auf das Gesamtkonstrukt, dann fungiert Trino als nach außen als „Query Engine“ verschiedener Prozesse: Zum einem wird zumindest ein Zweig der Datenspeicherung, der Zweig über MinIO, nach außen gekapselt, sodass auch Datenquellen an MinIO Daten liefern, die vorher nicht an MinIO angebunden werden konnten. Zum zweiten gibt es aus Sicht der Analysewerkzeuge keinen zwingenden Grund, MinIO als einzigen Datenspeicher zu nutzen: Parallel zu MinIO können auch andere Datenspeicher an Trino angebunden und ebenfalls ausgewertet werden, die dann nicht über MinIO repliziert oder abgefragt werden können. ![](https://thecattlecrew.net/wp-content/uploads/2023/03/OSBI_Gesamtarchitektur.png)Abbildung 10: Gesamtüberblick über die logische Architektur des betrachteten OSBI – Systems Insgesamt ist die Erstellung eines Data Lakes mit Open Source-Mitteln jedoch eine interessante Option. Ein paar Fußangeln auf dem Weg sind nicht unlösbar und eine sehr rege Community bietet ihre Unterstützung an. Klar ist aber auch, dass jedes Open-Source-Tool für sich seine Aufgabe erledigt – mal etwas hemdsärmelig über Kommandozeilenschnittstellen und mal auch recht elegant. Hier muss von Fall zu Fall unter Beachtung der jeweiligen Randbedingungen entschieden werden. Die eigentliche Kraft von Open-Source-Tools ergibt sich aber aus dem Zusammenwirken der verschiedenen Komponenten mit den Erfahrungen von der Anwendenden. **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** AWS, Google, Microsoft, Open Source --- ### [Visuelle Analysen mit Open Source BI Tools – Teil 1: Plotly versus Tableau](https://thecattlecrew.net/2023/05/11/visualisierung-von-daten-in-data-science-projekten/) **Published:** Mai 11, 2023 **Author:** Ansgar Große-Wilde **Content:** „Ein Bild sagt mehr als tausend Worte.” Dieses Sprichwort besagt, dass Bilder schneller und unmittelbarer Informationen übermitteln können als Text oder Zahlen. Dass bei geschäftlichen Anliegen häufig auf Graphen und Dashboards zurückgegriffen wird, ist nichts Neues, nur haben sich mit den wachsenden Möglichkeiten auch die Anforderungen verschoben: - Dashboards und datengetriebene Prozesse sind heute eine Selbstverständlichkeit. - Reproduzierbarkeit und schnelle Verfügbarkeit von Daten sind unverzichtbar. - Datenbestände in Pipelines werden zunehmend programmatisch integriert - Self-Service verlangt nach Einfachheit im ganzen Daten-Workflow. - Darstellung von Ergebnissen muss schnell, einfach, klar und ansprechend sein. Nun sind die großen Business Intelligence-Plattformen, die sich rund um diese Anforderungen ihren Platz erobert haben, nicht mehr allein: sie bekommen Konkurrenz von Open Source, beispielsweise im Kontext der Open-Source-Programmiersprache Python durch Bibliotheken, die die Aufgaben der Datenaufbereitung und Datenvisualisierung einfacher machen. Wie ihre großen Geschwistern liefern sie Plots, Dashboarding, Grafiken für Web-Publishing bis hin zur Daten-Applikation. Was es damit auf sich hat, erfährst du in diesem Artikel. # Was erwartet dich in dieser Blogserie? In dieser Blogserie beleuchten wir eine Familie von Tools, die bei der Erstellung interaktiver Visualisierungen und hochwertiger Grafiken helfen. Im ersten Teil der Serie stellen wir die Bibliothek Plotly vor und bauen Visualisierung eines Tableau-Tutorials nach, zum Mitmachen. In den nächsten Teilen zeigen wir, wie solche Grafiken in vollwertige, interaktive Dashboards integriert werden. # Wohin geht Visualisierungstechnologie heute? Elegante und aussagekräftige Berichterstellung ist nach wie vor unerlässlich für die Gewinnung von Insights aus Daten. Mit ein paar Spreadsheets und statischen Graphiken ist es nicht getan. Während kommerzielle BI-Tools seit einigen Jahren ein immer breiteres Funktionalitätsspektrum über die graphische Darstellung hinaus anbieten, von der Entwicklungsumgebung, Datenabfrage, Datenexploration, Datentransformation, Datenmodellierung bis zum Dashboard inklusive Data Governance, haben sich Lösungen im Open-Source-Bereich ebenfalls einen Weg gebahnt. Dies zeigt sich in der Entstehung einer Vielzahl von leistungsfähigen Bibliotheken wie etwa Matplotlib, Bokeh, Plotly, Seaborn oder Streamlit u.a. für die Datenvisualisierung. Dieses lebendige Ökosystem ermöglicht es, über die Integration und Berechnung von numerischen Daten hinaus, Ergebnisse in Graphiken umzusetzen, zu aktualisieren, mit formatiertem Text zu kommentieren, und ist somit der Kern für multimediales Storytelling. ## Können Open-Source-Bibliotheken auch im Businesskontext genutzt werden? Eine wichtige Frage stellt sich unweigerlich: Können sich Python-Bibliotheken mit kommerziellen BI-Tools auch im Businesskontext messen? Die Antwort ist grundsätzlich: Ja. Statische Grafiken, die man aus wissenschaftlichen Publikationen kennt – die Wiege dieser Entwicklung sind ggplot oder matplotlib – sind längst passé. Mit ein paar Zeilen Code kann man visuell ansprechende Darstellungen erzeugen, mit Styling anpassen, exportieren und sogar live teilen. Vorteile auf dem Gebiet des Self-Service BI kommen dazu: durch nützliche Funktionen wie Zoomen und Filtern sind Daten stets in Interaktion mit den Anwendenden. Auf der Ebene der Anpassungsmöglichkeiten, Performance und bei der Anzahl der Standardvisuals können die Open-Source-Bibliotheken ebenfalls mit den großen Geschwistern Power BI, Qlik oder Tableau mithalten. Man muss allerdings im Auge behalten, dass Python eine Programmierumgebung darstellt. Ob Businessanwendende weiterhin vorwiegend über graphische Benutzerschnittstellen arbeiten, oder ob sie den Schritt Richtung Datenprogrammierung wagen und sich auf Code einlassen, ist also ein wichtiges Entscheidungskriterium. Aber so groß, wie es früher schien, ist der Schritt zur programmierten Datenvisualisierung gar nicht. Es gehört Vertrauen in die Benutzung einer Programmiersprache dazu und man sollte sich mit den Open-Source-Bibliotheken ein wenig vertraut machen. Dass dies nicht zu schwer ist, wird zunächst mit Plotly gezeigt, und in weiteren Folgen der Serie auch mit weiteren Bibliotheken. # Voilá: Plotly Warum haben wir uns dafür entschieden, das Tool Plotly näher vorzustellen? Zunächst hat das Tool einige wichtige Vorteile: - Plotly ist eine Open-Source-Bibliothek und auch im kommerziellen Einsatz kostenfrei. - Plotly setzt auf plotly.js auf, einer JavaScript Graphik–Bibliothek. Man muss also kein Webentwickler sein. - Plotly kann sowohl in Python als auch in R genutzt werden, ist also vielseitig. - Plotly unterstützt standardmäßig über 40 Typen von Charts. - Plotly kann sogenannte Plots produzieren: anstelle von statischen Einzelgraphiken werden interaktive Graphiken erzeugt. Plots können in Webseiten oder Notebooks integriert werden. - Plotly unterstützt Funktionen wie Zoomen oder Mouse-Over mit zusätzlichen Informationen oder der Anpassung der Achsen. ## Wie werden die Daten angebunden? Der Datenimport für die Nutzung von Plotly erfolgt über Python-Code. Die Beispiele in diesen Blogeintrag verwenden eine Excel Beispieldatei mit Daten aus einem fiktiven Online-Shop. Diese Datei wird auch im Tableau-Tutorial genutzt. Wir stellen hier eine Möglichkeit vor, Daten über einen zweidimensionalen Pandas DataFrame an Plotly zu übergeben. Dafür ist es gut, im Hinterkopf zu behalten, dass DataFrames aus verschiedenen Dateitypen und Datenbanken befüllt werden können. ``` #import pandas and load data import pandas as pd Orders_df = pd.read_excel(r'’Sample – Superstore.xls’, sheet_name=’Orders’) #adjust dataframe Orders_df.drop("Row ID", axis = 1, inplace=True) Orders_df.head() ``` Im folgenden Beispiel werden Bestellsummen aggregiert und auf der Ebene des Bestelldatums als DataFrame bereitgestellt. Während Tools wie Tableau automatisch Aggregationen auf verschiedenen Ebenen anbieten, ist dies bei der Nutzung von Plotly oder anderen Python Libraries nicht der Fall. Jede Ebene muss eigens im DataFrame bereitgestellt werden. Diese Vorgehensweise erfordert deutlich mehr Programmieraufwand als in Tableau, wo Dimensionen und Kennzahlen per Drag & Drop einer Grafik zusammengeführt werden und die benötigte Aggregation automatisch erstellt wird. ``` #aggregate Orders dataframe df_line_plot_year = Orders_df.groupby(pd.Grouper(key='Order Date', axis=0, freq='Y')).agg({'Sales':'sum'}).reset_index() df_line_plot_year['year']= pd.DatetimeIndex(df_line_plot_year['Order Date']).year df_bar_plot_segment = Orders_df.groupby([pd.Grouper(key='Order Date', axis=0, freq='Y'), 'Category' ]).agg({'Sales':'sum'}).reset_index() df_bar_plot_segment['year']= pd.DatetimeIndex(df_bar_plot_segment['Order Date']).year ``` **Schritt 1:** Für den ersten Plot *line\_plot\_year* wird mit dem Input der Bestellungen aus der Excel Datei *Orders\_df* ein DataFrame erstellt. Dieser DataFrame wird gruppiert über die Spalte *Order Date* nach dem Jahr des Bestelldatums. Die Spalte *Sales* wird als Summe aggregiert. **Schritt 2:** Im zweiten Schritt wird eine neue Spalte mit dem Jahr des Bestelldatums als Zahl hinzugefügt. Für weitere Plots werden die DataFrames um Spalten erweitert, die in den Grafiken angezeigt werden sollen wie z.B. die Produkategorie. Es ist übrigens nicht zwingend notwendig, für jede einzelne Grafik einen DataFrame zu erstellen. Die Aggregation eines vorhandenen DataFrames kann auch direkt im Plotly Express-Aufruf erfolgen. ## Geht es auch einfach? – Plotly und Plotly Express Plotly Visualisierungen basieren auf plotly.graph\_objects.Figure-Objekten im JSON Format. Mit diesen Objekten werden plotly.js gefüttert und Grafiken gerendert. Ein Barplot aus der Plotly Doku mit Daten über ein Obstwettessen sieht beispielsweise so aus: ``` Figure({ 'data': [{'hovertemplate': 'Contestant=Alex Fruit=%{x} Number Eaten=%{y}', 'name': 'Alex','type': 'bar', 'x': array(['Apples', 'Oranges', 'Bananas'], dtype=object), 'y': array([2, 1, 3], dtype=int64)}, {'hovertemplate': 'Contestant=Jordan Fruit=%{x} Number Eaten=%{y}', 'name': 'Jordan','type': 'bar', 'x': array(['Apples', 'Oranges', 'Bananas'], dtype=object), 'y': array([1, 3, 2], dtype=int64)}], 'layout': {'legend': {'title': {'text': 'Contestant'}}, 'template': '...','xaxis': {'title': {'text': 'Fruit'}}, 'yaxis': {'title': {'text': 'Number Eaten'}}} }) ``` Du kannst die Top-Level Attribute *data* und *layout* mit dazugehörigen Attributen manuell erstellen und befüllen, um ein Graph Object zu generieren. Dabei arbeitest du direkt mit dem Modul plotly.graph\_objects. Der Vorteil ist, dass du den Plot von Grund auf erstellst und so von Anfang an alle Gestaltungsmöglichkeiten in der Hand hast. Dennoch empfiehlt es sich, die Plotly-Dokumentation als Startpunkt bei der Visualisierung das Modul ‚plotly.express‘ zu nutzen. Dabei werden für einen gewählten Plottyp (Barchart, Histogram etc.) und den Dateninput bestimmte Attribute des Graph Objects vorbefüllt. So brauchst du deutlich weniger Code, um eine Standardvisualisierung zu erstellen. Hier ein Vergleich der zwei Herangehensweisen für den Beispielplot: 1\. Verwendung von Plotly Express: ``` import plotly.express as px fig = px.bar(df, x="Fruit", y="Number Eaten", color="Contestant", barmode="group") fig.show() ``` 2\. Verwendung von Graph Objects: ``` import plotly.graph_objects as go fig = go.Figure() for contestant, group in df.groupby("Contestant"): fig.add_trace(go.Bar(x=group["Fruit"], y=group["Number Eaten"], name=contestant, hovertemplate="Contestant=%s Fruit=%%{x} Number Eaten=%%{y}"% contestant)) fig.update_layout(legend_title_text = "Contestant") fig.update_xaxes(title_text="Fruit") fig.update_yaxes(title_text="Number Eaten") fig.show() ``` Die Resultate sind die gleichen, wie diese Abbildung zeigt. ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Bar_Fruot.png) ## Empfehlung: Plotly Express als Ausgangspunkt, Anpassungen später Ob Plotly oder Plotly Express – die Visualisierung sieht am Ende identisch aus. Der Weg mit Plotly Express ist jedoch deutlich einfacher. Das Modul versucht, sinnvolle Standards für Attribute zu definieren und erstellt so zum Beispiel passende Achsen-Labels oder automatische Hover-Informationen. Wenn die automatisch generierten Plots nicht passen, gibt es verschiedene Parameter für das Styling, die du direkt anpassen kannst, wenn du Plotly Express aufrufst. So z. B. Titel, Farbe oder Breite der Grafik. Wenn das nicht ausreicht, kann auch das Graph Object mit bestimmten Methoden verändert werden. Z. B. mit ‚*update\_layout()*‘ oder ‚*add\_trace()*‘. Dies ist insbesondere relevant, wenn Filtermöglichkeiten für interaktive Grafiken oder komplexe Visualisierungen mit verschiedenen Sub-Plots erstellt werden sollen. Kurzum: Der Workflow mit Plotly Express als Startpunkt ist intuitiv und wird mit einer umfangreichen und nützlichen Doku unterstützt, die zu den einzelnen Plot-Typen verschiedene Gestaltungsmöglichkeiten aufzeigt. ## Beispiel 1: Lineplot für Verkaufssummen Für unser erstes Beispiel haben wir den ersten Plot aus dem Tableau-Tutorial nachgebaut. Es ist ein Lineplot mit Verkaufssummen, aggregiert auf einzelne Jahre. ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Tableau_Line.png) Der erste Aufruf definiert ein Graph Object *fig\_year* mit dem bereits generierten Daten-Input *df\_line\_plot\_year* und Attribute für die X- und Y-Achsen. ``` fig_year = plx.line(df_line_plot_year, x='year', y="Sales") fig_year.show() ``` ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Line_1.png) Weil der daraus resultierende Plot zu breit ist und wenig sinnvolle Bezeichnungen für die X-Achsen produziert, legen wir eine geeignete Breite selber fest. Das Label der X-Achse soll wie bei Tableau oberhalb des Plots zu sehen sein. Dazu werden die Labels der X-Achse zunächst als leerer String definiert ``` fig_year = plx.line(df_line_plot_year, x='year', y="Sales", width= 400, labels={'x':'', 'y':'Sales'}) ``` ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Line_2.png) Das Zwischenergebnis ist schon ansehnlicher, aber noch deutlich von der Tableau-Vorlage entfernt. Für weitere Anpassungen werden Methoden des Graph Objects genutzt. - Mit *.update\_xaxes* und *.update\_yaxes* werden die Achsen entsprechend definiert. - Über .update\_layout wird die Bezeichnung der X-Achse mit *Order Date* als Titel mittig über dem Plot platziert. Damit kommt das Resultat der Vorlage jetzt recht nahe. ``` fig_year.update_yaxes(range=[0, 800000]) fig_year.update_xaxes(range=[2018, 2022] , nticks=5, tickangle=45) fig_year.update_layout(xaxis=dict(tickformat="%Y"), title_text='Order Date', title_x=0.5, title_font_size=14) ``` ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Line_3.png) ## Beispiel 2: Barplot mit Verkaufssummen verschiedener Produktkategorien Für das nächste Beispiel haben wir einen Barplot mit den Verkaufssummen von Produktkategorien für verschiedene Jahre nachgebaut.![](https://thecattlecrew.net/wp-content/uploads/2023/02/Tableau_Cat.png) ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Cat_1.png)Dabei sind wir auf kleine Hindernisse gestoßen: In Tableau ist es sehr einfach, eine kategorische X-Achse mit zwei Attributen zu erstellen (hier: Bestelldatum und Produktkategorie). In Plotly dagegen war das deutlich komplizierter. Mit Plotly Express gar nicht machbar. Bei einem Plot mit den Attributen *year* und *sales* siehst du zwar die einzelnen horizontalen Balken, welche die Produktkategorie repräsentieren. Du kannst diese aber nicht identifizieren. ``` fig_month = plx.bar(df_bar_plot_segment, x='year', y="Sales",) fig_month.update_xaxes(nticks=6) ``` ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_CAT_2_Hover.png) Als Workaround bietet es sich an, einen gruppierten Barplot zu erstellen, der als X-Achse die Jahre des Bestelldatums verwendet. Die Y-Achse sind die aggregierten Verkaufssummen. Über das Argument *color* kann dann die Produktkategorie in den Plot gebracht werden. Aus den horizontalen anonymen Balken werden so vertikale, farbliche Balken, die über *text* auch den Namen der jeweiligen Produktkategorie bekommen. Dazu wird automatisch eine Legende zu den Farben erstellt. Die Layouts der einzelnen Positionen werden über *update\_layout* und *update\_traces* angepasst. Wie bereits erwähnt, erstellt Plotly automatisch interaktive Grafiken. D. h. wenn du über einen Balken hoverst, werden relevante Informationen angezeigt, u. a. der genaue Wert der *Sales*-Kennzahl. Über die Leiste am rechten oberen Rand des Plots sind weitere Funktionen wie Zoomen oder Exportieren des Plots verfügbar. ``` fig_month_color = plx.bar(df_bar_plot_segment, x='year', y="Sales", color='Category', barmode= 'group', text = 'Category') fig_month_color.update_layout(xaxis=dict({'side' : 'top'},tickformat="%Y", nticks=5)) fig_month_color.update_traces(textposition='auto', textfont_size = 9) ``` ## Beispiel 3: Erweiterung des Barplots Für das nächste Beispiel haben wir aus dem Tableau-Tutorial einen Barplot um Unterkategorien der Produkte erweitert: ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Tableau_Multi_Cat.png) Dabei ergibt sich im Plotly Nachbau wieder ein Problem, das wir schon kennen: Da die Sub-Kategorie in den Plot integriert wird, kann die Kategorie nicht mehr über das *Color-*Argument abgebildet werden. Es gibt nun vier Dateninputs für die Grafik. Die Lösung für einen ähnlichen Plot wie Tableau ist ein *Stacked Bar Plot* mit sogenannten *Facet Columns*. Tableau zeigt alle Bestelljahre in einem Plot an. Mit der Übergabe von *year* in *facet\_col* werden in diesem Fall vier Einzelplots zu den jeweiligen Jahren gebaut, ohne, dass das Jahr Bestandteil einer Achse ist. ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Multi_Cat_1.png) Dadurch kann *Category* die X-Achse normal befüllen und *Sub-Category* wird an das *Color-*Argument übergeben. Mit der Option *barmode = stack* werden die Subkategorien in einem Balken übereinander dargestellt. Das Ergebnis weicht optisch von der Vorlage ab, enthält inhaltlich aber die gleichen Informationen. Diese Art von Workaround bietet sich bei Plotly öfter an, um zu einem Zielbild zu kommen. Für sehr kleine Balken, die schlecht sichtbar sind, kann neben Hovern die Zoom-Funktion genutzt werden, um alle Informationen anzeigen zu lassen. ``` fig_month = plx.bar(df_bar_plot_sub_segment, x='Category', y="Sales", color='Sub-Category', barmode= 'stack',text = 'Sub-Category', facet_col=df_bar_plot_sub_segment['year'], labels={'Category':''}) fig_month.update_traces(textposition='auto', textfont_size = 10, width=0.8) fig_month.update_xaxes(tickangle=45) ``` ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Tableau_Multi_Cat_Sub.png) ## Beispiel 4: Einfärbung in der Darstellung Im nächsten Beispiel wird der Tableau Barplot um eine Einfärbung erweitert, die den Gewinn der einzelnen Subkategorien sichtbar macht. Dafür erweiterst du den DataFrame um die Spalte ‚Profit‘ und passt den Plotly-Aufruf der Visualisierung an. Dabei wird das *text*-Argument der Balken auf *Sub-Category* gesetzt und *Profit* über *Color* abgebildet. Im Ergebnis erhältst du eine abweichende Art der Darstellung, die aber inhaltlich nicht schlechter ist. ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Multi_Cat_Sub.png) ``` df_bar_plot_profit = Orders_df.groupby([pd.Grouper(key='Order Date', axis=0,freq='Y'), pd.Grouper(key='Category') , pd.Grouper(key='Sub-Category')]).agg({'Sales':'sum', 'Profit':'sum'}).reset_index() df_bar_plot_profit['year']= pd.DatetimeIndex(df_bar_plot_profit['Order Date']).year fig_month = plx.bar(df_bar_plot_profit, x='Category', y="Sales", color='Profit', text='Sub-Category', barmode= 'stack', facet_col=df_bar_plot_profit['year'] ,labels={'Category':''}) fig_month.update_traces(textposition='auto', textfont_size = 10, width=0.6) fig_month.update_xaxes(tickangle=45) ``` ## Beispiel 5: Geografische Zuordnung Gerade im Hinblick auf Verkaufsszahlen ist das Visualisieren auf geographischer Ebene interessant. Tools wie Tableau unterstützen die Datenanzeige auf Karten. Anhand der Spalte *State/Province* aus dem Beispieldatensatz kann Tableau eine automatische geographische Zuordnung vornehmen. Die Darstellung der Verkaufsszahlen für einzelne Bundesstaaten (hier in der Region ‚South‘) sieht dann wie folgt aus: ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Tableau_Map.png) Auch Plotly unterstützt das Visualisieren von Daten auf Karten. Das Verarbeiten von Geodaten kann in unterschiedlichen Formen erfolgen. Du kannst z. B. *Geopanda*, Iso-Codes oder das *Geo-JSON* Format nutzen, um die Input-Daten auf eine Karte zu mappen. Auch die Anbindung von kommerziellen Anbietern wie *Mapbox* wird unterstützt. Der Umsetzung sind damit eigentlich keine Grenzen gesetzt und es kann im gewünschten Detailgrad auf Karten visualisiert werden. ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Map.png) In diesem Beispiel haben wir die Plotly Express *Chloropleth* *Map* genutzt. In diese Karte wurden schon Geodaten für Länder weltweit und US-Staaten integriert. Tableau erstellt automatisch eine Geo-Hierachie und ordnet z. B. der Region *South* die entsprechenden Bundesstaaten zu. Das Nutzen von Hierarchien ist grundsätzlich ein großer Vorteil von Visualisierungstools. In Plotly muss die Liste der Staaten für die Ansicht der Region *South* händisch eingerichtet werden. Dafür filterst du zunächst den DataFrame auf das Land *United States* und schränkst ihn auf die Region *South* ein. Mit diesem DataFrame wird der Befehl *plx.chloropleth* ausgeführt. ``` df_state_sales = Orders_df[(Orders_df['Country/Region']== 'United States')& (Orders_df['Region']== 'South')].groupby(pd.Grouper(key='State/Province', axis=0, )).agg({'Sales':'sum', 'Order ID': 'nunique'}).reset_index() fig_state_sales = plx.choropleth(df_state_sales, locations='State/Province',locationmode="USA-states", scope="usa", color='Sales',color_continuous_scale="Viridis_r",) fig_state_sales.show() ``` Der Code produziert eine US-Karte mit zugehöriger Legende, die Karte ist allerdings noch leer. Das liegt daran, dass die Zuordnung der *State/Province*-Spalte aus dem DataFrame zur Karte fehlt. Die Staaten liegen im falschen Format vor. Das *locations-*Argument der Choropleth Map benötigt die US-Staaten in einem Zwei-Buchstaben Format. Dafür muss ein Mapping angelegt und eine Spalte im DataFrame mit dem Staatenkürzel generiert werden. Diese Art von manueller Anpassung des Dateninputs ist ein ständiger Bestandteil des Arbeiten mit Plotly. ``` us_state_to_abbrev = { "Alabama": "AL", "Alaska": "AK", "Arizona": "AZ", "Arkansas": "AR", "California": "CA", "Colorado": "CO", ...... } df_state_sales['State_Code'] = df_state_sales['State/Province'].map(us_state_to_abbrev) df_state_sales['State_Code'].head() ``` Nun erfolgt der erneute Aufruf der *plx-*Funktion mit der korrekten Location-Spalte. Beim Hovern soll neben der genauen Verkaufssumme nun auch die Anzahl der Bestellungen pro Staat angezeigt werden. Dafür passen wir die Hover-Informationen bzw. -Labels an und ersetzen den automatisch festgelegten *State\_Code* mit dem Voll-Namen *State/Province*. Zusätzlich soll die Ausgabe der Sales-Kennzahl in Dollar erfolgen. Ein Titel und eine angepasste Legende werden wieder mit *update\_layout* umgesetzt. Das Resultat ist vergleichbar mit der Tableau Vorlage. ### ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Plotly_Map_2.png) ``` fig_state_sales = plx.choropleth(df_state_sales,locations='State_Code', locationmode="USA-states",scope="usa",color='Sales', color_continuous_scale="Viridis_r", hover_data={'State/Province':True,'Order ID': True, 'State_Code':False,'Sales':':$.2f'} , labels={'State/Province': 'State', 'Order ID':'Number of Orders', 'Sales':'Sales'}) fig_state_sales.update_layout( title_text = 'Sales by State', title_font_family="Times New Roman", title_font_size = 22, title_font_color="black", title_x=0.45, coloraxis_colorbar_title_text = 'Sales in Dollar' ) ``` # **Fazit** Welche wichtigen Erkenntnisse können wir am Ende dieses Selbstversuchs festhalten? 1. Der Workflow von Plotly unterscheidet sich grundsätzlich stark von BI-Tools wie Tableau: Das Erstellen von Visualisierungen erfordert grundlegende Programmierkenntnisse und spricht deshalb eine andere Zielgruppe an. So würden wir z. B. nicht empfehlen, Plotly als BI Self-Service Tool auf weniger technik-affine Menschen loszulassen. 2. Das Neuerstellen bzw. Nachbauen von Grafiken ist im Vergleich zu Standard-BI-Tools mit deutlich mehr Aufwand verbunden. Dies gilt sowohl für die Datenaggregation als auch für das Anpassen der Visualisierungen. Das Endergebnis in unseren Beispielen war aber in Form und Funktionalität vergleichbar. 3. Plotly bietet durch das direkte Anpassen von Grafikobjekten über Code weitreichende Möglichkeiten zum Customizing, die so in den meisten Standard-BI-Tools nicht gegeben sind. Durch den damit verbundenen Aufwand ist Plotly aber wahrscheinlich eher für Anwendungsfälle geeignet, wo es darum geht eine begrenzte Anzahl von Visualisierungen umzusetzen, die sich weniger häufig ändern. Das hier gezeigte Nachbauen von Grafiken aus dem Tableau-Tutorial ist nur der erste Schritt zur Nutzung von Open-Source-Visualisierungstools im Businesskontext. In den nächsten Teilen dieser Blog-Serie kannst du dabei sein, wenn mithilfe der Tools Plotly Dash und Streamlit aus einzelnen Grafiken ein interaktives Dashboard mit Inputmöglichkeiten für Nutzer entsteht. Stay tuned! **Kategorien:** Analytics & Insights, Automation, Tools & Methoden **Schlagwörter:** Analytics, BI-Plattform, Open Source, Plotly, Python, Tableau, Visual BI --- ### [Daten integrieren mit Airbyte – Teil 2: Octavia-cli](https://thecattlecrew.net/2023/04/28/daten-integrieren-mit-airbyte-teil-2-octavia-cli/) **Published:** April 28, 2023 **Author:** Caroline Aretz **Content:** In [Teil 1](https://thecattlecrew.net/2023/03/28/daten-integrieren-mit-airbyte-teil-1-einfuehrung-installation/ "Den ersten Artikel der Serie ansehen") dieser Artikelserie ging es darum, wie du Airbyte installierst und wie du Verbindungen in der Airbyte-Instanz über die Weboberfläche konfigurierst. Dabei hast du auch erfahren, dass das Deployment auf andere Airbyte-Instanzen nur mit großem manuellem Aufwand möglich ist. Jetzt fragst du dich wahrscheinlich, ob bei Airbyte auch ein Command-Line-Tool inklusive Versionierung in Git eingesetzt werden kann. Die Antwort auf deine Frage lautet: Ja. Dafür gibt es das Tool Octavia-cli. # Was kann Octavia-cli? Octavia-cli ist ein Command-Line-Tool zur deklarativen Verwaltung von Datenintegrationskonfigurationen mithilfe von YAML-Dateien. Octavia-cli bietet: - Generierung von YAML-Dateien inkl. Versionierung in Git - Dynamische Generierung von Konfigurationen für Sources, Destinations und Connections - Deployment der Konfiguration auf multiplen Airbyte Instanzen - Integration in einen CI-Workflow zur Automatisierung des Deployments Octavia-cli läuft in einem Docker Image. Details zur Installation findest du hier: [https://github.com/airbytehq/airbyte/blob/master/octavia-cli/README.md#install](https://github.com/airbytehq/airbyte/blob/master/octavia-cli/README.md#install "Zur Installations-Doku") Im Docker-Container erfolgt die Installation mit folgendem Befehl im Bash-Profil: ``` curl -s -o- https://raw.githubusercontent.com/airbytehq/airbyte/master/octavia-cli/install.sh | bash ``` # Wie wird Octavia-cli verwendet? Die Arbeit mit Octavia-cli lässt sich in 5 Schritte aufteilen: ## 1. Der Einstieg Am besten arbeitest du mit einer IDE (z. B. Visual Studio Code). Nach der Installation von Octavia-cli erstellst du in deinem Projektverzeichnis ein Unterverzeichnis (z. B. octavia\_directory). Hier werden später die YAML-Dateien der Sources, Destinations und Connections abgelegt. Dann wechselst du in dieses Verzeichnis und führst den Befehl ``` octavia init ``` aus. Mit diesem Befehl erstellst du unterhalb des zuvor erstellten Octavia-Verzeichnisses die Verzeichnisstruktur für Connections, Destinations und Sources. ![](https://thecattlecrew.net/wp-content/uploads/2023/04/Bild1.png)*Aufbau des Octavia-Verzeichnisses* Mithilfe der Befehle ``` octavia list connectors sources ``` ``` octavia list connectors destinations ``` kannst du dir sämtliche Source- und Destination-Konnektoren auflisten lassen. ![](https://thecattlecrew.net/wp-content/uploads/2023/04/Bild2.png)![](https://thecattlecrew.net/wp-content/uploads/2023/04/Bild3.png) *Liste aller Source- und Destination-Konnektoren* Später, z. B. in Schritt 3 – wenn es um die Generierung der Source bzw. Destination geht – benötigst du die *SOURCE\_DEFINITION\_ID* bzw. die *DESTINATION\_DEFINITION\_ID* aus der letzten Spalte. Natürlich kannst du auch mit bestimmten Befehlen ganz gezielt nach einem bestimmten Source- oder Destination-Konnektor suchen. Für PostgreSQL sähe das beispielsweise so aus: ``` octavia list connectors sources | grep postgres ``` ``` octavia list connectors destinations | grep postgres ``` ## **2. Sources generieren** Wie die Source-Generierung funktioniert, beschreibe ich dir wieder anhand von PostgreSQL, weil das sehr verbreitet ist: Mit dem oben genannten Octavia-List-Befehl für PostgreSQL wurde die SOURCE\_DEFINITION\_ID decd338e-5647-4c0b-adf4-da0e75f5a750 ermittelt. Diese ID und den Namen der PostgreSQL Source hängst du an den Befehl ``` octavia generate source ``` an. In meinem Beispiel habe ich die PostgreSQL Source *my\_postgres\_source* mit diesem Befehl generiert: ``` octavia generate source decd338e-5647-4c0b-adf4-da0e75f5a750 my_postgres_source ``` Die Konsole zeigt daraufhin diesen Text an: ``` ``` Mit diesem Befehl habe ich unterhalb von *octavia\_directory/sources* das Verzeichnis *my\_postgres\_source* inklusive der Datei *configuration.yaml* erstellt. Bei *configuration.yaml* handelt es sich um das Konfigurations-Template, in dem notwendige Parameter wie Host, User, Password, Port etc. ergänzt werden müssen. ## **3. Destinations generieren** Auch die Destination-Generierung beschreibe ich dir wieder anhand von PostgreSQL. Mit dem oben genannten Octavia-list-Befehl für PostgreSQL wurde die *DESTINATION\_DEFINITION\_ID 25c5221d-dce2-4163-ade9-739ef790f503* ermittelt. Diese ID und den Namen der PostgreSQL Destination musst du an den Befehl *octavia generate destination* anhängen. Im konkreten Beispiel zur Generierung der PostgreSQL Destination my\_postgres\_destination lautet der Befehl: ``` octavia generate destination 25c5221d-dce2-4163-ade9-739ef790f503 my_postgres_destination ``` Die Konsole zeigt daraufhin diesen Text an: ``` ``` Mit diesem Befehl habe ich unterhalb von *octavia\_directory/destinations* das Verzeichnis *my\_postgres\_destination* einschließlich der Datei c*onfiguration.yaml* erstellt. Bei configuration.yaml handelt es sich auch hier wieder um das Konfigurations-Template, in dem notwendige Parameter wie H*ost, User, Password, Port* etc. ergänzt werden müssen. ## 4. Connections generieren Bevor du eine Connection zwischen neu angelegten Sources und Destinations anlegen kannst, musst du Source und Destination als Remote-Ressourcen auf der Airbyte Instanz anlegen. Dies machst du mit dem Befehl ``` octavia apply ``` Die Konsole zeigt daraufhin diesen Text an: ``` ``` *![](https://thecattlecrew.net/wp-content/uploads/2023/04/Bild6.png)So werden Source und Destination anschließend auf der Weboberfläche angezeigt* Jetzt kannst du die Verbindung zwischen *my\_postgres\_source* und *my\_postgres\_destination* herstellen. Hierzu dient der Befehl ``` octavia generate connection ``` Als Source-Parameter gibst du den Pfad der Yaml-Datei für die Source-Konfiguration an und als Destination-Parameter den Pfad der Yaml-Datei für die Destination-Konfiguration. Dann nur noch einen Namen für deine Verbindung übergeben und fertig! In meinem Beispiel sähe das so aus: ``` octavia generate connection --source sources/my_postgres_source/configuration.yaml --destination destinations/my_postgres_destination/configuration.yaml Postgres_2_Postgres ``` Mit diesem Befehl wird unterhalb von *octavia\_directory/connections* das Verzeichnis *postgres\_2\_postgres* einschließlich des Konfigurations-Template *configuration.yaml* erstellt. In diesem Template sind sämtliche Default-Einstellungen aus der „leeren“ Connection-Konfigurationsmaske in der Weboberfläche gesetzt. Du musst das Template also noch an die Dataingestion-Anforderungen anpassen. Dafür einfach in der Datei *configuration.yaml* unter anderem Folgendes konfigurieren: - Frequenz der Datenreplikation einstellen (einmal täglich, alle 10 Minuten etc.) - Destination Namespace angeben (z. B. Schema auf der Destination-Datenbank) - Tabellen aktivieren, die aus der Source synchronisiert werden sollen. Achtung: Die Datei *configuration.yaml* enthält alle Tabellen der Source. Rein theoretisch können also alle Tabellen über eine Connection geladen werden, sofern bei jeder Tabelle *selected=true* gesetzt ist. Dies ist die Default-Einstellung in der YAML-Datei. Deshalb muss bei der Konfiguration genau geprüft werden, welche Tabellen über die Connection synchronisiert werden sollen. - Sync-Mode bei selektierten Tabellen angeben - Basic-Normalization aktivieren oder deaktivieren (*ja/nein*) Nach Abschluss der Konfiguration übergibst du die Connection per *octavia apply* an die Airbyte Instanz. Dieser Schritt macht sie auf der Weboberfläche verfügbar. Durch den Apply-Befehl wird im Verzeichnis der Connection eine *state.yaml*-Datei erzeugt. Diese Datei enthält den Zustand der Konfiguration zum Zeitpunkt der Generierung in Form des Hashwerts *configuration\_hash* und des Zeitstempels *generation\_timestamp*. ![](https://thecattlecrew.net/wp-content/uploads/2023/04/Bild6.png)*Auf der Web-Oberfläche verfügbar* ## **5. Import von Instanz-Ressourcen aus Airbyte ins Git-Verzeichnis** Du kannst dir den Import-Befehl zu Nutze machen, um sämtliche über die Weboberfläche fertig entwickelten Airbyte Verbindungen auf andere Airbyte Instanzen zu deployen. Der Import-Befehl überträgt die Konfigurationen aller Sources, Destinations und Connections von der Airbyte Instanz ins Git-Verzeichnis. Und zwar als YAML-Datei. Du fragst dich, wofür das nötig ist? Stelle dir bitte folgendes Szenario vor: In der Entwicklungsumgebung hast du alle Sources, Destinations und Connections über die Airbyte-Weboberfläche konfiguriert. Im Git Repository hast du das zugehörige Projekt mit der entsprechenden Ordner-Struktur (*airbyte/octavia\_directory*) angelegt und ausgecheckt. Octavia-cli ist installiert und durch Ausführung von *octavia init* im Verzeichnis *octavia\_directory* legst du die in Schritt 1 beschriebenen Unterverzeichnisse an. Jetzt führst du diesen Befehl aus: ``` octavia import all ``` Das machst du ebenfalls im Verzeichnis *octavia\_directory*, wodurch zu jede Source, Destination und Connection unterhalb der Verzeichnisse *sources*, *destinations* und *connections* weitere Verzeichnisse mit den Namen der Sources, Destinations, und Connections erstellt werden. ![](https://thecattlecrew.net/wp-content/uploads/2023/04/Bild7.png)*In diesen Verzeichnissen findest du die Dateien configuration.yaml und state.yaml* Wichtig: Bevor du dein lokales Git-Repository in das Remote-Git-Repository eincheckst, müssen die Verbindungsdaten der *configuration.yaml* Dateien für Source und Destination geprüft werden, da die Passwörter nicht mit übertragen werden. Aus Sicherheitsgründen solltest du die Passwörter als Umgebungsvariablen abgelegen. So stehen sie während der Konfiguration zur Verfügung. Wenn du die Verbindungsdaten angepasst hast, führst du im lokalen Git-Repository git *add, git commit* und git *push* aus, so dass die Airbyte Konfiguration ins Remote-Git-Repository eingecheckt wird. Andere Entwickler:innen können deinen Entwicklungsstand nun aus dem Remote-Git-Repository auschecken und in ihrer lokalen Entwicklungsumgebung im Verzeichnis *octavia\_directory octavia apply* ausführen. Dadurch werden die von dir entwickelten Airbyte Ressourcen auf den Airbyte Instanzen der anderen angelegt. # Fazit Das Command-Line-Tool Octavia-cli erleichtert die Entwicklung und das Deployment: - Airbyte-Instanz-Ressourcen können per octavia import ins Git übertragen und dort verwaltet werden. - Mit dem Befehl octavia apply können Ressourcen, die in Git verwaltet werden, auf anderen Airbyte-Instanzen eingespielt werden. - Außerdem helfen Templates bei der dynamischen Generierung von Sources, Destinations und Connections. Diese Templates müssen vorher allerdings mithilfe von Skripts, z. B. in Python, überarbeitet werden. Denn durch eine rein manuelle Konfiguration in der Datei hätte man gegenüber der Weboberfläche nichts gewonnen. Leider ist auch Octavia-cli nicht frei von Stolpersteinen. So hat das Deployment der configuration.yaml-Dateien in meinem Beispielprojekt nur innerhalb der gleichen Airbyte Version funktioniert. Ferner ist noch anzumerken, dass sich die Connection-ID ändert, wenn auf eine andere Airbyte-Instanz deployt wird. In meinem Beispiel wirkte sich das auf das Deployment des Modern Data Stack aus. Der bestand aus Airbyte, dbt und Airflow. Mit Airflow werden Airbyte und dbt-Prozesse orchestriert. Im Directed Acyclic Graph (DAG) von Airflow muss bei jedem Airbyte-Prozess die entsprechende Connection-ID angegeben werden. Als sich diese änderte, musste der DAG angepasst werden. Damit wäre ich auch schon am Ende von Teil 2 angelangt. Im abschließenden Teil der Airbyte-Trilogie erwartet dich ein tieferer Einblick in den eigentlichen Data-Ingestion-Prozess. Darum, stay tuned! [Teil 1: Daten integrieren mit Airbyte – Teil 1: Einführung & Installation](https://thecattlecrew.net/2023/03/28/daten-integrieren-mit-airbyte-teil-1-einfuehrung-installation/) [Teil 2: Daten integrieren mit Airbyte – Teil 2: Octavia-cli](https://thecattlecrew.net/2023/04/28/daten-integrieren-mit-airbyte-teil-2-octavia-cli/ "Zum Blogbeitrag") [Teil 3: Wie funktioniert Data Ingestion genau?](https://thecattlecrew.net/2023/05/17/daten-integrieren-mit-airbyte-teil-3-wie-funktioniert-data-ingestion-genau/ "Zum Blogbeitrag") **Kategorien:** Analytics & Insights, Integration, Tools & Methoden --- ### [Daten integrieren mit Airbyte – Teil 1: Einführung & Installation](https://thecattlecrew.net/2023/03/28/daten-integrieren-mit-airbyte-teil-1-einfuehrung-installation/) **Published:** März 28, 2023 **Author:** Caroline Aretz **Excerpt:** Für alle, die Self Service BI einführen, Data Replication steuern oder APIs managen wollen, hält die Dateningestplattform Airbyte einiges bereit. In dieser Artikelserie nehme ich dich Schritt für Schritt mit – von der Installation bis zum täglichen Einsatz von Airbyte. Dabei klettern wir auch über Stolpersteine. Im ersten Teil erfährst du, was für die Installation wichtig ist. Die ersten Handgriffe gehen wir an einem Beispiel durch. **Content:** Für alle, die Self Service BI einführen, Data Replication steuern oder APIs managen wollen, hält die Dateningestplattform Airbyte einiges bereit. In dieser Artikelserie nehme ich dich Schritt für Schritt mit – von der Installation bis zum täglichen Einsatz von Airbyte, dabei klettern wir auch über Stolpersteine. Im ersten Teil erfährst du, was für die Installation wichtig ist. Die ersten Handgriffe gehen wir an einem Beispiel durch. Viel Spaß beim Lesen! # Was kann Airbyte? Airbyte ist eine Open-Source-Datenintegrationsplattform, die zunehmend an Popularität gewinnt. Sie konzentriert sich auf die ersten beiden Buchstaben des ELT-Prozesses, also auf Extract und Load und wird im Umfeld moderner Data Stacks eingesetzt. Also dort, wo es viele verschiedene Software Tools gibt, die dabei helfen, Daten zu sammeln, Datenflüsse zu steuern und Daten zu speichern. Aktuell bietet Airbyte über 300 Konnektoren out of the Box. Mit diesen Konnektoren lassen sich Daten von Applikationen, APIs und Datenbanken zu Data Warehouses, Lakes und anderen Zielen übertragen. Die Lade- und Synchronisationsjobs werden über eine Weboberfläche konfiguriert. Airbyte läuft in einem containerbasierten Betrieb, in dem jeder Konnektor seinen eigenen Container hat. # Wo kann Airbyte installiert werden? Airbyte läuft auf vielen Umgebungen, wobei immer ein paar Dinge zu beachten sind: - Lokale Maschinen oder VM in der Cloud Wenn du Airbyte auf lokalen Maschinen und auf den VMs in der Cloud installieren willst, brauchst du Docker und Docker-Compose. Beide sind eine Voraussetzung für die Airbyte-Installation. - Kubernetes Für die Installation in Kubernetes gibt es zwei Verfahren: Kustomize oder Helm. Kustomize würde ich allerdings nicht empfehlen, da es nur bis Airbyte Version 0.40.32 unterstützt wird. Also lieber die Kubernetes Installation über Helm wählen. Die momentan aktuelle Version ist die 0.42.0. - Restack Restack ist eine Distributionsplattform für Open-Source-Produkte. Mit Hilfe von Restack lässt sich Airbyte über eine Weboberfläche in einer AWS-Infrastruktur installieren. Hierzu wird ein AWS-Account mit Administratorrechten benötigt. - Plural in der Cloud Plural ist eine Open-Source-Plattform, die einen Kubernetes-Cluster und ausgewählte Anwendungen wie Airbyte bei verschiedenen Cloud-Anbietern bereitstellt. Der Infrastruktur-Code wird durch Plural in einem Git-Repository gespeichert. Ein Plural Account und die Installation des Plural CLI werden vorausgesetzt. Die Airbyte-Installation erfolgt über das Plural CLI. # Von der SQL-DB ins DWH … In einem meiner Kundenprojekte ging es darum, mithilfe von Airbyte Daten von einer PostgreSQL-DB in ein Data Warehouse zu laden, das ebenfalls auf einer PostgreSQL-DB läuft. Neben Airbyte waren hier auch noch dbt und Airflow im Einsatz. Die Entwicklungsumgebung haben wir in diesem Projekt als Docker Container aufgesetzt, der auf einer lokal installierten Ubuntu 22.04 VM läuft. In der Produktionsumgebung wurde ein Kubernetes Cluster aufgesetzt. # Einstellungen über die Airbyte Weboberfläche Über http://localhost:8000 gelangst du auf die Weboberfläche. Das meiste erklärt sich hier von selbst. Hier gibt es die Bereiche „Connections“, „Sources“ und „Destinations“, in denen die Konfigurationen vorgenommen werden. ## 1. Sources definieren Über den Button „+ New source“ wird eine neue Source erstellt. Hierzu wählst du zunächst den Source-Typ aus einer Dropdown-Liste aus. ![Screenshot Sources definieren](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild1.png)So werden die Sources definiert Hierzu wählst du zunächst den Source-Typ aus einer Dropdown-Liste aus. Es öffnet sich linksseitig die Source-spezifische Konfigurationsmaske und auf der rechten Seite wird der zugehörige Setup Guide angezeigt. In diesem Fall für PostgreSQL. ![Screenshot: Konfigurationsmaske](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild2.png)Die Konfigurationsmaske öffnet sich Wenn alle Pflichtangaben vorhanden sind, kannst du die Source über den Button „Set up source“ erstellen. Hierbei wird auch gleich die Verbindung zur Source getestet. Wenn Erstellung und Verbindungstest erfolgreich waren, öffnet sich eine Maske, auf der man die Destination an die Source anbinden kann. Über den Button „add destination“ hast du die Möglichkeit, eine bereits existierende Destination auszuwählen oder eine neue Destination („+ add a new destination“) anzulegen. ![Screenshot Destination hinzufügen](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild3-1.png)Hier kannst du eine Destination hinzufügen Wenn der Source eine Destination zugewiesen wurde, startet der Prozess „Set up connection“. Hierbei öffnet sich eine Maske, über die die Connection konfiguriert wird. - Name der Connection - Frequenz der Datenreplikation - Destination Namespace (z. B. Schema auf der Destination-Datenbank) - Aktivierung und Konfiguration der zu synchronisierenden Streams (z. B. Quelltabellen auf der Source-Datenbank inkl. Sync-Mode) - Normalization & Transformation - - - - Nur Raw Data als JSON-Blob (Radio Button „Raw data (JSON)“) - Normalisierung des JSON-Formats in eine relationale Tabelle (Radio Button „Normalized tabular data“) Airbyte überträgt einen Datensatz immer als ein JSON-Blob, egal aus welcher Quelle die Daten stammen. Die anschließende Normalisierung wandelt das JSON-Format in relationale Tabellendaten um. Darum ist die Normalisierung nur möglich, wenn relationale Datenbanken als Destination verwendet werden. Doch dazu mehr in Teil 3 der Blogreihe. Nach abgeschlossener Konfiguration wird über den Button „Set up connection“ die Verbindung aufgebaut und getestet. ## 2. Destination bestimmen Wenn du über den Button „+ New destination“ eine neue Destination erstellst, wählst du zuerst den Destinationstyp aus einer Dropdown-Liste aus. ![Screenshot Destination bestimmen](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild4.png)In dieser Maske spezifizierst du die Destination Es öffnet sich linksseitig die Destinations-spezifische Konfigurationsmaske und auf der rechten Seite wird der zugehörige Setup Guide angezeigt (z.B. für PostgreSQL). ![Screeshot Konfiguration der Destination](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild5.png)In dieser Maske kannst du die Destination konfigurieren Wenn alle Pflichtangaben vorhanden sind, wird die Destination über den Button „Set up destination“ erstellt, hierbei wird auch gleich die Verbindung zur Destination getestet. Nach erfolgreicher Erstellung und erfolgreichem Verbindungstest öffnet sich eine Maske, auf der man die Source an die Destination anbinden kann. ![Screenshot Source anbinden](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild6.png)Hier kannst du eine Source an die Destination anbinden Über den Button „add source“ hast du die Möglichkeit, eine bereits existierende Source auszuwählen oder eine neue Source („+ add a new source) anzulegen. Wenn der Destination eine Source zugewiesen wurde, startet der Prozess „Set up connection“. Hierbei öffnet sich die bereits oben beschriebene Maske zur Konfiguration der Verbindung. ## 3. Connections herstellen Über den Button „+ New connection“ wird eine neue Connection erstellt. ![Screenshot Neue Connections herstellen](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild7.png)So erstellst du eine neue Connection Hierbei öffnet sich eine Maske, auf der aus bereits existierenden Sources ausgewählt werden kann oder über die per „Set up the source“ eine neue Source erstellt werden kann. ![Screenshot Source verbinden](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild8.png)Wähle eine Verbindung aus Nach Auswahl bzw. Konfiguration der Source öffnet sich eine Maske mit einer Auswahl an Destinations, die schon existieren. Alternativ kannst du per „Set up destination“ eine neue Destination erstellen. ![Screenshot neue Destination erstellen](https://thecattlecrew.net/wp-content/uploads/2023/03/Bild9.png)Hier kannst du eine neue Destination erstellen Sobald Source und Destination bekannt sind, öffnet sich die oben beschriebene Maske zur Konfiguration der Verbindung. Wenn die Konfiguration der Connection abgeschlossen und die Connection erfolgreich erstellt wurde, kann über den Button „Sync now“ erstmalig die Datenreplikation gestartet werden. Die Datenreplikation bereits existierender Connections kann über den Launch-Button gestartet werden. Die technischen Details zu den Installationsanweisungen kannst du in der [Installationsdoku von Airbyte](https://docs.airbyte.com/category/deploy-airbyte-open-source/) nachlesen. # Fazit Ob Sources, Destinations oder Connections: Egal über welchen Bereich du auf der Weboberfläche einsteigst, auf Airbyte wird immer ein Workflow gestartet, der dich in der richtigen Reihenfolge durch alle notwendigen Schritte führt. Die Weboberfläche macht die manuelle Konfiguration auf einer Airbyte-Instanz also schnell und einfach möglich. Schwieriger wird es, wenn du diese Objekte ohne großen manuellen Aufwand auf andere Airbyte-Instanzen deployen willst. Die unter Settings/Configuration angebotenen Funktionen zum Export und Import der Konfigurationen haben in unserem Projektkontext beispielsweise nicht funktioniert. Deshalb haben wir Alternativen, wie das Command-Line-Tool Octavia-cli geprüft. Was dabei herausgekommen ist, kannst du [im zweiten Teil](https://thecattlecrew.net/2023/04/28/daten-integrieren-mit-airbyte-teil-2-octavia-cli/ "Zum zweiten Teil") dieser Serie erfahren. Im dritten Teil geht es um den Data-Ingestion-Prozess, was dabei hinter den Kulissen von Airbyte passiert und was es mit den Sync-Modes auf sich hat. Bleib also gerne dabei! [Teil 1: Daten integrieren mit Airbyte – Teil 1: Einführung & Installation](https://thecattlecrew.net/2023/03/28/daten-integrieren-mit-airbyte-teil-1-einfuehrung-installation/) [Teil 2: Daten integrieren mit Airbyte – Teil 2: Octavia-cli](https://thecattlecrew.net/2023/04/28/daten-integrieren-mit-airbyte-teil-2-octavia-cli/ "Zum Blogbeitrag") [Teil 3: Wie funktioniert Data Ingestion genau?](https://thecattlecrew.net/2023/05/17/daten-integrieren-mit-airbyte-teil-3-wie-funktioniert-data-ingestion-genau/ "Zum Blogbeitrag") **Kategorien:** Analytics & Insights, Infrastructure, Integration, Tools & Methoden **Schlagwörter:** Airbyte, Container-basiert, ELT, Integrationsplattform, Moderner Data Stack --- ### [Developers first! Oracle 23c free - Developer Release](https://thecattlecrew.net/2023/04/05/developers-first-oracle-23c-free-developer-release/) **Published:** April 5, 2023 **Author:** Sven Bernhardt **Content:** Oracle announced a new version of Oracle Database, the Oracle 23c free – Developer Release. Within this blog post, I will very briefly introduce the new release. Rather than repeat content from other posts, I link to additional sources for more detailed content. ## Developers in the spotlight As the name suggests, the latest release marks a significant change in Oracle’s database release strategy. You may have noticed that the release name contains the terms „free“ as well as „Developer Release“. This is evident that it changes the way, how new database releases will occur in the future: With a developer-first mindset, in a free-to-use version of Oracle database. If you’re interested about consequences, read [my blog](https://svenbernhardt.wordpress.com/2023/04/05/developers-first-mindset-arrives-with-oracle-23c-free-version/) about what this means to developers. ## New features: JSON Relational Durability and more Besides the changes concerning the release strategy and focus, the release also comes with new features. Those features aim to simplify and enhance the development of modern applications. Developers can access the latest and most advanced tools to build innovative and scalable applications. One of the key highlights of Oracle 23c – Developers edition is the ability to build applications using either relational or JSON paradigms, using a single source of truth (JSON Relational Durability). This eliminates the need for complex object-relational mappings, allowing developers to access, modify, and write data with ease. The edition also provides ACID-compliant transactions and concurrency controls, ensuring data consistency and eliminating the tradeoffs between different data models. Moreover, we can leverage the in-memory column store and database sharding capabilities to manage large data sets with greater ease. These features improve application performance and provide lower latency, delivering an unparalleled experience to end users. More details about new features can be found in the official Oracle announcement blogs: - [Technical blog by Gerald Venzl: Introducing Oracle Database 23c Free – Developer Release](https://blogs.oracle.com/database/post/oracle-database-23c-free) - [Press Release: Oracle Database 23c Free Version Now Available to Developers](https://www.oracle.com/news/announcement/oracle-database-23c-free-developer-release-2023-04-03/) ## Conclusion Oracle is committed to delivering the best tools and resources to developers worldwide, and Oracle 23c – Developers edition is a testament to that commitment. The release offers cutting-edge features that help developers build robust and scalable applications with ease. I am more than excited to see the innovations thriven by this new release. **Kategorien:** Database, Development, Infrastructure **Schlagwörter:** Announcement, Developer Experience, Multi-model Database, oracle, Oracle DB --- ### [Die Dbvisit MultiPlatform 11.3 ist da](https://thecattlecrew.net/2023/03/23/dbvisit-11-3-verfuegbar/) **Published:** März 23, 2023 **Author:** Rainier Kaczmarczyk **Content:** Servus! Nachdem es in den letzten Monaten mit den Release Updates 19.17 und 19.18 von Dbvisit ein paar Probleme gab, ihr konntet es in meinem vorigen Blogbeitrag lesen: [Probleme bei der Installation des Oracle CPU 19.17/19.18 mit Dbvisit](https://thecattlecrew.net/2023/01/26/probleme-bei-installation-von-oracle-cpu-19-17-19-18-mit-dbvisit/ "Zum Artikel") – ist nun alles wieder in trockenen Tüchern: Die StandbyMP 11.3, das neueste Release der Standby MultiPlatform vom 16. März 2023, ist meines Erachtens sehr stabil. Mein persönliches Highlight: dbvctl ist wieder vollumfänglich verfügbar! Weitere Features: - Einführung von „Custom User Scripts/SQL Server Application Switchover“. Das heißt, Anwendende können jetzt ein optionales Systemskript erstellen und zu StandbyMP hinzufügen, das dann am Ende eines erfolgreichen Switchover- oder Failover-Vorgangs mit einem einzigen Klick verwendet werden kann. - Die neue Option Time Gap Monitoring Observer ist jetzt auch für SQL Server verfügbar – Ihr erhaltet also über mehrere Kanäle hinweg Warnungen, wenn die Konfiguration eine voreingestellte Zeitspanne überschreitet. - Verschlüsselte SQL-Server-Verbindungen werden unterstützt. - Die neue „Version Mismatch“-Erkennung wurde produktweit eingeführt, mit entsprechenden Benutzerwarnungen in der GUI, wenn Versionskonflikte zwischen StandbyMP-Komponenten festgestellt werden. Ich bin gespannt, wann Version 12 mit der Unterstützung eines weiteren Datenbanksystems veröffentlicht wird. Euer Rainier **Kategorien:** Database, Infrastructure, Tools & Methoden **Schlagwörter:** Database, Dbvisit, High Availability, Standby --- ### [Mehr als die Summe ihrer Datensätze – Was kann die Neo4j?](https://thecattlecrew.net/2023/02/03/mehr-als-die-summe-ihrer-datensaetze-was-kann-die-neo4j/) **Published:** Februar 3, 2023 **Author:** Stefan Schubert **Content:** Darf ich vorstellen: Neo4j, NoSQL-Datenbank, in Java implementiert, Open-Source-Produkt und Heldin dieses Blogbeitrags. Was aber viel spannender ist: Neo4j ist eine der wenigen nativen Graphdatenbanken, die es gibt, also eine Datenbank, die auf vernetzte Daten spezialisiert ist. Heldin? Ist das nicht ein bisschen übertrieben? Und was kann sie wirklich, diese Neo4j? Oder anders gefragt: Was macht ein Netzwerk, oder genauer, die Strukturen eines Netzwerks, für Datenanalysen so interessant? Und was in aller Welt hat eine eigene Datenbank dafür anzubieten? ## Was Netzwerke über Menschen und Eigenschaften verraten Ein Netzwerk besteht aus unzähligen Verbindungen und Knotenpunkten. Soziale Netzwerke sind dafür ein schönes Beispiel. Wie bei allen Netzwerken kommt es bei Facebook, Instagram und Co. vor allem darauf an, wer wen kennt, was zwei Personen verbindet oder über wie viele Ecken zwei Menschen verbunden sind. Die Beziehungen stehen also im Vordergrund und spielen insgesamt eine größere Rolle als die Eigenschaften einer einzelnen Person. Die Beziehungen können sehr unterschiedlich ausgeprägt sein. So können Personen befreundet sein, verheiratet und verwandt sein, einander blockieren, Mitglieder von Gruppen und Ausbildungsstätten sein, Unternehmen angehören und so weiter. Dazu kommt, dass die Beziehungen zwischen den „Entitäten“ eines sozialen Netzwerks versteckte Informationen enthalten, die aus den reinen Eigenschaften einer Person nicht herauszulesen wären. Von einer völlig fremden Person erfahren wir zum Beispiel, dass sie Mitglied eines Tennisclubs ist. Daraus können wir schlussfolgern, dass diese Person Tennis mag, sportlich ist und im Großraum des Tennisclubs wohnt. Diese Informationen werden kommerziell genutzt, um personalisierte Werbung zu generieren … und schon erhält der oder diejenige Angebote für Vitaminpräparate und Nahrungsergänzungsmittel im nächsten Supermarkt. ## Graphen: Große Netze mit Knoten und Kanten Eine native Graphdatenbank macht es möglich, vernetzten Daten effizient abzulegen und sogar zu verarbeiten. Sie hilft uns, mithilfe von mathematischen Graphen unter anderem komplexe Muster im Detail zu erfassen, darstellen und zu speichern. Graphen sehen aus wie ein großes Fischernetz, eine Struktur aus Knoten und Kanten. Mit mächtige Algorithmen können wir sie lesen, Gruppierungen erkennen, einflussreiche Elemente und kürzeste Wege finden oder Ähnlichkeiten von Objekten analysieren. Eine Graphdatenbank hilft uns dabei und ist in der Lage, über Entitäten und Beziehungen neue Informationen zu generieren. Oder verdeckte Informationen zu finden und beispielsweise Betrugsversuche aufzudecken. ## Wo relationale Datenbanken straucheln Relationale Datenbanken sind weiterhin ein wertvolles Werkzeug, um Daten zu speichern und sollten nicht als Gegenstück einer Graphdatenbank angesehen werden, bieten aber in manchen Anwendungsfällen nicht die Mächtigkeit, die eine Graphdatenbank mitbringt. Stellen wir uns vor, wir befinden uns in einer der besagten Social Network Domains. Würden wir hier die Beziehungen zwischen Personen für eine relationale Datenbank modellieren, würden wir im ersten Schritt vermutlich zwei Tabellen *Person* und *Relation* anlegen. Hierbei bildet *Person* die Tabelle, die die Daten, wie beispielsweise den Namen einer Person enthält – *Relation* bildet die Verbindung der Personen, mit Fremdschlüsseln auf die aktive Person (*fromPersonId*) und die passive Person (*toPersonId*). ![](https://thecattlecrew.net/wp-content/uploads/2023/02/relational-300x84.png)Fig. 1 Relationale Modellierung Ein Netzwerks mit einer enormen Menge an Entitäten belastet eine relationale Datenbank. Das liegt daran, dass die Anfragen an eine relationale Datenbanken auf der Datenmenge skalieren, oder einfach ausgedrückt: Je mehr Daten berücksichtigt werden, desto langsamer ist die Anfrage. Zwar sind die meisten relationalen Datenbanken für große Anfragevolumen optimiert, aber das Problem bleibt grundsätzlich bestehen und führt gerade im (very) Big-Data-Umfeld schnell zu Performance-Problemen. Besonders die Beantwortung der Frage „Über wie viele Ecken kennen sich zwei gegebene Personen?“ ist im relationalen Modell schwer zu beantworten. Dafür müssten genauso viele Joins erfolgen, wie es Relationen zwischen den Personen gibt – also eine in der Regel unbekannte Größe. Und Joins sind teuer. Bei Personen, die einander nicht kennen oder deren Distanz größer ist, als wir per Joins in vertretbarer Zeit bestimmen können, müssen wir irgendwann aufgeben. ## Relationen von der anderen Seite betrachten – die Kernkompetenz der Graphdatenbank Modellieren wir die gleiche Situation in einer Graphdatenbank, erhalten wir zwei Knoten: einen für jede Person; sowie zwei Relationen: eine für jede (gerichtete) Beziehung zwischen den Personen. ![](https://thecattlecrew.net/wp-content/uploads/2023/02/Person-graph-300x123.png)Fig. 2 Modellierung als Graph Was auf den ersten Blick recht ähnlich aussieht, hat eine Reihe von Vorteilen. 1. An jedem Knoten haften technisch nur die ausgehenden Relationen an. Das bedeutet, wir übergeben dem Objekt selbst die Verantwortung für seine „Join“-Partner. Haben wir einen konkreten Knoten an der Hand, müssen wir nur die Beziehungen betrachten, die diesen Knoten betreffen. Das gleiche gilt für Folgeknoten. Damit skalieren die Anfragen nicht auf der Datenmenge, sondern auf der Suchtiefe. Die Menge der Objekte fällt bei einer Graphdatenbank damit deutlich weniger ins Gewicht als bei einer relationalen Datenbank. 2. Die Frage, über wie viele Ecken sich zwei Personen kennen, löst die Graphdatenbank über einen fertigen Algorithmus (eine Implementierung des Shortest-Paths). Dieser wird von Neo4j direkt mitgeliefert und funktioniert out-of- the-box. Diese Vorteile kommen zustande, weil die Graphdatenbank Relationen als persistente Objekte behandelt. Das hat aber auch seinen Preis: Je mehr persistente Objekte, umso größer der Aufwand beim Speichern. Denn was in einer relationalen Datenbank ein *Fremdschlüssel* ist, ist hier eine *Entität*. Etwas überspitzt könnte man sagen: Ein Objekt mit 100 Fremdschlüsseln bildet in einer relationalen Datenbank nur eine einzige Entität, in Neo4j dagegen 101 Entitäten. Es lohnt sich also, im Vorfeld zu prüfen, wie viele Objekte wie oft gespeichert werden müssen und welches System wir hier aufsetzen wollen. Ein Event-System, das sehr viele Elemente in sehr kurzer Zeit speichert, wäre beispielsweise kein guter Anwendungsfall für Neo4j. Wie erwähnt handelt es sich bei Neo4j um eine *native* Graphdatenbank. Was ist das Besondere daran? Wie unterscheidet sich eine native Graphdatenbank von anderen Graphdatenbanken wie Amazon Neptune oder Azure Cosmos DB mit Gremlin, denen wir am Markt recht häufig begegnen? Neo4j ist eine der wenigen Graphdatenbanken, bei denen die Daten tatsächlich als echter Graph gespeichert werden, ergo: *nativ*. Bei nicht-native Graphdatenbanken handelt es sich dagegen in der Regel um relationale Datenbanken, die mit einem zusätzlichen Layer ausgestattet wurden, der die Daten als Graph anbietet. Zwar sind diese Datenbanken durchaus für Graphstrukturen optimiert, doch die Nachteile relationaler Datenbanken werden sie, wenn es um vernetzte Strukturen geht, dadurch leider nicht los. ## Wie viele Label hat ein Knoten? Was SQL für eine relationale Datenbank, ist Cypher für Neo4j. Bei Cypher handelt es sich also um eine deklarative Abfragesprache für die Interaktion mit Neo4j. Im Gegensatz zu SQL baut Cypher hauptsächlich auf Pattern-Matching auf. Das heißt, Anwendende beschreiben den Sub-Graph mit denen sie interagieren möchten und die gewünschten Aktionen. Was steckt dahinter? Neo4j arbeitet mit einem sogenannten Label-Property Graph. Das bedeutet, alle Entitäten bekommen ein Label, also ein Etikett, das die Art der Entität beschreibt. Ein Knoten im sozialen Netzwerk könnte beispielsweise das Label „Person“ haben. Während Knoten mit beliebig vielen Labels bezeichnet werden können, haben Relationen genau ein Label: den Type. Alle Entitäten, oder besser: Knoten und Kanten eines Label-Property-Graphen, können außerdem Properties besitzen. In Neo4j werden die Properties als Json Objekt abgelegt. Darin können alle Eigenschaften eines Knotens oder einer Kante schemalos enthalten sein. Durch die Tatsache, dass es Knoten, Kanten und Properties gibt, sieht Cypher auf den ersten Blick etwas kryptisch aus: - Knoten werden als runde Klammern geschrieben, die ihre Labels enthalten können, - Relationen als Pfeile mit eckigen Klammern, die den Type enthalten - Properties als Json Objekt in geschweiften Klammern Ein Beispiel: Nehmen wir Stefan, er ist 38 und spielt seit 2020 Gitarre. Daraus ergäbe sich folgender Sub-Graph und darunter die Beschreibung in Cypher: ![](https://thecattlecrew.net/wp-content/uploads/2023/02/stefan-guitar-300x100.png) ![](https://thecattlecrew.net/wp-content/uploads/2023/02/stefan-guitar-cypher-300x23.png)Fig. 3 Graph und Cypher-Query In Neo4j würde Stefan als ein Knoten geführt mit dem Label *Person*, zwei Properties *name* (ein String) und *age* (ein Integer) und mit einer Relation vom Type *PLAYS* , der eine Property *since* besitzt. Die Gitarre würde dargestellt als Knoten mit zwei Labels *Instrument* und *Guitar* und die Relation geht von Stefan zur Gitarre. Cypher kommt nun mit einer Reihe von Befehlen daher, die beschreiben, wie mit Sub-Graphen interagiert werden soll, wie z. B. *Match*, was so viel bedeutet wie „Finde das Muster“. So würde beispielsweise die Query ***MATCH (p:Person {age:35})-\[:PLAYS\]->(:Guitar) RETURN p.name*** die Namen aller Nutzer zurückgeben, die 35 sind und Gitarre spielen. Dies nur als allererster Eindruck. Cypher ist mächtig und damit groß. Wer mehr über Cypher erfahren möchte, der sollte hier fündig werden: ## Algorithmen ausführen Eine Besonderheit von Neo4j ist, – wir hatten es schon erwähnt – dass Graph-Algorithmen direkt auf der Datenbank ausgeführt werden können. Dabei kommen Plugins zum Einsatz. Diese Plugins erhalten wir in Form von JAR-Files, die im Plugin-Ordner der Neo4j-Installation abgelegt werden können. Da Neo4j selbst in Java entwickelt ist, werden diese Plugins in der kommerziellen Version direkt, in der Community-Version beim Neustart, in den Kontext der Datenbank aufgenommen. Von hier aus liefern sie Hintergrundprozesse oder aus Cypher heraus aufgerufene Funktionen. Unter den Akronymen APOC und GDS publiziert Neo4j selbst zwei offizielle Plugin-Libraries: *Graph-Data-Science* und *Awesome Procedures on Cypher.* GDS enthält alle relevanten Graph-Algorithmen wie - Community Detection, - Path-Finding, - u. s. w. APOC enthält alles, was sich darüber hinaus als interessant erwiesen hat, wie - Lucene-Indexing, - OpenStreetMaps-Anbindung, - Anbindungen an eine sekundäre Couch-DB - u. s. w. Produktiv lohnt es sich fast immer, APOC zu installieren. GDS ist empfehlenswert, wenn Graph-Algorithmen konkret benötigt werden. ## Was kann Neo4j, und was nicht? Fassen wir einmal zusammen: Neo4j glänzt beim Lesen langer Pfade, hat jedoch Probleme, wenn es um das schnelle Schreiben von Entitäten geht. Ein Vorteil ist wiederum, dass an jedem Knoten technisch nur seine ausgehende Relation anhaftet. Die Performance bei Suchanfragen wird bei ihr demnach nur beeinträchtigt, wenn die betrachteten Pfade sehr tief ausfallen. Genau genommen versucht Neo4j bei jeder Cypher-Query durch Indexing das konkreteste Element zu finden und sich von dort aus über die Relationen weiterzuhangeln. Eine Anfrage wie ***MATCH (n)<-\[:R\]-(p:Person) WHERE id(p)=11 return n*** lädt beispielsweise alle Knoten, die von der Person mit der ID 11 durch eine ausgehende Relation vom Typ R erreichbar sind. Es werden also nicht alle Relationen vom Typ *R* betrachtet, sondern mittels Indexing wird die Person mit ID 11 ermittelt und nur deren Relationen betrachtet. Sind solche Relationen vorhanden, ist dieses Vorgehen natürlich toll. Dafür müssen diese jedoch erstmal gespeichert worden sein, was in der Regel ausfällt, wenn die Relationen für uns nicht im Fokus stehen. Daher lässt sich als Faustregel sagen, dass eine Neo4j gut geeignet ist, wenn die Verbindungen zwischen den Entitäten genauso wichtig, oder wichtiger sind als diese selbst. Besitzt unsere Domain hingegen wenige oder keine Relationen, müsste Neo4j ständig auf den Index zugreifen. Dabei würde mit der Datenmenge skaliert, sodass Neo4j bestenfalls nicht performanter wäre als eine relationale Datenbank. Daher eignet sich Neo4j wie erwähnt auch nicht für den Einsatz bei einem Event-Speicher. Weiterhin legt die Neo4j jedes Attribut eines Knotens als Datei ab, daher sollten hier keine Blobs, also große Dateien in binärer Form, abgelegt werden. Sie eignet sich also nicht für einen reinen Bild-Speicher. ## In welchen Gebieten kann Neo4j eingesetzt werden? Oben wurde bereits erwähnt, dass sich die Neo4j für den Einsatz in sozialen Netzwerken eignet. Also dort, wo die Domain lange und wichtige Verbindungen zwischen den Daten aufweist. Auch die Versorgungswege oder Netzwerk-Infrastrukturen sind für den Einsatz interessant. ### Empfehlungen aussprechen ![](https://thecattlecrew.net/wp-content/uploads/2023/02/recommend-300x263.png)Fig. 4 Recommendation Muster Ein Musterbeispiel für den Einsatz der Neo4j sind Recommendation-Engines, die Vorlieben der Nutzer erkennen und Empfehlungen aussprechen. Da Cypher Daten anhand von Pattern-Matching laden kann, fällt es leicht, Muster zu beschreiben wie „Dinge, die von einer Person gemocht werden, die das gleiche Ding mag wie ich“. ### Verwandte Inhalte finden ![](https://thecattlecrew.net/wp-content/uploads/2023/02/onthology-249x300.png)Fig. 5 Ontologie Nicht ganz so leicht, aber immer noch relativ einfach lassen sich „Best Match“-Suchen umsetzen. Stellen wir uns vor, wir suchen in einer Datenbank, die Dokumente über Metallverarbeitung verwaltet nach einer Anleitung zur Goldverarbeitung. Selbst wenn ein solches Dokument nicht existiert, wird uns weitergeholfen. Denn die Relationen, die dem Edelmetall Gold anhaften, liefern verwandte Ergebnisse, vielleicht ein Dokument, das beschreibt wie ein anderes Edelmetall (z. B. Silber) verarbeitet werden kann. Die Neoj4 hilft hierbei, indem sie uns eine Möglichkeit liefert, diese Ähnlichkeit zu berechnen. Dafür wird die Distanz im Graphen zum perfekten Ergebnis berechnet. Die Anleitung zur Goldverarbeitung hätte demnach einen Distanzwert von 0 zum „perfekten Ergebnis“, weil es das perfekte Ergebnis ist. Das Dokument, in dem beschrieben wird, wie Silber verarbeitet wird, ist hingegen eine Pfadlänge von zwei Kanten vom perfekten Ergebnis entfernt, könnte damit aber durchaus interessante Informationen für die suchende Person besitzen. Eine baumartige Konkretisierung nennt sich Ontologie. ### *Neo4j und Ontologie* *Wir können behaupten, dass Neo4j in fast allen Domainen, in denen Ontologie genutzt wird, einen Mehrwert liefert. Wie bei der Dokumentsuche eignet sich die Datenbank beispielsweise auch, wenn es darum geht, chemische oder biologische Testverfahren zu verwalten, eine passende Fachkraft für ein bestimmtes Projekt zu finden oder Herbizide und deren EU-Gesetzesnormen zu verbinden.* ### Künstliche Intelligenz und Machine Learning Nach eigenen Aussagen ist die Neo4j auch bestens für KI![](https://thecattlecrew.net/wp-content/uploads/2023/02/ai-300x230.png) und Machine Learning geeignet und funktioniert gut im Einklang mit Googles Vertex AI. Tatsächlich liefert die bereits erwähnte Plugin-Library GDS Algorithmen für viele Machine-Learning-Anwendungsfälle oder vorbereitende Maßnahmen, wieMissing-Link-Prediction, Fraud Detection, Entity Resolution und viele andere. Beim Thema Machine Learning mit der Neo4j tun sich also riesige Möglichkeiten auf. Da lohnt es sich, einen Blick reinzuwerfen, zumal die Neo4j mit der [Graph-Academy](https://graphacademy.neo4j.com/) viele Ressourcen und kostenlose Zertifikate fürs Selbstlernen liefert ## Los geht’s: Installieren und starten ### 1. Download und Infrastruktur Wie viele Datenbanken lässt sich Neo4j leicht auf diversen Wegen installieren: - Die Binary lässt sich von beziehen, das Docker-Image heißt schlicht „neo4j“. Mit den bekanntesten Cloud-Anbietern pflegt Neo4j eine Partnerschaft. - Die Neo4j Desktop-Applikation kann unter heruntergeladen werden. Allerdings nur als Spielwiese, nicht für den produktiven Einsatz. Als weitere Umgebung bietet Neo4j eine eigene Cloud an: die Neo4j Aura, für die zwar eine Kreditkarte verlangt wird, die aber zumindest eine Free-Instanz erlaubt. Achtung: Neo4j Aura wird aktuell nicht durch Terraform unterstützt. Dafür fehlt der dafür nötige API-Endpoint. Das Feature wird aber derzeit (Stand November 2022) entwickelt. ### 2. Die ersten Schritte Für die ersten Schritte kommt man mit Docker vermutlich am schnellsten an die Startlinie: - ***docker run -p 7474:7474 -p 7687:7687 neo4j*** startet die Datenbank, deren eigene GUI direkt unter *localhost:7474* erreichbar ist. Mit dem default Nutzer (und Passwort) *neo4j* darf man die Anwendung initial betreten, muss danach aber ein neues Passwort vergeben. - Zuletzt führt die Ausführung von ***:play*** in der GUI dazu, dass ein eigenes Tutorial auf der Datenbank gestartet wird mit dem man direkt herumspielen kann, um Cypher und die Fähigkeiten von Neo4j kennenzulernen. ![](https://thecattlecrew.net/wp-content/uploads/2023/02/neo4j-ui-300x73.png)Fig. 6 Neo4j Oberfläche Viel Spaß beim Ausprobieren! — Das könnte auch interessant sein: - [Mehr aus dem Themenfeld Analytics](https://thecattlecrew.net/category/analytics) - [Artikel rund um das Thema Database](https://thecattlecrew.net/category/database) **Kategorien:** Analytics & Insights, Database, Tools & Methoden **Schlagwörter:** Database, Graph, Neo4J --- ### [SAP Design Studio - Bericht-Bericht-Schnittstelle (RRI) und Open Document](https://thecattlecrew.net/2015/01/14/sap-design-studio-bericht-bericht-schnittstelle-rri-und-open-document/) **Published:** Januar 14, 2015 **Author:** Jürgen Möller **Content:** Ab Version 1.4 wird die Bericht-Bericht-Schnittstelle (Report-Report-Interface) nun auch im Design Studio unterstützt. Die Bericht-Bericht-Schnittstelle wird im SAP BW gepflegt und steuert Absprünge zwischen einer Quelle (BEx Query) zu einem Zielobjekt. Beim Design Studio werden **zwei Arten der Weitergabe** unterschieden: 1. Absprung mit automatischer Weiter­gabe der Filter an eine Zielquery (nur Design Studio). 2. Absprung in andere Zieldokumente (z.B. Crystal Reports, Design Studio) über eine Web-Adresse analog Open Document. Die hinterlegten Sprungziele können dann über das Kontextmenu abgerufen werden. **1. Absprung über Zielquery** Bei dieser Variante werden analog zu Analysis Office in der Bericht-Bericht-Schnittstelle zu einer Query eine oder mehrere Zielqueries hinterlegt. Als Sprungziel wird innerhalb der BI Platform nur eine Design Studio Applikation unterstützt, die fest hinterlegt werden muss. Diese Applikation darf nur eine DataSource besitzen und sollte so angelegt werden, dass die gewünschte Query beim Start geladen wird. Die Filter und der Name der entsprechenden Query werden von der Bericht-Bericht-Schnittstelle auto­matisch mitgegeben. Der Absprung erfolgt über das Kontextmenü, wobei automatisch die Merkmale der ausgewählten Zeile als Filter mitgegeben werden. **2. Absprung über Webadresse** Bei dieser Variante wird als Webadresse ein Open Document-Link hinterlegt. Die Filter müssen hier im Gegensatz zur ersten Variante in den Zuordnungsdetails einzeln fest hinterlegt werden. Der Absprung erfolgt über das Kontextmenü, wobei die in der Bericht-Bericht-Schnittstelle fest hinterlegten Filter der ausgewählten Zeile als Filter mitgegeben werden. Als Empfänger über eine Webadresse können folgende Tools fungieren: Crystal Reports**,** Web Intelligence**,** Analysis Office**,** Analysis OLAP**,** Design Studio **Kategorien:** Analytics & Insights **Schlagwörter:** Analytics, SAP --- ### [Oracle Business Intelligence und Highcharts - ein starkes Paar](https://thecattlecrew.net/2015/02/26/oracle-business-intelligence-und-highcharts-ein-starkes-paar/) **Published:** Februar 26, 2015 **Author:** Matthias Kietzke **Content:** Zwei aktuelle Themen im Reporting-Umfeld sind Visual Business Intelligence und Big-Data-Visualisierung. Bei dem einen geht es um die optimale und zielgruppengerechte Informationsdarstellung und bei dem anderen um die grafische Aufbereitung von Zusammenhängen und Mustern. Visual Business Intelligence hat vor allem durch [Success@Hichert](http://www.hichert.com/de/success) an Bedeutung gewonnen. Leider ist kaum ein BI-Tool in der Lage, die Anforderungen von Prof. Hichert umzusetzen, da die Visualisierungsmöglichkeiten zwar vielfältig, aber oft zu statisch sind. Parallel entwickeln sich Bibliotheken (oft auf JavaScript-Basis) wie [D3](http://d3js.org/) oder [Highcharts](http://www.highcharts.com/), die neuartige und dynamische Visualisierungen versprechen. Aus diesem Grund hat [OPITZ CONSULTING](http://www.opitz-consulting.de) einen Prototypen gebaut, bei dem die Oracle BI Suite die Highcharts-Bibliothek für die Visualisierung verwendet. Somit werden völlig neue Darstellungsformen möglich. **Beispiel 1 – Abweichung des monatlichen Umsatzes im Vergleich zum Vormonat** *Besonderheit: 0-Skala ist mittig, positive Werte gehen nach rechts und negative nach links, zweifarbige Darstellung der Balken abhängig von ihrer Ausrichtung* [![Chart1](https://thecattlecrew.net/wp-content/uploads/2015/02/chart11.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/chart11.png)Abweichung des monatlichen Umsatzes im Vergleich zum Vormonat **Beispiel 2 – Darstellung des Umsatzes zweier Produktgruppen im Jahresverlauf** *Besonderheit: Die Linien verlaufen in Bereichen (im Hintergrund erkennbar), die signalisieren, ob der Umsatz klein, mittel oder groß ist. Fachlich vielleicht nicht gerade super, aber uns ist kein besseres Beispiel eingefallen ![(wink)](https://thecattlecrew.net/wp-content/uploads/2023/02/wink.png "(wink)")* [![Chart2](https://thecattlecrew.net/wp-content/uploads/2015/02/chart21.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/chart21.png)Darstellung des Umsatzes zweier Produktgruppen im Jahresverlauf **Beispiel 3 – Umsatzspanne einer Produktgruppe im Jahresverlauf** *Besonderheit: Hier wird die Verteilung der Umsätze (min/max und Spanne) im Jahresverlauf dargestellt. Es ist erkennbar, wo die Spanne besonders groß ist, wo das Maximus besonders hoch ist und wie sich die zeitliche Verteilung darstellt.* [![Chart3](https://thecattlecrew.net/wp-content/uploads/2015/02/chart31.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/chart31.png)Umsatzspanne einer Produktgruppe im Jahresverlauf **Beispiel 4 – Heatmap: Umsatzverteilung nach Zeit und Produktgruppe** *Besonderheit: Es wird der Quartalsumsatz einer Produktgruppe dargestellt. Je dunkler, desto höher. Somit sind Häufungen optisch gut erkennbar (z. B. gute Umsätze in 5/2010 und 6/2010 über alle Produktgruppen hinweg).* [![Heatmap: Umsatzverteilung nach Zeit und Produktgruppe](https://thecattlecrew.net/wp-content/uploads/2015/02/chart41.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/chart41.png)Heatmap: Umsatzverteilung nach Zeit und Produktgruppe **Technische Umsetzung** Um diese Visualisierungen nutzen zu können, muss die sogenannte „Narrative View“ verwendet werden. Diese gliedert sich in die 3 Bereiche Prefix, Narrative und Postfix. [![Narrative View](https://thecattlecrew.net/wp-content/uploads/2015/02/narrative-view.png)](https://thecattlecrew.net/wp-content/uploads/2015/02/narrative-view.png)Narrative View in Oracle BI Im Prefix-Abschnitt muss die JavaScript-Bibliothek eingebunden werden: ``` Insert title here http://ajax.googleapis.com/ajax/libs/jquery/1.8.2/jquery.min.js http://code.highcharts.com/highcharts.js http://code.highcharts.com/highcharts-more.js var cat = []; var ser = []; var revenue = []; ``` Im Narrativebereich werden nun die im Code verwendeten Arrays cat und revenue dynamisch mit Hilfe des OBIEE-Eigenen Befehls @ gefühlt. Dieser ermöglicht einen Zugriff auf die Datenwerte. @2 liefert die Daten der 2. Spalte, @3 der Dritten usw. Das ganze sieht dann wie folgt aus. ``` cat.push('@2'); revenue.push(@3) ``` Zu guter Letzt muss der Bereich Postfix mit dem Rest des Codes befüllt werden (siehe hierzu auch die Highcharts-Dokumentataion) ``` ser.push({ name : 'Delta zum durchschnittl. monatl. Umsatz', data : revenue }); // Define the scalar for the yAxis    var MaxValue = Math.abs(Math.max.apply(null, revenue)); var MinValue = Math.abs(Math.min.apply(null, revenue)); if (MaxValue 0) {                                                     return Highcharts                                                             .numberFormat(sum);                                                 }                                             }                                         }                                     }                                 },                             },                             title : {                                 text : null                             },                             labels : {                                 formatter : function() {                                     return this.value                                             + '%';                                 }                             },                             min : -1 * (MaxValue),                             max : MaxValue                         },                         plotOptions : {                             series : {                                 stacking : 'normal',                                 negativeColor : '#E02525'                             },                             bar : {                                 color : '#25E054',                             }                         },                         tooltip : {                             formatter : function() {                                 return ''                                         + this.series.name                                         + ', für '                                         + this.point.category                                         + ''                                         + 'Abweichung: '                                         + this.point.y                                         + ' %';                             }                         },                         series : ser                     }); }); }); ``` **Fazit** Javascript-Bibliotheken ermöglichen es, bisher unmögliche Visualisierungen in BI-Tools nachzurüsten. Gerade unter Visual-BI- und Big-Data-Aspekten ist dies sehr interessant. Einige Bibliotheken sind frei, andere lizenzpflichtig für kommerzielle Zwecke (aber bezahlbar). Einige sind sehr aufwändig zu integrieren und zu verstehen (wie D3), andere sind eingängig und relativ schnell angewendet (wie Highcharts). **Kategorien:** Analytics & Insights **Schlagwörter:** Analytics --- ### [OC Expert Search - Mit Big Data den richtigen Experten finden](https://thecattlecrew.net/2015/02/27/oc-expert-search-mit-big-data-den-richtigen-experten-finden/) **Published:** Februar 27, 2015 **Author:** christopherthomsen **Content:** In einer Firma zu jedem Thema stets den richtigen Kopf zu finden, der einem damit weiterhelfen kann oder bereits Erfahrung gesammelt hat ist nicht immer leicht. Gerade für sehr innovative, neue oder aber auch exotische Themen gleicht dies der Suche nach der Nadel im Heuhaufen. Auch wir bei [OPITZ CONSULTING](http://www.opitz-consulting.com/) sind mit diesem Problem konfrontiert, dass wir für die Herausforderungen der Kunden stets den richtigen Experten zur Hand haben möchten. Diesen zu finden erweist sich jedoch bei der Vielzahl an Themen oft schwierig und das Pflegen von Skill-Datenbanken ist in dem sehr schnelllebigen IT-Business mühseelig. Ende letzten Jahres gingen wir diese Herausforderung mit einem neuen Ansatz an, weg von einem Ansatz Wissen durch Menschen zu strukturieren hin zu einem Ansatz jegliche Form von Daten zu nutzen, um daraus die gewüschten Informationen zu extrahieren. Wir gingen von der Voraussetzung aus, dass jemand der alle Daten innerhalb des OPITZ CONSULTING Intranets – Wissensdatenbanken, Foren, Blogs, Verträge, Profile, Projektberichte und -reports, Vertriebliche Dokumente, Fachartikel, etc. – und unserer extern genutzten Systemen wie Twitter oder unserem CattleCrew Blog lesen würde zu jedem Begriff, egal ob Kundenname, Methodik, Plattform oder Technologie, beurteilen könnte wer aus unserer Firma sich mit diesem Thema zumindest am meisten beschäftigt bzw. hierzu den aktivsten Austausch hat. Dies führte uns zu der Zielsetzung eine Maschine in die Lage zu versetzen verschiedenst strukturierte Daten zu verstehen und mit Personen in Korrelation zu setzen, um anschließend daraus abzuleiten wer mit welchen Themen wie viel Erfahrung gesammelt und sich tiefgehend damit beschäftigt hat und diese Informationen jedermann über eine intuitive Suchapplikmation zugänglich zu machen. Einen Anwendungsausschnitt der derzeit im Test befindlichen Applikation ist in folgendem Screenshot zu sehen: [![OC Expert Search - Suche](https://thecattlecrew.net/wp-content/uploads/2015/02/screenshot2.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/screenshot2.png)Suche nach Big Data in OC Expert Search Damit erfüllt diese Herausforderung, die die Verarbeitung von hunderttausenden polystrukturierten Dokumenten und die Auswertung dieser bezüglich Suchbegriffen in wenigen Sekunden voraussetzt, die 3 Dimensionskritierien eines Big Data Projektes. Die angestrebte Lösung lässt sich in 3 Lösungs-Komponenten untergliedern die basierend auf unterschiedlichen Technologien einen Part dieser Aufgabe erfüllen: [![FTS Process](https://thecattlecrew.net/wp-content/uploads/2015/02/fts-example1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/fts-example1.png)Schematischer Volltextsucheprozess **1. Ein Crawler System** Eine Komponente, welches in der Lage ist unterschiedlichste Datenquellen anzuzapfen, alle Inhalte aus diesen zu extrahieren, diesen Inhalt dann zu strukturieren, um in Folge gezielt Informationen wie Titel und Subtitel, Tags, Datum, Autoren, Referenzen und natürlich den eigentlichen Text zu erkennen und diese dann strukturiert in einem volltextindizierten Datenbank abzulegen, ist als erster Schritt erforderlich, um die auszuwertenden Daten überhaupt sammeln zu können. Das Abzapfen von Datenbanken war hier der einfachste Schritt. Komplizierter wurde es beim Auslesen von Webinhalten unserer eigenen Portale, Foren, Wikis, Ticketsystemen und externen Quellen. Hier kam eine eigensentwcikelte Komponente, welche [Crawler4J](https://github.com/yasserg/crawler4j) unter der Haube nutzte zur Anwendung, um Webseiten systematisch abzuwandern, jedoch keine Seite doppelt zu besuchen. Via [Apache Tika](http://tika.apache.org/) für PDF und Office Files und [JDOM](http://www.jdom.org/) für HTML Content wurden die Webinhalte dann tabellarisch strukturiert und gezielt die benötigten Datenfelder wie Textinhalt, Titel, Autor und Datum von nicht relevanten Inhalten der Webseite wie Navigationsleisten, Header, etc. getrennt. Diese Informationen wurden dann ebenso tabellarisch in einer Datenbank, nach Quelle getrennt persistiert. Derzeit suchen die Crawler jedes Wochenende das gesammte OPITZ CONSULTING Netzwerk ab und aktualisieren damit den nutzbaren Datenbestand. *Auszug aus einem Crawler für Lebensläufe* ``` class CVCrawler extends OCCrawler { TYPE_FILTER = """.*\.(css|js|bmp|gif|jpe?g|png|tiff?|mp3|mp4|wav|avi|mov|mpeg|m4v|rm|smil|wmv|swf|wma|zip|rar|gz|pptx?|xlsx?)(\?.*)?$""".r val VALID_TYPE_FILTER = """.*\.(pdf|docx?)""".r val PERSON_FROM_FILENAME = """([-_]|^)(\w{3})([-_]|$)""".r override protected def URL_CONTAINS_FILTER = "vertrieb/kurzprofileundprojektlisten" :: Nil override protected def URL_EXCLUDE_FILTER = "GetLogon?reason=1" :: Nil override protected def controller = CVController override def visit(page: Page) { val url = page.getWebURL.getURL.toLowerCase val filename = (url split "/").last.toLowerCase if (VALID_TYPE_FILTER findFirstIn url isDefined) try { if (page.getParseData.isInstanceOf[BinaryParseData] && ((filename contains "kurzprofil") || (filename contains "projektliste"))) { fetchDoc(url) } else if (url contains "vertrieb/_layouts/wordviewer.aspx?") { val newUrl = controller.URL_HOME + ("""id=(.{1,3}vertrieb.{1,3}kurzprofileundprojektlisten.+\.docx)""".r findAllMatchIn url map (_ subgroups 0)).fold("")(_ + _) replaceAll ("%2f", "/") val newFilename = (newUrl split "/").last.toLowerCase if (!newUrl.isEmpty && ((newFilename contains "kurzprofil") || (newFilename contains "projektliste"))) fetchDoc(newUrl) } } catch { case e: Exception => println("[ ERROR ] " + url); e.printStackTrace; throw e } } override protected def parse(url: String, rawTitle: String, utf8Html: String, utf8Text: String) {} private def fetchDoc(url: String) = { val filename = (url split "/").last.toLowerCase val output = String.format("%s/%s/%s-%s", CRAWLER_STORAGE, controller.CLASS_NAME, myId.toString, filename) val request = new HttpGet request setURI new URL(url).toURI val httpClient = new DefaultHttpClient(new PoolingClientConnectionManager) val response = httpClient execute (request, controller.httpContext) val outputStream = new FileOutputStream(output) response.getEntity writeTo outputStream outputStream.close val data = parseDoc(output) val doctype = if (filename contains "kurzprofil") "cv" else "projects" val person = (PERSON_FROM_FILENAME findAllMatchIn filename map (_ subgroups 1)).fold("")(_ + _).toUpperCase new File(output).delete if (!person.isEmpty) persist("CV", "url" -> url :: "person" -> person :: "text" -> data :: "doctype" -> doctype :: Nil) } private def parseDoc(file: String) = { val handler = new BodyContentHandler(Int.MaxValue) new AutoDetectParser().parse(new FileInputStream(file), handler, new Metadata, new ParseContext) handler.toString } } ``` **2. Ein trainiertes Suchmodell** Die gesammelten Daten wurden folgend genutzt um ein Suchmodell zu trainieren. Dies ist erforderlich, um z.B. zusammengehörige Begriffe und Terme in Relation zu setzen. So soll für die Suche nach „Business Process Management“ zum Beispiel auch berücksichtigt werden, dass jemand der sich mit der „camunda Engine“ oder der „Oracle SOA Suite“ beschäftigt auch BPM Erfahrung hat. Warum? Weil diese Begriffe zusammen mit BPM bzw. Business Process Management signifikant häufig in den gleichen Dokumenten verwendet werden. *Beispielkorrelation für den Begriff „BPMN“* ``` SELECT synonym, SUM(correlation) AS correlation FROM "WordCorrelation" WHERE to_tsvector('german', word) @@ plainto_tsquery('german', 'BPMN') GROUP BY synonym; synonym correlation soa 0.64738 bpm 0.63298 suit 0.49102 camunda 0.43847 middlewar 0.39210 bpel 0.30738 entwickl 0.26837 adapt 0.19283 twi 0.16736 auotiv 0.14746 osb 0.13263 methodik 0.11273 continent 0.10973 oracl 0.10263 poc 0.10012 ``` In [R](http://www.r-project.org/) führten wir mit den gesammelten Daten eine [Hauptkomponentenanalyse](http://de.wikipedia.org/wiki/Hauptkomponentenanalyse) durch, um Begriffe dessen relative Häufigkeit sich über alle Dokumente nur marginal unterschied zu entfernen und nur Begriffe zu behalten die für die Zuordnung eines Textes zu einem bestimmten Themencluster relevant sind. 120 solcher Themencluster konnten wir Bestimmen, für die wir dann die mittlere relative Vorkommenshäufigkeit der verbliebenden Begriffe ermittelten. So ergibt sich für jeden Cluster eine absteigende Folge der hierfür markanten Begriffe. Dies konnte im Folgeschritt genutzt werden, um für jedes Worte dessen Nähe zu jedem anderen Wort in jedem dieser Cluster zu ermitteln. Die daraus resultierende Ergebnismatrix kann dann genutzt werden, um für jede Wortkombination, sofern mindestens eines dieser Worte in unser Ergebnismatrix auftaucht, die hierzu ähnlichsten Begriffe mit der Bestimmung der Ü„hnlichkeit/Korrelation zu ermitteln. **3. Einen Such- & Scoringalgorithmus** Die eigentliche Suche, die primär erstmal eine Volltextsuche ist, welche jedoch das trainierte Modell nutzt, um nicht nach einem Begriff sondern nach einen Themenwolke zu suchen, bildet den Abschlusspunkt, um die gesammelten auf aufbereiteten Daten nutzbar zu machen. Gefundene Dokumente sollen dann nach Quelle, assoziierte Personen und Zusammenhang aggregiert werden, um durch einen adaptiven Scoring Algorithmus ein Ranking für die assoziierten Personen zu erstellen. Die FTS Engine [tsearch2](http://www.postgresql.org/docs/9.4/static/textsearch.html) wurde verwendet, um für Volltextsuche notwenige Funktionalitäten wie [Lexem](http://de.wikipedia.org/wiki/Lexem)bildung (verschiedene Deklinations- bzw. Konjugationsformen des Suchwortes finden), [Stemming](http://de.wikipedia.org/wiki/Stemming) (Wortstammbildung), [Tokenization](http://en.wikipedia.org/wiki/Tokenization_%28lexical_analysis%29) (Erkennung von Zusammengesetzten Begriffen und korrektes Trennen von Satzbausteinen sowie Interpretation von Satzzeichen) zu implementieren und das Framework zur Entwicklung eines Scoringmechanismus zu nutzen. Das Scoring stellt das Kernqualitätsmerkmal dieser Suche da und dessen Entwicklung war daher auch eines der aufwändigsten Unterfangen dieses Projektes und muss vielerlei Dinge berücksichtigen: - Die Mitarbeiter sind unterschiedlich lange im Unternehmen und es existiert dementsprechend unterschiedlich viel Inhalt zu ihnen. Daher sollen Inhalte immer über die Gesamtmenge an Inhalt zu einer Person relativiert werden. - Einige Nutzer nutzen bestimmte Datenquellen garnicht (z.B. unser Forum) andere Datenquellen aber extrem häufig. Hier muss ein verhältnismäßiger ausgleich zwischen den Datenquellen bei extremer Nutzung geschaffen werden. - Die Aktualität der Informationen muss eine Rolle spielen. - Die Kommunikation zwischen WIssenzellen soll berücksichtigt werden. So wird ermittelt, wer z.B. im Forum mit wem über die gesuchte Thematik spricht. Über das Ranking geben Personen einen Teil ihres Ranks an Personen ab, mit denen sie über dieses Thema kommunizieren. So profitiert man beim Ranking davon mit den „Experten“ bzgl. des Suchterms in Kontakt zu stehen und quasi Teil dessen Kompetenz-Clusters zu sein. *Ausschnitt aus der Such- und Scoringquery* ``` WITH qb1 AS ( SELECT c.person, c.source, SUM(oc_rank(query_hard, c.text, c.timestamp) + oc_rank(query_soft, c.text, c.timestamp) / 10) AS rank, COUNT(*) AS documents, string_agg(c.text1 || ' ' || c.text2 || ' ' || c.text3 || ' ' || c.text4, ' ') AS text FROM "Content" c, "PVS_Person" p, search_to_tsquery_hard($1) query_hard, search_to_tsquery_soft($1) query_soft WHERE query_soft @@ c.text AND p.name = c.person AND p.cu LIKE $2 AND p.site LIKE $3 GROUP BY c.person, c.source), qb2 AS ( SELECT person, source, documents FROM "Content_Count") SELECT qb1.person, SUM(qb1.rank / ln(qb2.documents + 10))::real AS rank, SUM(qb1.documents)::integer AS documents, string_agg(qb1.text, ' ') AS highlight FROM qb1, qb2 WHERE qb1.source = qb2.source AND qb1.person = qb2.person GROUP BY qb1.person HAVING SUM(qb1.rank / ln(qb2.documents + 10)) > 0.01 ORDER BY SUM(qb1.rank / ln(qb2.documents + 10)) DESC ``` **Da war doch noch was mit Datenschutz** Mit dieser Kernfunktionalität fehlte nur noch eine hübsche Suchoberfläche, um auch das Verhalten gewohnter Websuchmaschinen nachzuahmen, um dieses Werkzeug für jeden nutzbar zu machen. Einen Punkt darf man hierbei natürlich nicht unterschlagen, der auch für uns im Zusammenhang mit Big Data natürlich eine große Rolle spielt: Der Datenschutz. So hat jeder Mitarbeiter bei uns natürlich die Möglichkeit uns systemisch zu untersagen Daten über ihn aus einzelnen oder allen Quellen zu sammeln und auszuwerten. [![OC Expert Search - Datenschutz](https://thecattlecrew.net/wp-content/uploads/2015/02/screenshot1.png?w=640)](https://thecattlecrew.net/wp-content/uploads/2015/02/screenshot1.png)Über die Datenschutzeinstellungen Daten eines Nutzers exkludieren. **Kategorien:** Analytics & Insights **Schlagwörter:** Big Data, Crawler, German, R, Volltextsuche --- ### [SAP Partner Summit for Finance und Analytics - Kurzbericht](https://thecattlecrew.net/2015/03/09/sap-partner-summit-for-finanance-und-analytics-kurzbericht/) **Published:** März 9, 2015 **Author:** Jürgen Möller **Content:** Am 05.03. fand in St. Leon-Rot die jährliche Partner Summit for Finance und Analytics statt. Im Folgenden eine kurze Zusammenfassung der wichtigsten Informationen aus den Sessions an denen ich teilgenommen habe. **Allgemein** Run simple“ ist das künftige Motto der SAP. Die SAP Partner University heißt jetzt SAP Knowledge Center. **SAP S/4 HANA** Das ist **die** zukünftige Platform der SAP auf der künftig alle Neuentwicklungen und viele Weiterentwicklungen stattfinden werden. Um von den Neuentwicklungen und den meisten neuen Funktionalitäten profitieren zu können, muss man auf diese Platform gehen. Das hatte sich bereits letztes Jahr mit SAP BW7.4 on HANA abgezeichnet und wird nun auch offen von der SAP kommuniziert. **Simple Finance** Es gibt mit Simple Finance eine komplett neue Architektur von FI/CO. Es bleiben nur wenige große Tabellen über. Planung wandert zurück ins ERP. **Business Planing and Consolidation** Mit Version 10.1 werden die beiden Welten Integrierte Planung (IP) und BPC 10.0 nun in einer Version integriert und per Web-Frontend bedient. **Predictive Analysis** SAP Predictive Analysis + Infite Insight werden zusammengeführt und in **SAP Predictive Analysis 2.0** umbenannt. Dabei wird in den Automated Mode (ehemals Infite Insight) und Expert Mode (ehemals Predictive Analysis) unterschieden, um unterschiedliche Nutzergruppen zu bedienen. **SAP Lumira 1.23** Guido Adler zeigte speziell die Neuerungen, die mit der Version 1.23 kommen werden: - Möglichkeit zur Anlage von eigenen Hierarchien in Lumira - Erstellung von eigenen eingeschränkten Kennzahlen - assoziative Analyse analog QlikView - Zusammenführen von Datenquellen - Regeln für bedingte Formatierung (aktuell nur für Tabellen) - Nutzung von Hyperlinks (ohne Parameter) **Analysis für Office** Alexander Peter ging insbesondere auf die neue Archtitektur der AddOns ein. Das AddOn Analysis für Office wird architektonisch umgebaut, um Kollisionen mit anderen AddOns zu vermeiden (Unified Excel Client). **Design Studio 1.5** Jie Deng führte in gewohnt souveräner Weise durch die Neuerungen des Design Studio 1.5, wobei es neben den Folien reichlich Live Demo gab. - Das Design Studio wird voraussichtlich in Lumira Studio umbenannt werden - GeoMap wird dann standardmäßig unterstützt - DropDown-Felder können nun auch ohne Scripting befüllt werden - Queries können nun auch parallel abgesetzt werden, was große Performancegewinne bringen kann - Speichern von Smart Objects, als wiederverwendbare Objekte - Speichern von eigenen Sichten pro User als Bookmark **Fazit:** Bei den Frontend-Tools gibt es insbesondere bei den jüngeren Tools (Lumira, Design Studio Analysis Office) einen kontinuierlichen Ausbau der Funktionalitäten, so dass Funktionsrückstände gegenüber Mitbewerbern wie Tableau oder Qlik mit den neuen Versionen weitestgehend aufgeholt sein dürften. Mit der In-Memory-Technologie SAP HANA im Backend und der Ablösung der SAP GUI durch Fiori im Frontend geht die SAP den Weg der Modernisierung der Systeme konsequent weiter. Sofern man künftig SAP-Tools mit vollem Funktionsumfang einsetzen möchte, wird man früher oder später um eine SAP HANA bzw. SAP BW on HANA nicht herumkommen. Es wird sich zeigen, ob der Markt bereit ist, diesen Weg so mitzugehen. **Kategorien:** Analytics & Insights **Schlagwörter:** SAP --- ### [Social Media Analytics - Kategorisierung von Textbeiträgen?](https://thecattlecrew.net/2015/06/30/social-media-analytics-welche-themen-dominieren/) **Published:** Juni 30, 2015 **Author:** Clemens v. Bismarck-Osten **Content:** **Im Zeitalter der sozialen Medien ist es für Unternehmen äußerst interessant, die allgemeine Wahrnehmung von Marken, Produkten oder Personen regelmäßig zu beobachten. Durch die Vielfalt an Meinungen fällt es jedoch in der Regel schwer, zwischen Einzelmeinungen und der generellen Meinung zu unterscheiden.** **Der hier vorgestellte Ansatz zum „Social Media Monitoring“ schaut genau auf Beiträge großer Plattformen und erkennt durch eine automatisierte Themenzuordnung sofort Schwerpunkte in der Vielfalt an Meinungen. Auf diese Weise gelangt man in die komfortable Lage, Trends frühzeitig erkennen zu können, um jederzeit darauf reagieren zu können. Dies stellt für den Anwender einen klaren Wettbewerbsvorteil dar.** **Hintergrund** Angenommen, man interessiert sich dafür, wie eine Marke, eine Person oder ein bekanntes Produkt in der Ü–ffentlichkeit, und damit auch in den sozialen Medien, wahrgenommen und besprochen wird. Also: „Wer schreibt was, und vor allem wo, darüber?“ Unregelmäßige und zufällige Checks sind hierbei wenig zielführend, da sich praktisch jede erdenkliche Meinung an irgendeiner Stelle finden lässt. Wie lässt sich also das Meinungsbild in seiner Gänze einfangen, zusammenfassen und quantifizieren, vielleicht sogar dessen zeitlicher Verlauf beobachten? Hierzu soll im Folgenden sehr kurz eine Lösung präsentiert werden, die den individuellen Wünschen des Anwenders so weit wie möglich entgegenkommt. **Kurzvorstellung des Ansatzes** Die wesentlichen Elemente und Features: - entdeckt, was zum Suchbegriff geschrieben wird - bewertet die Herkunft des Beitrags - klassifiziert die Inhalte automatisiert nach Themen - identifiziert die Top-Themen - .. und visualisiert die Ergebnisse in Ihrem zeitlichen Verlauf Auf diese Weise behält man konstant den Überblick über Relevanz und Lokalität von Meinungen und Trends und kann entsprechend frühzeitig gegensteuern. **Methodik** Um zum Ziel zu gelangen, werden gängige Verfahren des Text Mining, wie etwa das Entfernen von Sonderzeichen oder die Wortstammreduzierung, verwendet. Zusätzlich sind verschiedene Gewichtungen zur besseren Relevanz-Bewertung der Wortbausteine in die Lösung integriert. Auf diese Weise entsteht eine auswertbare Datengrundlage. Das Ganze wurde in R konzipiert und geschrieben. [![](https://thecattlecrew.net/wp-content/uploads/2015/06/bahn2-150x150.png)](https://thecattlecrew.net/2015/06/30/social-media-analytics-welche-themen-dominieren/bahn2/) [![](https://thecattlecrew.net/wp-content/uploads/2015/06/mining-150x150.png)](https://thecattlecrew.net/2015/06/30/social-media-analytics-welche-themen-dominieren/mining/) **Aufbereitung und Analyse** Die Ergebnisse zum Suchbegriff werden zur besseren Übersicht in einer Word-Cloud grafisch aufbereitet. Auf diese Weise so erscheinen die häufigsten Begriffe in Relation am größten. Weitere Schritte sind nun für eine automatisierte Themen-Zuordnung notwendig. Dies wird – vereinfacht dargestellt – über Worthäufigkeiten und den Abstand einzelner Wörter zueinander erreicht. So kann man über mathematische Verfahren, wie Zerlegung in Hauptkomponenten und Clusterzuordnung, bestimmte Themenblöcke extrahieren, um zu sehen, in welchem unterschiedlichen Kontext die Suchbegriffe genannt werden. Die Folge sind Unter-Themen zum Suchbegriff, die auf logische Themen-Einheiten zusammengefasst werden. Beispielsweise lässt sich häufig eine Unterscheidung in News, Werbung und individuelle User-Meinungen (positiv/ negativ) beobachten, die im Einzelnen und je nach Suchbegriff weiter logisch unterteilt werden können. **Der Mehrwert** Führt man die oben beschriebenen Arbeitsschritte beispielsweise mehrmals am Tag durch und integriert die Ergebnisse in die jeweiligen Reportings, so lassen sich frühzeitig Trends, Phänomene, aber auch Feedback zu Produkten oder Unternehmensstrategien beobachten. Ein rechtzeitiges Handeln oder Gegensteuern kann durch diese Impulse initiiert werden, was dem Unternehmen Geld und Aufwand erspart, denn es gilt: hat sich der Image-Schaden durch negative Presse, aber auch durch ein Nicht-Gegensteuern erst einmal in den sozialen Medien etabliert, ist dies nur schwer wieder rückgängig zu machen. **Kategorien:** Analytics & Insights **Schlagwörter:** Analytics, Big Data, data mining, predictive --- ### [NSA und Co - Auswertung von Massendaten in R am Beispiel E-Mail-Korrespondenz](https://thecattlecrew.net/2015/10/07/die-nsa-und-co-auswertung-von-massendaten-in-r-am-beispiel-email-korrespondenz/) **Published:** Oktober 7, 2015 **Author:** Clemens v. Bismarck-Osten **Content:** Seit den Enthüllungen der NSA Aktivitäten durch ehemalige Mitarbeiter (sogenannte „Whistleblower“) rückt die Thematik der generellen und verdachtsunabhängigen Überwachung auch bei uns in Deutschland immer weiter in den Vordergrund. Dies ist vor allem der Tatsache geschuldet, dass eigentlich alle modernen Kommunikationswege davon betroffen waren und sind, egal ob es sich um Telefonate, Textmitteilungen oder E-Mails handelt. Ausgewertet werden dabei: der eigentliche Inhalt, Aufenthaltsstandort(e) und damit Bewegungsprofile, Zeitpunkt, benutzte Hardwarekomponenten, und viele weitere. Diese Daten werden auf bekannte Muster untersucht, oder sie dienen dazu, neue Muster in den Daten zu identifizieren und die vorhandenen Erkennungs-Algorithmen zu optimieren. [![Länder, die im Zusammenhang mit ](https://thecattlecrew.net/wp-content/uploads/2015/10/blatt-11.png?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/10/blatt-11.png)Länder, die im Zusammenhang mit „verdächtigem“ Content am häufigsten in der Korrespondenz auftauchen. Je dunkler der Farbton, desto „verdächtiger“ der Content im Mittel. Die Größe spiegelt die absolute Anzahl der Nachrichten wider. Aber was genau lässt sich eigentlich auswerten, und ab wann mache ich mich als User „verdächtig“, gerate also in den engeren Kreis potenziell Verdächtiger? Mit absoluter Sicherheit lässt sich dies ohne konkreten Einblick in die Praxis wohl nicht präzise sagen. Dennoch braucht es kein Detailwissen, um zu mutmaßen, dass ein bestimmtes Nutzerverhalten wie das Verschicken von Texten, die bestimmte Schlagwörter enthalten, die Chance erhöht, in die engere Auswahl „verdächtiger Elemente“ zu gelangen. (…) Aufgrund der Vielzahl an Code-Beispielen ist der gesamte Artikel als PDF angehängt. Ganzen Artikel lesen? Bitte klicken Sie auf das PDF. [Artikel\_NSA und Co](https://thecattlecrew.net/wp-content/uploads/2015/10/artikel_nsa-und-co1.pdf) **Kategorien:** Analytics & Insights **Schlagwörter:** Advanced Analytics, Big Data, R, Text mining --- ### [Sentiment analysis concerning the refugee debate on Twitter - How R and Tableau go together](https://thecattlecrew.net/2015/11/12/sentiment-analysis-concerning-the-refugee-debate-on-twitter-how-r-and-tableau-go-together/) **Published:** November 12, 2015 **Author:** Clemens v. Bismarck-Osten **Content:** This very short article will contribute to the section „Analytics with R“ and how results can be visualized using Tableau. The following few maps depict those Twitter posts that match the keywords „refugee“, „asyl“ or „flüchtlinge“ and that include readable information about the origin (location) of the post. After data was collected and preprocessed in R, we used a Tableau Trial-Version to visualize results in the best possible manner. Tableau is an easy-to-use Software for visualisation and comes with a 14-days free-to-use version after installation. [![Blatt 2 (3)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-2-3.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-2-3.jpg)Origin of Tweets concerning the refugee debate [![Blatt 1 (3)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-1-3.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-1-3.jpg)Origin of Tweets concerning the refugee debate (Europe) The color represents the average sentiment score of the posts originating from the location, the size of the bubbles shows the number of tweets per Location. Tweets have been collected between 06th and 8th of November 2015. [![Blatt 3 (3)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-3-3.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-3-3.jpg)Random Tweets per location The upper map additionally illustrates, what kind of tweets are included in total analysis. For this one tweet per location was randomly chosen to be displayed on the map. [![Follower per Twitter Account including average sentiment score.](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-41.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2015/11/blatt-41.jpg)Number of Follower per Twitter User contributing to the refugee debate (including average sentiment score per user posts). If you are further interested in data analysis in R and visualization in Tableau do not hesitate to contact me. If you simply want to practice with Tableau, download the Software from the Tableau Website (http://www.tableau.com/). The final dataset for the Tableau analysis: [Tweets\_refugee\_Tableau](https://thecattlecrew.net/wp-content/uploads/2015/11/tweets_asyl_tableau.xlsx) … here comes the original json file and additional information required for full analysis: … and here comes the R Skript for preprocessing the data (assumes the input data being a json file from twitter developer API): \#set JAVA HOME PATH Sys.setenv(JAVA\_HOME=“C:\\\\Program Files\\\\Java\\\\jre1.8.0\_40″) library(tm) library(class) library(rJava) library(RWeka) library(wordcloud) library(stringi) library(plyr) library(rjson) library(jsonlite) library(stringr) library(data.table) library(plyr) url = ‚path\_to\_JSON‘ plainText = readLines(url, encoding = „UTF-8“) length(plainText) \#—————————————————– \# read json tweets = ls() text = matrix(„0“, length(plainText), 8) for (i in 1:length(plainText)) { #tweets\[i\] = jsonlite::fromJSON(plainText\[i\]) tweets = fromJSON(plainText\[i\]) if (!is.null(tweets$user$screen\_name)){ text\[i,1\] = tweets$user$screen\_name } else { text\[i,1\] = NA } if (!is.null(tweets$text)){ text\[i,2\] = tweets$text } else { text\[i,2\] = NA } if (!is.null(tweets$place$country)){ text\[i,3\] = tweets$place$country } else { text\[i,3\] = NA } if (!is.null(tweets$place$country\_code)){ text\[i,4\] = tweets$place$country\_code } else { text\[i,4\] = NA } if (!is.null(tweets$user$location)){ text\[i,5\] = tweets$user$location } else { text\[i,5\] = NA } if (!is.null(tweets$lang)){ text\[i,6\] = tweets$lang } else { text\[i,6\] = NA } if (!is.null(tweets$timestamp\_ms)){ text\[i,7\] = tweets$timestamp\_ms } else { text\[i,7\] = NA } if (!is.null(tweets$user$followers\_count)){ text\[i,8\] = tweets$user$followers\_count } else { text\[i,8\] = NA } # print if (i/100 == floor(i / 100) ) { print(paste(floor(i/length(plainText) \* 100),‘ Prozent ausgelesen.‘)) } } \#——————————————————- \# check results length(text\[ ,1\]) \# regexp: screenName = gsub(„\[^\[:alnum:\]///‘ \]“, „“, text\[ ,1\]) message = text\[ ,2\] location\_1 = gsub(„\[^\[:alnum:\]///‘ \]“, „“, text\[ ,3\]) location\_2 = gsub(„\[^\[:alnum:\]///‘ \]“, „“, text\[ ,4\]) location\_3 = gsub(„\[^\[:alnum:\]///‘ \]“, „“, text\[ ,5\]) lang = text\[ ,6\] timestamp = as.numeric(text\[ ,7\]) follower\_count = text\[ ,8\] Data <- data.frame(screenName = as.factor(screenName), message = as.factor(message), location\_1 = as.factor(location\_1), location\_2 = as.factor(location\_2), location\_3 = as.factor(location\_3), lang = as.factor(lang), timestamp = as.factor(timestamp), follower\_count = as.factor(follower\_count) ) \#function most frequent elements freqfunc <- function(x, n) { tail( sort(table(as.character(x)), decreasing = FALSE, na.last = NA), n) } \#call function freqfunc(Data$message, 5) freqfunc(Data$screenName, 5) \## z.B. remove duplicates g = Data\[ !duplicated(Data$message), \] \# clean text \# tolower g$message = stri\_trans\_tolower(g$message, locale = NULL) g$message\[3\] \# URLs g$mentionedURL = sapply( g$message, function(x) { ww = regmatches(x, gregexpr(‚http\[s\]?://(?:\[a-zA-Z\]|\[0-9\]|\[$-\_@.&+\]|\[!\*\\\\(\\\\),\]|(?:%\[0-9a-fA-F\]\[0-9a-fA-F\]))+‘, x)) ww2 = do.call(paste, c(as.list(ww))) ww3 = paste(ww2, collapse = ‚ ‚) return(ww3) } ) g$message\[3\] \# blanks g$message = gsub(‚\\n‘, ‚ ‚, g$message) g$message\[3\] \# delete referrer g$message = gsub(„rt @\[a-zA-Z0-9\]+: „, “ „, g$message, perl=T) g$message\[3\] \# URLs by ‚URL‘ g$message = gsub(‚http\[s\]?://(?:\[a-zA-Z\]|\[0-9\]|\[$-\_@.&+\]|\[!\*\\\\(\\\\),\]|(?:%\[0-9a-fA-F\]\[0-9a-fA-F\]))+‘, “, g$message) \# signs to ignore g$message = gsub(„\[^a-zA-Z0-9 ‚@#öäüßÜ–Ü„Ü\]“, “ „, g$message) \# multiple blanks g$message = gsub(„(?<=\[\\\\s\])\\\\s\*|^\\\\s+$", "", g$message, perl=TRUE) \# numbers alone g$message = gsub(‚\\\\s\*(? 3) countryList = subset(countryList, Population > 100000) countryList2 = read.csv(‚path\_to\_csv/countries.csv‘, sep=‘,‘, header = TRUE, dec=‘.‘) countryList2 = tolower(countryList2$English.Name) countryList2 = gsub(„\[^a-zA-Z0-9 ‚öäüßÜ–Ü„Ü\]“, “ „, countryList2) suchVector = as.vector(c(as.character(countryList$City), as.character(countryList2))) Text = stri\_trans\_tolower(g$location\_3, locale = NULL) \#Text = g$message suchVectorTokenized = gsub(“ „, „@“, suchVector) indexDoppel = which(grepl(„@“, suchVectorTokenized)) nurDoppelnamen = suchVectorTokenized\[indexDoppel\] for (i in 1:length(nurDoppelnamen)) { Text = gsub(suchVector\[indexDoppel\]\[i\], nurDoppelnamen\[i\], Text) print(i\*length(Text)) } findCity = function(sentences, countryList) { scores = laply(sentences, function(sentence, Countries\_and\_Cities) { word.list = str\_split(sentence, ‚\\\\s+‘) words = unlist(word.list) pos.matches = match(words, Countries\_and\_Cities) pos.matches = as.factor(pos.matches\[!is.na(pos.matches)\]) best = names(sort(summary(pos.matches), decreasing=TRUE))\[1:3\] if (is.null(best) || is.na(best)) { return (c(NA, NA, NA)) } countryIndex = as.integer(best) return(Countries\_and\_Cities\[countryIndex\]) }, countryList) country.df = scores return(country.df) } Countries = findCity(Text, suchVectorTokenized) Countries = gsub(‚@‘, ‚ ‚, Countries) g$City1 = as.factor(Countries\[ ,1\]) g$City2 = as.factor(Countries\[ ,2\]) g$City3 = as.factor(Countries\[ ,3\]) \# ——- coordinates —————- a = numeric() latt = numeric() long = numeric() x <- countryList$City for (i in 1:length(g$City1)) { if (length(which(x %in% g$City1\[i\])) == 1) { # hier stadt mit den meisten einwohnern auswählen… a = which(x %in% g$City1\[i\])\[1\] latt\[i\] = countryList\[a, 6\] long\[i\] = countryList\[a, 7\] print(i) } else if (length(which(x %in% g$City1\[i\])) > 1) { a = which(x %in% g$City1\[i\]) b = which.max(countryList\[a, 5\]) latt\[i\] = countryList\[a, 6\]\[b\] long\[i\] = countryList\[a, 7\]\[b\] print(i) } else { latt\[i\] = NA long\[i\] = NA } } g$latt = as.numeric(latt) g$long = as.numeric(long) \# ———— frequent words in vectors ————— frequentWords = strsplit(as.character(g$frequentWords), split=’|‘, fixed=TRUE) relevantWords = matrix(‚NA‘, length(frequentWords), 4) for (i in 1:length(frequentWords)) { temp = unlist(frequentWords\[i\]) #print(temp) if (length(temp) == 0) { relevantWords\[i, \] = c(NA, NA, NA, NA) } else if (length(temp) == 1) { relevantWords\[i, \] = c(temp\[1\], NA, NA, NA) } else if (length(temp) == 2) { relevantWords\[i, \] = c(temp\[1:2\], NA, NA) } else if (length(temp) == 3) { relevantWords\[i, \] = c(temp\[1:3\], NA) } else if (length(temp) == 4) { relevantWords\[i, \] = c(temp\[1:4\]) } } g$relevantWord1 = relevantWords\[ ,1\] g$relevantWord2 = relevantWords\[ ,2\] g$relevantWord3 = relevantWords\[ ,3\] g$relevantWord4 = relevantWords\[ ,4\] \#————— Sentimentanalyse ——————- pos = scan(‚E:/TEMP Ordner TestDaten/TEMP Twitter/positive-words.txt‘, what=’character‘, comment.char=‘;‘) neg = scan(‚E:/TEMP Ordner TestDaten/TEMP Twitter/negative-words.txt‘, what=’character‘, comment.char=‘;‘) \#Funktion score.sentiment = function(sentences, pos.words, neg.words, .progress=’none‘) { sentiments = laply(sentences, function(sentence, pos.words, neg.words) { word.list = str\_split(sentence, ‚\\\\s+‘) words = unlist(word.list) pos.matches = match(words, pos.words) neg.matches = match(words, neg.words) pos.matches = !is.na(pos.matches) neg.matches = !is.na(neg.matches) # score ermitteln durch summe(pos) – summe(neg) und durch tweetlänge teilen score = sum(pos.matches) – sum(neg.matches) score2 = (sum(pos.matches) – sum(neg.matches)) / length(words) return(c(score, score2)) }, pos.words, neg.words, .progress=.progress ) sentiments.df = data.frame(Sentiment\_1=sentiments\[ ,1\], Sentiment\_2=sentiments\[ ,2\]) return(sentiments.df) } \# call Sentimentanalyse: sentiment = score.sentiment(g$message, pos, neg) g$Sentiment1 = sentiment\[ ,1\] g$Sentiment2 = sentiment\[ ,2\] \# —————————Corpus for WordCloud———————————- cleanText = g\[ ,2\] \#create Corpus german germanTweets = cleanText\[g$lang == ‚de‘\] length(germanTweets) text\_corpus\_german <- Corpus(VectorSource(germanTweets)) \# Stemming c1 <- tm\_map(text\_corpus\_german, stripWhitespace) c2 <- tm\_map(c1, stemDocument, language = "german") c3 <- tm\_map(c2, removeWords, stopwords("german")) \# Ergebnisse anschauen: lapply(c3\[1:3\], as.character) \# Erstelle WordCount über Corpus BigramTokenizer <- function(x) NGramTokenizer(x, Weka\_control(min = 2, max = 2)) unigrams = DocumentTermMatrix(c3) bigrams = DocumentTermMatrix(c3, control = list(tokenize = BigramTokenizer)) \# Ergebnisse sichten dimnames(unigrams)$Terms length(dimnames(unigrams)$Terms) \# reduce no of terms s.unigram\_german = removeSparseTerms(unigrams, 0.999) s.bigram\_german = removeSparseTerms(bigrams, 0.999) s.unigram\_german = data.matrix(s.unigram\_german) s.bigram\_german = data.matrix(s.bigram\_german) m\_german = cbind(s.unigram\_german, s.bigram\_german) dim(m\_german) \#————-create Corpus english———————————— nongermanTweets = cleanText\[g$lang != ‚de‘\] length(nongermanTweets) text\_corpus\_nongerman <- Corpus(VectorSource(nongermanTweets)) \# Stemming c1 <- tm\_map(text\_corpus\_nongerman, stripWhitespace) c2 <- tm\_map(c1, stemDocument, language = "english") c3 <- tm\_map(c2, removeWords, stopwords("english")) \# Ergebnisse anschauen: lapply(c3\[1:3\], as.character) \# Erstelle WordCount über Corpus BigramTokenizer <- function(x) NGramTokenizer(x, Weka\_control(min = 2, max = 2)) unigrams = DocumentTermMatrix(c3) bigrams = DocumentTermMatrix(c3, control = list(tokenize = BigramTokenizer)) \# Ergebnisse sichten dimnames(unigrams)$Terms length(dimnames(unigrams)$Terms) s.unigram\_nongerman = removeSparseTerms(unigrams, 0.999) s.bigram\_nongerman = removeSparseTerms(bigrams, 0.999) s.unigram\_nongerman = data.matrix(s.unigram\_nongerman) s.bigram\_nongerman = data.matrix(s.bigram\_nongerman) m\_nongerman = cbind(s.unigram\_nongerman, s.bigram\_nongerman) colnames(m\_nongerman) \# —————TF-IDF Standardization:———————————————– \# chose whether german or english m = m\_nongerman \#m = m\_german docsize = rowSums(m\*(m > 0)) res1 = m / docsize\*log(nrow(m) / (1 + rep(colSums(m > 0), each = nrow(m)))) \* (m > 0) Y\_TFIDF = res1 Y\_TFIDF = na.omit(Y\_TFIDF) \#——————— PLOTS —————————————————— \# Sum wordcount \# … without standardization \#termDocMatrix = t(as.data.frame(apply(m, 2, sum))) \# … or with standardization termDocMatrix = t(as.data.frame(apply(Y\_TFIDF, 2, sum))) termDocMatrix = as.data.frame(termDocMatrix) colnames(termDocMatrix) = colnames(m) \# Word Cloud erstellen ap.m <- t(as.matrix(termDocMatrix)) ap.v <- sort(rowSums(ap.m), decreasing=TRUE) ap.d <- data.frame(word=names(ap.v), freq=ap.v) table(ap.d$freq) pal2 <- brewer.pal(8, "Set1") png(„c:/wordcloud.png“, width=1200, height=800) wordcloud(ap.d$word, ap.d$freq, scale=c(7, 0.4), min.freq=3, max.words=150, random.order=FALSE, rot.per=.15, colors=pal2) dev.off() \# save write.table(g, „your\_path/Tweets\_Asyl.csv“, sep = „;“, row.names = FALSE, dec=‘,‘, quote=TRUE) **Kategorien:** Analytics & Insights **Schlagwörter:** Analytics, Big Data, English --- ### [Data Lineage mit dem Oracle© Data Integrator 12c](https://thecattlecrew.net/2017/02/22/data-lineage-mit-dem-oracle-data-integrator-12c/) **Published:** Februar 22, 2017 **Author:** manuelmarowski **Content:** In diesem Beitrag geht es darum, wie man Data Lineage mit dem ODI 12c umsetzen kann. Der Beitrag richtet sich u. a. an diejenigen, die den Ursprung ihrer Daten im DWH nicht mehr nachvollziehen können und vielleicht auch das Vertrauen in die Kennzahlen verloren haben. Data Lineage beschreibt das Zurückverfolgen der Daten vom Ziel bis zur Quelle. Da ein DWH in den meisten Fällen aus mehreren komplexen ETL-Prozessen besteht, ist oft schwer nachzuvollziehen, aus welchen Quelldaten, Daten aus dem Frontend abgeleitet wurden. Bei der Umsetzung von Data Lineage profitiert man u. a. von einem erhöhten Vertrauen der Endanwender in die Daten im DWH. Weitere Vorteile, die sich aus einer Umsetzung ergeben, finden sich z. B. hier: [Lineage tracing for general data warehouse transformations.](https://pdfs.semanticscholar.org/40df/7feb07c11a49b0e6f1a43524930f0b8f5606.pdf) Für ein Kunden-DWH, das aus diversen komplexen ETL-Strecken besteht, wurde ein Prototyp zur Visualisierung, der Herkunft der Daten erstellt. Da die ETL-Strecken mithilfe des Oracle Data Integrator 12c entwickelt worden sind, wurde auch zum Abgreifen der Metadaten und zur Entwicklung des Prototyps die von Oracle zur Verfügung gestellte Java SDK genutzt. Mithilfe der SDK wird eine Schnittstelle zum ODI entwickelt, welche die Metadaten ausliest und diese so aufbereitet, dass diese sinnvoll in einer Graphendatenbank, in diesem Fall Neo4J, gespeichert werden können. Dabei ist die Schnittstelle so implementiert, dass diese universell für jedes Projekt, das mit dem ODI entwickelt wird, verwendet werden kann. Die Daten werden einmal aus dem ODI geladen und bereitgestellt. Nach Ü„nderungen sollen die Daten aus dem ODI neu geladen werden. Die Daten in der Graphendatenbank werden mithilfe von D3js im Browser visualisiert. Dabei wird dem Nutzer eine Suchoption geboten, um sich nur die gewünschten Objekte darstellen zu lassen. Komponenten, die sich im selben Mapping befinden, werden „gehighlightet“, somit wird der Fluss der Daten transparent. (Für eine Defintion der ODI typischen Begriffe sei hier auf den [Developers Guide für den Oracle© Data Integrator ](https://docs.oracle.com/middleware/1212/odi/ODIDG/toc.htm)verwiesen.) Außerdem werden detaillierte Informationen zu den Komponenten visualisiert, wobei zwischen verschiedenen Typen unterschieden wird. So wird z. B. zwischen Join- und Expression-Komponenten differenziert. Ferner wird bei Join-Komponenten der Jointyp dargestellt. Die Transformationen lassen sich daher besser nachvollziehen. Diese Lösung bietet im Gegensatz zum OEMM 12c eine leichte Anpassbarkeit und Erweiterbarkeit sowie eine moderne Visualisierung. **Kategorien:** Analytics & Insights **Schlagwörter:** D3JS, Data Lineage, Java, Neo4J, OC|Lab, ODI --- ### [Scripted Fields in the Elastic-Stack](https://thecattlecrew.net/2017/03/03/scripted-fields-in-the-elastic-stack/) **Published:** März 3, 2017 **Author:** danielzellmann **Content:** Right now the Elastic-Stack (also known as ELK-Stack) is an increasingly used tool to realize BI- and Big-Data projects covering the whole challenges from the ETL-process to the graphical visualization. In one of our projects at the „Digitallab“ OC|Lab we were analyzing Logfiles, trying to improve the readability of the logs and gathering new knowledge within the data. For these tasks we used the powerful Stack. The Stack is divided in three parts: Logstash, Elasticsearch and Kibana. Briefly summarized Logstash extracts data from various sources, transforms it by defined business rules and sends it to Elasticsearch. The Clusterstorage provides extremely fast and multi-purpose searching. Among others this is possible due to the scalable architecture. Kibana is the frontend of the Stack and is responsible for the visualization of data. The Elastic website offers complex, in-depth explanations about Scripted Fields. However, the hints Kibana shows while creating a scripted field are very helpful and much easier to understand. An example would be the calculation of the characteristic factor „Sells per \[timeunit\]“. With this tool you simply have to create a new Scripted Field and write the following Code: ![scriptedfields1](https://thecattlecrew.net/wp-content/uploads/2017/03/scriptedfields1.png) This script now calculates the sells per minute if needed. Of course you can do more challenging operations. For those you will need the language „painless“ (same Syntax as Groovy) in order to access multiple fields and apply logic on top. Furthermore you can import plugins to create Scripted Fields with JavaScript or Python. Another sample: ![scriptedfields2](https://thecattlecrew.net/wp-content/uploads/2017/03/scriptedfields2.png) If you“™re interested in learning more about Scripted Fields: **Kategorien:** Analytics & Insights **Schlagwörter:** BI, Big Data, Elastic --- ### [Machine Learning for Optimizing Containerstorage](https://thecattlecrew.net/2017/03/22/machine-learning-for-optimizing-containerstorage/) **Published:** März 22, 2017 **Author:** Benedikt Böing **Content:** ![595px-Container_Augsburg](https://thecattlecrew.net/wp-content/uploads/2017/03/595px-container_augsburg.jpg) Von Eigenes Werk, CC BY-SA 3.0, https://commons.wikimedia.org/w/index.php?curid=1923693 Consider the following setup. You provide space to store containers and your customers have, after bringing the containers to you, the flexibility to retrieve them whenever they like. In order to not waste space you stack containers onto each other leaving you with a fundamental question: which container should be on top and which at the bottom? It is clear that you want „fast“ containers, i.e. containers that will probably be retrieved in near future, should not be stored under a „slow“ container, because then you will have to rearrange the containers in order to get access to the fast one. The key question hence is, how to find out in advance, which containers will be slow and fast. To address this problem we applied maching learning: We were given a historical dataset with information about the containers such as where they came from or whether it contained products that needed cooling. This information allowed us to categorize the containers in term of time-tresholds. We predict whether a container will stay longer or shorter than the treshold. We tried different basic algorithms such as DecisionTree, GaussianNaiveBayes or K-Nearest-Neighbours and using these approaches we could already yield very good results. As this was my first encounter with Machine Learning I was quite impressed by its capability. Nevertheless I am sure that there are much more sophisticated algorithms and techniques that can enhance the accuracy of the predictions made by the algorithm. To go a little more into detail I will describe a problem to you that we faced. First of all it is important to mention, that the algorithms we use are based on computing distances. In order to enable this we need the values of each feature to be numerical. Since the information about the containers where mainly given in categories such as „containerType“ with values A,…,G the first idea was to simply map them to integer values 1,…,7. The problem with this is that you implicitely would have encoded more structure onto the containers than what was initially there: you say that „containerType\_A“ is further away of „containerType\_D“ than of „containerType\_B“, because the distance of one and four is greater than the distance of one and two. Of course that is not true and hence you have to be careful not to loose the symmetry inherent in the data. Otherwise the algorithm, based in computing distances, will use this „order“ yielding results that will probably differ from reality. To get around this problem you artificially blow up the number of features of a container: instead of just one dimension for the feature „containerType“ you create seven features namely „containerType\_A, …, containerType\_G“. Then, for a container that originally had the feature „containerType“ being equal to „A“, you encode this information by setting the feature „containerType\_A“ to one and all the other containerType features to zero. In other words: the new features act as indicatorfunctions for what type of container we have. As I have mentioned before most of our information had this form leaving us eventually with a space of 1182 dimenions on which we could then apply our algorithm. Luckily, using python libraries, it is very easy to use the algorithms mentioned above: ![How_to_use_ML_2](https://thecattlecrew.net/wp-content/uploads/2017/03/how_to_use_ml_2.png) You need your data to have the form of a (feature-)matrix (X\_data) and a vector with the label on which you train and which afterwards you want to predict (y\_data). Then, as a first step you split your data into a training- and a testset. This allows you to check how your algorithm performs. You use the training data to (surprise) train your model. Afterwards you use your model to predict on the testdata and measure your performance using the accuracy\_score. The last step can of course be replaced with any other measure dependent on what is most important to you. The take-home message here is, that, once your data is „clean“, i.e. has the right form, no NaN-values, etc…, the actual application of a basic Algorithm, which can already give you a good intuition whether information can be extracted from the data using Maching Learning, is very easy and does not require a horrific amount of coding. This first prototype for containerclassification were merely 60 lines of code, which showed the potential gain of maching learning in this setup. **Kategorien:** Analytics & Insights **Schlagwörter:** Artificial Intelligence, Python, sklearn --- ### [High Availability und Big Data "“ Simples Einrichten einer hochverfügbaren HDFS Umgebung](https://thecattlecrew.net/2017/08/14/high-availability-und-big-data-simples-einrichten-einer-hochverfuegbaren-hdfs-umgebung/) **Published:** August 14, 2017 **Author:** Simon Hahn **Content:** Hochverfügbarkeit ist ein unterschätztes und leider häufig vernachlässigtes Thema. Auch eine Big-Data-Distribution, in der per se eine Datenreplikation auf einzelne DataNodes eingeschaltet ist, sollte hier miteinbezogen und hochverfügbar konfiguriert werden. Es reicht nicht aus, nur die Replikation der DataNodes zu benutzen, sondern die High-Availability-Funktion kann zusätzlich aktiviert werden. Denn sollte der zentrale NameNode ausfallen, ist ein Zugriff auf die im Hadoop Distributed File System (HDFS) zugrunde liegenden Daten nicht mehr möglich. Nicht alle Services können aktuell mit Hochverfügbarkeit konfiguriert werden, aber für einen Großteil ist dies durchaus möglich. So auch für die extrem wichtige Komponente HDFS. Anhand einer Beispielkonfiguration in einem Cloudera Cluster Stack werden die Aufgaben von NameNode, Standby NameNode oder Secondary NameNode verdeutlicht und es wird mit wenigen Mausklicks eine High-Availability-Konfiguration für den HDFS Service ausgerollt. Der mitinstallierte Secondary NameNode bietet keine Hochverfügbarkeit. Dieser wird als eine Art Unterstützer („Helper“) angesehen, der sich um zeitliche Checkpoints der Metadaten kümmert und für das Verknüpfen von „editlogs“ mit dem „fsimage“ verantwortlich ist. Dies ermöglicht einen schnelleren Restart des NameNodes. Der NameNode, der die Metadaten des HDFS Clusters hält, wird durch einen zusätzlichen Standby NameNode abgesichert. Es ist dann nicht möglich, einen Secondary NameNode zu benutzen. Andere Aufgaben des NameNodes sind es, die Replikationen bzw. Kopien der Dateien zu überwachen. Sollte eine Kopie beschädigt werden, sorgt dieser für eine erneute Replikation auf den einzelnen DataNodes. In Hadoop Version 2 ist der „Singlepoint of Failure“ des NameNodes nicht mehr vorhanden wie in Version 1. Im „Worst Case“-Scenario übernimmt der Standby NameNode die primäre Aufgabe des ausgefallenen NameNodes. In diesem Active/Passiv-Szenario wird schnell und automatisch über einen vorher definierten Service mit minimaler Downtime umgeschaltet. Erreicht wird dies durch den Hochverfügbarkeitsdienst Zookeeper, der Ausfälle registriert und entsprechende Maßnahmen ergreift. Dabei wird anhand von zwei Wegen unterschieden, ob dieser über das „Quorum Journal“-basierte System oder per „Shared NFS Storage“ eingerichtet wird. Cloudera nutzt standardmäßig ersteres. Hierdurch bleibt der NameNode und Standby NameNode durch eine separate Gruppe von JournalNodes synchronisiert. *Anmerkung:* *Im Cloudera Manager werden jegliche Konfigurationen über das grafische Interface konfiguriert. Direkt auf dem Server befindliche manuelle Konfigurationsanpassungen werden ignoriert und gegebenenfalls zurückgerollt*. ### Konfiguration High Availability Cloudera am Beispiel einer 5.11-Installation. 1. #### HDFS Service über den Cloudera Manager auswählen ![step1-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step1-hdfs.png) 2. #### Aus dem Menüpunkt Action –> Enable High Availibility auswählen ![step2-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step2-hdfs.png) 3. #### Nameservice benennen –> namerservice1 ![step3-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step3-hdfs.png) 4. #### Rollen zuordnen ![step4-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step4-hdfs.png) 5. #### Ü„nderungen überprüfen und gegebenenfalls überschreiben ![step5-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step5-hdfs.png) 6. #### Ausführen ![step6-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step6-hdfs.png) 7. #### Gratulation ![step7-hdfs](https://thecattlecrew.net/wp-content/uploads/2017/08/step7-hdfs.png) Nachdem für HDFS High Availability eingeschaltet ist, müssen noch Hue und Hive entsprechend des Dokumentationslinks angepasst werden. Durch einen Test, bei dem der NameNode im laufenden Betrieb hart ausgeschaltet wird, wird überprüft, ob der Zookeeper sich um den automatischen Failover kümmert, in dem der Standby NameNode zum aktiven NameNode gemacht wird. ![step8-hdfs-failover](https://thecattlecrew.net/wp-content/uploads/2017/08/step8-hdfs-failover.png) Nach simuliertem Systemausfall von Namenode und einer kurzen Downtime werden die Rollen automatisch getauscht und HDFS stellt den Dateizugriff sicher. ![step8-hdfs-failover2](https://thecattlecrew.net/wp-content/uploads/2017/08/step8-hdfs-failover2.png) *Es gilt zu beachten, dass jeder einzelne Dienst hochverfügbar konfiguriert und getestet wird.* Weiterführende Konfiguration von Hochverfügbarkeit kann der offiziellen Cloudera Dokumentation entnommen werden. **Links:** [https://www.cloudera.com/documentation/enterprise/5-11-x/topics/cdh\_hag\_hdfs\_ha\_enabling.html](https://www.cloudera.com/documentation/enterprise/5-11-x/topics/cdh_hag_hdfs_ha_enabling.html) [https://www.cloudera.com/documentation/enterprise/5-11-x/topics/cdh\_hag\_hdfs\_ha\_cdh\_components\_config.html#topic\_2\_6](https://www.cloudera.com/documentation/enterprise/5-11-x/topics/cdh_hag_hdfs_ha_cdh_components_config.html#topic_2_6) **Kontakt:** *Simon Hahn simon.hahn@opitz-consulting.de* **Kategorien:** Analytics & Insights **Schlagwörter:** Big Data Cluster, cloudera, Failover, HDFS, Hochverfügbar --- ### [In-Memory-Technologien im BI/Analytics-Umfeld](https://thecattlecrew.net/2018/03/06/in-memory-technologien-im-bi-analytics-umfeld/) **Published:** März 6, 2018 **Author:** christophsimm **Content:** Die wachsenden Anforderungen für komplexe Datenauswertungen im **BI/Analytics**-Umfeld erfordern immer schnellere hochtechnisierte Hardware, um auch langfristig die strategischen Entscheidungen eines Unternehmens zu unterstützen. Der Begriff „**In-Memory**“ wurde zuletzt durch andere Hype-Keywords von den vorderen Plätzen verdrängt. ![CSI_In-Memory (2)](https://thecattlecrew.net/wp-content/uploads/2018/03/csi_in-memory-2.jpg) Nun gehört das Thema wieder auf die Tagesordnung. „**In-Memory**“ stellt eine Möglichkeit dar sich den wachsenden Anforderungen zu stellen. Mit unserem Whitepaper möchten wir einen Überblick über die aktuellen Lösungen einiger Softwarehersteller geben. Das Whitepaper untergliedert sich in drei Abschnitte: - Definition und Erläuterung der In-Memory-Technologie - Überblick der Produktpalette relevanter Softwarehersteller - Szenarien für den Einsatz einer In-Memory-Technologie Sie können das Whitepaper unter folgenden Link abrufen: [https://www.opitz-consulting.com/fileadmin/user\_upload/Collaterals/Artikel/whitepaper-in-memory-technologien-fuer-business-intelligence\_sicher.pdf](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/whitepaper-in-memory-technologien-fuer-business-intelligence_sicher.pdf) **Kategorien:** Analytics & Insights --- ### [Probleme bei der Installation des Oracle CPU 19.17/19.18 mit Dbvisit](https://thecattlecrew.net/2023/01/26/probleme-bei-installation-von-oracle-cpu-19-17-19-18-mit-dbvisit/) **Published:** Januar 26, 2023 **Author:** Rainier Kaczmarczyk **Content:** Servus! Habt ihr auch Probleme mit dem Oracle CPU 19.17/19.18 auf der Dbvisit Standby Datenbank? Wenn eine ältere Version von Dbvisit installiert ist (und das sind meines Erachtens 99 % aller Installationen) und ein CPU 19.17 bzw. der neueste CPU 19.18 eingespielt worden ist, funktioniert der „Create Standby Database“ Befehl nicht mehr. Der Grund ist eine Änderung im Verhalten von Oracle. Eigentlich sollte ein CPU ja nur sicherheitsrelevante Funktionen einspielen. Aber so ist es im Moment nun mal. Genauere Erläuterungen sind hier zu finden: [https://support.dbvisit.com/hc/en-us/articles/5825960076431-Probable-Oracle-Bug-with-19-17-impacting-Dbvisit?utm\_medium=email&\_hsmi=242858463&\_hsenc=p2ANqtz-99UzEqA9SUWKM22L2878V7-8nZp9KB3qUWoaawtrIN6n4BTBCff5VPtjoz4DWXob6Ot1WmdmciSLFcb2T-nV\_GnRvYDJjjOUcP24Q1gXhNGQ\_lhh0&utm\_content=242858463&utm\_source=hs\_email](https://support.dbvisit.com/hc/en-us/articles/5825960076431-Probable-Oracle-Bug-with-19-17-impacting-Dbvisit?utm_medium=email&_hsmi=242858463&_hsenc=p2ANqtz-99UzEqA9SUWKM22L2878V7-8nZp9KB3qUWoaawtrIN6n4BTBCff5VPtjoz4DWXob6Ot1WmdmciSLFcb2T-nV_GnRvYDJjjOUcP24Q1gXhNGQ_lhh0&utm_content=242858463&utm_source=hs_email) Meine Empfehlung: Probiert mal vor dem Einspielen des CPUs die Dbvisit Standby Datenbank auf die neueste Version 11.2.0 bzw. 10.2.1 upzugraden. Version 9 ist seit Ende letzten Jahres nicht mehr im Support. Daher gibt es hier keinen Hotfix. Ein kleines Update: Den Oracle RU (oder CPU) 19.18 hat Oracle vom Netz genommen. Wer den vorher heruntergeladen hat, sollte den also NICHT einspielen! Es wird Gründe haben, warum dieser Patch im Moment nicht verfügbar ist … Genaueres ist (mir) nicht bekannt. Heute habe ich bei einem Kunden das Patch Release 11.2.1 für Linux installiert. Es kann sooo einfach sein: - Alle Dbvisit Prozesse herunterfahren - Das Download File entpacken - Das Setup starten - Man wird sogar gefragt: „Willst Du von 11.2.0 auf 11.2.1 upgraden?“ - Return, Return, manchmal mal auch „Y“ - Alle Dbvisit Prozesse wieder starten - Fertig! Bis demnächst, Rainier **Kategorien:** Database, Infrastructure, Tools & Methoden **Schlagwörter:** Dbvisit, Installation, oracle, update --- ### [Integration eines Kong API Gateways für eine Spring Boot Anwendung mit Apache Camel](https://thecattlecrew.net/2020/08/10/integration-eines-kong-api-gateways-fuer-eine-spring-boot-anwendung-mit-apache-camel/) **Published:** August 10, 2020 **Author:** Maximilian Vogel **Content:** **Teil 1** In einer Reihe von drei Blogbeiträgen präsentieren wir einen Architekturentwurf, der ein Kong API Gateway für eine Spring Boot Anwendung mit Apache Camel implementiert. Mit dem Kong API Gateway können Zugriffe auf verschiedene Backendservices über eine Vielzahl von Plugins einfach verwaltet und gesteuert werden. Camel bietet im Backend eine Unterstützung für eine Vielzahl an EIPs (Enterprise Integration Patterns https://www.enterpriseintegrationpatterns.com). So können beispielsweise Daten aus unterschiedlichen Bestandssystemen- oder services kombiniert und zur Verfügung gestellt werden. Dieser Architekturentwurf eignet sich besonders für vertikale Integrationsprobleme. Unter der vertikalen Integration verstehen wir hier Schnittstellen die in Richtung der Endbenutzern operieren. In *Abbildung 1* werden die Integrationsrichtungen eines generellen Softwareaufbaus dargestellt und in der vertikalen Richtung in verschiedene Tiers unterteilt. In unserem Fall würde das Kong API Gateway in der Delivery Tier und die Spring Boot Anwendung in der Service Tier liegen. ![](https://thecattlecrew.net/wp-content/uploads/2020/09/IntegrationRichtungenEbookOC.png) *Abbildung 1 Softwarearchitektur Integerationsrichtungen* Wir wollen für diese Lösungsarchitektur nun eine Konfiguration erstellen, sodass diese mit all ihren Komponenten über Docker Compose „out of the Box“ gestartet werden kann. Dies ermöglicht, ein einfaches und schnelles Deployment sowie eine flexible Skalierbarkeit. Der Beispielcode ist vollständig unter zu finden. Im ersten Teil dieser Reihe stellen wir zunächst Kong und Apache Camel vor und zeigen das grundsätzliche Setup unserer Architektur. Im zweiten Teil () präsentieren wir eine Beispielanwendung mit Springboot und Apache Camel. Der letzte Teil (https://thecattlecrew.net/?p=32586) behandelt dann die Integration des Kong API Gateways und dessen Konfiguration. **Was ist Kong?** Kong ist ein Open Source API Gateway, welches unter einer Apache 2.0 License veröffentlicht wurde. Ein API Gateway dient als zentraler Zugangspunkt zwischen Clients und Backend-Systemen und wird in der Regel verwendet, um Querschnittsfunktionalitäten wie Routing, Load Balancing oder Authentifikationsmechanismen zentral zu implementieren. Durch seine leichtgewichtige Architektur und Flexibilität, eignet sich Kong sowohl für Microservice Architekturen als auch für klassische, monolithische Applikationen. Zudem bietet das Kong API Gateway eine einfache Skalierbarkeit bei geringen Latenzzeiten. Kong bietet eine Vielzahl von konfigurierbaren Plugins für verschiedene API Gateway Funktionalitäten. Dies beinhaltet zahlreiche Authentifikationsmechanismen, weitere Security Features, Traffic Control Mechanismen, Monitoring Optionen und vieles mehr. Die vollständige Dokumentation von Kong ist unter verfügbar. **Was ist Apache Camel?** Apache Camel ist ein Open Source Integration Framework, welches die Implementierung von EIPs unterstützt. Das Hauptziel von EIPs ist es technologieunabhängig Entwurfsmuster mit einheitlichen Begrifflichkeiten und Notationen bereitzustellen. Die einzelnen Entwurfsmuster bieten bewährte Lösungen für häufig auftretende Probleme, dazu werden verschiedene Design Überlegungen bereitgestellt. Ein zentrales Element, welches in diesem Beitrag zum Einsatz kommt, ist das Message Routing. Apache Camel ist ebenfalls unter einer Apache 2.0 License veröffentlicht. Die vollständige Dokumentation ist unter verfügbar. **Setup der Architektur** *Abbildung 1* zeigt den grundlegenden Aufbau der hier vorgestellten Architektur. Die grundlegenden Verantwortlichkeiten der verschiedenen Komponenten sind wie folgt: ![](https://thecattlecrew.net/wp-content/uploads/2020/09/setupVertikal-788x1024.png) *Abbildung 1 Grundlegender Aufbau der Architektur* Ein API Client ruft mit einer URL die Schnittstelle des Kong API Gateways auf. Das Gateway leitet diese Anfrage dann im Falle eines erfolgreichen Zugriffs z.B. nach Authentifikationsprüfung weiter an die eigentliche Anwendung. Kong speichert die Konfiguration einer API, wie z.B. Routen, User, API Keys oder Plugins in eine Datenbank (hier Postgres DB). Kong stellt mittlerweile auch einen DB-less Modus zur Verfügung, der ohne eine Datenbank auskommt. Dieser dient als ein Enabler für weitergehende Deploymentszenarien wie dem Hybrid Mode oder dem Ingress Controller. Kong kann über verschiedene Varianten konfiguriert werden, dies wäre zum einen über eine REST basierte Admin API oder über die Open Source GUI Konga. Kong bietet auch eine eigene Manager GUI, diese ist jedoch ein Enterprise Feature. Wir verwenden deshalb Konga als GUI um eine übersichtliche grafische Darstellung unserer Gateway Konfiguration zu haben. Da wir eine automatische Konfiguration unserer Kong Instanz beim Starten unseres Docker Compose Files laden wollen verwenden wir zusätzlich das Konfigurationstool decK. Dieses bietet die Möglichkeit Kong mit einer deklarativen Beschreibung zu konfigurieren. Hiermit können wir eine vordefinierte Konfiguration von Kong mithilfe eines YAML Konfigurationsfiles laden. Kong leitet die Anfragen auf den dahinter liegenden Service weiter. Dieser ist in unserem Fall mittels Spring Boot und Camel umgesetzt. Camel leitet diese wiederum über Message Channels weiter an die in der Anwendung definierten Endpoints. Hierbei können die Daten beliebig geroutet, verarbeitet und transformiert werden. Alle in dieser Architektur benötigten Komponenten werden über ein Docker Compose File konfiguriert und können so automatisch auf einem beliebigen System deployed werden. Im nächsten Teil stellen wir eine kleine Beispielanwendung für eine Springboot Anwendung mit Apache Camel vor. Hier geht’s weiter zu Teil 2: **Kategorien:** Cloud, Development, Integration **Schlagwörter:** API, Camel, Integration, Kong, Spring --- ### [Integration eines Kong API Gateways für eine Spring Boot Anwendung mit Apache Camel](https://thecattlecrew.net/2020/09/02/integration-eines-kong-api-gateways-fuer-eine-spring-boot-anwendung-mit-apache-camel-2/) **Published:** September 2, 2020 **Author:** Maximilian Vogel **Content:** **Teil 2** Im zweiten Teil unserer Reihe stellen wir nun den ersten Teil unserer Anwendung vor, dies entspricht dem rot umrahmten Fenster unserer Architektur in *Abbildung 1.* ![](https://thecattlecrew.net/wp-content/uploads/2020/09/setupVertikalSpring-785x1024.png) *Abbildung 1 Aufbau der Architektur* Dieser beinhaltet eine Beispielanwendung mit Spring Boot und Apache Camel. Wir stellen dabei zwei verschiedene Routing Mechanismen von Camel vor. Vollständiger Code verfügbar unter: **Aufbau der Spring Boot Anwendung mit Camel Integration** Unsere Spring Boot Anwendung wird als Maven Projekt angelegt, hierfür benötigen wir folgende Dependencies in unserer pom.xml: ``` org.springframework.boot spring-boot-starter-web org.apache.camel camel-core ${camel.version} org.apache.camel.springboot camel-bean-starter ${camel.version} org.apache.camel camel-servlet ${camel.version} org.apache.camel.springboot camel-rest-starter ${camel.version} org.apache.camel camel-rest ${camel.version} org.apache.camel camel-http ${camel.version} org.apache.camel camel-jackson ${camel.version} org.apache.camel camel-swagger-java ${camel.version} ``` Diese beinhaltet den Spring Boot Web Starter, sowie die für unsere Camel Integration notwendigen Dependencies. Wir werden in dieser Beispiel Anwendung Camel Routen auf zwei verschiedene Arten implementieren: 1. Mit Hilfe eines Producer Templates der durch eine Spring Boot Rest Controller aufgerufen wird 2. Über ein Servlet, welches einen HTTP Endpoint zur Verfügung stellt und intern die Camel Rest Schnittstelle verwendet Die ersten Variante ist prinzipiell flexibler und erlaubt somit mehr Kontrolle über den Prozess. Bei der zweiten Variante ist hingegen weniger manuelle Konfiguration notwendig. Unsere Spring Boot Anwendung hat die folgende Struktur: ![](https://thecattlecrew.net/wp-content/uploads/2020/09/springsetup.png) *Abbildung 2 Verzeichnisstruktur Spring Boot Anwendung* Die einzelnen Dateien unserer Anwendung werden nun hier mit ihren jeweiligen Funktionen beschrieben: **GatewayApplication:** ``` @SpringBootApplication @Configuration @ComponentScan("com.opitzconsulting.demo.kongcamel") public class GatewayApplication { public static void main(String[] args) throws Exception { SpringApplication.run(GatewayApplication.class, args); } @Bean public ServletRegistrationBean servletRegistrationBean() { ServletRegistrationBean registration = new ServletRegistrationBean(new CamelHttpTransportServlet(), "/camel/*"); registration.setName("CamelServlet"); return registration; } } ``` In der GatewayApplication wird unsere Anwendung gestartet. Hier wird außerdem unser Camel Servlet erstellt, welches dann einen HTTP Endpoint unter der URL „/camel/\*“ zur Verfügung stellt. **CamelConfig:** ``` @Configuration public class CamelConfig { @Bean public CamelContext createContext() throws Exception { // create and return the camel context CamelContext context = new DefaultCamelContext(); context.addRoutes(new MyRouter()); context.start(); return context; } } ``` Die CamelConfig ist eine Konfigurationsdatei, in der ein CamelContext erstellt wird. Dieser ist vergleichbar mit dem Spring ApplicationContext, der die zentralen Konfigurationseinheit einer Spring Boot Anwendung ist. **MyRouter:** ``` @Component public class MyRouter extends RouteBuilder { @Override public void configure() throws Exception { // route via rest controller + producerTemplate from("direct:start").bean(new MyBean(), "saySomething"); // Route via servlet from rest: to endpoint with producer restConfiguration() .component("servlet") .bindingMode(RestBindingMode.json); rest().get("/hello") .to("direct:hello"); from("direct:hello") .log(LoggingLevel.INFO, "Hello World") .transform().simple("Hello World"); } } ``` Die Klasse MyRouter implementiert die Camel Routen, die dann im dazugehörigen CamelContext registriert werden. Wir stellen in unserem Setup zwei Routen zur Verfügung. 1. Die erste Route leitet Daten welche an den Endpoint „direct:start“ gesendet werden weiter an die Bean MyBean und ruft dort die Methode „saySomething“ auf. 2. Die zweite Route hingegen leitet Anfragen die an die URL „camel/hello“ gesendet werden an den Endpoint „direct:hello“ weiter. Die URL setzt sich hierbei aus der Servlet URL und der in „rest“ definierten Route zusammen. Der Endpoint „direct:hello“ gibt wiederum einen einfach String mit „Hello World“ zurück. **ApiController + MyBean:** ``` @RestController public class ApiController { @Autowired CamelContext camelContext; @GetMapping("/greeting") public String greeting(@RequestParam(value = "name", defaultValue = "World") String name) throws Exception { ProducerTemplate template = camelContext.createProducerTemplate(); String result = (String) template.sendBody("direct:start", ExchangePattern.InOut, "Hi!"); return result; } } ``` ``` @Component("myBean") public class MyBean { private int counter; public String saySomething(String body) { return String.format("%s I am invoked %d times", body, counter++); } } ``` Die registrierten Routen werden bislang nicht aufgerufen. Wir werden dies nun über einen einfachen Spring Boot Rest Controller ermöglichen. Dafür legen wir eine Schnittstelle unter dem Pfad „/greeting“ an, bei deren Aufruf ein Producer Template erstellt wird. Mit Hilfe dieses Producer Templates kann man nun einen vordefinierten Camel Endpoint, in unserem Fall „direct:start“ ansteuern und diesem ein Exchange Pattern und einen Message Body mitgeben. Das Exchange Pattern signalisiert die Richtung des Nachrichtenflusses. „InOut“ ermöglicht es in unserem Beispiel eine Nachricht zu senden und im Anschluss wieder eine Antwort zu empfangen. Am Ende geben wir den hier erhaltenen String unter der Rest Schnittstelle aus. Die MyBean Klasse gibt lediglich einen einfachen String mit einem Counter zurück und wird über den Endpoint „direct:start“ unserer Route aufgerufen. Zu guter Letzt verwenden wir in unserer pom.xml noch das jib-maven-plugin. Dies ermöglicht es ein Docker Image unserer Anwendung zu erstellen. Die hier gezeigt Anwendung zeigt lediglich zwei sehr einfache Anwendungsfälle für Camel. Bei beiden Varianten ist es zum Beispiel möglich während des Nachrichtentransport gesendete Daten über sogenannte Processor Klassen beliebig zu transformieren. Im nächsten und letzten Beitrag werden wir nun das Kong API Gateway für unsere Spring Boot Anwendung integrieren und hierfür verfügbare Konfigurationsmöglichkeiten vorstellen. Zum nächsten Teil gehts hier: https://thecattlecrew.net/?p=32586 **Kategorien:** Cloud, Development, Integration **Schlagwörter:** API, Camel, Integration, Kong, Spring --- ### [Integration eines Kong API Gateways für eine Spring Boot Anwendung mit Apache Camel](https://thecattlecrew.net/2020/09/02/integration-eines-kong-api-gateways-fuer-eine-spring-boot-anwendung-mit-apache-camel-3/) **Published:** September 2, 2020 **Author:** Maximilian Vogel **Content:** **Teil 3** Im finalen Teil unserer Reihe behandeln wir nun die Integration und Konfiguration des Kong API Gateways für unsere Spring Boot Anwendung. Die hierfür verwendeten Komponenten sind in *Abbildung 1* rot umrahmt. ![](https://thecattlecrew.net/wp-content/uploads/2020/09/SetupVertikalKong-788x1024.png) *Abbildung 1 Aufbau der Architektur* Vollständiger Code verfügbar unter: **Konfiguration des API Gateways Kong:** Die Initiale Docker Konfiguration des API Gateways kann dem Docker Compose File im Verzeichnis „/docker“ entnommen werden. Diese beinhaltet die Container Konfigurationen für Kong, Konga, eine Autokonfiguration für Kong mittels decK, eine Postgres Datenbank, die mit Kong verknüpft ist, sowie unsere Spring Boot Anwendung. Über Docker Compose können die Komponenten einfach gestartet werden. Die Kong Admin API ist dabei lokal unter der URL „http://localhost:8001“ verfügbar. Wir möchten nun zeigen wie wir das API Gateway Kong konfigurieren können. Dabei verwenden wir zwei weitere Open Source Tools, Konga und decK. Konga ist ein Open Source GUI Tool für Kong und eine kostenlose alternative zur Enterprise Kong Manager GUI. Konga ermöglicht eine einfache grafische Steuerung von Kong, hier können die gleichen Einstellungen wie über die REST basierte Admin API vorgenommen werden, die ausführlich auf der offiziellen Seite von Kong dokumentiert ist. Konga läuft standardmäßig auf dem Port 1337. In unserem Setup muss für die erste Nutzung von Konga lediglich einmal manuell eine Verbindung zum Kong Admin Interface erstellt werden. Dafür müssen die Kong Admin URL und die für Kong konfigurierten Authentifikationsdaten (in unserem Fall nur die default Werte) eingegeben werden. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/Konga-Connection-1024x611.jpg) *Abbildung 2 Verbindungskonfiguration Konga* Um das Kong Gateway unter einer bestimmten URL erreichbar zu machen benötigen wir zunächst einen Kong **Service**. Ein Service repräsentiert eine externe Upstream API oder einen Microservice. Der Service verweist also auf die von unserem Gateway geschützten Anwendung. Ein Service kann wiederum mehrere Kong **Routen** exponieren, mit den hier definierten URLs können Anfragen an unser Gateway gesendet werden. Ohne Route kann ein Service nicht angesteuert werden. In unserer Beispielanwendung haben wir zwei Services über die Kong Admin API angelegt, die dafür benötigten Schritte können der offiziellen Dokumentation auf entnommen werden. Diese Konfiguration ist ebenso grafisch über Konga möglich. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/Konga-Routen-1024x235.jpg) *Abbildung 3 Routen mit dazugehörigen Services in Konga* In *Abbildung 3* sind unsere zwei Kong Routen mit ihrem jeweiligen Service zu sehen. Über die hier definierten Routen „/servlet“ und „/greeting“ können wir diese nun über - und - ansprechen. Wird nun beispielsweise die Route „/servlet“ aufgerufen wird eine Anfrage an den Upstream Service gestellt. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/CamelService-Konga-1024x752.jpg) *Abbildung 4 Kong „camle\_service“ in Konga* In *Abbildung 4* ist ein Teil der Konfiguration des Kong Services zu sehen. Unsere Anfrage an diesen werden weiter an die Route „/camel/hello/“ auf den Port 8080 geleitet, hier läuft standardmäßig unsere Spring Boot Anwendung. Eine Antwort der Anwendung wird dann auf dem umgekehrten Weg zurückgesendet. In diesem Beispiel hat unser Gateway noch nichts weiter als ein Re-routing gemacht. Um nun verschiedene Gateway Features zu implementieren bietet Kong eine Reihe verschiedener Plugins. Wir werden beispielhaft die Verwendung eines dieser Plugins für unsere zweite Route „/greeting“ darstellen. Die Konfiguration nehmen wir hierbei mittels HTTPie (https://httpie.org/) über die Kong Admin API vor. Alternativ ist dies auch über curl möglich. Wir möchten hier unsere Route über einen einfachen Authentifizierungsmechanismus absichern. Dafür verwenden wir das Plugin Key-Auth und fügen dies zu unserer Route „/greeting“ hinzu. Dafür verwenden wir folgenden Befehl: ``` http :8001/routes/greeting/plugins name=key-auth ``` Nach der Installation dieses Plugins wird Kong Anfragen auf dieser URL nur noch mit einem gültigen API Key an unsere im Service hinterlegte Spring Boot Route weiterleiten. Um nun eine erfolgreiche Authentifikation zu ermöglichen muss zunächst ein Kong **Consumer** angelegt werden. Per Kong Admin API kann man mit dem Befehl: ``` http :8001/consumers username=consumer custom_id=consumer ``` einen Consumer mit der Id consumer anlegen. Zusätzlich fügen wir diesem Consumer dann noch einenen API Key hinzu: ``` http :8001/consumers/consumer/key-auth key=apikey ``` Nun kann man die URL mithilfe des API Keys beispielsweise mit ``` http :8000/greeting apikey:apikey ``` aufrufen. Unsere Authentifizierung ist nun erfolgreich und unsere Anfrage wird wie zuvor auf unsere Spring Boot Anwendung weitergeleitet. Wir haben hier in diesem Beispiel den API Key explizit zugewiesen, in konkreten Anwendungsfällen ist es Best-practice diese automatisch von Kong generieren zu lassen. Dafür muss lediglich der vorherige Befehl für key-auth ohne expliziten key aufgerufen werden. ``` http :8001/consumers/consumer/key-auth **Kategorien:** Cloud, Development, Integration **Schlagwörter:** API, Camel, Integration, Kong, Spring --- ### [Kong API Gateway Basics - Grundkonzepte und Architektur](https://thecattlecrew.net/2022/08/17/kong-api-gateway-basics-grundkonzepte-und-architektur/) **Published:** August 17, 2022 **Author:** Fabian Hardt **Content:** Bei diesem Blogbeitrag handelt es sich um Teil 1 eines Kong API Gateway Basics Videoblogs, der sich mit dem Aufbau des Kong API Gateways, sowie dem damit verbundenen Automatisierungspotenzial beschäftigt. Der automatisierte Setup einer einfachen Kong API Gatewayarchitektur im Hybrid Mode, wird hierbei begleitend in kurzen Videosequenzen Schritt-für-Schritt demonstriert. In diesem Zusammenhang wird die Installation der Kong Control Plane und einer Data Plane im Azure Kubernetes Service (AKS) sowie die Installation einer weiteren Kong Data Plane auf einer VM gezeigt. Und wenn für Dich hier noch viele Buzzwords dabei waren und Du die Fragezeichen gerne loswerden willst, dann bis Du hier genau richtig! ## Teil 1 des Kong API Gateway Basics Videoblogs In diesem ersten Teil des Videoblogs erhältst du einen kurzer Überblick über die ![Kong-Haus](https://thecattlecrew.net/wp-content/uploads/2022/08/Kong-Haus-300x264.png)Funktionalität von API Gateways im Allgemeinen. Anschließend tauchen wir in die Welt des Kong API Gateways ab. Es werden der Grundaufbau und die Terminologie von Kong sowie die Verwendung von Plugins erläutert. Abgerundet wird dieser erste Teil mit der Erläuterung der verschiedenen Lizensierungsvarianten von Kong und den zahlreichen Konfigurationsmöglichkeiten, die Kong von Hause aus mitbringt. ### Alle Teile ansehen: [Teil 1: Kong API Gateway Basics – Grundkonzepte und Architektur](https://thecattlecrew.net/2022/08/17/kong-api-gateway-basics-grundkonzepte-und-architektur/) [Teil 2: Kong API Gateway Basics – Deployment Modes und Data Plane Installation per Ansible](https://thecattlecrew.net/2022/09/02/kong-api-gateway-basics-deployment-modes-und-data-plane-installation-per-ansible/) [Teil 3: Kong API Gateway Basics – Kong Control Plane Installation mit HELM](https://thecattlecrew.net/2022/09/14/kong-api-gateway-basics-kong-control-plane-installation-mit-helm/) [Teil 4: Kong API Gateway Basics – TLS-Absicherung und Integration in der Cloud-Landschaft](https://thecattlecrew.net/2022/09/23/kong-api-gateway-basics-tls-absicherung-und-integration-in-der-cloud-landschaft/) [Teil 5: Kong API Gateway Basics – Kong Ingress Controller](https://thecattlecrew.net/2022/10/06/kong-api-gateway-basics-kong-ingress-controller/) Auf [YouTube](https://youtube.com/playlist?list=PLMWddfzXOIzklhJbk-uXMO_ktMpI2a_OV) haben wir alle Videos zu Kong in einer [Playlist](https://youtube.com/playlist?list=PLMWddfzXOIzklhJbk-uXMO_ktMpI2a_OV) zusammengefasst. **Kategorien:** Automation, DevOps, Infrastructure, Integration, Tools & Methoden **Schlagwörter:** ansible, API Management, Automation, Helm, Kong, Microsoft --- ### [Kong API Gateway Basics – TLS-Absicherung und Integration in der Cloud-Landschaft](https://thecattlecrew.net/2022/09/23/kong-api-gateway-basics-tls-absicherung-und-integration-in-der-cloud-landschaft/) **Published:** September 23, 2022 **Author:** Fabian Hardt **Content:** Im vierten Teil dieses Kong API Gateway Basics Videoblogs geht es darum, die Kommunikation zwischen der externen – VM basierten – Data Plane und der Control Plane einzurichten. Hierzu sind zunächst einige Dinge für die Cloud vorzubereiten, wie die Einrichtung passender Loadbalancer und die Erzeugung von DNS-Einträgen in einer Private DNS Zone. ![TLS-Spring-API-Kong](https://thecattlecrew.net/wp-content/uploads/2022/09/Spring-API-Kong-300x119.png)Nach der erfolgreichen Integration erlebst du, wie die Synchronisation zwischen Control und Data Plane funktioniert. Damit die Gateways, aber auch die Kong APIs und UIs abgesichert sind und per TLS-Verbindungen auf sie zugegriffen werden kann, zeigen wir, wie du gemeinsame SSL-Zertifikate einrichtest und in Kong hinterlegst. Am Ende dieses Videos siehst du das Resultat: eine funktionierende und abgesicherte Kong API-Gateway-Umgebung mit mehreren Data Planes. Und nun schau gerne rein. Vielleicht sind ja noch einige hilfreiche Tipps für dich dabei: ### Alle Teile ansehen: [Teil 1: Kong API Gateway Basics – Grundkonzepte und Architektur](https://thecattlecrew.net/2022/08/17/kong-api-gateway-basics-grundkonzepte-und-architektur/) [Teil 2: Kong API Gateway Basics – Deployment Modes und Data Plane Installation per Ansible](https://thecattlecrew.net/2022/09/02/kong-api-gateway-basics-deployment-modes-und-data-plane-installation-per-ansible/) [Teil 3: Kong API Gateway Basics – Kong Control Plane Installation mit HELM](https://thecattlecrew.net/2022/09/14/kong-api-gateway-basics-kong-control-plane-installation-mit-helm/) [Teil 4: Kong API Gateway Basics – TLS-Absicherung und Integration in der Cloud-Landschaft](https://thecattlecrew.net/2022/09/23/kong-api-gateway-basics-tls-absicherung-und-integration-in-der-cloud-landschaft/) [Teil 5: Kong API Gateway Basics – Kong Ingress Controller](https://thecattlecrew.net/2022/10/06/kong-api-gateway-basics-kong-ingress-controller/) **Kategorien:** Automation, DevOps, Infrastructure, Integration, Tools & Methoden **Schlagwörter:** ansible, API Management, Automation, Helm, Kong, Microsoft --- ### [Kong API Gateway Basics – Kong Ingress Controller](https://thecattlecrew.net/2022/10/06/kong-api-gateway-basics-kong-ingress-controller/) **Published:** Oktober 6, 2022 **Author:** Fabian Hardt **Content:** In diesem letzten Teil des Kong API Gateway Basics Videoblogs wird die letzte Komponente der *Kong for Kubernetes* Installationsvariante aufgesetzt und konfiguriert. ![Kong for Kubernetes](https://thecattlecrew.net/wp-content/uploads/2022/10/Kong-K8s-1024x655.png)Anschließend werfen wir einen Blick „unter die Haube“ und schauen uns an, wie der Kong Ingress Controller funktioniert und wie er uns im Alltag unterstützten kann. Dies erlebt ihr an einem Beispiel-Deployment in Kubernetes, für das wir mittels Ingress Controller vollständig automatisiert passende Ressourcen im Kong angelegt haben. Schaut einfach rein: Ich hoffe, ihr hattet Spaß mit diesem Videoblog und könnt ein wenig neues Wissen zu Kong in euren Alltag mitnehmen. ### Alle Teile ansehen: [Teil 1: Kong API Gateway Basics – Grundkonzepte und Architektur](https://thecattlecrew.net/2022/08/17/kong-api-gateway-basics-grundkonzepte-und-architektur/) [Teil 2: Kong API Gateway Basics – Deployment Modes und Data Plane Installation per Ansible](https://thecattlecrew.net/2022/09/02/kong-api-gateway-basics-deployment-modes-und-data-plane-installation-per-ansible/) [Teil 3: Kong API Gateway Basics – Kong Control Plane Installation mit HELM](https://thecattlecrew.net/2022/09/14/kong-api-gateway-basics-kong-control-plane-installation-mit-helm/) [Teil 4: Kong API Gateway Basics – TLS-Absicherung und Integration in der Cloud-Landschaft](https://thecattlecrew.net/2022/09/23/kong-api-gateway-basics-tls-absicherung-und-integration-in-der-cloud-landschaft/) [Teil 5: Kong API Gateway Basics – Kong Ingress Controller](https://thecattlecrew.net/2022/10/06/kong-api-gateway-basics-kong-ingress-controller/) **Kategorien:** Automation, DevOps, Infrastructure, Integration, Tools & Methoden **Schlagwörter:** ansible, API Management, Automation, Helm, Kong, Microsoft --- ### [IT-Security (Part 3): WebLogic Server and Java Security Features](https://thecattlecrew.net/2014/03/14/it-security-part-3-weblogic-server-and-java-security-features/) **Published:** März 14, 2014 **Author:** Mohammad Esad-Djou **Content:** ## WebLogic Server and Java Security Features \[1\] WebLogic Server supports the Java SE and Java EE Security to protect the resources of whole system. The resources could be Web applications, Uniform Resource Locator (URL), Enterprise JavaBeans (EJBs), and Connector components. ## Java SE capabilities: Security APIs Java uses APIs to access security features and functionality and its architecture contains a large set of application programming interfaces (APIs), tools, and implementations of commonly-used security algorithms, and protocols. This delivers the developer a complete security framework for writing applications and enables them to extend the platform with new security mechanisms.[\[2\]](http://docs.oracle.com/javase/7/docs/technotes/guides/security/overview/jsoverview.html) ### Java Authentication and Authorization Services (JAAS) WebLogic Server uses the Java Authentication and Authorization Service (JAAS) classes to consistently and securely authenticate to the client. JAAS is a part of Java SE Security APIs and a set of Java packages that enable services to authenticate and enforce access controls upon users and /or fat-client authentication for applications, applets, Enterprise JavaBeans (EJB), or servlets. JAAS uses a Pluggable Authentication Module (PAM) framework, and permits the use of new or updated authentication technologies without requiring modifications to the application. Therefore, only developers of ***custom*** Authentication providers and developers of remote fat client applications need to be involved with JAAS directly. Users of thin clients or developers of within-container fat client applications do not require the direct use or knowledge of JAAS. #### JAAS LoginModules All LoginModules are responsible for authenticating users within the security realm (we are going to discuss about that later) and for populating a subject with the necessary principals (users/groups). LoginModules contains necessary methods for Login Context, Accounts, Credentials, configuration of them, and different ways to exception handling. Each Authentication providers will be configured in a security realm, its LoginModules will store principals within the same subject too. I try to present that with an example: Via WebLogic Server Admin Console: Home >myDomain > Domain Structure click on Security Realms and then create a new realm „Moh\_Realm-0″ and then click on „OK“ [![p3_realm_1](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_realm_1.jpg?w=298)](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_realm_1.jpg) Figure 1 create a new Realm Select new realm and then click on tab „provider“, and then click on „New“, in order to create a new provider: [![p3_realm_2](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_realm_2.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_realm_2.jpg) Figure 2 open the new Realm In this use case, we select type: „WebLogic Authentication Provider“ and give a name e.g. „DefAuthN“, then „OK“. The WebLogic Authentication provider is configured in the default security realm (myrealm). The WebLogic Authentication provider allows you to edit, list, and manage users, groups, and group membership. User and group information is stored in the embedded LDAP server.[\[3\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_edn3) [![p3_AuthenticationProvider_3](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_authenticationprovider_3.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_authenticationprovider_3.jpg) Figure 3 create a new Authentication Provider After define „Provider“, we have to restart Admin Server. Now, we can check and compare users of new realm (Moh\_Realm-0) with default realm (myrealm) of WebLogic. For myrealm, Icreated a new user named „userDOAG“ and we see the following list there (Home >Summary of Security Realms >myrealm >Users and Groups) [![p3_users_4](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_users_4.jpg)](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_users_4.jpg) Figure 4 users of myrealm But I didn“™t create same user for Moh\_Realm-0 (Home >DefAuthN>Summary of Security Realms >Moh\_Realm-0 >Users and Groups): [![p3_users_5](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_users_5.jpg?w=300)](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_users_5.jpg) Figure 5 users of Moh\_Realm-0 It shows, that we can use security provider in different gatherings und expand our security realm with additional user, groups, and security providers. We are working on it in next part of this article. #### JAAS Control Flags The JAAS Control Flag attribute determines how the LoginModule for the WebLogic Authentication provider is used in the login sequence. The values for the Control Flag attribute are as follows: Home >Summary of Security Realms > Moh\_Realm-0 >Providers > **DefAuthN** [![p3_JAAS_ControlFlag_6](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_jaas_controlflag_6.jpg?w=295)](https://thecattlecrew.net/wp-content/uploads/2014/03/p3_jaas_controlflag_6.jpg) Figure 6 Control flags via Admin Consol - REQUIRED – This LoginModule must succeed. Even if it fails, authentication proceeds down the list of LoginModules for the configured Authentication providers. This setting is the default. - REQUISITE – This LoginModule must succeed. If other Authentication providers are configured and this LoginModule succeeds, authentication proceeds down the list of LoginModules. Otherwise, return control to the application. - SUFFICIENT – This LoginModule needs not succeed. If it does succeed, return control to the application. If it fails and other Authentication providers are configured, authentication proceeds down the LoginModule list - OPTIONAL – The user is allowed to pass or fail the authentication test of these Authentication providers. However, if all Authentication providers configured in a security realm have the JAAS Control Flag set to OPTIONAL, the user must pass the authentication test of one of the configured providers.[\[4\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_edn4) Now, we can focus on two important JAAS-tasks: authentication and authorization of users“¦[\[5\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_edn5) ## References --- [\[1\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_ednref1) IT-Security (Part 1): IT-Security (Part 2): [\[2\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_ednref2) See: [\[3\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_ednref3) More detail in: [http://docs.oracle.com/cd/E24329\_01/apirefs.1211/e24403/core/index.html](http://docs.oracle.com/cd/E24329_01/apirefs.1211/e24403/core/index.html) [\[4\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_ednref4) Oracle Fusion Middleware: Understanding Security for Oracle WebLogic Server 12c Release 1, (12.1.1), E24484-02, January 2012: [http://docs.oracle.com/cd/E24329\_01/web.1211/e24484.pdf](http://docs.oracle.com/cd/E24329_01/web.1211/e24484.pdf) [\[5\]](/ME_Aktuell/01_Projekte/EFS/Call4Paper/06_IT-Security/WebLogic-Server_IT_Security_3.docx#_ednref5) See too: Do you forget your WebLogic Server password? No problem!, **Kategorien:** Infrastructure, IT-Security **Schlagwörter:** BPM, English, IT Security, JDeveloper, Oracle FMW, Service Bus, WebCenter Content, Weblogic --- ### [Partnerschaft für native Cloud-Architekturen mit OpenShift](https://thecattlecrew.net/2019/09/12/partnerschaft-fuer-native-cloud-architekturen-mit-openshift/) **Published:** September 12, 2019 **Author:** stkuehnlein **Content:** ![](https://thecattlecrew.net/wp-content/uploads/2019/09/AdvancedBusinessPartner.png)OPITZ CONSULTING wird Advanced Business Partner von Red HatSeit längerem ist die OPITZ CONSULTING Deutschland GmbH Business Partner des führenden Softwareherstellers im Open-Source-Bereich „“ Red Hat. Nun wurde die Partnerschaft mit der Auszeichnung „Advanced Business Partner“ auf ein neues Level gehoben. Von der gehobenen Partnerschaft des IT-Dienstleisters profitieren seine Kunden: Die Open-Source-Produkte von Red Hat gelten als elementare Bausteine auf dem Weg in die Cloud und damit in die Digitalisierung; insbesondere beim Aufbau einer privaten oder hybriden Cloud-Architektur. DieTechnologie OpenShifthilft mithilfe einer passenden Laufzeitumgebung dabei, bestehende Monolithen in Microservices zu zerlegen und zu betreiben. Die Partnerschaft mit Red Hat vergrößert und verstärkt die Kompetenzen des IT-Dienstleisters. *„Wir können unsere Kunden mit dieser Partnerschaft noch stärker bei der Transformation von Monolithen in eine native Cloud-Architektur unterstützen. Dazu kommen unsere Partnerschaften mit AWS und Microsoft. Da insbesondere OpenShift auch in der Cloud angeboten wird, ist es für unser Kunden ein großer Vorteil, wenn sie die Produkte der jeweiligen Partner miteinander verknüpfen können.“*, sagt Stefan Kühnlein, Partner Manager und Senior Solution Architekt bei OPITZ CONSULTING. Ein zentraler Anknüpfungspunkt ist der [OpenDevStack](https://opendevstack.org), eine Open-Source-Entwicklungsplattform für die schnelle Auslieferung von Software, die Experten der OPITZ CONSULTING Deutschland GmbH und der Boehringer Ingelheim RCV GmbH & Co KG gemeinsam initiiert haben. Um dem OpenDevStack bietet OPITZ CONSULTING [Beratungsdienstleistungen ](https://www.opitz-consulting.com/openDevStack)an. OPITZ CONSULTING nutzt OpenShift bereits in vielen Projekten, wenn es darum geht dynamische Cloud-Architekturen aufzubauen. Dazu kommen Services für weitere Produkte des Partners, beispielsweise für die Installation und Wartung von Red Hat Linux, Red Hat Enterprise Virtualization und Red Hat OpenShift Installationen.“ Für die Advanced Partnerschaft mit Red Hat musste OPITZ CONSULTING eine Reihe von Vorgaben erfüllen. Dass dies gelang, ist vor allem der Leistung und dem Engagement seiner Mitarbeiter zu verdanken. **Kategorien:** Cloud **Schlagwörter:** OpenShift, Red Hat --- ### [How to "œApache Solr": an Introduction to Apache Solr](https://thecattlecrew.net/2017/07/18/how-to-apache-solr-an-introduction-to-apache-solr/) **Published:** Juli 18, 2017 **Author:** binyaoopitz **Content:** **Foreword**: The information society has brought people a lot of information; on one side we enjoy endless information, on the other side we also feel a bit lost: how can we quickly and accurately filter the useful information from all the information the internet provides? The IT elites need to solve this problem urgently. The emergence of full-text searching technology provides powerful tools to solve the information retrieval problem: Apache Solr is one of those tools. This article deals with many aspects of Apache Solr „“ feel free to take a quick break from reading this blog occasionally and start practicing on your own! We“™re sure that this can help you in getting an even more comprehensive understanding of Apache Solr. In this article, we will talk about how to install the latest version of Apache Solr and tell you how to configure it properly. In addition, we will also tell you how to index a sample data file using Solr. Apache Solr supports different formats, including various databases as well as PDF, XML or CSV files etc. In this post, we will look at how to index data from an XML file. At the end of the article we will show you how to present your searching results using a web browser. We leverage a Linux operating system in this article to run the examples (using Solr in a Windows environment shouldn“™t make a big difference whatsoever). One more thing: before you start the Solr installation, make sure that you have installed a JDK 1.6 or above and that the JAVA\_HOME environment variable is set properly. ### **Why use Apache Solr?** Apache Solr is an open source enterprise search server, implemented in Java and thus easy-to-extend and modifiable. It uses the Lucene Java searching library at its core for full-text indexing and search. The server communication uses standard HTTP and XML but also supports REST APIs and JSON. Solr supports both schema and schemaless configuration without Java coding, and it has also a plugin architecture system to support more advanced customization. Apache Solr provides a wide variety of features; we just list some of the most important features here: - Full-text searching function - Support of XML, JSON and standard HTTP communication - Highly scalable and fault tolerant - Faceted searching and filtering - Support of many major languages like English, German, Chinese, Japanese, etc. - Rich document parsing ### **Solr VS Lucene** Solr and Lucene are not competing; on the contrary, Solr is dependent on Lucene: the core technology of Solr is implemented using Apache Lucene. It is important to note that Solr is not a simple wrapper for Lucene but that the functionality it provides goes far beyond the capabilities that Lucene provides. A simple way to describe the relationship between Solr and Lucene is like a car and the engine. So better we drive a car than just an engine, am I right? For more details about Lucene please see this blog article from one of my colleagues: [Apache Lucene Basics](https://thecattlecrew.net/2017/04/27/apache-lucene-basics/) The homepage for Apache Solr can be found here: ### **Installing Apache Solr** Requirement: Linux or Windows system with JDK 6 or above installed ``` wget http://mirror.softaculous.com/apache/lucene/solr/6.6.0/solr-6.6.0.tgz tar -zxvf solr-6.6.0.tgz cd solr-6.6.0 ``` ### **Architecture of Apache Solr** Once Solr“™s Zip file is downloaded, unzip it into a folder (*solr-6.6.0*). The extracted folder will look as depicted in the following picture: ![HowtoSolr1](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr1.jpg) The folder system of Solr is arranged as follows: - The *bin* folder contains scripts which are used to start and stop the server; we can also use the command „*status*„ to check server status. - The *example* folder contains several sample files. Some tutorials leverage one of these to show how Solr indexes data. But as we want to create our examples step by step and use curl via HTTP REST service we don“™t use this folder in this article. - The *server* folder is the most important folder. It contains the *logs* folder – all the Solr logs are written into this folder. This will surely help us in checking for any errors during the indexing process. The *Solr* folder under the *server* folder contains one sub-folder for each collection or core that is managed by the server. We will go into more detail on those two artefacts later on. The configuration of Core and Collection elements is contained in a file called „managed-schema“, there is one such file for each Core or Collection. Let us now have a look at the big picture of Solr Architecture ![HowtoSolr2](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr2.jpg) A customer can use REST clients, cURL, wget, Postman, as well as native clients (available for many programming languages) to communicate with Solr. Solr will send the corresponding command to Lucene Core for - Index - Update - Delete - Search The managed schema file is used to configure a core or collection. Let“™s assume the following example: in case we want to analyze log data from an Apache HTTP Server in our Lucene core, first of all we should start the Solr server, create a core in Solr and then add some useful fields to the managed schema file of the core. Those fields could for example include - Timestamp (as unique key) - Error\_Code - Error\_Message etc. The next step is to implement an application which sends the log data from the Apache Server to Solr and indexes the documents by using Lucene Core. Once the date has been indexed Solr can be queried (using its REST API for instance). We will have a more detailed look on the necessary steps in the rest of the article. ### **Start and stop Solr** Apache Solr has a built-in Jetty Server, and we can use command-line scripts to start the Solr server. Just go to the *bin* directory under folder *solr-6.6.0*, and enter the following command into the command window. ``` solr start ``` This command will start the Solr server using default port 8983 in our local environment. Now we can open the following URL and validate in the browser that our Solr instance is running. ``` firefox http://localhost:8983/Solr/ ``` This opens the main page of the Solr admin server. For further information on the admin server please visit . As can be seen in the red box on the left which says „No cores available“ we haven“™t created any cores in our Solr server yet. So our next task is to create a new core. Checking the server status can be done using the command: ``` solr status ``` To stop the server, please use the following command. ``` solr stop ``` ### **Create a core** Before we start to create a core, it is mandatory for you to understand the different artefacts (as, for example, „documents“ as a basic unit of information) that Solr is managing. Please use this link to first understand some basic definitions in Solr: Once you have a basic understanding of the Solr definitions we are ready to create our first Core now. Cores and Collections are similar to a table in a relational database „“ whether a Core or a Collection is created depends on whether Solr is running in standalone (Core) or SolrCloud mode (Collection). As we have started the Solr server in standalone mode a few steps before we will be just creating a Core later on. More details on the usage of the SolrCloud will be discussed in one of my next blog posts. In this article we use XML files containing employee data as an input and want to analyze or query this data using Apache Solr. First of all we must create a core „employeedata“. Let“™s go to the bin directory under folder *solr-6.6.0*, and enter the following command in the command window: ``` solr create -c employeedata ``` The *solr create* command detects which mode Solr is running in, and then takes the appropriate action (either creating a Core or a Collection). For more details and more options please enter this command: ``` solr create_core -help or solr create_collection -help ``` We can see the output below in the command window: ``` Creating new core 'employeedata' using command: http://localhost:8983/solr/admin/cores?action=CREATE&name=employeedata&instanceDir=employeedata { "responseHeader":{ "status":0, "QTime":822}, "core":"employeedata"} ``` In the Apache Solr admin server we will see that we have one core in the pulldown list at the end of left-side menu now. Clicking on the core name shows additional menus of information for our employee core, such as a Schema Browser, Config Files, Plugins & Statistics, and an ability to perform queries on indexed data. ![HowtoSolr4](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr4.png) ### **Modify the managed schema file** The employee data we use in our example looks like the following picture:![HowtoSolr5](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr5.png) As you noticed in the Employee.xml, the fields employeeId, name, skills and comment should be added to the managed schema file, so that we can add the corresponding data from the document to those fields in the employeedata Core. If you want, you can check the default schema fields and field types via curl. Make sure that you have already installed curl in your Linux or Windows system. ``` curl http://localhost:8983/solr/employeedata/schema curl http://localhost:8983/solr/employeedata/schema/fields curl http://localhost:8983/solr/employeedata/schema/fieldtypes ``` The managed schema file can be modified directly in the folder */solr-6.6.0/server/solr/employeedata/conf*. Another way to change this file is to use Apache Solr admin server which is also quite simple. In this article, I will introduce a third method „“ using the REST API. Assume we have only remote access to our Solr server; so we can create a local file, which includes what we want to add and to change in the managed schema file and after Creation just send this local file via HTTP POST to the server. The local file looks like in the following picture:![HowtoSolr6](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr6.png) For more details about properties and types in the field please use this link: Please then navigate to the employeeFieldConf.json file directory and enter this command in command window: ``` curl -X POST -H Content-type:application/json http://localhost:8983/solr/employeedata/schema/fields --data-binary @employeeFieldConf.json ``` After execution of this command, we can check the new fields using the admin server console:![HowtoSolr7](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr7.png) As one can see the fields employeeid, name, skill and comment have been created successfully in the managed schema. Wait! We didn“™t create a field called „id“ in this case. But nonetheless it has obviously been created. Why? Because every Core must have a unique key, the id is automatically created in the default managed schema file. Of course you can remove this field from the managed schema and change the unique key to another field. ### **Add documents** Everything is ready now, so we just need to add documents to our core now and index the data in those documents. Note that there are two main ways of adding data to Solr: HTTP GET and using a native client. For this small example we will use curl with HTTP GET. Please navigate to the Employee.xml file directory and enter this command into the command window: ``` curl -H Content-type:text/xml http://localhost:8983/solr/employeedata/update?commit=true --data-binary @Employee.xml ``` The content type used in this example is text/xml. For Json objects, we need to change the content type to application/json. Now we can check our core in admin server again, the new 4 documents have been already inserted und indexed.![HowtoSolr8](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr8.png) ### **Searching data** Now the documents have already been indexed and we can perform some queries on them. Apache Solr provides a REST API to access data and also provides different parameters to retrieve data. That means: for querying data we use HTTP GET by building a URL that includes the query parameters. For example: the following query shows all documents with field name equal „BYA“. ``` http://localhost:8983/solr/employeedata/select?q=name:BYA ``` The output will be shown as below:![HowtoSolr9](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr9.png) The response contains two parts: a response header and the response in XML format. The response header shows some status and query information, and the results are shown in the response part. Please also notice how to create a query URL. This URL includes hostname, port, application name, core name and query parameter q (query: name=BYA). We can also use wildcards, the filter query parameter „fq“ etc. Please try some of the commands below by yourself and see the results in the web browser. Are the running results just like what you were expecting? ``` http://localhost:8983/solr/employeedata/select?fq=employeeId:[0 TO 30]&q=*:* http://localhost:8983/solr/employeedata/select?fq=employeeId:[0 TO 5999]&indent=on&q=skills:Java&wt=json http://localhost:8983/solr/employeedata/select?fq=employeeId:[0 TO 5999]&indent=on&q=(skills:Java) AND (comment:big*)&wt=json ``` ### Updating documents Please see this example below first:![HowtoSolr10](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr10.png) As you noticed, the last employee in our document has no skill data, therefore we want to add a new „skills“ field to this employee, and in addition we also want to modify the comment, as we want to get rid of the typo. Additionally, „unknown“ is not a very good comment regarding an employee in the company. So how can we achieve that? We will use the same approach like adding documents to Apache Solr. First we create an updating data file in our local system, the example will be shown as below:![HowtoSolr11](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr11.png) We should talk about some aspects of this XML file. The most important point is that you can only update an existing file with a unique key; in this example the key is stored to the „id“ field, as this field has been defined to contain the unique key. Second, if you want to add a new field to a document, you must set attribute update=“add“, in opposite if you need modify an existing field, then you just set attribute update=“set“. Once the file is created we can send it via HTTP GET to Apache Solr server by using this command under the EmployeeUpdate.xml file directory. ``` curl -H Content-type:text/xml http://localhost:8983/solr/employeedata/update?commit=true --data-binary @EmployeeUpdate.xml ``` The output will be shown as below: ![HowtoSolr12](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr12.png) For more details, options and attributes by updating file please see this link: [https://wiki.apache.org/solr/UpdateXmlMessages#add.2Freplace\_documents](https://wiki.apache.org/solr/UpdateXmlMessages#add.2Freplace_documents) ### **Delete document and core** The difference between deleting documents and updating documents is that you can remove documents by using a query clause. That means you can also delete a document with normal fields. The unique key is not necessary in this situation. Once again we use curl via HTTP GET to send our command. The first command is used to delete one document with name „BYA“, the second command is used to delete all documents in the employeedata Core. ``` curl http://localhost:8983/solr/employeedata/update?commit=true -H Content-type:text/xml --data-binary 'name:BYA' curl http://localhost:8983/solr/employeedata/update?commit=true -H Content-type:text/xml --data-binary '*:*' ``` In Order to remove a Core, we can run a command with curl or we can delete the Core by using a script in the *bin* folder. ``` solr delete -c employeedata curl http://localhost:8983/solr/admin/cores?action=UNLOAD&core=employeedata&deleteIndex=true&deleteDataDir=true&deleteInstanceDir=true ``` ### Scoring and Boosting Assume that we found four documents as the result using the query. Which document should be placed on top of the result list? How does Solr rank documents and how can we tune the way Solr ranks and returns search results? To answer that question we need to understand the scoring system as well as the boosting system in Solr. Solr uses the Lucene Java search library at its core. Therefore we must understand the Lucene scoring system. But this is quite complex, so in this article I don“™t want to go into more detail. If you want to know more about Lucene scoring system, please use this link: [https://lucene.apache.org/core/2\_9\_4/scoring.html](https://lucene.apache.org/core/2_9_4/scoring.html). There will be another article explaining the Lucene scoring system in detail coming soon. The boosting system is more interesting as far as Apache Solr is concerned. In order to change the rank, the primary method of modifying document scores is by boosting. There are two ways to change the rank in Apache Solr: Index-time boost and Query-time boost. - Index-time: boosts are set during configuration our add document file. We can set boost at document level or at field level. We will see an example later. - Query-time: boosts are added in the query; you can give different weight with search words in the query. **Let us see an example for Index-time**:![HowtoSolr13](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr13.png) We have already seen this file before and used it to add documents to the Apache Solr server. The first and second red boxes are document level boosts settings. The whole document should be weighted in the system. The bigger the number, the higher the document appears on the rank. The last red box is the field level boost setting. That means: only this field“™s „comment“ is weighted for this document. **Query-time boosting**: An example: we want to know, which employees have skill c or skill Perl, the result will be shown as below:![HowtoSolr14](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr14.png)The important point is that we use the logical function „or“ in this query URL. The result shows us that the employee „lala“ is placed at top and then employee ADB comes in second place. But unfortunately we need a Perl skill employee immediately. That means we should search also skill „C“ and skill „Perl“. But skill „Perl“ is more important than skill „C“. How can we do that in Solr. In query clauses we can use caret character ^ followed by a positive number as query boost to weight an important word. ``` http://localhost:8983/solr/employeedata/select?indent=on&q=skills:C or (skills:Perl)^10&wt=json ``` So run this URL again in a web browser. You will see the other result below:![HowtoSolr15](https://thecattlecrew.net/wp-content/uploads/2017/07/howtosolr15.png)As we saw, the rank is just in the reverse. Solr doesn“™t allow negative boots, so if you want to add some negative weight in your query clause, please use negative field install negative boots. For example: (-skills:Perl)^2. **Query-time boosting via function**: In addition Solr providers many functions to add boosting in query, if you want to know more about the list of functions and the usage of those functions, please use this link: ### **Conclusion** That“™s it. This article describe only the basis of Solr and I wish this article can bring you nearly to the Apache Solr world and hope you have a good time during travelling this world. . **Kategorien:** Analytics & Insights **Schlagwörter:** Apache Lucene, Apache Solr, HowTo, Java, SearchEngines, Softwarenentwicklung --- ### [Ein Reifegradmodell zur Einstufung eines DWH Deployments](https://thecattlecrew.net/2017/05/08/ein-reifegradmodell-zur-einstufung-eines-dwh-deployments/) **Published:** Mai 8, 2017 **Author:** manuelmarowski **Content:** Es gibt eine Vielzahl von Reifegradmodellen, die diverse Aspekte in der Entwicklung in Reifegrade unterteilen. Zum jetzigen Zeitpunkt exisitiert, jedoch kein Reifegradmodell, dass die Reife eines DWH Deployments bestimmt. Innerhalb meiner Bachelorthesis habe ich mich diesem Thema gewidmet und das Deployment eines DWH in Reifegrade unterteilt. Dabei habe ich mich ausschließlich auf ein agiles Deployment durch die Umsetzung von Continuous Delivery (CD) fokussiert. Neue Anforderungen schneller dem Kunden zur Verfügung zu stellen, wird im Zuge der Digitalisierung wichtiger. Um dies zu erreichen, lassen sich agile Methoden im Umfeld der Entwicklung eines DWH adaptieren. Dabei liegt der Fokus des Modells darauf, wie bei steigenden Reifegrad die Umsetzung von CD voranschreitet. Es wird darauf eingegangen, warum man Continuous Delivery auf eine datengetriebene Entwicklung anwenden kann. Das Modell basiert zum Teil auf existierenden Modellen und bündelt weitere Aspekte, um die Anforderungen beim Deployment eines neuen Releases zu berücksichtigen. Der Aufbau des Modells orientiert sich an dem Capability Maturity Model. Das CMM ist ein Reifegradmodell zur Beurteilung der Qualität von Softwareprozessen, welches bereits in den verschiedensten Varianten existiert. Das Reifegradmodell stellt einen umfassenden Blick auf diese Problematik dar. Neben den technischen Voraussetzungen werden auch die Prozesse und der Mindset der Organisation betrachtet. Insbesondere die Zusammenarbeit zwischen den Fachbereich, den Entwicklern und der IT während des gesamten Entwicklungszyklus wird akzentuiert. Des Weiteren wird das Konzept des BICC in dem Modell berücksichtigt. Im ersten Reifegrad wird eine Organisation skizziert, dessen Deployment fehleranfällig und unzuverlässig ist, wohingegen eine Organisation im fünften Reifegrad durch die Umsetzung von CD und DevOps das Deployment verbessert. **Kategorien:** Analytics & Insights --- ### [TDWI 2017 "“ Ein Erfahrungsbericht der OC Young Guns](https://thecattlecrew.net/2017/07/26/tdwi-2017-ein-erfahrungsbericht-der-oc-young-guns/) **Published:** Juli 26, 2017 **Author:** Christian Lenzhölzer **Content:** Vom 26. bis 28.06.2017 war OPITZ CONSULTING mit einem starken Team auf der TDWI Konferenz in München vertreten. Die TDWI Konferenz ist ein Branchentreffpunkt der BI Community mit über 1200 BI-Experten, bei dem die meisten namenhaften Unternehmen der BI-Branche zusammenkommen, um Expertenwissen auszutauschen. Mit OC Beteiligung gab es drei spannende Vorträge zu folgenden Themen: - [Künstliche Intelligenz & German Angst – alles nicht so schlimm](http://www.tdwi-konferenz.de/tdwi2017/konferenz/konferenzprogramm/sessiondetails/action/detail/session/mo-12/title/kuenstliche-intelligenz-german-angst-alles-nicht-so-schlimm.html) (Dimitri Gross) - [TDWI Meinungsforum: Von Self Service Discovery, -Data Preparation bis hin zu Data Story Telling: Die eierlegende Wollmichsau Endanwender!](http://www.tdwi-konferenz.de/tdwi2017/konferenz/konferenzprogramm/sessiondetails/action/detail/session/di-22-1/title/tdwi-meinungsforum-von-self-service-discovery-data-preparation-bis-hin-zu-data-story-telling-die.html) (u. a. Lars Tams) - [No DWH without effect „“ BI für den Mittelstand leicht gemacht](http://www.tdwi-konferenz.de/tdwi2017/konferenz/konferenzprogramm/sessiondetails/action/detail/session/di-52-1/title/no-dwh-without-effect-bi-fuer-den-mittelstand-leicht-gemacht.html) (Thomas Unterbörsch und Oliver Dammann) Besonders hervorzuheben ist hier der letzte Vortrag der Liste, welcher in Kooperation mit dem Kunden Miller Brands Germany GmbH (MBG) gehalten wurde. Bereits am ersten Tag konnten wir einige interessante Vorträge, insbesondere über Trendthemen wie Big Data und Analytics, verfolgen. Abgeschlossen haben wir den ersten Konferenztag mit dem Besuch der Keynote von Robert Schröder, der in spannender Art und Weise zum Thema „Der Unterschied zwischen Fehlern und Versagen „“ die Entwicklung der Sicherheitskultur in der Luftfahrt“ referierte. ![tdwi_schroeder-e1500989051763.jpg](https://thecattlecrew.net/wp-content/uploads/2017/07/tdwi_schroeder-e1500989090624.jpg?w=450)*Vortrag Robert Schröder „Der Unterschied zwischen Fehlern und Versagen“* Dabei stellte Herr Schröder sehr gekonnt die Vergleiche der Sicherheitskultur in der Luftfahrt zu Bi Projekten und dem täglichen Leben dar. Nach dieser aufschlussreichen und spannenden Special Keynote wurde es aber dann auch Zeit für die TDWI Welcome Reception. Innerhalb dieser lockeren Abendveranstaltung sorgte OC gemeinsam mit seinem Kunden MBG für ausreichend Getränke und Fingerfood. Am zweiten Konferenztag haben wir uns dazu entschlossen, unterschiedliche Slots zu besuchen, um möglichst viel Wissen von den Experten abgreifen zu können. Im Nachhinein haben wir uns dann gegenseitig über die spannenden Vorträge inklusive einer inhaltlichen Bewertung informiert. ![tdwi_oc](https://thecattlecrew.net/wp-content/uploads/2017/07/tdwi_oc.jpg)*Tom Gansor von Opitz Consulting vor dem Stand von MBG* Außerdem fand an diesem Tag unser Young Guns Jahrestreffen statt, welches sich nun ein Jahr nach Gründung wiederholte, doch diesmal mit uns. 🙂 Dort wurde rückblickend über das bisher Erreichte gesprochen, sowie weitere Ziele für die Zukunft gesteckt. Seid gespannt auf die noch in diesem Jahr stattfindenden Barcamps in Hamburg und Stuttgart. Am letzten und dritten Konferenztag hatten wir dann die Chance, am Hackathon teilzunehmen. Dort ging es diesmal darum, ob es möglich ist, neue und vor allem verwertbare Erkenntnisse aus unstrukturierten Daten mithilfe von „Cognitive Computing“ automatisiert in wenigen Stunden zu generieren. Fazit: Ja, das ist durchaus mit den zur Verfügung stehenden Services von IBM möglich. Ein ausführlicher Bericht kann gerne [hier](https://thecattlecrew.net/2017/07/13/hackathon-tdwi-young-guns/) nachgelesen werden. Alles in allem blicken wir auf eine sehr gelungene und lehreiche Konferenz mit vielen spannenden Einzelgesprächen zurück. Viele Grüße Fabian und Christian Bildquellen: [https://www.sigs-datacom.de](https://www.sigs-datacom.de/sd/media/pictures/?f=TDWI%2FTDWI2017&_ga=2.120292239.68873714.1500969998-249070945.1499698287) **Kategorien:** Analytics & Insights **Schlagwörter:** Analytics, BI, Business Intelligence, TDWI, Young Guns --- ### [Apache Kafka - im Detail (Teil 2)](https://thecattlecrew.net/2017/09/28/apache-kafka-im-detail-teil-2/) **Published:** September 28, 2017 **Author:** Martin Münn **Content:** Schaut man sich Kafka im Detail an, wird der Aufbau schnell komplex. Dort gibt es dann Broker, Partitionen, Replica, Leader, Follower und die aus [Teil 1](https://thecattlecrew.net/2017/03/30/apache-kafka-einfuehrung/) schon bekannten Topics. Aber der Reihe nach: Kafka selbst läuft auf sogenannten Brokern, oft auch Nodes genannt, wobei ein Broker im Prinzip ein Kafka Server ist. Ab zwei oder mehr Brokern spricht man auch von einem Broker Cluster bzw. Kafka Cluster. ### Kafka Cluster Im Prinzip speichern die Broker die Nachrichten oder Daten einfach nur, sodass die Consumer sich diese dann abholen können. Diese Daten werden dazu in Topics unterteilt, sodass nicht jeder Consumer jede Nachricht bedenken muss. Der Producer bestimmt dabei, welche Nachricht in welchem Topic landet. Die Topics müssen dafür vorher manuell erstellt werden. ![Kafka Aufbau - Page 1](https://thecattlecrew.net/wp-content/uploads/2017/09/kafka-aufbau-page-1.png)Abbildung 1 – Darstellung eines Kafka Clusters Interessant wird es, wenn man betrachtet wie die Broker die Nachrichten speichern. Dazu werden die Topics in Partitionen unterteilt. Die gespeicherten Nachrichten in jeder Partition sind nach zeitlichem Eingang sortiert und diese Reihenfolge ist unveränderbar. Die zeitliche Reihenfolge der Nachrichten ist dabei nur per Partition, nicht aber pro Topic sichergestellt. Es sei denn ein Topic hat nur eine Partition. Zur Identifizierung bekommt jede Nachricht eine eindeutige ID, das sogenannte Offset. Dadurch können Consumer ganz gezielt bestimmte Nachrichten abfragen. (siehe Abbildung 2) Kafka speichert alle Nachrichten über einen einstellbaren Zeitraum und da es eine konstante Skalierung in Bezug zur Datenmenge aufweist, ist auch das Speichern großer Datenmengen über einen längeren Zeitraum kein Problem, zumindest nicht für Kafka. ![topicKafka](https://thecattlecrew.net/wp-content/uploads/2017/09/topickafka.png)Abbildung 2 – Darstellung eines Topics (kafka.apache.org/documentation/) Ein großer Vorteil der Partitionen ist es, dass die Datenmenge eines Topics größer werden kann als die Speicherkapazität des Brokers. Dies ist in Abbildung 1 in Topic 1 veranschaulicht. ### Ausfallsicherheit Um die Ausfallsicherheit zu gewährleisten, können von den Topics bzw. von den Partitionen Kopien, sogenannte Replicas, erstellt werden. Das ergibt natürlich nur Sinn, wenn es mindestens so viele Broker wie Replicas gibt. Unter allen Brokern, die Kopien einer Replica haben, wird mit Hilfe von Zookeeper bestimmt, wer der Leader wird. Da in Zookeeper die Informationen über den Aufbau des Clusters gespeichert werden. Der Leader bekommt die Nachrichten von den Producern und wird von den Consumern angefragt, wenn sie Nachrichten haben wollen. Außerdem sorgt er dafür, dass die Follower aktuelle Kopien des Leaders haben. In Abbildung 1 sind die Leader die grün umrahmten Partitionen und die schwarzen sind die Follower. Die Partitionen aus Topic 1 haben dabei nichts mit denen aus Topic 2 zu tun. ### Consumer Der letzte hier noch nicht weiter erläuterte Teil von Kafka sind die Consumer. Alle Anwendungen, die Nachrichten von Kafka empfangen, werden als Consumer bezeichnet. Es ist möglich, dass ein einzelner Consumer alle Nachrichten aus einem bestimmten Topic oder aber nur aus bestimmten Partitionen eines Topics lesen kann. Letzteres Szenario entspräche dann eher einer klassischen Message Queue. Mit dem Unterschied, dass auch in diesem Fall der Consumer Nachrichten mehrmals lesen könnte und nicht zwangsweise die Nachrichten in der Reihenfolge lesen muss wie sie auf den Partitionen gespeichert sind. Dieses Szenario hat allerdings ein Problem. Angenommen wir haben einen Producer, der schneller Nachrichten an das Topic sendet, als unser Programm verarbeiten kann. In diesem Fall würde unser Consumer weiter und weiter beim Konsumieren der Nachrichten zurückfallen und ein merkbarer Lag zwischen Senden und Empfangen würde entstehen, der nicht mehr aufgeholt werden könnte. Hier hätte man jetzt zwei Möglichkeiten. Entweder man optimiert den Consumer (Bessere Hardware oder besserer Code) oder aber man schaltet einen zweiten Consumer dazu, der parallel zum Ersten auch Nachrichten empfangen kann. Um Letzteres implementieren zu können, gibt es bei Kafka die sogenannten Consumer Groups. ### Consumer Groups Ein Consumer kann einer Consumer Group beitreten, die immer einem Topic zugeordnet ist. Innerhalb einer solchen Consumer Group werden eine oder mehrere Partitionen genau einem Consumer zugeordnet. Das heißt ein Consumer kann mehreren Partitionen zugeordnet sein, eine Partition aber immer nur genau einem Consumer. Der Vorteil hierbei liegt in der Parallelität. Je mehr Partitionen ein Topic hat, desto mehr Nachrichten können parallel von einer Consumer Group empfangen werden. Ein weiterer Vorteil Kafkas ist es, dass während der Laufzeit Consumer die Consumer Group verlassen oder hinzukommen können. Jedes Mal wenn dies passiert führt Kafka ein sogenanntes rebalancing aus und verteilt die Partitionen auf alle verfügbaren Consumer. Dabei ist die Parallelität durch die Anzahl der Partitionen beschränkt. Gibt es mehr Consumer als Partitionen, sind diese überschüssigen Consumer solange im Leerlauf. Im normalen Use Case von Kafka gibt es daher viele Producer (Datenproduzierende Systeme), die in viele verschiedene Topics schreiben. Diese Topics werden dann von Consumern abgerufen, und die Daten werden analysiert, verarbeitet und abgespeichert. Kafka erlaubt hierzu eine extrem hohe Durchsatzrate, kann aber auch als Puffer dienen, falls bei den Consumern mal etwas schief läuft. **Kategorien:** Analytics & Insights, Development --- ### [Sequences and Flow Control in Oracle Data Integrator](https://thecattlecrew.net/2017/10/20/sequences-and-flow-control-in-oracle-data-integrator/) **Published:** Oktober 20, 2017 **Author:** Christian Kaul **Content:** Most developers that start working with [Oracle Data Integrator](http://www.oracle.com/technetwork/middleware/data-integrator/overview/index.html) (ODI) and create their first mappings will stumble upon an error message like this pretty early in their ODI career: ![ODI Sequences Error Message](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-error-message.png) In this blog post, I will first recreate this error with ODI 12.2.1.2.6 and then show what you can do about it. For understanding this post, you should have some basic ODI knowledge (what mappings are, that they have a logical and a physical design, and that you can use different knowledge modules in the latter). ## The Problem In my example, I get files with revenue data from cinemas and load them into an Oracle database table. To make sure that I don“™t get in any trouble when a cinema shows the same film more at the same time more than once (maybe everybody wants to see the new Star Wars film), I add an aggregator between source datastore (the file) and target datastore (the database table): ![ODI Sequences Logical Design](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-logical-design.png) For the target datastore, I chose the knowledge module *IKM Oracle Incremental Update (MERGE)* that uses an intermediate table (what ODI calls I$ table) and allows for Flow Control (validating the loaded data). Apart from that, I didn“™t do any other changes in datastore properties or physical design. When I run this mapping as it is, I can see in the Operator tab of ODI Studio that it fails: ![ODI Sequences Execution with Error](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-execution-with-error.png) When I open the task where the error happened, I see the aforementioned error message: ![ODI Sequences Error Message](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-error-message.png) When I look at the target code, I find the reason for this error: ![ODI Sequences Error Cause](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-error-cause.png) The mapping selects the next sequence value for the primary key column of my target datastore in the same SELECT statement where I group by the source attributes. Unfortunately for me, Oracle database doesn“™t accept that. How can I deal with this problem? There is a relatively obvious and a not-so-obvious way. First, let“™s talk about the relatively obvious one. ## The Relatively Obvious Solution I open the mapping again and click on the primary key attribute of the target datastore (the one where you select the next sequence value). As *Execute on Hint*, I select „Target“. ![ODI Sequences Execute on Target](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-execute-on-target.png) When I run the mapping again, I don“™t get the error anymore but I still get a warning: ![ODI Sequences Execution with Warning](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-execution-with-warning.png) When I look at the session details, I see the reason for this warning: The mapping completed its run but two erroneous records were found during flow control (in task 260 when looking for potential not null constraint violations, to be precise): ![ODI Sequences Warning Message](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-warning-message.png) The mapping has put these records into an error table (ODI calls them E$ table) that I can query using ODI Studio or the database development tool of my choice: ![ODI Sequences Error Records](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-error-records.png) That way, I can understand what happened: I didn“™t insert any values for the primary key column into my I$ table but I still checked if this column was null (which it was since I didn“™t insert any values). This means I have to go back to the datastore properties. For the primary key attribute of the target datastore, I have to un-check the box that says *Check Not Null (Flow Control only):* ![ODI Sequences Check Not Null](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-check-not-null.png) When I run the mapping again after this change, it finishes without any errors or warnings. ![ODI Sequences Execution Successful](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-execution-successful.png) That was the first, relatively obvious way of dealing with our ODI sequence error. The second, not-so-obvious way is changing the knowledge module I use in the mapping. ## The Not-So-Obvious Solution In the Global Objects section of ODI Studio“™s Designer tab, I duplicate the knowledge module *IKM Oracle Incremental Update (MERGE)* and give it a new name like *IKM Oracle Incremental Update (Sequence).* ![ODI Sequences IKM Duplicate](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-ikm-duplicate.png) In the new knowledge module, I have to change two tasks: the one called *Insert flow into I$ table* where data is written into the intermediate table and the one called *Merge Rows* where I update the target datastore. In the *Insert flow into I$ table* task, I have to make sure that I don“™t insert any values for the primary key column (the one that is populated by the sequence). I achieve this by adding „and !PK“ both to the column lists of the I$ table itself and the SELECT statement that is used to fill it: ![ODI Sequences IKM Change Integration Table](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-ikm-change-integration-table.png) The meaning of selectors like „TRG“ and „PK“ can be found in the [ODI Substitution API Reference](http://docs.oracle.com/middleware/122126/odi/develop-km/GUID-5A73E952-7E55-4F61-89BD-FB6641035C4D.htm#GUID-CC31D7D9-2601-4ED7-98A5-8474E0917288) that is a valuable resource when working with knowledge modules. In the *Merge Rows* task of my new knowledge module, I make a similar change so that the mapping won“™t load the values for the primary key column from the intermediate table anymore: ![ODI Sequences IKM Change Target Table](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-ikm-change-target-table.png) Sometimes it“™s good to remember your Boolean logic: the negation of „and !PK“ is, of course, „or PK“. What have I achieved with these knowledge module modifications? Thanks to them, I won“™t have to worry about the correct *Execute on Hint* settings anymore: ![ODI Sequences No Execute on Hint](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-no-execute-on-hint.png) I just have to make sure that in the physical design of my mapping, the new knowledge module is set for the target datastore: ![ODI Sequences New IKM](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-new-ikm.png) If I always fill my primary key columns with a sequence, I can even set this knowledge module as default so that all future mappings will use it: ![ODI Sequences IKM Default for this Pair](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-ikm-default-for-this-pair.png) When I run the mapping with the new knowlege module, it finishes without any errors or warnings: ![ODI Sequences Execution Successful with New IKM](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-execution-successful-with-new-ikm.png) When I look into the generated code for the *Insert flow into I$ table* task, I see the difference the knowledge module changes made: ![ODI Sequences Target Code with New IKM](https://thecattlecrew.net/wp-content/uploads/2017/10/odi-sequences-target-code-with-new-ikm.png) As expected, the I$ table ignores the primary key column and everything works fine. That was the second, not-so-obvious way of dealing with our ODI sequence error. ## Lessons Learned Is there a lesson to learn from this? I think there are at least two: 1. Almost always, there are multiple ways to solve an ODI problem. 2. If the way you found doesn“™t include fiddling around with knowledge modules, maybe it should. **Kategorien:** Analytics & Insights **Schlagwörter:** ETL, Oracle Data Integrator --- ### [Innovation im Mittelstand](https://thecattlecrew.net/2017/11/13/innovation-im-mittelstand/) **Published:** November 13, 2017 **Author:** Otto Fitz **Content:** Ein Kunde der im Bau von Maschinen und Bearbeitungslinien zur Fischverbeitung in Deutschland tätig ist, möchte nicht nur seinen Fertigungsprozess effizienter gestalten, sondern auch eine innovative und smarte Steuerung für seine Maschinen entwickeln. Das Unternehmen hat erkannt, dass für den Wirtschaftsstandort Deutschland die Unternehmensstrategie angepasst werden muss, um die Marktposition ausbauen zu können und als Innovator in der Industrie 4.0 wahrgenommen zu werden. Um die Aktivität in der Industrie 4.0 zu demonstrieren, hat das Unternehmen eine Fachmesse für seine Kunden veranstaltet wo effektiv veranschaulicht wird, wie das Unternehmen mit der Digitalisierung umgeht. Ein Teil der digitalen Transformation, mit der sich Opitz Consulting Deutschland GmbH und das OC|Lab für das Unternehmen beschäftigt hat, ist die smarte Interaktion mit einer Maschine für die Fischverarbeitung. Dazu wurde ein Case entwickelt, in der eine Datenbrille, die HoloLens von Microsoft, als ein Werkzeug zur Bedienung der Maschine dient und statistische Daten der Maschine als Hologramme in einem reellen Raum visualisiert. Dies wird durch die Kameras der MS HoloLens ermöglicht, welche mehrmals die Sekunde die Umgebung scannen und die aktuellen Daten der Maschine auf einem virtuellen Dashboard darstellen können. Des Weiteren bietet die HoloLens die Möglichkeit, per Gesten mit der Maschine zu interagieren. Wie die Realisierung des Cases aussieht, ist auf dem unteren Bild veranschaulicht. ![opcua_hololens_interaktion](https://thecattlecrew.net/wp-content/uploads/2017/11/opcua_hololens_interaktion.png) Für die Interaktion mit einem modernen Client wie der Microsoft HoloLens, ist die Maschine mit einen OPC UA Server ausgestattet. Der OPC UA Server ist das Kommunikationsprotokoll, welches sich als Standard in der Industrie durchgesetzt hat. Der Server stellt die Sensoren als Nodes zu Verfügung, mit denen nach dem Publish/Subscribe Verfahren kommuniziert werden kann. Im ersten Schritt wurden die Nodes zur Interaktion mit der Maschine für die HoloLens identifiziert. Nachdem dem abonnieren der Nodes, standen die Daten der Maschine zur Visualisierung in einem Hologrammdashboard bereit. Das Hologrammdashboard welches mit Unity designt worden ist, ist mit C# Scripten versehen, welche die Publish/Subscribe Methoden enthalten. Die Hologramme visualisieren zum einen die Maschinendaten in der realen Umgebung in Echtzeit und zum anderen bieten sie die Möglichkeit durch Gesten die Maschine zu steuern. Im Bild unten sind einige virtuelle Objekte/Hologramme, die mit Blender und Unity entwickelt worden sind und zur Interaktion mit der Maschine dienen. Links auf dem Bild wird durch einen „AirTap“ auf den blauen Button, die Statistik des aktuell verarbeitenden Fisches angezeigt. In der Mitte bietet das Hologramm die Gesamtanzahl der Fische an, die mit der Maschine verarbeitet worden sind. Darüber hinaus werden die kritischen Fehler der Maschine durch ein Warnsymbol als Hologramm auf der Maschine dargestellt. Die Minus/Plus Buttons verändern in Echtzeit die Verarbeitungsgeschwindigkeit der Maschine die durch die Gesten ausgelöst werden. ![hologramme](https://thecattlecrew.net/wp-content/uploads/2017/11/hologramme.png) Mit diesem Industrie 4.0 Case hat das Unternehmen, mit Hilfe von Opitz Consulting Deutschland GmbH, seinen Fachbesuchern veranschaulicht, dass man in die Zukunft investiert und Innovationen in laufenden Prozessen testet. Die Hologramme und der Einsatz von Datenbrillen zur Steuerung der Maschinen, hat einen bleibenden Eindruck bei den Messebesuchern hinterlassen und war die Innovation, die auf der Messeparty zum Gesprächsthema wurde. Der Case hat auch intern die Herausforderungen verdeutlicht die in der industriellen Revolution 4.0 zu bewältigen sind. Die wichtigste Herausforderung ist jedoch, Ressourcen zu schaffen um digitale Strategien zu erproben. In solchen Fällen ist es unabdingbar auf IT Consultants zurückzugreifen und auf einen starken Partner in der digitalen Transformation zu setzen. **Kategorien:** Analytics & Insights, Cloud --- ### [TDWI Young Guns Barcamp @Hamburg](https://thecattlecrew.net/2017/11/21/tdwi-young-guns-barcamp-hamburg/) **Published:** November 21, 2017 **Author:** Arjuna Mittwede **Content:** Am 27.10.2017 fand in der Superbude in St. Pauli / Hamburg das Business-Intelligence-Barcamp, organisiert vom TDWI, statt. Das lockere Treffen in einer sehr coolen Location wurde extra für die „Young Guns“ ausgerichtet. Somit waren vor allem Studenten, Berufseinsteiger, Young Professionals oder erfahrene BI-Experten in Begleitung eines Juniors anwesend. ![20171027_140240 (2)](https://thecattlecrew.net/wp-content/uploads/2017/11/20171027_140240-2.jpg) Der Sinn dahinter ist, dass der jüngeren Generation der Einstieg in die BI-Welt durch offene Diskussionen auf Augenhöhe vereinfacht wird. Durch vorbereitete oder spontane (auch von Opitz Kollegen gehaltene) Vorträge wurde eine offene Diskussion zu verschiedensten Themen angestoßen. Zu Beginn des Events gab es keine feste Agenda. Diese wurde – ganz agil natürlich – aus den Interessen der Teilnehmer aufgestellt. Dabei konnte jeder der wollte ein Thema vorstellen, über welches anschießen abgestimmt wurde, ob es Teil der Tagesagenda wird. Das Hauptaugenmerk lag auf Business Intelligence, Big Data und Analytics Themen. Jedoch wurden weitere große Themen wie IoT, Machine Learning und Cloud-Computing auch angerissen. ![20171027_151415](https://thecattlecrew.net/wp-content/uploads/2017/11/20171027_151415.jpg) Das Barcamp startete direkt mit einem spannenden Vortrag zu einer Digitalen Plattform, die bei WMF entwickelt wurde. Hierbei ging es um die Möglichkeiten der Datenanalyse an dem Beispiel einer Kaffeemaschine. Das Aufzeichnen der Nutzungsdaten bot viel Potenzial für spannende Analysen. Beispielsweise wurde eine App entwickelt, die dem Nutzer ein Dashboard anzeigt, das die tägliche Nutzung der Maschine darstellt, Fehlermeldungen oder Alarm ausgibt und bei Bedarf direkt einen Techniker rufen kann. Ein sehr spannender Teil in diesem Vortrag war als über die weiteren zukünftigen Möglichkeiten diskutiert wurde. Ein Beispiel wäre, dass es durchaus realistisch ist, dass es in wenigen Jahren Kaffeemaschinen mit Gesichtserkennung geben könnte, die den Konsumenten erkennen und ihnen direkt ihr gewünschtes Getränk zubereiten ohne etwas einstellen zu müssen. Auch das selbstständige Reparieren eines Vollautomaten könnte mit Hilfe einer VR-Brille umgesetzt werden. Diese Ideen werden scheinbar in einigen Unternehmen tatsächlich evaluiert und für die Zukunft angedacht. Auch wenn die Maschinen vielleicht bald die Welt übernehmen „“ technisch gesehen ist das auf jeden Fall spannend! Ein weiterer Slot wurde mit einem Impulsvortrag zu „Realtime Analytics“ gefüllt. Hierbei ist mir vor allem der Spruch „Batch Analysis ist wie Autofahren und nur in den Rückspiegel schauen“ im Kopf geblieben. Weiter ging es in dem Vortrag um den Aufbau eines Azure Stacks, der Realtime Analytics mit Hilfe von IoT Daten darstellte. Durch das Hinzufügen von größeren Batch-Loads und dem anschließenden Abgreifen beider Datenströme mit Machine Learning Algorithmen für Predictive Analytics, zog großes Interesse auf sich. Besonders spannendend war für mich in diesem Kontext vor allem die komplette Bereitstellung der Ressourcen in der Microsoft Cloud. Auch von Opitz-Consulting wurde eine Diskussionsrunde geleitet, in welcher die Datenmodellierung mit Data Vault behandelt wurde. Hierbei entstand eine kontroverse Diskussion über die Handhabbarkeit und Langfristigkeit der Modellierung. Außerdem flossen verschiedene Erfahrungsberichte von Projekten mit ein. ![20171027_173811](https://thecattlecrew.net/wp-content/uploads/2017/11/20171027_173811.jpg) Nach einigen weiteren Vorträgen und Diskussionen wurde der Name des Barcamps auch Programm. Nachdem das Barcamp offiziell vorbei war, blieben wir noch mit einigen anderen Teilnehmern eine Weile bei Drinks und Snacks, da es noch einigen Gesprächsbedarf zu verschiedenen Themen gab. Anschließend ließen wir mit den Hamburgern (Christoph, Arjuna, Daniel, Björn) und den angereisten Kollegen (Luka aus Bad Homburg und Clarissa aus Essen) entspannt den Abend ausklingen. Fazit: Cooles Event, nette Leute „“ wir (Daniel und Arjuna) können das BI-Barcamp auf jeden Fall sehr empfehlen! ![20171027_163045](https://thecattlecrew.net/wp-content/uploads/2017/11/20171027_163045.jpg) **Kategorien:** Analytics & Insights **Schlagwörter:** Barcamp, Business Intelligence, Events, TDWI, Young Guns --- ### [Datenmodellierungsübung an der der TH Köln](https://thecattlecrew.net/2018/01/08/datenmodellierungsuebung-an-der-der-th-koeln/) **Published:** Januar 8, 2018 **Author:** clarissamoeller **Content:** Heute sind Janine Ellner, Thomas Kopp, Fabian Hardt und ich nicht zum Kunden gefahren, sondern zur TH Köln (Campus Gummersbach). Wir haben dort eine Übung zu der Veranstaltung Betriebliche Anwendungssysteme 1 (BA1) gehalten. Begonnen haben wir die Übung mit dem folgenden Architekturbild eines Data Warehouses: ![DWH-Architektur.png](https://thecattlecrew.net/wp-content/uploads/2018/01/dwh-architektur.png) Der Sinn eines Data Warehouses ist die Konsolidierung und Aufbereitung verschiedener Datenquellen. Dies können hierbei ERP-Systeme, Flat Files, externe Schnittstellen und vieles mehr sein. Diese werden zunächst „“ in der Regel „“ 1:1 in die Staging Area geladen. Im Core-Data Warehouse werden die Daten aus der Staging Area klassicher Weiser in einem 3NF-Modell abgebildet. 3NF steht für die 3. Normalform und entspricht einem Normalisierungsgrad der Datenbank, welcher Redundanzen und Anomalien vermeidet. Im Data Mart des Data Warehouses liegt der Fokus auf der Abbildung der fachlichen Welt. Hier bewegen wir uns im multidimensionalen Raum. Im Data Mart werden Dimensionen und Fakten aufgespannt, um so die Abfrageperformance für den Endanwender zu optimieren und eine einfache Auswertung der Daten zu ermöglichen. Bevor die tatsächliche Modellierung beginnen konnte, haben wir Begriffe Dimensionen und Fakten noch einmal kurz erläutert. Dimensionen beschreiben ein Objekt, typische Beispiele hierfür sind Produkt, Kunde und die Zeit. Solche oder so ähnliche Dimensionen befinden sich in den meisten multidimensionalen Data Marts. Dimensionen enthalten Attribute, welche die Eigenschaften eines Objektes beschreiben. Dimensionen verändern sich über die Zeit und wenn man diese Veränderungen auch im Nachhinein betrachten möchte, benötigt man hierfür ein Historisierungskonzept. Dabei wird sehr häufig das Prinzip der „Slowly Changing Dimensions“ genutzt, insbesondere der Typ 2. In diesem Fall werden Gültigkeitsstempel beispielsweise „GÜLTIG\_VON“ und „GÜLTIG BIS“ verwendet. Allerdings gibt es auch Data Warehouse-Systeme die stets nur den aktuellen Stand anzeigen und keine Historisierung benötigen. Fakten hingegen enthalten Kennzahlen, also numerische und meist additive Werte. Beispiele hierfür sind Anzahlen, Kosten und Mengen. Der Primärschlüssel einer Faktentabelle setzt sich üblicherweise aus den Fremdschlüsseln zu den verknüpften Dimensionen zusammen. Wichtig bei Fakten ist die Granularität. Je atomarer die Faktentabelle aufgebaut wird, desto mehr Flexibilität hat der Anwender bei der Auswertung. Allerdings hat die Faktentabelle dadurch einen größeren Umfang und kann somit zu Performanceproblemen führen. Hier gilt es zwischen der fachlichen Notwendigkeit des Detailgrades und dem technischen Gegebenheiten abzuwägen. Ziel der Übung war die Überführung eines Core-Datenmodells in ein Data Mart-Datenmodell. Basierend auf dem folgenden Core-Datenmodell sollten die Studenten unter anderem folgende Fragestellungen mit einem Data Mart-Datenmodell abbilden: - Wie viele Buchungen gab es im letzten Monat? - Wie viele Buchungen gab es pro Agent im letzten Jahr? - Wie viele Stornierungen gab es im letzten Monat? ![Core-Modell.png](https://thecattlecrew.net/wp-content/uploads/2018/01/core-modell.png) Die Fragestellungen sind bewusst sehr unspezifisch gehalten, damit rege Diskussionen entstehen können. Außerdem haben wir offen gelassen, ob ein Star- oder Snowflake Modell für den Data Mart entworfen werden soll. Allerdings sollten die Studenten Ihre Entscheidungen begründen können. Bei einem Star Modell steht eine Faktentabelle im Zentrum und ist mit den dazugehörigen Dimensionen direkt verknüpft. ![Star_Schema.png](https://thecattlecrew.net/wp-content/uploads/2018/01/star_schema1.png) Das Star-Modell ist dementsprechend ein denormalisiertes Modell. Es sind Redundanzen vorhanden und diese erzeugen einen etwas höheren Wartungsaufwand. Diesen nimmt man aber gern in Kauf, da die Queries eines Star-Modells weniger komplex sind als die eines Snowflake-Modells. Das Snowflake-Modell ist eine Weiterentwicklung des Star-Modells. Hier werden die Dimensionen normalisiert, das heißt falls möglich in verschiedene Tabellen hinunter gebrochen. Hier ein Beispiel für ein Snowflake-Modell: ![Snowflake Schema.png](https://thecattlecrew.net/wp-content/uploads/2018/01/snowflake-schema2.png) Dadurch, dass das Snowflake-Modell mehr Tabellen als das Star-Schema enthält, werden je nach fachlicher Fragestellung mehr Joins benötigt, um eine Query abzubilden. Nach ungefähr einer Stunde Diskussionen, Austausch und Modellierungsarbeit haben wir gemeinsam die Ergebnisse besprochen. Wir haben bereits zu Beginn angekündigt, dass es vollkommen legitim ist, wenn die Gruppen unterschiedliche Ergebnisse hervorbringen. Auch unsere Lösung ist lediglich eine Beispiellösung, die auf verschiedenen Annahmen basiert. ![Mart Modell.png](https://thecattlecrew.net/wp-content/uploads/2018/01/mart-modell.png) Mit dem obigen Datenmodell für den Data Mart können wir die Frage, wie viele Buchungen es im letzten Monat gab mit Hilfe der Tabelle Fact Booking (Booking Count) und der Dim Time (Month) abbilden. Um herauszufinden, wie viele Buchungen die jeweiligen Agenten im vergangenen Jahr getätigt haben, benötigen wir erneut die Fact Booking (Booking Count), die Dim Agent (Last Name) und die Dim Time (Year). Damit wir die Anzahl der Stornierungen im letzten Monat berechnen können, benötigen wir den Cancellation Count aus der Fact Booking und dazu das Cancellation Date aus der Dim Booking. Auch bei den Kennzahlen haben die Gruppen verschiedene Definitionen und Annahmen getroffen. In der Praxis würde man die Kennzahlendefinition mit dem Fachbereich des jeweiligen Unternehmens besprechen. Wir hoffen, dass wir mit unserer Übung den Studenten unseren Alltag in der Praxis näher bringen konnten und der ein oder andere so viel Spaß an der Datenmodellierung hatte, dass er sich seine berufliche Zukunft in der BI-Welt vorstellen kann. Clarissa **Kategorien:** Analytics & Insights **Schlagwörter:** Datenmodellierung, Student --- ### [AWS kann Big Data Analytics "“ aber wie?!](https://thecattlecrew.net/2018/04/16/aws-kann-big-data-analytics-aber-wie/) **Published:** April 16, 2018 **Author:** rolandwammers **Content:** Als Partnerunternehmen von Amazon wird von uns bei OPITZ CONSULTING eigentlich immer erwartet, dass wir die durch AWS zur Verfügung gestellte Plattform bestens kennen. Unsere Kunden tun das „“ und Amazon selbst eigentlich auch. Damit wir dieser Erwartungshaltung gerecht werden, müssen wir permanent am „Puls der Zeit“ sein und die aktuellen Entwicklungen in den jeweiligen Technologien und Produkten verfolgen und verstehen. Dann und wann muss bzw. darf der geneigte Berater dann allerdings auch sein permanentes Selbststudium eintauschen gegen einen durch den Hersteller veranstalteten Workshop. Genau so ein Workshop bzw. eine Workshopreihe ist die brandneue AWS Data Master Path Series, eine Folge von drei eintägigen Workshops, bei dem die Teilnehmer durch sachkundige Lösungsarchitekten durch verschiedene Aspekte der AWS-Landschaft geführt werden. Konkret geht es in den drei Terminen um - Big Data und Data Lake, - Internet of Things (IoT) und - Machine Learning (ML) und wie diese Lösungen mittels in AWS vorhandener Komponenten aufgebaut werden können. Selbstredend ist das nur die AWS-Sicht der Dinge, aber genau die ist ja wichtig um zu verstehen, wie welche Komponenten gemäß ihrem Hersteller miteinander kombiniert und zu einem effektiven Lösungsdesign verwoben werden können. Am 12. April hat nun der europaweit erste Termin in Berlin stattgefunden. Teilnehmer waren insgesamt 17 Berater unterschiedlicher Partner von AWS, darunter auch drei meiner Kollegen und ich selbst. Zum Auftakt gab es quasi einmal den theoretischen „Rundumschlag“ zu AWS: Was kann es alles, welche Produkte stecken drin und sind für welche Aufgaben zuständig? Trotz meiner Befürchtung, dass dieser „Workshop“ zu stark in die Theorie abdriftet, wurde dem Vortragsmonolog bald ein Ende gesetzt und es begann die Zeit der Hands-on-Übungen, welche den Kern des gesamten Workshops bildeten: 1. Zuerst ging es um Kinesis mit seinen Komponenten Kinesis Streams, Kinesis Firehose und Kinesis Analytics (immer flankiert vom unweigerlichen S3 als der Basis eines Data Lake nach AWS-Manier). Es wurde innerhalb kürzester Zeit ein Eventstream erzeugt, der in S3 persistiert wurde. Dabei wurden mittels Kinesis Analytics per SQL-artiger Befehle Kennzahlen auf dem Datenstrom erzeugt wie bspw. Aggregationen über eine bestimmte Gruppe von Events oder ein bestimmtes Zeitfenster.![Kinesis](https://thecattlecrew.net/wp-content/uploads/2018/04/kinesis.png) 2. Nach dem Mittagessen, welches ganz in typischer IT-Manier gehalten war, ging es dann um den theoretischen Lösungsentwurf für einen gegebenen Anwendungsfall. In Gruppen wurden so Grobarchitekturen erarbeitet, die „“ wie wir später erfuhren „“ auf konkreten und bereits auf AWS umgesetzten Lösungen basierten. So konnten wir also bereits unser erworbenes Wissen auf seine Konsistenz und Vollständigkeit hin überprüfen.![Architektur](https://thecattlecrew.net/wp-content/uploads/2018/04/architektur.jpg) 3. Anschließend wurde es wieder etwas handfester mit einer Übung zu den Themen Glue, Athena und Quicksight. Die in Übung 1 erzeugten Daten wurden nun also transformiert, analysiert und mittels QuickSight visualisiert. Hierbei wurde schnell deutlich, wie wichtig eine saubere Optimierung von Datenstrukturen und -abfragen ist, denn im Falle von Athena erfolgt die Abrechnung bspw. anhand der für die Beantwortung einer Abfrage gescannten Datenmenge. Vergisst man hier einen Filter oder eine Partitionierung, kann das schnell ein teures Vergnügen werden. 4. Zum Schluss des Workshops gab es dann noch eine Übung zum Thema AWS Elastic MapReduce (EMR) in Kombination mit Hive und Spark SQL sowie Zeppelin. Hier besticht die Kürze der Zeit, innerhalb derer man einen vollständigen Rechencluster zur Verarbeitung seiner (in S3 befindlichen) Daten hochziehen und damit anfassbare Ergebnisse produzieren kann. Hieran anschließend hätte es noch eine fünfte Übung zum Produkt Redshift gegeben, doch war leider – leider! – zu diesem Zeitpunkt der Tag schon wieder rum, so dass wir diese Übung nur als „Hausaufgabe“ mit nach Hause nehmen konnten.![Pizza](https://thecattlecrew.net/wp-content/uploads/2018/04/pizza.jpg) Als Fazit bleibt, dass es Amazon gelungen ist, innerhalb eines Tages einen (kleinen) Überblick über seine Produktpalette und damit lösbare Anwendungsfälle zu geben. Selbstredend ist das nur die Spitze des Eisbergs, und sicherlich kann dieser Workshop nicht die tiefere Beschäftigung mit den Produkten und Technologien ersetzen, aber als kompakter Einstieg in die Welt von AWS, und wie Amazon selbst sie sieht, war es eine gelungene Veranstaltung mit netten und kompetenten Trainern. Ich freue mich bereits auf die folgenden Termine. **Kategorien:** Analytics & Insights, Cloud --- ### [Intro in Machine Learning für alle Interessierten am 9. Juni in München](https://thecattlecrew.net/2018/06/07/ocexpert-camp-machine-learning-fuer-alle-interessierten-am-9-juni-in-muenchen/) **Published:** Juni 7, 2018 **Author:** Thomas Temme **Content:** Codest du gern in deiner Freizeit? Bist du Student? Hast du schon Erfahrung im Entwickeln oder bist neugierig darauf? Dann bist du beim OC|Expert Camp richtig! Das Meetup Event „OC|Expert Camp“ richtet sich vor allem an Neulinge im Bereich Machine Learning. Beim Termin am **9. Juni 2018** in München werden wir uns die Grundlagen der Ideen und Algorithmen von Neuronalen Netzen einmal näher angucken. Und weil „Gucken“ alleine auf Dauer langweilig ist, werden wir zusammen direkt mal ein kleines Projekt gestalten. Wenn ihr einen Hund oder eine Katze habt, bringt bitte unbedingt Bilder von ihnen mit – je süßer, desto besser. Für den Einstieg haben wir außerdem ein GitHub Repo vorbereitet. Ihr solltet die Steps 0, 1, und 2 gemacht haben, damit wir gleich loslegen können. Das Repo findet ihr hier: Das OC|Expert Camp startet am **9. Juni um 13 Uhr** **bei OPITZ CONSULTING am Münchner Standort** **OPITZ CONSULTING Deutschland GmbH** **Weltenburger Straße 4** **81677 München.** Damit wir besser planen können, bitten wir euch vorab um eine Anmeldung unter . Wir sind eine offene lustige Truppe stets auf der Suche nach neuen Herausforderungen. In unseren Coding Katas, Hackathons und Workshops beschäftigen wir uns mit allem, was mit Software möglich ist. Wir freuen uns auf dich! **Kategorien:** AI & Data Science --- ### [IoT Hackathon auf der Bosch Connnected Experience 2018](https://thecattlecrew.net/2018/05/20/iot-hackathon-auf-der-bosch-connnected-experience-2018/) **Published:** Mai 20, 2018 **Author:** philpz **Content:** Vom 20. bis zum 22. Februar nahmen Alexis Premet und Philipp Perez an der [Bosch ConnectedExperience (BCX)](http://bcw.bosch-si.com/berlin/hackathon/) „“ dem IoT Hackathon auf der [Bosch Connected World (BCW)](http://bcw.bosch-si.com/berlin/) „“ teil. Hackathon und Konferenz fanden verteilt in mehreren Hallen der STATION Berlin statt. Dabei lag der Schwerpunkt der Konferenz auf dem Thema Internet of Things (IoT). Während auf der Konferenz Keynotes von bedeutenden Persönlichkeiten, darunter die CEOs von Daimler, Kaspersky, Bosch und der Deutschen Post, stattfanden, trafen sich Developer, Data Scientists und Machine Learning Experts, aber auch UI/UX Experts und Product Manager/-Owner auf dem Hackathon. Mit über 800 Teilnehmern konnte dieses Jahr ein neuer Rekord aufgestellt werden. ## Hack Challenges Der Hackathon ist in folgende, fünf Hack Challenges aufgeteilt: - Connected Mobility Services - Autonomous Driving - Manufacturing 4.0 - Logistics & Supply Chain 4.0 - Connected Life Jede Hack Challenge wurde von einem Hack MC (Master of Ceremonies) geleitet. Ihm stehen rund einem Dutzend Hack Coaches zur Seite, die den Teilnehmern des Hackathons bei allen Belangen helfen. Dabei verfügt jede Challenge über eigene Hardware und Software sowie über eigene Herausforderungen bzw. Tasks. Daneben gibt es Sponsoren, welche die Soft- und Hardware zur Verfügung stellen. Die meisten Sponsoren sind mit eigenen Developern oder Product Ownern vor Ort vertreten, um jederzeit für Fragen bereitzustehen. Unter den diesjährigen Sponsoren befanden sich einige namhafte Firmen wie Cloudera, Google, Red Hat, MongoDB, Telekom, Cisco, Eclipse und Microsoft. Bosch selbst lieferte mit ihren Produkten einen Großteil der IoT Hard- und Software. ## Zeitplan Los ging es am Dienstagabend um 18 Uhr. Nachdem alle Hack Challenges durch ihre Hack MCs vorgestellt worden waren, galt es, sich für eine Hack Challenge zu entscheiden. Überall verteilt standen Flip Charts, auf denen kreative Hacker ihre Ideen präsentieren und um Mitstreiter werben konnten. Unentschiedene Hacker konnten durch das Gebäude laufen und dabei mit anderen ins Gespräch kommen, um sich entweder einem Team anzuschließen oder am Ende doch die eigene Idee zu verwirklichen. Für Mittwochmorgen war der erste Pitch jedes Teams vor der versammelten Hack Challenge geplant. Hierbei konnten die Teams ihre Idee präsentieren und bei Bedarf erneut um Mitstreiter werben. Danach ging es direkt ans Hacken. ![FishChainPitchPoster](https://thecattlecrew.net/wp-content/uploads/2018/05/fishchainpitchposter.jpg)*Unser Plakat für den ersten Pitch mit der Beschreibung unserer Idee.* Generell war die Zeit des Hackathons sehr knapp bemessen. Verteilt über Dienstag, Mittwoch und Donnerstag standen insgesamt 26,5 h für die Umsetzung unserer Ideen zur Verfügung. Nachts wurde das Gebäude leider geschlossen, aber wir mussten ja auch irgendwann schlafen. Am Donnerstag um 14 Uhr mussten alle ihre Arbeit beenden, um ihre Idee sowie die Umsetzung in einem finalen Pitch innerhalb der jeweiligen Hack Challenge zu präsentieren. Dabei standen exakt 120 Sekunden für den Pitch zur Verfügung (wie bei einem Elevator Pitch). Mit einer Stoppuhr wurde die Zeit gemessen. Auf die Sekunde genau wurde nach 120 Sekunden geklatscht und der Pitch war vorbei. Die Schwierigkeit bestand also darin, in nur 2 Minuten seine Idee und zusätzlich die Umsetzung zu präsentieren. Dabei gilt es die anderen Hacker von seiner Idee zu überzeugen und in ihnen Begeisterung zu entfachen. Denn zum Schluss entscheiden die Hacker jeder Challenge per Dot Voting, welches Team gewinnen soll. Die Gewinner der fünf Hack Challenges traten dann in einem finalen Pitch auf der Hauptbühne vor der gesamten Konferenz auf. ## Unsere Idee Alexis und ich interessierten uns insbesondere für die Hack Challenge #4 Logistics & Supply Chain 4.0. In dem folgenden Video stellt der Hack MC Antonio Martinez seine Hack Challenge vor: https://youtu.be/vuAd3napMVQ Nachdem wir einige Wochen im Voraus die Beschreibung der Hack Challenge gelesen hatten, entwickelten wir eine Idee, an der wir in mehreren Skype-Gesprächen feilten. Aufgrund der Hard- und Software unserer Hack Challenge in Verbindung mit den neuesten Entwicklungen in der IT der letzten Monate kamen wir auf die Idee einer „*Blockchain for Fish“*. Der Gedanke der „*Blockchain for Fish“* besteht darin, die gesamte Supply Chain eines Speisefisches lückenlos unter Beihilfe der Blockchain zu dokumentieren und überwachen. Über Mikrocontroller können Daten wie die Temperatur des Fisches sowie seine Geo-Location permanent erfasst werden. Letztere Information ist vor allem dann interessant, wenn man wissen möchte, woher der Fisch tatsächlich kommt, den man im Supermarkt kaufen möchte. Die Aufzeichnung der Temperatur ist insofern wichtig, dass damit sichergestellt werden kann, dass die Kühlkette zu keinem Zeitpunkt unterbrochen wurde. Dabei ist die Temperatur ab dem Zeitpunkt, zu dem der Fisch gefangen wird, über den Transportweg zum Hafen, während der Verarbeitung in der Fischfabrik bis über den Transport zu den Supermärkten hinweg von Interesse. Alle diese Daten werden in der Blockchain gespeichert, um Vertrauen zu schaffen. D.h. Vertrauen gegenüber dem Endkunden, der den Fisch im Supermarkt kauft, aber auch zwischen den einzelnen Akteuren der Supply Chain. Dadurch dass die Informationen in der Blockchain gespeichert werden, sind sie praktisch vor nachträglicher Manipulation geschützt. Der Fabrikbesitzer kann so dem Fischer vertrauen, dass der Fisch noch frisch ist und über die Blockchain auch das zugehörige Fischfanggebiet identifizieren. Daneben ergeben sich viele weitere Vorteile. Wer sich für das Thema „*Blockchain for Food“* interessiert, findet auf [Forbes.com einen interessanten Artikel](https://www.forbes.com/sites/themixingbowl/2017/10/23/the-blockchain-of-food/#17b38adf775f) zu dem Thema. Um unsere Idee abzurunden, bieten wir dem Endkunden einen „*Fish Sustainability Report“* an, der die Informationen zu jedem Fisch in aggregierter Form zur Verfügung stellt. Der Zugriff auf diesen Report erfolgt in unserer Umsetzung sehr pragmatisch. Jeder Fisch hat einen QR-Code aufgedruckt, welcher den Link zu dem zugehörigen Report enthält. Über sein Smartphone kann der Kunde im Supermarkt den QR Code scannen, den Link im Browser öffnen und so den Report sehen. ![fishwithqrcodes.jpg](https://thecattlecrew.net/wp-content/uploads/2018/05/fishwithqrcodes-e1526820433362.jpg)Die beiden Plastikfische mit aufgeklebten QR-Codes. Ihr habt es bestimmt bereits bemerkt, ohne auf technische Details unserer Umsetzung einzugehen (MQTT, T-Lab Blockchain, Spring Boot, NodeJS, Docker), unsere Idee ist zu komplex, um sie in einem Post vollständig zu erläutern. Falls ihr Fragen habt, lasst es uns in den Kommentaren wissen. Bevor wir hier noch weiter ausschweifend über unsere Idee berichten, kommt hier das Video unseres Prototyps: \[youtube https://www.youtube.com/watch?v=YqJoj6XeMA0?rel=0&w=560&h=315\] ## The winner takes it all Selbstverständlich möchten wir euch an dieser Stelle nicht vorenthalten, dass wir zwei als Gewinner aus der Hack Challenge „*Logistics & Supply Chain 4.0″* hervorgegangen sind. Unter den 20 Teams unserer Hack Challenge konnten wir mit Abstand die meisten Votes der übrigen Hacker auf uns ziehen. Der Druck war am letzten Tag bereits sehr hoch und der Stresspegel stieg von Stunde zu Stunde. Aber nach unserem Sieg in der Challenge mussten wir unsere Idee natürlich auch noch auf der Hauptbühne vor der versammelten Konferenz präsentieren. Bei den sogenannten „*Winner Pitches“* traten die Gewinner der fünf Hack Challenges gegeneinander an und wurden dabei von einer Jury aus verschiedenen CEOs bewertet.“‹ Aus den anderen Teams kamen t“‹eils beeindruckende Ideen mit bereits sehr fortgeschrittenen Umsetzungen. Gewonnen hat letztendlich das Team „*E-mute“*, welches ein Sensorsystem zur Erfassung der Wasserqualität von Flüssen in Indien vorstellte. Im Anschluss an die Winner Pitches kam John Calian, der Vice President von T-Labs (Telekom Innovation Laboratories), auf uns zu, um sich bei uns für die Nutzung der T-Labs Blockchain-Technologie zu bedanken. Eine detaillierte Bewertung der einzelnen Teams wurde leider nicht veröffentlicht, laut unserem Hack MC sollen wir aber weit vorne dabei gewesen sein. Nachdem wir auch diesen Pitch durchgestanden hatten, lagen bei uns die Nerven vollends blank, und wir fühlten uns reif für die Heimreise. Auf Twitter findet ihr entsprechende Tweets dazu: > the fish chain wins 1st round pitch at [\#BCX18](https://twitter.com/hashtag/BCX18?src=hash&ref_src=twsrc%5Etfw) using hashataX in supplyxhain [@T\_Labs](https://twitter.com/T_Labs?ref_src=twsrc%5Etfw) [\#IOTA](https://twitter.com/hashtag/IOTA?src=hash&ref_src=twsrc%5Etfw) [@BigchainDB](https://twitter.com/BigchainDB?ref_src=twsrc%5Etfw) [@riddleandcode](https://twitter.com/riddleandcode?ref_src=twsrc%5Etfw) [@GETJolocom](https://twitter.com/GETJolocom?ref_src=twsrc%5Etfw) [pic.twitter.com/rRetdHj5up](https://t.co/rRetdHj5up) > > — Joachim Lohkamp (@JoachimLohkamp) [February 22, 2018](https://twitter.com/JoachimLohkamp/status/966680128662228998?ref_src=twsrc%5Etfw) > At the @BoschSI hackathon pitch, one of the 5 teams used our [\#hashstaX](https://twitter.com/hashtag/hashstaX?src=hash&ref_src=twsrc%5Etfw) prototype [\#blockchain](https://twitter.com/hashtag/blockchain?src=hash&ref_src=twsrc%5Etfw) service[@GETJolocom](https://twitter.com/GETJolocom?ref_src=twsrc%5Etfw) [@riddleandcode](https://twitter.com/riddleandcode?ref_src=twsrc%5Etfw) [@iotatoken](https://twitter.com/iotatoken?ref_src=twsrc%5Etfw) [\#magenta](https://twitter.com/hashtag/magenta?src=hash&ref_src=twsrc%5Etfw) [@T\_Labs](https://twitter.com/T_Labs?ref_src=twsrc%5Etfw) [\#telekomwall](https://twitter.com/hashtag/telekomwall?src=hash&ref_src=twsrc%5Etfw) [\#BCX18](https://twitter.com/hashtag/BCX18?src=hash&ref_src=twsrc%5Etfw) [pic.twitter.com/xP1sMkW8pX](https://t.co/xP1sMkW8pX) > > — Mr. Calian (@SideShowJohn) [February 22, 2018](https://twitter.com/SideShowJohn/status/966703986026995713?ref_src=twsrc%5Etfw) Bei der Umsetzung unserer Idee lief bei Weitem nicht alles so glatt, wie wir es uns gewünscht hätten. Neben den typischen Problemen mit Windows standen Alexis und Philipp (2x Big Data Software Engineers) vor der Schwierigkeit, plötzlich sich mit dem Thema IoT und damit mit Mikrocontrollern sowie deren Programmierung auseinandersetzen zu müssen. Gleichzeitig mussten wir uns um die Pitches kümmern, um damit die anderen Hacker von uns zu überzeugen. Für den finalen Pitch hatten wir sogar ein kleines Rollenspiel einstudiert. Eine nicht ganz nebensächliche Rolle spielte auch unser kleiner Gag. Für die Demonstration hatte Philipp im Voraus zwei Plastikfische bestellt, welche wir bei unseren Pitches zu Demonstrationszwecken nutzen und uns so die Sympathie der grölenden Menge sicherten. Das Beste an dem Hackathon war definitiv, mit so vielen Hackern mit teils inspirierenden Persönlichkeiten / Lebenseinstellungen aus aller Welt zusammenzukommen, Englisch zu sprechen, über Ideen zu diskutieren und zu coden. Vor Ort konnten wir eine riesige Menge an Technologien ausprobieren und für die Entwicklung nutzen. Die Größe des Events war beeindruckend und die Stimmung auf dem Hackathon inspirierend. Alles war sehr professionell organisiert (kostenlose Verpflegung). Die BCX hat uns einfach mega Spaß gemacht. Wer weiß, vielleicht finden wir ja im nächsten Jahr erneut Zeit, am Bosch IoT Hackathon teilzunehmen und können dann als eine größere Truppe mit ein paar Werkstudenten antreten. ![DeveloperLaptopWithFishAndMicrocontrollerWIthSensors](https://thecattlecrew.net/wp-content/uploads/2018/05/developerlaptopwithfishandmicrocontrollerwithsensors.jpg)*Alexis“™ Laptop mit Mikrocontroller (inklusive GPS- und Temperatursensor) sowie unseren beiden Plastikfischen* **Kategorien:** AI & Data Science, Analytics & Insights **Schlagwörter:** BCW, BCX, blockchain, Bosch ConnectedExperience, Bosch IoT Hackathon, Hackathon, IoT --- ### [Azure als Big Data Basis für Stream Analytics - Studenten erproben die Cloud Computing Plattform (1/3)](https://thecattlecrew.net/2018/10/30/12229/) **Published:** Oktober 30, 2018 **Author:** pbockje **Content:** ## Kapitel 1: Welche Big Data Komponenten sind notwendig und wie lassen sich Tweets streamen? Die Studenten des Business Intelligence & Analytics-Bereichs in Gummersbach beschäftigten sich seit Juni diesen Jahres mit der Implementierung des bekannten AWS Twitter Showcase in Microsoft Azure. Der folgende Beitrag stellt „“ in nicht ganz chronologischer Reihenfolge „“ dar, wie das Projekt abgelaufen ist. Hierbei sollte der Azure Showcase möglichst an einen bei Opitz Consulting durchgeführten AWS (Amazon Web Services) basierten BigData Showcase angelehnt sein, um eine Vergleichbarkeit der beiden Plattformen zu ermöglichen. Der AWS Showcase ermöglichte, basierend auf Apache Kafka, Apache Spark, Apache Hadoop und dem ELK-Stack, das Streaming und die Verarbeitung von Tweets. Somit ging es auch hier um das Streamen von Tweets mittels Apache Kafka, die Verarbeitung der Daten in Form einer Stimmungsanalyse mithilfe von Apache Spark und die abschließende Visualisierung ebendieser Daten mittels ELK-Stack. Zusätzlich wurde ein entsprechendes DWH Offloading implementiert, um Twitter-Daten mit wertvollen Informationen (bspw. Business-Daten) anzureichern. Außerdem kann das Data Warehouse von Daten befreit werden, welche nicht verwendet werden, wodurch diese wiederum kostengünstig abgespeichert werden. Die ankommenden Daten wurden mittels Kibana in Echtzeit visualisiert und zusätzlich in einem Data Lake persistiert. Der Showcase wurde in diesem Zusammenhang demnach in die folgenden Bestandteile gegliedert, die zwar nicht vollständig voneinander abgrenzbar sind, aber dennoch eine Arbeit in kleineren Teams ermöglicht haben: **Kafka Cluster:** Streamen der Tweets **Spark Cluster (Machine Learning):** Durchführung der Stimmungsanalyse **ELK-Stack:** Echtzeit-Visualisierung der Daten **Hadoop Cluster:** DWH Offloading Das Projekt, wie auch seine Bestandteile, war für sämtliche Teammitglieder neu, sodass zu Beginn die einzelnen Komponenten unabhängig von Microsoft Azure getestet wurden, um hohe Kosten für die Einarbeitung zu vermeiden. Hierzu wurden die einzelnen Komponenten zuvor auf einer lokalen virtuellen Maschine installiert und miteinander verbunden. Der nächste Beitrag wird auf die Installation und die Nutzung von Apache Kafka für das Streamen von Daten in Azure eingehen. Im Folgenden wird mit der Entwicklung des Azure Showcases begonnen. Apache Kafka wird in einem ersten Schritt aufgesetzt und konfiguriert. Gestartet wurde mit einer virtuellen Maschine, auf der Apache Kafka installiert wurde. Dies gestaltete sich als vergleichsweise einfach, sodass das System im Anschluss direkt in Azure umgesetzt wurde. Hierzu werden in Azure eigene HDInsight Cluster verwendet, auf denen bereits eine Version von Kafka (Spark, Hadoop) vorinstalliert ist. Somit ergibt sich durch die Nutzung von Azure der Vorteil, dass keine virtuelle Maschine für Kafka konfiguriert werden muss, da diese automatisch nach der Eingabe der notwenigen Parameter (z.B. Benutzername, Passwort, etc.) erstellt wird. Apache Kafka folgt einem Publish-Subscribe-Prinzip, bei dem die Daten in eigenen Speicherkomponenten (Topics) gebuffert werden. Der Producer veröffentlicht Daten im Kafka Topic, während der Consumer ein solches Topic abonniert und damit auf die zugrundeliegenden Daten zugreifen kann. Der folgende Screenshot zeigt dabei eine mögliche Konfiguration eines Apache ![](https://thecattlecrew.net/wp-content/uploads/2018/10/konfiguration-1.png?w=900 "Konfiguration") Microsoft Azure hat hierbei allerdings die Eigenheit, dass Azure-Cluster gelöscht werden müssen, damit diese keine weiteren Kosten verursachen. Die Kosten für das Cluster werden stündlich in Abhängigkeit von der verwendeten Hardware abgerechnet. Dies bedeutete für uns, dass die Cluster morgens aufgesetzt und nach der Arbeit wieder gelöscht werden mussten. Nach der Generierung einer Umgebungsvariable und der Erzeugung eines Kafka Topics, konnte mittels Consumer auch schon getestet werden, ob das Streaming funktioniert. Da allerdings auch auf die Twitter-API zugegriffen werden muss, wurde ein Juypter Notebook erstellt, welches das Streaming der Tweets anstößt. Zur Kontrolle musste eine Verbindung via SSH hergestellt werden, um daraufhin einen Consumer zu starten, der das Topic abonniert und damit die Daten abruft. Im nächsten Beitrag möchten wir auf die Verarbeitung der Tweets mit Apache Spark eingehen und ein DWH-Offloading integrieren, um Business-Daten aus einer Datenbank mit den Twitterdaten verbinden zu können. **Kategorien:** Analytics & Insights, Cloud --- ### [Azure als Big Data Basis für Stream Analytics - Studenten erproben die Cloud Computing Plattform (2/3)](https://thecattlecrew.net/2018/11/06/wie-erzeugen-wir-aus-tweets-stimmungen-und-wo-speichern-wir-daten-ab/) **Published:** November 6, 2018 **Author:** mrogolowski **Content:** ## Kapitel 2: Wie erzeugen wir aus Tweets Stimmungen und wo speichern wir Daten ab? **Apache Spark als Framework für maschinelles Lernen** Im vorangegangenen Beitrag sind wir darauf eingegangen, wie Apache Kafka in Microsoft Azure aufgesetzt und konfiguriert wird. Im folgenden Abschnitt geht es ergänzend hierzu um die Konfiguration von Apache Spark und Apache Hadoop. Während sich ein Team mit der Umsetzung von Apache Kafka und mit der Erstellung des zugehörigen Notebooks beschäftigte, arbeitete ein zweites Team an dem Machine Learning in Apache Spark und ein drittes Team beschäftigte sich mit dem DWH Offloading mittels Hadoop. Zur Nutzung der Spark ML Komponente wurde erneut auf ein Azure HDInsight Cluster zugegriffen, welches eine vorkonfigurierte Version von Apache Spark bereitstellt. Microsoft empfiehlt für die Steuerung der Cluster die Nutzung von Jupyter Notebooks. Somit wurde ein Jupyter Notebook angelegt, um ein Modell zu erstellen, während ein zweites Jupyter Notebook dazu dient, den Stream zu analysieren und dabei die entsprechende Stimmung (1= positiv, 0=negativ) zu den Tweets zu ergänzen. Theoretisch betrachtet, wurden aus jedem Tweet nur die relevanten Worte isoliert und in einzelne Bestandteile (Tokens) zerlegt. In diesem Kontext ist es wichtig, dass nicht nur das einzelne Wort, sondern auch der Zusammenhang zwischen dem vorangestellten und dem nachfolgenden Wort erkannt wird, um ein negiertes positives Wort erkennen zu können. Jedes Wort erhält anschließend einen Wert und wird mittels logistischer Regression einem Wert angenähert. Falls der Wert höher als 0,5 ist, so ist dieser positiv, andernfalls ist der Wert negativ. Für das Training des Modells wurden 1,6 Millionen Datensätze verwendet, die jeweils einen Tweet und eine entsprechende Stimmung beinhalten. Diese Datensätze wurden durch sentiment140.com bereits zuvor ausgewertet. Im Folgenden ist sichtbar wie der Beispieltweet: „Das Wetter ist heute aber schön. Super Sache“ ausgewertet wird: „Das“ -> Neutral -> 0 „Wetter“ -> Neutral -> 0 „ist“ -> Neutral -> 0 „heute“ -> Neutral -> 0 „aber“ -> Neutral -> 0 „schön“ -> Positiv -> +1 „Super“ -> Positiv -> +1 „Sache“ -> Neutral -> 0 Damit ist der Wert +2. Dieser Wert (+2) wird in die Formel eingesetzt, welche in der unten stehenden Abbildung dargestellt ist. Es ergibt sich ein Wert von ca. 0,88. Damit ist die Stimmung des Tweets positiv! ![Logistische_Regression](https://thecattlecrew.net/wp-content/uploads/2018/11/logistische_regression.png) Das erzeugt Modell und die gestreamten Tweets werden in einem erstellten Azure Data Lake abgelegt. Zur einfachen Navigation durch die Dateien empfiehlt sich die Nutzung des Azure Storage Explorers. **Umsetzung eines DWH-Offloading mittels Hadoop und Sqoop** Während der Umsetzung des Machine Learnings, wurde das DWH Offloading umgesetzt, welches das Importieren von Daten aus einem DWH in einen kostengünstigeren Speicher ermöglichen sollte. Da sich keine geeigneten Daten finden ließen, wurde die Funktionalität mittels Beispieldaten getestet. In einem ersten Schritt wurde eine SQL-Datenbank als Ressource in Azure angelegt, um die Beispieldaten in dieser Datenbank abzuspeichern. Azure bietet auch hier eine vorkonfigurierte Ressource an, die in wenigen Schritten aufgesetzt ist. Anschließend wurde ein Hadoop-Cluster aufgesetzt, welches der Speicherung der importierten Daten dient. In diesem Zusammenhang empfiehlt sich die Nutzung eines Azure HD-Insight Clusters, welches einen kompletten Hadoop Stack vorkonfiguriert hat (Hive, Sqoop, HDFS). Zur Vereinfachung der Kommunikation zwischen Datenbank und Hadoop-Cluster wurden beide Ressourcen im gleichen Netzwerk angelegt, wie es auch schon bei Apache Kafka und Apache Spark durchgeführt wurde. Microsoft empfiehlt für Azure die Zuweisung eines virtuellen Netzwerks bei der Erzeugung eines Clusters. Zur Übertragung der Daten wurde Apache Sqoop verwendet. Hierzu müssen Jobs angelegt werden, die eine Übertragung der Daten von der relationalen Datenbank zu Hadoop anstoßen. Ein Beispiel für einen Sqoop-Job ist im Folgenden dargestellt: ![SqoopJob_example](https://thecattlecrew.net/wp-content/uploads/2018/11/sqoopjob_example.png) Dieser Job wurde allerdings in einer inkrementellen, manuellen Form angelegt, sodass er jedes Mal einzeln hätte angestoßen werden müssen. Daher wurde ein CronTab angelegt, der dazu dient, den Sqoop-Job minütlich auszuführen. Im abschließenden Beitrag werden wir zeigen, wie wir die Visualisierung der Tweets aufgebaut haben. Ergänzend hierzu möchten wir auf die Lessons Learned eingehen, die sich in diesem Azure Projekt ergeben haben. **Kategorien:** Analytics & Insights, Cloud --- ### [Azure als Big Data Basis für Stream Analytics - Studenten erproben die Cloud Computing Plattform (3/3)](https://thecattlecrew.net/2018/11/09/kapitel-3-wie-laesst-sich-eine-stream-analytics-visualisierung-durchfuehren/) **Published:** November 9, 2018 **Author:** mrogolowski **Content:** ## **Kapitel 3: Wie lässt sich eine Stream-Analytics-Visualisierung durchführen?** **Visualisierung der Daten mittels ELK-Stack:** In den vorangegangenen Beiträgen haben wir gezeigt, wie Apache Kafka, Apache Spark und Apache Hadoop aufgesetzt und für den Showcase miteinander verbunden wurden. Nun fehlt allerdings noch die Visualisierung der Daten, welche in diesem Beitrag vorgestellt wird. Nachdem Apache Kafka erfolgreich aufgesetzt und getestet wurde, das Machine Learning allerdings noch etwas Zeit benötigte, wurde die Implementierung des ELK-Stack gestartet, da dieser eine Sortierung und Visualisierung der Daten ermöglicht. Es wurde eine virtuelle Maschine in Azure erstellt, welche die Komponenten des ELK beinhalten sollte. Darüber hinaus wurde darauf geachtet, dass sich die virtuelle Maschine und das Kafka-Cluster im gleichen Netz befinden, da Logstash andernfalls Probleme beim Zugriff auf Kafka gehabt hätte. Auf die virtuelle Maschine konnte daraufhin mittels SSH zugegriffen werden, um einerseits die aktuelle Java-Version und andererseits Elasticsearch, Logstash und Kibana zu installieren. Empfehlenswert ist in diesem Zusammenhang die Nutzung der Azure Shells, welche bereits in der Azure-Oberfläche integriert sind. Es besteht die Auswahl zwischen einer einfachen Bash-Console und einer Powershell, welche weitreichende Ü„nderungen ermöglicht (z.B. das Ü–ffnen von Ports). Nach der Installation konnten die Komponenten gestartet werden, allerdings musste darauf geachtet werden, dass die Konfigurationen von Elasticsearch (elasticsearch.yml) und Kibana (kibana.yml) derart geändert werden, dass die Weboberfläche von außen erreichbar ist. Die zugehörigen Ports müssen ebenfalls geöffnet sein. ![Kibana_Konfiguration](https://thecattlecrew.net/wp-content/uploads/2018/11/kibana_konfiguration.jpg) Die Tweets werden mittels des entsprechenden Kafka-Plugin in Logstash gesammelt. Hierzu wird Logstash auf Basis einer Konfigurationsdatei gestartet, welche Informationen zu Input und Output beinhaltet und zusätzlich die Ortsinformationen eines Tweets in ein „“ für Kibana verständliches „“ Format bringt. Dieser Aspekt ist besonders wichtig, da Kibana einen geoPoint benötigt, um eine Visualisierung in Form einer Landkarte vornehmen zu können. ![Logstash_Konfiguration](https://thecattlecrew.net/wp-content/uploads/2018/11/logstash_konfiguration.png) Schließlich konnte die Visualisierung in Kibana konfiguriert werden, sodass der Ort, an dem die Tweets geäußert wurden, in Form einer Kartendarstellung abgebildet wurde. Die Stimmung der Tweets wurde in einem anschließenden Schritt ergänzt, sodass das folgende Dashboard erzeugt werden konnte. Interessanterweise zeigte sich, dass in nur ca. 50 von 10000 Tweets die Ortsangabe aktiviert war, sodass auch nur diese dargestellt werden konnten. ![Result](https://thecattlecrew.net/wp-content/uploads/2018/11/result.jpg) **Lessons Learned:** Abschließend kann zusammengefasst werden, dass mittels einfach zu bedienender Software eine Big Data-Architektur umgesetzt werden kann. Diese Architektur beinhaltete insbesondere Open Source Software, welche keine Lizenzkosten verursachten (bspw. Apache Kafka, Apache Spark oder Apache Hadoop). Microsoft Azure bietet in diesem Zusammenhang eine Cloud Plattform, welche einfach zu bedienen ist und dabei Cluster zur Verfügung stellt, die bereits zahlreiche konfigurierte Komponenten zum Aufbau einer Big Data Architektur enthalten. Die Kosten werden stündlich abgerechnet, dabei ist die Anzahl der Cores allerdings begrenzt und kann nur durch den entsprechenden Admin erhöht werden. Hierdurch lässt sich eine Kostenexplosion durch unsachgemäße Nutzung des Accounts vermeiden. Wichtig bleibt in diesem Kontext auch die entsprechende Löschung der Cluster, um die Kosten für die Nutzung gering zu halten. Ein Ausschalten der Cluster hilft hier leider nicht weiter, da die Kosten für die Cluster unabhängig davon entstehen, ob diese genutzt werden. Darüber hinaus stehen zum aktuellen Zeitpunkt bereits viele Guidelines und Informationen für die Nutzung der Microsoft Azure Komponenten zur Verfügung, sodass der Einstieg insgesamt einfach fällt **Kategorien:** Analytics & Insights, Cloud --- ### [Infrastructure as Code: Ansible und Elastic Stack](https://thecattlecrew.net/2019/02/04/infrastructure-as-code-ansible-und-elastic-stack/) **Published:** Februar 4, 2019 **Author:** Mohammad Esad-Djou **Content:** Opitz Consulting lebt und verbreitet den DevOps Gedanken und schult seine Mitarbeiter mit einem Fast Track Schulungsprogramm. Dieses besteht aus mehreren Teilen, in denen alle DevOps Aspekte inklusive der Grundlagen des Organisation Change, Entwicklungspraktiken und Infrastrukturveränderungen. Dieser Bericht bezieht sich auf den dritten Teil dieses Programms. Im Rahmen des DevOps Fast Track Teil 3 haben die Opitz Kollegen Kai Weingärtner und Mohammad Esad-Djou eine 2 Tagesschulung erarbeitet und ausgerollt ![](https://thecattlecrew.net/wp-content/uploads/2019/02/P1020943-1024x768.jpg) Der erste Rollout fand nunmehr am 24. und 25.Jänner 2019 im „Pferdestall“ statt. Hier auf dem Gelände von Opitz Consulting in den großen hellen Räumlichkeiten, finden die Teilnehmer eine ideale Umgebung für Vorträge und praktische Übungen. Um es vorweg zu nehmen, es war einfach von „A-Z“ eine super gelungene Veranstaltung. Neben den beiden Instruktoren waren 15 weitere OC“™ler anwesend und haben diese Chance auf Weiterbildung genutzt. Wie es sich für eine DevOp Schulung gehört, war das Auditorium optimal gemischt. Es haben sich in etwa gleich viel Developer und Vertreter von Operation der DevOps Challenge gestellt. Die Veranstaltung war so gegliedert, dass es zwei thematische Schwerpunkte gab, welche jeweils durch einen der beiden Trainer vorbereitet und vorgestellt wurde. Am ersten Tag führte Kai die Teilnehmer in die Welt der Infrastrukturautomatisierung ein und vermittelte einen guten Überblick art und Umfang verschiedener Wrkzeuge. Dann stellte er insbesondere Ansible als Werkzeug der Wahl und defacto Standard im DevOps Umfeld vor. ![](https://thecattlecrew.net/wp-content/uploads/2019/02/ansible.png) Somit stand Tag 1 ganz im Sinne von Methoden und Werkzeugen im Bereich Automatisierung. Trainer Kai konnte den Stoff sehr gut vermitteln und überzeugte immer wieder durch gut präparierte Demonstrationen und Anwendungsbeispiele In Übungen konnten die Teilnehmer intensiv mit dem Automati-sierung und Orchestration Tools „Ansible“ arbeiten und praktische Erfahrungen vertiefen. Die Übungsaufgaben waren aufeinander abgestimmt und über Opitz Git Repository für die Teilnehmer abrufbar. Nach der Implementierung geringfügige Pre-Requisiten waren die Teilnehmer mit einem „vagrant up“ direkt in der virtuellen Übungsumgebung von mehreren Maschinen, welche als Ansible Master und Managed Nodes fungierten. Im Zweiten Teil (Tag 2) konnten die Teilnehmer sich mit dem „Elastic Stack“ (ELK) vertraut machen. ![](https://thecattlecrew.net/wp-content/uploads/2019/02/elk_stack.png)Abbildung 2 Tools im Elastic Stack Dieser Trainings Part wurde durch Mohammad vorbereitet und hervorragend präsentiert. ![](https://thecattlecrew.net/wp-content/uploads/2019/02/splunk.jpg)Abbildung 3 Mohammad Esad-Djou beim präsentieren Er hat den Teilnehmern zunächst die Notwendigkeit zur Tools Auswahl erläutert und mit vielen konkreten Beispielen und Anwendungsfällen die Vorteile von Analytics mit ELK aufgezeigt. Er erklärte anschaulich, wie derartigen Tools in verschiedenen Bereichen der IT und auch im Management einen hohen Mehrwert erzeugen können. Hier kam ihm sein umfangreicher Erfahrungsschatz als Solution Architekt bei Opitz Consulting zugute, und die Teilnehmer konnten hier stark partizipieren. ![](https://thecattlecrew.net/wp-content/uploads/2019/02/kibana.png)Abbildung 4 Kibana Geografische Verteilung geloggter Daten Um den Teilnehmern „Hands-on“ zu ermöglichen hat Mohammad eine vollständig vorinstallierte und getestete Virtual Maschine für den Import in VirtualBox zum Download bereitgestellt, sodass die Teilnehmer sehr schnell praktisch tätig werden konnten. Beide Trainer haben hervorragend präsentiert und sind zusätzlich auf individuellen Fragen der Teilnehmer eingegangen. ![](https://i1.wp.com/thecattlecrew.net/wp-content/uploads/2019/02/training.jpg?fit=1024%2C768&ssl=1)Abbildung 5 Beide Trainer geben bereitwillig Hilfen, wo nötig In der abschließenden Feedback Runde wurde den beiden Trainern die Exzellenz der Trainingsqualität durch die überwiegende Mehrheit der Teilnehmer bestätigt. Zusätzlich nahmen die Trainer wertvolle Ergänzungsvorschläge entgegen, welche die nächsten Rollouts noch besser werden lassen können. Steffen Nothmann **Kategorien:** Cloud, Infrastructure **Schlagwörter:** ansible, Beats, Elastic Search, Kibana, Logstash --- ### [Data Storytelling - Schöne Geschichte oder echter Mehrwert?](https://thecattlecrew.net/2019/03/05/data-storytelling-schoene-geschichte-oder-echter-mehrwert/) **Published:** März 5, 2019 **Author:** Janine Ellner **Content:** ## Wer kennt es nicht? Es findet ein Meeting statt, in dem typische Unternehmenskennzahlen wie Umsatz, Ertrag, Mitarbeiterzahlen etc. präsentiert werden. Eine Person steht vor einer Gruppe Menschen und versucht, in dem zur Verfügung stehenden Time Slot alle Informationen unterzubringen, die für ihn und das Unternehmen wichtig sind. Die Zuhörer sitzen auf ihren Stühlen, versuchen dem Präsentierenden zu folgen. Sie verlieren den Faden oder fragen sich, was ihnen diese Zahlen denn nun sagen und bedeuten sollen. Nach der Präsentation verlassen die Zuhörer den Raum. Sie haben die Informationen zur Kenntnis genommen, sind sich aber unter Umständen nicht sicher, wie sie diese für sich einsortieren können und sind im schlimmsten Fall sogar irritiert oder besorgt. Leider sind solche Meetings immer noch an der Tagesordnung. Wichtige Themen, die eigentlich zum Nachdenken anregen und Handlungen nach sich ziehen sollten, werden zwar vernommen, aber nicht unbedingt auch verstanden und verinnerlicht. Wäre es nicht viel angenehmer, wenn Zahlen nicht nur heruntergebetet, sondern mit Leben gefüllt würden? Jede Zahl ist auf irgendeine Weise entstanden. Um die Zahl zu verstehen hilft es, ihre Geschichte zu kennen. ## Vom Begriff zur Story „¦ Was uns Menschen und unsere Kommunikation untereinander ausmacht ist unsere Sprache. Wird ein Begriff in einem vollständigen, zusammenhängenden Satz untergebracht, können wir ihm leichter eine Bedeutung beimessen. Wird derselbe Begriff alleinstehend verwendet, entstehen Mehrdeutigkeiten oder es bleibt Erklärungsbedarf. Genauso verhält es sich bei der Präsentation von Zahlen. Ohne den richtigen Kontext kann unser Gehirn sie nicht einordnen und nimmt sie höchstens zur Kenntnis. Wird die Zahl hingegen von einer Geschichte umrahmt, kann sie von uns richtig eingeordnet und begriffen werden. Hier kommt Data Storytelling ins Spiel. Beim Data Storytelling geht es darum, Daten in einer spannenden, leicht verständlichen Geschichte zu verpacken. ## Trockene Zahlen vs. spannende Geschichten Sehr deutlich zu beobachten war die Wirkung bloßer Zahlenanalysen zum Beispiel in einem unserer jährlich stattfindendes Meetings, in dem Kennzahlen für einen Bereich des Unternehmens präsentiert werden. Im letzten Jahr fielen die Zahlen sehr gut aus, was die Zuhörer, die ja maßgeblich zum Erfolg beigetragen hatten, eigentlich hätte begeistern müssen. Doch stattdessen war die Grundstimmung gedämpft und viele Teilnehmer trotteten sogar in getrübter Stimmung nach Hause. Ob es helfen würde, die Präsentation als Geschichte zu gestalten? Das wollten wir aus unserem Competence Team Analyse und Reporting heraus ausprobieren und führten beim diesjährigen Kennzahlen-Meeting kurzerhand die Technik des Data Storytellings ein. ## Echte Themen und Spannung aufbauen In einem Workshop bestimmten wir zuerst die Hauptthemen der Geschichte. Schnell wurde klar, dass es sich dabei nicht um die reinen Kennzahlen des Bereichs handelte, sondern um Dinge, die maßgeblich zu diesen Zahlen beigetragen hatten. Nachdem die eigentlichen Höhepunkte der Geschichte identifiziert waren, trugen wir zusammen, aus welchen Problemstellungen diese Ereignisse entstanden sind und was geschehen wäre, hätte man sich der Probleme nicht angenommen. Diese Punkte fügten wir am Ende zu einer für den Zuhörer interessanten und nachvollziehbaren Geschichte zusammen. Hierzu haben wir unsere Geschichte entlang einer Spannungskurve aufgebaut, wie man Sie aus der Literatur kennt: Es gab eine Einleitung, in der kurz der Rahmen gesteckt wurde. Danach wurde von Problemen und Stolpersteinen berichtet, die sich über das Jahr aufgetan hatten. Für diese Probleme wurden dann die Lösungen anhand von greifbaren Beispielen und kurzen Projektberichten präsentiert, die zu guter Letzt zum Erfolg der daraufhin eingeblendeten KPIs geführt haben. Um einen runden Abschluss zu schaffen wurde die Präsentation mit einigen motivierenden Sätzen für das nächste Jahr und einem Abspann beendet. ## Und was meinte das Publikum dazu? Die Reaktionen auf die andere Art der Präsentation waren sehr positiv. Durch die Geschichte konnten die Zuhörer die Höhen und Tiefen des letzten Jahres miterleben und die Zahlen, die im Jahr davor ebenso gut waren, aber nicht so aufgenommen wurden, besser nachvollziehen. Die Erfolge des abgeschlossenen Jahres wurden als solche erkannt und wertgeschätzt. Wir fühlen uns bestärkt und haben uns fest vorgenommen, das Thema Data Storytelling in weiteren Workshops voranzutreiben, um diese wertvolle Methode bekannter zu machen und zu verbreiten. Mehr dazu demnächst auf diesem Kanal. ![Zahlen und Fakten nachvollziehbar verpackt: Data Storytelling](https://thecattlecrew.net/wp-content/uploads/2019/03/data-storytelling-abbildung.jpg) **Kategorien:** Analytics & Insights --- ### [Sensordaten live erleben: Big Data im Kontext der Industrie 4.0 - Teil 2](https://thecattlecrew.net/2019/05/08/sensordaten-live-erleben-big-data-im-kontext-der-industrie-4-0-teil-2/) **Published:** Mai 8, 2019 **Author:** Lukas Babinsky **Content:** ## Kapitel 2: Verarbeitung der Daten ### Aufnahme über den IoT Core Wie bereits in Kapitel 1 erwähnt, erhalten wir alle eingehenden Maschinen-Daten im JSON-Format über das MQTT-Protokoll. Damit diese reibungslos in die Cloud-Architektur aufgenommen werden können, fungiert zu Beginn der IoT Core als sogenannter Broker, der in unserem Fall alle Nachrichten eines bestimmten Topics aufnimmt. Das Topic wird vor dem Senden einer Nachricht angegeben und dient dabei als eine Art Zielordner eines Dateisystems. Abhängig nach bspw. der Anzahl der Maschinen oder Sensoren kann somit in verschiedene Pfade unterteilt werden. Über vorab definierte Regeln ist der IoT Core anschließend in der Lage, alle ankommenden Nachrichten an die entsprechenden Services weiterzuleiten. Der IoT Core bietet an dieser Stelle den Vorteil, dass er die ankommenden JSON-Daten als solche erkennt und ohne weitere Anpassungen im selben Format weitergibt. Gleichzeitig ist für uns die unkomplizierte Anbindung an weitere AWS-Dienste von großer Bedeutung. Somit sind wir in der Lage, Sensordaten, die nicht weiterverarbeitet werden müssen, direkt an den Elasticsearch Service zur finalen Visualisierung weiterzugeben. Zusätzlich landen diese ebenfalls direkt in einem S3-Bucket zur persistenten Speicherung. Diese unbearbeiteten Daten spiegeln vor allem den aktuellen Zustand der Maschine wider. Des Weiteren gehen gleichzeitig Sensordaten, die vorab für Berechnungen benötigt werden, an eine Lambda-Function. Da die Verbindung zwischen Industrie-Maschine und IoT Core außerhalb unserer Cloud-Infrastruktur erfolgt, muss eine sichere Kommunikation gewährleistet werden. In unserem Showcase nutzen wir daher eine MQTT-Verbindung über TLS 1.2 mit X.509 basierter Zertifikat-Authentifizierung. Eine Verbindung erfolgt daher nur, wenn ein gültiges Zertifikat mit dazu passendem Schlüssel vorliegt. Gleichzeitig arbeiten wir mit einer ID-zugewiesenen Topic-Richtlinie, die bei jeder Verbindung zusätzlich definiert sein muss. ### Anpassungen über eine Lambda-Function Eine Lambda-Function ermöglicht die Ausführung von Programmcode, ohne selbst dafür Server zur Verfügung stellen zu müssen. Der Code muss hierbei nur ein einziges Mal in einer, von AWS unterstützten, Programmiersprache geschrieben werden. Anschließend wird dieser durch den Eingang jeder einzelnen Nachricht getriggert und somit dynamisch ausgeführt. Die Nachrichten, die dabei eingehen, sind genau dieselben, die der IoT Core weitergeleitet hat. Das Augenmerk unserer Visualisierungen liegt auf der Darstellung einiger Durchschnittswerte, die dem Betrachter eine bestmögliche Tendenz geben sollen, zu welchem Zeitpunkt die maximale Laufleistung einer Maschinenkomponente voraussichtlich erreicht ist. Damit sich dieser Orientierungspunkt bilden kann, sammeln wir kontinuierlich alle maximal erreichten Laufleistungen jeder einzelnen Maschinenkomponente und verrechnen diese auf die Anzahl ihrer jeweiligen Wechsel. Auf lange Sicht betrachtet, erhalten wir hiermit eine ziemlich genaue Einschätzung für einen vorhersehbaren und optimalen Komponentenwechsel. Es kann also ein reibungsloser Wartungsaufwand prognostiziert werden, der sich als zeit- und ressourcensparend darstellt. Unsere Lambda-Function zur Durchschnittsberechnung geht dabei nach einem bestimmten Schema vor: - Ein aktueller Datensatz als Vergleichsrechnung ist für genau einen weiteren Durchlauf gespeichert. - Es wird überprüft, ob der neu eintreffende Datensatz eine geringere Laufleistung (bspw. 0) als der Letzte, vorher abgespeicherte, aufweist. - **Falls: Nein ->** Die Laufleistung ist wie erwartet gestiegen. Die Maschine befindet sich im Normalbetrieb. - **Falls: Ja ->** Es liegt ein Wechsel an der Maschinenkomponente vor. Die festgestellte maximale Laufleistung aus dem letzten Datensatz wird abgespeichert und zu neuen Berechnungen herangezogen. - Der gespeicherte Datensatz zur Vergleichsrechnung wird mit neuen Werten überschrieben. - Die als Array gebündelten Maschinendaten der Laufleistung werden entsprechend aufgeteilt, um sie verarbeitungskonform nach Elasticsearch Service übertragen zu können. - Zu den jeweils aktuellen Laufleistungen werden Durchschnittswerte, sowie Restlaufleistungen angefügt und sowohl an Elasticsearch Service, als auch an einen S3-Bucket übergeben. Da sich Variablen über eine Lambda-Ausführung hinaus nicht wieder aufrufen lassen, gehen wir für das Abspeichern des Datensatzes der Vergleichsrechnung einen kleinen Umweg über einen S3-Bucket. Aus diesem wird bei jeder Ausführung zu Beginn eine Datei gelesen und zum Ende wieder mit aktuellen Werten überschrieben. Die Datei enthält neben der momentanen Laufleistung jeder Maschinenkomponente ebenfalls die aktuellen Durchschnitts-, sowie Restlaufleistungswerte. Die Lese- und Schreibzugriffe auf die S3-Datei halten sich dabei in Grenzen, sodass sie sich auf die Ausführungszeit der Lambda-Function nicht negativ auswirken. Am Ende jeder Funktion erhält Elasticsearch Service für jede Maschinenkomponente einen einzelnen Datensatz, der dabei alle nötigen Informationen beinhaltet. Wie schon aus dem IoT Core, handelt es sich hierbei ebenfalls um Daten im JSON-Format, die schlussendlich durch Kibana problemlos aufgenommen und dargestellt werden können. In Kapitel 3 folgt ein genauerer Überblick der erarbeiteten Visualisierungen. **Kategorien:** Analytics & Insights --- ### [Sensordaten live erleben: Big Data im Kontext der Industrie 4.0 - Teil 3](https://thecattlecrew.net/2019/05/09/sensordaten-live-erleben-big-data-im-kontext-der-industrie-4-0-teil-3/) **Published:** Mai 9, 2019 **Author:** Lukas Babinsky **Content:** ## Kapitel 3: Visualisierungsansicht Die Daten, die aus IoT Core und Lambda-Function in den Elasticsearch Service (ES-Service) übergehen, werden automatisch einem Index zugeteilt. Die Instanzen des ES-Service bieten eine gewisse Speicherkapazität, die es ermöglicht, bereits mehrere Wochen zurückliegende Daten mit Kibana darzustellen. Kibana benötigt als ES-Service-Plugin keinerlei Installation und kann somit über einen beliebigen Browser aufgerufen werden. Alle mitgelieferten Daten sind in nahezu „Echtzeit“ abrufbereit. ### Geeignete Visualisierungen Da für die in den ES-Service eingehenden Daten bereits ein geeignetes Format vorliegt, können diese direkt in den entsprechenden Visualisierungen angezeigt werden. Um einen ausdrucksstarken und schnell ersichtlichen Statuseinblick zu ermöglichen, begrenzen wir uns bei den Daten der Maschinen-Überwachung auf einfache und einprägende Darstellungen. Hierzu kommen etwa für Geschwindigkeiten und Drücke mehrere Tachometerdiagramme zum Einsatz. Durch das Beschränken auf die Darstellung des letzten eingegangenen Wertes, in Verbindung mit einem prägnanten farblichen Diagramm, ist dem Bediener in kurzer Zeit klar, in welchem Fall es sich an der Maschine um ein Problem handeln könnte. Ein zusätzliches Liniendiagramm wird genutzt, um für dieselben Werte eine Ansicht der letzten Minuten oder ggf. Stunden zu ermöglichen. Für die Einsicht in die Laufleistungen der Maschinenkomponenten haben wir uns für Balkendiagramme entschieden. Durch das kontinuierliche Anwachsen der Balkenhöhe, erhält der Endnutzer eine nachvollziehbare Einschätzung für die bereits zurückgelegte Strecke jeder einzelnen Komponente. Neben der aktuellen Laufleistung ist ebenfalls ein dazugehöriger Durchschnittswert angegeben, der im Detail beschreibt, welche maximalen Laufleistungen die zuvor eingesetzten Komponenten erzielt haben. Ein Komponentenwechsel ist somit schon im Voraus an der entsprechenden Stelle zu erahnen und dadurch planbar. Insbesondere wenn eine Maschine genutzt wird, an der deutlich mehr Komponenten vorzufinden sind, kann die Laufleistungsdarstellung in Verbindung mit den Durchschnittswerten etwas unübersichtlich werden. Um diesem Problem zuvorzukommen, wählen wir in unserem Dashboard eine zusätzliche Visualisierung zur ausschließlichen Anzeige der Restlaufleistungen. Die Balken nehmen dabei fortlaufend ab, bis sie zu dem Zeitpunkt, an dem sie auf den Wert „0“ fallen, nicht mehr zu sehen sind. Dies soll dem Betrachter in möglichst kurzer Zeit zu verstehen geben, wann sich der nächste Wechsel anbahnt. ### Dashboard – Darstellung ![](https://i2.wp.com/thecattlecrew.net/wp-content/uploads/2019/05/Dashboard.png?fit=1024%2C579&ssl=1)### Fazit – Showcase Die MQTT-Anbindung über den IoT Core erwies sich als sehr praktisch und komfortabel umsetzbar. Gerade die direkte Anbindung an weitere Services innerhalb von AWS ist dabei ohne größere Probleme zu realisieren. Es stellte sich heraus, dass die ES-Service Variante in der AWS-Umgebung keine größeren Anpassungen umsetzen ließ. Bereits die Darstellung eines Array-Datensatzes, musste deshalb über einen Umweg mithilfe einer Lambda-Function bewerkstelligt werden. Der verhältnismäßig langsame Schreibzugriff auf den ES-Service brachte außerdem das Problem mit sich, dass sich die Lambda-Function bei annähernd gleichzeitig eintreffenden Daten simultan ausführt, noch bevor die vorherige abgeschlossen wurde. Sollte sich während einer Ausführungsüberschneidung zusätzlich die Ausführungszeit unterscheiden, kann die Ausgabe der Datensätze in ihrer Reihenfolge variieren. Wird darauf geachtet, dass die Ausführung sequenziell erfolgt, umgeht man dieses Problem. Besonders die unabhängige Wartung, in Verbindung mit einer durchgängigen Verfügbarkeit und selbstskalierenden Anwendungen zeichnet diese Architekturlösung aus. Die Services werden zum Großteil lediglich während ihrer Nutzung beansprucht. Kosten entstehen somit nur, wenn die Services auch tatsächlich benötigt werden. In Anbetracht der Tatsache, dass die Datenauswertung unabhängig des Standorts einsichtig ist und sich weitere Maschinen problemlos anbinden lassen, kann man von einer gelungen Cloud-Alternativlösung sprechen. **Kategorien:** Analytics & Insights --- ### [Access a Standby System with a Single IP Address? Yes, it works!](https://thecattlecrew.net/2020/02/01/access-a-standby-system-with-a-single-ip-address-yes-it-works/) **Published:** Februar 1, 2020 **Author:** Rainier Kaczmarczyk **Content:** Accessing a Standby System like Oracle Dataguard or Dbvisit Standby via Transparent Application Failover (TAF) is a standard approach. It works well. Without any obvious hints. But what, if the customer tells you, that the clients used are only able to work with one **SINGLE IP ADDRESS**? And if there are hundreds of devices. What do you do, in case of a switch- or failover? Reconfigure all of them within minutes? First idea: rename the new primary system (including the IP) to the one used by all devices. But, no, this is not a good idea. In case of a switchover one would have to change the whole setup of the standby definition. What a hassle! The solution: change your basic architecture and **use the Oracle Remote Listener Option**! ## **How does it work?** First let“™s define the setup: we have two machines working as a Primary/Standby system. Let“™s call them „M-A“ and „M-B“ for machine A and machine B respectively. Here is, where a third machine (could be a virtual machine or the machine where your e.g. Cloud Control resides) comes into play. Let“™s call it „M-RL“ for machine RemoteListener. On this machine we have to install the Oracle software. No, not the full stack, „only“ the Clusterware (This is for the sake of being license compliant. With this type of installation no extra license is needed!). Now this machine „M-RL“ has to have the name and IP of the machine all client devices access. This machine just works as kind of a relay. It routes all requests to the actual primary database running on „M-A“ or „M-B“. ## **So how is the setup done? Easy!** On the remote listener machine „M-RL“ the following line has to be added to listener.ora and the listener process has to be restarted: *`REGISTRATION_INVITED_NODES_LISTENER=(M-A,M-B)`* On both primary/standby machine one parameter has to be added or changed: *`ALTER SYSTEM SET REMOTE_LISTENER = "(ADDRESS=(PROTOCOL=TCP)(HOST=M-RL)(PORT=1521))";`* And here is a sample tnsnames.ora entry: `orcl = (DESCRIPTION = (ADDRESS = (PROTOCOL = TCP)(HOST = M-RL)(PORT = 1521)) (CONNECT_DATA = (SERVICE_NAME = orcl) ) )` That“™s it! The only command that has to be added to a switchover, is to stop the listener on the new standby machine. OK, I have to admit, this is a very technical article. But in case you have devices, that only know of ONE IP address, this is a feasible and easy solution. As always, comments are very welcome! **Kategorien:** Database, Infrastructure **Schlagwörter:** cloud, Configuration, Dbvisit, English, Hochverfügbarkeit, listener, oracle, Standby, system --- ### [Kong API Gateway Basics – Deployment Modes und Data Plane Installation per Ansible](https://thecattlecrew.net/2022/09/02/kong-api-gateway-basics-deployment-modes-und-data-plane-installation-per-ansible/) **Published:** September 2, 2022 **Author:** Fabian Hardt **Content:** In diesem zweiten Teil des Kong API Gateway Basics Videoblogs erfährst du mehr über die möglichen Deployment-Varianten des Kong API Gateways. Diese reichen vom Standalone Mode bis hin zum Hybrid Mode. [![Kong Hybrid Mode](https://thecattlecrew.net/wp-content/uploads/2022/09/Kong-hybrid-Mode-02-300x221.png)](https://thecattlecrew.net/wp-content/uploads/2022/09/Kong-hybrid-Mode-02.png) Auch die Installationsvariante *Kong for Kubernetes*, die den Kong Ingress Controller miteinschließt, werde ich dir im Detail erklären. Selbst wenn du es eilig hast, lohnt es sich, bis zum Ende zu zappen: Dort erwartet dich eine Live-Installation des Kong API Gateways! ### Alle Teile ansehen: [Teil 1: Kong API Gateway Basics – Grundkonzepte und Architektur](https://thecattlecrew.net/2022/08/17/kong-api-gateway-basics-grundkonzepte-und-architektur/) [Teil 2: Kong API Gateway Basics – Deployment Modes und Data Plane Installation per Ansible](https://thecattlecrew.net/2022/09/02/kong-api-gateway-basics-deployment-modes-und-data-plane-installation-per-ansible/) [Teil 3: Kong API Gateway Basics – Kong Control Plane Installation mit HELM](https://thecattlecrew.net/2022/09/14/kong-api-gateway-basics-kong-control-plane-installation-mit-helm/) [Teil 4: Kong API Gateway Basics – TLS-Absicherung und Integration in der Cloud-Landschaft](https://thecattlecrew.net/2022/09/23/kong-api-gateway-basics-tls-absicherung-und-integration-in-der-cloud-landschaft/) [Teil 5: Kong API Gateway Basics – Kong Ingress Controller](https://thecattlecrew.net/2022/10/06/kong-api-gateway-basics-kong-ingress-controller/) **Kategorien:** Automation, DevOps, Infrastructure, Integration, Tools & Methoden **Schlagwörter:** ansible, API Management, Automation, Helm, Kong, Microsoft --- ### [Kong API Gateway Basics – Kong Control Plane Installation mit HELM](https://thecattlecrew.net/2022/09/14/kong-api-gateway-basics-kong-control-plane-installation-mit-helm/) **Published:** September 14, 2022 **Author:** Fabian Hardt **Content:** In diesem dritten Teil dieses Kong API Gateway Basics Videoblogs geht es mit der Installation der *Kong Control Plane* in Kubernetes weiter, genauer gesagt im AKS Cluster der Microsoft Azure Cloud. Die Control-Plane-Instanz wird mit einer Komination aus Ansible und HELM installiert. ![Deployment-Ansible-Helm](https://thecattlecrew.net/wp-content/uploads/2022/09/Deployment-Ansible-Helm.png)Was es damit genau auf sich hat und warum diese Kombination der beiden Tools zum Einsatz kommt, erfährst Du im Video. Abschließend, nachdem Datenbank und Control Plane installiert wurden, erlebst du den Kong Manager sowie die zuvor installierte Data Plane live in Aktion. Aber genug geredet 😉 … schau am besten einfach rein in das dritte Video dieser Serie: ### Alle Teile ansehen: [Teil 1: Kong API Gateway Basics – Grundkonzepte und Architektur](https://thecattlecrew.net/2022/08/17/kong-api-gateway-basics-grundkonzepte-und-architektur/) [Teil 2: Kong API Gateway Basics – Deployment Modes und Data Plane Installation per Ansible](https://thecattlecrew.net/2022/09/02/kong-api-gateway-basics-deployment-modes-und-data-plane-installation-per-ansible/) [Teil 3: Kong API Gateway Basics – Kong Control Plane Installation mit HELM](https://thecattlecrew.net/2022/09/14/kong-api-gateway-basics-kong-control-plane-installation-mit-helm/) [Teil 4: Kong API Gateway Basics – TLS-Absicherung und Integration in der Cloud-Landschaft](https://thecattlecrew.net/2022/09/23/kong-api-gateway-basics-tls-absicherung-und-integration-in-der-cloud-landschaft/) [Teil 5: Kong API Gateway Basics – Kong Ingress Controller](https://thecattlecrew.net/2022/10/06/kong-api-gateway-basics-kong-ingress-controller/) **Kategorien:** Automation, DevOps, Infrastructure, Integration, Tools & Methoden **Schlagwörter:** ansible, API Management, Automation, Helm, Kong, Microsoft --- ### [Was ist Agilität?](https://thecattlecrew.net/2020/05/29/was-ist-agilitaet/) **Published:** Mai 29, 2020 **Author:** Manuel Styrsky **Excerpt:** Eine Positionierung zum Thema Agilität, angelehnt an das gleichnamige YouTube-Video im meinem Kanal Smart Leadership: https://www.youtube.com/channel/UCRpiXn5fgfAeIAg4l16QLkg Hast du auch manchmal das Gefühl, dass alle von Agilität reden aber jeder was anderes meint? Oder fragst du dich, warum eigentlich jeder und alles agil sein will? Oder aber hast du das Gefühl, dass Agilität ein Buzzword ist, mit dem sich viele Unternehmen schmücken wollen? Doch was hat es nun wirklich mit der Agilität auf sich? Was genau bedeutet es agil zu sein und warum braucht es das überhaupt? Diese Frage soll in diesem Blogbeitrag beantwortet werden. **Content:** ## **Und warum sie mehr denn je gelernt werden sollte!** Eine Positionierung zum Thema Agilität, angelehnt an das gleichnamige YouTube-Video im meinem Kanal Smart Leadership: [zum Video](https://youtu.be/MFwm-xxZL8k)![](https://thecattlecrew.net/wp-content/uploads/2020/05/SmartLeadership_Icon.jpg) --- Hast du auch manchmal das Gefühl, dass alle von Agilität reden aber jeder was anderes meint? Oder fragst du dich, warum eigentlich jeder und alles agil sein will? Oder aber hast du das Gefühl, dass Agilität ein Buzzword ist, mit dem sich viele Unternehmen schmücken wollen? Doch was hat es nun wirklich mit der Agilität auf sich? Was genau bedeutet es agil zu sein und warum braucht es das überhaupt? Diese Frage soll in diesem Blogbeitrag beantwortet werden. #### **Was ist Agilität?** Das Gabler Wirtschaftslexikon definiert Agilität als die Gewandtheit, Wendigkeit oder Beweglichkeit von Organisationen, dabei kommt das Wort Agilität oder auch das Adjektiv agil sein aus dem Lateinischen und heißt so viel wie zu schnellen Bewegungen und Handlungen fähig sein. Und damit ist nicht nur eine körperliche, sondern auch eine geistige Wandlungsfähigkeit gemeint. Verglichen mit einem Läufer im Sport, ist die Agilität kein Sprinter, der auf grader Strecke schnellstmöglich ans Ziel kommt, sondern eher der Crossläufer, der sich schnell und wenig seine Umgebung anpasst. Agilität ist also in erster Linie keine Methode, Einstellung oder Unternehmenskultur, sondern ein Zustand, der auch das Ergebnis langer Arbeit sein kann. Doch dazu kommen wir später. Angewandt auf Unternehmen, sind diese also agil, wenn sie schnell auf Veränderungen reagieren können. Das klingt erstmal recht einfach. Doch meistens stehen der Agilität Bürokratie, Konservatismus, Hierarchien und lange Dienstwege im Weg. #### **Doch was genau bewirkt Agilität?** Um diese Frage zu beantworten, müssen zunächst die Begriffe Effizienz und Effektivität getrennt werden: Denn diese Begriffe werden oft im selben Kontext verwendet, obwohl sie einen anderen Fokus bedingen. Bei der Effizienz geht es grundsätzlich um das Verhältnis zwischen Aufwand und Ertrag und klärt somit wie schnell oder ökonomisch Aufgaben erledigt werden. Effektivität hingegen klärt, ob eine Handlung auf das Ziel einzahlt, wobei der Aufwand erstmal nebensächlich ist, da das Ziel selbst im Fokus steht. Zusammenfassend konzentriert sich die Effizienz auf Wie wir die Dinge erledigen und die Effektivität auf Was wir überhaupt bewirken wollen. Methoden, Vorgehens- und Denkweisen aus dem agilen Umfeld, erhöhen (wenn richtig angewandt) die Effektivität. Es werden also die richtigen Dinge gemacht, wobei sich positiver Nebeneffekt bewiesen hat, dass dies wiederum dafür sorgt, dass weniger Ressourcen verschwendet werden. Oder anders ausgedrückt, können mit dem bisherigen Aufwand bessere und zum sich verändernden Umfeld passendere Dinge produziert werden. #### **Warum ist es oft hilfreich, agil zu sein?** Nie wieder wird sich die Welt so langsam verändern wie heute. Smartphones, Streamingdienste, Autonomes Fahren und Gentechnik dienen da als Paradebeispiele. Und da sich die Umwelt immer schneller verändert, müssen sich Unternehmen dieser auch immer schneller anpassen, um erfolgreich auf dem Markt zu bestehen. Es ist also ein Paradigmen shift von predict and control hin zu probe-sense-respond notwendig, um in einem komplexen Umfeld nicht den Fokus zu verlieren. Denn die Welt auf mittel bis langfristige Sicht vorherzusagen und mit starken Hierarchien sowie Bürokratie den Lauf der Dinge zu kontrollieren funktioniert nicht mehr, stattdessen müssen wir aufmerksam beobachten, wie sich die Dinge um uns herum verändern und uns entsprechend anpassen. Denn für Unternehmen gilt wie für alle Lebewesen der Darwinismus: Survival of the fittest. Daher kann die Frage nach dem Grad der Agilität auch schnell zu einer Existenzfrage werden. Und wenn du jetzt sagst, dein Umfeld verändert sich gerade nicht, dann überleg dir doch mal, wie es in fünf oder zehn Jahren aussieht. #### **Wie wird man Agil?** Es gibt viele Projektmanagement Methoden, die das Ziel haben agil zu sein. Das ist verständlich ist, da es per Definition der Agilität nicht nur einen starren Weg gibt. Zentral in diesen Methoden ist jedoch die Eigenverantwortung der Teams. Die Teams müssen selbstständig arbeiten und entscheiden können. Dies ist wichtig, um schnell reagieren zu können. Da die Teams direkt an der Quelle und dem Kunden sitzen, haben sie die nötigen Informationen, um am besten zu Entscheiden und sich Feedback zu holen. Der Weg hin zur Agilität ist kein leichter. Süßigkeiten, Sofaecken und bunte Post-Ist sind zwar schön und sicherlich an vielen Stellen hilfreich aber eine Garantie für erfolgreiche Agilität sind sie keineswegs, denn dazu braucht es viel Mut, Arbeit, Selbstdisziplin und vor allem Transparenz. Auch das richtige Mindset und den Willen agil zu werden sind von entscheidender Bedeutung. #### **Was sind die vier Leitsätze zur Förderung von Agilität?** Jeff Sutherland und Ken Schwaber haben mit 15 weiteren Personen in dem [Manifest für agile Softwareentwicklung](http://agilemanifesto.org/iso/de/manifesto.html) vier Leitsätze und 12 Prinzipien aufgestellt, deren Umsetzung Agilität in der Softwareentwicklung fördern. Die vier Leitsätze sind: > **Individuen und Interaktionen** mehr als Prozesse und Werkzeuge > **Funktionierende Software mehr** als umfassende Dokumentation > **Zusammenarbeit mit dem Kunden** mehr als Vertragsverhandlung > **Reagieren auf Veränderung** mehr als das Befolgen eines Plans Das heißt, obwohl die Werte auf der rechten Seite als wichtig gelten, schätzen wir die Werte auf der linken Seite höher ein. #### **Mein persönliches Verständnis von Agilität** ![](https://thecattlecrew.net/wp-content/uploads/2020/05/Agile.png)Mein Verständnis von Agilität in einem Bild ausgedrückt: Iterative, inkrementelle Prozesse bilden den Rahmen für Agilität. Doch ohne die Werte, die die Grundlage bilden (hier die Wurzeln), kann agiles Arbeiten nicht gedeihen. Diese Werte sind Selbstverpflichtung, Mut, Offenheit, Fokus und Respekt. Die Baumkrone bilden die Frameworks und Vorgehensweisen, mit deren Hilfe das agile Arbeiten praktiziert wird. Der Stamm verbindet die Werte und die Praktiken und steht letztendlich für die agilen Prinzipien, wie sie im agilen Manifest geschrieben sind: > **Individuen und Interaktionen** mehr als Prozesse und Werkzeuge > **Funktionierende Software** mehrals umfassende Dokumentation > **Zusammenarbeit mit dem Kunden** mehr als Vertragsverhandlung > **Reagieren auf Veränderung mehr** als das Befolgen eines Plans > > Quelle: gleichnamiges YouTube-Video im meinem Kanal Smart Leadership: Hier geht es zum Video: Hier geht es zum Kanal: ![](https://thecattlecrew.net/wp-content/uploads/2020/05/SmartLeadership_Icon.jpg) **Kategorien:** Architecture & Process Models **Schlagwörter:** Agil, agile, agilität, Scrum, Selbstorganisation --- ### [Priorisierung von Product Backlogs in agilen Projekten](https://thecattlecrew.net/2020/07/22/priorisierung-von-product-backlogs-in-der-agilen-softwareentwicklung/) **Published:** Juli 22, 2020 **Author:** Leon Sienknecht **Content:** ![](https://thecattlecrew.net/wp-content/uploads/2020/07/stopwatch-3216241_1920-1024x505.png)## Motivation Heutzutage werden besonders in der IT-Branche immer mehr Projekte agil und nicht mehr klassisch durchgeführt. Es entfällt die Rolle des Projektmanagers und Teams organisieren sich selbst. Das Entwicklungsteam muss wissen, warum es etwas tun soll und welche Vision dahintersteckt. Da die Produktverantwortlichen jedoch oftmals nicht diejenigen sind, die das voll umfängliche technische Verständnis für das entstehende Endprodukt besitzen, wird eine Methode benötigt, um das technische Know-how der Produktentwickler und das betriebswirtschaftliche Verständnis der Produktverantwortlichen zusammenzubringen. So kann herausgefunden werden, welche Arbeit in einem Projekt Vorrang gegenüber anderen Aufgaben hat. Um dieses Problem zu lösen, habe ich mich in meiner Bachelorarbeit damit beschäftigt, wie die Priorisierungsmethode Weighted Shortest Job First (WSJF) in Projekten eingesetzt werden kann die technisch voneinander abhängige Product Backlog Items (PBIs) besitzen. Meine Bachelorarbeit trägt den Titel „Adaption der Priorisierungstechnik <> für agile Backlogs in das SCRUM Framework angewendet in der Softwareentwicklung.“ Die Motivation für das Thema wurde zum einen von Seiten der FH Westküste getrieben. Dort befasst sich Prof. Dr. Ingmar Georg Stauff, der Betreuer meiner Bachelorarbeit, intensiv mit der Lehre des agilen Projektmanagements. Zum anderen bestand ein Bedarf in einem Kundenprojekt, die Priorisierung des Product Backlogs besser zu strukturieren. So konnte ich ein Thema, welches mir sowohl privat als auch in der Hochschulausbildung sehr viel Freude bereitet bei der Arbeit einsetzen und daraus einen Mehrwert erzielen. ## Thematische Einführung Das agile Projektmanagement wurde ab dem Jahre 1990 in Teilbereichen der Softwareentwicklung erstmals angewendet. (Ziegler, 2018, S. 4) Teammitglieder sind für den Fortschritt im Projekt selbst verantwortlich und arbeiten i.d.R. in einer Bottom-Up-Projektorganisation. Dies bedeutet, dass die Organisation von der untersten Hierarchieebene hin zur Führungsspitze verläuft. Probleme können bei Bedarf zur nächst höheren Organisationseinheit getragen und mit erweiterten Kompetenzen gelöst werden. Durch Anregungen und neue Ideen beeinflussen alle Beteiligten den Verlauf des Projekts mit. Projektverantwortliche sind dafür zuständig, Aufgaben zu priorisieren und dem Entwicklungsteam mit den richtigen Aufgaben zur richtigen Zeit den Weg zum Erfolg zu ermöglichen. Dafür weist der Projektverantwortliche Aufgabenpakete zu, welche vom Entwicklungsteam umgesetzt werden. Innerhalb dieser Aufgabenpakete organisiert sich das Team ausschließlich selbst. Nur wie kann ein Projektverantwortlicher sinnvoll bestimmen, welches die nächsten wichtigen Aufgaben sind, wenn noch gar nicht alle Aufgaben definiert sind bzw. eventuell noch viel wichtigere Aufgaben im Verlauf des Projekts hinzukommen? Das Product Backlog ist der Ideenspeicher des gesamten Projekts. Projektverantwortliche halten hier die wichtigen Aufgaben an oberster Stelle und sortieren meist mit einem absteigenden Detaillierungsgrad die Aufgaben nach der Wichtigkeit. Diese Aufgaben lassen sich oft in sogenannten Epics als Überkategorie zusammenfassen. Ist ein Epic vollständig bearbeitet, ist ein Teilbereich des Projekts abgeschlossen. Somit tragen Epics mit all ihren Unteraufgaben wesentlich zur Verbesserung des entstehenden Produkts bei. Im Product Backlog werden PBIs üblicher Weise jedoch nicht nach Epics geordnet dargestellt, da Epics keine zeitliche Abfolge definieren, sondern eine Bündelung von Funktionalitäten. Mithilfe der Cost-of-Delay-Betrachtung kann die Wichtigkeit der PBIs bestimmt werden. Wird eine Aufgabe nicht rechtzeitig oder gar nicht fertiggestellt, entstehen oft zusätzliche Kosten für das betreffende Unternehmen. Durch eine gute Priorisierung werden Verzögerungen minimiert und somit etwaig entstehende Mehrkosten durch schlechte Organisation der Arbeitsreihenfolge vermieden. Übliche Bewertungskriterien zur Bestimmung der Cost of Delay sind: Business Value, Time Criticality und Risk Reduction. Um die entstehenden Kosten in der Produktentwicklung zu minimieren, gibt es Ansätze wie zum Beispiel „High Delay Cost First“ oder „Shortest Job First“. Die Betrachtung der Verzögerungskosten kann darüber hinaus noch in das Verhältnis zur Aufgabengröße gesetzt werden. Diese Bewertungsmethode nennt sich „Weighted Shortest Job First“ und betrachtet den erzeugten Nutzen bzw. die entstehenden Verzögerungskosten eines PBIs in der Relation zum entstehenden Aufwand. Diese bereits weit verbreiteten Methoden zur Priorisierung von Product Backlogs betrachten jedoch keine Abhängigkeiten zwischen PBIs in Projekten. Daher wird im folgenden Abschnitt eine Formel auf Basis der Methode WSJF vorgestellt, welche durch ihre Flexibilität der Einzigartigkeit von Projekten Rechnung trägt und unter Berücksichtigung der relevanten Faktoren eine höhere Planungssicherheit im Projekt ermöglichen soll. Durch die Berücksichtigung von Epics, Abhängigkeiten, Risiken im Projektteam und der Bewertung der Aufgabengröße, kann eine nachvollziehbare Bewertung des Product Backlogs durchgeführt werden. ## Analyse Folgende Formel (Formel 1) wurde abgeleitet, um bei agil durchgeführten Projekten drei Ebenen des Projektmanagements zu betrachten und bei der Durchführung mit einzubeziehen. Die erste Ebene bezieht sich auf die verschiedenen Teilaufgaben im Projekt. Diese werden bei agilen Projekten in Epics gegliedert und können gebündelt priorisiert werden. Wenn sich PBIs im Projekt gegenseitig beeinflussen und es Abhängigkeiten gibt, werden diese auf der zweiten Ebene betrachtet. Die dritte Ebene berücksichtigt vor allem die Standartwerte des Cost-of-Delay-Ansatzes. Sie befindet sich auf der innersten Ebene, da hier nicht funktional priorisiert wird. Eine fehlerhafte Bewertung an dieser Stelle kann zwar negative Folgen haben, das Projekt als solches kann jedoch mit den nächsten Aufgaben fortgeführt werden. Da sich die drei Ebenen der Bewertung von innen heraus beeinflussen, erfolgt auch die Gewichtung ausgehend von der innersten Ebene. Die Anzahl und der maximal mögliche Wert der Kriterien entscheiden über den Faktor, mit dem die zweite Ebene multipliziert wird, um ein K.-o.-Kriterium darzustellen. Aus den Maximalwerten der Ebenen zwei und drei ergibt sich der Faktor für die erste Ebene. Dies verdeutlicht Abbildung 1. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image.png)Abbildung 1: Schichten der Formel Aus diesem Modell der drei Ebenen ergibt sich die folgende Formel: ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-1.png)Formel 1: Bestimmung der Backlogpriorität *EP: Epicpriorität* *FT: Folgetasks* *PP: Product Owner Priorität* *RR: Risikoreduzierung* *D: Dauer* *AVT: Aufwand Vorgängertasks* Alle Variablen werden mithilfe der Fibonacci-Folge im Bereich von 1 bis 21 bewertet. Diese mathematische Zahlenfolge wird üblicherweise bei Schätzungen im Rahmen agiler Methoden verwendet. Bei der Fibonacci-Folge wird mit zunehmendem Zahlenwert der Abstand zu Vorgängern größer. Dies entspricht einer wichtigen Voraussetzung bei Schätzungen, wo mit zunehmender Komplexität auch die Schätzungsunsicherheit zunimmt. (Wiechmann, o. J.) Als Maximalwert der Skala wurde hier die 21 gewählt, da an dieser Stelle häufig schon eine Komplexität auftritt, welche sich nicht in einer einzelnen Iteration der inkrementellen Produktentwicklung unterbringen lässt (Domin, 2019). Formel 1 berücksichtigt zum einen die Vision des entstehenden Produkts und die zur Realisierung notwendige Product Roadmap. Ein weiterer Aspekt ist die Einbeziehung von PBIs, welche innerhalb ihres Epics Abhängigkeiten zu anderen PBIs haben. Diese gilt es im Idealfall schnellstmöglich aufzulösen. So sollten PBIs, die nachfolgende Product Backlog Items blockieren, möglichst schnell durchgeführt werden, um Warteschlangen im Projekt zu vermeiden. Die dritte Ebene, die diese Formel berücksichtigt, bezieht sich auf die Substitution der Standardplanungsfaktoren in einem agilen Projekt. Wenn bei Projekten die Bestandteile von Cost of Delay für Teilaspekte oder auch für das gesamte Projekt nicht definiert werden können, so zeigt diese Formel, welche Aspekte in der Bewertung von Prioritäten bei Projekten sinnvoll berücksichtigt werden können. So werden die Abläufe in der Produktentwicklung enorm unterstützt. Zuerst wird die oberste Ebene der Formel betrachtet. Die Epic-Priorität beschreibt die äußerste Schicht der Formel. Sie wird im Projekt- bzw. Managementkreis durch die Erarbeitung der Product Roadmap definiert. Die dazugehörigen Aufgaben können beispielsweise durch eine User Story Map visualisiert werden. Product Backlog Items, deren Epic eine aktuell hohe Dringlichkeit im Projekt hat, werden gegenüber PBIs, die im Projekt erst deutlich später relevant sind, vorgezogen. In der Formelerläuterung 1 wird die Epic-Priorität deutlich. Sie wird mit dem Wert 924 multipliziert. Dieser Wert setzt sich aus den Maximalwerten der Risikoreduzierung (RR), der Product Owner Priorität (PP) und der Anzahl der Folgetasks (FT) zusammen. Da diese Werte alle den Maximalwert 21 für eine Bewertung tragen, benötigen wir den Wert 924, um ein Übergewicht zu erzeugen. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-2.png)Formelerläuterung 1: Verdeutlichung der Epic-Priorität Durch den Faktor 924 erhält die Epic-Priorität eine höhere Priorität als alle weiteren Bewertungsfaktoren. Die Produktvision und die daraus abgeleitete Product Roadmap sind also richtungsweisend und bilden eines der stärksten Steuerungselemente in der Produktentwicklung ab. Daher ist es an dieser Stelle besonders wichtig, sich über Vision und Product Roadmap intensiv Gedanken zu machen und diese explizit zu definieren. An zweiter Stelle steht die Betrachtung von Abhängigkeiten innerhalb der Epics. Product Backlog Items, die andere beeinflussen, die also in einer Ende-Anfang-Beziehung stehen, sollten bei der Planung der Produktentwicklung berücksichtigt und entsprechend vorgezogen werden. Dies führt zum einen dazu, dass das Backlog schnell eine unabhängige Struktur aufweist. Zum anderen werden Aufgaben detaillierter geplant und mit dem Entwicklungsteam besprochen. So können Abhängigkeiten aufgedeckt werden, die in der Kollaboration von Produktverantwortlichen und Produktentwicklern entstanden sind. Damit die Folgetasks Vorrang gegenüber etwaigen Projektrisiken oder auch der rein intuitiven Priorität des Product Owners bekommen, wird ihre Anzahl festgelegt, anhand einer Umrechnung auf Fibonacci-Werte übertragen und mit dem addierten Maximalwert von PP und RR multipliziert. So bekommen Tasks aufgrund ihrer Abhängigkeiten zu nachfolgenden Tasks eine höhere Priorität gegenüber den Bewertungen durch die Priorität des Product Owners und der Risikobewertung. Wichtig ist hierbei, dass bei der Betrachtung der Folgetasks stets alle Folgetasks, auch die der Unteraufgaben, mit einbezogen werden. Es kann also nicht vorkommen, dass PBI 1 vor PBI 2 fertig sein muss und PBI 2 dabei mehr Folgetasks ermöglicht als PBI 1. Nach jeder abgeschlossenen Iteration in der Produktentwicklung müssen Abhängigkeiten neu betrachtet und die Bewertung der Folgetasks bei betroffenen PBIs angepasst werden. Anhand der nachstehenden Formel wird dies verdeutlicht: ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-3.png)Formelerläuterung 2: Verdeutlichung der Folgetasks Bei zwei PBIs, die in einer Ende-Anfang-Beziehung stehen, kann der Fall eintreten, dass durch die Gewichtung, die durch starke Abweichungen bei der Dauer entsteht, eine falsche Priorisierung errechnet wird. Daher wird in der Formel die Dauer um den Wert AVT erweitert (siehe Formelerläuterung 3). Dieser Faktor beschreibt den Aufwand von Vorgängertasks. Er beschreibt die kumulierte Dauer von PBI´s, die vor der Durchführung des betrachteten Product Backlog Items abgeschlossen sein müssen. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-4.png)Formelerläuterung 3: Verdeutlichung des Aufwandes von Vorgängertasks Durch diese künstliche Erhöhung des Aufwands soll vermieden werden, dass in der Produktentwicklung Aufgaben angegangen werden, für die Grundvoraussetzungen noch nicht erfüllt sind. Sind berücksichtigte Vorgängeraufgaben abgeschlossen, vermindert sich der AVT-Wert bei den folgenden Aufgaben entsprechend. Der zu beachtende Aufwand von Vorgängertasks ist unabhängig von der Anzahl der Folgetasks, die ein PBI nach Abschluss ermöglicht. Beispielsweise könnte das letzte Item in einer Kette abhängiger Tasks darauf angewiesen sein, dass vorherige Aufgaben abgeschlossen wurden, was sich in einem entsprechenden AVT-Wert widerspiegeln würde. Jedoch ist kein weiteres PBI von diesem abhängig. Somit fiele der FT-Wert weg. Die innerste Ebene, die mit der Formel betrachtet wird, ist die Substitution der Standardplanungsfaktoren der Bewertungsmethode Cost of Delay. Business Value, zeitliche Abhängigkeiten oder auch interne sowie externe Projektrisiken können nicht immer so detailliert beschrieben werden, dass sie auf jedes Product Backlog Item im Projekt heruntergebrochen werden können. In solchen Fällen ist es nicht sinnvoll, künstlich einen Business Value oder fiktive Liefertermine für Deadlines herzuleiten. Diese beziehen sich letztlich allein auf die Intuition des Product Owners oder auf das Know-how der Person, die diese Planung erstellt. Somit kann diese Intuition bzw. der Erfahrungswert der planenden Person besser von Anfang an in einem Faktor zur Priorisierung festgehalten werden. Dies verdeutlicht die Priorität des Product Owners (PP) (siehe Formelerläuterung 4). ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-5.png)Formelerläuterung 4: Verdeutlichung der Priorität des Product Owners Zeitliche Fertigstellungstermine wurden in der Formel durch die Anzahl der Abhängigkeiten innerhalb eines Epics ersetzt. Somit entsteht wie in der Beschreibung zur zweiten Ebene der Formel ein mit der Zeit stets unabhängiger werdendes Backlog, welches eine sachlich logische Reihenfolge der Projektplanung berücksichtigt. Auch die Bewertung interner oder externer Projektrisiken lässt sich oftmals schwer auf einzelne PBIs übertragen. Es fehlt für den Vergleich mit Mitbewerbern die nötige Transparenz am Markt oder interne Abteilungen geben nicht genügend Vergleichswerte zum Benchmarking her. Daher betrachtet die Risikoreduzierung (siehe Formelerläuterung 5) in dieser Formel lediglich die Eintrittswahrscheinlichkeit, dass ein PBI nicht abgeschlossen werden kann. Je nach Know-how und Erfahrung des Entwicklungsteams wird dieser Faktor, entsprechend einer vorher definierten Skala, hoch oder niedrig bewertet. Aufgaben, die durch eine hohe Eintrittswahrscheinlichkeit eine hohe Risikobewertung bekommen, werden im Projekt höher priorisiert als PBIs mit niedriger Risikowahrscheinlichkeit. Hoch bewertete PBIs gilt es, möglichst frühzeitig abzuschließen, um Wissenslücken im Projekt schon am Anfang zu füllen. Auf dieses Wissen kann im späteren Projektverlauf aufgebaut werden. Mit dem Wert der Risikominimierung werden hier keine externen Projektrisiken betrachtet, sondern die Fähigkeiten der Organisation bewertet. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-6.png)Formelerläuterung 5: Verdeutlichung der Risikoreduzierung Die gesamten Werte der Formel stehen im Verhältnis zur Dauer (D). Aufgrund des unterschiedlichen Aufwands der PBIs kann es daher vorkommen, dass ein PBI mit der aktuell nicht höchsten Epic-Priorität einer Aufgabe vorgezogen wird, die durch die aktuelle Planung der Product Roadmap die höchste Einstufung der Epic-Priorität besitzt. Es handelt sich also stets um eine Gewichtung zwischen Aufwand, der in dem Projekt entsteht und Nutzen, der für das Projekt und somit auch für den Kunden gewonnen wird (siehe Formelerläuterung 6). Gleichzeitig sorgt dieses Verhalten dafür, dass verschiedene Epics im Projekt weiterhin parallel bearbeitet werden können und nicht die Epics anhand der Anzahl der enthaltenen Abhängigkeiten angegangen werden. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-7.png)Formelerläuterung 6: Verdeutlichung der Dauer ## Ergebnisse Die hier beschriebene Formel bewertet das Product Backlog auf drei Ebenen. Zuerst wird die Wichtigkeit der Epics zueinander untersucht. Diese spiegeln die Product Roadmap wider und zeigen den zeitlichen Ablauf der zu erreichenden Meilensteine im Projekt (vgl. rote Werte Formelerläuterung 7). Auf der zweiten Ebene werden Abhängigkeiten innerhalb der Epics aufgedeckt. Diese gilt es, möglichst schnell aus dem Projekt zu entfernen, um ein möglichst unabhängiges Product Backlog zu bekommen (vgl. grüne Werte Formelerläuterung 7). Insbesondere bei technischen Projekten ist ein Vorgehen unter der Berücksichtigung bestimmter Abhängigen jedoch unabdingbar. Zu beachten ist hier, dass agile Vorgehensmodelle bei Projektstart kein vollständiges Lastenheft der zukünftigen Aufgaben vorsehen. Die Betrachtung der Abhängigkeiten beschränkt sich im agilen Projektmanagement also auf das zur Zeit der Planung vorhanden Wissen der Entwickler sowie Wissen, welches aus Dialogen von Mitarbeitern bei der Planung entsteht. Die dritte Ebene betrachtet die individuelle Priorisierung des Product Owners aufgrund seiner Erfahrung und der Bewertung des Projektumfeldes. Als möglicher Rückschluss kann hier eine Aussage über die Leistungs- und Teamfähigkeit des Projektteams getroffen werden (vgl. blaue Werte Formelerläuterung 7). Alle Ebenen der Bewertung stehen in Relation zum jeweiligen Aufwand der Aufgabe (vgl. schwarze Werte Formelerläuterung 7). ![](https://thecattlecrew.net/wp-content/uploads/2020/07/image-8.png)Formelerläuterung 7: Beschreibung der Ebenen *Priorität der Epics* *Abhängigkeiten innerhalb von Epics* *Individuelle Priorisierung des Product Owners* *Aufwand der Aufgabe* ## **Diskussion** Anwendung kann diese Art der Priorisierung von Product Backlog Items in jedem Projekt finden. Besonders wenn die agile Vorgehensweise in einem Unternehmen oder auch Projektteam noch nicht routiniert ist, kann es sehr hilfreich sein, Bezugsgrößen zu benennen, die die Basis für Entscheidungen bilden. Vergangene Entscheidungen können so retrospektiv nachvollzogen werden und künftig zu treffende Entscheidungen werden besser eingeordnet. Die erste Ebene der Formel kann in jedem Projekt angewendet werden, da jedes Projekt Teilaufgaben besitzt, welche zu unterschiedlichen Zeitpunkten unterschiedlich wichtig sind. Ebene zwei der Formel findet Anwendung, sobald sich Teilaufgaben in Projekten gegenseitig beeinflussen. Ist dies nicht der Fall, kann die Wichtigkeit künftiger Aufgaben für jedes PBI einzeln bewertet werden. Sind im Product Backlog alle Items unabhängig, so fallen bei der Bewertung die Faktoren FT und AVT weg und es wird die dritte Ebene der Formel verstärkt betrachtet. Dort kann je nach Art des Projektsettings und Wunsch der Projektverantwortlichen ein Maßstab zur Bewertung der Wichtigkeit von Product Backlog Items festgelegt werden. Hier kann eine Bewertung nach der Methode Cost of Delay stattfinden. Möglich ist es auch, die Wichtigkeit der PBIs mithilfe von Teilaspekten von Cost of Delay zu bewerten. Es kann jedoch, wie im Kapitel 3 beschrieben, auch auf reine Wünsche und intuitive Bewertungen der Projektverantwortlichen zurückgegriffen werden. Durch die Gewichtung der Bewertungsfaktoren auf Ebene drei, können je nach Bedürfnis der Projektverantwortlichen andere Eigenschaften definiert werden, welche die Wichtigkeit der Product Backlog Items lenken. ## Zusammenfassung Auf den Punkt gebracht zeigt diese Formel eine Erweiterung der Möglichkeiten im agilen Projektmanagement Backlogs zu organisieren. Backlogs werden nicht nur nach Kosten, Terminen, Risiken und Aufwand geordnet, sondern können auch Projektbesonderheiten wie beispielsweise unauflösbare Abhängigkeiten berücksichtigen. Ob technische Abhängigkeiten, stetig wechselnde Mitarbeiterstrukturen oder auch zwischendurch anfallende Aufgaben aus der nebenherlaufenden Linienorganisation – egal welche Umstände sich auf die Durchführung des Projektes auswirken: Die Formel hilft dabei, eine Grundlage zu definieren, die Sicherheit und Struktur in die Planung sowie Durchführung des Projekts bringen kann. ## References Domin, A. (2019) *Scrum: Was ist eigentlich Planning-Poker?* \[Online\]. Available at https://“‹t3n.de“‹/“‹news/“‹scrum-„‹planning-„‹poker-„‹1138385/“‹ (Accessed 28 January 2020). Wiechmann, R. (o. J.) *Fibonacci Sequenz* \[Online\]. Available at https://“‹scrum-in-der-praxis.de“‹/“‹glossary/“‹fibonacci (Accessed 17 January 2020). Ziegler, M. (2018) *Agiles Projektmanagement mit Scrum für Einsteiger: Agiles Projektmanagement jetzt im Berufsalltag erfolgreich einsetzen*, München, Prima Media. **Kategorien:** Architecture & Process Models, Development, DevOps **Schlagwörter:** Agil, agile, agilität, Backlog, Projektmanagement, Scrum, Softwarenentwicklung --- ### [Eine digitale Expertin für die Altersvorsorge](https://thecattlecrew.net/2021/11/26/eine-digitale-expertin-fuer-die-altersvorsorge/) **Published:** November 26, 2021 **Author:** Leon Sienknecht **Content:** **Bessere Customer Experience im B2B-Umfeld durch den Einsatz von Chatbot LAURA** Mit einem Portal für die betriebliche Altersvorsorge fing es an: bav|guard, eine Cloud native Software-as-a-Service-Lösung, hilft, Vorgänge zur betrieblichen Altersvorsorge (bAV) digital zu verwalten. Das Produkt hatte die bavonline GmbH, ein Startup in der Versicherungsbranche, im Jahr 2019 zusammen mit unseren Fachleuten entwickelt. bav|guard vereinfacht und automatisiert die vorgeschriebenen bAV-Prozesse, schafft Transparenz und hilft den Betrieben, Prozesskosten und gesetzliche Haftungsrisiken zu reduzieren. Das Innovative an diesem Geschäftsmodell war eine digitale Plattform, die alle Beteiligten an einen (digitalen) Tisch brachte. So bietet die Lösung allen Beteiligten, also Betrieben, Beschäftigten und Versicherungsagentur, die Hilfe und Transparenz an, die sie brauchen. Die Sache lief gut an, hatte jedoch einen kleinen Haken: Die vielen Anleitungen, Checklisten, Websites und PDFs — so gut sie auch aufbereitet waren — wurden für die Kundschaft schnell unüberschaubar. Das war die Geburtsstunde von LAURA: Der Chatbot sollte helfen, insbesondere den FAQ-Bereich für den Nutzer einfacher zugänglich zu gestalten. OPITZ CONSULTING war von Anfang an dabei und half, LAURA zu implementieren und weiterzuentwickeln. **Hilfen zur Altersvorsorge** Ist sie einmal abgeschlossen, gibt es bei der gesetzliche Altersvorsorge für die Kunden eher selten etwas zu tun. Typische Vorgänge sind Beitragsfreistellung oder -änderung bei Kurzarbeit, Elternzeit etc., eine dynamische Beitragserhöhung oder Stammdatenänderungen durch Hochzeit oder Umzug. Solche bAV-Vorgänge fallen eher sporadisch an und werden von den bAV-Verantwortlichen in den Betrieben selten oder gar zum ersten Mal erledigt. Gut also, dass sie auf der digitalen Kollaborationsplattform bav|guard umfangreiche FAQs und Anleitungen finden, die ihnen bei den einzelnen Prozessschritten weiterhelfen. **Mehr als ein Chatbot** In der initialen Phase des Projekts wurde klar, dass ein reiner Chatbot, der kurze, präzise Antworten gibt, in diesem Fall nicht ausreichen würde. Im bav|guard Portal werden Prozessschritte häufig mit Grafiken oder kurzen Videos erläutert. Dazu bestand der Wunsch bereits vorhandene PDF-Anleitungen wiederzuverwenden und über den Chatbot zur Verfügung zu stellen. LAURA sollte also mehr können als Fragen beantworten. Schon bald entwickelte sie sich zu einer Digitalen Assistentin, die bei Arbeitsschritten konkret weiterhelfen kann. Entwickelt mit dem Microsoft Bot Framework sowie dem QnA Maker in der Azure Cloud. **Was kann LAURA?** Wie jeder Chatbot beherrscht auch LAURA den Smalltalk mit der Kundschaft und liefert anstandslos kurze und präzise Antworten. Sollte dies bei einer komplizierten Frage nicht ausreichend sein, dann bekommen die Anfragenden umfangreiche Infos unterstützt durch Bilder, Videos und Prozessanleitungen, die mit einem Klick heruntergeladen werden können. Die erweiterten Antworten werden neben dem üblichen iFrame des Chatbots angezeigt. Dieser zusätzliche Content-Bereich öffnet oder schließt sich dynamisch, je nachdem ob entsprechende Inhalte für diesen Bereich hinterlegt sind. ![](https://thecattlecrew.net/wp-content/uploads/2022/07/cattlecrew1.png)![](https://thecattlecrew.net/wp-content/uploads/2022/07/cattlecrew2.png)**Wie kommen die Inhalte in den Chatbot?** Mithilfe eines Redaktionssystems kann die bavonline GmbH den Inhalt des Chatbots auf einem aktuellen Stand halten. Das Redaktionssystem wurde in die bestehende IT-Landschaft integriert. Damit können Frage- und Antwortpaare bearbeitet oder neu erstellt werden, um das Chatbot-Modell zu trainieren. Zu den Antworten können Assoziationen mit weiteren Inhalten hergestellt werden. Inhalte, die dann im Content-Bereich des Chatbots angezeigt werden. **Zwei Fliegen mit einer Klappe…** Assistenzsystem LAURA hat also direkt zwei Riesen-Vorteile: Während sie nach außen für die Anwendenden da ist und hilft, deren User Experience zu verbessern, kann die bavonline im Hintergrund ihre FAQs pflegen. **Mehr über Laura:** **Kategorien:** AI & Data Science, Automation **Schlagwörter:** Artificial Intelligence, Case Study, Conversational AI --- ### [OC Data Kitchen: Schritt für Schritt mit Co-Creation sinnvolle Datenlösungen entwickeln. Teil 1.](https://thecattlecrew.net/2020/08/04/oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-1/) **Published:** August 4, 2020 **Author:** Andreas Lehner **Content:** ## Überblick Im Rahmen der OC Data Kitchen entwickeln wir Data-Lösungen in Co-Creation. Ein erster fundamentaler Baustein der OC Data Kitchen ist es, zu verstehen, wo der Mehrwert für den Menschen bzw. Kunden liegt. Gemäß dem Motto: „There is only one valid definition of business purpose: to create a customer“ (Peter Drucker). Wir nennen diesen Baustein „Business Understanding“. Die folgende Artikelreihe gibt einen Einblick, welche konkrete Form das „Business Understanding“ annehmen kann. An einem Beispiel aus der echten erlebten Welt skizzieren wir Schritt für Schritt, wie wir mit Co-Creation, Mapping Methoden und Visualisierungen zukünftige, sinnvolle Lösungen entwickelt haben. ## Vom Maulwurf zum Adler Mapping Methoden wie Customer Journey Maps, Experience Maps oder Service Blueprints sind eine wundervolle Sache. Warum? Denn Du nimmst eine neue Perspektive ein. Meist bist du tief in den Alltag und seine Details vergraben. Wir nennen das die Maulwurf-Perspektive. Manchmal lohnt es sich als Maulwurf zum Adler zu werden, sich aus der Erde zu buddeln, die Äuglein zu reiben, in die Sonne zu blinzeln und aufzusteigen in den weitern, endlosen blauen Himmel. Dort triffst du dich mit den anderen Adlern und schaust von weit oben nach unten auf die Welt. Dein Blick ist weit. Und wenn Du willst kannst du im Sturzflug nach unten, um dir Details genauer anzusehen, vielleicht findet sich ja ein kleiner Leckerbissen da unten. So ähnlich kannst Du dir den Prozess des Mappings vorstellen. Um konkreter zu werden, stelle ich Dir ein Beispiel aus der Praxis vor. Die Aufgabe bestand darin, sinnvolle Lösungsideen und Use Cases für Data Analytics zu finden, um in Zukunft durch Daten die Kundenbindung zu stärken. Ich zeige dir Schritt für Schritt wie wir vorgegangen sind und was wir dabei gelernt haben. ## Schritt 1: Absichten und Ziele definieren für das Mapping-Projekt In einem gemeinsamen Brainstorming definierten und priorisierten wir die Absichten und Ziele unserer Mapping Initiative. Diese Ziele geben auch Aufschluss darüber, ob und welche Form von Mapping sich überhaupt lohnt. Ein Bull-Eye Diagramm half uns, die Ziele zu sammeln, einzuordnen und zu priorisieren und so den Fokus bzw. Rahmen zu identifizieren. Beispiele von Zielen: - Wir beabsichtigen Mehrwert für unsere Kunden zu erzeugen - Wir beabsichtigen die Mehrwerte mit Hilfe von „Customer Analytics“ und Daten zu erzielen - Wir beabsichtigen die Kundenbindung mit Hilfe von Daten zu stärken ![](https://thecattlecrew.net/wp-content/uploads/2020/08/Beispiel-Bull-Eye-Absichten-und-Ziele-1-1016x1024.png)Absichten und Ziele visualisiert in einem Bull-Eye Diagramm### Ergebnis Gemeinsam identifizierten wir „Kundenbindung durch Daten stärken“ als jenen Rahmen (Frame), den wir genauer betrachten wollen und für den wir eine Map erstellen wollen. Unsere Hoffnung besteht nun darin, durch das Mapping die Schnittstelle zwischen Individuum/Mensch/Kunde/Nutzer und der Organisation visualisieren zu können, um zu Gunsten des Mehrwerts für den Kunden Lösungsideen zu entwickeln. Doch bis dahin haben wir noch ein paar kleine Schritte und Erkenntnisse vor uns. ## Schritt 2: Entscheiden, welche Art von „Mapping“ uns weiterhilft? Welche Komponenten sind sinnvoll? Ausgehend von den vereinbarten Absichten und Zielen überlegten wir welche Komponenten für die Map sinnvoll sind. In gemeinsamen Diskussionen hoben sich folgende Perspektiven hervor: - Daten: klar wir wollen ja irgendwas mit Daten machen - Customer Intelligence: schreit nach Kundensicht - Individuum/Mensch: wenn wir was machen, dann immer mit dem Menschen im Fokus. Wir identifizierten zwei relevante Gruppen: 1. Die Kunden da draußen in der Marktwelt 2. organisationsinterne Nutzer der Data-Lösungen bzw. Stakeholder ### Ergebnis Die oben genannten Perspektiven ergeben unsere wichtigsten Komponenten. Diese Perspektiven wollen wir einnehmen. Sie stellen ein Grundgerüst dar und eine vielversprechende Ausgangsbasis dar, um die Perspektiven in weiteren Schritten zu vertiefen. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/Grobstruktur-Mapping.png)Grobstruktur der Map## Wie es weitergeht? Wie die Geschichte weitergeht, erfährst du in **[Teil 2](https://thecattlecrew.net/2020/08/06/aufbau-der-analytics-map-oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-2/)** Welche Erfahrungen hast du mit der Entwicklung von Datenlösungen gemacht? Welche Themen und Herausforderungen beschäftigen Dich? Wir freuen uns von Dir zu hören **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** analytics map, Co-Creation, customer journey map, data analytics, Design Thinking, service blueprint --- ### [Aufbau der Analytics Map - OC Data Kitchen: Schritt für Schritt mit Co-Creation sinnvolle Datenlösungen entwickeln. Teil 2.](https://thecattlecrew.net/2020/08/06/aufbau-der-analytics-map-oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-2/) **Published:** August 6, 2020 **Author:** Andreas Lehner **Content:** Wir kümmerten uns in **[Teil 1](https://thecattlecrew.net/2020/08/04/oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-1/)**, in den Schritten 1 und 2 um die Absichten, den Zweck und die Ziele unseres Vorhabens, sinnvolle Datenlösungen zu entwickeln. Jede der Teilnehmer/innen verfügte so über ein gemeinsames Bild, wo die Reise hingehen soll. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/warum-absichten-zweck-ziele.png)Gemeinsames Verständnis über das WARUM wollen wir Data Anwendungen?## Schritt 3 — Entstehung der Visualisierung – Die Analytics Map Wir starten mit der Entwicklung der Mapping Visualisierung. Wir geben der Map den Namen „Analytics Map“. Wir bauen sie gemeinschaftlich in Co-Creation Schritt für Schritt auf. Die folgenden Abschnitte zeigen wie. ### Vorher nicht vergessen: Scope definieren, Persona definieren, Titel für die Map Um der Map einen klaren Rahmen und Fokus zu geben, definieren wir zu Beginn drei wichtige Kriterien: 1. Scope der Map: eine Visualisierung kann aus sehr unterschiedlichen Perspektiven und Flughöhen betrachtet werden. Diese vorab zu definieren ist maßgeblich für den weiteren Verlauf. Daher definieren wir den Scope der Map: Unser Scope: wir wollen die komplette Customer Journey betrachten und nicht eine spezielle Phase wie etwa Kundenakquisition oder Kundenbindung. 2. Persona: aus welcher Kundenperspektive betrachten wir die Map? Häufig haben Unternehmen viele Kundensegmente. Sich auf eines zu einigen ist wichtig, um keine Durchmischung und Verzerrungen zu bekommen. 3. Gib dem Kind einen Namen und Titel. ### Perspektive 1: Die Perspektive des Kunden — Customer Journey Jede Teilnehmer/in sammelt für sich Ideen, wie die Customer Journey aktuell abläuft. Die Ideen auf Sticky Notes werden an die Wand geklebt. Dort kann jeder nachlesen, was andere geschrieben haben. Dort können die Ideen in eine Abfolge und Ordnung gebracht werden. Dort können die einzelnen Schritte in grobe Phasen eingeteilt werden. So entsteht eine Customer Journey mit der alle Teilnehmer/innen einverstanden sind. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/analytics-map-1-1024x320.png)Die Customer Journey### Perspektive 2: Die Perspektive der bestehenden „Use Cases“ und Data Anwendungen Für das Team war es sehr wichtig zu verstehen, was bereits an Data Anwendungen existiert und wo noch Potential liegt. Daher sammelten wir alle Use Cases von Anwendungen und ordneten diese den Phasen und Schritten der Kundenreise zu. Auf diese Weise konnten interessante Erkenntnisse gewonnen werden, wie etwa: bei der Kundenakquise werden schon sehr erfolgreich viele Daten-Apps eingesetzt. Weiter hinten in der Kundenreise eher weniger, obwohl in diesen Phasen gemäß User Research großes Potential liegt. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/analytics-map-2-1024x441.png)Sammeln und ordnen der Data Use Cases### Perspektive 3: Die Perspektive der bestehenden KPIs Wir sammelten und ordneten den Use Cases KPIs zu. So erhielten wir ein umfassendes gemeinsames und geteiltes Bild über Use Cases, genutzte KPIs und Phasen der Kundenreise. Durch die Diskussion im Aufbau der Map konnten viele Erkenntnisse gewonnen werden über die Komplexität des Vorhabens. Doch das wichtigste von allem: Jede und jeder aus dem Team hatte nun ein gemeinsames Verständnis darüber wie die Kunden und das Business von den aktuellen Daten profitieren und wo Potentiale liegen. Auf diese Weise können wir wesentlich entspannter in die nächste Phase übergehen: der Ideenfindung für neue KPIs und Use Cases. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/analytics-map-1024x590.png)Sammeln und ordnen der KPIs# Wie es weitergeht? Wie die Geschichte weitergeht, nämlich mit der Ideenfindung für KPIs, erfährst du in **[Teil 3](https://thecattlecrew.net/2020/08/10/kpi-ideenfindung-oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-3/)** Welche Erfahrungen hast du mit der Entwicklung von Datenlösungen gemacht? Welche Themen und Herausforderungen beschäftigen Dich? Wir freuen uns von Dir zu hören. **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** Analytics, Co-Creation, Customer Journey, Design Thinking --- ### [KPI Ideenfindung - OC Data Kitchen: Schritt für Schritt mit Co-Creation sinnvolle Datenlösungen entwickeln. Teil 3.](https://thecattlecrew.net/2020/08/10/kpi-ideenfindung-oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-3/) **Published:** August 10, 2020 **Author:** Andreas Lehner **Content:** Auf unserer gemeinsamen Reise zu sinnvollen Data Analytics Lösungen erlebten wir die Co-Creation von Absichten und Zielen und richtungsweisenden Entscheidungen für den Rahmen und Fokus unserer Arbeit ([Teil 1](https://thecattlecrew.net/2020/08/04/oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-1/)). Wir starteten mit dem Aufbau einer Analytics Map für den IST-Zustand zu Perspektiven Mensch, Kunde, Daten, Use Cases und KPI. Die Map ermöglicht ein gemeinsames Verständnis ([Teil 2](https://thecattlecrew.net/2020/08/06/aufbau-der-analytics-map-oc-data-kitchen-schritt-fuer-schritt-mit-co-creation-sinnvolle-datenloesungen-entwickeln-teil-2/)). Sie bildet die die Basis für die nächste Station unsere Reise: die Ideenfindung für KPIs. Im Folgenden beschreibe ich die Schritte einer KPI Ideation. ## Schritt 4: Fokus abstimmen? Welches strategische Business-Ziel wollen wir adressieren? Wir entschieden uns, im Rahmen der verfügbaren Workshop-Zeit als ersten Schritt auf einen bestimmten Teil der Customer Journey zu fokussieren: Wie können wir die Kundenbindung stärken? Die strategischen Businessziele, die sich aus diesem Fokus ableiten, brachten die Fachexperten/Fachexpertinnen mit. Wir klebten dieses strategische Ziel auf die oberste Ebene unseres KPI Ideation Boards und definierten ein KPI womit wir den Erfolg messen wollen. Beispiel KPI: wir wollen eine Kundenbindungsrate von 50%. Anschließend stellten wir die Frage: Welches Kundeverhalten trägt zum definierten Unternehmensziel bei? Diese Frage diente uns als Ausgangspunkt für ein Brainstorming. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/KPI-Ideation.png)## Schritt 5: Brainstorming von Ideen: Welches Kundenverhalten beeinflusst die definierten KPIs? Beim Brainstorming empfiehlt es sich, mehrere Runden zu drehen und als Ausgangsbasis immer das aktuelle Kundenverhalten / KPI zu nutzen. Auf diese Weise entsteht eine aussagekräftige Sammlung an möglichen messbaren Kundenverhalten. ![](https://thecattlecrew.net/wp-content/uploads/2020/08/KPI-Ideation-Customer-Behaviour.png)Habt ihr das Brainstorming abgeschlossen? Dann ist es nun an der Zeit eine Entscheidung herbeizuführen, welche Ideen ihr fortführen möchtet. Für die Entscheidungsfindung gibt es mehrere bewährte Methoden: 1. Dot Voting 2. 2×2 Matrix oder 3. NUF Test. Mit den neuen evaluierten und gemeinsam entschiedenen Ideen könnt ihr nun definieren, wie es damit weitergeht: z.B. Epics, User Stories, ToDos, etc. Happy Data! Ach ja, zum Abschluss noch ein paar Tipps aus unseren Lessons Learned: # 5 TIPPS - Engagiere Facilitatoren, die den Workshop designen, strukturieren, vorbereiten, moderieren und nachbereiten. So werden Doppel- und Mehrfachrollen vermieden. So kann sich das Potential der Teilnehmer/innen besser entfalten und effizient in Co-Creation gearbeitet werden. - Nutze die Möglichkeiten von Remote Workshops. Mural, Miro, Teams und zoom sind exzellente digitale Tools, die Nähe schaffen und eine wirkungsvolle und effiziente Arbeitsweise in Gruppen ermöglichen. - Investiere mehr Energie als du anfangs planst in die Vorbereitung des Workshops. Es lohnt sich. Spiele Szenarien durch. Entwickle Plan B, Plan C. Lerne die Gruppe und die Teilnehmer/innen und ihre Rollen in der Gruppe vorab kennen. - Analytics Map: Oft ist die eindeutige Zuordnung zu Phasen nicht möglich. Egal: wir können Sticky Notes doppelt kleben. Und: der wichtigste Zweck der Map-Erstellung besteht im Herstellen eines gemeinsamen Verständnisses im Team. Die Map ist keine Spezifikation für Software, sondern ein Abstimmungswerkzeug. Da reicht es aus ungefähr zu kleben, interaktiv zu sein, Dinge leben lassen, hin und herzuschieben, zu ergänzen, zu diskutieren. - Analytics Map: Oft gibt es mehrfache Nennungen, weil Teilnehmer/innen gleiche Ideen haben. Mehrfache Nennungen nicht wegwerfen, sondern übereinander kleben. Mehrfachnennungen sind immer ein Hinweis auf Validierung. Ich hoffe die Artikelreihe (Teil 1, Teil 2, Teil 3) bringt euch etwas und ihr könnt davon was in euren Projekten nutzen. - Was sind deine Erfahrungen in der Entwicklung von Data Lösungen und mit Data Workshops? - Welche Empfehlungen hast Du, um kundenzentriert und in Co-Creation Datalösungen zu gestalten? - Welche Fragen hast Du? **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** Co-Creation, data analytics, Design Thinking --- ### [Von Problembären und Solutiontigern. Oder: Wie caste ich mein Digitalisierungsprojekt?](https://thecattlecrew.net/2020/11/20/von-problembaeren-und-solutiontigern-oder-wie-caste-ich-mein-digitalisierungsprojekt/) **Published:** November 20, 2020 **Author:** Mario Nolte **Content:** #### In der heutigen Folge meiner Artikelreihe geht es wieder rund um die Digitalisierung und einen weiteren Punkt für eine gute und weniger gute Strategie. Ansätze – was alles möglich ist und wie du es auch sehen kannst (und wie immer zählt „“ entscheide selbst, was für dich passt). **Folge 2 – Wen hol ich mir als Unterstützer, oder mach ich es allein?** Als Einstieg in das Thema, habe ich mir diese Analogie herausgesucht: ***Wer am Ende einer sehr langen Kette zieht, braucht viel Kraft und Ausdauer, um die Kette zu spannen und dann so zu bewegen, dass sie passgenau ans Ziel kommt.*** Wir könnten jetzt anfangen zu spekulieren, doch schauen wir uns Digitalisierung und digitale Transformation von einem speziellen Winkel an. **Um was geht es dabei?** Bei der Digitalisierung und der digitalen Transformation sehen wir Ereignisse, die dazu führen, dass ein spezieller digitaler Abzug erstellt und dieser einem Prozess zugeführt wird. Dieser Prozess soll dann schlanker und effektiver sein als die bisherigen. Bei genauerem Hinschauen dieser Abläufe werden wir feststellen, dass es um die Neugestaltung von Prozessen und Abläufen sowie der fortlaufenden Optimierung und Automatisierung geht. **Was bedeutet das genauer?** Schauen wir uns ein Beispiel aus der Praxis an, wo durch Digitalisierung ein erheblicher Nutzen entstanden ist. Vielleicht kannst du dich noch an die BMW [Sicherheitslücke](https://www.heise.de/ct/ausgabe/2015-5-Sicherheitsluecken-bei-BMWs-ConnectedDrive-2536384.html) im ConnectedDrive erinnern. Nach dem der Fix bereitgestellt worden ist „“ wie lange hätte es wohl gedauert ohne digitale Prozesse? Mal sehen, was wären so die typischen Schritte? Erstellen einer Liste der betroffenen Wagen, Informieren der Halter, Werkstatttermine organisieren, Firmware tauschen/updaten „¦ Ob die Werkstätten in einer überschaubaren Zeit fertig gewesen wären, das kann keiner so genau sagen. Nur sicher ist, es hätte ganz schön lange gedauert. Mit Hilfe der Digitalisierung wurde ein Teil des Problems tatsächlich quasi über Nacht gelöst. Indem sich das Auto beim Hersteller angemeldet und so direkt die neue Firmware bezogen hat. Es wurden so viele Zwischenschritte ausgelassen und eingespart – eine Effizienzsteigerung von enormem Ausmaß. Das Beispiel runtergebrochen und zusammengefasst, geht es im Einzelnen also darum, Einflussfaktoren zu minimieren und so ein definiertes, übergeordnetes Ziel zu erreichen. Jetzt ist es wahrscheinlich interessant zu wissen, um welche Einflussfaktoren es dabei geht. **Mit welchen typischen Einflussfaktoren kommen wir in Berührung?** Die Einflussfaktoren selbst sind mannigfaltig. Hier ein kurzer Überblick zu den Einflussfaktoren, die wir (nicht nur) bei der Digitalisierung antreffen. Da haben wir das **Unternehmen** mit den gelebten Strukturen (Größe, Aufteilung, Abgrenzungen, Compilance oder Governance). Wir haben das **Umfeld** mit den Elementen Partner, Gesellschaft, technologische Treiber, Mitbestimmungen und Abhängigkeiten. Wie immer gibt es unternehmerische **Ziele** und Visionen also sowas wie Umsatz, Marktführerschaft, IT-Strategie, Umgang mit neuen Themen (Innovation). Und ganz wichtig ist der Faktor **Mensch**. Hier sind die Themen der Kompetenz (Skills), Motivation, Changeability, Führungsverhalten als auch Unternehmensstruktur verankert (siehe auch „[eBook: Leseprobe zu Dynamik Robuste Architekturen für die Digitalisierung](https://www.opitz-consulting.com/fileadmin/user_upload/Collaterals/Artikel/ebook_dynamikrobuste-architekturen-fuer-die-digitalisierung_heise-opitz-consulting_leseprobe.pdf)„). Bezogen auf unser Thema „Wen hol ich mir als Unterstützer, oder mach ich es allein“ konzentriere ich mich in diesem Beitrag auf den Faktor Mensch. Um den Faktor Mensch etwas besser einzuschätzen, ist es durchaus wichtig zu erfahren, wie wir Menschen eigentlich vorgehen, um zu einer Lösung kommen. Hier nun ein kleiner Auszug zum Thema Lösungsfindung: **Wie kommen wir zu einer tragfähigen Lösung?** Am Anfang steht die Wahrnehmung einer Situation. Diese Wahrnehmung verknüpfen wir mit Bildern und vergleichbaren Situationen. Dies passiert im Inneren unseres Selbst und wird auch als ein Gedanke bezeichnet. Rufen diese Bilder und Wahrnehmung eine Emotion hervor, dann erkennen wir diesen Gedanken als wichtig. Von solchen Gedanken hat ein Mensch ca. 70.000 am Tag. Diese wichtigen Gedanken überprüfen wir hinsichtlich der Tatsache, ob es ein lohnender Gedanke ist oder nicht. Lohnende Gedanken verankern wir mit der Emotion und besprechen diese mit uns selbst, bis wir bereit sind, diesen Gedanken durch Sprache nach außen zu tragen. Bis zu diesem Zeitpunkt sprechen wir auch vom „Inner Game“. Das Inner-Game-Prinzip stammt aus einem Lern- und Coachingansatz, welcher von W. Thimothy Gallwey in den 1970er Jahren entwickelt wurde. Mehr dazu könnt Ihr in Tim Gallweys fünften Buch „Inner Game Coaching“ nachlesen. ![](https://thecattlecrew.net/wp-content/uploads/2020/09/image-1.png) Mit dem Aussprechen des Gedankens oder dem ersten Handlungsimpuls des Gedankens wird der Gedanke zur Idee. Und je nachdem, ob die Idee auf eine Reihe fruchtbarer Wahrnehmungen trifft, wird diese Wahrnehmung aufgegriffen und weiterverfolgt oder wieder fallen gelassen. Solange eine Idee mit fruchtbaren Wahrnehmungen verknüpft werden kann, solange kann eine Idee wachsen – alle anderen Ideen verschwinden. Und so wie ein Gedanke groß wird, werden irgendwann signifikante Investitionen folgen. Und wahrscheinlich sind wir hier an einer Grenze, ab der es Unterstützer braucht. Damit also ein Gedanke groß werden kann, zu einer Idee und später zu einem konkreten Etwas heranreift, ist es wichtig, rechtzeitig und gezielt den Kreis der Interessierten Stück für Stück zu erweitern. **Um Grenzen zu überwinden, braucht es immer etwas Mut.** Wieviel Mut du brauchst, das kommt auf die jeweilige Person und deren Erfahrungen an. Einen interessanten Einstieg dazu findest du hier: „[Stopp MIMIMI](https://www.youtube.com/watch?v=5hK18qjaqA4)“ oder „[So überwindest du deine Ü„ngste](https://www.youtube.com/watch?v=YaHNVnQ631c)„. Folgen wir diesen Ansätzen, so besteht **Mut darin, das Richtige zu tun obwohl man Bedenken oder Angst hat.** **Was haben alle Projekte auf dem Weg zum Erfolg gemeinsam?** **Wie sieht ein typischer Weg zum Erfolg aus?** Wenn wir uns erfolgreich umgesetzte Projekte anschauen, dann stellen wir fest, dass Personen zusammengearbeitet haben, die sich in der Summe befruchtet haben und die ein gemeinsamer Wille eint, ein Ziel zu erreichen. Andererseits kennen wir auch Projekte, die glorreich in den Sand gesetzt werden. Unter anderem, weil die Zusammenarbeit misslang oder keine gemeinsame Basis/Schnittstelle gefunden werden konnte. Schauen wir uns das Muster von unterschiedlichen Projekten an. Hier hilft ganz gut das Bild eines Orcas. ![](https://thecattlecrew.net/wp-content/uploads/2020/11/Projekt-Orca-1024x560.jpg)Wie aus der Abbildung zu erkennen ist, gibt es mehrere kritische Stellen. Entsprechend wichtig ist es, genau zu wissen, wer zu einem Projekt passt und wer weniger. ***Wer passt für mich, um eine Idee groß werden zu lassen?*** Diese Frage ist nicht immer ganz leicht zu beantworten. Die häufigsten Antworten sind: „Mein Netzwerk“, „der Freund von“, „ich kenn da den von“ „¦ Als ein Gedanke, es kann durch aus hilfreich sein, die DevOps Prinzipien einfließen zu lassen. Speziell der Bereich „Culture and Mindset“ aus DevOps spielt hier sehr gut rein. Gern auch mehr hierzu: ![](https://thecattlecrew.net/wp-content/uploads/2020/11/DevOps-300x202.jpg) Und ja, die Wahrscheinlichkeit ist hoch, dass es passt. Da wir Menschen sehr unterschiedlich sind. Und obwohl wir jemanden schon sehr lange kennen, sind wir immer wieder überrascht, was sonst noch in demjenigen steckt – also nur Mut. **Nur wie erkenne ich, ob jemand zu meinem Projekt passt? Was sind die wichtigsten Punkte?** Jetzt wird es Zeit sich an die Nase zu packen, und zu fragen: Kennst du dich und deine Antreiber? Ja, nein, ein paar Schatten sind da schon? Es gibt mehrere Modelle, wie wir uns besser charakterisieren können, so z. B. das Tier-Modell von Tobias Beck, die [Temperamentenlehre](https://de.wikipedia.org/wiki/Temperamentenlehre) oder die [Big Five (Psychologie)](https://de.wikipedia.org/wiki/Big_Five_(Psychologie)). Für diesen Betrag habe ich mich mehr an die [Metaprogramme des NLP](https://www.nlp.at/begriffe/metaprogramme) angelehnt. Was meinst du, bist du eher ein Mismatcher oder Matcher, ein Problembär oder ein Solution-Tiger? Mal kurz zusammengefasst, was die 4 Typen umschreibt. **Was ist ein Matcher?** Ein Matcher vergleicht Dinge, die schon mal gut gelungen sind. Diese Person baut so auf gute Erfahrungen auf und findet so oftmals gute neue Möglichkeiten auf Basis seiner guten Erfahrungen. **Was ist ein Mismatcher?** Ein Mismatcher ist jemand, der Situationen vergleicht, die primär schiefgelaufen sind. Diese Person kommt zum Erfolg, in dem sie begangene Fehler analysiert und dann vermeidet. **Der Problembär** Der Problembär sieht bei allen Vorhaben alle Probleme, die ihm im Weg liegen, teils bevor sie entstehen oder bevor sie zum Problem werden konnten. Dabei kann es passieren, dass der Problembär die Lösung und das Ziel vor lauter Problemen aus den Augen verliert. **Der Solution-Tiger** Der Solution-Tiger wiederum sieht Möglichkeiten und Chancen. Dieser Typ hat für alles und jeden einen Rat oder eine Lösung parat. Dabei kann es passieren, dass er die kleinen Stolperfallen und Probleme übersieht. Aus diesen vier Grundtypen lassen sich Kombinationen aufbauen: Matcher-Solution-Tiger, Mismatcher-Solution-Tiger, Matcher-Problembär und Mismatcher-Problembär. Interessant wird es, wenn wir uns anschauen, was diese Kombinationen so speziell machen. ***Mismatcher-Problembär***: Die Tage, an denen man mit einem Typ dieser Kombination konfrontiert wird, wird man nicht vergessen. Dieser Typ findet jedes noch so kleine Problem und erzählt dir in jeder Facette, was alles schief gehen kann. Und, wenn du glaubst die Sonne ist schon lange untergegangen und du wurdest gefühlt dreimal durch den Kakao gezogen und rundgelutscht, dann und wirklich in allerletzter Minute bekommst du die Information, die du hören möchtest. Und nicht selten hast du noch Fragen, hast aber Angst, die Information zu vergessen, die du gerade mühsam bekommen hast. Also nimmst du die Informationen, packst sie gut ein, damit du diese nie vergisst und schaust, das du das Weite erreichst. Denn eins ist dir klar, noch einmal mit der gleichen Frage zu kommen, wirst du nicht durchhalten. „*Jede Lösung eines Problems ist ein neues Problem*„, ein Zitat von Johann Wolfgang von Goethe, könnte von diesen Typ stammen. ***Matcher-Problembär***: Dieser Typ ist ähnlich wie der Mismatcher-Problembär. Nur er erzählt dir nicht nur von den Problemen, sondern er führt auch aus, welche Probleme wo und wie auftreten und dass du dafür eine Lösung finden müsstest. Du kennst diesen Typ auch als den typischen „Bedenkenträger“. Von diesem Typ wirst du Sätze hören wie diesen: „*Talente finden Lösungen, Genies entdecken Probleme.*„, ein Zitat von Hans Krailsheimer. ***Mismatcher-Solution-Tiger***: Dieser Typ wird dir richtig viel Freude machen. Freude, ja wenn man es liebt kalt und heiß zu Duschen. Dieser Typ schafft es, dir in einer langen Liste die Probleme so richtig schmackhaft zu machen und dann wie von Zauberhand eine Lösung dafür zu präsentieren. Von diesem Typen wirst du Sätze hören wie diese von Albert Einstein: „*Probleme kann man niemals mit derselben Denkweise lösen, durch die sie entstanden sind.*„. ***Matcher-Solution-Tiger***: Mit diesem Typ kannst Du Visionen und Missionen gestalten. Mit diesem Typ fliegst du, wie von Zauberhand getragen, durch die blühenden Landschaften des Alltags. Es ist fast immer so, als ob du nur einen Schritt vor dem Ziel bist. Bei solchen Personen wirst du das Gefühl nie los, das sie einem eigenen Stern folgen. Von solchen Personen kannst du so was hören: „*Wenn Du ein Schiff bauen willst, dann trommle nicht Männer zusammen um Holz zu beschaffen, Aufgaben zu vergeben und die Arbeit einzuteilen, sondern lehre die Männer die Sehnsucht nach dem weiten, endlosen Meer.*„, ein Zitat von Antoine de Saint-Exupery. ***So, und welcher Typ bist du?*** ***Hast du dich wiedergefunden?*** ***Welcher Typ möchtest du sein?*** ***Und wie passt das zu diesem Thema?*** ***Ja, das sind spannende Fragen – nur was jetzt?*** Überrascht es dich jetzt, wenn ich sage, dass du von allen etwas in dir hast? Ist es dann nicht um so wichtiger, zu hinterfragen und einzuschätzen was es jetzt gerade braucht? Ist das jetzt für dich schwierig – dann schau doch mal hier vorbei: ![](https://thecattlecrew.net/wp-content/uploads/2020/11/Design-Thinking-300x195.jpg) Also höre in dich hinein und auf das, was es gerade braucht: Stellst du fest, dass du gerade den Boden unter den Füssen in diesem Projekt verlierst. Dann könnte ein Problembär helfen. Oder merkst du, dass dein Projekt schwerfällig wird und nicht mehr so leicht vorangeht? Könnte dir hier ein Matcher-Solution-Tiger helfen und dir die gewünschte Leichtigkeit zurückgeben? Vielleicht hilft Dir auch das 5-Finger Prinzip. ![](https://thecattlecrew.net/wp-content/uploads/2020/11/5-Finger-Prinzip-1024x545.jpg)Schau dir dein Problem an – auf was du zeigst und überlege – **Was**, **Wie** und **Wo** du Ü„nderungen rein geben kannst. **Wofür du dich auch entscheidest, achte darauf, dass deine Gedanken und Ideen groß werden können.** **Fazit**: Es ist durchaus hilfreich, frühzeitig Unterstützung zu finden und anzunehmen. Den Einstieg am Anfang möchte ich somit erweitern auf: ***Wer am Ende einer sehr langen Kette zieht, braucht viel Kraft und Ausdauer, um die Kette zu spannen und dann so zu bewegen, dass sie pass genau ans Ziel kommt. Es ist viel leichter die Kette neu zu positionieren, wenn es Unterstützer auf dem Weg gibt.*** Wer es etwas handfester braucht, für den fällt mir ein Spruch aus meiner Jugend ein: „Eine Liebe, von der keiner weiß, so ein Scheiß“. In der nächsten Folge geht es, um die Themen: **Digitalisierung oder Digitale Transformation?** **Wer ist der beste Ansprechpartner im Unternehmen für die digitale Transformation?** Übergeordnetes Dokument: https://thecattlecrew.net/2020/05/22/digitalisierung-und-der-tanz-auf-dem-vulkan-beginnt/ **Kategorien:** Architecture & Process Models **Schlagwörter:** Digitalisierung, Mindset --- ### [Eine Real-Time-Chat-App mit Google Firebase (baas)](https://thecattlecrew.net/2020/11/16/eine-real-time-chat-app-mit-google-firebase-baas/) **Published:** November 16, 2020 **Author:** Eric Nguyen **Content:** Mobile Geräte wie Smartphone, Tablets oder Laptops können wir heutzutage kaum noch wegdenken. Auch die Programme auf diesen Geräten werden immer schneller und der Nutzer möchte seine Daten und Anwendungen in Real-Time bedienen. Um nicht bei jedem neuen Programm oder App ein aufwändiges Backend zu entwickeln, nur um dann später festzustellen, dass es doch auch viel einfacher und anders gegangen wäre, haben die zwei großen Klassenprimi im Cloud Computing Bereich, Google und Amazon Web Services, ein Framework bzw. einen Dienst in ihrem Angebot. Dieser Service soll es den Entwicklern deutlich einfacher machen, ihre Apps mit einem schnellen und skalierbaren Backend zu verknüpfen. Jetzt stellt sich nur noch die Frage, was denn die Dienste sind und was sie können. ## Was ist Firebase? Firebase ist ein Backend as a Service, welches dazu gedacht ist, App-Entwickler zu unterstützen und es den Entwicklern so einfach wie möglich zu machen, moderne Funktionen, wie Authentication und Real-Time Datenabgleich in ihre Apps zu integrieren. Unterstützt werden dabei selbstverständlich Android und iOS, aber auch C++, Webapps und Unity. ## Welche Funktionen bietet Firebase für unsere Chat App an? ### Firebase Authentication Mit dieser Lösung bietet Firebase dem Entwickler eine sehr einfache Möglichkeit User Authentication für seine Application zu implementieren. Dabei muss sich der Entwickler nicht um lästige Funktionen wie das Speichern der User Session oder das sichere Abspeichern des Nutzers kümmern. Die API für die Authentication bietet mehrere einfache Funktionen, welche sich um das Registrieren und das Einloggen, sowie Ausloggen kümmern. Neben Email und Passwort unterstützt Firebase ebefalls das Authentifizieren mittels Social Media wie Facebook, Google, oder auch Diensten wie Sign In with Apple. Somit kann ein Entwickler auf eine Vielzahl von Authentication Methoden zurückgreifen. ### Firebase Firestore Nachdem ein Nutzer in der App authentifiziert ist, benötigt er schließlich auch Daten, welche in der App angezeigt werden können. Hier kommt Firestore ins Spiel. Firestore ist eine document based Datenbank. Es können verschiedene Collections angelegt werden und dort Dokumente gespeichert werden. Aufgebaut kann ein Dokument aus Daten des Formats: String, Bool, Timestamp, Array, Numer, Reference, Geopoint, Null und Map. Map repräsentiert dabei ein JSON Typ. Die Firebase API bietet ebenfalls vielfältige Funktionen, um Dokumente von Firestore herunterzuladen, zu updaten oder zu speichern. Interessant hierbei ist der SnapshotListener. Dieser ermöglicht es, dass die App auf Echtzeitupdates im Firestore hört und bei Bedarf automatisch die neuen Daten updatet. Neben Dokumenten, können ebenfalls auch die Zugriffsregeln definiert werden. Diese können vielfältig angepasst werden. So kann definiert werden, wer Zugriff auf die Daten hat. Hierbei lassen sich auch die Nutzer aus Firebase Authentication integrieren. Es lässt sich einstellen das nur authentifizierte Nutzer Zugriff auf den Firestore haben, oder beispielsweise nur die vom eigenen Nutzer erstellten Daten verändert, oder gelesen werden dürfen. ### Weitere Funktionen Neben diesen beiden Hauptfunktionen bietet Firebase noch etliche weitere Funktionen. So kann man ebenfalls große Dateien, wie Fotos oder Dokumente, im Firebase Storage speichern, oder ein eigenes Machine Learning Modell zu Firebase deployen, um dieses schnell und günstig in eine App zu integrieren. Doch einige der mächtigsten Funktionen sind die Firebase Functions. Diese sind Funktionen, welche mittels JavaScript entwickelt werden und zu Firebase deployed werden können. Anschließend können diese über einen Request aufgerufen, zeitlich gesteuert oder bei bestimmten Ü„nderungen ausgelöst werden. So lässt sich beispielsweise eine Funktion erstellen, welche ausgelöst wird, sobald ein neuer Nutzer registriert wurde. Anschließend können alle Daten aggregiert werden. So lässt es sich beispielsweise einstellen, dass sobald ein Nutzer registriert wurde, der Nutzer bei einem anderen Dienstleister, wie beispielsweise Stripe, ebenfalls registriert werden kann. Oder es lässt sich ebenfalls ein ganzes REST Backend mittels Firebase Functions entwickeln. ## Fazit Firebase bietet eine Vielzahl an Möglichkeiten, Real-Time Funktionalität ganz einfach in seine App einzubauen. Dazu stellt Google bzw. Firebase eine umfangreiche Library bereit, welche etliche Sprachen, bspw. Swift, Java, C++ etc. unterstützt. Somit ist es eine relativ allumfassende Plattform, welche viele Funktionen anbietet, die sehr einfach eingebunden werden können. Folglich lohnt sich auf jeden Fall ein Blick in Richtung Firebase, sofern man relativ schnell eine moderne App entwickeln möchte. Falls noch jemand Interesse hat Firebase auszutesten, kann unter dem folgenden Link das Projekt gerne runterladen und für seinen Firebase Account aufsetzen. Keine Angst, eine Anleitung, wie man das Projekt mit seinem Account verbindet und startet ist auch vorhanden. Viel Spaß! 🙂 [Link zum GitRepo](https://github.com/opitzconsulting/baas-demo) **Kategorien:** Cloud, Development, Infrastructure, Tools & Methoden **Schlagwörter:** Apps, BaaS, Chat, Firebase, Google, Mobile --- ### [Amplify - Ein Backend as a Service Framework von AWS](https://thecattlecrew.net/2020/11/23/amplify-ein-backend-as-a-service-framework-von-aws/) **Published:** November 23, 2020 **Author:** Eric Nguyen **Content:** Ein großer Trend in unserer heutigen Industrie ist der Übergang in die Cloud. Sie bietet eine Varietät von Möglichkeiten, um den Entwicklern das Leben zu erleichtern. Der Hauptakteur im Cloud Computing ist AWS. AWS wurde im März 2006 gestartet und war somit das erste Unternehmen, was den Cloud Service angeboten hat. Dementsprechend hat sich dieser Vorsprung bis heute gehalten und hat AWS somit zum größten Cloud Provider gemacht. Cloud Services bieten verschiedene Frameworks an, um beispielsweise ein Backend oder eine UI schnell aufzusetzen, um Zeit zu sparen. Da sich die App Entwicklung immer mehr in die Richtung von Real-Time Apps bewegt, gibt es natürlich auch für diese Kategorie ein Framework von AWS, „AWS Amplify“, um genau diesen Entwicklungsprozess zu vereinfachen und die App auf die breite Masse zu skalieren. ## Was ist Amplify? AWS Amplify ermöglicht es dem Entwickler eine App schnell aufzubauen ohne sich dabei um das Einrichten einer Infrastruktur zu kümmern. Somit gehört es in die Kategorie „Backend as a Service“ zu der auch beispielsweise Google Firebase gehört. Der Service ermöglicht das schnelle und einfache Integrieren von Diensten wie Authentication, Analytics, Storage etc. ## Welche Funktionen bietet Amplify für eine Real-Time App an? ### AWS Cognito Dieser Service von AWS ermöglicht es Nutzern sich auch über soziale Dienste, wie Google, Facebook etc. anzumelden. Alternativ kann man auch festlegen, dass sich Nutzer nur über E-Mail und Passwort bzw. Benutzername und Passwort authentifizieren können. In der AWS Web Console kann man einen Userpool für eine App erstellen, in dem man alle registrierten User sehen kann. Des Weiteren ist es auch möglich dort die Berechtigungen für die User anzupassen. Somit kann man flexibel bestimmen, welche User auf welche Ressourcen zugreifen darf, indem man Rollen erstellt. Das Anlegen und Abspeichern der User übernimmt hier die API von AWS. ### AWS AppSync AppSync ist ein verwalteter Service, der die Entwicklung von GrapQL-APIs vereinfacht. Somit kann der Entwickler mit einem einzigen Request durch Verwendung von GraphQL, seine App mit mehreren Datenquellen verbinden. Das hat beispielsweise zum Vorteil, dass man die Authentifikation nur einmal für diese Verbindung definieren und einrichten muss, anstatt dies für jede einzelne Datenquelle zu tun. Des Weiteren ermöglicht AppSync die Datenaktualisierung in Real-Time über Websockets, aber auch den lokalen offline Zugriff auf die App. Sobald der User wieder Online ist, werden die Daten synchronisiert. ### Weitere Funktionen Neben den oben genannten Funktionen besitzt Amplify aber auch noch weitaus mehr Features. Diese reichen von Analytics, Predictions bis zur UI Gestaltung. Beispielsweise lassen sich Daten in der eigenen App durch Analytics ansammeln, um diese später in Predictions zu verarbeiten. Somit kann man die User-Experience angenehmer gestalten, indem man beispielsweise seine gesammelten Daten dafür benutzt, um das Nutzerverhalten hervorzusehen und so Ads auf ihn zuzuschneiden. Abgesehen von verschiedenen Services bietet AWS auch AWS Lambda an. AWS Lambda ermöglicht es dem Entwickler bestimmte Auslöser zu definieren, bevor ein Code ausgeführt wird. Diese Auslöser können Aufrufe in der App sein, aber auch andere AWS Services, welches das Zusammenspiel der einzelnen Frameworks noch einmal vereinfacht. ## Wie sieht der Marktanteil von AWS Amplify aus? Laut „hgdata.com“ wird Amplify derzeit von 450 Unternehmen benutzt, um eine App zu hosten. Über die letzten zwölf Monate konnte AWS Amplify einen Wachstumsanstieg von starken 80,50% vorweisen, was eine gute Vorahnung gibt, in welche Richtung sich Amplify entwickelt. Auch in den sozialen Medien ist Amplify vertreten. Auf Twitter hat die offizielle Seite des Cloud Services bereits knapp 15.500 Follower. Des Weiteren gibt es auch kleine Entwickler Communites auf Discord und Slack, wo man sich gegenseitig über das Framework austauschen kann. ## Wie ist die Meinung von Entwicklern zu AWS Amplify Der Großteil der Entwickler, die mit Amplify Kontakt hatten, finden es wirklich sehr benutzerfreundlich. Auch das leichte Zusammenspiel mit anderen AWS Cloud Services wird des Ü–fteren erwähnt. Das Aufsetzen einer kleinen App geht wirklich extrem schnell und setzt kein Basis Wissen voraus. Ein weiterer Vorteil ist, dass AWS Amplify das Bezahlungsmodel „Pay as you go“ benutzt. Das heißt für den Entwickler, dass es keine versteckten Kosten gibt und man wirklich nur die Dienste zahlt, die man in Anspruch genommen hat. Allerdings bemängeln aber viele User auch, dass es leider noch keine ausreichende Dokumentation und somit die Lernkurve höher ist als bei anderen Services wie Google Firebase. Dies lässt sich aber auf das junge Alter von AWS Amplify zurückschließen. ## Fazit AWS Amplify bietet viele verschiedene Funktionen an, um Real-Time Funktionalitäten in die eigene App einzubauen. Des Weiteren kann man auch die UI über AWS programmieren. Hierbei werden diverse Front-End Sprachen wie React oder Angular unterstützt. Daraus kann man schließen, dass AWS Amplify auf jeden Fall sehr viele verschieden Funktionalitäten anbietet, um einem App Entwicklern das Leben zu vereinfachen, um schnell und kostengünstig eine skalierbare App zu programmieren. **Kategorien:** Cloud, Development, Infrastructure **Schlagwörter:** Amplify, AWS, BaaS --- ### [AWS Amplify vs. Google Firebase - Zwei BaaS im Vergleich](https://thecattlecrew.net/2020/11/30/aws-amplify-vs-google-firebase-zwei-baas-im-vergleich/) **Published:** November 30, 2020 **Author:** Eric Nguyen **Content:** In unserer heutigen Zeit, wo die Entwicklung von Apps und Software im Allgemeinen eine extrem wichtige Rolle spielt, ist es notwendig genau diesen Prozess für die Entwickler zu vereinfachen. Ein Programmarchitektur, die sich über die letzte Zeit herauskristallisiert hat, heißt „Serverless Architecture“. Diese Architektur ermöglicht es eine App ohne Serversoftware und Hardware Management laufen zu lassen. Das heißt, dass der Code nur ausgeführt wird, wenn er einen Request erhält und sonst keine Kosten verursacht. Das ist besonders in Real-Time Apps von Vorteil, da man sich nicht um das Management der Ressourcen auf dem Server kümmern muss. Der Entwickler kann also alle Hintergrundservices, wie Database-Management, User authentication, Hosting etc. , seiner Anwendung auslagern. Zwei große Anbieter in diesem Backend-as-a-Service Bereich sind Google Firebase und AWS Amplify. Im folgenden werden diese zwei „Backend as a Service“ Dienste miteinander verglichen. ## Kosten ### AWS Amplify basiert auf dem „Pay as you go“ Kostenmodell. Das heißt, dass Nutzer nur für den Service zahlen, den sie auch wirklich aktiv nutzen. Nach der Anmeldung erhalten Nutzer bei AWS 1000 kostenlose Build Minuten pro Monat, 5 GB Datenspeicher pro Monat und 15 GB bereitgestellt. Dieses Kontingent läuft aber nach dem 12-monatigen kostenlosen Nutzungskontingent ab. Nachdem man das kostenlose Kontingent aufgebraucht hat, tritt die Berechnung auf der „Pay as you go“ Basis ein. ### Google Firebase im Vergleich dazu hat auch ein „Pay as you go“ Kostenmodell ist aber für kleinere Projekte komplett kostenlos. Das heißt, dass man eine bestimmte Anzahl an Requests für beispielsweise den Authentication Service oder eine gewisse Anzahl an GB an freien Speicher im Firestore hat. Alle Nutzungen, die über diese Grenzwerte hinausgehen, werden dann nach dem „Pay as you go“ Modell berechnet. ## Benutzerfreundlichkeit und Funktionalitäten Amplify hat gegenüber Firebase mehr Funktionalitäten und Features, da AWS an sich älter als die Google Cloud services ist. Somit hat man als Entwickler mehr Spielraum für seine App und ist nicht eingeschränkt durch die fehlende Anzahl an Diensten in der Cloud. Ein Nachteil, der sich natürlich aus der Vielzahl an Möglichkeiten ergibt ist, dass man erstmal das Zusammenspiel dieser Services verstehen muss, bevor man sie in seine App integrieren kann. Ein weiterer Punkt ist, dass Amplify jünger als Firebase ist und deswegen auch die Community vergleichsweise kleiner ist. Das führt dazu, dass es weniger Dokumentationen zu Amplify im Internet gibt und man vieles durch „Learning by Doing“ herausfinden muss. Für komplette Neulinge im App Development oder in der Cloud ist somit der Einstieg in AWS Amplify schwieriger als bei Google Firebase. Dementsprechend ist die Lernkurve für Amplify deutlich höher als für Firebase. AWS Veteranen sind aber mit Amplify gut bedient, da sie sich bereits mit der Infrastruktur und dem Zusammenspiel der Services gut auskennen. ## Fazit Zusammenfassend kann man sagen, dass Firebase deutlich angenehmer für Einsteiger ist, da einerseits die Lernkurve niedriger ist und andererseits die Dienste für kleinere Projekte komplett kostenlos sind. Die große Entwickler-Community von Firebase ist hier ausschlaggebend, weil man zu jedem Problem eine Lösung findet oder in beispielsweise Discord oder Slack Channeln sich mit anderen Entwicklern austauschen kann. Das macht den Prozess der Integration von Firebase deutlich einfacher. Für Leute, die zum ersten Mal mit einem Cloud Service experimentieren wollen, ist Firebase also die bessere Lösung. Amplify hingegen ist für Einsteiger eher ungeeignet aufgrund der kleineren Community und der mangelnden Dokumentationen. Für größere Projekte ist es aber aufgrund der bereits vorhandenen AWS Infrastruktur besser geeignet. Gegen die Varietät an Funktionen und das Zusammenspiel der einzelnen AWS Diensten kann Googles Cloud Service nicht konkurrieren. Allerdings tritt dieser Fall nur ein, wenn man Entwickler zur Hand hat, die sich wirklich bereits sehr gut mit AWS auskennen, da die Divise „Learning by Doing“ in der AWS Umgebung teuer werden könnte. Falls ihr die Tools noch einmal genauer anschauen wollt, verlinke ich euch unten die dazugehörigen Blogartikel! 🙂 **Links:**- [AWS Amplify](https://thecattlecrew.net/2020/11/23/amplify-ein-backend-as-a-service-framework-von-aws/) - [Google Firebase](https://thecattlecrew.net/2020/11/16/eine-real-time-chat-app-mit-google-firebase-baas/) **Kategorien:** Cloud, Development, Infrastructure **Schlagwörter:** Amplify, AWS, BaaS, Firebase, Google, Serverless --- ### [Evaluierung Java Microframeworks: Micronaut](https://thecattlecrew.net/2020/12/01/evaluierung-java-microframeworks-micronaut/) **Published:** Dezember 1, 2020 **Author:** Meryem Cigdem **Content:** Wir haben es uns zur Aufgabe gemacht, verschiedene Microframeworks anhand eines kleinen Anwendungsfalles zu evaluieren, der detaillierte Anwendungsfall wurde bereits in unserem ersten [Blog-Post](https://thecattlecrew.net/2020/07/01/evaluierung-java-microframeworks-setting-the-scene/) beschrieben. Unser Artikel über Javalin ist [unter dieser Adresse](https://thecattlecrew.net/2020/07/15/evaluierung-java-microframeworks-javalin) zu finden. Heute werden wir uns auf das Microframework Micronaut konzentrieren. Im Folgenden zeigen wir die wichtigsten Eigenschaften, Stärken und Schwächen von Micronaut. Das Codebespiel ist [unter diesen Link auf Github](https://github.com/opitzconsulting/micronaut-demo) zu finden. ![](https://thecattlecrew.net/wp-content/uploads/2020/11/MIC-1.jpg) Bei Micronaut handelt es sich um ein modernes, JVM-basiertes Full-Stack-Framework zum Aufbau modularer, leicht testbarer Microservices- und Serverless Anwendungen. Das Framework unterstützt die Implementierung in Java, Groovy und Kotlin. Weitere Eigenschaften des Frameworks sind ein geringer Speicherbedarf und eine schnelle Start-Up Zeit, was vor allem in Bezug auf die Verwendung im Serverless-Umfeld wichtig ist. Außerdem wird Micronaut unter Apache License 2.0 veröffentlicht. Wenn man mit Micronaut arbeitet, ist häufig die Implementierung/Erweiterung bestehender Framework-Klassen notwendig. Einige Aspekte können einfach durch die Verwendung der entsprechenden Annotationen (@GET, @POST“¦) deklarativ hinzugefügt werden. In diesem Teil haben wir erstmal allgemeine Informationen über Micronaut gegeben. Im Folgenden betrachten wir wie eine Micronaut Applikation entwickelt wird und beschreiben wichtigste Eigenschaften und Elemente des Frameworks. ### Micronaut Projekt erstellen und kompilieren Bevor wir anfangen, stellen wir sicher, dass wir ein Java 8 SDK oder höher installiert haben Micronaut bietet eine CLI an. Mit Hilfe der CLI kann man Projekte erstellen und löschen. Verschiedene Möglichkeiten die Micronaut CLI zu installieren finden sich in der offiziellen Dokumentation (). Um Micronaut CLI benutzen zu können, muss man zuerst die letzte Binärdatei aus herunterladen und die an einen geeigneten Ort extrahieren. Danach wird eine Umgebungsvariable MICRONAUT\_HOME erstellt, die auf das Installationsverzeichnis zeigt und die Umgebungsvariable PATH wird aktualisiert. Nachher kann man das Micronaut CLI ausführen über die Command Line ausgeführt werden (siehe Abbildung 1). Über das Micronaut CLI kann einen neue Micronaut Anwendung am schnellsten und einfachsten erzeugt werden. ``` 1. $ mn 2. | Starting interactive mode... 3. | Enter a command name to run. Use TAB for completion: 4. mn> Abbildung 1-Micronaut CLI von der Eingabeaufforderung starten ``` Der folgende Befehl (siehe Abbildung 2) erstellt eine neue „micronaut-demo“- Anwendung in **Java mit einem Gradle-Build**. ``` 1. mn create-app micronaut-demo Abbildung 2-Applikation über Micronaut CLI erstellen ``` Wenn Maven anstelle von Gradle verwendet werden soll, kann dies im Rahmen der Anwendungserstellung mittels des Parameters „–build maven“ definiert werden. Eine Gradle-baiserte Anwendung kann mit dem folgenden Befehl ausgeführt werden: ``` 1. $ ./gradlew run 2. > Task :run Abbildung 3 - Applikation über CLI ausführen ``` ### Ein Java-Microservice mit Micronaut Kommen wir nun zur Implementierung unsereres Microservices. Wir benötigen für unsere Technologie Management Webseite jeweils eine Detailseite pro Technologie. Dafür haben wir erstmal unsere „TechnologyApplication“ Main-Klasse (siehe Abbildung 4) erstellt, diese wird beim Ausführen der Anwendung verwendet. ``` 1. public class TechnologyApplication { 2. public static void main(String[] args) { 3. Micronaut.run(TechnologyApplication.class); 4. } 5. } Abbildung 4- Main Klasse Technology Applikation ``` Danach haben wir unsere Controller Klasse implementiert. In dieser Klasse sehen wir schon manche Eigenschaften von Micronaut, und zwar Annotationen(siehe bitte Codebeispiel unter den „LINK“) . GET, POST, PUT, DELETE Methoden werden in der Controllerklasse (siehe bitte Abbildung 5)implementiert und für die Bearbeitung von Requests verwendet. In diesen Methoden neben den Annotationen steht in Klammern („/technologies/{id}“), das ist unsere URI und id ist eine Variable. Beispielsweise werden alle Informationen zu der Technologie Micronaut mit id Nummer 2 unter folgender URL „http://localhost:7000/technologies/2“ zurückgegeben. Wichtig: Standardmäßig ist der Micronaut Server so konfiguriert, dass er auf Port 8080 läuft. Dies kann aber geändert werden. Wir haben es auch als 7000 geändert. (siehe bitte ). ``` 1. @Controller("/") 2. public class TechnologyController { 3. protected final TechnologyRepository technologyRepository; 4. 5. public TechnologyController(TechnologyRepository technologyRepository) { 6. this.technologyRepository = technologyRepository; 7. } 8. 9. @Get("/technologies/{id}") 10. public Technology getTechnology(@PathVariable int id) { 11. return technologyRepository.getTechnology(id).orElse(null); 12. } 13. 14. @Post("/technologies") 15. public HttpResponse insertTechnology(@Body @Valid TechnologyInsertCommand cmd) { 16. "¦"¦"¦"¦"¦"¦"¦"¦ 17. } 18. 19. @Put("/technologies/{id}") 20. public HttpResponse updateTechnology(@Body @Valid TechnologyUpdateCommand cmd){ 21. "¦"¦"¦"¦"¦"¦"¦ 22. } 23. 24. @Delete("/technologies/{id}") 25. public void removeTechnology(@PathVariable int id) { 26. technologyRepository.removeTechnology(id); 27. return location(technology.getId()); 28. } 29. } Abbildung 5 -Controller Klasse ``` ### Datenbankverbindung Wir wollen in unserem Beispiel die Technologien in einer Datenbank speichern oder auch gespeicherte Daten auslesen. Micronaut ermöglicht unter anderem die Anbindung von relationalen Datenbanken via JDBC/JPA/Hibernate. Um uns mit der Datenbank zu verbinden, haben wir uns für MyBatis entschieden. MyBatis ist ein Java-Persistenz-Framework, das Objekte mit Stored Procedures oder SQL-Anweisungen unter Verwendung eines XML-Deskriptors oder von Annotationen koppelt. Im Gegensatz zu ORM-Frameworks bildet MyBatis keine Java-Objekte auf Datenbanktabellen ab (kein Mapping), sondern Java-Methoden auf SQL-Anweisungen. Um MyBatis benutzen zu können, müssen wir die notwendigen Dependencies in unserer „build.gradle“-Datei hinzufügen.(siehe Abbildung 6) ``` 1. implementation("org.mybatis:mybatis:3.4.6") 2. //MyBatis-Abhängigkeit hinzufügen. 3. 4. implementation("io.micronaut.sql:micronaut-jdbc-hikari") 5. // Konfiguriert SQL-DataSource-Instanzen 6. 7. compile group: 'org.postgresql', name: 'postgresql', version: '42.2.8.jre7' 8. //postgresql jdbc driver dependency Abbildung 6 "“ build.gradle ``` Zudem müssen wir unsere Datenquelle in der zentralen Applikationskonfigurationsdatei „application.yml“ Datei definieren (siehe Abbildung 7). ``` 1.datasources: 2. default: 3. url: ${JDBC_URL:`jdbc:postgresql://localhost:5432/postgres`} 4. driverClassName: org.postgresql.Driver 5. username: ${JDBC_USER:postgres} 6. password: ${JDBC_PASSWORD:*********} Abbildung 7-application.yaml ``` Da es in Micronaut noch keinen Out-of-the-Box-Support für MyBatis gibt, ist es notwendig, SqlSessionFactory manuell zu verdrahten (siehe Abbildung 8). ``` 1.@Factory 2.public class MyBatisFactory { 3. private DataSource dataSource ; 4. public MyBatisFactory(DataSource dataSource) {this.dataSource=dataSource;}} 5. 6.@Bean 7.SqlSessionFactory sqlSessionFactory() { 8. TransactionFactory transactionFactory = new JdbcTransactionFactory(); 9. Environment environment = new Environment("dev", transactionFactory, dataSource); 10. Configuration configuration = new Configuration(environment); 11. configuration.addMappers("micronaut"); 12. return new SqlSessionFactoryBuilder().build(configuration); 13. } 14.} Abbildung 8-src/main/java/micronaut/MybatisFactory.java ``` Nachdem Domänenobjekte (in unserem Fall die Klasse „Technology“) erstellt wurden, erstellen wir ein Interface, um die Operationen für den Zugriff auf die Datenbank zu definieren. Wir verwenden die Annotations von MyBatis, um die Methoden auf SQL-Abfragen abzubilden (siehe Abbildung 9). ``` 1. public interface TechnologyMapper { 2. 3. @Select("SELECT * FROM technologies") 4. List getTechnologies(); 5. 6. @Select("SELECT * FROM technologies WHERE id=#{id}") 7. Technology getTechnology(int id) ; 8. 9. @Insert("INSERT INTO technologies (name, description, recommendation, relevance, complexity, url,) values(#{name}," + 10. "#{description},#{recommendation},#{relevance},#{complexity},#{url})") 11. void insertTechnology(Technology technology) ; 12. 13. @Delete("DELETE FROM technologies WHERE id=#{id}") 14. void removeTechnology(int id); 15. 16. @Update("UPDATE technologies SET name=#{name}, description=#{description},recommendation=#{recommendation}, " + 17. "relevance=#{relevance}, complexity=#{complexity}, url=#{url}, WHERE id=#{id}") 18. void update(@Param("id") Integer id, @Param("name") String name, @Param("description") String description, 19. @Param("relevance") Integer relevance, @Param("recommendation")Integer recommendation, 20. @Param("complexity")Integer complexity, @Param("url") String url); 21. } Abbildung 9-TechnologyMapper.java ``` Nun gibt es noch eine wichtige Sache, und zwar die Erstellung des Datenbankschemas. Dafür haben wir die Micronaut-Integration mit Flyway verwendet. Zunächst wird die Dependency hinzugefügt (Abbildung 10): ``` 1.implementation("io.micronaut.flyway:micronaut-flyway") Abbildung 10-build.gradle ``` Danach konfigurieren wir die application.yaml für das Datenbankmigrationsverzeichnis(Abbildung 11): ``` 1. flyway: 2. datasources: 3. default: 4. locations: classpath:db/migration Abbildung 11 - application.yaml ``` Nun erstellen wir das Datenbankschema unter dem Verzeichnis „src/main/resources/db/migration/V1\_\_schema.sql*“* siehe Abbildung 12: ``` 1. CREATE TABLE technologies( 2. id SERIAL primary key, 3. name VARCHAR(100) NOT NULL, 4. description VARCHAR(1500) NOT NULL, 5. recommendation smallint CHECK (recommendation >0 AND recommendation 0 AND relevance 0 AND complexity **Kategorien:** Development **Schlagwörter:** framework, Java, Javalin, micronaut, Microservices --- ### [20 Jahre Agiles Manifest - und du?](https://thecattlecrew.net/2021/02/04/20-jahre-agiles-manifest-und-du/) **Published:** Februar 4, 2021 **Author:** djaehrling **Excerpt:** Vor 20 Jahren wurden das Agiles Manifest und die 12 Prinzipien hinter dem agilen Manifest postuliert und prägen seither in der "Neuzeit" mittlerweile weit mehr als unseren Alltag der Softwareentwicklung. **Content:** Vor 20 Jahren wurden das [Agiles Manifest](https://agilemanifesto.org/iso/de/manifesto.html) und die [12 Prinzipien](https://agilemanifesto.org/iso/de/principles.html) hinter dem agilen Manifest postuliert und prägen seither in der „Neuzeit“ mittlerweile weit mehr als unseren Alltag der Softwareentwicklung. 20 Jahre – eine echt lange Zeit, vor allem in der Softwareentwicklung. [Windows XP](https://de.wikipedia.org/wiki/Microsoft_Windows_XP) war noch Zukunftsmusik. Interessanterweise ist Agilität nicht erst seit dem 11.02.2001 ein Thema, wie man verschiedenen statistischen Erhebungen entnehmen kann. ![](https://www.schwarmorganisation.de/wp-content/uploads/2017/08/Agile-Hype-Cycle-170803.png)Agile-Hype-Cycle – Die Historie agiler Konzepte Auch bei uns als Organisation hat das Manifest Spuren hinterlassen. Wir haben unsere Mitarbeitenden online eingeladen anhand zweier Pilotfragen uns mitzuteilen: - „Wie das Agile Manifest Einfluss auf dich nimmt?“ - „Was du mit dem Agilen Manifest verbindest?“ Je zehn Schlagwortangaben je Teilnehmer waren erlaubt. Mit Unterstützung von [mentimeter.com](https://www.mentimeter.com) ist dabei, wie wir finden, eine beeindruckene Wortwolke entstanden: [![](https://thecattlecrew.net/wp-content/uploads/2021/02/Screenshot_2021-02-03-Interactive-presentation-software_2-1024x528.png)](https://thecattlecrew.net/wp-content/uploads/2021/02/Screenshot_2021-02-03-Interactive-presentation-software_2.png)Word Cloud – 20 Jahre agiles Manifest (Bild © 2001, Ward Cunningham)Es macht uns besonders stolz, dass die Befragten offenbar das Schlagwort „team“ als häufigstes mit dem Agilen Manifest heuer verbinden. Schaut man auf OPITZ CONSULTING als eine Organisation im Wandel und unter dem Eindruck der agilen Bewegung, so kommt man auch dort zur Erkenntnis, dass wir nicht stehen geblieben sind, sondern uns stetig weiterentwickelt haben und die Fähigkeit zu weiterem Wandel bewahren – [inspect and adapt](https://www.opitz-consulting.com/kompetenz/ocweekly-talk-inspectnadapt-make-change-come-true). Wie stark die Team-Gedanken hinter dem [Agilen Manifest](https://thecattlecrew.net/2020/05/29/was-ist-agilitaet/) auch Auswirkungen auf die Organisation unseres Unternehmen haben, zeigt das Zitat von Rolf Scheuch: > Je stärker du die Org-Einheiten gegeneinander abkapselst, umso schwieriger wird es dem Kunden den vollen Value zu liefern“¦ > > Rolf Scheuch – Mitgründer von OPITZ CONSULTING These: *abgekapselte Org-Einheiten erschweren die Cross-Funktionale-Team-Bildung und die Value-Delivery bleibt auf der Strecke.* Über die Zeit der letzten Jahrzehnte durchlief auch OPITZ CONSULTING unterschiedliche Organisationsveränderungen. Wir befinden uns auf dem Weg mehr und mehr in Teams und einer adaptiven Netzwerk-Organisation zu denken und zu handeln. Und wir teilen unser Wissen gerne. Auf unserem YouTube Channel zum [OC|Weekly Talk](https://www.youtube.com/playlist?list=PLMWddfzXOIzl5DlyXhJaBWP2WKP9S5ElP) greifen wir viele Themen rund um Agilität auf. Beispielsweise auch, wie [Agilität Einzug in die Unternehmensführung](https://youtu.be/9mOiQqykhek) erhält. Mit den gemachten Erfahrungen aus der Vergangenheit und dem Rüstzeug engagierter und mit Sinn ausgestatteter Individuen freuen wir uns, heute das Element der Zukunft von morgen zu gestalten – Teams. **Kategorien:** Architecture & Process Models, Development **Schlagwörter:** Agil, Digitalisierung, Leadership, Softwarenentwicklung --- ### [OCI - Squid Proxy HA](https://thecattlecrew.net/2021/02/08/oci-squid-proxy-ha/) **Published:** Februar 8, 2021 **Author:** Steffen Nothmann **Content:** In diesem Artikel geht es um die Erstellung eines hochverfügbaren Internet Proxy in der Cloud, der die Zugriffe von Applikationsservern auf das Internet beschränken soll. Insbesondere wird auf die Hochverfügbarkeitsproblematik eingegangen, die sich aus der Anforderung „Client Based Filtering“ ergibt. Auf die konventionelle Squid Installation und Konfiguration wird an der Stelle nicht eingegangen, da diese nach Standard erfolgten. Ebenso nicht auf die Erstellung sämlicher Standard OCI-Komponenten. ## Motivation Um Hochverfügbarkeit von Applikationen zu erreichen, stellt Oracle in der OCI einen Loadbalancer (LB) zur Verfügung, welcher über konfigurierbare „Listener“ verfügt und mit verschiedenen Shapes auch Leistungsparameter variieren kann. Dennoch sind diese Loadbalancer nicht für alle Einsatzfälle gleichermaßen gut geeignet. Auch in unserem Anwendungsfall stellte sich dies als schwierig dar, wie im Bild dargestellt. [![](https://thecattlecrew.net/wp-content/uploads/2021/02/grafik-1-1024x470.png)](https://thecattlecrew.net/wp-content/uploads/2021/02/grafik-1.png) Abb.1 Ursprünglich geplante Architektur des Squid HA mit OCI Loadbalancer In unserem Projekt stellte sich heraus, dass die Anforderung, Quell-Hosts basierende Security Rules im HA-Squid zu implementieren, mit dem OCI-Loadbalancer ( Stand: 11/2020 ) nicht umsetzbar war. Der Grund war, dass dieser zwar eingehend HTTP- und TCP-basierende Verbindungen zulässt, nicht aber HTTPs. Der Versuch mit TCP/443 zu arbeiten scheiterte daran, dass der LB im TCP-Modus zwei Connections aufbaut, eingangsseitig mit dem Client und ausgangsseitig mit dem Backend (Squid) . Dabei geht die ursprüngliche Quell-Host-Information (also die IP-Adresse des Client Hosts) verloren und der Squid-Proxy bekommt die IP des Loadbalancers als Quelle übermittelt. Somit war eine hochverfügbare „Client Based Filtering“-Lösung mit Squid Proxy und dem OCI Loadbalancer nicht möglich. Eine andere Lösung musste gefunden werden. Alternativ wären ein F5 Loadbalancer oder ähnliche kommerzielle Produkte einsetzbar gewesen, welche jedoch zum einen meist mit höheren Lizenzkosten verbunden sind, und zum anderen unter Umständen einfach zu mächtig sind und die Komplexität im Gesamt Projekt unnötig erhöhen, wenn es darum geht einfache Anwendungen hochverfügbar zu machen. Unser Ansatz war eine „Self-Made“-Cluster-Lösung mit zwei Nodes in einer „Active/Passive“-Variante. Nachfolgend stelle ich ein Szenario vor, bei dem wir einen HA-Internet-Proxy in Rahmen eines größeren Migrationsprojekts verwendet haben und die folgenden Ziele verfolgten: - die Limitierung des OCI Loadbalancer ausgleichen - die Standard-Konfiguration des „Squid“ auf einer simplen HA-Storage-Lösung - kein Loadbalancing, aber Hochverfügbarkeit durch Implementierung eines Active/Passive-Verhaltens - Verwendung des Oracle Linux Software Stack, unter Einbeziehung der in OCI verfügbaren OS Base Images - IaC-Anwendung auf der Plattform einer Oracle Cloud Infrastructure Mit welchen Konzept und welchen Komponenten haben wir diese Ziele erreicht? Da gibt es sicher nicht den Golden Weg. Wir sahen die besten Chancen in der Verwendung populärer und von RedHat und Oracle unterstützter Komponenten. Dabei kam folgendes Konzept heraus: ## Konzept Squid HA mit Pacemaker/Corosync in OCI [![](https://thecattlecrew.net/wp-content/uploads/2021/02/grafik-2-1024x624.png)](https://thecattlecrew.net/wp-content/uploads/2021/02/grafik-2.png) Abb.2 Squid HA Architektur mit Pacemaker (active/passive) und Resource Agent IPAddr2 Auf beiden Nodes läuft Pacemaker als Resource Manager im Duo mit Corosync. Zwei Resource-Agenten sorgen dafür, dass die Virtuelle IP (RA:Heartbeat:IPAddr2) nd Squid (Heartbeat:Squid) stets auf einem Node aktive sind (Active/Passive-Verhalten). Die Squid-Konfiguration liegt auf einem via „s3fs-fuse gemounteten“ Shared Bucket (Object Storage), sodass beide Instanzen exakt die gleiche Konfiguration verwenden. Hier wäre auch DRBD mit einfachen Blockvolume Devices denkbar, aber das würde einen höheren Verwaltungsaufwand mit sich bringen, wie z. B. ein „Splitt-Brain“-Handling. ### Pacemaker/Heartbeat /Corosync Diese Software-Komponenten sind für Resource Management (Pacemaker) und Membership Management (corosync) zuständig. Ab RHEL 7 ist **Pacemaker** der Standard Cluster Resource Manager bei Red Hat und zusammen mit **Corosync** aktuell der „De-Facto“-Standard für das Management von Resource und Membership Layer, insbesondere in RHEL-basierten Systemen. ### Squid Squid ist eine sehr ausgreifte und stabile Proxy Server Software, die normalerweise mittels Systemd Service implementiert ist, hier aber durch einen Resource Agent auf beiden Squid-Nodes gesteuert wird. Die Konfigurationdateien für den Squid sollten nur einmal vorhanden sein und auf einem S3 Bucket (Object Storage) vom jeweils aktiven Node eingelesen werden (Aktiv/Passive-Konzept). Erhöhte Sicherheit des Proxy wird durch ein „WhiteListing“ ausgehender Aufrufe und zusätzlicher Quell-Host-Restriktion erreicht. Für letztere wird die „x-forwarded-for“-Eigenschaft von Squid verwendet. So wird der Traffic zu den white-gelisteten Targets zusätzlich stringiert. Das war Ausgangspunkt für dieses Teilprojekt und eines der Hauptziele. ### S3FS-Fuse S3FS-Fuse ist das Mittel der Wahl, um S3-kompatible Storages in Filesysteme einzubinden. Die OCI Object Storages sind S3-kompatibel und hochverfügbar ausgelegt. Sie sind für einfachere Aufgaben, wie in diesem Fall als Shared Storage für die Squid Konfiguration Files (Squid im Active/Passive Mode) gut geeignet und parallel an beiden Nodes „gemountet“. ## Umsetzung Die beiden Compute Nodes und die gesamte OCI-spezifische Infrastruktur wird mit Terragrunt/Terraform als Teil eines größeren Projekts erstellt. Zu beachten ist dabei, dass einer der Nodes eine zusätzliche Private IP bekommt, welche dann als VIP, also als Floating IP, fungiert. Auf die Besonderheit, die sich daraus für den Failover Fall in der OCI ergibt, wird später noch im Detail eingegangen. Das Provisionieren erfolgt über OCI-Metadaten, welche neben dem „cloud-init“-Skript zum Provisionieren auch weitere encrypted Informationen enthalten (Secrets). ### Spezielle OCI-Komponenten Für das Funktionieren der später beschriebenen VIP-Failover-Funktion, werden „Dynamic Groups“ mit entsprechenden Policys benötigt, um das OCI feature „Instance Principal“ verwenden zu können. Im Prinzip ermöglicht dies, dass sich die Compute Instances selbst modifizieren. Durch gezielte Policys wird diese Fähigkeit auf die Relokation der VIP und durch eine „Matching Rule“ der „Dynamic-Group“ auf ganz bestimmte Compute-Instanzen beschränkt. Eine Dynamic Group und zugehörige Policy könnte in Terragrunt/Terraform wie folgt aussehen: ``` dynamic_groups = [ {name = "Cluster", description = "Dynamic groups to give OCI access to relocate network interfaces between cluster members", matching_rule = " tag.value='SQUID'"} ] policy_ha = {name = "SQUID-HA", description = "Policy for Clusters managing floating-ips", statements = [ "Allow dynamic-group Cluster to manage private-ips in compartment XYZ", "Allow dynamic-group Cluster to use vnic in compartment XYZ", "Allow dynamic-group Cluster to read compute-management-family in compartment XYZ" ]}, ``` ### Erforderliche Linux Pakete für alle Software-Komponenten Neben den Paketen für Pacemaker gibt es von RedHat ein CLI namens „pcs“ , welches den Zugriff auf die Pacemaker-Konfiguration über einen „pcsd daemon“ (Systemd Service) ermöglicht. Für „Fencing“ werden entsprechende „fence-agents“ installiert, sofern auf Fencing zurückgegriffen werden muss. Formal sollte darauf geachtet werden, dass auch „net-tools“ und „jq“ installiert sind, die das Framework implizit benötigt bzw. welche für die Cloud Metadaten-Auswertung gebraucht werden . ``` $ ``` yum -y install `python-oci-sdk python-oci-cli` ``` ``` net-tools jq s3fs-fuse corosync pcs pacemaker fence-agents-all squid ``` ``` Loaded plugins: langpacks, ulninfo ``` ``` Package net-tools-2.0-0.25.20131004git.el7.x86_64 already installed and latest version ``` ``` Package jq-1.5-1.0.1.el7.x86_64 already installed and latest version ``` ``` Package s3fs-fuse-1.86-2.el7.x86_64 already installed and latest version ``` ``` Package corosync-2.4.5-7.el7.x86_64 already installed and latest version ``` ``` Package pcs-0.9.169-3.0.1.el7.x86_64 already installed and latest version ``` ``` Package pacemaker-1.1.23-1.0.1.el7.x86_64 already installed and latest version ``` ``` Package fence-agents-all-4.2.1-41.el7_9.2.x86_64 already installed and latest version ``` ``` Package 7:squid-3.5.20-17.el7_9.5.x86_64 already installed and latest version ``` ``` Nothing to do ``` ``` ### OCI-Object-Storage-(Bucket)-Konfiguration Das Paket für „s3fs-fuse“ ist bereits installiert und kann nun das zuvor mittels Terragrunt/Terragrunt erzeugte Bucket über einen „/etc/fstab“-Eintrag auf beiden Nodes wie folgt an den Mount Point „/data“ mounten: *(Fett gedruckte **x** stehen für Zeilennummern und setzen die Kenntnis der Struktur der übertragenen Daten voraus.)* ``` # Extract secrets from OCI Metadata (s3fs password) ``` ``` $ sudo /bin/curl -s http://169.254.169.254/opc/v1/instance/ | jq -j .metadata.secret_key| base64 -d | sed -n xp > /usr/local/etc/.passwd-s3fs ``` ``` $ sudo sed -i "\$a Proxy /data fuse.s3fs use_xattr,_netdev,allow_other,passwd_file=/usr/local/etc/.passwd-s3fs,url=https://.compat.objectstorage.eu-frankfurt-1.oraclecloud.com/,nomultipart,use_path_request_style,context="system_u:object_r:squid_conf_t:s0" 0 0" /etc/fstab ``` ``` $ sudo mount -a ``` Dabei werden die Credentials des Cloud Users im Password File übergeben und auch der Squid SELinux Context, der für den Mount Point benötigt wird. Die URL verweist auf den Object Storage und muss natürlich durch den konkreten Identifier ersetzt werden. Ist das Bucket auf beiden Nodes gemountet, kann die komplette Squid-Konfiguration, nachdem sie auf dem ersten Node vorverarbeitet wurde (Erzeugen der Whitelists etc.), auf das Bucket kopiert werden. Der entsprechende Verweis in der „squid sysconfig“ wird ebenfalls auf das Bucket „umgebogen“. ``` $ ``` cp -pr /etc/squid/ /data/squid_config/ ``` $ ``` sed -i "s/\/etc\/squid\//\/data\/squid_config\//g" /etc/sysconfig/squid ``` ``` ### Pacemaker und Resource-Agents-Konfiguration Die Cluster Installation/Konfiguration erfolgte „straight forward“ und kann u. a. auch [bei clusterlabs.org](https://clusterlabs.org/quickstart-redhat.html) oder [bei Oracle](https://docs.oracle.com/en/operating-systems/oracle-linux/7/network/ol7-pacemaker.html#ol7-pacemaker-about) im Detail nachgelesen werden. Dieser Teil ist eigentlich nicht sonderlich spannend. Interessant wird er, wenn man sich die Aufgabe stellt, die Installation und Konfiguration völlig „unattended“ zu gestalten, also ohne manuelle Eingriffe. Hier der grundsätzliche Vorgang als Pseudo Script: *(Fett gedruckte **x** stehen für Zeilennummern und setzen die Kenntnis der Struktur der übertragenen Daten voraus.)* ``` # Zunächst den pcs service auf beiden Hosts starten $ sudo systemctl enable pcsd $ sudo systemctl start pcsd # und dann das password für den Default Cluster user "hacluster" setzen ``` `# Extract secrets from OCI Metadata (`hacluster password ```) $ HAPASSWD=`sudo /bin/curl -s http://169.254.169.254/opc/v1/instance/ | jq -j .metadata.secret_key| base64 -d | sed -n xp` $ echo "$HAPASSWD" | sudo passwd --stdin hacluster ``` Bis hierher erfolgten alle Aktionen auf beiden Cluster Nodes. Das Paket für den Pacemaker wurde ja bereits installiert und damit auch die benötigten Resource Agents für den Cluster. Somit können wir jetzt den Cluster und die Agents nacheinander konfigurieren. ``` $ sudo /sbin/pcs cluster auth NODE1 NODE2 -u hacluster -p $HAPASSWD sudo /sbin/pcs cluster setup --start --name proxy_cluster squid1 squid2 # cluster start right now and after reboot $ sudo /sbin/pcs cluster start --all $ sudo /sbin/pcs cluster enable --all # properties: without STONITH, No quorum policy in 2 node cluster, and resource stickyness (no automatic failback) $ sudo /sbin/pcs property set stonith-enabled=false $ sudo /sbin/pcs property set no-quorum-policy=ignore $ sudo /sbin/pcs resource defaults resource-stickiness=100 # ``` Virtual "floating-ip" service ``` ``` $ sudo pcs resource create floating-ip IPaddr2 ip=10.0.0.111 cidr_netmask=24 op monitor interval=15 meta target-role="Started" ``` # ``` Adding virtual "ha-squid" service using ocf-resource and bind it together with the floating-ip service to a resource group ``` $``` sudo /sbin/pcs resource create ha-squid ocf:heartbeat:Squid squid_exe="/usr/sbin/squid" ``` ``` squid_conf="/data/squid_config/squid.conf" ``` ``` squid_pidfile="/var/run/squid.pid" ``` ``` squid_port="3128" ``` ``` squid_stop_timeout="30" ``` ``` op start interval="0" ``` ``` timeout="60s" ``` ``` op stop interval="0" ``` ``` timeout="120s" ``` ``` op monitor interval="15s" ``` ``` timeout="30s" ``` ``` meta target-role="Started" ``` ``` $ sudo /sbin/pcs resource group add SquidAndIP floating-ip ha-squid ``` ``` $ sudo /sbin/pcs resource meta SquidAndIP target-role="Started" ``` ``` Damit wäre die grundlegende Cluster-Funktionalität gegeben. Auch ein Failover scheint „out-of-the-box“ zu funktionieren, zumindest suggeriert uns Linux auf beiden Hosts, dass die virtuelle IP 10.0.0.111 zwischen den Knoten und deren Primary Interfaces wechselt. Leider reicht das in der OCI Cloud nicht aus, weil die IP dort nicht erreichbar ist. Für die Erreichbarkeit der Instanz über die VIP muss das private\_ip object, welches dem Primary Network Interface der Compute Instance zugewiesen wurde, ebenfalls auf die jeweils andere zugewiesen werden. ### Konfiguration der VIP-Failover-Funktion in OCI Um der Cloud-Architektur Rechnung zu tragen, waren einige Besonderheiten zu beachten. In diesem Teil beschreibe ich, was zu tun ist, um die Private IP wirklich „floaten“ zu lassen. im Abschnitt „Spezielle OCI-Komponenten“ erwähnte ich bereits, dass einer der Knoten („sagen wir squid1“) initial mit einem „Private IP Object“ ausgestattet werden muss. Diese Private IP ist mit 10.0.0.111 assoziert und an das Primary Interface gebunden. Beim Failover macht Linux wie bereits erwähnt schon alles richtig, dafür sorgt der IPAddr2 Agent von Heartbeat. Aber das Cloud Object bekommt davon nichts mit. Um dies zu ändern, ist eine spezielle Aktion mittels OCI Command Line Interface erforderlich, das dafür auf beiden Cluster Nodes eingerichtet sein muss. Weitere Pre-Requisites sind „dynamic\_groups“ und „policies“, wie bereits beschrieben. Die Kerngedanken dabei sind folgende: - Der RA IPAddr2 wird so manipuliert, dass er zusätzlich auch die OCI IP umschaltet. Dafür implementiert man ihm ein „Floating Script“ in die „add\_interface function“. - Das „Floating Script“ nutzt via gesetzter Enviroment-Variable dann „Instance Principal“ - und kann via oci command die VIP an Ihren eigenen VNIC binden Die dazu gehörenden Code-Snippets sehen wie folgt aus: ``` /bin/sed -i "/add_interface ()/a /bin/float_ip" /usr/lib/ocf/resource.d/heartbeat/IPaddr2 ``` ``` export LC_ALL=C.UTF-8 export LANG=C.UTF-8 export OCI_CLI_AUTH=instance_principal ``` ``` vnicid=`/bin/curl -s http://169.254.169.254/opc/v1/vnics/ | /bin/jq -j .[].vnicId` /bin/oci network vnic assign-private-ip --unassign-if-already-assigned --vnic-id $vnicid --ip-address 10.0.0.111 ``` ## Fazit Das Ziel, eine relativ einfache Lösung als Alternative zum OCI Loadbalancer bzgl. dessen Limitierung der Quell Host Information zu erstellen, ist uns gelungen. Bewusst in Kauf genommen haben wir dabei, dass es mit der neuen Lösung kein Loadbalancing gibt, das war aber bereits in der Ausganglösung nachrangig gegenüber der Verfügbarkeit. Trotz der Einfachheit der vorgestellten HA-Lösung eines Internet Proxy mit Pacemaker und Squid , waren dennoch eine Menge kleinerer Hürden zu bewältigen. Diese waren unter anderem - der Umgebung (Oracle Cloud Infrastructure mit Object-Storage ) - den favorisierten Software-Komponenten (Squid + Pacemaker + s3fs) - und „last but not least“ den Sicherheitsansprüchen (Authentifizierung) im Zusammenhang mit „Instance Principals“ und „s3fs“ geschuldet. Aber genau diese sind es auch, die diesen Teil des Cloud-Migrationsprojekts interessant für weitere Anwendungen in der Cloud machen. Die Lösung kann selbstverständlich auch als Basis für komplexere HA-Anforderungen dienen. Denkbar scheint auch die Anwendung in Bereichen, in denen Standard Loadbalancer nicht über die gewünschten Protokolle wie sftp verfügen. Desweiteren würde man ggf. auch Local Block Storage mittels DRBD Master/Slave Set in den Pacemaker einbinden und somit eine kostengünstige, aber immer noch einfache Lösung mit hochverfügbarem Storage für die Daten erhalten. **Kategorien:** Cloud, Infrastructure **Schlagwörter:** cloud, Hochverfügbarkeit, HowTo, OCI, oracle, Oracle Cloud, Pacemaker, s3fs, Squid --- ### [AES Blockchiffre einfach & schnell erklärt](https://thecattlecrew.net/2022/06/10/aes-blockchiffre/) **Published:** Juni 10, 2022 **Author:** Leon Iking **Excerpt:** Sicherheit ist aktuell wichtiger denn je und wird auch in Zukunft immer wichtiger werden. Um diese Sicherheit zu gewährleisten sind gute, schnelle und effiziente Verschlüsselungsalgorithmen von Nöten. Blockchiffren sind Verschlüsselungen für große Dateien und zählen zur sog. symmetrischen Kryptographie, wo Sender und Empfänger den gleichen Schlüssel für Ver- und Entschlüsselung nutzen. Einer der genannten Verschlüsselungen ist die 1998 veröffentlichte Blockchiffre AES, deren Aufbau hier genauer erläutert wird. **Content:** ## Aufbau von Blockchiffren: Blockchiffren verschlüsseln blöckeweise, d.h. sie teilen den zu verschlüsselnen Text in Blöcke auf, die sie dann einzeln verschlüsseln. Blockchiffren haben zwei grundlegende Operationen, Konfusion und Diffusion. Die Konfusion soll den Text konfus, also unleserlich und für den Menschen unverständlich machen. Die Diffusion soll einzelne Änderungen am Schlüssel auf das ganze Ergebnis der Verschlüsselung (=verschlüsselter Text) auswirken. Wichtig für ein gutes Verständnis von Verschüsselungsmethoden sind die verschiedenen Zahlensysteme wie das Binär -und das Hexadezimalsystem. Des Weiteren wird häufig auf die modulare Reduktion zurückgegriffen, die ebenfalls wichtig für ein gutes Verständnis ist, da so die Zahlen klein bleiben, dass auch jedes Gerät in der Lage bleibt sicher zu verschlüsseln, auch wenn die Zahlen dabei recht groß werden können. Am Ende der Seite befinden sich Links, falls diese noch nicht klar sind. ## Runden von AES: AES ist iterativ, d.h. er wiederholt Abschnitte seiner Funktionsweise, diese Abschnitte heißen Runden. Je nach gewählter Schlüssellänge variieren diese Runden zwischen 10, 12 und 14. ### Key-Addition-Schicht: Die Key-Addition-Schicht „xoriert“ den jeweiligen Unterschlüssel aus dem hier nicht betrachteten Schlüsselfahrplan, auf die Blocklänge. Da bei der XOR-Operation die zu „xorienden“ Zahlen gleich viele Binärziffern benötigen, beträgt der Unterschlüssel unabhängig von der zu Beginn ausgewählten Schlüssellänge, die 128, 192 und 256 Bits betragen kann, 128 Bit, da dies die fixe Blocklänge ist. ### Byte-Substitution-Schicht: Zu Anfang werden die 128 Bit Blocklänge in 16 ein Byte große Blöcke aufgeteilt. Wenn man einen einzelnen Block betrachtet, besteht dieser aus zwei Hexadezimalziffern, mit diesen kann man einen Tabelleneintrag in der S-Box des AES ermitteln (1. Stelle gibt Zeile an und 2. Stelle gibt Spalte an). ### Shift-Rows-Schicht: Für die zweite Schicht werden die 16 Blöcke in eine 4×4 Matrix eingetragen, wobei die Einträge nicht von links nach rechts, sondern von oben nach unten eingetragen werden. Dann werden die Reihen wie gezeigt verschoben: [![](https://thecattlecrew.net/wp-content/uploads/2022/06/grafik.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/grafik.png)4×4 Matrix mit Beispielwort[![](https://thecattlecrew.net/wp-content/uploads/2022/06/grafik-1-1024x199.png)](https://thecattlecrew.net/wp-content/uploads/2022/06/grafik-1.png)4×4 Matrix DurchführungWie man an dem Beispiel erkennen kann, sorgt die Verschiebung dafür, dass man das anfangs noch zu lesende Wort Verschluesselung nun nicht mehr lesen kann, da an dieser Stelle nun VHSGCSNSEURULELE steht. ### Mix-Column-Schicht: Für die Mix-Column-Schicht werden die Bytes in Polynome umgewandelt. Hierfür werden die Bytes in achtstellige Binärzahlen aufgeschrieben und dann von rechts nach links mit aufsteigendem Exponenten in ein Polynom umgewandelt. Bsp.: 1000 1000 = 0 \* x^0 + 0 \* x^1 + 0 \* x^2 + 1 \* x^3 + 0 \* x^4 + 0 \* x^5 + 0 \* x^6 + 1 \* x^7 = x^3 + x^7 ![](https://thecattlecrew.net/wp-content/uploads/2022/06/grafik-3.png)Dann werden alle Bytes in vier Vektoren eingeteilt, diese entsprechen den Spalten der 4×4 Matrix nach der Shift-Rows-Schicht. Diese vier Vektoren werden nacheinander mit der rechtsstehenden festgelegten Matrix via Matrix-Vektor-Multiplikation als Polynom verrechnet. Um auch hier zu verhindern, dass die Polynome zu groß werden und so den Wert eines Bytes überschreiten würden, wird auch hier reduziert. Dies erfolgt durch ein Reduktionspolynom, welches bei AES auf P(x)= x^8 + x^4 + x^3 + x + 1. Durch Umstellung und wegen der Binärdarstellung der ursprünglichen Zahl, aus welcher das Polynom abgeleitet wurde, kann man P(x) so umstellen, dass dort folgende Gleichung steht: x^8 = x^4 + x^3 + x + 1 Um die gelösten Polynome wieder in Hexadezimalzahlen umzuwandeln, wird wie zu Beginn der Umweg über die Binärzahlen genommen und kann äquivalent zurückgerechnet werden. ![](https://thecattlecrew.net/wp-content/uploads/2022/06/grafik-4.png)Um mit AES zu verschlüsseln, muss man diese Schichten einer einzelnen Runde immer durchführen außer in der letzten Runde, dort wird die Mix-Column-Schicht übersprungen. Des Weiteren wird aus historischen Gründen vor der ersten Runde der ersten Rundenschlüssel „xoriert“, also die Key-Addition-Schicht durchgeführt, dies hat keine großen Auswirkungen auf die Sicherheit von AES. [Wie funktionieren Zahlensysteme?](https://www.elektronik-kompendium.de/sites/dig/0208031.htm) [Wie funktioniert Modulo?](https://meinstein.ch/math/die-modulo-rechnung-einfach-erklaert/) **Kategorien:** Development, IT-Security **Schlagwörter:** Blockchiffre, IT Security, Verschlüsselung --- ### [Data Catalog -- Der digitale Kompass für Unternehmensdaten](https://thecattlecrew.net/2021/07/21/data-catalog/) **Published:** Juli 21, 2021 **Author:** Fabian Heidenstecker **Content:** Kataloge waren bereits in der Antike populär. In seinem Epos Ilias widmet der griechische Dichter Homer mehr als 200 Verse der Beschreibung der gemeinsamen Flotte, die sich anschickte, Troja zu unterwerfen. Er ordnet die Geschwader nach der Herkunftsregion, benennt deren Anführer und die Anzahl der Schiffe. Damit wird bereits der Kern eines Kataloges deutlich. „Objekte“ werden dort aufgezählt, geordnet und kategorisiert und durch weitere Informationen ergänzt. Womit wir schon beim Thema Metadaten wären, aber dazu später mehr. ## Daten, Daten, Daten Wir verlassen das Mittelmeer aber bleiben bei Wasser im weitesten Sinne. Heute setzen viele Unternehmen einen Data Lake ein, und sammeln dort allerlei Daten. Dies umfasst zum einen strukturierte Daten aus ERP- und CRM-Systemen, aber auch semi- und unstrukturierte Daten, wie z. B. Webseiteninteraktionen, Social-Media-Beiträge oder Bilder und Videos. In diesem Sammelbecken fließen Informationen aus unterschiedlichen Unternehmensbereichen zusammen und es wird zunehmend schwieriger, einen Überblick über die Daten zu behalten. Wichtig sind in diesem Zusammenhang unter anderem die Herkunft und die Verwendung der Daten, die Qualität und Aktualität, sowie die Kategorie. Daten zählen zu den wertvollsten Assets des Unternehmens überhaupt und können in ihrer Funktion als wirtschaftliches Gut gewinnbringend eingesetzt werden. Im Rahmen der Kundenbindung und der entsprechenden Customer Experience können Daten eingesetzt werden, um den Kunden passgenaue Vorschläge zu liefern. Dienstleister wie Netflix oder der Versandhändler Amazon sind in der Lage, anhand des Kundenverhaltenes, welches sie gespeichert haben, solche Empfehlungen zu generieren. Ein weiterer Use Case ist die effizientere Nutzung von Unternehmensressourcen, z. B. durch den Aufbau von Predictive Maintainance um Wartungs- und Reparaturkosten zu senken bzw. Ausfallzeiten in der Produktion zu minimieren. (Mehr dazu siehe in folgendem [Beitrag](https://thecattlecrew.net/2019/11/07/moglichkeiten-einer-cloud-plattform-fur-predictive-maintenance/)) . Der Einsatz von Datenanalyse und die Bereitstellung von Daten können auch im Rahmen der Umsetzung von Sustainability-Zielen eingesetzt werden, um beispielsweise Food Waste zu reduzieren, indem die Logistik und Lagerung von Lebensmitteln optimiert und besser an die Bedarfe angepasst wird. Die Vorteile und Anwendungsfälle für die Verwendung von Daten für die Analyse, zur Vorhersage oder zur Unterstützung der Entscheidungsfindung liegen auf der Hand, aber laut einer Studie von Forrester werden zwischen 60% – 73% nicht für analytische Zwecke genutzt ([Link](https://www.inc.com/jeff-barrett/misusing-data-could-be-costing-your-business-heres-how.html)). Hier kann ein Data Catalog einen wesentlichen Beitrag leisten, damit Unternehmen eine bessere Transparenz über die zur Verfügung stehenden Daten erhalten und die Nutzung erhöhen können. ## Ich suche nicht — ich finde Eine Umfrage unter amerikanischen Unternehmen mit mehr als 1.000 Mitarbeitern ergab, dass im Durchschnitt 400 Datenquellen in Unternehmen für Analysen und Reports genutzt werden. 20 % der befragten Unternehmen nutzen sogar mehr als 1.000 Datenquellen ([Link](https://pages.matillion.com/rs/992-UIW-731/images/Optimize%20Analytics%20-%20Matillion_Final.pdf)). Dies ist eine unglaubliche Menge, die sich durch die Tatsache, dass aus einer Quelle mehrere Datensets mit einer beliebigen Anzahl von Attributen stammen können, noch potenziert. Gleichzeitig zur wachsenden Menge an Datenquellen und Daten steigt bei Organisationen der Bedarf nach Self-Service-Analysen und Reports. In Zeiten, in denen man auf äußere Einflüsse immer schneller reagieren muss, ist die Notwendigkeit der schnellen Informationsbeschaffung und deren Aufbereitung entscheidend für den unternehmerischen Erfolg. Gerade Fachbereiche stehen daher oft vor dem Problem, dass die Herkunft und Qualität der Daten unbekannt sind, und auch der Ansprechpartner bzw. Owner der Daten ist nicht ersichtlich. In diesem Umfeld kann ein Datenkatalog einen wesentlichen Beitrag leisten, indem er zwei wesentliche Dinge tut: 1. **Automatisierte Inventarisierung und Kategorisierung** Durch eine einfache Anbindung an die bestehende Infrastruktur unter Verwendung von Standard-Connectoren können Data-Catalog-Lösungen eine automatisierte Inventarisierung von On-Prem- und Cloud-Datenquellen vornehmen. Die Inventarisierung erfolgt zunächst initial und dann im Betrieb regelmäßig, um die Aktualität der Informationen zu gewährleisten. Ein Data Profiling erfolgt automatisiert, so werden z. B. Anzahl der Datensätze und Datentypen erkannt. Darüber hinaus können regelgestützt bestimmte Kategorien bzw. Klassifizierungen zugeordnet werden, z. B. die Kennzeichnung von Kreditkartennummern als personenbezogene Daten. Besonders fortschrittliche Lösungen nutzen KI-gestützte Verfahren und Algorithmen, um die Klassifizierung vorzunehmen und damit die Notwendigkeit für manuelle Eingriffe zu minimieren. Das Ergebnis sind „Metadaten“, also Daten über Daten. Diese erweitern die gespeicherten Informationen um weitere Attribute. Sehr nützlich ist diese Funktion beispielsweise, um automatisiert personenbezogene Daten zu kennzeichnen. 2. **Zugängliche und zugleich mächtige Suchfunktion** Für die Konsumenten von Daten spielt die Suche eine zentrale Rolle. Die Suchfunktion muss möglichst einfach sein und sollte neben den reinen Daten auch andere Inhalte, wie z. B. ein Glossar umfassen. Die Ergebnisse der Suche werden übersichtlich dargestellt und die Reihenfolge, in der die Ergebnisse präsentiert werden, berücksichtigt allerlei Faktoren, um ein entsprechendes Ranking zu errechnen. In diese Faktoren kann auch „Wisdom of the Crowd“ mit einfließen, also Kommentare, Bemerkungen und Bewertungen anderer Benutzer. Mittels der Attribute aus Metadaten und Klassifizierungen lassen sich Suchergebnisse weiter filtern und verfeinern. [![Beispiel für einen Suche - Atlan | Modern Data Catalog & Discovery](https://thecattlecrew.net/wp-content/uploads/2021/07/Atlan-Search-Page.png)](https://atlan.com/platform/data-catalog/)*Beispiel für einen Suche – Atlan | Modern Data Catalog & Discovery* ## Die wichtigsten Funktionen / Features - **Konnektoren / Anbindung der Datenquellen** Die Inventarisierung aller Datenquellen ist einer der wichtigsten Anforderungen an einen Data Catalog. Natürlich sollten hier On-Prem- und Cloud-Datenquellen berücksichtigt werden. Der Datenkatalog kann neben den klassischen Quellsystemen auch BI-Lösungen umfassen, z. B. Power-BI-Datasets. Ziel ist der Aufbau einer „Single Source of Trust“ mit möglichst hoher Automatisierung. Je nach Lizenzmodell der Lösung können für das Scannen der Quellen Kosten entstehen, dies sollte in den Überlegungen berücksichtigt werden. - Eine **Suchfunktion,** welche „multi-faceted“ ist, berücksichtigt neben einer reinen Stichwortsuche auch weiterführende Filter- und Suchmöglichkeiten. - **Data Lineage** ist die meist grafische Repräsentation zur Visualisierung der Datenherkunft und der Datenverwendung. Dies ist durchaus noch eine wichtige Anforderung im Rahmen eines Data Catalogs. Durch den Shift der Paradigmen von ETL und ELT und der Ü„nderung der Architektur in Richtung Data Lake / Lakehouse-Architektur muss dieser Aspekt nicht unbedingt im Fokus der Überlegungen stehen. Hilfreich ist diese Funktion, um z. B. die Herkunft von Daten, die in einem Report angezeigt werden, zu ihrem Quellsystem zurückzuverfolgen und beispielweise bei Qualität- oder Aktualitätsproblemen reagieren zu können. Außerdem spielt das Thema Datenschutz ggf. eine Rolle. - **Kategorisierung** Hier setzen viele Hersteller auf Regelwerke und AI. Hier hat beispielsweise der Software-Hersteller Microsoft ein umfangreiches Werk und Definitionen geschaffen, um alle möglichen Informationstypen, besonders wenn es um Informationen sensibler Natur geht, zu identifizieren. Mehr Informationen sind unter folgendem [Link](https://docs.microsoft.com/de-de/microsoft-365/compliance/sensitive-information-type-entity-definitions?view=o365-worldwide#credit-card-number) zu finden. Für die Erkennung einer Kreditkartennummer wird ein entsprechendes Muster geprüft, Feldnamen (in mehreren Sprachen) gematcht und eine Prüfsumme gecheckt. [![Benutzerdefinierte Klassifizierungen in Azure Purview](https://thecattlecrew.net/wp-content/uploads/2021/07/classification-1024x371.png)](https://docs.microsoft.com/de-de/azure/purview/create-a-custom-classification-and-classification-rule)*Benutzerdefinierte Klassifizierungen in Azure Purview*- **Data Quality** Die Datenqualität ist in jedem Data-Projekt der maßgebliche Faktor. Stimmen die Daten nicht, dann können die errechneten Kennzahlen zu fehlerhaften Entscheidungen führen. Aufgabe eines Data Catalogs ist jedoch nicht die Sicherstellung der Datenqualität. Die Daten sollten dort qualitätsgesichert werden, wo es sinnvoll ist. Dies ist meist am Anfang des Prozesses der Fall, da dort auch der Aufwand für die Korrektur am geringsten ist. - **Weitere Features eines Data Catalogs:** - Unterstützung von Collaboration, um Notizen, Bewertungen, Kommentare und manuelle Klassifizierungen vernehmen zu können - Modelle auf Business-Ebene, um Geschäftsprozesse und die zugehörigen Daten darstellen zu können - Glossar zur Klärung von Begrifflichkeiten und Regeln ## Data Catalog als Bestandteil einer ganzheitlichen Data Governance „Data Governance ist eine Ansammlung von Prozessen, Rollen, Richtlinien, Standards und Kennzahlen, die eine effektive Nutzung von Informationen ermöglichen und Organisationen bei der Umsetzung ihrer Ziele unterstützen.“ (Definition von [Talend](https://www.talend.com/de/resources/what-is-data-governance/)) Der Data Catalog ist ein Bestandteil der Data Governance und operationalisiert bestimmte Aspekte. Wie bereits angesprochen, ist die Aufgabe eines Data Catalogs nicht, die Datenqualität sicherzustellen. Im Katalog sollte lediglich die Güte der Qualität angezeigt werden. Für den Anwender sollte ersichtlich und nachvollziehbar sein, was die Einordnung in eine Qualitätsstufe bedeutet. [![](https://thecattlecrew.net/wp-content/uploads/2021/07/Delta-Lake-Multi-Hop-Architecture-Bronze-1024x297.png)](https://databricks.com/blog/2019/08/14/productionizing-machine-learning-with-delta-lake.html)*Beispiel für die Güteklassen der Datenqualität – Anbieter Databricks* Gleiches gilt für Data Compliance. Die Einhaltung der Vorgaben aus Gesetzen und regulatorischen Anforderungen ist ein komplexes Thema und kann regional unterschiedlich sein. Schützenswerte personenbezogene oder personenidentifizierbare Daten können in einem Data Catalog entsprechend gekennzeichnet werden, um die Verwender der Daten dafür zu sensibilisieren. ## Open Data als prominentes Beispiel für Data Catalogs Hinter Open Data verbirgt sich die Idee, Daten frei zugänglich zu machen und eine Nutzung ohne Einschränkungen zu erlauben. Zu den Produzenten dieser Daten zählen vor allem staatliche Stellen und Organisationen. Um auch in diesem Zusammenhang die Organisation und Auffindbarkeit der Daten zu gewährleisten, werden die Daten über einen Data Catalog bereitgestellt. Eine weit verbreitete Lösung aus der Open Source Community ist CKAN. Zu den Verwendern zählen z. B. die Verwaltungen der USA ([data.gov](https://www.data.gov/)) und Großbritanniens ([data.gov.uk](https://data.gov.uk/)). Auch der deutschsprachige Katalog [govdata.de](https://www.govdata.de/) wird über CKAN betrieben. [![CKAN - The world](https://thecattlecrew.net/wp-content/uploads/2021/07/CKAN-Powering-Open-Data-1024x195.png)](https://ckan.org/)*CKAN – The world“™s leading open source data management system*Diese Software ist frei verfügbar und kann als Einstieg und Spielwiese in das Thema Data Catalog heruntergeladen und installiert werden. Natürlich gibt es auch eine Reihe von kommerziellen Anbietern, die Demo- oder Trial-Versionen anbieten. Ein weiterer Contributor aus der Open Source Community ist die Apache Software Foundation. Mit [Apache Atlas](https://atlas.apache.org/#/) wird ein Meta Data Management bereitgestellt, welches zu einem Data Catalog ausgebaut werden kann und besonders gut mit weiteren Apache Produkten aus dem Data Umfeld interagiert, unter anderem HIVE bzw. Hadoop und Storm/Kafka. ## Fazit Die Menge an Daten, die jeden Tag auf der Welt generiert werden, steigt rasant an. Dazu kommen neue Architekturen und Technologien, um Daten zu speichern und zu verarbeiten, wie z. B. Data Lakes und Streaming Data. Ein Data Catalog kann ein Hilfsmittel sein, um Organisationen bei der Verwendung und Nutzung der Daten zu unterstützen. Data Scientists verwenden nur einen geringen Teil ihrer täglichen Arbeitszeit darauf, Daten auszuwerten und Modelle zu entwickeln ([Link](https://www.forbes.com/sites/gilpress/2016/03/23/data-preparation-most-time-consuming-least-enjoyable-data-science-task-survey-says/?sh=52bf448b6f63)). Stattdessen verbringen sie viel Zeit mit dem Suchen und Organisieren von Daten. Ein Data Catalog kann dazu beitragen, dass diese Zeiten sinnvoller genutzt werden. Aus Daten können neue Business Cases entstehen und bestehende Prozesse deutlich verbessert werden. Mittels Automatisierung und KI können Data Catalogs mit wenig manuellem Aufwand befüllt und aktuell gehalten werden, menschlicher Input erhöht die Qualität des Data Catalogs. Im Zentrum der Nutzung und des Mehrwerts steht die Suchfunktion. Als Bestandteil und als Instrument einer Data-Governance-Strategie kann ein Data Catalog dazu beitragen, die Strategie im Unternehmen umzusetzen. Open Source Software ist eine Möglichkeit, sich dem Thema von technischer Seite her zu nähern. Kommerzielle Anbieter bieten oft die Möglichkeit, ihre Produkte in Trial- und Demo-Versionen besser kennenzulernen. **Kategorien:** Analytics & Insights, Tools & Methoden **Schlagwörter:** data analytics, Data Catalog, Data Governance, Data Lineage, Data Management, Datenstrategie, Strategy --- ### [Schnelleres Data Warehouse mit dem Datavault Builder - Zielplattformen im Performancetest](https://thecattlecrew.net/2021/12/22/schnelleres-data-warehouse-mit-dem-datavault-builder-zielplattformen-im-performancetest/) **Published:** Dezember 22, 2021 **Author:** Kevin Ullrich **Content:** Die digitale Transformation ist wie ein Tor zu einer neuen Welt: Vor allem mithilfe von Daten, die in großen Mengen generiert werden, können Unternehmen mehr und bessere Geschäfte tätigen und tiefere Erkenntnisse über Kunden, Produkte, Konkurrenten und neue Märkte gewinnen. Das kann ein entscheidender Wettbewerbsvorteil sein. Vorausgesetzt, sie sind in der Lage, die Daten so zu verwalten, dass, sie von einer digitalen Lösung effizient genutzt und ausgewertet werden können. Das Zauberwort dafür heißt DWH-Automatisierung. Mit agilen Entwicklungsmethoden, hochgradiger Standardisierung und Automatisierung können BI-Analysten die Vorgänge im DWH beschleunigen und Handarbeit reduzieren. Das Ergebnis sind weniger Fehler bei höherer Qualität und Konsistenz. Ein bekanntes Tool für die DWH-Automatisierung ist der Datavault Builder der Firma 2150 GmbH. Im Rahmen meiner Masterarbeit wollte ich mir die Funktionsweise dieses Tools näher anschauen und herausfinden, welche Zielplattform die beste Performance hergibt. Zum Vergleich standen drei Plattformen: die Azure SQL-Datenbank, Exasol und Snowflake. Die drei wurden jeweils in Kombination mit dem Datavault Builder im Hinblick auf Performance und Nutzung miteinander verglichen. Die Ergebnisse haben mich ehrlich gesagt überrascht. Hier findet ihr die Untersuchung mit allen Details: [Link zur Masterarbeit als PDF](https://thecattlecrew.net/wp-content/uploads/2021/12/Kevin_Ullrich_Masterarbeit.pdf). **Kategorien:** Analytics & Insights, Database **Schlagwörter:** Data Vault, Data Warehouse, Datavault Builder, DWH, DWH Automation, DWH Automatisierung, Exasol, Snowflake --- ### [Running APEX 21.1 in Docker](https://thecattlecrew.net/2021/05/18/running-apex-21-1-in-docker/) **Published:** Mai 18, 2021 **Author:** Holger Lehmann **Content:** This blog post about running APEX 21.1 in Docker was orignally published in my personal blog via blogger. Last week I posted a screenshot on Twitter of the new Oracle APEX 21.1 running in my docker environment on Ubuntu Linux. I was asked to give a futher view of installing the new version. Here it comes right now. To make things easier I searched the internet for a template of a docker project and I found the git repository from fuzzlebrain [fuzziebrain/docker-apex-stack: Utility scripts for creating an Oracle Application Express stack as a Docker container. (github.com)](https://github.com/fuzziebrain/docker-apex-stack). In general the process clones the official Oracle docker images and installs the needed software that is configured in a configuration file. **Step 1** is cloning the git repository to my local file system. [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image.png)Prerequisites of software packages needed for this docker image: Install the following things in your host: - Git - Curl - Docker (of course) **Step 2** is getting the required the installation files and placing them in the subfolder of the downloaded repository - Oracle Database 18c XE or any of the required installation files from OTN (supports versions up to 19.3 as of April 25, 2019) - Oracle Application Express (supports versions up 21.1 as of May 12, 2021) - Oracle REST Data Services (supports versions up to 20.4.3 as of May 12, 2021) or ords-21.1.1.116.2032.zip - Java Development Kit SE 8 (IMPORTANT: Please download the tarball, e.g. jdk-8u291-linux-x64.tar.gz.) [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-1.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-1.png)You can even try to build your docker images with different versions of ORDS or APEX. After executing the first step for several times I changed the first script 01-build.sh a little bit and removed the line where the official docker images are pulled. Why ? Because they are placed in the folder dockerfiles after the first run and pulled every time the build process is started. A little bit too much downloads… [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-2.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-2.png)The second „issue“ I faced is in the used 18c XE database Dockerfile as the install file is downloaded every time docker creation runs, But it should use the rpm file from the files folder. **old**: INSTALL\_FILE\_1=“https://download.oracle.com/otn-pub/otn\_software/db-express/oracle-database-xe-18c-1.0-1.x86\_64.rpm“ \\ **new**: INSTALL\_FILE\_1=“oracle-database-xe-18c-1.0-1.x86\_64.rpm“ \\ [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-3-1024x348.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-3.png)**Step 3** is to configure my settings for the creation process in the file mysettings.env. Make a copy of settings.env.sample, e.g. mysettings.env, and modify as desired. mysettings.env should contain the following variables: [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-4.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-4.png)You can change many parameters in there e.g. the oracle SID, the versions, the ports and the passwords for Oracle, APEX and ORDS. When you are done the DB creation process can be started. **Step 4** is to run the first script to grab the latest Docker images from Oracle (if not disabled) and build the Oracle Database image. The script takes one parameter, the environment filename (mysettings.env). [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-5.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-5.png)**Step 5** is to run the final script to create and run the container, where the container name is of your choice e.g. das. [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-6.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-6.png)When the script is ready or when I restart my previous built container again I can login to the APEX internal workspace http://localhost:50080/ the initital password for the ADMIN user can be retrieved from mysettings.env [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-8.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-8.png)Using the sample settings, the following URLs are accessible: [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-7.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-7.png)The APEX About Dialog: [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-9.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-9.png)After login ypu are able to create other workspaces in APEX or applications if you like. That is pretty easy to use and play with APEX in Docker. Still another approach without docker is to claim for a workspace on [Oracle APEX](https://apex.oracle.com/de/) ( https://apex.oracle.com/de/ ) where Oracle has upgraded APEX to v21.1, too. [![](https://thecattlecrew.net/wp-content/uploads/2021/05/image-10.png)](https://thecattlecrew.net/wp-content/uploads/2021/05/image-10.png)One thing that changed in APEX 21 is the location of the sample apps. Now they are hosted on github https://oracle.github.io/apex/ and not shipped with the APEX installation anymore. Cheers Holger **Kategorien:** Development, Infrastructure **Schlagwörter:** APEX, Docker, oracle, ORDS --- ### [Informationen zu den aktuellen Oracle Weblogic Security Issues](https://thecattlecrew.net/2020/11/10/informationen-zu-den-aktuellen-oracle-weblogic-security-issues/) **Published:** November 10, 2020 **Author:** Michael Schulze **Content:** Aus aktuellem Anlass möchten wir alle Kunden, die das Produkt Oracle Weblogic einsetzen, auf die folgenden bestehenden Sicherheitsrisiken aufmerksam machen. Aktuell sind zwei Common Vulnerabilities and Exposures (CVEs) bekannt, die erhebliche Sicherheitsrisiken für existierende Installationen der o.g. Produkte haben. Hintergrund CVE: CVEs vereinfachen die Identifizierung von Oracle-Schwachstellen, wenn in externen Sicherheitsberichten darauf verwiesen wird, z.B. von Sicherheitsforschern und Schwachstellenmanagementsystemen. Konkret handelt es sich hierbei um die folgenden CVEs: # CVE-2020-14882 - - # CVE-2020-14750 - - # Beschreibung, Bewertung und Status Die beiden bekannten Weblogic Server Schwachstellen CVE-2020-14750 und CVE-2020-14882 wurden mit einem Score von **9.8** **von 10** und damit als **High Critical** eingestuft. Über die URL der Konsolenkomponente (/console) des Weblogic AdminServers kann der Angreifer privilegierten Zugriff auf das darunterliegende Betriebssystem erlangen. *Besonders kritisch ist hierbei, dass nicht authentifizierte Angreifer über diesen Remote Code Execution (RCE)-Fehler **ohne Authentifizierung** in der Konsolenkomponente des Servers über http (d.h. ohne Angabe eines Benutzeraccounts) über das Netzwerk zugreifen können, um hier potenziell Server zu übernehmen*. Davon sind alle bekannten Weblogic Versionen betroffen. **Deshalb raten wir dringend allen Kunden, die Oracle Weblogic einsetzen, zeitnah ihre betroffenen Systeme zu patchen, um diese gravierenden Sicherheitslücken zu schließen (s. Liste** **Patching-Eempfehlungen).** # Präventive Maßnahmen Als temporäre Lösung zur schnellen Abhilfe können folgende Maßnahmen angewendet werden: - Oracle Weblogic AdminServer deaktivieren, bzw. den Zugang zur Adminkonsole durch Konfigurationsanpassung sperren - Entfernung des Admin-Portals aus dem öffentlichen Internet - Überprüfung von Anwendungsprotokollen auf HTTP-Anforderungen, die den doppelt codierten Pfaddurchlauf: %252E%252E%252F und das Administratorportal console.portal im Anforderungs-URI enthalten (weitere Möglichkeiten denkbar) - Überwachung des Netzwerkverkehrs auf verdächtige HTTP-Anforderungen (falls möglich) - Überwachung auf verdächtige Prozesse, die von der Anwendung erstellt wurden Detaillierte Weblogic Security-Maßnahmen hier: # Solution / Patching-Empfehlungen Die Sicherheitslücken betreffen **alle Versionen** des Oracle Weblogic Servers (10.3.6 „“ 14.1.1) und damit alle Kunden, die den Weblogic Server als Application-Server und Grundlage für Oracle Fusion Produkte wie z.B. die folgenden verwenden: - Oracle SOA Suite - Oracle Access Manager / IDM - Oracle ODI - Oracle BI-Publisher - Oracle Forms/Reports - „¦ Weiterhin betroffen sind auch folgende Systeme/Software, die Weblogic intern verwenden und separat zu behandeln sind: - Exadata Systems (prüfen Patches über MOS-Note: 888828.1) - Oracle EM Cloud Control (abweichende Patchmechanismen) Um die Weblogic Sicherheitslücken zu schließen, ist **zeitnah** das jeweilige Weblogic CPU von Oktober 2020 einzuspielen, sowie additional dazu der jeweilige Overlay Patch, (siehe Liste unten): ## Oracle WebLogic Server 10.3.6 - WLS PATCH SET UPDATE 10.3.6.0.201020, Patch **31641257** - Overlay Patch **32097188** für CVE-2020-14750 ## Oracle WebLogic Server 12.1.3 - WLS PATCH SET UPDATE 12.1.3.0.201020, Patch **31656851** - Overlay Patch **32097177** für CVE-2020-14750 ## Oracle WebLogic Server 12.2.1.3 - WLS PATCH SET UPDATE 12.2.1.2.201001, Patch **31961038** - Overlay Patch **32097173** für CVE-2020-14750 ## Oracle WebLogic Server 12.2.1.4 - WLS PATCH SET UPDATE 12.2.1.4.201001, Patch **31960985** - Overlay Patch **32097167** für CVE-2020-14750 ## Oracle WebLogic Server 14.1.1 - WLS PATCH SET UPDATE 14.1.1.0.200930, Patch **31957062** - Overlay Patch **32097180** für CVE-2020-14750 ## EM Cloud Control - Der Enterprise Manager nutzt ebenso den Weblogic Server als Grundlage, hier sind die aktuellsten EM-Release Updates einzuspielen! Stand 10.11.2020 muss hierzu die opatch Version aktualisiert werden. ## Exadata-Systeme - für Exadata Systeme, die Weblogic intern verwenden, kann über MOS-Note: 888828.1 recherchiert werden - aktuell sind uns hier aber noch keine Fälle bekannt geworden. **Gern unterstützen wir Sie bei der Planung und Durchführung der notwendigen Updates. Sprechen Sie uns gerne an, und reagieren Sie zeitnah um weitere Probleme zu vermeiden!** **Kategorien:** Cloud, Infrastructure, IT-Security **Schlagwörter:** CVE, IT Security, oracle, Weblogic --- ### [Evaluierung Java Microframeworks: JAVALIN](https://thecattlecrew.net/2020/07/15/evaluierung-java-microframeworks-javalin/) **Published:** Juli 15, 2020 **Author:** Meryem Cigdem **Content:** Wir haben es uns zur Aufgabe gemacht, verschiedene Microframeworks anhand eines kleinen Anwendungsfalles zu evaluieren, der detaillierte Anwendungsfall wurde bereits in unserem ersten Blog-Post „“ beschrieben. Heute werden wir uns auf das Microframework Javalin konzentrieren. Im Folgenden zeigen wir die wichtigsten Eigenschaften, Stärken und Schwächen von Javalin. Das Codebespiel ist unter diesen Link „“ zu finden. ![](https://thecattlecrew.net/wp-content/uploads/2020/07/javalinlogo.png) Javalin ist ein einfaches Framework für die Programmiersprachen Java und Kotlin, welches geringerer Speicherverbrauch und schnelle Start-Up Zeit hat. Javalin wird unter der Apache 2.0 Licence veröffentlicht. Javalin ist eher eine Bibliothek als ein Framework und verfügt nur über sehr wenige Konzepte, die man lernen muss. Es müssen niemals Klassen erweitert und nur selten Schnittstellen implementiert werden. Außerdem verwendet Javalin weder Annotationen noch Reflection. Bei Javalin steht zudem das Thema Interoperabilität im Fokus. Apps können dabei transparent – ohne Ü„nderungen an Frameworkversionen oder -komponenten – sowohl in Java als auch in Kotlin entwickelt werden. Neben der JVM wird zudem GraalVM als Laufzeitumgebung unterstützt. Bei der Verwendung GraalVM Native Images können sowohl die Docker Imagegrößen, als auch die Startupzeiten massiv gesenkt werden, was bspw. für Serverless Apps sehr interessant ist. Weiterhin setzt das Framework technologisch auf Jetty. Weitere Javalin-Features sind eine funktionale Schnittstelle namens **Access Manager**, mit der man die Authentifizierung und / oder Autorisierung pro Endpoint festlegen kann oder auch der Support für OpenAPI, der die Beschreibung der exponierten Schnittstellen erlaubt. In diesem Teil haben wir erstmal allgemeine Informationen über Javalin gegeben. Im Folgenden betrachten wir wie eine Javalin Applikation entwickelt wird und die wichtigsten Eigenheiten und Elemente von Javalin. #### Javalin Projekt erstellen und kompilieren Das Erstellen eines Javalin-Projekts ist einfach und bereits nach ein paar Minuten kann man mit der Programmierung beginnen. Zuerst erstellt man ein Maven oder Gradle Projekt. Danach fügt man Javalin als normale Dependency hinzu. Wir haben mit Gradle ein Projekt erstellt und dort Javalin hinzugefügt, siehe Abbildung unterhalb. ``` 1. dependencies { 2. ... 3. compile "org.slf4j:slf4j-simple:1.8.0-beta4" 4. compile 'io.javalin:javalin:3.7.0' 5. } Abbildung 1 "“ Gradle Projekt Dependencies/ build.gradle Datei ``` Nachdem wir unseres Javalin Projekt erstellt haben, können wir anfangen mit Javalin zu programmieren. Im folgenden Teil werden wir dann eine Beispiel Applikation mit Javalin betrachten. #### Ein Java-Microservice mit Javalin Nachdem nun ein Projekt erstellt ist, kommen wir zu der eigentlichen Stärke der Microframeworks – den Microservices. Wir benötigen für unsere Technologie Management Webseite jeweils eine Detailseite pro Technologie. Dafür haben wir einen Get-Handler () implementiert, welcher in der vierten Programmzeile in der Abbildung 2 zu sehen ist. Dank dieses Handlers kann man durch Aufrufen einiger Methoden Ergebnisse aus der Controller-Klasse erhalten. Der erste Bestandteil des Handlers, „/technologies/:key“ ist der URL. ``` 1. public class TechnologyApplication { 2. public static void main(String[] args) { 3. Javalin app = Javalin.create().start(7000); 4. app.get("/technologies/:key", 5. TechnologiesController::getSpecialTech); 6. } 7. } Abbildung 2-Get Handler ``` Das Wort „key“ ist die Variable für die gewünschte Technologie. Beispielsweise werden alle Informationen zu der Technologie Angular unter folgender URL „http://localhost:7000/technologies/Angular“ zurückgegeben Nachdem nun der Handler implementiert ist, muss noch der Controller sowie die Methode, die im Controller eingefügt wird, erstellt werden. Der Controller wird vom Handler aufgerufen (TechnologiesController, siehe Abb. 2 Zeile 5). Javalin bietet für HTTP Anfragen einen Standardübergabeparameter vom Typ „Context“( ) (siehe Abb. 3 Zeile 5). Der Context bietet alles, was zur Bearbeitung benötigt wird (für mehr Details siehe bitte Abschnitt Context Objekt). In unserem Beispiel benutzen wir das Context Objekt, um alle Informationen unserer Technologie als Ergebnis zurückzugeben. ``` 1. public final class TechnologiesController { 2. private TechnologiesController () { } 3. static String [] availableTechnologies= {"Angular","4G", "Kotlin"}; 4. 5. public static void getSpecialTech(Context ctx) { 6. for(String tech : availableTechnologies){ 7. if(tech.contains(ctx.pathParam("special"))){ 8. ctx.result(tech); 9. return; 10. } 11. } 12. ctx.result("No Technologie :("); 13. } 14. } Abbildung 3-Controller Klasse ``` #### Handler in Javalin Wenn man schon mal mit einem Java Framework wie zum Beispiel Spring Boot gearbeitet hat, sollte man Annotationen schon kennengelernt haben. Wenn wir bspw. eine Get-Anfrage in üblichen Frameworks bearbeiten wollen, annotieren wir unsere Methode mit @GET (siehe Abbildung 4 Zeile 1) ``` 1. @GET 2. public static void exampleMethod (){ 3. } Abbildung 4- Beispiel für eine Annotation in anderen Frameworks ``` In Javalin gibt es jedoch genau diese Annotationen nicht! Diese Aufgabe übernehmen in Javalin die Handler. Es gibt drei Haupthandlertypen. Before Handler, Endpoint Handler und After Handler, wobei meistens der Endpoint Handler verwendet wird. **Endpoint Handler** Endpoint-Handler (GET, POST, PUT, DELETE) werden in der Mainklasse implementiert und für die Bearbeitung von Anfragen (Requets) verwendet. Abbildung 5 zeigt wie wir die Endpoint Handler implementiert haben. ``` 1. app.get("/technologies/:id", TechnologyController::getTechnology); 2. app.delete("/technologies/:id",TechnologyController::removeTechnology); 3. app.post("/technologies", TechnologyController::insertTechnology); 4. app.put("/technologies", TechnologyController::updateTechnology); Abbildung 5- Beispiele für Endpoint Handler ``` In Abbildung 5 sieht man, dass wir alle Handler in unserer Applikation benutzt haben. Durch die Namen der Handler, ist deren Funktion selbsterklärend. In Zeile 1 und 2 ist „id“ eine Variable. In dieser steht dann die Technologie id . Beispielsweise werden alle Informationen zu der Technologie Javalin mit id Nummer 2 unter folgender URL „http://localhost:7000/technologies/2“ zurückgegeben. #### Javalin Context Objekt Wie bereits erwähnt, bietet Javalin für HTTP Anfragen das Context Objekt (siehe Abbildung 6 Zeile 1).Beispielsweise kann man mit „context.pathParam(„id“);“ ein übergebener Pfad-Parameter ausgelesen werden (siehe Abbildung 6 Zeile 3). In unserem Beispiel benutzten wir dieses Context Objekt auch, um einen Status zurückzugeben (siehe Abbildung 6 Zeile 6). ``` 1. public static void getTechnology(Context context) { 2. DBService con = new DBService(); 3. String string_id = context.pathParam("id"); 4. 5. if(string_id==null) { 6. context.status(404); 7. return; 8. } 9. "¦ Abbildung 6-Context Objekt ``` #### Datenbankverbindung Wir wollen in unserem Beispiel die Technologien in einer Datenbank speichern oder auch gespeicherte Daten auslesen. Da Javalin dafür nichts Besonderes anbietet, haben wir uns für die Anbindung der Datenbank für die klassische Plain JDBC-Variante ohne die Verwendung eines Objektrelationalen Mapping (ORM) Frameworks entschieden. Dies macht auch die Anzahl der zusätzlich benötigten Dependencies überschaubar. Natürlich könnten auch entsprechende ORM-Frameworks wie bspw. Hibernate eingebunden und in der Implementierung verwendet werden. Wir haben in unsere Datenbankservice Klasse die Connection definiert und initialisiert. (siehe Abbildung 7 Zeile 5).“DB\_URL“ (siehe Abbildung 7 Zeile 17) ist die URL-Adresse von unserem Datenbank und „DB\_PORT“(siehe Abbildung 7 Zeile 17) ist die Portadresse der Datenbank, diese haben wir als Umgebungsvariablen gespeichert. Außerdem haben wir in dieser Klasse die benötigen Methoden implementiert (siehe bitte Codebespiel in GitHub), um die Informationen in der Datenbank zu schreiben und auch Informationen aus der Datenbank auszulesen. ``` 1.public class DBService { 2. private Connection conn; 3. public DBService() { 4. try { 5. conn = initConnection(); 6. } catch (ClassNotFoundException e) { 7. e.printStackTrace(); 8. } catch (SQLException e) { 9. e.printStackTrace(); 10. } 11. } 12. private Connection initConnection() throws ClassNotFoundException, SQLException{ 13. 14. Class.forName("org.postgresql.Driver"); 15. String user = "postgres" 16. String password = "********"; 17. String dbUrl = System.getenv("DB_URL"); 18. String dbPort = System.getenv("DB_PORT"); 19. String dbConnectionString = "jdbc:postgresql://" + dbUrl + ":" + dbPort + "/postgres?ssl=false"; 20. 21. return DriverManager.getConnection(dbConnectionString, user, password); 22. } 23. } Abbildung 7-Datenbankverbindung ``` #### Sonstige Features von Javalin **Asynchronität in Javalin** Wir haben in unserem Anwendungsbeispiele keine Asynchronität (https://javalin.io/news/2018/04/14/javalin-1.6.0-released.html) verwendet. Es ist jedoch ab Javalin 1.6.0 möglich eine asynchrone Request Bearbeitung zu verwenden, um die Performance zu verbessern und den Ressourcenverbrauch zu verringern. **Open API in Javalin** Ebenso ist noch zu erwähnen, das Javalin OpenAPI vollständig unterstützt, was bei viele anderen leichtgewichtigen Java-Frameworks nicht der Fall ist. Um OpenAPI Plugins nutzen zu können, sollte man „javalin-openapi“ als Dependency hinzufügen. ( ). **Logging in Javalin** Für das Anwendungslogging bringt Javalin nichts Besonderes mit. Somit kann eine beliebige Logging-Implementierung, wie bspw. Slf4J verwendet werden. Dazu muss einfach nur die entsprechende Dependency in dem Projekt hinzugefügt werden. Mehr Informationen über Logging Optionen in Javalin findet man unter https://javalin.io/documentation#logging. #### Zusammenfassung Die Implementierung von Javalin ist ziemlich einfach. Man muss keine externen Dateien installieren. In wenigen Minuten kann man seine erste Javalin-Anwendung implementieren. Außerdem gibt es nicht so viele Funktionen von Javalin, daher empfanden wir, dass Javalin ein einfaches Framework ist, welches man ohne großen Lernaufwand nutzen kann. Nach einer Umfrage von Javalin benutzen 92% der Entwickler Javalin für REST APIs, das war bei uns ebenso der Fall. Es wird aber auch sehr oft für WebSockets und für Websites benutzt. Obwohl Javalin ein sehr leichtgewichtiges Framework und einfach zu verstehen war, ist das Framework ziemlich neu, deswegen gibt es auch nur wenige andere Wissensquellen, deswegen hätten wir uns gefreut, wenn es Anwendungsbeispiele in der Javalin Dokumentation gegeben hätte, damit ein Einstieg ins Framework noch leichter gewesen wäre. **Kategorien:** Development **Schlagwörter:** framework, Java, Javalin --- ### [Auf dem Weg zum datengetriebenen Unternehmen: Wie man seinen analytischen Reifegrad erhöht und mehr Menschen beteiligt (Teil 2/3)](https://thecattlecrew.net/2020/04/03/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-2/) **Published:** April 3, 2020 **Author:** Jens Bleiholder **Excerpt:** Im ersten Teil dieser Blogpostserie haben wir uns damit beschäftigt was es bedeutet "datengetrieben" zu sein und welche Themenfelder dabei wichtig sind. In diesem zweiten Teil beschäftigen wir uns mit den beiden weiteren Themenfeldern "Data Analytics" (Wie kann ich die Daten besser nutzen?) und "Data Democratization" (Wie können Daten von mehr Personen genutzt werden?) bevor wir im abschließenden Teil 3 der Serie darstellen, wie ein Transformationspfad in ein datengetriebenes Unternehmen konkret aussehen kann. **Content:** Viele Unternehmen treffen heute immer noch wesentliche Entscheidungen aus dem Bauch heraus oder auf der Basis klassischer Business Intelligence, also aufgrund von Erfahrungen, die sich mithilfe historischer Daten begründen lassen. In Zeiten der Digitalisierung reicht dies allein nicht mehr aus, um als Unternehmen erfolgreich zu sein. Im [ersten Teil dieser Blogpostserie](https://thecattlecrew.net/2020/03/25/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-1/) haben wir uns damit beschäftigt was es bedeutet „datengetrieben“ zu sein und welche Themenfelder dabei wichtig sind. Im ersten Themenfeld „Data Management“ (Wie kann ich mehr Daten nutzen?) geht es darum die Grundlage an Daten zu erweitern, auf deren Basis Entscheidungen getroffen und Wissen generiert wird. In diesem zweiten Teil beschäftigen wir uns mit den beiden weiteren Themenfeldern „Data Analytics“ (Wie kann ich die Daten besser nutzen?) und „Data Democratization“ (Wie können Daten von mehr Personen genutzt werden?) bevor wir im [abschließenden Teil 3 der Serie](https://thecattlecrew.net/2020/04/09/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-3/) darstellen, wie ein Transformationspfad in ein datengetriebenes Unternehmen konkret aussehen kann. **Data Analytics, oder: Wie kann ich die Daten besser nutzen?** Die Bandbreite an Verfahren und Techniken, um Daten zu analysieren reicht von deskriptiven Verfahren wie Reporting oder Dashboarding bis zu ausgefeilten Verfahren aus dem Bereich Machine Learning wie Prognosen und Vorhersagen. Während einfachere Verfahren auch heute noch unter dem Begriff Business Intelligence laufen, haben sich für die prediktiven und preskriptiven Verfahren die Begriffe Business Analytics oder auch Advanced Analytics eingebürgert (siehe Abb. 1). ![Data Analytics nach Reifegrad und erzieltem Wert, angelehnt an [1]](https://thecattlecrew.net/wp-content/uploads/2020/04/analytics.png)Abb. 1: Data Analytics nach Reifegrad und erzieltem Wert, angelehnt an \[1\]Die Entwicklung hin zur Verwendung komplexer Methoden erfolgt dabei üblicherweise über die Zeit. So wird es mit zunehmendem Reifegrad möglich, komplexe Muster in Daten zu erkennen sowie Vorhersagen über vermutlich eintretende Ereignisse abzuleiten. Kamen diese Verfahren aufgrund der hohen Anforderungen an Skills, Daten und Rechenleistung früher nur sehr vereinzelt zum Einsatz, hat sich der Markt der Produkt- und Toolanbieter inzwischen so verändert, dass solche Analysen für weitaus mehr Personen im Unternehmen möglich sind. Mit steigendem Reifegrad steigt üblicherweise auch der Nutzen für das Unternehmen und damit auch der Nutzen und Wert der analysierten Daten. Wie im Themenfeld „Data Management“ ist auch hier ein durch Anwendungsfälle getriebenes schrittweises Vorgehen von Vorteil: konkrete Anwendungsfälle wie „Finanzreporting“, „Risikoanalyse“, „Churn Prevention“ oder „Absatzprognose“ werden durch Methoden aus dem Bereich Business Intelligence (z.B. Ad hoc Reporting) oder Business Analytics (z.B. Prognose) unterstützt. So können sich Unternehmen mit jedem neuen Anwendungsfall auch eine neue Methode erschließen und damit den eigenen Reifegrad und schlussendlich auch den erzeugten Nutzen Schritt für Schritt erhöhen. Gleichzeitig bleiben die klassischen BI-Methoden aber immer noch sinnvoll einsetzbar. Das Zusammenspiel von Data Analytics und Data Management ist hier entscheidend: Bessere Analyseverfahren helfen bereits weiter, aber deutlich mehr Nutzen wird erreicht, wenn auch die Datenbasis sukzessive deutlich ausgebaut wird. Für einige Verfahren ist eine große Menge an Daten sogar unabdingbar. Der nächste Schritt geht in Richtung Automatisierung: Systeme stellen dem Anwender zukünftig nicht mehr nur wertvolle Erkenntnisse für Entscheidungs- bzw. Optimierungsprozesse zur Verfügung, sondern überführen berechnete, bestmögliche Handlungsoptionen automatisch in Aktionen („Automated Decision Making“). Ein Beispiel hierfür sind in Echtzeit angezeigte persönliche Empfehlungen oder personalisierte Werbeanzeigen in einem Webshop. Wird dieser Ansatz weiter optimiert, ist es zum Teil heute schon möglich, kognitiv arbeitende Systeme zu erstellen, die menschliche Lern- und Denkprozesse simulieren und sich durch die gemachten Erfahrungen und gesammelten Daten selbstständig weiterentwickeln. Solche selbstlernenden Systeme können in Echtzeit mit ihrem Umfeld interagieren und die erhaltenen Informationen für ihre eigenständig entwickelten Erkenntnisse berücksichtigen (\[2\]). Sieht man sich diese Potenziale an, wird klar warum Gartner bereits 2015 davon ausging, dass „im Jahr 2020 Informationen verwendet werden, um 80 % der Geschäftsprozesse, die älter als zehn Jahre sind, zu erneuern bzw. abzuschaffen“ (\[3\]). **Data Democratization, oder: Wie können Daten von mehr Personen genutzt werden?** Besseres Datenmanagement und neue Analysemöglichkeiten alleine reichen jedoch noch nicht aus. Die Transformation hin zu einem datengetriebenen Unternehmen erfordert auch einen Kulturwandel in Bezug auf handelnde Personen, deren Organisation, Skills, Aufgaben und Fähigkeiten. Dies betrifft speziell das Bewusstsein für und den Umgang mit Daten. Um den vollen Nutzen aus den vorhandenen Daten zu ziehen, sollten möglichst viele Mitarbeiter im Unternehmen, auf Daten zugreifen und sie täglich in die eigenen Entscheidungen einbeziehen. Daten können auf diese Weise das Know-how innerhalb eines Unternehmens demokratisieren und vervielfachen. Geänderte Governance-Prozesse, die für eine Demokratisierung im Umgang mit den Daten sorgen, oder die Einführung von Self-Service BI sind dafür ein guter Anfang. Des Weiteren kommen hier Programme zum Thema Data Literacy ins Spiel, die Mitarbeitern die nötigen Fähigkeiten zur aktiven und sinnvollen Nutzung von Daten vermitteln. Dies betrifft nicht nur technische Fertigkeiten für den Umgang mit Tools und Methoden sondern auch das Verständnis für Wertschöpfungsprozesse und die Frage, wie Daten darin genutzt werden. Mitarbeiter müssen also in die Lage versetzt werden, die richtigen analytischen Fragen zu stellen, Daten auch mal kritisch bzgl. Herkunft, Qualität oder Eignung zu hinterfragen, Analyseergebnisse korrekt zu interpretieren, richtige Darstellungsformen, zum Beispiel mit Data Visualization oder Data Storytelling, für Daten zu finden und so gewinnbringend für die eigenen Aufgaben einzusetzen. Neben der Befähigung vorhandener Mitarbeiter ist es aber auch unabdingbar für Unternehmen, sich mit neuen Rollen rund um die Datenverarbeitung zu befassen. Dabei geht es um Rollen wie Data Stewards, Chief Data Officer, Data Coach, Citizen Data Scientist oder Produktmanager sowie dem Recruiting entsprechender Mitarbeiter. Nach der Beschreibung der drei Themenfelder wollen wir im [abschließenden Teil 3](https://thecattlecrew.net/2020/04/09/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-3/) dieser Blogpostserie noch darauf eingehen, wie ein Plan zu einer Transformation in ein datengetriebenes Unternehmen aussehen kann. **Literaturhinweise zu diesem Blogpost:** \[1\] „Eight Levels of Analytics“, sascom magazine, SAS Institute, Inc., Cary, NC, 2008(4) \[2\] https://www.bigdata-insider.de/was-ist-cognitive-computing-a-641356/, abgerufen 23.3.2020 \[3\] https://www.forbes.com/sites/gartnergroup/2015/02/12/gartner-predicts-three-big-data-trends-for-business-intelligence/#247e4aa86de4, abgerufen 23.3.2020 **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** Analytics, data driven, Data Management, Daten, Datenstrategie, Digitalisierung --- ### [Auf dem Weg zum datengetriebenen Unternehmen: Was es bedeutet datengetrieben zu sein und welche Themenfelder wichtig sind (Teil 1/3)](https://thecattlecrew.net/2020/03/25/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-1/) **Published:** März 25, 2020 **Author:** Jens Bleiholder **Content:** Viele Unternehmen treffen heute immer noch wesentliche Entscheidungen aus dem Bauch heraus oder auf der Basis klassischer Business Intelligence, also aufgrund von Erfahrungen, die sich mithilfe historischer Daten begründen lassen. In Zeiten der Digitalisierung reicht dies allein nicht mehr aus, um als Unternehmen erfolgreich zu sein. Erfolgreiche Unternehmen wie Facebook oder Netflix gewinnen Informationen und Erkenntnisse heute auf innovative Weise aus vielfältigsten Daten und fällen auf dieser Grundlage ihre Entscheidungen. Sie entscheiden also „datengetrieben“. „“ „Datengetrieben“ bedeutet, Erkenntnisse zu gewinnen durch eine konsequent ganzheitliche Betrachtung aller zur Verfügung stehender Daten und dem Einsatz geeigneter intelligenter Analysemethoden. Das Ziel sind bessere Entscheidungen und die Optimierung der eigenen Wertschöpfungsprozesse, um die Wettbewerbsfähigkeit des Unternehmens nachhaltig zu verbessern. Teilweise entstehen durch diese Erkenntnisse auch neue und zum Teil disruptive Geschäftsmodelle. Für manche Unternehmen ist dies heute die einzige Chance, ihr Überleben langfristig zu sichern. **Was bedeutet es „datengetrieben“ zu sein?** Dieses oben geschilderte Verständnis von „datengetrieben“ geht sogar noch darüber hinaus, was üblicherweise als Definition angesehen wird, nämlich der reine Übergang vom Bauchgefühl zur Begründung von Entscheidungen mit Daten: „The adjective data-driven means that progress in an activity is compelled by data, rather than by intuition or by personal experience.“ \[1\] Die meisten DWH- und BI-Systeme, die seit Mitte der 90er Jahre in vielen Unternehmen aufgebaut wurden, sind in der Regel auf Auswertungen von fachlich konsolidierten, historisierten Daten ausgelegt (klassische BI). Diese stellen gut aufbereitete Informationen über die Entwicklung und Zusammenhänge von Vergangenem zur Verfügung, wodurch das Bauchgefühl für anstehende Entscheidungen abgesichert wird. Diese rückwärtsgerichtete Datenanalyse reicht heute nicht mehr aus. Es bedarf vor allem einer deutlich optimierten Basis von Daten, geeigneter Tools und Methoden zur Analyse, und eine darauf abgestimmte Organisation. Damit einhergehen muss gleichfalls ein Kulturwandel im Umgang mit den Daten. Datengetrieben zu arbeiten hat seinen Vorteil. Diverse Untersuchungen aus den letzten Jahren, deuten darauf hin, dass datengetriebene Unternehmen erfolgreicher sind, weil sie … - … informierter sind und somit bessere Entscheidungen treffen. - … ihre Prozesse kennen und optimiert haben, was sich z. B. in schnelleren Produktionszeiten, höherer Qualität oder einfach geringeren Stückkosten zeigt. - … Entscheidungen zunehmend automatisieren (und damit auch beschleunigen) können. - … Risiken und Veränderungen im Markt frühzeitig erkennen und rechtzeitig sowie zielgerichtet darauf reagieren können. - … konkret Mehrwerte aus ihren Daten generieren, indem z.B. neue Geschäftsmodelle darauf aufgebaut werden (bspw. Monetarisierung von IoT-Daten aus verkauften Maschinen) In vielen Unternehmen werden die entstehenden Daten nur selten vollumfänglich genutzt. Dabei bezieht sich „vollumfänglich“ sowohl auf die Breite (alle Daten werden genutzt), als auch auf die Tiefe (vielfältigste Anwendungsfälle werden optimal unterstützt). Was also benötigen nun Unternehmen, um sich ausgehend von klassischer BI weiter in Richtung eines datengetriebenen Unternehmens zu entwickeln? ![Drei Themenfelder, die auf dem Weg zu datengetriebenem Arbeiten zu beachten sind](https://thecattlecrew.net/wp-content/uploads/2020/03/datadriven.png)Abb. 1: Drei Themenfelder, die auf dem Weg zu datengetriebenem Arbeiten zu beachten sind Aus unserer Sicht sind für die Entwicklung eines datengetriebenen Ansatzes drei Themenfelder wichtig (siehe auch Abb. 1): 1. Data Management (Wie kann ich mehr Daten nutzen?) 2. Data Analytics (Wie kann ich die Daten besser nutzen?) 3. Data Democratization (Wie können Daten von mehr Personen genutzt werden?) Im Folgenden und in den zwei weiteren Teilen dieser Blogpost-Serie wollen wir auf diese drei Themenfelder genauer eingehen und abschließend auch auf den Weg zu datengetriebenem Arbeiten eingehen. **Data Management, oder: Wie kann ich mehr Daten nutzen?** Durch die zunehmende Digitalisierung nimmt die insgesamt zur Verfügung stehende Datenmenge immer mehr zu, einzelne Schätzungen rechnen mit einer Verzehnfachung der Datenmenge alle 5 Jahre auf insgesamt über 175 Zettabyte im Jahr 2025 \[2\]. Auch die Heterogenität der Formate, in denen die Daten gespeichert sind, nimmt zu: Die Bandbreite der Formate reicht von relational oder semistrukturiert (z. B. JSON oder XML) bis zu ganz anderen Informationsträgern wie Videos, Texten oder Bildern. Neben unternehmensinternen Daten hat die Verwendung von externen Datenquellen in den letzten Jahren deutlich zugenommen: frei verfügbare Datenquellen (OpenData), aber auch der immense Datenpool aus Social-Media-Plattformen wie Twitter oder Facebook sowie die zunehmend verfügbaren Sensordaten zum Beispiel aus Maschinen in der Produktion oder intelligenten Produkten. Daraus ergeben sich vielfältige Herausforderungen: Auf der technischen Seite ist das zum Beispiel die Frage nach der richtigen Architektur. Hierbei gilt es, aktuelle Themen wie Big Data, Data Lake, Data Vault, Automatisierung und Cloud bestmöglich mit einzubeziehen. Cloud-basierte Ansätze mit hybriden Architekturen bieten hier Vorteile, weil vorhandene Systeme weiter genutzt werden (Investitionsschutz), gleichzeitig aber auch die Erweiterung um aktuelle Technologien und Ansätze und die Umsetzung neuer, innovativer Anwendungsfälle sichergestellt werden kann. So können z.B. Management und Integration von IoT-Daten oder Streaming-Anwendungsfälle von Beginn an in der Cloud umgesetzt werden. Der Cloud-basierte Ansatz gewährleistet darüber hinaus, einfache Skalierbarkeit der Systeme, um möglichst flexibel und effizient mitwachsen zu können. Auf der organisatorischen Seite zeigt sich, dass mit zunehmender Datenmenge auch die Handhabung der Daten umfangreicher und komplexer wird. Aus diesem Grund ist eine klare Datenstrategie mit entsprechenden Leitplanken und einer expliziten Daten-Governance unabdingbar. Mehr und vielfältigere Daten bedeuten zwar in der Theorie mehr Nutzen, allerdings bringt die reine Speicherung von Daten noch keinen Mehrwert. Bei der Erschließung neuer Datenquellen ist folglich eine Fokussierung auf konkrete nutzenbringende Anwendungsfälle wichtig. Bei einer solchen anwendungsfallbasierten Erweiterung der Systeme, bietet es sich an, agile Vorgehensweisen zu nutzen und bei der Umsetzung der Vorhaben einzusetzen. Mit steigender Datenmenge werden auch die Themen Datenqualität (\[3\]), Master- und Metadatenmanagement wichtig. Viele neue Daten nutzen nichts, wenn sie nicht die zur Analyse benötigte Qualität besitzen. Ein Programm zum Management der Datenqualität ist irgendwann unabdingbar, genauso wie ein ordentliches Management der Metadaten, um in der steigenden Datenmenge nicht den Überblick zu verlieren. Hier bietet sich die Einführung eines Metadatenkataloges an, in dem nicht nur gespeichert wird, welche Daten wo zu finden sind, sondern auch Verantwortlichkeiten für Daten und welche Daten wie und von wem genutzt werden. Die Beschäftigung mit neuen und mehr Daten alleine ist allerdings nicht ausreichend. Zusätzlich sollte man sich auch Gedanken machen, auf welche Art und Weise diese Daten ausgewertet werden und wie mehr Personen in ihrem Unternehmen die Ergebnisse nutzen können. Über diese beiden weiteren Themenfelder (Data Analytics und Data Democratization) und die konkrete Ausgestaltung des Weges zum datengetriebenen Unternehmen lesen sie mehr [in Teil 2](https://thecattlecrew.net/2020/04/03/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-2/) und [Teil 3](https://thecattlecrew.net/2020/04/09/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-3/) dieser Blogpost-Serie. **Literaturhinweise zu diesem Blogpost:** \[1\] , abgerufen 23.3.2020 \[2\] Reinsel, D. / Gantz, J. / Rydning, J.: Data Age 2025 – The Digitization of the World – From Edge to Core. IDC Whitepaper, November 2018. \[3\] Apel, D. et al.: Datenqualität erfolgreich steuern: Praxislösungen für Business-Intelligence-Projekte. Hanser Verlag 2009 **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** Analytics, data driven, Data Management, Daten, Datenstrategie, Digitalisierung --- ### [Auf dem Weg zum datengetriebenen Unternehmen: Wie eine Datenstrategie die Leitlinien für die Transformation vorgibt (Teil 3/3)](https://thecattlecrew.net/2020/04/09/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-3/) **Published:** April 9, 2020 **Author:** Jens Bleiholder **Content:** Viele Unternehmen treffen heute immer noch wesentliche Entscheidungen aus dem Bauch heraus oder auf der Basis klassischer Business Intelligence, also aufgrund von Erfahrungen, die sich mithilfe historischer Daten begründen lassen. In Zeiten der Digitalisierung reicht dies allein nicht mehr aus, um als Unternehmen erfolgreich zu sein. In den ersten zwei Teilen dieser Blogpostserie ([Teil 1](https://thecattlecrew.net/2020/03/25/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-1/) / [Teil 2](https://thecattlecrew.net/2020/04/03/auf-dem-weg-zum-datengetriebenen-unternehmen-teil-2/)) haben wir uns damit beschäftigt was es bedeutet „datengetrieben“ zu sein und welche Themenfelder dabei wichtig sind. Im Einzelnen sind dies „Data Management“ (Wie kann ich mehr Daten nutzen?), „Data Analytics“ (Wie kann ich die Daten besser nutzen?) und „Data Democratization“ (Wie können Daten von mehr Personen genutzt werden?). **Transformation in eine datengetriebene Organisation** ![Eine Datenstrategie als Leitlinie auf dem Weg zum datengetriebenen Unternehmen](https://thecattlecrew.net/wp-content/uploads/2020/04/datastrategy.png)Abb. 1: Eine Datenstrategie als Leitlinie auf dem Weg zum datengetriebenen Unternehmen Unternehmen sind meist nicht in allen drei genannten Themenfeldern gleich stark entwickelt. Es empfiehlt sich, zuerst den aktuellen Entwicklungsstand in jedem Themenfeld zu analysieren und diesen dann schrittweise zu verbessern. Dabei hilft eine Datenstrategie (siehe Abbildung 1), welche erforderliche Maßnahmen nach fachlichen, organisatorischen und technischen Aspekten ordnet und so ein geeignetes Programm für die Transformation definiert. Dieses Programm wird beispielsweise von der Rolle des Chief Data Officers (CDO) verantwortet. Unter fachlichen Aspekten werden hierbei die möglichen Analysebedarfe und konkreten Anwendungsfälle verstanden, die verschiedenen Nutzern helfen. Diese treiben die organisatorischen und technischen Aspekte, wie z.B. benötigte (neue) Rollen und Prozesse und Tools und Technologien, um eine moderne analytische Architektur umzusetzen. ![Handlungsfelder auf dem Weg zum datengetriebenen Unternehmen](https://thecattlecrew.net/wp-content/uploads/2020/04/methode.png)Abb. 2: Handlungsfelder auf dem Weg zum datengetriebenen Unternehmen Abbildung 2 zeigt beispielhaft, welche Schritte in den drei einzelnen Aspekten berücksichtigt werden können. Durch eine Fokussierung auf den Nutzen konkreter Anwendungsfälle treiben die fachlichen Aspekte die organisatorischen und technischen. Was Unternehmen dabei beachten sollten: - **Die Vision steht am Anfang.** Die Transformation in ein datengetriebenes Unternehmen ist eine wichtige und strategische Aktivität, welche die Unterstützung der Geschäftsführung erfordert. Es empfiehlt sich, sich zu Beginn mit der Vision zu befassen (Warum machen wir das?) und diese entsprechend zu kommunizieren. Datengetriebenes Arbeiten wird idealerweise in der Kultur verankert. - **Betrachtung/Würdigung/Nutzung des Vorhandenen**. Neues und Bestehendes (meist DWH/BI-System und Data Lake/Data Science) ergänzen sich oft sehr gut in gemeinsamer Koexistenz, und stützt dabei jeweils unterschiedliche Anwendungsfälle. Bestehende Anwendungsfälle sind nach wie vor relevant und auch für neue können vorhandene Praktiken noch gut funktionieren. Klassische BI verliert nicht plötzlich ihren Wert. Hier gibt es keinen Widerspruch zur notwendigen technologischen und methodischen Modernisierung. - **Nutzengetrieben arbeiten.** Wie schon mehrfach erwähnt sind weder Technologien noch Daten reiner Selbstzweck. Das stetige Umsetzen von nutzbringenden Anwendungsfällen steht im Vordergrund und bestimmt die einzusetzenden Daten, Tools, Skills und Techniken. Für jeden Anwendungsfall müssen die Voraussetzungen geschaffen werden: Daten sind vorhanden und zugänglich (Data Management), die notwendigen Methoden und Analysetools sind vorhanden (Data Analytics) und die richtigen Mitarbeiter wissen wie sie Daten und Tools nutzen (Data Democratization). - **Agilität und Priorisierung**. Ein agiles Vorgehen hilft flexibel zu sein. Je nach Entwicklungsstand in den einzelnen Themenbereichen ergibt sich die Priorisierung der Aktivitäten (zum Beispiel Datenmanagement-Verbesserungen vor Data Analytics vor Aktivitäten zur Data Democratization oder umgekehrt). - **Change Facilitation.** Ein Kulturwandel sollte professionell begleitet werden. Auf dem Weg zu einem datengetriebenen Arbeiten werden auf diese Art alle Mitarbeiter mitgenommen. Für den Erfolg der Transformation in ein datengetriebenes Unternehmen sind also technologische Fragestellungen genauso wichtig wie die Fokussierung auf den Nutzen mit den entsprechenden Anwendungsfällen und die Verankerung in der Organisation (Kulturwandel). **Fazit** Anwendungsfälle, die mit Mitteln der klassischen BI (z.B. in die Vergangenheit gerichtetes Reporting und Dashboarding) gelöst werden, existieren nach wie vor. Damit hat klassische BI weiterhin ihre Existenzberechtigung. Sie ist heutzutage allerdings nicht mehr ausreichend, um erfolgreich zu sein. Neue Anwendungsfälle müssen auch mit neuen Konzepten zur Speicherung, Verarbeitung und Nutzung von Daten einhergehen. Die dabei vorhandenen Herausforderungen liegen in den Bereichen Data Management (wie nutze ich mehr Daten), Data Analytics (wie nutze ich Daten besser) und Data Democratization (wie werden Daten mehr genutzt). Mit jeder erfolgreich gemeisterten Herausforderung auf diesen Gebieten entsteht Stück für Stück etwas Größeres: Aus klassischer BI wird Analytics, Analysemöglichkeiten werden vielfältiger und komplexer, der Umgang mit und das Bewusstsein für Daten wandelt sich; und schlussendlich werden Unternehmen zunehmend datengetriebener. **Kategorien:** Analytics & Insights, Architecture & Process Models **Schlagwörter:** Analytics, data driven, Data Management, Daten, Datenstrategie, Digitalisierung --- ### [Spring Security "“ JSON Web-Token-Authentifizierung (2/3)](https://thecattlecrew.net/2020/01/27/spring-security-json-web-token-authentifizierung-2-3/) **Published:** Januar 27, 2020 **Author:** Szymon Stuszek **Content:** 2\. **Anmeldung testen „“ Vorbereitung** Sobald wir einen Benutzer erstellt haben, können wir die Anmeldung testen. Ein LoginRequest erreicht den AuthenticationController. Dieser enthält eine Referenz auf AuthenticationManager und JwtProvider. JwtProvider ist eine Klasse, die aus der io.jsonwebtoken Biblithek stammt. Sie stellt uns einige Tools für Token Generierung und Validierung zur Verfügung. Beim LoginRequest werden Username und Password ausgenommen. Für diesen entwickeln wir ein UsernamePasswordAuthenticationToken und der AuthenticationManager gleicht dann wie bereits erwähnt die Credentials mit denen ab, die wir in der Datenbank haben. Sollte die Authentifizierung erfolgreich sein, setzen wir die Authentication Instanz im SecurityContext ein. Der JwtProvider benutzt das Objekt, um uns ein Token zu generieren. Falls wir z. B. das falsche Password eingeben, wird eine Exception ausgegeben und vom RestSecurityErrorHandler übernommen. **AuthenticationController** ``` @RestController @RequestMapping("/auth/") public class AuthenticationController { @Autowired private AuthenticationManager authenticationManager; @Autowired private JwtProvider jwtProvider; @RequestMapping(value = "login", method = RequestMethod.POST) public ResponseEntity authenticateUser(@RequestBody LoginRequest loginRequest) { Authentication authentication = authenticationManager.authenticate( new UsernamePasswordAuthenticationToken( loginRequest.getUsername(), loginRequest.getPassword()) ); SecurityContextHolder.getContext().setAuthentication(authentication); String jwt = jwtProvider.createToken(authentication); UserDetails userDetails = (UserDetails) authentication.getPrincipal(); return ResponseEntity.ok(new JwtResponse(jwt, userDetails.getUsername())); } } ``` **LoginRequest** ``` @Data public class LoginRequest { private String username; private String password; } ``` **JwtResponse** DerString „Bearer“ ist eine Konvention für JWTs, er wird bei Requests in die Headers gesetzt. Nach „Bearer“ folgt das Token selbst. ``` @Data public class JwtResponse { private String token; private String type = "Bearer"; private String username; public JwtResponse(String accessToken, String username) { this.token = accessToken; this.username = username; } } ``` **JwtProvider** ``` @Component public class JwtProvider { private static final Logger LOGGER = LoggerFactory.getLogger(JwtProvider.class); public String createToken(Authentication authentication) { UserDetailsImpl userDetails = (UserDetailsImpl) authentication.getPrincipal(); Date expirationDate = new Date(new Date().getTime() + SecurityConstants.EXPIRATION_DATE); String token = Jwts.builder() .setSubject(userDetails.getUsername()) .setIssuedAt(new Date()) .setExpiration(expirationDate) .signWith(SignatureAlgorithm.HS512, SecurityConstants.SECRET) .compact(); LOGGER.info("Created token: " + token); return token; } public boolean validateToken(String token) { try{ Jwts.parser().setSigningKey(SecurityConstants.SECRET).parseClaimsJws(token); return true; } catch (SignatureException e) { LOGGER.error("Invalid JWT signature -> Message: {} ", e); } catch (MalformedJwtException e) { LOGGER.error("Invalid JWT token -> Message: {}", e); } catch (ExpiredJwtException e) { LOGGER.error("Expired JWT token -> Message: {}", e); } catch (UnsupportedJwtException e) { LOGGER.error("Unsupported JWT token -> Message: {}", e); } catch (IllegalArgumentException e) { LOGGER.error("JWT claims string is empty -> Message: {}", e); } return false; } public String getUsernameFromToken(String token) { return Jwts.parser() .setSigningKey(SecurityConstants.SECRET) .parseClaimsJws(token) .getBody().getSubject(); } } ``` **UserDetailsImpl** Spring Security benötigt die Implementierung von UserDetails und UserDetailsService. Diese beiden Interfaces helfen uns, die Konten zu verwalten und z. B die Benutzerdaten anhand der Datenbank zu überprüfen. ``` @Getter public class UserDetailsImpl implements UserDetails { private Long id; private String username; @JsonIgnore private String password; private Collection authorities; private boolean accountNonExpired = true; private boolean accountNonLocked = true; private boolean credentialsNonExpired = true; private boolean enabled = true; public UserDetailsImpl(Long id, String username, String password) { this.id = id; this.username = username; this.password = password; } public static UserDetailsImpl build(ApplicationUser user) { return new UserDetailsImpl( user.getId(), user.getUsername(), user.getPassword() ); } } ``` **RestSecurityErrorHandler** Exceptions, die bei den verschiedenen Security-Vorgängen entstehen, werden von einer separaten Klasse behandelt. Der Security Container steht „vor“ den anderen Endpoints und die Ausnahmen, die hier generiert werden, z. B. bei falschen Anmeldungsdaten, werden durch die üblichen ExceptionHandlers nicht sichtbar. „“ Dafür definieren wir einen entsprechenden Handler. ``` @Component public class RestSecurityErrorHandler implements AuthenticationEntryPoint { @Autowired private HandlerExceptionResolver resolver; @Override public void commence(HttpServletRequest request, HttpServletResponse response, AuthenticationException authException) throws IOException, ServletException { resolver.resolveException(request, response, null, authException); } } ``` 3\. **Anmeldung testen „“­ Durchführung** Um die Anmeldung zu testen, registrieren wir zunächst einen User: ![](https://thecattlecrew.net/wp-content/uploads/2022/07/1-5.png)Dann schicken wir die Daten an den AuthController: ![](https://thecattlecrew.net/wp-content/uploads/2020/01/2-3.png)Als Antwort bekommen wir das Token. Für den /security/v1/claimapp/claims Pfad muss man authentifiziert sein. Ohne Token sieht das so aus: ![](https://thecattlecrew.net/wp-content/uploads/2020/01/3-2.png)Mit Token so: ![](https://thecattlecrew.net/wp-content/uploads/2020/01/4-2.png)--- [Spring Security „“ JSON Web-Token-Authentifizierung (1/3)](https://thecattlecrew.net/?p=29598&preview=true) | [Spring Security „“ JSON Web-Token-Authentifizierung (3/3)](https://thecattlecrew.net/?p=29645&preview=true) **Kategorien:** Development **Schlagwörter:** Java, JWT, Spring --- ### [Part 4: Configure APEX with ORDS, Apache-Tomcat und Nginx](https://thecattlecrew.net/2019/06/06/part-4-configure-apex-with-ords-apache-tomcat-und-nginx/) **Published:** Juni 6, 2019 **Author:** Neselovskyi, Borys **Content:** This blog entry is the third and last part of the series „Create APEX in AWS“. Here I describe the installation and configuration of Apache Tomcat and the deployment of the ORDS application in Tomcat. Later I will explain the installation of the Webserver Nginx and configure it to access APEX via Apache Tomcat and ORDS. Information about the installation of the APEX application in AWS can be found [here](https://thecattlecrew.net/2019/06/06/part-2:-create-the-oracle-apex-database-in-amazon-relation-data-service-(rds)/). The installation and configuration of Oracle Data rest service is described [here](https://thecattlecrew.net/2019/06/06/part-3:-configure-apex-with-oracle-rest-data-service-(ords)-in-the-new-ec2-container). ## Installation Apache Tomcat on the EC2 Container As root: Download and extract the software: \[root@\]# cd /usr/local \[root@\]# wget \[root@\]# tar -xvf apache-tomcat-9.0.20.tar.gz \[root@\]# mv apache-tomcat-9.0.20 tomcat9 Create the Linux Service for the Tomcat. It is necessary for the automatically start and stop of the Tomcat by the Server reboot. Create the File tomcat.service: \[root@@\]# vi /etc/systemd/system/tomcat.service Content: \[Unit\] Description=Apache Tomcat Web Application Container Wants=network.target After=network.target \[Service\] Type=forking Environment=JAVA\_HOME=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.201.b09-0.amzn2.x86\_64/jre Environment=CATALINA\_PID=/usr/local/tomcat9/temp/tomcat.pid Environment=CATALINA\_HOME=/usr/local/tomcat9 Environment=’CATALINA\_OPTS=-Xms512M -Xmx1G -Djava.net.preferIPv4Stack=true‘ Environment=’JAVA\_OPTS=-Djava.awt.headless=true‘ ExecStart=/usr/local/tomcat9/bin/startup.sh ExecStop=/usr/local/tomcat9/bin/shutdown.sh SuccessExitStatus=143 User=root Group=root UMask=0007 RestartSec=10 Restart=always \[Install\] WantedBy=multi-user.target \*Note: for the production environment the tomcat should be started from non-privileged user! In my test case I will start and top the tomcat as the user root. Enable Service tomcat and start it: \[root@\]# systemctl enable tomcat \[root@\]# systemctl start tomcat Check if Tomcat is running and accessible from the Browser: ![](https://thecattlecrew.net/wp-content/uploads/2023/01/060619_1019_part4config1.png)## Configure Apache Tomcat for the access APEX via Oracle Rest Data Service (ORDS) Copy the Java binary ords.was and apex images into Tomcat directory: \[root@\]# cp /home/apexuser/ORDS/ords.war /usr/local/tomcat9/webapps/ \[root@\]# mkdir /usr/local/tomcat9/webapps/i \[root@\]# cp -Rf /home/apexuser/apex/images/\* /usr/local/tomcat9/webapps/i Change the permissions for the ORDS Directory for the user tomcat (created during the tomcat installation): As root: \[root@\]# chmod -R 777 /home/apexuser/ORDS/ords/conf/ Restart the Apache Tomcat: \[root@\]# systemctl restart tomcat Test the access to APEX via Apache Tomcat: http://xxxxxxxxxxxxxxx.eu-central-1.compute.amazonaws.com:8080/ords ![](https://thecattlecrew.net/wp-content/uploads/2023/01/060619_1019_part4config2.png)It works! ## Install Nginx HTTP Server: \[root@\]# amazon-linux-extras install nginx1.12 \[root@\]# systemctl enable nginx \[root@\]# systemctl start nginx Check the availability of nginx in Browser: ![](https://thecattlecrew.net/wp-content/uploads/2023/01/060619_1019_part4config3.png)## Configure Nginx to forward requests from Tomcat-ORDS-APEX Check the Public Hostname/IP Address of the EC2 Container in the AWS Console: ![](https://thecattlecrew.net/wp-content/uploads/2023/01/060619_1019_part4config4.png)Create the Cache Directory: \[root@\]# mkdir -p /var/cache/nginx/one Create the File default.conf. \[root@\]# vi /etc/nginx/conf.d/default.conf File Content: proxy\_cache\_path /var/cache/nginx/one levels=1:2 keys\_zone=one:128m; server { listen 80; listen \[::\]:80; server\_name ; proxy\_cache one; location / { proxy\_set\_header X-Forwarded-Host $host; proxy\_set\_header X-Forwarded-Server $host; proxy\_set\_header X-Forwarded-For $proxy\_add\_x\_forwarded\_for; proxy\_pass http://127.0.0.1:8080/; } } Save the file and check the nginx configuration: \[root@\]# nginx -t Output: nginx: the configuration file /etc/nginx/nginx.conf syntax is ok nginx: configuration file /etc/nginx/nginx.conf test is successful Reload nginx configuration: \[root@\]# nginx -s reload Test Apex via Nginx (Port 80): http:///ords/ ![](https://thecattlecrew.net/wp-content/uploads/2023/01/060619_1019_part4config5.png)It works!!! Previously Blog posts in this series: - [Create Oracle APEX Environment in the Amazon Cloud with RDS: Part 1 – Overview](https://thecattlecrew.net/2019/06/06/create-oracle-apex-environment-in-the-amazon-cloud-with-rds:-part-1---overview) - [Part 2: Create the Oracle APEX Database in Amazon Relation Data Service (RDS)](https://thecattlecrew.net/2019/06/06/part-2:-create-the-oracle-apex-database-in-amazon-relation-data-service-(rds)/) - [Part 3: Configure APEX with Oracle Rest Data Service (ORDS) in the EC2 Container](https://thecattlecrew.net/2019/06/06/part-3:-configure-apex-with-oracle-rest-data-service-(ords)-in-the-new-ec2-container) **Kategorien:** Cloud, Infrastructure **Schlagwörter:** Apache, APEX, AWS, Configuration, English, HowTo, Installation, IT Security, Nginx, oracle, ORDS, RDS, SYSDBA, Tomcat, VPC --- ### [Create Oracle APEX Environment in the Amazon Cloud with RDS: Part 1 - Overview](https://thecattlecrew.net/2019/06/06/create-oracle-apex-environment-in-the-amazon-cloud-with-rds-part-1-overview/) **Published:** Juni 6, 2019 **Author:** Neselovskyi, Borys **Content:** In this article I will describe the installation of Oracle APEX Environment in Amazon Web Service (AWS). The whole environment includes following components: - AWS RDS: Oracle Database with activated APEX - VM (EC2 Container) with: - Oracle Rest Data Service (ORDS) - Apache Tomcat for the Hosting of the ORDS - Nginx: http Server The major challenge is to install APEX without SYSDBA privilege, because the Oracle Database in the RDS is Vendor-Managed. Users cannot access the OS and do not have the database DBA role. Blue Print of the APEX environment in the AWS: ![](https://thecattlecrew.net/wp-content/uploads/2023/01/apx_blueprint.png)In my next Posts I will cover the following topics: Part 2: [Create the APEX Database in Amazon Relation Data Service (RDS)](https://thecattlecrew.net/2019/06/06/part-2:-create-the-oracle-apex-database-in-amazon-relation-data-service-(rds)/) Part 3: [Configure APEX with Oracle Rest Data Service (ORDS) in the new EC2 Container](https://thecattlecrew.net/2019/06/06/part-3:-configure-apex-with-oracle-rest-data-service-(ords)-in-the-new-ec2-container) Part 4:[ Configuration APEX with ORDS, Apache-Tomcat und Nginx](https://thecattlecrew.net/2019/06/06/part-4:-configure-apex-with-ords,-apache-tomcat-und-nginx) **Kategorien:** Cloud, Infrastructure **Schlagwörter:** Apache, APEX, AWS, Configuration, HowTo, Installation, IT Security, Nginx, oracle, ORDS, RDS, SYSDBA, Tomcat, VPC --- ## Seiten ### [Über uns](https://thecattlecrew.net/ueber-uns/) **Published:** November 15, 2018 **Author:** patschart **Content:** # Wir über uns Wir verzichten mal auf ein klassisches „Über uns“. Doch wofür stehen wir auf? Vordergründig würden wir sagen: Wir lieben IT! Und das stimmt, absolut. Trotzdem wäre das nur die halbe Wahrheit. Digitale Produkte und eine moderne, passgenaue IT sind auch unser Weg, die Welt zu verändern, zu verbessern: Wenn wir mit mehr als 500 IT-Fachleuten Lösungen entwickeln, die Organisationen in Deutschland besser machen, ist das ein tolles Gefühl! Warum stehen Sie morgens auf? Um Ihr Unternehmen besser zu machen? Die richtigen Entscheidungen auf Basis der aktuellen Daten und Vorhersagen zu treffen? Sie wollen Prozesse verschlanken und automatisieren? Sich auf Ihr Geschäft konzentrieren und nicht auf Ihre IT? Und wir stehen morgens auf, um Sie dabei zu unterstützen. Wir wissen, es braucht gute IT-Lösungen und mehr … Mehr als 500 Kolleg:innen an 10 Standorten treten jeden Tag an, um Ihre Herausforderungen zu meistern und Sie in Ihrem Geschäft besser zu machen. Indem wir Menschen befähigen und für sie passende digitale Lösungen bauen. 2/3 der DAX-Unternehmen vertrauen uns. Wir sind die Digitale Service Manufaktur. Als Digitale Service Manufaktur enablen wir Menschen und entwickeln für sie passende digitale Lösungen. „Mit unserer Leidenschaft für neue Technologien und unserem Anspruch an herausragende Beratung sind wir bei unseren Kunden der Motor für die digitale Transformation.“ Bernhard Opitz (Gründer, OPITZ CONSULTING GmbH) Mehr auf [www.opitz-consulting.com](http://www.opitz-consulting.com) --- ### [Kontakt](https://thecattlecrew.net/kontakt/) **Published:** Dezember 1, 2018 **Author:** patschart **Content:** # Wir freuen uns auf Ihre Kontaktaufnahme: **Fehler:** Kontaktformular wurde nicht gefunden. --- ## Kategorien ### [Analytics & Insights](https://thecattlecrew.net/category/analytics/) **Description:** Infos zu DWH, Data Warehouse, Analytics, Reports, Modern Cloud Analytics, Analysen, Dashboards --- ### [Architecture & Process Models](https://thecattlecrew.net/category/architecture-methods-and-process-models/) --- ### [AI & Data Science](https://thecattlecrew.net/category/artificial-intelligence/) **Description:** Rund um Machine Learning, Künstliche Intelligenz, Neurone Netzwerke, Artificial Intelligence --- ### [Automation](https://thecattlecrew.net/category/automation/) **Description:** Alles zu Automation, RPA, Process Automation, Intelligent Automation --- ### [Cloud](https://thecattlecrew.net/category/cloud/) --- ### [Tech Events & Networking](https://thecattlecrew.net/category/tech-events-networking/) --- ### [Database](https://thecattlecrew.net/category/database/) --- ### [Development](https://thecattlecrew.net/category/development/) --- ### [DevOps](https://thecattlecrew.net/category/devops/) --- ### [Infrastructure](https://thecattlecrew.net/category/infrastructure/) --- ### [Integration](https://thecattlecrew.net/category/integration/) **Description:** Alles rund um Message-Queues, API-Gateways oder Service-Meshes, BPM, Integration von IT-Systemen, API-Management und API allgemein --- ### [IT-Security](https://thecattlecrew.net/category/security/) --- ### [Tools & Methoden](https://thecattlecrew.net/category/tools/) --- ### [Sustainability & Awareness](https://thecattlecrew.net/category/sustainability-awareness/) --- ## Schlagwörter ### [#OCVoicePioneers](https://thecattlecrew.net/tag/ocvoicepioneers/) --- ### [ACM](https://thecattlecrew.net/tag/acm/) --- ### [ADF](https://thecattlecrew.net/tag/adf/) --- ### [Administration](https://thecattlecrew.net/tag/administration/) --- ### [AdminServer](https://thecattlecrew.net/tag/adminserver/) --- ### [Advanced Analytics](https://thecattlecrew.net/tag/advanced-analytics/) --- ### [Agil](https://thecattlecrew.net/tag/agil/) --- ### [agile](https://thecattlecrew.net/tag/agile-2/) --- ### [agilität](https://thecattlecrew.net/tag/agilitat/) --- ### [Alexa](https://thecattlecrew.net/tag/alexa/) --- ### [Alexa node.js](https://thecattlecrew.net/tag/alexa-node-js/) --- ### [Alexa sdk](https://thecattlecrew.net/tag/alexa-sdk/) --- ### [Alexa Skill](https://thecattlecrew.net/tag/alexa-skill/) --- ### [Alexa-cli](https://thecattlecrew.net/tag/alexa-cli/) --- ### [ALM](https://thecattlecrew.net/tag/alm/) --- ### [Amazon](https://thecattlecrew.net/tag/amazon/) --- ### [Amazon API Gateway](https://thecattlecrew.net/tag/amazon-api-gateway/) --- ### [Amazon AppStream](https://thecattlecrew.net/tag/amazon-appstream/) --- ### [Amazon Aurora](https://thecattlecrew.net/tag/amazon-aurora/) --- ### [Amazon Chime](https://thecattlecrew.net/tag/amazon-chime/) --- ### [Amazon CloudWatch](https://thecattlecrew.net/tag/amazon-cloudwatch/) --- ### [Amazon Connect](https://thecattlecrew.net/tag/amazon-connect/) --- ### [Amazon DocumentDB](https://thecattlecrew.net/tag/amazon-documentdb/) --- ### [Amazon EFS](https://thecattlecrew.net/tag/amazon-efs/) --- ### [Amazon EKS](https://thecattlecrew.net/tag/amazon-eks/) --- ### [Amazon Elastic Search](https://thecattlecrew.net/tag/amazon-elastic-search/) --- ### [Amazon FreeRTOS](https://thecattlecrew.net/tag/amazon-freertos/) --- ### [Amazon Glacier](https://thecattlecrew.net/tag/amazon-glacier/) --- ### [Amazon Kinesis](https://thecattlecrew.net/tag/amazon-kinesis/) --- ### [Amazon Lex](https://thecattlecrew.net/tag/amazon-lex/) --- ### [Amazon Lightsail](https://thecattlecrew.net/tag/amazon-lightsail/) --- ### [Amazon Polly](https://thecattlecrew.net/tag/amazon-polly/) --- ### [Amazon RDS](https://thecattlecrew.net/tag/amazon-rds/) --- ### [Amazon Redshift](https://thecattlecrew.net/tag/amazon-redshift/) --- ### [Amazon Route53](https://thecattlecrew.net/tag/amazon-route53/) --- ### [Amazon SageMaker](https://thecattlecrew.net/tag/amazon-sagemaker/) --- ### [Amazon Transcribe](https://thecattlecrew.net/tag/amazon-transcribe/) --- ### [Amazon Translate](https://thecattlecrew.net/tag/amazon-translate/) --- ### [Amazon WorkDocs](https://thecattlecrew.net/tag/amazon-workdocs/) --- ### [Amazon WorkLink](https://thecattlecrew.net/tag/amazon-worklink/) --- ### [Analytics](https://thecattlecrew.net/tag/analytics/) --- ### [analytics map](https://thecattlecrew.net/tag/analytics-map/) --- ### [Android](https://thecattlecrew.net/tag/android/) --- ### [Angular](https://thecattlecrew.net/tag/angular/) --- ### [AngularJS](https://thecattlecrew.net/tag/angularjs/) --- ### [AngularJS 2.0](https://thecattlecrew.net/tag/angularjs-2-0/) --- ### [ansible](https://thecattlecrew.net/tag/ansible/) --- ### [Apache](https://thecattlecrew.net/tag/apache/) --- ### [Apache Lucene](https://thecattlecrew.net/tag/apache-lucene/) --- ### [Apache Solr](https://thecattlecrew.net/tag/apache-solr/) --- ### [Apache Zeppelin](https://thecattlecrew.net/tag/apache-zeppelin/) --- ### [APEX](https://thecattlecrew.net/tag/apex/) --- ### [API](https://thecattlecrew.net/tag/api/) --- ### [API Management](https://thecattlecrew.net/tag/api-management/) --- ### [API Managment](https://thecattlecrew.net/tag/api-managment/) --- ### [ApolloEngine](https://thecattlecrew.net/tag/apolloengine/) --- ### [Application Load Balancer](https://thecattlecrew.net/tag/application-load-balancer/) --- ### [Applikationswartung](https://thecattlecrew.net/tag/applikationswartung/) --- ### [Apps](https://thecattlecrew.net/tag/apps/) --- ### [Architecture](https://thecattlecrew.net/tag/architecture/) --- ### [Articles](https://thecattlecrew.net/tag/articles/) --- ### [ASM](https://thecattlecrew.net/tag/asm/) --- ### [Assign](https://thecattlecrew.net/tag/assign/) --- ### [asynchronous](https://thecattlecrew.net/tag/asynchronous/) --- ### [Attachements](https://thecattlecrew.net/tag/attachements/) --- ### [Augmented Reality](https://thecattlecrew.net/tag/augmented-reality/) --- ### [Authentication](https://thecattlecrew.net/tag/authentication/) --- ### [authentication’s process](https://thecattlecrew.net/tag/authentications-process/) --- ### [Authorization](https://thecattlecrew.net/tag/authorization/) --- ### [authorization process](https://thecattlecrew.net/tag/authorization-process/) --- ### [automatisierung](https://thecattlecrew.net/tag/automatisierung/) --- ### [autonomous](https://thecattlecrew.net/tag/autonomous/) --- ### [Award](https://thecattlecrew.net/tag/award/) --- ### [AWS](https://thecattlecrew.net/tag/aws/) --- ### [Axon](https://thecattlecrew.net/tag/axon/) --- ### [Axon framework](https://thecattlecrew.net/tag/axon-framework/) --- ### [Backlog](https://thecattlecrew.net/tag/backlog/) --- ### [backup](https://thecattlecrew.net/tag/backup/) --- ### [backuppiece](https://thecattlecrew.net/tag/backuppiece/) --- ### [Barcamp](https://thecattlecrew.net/tag/barcamp/) --- ### [BCW](https://thecattlecrew.net/tag/bcw/) --- ### [BCX](https://thecattlecrew.net/tag/bcx/) --- ### [bdd](https://thecattlecrew.net/tag/bdd/) --- ### [Beats](https://thecattlecrew.net/tag/beats/) --- ### [Beraterleben](https://thecattlecrew.net/tag/beraterleben/) --- ### [Berlin](https://thecattlecrew.net/tag/berlin/) --- ### [BI](https://thecattlecrew.net/tag/bi/) --- ### [Big Data](https://thecattlecrew.net/tag/big-data/) --- ### [Big Data Cluster](https://thecattlecrew.net/tag/big-data-cluster/) --- ### [bigdata](https://thecattlecrew.net/tag/bigdata/) --- ### [Bitzer](https://thecattlecrew.net/tag/bitzer/) --- ### [blockchain](https://thecattlecrew.net/tag/blockchain/) --- ### [Bosch ConnectedExperience](https://thecattlecrew.net/tag/bosch-connectedexperience/) --- ### [Bosch IoT Hackathon](https://thecattlecrew.net/tag/bosch-iot-hackathon/) --- ### [Bot](https://thecattlecrew.net/tag/bot/) --- ### [bpel](https://thecattlecrew.net/tag/bpel/) --- ### [BPM](https://thecattlecrew.net/tag/bpm/) --- ### [BPMCon](https://thecattlecrew.net/tag/bpmcon/) --- ### [BPMN](https://thecattlecrew.net/tag/bpmn/) --- ### [Bring your own Device](https://thecattlecrew.net/tag/bring-your-own-device/) --- ### [Browser](https://thecattlecrew.net/tag/browser/) --- ### [Bugs](https://thecattlecrew.net/tag/bugs/) --- ### [Bundle patch](https://thecattlecrew.net/tag/bundle-patch/) --- ### [Business Intelligence](https://thecattlecrew.net/tag/business-intelligence/) --- ### [Business Models](https://thecattlecrew.net/tag/business-models/) --- ### [Business Technology Magazin](https://thecattlecrew.net/tag/business-technology-magazin/) --- ### [Business Intelligence](https://thecattlecrew.net/tag/busines-intelligence/) --- ### [BYOD](https://thecattlecrew.net/tag/byod/) --- ### [C#](https://thecattlecrew.net/tag/c/) --- ### [CA](https://thecattlecrew.net/tag/ca/) --- ### [Caching](https://thecattlecrew.net/tag/caching/) --- ### [Camel](https://thecattlecrew.net/tag/camel/) --- ### [Camel K](https://thecattlecrew.net/tag/camel-k/) --- ### [Camunda](https://thecattlecrew.net/tag/camunda/) --- ### [Case Management](https://thecattlecrew.net/tag/case-management/) --- ### [catalog](https://thecattlecrew.net/tag/catalog/) --- ### [Certificate](https://thecattlecrew.net/tag/certificate/) --- ### [Change](https://thecattlecrew.net/tag/change/) --- ### [cloud](https://thecattlecrew.net/tag/cloud/) --- ### [Cloud Computing](https://thecattlecrew.net/tag/cloud-computing/) --- ### [Cloud Control](https://thecattlecrew.net/tag/cloud-control/) --- ### [cloud native](https://thecattlecrew.net/tag/cloud-native/) --- ### [Cloud9](https://thecattlecrew.net/tag/cloud9/) --- ### [cloudera](https://thecattlecrew.net/tag/cloudera/) --- ### [Cluster](https://thecattlecrew.net/tag/cluster/) --- ### [clusternetwork](https://thecattlecrew.net/tag/clusternetwork/) --- ### [Co-Creation](https://thecattlecrew.net/tag/co-creation/) --- ### [Coding Dojo](https://thecattlecrew.net/tag/coding-dojo/) --- ### [Coherence](https://thecattlecrew.net/tag/coherence/) --- ### [communication](https://thecattlecrew.net/tag/communication/) --- ### [Composites](https://thecattlecrew.net/tag/composites/) --- ### [Conference](https://thecattlecrew.net/tag/conference/) --- ### [Configuration](https://thecattlecrew.net/tag/configuration/) --- ### [Container](https://thecattlecrew.net/tag/container/) --- ### [Continuous Delivery](https://thecattlecrew.net/tag/continuous-delivery/) --- ### [Continuous Integration](https://thecattlecrew.net/tag/continuous-integration/) --- ### [continuous integration Raspberry pi](https://thecattlecrew.net/tag/continuous-integration-raspberry-pi/) --- ### [Conversational UI](https://thecattlecrew.net/tag/conversational-ui/) --- ### [CORS](https://thecattlecrew.net/tag/cors/) --- ### [CQRS](https://thecattlecrew.net/tag/cqrs/) --- ### [Crawler](https://thecattlecrew.net/tag/crawler/) --- ### [Cross-Browser Testing](https://thecattlecrew.net/tag/cross-browser-testing/) --- ### [Crowdfunding](https://thecattlecrew.net/tag/crowdfunding/) --- ### [Crowdsourcing](https://thecattlecrew.net/tag/crowdsourcing/) --- ### [CSV](https://thecattlecrew.net/tag/csv/) --- ### [cucumber](https://thecattlecrew.net/tag/cucumber/) --- ### [customer journey map](https://thecattlecrew.net/tag/customer-journey-map/) --- ### [Customize](https://thecattlecrew.net/tag/customize/) --- ### [CVE](https://thecattlecrew.net/tag/cve/) --- ### [D3JS](https://thecattlecrew.net/tag/d3js/) --- ### [data analytics](https://thecattlecrew.net/tag/data-analytics/) --- ### [Data Catalog](https://thecattlecrew.net/tag/data-catalog/) --- ### [data driven](https://thecattlecrew.net/tag/data-driven/) --- ### [Data Governance](https://thecattlecrew.net/tag/data-governance/) --- ### [Data Lineage](https://thecattlecrew.net/tag/data-lineage/) --- ### [Data Management](https://thecattlecrew.net/tag/data-management/) --- ### [data mining](https://thecattlecrew.net/tag/data-mining/) --- ### [Daten](https://thecattlecrew.net/tag/daten/) --- ### [datenbank](https://thecattlecrew.net/tag/datenbank/) --- ### [Datenmodellierung](https://thecattlecrew.net/tag/datenmodellierung/) --- ### [Datenstrategie](https://thecattlecrew.net/tag/datenstrategie/) --- ### [DBFreedom](https://thecattlecrew.net/tag/dbfreedom/) --- ### [dbsat](https://thecattlecrew.net/tag/dbsat/) --- ### [Dbvisit](https://thecattlecrew.net/tag/dbvisit/) --- ### [DDD](https://thecattlecrew.net/tag/ddd/) --- ### [Debugging](https://thecattlecrew.net/tag/debugging/) --- ### [Deployment](https://thecattlecrew.net/tag/deployment/) --- ### [design](https://thecattlecrew.net/tag/design/) --- ### [Design Thinking](https://thecattlecrew.net/tag/design-thinking/) --- ### [Device Defender](https://thecattlecrew.net/tag/device-defender/) --- ### [DevOps](https://thecattlecrew.net/tag/devops/) --- ### [DevSecOps](https://thecattlecrew.net/tag/devsecops/) --- ### [Digest Authentication](https://thecattlecrew.net/tag/digest-authentication/) --- ### [Digital Innovation](https://thecattlecrew.net/tag/digital-innovation/) --- ### [digitaler Assistent](https://thecattlecrew.net/tag/digitaler-assistent/) --- ### [Digitalisierung](https://thecattlecrew.net/tag/digitalisierung/) --- ### [Digitalization](https://thecattlecrew.net/tag/digitalization/) --- ### [Digitization](https://thecattlecrew.net/tag/digitization/) --- ### [DOAG](https://thecattlecrew.net/tag/doag/) --- ### [Docker](https://thecattlecrew.net/tag/docker/) --- ### [Domain](https://thecattlecrew.net/tag/domain/) --- ### [duperemove](https://thecattlecrew.net/tag/duperemove/) --- ### [Dynamic](https://thecattlecrew.net/tag/dynamic/) --- ### [E2E Testing](https://thecattlecrew.net/tag/e2e-testing/) --- ### [EAM](https://thecattlecrew.net/tag/eam/) --- ### [Elastic](https://thecattlecrew.net/tag/elastic/) --- ### [Elastic Search](https://thecattlecrew.net/tag/elastic-search/) --- ### [ElastiCache](https://thecattlecrew.net/tag/elasticache/) --- ### [Empathy](https://thecattlecrew.net/tag/empathy/) --- ### [Endpoints](https://thecattlecrew.net/tag/endpoints/) --- ### [Engineered System](https://thecattlecrew.net/tag/engineered-system/) --- ### [English](https://thecattlecrew.net/tag/english/) --- ### [Enterprise Architecture](https://thecattlecrew.net/tag/enterprise-architecture/) --- ### [Enterprise Manager](https://thecattlecrew.net/tag/enterprise-manager/) --- ### [Entpoints](https://thecattlecrew.net/tag/entpoints/) --- ### [Entscheidungsfindung](https://thecattlecrew.net/tag/entscheidungsfindung/) --- ### [Erfahrungsbericht](https://thecattlecrew.net/tag/erfahrungsbericht/) --- ### [ETL](https://thecattlecrew.net/tag/etl/) --- ### [Event Sourcing](https://thecattlecrew.net/tag/event-sourcing/) --- ### [Event-driven](https://thecattlecrew.net/tag/event-driven/) --- ### [Events](https://thecattlecrew.net/tag/events/) --- ### [ExaCS](https://thecattlecrew.net/tag/exacs/) --- ### [Exadata](https://thecattlecrew.net/tag/exadata/) --- ### [Exadata Cloud Service](https://thecattlecrew.net/tag/exadata-cloud-service/) --- ### [express app](https://thecattlecrew.net/tag/express-app/) --- ### [express applikation](https://thecattlecrew.net/tag/express-applikation/) --- ### [Facebook](https://thecattlecrew.net/tag/facebook/) --- ### [Facilitation](https://thecattlecrew.net/tag/facilitation/) --- ### [Failover](https://thecattlecrew.net/tag/failover/) --- ### [Federation](https://thecattlecrew.net/tag/federation/) --- ### [Feedback](https://thecattlecrew.net/tag/feedback/) --- ### [FileUpload](https://thecattlecrew.net/tag/fileupload/) --- ### [Flutter](https://thecattlecrew.net/tag/flutter/) --- ### [Forms](https://thecattlecrew.net/tag/forms/) --- ### [framework](https://thecattlecrew.net/tag/framework/) --- ### [Frameworks](https://thecattlecrew.net/tag/frameworks/) --- ### [Frontend](https://thecattlecrew.net/tag/frontend/) --- ### [FTP](https://thecattlecrew.net/tag/ftp/) --- ### [Geek](https://thecattlecrew.net/tag/geek/) --- ### [German](https://thecattlecrew.net/tag/german/) --- ### [Google Home Assistant](https://thecattlecrew.net/tag/google-home-assistant/) --- ### [Grails](https://thecattlecrew.net/tag/grails/) --- ### [GraphQL](https://thecattlecrew.net/tag/graphql/) --- ### [Grid Infrastructure 12.2](https://thecattlecrew.net/tag/grid-infrastructure-12-2/) --- ### [Groovy](https://thecattlecrew.net/tag/groovy/) --- ### [Hackathon](https://thecattlecrew.net/tag/hackathon/) --- ### [Hacking Waage](https://thecattlecrew.net/tag/hacking-waage/) --- ### [Hadoop](https://thecattlecrew.net/tag/hadoop/) --- ### [HDFS](https://thecattlecrew.net/tag/hdfs/) --- ### [Heapsize](https://thecattlecrew.net/tag/heapsize/) --- ### [Heroku](https://thecattlecrew.net/tag/heroku/) --- ### [High Availability](https://thecattlecrew.net/tag/high-availability/) --- ### [Hochverfügbar](https://thecattlecrew.net/tag/hochverfuegbar/) --- ### [Hochverfügbarkeit](https://thecattlecrew.net/tag/hochverfuegbarkeit/) --- ### [HoloLens](https://thecattlecrew.net/tag/hololens/) --- ### [host subnet length](https://thecattlecrew.net/tag/host-subnet-length/) --- ### [hostsubnetlength](https://thecattlecrew.net/tag/hostsubnetlength/) --- ### [HowTo](https://thecattlecrew.net/tag/howto/) --- ### [HTTP Binding](https://thecattlecrew.net/tag/http-binding/) --- ### [HTTP Server](https://thecattlecrew.net/tag/http-server/) --- ### [HX-711](https://thecattlecrew.net/tag/hx-711/) --- ### [IaaS](https://thecattlecrew.net/tag/iaas/) --- ### [ICOT](https://thecattlecrew.net/tag/icot/) --- ### [Identity](https://thecattlecrew.net/tag/identity/) --- ### [Identity Assertion](https://thecattlecrew.net/tag/identity-assertion/) --- ### [Identity Circle of Trust](https://thecattlecrew.net/tag/identity-circle-of-trust/) --- ### [Image](https://thecattlecrew.net/tag/image/) --- ### [ImpactMapping](https://thecattlecrew.net/tag/impactmapping/) --- ### [industrie4.0](https://thecattlecrew.net/tag/industrie4-0/) --- ### [Innovation](https://thecattlecrew.net/tag/innovation/) --- ### [Installation](https://thecattlecrew.net/tag/installation/) --- ### [Integration](https://thecattlecrew.net/tag/integration/) --- ### [Integration Testing](https://thecattlecrew.net/tag/integration-testing/) --- ### [Internet](https://thecattlecrew.net/tag/internet/) --- ### [iOS](https://thecattlecrew.net/tag/ios/) --- ### [IoT](https://thecattlecrew.net/tag/iot/) --- ### [IT Security](https://thecattlecrew.net/tag/it-security/) --- ### [Java](https://thecattlecrew.net/tag/java/) --- ### [Javalin](https://thecattlecrew.net/tag/javalin/) --- ### [JavaScript](https://thecattlecrew.net/tag/javascript/) --- ### [JAX-WS](https://thecattlecrew.net/tag/jax-ws/) --- ### [JDeveloper](https://thecattlecrew.net/tag/jdeveloper/) --- ### [jenkins](https://thecattlecrew.net/tag/jenkins/) --- ### [JMS](https://thecattlecrew.net/tag/jms/) --- ### [json](https://thecattlecrew.net/tag/json/) --- ### [JUnit](https://thecattlecrew.net/tag/junit/) --- ### [JVM](https://thecattlecrew.net/tag/jvm/) --- ### [JVM Runing](https://thecattlecrew.net/tag/jvm-runing/) --- ### [JVM Tuning](https://thecattlecrew.net/tag/jvm-tuning/) --- ### [JWT](https://thecattlecrew.net/tag/jwt/) --- ### [Kanban](https://thecattlecrew.net/tag/kanban/) --- ### [Kaner](https://thecattlecrew.net/tag/kaner/) --- ### [karma](https://thecattlecrew.net/tag/karma/) --- ### [Kibana](https://thecattlecrew.net/tag/kibana/) --- ### [Kickstarter](https://thecattlecrew.net/tag/kickstarter/) --- ### [Knative](https://thecattlecrew.net/tag/knative/) --- ### [Kong](https://thecattlecrew.net/tag/kong/) --- ### [Krypto](https://thecattlecrew.net/tag/krypto/) --- ### [Kubernetes](https://thecattlecrew.net/tag/kubernetes/) --- ### [Lambda Architecture](https://thecattlecrew.net/tag/lambda-architecture/) --- ### [Leadership](https://thecattlecrew.net/tag/leadership/) --- ### [libopc](https://thecattlecrew.net/tag/libopc/) --- ### [libopc.so](https://thecattlecrew.net/tag/libopc-so/) --- ### [Lightsail](https://thecattlecrew.net/tag/lightsail/) --- ### [ListView](https://thecattlecrew.net/tag/listview/) --- ### [log4j](https://thecattlecrew.net/tag/log4j/) --- ### [log4j2](https://thecattlecrew.net/tag/log4j2/) --- ### [Logstash](https://thecattlecrew.net/tag/logstash/) --- ### [longpolling](https://thecattlecrew.net/tag/longpolling/) --- ### [Loop](https://thecattlecrew.net/tag/loop/) --- ### [low](https://thecattlecrew.net/tag/low/) --- ### [LowCode](https://thecattlecrew.net/tag/lowcode/) --- ### [Managed Services](https://thecattlecrew.net/tag/managed-services/) --- ### [Management](https://thecattlecrew.net/tag/management/) --- ### [Market Research](https://thecattlecrew.net/tag/market-research/) --- ### [Marketing](https://thecattlecrew.net/tag/marketing/) --- ### [Master Data Management](https://thecattlecrew.net/tag/master-data-management/) --- ### [material design](https://thecattlecrew.net/tag/material-design/) --- ### [Maven](https://thecattlecrew.net/tag/maven/) --- ### [München](https://thecattlecrew.net/tag/muenchen/) --- ### [MDM](https://thecattlecrew.net/tag/mdm/) --- ### [MDS](https://thecattlecrew.net/tag/mds/) --- ### [Meetup](https://thecattlecrew.net/tag/meetup/) --- ### [MeinLieblingsJob](https://thecattlecrew.net/tag/meinlieblingsjob/) --- ### [methoden](https://thecattlecrew.net/tag/methoden/) --- ### [Methods](https://thecattlecrew.net/tag/methods/) --- ### [micronaut](https://thecattlecrew.net/tag/micronaut/) --- ### [Microservices](https://thecattlecrew.net/tag/microservices/) --- ### [Microsoft](https://thecattlecrew.net/tag/microsoft/) --- ### [Migration](https://thecattlecrew.net/tag/migration/) --- ### [Mindset](https://thecattlecrew.net/tag/mindset/) --- ### [Mobile](https://thecattlecrew.net/tag/mobile/) --- ### [Mocks](https://thecattlecrew.net/tag/mocks/) --- ### [Moderation](https://thecattlecrew.net/tag/moderation/) --- ### [Modern Clients](https://thecattlecrew.net/tag/modern-clients/) --- ### [Moderne Clients](https://thecattlecrew.net/tag/moderne-clients/) --- ### [mqtt](https://thecattlecrew.net/tag/mqtt/) --- ### [MSA](https://thecattlecrew.net/tag/msa/) --- ### [Namespace](https://thecattlecrew.net/tag/namespace/) --- ### [Neo4J](https://thecattlecrew.net/tag/neo4j/) --- ### [Network Load Balancer](https://thecattlecrew.net/tag/network-load-balancer/) --- ### [network nodes](https://thecattlecrew.net/tag/network-nodes/) --- ### [News](https://thecattlecrew.net/tag/news/) --- ### [Nginx](https://thecattlecrew.net/tag/nginx/) --- ### [No-Code](https://thecattlecrew.net/tag/no-code/) --- ### [NoClassDefFoundError](https://thecattlecrew.net/tag/noclassdeffounderror/) --- ### [Node.js](https://thecattlecrew.net/tag/node-js/) --- ### [OC-Familie](https://thecattlecrew.net/tag/oc-familie/) --- ### [OCI](https://thecattlecrew.net/tag/oci/) --- ### [OC|Expert Camp](https://thecattlecrew.net/tag/ocexpert-camp/) --- ### [OC|Lab](https://thecattlecrew.net/tag/oclab/) --- ### [ODI](https://thecattlecrew.net/tag/odi/) --- ### [OFMForum](https://thecattlecrew.net/tag/ofmforum/) --- ### [OHS](https://thecattlecrew.net/tag/ohs/) --- ### [Okaloa Flowlab](https://thecattlecrew.net/tag/okaloa-flowlab/) --- ### [OKD](https://thecattlecrew.net/tag/okd/) --- ### [ON-Premise](https://thecattlecrew.net/tag/on-premise/) --- ### [oow](https://thecattlecrew.net/tag/oow/) --- ### [Open Source](https://thecattlecrew.net/tag/open-source/) --- ### [OpenDevStack](https://thecattlecrew.net/tag/opendevstack/) --- ### [OpenShift](https://thecattlecrew.net/tag/openshift/) --- ### [opitz](https://thecattlecrew.net/tag/opitz/) --- ### [Optimization](https://thecattlecrew.net/tag/optimization/) --- ### [oracle](https://thecattlecrew.net/tag/oracle/) --- ### [Oracle ADF](https://thecattlecrew.net/tag/oracle-adf/) --- ### [Oracle CEP Embedded application](https://thecattlecrew.net/tag/oracle-cep-embedded-application/) --- ### [Oracle Cloud](https://thecattlecrew.net/tag/oracle-cloud/) --- ### [Oracle Data Integrator](https://thecattlecrew.net/tag/oracle-data-integrator/) --- ### [Oracle Database Appliance](https://thecattlecrew.net/tag/oracle-database-appliance/) --- ### [Oracle Engineered Systems](https://thecattlecrew.net/tag/oracle-engineered-systems/) --- ### [Oracle FMW](https://thecattlecrew.net/tag/oracle-fmw/) --- ### [Oracle Forms](https://thecattlecrew.net/tag/oracle-forms/) --- ### [Oracle IoT Cloud](https://thecattlecrew.net/tag/oracle-iot-cloud/) --- ### [Oracle Platform Security Services (OPSS)](https://thecattlecrew.net/tag/oracle-platform-security-services-opss/) --- ### [oracle secure bacup](https://thecattlecrew.net/tag/oracle-secure-bacup/) --- ### [Oracle Service Bus](https://thecattlecrew.net/tag/oracle-service-bus/) --- ### [Oracle WebLogic](https://thecattlecrew.net/tag/oracle-weblogic/) --- ### [OracleCode](https://thecattlecrew.net/tag/oraclecode/) --- ### [ORDS](https://thecattlecrew.net/tag/ords/) --- ### [OSB](https://thecattlecrew.net/tag/osb/) --- ### [OWSM](https://thecattlecrew.net/tag/owsm/) --- ### [PaaS](https://thecattlecrew.net/tag/paas/) --- ### [Patch](https://thecattlecrew.net/tag/patch/) --- ### [Patchset](https://thecattlecrew.net/tag/patchset/) --- ### [Performance](https://thecattlecrew.net/tag/performance/) --- ### [perimeter authentication](https://thecattlecrew.net/tag/perimeter-authentication/) --- ### [Persona](https://thecattlecrew.net/tag/persona/) --- ### [Pioneering](https://thecattlecrew.net/tag/pioneering/) --- ### [Pivotal](https://thecattlecrew.net/tag/pivotal/) --- ### [Pluggable Database](https://thecattlecrew.net/tag/pluggable-database/) --- ### [Poster](https://thecattlecrew.net/tag/poster/) --- ### [predictive](https://thecattlecrew.net/tag/predictive/) --- ### [Principal Validation Process](https://thecattlecrew.net/tag/principal-validation-process/) --- ### [Privilege Management Infrastructure (PMI)](https://thecattlecrew.net/tag/privilege-management-infrastructure-pmi/) --- ### [Process Mining](https://thecattlecrew.net/tag/process-mining/) --- ### [Product Development](https://thecattlecrew.net/tag/product-development/) --- ### [Product Owner](https://thecattlecrew.net/tag/product-owner/) --- ### [Prototying](https://thecattlecrew.net/tag/prototying/) --- ### [prototype](https://thecattlecrew.net/tag/prototype/) --- ### [protractor](https://thecattlecrew.net/tag/protractor/) --- ### [public key infrastructure (PKI)](https://thecattlecrew.net/tag/public-key-infrastructure-pki/) --- ### [Python](https://thecattlecrew.net/tag/python/) --- ### [q-loud](https://thecattlecrew.net/tag/q-loud/) --- ### [Quality](https://thecattlecrew.net/tag/quality/) --- ### [Quarkus](https://thecattlecrew.net/tag/quarkus/) --- ### [QuickSight](https://thecattlecrew.net/tag/quicksight/) --- ### [QuickTip](https://thecattlecrew.net/tag/quicktip/) --- ### [R](https://thecattlecrew.net/tag/r/) --- ### [Raspberry Pi](https://thecattlecrew.net/tag/raspberry-pi/) --- ### [RDS](https://thecattlecrew.net/tag/rds/) --- ### [React](https://thecattlecrew.net/tag/react/) --- ### [Red Hat](https://thecattlecrew.net/tag/red-hat/) --- ### [reduce](https://thecattlecrew.net/tag/reduce/) --- ### [Refactoring](https://thecattlecrew.net/tag/refactoring/) --- ### [Refinement](https://thecattlecrew.net/tag/refinement/) --- ### [Release Update](https://thecattlecrew.net/tag/release-update/) --- ### [reporting](https://thecattlecrew.net/tag/reporting/) --- ### [Reports](https://thecattlecrew.net/tag/reports/) --- ### [Reports Server Stand Alone](https://thecattlecrew.net/tag/reports-server-stand-alone/) --- ### [Resilience Testing](https://thecattlecrew.net/tag/resilience-testing/) --- ### [rest](https://thecattlecrew.net/tag/rest/) --- ### [retreat](https://thecattlecrew.net/tag/retreat/) --- ### [Retrospektive](https://thecattlecrew.net/tag/retrospektive/) --- ### [rman](https://thecattlecrew.net/tag/rman/) --- ### [Robotik](https://thecattlecrew.net/tag/robotik/) --- ### [Role Mapping](https://thecattlecrew.net/tag/role-mapping/) --- ### [Roles](https://thecattlecrew.net/tag/roles/) --- ### [RU](https://thecattlecrew.net/tag/ru/) --- ### [ruhrjug](https://thecattlecrew.net/tag/ruhrjug/) --- ### [Run-time](https://thecattlecrew.net/tag/run-time/) --- ### [S3](https://thecattlecrew.net/tag/s3/) --- ### [SageMaker](https://thecattlecrew.net/tag/sagemaker/) --- ### [SAML](https://thecattlecrew.net/tag/saml/) --- ### [SAP](https://thecattlecrew.net/tag/sap/) --- ### [SB](https://thecattlecrew.net/tag/sb/) --- ### [sbt_tape](https://thecattlecrew.net/tag/sbt_tape/) --- ### [Scrum](https://thecattlecrew.net/tag/scrum/) --- ### [sdn](https://thecattlecrew.net/tag/sdn/) --- ### [SearchEngines](https://thecattlecrew.net/tag/searchengines/) --- ### [SecDevSecOps](https://thecattlecrew.net/tag/secdevsecops/) --- ### [Secured Operation](https://thecattlecrew.net/tag/secured-operation/) --- ### [Selbstorganisation](https://thecattlecrew.net/tag/selbstorganisation/) --- ### [Selenium](https://thecattlecrew.net/tag/selenium/) --- ### [Self-Service](https://thecattlecrew.net/tag/self-service/) --- ### [SELinux](https://thecattlecrew.net/tag/selinux/) --- ### [Serverless](https://thecattlecrew.net/tag/serverless/) --- ### [service blueprint](https://thecattlecrew.net/tag/service-blueprint/) --- ### [Service Bus](https://thecattlecrew.net/tag/service-bus/) --- ### [Service Mesh](https://thecattlecrew.net/tag/service-mesh/) --- ### [Service Testing](https://thecattlecrew.net/tag/service-testing/) --- ### [Servicebus](https://thecattlecrew.net/tag/servicebus/) --- ### [Servlet](https://thecattlecrew.net/tag/servlet/) --- ### [shared storage](https://thecattlecrew.net/tag/shared-storage/) --- ### [sklearn](https://thecattlecrew.net/tag/sklearn/) --- ### [slow](https://thecattlecrew.net/tag/slow/) --- ### [Smart](https://thecattlecrew.net/tag/smart/) --- ### [Smells](https://thecattlecrew.net/tag/smells/) --- ### [SOAP](https://thecattlecrew.net/tag/soap/) --- ### [Softwarenentwicklung](https://thecattlecrew.net/tag/softwarenentwicklung/) --- ### [Spock](https://thecattlecrew.net/tag/spock/) --- ### [sprachassistent](https://thecattlecrew.net/tag/sprachassistent/) --- ### [Sprachassistenten](https://thecattlecrew.net/tag/sprachassistenten/) --- ### [Spring](https://thecattlecrew.net/tag/spring/) --- ### [SQL-Zauberkasten](https://thecattlecrew.net/tag/sql-zauberkasten/) --- ### [SQS](https://thecattlecrew.net/tag/sqs/) --- ### [SSL](https://thecattlecrew.net/tag/ssl/) --- ### [Stammdaten](https://thecattlecrew.net/tag/stammdaten/) --- ### [Start-Stop](https://thecattlecrew.net/tag/start-stop/) --- ### [Startup](https://thecattlecrew.net/tag/startup/) --- ### [Storm](https://thecattlecrew.net/tag/storm/) --- ### [Strategie](https://thecattlecrew.net/tag/strategie/) --- ### [Strategy](https://thecattlecrew.net/tag/strategy/) --- ### [Stream Processing](https://thecattlecrew.net/tag/stream-processing/) --- ### [Student](https://thecattlecrew.net/tag/student/) --- ### [Summer Camp](https://thecattlecrew.net/tag/summer-camp/) --- ### [SYSDBA](https://thecattlecrew.net/tag/sysdba/) --- ### [tdd](https://thecattlecrew.net/tag/tdd/) --- ### [TDWI](https://thecattlecrew.net/tag/tdwi/) --- ### [Teams](https://thecattlecrew.net/tag/teams/) --- ### [Test Pyramid](https://thecattlecrew.net/tag/test-pyramid/) --- ### [Testcontainers](https://thecattlecrew.net/tag/testcontainers/) --- ### [Testing](https://thecattlecrew.net/tag/testing/) --- ### [Text mining](https://thecattlecrew.net/tag/text-mining/) --- ### [tip](https://thecattlecrew.net/tag/tip/) --- ### [Tomcat](https://thecattlecrew.net/tag/tomcat/) --- ### [Toxiproxy](https://thecattlecrew.net/tag/toxiproxy/) --- ### [Tracing](https://thecattlecrew.net/tag/tracing/) --- ### [Transformation](https://thecattlecrew.net/tag/transformation/) --- ### [Trigonometrie der Identity](https://thecattlecrew.net/tag/trigonometrie-der-identity/) --- ### [Troubleshooting](https://thecattlecrew.net/tag/troubleshooting/) --- ### [tuning garbage collection](https://thecattlecrew.net/tag/tuning-garbage-collection/) --- ### [tuning jvm](https://thecattlecrew.net/tag/tuning-jvm/) --- ### [TypeScript](https://thecattlecrew.net/tag/typescript/) --- ### [UI Testing](https://thecattlecrew.net/tag/ui-testing/) --- ### [unit of order](https://thecattlecrew.net/tag/unit-of-order/) --- ### [unit test](https://thecattlecrew.net/tag/unit-test/) --- ### [Unity](https://thecattlecrew.net/tag/unity/) --- ### [unsupported operation](https://thecattlecrew.net/tag/unsupported-operation/) --- ### [UnsupportedOperationException](https://thecattlecrew.net/tag/unsupportedoperationexception/) --- ### [update](https://thecattlecrew.net/tag/update/) --- ### [Upgrade](https://thecattlecrew.net/tag/upgrade/) --- ### [usability](https://thecattlecrew.net/tag/usability/) --- ### [usability engineering](https://thecattlecrew.net/tag/usability-engineering/) --- ### [user experience](https://thecattlecrew.net/tag/user-experience/) --- ### [ux](https://thecattlecrew.net/tag/ux/) --- ### [verteilteteams](https://thecattlecrew.net/tag/verteilteteams/) --- ### [vip](https://thecattlecrew.net/tag/vip/) --- ### [Virtual Box](https://thecattlecrew.net/tag/virtual-box/) --- ### [Visual Studio](https://thecattlecrew.net/tag/visual-studio/) --- ### [VM](https://thecattlecrew.net/tag/vm/) --- ### [Voice](https://thecattlecrew.net/tag/voice/) --- ### [Voice Assistant](https://thecattlecrew.net/tag/voice-assistant/) --- ### [Voice First](https://thecattlecrew.net/tag/voice-first/) --- ### [Volltextsuche](https://thecattlecrew.net/tag/volltextsuche/) --- ### [VPC](https://thecattlecrew.net/tag/vpc/) --- ### [VPD](https://thecattlecrew.net/tag/vpd/) --- ### [VUI](https://thecattlecrew.net/tag/vui/) --- ### [Wartung](https://thecattlecrew.net/tag/wartung/) --- ### [web application](https://thecattlecrew.net/tag/web-application/) --- ### [Web Developement](https://thecattlecrew.net/tag/web-developement/) --- ### [WebCenter Content](https://thecattlecrew.net/tag/webcenter-content/) --- ### [WebCenter Portal](https://thecattlecrew.net/tag/webcenter-portal/) --- ### [webinar](https://thecattlecrew.net/tag/webinar/) --- ### [Weblogic](https://thecattlecrew.net/tag/weblogic/) --- ### [WebLogic Domain](https://thecattlecrew.net/tag/weblogic-domain/) --- ### [Webservice](https://thecattlecrew.net/tag/webservice/) --- ### [WebTier 12c](https://thecattlecrew.net/tag/webtier-12c/) --- ### [Weiterentwicklung](https://thecattlecrew.net/tag/weiterentwicklung/) --- ### [Wercker](https://thecattlecrew.net/tag/wercker/) --- ### [WLST](https://thecattlecrew.net/tag/wlst/) --- ### [Workshop](https://thecattlecrew.net/tag/workshop/) --- ### [Workshopgruppen](https://thecattlecrew.net/tag/workshopgruppen/) --- ### [Workshopmethoden](https://thecattlecrew.net/tag/workshopmethoden/) --- ### [Workshopmoderator](https://thecattlecrew.net/tag/workshopmoderator/) --- ### [X509](https://thecattlecrew.net/tag/x509/) --- ### [XACML Role Mapping Provider](https://thecattlecrew.net/tag/xacml-role-mapping-provider/) --- ### [XFS](https://thecattlecrew.net/tag/xfs/) --- ### [XFS Reflink](https://thecattlecrew.net/tag/xfs-reflink/) --- ### [Young Guns](https://thecattlecrew.net/tag/young-guns/) --- ### [ZDM](https://thecattlecrew.net/tag/zdm/) --- ### [Zero Downtime Migration](https://thecattlecrew.net/tag/zero-downtime-migration/) --- ### [Zusammenarbeit](https://thecattlecrew.net/tag/zusammenarbeit/) --- ### [Kundenstory](https://thecattlecrew.net/tag/kundenstory/) --- ### [css](https://thecattlecrew.net/tag/css/) --- ### [NLP](https://thecattlecrew.net/tag/nlp/) --- ### [Power BI](https://thecattlecrew.net/tag/power-bi/) --- ### [Verschlüsselung](https://thecattlecrew.net/tag/verschluesselung/) --- ### [MongoDB](https://thecattlecrew.net/tag/mongodb/) --- ### [RapidMIner](https://thecattlecrew.net/tag/rapidminer/) --- ### [Weka](https://thecattlecrew.net/tag/weka/) --- ### [Community Day](https://thecattlecrew.net/tag/community-day/) --- ### [Showcase](https://thecattlecrew.net/tag/showcase/) --- ### [Realtime](https://thecattlecrew.net/tag/realtime/) --- ### [Google](https://thecattlecrew.net/tag/google/) --- ### [Spacy](https://thecattlecrew.net/tag/spacy/) --- ### [Word Cloud](https://thecattlecrew.net/tag/word-cloud/) --- ### [Data Visualization](https://thecattlecrew.net/tag/data-visualization/) --- ### [PartOfSpeech](https://thecattlecrew.net/tag/partofspeech/) --- ### [Blockchiffre](https://thecattlecrew.net/tag/blockchiffre/) --- ### [SQL Server](https://thecattlecrew.net/tag/sql-server/) --- ### [Standby](https://thecattlecrew.net/tag/standby/) --- ### [KCNA](https://thecattlecrew.net/tag/kcna/) --- ### [Data Vault](https://thecattlecrew.net/tag/data-vault/) --- ### [Datavault Builder](https://thecattlecrew.net/tag/datavault-builder/) --- ### [Snowflake](https://thecattlecrew.net/tag/snowflake/) --- ### [Exasol](https://thecattlecrew.net/tag/exasol/) --- ### [DWH Automatisierung](https://thecattlecrew.net/tag/dwh-automatisierung/) --- ### [DWH Automation](https://thecattlecrew.net/tag/dwh-automation/) --- ### [DWH](https://thecattlecrew.net/tag/dwh/) --- ### [Data Warehouse](https://thecattlecrew.net/tag/data-warehouse/) --- ### [Case Study](https://thecattlecrew.net/tag/case-study/) --- ### [Conversational AI](https://thecattlecrew.net/tag/conversational-ai/) --- ### [Squid](https://thecattlecrew.net/tag/squid/) --- ### [Pacemaker](https://thecattlecrew.net/tag/pacemaker/) --- ### [s3fs](https://thecattlecrew.net/tag/s3fs/) --- ### [text classification](https://thecattlecrew.net/tag/text-classification/) --- ### [text preprocessing](https://thecattlecrew.net/tag/text-preprocessing/) --- ### [Amplify](https://thecattlecrew.net/tag/amplify/) --- ### [Firebase](https://thecattlecrew.net/tag/firebase/) --- ### [BaaS](https://thecattlecrew.net/tag/baas/) --- ### [Chat](https://thecattlecrew.net/tag/chat/) --- ### [Recommendation](https://thecattlecrew.net/tag/recommendation/) --- ### [Filtering](https://thecattlecrew.net/tag/filtering/) --- ### [Customer Journey](https://thecattlecrew.net/tag/customer-journey/) --- ### [Projektmanagement](https://thecattlecrew.net/tag/projektmanagement/) --- ### [Automation](https://thecattlecrew.net/tag/automation/) --- ### [Helm](https://thecattlecrew.net/tag/helm/) --- ### [API design-first](https://thecattlecrew.net/tag/api-design-first/) --- ### [Insomnia](https://thecattlecrew.net/tag/insomnia/) --- ### [Kuma](https://thecattlecrew.net/tag/kuma/) --- ### [CI](https://thecattlecrew.net/tag/ci/) --- ### [Java image](https://thecattlecrew.net/tag/java-image/) --- ### [JRE](https://thecattlecrew.net/tag/jre/) --- ### [awx](https://thecattlecrew.net/tag/awx/) --- ### [listener](https://thecattlecrew.net/tag/listener/) --- ### [system](https://thecattlecrew.net/tag/system/) --- ### [data science](https://thecattlecrew.net/tag/data-science/) --- ### [workaround](https://thecattlecrew.net/tag/workaround/) --- ### [Streamlit](https://thecattlecrew.net/tag/streamlit/) --- ### [responsibility](https://thecattlecrew.net/tag/responsibility/) --- ### [social impact](https://thecattlecrew.net/tag/social-impact/) --- ### [nachhaltig](https://thecattlecrew.net/tag/nachhaltig/) --- ### [Graph](https://thecattlecrew.net/tag/graph/) --- ### [Database](https://thecattlecrew.net/tag/database/) --- ### [Technologiemanagement](https://thecattlecrew.net/tag/technologiemanagement/) --- ### [Corporate Development](https://thecattlecrew.net/tag/corporate-development/) --- ### [Technologieradar](https://thecattlecrew.net/tag/technologieradar/) --- ### [Airbyte](https://thecattlecrew.net/tag/airbyte/) --- ### [Integrationsplattform](https://thecattlecrew.net/tag/integrationsplattform/) --- ### [ELT](https://thecattlecrew.net/tag/elt/) --- ### [Moderner Data Stack](https://thecattlecrew.net/tag/moderner-data-stack/) --- ### [Container-basiert](https://thecattlecrew.net/tag/container-basiert/) --- ### [Developer Experience](https://thecattlecrew.net/tag/developer-experience/) --- ### [Multi-model Database](https://thecattlecrew.net/tag/multi-model-database/) --- ### [Announcement](https://thecattlecrew.net/tag/announcement/) --- ### [Product Discovery](https://thecattlecrew.net/tag/product-discovery/) --- ### [Produktentwicklung](https://thecattlecrew.net/tag/produktentwicklung/) --- ### [Problem Framing](https://thecattlecrew.net/tag/problem-framing/) --- ### [OKR](https://thecattlecrew.net/tag/okr/) --- ### [Unternehmensstrategie](https://thecattlecrew.net/tag/unternehmensstrategie/) --- ### [Ziele](https://thecattlecrew.net/tag/ziele/) --- ### [Objectives](https://thecattlecrew.net/tag/objectives/) --- ### [Key Results](https://thecattlecrew.net/tag/key-results/) --- ### [Agile Methode](https://thecattlecrew.net/tag/agile-methode/) --- ### [Agility](https://thecattlecrew.net/tag/agility/) --- ### [zukunftswirksam](https://thecattlecrew.net/tag/zukunftswirksam/) --- ### [Visual BI](https://thecattlecrew.net/tag/visual-bi/) --- ### [BI-Plattform](https://thecattlecrew.net/tag/bi-plattform/) --- ### [Plotly](https://thecattlecrew.net/tag/plotly/) --- ### [Tableau](https://thecattlecrew.net/tag/tableau/) --- ### [Assistant](https://thecattlecrew.net/tag/assistant/) --- ### [Nachhaltigkeit](https://thecattlecrew.net/tag/nachhaltigkeit/) --- ### [Qualitätskriterien](https://thecattlecrew.net/tag/qualitaetskriterien/) --- ### [Software-Architektur](https://thecattlecrew.net/tag/software-architektur/) --- ### [Design-Prinzipien](https://thecattlecrew.net/tag/design-prinzipien/) --- ### [Energieeffizienz](https://thecattlecrew.net/tag/energieeffizienz/) --- ### [Infrastruktur](https://thecattlecrew.net/tag/infrastruktur/) --- ### [Stromverbrauch](https://thecattlecrew.net/tag/stromverbrauch/) --- ### [Hyperscaler](https://thecattlecrew.net/tag/hyperscaler/) --- ### [Oracle DB](https://thecattlecrew.net/tag/oracle-db/) --- ### [Legacy](https://thecattlecrew.net/tag/legacy/) --- ### [Altsystem](https://thecattlecrew.net/tag/altsystem/) --- ### [DB](https://thecattlecrew.net/tag/db/) --- ### [Sharing](https://thecattlecrew.net/tag/sharing/) --- ### [Wissen](https://thecattlecrew.net/tag/wissen/) --- ### [OC Academy](https://thecattlecrew.net/tag/oc-academy/) --- ### [Fortbildung](https://thecattlecrew.net/tag/fortbildung/) --- ### [Development](https://thecattlecrew.net/tag/development/) --- ### [Signals](https://thecattlecrew.net/tag/signals/) --- ### [Computed](https://thecattlecrew.net/tag/computed/) --- ### [Effects](https://thecattlecrew.net/tag/effects/) --- ### [Change Detection](https://thecattlecrew.net/tag/change-detection/) --- ### [Change Detection Cycle](https://thecattlecrew.net/tag/change-detection-cycle/) --- ### [Zone.js](https://thecattlecrew.net/tag/zone-js/) --- ### [Reaktivität](https://thecattlecrew.net/tag/reaktivitaet/) --- ### [Green IT](https://thecattlecrew.net/tag/green-it/) --- ### [Programmiersprachen](https://thecattlecrew.net/tag/programmiersprachen/) --- ### [OCR](https://thecattlecrew.net/tag/ocr/) --- ### [Tesseract](https://thecattlecrew.net/tag/tesseract/) --- ### [Java Full Stack](https://thecattlecrew.net/tag/java-full-stack/) --- ### [Thymeleaf](https://thecattlecrew.net/tag/thymeleaf/) --- ### [HTMX](https://thecattlecrew.net/tag/htmx/) --- ### [Vaadin Flow](https://thecattlecrew.net/tag/vaadin-flow/) --- ### [Hilla](https://thecattlecrew.net/tag/hilla/) --- ### [Server-seitiges Rendern](https://thecattlecrew.net/tag/server-seitiges-rendern/) --- ### [Client-seitiges Rendern](https://thecattlecrew.net/tag/client-seitiges-rendern/) --- ### [Webentwicklung](https://thecattlecrew.net/tag/webentwicklung/) --- ### [Spring Boot](https://thecattlecrew.net/tag/spring-boot/) --- ### [JavaScript-Bibliothek](https://thecattlecrew.net/tag/javascript-bibliothek/) --- ### [Server-seitige Template Engine](https://thecattlecrew.net/tag/server-seitige-template-engine/) --- ### [Rich Internet Application (RIA)](https://thecattlecrew.net/tag/rich-internet-application-ria/) --- ### [TypeScript Frontend](https://thecattlecrew.net/tag/typescript-frontend/) --- ### [single page apps](https://thecattlecrew.net/tag/single-page-apps/) --- ### [Reactives Webdesign](https://thecattlecrew.net/tag/reactives-webdesign/) --- ### [CO2-Fußabdruck](https://thecattlecrew.net/tag/co2-fussabdruck/) --- ### [Energieverbrauch](https://thecattlecrew.net/tag/energieverbrauch/) --- ### [Code Generator](https://thecattlecrew.net/tag/code-generator/) --- ### [LLM](https://thecattlecrew.net/tag/llm/) --- ### [Ökobilanz](https://thecattlecrew.net/tag/oekobilanz/) --- ### [Bewusste IT](https://thecattlecrew.net/tag/bewusste-it/) --- ### [Carbon Footprint](https://thecattlecrew.net/tag/carbon-footprint/) --- ### [Ecodesign](https://thecattlecrew.net/tag/ecodesign/) --- ### [Generative AI](https://thecattlecrew.net/tag/generative-ai/) --- ### [Retrieval Augmented Generation](https://thecattlecrew.net/tag/retrieval-augmented-generation/) --- ### [Semantische Suche](https://thecattlecrew.net/tag/semantische-suche/) --- ### [Prompt](https://thecattlecrew.net/tag/prompt/) --- ### [IT-Grundschutz](https://thecattlecrew.net/tag/it-grundschutz/) --- ### [Code Assistent](https://thecattlecrew.net/tag/code-assistent/) --- ### [Programmieren](https://thecattlecrew.net/tag/programmieren/) --- ### [RAG](https://thecattlecrew.net/tag/rag/) --- ### [Spezialwissen](https://thecattlecrew.net/tag/spezialwissen/) --- ### [Prompts](https://thecattlecrew.net/tag/prompts/) --- ### [SBOM](https://thecattlecrew.net/tag/sbom/) --- ### [Hackerangriff](https://thecattlecrew.net/tag/hackerangriff/) --- ### [Cyber-Angriff](https://thecattlecrew.net/tag/cyber-angriff/) --- ### [Cyberattack](https://thecattlecrew.net/tag/cyberattack/) --- ### [gehackt](https://thecattlecrew.net/tag/gehackt/) --- ### [Cyber Resilience](https://thecattlecrew.net/tag/cyber-resilience/) --- ### [Open AI](https://thecattlecrew.net/tag/open-ai/) --- ### [Assistenzsystem](https://thecattlecrew.net/tag/assistenzsystem/) --- ### [Context Mapping](https://thecattlecrew.net/tag/context-mapping/) --- ### [Building Blocks](https://thecattlecrew.net/tag/building-blocks/) --- ### [IT-Modernisierung](https://thecattlecrew.net/tag/it-modernisierung/) --- ### [Moderne IT](https://thecattlecrew.net/tag/moderne-it/) --- ### [Legacy System](https://thecattlecrew.net/tag/legacy-system/) --- ### [Systemintegration](https://thecattlecrew.net/tag/systemintegration/) --- ### [CNI](https://thecattlecrew.net/tag/cni/) --- ### [Plugin](https://thecattlecrew.net/tag/plugin/) --- ### [Vergleich](https://thecattlecrew.net/tag/vergleich/) --- ### [Datenmigration](https://thecattlecrew.net/tag/datenmigration/) --- ### [Datenbankmigration](https://thecattlecrew.net/tag/datenbankmigration/) --- ### [context map](https://thecattlecrew.net/tag/context-map/) --- ### [kopplung](https://thecattlecrew.net/tag/kopplung/) --- ### [Disy](https://thecattlecrew.net/tag/disy/) --- ### [geo-located](https://thecattlecrew.net/tag/geo-located/) --- ### [web](https://thecattlecrew.net/tag/web/) --- ### [web components](https://thecattlecrew.net/tag/web-components/) --- ### [microfrontends](https://thecattlecrew.net/tag/microfrontends/) --- ### [Tutorial](https://thecattlecrew.net/tag/tutorial/) --- ### [Zod](https://thecattlecrew.net/tag/zod/) --- ### [unreachable](https://thecattlecrew.net/tag/unreachable/) --- ### [Remix](https://thecattlecrew.net/tag/remix/) --- ### [Business Application](https://thecattlecrew.net/tag/business-application/) --- ### [Geschäftsanwendung](https://thecattlecrew.net/tag/geschaeftsanwendung/) --- ### [Full Stack Framework](https://thecattlecrew.net/tag/full-stack-framework/) --- ### [Formulare](https://thecattlecrew.net/tag/formulare/) --- ### [Data Observability](https://thecattlecrew.net/tag/data-observability/) --- ### [Artificial Intelligence](https://thecattlecrew.net/tag/artificial-intelligence/) --- ### [Datenarchitekturen](https://thecattlecrew.net/tag/datenarchitekturen/) --- ### [Data](https://thecattlecrew.net/tag/data/) --- ### [Konferenz](https://thecattlecrew.net/tag/konferenz/) --- ### [Gartner](https://thecattlecrew.net/tag/gartner/) --- ### [Summit](https://thecattlecrew.net/tag/summit/) ---